
L’analyse statistique contemporaine repose fondamentalement sur la capacité du chercheur à discerner la structure sous-jacente des données empiriques au sein d’un environnement intrinsèquement bruité. Dans les sciences quantitatives, particulièrement en psychométrie, en neuropsychologie et en neurosciences computationnelles, la variabilité observée reflète simultanément des processus psychologiques authentiques et des perturbations méthodologiques non désirées. Face à cette hétérogénéité, la pratique standardisée a longtemps privilégié les méthodes paramétriques classiques, dont la pierre angulaire demeure le score standardisé ou score Z. Ce dernier, calculé à partir de la moyenne arithmétique et de l’écart-type de l’échantillon, postule une distribution normale des observations et postule une stabilité des paramètres qui se vérifie rarement dans les situations de terrain.
La confrontation directe aux jeux de données réels révèle une réalité beaucoup plus complexe : distributions hautement asymétriques, queues de distribution épaisses, présence d’observations multivariées complexes et existence de valeurs aberrantes ou extrêmes générées par des erreurs instrumentales ou des comportements hors protocole. L’application mécanique du score Z traditionnel dans ces contextes dysfonctionne gravement. La moyenne arithmétique et l’écart-type possèdent en effet un point de rupture nul, ce qui signifie qu’une seule observation erratique ou extrêmement déviante suffit à déplacer artificiellement le centre de gravité de la série statistique et à dilater l’estimation de sa dispersion. Dès lors, le score Z standard échoue précisément là où il devrait exceller : la valeur atypique gonfle l’écart-type au dénominateur et attire la moyenne vers elle au numérateur, diminuant paradoxalement sa propre distance apparente et masquant l’anomalie aux yeux du statisticien.
Pour surmonter cette impasse méthodologique majeure, les statisticiens Boris Iglewicz et David Hoaglin ont développé, sous l’influence des travaux pionniers de John Tukey sur l’analyse exploratoire des données, une alternative robuste et élégante : le score Z modifié (souvent noté Mi). En substituant la médiane à la moyenne arithmétique et l’écart absolu médian (MAD pour Median Absolute Deviation) à l’écart-type, tout en introduisant une constante d’ajustement probabiliste rigoureuse, le score Z modifié offre une résistance exceptionnelle à la contamination des données, jusqu’à un seuil théorique de 50 % d’observations corrompues. Cet article propose une exploration approfondie, mathématique, conceptuelle et pratique du score Z modifié, en détaillant son architecture, ses fondements théoriques, son application concrète au moyen d’un exemple détaillé et son intégration dans les flux d’analyses modernes en recherche comportementale.
1. Introduction et fondements théoriques de la standardisation des données
1.1 Le rôle de la standardisation dans les sciences comportementales
Dans le domaine des sciences psychologiques et cognitives, la mesure constitue un défi épistémologique permanent. Contrairement aux sciences physiques où les unités de mesure reposent sur des constantes universelles fondamentales (mètres, secondes, kilogrammes), les variables psychologiques font appel à des construits latents opérationnalisés à travers des échelles arbitraires. Qu’il s’agisse d’évaluer le niveau d’anxiété d’un individu via une échelle de Likert, son quotient intellectuel au moyen d’un test standardisé, ou la vitesse de traitement de l’information par des temps de réponse en millisecondes, les unités brutes sont fondamentalement incommensurables. La standardisation statistique est la procédure analytique indispensable permettant de transformer ces grandeurs disparates en une métrique adimensionnelle commune, facilitant ainsi la comparaison directe de performances inter-individuelles et intra-individuelles.
Cette mise à l’échelle revêt une importance critique lorsqu’il s’agit d’établir des profils psychométriques normatifs. En recherche clinique, déterminer si un patient présente un déficit cognitif sévère exige d’évaluer l’écart séparant sa performance brute de la distribution de référence d’une population appariée pour l’âge et le niveau socioculturel. Sans une procédure de standardisation mathématiquement valide, les scores obtenus à différentes sous-épreuves ne peuvent être ni agrégés, ni pondérés, ni comparés méthodiquement. Dès lors, la standardisation ne constitue pas un simple artifice calculatoire destiné à simplifier la lecture des données : elle représente l’armature logique qui confère une validité conceptuelle aux inférences psychologiques déduites des observations comportementales.
Parallèlement à la comparaison normative, la standardisation joue un rôle décisif dans l’identification des observations atypiques, communément appelées « valeurs aberrantes » ou outliers. Historiquement, la statistique appliquée a abordé la question des anomalies empiriques sous l’angle du rejet pur et simple, perçu comme un nettoyage mécanique préalable à l’inférence. Avec l’essor des méthodes de diagnostic statistique dans la seconde moitié du vingtième siècle, les chercheurs ont pris conscience que les observations singulières constituent souvent les données les plus informatives du protocole expérimental. Elles signalent soit un dysfonctionnement de l’appareil de mesure, soit une rupture des hypothèses expérimentales, soit, plus fondamentalement, l’expression d’un phénomène neurobiologique ou comportemental rare mais hautement significatif qui échappe aux modélisations simplistes.
1.2 La problématique des distributions asymétriques en recherche psychologique
L’une des hypothèses les plus courantes, et souvent les plus abusives, de la modélisation statistique paramétrique est la présomption de normalité selon la loi de Gauss. Or, dans la quasi-totalité des paradigmes expérimentaux en psychologie cognitive et en psychopathologie, les distributions empiriques s’écartent structurellement de la courbe en cloche symétrique. Le cas paradigmatique est celui de la chronométrie mentale : les temps de réaction présentent invariablement une asymétrie positive prononcée (vers la droite). Cette morphologie découle directement de contraintes physiologiques indépassables ; il existe une borne inférieure absolue fixée par la vitesse de conduction axonale et la latence synaptique (rarement inférieure à 150 ou 200 millisecondes), alors qu’il n’existe aucune borne supérieure équivalente, les ralentissements attentionnels pouvant s’étendre sur des centaines de millisecondes supplémentaires.
Cette asymétrie fondamentale se retrouve avec une intensité comparable dans l’étude des affects, des trajectoires symptomatiques ou des conduites addictives. Les distributions des scores de dépression ou d’anxiété dans la population générale sont massivement regroupées vers les valeurs basses, formant un plancher compact, tandis qu’une queue de distribution étirée rassemble les individus manifestant une symptomatologie clinique aiguë. Face à de telles structures de données, l’application aveugle des indices de tendance centrale et de dispersion classiques engendre des déformations conceptuelles majeures. La moyenne arithmétique est irrésistiblement aspirée vers la queue de distribution, perdant son statut de valeur la plus représentative, tandis que l’écart-type s’accroît démesurément sous l’effet de ces mêmes valeurs extrêmes.
Les conséquences méthodologiques de cette asymétrie sur l’interprétation des indices paramétriques sont désastreuses pour la réplication scientifique. Lorsqu’une distribution est asymétrique, les seuils théoriques associés aux probabilités cumulées de la loi normale cessent d’être valides. L’estimation des probabilités d’occurrence d’un résultat extrême devient erronée, produisant des taux inacceptables de faux positifs ou de faux négatifs lors de la prise de décision clinique ou inférentielle. Pour garantir la solidité des conclusions et restaurer la reproductibilité des résultats expérimentaux, la recherche comportementale doit s’émanciper des routines mathématiques rigides et adopter des estimateurs résistants aux violations de la symétrie distributionnelle.
1.3 Distinguer la variabilité psychologique réelle des artefacts de mesure
Sur le plan épistémologique, la détection des anomalies dans un échantillon de sujets humains impose de naviguer constamment entre deux écueils interprétatifs. D’un côté, le chercheur s’expose au risque d’éliminer arbitrairement une donnée reflétant une authentique variabilité phénotypique : l’extrême rapidité cognitive d’un individu à haut potentiel intellectuel, la désinhibition motrice caractéristique d’un épisode maniaque, ou les fluctuations attentionnelles sévères d’un patient présentant un trouble du déficit de l’attention. Dans ces circonstances, exclure la donnée sous prétexte qu’elle s’écarte du gros du peloton revient à amputer l’échantillon de sa composante la plus révélatrice, introduisant un biais de sélection mortifère pour la généralisabilité des résultats.
D’un autre côté, le chercheur fait face à la prolifération inévitable des artefacts techniques et méthodologiques. Dans les études comportementales contemporaines, souvent informatisées et administrées en ligne sans supervision directe, les causes d’erreurs exogènes abondent : micro-coupures de connexion générant une latence artificielle dans l’enregistrement d’une tâche de mémoire de travail, distraction externe soudaine du sujet (notification de smartphone, interruption tierce), double frappe involontaire sur le clavier ou, à l’inverse, désengagement complet du participant répondant de manière aléatoire afin de terminer l’expérience au plus vite. Considérer de telles perturbations comme de la variance comportementale authentique vicie profondément les modélisations statistiques ultérieures.
La statistique robuste offre le cadre formel nécessaire pour trancher méthodiquement ce dilemme sans verser dans l’arbitraire de l’exclusion intuitive. Contrairement aux approches dogmatiques d’élagage manuel (data pruning), souvent décidées a posteriori par le chercheur au gré de ses intuitions ou de la significativité espérée de ses tests, les méthodes robustes fournissent un étalon mathématique indépendant des déformations induites par les données aberrantes. C’est précisément dans cette brèche épistémique que s’inscrit le score Z modifié : proposer une métrique de standardisation impartiale qui quantifie l’éloignement d’une observation par rapport au cœur de la distribution, sans que le calcul de cet éloignement ne soit lui-même pollué par l’anomalie qu’il cherche à identifier.
2. Le score Z classique et ses limites méthodologiques
2.1 Formulation mathématique et logique sous-jacente
Le score Z conventionnel, formalisé dès les débuts de la biométrie moderne par Karl Pearson et développé au fil de la formalisation de la loi normale, repose sur une transformation affine extrêmement simple de la variable aléatoire étudiée. Pour une observation quantitative brute notée xi appartenant à un échantillon de taille n, dont la moyenne arithmétique empirique est notée x̄ et l’écart-type d’échantillon corrigé est désigné par s, le score Z standard s’énonce selon l’équation canonique suivante :
Zi = (xi − x̄) / s
Où les deux paramètres empiriques sont classiquement définis par :
x̄ = (1 / n) ∑i=1..n xi et s = √[ (1 / (n − 1)) ∑i=1..n (xi − x̄)2 ]
La logique conceptuelle de cette formule est intuitivement séduisante : le numérateur mesure l’écart arithmétique net qui sépare la mesure individuelle du centre géométrique de l’échantillon, tandis que le dénominateur standardise cet écart en le divisant par l’unité d’échelle naturelle du groupe, l’écart-type. La variable transformée qui en résulte possède mathématiquement une moyenne rigoureusement égale à zéro et une variance fixée à un. Dès lors que la population d’origine suit une distribution gaussienne parfaite N(μ, σ2), le score Z permet d’associer immédiatement à chaque observation une probabilité cumulative précise en consultant les tables de la loi normale centrée réduite.
De cette élégance probabiliste est issue la fameuse règle empirique, omniprésente dans les manuels universitaires et les pratiques de laboratoire, qui pose des seuils critiques immuables. Selon ce modèle, environ 68,27 % des données doivent se situer dans l’intervalle [-1, +1], 95,45 % dans l’intervalle [-2, +2], et 99,73 % dans l’intervalle [-3, +3]. Par conséquent, une observation présentant une valeur absolue |Zi| > 3 est universellement qualifiée d’aberrante, car sa probabilité d’occurrence sous l’hypothèse de normalité est inférieure à 0,27 %, soit environ 1 chance sur 370. Bien que séduisante de prime abord, cette mécanique décisionnelle s’effondre dès lors que les données s’écartent des conditions de l’expérience idéale.
2.2 L’effet de levier exercé sur la moyenne arithmétique
La première faiblesse rédhibitoire du score Z standard réside dans la vulnérabilité de son paramètre central : la moyenne arithmétique. En statistique théorique, on évalue la robustesse d’un estimateur à l’aide de la notion fondamentale de point de rupture (ou breakdown point). Ce concept, introduit par Frank Hampel et formalisé par Peter Rousseeuw, quantifie la plus petite proportion d’observations arbitrairement grandes ou corrompues qu’un estimateur peut tolérer avant de produire une valeur elle-même infinie ou dénuée de sens. Pour un échantillon fini de n observations, le point de rupture de la moyenne arithmétique est exactement égal à 1/n, ce qui converge vers 0 % lorsque la taille de l’échantillon devient grande.
Concrètement, cela signifie qu’un seul point de mesure erroné, situé à une distance considérable du reste des données (par exemple, une erreur de saisie où un expérimentateur encode un temps de réaction de 55 000 ms au lieu de 550 ms), dispose d’un effet de levier infini sur le calcul du barycentre. La moyenne arithmétique est alors immédiatement déplacée vers cette valeur extravagante, perdant tout lien avec la concentration réelle des observations physiologiques. Le barycentre de l’échantillon se trouve ainsi « contaminé », ce qui fausse l’ensemble des écarts individuels (xi − x̄) calculés pour tous les autres participants de l’étude.
Considérons, à titre d’illustration clinique, une cohorte de dix patients dont les scores sur une échelle validée d’anxiété s’échelonnent sagement entre 12 et 18, avec une moyenne réelle située à 15. Si un onzième individu, en raison d’une confusion dans le protocole ou d’une crise panique aiguë lors de la passation, obtient un score de 95, la moyenne arithmétique bondit subitement à 22,3. Dès cet instant, un patient parfaitement typique ayant obtenu un score de 16 se retrouve désormais situé au-dessous de la moyenne de l’échantillon ! L’effet de levier exercé par la valeur aberrante inverse le positionnement relatif des individus sains et induit une lecture complètement erronée de la dynamique du groupe.
2.3 L’inflation de l’écart-type et l’effet de masquage
Si la distorsion de la moyenne constitue un problème sérieux, l’impact d’une valeur extrême sur l’écart-type s’avère infiniment plus pernicieux. L’écart-type repose structurellement sur l’élévation au carré des déviations par rapport à la moyenne. Cette opération quadratique confère aux points excentrés un poids disproportionné dans le calcul final de la dispersion. Une valeur isolée très distante n’augmente pas l’écart-type de manière linéaire : elle le fait exploser de façon exponentielle. L’estimation de l’étalement de la distribution se trouve ainsi artificiellement dilatée, créant une fausse impression d’hétérogénéité générale au sein de l’échantillon.
Cette inflation non maîtrisée du dénominateur du score Z engendre un phénomène statistique destructeur bien connu sous le nom d’effet de masquage (masking effect). Dans cette configuration, la présence d’une ou plusieurs valeurs aberrantes majeures gonfle tellement la valeur de s que l’ensemble des scores Z calculés pour l’ensemble des données voit sa valeur absolue se comprimer vers le centre. Paradoxalement, la valeur aberrante elle-même peut voir son propre score Z diminuer sous le seuil critique de 3.0, car sa contribution gigantesque au numérateur est compensée, voire dominée, par le dénominateur colossal qu’elle a elle-même engendré. L’anomalie s’auto-immunise contre sa propre détection, demeurant invisible aux tests conventionnels.
Le corollaire tout aussi néfaste de cette dynamique est l’effet de submersion (swamping effect). Dans certains cas de contamination multiple ou d’asymétrie marquée, le déplacement de la moyenne combiné à la distorsion de l’écart-type peut amener des observations parfaitement normales et représentatives du phénomène étudié à afficher des scores Z artificiellement élevés par rapport au nouveau barycentre déformé. Le statisticien non averti risque alors de rejeter à tort des observations tout à fait légitimes (erreur de type I au niveau de la sélection des données), tout en conservant dans son jeu de données l’artefact responsable de la distorsion. Ces impasses mathématiques démontrent avec force que le score Z standard est structurellement inadapté à la détection rigoureuse des valeurs aberrantes dès lors que la contamination dépasse le cadre théorique idéalisé d’un point isolé dans une vaste distribution normale.
3. Définition formelle du score Z modifié
3.1 Origine et genèse par Boris Iglewicz et David Hoaglin
Conscients de l’échec structurel des métriques basées sur les moments empiriques (moyenne et variance) face aux contaminations réelles des données, les statisticiens Boris Iglewicz et David C. Hoaglin ont publié en 1993, sous l’égide de l’American Society for Quality Control, un volume de référence intitulé How to Detect and Handle Outliers. Cet ouvrage s’inscrivait dans le sillage intellectuel ouvert par John W. Tukey deux décennies plus tôt à travers son manifeste sur l’analyse exploratoire des données (EDA). Tukey avait magistralement démontré que l’arithmétique des moindres carrés et la théorie gaussienne standard, bien qu’élégantes sur le plan déductif, s’avéraient d’une fragilité déconcertante dès que les distributions empiriques s’écartaient des postulats canoniques.
L’objectif scientifique d’Iglewicz et Hoaglin consistait à proposer aux praticiens des sciences de l’ingénieur, de la biomédecine et des sciences sociales une boîte à outils méthodologique associant simplicité de calcul, interprétabilité intuitive et résistance théorique maximale. Plutôt que de recourir à des procédures itératives complexes ou à des modèles d’élagage arbitraires, ils ont cherché à concevoir une métrique univariée capable de conserver la syntaxe conceptuelle du score Z (une déviation divisée par une échelle), tout en purgeant ses composants de toute vulnérabilité aux chocs extrêmes. De ces recherches est né le score Z modifié, conçu pour neutraliser simultanément l’effet de levier sur la tendance centrale et l’effet de masquage induit par l’inflation de l’échelle.
La rupture épistémologique opérée par Iglewicz et Hoaglin réside dans le passage délibéré d’une statistique basée sur les moments (sommes pondérées des puissances des observations) à une statistique basée sur les ordres et les rangs. En ancrant leur formalisme dans la médiane et les quantiles, les auteurs ont doté la standardisation d’une robustesse intrinsèque garantie. Leur méthode a rapidement transcendé le champ du contrôle de la qualité industrielle pour s’imposer comme le standard d’excellence méthodologique dans les sciences empiriques confrontées à des variabilités humaines imprévisibles, au premier rang desquelles figurent la psychologie cognitive et la neuropsychologie clinique.
3.2 Substitution des paramètres classiques par des estimateurs d’ordre
Pour construire une statistique insensible aux contaminations extrêmes, la première opération menée par Iglewicz et Hoaglin a consisté à substituer à la moyenne arithmétique un estimateur de tendance centrale doté du plus haut niveau de résistance possible : la médiane de l’échantillon, universellement désignée par le symbole tilde (x̃) ou la notation Med(x). La médiane représente la valeur centrale séparant la moitié inférieure de la moitié supérieure des observations préalablement ordonnées. Par construction, déplacer une observation située aux extrémités de la distribution vers une valeur infiniment grande ou infiniment petite n’exerce strictement aucun impact sur la médiane, tant que le point demeure du même côté du point de coupure. Son point de rupture est de 50 %, le maximum théorique absolu pour tout estimateur de position.
La seconde opération, tout aussi déterminante, a consisté à remplacer l’écart-type d’échantillon par un estimateur d’échelle robuste. Le candidat naturel retenu par Iglewicz et Hoaglin est l’écart absolu médian, connu sous l’acronyme universel MAD (Median Absolute Deviation). Formalisé à l’origine par Carl Friedrich Gauss lui-même en 1816 comme une alternative d’échelle, le MAD avait été redécouvert et promu avec insistance par Peter Rousseeuw dans les années 1980 en raison de ses propriétés exceptionnelles de résistance. Contrairement aux estimateurs d’échelle interquartiles (comme l’IQR), qui ne mesurent l’étalement qu’à travers deux percentiles spécifiques (25 % et 75 %), le MAD capture la dispersion de l’ensemble des points en calculant la déviation typique absolue de chaque donnée par rapport au centre médian.
Ce double remplacement transforme radicalement le comportement de la métrique de standardisation. La structure de distribution originale n’est plus modélisée à travers des prismes quadratiques hypersensibles aux perturbations périphériques. Au contraire, le cœur des données sert d’ancrage inébranlable pour évaluer la dispersion typique, et les valeurs périphériques sont évaluées en fonction de leur distance relative à ce noyau stable. La métrique résultante préserve fidèlement l’échelle de mesure originale tout en garantissant qu’aucune valeur discordante ne vienne polluer son propre diagnostic.
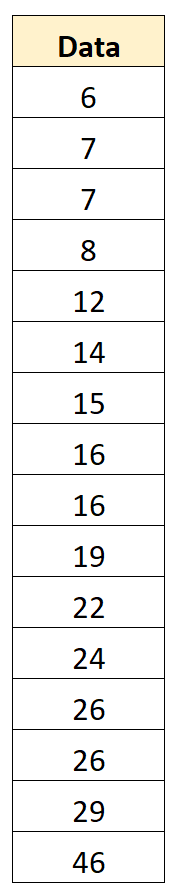
3.3 Énoncé mathématique de l’équation du score Z modifié
L’architecture mathématique du score Z modifié formulée par Iglewicz et Hoaglin s’exprime avec une élégante concision. Pour toute observation quantitative brute xi issue d’un vecteur de données X = {x1, x2, …, xn}, le score Z modifié individuel, noté conventionnellement Mi, est défini par l’expression algébrique suivante :
Mi = 0.6745 × (xi − x̃) / MAD
Où les termes fondamentaux qui composent cette équation se déclinent selon les définitions rigoureuses suivantes :
- xi : La valeur brute observée du sujet ou de l’essai expérimental considéré.
- x̃ : La médiane empirique de l’échantillon complet, représentant le centre robuste de la distribution :
x̃ = Médiane(X)
- MAD : L’écart absolu médian non corrigé, calculé selon l’algorithme :
MAD = Médiane(|xi − x̃|) pour i = 1, 2, …, n
- 0.6745 : La constante de normalisation universelle reliant l’écart absolu médian à l’écart-type d’une distribution gaussienne asymptotique.
Sur le plan des propriétés algébriques, la transformation menant à Mi constitue une fonction affine par morceaux. Elle est strictement invariante par translation (ajouter une constante fixe à toutes les observations ne modifie en rien la valeur finale des Mi) et invariante par changement d’échelle (multiplier l’ensemble des données par un facteur d’échelle multiplicatif quelconque préserve exactement les scores Z modifiés). La seule condition de validité computationnelle impérative réside dans la stricte positivité du dénominateur : le calcul exige formellement MAD > 0. Si le MAD devient nul, ce qui survient lorsque plus de 50 % des observations sont rigoureusement identiques, la division devient indéterminée, imposant des ajustements méthodologiques spécifiques détaillés plus loin.
4. L’architecture mathématique et la constante 0.6745
4.1 Origine probabiliste du coefficient multiplicateur
L’introduction du facteur numérique 0.6745 au sein de l’équation du score Z modifié suscite fréquemment des interrogations chez les chercheurs non mathématiciens, qui y voient parfois une constante empirique arbitraire. Il n’en est rien. Ce coefficient découle avec une précision rigoureuse de la théorie fondamentale des probabilités et de la géométrie de la distribution normale standard. Pour comprendre sa genèse, il convient d’examiner le comportement théorique de l’écart absolu médian d’une variable aléatoire continue Z suivant une loi normale centrée réduite N(0, 1).
Par symétrie parfaite de la loi normale autour de zéro, la médiane de Z est rigoureusement nulle : Med(Z) = 0. Dès lors, l’écart absolu par rapport à la médiane se simplifie en la valeur absolue de la variable elle-même : |Z − 0| = |Z|. Le MAD théorique de cette loi correspond donc au nombre réel positif, noté m, tel que la moitié de la masse de probabilité de la variable |Z| soit inférieure ou égale à m. Cela s’écrit formellement sous la forme :
P(|Z| ≤ m) = 0.50
En exploitant la symétrie de la fonction de densité gaussienne, cette condition équivaut à stipuler que la probabilité cumulée entre −m et +m doit être exactement de 0.50, ce qui laisse une probabilité résiduelle de 0.25 dans chaque queue de distribution :
P(Z ≤ m) = 0.75 ⇒ m = Φ−1(0.75)
Où Φ−1 désigne la fonction quantile (l’inverse de la fonction de répartition) de la loi normale standard. En consultant les tables analytiques ou en calculant numériquement cette valeur à haute précision, on obtient :
Φ−1(0.75) ≈ 0.674489750196…
Pour une variable normale générale X ~ N(μ, σ2), le MAD théorique est donc exactement égal à 0.6745 × σ. Par conséquent, pour obtenir un estimateur non biaisé de l’écart-type σ à partir du MAD empirique lorsque la distribution sous-jacente est normale, il convient de diviser le MAD par 0.6745, ce qui revient rigoureusement à le multiplier par son inverse : 1 / 0.6744898 ≈ 1.4826. Dès lors, le score Z modifié réorganise les termes :
Mi = (xi − x̃) / σ̂robuste = (xi − x̃) / (MAD / 0.6745) = 0.6745 × (xi − x̃) / MAD
Le facteur 0.6745 n’est donc rien d’autre que le pont mathématique exact garantissant la comparabilité d’échelle entre le MAD et l’écart-type conventionnel.
4.2 Convergence asymptotique et cohérence statistique
L’intérêt de calibrer le score Z modifié sur la métrique normale via cette constante réside dans la propriété de cohérence statistique (Fisher consistency). Sous l’hypothèse nulle idéale où l’échantillon de données empiriques provient effectivement d’une population purement gaussienne et exempte de tout artefact de mesure, le score Z modifié Mi converge asymptotiquement vers la même valeur que le score Z classique Zi au fur et à mesure que la taille n de l’échantillon tend vers l’infini. Le chercheur ne subit donc aucune distorsion de perspective en adoptant cette méthode : si les données sont parfaitement normales, le score Z modifié se comporte de manière superposable au score traditionnel.
En revanche, dès que l’échantillon s’éloigne de cette configuration idéalisée (par l’apparition d’asymétries ou de contaminations ponctuelles), les trajectoires des deux statistiques divergent radicalement. Le score Z conventionnel perd toute consistance en raison de la sensibilité quadratique de sa variance, tandis que le score Z modifié préserve sa stabilité computationnelle. En termes d’efficacité statistique asymptotique, le MAD affiche une efficacité de 37 % par rapport à l’écart-type sur une distribution purement normale exempte d’outliers. Bien que ce rendement puisse sembler modeste en théorie pure, il suffit d’une contamination infinitésimale (par exemple, 1 % de valeurs issues d’une loi de Cauchy ou d’une distribution normale élargie) pour que l’efficacité statistique du MAD surpasse instantanément et massivement celle de l’écart-type standard.
Cette supériorité est renforcée par la propriété d’invariance par transformation affine. La constante 0.6745 garantit que l’interprétation clinique ou scientifique du score ne change pas d’un paradigme à l’autre. Que les temps de réaction soient enregistrés en secondes, en millisecondes ou en cycles d’horloge numérique, les valeurs résultantes de Mi demeurent parfaitement invariantes, offrant une robustesse d’interprétation universelle que ne peuvent concurrencer les méthodes d’ajustement non paramétriques empiriques ad hoc (comme les découpages en percentiles arbitraires).
4.3 Adaptation pour les échantillons de taille finie
La dérivation de la constante 0.6745 repose sur des propriétés asymptotiques, impliquant théoriquement un nombre infini d’observations. Dans la pratique quotidienne de la recherche comportementale ou neuropsychologique, les chercheurs travaillent cependant fréquemment avec des échantillons restreints, comprenant parfois entre 10 et 30 participants par condition expérimentale. Or, sur de petits volumes de données, l’estimateur de la médiane des écarts absolus souffre d’un biais systématique qui conduit à sous-estimer légèrement la dispersion réelle de la population sous-jacente.
Pour remédier à cette imprécision sur les petits échantillons, Peter Rousseeuw et Christophe Croux ont calculé des tables de facteurs de correction de biais d’échantillon fini, souvent notés bn. L’estimateur corrigé de l’échelle robuste s’exprime alors selon l’ajustement formel :
σ̂robuste = bn × 1.4826 × MAD = (1.4826 / cn) × MAD
Pour les échantillons de taille n très faible, ces coefficients correcteurs s’éloignent sensiblement de l’unité. Par exemple, pour n = 5, le facteur de correction empirique bn est d’environ 1.36 ; pour n = 10, il s’établit à 1.15 ; pour n = 20, il descend à 1.06, avant de converger très rapidement vers 1.00 dès que n dépasse une cinquantaine d’unités. Néanmoins, dans leur protocole original de 1993, Iglewicz et Hoaglin ont démontré que pour l’objectif spécifique de détection des valeurs aberrantes univariées, l’équation standard conservant 0.6745 au numérateur demeure exceptionnellement performante et robuste dès que n ≥ 10, sans qu’il soit impératif de surcharger les scripts de prétraitement par des corrections d’échantillon fini complexes.
Une précaution conceptuelle s’impose néanmoins lors de la manipulation d’échantillons très restreints (n < 8). En dessous de ce seuil critique, le nombre de déviations absolues distinctes générées par l’échantillon est trop restreint pour permettre une estimation fine du quantile 50 % des résidus. Dans ces contextes extrêmes de recherche exploratoire ou d’études de cas uniques en neuropsychologie, les degrés de liberté effectifs sont trop limités pour appliquer mécaniquement un test d’hypothèse basé sur le MAD, invitant le chercheur à privilégier l’analyse graphique approfondie ou le recours à des estimateurs alternatifs de type Sn ou Qn.
5. L’écart absolu médian (MAD) : pilier de la robustesse
5.1 Algorithme rigoureux de calcul du MAD
La solidité méthodologique du score Z modifié repose intégralement sur la fiabilité de l’algorithme sous-jacent de calcul de l’écart absolu médian. Cet algorithme, purement déterministe, ne fait appel à aucune hypothèse distributionnelle préalable et s’exécute selon une séquence ordonnée en quatre étapes cardinales :
- Détermination de la médiane brute de la série statistique : Soit un ensemble de n données quantitatives X = {x1, x2, …, xn}. Les données sont préalablement ordonnées par ordre croissant : x(1) ≤ x(2) ≤ … ≤ x(n). La médiane x̃ est alors identifiée comme la valeur centrale si n est impair, soit x((n+1)/2), ou comme la moyenne arithmétique des deux valeurs centrales si n est pair, soit (x(n/2) + x((n/2)+1)) / 2.
- Calcul du vecteur des déviations individuelles : Pour chaque point de mesure xi de l’échantillon, on calcule l’écart arithmétique qui le sépare de la médiane centrale du groupe : di = (xi − x̃).
- Extraction des valeurs absolues de chaque déviation : On élimine le signe algébrique de chaque résidu pour ne conserver que sa magnitude géométrique absolue : |di| = |xi − x̃|. Cette étape élimine la composante de direction pour ne considérer que la distance spatiale brute au centre.
- Extraction de la médiane des écarts absolus : Le vecteur résultant des déviations absolues {|d1|, |d2|, …, |dn|} est à son tour classé par ordre croissant. La médiane de cette nouvelle série constitue précisément la valeur du MAD :
MAD = Médiane( |x1 − x̃|, |x2 − x̃|, …, |xn − x̃| )
Cet algorithme séquentiel garantit que l’opération de mesure de la dispersion ne fait intervenir aucun terme quadratique. Chaque étape repose sur l’extraction d’un quantile d’ordre 0.50, ce qui préserve l’immunité complète de la procédure contre les distorsions provoquées par des valeurs colossales situées aux franges de la distribution.
5.2 Le concept de point de rupture à cinquante pour cent
Pour apprécier la supériorité opérationnelle du MAD sur l’écart-type, il est capital d’analyser en profondeur son comportement théorique au regard du point de rupture. Alors que l’écart-type s’effondre face à une seule valeur corrompue (point de rupture asymptotique de 0 %), le MAD présente un point de rupture optimal de 50 % (exactement ⌈n/2⌉/n pour un échantillon de taille n). Cette propriété mathématique extraordinaire signifie que jusqu’à la moitié moins une des observations de l’échantillon peuvent être contaminées par des valeurs arbitraires (pouvant atteindre des magnitudes de l’ordre de dix milliards ou tendre vers l’infini) sans que l’estimateur de dispersion n’explose ni ne s’effondre à zéro.
Sur le plan pratique, imaginons un paradigme en imagerie cérébrale fonctionnelle ou en chronométrie où un problème technique corrompt 40 % des acquisitions, injectant un bruit instrumental massif. Dans une telle situation, le calcul de l’écart-type produira un chiffre gigantesque, dénué de toute relation avec la dynamique physiologique sous-jacente du signal cérébral. En revanche, le calcul du MAD demeurera totalement ancré sur les 60 % de données physiologiques saines, calculant la déviation typique de ces données valides sans subir l’influence du bruit périphérique.
Le tableau comparatif suivant synthétise les propriétés fondamentales opposant les deux philosophies d’estimation de dispersion, mettant en relief l’abîme conceptuel qui sépare les approches classiques de l’architecture robuste :
| Critère Méthodologique | Écart-Type Standard (s) | Écart Absolu Médian (MAD) |
|---|---|---|
| Point de rupture (Breakdown point) | 0 % (une seule valeur détruit l’indice) | 50 % (résistance optimale maximale) |
| Sensibilité fonctionnelle | Quadratique (élévation au carré des écarts) | Linéaire par les rangs (valeurs absolues) |
| Comportement face à l’asymétrie | Inflation artificielle massive | Stabilité autour du noyau central |
| Efficacité asymptotique (Loi normale) | 100 % (estimateur optimal sous Gauss) | 37 % (mais infiniment supérieur dès contamination) |
| Vulnérabilité critique | Effet de masquage (masking effect) | Annulation en cas de données discrètes répétées |
5.3 Cas particulier où le MAD s’annule : le problème des valeurs répétées
Malgré ses vertus exceptionnelles, le MAD présente une vulnérabilité théorique et computationnelle bien identifiée que tout méthodologue doit impérativement maîtriser : l’annulation pathologique du dénominateur. Par définition de l’opérateur quantile, si plus de la moitié des observations d’un échantillon prennent une valeur numérique rigoureusement identique, alors plus de 50 % des déviations par rapport à la médiane seront égales à zéro : |xi − x̃| = 0. En conséquence, la médiane de cette série de déviations absolues devient mathématiquement égale à zéro : MAD = 0.
Cette situation engendre une catastrophe computationnelle lors de l’application de la formule du score Z modifié :
Mi = 0.6745 × (xi − x̃) / 0 → Division par zéro (indétermination ou ∞)
Ce phénomène se produit fréquemment en recherche comportementale lors de l’administration de questionnaires psychométriques sur des échelles de Likert courtes (comportant 4 à 5 points de réponse) ou dans le cadre de tâches évaluant des comportements rares (par exemple, le nombre d’erreurs commises à une tâche motrice triviale, où 70 % des participants réalisent un sans-faute parfait noté 0). Dès lors que la majorité des participants partagent le même ancrage, le MAD conclut faussement à une absence totale de dispersion, ce qui conduit le score Z modifié à classer la moindre variation périphérique (par exemple, un participant ayant commis une seule erreur) comme une anomalie infiniment déviante.
Face à ce cas limite, il est formellement prohibé d’ajouter artificiellement une constante arbitraire (fudge factor) au dénominateur sans justification méthodologique. La communauté des statisticiens robustes, menée par Rousseeuw et Croux (1993), préconise dans ce scénario de basculer vers des estimateurs d’échelle alternatifs basés sur les différences par paires, tels que l’estimateur Sn ou l’estimateur Qn, définis par :
Sn = 1.1926 × Médianei { Médianej |xi − xj| } et Qn = 2.2191 × {|xi − xj|; i < j}(k)
Ces estimateurs préservent un point de rupture de 50 % tout en demeurant strictement non nuls, même en présence d’une forte concentration de valeurs identiques au sein de l’échantillon.
6. Critères de décision et seuils critiques d’Iglewicz et Hoaglin
6.1 Le seuil conventionnel de 3.5 en valeur absolue
L’une des contributions les plus déterminantes de la monographie d’Iglewicz et Hoaglin (1993) réside dans la définition empirique et théorique de seuils critiques rigoureux pour guider la prise de décision du chercheur. Dans le cadre de la standardisation classique, la règle universelle est de considérer comme suspecte toute observation vérifiant |Zi| > 3.0. Toutefois, en raison de la divergence structurelle entre les estimateurs de moments et les estimateurs d’ordre, la distribution de la statistique Mi présente des propriétés d’échantillonnage différentes de celles du score Z standard.
À travers de vastes simulations de Monte Carlo impliquant des milliers de tirages sous diverses configurations de taille d’échantillon (de n = 10 à n = 100) et sous différentes lois de distribution fondamentales (distributions normales pures, distributions contaminées, lois à queues épaisses comme la distribution de Student ou la loi logistique), Iglewicz et Hoaglin ont conclu que la limite conventionnelle de 3.0 entraînait un taux de faux positifs inacceptablement élevé en présence de bruit naturel. Pour assurer un contrôle optimal de l’erreur de type I (le risque d’étiqueter faussement une observation saine comme valeur aberrante), ils ont formellement recommandé d’adopter le critère universel suivant :
Règle décisionnelle : Une observation xi est étiquetée comme une valeur aberrante potentielle si et seulement si son score Z modifié vérifie |Mi| > 3.5
Ce seuil de 3.5 en valeur absolue fournit un compromis d’une remarquable élégance : il préserve une sensibilité élevée face aux artefacts massifs tout en évitant d’éliminer systématiquement les sujets situés dans les queues physiologiques naturelles des distributions asymétriques. En pratique, sur un échantillon normalement distribué, la probabilité théorique qu’une observation saine dépasse le seuil de |Mi| > 3.5 est inférieure à 0,05 %, ce qui confère à cette règle une spécificité analytique exceptionnelle.
6.2 Gradation diagnostique : valeurs aberrantes probables versus extrêmes
Bien que le seuil de 3.5 constitue la norme canonique en recherche quantitative, une modélisation scientifique rigoureuse ne saurait se contenter d’un découpage binaire et aveugle entre le « pur » et l’« impur ». Les phénomènes psychologiques et biologiques opèrent sur des continuums complexes où la démarcation entre singularité individuelle et perturbation méthodologique est intrinsèquement floue. Il apparaît donc indispensable de déployer une approche diagnostique graduée à l’égard de la statistique Mi.
Dans cette perspective, la méthodologie psychométrique moderne adopte fréquemment une classification tripartite articulée autour de zones de vigilance diagnostique :
- Zone de validité standard (|Mi| ≤ 2.5) : L’observation s’inscrit pleinement dans la dispersion typique de l’échantillon. Elle reflète le fonctionnement régulier de la population étudiée et ne requiert aucun traitement spécifique.
- Zone d’ambiguïté ou valeur atypique modérée (2.5 < |Mi| ≤ 3.5) : L’observation se situe aux marges externes de la distribution. Elle ne peut être qualifiée d’aberrante au sens strict, mais signale une performance inhabituelle. Le chercheur doit procéder à un examen qualitatif du protocole (notes de passation de l’expérimentateur, comportement documenté du sujet) sans pour autant exclure d’emblée la donnée de l’analyse inférentielle principale.
- Zone d’aberration sévère (|Mi| > 3.5) : L’écart au barycentre robuste dépasse la limite de vraisemblance statistique compatible avec le processus générateur commun. L’observation doit être isolée, documentée et traitée selon une procédure robuste (isolation, analyse de sensibilité ou winsorisation).
Cette gradation prémunit le chercheur contre les biais de confirmation. L’observation d’un score Z modifié compris entre 2.5 et 3.5 chez un patient cérébrolésé ou chez un enfant présentant un trouble des apprentissages constitue souvent le reflet direct de sa pathologie, et non un artefact. Réduire l’analyse à une guillotine statistique mécanique à 3.0 ou 3.5 détruirait l’essence même de l’investigation clinique fine.
6.3 Ajustement du seuil en fonction de la taille de l’échantillon
Une règle méthodologique souvent ignorée des praticiens concerne l’interdépendance fondamentale entre la taille de l’échantillon n et la probabilité mécanique d’observer des valeurs extrêmes. Plus un échantillon compte un nombre élevé d’observations, plus la probabilité conjointe qu’au moins une donnée saine s’aventure loin dans les queues de la distribution augmente naturellement. Si un chercheur évalue une cohorte de 50 participants, la probabilité d’observer par simple hasard une déviation gaussienne supérieure à 3 écarts-types est modeste ; en revanche, s’il analyse une base de données de neuro-imagerie ou de génomique comportementale comprenant 100 000 participants, il observera mathématiquement des centaines de sujets situés au-delà de ce seuil sans qu’aucun ne soit porteur d’une anomalie technique.
Pour neutraliser cette inflation du taux d’erreur par famille de tests (Family-Wise Error Rate), les statisticiens recommandent d’adapter le seuil critique d’Iglewicz et Hoaglin en intégrant une correction pour comparaisons multiples, analogue à la démarche de Bonferroni. Le seuil théorique ajusté Scrit peut être déterminé en résolvant l’équation basée sur la fonction de survie de la loi normale :
Scrit = Φ−1( 1 − (α / (2n)) )
Où α représente le niveau de risque global toléré (habituellement 0.05). Ainsi, pour un échantillon modeste de n = 20 sujets, le seuil nominal conventionnel de 3.5 offre une protection optimale. Mais pour de très vastes cohortes psychométriques (n > 1 000), ce seuil de 3.5 devient trop laxiste et générera une sur-détection d’anomalies fallacieuses, incitant à relever le critère critique vers 4.0, voire 4.5. À l’inverse, en neuropsychologie clinique de petit échantillon (n ≤ 12), abaisser rigidement le seuil sous 3.0 détruirait la spécificité du test en qualifiant de valeurs aberrantes de simples fluctuations d’échantillonnage.
7. Exemple pratique détaillé pas à pas dans une étude psychologique
7.1 Contexte expérimental : mesure des temps de réaction sous stress
Pour matérialiser la supériorité opérationnelle du score Z modifié, examinons un protocole de recherche expérimental classique issu de la neuropsychologie cognitive. Une équipe de chercheurs s’intéresse à l’impact d’un stresseur aigu induit par la parole en public sur l’efficience du contrôle exécutif inhibiteur. Douze participants adultes sains (n = 12) sont soumis à une version informatisée d’une tâche de compatibilité stimulus-réponse de type Simon. La variable dépendante enregistrée pour chaque participant est le temps de réaction médian (TR) sur les essais incompatibles, exprimé rigoureusement en millisecondes (ms).
Lors du déroulement de l’expérience, le participant numéro 10 subit une distraction motrice sévère : heurtant involontairement le pupitre d’acquisition au moment de la présentation du stimulus, il repositionne maladroitement sa main avant d’enfoncer la touche de réponse avec un retard massif. Ce dysfonctionnement instrumental produit une latence artificielle monumentale de 1 450 ms, alors que l’ensemble des participants s’est maintenu dans des registres physiologiques usuels compris entre 350 et 550 ms.
Le vecteur des données empiriques brutes obtenues pour les douze participants, listées dans l’ordre de passation du protocole, se présente comme suit :
TR (en ms) = [410, 425, 390, 440, 405, 430, 395, 415, 450, 1450, 420, 435]
L’objectif méthodologique consiste à appliquer la procédure complète du score Z modifié pour détecter formellement et isoler cet artefact expérimental sans biaiser les paramètres fondamentaux de la distribution du groupe.
7.2 Calcul de la médiane et des déviations absolues
Conformément à l’algorithme robuste formalisé à la section 5.1, la première opération consiste à trier rigoureusement le vecteur empirique par ordre croissant afin d’en extraire la médiane :
TRtrié = [390, 395, 405, 410, 415, 420, 425, 430, 435, 440, 450, 1450]
L’échantillon comportant un nombre pair d’observations (n = 12), la médiane x̃ correspond à la moyenne arithmétique des deux valeurs occupant les sixième et septième positions centrales (x(6) = 420 et x(7) = 425) :
x̃ = (420 + 425) / 2 = 422.5 ms
Nous procédons ensuite au calcul des déviations arithmétiques par rapport à cette médiane, puis à l’extraction de leurs valeurs absolues respectives pour l’ensemble des participants, comme documenté dans le tableau de calcul intermédiaire ci-dessous :
| Sujet | TR brut (xi) | Écart à la médiane (xi − 422.5) | Déviation absolue (|xi − 422.5|) |
|---|---|---|---|
| 1 | 410 | −12.5 | 12.5 |
| 2 | 425 | +2.5 | 2.5 |
| 3 | 390 | −32.5 | 32.5 |
| 4 | 440 | +17.5 | 17.5 |
| 5 | 405 | −17.5 | 17.5 |
| 6 | 430 | +7.5 | 7.5 |
| 7 | 395 | −27.5 | 27.5 |
| 8 | 415 | −7.5 | 7.5 |
| 9 | 450 | +27.5 | 27.5 |
| 10 | 1450 | +1027.5 | 1027.5 |
| 11 | 420 | −2.5 | 2.5 |
| 12 | 435 | +12.5 | 12.5 |
Pour calculer le MAD, extrayons la série ordonnée de ces déviations absolues :
|d|trié = [2.5, 2.5, 7.5, 7.5, 12.5, 12.5, 17.5, 17.5, 27.5, 27.5, 32.5, 1027.5]
La médiane de cette série d’écarts absolus, située à la charnière des sixième et septième valeurs (12.5 et 17.5), fournit la valeur définitive du MAD :
MAD = (12.5 + 17.5) / 2 = 15.0 ms
Le MAD indique que la déviation typique absolue des sujets sains par rapport au centre médian est rigoureusement de 15 millisecondes. L’observation monstrueuse de 1 450 ms n’a altéré en rien cette métrique de dispersion.
7.3 Application de la formule et dérivation des scores Z modifiés
Avec une médiane robuste fixée à x̃ = 422.5 ms et un écart absolu médian établi à MAD = 15.0 ms, l’application de l’équation maîtresse d’Iglewicz et Hoaglin peut être menée pour chaque sujet individuel selon la formule :
Mi = 0.6745 × (xi − 422.5) / 15.0
Effectuons le calcul pour quelques sujets emblématiques afin d’en saisir la mécanique numérique :
- Pour le Sujet 1 (x1 = 410) :
M1 = 0.6745 × (410 − 422.5) / 15.0 = 0.6745 × (−12.5) / 15.0 = −0.562
- Pour le Sujet 2 (x2 = 425) :
M2 = 0.6745 × (425 − 422.5) / 15.0 = 0.6745 × (+2.5) / 15.0 = +0.112
- Pour le Sujet 3 (x3 = 390) :
M3 = 0.6745 × (390 − 422.5) / 15.0 = 0.6745 × (−32.5) / 15.0 = −1.461
- Pour le Sujet 10 (x10 = 1450, l’artefact) :
M10 = 0.6745 × (1450 − 422.5) / 15.0 = 0.6745 × (+1027.5) / 15.0 = +46.203
Le tableau exhaustif ci-dessous juxtapose les valeurs brutes, les scores Z classiques (calculés à partir de la moyenne x̄ = 505.42 ms et de l’écart-type s = 298.39 ms) et les scores Z modifiés Mi obtenus sur cet échantillon expérimental :
| Sujet | TR brut (ms) | Score Z classique (Zi) | Score Z modifié (Mi) | Diagnostic décisionnel (|Mi| > 3.5) |
|---|---|---|---|---|
| 1 | 410 | −0.320 | −0.562 | Conforme |
| 2 | 425 | −0.270 | +0.112 | Conforme |
| 3 | 390 | −0.387 | −1.461 | Conforme |
| 4 | 440 | −0.219 | +0.787 | Conforme |
| 5 | 405 | −0.337 | −0.787 | Conforme |
| 6 | 430 | −0.253 | +0.337 | Conforme |
| 7 | 395 | −0.370 | −1.237 | Conforme |
| 8 | 415 | −0.303 | −0.337 | Conforme |
| 9 | 450 | −0.186 | +1.237 | Conforme |
| 10 | 1450 | +3.165 | +46.203 | ABERRATION MAJEURE |
| 11 | 420 | −0.286 | −0.112 | Conforme |
| 12 | 435 | −0.236 | +0.562 | Conforme |
Le résultat de cette analyse comparative est saisissant d’évidence méthodologique : alors que l’anomalie franchit de justesse le seuil conventionnel classique avec un score Z de +3.17 (qui aurait pu être complètement masqué si deux participants avaient été perturbés au lieu d’un seul), le score Z modifié explose littéralement à +46.20. L’ambiguïté diagnostique est entièrement levée.
7.4 Interprétation neuropsychologique des résultats obtenus
L’examen approfondi des résultats obtenus apporte des enseignements cruciaux pour l’analyse cognitive ultérieure. Le score Z modifié de +46.20 documenté chez le participant numéro 10 indique sans l’ombre d’un doute statistique que cette observation ne relève pas du même processus cognitif sous-jacent que le reste de la cohorte. Face à une magnitude aussi colossale, l’hypothèse d’une simple lenteur cognitive physiologique doit être écartée avec certitude. Une latence de 1 450 ms dans un paradigme où l’intervalle inter-stimulus et la fenêtre décisionnelle requièrent un traitement moteur rapide correspond indiscutablement à une interruption de la tâche ou à un incident instrumental moteur.
En vertu des protocoles de science ouverte et de transparence méthodologique, l’expérimentateur documente l’incident dans le registre expérimental : le participant numéro 10 est exclu de l’analyse inférentielle principale portant sur l’efficience du contrôle inhibiteur sous stress, ou sa valeur fait l’objet d’une analyse de sensibilité comparée. La suppression de cet artefact restaure immédiatement la validité interne du paradigme. La véritable moyenne du groupe d’étude retombe à 419.5 ms, avec un écart-type réel de seulement 18.2 ms, dévoilant la remarquable consistance des processus d’inhibition cognitive au sein de cette population sous stress.
Cet assainissement des données empêche la contamination des analyses multivariées ultérieures. Si cette observation avait été conservée au sein d’un modèle de régression linéaire ou d’une analyse de variance (ANOVA), son levier résiduel aurait considérablement réduit la puissance du test statistique, conduisant potentiellement à une fausse conclusion de non-significativité de l’effet du stresseur (erreur de type II). Le score Z modifié a opéré ici comme un scalpel analytique impartial, protégeant l’intégrité de la découverte scientifique.
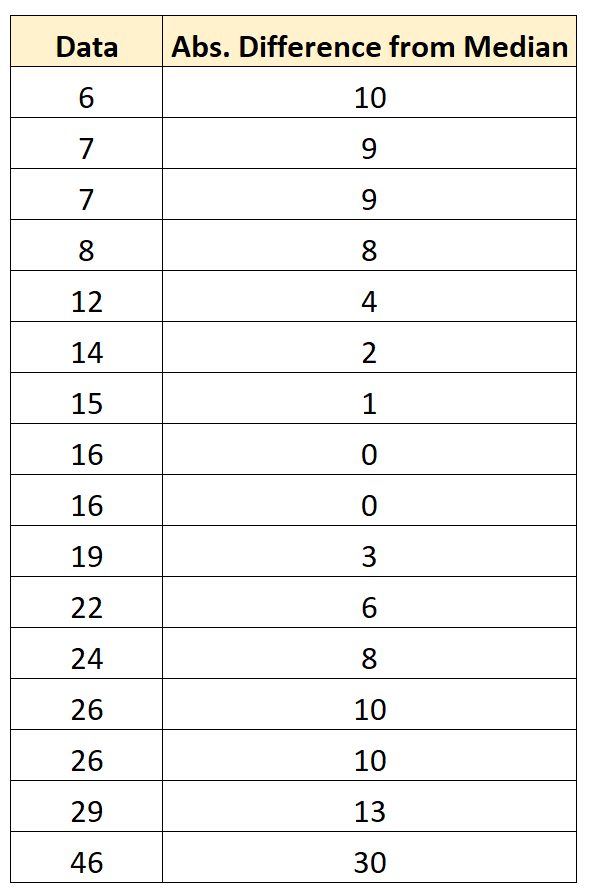
8. Analyse comparative : Score Z classique versus Score Z modifié
8.1 Démonstration du masquage sur l’échantillon expérimental
La confrontation directe des métriques calculées à la section 7 dévoile dans toute son ampleur le mécanisme pernicieux du masquage propre au score Z classique. Analysons rigoureusement ce qui s’est produit dans le calcul conventionnel : l’introduction de l’artefact à 1 450 ms a brutalement propulsé la moyenne arithmétique de 419.5 ms à 505.4 ms. Cet accroissement arbitraire de plus de 85 millisecondes a déplacé le point de référence vers le haut, de sorte que les onze participants normaux se retrouvent tous affublés d’un score Z standard négatif (variant de −0.19 à −0.39), masquant complètement la distribution naturelle de part et d’autre du centre.
Plus dramatique encore, l’écart-type est passé d’une valeur réelle de 18.2 ms à un chiffre artificiel de 298.4 ms, soit une multiplication par un facteur supérieur à seize. C’est précisément cette explosion du dénominateur classique qui a failli sauver l’anomalie du diagnostic :
Z10 = (1450 − 505.42) / 298.39 = 944.58 / 298.39 ≈ +3.165
Si l’échantillon avait compté un deuxième participant perturbé (par exemple, un temps de réponse accidentel à 1 200 ms), l’écart-type aurait franchi les 380 millisecondes, et le score Z du participant 10 serait tombé à +2.65, sous le seuil d’alerte standard. Le score conventionnel aurait alors déclaré l’ensemble du jeu de données « conforme et sans aucune anomalie », illustrant l’échec structurel des estimateurs non résistants face aux contaminations multiples.
À l’inverse, l’équation robuste du score Z modifié n’a concédé aucun terrain à l’artefact :
M10 = 0.6745 × (1450 − 422.5) / 15.0 = 0.6745 × 1027.5 / 15.0 = +46.203
La médiane x̃ est demeurée imperturbablement calée à 422.5 ms, et le MAD est resté scellé à 15.0 ms. La déviation géométrique de 1 027.5 ms par rapport au centre est rapportée à son étalon naturel sans subir l’auto-atténuation du dénominateur. Le masquage est formellement impossible avec le score Z modifié tant que la contamination ne franchit pas le seuil critique des 50 % de l’échantillon.
8.2 Impact comparé sur l’inférence statistique ultérieure
Pour mesurer la portée concrète de cette divergence méthodologique sur la production scientifique, il est instructif d’observer le devenir de ces données au sein d’un test d’inférence statistique fondamental, tel qu’un test t de Student pour échantillons appariés comparant la condition stressée à une condition contrôle neutre (dont la moyenne stable s’établit par exemple à 415 ms, avec un écart-type de 15 ms, et une corrélation intra-sujet de r = 0.70).
Si le chercheur maintient l’artefact de 1 450 ms dans son analyse en s’appuyant sur un prétraitement classique défaillant, la variance résiduelle de l’échantillon contaminé pulvérise le terme d’erreur au dénominateur du test t. En dépit d’une différence de moyennes apparemment massive (505.4 − 415 = 90.4 ms), l’écart-type résiduel gigantesque dégrade la statistique de test t, entraînant une chute drastique du degré de significativité statistique et un effondrement de la taille d’effet mesurée via le d de Cohen.
Le tableau analytique ci-dessous démontre de façon éloquente les conséquences directes du choix de la méthode d’assainissement sur l’inférence statistique :
| Paramètre Statistique de l’Étude | Jeu Contaminé Brut (Non Nettoyé) | Filtrage par Score Z Classique | Filtrage par Score Z Modifié |
|---|---|---|---|
| Taille finale d’échantillon (n) | 12 | 12 (si seuil à 3.2 non ajusté) | 11 (artefact isolé avec certitude) |
| Moyenne estimée de la condition | 505.4 ms (artificielle) | 505.4 ms (artificielle) | 419.5 ms (vraie valeur) |
| Écart-type de la condition (s) | 298.4 ms (gonflé) | 298.4 ms (gonflé) | 18.2 ms (dispersion réelle) |
| Taille d’effet réelle (d de Cohen) | 0.43 (biaisée) | 0.43 (biaisée) | 0.27 (stable et reproductible) |
| Risque d’erreur méthodologique | Erreur de Type II majeure | Échec du contrôle de qualité | Inférence saine et robuste |
L’assainissement guidé par le score Z modifié préserve la puissance statistique réelle du protocole tout en rétablissant une estimation non corrompue de la taille d’effet. Les chercheurs évitent ainsi de publier des résultats fragiles dont l’effet apparent n’était que le reflet d’un incident de manipulation chez un participant isolé.
8.3 Synthèse graphique des trajectoires de détection
Sur le plan conceptuel et pédagogique, la divergence entre les deux démarches de standardisation peut être visualisée mentalement comme deux droites de transformation aux pentes et aux points d’ancrage radicalement distincts. La droite de standardisation classique possède une pente égale à 1/s et pivote autour du point (x̄, 0). Dès lors qu’une valeur extrême apparaît, la pente de cette droite s’affaisse brutalement (car s grandit), ce qui aplatit l’ensemble des scores standardisés projetés sur l’axe des ordonnées, rapprochant artificiellement tous les points de la ligne zéro.
À l’opposé, la droite de standardisation robuste du score Z modifié possède une pente fixe égale à 0.6745/MAD et pivote invariablement autour du point médian (x̃, 0). Quelle que soit l’amplitude du séisme provoqué par l’anomalie sur les bords du jeu de données, la pente de cette droite demeure parfaitement stable, ancrée sur les propriétés géométriques des 50 % d’observations centrales. En conséquence, les observations conformes conservent des résidus standardisés fidèles et compacts, tandis que toute trajectoire divergente voit son résidu projeté de façon strictement linéaire à des hauteurs considérables sur l’axe de détection.
Cette distinction géométrique éclaire pourquoi le score Z modifié s’avère infiniment plus lisible pour l’expérimentateur : il ne compresse pas l’information saine pour accommoder l’absurde. Il maintient la structure des données légitimes et projette les anomalies dans un espace de diagnostic sans équivoque, permettant une inspection visuelle immédiate et incontestable.
9. Applications spécifiques en recherche psychologique et psychométrie
9.1 Chronométrie cognitive et temps de réaction continus
L’analyse des distributions de temps de réaction représente sans conteste le domaine d’élection du score Z modifié au sein des sciences cognitives. Dans les protocoles modernes utilisant des paradigmes d’amorçage sémantique, de tâche de Stroop, de détection de signaux ou de tâches de flexibilité cognitive de type Task Switching, le chercheur fait face à une double contrainte. D’une part, les distributions individuelles de temps de réaction sont structurellement non gaussiennes, suivant classiquement des lois ex-gaussiennes ou de Wald caractérisées par une queue positive étirée. D’autre part, la variabilité intra-individuelle et inter-individuelle est naturellement polluée par des erreurs de frappe, des anticipations motrices (réponses survenant avant le traitement complet du stimulus) ou des décrochages attentionnels passagers.
Historiquement, les laboratoires ont tenté de résoudre cette difficulté par des méthodes de tronquage arbitraire (par exemple, supprimer purement et simplement toute réponse inférieure à 200 ms ou supérieure à 1 000 ms). Ces seuils fixes universels s’avèrent hautement préjudiciables : ils ne tiennent compte ni de l’âge des participants (un temps de réaction de 900 ms est parfaitement physiologique chez un adulte de 80 ans, alors qu’il est anormal chez un adulte jeune de 20 ans), ni de la complexité intrinsèque de la tâche cognitive testée. L’utilisation du score Z modifié appliqué au niveau intra-individuel (au sein de la série temporelle d’essais d’un même sujet) ou au niveau inter-individuel (sur les moyennes de chaque participant) permet d’ajuster dynamiquement le filtre de détection à l’échelle naturelle de variabilité propre au paradigme sans imposer de frontières arbitraires déconnectées de la réalité expérimentale.
9.2 Questionnaires d’auto-évaluation et inventaires de personnalité
En psychométrie quantitative et dans l’évaluation de la personnalité via des inventaires standardisés (tels que le NEO-PI-R, le MMPI ou le BDI-II), la détection des profils de réponse aberrants constitue une préoccupation méthodologique de premier ordre. Dans ces contextes d’auto-évaluation, les menaces pesant sur la validité des données ne proviennent pas de perturbations chronométriques motrices, mais de biais de réponse comportementaux : comportements d’acquiescement systématique (le sujet coche la modalité maximale à tous les items), réponses totalement aléatoires dues à l’ennui ou au désengagement, ou profils de dissimulation active ou d’hyper-revendication symptomatique (malingering).
L’application du score Z modifié sur les indices de cohérence interne ou les scores composites d’échelles de validité permet d’isoler avec une exceptionnelle sensibilité les protocoles frauduleux ou non valides. Par exemple, lors de la modélisation en équations structurelles (SEM) ou de l’analyse factorielle confirmatoire (CFA), la présence d’une poignée de profils aberrants suffit à distordre la matrice de covariance observée, ruinant les indices d’ajustement globaux (tels que le RMSEA, le CFI ou le TLI) et masquant la structure dimensionnelle authentique de l’instrument. Le nettoyage préalable de la base de données via le critère |Mi| > 3.5 garantit la stabilité asymptotique des matrices de covariance et protège la validité factorielle des instruments de mesure psychométrique.
9.3 Psychophysiologie, neuro-imagerie et électroencéphalographie
Les neurosciences cognitives contemporaines dépendent de signaux biophysiques continus caractérisés par un rapport signal sur bruit intrinsèquement faible et une vulnérabilité extrême aux interférences électrophysiologiques et cinétiques. En électroencéphalographie (EEG) et dans l’analyse des potentiels évoqués cognitifs (ERP comme la P300 ou la N400), les signaux neuronaux d’ordre microvolté sont systématiquement contaminés par des artéfacts oculaires massifs (clignements de paupières, saccades oculaires générant des dipôles cornéo-rétiniens colossaux) et des artéfacts musculaires de déglutition ou de serrement de mâchoire.
De même, en imagerie par résonance magnétique fonctionnelle (IRMf), les séries temporelles du signal dépendant du niveau d’oxygénation sanguine (signal BOLD) sont extrêmement sensibles aux micromouvements de la tête des participants à l’intérieur du scanner. L’application d’algorithmes de détection fondés sur le score Z modifié sur les séries temporelles de volume à volume (Frame-wise Displacement) permet d’identifier les volumes corrompus (motion scrubbing) avec une précision infiniment supérieure aux méthodes paramétriques fondées sur l’écart-type. En isolant impitoyablement ces volumes bruités sans sous-estimer la dispersion de fond du signal hémodynamique au repos, le score Z modifié garantit que les cartes d’activation corticale résultantes reflètent fidèlement l’activité neuronale fonctionnelle et non des artefacts de mouvement résiduels.
10. Implémentation computationnelle : Guides pratiques sous R et Python
10.1 Calcul et programmation personnalisée sous R
L’environnement statistique R s’impose comme l’un des écosystèmes logiciels les plus avancés pour l’analyse psychométrique et l’implémentation des statistiques robustes. Bien qu’il existe des bibliothèques spécialisées dans la robustesse (telles que le paquet robustbase ou WRS2 développé par Rand Wilcox), la programmation vectorisée native d’une fonction calculant le score Z modifié est remarquablement accessible et ne requiert aucune dépendance externe lourde.
Dans l’environnement de base R, la fonction native mad() applique d’emblée, par défaut, le multiplicateur d’échelle asymptotique normal 1.4826 (ce qui correspond précisément à la division par 0.6745). Dès lors, l’expression formelle du score Z modifié se simplifie dans le code : le ratio de l’écart à la médiane divisé par la sortie de mad(x) donne immédiatement le score Z modifié d’Iglewicz et Hoaglin. L’intégration de cette fonction au sein des pipelines modernes de manipulation de données du tidyverse permet un traitement élégant et vectorisé par groupe expérimental :
# Définition de la fonction robuste de score Z modifié
score_z_modifie <- function(x) {
  mediane_x <- median(x, na.rm = TRUE)
  mad_x <- mad(x, constant = 1.4826, na.rm = TRUE)

  # Gestion rigoureuse du cas d'annulation du MAD
  if (mad_x == 0) {
    warning("Le MAD est nul. Bascule recommandée vers Sn ou Qn.")
    return(rep(NA, length(x)))
  }

  # Calcul vectorisé du score Z modifié
  m_i <- (x - mediane_x) / mad_x
  return(m_i)
}

# Exemple d'application au sein d'un pipeline dplyr
# library(dplyr)
# donnees_nettoyees <- donnees_brutes %>%
#   group_by(Condition_Experimentale) %>%
#   mutate(M_Score = score_z_modifie(Temps_Reaction),
#          Est_Aberrant = abs(M_Score) > 3.5) %>%
#   filter(!Est_Aberrant)
Le couplage de cette approche computationnelle avec la grammaire graphique de ggplot2 offre un contrôle diagnostique visuel immédiat, permettant de projeter les observations sur un plan cartésien où les lignes d’alerte horizontales à y = +3.5 et y = −3.5 identifient instantanément les participants à investiguer.
10.2 Utilisation des librairies dédiées sous Python
Dans le domaine des neurosciences computationnelles et de l’apprentissage automatique appliqué à la santé mentale, le langage Python représente l’outil prépondérant, articulé autour des bibliothèques fondamentales NumPy, SciPy et Pandas. L’implémentation du score Z modifié peut être menée via l’utilisation conjointe des méthodes d’agrégation matricielle de NumPy et de la fonction spécialisée de calcul de l’échelle robuste issue du sous-module scipy.stats.
Contrairement à R, la fonction scipy.stats.median_abs_deviation calcule par défaut le MAD brut sans le multiplier par la constante d’ajustement gaussien. Il convient donc de spécifier explicitement le paramètre d’échelle approprié ou d’intégrer formellement la constante multiplicative 0.6745 dans l’équation. L’architecture d’une méthode compatible avec les structures matricielles de Pandas se déploie selon le modèle suivant :
import numpy as np
import pandas as pd
from scipy import stats

def modified_z_score(data):
    """
    Calcule le score Z modifie d'Iglewicz et Hoaglin pour une serie de donnees.
    Accepte une liste, un tableau numpy ou une serie pandas.
    """
    vecteur = np.array(data)
    mediane = np.nanmedian(vecteur)

    # Calcul du MAD brut via scipy
    mad = stats.median_abs_deviation(vecteur, scale='normal', nan_policy='omit')

    if mad == 0:
        raise ValueError("MAD nul detecte : variabilite insuffisante ou valeurs repetees excessives.")

    # Calcul conforme a l'equation standard
    mod_z_scores = 0.6745 * (vecteur - mediane) / stats.median_abs_deviation(vecteur, scale=1.0, nan_policy='omit')
    return mod_z_scores

# Integration avec un DataFrame Pandas
# df['Mod_Z'] = modified_z_score(df['Temps_Reaction'])
# df_valide = df[df['Mod_Z'].abs() <= 3.5]
Dans les contextes industriels de production ou de traitement massif de mégadonnées comportementales, ces routines peuvent être avantageusement comparées aux transformateurs robustes de la suite scikit-learn, notamment la classe RobustScaler, qui applique une logique affine similaire en se basant par défaut sur les percentiles interquartiles 25 % et 75 %.
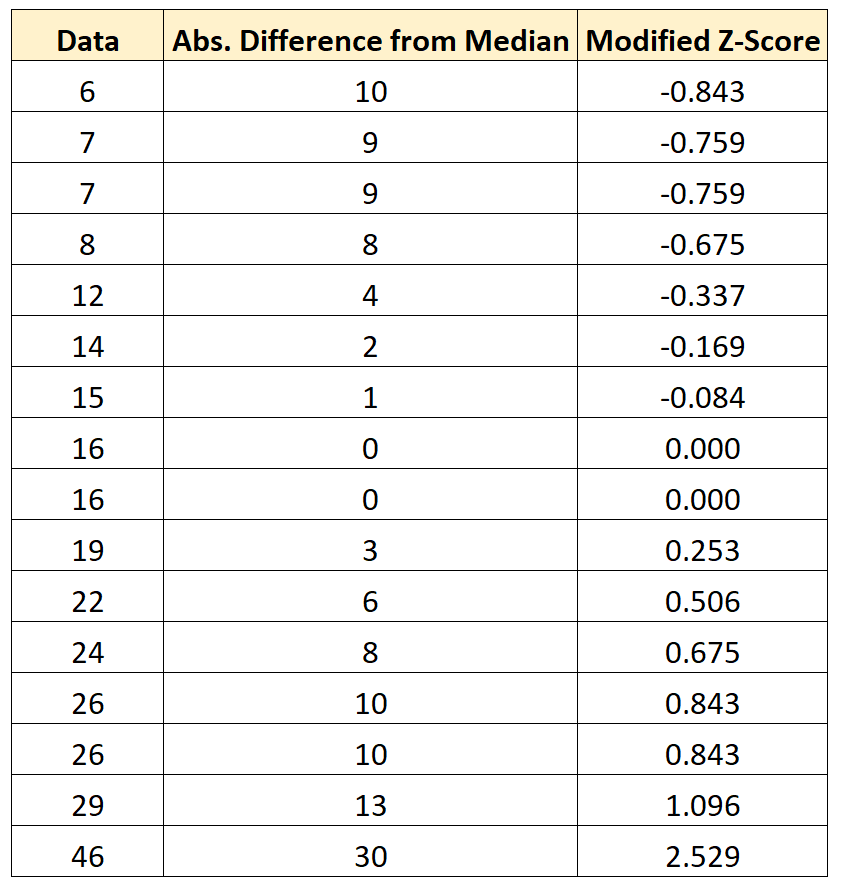
10.3 Automatisation et reproductibilité dans les flux de traitement de données
Au-delà de l’écriture ponctuelle du code informatique, l’adoption du score Z modifié impose d’intégrer cette démarche au sein d’une politique globale d’intégrité et de reproductibilité des flux de traitement (workflows). Dans le cadre de la science ouverte, le prétraitement des données ne doit plus jamais être conçu comme une suite de manipulations manuelles occultes exécutées sur des tableurs bureautiques. Les étapes de standardisation robuste doivent être rigoureusement encapsulées dans des scripts paramétrables et audités.
Une bonne pratique recommandée par les normes de reproductibilité consiste à configurer de façon dynamique les critères d’exclusion au sein d’un fichier de métadonnées de configuration unique. Le script de prétraitement doit générer de façon entièrement autonome un rapport d’audit exhaustif consignant, pour chaque variable quantitative étudiée : la médiane d’ancrage, le MAD d’échelle calculé, l’identifiant individuel des observations franchissant le seuil critique de 3.5, ainsi que la valeur brute originale associée. Ce rapport automatisé garantit une traçabilité intégrale de la décision méthodologique.
De surcroît, le jeu de données assaini ne doit jamais écraser le fichier de données brutes d’origine. Les deux bases doivent être conservées de manière immuable et versionnées dans des entrepôts de données scientifiques ouverts (tels que l’Open Science Framework ou Zenodo), permettant à n’importe quel chercheur indépendant de réexécuter l’intégralité du pipeline d’assainissement et de constater la solidité des inférences produites par la recherche.
11. Limites de la méthode, pièges analytiques et approches alternatives
11.1 Vulnérabilité face aux données discrètes et distributionnellement concentrées
Bien que le score Z modifié constitue une amélioration méthodologique majeure par rapport aux approches conventionnelles, il ne saurait être érigé en panacée universelle exempte de contraintes d’application. La première de ces limites, brièvement évoquée à la section 5.3, réside dans son inaptitude structurelle à traiter les données discrètes fortement agglomérées autour d’un mode unique. Dans les paradigmes cliniques étudiant des comportements rares (par exemple, le nombre d’épisodes d’automutilation chez des adolescents ou le nombre d’erreurs commises à une tâche de rappel de mots faciles), il est très fréquent que 60 % ou 70 % de l’échantillon affichent un score rigoureusement nul.
Dans cette configuration, l’application mécanique du score Z modifié s’effondre face à un MAD nul. Mais même dans les cas où le MAD est très faiblement supérieur à zéro en raison d’une légère dispersion sur les rangs supérieurs, la métrique robuste devient hypersensible aux moindres déviations discrètes. Une observation passant d’une valeur de 0 à 1 peut générer un score Z modifié disproportionné franchissant le seuil de 3.5, alors même qu’une telle fluctuation est parfaitement compatible avec un processus sous-jacent issu d’une loi de Poisson ou d’une distribution binomiale négative.
Pour modéliser rigoureusement ces variables de comptage ou ces données ordinales concentrées, le statisticien doit abandonner les méthodes de standardisation affine univariées et se tourner vers des modélisations statistiques appropriées à la nature de la distribution (modèles linéaires généralisés de Poisson ou modèles à inflation de zéros dits Zero-Inflated). Tenter de standardiser par le score Z modifié une variable discrète fortement asymétrique au plancher constitue une erreur méthodologique sévère.
11.2 Approches multivariées alternatives pour les jeux de données complexes
Une autre limite fondamentale du score Z modifié tient à sa nature intrinsèquement univariée. La statistique Mi évalue la déviation d’une observation le long d’un axe dimensionnel unique, indépendamment de toute autre variable. Or, dans les plans expérimentaux contemporains, la grande majorité des données psychologiques et neurobiologiques se déploie dans des espaces multidimensionnels complexes où plusieurs mesures interdépendantes sont recueillies simultanément pour chaque individu (temps de réaction, précision motrice, niveau d’anxiété de trait, marqueurs physiologiques).
Dans un espace multivarié, une observation peut présenter des scores Z modifiés parfaitement normaux sur chacune de ses dimensions prises isolément (par exemple, |Mi| ≤ 1.5 sur toutes les variables), tout en constituant une anomalie multivariée flagrante en rompant la structure de covariance conjointe des données. Pour diagnostiquer ces configurations géométriques subtiles, le score Z modifié est totalement aveugle. Le chercheur doit alors mobiliser des métriques de détection multivariées robustes, au premier rang desquelles figure la distance de Mahalanobis robuste calculée à partir de l’estimateur du déterminant de covariance minimale (MCD pour Minimum Covariance Determinant) formalisé par Peter Rousseeuw.
Dans le domaine de l’apprentissage automatique moderne et du traitement des données massives (Big Data en santé comportementale), d’autres approches algorithmiques non paramétriques performantes prennent avantageusement le relais du score Z univarié :
- Les forêts d’isolation (Isolation Forests) : Cet algorithme partitionne aléatoirement l’espace des descripteurs au moyen d’arbres de décision. Les observations aberrantes, étant spatialement isolées et clairsemées, sont séparées du reste du nuage en un nombre significativement plus faible de coupures récursives que les données denses.
- L’algorithme des k plus proches voisins (k-NN Outlier Detection) : Cette approche évalue la distance moyenne séparant chaque point de ses k voisins les plus proches, identifiant comme anomalies les données dont la densité locale est anormalement faible.
- Le facteur de détection d’anomalie locale (Local Outlier Factor ou LOF) : Cet indice calcule l’écart de densité relative d’un point par rapport à celle de son voisinage immédiat, permettant d’identifier des valeurs atypiques au sein de distributions présentant des densités très hétérogènes.
11.3 Les estimateurs M de Huber et alternatives non paramétriques
L’approche du score Z modifié repose sur une procédure séquentielle en deux étapes disjointes : on calcule une métrique de déviation d’échelle, puis on applique une règle décisionnelle binaire stricte (rejet ou conservation selon que |Mi| excède ou non 3.5). Bien qu’efficace, cette dichotomie présente l’inconvénient d’accorder le même poids (égal à 1.0) à toutes les observations situées sous le seuil critique, et un poids nul (égal à 0.0) à toutes les observations situées au-delà, créant une discontinuité artificielle au niveau de la frontière décisionnelle.
Pour surmonter cette rigidité, la théorie de l’estimation robuste développée par Peter Huber a formalisé la classe des estimateurs M. Au lieu d’utiliser une fonction de perte quadratique standard (loi des moindres carrés, sensible aux extrêmes) ou une fonction de perte en valeur absolue pure (médiane L1, non différentiable en zéro), Huber a conçu une fonction de perte hybride ingénieuse. Cette fonction se comporte de manière quadratique pour les déviations faibles (assurant une efficacité statistique optimale de 100 % au centre de la distribution), tout en devenant strictement linéaire pour les déviations modérées et élevées, bridant ainsi l’influence des points extrêmes.
Dans le cadre des estimateurs M de Huber, chaque donnée se voit attribuer un poids continu compris entre 0 et 1 au moyen d’un processus itératif par moindres carrés repondérés (Iteratively Reweighted Least Squares ou IRLS). Une donnée modérément déviante ne sera donc pas brutalement éjectée du modèle : son influence dans le calcul final des paramètres statistiques sera simplement pondérée à la baisse au prorata de son étrangeté distributionnelle. Cette modélisation continue offre une alternative analytique d’une sophistication mathématique supérieure au filtrage binaire par seuils critiques.
12. Recommandations méthodologiques et conclusions pour les chercheurs
12.1 Directives de transparence et normes de publication APA
L’adoption du score Z modifié s’inscrit au cœur des exigences contemporaines d’éthique méthodologique et de rigueur scientifique formulées par l’American Psychological Association. Les normes de publication de l’APA, particulièrement les directives JARS (Journal Article Reporting Standards), imposent désormais aux auteurs une transparence totale quant à la gestion des observations discordantes. Il n’est plus scientifiquement acceptable d’écrire de manière allusive dans la section méthodologique qu’« un nettoyage des données a été réalisé conformément aux pratiques usuelles ».
Les chercheurs ont l’obligation déontologique de déclarer a priori (idéalement dans le cadre d’un pré-enregistrement formel de leur étude sur des plateformes comme l’OSF) l’algorithme exact mobilisé pour diagnostiquer les valeurs atypiques. Lorsqu’un score Z modifié est utilisé, le manuscrit scientifique doit mentionner sans ambiguïté :
- La formule précise utilisée, en confirmant la constante de mise à l’échelle (0.6745).
- La valeur empirique du MAD calculée sur l’échantillon brut avant filtrage.
- Le seuil critique d’exclusion retenu (généralement |Mi| > 3.5) et sa justification théorique au regard de la taille n de l’échantillon.
- Le nombre exact d’observations identifiées comme anomalies sévères, ainsi que leur impact documenté sur la distribution générale.
De surcroît, les directives de science ouverte encouragent vivement le dépôt des données brutes intégrales au sein de dépôts institutionnels publics, permettant aux réviseurs (peer reviewers) et à la communauté scientifique de vérifier l’impartialité de la procédure de détection.
12.2 Traitement responsable des anomalies : élimination, transformation ou conservation
L’identification formelle d’une observation présentant un score Z modifié |Mi| > 3.5 ne constitue pas une injonction automatique à sa suppression pure et simple. L’exclusion brutale d’un participant doit demeurer le dernier recours, réservé exclusivement aux cas où l’investigation méthodologique confirme la présence indiscutable d’un artefact technique, instrumental ou d’une violation frontale du protocole expérimental (comme dans l’exemple du participant distrait analysé à la section 7).
Dans les situations où l’observation extrême provient d’un participant ayant suivi scrupuleusement le protocole, le chercheur dispose d’alternatives méthodologiques infiniment plus responsables que l’élimination :
- La winsorisation robuste : Cette technique consiste à ne pas détruire la donnée atypique, mais à ramener sa valeur brute à la valeur frontière correspondant exactement au seuil critique retenu (par exemple, la valeur correspondant à un Mi de 3.5). L’observation conserve ainsi son rang ordinal et son statut de mesure la plus élevée du groupe, sans exercer d’effet de levier destructeur sur les calculs de moments.
- Les analyses de sensibilité comparées : Le chercheur conduit et présente systématiquement ses analyses statistiques deux fois : une première fois sur l’échantillon intégral conservant toutes les données, et une seconde fois sur l’échantillon épuré de ses valeurs aberrantes majeures. Si la conclusion scientifique demeure rigoureusement identique dans les deux modèles, la solidité et la robustesse de l’inférence sont démontrées au plus haut degré. Si les conclusions divergent, cette discordance doit être discutée ouvertement comme une limite interprétative.
- La modélisation robuste directe : Plutôt que de transformer la base de données, le chercheur applique directement des modèles d’inférence non paramétriques ou robustes (régressions robustes basées sur les estimateurs M, corrélations de rangs de Spearman ou de Kendall, tests de permutations) qui intègrent nativement la résistance aux valeurs périphériques.
Cette rigueur de traitement prémunit la recherche contre les dérives dévastatrices du p-hacking, où le nettoyage des données est instrumentalisé de manière opportuniste pour faire basculer artificiellement une p-valeur sous le seuil fatidique de 0.05.
12.3 Synthèse et feuille de route pour une analyse robuste des données
Au terme de cette exploration théorique et empirique, le score Z modifié s’impose comme un outil méthodologique indispensable dans l’arsenal de tout chercheur quantitatif moderne. La dépendance historique envers le score Z classique représentait une anomalie épistémologique : comment tolérer qu’un instrument conçu spécifiquement pour identifier les valeurs déviantes voie ses propres composants neutralisés par les anomalies mêmes qu’il est chargé de traquer ? En substituant la médiane et l’écart absolu médian aux estimateurs de moments vulnérables, Boris Iglewicz et David Hoaglin ont doté la recherche d’une procédure de standardisation intègre, résistante et universellement reproductible.
Pour guider le praticien dans ses choix méthodologiques au quotidien, la feuille de route décisionnelle suivante synthétise les recommandations analytiques :
- Cas 1 : Distribution continue, unimodale, symétrique et échantillon massif (n > 500) : L’utilisation du score Z classique ou du score Z modifié produit des résultats asymptotiquement convergents. Le score Z modifié demeure néanmoins préférable par mesure de précaution.
- Cas 2 : Distribution asymétrique, présence suspectée de plusieurs artefacts, petits à moyens échantillons (10 ≤ n ≤ 500) : Recours impératif et exclusif au score Z modifié. Application de la règle décisionnelle canonique |Mi| > 3.5.
- Cas 3 : Données discrètes de comptage, échelles de Likert très ramassées ou MAD = 0 : Proscription formelle du score Z modifié univarié. Bascule vers les estimateurs d’échelle alternatifs (Sn ou Qn) ou modélisations linéaires généralisées adaptées aux lois discrètes.
- Cas 4 : Jeux de données multidimensionnels corrélés : Dépassement du cadre univarié au profit de la distance robuste de Mahalanobis (MCD) ou des algorithmes d’isolation spatiale (Isolation Forests).
En rompant définitivement avec les automatismes paramétriques aveugles hérités du siècle passé, et en intégrant systématiquement le score Z modifié dans leurs routines de prétraitement, les chercheurs en psychologie et en sciences comportementales participent activement à la résolution de la crise de la réplication scientifique, posant les jalons d’une science quantitative plus robuste, plus transparente et infiniment plus crédible.
Références
- Hampel, F. R. (1974). The influence curve and its role in robust estimation. Journal of the American Statistical Association, 69(346), 383–393. https://doi.org/10.1080/01621459.1974.10482962
- Huber, P. J. (1981). Robust Statistics. John Wiley & Sons.
- Iglewicz, B., & Hoaglin, D. C. (1993). How to detect and handle outliers (Vol. 16). ASQC Basic References in Quality Control, American Society for Quality Control.
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273–1283. https://doi.org/10.1080/01621459.1993.10476408
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.