
L’écosystème analytique SAS (Statistical Analysis System) constitue depuis plusieurs décennies l’un des piliers technologiques majeurs du traitement de données massives, de la modélisation statistique avancée et de l’informatique décisionnelle dans les secteurs bancaires, pharmaceutiques, assurantiels et académiques. Au sein de cette architecture logicielle robuste, la gestion rigoureuse des types de données représente une condition préalable absolue à toute démarche computationnelle valide. Contrairement à des environnements de programmation modernes autorisant un typage dynamique ou une inférence polymorphique permissive, SAS repose sur un système binaire strict où chaque variable appartient de manière immuable à l’une des deux catégories fondamentales : le type numérique ou le type caractère. Cette dichotomie originelle, forgée dès la conception du compilateur de l’étape DATA, conditionne directement la façon dont les octets sont agencés en mémoire vive et pérennisés sur disque.
Dans la pratique quotidienne des biostatisticiens, des ingénieurs de données et des scientifiques de données, l’importation de fichiers plats hétérogènes, tels que des fichiers délimités (CSV), des extractions de bases de données relationnelles non normalisées ou des documents textuels issus du web scraping, génère fréquemment des discordances de typage. Très souvent, des grandeurs purement quantitatives — qu’il s’agisse de montants transactionnels, de concentrations sériques, de scores psychométriques ou d’identifiants temporels — se retrouvent encapsulées sous la forme de chaînes de caractères alphanumériques. Cette défaillance de représentation compromet l’intégrité de la chaîne de traitement statistique en interdisant le recours aux opérateurs arithmétiques standards et en faussant les résultats des procédures analytiques.
La conversion explicite d’une variable caractère en variable numérique sous SAS ne constitue pas une simple formalité syntaxique, mais une opération d’ingénierie logicielle exigeant une maîtrise approfondie des mécanismes sous-jacents du compilateur, notamment le fonctionnement du vecteur de travail (Program Data Vector ou PDV) et la sémantique des informats d’entrée. Cet article propose une exploration exhaustive, théorique et appliquée, des méthodologies permettant de métamorphoser des chaînes textuelles en grandeurs numériques précises. À travers l’analyse détaillée de la fonction INPUT, la manipulation experte des informats, le prétraitement des données textuelles corrompues et l’automatisation par macros et tableaux dynamiques, ce guide exhaustif fournit les clés méthodologiques indispensables pour garantir l’intégrité, la robustesse et la haute performance de vos flux de données SAS.
1. Introduction aux types de données dans SAS et impératif de conversion
Pour appréhender la nécessité de la conversion de type au sein du logiciel SAS, il convient d’abord d’analyser la structure architecturale qui régit le stockage des données et les limitations intrinsèques imposées par une mauvaise qualification des attributs d’une variable lors de son instanciation dans une table.
1.1 Distinction fondamentale entre variables caractères et numériques
Au niveau le plus élémentaire du compilateur SAS, la distinction entre une variable caractère et une variable numérique est gravée dans la structure même de la table de données (le fichier d’extension standard .sas7bdat). Une variable numérique est invariablement enregistrée en virgule flottante sur une longueur par défaut de 8 octets (soit 64 bits), conformément à la norme internationale standardisée pour le calcul binaire. Cette représentation en double précision permet à SAS de modéliser des valeurs numériques s’étendant sur un spectre dynamique colossal, allant approximativement de 10 à la puissance -307 jusqu’à 10 à la puissance +308, tout en conservant une précision mathématique remarquable pouvant atteindre de 15 à 17 chiffres significatifs.
À l’inverse, une variable caractère est stockée sous la forme d’une séquence linéaire d’octets codés selon le jeu de caractères de la session active (qu’il s’agisse d’un encodage mono-octet comme Latin-1 ou multi-octets comme UTF-8). Chaque caractère alphabétique, chiffre ou symbole spécial y occupe un ou plusieurs octets dédiés, sans aucune pondération arithmétique inhérente. Le compilateur SAS refuse catégoriquement d’allouer des registres de calcul arithmétique à une zone mémoire typée comme caractère. Par conséquent, toute tentative d’appliquer un opérateur mathématique tel que l’addition, la division ou l’exponentiation sur un champ textuel engendre soit une erreur bloquante de compilation, soit un processus de conversion implicite délétère.
Sur le plan des procédures statistiques fondamentales, telles que les procédures univariées ou multivariées, cette distinction est discriminatoire. Les procédures spécialisées dans l’analyse descriptive et inférentielle, à l’image de la procédure descriptive générale ou de la procédure d’analyse univariée approfondie, exigent impérativement des variables numériques dans leurs instructions de sélection. Tenter de soumettre une chaîne de caractères représentant un dosage biologique ou un chiffre d’affaires à une procédure de régression linéaire ou à un modèle mixte conduit inévitablement à un arrêt immédiat du traitement avec une notification d’erreur explicite dans le journal d’exécution.
1.2 Conséquences méthodologiques d’un mauvais typage de données
Les répercussions d’un typage erroné dépassent largement la simple impossibilité d’exécuter des calculs mathématiques immédiats ; elles corrompent l’ensemble de l’architecture méthodologique d’un projet d’analyse quantitative. En premier lieu, la construction de modèles prédictifs complexes ou de scores actuariels devient irréalisable, car les algorithmes d’apprentissage automatique et d’estimation statistique matricielle ne peuvent opérer que sur des tenseurs ou matrices de nombres réels. Lorsqu’une colonne d’intérêt est stockée sous forme textuelle, elle est traitée par le système comme une modalité catégorielle nominale, démultipliant artificiellement les degrés de liberté si des stratégies d’encodage disjonctif complet sont employées par inadvertance.
En second lieu, l’intégration relationnelle des données est sévèrement entravée. Lors de la fusion de tables hétérogènes au moyen de l’instruction de combinaison par clé ou via des requêtes de jointure en langage relationnel structuré intégré, l’égalité stricte des types de données pour les variables d’appariement constitue un prérequis inviolable. Si un identifiant d’assuré ou un code de transaction est typé en numérique dans une table maître et en caractère dans une table secondaire, le compilateur SAS refuse la jointure et interrompt la chaîne de production analytique, signalant une incompatibilité rédhibitoire de signature de type.
Enfin, le typage textuel d’informations quantitatives induit des biais d’ordonnancement dramatiques lors des opérations de tri et de partitionnement. Le tri d’une variable caractère obéit à l’ordre lexicographique basé sur le code binaire des symboles et non à l’ordre arithmétique naturel des grandeurs sous-jacentes. Dans un tri lexicographique standard, la valeur textuelle « 100 » est systématiquement positionnée avant la valeur textuelle « 2 », car le premier caractère « 1 » possède un rang ordinal inférieur au caractère « 2 ». Un tel comportement compromet irrémédiablement le calcul des percentiles, la segmentation en quartiles, l’évaluation des seuils cliniques ou l’application de filtres de bornage temporel.
1.3 Vue d’ensemble du processus de conversion explicite
Face aux périls méthodologiques du typage inadéquat, le praticien de la donnée sous SAS doit orchestrer un processus de conversion explicite et déterministe. Cette opération s’exécute traditionnellement au sein de l’étape DATA, l’environnement de programmation procédural où s’articulent la lecture séquentielle des flux d’enregistrements, la manipulation des métadonnées structurelles et l’instanciation des nouveaux vecteurs de données. L’approche déterministe s’oppose formellement aux mécanismes automatiques de secours déployés par SAS, garantissant que chaque transformation découle d’une règle algorithmique parfaitement contrôlée, auditable et reproductible.
Le cycle de vie de la transformation implique une compréhension fine de la mutation des variables au cours du traitement. Comme nous l’examinerons en détail, le système SAS ne permet pas de modifier dynamiquement et in situ le type d’une variable déjà enregistrée dans le dictionnaire de la table en cours de compilation. Le paradigme de conversion exige donc une séquence ordonnée : la lecture de la chaîne textuelle source, son interprétation à travers un patron de décodage formel, l’affectation du résultat binaire obtenu à une variable cible réceptrice préalablement typée en numérique, et enfin, la restructuration optionnelle des métadonnées pour préserver les conventions de nommage initiales.
Cette approche rigoureuse protège l’analyste contre l’introduction subreptice de valeurs manquantes artificielles et assure une traçabilité totale des flux de transformation, condition indispensable dans les environnements réglementés tels que les essais cliniques régis par la Food and Drug Administration (FDA) ou les calculs de solvabilité financière soumis aux directives bancaires internationales.
2. La fonction INPUT : Mécanisme fondamental et syntaxe théorique
L’opérateur cardinal dédié à la métamorphose d’une représentation textuelle en entité computationnelle numérique sous SAS est la fonction native INPUT. Son fonctionnement repose sur une logique d’analyse syntaxique guidée par des spécificateurs d’entrée appelés informats.
2.1 Anatomie de la fonction INPUT dans l’environnement SAS
D’un point de vue formel, la fonction INPUT prend en charge deux arguments obligatoires et se présente sous une structure canonique bien précise : variable_numerique = INPUT(source, informat.). Le premier paramètre, désigné comme l’argument source, représente la chaîne de caractères à décoder ; il peut s’agir d’une variable textuelle issue d’une table d’entrée, d’une constante littérale délimitée par des guillemets ou d’une expression scalaire complexe renvoyant une valeur de type chaîne. Le second paramètre, l’informat, agit comme une grille de lecture décrivant au compilateur la disposition interne et les particularités morphologiques de la chaîne à analyser.
Pour saisir l’évaluation de cette fonction, il est capital de modéliser le comportement du vecteur de travail ou Program Data Vector (PDV). Le PDV constitue la zone de mémoire tampon allouée par le compilateur SAS pour construire pas à pas chaque enregistrement d’une table avant de l’écrire physiquement sur le disque. Lorsque le compilateur analyse l’instruction d’assignation contenant la fonction INPUT, il examine le type retourné par l’informat spécifié. Puisque l’informat sélectionné est de nature numérique, le compilateur configure la variable réceptrice positionnée à la gauche du signe d’égalité comme une variable numérique flottante de 8 octets au sein du PDV.
Pendant la phase d’exécution ligne par ligne, la fonction INPUT extrait la séquence de caractères logée dans la variable source, transmet ces octets au moteur d’analyse de l’informat spécifié, puis procède à la conversion arithmétique. Le résultat binaire résultant est immédiatement injecté dans l’emplacement mémoire alloué à la variable numérique au sein du PDV. Il existe ainsi une étanchéité absolue entre la variable d’origine, qui conserve immuablement son statut textuel dans son propre compartiment mémoire, et la variable nouvellement générée, qui hérite des attributs mathématiques requis pour l’analyse.
2.2 Le rôle primordial des informats de lecture
La notion d’informat constitue la pierre angulaire du mécanisme de lecture sous SAS. Un informat est une instruction de bas niveau destinée au compilateur, stipulant la manière dont une séquence brute de symboles textuels doit être interprétée pour être transmutée en une représentation interne binaire valide. Il importe de dissocier rigoureusement l’informat (spécificateur de saisie ou d’entrée) du format (spécificateur de restitution ou de sortie). Alors que le format supervise exclusivement la présentation visuelle superficielle d’une valeur déjà stockée en mémoire sans altérer son contenu sous-jacent, l’informat intervient lors de la phase d’encodage initial et détermine la valeur binaire exacte qui sera pérennisée.
La morphologie générale d’un informat obéit à la syntaxe standardisée informatw.d, où la lettre initiale caractérise la règle algorithmique de décodage, la lettre w (pour width) définit la largeur maximale du champ textuel à explorer en nombre de colonnes ou d’octets, et la lettre d (pour decimals) quantifie le nombre optionnel de décimales à appliquer de manière implicite. Si la chaîne textuelle comporte un séparateur décimal physique explicite, l’évaluation de ce dernier outrepasse généralement la valeur stipulée par le paramètre d, garantissant une flexibilité d’analyse substantielle.
Lorsque le compilateur SAS est confronté à un informat sous-dimensionné par rapport à la taille réelle de la chaîne de caractères à lire, une troncature de lecture survient, induisant une corruption grave de la valeur convertie. Inversement, un informat trop généreux peut balayer des espaces contigus indésirables si la chaîne n’est pas convenablement alignée. Le choix scrupuleux de l’informat conditionne donc directement le succès de l’opération de transcodage.
2.3 Distinction essentielle entre la fonction INPUT et la fonction PUT
Une confusion récurrente parmi les développeurs SAS, qu’ils soient débutants ou praticiens intermédiaires, réside dans la symétrie apparente entre les fonctions natives INPUT et PUT. Ces deux opérateurs accomplissent des tâches diamétralement opposées au sein de la tuyauterie de transformation de données, et leur interversion constitue l’une des causes les plus fréquentes d’erreurs d’exécution dans le journal SAS. La règle mnémotechnique fondamentale enseignée dans les manuels de référence s’énonce ainsi : la fonction INPUT prend du caractère en entrée et produit du numérique (lorsqu’elle est associée à un informat numérique), tandis que la fonction PUT prend une valeur quelconque (souvent numérique) et produit invariablement une chaîne de caractères.
La fonction inverse PUT utilise des formats de restitution pour projeter une valeur binaire interne vers une représentation textuelle human-readable. Sa signature syntaxique s’écrit variable_caractere = PUT(source, format.). Si un analyste applique par méprise la fonction PUT sur une variable textuelle dans le but d’obtenir un nombre, le compilateur génère une chaîne textuelle formatée et non une entité mathématique, ce qui perpétue le problème d’incompatibilité de type au lieu de le résoudre.
L’utilisation malavisée de ces fonctions engendre des avertissements sévères dans le journal, signalant des conversions implicites redondantes où le système tente désespérément de rectifier l’appel erroné. Pour garantir une hygiène de codage irréprochable et optimiser l’usage des cycles CPU sur des téraoctets de données, l’opérateur INPUT doit être réservé de manière exclusive aux opérations de déchiffrement de chaînes textuelles vers l’espace numérique.
3. Préparation et inspection préalable des données avec PROC CONTENTS
Avant d’initier la moindre modification programmatique sur un jeu de données, une phase rigoureuse d’audit structural et d’exploration descriptive s’impose pour cerner précisément les anomalies de typage et la morphologie des données sources.
3.1 Diagnostic structural du jeu de données via PROC CONTENTS
L’examen clinique de toute table SAS débute impérativement par l’appel de la procédure de métadonnées de référence : la procédure d’inspection de contenu, couramment dénommée PROC CONTENTS. Cette procédure extrait l’en-tête descripteur de la table SAS sans parcourir intégralement les millions de lignes d’enregistrements qu’elle peut abriter, fournissant ainsi un diagnostic instantané et hautement économe en ressources système sur la nature des variables présentes.
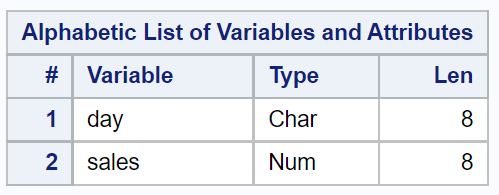
Dans le rapport généré par cette procédure d’inspection, l’attention de l’ingénieur de données doit se focaliser sur la colonne décrivant le type d’attribut. Dans le système interne SAS, les types sont codifiés de façon binaire : le Type 1 désigne une variable purement numérique, tandis que le Type 2 identifie une variable de nature caractère. Si une colonne dénommée par exemple Montant_Pret ou Index_Temporel affiche un Type 2 assorti d’une longueur textuelle fixe (par exemple 20 octets), le diagnostic est posé : la variable est perçue par le système comme un texte littéral et nécessite une réingénierie de type.
Parallèlement, la consultation de cette cartographie renseigne sur l’ordre séquentiel des variables au sein du dictionnaire de données, les étiquettes descriptives éventuellement associées et la présence d’informats résiduels obsolètes issus d’étapes d’ingestion antérieures. Cette photographie initiale sert de point de référence absolu pour valider ultérieurement que l’intervention sur la structure n’a altéré aucune propriété périphérique du schéma relationnel de la table.
3.2 Analyse descriptive préliminaire avec PROC PRINT et PROC FREQ
Si la procédure d’inspection de contenu révèle la nature structurelle abstraite de la table, elle ne dévoile en rien le contenu pragmatique des cellules textuelles. Il est impératif d’adjoindre à cette inspection des métadonnées une exploration empirique des données vivantes au moyen des procédures d’impression ciblée et d’analyse fréquentielle univariée.
L’exécution de la procédure d’impression sur un échantillon restreint de lignes (en bornant l’analyse aux cinquante premières observations via l’option dédiée d’interruption de lecture) permet d’inspecter visuellement les chaînes de caractères. Cette auscultation visuelle a pour objectif d’identifier la présence de parasites typographiques : espaces insécables en tête ou en queue de chaîne, signes monétaires préfixés (symboles dollar, euro, livre sterling), délimiteurs de milliers sous forme de virgules ou d’apostrophes, et surtout la nature précise du séparateur fractionnaire.
L’enjeu du séparateur décimal est particulièrement critique dans les contextes internationaux. La convention anglo-saxonne recourt exclusivement au point décimal standard, tandis que les conventions francophones et européennes continentales emploient la virgule comme séparateur arithmétique. L’utilisation conjointe de la procédure de distribution fréquentielle sur les colonnes textuelles à convertir permet d’isoler les valeurs extrêmes ou aberrantes, révélant par exemple l’existence d’annotations qualitatives toxiques glissées dans des champs quantitatifs, telles que des mentions textuelles de non-réponse, des seuils de détection biologiques ou des libellés d’indisponibilité de l’information.
3.3 Cartographie des dépendances et du flux de données
La modification du type d’une variable au sein d’une infrastructure décisionnelle d’entreprise ne s’opère jamais en vase clos. Elle s’inscrit au cœur d’un graphe orienté de dépendances logiques comprenant des programmes d’extraction en amont, des routines de nettoyage intermédiaire et des rapports de restitution analytique ou des pipelines d’apprentissage automatique en aval.
Avant d’altérer la structure d’une colonne, le concepteur du pipeline de données doit évaluer l’impact transversal de cette métamorphose. Si des programmes préexistants exécutent des opérations textuelles spécifiques sur ladite variable — telles que des extractions de sous-chaînes au moyen de fonctions d’analyse lexicale, des concaténations de chaînes ou des comparaisons par motifs textuels —, la conversion numérique de cette colonne brisera inéluctablement ces scripts dépendants s’ils ne sont pas mis à jour de concert.
En vertu des bonnes pratiques de gouvernance de données et de reproductibilité scientifique, toute opération de transformation de schéma doit être scrupuleusement consignée dans un dictionnaire de transformation. De surcroît, une politique élémentaire de précaution exige la sanctuarisation de la table originelle brute par le biais d’une copie de sauvegarde immuable ou d’une vue logique protégée en écriture, assurant une capacité de retour en arrière instantanée en cas de détection d’une altération de données non sollicitée.
4. Cas pratique élémentaire : Conversion d’une variable chaîne simple
Une fois les données méthodiquement inspectées, la mise en œuvre de la transformation algorithmique s’opère au sein d’une étape DATA standard au moyen d’instructions précises et ordonnées.
4.1 Déclaration du jeu de données source et simulation
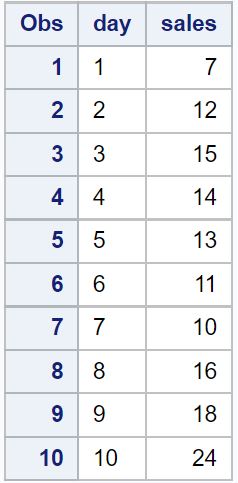
Afin d’illustrer la mécanique fondamentale de l’opération sans dépendre d’une source externe d’information, concevons un environnement de démonstration maîtrisé au moyen de l’instruction de saisie en ligne de données intégrées dans le script. Ce jeu de données synthétique, que nous désignerons sous le nom de table d’expérimentation, héberge une série d’identifiants temporels et de mesures physiques malencontreusement instanciés sous forme de chaînes de caractères.
Dans ce scénario typique, l’analyste fait face à une variable textuelle contenant des grandeurs scalaires entières simples, par exemple des valeurs oscillant entre cent et dix mille, stockées dans une colonne textuelle d’une largeur déclarée de huit caractères. Lors de l’ingestion initiale, ces grandeurs ont été incorporées sans traitement particulier, ce qui a contraint le compilateur SAS à leur affecter la signature d’une chaîne de caractères.
L’observation attentive des métadonnées de cette table confirme que la variable d’observation possède le statut caractère. Aucune sommation, aucun calcul d’écart-type ni aucune agrégation descriptive ne peut être menée sur ces informations sans une intervention chirurgicale sur le typage au niveau de l’étape DATA.
4.2 Implémentation du code DATA step avec la fonction INPUT
La conversion s’orchestre par la rédaction d’un bloc DATA qui lit la table initiale via l’instruction de lecture séquentielle et engendre une nouvelle table cible perfectionnée. C’est au cœur de cette étape que prend place la syntaxe canonique d’assignation faisant intervenir l’opérateur INPUT.
Puisque la règle architecturale de SAS stipule qu’une variable ne peut changer d’identité de type au sein d’une exécution continue sur la même étiquette, l’ingénieur doit obligatoirement instancier un nouvel identifiant pour recueillir le résultat arithmétique. La formulation s’énonce selon le principe où le nouvel identifiant reçoit le résultat de la fonction INPUT appliquée sur l’ancien identifiant, complétée par l’informat numérique adéquat. Pour un scalaire standard non pollué par des artifices de ponctuation, l’informat standard w.d ou l’informat adaptatif BEST12. constitue le choix par excellence.
Durant l’exécution séquentielle, le compilateur procède avec une efficacité maximale. Pour chaque enregistrement transféré de la mémoire disque vers le PDV, la chaîne source est lue, convertie à la volée en sa valeur binaire équivalente selon la logique de l’informat spécifié, puis insérée dans la cellule correspondante de la variable réceptrice. Aucune dégradation de précision n’est à déplorer, et le compilateur traite chaque enregistrement sans émettre le moindre avertissement d’incompatibilité.
4.3 Validation de la transformation et suppression de l’ancienne variable
L’obtention de la nouvelle variable numérique ne clôt pas l’opération de refonte de la table ; il convient de procéder au nettoyage de la structure relationnelle. Conserver simultanément l’ancienne colonne textuelle obsolète et la nouvelle colonne numérique génère une redondance informationnelle stérile qui alourdit inutilement l’empreinte spatiale de la table sur les supports de stockage et crée de la confusion pour les utilisateurs finals.
L’élimination de la variable textuelle initiale s’accomplit par l’invocation de l’instruction de suppression (l’instruction DROP) au sein de l’étape DATA, ou par l’adjonction de l’option de table correspondante lors de l’écriture du jeu de données final. L’espace mémoire alloué à l’ancienne chaîne est ainsi purgé du dictionnaire et des lignes d’enregistrements de la table de sortie.
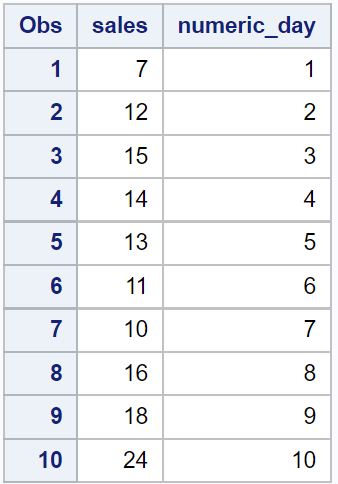
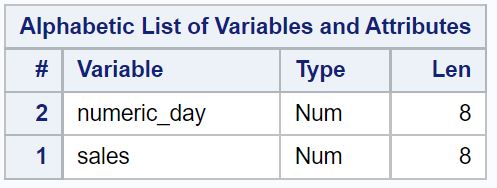
Pour parachever ce cas pratique, un protocole strict de validation croisée est immédiatement déployé. Une nouvelle invocation de la procédure d’inspection de contenu certifie que la table finale contient bien l’identifiant désiré avec le statut de Type 1 (numérique). Simultanément, la mobilisation d’une procédure statistique élémentaire de calcul de moyennes et d’extrêmes sur la variable transformée valide la cohérence de la distribution numérique obtenue face aux chaînes textuelles d’origine.
5. Maîtrise des informats numériques fondamentaux et spécialisés
Le succès d’une conversion de variable sous SAS repose sur la sélection minutieuse de l’informat. Une mauvaise adéquation entre la morphologie du texte et l’algorithme interne de l’informat engendre des erreurs critiques ou la génération involontaire de données manquantes.
5.1 Informats numériques standards
La famille des informats numériques élémentaires s’articule principalement autour de la forme standardisée w.d et de sa variante optimisée BESTw.. L’informat standard w.d procède à la lecture d’une valeur numérique positionnée sur une largeur totale de w colonnes, en appliquant un décalage décimal de d rangs vers la gauche si la chaîne source est dépourvue de point décimal matériel explicite. Si un point est présent physiquement dans la chaîne analysée, SAS ignore délibérément la valeur de d et se conforme scrupuleusement à l’emplacement physique du séparateur au sein du texte.
L’informat universel BESTw. représente sans conteste l’outil le plus résilient pour la lecture de données numériques non formatées issues d’architectures tierces. Le terme BEST indique au moteur d’analyse lexicale de SAS d’adopter la meilleure stratégie heuristique possible pour interpréter le champ de w octets. Il gère avec une remarquable flexibilité les alignements irréguliers à droite ou à gauche, absorbe les espaces résiduels et déchiffre spontanément les nombres entiers aussi bien que les réels comportant des fractions décimales régulières.
Il importe de souligner le danger inhérent à l’omission d’un point dans la déclaration textuelle de l’informat. Dans la grammaire formelle du langage SAS, un identifiant d’informat doit impérativement comporter un point terminal pour être reconnu en tant que tel par le compilateur. L’écriture erronée d’un identifiant sans ponctuation le fait interpréter par le système comme un nom de variable standard, ce qui déclenche une erreur d’arrêt de compilation pour variable inexistante.
5.2 Gestion des séparateurs et des représentations monétaires
Les fichiers de données opérationnels reflètent fréquemment les habitudes de saisie humaine ou les règles de mise en page des logiciels comptables, intégrant des séparateurs de groupes de chiffres pour faciliter la lecture visuelle des grands nombres. Face à une chaîne textuelle structurée telle que « 1,500,250.75 », l’application d’un informat standard w.d ou BESTw. échoue lamentablement : le compilateur bute sur la première virgule rencontrée, qu’il juge inadmissible dans un registre arithmétique standard, génère une valeur manquante et consigne une erreur dans le journal.
Pour neutraliser cette contrainte, SAS met à disposition l’informat spécialisé COMMAw.d. Cet algorithme sophistiqué procède à un filtrage intelligent de la chaîne : il ignore automatiquement les virgules insérées comme séparateurs de milliers, élimine les espaces intercalaires et décode la partie décimale délimitée par un point. Pour la lecture de grandeurs financières intégrant des devises, l’informat DOLLARw.d enrichit ce mécanisme en extirpant en outre les symboles monétaires tels que le signe dollar ou le signe livre sterling placés en préambule de la valeur chiffrée.
Dans l’espace européen et francophone, où la virgule incarne le séparateur décimal officiel et où le point ou l’espace matérialise les milliers (par exemple « 1.500.250,75 »), l’utilisation des informats précédents conduit à un désastre d’interprétation. SAS a donc forgé l’informat spécifique COMMAXw.d (la terminaison X signifiant l’inversion des conventions typographiques). L’informat COMMAXw.d élimine les points séparateurs de milliers et érige la virgule en séparateur fractionnaire absolu, garantissant un décodage conforme de la comptabilité européenne sans nécessiter de prétraitement chirurgical préalable de la chaîne textuelle.
5.3 Informats scientifiques et notations exponentielles
Les données émanant de protocoles expérimentaux de laboratoire, d’instruments de spectrométrie, d’analyses génomiques ou d’environnements de simulation astrophysique recourent universellement à la notation scientifique exponentielle en base dix pour consigner des amplitudes infinitésimales ou gigantesques. Des chaînes de caractères telles que « 1.45E-06 » ou « 3.892D+04 » sont monnaie courante dans ces flux d’ingestion.
Pour absorber ces structures sans aucune déperdition scalaire, l’environnement SAS propose l’informat Ew.. Cet informat est spécifiquement programmé pour traquer la présence des marqueurs exponentiels ‘E’ ou ‘D’ (la lettre D étant traditionnellement associée à la double précision en langage Fortran et assimilés), décomposer la chaîne entre sa mantisse arithmétique et son exposant entier relatif, puis calculer instantanément la valeur flottante équivalente au standard IEEE 754.
Par ailleurs, la manipulation d’indicateurs de performance statistique implique régulièrement la gestion de ratios exprimés sous forme de pourcentages textuels (par exemple « 18.5% »). L’informat PERCENTw. accomplit une double mission particulièrement élégante : il supprime le symbole graphique de pourcentage situé en fin de chaîne, convertit le texte numérique en valeur arithmétique et procède immédiatement à sa division par cent pour consigner la proportion réelle (0.185) en mémoire. Cette automatisation évite à l’analyste l’écriture d’étapes d’arithmétique multiplicative complémentaires.
6. Conversion de formats complexes : Dates, heures et horodatages
Dans l’univers SAS, la manipulation des données temporelles représente un domaine d’expertise à part entière où la notion de conversion caractère-numérique joue un rôle fondamental et permanent.
6.1 Spécificités du stockage interne temporel dans SAS
Contrairement à d’autres systèmes de gestion de bases de données qui réservent des types primitifs autonomes et opaques pour encapsuler le temps, SAS traite l’intégralité de ses grandeurs chronologiques sous la forme de véritables variables numériques scalaires. La compréhension du point d’ancrage zéro est fondamentale : pour le moteur SAS, le temps a débuté arbitrairement le 1er janvier 1960. Une date SAS n’est rien d’autre qu’un nombre entier représentant le nombre exact de jours écoulés depuis ce point d’origine séculaire.
Ainsi, le 2 janvier 1960 est encodé par l’entier positif 1, le 31 décembre 1959 par l’entier négatif -1, et le 1er janvier 2024 par l’entier 23376. Cette modélisation mathématique confère une puissance inouïe aux calculs d’intervalles chronologiques, autorisant des opérations de soustraction directe entre deux dates pour déduire instantanément une durée calendaire exacte en jours, sans devoir invoquer des fonctions tierces complexes de différentiation temporelle.
Cependant, cette élégance interne implique une conséquence capitale lors du processus de conversion. Si l’on métamorphose une chaîne calendaire (comme « 15/03/2023 ») en numérique via un informat de date, la valeur stockée dans le PDV sera un entier abstrait (dans cet exemple, 23084). Pour rendre cette valeur lisible lors de restitutions tabulaires ou graphiques, il est rigoureusement impératif d’adjoindre à cette nouvelle variable numérique un format de présentation chronologique adapté (tel que le format d’affichage journalier standard ou international).
6.2 Conversion de chaînes calendaires usuelles
Les expressions textuelles des dates varient considérablement selon l’origine géographique et organisationnelle des données. L’écosystème SAS abrite une pléthore d’informats dédiés à la capture de ces structures polymorphes. Les plus réputés incluent l’informat DATEw. (qui décode des chaînes du type « 01JAN2024 »), l’informat américain MMDDYYw. (pour les chaînes configurées en mois/jour/année) et l’informat continental DDMMYYw. (pour les agencements usuels jour/mois/année).
Une problématique récurrente réside dans le traitement des dates dont le millésime est tronqué sur deux chiffres (par exemple « 12/05/24 »). Pour désambiguïser ce type d’information et statuer si l’année renvoie à 1924 ou 2024, le compilateur SAS consulte une option système centrale désignée sous le nom de YEARCUTOFF. Cette option définit le point de départ d’une fenêtre temporelle glissante d’un siècle. Configurée par défaut sur l’année 1926 dans la plupart des déploiements contemporains, elle stipule que toute année à deux chiffres comprise entre 26 et 99 sera affectée au vingtième siècle (1926-1999), tandis que les valeurs entre 00 et 25 basculeront dans le vingt-et-unième siècle (2000-2025).
Face à des sources de données particulièrement disparates où le formalisme d’agencement change d’un enregistrement à l’autre au sein d’une même table, SAS déploie un informat adaptatif révolutionnaire : l’informat ANYDTDTEw.. Ce puissant analyseur heuristique examine dynamiquement la structure de chaque chaîne, détecte les séparateurs (barres obliques, tirets, points) et déduit de manière probabiliste l’ordre des éléments pour opérer la conversion numérique de manière transparente, réduisant considérablement la complexité de programmation préparatoire.
6.3 Traitement des valeurs temporelles et combinées
Au-delà de la métrique journalière, la capture fine des processus industriels ou transactionnels exige l’enregistrement du temps horaire et des horodatages combinés. À l’instar des dates, les heures SAS sont des nombres réels purs : une heure SAS correspond au nombre de secondes écoulées depuis minuit. Par conséquent, une journée complète équivaut à 86 400 secondes numériques.
Pour transcrire une chaîne horaire textuelle telle que « 14:30:15 » en son équivalent arithmétique, l’informat TIMEw. est mobilisé. Ce dernier décompose les segments horaires, applique les coefficients multiplicateurs de soixante et trois mille six cents, et enregistre l’accumulation des secondes dans la variable numérique réceptrice. De façon analogue, l’informat TODw. (Time Of Day) permet de lire des chaînes horaires associées à des fractions de seconde d’une très haute précision.
Le pinacle de la complexité temporelle est atteint lors du décodage d’horodatages complets, fusionnant dans une même chaîne le quantième calendaire et la précision de l’instant. Dans la mémoire SAS, une variable d’horodatage (dénommée DATETIME) consigne le nombre de secondes écoulées depuis le 1er janvier 1960 à minuit zéro seconde. La conversion de chaînes telles que « 15MAR2023:14:30:00 » ou des représentations conformes à la norme ISO 8601 fait appel aux informats DATETIMEw. et B8601DNw.. La maîtrise de ces informats spécialisés prévient toute distorsion lors de l’intégration de métriques de journalisation système ou d’audits financiers haute fréquence.
7. Gestion des valeurs manquantes, chaînes invalides et erreurs d’exécution
Le traitement des données en conditions réelles confronte inévitablement l’ingénieur à des imperfections textuelles. L’interception et la gouvernance des anomalies d’exécution lors de la conversion constituent un marqueur d’excellence technique.
7.1 Comportement du moteur face aux données manquantes
L’une des singularités architecturales les plus remarquables de SAS réside dans sa prise en charge native des données manquantes. Dans une variable caractère, une valeur manquante est simplement matérialisée par une chaîne vide ou exclusivement constituée d’espaces blancs. En revanche, pour une variable numérique, une donnée manquante standard est représentée en mémoire et à l’écran par un point d’isolation (« . »).
Lorsque la fonction INPUT prend pour argument une chaîne textuelle entièrement vide, un ensemble d’espaces ou une chaîne contenant expressément un point isolé, elle ne déclenche aucune alerte de dysfonctionnement : elle transmet sereinement la valeur manquante numérique standard au vecteur de travail PDV. Ce comportement élégant préserve l’intégrité de la table sans polluer le journal de messages d’avertissement.
De surcroît, SAS propose aux statisticiens un raffinement analytique d’une valeur inestimable : les valeurs manquantes spéciales, codifiées du point suivi d’une lettre (.A jusqu’à .Z) ainsi que le point suivi du caractère souligné (._). Ces valeurs permettent de catégoriser la cause d’une absence d’information (par exemple : .R pour un refus de répondre dans une enquête épidémiologique, .N pour une donnée non applicable, ou .I pour une impossibilité instrumentale de mesure). L’utilisation d’informats appropriés permet de convertir des libellés textuels spécifiques directement en ces entités manquantes typées, préservant la richesse sémantique de l’absence de donnée pour les procédures de fouille ultérieures.
7.2 Interception des messages d’avertissement et variables automatiques
La situation devient critique lorsqu’une chaîne de caractères soumise à la fonction INPUT contient des données invalides ne respectant aucunement le contrat d’entrée de l’informat spécifié, par exemple tenter de convertir le libellé textuel « Cent Vingt » au moyen de l’informat numérique standard BEST12.. Dans cette conjecture, le moteur d’exécution déclenche un protocole d’alerte standardisé bien documenté.
En premier lieu, un message d’avertissement explicite est consigné en lettres capitales dans le journal d’exécution, sous la forme standardisée NOTE: Invalid data for variable…. Ce message est immédiatement suivi de l’affichage textuel de l’enregistrement incriminé, du numéro de ligne physique au sein du fichier ou de la table d’entrée, et d’un dump complet de l’état instantané du vecteur de travail (PDV).
Simultanément, le compilateur bascule la variable système automatique _ERROR_ de sa valeur par défaut zéro vers la valeur un pour signifier l’anomalie d’exécution sur l’itération en cours. Bien que cette alerte n’interrompe pas la poursuite de l’étape DATA — SAS assigne silencieusement une valeur manquante standard à la variable cible et passe à l’enregistrement suivant —, une prolifération de ces alertes peut saturer le journal d’exécution de millions de lignes de diagnostics, entraînant une dégradation catastrophique des performances globales et l’impossibilité pratique d’auditer le déroulement de la production.
7.3 Utilisation des modificateurs de suppression d’erreur
Pour discipliner ce comportement sans pour autant renoncer au contrôle de la qualité des données, SAS a doté la syntaxe de l’informat de modificateurs d’erreur d’une redoutable efficacité : les opérateurs points d’interrogation simple (« ? ») et double (« ?? »). Ces modificateurs se positionnent immédiatement devant le nom de l’informat au sein de l’appel de la fonction INPUT.
L’utilisation du modificateur simple sous la forme INPUT(champ_texte, ? BEST12.) intime au compilateur l’ordre de réprimer l’émission des volumineux messages d’avertissement textuels dans le journal lorsqu’une chaîne invalide est rencontrée. Toutefois, le système continue d’incrémenter la variable automatique _ERROR_ à un pour chaque cas litigieux.
L’application du modificateur double, formalisée par INPUT(champ_texte, ?? BEST12.), offre un contrôle absolu : elle supprime radicalement toute trace du message d’erreur dans le journal et neutralise totalement l’élévation de la variable _ERROR_. La chaîne non convertible est muée pacifiquement en valeur manquante numérique. Cette technique d’ingénierie avancée doit néanmoins être maniée avec une extrême probité méthodologique : employée à l’aveugle, elle risque de masquer des corruptions massives de sources de données sous un voile trompeur de fausse propreté d’exécution.
8. Nettoyage et prétraitement des chaînes de caractères avant conversion
Dans la grande majorité des architectures industrielles de données, l’application immédiate de la fonction INPUT sur des chaînes textuelles brutes se heurte à des pollutions typographiques qui exigent une phase de prophylaxie textuelle minutieuse.
8.1 Élimination des espaces superflus et caractères non imprimables
La présence d’espaces invisibles constitue l’une des causes prépondérantes de friction lors de l’analyse lexicale opérée par les informats numériques. Ces espaces peuvent être positionnés en tête de chaîne (justification à droite), en queue de chaîne (espaces de remplissage des champs à longueur fixe) ou s’immiscer sous forme de doublons au cœur de l’information quantitative.
Pour purifier ces agencements, la boîte à outils des fonctions de chaînes de SAS offre des ressources puissantes. La fonction unifiée STRIP condense l’action conjointe de la suppression des espaces initiaux et terminaux, garantissant que la chaîne transmise à la fonction INPUT débute et s’achève rigoureusement sur des caractères effectifs. Pour résorber les espacements multiples au sein d’une chaîne sans altérer son ordonnancement, la fonction COMPBL remplace chaque grappe d’espaces consécutifs par un unique espace standard.
Les extractions de données issues d’environnements distants ou de protocoles d’échanges non sécurisés charrient par ailleurs des caractères non imprimables pernicieux, tels que des tabulations, des retours chariot de fin de ligne ou des octets de contrôle du code ASCII. La fonction d’élagage radical COMPRESS, enrichie de modificateurs d’attributs spécifiques (notamment le modificateur ‘c’ pour cibler les caractères de contrôle), permet de balayer ces pollutions invisibles qui, autrement, feraient inexorablement échouer le processus de décodage numérique.
8.2 Substitution et homogénéisation des séparateurs décimaux
Un écueil récurrent dans les bases de données multicentriques réside dans la coexistence conflictuelle de normes typographiques rivales. Il n’est pas rare de voir cohabiter dans une même colonne textuelle des enregistrements rédigés selon la syntaxe anglo-saxonne (« 1250.50 ») et d’autres rédigés selon la nomenclature européenne (« 1250,50 »), fruit de consolidations de filiales internationales disparates.
Dans une telle configuration, aucun informat standard ou inversé ne peut triompher seul, car l’application de COMMAw.d corrompra les nombres à virgule, tandis que l’usage de COMMAXw.d faossera les nombres à point. La solution élégante réside dans l’homogénéisation chirurgicale de la chaîne préalablement à l’appel de l’opérateur INPUT. La fonction de substitution textuelle par table de correspondance TRANSLATE ou la fonction de remplacement de chaînes TRANWRD s’avèrent ici providentielles.
En ordonnant la substitution systématique de tout caractère virgule par un caractère point canonique, le développeur normalise l’ensemble de la cohorte d’observations sous un paradigme arithmétique unique. Parallèlement, l’élimination des caractères alphabétiques parasites glissés par erreur dans les champs numériques peut être automatisée via la fonction COMPRESS dotée du modificateur ‘kd’ (qui conserve sélectivement les chiffres décimaux et détruit tout le reste), préparant un terrain parfaitement réceptif pour la fonction INPUT.
8.3 Validation conditionnelle en amont de la fonction INPUT
Les standards de gouvernance modernes imposent d’isoler et de documenter chaque valeur non conforme avant qu’elle ne soit métamorphosée en valeur manquante par le moteur de conversion. Cette approche préventive repose sur la validation logique conditionnelle des chaînes candidates.
Une première approche classique consiste à mobiliser la fonction de vérification lexicale VERIFY. Cette fonction confronte chaque caractère de la chaîne source à une liste blanche de symboles explicitement autorisés (les chiffres de zéro à neuf, le point, le signe négatif). Dès qu’un symbole hors protocole est détecté, la fonction renvoie l’index de sa position spatiale, permettant de dériver instantanément une variable indicatrice d’anomalie pour orienter l’enregistrement vers une table de quarantaine dédiée.
Pour une granularité de contrôle supérieure, l’usage des expressions régulières compilées au travers des fonctions SAS dédiées (la famille PRX, notamment les fonctions de parsing et de mise en correspondance lexicale) permet de valider avec une rigueur mathématique la conformité structurelle de la chaîne. Un motif d’expression régulière validant la présence exclusive de nombres signés optionnels avec décimales permet de scinder le flux de données : les enregistrements parfaitement conformes subissent la conversion INPUT, tandis que les anomalies typographiques complexes sont sauvegardées dans un registre d’audit pour investigation manuelle.
9. Techniques avancées de renommage et substitution directe de variables
L’une des contraintes les plus déroutantes pour le néophyte réside dans l’incapacité de modifier le type d’une variable existante sans en altérer l’étiquette nominative au cours de la même étape DATA.
9.1 L’impossibilité de modifier le type in situ sous SAS
L’architecture interne du compilateur SAS impose une règle d’or d’immutabilité structurelle : au sein d’une étape DATA donnée, le premier énoncé qui mentionne une variable fixe de manière irrévocable son type (numérique ou caractère) et sa longueur physique dans le dictionnaire du Program Data Vector. Toute tentative ultérieure de réassigner cette même variable au travers d’une opération renvoyant un type antagoniste provoque une erreur d’incompatibilité de type au moment de la phase de compilation.
Par conséquent, une instruction schématique directe telle que Variable_A = INPUT(Variable_A, BEST12.); est catégoriquement rejetée par le moteur SAS. Le compilateur constate que Variable_A est initialement convoquée comme argument d’une fonction réclamant un caractère (ce qui définit Variable_A comme de Type 2), mais se voit simultanément assigner le résultat d’un informat numérique à la gauche de l’opérateur d’égalité (ce qui exigerait qu’elle soit de Type 1). Face à cette antinomie logique, l’étape DATA avorte immédiatement avec une mention d’erreur fatale dans le journal.
Pour contourner ce verrou architectural inhérent à la stabilité du compilateur, l’ingénieur doit orchestrer une manœuvre en deux temps, consistant à faire transiter temporairement la grandeur quantitative par un réceptacle intermédiaire avant de redistribuer les identifiants originels par permutation de métadonnées.
9.2 Stratégie de substitution élégante avec l’instruction RENAME
La méthodologie standard préconisée dans l’ingénierie des systèmes d’information SAS pour préserver l’appellation d’origine d’une colonne tout en transformant son essence physique repose sur l’usage coordonné de l’instruction d’exclusion DROP et de l’instruction de renommage RENAME, ou plus élégamment, via les options de table appliquées aux déclarations d’entrée et de sortie.
Le patron de conception (design pattern) le plus robuste s’articule comme suit : lors de l’instruction d’appel de la table source dans l’étape DATA, l’ancienne variable caractère est temporairement renommée au moyen de l’option de table dédiée (par exemple renommée en un identifiant temporaire textuel). Dès cet instant, le nom canonique officiel de la variable est libéré de tout engagement typologique dans le PDV.
Au sein du corps de l’étape DATA, la fonction INPUT est invoquée pour lire cet identifiant temporaire et son résultat est directement assigné à l’identifiant originel, qui naît alors légitimement dans le dictionnaire comme une variable de Type 1 (numérique). Enfin, l’identifiant temporaire textuel est exclu de la table de sortie par l’instruction DROP. Cette chorégraphie logicielle assure que la table résultante présente exactement le même schéma de colonnes que la table d’entrée, garantissant une compatibilité descendante absolue avec tous les programmes d’analyse situés en aval de la chaîne de production.
9.3 Gestion des métadonnées associées lors du renommage
Une conversion de variable accomplie selon les règles de l’art ne se limite pas à la translation des octets de données brutes ; elle doit également préserver le patrimoine informationnel constitué par les métadonnées satellites rattachées à la colonne originelle.
Lorsqu’une variable est ainsi recréée de toutes pièces au sein du PDV, elle émerge par défaut vierge de toute étiquette descriptive humaine (l’attribut LABEL), dénuée de tout format d’affichage personnalisé et délestée de ses informats historiques. Il incombe impérativement au développeur de réinjecter ces métadonnées au moyen de l’instruction explicite LABEL, redéfinissant formellement l’intitulé métier complet de la nouvelle entité numérique.
De même, l’adjonction d’un format de restitution adapté au sein de l’instruction FORMAT garantit que la nouvelle variable numérique sera immédiatement projetée selon les normes de l’organisation lors des futures impressions ou extractions de tableaux de bord. Un audit post-substitution mené via PROC CONTENTS clôture cette phase, certifiant que la colonne transformée arbore son intitulé historique, son label métier et son nouveau statut numérique avec une transparence totale pour les statisticiens et modélisateurs.
10. Conversion de masse et automatisation sur tables volumineuses
Lorsque le processus d’intégration ne concerne plus une poignée de variables isolées, mais implique des centaines de colonnes textuelles disséminées dans des tables relationnelles colossales, l’écriture manuelle d’instructions répétitives devient intenable et source d’erreurs humaines. L’automatisation s’impose alors par le recours aux tableaux dynamiques et au méta-moteur SAS.
10.1 Traitement par tableaux dynamiques (ARRAYs)
Pour traiter de concert des dizaines de colonnes de façon vectorielle et itérative au sein d’une seule et même étape DATA, le mécanisme des tableaux SAS (ARRAY) constitue l’infrastructure programmatique privilégiée. Un tableau SAS ne constitue pas une structure de données physique nouvelle, mais un ensemble temporaire de pointeurs logiques orientés vers des variables déjà logées dans le vecteur de travail (PDV).
La méthodologie de conversion matricielle requiert l’instanciation de deux tableaux distincts : un premier vecteur rassemblant les variables caractères sources à convertir, et un second vecteur dimensionné à l’identique pour héberger les nouvelles variables numériques cibles. L’algorithme déploie ensuite une boucle itérative séquentielle (une boucle DO…END) qui parcourt l’ensemble des dimensions de ces vecteurs grâce à la fonction de dimensionnement dynamique DIM.
À chaque itération de la boucle, l’élément courant du tableau numérique reçoit le produit de la fonction INPUT appliquée sur l’élément correspondant du tableau de chaînes textuelles. Cette vectorisation logicielle offre une concision syntaxique exceptionnelle, réduit drastiquement les risques d’omission et exploite au maximum l’efficacité des boucles compilées en mémoire vive, accélérant de façon spectaculaire le traitement d’enquêtes ou de registres épidémiologiques massifs.
10.2 Exploitation des tables du dictionnaire SAS (SASHELP.VCOLUMN)
Pour atteindre un degré supérieur d’agilité, il est possible d’éliminer totalement la saisie manuelle du nom des variables à convertir en déléguant cette tâche à l’interrogation automatique des métadonnées du système. SAS maintient en temps réel des vues système hautement informatives, au premier rang desquelles trône la vue SASHELP.VCOLUMN, qui inventorie l’intégralité des attributs de chaque variable résidant dans les bibliothèques actives.
En interrogeant cette vue au moyen du langage de requête relationnel intégré (la procédure PROC SQL), l’analyste peut filtrer dynamiquement toutes les variables appartenant à une table cible dont le type textuel est avéré (TYPE=’char’), tout en appliquant des critères de sélection morphologiques avancés (par exemple cibler les colonnes dont l’intitulé débute par un préfixe spécifique ou dont la longueur maximale ne dépasse pas un seuil donné).
Cette extraction programmatique permet de peupler instantanément des macro-variables globales contenant des listes exhaustives séparées par des espaces de toutes les colonnes candidates à la conversion. Cette technique élimine tout risque d’oubli lors de l’intégration de fichiers sources complexes dont la nomenclature évolue au fil des versions logicielles de capture.
10.3 Conception d’une macro-procédure polyvalente
Le point d’orgue de l’ingénierie logicielle sous SAS réside dans l’encapsulation de ces briques algorithmiques au sein d’une macro-procédure modulaire, paramétrable et réutilisable à l’échelle d’une entreprise. Ce programme générique prend typiquement pour arguments le nom de la bibliothèque d’entrée, le nom de la table source, la table de destination souhaitée, la liste des colonnes visées et l’informat de référence à déployer.
À l’intérieur de cette macro-procédure, le compilateur du macro-processeur analyse les arguments et génère de façon dynamique le code SAS optimisé correspondant, incorporant la gestion automatique des renommages temporaires, l’affectation matricielle via des tableaux et le rétablissement scrupuleux des métadonnées originelles.
Une macro-procédure de qualité industrielle incorpore systématiquement des mécanismes d’autocontrôle et d’intégrité : vérification préalable de l’existence des tables, validation que les variables ciblées sont bien de type caractère pour éviter des erreurs d’inversion, et capture d’éventuels codes retour anormaux du système d’exploitation. Cette industrialisation du code sécurise les flux de production récurrents et assure un gain de productivité majeur pour l’ensemble des équipes analytiques.
11. Optimisation des performances et intégrité numérique
Le traitement de volumes gigantesques de données (Big Data) sous SAS exige une vigilance permanente quant à l’empreinte spatiale des structures générées et à la préservation de la précision arithmétique lors du transcodage binaire.
11.1 Gestion de la longueur de stockage et allocation mémoire
Par défaut, toute variable numérique déclarée dans une étape DATA sous SAS se voit allouer une longueur physique de stockage de 8 octets au standard de virgule flottante double précision. Cette convention par défaut garantit une couverture mathématique maximale, mais se révèle dispendieuse lorsqu’elle est appliquée à des millions d’observations hébergeant des grandeurs discrètes de faible amplitude, comme des codes d’état civil, des indicateurs booléens ou des index de petite taille.
Pour optimiser l’usage du stockage disque et accélérer les temps de transfert vers le processeur, l’ingénieur peut contraindre explicitement la longueur de stockage physique d’une variable numérique au moyen de l’instruction LENGTH, descendue par exemple à 3, 4 ou 5 octets selon la plage de valeurs attendue. Il convient toutefois de manier cette optimisation avec une rigueur mathématique absolue : une longueur de 3 octets ne permet d’enregistrer de façon intègre et sans perte de précision que des entiers n’excédant pas 8 192, sous peine de subir des troncatures binaires destructrices.
Le compromis entre économie d’octets et préservation de l’exactitude computationnelle doit donc toujours pencher vers la sécurité en présence de nombres réels ou de décimales fines, l’allocation de 8 octets demeurant la norme inviolable pour toute variable destinée à faire l’objet de calculs matriciels, d’optimisations de convergence ou d’analyses statistiques complexes.
11.2 Préservation de la précision numérique en virgule flottante
La conversion d’une chaîne textuelle décimale vers une représentation binaire est tributaire des lois immuables de l’arithmétique des ordinateurs, régie par la norme IEEE 754. Tout nombre réel décimal ne possède pas nécessairement un développement fini en base deux ; ainsi, une fraction d’apparence élémentaire comme un dixième (0.1) se transforme en une suite binaire périodique infinie lorsqu’elle est transcodée en mémoire.
Cette réalité physique induit des erreurs d’arrondi infinitésimales imperceptibles à l’affichage superficiel, mais potentiellement dévastatrices lors d’évaluations conditionnelles strictes. Si une chaîne « 0.1 » est convertie en variable numérique, tester rigoureusement l’égalité arithmétique de cette variable avec la constante 0.1 au sein d’une clause logique conditionnelle peut échouer de façon inattendue en raison d’un reliquat de bits dans les registres de précision.
Pour garantir une intégrité computationnelle parfaite, les bonnes pratiques de codage sous SAS prescrivent l’usage systématique de la fonction ROUND pour borner le résultat de la fonction INPUT au niveau de décimales métier attendu, ou le recours à la fonction heuristique FUZZ lors des comparaisons logiques, neutralisant ainsi les artefacts infinitésimaux de virgule flottante consécutifs à la conversion.
11.3 Stratégies d’optimisation pour les bases de données massives (Big Data)
Lorsque la volumétrie des tables atteint des dizaines ou des centaines de gigaoctets, chaque manipulation structurelle doit être pensée pour minimiser les opérations d’entrées/sorties (I/O) sur disque, qui constituent le goulot d’étranglement historique du traitement de données.
En premier lieu, les conversions de variables doivent être fusionnées au sein d’étapes DATA polyvalentes préexistantes au lieu de multiplier les étapes DATA séquentielles intermédiaires. Chaque étape DATA supplémentaire implique une lecture et une écriture complète de la table sur disque ; consolider l’ensemble des transformations numériques au sein d’un passage unique d’écriture divise instantanément l’empreinte I/O par le nombre de passes évitées.
En second lieu, le dimensionnement des mémoires tampons d’accès au moyen des options de performance BUFSIZE (pour allouer des blocs de lecture volumineux alignés sur la géométrie du stockage) et BUFNO (pour démultiplier le nombre de pages conservées simultanément en mémoire vive) permet d’injecter les enregistrements à une cadence maximale vers la fonction INPUT. Enfin, dans une architecture hybride connectée à des entrepôts de données distants (systèmes distribués ou SGBD d’entreprise), la délégation de la conversion directement au moteur distant via des instructions relationnelles de passage direct (SQL Pass-Through Facility) décharge entièrement le serveur SAS de cette charge de travail computationnelle.
12. Synthèse méthodologique, pièges récurrents et assurance qualité
Pour clore ce panorama technologique approfondi, il importe de synthétiser les meilleures pratiques opérationnelles et d’ériger des protocoles d’assurance qualité stricts destinés à pérenniser l’intégrité de vos actifs de données.
12.1 Les écueils de la conversion implicite non maîtrisée
Le piège méthodologique le plus insidieux au sein de l’environnement SAS réside dans sa permissivité vis-à-vis des conversions implicites, également désignées sous le terme de conversions automatiques de secours. Lorsque le compilateur détecte une variable caractère impliquée au sein d’une opération arithmétique explicite (par exemple l’évaluation d’une somme), il ne bloque pas le traitement : il tente d’appliquer d’autorité l’informat standard BEST12. pour accomplir la conversion à la volée.
Bien que cette fonctionnalité de secours puisse sembler séduisante de prime abord pour le programmeur pressé, elle constitue une anomalie méthodologique majeure et une faute technique lourde. D’une part, cette manœuvre force le système à générer une notification d’avertissement formelle dans le journal (NOTE: Character values have been converted to numeric…), polluant les rapports d’exécution. D’autre part, elle consomme des cycles de traitement considérablement plus élevés qu’une conversion déterministe via la fonction INPUT, ralentissant sensiblement les pipelines de production.
Mais le danger le plus critique réside dans l’incapacité de la conversion implicite à s’adapter à des typologies complexes. Confrontée à une virgule européenne, à une notation monétaire ou à une date calendaire, la conversion automatique échoue aveuglément, remplaçant la valeur par une donnée manquante sans que le développeur n’ait eu la main sur la stratégie de sauvetage de l’information. L’interdiction absolue des conversions implicites figure ainsi au sommet des chartes de programmation SAS rigoureuses.
12.2 Matrice de décision pour le choix de l’informat de conversion
Afin de guider l’ingénieur et le statisticien face à un défi d’intégration concret, l’arbre de décision méthodologique suivant synthétise le choix optimal de l’informat à convoquer dans la fonction INPUT en fonction de la nature sémantique et typographique de la chaîne textuelle source :
- Nombres décimaux ou entiers purs avec point : Déployer l’informat adaptatif standard BESTw. ou la notation fixe w.d pour une efficacité computationnelle maximale et un respect scrupuleux de l’alignement binaire.
- Nombres occidentaux avec séparateurs de milliers ou devises : Adopter l’informat COMMAw.d (pour éliminer virgules et espaces) ou l’informat DOLLARw.d (si des symboles monétaires préfixent l’information quantitative).
- Nombres rédigés selon la nomenclature européenne continentale : Sélectionner sans réserve l’informat COMMAXw.d pour ériger la virgule en séparateur fractionnaire absolu et neutraliser les points de groupement.
- Mesures scientifiques à très haute ou très faible amplitude : Recourir à l’informat de notation scientifique Ew. afin de décoder fidèlement les représentations en puissance de dix conformes à la norme IEEE.
- Variables calendaires et temporelles disparates : Exploiter les informats standards chronologiques dédiés (DDMMYYw., DATEw.) ou convoquer l’informat heuristique polyvalent ANYDTDTEw. lorsque la structure de date est fluctuante.
12.3 Check-list d’assurance qualité avant l’analyse statistique
L’achèvement d’un cycle de conversion de données doit obligatoirement être validé par un protocole formel de recette statistique et informatique articulé autour des points de contrôle fondamentaux suivants :
- Contrôle de conservation des décomptes d’observations : S’assurer que le nombre total d’enregistrements au sein de la table de sortie est strictement identique à celui de la table d’origine, excluant tout abandon inopiné de lignes par le moteur d’exécution.
- Audit différentiel des valeurs manquantes : Calculer le différentiel exact du nombre de données manquantes avant et après la conversion. Toute augmentation anormale du volume de données manquantes non imputable à des cellules initialement vides ou documentées signale une inadéquation de l’informat ou la présence de corruptions typographiques non traitées.
- Inspection des synthèses de dispersion via PROC MEANS : Exécuter une procédure descriptive complète (moyennes, percentiles, valeurs minimales et maximales) sur les nouvelles variables numériques pour vérifier la plausibilité des ordres de grandeur obtenus face aux réalités du domaine métier.
- Audit approfondi du journal d’exécution (Log Review) : Scrupuleusement scruter le journal de la session pour attester de l’absence totale de messages d’avertissement relatifs à des conversions implicites, des dépassements de capacité ou des données invalides non interceptées.
- Archivage documentaire et reproductibilité : Consigner scrupuleusement les choix algorithmiques, les informats mobilisés et les scripts de validation dans le dictionnaire de gouvernance du projet, garantissant ainsi une auditabilité totale et une conformité rigoureuse aux standards de la science des données moderne.
Références
Allison, P. D. (2012). Logistic regression using SAS: Theory and application (2nd ed.). SAS Institute.
Cody, R. (2018). Cody’s data cleaning techniques using SAS (3rd ed.). SAS Institute.
Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute.
IEEE Computer Society. (2019). IEEE standard for floating-point arithmetic (IEEE Std 754-2019). IEEE. https://standards.ieee.org/ieee/754/6210/
SAS Institute Inc. (2020). SAS 9.4 language reference: Concepts (6th ed.). SAS Institute Inc. https://documentation.sas.com/?docsetId=lrcon&docsetTarget=titlepage.htm
SAS Institute Inc. (2021). SAS 9.4 functions and CALL routines: Reference. SAS Institute Inc. https://documentation.sas.com/?docsetId=lefunctionsref&docsetTarget=titlepage.htm
SAS Institute Inc. (2023). SAS 9.4 formats and informats: Reference. SAS Institute Inc. https://documentation.sas.com/?docsetId=leformatsref&docsetTarget=titlepage.htm
Torfason, R. (2016). Efficient SAS programming shortcuts: Arrays and macros. Pharmaceutical Programming, 9(1-2), 45-52.