
La modélisation des phénomènes non linéaires constitue l’un des piliers fondamentaux de l’analyse quantitative moderne, traversant les frontières des sciences physiques, de l’épidémiologie, de l’économétrie et des sciences cognitives. Alors que la régression linéaire classique suppose une proportionnalité constante entre les variations d’une variable explicative et les réponses du système étudié, les dynamiques réelles exhibent fréquemment des accélérations fulgurantes ou des amortissements asymptotiques. Face à ces trajectoires non linéaires, l’ajustement empirique exige des formalismes mathématiques capables de capturer des taux de variation proportionnels à l’état instantané du phénomène. C’est précisément le domaine d’élection de la régression exponentielle, un outil analytique d’une puissance remarquable lorsqu’il s’agit de décrire des mécanismes d’amplification sans saturation apparente ou des processus de dissipation progressive.
Au sein de l’écosystème scientifique contemporain, le langage de programmation Python s’est imposé comme le standard de facto pour l’exécution d’analyses statistiques avancées et l’apprentissage automatique. Grâce à la synergie d’environnements computationnels hautement optimisés tels que NumPy pour les opérations matricielles, SciPy pour l’optimisation numérique non linéaire, et Matplotlib pour la représentation visuelle de haute fidélité, le chercheur ou l’ingénieur dispose d’un appareil méthodologique complet pour ajuster, évaluer et valider des modèles exponentiels. Néanmoins, l’apparente simplicité syntaxique de ces outils dissimule des enjeux mathématiques et statistiques critiques, allant du choix entre la linéarisation logarithmique et l’optimisation directe par les moindres carrés non linéaires jusqu’à la propagation des incertitudes paramétriques et la gestion des instabilités numériques.
Le présent traité propose une exploration exhaustive, méthodique et rigoureuse de la régression exponentielle sous Python. Conçu pour guider le praticien de la théorie mathématique fondamentale jusqu’au déploiement de pipelines d’ajustement automatisés, ce guide détaille chaque phase computationnelle. À travers l’examen approfondi des fondements analytiques, des spécifications d’algorithmes d’optimisation tels que Levenberg-Marquardt, des diagnostics résiduels et d’applications concrètes issues des sciences comportementales, cette monographie dresse un panorama complet des meilleures pratiques méthodologiques indispensables à l’obtention de résultats reproductibles et statistiquement irréprochables.
1. Fondements théoriques et mathématiques de la régression exponentielle
1.1 Définition formelle et formulation mathématique du modèle
D’un point de vue analytique strict, un modèle de régression exponentielle postule l’existence d’une relation fonctionnelle non linéaire où le taux d’accroissement marginal de la variable réponse est directement proportionnel à sa magnitude actuelle. Dans la littérature mathématique et appliquée, cette relation s’exprime conventionnellement selon deux formulations canoniques équivalentes. La première s’écrit sous la forme algébrique discrète $y = a \cdot b^x$, tandis que la seconde, privilégiée en calcul différentiel et dans les sciences physiques, utilise la base naturelle népérienne $y = a \cdot \exp(k \cdot x)$.
Dans ces expressions, la variable dépendante continue, notée $y$, représente le phénomène quantitatif observé soumis à l’influence de la variable explicative ou régresseur, noté $x$, qui prend généralement la forme d’un continuum temporel ou d’une coordonnée spatiale. Les paramètres structurels du modèle possèdent une interprétation phénoménologique précise. Le paramètre $a$, également désigné sous le terme d’amplitude ou d’ordonnée à l’origine, fixe la valeur théorique attendue de la réponse lorsque le prédicteur est nul, c’est-à-dire $y(0) = a$. Le coefficient $b$, ou de manière analogue la constante de taux $k = ln(b)$, régit la dynamique intrinsèque de la trajectoire. Lorsque $k$ est positif, le système expérimente une croissance continue ; lorsqu’il est négatif, il subit une atténuation progressive.
Sur le plan stochastique, la spécification d’un modèle de régression nécessite de définir précisément le mécanisme de génération des erreurs aléatoires. Deux hypothèses fondamentales s’opposent : le modèle à erreur additive, formulé par $y_i = a \cdot \exp(k \cdot x_i) + \varepsilon_i$, et le modèle à erreur multiplicative, formulé par $y_i = a \cdot \exp(k \cdot x_i) \cdot \exp(\varepsilon_i)$. Dans le cadre de l’inférence statistique classique sous hypothèse additive, les perturbations aléatoires $\varepsilon_i$ sont supposées indépendantes, identiquement distribuées selon une loi normale d’espérance nulle et de variance constante $\sigma^2$, garantissant la propriété d’homoscédasticité. La violation de cette condition ou le choix erroné de la structure d’erreur altère profondément la validité des estimateurs et la précision des intervalles de confiance associés.
1.2 Croissance versus décroissance exponentielle : principes et propriétés
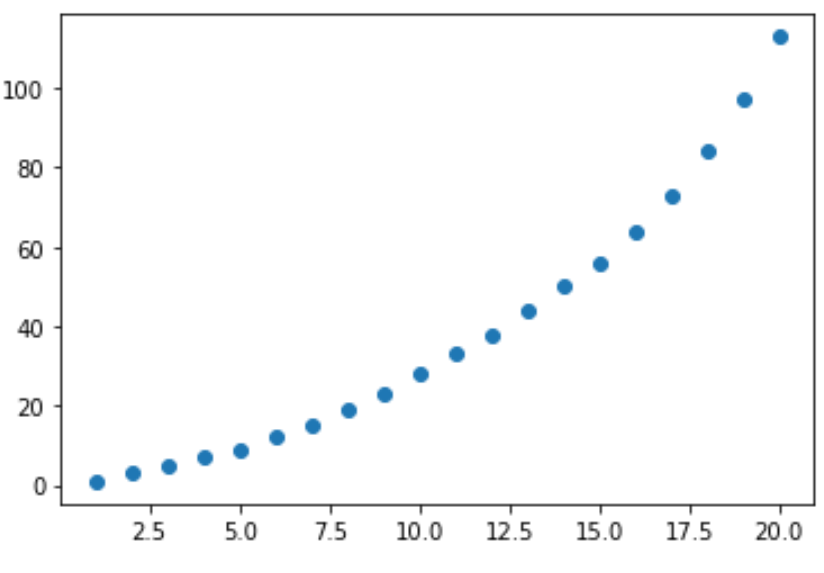
L’espace paramétrique de la régression exponentielle engendre deux régimes dynamiques distincts, gouvernés par la valeur du taux continu $k$ ou de la base multiplicative $b$. Le régime de croissance exponentielle, caractérisé par une condition où $b > 1$ (ou $k > 0$), décrit une accélération perpétuelle. Dans cette configuration, la dérivée première par rapport à $x$, donnée par $dy/dx = k \cdot a \cdot \exp(k \cdot x) = k \cdot y$, démontre que la vitesse instantanée d’expansion est une fonction linéaire croissante de la magnitude atteinte. En l’absence de terme de saturation ou de capacité d’accueil — comme on en rencontre dans les modèles logistiques —, la fonction diverge vers l’infini positif lorsque $x$ tend vers des valeurs arbitrairement grandes. Ce comportement modélise fidèlement les phases initiales de propagation épidémique, les réactions chimiques en chaîne ou l’expansion non contrainte de populations biologiques.
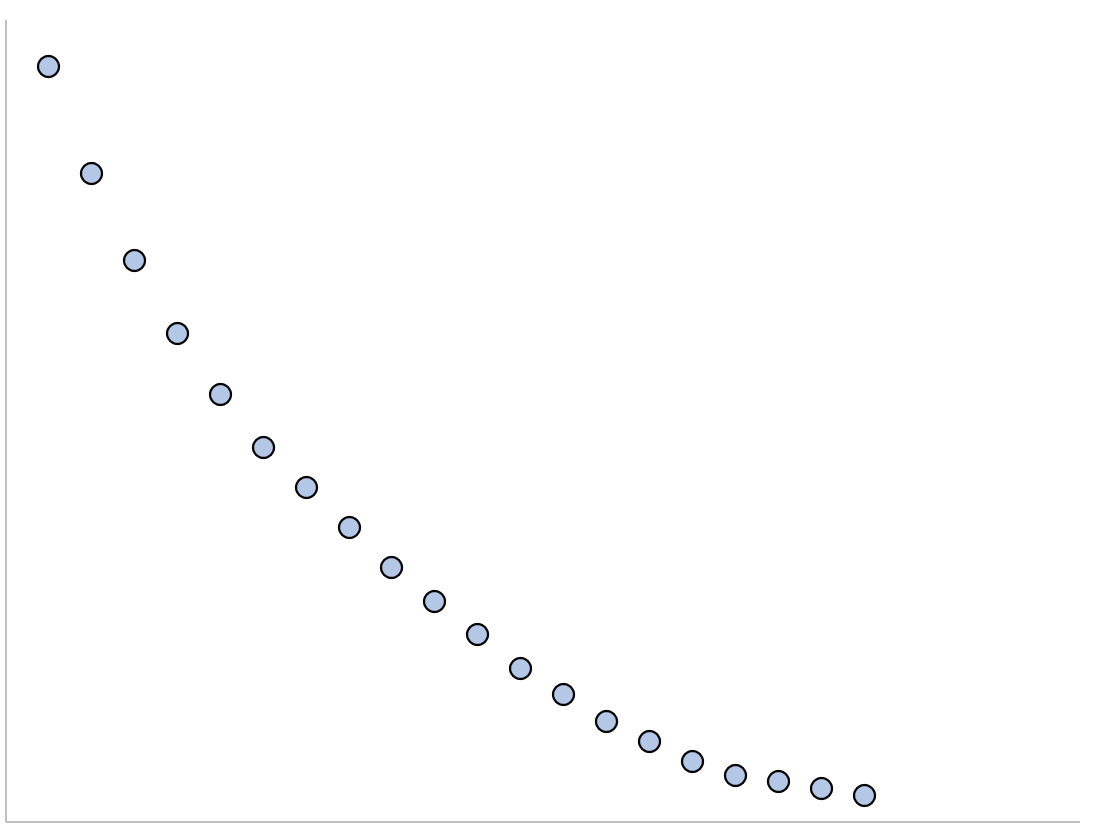
À l’inverse, le régime de décroissance exponentielle se matérialise dès lors que le paramètre respecte la condition $0 < b < 1$ (soit $k < 0$). La fonction décrit alors un amortissement monotone rapide, convergeant asymptotiquement vers zéro sans jamais l'atteindre pour des valeurs finies de $x$. La dérivée première demeure négative sur l'ensemble du domaine de définition, tandis que la dérivée seconde, strictement positive, traduit une courbure convexe orientée vers le haut. Cette dynamique régit des phénomènes physiques fondamentaux tels que la désintégration radioactive, le refroidissement thermique régi par la loi de Newton, ou la relaxation des circuits électroniques.
Une propriété remarquable de ces deux régimes réside dans l’invariance temporelle de leurs métriques d’échelle. Pour la croissance exponentielle, le temps de doublement $T_d$, défini comme la durée nécessaire pour que la réponse double sa valeur initiale, s’avère totalement indépendant de la valeur de départ et s’exprime par la relation $T_d = \ln(2) / k$. Réciproquement, pour les régimes de décroissance, la demi-vie $T_{1/2}$, correspondant à l’intervalle requis pour réduire la grandeur de moitié, obéit à la formulation $T_{1/2} = \ln(2) / |k|$. Dans les sciences cognitives et comportementales, ces propriétés fournissent un cadre théorique puissant pour modéliser la dégradation des traces mnésiques au fil du temps ou la dépréciation temporelle de la valeur subjective d’une récompense.
1.3 Approches méthodologiques d’estimation : linéarisation vs ajustement non linéaire
L’estimation des paramètres $a$ et $k$ à partir d’un échantillon empirique d’observations $(x_i, y_i)$ confronte le statisticien à un arbitrage méthodologique fondamental entre la linéarisation par transformation logarithmique et l’optimisation non linéaire directe. Historiquement, avant l’avènement des calculateurs numériques modernes, la technique dominante consistait à appliquer le logarithme népérien aux deux membres de l’équation exponentielle. Sous l’hypothèse d’une perturbation multiplicative, cette transformation convertit le modèle en une relation strictement linéaire : $\ln(y_i) = \ln(a) + k \cdot x_i + \varepsilon_i$. Il devient alors trivial d’estimer l’ordonnée à l’origine transformée $\alpha = \ln(a)$ et la pente $k$ par la méthode standard des moindres carrés ordinaires (MCO).
Néanmoins, cette élégance calculatoire s’accompagne d’un biais statistique substantiel dès lors que les données empiriques d’origine comportent une composante d’erreur additive homoscédastique. En vertu de l’inégalité de Jensen, l’espérance du logarithme d’une variable aléatoire n’est pas égale au logarithme de son espérance : $\mathbb{E}[\ln(Y)] le \ln(\mathbb{E}[Y])$. Par conséquent, réappliquer la fonction exponentielle à l’estimateur linéaire pour retrouver l’amplitude $a = \exp(\hat{\alpha})$ introduit un biais d’estimation systématique par sous-estimation de la trajectoire moyenne. De surcroît, la transformation logarithmique compresse l’échelle des grandes valeurs de $y$ et dilate celle des valeurs résiduelles proches de zéro, ce qui déforme profondément la structure de variance des erreurs et induit une hétéroscédasticité artificielle violant les hypothèses de Gauss-Markov.
Pour surmonter ces distorsions, l’approche moderne privilégie l’ajustement non linéaire direct par la méthode des moindres carrés non linéaires (NLLS). Cette démarche cherche à minimiser directement la somme des carrés des écarts sur l’échelle originale non transformée des observations :
$$S(a, k) = \sum_{i=1}^n \left( y_i – a \cdot \exp(k \cdot x_i) \right)^2$$
Puisque les dérivées partielles du modèle par rapport à $a$ et $k$ dépendent elles-mêmes des paramètres inconnus, ce problème d’optimisation ne dispose pas de solution analytique fermée. Il requiert l’emploi d’algorithmes itératifs sophistiqués, au premier rang desquels figure l’algorithme de Levenberg-Marquardt. Ce dernier réalise une interpolation dynamique entre la méthode de descente de gradient, robuste dans les phases initiales éloignées de l’optimum, et l’algorithme de Gauss-Newton, caractérisé par une convergence quadratique rapide au voisinage du minimum local. Le tableau suivant synthétise les critères de sélection guidant le choix entre ces deux paradigmes méthodologiques :
- Structure des erreurs : Privilégier la linéarisation si l’erreur est multiplicative et suit une loi log-normale ; opter impérativement pour l’optimisation non linéaire directe si le bruit de mesure est additif et homoscédastique sur l’échelle naturelle.
- Comportement aux limites : La linéarisation interdit formellement la présence de valeurs expérimentales négatives ou nulles ($y_i le 0$), alors que l’optimisation directe s’accommode naturellement d’observations proches de zéro ou légèrement bruitées en dessous de l’asymptote.
- Sensibilité algorithmique : La linéarisation MCO garantit une solution unique et déterministe sans nécessiter de conditions initiales, tandis que l’optimisation non linéaire requiert des valeurs d’amorce cohérentes pour éviter les pièges des minima locaux ou les divergences numériques.
2. Configuration de l’environnement Python et bibliothèques scientifiques
2.1 Installation et gestion des dépendances computationnelles
L’exécution rigoureuse d’analyses quantitatives sous Python exige une architecture computationnelle stable, isolée et reproductible. L’installation de bibliothèques scientifiques au sein de l’interpréteur système global constitue une pratique déconseillée, susceptible d’engendrer des conflits de versions entre paquets et d’altérer la stabilité des environnements d’exécution. Il convient par conséquent de créer un environnement virtuel dédié au projet en utilisant les utilitaires standards du système tels que l’environnement venv natif ou le gestionnaire multi-plateforme Conda.
Au cœur de cette architecture se trouve la bibliothèque NumPy, dont les structures de tableaux multidimensionnels ndarray reposent sur des blocs de mémoire contigus écrits en langage C. Cette conception offre des gains de performance massifs par rapport aux structures natives de Python en évitant les surcoûts d’encapsulation dynamique et en autorisant la vectorisation des opérations mathématiques fondamentales. C’est sur ces structures vectorielles que vient se greffer le module d’optimisation numérique de SciPy, plus particulièrement son sous-module scipy.optimize. Ce dernier renferme les algorithmes de pointe pour la résolution de systèmes non linéaires et l’ajustement de courbes par moindres carrés généralisés.
Pour le traitement exploratoire des séries d’observations et l’encapsulation tabulaire des variables expérimentales, la bibliothèque Pandas s’avère indispensable, facilitant la manipulation d’indices temporels et le nettoyage préalable des enregistrements manquants. Enfin, l’investigation visuelle et la restitution inférentielle des modélisations reposent sur l’orchestration conjointe de Matplotlib et de Seaborn. Matplotlib opère comme le moteur graphique de bas niveau assurant un contrôle typographique et spatial millimétré sur chaque élément d’axe ou d’annotation, tandis que Seaborn fournit des abstractions de haut niveau parfaitement adaptées à l’exploration statistique des corrélations.
2.2 Bonnes pratiques de codage et reproductibilité scientifique
La reproductibilité computationnelle constitue l’un des piliers méthodologiques de la recherche scientifique empirique. Lors de la mise en œuvre d’ajustements statistiques impliquant la génération de bruits stochastiques ou l’usage d’heuristiques probabilistes, il est impératif de contrôler explicitement les générateurs de nombres pseudo-aléatoires. Dans les versions modernes de NumPy, cela s’accomplit par l’initialisation explicite d’un générateur via la méthode np.random.default_rng(seed), en substituant cette pratique à l’ancien appel global np.random.seed(). Cette précaution garantit qu’une chaîne de calcul exécutée sur des plateformes matérielles distinctes produira des séries synthétiques rigoureusement identiques.
La robustesse du code repose également sur une conception modulaire fondée sur des fonctions analytiques dotées d’annotations de types complètes (type hints). Ces annotations clarifient les contrats d’interface entre les routines d’optimisation et les matrices de données, facilitant la détection statique d’incohérences dimensionnelles avant même le lancement des calculs intensifs. Par exemple, expliciter qu’une fonction d’ajustement accepte un argument vectoriel de type np.ndarray et renvoie une structure équivalente prévient l’injection accidentelle de listes natives scalaires.
Enfin, le traitement des équations exponentielles expose le système à des instabilités de précision numérique, notamment les phénomènes de dépassement de capacité vers l’infini (overflow) ou d’annulation par sous-dépassement vers zéro (underflow). En arithmétique flottante standard à double précision (IEEE 754 float64), l’évaluation de la fonction exponentielle diverge dès lors que son argument outrepasse approximativement la valeur 709,78. Le concepteur d’algorithmes doit intégrer des mécanismes de garde préventifs, tels que le bornage des arguments exponentiels ou le rééchelonnement des variables prédictives, sous peine de voir les optimiseurs renvoyer des valeurs non définies (NaN) qui interrompent brutalement la convergence des solveurs.
3. Étape 1 – Structuration et importation des jeux de données
3.1 Création programmatique d’un jeu de données synthétique
L’apprentissage rigoureux et la validation des protocoles d’ajustement non linéaire débutent avantageusement par la manipulation d’un jeu de données synthétique dont les paramètres générateurs sont connus a priori avec certitude. Cette approche permet de confronter les estimations issues des algorithmes aux valeurs théoriques exactes et d’évaluer la résilience des estimateurs face à différentes intensités de bruit stochastique. Pour construire un tel système, on commence par générer un vecteur prédictif $x$ régulièrement espacé à l’aide de l’utilitaire np.linspace(), définissant une fenêtre d’observation comprise par exemple entre 0 et 10 unités avec une résolution dense de cent points de mesure.
La trajectoire sous-jacente déterministe est ensuite synthétisée en appliquant la fonction exponentielle pure à ce vecteur de support. En fixant arbitrairement l’amplitude théorique à $a = 2.5$ et le taux de croissance intrinsèque à $k = 0.45$, la fonction génère une courbe théorique parfaite exempte de toute distorsion. Afin d’émuler la variabilité empirique inhérente à tout dispositif de mesure expérimental, on injecte un terme de perturbation stochastique sous forme d’un bruit blanc gaussien centré, issu d’une loi normale $\mathcal{N}(0, \sigma^2)$, où l’écart-type $\sigma$ contrôle le degré de dégradation du signal.
L’ensemble de ces vecteurs est ensuite agrégé dans une structure de données tabulaire au format pandas.DataFrame. Cette organisation unifiée permet d’associer explicitement les séries prédictives, les composantes de signal théorique et les observations bruitées. Elle offre également une interface idéale pour exporter la simulation vers des formats pérennes ou pour appliquer des filtres conditionnels. La manipulation sous Pandas garantit en outre un alignement rigoureux des index lors des étapes ultérieures de calcul résiduel.
3.2 Importation et nettoyage de données empiriques
Lors du passage à des données expérimentales réelles, issues de capteurs de laboratoire, de bases de données transactionnelles SQL ou d’archives de surveillance épidémiologique au format CSV, la phase d’ingestion des données requiert une vigilance analytique décuplée. L’importation s’opère typiquement via la routine pandas.read_csv(), en configurant rigoureusement le typage des colonnes temporelles et les symboles décimaux. Dès l’ingestion terminée, un audit structurel de la variable réponse s’impose impérativement avant toute tentative d’ajustement exponentiel.
La contrainte la plus impérieuse réside dans la vérification de la stricte positivité des données si une approche par linéarisation logarithmique est envisagée à des fins exploratoires ou d’initialisation. En effet, l’opérateur logarithmique népérien présente une singularité en zéro et n’est pas défini pour les nombres réels strictement négatifs dans le corps des réels $\mathbb{R}$. La présence de zéros structurels, d’artefacts de numérisation négatifs ou de valeurs manquantes (NaN) commande l’application de stratégies de nettoyage systématiques. Celles-ci peuvent consister en une élimination raisonnée des enregistrements aberrants ou en l’imputation de valeurs seuils déterministes validées par la théorie du domaine applicatif.
Au-delà de la positivité, l’échantillonnage temporel doit être minutieusement documenté. Des pas d’échantillonnage irréguliers, la présence de ruptures structurelles franches au sein de la série chronologique, ou des changements d’échelle expérimentale au cours de la collecte exigent une phase de pré-traitement dédiée. Celle-ci peut intégrer un rééchelonnement (scaling) unitaire des variables explicatives afin d’éviter que des amplitudes numériques disproportionnées n’induisent un mauvais conditionnement de la matrice d’information de Fisher au cours de l’optimisation non linéaire.
4. Étape 2 – Analyse exploratoire et visualisation initiale des données
4.1 Construction du diagramme de dispersion standard
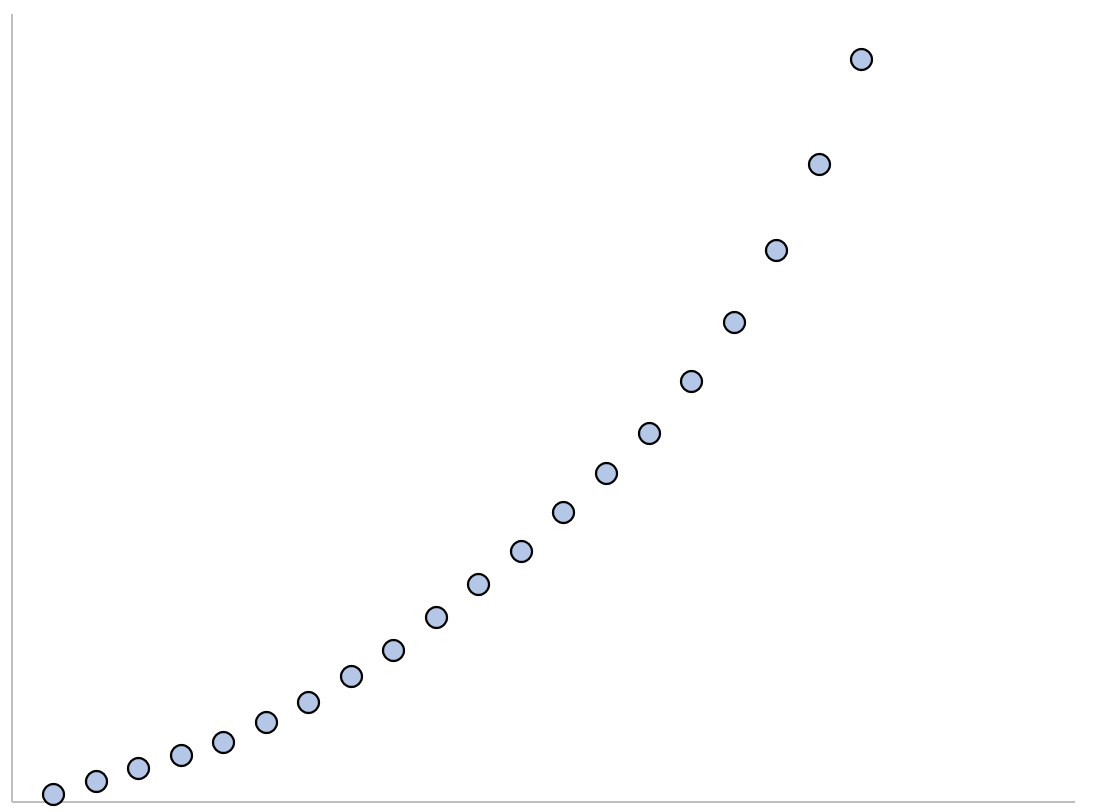
La démarche exploratoire initiale face à un jeu de données quantitatif repose sur la représentation graphique brute des observations dans un système de coordonnées cartésiennes linéaires conventionnelles. À l’aide de la fonction matplotlib.pyplot.scatter(), chaque paire d’observations $(x_i, y_i)$ est projetée sur le plan orthogonal. Cette inspection visuelle primaire a pour objectif d’évaluer la morphologie globale du nuage de points et de déceler les signatures empiriques qui justifient l’adoption d’une classe de modèles spécifiques.
Dans le cas d’une dynamique exponentielle en phase de croissance, l’analyste observe une courbure convexe caractéristique : la pente locale du nuage de points, initialement modérée voire imperceptible pour les faibles valeurs de l’abscisse, croît de manière continue et soutenue à mesure que le prédicteur progresse. Cette observation visuelle disqualifie immédiatement les modèles linéaires standards, dont la constance de la dérivée première se traduirait par un alignement rectiligne invariable des points de dispersion. De surcroît, le diagramme linéaire permet d’identifier qualitativement la présence d’hétéroscédasticité empirique, se manifestant sous la forme d’un écartement croissant des observations autour de la tendance centrale pour les valeurs élevées de la réponse.
Ce premier tracé graphique constitue également une étape critique pour la détection visuelle d’observations atypiques ou aberrantes (outliers). En raison de la rapidité d’élévation d’une fonction exponentielle, un point isolé possédant une abscisse élevée et une ordonnée disproportionnée exerce un effet de levier considérable sur les mécanismes d’ajustement. Repérer ces anomalies en amont de toute régression évite d’ajuster des modèles biaisés par des artefacts expérimentaux.
4.2 Inspection graphique par transformation semi-logarithmique
Bien que le diagramme linéaire permette d’observer la courbure globale du phénomène, il ne constitue pas une méthode probante pour discriminer de façon catégorique un profil exponentiel pur d’une trajectoire polynomiale de degré élevé ou d’une loi de puissance. L’outil analytique décisif lors de la phase exploratoire demeure le diagramme semi-logarithmique, obtenu en configurant l’axe vertical des ordonnées sur une échelle logarithmique au moyen de l’instruction plt.yscale('log').
Sur le plan mathématique, si la relation théorique sous-jacente respecte rigoureusement la forme $y = a \cdot \exp(k \cdot x)$, la projection de cette fonction sur un système d’axes où l’axe des ordonnées affiche $ln(y)$ tandis que l’axe des abscisses conserve son échelle linéaire transforme la trajectoire en une droite parfaite d’équation affine $\ln(y) = \ln(a) + k \cdot x$. Ainsi, si le nuage de points projeté sur le repère semi-logarithmique exhibe une distribution rectiligne uniforme, l’analyste dispose d’une confirmation empirique extrêmement solide quant à la validité de l’hypothèse de régression exponentielle.
Si, à l’inverse, le tracé semi-logarithmique révèle une courbure résiduelle persistante — par exemple une concavité dirigée vers le bas —, cette distorsion indique sans ambiguïté que le rythme d’accroissement effectif est inférieur à celui d’une exponentielle pure, suggérant plutôt l’implication d’une cinétique de type puissance ($y = a \cdot x^b$) ou l’émergence d’une saturation logistique naissante. Ce diagnostic visuel simple oriente de manière décisive le choix du formalisme fonctionnel avant d’engager les étapes d’optimisation numérique.
5. Étape 3 – Linéarisation logarithmique et ajustement par moindres carrés
5.1 Application de la transformation mathématique en Python
La première stratégie calculatoire pour accomplir une régression exponentielle consiste à transposer l’espace des données dans un domaine linéaire par l’application systématique du logarithme népérien. Sous l’environnement Python, cette transformation est exécutée à l’aide de la fonction vectorisée numpy.log(). Cette routine opère un calcul élément par élément optimisé sur les registres processeurs, assurant une vitesse de traitement optimale même sur des vecteurs massifs de plusieurs millions d’éléments.
Toutefois, avant de solliciter cette routine numérique, le statisticien doit impérativement exécuter une vérification logique d’intégrité sur le vecteur réponse. L’introduction d’une valeur nulle ou strictement négative dans np.log() déclenche un avertissement système d’invalidité numérique (RuntimeWarning: divide by zero encountered in log ou invalid value encountered in log) et génère des entités non exploitables de type -inf ou nan. Ces singularités mathématiques compromettent l’intégrité des calculs ultérieurs. Un filtrage booléen rigoureux doit donc garantir que seules les observations satisfaisant la condition $y_i > 0$ sont transmises à l’opérateur logarithmique.
Une fois la transformation menée à bien, le système d’équations reliant les variables s’établit selon la structure linéaire équivalente $z_i = \beta_0 + \beta_1 \cdot x_i$, où la nouvelle variable transformée $z_i = \ln(y_i)$ fait office de réponse linéaire, $\beta_0 = \ln(a)$ matérialise l’ordonnée à l’origine du plan transformé, et $\beta_1 = k$ représente la pente directement identifiable au taux continu originel. Le problème statistique est ainsi reformulé sous une forme canonique soluble par l’algèbre linéaire classique.
5.2 Ajustement polynomial de degré 1 avec numpy.polyfit
La résolution analytique du système linéaire ainsi constitué est prise en charge de manière robuste par la fonction numpy.polyfit(). En paramétrant le degré d’ajustement à l’unité deg=1, cette routine calcule la solution exacte du système des équations normales de Gauss par décomposition en valeurs singulières (SVD) ou factorisation QR de la matrice de Vandermonde associée aux observations $(x_i, \ln(y_i))$. Cette méthode garantit une stabilité numérique optimale, prévenant l’amplification des erreurs d’arrondi machine.
L’exécution de la commande renvoie un tableau contenant les deux coefficients optimaux de la droite transformée : la pente estimée $\hat{\beta}_1$ et l’ordonnée à l’origine transformée $\hat{\beta}_0$. L’étape décisive réside ensuite dans la conversion inverse exponentielle afin de recouvrer les paramètres originaux définissant le modèle non linéaire. Alors que le taux $k$ est immédiatement obtenu par identification directe $\hat{k} = \hat{\beta}_1$, l’amplitude originale $\hat{a}$ nécessite l’application de la fonction exponentielle inverse : $\hat{a} = \exp(\hat{\beta}_0)$ via la routine numpy.exp().
Il importe de réitérer que ces estimateurs minimisent la somme des carrés des erreurs résiduelles sur l’espace des logarithmes, c’est-à-dire $\sum (\ln(y_i) – \ln(\hat{y}_i))^2$, et non l’écart quadratique direct sur la série brute. Cette distinction conceptuelle implique que le modèle ainsi obtenu offre un ajustement optimal pour des données dont le bruit est proportionnel à l’amplitude du signal (erreur relative constante), mais s’avère biaisé si le mécanisme générateur d’erreurs réelles sous-jacent est un bruit blanc additif indépendant de la magnitude de la réponse.
6. Étape 4 – Régression non linéaire directe avec scipy.optimize.curve_fit
6.1 Définition de la fonction d’ajustement personnalisée
Pour s’affranchir des limitations et des biais structurels induits par la linéarisation logarithmique, l’approche préconisée en analyse non linéaire moderne consiste à modéliser directement les observations sur leur échelle d’origine. La pierre angulaire de ce processus sous Python réside dans l’utilisation de la fonction curve_fit intégrée au sous-module scipy.optimize. Cette démarche exige en tout premier lieu la définition explicite de la fonction objectif paramétrique représentant le modèle théorique.
Cette fonction utilisateur doit impérativement accepter en premier argument la variable indépendante vectorielle $x$, suivie individuellement de l’ensemble des paramètres scalaires dont l’optimiseur doit déterminer les valeurs optimales. Pour un modèle exponentiel standard, la signature s’articule sous la forme def modele_exponentiel(x, a, k):, renvoyant l’expression mathématique vectorisée a * np.exp(k * x). L’utilisation stricte d’opérateurs vectorisés NumPy au sein de cette fonction est indispensable : elle permet à l’optimiseur d’évaluer le modèle sur l’ensemble de la grille d’observation en un unique appel compilé en langage machine, accélérant considérablement les calculs itératifs.
Outre la définition mathématique de la trajectoire, il est hautement recommandé de fournir à l’algorithme une estimation initiale raisonnée des paramètres cibles par l’intermédiaire de l’argument p0. En l’absence de spécification explicite, curve_fit initialise par défaut tous les paramètres à la valeur scalaire 1.0. Dans le cadre de fonctions non linéaires hautement sensibles comme l’exponentielle, une telle valeur initiale peut s’avérer désastreusement éloignée du domaine de convergence, provoquant une divergence algorithmique précoce ou piégeant le solveur dans un optimum local aberrant. Une heuristique reconnue consiste précisément à utiliser les résultats dérivés de la linéarisation préliminaire par moindres carrés pour initialiser le vecteur p0 = [a_linearise, k_linearise].
6.2 Exécution de l’algorithme d’optimisation non linéaire
Une fois la fonction cible définie et les conditions initiales fixées, l’ajustement non linéaire est déclenché par l’appel de la fonction curve_fit(). En coulisses, l’algorithme met en œuvre une procédure d’optimisation itérative par moindres carrés non linéaires, s’appuyant par défaut sur l’algorithme de Levenberg-Marquardt (implémenté via le paquet MINPACK sous-jacent) lorsque le problème ne comporte aucune contrainte de bornes. Cet algorithme calcule continuellement le vecteur des résidus et la matrice jacobienne des dérivées partielles afin d’ajuster dynamiquement les paramètres jusqu’à satisfaire des critères stricts de convergence sur la tolérance relative de la fonction ou du gradient.
L’exécution de la routine renvoie un tuple fondamental composé de deux éléments : popt et pcov. Le premier objet, popt (pour parameter optimal values), est un tableau unidimensionnel regroupant les valeurs numériques convergées pour chaque paramètre du modèle, correspondant aux estimateurs d’amplitude $\hat{a}$ et de taux $\hat{k}$ minimisant la somme des carrés résiduels dans l’espace original. Le second objet, pcov, est la matrice de covariance estimée des paramètres ajustés. Cette matrice symétrique carrée fournit une information statistique de premier ordre : les éléments situés sur sa diagonale principale représentent les variances asymptotiques d’échantillonnage de chaque estimateur, tandis que les éléments hors diagonale quantifient leurs covariances mutuelles.
À partir de cette matrice de dispersion pcov, il devient trivial d’extraire les erreurs-types asymptotiques associées aux estimateurs. Celles-ci s’obtiennent en calculant la racine carrée des éléments diagonaux via l’instruction vectorisée perr = np.sqrt(np.diag(pcov)). Ces erreurs-types constituent la base nécessaire à l’établissement des intervalles de confiance statistiques et à la conduite de tests d’hypothèses visant à évaluer la significativité du taux de croissance au regard des standards d’inférence de Wald.
6.3 Définition des bornes de contrainte sur les paramètres
L’optimisation mathématique sans contraintes présente parfois le risque de converger vers des solutions formellement valides au sens des moindres carrés mais dépourvues de sens physique ou théorique, telles qu’une amplitude négative pour un phénomène biologique ou un taux de décroissance instable. Pour conjurer ces dérives, la routine curve_fit autorise l’encadrement strict de l’espace de recherche grâce au passage de l’argument bounds. Ce paramètre se matérialise sous la forme d’un tuple de deux séquences fixant respectivement les bornes inférieures et supérieures autorisées pour chaque paramètre, par exemple bounds=(0, [np.inf, 5.0]) pour imposer la stricte positivité de l’amplitude $a$ tout en limitant le taux $k$ à un plafond de 5,0.
L’activation de contraintes de bornes entraîne une modification fondamentale du moteur d’optimisation sous-jacent. L’algorithme standard de Levenberg-Marquardt ne supportant pas nativement les frontières d’inégalité, curve_fit bascule automatiquement vers l’algorithme Trust Region Reflective (TRF). Cet algorithme sophistiqué gère les frontières en définissant des régions de confiance ellipsoidales et en appliquant des réflexions directionnelles au vecteur d’incrément chaque fois qu’une itération heurte l’une des limites imposées à l’espace des paramètres.
Cette approche sécurise remarquablement l’invariance physique des modèles en prévenant les excursions dans des régimes numériques susceptibles de provoquer des dépassements d’arithmétique flottante (overflow). Toutefois, ce surcroît de robustesse s’accompagne d’un coût calculatoire légèrement supérieur en nombre d’évaluations de fonctions par itération et peut masquer des problèmes sous-jacents de spécification du modèle : si l’estimateur final se retrouve collé sur une borne artificielle, cela indique généralement que le formalisme mathématique choisi est inadéquat pour décrire fidèlement le jeu de données considéré.
7. Étape 5 – Évaluation statistique et quantification de la qualité d’ajustement
7.1 Calcul et interprétation du coefficient de détermination (R²)
La quantification de la performance explicative d’un modèle statistique ajusté passe conventionnellement par le calcul du coefficient de détermination, universellement désigné sous le symbole $R^2$. Sur le plan computationnel, ce score s’obtient à partir de deux grandeurs fondamentales : la somme des carrés des erreurs résiduelles ($SS_{\text{res}}$), qui mesure la dispersion des observations empiriques autour de la courbe ajustée, et la somme totale des carrés ($SS_{\text{tot}}$), qui quantifie la dispersion intrinsèque des données autour de leur moyenne empirique globale $\bar{y}$ :
$$SS_{\text{res}} = \sum_{i=1}^n (y_i – \hat{y}_i)^2 \quad \text{et} \quad SS_{\text{tot}} = \sum_{i=1}^n (y_i – \bar{y})^2$$
Le coefficient s’évalue alors selon la relation d’homologie $R^2 = 1 – (SS_{\text{res}} / SS_{\text{tot}})$, opération que l’on peut exécuter directement en Python ou déléguer à la fonction spécialisée r2_score du module sklearn.metrics de Scikit-Learn.
Cependant, une mise en garde méthodologique majeure s’impose quant à l’interprétation du coefficient $R^2$ appliqué aux architectures de régression non linéaire. Dans le cadre de la régression linéaire standard estimée par moindres carrés ordinaires avec constante, le théorème de Pythagore garantit que la somme totale des carrés se décompose exactement en la somme des carrés expliqués et la somme des carrés résiduels ($SS_{\text{tot}} = SS_{\text{reg}} + SS_{\text{res}}$), contraignant mathématiquement le ratio $R^2$ à osciller rigoureusement dans l’intervalle fermé $[0, 1]$. Dans l’univers de la modélisation non linéaire, cette orthogonalité fondamentale entre le vecteur des résidus et le sous-espace des prédictions n’est plus satisfaite.
En conséquence, le calcul formel du $R^2$ sur un modèle non linéaire peut exhiber des comportements pathologiques, voire générer des valeurs négatives lorsque la performance prédictive de la fonction ajustée s’avère pire que celle consistant à prédire systématiquement la simple moyenne arithmétique de l’échantillon. Ainsi, bien que le $R^2$ demeure un indice synthétique largement réclamé par les comités de lecture académiques pour son intuitivité, il ne doit jamais être utilisé comme l’unique arbitre de la validité d’un ajustement exponentiel, sous peine d’induire en erreur le diagnostic expérimental.
7.2 Métriques d’erreur absolue et quadratique
Pour contourner les limites structurelles et les paradoxes d’interprétation du coefficient de détermination dans les espaces non linéaires, l’analyse prédictive privilégie des métriques d’erreur absolues calculées directement sur l’échelle dimensionnelle originelle du système étudié. Deux indices prévalent : l’erreur quadratique moyenne (Root Mean Squared Error ou RMSE) et l’erreur absolue moyenne (Mean Absolute Error ou MAE). Leurs définitions mathématiques respectives s’énoncent comme suit :
$$\text{RMSE} = \sqrt{\frac{1}{n} \sum_{i=1}^n (y_i – \hat{y}_i)^2} \quad \text{et} \quad \text{MAE} = \frac{1}{n} \sum_{i=1}^n |y_i – \hat{y}_i|$$
Sous Python, ces métriques s’implémentent de manière concise et optimisée à l’aide des opérations matricielles vectorisées de NumPy :
rmse = np.sqrt(np.mean((y_observe - y_predit)**2))
mae = np.mean(np.abs(y_observe - y_predit))
Ces deux métriques incarnent des philosophies complémentaires vis-à-vis de la pénalisation des écarts résiduels. En élevant les erreurs individuelles au carré avant d’opérer la moyenne, la RMSE accorde un poids disproportionné aux écarts de grande magnitude. Cette caractéristique la rend particulièrement sensible aux déviations intervenant dans les zones de forte amplitude d’une cinétique exponentielle, où une erreur absolue modérée en proportion peut peser lourdement sur le bilan numérique global. À l’opposé, la MAE pénalise les déviations de manière strictement linéaire, offrant une estimation d’erreur globale plus robuste face aux points aberrants sporadiques et reflétant l’écart typique attendu entre une observation empirique et la trajectoire théorique sous-jacente.
7.3 Critères d’information pour la sélection de modèles
L’évaluation rigoureuse d’un modèle statistique ne saurait se limiter à sa capacité d’ajustement aux données ayant servi à son entraînement, sous peine de favoriser systématiquement des architectures sur-paramétrées sujettes au surapprentissage (overfitting). La sélection objective entre différents modèles compétitifs repose sur l’emploi des critères de parcimonie informationnelle, au premier rang desquels se placent le critère d’information d’Akaike (AIC) et le critère d’information bayésien de Schwarz (BIC). Ces indicateurs quantifient la perte relative d’information statistique tout en introduisant une pénalisation explicite proportionnelle à la complexité structurelle du modèle, mesurée par son nombre de paramètres libres $p$.
Dans le cadre des modèles de régression non linéaire dont les erreurs aléatoires sont distribuées normalement avec une variance homogène, les formulations de ces critères se dérivent directement à partir de la somme résiduelle des carrés selon les équations canoniques suivantes :
$$\text{AIC} = n \cdot \ln\left(\frac{SS_{\text{res}}}{n}\right) + 2p \quad \text{et} \quad \text{BIC} = n \cdot \ln\left(\frac{SS_{\text{res}}}{n}\right) + p \cdot \ln(n)$$
où $n$ désigne l’effectif total de l’échantillon d’observations et $p$ le nombre total de paramètres estimés par le modèle (en intégrant le terme de variance d’erreur dans le compte formel des degrés de liberté).
Lors de la comparaison d’un modèle exponentiel ($p = 2$ ou $p = 3$ si une asymptote non nulle est introduite) avec une régression polynomiale de degré arbitraire ou un modèle de loi de puissance, le modèle présentant la valeur numérique d’AIC ou de BIC la plus faible est considéré comme le modèle théorique optimal. Le BIC applique une pénalité logarithmique $ln(n)$ sensiblement plus sévère à l’encontre de la dimension paramétrique lorsque la taille de l’échantillon s’accroît, réduisant considérablement le risque de retenir des architectures arbitrairement complexes au détriment de la parcimonie explicative.
8. Étape 6 – Visualisation graphique avancée et inférence visuelle
8.1 Tracé de la courbe de prédiction continue
Une erreur fréquente lors de la restitution graphique d’un ajustement non linéaire consiste à relier par des segments rectilignes les prédictions calculées uniquement aux abscisses des points expérimentaux originaux. Si l’échantillonnage temporel est espacé ou irrégulier, cette pratique engendre des cassures visuelles qui trahissent la fluidité courbée intrinsèque à la fonction exponentielle. Pour obtenir un rendu visuel digne des publications scientifiques de référence, il convient de générer une grille de prédiction artificielle continue et dense.
Sous Python, cette opération est exécutée en instanciant un vecteur d’abscisses de haute résolution au moyen de l’instruction x_dense = np.linspace(x.min(), x.max(), 500). Ce vecteur synthétique de cinq cents coordonnées est ensuite injecté dans la fonction de modélisation paramétrée par les coefficients optimaux extraits de l’optimiseur : y_pred = modele_exponentiel(x_dense, *popt). Cette démarche assure la continuité graphique absolue de la courbe théorique projetée sur le canevas d’affichage.
La composition de la figure finale sous Matplotlib obéit à des règles esthétiques et ergonomiques rigoureuses. Les observations empiriques réelles doivent être représentées par des marqueurs discrets (plt.scatter ou plt.plot avec marqueurs sans liaison linéaire) afin de matérialiser clairement la granularité de l’échantillonnage et la dispersion aléatoire. Par-dessus ce nuage s’articule la courbe continue, mise en valeur par un contraste chromatique franc et une épaisseur de ligne affirmée. Enfin, la lisibilité scientifique du graphique est parachevée par l’adjonction de labels typographiques enrichis de syntaxe mathématique LaTeX pour les axes, d’une légende explicitant les modèles comparés et, idéalement, d’un cartouche textuel rapportant avec rigueur les valeurs des estimateurs optimaux accompagnées de leurs incertitudes d’échantillonnage respectives.
8.2 Estimation et tracé des bandes de confiance statistiques
L’estimation ponctuelle d’une trajectoire médiane demeure incomplète si elle ne s’accompagne pas d’une quantification visuelle de l’incertitude pesant sur l’ajustement fonctionnel. Le tracé d’intervalles ou de bandes de confiance à 95 % autour de la courbe moyenne permet d’appréhender visuellement les zones du domaine prédictif où les paramètres sont solidement contraints par les données, et celles où la dispersion ou la rareté de l’échantillonnage élargit le faisceau des trajectoires théoriquement admissibles.
Dans le domaine non linéaire, la propagation de l’incertitude des estimateurs $\hat{\theta} = [\hat{a}, \hat{k}]$ vers la fonction prédictive $f(x, \hat{\theta})$ s’établit par l’intermédiaire de la méthode delta, reposant sur une linéarisation locale de premier ordre par développement en série de Taylor autour de l’optimum. La variance de la réponse moyenne prédite pour une coordonnée $x$ donnée se calcule matriciellement selon l’équation de projection suivante :
$$\sigma^2_{\hat{y}}(x) \approx \nabla_\theta f(x, \hat{\theta})^T \cdot \Sigma_\theta \cdot \nabla_\theta f(x, \hat{\theta})$$
où $\nabla_\theta f(x, \hat{\theta}) = \left[ \frac{\partial f}{\partial a}, \frac{\partial f}{\partial k} \right]^T = \left[ \exp(k \cdot x), a \cdot x \cdot \exp(k \cdot x) \right]^T$ représente le vecteur du gradient des dérivées partielles par rapport aux paramètres évalué en $\hat{\theta}$, et $\Sigma_\theta$ correspond directement à la matrice de covariance asymptotique pcov retournée par curve_fit.
Après avoir calculé l’écart-type prédictif local $\sigma_{\hat{y}}(x)$ pour l’ensemble des points constituant la grille d’interpolation dense, les limites de l’intervalle de confiance à 95 % s’obtiennent en appliquant le facteur critique tabulé de Student ou de Gauss ($y_{\text{\sup, \inf}} = \hat{y} \pm 1.96 \cdot \sigma_{\hat{y}}$). La matérialisation graphique de cette incertitude paramétrique s’exécute avec élégance sous Matplotlib au moyen de la méthode plt.fill_between(x_dense, y_inf, y_sup, alpha=0.2), projetant un voile translucide autour de la fonction centrale sans jamais occulter la visibilité des données expérimentales sous-jacentes.
9. Analyse rigoureuse des résidus et validation des hypothèses
9.1 Calcul et visualisation du nuage des résidus
L’obtention d’un coefficient de détermination proche de l’unité ou d’une courbe en apparence harmonieuse ne dispense en aucun cas d’un audit approfondi du comportement des erreurs résiduelles. Le résidu empirique, formellement défini par la différence algébrique entre l’observation brute et la valeur théorique calculée par le modèle $e_i = y_i – \hat{y}_i$, matérialise la portion de variance que le formalisme mathématique n’a pas été capable d’absorber. Une régression est réputée statistiquement recevable si et seulement si ses résidus se comportent comme un bruit blanc stochastique dénué de tout motif informatif structuré.
Le diagnostic fondamental repose sur la construction graphique du diagramme de dispersion des résidus bruts tracés en fonction des valeurs prédites $\hat{y}_i$ (ou en fonction de l’abscisse $x_i$). Dans une configuration conforme aux hypothèses de Gauss-Markov, le nuage de résidus doit former une bande horizontale symétrique et homogène, centrée rigoureusement sur l’axe zéro, sans dérive ascendante ou descendante visible.
Deux pathologies structurelles fréquentes sont régulièrement mises en lumière par ce tracé :
- La violation d’homoscédasticité (hétéroscédasticité) : Elle se manifeste visuellement par un profil en entonnoir (fanning out), où l’amplitude de dispersion des résidus croît proportionnellement à la grandeur des valeurs prédites. Ce schéma récurrent dans les cinétiques exponentielles atteste que l’erreur de mesure réelle est multiplicative et non additive, requérant l’emploi de moindres carrés pondérés ou d’une transformation logarithmique stabilisatrice de variance.
- Le défaut de spécification fonctionnelle : Si les résidus affichent une oscillation systématique en U ou une courbure parabolique cohérente, le modèle exponentiel pur est empiriquement réfuté. Une telle déviation révèle que la vitesse d’accélération ou d’amortissement réelle dérive du postulat exponentiel élémentaire et commande l’adjonction d’un terme polynomial d’ajustement ou d’un paramètre d’asymptote horizontale.
9.2 Tests de normalité et d’indépendance statistique
Au-delà du diagnostic visuel exploratoire, la validation statistique des inférences (notamment la légitimité des erreurs-types asymptotiques et des intervalles de confiance) exige la mise en œuvre de tests d’hypothèses formels portant sur les propriétés distributionnelles des résidus. La première condition à auditer concerne la normalité de ces perturbations. L’investigation visuelle débute par le tracé d’un diagramme Quantile-Quantile (Q-Q plot), réalisable via la routine scipy.stats.probplot, qui juxtapose la distribution empirique des résidus standardisés aux quantiles théoriques d’une loi normale univariée standard.
Ce contrôle visuel est formellement complété par l’exécution du test de Shapiro-Wilk au moyen de la fonction scipy.stats.shapiro(residus). Ce test statistique évalue l’hypothèse nulle $H_0$ selon laquelle l’échantillon résiduel est issu d’une population parente distribuée normalement. L’obtention d’une p-valeur inférieure au seuil alpha conventionnel de 0,05 conduit au rejet de l’hypothèse de normalité. Un tel résultat signale que les intervalles de confiance asymptotiques issus de curve_fit sous-estiment l’incertitude réelle et suggère le recours à des protocoles de rééchantillonnage non paramétriques de type bootstrap pour quantifier rigoureusement la variabilité des estimateurs.
La seconde condition fondamentale concerne l’indépendance mutuelle des erreurs aléatoires. Dans les séries temporelles ou spatiales ordonnées, les perturbations subissent fréquemment des phénomènes de mémoire ou de rémanence appelés autocorrélation sérielle. Pour diagnostiquer cette pathologie, on utilise classiquement la statistique de Durbin-Watson, dont l’implémentation est disponible dans le module statsmodels.stats.stattools.durbin_watson. Cette statistique prend des valeurs comprises dans l’intervalle $[0, 4]$. Une valeur proche du pivot central de 2 confirme l’absence d’autocorrélation linéaire d’ordre 1, tandis qu’une valeur convergeant vers 0 met en lumière une autocorrélation sérielle positive marquée, invalidant le postulat d’indépendance des observations et faussant l’estimation des matrices de covariance.
10. Modélisation de la décroissance exponentielle : Application à la mémoire
10.1 Contextualisation comportementale : La courbe de l’oubli d’Ebbinghaus
L’un des terrains d’application les plus fertiles et historiquement significatifs de la modélisation par décroissance exponentielle réside dans l’étude des processus mnésiques au sein des sciences psychologiques et cognitives. En 1885, le psychologue expérimental allemand Hermann Ebbinghaus publia une monographie fondatrice consignant des années d’auto-expérimentations rigoureuses sur l’assimilation et la dégradation temporelle de séries de syllabes dépourvues de signification phonétique ou sémantique. Ses observations empiriques mirent en lumière un profil de dissipation temporelle du souvenir d’une régularité mathématique stupéfiante.
Le formalisme quantitatif moderne exprime couramment cette loi d’oubli sous la forme d’une décroissance exponentielle négative de la force de rétention mnésique en fonction du temps écoulé depuis la phase d’apprentissage initial :
$$R(t) = a \cdot \exp(-k \cdot t) + c \quad \text{ou} \quad R(t) = a \cdot \exp\left(-\frac{t}{S}\right)$$
Dans ce modèle neurocognitif, la variable dépendante $R(t)$ représente le score de rétention ou l’indice d’économie à la ré-assimilation, tandis que la variable $t$ désigne l’intervalle de rétention chronologique. Le paramètre $a$ désigne le niveau d’accessibilité immédiate de l’information stockée dans la mémoire de travail à l’issue immédiate de la session d’acquisition ($t=0$). La constante $k$ s’interprète phénoménologiquement comme le taux d’attrition ou de dégradation de la trace cérébrale mnésique par unité de temps, dont l’inverse $S = 1/k$ matérialise la stabilité ou la solidité structurelle du souvenir au sein du réseau synaptique. L’éventuelle constante additive $c$ traduit l’existence d’une fraction résiduelle d’information transférée de façon permanente vers la mémoire épisodique ou sémantique à long terme, insensible à l’érosion temporelle ultérieure.
10.2 Implémentation complète en Python sur données de rétention
La transcription computationnelle de l’expérience d’Ebbinghaus sous Python permet d’illustrer la chaîne de traitement complète appliquée à un cas concret de décroissance. Pour ce faire, on synthétise un tableau d’intervalles de réévaluation s’échelonnant typiquement de vingt minutes à un mois complet (converti sur une base temporelle homogène en heures ou en jours), auquel on associe les taux moyens de reconnaissance observés lors des phases de rappel expérimental, altérés par un bruit de dispersion interindividuelle.
L’ajustement du modèle à décroissance requiert une vigilance particulière lors de l’écriture de la fonction cible transmise à curve_fit. Le taux d’atténuation étant structurellement orienté vers une dissipation, on paramètre la fonction soit en explicitant le signe négatif dans l’opérateur exponentiel a * np.exp(-k * t) avec une contrainte de positivité sur $k$, soit en autorisant l’optimiseur à converger vers une valeur de $k$ négative. La spécification de bornes inférieures strictes $k > 0$ et $0 le a le 100$ (dans le cadre d’un rappel exprimé en pourcentage) s’avère particulièrement efficace pour contraindre l’algorithme à converger vers une solution cognitivement interprétable.
L’exploitation des paramètres convergés débouche directement sur le calcul de métriques psychophysiques d’intérêt majeur. En appliquant la formulation déduite de l’invariance temporelle, la demi-vie du souvenir se calcule instantanément via l’expression analytique $T_{1/2} = \ln(2) / \hat{k}$. Sur le plan théorique, cette constante temporelle indique avec précision le délai au terme duquel la probabilité de rappel spontané d’un item appris est exactement réduite de moitié. Cette approche quantitative permet de mesurer scientifiquement l’efficacité différentielle de protocoles d’apprentissage, par exemple en démontrant que la répétition espacée dans le temps a pour conséquence directe de réduire drastiquement la constante $k$, augmentant ainsi la demi-vie de consolidation de la trace mnésique.
11. Dépannage, singularités numériques et pièges méthodologiques
11.1 Gestion des problèmes de non-convergence et choix des valeurs initiales
L’un des écueils les plus récurrents rencontrés lors de l’ajustement d’un modèle exponentiel via la fonction curve_fit se manifeste par l’interruption inopinée de l’exécution, assortie de l’exception RuntimeError: Optimal parameters not found: Number of calls to function has reached maxfev. Cet échec signifie sans équivoque que le solveur non linéaire a consommé la totalité de son quota d’itérations alloué sans réussir à satisfaire les critères de convergence sur la tolérance relative du gradient ou de la fonction de coût résiduelle.
Dans l’immense majorité des cas, cette anomalie ne provient pas d’une défaillance intrinsèque de la bibliothèque computationnelle, mais d’une mauvaise initialisation du vecteur des paramètres de départ p0. Lorsque la fonction exponentielle opère sur des ordres de grandeur d’abscisses éloignés de zéro, une estimation initiale arbitraire peut placer l’état de l’algorithme dans une zone d’extrême platitude fonctionnelle (gradient quasi-nul) ou, à l’inverse, dans une zone de pente quasi-infinie provoquant des dépassements de registres en virgule flottante. Pour dériver une approximation initiale robuste de façon automatisée, on implémente avantageusement une heuristique déterministe basée sur les extrema des données ou sur le résultat d’une pré-estimation logarithmique MCO expédiée sur deux points d’ancrage robustes (par exemple le 10ème et le 90ème centiles du jeu de données).
Si la non-convergence persiste malgré une initialisation soignée, plusieurs leviers d’action numériques peuvent être activés :
- Augmenter explicitement le plafond maximal d’évaluations de la fonction en renseignant le paramètre
maxfev=10000au sein de l’appel àcurve_fit. - Ajuster les hyperparamètres de tolérance relative
ftoletxtolà des seuils légèrement plus permissifs (par exemple $10^{-6}$ au lieu de la précision machine native de $10^{-8}$), notamment lorsque les données empiriques sont affectées d’un niveau de bruit stochastique particulièrement prononcé empêchant une stabilisation fine. - Rééchelonner la variable prédictive : si $x$ représente des millésimes chronologiques élevés (ex. 2000 à 2024), effectuer un changement de variable par centrage $x’ = x – x_{\min}$ afin d’éviter que l’exponentielle n’évalue des puissances hors de portée de l’arithmétique standard.
11.2 Impact des valeurs négatives ou nulles dans les séries de données
La présence de valeurs nulles ou négatives au sein de la série des observations $y_i$ constitue un défi d’ordre théorique et computationnel. D’un point de vue analytique strict, une fonction exponentielle pure $y = a \cdot \exp(k \cdot x)$ admettant une amplitude strictement positive $a > 0$ demeure strictement supérieure à zéro sur l’intégralité du corps des nombres réels, présentant une asymptote horizontale en $y = 0$ lorsque l’argument exponentiel diverge vers $-\infty$. Par conséquent, la survenue empirique d’un zéro ou d’une valeur négative ne peut résulter que de deux causes : soit le phénomène réel sous-jacent incorpore un bruit de mesure additif dont la fluctuation stochastique franchit ponctuellement l’axe zéro, soit le système physique converge vers une asymptote d’équilibre non nulle négative.
Une tentation empirique fréquente consiste à appliquer une translation artificielle arbitraire aux données au moyen d’une constante de décalage positive $c$, calculant $\ln(y_i + c)$ afin de forcer l’admissibilité du vecteur dans le cadre d’une linéarisation logarithmique. Cette pratique est méthodologiquement pernicieuse : l’adjonction de cette constante déforme irrémédiablement la courbure relative du signal d’origine, modifiant artificiellement le taux de croissance estimé et violant les propriétés d’invariance d’échelle intrinsèques à la fonction exponentielle.
La résolution rigoureuse de cette singularité impose d’abandonner définitivement toute tentative de linéarisation logarithmique sur les séries concernées et d’adopter exclusivement l’optimisation non linéaire directe par curve_fit. Cette méthode opère sans encombre sur des points négatifs dès lors que la fonction résiduelle $(y_i – \hat{y}_i)^2$ demeure parfaitement différentiable en tout point. Si les données manifestent une dérive asymptotique stable non centrée sur zéro, il devient indispensable d’amender l’architecture fonctionnelle elle-même en adoptant un modèle exponentiel à trois paramètres : $f(x, a, k, c) = a \cdot \exp(k \cdot x) + c$, où la constante $c$ est directement estimée conjointement par l’algorithme d’optimisation.
11.3 Sensibilité extrême aux points aberrants et régression robuste
En vertu de l’accélération mathématique continue caractérisant les cinétiques exponentielles, les estimateurs issus des moindres carrés traditionnels présentent une vulnérabilité critique face à la présence de points de mesure aberrants situés aux extrémités de la distribution. Dans un protocole standard minimisant la somme des carrés résiduels, un point divergent localisé dans la zone terminale de forte magnitude développe un résidu absolu considérable ; son élévation au carré confère à cette observation unique un effet de levier (leverage) disproportionné, capable à lui seul de dévier arbitrairement la trajectoire du modèle et d’annihiler la précision de l’estimation sur l’ensemble de la phase initiale.
Pour immuniser l’ajustement non linéaire contre ce risque de distorsion, il convient de substituer à la perte quadratique standard des fonctions de coût robustes, conçues pour réduire l’influence marginale des écarts excessifs. Cette modification s’exécute de façon transparente au sein de scipy.optimize.curve_fit grâce à l’argument loss, conjointement avec le passage au solveur d’optimisation par région de confiance method='trf'.
Plusieurs formulations de fonctions de coût robustes sont nativement supportées par SciPy :
- La perte de Huber (
loss='huber') : Cette approche se comporte comme une fonction quadratique classique pour les résidus de faible amplitude situés à l’intérieur d’un seuil prédéfini, puis commute de manière fluide vers une pénalisation strictement linéaire pour les écarts excédentaires, tempérant radicalement l’effet d’entraînement des observations aberrantes. - La perte de Cauchy (
loss='cauchy') ou perte sécante : Cette fonction de coût applique une pénalisation logarithmique progressive $\ln(1 + r^2)$ qui sature rapidement pour les résidus massifs, permettant au modèle de s’ajuster avec une remarquable stabilité sur la masse centrale des données en ignorant quasi totalement les anomalies extrêmes. - La perte Soft L1 (
loss='soft_l1') : Offrant une approximation lisse et continuellement différentiable de la norme $L_1$ absolue, elle garantit un compromis d’une grande stabilité analytique pour les systèmes soumis à des distributions de bruits caractérisées par des queues lourdes.
12. Comparaison de modèles et extensions avancées
12.1 Arbitrage entre modèles exponentiel, polynomial et puissance
Dans la pratique scientifique, l’analyste se trouve rarement confronté à l’obligation dogmatique d’ajuster un unique modèle prédéfini ; la tâche consiste bien plutôt à arbitrer scientifiquement entre plusieurs hypothèses fonctionnelles concurrentes aptes à rendre compte d’une accélération morphologiquement similaire. Trois classes fonctionnelles dominent l’analyse descriptive non linéaire : le modèle exponentiel pur $y = a \cdot \exp(k \cdot x)$, le modèle de loi de puissance $y = a \cdot x^b$, et le modèle polynomial d’ordre deux $y = a \cdot x^2 + b \cdot x + c$. Bien que ces trois trajectoires puissent paraître indiscernables sur une fenêtre d’échantillonnage étroite, leurs extrapolations asymptotiques divergent radicalement.
Pour trancher objectivement entre ces formulations théoriques, on procède à l’ajustement simultané des trois modèles sur le même jeu d’observations empiriques via scipy.optimize.curve_fit. Une fois la convergence atteinte pour chacun, on déploie une grille d’évaluation statistique multicritère combinant la RMSE de précision brute et les critères pénalisés d’information AIC et BIC détaillés au sein de la section 7.3. Le tableau synoptique suivant illustre la structure méthodologique d’une telle confrontation empirique :
- Modèle exponentiel ($y = a \cdot e^{kx}$) : Paramètres estimés = 2. Taux de variation proportionnel au niveau instantané. Signature théorique : alignement rectiligne parfait en coordonnées semi-logarithmiques ($ln(y)$ vs $x$).
- Loi de puissance ($y = a \cdot x^b$) : Paramètres estimés = 2. Élasticité constante entre les variations relatives des deux grandeurs. Signature théorique : alignement rectiligne parfait en coordonnées log-log ($ln(y)$ vs $ln(x)$).
- Polynôme quadratique ($y = a \cdot x^2 + bx + c$) : Paramètres estimés = 3. Accélération constante sans invariance multiplicative. Signature théorique : alignement rectiligne de la dérivée première par rapport à $x$.
L’observation d’un écart d’AIC supérieur à 10 unités ($\Delta\text{AIC} > 10$) en faveur du modèle exponentiel permet de récuser catégoriquement les structures polynomiales ou de puissance concurrentes, apportant la confirmation statistique que le mécanisme générateur sous-jacent obéit bel et bien à une cinétique d’auto-amplification proportionnelle.
12.2 Automatisation avec Scikit-Learn et pipelines de transformation
L’intégration de la régression exponentielle au sein d’environnements prédictifs industriels ou de flux de travail d’apprentissage automatique contemporains impose d’automatiser les transformations mathématiques et de se conformer aux interfaces logicielles standardisées. Bien que l’écosystème Scikit-Learn ne propose pas d’estimateur non linéaire fondé sur curve_fit dans son architecture native, il met à disposition un méta-estimateur d’une remarquable élégance conceptuelle pour encapsuler les régressions linéarisées : le TransformedTargetRegressor.
Ce module encapsule un algorithme de régression linéaire de base — tel que LinearRegression, Ridge ou Lasso — en lui appliquant automatiquement une transformation fonctionnelle sur la variable dépendante $y$ en amont de l’ajustement, tout en inversant automatiquement cette opération lors de la phase d’inférence prédictive via la méthode predict(). L’architecture se configure en spécifiant explicitement les fonctions de transformation directe et réciproque, soit func=np.log et inverse_func=np.exp. Cette conception garantit une étanchéité parfaite des calculs et élimine tout risque de fuite de données (data leakage) lors de la manipulation des cibles numériques.
L’avantage décisif de cette intégration réside dans la possibilité d’insérer ce méta-estimateur au sein d’un Pipeline Scikit-Learn complet, incorporant des étapes en amont de normalisation des prédicteurs (StandardScaler) ou de sélection d’attributs. De surcroît, cette harmonisation logicielle autorise l’application directe des protocoles de validation croisée k-fold (k-fold cross-validation) via la fonction cross_val_score. L’analyste peut ainsi évaluer la capacité de généralisation réelle de son modèle exponentiel sur des plis de données indépendants et optimiser les hyperparamètres de régularisation dans un cadre statistique formel, industrialisable et hautement reproductible.
Références
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716-723. https://doi.org/10.1109/TAC.1974.1100705
Bates, D. M., & Watts, D. G. (1988). Nonlinear regression analysis and its applications. John Wiley & Sons.
Ebbinghaus, H. (1885). Über das Gedächtnis: Untersuchungen zur experimentellen Psychologie. Duncker & Humblot.
Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
Levenberg, K. (1944). A method for the solution of certain non-linear problems in least squares. Quarterly of Applied Mathematics, 2(2), 164-168. https://doi.org/10.1090/qam/10666
Marquardt, D. W. (1963). An algorithm for least-squares estimation of nonlinear parameters. Journal of the Society for Industrial and Applied Mathematics, 11(2), 431-441. https://doi.org/10.1137/0111030
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830.
Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461-464. https://doi.org/10.1214/aos/1176344136
Seber, G. A. F., & Wild, C. J. (2003). Nonlinear regression. John Wiley & Sons.
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2