
L’analyse statistique moderne et la modélisation prédictive se heurtent fréquemment à l’écueil de la redondance informationnelle, tout particulièrement au sein des disciplines empiriques telles que les sciences psychologiques, les neurosciences comportementales et la biométrie. Lorsque l’investigateur déploie des batteries de tests exhaustives comprenant des dizaines ou des centaines d’indicateurs psychométriques, les variables explicatives manifestent inévitablement des interdépendances structurelles intenses. Ce phénomène de corrélation mutuelle, qualifié de multicolinéarité dans le paradigme linéaire classique, altère dramatiquement la stabilité numérique des estimateurs issus des moindres carrés ordinaires. Les erreurs-types des coefficients régressifs enflent de manière disproportionnée, détruisant la puissance inférentielle des tests d’hypothèses et conduisant parfois à des aberrations interprétatives majeures, telles que l’inversion contre-intuitive de signes théoriquement établis.
Face à cette dégénérescence matricielle, la tentation historique de procéder à une sélection pas à pas (stepwise selection) ou à l’élimination arbitraire de prédicteurs introduit des biais d’omission substantiels, compromettant la reproductibilité des inférences scientifiques. C’est précisément au confluent de l’analyse multivariée exploratoire et de l’économétrie prédictive que s’impose la régression sur composantes principales (Principal Components Regression, ou PCR). Conçue pour surmonter l’instabilité induite par la quasi-singularité des matrices de covariance, la PCR conjugue la décomposition spectrale de l’analyse en composantes principales (ACP) à la rigueur paramétrique du modèle linéaire généralisé. En projetant l’espace originel des variables prédictives vers un sous-espace orthogonal de dimension réduite, cette méthodologie neutralise intégralement la colinéarité tout en préservant le maximum de variance informative.
Le présent traité propose une immersion théorique, méthodologique et computationnelle dans l’architecture de la régression sur composantes principales au sein de l’environnement statistique R. À travers un protocole pas à pas exhaustif, nous disséquerons les fondements mathématiques sous-tendant l’effondrement des moindres carrés conventionnels, la mécanique de diagonalisation des matrices de dispersion, l’implémentation opérationnelle via le package spécialisé pls, ainsi que les critères stricts de validation croisée présidant à l’arbitrage entre biais et variance. Destiné aux chercheurs, biostatisticiens et data scientists confrontés à des données comportementales complexes, ce guide articule rigueur formelle, interprétabilité psychométrique et impératifs de reproductibilité computationnelle selon les standards les plus exigeants de la science ouverte.
1. Fondements de la régression linéaire et écueils de la multicolinéarité
1.1 Principe des moindres carrés ordinaires (MCO) et résidus
L’estimation des paramètres au sein du modèle de régression linéaire multiple repose traditionnellement sur la méthode des moindres carrés ordinaires (MCO), dont la vocation est de minimiser la somme des carrés des résidus (Residual Sum of Squares, RSS). Dans une formulation matricielle canonique où le vecteur des observations de la variable réponse est désigné par $Y in \mathbb{R}^n$ et la matrice des prédicteurs par $X in \mathbb{R}^{n \times p}$, le vecteur des coefficients de régression $\beta in \mathbb{R}^p$ est déterminé en résolvant le problème d’optimisation quadratique suivant :
$$\min_{\beta} | Y – X\beta |_2^2 = \min_{\beta} (Y – X\beta)^T (Y – X\beta)$$
La dérivation analytique de cette fonctionnelle par rapport au vecteur $\beta$ conduit au système d’équations normales :
$$X^T X \beta = X^T Y$$
Pourvu que la matrice de dispersion empirique $X^T X$ soit inversible (c’est-à-dire de plein rang de colonnes, $\text{rang}(X) = p$), l’unique estimateur des moindres carrés s’exprime sous la forme fermée universelle :
$$\hat{\beta} = (X^T X)^{-1} X^T Y$$
Sous l’égide du théorème de Gauss-Markov, cet estimateur jouit des propriétés remarquables d’être sans biais et de variance minimale parmi l’ensemble des estimateurs linéaires sans biais (propriété BLUE : Best Linear Unbiased Estimator). Ce théorème postule formellement l’espérance conditionnelle nulle des perturbations stochastiques ($\mathbb{E}[\varepsilon | X] = 0$), une structure de variance scalaire caractérisée par l’homoscédasticité et l’absence d’autocorrélation ($\text{Var}(\varepsilon | X) = \sigma^2 I_n$), ainsi que le caractère déterministe ou strictement exogène des régresseurs incorporés dans la matrice de conception $X$.
Néanmoins, l’optimalité théorique de Gauss-Markov dépend de manière critique du conditionnement de la matrice $X^T X$. Dans les contextes expérimentaux où les variables explicatives sont tirées de processus naturels intercorrélés, la matrice empirique s’écarte radicalement de l’orthogonalité idéale. Dès lors que les colonnes de $X$ présentent des dépendances linéaires substantielles, la dispersion des estimateurs individuels subit une dégradation exponentielle, rendant la solution MCO hautement instable face aux fluctuations d’échantillonnage les plus minimes.
1.2 Pathologie de la multicolinéarité entre prédicteurs
La multicolinéarité traduit une situation dans laquelle deux ou plusieurs colonnes de la matrice $X$ manifestent une dépendance quasi-linéaire. D’un point de vue géométrique, cela signifie que les vecteurs colonnes de $X$ ne balaient pas l’espace euclidien à $p$ dimensions de manière isotrope, mais s’agglutinent le long d’un sous-espace de dimension inférieure. Sur le plan algébrique, cette redondance engendre une quasi-singularité de la matrice $X^T X$, se traduisant par des déterminants infinitésimaux et des valeurs propres minimales très proches de zéro.
La matrice de covariance de l’estimateur des moindres carrés ordinaires est explicitée par la formule :
$$\text{Var}(\hat{\beta}) = \sigma^2 (X^T X)^{-1}$$
Lorsque $X^T X$ approche la singularité, les éléments diagonaux de son inverse divergent vers l’infini. Cette explosion de la variance d’échantillonnage est classiquement quantifiée à travers le Facteur d’Inflation de la Variance (VIF, Variance Inflation Factor), défini pour le $j$-ème prédicteur par :
$$\text{VIF}_j = \frac{1}{1 – R_j^2}$$
où $R_j^2$ représente le coefficient de détermination issu de la régression auxiliaire de la variable $X_j$ sur l’ensemble des $p-1$ autres prédicteurs. Un coefficient $R_j^2$ avoisinant $0{,}95$ projette le VIF à des niveaux supérieurs à $20$, signalant que la variance de l’estimateur est vingt fois supérieure à ce qu’elle serait sous des conditions d’orthogonalité stricte.
Les répercussions de ce gonflement sur l’inférence statistique s’avèrent délétères. Les intervalles de confiance associés aux coefficients s’élargissent au point d’englober la valeur nulle, masquant des effets substantiels pourtant significatifs. Plus pernicieux encore, la corrélation négative induite entre les estimateurs eux-mêmes conduit régulièrement au basculement paradoxal des signes algébriques : un prédicteur dont la relation bivariée avec la variable réponse est fortement positive se voit attribuer un coefficient partiel négatif au sein du modèle multivarié, invalidant toute interprétation substantive ou causale conforme à la théorie du domaine investigué.
1.3 Limites de la régression multiple conventionnelle
Dans un contexte dominé par une colinéarité structurelle, les tests statistiques individuels basés sur la distribution de Student perdent presque toute puissance analytique. L’observateur se trouve fréquemment confronté au paradoxe statistique canonique où le test global de Fisher rejette massivement l’hypothèse nulle ($p < 0{,}001$, attestant qu'au moins un sous-ensemble de prédicteurs explique une part significative de la variance de $Y$), tandis qu'aucun test individuel de Student ne parvient à franchir le seuil conventionnel de significativité pour les coefficients $\hat{\beta}_j$ pris isolément. Les prédicteurs se masquent mutuellement en revendiquant la même fraction de variance partagée.
Par ailleurs, la régression conventionnelle par MCO devient particulièrement vulnérable au surajustement prédictif (overfitting). En forçant l’estimation simultanée de tous les coefficients au sein d’un espace dégénéré, le modèle capture non seulement le signal sous-jacent, mais également le bruit aléatoire spécifique à l’échantillon d’étalonnage. Bien que le coefficient de détermination empirique $R^2$ atteigne des valeurs flatteuses au sein de l’échantillon d’apprentissage, la capacité du modèle à généraliser ses prédictions à des cohortes indépendantes s’effondre drastiquement, générant une erreur quadratique moyenne de prédiction excessivement élevée.
Face à ces limitations structurelles, l’élagage manuel ou algorithmique pas à pas (sélection ascendante, descendante ou bidirectionnelle) offre un remède souvent trompeur. Ces procédures discrètes souffrent d’une instabilité majeure face au rééchantillonnage, biaisent systématiquement les distributions d’échantillonnage vers le haut et altèrent la validité des valeurs p nominales. Il s’avère donc méthodologiquement impératif de substituer à ces heuristiques fragmentaires des approches intégrées de réduction de dimensionnalité, au premier rang desquelles figure la projection orthogonale sur composantes principales.
2. Cadre théorique de la régression sur composantes principales (PCR)
2.1 Décomposition spectrale et réduction de dimensionnalité
L’Analyse en Composantes Principales (ACP) constitue la clé de voûte de la PCR. Elle formalise une transformation linéaire orthogonale destinée à convertir un ensemble de variables initiales corrélées en un système de variables composites décorrélées appelées composantes principales. Considérons la matrice centrée des prédicteurs $X in \mathbb{R}^{n \times p}$. L’ACP repose sur la décomposition spectrale de la matrice de dispersion empirique symétrique (matrice de covariance ou de corrélation) :
$$\Sigma = \frac{1}{n-1} X^T X$$
En vertu du théorème spectral pour les matrices symétriques semi-définies positives, il existe une matrice orthogonale $V in \mathbb{R}^{p \times p}$ dont les colonnes constituent les vecteurs propres orthonormés ($v_1, v_2, dots, v_p$) et une matrice diagonale $\Lambda = \text{diag}(\lambda_1, \lambda_2, dots, \lambda_p)$ regroupant les valeurs propres ordonnées de manière décroissante ($\lambda_1 ge \lambda_2 ge dots ge \lambda_p ge 0$), telles que :
$$\Sigma = V \Lambda V^T \quad \text{a\vec} \quad V^T V = V V^T = I_p$$
Chaque vecteur propre $v_m$ définit une direction principale dans l’espace des descripteurs, le long de laquelle la projection des données présente une dispersion maximale. La variance projetée sur le $m$-ème axe est rigoureusement égale à la valeur propre associée $\lambda_m$. La réduction de dimension s’opère en conservant uniquement les $M$ premiers vecteurs propres correspondant aux $M$ valeurs propres dominantes ($M ll p$), capturant ainsi la part prépondérante de la variance totale du système initial tout en filtrant les directions de dispersion résiduelle assimilables à du bruit de mesure.
2.2 Mécanique d’intégration de l’ACP dans la régression
La régression sur composantes principales articule cette projection spectrale au sein du cadre des moindres carrés. Soit $V_M in \mathbb{R}^{p \times M}$ la sous-matrice tronquée formée par les $M$ premiers vecteurs propres de $X^T X$. Les scores des composantes principales, désignés par la matrice $Z_M in \mathbb{R}^{n \times M}$, sont générés par la transformation linéaire directe :
$$Z_M = X V_M$$
Par construction, les colonnes de $Z_M$ (notées $z_1, z_2, dots, z_M$) présentent des propriétés de découplage remarquables. La matrice de dispersion associée $Z_M^T Z_M$ est rigoureusement diagonale :
$$Z_M^T Z_M = (X V_M)^T (X V_M) = V_M^T (X^T X) V_M = V_M^T (V \Lambda V^T) V_M = \Lambda_M$$
où $\Lambda_M = \text{diag}(\lambda_1, dots, \lambda_M)$. Cette orthogonalité intrinsèque élimine la moindre trace de colinéarité : pour tout $j ne k$, la corrélation empirique entre $z_j$ et $z_k$ est strictement nulle ($r(z_j, z_k) = 0$). Le modèle de régression par les MCO est subséquemment estimé non pas sur les variables originales $X$, mais sur la matrice des scores orthogonaux $Z_M$ :
$$Y = Z_M \gamma_M + \varepsilon$$
L’estimateur des coefficients associés aux composantes s’écrit dès lors avec une simplicité algébrique remarquable, exempte de toute inversion matricielle complexe :
$$\hat{\gamma}_M = (Z_M^T Z_M)^{-1} Z_M^T Y = \Lambda_M^{-1} Z_M^T Y$$
Chaque coefficient $\hat{\gamma}_m$ peut être calculé indépendamment des autres : $\hat{\gamma}_m = \lambda_m^{-1} z_m^T Y$. Une fois ces paramètres estimés dans l’espace factoriel, ils peuvent être réassignés dans l’espace d’origine par rétro-projection vectorielle afin d’exprimer le modèle final en fonction des prédicteurs natifs :
$$\hat{\beta}_{PCR} = V_M \hat{\gamma}_M$$
2.3 Distinction fondamentale entre PCR et régression supervisée
Une distinction épistémologique et fonctionnelle absolue sépare la PCR des architectures prédictives supervisées. L’étape d’extraction factorielle dans la PCR est entièrement non supervisée : les vecteurs propres $V_M$ sont dérivés exclusivement à partir de la matrice des régresseurs $X$, sans que l’information contenue dans le vecteur de réponse $Y$ ne soit sollicitée à aucun moment de cette réduction dimensionnelle.
Cette cécité sélective engendre un risque théorique bien documenté dans la littérature statistique. La PCR repose sur le postulat implicite que les directions de variance maximale au sein de l’espace des descripteurs coïncident avec les directions dotées du plus fort pouvoir prédictif à l’égard de $Y$. Or, rien dans les lois de l’algèbre linéaire ne garantit la validité universelle d’une telle hypothèse. Il est parfaitement concevable, dans certaines configurations empiriques, qu’une composante d’ordre élevé (associée à une valeur propre modeste, traduisant une faible variabilité propre au sein de $X$) soit fortement corrélée à la variable dépendante $Y$, tandis que la première composante principale synthétise une variance massive totalement indépendante du phénomène modélisé.
Cette vulnérabilité constitue la justification majeure du développement de la régression par les moindres carrés partiels (Partial Least Squares, PLS). Contrairement à la PCR, la PLS extrait des composantes latentes conçues pour maximiser simultanément la variance dans $X$ et la covariance avec $Y$. Si la PLS optimise directement la liaison explicative, la PCR offre en contrepartie une protection accrue contre le surajustement lorsque le signal prédictif est dispersé à travers des facteurs dominants et que le rapport signal sur bruit dans la variable critère demeure modéré.
3. Pertinence de la PCR dans les sciences psychologiques et comportementales
3.1 Multicolinéarité structurelle des batteries psychométriques
Les protocoles de recherche en psychologie clinique, différentielle et organisationnelle recourent intensivement à des batteries d’instruments de mesure composées d’échelles de Likert et d’inventaires d’attitudes. Par essence psychométrique, les items constituant une même dimension théorique sont formulés de manière redondante pour capturer un construit latent avec une fidélité interne satisfaisante (mesurée par le coefficient alpha de Cronbach ou l’oméga de McDonald). Il en résulte une multicolinéarité intrinsèque, systémique et indissociable de la validité de contenu des instruments.
Cette interpénétration s’observe de manière frappante dans l’évaluation de la personnalité via le modèle en cinq facteurs (le modèle Big Five). Chacun des cinq traits cardinaux (Ouverture, Conscienciosité, Extraversion, Agréabilité, Neuroticisme) se décompose en de multiples sous-facettes étroitement intriquées. Lorsqu’un chercheur cherche à prédire un comportement complexe, tel que l’adhésion thérapeutique, le comportement organisationnel citoyen ou l’indice d’épuisement professionnel (burnout), l’inclusion simultanée de toutes les sous-échelles génère des corrélations bivariées oscillant fréquemment entre $0{,}70$ et $0{,}90$.
Le traitement de ces données au moyen d’une régression multiple conventionnelle aboutit quasi invariablement à des artefacts déroutants. Deux facettes de l’anxiété ou de l’impulsivité, bien que corrélées positivement avec la symptomatologie dépressive, voient l’une de leurs saturations devenir négative du fait du conditionnement matriciel, poussant les analystes non avertis à échafauder des hypothèses compensatoires erronées. La PCR neutralise cette pathologie en condensant les facettes redondantes en axes factoriels orthogonaux cohérents avec les structures psychologiques macroscopiques sous-jacentes.
3.2 Gestion des plans expérimentaux à haute dimensionnalité
L’évolution contemporaine des protocoles expérimentaux en neurosciences cognitives et en psychologie de la santé confronte régulièrement les analystes au paradigme dit de haute dimensionnalité, caractérisé par une inflation du nombre de variables explicatives $p$ au point d’égaler ou de surpasser le nombre de participants disponibles $n$ ($p \approx n$ voire $p > n$). Les paradigmes associant des biomarqueurs neurophysiologiques (potentiels évoqués cognitifs, connectivité électroencéphalographique, morphométrie IRMf) à des indicateurs comportementaux continus (temps de réaction séquentiels, scores d’inhibition cognitive) souffrent particulièrement de cette asymétrie dimensionnelle.
Dans de telles configurations, la matrice $X^T X$ devient tout simplement non inversible si $p ge n$, provoquant l’effondrement immédiat de l’estimateur MCO conventionnel. Même lorsque la taille d’échantillon $n$ demeure légèrement supérieure à $p$, le ratio $n/p$ devient dramatiquement insuffisant pour autoriser une estimation asymptotique fiable des degrés de liberté résiduels. Les erreurs standard explosent et le pouvoir de généralisation devient quasi nul.
La régression sur composantes principales permet de contourner cette impasse méthodologique sans imposer de sacrifice aveugle au niveau du recueil de données. En projetant la masse volumineuse des prédicteurs neurocomportementaux sur un nombre restreint $M$ de dimensions orthogonales ($M ll n$), la PCR rétablit une marge adéquate de degrés de liberté. Elle permet ainsi d’exploiter la richesse multidimensionnelle des données sans compromettre la puissance des tests ni la stabilité mathématique du système de régression.
3.3 Objectifs de généralisabilité en recherche translationnelle
Au-delà de la simple modélisation statistique, la recherche translationnelle en psychiatrie et en médecine comportementale poursuit un impératif d’application clinique individualisée. Il ne s’agit plus seulement d’établir la validité conceptuelle d’un effet au niveau d’un groupe expérimental homogène, mais de construire des algorithmes prédictifs fiables capables de guider l’orientation diagnostique, le pronostic d’évolution ou le choix d’une stratégie d’intervention ciblée chez un patient unique.
Dans cette perspective, le bruit de mesure inhérent aux questionnaires psychométriques et aux épreuves neuropsychologiques constitue un perturbateur redoutable. Les modèles régularisés par régression linéaire ordinaire intègrent ce bruit d’échantillonnage de façon spécifique, affichant des performances diagnostiques artificiellement élevées sur la cohorte d’origine, qui s’effondrent lamentablement lorsqu’ils sont testés dans un hôpital ou un centre de soin indépendant.
En condensant les indicateurs primaires au sein de composantes orthogonales d’ordre supérieur, la PCR opère un filtrage des composantes de haute fréquence correspondant à la variance spécifique et aux erreurs idiosyncratiques de mesure. Cette régularisation discrète introduit un léger biais d’estimation, délibérément consenti en échange d’une réduction substantielle de la variance des prédictions (le compromis canonique biais-variance). Le modèle ainsi calibré présente une reproductibilité inter-échantillons significativement supérieure, satisfaisant aux exigences de robustesse indispensables à la validation d’outils d’évaluation psychologique translationnels.
4. Étape 1 : Configuration de l’environnement R et chargement des packages
4.1 Installation et chargement du package pls
La mise en œuvre de la régression sur composantes principales sous l’environnement statistique R repose sur un écosystème éprouvé, dominé par le package pls (conçu par Ron Wehrens et Bjørn-Helge Mevik). Cette bibliothèque met à disposition une infrastructure complète pour l’ajustement, la validation et la prédiction de modèles PCR et PLSR. Elle gère nativement le centrage, la standardisation, ainsi que des schémas avancés de validation croisée intégrée.
L’installation s’effectue directement depuis les dépôts officiels du Comprehensive R Archive Network (CRAN). Dans la console R, l’instruction suivante initialise l’acquisition des binaires précompilés et de leurs dépendances logicielles sous-jacentes :
install.packages("pls")
Une fois l’installation confirmée, le package est incorporé au sein de l’espace de noms de la session active à l’aide de l’instruction library(pls). Il convient de prêter une attention rigoureuse aux avertissements de masquage de fonctions : certains utilitaires génériques de manipulation matricielle ou de diagnostic résiduel partagent des noms identiques avec des fonctions issues d’autres extensions statistiques (comme les modules de machine learning génériques ou d’économétrie spatiale). L’assignation explicite des fonctions via l’opérateur de double deux-points (par exemple, pls::pcr) constitue une pratique défensive recommandée au sein des scripts de production analytique.
4.2 Outils complémentaires pour la manipulation et la visualisation
Bien que le package pls intègre ses propres routines graphiques primitives, un pipeline analytique moderne et rigoureux s’appuie sur une suite d’outils complémentaires dédiés à la manipulation structurée des données, à l’évaluation psychométrique préalable et au rendu graphique publiable. L’écosystème tidyverse, articulé autour de dplyr, tidyr, purrr et ggplot2, forme le socle indispensable pour l’ingestion, le nettoyage tabulaire et l’ingénierie des descripteurs.
Pour l’audit psychométrique préliminaire, le package psych (développé par William Revelle) constitue une ressource de premier plan pour calculer les indices de cohérence interne, estimer la sphéricité de Bartlett et évaluer les matrices de corrélation partielles. Parallèlement, la bibliothèque FactoMineR et son pendant de visualisation factoextra permettent d’approfondir l’analyse géométrique des données en amont de la régression, facilitant l’exploration des ellipses de confiance et des contributions dimensionnelles individuelles.
L’installation combinée de ces modules est exécutée selon la commande :
install.packages(c("tidyverse", "psych", "FactoMineR", "factoextra", "corrplot", "car", "gridExtra"))
Leur importation concertée dote l’analyste d’un environnement polyvalent, autorisant une transition fluide entre l’audit descriptif des distributions, l’estimation factorielle et la mise en forme graphique des résultats selon les chartes éditoriales académiques internationales.
4.3 Paramétrage de la reproductibilité computationnelle
L’un des piliers de la rigueur scientifique réside dans la reproductibilité computationnelle exacte des analyses publiées. Au sein de la PCR, la détermination du nombre optimal de composantes fait systématiquement appel à des procédures de rééchantillonnage stochastique, telles que la validation croisée partitionnée en $K$ blocs (K-fold cross-validation). Lors de ce découpage, l’attribution des observations aux différents blocs d’apprentissage et de test dépend du générateur de nombres pseudo-aléatoires de R.
En l’absence de fixation délibérée d’une graine d’initialisation, chaque exécution subséquente du script produira une partition légèrement distincte des données, générant des variations marginales sur les courbes d’erreur quadratique moyenne de prédiction (RMSEP). Pour neutraliser cette instabilité stochastique et garantir que les résultats, graphiques et décisions de sélection factorielle demeurent strictement identiques à chaque ré-exécution, il est impératif d’initialiser le générateur dès l’ouverture du script via l’instruction canonique :
set.seed(2026)
En complément de cette précaution algorithmique, une pratique de science ouverte exemplaire impose de consigner systématiquement l’état complet de l’environnement logiciel au terme de la session. L’appel à la fonction sessionInfo() archive avec précision la version exacte du noyau R, le système d’exploitation hôte, ainsi que les versions détaillées de tous les packages chargés et de leurs dépendances dynamiques associées, prévenant toute rupture d’incompatibilité logicielle ultérieure.
5. Étape 2 : Préparation, inspection et prétraitement des données
5.1 Audit structurel et détection de la colinéarité initiale
Avant d’engager toute modélisation dimensionnelle, un audit exploratoire rigoureux de la structure de corrélation s’impose. L’investigateur doit calculer la matrice d’inter-corrélations de Pearson pour l’ensemble des variables prédictives candidates. La visualisation de cette matrice à travers un corrélogramme hiérarchique, configuré via le package corrplot, offre une cartographie immédiate des blocs de variables interdépendantes. La présence de grappes de prédicteurs affichant des coefficients bivariés $r ge 0{,}70$ constitue un indicateur précurseur évident de multicolinéarité.
L’inspection visuelle doit impérativement être complétée par une évaluation formelle des Facteurs d’Inflation de la Variance (VIF). Dans un premier temps, l’ajustement d’un modèle linéaire standard par la fonction primitive lm(Y ~ ., data = train_data) permet d’extraire les VIF associés à chaque variable explicative via la fonction car::vif() :
modele_preliminaire <- lm(Y ~ ., data = donnees_analyse)
vif_scores <- car::vif(modele_preliminaire)
Dans la littérature méthodologique, un seuil de VIF excédant $5$ ou $10$ est couramment interprété comme la manifestation d’une colinéarité sévère justifiant l’abandon des MCO classiques. Lorsque les prédicteurs partagent une redondance conceptuelle inhérente (comme des scores de sous-échelles psychométriques), il n’est pas rare de constater des VIF franchissant le seuil critique de $15$, confirmant sans ambiguïté la pertinence de l’approche par composantes principales.
5.2 Traitement des valeurs manquantes et déviantes
L’Analyse en Composantes Principales sous-jacente à la PCR s’avère particulièrement intolérante aux valeurs manquantes et hypersensible aux observations aberrantes multivariées. Contrairement à des algorithmes décisionnels basés sur des arbres de partitionnement, les calculs de projection spectrale imposent des matrices sans case vide. L’élimination par liste entière (listwise deletion) étant hautement pénalisante pour la puissance statistique dès lors que le nombre d’items s’accroît, des techniques d’imputation adaptées doivent être appliquées.
Pour les inventaires psychologiques, l’imputation multivariée par équations chaînées (via le package mice) ou l’imputation factorielle itérative (via la fonction missMDA::imputePCA) respectent l’architecture corrélationnelle des données sans affaiblir artificiellement les covariances empiriques. Une attention tout aussi soutenue doit être portée aux valeurs atypiques extrêmes, susceptibles de distordre unilatéralement l’orientation des axes factoriels initiaux.
La détection de ces valeurs déviantes multivariées s’effectue avantageusement par le calcul de la distance de Mahalanobis pour chaque profil individuel :
$$D_M^2(x) = (x – \mu)^T S^{-1} (x – \mu)$$
où $\mu$ représente le vecteur moyen et $S$ la matrice de covariance empirique. Les participants dont la distance de Mahalanobis dépasse le quantile critique de la distribution du Chi-deux au seuil $\alpha = 0{,}001$ (avec $p$ degrés de liberté) doivent faire l’objet d’un examen qualitatif minutieux afin de trancher entre une erreur d’encodage, une réponse non attentive ou une singularité clinique authentique, avant d’engager la décomposition spectrale.
5.3 Centrage et réduction des prédicteurs
Le calcul des composantes principales est gouverné par la maximisation de la variance projetée. Si les variables explicatives s’expriment dans des unités de mesure disparates ou présentent des étendues de dispersion divergentes, les variables affichant les variances numériques brutes les plus élevées capteront artificiellement les premières composantes principales, indépendamment de leur pertinence statistique ou substantive.
Par exemple, si une batterie clinique agrège des scores d’inventaires psychologiques bornés entre $1$ et $5$, des temps de réaction psychomoteurs mesurés en millisecondes (avec des variances de l’ordre de plusieurs milliers d’unités) et des concentrations de cortisol salivaire en nanomoles par litre, l’ACP brute sera intégralement biaisée en faveur des temps de réaction. Pour conférer un poids initial strictement équivalent à chaque descripteur, il est impératif d’opérer un centrage sur la moyenne suivi d’une standardisation par l’écart-type :
$$X_{ij}^{standardise} = \frac{X_{ij} – \bar{X}_j}{s_j}$$
Dans l’écosystème R, la standardisation matricielle explicite peut être formulée en amont à l’aide de la fonction native scale(X, center = TRUE, scale = TRUE). Cependant, l’architecture du package pls simplifie et sécurise ce processus en intégrant l’argument formel scale = TRUE au sein même de l’instruction pcr(). Cette automatisation garantit que les mêmes paramètres de centrage et d’échelle soient strictement appliqués lors des projections sur les échantillons de validation croisée et de test, neutralisant tout risque d’infiltration d’information externe.
6. Étape 3 : Ajustement du modèle PCR avec la fonction pcr()
6.1 Syntaxe formelle et spécification du modèle
L’estimation de la régression sur composantes principales sous R s’orchestre via la fonction cardinale pcr() du package pls. La syntaxe respecte la convention standardisée des modèles statistiques en environnement R, articulant une formule symbolique qui définit la relation théorique entre la réponse et les variables explicatives.
Considérons un tableau de données dénommé cohorte_clinique dans lequel la variable dépendante d’intérêt est étiquetée Score_Symptomatique, et les prédicteurs psychométriques correspondent à dix indicateurs d’échelle notés de Item_1 à Item_10. L’appel canonique s’exécute selon l’instruction suivante :
modele_pcr <- pls::pcr(Score_Symptomatique ~ Item_1 + Item_2 + Item_3 + Item_4 + Item_5 + Item_6 + Item_7 + Item_8 + Item_9 + Item_10, data = cohorte_clinique, scale = TRUE, validation = "CV")
Alternativement, si l’ensemble des colonnes du tableau à l’exception de la variable dépendante constituent les prédicteurs admissibles, la notation abrégée Score_Symptomatique ~ . s’avère parfaitement légitime. Le paramètre scale = TRUE instruit l’algorithme de calculer les composantes principales à partir de la matrice de corrélation empirique (données standardisées) plutôt que de la matrice de covariance brute, prémunissant l’ajustement contre les disparités d’unités de mesure.
6.2 Paramétrage de la validation croisée intégrée
L’argument validation présent dans l’appel à la fonction pcr() contrôle la procédure computationnelle employée pour évaluer la qualité prédictive du modèle et guider le choix du nombre optimal de composantes à retenir. Le package pls implémente nativement deux architectures d’évaluation par rééchantillonnage interne :
- La validation croisée à $K$ blocs (K-fold cross-validation) : Spécifiée par
validation = "CV", cette méthode scinde aléatoirement l’échantillon d’apprentissage en $K$ sous-ensembles d’égale proportion (par défaut, $K = 10$). À chaque itération, le modèle est ajusté sur $K-1$ blocs et ses prédictions sont rigoureusement confrontées au bloc résiduel exclu. Cette modalité est particulièrement recommandée pour les cohortes volumineuses ($n > 100$), offrant un compromis optimal entre stabilité des estimations d’erreur et temps de calcul machine. Des arguments complémentaires, tels quesegments = 10ousegment.type = "random", permettent d’en affiner le paramétrage. - La validation par exclusion unitaire (Leave-One-Out, LOO) : Activée par
validation = "LOO", cette procédure itérative exclut successivement chaque observation individuelle ($n$ itérations complètes). Particulièrement adaptée aux cohortes psychologiques ou psychiatriques restreintes ($n < 50$) où le sacrifice d'un dixième des observations amputerait excessivement l'estimation matricielle, la méthode LOO fournit un estimateur sans biais de l'erreur prédictive globale, au prix d'une corrélation accrue entre les estimations résiduelles et d'une demande de calcul accrue.
6.3 Inspection structurelle de l’objet mvr généré
L’exécution de la commande pcr() génère en mémoire une structure de données complexe de classe S3 nommée mvr (Multivariate Regression). Cet objet encapsule l’intégralité des métadonnées numériques requises pour l’inférence, la rétro-projection et le diagnostic statistique. Une inspection programmatique de cet objet permet de décomposer ses principaux éléments :
modele_pcr$coefficients: Tableau multidimensionnel stockant les coefficients de régression rétro-projetés dans l’espace originel des prédicteurs, calculés incrémentalement pour chaque niveau de troncature allant de 1 jusqu’au nombre maximal de composantes $p$.modele_pcr$scores: Matrice des coordonnées individuelles ($Z$) obtenues par projection des observations sur les axes factoriels principaux.modele_pcr$loadings: Matrice des saturations ou charges factorielles ($V$), explicitant la composition linéaire exacte de chaque composante à partir des variables d’origine standardisées.modele_pcr$validation: Sous-objet regroupant les statistiques d’évaluation croisée, notamment la somme des carrés des erreurs de prédiction (PRESS) et les résidus d’exclusion.
Un appel sommaire à la méthode standard summary(modele_pcr) affiche un panorama structuré synthétisant le pourcentage de variance capturé au sein de la matrice $X$, la fraction cumulative de variance expliquée dans la variable réponse $Y$, ainsi que les valeurs de RMSEP associées à chaque palier de complexité dimensionnelle.
7. Étape 4 : Détermination du nombre optimal de composantes principales
7.1 Analyse de l’erreur quadratique moyenne de prédiction (RMSEP)
L’un des choix les plus décisifs dans l’application de la PCR réside dans l’arbitrage du nombre optimal de composantes factorielles $M$ à conserver au sein de l’équation prédictive finale. La métrique cardinale régissant cette sélection est l’erreur quadratique moyenne de prédiction estimée par validation croisée (Root Mean Squared Error of Prediction, RMSEP). Cette statistique quantifie l’écart moyen quadratique entre les observations réelles $y_i$ et les estimations prédictives hors échantillon $\hat{y}_{-i}(m)$ obtenues lorsque l’observation $i$ est exclue du processus d’apprentissage :
$$\text{RMSEP}(m) = \sqrt{\frac{1}{n} \sum_{i=1}^n \left( y_i – \hat{y}_{-i}(m) \right)^2}$$
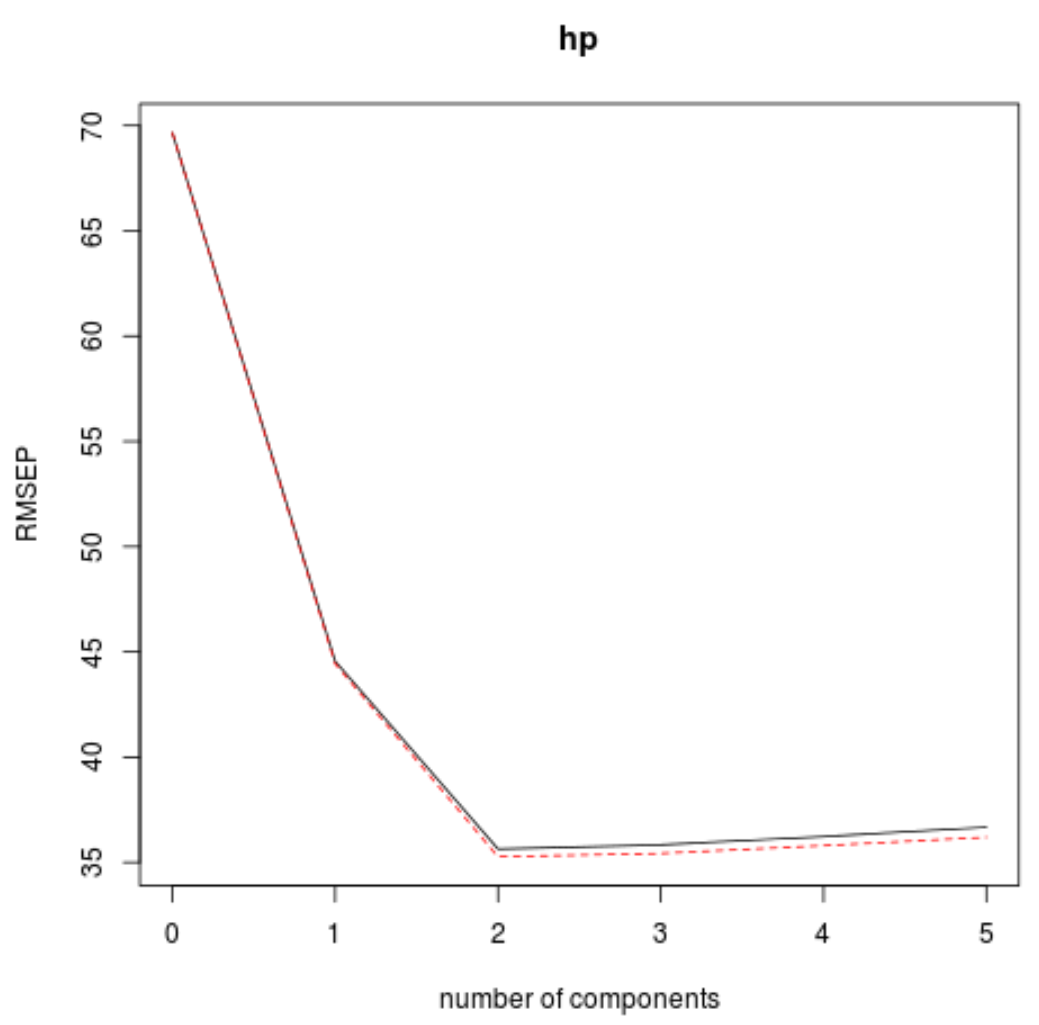
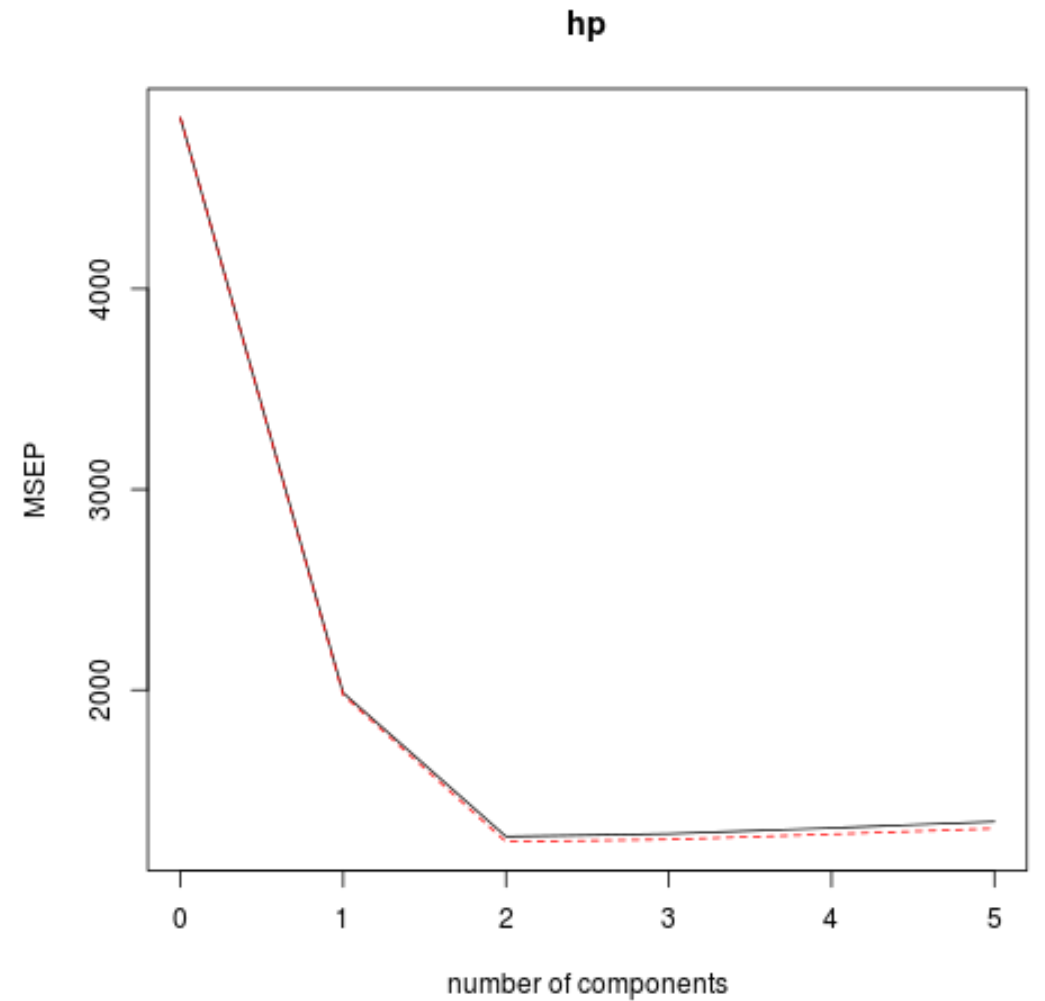
L’extraction numérique de ces critères s’effectue sous R au moyen de la fonction dédiée RMSEP(modele_pcr). Typiquement, la trajectoire de l’erreur d’ajustement intra-échantillon (training error) décroît de manière monotone à mesure que des composantes additionnelles sont injectées. En revanche, la courbe de RMSEP issue de la validation croisée adopte une trajectoire convexe caractéristique : elle décroît vivement lors de l’intégration des premiers axes factoriels porteurs de signal régulier, atteint un minimum d’inflexion global, puis se stabilise ou commence à ré-augmenter sous l’effet du surapprentissage (surajustement au bruit spécifique).
7.2 Application de la règle du coude et critères de parcimonie
Bien que la minimisation arithmétique brute de la RMSEP offre un critère objectif mécanique, l’adoption inconditionnelle du minimum absolu conduit souvent à sélectionner un modèle surdimensionné intégrant des composantes marginales instables. Pour instaurer une sélection méthodologiquement robuste, les statisticiens recourent à des principes de parcimonie formalisés, au premier rang desquels figure la règle du coude combinée au principe de l’écart-type unique (One-Standard-Error rule, popularisée par Hastie, Tibshirani et Friedman).
Le principe de l’écart-type unique postule que si un modèle plus parcimonieux (comportant moins de composantes principales) affiche une performance d’erreur de prédiction qui s’inscrit à l’intérieur d’un intervalle d’un écart-type autour du minimum absolu de RMSEP, ce modèle simplifié doit être systématiquement préféré car il offre une garantie supérieure de généralisabilité et d’interprétabilité théorique. Le package pls permet d’automatiser cette sélection prudente grâce à la fonction selectNcomp() :
nb_comp_opt <- pls::selectNcomp(modele_pcr, method = "onesigma", plot = FALSE)
Cette approche protège le chercheur contre la surinterprétation d’oscillations résiduelles non significatives au sein de la courbe d’erreur, ancrant la sélection dans un compromis optimal entre simplicité paramétrique et puissance prédictive.
7.3 Statistiques de variance expliquée
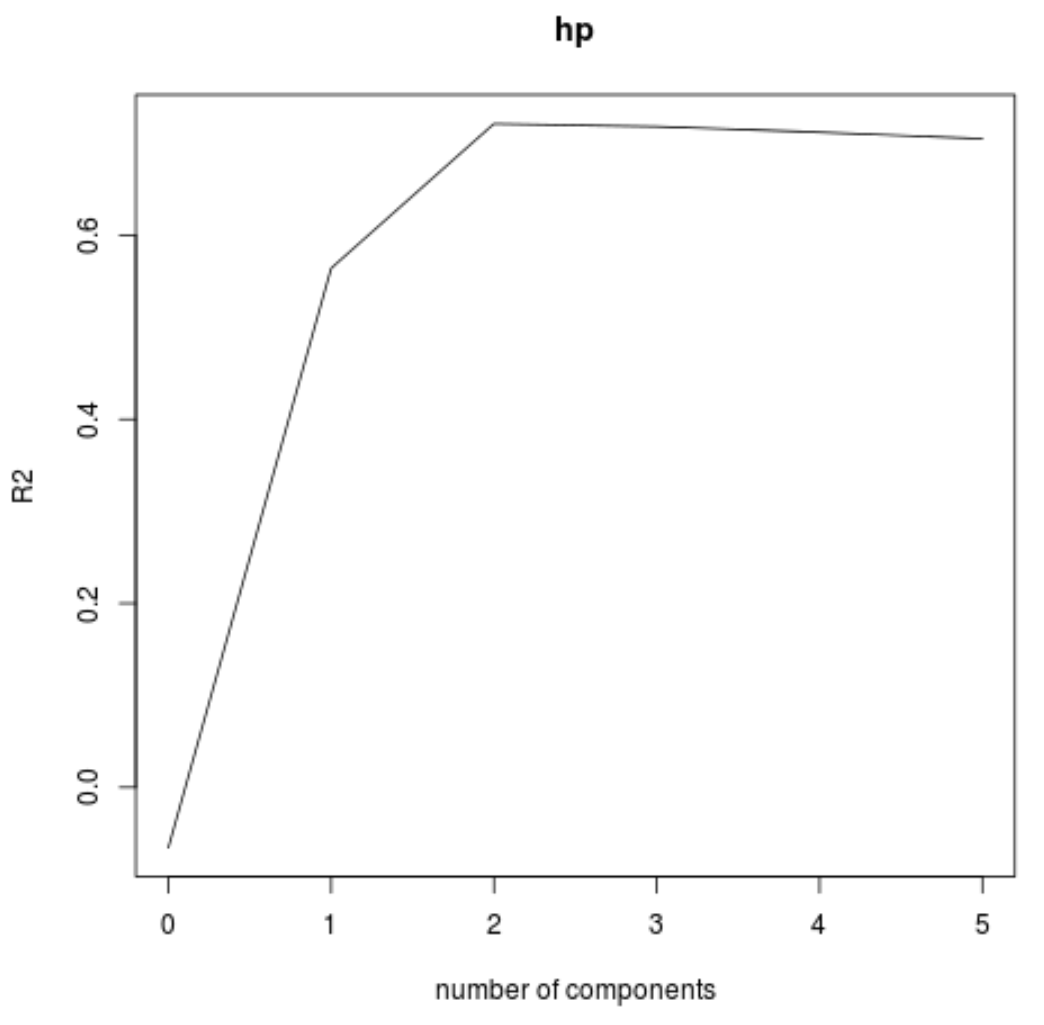
La délibération relative au choix de $M$ impose une analyse conjointe des proportions de variance expliquée, à la fois dans le bloc des régresseurs $X$ et dans le vecteur réponse $Y$. L’inspection du tableau issu de summary(modele_pcr) ventile ces pourcentages de façon cumulée.
Dans de nombreuses applications en psychométrie, on observe fréquemment une asymétrie structurale : les trois premières composantes principales peuvent capturer par exemple $75,%$ de la variance globale de la matrice des items $X$, mais seulement $22,%$ de la variance du critère comportemental $Y$. Inversement, l’adjonction d’une quatrième composante n’accroissant la variance expliquée de $X$ que de $3,%$ peut subitement induire un bond de $15,%$ dans la variance expliquée de $Y$.
Ce scénario illustre parfaitement la nature non supervisée de la PCR abordée à la section 2.3. L’analyste doit veiller à ne pas interrompre l’extraction factorielle uniquement sur la base de critères internes à $X$ (tels que le critère d’arrêt de Kaiser-Guttman requérant des valeurs propres supérieures à 1). Le critère d’arbitrage ultime demeure le gain marginal de prédiction apporté à la variable dépendante $Y$ sous contrôle de la validation croisée, attestant que la structure factorielle retenue participe activement à l’explication du phénomène sous observation.
8. Étape 5 : Interprétation psychologique des composantes et des saturations
8.1 Extraction et analyse des matrices de charges (loadings)
Une fois le nombre optimal de composantes $M$ validé, l’investigateur doit conférer un sens substantif aux axes factoriels abstraits sur lesquels repose la régression. Cette herméneutique statistique s’appuie sur la matrice des saturations factorielles (loadings), accessible via la fonction loadings() appliquée au modèle ajusté :
saturations <- loadings(modele_pcr)[, 1:nb_comp_opt]
Les saturations représentent les coefficients des combinaisons linéaires traduisant la projection des variables initiales sur chaque composante principale :
$$z_{im} = v_{1m} x_{i1} + v_{2m} x_{i2} + dots + v_{\pm} x_{ip}$$
La magnitude algébrique et le signe de chaque élément $v_{jm}$ traduisent l’importance relative et la direction de la contribution de la variable originelle $j$ à l’édification de la composante $m$. Par convention psychométrique, une saturation dont la valeur absolue excède $0{,}30$ ou $0{,}40$ est considérée comme substantielle. En identifiant les sous-ensembles d’items qui s’agrègent avec de fortes charges sur un axe donné, le chercheur peut identifier les construits psychologiques sous-jacents — par exemple, un axe synthétisant l’ensemble des indicateurs de dérégulation émotionnelle opposé à des variables d’inhibition cognitive.
8.2 Projection et dispersion des scores individuels
L’exploration des coordonnées factorielles attribuées aux participants fournit des enseignements diagnostiques de premier plan. La matrice des scores individuels $Z_M$, extraite via la commande scores(modele_pcr)[, 1:nb_comp_opt], positionne chaque participant dans le nouvel espace euclidien orthogonal de dimension réduite.
Cette cartographie spatiale permet de visualiser la dispersion phénotypique des individus, d’identifier des trajectoires de développement comportemental ou de repérer d’éventuels sous-groupes cliniques latents caractérisés par des profils extrêmes le long de gradients factoriels spécifiques. De surcroît, la projection des scores facilite la détection d’observations multivariées hautement influentes (points de levier), situées à la périphérie du nuage de points, dont la configuration singulière est susceptible d’exercer une influence disproportionnée sur l’orientation des plans de régression.
Le couplage des scores et des saturations au sein de biplots synthétiques permet d’interpréter simultanément la proximité relative des sujets et l’alignement directionnel des items d’évaluation psychologique, matérialisant ainsi la géométrie globale de l’espace de mesure.
8.3 Dérivation des coefficients finaux dans l’espace d’origine
Bien que la régression soit formellement calibrée sur les scores décorrélés $Z_M$, la communication scientifique et l’application pratique des résultats exigent généralement d’exprimer l’équation de prédiction finale en fonction des prédicteurs natifs de l’instrument d’évaluation. Cette formulation s’obtient par la rétro-projection des coefficients factoriels $\hat{\gamma}_M$ vers l’espace initial des $p$ variables via la relation $\hat{\beta}_{PCR} = V_M \hat{\gamma}_M$.
Le package pls met à disposition la fonction coef() pour extraire directement ces coefficients natifs standardisés en spécifiant explicitement la dimensionnalité optimale retenue :
coefficients_finaux <- coef(modele_pcr, ncomp = nb_comp_opt, intercept = TRUE)
Ces coefficients rétro-projetés traduisent l’impact marginal net associé à l’incrémentation d’une unité de chaque variable originelle sur la réponse prédite, sous la contrainte régularisatrice de l’espace factoriel à $M$ dimensions. Contrairement aux coefficients issus des MCO ordinaires, ces estimations ont été assainies des distorsions induites par la multicolinéarité : les variances d’échantillonnage demeurent contenues, et la distribution globale des poids relatifs reflète fidèlement la contribution combinée des items telle que transmise à travers les composantes principales retenues.
9. Étape 6 : Évaluation de la performance et généralisabilité prédictive
9.1 Prédiction sur données indépendantes de test
L’évaluation rigoureuse de la validité d’un modèle statistique exige une distinction formelle entre les phases d’étalonnage et les phases de généralisation. Afin de se prémunir contre l’optimisme d’apprentissage (training optimism), le jeu de données global doit être préalablement partitionné en un ensemble d’apprentissage (training set, par exemple $70,%$ de la cohorte) et un ensemble de test indépendant (test set, $30,%$), hermétique à toute étape de calibration préalable.
La conformité méthodologique impose un contrôle strict des fuites d’information (data leakage). Les paramètres de prétraitement (les moyennes $\bar{X}_j$ et les écarts-types $s_j$ mis en œuvre pour le centrage et la standardisation) doivent être exclusivement dérivés sur le jeu d’apprentissage, puis appliqués de manière exogène aux matrices du jeu de test. Une fois le modèle modele_pcr ajusté sur les données d’entraînement, l’inférence prédictive sur la cohorte de test s’exécute à l’aide de la méthode générique predict() :
predictions_test <- predict(modele_pcr, newdata = donnees_test, ncomp = nb_comp_opt)
Cette approche garantit que la performance observée reflète fidèlement la capacité opérationnelle du système à extrapoler ses déductions à de futurs individus n’ayant pas participé à l’édification de l’espace factoriel.
9.2 Métriques de validation empirique
La quantification de la performance prédictive hors échantillon repose sur un ensemble de métriques d’évaluation complémentaires. La métrique de référence pour mesurer le pouvoir explicatif généralisé est le coefficient de détermination prédictif, usuellement désigné sous le symbole $Q^2$ ou $R^2_{test}$ :
$$Q^2 = 1 – \frac{\sum_{i in \text{test}} (y_i – \hat{y}_i)^2}{\sum_{i in \text{test}} (y_i – \bar{y}_{\text{train}})^2}$$
Contrairement au $R^2$ descriptif standard qui croît mécaniquement à chaque variable ajoutée, le $Q^2$ prédictif peut s’effondrer vers des valeurs négatives si le modèle s’avère moins performant qu’une simple prédiction par la moyenne arithmétique de référence. En complément de cette statistique adimensionnelle, l’erreur absolue moyenne (Mean Absolute Error, MAE) et la racine carrée de l’erreur quadratique moyenne de test ($RMSE_{test}$) fournissent des évaluations concrètes exprimées dans l’unité de mesure directe de la variable réponse :
$$\text{RMSE}_{\text{test}} = \sqrt{\frac{1}{n_{\text{test}}} \sum_{i=1}^{n_{\text{test}}} (y_i – \hat{y}_i)^2}$$
L’analyse comparée des résidus à travers les différentes strates de la population évaluée permet de vérifier la calibration équilibrée des erreurs et l’absence de dérives prédictives asymétriques aux extrêmes de l’échelle clinique.
9.3 Confrontation directe avec le modèle MCO standard
Pour démontrer formellement la plus-value méthodologique de la PCR en présence de prédicteurs corrélés, il convient de confronter directement ses performances à celles d’un modèle de régression linéaire multiple conventionnel estimé par les MCO sur les mêmes données de départ. Un modèle linéaire complet est calibré sur le jeu d’apprentissage via lm(), puis déployé pour générer des prédictions sur le jeu de test :
modele_mco <- lm(Score_Symptomatique ~ ., data = donnees_train)
predictions_mco <- predict(modele_mco, newdata = donnees_test)
rmse_mco <- sqrt(mean((donnees_test$Score_Symptomatique - predictions_mco)^2))
rmse_pcr <- sqrt(mean((donnees_test$Score_Symptomatique - predictions_test)^2))
Dans un contexte de forte multicolinéarité, la confrontation révèle de façon systématique la supériorité de la PCR. Bien que le modèle MCO présente souvent une $RMSE$ intra-échantillon inférieure sur le jeu d’entraînement, son $RMSE_{test}$ hors échantillon s’accroît lourdement sous l’effet de la variance excessive de ses coefficients. La PCR, en élaguant les directions spectrales instables, enregistre une baisse substantielle de l’erreur globale hors échantillon, validant empiriquement l’efficacité de la régularisation par projection orthogonale.
10. Étape 7 : Visualisation graphique avancée des résultats sous R
10.1 Graphiques de validation et de trajectoire d’erreur
L’exploration visuelle constitue une composante intégrale du diagnostic statistique. Le package pls met à disposition la fonction primitive validationplot(), qui permet de tracer l’évolution de la statistique RMSEP ou du critère d’évaluation croisée (MSEP, $R^2$) en fonction de l’adjonction séquentielle des composantes principales :
pls::validationplot(modele_pcr, val.type = "RMSEP", estimate = c("train", "CV"), legendpos = "topright")
Pour satisfaire aux exigences de publication académique, ce tracé peut être entièrement recréé sous l’environnement ggplot2. L’analyste extrait les composantes du slot modele_pcr$validation pour structurer un tableau de données rectangulaire contenant les erreurs d’entraînement et les erreurs de validation croisée associées à chaque dimension. La superposition des courbes révèle immédiatement :
- La zone de sous-ajustement (underfitting) : située en amont du coude d’inflexion, où tant l’erreur d’entraînement que l’erreur de validation demeurent élevées car les axes initiaux n’ont pas encore extrait tout le signal pertinent.
- Le point d’inflexion optimal : point où l’erreur de validation croisée atteint son plateau minimal d’efficacité.
- La zone de surajustement (overfitting) : au-delà de la dimension optimale, où la trajectoire de validation croisée commence à remonter tandis que la courbe d’apprentissage continue de chuter artificiellement.
10.2 Diagrammes de corrélation et de scores (Score & Loading Plots)
La représentation des relations spatiales multivariées s’illustre particulièrement à travers les tracés conjoints de scores et de saturations, réalisables via les méthodes graphiques plot(modele_pcr, plottype = "scores") et plot(modele_pcr, plottype = "loadings"). L’agencement d’un biplot factoriel vectoriel permet de matérialiser sur un même plan bidimensionnel les positions respectives des participants et les vecteurs de projection des variables descriptives d’origine.
Grâce à la bibliothèque factoextra, ces cartographies atteignent une grande clarté esthétique :
factoextra::fviz_pca_biplot(modele_pcr$model$X, geom.ind = "point", col.ind = "cos2", col.var = "contrib", gradient.cols = c("#00AFBB", "#E7B800", "#FC4E07"), repel = TRUE)
Sur ces diagrammes, le cosinus de l’angle séparant deux vecteurs de variables approxime leur coefficient d’inter-corrélation empirique (des angles aigus traduisant des corrélations fortement positives, des angles droits signalant une orthogonalité parfaite, et des angles plats caractérisant une opposition inverse). La projection orthogonale des points-sujets sur ces axes vectoriels permet d’appréhender intuitivement pourquoi tel participant singulier présente une prédiction clinique particulièrement élevée ou atypique sur la variable réponse.
10.3 Diagnostics graphiques des résidus finaux
La validité statistique finale du modèle PCR impose de vérifier la distribution des résidus d’estimation afin de s’assurer du respect des postulats gaussiens fondamentaux. Trois diagnostics visuels majeurs doivent être exécutés de façon systématique :
- Le graphique de dispersion résidus-valeurs ajustées : En projetant les résidus $\hat{\varepsilon}_i = y_i – \hat{y}_i$ sur l’axe des ordonnées et les valeurs prédictives $\hat{y}_i$ sur l’axe des abscisses, l’observateur contrôle l’homoscédasticité de la variance. La dispersion des points doit former une bande horizontale d’épaisseur constante et homogène, dépourvue de configurations coniques (hétéroscédasticité) ou de courbures paraboliques révélatrices d’une non-linéarité omise.
- Le diagramme quantile-quantile normal (Q-Q plot) : Ce tracé évalue l’adéquation des résidus empiriques standardisés à une distribution théorique gaussienne. Les quantiles d’échantillon doivent s’aligner rigoureusement le long de la bissectrice asymptotique idéale à $45^circ$, toute divergence marquée aux extrémités signalant des queues de distribution lourdes ou la présence d’observations résiduelles aberrantes.
- L’inspection des résidus standardisés face aux composantes : S’assurer que les résidus ne manifestent aucune dépendance résiduelle à l’égard de l’une des composantes factorielles exclues du modèle prédictif final.
11. Comparaison méthodologique : PCR versus PLS, Ridge et Lasso
11.1 PCR versus Régression par Moindres Carrés Partiels (PLS)
La distinction conceptuelle entre la PCR et la régression par Moindres Carrés Partiels (Partial Least Squares, PLS) réside dans le statut accordé à la variable dépendante $Y$ lors de la réduction dimensionnelle. Alors que la PCR opère une décomposition spectrale purement interne à la matrice $X$ sans considération de $Y$, la PLS recherche activement un ensemble de composantes latentes $T$ qui maximisent conjointement la variance interne de $X$ et le carré de la covariance entre $X$ et $Y$ :
$$\max_{w, c} \text{Cov}^2(Xw, Yc) \quad \text{sous contrainte} \quad |w|_2 = 1, |c|_2 = 1$$
En conséquence pratique, la PLS s’avère nettement plus agressive et parcimonieuse lorsque le signal pertinent pour prédire $Y$ ne réside pas dans les dimensions dominantes de variabilité de $X$. Là où la PCR nécessite parfois l’inclusion de six ou sept composantes pour capturer une portion modeste d’un sous-espace explicatif spécifique, la PLS parvient souvent à condenser l’équivalent de variance prédictive en seulement deux ou trois composantes dirigées. Néanmoins, cette supervision active accroît la susceptibilité de la PLS à incorporer du bruit de co-occurrence fortuite lorsque la taille d’échantillon $n$ est restreinte, conférant alors à la PCR un avantage de robustesse structurelle supérieur.
11.2 PCR versus Régularisation Ridge (Pénalisation L2)
La PCR partage une affinité mathématique fondamentale avec la régression pénalisée de Hoerl et Kennard, connue sous le nom de régression Ridge ou régularisation $L_2$. La régression Ridge incorpore une pénalisation quadratique sur la norme des coefficients à la fonction de coût des moindres carrés :
$$\min_{\beta} | Y – X\beta |_2^2 + \lambda |beta|_2^2$$
La solution analytique s’exprime par $\hat{\beta}_{\text{Ridge}} = (X^T X + \lambda I_p)^{-1} X^T Y$. Par le prisme de la décomposition en valeurs singulières (SVD) où $X = U D V^T$, il devient manifeste que la régression Ridge et la PCR opèrent toutes deux une transformation de rétrécissement (shrinkage) appliquée aux valeurs propres de la matrice de covariance. La PCR applique un rétrécissement discontinu ou discret en conservant intactes les $M$ premières composantes et en assignant un poids rigoureusement nul ($\text{poids} = 0$) à toutes les composantes d’ordre supérieur à $M$.
En contraste, la régression Ridge applique un rétrécissement continu et différencié : elle atténue l’impact de chaque axe principal proportionnellement au ratio $\frac{d_j^2}{d_j^2 + \lambda}$. Les directions associées à de faibles valeurs propres ($d_j \approx 0$) voient leurs coefficients lourdement comprimés vers zéro sans jamais être strictement éliminés, tandis que les directions majeures restent presque intactes. La régression Ridge s’avère méthodologiquement supérieure lorsque l’ensemble des prédicteurs natifs recèlent une fraction réelle d’influence marginale, alors que la PCR prévaut lorsque l’espace des données s’organise véritablement autour de structures dimensionnelles denses et isolables.
11.3 PCR versus Lasso et Elastic Net (Pénalisation L1/L2)
Une divergence épistémologique majeure sépare la PCR des approches de régularisation pénalisées par la norme $L_1$, incarnées par le Lasso (Least Absolute Shrinkage and Selection Operator) et l’Elastic Net. La formulation mathématique du Lasso substitue à la contrainte quadratique une pénalité absolue :
$$\min_{\beta} | Y – X\beta |_2^2 + \lambda |beta|_1$$
La singularité géométrique de la boule unité associée à la norme $L_1$ possède la propriété singulière de contraindre certains coefficients $\hat{\beta}_j$ à devenir rigoureusement nuls dès que le paramètre de pénalité $lambda$ est suffisant. Le Lasso opère ainsi une sélection discrète de variables natives, générant des modèles parcimonieux (sparse models) hautement interprétables au niveau individuel des items. En revanche, face à des prédicteurs très fortement corrélés entre eux, le Lasso manifeste une instabilité pathologique connue : il a tendance à sélectionner arbitrairement une unique variable au sein d’un groupe colinéaire et à annuler tous les autres, ignorant la structure systémique sous-jacente.
La PCR adopte la posture exactement inverse : elle préserve l’ensemble des variables d’origine au sein de combinaisons linéaires denses. Si un item clinique spécifique doit impérativement être isolé pour des motifs de tarification ou de prise de décision unitaire, le Lasso ou l’Elastic Net (combinant pénalités $L_1$ et $L_2$) seront privilégiés. Si l’hypothèse substantive postule au contraire que le phénomène est piloté par des construits psychologiques généraux s’exprimant à travers l’action conjointe de multiples indicateurs corrélés, la régression sur composantes principales demeure conceptuellement et empiriquement plus adéquate.
12. Bonnes pratiques, reproductibilité et limites épistémologiques
12.1 Écueils fréquents et mauvaises interprétations
Le déploiement de la PCR en recherche empirique est fréquemment émaillé d’erreurs d’interprétation conceptuelle qu’il convient de dissiper rigoureusement. La méprise la plus répandue consiste à assimiler indûment les composantes principales issues de l’ACP aux facteurs latents dérivés de l’Analyse Factorielle Exploratoire (AFE). Tandis que l’AFE postule un modèle formel de mesure fondé sur l’hypothèse de facteurs sous-jacents inobservables causant la variance commune des items (séparant la variance commune de la variance spécifique et d’erreur), l’ACP constitue une pure opération de réduction de variance sans postulat causal sous-jacent, agrégeant indifféremment l’ensemble de la variance observée.
Un second écueil réside dans la tentation d’inférer des causalités directes à partir des coefficients rétro-projetés $\hat{\beta}_{PCR}$. Ces valeurs traduisent une contribution prédictive conditionnelle au sein d’un sous-espace factoriel tronqué, et ne sauraient en aucun cas être assimilées à des effets causaux structurels au sens de Pearl ou de l’analyse contrefactuelle. L’analyste doit constamment garder à l’esprit que la manipulation expérimentale isolée d’un item n’induira pas nécessairement la modification prédite par son coefficient de rétro-projection.
Enfin, comme souligné dans l’analyse de son architecture non supervisée, l’élagage prématuré de composantes de faible variance peut masquer des signaux prédictifs cruciaux. L’investigateur doit impérativement auditer la corrélation bivariée entre chacune des composantes extraites et la réponse $Y$, afin de confirmer qu’aucun axe factoriel négligé ne présentait une liaison fonctionnelle majeure avec le critère modélisé.
12.2 Normes de reporting académique et standards APA
La diffusion transparente des modèles PCR au sein de revues scientifiques à comité de lecture doit se conformer aux standards stricts de l’American Psychological Association (APA Style, 7e édition) et aux lignes directrices pour les modèles prédictifs multivariés (guidelines TRIPOD). Les manuscrits doivent expliciter sans ambiguïté les éléments méthodologiques suivants :
- Le protocole de prétraitement complet : Documenter rigoureusement la modalité d’imputation des données manquantes, les règles d’éviction des valeurs aberrantes multivariées, ainsi que la formalisation de la standardisation des prédicteurs.
- La méthode de validation croisée : Préciser la topologie de partitionnement retenue ($K$-fold avec le nombre de segments et de répétitions, ou Leave-One-Out), ainsi que la fixation explicite de la graine pseudo-aléatoire.
- Le tableau de décomposition factorielle : Publier un tableau synthétique consignant pour chaque composante : la valeur propre associée, le pourcentage de variance expliqué au sein de la matrice $X$, le pourcentage cumulé de variance expliqué dans le critère $Y$, et l’erreur RMSEP associée.
- L’inventaire des saturations (loadings) : Divulguer la matrice complète des saturations factorielles pour les $M$ composantes optimales, en indiquant le seuil conventionnel adopté pour isoler les variables substantiellement contributives.
- La comparaison des performances : Rapporter conjointement le $R^2$ d’entraînement, le $Q^2$ de test, le RMSEP et la MAE, accompagnés de leur confrontation explicite aux performances obtenues via le modèle des moindres carrés ordinaires non régularisé.
12.3 Protocoles de science ouverte et flux de travail reproductibles
L’éthique moderne de la recherche translationnelle impose une conformité totale avec les principes de la science ouverte (Open Science). La seule description textuelle des analyses au sein de la section méthodologique d’un article ne suffit plus à garantir la réplicabilité exacte des calculs. L’investigateur doit élaborer un flux de travail computationnel transparent articulé autour de documents computationnels dynamiques sous Quarto ou R Markdown.
Pour immuniser l’analyse contre les futures dépréciations logicielles et l’évolution imprévisible des packages CRAN, le projet analytique doit intégrer un système de gestion d’environnement virtuel localisé, tel que fourni par le package renv. La commande renv::snapshot() permet de consigner dans un fichier de verrouillage structuré (renv.lock) les empreintes numériques exactes de toutes les extensions sollicitées, autorisant n’importe quel chercheur tiers à restaurer l’écosystème à l’identique via renv::restore().
Enfin, le code source complet, annoté pas à pas, ainsi que les données empiriques dé-identifiées (respectant les impératifs de confidentialité clinique et du RGPD) doivent être déposés sur des archives pérennes de confiance dotées d’identifiants numériques d’objets (DOI), à l’instar de l’Open Science Framework (OSF) ou du consortium Zenodo/CERN. Cette rigueur algorithmique et archivistique concourt à asseoir la crédibilité méthodologique des inférences psychologiques et comportementales, élevant la modélisation statistique au rang de standard scientifique pérenne.
Références
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Jolliffe, I. T. (1982). A note on the use of principal components in regression. Journal of the Royal Statistical Society: Series C (Applied Statistics), 31(3), 300–303. https://doi.org/10.2307/2347988
- Jolliffe, I. T. (2002). Principal Component Analysis (2nd ed.). Springer. https://doi.org/10.1007/b98835
- Mevik, B.-H., & Wehrens, R. (2007). The pls package: Principal component and partial least squares regression in R. Journal of Statistical Software, 18(2), 1–23. https://doi.org/10.18637/jss.v018.i02
- Revelle, W. (2023). psych: Procedures for Psychological, Psychometric, and Personality Research. Northwestern University, Evanston, Illinois. https://CRAN.R-project.org/package=psych
- Wehrens, R. (2020). Chemometrics with R: Multivariate Data Analysis in the Natural Sciences and Life Sciences (2nd ed.). Springer. https://doi.org/10.1007/978-3-662-62027-4
- Wold, S., Sjöström, M., & Eriksson, L. (2001). PLS-regression: A basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2), 109–130. https://doi.org/10.1016/S0169-7439(01)00155-1