
L’analyse prédictive contemporaine est régulièrement confrontée à l’accroissement vertigineux de la dimensionnalité des données. Dans les disciplines scientifiques quantitatives, qu’il s’agisse de la chimiométrie, de la génomique, de l’économétrie appliquée ou du traitement du signal, le statisticien fait face à des configurations matricielles où le nombre de variables explicatives rivalise avec le nombre d’observations, voire le surpasse. Cette profusion informationnelle s’accompagne d’un écueil méthodologique redoutable : la multicolinéarité sévère. Lorsque les prédicteurs présentent de fortes interdépendances linéaires, le modèle linéaire généralisé conventionnel s’effondre, incapable de fournir des estimations stables et interprétables. L’inversion de la matrice de covariance devient numériquement instable, provoquant une explosion de la variance des estimateurs et rendant toute inférence statistique caduque.
Face à cette impasse computationnelle, la régression sur composantes principales (PCR, pour Principal Component Regression) s’impose comme une stratégie de régularisation et de réduction dimensionnelle de premier plan. Fondée sur la synthèse élégante de l’analyse factorielle et de la théorie de l’estimation par les moindres carrés, la PCR transforme l’espace initial des régresseurs, saturé de redondances, en un sous-espace vectoriel constitué de dimensions strictement orthogonales. En substituant aux prédicteurs bruts une sélection parcimonieuse de scores factoriels ordonnés par ordre décroissant de variance capturée, cette méthode restaure la condition mathématique nécessaire à une estimation robuste, tout en réduisant drastiquement le bruit stochastique sous-jacent.
L’objet de cet article est d’offrir une exploration exhaustive, tant sur le plan théorique que pratique, de la régression sur composantes principales au sein de l’écosystème Python. En s’appuyant sur les bibliothèques scientifiques fondamentales telles que NumPy, Pandas et scikit-learn, nous détaillerons pas à pas chaque phase du processus d’ingénierie statistique : de la décomposition spectrale sous-jacente au diagnostic rigoureux des résidus, en passant par le partitionnement méthodique des données, le calibrage d’hyperparamètres par validation croisée et la rétro-projection des coefficients dans l’espace physique d’origine. Cette démarche académique et appliquée fournira aux chercheurs et praticiens de la science des données les clés nécessaires pour maîtriser l’architecture de la PCR et l’exploiter dans des contextes prédictifs exigeants.
1. Fondements théoriques et mathématiques de la régression sur composantes principales
1.1 Origine et définition de la régression sur composantes principales (PCR)
L’émergence de la régression sur composantes principales s’inscrit au confluent de deux traditions quantitatives majeures du vingtième siècle : la psychométrie factorielle initiée par Charles Spearman et Harold Hotelling, et la statistique inférentielle formalisée par Carl Friedrich Gauss et Ronald Fisher. Historiquement, l’analyse factorielle visait à résumer la morphologie des corrélations entre variables manifestes par l’extraction d’axes latents non observables. Ce n’est qu’au milieu des années 1950 et 1960 que des théoriciens comme Kendall (1957) et Massy (1965) ont formalisé l’utilisation des composantes issues de l’Analyse en Composantes Principales (ACP) comme variables indépendantes dans une structure de régression linéaire standard. Cette transition a marqué un changement paradigmatique, faisant passer l’ACP d’un outil purement descriptif et exploratoire à un puissant réducteur dimensionnel dédié à la modélisation conditionnelle et prédictive.
Formellement, la PCR se définit comme une méthodologie d’estimation linéaire en deux étapes distinctes : la projection linéaire sans supervision de l’espace des prédicteurs sur un ensemble restreint d’axes orthogonaux maximisant la dispersion géométrique, suivie de la régression par les moindres carrés de la variable réponse sur ces nouvelles coordonnées, désignées sous le terme de scores factoriels. Contrairement à la régression linéaire multiple ordinaire qui calibre simultanément les coefficients associés à chaque dimension observée, la PCR brise le couplage dimensionnel en opérant sur des prédicteurs décorrélés par construction algébrique. Cette décorrélation garantit une additivité parfaite de la variance expliquée par chaque composante dans le modèle linéaire.
La distinction conceptuelle entre la régression multiple conventionnelle et la PCR réside principalement dans le traitement de l’espace des paramètres. Dans un modèle standard, l’objectif d’optimisation se concentre exclusivement sur la minimisation de l’erreur quadratique de prédiction le long de l’axe de la variable cible, sans considération pour la géométrie interne de la matrice des variables explicatives. La PCR, en revanche, impose une contrainte structurelle préalable : les coefficients de régression doivent impérativement appartenir au sous-espace linéaire engendré par les vecteurs propres dominants de la matrice de variance-covariance des prédicteurs. Ce mécanisme de régularisation par projection permet d’éliminer les composantes directionnelles associées aux plus faibles valeurs propres, souvent assimilables à du bruit de mesure ou à des instabilités d’échantillonnage, stabilisant ainsi considérablement l’estimation finale.
1.2 Formulation algébrique de la régression linéaire classique
Pour appréhender rigoureusement les apports de la PCR, il convient de revisiter l’architecture algébrique du modèle linéaire standard. Soit un échantillon de n observations indépendantes décrit par un vecteur de réponses continues y de dimension (n, 1) et une matrice de plan d’expérience X de dimension (n, p), où p représente le nombre de variables prédictives préalablement centrées. Le modèle linéaire postule la relation stochastique fondamentale : y = X β + ε, où β est le vecteur de dimension (p, 1) des coefficients régressifs inconnus, et ε désigne le vecteur des perturbations aléatoires de dimension (n, 1). L’estimation classique repose sur le critère d’optimisation de Gauss, consistant à minimiser la somme des carrés des résidus, formellement exprimée par la forme quadratique : RSS(β) = (y – X β)T (y – X β).
L’annulation du gradient de cette fonctionnelle convexe par rapport au vecteur β conduit au système des équations normales standard : (XT X) β = XT y. Lorsque la matrice de Gram XT X, d’ordre (p, p), est de rang plein égal à p, elle admet une inverse unique. L’estimateur des moindres carrés ordinaires (MCO) prend alors l’expression analytique canonique : β̂MCO = (XT X)-1 XT y. D’après le théorème fondamental de Gauss-Markov, sous les hypothèses d’espérance conditionnelle nulle de l’aléa et d’homoscédasticité sphérique (matrice de variance-covariance de ε proportionnelle à la matrice identité σ2 In), l’estimateur β̂MCO est le meilleur estimateur linéaire non biaisé (BLUE), conférant à ses composantes une variance minimale parmi la classe des estimateurs linéaires sans biais.
Néanmoins, l’édifice mathématique de Gauss-Markov s’effondre face aux limites computationnelles et statistiques inhérentes à l’inversion de la matrice XT X en grande dimension. Si deux ou plusieurs colonnes de X présentent une dépendance linéaire forte, la matrice XT X tend vers la singularité. Ses valeurs propres s’effondrent vers zéro, provoquant une explosion spectaculaire de la trace de sa matrice inverse, Tr((XT X)-1). Or, la matrice de covariance de l’estimateur des MCO étant directement donnée par Var(β̂MCO) = σ2 (XT X)-1, cette quasi-singularité induit une dispersion exorbitante des coefficients estimés. Dans la situation limite où p > n, le rang de la matrice ne peut dépasser n, rendant XT X structurellement non inversible et interdisant formellement l’application des moindres carrés ordinaires sans recours préalable à une méthode de régularisation ou de réduction de rang.
1.3 Mécanismes de la transformation des prédicteurs en composantes principales
L’Analyse en Composantes Principales apporte une solution analytique élégante à cette aporie matricielle en opérant une décomposition spectrale de la matrice de dispersion. Considérons la matrice de variance-covariance empirique des prédicteurs, proportionnelle à la matrice symétrique semi-définie positive S = (1 / (n – 1)) XT X, sous l’hypothèse de variables préalablement centrées à moyenne nulle. En vertu du théorème spectral, toute matrice symétrique réelle admet une décomposition en éléments propres de la forme : S = V Λ VT, où V est une matrice orthogonale (p, p) dont les colonnes vj constituent une base orthonormée de vecteurs propres, et Λ = diag(λ1, λ2, …, λp) est la matrice diagonale des valeurs propres associées, conventionnellement ordonnées selon la hiérarchie décroissante : λ1 ≥ λ2 ≥ … ≥ λp ≥ 0.
Chaque vecteur propre vj définit une direction géométrique d’extension maximale au sein du nuage de points multidimensionnel. La projection de la matrice originale X sur cette base orthonormée engendre la matrice des coordonnées factorielles, communément dénommée matrice des scores factoriels et notée Z, telle que : Z = X V. La j-ième colonne de Z, définie par zj = X vj, représente la j-ième composante principale de l’échantillon. La propriété d’orthogonalité stricte des vecteurs propres, satisfaisant la relation VT V = V VT = Ip, confère aux composantes principales une propriété statistique cardinale : la décorrélation mutuelle totale.
En effet, la matrice de variance-covariance empirique associée aux nouvelles variables synthétiques Z est rigoureusement diagonale : Var(Z) = (1 / (n – 1)) ZT Z = (1 / (n – 1)) VT XT X V = VT S V = Λ. Il en résulte que la covariance empirique entre deux composantes distinctes zj et zk est rigoureusement nulle pour tout j ≠ k. De surcroît, la variance empirique de chaque score factoriel zj est exactement égale à la valeur propre correspondante λj. Cette décomposition préserve l’intégralité de la dispersion spatiale originelle, la trace de la matrice initiale étant préservée en vertu de l’invariance cyclique de la trace : Tr(S) = Tr(V Λ VT) = Tr(Λ VT V) = Tr(Λ) = ∑j=1p λj. L’information géométrique globale se trouve ainsi hiérarchisée, concentrée sur les premiers axes de dispersion maximale et purgée de toute colinéarité redondante.
2. La problématique de la multicollinéarité dans l’analyse de données
2.1 Nature et manifestations de la multicolinéarité sévère
La multicolinéarité désigne un état structural du tableau expérimental dans lequel plusieurs prédicteurs entretiennent des dépendances linéaires approximatives ou parfaites. Dans la pratique empirique des sciences expérimentales, les capteurs spectroscopiques, les relevés macroéconomiques synchronisés ou les marqueurs transcriptomiques collectent fréquemment des signaux redondants qui évoluent de concert. Contrairement à la colinéarité parfaite, qui est une anomalie déterministe où le déterminant de XT X s’annule strictement, la multicolinéarité sévère est une condition stochastique insidieuse où le déterminant approche asymptotiquement zéro sans jamais l’atteindre complètement. La matrice de Gram demeure techniquement inversible au sens mathématique, mais elle devient numériquement mal conditionnée au regard de l’analyse numérique matricielle.
La conséquence statistique la plus immédiate de cette quasi-dépendance linéaire réside dans l’inflation spectaculaire de la variance des estimateurs des coefficients de régression. Mathématiquement, la variance de l’estimateur du coefficient β̂j par les moindres carrés peut s’écrire sous la forme factorisée : Var(β̂j) = (σ2 / ((n – 1) Var(Xj))) × (1 / (1 – Rj2)), où Rj2 désigne le coefficient de détermination issu de la régression linéaire de la variable Xj sur l’ensemble des p – 1 autres prédicteurs. Lorsque Xj est fortement couplée au reste de l’espace prédictif, Rj2 tend vers l’unité, propulsant le second terme vers l’infini. Les intervalles de confiance associés aux paramètres estimés s’élargissent alors de manière démesurée, rendant les estimations statistiquement insignifiantes et instables face aux micro-perturbations des données.
Cette instabilité numérique a des répercussions directes sur l’interprétabilité du modèle. Les tests d’hypothèse paramétriques, tels que le test de Student de significativité individuelle, perdent toute puissance statistique en générant des p-values anormalement élevées, même en présence d’une relation causale réelle et d’une significativité globale attestée par le test de Fisher global. De surcroît, les coefficients peuvent adopter des valeurs aberrantes, voire changer de signe algébrique de manière contre-intuitive, contredisant les lois physiques ou économiques régissant le phénomène sous-jacent. Ce paradoxe démontre qu’un modèle de régression ordinaire hautement colinéaire peut afficher un coefficient de détermination global R2 trompeusement élevé tout en s’avérant parfaitement incapable d’isoler l’effet marginal propre de chaque prédicteur.
2.2 Outils diagnostiques de la corrélation entre prédicteurs
La détection et la caractérisation formelle de la multicolinéarité requièrent la mobilisation d’un ensemble d’outils analytiques complémentaires, dépassant la simple inspection visuelle des nuages de points. Le facteur d’inflation de la variance (VIF, pour Variance Inflation Factor) constitue l’indice standard d’évaluation univariée de la colinéarité. Directement dérivé de la formulation de la variance des estimateurs, le VIF associé à la variable Xj est défini par : VIFj = 1 / (1 – Rj2). En l’absence totale de corrélation linéaire entre Xj et les autres colonnes de la matrice X, Rj2 = 0 et VIFj = 1. Bien qu’aucun seuil absolu ne fasse l’unanimité absolue dans la littérature statistique, un VIF excédant une valeur seuil conventionnelle de 5 ou 10 indique une multicolinéarité problématique justifiant l’abandon des MCO classiques ou l’application d’un protocole de remédiation tel que la PCR.
Une approche diagnostique globale plus rigoureuse repose sur l’analyse spectrale de la matrice de corrélation ou de la matrice de conception standardisée. Cette démarche s’appuie sur le calcul de l’indice de conditionnement (Condition Index), formalisé notamment par Belsley, Kuh et Welsch (1980). Soit λmax la plus grande valeur propre de la matrice XT X et λj la j-ième valeur propre ; l’indice de conditionnement associé à l’axe j est défini par : κj = √(λmax / λj). Le nombre de conditionnement global de la matrice correspond au supremum de ces indices, à savoir κ = √(λmax / λmin). Un nombre de conditionnement inférieur à 10 dénote une matrice saine et bien conditionnée ; une valeur comprise entre 10 et 30 signale une colinéarité modérée ; enfin, un indice excédant 30 révèle une colinéarité sévère et une instabilité numérique critique lors de l’inversion matricielle.
Enfin, la construction de la matrice de corrélation linéaire de Pearson offre une cartographie synoptique des interdépendances bivariées. Bien qu’elle s’avère aveugle face aux colinéarités d’ordre supérieur (c’est-à-dire les relations où une variable est une combinaison linéaire de plusieurs prédicteurs sans être fortement corrélée à aucun d’eux individuellement), elle permet d’identifier immédiatement les blocs de forte covariance et les grappes de variables redondantes. Ces diagnostics conjoints fournissent la justification théorique et empirique nécessaire à la transition vers une technique d’orthogonalisation des prédicteurs telle que la régression sur composantes principales.
2.3 Pourquoi la PCR constitue une réponse robuste à la redondance
La régression sur composantes principales désamorce structurellement la crise de la multicolinéarité en modifiant la géométrie même des prédicteurs soumis à l’estimation linéaire. Puisque les composantes principales Z = X V satisfont la condition d’orthogonalité stricte ZT Z = (n – 1) Λ, la matrice d’information de Fisher associée au nouveau problème d’estimation, ZT Z, est rigoureusement diagonale. L’inversion d’une telle matrice ne nécessite aucun algorithme complexe de pivotement d’élimination de Gauss-Jordan sujet aux erreurs d’arrondi : l’inverse d’une matrice diagonale s’obtient trivialement en inversant chacun de ses termes diagonaux scalaires, soit (ZT Z)-1 = (1 / (n – 1)) Λ-1, où Λ-1 = diag(1/λ1, 1/λ2, …, 1/λp).
Cette simplification algébrique élimine toute interférence croisée entre régresseurs. Le VIF de chaque score factoriel devient identiquement égal à 1, attestant de l’éradication totale de toute inflation de variance attribuable à la colinéarité. De plus, la PCR ne se contente pas d’orthogonaliser l’espace : elle procède à un filtrage délibéré des dimensions projectives. En sélectionnant un sous-ensemble des M premières composantes (avec M < p), le statisticien écarte sciemment les axes directionnels associés aux plus petites valeurs propres λM+1, …, λp. Ce sont précisément ces directions asymptotiquement plates qui portent la quasi-singularité matricielle et amplifient démesurément la variance de l’estimateur.
La robustesse conférée par la PCR s’explique ainsi par un arbitrage classique et salutaire au sens du compromis biais-variance. L’omission des p – M dernières composantes introduit un biais mathématique délibéré dans l’estimation des coefficients originels, rompant avec le dogme de l’absence de biais des moindres carrés ordinaires. Cependant, ce compromis permet une diminution massive de la variance globale de l’estimateur. L’erreur quadratique moyenne totale de prédiction (MSE), qui somme le carré du biais et la variance, s’en trouve significativement amoindrie. La PCR préserve ainsi la presque totalité du signal informationnel structuré contenu dans l’échantillon tout en purgeant la structure matricielle de ses redondances déstabilisatrices.
3. Architecture algorithmique de l’Analyse en Composantes Principales (ACP)
3.1 Décomposition en valeurs singulières (SVD)
Dans l’ingénierie algorithmique moderne, l’extraction des composantes principales ne passe que très rarement par le calcul explicite de la matrice de variance-covariance empirique XT X, dont l’évaluation directe peut dégrader la précision numérique par l’accumulation d’erreurs de troncature en virgule flottante. La norme algorithmique contemporaine repose sur la Décomposition en Valeurs Singulières (SVD, pour Singular Value Decomposition), formalisée par Gene Golub et William Kahan. La SVD établit que toute matrice réelle rectangulaire X de dimensions (n, p) peut être factorisée de manière exacte sous la forme : X = U Σ VT.
Dans cette factorisation fondamentale, U est une matrice semi-orthogonale de dimension (n, p) dont les colonnes, appelées vecteurs singuliers gauches, constituent une base orthonormée de l’espace des colonnes de X vérifiant UT U = Ip. La matrice V est une matrice orthogonale de dimension (p, p) dont les colonnes sont les vecteurs singuliers droits, satisfaisant VT V = V VT = Ip. Enfin, la matrice centrale Σ est une matrice diagonale de dimension (p, p) contenant les valeurs singulières scalaires réelles positives σ1 ≥ σ2 ≥ … ≥ σp ≥ 0, ordonnées de manière strictement non croissante.
Le lien analytique entre la SVD et la décomposition spectrale de la covariance est direct et élégant. En formant le produit matriciel XT X à partir de sa décomposition singulière, il vient : XT X = (U Σ VT)T (U Σ VT) = V ΣT UT U Σ VT = V Σ2 VT. Par identification avec l’équation aux éléments propres XT X = V ((n – 1) Λ) VT, on constate immédiatement que les vecteurs singuliers droits de X sont rigoureusement identiques aux vecteurs propres de la matrice de dispersion XT X. De surcroît, les valeurs singulières σj sont directement reliées aux valeurs propres par la relation : λj = σj2 / (n – 1). L’algorithme d’ACP de la bibliothèque scikit-learn s’appuie exclusivement sur des variantes optimisées de la SVD (telles que la SVD tronquée ou la SVD randomisée de Halko et al.), garantissant une stabilité numérique optimale et une complexité temporelle réduite face aux jeux de données massifs.
3.2 Calcul et sélection de la variance expliquée
L’exploitation opérationnelle de l’ACP nécessite une métrique rigoureuse pour quantifier la proportion d’information conservée par chaque axe factoriel successif. La variance totale contenue dans l’ensemble des prédicteurs standardisés est équivalente à la somme des valeurs propres de la matrice de covariance, soit ∑j=1p λj. Pour chaque composante principale j, le ratio de variance expliquée (explained variance ratio) est défini par la quantité sans dimension : EVRj = λj / (∑k=1p λk) = σj2 / (∑k=1p σk2). Cette métrique exprime la fraction unitaire d’inertie statistique résumée par la j-ième projection géométrique.
L’outil privilégié d’analyse exploratoire de cette dispersion réside dans le tracé du diagramme des éboulis (scree plot), proposé par Raymond Cattell. Ce graphique séquentiel représente l’évolution des valeurs propres λj ou du ratio individuel en fonction de l’indice ordonné de la composante. L’analyse visuelle recherche traditionnellement un point d’inflexion marqué, souvent qualifié de « coude », au-delà duquel les valeurs propres décroissent lentement le long d’une pente résiduelle assimilable à un éboulis géologique de bruit aléatoire. Cependant, l’inspection heuristique du coude comporte une part d’arbitraire subjectif, poussant les statisticiens à adopter des critères de décision plus quantitatifs.
Parmi ces règles d’arrêt formalisées, le critère de Kaiser-Guttman préconise de retenir uniquement les composantes principales dont la valeur propre empirique est strictement supérieure à la moyenne des valeurs propres. Dans le cas de données préalablement standardisées, la variance de chaque variable originale est unitaire, fixant la moyenne des valeurs propres à exactement 1 ; le critère stipule alors d’éliminer toute composante dont λj < 1, considérant qu’un axe factoriel n’est statistiquement légitime que s’il synthétise au minimum l’équivalent informationnel d’une variable initiale isolée. Un second critère fréquent est celui du seuil de variance cumulée, imposant de conserver un nombre suffisant de composantes M pour garantir que la somme cumulée des ratios de variance atteigne un seuil préétabli, couramment fixé à 80 %, 90 % ou 95 %. En régression sur composantes principales, néanmoins, ces règles strictement descriptives doivent être complétées par un critère prédictif externe supervisé par la variable cible y.
3.3 Projection des observations dans le nouvel espace orthogonal
La projection des données d’origine vers l’espace factoriel constitue l’acte opératoire transformant l’ensemble d’apprentissage avant la régression. Considérons la matrice de centrage et de réduction appliquée à la matrice originelle pour obtenir X. L’opérateur de projection orthogonale associant le nuage de points aux axes factoriels optimaux est régi par la transformation linéaire : Z = X V. En utilisant les propriétés de la SVD où X = U Σ VT, cette projection prend la forme matricielle explicite : Z = U Σ VT V = U Σ. Les colonnes de Z représentent les coordonnées intrinsèques des observations dans le repère vectoriel formé par les vecteurs propres décorrélés.
Cette transformation linéaire préserve scrupuleusement la géométrie euclidienne globale du nuage d’observations. En effet, en vertu de l’orthogonalité de la matrice de passage V, la distance euclidienne multidimensionnelle entre deux observations quelconques xi et xk est rigoureusement conservée lorsqu’elle est calculée dans l’espace factoriel complet de dimension p : ||zi – zk||22 = (xi – xk) V VT (xi – xk)T = ||xi – xk||22. La réduction dimensionnelle opérée par la PCR consiste à tronquer cette matrice de passage en ne retenant que les M premières colonnes de V, formant la sous-matrice VM de dimension (p, M).
La matrice résultante des scores réduits, notée ZM = X VM, est de rang M et dimension (n, M). Sur le plan structural, cette projection orthogonale garantit que le sous-espace affine de projection est celui qui minimise la somme des carrés des distances perpendiculaires (distances euclidiennes résiduelles) entre les points d’origine et leurs projetés. Les coordonnées factorielles ZM capturent la morphologie dominante du jeu de données avec une perte d’inertie minimale. Ce sont ces nouvelles coordonnées sans redondance colinéaire qui constituent désormais les régresseurs légitimes destinés à alimenter le modèle d’estimation finale.
4. Étape 1 : Configuration de l’environnement Python et importation des modules
4.1 Environnement d’exécution et bibliothèques scientifiques de base
La mise en œuvre pratique de la PCR exige un environnement d’exécution Python robuste et standardisé. Les architectures de calcul scientifique modernes s’appuient sur un ensemble de bibliothèques éprouvées garantissant des performances vectorisées proches du langage C et une syntaxe analytique intuitive. Le socle fondamental est constitué par NumPy, bibliothèque de référence pour la manipulation de tenseurs multidimensionnels et les opérations d’algèbre linéaire hautement optimisées grâce aux routines BLAS et LAPACK. NumPy offre la structure de base ndarray, permettant d’exécuter des transformations matricielles complexes en mémoire contiguë avec une efficacité computationnelle maximale.
Pour la manipulation des données tabulaires et le traitement préliminaire des métadonnées, l’importation de Pandas s’avère indispensable. À travers ses structures phares DataFrame et Series, Pandas simplifie l’indexation, le découpage conditionnel, le nettoyage des formats d’entrée et le suivi des noms de caractéristiques (feature names), facilitant ainsi le lien entre l’abstraction mathématique des scores factoriels et les identifiants originels des prédicteurs. Enfin, l’interprétation diagnostique d’un modèle statistique ne saurait se concevoir sans un moteur de visualisation rigoureux. Le couplage fonctionnel de Matplotlib, pour le contrôle de bas niveau de la mise en page vectorielle, et de Seaborn, pour la sémiologie graphique statistique avancée, fournit les outils requis pour tracer les matrices de corrélation, les éboulis factoriels et les distributions résiduelles.
Dans un script d’analyse structuré, ces modules sont conventionnellement importés sous leurs alias standards dès les premières lignes d’instruction : import numpy as np, import pandas as pd, import matplotlib.pyplot as plt, et import seaborn as sns. Il est également recommandé d’ajuster les paramètres globaux d’affichage graphique de Matplotlib (tels que la résolution en points par pouce et les palettes chromatiques adaptées aux publications scientifiques) afin d’assurer une lisibilité irréprochable des graphiques diagnostiques qui jalonneront le pipeline d’estimation.
4.2 Modules spécialisés de scikit-learn pour la modélisation
L’implémentation industrielle de la PCR bénéficie grandement de la modularité de scikit-learn, référence incontournable de l’apprentissage automatique en Python. Bien que scikit-learn ne propose pas de classe unifiée monolithique portant explicitement le nom de PrincipalComponentRegression, la méthode se déploie via la composition fonctionnelle de modules spécialisés respectant l’interface cohérente des estimateurs et transformateurs de la bibliothèque. Pour l’étape de factorisation dimensionnelle, la classe PCA issue du sous-module sklearn.decomposition s’impose par sa robustesse et sa gestion transparente des différentes approches de factorisation SVD.
Pour la phase d’ajustement prédictif, l’estimateur canonique LinearRegression localisé dans sklearn.linear_model fournit l’implémentation standard de la résolution des équations normales par moindres carrés. Le conditionnement préalable des variables nécessite la mobilisation d’outils de prétraitement rigoureux : la classe StandardScaler du sous-module sklearn.preprocessing assure le centrage et la réduction unitaire des prédicteurs, tout en mémorisant les statistiques d’échelle pour neutraliser tout risque de contamination informationnelle entre partitions.
Enfin, l’évaluation diagnostique et le calibrage de la complexité du modèle requièrent l’importation d’outils de validation croisée et de calcul de métriques. Les classes train_test_split et RepeatedKFold, issues de sklearn.model_selection, permettent d’organiser la séparation des données et d’exécuter des protocoles de rééchantillonnage stochastique répétés. Le sous-module sklearn.metrics fournit quant à lui les fonctions d’évaluation quantitative indispensables, à l’instar de mean_squared_error, r2_score et mean_absolute_error, assurant un étalonnage objectif des performances prédictives du pipeline complet.
4.3 Reproductibilité et gestion des paramètres aléatoires
L’intégrité de la démarche scientifique repose sur le principe cardinal de reproductibilité algorithmique. Bien que l’ACP déterministe exacte par SVD complète ne comporte aucun élément intrinsèque d’aléa mathématique, plusieurs étapes périphériques du protocole de modélisation introduisent des composantes stochastiques substantielles. C’est tout particulièrement le cas lors de la partition aléatoire du jeu de données entre échantillons d’apprentissage et de test, de l’affectation des observations aux différents plis (folds) de la validation croisée, ou encore lors de l’usage éventuel d’algorithmes de décomposition SVD randomisée accélérée pour des matrices de grande envergure.
Pour garantir que l’ensemble des résultats numériques, des courbes d’erreur et des coefficients estimés puissent être reproduits à l’identique lors d’exécutions ultérieures ou sur des plateformes de calcul distinctes, il est impératif d’initialiser formellement un germe aléatoire global (seed). Cette fixation s’opère classiquement en renseignant systématiquement l’argument random_state=42 (ou tout autre entier strictement fixé) au sein de chaque classe ou fonction mobilisant de l’aléa, notamment train_test_split et RepeatedKFold. De même, la commande np.random.seed(42) peut être invoquée pour figer les générateurs de nombres pseudo-aléatoires de NumPy sous-jacents.
Au-delà de la gestion des germes aléatoires, la rigueur logicielle impose de documenter explicitement les versions des bibliothèques mobilisées au sein de l’environnement d’exécution. Les variations incrémentales de comportement algorithmique, de gestion des exceptions ou d’optimisation d’arrondi entre versions successives de scikit-learn ou NumPy peuvent induire des écarts d’estimation marginaux. L’organisation du code doit ainsi suivre une structure modulaire, claire et abondamment commentée, partitionnant logiquement le flux de travail en blocs fonctionnels distincts, de la configuration initiale jusqu’à la production des inférences finales.
5. Étape 2 : Chargement et exploration préalable des données
5.1 Acquisition et structuration du jeu de données
Le point de départ opérationnel d’une régression sur composantes principales réside dans l’acquisition d’une structure de données rectangulaire cohérente, reflétant les contraintes d’une problématique multidimensionnelle concrète. Dans les contextes industriels ou académiques, ces données proviennent typiquement de lectures de capteurs physico-chimiques (spectrométrie proche infrarouge, chromatographie) ou de séries microéconomiques interconnectées. Ces jeux de données se caractérisent généralement par un nombre substantiel de prédicteurs continus présentant des variations conjointes complexes face à une variable réponse scalaire d’intérêt.
Dès la phase d’ingestion des données à l’aide des fonctions de lecture spécialisées de Pandas (telles que pd.read_csv), la première opération structurante consiste à opérer une scission nette entre la matrice des régresseurs, notée X, et le vecteur de la variable cible continue, noté y. Cette démarcation isole l’espace des prédicteurs sur lequel portera ultérieurement l’orthogonalisation non supervisée, empêchant toute interaction computationnelle prématurée avec la cible. L’intégrité matricielle doit immédiatement faire l’objet d’un audit systématique : vérification de l’homogénéité des types numériques (conversion des entiers ou flottants encodés en chaînes de caractères), identification et quantification des éventuelles valeurs manquantes (NaN), et détection d’observations aberrantes ou redondantes.
L’imputation ou l’exclusion rigoureuse des valeurs manquantes doit être menée avec prudence avant toute décomposition factorielle. L’Analyse en Composantes Principales standard ne tolère aucune lacune d’observation au sein de la matrice X, chaque vecteur d’observation devant être complet pour permettre le calcul des produits scalaires et des projections géométriques. Une fois cette étape de nettoyage validée, les dimensions géométriques formelles de la matrice (n, p) et du vecteur (n, 1) sont figées, définissant le périmètre d’analyse statistique.
5.2 Analyse exploratoire des distributions et des covariances
Avant d’engager toute machinerie algorithmique lourde, une phase d’analyse statistique exploratoire s’impose pour appréhender la morphologie spatiale des données. Le calcul des statistiques descriptives fondamentales (moyennes empiriques, écarts-types, médianes, quartiles et coefficients d’asymétrie) via la méthode describe() de Pandas permet d’évaluer la dispersion marginale de chaque variable et de mettre en lumière d’éventuelles disparités massives d’unités de mesure ou d’amplitude numérique. Ces disparités constituent le premier indicateur signalant la nécessité impérieuse d’une étape ultérieure de standardisation.
L’exploration des dépendances mutuelles s’effectue principalement par l’évaluation de la matrice des corrélations bivariées de Pearson, calculée par X.corr(). La sémiologie graphique offre ici une valeur analytique substantielle par le biais d’une carte thermique de covariance (correlation heatmap) colorée à l’aide de Seaborn. Cette représentation met immédiatement en relief l’organisation interne des prédicteurs : la présence de grands blocs rectangulaires aux teintes chaudes, caractérisés par des coefficients de corrélation par paires oscillant entre 0,80 et 0,99, apporte la preuve directe d’une multicolinéarité systémique et sévère.
Cette condensation d’interdépendances linéaires confirme que les variables prédictives ne varient pas de manière autonome, mais réagissent à des facteurs sous-jacents partagés. Face à une telle topologie de corrélation, un modèle de régression linéaire standard conduira inévitablement à un fractionnement instable des effets marginaux et à des erreurs standard disproportionnées. L’identification graphique de ces grappes de covariance justifie méthodologiquement le recours à la décomposition en composantes principales pour synthétiser ces faisceaux de variables redondantes en axes factoriels indépendants.
5.3 Partitionnement méthodologique des données
Le partitionnement méthodique du jeu de données constitue un jalon méthodologique critique pour prémunir l’analyse contre le surapprentissage (overfitting) et garantir une évaluation impartiale de la capacité de généralisation du modèle. Il est indispensable de scinder l’échantillon initial en deux sous-ensembles mutuellement exclusifs : un ensemble d’apprentissage (training set), destiné à calibrer les paramètres du modèle, et un ensemble de test indépendant (test set ou hold-out), strictement sanctuarisé jusqu’à la phase d’évaluation finale. Cette scission s’opère par l’instruction train_test_split(X, y, test_size=0.2, random_state=42), allouant classiquement 70 % à 80 % des données à l’entraînement.
La règle méthodologique absolue régissant cette étape est la prévention rigoureuse de la fuite d’information (data leakage). Toute information relative à la distribution de l’ensemble de test qui viendrait contaminer, directement ou indirectement, la phase d’apprentissage fausserait gravement l’estimation des performances réelles. Dans le cadre précis de la PCR, ce risque de contamination est particulièrement aigu lors des étapes de centrage-réduction et d’extraction des composantes principales. L’espace vectoriel des prédicteurs doit impérativement être structuré sans la moindre référence aux observations du jeu de test.
Ainsi, les moyennes, les variances empiriques ainsi que les vecteurs propres de l’ACP doivent être dérivés exclusivement à partir de la matrice d’entraînement X_train. Le jeu de test X_test ne doit intervenir que sous forme d’observations passives projetées a posteriori sur les repères factoriels appris, simulant avec une fidélité mathématique parfaite le comportement du modèle face à des données réelles totalement inédites. De plus, un examen sommaire des distributions marginales de la variable cible y entre les partitions permet de s’assurer de la bonne représentativité de l’échantillon de test par rapport à la population étudiée.
6. Étape 3 : Centrage et réduction des variables explicatives
6.1 Nécessité théorique de la standardisation en ACP
L’Analyse en Composantes Principales est une technique géométrique intrinsèquement dépendante des unités de mesure et des échelles d’amplitude des prédicteurs d’origine. Cette vulnérabilité découle de son objectif même d’optimisation : l’ACP cherche à identifier les directions spatiales qui maximisent la variance projetée. Si une variable prédictive est exprimée dans un ordre de grandeur considérablement supérieur aux autres (par exemple, un revenu annuel exprimé en dizaines de milliers d’unités face à un âge mesuré en décennies), sa variance empirique brute sera artificiellement gigantesque par rapport à celle des autres régresseurs.
Dans un tel scénario non standardisé, le premier axe principal s’alignera presque exclusivement sur la variable affichant la plus grande variance brute, non pas en vertu d’un contenu informationnel structurel supérieur, mais par simple artefact de son unité de mesure. L’ACP devient alors mathématiquement myope, ignorant les covariations subtiles reliant les variables aux amplitudes plus modestes. Pour neutraliser cette distorsion métrique arbitraire, il est indispensable de transformer les variables pour les rendre comparables, en opérant une mise à l’échelle rigoureuse garantissant que chaque prédicteur contribue équitablement à la topologie globale de la dispersion.
La transformation canonique requise est la standardisation Z-score. Pour chaque variable Xj, cette transformation soustrait sa moyenne empirique μj et divise le résultat par son écart-type empirique σj, produisant une variable centrée-réduite X̃j = (Xj – μj) / σj. Par construction mathématique, chaque variable transformée possède une moyenne strictement nulle (E(X̃j) = 0) et une variance empirique unitaire (Var(X̃j) = 1). L’application de l’ACP sur ces variables standardisées équivaut formellement à réaliser la décomposition spectrale sur la matrice de corrélation de Pearson plutôt que sur la matrice de covariance brute, conférant à la méthode une invariance d’échelle totale.
6.2 Implémentation technique avec StandardScaler
Dans l’écosystème scikit-learn, la mise en œuvre technique de cette opération repose sur la classe StandardScaler du sous-module sklearn.preprocessing. L’architecture de cette classe distingue rigoureusement la phase d’apprentissage des paramètres d’échelle de la phase de transformation effective des matrices, garantissant le respect scrupuleux des principes anti-fuite d’information mentionnés précédemment.
Concrètement, l’instanciation de l’objet s’effectue via scaler = StandardScaler(). L’ajustement est ensuite réalisé sur la partition d’apprentissage exclusivement via la commande scaler.fit(X_train), ce qui déclenche le calcul et la mise en cache des moyennes vectorielles (scaler.mean_) et des variances d’échantillon (scaler.var_). Une fois cette calibration établie, la standardisation effective de la matrice d’entraînement s’opère par l’instruction X_train_scaled = scaler.transform(X_train). Les observations de test sont ensuite transformées à leur tour à l’aide des paramètres de l’entraînement : X_test_scaled = scaler.transform(X_test).
Il est critique de souligner qu’il ne faut sous aucun prétexte invoquer scaler.fit(X_test) ou scaler.fit_transform(X_test) sur les données de validation. Une telle opération recalculerait les moyennes et variances sur l’ensemble de test, introduisant une fuite informationnelle substantielle et détruisant la cohérence géométrique relative entre les deux sous-espaces. Alternativement, la fonction scale() de scikit-learn permet de centrer-réduire rapidement un tableau NumPy ponctuel, mais elle n’encapsule pas l’état des paramètres statistiques calculés, ce qui la rend impropre à une intégration sécurisée dans un pipeline de production rigoureux confronté à des données futures.
6.3 Validation de l’état standardisé des prédicteurs
À l’issue de l’étape de transformation métrique, une validation diagnostique algorithmique doit confirmer la conformité des données préparées avant d’aborder l’Analyse en Composantes Principales. Cette vérification s’opère par l’évaluation computationnelle directe des deux premiers moments statistiques de la matrice X_train_scaled. Le calcul des moyennes de chaque colonne via np.mean(X_train_scaled, axis=0) doit renvoyer un vecteur de scalaires infinitésimaux, strictement équivalents à zéro aux erreurs d’arrondi numérique près (typiquement de l’ordre de 10-16 en précision double 64-bit).
Parallèlement, l’évaluation des variances par colonne, calculée par np.var(X_train_scaled, axis=0), doit attester d’une égalité stricte à l’unité (valeur exacte de 1,0 pour l’ensemble des régresseurs). Un contrôle d’intégrité numérique complémentaire doit être exécuté pour s’assurer de l’absence totale de valeurs non numériques (NaN) ou infinies (inf), qui pourraient être générées lors de la division matricielle dans l’hypothèse pathologique où un prédicteur d’origine présenterait une variance strictement nulle (variable constante non informative).
L’invariance d’échelle obtenue stabilise le comportement des estimateurs ultérieurs. Chaque dimension descriptive participe désormais sur un pied d’égalité à la métrique de dissimilarité euclidienne. Les coordonnées spatiales résultantes garantissent que les composantes principales extraites captureront fidèlement la covariance corrélative intrinsèque de l’écosystème de données, sans être polluées par des facteurs multiplicatifs exogènes liés aux systèmes d’unités physiques d’origine.
7. Étape 4 : Décomposition en composantes principales avec scikit-learn
7.1 Instanciation et ajustement de l’objet PCA
Une fois les variables prédictives rigoureusement standardisées, la phase d’extraction factorielle peut être initiée au moyen de la classe PCA de scikit-learn. Lors de cette première approche analytique globale, il est recommandé d’instancier l’estimateur sans restreindre a priori le nombre d’axes, en omettant le paramètre n_components ou en le fixant formellement au nombre total initial de prédicteurs p : pca = PCA(). Ce paramétrage exhaustif permet d’extraire la totalité des p composantes principales possibles, offrant une visibilité intégrale sur le spectre complet de dispersion de la matrice de données.
L’ajustement du modèle factoriel s’exécute par l’invocation de la méthode pca.fit(X_train_scaled). En arrière-plan, scikit-learn mobilise des algorithmes de factorisation SVD adaptés, calculant les valeurs singulières et la matrice de projection V. L’accès aux vecteurs propres directeurs, représentant les axes factoriels dans l’espace originel, s’effectue via l’attribut pca.components_. Il s’agit d’un tableau bidimensionnel NumPy de dimensions (p, p) dans lequel chaque ligne j contient les coefficients du j-ième vecteur propre vjT (également désignés sous le terme de saturations ou loadings).
Il importe de noter une convention d’orientation spatiale inhérente à la SVD : les vecteurs propres ne sont définis qu’à un facteur scalaire multiplicatif de signe près (un vecteur propre multiplié par -1 demeure une base propre valide de l’opérateur linéaire). Bien que cela n’altère en rien la modélisation géométrique globale ni la qualité prédictive de la PCR, cette propriété exige de la vigilance lors de la comparaison de chargements factoriels entre différents logiciels statistiques. L’objet pca conserve en mémoire l’intégralité de la géométrie factorielle apprise sur l’échantillon d’entraînement, prêt pour l’analyse spectrale quantitative.
7.2 Analyse de la variance expliquée par composante
L’inspection de la variance synthétisée par les nouveaux axes directeurs est une étape cardinale de l’ingénierie factorielle. L’estimateur PCA fournit deux attributs fondamentaux à cette fin : explained_variance_, qui restitue les valeurs propres empiriques réelles λj de la matrice de covariance standardisée, et explained_variance_ratio_, qui exprime ces grandeurs sous la forme d’un ratio unitaire par rapport à la variance totale. L’observation directe de ce vecteur ordonné confirme la décroissance monotone stricte de l’énergie statistique capturée au fil des dimensions projectives successives.
Pour appréhender l’accumulation de l’information statistique à travers les dimensions factorielles, on procède au calcul du cumul séquentiel des ratios au moyen de la fonction vectorisée de NumPy : cumulative_variance = np.cumsum(pca.explained_variance_ratio_). Cette série discrète décrit une courbe concave bornée par l’unité, reflétant le pourcentage total de dispersion préservé à mesure que l’on intègre des axes factoriels additionnels dans la structure du modèle.
La formalisation graphique de cette analyse s’opère par la superposition conjointe de deux courbes sur un même graphique : un diagramme en barres figurant le ratio de variance individuelle pour chaque axe j, et une courbe en ligne superposée illustrant la variance cumulée en fonction du rang de la composante. Ce diagnostic visuel met immédiatement en évidence la vitesse de décroissance de l’information. Dans un système de données marqué par une forte colinéarité, les deux ou trois premières composantes absorbent fréquemment plus de 70 % à 85 % de la dispersion globale, tandis que les axes distaux se cantonnent à des pourcentages infinitésimaux, attestant de leur nature de bruit résiduel non informatif.
7.3 Génération des matrices de scores factoriels
La matérialisation opérationnelle de l’Analyse en Composantes Principales s’achève par la transformation des observations d’origine en scores factoriels via la projection orthogonale. Cette étape s’exécute par l’appel de la méthode transform() appliquée à la matrice d’entraînement standardisée : Z_train = pca.transform(X_train_scaled). Les colonnes de la matrice Z_train ainsi générée contiennent les coordonnées spatiales exactes de chaque individu statistique dans le nouveau repère orthogonal, constituant les composantes principales effectives.
Il est scientifiquement instructif de valider empiriquement la décorrélation parfaite des variables synthétiques ainsi construites. Le calcul de la matrice de corrélation empirique des scores via np.corrcoef(Z_train, rowvar=False) produit une matrice identité stricte aux tolérances de calcul près. Tous les coefficients hors diagonale affichent des valeurs de l’ordre de 10-15, apportant la confirmation numérique directe de l’élimination absolue de toute multicolinéarité au sein du nouvel espace des prédicteurs.
Parallèlement, la matrice de test doit subir la même projection géométrique à l’aide de l’instruction Z_test = pca.transform(X_test_scaled). Conformément au protocole de cloisonnement strict, cette projection réutilise exclusivement les matrices de chargements factoriels pca.components_ calibrées sur l’échantillon d’entraînement. La structure de test se trouve dès lors transposée dans le référentiel orthogonal établi, sans avoir participé à sa construction géométrique originelle, prête à être mobilisée lors de la phase de validation finale.
8. Étape 5 : Détermination du nombre optimal de composantes par validation croisée
8.1 Configuration du protocole de validation croisée k-fold répétée
Le choix du nombre M de composantes principales à retenir dans l’ajustement du modèle prédictif final représente la décision architecturale critique de la PCR. Une troncature trop agressive (faible valeur de M) éliminerait des composantes factorielles porteuses de signal prédictif pertinent vis-à-vis de la variable cible y, plongeant le modèle dans le sous-apprentissage (underfitting). Inversement, l’inclusion d’un nombre excessif de composantes réintroduit les axes associés aux bruits parasites et à la multicolinéarité résiduelle, dégradant la stabilité des estimations et conduisant au surapprentissage (overfitting).
Pour identifier ce point d’équilibre optimal de manière objective et exempte de biais de sélection, le recours à un protocole d’évaluation par validation croisée (cross-validation) s’avère indispensable. Face à la variabilité inhérente aux découpages aléatoires simples d’un K-Fold conventionnel, l’implémentation de la validation croisée K-fold répétée (RepeatedKFold) constitue la méthode de référence statistique. En moyennant les résultats sur un ensemble de fractionnements distincts et itératifs, cette procédure lisse les fluctuations d’échantillonnage et fournit un profil d’erreur hautement convergent.
Sur le plan paramétrique, un schéma standard éprouvé consiste à configurer un découpage en 10 plis répété 5 ou 10 fois : cv = RepeatedKFold(n_splits=10, n_repeats=10, random_state=42). Cette configuration garantit que le modèle sera calibré et évalué sur cent combinaisons d’apprentissage et de validation partielles distinctes. Ce niveau d’exigence méthodologique est le garant d’une estimation robuste de l’erreur généralisée et préserve le praticien des illusions de performance imputables à un découpage d’échantillonnage singulier ou atypique.
8.2 Boucle itérative d’évaluation des modèles emboîtés
L’implémentation algorithmique de la recherche de l’hyperparamètre dimensionnel M s’organise autour d’une boucle itérative évaluant systématiquement l’ensemble des modèles emboîtés pour chaque valeur candidate de M ∈ {1, 2, …, p}. Afin de respecter rigoureusement l’étanchéité méthodologique à chaque pli de validation croisée, le pipeline complet — intégrant le centrage-réduction, l’ajustement de l’ACP et la calibration de la régression linéaire — doit être réajusté de manière hermétique sur les sous-échantillons d’entraînement propres au pli considéré.
À chaque itération sur la dimension candidate M, le modèle projette les données d’entraînement du pli sur les M premiers axes factoriels, puis ajuste une instance de LinearRegression par les moindres carrés ordinaires. Les données de validation du pli subissent ensuite la même standardisation et la même projection factorielle sur ces M axes, avant d’être soumises à la fonction prédictive du régresseur. L’erreur quadratique moyenne de prédiction (MSE) est évaluée sur le pli à l’aide de mean_squared_error(y_val, y_pred).
Ces scores d’erreur sont collectés et agrégés sur l’intégralité des plis et répétitions du protocole de rééchantillonnage, fournissant pour chaque valeur de M une distribution d’erreurs empiriques dont on extrait la moyenne arithmétique globale ainsi que l’écart-type d’échantillonnage. Ce balayage exhaustif produit une cartographie quantitative précise de l’erreur quadratique moyenne généralisée en fonction de la complexité dimensionnelle allouée au régresseur.
8.3 Sélection objective du seuil de coupure dimensionnel
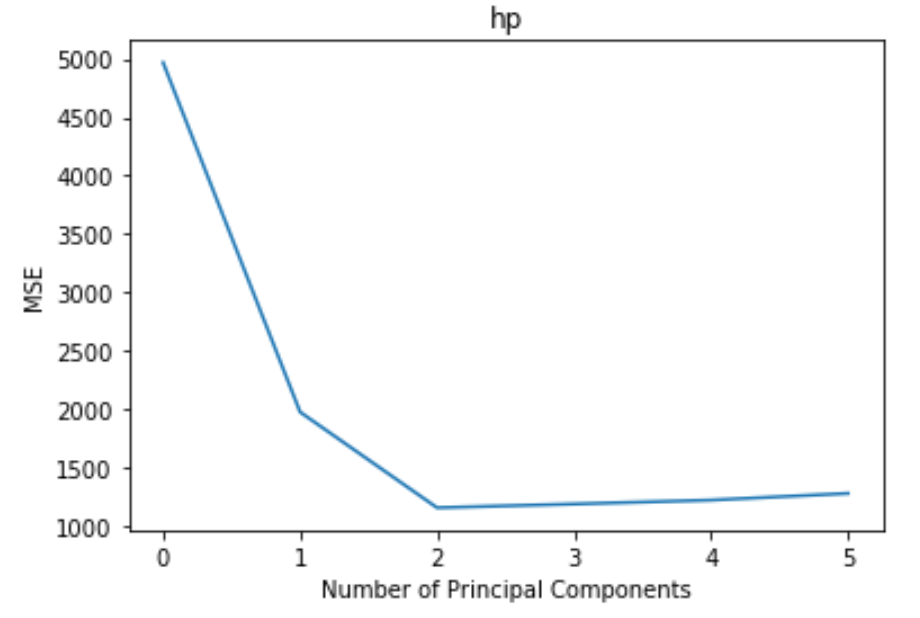
L’arbitrage dimensionnel final s’opère par l’analyse formelle de la trajectoire de l’erreur quadratique moyenne en fonction du nombre de composantes M. Le tracé graphique de cette fonction montre typiquement une décroissance rapide du MSE lors de l’intégration des premières composantes fondamentales, traduisant l’acquisition progressive du signal explicatif structuré. La courbe atteint ensuite un minimum global, avant de se stabiliser ou de remonter plus ou moins nettement lorsque les composantes mineures, chargées en bruit aléatoire, commencent à dégrader la robustesse de l’ajustement.
Le critère d’arrêt le plus immédiat consiste à désigner comme dimension optimale M* l’entier exact qui minimise formellement l’erreur moyenne de validation croisée : M* = argminM MSECV(M). Cette règle garantit mathématiquement l’optimisation directe de la précision de généralisation empirique sur la grille discrète testée.
Cependant, en statistique appliquée et en apprentissage machine rigoureux, on privilégie fréquemment l’application de la règle heuristique de la « plus grande parcimonie à une erreur standard » (one-standard-error rule), formalisée par Hastie, Tibshirani et Friedman (2009). Cette règle consiste à identifier d’abord le minimum global absolu de MSE, puis à retenir le modèle possédant le plus faible nombre de composantes M dont l’erreur moyenne de validation croisée demeure contenue dans un intervalle d’un écart-type autour de ce minimum. Cette stratégie protège efficacement le modèle contre le surapprentissage marginal, sélectionnant une architecture délibérément plus compacte sans dégradation statistiquement significative de ses performances prédictives.
9. Étape 6 : Entraînement et ajustement du modèle final de régression
9.1 Filtrage dimensionnel définitif des prédicteurs
Une fois le nombre optimal de composantes M* formellement établi par le protocole de validation croisée, il convient de figer l’architecture du système de transformation dimensionnelle. Pour exploiter l’intégralité de l’information disponible sans déperdition d’efficacité d’échantillonnage, l’opérateur d’extraction factorielle est réajusté sur l’intégralité de la partition d’apprentissage X_train_scaled, en configurant cette fois de manière stricte le paramètre de troncature : pca_final = PCA(n_components=M_optimal).
L’exécution de la méthode pca_final.fit(X_train_scaled) extrait les M* vecteurs propres dominants de l’ensemble d’entraînement, stockés dans une matrice de chargements factoriels V_M de dimensions (p, M*). L’application séquentielle de la méthode de projection factorielle transform() engendre les matrices de scores finales pour l’apprentissage et le test :
Z_train_optimal = pca_final.transform(X_train_scaled), de dimensions (n_train, M*) ;Z_test_optimal = pca_final.transform(X_test_scaled), de dimensions (n_test, M*).
Cette étape matérialise l’opération de filtrage spatial : les p – M* dimensions résiduelles, identifiées par le protocole précédent comme des vecteurs de bruit ou de redondance délétère, sont définitivement purgées de la base d’apprentissage. L’espace prédictif ne contient désormais que des prédicteurs de rang plein, totalement décorrélés entre eux et porteurs de l’essentiel de la dispersion explicative.
9.2 Ajustement par les moindres carrés sur les composantes sélectionnées
La seconde phase constitutive de la PCR réside dans l’ajustement linéaire classique de la variable de réponse sur ces coordonnées orthogonales réduites. Cette calibration est confiée à l’estimateur des moindres carrés ordinaires, instancié par regressor = LinearRegression() et ajusté via l’instruction directe : regressor.fit(Z_train_optimal, y_train).
Sur le plan mathématique, l’absence totale de multicolinéarité entre les colonnes de Z_train_optimal confère à cette opération une stabilité algorithmique absolue. L’estimation du vecteur de coefficients factoriels γ̂, de dimension (M*, 1), obéit à la résolution directe de l’équation normale simplifiée : γ̂ = (ZMT ZM)-1 ZMT y. Puisque la matrice ZMT ZM est strictement diagonale, chaque coefficient factoriel scalaire γ̂m est mathématiquement indépendant de la présence des autres composantes dans le modèle, s’écrivant simplement comme le produit scalaire standard normalisé : γ̂m = (zmT y) / (zmT zm).
L’estimateur ajuste également l’ordonnée à l’origine (intercept) du modèle, accessible via l’attribut regressor.intercept_. Puisque les composantes principales sont à moyenne nulle par construction du centrage initial des prédicteurs, l’intercept estimé γ̂0 correspond rigoureusement à la moyenne empirique de la variable réponse ȳ de l’échantillon d’apprentissage. L’ajustement garantit une minimisation optimale de la somme des carrés résiduels dans le sous-espace factoriel contraint.
9.3 Rétro-projection des coefficients dans l’espace des variables initiales
Bien que la PCR effectue son ajustement prédictif dans l’espace abstrait des scores factoriels Z, il est indispensable, pour des raisons de diagnostic physique et de cohérence applicative, de pouvoir restituer l’équation de régression en fonction des variables prédictives initiales X. Cette rétro-projection mathématique permet d’exprimer les prédictions comme une combinaison linéaire directe des prédicteurs originaux standardisés.
L’équation prédictive factorielle s’énonce comme suit : ŷ = γ̂0 + ZM γ̂ = γ̂0 + (Xscaled VM) γ̂. En réassociant les termes par associativité du produit matriciel, on obtient la relation : ŷ = γ̂0 + Xscaled (VM γ̂) = γ̂0 + Xscaled β̂PCR. Il apparaît clairement que le vecteur équivalent des coefficients de régression associé aux prédicteurs standardisés s’obtient par le produit matriciel de la matrice des chargements factoriels transposée et du vecteur des coefficients estimés sur les scores : β̂PCR = VM γ̂. En Python, cette synthèse matricielle s’exécute directement à l’aide de l’opérateur de multiplication tensorielle de NumPy : beta_pcr_scaled = pca_final.components_.T @ regressor.coef_.
Pour exprimer ces coefficients dans l’unité de mesure physique non standardisée d’origine, une dernière transformation algébrique de dénormalisation doit être appliquée. Le coefficient d’échelle physique de la variable j s’obtient en divisant son coefficient standardisé par l’écart-type d’origine stocké par le scaler : β̂j, brut = β̂PCR, j / σj. De même, la constante originelle est recalculée en ajustant l’intercept selon la somme pondérée des moyennes des prédicteurs : β̂0, brut = γ̂0 – ∑j=1p β̂j, brut μj. Cette rétro-projection restitue une équation exploitable directement sur les flux de données brutes, éliminant toute contrainte computationnelle de transformation lors du déploiement en production.
10. Étape 7 : Évaluation diagnostique et performance prédictive du modèle
10.1 Métriques quantitatives d’évaluation sur le jeu de test indépendant
L’appréciation impartiale de l’efficacité prédictive du modèle de régression sur composantes principales repose impérativement sur son déploiement face à la partition de test sanctuarisée Z_test_optimal. L’inférence s’exécute par l’appel de y_test_pred = regressor.predict(Z_test_optimal). La confrontation entre ce vecteur de prédictions et les valeurs réelles observées y_test nécessite l’évaluation d’un faisceau complémentaire d’indicateurs quantitatifs d’erreur et d’adhérence.
La première métrique structurante est l’erreur quadratique moyenne (MSE), calculée par mean_squared_error(y_test, y_test_pred), ainsi que sa racine carrée (RMSE, pour Root Mean Squared Error). Le RMSE possède l’avantage théorique majeur de s’exprimer dans la même unité dimensionnelle que la variable cible, pénalisant lourdement les grands écarts prédictifs par l’élévation des résidus au carré. Pour évaluer la sensibilité du modèle face aux anomalies locales sans surpondération quadratique, l’erreur absolue moyenne (MAE, pour Mean Absolute Error) est simultanément quantifiée via mean_absolute_error(y_test, y_test_pred), apportant une mesure de dispersion médiane hautement robuste.
Enfin, la proportion de variance expliquée par le modèle face à des données inconnues est évaluée au moyen du coefficient de détermination empirique R2, formalisé par r2_score(y_test, y_test_pred). Ce critère sans dimension, borné supérieurement par 1, quantifie la réduction relative de variabilité obtenue par la PCR par rapport à un modèle simpliste se bornant à prédire la moyenne empirique de la variable réponse. L’examen conjoint de ces métriques atteste du degré d’exactitude et de régularisation atteint par le pipeline de traitement.
10.2 Analyse rigoureuse de la structure des résidus
L’analyse statistique d’un modèle linéaire prédictif ne saurait s’arrêter aux métriques d’erreur scalaires : elle impose une inspection approfondie du comportement structurel des résidus d’estimation ei = yi – ŷi. Un modèle correctement spécifié et exempt de biais sous-jacent doit générer des résidus statistiquement indiscernables d’un bruit blanc gaussien sphérique.
Le premier diagnostic graphique réside dans le diagramme de dispersion confrontant les valeurs prédites ŷ en abscisse aux résidus e en ordonnée. Ce graphique permet d’évaluer visuellement l’hypothèse cardinale d’homoscédasticité (constance de la variance résiduelle). La présence d’une structure en entonnoir (expansion ou contraction de la dispersion verticale) révèle une hétéroscédasticité exigeant une transformation préalable de la cible, tandis qu’une courbure parabolique ou sinusoïdale indique une incapacité du modèle linéaire à capturer certaines relations polynomiales ou non linéaires latentes.
Le second contrôle porte sur la distribution de normalité des résidus. L’évaluation repose sur la construction d’un diagramme quantile-quantile (Q-Q plot) confrontant les quantiles empiriques des erreurs aux quantiles théoriques d’une loi normale standard, complété éventuellement par un test d’hypothèse formel tel que celui de Shapiro-Wilk ou de D’Agostino-Pearson. L’alignement rigoureux des points le long de la bissectrice confirme la gaussianité des perturbations. Enfin, l’absence d’autocorrélation entre résidus successifs est validée, garantissant qu’aucun artefact d’ordre séquentiel n’altère la validité de l’inférence.
10.3 Comparaison directe avec la régression multiple conventionnelle
Pour mesurer sans ambiguïté la plus-value méthodologique de la PCR face à la multicolinéarité, il est indispensable de confronter directement ses performances à celles d’un modèle de régression linéaire multiple standard (MCO) ajusté sans réduction dimensionnelle préalable sur l’intégralité des variables d’origine standardisées : ols = LinearRegression().fit(X_train_scaled, y_train).
Dans un contexte de données fortement corrélées, la comparaison des résultats numériques entre les deux approches fait ressortir des contrastes éloquents. Bien que le modèle MCO conventionnel affiche fréquemment un R2 trompeusement compétitif, voire supérieur sur le sous-ensemble d’apprentissage en exploitant la sur-paramétrisation pour épouser les fluctuations d’échantillonnage, ses performances s’effondrent régulièrement lors de l’application à la partition de test indépendante. Son RMSE de test explose sous l’effet de la variance excessive des coefficients individuels instables.
À l’inverse, la PCR démontre une supériorité prédictive nette et une remarquable stabilité de généralisation. En acceptant une infime augmentation du biais d’ajustement sur les données d’entraînement (due à la suppression délibérée des composantes mineures), la PCR compense largement cette perte par une contraction majeure de la variance prédictive globale. L’affichage synoptique des coefficients estimés illustre également ce phénomène : là où les moindres carrés ordinaires affichent des coefficients gigantesques aux polarités opposées compensatoires aberrantes, la PCR restitue des valeurs équilibrées, alignées avec la réalité empirique du phénomène étudié.
11. Interprétation avancée des composantes et des contributions individuelles
11.1 Analyse des saturations factorielles (loadings)
L’un des défis majeurs de l’ingénierie factorielle réside dans la préservation de la transparence interprétative. Alors que la régression classique permet de lire directement l’effet marginal ceteris paribus d’une variable spécifique à travers son coefficient βj, la PCR manipule des scores factoriels synthétiques dont la signification substantielle n’est pas immédiatement évidente. La levée de cette opacité requiert une analyse fine des saturations factorielles (loadings).
La matrice de transformation pca.components_, de dimension (M*, p), définit précisément le poids projectif ou la contribution scalaire de chaque variable initiale au sein de chaque composante retenue. Mathématiquement, la corrélation empirique entre une variable initiale standardisée Xj et la composante principale zm est directement donnée par la relation : Corr(Xj, zm) = vjm √(λm), où vjm représente l’élément de saturation localisé à la ligne m et colonne j de la matrice factorielle, et λm est la valeur propre associée à l’axe. Ces saturations s’interprètent comme des coefficients de projection normalisés oscillant entre -1 et +1.
L’inspection analytique de ces poids permet de convertir une dimension mathématique abstraite en un concept théorique tangible. Par exemple, si une composante principale présente de fortes saturations positives conjointes sur l’ensemble des variables caractérisant la taille physique, la masse et l’envergure d’un système mécanique, cette composante peut légitimement être conceptualisée comme un « facteur d’échelle globale ». Inversement, un axe opposant des variables d’accélération à des variables de consommation énergétique constituera un « axe d’arbitrage de performance ». La cartographie des saturations via des diagrammes en barres horizontales ordonnées permet d’expliciter le contenu informationnel canalisé par le modèle.
11.2 Visualisation du cercle des corrélations et biplots
La sémiologie graphique factorielle trouve son expression la plus riche dans la construction de plans factoriels bidimensionnels, couramment dénommés biplots et cercles des corrélations. Le cercle des corrélations projette les saturations des variables initiales sur un plan formé par deux composantes principales distinctes (typiquement les deux premiers axes PC1 et PC2). L’espace géométrique y est circonscrit par un cercle de rayon unitaire R = 1.
La lecture de ce cercle s’appuie sur des propriétés trigonométriques précises :
- La longueur de la flèche vectorielle associée à une variable reflète la qualité de sa représentation sur le plan factoriel considéré (une flèche approchant la circonférence unitaire signale une variable dont l’information est quasi intégralement capturée par ces deux dimensions) ;
- Le cosinus de l’angle formé entre deux flèches vectorielles approxime directement le coefficient de corrélation linéaire de Pearson entre les variables correspondantes (un angle aigu signale une corrélation positive forte, un angle droit indique une indépendance linéaire totale, et un angle plat à 180 degrés traduit une corrélation négative stricte) ;
- L’angle entre un vecteur variable et un axe factoriel quantifie la contribution de cette variable à la définition structurelle de la composante considérée.
Le biplot factoriel superpose à ce cercle de corrélations le nuage de points des scores individuels des observations dans le même repère géométrique. Cette représentation conjointe offre une vision holistique remarquable : elle permet de repérer simultanément les grappes d’individus typologiques, d’isoler les points atypiques ou déviants et d’identifier instantanément les faisceaux de variables sous-jacentes régissant ces différenciations structurelles. Cette cartographie visuelle transforme l’abstraction matricielle en un puissant outil de diagnostic heuristique.
11.3 Synthèse et formulation de conclusions explicatives
L’étape finale de l’exploitation analytique consiste à synthétiser l’ensemble des éléments de modélisation pour formuler des inférences rigoureuses et transparentes. Le statisticien doit conjuguer les résultats quantitatifs prédictifs (coefficients rétro-projetés β̂PCR) avec les interprétations factorielles qualitatives issues de l’analyse des chargements et des cercles de corrélation.
Une mise en garde épistémologique fondamentale s’impose néanmoins dans la formulation des conclusions : la PCR, tout comme la régression linéaire ordinaire, identifie des associations statistiques corrélatives au sein d’un sous-espace de dispersion, mais ne constitue en aucun cas une démonstration formelle de causalité physique ou économique. L’interprétation des composantes comme dimensions latentes doit demeurer prudente, en évitant le piège de la réification abusive, consistant à prêter une existence ontologique matérielle à un simple opérateur de rotation géométrique orthogonale.
Enfin, la gouvernance algorithmique moderne impose une documentation intégrale du processus de modélisation. Les équations de transformation, la liste des hyperparamètres validés (seuil optimal M*, métriques de variance cumulée), ainsi que la matrice des coefficients rétro-projetés dans leur échelle naturelle doivent être consignées de manière exhaustive. Cette rigueur assure une traçabilité sans faille du système d’inférence, garantissant que le modèle final puisse être audité, interprété et redéployé dans un environnement opérationnel en toute fiabilité.
12. Limites méthodologiques, bonnes pratiques et alternatives à la PCR
12.1 Limites structurelles de la régression sur composantes principales
Bien que la régression sur composantes principales apporte une solution élégante à l’instabilité numérique des moindres carrés, elle souffre d’une vulnérabilité théorique majeure inhérente à son architecture computationnelle : son caractère totalement non supervisé lors de la phase de réduction dimensionnelle. En effet, l’Analyse en Composantes Principales opère la décomposition spectrale sur la seule matrice des prédicteurs X, sans jamais interroger ni prendre en considération le vecteur de la variable dépendante y.
Cette indépendance vis-à-vis de la cible repose sur un postulat implicite risqué : la présomption que les directions spatiales présentant la plus grande variance au sein de l’espace des prédicteurs sont nécessairement celles qui possèdent le plus fort pouvoir explicatif ou prédictif vis-à-vis de y. Or, ce postulat peut être mis en échec. Il est parfaitement concevable, dans des scénarios réels complexes, qu’un signal prédictif déterminant pour y ne soit aligné qu’avec une infime fraction de la variance totale de X, localisée sur la cinquième ou dixième composante principale. Dans une telle configuration, la troncature opérée par la PCR élimine délibérément la composante porteuse du signal au motif de sa faible dispersion brute, sacrifiant irrémédiablement la performance prédictive du modèle.
Par ailleurs, la PCR présente une sensibilité marquée aux valeurs aberrantes multidimensionnelles (multivariate outliers). L’Analyse en Composantes Principales standard reposant sur la minimisation d’écarts quadratiques euclidiens, quelques observations hautement excentrées peuvent fausser l’orientation des vecteurs singuliers de la SVD, déviant ainsi l’orientation des axes factoriels. Enfin, la complexité de transmission de la variance d’échantillonnage à travers l’étape non linéaire de sélection dimensionnelle complique grandement l’établissement d’intervalles de confiance asymptotiques rigoureux pour les coefficients finaux rétro-projetés, limitant la portée des inférences чисто paramétriques sans recours intensif au bootstrap computationnel.
12.2 Comparaison avec la régression des moindres carrés partiels (PLS)
Face à la cécité structurelle de l’ACP vis-à-vis de la variable cible, la régression des moindres carrés partiels (PLS, pour Partial Least Squares), développée par Herman Wold dans les années 1970, s’affirme comme l’alternative supervisée directe à la PCR. Contrairement à la PCR qui maximise unilatéralement la variance projetée des prédicteurs Var(X v), l’algorithme PLS (fondé sur des schémas itératifs tels que NIPALS ou SIMPLS) extrait des scores latents en maximisant délibérément la covariance au carré entre les projections des prédicteurs et la variable cible : Cov2(X w, y) = Var(X w) × Corr2(X w, y) × Var(y).
Ce guidage supervisé confère à la PLS un avantage computationnel marquant : elle concentre l’information directement utile à la prédiction de y dès les toutes premières dimensions factorielles. Là où une PCR peut nécessiter l’extraction de sept ou huit composantes non supervisées pour capter indirectement les variations fines régissant la réponse, un modèle PLS parvient fréquemment à une précision équivalente, voire supérieure, avec seulement deux ou trois composantes latentes orientées vers l’objectif prédictif.
Sur le plan des cas d’usage, la PLS s’est imposée comme le standard incontournable en chimiométrie, en métabolomique et en bio-informatique, où les spectres d’absorption ou les puces à ADN comportent des milliers de descripteurs pour quelques dizaines d’échantillons seulement (p >> n). La PCR conserve toutefois une pertinence certaine lorsque l’on souhaite délibérément découpler la construction de l’espace des caractéristiques de l’observation de la cible, ou lorsque le risque de surapprentissage supervisé induit par la PLS face à des données extrêmement bruitées incite à préférer une réduction géométrique strictement intrinsèque et neutre.
12.3 Comparaison avec les méthodes de pénalisation (Ridge, Lasso, ElasticNet)
Une autre alternative majeure à la réduction dimensionnelle par projection orthogonale réside dans l’usage des techniques de régularisation par pénalisation de la norme des coefficients, incarnées par la régression Ridge, le Lasso et l’ElasticNet. Plutôt que de contraindre les coefficients à évoluer dans un sous-espace linéaire de dimension réduite M < p, les méthodes de régularisation conservent l’intégralité des p variables initiales, mais modifient la fonction de coût des moindres carrés en lui adjoignant un terme de pénalité sur l’amplitude vectorielle des paramètres.
La régression Ridge (Hoerl et Kennard, 1970) applique une pénalisation quadratique L2 sur la norme euclidienne des coefficients : Min [ RSS(β) + λ ||β||22 ]. Sur le plan analytique, la solution explicite de la régression Ridge prend la forme : β̂Ridge = (XT X + λ Ip)-1 XT y. En injectant une constante positive λ le long de la diagonale principale de la matrice de Gram, Ridge stabilise artificiellement l’inversion matricielle en rehaussant l’ensemble des valeurs propres d’une valeur scalaire fixe. La parenté avec la PCR est frappante : alors que la PCR applique une troncature brutale binaire (conservation intacte des M premières composantes et annulation complète des p – M suivantes), la régression Ridge opère un rétrécissement continu et progressif (shrinkage), appliquant un coefficient d’atténuation λj / (λj + λ) aux composantes factorielles, réduisant plus fortement les axes associés aux faibles valeurs propres sans jamais les éliminer totalement.
Le Lasso (Tibshirani, 1996) mobilise quant à lui une pénalisation L1 fondée sur la somme des valeurs absolues des coefficients : Min [ RSS(β) + λ ||β||1 ]. La singularité géométrique de la boule L1 en forme de polyèdre confère au Lasso une propriété remarquable : la sélection automatique de variables (feature selection). Le Lasso annule rigoureusement certains coefficients, produisant un modèle parcimonieux directement interprétable sur un sous-ensemble restreint de prédicteurs originaux. Enfin, l’ElasticNet synthétise les pénalités L1 et L2 pour combiner la sélection de variables du Lasso et la gestion collective des groupes de variables colinéaires de Ridge. Dans la pratique, le choix entre PCR, Ridge ou ElasticNet dépendra de la structure du signal : face à des prédicteurs denses et continus fortement couplés par une physique commune, la PCR et Ridge dominent fréquemment ; face à des systèmes où seule une poignée de prédicteurs isolés pilote véritablement le phénomène, le Lasso et ses dérivés s’avèrent structurellement supérieurs.
12.4 Synthèse des recommandations pour une implémentation rigoureuse
Pour assurer le succès opérationnel et la reproductibilité d’un pipeline d’apprentissage fondé sur la régression sur composantes principales en Python, il est indispensable de formaliser un ensemble de bonnes pratiques méthodologiques et logicielles éprouvées :
- Encapsulation stricte via le module Pipeline de scikit-learn : L’erreur d’ingénierie la plus fréquente consiste à effectuer la standardisation ou l’ACP sur l’ensemble complet des données avant de scinder les partitions ou de lancer la validation croisée. Pour éliminer tout risque d’artefact de fuite d’information (data leakage), l’ensemble du flux de traitement doit être consolidé dans un objet formel
Pipeline:
pipeline_pcr = Pipeline([('scaler', StandardScaler()), ('pca', PCA()), ('regressor', LinearRegression())]).
Cette architecture garantit que l’apprentissage des moyennes, des échelles et des axes factoriels sera hermétiquement circonscrit aux sous-échantillons d’apprentissage à chaque pli de validation croisée. - Optimisation conjointe des hyperparamètres via GridSearchCV : L’évaluation dimensionnelle doit être couplée à l’infrastructure d’optimisation standard de scikit-learn en formulant une grille de paramètres explicite :
param_grid = {'pca__n_components': range(1, X.shape[1] + 1)}.
Le couplage avec un estimateurGridSearchCVoucross_val_scoreadossé à un schéma deRepeatedKFoldpermet d’automatiser l’identification du minimum global de l’erreur quadratique moyenne avec une fiabilité mathématique totale. - Sanctuarisation absolue d’un échantillon de test indépendant : Aucune décision architecturale ou de calibrage d’hyperparamètre ne doit s’appuyer sur la partition de test finale (hold-out). Celle-ci doit demeurer vierge de toute sollicitation jusqu’à la phase ultime d’estimation impartiale des métriques prédictives généralisées (RMSE, MAE, R²).
- Audit critique de la pertinence des prédicteurs en amont : La PCR ne doit pas être perçue comme une panacée dispensant l’analyste d’un travail d’ingénierie des caractéristiques en amont. L’intégration aveugle de prédicteurs sans fondement théorique ou physique augmente l’inertie de dispersion inutile et dégrade l’efficacité de l’espace factoriel résultant.
En suivant rigoureusement ces préceptes méthodologiques et logiciels, le praticien dispose d’un cadre analytique puissant et reproductible pour dompter la multicolinéarité, transformer des espaces de données bruités et redondants en représentations factorielles stables, et construire des modèles de régression linéaires performants et pérennes.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cattell, R. B. (1966). The scree test for the number of factors. Multivariate Behavioral Research, 1(2), 245-276. https://doi.org/10.1207/s15327906mbr0102_10
- Golub, G. H., & Kahan, W. (1965). Calculating the singular values and pseudo-inverse of a matrix. Journal of the Society for Industrial and Applied Mathematics, Series B: Numerical Analysis, 2(2), 205-224. https://doi.org/10.1137/0702016
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55-67. https://doi.org/10.1080/00401706.1970.10488634
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24(6), 417-441. https://doi.org/10.1037/h0071325
- Kendall, M. G. (1957). A course in multivariate analysis. Charles Griffin & Company.
- Massy, W. F. (1965). Principal components regression in exploratory statistical research. Journal of the American Statistical Association, 60(309), 234-256. https://doi.org/10.1080/01621459.1965.10480787
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830. https://jmlr.csail.mit.edu/papers/v12/pedregosa11a.html
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267-288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Wold, H. (1975). Soft modelling by latent variables: The non-linear iterative partial least squares (NIPALS) approach. In J. Gani (Ed.), Perspectives in probability and statistics: Papers in honour of M. S. Bartlett (pp. 117-142). Academic Press.