
La recherche de la causalité constitue la pierre angulaire de l’édifice scientifique moderne. Depuis les premières réflexions épistémologiques de David Hume jusqu’aux développements contemporains de l’apprentissage automatique et de l’économétrie, distinguer une simple corrélation d’un véritable lien de cause à effet demeure un défi méthodologique fondamental. Dans les systèmes complexes — qu’il s’agisse de la physiologie humaine, des dynamiques sociales ou des comportements psychologiques —, une multitude de variables interagissent simultanément. Tenter d’isoler l’effet spécifique d’une intervention au sein d’un tel réseau de facteurs confondants relève de la gageure sans un cadre expérimental rigoureux. C’est précisément pour répondre à cette exigence que la randomisation s’est imposée comme l’innovation méthodologique la plus déterminante du XXe siècle.
En statistique inférentielle, la randomisation ne se résume pas à un simple tirage au sort intuitif ou à une commodité opératoire. Elle représente un dispositif mathématique puissant conçu pour neutraliser l’ensemble des biais de sélection, qu’ils soient connus de l’expérimentateur ou totalement occultes. En rompant de manière exogène les liens unissant les caractéristiques intrinsèques des participants aux modalités de l’intervention, l’assignation aléatoire transforme une observation passive en une expérimentation active. Ce faisant, elle crée les conditions d’une comparabilité stochastique parfaite entre les groupes, permettant d’attribuer sans ambiguïté les variations observées sur la variable dépendante à l’intervention étudiée, et à elle seule.
Le présent traité propose une analyse exhaustive et interdisciplinaire de la randomisation en statistique. À travers l’examen de ses fondements formels, de son appareillage probabiliste, de ses différentes variantes algorithmiques et de ses enjeux éthiques, nous explorerons comment ce principe fondamental garantit la validité interne de la démarche empirique. Que l’on considère la recherche biomédicale, les sciences comportementales ou l’évaluation des politiques publiques, la maîtrise de la randomisation constitue le prérequis indispensable à toute inférence causale rigoureuse.
1. Introduction conceptuelle et définition formelle de la randomisation en statistique
1.1 Définition statistique fondamentale et principes opératoires
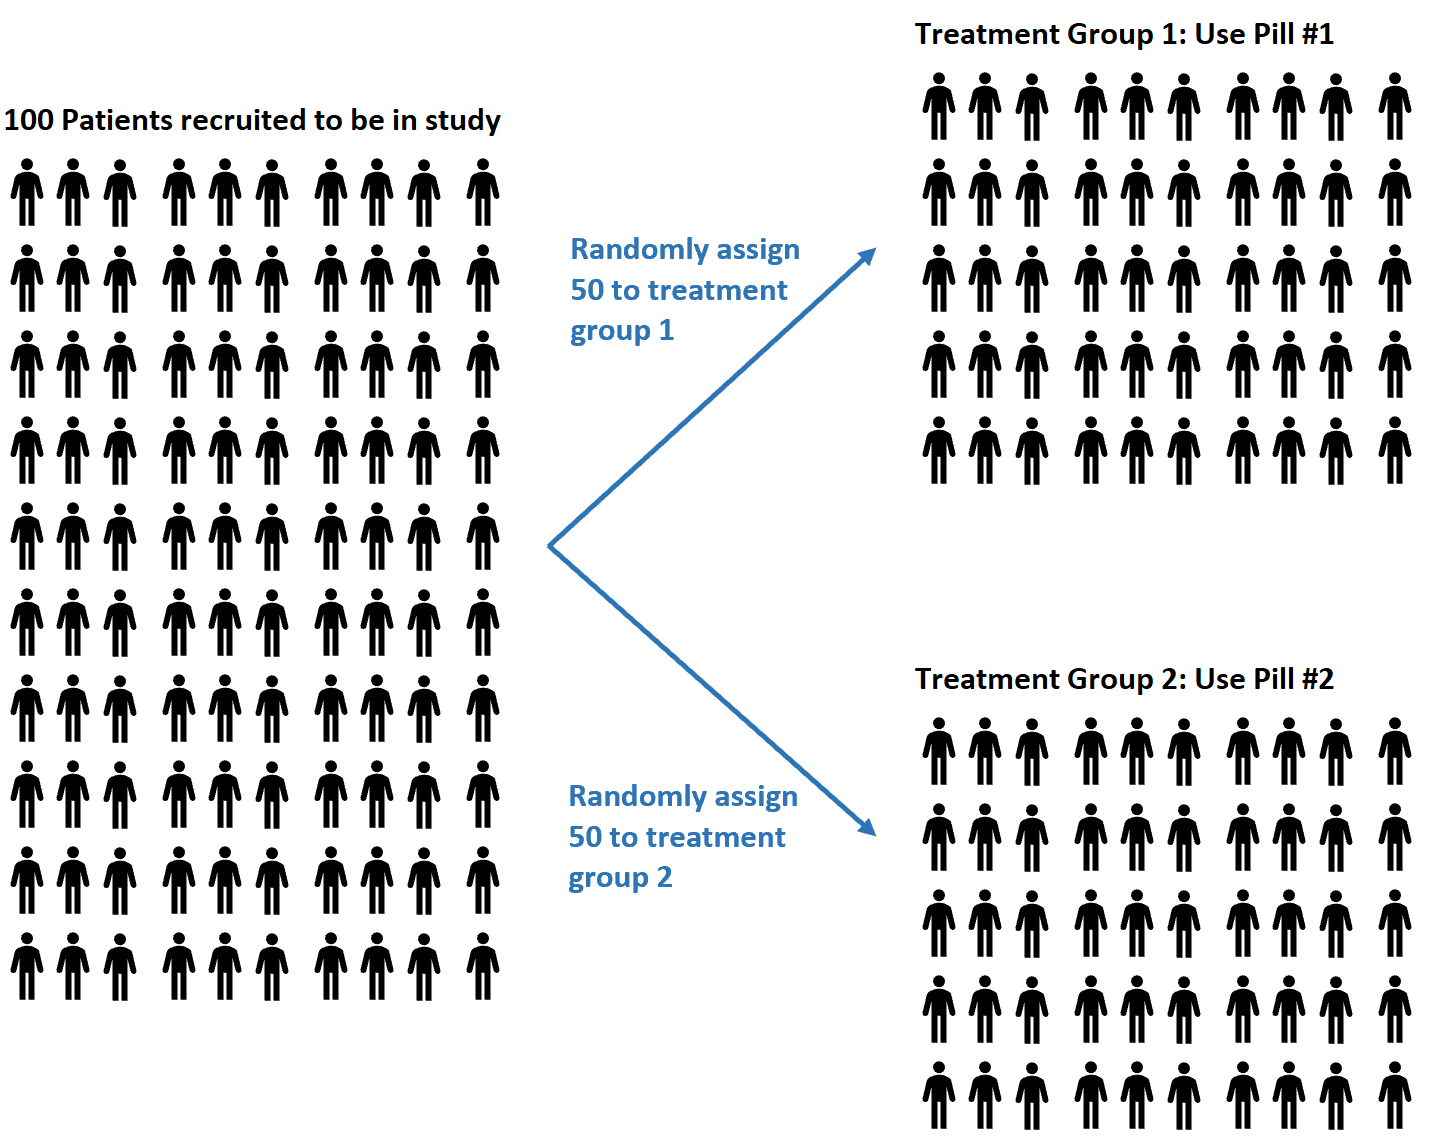
La randomisation, ou assignation aléatoire, désigne le processus méthodologique par lequel des unités expérimentales (qu’il s’agisse d’individus, d’animaux, de parcelles agricoles ou de cellules institutionnelles) sont affectées aux différents groupes d’une étude selon un mécanisme strictement probabiliste et non déterministe. Chaque unité expérimentale dispose d’une probabilité d’attribution connue a priori et strictement positive d’être allouée à l’un des bras de l’expérience, le plus souvent selon un principe d’équiprobabilité (par exemple, une probabilité de 0,5 pour un protocole à deux bras : groupe d’intervention versus groupe contrôle). La caractéristique centrale de ce processus réside dans le fait que l’assignation finale échappe totalement à la volonté de l’expérimentateur, aux préférences du sujet et à ses caractéristiques pronostiques ou sociodémographiques préalables.
Il convient d’établir une distinction conceptuelle majeure, souvent négligée dans le langage profane, entre la sélection aléatoire (ou échantillonnage probabiliste) et l’assignation aléatoire (randomisation proprement dite). L’échantillonnage aléatoire régit le mode de prélèvement d’un sous-ensemble d’individus au sein d’une population cible plus vaste ; il conditionne directement la validité externe et la représentativité générale des observations. En revanche, l’assignation aléatoire régit la répartition de ces individus, une fois recrutés, entre les différentes conditions d’une expérience ; elle constitue le garant exclusif de la validité interne de l’étude. Une recherche peut fort bien employer une sélection de convenance non probabiliste tout en mettant en œuvre une randomisation intra-protocolaire impeccable, garantissant ainsi une inférence causale valide sur l’échantillon analysé.
Sur le plan opératoire, la randomisation élimine de façon structurelle les biais d’attribution subjectifs. Dans une étude non randomisée, l’affectation à un traitement est généralement guidée par des critères d’indication clinique, des facteurs de gravité ou des prédispositions psychologiques sous-jacentes. Par exemple, un clinicien aura naturellement tendance à prescrire une thérapie innovante plus risquée aux patients les plus lourdement atteints ou, à l’inverse, à réserver un traitement complexe aux participants les plus compliants. La randomisation supprime cette interférence humaine en interposant un mécanisme d’indépendance statistique entre l’état initial du participant et son exposition au facteur d’étude.
1.2 Genèse historique et évolution épistémologique
L’émergence formelle de la randomisation constitue un tournant épistémologique fondamental dans l’histoire de la méthode scientifique. Bien que des formes embryonnaires de tirage au sort aient été ponctuellement utilisées au XIXe siècle par des figures pionnières telles que Charles Sanders Peirce en psychophysique, c’est au statisticien et généticien britannique Sir Ronald Aylmer Fisher que l’on doit la théorisation complète et l’institutionnalisation mathématique du concept dans les années 1920, lors de ses travaux agronomiques à la station expérimentale de Rothamsted.
Confronté à l’hétérogénéité naturelle et spatiale des sols — où la fertilité varie de manière continue et imprévisible d’un mètre carré à l’autre —, Fisher constata que les méthodes de contrôle physique par blocs systématiques ne parvenaient pas à éliminer les corrélations spatiales fallacieuses. Dans son ouvrage séminal de 1935, The Design of Experiments, Fisher démontra que l’assignation aléatoire des parcelles aux différents engrais constituait le seul moyen de convertir la variabilité non contrôlée en une erreur d’échantillonnage stochastique traitable par le calcul des probabilités. La randomisation devint ainsi l’instrument formel validant l’application des tests statistiques d’hypothèse, en fournissant elle-même la distribution théorique sous l’hypothèse nulle sans nécessiter de postulats arbitraires sur la distribution des erreurs.
Le paradigme fisherien s’est ensuite diffusé à la recherche biomédicale au milieu du XXe siècle, principalement sous l’impulsion de Sir Austin Bradford Hill. L’essai clinique mené sous l’égide du Medical Research Council britannique en 1948 sur l’efficacité de la streptomycine dans la tuberculose pulmonaire est universellement reconnu comme le premier essai randomisé contrôlé (ERC) moderne à grande échelle. Cette transition de l’observation empirique passive vers l’expérimentation randomisée contrôlée a profondément renouvelé la psychologie scientifique, l’épidémiologie clinique et les sciences sociales, consacrant la randomisation comme le gold standard méthodologique indiscutable pour l’établissement des preuves d’efficacité thérapeutique et interventionnelle.
1.3 Les postulats théoriques sous-jacents au paradigme expérimental
La puissance inférentielle de la randomisation repose sur un modèle formel d’une grande élégance mathématique : le modèle causal de Rubin-Neyman (souvent désigné sous l’acronyme RCM pour Rubin Causal Model). Dans ce cadre théorique, chaque unité expérimentale $i$ dispose de deux issues potentielles (ou contre-factuelles) : $Y_i(1)$, représentant la réponse de l’individu s’il est exposé au traitement actif, et $Y_i(0)$, sa réponse s’il est exposé au traitement témoin. Le véritable effet causal individuel est défini par la différence :
$$\tau_i = Y_i(1) – Y_i(0)$$
Or, le « problème fondamental de l’inférence causale » réside dans le fait qu’il est impossible d’observer simultanément $Y_i(1)$ et $Y_i(0)$ pour une même unité $i$ au même instant précis. L’observateur n’a accès qu’à l’issue factuelle correspondant au statut d’assignation effectif $T_i in {0, 1}$. Le second état demeure irrémédiablement contre-factuel. Dans les études non randomisées, comparer la moyenne des individus traités à celle des témoins aboutit généralement à une estimation biaisée de l’effet causal moyen (ATE, Average Treatment Effect), car le groupe exposé diffère systématiquement du groupe non exposé sur le plan de leurs issues potentielles de base.
La randomisation résout cette impasse épistémologique en instaurant l’hypothèse d’indépendance conditionnelle fondamentale :
$${Y_i(1), Y_i(0)} perp!!perp T_i$$
Cette indépendance implique que l’attribution du traitement est entièrement orthogonale aux issues potentielles et à l’ensemble des caractéristiques pré-interventionnelles des sujets. Dès lors, le groupe témoin fournit une estimation parfaitement non biaisée de ce qu’aurait été la trajectoire du groupe traité en l’absence d’intervention. La comparabilité initiale des groupes à l’état de référence (dite baseline) est ainsi garantie sur le plan espéré, ce qui autorise l’identification mathématique formelle de l’effet causal moyen au niveau de la population.
2. Fondements mathématiques et théorie des probabilités appliqués à la randomisation
2.1 Théorie de la probabilité et distributions d’échantillonnage
D’un point de vue probabiliste, le mécanisme de randomisation simple s’apparente à une succession d’épreuves de Bernoulli indépendantes et identiquement distribuées (i.i.d.). Considérons une population de taille $N$ dont chaque membre présente un vecteur de caractéristiques multidimensionnel $\mathbf{X}_i = (X_{i1}, X_{i2}, dots, X_{ik})’$. Lorsque l’on applique une règle d’assignation aléatoire définie par une variable indicatrice $T_i$ telle que $P(T_i = 1) = p$ et $P(T_i = 0) = 1 – p$, l’espérance mathématique de la moyenne d’une covariable quelconque $X$ au sein du groupe recevant l’intervention est rigoureusement égale à son espérance au sein du groupe témoin :
$$\mathbb{E}[\bar{X}_{T=1}] = \mathbb{E}[\bar{X}_{T=0}] = \mu_X$$
En vertu de la loi forte des grands nombres, lorsque la taille de l’échantillon $N$ tend vers l’infini, la moyenne observée de chaque covariable converge presque sûrement vers son espérance théorique. Par conséquent, la différence observée entre les moyennes des covariables des deux groupes, $\bar{X}_{T=1} – \bar{X}_{T=0}$, converge stochastiquement vers zéro :
$$\lim_{N to \infty} P(|\bar{X}_{T=1} – \bar{X}_{T=0}| > \varepsilon) = 0, \quad \forall \varepsilon > 0$$
Ce résultat théorique démontre la convergence asymptotique vers l’équivalence intergroupe absolue. Cependant, pour un échantillon de taille finie $n$, la différence des moyennes n’est pas strictement nulle mais suit une distribution d’échantillonnage centrée sur zéro, dont la variance est inversement proportionnelle à la taille des groupes :
$$\text{Var}(\bar{X}_{T=1} – \bar{X}_{T=0}) = \sigma_X^2 \left( \frac{1}{n_1} + \frac{1}{n_0} \right)$$
Sous l’hypothèse nulle $H_0$ stipulant l’absence complète d’effet du traitement ($\tau_i = 0, \forall i$), la distribution de la statistique de test dérive directement de la combinatoire induite par le processus de randomisation lui-même, et non de suppositions ad hoc sur la normalité des populations sous-jacentes.
2.2 Tests de permutation et inférence basée sur la randomisation
L’un des apports conceptuels les plus profonds de Ronald Fisher est la démonstration que la randomisation constitue le socle physique justifiant l’inférence statistique. Contrairement aux approches paramétriques qui présupposent que les données proviennent d’une distribution gaussienne théorique, l’inférence basée sur la randomisation (tests de permutation ou tests exacts de Fisher) opère conditionnellement aux valeurs observées, en considérant que seule l’assignation du traitement relève du hasard.
Supposons une expérience portant sur $N = n_1 + n_0$ sujets, où $n_1$ reçoivent le traitement actif et $n_0$ le contrôle. Le nombre total de configurations d’assignation possibles est donné par le coefficient binomial :
$$\Omega = \binom{N}{n_1} = \frac{N!}{n_1! n_0!}$$
Chacune de ces permutations représentait, au moment de l’expérimentation, une trajectoire équiprobable d’attribution du traitement avec une probabilité théorique de $1/\Omega$. Sous l’hypothèse nulle d’invariance totale des réponses individuelles au traitement, les valeurs observées $y_1, y_2, dots, y_N$ sont fixes et indépendantes du groupe assigné.
Pour chaque vecteur de permutation possible $\mathbf{t}^{(k)} in \Omega$, le statisticien recalcule la statistique d’intérêt choisie, par exemple la différence brute des moyennes arithmétiques $D^{(k)} = \bar{Y}_1^{(k)} – \bar{Y}_0^{(k)}$. La distribution empirique exacte de l’ensemble de ces valeurs forme la distribution de permutation de la statistique de test. La valeur $p$ exacte bilatérale se définit alors comme la proportion exacte de permutations pour lesquelles la statistique absolue calculée est au moins aussi extrême que la valeur empirique observée $D_{\text{obs}}$ lors de l’expérience réelle :
$$p = \frac{1}{\Omega} \sum_{k=1}^{\Omega} \mathbb{I}\left( |D^{(k)}| ge |D_{\text{obs}}| \right)$$
Cette approche fournit une inférence non paramétrique exacte, exempte de tout biais d’approximation asymptotique, et valide formellement l’usage des tests statistiques même sur des échantillons extrêmement restreints.
2.3 L’indépendance stochastique comme garantie d’inférence causale
La randomisation opère une coupure chirurgicale dans le graphe causal orienté (DAG, pour Directed Acyclic Graph) décrivant les relations entre les variables. Dans un cadre observationnel, la variable d’exposition $T$ et la variable de résultat $Y$ sont généralement reliées non seulement par la flèche causale directe $T to Y$, mais également par des chemins secondaires dits « chemins arrière » (backdoor paths) induits par des variables préexistantes $U$ agissant conjointement sur $T$ et sur $Y$ ($T \leftarrow U to Y$). Ces structures confondues sont la cause directe de corrélations fallacieuses.
Sur le plan mathématique, l’introduction d’un générateur de nombres aléatoires exogène $R$ pour dicter l’état de $T$ ($R to T$) supprime structurellement toute dépendance probabiliste entre le vecteur global des caractéristiques du sujet $\mathbf{X}$ (qu’elles soient génétiques, comportementales, psychologiques ou environnementales) et la variable d’assignation $T$. L’indépendance stochastique s’énonce par :
$$P(\mathbf{X} mid T = 1) = P(\mathbf{X} mid T = 0) = P(\mathbf{X})$$
Cette orthogonalité formelle garantit que l’espérance conditionnelle des issues potentielles sachant l’assignation se simplifie en leur espérance marginale non conditionnée :
$$\mathbb{E}[Y(1) mid T = 1] = \mathbb{E}[Y(1)] \quad \text{et} \quad \mathbb{E}[Y(0) mid T = 0] = \mathbb{E}[Y(0)]$$
Dès lors, l’estimateur standard de la différence des moyennes observées devient rigoureusement sans biais pour l’effet causal moyen :
$$\widehat{\text{ATE}} = \mathbb{E}[Y mid T = 1] – \mathbb{E}[Y mid T = 0] = \mathbb{E}[Y(1)] – \mathbb{E}[Y(0)] = \tau$$
C’est cette propriété formelle d’espérance nulle des différences sous traitement nul qui confère à la randomisation sa suprématie pour l’inférence causale directe.
3. Le contrôle des variables confondantes et parasites (lurking variables)
3.1 Nature et dynamique des variables confondantes
Pour appréhender pleinement le saut qualitatif offert par la randomisation, il est impératif d’analyser la dynamique d’une variable confondante (ou facteur de confusion). En épidémiologie et en statistique causale, une covariable $Z$ est qualifiée de facteur de confusion pour la relation entre une exposition $T$ et un critère de jugement $Y$ si elle remplit simultanément trois critères fondamentaux :
- Elle est une cause directe ou indirecte de la survenue de $Y$ dans la population non exposée.
- Elle est statistiquement associée à l’exposition $T$ au sein de la population étudiée.
- Elle ne se situe pas sur le trajet causal intermédiaire reliant directement l’exposition $T$ à l’issue $Y$ (ce n’est pas un médiateur causal).
La présence d’un tel facteur crée une distorsion majeure de la mesure d’association statistique brute. Par exemple, si l’on étudie la corrélation entre la consommation de café ($T$) et l’incidence du cancer du pancréas ($Y$), le tabagisme ($Z$) agit comme un puissant facteur de confusion. Les fumeurs consomment statistiquement plus de café, et le tabac augmente considérablement le risque carcinologique. Une analyse naïve non contrôlée conclura faussement à la toxicité du café, alors que l’association observée n’est qu’un artefact induit par la variable parasite sous-jacente.
Le problème s’aggrave exponentiellement lorsque l’on distingue les variables parasites manifestes (faciles à repérer et à quantifier, comme l’âge ou le sexe biologique) des variables latentes ou inobservables. Ces dernières regroupent des entités évanescentes telles que la prédisposition génétique fine, la motivation intrinsèque d’un patient, la tolérance à la douleur, l’anxiété diffuse ou le capital de résilience psychosociale. Dans les contextes observationnels, ces dimensions non mesurées demeurent hors de portée du contrôle empirique.
3.2 Mécanisme d’équilibrage stochastique par randomisation
La propriété exceptionnelle de la randomisation réside dans sa capacité unique à neutraliser simultanément l’ensemble des variables confondantes, qu’elles soient parfaitement connues, suspectées, ou totalement inconnues des investigateurs. Contrairement aux méthodes d’équilibrage déterministes qui requièrent l’identification préalable et la mesure explicite de chaque facteur perturbateur, le tirage au sort opère un équilibrage stochastique global.
Considérons une variable confuse non mesurée $U$, qu’elle soit binaire ou continue. Étant donné que le protocole de randomisation alloue les sujets indépendamment de toute considération biologique ou comportementale, la distribution de probabilité conjointe de $U$ se scinde de manière uniforme entre les conditions expérimentales. Cela signifie concrètement que la probabilité qu’un sujet possédant un profil génétique rare ou une vulnérabilité biologique particulière se retrouve dans le groupe expérimental est rigoureusement identique à sa probabilité de se retrouver dans le groupe témoin.
Cet équilibrage n’implique pas une égalité mathématique absolue sur un échantillon individuel donné, mais une absence systématique de biais structurel. L’amplitude des déséquilibres fortuits suit une loi normale d’écart-type connu $\sigma / \sqrt{n}$. Au fur et à mesure que la taille d’échantillon $N$ croît, l’espace probabiliste se contracte, compressant l’asymétrie résiduelle vers zéro. La randomisation constitue ainsi la seule protection méthodologique absolue contre les biais d’omission de variables pertinentes au moment de l’élaboration du protocole de recherche.
3.3 Comparaison entre contrôle expérimental et ajustement statistique post-hoc
Dans les schémas non randomisés (études de cohortes observationnelles, études rétrospectives cas-témoins), les analystes tentent d’éliminer les biais de confusion par le biais d’artifices statistiques post-hoc. Les deux démarches les plus courantes sont les modèles de régression multivariée (linéaire, logistique, modèles de Cox) et l’appariement sur le score de propension (propensity score matching).
Toutefois, ces modélisations rétrospectives souffrent d’une limite structurelle infranchissable, formellement conceptualisée sous le nom d’hypothèse de « non-confusion résiduelle » (unconfoundedness ou ignorability). Ces approches supposent péremptoirement que toutes les covariables confondantes ont été identifiées, mesurées sans erreur d’échantillonnage et correctement intégrées sous une forme fonctionnelle exacte (linéarité, absence d’interactions non modélisées) dans l’équation mathématique. Dès lors qu’une variable confondante importante n’a pas été colligée — ce qui représente la norme dans l’étude des phénomènes humains hautement complexes —, les estimateurs issus des régressions sont inévitablement biaisés et inconsistants (phénomène d’endogénéité par omission de variable).
Le tableau suivant met en relief la supériorité épistémique du contrôle expérimental fourni par la randomisation face aux palliatifs statistiques a posteriori :
- Ajustement statistique multivarié / Score de propension : Ne contrôle que les covariables formellement mesurées dans le jeu de données ; vulnérable aux erreurs de mesure sur les covariables ; suppose une spécification correcte du modèle mathématique ; incapable d’éliminer le biais d’indication sous-jacent.
- Randomisation expérimentale préalable : Équilibre uniformément les covariables mesurées et non mesurées ; insensible aux erreurs d’instrumentation sur les variables de base ; ne repose sur aucune hypothèse paramétrique relative aux mécanismes de confusion ; détruit physiquement le biais d’indication à la source.
La randomisation s’affirme donc non pas comme un substitut sophistiqué aux corrections statistiques, mais comme la condition expérimentale pré-interventionnelle indispensable qui rend superflue la spéculation sur les facteurs d’interférence inobservés.
4. Exemple détaillé et empirique : Étude pharmacologique et psychophysiologique
4.1 Contexte de l’expérimentation et formulation des hypothèses
Afin de concrétiser les principes probabilistes exposés précédemment, développons un exemple empirique rigoureusement documenté issu de la recherche clinique cardiovasculaire. Imaginons une étude interventionnelle randomisée en double insu visant à comparer l’efficacité de deux principes actifs antihypertenseurs : une molécule novatrice ciblant un récepteur neuro-vasculaire spécifique, la Molécule A, face au traitement de référence actuel, la Molécule B.
L’essai recrute un échantillon de $N = 100$ patients adultes présentant une hypertension artérielle essentielle de grade 1 à 2 non stabilisée. La variable dépendante continue principale ($Y$) est la pression artérielle systolique (PAS) mesurée en millimètres de mercure (mmHg) au terme de huit semaines de traitement standardisé, dans des conditions cliniques strictement calibrées selon les recommandations internationales (mesure ambulatoire automatisée au repos). L’hypothèse scientifique est que la Molécule A induit une réduction moyenne supérieure de la PAS par rapport à la Molécule B.
Dans ce contexte pathologique, trois facteurs confondants majeurs exercent une influence pronostique déterminante sur les variations tensionnelles :
- Le statut tabagique actif (inducteur de vasoconstriction et de rigidité artérielle).
- Le régime sodé quotidien (apport en chlorure de sodium supérieur ou inférieur à 6 grammes par jour).
- Le niveau d’activité physique aérobie hebdomadaire (quantifié en équivalents métaboliques ou MET-minutes).
Si l’affectation du traitement était laissée à la discrétion des médecins, il existerait un risque prépondérant d’orienter les profils les plus hygiéniques ou les moins tabagiques vers la nouvelle molécule, créant une illusion d’efficacité thérapeutique.
4.2 Mise en œuvre concrète du protocole d’assignation aléatoire
Pour neutraliser ces menaces méthodologiques, un protocole d’assignation aléatoire simple et informatisé est déployé. Avant l’inclusion du premier participant, un biostatisticien indépendant génère une séquence d’allocation aléatoire à l’aide d’un algorithme pseudo-aléatoire cryptographiquement sûr sous le logiciel R, en fixant une graine de départ (seed) pour en garantir l’auditabilité réglementaire :
Chaque patient recevant un numéro d’identification séquentiel de P001 à P100 se voit attribuer une valeur aléatoire issue d’une distribution uniforme continue $U(0, 1)$. Si la valeur générée est strictement inférieure à 0,50, le patient est alloué au bras Molécule A ($T_i = 1$) ; si elle est supérieure ou égale à 0,50, il est affecté au bras Molécule B ($T_i = 0$).
Le tableau d’inclusion initial à l’état de référence (baseline) permet d’attester empiriquement de la qualité de la distribution stochastique sur les 100 patients enrôlés :
- Bras Molécule A ($n = 49$) : Âge moyen de 54,2 ans ($\pm 6,1$) ; 44,9 % de femmes ($n = 22$) ; 32,7 % de fumeurs actifs ($n = 16$) ; Consommation sodée moyenne de 7,8 g/j ($\pm 1,4$) ; PAS initiale moyenne de 158,4 mmHg ($\pm 8,2$).
- Bras Molécule B ($n = 51$) : Âge moyen de 54,8 ans ($\pm 5,9$) ; 45,1 % de femmes ($n = 23$) ; 33,3 % de fumeurs actifs ($n = 17$) ; Consommation sodée moyenne de 7,6 g/j ($\pm 1,5$) ; PAS initiale moyenne de 157,9 mmHg ($\pm 8,5$).
Ce tableau illustre parfaitement l’équilibrage stochastique : les proportions de fumeurs, la consommation moyenne de sel et la pression artérielle initiale sont quasi superposables d’un groupe à l’autre. Les variations résiduelles sont infimes et relèvent de la seule fluctuation d’échantillonnage théorique.
4.3 Analyse des résultats et interprétation causale sans biais
Au terme des huit semaines de suivi protocolaire, l’évaluation des pressions artérielles systoliques finales révèle les paramètres descriptifs et inférentiels suivants :
- Pour le groupe recevant la Molécule A, la moyenne observée de la PAS finale est de $\bar{Y}_A = 132,1 \text{ mmHg}$ avec un écart-type de $s_A = 7,4 \text{ mmHg}$.
- Pour le groupe recevant la Molécule B, la moyenne observée de la PAS finale s’établit à $\bar{Y}_B = 141,6 \text{ mmHg}$ avec un écart-type de $s_B = 8,1 \text{ mmHg}$.
La différence brute observée entre les deux traitements s’élève à :
$$\Delta = \bar{Y}_A – \bar{Y}_B = 132,1 – 141,6 = -9,5 \text{ mmHg}$$
L’erreur standard de la différence des moyennes se calcule selon la formule classique :
$$SE_{\Delta} = \sqrt{\frac{s_A^2}{n_A} + \frac{s_B^2}{n_B}} = \sqrt{\frac{7,4^2}{49} + \frac{8,1^2}{51}} = \sqrt{\frac{54,76}{49} + \frac{65,61}{51}} \approx \sqrt{1,118 + 1,286} = \sqrt{2,404} \approx 1,55 \text{ mmHg}$$
L’intervalle de confiance à 95 % pour la différence d’efficacité thérapeutique s’établit ainsi à $[-12,54 \text{ mmHg} ; -6,46 \text{ mmHg}]$. Le test $t$ de Student bilatéral pour échantillons indépendants livre une statistique de $t \approx -6,13$, correspondant à une valeur $p < 0,0001$.
Grâce au dispositif expérimental randomisé, toute interprétation alternative reposant sur des variables parasites peut être définitivement réfutée :
- L’écart de 9,5 mmHg ne peut être imputé à une disparité de consommation de sel, puisque la randomisation a garanti une distribution homogène de l’apport sodé à l’état initial.
- L’effet hypotenseur ne peut être attribué à un déséquilibre de tabagisme ou de sédentarité, ces facteurs ayant été répartis de façon comparable dans les deux bras d’étude.
- Même l’hypothèse d’une résilience psychologique supérieure ou d’un métabolisme enzymatique hépatique non testé est invalidée stochastiquement, la probabilité d’une asymétrie systématique simultanée sur l’ensemble de ces facteurs étant statistiquement négligeable.
La conclusion causale s’impose avec une certitude scientifique maximale : la Molécule A exerce un effet pharmacodynamique supérieur direct et direct sur la réduction de la pression artérielle systolique par rapport à la Molécule B.
5. Typologie des méthodes de randomisation : De la randomisation simple aux protocoles adaptatifs
5.1 Randomisation simple (complète) : Fonctionnement et vulnérabilités
La randomisation simple, également appelée randomisation complète, constitue la modalité la plus intuitive d’allocation expérimentale. Elle repose sur l’indépendance statistique absolue de chaque affectation successive par rapport aux affectations antérieures. Chaque sujet entrant dans le protocole fait l’objet d’un tirage probabiliste indépendant, semblable au lancer répété d’une pièce de monnaie équilibrée. Dans sa formulation mathématique, pour un ratio d’allocation cible de 1:1, chaque participant dispose d’une probabilité d’assignation $P(T_i = 1) = 0,5$, sans aucune contrainte régulant le nombre cumulé d’individus affectés à chaque groupe au fil du temps.
Si la randomisation simple présente une pureté théorique indiscutable et prévient totalement le biais de prévisibilité de l’assignation, elle présente une vulnérabilité majeure : le déséquilibre d’effectif fortuit (chance imbalance). Dans les études impliquant des échantillons de taille modeste (par exemple, $N < 80$), la variance binomiale d'assignation peut conduire à des dissymétries numériques substantielles. Par exemple, pour une cohorte de 40 individus, la probabilité d'obtenir une répartition déséquilibrée telle que 26 sujets dans un groupe et 14 dans l'autre (ou pire) dépasse 15 %.
Ces asymétries numériques dégradent significativement la puissance statistique du test d’hypothèse final. En effet, l’efficacité statistique relative d’un plan d’expérience par rapport à un plan parfaitement équilibré est proportionnelle au facteur :
$$\text{Efficacité} = \frac{4 , n_1 n_0}{(n_1 + n_0)^2}$$
En outre, la randomisation simple expose l’expérimentateur au risque de dérive temporelle : un groupe peut concentrer par hasard une majorité d’inclusions au début de l’essai et un déficit à la fin, rendant l’analyse vulnérable aux modifications concomitantes de l’environnement clinique ou institutionnel.
5.2 Randomisation adaptative et procédure d’ajustement dynamique
Pour pallier les contraintes de la randomisation simple et répondre à des impératifs éthiques ou d’efficacité clinique, les biostatisticiens ont développé des protocoles de randomisation adaptative. Ces méthodes modifient les probabilités d’assignation futures au fur et à mesure de l’essai en fonction soit de la structure des inclusions antérieures, soit des réponses thérapeutiques intermédiaires accumulées.
La randomisation adaptative à la réponse (RAR, Response-Adaptive Randomization) illustre cette dynamique. Dans les essais en oncologie ou dans les pathologies à pronostic sévère, il apparaît éthiquement délicat de continuer à allouer 50 % des nouveaux patients à un bras expérimental s’avérant significativement moins performant lors des analyses intermédiaires séquentielles. L’algorithme réévalue les probabilités d’affectation : la proportion d’individus assignés au bras présentant le taux de survie ou de rémission le plus élevé augmente dynamiquement selon une règle bayésienne ou fréquentiste prédéfinie.
Un modèle historique représentatif de cette logique est la règle de l’urne de Wei (Urn design). Une urne théorique contient initialement un nombre identique de boules de couleurs représentant les groupes A et B. Lorsqu’un patient est inclus, une boule est tirée au sort pour dicter son assignation. Si le traitement alloué produit un succès thérapeutique, plusieurs boules de la même couleur sont réintroduites dans l’urne, augmentant la probabilité que les futurs participants reçoivent le traitement gagnant. Toutefois, ces protocoles adaptatifs introduisent une complexité statistique substantielle :
- Perte d’indépendance des observations successives (structure temporelle induite).
- Nécessité de recourir à des corrections d’estimation pour éviter la surestimation de l’ampleur de l’effet du traitement (biais de sélection adaptatif).
- Inflation potentielle de l’erreur de type I nécessitant des simulations numériques intensives lors de la phase de modélisation du protocole.
5.3 Arbres de décision pour la sélection de la méthode de randomisation
Le choix méthodologique d’une stratégie de randomisation dépend d’un faisceau de contraintes scientifiques, logistiques et dimensionnelles. L’investigateur doit arbitrer entre la simplicité algorithmique, la garantie d’un équilibre numérique parfait et le contrôle des covariables majeures. Le processus décisionnel peut se schématiser selon plusieurs règles discriminantes fondamentales :
Si la taille prévisionnelle de l’échantillon est très importante ($N > 500$ participants par bras) et qu’aucune dérive temporelle majeure n’est anticipée, la randomisation simple s’avère souvent suffisante, la loi des grands nombres garantissant l’équilibre des effectifs et des covariables sans générer de vulnérabilité opérationnelle. À l’inverse, dès lors que l’effectif total est restreint ($N < 200$), la randomisation simple doit être écartée au profit de méthodes structurées.
Lorsque l’on identifie des facteurs pronostiques fortement prédictifs de l’issue (comme l’âge avancé ou le stade tumoral) sur un échantillon modéré, la randomisation stratifiée ou la minimisation dynamique deviennent impératives. Par ailleurs, si le recrutement clinique est échelonné sur plusieurs années et susceptible d’être interrompu précocement pour des raisons d’efficacité ou de tolérance, la randomisation par blocs permutés s’impose pour préserver une balance d’effectif rigoureuse à tout moment du déroulement de l’étude.
Enfin, si le risque de contamination comportementale ou pédagogique entre les participants d’un même centre est majeur, l’analyste doit impérativement s’orienter vers une randomisation en grappes, en acceptant en contrepartie une augmentation notable de la taille de cohorte requise pour compenser la perte de puissance statistique.
6. La randomisation par blocs : Principe, méthodologie et modélisation
6.1 Architecture et logique structurelle de la randomisation par blocs
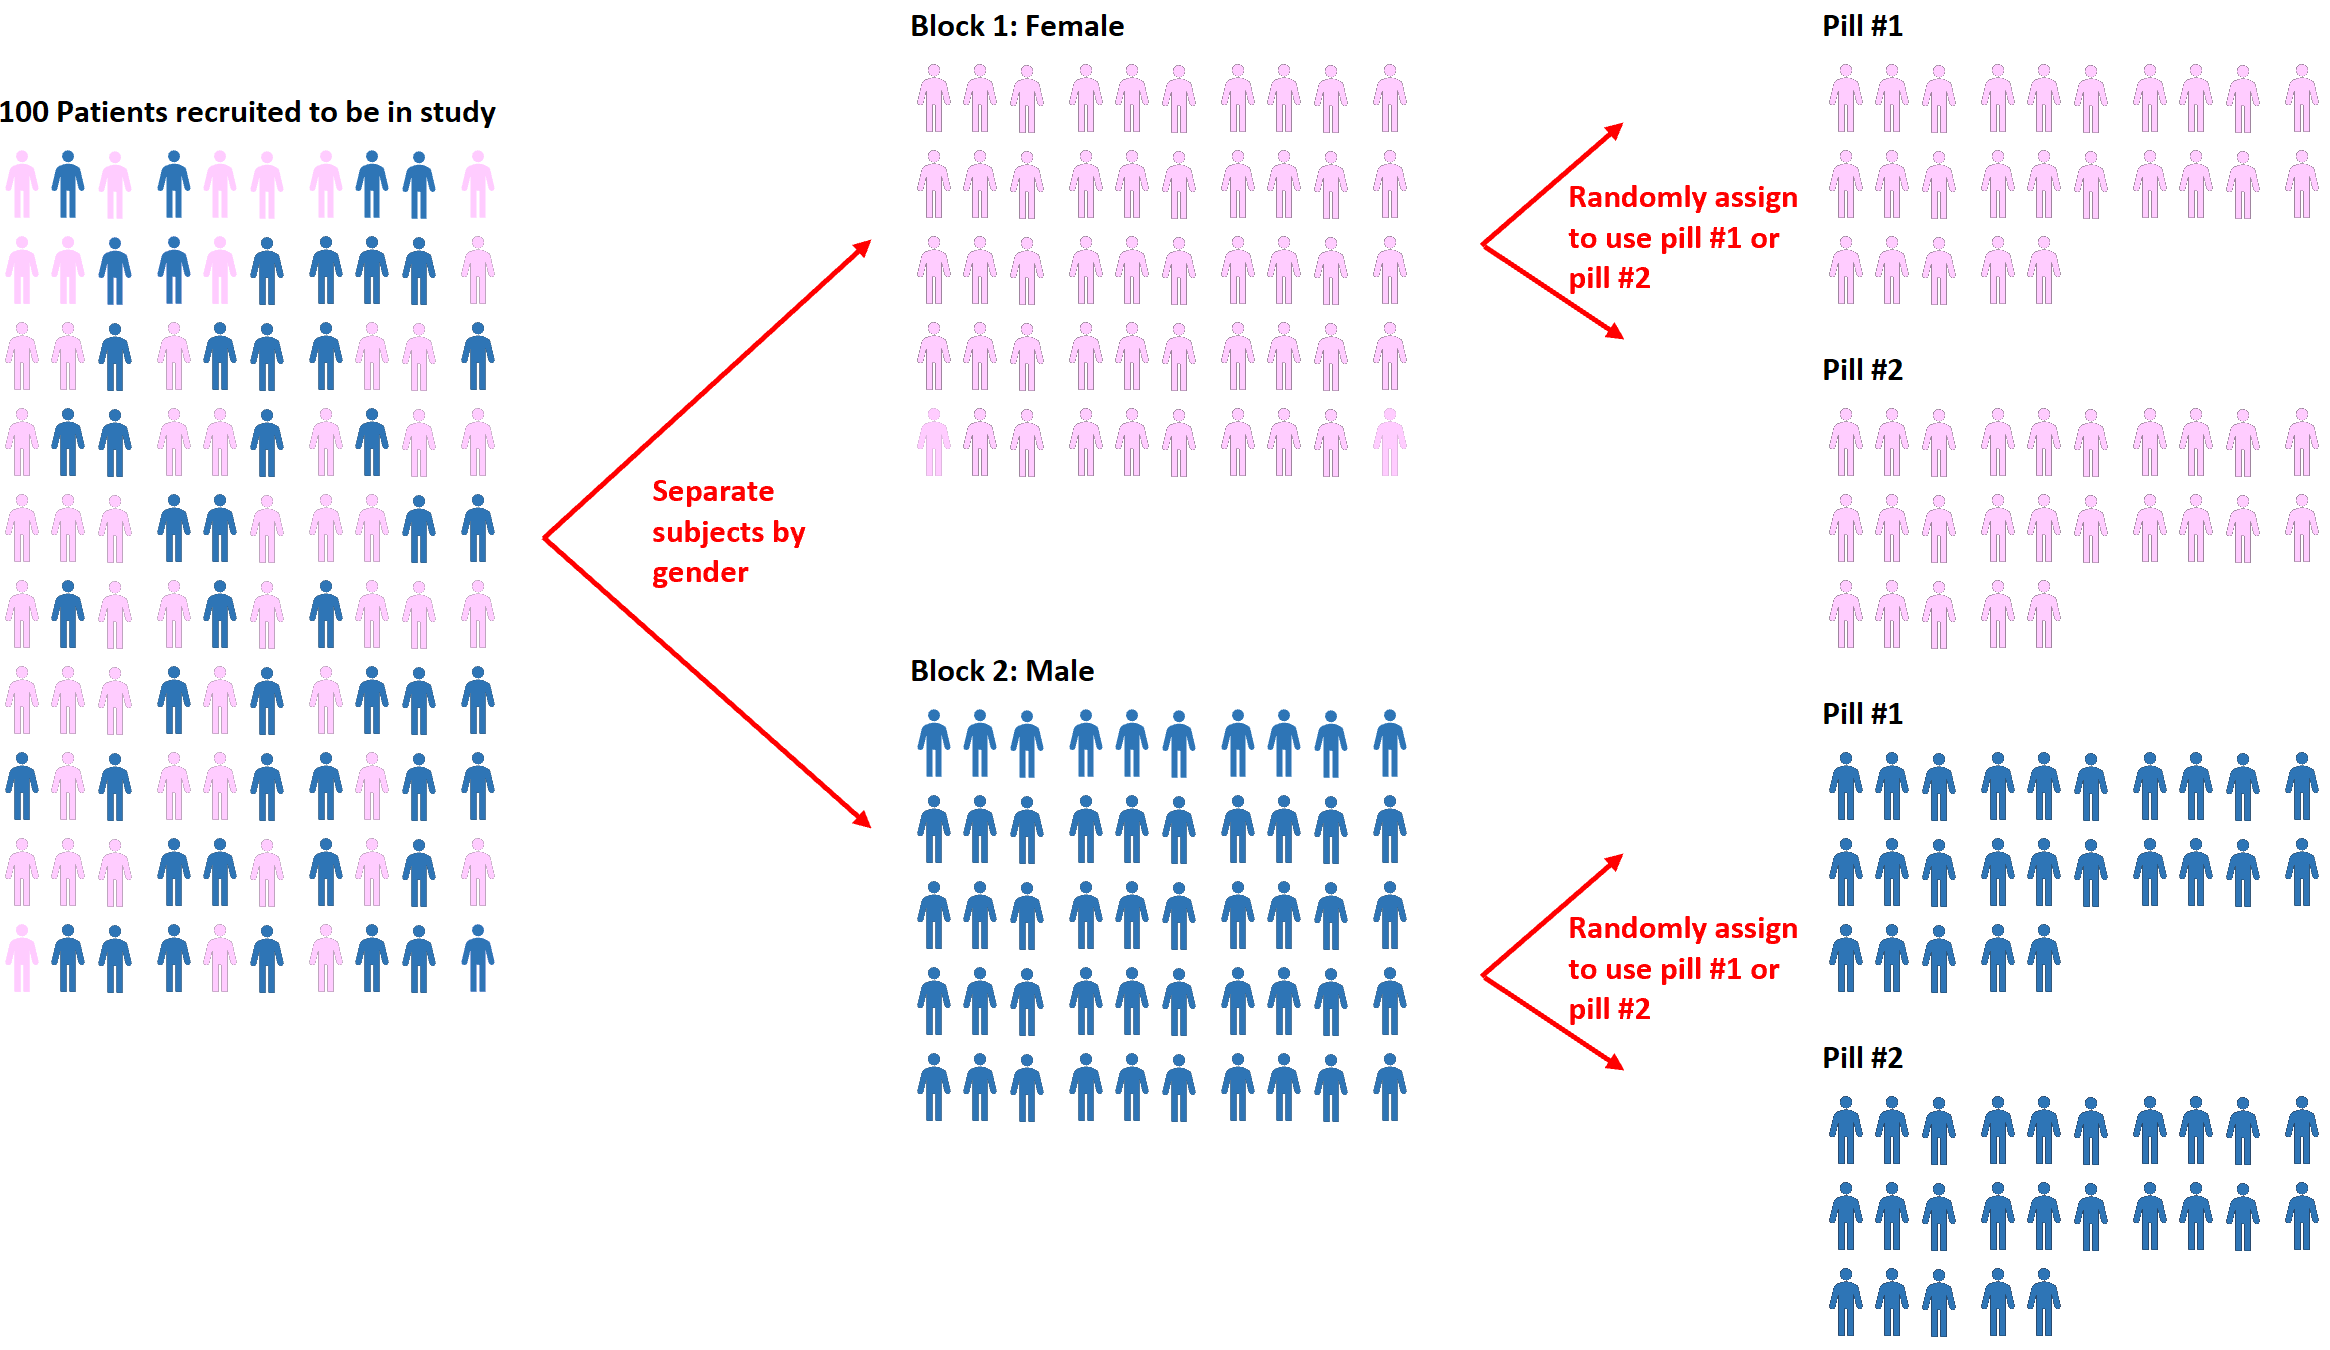
La randomisation par blocs, également nommée randomisation par blocs permutés, est le protocole standardisé le plus largement déployé dans la recherche clinique contemporaine. Son objectif méthodologique prioritaire est d’assurer une stricte parité numérique d’allocation entre les différents bras de traitement à intervalles réguliers et rapprochés au cours du processus d’inclusion.
Le principe structurel repose sur la décomposition de la séquence globale de recrutement en sous-ensembles expérimentaux étanches et équilibrés de taille fixe prédéterminée, désignés sous le terme de « blocs ». Chaque bloc contient un nombre d’unités qui est obligatoirement un multiple entier du nombre de bras de l’essai. Pour une comparaison classique 1:1 entre un groupe Intervention (A) et un groupe Contrôle (B), la taille du bloc ($k$) doit être un nombre pair, typiquement $k in {4, 6, 8}$.
Au sein de chaque bloc unitaire, la proportion des assignations respecte rigoureusement le ratio expérimental ciblé. Ainsi, dans un bloc de taille 4 avec un ratio 1:1, il y aura impérativement 2 allocations vers le traitement A et 2 allocations vers le traitement B. L’allocation des sujets successifs à l’intérieur du bloc fait l’objet d’une permutation aléatoire parmi l’ensemble des combinaisons combinatoirement permises. Ce procédé prévient tout déséquilibre numérique excédant la demi-taille d’un bloc, sécurisant ainsi l’essai contre les dérives temporelles d’allocation liées à la saisonnalité, aux changements d’opérateurs ou à l’interruption prématurée du protocole.
6.2 Le problème de la prévisibilité et l’introduction de blocs permutés aléatoires
Malgré sa robustesse arithmétique, la randomisation par blocs de taille fixe expose le protocole à une menace méthodologique insidieuse : le biais de sélection par déduction déterministe. Ce phénomène survient lorsque l’insu clinique n’est pas absolu ou lorsque l’effet thérapeutique/secondaire d’une molécule est rapidement identifiable par les soignants sur le terrain.
Considérons un protocole utilisant des blocs fixes de taille 4 pour allouer les traitements A et B. Si l’expérimentateur sait que le bloc courant comporte deux A et deux B, et qu’il observe que les trois premiers patients du bloc ont reçu respectivement la séquence A, puis B, puis A, il déduit avec une certitude absolue de 100 % que le quatrième patient recevra obligatoirement le traitement B. Cette certitude mathématique anéantit le principe stochastique fondamental de la randomisation. L’expérimentateur peut alors, consciemment ou non, modifier le recrutement en différant l’inclusion d’un patient fragile ou, au contraire, en précipitant l’inscription d’un sujet répondant favorablement au profil clinique attendu pour le traitement B.
Pour neutraliser cette prévisibilité délétère, les bonnes pratiques méthodologiques imposent l’usage de blocs de tailles variables permutées de façon aléatoire. L’algorithme central ne se contente pas de permuter les traitements au sein d’un bloc, il tire également au sort la taille de chaque bloc successif parmi un éventail secret (par exemple, une succession aléatoire de blocs de taille 4, 6 ou 8). Dans cette configuration, même si un clinicien connaît les assignations antérieures, il demeure incapable de prédire à quel moment un bloc se termine, restaurant l’incertitude probabiliste indispensable à la préservation de l’insu méthodologique tout au long de la phase d’enrôlement.
6.3 Exemple de calcul et de simulation d’une séquence de blocs
Afin de modéliser mathématiquement ce processus, analysons l’espace combinatoire pour un ratio 1:1 avec des blocs de taille $k = 4$. Le nombre d’arrangements possibles comprenant exactement deux attributions au groupe A et deux attributions au groupe B correspond au coefficient binomial :
$$\binom{4}{2} = \frac{4!}{2! , 2!} = \frac{24}{4} = 6 \text{ arrangements uniques}$$
L’ensemble fondamental des blocs admissibles s’écrit de la façon suivante :
- Bloc 1 : { A, A, B, B }
- Bloc 2 : { A, B, A, B }
- Bloc 3 : { A, B, B, A }
- Bloc 4 : { B, A, A, B }
- Bloc 5 : { B, A, B, A }
- Bloc 6 : { B, B, A, A }
Considérons à présent une cohorte de neuropsychologie cognitive comprenant $N = 40$ participants répartis à l’aide de blocs de taille variable ($k in {4, 6}$). Pour un bloc de taille $k = 6$, le nombre de combinaisons d’assignations comptant trois A et trois B s’élève à :
$$\binom{6}{3} = \frac{6!}{3! , 3!} = 20 \text{ arrangements uniques}$$
La génération informatique tire d’abord au sort la séquence des tailles de blocs, par exemple : Bloc initial de 4, suivi d’un bloc de 6, puis d’un bloc de 4, etc. Ensuite, pour chaque segment, un tirage pseudo-aléatoire uniforme dans l’espace combinatoire respectif (entre 1 et 6 pour la taille 4 ; entre 1 et 20 pour la taille 6) détermine la séquence finale d’attribution des identifiants patients. L’application de tests d’autocorrélation sérielle (test des suites ou test de Ljung-Box) sur le vecteur global d’assignation confirme l’absence de toute périodicité détectable par l’observateur humain, assurant à la fois un équilibre parfait à court terme et une imprévisibilité totale.
7. Randomisation stratifiée et minimisation dynamique
7.1 La randomisation stratifiée : Mécanisme et indications
Bien que la randomisation par blocs garantisse l’équilibre numérique global, elle n’assure pas systématiquement la balance parfaite des facteurs pronostiques critiques au sein des sous-groupes cliniques, particulièrement lorsque la taille de l’échantillon est limitée. La randomisation stratifiée apporte une solution structurelle à cette limitation en combinant la stratification pré-expérimentale et la randomisation par blocs.
Le mécanisme consiste à identifier a priori un ou deux facteurs pronostiques hautement corrélés à l’issue de l’étude (par exemple, la tranche d’âge : $< 65$ ans versus $ge 65$ ans ; et le stade de sévérité de la pathologie : Stade I/II versus Stade III/IV). Le croisement de ces modalités génère un tableau de sous-populations distinctes, appelées strates. Dans notre exemple, nous obtenons $2 \times 2 = 4$ strates étanches :
- Strate 1 : Âge $< 65$ ans et Sévérité Stade I/II
- Strate 2 : Âge $< 65$ ans et Sévérité Stade III/IV
- Strate 3 : Âge $ge 65$ ans et Sévérité Stade I/II
- Strate 4 : Âge $ge 65$ ans et Sévérité Stade III/IV
Le principe fondamental réside dans le déploiement d’une liste de randomisation par blocs permutés totalement indépendante et autonome au sein de chacune de ces 4 strates. Lorsqu’un patient est inclus dans l’étude, l’investigateur renseigne d’abord ses caractéristiques cliniques, ce qui l’oriente vers sa strate d’appartenance. L’assignation au groupe A ou B est ensuite extraite de la séquence de blocs propre à cette strate spécifique. Cette architecture garantit une comparabilité initiale optimale des groupes au sein de chaque profil pronostique majeur, éliminant tout déséquilibre sur ces variables stratégiques.
7.2 Le fléau de la dimensionalité dans les protocoles hautement stratifiés
Si la randomisation stratifiée séduit par son élégance conceptuelle, elle se heurte rapidement à une limite mathématique connue sous le nom de fléau de la dimensionalité (curse of dimensionality). Le nombre global de cellules de stratification s’accroît de manière exponentielle avec l’adjonction de nouvelles variables pronostiques.
Supposons un essai où l’on souhaiterait stratifier selon quatre covariables :
- Le centre de recrutement (10 centres hospitaliers différents).
- Le sexe biologique (2 modalités).
- La classe d’âge (3 tranches d’âge).
- Le statut génétique d’un biomarqueur (3 variants).
Le nombre total de strates distinctes atteint alors :
$$\text{Nombre de strates} = 10 \times 2 \times 3 \times 3 = 180 \text{ strates}$$
Si l’essai prévoit d’enrôler un total de 200 patients, la majorité écrasante des strates ne contiendra qu’un seul patient, voire aucun. Or, pour que la randomisation par blocs au sein des strates fonctionne efficacement, chaque bloc doit être complété. Lorsque de multiples strates demeurent incomplètes à la clôture de l’essai, il se produit une fragmentation dommageable des blocs permutés. L’analyste se retrouve alors avec une multitude d’assignations résiduelles non appariées, ce qui annule l’intérêt de la procédure et peut paradoxalement accroître le déséquilibre numérique global de l’essai. Les règles de bonne pratique biostatistique recommandent formellement de restreindre la stratification à un maximum de deux ou trois covariables cliniques majeures rigoureusement validées par la littérature.
7.3 La méthode de minimisation (Pocock et Simon)
Face aux limites de la stratification multidimensionnelle, Stuart Pocock et Richard Simon ont conçu en 1975 une approche algorithmique novatrice : la méthode de minimisation dynamique. Contrairement à la randomisation classique qui s’appuie sur des listes prédéterminées statiques, la minimisation est une méthode adaptative séquentielle en temps réel qui ajuste l’allocation de chaque nouvel entrant en fonction du profil global des sujets déjà inclus.
Le fonctionnement de l’algorithme de Pocock et Simon s’articule comme suit :
- Lorsqu’un nouveau participant intègre le protocole, l’algorithme extrait ses covariables d’intérêt (par exemple : Femme, $> 60$ ans, Fumeur).
- Pour chacun des bras d’intervention possibles (A ou B), le système simule l’assignation hypothétique de ce sujet et calcule le déséquilibre marginal cumulé sur chacune des modalités considérées individuellement.
- Une fonction de distance mathématique calcule le score de discordance globale résultant pour chaque scénario.
- Le sujet est alors préférentiellement alloué au groupe de traitement qui minimise la somme pondérée des déséquilibres marginaux.
Afin de préserver une composante probabiliste et d’éviter un algorithme entièrement déterministe, une probabilité stochastique $p$ (par exemple $p = 0,80$ au lieu de $1,0$) est traditionnellement assignée au groupe minimisant le déséquilibre, laissant une probabilité résiduelle ($1 – p = 0,20$) d’orienter le sujet vers le groupe majoritaire. La minimisation permet d’équilibrer simultanément un grand nombre de facteurs pronostiques sans subir la prolifération des strates vides. Bien que qualifiée de quasi-aléatoire par certains puristes en raison de sa nature séquentielle dynamique, la minimisation bénéficie d’une pleine reconnaissance méthodologique par les autorités de régulation biomédicale telles que l’EMA et la FDA.
8. Randomisation en grappes (Cluster Randomization) : Enjeux et analyses multiniveaux
8.1 Fondements de l’attribution par groupe ou unité collective
Dans de nombreux contextes de recherche en éducation, en santé publique ou en sociologie des organisations, l’assignation aléatoire au niveau purement individuel s’avère matériellement impossible ou méthodologiquement inappropriée. L’intervention évaluée cible alors naturellement des structures collectives préexistantes. Ce schéma expérimental correspond à la randomisation en grappes (cluster randomized trial).
Dans un essai en grappes, l’unité de randomisation (l’entité soumise au tirage au sort) n’est pas le participant individuel, mais un groupe complet d’individus partageant un environnement fonctionnel commun : des classes scolaires entières, des services hospitaliers, des cabinets de médecine générale ou des communautés villageoises. Les individus appartenant à une même grappe reçoivent tous, obligatoirement, la même modalité d’intervention.
La justification prééminente de la randomisation en grappes est la prévention de la contamination expérimentale. Imaginons l’évaluation d’un programme pédagogique innovant visant à modifier les habitudes nutritionnelles des enfants. Si l’on procédait à une randomisation individuelle au sein d’une même salle de classe, les enfants du groupe interventionnel échangeraient inévitablement avec leurs camarades témoins durant les récréations, partageant le contenu éducatif reçu. Dès lors, le groupe témoin adopterait progressivement les comportements du groupe d’intervention, diluant artificiellement la mesure de l’effet causal. La randomisation d’écoles complètes élimine cette contamination croisée, tout en respectant les impératifs logistiques du terrain éducatif ou hospitalier.
8.2 L’effet de grappe et le coefficient de corrélation intraclasse (CCI)
Sur le plan mathématique, l’assignation en grappes viole frontalement l’un des postulats fondamentaux de la statistique inférentielle conventionnelle : l’indépendance conditionnelle des observations individuelles. Deux sujets recrutés au sein d’une même grappe (par exemple, deux patients soignés dans le même service hospitalier par la même équipe soignante) présentent des similitudes physiologiques, comportementales et environnementales bien supérieures à celles mesurées entre deux sujets issus de grappes distinctes.
Ce niveau d’homogénéité intra-groupe est rigoureusement quantifié par le coefficient de corrélation intraclasse (CCI), traditionnellement désigné par la lettre grecque $rho$ (rho). En décomposant la variance globale de l’issue continue $Y_{ij}$ du sujet $i$ dans la grappe $j$ en une composante de variance inter-grappes ($\sigma_b^2$) et une composante intra-grappe ($\sigma_w^2$), le CCI s’énonce mathématiquement par :
$$\rho = \frac{\sigma_b^2}{\sigma_b^2 + \sigma_w^2}$$
Cette dépendance sérielle engendre une redondance informationnelle qui réduit la variance globale effective de l’échantillon. L’impact direct sur la puissance statistique est mesuré par l’effet de plan (Design Effect, $DE$), qui agit comme un coefficient d’inflation de la variance d’échantillonnage :
$$DE = 1 + (m – 1)\rho$$
où $m$ désigne la taille moyenne (nombre d’individus) de chaque grappe. Même un CCI d’apparence modeste, tel que $rho = 0,02$, peut avoir des répercussions considérables sur le calcul d’effectif : si la taille des grappes est de $m = 101$ sujets, l’effet de plan atteint $DE = 1 + (100 \times 0,02) = 3$. Cela signifie que la variance d’estimation est triplée par rapport à une randomisation individuelle, imposant de multiplier l’échantillon brut total de participants par 3 pour conserver la même puissance statistique.
8.3 Modèles statistiques requis pour les essais randomisés en grappes
L’erreur méthodologique la plus grave lors de l’exploitation de données issues d’un essai en grappes consiste à ignorer la structure hiérarchique des observations et à appliquer des tests statistiques ordinaires (comme le test $t$ de Student ou la régression linéaire des moindres carrés ordinaires) directement au niveau des individus. Cette analyse naïve conduit à une sous-estimation dramatique des erreurs standards des estimateurs, provoquant une inflation catastrophique du taux d’erreur de type I (faux positifs) : la valeur $p$ rapportée peut sembler hautement significative ($p < 0,01$) alors que le seuil réel ajusté dépasse largement 0,10.
L’analyse valide des essais en grappes requiert l’implémentation exclusive de modèles statistiques hiérarchiques ou multiniveaux :
- Les modèles linéaires mixtes (LMM) ou modèles additifs généralisés mixtes (GLMM) : Ils intègrent explicitement des effets aléatoires spécifiques à chaque grappe ($u_j \sim \mathcal{N}(0, \sigma_b^2)$) afin de capturer l’hétérogénéité contextuelle non modélisée. Le modèle formel pour un essai à deux bras s’écrit :
$$Y_{ij} = \beta_0 + \beta_1 T_j + \mathbf{\beta}’ \mathbf{X}_{ij} + u_j + \varepsilon_{ij}$$
où $T_j$ est l’indicateur de traitement attribué à la grappe $j$, et $\beta_1$ quantifie sans biais l’effet causal moyen du traitement. - Les équations d’estimation généralisées (GEE, Generalized Estimating Equations) : Approche semi-paramétrique qui modélise directement la moyenne marginale au niveau de la population en ajustant la matrice de variance-covariance des erreurs par une structure de travail appropriée (échangeable, autorégressive) couplée à des estimateurs de variance robustes dits « en sandwich » (Huber-White).
Dans une étude de terrain évaluant une intervention psycho-éducative sur l’anxiété scolaire déployée sur 24 collèges (12 traités, 12 témoins) regroupant 2 400 élèves, seuls ces modèles mixtes garantissent une inférence causale rigoureusement valide, en tenant compte du regroupement écologique des élèves au sein de leurs établissements respectifs.
9. Applications de la randomisation en psychologie et sciences comportementales
9.1 Défis spécifiques de la randomisation en psychothérapie
L’application du paradigme de la randomisation à l’évaluation des interventions psychologiques et comportementales soulève des difficultés méthodologiques singulières qui ne se posent pas avec la même intensité dans l’expérimentation pharmacologique pure. Le premier écueil réside dans la modélisation et la validation d’un groupe contrôle conceptuellement adéquat.
En médecine somatique, le groupe témoin reçoit le plus souvent un placebo inerte (pilule de lactose) indiscernable de la molécule active. En psychothérapie, concevoir un « placebo psychologique » satisfaisant s’avère d’une complexité redoutable. Une condition témoin courante est la liste d’attente (waitlist control), où les participants attendent plusieurs semaines avant de bénéficier de la thérapie. Or, cette conception introduit un biais négatif avéré : les sujets placés en attente développent un sentiment de passivité et d’impuissance acquise, ce qui tend à dégrader artificiellement leur score de bien-être mental. Dès lors, la supériorité observée de la thérapie active ne reflète pas uniquement l’efficacité de l’intervention, mais également la détérioration induite par le statut d’attente passive.
Une alternative méthodologique plus exigeante consiste à comparer la modalité psychothérapeutique d’intérêt (par exemple, la thérapie cognitivo-comportementale ou TCC) à une condition de soutien relationnel non directif ou au traitement usuel optimisé (TAU, Treatment As Usual). Cependant, une composante confondante majeure réside dans la variabilité du clinicien : l’alliance thérapeutique, l’empathie, l’expertise et la conviction intime du thérapeute (facteurs communs de Rosenzweig) constituent des prédicteurs puissants de l’amélioration clinique, venant se superposer aux techniques comportementales formelles.
9.2 Protocoles intra-sujets et contrebalancement aléatoire
Dans les paradigmes de psychologie cognitive expérimentale, de neurosciences et d’ergonomie, les investigateurs privilégient souvent les protocoles à mesures répétées ou plans intra-sujets (within-subject designs). Dans ce schéma, chaque participant ne reçoit pas une seule condition, mais est soumis successivement à l’ensemble des conditions expérimentales de l’étude. Cette architecture offre l’avantage inestimable d’éliminer totalement la variance interindividuelle, chaque sujet constituant son propre groupe contrôle.
Cependant, les protocoles intra-sujets sont confrontés au problème critique des effets de report (carryover effects) et des effets de séquence :
- L’effet d’apprentissage ou d’entraînement (la performance s’améliore naturellement aux tâches successives).
- L’effet de fatigue cognitive ou de lassitude attentionnelle (le temps de réaction augmente mécaniquement en fin d’épreuve).
- L’effet de contraste psychologique d’un stimulus sur le suivant.
Pour neutraliser ces artefacts séquentiels, les psychologues appliquent le contrebalancement aléatoire. Si le nombre de conditions est restreint, un plan en carré latin équilibré est mis en place : l’ordre de passation des conditions est permuté aléatoirement entre les participants de telle sorte que chaque modalité apparaisse un nombre égal de fois à chaque position séquentielle et qu’elle soit précédée et suivie par chaque autre modalité un nombre rigoureusement identique de fois. Dans les tâches d’attention visuelle ou de poursuite oculaire (eye-tracking), l’ordre d’affichage de centaines de stimuli est entièrement randomisé de manière sérielle pour chaque sujet afin d’assurer l’orthogonalité totale des mesures cognitives vis-à-vis du temps.
9.3 L’insu psychologique et la gestion des attentes expérimentales
L’une des plus grandes vulnérabilités de la recherche expérimentale en sciences humaines concerne l’impossibilité d’appliquer un double insu strict. Si un pharmacologue peut masquer visuellement une molécule au médecin comme au patient, un psychologue clinicien sait pertinemment s’il applique un protocole d’exposition cognitive structuré ou un simple entretien d’écoute bienveillante ; de son côté, le patient réalise rapidement la nature de l’échange engagé.
Cette absence d’insu ouvre la voie à des biais psychosociaux puissants :
- Les caractéristiques de la demande (demand characteristics) : Les sujets inclus devinent les hypothèses des chercheurs et adaptent inconsciemment leurs réponses pour complaire aux attentes perçues.
- L’effet Rosenthal (effet Pygmalion) : L’enthousiasme inconscient du chercheur pour son modèle théorique induit un renforcement comportemental subtil des réponses des participants exposés au traitement actif.
- L’effet Hawthorne : L’amélioration du comportement des individus provient du simple fait d’avoir conscience d’être observés et valorisés dans le cadre d’un protocole scientifique prestigieux.
Pour pallier l’inaccessibilité du double aveugle classique, la méthodologie contemporaine impose l’intervention d’évaluateurs indépendants en aveugle (blinded outcome assessors). Les échelles cliniques diagnostiques ou les tests projectifs post-intervention sont administrés par des psychologues tiers n’ayant eu aucun contact antérieur avec les sujets et ignorant totalement la condition d’assignation attribuée par le système de randomisation. Cette précaution sécurise l’impartialité de la métrologie psychologique finale.
10. Outils technologiques et procédures d’implémentation opérationnelle
10.1 Génération algorithmique de nombres aléatoires
Sur le plan opérationnel, la mise en œuvre de la randomisation requiert des outils informatiques capables de produire des suites numériques statistiquement irréprochables. Les ordinateurs étant des machines intrinsèquement déterministes, ils ne peuvent générer spontanément du hasard pur sans recourir à des dispositifs physiques externes (capteurs de bruit thermique ou de désintégration radioactive quantique). La recherche quantitative s’appuie donc quasi universellement sur des générateurs de nombres pseudo-aléatoires (PRNG).
Un PRNG hautement performant, tel que l’algorithme du Mersenne Twister (implémenté par défaut dans la quasi-totalité des logiciels d’analyse de données modernes), utilise une récurrence matricielle produisant une séquence de nombres dont la période théorique est gigantesque : $2^{19937}-1$. Pour les besoins de la recherche expérimentale, cette séquence est indiscernable d’un tirage purement stochastique selon l’ensemble des batteries de tests cryptographiques connus.
L’exigence impérative régissant l’usage d’un PRNG en science est la reproductibilité computationnelle. Un chercheur doit obligatoirement initialiser son algorithme en déclarant formellement une graine aléatoire (random seed), un entier fixé servant de point d’entrée dans la trajectoire déterministe sous-jacente. L’inscription formelle de cette graine dans le plan d’analyse statistique garantit qu’un auditeur indépendant exécutant le même code logiciel obtiendra rigoureusement la même liste séquentielle d’assignation, attestant de l’intégrité de la procédure.
Dans l’environnement de programmation statistique open-source R, la commande s’articule simplement à travers des fonctions natives :
L’opérateur configure d’abord l’état initial par set.seed(42), garantissant que l’expérience est reproductible à l’identique. Il génère ensuite un vecteur d’assignations équilibré pour $N = 100$ sujets au moyen de la fonction de rééchantillonnage sample(rep(c("Traitement", "Controle"), each = 50)). Des approches similaires sont déployées en Python via le module numpy.random ou sous la syntaxe propriétaire d’IBM SPSS Statistics.
10.2 Dissimulation de l’allocation (Allocation Concealment)
Une confusion méthodologique grave persiste parfois entre la génération de la séquence d’assignation et sa dissimulation concrète. Un protocole peut reposer sur une séquence d’allocation aléatoire théoriquement parfaite tout en étant complètement dévoyé si le processus d’inscription permet à l’expérimentateur de découvrir l’affectation du prochain patient avant sa décision définitive d’inclusion. Ce rempart opérationnel porte le nom de dissimulation de l’allocation (allocation concealment).
La dissimulation de l’affectation constitue la barrière logistique protégeant la randomisation jusqu’au moment irréversible de l’enrôlement du sujet. Historiquement, les chercheurs ont utilisé la technique des enveloppes scellées, opaques et numérotées séquentiellement (procédure SNOSE, pour Sequentially Numbered Opaque Sealed Envelopes). Chaque enveloppe renferme le papier indiquant le traitement attribué ; elle n’est descellée qu’après l’enregistrement formel et définitif du nom du participant sur le carnet d’observation. Toutefois, les audits ont montré que cette méthode manuelle demeurait vulnérable à des fraudes : éclairage des enveloppes par transparence à travers des sources lumineuses intenses, ou forçage de l’ordre d’ouverture par des équipes cliniques soucieuses d’orienter certains profils.
Aujourd’hui, les standards de la recherche internationale imposent l’usage exclusif de systèmes centralisés automatisés en ligne : les plateformes IWRS (Interactive Web Response Systems) ou IRT (Interactive Response Technology). Le clinicien se connecte à un serveur sécurisé distant, saisit les critères d’éligibilité et l’accord éclairé du participant. Une fois l’inclusion verrouillée de manière inaltérable dans la base centrale, le serveur transmet instantanément le numéro de boîte médicamenteuse masquée correspondant au bras attribué. Aucun clinicien ne dispose de la possibilité d’anticiper l’assignation à venir.
10.3 Audit trail et traçabilité réglementaire
Dans le domaine des essais cliniques soumis aux directives de l’ICH (International Council for Harmonisation) et aux Bonnes Pratiques Cliniques (BPC), la documentation de la randomisation fait l’objet d’audits juridiques rigoureux. Les organismes régulateurs (ANSM en France, EMA en Europe, FDA aux États-Unis) exigent une traçabilité inviolable de chaque étape de la chaîne d’allocation.
Cette traçabilité repose sur le concept technique de piste d’audit (Audit Trail). Chaque transaction opérée sur la plateforme centrale de randomisation fait l’objet d’un horodatage électronique certifié à la milliseconde près, documentant :
- L’identifiant cryptographique de l’opérateur ayant procédé à l’inscription.
- La date, l’heure exacte et l’adresse IP de la connexion.
- Les caractéristiques cliniques saisies justifiant l’inclusion.
- Le statut de la séquence algorithmique au moment du calcul d’assignation.
- L’accusé de réception confirmant l’attribution du code d’intervention.
La liste maîtresse de randomisation générée avant le lancement de l’étude est placée sous le contrôle exclusif d’un statisticien désigné indépendant de l’équipe de coordination opérationnelle. Elle est verrouillée au moyen de clés de chiffrement asymétrique dans des référentiels sécurisés, restant strictement inaccessible aux promoteurs, aux investigateurs et aux moniteurs d’étude clinique jusqu’au verrouillage définitif de l’intégralité de la base de données (étape dite de levée de l’insu ou database unblinding).
11. Limites méthodologiques, biais résiduels et défis éthiques
11.1 Limites statistiques : Déséquilibres de hasard et validité externe
Bien que la randomisation soit l’outil statistique le plus puissant pour sécuriser la validité interne, elle ne constitue en aucun cas une panacée exempte de limitations structurelles. La première limite concerne le paradoxe stochastique des petits échantillons. La randomisation garantit une équiprobabilité théorique à l’infini, mais ne confère aucune protection absolue contre les anomalies distributionnelles à court terme. Dans une petite cohorte de 30 patients, un tirage au sort parfaitement impartial peut, par pur caprice probabiliste, regrouper 80 % des patients diabétiques dans le bras contrôle, générant un déséquilibre accidentel susceptible de biaiser l’estimation finale si aucun ajustement n’est effectué.
La seconde tension majeure réside dans le compromis structurel entre validité interne et validité externe (représentativité écologique). Pour maximiser l’efficacité de la randomisation et isoler rigoureusement l’effet causal d’une molécule ou d’une intervention psychosociale, les essais randomisés imposent des critères d’inclusion et d’exclusion drastiques : élimination des sujets présentant des comorbidités multiples, des sujets âgés, des femmes enceintes ou des personnes polymédiquées.
Ce filtrage drastique aboutit à une cohorte expérimentale extrêmement homogène mais sociologiquement et biologiquement artificielle. Les résultats magistralement démontrés au sein d’un ERC s’avèrent alors fréquemment non reproductibles dans la vie réelle (« vie réelle » de la pratique clinique quotidienne), où les praticiens soignent des patients vulnérables, hétérogènes et peu compliants aux ordonnances. De surcroît, le biais de consentement (ou de volontariat) induit une distorsion systématique : les individus acceptant d’entrer dans un processus expérimental où leur traitement sera tiré au sort présentent un profil motivationnel, socio-économique et d’observance radicalement différent de la population générale.
11.2 Dilemmes déontologiques et éthiques de la randomisation
La mise en œuvre pratique de la randomisation suscite des dilemmes moraux d’une intensité particulière dans le champ de la santé physique et mentale. Sur le plan éthique, l’assignation d’un traitement par le hasard n’est juridiquement et déontologiquement acceptable qu’en présence d’un état de fait rigoureusement qualifié : l’équipoise clinique (clinical equipoise).
L’équipoise clinique stipule qu’il doit exister une incertitude honnête et partagée au sein de la communauté scientifique experte quant à la supériorité relative des options thérapeutiques comparées. Dès l’instant où des preuves tangibles indiquent qu’un traitement expérimental offre une efficacité indiscutable ou, à l’inverse, génère des toxicités inacceptables par rapport au témoin, le fondement moral de la randomisation s’effondre. Forcer un patient à entrer dans un protocole où il a une chance sur deux de recevoir une molécule inférieure enfreint le principe hipococratique de non-malfaisance et le code d’éthique médicale international.
Ce problème prend une résonance tragique lors des crises sanitaires aiguës (épidémies émergentes) ou dans la prise en charge de détresses psychologiques majeures (états suicidaires aigus). L’assignation aléatoire à un groupe placebo ou à un groupe sans intervention (soin usuel insuffisant) de sujets en proie à une souffrance intolérable pose un problème de conscience aux investigateurs. C’est pour cette raison que les comités de protection des personnes (CPP) et les comités d’éthique de la recherche (CER) imposent désormais la mise en place de comités de surveillance indépendants des données et de la sécurité (DSMB, Data Safety and Monitoring Boards). Ces instances réalisent des analyses intermédiaires confidentielles et disposent du pouvoir légal d’ordonner l’arrêt immédiat et anticipé de la randomisation dès qu’un seuil de supériorité statistique formel (défini par les frontières de Haybittle-Peto ou d’O’Brien-Fleming) est franchi.
11.3 Attrition différentielle et rupture post-randomisation
La randomisation n’agit qu’au moment précis de l’inclusion : elle protège l’expérience à son origine chronologique ($t_0$). Cependant, une expérimentation scientifique se déploie dans la durée, souvent sur des mois ou des années. Durant cette période de suivi, l’intégrité du protocole peut être ruinée par un phénomène pathologique pour l’inférence : l’attrition différentielle (perdus de vue et abandons asymétriques).
Supposons un essai comparant un antidépresseur standard bien toléré à une molécule innovante hautement puissante mais causant des nausées sévères durant les premières semaines. Il est probable que les patients du groupe novateur abandonnent l’étude en cours de route dans une proportion nettement supérieure (par exemple 30 % d’abandons contre 5 % dans le bras standard). Or, les participants qui quittent l’essai sont généralement ceux qui présentent la vulnérabilité physique ou psychologique la plus élevée.
Cet abandon sélectif détruit irréversiblement la comparabilité stochastique initialement créée par la randomisation. Le groupe novateur se retrouve progressivement purgé de ses patients les plus fragiles, ne laissant subsister au terme de l’étude que les individus les plus robustes et les meilleurs répondeurs biologiques. Une comparaison finale non corrigée entre les deux groupes conclura fallacieusement à une tolérance et à une efficacité remarquables de la nouvelle molécule, alors que ce résultat n’est que le pur produit d’un biais de survie post-randomisation.
12. Bonnes pratiques de reporting et analyse statistique des données randomisées
12.1 Analyse en Intention de Traiter (ITT) versus Per-Protocole (PP)
Face au défi majeur posé par les écarts au protocole, les non-observances médicamenteuses et les perdus de vue, la discipline biostatistique a érigé une règle d’analyse canonique : le principe de l’Intention de Traiter (ITT, Intention-To-Treat). Ce paradigme s’énonce d’une façon lapidaire et intransigeante : « Une fois randomisé, toujours analysé ».
Sous la stratégie ITT, l’ensemble des données de chaque sujet enrôlé est obligatoirement analysé au sein du groupe auquel le système de randomisation l’avait initialement alloué, quelles que soient les péripéties survenues ultérieurement :
- Même si le patient a refusé de prendre son traitement dès le premier jour.
- Même s’il s’est trompé de posologie ou a pris par erreur le médicament du groupe opposé (cross-over).
- Même s’il a déménagé et interrompu définitivement le suivi protocolaire.
À l’inverse, l’analyse dite Per-Protocole (PP) ne conserve dans les calculs finaux que les participants ayant fait preuve d’une observance exemplaire et ayant fidèlement exécuté l’intégralité du programme thérapeutique. Si cette approche semble intuitivement séduisante pour évaluer la pure efficacité biologique idéale de la molécule, elle réintroduit directement le redoutable biais de sélection. Les patients observants partagent des facteurs de discipline de vie, de soutien socio-familial et de compliance globale qui en font des sujets à meilleur pronostic intrinsèque, indépendamment du traitement testé.
L’analyse en intention de traiter préserve la balance de confusion établie par la randomisation et fournit une estimation pragmatique de l’efficacité de l’intervention dans les conditions réelles d’une politique de santé (tenant compte des abandons et de la mauvaise observance). Sur le plan opératoire, l’implémentation rigoureuse de l’ITT face aux données manquantes repose sur des méthodes d’imputation multiple par équations chaînées (MICE) ou des modèles mixtes à effets aléatoires supposant des données manquantes au hasard (MAR, Missing At Random), proscrivant les approches naïves comme le transport de la dernière observation observée (LOCF, Last Observation Carried Forward).
12.2 Normes de publication et directives CONSORT
Pour garantir l’intégrité de la communication scientifique et enrayer la publication d’essais méthodologiquement viciés, un panel international d’épidémiologistes et de rédacteurs en chef de grandes revues médicales a formulé les directives CONSORT (Consolidated Standards of Reporting Trials).
Les recommandations CONSORT imposent la présence obligatoire au sein de toute publication de recherche expérimentale d’un diagramme de flux (flow diagram) normalisé détaillant de manière transparente le parcours complet des participants à travers quatre étapes chronologiques clés :
- Recrutement : Nombre total d’individus évalués pour l’éligibilité, et détail des exclusions (critères d’exclusion satisfaits, refus de consentir, autres motifs).
- Attribution : Nombre précis de participants alloués par la randomisation à chacun des bras de l’essai, et mention explicite de la réception effective ou non de l’intervention attribuée.
- Suivi : Quantification rigoureuse des abandons de traitement, des perdus de vue et des sorties d’étude prématurées au fil des semaines.
- Analyse : Nombre exact de sujets inclus dans l’analyse statistique finale, avec justification impérative de toute exclusion éventuelle de la population en ITT.
Par ailleurs, la directive CONSORT proscrit formellement une pratique analytique pourtant longtemps répandue : l’usage de tests statistiques de significativité (valeurs $p$) sur le tableau comparant les caractéristiques démographiques et cliniques initiales à l’état de référence (la célèbre « Table 1 »). Ce sophisme méthodologique est connu sous l’appellation de Table One Fallacy. Si la randomisation a été correctement réalisée, l’hypothèse nulle d’absence de différence systématique est mathématiquement vraie par construction. Tout écart observé sur une covariable initiale ne peut être imputable qu’au seul hasard d’échantillonnage ; calculer une valeur $p$ sur ces variables n’a donc aucun sens épistémologique et distrait l’attention du lecteur de la seule dimension pertinente : l’importance clinique et l’amplitude concrète des éventuels déséquilibres fortuits.
12.3 Ajustement par régression sur les données randomisées
Une interrogation fréquente parmi les chercheurs praticiens est de savoir s’il est légitime ou redondant de procéder à des ajustements statistiques a posteriori (comme l’analyse de covariance, ANCOVA) sur des données issues d’une expérience déjà randomisée. La réponse statistique contemporaine est univoque : l’ajustement pré-spécifié sur des covariables pronostiques clés est non seulement parfaitement légitime, mais chaudement recommandé.
Bien que la randomisation rende l’estimateur brut de la différence des moyennes non biaisé, la variabilité individuelle liée aux facteurs pronostiques de base majeurs (par exemple, le score cognitif de départ ou l’âge des sujets) demeure présente au sein de la variance résiduelle du modèle. En introduisant la valeur initiale de la variable d’intérêt ($Y_{i,\text{baseline}}$) comme covariable dans un modèle ANCOVA linéaire :
$$Y_{i,\text{post}} = \beta_0 + \tau , T_i + \beta_1 , Y_{i,\text{baseline}} + \varepsilon_i$$
le statisticien extrait mécaniquement une fraction substantielle de la variance inexpliquée résiduelle ($\sigma_\varepsilon^2$). Cette réduction de l’erreur quadratique moyenne resserre considérablement l’intervalle de confiance de l’estimateur de l’effet causal $tau$ et diminue son erreur standard d’un facteur proportionnel à $\sqrt{1 – r^2}$, où $r$ est la corrélation de Pearson entre la mesure initiale et la mesure finale.
Cette démarche engendre un gain direct et massif de puissance statistique, équivalant souvent à une augmentation virtuelle de 20 à 30 % de la taille d’échantillon sans coût financier ou logistique additionnel. De surcroît, cet ajustement préserve intégralement la validité mathématique de l’inférence causale, à la condition expresse et indérogeable que les covariables d’ajustement aient été identifiées et gravées dans le marbre du plan d’analyse statistique (SAP) rédigé et déposé avant toute consultation des données d’évaluation finale, écartant ainsi tout soupçon de « pêche aux données » (p-hacking).
Références
Altman, D. G., & Bland, J. M. (1999). How to randomise. BMJ, 319(7211), 703-704. https://doi.org/10.1136/bmj.319.7211.703
Fisher, R. A. (1935). The Design of Experiments. Oliver and Boyd.
Greenland, S., Pearl, J., & Robins, J. M. (1999). Confounding and collapsibility in causal inference. Statistical Science, 14(1), 29-46. https://doi.org/10.1214/ss/1009211805
Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: updated guidelines for reporting parallel group randomised trials. BMJ, 340, c869. https://doi.org/10.1136/bmj.c869
Pocock, S. J., & Simon, R. (1975). Sequential treatment assignment with balancing for prognostic factors in the controlled clinical trial. Biometrics, 31(1), 103-115. https://doi.org/10.2307/2529712
Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41-55. https://doi.org/10.1093/biomet/70.1.41
Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688-701. https://doi.org/10.1037/h0037350
Schulz, K. F., & Grimes, D. A. (2002). Allocation concealment in randomised trials: defending against deciphering. The Lancet, 359(9306), 614-618. https://doi.org/10.1016/S0140-6736(02)07750-4