
Dans le champ de la psychologie quantitative, des neurosciences cognitives et de la psychométrie, l’exploration initiale des données constitue une étape déterminante dont dépend la validité de l’ensemble de la chaîne inférentielle. Bien souvent, les praticiens et les chercheurs abordent le traitement de leurs distributions empiriques en s’appuyant sur des indicateurs de tendance centrale et de dispersion élémentaires. Pourtant, ces métriques de réduction statistique condensent l’information au risque de dissimuler des hétérogénéités sous-jacentes majeures, des effets de seuil expérimentaux ou des anomalies d’échantillonnage. La représentation graphique des distributions au moyen de l’histogramme demeure, depuis son introduction formelle à la fin du XIXe siècle par Karl Pearson, la méthode d’inspection visuelle la plus directe et la plus universellement reconnue pour appréhender la forme probabiliste d’un ensemble de mesures quantitatives.
Cependant, l’histogramme possède une vulnérabilité théorique intrinsèque que beaucoup d’analystes négligent dans leur pratique quotidienne sous le logiciel R : sa topographie visuelle dépend de façon critique du nombre et de la largeur des classes, communément désignées sous l’anglicisme bins. Une modification, même modeste, du découpage des intervalles peut transformer radicalement l’apparence d’une distribution, faisant apparaître un faux mode de réponse, masquant une asymétrie clinique cruciale ou effaçant la présence d’une sous-population atypique. L’environnement statistique R offre une panoplie remarquable de fonctions et d’arguments permettant de paramétrer ce partitionnement, allant de la fonction historique hist() intégrée au moteur de base jusqu’aux couches vectorielles sophistiquées du module ggplot2. Maîtriser le réglage de ce paramètre ne relève donc pas d’une simple coquetterie esthétique, mais d’une exigence méthodologique impérative garantissant l’intégrité de l’interprétation empirique.
Cet article propose une exploration approfondie, exhaustive et rigoureusement documentée des mécanismes mathématiques et programmatiques qui régissent le découpage en classes des histogrammes dans l’écosystème R. À travers l’analyse détaillée des algorithmes classiques de Sturges, de Scott et de Freedman-Diaconis, la déconstruction des arguments de syntaxe et l’examen d’études de cas réalistes en psychométrie clinique et cognitive, nous fournirons au chercheur les repères nécessaires pour choisir, ajuster et justifier scientifiquement ses options de visualisation. Cette démarche s’inscrit dans les standards contemporains de la science ouverte et de la reproductibilité computationnelle, en insistant sur la transparence méthodologique exigée par les revues internationales à comité de lecture.
1. Introduction aux histogrammes dans l’analyse de données psychologiques avec R
1.1 Rôle de la visualisation distributionnelle en psychométrie
L’évaluation psychologique moderne repose massivement sur la quantification de construits inobservables, appelés variables latentes, tels que l’anxiété état, le quotient intellectuel, la mémoire de travail ou les traits de personnalité. Ces entités théoriques sont généralement opérationnalisées au moyen de scores composites issus d’échelles de Likert, de batteries d’épreuves chronométrées ou de grilles d’observation comportementale. Lors de la phase de validation ou d’exploitation de ces outils, l’inspection visuelle de la distribution empirique est indispensable. Elle permet de vérifier si les données respectent les hypothèses de normalité univariée requises par la majorité des modèles linéaires, qu’il s’agisse de l’analyse de variance, de la régression multiple ou de la modélisation en équations structurelles.
L’examen des moments d’ordre supérieur, particulièrement l’asymétrie (ou skewness) et l’aplatissement (ou kurtosis), ne peut se satisfaire d’une simple lecture tabulaire. Un coefficient d’asymétrie modéré peut en réalité résulter de quelques valeurs extrêmes isolées ou, au contraire, d’un glissement systématique de l’ensemble de l’échantillon vers une extrémité de l’échelle. Seule la représentation graphique permet de trancher avec certitude. De plus, les résumés numériques stricts tels que la moyenne et l’écart-type se révèlent aveugles face à des distributions multimodales : une distribution présentant deux bosses bien distinctes peut arborer une moyenne parfaitement centrée et un écart-type en apparence banal, dissimulant le fait que la moyenne statistique correspond précisément à la zone où les observations sont les plus rares.
Dans les contextes expérimentaux et cliniques, la visualisation graphique constitue également la première ligne de défense pour identifier les anomalies de mesure. Les effets de plancher, où une proportion excessive de participants obtient le score minimal en raison d’une tâche trop difficile ou d’une échelle inadaptée, et les effets de plafond, où les scores s’accumulent artificiellement au sommet de l’intervalle d’évaluation, se signalent instantanément sur un histogramme par une barre disproportionnée à l’une des bornes. Ignorer ces patrons distributionnels conduit invariablement à des erreurs d’inférence, à une atténuation fallacieuse des corrélations observées et à des conclusions erronées sur l’efficacité d’une intervention psychologique ou pharmacologique.
1.2 Définition mathématique et terminologique des classes (bins)
D’un point de vue formel, la construction d’un histogramme repose sur le partitionnement de l’ensemble de définition d’une variable quantitative continue en un ensemble fini d’intervalles contigus et mutuellement disjoints. Ces intervalles élémentaires portent le nom de classes ou de bins. Si l’on note l’étendue des données observées sur l’axe réel, le partitionnement découpe cet espace en plusieurs segments définis chacun par une borne inférieure et une borne supérieure. Tout point de données de l’échantillon appartient à une et une seule classe, garantissant que la somme des effectifs associés à chaque classe soit rigoureusement égale à la taille totale de l’échantillon étudié.
La largeur d’une classe, fréquemment appelée largeur de bande ou binwidth, entretient une relation géométrique et arithmétique directe avec le nombre total de classes. Lorsque l’on impose une largeur constante à travers tout l’espace d’échantillonnage, le nombre de classes correspond au rapport entre l’étendue globale des scores (la différence entre le maximum et le minimum) et cette largeur de bande unitaire. Selon l’objectif visé par l’analyste, l’axe vertical de l’histogramme peut représenter soit le comptage des fréquences absolues, c’est-à-dire le dénombrement brut des sujets dont le score tombe dans l’intervalle considéré, soit une estimation de la densité de probabilité relative. Dans ce dernier cas, la surface totale de l’histogramme, obtenue en sommant le produit de la largeur de chaque classe par sa hauteur relative, doit égaler exactement 1, s’alignant ainsi sur les principes axiomatiques du calcul des probabilités de Kolmogorov.
Le paramétrage du nombre de classes induit une tension mathématique fondamentale entre le sous-lissage et le sur-lissage de la distribution empirique. Lorsque les classes sont excessivement nombreuses et étroites, l’histogramme souffre d’un sous-lissage marqué : la courbe devient bruitée, fragmentée et hérissée de pics artificiels qui reflètent la variabilité d’échantillonnage aléatoire plutôt que la loi génératrice sous-jacente. Inversement, si le nombre de classes est trop restreint et leur largeur démesurée, le sur-lissage efface les caractéristiques morphologiques indispensables, telles que les creux de densité, les infléchissements de pente ou la présence de sous-groupes cliniques distincts au sein de la cohorte.
1.3 Présentation de la fonction de base hist() dans le logiciel R
Le langage de programmation R intègre nativement, au sein de son module graphique de base nommé graphics, la commande canonique hist(). Cette fonction prend en entrée un vecteur numérique représentant la variable continue d’intérêt et produit immédiatement une figure dans la fenêtre graphique active. D’une grande souplesse, hist() accepte une multitude d’arguments permettant de piloter l’apparence du tracé, notamment main pour le titre principal, xlab et ylab pour les étiquettes des axes, col pour la teinte de remplissage des barres, et border pour le tracé de leurs contours géométriques.
Le paramètre central qui contrôle la granularité du découpage est l’argument breaks. Cet argument se distingue par son polymorphisme remarquable : il peut recevoir un vecteur numérique énumérant explicitement l’ensemble des points de coupure, un entier scalaire suggérant un nombre approximatif d’intervalles, une chaîne de caractères spécifiant le nom d’un algorithme mathématique reconnu, ou même une fonction personnalisée programmée par l’utilisateur. La maîtrise de cet argument breaks constitue le pivot technique autour duquel s’articule toute manipulation fine de la résolution distributionnelle sous R.
Dans la pratique des sciences sociales, les jeux de données bruts comportent fréquemment des valeurs manquantes, codées par la constante NA. Par défaut, la fonction hist() ne tolère pas la présence de données non définies et renvoie un message d’erreur bloquant. L’analyste doit impérativement procéder à un filtrage préalable en utilisant des fonctions d’extraction conditionnelle ou en encapsulant son vecteur dans l’appel na.omit(). Ce comportement rigoureux évite d’introduire des biais invisibles dans le calcul des coupures et force le chercheur à prendre conscience du taux d’attrition présent dans son échantillon psychométrique avant toute tentative de représentation visuelle.
2. Le comportement par défaut de hist() et le calcul via la règle de Sturges
2.1 Origine et formulation mathématique de la règle de Sturges
Lorsque la fonction hist() est invoquée sans aucune mention explicite de l’argument breaks, R ne procède pas à un tirage au sort de la largeur des classes. Il applique un protocole d’estimation déterministe basé sur la formule logarithmique historique formulée en 1926 par le statisticien américain Herbert Sturges. Conçue à une époque où le calcul manuel imposait des contraintes arithmétiques sévères, la formulation de Sturges visait à déterminer le nombre optimal de classes pour représenter graphiquement une série statistique continue en postulant que la distribution sous-jacente se comporte de manière approximativement gaussienne.
La formule mathématique s’exprime sous la forme : k = 1 + log2(n), où k représente le nombre théorique de classes et n l’effectif total de l’échantillon. Cette équation découle directement du développement des coefficients binomiaux issus du triangle de Pascal. En assimilant une distribution normale discrétisée à une loi binomiale symétrique de paramètres n et p = 0.5, Sturges considérait que le nombre idéal d’intervalles devait refléter le nombre de termes dans l’expansion binomiale permettant d’éviter que les queues de distribution ne soient dépeuplées.
Dans le code source interne du moteur R, cette logique est implémentée dans la fonction auxiliaire nclass.Sturges(). Si l’on inspecte le corps de cette fonction élémentaire, on constate qu’elle exécute l’opération arithmétique : ceiling(log2(length(x)) + 1), où ceiling() assure l’arrondi à l’entier supérieur immédiat. Cette formule a été conservée au fil des décennies dans les versions successives du logiciel R principalement pour des impératifs de rétrocompatibilité logicielle et de standardisation des affichages initiaux. Elle offre un compromis acceptable pour les jeux de données pédagogiques de très faible envergure, mais dévoile rapidement des failles conceptuelles majeures dans le cadre de la recherche quantitative contemporaine.
2.2 Application concrète sur un échantillon psychométrique simulé
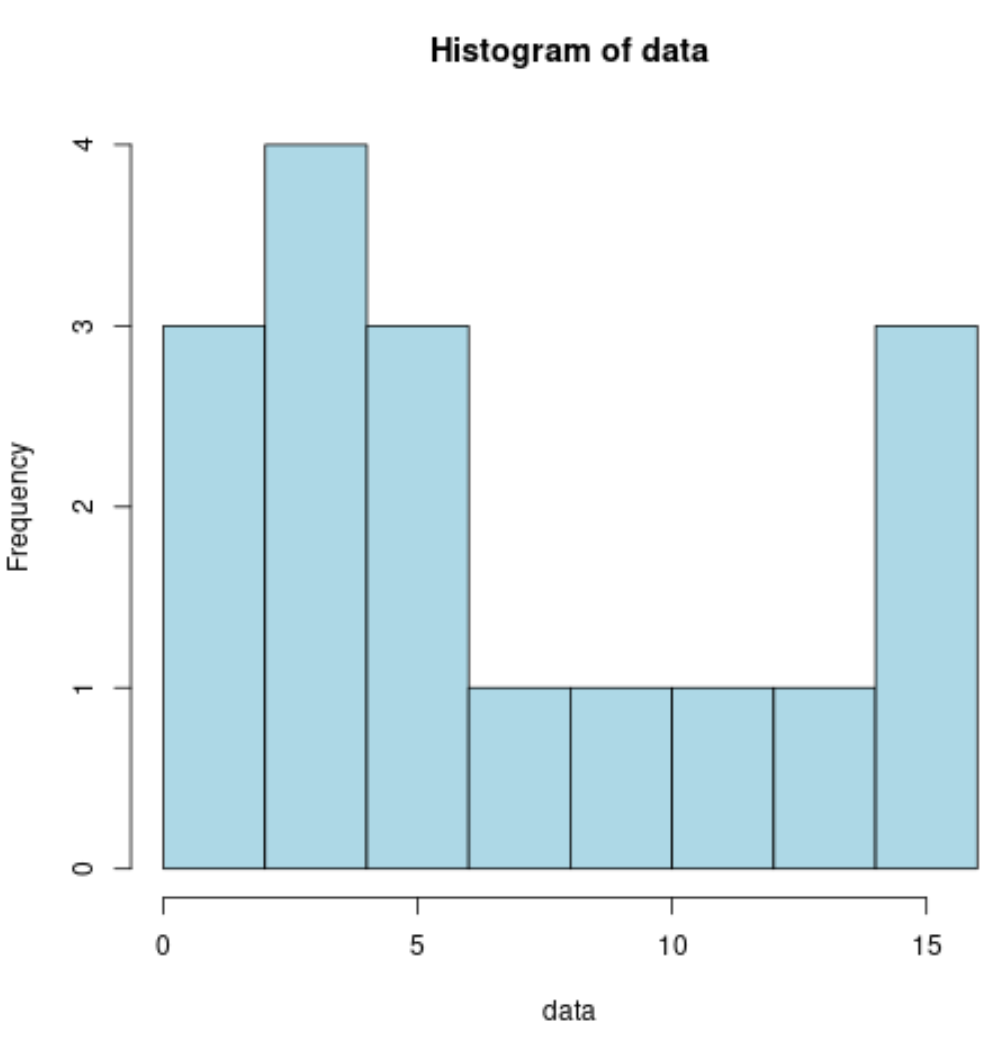
Pour observer l’opérationnalisation pratique de la règle de Sturges, imaginons une expérience standard en psychologie cognitive portant sur l’évaluation de la mémoire de travail chez 100 participants adultes. Les scores composites varient de façon continue sur une échelle arbitraire centrée autour de 50. Si l’on applique la formule analytique de Sturges pour un effectif de n = 100, le calcul donne : k = 1 + log2(100) = 1 + 6.643856 = 7.643856, ce qui, après application du plafond arithmétique, conduit à un total théorique attendu de 8 classes.
Cependant, si l’on exécute la commande hist(scores) sans spécification complémentaire, le graphique résultant ne comporte pas nécessairement les 8 barres attendues. Bien souvent, R produira un histogramme constitué de 7, 9 ou 10 classes. Cette divergence apparente entre la théorie mathématique de Sturges et le tracé effectif s’explique par l’intervention d’un mécanisme algorithmique intermédiaire : l’appel à la fonction interne pretty(). Les concepteurs du moteur graphique de R ont privilégié la lisibilité cognitive de l’axe des abscisses pour l’œil humain plutôt que le respect rigide d’un entier théorique.
La fonction pretty() prend en compte l’étendue brute des données et le nombre de classes suggéré par Sturges, puis détermine une séquence de bornes d’intervalles qui correspondent à des nombres dits « élégants » ou commodes à la lecture, typiquement des multiples de 1, 2, 5 ou 10. Ainsi, les limites de classes réelles se trouvent réalignées sur des repères décimaux intuitifs. Ce compromis visuel, bien qu’extrêmement confortable pour une lecture superficielle des données, introduit une distorsion supplémentaire entre la préconisation formelle de l’algorithme et la géométrie concrète de l’histogramme affiché à l’écran.
2.3 Pourquoi la règle par défaut échoue souvent en recherche quantitative
L’inadéquation de la règle de Sturges pour les protocoles de recherche contemporains est aujourd’hui documentée par l’ensemble des théoriciens de la statistique computationnelle. Le premier défaut structurel de cette formule réside dans sa dépendance logarithmique excessivement lente vis-à-vis de la taille de l’échantillon n. Alors qu’un échantillon de 100 sujets produit environ 8 classes, un échantillon de 1 000 sujets n’en produira que 11, et une cohorte épidémiologique massive de 100 000 participants ne générera que 18 classes. Dès lors que l’effectif dépasse 200 à 300 observations, la règle de Sturges sous-estime dramatiquement le nombre d’intervalles requis, entraînant un sur-lissage sévère de la distribution.
Ce sur-lissage systématique neutralise la capacité de détection du chercheur face à des structures sous-jacentes complexes. En psychologie clinique, de nombreuses variables ne suivent pas une loi normale univariée mais résultent d’un mélange probabiliste de plusieurs sous-populations : par exemple, un groupe d’individus sains mélangé à une sous-population manifestant une symptomatologie prodromique d’un trouble psychiatrique. La règle de Sturges regroupe des masses critiques d’observations dans des intervalles si larges qu’elle nivelle mécaniquement les creux de densité. Le chercheur qui observe le tracé peut conclure à tort à l’existence d’une distribution unimodale continue, là où coexistent en réalité deux modes parfaitement discernables avec une discrétisation plus fine.
Enfin, l’hypothèse de normalité intrinsèque formulée par Sturges constitue une pétition de principe problématique dans l’analyse exploratoire des données. L’histogramme est censé être un instrument heuristique permettant de découvrir la forme d’une distribution inconnue. Présupposer la normalité de la loi pour calibrer la grille d’observation aboutit à forcer artificiellement les données empiriques à ressembler à une gaussienne lissée. Pour des distributions asymétriques, leptokurtiques ou tronquées, comme c’est systématiquement le cas des temps de réaction ou des échelles de consommation de substances, l’utilisation aveugle du réglage par défaut de R constitue une faille méthodologique évidente.
3. Technique fondamentale : Forcer un nombre précis de classes avec seq() et breaks
3.1 Mécanisme formel de l’argument breaks dans la fonction hist()
Pour s’affranchir des arbitrages automatiques et potentiellement trompeurs du moteur de base, l’analyste dispose d’un levier direct et déterministe : la transmission d’un vecteur numérique explicite au paramètre breaks de la fonction hist(). Lorsqu’un vecteur numérique est fourni, l’algorithme interne de R désactive immédiatement les modules d’estimation de Sturges ainsi que les ajustements cosmétiques de la fonction pretty(). Le logiciel exécute fidèlement le découpage en utilisant les valeurs du vecteur comme bornes d’intervalles strictes.
Il est indispensable de maîtriser la relation de dimensionnalité qui régit ce paramètre : pour délimiter un nombre k de classes contiguës, il faut impérativement fournir un vecteur de coupure contenant exactement k + 1 éléments numériques. Par exemple, pour obtenir 10 classes, le vecteur breaks devra contenir 11 valeurs ordonnées définissant les extrémités de chaque tranche. La confusion entre le nombre de seuils de coupure et le nombre effectif d’intervalles produits représente l’une des erreurs d’inattention les plus courantes chez les utilisateurs néophytes de R.
Un autre point de rigueur méthodologique concerne la gestion des bornes d’intervalles, pilotée par l’argument logique right. Par défaut, la fonction hist() fonctionne avec right = TRUE, ce qui implique que les classes sont fermées à droite et ouvertes à gauche, modélisées selon la topologie des intervalles semi-ouverts de la forme (a, b]. Une valeur tombant rigoureusement sur la borne supérieure b est donc comptabilisée dans cet intervalle. Si l’on configure right = FALSE, la convention s’inverse : les classes deviennent fermées à gauche et ouvertes à droite, sous la forme [a, b). Pour garantir que l’observation la plus minimale ne soit pas exclue du premier intervalle lorsque right = TRUE, R inclut par défaut une tolérance automatique via le paramètre include.lowest = TRUE, assurant que l’extrémité basse du domaine fasse partie intégrante de la première classe.
3.2 Construction syntaxique rigoureuse avec seq(), min() et max()
La formulation la plus élégante, dynamique et reproductible pour imposer un nombre exact k de classes consiste à associer la fonction génératrice de séquences seq() aux fonctions descriptives min() et max() appliquées au vecteur de scores. La syntaxe canonique s’écrit : hist(data, breaks = seq(min(data), max(data), length.out = k + 1)). Dans cette construction, l’argument length.out garantit formellement la production d’un vecteur comportant exactement le nombre requis de délimitations pour générer les k tranches voulues.
Toutefois, une telle implémentation littérale peut occasionnellement provoquer l’omission d’une valeur extrême en raison des arrondis inhérents au calcul en virgule flottante sur architecture informatique. Si la borne maximale générée par la séquence est infinitésimalement inférieure à la valeur maximale réelle contenue dans les données en raison d’une imprécision de troncature décimale, R déclenchera une erreur fatale stipulant que certains points tombent en dehors des intervalles définis. Pour immuniser son code contre cette défaillance, il est d’usage en programmation statistique d’élargir très légèrement l’intervalle d’échantillonnage, par exemple en soustrayant une fraction d’unité à la borne inférieure et en l’ajoutant à la borne supérieure.
Prenons l’exemple d’une échelle d’évaluation du sentiment d’efficacité personnelle où les participants s’expriment sur un continuum théorique borné entre 10 et 50. Si le chercheur souhaite analyser la distribution au moyen de 8 classes de taille égale, la séquence vectorielle sera programmée comme suit : les coupures seront définies par seq(from = 10, to = 50, length.out = 9). Les valeurs résultantes seront 10, 15, 20, 25, 30, 35, 40, 45 et 50, partitionnant parfaitement le spectre des réponses en 8 intervalles contigus de 5 unités de large chacun. Cette maîtrise déterministe permet d’aligner la granularité visuelle sur les exigences sémantiques de l’instrument de mesure.
3.3 Pièges courants lors de l’application directe d’un entier scalaire
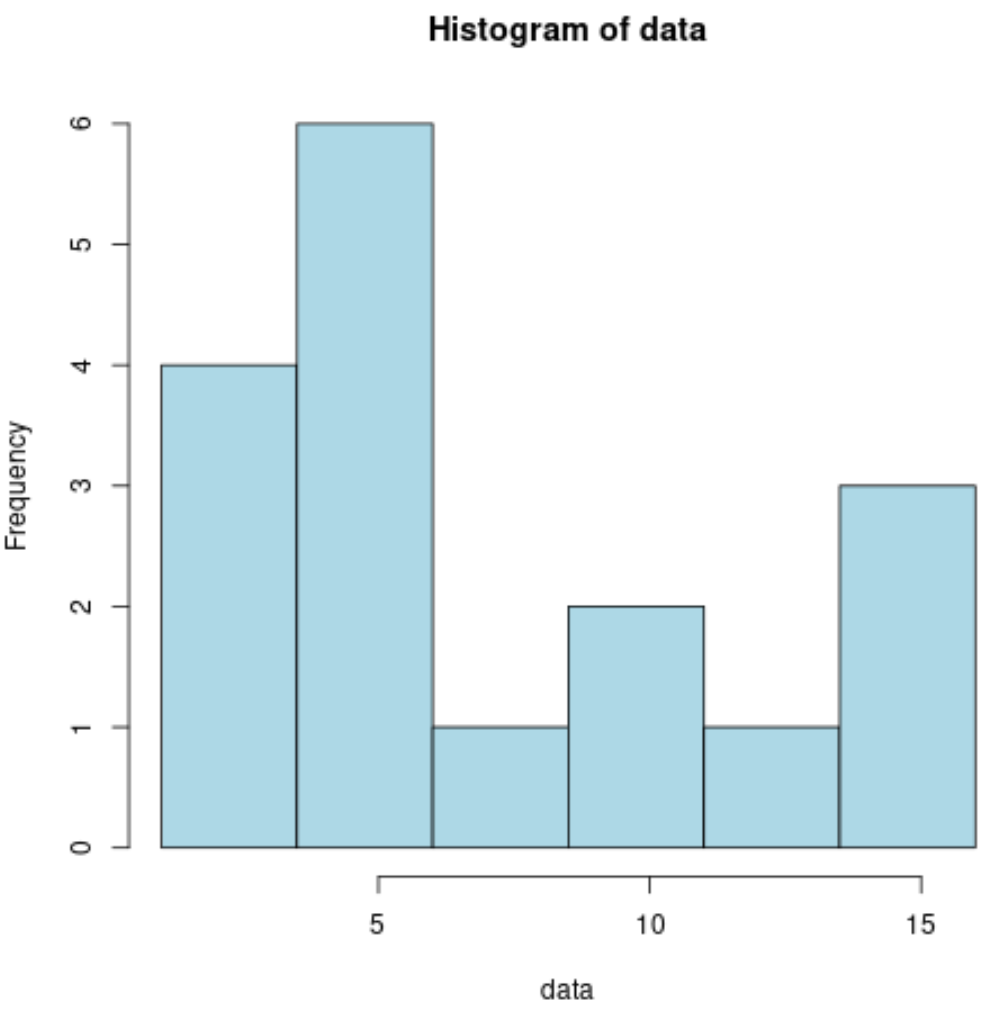
Face à la complexité perçue de l’écriture d’un vecteur seq(), de nombreux praticiens tentent d’ajuster le découpage en fournissant directement un entier scalaire à l’argument, en écrivant simplement hist(data, breaks = 15) avec l’illusion d’obtenir immédiatement un graphique à 15 barres. C’est ici que réside l’un des pièges les plus déroutants de l’environnement R de base. Dans la signature de la fonction hist(), l’argument breaks n’interprète pas un scalaire unique comme un ordre contraignant, mais comme une simple indication suggestive transmise à l’algorithme d’affichage.
Lorsque R reçoit un scalaire entier, il prend cette valeur comme un objectif indicatif et la transmet à la fonction pretty(), qui recalcule immédiatement des bornes de coupure arrondies sur des pas décimaux familiers. En conséquence, l’exécution de hist(data, breaks = 15) se solde presque toujours par l’obtention d’un histogramme comportant 12, 14, 17 ou 20 classes, mais très rarement exactement 15. Cette absence de déterminisme strict déconcerte fréquemment les chercheurs qui tentent d’harmoniser visuellement plusieurs graphiques destinés à une publication comparative.
Cette distinction conceptuelle entre suggestion indicative (fournie par un scalaire) et contrainte déterministe (imposée par un vecteur de coupures numériques) doit être solidement intégrée dans les pratiques de laboratoire. Dès lors qu’une démarche méthodologique exige un calibrage rigoureux du nombre de tranches ou de leur largeur d’intervalle, l’usage du scalaire unique doit être formellement banni au profit de la construction explicite du vecteur de partitionnement. C’est l’unique garantie d’une reproductibilité graphique absolue d’un poste de travail à un autre.
4. Algorithmes alternatifs intégrés dans R : Scott et Freedman-Diaconis
4.1 La règle de Scott basée sur la variance théorique
Conscient des limites structurelles de la formule de Sturges face à des cohortes expérimentales volumineuses, le statisticien David W. Scott a formulé en 1979 une règle de partitionnement optimale fondée sur des principes de minimisation de l’erreur quadratique intégrée moyenne (ou MISE pour Mean Integrated Squared Error). Contrairement à Sturges, la règle de Scott intègre directement la variabilité statistique des données empiriques en tenant compte de l’écart-type de l’échantillon en plus du volume des observations.
La largeur optimale des classes selon la formule de Scott s’établit selon l’équation mathématique : w = 3.49 * s * n^(-1/3), où s désigne l’écart-type non biaisé de l’échantillon et n la taille de la cohorte. Une fois cette largeur unitaire w déterminée, le nombre de classes se calcule en divisant l’étendue des données par cette valeur. L’environnement R intègre cette procédure de façon native : l’analyste peut l’invoquer directement au moyen de l’argument textuel breaks = « Scott » ou en appelant la fonction dédiée nclass.scott() pour récupérer la valeur entière calculée avant de construire son graphique.
La règle de Scott s’avère particulièrement performante pour le traitement des variables psychologiques standardisées, telles que les scores Z ou les scores d’aptitude issus de modèles de réponse à l’item (TRI). En exploitant l’écart-type empirique, l’algorithme adapte la finesse du grain visuel à la dispersion effective des données : une distribution très resserrée conduira à des classes plus étroites, tandis qu’une dispersion étendue élargira les tranches pour prévenir l’apparition d’intervalles vides artificiels. Pour des effectifs modérés à larges compris entre 200 et 2 000 participants, Scott offre un rendu visuel incomparablement supérieur à celui de Sturges.
4.2 La règle robuste de Freedman-Diaconis (FD)
Bien que la règle de Scott constitue une avancée méthodologique indéniable, elle partage avec Sturges une dépendance critique à l’égard de l’hypothèse de normalité : l’utilisation de l’écart-type s comme paramètre d’échelle rend la formule extrêmement vulnérable à l’influence des valeurs aberrantes ou extrêmes (les outliers). Pour surmonter cette faiblesse, David Freedman et Persi Diaconis ont publié en 1981 une variante non paramétrique et robuste de l’algorithme d’optimisation de l’erreur quadratique intégrée.
La règle de Freedman-Diaconis, universellement abrégée sous le sigle FD, substitue l’écart-type classique par l’écart interquartile (ou IQR pour Interquartile Range), qui correspond à la distance statistique séparant le 25e percentile du 75e percentile de la distribution. La largeur optimale de classe s’établit selon la formulation : w = 2 * IQR * n^(-1/3). Dans l’écosystème R, cette méthode s’active instantanément au moyen de l’argument breaks = « FD » au sein de la fonction hist(), ou programmée via la fonction sous-jacente nclass.FD().
Cette approche robuste constitue l’étalon-or pour l’exploration de nombreuses données de la psychologie empirique, tout particulièrement les mesures de temps de réaction, les indicateurs psychophysiologiques de conductance cutanée ou les indices oculométriques de fixation visuelle. Ces variables se caractérisent fréquemment par une asymétrie positive marquée et la présence inévitable de quelques observations très dispersées reflétant des moments de déconcentration ou des latences motrices exceptionnelles. Alors que la règle de Scott serait déformée par l’inflation de l’écart-type causée par ces valeurs isolées, produisant des classes anormalement larges, l’algorithme Freedman-Diaconis isole le cœur de la distribution et préserve une résolution optimale sur les 50 % centraux de l’échantillon.
4.3 Matrice comparative des performances algorithmiques
Le choix d’un algorithme de découpage ne doit jamais résulter d’une habitude arbitraire, mais d’une adéquation formelle entre les postulats mathématiques de la méthode et les caractéristiques distributionnelles de la variable étudiée. L’impact de ce choix s’accentue à mesure que la taille de l’échantillon progresse, révélant des divergences quantitatives majeures dans la morphologie des graphiques obtenus.
Afin de structurer la prise de décision de l’analyste, examinons les dynamiques comparées de ces algorithmes en fonction de l’effectif et de la forme de la distribution :
- Règle de Sturges : Idéale pour n < 50 sur des distributions strictement normales. Dès que n > 200, elle génère un sur-lissage critique et écrase toute détection d’asymétrie ou de multimodalité.
- Règle de Scott : Excellente pour n > 100 sur des distributions unimodales approximativement symétriques, platykurtiques ou mésokurtiques. Sensible aux valeurs extrêmes qui élargissent artificiellement la largeur de classe.
- Règle de Freedman-Diaconis : Algorithme par excellence pour les distributions leptokurtiques, fortement asymétriques ou contaminées par des scores aberrants, efficace de n = 50 jusqu’aux cohortes massives de n > 100 000.
Face à une distribution empirique inconnue, l’arbre de décision méthodologique recommande de débuter systématiquement par l’algorithme Freedman-Diaconis. Si la variable étudiée découle d’un étalonnage psychométrique standardisé garantissant une symétrie rigoureuse et une absence d’asymétrie résiduelle, la règle de Scott peut être adoptée pour affiner le lissage. En revanche, l’utilisation de la règle de Sturges devrait être formellement circonscrite aux applications pédagogiques illustrant de minuscules séries de scores, et systématiquement évitée dans les protocoles de publication de recherche contemporains.
5. Impact psychologique et méthodologique du choix des classes
5.1 Le phénomène d’artefact distributionnel et les biais de confirmation
L’acte d’observation en science n’est jamais purement passif : l’instrument utilisé façonne en partie l’objet observé. Dans le contexte de l’analyse exploratoire sous R, un calibrage imprudent du nombre de classes peut transformer l’histogramme en une source majeure d’artefacts cognitifs pour l’analyste lui-même. Le premier écueil réside dans la génération involontaire de faux modes : lorsque les classes sont trop étroites par rapport à la densité locale des données, des fluctuations d’échantillonnage totalement aléatoires se traduisent visuellement par des successions de pics et de creux que le chercheur, guidé par son biais de confirmation, sera tenté d’interpréter comme des typologies psychologiques distinctes.
Le phénomène symétrique est tout aussi destructeur sur le plan scientifique : il s’agit du masquage d’une bimodalité authentique par regroupement excessif. Imaginons une étude clinique portant sur des scores d’anxiété post-traumatique au sein d’une population exposée à un événement critique. Si la cohorte est constituée de deux profils distincts — les individus résilients et les sujets développant un trouble caractérisé —, la distribution réelle présente deux modes séparés par une baisse d’incidence. Un découpage basé sur un nombre insuffisant de classes peut fondre ces deux populations au sein d’un palier unique et étendu, occultant totalement l’hétérogénéité diagnostique et conduisant à l’élaboration de modèles thérapeutiques inadaptés.
Un autre phénomène sous-estimé concerne le décalage de phase des classes. En conservant un nombre constant de classes mais en déplaçant légèrement l’origine de l’axe des abscisses ou en modifiant les bornes d’un demi-intervalle, l’apparence générale de la distribution peut être modifiée de façon spectaculaire. Une observation qui se situait au centre d’une classe peut se retrouver basculée à la limite d’un autre intervalle, modifiant la silhouette perçue de l’asymétrie. Ce phénomène souligne la nécessité d’une grande prudence intellectuelle et invite à ne jamais fonder une interprétation clinique sur une configuration graphique unique.
5.2 Arbitrage entre variance et biais d’estimation
Sur le plan fondamental de la théorie statistique de l’estimation, le choix de la largeur des classes incarne parfaitement le compromis canonique entre biais et variance, un concept central formalisé dans la théorie de l’apprentissage statistique par des auteurs comme Trevor Hastie et ses collaborateurs. L’histogramme n’est rien d’autre qu’un estimateur non paramétrique de la fonction de densité de probabilité sous-jacente. À ce titre, sa performance mathématique est gouvernée par deux composantes d’erreur antagonistes.
D’un côté, choisir des classes d’une largeur infinitésimale réduit considérablement le biais d’estimation : l’histogramme colle au plus près des observations individuelles et peut capturer les variations infinitésimales de la courbe théorique. Cependant, cette réduction drastique du biais s’opère au détriment d’une explosion de la variance d’échantillonnage. Si l’on prélevait un nouvel échantillon de même taille dans la même population, l’histogramme à classes ultra-étroites arborerait une forme totalement différente, chaque barre oscillant de façon erratique sous l’effet de l’aléa stochastique.
D’un autre côté, imposer des classes très larges stabilise l’estimateur en réduisant la variance d’échantillonnage à son minimum : deux échantillons distincts produiront des figures presque superposables. Cependant, cette stabilité s’accompagne d’un biais d’estimation massif : la fonction en escalier obtenue simplifie outrancièrement la réalité et devient incapable d’approcher la véritable courbure de la densité sous-jacente. L’objectif des formules comme celles de Scott ou de Freedman-Diaconis est précisément de calculer le point d’équilibre asymptotique qui minimise la somme du carré du biais et de la variance de l’estimateur.
5.3 Sensibilité aux spécificités des échelles psychologiques
L’application brute des règles statistiques théoriques se heurte souvent aux particularités morphologiques des données psychologiques. Contrairement aux variables physiques comme la taille ou la masse corporelle, les scores issus d’échelles d’auto-évaluation psychométrique se présentent sous la forme de variables discrètes pseudo-continues. Un score total à l’inventaire de personnalité NEO-PI ou à l’échelle d’estime de soi de Rosenberg résulte de la sommation d’items discrets ordonnés, produisant des valeurs qui ne peuvent être que des nombres entiers strictement étalonnés.
Lorsque l’on applique des algorithmes de calcul automatique continu à ces scores discrets, il n’est pas rare que la largeur de classe calculée mathématiquement soit une valeur fractionnaire non entière, par exemple 1.45 point. Cette incohérence entre la granularité de l’instrument de mesure et celle de la grille graphique produit ce que les statisticiens nomment un « effet de peigne » ou motif d’interférence : certaines classes recouvriront deux valeurs entières possibles (par exemple les scores 12 et 13), tandis que la classe adjacente n’en recouvrira qu’une seule (le score 14). Il en résulte une alternance visuelle de barres hautes et basses purement artificielle, qui ne traduit aucune réalité psychologique mais trahit un artefact géométrique de discrétisation.
Pour immuniser ses graphiques contre ces illusions visuelles, l’analyste doit veiller à aligner impérativement la largeur de bande sur le pas de variation intrinsèque de l’instrument. Si l’échelle produit des scores entiers, la largeur de chaque classe doit impérativement être configurée comme un entier (1, 2, 5, etc.), et les bornes doivent être positionnées de façon à englober symétriquement les valeurs réelles, typiquement en positionnant les coupures sur des demi-entiers (par exemple 0.5, 1.5, 2.5) pour que chaque entier repose exactement au barycentre géométrique de sa classe respective.
6. Spécification avancée : Classes de largeurs inégales et seuils diagnostiques
6.1 Configuration manuelle de vecteurs de coupure personnalisés
Si la convention standard privilégie l’usage de classes d’amplitudes strictement égales à travers tout le domaine de variation, la fonction hist() de R autorise la définition d’intervalles aux largeurs totalement arbitraires et asymétriques. Pour ce faire, il suffit de passer à l’argument breaks un vecteur dont les écartements successifs ne sont pas constants, par exemple : breaks = c(0, 10, 15, 25, 40, 60). Cette modalité technique offre une flexibilité considérable pour modéliser des phénomènes dont la variabilité change d’ordre de grandeur le long du continuum de mesure.
Cependant, l’introduction de classes inégales modifie radicalement les lois de représentation de l’histogramme, imposant une rigueur d’interprétation sans faille. Sous R, dès lors que le vecteur breaks présente des largeurs variables, le logiciel bascule de manière automatique et obligatoire l’axe vertical du mode des fréquences absolues vers le mode de la densité de probabilité, désactivant l’argument freq = TRUE. Tenter de forcer l’affichage des effectifs bruts sur des barres de largeurs inégales constituerait une faute méthodologique majeure : une classe deux fois plus large apparaîtrait deux fois plus imposante à l’œil simplement parce qu’elle capte des données sur un territoire deux fois plus vaste.
Dans un histogramme à classes inégales, l’information quantitative est codée par la surface géométrique de chaque rectangle (base multipliée par la hauteur) et non plus par sa seule hauteur verticale. Une barre très haute mais très étroite peut renfermer un effectif d’observations identique ou inférieur à celui d’une barre basse mais largement étalée. Les chercheurs non avertis commettent fréquemment des contresens en interprétant les hauteurs relatives de ces représentations, oubliant que l’axe vertical traduit une densité unitaire (probabilité par unité de mesure) et non un décompte d’individus.
6.2 Application aux normes cliniques et percentiles standardisés
En psychopathologie et en neuropsychologie clinique, l’analyse d’une distribution n’a que rarement pour finalité d’apprécier une simple courbe théorique : elle vise avant tout à situer des individus par rapport à des seuils d’intervention diagnostique normalisés. Les échelles cliniques majeures partitionnent conventionnellement le score continu en catégories ordinales de sévérité, telles que les zones « asymptomatique », « légère », « modérée » et « sévère ». L’utilisation de coupures inégales calquées précisément sur ces bornes nosologiques permet de convertir l’histogramme en un tableau de bord épidémiologique explicite.
Supposons un inventaire d’évaluation de l’anxiété dont l’amplitude théorique s’étend de 0 à 60 points, et dont la standardisation nationale établit les seuils suivants : score de 0 à 15 (état normal), de 16 à 25 (anxiété légère), de 26 à 35 (anxiété modérée), et de 36 à 60 (anxiété sévère à critique). En transmettant le vecteur breaks = c(0, 15.5, 25.5, 35.5, 60), le chercheur génère un histogramme dont les tranches coïncident parfaitement avec les entités nosographiques reconnues par la communauté médicale. Chaque barre condense alors directement la densité d’individus relevant de chaque catégorie clinique.
Pour accroître l’intelligibilité de ces représentations, il est d’usage d’associer ces classes asymétriques à une palette chromatique signifiante. En exploitant l’argument vectoriel col de la fonction hist(), l’analyste peut assigner une couleur distincte à chaque intervalle : par exemple, un vert doux pour la classe asymptomatique, un jaune pâle pour le groupe léger, un orange soutenu pour le niveau modéré et un rouge carmin pour la tranche sévère. Cette sémiotique visuelle aligne la forme statistique sur la signification praxéologique des données.
6.3 Intégration d’éléments graphiques complémentaires
Un histogramme configuré manuellement gagne substantiellement en clarté lorsqu’il est enrichi de repères graphiques contextuels qui facilitent la lecture des seuils critiques. Le moteur graphique standard de R excelle dans cette approche par couches successives. Immédiatement après l’appel à la fonction hist(), l’analyste peut mobiliser la commande abline() pour superposer des lignes verticales marquant les moyennes théoriques ou les limites d’alerte clinique, par exemple via abline(v = 35.5, col = « darkred », lty = 2, lwd = 2) pour signaler visuellement le point de bascule vers la détresse sévère.
De surcroît, lorsque l’histogramme est paramétré en densité relative (soit automatiquement par des classes inégales, soit manuellement via freq = FALSE), il devient possible d’y superposer directement l’ajustement continu d’un estimateur à noyau non paramétrique. L’instruction lines(density(data), col = « blue », lwd = 2) trace une courbe lissée fluide par-dessus les barres discrètes. La confrontation visuelle entre l’histogramme empirique et la courbe de densité permet d’apprécier instantanément dans quelle mesure la discrétisation choisie épouse fidèlement la dynamique probabiliste continue des observations sans en déformer l’allure.
Enfin, l’ajout d’une légende explicative rigoureuse au moyen de la commande legend() garantit l’autonomie de la figure. Cette légende doit systématiquement expliciter les codes couleur retenus, la signification des tracés verticaux en pointillés et, le cas échéant, le type de fonction de noyau utilisé pour la courbe continue. Une telle composition graphique élève l’histogramme au rang de support de communication scientifique de haut niveau, prêt à être intégré dans un rapport psychométrique ou une publication spécialisée.
7. Contrôle du nombre de classes dans le formalisme moderne de ggplot2
7.1 La philosophie de la grammaire des graphiques pour les histogrammes
Au cours des quinze dernières années, l’écosystème du langage R a connu une transformation paradigmatique majeure avec l’avènement du Tidyverse et la généralisation du module ggplot2, conçu par Hadley Wickham sur la base formelle de la « grammaire des graphiques » de Leland Wilkinson. Dans ce formalisme, la production d’une figure ne repose plus sur l’exécution d’une commande monolithique à l’instar de hist(), mais sur l’assemblage déclaratif et modulaire de couches sémantiques distinctes : les données tabulaires, les correspondances esthétiques (aesthetics) et les objets géométriques (geoms).
La génération d’un histogramme sous ggplot2 s’effectue via l’adjonction de la couche vectorielle geom_histogram(). Dès cette étape liminaire, la philosophie de conception de la bibliothèque s’affirme de manière tranchée. Si l’on écrit simplement ggplot(df, aes(x = score)) + geom_histogram(), la fonction génère par défaut un histogramme calibré sur exactement 30 classes, tout en émettant un avertissement explicite dans la console R : l’utilisateur est averti que stat_bin() a utilisé bins = 30 par défaut et qu’il est vivement recommandé de choisir une meilleure largeur de bande au moyen de l’argument binwidth ou d’un nombre de classes adapté via l’argument bins.
Cet avertissement programmatique délibéré incarne un choix épistémologique fort des concepteurs de ggplot2 : refuser de faire croire à l’analyste qu’il existerait une valeur par défaut universellement valide. En imposant un nombre fixe de 30 classes tout en incitant activement à sa modification, le logiciel oblige le chercheur à s’interroger sur la granularité de son découpage. La modularité graphique offerte par ggplot2 permet ensuite une personnalisation sans équivalent de la typographie, des thèmes visuels et de la mise en page, éléments devenus indispensables pour satisfaire aux critères de soumission des revues scientifiques internationales.
7.2 Manipuler l’argument bins pour fixer un nombre arbitraire
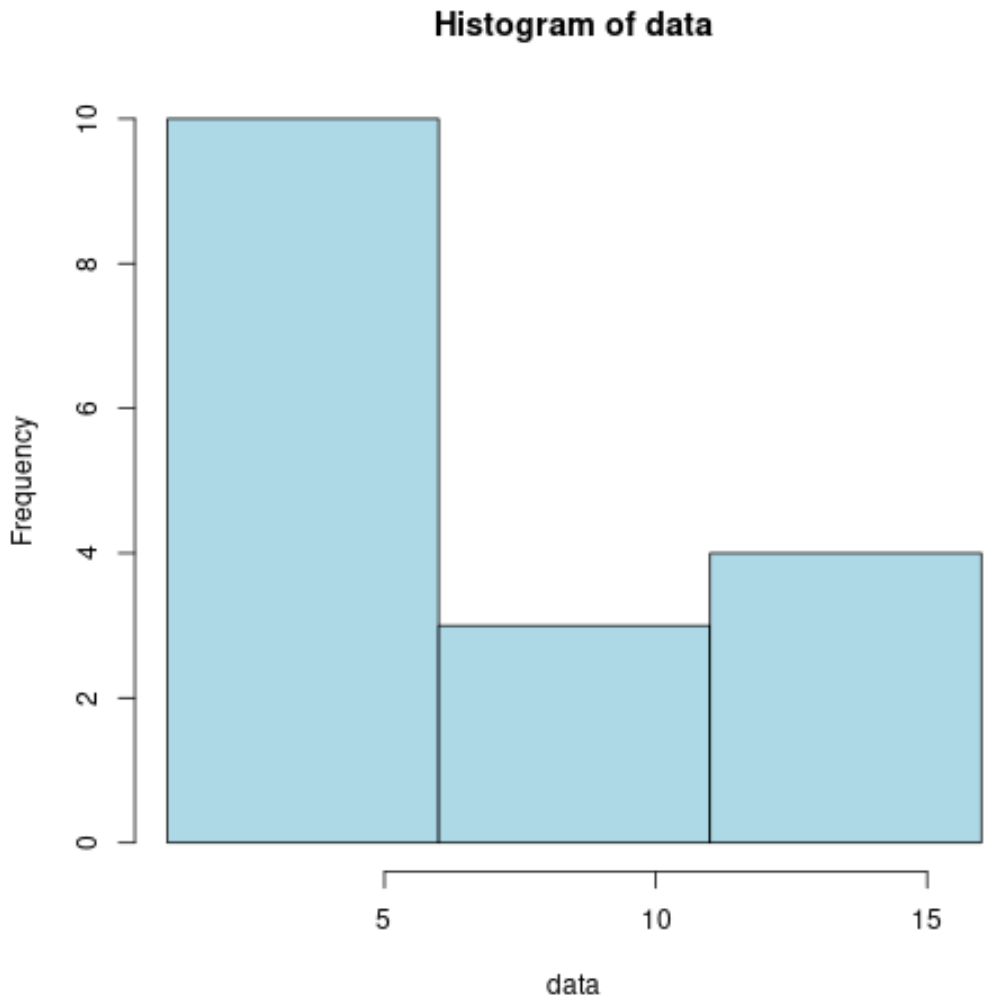
Dans l’architecture de geom_histogram(), le contrôle du nombre de classes s’effectue de façon totalement déterministe grâce à l’argument scalaire bins. Contrairement à la fonction historique hist() où l’attribution d’un entier scalaire n’était traitée que comme une suggestion indicative reformulée par pretty(), l’instruction bins = 15 au sein de ggplot2 garantit formellement la découpe des données en exactement 15 intervalles géométriques. Cette conformité stricte entre le paramètre saisi et le résultat graphique élimine tout aléa computationnel.
Pour affiner la disposition des barres, ggplot2 met à la disposition du chercheur deux arguments de positionnement cruciaux : boundary et center. L’argument boundary permet de verrouiller l’une des coupures sur une valeur numérique précise, forçant l’ensemble du quadrillage des classes à s’aligner à partir de ce point d’ancrage. Par exemple, si l’on étudie une échelle psychométrique dont le minimum théorique est 0, renseigner boundary = 0 garantit qu’aucune barre ne débordera inutilement dans les valeurs négatives. À l’inverse, l’argument center force le centre de l’une des classes à coïncider rigoureusement avec la valeur indiquée, ce qui s’avère particulièrement pertinent pour les distributions centrées sur zéro où l’on souhaite qu’une barre unique couvre la zone de neutralité.
La reproductibilité graphique offerte par cette approche est exemplaire. Dans un pipeline d’analyse de données psychologiques, l’écriture d’un appel tel que ggplot(data_patients, aes(x = score_depression)) + geom_histogram(bins = 20, boundary = 0, color = « black », fill = « steelblue ») produit un rendu graphique prévisible, constant d’un système d’exploitation à un autre, totalement insensible aux variations d’affichage des moteurs graphiques locaux. Ce déterminisme rigoureux constitue un atout précieux pour le partage collaboratif de scripts d’analyse au sein d’équipes de recherche distribuées.
7.3 Ajustement par binwidth pour des scores discrets psychométriques
Bien que le paramètre bins offre un contrôle direct sur le nombre de tranches, les spécialistes de la visualisation recommandent très majoritairement de privilégier l’argument alternatif binwidth lors du traitement de variables psychométriques. L’argument binwidth définit la largeur d’intervalle en unités réelles de l’échelle mesurée. Cette formulation mentale s’avère bien plus intuitive pour le clinicien ou l’expérimentateur : plutôt que de raisonner sur un nombre abstrait de barres étalées sur l’écran, le chercheur formule son intention en déclarant qu’il souhaite regrouper ses observations par tranches de 2 points, 5 points ou 10 points.
L’argument binwidth se révèle indispensable pour neutraliser définitivement les effets de moiré ou les fausses lacunes distributionnelles évoquées précédemment sur les scores entiers. Pour un questionnaire de personnalité composé de scores discrets variant de 0 à 50, fixer geom_histogram(binwidth = 1, center = 0) assure que chaque barre de l’histogramme recouvre rigoureusement un et un seul point de score entier. L’histogramme affiche ainsi la fréquence exacte de chaque niveau de réponse sans aucun fractionnement parasite, combinant la lisibilité d’un diagramme en bâtons et la modélisation sous-jacente d’une variable continue discrétisée.
Sur le plan stylistique, la lisibilité d’un tracé sous ggplot2 exige d’expliciter clairement les délimitations spatiales de chaque intervalle. Par défaut, geom_histogram() trace des rectangles monochromes sans bordures visibles, ce qui rend les plateaux de données denses parfaitement indifférenciables visuellement. Il est impératif de déclarer explicitement une couleur de contour distincte au moyen du paramètre color (par exemple color = « white » ou color = « grey30 ») tout en assignant une teinte harmonieuse au corps de la barre avec le paramètre fill. Cette séparation nette des barres est une condition indispensable pour que l’œil humain puisse quantifier visuellement les variations relatives de hauteur d’un bin à l’autre.
8. Cas pratique 1 : Distribution des scores au test de dépression de Beck (BDI)
8.1 Préparation et inspection des données cliniques
Pour ancrer ces concepts théoriques dans la réalité concrète de la recherche en psychologie, développons une étude de cas clinique centrée sur le célèbre inventaire de dépression de Beck (le Beck Depression Inventory-II, ou BDI-II). Cet instrument standardisé comprend 21 items cotés de 0 à 3, produisant un score total continu compris entre 0 et 63 points. Dans une population clinique tout-venant ou au sein d’un échantillon communautaire, la distribution des scores ne suit absolument pas une courbe de Gauss symétrique : elle se caractérise par une forte asymétrie positive, la très grande majorité des participants concentrant leurs scores dans la zone des valeurs faibles (de 0 à 13), tandis qu’une minorité clinique s’étire le long d’une longue traîne vers les scores élevés marquant une détresse sévère.
Imaginons un jeu de données simulé de façon réaliste pour une cohorte de n = 500 patients admis dans un service hospitalier d’évaluation psychologique. Sous R, une telle distribution peut être fidèlement reproduite en utilisant une loi gamma ou une loi bêta rééchelonnée sur l’intervalle 0-63. Une première inspection descriptive menée à l’aide des fonctions de base indique une moyenne située autour de 16 points, une médiane à 12 points, un coefficient d’asymétrie positif marqué (skewness > 1.2) et un kurtosis supérieur à 4, confirmant la nature leptokurtique de la distribution. Ces indicateurs tabulaires imposent d’emblée une vigilance extrême lors du calibrage de la visualisation.
Le chercheur se trouve ici face à un défi méthodologique classique : comment représenter fidèlement la concentration massive de patients asymptomatiques ou subcliniques dans le premier tiers de l’échelle sans pour autant écraser ni rendre invisibles les cas les plus sévères dont le score dépasse 40 ? Une mauvaise sélection de la résolution des classes aura un impact direct sur la perception de l’acuité clinique de l’échantillon par les praticiens de l’établissement.
8.2 Évaluation comparative de plusieurs paramétrages de classes
Procédons à l’évaluation comparative de trois stratégies distinctes de découpage sous R. La première approche consiste à exécuter le tracé par défaut de la fonction de base : hist(scores_bdi). Appliquant la règle de Sturges pour n = 500, l’algorithme génère 10 classes, que la fonction pretty() aligne sur des tranches larges d’environ 7 à 10 points. Le graphique obtenu produit un sur-lissage particulièrement dommageable : la longue traîne clinique de droite se trouve compactée en deux ou trois barres épaisses et aplaties. Les spécificités des cas extrêmement sévères (scores supérieurs à 45) sont totalement gommées, donnant l’impression trompeuse d’un déclin régulier et homogène de la pathologie.
La deuxième stratégie consiste à solliciter la règle robuste de Freedman-Diaconis en saisissant l’instruction : hist(scores_bdi, breaks = « FD »). L’algorithme calcule l’écart interquartile de la cohorte et divise l’espace en un nombre significativement plus élevé de classes, typiquement entre 22 et 26 intervalles. Le contraste visuel est saisissant : la zone des scores faibles révèle des nuances morphologiques inédites, délimitant clairement la séparation entre les individus totalement asymptomatiques (scores de 0 à 5) et ceux manifestant une symptomatologie modérée (scores de 14 à 19). De surcroît, la traîne des scores extrêmes ne forme plus un bloc informe mais laisse apparaître des micro-regroupements de cas critiques hautement informatifs pour la prise en charge médicale.
La troisième approche privilégie une contrainte clinique déterministe via la combinaison de seq() et de breaks : hist(scores_bdi, breaks = seq(0, 65, by = 5)). Ce paramétrage découpe l’ensemble de l’inventaire en 13 classes homogènes de 5 points de large chacune. Cette granularité offre le meilleur compromis heuristique pour l’équipe soignante : 5 points correspondent approximativement au changement minimal cliniquement significatif sur le BDI-II. L’analyse visuelle permet instantanément de quantifier le pourcentage de patients franchissant chaque palier thérapeutique sans introduire de bruit stochastique parasite dans l’affichage.
8.3 Génération de graphiques publiables conformes aux normes APA
Pour intégrer ces résultats dans un manuscrit destiné à une revue savante affiliée à l’American Psychological Association (APA), la production graphique doit respecter des règles typographiques strictes : élimination des grilles superflues, choix d’une typographie sans empattement claire, fond rigoureusement blanc, contrastes accessibles pour l’impression monochrome et titrage normalisé sous forme de légende inférieure. Nous pouvons mobiliser la puissance de ggplot2 associée au thème formel theme_classic() pour atteindre cette conformité éditoriale.
Le code d’assemblage sous R s’articule comme suit :
Le modèle graphique appelle ggplot(df, aes(x = scores_bdi)), complété par geom_histogram(binwidth = 5, boundary = 0, fill = « grey80 », color = « black »). On ajoute des axes explicites avec scale_x_continuous(name = « Score total au BDI-II », breaks = seq(0, 65, 5), limits = c(0, 65)) et scale_y_continuous(name = « Fréquence absolue (Nombre de patients) », expand = expansion(mult = c(0, 0.05))). L’application de theme_classic() finalise l’élagage visuel en supprimant tout artéfact distrayant et en traçant des lignes d’axes noires d’une épaisseur standard de 0.5 point.
L’exportation finale de la figure doit s’effectuer à un standard de résolution industrielle pour prévenir toute pixellisation lors de la composition typographique de la revue. La commande ggsave(« figure1_bdi.tiff », width = 7, height = 4.5, units = « in », dpi = 600, compression = « lzw ») permet de générer un fichier vectoriel compressé respectant scrupuleusement les exigences des imprimeurs universitaires internationaux, garantissant une netteté absolue des délimitations de classes et du texte descriptif.
9. Cas pratique 2 : Données chronométriques et distribution log-normale des temps de réaction
9.1 Nature mathématique des temps de réaction en psychologie cognitive
Dans l’arsenal méthodologique des sciences cognitives, la chronométrie mentale occupe une place d’honneur pour sonder l’architecture du système nerveux central. Les temps de réaction (TR), mesurés en millisecondes lors de tâches d’inhibition comme le test de Stroop ou lors d’épreuves de détection lexicale, constituent la variable quantitative par excellence. Cependant, sur le plan purement distributionnel, les temps de réaction se situent aux antipodes de la symétrie gaussienne : ils sont caractérisés par une frontière physique stricte à gauche (l’impossibilité physiologique de répondre en dessous d’environ 150 à 200 ms en raison des délais de transmission synaptique et neuromusculaire), une montée de densité fulgurante vers le mode de réponse rapide, et une longue traîne asymétrique à droite s’étirant vers des valeurs temporelles élevées.
Les modélisations mathématiques formelles, issues notamment des travaux fondateurs de Roger Ratcliff sur le modèle de diffusion, démontrent que les temps de réaction empiriques suivent d’ordinaire une loi ex-gaussienne (convolution probabiliste d’une loi normale et d’une loi exponentielle) ou une loi log-normale. Tenter de visualiser ces chronométries brutes au moyen d’algorithmes présupposant une distribution normale relève de l’aberration méthodologique. Pour une cohorte expérimentale classique de n = 1 500 essais chronométrés, l’inadéquation entre la réalité neuro-fonctionnelle et la géométrie des classes de l’histogramme peut complètement occulter la structure des processus cognitifs sous-jacents.
La présence incontournable de quelques essais extrêmement lents — causés par des micro-sommeils attentionnels, des clignements oculaires ou des distractions environnementales fugaces — produit des valeurs isolées atteignant parfois 2 000 ou 3 000 ms. Si l’on ne maîtrise pas rigoureusement la formation des intervalles de l’histogramme, ces valeurs périphériques vont peser de façon démesurée sur le calcul de la largeur des tranches, diluant la résolution visuelle exactement là où se joue la discrimination cognitive : dans la fenêtre critique comprise entre 300 et 800 ms.
9.2 Optimisation du découpage en classes pour données fortement asymétriques
L’application directe de la règle de Scott sur un vecteur de temps de réaction brut démontre instantanément sa vulnérabilité structurelle. Parce que l’écart-type s est mathématiquement hypertrophié par la traîne exponentielle et les temps de réponse extrêmes, la formule de Scott préconise une largeur de classe w excessivement grande. L’histogramme qui en résulte affiche une silhouette fruste où l’ensemble des réponses rapides et modérées se retrouve amassé dans une poignée de barres compactes, rendant totalement indiscernables les variations de latence de l’ordre de 30 à 50 ms qui distinguent expérimentalement une condition congruente d’une condition incongruente dans une tâche cognitive.
Le recours à la règle robuste de Freedman-Diaconis (breaks = « FD ») rétablit immédiatement la balance. En fondant son estimation sur l’écart interquartile, l’algorithme neutralise l’impact déstabilisateur des temps supérieurs à 1 500 ms. Le découpage obtenu produit des classes d’une finesse adaptée à la densité principale des réponses, offrant une vue détaillée du mode et de la pente d’ascension initiale de la distribution. C’est l’illustration éclatante de la supériorité des estimateurs d’échelle non paramétriques face aux chronométries neurocomportementales.
Une alternative analytique d’une grande élégance consiste à coupler la sélection des classes à une transformation mathématique de l’espace de mesure. En appliquant une transformation logarithmique népérienne aux données brutes via log(TR), l’analyste symétrise la distribution empirique, compressant la longue traîne de droite tout en étirant les latences courtes. Sur cette nouvelle échelle log-transformée, la distribution se rapproche remarquablement d’une courbe normale idéale. L’application séquentielle de la règle de Scott ou de Sturges sur ces données transformées devient alors parfaitement justifiée d’un point de vue théorique, offrant une visualisation géométrique équilibrée de la performance cognitive de l’échantillon.
9.3 Visualisation des percentiles critiques et des seuils d’exclusion
Dans tout protocole d’analyse de données chronométriques, l’étape de nettoyage et de filtrage statistique s’avère déterminante : le chercheur doit identifier et élaguer les réponses non valides sans introduire de biais d’attrition arbitraire. L’histogramme calibré avec précision constitue le meilleur guide visuel pour formaliser ces critères d’exclusion. Deux frontières nosologiques critiques doivent être systématiquement isolées : les réponses prématurées ou anticipatoires (typiquement les temps de réaction inférieurs à 180 ou 200 ms, incompatibles avec un traitement cortical conscient) et les temps d’inattention pathologique (souvent fixés au-delà de 1 500 ms ou à plus de 3 écarts-types de la moyenne tronquée).
Pour matérialiser visuellement ces coupes opérationnelles dans R, l’analyste peut élaborer un vecteur de coupures personnalisées intégrant formellement ces seuils comme points de rupture frontières. Par exemple, en programmant : breaks = c(0, 200, seq(250, 1500, by = 50), max(donnees_tr)). Une telle architecture isole structurellement la zone d’anticipation dans une première classe dédiée, déploie une grille régulière et fine sur l’espace d’intérêt expérimental (classes de 50 ms entre 200 et 1 500 ms), et rassemble les latences démesurées dans un intervalle final d’inattention.
En associant à cette cartographie une coloration conditionnelle des barres — par exemple un gris sombre pour la fenêtre valide et un rouge hachuré pour les zones de rebut —, le chercheur dispose d’une preuve graphique irréfutable pour justifier son protocole d’épuration statistique auprès des évaluateurs d’articles scientifiques. Cette pratique élimine tout soupçon de manipulation sélective des données (le p-hacking) en démontrant avec transparence que les observations élaguées se situaient incontestablement en dehors du régime cognitif principal de la tâche expérimentale.
10. Comparaisons empiriques et modélisation de mélanges de distributions
10.1 Détection visuelle de la multimodalité dans les populations hétérogènes
L’un des défis les plus stimulants en modélisation psychologique réside dans l’identification des populations hétérogènes dissimulées sous un indicateur composite global. Prenons l’exemple d’un protocole d’évaluation neuropsychologique administré à une cohorte mixte de personnes âgées, comprenant à la fois des participants sains et des individus présentant des signes précoces de trouble neurocognitif léger (MCI). La distribution des scores d’efficience mnésique ne relève pas d’une loi statistique simple, mais d’un mélange fini de distributions de probabilités (finite mixture models), caractérisé par la superposition de deux composantes normales distinctes possédant chacune leur propre moyenne et leur propre variance.
Si l’analyste applique de façon paresseuse l’histogramme par défaut de R gouverné par Sturges, le sur-lissage mathématique inhérent à l’algorithme va purement et simplement fusionner ces deux densités. Le tracé résultant montrera une distribution unique, large et étalée, éventuellement dotée d’un sommet légèrement aplati. Le chercheur passera totalement à côté de la bimodalité fondamentale de son échantillon. En revanche, si l’on force un partitionnement plus ambitieux au moyen de l’algorithme Freedman-Diaconis ou en imposant manuellement un nombre de classes élevé via breaks = 35, le creux de densité situé entre les deux moyennes émerge avec netteté, révélant la présence de deux modes séparés.
Pour valider formellement que la dualité modale révélée par l’histogramme ne constitue pas un artefact de sur-résolution graphique, le chercheur peut confronter son tracé aux résultats d’un modèle formel de mélange gaussien en utilisant le célèbre package R mclust. L’estimation des paramètres par l’algorithme Espérance-Maximisation (EM) fournit les proportions de mélange, les moyennes et les variances des deux sous-groupes latents. Superposer les courbes théoriques pondérées issues de mclust sur l’histogramme finement partitionné confirme avec une rigueur géométrique irréfutable l’existence empirique des deux sous-populations cliniques.
10.2 Histogrammes conditionnels et facettage par sous-groupes expérimentaux
Dans les plans factoriels complexes, la comparaison de la distribution d’une variable psychologique à travers différentes conditions expérimentales ou sous-groupes sociodémographiques (par exemple selon le genre ou la tranche d’âge) constitue une démarche standard. Sous l’environnement ggplot2, cette mise en miroir s’opère élégamment par la commande de facettage facet_wrap() ou facet_grid(), qui génère une matrice de sous-graphiques alignés sur une échelle commune.
Cependant, l’utilisation conjointe de geom_histogram() et du facettage recèle un piège méthodologique sournois : la synchronisation des largeurs de classes face à des groupes d’effectifs inégaux. Si l’on spécifie un nombre fixe de barres avec bins = 20, ggplot2 applique cette contrainte de façon globale ou par facette. Mais si les groupes présentent des étendues empiriques différentes, fixer un argument bins sans précaution peut aboutir à ce que la largeur unitaire des barres varie subtilement d’un panneau à l’autre, faussant insidieusement toute comparaison visuelle directe de la dispersion des groupes.
La parade méthodologique absolue consiste à proscrire l’argument bins dans les graphiques facettés au profit exclusif de l’argument binwidth, couplé à un argument boundary invariable. En écrivant formellement geom_histogram(binwidth = 2, boundary = 0, color = « black », fill = « cornflowerblue ») + facet_wrap(~ Condition), le chercheur impose une largeur de classe strictement identique sur l’ensemble des panneaux de la figure. Même si un groupe contient 500 sujets et un autre seulement 150, chaque barre individuelle possédera la même signification métrique sur l’axe des abscisses, rendant les asymétries et les décalages de tendance centrale immédiatement perceptibles et scientifiquement comparables d’une condition à l’autre.
10.3 Superposition avec les estimateurs à noyau (Kernel Density Estimation)
L’histogramme en escalier et l’estimateur de densité à noyau (connu sous l’acronyme KDE pour Kernel Density Estimation) sont deux outils de visualisation complémentaires qui gagnent à être confrontés sur une même figure. L’histogramme matérialise la réalité brute de la partition discrète, tandis que la courbe de noyau, calculée via une fonction continue comme le noyau gaussien ou d’Epanechnikov, lisse les discontinuités pour approcher la fonction de densité théorique de la population.
Dans la syntaxe contemporaine de ggplot2, cette superposition requiert une manipulation précise de l’axe vertical de l’histogramme. Par défaut, geom_histogram() calcule et affiche les fréquences brutes (les comptages absolus), alors que geom_density() exprime nécessairement ses valeurs en unités de densité relative intégrée. Si l’on tente une superposition sans recalibrage, la courbe de densité apparaîtra écrasée sur la ligne de base zéro, invisible sous les barres dont les hauteurs atteignent plusieurs dizaines ou centaines d’unités. Il faut impérativement contraindre l’histogramme à projeter la même dimension mathématique en écrivant : geom_histogram(aes(y = after_stat(density)), binwidth = 2, fill = « grey90 », color = « grey50 »).
Cette harmonisation permet ensuite de superposer la couche continue : geom_density(adjust = 1.2, color = « darkblue », linewidth = 1). L’argument adjust au sein de geom_density() joue un rôle mathématique rigoureusement symétrique à celui de binwidth pour l’histogramme : il contrôle le facteur multiplicatif de la fenêtre de lissage (bandwidth). En ajustant conjointement la finesse de l’histogramme (via binwidth) et la flexibilité de la courbe continue (via adjust), l’analyste dispose d’un instrument d’exploration d’une puissance inégalée, capable de distinguer instantanément les véritables caractéristiques morphologiques de la distribution des artefacts stochastiques locaux.
11. Erreurs méthodologiques, pièges statistiques et comment les éviter
11.1 Le piège de la discrétisation des variables à pas constant
L’une des méprises les plus insidieuses en visualisation quantitative concerne l’application aveugle d’algorithmes conçus pour des variables parfaitement continues à des données issues de dénombrements ou de scores à pas constant. En psychologie et en neurosciences, de nombreuses métriques prennent la forme de comptages discrets : nombre d’erreurs d’inhibition à un test Go/No-Go, nombre de réminiscences lors d’un protocole de mémoire épisodique, ou nombre de symptômes validés dans une grille diagnostique de 10 critères. Ces grandeurs progressent par bonds entiers stricts et ne peuvent jamais adopter de valeurs intermédiaires telles que 2.37 ou 4.81.
Si l’analyste sollicite un calcul automatique sous R sans encadrer les bornes, l’algorithme découpe l’intervalle selon des limites fractionnaires arbitraires. Supposons une variable de comptage variant de 0 à 10 et un algorithme qui génère 7 classes. Certaines classes recouvriront deux valeurs entières possibles tandis que d’autres n’en recouvriront qu’une seule. Il s’ensuit une distorsion dramatique du tracé, connue sous le terme d’« effet d’aliasing » ou d’interférence géométrique : l’histogramme affiche des variations erratiques de hauteur qui ne reflètent en rien la fréquence réelle d’apparition des erreurs chez les participants, mais découlent exclusivement d’un partitionnement incohérent avec la physique de la mesure.
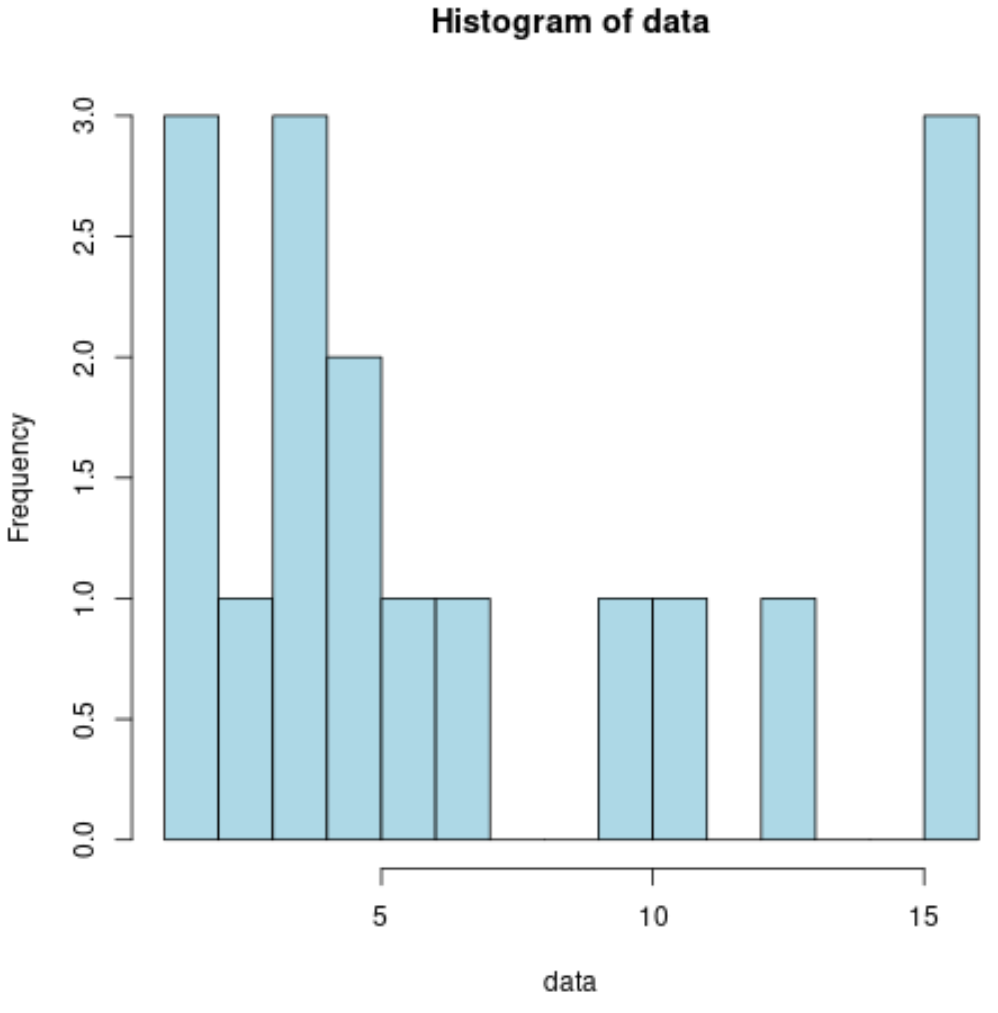
Pour éliminer définitivement cette anomalie, la règle d’or est programmatique : il faut forcer l’alignement strict de la géométrie de l’histogramme sur l’arithmétique discrète de la variable. Sous la fonction de base hist(), on définira systématiquement le vecteur de découpage en centrant chaque entier au moyen de bornes décalées d’un demi-pas : breaks = seq(-0.5, max_score + 0.5, by = 1). Sous ggplot2, on écrira rigoureusement : geom_histogram(binwidth = 1, center = 0). Par cette configuration, chaque barre unique englobera exactement un chiffre entier, garantissant une représentation pure et fidèle de la structure sous-jacente des données de comptage.
11.2 La manipulation involontaire des résultats par le ‘Bin Shopping’
Dans le contexte actuel de crise de la reproductibilité scientifique qui traverse les sciences du comportement, une attention scrupuleuse est portée aux degrés de liberté non documentés du chercheur (souvent qualifiés de researcher degrees of freedom). Parmi ces pratiques discutables, le « bin shopping » (ou « magasinage de classes ») représente un biais cognitif et méthodologique majeur. Cette pratique consiste à faire varier interactivement et de manière opportuniste le nombre de classes d’un histogramme jusqu’à obtenir l’allure visuelle qui flatte le plus l’hypothèse théorique initiale du chercheur.
En ajustant à tâtons la largeur de bande, un analyste peut aisément estomper un mode dérangeant qui contredirait son modèle théorique d’un construit unifié, ou à l’inverse créer artificiellement l’illusion d’une discontinuité distributionnelle là où il n’existe qu’une fluctuation d’échantillonnage aléatoire. Cette flexibilité non déclarée menace directement l’intégrité de la recherche exploratoire : la figure publiée devient alors un support rhétorique destiné à persuader plutôt qu’un outil statistique destiné à mesurer objectivement la réalité.
Pour prévenir cette dérive épistémologique, la communauté scientifique préconise le pré-enregistrement des protocoles d’analyse (pre-registration) sur des plateformes institutionnelles telles que l’Open Science Framework (OSF). Lorsque l’analyse est strictement exploratoire, l’analyste a le devoir éthique d’adopter des règles de décision algorithmiques formelles (comme le recours invariable à la méthode Freedman-Diaconis) plutôt que des sélections manuelles intuitives, et de justifier toute déviation par rapport aux standards par des contraintes métriques ou cliniques objectivement démontrées.
11.3 Erreurs de syntaxe courantes et messages d’alerte dans R
La pratique quotidienne du code R s’accompagne inévitablement de messages d’alerte et d’erreurs d’exécution dont l’élucidation rapide conditionne la fluidité du travail d’analyse. L’une des erreurs les plus fréquentes lors de l’usage de la fonction de base est l’interruption brutale du tracé accompagnée du message d’erreur : Error in hist.default(x, breaks) : some ‘x’ not in any bin. Cette notification indique sans équivoque que le vecteur numérique transmis à breaks ne couvre pas l’intégralité du domaine de variation des données, la borne minimale étant supérieure au minimum des données ou la borne maximale étant inférieure au score le plus élevé. La correction immédiate consiste à encapsuler les bornes dans des appels dynamiques garantissant l’inclusion totale : breaks = seq(floor(min(x)), ceiling(max(x)), length.out = k + 1).
Un autre écueil classique réside dans l’avertissement : ‘breaks’ are not strictly increasing. R exige formellement que le vecteur de coupure soit rigoureusement monotone et croissant. Toute présence de valeurs dupliquées (souvent causée par l’arrondi maladroit d’une séquence calculée) ou tout désordre d’ordonnancement conduira au blocage immédiat de la commande. Il est aisé de vérifier la stricte monotonie d’un vecteur avant son injection dans hist() en testant l’expression logique all(diff(breaks) > 0).
Enfin, sous ggplot2, les utilisateurs s’interrogent fréquemment sur la divergence subtile entre l’utilisation combinée de bins et de binwidth. R renvoie un message explicatif lorsqu’on tente de déclarer simultanément ces deux arguments antagonistes dans geom_histogram() : stat_bin() : Can only specify one of ‘bins’ and ‘binwidth’. Preferring ‘binwidth’. Comprendre cette hiérarchie interne évite les redondances syntaxiques et permet de rédiger un code propre, élégant et immédiatement compréhensible lors de la relecture par les pairs.
12. Recommandations rédactionnelles et intégration dans les publications académiques
12.1 Transparence méthodologique selon les standards APA (7e édition)
Les normes éditoriales contemporaines édictées par l’American Psychological Association dans la 7e édition de son manuel de publication imposent des standards de transparence et de reproductibilité drastiques pour tout document scientifique. Les graphiques statistiques ne sont plus considérés comme de simples ornements visuels, mais comme des arguments quantitatifs à part entière qui doivent être décrits avec la même précision méthodologique qu’un coefficient de régression ou une p-valeur issue d’un test inférentiel.
Lors de l’intégration d’un histogramme dans un manuscrit académique, le corps du texte ou la légende sous-jacente de la figure (Figure Note) doit expliciter sans aucune ambiguïté la procédure exacte ayant présidé au choix du nombre et de la largeur des classes. Il est impératif de mentionner l’algorithme formel utilisé (par exemple : « Le découpage en classes a été calibré selon l’algorithme robuste de Freedman-Diaconis ») ou de préciser la largeur unitaire retenue sur l’échelle métrique (par exemple : « Largeur unitaire de classe fixée à 2 points sur l’inventaire BDI-II, alignée sur l’origine zéro »).
De surcroît, si des regroupements spécifiques ou des classes de largeurs inégales ont été mobilisés pour refléter des seuils nosologiques ou diagnostiques, le chercheur doit fournir la justification clinique formelle de ces coupures dans la section « Méthode / Matériel et mesures ». Dissimuler un réglage manuel ou omettre d’expliquer pourquoi une distribution continue a été segmentée d’une façon spécifique expose l’auteur à des critiques sévères de la part des réviseurs et fragilise la crédibilité de l’ensemble du travail de recherche.
12.2 Alternatives et compléments visuels recommandés en psychologie
Bien que l’histogramme demeure un jalon indispensable de l’exploration descriptive, la visualisation moderne en psychologie quantitative encourage vivement le recours à des compositions graphiques hybrides qui surmontent ses limitations intrinsèques. L’une des approches les plus stimulantes consiste à associer l’histogramme à un diagramme en boîte et moustaches (boxplot) ou à un tracé d’observations individuelles (stripchart ou tracé de dispersion unidimensionnel). Positionner un tracé marginal en boîte au-dessus de l’histogramme permet d’appréhender d’un seul coup d’œil les percentiles fondamentaux (médiane, quartiles, limites d’exclusion) tout en conservant la silhouette topologique détaillée des barres.
Dans cette perspective intégrative, les visualisations de type « nuage de pluie » (ou Raincloud plots), popularisées notamment par Micah Allen et ses collègues dans le champ des neurosciences, représentent aujourd’hui l’étalon-or pour la présentation d’échantillons continus. Un Raincloud plot condense sur un axe unique une estimation de densité demi-violon fluide (analogue conceptuel supérieur de l’histogramme), un diagramme en boîte compact matérialisant les résumés non paramétriques, et la projection brute intégrale de l’ensemble des points de données individuels légèrement dispersés (jittering).
Cette exhaustivité graphique élimine totalement le risque d’artefact lié au choix des classes : le chercheur offre à la communauté une visibilité totale sur l’épaisseur de son échantillonnage, le volume des effectifs, l’éventuelle bimodalité et la position exacte de chaque participant. Pour les études reposant sur des échantillons d’envergure restreinte à modérée (n < 100), fréquentes en neuropsychologie expérimentale, substituer l’histogramme conventionnel par un tracé de type nuage de pluie constitue un gage de rigueur scientifique unanimement salué par les comités de lecture.
12.3 Checklist pour la reproductibilité du code R en recherche ouverte
Dans l’esprit du mouvement pour une science ouverte et reproductible (Open Science), la publication d’un article scientifique doit idéalement s’accompagner du dépôt public des scripts d’analyse informatique complets sur des plateformes certifiées telles que le réseau de dépôts ouverts OSF, Zenodo ou GitHub. Pour que le pipeline graphique relatif aux histogrammes réponde aux critères de reproductibilité FAIR (Facile à trouver, Accessible, Interopérable et Réutilisable), l’analyste veillera à valider systématiquement les points de la checklist méthodologique suivante :
- Fixation de la graine aléatoire : Tout script procédant à des simulations ou à l’introduction d’un léger bruit visuel (jittering) doit débuter par l’appel formel à set.seed(…) pour garantir que les graphiques produits soient rigoureusement superposables à chaque exécution.
- Explicitation intégrale des arguments : Éviter les appels par défaut laconiques tels que hist(x) dans les scripts de production finale. Documenter systématiquement la valeur attribuée à breaks, binwidth, boundary ou center.
- Indépendance logicielle et gestion des versions : Mentionner explicitement dans l’en-tête du script la version exacte du logiciel R et des bibliothèques mobilisées (particulièrement ggplot2), en exploitant éventuellement des outils d’encapsulation d’environnement tels que renv.
- Détachement des données manquantes : Déclarer de manière transparente et automatisée l’exclusion des NA en consignant dans les fichiers journaux d’analyse le nombre précis d’observations écartées lors de la composition de la figure.
- Vectorisation haute résolution : Bannir formellement les captures d’écran matricielles floues au format JPEG basse résolution au profit d’instructions d’exportation programmatiques générant des figures vectorielles en PDF ou des fichiers TIFF compressés d’une résolution minimale de 300 à 600 DPI.
En observant scrupuleusement ces principes computationnels et méthodologiques, le chercheur transforme une tâche technique en apparence banale — paramétrer le nombre de barres d’un graphique — en un acte de communication scientifique irréprochable. La maîtrise rigoureuse de la discrétisation spatiale sous le logiciel R garantit que la figure finale ne trahira jamais la réalité empirique, permettant aux données psychologiques d’exprimer toute leur richesse et leur complexité au service de la découverte scientifique.
Références
- Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: a multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63. https://doi.org/10.12688/wellcomeopenres.15191.1
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Ratcliff, R. (1979). Group reaction time distributions and an analysis of distribution statistics. Psychological Bulletin, 86(3), 446–461. https://doi.org/10.1037/0033-2909.86.3.446
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Scrucca, L., Fop, M., Murphy, T. B., & Raftery, A. E. (2016). mclust 5: clustering, classification and density estimation using Gaussian finite mixture models. The R Journal, 8(1), 289–317. https://doi.org/10.32614/RJ-2016-021
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0