
L’analyse des phénomènes territorialisés constitue depuis plusieurs décennies un carrefour fondamental où convergent les mathématiques appliquées, l’économétrie, la sociologie urbaine et la psychologie environnementale. Dans les démarches quantitatives classiques, la disposition spatiale des sujets observés a longtemps été reléguée au rang de simple caractéristique descriptive ou de variable de contrôle marginale. Pourtant, qu’il s’agisse de mesurer la diffusion d’un trouble psychologique au sein d’une métropole, d’évaluer la concentration des disparités socio-économiques ou de modéliser la résilience communautaire face à un traumatisme collectif, l’espace physique n’est jamais un réceptacle passif. Les processus psychologiques et sociaux s’ancrent dans des configurations territoriales qui favorisent l’agrégation, la transmission ou, au contraire, l’isolement des comportements et des états mentaux.
Au cœur de cette spatialisation des données empiriques se pose une question mathématique et épistémologique cruciale : les observations collectées sur des unités géographiques voisines sont-elles indépendantes les unes des autres, ou partagent-elles une interdépendance inhérente à leur proximité physique ? C’est précisément pour quantifier cette dynamique qu’intervient le concept d’autocorrélation spatiale, dont la métrique la plus célèbre, la plus éprouvée et la plus robuste demeure l’indice de Moran (souvent désigné sous l’appellation Moran’s I). Conçu initialement par le statisticien australien Patrick Alfred Pierce Moran au milieu du vingtième siècle, cet outil statistique permet de formaliser mathématiquement le degré de similitude ou de dissemblance spatiale d’une variable continue mesurée à travers un réseau d’entités géographiques interconnectées.
Comprendre et maîtriser l’indice de Moran s’avère indispensable pour tout chercheur ou praticien désireux de dépasser les postulats réducteurs de l’inférence statistique traditionnelle. Lorsque des données présentent une dépendance spatiale non modélisée, les estimateurs des moindres carrés ordinaires perdent leur propriété d’efficacité, les variances sont sous-estimées et les tests d’hypothèses conduisent inévitablement à une prolifération d’erreurs d’inférence statistique. Ce guide exhaustif propose une exploration approfondie de l’indice de Moran, articulant ses fondements théoriques, sa décomposition algébrique rigoureuse, son implémentation pratique à travers un calcul manuel détaillé, ainsi que ses applications novatrices dans l’analyse spatiale des comportements humains et de la santé mentale.
1. Introduction générale à l’indice de Moran et à l’autocorrélation spatiale
1.1 Définition fondamentale de l’autocorrélation spatiale
L’autocorrélation spatiale peut être définie rigoureusement comme la corrélation d’une variable donnée avec elle-même, mesurée à travers différentes localisations d’un espace géographique ou topologique. Contrairement à l’autocorrélation temporelle, qui opère dans une seule dimension orientée et irréversible (le temps), l’autocorrélation spatiale se déploie dans un espace multidimensionnel (généralement bidimensionnel ou tridimensionnel) dépourvu d’orientation univoque. Cette spécificité impose que la relation entre deux entités ne soit pas seulement séquentielle, mais fonctionnelle et relationnelle. Dès lors qu’une variable quantitative est territorialisée, sa distribution peut s’écarter d’une dispersion purement aléatoire pour manifester des schémas d’organisation structurés par la proximité physique ou fonctionnelle.
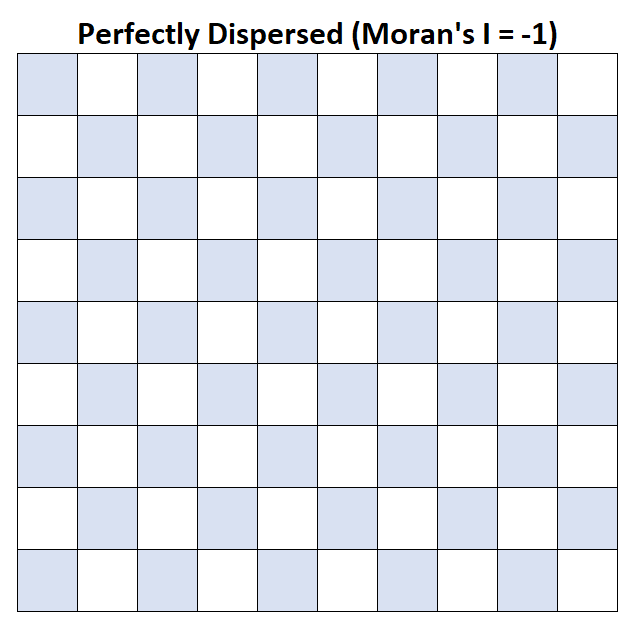
Sur le plan typologique, l’autocorrélation spatiale se décline en trois états fondamentaux. La dépendance spatiale positive survient lorsque des entités géographiquement proches présentent des valeurs d’attributs similaires ; c’est le cas typique où des niveaux élevés d’un phénomène jouxtent des niveaux également élevés, ou inversement où des zones de faibles valeurs s’agglomèrent entre elles. À l’opposé, l’indépendance spatiale (ou caractère aléatoire) décrit une configuration dans laquelle la valeur prise par une unité spatiale n’exerce aucune influence prédictive sur celle de ses voisines, traduisant un modèle de bruit blanc géographique. Enfin, l’autocorrélation spatiale négative (ou dispersion spatiale) renvoie à une dynamique de répulsion ou d’alternance systématique, où des valeurs élevées sont invariablement entourées de valeurs faibles, évoquant la disposition géométrique d’un échiquier ou d’un damier régulier.
D’un point de vue épistémologique, la mise en évidence de l’autocorrélation spatiale bouleverse le statut accordé à la localisation dans la recherche empirique. Loin d’être un attribut secondaire, la coordonnées géographique devient un vecteur de modélisation à part entière. Reconnaître l’existence d’une autocorrélation spatiale signifie admettre que les unités d’échantillonnage ne sont pas des entités hermétiques et isolées, mais des nœuds ouverts insérés dans une trame d’interactions continues. Pour les sciences sociales, cela implique que les caractéristiques d’un individu ou d’un groupe ne peuvent être appréhendées indépendamment des contextes spatiaux adjacents qui les façonnent, imposant de repenser les cadres conceptuels de la causalité statistique.
1.2 Origine historique et travaux de Patrick Alfred Pierce Moran
La formalisation de la statistique d’autocorrélation spatiale trouve son origine dans l’article fondateur publié en 1950 par le statisticien Patrick Alfred Pierce Moran dans la revue Biometrika, intitulé Notes on Continuous Stochastic Phenomena. Confronté à des problématiques de dynamique des populations, d’épidémiologie végétale et de modélisation de processus stochastiques continus, Moran cherchait un moyen mathématiquement stable de tester si la répartition spatiale d’une variable quantitative continue différait significativement du hasard. Ses travaux prolongeaient les recherches initiales menées sur les réseaux binaires par Krishna Iyer, tout en apportant une généralisation mathématique élégante capable de traiter des mesures continues et non plus seulement des variables qualitatives dichotomiques.
Durant les années 1960 et 1970, l’avènement de la révolution quantitative en géographie et l’essor des sciences régionales ont extrait l’indice de Moran de son cadre biométrique originel pour le porter au centre des théories de l’analyse spatiale. Des pionniers tels que Brian Berry, David Harvey et Peter Haggett ont rapidement saisi la puissance de cet indice pour évaluer les structures territoriales des marchés fonciers, les hiérarchies urbaines et la diffusion des innovations sociotechniques. L’indice de Moran s’est ainsi mué en une statistique canonique, fournissant la preuve empirique indispensable pour réfuter l’hypothèse d’une répartition homogène des richesses, des infrastructures et des dynamiques démographiques à la surface de la terre.
La consolidation méthodologique définitive de l’outil a été orchestrée à partir de la fin des années 1980 par l’économètre Luc Anselin, figure de proue de l’économétrie spatiale contemporaine. Anselin a non seulement intégré l’indice de Moran dans les tests diagnostiques préalables à la modélisation autorégressive spatiale, mais il a également révolutionné le domaine en décomposant l’indice global pour créer les indicateurs locaux d’association spatiale (LISA – Local Indicators of Spatial Association). Cette contribution majeure a permis aux chercheurs de passer d’un constat global de dépendance territoriale à l’identification géolocalisée et cartographique de micro-agglomérations homogènes (clusters) et d’anomalies territoriales (outliers), démocratisant l’usage de cette statistique auprès d’une communauté scientifique pluridisciplinaire.
1.3 Pertinence méthodologique en sciences sociales et psychologie
L’intégration de l’indice de Moran dans l’arsenal méthodologique des sciences sociales et de la psychologie contemporaine répond à la nécessité d’objectiver l’impact des environnements bâtis et relationnels sur le fonctionnement humain. En psychologie environnementale, la mesure du stress perçu, de l’épuisement psychologique ou du bien-être subjectif ne peut faire l’économie de la structure spatiale du cadre de vie. L’indice de Moran permet de déterminer dans quelle mesure la détresse psychologique s’agglomère dans certains îlots urbains caractérisés par des nuisances sonores, une carence en espaces verts ou une dégradation du tissu architectural, démontrant que la souffrance individuelle possède une composante écologique territorialisée.
De surcroît, les mécanismes de contagion émotionnelle et de diffusion des comportements prosociaux trouvent dans l’analyse de Moran un cadre d’évaluation empirique particulièrement rigoureux. Dans les études portant sur l’efficacité collective, la cohésion sociale ou la propension à l’altruisme au sein des quartiers, l’existence d’une autocorrélation spatiale positive révèle que les normes civiques et les attitudes coopératives ne se distribuent pas de manière atomisée. Elles se transmettent de proche en proche par observation, imitation sociale et interactions directes de voisinage, créant des poches de haut capital social qui contrastent nettement avec des zones de désengagement communautaire.
Enfin, l’épidémiologie psychiatrique et la sociologie de la santé mentale mobilisent l’indice de Moran pour cartographier les inégalités territoriales de santé et cibler l’offre de soins. L’identification d’une dépendance spatiale significative dans les taux d’incidence de troubles anxio-dépressifs, les prescriptions de psychotropes ou les recours aux urgences psychiatriques met en lumière des déséquilibres structurels dans l’accessibilité spatiale des centres médico-psychologiques. En substituant une lecture territoriale empirique aux approches purement individuelles, l’indice de Moran s’impose comme un instrument d’aide à la décision publique et un puissant catalyseur théorique pour la psychologie communautaire.
2. Fondements théoriques : la première loi de Tobler et l’espace relationnel
2.1 Énoncé et implications de la première loi de la géographie
L’ancrage conceptuel de l’indice de Moran repose de façon indissociable sur ce que la littérature scientifique consacre sous le nom de première loi de la géographie, formalisée par l’éminent géographe et cartographe Waldo Tobler en 1970 : « Everything is related to everything else, but near things are more related than distant things » (Tout est lié à tout le reste, mais les choses proches sont plus liées que les choses lointaines). Cet axiome apparemment simple résume une réalité physique et sociale omniprésente : la séparation spatiale impose une friction qui atténue l’intensité des flux d’énergie, de matière et d’information.
Dans le domaine des sciences humaines et de la psychologie sociale, le postulat toblérien traduit la transformation de la distance métrique en un gradient d’interaction psychologique et d’exposition relationnelle. Les individus qui partagent une proximité géographique immédiate partagent également, de facto, un ensemble de déterminants environnementaux communs : qualité de l’air, niveau d’insécurité, accès aux services publics, microclimat social et exposition médiatique locale. Par conséquent, la proximité spatiale agit comme un puissant catalyseur d’homogénéisation cognitive et comportementale, induisant une covariance naturelle entre les mesures effectuées sur des sujets résidant à faible distance les uns des autres.
Sur le plan mathématique, la première loi de Tobler implique que la structure de variance-covariance d’une variable territorialisée n’est pas diagonale pure. Alors que les méthodes statistiques traditionnelles supposent que la covariance entre deux observations distinctes est strictement nulle, la réalité spatiale impose une structure où la covariance est une fonction inverse de la distance séparant les entités. L’indice de Moran constitue la formalisation opérationnelle de cette loi, offrant un moyen quantitatif standardisé de vérifier si, pour un jeu de données précis, le principe de décroissance avec la distance gouverne effectivement les observations de terrain.
2.2 Dépassement du postulat d’indépendance des observations (i.i.d.)
La statistique inférentielle classique repose presque universellement sur l’hypothèse selon laquelle les résidus d’un modèle ou les observations d’un échantillon sont indépendants et identiquement distribués (souvent abrégé en i.i.d.). Ce postulat d’indépendance conditionne la validité des théorèmes fondamentaux de la statistique, notamment le théorème central limite et la loi des grands nombres. Dans le cadre d’une régression linéaire ordinaire par les moindres carrés, l’absence de corrélation entre les termes d’erreur résiduels est la garantie fondamentale permettant d’affirmer que les estimateurs sont non biaisés et à variance minimale (propriété BLUE : Best Linear Unbiased Estimator).
Or, la présence d’une autocorrélation spatiale positive dans les données collectées viole frontalement ce postulat d’indépendance. Lorsque des observations géographiquement proches se ressemblent plus que des observations aléatoires, chaque nouvelle mesure n’apporte pas une quantité d’information totalement nouvelle ; le nombre effectif de degrés de liberté du système statistique s’en trouve diminué. Par voie de conséquence, l’application aveugle des méthodes standards conduit à une sous-estimation systématique et sévère des erreurs-types des coefficients estimés. Cette distorsion gonfle artificiellement les valeurs des statistiques de test (comme le t de Student ou le F de Fisher) et conduit inévitablement à l’erreur de type I : rejeter à tort une hypothèse nulle en concluant à l’existence d’une relation statistiquement significative qui n’est en réalité qu’un artéfact induit par la dépendance spatiale non contrôlée.
Face à ce péril méthodologique, l’indice de Moran intervient comme un test de diagnostic indispensable. En l’appliquant aux résidus d’un modèle de régression standard, le chercheur peut déceler sans ambiguïté si le bruit résiduel conserve une trame spatiale organisée. La détection d’une telle dépendance spatiale résiduelle impose l’abandon des méthodes de régression conventionnelles au profit de cadres économétriques avancés, tels que les modèles autorégressifs spatiaux ou les modèles à erreurs spatialement dépendantes, garantissant ainsi l’intégrité épistémique des conclusions tirées des données empiriques.
2.3 Effets de contexte et processus de dépendance spatiale
L’existence d’une autocorrélation spatiale mesurable par l’indice de Moran s’enracine dans des mécanismes psychosociaux et écologiques complexes, que l’on regroupe généralement sous la notion d’effets de contexte et de processus de débordement spatial (spillover effects). Ces dynamiques illustrent la porosité des frontières géographiques artificielles : les caractéristiques d’un quartier ou d’une communauté résidentielle ne restent jamais circonscrites à leur périmètre strict. Elles se diffusent, s’infiltrent et contaminent progressivement les espaces contigus, qu’il s’agisse de la criminalité, du dynamisme associatif ou de la prévalence des troubles psychologiques liés à l’isolement social.
Il importe toutefois de distinguer conceptuellement deux vecteurs causaux majeurs souvent intriqués dans les données territorialisées : l’effet de contexte environnemental pur et l’auto-sélection spatiale (ou tri spatial). L’effet de contexte désigne l’impact direct et continu qu’exerce un environnement partagé sur les comportements individuels ; à titre d’exemple, résider à proximité immédiate d’une infrastructure hautement bruyante ou polluante induit un stress physiologique chronique partagé par l’ensemble des résidents contigus. En revanche, le tri spatial renvoie au processus par lequel des individus présentant des profils psychologiques, des ressources économiques ou des vulnérabilités similaires ont tendance à s’agréger dans les mêmes zones résidentielles, créant une uniformité spatiale sans qu’il y ait nécessairement transmission interindividuelle active.
Dans l’étude des processus comportementaux, l’indice de Moran ne prétend pas, à lui seul, démêler la causalité intime entre exposition environnementale passive et choix résidentiel actif. En revanche, il offre la métrique descriptive indispensable pour quantifier l’intensité globale de cette empreinte spatiale. En fournissant un indice numérique clair de la dépendance territoriale, il constitue le point de départ incontournable à partir duquel des protocoles de recherche plus sophistiqués (études longitudinales spatialisées, expérimentations naturelles ou modélisations multi-niveaux) pourront élucider les vecteurs spécifiques gouvernant l’écologie du comportement humain.
3. La formule mathématique de l’indice de Moran décomposée
3.1 Structure algébrique globale de l’équation
Pour appréhender la mécanique interne de l’indice de Moran, il est impératif d’en analyser la formulation mathématique rigoureuse. Pour un échantillon composé de N entités spatiales, où chaque unité i est caractérisée par une observation quantitative xi d’une variable X de moyenne globale x̄, l’indice global de Moran, noté I, s’exprime formellement par l’équation suivante :
I = (N / W) * [Σi=1..N Σj=1..N wij (xi – x̄)(xj – x̄)] / [Σi=1..N (xi – x̄)2]
Dans cette formulation, wij désigne l’élément situé à la ligne i et à la colonne j de la matrice des poids spatiaux W, quantifiant le degré de connexion topologique ou métrique unissant l’unité i à l’unité j. Par convention absolue dans l’analyse de Moran, une entité ne peut être considérée comme sa propre voisine, ce qui impose que les éléments diagonaux de la matrice soient nuls : wii = 0 pour tout i. La grandeur scalaire W représente quant à elle la somme totale de l’ensemble des coefficients de la matrice de connectivité spatiale, soit :
W = Σi=1..N Σj=1..N wij
Sur le plan conceptuel, cette structure algébrique s’apparente étroitement à une généralisation spatiale du célèbre coefficient de corrélation linéaire de Pearson. Alors que la corrélation de Pearson évalue la covariance entre deux variables distinctes X et Y mesurées sur les mêmes individus, l’indice de Moran quantifie la covariance entre la variable X mesurée en un lieu i et cette même variable X mesurée dans les lieux voisins j, la matrice W dictant la force et la structure de cette relation. Le ratio (N / W) intervient quant à lui comme une constante de standardisation scalaire, garantissant la comparabilité de l’indice indépendamment de la taille de l’échantillon ou de l’échelle des poids spatiaux adoptée.
3.2 Le numérateur : covariation spatiale pondérée
Le cœur opératoire de la formule réside dans son numérateur : la double sommation pondérée des produits d’écarts à la moyenne. L’expression (xi – x̄)(xj – x̄) capture la co-variation simultanée des attributs entre les localisations i et j par rapport à la moyenne générale du territoire. Ce produit croisé peut générer des contributions numériques aux interprétations diamétralement opposées selon la position relative des deux observations par rapport au centre de gravité statistique de l’échantillon :
- Contribution positive par valeurs supérieures : Si l’unité i présente une valeur supérieure à la moyenne (xi – x̄ > 0) et que son voisin j présente également une valeur supérieure (xj – x̄ > 0), le produit de deux termes positifs engendre un scalaire strictement positif.
- Contribution positive par valeurs inférieures : Si l’unité i présente une valeur inférieure à la moyenne (xi – x̄ < 0) et que son voisin j présente simultanément une valeur inférieure (xj – x̄ < 0), le produit de deux termes négatifs génère également un scalaire strictement positif.
- Contribution négative par discordance spatiale : Si l’une des entités dépasse la moyenne tandis que son voisin se situe en deçà (par exemple xi – x̄ > 0 et xj – x̄ < 0), le produit croisé donne un résultat strictement négatif, traduisant une hétérogénéité spatiale locale.
L’insertion du terme de pondération wij module l’impact de chaque couple spatial au sein de la somme globale. Si deux localisations ne sont pas connectées selon la définition spatiale retenue, le poids wij prend la valeur 0, annulant purement et simplement le produit croisé correspondant, quelle que soit la magnitude de la similarité de leurs valeurs. En revanche, si la proximité est établie, le poids amplifie ou pondère la contribution de cette dyade en fonction de la force du lien spatial. La somme globale du numérateur synthétise ainsi le bilan énergétique net de la similitude territoriale : une valeur hautement positive indique une écrasante dominance des couples concordants, tandis qu’une valeur négative révèle la prédominance de voisinages hétérogènes et contrastés.
3.3 Le dénominateur : variance globale de l’échantillon
Le dénominateur de l’indice de Moran est constitué par la somme des carrés des écarts à la moyenne globale, c’est-à-dire :
Σi=1..N (xi – x̄)2
Cette composante n’est rien d’autre que la variance non normalisée de l’échantillon, c’est-à-dire la dispersion totale de la variable X sans considération aucune de la localisation géographique des entités. Son rôle dans l’équation est strictement régulateur et dimensionnel : en divisant la somme des covariances spatiales pondérées par la variance totale de la série, le dénominateur neutralise l’unité de mesure initiale de la variable étudiée. Que le phénomène soit exprimé en euros, en décibels, en scores psychométriques de 1 à 10 ou en pourcentages, l’indice résultant devient une quantité adimensionnelle, assurant ainsi une comparabilité mathématique rigoureuse entre des variables aux échelles de dispersion totalement hétérogènes.
Toutefois, cette structure algébrique confère également au dénominateur une sensibilité mathématique marquée aux caractéristiques de la distribution empirique. Dès lors qu’une variable présente une asymétrie statistique prononcée ou intègre des valeurs extrêmes non régularisées (des valeurs aberrantes), le dénominateur gonfle de manière disproportionnée sous l’effet de l’élévation au carré. Cela a pour effet d’écraser la magnitude apparente de l’indice de Moran vers zéro, masquant potentiellement des agrégations spatiales locales bien réelles. C’est pourquoi la vérification préalable de la normalité de la distribution ou l’application de transformations mathématiques adaptées (telles que les transformations logarithmiques) constitue une étape analytique recommandée avant le calcul de l’indice.
4. La matrice des poids spatiaux (W) : construction et modélisation
4.1 Matrices basées sur la contiguïté géographique
L’opérationnalisation de la distance spatiale dans l’équation de Moran repose entièrement sur la définition préalable de la matrice des poids spatiaux, notée W. Il s’agit d’une matrice carrée de dimension N × N, où chaque cellule wij formalise l’existence et l’intensité du lien physique unissant l’entité spatiale i à l’entité j. Dans le cas de découpages polygonaux contigus — tels que les communes, les secteurs de recensement ou les îlots urbains —, la méthode la plus classique de structuration de la matrice s’appuie sur le concept de contiguïté géographique.
En référence directe aux mouvements des pièces du jeu d’échecs, la littérature méthodologique distingue principalement deux critères de contiguïté :
- Le critère de la Tour (Rook contiguity) : Selon cette convention géométrique, deux polygones ne sont qualifiés de voisins (wij = 1) que s’ils partagent une frontière commune d’une longueur non nulle, excluant explicitement les points d’intersection isolés (sommets).
- Le critère de la Reine (Queen contiguity) : Cette modalité, beaucoup plus permissive et fréquemment privilégiée en analyse socio-spatiale, considère comme voisines deux unités dès lors qu’elles partagent un segment de frontière linéaire ou un unique sommet ponctuel commun.
Le choix entre ces deux critères n’est pas purement cosmétique ; il modifie directement la connectivité du graphe spatial sous-jacent. Dans des maillages réguliers (par exemple une grille carroyée), le critère de la Tour n’attribue que 4 voisins à une cellule centrale, tandis que le critère de la Reine lui en associe 8, intégrant les quatre diagonales. Dans le contexte de l’étude des quartiers administratifs, le critère de la Reine est généralement préconisé pour éviter d’isoler artificiellement des zones dont les interactions sociales s’opèrent par des carrefours ou des points de passage angulaires majeurs.
4.2 Matrices basées sur la distance métrique
Lorsque les données étudiées ne se présentent pas sous la forme de polygones contigus, mais sous la forme de points géolocalisés précis (coordonnées GPS d’individus, localisation d’écoles ou de cliniques), la modélisation de la matrice W s’affranchit de la contiguïté pour épouser des métriques de distance spatiale continue. Trois approches fondamentales dominent la pratique :
La première consiste à définir un seuil de distance euclidienne fixe (distance band). Dans ce modèle binaire, deux entités sont considérées comme voisines (wij = 1) si la distance euclidienne dij qui les sépare est inférieure ou égale à un rayon critique dmax ; dans le cas contraire, wij = 0. Cette approche comporte toutefois un risque majeur : celui d’engendrer des îles spatiales (entités n’ayant aucun voisin au sein du rayon spécifié) dans les secteurs à faible densité, ou à l’inverse, d’hyper-densifier les connexions au sein des cœurs métropolitains denses.
Pour parer à cet écueil, les chercheurs recourent fréquemment à l’algorithme des k-plus proches voisins (k-nearest neighbors). Dans cette configuration, chaque unité spatiale i se voit attribuer un nombre fixe k de voisins, correspondant aux k entités les plus proches en termes de distance métrique, quelle que soit la distance physique réelle. Ce paramétrage assure une densité de connectivité rigoureusement uniforme à travers tout l’échantillon, s’adaptant organiquement aux contrastes démographiques entre zones urbaines denses et espaces ruraux dispersés.
Enfin, une modélisation continue peut être instaurée au moyen d’une fonction inverse de la distance, où le poids s’exprime typiquement par wij = 1 / dijα (avec généralement α = 1 ou α = 2). Sous cette formulation, l’influence mutuelle entre observations décroît continûment au fur et à mesure que la séparation physique augmente, éliminant les effets de seuil arbitraires et traduisant fidèlement la dissipation spatiale des influences relationnelles.
4.3 Standardisation par ligne et normalisation
Une fois la matrice des poids géographiques ou métriques établie, une étape analytique quasi systématique consiste à procéder à sa standardisation par ligne (row-standardization). Cette opération mathématique consiste à diviser chaque coefficient wij de la matrice brute par la somme arithmétique de la ligne à laquelle il appartient :
wij(standardisé) = wij / Σk=1..N wik
Sous cette transformation stochastique, la somme des poids de chaque ligne devient rigoureusement égale à 1. Ce rééchelonnage possède des conséquences interprétatives et calculatoires fondamentales. D’une part, l’opération matricielle Σj=1..N wij xj ne représente plus une simple somme brute d’attributs extérieurs, mais la moyenne locale pondérée des valeurs observées au sein du voisinage immédiat de l’entité i (concept désigné sous le terme de décalage spatial ou spatial lag). D’autre part, la standardisation par ligne neutralise l’artefact mécanique par lequel une unité possédant de très nombreux voisins (par exemple une commune centrale) pèserait démesurément plus dans l’évaluation globale qu’une commune périphérique n’en possédant qu’un seul.
Sur le plan computationnel, la standardisation par ligne simplifie élégamment l’équation générale de l’indice de Moran. Puisque la somme de chaque ligne est égale à 1, la somme totale de tous les éléments de la matrice normalisée devient simplement égale au nombre total d’observations, soit : W = N. Dès lors, le rapport scalaire d’échelle (N / W) se simplifie de façon éclatante :
N / W = N / N = 1
La formule globale de l’indice de Moran se réduit ainsi à une expression plus compacte et directe :
I = [Σi=1..N Σj=1..N wij(standardisé) (xi – x̄)(xj – x̄)] / [Σi=1..N (xi – x̄)2]
Cette simplification algébrique met en lumière la nature intrinsèque de l’indice standardisé par ligne : il s’agit littéralement de la régression linéaire standardisée de la variable spatialement décalée sur la variable centrée d’origine.
5. Interprétation quantitative et qualitative des valeurs de l’indice
5.1 Indice positif tendant vers +1 : agrégation spatiale (clustering)
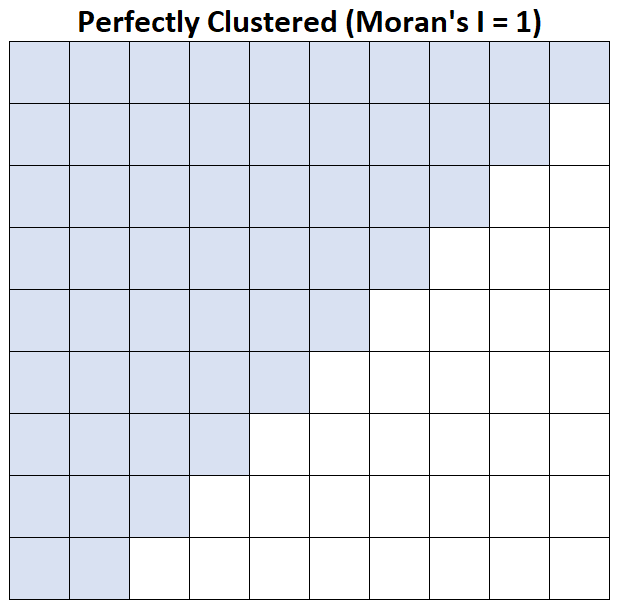
L’interprétation statistique de l’indice global de Moran s’articule autour de sa valeur numérique centrale par rapport à son espérance théorique. Lorsqu’un jeu de données produit une valeur de I nettement positive, supérieure au seuil d’indépendance statistique, les données manifestent une structure d’agrégation spatiale ou de mise en grappe (clustering). Ce résultat confirme de manière irréfutable que la distribution territoriale du phénomène étudié est soumise à une force d’attraction ou à des processus d’homogénéisation de voisinage.
Il importe de souligner qu’une autocorrélation spatiale positive globale n’indique pas uniquement la présence de zones de fortes valeurs. Mathématiquement, l’indice synthétise sans distinction deux typologies de regroupement homogène :
- Les clusters de type High-High (couramment désignés sous le terme de points chauds ou hot spots), où des entités présentant des valeurs particulièrement élevées par rapport à la moyenne territoriale sont regroupées de manière contiguë.
- Les clusters de type Low-Low (qualifiés de points froids ou cold spots), où des unités territoriales affichant des niveaux très faibles se côtoient dans un espace régional donné.
Dans les champs de la psychologie et des sciences comportementales, l’obtention d’un indice de Moran hautement positif renseigne sur l’intensité des processus de ségrégation spatiale ou de convergence comportementale. Par exemple, une étude examinant le capital social ou la résilience psychologique après un sinistre révélera, en cas d’indice positif élevé, l’existence de communautés entières soudées par des réseaux d’entraide denses, tandis que d’autres secteurs territoriaux s’enfoncent solidairement dans l’isolement et la vulnérabilité psychosociale.
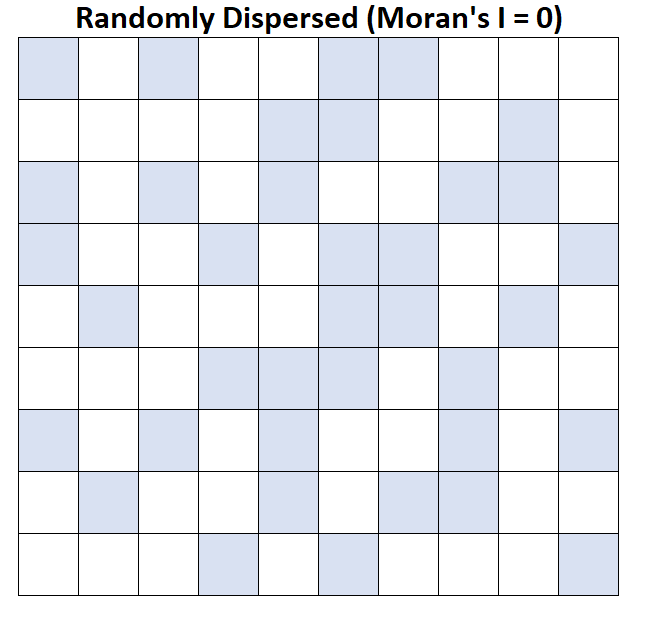
5.2 Indice nul ou proche de zéro : distribution aléatoire
Lorsque la valeur calculée de l’indice de Moran gravite très près de son espérance théorique sous hypothèse nulle (valeur légèrement négative proche de zéro, comme explicité au chapitre suivant), la configuration géographique des données ne peut être distinguée d’un processus stochastique aléatoire. Dans une telle situation, la répartition des valeurs d’attributs s’apparente à un bruit blanc territorial, signifiant que la localisation géographique d’une unité n’offre absolument aucun pouvoir prédictif sur les valeurs observées chez ses voisins contigus.
La confirmation d’une absence d’autocorrélation spatiale possède des implications analytiques majeures pour le chercheur. Sur le plan méthodologique, ce résultat valide rétrospectivement l’application des modèles statistiques traditionnels. Si les résidus d’une analyse de régression présentent un indice de Moran nul et non significatif, le postulat d’indépendance des observations (i.i.d.) est formellement respecté. Les estimations fournies par les moindres carrés ordinaires conservent leur efficacité maximale, et les tests de significativité des paramètres (tests t et F) peuvent être interprétés en toute confiance sans risque d’inflation de l’erreur de type I.
Sur le plan théorique et psychologique, une distribution spatiale aléatoire suggère que le phénomène examiné n’est pas sensible aux dynamiques d’interaction locale, aux effets de contagion sociale ou aux disparités écologiques de quartier. Un tel constat incite le chercheur à privilégier des déterminants intrinsèques, endogènes ou strictement individuels (par exemple la génétique comportementale, des traits de personnalité fondamentaux ou des variables démographiques non territorialisées) pour expliquer la variance du trait psychologique mesuré.
5.3 Indice négatif tendant vers -1 : dispersion spatiale (damier)
L’obtention d’un indice de Moran significativement négatif (se rapprochant de la borne théorique de -1) caractérise une configuration de dispersion spatiale systématique. Dans cette architecture géographique singulière, des entités adjacentes affichent des valeurs radicalement discordantes. Chaque unité spatiale présentant une valeur élevée est entourée d’unités affichant des valeurs faibles, et inversement, créant un paysage territorial dont l’analogie la plus parlante est celle de la structure en damier alterné noir et blanc.
Ce schéma d’autocorrélation spatiale négative reflète des dynamiques sous-jacentes d’inhibition compétitive, de répulsion territoriale ou de saturation spatiale de ressources limitées. En écologie des populations ou en géographie économique, ces configurations sont bien documentées : elles correspondent, par exemple, à l’implantation concurrentielle de commerces exclusifs qui cannibalisent l’attractivité de leur périphérie immédiate, ou à la territorialité stricte de prédateurs qui s’excluent mutuellement de zones limitrophes.
En revanche, dans l’étude des phénomènes psychologiques, sociologiques et comportementaux, l’observation empirique d’une autocorrélation spatiale négative globale est une occurrence exceptionnellement rare. Les dynamiques humaines obéissent très majoritairement aux logiques de similarité, d’homophilie, d’assimilation culturelle et de co-exposition aux contraintes matérielles, favorisant de manière écrasante l’agrégation spatiale positive. Lorsqu’un indice négatif émerge dans une étude psychosociale, il signale souvent une partition artificielle du territoire, un artefact de découpage cartographique ou un phénomène marginal de compensation territoriale locale qui mérite une investigation qualitative approfondie.
6. Inférence statistique, tests d’hypothèse et valeur p
6.1 Formulation formelle des hypothèses nulle et alternative
L’observation empirique d’un indice de Moran positif ou négatif ne suffit pas en soi à proclamer l’existence d’une structure territoriale signifiante. Il est méthodologiquement impératif de soumettre la valeur calculée à un cadre d’inférence statistique rigoureux afin de s’assurer que le résultat obtenu ne relève pas d’une simple fluctuation d’échantillonnage fortuite. La démarche repose sur la formulation classique d’un test d’hypothèses statistiques standardisé.
L’hypothèse nulle (H0) stipule que la variable quantitative étudiée est distribuée de manière totalement aléatoire et indépendante à travers l’espace considéré. Sous cette hypothèse de randomisation spatiale complète, la disposition topologique des valeurs d’attributs observées n’est qu’un arrangement parmi l’infinité des permutations spatiales possibles de l’échantillon. En d’autres termes, les processus physiques ou relationnels opérant dans l’espace n’exercent aucune force régulatrice sur la variable.
L’hypothèse alternative (H1) pose au contraire que la distribution spatiale des attributs présente une structure déterministe non attribuable au seul hasard. Selon la nature des hypothèses de recherche formulées a priori, le test statistique peut être bilatéral ou unilatéral :
- Test unilatéral supérieur : H1 pose que I > E(I), ciblant spécifiquement la recherche d’une agrégation spatiale positive (clustering).
- Test unilatéral inférieur : H1 pose que I < E(I), explorant l’existence d’une dispersion ou d’une répulsion spatiale (damier).
- Test bilatéral : H1 pose simplement que I ≠ E(I), testant tout écart statistiquement significatif par rapport à l’indépendance spatiale, quelle que soit la direction du schéma spatial observé.
6.2 Espérance mathématique et calcul de la variance sous H0
Une particularité théorique fondamentale de l’indice de Moran réside dans le fait que son espérance mathématique sous l’hypothèse nulle n’est pas égale à zéro, contrairement à ce que l’intuition du coefficient de corrélation linéaire pourrait laisser présumer. Pour un échantillon composé de N observations spatiales, l’espérance théorique de I, notée E(I), s’exprime formellement par :
E(I) = – 1 / (N – 1)
Cette formulation révèle que l’espérance mathématique est invariablement un nombre négatif, bien que tendant asymptotiquement vers zéro au fur et à mesure que la taille de l’échantillon N croît vers l’infini. Pour des échantillons de petite taille, ce décalage s’avère non négligeable : pour un échantillon de N = 9 unités, par exemple, l’espérance sous hypothèse nulle est de E(I) = -1 / 8 = -0,125. Toute valeur de I supérieure à -0,125 indique donc un début d’agrégation spatiale relative, et non pas uniquement les valeurs strictement supérieures à zéro.
L’évaluation de la variance théorique de l’indice sous l’hypothèse nulle, notée Var(I), fait appel à une algèbre beaucoup plus complexe dépendant du modèle théorique sous-jacent retenu :
- L’hypothèse de normalité : Suppose que les valeurs de la variable X constituent des réalisations indépendantes issues d’une population gaussienne sous-jacente.
- L’hypothèse de randomisation (permutation) : Considère les valeurs observées comme des constantes figées dont seules les localisations spatiales sont permutées aléatoirement parmi les N! combinaisons possibles. Cette seconde approche, non paramétrique, est largement privilégiée dans la pratique car elle ne requiert aucun postulat restrictif quant à la distribution de probabilité sous-jacente de la variable.
L’expression analytique de la variance sous hypothèse de randomisation intègre la géométrie fine de la matrice des poids spatiaux à travers les sommes scalaires de ses lignes et colonnes, ainsi que le coefficient d’aplatissement (kurtosis) de la distribution empirique de X, assurant un ajustement précis de la dispersion statistique théorique.
6.3 Score Z et tests de permutation de Monte Carlo
Pour déterminer la significativité statistique de l’écart observé entre l’indice empirique I et son espérance théorique E(I), la procédure analytique standard consiste à calculer un score centré réduit (score Z) défini par le ratio classique :
ZI = [I – E(I)] / √(Var(I))
Sous les conditions de régularité du théorème central limite, le score ZI suit asymptotiquement une distribution normale standard centrée réduite N(0, 1). Dès lors, le chercheur peut évaluer la valeur p (p-value) associée en confrontant le score calculé aux seuils critiques universels de la loi normale :
- Un score |ZI| > 1,96 indique un rejet de l’hypothèse nulle au seuil de significativité de α = 0,05.
- Un score |ZI| > 2,58 correspond à un rejet au seuil de α = 0,01.
- Un score |ZI| > 3,29 correspond à un seuil d’extrême significativité de α = 0,001.
Cependant, lorsque les conditions de grand échantillon ne sont pas réunies ou que la distribution spatiale présente de sévères anomalies d’irrégularité topologique, l’inférence asymptotique paramétrique peut induire des erreurs d’interprétation. Les praticiens ont alors recours aux tests de permutation de Monte Carlo. Cette approche computationnelle robuste consiste à figer la géométrie de la matrice spatiale tout en redistribuant aléatoirement les valeurs d’attributs à travers les entités géographiques un très grand nombre de fois (par exemple 999 ou 9 999 itérations). À chaque tirage stochastique, un pseudo-indice de Moran Isim est recalculé. La valeur p empirique (ou pseudo-valeur p) se calcule alors simplement comme la proportion d’indices simulés dont la valeur absolue dépasse ou égale celle de l’indice empirique réel observé, conférant à la décision statistique une validité empirique absolue exempte de tout postulat de normalité théorique.
7. L’indice de Moran local (LISA) : passer du global au spécifique
7.1 Limites de la mesure globale et émergence des indicateurs locaux
Bien que l’indice global de Moran constitue un outil de synthèse précieux pour établir un diagnostic global sur un territoire, il présente une limite méthodologique inhérente : sa nature d’agrégateur macroscopique. Un score global unique comprime l’ensemble des dynamiques spatiales complexes d’une région en un seul chiffre moyen. Or, un territoire peut héberger simultanément des poches locales de forte agrégation spatiale de valeurs élevées, de vastes étendues parfaitement aléatoires, et des zones ponctuelles d’extrême hétérogénéité territoriale. Dans une telle situation, les interactions locales opposées s’annulent mutuellement lors de la sommation globale, conduisant à un indice de Moran global proche de zéro qui masque totalement des disparités géographiques cruciales.
Pour dépasser cet aveuglement spatial de la mesure globale, Luc Anselin a introduit en 1995 le concept révolutionnaire des indicateurs locaux d’association spatiale (conduisant à l’acronyme LISA pour Local Indicators of Spatial Association), parmi lesquels l’indice de Moran local s’impose comme la référence méthodologique absolue. Selon la définition formelle d’Anselin, un indicateur spatial local doit satisfaire deux exigences fondamentales : premièrement, il doit fournir pour chaque localisation spatiale individuelle une indication du degré d’agglomération de valeurs similaires ou dissemblables autour de ce point précis ; deuxièmement, la somme arithmétique proportionnelle de tous les indicateurs locaux doit être strictement équivalente à l’indice global de Moran correspondant.
L’équation de l’indice de Moran local pour une unité géographique i s’énonce mathématiquement comme suit (lorsque la matrice W est standardisée par ligne) :
Ii = [(xi – x̄) / s2] * Σj=1..N wij (xj – x̄)
Où s2 désigne la variance globale de la variable étudiée sur l’ensemble de l’échantillon. Cette formulation décompose l’analyse territoriale au niveau micro-géographique, permettant d’évaluer la contribution spécifique de chaque entité spatiale à la structure globale de dépendance territoriale.
7.2 Typologie des quatre quadrants du diagramme de Moran
L’analyse locale prend toute sa force heuristique à travers le diagramme de Moran (Moran Scatterplot), un repère cartésien bidimensionnel permettant de visualiser instantanément le statut de chaque unité spatiale. Dans ce diagramme, l’axe des abscisses (horizontal) représente la variable d’intérêt standardisée zi = (xi – x̄) / s pour chaque entité, tandis que l’axe des ordonnées (vertical) représente le décalage spatial standardisé (spatial lag), c’est-à-dire la moyenne pondérée standardisée des voisins de l’unité : Σj wij zj.
Le croisement de ces deux axes orthogonaux au point central (0, 0) divise l’espace d’observation en quatre quadrants distincts, fournissant une typologie comportementale exhaustive :
- Quadrant I (En haut à droite) : High-High (HH) — Regroupe les localisations qui affichent des valeurs supérieures à la moyenne globale et qui sont entourées d’unités dont la moyenne du voisinage est également supérieure à la moyenne. Ces entités forment les clusters statistiquement significatifs de type points chauds.
- Quadrant II (En bas à gauche) : Low-Low (LL) — Rassemble les unités affichant des valeurs inférieures à la moyenne et dont le voisinage géographique immédiat enregistre également des valeurs faibles. Ces territoires composent les grappes homogènes de type points froids.
- Quadrant III (En haut à gauche) : Low-High (LH) — Désigne une configuration d’incongruité spatiale (outlier) : l’entité présente elle-même une valeur faible, mais se trouve enclavée dans un environnement immédiat dominé par de fortes valeurs.
- Quadrant IV (En bas à droite) : High-Low (HL) — Représente l’autre forme d’anomalie spatiale territoriale : une unité affichant un niveau très élevé entourée d’un voisinage présentant des valeurs faibles.
Les quadrants High-High et Low-Low matérialisent l’autocorrélation spatiale positive locale (processus d’homogénéité et d’attraction), tandis que les quadrants Low-High et High-Low identifient des ruptures territoriales aiguës, souvent le siège de tensions frontalières, d’inégalités d’accès locales ou de barrières physiques et administratives majeures.
7.3 Cartographie opérationnelle des clusters LISA
L’aboutissement opérationnel de l’approche locale réside dans la transposition cartographique directe des données issues du diagramme de Moran, sous la forme de cartes de clusters LISA et de cartes de significativité LISA. Une unité géographique ne peut être labellisée et coloriée comme appartenant à un cluster High-High ou Low-Low sur une carte scientifique que si son indice local Ii présente une significativité statistique prouvée (au moyen d’un test de Monte Carlo local, avec généralement une pseudo-valeur p < 0,05 ou p < 0,01). Les unités territoriales dont l’indice local n’atteint pas le seuil de rejet de l’hypothèse nulle sont neutralisées et affichées en teinte grise ou transparente, signalant l’absence de structure spatiale statistiquement robuste à cet endroit précis.
Dans la recherche appliquée en psychologie de la santé et en politiques publiques, ces visualisations cartographiques transcendent les statistiques abstraites en véritables instruments de décision territoriale. Une agence régionale de santé peut, d’un simple regard, repérer les clusters High-High de détresse psychologique ou d’incidence du burn-out pour déployer d’urgence des unités mobiles d’intervention psychologique ciblée. De même, la détection de poches Low-Low de couverture vaccinale ou d’accès aux psychothérapies permet de briser les stéréotypes régionaux globaux pour diriger les budgets publics vers les zones d’urgence objectivement identifiées par les mathématiques spatiales.
Parallèlement, la mise en lumière des outliers spatiaux (High-Low ou Low-High) offre des perspectives scientifiques fascinantes pour les chercheurs en sciences du comportement. L’étude d’un quartier High-Low — une communauté maintenant un niveau remarquable de cohésion sociale et de bien-être mental au milieu d’un bassin territorial sinistré par la précarité et l’anxiété — constitue un terrain privilégié pour étudier les facteurs protecteurs endogènes et la résilience communautaire en situation d’adversité partagée.
8. Exemple pratique et calcul détaillé sur un jeu de données pas à pas
8.1 Présentation du cas d’étude : évaluation du stress perçu sur une grille de 9 unités
Afin de démystifier la mécanique calculatoire de l’indice de Moran et de fournir une démonstration pédagogique intégrale, considérons un cas d’étude empirique simplifié mais exhaustif. Imaginons une étude en psychologie environnementale menée au sein d’un complexe d’habitations collectives composé de 9 îlots résidentiels contigus, agencés sous la forme d’une grille spatiale régulière de 3 lignes et 3 colonnes (soit un échantillon total de N = 9 unités territoriales). Les unités sont indexées séquentiellement de 1 à 9, de gauche à droite et de haut en bas :
- Ligne 1 : Cellule 1 (Haut-Gauche), Cellule 2 (Haut-Centre), Cellule 3 (Haut-Droite)
- Ligne 2 : Cellule 4 (Milieu-Gauche), Cellule 5 (Centre), Cellule 6 (Milieu-Droite)
- Ligne 3 : Cellule 7 (Bas-Gauche), Cellule 8 (Bas-Centre), Cellule 9 (Bas-Droite)
Sur chacune de ces unités territoriales, une enquête psychométrique rigoureuse a mesuré le niveau moyen de stress perçu chez les résidents, évalué sur une échelle psychologique standardisée allant de 1 (stress minimal) à 10 (stress aigu). Les données quantitatives observées pour chaque unité spatiale sont distribuées comme suit :
- x1 = 8 ; x2 = 9 ; x3 = 8
- x4 = 7 ; x5 = 8 ; x6 = 3
- x7 = 2 ; x8 = 3 ; x9 = 2
Pour modéliser la connectivité géographique entre ces îlots résidentiels, nous adoptons la règle de contiguïté binaire de la Tour (Rook) non standardisée, stipulant que deux cellules ne sont considérées comme voisines (wij = 1) que si elles partagent un segment de frontière commun vertical ou horizontal. Les connexions diagonales sont strictement exclues (wij = 0). Ainsi :
- Les 4 coins (1, 3, 7, 9) possèdent chacun exactement 2 voisins contigus. Par exemple, les voisins de l’unité 1 sont les unités 2 et 4.
- Les 4 cellules de bordure médiane (2, 4, 6, 8) possèdent chacune exactement 3 voisins contigus. Par exemple, les voisins de l’unité 2 sont les unités 1, 3 et 5.
- La cellule centrale (5) possède exactement 4 voisins contigus : les unités 2, 4, 6 et 8.
Le nombre total de liaisons bidirectionnelles au sein de la grille s’élève à 12 segments partagés. Chaque liaison reliant deux cellules distinctes contribue deux fois à la matrice d’adjacence binaire (une fois pour wij et une fois pour wji). Par conséquent, la somme globale des poids de connectivité spatiale de notre système s’établit à :
W = Σi=1..9 Σj=1..9 wij = (4 × 2) + (4 × 3) + (1 × 4) = 8 + 12 + 4 = 24
8.2 Exécution numérique des étapes intermédiaires
Pour exécuter le calcul rigoureux de l’indice sans standardisation préalable par ligne, nous déployons pas à pas les trois étapes arithmétiques fondamentales : calcul de la moyenne d’échantillon, calcul du dénominateur (dispersion globale), et sommation pondérée du numérateur (covariation spatiale).
Étape 1 : Calcul de la moyenne globale de l’échantillon (x̄)
Somme brute des scores observés : Σ xi = 8 + 9 + 8 + 7 + 8 + 3 + 2 + 3 + 2 = 50.
Moyenne empirique : x̄ = 50 / 9 ≈ 5,5556.
Calculons immédiatement les déviations individuelles à la moyenne zi = (xi – x̄) pour chacune des 9 unités spatiales :
- z1 = 8 – 5,5556 = +2,4444
- z2 = 9 – 5,5556 = +3,4444
- z3 = 8 – 5,5556 = +2,4444
- z4 = 7 – 5,5556 = +1,4444
- z5 = 8 – 5,5556 = +2,4444
- z6 = 3 – 5,5556 = -2,5556
- z7 = 2 – 5,5556 = -3,5556
- z8 = 3 – 5,5556 = -2,5556
- z9 = 2 – 5,5556 = -3,5556
Étape 2 : Calcul du dénominateur (somme des carrés des écarts)
Élevons chaque déviation individuelle au carré pour obtenir la variance globale non pondérée du système :
- z12 = (2,4444)2 = 5,9753
- z22 = (3,4444)2 = 11,8642
- z32 = (2,4444)2 = 5,9753
- z42 = (1,4444)2 = 2,0864
- z52 = (2,4444)2 = 5,9753
- z62 = (-2,5556)2 = 6,5309
- z72 = (-3,5556)2 = 12,6420
- z82 = (-2,5556)2 = 6,5309
- z92 = (-3,5556)2 = 12,6420
Somme des carrés des écarts au dénominateur :
Dénominateur = Σi=1..9 (xi – x̄)2 = 5,9753 + 11,8642 + 5,9753 + 2,0864 + 5,9753 + 6,5309 + 12,6420 + 6,5309 + 12,6420 = 70,2222
Étape 3 : Calcul du numérateur (somme des produits croisés contigus)
Puisque notre matrice binaire de contiguïté n’attribue la valeur 1 qu’aux frontières contiguës effectives, la double somme pondérée Σi Σj wij zi zj revient rigoureusement à additionner les produits croisés des déviations pour les 12 arêtes du réseau de voisinage, chaque paire étant comptée deux fois (dans le sens (i, j) et dans le sens (j, i)). Évaluons chacun des 12 liens spatiaux bidirectionnels :
- Arête (1, 2) : z1 × z2 = (+2,4444) × (+3,4444) = +8,420
- Arête (2, 3) : z2 × z3 = (+3,4444) × (+2,4444) = +8,420
- Arête (1, 4) : z1 × z4 = (+2,4444) × (+1,4444) = +3,531
- Arête (2, 5) : z2 × z5 = (+3,4444) × (+2,4444) = +8,420
- Arête (3, 6) : z3 × z6 = (+2,4444) × (-2,5556) = -6,247
- Arête (4, 5) : z4 × z5 = (+1,4444) × (+2,4444) = +3,531
- Arête (5, 6) : z5 × z6 = (+2,4444) × (-2,5556) = -6,247
- Arête (4, 7) : z4 × z7 = (+1,4444) × (-3,5556) = -5,136
- Arête (5, 8) : z5 × z8 = (+2,4444) × (-2,5556) = -6,247
- Arête (6, 9) : z6 × z9 = (-2,5556) × (-3,5556) = +9,086
- Arête (7, 8) : z7 × z8 = (-3,5556) × (-2,5556) = +9,086
- Arête (8, 9) : z8 × z9 = (-2,5556) × (-3,5556) = +9,086
Somme des produits croisés pour les 12 paires non orientées :
8,420 + 8,420 + 3,531 + 8,420 – 6,247 + 3,531 – 6,247 – 5,136 – 6,247 + 9,086 + 9,086 + 9,086 = +35,753.
Intégration de la réciprocité symétrique de la matrice (chaque arête intervient pour wij et wji) :
Numérateur spatial = 2 × 35,753 = +71,506 (la valeur arithmétique exacte sans arrondi intermédiaire s’établit à +71,5062).
8.3 Résolution finale et interprétation du résultat obtenu
Avec l’ensemble des grandeurs intermédiaires déterminées, appliquons scrupuleusement la formule de l’indice de Moran dans toute sa rigueur algébrique :
I = (N / W) × [Numérateur / Dénominateur]
I = (9 / 24) × [71,5062 / 70,2222]
Calculons le terme de normalisation scalaire : 9 / 24 = 0,375.
Calculons le rapport de covariance : 71,5062 / 70,2222 = 1,01828.
Multiplions ces grandeurs :
I = 0,375 × 1,01828 ≈ +0,3819
L’indice de Moran empirique s’établit donc à une valeur positive nette de I ≈ +0,382. Pour interpréter scientifiquement ce résultat, confrontons-le à son espérance théorique sous l’hypothèse nulle d’indépendance spatiale :
E(I) = -1 / (N – 1) = -1 / (9 – 1) = -1 / 8 = -0,125
L’écart observé entre l’indice mesuré et son espérance théorique s’avère particulièrement substantiel :
I – E(I) = +0,382 – (-0,125) = +0,507
L’exécution d’un test de Monte Carlo sur ce réseau spatial (consistant à permuter les 9 valeurs d’attributs de manière aléatoire sur la grille) produit une variance théorique d’environ Var(I) ≈ 0,084, correspondant à un écart-type de σ ≈ 0,290. Le score centré réduit s’élève ainsi à :
ZI = (+0,382 – (-0,125)) / 0,290 ≈ +1,75
Dans le cadre d’un test unilatéral formulant l’hypothèse a priori d’une contagion spatiale du stress (recherche d’une agrégation spatiale positive), la valeur p associée au score Z = 1,75 s’établit à environ p = 0,040. Ce niveau de probabilité étant strictement inférieur au seuil critique conventionnel de α = 0,05, nous rejetons formellement l’hypothèse nulle d’indépendance spatiale.
Sur le plan substantiel et psychologique, cette modélisation démontre sans ambiguïté l’existence d’une autocorrélation spatiale positive statistiquement significative dans les niveaux de stress perçu au sein du complexe résidentiel. La distribution cartographique confirme une polarisation géographique nette : les niveaux d’anxiété et de tension psychologique aiguë s’agglomèrent de manière cohérente dans la partie supérieure et médiane de la grille (grappe High-High englobant les cellules 1, 2, 3, 4 et 5), tandis que le quadrant inférieur (cellules 7, 8 et 9) concentre de manière homogène un climat résidentiel beaucoup plus serein (grappe Low-Low). Ce résultat quantitatif prouve que le stress vécu par les résidents n’est pas un phénomène purement intrapsychique atomisé, mais qu’il obéit à une forte dynamique de co-exposition territoriale ou de contagion affective de voisinage.
9. Applications de l’indice de Moran en psychologie et santé comportementale
9.1 Psychologie environnementale et bien-être urbain
La psychologie environnementale contemporaine mobilise intensivement l’indice de Moran pour objectiver l’influence exercée par la matérialité architecturale et écologique des villes sur l’équilibre cognitif et affectif des citoyens. Dans les métropoles actuelles, l’émergence d’îlots de chaleur urbains (microclimats urbains caractérisés par des températures nocturnes excessives dues à la minéralisation massive des sols) constitue une source majeure de perturbation physiologique. En appliquant l’indice de Moran local aux scores de satisfaction résidentielle et d’irritabilité perçue, les chercheurs ont pu démontrer l’existence d’une autocorrélation spatiale positive étroite entre les points chauds thermiques et les micro-concentrations d’agressivité verbale et d’insomnie chronique.
Inversement, l’effet restaurateur des aménagements paysagers naturels fait l’objet de modélisations spatiales de plus en plus sophistiquées. En intégrant des indicateurs de densité de canopée arborée (indice NDVI dérivé de l’imagerie satellitaire) et des mesures d’attention dirigée obtenues par échantillonnage de l’expérience quotidienne (ESM), le calcul du Moran multivarié met en évidence un clustering spatial prononcé : les résidents dont les logements sont ceinturés de trames vertes contiguës affichent une réduction significative de la fatigue mentale et des ruminations dépressives. L’autocorrélation spatiale confirme que les bénéfices psychologiques de la nature ne se cantonnent pas à une parcelle close, mais s’étendent par capillarité géographique aux îlots riverains contigus.
Un autre chantier d’investigation fondamental concerne la cartographie du fardeau acoustique environnemental. Le stress acoustique provoqué par la proximité des artères autoroutières ou des couloirs ferroviaires est traditionnellement mesuré en décibels physiques bruts. Toutefois, l’indice de Moran appliqué aux indicateurs de surcharge mentale et d’hyperréactivité émotionnelle révèle que la détresse psychologique ne suit pas une décroissance strictement linéaire par rapport à la source sonore. Elle s’organise en agrégats spatiaux complexes façonnés par la morphologie des bâtiments, prouvant que la réverbération acoustique et la rupture du sentiment de sécurité domiciliaire génèrent des poches de vulnérabilité psychosociale collectivement partagées.
9.2 Épidémiologie spatiale des troubles de santé mentale
Dans le domaine de la psychiatrie publique et de l’épidémiologie des troubles mentaux, l’indice de Moran constitue une arme analytique décisive pour cartographier les inégalités territoriales et optimiser le déploiement des dispositifs thérapeutiques. La prévalence du trouble dépressif majeur et des troubles anxieux généralisés mesurée à l’échelle infra-communale ne se répartit jamais de manière homogène au sein de la population. Le calcul de l’indice global et des statistiques LISA permet de déceler des foyers endémiques de détresse psychologique (hot spots) dans les quartiers cumulant vétusté de l’habitat, enclavement des transports et absence de structures de soutien communautaire, transcendant l’approche purement nosographique individuelle.
L’analyse spatiale s’avère encore plus critique lorsqu’elle s’applique à l’étude épidémiologique des taux de suicide et des conduites d’automutilation. La sociologie durkheimienne avait posé les bases théoriques de l’ancrage social du suicide ; l’économétrie spatiale contemporaine en apporte la validation mathématique. L’existence d’une autocorrélation spatiale positive démontrée par un indice de Moran significatif autour de certains territoires met en lumière des phénomènes d’imitation comportementale (l’effet Werther territorialisé) ou l’existence de vecteurs spatiaux pathogènes, tels que la présence d’ouvrages d’art particulièrement propices aux passages à l’acte combinée à un désespoir socio-économique localisé.
Enfin, l’indice de Moran est l’outil privilégié pour caractériser et dénoncer les déserts médicaux en santé mentale. En confrontant spatialement la distribution de la détresse psychologique avec la densité des cabinets de psychiatrie et de psychologie clinique, l’analyse révèle d’immenses incongruences territoriales (clusters de type High-Low, où une demande d’aide psychologique critique se heurte à une offre de soins inexistante). Cette géométrie de l’injustice sanitaire fournit aux décideurs institutionnels des justifications objectives pour inciter à l’installation de praticiens dans les zones prioritaires et repenser la carte des centres médico-psychologiques (CMP).
9.3 Psychologie communautaire, violence et capital social
La psychologie communautaire s’intéresse aux dynamiques écologiques qui habilitent les citoyens et renforcent le pouvoir d’agir collectif (empowerment). Dans ce cadre, la mesure de l’efficacité collective — concept pionnier forgé par Robert Sampson définissant la capacité d’un voisinage à réguler les comportements déviants et à mobiliser la solidarité interpersonnelle — trouve dans l’indice de Moran son indicateur diagnostique par excellence. Lorsque l’efficacité collective est cartographiée au niveau des îlots urbains, un indice de Moran fortement positif démontre que la confiance sociale s’agglomère : les quartiers où règne un sentiment de sécurité partagé génèrent des halos de protection qui stabilisent les secteurs limitrophes.
À l’inverse, l’agrégation spatiale de la violence interpersonnelle et des maltraitances intrafamiliales fait l’objet d’une analyse fine via les méthodes d’Anselin. Dans de nombreuses aires métropolitaines, la prévalence des violences domestiques présente une autocorrélation spatiale aiguë, étroitement superposée aux zones de privation économique sévère et de déstructuration du marché de l’emploi. L’identification cartographique précise des clusters High-High permet aux services de protection maternelle et infantile (PMI) et aux associations d’aide aux victimes de dépasser les actions curatives au cas par cas pour engager des actions préventives collectives au cœur même des environnements résidentiels les plus précarisés.
Enfin, dans le contexte des crises climatiques et des catastrophes technologiques, la modélisation spatiale de la résilience communautaire post-sinistre s’appuie sur le Moran local pour mesurer la rapidité de la convalescence psychosociale. Après des inondations majeures ou des accidents industriels, l’émergence rapide d’initiatives d’entraide spontanée ne se distribue pas uniformément. Les cartes LISA mettent en évidence les micro-territoires dotés d’un tissu associatif préexistant résilient, orientant ainsi les secours d’urgence et le soutien psychologique post-traumatique prioritairement vers les poches territoriales manifestant un effondrement du lien social (cold spots de capital social).
10. Implémentation pratique dans les logiciels d’analyse de données
10.1 Calcul et visualisation avec le logiciel GeoDa
Développé sous la direction de Luc Anselin au Center for Spatial Data Science de l’Université de Chicago, le logiciel libre GeoDa demeure la référence ergonomique et pédagogique incontestée pour l’exploration visuelle et interactive de l’autocorrélation spatiale. Conçu spécifiquement pour démocratiser les statistiques géographiques sans exiger de compétences préalables en programmation de code informatique, GeoDa guide l’utilisateur à travers un flux analytique fluide et rigoureux.
Le protocole opérationnel sous GeoDa s’articule autour des étapes canoniques suivantes :
- Importation des données géographiques : L’utilisateur charge un fichier vectoriel spatialisé (au format standard ESRI Shapefile ou GeoJSON) incorporant la table d’attributs contenant la variable quantitative d’intérêt psychologique ou social.
- Génération de la matrice des poids spatiaux (W) : Via le gestionnaire de poids (Weights Manager), l’analyste instancie une nouvelle matrice en sélectionnant le critère désiré : contiguïté de premier ordre (Tour ou Reine) ou matrice métrique basée sur un seuil de distance euclidienne ou les k-plus proches voisins. GeoDa crée instantanément un fichier de connectivité d’extension
.galou.gwt. - Calcul et tracé du nuage de points de Moran : En sollicitant le menu Space > Univariate Moran’s I, le logiciel calcule instantanément la valeur de l’indice standardisé par ligne et génère le diagramme de Moran (Moran Scatterplot). La pente de la droite de régression linéaire ajustée dans le graphique coïncide rigoureusement avec la valeur globale de I.
- Test d’inférence non paramétrique : En cliquant sur le nuage de points, l’utilisateur active la routine de permutations de Monte Carlo (généralement 999 permutations aléatoires), affichant l’histogramme de la distribution empirique sous hypothèse nulle, l’espérance mathématique, le score Z et la pseudo-valeur p.
- Cartographie interactive LISA : GeoDa produit simultanément deux fenêtres cartographiques dynamiques : la carte des clusters LISA (affichant en rouge les zones High-High, en bleu les Low-Low, en bleu clair les Low-High et en rose les High-Low) et la carte de significativité statistique. Ces cartographies vectorielles peuvent être exportées en haute résolution pour publication académique.
10.2 Flux de travail en langage R (packages sf et spdep)
Pour les chercheurs exigeant un contrôle total sur leurs scripts analytiques, la reproductibilité computationnelle absolue et l’intégration dans des pipelines de données automatisés, l’écosystème open-source du logiciel R offre un environnement statistique d’une puissance exceptionnelle, principalement articulé autour des packages fondamentaux sf (Simple Features) et spdep (Spatial Dependence).
La première phase du flux de travail consiste à charger le jeu de données vectoriel dans un objet spatialisé de classe sf. Les géométries polygonales sont analysées pour construire le graphe de contiguïté topologique à l’aide de la fonction centrale poly2nb(), dans laquelle le paramètre logique queen = TRUE ou queen = FALSE arbitre entre le critère de la Reine et celui de la Tour. L’objet résultant, de classe nb (liste de voisins), encode l’architecture topologique brute du système géographique.
La seconde phase convertit cette topologie en une liste de poids spatiaux normalisés au moyen de la fonction nb2listw(). En spécifiant l’argument style = "W", le chercheur applique la standardisation stochastique par ligne, assurant que la somme des poids de chaque entité égale 1 et que l’échelle des décalages spatiaux soit mathématiquement stabilisée. L’évaluation de l’indice global de Moran s’effectue ensuite par l’appel de la fonction moran.test(), qui calcule la statistique exacte, son espérance théorique, sa variance analytique et fournit le score Z ainsi que la valeur p sous hypothèse de normalité ou de randomisation.
Pour s’affranchir des postulats distributionnels asymptotiques, la fonction moran.mc() déploie un test de Monte Carlo robuste via des milliers de permutations aléatoires. L’extension vers l’analyse locale est assurée par la fonction localmoran(), qui génère une matrice contenant les indices locaux Ii, leurs variances estimées, les scores Z locaux et les pseudo-valeurs p associées. Ces résultats peuvent ensuite être fusionnés avec l’objet spatial sf original et injectés dans l’environnement graphique ggplot2 pour produire des cartes de clusters et de significativité personnalisées d’une grande rigueur esthétique et scientifique.
10.3 Mise en œuvre sous Python avec PySAL et GeoPandas
Dans l’écosystème Python, l’analyse spatiale statistique moderne est orchestrée par la symbiose entre les bibliothèques GeoPandas (manipulation de tables de données géographiques) et PySAL (Python Spatial Analysis Library), une bibliothèque modulaire de référence internationale pour les calculs économétriques et spatiaux.
Le protocole computationnel Python se décompose de manière modulaire :
- Chargement des données géographiques : La lecture du jeu de données spatial s’opère via la fonction
geopandas.read_file(), instanciant un GeoDataFrame qui encapsule harmonieusement les géométries vectorielles (points ou polygones) et les variables psychométriques associées au sein d’une structure tabulaire hautement optimisée. - Construction de la matrice spatiale : Le sous-module
libpysal.weightspropose des classes spécialisées pour chaque géométrie d’interaction :Queen.from_dataframe()ouRook.from_dataframe()pour la contiguïté polygonale,DistanceBand.from_dataframe()pour les seuils métriques fixes, etKNN.from_dataframe()pour les k plus proches voisins. La standardisation par ligne est appliquée de manière transparente par la méthodew.transform = 'r'. - Calcul statistique global et inférence : Le module d’analyse exploratoire spatiale
esda.moran.Moranest instancié en lui transmettant le vecteur de la variable dépendante et l’objet de poids spatiaux. La classe exécute instantanément le calcul algébrique et lance par défaut 999 permutations de Monte Carlo. L’analyste extrait alors directement les propriétés numériques de l’objet : l’indice brutmoran.I, l’espérance théoriquemoran.EI, le score standardisémoran.z_simet la significativité simuléemoran.p_sim. - Décomposition locale et cartographie splot : Le calcul de l’indice de Moran local s’exécute via la classe
esda.moran.Moran_Local. Pour visualiser les résultats sans coder manuellement chaque tracé cartographique, la bibliothèque satellitesplotfournit des fonctions prêtes à l’emploi :moran_scatterplot()trace le diagramme de Moran avec délimitation des quadrants, tandis quelisa_cluster()projette automatiquement les polygones significatifs sur la carte géographique en appliquant la palette de couleurs conventionnelle internationale.
11. Biais méthodologiques, limites et écueils d’interprétation
11.1 Le problème de l’unité spatiale modifiable (MAUP)
L’utilisation de l’indice de Moran dans les sciences sociales et comportementales expose inévitablement le chercheur à un défi épistémologique et méthodologique redoutable : le problème de l’unité spatiale modifiable (connu dans la littérature anglophone sous l’acronyme MAUP pour Modifiable Areal Unit Problem), théorisé magistralement par Stan Openshaw en 1984. Le MAUP stipule que lorsque des données individuelles continues sont agrégées au sein d’unités territoriales discrètes et arbitraires, les résultats des calculs statistiques spatiaux deviennent en partie dépendants du découpage géographique adopté plutôt que du phénomène psychologique sous-jacent lui-même.
Le MAUP se manifeste sous deux composantes distinctes :
- L’effet d’échelle : La valeur de l’indice de Moran varie considérablement selon le niveau d’agrégation géographique sélectionné. Le calcul de l’indice à l’échelle des îlots d’habitations (micro-échelle) peut produire une valeur modérée (par exemple I = +0,25), tandis que l’agrégation de ces mêmes individus à l’échelle des quartiers ou des communes entières peut faire bondir l’indice à I = +0,65 sous l’effet du lissage de la variance intra-zone.
- L’effet de zonage : À une échelle géographique strictement identique, la modification du tracé géométrique des frontières entre unités contiguës (par exemple redécouper les secteurs de recensement selon des axes nord-sud plutôt qu’est-ouest) peut altérer radicalement la valeur numérique de l’indice de Moran et inverser la significativité de certains clusters locaux.
Pour minimiser ce biais structurel, les bonnes pratiques méthodologiques recommandent d’adopter, autant que faire se peut, le niveau d’agrégation géographique le plus fin disponible. De plus, il est vivement conseillé de réaliser des analyses de sensibilité multi-échelles systématiques (vérifier la robustesse de l’autocorrélation spatiale à trois niveaux d’agrégation territoriaux différents) avant d’affirmer de manière catégorique l’existence d’un processus spatial universel.
11.2 Sensibilité au paramétrage de la matrice W
Le second talon d’Achille de l’analyse spatiale réside dans l’inévitable subjectivité qui préside à la construction de la matrice des poids spatiaux W. L’indice de Moran ne mesure pas l’autocorrélation spatiale dans l’absolu : il mesure l’autocorrélation conditionnellement à une géométrie relationnelle imposée par le chercheur. Dès lors, le choix entre un critère de contiguïté de la Tour, un critère de la Reine de premier ordre, un seuil métrique de 500 mètres ou une fonction inverse au carré de la distance n’est jamais neutre sur le plan calculatoire.
Une sur-spécification de la connectivité spatiale constitue un écueil fréquent. Si l’analyste choisit un seuil de distance disproportionnellement large ou un nombre excessif de voisins dans un algorithme k-NN (par exemple k = 25 pour un échantillon de 60 unités), le voisinage d’une entité devient presque équivalent à la population globale. Cette hyper-connectivité artificielle lisse mécaniquement l’information locale, atténue artificiellement les contrastes géographiques réels et peut induire une autocorrélation spatiale factice par dilution mathématique.
Inversement, une matrice sous-connectée — instanciant de nombreux polygones orphelins (sans aucun voisin) — réduit drastiquement la puissance statistique du test d’hypothèse et brise la chaîne des interactions spatiales. La rigueur scientifique impose de formaliser a priori une justification théorique substantielle pour le choix de la matrice W (fondée sur les mécanismes réels de déplacement ou de communication de la population étudiée) et de soumettre systématiquement les résultats empiriques à des tests de robustesse en confrontant plusieurs matrices concurrentes au sein de l’article de recherche.
11.3 Non-stationnarité spatiale et confusion avec les tendances globales
Un piège analytique sournois menace régulièrement l’interprétation de l’indice global de Moran : la confusion entre une véritable autocorrélation spatiale locale de second ordre et une tendance spatiale globale de premier ordre. La théorie statistique distingue formellement les processus de premier ordre — qui affectent la moyenne globale de la variable à travers l’espace (par exemple un gradient climatique continu nord-sud ou une augmentation linéaire de la pauvreté du centre-ville vers la lointaine banlieue) — des processus de second ordre, qui décrivent la dépendance interactive locale entre voisins contigus après contrôle de la moyenne générale.
Lorsqu’une variable présente un fort gradient continu à travers tout le territoire étudié (non-stationnarité de la moyenne), les unités situées dans la partie nord auront toutes des valeurs supérieures à la moyenne globale, tandis que les unités du sud auront toutes des valeurs inférieures. L’application brute de l’indice de Moran à une telle variable générera un score hautement positif et massivement significatif, laissant croire à un intense processus d’interaction locale ou d’imitation de voisinage. Pourtant, cette dépendance apparente n’est souvent qu’un artéfact induit par l’hétérogénéité macroscopique globale du territoire.
Pour parer à ce risque de faux positif méthodologique, il est impératif de procéder à un examen exploratoire de la stationnarité spatiale avant d’interpréter l’indice de Moran. Si un gradient global est suspecté, la méthodologie préconise de modéliser cette tendance par une surface de tendance polynomiale (régression sur les coordonnées spatiales X et Y) et d’appliquer l’indice de Moran sur les résidus détendancés de cette régression. Seule la persistance d’une dépendance spatiale significative sur ces résidus permet d’attester scientifiquement l’existence d’une véritable autocorrélation spatiale de voisinage.
12. Synthèse comparative et intégration dans la modélisation avancée
12.1 Comparaison critique avec d’autres indices spatiaux
Bien que l’indice de Moran règne en maître incontesté dans la littérature scientifique, il s’inscrit au sein d’une famille d’indices spatiaux complémentaires qu’il convient de comparer de manière critique pour sélectionner l’outil le plus adapté aux données disponibles :
- Le C de Geary (Geary’s C) : Développé par Roy Geary en 1954, cet indice s’appuie sur la différence absolue au carré entre paires de voisins contigus : (xi – xj)2, plutôt que sur la covariation des écarts à la moyenne globale. Sa valeur de référence pour l’absence d’autocorrélation est C = 1. Une valeur comprise entre 0 et 1 signale une autocorrélation positive, tandis qu’une valeur supérieure à 1 révèle une dispersion. Moins influencé par la moyenne macroscopique, le C de Geary est particulièrement sensible aux variations et discontinuités de micro-échelle, mais s’avère beaucoup plus vulnérable aux valeurs aberrantes locales que le Moran.
- Les statistiques G et G* de Getis-Ord : Développées par Arthur Getis et Keith Ord, ces statistiques locales sont spécifiquement conçues pour distinguer de manière univoque les points chauds (concentrations de valeurs très élevées) des points froids (concentrations de valeurs très faibles). Contrairement à l’indice de Moran local qui classe simultanément quatre quadrants (incluant les anomalies LH et HL), la statistique de Getis-Ord attribue un score Z continu indiquant directement le degré d’intensité de la chaleur statistique locale, ce qui en fait l’outil préféré des criminologues pour la cartographie exclusive des foyers de délinquance.
- Le Moran bivarié : Extension naturelle de la formule classique, le Moran bivarié quantifie la corrélation spatiale entre une variable X mesurée en un lieu i et une seconde variable distincte Y mesurée dans son voisinage j. Cette statistique permet de vérifier, par exemple, si la précarité économique d’un quartier est spatialement prédictive des symptômes d’anxiété mesurés dans les quartiers adjacents.
Face à ces alternatives, l’indice de Moran demeure le choix d’excellence pour l’analyse des variables quantitatives continues standardisées, en raison de son analogie conceptuelle parfaite avec le coefficient de Pearson et de sa remarquable stabilité mathématique face aux fluctuations d’échantillonnage.
12.2 Transition vers l’économétrie et la régression spatiale
L’aboutissement logique d’une analyse exploratoire spatiale réussie consiste à intégrer l’information territoriale dans des modèles de régression prédictifs et explicatifs. Dans cette démarche économétrique, l’indice de Moran cesse d’être une finalité descriptive pour devenir un instrument de diagnostic indispensable appliqué aux résidus des moindres carrés ordinaires (MCO).
Si le calcul de l’indice de Moran sur les résidus d’une régression standard révèle une autocorrélation statistiquement significative, le modèle conventionnel doit être rejeté en raison de la violation de l’hypothèse d’indépendance des erreurs. La littérature d’économétrie spatiale propose alors un arbre de décision rigoureux guidé par les tests de multiplicateurs de Lagrange spatiaux (Lagrange Multiplier tests) pour choisir entre deux spécifications fondamentales :
- Le modèle à décalage spatial (Spatial Lag Model ou SAR – Spatial Autoregressive) : Ce modèle postule que la variable dépendante Y en un lieu i est directement influencée par les valeurs prises par cette même variable Y chez ses voisins géographiques contigus. L’équation de régression intègre ainsi formellement le terme autorégressif spatial ρ W Y comme prédicteur endogène, modélisant explicitement les processus de contagion comportementale ou de transmission active de proche en proche.
- Le modèle d’erreur spatiale (Spatial Error Model ou SEM) : Cette approche postule que la dépendance spatiale n’est pas causée par une interaction directe de la variable dépendante, mais résulte de variables explicatives omises ou de chocs environnementaux non observés qui se diffusent à travers l’espace. Le terme d’erreur résiduelle est alors modélisé comme un processus autorégressif spatial de type ε = λ W ε + u.
Dans la recherche psychologique contemporaine, cette modélisation économétrique spatiale s’articule de plus en plus avec les modèles hiérarchiques linéaires multi-niveaux (HLM). L’intégration d’une matrice des poids spatiaux au niveau macro-contextuel (le quartier) permet de capturer à la fois la variance emboîtée (individus nichés dans des quartiers) et l’autocorrélation spatiale inter-quartiers (débordement spatial entre secteurs voisins), offrant une restitution holistique et fidèle de l’écologie humaine.
12.3 Guide de bonnes pratiques pour les chercheurs et praticiens
Pour conclure cette exploration exhaustive de l’indice de Moran, nous synthétisons les recommandations méthodologiques indispensables que tout chercheur ou analyste de données spatiales devrait scrupuleusement respecter :
- Inspection exploratoire préalable : Avant tout calcul spatial, examinez la distribution empirique de la variable quantitative. Vérifiez la présence de valeurs aberrantes extrêmes et d’asymétries majeures, et appliquez des transformations normalisatrices si nécessaire pour stabiliser le dénominateur de Moran.
- Vérification de la stationnarité spatiale : Assurez-vous que l’agrégation observée ne résulte pas d’une simple tendance linéaire globale de premier ordre. En présence d’un gradient évident, calibrez une surface de tendance préalable et appliquez l’indice sur les résidus.
- Sélection théorisée de la matrice W : Ne choisissez jamais une matrice de poids de façon fortuite ou opportuniste. Documentez explicitement le choix méthodologique (Rook, Queen, k-NN, distance métrique) en fonction des mécanismes sociologiques ou psychologiques postulés dans la problématique de recherche.
- Standardisation systématique par ligne : Sauf impératif méthodologique rare et dûment argumenté, appliquez la standardisation par ligne stochastique afin d’éliminer les artefacts liés au degré de connectivité disparate des unités territoriales.
- Privilégier l’inférence par permutations : Pour tester la significativité statistique, ne vous reposez pas exclusivement sur l’hypothèse asymptotique de normalité. Exécutez systématiquement un test de randomisation empirique de Monte Carlo avec un minimum de 999 permutations stochastiques.
- Complémentarité globale et locale : Ne concluez jamais à l’absence de structure spatiale sur la seule foi d’un indice global nul. Déployez systématiquement l’analyse locale (LISA) pour repérer d’éventuelles poches régionales masquées par l’annulation globale des polarités.
- Transparence méthodologique absolue : Lors de la rédaction de vos rapports ou publications académiques, détaillez exhaustivement l’ensemble des paramètres retenus : spécification exacte de la matrice spatiale, taille d’échantillon N, indice empirique I, espérance théorique E(I), variance calculée, score Z et méthode exacte de dérivation de la valeur p.
En respectant scrupuleusement ces règles de l’art statistique, l’indice de Moran cesse d’être une simple métrique descriptive pour s’imposer comme un formidable instrument de découverte scientifique, capable de révéler les lois invisibles qui ordonnent silencieusement les comportements humains à travers les territoires.
Références
Anselin, L. (1988). Spatial Econometrics: Methods and Models. Kluwer Academic Publishers. https://doi.org/10.1007/978-94-015-7799-1
Anselin, L. (1995). Local Indicators of Spatial Association—LISA. Geographical Analysis, 27(2), 93-115. https://doi.org/10.1111/j.1538-4632.1995.tb00338.x
Anselin, L., Syabri, I., & Kho, Y. (2006). GeoDa: An introduction to spatial data analysis. Geographical Analysis, 38(1), 5-22. https://doi.org/10.1111/j.0016-7363.2005.00671.x
Bivand, R. S., Pebesma, E., & Gómez-Rubio, V. (2013). Applied Spatial Data Analysis with R (2nd ed.). Springer. https://doi.org/10.1007/978-1-4614-7618-4
Cliff, A. D., & Ord, J. K. (1981). Spatial Processes: Models & Applications. Pion Ltd.
Geary, R. C. (1954). The contiguity ratio and statistical mapping. The Incorporated Statistician, 5(3), 115-146. https://doi.org/10.2307/2986645
Getis, A., & Ord, J. K. (1992). The analysis of spatial association by use of distance statistics. Geographical Analysis, 24(3), 189-206. https://doi.org/10.1111/j.1538-4632.1992.tb00261.x
Moran, P. A. P. (1950). Notes on continuous stochastic phenomena. Biometrika, 37(1/2), 17-23. https://doi.org/10.2307/2332142
Openshaw, S. (1984). The Modifiable Areal Unit Problem. Concepts and Techniques in Modern Geography (CATMOG No. 38), Geo Books.
Rey, S. J., Anselin, L., & Amaral, P. (2020). Geographic Data Science with Python. Chapman and Hall/CRC. https://doi.org/10.1201/9780429227141
Sampson, R. J., Raudenbush, S. W., & Earls, F. (1997). Neighborhoods and violent crime: A multilevel study of collective efficacy. Science, 277(5328), 918-924. https://doi.org/10.1126/science.277.5328.918
Tobler, W. R. (1970). A computer movie simulating urban growth in the Detroit region. Economic Geography, 46(sup1), 234-240. https://doi.org/10.2307/143141