
Dans la genèse des sciences contemporaines, la quantification de l’incertitude s’est heurtée à une réalité fondamentale : aucun phénomène complexe n’évolue de manière strictement isolée. Que l’on s’intéresse à la neurobiologie comportementale, aux fluctuations macroéconomiques ou à la mécanique quantique, l’illusion d’une variable aléatoire solitaire gouvernant un mécanisme unitaire s’effondre invariablement face à l’enchevêtrement des causalités et des concomitances. La distribution de probabilité univariée, si utile pour décrire la dispersion d’un attribut singulier, se révèle incapable de saisir les dynamiques relationnelles, les covariations et les dépendances mutuelles qui constituent l’essence même de l’architecture du monde réel.
Pour dépasser cette réduction épistémologique, le calcul des probabilités a développé le cadre mathématique de la distribution de probabilité conjointe. Cet édifice conceptuel ne se contente pas d’aligner en parallèle plusieurs distributions marginales indépendantes ; il érige un espace géométrique et probabiliste multidimensionnel capable de cartographier la structure intime de dépendance liant simultanément deux ou plusieurs variables aléatoires. En attribuant une mesure de vraisemblance à chaque combinaison concevable d’états, la loi conjointe devient le socle indispensable à toute inférence prédictive, à toute modélisation causale et à toute décomposition structurelle des systèmes complexes.
Le présent traité propose une exploration exhaustive de la distribution conjointe, guidant le lecteur depuis ses fondations intuitives dans les tableaux de contingence jusqu’aux théorèmes asymptotiques les plus sophistiqués de la modélisation en haute dimension. À travers un dialogue constant entre formalisation mathématique rigoureuse et applications méthodologiques issues notamment de la psychométrie, des sciences cognitives et de la science des données, nous exposerons la mécanique qui permet de condenser, d’analyser et d’exploiter la totalité de l’information contenue dans les aléas multiples.
1. Introduction épistémologique et conceptuelle à la distribution conjointe
1.1 Origine et nécessité de l’analyse multivariée simultanée
L’histoire de la pensée statistique est indissociable du passage progressif d’une vision réductionniste et unidimensionnelle à une appréhension globale et multivariée des phénomènes. Aux prémices de la discipline, l’attention des observateurs se focalisait sur des grandeurs isolées : la taille moyenne d’une population, le taux de natalité annuel ou la vitesse de sédimentation d’un composé chimique. Cependant, ces distributions univariées manifestent rapidement des limites structurelles insurmontables dès lors que l’on cherche à expliquer, et non plus simplement à décrire. En isolant une variable de son contexte écologique, l’analyste commet une amputation informationnelle : il ignore délibérément les forces d’entraînement réciproques, les rétroactions et les régulations systémiques qui gouvernent l’ensemble étudié.
La transition conceptuelle de l’observation isolée à la covariation de variables multiples s’est opérée au cours du XIXe siècle, sous l’impulsion de pionniers comme Francis Galton et Karl Pearson. Confrontés à l’étude des caractères biologiques héréditaires, ces chercheurs comprirent que la distribution des statures des enfants ne pouvait être appréhendée sans y associer simultanément celle des parents. Considérer séparément la distribution univariée de la taille des géniteurs et celle des descendants dissimulait le phénomène essentiel : le degré de transmission du trait d’une génération à l’autre. Il devint alors impératif d’élaborer un formalisme mathématique capable d’assigner une probabilité non pas à une valeur isolée, mais à un vecteur d’observations conjointes, capturant ainsi la courbure et l’intensité des liens probabilistes unissant les composantes du système.
Dans la modélisation quantitative moderne, la prise en compte simultanée des aléas est devenue un prérequis méthodologique fondamental. Lorsqu’un algorithme évalue le risque de crédit d’un individu, qu’un modèle météorologique prévoit la trajectoire d’une dépression ou qu’un psychologue cognitif analyse l’interaction entre mémoire de travail et raisonnement abstrait, l’objet mathématique sous-jacent n’est jamais une succession de lois univariées arbitrairement juxtaposées. Il s’agit d’une fonction de distribution conjointe, qui prend en charge la totalité de la structure d’interdépendance. Sans cette approche multivariée, la statistique inférentielle moderne perdrait sa puissance prédictive et son aptitude à isoler les structures sous-jacentes à travers des méthodes avancées telles que les modèles d’équations structurelles, l’analyse factorielle ou les réseaux de neurones profonds probabilistes.
1.2 Définition formelle intuitive de l’événement conjoint
Sur le plan intuitif, un événement probabiliste classique renvoie à la réalisation d’un état particulier au sein d’un univers des possibles Ω. Lorsque l’on s’élève au rang de l’analyse multivariée, la notion centrale devient celle d’événement conjoint. Considérons deux espaces probabilisables associés respectivement aux variables aléatoires $X$ et $Y$. Un événement conjoint désigne la survenue simultanée, concomitante et indissociable de la condition $X = x$ et de la condition $Y = y$. Géométriquement et ensemblistement, cet état correspond précisément à l’intersection logique de deux sous-ensembles au sein de la tribu des événements : $A cap B$, où $A = {\omega in \Omega mid X(\omega) = x}$ et $B = {\omega in \Omega mid Y(\omega) = y}$.
Le qualificatif de « conjoint » requiert une attention sémantique particulière. Il ne traduit pas une simple consécution temporelle ou une causalité directionnelle préétablie, mais une co-occurrence dans l’espace des phases mesurable. Il convient d’établir une distinction épistémologique stricte entre des événements mutuellement exclusifs et des événements concomitants. Deux événements sont disjoints ou mutuellement exclusifs lorsque leur intersection est vide ($A cap B = emptyset$), ce qui rend leur réalisation conjointe rigoureusement impossible ($P(A cap B) = 0$). À l’inverse, l’analyse conjointe cible des événements compossibles, dont la réalisation synchrone révèle la texture informationnelle liant les attributs observés.
Des illustrations élémentaires issues de l’observation empirique et de la psychométrie éclairent immédiatement cette construction. Imaginons un protocole d’évaluation neuropsychologique où un sujet est soumis à un test d’inhibition cognitive. La performance peut être caractérisée par deux variables : le succès ou l’échec à la tâche (variable binaire $X$) et la manifestation d’un signe d’anxiété neurovégétative mesuré par la réponse électrodermale (variable dichotomisée $Y$). L’événement isolé « le sujet échoue » n’offre qu’un aperçu partiel du fonctionnement cognitif ; de même, l’événement isolé « le sujet présente une activation électrodermale élevée » reste ambigu sur le plan clinique. C’est l’événement conjoint — « le sujet échoue ET présente une réponse électrodermale élevée » — qui constitue l’unité d’analyse signifiante. La distribution de probabilité conjointe a pour rôle d’affecter un poids stochastique à chacune de ces configurations synchrones pour dresser la cartographie exhaustive du comportement étudié.
2. Du tableau de contingence à la loi de probabilité discrète
2.1 Structure et lecture d’un tableau croisé à deux entrées
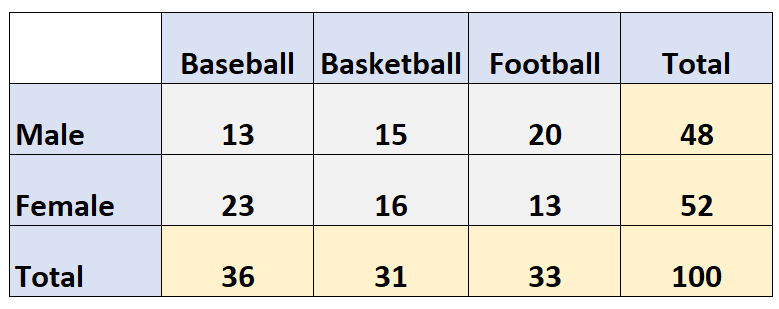
La porte d’entrée la plus concrète vers la formalisation d’une loi conjointe discrète réside dans le tableau de contingence, ou tableau croisé à deux entrées. Imaginé pour consigner les observations empiriques de deux variables qualitatives ou discrètes, ce dispositif organise les données selon une architecture matricielle bidimensionnelle. Les lignes du tableau correspondent aux différentes modalités ou valeurs réalisables par la première variable $X$, indicées par $i in {1, dots, r}$, tandis que les colonnes matérialisent les modalités de la seconde variable $Y$, indicées par $j in {1, dots, c}$.
Chaque cellule interne à l’intersection de la $i$-ième ligne et de la $j$-ième colonne héberge un effectif conjoint observé, conventionnellement noté $n_{ij}$. Ce nombre entier représente la quantité exacte d’individus ou d’unités expérimentales qui manifestent simultanément la modalité $x_i$ et la modalité $y_j$. La rigueur méthodologique impose de tracer une frontière conceptuelle infranchissable entre ces effectifs observés $n_{ij}$, contingents à l’échantillon prélevé et soumis aux aléas d’échantillonnage, et les probabilités théoriques sous-jacentes $p_{ij} = P(X = x_i, Y = y_j)$, qui gouvernent le mécanisme générateur de données au sein de la population cible globale.
Prenons un exemple paradigmatique emprunté à la psychologie sociale du consommateur : croisons le style décisionnel d’un groupe d’individus ($X$, prenant les modalités {Rationnel, Intuitif}) avec leur modalité d’engagement envers une nouvelle technologie ($Y$, prenant les valeurs {Adoption immédiate, Hésitation, Rejet}). Le tableau de contingence issu d’une enquête sur un échantillon de 500 participants comportera 2 lignes et 3 colonnes, générant 6 cellules d’intersection. L’effectif $n_{11}$ indiquera combien d’individus sont à la fois rationnels et adoptants immédiats, tandis que $n_{23}$ dénombrera les profils intuitifs ayant rejeté l’innovation. Cette disposition bidimensionnelle condense l’intégralité du profil d’association empirique sans altérer l’individualité de chaque combinaison d’attributs.
2.2 Normalisation et passage aux fréquences relatives conjointes
Pour s’extraire de la dépendance à la taille d’un échantillon spécifique et amorcer la transition vers la théorie des probabilités, les effectifs bruts doivent subir une opération de normalisation arithmétique. Cette étape consiste à diviser chaque effectif conjoint $n_{ij}$ par l’effectif total d’observations $N$, où :
$$N = \sum_{i=1}^r \sum_{j=1}^c n_{ij}$$
Le ratio obtenu définit la fréquence relative conjointe, notée $f_{ij} = \frac{n_{ij}}{N}$. Selon la loi forte des grands nombres, sous des conditions d’échantillonnage aléatoire et simple, cette fréquence empirique converge presque sûrement vers la probabilité théorique conjointe lorsque la taille de l’échantillon tend vers l’infini : $\lim_{N to \infty} f_{ij} = P(X = x_i, Y = y_j)$. La fréquence relative constitue ainsi un estimateur non biaisé et convergent de la loi de probabilité conjointe du système bivarié.
Une propriété fondamentale découle mécaniquement de cette normalisation : la contrainte de sommabilité unitaire. Puisque la somme de toutes les cellules internes reproduit par construction l’effectif total $N$, la double sommation des fréquences relatives conjointes sur l’ensemble de la grille matricielle est obligatoirement égale à l’unité :
$$\sum_{i=1}^r \sum_{j=1}^c f_{ij} = \sum_{i=1}^r \sum_{j=1}^c \frac{n_{ij}}{N} = \frac{N}{N} = 1$$
Sur le plan épistémologique, cette égalité traduit l’exhaustivité de la partition de l’univers des états possibles : l’espace produit des modalités de $X$ et de $Y$ circonscrit l’intégralité des réalisations concevables. Chaque case du tableau normalisé n’exprime plus une quantité d’individus, mais une mesure de masse probabiliste, fournissant l’évaluation empirique de la propension d’un sujet aléatoirement tiré à occuper cet état bivarié précis.
2.3 Notation mathématique standard pour les variables discrètes
L’expression probabiliste rigoureuse des structures observées dans les tableaux croisés requiert un appareillage formel unifié. Lorsque les variables $X$ et $Y$ sont des variables aléatoires discrètes prenant respectivement leurs valeurs dans les ensembles dénombrables $\mathcal{X} = {x_1, x_2, dots}$ et $\mathcal{Y} = {y_1, y_2, dots}$, la probabilité que $X$ prenne la valeur $x$ et que $Y$ prenne la valeur $y$ se formule indistinctement sous les notations équivalentes :
$$P(X = x \text{ et } Y = y) \equiv P({X = x} \cap {Y = y}) \equiv P(X = x, Y = y)$$
La virgule séparant les deux variables dans l’écriture abrégée $P(X = x, Y = y)$ joue le rôle d’un connecteur logique de conjonction conjonctive. Pour manipuler aisément cet objet, on définit la fonction de masse conjointe (ou loi de probabilité conjointe), traditionnellement désignée par $p_{X, Y}(x, y)$ ou plus sobrement par $p(x, y)$ lorsque l’assignation des variables ne présente aucune ambiguïté. Cette fonction est une application formelle dont le domaine de départ est le produit cartésien des supports discrets et dont l’espace d’arrivée est l’intervalle réel $[0, 1]$ :
$$p_{X, Y} : \mathcal{X} \times \mathcal{Y} to [0, 1], \quad (x, y) \mapsto P(X = x, Y = y)$$
Lorsque les supports $\mathcal{X}$ et $\mathcal{Y}$ sont finis, comprenant respectivement $r$ et $c$ éléments ordonnés, la fonction de masse conjointe admet une représentation matricielle compacte. On note cette matrice stochastique $\mathbf{P} in \mathbb{R}^{r \times c}$, où chaque coefficient $[\mathbf{P}]_{ij} = p(x_i, y_j)$ vérifie scrupuleusement les contraintes de non-négativité et de normalisation globale. Cette écriture algébrique s’avère particulièrement puissante pour automatiser les calculs d’espérances, de moments croisés et de projections marginales via des produits matriciels matriciels vectoriels élémentaires.
3. Formalisation mathématique : Le cas des variables discrètes
3.1 Axiomatique et propriétés de la fonction de masse conjointe
L’assise mathématique d’une distribution conjointe discrète repose sur l’axiomatique de Kolmogorov adaptée aux espaces produits. Une fonction arbitraire $p(x, y)$ définie sur un ensemble produit discret $\mathcal{S} = \mathcal{X} \times \mathcal{Y}$ constitue une fonction de masse de probabilité conjointe valide si et seulement si elle satisfait impérativement deux axiomes directeurs :
- Axiome de non-négativité : Pour tout couple $(x, y) in \mathcal{X} \times \mathcal{Y}$, $p(x, y) ge 0$. Aucune probabilité ne peut être strictement négative, et les couples appartenant au produit cartésien mais impossibles dans les faits se voient assigner une valeur nulle ($p(x, y) = 0$).
- Axiome de normalisation totale : La double somme étendue à l’ensemble du support conjoint doit converger et valoir rigoureusement l’unité :
$$\sum_{x in \mathcal{X}} \sum_{y in \mathcal{Y}} p(x, y) = 1$$
À partir de ces deux contraintes fondamentales, le calcul de la probabilité d’un événement arbitraire $A \subseteq \mathcal{X} \times \mathcal{Y}$ s’obtient par l’application de la propriété d’additivité dénombrable. Si l’événement d’intérêt correspond à une région géométrique spécifique du plan discret (par exemple, la probabilité que la somme des variables excède un seuil critique $k$), la mesure de cet événement se calcule en sommant la fonction de masse conjointe sur l’ensemble des couples satisfaisant ce critère :
$$P((X, Y) in A) = \sum_{(x, y) in A} p(x, y)$$
La distinction mathématique entre un support discret fini et un support dénombrable infini introduit des subtilités d’analyse réelle. Lorsque les supports $\mathcal{X}$ et $\mathcal{Y}$ sont infinis dénombrables (comme l’ensemble des entiers naturels $\mathbb{N}$ dans le cadre de lois de Poisson bivariées), la double somme doit faire preuve d’une convergence absolue. En vertu du théorème de Fubini pour les séries doubles à termes positifs, la non-négativité garantit que l’ordre de sommation peut être interverti sans altérer la valeur de la somme globale, assurant ainsi la robustesse théorique des calculs d’espérances et de probabilités marginales.
3.2 Construction d’une fonction de répartition conjointe discrète
Parallèlement à la fonction de masse, la description d’un vecteur aléatoire discret s’effectue au moyen de la fonction de répartition conjointe (ou fonction de distribution cumulative bivariée), notée $F_{X, Y}(x, y)$. Pour un vecteur bidimensionnel $(X, Y)$, cette fonction est définie sur l’espace continu $\mathbb{R}^2$ tout entier par l’accumulation des probabilités situées dans le quadrant inférieur gauche indéfini :
$$F_{X, Y}(x, y) = P(X le x, Y le y) = \sum_{u le x} \sum_{v le y} p(u, v)$$
Cette fonction de répartition cumulative hérite de propriétés structurelles rigoureuses qui reflètent la topologie des probabilités sur le plan euclidien. En premier lieu, $F(x, y)$ est une fonction monotone non décroissante par rapport à chacune de ses composantes évaluées séparément. Fixer une coordonnée tout en augmentant l’autre ne peut qu’élargir l’ensemble d’événements cumulés, induisant une valeur de probabilité supérieure ou égale : si $x_1 le x_2$, alors $F(x_1, y) le F(x_2, y)$ pour tout $y$ fixé.
En second lieu, le comportement asymptotique aux frontières de l’espace infini respecte scrupuleusement les contraintes d’absorption probabiliste :
$$\lim_{x to -\infty} F(x, y) = 0, \quad \lim_{y to -\infty} F(x, y) = 0$$
$$\lim_{x to \infty, y to \infty} F(x, y) = 1$$
Dans l’univers discret, $F(x, y)$ présente une allure géométrique caractéristique en « escalier bidimensionnel », formée d’une mosaïque de plateaux horizontaux discontinus, continus à droite le long de chaque dimension. Un intérêt majeur de cette fonction réside dans la détermination de la probabilité d’appartenance à un pavé rectangulaire semi-ouvert de la forme $]a, b] \times ]c, d]$. Par le principe d’inclusion-exclusion, cette probabilité ne se résume pas à une simple différence bivariée, mais implique quatre évaluations de la fonction de répartition cumulative :
$$P(a < X le b, c < Y le d) = F(b, d) – F(a, d) – F(b, c) + F(a, c)$$
Le terme correctif $+ F(a, c)$ compense la double soustraction du quadrant $X le a, Y le c$, garantissant que la mesure résultante demeure strictement non négative pour tout rectangle considéré.
3.3 Étude de cas numérique détaillé d’une loi conjointe discrète
Afin de concrétiser ces concepts, formalisons un univers d’échantillonnage psychométrique où deux variables binaires décrivent les réactions d’étudiants face à une épreuve d’évaluation sous pression chronométrée. Définissons la variable $X in {0, 1}$ mesurant l’état de panique cognitive ($0 = \text{serein}, 1 = \text{paniqué}$) et la variable $Y in {0, 1}$ indiquant la réussite finale à l’évaluation ($0 = \text{échec}, 1 = \text{succès}$). Supposons que l’administration du test à une vaste population calibrée établisse la fonction de masse conjointe $p(x, y)$ suivante :
- $p(0, 0) = P(X = 0, Y = 0) = 0{,}10$ : l’étudiant est serein mais échoue par manque de révision.
- $p(0, 1) = P(X = 0, Y = 1) = 0{,}55$ : l’étudiant est serein et valide avec brio l’épreuve.
- $p(1, 0) = P(X = 1, Y = 0) = 0{,}25$ : la panique cognitive entraîne la désorganisation et l’échec.
- $p(1, 1) = P(X = 1, Y = 1) = 0{,}10$ : l’étudiant surmonte sa panique et réussit malgré tout le test.
Vérifions en premier lieu la conformité aux axiomes fondamentaux : chaque probabilité individuelle est strictement positive ($p(x, y) ge 0$), et la somme totale s’élève à $0{,}10 + 0{,}55 + 0{,}25 + 0{,}10 = 1{,}00$. Le cadre kolmogorovien est intégralement honoré. Déterminons à présent la probabilité de l’événement composite $E$ : « l’étudiant a au moins éprouvé de la panique ou a échoué à l’épreuve ». L’ensemble des issues favorables s’écrit $E = {(0, 0), (1, 0), (1, 1)}$.
En mobilisant la propriété d’additivité pour les événements disjoints, nous calculons :
$$P(E) = p(0, 0) + p(1, 0) + p(1, 1) = 0{,}10 + 0{,}25 + 0{,}10 = 0{,}45$$
Alternativement, le recours à l’événement complémentaire simplifie le calcul : $E^c = {(0, 1)}$, d’où $P(E) = 1 – p(0, 1) = 1 – 0{,}55 = 0{,}45$. Ce modèle bivarié simple met immédiatement en exergue l’interdépendance des deux mécanismes : la proportion d’échec est de $0{,}10 / (0{,}10 + 0{,}55) \approx 15{,}4%$ chez les étudiants sereins, tandis qu’elle culmine à $0{,}25 / (0{,}25 + 0{,}10) \approx 71{,}4%$ chez les étudiants paniqués. La loi conjointe révèle ainsi la vulnérabilité différentielle induite par l’état émotionnel, une réalité que la seule observation isolée du taux de réussite global ($65%$) aurait totalement masquée.
4. La distribution conjointe pour variables continues : Densité conjointe
4.1 Concept et définition de la fonction de densité conjointe
Lorsque nous franchissons la frontière des variables quantitatives continues — telles que le temps d’inférence neuronale, la concentration sérique d’un neurotransmetteur ou la température corporelle —, l’appareil conceptuel de la fonction de masse s’avère caduc. Dans un continuum réel, la cardinalité du support d’une variable devient infinie non dénombrable. En conséquence, la probabilité ponctuelle exacte affectée à n’importe quel point précis $(x, y) in \mathbb{R}^2$ est rigoureusement nulle :
$$P(X = x, Y = y) = 0, \quad \forall (x, y) in \mathbb{R}^2$$
Ce paradoxe apparent ne signifie nullement que l’événement est impossible, mais traduit la granularité infinie de l’espace continu. Pour quantifier l’incertitude dans un tel environnement, la théorie de la mesure introduit la fonction de densité conjointe (ou fonction de densité de probabilité bivariée), usuellement notée $f_{X, Y}(x, y)$ ou simplement $f(x, y)$. Cette fonction se définit rigoureusement comme la dérivée partielle seconde croisée de la fonction de répartition conjointe bivariée, là où celle-ci est différentiable :
$$f(x, y) = \frac{\partial^2 F(x, y)}{\partial x \partial y}$$
Le sens physique de $f(x, y)$ ne correspond donc pas à une probabilité brute, mais à une densité surfacique de probabilité sur le plan euclidien. La quantité infinitésimale $f(x, y) , dx , dy$ exprime la probabilité que le vecteur stochastique $(X, Y)$ vienne se loger au sein du rectangle différentiel élémentaire $[x, x + dx] \times [y, y + dy]$ :
$$P(x le X le x + dx, y le Y le y + dy) \approx f(x, y) , dx , dy$$
Pour être qualifiée de densité conjointe admissible au sens des théories de Riemann et de Lebesgue, la fonction $f(x, y)$ doit être localement intégrable, mesurable au sens de Borel, et se plier à la condition de non-négativité absolue : $f(x, y) ge 0$ pour tout $(x, y) in \mathbb{R}^2$. Contrairement aux probabilités ponctuelles discrètes, la valeur locale $f(x, y)$ peut parfaitement excéder la valeur 1, à la condition expresse que son intégrale surfacique globale demeure strictement contrainte.
4.2 Calcul intégral des probabilités sur des domaines continus
L’extraction d’une mesure de probabilité concrète à partir d’une fonction de densité bivariée requiert le passage à l’intégration sur des domaines bidimensionnels. La probabilité que le couple aléatoire $(X, Y)$ appartienne à une région géométrique arbitraire $\mathcal{D} \subset \mathbb{R}^2$ est donnée par l’intégrale double de la densité conjointe sur ce domaine :
$$P((X, Y) in \mathcal{D}) = \iint_{\mathcal{D}} f(x, y) , dx , dy$$
La contrainte de normalisation fondamentale impose que l’intégrale double étendue au plan réel infini tout entier soit égale à l’unité sans équivoque :
$$\int_{-\infty}^{\infty} \int_{-\infty}^{\infty} f(x, y) , dx , dy = 1$$
Lorsque le domaine d’intégration $\mathcal{D}$ n’est pas un rectangle euclidien standard à bornes indépendantes, mais présente une géométrie complexe délimitée par des frontières fonctionnelles (par exemple, un triangle ou un cercle), la définition minutieuse des bornes d’intégration devient une opération critique. Si le domaine s’écrit $\mathcal{D} = {(x, y) in \mathbb{R}^2 mid a le x le b, , g_1(x) le y le g_2(x)}$, le calcul s’opère par intégrales itérées en respectant l’ordre d’imbrication des variables :
$$P((X, Y) in \mathcal{D}) = \int_{a}^{b} \left( \int_{g_1(x)}^{g_2(x)} f(x, y) , dy \right) dx$$
Dans de nombreuses configurations analytiques — notamment lors de l’évaluation de densités normales bivariées ou de lois radiales —, la géométrie cartésienne induit des intégrales insolubles sous leur forme primitive. Le recours à un changement de variables bivarié s’avère alors indispensable. Si l’on effectue la transformation $u = \phi_1(x, y)$ et $v = \phi_2(x, y)$, la distribution conjointe transformée fait intervenir la valeur absolue du déterminant jacobien de la transformation inverse :
$$f_{U, V}(u, v) = f_{X, Y}(x(u, v), y(u, v)) \cdot left| det \begin{\pmatrix} \frac{\partial x}{\partial u} &a\mp; \frac{\partial x}{\partial v} \frac{\partial y}{\partial u} &a\mp; \frac{\partial y}{\partial v} \end{\pmatrix} right|$$
Ce multiplicateur différentiel compense la distorsion géométrique locale de l’élément de surface induite par la transformation, garantissant la stricte conservation de la masse probabiliste.
4.3 Fonction de répartition cumulative bivariée continue
À l’instar du contexte discret, la fonction de répartition cumulative conjointe dans l’espace continu cumule la densité de probabilité depuis l’infini négatif jusqu’au point d’évaluation $(x, y)$. Elle s’exprime analytiquement par l’intégrale paramétrique bivariée :
$$F(x, y) = P(X le x, Y le y) = \int_{-\infty}^{x} \int_{-\infty}^{y} f(u, v) , dv , du$$
Sur le plan géométrique, $F(x, y)$ représente le volume sous la surface de densité $z = f(u, v)$ érigée au-dessus de la région quadrantale délimitée par ${u le x, v le y}$. Par le théorème fondamental de l’analyse étendu au calcul différentiel multidimensionnel, dériver continûment cette fonction cumulative permet de reconstituer instantanément la densité conjointe locale :
$$\frac{\partial^2 F(x, y)}{\partial x \partial y} = f(x, y)$$
La probabilité qu’un vecteur stochastique réside dans une boîte euclidienne $[x_1, x_2] \times [y_1, y_2]$ s’obtient avec une parfaite élégance algébrique :
$$P(x_1 le X le x_2, y_1 le Y le y_2) = F(x_2, y_2) – F(x_1, y_2) – F(x_2, y_1) + F(x_1, y_1)$$
Cette relation met en lumière l’équivalence opérationnelle entre l’intégration de la densité et la différentiation de la fonction de répartition. Visuellement, une fonction de densité continue se projette dans l’espace sous la forme d’un paysage tridimensionnel : une surface en dôme dont l’élévation indique les zones de forte concentration stochastique. L’intersection de cette surface par des plans d’altitude constante dessine des courbes d’isodensité sur le plan orthogonal $(X, Y)$, fournissant une représentation topologique compacte de la morphologie conjointe et des axes préférentiels de variation stochastique.
5. Extraction des distributions marginales à partir de la loi conjointe
5.1 Le processus de marginalisation discrète par sommation
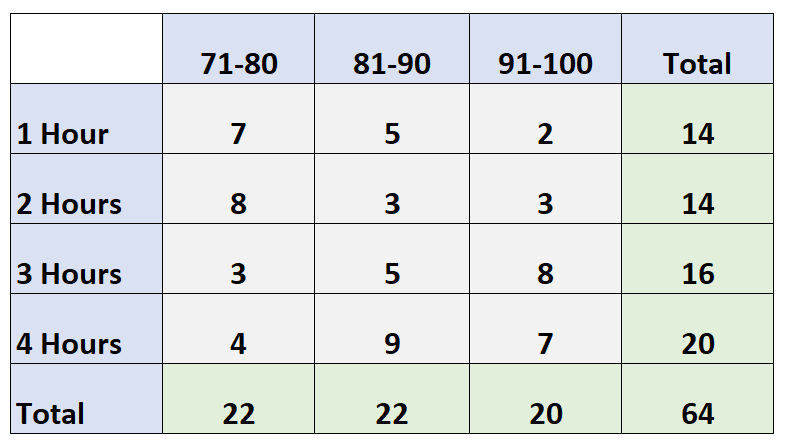
L’un des apports majeurs de la théorie de la probabilité réside dans sa cohérence projective : posséder la distribution conjointe d’un système multivarié permet de retrouver automatiquement les lois régissant chaque variable prise isolément. Cette opération de réduction dimensionnelle porte le nom de marginalisation. Son étymologie renvoie directement à la pratique des statisticiens qui, dans les tableaux de contingence, notaient la somme des fréquences de chaque ligne et de chaque colonne dans les marges blanches du registre papier.
Sur le plan mathématique, pour un couple de variables aléatoires discrètes $(X, Y)$ doté d’une fonction de masse conjointe $p_{X, Y}(x, y)$, la loi marginale de la variable $X$, notée $p_X(x)$, s’obtient en sommant les probabilités conjointes sur la totalité des valeurs concevables que peut prendre la variable concomitante $Y$ :
$$p_X(x) = P(X = x) = \sum_{y in \mathcal{Y}} p_{X, Y}(x, y)$$
De manière symétrique, la distribution marginale de la variable $Y$ s’obtient en « intégrant » ou sommant sur l’ensemble du support de la variable $X$ :
$$p_Y(y) = P(Y = y) = \sum_{x in \mathcal{X}} p_{X, Y}(x, y)$$
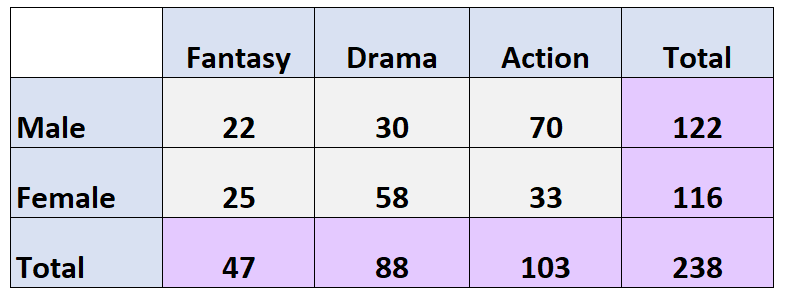
L’opération de marginalisation dissout littéralement l’hétérogénéité introduite par la variable neutralisée. En sommant selon les colonnes pour une ligne $x$ donnée, on regroupe tous les états où $X = x$, quelle que soit l’issue constatée pour $Y$. Cette agrégation préserve fidèlement la distribution univariée de la variable focale tout en éliminant délibérément l’information relative à sa structure de dépendance croisée avec le second aléa.
5.2 Marginalisation continue par intégration partielle
Dans l’univers des variables continues gouvernées par une fonction de densité bivariée $f_{X, Y}(x, y)$, la sommation discrète cède la place à l’intégration partielle définie sur toute l’étendue de l’espace orthogonal. La fonction de densité marginale $f_X(x)$ de la variable aléatoire $X$ se calcule en intégrant la densité conjointe par rapport à la variable $y$, le long de son support complet allant de $-\infty$ à $+\infty$ :
$$f_X(x) = \int_{-\infty}^{\infty} f_{X, Y}(x, y) , dy$$
Réciproquement, la densité marginale de la variable continue $Y$ résulte de la projection intégrale de la surface conjointe le long de l’axe des abscisses régies par $x$ :
$$f_Y(y) = \int_{-\infty}^{\infty} f_{X, Y}(x, y) , dx$$
Géométriquement, cette marginalisation s’apparente à un effondrement dimensionnel : on calcule l’aire de la section transversale découpée dans le volume de densité conjointe à une coordonnée fixée. En effectuant cette opération pour chaque coordonnée, on projette la totalité de la masse tridimensionnelle sur une ligne plane univariée. Il est immédiat de vérifier que les fonctions ainsi obtenues respectent scrupuleusement les exigences régissant les densités univariées. L’intégration de la marginale $f_X(x)$ sur son domaine rétablit l’intégrale double globale du système :
$$\int_{-\infty}^{\infty} f_X(x) , dx = \int_{-\infty}^{\infty} \left( \int_{-\infty}^{\infty} f_{X, Y}(x, y) , dy \right) dx = 1$$
Ce procédé de dérivation analytique permet de retrouver les lois univariées classiques (comme une loi bêta, gamma ou gaussienne) à partir de constructions conjointes complexes décrivant des interactions physiques ou psychophysiques intriquées.
5.3 Perte d’information lors du passage de la loi conjointe aux marginales
Il est impératif de souligner un principe méthodologique capital : l’opération de marginalisation est irréversible en l’absence d’hypothèses structurelles fortes. Connaître la distribution conjointe $p(x, y)$ confère une omniscience probabiliste sur le système bivarié, permettant d’extraire sans ambiguïté les deux distributions marginales $p_X(x)$ et $p_Y(y)$. En revanche, la réciproque est rigoureusement fausse : posséder les marginales $p_X(x)$ et $p_Y(y)$ ne permet en aucun cas de reconstituer la loi conjointe dont elles sont issues.
Cette asymétrie informationnelle découle du fait que la marginalisation condense et dissipe la structure de dépendance mutuelle. Pour s’en convaincre mathématiquement, considérons deux variables de Bernoulli prenant les valeurs dans ${0, 1}$. Définissons une première distribution conjointe où les deux variables sont en dépendance déterministe parfaite : $P(0, 0) = 0{,}5$, $P(1, 1) = 0{,}5$, et $P(0, 1) = P(1, 0) = 0$. Les lois marginales associées attribuent trivialement la probabilité $0{,}5$ à chaque état pour les deux variables ($P(X = 0) = P(X = 1) = 0{,}5$ et $P(Y = 0) = P(Y = 1) = 0{,}5$).
Considérons à présent une seconde distribution conjointe régie par l’indépendance stochastique totale : $P(0, 0) = 0{,}25$, $P(0, 1) = 0{,}25$, $P(1, 0) = 0{,}25$ et $P(1, 1) = 0{,}25$. Un calcul marginal immédiat révèle que les distributions univariées de $X$ et de $Y$ sont rigoureusement identiques à celles du premier scénario, avec $50%$ de chances pour chaque modalité. Pourtant, la nature de l’association empirique est radicalement divergente : dans un cas, la connaissance de $X$ prédit avec une certitude absolue l’état de $Y$ ; dans l’autre, elle n’apporte aucune réduction d’incertitude.
Les répercussions de ce constat en psychométrie et en sciences du comportement sont profondes. Deux cohortes cliniques peuvent présenter des distributions parfaitement superposables de symptômes anxieux et de troubles dépressifs lorsqu’on les évalue échelle par échelle, tout en abritant des distributions conjointes totalement dissemblables. Dans le premier groupe, l’anxiété et la dépression peuvent coexister systématiquement chez les mêmes patients, tandis que dans le second, les pathologies touchent des sous-groupes mutuellement disjoints. Restreindre son analyse aux seules lois marginales induit une cécité diagnostique majeure, occultant la dynamique syndromique réelle sous-tendue par la distribution conjointe.
6. Conditionnement probabiliste et liens bayésiens
6.1 Définition mathématique de la distribution conditionnelle
L’observation du monde réel s’opère presque toujours sous contrainte d’information partielle : nous apprenons qu’un événement s’est produit, et nous cherchons à recalculer la probabilité d’une autre variable à la lumière de cette acquisition empirique. Ce processus d’actualisation est formellement décrit par la distribution conditionnelle. Sur le plan structural, la distribution conditionnelle représente le quotient normalisé de la distribution conjointe par la distribution marginale de la variable conditionnante.
Pour des variables aléatoires discrètes, la probabilité conditionnelle que la variable $X$ prenne la valeur $x$ sachant que la variable $Y$ a été observée à la valeur $y$ (sous la condition préalable impérative que $p_Y(y) > 0$) est formulée par :
$$p_{X mid Y}(x mid y) = P(X = x mid Y = y) = \frac{p_{X, Y}(x, y)}{p_Y(y)} = \frac{p_{X, Y}(x, y)}{\sum_{u in \mathcal{X}} p_{X, Y}(u, y)}$$
Dans l’univers des variables continues, malgré le fait que la probabilité de l’événement conditionnant soit ponctuellement nulle ($P(Y = y) = 0$), la fonction de densité conditionnelle $f_{X mid Y}(x mid y)$ est rigoureusement définie comme la limite du rapport de mesures sur des voisinages évanescents, aboutissant à l’expression homotrope :
$$f_{X mid Y}(x mid y) = \frac{f_{X, Y}(x, y)}{f_Y(y)}, \quad \text{pour tout } y \text{ tel que } f_Y(y) > 0$$
Sur le plan morphologique, la distribution conditionnelle correspond à l’isolation d’une « tranche » unidimensionnelle découpée dans la surface conjointe le long de l’hyperplan orthogonal défini par la condition $Y = y$. Le dénominateur marginal $f_Y(y)$ fait office de facteur d’échelle régulateur : il dilate ou contracte verticalement cette coupe géométrique pour contraindre son aire totale à valoir rigoureusement 1, respectant ainsi l’axiomatique élémentaire d’une mesure de probabilité univariée :
$$\int_{-\infty}^{\infty} f_{X mid Y}(x mid y) , dx = \frac{\int_{-\infty}^{\infty} f_{X, Y}(x, y) , dx}{f_Y(y)} = \frac{f_Y(y)}{f_Y(y)} = 1$$
6.2 La règle du produit et la chaîne des probabilités
La relation de définition du conditionnement peut être réarrangée pour déboucher sur un principe opératoire cardinal : la règle du produit. Celle-ci stipule que la probabilité conjointe de deux événements s’exprime comme le produit de la probabilité marginale de l’un par la probabilité conditionnelle de l’autre sachant le premier :
$$p_{X, Y}(x, y) = p_Y(y) \cdot p_{X mid Y}(x mid y) = p_X(x) \cdot p_{Y mid X}(y mid x)$$
Cette symétrie opératoire met en relief la plasticité de la modélisation probabiliste : une même distribution conjointe admet deux factorisations directionnelles distinctes, permettant de choisir l’ordre de décomposition le plus naturel ou le plus aisément estimable selon le protocole expérimental en vigueur.
Cette logique se généralise de manière immédiate à un système formé d’un nombre arbitraire $n$ de variables aléatoires grâce à la règle de factorisation en chaîne (ou formule des probabilités composées) :
$$p(x_1, x_2, dots, x_n) = p(x_1) \cdot p(x_2 mid x_1) \cdot p(x_3 mid x_1, x_2) \cdots p(x_n mid x_1, dots, x_{n-1}) = \prod_{k=1}^n p\left(x_k mid x_1, dots, x_{k-1}\right)$$
Ce développement constitue le fondement architectural de la modélisation graphique probabiliste et des réseaux bayésiens. Dans ces représentations en graphes acycliques orientés (DAG), l’immense complexité combinatoire d’une loi conjointe de dimension élevée se décompose en un produit de conditionnements locaux simplifiés, tirant parti des hypothèses d’indépendance conditionnelle inhérentes à la topologie du réseau.
6.3 Actualisation bayésienne et inversion des conditionnements
L’articulation entre distribution conjointe, marginales et lois conditionnelles culmine avec le théorème de Bayes. Ce théorème orchestre l’inversion rigoureuse des conditionnements stochastiques : il formalise la façon dont la connaissance a posteriori sur une variable latente, un état inobservé ou un paramètre théorique $Theta$ s’ajuste après la prise en compte d’un vecteur d’observations conjointes $X$ :
$$f_{\Theta mid X}(\theta mid x) = \frac{f_{X, \Theta}(x, \theta)}{f_X(x)} = \frac{f_\Theta(\theta) \cdot f_{X mid \Theta}(x mid \theta)}{\int_{\Omega_\Theta} f_\Theta(\vartheta) \cdot f_{X mid \Theta}(x mid \vartheta) , d\vartheta}$$
Dans ce formalisme continu, $f_\Theta(\theta)$ représente la densité de probabilité a priori (prior), traduisant l’état de croyance ou de plausibilité épistémique avant toute mesure. Le terme $f_{X mid \Theta}(x mid \theta)$, envisagé en fonction de $\theta$ pour une réalisation empirique $x$ observée, correspond à la fonction de vraisemblance conjointe des données. Enfin, le dénominateur $f_X(x)$ constitue la densité prédictive marginale des observations — ou constante de normalisation —, obtenue par intégration de la densité conjointe globale $f_{X, \Theta}(x, \theta)$ sur l’espace des paramètres.
Dans le domaine des sciences cognitives computationnelles, ce cadre bivarié régit l’hypothèse du « cerveau bayésien ». On y modélise la perception comme le calcul continu d’une distribution a posteriori sur les causes environnementales distales $Theta$, sachant les signaux sensoriels conjoints proximaux $X$ captés par les récepteurs biologiques. L’exactitude des inférences et des comportements décisionnels découle ainsi de la fidélité avec laquelle les circuits neuronaux parviennent à manipuler la loi conjointe régissant les interactions entre l’organisme et son milieu.
7. Indépendance stochastique au prisme de la loi conjointe
7.1 Critère formel de factorisation de la loi conjointe
Le concept d’indépendance stochastique est l’un des piliers théoriques les plus déterminants des probabilités multivariées. Deux variables aléatoires $X$ et $Y$ sont dites mutuellement indépendantes au sens probabiliste si et seulement si leur fonction de distribution conjointe se factorise exactement en le produit pur de leurs distributions marginales respectives. Pour des variables discrètes, cette condition impérative s’énonce :
$$p_{X, Y}(x, y) = p_X(x) \cdot p_Y(y), \quad \forall (x, y) in \mathcal{X} \times \mathcal{Y}$$
Dans le domaine continu, la factorisation s’applique de manière isomorphe sur la fonction de densité conjointe presque partout :
$$f_{X, Y}(x, y) = f_X(x) \cdot f_Y(y), \quad \forall (x, y) in \mathbb{R}^2$$
Ce critère multiplicatif entraîne une conséquence épistémique fondamentale : l’indépendance stochastique équivaut à affirmer que l’information apportée par une variable n’altère en rien la structure probabiliste de la seconde. Mathématiquement, cette stabilité se traduit par la superposition parfaite entre distributions conditionnelles et distributions marginales :
$$f_{X mid Y}(x mid y) = \frac{f(x, y)}{f_Y(y)} = \frac{f_X(x) \cdot f_Y(y)}{f_Y(y)} = f_X(x)$$
Au niveau de la fonction de répartition cumulative bivariée, l’indépendance impose symétriquement une séparabilité multiplicative totale : $F_{X, Y}(x, y) = F_X(x) \cdot F_Y(y)$. L’existence d’une telle factorisation garantit que l’espérance du produit croisé se réduit au produit des espérances individuelles :
$$\mathbb{E}[XY] = \iint xy , f(x, y) , dx , dy = \left(\int x f_X(x) , dx\right) \left(\int y f_Y(y) , dy\right) = \mathbb{E}[X] \cdot \mathbb{E}[Y]$$
7.2 Distinction cruciale entre indépendance et décorrélation
L’une des erreurs conceptuelles les plus tenaces et dommageables dans la pratique de l’analyse quantitative réside dans l’assimilation hâtive de la décorrélation à l’indépendance stochastique. Il existe une asymétrie logique stricte entre ces deux notions : l’indépendance stochastique implique systématiquement une décorrélation linéaire, mais la réciproque est généralement fausse.
Pour établir la première implication, calculons la covariance entre deux variables stochastiquement indépendantes $X$ et $Y$ :
$$\mathrm{Cov}(X, Y) = \mathbb{E}[XY] – \mathbb{E}[X]\mathbb{E}[Y] = \mathbb{E}[X]\mathbb{E}[Y] – \mathbb{E}[X]\mathbb{E}[Y] = 0$$
La covariance étant nulle, le coefficient de corrélation linéaire s’annule obligatoirement ($\rho_{X, Y} = 0$).
À l’inverse, l’annulation de la corrélation ne garantit en aucun cas l’indépendance stochastique. Cette dissociation se démontre élégamment au moyen d’un contre-exemple analytique classique. Soit $X$ une variable aléatoire continue symétrique centrée autour de zéro, dont la densité vérifie $f_X(x) = f_X(-x)$ pour tout $x in [-1, 1]$, et définissons la variable $Y$ par une relation fonctionnelle déterministe non linéaire : $Y = X^2$. Par construction, $Y$ est totalement dépendante de $X$ : connaître $X$ permet de prédire la valeur exacte de $Y$ avec une erreur nulle. Évaluons néanmoins leur covariance :
$$\mathbb{E}[XY] = \mathbb{E}[X \cdot X^2] = \mathbb{E}[X^3] = \int_{-1}^{1} x^3 f_X(x) , dx = 0$$
Puisque la fonction $x^3 f_X(x)$ est une fonction impaire intégrée sur un intervalle symétrique, l’espérance croisée s’annule. Par suite, $\mathrm{Cov}(X, Y) = \mathbb{E}[XY] – \mathbb{E}[X]\mathbb{E}[Y] = 0 – 0 = 0$. Le coefficient de corrélation de Pearson entre ces deux variables est rigoureusement nul ($\rho_{X, Y} = 0$).
Cet exemple atteste avec éclat que la corrélation linéaire ne mesure que l’alignement rectiligne des variations. La distribution conjointe $f(x, y)$ héberge quant à elle l’intégralité des dépendances d’ordres supérieurs, qu’elles soient quadratiques, exponentielles ou sinusoïdales. Se fier exclusivement à un indicateur linéaire pour conclure à l’absence de lien au sein d’une distribution conjointe constitue une impasse analytique majeure.
7.3 Tests statistiques d’indépendance fondés sur la distribution conjointe
La validation empirique de l’hypothèse d’indépendance stochastique nécessite la mise en œuvre de tests d’hypothèses rigoureux comparant la distribution conjointe observée à la distribution théorique sous condition d’indépendance. Le cadre paradigmatique pour les variables qualitatives ou discrètes est le test du chi-deux ($\chi^2$) d’indépendance de Karl Pearson.
Ce test évalue l’écart quadratique entre les effectifs conjoints observés $n_{ij}$ au sein du tableau de contingence et les effectifs théoriques attendus sous l’hypothèse nulle $H_0 : p_{ij} = p_{i\cdot} \cdot p_{\cdot j}$. L’effectif attendu dans la cellule $(i, j)$ s’exprime par :
$$e_{ij} = \frac{n_{i\cdot} \cdot n_{\cdot j}}{N}$$
La statistique de test s’écrit alors :
$$\chi^2 = \sum_{i=1}^r \sum_{j=1}^c \frac{(n_{ij} – e_{ij})^2}{e_{ij}}$$
Sous $H_0$ et sous réserve du respect des critères asymptotiques de Cochran (effectifs théoriques $e_{ij} ge 5$ dans la majorité des cellules), cette grandeur converge asymptotiquement vers une loi du $\chi^2$ à $(r – 1)(c – 1)$ degrés de liberté.
Dans le champ de l’inférence moderne et de la théorie de l’information, le test du rapport de vraisemblance (ou statistique $G^2$) offre une alternative robuste. Il entretient un lien direct avec la divergence de Kullback-Leibler $D_{\mathrm{KL}}$, qui quantifie la distance relative entre la distribution conjointe empirique $P_{X, Y}$ et le modèle produit $P_X o\times P_Y$ :
$$I(X; Y) = D_{\mathrm{KL}}(P_{X, Y} parallel P_X o\times P_Y) = \sum_{x in \mathcal{X}} \sum_{y in \mathcal{Y}} p(x, y) \log \left( \frac{p(x, y)}{p_X(x) p_Y(y)} \right)$$
Cette mesure, désignée sous le nom d’information mutuelle, est strictement positive ou nulle, ne s’annulant si et seulement si l’indépendance stochastique est rigoureusement vérifiée sur l’ensemble du domaine conjointe. Elle transcende les contraintes de linéarité pour capter la totalité des structures d’association discrètes ou continues.
8. Moments bivariés : Espérance conjointe, covariance et corrélation
8.1 Espérance mathématique d’une fonction de variables conjointes
L’analyse des distributions conjointes s’étend naturellement au calcul des caractéristiques numériques résumant le comportement moyen des systèmes bivariés. Pour évaluer l’espérance mathématique d’une fonction déterministe arbitraire $g(X, Y)$ appliquée au couple stochastique, la théorie statistique mobilise le théorème de l’espérance non consciente (connu sous l’acronyme anglophone LOTUS pour Law of the Unconscious Statistician). Ce résultat majeur dispense d’établir préalablement la loi univariée de la variable transformée $Z = g(X, Y)$, permettant de calculer l’espérance directement à partir de la fonction conjointe de départ.
Dans le cas discret, cette espérance correspond à la sommation pondérée par la masse de chaque point du support :
$$\mathbb{E}[g(X, Y)] = \sum_{x in \mathcal{X}} \sum_{y in \mathcal{Y}} g(x, y) \cdot p_{X, Y}(x, y)$$
Dans le cas continu, l’expression s’énonce sous forme d’une intégrale surfacique bivariée :
$$\mathbb{E}[g(X, Y)] = \int_{-\infty}^{\infty} \int_{-\infty}^{\infty} g(x, y) \cdot f_{X, Y}(x, y) , dx , dy$$
Une propriété fondamentale de cet opérateur réside dans la linéarité stricte de l’espérance. Quelle que soit la nature de la loi conjointe et sans exiger la moindre hypothèse d’indépendance, l’espérance d’une combinaison linéaire de variables aléatoires équivaut invariablement à la combinaison linéaire de leurs espérances individuelles :
$$\mathbb{E}[aX + bY + c] = a\mathbb{E}[X] + b\mathbb{E}[Y] + c, \quad \forall (a, b, c) in \mathbb{R}^3$$
En théorie hilbertienne des espaces probabilisés, l’espérance conditionnelle $\mathbb{E}[X mid Y = y]$ s’interprète comme la projection orthogonale de la variable aléatoire $X$ sur le sous-espace fermé des fonctions de carré intégrable $L^2(\Omega)$ engendré par la variable $Y$. Cette formulation géométrique établit que la fonction conditionnelle $\mu(Y) = \mathbb{E}[X mid Y]$ constitue le meilleur prédicteur de $X$ au sens de la minimisation de l’erreur quadratique moyenne.
8.2 La covariance comme mesure du moment conjoint centré
Pour appréhender l’amplitude de la covariation linéaire conjointe de deux grandeurs, on introduit le deuxième moment conjoint centré, universellement désigné sous le terme de covariance. Formellement, la covariance entre les variables aléatoires $X$ et $Y$ se définit comme l’espérance du produit de leurs écarts respectifs à leurs moyennes marginales :
$$\mathrm{Cov}(X, Y) = \sigma_{XY} = \mathbb{E}[(X – \mathbb{E}[X])(Y – \mathbb{E}[Y])]$$
En déployant cette expression par bilinéarité de l’espérance, on obtient la formule calculatoire canonique (identité de Huygens-König bivariée) :
$$\mathrm{Cov}(X, Y) = \mathbb{E}[XY] – \mathbb{E}[X]\mathbb{E}[Y]$$
Sur le plan interprétatif, la covariance prend une valeur positive lorsque les réalisations supérieures à la moyenne de $X$ ont tendance à s’associer préférentiellement aux réalisations supérieures à la moyenne de $Y$, et inversement pour les valeurs inférieures. À l’opposé, si les valeurs élevées de l’une coïncident de manière prépondérante avec les valeurs basses de l’autre, le produit des écarts est majoritairement négatif, induisant une covariance globale négative.
La covariance obéit à des propriétés algébriques rigoureuses : elle est symétrique ($\mathrm{Cov}(X, Y) = \mathrm{Cov}(Y, X)$), bilinéaire, et sa valeur appliquée à une variable avec elle-même restitue immédiatement sa variance univariée ($\mathrm{Cov}(X, X) = \mathrm{Var}(X) = \sigma_X^2$). La variance d’une somme de variables s’exprime ainsi directement par l’intégration de leur terme de dépendance conjointe :
$$\mathrm{Var}(aX + bY) = a^2 \mathrm{Var}(X) + b^2 \mathrm{Var}(Y) + 2ab , \mathrm{Cov}(X, Y)$$
Néanmoins, la covariance souffre d’une limitation méthodologique intrinsèque : sa magnitude dépend strictement des unités d’échelle adoptées pour mesurer $X$ et $Y$. Si l’on multiplie l’une des grandeurs par un facteur d’échelle (par exemple, en convertissant des secondes en millisecondes), la covariance se trouve mécaniquement multipliée par ce même facteur, interdisant toute comparaison directe d’intensité d’association entre des couples de variables distincts.
8.3 Le coefficient de corrélation linéaire de Pearson
Pour affranchir la mesure d’association linéaire des contingences dimensionnelles et des choix d’unités de mesure, Karl Pearson a formalisé le coefficient de corrélation linéaire bivarié, conventionnellement noté $\rho_{X, Y}$ ou plus sobrement $r$. Ce coefficient résulte de la normalisation rigoureuse de la covariance par le produit des écarts-types marginaux :
$$\rho_{X, Y} = \frac{\mathrm{Cov}(X, Y)}{\sigma_X \sigma_Y} = \frac{\mathbb{E}[(X – \mu_X)(Y – \mu_Y)]}{\sqrt{\mathbb{E}[(X – \mu_X)^2]} \sqrt{\mathbb{E}[(Y – \mu_Y)^2]}}$$
En vertu de l’inégalité de Cauchy-Schwarz appliquée aux variables aléatoires centrées considérées comme des vecteurs dans l’espace préhilbertien $L^2$, la valeur de $rho$ est théoriquement bornée dans l’intervalle compact fermé $[-1, 1]$ :
$$-1 le \rho_{X, Y} le 1$$
Les bornes extrêmes correspondent à des situations limites d’une clarté géométrique absolue : $\rho_{X, Y} = 1$ indique une colinéarité déterministe positive exacte ($Y = aX + b$ avec $a > 0$), tandis que $\rho_{X, Y} = -1$ caractérise une relation linéaire décroissante parfaite ($a < 0$). Une valeur $\rho_{X, Y} = 0$ atteste quant à elle d'une décorrélation linéaire complète au sein du couple bivarié.
Le coefficient de corrélation présente l’avantage majeur d’être invariant face à toute transformation affine strictement croissante des variables d’origine : si $X’ = aX + b$ et $Y’ = cY + d$ avec $a > 0$ et $c > 0$, alors $\rho_{X’, Y’} = \rho_{X, Y}$. Au sein d’une distribution conjointe continue, le coefficient de corrélation gouverne directement l’ellipticité et l’inclinaison des lignes d’isodensité projetées sur le plan orthogonal : plus $|rho|$ converge vers 1, plus les contours concentriques s’amincissent jusqu’à se fondre en un segment linéaire unidimensionnel.
9. Distributions conjointes notables : Modèles théoriques de référence
9.1 La distribution multinomiale : Extension conjointe de la loi binomiale
Parmi les distributions conjointes discrètes régissant les processus combinatoires fondamentaux, la loi multinomiale représente le modèle de référence par excellence. Elle constitue la généralisation multivariée directe de la loi binomiale au cas où chaque épreuve expérimentale indépendante admet non plus deux issues (succès/échec), mais un ensemble fini de $k$ issues mutuellement exclusives et collectivement exhaustives, survenant avec des probabilités respectives $p_1, p_2, dots, p_k$ telles que $\sum_{j=1}^k p_j = 1$.
Si l’on réitère cette expérience aléatoire $n$ fois de façon indépendante et stationnaire, le vecteur aléatoire $\mathbf{X} = (X_1, X_2, dots, X_k)^T$ consigne le nombre de réalisations observées pour chacune des $k$ catégories, sous la contrainte stochastique rigide $\sum_{j=1}^k X_j = n$. La fonction de masse conjointe de ce vecteur s’énonce par la formule multinomiale classique :
$$P(X_1 = x_1, X_2 = x_2, dots, X_k = x_k) = \frac{n!}{x_1! x_2! \cdots x_k!} p_1^{x_1} p_2^{x_2} \cdots p_k^{x_k}$$
pour tout uplet d’entiers naturels vérifiant $\sum_{j=1}^k x_j = n$, et s’annule pour toute autre configuration.
L’étude des moments conjoints de la loi multinomiale illustre parfaitement les mécanismes de dépendance stochastique induits par des contraintes de conservation globales. Si l’espérance marginale de chaque comptage reproduit la moyenne binomiale standard ($\mathbb{E}[X_j] = n p_j$) et sa variance marginale prend la forme $\mathrm{Var}(X_j) = n p_j (1 – p_j)$, la covariance croisée entre deux composantes distinctes $i ne j$ est structurellement négative :
$$\mathrm{Cov}(X_i, X_j) = -n p_i p_j < 0$$
Ce signe négatif traduit le phénomène de compétition inhérent à un échantillon de taille fixée : toute réalisation surnuméraire dans la modalité $i$ s’opère obligatoirement au détriment statistique du nombre d’observations disponibles pour les autres catégories. La loi multinomiale constitue le socle indispensable au codage et à la modélisation statistique des réponses catégorielles multiples, des tables de contingence polydimensionnelles et des données d’annotation linguistique ou génomique.
9.2 La distribution normale bivariée et multivariée
Au panthéon des distributions continues multivariées, la loi normale bivariée (et son extension multivariée générale) occupe une place hégémonique, dictée par la puissance régulatrice du théorème central limite multidimensionnel. Pour un couple continu $(X, Y)$, la distribution normale conjointe est entièrement déterminée par un ensemble fini de cinq paramètres scalaires : les moyennes marginales $\mu_X$ et $\mu_Y$, les écarts-types marginaux $\sigma_X > 0$ et $\sigma_Y > 0$, et le coefficient de corrélation linéaire $rho in ]-1, 1[$.
La fonction de densité conjointe analytique se formule par l’expression gaussienne bivariée canonique :
$$f(x, y) = \frac{1}{2\pi \sigma_X \sigma_Y \sqrt{1 – \rho^2}} \exp\left( -\frac{1}{2(1 – \rho^2)} \left[ \frac{(x – \mu_X)^2}{\sigma_X^2} – \frac{2\rho(x – \mu_X)(y – \mu_Y)}{\sigma_X \sigma_Y} + \frac{(y – \mu_Y)^2}{\sigma_Y^2} \right] \right)$$
En notation matricielle compacte, pour un vecteur aléatoire $\mathbf{X} = (X_1, dots, X_p)^T \sim \mathcal{N}_p(boldsymbol{\mu}, boldsymbol{\Sigma})$, la densité s’écrit de manière synthétique :
$$f(\mathbf{x}) = \frac{1}{(2\pi)^{p/2} |boldsymbol{\Sigma}|^{1/2}} \exp\left( -\frac{1}{2} (\mathbf{x} – boldsymbol{\mu})^T boldsymbol{\Sigma}^{-1} (\mathbf{x} – boldsymbol{\mu}) \right)$$
où $boldsymbol{\mu}$ est le vecteur des espérances mathématiques et $boldsymbol{\Sigma}$ désigne la matrice de variance-covariance symétrique définie positive de dimension $p \times p$, dont $|boldsymbol{\Sigma}|$ représente le déterminant.
La loi normale bivariée possède des propriétés analytiques singulières d’une élégance remarquable :
- Toute combinaison linéaire univariée d’un vecteur gaussien conjoint est elle-même rigoureusement gaussienne.
- Les distributions marginales dérivées d’une gaussienne multivariée sont purement gaussiennes : $X \sim \mathcal{N}(\mu_X, \sigma_X^2)$ et $Y \sim \mathcal{N}(\mu_Y, \sigma_Y^2)$.
- Toutes les lois conditionnelles sont rigoureusement gaussiennes univariées, et leurs moments s’expriment par des fonctions affines simples :
$$\mathbb{E}[Y mid X = x] = \mu_Y + \rho \frac{\sigma_Y}{\sigma_X}(x – \mu_X)$$
$$\mathrm{Var}(Y mid X = x) = \sigma_Y^2 (1 – \rho^2)$$ - Équivalence exceptionnelle : Dans le cadre exclusif d’une loi normale conjointe, la décorrélation ($rho = 0$) équivaut strictement et sans réserve à l’indépendance stochastique mutuelle.
La topologie de cette distribution se traduit par des ellipsoïdes de confiance concentriques : les lieux de niveau d’égale densité dessinent des ellipses sur le plan réel, dont le grand axe s’aligne selon la première composante principale de dispersion du système.
9.3 Théorie des copules et théorème de Sklar
Bien que la distribution normale conjointe offre un confort analytique exceptionnel, elle impose une contrainte structurelle rigide : elle suppose implicitement que les distributions marginales sont toutes deux gaussiennes et que leur interdépendance est parfaitement symétrique et linéaire. Confrontés à des phénomènes réels présentant des queues lourdes asymétriques ou des dépendances non linéaires complexes, les mathématiciens ont forgé un outil révolutionnaire : la théorie des copules.
Une copule est, par définition, une fonction de répartition cumulative multivariée définie sur l’hypercube unité $[0, 1]^d$, dont chaque loi marginale univariée est uniforme sur l’intervalle $[0, 1]$. Le socle de cette discipline repose intégralement sur le célèbre théorème de Sklar (établi en 1959 par Abe Sklar). Ce théorème stipule que toute fonction de répartition conjointe multivariée $F(x_1, dots, x_d)$ reliant des variables aux marginales quelconques $F_1(x_1), dots, F_d(x_d)$ peut être représentée sous la forme d’une copule $C$ opérant sur les probabilités cumulées :
$$F(x_1, x_2, dots, x_d) = C(F_1(x_1), F_2(x_2), dots, F_d(x_d))$$
Si les distributions marginales $F_i$ sont toutes rigoureusement continues, la copule $C$ associée est unique. Le théorème de Sklar réalise ainsi une séparation conceptuelle majeure : il permet de dissocier totalement l’étude des caractéristiques marginales univariées de chaque variable (leur forme, leur asymétrie, leurs moments) de l’analyse de leur structure de dépendance pure, celle-ci étant entièrement capturée par la copule $C$.
Parmi les familles de copules abondamment mobilisées en modélisation avancée, citons les copules gaussiennes et de Student (dites copules elliptiques), ainsi que les copules archimédiennes (telles que les copules de Clayton, Gumbel ou Frank). Ces dernières sont définies au moyen d’un générateur continu et possèdent la propriété cruciale de pouvoir modéliser l’asymétrie de dépendance dans les queues de distribution. Une copule de Clayton, par exemple, permet de formaliser un comportement où deux variables deviennent hautement interdépendantes lors d’épisodes de défaillance extrême (effondrement boursier ou comorbidité clinique sévère), tout en demeurant quasi-indépendantes dans leur régime de variation modéré habituel.
10. Généralisation aux espaces multivariés de dimension supérieure
10.1 Vecteurs aléatoires et notation matricielle en dimension p
L’appréhension formelle de systèmes complexes comportant des dizaines, voire des centaines de descripteurs stochastiques simultanés exige une généralisation élégante de l’algèbre bivariée vers l’espace multidimensionnel $\mathbb{R}^p$. On définit alors un vecteur aléatoire $\mathbf{X} = (X_1, X_2, dots, X_p)^T$ comme une application mesurable reliant l’espace probabilisable universel $(\Omega, \mathcal{F}, P)$ à l’espace euclidien muni de sa tribu borélienne $(\mathbb{R}^p, \mathcal{B}(\mathbb{R}^p))$.
La fonction de répartition conjointe multidimensionnelle s’exprime par le cumul stochastique sur le cône négatif infini multidimensionnel :
$$F(\mathbf{x}) = F(x_1, x_2, dots, x_p) = P(X_1 le x_1, X_2 le x_2, dots, X_p le x_p)$$
Pour un vecteur à composantes continues, la fonction de densité de probabilité conjointe se formalise par la dérivation d’ordre $p$ croisée totale :
$$f(\mathbf{x}) = \frac{\partial^p F(x_1, dots, x_p)}{\partial x_1 \partial x_2 \cdots \partial x_p}$$
L’architecture linéaire des moments conjoints d’ordre 1 et 2 se condense au sein de matrices aux propriétés spectrales fondamentales. L’espérance mathématique vectorielle s’écrit sous la forme du vecteur moyen :
$$boldsymbol{\mu} = \mathbb{E}[\mathbf{X}] = (\mathbb{E}[X_1], \mathbb{E}[X_2], dots, \mathbb{E}[X_p])^T$$
Tandis que la structure des dispersions conjointes s’incarne dans la matrice de variance-covariance $boldsymbol{\Sigma} in \mathbb{R}^{p \times p}$ :
$$boldsymbol{\Sigma} = \mathrm{Var}(\mathbf{X}) = \mathbb{E}[(\mathbf{X} – boldsymbol{\mu})(\mathbf{X} – boldsymbol{\mu})^T] = \begin{\pmatrix} \sigma_1^2 &a\mp; \sigma_{12} &a\mp; \cdots &a\mp; \sigma_{1p} \sigma_{21} &a\mp; \sigma_2^2 &a\mp; \cdots &a\mp; \sigma_{2p} \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots \sigma_{p1} &a\mp; \sigma_{p2} &a\mp; \cdots &a\mp; \sigma_p^2 \end{\pmatrix}$$
Cette matrice $boldsymbol{\Sigma}$ est par essence symétrique ($boldsymbol{\Sigma}^T = boldsymbol{\Sigma}$) et semi-définie positive, ce qui garantit que pour tout vecteur déterministe non nul $\mathbf{a} in \mathbb{R}^p$, la variance de la combinaison scalaire résultante demeure strictement non négative : $\mathrm{Var}(\mathbf{a}^T \mathbf{X}) = \mathbf{a}^T boldsymbol{\Sigma} \mathbf{a} ge 0$. En pratique algorithmique et computationnelle, l’exploitation de cette propriété permet la décomposition de Cholesky de la matrice ($boldsymbol{\Sigma} = \mathbf{L}\mathbf{L}^T$), étape indispensable pour simuler numériquement des vecteurs aléatoires conjoints corrélés à partir de simples générateurs gaussiens standard indépendants.
10.2 Marginalisation et conditionnement multidimensionnels
L’un des accomplissements les plus raffinés du calcul stochastique multivarié réside dans le partitionnement analytique des vecteurs aléatoires. Imaginons un vecteur aléatoire gaussien conjoint $\mathbf{X} \sim \mathcal{N}_p(boldsymbol{\mu}, boldsymbol{\Sigma})$ partitionné en deux sous-vecteurs de dimensions respectives $q$ et $p-q$ :
$$\mathbf{X} = \begin{\pmatrix} \mathbf{X}_1 \mathbf{X}_2 \end{\pmatrix}, \quad boldsymbol{\mu} = \begin{\pmatrix} boldsymbol{\mu}_1 boldsymbol{\mu}_2 \end{\pmatrix}, \quad boldsymbol{\Sigma} = \begin{\pmatrix} boldsymbol{\Sigma}_{11} &a\mp; boldsymbol{\Sigma}_{12} boldsymbol{\Sigma}_{21} &a\mp; boldsymbol{\Sigma}_{22} \end{\pmatrix}$$
L’opération de marginalisation multidimensionnelle présente une simplicité opératoire remarquable : la loi marginale conjointe du sous-vecteur $\mathbf{X}_1$ s’obtient simplement en extrayant ses paramètres au sein de la partition globale, ignorant purement et simplement le bloc $\mathbf{X}_2$ sans nécessiter la moindre intégration analytique fastidieuse :
$$\mathbf{X}_1 \sim \mathcal{N}_q(boldsymbol{\mu}_1, boldsymbol{\Sigma}_{11})$$
Plus remarquable encore, la distribution conditionnelle conjointe multivariée du sous-vecteur $\mathbf{X}_1$ sachant la fixation empirique du vecteur $\mathbf{X}_2 = \mathbf{x}_2$ demeure rigoureusement une distribution normale multidimensionnelle :
$$\mathbf{X}_1 mid \mathbf{X}_2 = \mathbf{x}_2 \sim \mathcal{N}_q(boldsymbol{\mu}_{1|2}, boldsymbol{\Sigma}_{1|2})$$
Les paramètres de cette loi conditionnelle se déduisent analytiquement au moyen du complément de Schur de la matrice de covariance :
$$boldsymbol{\mu}_{1|2} = boldsymbol{\mu}_1 + boldsymbol{\Sigma}_{12}boldsymbol{\Sigma}_{22}^{-1}(\mathbf{x}_2 – boldsymbol{\mu}_2)$$
$$boldsymbol{\Sigma}_{1|2} = boldsymbol{\Sigma}_{11} – boldsymbol{\Sigma}_{12}boldsymbol{\Sigma}_{22}^{-1}boldsymbol{\Sigma}_{21}$$
Ce résultat théorique profond sous-tend l’intégralité de la théorie des modèles d’équations structurelles, des séries temporelles multivariées (filtres de Kalman) et de l’analyse causale. L’annulation d’un coefficient spécifique dans la matrice de précision conditionnelle inverse $boldsymbol{\Theta} = boldsymbol{\Sigma}^{-1}$ équivaut formellement à une hypothèse d’indépendance conditionnelle entre les deux variables concernées étant donné toutes les autres, matérialisant ainsi l’absence d’arête directe dans un modèle graphique gaussien non orienté (Markov Random Field).
10.3 Le fléau de la dimensionnalité en modélisation conjointe
Dès lors que l’on s’efforce d’étendre la modélisation conjointe à un nombre élevé de dimensions, le statisticien se heurte à un obstacle théorique et pratique redoutable : le fléau de la dimensionnalité (expression originellement forgée par Richard Bellman). Dans un espace discret, ce phénomène se traduit par une explosion combinatoire incontrôlable du nombre de cellules à estimer. Si un tableau de contingence croise $p$ variables binaires, le nombre d’états conjoints distincts s’élève à $2^p$. Pour $p = 30$ variables, le nombre de paramètres de masse libres excède un milliard ($2^{30} \approx 1{,}07 \times 10^9$), rendant illusoire toute tentative d’estimation empirique non régularisée sur des cohortes humaines réelles.
Dans un espace continu, le fléau prend une dimension géométrique : à mesure que la dimensionnalité $p$ croît, le volume de l’espace euclidien augmente de manière exponentielle, provoquant une dispersion et une raréfaction drastique des observations empiriques. La quasi-totalité de la masse de probabilité conjointe se retrouve expulsée vers les zones périphériques et les coquilles externes de l’espace, tandis que le centre géométrique se dépeuple entièrement. En conséquence, le nombre d’échantillons nécessaires pour interpoler localement une densité conjointe au moyen d’approches non paramétriques croît exponentiellement avec la dimension ($O(n^{-4/(4+p)})$ pour un estimateur par noyau), détruisant l’efficacité statistique des estimateurs.
Face à cette impasse computationnelle, la recherche statistique s’est tournée vers des stratégies de parcimonie paramétrique et de réduction structurelle de dimension :
- L’imposition de structures de dépendance contraintes (matrices de covariance de rang faible, factorisation de Toeplitz ou modèles autorégressifs multivariés).
- L’adoption d’a priori de régularisation bayésienne et de pénalisations par norme $ell_1$ (Graphical Lasso) forçant la matrice de précision à adopter un profil creux (sparse).
- Le déploiement de techniques de projection sous-spatiale, telles que l’analyse en composantes principales (ACP) probabiliste ou les autoencodeurs variationnels, qui projettent la loi conjointe de haute dimension sur une variété latente de basse dimensionnalité préservant l’information topologique essentielle.
11. Applications pratiques en psychométrie et méthodologie comportementale
11.1 Modélisation conjointe des réponses aux items et des traits latents
L’édification des instruments psychométriques modernes constitue l’un des terrains d’élection les plus achevés pour l’application des lois conjointes. Dans le cadre théorique de la théorie de la réponse à l’item (TRI), l’ambition centrale est de relier un ensemble de variables manifestes observables (les réponses binaires ou polytomiques $Y_1, dots, Y_m$ données à un questionnaire de personnalité ou d’évaluation intellectuelle) à une ou plusieurs variables continues inobservables appelées traits latents, notées $Theta$.
Le modèle mathématique prend la forme d’une distribution de probabilité conjointe paramétrée reliant l’ensemble des réponses observables et le continuum psychologique latent du sujet :
$$f(\mathbf{y}, \theta) = f_\Theta(\theta) \cdot P(\mathbf{Y} = \mathbf{y} mid \Theta = \theta)$$
Pour rendre calculable ce produit multidimensionnel, la psychométrie introduit l’hypothèse centrale d’indépendance locale (ou principe d’indépendance conditionnelle). Cette hypothèse postule que pour un niveau de trait latent $\theta$ parfaitement contrôlé et fixé, les réponses apportées aux différents items du test deviennent stochastiquement indépendantes les unes des autres :
$$P(\mathbf{Y} = \mathbf{y} mid \Theta = \theta) = \prod_{j=1}^m P(Y_j = y_j mid \Theta = \theta)$$
Chaque terme individuel $P(Y_j = 1 mid \Theta = \theta)$ est modélisé par une fonction logistique (courbe caractéristique de l’item), paramétrée par la difficulté de la question et son pouvoir de discrimination. La distribution conjointe globale permet ainsi, par le truchement d’algorithmes d’estimation de type marginal maximum de vraisemblance (MMLE) utilisant l’algorithme EM, d’inférer simultanément les caractéristiques psychométriques des items et les coordonnées factorielles des individus sur l’espace latent.
11.2 Distribution conjointe du temps de réponse et de la précision
En psychologie cognitive expérimentale, les théories traditionnelles évaluaient séparément le taux d’exactitude des réponses (pourcentage de réussite à une tâche motrice ou perceptive) et la latence moyenne de réponse (chronométrie mentale univariée). Or, ce fractionnement méthodologique ignore délibérément le phénomène cognitif sous-jacent universel : le compromis vitesse-précision (speed-accuracy tradeoff). Un sujet peut artificiellement maximiser son exactitude en adoptant une stratégie d’accumulation d’information lente et précautionneuse, ou inversement écourter ses latences au prix d’une prolifération d’erreurs stochastiques.
Pour dépasser cette scission réductrice, la modélisation contemporaine s’appuie sur des modèles de processus stochastiques conjoints continus-discrets, au premier rang desquels figure le modèle de diffusion de drift (Drift Diffusion Model, DDM) formulé par Roger Ratcliff. Ce cadre mathématique décrit le processus de délibération décisionnelle binaire comme l’évolution temporelle d’un mouvement brownien avec dérive (dérive de drift $v$, variabilité stochastique $s$), progressant entre deux barrières absorbantes distantes de $a$ (la frontière supérieure matérialisant la décision correcte, la frontière inférieure codant l’erreur).
Le point d’arrivée analytique du modèle est une fonction de densité de probabilité conjointe bivariée $f(t, r)$, où $T$ est une variable continue mesurant le temps de réaction physique et $R in {0, 1}$ est une variable discrète indiquant la précision du choix. Cette densité conjointe calcule avec exactitude le temps de premier passage stochastique à travers les frontières d’absorption du modèle :
$$f(t, R=1 mid v, a) = \frac{\pi}{a^2} e^{-v a – \frac{v^2 t}{2}} \sum_{k=1}^\infty k \sin(k \pi) \exp\left( -\frac{k^2 \pi^2 t}{2 a^2} \right)$$
Grâce à cette loi conjointe, les chercheurs peuvent décomposer les performances individuelles en composantes neuro-cognitives invariantes : le taux d’accumulation de preuve sensorielle ($v$), le degré de conservatisme stratégique ($a$) et le temps d’encodage perceptif et moteur non décisionnel ($T_{er}$). L’ajustement conjoint sur l’ensemble de la surface bidimensionnelle temps-précision surpasse infiniment les régressions univariées conduites sur les seules moyennes arithmétiques empiriques.
11.3 Validité de construit et structures de corrélation inter-échelles
L’évaluation des instruments diagnostiques en neuropsychologie clinique et en psychopathologie quantitative (cadre HiTOP — Hierarchical Taxonomy of Psychopathology) fait un usage intensif de l’analyse conjointe multidimensionnelle pour asseoir la validité de construit. Lorsqu’un clinicien administre une batterie multi-échelles mesurant simultanément le névrosisme, l’affectivité négative et la symptomatologie obsessionnelle-compulsive, l’enjeu diagnostique ne se limite pas aux scores isolés.
Historiquement formalisée par Donald Campbell et Donald Fiske à travers la matrice multi-traits multi-méthodes (MTMM), cette démarche examine l’architecture de la loi conjointe sous l’angle de la validité convergente (les distributions conjointes de construits homologues mesurés par des instruments distincts doivent présenter une forte densité sur la diagonale principale) et de la validité discriminante (les distributions conjointes liant des construits théoriquement orthogonaux doivent exhiber une circularité quasi parfaite, témoignant d’une décorrélation robuste).
De surcroît, l’inspection visuelle et géométrique de la distribution conjointe permet d’isoler des profils nosographiques atypiques situés aux confins des queues de distribution multidimensionnelles. Un patient manifestant simultanément un score extrême de désinhibition comportementale et un score exceptionnellement bas de réactivité anxieuse occupera une position excentrée singulière au sein du volume probabiliste conjoint. Cette conjonction précise, invisible si l’on examine chaque trait séparément, signe une configuration psychopathologique spécifique (comme la psychopathie primaire) dont la prise en charge clinique diffère radicalement de celle de sujets occupant d’autres quadrants de l’espace multivarié.
12. Estimation empirique, inférence et écueils computationnels
12.1 Méthodes d’estimation paramétrique et non paramétrique
Dans la pratique de la recherche empirique, la véritable loi conjointe sous-jacente d’une population demeure inconnue de l’observateur. Elle doit être inférée à partir d’un échantillon fini de réalisations vectorielles indépendantes et identiquement distribuées (i.i.d.) $\mathcal{D} = {\mathbf{x}_1, \mathbf{x}_2, dots, \mathbf{x}_n}$, où chaque observation est un point de $\mathbb{R}^p$. Deux paradigmes théoriques s’opposent et se complètent pour concrétiser cette estimation : l’approche paramétrique et l’approche non paramétrique.
L’estimation paramétrique postule a priori une famille mathématique explicite pour la loi conjointe, indexée par un vecteur de paramètres finis $boldsymbol{\theta}$ (par exemple, une loi normale bivariée régie par $boldsymbol{\theta} = (\mu_X, \mu_Y, \sigma_X, \sigma_Y, \rho)$). L’estimation s’opère canoniquement par la méthode du maximum de vraisemblance (MLE), consistant à déterminer la valeur optimale des paramètres qui maximise la vraisemblance conjointe globale de l’échantillon collecté :
$$\hat{boldsymbol{\theta}}_{\mathrm{MLE}} = arg\max_{boldsymbol{\theta}} \sum_{i=1}^n \log f(\mathbf{x}_i mid boldsymbol{\theta})$$
Lorsque des données sont incomplètes ou que des variables latentes inobservées s’immiscent dans le système, le recours à l’algorithme d’espérance-maximisation (EM) devient incontournable pour optimiser itérativement l’espérance de la log-vraisemblance conjointe conditionnelle.
À l’inverse, l’estimation non paramétrique s’affranchit de toute conjecture structurelle rigide quant à la géométrie de la distribution sous-jacente. L’approche phare est l’estimation de la densité conjointe par noyau bivarié (Bivariate Kernel Density Estimation, KDE). Pour un échantillon bivarié $(X_i, Y_i)_{i=1,dots,n}$, l’estimateur de densité conjointe s’écrit formellement :
$$\hat{f}_{\mathbf{H}}(x, y) = \frac{1}{n |\mathbf{H}|^{1/2}} \sum_{i=1}^n K\left( \mathbf{H}^{-1/2} \begin{\pmatrix} x – X_i y – Y_i \end{\pmatrix} \right)$$
où $K$ représente une fonction de noyau bivariée multivariée symétrique (couramment un noyau gaussien standard) et $\mathbf{H}$ désigne la matrice de lissage (bandwidth matrix) symétrique définie positive de dimension $2 \times 2$. Le choix de $\mathbf{H}$ est d’une criticité méthodologique absolue : une matrice sous-dimensionnée induit un « sous-lissage » générant une multitude d’aspérités et de modes parasites artéfactuels, tandis qu’une matrice surdimensionnée provoque un « sur-lissage » diluant totalement la topologie conjointe et masquant les corrélations et sous-populations réelles.
12.2 Génération d’échantillons et simulation de Monte-Carlo
L’exploration des distributions conjointes complexes, notamment lorsqu’elles ne disposent pas de formes intégrales analytiquement solubles, requiert des outils de simulation stochastique computationnelle : les méthodes de Monte-Carlo. Pour simuler informatiquement un vecteur aléatoire gouverné par une loi conjointe continue, la méthode universelle en basse dimension s’appuie sur la règle de décomposition conditionnelle en chaîne combinée à la méthode de la transformation inverse univariée :
- On échantillonne un premier nombre pseudo-aléatoire uniforme $u_1 \sim \mathcal{U}[0, 1]$ et on détermine $x = F_X^{-1}(u_1)$ via l’inverse de la fonction de répartition marginale cumulative de $X$.
- On échantillonne un second nombre uniforme $u_2 \sim \mathcal{U}[0, 1]$ et on résout la valeur $y = F_{Y mid X}^{-1}(u_2 mid x)$ au moyen de la fonction de répartition conditionnelle calculée au point $x$ préalablement fixé.
Dans des espaces de dimension arbitraire ou lorsque la constante de normalisation de la loi conjointe s’avère intraçable (comme dans l’inférence a posteriori de modèles bayésiens complexes), on déploie les algorithmes de chaînes de Markov Monte-Carlo (MCMC). L’échantillonneur de Gibbs est spécifiquement adapté à l’architecture des lois conjointes : au lieu de tenter de tirer directement le vecteur multidimensionnel $\mathbf{X} = (X_1, dots, X_p)$ en un bloc unique, l’algorithme tire cycliquement chaque variable scalaire selon sa distribution conditionnelle univariée complète sachant l’ensemble de toutes les autres variables actualisées :
$$X_j^{(t+1)} \sim f\left(X_j mid X_1^{(t+1)}, dots, X_{j-1}^{(t+1)}, X_{j+1}^{(t)}, dots, X_p^{(t)}\right)$$
Sous réserve du respect des conditions de chaîne ergodique et de réversibilité microscopique, la distribution stationnaire de cette chaîne de Markov converge exactement vers la loi conjointe cible $f(\mathbf{x})$, permettant d’approximer numériquement toute intégrale ou moment complexe avec une précision régie par la loi des grands nombres.
12.3 Écueils fréquents et erreurs d’interprétation méthodologique
L’utilisation pratique des distributions conjointes en recherche appliquée s’accompagne d’une série de pièges épistémologiques et computationnels qui peuvent compromettre la validité des conclusions scientifiques :
1. L’assimilation erronée de la dépendance conjointe à la causalité : Une distribution conjointe $f(x, y)$ est, par essence, une construction stochastique purement symétrique. L’observation d’une concentration conjointe élevée, d’une covariance forte ou d’un rapport de cotes déséquilibré n’autorise en aucun cas à déduire qu’une variable exerce une action causale sur la seconde. En l’absence d’assignation randomisée ou d’intervention au sens du calcul des interventions de Judea Pearl (l’opérateur $do(X = x)$), la covariation mesurée au sein d’une distribution conjointe peut résulter intégralement de l’action non mesurée d’un facteur de confusion latent $Z$ gouvernant simultanément les deux variables observées.
2. Le paradoxe de Simpson : Cet écueil spectaculaire met en scène l’inversion pure et simple de l’orientation d’une dépendance conjointe lors de l’agrégation ou de la marginalisation des données. Deux variables $X$ et $Y$ peuvent présenter une corrélation marginale positive lorsqu’on évalue leur distribution conjointe globale, tout en manifestant une corrélation conditionnelle rigoureusement négative au sein de chaque sous-strate définie par une troisième variable polytomique $Z$ :
$$\mathrm{Cov}(X, Y mid Z = z) 0$$
Ce paradoxe rappelle avec force qu’une loi conjointe bivariée apparente peut être une projection trompeuse dès lors qu’elle marginalise à son insu une variable de stratification déterminante.
3. La déformation stochastique induite par les données manquantes : Dans les protocoles comportementaux, les observations vectorielles sont fréquemment incomplètes. Selon la taxonomie fondamentale établie par Donald Rubin, les mécanismes de perte se divisent en données manquantes complètement de manière aléatoire (MCAR), manquantes de manière aléatoire (MAR) et manquantes de manière non aléatoire (MNAR). Traiter un profil conjoint lacunaire par simple suppression des listes (listwise deletion) lorsque le mécanisme sous-jacent est MAR ou MNAR détruit la représentativité du sous-espace d’échantillonnage et introduit un biais systématique majeur dans l’estimation de la matrice de covariance et des paramètres conjoints.
4. Le biais de troncature et de censure conjointe : Lorsque la collecte des données impose des seuils de détection physiques ou méthodologiques sur une variable (par exemple, un temps de réaction plafonné à 1500 millisecondes ou une échelle psychométrique saturée par effet de plafond), la distribution conjointe observée subit une distorsion géométrique sévère. Cette coupure artificielle rabote les ellipsoïdes de confiance et contractedrastiquement les variances et covariances apparentes (effet d’atténuation de restriction de variance). L’omission de correctifs statistiques appropriés (comme les modèles de Tobit bivariés) aboutit à une sous-estimation systématique de l’intensité de la dépendance conjointe réelle liant les attributs examinés.
Références
- Ash, R. B. (2000). Probability and measure theory (2nd ed.). Academic Press.
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Thomson Learning.
- Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/b16018
- Joe, H. (2014). Dependence modeling with copulas. Chapman and Hall/CRC. https://doi.org/10.1201/b17116
- Kolmogorov, A. N. (1956). Foundations of the theory of probability (2nd ed., N. Morrison, Trans.). Chelsea Publishing Co.
- Nelsen, R. B. (2006). An introduction to copulas (2nd ed.). Springer. https://doi.org/10.1007/0-387-28678-0
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Ratcliff, R., & McKoon, G. (2008). The diffusion decision model: Theory and data for two-choice decision tasks. Neural Computation, 20(4), 873–922. https://doi.org/10.1162/neco.2008.12-06-420
- Sklar, A. (1959). Fonctions de répartition à n dimensions et leurs marges. Publications de l’Institut de Statistique de l’Université de Paris, 8, 229–231.
- Wasserman, L. (2004). All of statistics: A concise course in statistical inference. Springer. https://doi.org/10.1007/978-0-387-21736-9