
Dans le domaine des sciences psychologiques, comportementales et biomédicales, la quête d’une compréhension empirique des lois régissant l’esprit humain repose sur un acte d’inférence permanent. Puisqu’il est structurellement et matériellement impossible d’interroger ou de mesurer l’intégralité des individus composant l’espèce humaine, ou même un sous-groupe clinique déterminé, le chercheur est contraint d’extraire une fraction finie de cette population. Cet ensemble restreint, appelé échantillon, constitue le prisme au travers duquel se construisent nos théories scientifiques. Dès lors, la question du volume numérique de cette cohorte — la taille de l’échantillon, notée conventionnellement N — transcende la simple considération technique ou logistique pour devenir l’un des piliers épistémologiques majeurs de la démarche scientifique moderne.
Pendant des décennies, une part substantielle de la recherche psychologique a fonctionné sous l’empire d’une illusion méthodologique : la croyance intuitive que des effets psychologiques majeurs pouvaient être documentés de manière fiable à partir de cohortes restreintes, souvent composées d’une vingtaine ou d’une trentaine de participants recrutés commodément sur les campus universitaires. Les soubresauts méthodologiques survenus au cours des deux dernières décennies, communément qualifiés de « crise de la reproductibilité », ont cruellement mis en lumière la fragilité de cet édifice. Une taille d’échantillon déficiente n’engendre pas seulement un manque d’acuité dans l’estimation statistique ; elle altère insidieusement la dynamique même de la découverte scientifique, en générant des taux élevés de faux négatifs, en amplifiant artificiellement la magnitude des effets observés et en polluant la littérature empirique de résultats non reproductibles.
L’objectif du présent traité est de disséquer de manière exhaustive les fondements mathématiques, conceptuels et pratiques régissant la détermination de la taille de l’échantillon dans la recherche contemporaine. En explorant l’articulation entre variabilité d’échantillonnage, théorie de l’estimation, calcul de puissance statistique, dérives inférentielles et impératifs déontologiques, nous établirons pourquoi le dimensionnement rigoureux des cohortes constitue la condition préalable indispensable à toute prétention d’accumulation des connaissances scientifiques vérifiables et cliniquement signifiantes.
1. Fondements conceptuels de l’échantillonnage dans la recherche en psychologie
1.1 Définition de l’échantillon et de la population cible en psychologie
L’acte d’échantillonnage s’enracine dans la distinction fondamentale que trace la statistique inférentielle entre la population cible (ou population parente) et l’échantillon empirique observé. La population représente l’ensemble théorique exhaustif de toutes les unités d’observation — qu’il s’agisse d’individus, de dyades ou d’organisations — possédant un ensemble défini de caractéristiques biologiques, psychologiques ou socioculturelles sur lesquelles porte l’interrogation théorique. Par exemple, une recherche portant sur la régulation émotionnelle chez les patients souffrant de trouble dépressif majeur vise, par essence, l’universalité des personnes répondant aux critères diagnostiques de ce trouble. En revanche, l’échantillon se définit strictement comme le sous-ensemble fini, observable et mesurable extrait de cette population par un protocole de sélection particulier.
Cette distinction met en exergue l’impossibilité matérielle, financière et logistique de procéder à un recensement exhaustif. Mesurer l’ensemble des individus d’une population supposerait des ressources infinies, une accessibilité géographique universelle et une stabilité temporelle incompatible avec la dynamique du vivant. Dès lors, le protocole scientifique impose une transition : passer de l’observation contingente, idiosyncrasique et locale d’une poignée d’individus à une inférence théorique universalisable. Cette inférence repose sur l’hypothèse sous-jacente que les lois fonctionnelles régissant l’architecture cognitive ou émotionnelle des participants étudiés reflètent adéquatement celles de la population dont ils sont issus. Si cette extrapolation ne s’appuie pas sur une méthodologie solide, l’édifice théorique bâti sur l’échantillon s’effondre sous le poids de son illégitimité statistique.
1.2 La représentativité comme condition de validité externe
La validité externe d’un protocole expérimental mesure le degré auquel ses conclusions empiriques peuvent être généralisées au-delà du cadre contraignant du laboratoire ou du contexte spécifique de l’observation. Dans cette perspective, la taille de l’échantillon interagit de façon intime avec sa représentativité, bien que ces deux notions renvoient à des dimensions méthodologiques distinctes mais complémentaires. Historiquement, la recherche en psychologie cognitive et sociale a massivement puisé ses sujets au sein de populations dites « WEIRD » (occidentales, éduquées, industrialisées, riches et démocratiques), surreprésentant de façon chronique les cohortes d’étudiants de premier cycle universitaire. Ce biais de sélection structurel menace l’isomorphisme entre la distribution des variables de l’échantillon et celle de la population générale.
L’hétérogénéité psychologique inhérente à l’espèce humaine — qu’elle concerne les traits de personnalité, les capacités mnésiques, l’expression phénotypique des pathologies ou les modulations neurodéveloppementales — introduit une variance considérable dans les mesures paramétriques. Si la taille d’un échantillon est trop exiguë, la composition de celui-ci devient hypersensible aux aléas du recrutement. Seule une taille critique, combinée à des mécanismes de sélection probabiliste ou de randomisation stricte, permet d’espérer que les variables parasites, non contrôlées ou confondantes, se distribuent de façon homogène entre les groupes expérimentaux. Un échantillon restreint, même prélevé aléatoirement, demeure structurellement vulnérable à des asymétries fortuites susceptibles d’invalider toute tentative de généralisation écologique.
1.3 L’échantillonnage comme compromis épistémologique et pragmatique
La planification d’un protocole de recherche scientifique s’apparente constamment à une négociation délicate entre rigueur méthodologique idéale et contraintes pragmatiques indépassables. D’un côté, l’optimisation mathématique de la puissance analytique plaide pour l’inclusion du plus grand nombre possible de participants ; de l’autre, chaque unité d’observation additionnelle engendre des coûts logistiques, temporels, humains et financiers exponentiels. Rémunérer les sujets, mobiliser des plateformes d’imagerie cérébrale coûteuses comme l’IRM fonctionnelle, rémunérer des psychologues évaluateurs formés à des échelles cliniques semi-structurées sont autant de réalités matérielles qui imposent des limites objectives aux velléités d’exhaustivité.
Par ailleurs, cette tension ne se limite pas à des aspects économiques : elle embrasse une dimension éthique fondamentale. Selon les principes inscrits dans la Déclaration d’Helsinki et les directives déontologiques institutionnelles, exposer un nombre démesuré de participants à des protocoles potentiellement inconfortables, chronophages, anxiogènes ou invasifs sans nécessité statistique constitue une faute éthique caractérisée. Inversement, recruter délibérément un échantillon trop restreint pour détecter un effet thérapeutique réel l’est tout autant, dans la mesure où les efforts et le temps des participants sont dilapidés dans une étude condamnée d’avance à l’indétermination statistique. L’inférence scientifique basée sur des données parcellaires crée ainsi un double préjudice : un préjudice éthique immédiat envers les participants et un préjudice théorique différé envers la communauté académique, polluée par des assertions fragiles.
2. L’estimation des paramètres de population et la variabilité d’échantillonnage
2.1 Paramètres de population versus statistiques d’échantillon
Le formalisme mathématique de la statistique inférentielle repose sur la dichotomie fondamentale entre les paramètres de la population et les statistiques d’échantillon. Un paramètre de population représente une valeur numérique fixe, constante mais généralement inconnue, qui caractérise une variable aléatoire au sein de l’ensemble universel d’intérêt. On désigne conventionnellement ces grandeurs par des lettres grecques, notamment la moyenne vraie de la population ($\mu$) et sa variance intrinsèque ($\sigma^2$). À l’opposé, les statistiques calculées à partir de l’échantillon observé, notées généralement par des caractères latins tels que $\bar{X}$ pour la moyenne empirique et $s^2$ (ou $s$) pour la variance (ou l’écart-type), constituent des variables aléatoires dont la valeur oscille d’une collecte de données à une autre en fonction du hasard de l’échantillonnage.
L’objectif central de l’estimation consiste à employer les statistiques d’échantillon comme des estimateurs ponctuels fiables des paramètres théoriques sous-jacents. Pour répondre aux exigences de la rigueur mathématique, ces estimateurs doivent posséder certaines propriétés asymptotiques, au premier rang desquelles figure l’absence de biais : l’espérance mathématique de l’estimateur doit égaler la valeur exacte du paramètre inconnu, soit $E(\bar{X}) = \mu$. Cependant, la fidélité de cette approximation est perpétuellement menacée par la variabilité intrinsèque des mesures psychométriques. En psychologie, où l’erreur de mesure s’ajoute systématiquement à la variabilité biologique et comportementale interindividuelle, l’écart entre la valeur observée et la valeur paramétrique réelle peut s’avérer colossal si le nombre d’observations n’est pas suffisant pour stabiliser l’estimation.
2.2 La distribution d’échantillonnage et le théorème central limite
Pour appréhender la portée de la taille d’échantillon, il convient de concevoir non pas un échantillon unique, mais l’infinité théorique des échantillons de taille $N$ que l’on pourrait extraire de la même population cible. L’agrégation des moyennes calculées pour chacun de ces échantillons hypothétiques engendre ce que la statistique nomme la distribution d’échantillonnage de la moyenne. C’est ici qu’intervient l’un des monuments analytiques les plus élégants de la théorie des probabilités : le théorème central limite (TCL). Ce théorème stipule que, quelle que soit la forme de la distribution de la variable au sein de la population d’origine — qu’elle soit symétrique, bimodale, uniforme ou fortement asymétrique —, la distribution d’échantillonnage de la moyenne converge vers une loi normale dès lors que la taille $N$ de l’échantillon devient suffisamment grande.
Dans la recherche cognitive ou neuropsychologique, les variables mesurées, telles que les temps de réaction ou les scores d’apprentissage par essais et erreurs, présentent quasi systématiquement une asymétrie positive marquée, caractérisée par une longue traîne vers les valeurs élevées. Dans ces conditions de non-normalité sévère, travailler avec des effectifs minuscules viole les présupposés de l’inférence classique, car la distribution de la statistique ne suit pas la loi normale présumée. Dès que $N$ franchit des seuils substantiels, la distribution des moyennes d’échantillon s’arrondit, s’homogénéise et se concentre de façon symétrique autour de $\mu$. Parallèlement, la dispersion de cette distribution d’échantillonnage décroît, traduisant une stabilisation mathématique implacable qui réduit les risques d’obtenir une moyenne d’échantillon totalement déconnectée de la réalité sous-jacente.
2.3 L’erreur type de la moyenne comme mesure d’incertitude
La dispersion de la distribution d’échantillonnage de la moyenne est formalisée mathématiquement par l’erreur type de la moyenne (souvent désignée par l’acronyme anglais SEM, pour Standard Error of the Mean). Dérivée directement des lois fondamentales de la variance des sommes de variables aléatoires indépendantes, l’équation s’écrit de la façon suivante :
$$\sigma_{\bar{X}} = \frac{\sigma}{\sqrt{N}}$$
où $\sigma$ désigne l’écart-type de la population et $N$ la taille de l’échantillon. Dans la pratique empirique où $\sigma$ est inconnu, on lui substitue l’écart-type non biaisé de l’échantillon $s$, donnant l’estimateur $SE = s / \sqrt{N}$. Cette formulation dévoile une vérité mathématique d’une portée monumentale : l’incertitude pesant sur l’estimation de la moyenne ne décroît pas proportionnellement à $N$, mais proportionnellement à la racine carrée de $N$.
Cette relation non linéaire signifie que le rendement marginal de chaque sujet additionnel décroît à mesure que la cohorte grandit. Pour réduire de moitié l’erreur type, c’est-à-dire pour doubler la précision de l’estimation, le chercheur ne doit pas doubler son effectif, mais le quadrupler. Si l’on dispose d’un échantillon initial de 25 sujets, passer à 50 participants apporte un gain de précision substantiel ; en revanche, pour observer un gain équivalent en partant de 500 sujets, il faudra ajouter 1500 individus supplémentaires pour atteindre un effectif de 2000. Face au bruit de mesure omniprésent dans les batteries d’évaluation psychologique, un faible $N$ gonfle considérablement le dénominateur de l’incertitude, rendant les estimations ponctuelles intrinsèquement fluctuantes et hautement instables.
3. Les intervalles de confiance : formalisation et impact de la taille d’échantillon
3.1 Mécanique théorique de l’intervalle de confiance
L’estimation ponctuelle consistant à attribuer à un paramètre inconnu la valeur unique d’une statistique d’échantillon s’avère fondamentalement incomplète sans l’adjonction d’une métrique d’incertitude. C’est précisément la fonction épistémologique de l’intervalle de confiance (IC). Dans le cadre de l’inférence fréquentiste classique formalisée par Jerzy Neyman, un intervalle de confiance à 95 % ne signifie pas qu’il y a 95 % de chances que le paramètre vrai de la population soit confiné dans les bornes numériques issues d’une étude particulière. Il signifie plutôt que, si l’on répétait indéfiniment la même expérience dans des conditions méthodologiques identiques, 95 % des intervalles ainsi construits recouvriraient la valeur réelle, inconnue et immuable du paramètre $\mu$.
L’intervalle de confiance délimite donc la zone de plausibilité statistique du paramètre inconnu, conditionnellement aux données observées et au modèle probabiliste sous-jacent. Il est capital de le distinguer scrupuleusement de l’intervalle de prédiction. Alors que l’intervalle de prédiction modélise la variabilité attendue des observations individuelles futures (incorporant à la fois l’erreur d’échantillonnage et la variance intrinsèque entre sujets, restant par conséquent toujours très large), l’intervalle de confiance quantifie exclusivement l’imprécision entourant la localisation de la grandeur populationnelle moyenne. Sa largeur reflète directement le niveau d’exactitude ou, à l’inverse, l’indécision de notre instrumentation empirique.
3.2 Rétrécissement de l’intervalle sous l’effet de l’accroissement de N
La formalisation mathématique de l’intervalle de confiance pour une moyenne d’échantillon, en utilisant une distribution normale ou la distribution de Student $t$ à $N-1$ degrés de liberté, illustre la dépendance directe de la marge d’erreur vis-à-vis de l’effectif :
$$IC_{1-\alpha} = \left[ \bar{X} – t_{alpha/2, , N-1} \cdot \frac{s}{\sqrt{N}} , ; ; \bar{X} + t_{alpha/2, , N-1} \cdot \frac{s}{\sqrt{N}} \right]$$
À travers cette formule, il apparaît que le rétrécissement de l’intervalle procède d’un double mécanisme dépendant de l’effectif. D’une part, le terme d’erreur type $s/\sqrt{N}$ diminue de manière continue lorsque le dénominateur croît. D’autre part, la valeur critique $t_{alpha/2}$ diminue elle aussi à mesure que les degrés de liberté augmentent, passant par exemple de 2,093 pour un effectif de 20 participants à 1,962 pour un échantillon de 500 sujets.
Ce resserrement géométrique des bornes transforme radicalement la qualité de l’information scientifique transmise. Dans le domaine de la psychométrie appliquée — qu’il s’agisse de mesurer le quotient intellectuel au moyen de la Wechsler Adult Intelligence Scale ou d’évaluer les facettes de la personnalité via le modèle des Big Five —, un échantillon restreint fournit des intervalles si béants qu’ils interdisent toute classification discriminante fiable. Une estimation vague, matérialisée par un intervalle de confiance recouvrant simultanément des effets minuscules et des variations massives, n’apporte presque aucune valeur ajoutée à la construction de modèles théoriques prédictifs et contraint la clinique à l’ambiguïté interprétative.
3.3 Exemple chiffré : Évaluation de l’anxiété préopératoire
Afin de rendre palpable l’impact mathématique de la taille de l’échantillon sur la marge d’erreur, considérons une étude clinique fictive consacrée à l’évaluation de l’anxiété préopératoire chez des patients programmés pour une chirurgie cardiothoracique lourde. L’anxiété est mesurée à l’aide de l’inventaire d’anxiété état-trait de Spielberger (STAI-Y), dont l’échelle s’étend théoriquement de 20 à 80 points, avec un écart-type observé dans la littérature médicale d’environ $s = 10$ points. Supposons deux contextes méthodologiques contrastés : le premier laboratoire recrute une cohorte modeste de $N = 20$ patients, tandis qu’un consortium hospitalier déploie un recueil étendu incluant $N = 500$ patients. Dans les deux cas, la moyenne empirique observée se fixe exactement à $\bar{X} = 45$ points.
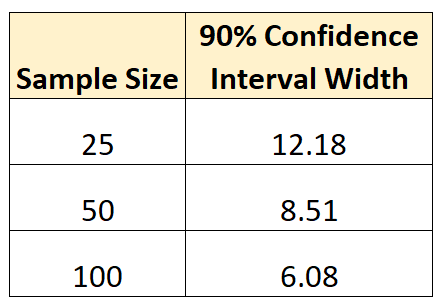
Pour le petit groupe ($N = 20$), la valeur critique de la loi de Student à $df = 19$ pour un seuil bilatéral de $\alpha = 0{,}05$ est égale à $t = 2{,}093$. L’erreur type s’élève à :
$$SE_1 = \frac{10}{\sqrt{20}} = \frac{10}{4{,}472} \approx 2{,}236$$
La marge d’erreur associée s’établit par conséquent à $2{,}093 \times 2{,}236 = 4{,}68$ points. L’intervalle de confiance à 95 % s’étend donc de 40,32 à 49,68 points. Un tel éventail englobe des profils cliniques distincts : un score de 40 caractérise une anxiété situationnelle modérée ou proche de la norme générale, alors qu’un score de 50 signale une anxiété sévère, nécessitant fréquemment une anxiolyse médicamenteuse préparatoire immédiate.
Examinons désormais le grand groupe ($N = 500$). La valeur critique pour $df = 499$ converge vers la valeur normale z de 1,965. L’erreur type se contracte de manière drastique :
$$SE_2 = \frac{10}{\sqrt{500}} = \frac{10}{22{,}36} \approx 0{,}447$$
La marge d’erreur n’est plus que de $1{,}965 \times 0{,}447 = 0{,}88$ point, circonscrivant l’intervalle de confiance à 95 % dans les bornes extrêmement étroites de 44,12 à 45,88 points. Ici, l’incertitude est quasi dissipée : l’équipe médicale peut certifier avec une haute précision statistique le degré exact de détresse psychologique éprouvé en moyenne par cette typologie de patients. Cette finesse d’évaluation permet de calibrer les protocoles d’intervention anesthésique ou de soutien psychologique préopératoire sans risquer de fonder la décision thérapeutique sur un artefact d’échantillonnage.
4. Puissance statistique et détection rigoureuse des effets réels
4.1 Définition formelle de la puissance statistique (1 – Bêta)
Dans le cadre de l’épistémologie de l’inférence par test d’hypothèse nulle formalisée par Neyman et Pearson, tout protocole expérimental s’organise autour de deux hypothèses concurrentes : l’hypothèse nulle ($H_0$), postulant l’absence de différence ou de corrélation dans la population, et l’hypothèse alternative ($H_1$), affirmant l’existence effective d’une divergence ou d’un lien fonctionnel. Cette structure probabiliste génère une matrice décisionnelle à quatre cadrans, gouvernée par deux types d’erreurs potentielles. L’erreur de première espèce (ou risque alpha, $\alpha$) survient lorsque le chercheur rejette à tort une hypothèse nulle qui est pourtant vraie. À l’inverse, l’erreur de seconde espèce (ou risque bêta, $\beta$) se produit lorsque le chercheur échoue à rejeter une hypothèse nulle qui est en réalité fausse dans la nature.
La puissance statistique d’un test se définit rigoureusement comme le complémentaire mathématique du risque bêta, c’est-à-dire $1 – \beta$. Elle quantifie la probabilité conditionnelle qu’un protocole expérimental détecte un effet et rejette formellement $H_0$, sachant que cet effet existe bel et bien dans la population parente. Dans les travaux fondateurs de Jacob Cohen, une convention empirique s’est imposée, fixant la puissance nominale minimale acceptable à 0,80 (soit 80 % de chances de détecter un effet existant, ce qui concède symétriquement un risque de faux négatif de 20 %). La puissance dépend d’un système interdépendant liant quatre grandeurs fondamentales :
- Le niveau de signification alpha ($\alpha$), conventionnellement fixé à 0,05 ;
- L’amplitude de l’effet existant dans la population (taille d’effet) ;
- La variabilité ou dispersion des mesures dans les groupes ;
- La taille de l’échantillon ($N$).
Dans ce quatuor, la taille de l’échantillon constitue la variable d’ajustement opérationnelle majeure sous le contrôle direct du chercheur.
4.2 L’erreur de type II dans les études sous-dimensionnées
L’erreur de type II ne constitue pas une simple abstraction statistique : elle possède des conséquences pratiques, scientifiques et sociétales dévastatrices. Lorsqu’un essai clinique ou une étude de psychologie appliquée souffre d’un sous-dimensionnement chronique, sa puissance statistique s’effondre fréquemment à des seuils oscillant entre 20 % et 40 %. Dans de telles conditions, le protocole ressemble à un jeu de hasard défavorable où, même si une intervention thérapeutique apporte un bénéfice authentique aux patients, l’étude échoue à atteindre le seuil conventionnel de significativité statistique ($p < 0{,}05$) plus d'une fois sur deux.
Le risque inhérent à cette situation est l’abandon pur et simple d’innovations cliniques ou psychothérapeutiques majeures. Un programme d’intervention cognitivo-comportementale ciblant la prévention du suicide ou le sevrage tabagique peut être abandonné par des décideurs de santé publique ou des investisseurs institutionnels au seul motif qu’une étude pilote sous-dimensionnée n’a pas affiché de valeur p statistiquement significative. L’accumulation historique de faux négatifs dans la littérature psychiatrique, neuropsychologique et éducative a ainsi retardé l’adoption de pratiques thérapeutiques prometteuses, tout en engloutissant en pure perte des capitaux publics et privés massifs dans des protocoles dont l’échec statistique était mathématiquement programmé dès leur conception.
4.3 Analyse de sensibilité : quelles variations de performance détecter ?
L’analyse de puissance ne se limite pas à déterminer le volume de recrutement requis avant le lancement d’une expérimentation ; elle permet également de mener des analyses dites de sensibilité à rebours. L’analyse de sensibilité consiste à calculer, pour une taille d’échantillon $N$ donnée et des paramètres d’erreur fixés (généralement $\alpha = 0{,}05$ et $1 – \beta = 0{,}80$), la magnitude minimale de l’effet que le dispositif est statistiquement capable de mettre en évidence. Cette démarche s’avère particulièrement éclairante lors de l’examen de protocoles portant sur les performances cognitives fines, telles que les variations de temps de réaction dans des tâches d’inhibition comme le test de Stroop ou la tâche de Simon.
Si une manipulation cognitive induit un ralentissement moyen du temps de réaction de l’ordre de 15 millisecondes avec un écart-type résiduel de 60 millisecondes, cela correspond à une taille d’effet modeste ($d = 0{,}25$). Si un laboratoire teste ce protocole sur un échantillon restreint de 30 participants par condition, l’analyse de sensibilité révèle que le test ne possède la puissance requise que pour repérer des variations massives, supérieures à 45 ou 50 millisecondes. Tout effet psychologique plus subtil mais scientifiquement fondamental devient alors indiscernable du bruit de fond expérimental. Cette incapacité méthodologique à discerner le signal psychologique conduit à confondre absence de significativité statistique et absence d’effet empirique, alimentant des controverses théoriques stériles qui trouvent leur origine exclusive dans le sous-dimensionnement méthodologique des cohortes.
5. L’erreur de type I et le paradoxe des petits échantillons
5.1 La fragilité statistique des découvertes basées sur de faibles effectifs
Si l’on conçoit intuitivement qu’un manque de puissance amplifie le risque de faux négatifs (erreur de type II), il est un paradoxe bien plus pernicieux, mis en lumière par la métascience contemporaine : les études fondées sur de faibles échantillons sont également le terreau de découvertes illusoires et de faux positifs. Certes, le formalisme fréquentiste garantit qu’en présence d’une hypothèse nulle stricte, le taux d’erreur de type I est bridé par le seuil nominal $\alpha$ (généralement 5 %). Cependant, la trajectoire des valeurs p dans des contextes de faible puissance présente une instabilité stochastique extrême. Dans un petit groupe, l’adjonction ou la suppression fortuite d’un unique participant peut faire basculer le résultat d’un p hautement significatif ($p = 0{,}01$) à une totale non-significativité ($p = 0{,}15$).
De plus, cette dynamique engendre ce que les statisticiens et économistes appellent l’effet de la « malédiction du vainqueur » (winner’s curse). Dans un paysage où la puissance moyenne d’un champ disciplinaire est basse et où seules les études franchissant la barrière de $p < 0{,}05$ sont sélectionnées pour publication, le processus de filtrage statistique sélectionne mécaniquement les fluctuations aléatoires qui s'alignent par hasard dans le sens de l'hypothèse testée. En conséquence, les effets publiés issus de petits échantillons ne reflètent presque jamais la réalité du phénomène ; ils correspondent systématiquement à sa plus haute surestimation possible. Cette vulnérabilité est amplifiée par la sensibilité disproportionnée des petits échantillons aux données aberrantes (outliers), où la présence d’un seul individu aux performances atypiques déplace artificiellement la moyenne et induit une corrélation illusoire.
5.2 La valeur prédictive positive d’une recherche empirique
L’impact de la taille d’échantillon sur la véracité des connaissances scientifiques prend toute sa dimension lorsqu’on quitte le cadre fréquentiste classique pour adopter un cadre probabiliste bayésien. La valeur prédictive positive (VPP) d’une recherche scientifique se définit comme la probabilité a posteriori qu’une hypothèse ayant généré un résultat statistiquement significatif soit réellement vraie dans l’univers. Dans un article devenu classique, le professeur John Ioannidis a formalisé mathématiquement les déterminants de cette valeur prédictive :
$$VPP = \frac{(1 – \beta) \cdot R}{(1 – \beta) \cdot R + \alpha}$$
où $(1 – \beta)$ représente la puissance statistique du test, $\alpha$ le risque d’erreur de type I, et $R$ le rapport des cotes (odds ratio) de la plausibilité a priori que l’hypothèse soit vraie avant l’expérimentation ($R = P(H_1) / P(H_0)$).
L’analyse de cette formule démontre que la véracité des résultats d’une discipline dépend directement de la puissance statistique moyenne de ses études. Lorsque la puissance $(1 – \beta)$ s’effondre en raison d’échantillons structurellement trop restreints, le numérateur rétrécit tandis que le terme alpha ($\alpha = 0{,}05$) conserve un poids relatif majeur au dénominateur. Si, de surcroît, le domaine explore des hypothèses novatrices ou audacieuses (faible cote a priori $R$), la valeur prédictive positive chute sous le seuil de 50 %. Cela signifie que, parmi toutes les découvertes déclarées statistiquement significatives et validées par l’arbitrage par les pairs dans une discipline dominée par de faibles effectifs, plus de la moitié constituent en réalité des faux positifs purs, induits par la conjonction néfaste d’une faible puissance et du hasard d’échantillonnage.
5.3 Exemple en neuropsychologie : Neuro-imagerie et faux positifs
Le champ de la neuropsychologie cognitive et de la neuro-imagerie fonctionnelle par résonance magnétique (IRMf) fournit une illustration historique des ravages induits par les petits échantillons. Au début des années 2000, le coût prohibitif des protocoles d’IRMf (pouvant dépasser plusieurs centaines d’euros par heure de scanner) a conduit de nombreuses équipes à publier des articles fondés sur des cohortes d’une faiblesse extrême, comprenant régulièrement entre 8 et 15 participants. Dans le même temps, le cerveau humain est numérisé en un maillage tridimensionnel contenant entre 50 000 et 150 000 unités de volume appelées « voxels ». Analyser ces données revient à conduire des dizaines de milliers de tests d’hypothèses simultanés pour repérer quelles régions s’activent lors d’une tâche cognitive.
La combinaison de petits échantillons et d’un volume colossal de tests multiples a engendré un nombre alarmant de faux positifs spectaculaires. L’illustration la plus célèbre de cette impasse méthodologique reste l’expérience menée par Bennett et ses collaborateurs en 2009, qui ont placé un saumon de l’Atlantique mort dans un scanner IRMf et lui ont présenté des photographies d’êtres humains dans des situations sociales diverses. En appliquant les seuils statistiques non corrigés alors fréquemment employés dans les petits échantillons, les auteurs ont détecté des grappes d’activation statistiquement « significatives » dans le cerveau du poisson décédé. De manière tout aussi troublante, des corrélations massives ($r > 0{,}80$) entre des dimensions de personnalité et des activités cérébrales localisées (souvent qualifiées de « corrélations vaudoues ») ont été dénoncées par Vul et ses collègues. Ces anomalies ont contraint la communauté de neuro-imagerie à réagir, menant à la constitution de consortiums internationaux capables de scanner des milliers de cerveaux pour obtenir des résultats stables et reproductibles.
6. La taille d’effet : signification pratique versus signification statistique
6.1 Indices classiques de la taille d’effet en sciences comportementales
Face à la dépendance mécanique de la valeur p vis-à-vis du volume d’observations, l’évaluation de la pertinence d’une recherche scientifique exige le recours systématique aux indices de taille d’effet. Une taille d’effet quantifie l’amplitude brute ou standardisée d’un phénomène psychologique, indépendamment de la taille de l’échantillon mobilisé pour l’observer. Contrairement au test de signification dont l’indicateur principal est binaire (le résultat franchit ou non le seuil de significativité), la taille d’effet propose une métrique continue décrivant la force du signal expérimental.
Dans la boîte à outils des sciences comportementales, plusieurs indices prévalent selon l’architecture du devis expérimental :
- Le d de Cohen : Dédié à la comparaison de deux moyennes indépendantes, il exprime la divergence entre les groupes en unités d’écart-type composite :
$$d = \frac{\bar{X}_1 – \bar{X}_2}{s_{\text{pooled}}}$$
Des valeurs de 0,20, 0,50 et 0,80 ont été conventionnellement qualifiées par Cohen d’effets faibles, moyens et forts, bien que ces balises doivent toujours être contextualisées. - Le coefficient de corrélation r de Pearson : Il mesure l’intensité de l’association linéaire entre deux variables continues, oscillant de -1 à +1.
- L’êta-carré ($\eta^2$) et l’êta-carré partiel ($\eta_p^2$) : Utilisés dans les modèles d’analyse de variance (ANOVA), ils quantifient la proportion de la variance totale du critère attribuable au facteur manipulé.
Ces métriques possèdent la vertu cardinale de refléter l’ampleur fonctionnelle d’un mécanisme psychologique sans être mathématiquement gonflées par le seul empilement de sujets supplémentaires.
6.2 L’illusion de signification créée par des échantillons massifs
Si la faiblesse d’un échantillon paralyse la puissance statistique, l’autre extrémité du spectre — l’usage d’échantillons massifs comprenant plusieurs centaines de milliers ou millions de participants, comme dans l’ère naissante des mégadonnées (big data) — engendre un écueil d’une nature différente : l’illusion de signification pratique. La mécanique computationnelle de la valeur p s’organise de telle sorte que la statistique de test ($z$, $t$ ou $F$) croît proportionnellement à $\sqrt{N}$. En conséquence directe, lorsque $N$ tend vers l’infini, la valeur p converge inévitablement vers zéro, quelle que soit la petitesse ou l’insignifiance clinique de la différence observée.
Dans une base de données de 500 000 individus, une corrélation infinitésimale de $r = 0{,}01$ ou une différence moyenne de 0,05 point sur une échelle de bien-être mental obtiendra un niveau de significativité extrême ($p < 0{,}000001$). Déduire de ce verdict statistique que la variable observée présente un intérêt théorique ou une utilité clinique constitue une erreur d'interprétation majeure. Dans de grands corpus, des micro-différences imputables à d'infimes bruits de mesure ou à des biais de méthode systématiques non modélisés deviennent artificiellement significatives. Il devient donc méthodologiquement impératif d'ancrer toute recherche dans la définition préalable d'une taille d'effet minimale d'intérêt clinique (Smallest Effect Size of Interest ou SESOI), sous peine de gaspiller l’attention scientifique sur des trivialités statistiques.
6.3 Exemple comparatif : Thérapie brève versus contrôle
Considérons l’évaluation d’une nouvelle approche de thérapie brève visant la prise en charge d’épisodes dépressifs légers à modérés, comparée à un groupe témoin sur liste d’attente. La variable d’évaluation est le score au questionnaire de dépression de Beck (BDI-II), dont l’échelle s’étend de 0 à 63. Supposons que l’effet véritable de cette thérapie dans la population soit très ténu : elle ne diminue le score de dépression que de 0,8 point en moyenne, avec un écart-type de population fixé à 10 points. La taille d’effet standardisée correspondante est donc de $d = 0{,}8 / 10 = 0{,}08$, ce qui représente un effet d’une amplitude négligeable au regard du fonctionnement clinique.
Dans un premier scénario, un centre de consultation teste ce protocole sur un groupe de $N = 50$ participants (25 par condition). Le calcul du test t de Student intergroupes aboutit à une valeur de $t \approx 0{,}28$, associée à une valeur p avoisinant 0,78. Le résultat est sans ambiguïté : l’intervention n’est pas statistiquement significative, reflétant l’incapacité pratique de la méthode à générer une différence palpable sur ce faible contingent.
Imaginons à présent le second scénario : la même thérapie est déployée à grande échelle dans le cadre d’un consortium national intégrant $N = 10,000$ participants (5 000 par condition). La différence moyenne observée reste strictement identique, soit 0,8 point. Cependant, sous l’effet multiplicateur du grand effectif, la statistique du test s’envole :
$$t = \frac{0{,}8}{10 \cdot \sqrt{\frac{1}{5000} + \frac{1}{5000}}} = \frac{0{,}8}{10 \cdot 0{,}02} = \frac{0{,}8}{0{,}20} = 4{,}00$$
La valeur p résultante plonge à $p \approx 0{,}00006$, permettant aux promoteurs du protocole d’affirmer avec une assurance statistique indiscutable que la thérapie « diminue significativement la dépression ». Pourtant, sur le plan clinique, une diminution de 0,8 point au BDI-II est imperceptible pour le patient et n’apporte aucun bénéfice fonctionnel dans sa vie quotidienne. Cet exemple démontre l’obligation absolue de subordonner la prise de décision thérapeutique et l’élaboration des politiques de santé publique à l’ampleur concrète du d de Cohen et aux gains cliniques réels, plutôt qu’à l’obtention mécanique d’une valeur p infinitésimale permise par des échantillons gigantesques.
7. Exemples appliqués en psychologie clinique, sociale et cognitive
7.1 Étude de cas en thérapie cognitivo-comportementale (TCC)
L’évaluation des psychothérapies au moyen d’essais contrôlés randomisés (ECR) illustre avec force les enjeux cliniques liés à la taille d’échantillon. Imaginons une équipe de recherche souhaitant tester l’adjonction d’un module d’exposition en réalité virtuelle immersive à une thérapie cognitivo-comportementale (TCC) classique chez des sujets souffrant de trouble panique avec agoraphobie. Dans ce type de devis thérapeutique, l’amplitude moyenne d’amélioration additionnelle documentée dans la littérature se situe aux alentours d’un d de Cohen de $d = 0{,}40$, traduisant un bénéfice clinique modeste mais réel.
Si l’équipe conduit son essai sur un petit échantillon de 20 participants par groupe ($N_{\text{total}} = 40$), la puissance statistique du test t bilatéral pour capturer cet effet ne dépasse pas 24 %. Les chercheurs ont donc trois chances sur quatre d’échouer à démontrer l’apport de la réalité virtuelle, non pas en raison de son inefficacité, mais parce que leur outil de mesure statistique souffre d’une myopie structurelle. De surcroît, la trajectoire longitudinale de rémission mesurée par des échelles hebdomadaires présente une grande hétérogénéité d’un patient à l’autre. Dans un échantillon de 20 personnes, la rechute inopinée de deux patients pour des événements de vie extérieurs fait chuter la moyenne du groupe, masquant l’efficacité globale du soin. En revanche, menée sur une cohorte robuste de 100 participants par groupe ($N_{\text{total}} = 200$, conférant une puissance statistique de 80 %), l’étude stabilise les trajectoires moyennes, dilue les singularités biographiques individuelles et permet de conclure avec rigueur à l’efficacité du protocole.
7.2 Expérimentation en psychologie sociale expérimentale
La psychologie sociale expérimentale a été le théâtre privilégié des débats méthodologiques récents, en particulier autour des phénomènes d’amorçage comportemental et de conformité implicite. Au cours des décennies passées, des protocoles audacieux affirmaient, par exemple, que l’exposition inconsciente à des termes évocateurs de la vieillesse induisait un ralentissement de la vitesse de marche chez de jeunes étudiants, ou que la présentation subliminale de concepts monétaires réduisait l’altruisme. Ces études initiales, fondées sur des échantillons modestes oscillant habituellement entre 15 et 30 étudiants par condition expérimentale, affichaient des tailles d’effet spectaculaires ($d > 0{,}80$).
Toutefois, la vague de réplications directes menée dans le cadre de grands projets multicentriques a radicalement transformé ces affirmations. Lorsque ces protocoles d’amorçage ont été reproduits avec des effectifs décuplés — engageant fréquemment de 500 à 1 000 participants par condition afin de traquer des effets faibles à modérés ($d = 0{,}15$ à $0{,}25$) —, la significativité statistique s’est dans la plupart des cas totalement évaporée. Les tailles d’effet initiales ont convergé vers des valeurs proches de zéro. Ces échecs de réplication ont mis en évidence la fragilité intrinsèque des paradigmes d’amorçage face aux petits échantillons, démontrant que les conclusions des pionniers étaient tributaires de fluctuations fortuites, de sélections d’analyses post-hoc et d’un manque criant de puissance statistique rendant les découvertes initiales chimériques.
7.3 Protocole en psychométrie et étalonnage d’échelles de personnalité
L’édification d’un test psychométrique robuste et standardisé requiert un niveau d’effectif bien supérieur à celui nécessaire pour une simple comparaison de moyennes intergroupes. Qu’il s’agisse de construire un instrument mesurant l’intelligence émotionnelle, l’épuisement professionnel ou les traits de personnalité pathologiques, la validation psychométrique repose sur l’analyse factorielle (qu’elle soit exploratoire, AFE, ou confirmatoire, AFC) afin de garantir la validité de construit de l’instrument.
La littérature spécialisée a longtemps véhiculé des règles empiriques simplistes, recommandant par exemple d’inclure 5 ou 10 participants par item du questionnaire. La modélisation moderne a toutefois prouvé la caducité de ces formules toutes faites. Lorsque la taille de l’échantillon est insuffisante (par exemple $N < 150$), la matrice de corrélation de Pearson entre les items subit des perturbations substantielles dues à l'erreur d'échantillonnage. En conséquence, l'analyse factorielle exploratoire tend à sur-extraire des facteurs erronés, menant à l'illusion de l'existence de dimensions psychologiques sans fondement réel. De plus, les coefficients fondamentaux de consistance interne, tels que l'alpha de Cronbach ou l'oméga de McDonald, affichent des marges d'erreur trop larges pour établir des seuils de détection diagnostique précis. Stabiliser la structure factorielle d'un inventaire de personnalité et certifier l'invariance de mesure à travers divers groupes d'âge ou de genre exige un échantillonnage substantiel, franchissant typiquement le palier des 300 à 500 répondants qualifiés.
8. La crise de reproductibilité : rôle historique des cohortes sous-dimensionnées
8.1 Genèse et diagnostic de la crise des réplications
La seconde décennie du XXIe siècle restera marquée dans l’histoire de la psychologie comme l’ère d’un examen méthodologique lucide et impitoyable, couramment qualifié de « crise de la reproductibilité ». Le signal d’alarme a retenti avec force lors de la publication en 2015 des travaux du consortium Open Science Collaboration. Cette initiative sans précédent, coordonnée par Brian Nosek, a réuni 270 chercheurs internationaux pour tenter la réplication directe et scrupuleuse de 100 études empiriques parues dans trois revues phares de la discipline (Journal of Personality and Social Psychology, Journal of Experimental Psychology: Learning, Memory, and Cognition, et Psychological Science).
Le diagnostic final s’est révélé alarmant : alors que 97 % des articles initiaux déclaraient des effets statistiquement significatifs, seules 36 % des réplications ont réussi à obtenir une valeur de $p < 0{,}05$. De surcroît, l'amplitude moyenne des effets mis en évidence au sein des réplications s'est effondrée à la moitié de celle initialement publiée. Parmi les différents facteurs diagnostiqués par les métascientifiques pour expliquer cette discordance systémique, la faiblesse chronique des effectifs d'échantillon des articles princeps est ressortie comme la cause majeure. Des décennies de littérature avaient reposé sur des cohortes dont la puissance médiane plafonnait autour de 50 %, transformant une large fraction du corpus empirique en un champ d'affirmations fragiles incapables de résister à une réitération méthodologiquement robuste.
8.2 Les pratiques de recherche douteuses stimulées par le manque de puissance
Le sous-dimensionnement historique des échantillons de recherche en psychologie n’était pas neutre : il a fonctionné comme un catalyseur puissant favorisant le déploiement de pratiques de recherche douteuses (Questionable Research Practices ou QRP). Dans un environnement académique structuré par l’injonction impérieuse de « publier ou périr » (publish or perish), combiné au refus historique des revues scientifiques d’accueillir des résultats non significatifs (biais de publication), les chercheurs confrontés à des petits échantillons impuissants ont développé des stratégies compensatoires délétères.
L’une des dérives les plus documentées est le « p-hacking », qui englobe un éventail d’adaptations opportunistes au cours de l’analyse : exclusion rétroactive de participants déclarés atypiques, arrêt prématuré de la collecte dès que la barre de $p < 0{,}05$ est franchie, ou sélection opportuniste de variables dépendantes secondaires. À cette dérive s'ajoute le phénomène du « HARKing » (Hypothesizing After the Results are Known), formalisé par Kerr, où le chercheur réécrit son introduction théorique pour faire passer une fluctuation aléatoire inattendue survenue dans son petit groupe pour une hypothèse déduite a priori. Les cohortes réduites offrent une plasticité statistique idéale à ces pratiques : le bruit y étant très prononcé, il est aisé d’y sculpter une association fortuite et spectaculaire au détriment de l’intégrité de l’édifice scientifique cumulatif.
8.3 Réformes institutionnelles et méthodologiques contemporaines
Face à la profondeur de la crise, la communauté scientifique a impulsé une révolution méthodologique salutaire, reconfigurant les normes de diffusion du savoir. Les comités éditoriaux des principales revues internationales de psychologie ont considérablement durci leurs exigences, contraignant les auteurs à justifier rigoureusement, en amont de toute acceptation, la puissance statistique garantie par la taille de leur effectif empirique.
L’innovation structurelle majeure réside dans l’émergence des rapports pré-enregistrés (Registered Reports). Dans ce format éditorial novateur, le protocole expérimental, les hypothèses théoriques et le plan d’échantillonnage détaillé (incluant le calcul formel de puissance a priori) sont soumis à l’évaluation par les pairs avant même le commencement de la collecte des données. Si le devis est validé, la revue s’engage contractuellement à publier l’article final, que les résultats confirment ou infirment les hypothèses. Parallèlement, l’essor de vastes consortiums collaboratifs, tels que le Psychological Science Accelerator, permet désormais de mutualiser les moyens d’une centaine de laboratoires à travers le monde pour constituer des échantillons de plusieurs dizaines de milliers de personnes, asséchant ainsi les mécanismes d’erreur liés au travail isolé sur de petites cohortes.
9. Planification a priori : Le calcul de la taille d’échantillon
9.1 Composantes fondamentales de l’analyse de puissance a priori
L’analyse de puissance a priori s’impose aujourd’hui comme la norme méthodologique d’excellence dans la conception de toute étude quantitative. Conduite avant la phase de recueil des données, elle a pour fonction de déterminer mathématiquement le volume exact de sujets nécessaires pour tester une hypothèse scientifique avec un niveau de confiance et de puissance prédéterminé. Son exécution exige la fixation rigoureuse de quatre paramètres fondamentaux articulés par les équations de probabilité :
- Le risque d’erreur de première espèce ($\alpha$) : Fixé de manière standardisée à 0,05 dans les sciences humaines, il définit la propension tolérée à déceler un effet là où il n’existe pas.
- La puissance statistique ciblée ($1 – \beta$) : Si le seuil de 80 % demeure un plancher conventionnel, les devis contemporains visent préférentiellement une puissance de 90 % ou 95 % pour minimiser l’aléa méthodologique.
- L’amplitude présumée de l’effet ($\delta$, $r$, ou $f$) : Il s’agit du paramètre le plus délicat à renseigner. Fonder cette estimation sur des études antérieures publiées expose au risque de s’aligner sur des valeurs artificiellement gonflées par le biais de publication. L’approche la plus solide consiste à calibrer l’effectif sur la taille d’effet minimale considérée comme cliniquement ou théoriquement signifiante (SESOI).
- La structure du test d’hypothèse : Le choix d’une approche unilatérale ou bilatérale, ainsi que l’appariement des groupes (échantillons indépendants ou mesures répétées), conditionne directement le volume requis.
9.2 Outils informatiques de référence pour les chercheurs
L’intégration de la statistique computationnelle au travail des chercheurs a été facilitée par la mise à disposition de logiciels dédiés de haute technicité. Parmi les outils de référence trône le logiciel G*Power, développé à l’Université Heinrich Heine de Düsseldorf. Gratuit et exhaustif, il permet de calibrer les calculs de puissance à travers une multitude de devis, qu’il s’agisse de tests t, de familles de régressions multiples, ou de modélisations complexes sous ANOVA univariée ou multivariée.
Au sein de l’écosystème open-source R, les bibliothèques spécialisées offrent un contrôle algorithmique encore plus poussé. Le package pwr implémente les algorithmes canoniques de Cohen pour les devis expérimentaux standards. Lorsqu’il s’agit d’aborder des devis plus élaborés, tels que les modèles linéaires à effets mixtes (LMM) omniprésents en psycholinguistique et en neurosciences, le package simr s’impose comme un standard. Plutôt que de reposer sur des formules analytiques fermées souvent indisponibles dans les devis imbriqués, simr emploie des méthodes de simulation de Monte-Carlo : il simule des milliers de jeux de données synthétiques selon les paramètres postulés par le chercheur et calcule empiriquement le pourcentage d’itérations au sein desquelles le modèle parvient à rejeter l’hypothèse nulle, fournissant une estimation réaliste du $N$ nécessaire.
9.3 Ajustements méthodologiques pour attrition et données manquantes
Le calcul théorique de la puissance fournit un effectif idéal d’observations finales exploitables, mais il omet une composante récurrente du travail empirique : l’attrition. Dans les études longitudinales, les protocoles de suivi clinique ou les enquêtes impliquant des batteries de tests répétées sur plusieurs semaines, la déperdition de participants entre la ligne de base et le point final d’évaluation constitue une constante méthodologique. Les déménagements, la survenue d’effets secondaires, le désengagement motivationnel ou le décès de patients sont autant d’aléas réduisant la taille exploitable de la cohorte finale.
Face à cette réalité, le chercheur doit calculer un effectif d’inclusion corrigé préventif, noté $N^*$, intégrant le taux de désistement prévisible ($A$) au moyen de la formule classique :
$$N^* = \frac{N_{\text{requis}}}{1 – A}$$
Par exemple, si le protocole réclame impérativement $N = 160$ patients pour maintenir une puissance de 80 %, et que l’on anticipe une attrition de 20 % au terme des 12 mois de suivi thérapeutique, le volume d’inclusion initial doit être porté à $160 / (1 – 0{,}20) = 200$ patients. Cet ajustement permet de s’assurer que, malgré les données manquantes inéluctables, l’effectif final ne descendra pas en deçà du seuil critique de puissance statistique requis pour la validité des conclusions scientifiques.
10. Complexité expérimentale : Modèles avancés et implications pour l’échantillon
10.1 Plans factoriels et interactions psychologiques complexes
L’étude de l’esprit humain ne se limite que très rarement à l’analyse d’une seule variable indépendante isolée. Les modèles théoriques contemporains s’intéressent aux interactions complexes, cherchant à déterminer dans quelle mesure l’effet d’une manipulation psychologique est modulé ou amplifié par un second facteur contextuel ou individuel (par exemple, l’efficacité d’un traitement en fonction du niveau d’anxiété de base des individus, structuré selon un plan factoriel $2 \times 2$).
Sur le plan mathématique, détecter un effet d’interaction réclame une taille d’échantillon considérablement plus volumineuse que celle requise pour tester un simple effet principal. Comme l’a élégamment démontré le statisticien Andrew Gelman, l’estimation d’un terme d’interaction exige généralement un effectif au minimum quatre fois supérieur (et dans certaines configurations géométriques, seize fois supérieur) à celui nécessaire pour identifier un effet principal d’amplitude comparable avec le même niveau de puissance. Cette inflation tient au fait que le calcul de l’interaction compare des différences de différences, ce qui divise les groupes en sous-cellules matricielles d’effectifs réduits et démultiplie l’erreur d’échantillonnage combinée. Sous-estimer cette réalité mathématique conduit régulièrement les chercheurs à monter des protocoles factoriels sous-alimentés, dans lesquels les analyses de modération n’ont presque aucune chance d’atteindre le seuil de significativité statistique, même face à des modulations théoriquement substantielles.
10.2 Modélisation multiniveau et données hiérarchiques
De très nombreuses recherches en sciences du comportement collectent des données présentant une structure hiérarchique ou imbriquée (nested data). C’est le cas des élèves évalués au sein de différentes classes scolaires, des patients pris en charge par divers thérapeutes dans plusieurs centres hospitaliers, ou des mesures cognitives répétées dans le temps chez un même individu. Dans de tels contextes, l’hypothèse d’indépendance des erreurs — pierre angulaire des tests statistiques classiques de Gauss et de Student — est formellement violée par l’existence d’une ressemblance accrue entre observations appartenant à une même unité de regroupement.
Pour dimensionner correctement ces devis multiniveaux, il est impératif d’évaluer la dépendance contextuelle au moyen du coefficient de corrélation intraclasse (ICC, noté $rho$). Ce coefficient quantify le rapport entre la variance inter-groupes et la variance totale :
$$\rho = \frac{\sigma_{\text{entre}}^2}{\sigma_{\text{entre}}^2 + \sigma_{\text{intra}}^2}$$
L’accroissement de la taille globale de l’échantillon dans ces devis ne doit pas se faire uniquement par l’empilement d’individus de niveau 1. En présence d’un ICC non nul, la puissance statistique est massivement gouvernée par le nombre d’unités de regroupement de niveau 2 (le nombre de classes, d’écoles ou de thérapeutes). Recruter 1 000 élèves répartis au sein de seulement 4 écoles produit une puissance analytique médiocre pour tester des prédicteurs scolaires, alors que recruter ces mêmes 1 000 élèves distribués à travers 50 établissements différents offre une puissance supérieure et des estimations de variance non biaisées.
10.3 Modélisation par équations structurelles (SEM)
La modélisation par équations structurelles (Structural Equation Modeling, SEM) réunit en un cadre mathématique unifié l’analyse factorielle confirmatoire et la régression linéaire multivariée. Utilisée pour cartographier les réseaux de médiation complexes et tester la plausibilité de modèles théoriques globaux comprenant des variables latentes inobservées, la SEM impose des contraintes computationnelles sévères en matière de taille d’échantillon. Dans ce type d’approche, le nombre de paramètres libres à estimer (variances, covariances des variables latentes, coefficients de saturation, erreurs résiduelles) croît rapidement avec la complexité du réseau théorique.
Des règles heuristiques ont historiquement préconisé un ratio minimal de 10 à 20 participants par paramètre libre estimé dans le modèle, fixant dans la pratique un effectif absolu rarement inférieur à 200 ou 300 répondants pour les modèles simples. Ces recommandations doivent néanmoins être modulées en fonction du comportement distributionnel des variables. Si les données s’écartent de la normalité multivariée, les méthodes d’estimation classiques basées sur le maximum de vraisemblance (ML) voient leurs erreurs types sous-estimées et la statistique du Chi-deux de sur-ajustement artificiellement gonflée, réclamant l’application de corrections asymptotiques robustes (comme l’estimateur de Satorra-Bentler) et des effectifs supérieurs à 500 individus. De surcroît, le comportement des indices d’ajustement global les plus populaires, tels que le CFI (Comparative Fit Index) ou le RMSEA (Root Mean Square Error of Approximation), s’avère hautement instable dans les petits échantillons, générant des rejets erronés de modèles pourtant corrects.
11. Approches alternatives et paradigmes novateurs
11.1 Le paradigme bayésien face aux contraintes d’échantillonnage
Face aux rigidités formelles de l’inférence fréquentiste et aux impasses générées par le seuil binaire de la valeur p, de nombreux méthodologistes préconisent le recours à la statistique bayésienne pour repenser la question de la taille d’échantillon. Dans le cadre bayésien, l’objectif n’est pas d’accepter ou de rejeter formellement une hypothèse nulle en fonction d’un risque d’erreur théorique sur des réplications infinies, mais d’actualiser la distribution de probabilité des paramètres au vu des données empiriques observées, en utilisant les facteurs de Bayes (Bayes Factors, $BF$).
Le facteur de Bayes $BF_{10}$ quantifie directement le poids de l’évidence empirique en faveur du modèle de l’hypothèse alternative par rapport au modèle nul. Cette approche transforme la gestion de la taille d’échantillon en ouvrant la voie à l’échantillonnage séquentiel adaptatif. Dans le paradigme fréquentiste standard, collecter des données, réaliser un test, ajouter des sujets si le résultat n’est pas significatif et tester à nouveau viole gravement les présupposés probabilistes et multiplie le risque de faux positifs. À l’inverse, dans le formalisme bayésien, le chercheur peut évaluer le facteur de Bayes de façon séquentielle après chaque participant ou bloc de participants. La collecte s’interrompt naturellement dès lors qu’un seuil prédéterminé de preuve épistémique est atteint (par exemple un $BF > 10$ en faveur de l’effet, ou à l’inverse un $BF < 1/10$ documentant rigoureusement une absence d'effet). Cette méthode optimise l'allocation des ressources scientifiques en évitant d'inclure des participants inutiles lorsque la preuve empirique est déjà acquise.
11.2 Devis de recherche à cas unique (SCED) et mesures répétées intenses
Il existe des configurations cliniques ou neuroscientifiques spécifiques où le recrutement d’une large cohorte s’avère structurellement irréalisable : étude de pathologies cérébrales rarissimes (comme le syndrome de Kluver-Bucy), interventions thérapeutiques d’ultra-pointe ou protocoles de rééducation individualisés. L’alternative méthodologique consiste alors à renverser la perspective de l’échantillonnage : plutôt que d’échantillonner un grand nombre d’individus ($N$), la recherche échantillonne un très grand nombre d’observations temporelles concentrées sur un nombre minuscule de sujets ($N = 1$ ou devis à cas uniques, Single-Case Experimental Designs, SCED).
Dans ces protocoles expérimentaux à mesures répétées intenses (comme les devis en ligne de base multiple ABAB), l’individu sert de son propre témoin. La puissance statistique est obtenue par la densité temporelle des mesures plutôt que par la multiplicité des sujets. Cette logique a trouvé une extension contemporaine majeure à travers la méthode d’échantillonnage des expériences vécues (Experience Sampling Method, ESM) ou évaluation écologique momentanée (EMA). En sollicitant les participants plusieurs fois par jour via des applications mobiles pour mesurer leurs fluctuations d’humeur, d’anxiété ou de stress contextuel, ces protocoles cumulent des milliers de points de données pour quelques dizaines d’individus. Cette modélisation idiographique permet de capter la dynamique causale intra-individuelle des troubles psychiques avec une précision statistique que les analyses transversales de grands groupes ne parviennent pas à appréhender.
11.3 Méta-analyses et synthèse cumulative des données
Aucune étude empirique isolée, quelle que soit la rigueur de son dimensionnement initial, ne saurait clore définitivement un débat théorique ou clinique. L’accumulation méthodique du savoir psychologique repose sur la méta-analyse, un protocole mathématique visant à synthétiser statistiquement les résultats d’un ensemble d’études indépendantes consacrées à la même interrogation scientifique. La méta-analyse constitue le remède ultime aux faiblesses individuelles des échantillons en agrégeant les données de multiples cohortes modestes pour dégager une taille d’effet moyenne pondérée dotée d’une puissance statistique globale optimale.
Dans ce processus d’agrégation, chaque étude est pondérée par l’inverse de sa variance d’échantillonnage ($w_i = 1 / SE_i^2$). Cette formule mathématique attribue mécaniquement un poids substantiel aux cohortes étendues dotées d’une faible marge d’erreur, tout en minorant l’influence des petits échantillons intrinsèquement instables. De plus, la méta-analyse moderne intègre des outils d’évaluation diagnostique sophistiqués, tels que le tracé en entonnoir (funnel plot) et les tests de régression d’Egger. Ces instruments inspectent la symétrie de la distribution des tailles d’effet en regard de l’erreur type des études. Ils permettent de repérer la disparition anormale des petits échantillons affichant des résultats nuls et d’ajuster mathématiquement l’estimation globale pour corriger l’empreinte laissée par le biais de publication dans l’histoire de la discipline.
12. Recommandations pratiques pour la conception de recherches psychologiques robustes
12.1 Directives déontologiques et rédactionnelles (normes APA)
L’assainissement de la méthodologie en sciences psychologiques passe par l’adoption stricte des standards de transparence éditoriale édictés par les sociétés savantes, au premier rang desquelles figure l’American Psychological Association (normes APA 7e édition, via le document des Journal Article Reporting Standards, JARS). Ces directives obligent désormais les chercheurs à consigner dans la section Méthode de leurs manuscrits une justification transparente, détaillée et traçable de la taille de leur échantillon.
Cette formalisation impose de déclarer sans ambiguïté :
- L’ensemble des paramètres ayant guidé le calcul de puissance a priori (incluant le logiciel employé, la taille d’effet minimale attendue et sa justification théorique) ;
- Les règles d’arrêt précises de la collecte des données (certifiant que celle-ci a été achevée avant toute analyse d’hypothèse) ;
- La politique de gestion des abandons, des exclusions méthodologiques et des données manquantes.
De surcroît, les normes contemporaines exigent que chaque statistique d’inférence rapportée soit systématiquement accompagnée de sa taille d’effet standardisée et de son intervalle de confiance à 95 %, reléguant la valeur p à sa fonction d’indice d’incertitude décisionnelle et interdisant toute conclusion fondée exclusivement sur un statut binaire de significativité.
12.2 Stratégies d’optimisation en contexte de ressources limitées
Concevoir une recherche méthodologiquement robuste en présence de contraintes logistiques sévères ne condamne pas nécessairement le laboratoire à l’impuissance statistique. Il existe des stratégies de planification expérimentale permettant de maximiser la puissance statistique sans démultiplier l’effectif brut. La démarche la plus féconde consiste à privilégier les plans intra-sujets (mesures répétées) par rapport aux plans inter-sujets (groupes indépendants). En faisant passer chaque participant par l’ensemble des conditions expérimentales, la variabilité interindividuelle stable s’annule dans les calculs de comparaison différentielle, ce qui contracte l’erreur résiduelle et démultiplie la puissance du test pour un nombre total de sujets bien inférieur.
Une seconde stratégie repose sur l’optimisation psychométrique des instruments de recueil. L’erreur de mesure agit comme un bruit de fond qui compresse artificiellement la taille d’effet observée et dégrade la puissance du dispositif. En substituant à un questionnaire rudimentaire une batterie psychométrique affichant une haute fidélité test-retest et une consistance interne élevée, le chercheur réduit la variance d’erreur et amplifie le signal expérimental. Enfin, la voie de l’avenir pour les équipes aux moyens limités réside dans la science ouverte et la collaboration en réseaux : rejoindre des consortia de collecte multi-sites ou mutualiser des bases de données institutionnelles permet d’atteindre des effectifs massifs tout en partageant les coûts de recueil de manière équitable et solidaire.
12.3 Synthèse épistémologique : Vers une science psychologique cumulative et fiable
L’attention portée à la taille de l’échantillon ne relève pas d’une obsession procédurale déconnectée du fond théorique ; elle constitue la condition d’existence même d’une science psychologique cumulative. Le modèle des études sous-dimensionnées, conduites à la hâte sur quelques dizaines de participants captés pour valider une intuition théorique spectaculaire mais fragile, a atteint ses limites historiques. Ce paradigme a gaspillé des ressources humaines inestimables, alimenté le scepticisme du public et des institutions, et différé l’intégration pérenne de la psychologie dans le concert des sciences quantitatives rigoureuses.
Le calibrage consciencieux de la taille de l’échantillon représente, en dernière analyse, un engagement moral et civique envers la société. Les découvertes de la psychologie clinique, du développement de l’enfant, de l’ergonomie cognitive ou de la dynamique des groupes ont vocation à guider des décisions de politique publique, des protocoles de soin psychiatrique et des réformes éducatives fondamentales. Fonder ces choix de société sur des résultats empiriques fragiles constitue un risque éthique inacceptable. En réaffirmant le rôle de l’échantillon comme clé de voûte de la solidité théorique, la communauté scientifique se donne les moyens de bâtir un savoir reproductible, digne de la confiance de la société civile et à la hauteur de la complexité de l’esprit humain.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bennett, C. M., Miller, M. B., & Wolford, G. L. (2009). Neural correlates of interspecies perspective taking in the post-mortem Atlantic Salmon: An argument for multiple comparisons correction. NeuroImage, 47(Suppl 1), S125. https://doi.org/10.1016/S1053-8119(09)71202-9
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175-191. https://doi.org/10.3758/BF03193146
Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641-651. https://doi.org/10.1177/1745691614551642
Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2-3), 61-83. https://doi.org/10.1017/S0140525X0999152X
Ioannidis, J. P. A. (2005). Why most published research findings are false. PLOS Medicine, 2(8), e124. https://doi.org/10.1371/journal.pmed.0020124
Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196-217. https://doi.org/10.1207/s15327957pspr0203_4
Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267
Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333-380. https://doi.org/10.1098/rsta.1937.0005
Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359-1366. https://doi.org/10.1177/0956797611417632
Vul, E., Harris, C., Winkielman, P., & Pashler, H. (2009). Puzzlingly high correlations in fMRI studies of emotion, personality, and social cognition. Perspectives on Psychological Science, 4(3), 274-290. https://doi.org/10.1111/j.1745-6924.2009.01125.x