
Dans le domaine des sciences du comportement, de la psychologie cognitive, de la neuropsychologie et des sciences sociales, la conception expérimentale constitue le socle sur lequel repose la validité de toute inférence scientifique. Lorsque des chercheurs entreprennent de tester des hypothèses relatives aux effets différentiels d’interventions thérapeutiques, de paradigmes mnésiques ou de stimuli sensoriels, la distribution des sujets au sein des diverses conditions expérimentales détermine la structure sous-jacente des données recueillies. Cette répartition numérique engendre deux configurations méthodologiques fondamentales : les plans expérimentaux équilibrés, caractérisés par un nombre rigoureusement identique de participants au sein de chaque cellule du plan, et les plans non équilibrés, dans lesquels les effectifs cellulaires varient de manière plus ou moins prononcée.
Bien que cette distinction puisse paraître de prime abord comme un simple détail d’intendance logistique ou une commodité d’échantillonnage, elle entraîne en réalité des répercussions mathématiques, conceptuelles et interprétatives majeures. L’équilibre ou le déséquilibre d’un protocole affecte la structure géométrique du modèle linéaire général, la stricte orthogonalité des variables explicatives, l’estimation des sommes des carrés, la robustesse des tests statistiques face aux violations des postulats fondamentaux, ainsi que la puissance nécessaire pour détecter des effets réels. Méconnaître ces implications expose le chercheur à des erreurs méthodologiques insidieuses, allant de la sous-estimation de la taille d’effet à une inflation dramatique de l’erreur de Type I ou à une distorsion trompeuse des interactions factorielles.
Le présent article propose une exploration approfondie et rigoureuse des plans équilibrés et non équilibrés. À travers une analyse comparative des propriétés algébriques de la variance, de la théorie du modèle linéaire, de la décomposition des sommes des carrés et des stratégies d’estimation modernes (notamment les modèles mixtes et l’estimation par le maximum de vraisemblance restreint), nous exposerons les mécanismes par lesquels la symétrie ou l’asymétrie de l’échantillon conditionne la validité des conclusions empiriques en psychologie expérimentale.
1. Introduction aux plans expérimentaux en psychologie statistique
1.1 Le rôle central de l’analyse de variance dans la recherche expérimentale
L’analyse de variance (ANOVA), formalisée initialement par le statisticien et généticien Sir Ronald A. Fisher dans les années 1920, constitue la pierre angulaire de l’inférence statistique au sein de la psychologie comportementale et cognitive. Conçue initialement pour isoler les composantes de la variabilité dans des contextes agronomiques contrôlés, la technique a rapidement été adoptée par les psychologues expérimentateurs pour départager les effets systématiques induits par les manipulations expérimentales des fluctuations aléatoires inhérentes à l’échantillonnage des populations humaines. Dans le paradigme néo-béhavioriste puis cognitiviste, l’établissement d’une relation de cause à effet repose sur la manipulation délibérée de variables indépendantes catégorielles et sur la mesure de leurs répercussions sur une variable dépendante continue, opérationnalisant ainsi des construits théoriques complexes tels que le temps de réaction, le rappel mnésique ou l’intensité d’une réponse affective.
La puissance conceptuelle de l’ANOVA découle de sa capacité à partitionner la somme totale des écarts à la moyenne générale en composantes distinctes et identifiables. En décomposant la variabilité totale en une fraction attribuable aux différences entre les traitements expérimentaux (la variance inter-groupes) et une fraction reflétant l’hétérogénéité intrinsèque des participants au sein d’une même condition (la variance intra-groupe ou résiduelle), le chercheur calcule un ratio de variance, le test F de Fisher-Snedecor. Ce ratio permet de confronter directement l’hypothèse nulle d’égalité des moyennes de population à l’hypothèse alternative postulant l’existence d’au moins une divergence systématique induite par le traitement expérimental.
Cependant, l’élégance formelle de cette technique repose sur une modélisation mathématique précise, intégrée au modèle linéaire général. L’évaluation de l’impact des variables indépendantes présuppose que les données soient issues d’un processus de génération respectant certaines contraintes structurelles. Dans ce cadre, la structuration des groupes d’observation ne constitue pas un choix neutre : elle détermine la manière dont les vecteurs de prédiction sous-jacents se projettent dans l’espace multidimensionnel des observations, définissant l’indépendance statistique des sources de variation et conditionnant directement la validité des inférences déduites des tests de significativité.
1.2 La typologie générale des protocoles inter-sujets
Au sein de la méthodologie expérimentale en psychologie, les protocoles de recherche sont communément segmentés en deux grandes architectures fondamentales : les plans intra-sujets (ou à mesures répétées), où chaque participant est soumis à l’ensemble des modalités du facteur étudié, et les plans inter-sujets (ou protocoles à groupes indépendants), dans lesquels chaque individu n’est exposé qu’à une seule et unique condition expérimentale. Ces derniers se déclinent eux-mêmes en plans unifactoriels, n’impliquant qu’une seule variable indépendante distribuée en deux ou plusieurs modalités discrètes, et en plans factoriels multifactoriels (de type 2×2, 3×2, ou d’ordre supérieur), permettant d’examiner simultanément l’influence conjointe de plusieurs variables explicatives ainsi que leurs termes d’interaction.
La structuration interne de ces protocoles inter-sujets soulève immédiatement la question de l’allocation des unités expérimentales aux différentes cellules matricielles générées par le croisement des facteurs. Dans un monde expérimental idéal, le chercheur dispose du contrôle absolu sur le processus d’assignation aléatoire, ce qui lui permet de répartir un effectif prédéterminé de participants de façon strictement symétrique entre les différentes modalités. Néanmoins, la réalité des laboratoires de psychologie confronte fréquemment les investigateurs à des contraintes opérationnelles, éthiques ou intrinsèques aux populations cliniques, conduisant à des cellules de traitement dotées d’effectifs inégaux.
Cette distinction entre allocation symétrique et asymétrique n’est pas qu’une commodité descriptive ; elle constitue un élément déterminant de la robustesse inférentielle du protocole. L’architecture d’un plan factoriel inter-sujets impose des contraintes spécifiques sur la matrice d’expérience. Lorsque les tailles d’échantillons divergent d’une cellule à l’autre, les propriétés de décomposition de la variance s’altèrent de manière radicale. Dès lors, la typologie des plans d’expérience ne peut se limiter à la seule nomenclature du nombre de facteurs, mais doit obligatoirement intégrer la dynamique des effectifs cellulaires, conditionnant la sélection ultérieure des algorithmes d’estimation statistique et la portée théorique des conclusions tirées des données.
2. Définition et caractérisation mathématique des plans équilibrés
2.1 Le principe d’égalité des effectifs cellulaires
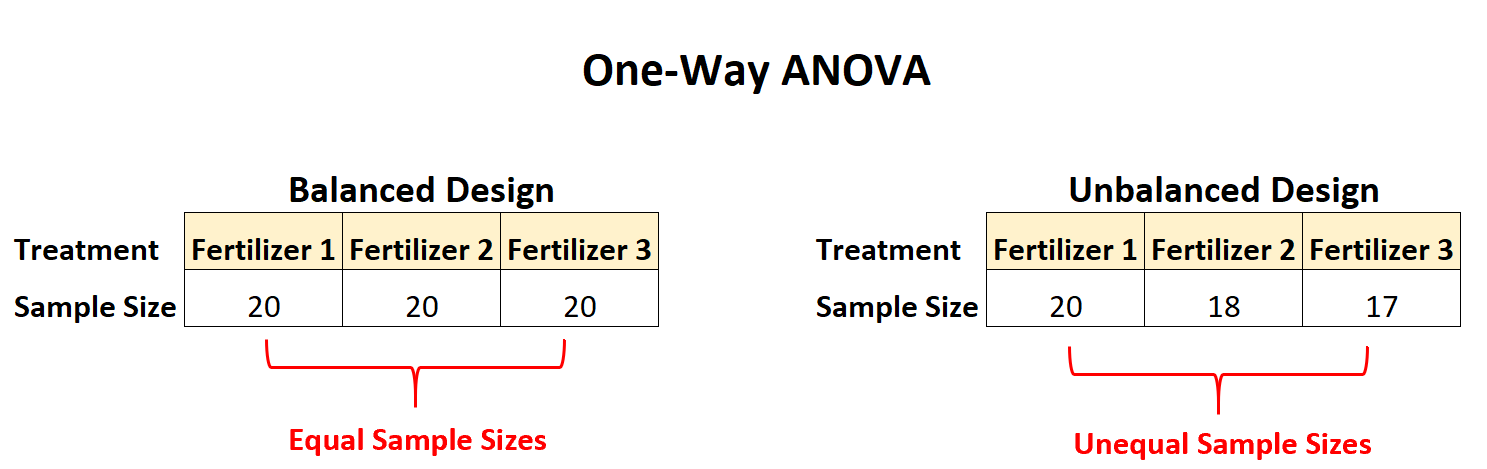
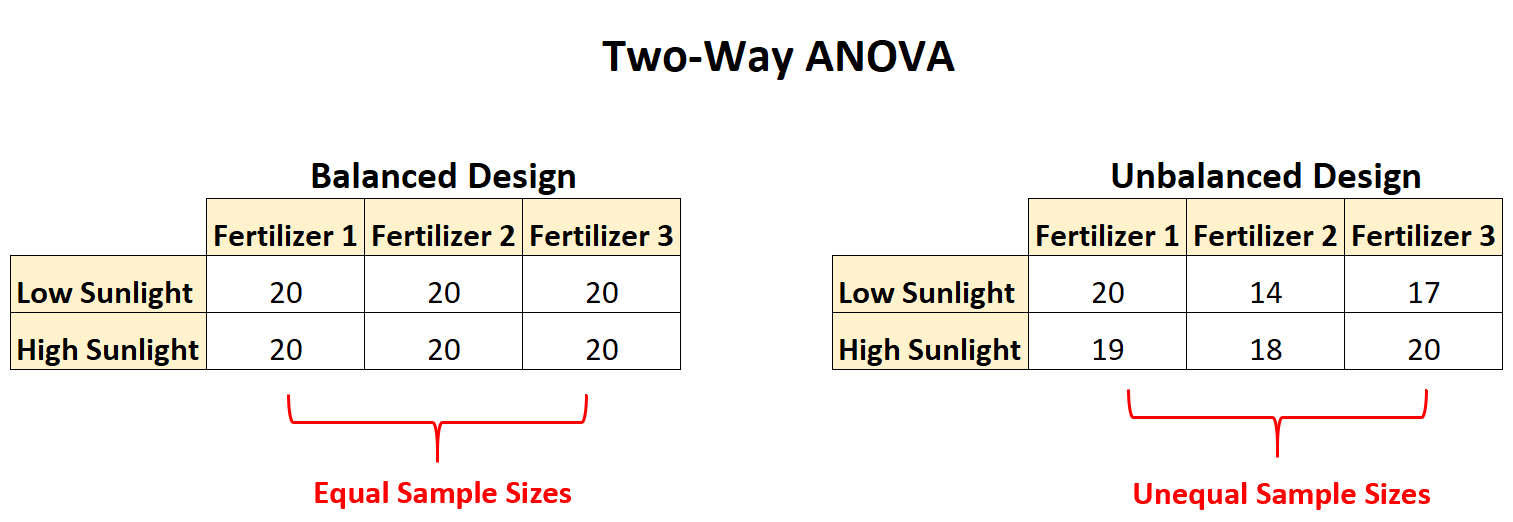
Un plan expérimental est formellement qualifié d’équilibré (ou de symétrique) lorsque la taille de l’échantillon assigné à chaque cellule de traitement expérimental est strictement identique. D’un point de vue algébrique, si l’on considère un plan unifactoriel comportant k modalités d’un facteur, la condition d’équilibre s’exprime par la relation rigoureuse n1 = n2 = … = nk = n, où n représente la taille commune de chaque groupe, le nombre total d’observations étant alors N = k × n. Dans le cas d’un plan factoriel à deux facteurs A et B comportant respectivement I et J modalités, l’équilibre impose que l’effectif de chaque cellule ij soit invariant, soit nij = n pour tout i appartenant à {1, …, I} et tout j appartenant à {1, …, J}, l’effectif total s’élevant alors à N = I × J × n.
Cette stricte égalité numérique confère au plan une propriété fondamentale : la distribution parfaitement uniforme des degrés de liberté associés à chaque condition d’observation. Dans un tel agencement, chaque sous-groupe expérimental contribue de façon égale à la détermination du pôle de référence global constitué par la moyenne générale de l’échantillon. La variance résiduelle intra-groupe est alors estimée par la moyenne arithmétique exacte des variances calculées au sein de chaque cellule, sans qu’il soit nécessaire d’appliquer une pondération différentielle pour compenser une quelconque asymétrie de représentativité :
Le carré moyen de l’erreur (CME ou MSE) correspond directement à la somme des variances d’échantillon divisée par le nombre de groupes :
MSE = (s12 + s22 + … + sk2) / k
D’un point de vue géométrique, l’égalité des effectifs garantit que les vecteurs indicatrices représentant les traitements au sein de la matrice de plan occupent des configurations d’équidistance dans l’espace euclidien de dimension N. Cette propriété élimine toute distorsion dans la projection des observations sur les sous-espaces vectoriels associés aux différents effets, assurant une parfaite indépendance géométrique entre les composantes du modèle linéaire.
2.2 L’orthogonalité parfaite des prédicteurs
La conséquence algébrique la plus remarquable de l’équilibre des effectifs réside dans la propriété d’orthogonalité stricte des prédicteurs au sein de la matrice de régression associée au modèle d’ANOVA. Dans le cadre de l’espace vectoriel engendré par les observations, deux facteurs ou prédicteurs sont dits orthogonaux si le produit scalaire de leurs vecteurs de contrastes respectifs est strictement nul. Dans un plan factoriel équilibré, les colonnes de la matrice de design codant pour l’effet du facteur A, l’effet du facteur B et l’effet de leur terme d’interaction (A × B) présentent une corrélation empirique exactement égale à zéro.
Cette absence totale de corrélation entraîne une décomposition non ambiguë et sans chevauchement de la variabilité globale. La somme des carrés totale ajustée pour la moyenne générale (SSTotal) se partitionne de façon limpide en une somme d’éléments additifs et mutuellement exclusifs :
SSTotal = SSA + SSB + SSAB + SSErreur
Dans cette équation canonique, la quantité de variance expliquée par le facteur A est totalement indépendante de la présence ou de l’absence du facteur B dans le modèle statistique. Aucune portion de variabilité n’est partagée de manière conjointe par deux facteurs. Il n’existe donc aucun phénomène de multicolinéarité ou de redondance informationnelle entre les effets principaux et les termes d’interaction. Sur le plan de l’inférence, cela garantit que la significativité du facteur A reflète exclusivement son impact marginal net, sans qu’aucun ajustement mathématique complexe ne soit requis pour démêler les contributions respectives des différentes variables manipulatrices.
2.3 Exemples canoniques dans les protocoles de laboratoire
Pour illustrer concrètement cette architecture, considérons un paradigme expérimental standard issu de la psychologie cognitive évaluant la flexibilité attentionnelle à l’aide d’une variante informatisée de la tâche de Stroop. Le chercheur souhaite mesurer l’effet de deux facteurs inter-sujets : la modalité de présentation du stimulus (Visuelle vs Auditive) et le niveau de privation de sommeil (Sommeil normal vs Privation totale de 24 heures). Pour constituer un plan équilibré 2×2, l’expérimentateur recrute une cohorte de 80 participants qu’il assigne aléatoirement et rigoureusement de manière à obtenir exactement 20 participants dans chacune des quatre conditions expérimentales :
- Groupe 1 : Présentation visuelle & Sommeil normal (n = 20)
- Groupe 2 : Présentation visuelle & Privation de sommeil (n = 20)
- Groupe 3 : Présentation auditive & Sommeil normal (n = 20)
- Groupe 4 : Présentation auditive & Privation de sommeil (n = 20)
Dans un autre cadre canonique de psychologie clinique empirique, un essai randomisé contrôlé vise à comparer l’efficacité de trois protocoles psychothérapeutiques distincts pour la réduction des symptômes du trouble panique : la thérapie cognitivo-comportementale classique, la thérapie d’acceptation et d’engagement (ACT), et une condition témoin sur liste d’attente. L’expérimentateur fixe un objectif d’échantillonnage de 40 participants par modalité, aboutissant à une allocation stricte de n1 = 40, n2 = 40, et n3 = 40, soit un effectif total de N = 120 participants.
Enfin, dans les plans randomisés en blocs complets, souvent déployés en neuropsychologie pour contrôler une variable parasite connue (comme la tranche d’âge ou le niveau d’éducation initial), les participants sont d’abord stratifiés en strates homogènes avant d’être assignés de manière symétrique aux différents traitements. Chaque bloc contient alors exactement le même nombre de sujets exposés aux diverses conditions, assurant à la fois un équilibrage local et une symétrie globale du protocole expérimental.
3. Définition et origines empiriques des plans non équilibrés
3.1 La nature des données déséquilibrées
Un plan expérimental est formellement désigné comme non équilibré (ou asymétrique) dès lors qu’il existe au moins une cellule de la matrice de traitement dont l’effectif diffère de celui des autres. D’un point de vue statistique formel, cette condition se traduit par l’existence d’une paire d’indices (j, k) telle que nj ≠ nk dans un plan unifactoriel, ou (ij, kl) telle que nij ≠ nkl dans un plan factoriel. Bien que l’inégalité puisse sembler bénigne lorsqu’elle n’implique que la perte d’un ou deux individus, elle brise irrémédiablement la symétrie algébrique fondamentale qui caractérise les protocoles orthogonaux.
La conséquence mathématique immédiate de cette asymétrie réside dans la perte de l’indépendance structurelle entre les variables indépendantes du modèle linéaire. Lorsque les cellules contiennent des effectifs inégaux, les prédicteurs vectoriels associés aux facteurs cessent d’être orthogonaux dans l’espace des données. Dès lors, les facteurs deviennent corrélés entre eux, ce qui signifie qu’une fraction de la variabilité globale de la variable dépendante peut être expliquée simultanément par plusieurs variables indépendantes. La décomposition directe de la somme totale des carrés devient impossible : la somme des variances associées à chaque facteur et à leurs interactions ne correspond plus à la variance inter-groupes globale calculée sur l’ensemble de l’échantillon.
Cette interdépendance induite complique considérablement l’estimation des paramètres de population sous-jacents. L’estimation de l’effet d’un facteur dépend alors de la manière dont on choisit d’ajuster ou de contrôler statistiquement l’effet des autres facteurs présents dans l’équation. Ce phénomène place le chercheur face à un défi analytique qui n’existe tout simplement pas sous le règne des plans équilibrés.
3.2 Causes inhérentes aux contextes de recherche psychologique
En psychologie scientifique, l’émergence de plans non équilibrés découle très rarement d’un dessein expérimental délibéré ; elle s’impose le plus souvent comme une conséquence inévitable des contraintes écologiques et humaines inhérentes à l’investigation empirique. La cause la plus répandue réside sans conteste dans le phénomène d’attrition différentielle au cours des protocoles longitudinaux ou des interventions thérapeutiques prolongées. Les participants assignés à une condition expérimentale particulièrement astreignante (par exemple, un entraînement cognitif quotidien sur plusieurs semaines ou une exposition prolongée à des stimuli anxiogènes) sont statistiquement plus susceptibles d’abandonner prématurément l’étude que ceux placés dans une condition témoin passive, créant de facto une asymétrie numérique finale entre les groupes.
Une seconde cause majeure réside dans les difficultés substantielles de recrutement associées aux cohortes cliniques rares ou spécifiques. Alors qu’il est relativement aisé de recruter des dizaines d’étudiants volontaires pour former un groupe témoin neurotypique au sein d’une université, l’accès à des patients souffrant de pathologies neuropsychologiques précises (comme une aphasie primaire progressive spécifique ou une lésion circonscrite du cortex orbitofrontal bilatéral) est structurellement restreint. L’expérimentateur se trouve alors contraint d’analyser des plans comportant, par exemple, 12 patients cérébrolésés pour 35 sujets contrôles appariés.
À ces contraintes structurelles s’ajoutent les inévitables défaillances techniques et exclusions de données post-expérimentales. En neuroimagerie fonctionnelle (IRMf), en électroencéphalographie (EEG) ou en oculométrie (eye-tracking), des artefacts de mouvement excessifs, des bruits physiologiques ou des bogues de synchronisation informatique obligent fréquemment à écarter un certain pourcentage d’enregistrements. Si ces exclusions surviennent de façon asymétrique entre les conditions expérimentales, l’équilibre initial du plan est anéanti.
Enfin, de nombreuses recherches en psychologie relèvent de devis quasi-expérimentaux, où les variables indépendantes correspondent à des caractéristiques préexistantes non manipulables (sexe, orientation politique, statut diagnostique, traits de personnalité extrêmes). Dans la mesure où ces caractéristiques ne sont pas distribuées de façon uniforme au sein de la population générale, l’échantillonnage naturel débouche inévitablement sur des cellules de tailles hétérogènes.
4. Comparaison conceptuelle : équilibre contre déséquilibre
4.1 Différences fondamentales d’architecture des données
La distinction entre un plan équilibré et un plan non équilibré dépasse largement une simple divergence de décompte arithmétique ; elle modifie en profondeur la structure distributionnelle sous-jacente des données et la manière dont les informations sont agrégées. Dans un plan équilibré, la moyenne globale de l’échantillon (dite « grand mean ») coïncide rigoureusement avec la moyenne arithmétique simple des moyennes de chaque condition. Chaque modalité factorielle pèse exactement du même poids dans la définition du barycentre des observations. Il existe une homogénéité structurelle parfaite dans l’espace de projection des variables.
À l’inverse, dans un plan non équilibré, une distinction conceptuelle fondamentale s’installe entre les moyennes marginales pondérées et les moyennes marginales non pondérées. La moyenne marginale pondérée d’une modalité factorielle est calculée en additionnant toutes les observations individuelles de cette modalité et en divisant par le nombre total de sujets qui la composent. Elle accorde donc mécaniquement un poids proportionnel à l’effectif des sous-cellules qui la constituent. Si une cellule particulière est surreprésentée, ses caractéristiques propres domineront l’estimation de la moyenne marginale.
En revanche, la moyenne marginale non pondérée (souvent désignée sous le terme de moyenne marginale estimée ou estimated marginal mean) est obtenue en calculant d’abord la moyenne de chaque cellule individuelle, puis en effectuant la moyenne arithmétique non pondérée de ces valeurs de cellules. Dans ce cas, chaque cellule reçoit un poids théorique rigoureusement égal, quelle que soit sa taille réelle d’échantillon. Cette divergence structurelle est résumée dans le tableau comparatif ci-dessous :
| Propriété méthodologique | Plan équilibré (ni = n) | Plan non équilibré (ni ≠ nj) |
|---|---|---|
| Orthogonalité des prédicteurs | Parfaite (corrélation nulle entre facteurs) | Absente (facteurs intercorrélés, variance partagée) |
| Décomposition des sommes des carrés | Unique et non ambiguë (SSTotal = Σ SSEffets + SSErreur) | Dépendante du type d’ajustement (Types I, II ou III) |
| Moyennes marginales | Moyennes pondérées et non pondérées identiques | Divergence entre moyennes pondérées et non pondérées |
| Puissance statistique | Maximale pour un N total donné | Réduite (gouvernée par la moyenne harmonique des n) |
| Robustesse face à l’hétéroscédasticité | Très élevée (protection par le théorème de Box) | Extrêmement faible (distorsion sévère de l’erreur de Type I) |
4.2 Clarté de l’interprétation des résultats
Dans un plan équilibré, la clarté herméneutique est absolue : l’effet principal d’une variable indépendante reflète la différence entre les niveaux moyens de cette variable, moyennés sur l’ensemble des niveaux des autres facteurs, sans la moindre ambiguïté d’attribution causale. Puisque les composantes du modèle ne partagent aucune variance commune, tester l’effet principal du facteur A revient rigoureusement à évaluer l’hypothèse nulle selon laquelle les moyennes marginales de population pour A sont identiques, sans craindre que cette estimation ne soit biaisée par un déséquilibre dans les effectifs du facteur B.
Dans un protocole non équilibré, l’interprétation des résultats se heurte au problème classique de la confusion partielle des variances et de la colinéarité induite. L’observateur non averti qui analyse des données asymétriques à l’aide d’outils statistiques inappropriés risque de commettre des erreurs inférentielles d’une gravité substantielle. Par exemple, si l’on examine l’effet du genre (Homme vs Femme) et du niveau de stress (Faible vs Élevé) sur la performance cognitive, et que le groupe des femmes contient une écrasante majorité d’individus à faible stress alors que le groupe des hommes est dominé par des individus à stress élevé, l’effet apparent du genre sera inévitablement confondu avec l’effet du stress.
En l’absence de correction analytique adéquate, l’expérimentateur risque d’attribuer au genre un effet différentiel qui n’est en fait que la manifestation indirecte du déséquilibre d’exposition au stress. Ce phénomène de distorsion interprétative, connu dans sa forme la plus radicale sous le nom de paradoxe de Simpson, démontre avec acuité pourquoi l’analyse de plans non équilibrés ne peut se réduire à l’application mécanique des formules classiques de l’ANOVA manuelle développées pour les structures symétriques.
5. L’impact critique sur la puissance statistique
5.1 Optimalité de la puissance dans les plans équilibrés
La puissance statistique d’un test d’hypothèse — c’est-à-dire la probabilité de rejeter l’hypothèse nulle (H0) lorsqu’elle est effectivement fausse dans la population générale (1 – β) — atteint son maximum théorique absolu lorsque la répartition des participants au sein des conditions expérimentales est parfaitement équilibrée, pour un effectif total N prédéterminé. Ce principe fondamental découle directement des propriétés mathématiques de la variance d’échantillonnage des contrastes statistiques.
Considérons la comparaison la plus élémentaire entre deux moyennes indépendantes (M1 et M2), sous l’hypothèse d’une variance d’erreur commune σ2. L’erreur type de la différence entre les deux moyennes s’exprime mathématiquement par la formule suivante :
SE(M1 – M2) = √ [ σ2 × (1 / n1 + 1 / n2) ]
Si l’on fixe l’effectif global à N = n1 + n2, la quantité (1 / n1 + 1 / n2) est strictement minimisée lorsque n1 = n2 = N / 2. En minimisant l’erreur type de l’estimation, le statisticien maximise la valeur du ratio statistique (qu’il s’agisse d’un test t de Student ou d’un test F de Fisher), propulsant ainsi la statistique de test le plus loin possible dans la région de rejet critique définie pour un seuil alpha donné.
Cette efficacité statistique optimale est un corollaire direct du théorème de Gauss-Markov, qui stipule que sous les postulats classiques du modèle linéaire, les estimateurs des moindres carrés ordinaires sont les meilleurs estimateurs linéaires sans biais (BLUE). Dans un plan équilibré, la variance de chaque contraste linéaire d’intérêt atteint sa borne inférieure théorique, garantissant une précision maximale pour détecter des effets réels avec la moindre dépense en ressources expérimentales.
5.2 L’amputation de puissance dans les configurations non équilibrées
Dès lors qu’un protocole dévie de la symétrie numérique, l’efficacité statistique se dégrade de façon progressive mais inexorable. La puissance globale du test cesse d’être déterminée par la moyenne arithmétique simple des tailles d’échantillons ; elle se trouve sévèrement bridée par la moyenne harmonique des effectifs cellulaires. Pour k groupes d’effectifs n1, n2, …, nk, la taille effective d’échantillon par groupe, notée nh, est donnée par la formule :
nh = k / Σ (1 / ni)
Pour mettre en lumière la sévérité de cette amputation de puissance, prenons un exemple numérique concret impliquant deux conditions avec un effectif total constant de N = 100 participants. Si le plan est équilibré, nous avons n1 = 50 et n2 = 50. La quantité (1 / 50 + 1 / 50) est égale à 0,04. Si, en raison d’un recrutement biaisé ou d’une attrition massive, les effectifs se répartissent en n1 = 10 et n2 = 90, la somme des inverses devient (1 / 10 + 1 / 90) ≈ 0,10 + 0,011 = 0,111. L’erreur type de la différence est alors multipliée par √(0,111 / 0,04) ≈ √2,775 ≈ 1,666, ce qui correspond à une inflation de 66,6 % de l’incertitude d’échantillonnage.
Dans cette configuration asymétrique (10 contre 90), la taille effective par groupe n’est que de nh = 2 / (1/10 + 1/90) = 18 individus. Bien que l’expérimentateur ait mobilisé 100 participants réels, son test présente une puissance statistique strictement équivalente à celle d’une étude équilibrée menée sur seulement 36 sujets au total (18 dans chaque groupe). L’adjonction de 40 sujets supplémentaires dans le groupe pléthorique (passant de 50 à 90) ne compense nullement le déficit structurel imposé par la cellule réduite à 10 participants. La plus petite cellule joue le rôle d’un véritable goulet d’étranglement pour la puissance statistique.
Les répercussions méthodologiques sont désastreuses, particulièrement en psychologie où les tailles d’effet réelles sont majoritairement petites à moyennes (souvent comprises entre d = 0,20 et d = 0,50 selon les critères de Jacob Cohen). L’amputation de puissance accroît massivement le risque d’erreur de Type II (omettre de détecter un effet réel), tout en réduisant considérablement la valeur prédictive positive des études publiées, un facteur directement corrélé à la crise de la reproductibilité scientifique.
6. Sensibilité aux violations des postulats de l’ANOVA
6.1 La robustesse des plans équilibrés face à l’hétéroscédasticité
L’une des propriétés les plus précieuses des plans équilibrés réside dans leur remarquable insensibilité relative à la violation du postulat d’homoscédasticité (l’hypothèse selon laquelle les variances de l’erreur sont identiques au sein de toutes les populations sous-jacentes, soit σ12 = σ22 = … = σk2). Ce phénomène a été mathématiquement formalisé par le statisticien George E. P. Box dans ses articles séminaux de 1953 et 1954, aboutissant à ce que l’on désigne communément sous le terme de théorème de robustesse de Box.
Box a démontré que lorsque les effectifs cellulaires sont rigoureusement égaux, le ratio F de l’ANOVA demeure robuste à des écarts modérés, voire substantiels, par rapport à l’égalité des variances. Sous la condition n1 = n2 = … = nk, le numérateur et le dénominateur de la statistique F subissent une distorsion d’échelle quasi identique en présence de variances inégales. En d’autres termes, l’hétéroscédasticité gonfle ou contracte simultanément l’espérance mathématique du carré moyen inter-groupes et celle du carré moyen résiduel dans des proportions très similaires.
En conséquence, pour un seuil nominal d’erreur de Type I fixé arbitrairement à α = 0,05, le taux d’erreur effectif observé empiriquement dans un plan équilibré reste généralement contenu dans une fourchette extrêmement acceptable (souvent entre 0,04 et 0,07), même lorsque le ratio entre la plus grande et la plus petite variance atteint un facteur de 3 ou 4. La distribution de probabilité théorique du F continue d’offrir une approximation satisfaisante de la distribution réelle de la statistique d’échantillonnage, protégeant ainsi le chercheur contre les fausses conclusions sans nécessiter impérativement de corrections mathématiques complexes.
6.2 La vulnérabilité majeure des plans non équilibrés
Cette protection providentielle s’effondre de manière dramatique dès lors que le protocole devient non équilibré. L’interaction conjointe entre l’inégalité des effectifs cellulaires et l’hétérogénéité des variances constitue une situation méthodologique critique pouvant entraîner une invalidation complète des résultats statistiques de l’ANOVA standard. Deux configurations structurellement opposées doivent être impérativement distinguées :
- Le couplage direct (ou concordant) : Dans cette situation, le sous-groupe disposant du plus grand effectif d’échantillon (n élevé) présente également la variance interne la plus importante (σ2 élevé), tandis que le petit groupe associe un faible effectif à une petite variance. Cette configuration conduit à un test F excessivement conservateur. L’estimation globale de la variance d’erreur résiduelle (MSE) étant dominée par le grand échantillon, elle surestime substantiellement l’erreur aléatoire moyenne, comprimant artificiellement la valeur du ratio F. Le taux d’erreur de Type I réel chute bien en deçà du seuil nominal (par exemple α effectif ≈ 0,01 au lieu de 0,05), engendrant une perte catastrophique de puissance et une inflation majeure de l’erreur de Type II.
- Le couplage inverse (ou discordant) : Il s’agit du scénario le plus pernicieux en recherche expérimentale. Ici, le sous-groupe comportant le plus petit effectif (faible n) présente la plus grande variance (σ2 élevé), tandis que le grand groupe présente une variance restreinte. Dans ce cas de figure, l’erreur résiduelle MSE sous-estime l’hétérogénéité réelle des données car elle accorde trop peu de poids au petit groupe instable. Il en résulte une surestimation massive de la statistique F, entraînant une inflation exponentielle du taux d’erreur de Type I. Des simulations statistiques révèlent que pour un α théorique de 0,05, le taux de faux positifs effectif peut grimper à 0,20, voire 0,40, transformant l’analyse en une machine à générer des résultats faussement significatifs.
Cette vulnérabilité structurelle disqualifie l’usage aveugle des tests préalables d’adéquation, tels que le test classique de Levene ou le test de Bartlett. Ces tests de conformité manquent cruellement de puissance précisément lorsque les effectifs sont faibles, échouant à détecter des hétéroscédasticités qui suffisent pourtant à dévoyer l’ANOVA sur des plans asymétriques. En présence de plans non équilibrés, l’hypothèse d’homogénéité des variances ne peut plus être présumée ou acceptée à la légère.
7. La décomposition de la somme des carrés : Types I, II et III
7.1 L’équivalence mathématique unique au sein des plans équilibrés
Dans la littérature méthodologique et dans les manuels de biostatistique, peu de notions suscitent autant d’interrogations et de confusions que la distinction entre les sommes des carrés de Type I, Type II et Type III. Pourtant, cette controverse s’évanouit entièrement lorsque le chercheur opère dans le cadre strict d’un plan factoriel équilibré. L’orthogonalité des variables prédictrices garantit en effet l’équivalence arithmétique absolue de ces trois approches d’estimation.
Sous la condition d’égalité stricte des effectifs par cellule, la projection des données sur le sous-espace associé à un facteur A est parfaitement indépendante de celle associée à un facteur B ou à leur interaction A × B. Par conséquent, que l’on calcule la variabilité attribuable au facteur A de façon isolée (séquentielle) ou de façon conditionnelle en ajustant simultanément pour les autres composantes du modèle, la valeur numérique obtenue pour SSA reste rigoureusement invariante. L’ordre d’entrée des facteurs dans l’algorithme computationnel n’exerce aucune influence sur les résultats finals.
Cette simplification computationnelle majeure offre un consensus universel : quel que soit le progiciel statistique mobilisé — qu’il s’agisse de la fonction standard anova() sous R, des routines d’analyse linéaire sous SPSS, de SAS, de Stata ou de Jamovi —, les résultats délivrés pour les valeurs de F, les degrés de liberté et les valeurs p sont rigoureusement identiques. Le statisticien opérant sur un plan équilibré est ainsi dispensé d’arbitrer entre les différents paradigmes de partitionnement de la somme des carrés.
7.2 La divergence analytique fondamentale sous déséquilibre
Dès lors que le protocole devient non équilibré, l’orthogonalité s’effondre et la corrélation induite entre les facteurs entraîne une scission radicale entre les trois méthodes de décomposition. Chacune d’entre elles teste une hypothèse statistique distincte et attribue les portions de variance partagée selon des principes conceptuels divergents :
1. Sommes des carrés de Type I (Approche séquentielle ou hiérarchique) : Dans cette méthode, les facteurs sont introduits successivement dans le modèle selon un ordre arbitrairement ou théoriquement prédéterminé par l’analyste. Si l’on spécifie le modèle Y ~ A + B + A×B, le terme SS(A) mesure l’effet brut du facteur A sans aucun contrôle sur B. Le terme SS(B | A) mesure ensuite le gain incrémental de variance expliqué par B une fois que l’effet de A a été intégralement extrait. Enfin, le terme SS(A×B | A, B) évalue l’interaction en contrôlant pour les deux effets principaux. Cette méthode possède une propriété remarquable : l’additivité exacte est préservée (la somme des composantes est strictement égale à la somme des carrés totale du modèle). Toutefois, elle présente un inconvénient majeur : si l’on inverse l’ordre d’introduction (par exemple Y ~ B + A + A×B), les valeurs de SS(A) et SS(B) sont substantiellement modifiées, rendant l’interprétation dépendante du choix de l’utilisateur.
2. Sommes des carrés de Type II (Approche hiérarchique ajustée ou marginale sans interaction) : Cette méthode calcule l’effet de chaque facteur en l’ajustant pour tous les autres facteurs de même ordre ou d’ordre inférieur, mais sans l’ajuster pour les interactions d’ordre supérieur qui l’impliquent. Ainsi, SS(A | B) évalue le rôle du facteur A en contrôlant pour B, et réciproquement SS(B | A) contrôle pour A. L’effet d’interaction SS(A×B | A, B) est testé en contrôlant pour les deux effets principaux. Le Type II est particulièrement puissant et recommandé lorsque l’interaction est théoriquement absente ou statistiquement négligeable. Cependant, si une interaction significative existe dans la réalité, le test des effets principaux en Type II teste des moyennes pondérées par la taille des cellules, ce qui peut fausser l’interprétation théorique des facteurs fondamentaux.
3. Sommes des carrés de Type III (Approche marginale stricte ou simultanée) : Dans cette formulation, chaque terme est évalué de manière conditionnelle à l’intégralité des autres composantes du modèle, y compris les interactions d’ordre supérieur. Ainsi, le facteur A est évalué par SS(A | B, A×B), et le facteur B par SS(B | A, A×B). Cette méthode teste l’égalité des moyennes marginales non pondérées (estimated marginal means). Même en présence d’une interaction complexe, le test de l’effet principal de A conserve un sens précis : il teste si l’effet moyen de A, moyenné de manière égale sur toutes les modalités de B, est nul. C’est l’approche paramétrée par défaut dans des logiciels comme SPSS ou SAS. Elle présente néanmoins le désavantage de tester des effets principaux dans un contexte où ils peuvent être théoriquement contredits par l’interaction sous-jacente.
Ce clivage suscite d’intenses débats épistémologiques au sein de la communauté des statisticiens. Des auteurs comme David L. Mindrila ou John Fox soulignent que le choix entre le Type II et le Type III ne doit pas être guidé par une habitude logicielle, mais par la plausibilité théorique de l’interaction et la nature des hypothèses substantielles formulées par le psychologue.
8. Plans factoriels complexes et analyse des interactions
8.1 L’interaction factorielle en condition d’équilibre
Dans un plan factoriel, l’interaction conceptuelle évalue dans quelle mesure l’amplitude ou la direction de l’effet d’une variable indépendante se modifie en fonction des niveaux pris par une autre variable manipulatrice. En condition d’équilibre strict des effectifs, l’évaluation de l’interaction bénéficie d’une transparence analytique et mathématique sans équivalent. Puisque les contrastes représentant les effets principaux et ceux représentant les termes d’interaction sont mutuellement orthogonaux, la partition de la variabilité entre l’explication par les facteurs isolés et l’explication par leur co-occurrence est parfaitement étanche.
Sur le plan de la représentation graphique, l’orthogonalité permet une visualisation univoque des profils de moyennes. L’absence d’interaction se matérialise sur le graphe par des segments reliant les moyennes qui sont rigoureusement parallèles. Réciproquement, la présence d’une interaction se traduit graphiquement par une déviation non aléatoire par rapport à ce parallélisme (lignes convergentes, divergentes ou sécantes). L’échelle des moyennes observées correspond exactement à l’échelle des moyennes modélisées, car aucune déformation due à des pondérations cellulaires disparates ne vient biaiser la hauteur relative des points d’observation.
De plus, la décomposition de l’erreur résiduelle demeure constante à travers toutes les comparaisons planifiées. L’analyste peut procéder à des décompositions en effets simples (analyser l’effet du facteur A à chaque niveau spécifique du facteur B) ou tester des contrastes polynomiaux spécifiques avec l’assurance que les sommes des carrés partielles s’additionnent sans le moindre résidu non expliqué, garantissant une cohérence théorique absolue entre l’ANOVA globale et les analyses de suivi (post-hoc).
8.2 Les pièges de l’interaction en situation de non-équilibre
L’introduction d’un déséquilibre au sein d’un plan factoriel transforme l’analyse des interactions en un terrain semé de chausse-trappes statistiques et d’artefacts interprétatifs. La perte d’orthogonalité engendre une intercorrélation complexe entre les contrastes codant pour les effets principaux et ceux modélisant le terme multiplicatif d’interaction. Ce phénomène pernicieux peut conduire à deux types d’erreurs méthodologiques inverses :
- Le masquage artificiel d’une interaction réelle : Lorsque la variance partagée entre les prédicteurs est importante, une partie significative de la variabilité attribuable à l’interaction peut être absorbée par le test des effets principaux si l’on applique une somme des carrés séquentielle inadaptée ou si l’on emploie des moyennes pondérées. L’interaction devient alors non significative, conduisant l’expérimentateur à conclure erronément que l’effet du traitement s’applique de façon uniforme à tous les individus, alors qu’il existe en réalité une hétérogénéité d’efficacité clinique majeure selon les sous-groupes.
- L’exagération fallacieuse d’une interaction : À l’inverse, l’asymétrie structurelle peut projeter des différences moyennes entre les cellules sur le terme d’interaction. Ce mécanisme crée une déviation artificielle par rapport au parallélisme des droites de régression, conduisant à détecter une interaction statistiquement significative qui ne reflète aucun mécanisme psychologique réel, mais constitue un simple artefact provoqué par le fait qu’une cellule particulière pèse d’un poids disproportionné sur la pente globale.
Face à ces distorsions, l’utilisation brute des moyennes arithmétiques observées pour tracer les profils d’interaction devient méthodologiquement proscrite. L’analyste doit impérativement recourir aux moyennes marginales estimées (Estimated Marginal Means ou EMMs), également dénommées least-squares means dans la littérature biomédicale. Ces valeurs prédictives reconstruisent les moyennes de cellules sous l’hypothèse d’une représentativité équilibrée et permettent de tester des contrastes linéaires ajustés, neutralisant ainsi les distorsions d’échelle inhérentes à l’asymétrie brute de l’échantillon.
9. Stratégies correctives traditionnelles pour les plans non équilibrés
9.1 Les méthodes d’ajustement classiques
Historiquement, bien avant que la puissance computationnelle des ordinateurs modernes ne démocratise l’ajustement matriciel direct du modèle linéaire général, les théoriciens de la statistique ont développé des stratagèmes calculatoires ingénieux pour remédier aux difficultés posées par les plans non équilibrés. Parmi ces approches pionnières, la méthode d’analyse par la moyenne non pondérée de Yates (formalisée par Frank Yates en 1934) a constitué une avancée décisive. Cette technique consistait à réaliser une ANOVA standard directement sur le tableau des moyennes de cellules plutôt que sur les observations individuelles, puis à multiplier la somme des carrés obtenue par la moyenne harmonique des effectifs cellulaires (nh). Si cette méthode fournissait une approximation remarquable lorsque les écarts d’effectifs étaient ténus, elle perdait toute précision en présence de variations massives de taille d’échantillon.
Une autre stratégie corrective, séduisante de prime abord mais méthodologiquement condamnable dans la majorité des cas, est le sous-échantillonnage aléatoire (ou élagage). Confronté à des cellules de tailles n1 = 80 et n2 = 40, l’expérimentateur pourrait être tenté de tirer au sort 40 participants au sein du premier groupe et d’éliminer arbitrairement les 40 autres pour rétablir une parité absolue n = 40. Si cette manœuvre restaure effectivement l’orthogonalité formelle du devis et la robustesse de Box face à l’hétérogénéité des variances, elle entraîne une perte sèche d’information empirique intolérable. L’amputation délibérée de la moitié de l’échantillon d’un groupe augmente dramatiquement la variance d’échantillonnage, dégrade la puissance statistique globale et soulève des interrogations déontologiques évidentes quant à l’utilisation des données fournies par des participants volontaires.
Enfin, la méthode des moindres carrés pondérés intégrée au cadre de la régression linéaire multiple s’est progressivement imposée comme la solution analytique de référence. En affectant à chaque observation un poids inversement proportionnel à la variance estimée ou en estimant simultanément les équations normales sans imposer l’orthogonalité, cette approche permet d’estimer avec rigueur les coefficients marginaux nets, jetant les bases des décompositions modernes de Type II et III.
9.2 Tests robustes alternatifs à l’ANOVA standard
Lorsque le protocole expérimental cumule à la fois un déséquilibre substantiel des effectifs cellulaires et une violation flagrante du postulat d’homoscédasticité, l’ANOVA classique basée sur le ratio de Fisher doit être formellement abandonnée au profit de tests statistiques robustes spécialement conçus pour préserver le taux d’erreur nominal :
- Le test F de Welch (ou ANOVA de Welch) : Conçu initialement comme une extension du test t de Welch pour deux échantillons indépendants, ce test constitue l’alternative paramétrique la plus éprouvée en présence d’hétérogénéité des variances sous déséquilibre. L’ANOVA de Welch ne calcule pas une variance d’erreur commune poolée ; elle pondère individuellement la contribution de chaque groupe par l’inverse de sa propre variance d’échantillon (wi = ni / si2). Les degrés de liberté du dénominateur sont ensuite ajustés dynamiquement selon une formule dérivée de l’approximation de Welch-Satterthwaite. De multiples études de simulation démontrent que le test de Welch maintient le taux d’erreur de Type I à un niveau rigoureusement conforme au seuil de 5 %, tant dans les conditions de couplage concordant que discordant.
- Le test de Brown-Forsythe : Proche du test de Welch dans son esprit, la procédure de Brown-Forsythe ajuste le dénominateur de la statistique F en utilisant les variances individuelles des groupes, tout en modifiant la structure des degrés de liberté. Bien que légèrement moins puissant que le test de Welch dans certaines configurations extrêmes, il offre une alternative crédible, particulièrement dans les extensions multifactorielles.
- Les tests de permutation et méthodes de rééchantillonnage (bootstrap) : En s’affranchissant totalement des postulats distributionnels paramétriques, les tests de permutation exacts ou approximatifs génèrent la distribution empirique de la statistique sous l’hypothèse nulle en redistribuant aléatoirement les scores observés au sein des conditions expérimentales. Ces procédures non paramétriques modernes garantissent une résilience inférentielle totale face à l’asymétrie des effectifs et aux distributions asymétriques ou leptokurtiques.
10. L’approche moderne : modèles mixtes et modèles linéaires généraux
10.1 Le dépassement du cadre strict de l’ANOVA classique
Au cours des deux dernières décennies, la méthodologie quantitative en psychologie a accompli une mutation paradigmatique majeure, délaissant progressivement le carcan rigide de l’ANOVA traditionnelle au profit du cadre beaucoup plus souple et englobant du modèle linéaire généralisé et des modèles linéaires mixtes (Linear Mixed-Effects Models ou LMM). Ce changement de paradigme résout de manière élégante et unifiée la problématique des plans non équilibrés.
Contrairement aux algorithmes manuels de l’ANOVA reposant sur la méthode des moindres carrés ordinaires (OLS), les modèles mixtes modernes font appel à des algorithmes d’estimation itératifs puissants, au premier rang desquels figure le maximum de vraisemblance restreint (REML, pour Restricted Maximum Likelihood). L’estimation REML sépare l’estimation des composantes de variance de celle des paramètres à effets fixes, évitant ainsi le biais systématique d’estimation de la variance résiduelle propre aux estimateurs du maximum de vraisemblance standard dans les petits échantillons.
Dans cette perspective intégrée, les cellules d’observation déséquilibrées cessent de constituer une anomalie structurelle ou une entrave calculatoire. Le modèle linéaire mixte traite chaque observation comme un point de données au sein d’une géométrie hiérarchique, sans qu’il soit nécessaire d’agréger arbitrairement les scores à l’échelle du sujet ou de la cellule. Les degrés de liberté ne sont plus distribués de manière monolithique par sous-groupe, mais sont approximés précisément au niveau des paramètres individuels à l’aide de méthodes sophistiquées comme l’approximation de Kenward-Roger ou de Satterthwaite, préservant ainsi la validité inférentielle même en présence d’asymétries sévères.
10.2 Application spécifique aux mesures répétées et protocoles longitudinaux
Le saut qualitatif opéré par les modèles mixtes s’avère particulièrement spectaculaire dans les protocoles à mesures répétées et les études longitudinales développementales ou cliniques. Dans l’ANOVA à mesures répétées classique (rANOVA), la survenue d’une seule donnée manquante chez un participant (par exemple, l’absence à la quatrième session de mesure d’un suivi thérapeutique comportant cinq temps) entraîne l’exclusion totale et définitive de l’individu de l’ensemble de l’analyse (procédure dite de listwise deletion). Cette pratique archaïque engendre une amputation colossale de puissance et introduit des biais d’échantillonnage redoutables dès lors que les données manquantes ne surviennent pas selon un processus strictement aléatoire.
Les modèles linéaires mixtes, quant à eux, s’accommodent nativement d’un nombre variable de points de mesure par individu. Un sujet ayant participé à trois sessions sur cinq contribue pleinement à l’estimation des paramètres pour les trois sessions où il était présent, sans qu’aucune donnée ne soit sacrifiée. Sous l’hypothèse moderne des données manquantes au hasard (MAR, pour Missing at Random) — selon laquelle la probabilité qu’une valeur soit manquante dépend des variables observées mais non de la valeur manquante elle-même —, l’estimation par REML garantit des estimations asymptotiquement non biaisées des trajectoires de changement temporel.
De surcroît, les modèles mixtes permettent de modéliser explicitement des structures de covariance intra-sujets asymétriques et hautement réalistes (structures autorégressives de premier ordre AR(1), toeplitz, ou hétérogènes), s’affranchissant du postulat extrêmement restrictif de sphéricité exigé par l’ANOVA intra-sujet classique. En psychologie cognitive contemporaine, l’analyse d’essais individuels de temps de réaction via des modèles mixtes (avec effets aléatoires croisés sur les participants et sur les items lexicaux) a supplanté l’ANOVA traditionnelle en plan non équilibré, inaugurant un standard méthodologique d’une précision inégalée.
11. Mise en œuvre pratique dans les logiciels de statistique (R, SPSS, Jamovi)
11.1 Paramétrages par défaut et risques associés
La transcription informatique d’un plan d’expérience non équilibré recèle de nombreux écueils pour l’expérimentateur, en grande partie imputables aux divergences d’architecture et de paramétrage par défaut entre les principaux logiciels d’analyse statistique utilisés en psychologie. L’incompatibilité la plus célèbre oppose historiquement l’environnement de programmation statistique R au logiciel propriétaire commercial SPSS d’IBM.
Dans SPSS, la procédure GLM (General Linear Model) paramètre par défaut la décomposition des sommes des carrés selon la méthode du Type III. L’utilisateur qui clique de façon standard sur les menus d’analyse exécute donc sans s’en rendre compte un test d’hypothèses portant sur les moyennes marginales non pondérées, sous le modèle marginal complet. R, au contraire, est profondément ancré dans la tradition de l’école statistique britannique et privilégie une approche séquentielle incrémentale. La commande standard anova(lm(Y ~ A * B)) sous R calcule systématiquement des sommes des carrés de Type I. Si le chercheur applique cette fonction à des données non équilibrées, l’ordre dans lequel il saisit ses prédicteurs dans la formule syntaxique modifiera radicalement les p-valeurs obtenues pour les effets principaux, créant une confusion méthodologique si l’ordre n’était pas délibérément fondé sur une théorie causale stricte.
Pour exécuter des analyses conformes aux standards de publication psychologiques sous R en présence de plans non équilibrés, il est impératif d’utiliser le package spécialisé car (développé par John Fox et Sanford Weisberg) et sa fonction dédiée Anova() (avec un ‘A’ majuscule). Cette fonction autorise explicitement la spécification du type de sommes des carrés via l’argument type = 2 ou type = 3. Il convient toutefois de noter une subtilité cruciale : pour obtenir des résultats de Type III rigoureusement exacts sous R, l’utilisateur doit impérativement redéfinir au préalable les contrastes de ses facteurs catégoriels en adoptant un codage orthogonal centré (tel que le codage par déviation contr.sum ou contr.helmert), sans quoi le terme de constante résiduelle faussera l’évaluation des effets marginaux :
options(contrasts = c("contr.sum", "contr.poly"))modele <- lm(Performance ~ Traitement * Groupe, data = donnees)car::Anova(modele, type = 3)
Pour le calcul, l’affichage et les tests post-hoc de contrastes sur les moyennes ajustées, le package R emmeans (Estimated Marginal Means) constitue aujourd’hui la référence incontournable. Il permet de s’extraire de l’arbitraire des décompositions de variance en ciblant directement les contrastes théoriques d’intérêt marginal :
emmeans::emmeans(modele, pairwise ~ Traitement | Groupe)
Dans les interfaces graphiques modernes de nouvelle génération comme Jamovi ou JASP — toutes deux adossées au moteur de calcul de R —, les développeurs ont heureusement fait le choix d’intégrer des sélecteurs transparents permettant de basculer en un clic entre les Types I, II et III, tout en automatisant l’extraction des moyennes marginales estimées et l’exécution directe de l’ANOVA de Welch en cas de suspicion d’hétéroscédasticité.
11.2 Protocole de décision informatique étape par étape
Afin de guider le chercheur à travers la complexité analytique imposée par les configurations expérimentales réelles, nous proposons ci-après un arbre décisionnel séquentiel, structuré en quatre étapes incontournables :
- Étape 1 : Diagnostic structurel de la matrice des effectifs. L’analyste extrait la table de contingence croisant l’ensemble des facteurs inter-sujets (par exemple via la fonction
table(donnees$FacteurA, donnees$FacteurB)). Si toutes les fréquences de cellules sont rigoureusement identiques, le plan est déclaré équilibré. L’analyste peut procéder à l’ANOVA classique ; les résultats des Types I, II et III seront rigoureusement superposables. Si au moins une cellule présente un effectif discordant, le plan est classé comme non équilibré et impose la suite du protocole. - Étape 2 : Évaluation conjointe de l’homoscédasticité et du rapport de déséquilibre. Le chercheur calcule le ratio entre la plus grande et la plus petite taille cellulaire (RatioN = nmax / nmin), ainsi que le ratio des variances d’échantillon au sein des cellules (RatioV = smax2 / smin2). Si RatioV excède 1,5 et que RatioN est substantiel, il convient d’examiner le couplage (concordant ou discordant). En cas de couplage discordant avéré (petit groupe avec grande variance), l’ANOVA standard à moindres carrés doit être immédiatement rejetée au profit de l’ANOVA robuste de Welch ou d’une modélisation linéaire généralisée avec fonction de variance hétéroscédastique.
- Étape 3 : Sélection argumentée de la stratégie de partitionnement de la variance. Si les variances sont approximativement homogènes mais que les effectifs demeurent inégaux :
- Si le protocole implique des hypothèses strictement hiérarchiques ou chronologiques où l’effet d’une variable doit être contrôlé a priori avant d’examiner les suivantes, opter pour la somme des carrés de Type I.
- Si le modèle comporte plusieurs facteurs sans prépondérance théorique a priori, et que l’hypothèse d’une absence d’interaction est théoriquement ou empiriquement solide, privilégier le Type II pour maximiser la puissance de détection des effets principaux.
- Si une interaction factorielle significative est plausible ou anticipée conceptuellement, et que l’objectif est d’évaluer les effets moyens non pondérés globaux, sélectionner impérativement le Type III en veillant à la conformité des contrastes orthogonaux dans le logiciel.
- Étape 4 : Post-estimation et reporting fondé sur les moyennes marginales estimées. Proscrire rigoureusement l’utilisation des moyennes descriptives brutes pour les inférences ou les représentations graphiques. Calculer systématiquement les Estimated Marginal Means (EMMs) accompagnées de leurs intervalles de confiance à 95 %, et baser l’ensemble des contrastes post-hoc ou des comparaisons planifiées sur ces métriques ajustées.
12. Directives méthodologiques et recommandations finales
12.1 Bonnes pratiques lors de la phase de conception expérimentale
Bien que les développements contemporains de la statistique computationnelle permettent de pallier une grande partie des écueils induits par le déséquilibre des données, la règle méthodologique d’or en recherche empirique demeure inchangée : la meilleure façon de gérer un plan expérimental non équilibré reste de tout mettre en œuvre pour concevoir et maintenir un plan équilibré dès la phase de design prospectif.
Cette démarche préventive débute par la réalisation systématique d’une analyse de puissance a priori (à l’aide d’outils standardisés tels que G*Power ou le package R pwr). En paramétrant les calculs pour une structure cellulaire symétrique (n identique par cellule), le chercheur optimise d’emblée le rendement d’échantillonnage en garantissant la détection de la taille d’effet minimale théoriquement pertinente au seuil α de 0,05 avec une puissance de test standard (idéalement 1 – β ≥ 0,80 ou 0,90).
Pour parer à l’inévitable attrition expérimentale qui menace tout protocole longitudinal ou toute étude clinique impliquant des contraintes répétées, l’expérimentateur avisé doit instaurer une stratégie de sur-recrutement prédictif proportionnel (over-sampling). Si un taux d’abandon empirique de 15 % est anticipé sur la base de la littérature antérieure dans un protocole requérant 40 sujets exploitables par modalité, le recrutement initial devra viser délibérément 48 participants par cellule.
De surcroît, le recours systématique à des techniques de randomisation stratifiée et à la randomisation par blocs permutés (permuted block randomization) permet de garantir que l’allocation des participants aux différentes conditions s’opère de façon parfaitement équilibrée tout au long du processus d’inclusion. Cette méthode prémunit le laboratoire contre les conséquences déstabilisatrices d’une interruption prématurée de l’expérimentation (causée par une panne matérielle définitive, une rupture budgétaire ou un confinement sanitaire imprévu), assurant qu’au moment de l’arrêt, les effectifs cumulés au sein de chaque condition soient aussi symétriques que possible.
12.2 Normes de transparence et de reporting scientifique (APA)
La rigueur méthodologique impose que l’intégralité des choix analytiques découlant de la nature équilibrée ou non équilibrée du plan expérimental soit scrupuleusement explicitée lors de la rédaction du rapport scientifique ou de l’article empirique, conformément aux recommandations édictées par l’American Psychological Association (APA 7th edition).
En premier lieu, les tableaux descriptifs et les sections de résultats textuelles ne doivent jamais se contenter de mentionner la taille d’échantillon globale (N). Il est impératif de déclarer de façon exhaustive les effectifs cellulaires exacts (les n spécifiques de chaque sous-groupe) associés à chaque modalité factorielle. Toute perte de sujets ou exclusion post-expérimentale doit être rigoureusement documentée au sein d’un diagramme de flux (de type diagramme CONSORT), précisant avec exactitude les motifs de l’attrition pour chaque modalité afin de permettre au lecteur d’évaluer la possibilité d’un mécanisme de perte non aléatoire.
En second lieu, lorsqu’une ANOVA multifactorielle est appliquée à des données non équilibrées, l’auteur a l’obligation formelle de stipuler expressément le type de décomposition de la somme des carrés retenu (Type II ou Type III), en fournissant une justification conceptuelle claire de ce choix par rapport aux hypothèses d’interaction formulées. Dans le cas où un modèle linéaire mixte ou une ANOVA robuste (comme l’ANOVA de Welch) a été substituée au modèle classique en raison d’une violation conjointe de l’homoscédasticité et de l’équilibre numérique, ce choix technique doit être transparent, assorti des méthodes d’approximation des degrés de liberté mobilisées (par exemple, Satterthwaite ou Kenward-Roger).
Enfin, la discussion de l’article doit intégrer une analyse réflexive critique sur les limitations potentielles imposées par un déséquilibre prononcé. Si la plus petite cellule d’un plan factoriel clinique n’a réuni qu’un nombre modeste d’individus, les conséquences de ce goulet d’étranglement sur la puissance effective des tests d’interaction doivent être admises en toute franchise scientifique. Ce n’est qu’au prix de cette transparence totale que la psychologie expérimentale pourra consolider la robustesse de ses fondations statistiques et garantir la pleine reproductibilité de ses découvertes empiriques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E. P. (1953). Non-normality and tests on variances. Biometrika, 40(3/4), 318–335. https://doi.org/10.2307/2333350
- Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification. The Annals of Mathematical Statistics, 25(2), 290–302. https://doi.org/10.1214/aoms/1177728786
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Lenth, R. V. (2023). emmeans: Estimated marginal means, aka least-squares means (R package version 1.8.5). https://cran.r-project.org/package=emmeans
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
- Searle, S. R., Speed, F. M., & Milliken, G. A. (1980). Population marginal means in the linear model: An alternative to least squares means. The American Statistician, 34(4), 216–221. https://doi.org/10.1080/00031305.1980.10483031
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579
- Yates, F. (1934). The analysis of multiple classifications with unequal numbers in the different classes. Journal of the American Statistical Association, 29(185), 51–66. https://doi.org/10.1080/01621459.1934.10502686