
L’apprentissage automatique contemporain se trouve à la croisée de multiples traditions intellectuelles, allant de la statistique mathématique classique à l’optimisation convexe, en passant par l’informatique théorique et les sciences cognitives. Au cœur de cette discipline réside une quête permanente : comment extraire, à partir d’observations empiriques bruitées et limitées, des règles de décision capables de généraliser avec une précision optimale à des situations inédites ? Pendant plusieurs décennies, les chercheurs ont concentré leurs efforts sur la conception d’architectures individuelles de plus en plus sophistiquées, postulant qu’un modèle unique, pourvu d’une capacité d’ajustement adéquate et d’une régularisation rigoureuse, suffirait à capturer la complexité sous-jacente des phénomènes observés. Des régressions régularisées aux machines à vecteurs de support, en passant par les réseaux de neurones artificiels, cette quête du prédicteur parfait a engendré des avancées considérables, mais s’est également heurtée à des limites géométriques et computationnelles intrinsèques.
Face aux compromis inévitables entre expressivité et stabilité, une rupture paradigmatique majeure s’est opérée à la fin du vingtième siècle à travers l’émergence des méthodes d’ensemble. Plutôt que de rechercher un estimateur universel d’une complexité vertigineuse, ce courant de pensée propose une démarche collaborative : agréger les prédictions d’une multitude de modèles élémentaires pour former un consensus statistique d’une robustesse supérieure. Si le paradigme du bagging, illustré de manière emblématique par les forêts aléatoires, a exploré la voie de la parallélisation et de la réduction de la variance par moyennage stochastique, une approche alternative, plus profonde sur le plan analytique, a vu le jour sous le nom de boosting. Fondé sur un principe de correction séquentielle des erreurs, le boosting transforme une suite d’apprenants rudimentaires, à peine plus performants qu’une heuristique aléatoire, en un estimateur composite doté d’une précision remarquable.
Le présent article se propose d’explorer de manière exhaustive, rigoureuse et didactique les fondements mathématiques, les intuitions mécaniques et les raffinements algorithmiques qui sous-tendent le boosting. En partant des contraintes inhérentes aux modèles prédictifs traditionnels jusqu’aux implémentations modernes à très haute performance comme XGBoost, LightGBM et CatBoost, nous déconstruirons chaque étape de ce voyage algorithmique. L’objectif n’est pas seulement de fournir un catalogue de recettes techniques, mais bien d’enraciner la compréhension du lecteur dans les principes premiers de l’optimisation fonctionnelle, de la décomposition des erreurs et du compromis biais-variance, offrant ainsi une grille de lecture pérenne pour la modélisation statistique avancée.
1. Introduction aux paradigmes d’apprentissage statistique et émergence du boosting
1.1 Limites inhérentes aux modèles prédictifs individuels
L’histoire de l’apprentissage statistique supervisé s’est longtemps articulée autour du perfectionnement d’architectures prédictives isolées. Qu’il s’agisse de la régression linéaire classique formulée par Legendre et Gauss, de la régression logistique développée pour la modélisation des probabilités d’événements binaires, ou encore des arbres de décision cartésiens formalisés par Breiman, ces approches reposent sur l’hypothèse qu’une fonction de paramétrage explicite ou qu’un découpage spatial rigide peut appréhender fidèlement la distribution sous-jacente des données. Or, cette confiance accordée à un estimateur monolithique révèle rapidement ses faiblesses dès lors que l’on est confronté à des espaces dimensionnels élevés ou à des variétés non linéaires complexes.
Les modèles linéaires, par exemple, pèchent par une rigidité structurelle indépassable : leur capacité de représentation est strictement bornée par l’hyperplan qui matérialise leur frontière de décision. Face à des interactions multiplicatives d’ordre supérieur ou à des dépendances géométriques circulaires et fragmentées, ils présentent un biais empirique incompressible. À l’inverse, des modèles hautement flexibles tels que les arbres de décision profonds sans contrainte de taille peuvent partitionner l’espace d’entrée de manière arbitrairement fine. Ce pouvoir d’expression accru s’accompagne toutefois d’une vulnérabilité pathologique à la variance : le modèle mémorise le bruit d’échantillonnage, les fluctuations idiosyncratiques des données d’entraînement, conduisant à une divergence spectaculaire entre la performance empirique et la performance de généralisation.
Cette oscillation perpétuelle entre la cécité structurelle (sous-apprentissage) et la paranoïa stochastique (surajustement) met en lumière l’insuffisance des modèles individuels pour résoudre le dilemme fondamental de la théorie de l’apprentissage. Aucun mécanisme intrinsèque ne permet à un estimateur rigide d’auto-corriger ses angles morts sans une déstabilisation majeure de ses paramètres. La communauté scientifique a donc été contrainte de repenser les fondations de l’inférence inductive : plutôt que de concevoir un modèle parfait, pourquoi ne pas organiser une coopération stratégique entre plusieurs modèles imparfaits ?
1.2 Genèse théorique de la combinaison de modèles
L’acte de naissance conceptuel du boosting trouve ses racines dans le cadre fondamental de la théorie de l’apprentissage probablement approximativement correct (PAC), introduit par Leslie Valiant en 1984. Ce cadre formalise mathématiquement les conditions sous lesquelles un algorithme peut, avec une probabilité arbitrairement élevée ($1 – \delta$), extraire une fonction prédictive dont l’erreur d’approximation est strictement inférieure à un seuil donné ($epsilon$), et ce en un temps polynomial par rapport à la taille de l’échantillon et au nombre de dimensions.
C’est dans cet environnement théorique que Michael Kearns et Leslie Valiant ont formulé en 1988 une question fondamentale : la classe des concepts apprenables de manière « faible » est-elle équivalente à celle des concepts apprenables de manière « forte » ? En d’autres termes, si l’on dispose d’un algorithme capable de générer un prédicteur dont l’exactitude n’est que marginalement supérieure à celle d’un tirage à pile ou face biaisé (un taux d’erreur strictement inférieur à 50 % pour une tâche binaire), est-il mathématiquement garanti que l’on puisse convertir ce prédicteur médiocre en un algorithme à haute précision, capable d’atteindre n’importe quel seuil d’erreur arbitrairement petit ?
La réponse à ce problème d’équivalence a été apportée de manière constructive par Robert Schapire en 1990, qui a démontré qu’un tel passage était théoriquement possible via une procédure récursive d’agrégation d’hypothèses faibles. Cette preuve originelle a ouvert la voie à une transition conceptuelle majeure : l’apprentissage computationnel s’est déplacé de l’analyse purement asymptotique vers la construction concrète d’algorithmes séquentiels. Le boosting s’est alors défini non plus comme une simple spéculation formelle, mais comme une machinerie déterministe apte à surmonter les frontières de l’erreur statistique par réinjection systématique de l’information résiduelle.
1.3 Objectifs pédagogiques et portée de cette introduction
Aborder le boosting nécessite de dépasser les simplifications abusives qui le réduisent souvent à une simple boîte noire logicielle. Le premier objectif de cette introduction détaillée est de démystifier les fondements mathématiques qui régissent cette famille d’algorithmes, en substituant à l’opacité des équations une intuition géométrique et analytique limpide. Nous expliciterons la manière dont la théorie des probabilités, l’optimisation convexe et le calcul différentiel s’entrelacent pour créer une convergence prédictive stable.
Le deuxième objectif consiste à tracer une cartographie structurée des évolutions méthodologiques du boosting. Depuis l’élégance pionnière d’AdaBoost jusqu’aux raffinements d’ingénierie logicielle et algorithmique contemporains incarnés par XGBoost, LightGBM et CatBoost, le lecteur découvrira comment une même intuition fondamentale s’est adaptée pour traiter des volumes massifs de données hétérogènes, des valeurs manquantes et des distributions asymétriques.
Enfin, cette démarche se veut résolument orientée vers la pratique réflexive. Il s’agit de sensibiliser les praticiens aux risques de surajustement, aux coûts computationnels inhérents à la nature séquentielle du calcul et aux règles de l’art relatives au réglage des hyperparamètres. À l’issue de cette lecture, les concepts de pseudo-résidus, de rétrécissement, d’échantillonnage de gradient et d’importance des variables cesseront d’être de simples termes techniques pour devenir les leviers conscients d’une modélisation rigoureuse.
2. Du modèle unique aux méthodes d’ensemble : fondements théoriques
2.1 Taxonomie générale des méthodes d’ensemble
En apprentissage automatique supervisé, une méthode d’ensemble désigne un méta-modèle dont la décision finale procède de la combinaison délibérée de multiples prédicteurs individuels, appelés estimateurs de base ou apprenants primaires. Cette démarche s’inscrit dans la lignée du théorème du jury de Condorcet en théorie du choix social, stipulant que si chaque membre d’un groupe possède une probabilité de jugement correcte supérieure à 0,5, la probabilité que la décision majoritaire soit conforme à la vérité tend asymptotiquement vers l’unité à mesure que la taille de l’assemblée s’accroît, sous réserve d’indépendance statistique des suffrages.
Dans l’univers algorithmique, la taxonomie des méthodes d’ensemble s’articule autour de deux grands axes structurels : l’apprentissage parallèle et l’apprentissage séquentiel. L’apprentissage parallèle, dominé par le bagging et les méthodes de sous-espaces aléatoires, construit l’ensemble de ses estimateurs de manière totalement découplée. Chaque modèle est instancié sur une variation du jeu de données originel sans communiquer avec ses pairs, l’objectif visé étant une décorrélation maximale des erreurs individuelles afin d’assurer une stabilisation par moyennage arithmétique ou par vote pluralitaire.
À l’opposé, l’apprentissage séquentiel, dont le boosting constitue le représentant le plus achevé, établit une dépendance temporelle stricte entre les estimateurs. Chaque nouvel apprenant introduit dans la chaîne analytique a pour mission explicite de neutraliser les défaillances de la coalition qui le précède. La construction du système prédictif ne s’opère donc pas par simple juxtaposition d’opinions indépendantes, mais par une négociation dynamique où chaque maillon affine les frontières de décision là où le collectif demeure incertain.
2.2 Le principe du bootstrap et l’émergence du bagging
Pour appréhender la singularité du boosting, il est indispensable de disséquer le fonctionnement de son pendant parallèle : le bagging, acronyme de Bootstrap Aggregating, formalisé par Leo Breiman en 1996. Le socle méthodologique du bagging repose sur la technique non paramétrique du bootstrap développée par Bradley Efron. Cette procédure consiste à engendrer de multiples pseudo-échantillons d’apprentissage, chacun étant constitué par un tirage uniforme avec remise d’un nombre d’observations identique à celui du jeu de données original ($N$). Sur le plan probabiliste, chaque échantillon bootstrap contient en moyenne approximativement 63,2 % des observations distinctes initiales, les 36,8 % restants formant la fraction dite hors-sac (out-of-bag).
Le paradigme du bagging exploite ce mécanisme pour entraîner, sur chaque pseudo-échantillon, un estimateur doté d’une très forte expressivité géométrique mais intrinsèquement instable, typiquement un arbre de décision profond poussé jusqu’à ses feuilles terminales sans élagage. Pris isolément, un tel arbre possède un biais théorique presque nul mais une variance colossale : une infime perturbation de l’échantillon d’apprentissage modifie radicalement les nœuds de scission et l’architecture arborescente globale.
En agrégeant les sorties de ces $B$ arbres indépendants, par la moyenne arithmétique pour une tâche de régression continue ou par un vote à la majorité simple pour une classification catégorielle, le bagging neutralise cette instabilité structurelle. L’erreur de variance du méta-modèle décroît à mesure que le nombre d’arbres augmente, sans dégrader le biais initialement faible des estimateurs profonds. L’extension ultime de cette approche a donné naissance aux forêts aléatoires, qui injectent une dose supplémentaire d’indépendance en contraignant chaque partition de nœud à n’examiner qu’un sous-ensemble aléatoire de variables explicatives.
2.3 La rupture conceptuelle introduite par le boosting
Le boosting opère une rupture radicale avec les postulats du bagging. Alors que ce dernier postule que la diversité des modèles doit être le fruit du hasard stochastique induit par l’échantillonnage avec remise et la sélection aléatoire des caractéristiques, le boosting conçoit l’hétérogénéité des estimateurs comme le résultat d’un guidage déterministe orchestré par l’erreur résiduelle. L’indépendance statistique des prédicteurs, si chère au bagging, est délibérément abandonnée au profit d’une dépendance adaptative hautement informative.
Dans un processus de boosting, l’échantillonnage n’est plus uniforme et statique : il est modulé dynamiquement. Les observations qui résistent à la sagacité des premiers modèles voient leur importance relative s’amplifier lors des itérations ultérieures. Le système force ainsi les apprenants subséquents à concentrer l’intégralité de leur capacité d’optimisation sur les régions les plus litigieuses du domaine de définition. Il ne s’agit plus de faire voter une foule d’experts formés séparément sur des données tronquées, mais d’orchestrer un dialogue continu au sein duquel chaque nouvel intervenant comble les lacunes cognitives de ses prédécesseurs.
Cette approche séquentielle confère au boosting une efficacité analytique sans commune mesure face aux structures de données complexes. Là où le bagging applique une force brute de réduction de variance sur des modèles inutilement volumineux, le boosting érige une cathédrale prédictive à partir de briques élémentaires extrêmement modestes. Ce recalibrage progressif transforme le problème de l’apprentissage en une trajectoire d’optimisation continue au sein de l’espace des modèles.
3. Le compromis biais-variance : comparaison structurelle entre bagging et boosting
3.1 Décomposition formelle de l’erreur quadratique moyenne
L’évaluation de la performance d’un modèle d’apprentissage supervisé en régression s’appuie classiquement sur la décomposition mathématique de l’espérance de l’erreur quadratique moyenne (EQM ou MSE pour Mean Squared Error) sur des données non observées. Pour une valeur cible continue $Y = f(X) + varepsilon$, où $varepsilon$ représente un bruit aléatoire gaussien irréductible d’espérance nulle et de variance $\sigma^2$, l’erreur quadratique attendue d’un estimateur $\hat{f}(X)$ conditionnée au point $X = x$ se décompose rigoureusement en trois composantes orthogonales distinctes :
$$\mathbb{E}\left[(Y – \hat{f}(x))^2\right] = \left(\text{Biais}[\hat{f}(x)]\right)^2 + \text{Var}(\hat{f}(x)) + \sigma^2$$
Le biais structurel mesure la divergence géométrique entre l’espérance de la prédiction du modèle et la véritable valeur cible sous-jacente : $\text{Biais}[\hat{f}(x)] = \mathbb{E}[\hat{f}(x)] – f(x)$. Un biais élevé traduit l’incapacité foncière de l’algorithme à appréhender la forme fonctionnelle réelle des données, signe d’un sous-apprentissage manifeste. La variance empirique, quant à elle, quantifie la variabilité des prédictions de l’estimateur lorsqu’il est entraîné sur différents jeux de données issus de la même population : $\text{Var}(\hat{f}(x)) = \mathbb{E}\left[\left(\hat{f}(x) – \mathbb{E}[\hat{f}(x)]\right)^2\right]$. Enfin, le terme $\sigma^2$ représente le bruit irréductible, limite absolue dictée par l’entropie inhérente au système de mesure et aux facteurs non observés.
Toute tentative d’accroître la complexité d’un modèle pour compresser le terme de biais s’accompagne inévitablement, pour un estimateur unique, d’une explosion du terme de variance, et réciproquement. La maîtrise de ce compromis structurel constitue le défi architectural majeur de la modélisation statistique prédictive.
3.2 Action ciblée du bagging sur la variance
Le bagging concentre son mécanisme opératoire presque exclusivement sur la réduction du terme de variance au sein de l’équation de l’erreur quadratique. Si l’on considère un ensemble de $B$ estimateurs $\hat{f}_b(x)$, chacun possédant individuellement une variance $\sigma^2_M$ et un biais $b$, et partageant une corrélation mutuelle moyenne positive notée $rho$, l’estimateur combiné obtenu par simple moyennage présente une variance globale dont la formulation analytique est donnée par :
$$\text{Var}\left(\frac{1}{B} \sum_{b=1}^B \hat{f}_b(x)\right) = \rho \sigma^2_M + \frac{1 – \rho}{B} \sigma^2_M$$
Lorsque le nombre d’arbres $B$ croît vers l’infini, le second terme s’éteint asymptotiquement, laissant la variance plancher du méta-modèle strictement bornée par le produit $\rho \sigma^2_M$. En forçant l’utilisation d’arbres très profonds et non élagués, le bagging garantit que le biais individuel $b$ est maintenu à un niveau extrêmement bas. Le moyennage stochastique se charge ensuite de réduire la variance empirique d’autant plus efficacement que les modèles sont décorrélés (c’est-à-dire que le coefficient $rho$ est minimisé).
Cette stratégie présente cependant un écueil théorique fondamental : le bagging est constitutionnellement incapable de corriger un modèle sous-jacent qui souffre d’un biais élevé. Si les apprenants individuels sont des arbres superficiels ou des modèles trop simples qui échouent à déceler les régularités des données, le processus d’agrégation parallèle ne fera que stabiliser une prédiction structurellement fausse. Le bagging présuppose une compétence analytique locale préexistante au sein de chaque unité du collectif.
3.3 Action privilégiée du boosting sur le biais
À l’inverse symétrique du bagging, le boosting oriente son action algorithmique en priorité vers l’éradication du biais d’apprentissage. La méthodologie repose sur l’exploitation délibérée d’apprenants de base caractérisés par un très fort biais structurel mais une variance minimale. Ces estimateurs rudimentaires, stables et insensibles aux fluctuations de surface, sont incapables d’engendrer à eux seuls des prédictions acceptables.
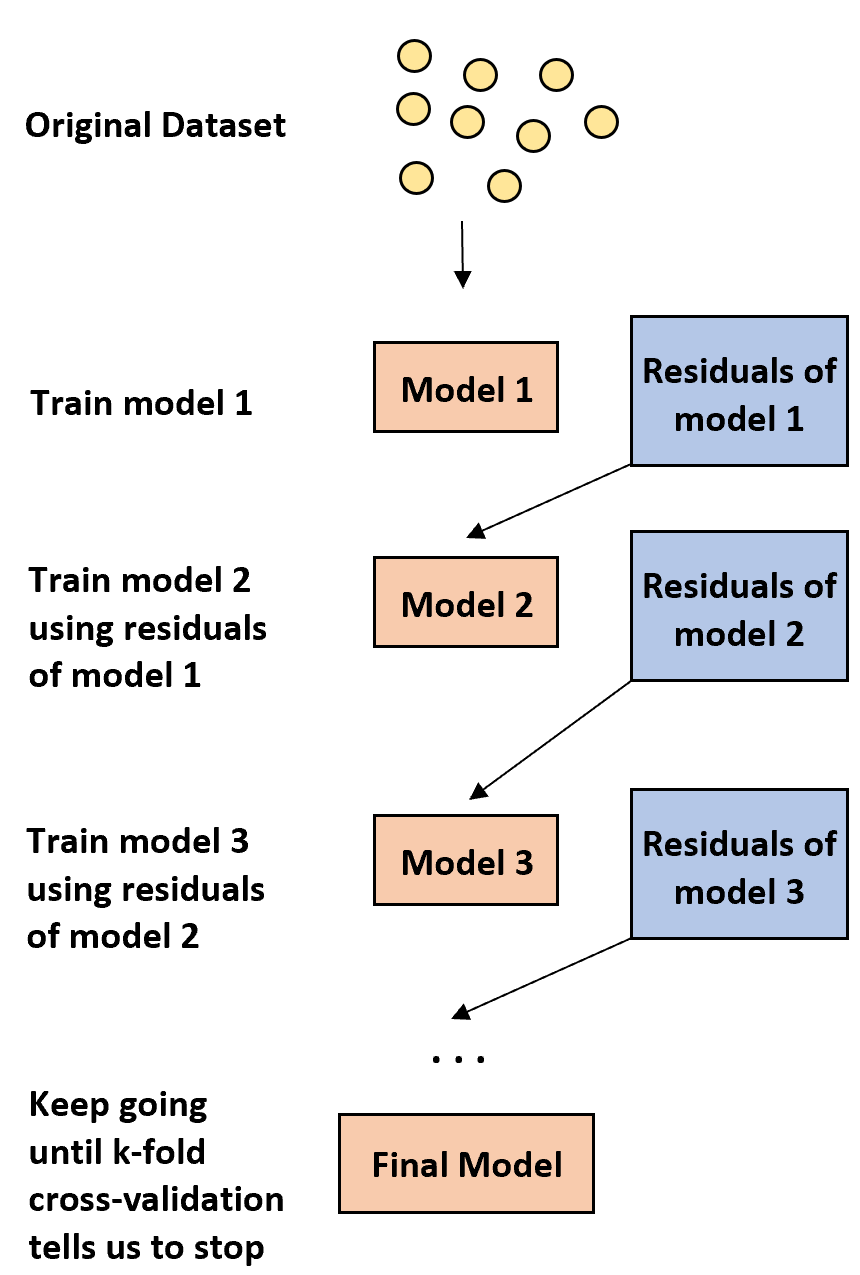
Le principe itératif du boosting consiste à soustraire systématiquement, à chaque pas de calcul, la part de variance expliquée par le modèle actuel pour ne laisser subsister que les résidus d’approximation. En forçant le nouvel apprenant à s’aligner sur ces résidus, l’algorithme comprime pas à pas la distance entre l’espérance de l’ensemble et la fonction génératrice des données. Le biais décroît ainsi de façon exponentielle ou polynomiale au gré des itérations successives.
Néanmoins, cette érosion continue du biais n’est pas sans danger : au fur et à mesure que les apprenants faibles s’empilent pour corriger des erreurs de plus en plus infinitésimales, la complexité géométrique de la frontière de décision combinée augmente drastiquement. L’ensemble acquiert une flexibilité accrue, ce qui finit par induire une hausse progressive de la variance globale du système. Dès lors, le risque majeur du boosting n’est pas le sous-apprentissage, mais la dérive progressive vers un surajustement caractérisé, nécessitant la mise en place de dispositifs de régularisation et de surveillance asymptotique rigoureux.
4. Qu’est-ce qu’un apprenant faible (Weak Learner) ?
4.1 Définition mathématique et conditions théoriques
Dans la formalisation de l’apprentissage PAC, la notion d’apprenant faible (weak learner) revêt une définition mathématique précise et contre-intuitivement permissive. Soit un problème de classification binaire où la variable dépendante $Y$ prend ses valeurs dans l’espace ${-1, +1}$ et où les vecteurs d’attributs $X$ sont issus d’une distribution de probabilité $\mathcal{D}$. Un algorithme est qualifié d’apprenant faible s’il existe une constante universelle $\gamma > 0$ telle que, pour toute distribution $\mathcal{D}$ imposée sur les données d’entraînement, l’algorithme renvoie en un temps polynomial une hypothèse $h : X to {-1, +1}$ vérifiant :
$$\mathbb{P}_{x \sim \mathcal{D}}[h(x) \neq Y] \leq \frac{1}{2} – \gamma$$
Cette condition signifie que l’apprenant doit simplement réaliser une prédiction légèrement plus avisée qu’une distribution de Bernoulli symétrique non informative (un simple tirage au sort équitable de probabilité 0,5). Aucune exigence de performance absolue n’est formulée : le modèle peut échouer dans 49,9 % des cas tout en demeurant un apprenant faible parfaitement viable, dès lors que cet avantage statistique infinitésimal $\gamma$ est garanti de manière déterministe et reproductible quelle que soit la pondération appliquée à l’espace d’entrée.
L’universalité théorique de ce concept réside dans sa totale agnostie architecturale. L’apprenant faible n’a pas besoin de posséder une forme paramétrique particulière. Il s’agit d’une propriété purement opérationnelle relative à la capacité d’un système à extraire une corrélation minimale, même ténue, entre la structure de l’information prédictive et la variable cible.
4.2 Les souches de décision (Decision Stumps) comme référence
Bien que la théorie n’impose aucune contrainte formelle sur l’architecture interne des apprenants faibles, un choix s’est imposé dans la pratique empirique et l’histoire du boosting : la souche de décision, ou decision stump. Il s’agit d’un arbre de décision dont la profondeur maximale est unitaire (profondeur égale à un). Une telle structure est composée d’un unique nœud décisionnel intérieur scindant l’espace en deux demi-plans le long d’une seule variable explicative, menant directement à deux feuilles terminales.
Isolément, une souche de décision est d’une indigence prédictive absolue. Elle ne peut considérer qu’un seuil scalaire unique sur une coordonnée axiale exclusive, ignorant superbement la totalité des interactions multivariées et des géométries circulaires ou obliques. Son biais d’apprentissage est considérable. Cependant, cette rusticité structurelle est compensée par trois atouts méthodologiques déterminants :
- Variance quasiment nulle : Sa simplicité limite drastiquement le risque de capturer des artéfacts stochastiques propres à un échantillon précis.
- Vitesse de calcul fulgurante : La recherche du seuil optimal et de la meilleure variable s’opère en un temps d’exécution minimal, permettant d’enchaîner des milliers d’itérations sans saturation computationnelle.
- Interprétabilité unitaire : Le comportement de chaque nœud est transparent et trivial à expliciter d’un point de vue décisionnel.
C’est l’agencement séquentiel et pondéré de ces milliers de découpages unidimensionnels primaires qui confère au modèle de boosting global la capacité de générer des surfaces de séparation non linéaires d’une complexité topologique arbitrairement sophistiquée.
4.3 Alternatives fonctionnelles aux arbres rudimentaires
L’hégémonie des arbres de décision superficiels au sein des algorithmes de boosting ne doit pas occulter la pluralité des mécanismes d’apprentissage faible explorés par la recherche théorique et empirique. Tout estimateur statistique paramétrique ou non paramétrique peut théoriquement assumer la fonction d’apprenant de base, sous réserve que sa complexité soit bridée de manière à contenir sa variance intrinsèque.
Les modèles de régression linéaire contraints, par exemple soumis à une pénalisation de type Tikhonov (régularisation Ridge) ou Lasso avec un coefficient de régularisation excessivement sévère, constituent des alternatives envisageables. Dans ce cadre, chaque itération du boosting incorpore un hyperplan fortement contraint qui extrait une direction de corrélation marginale dans l’espace résiduel. De même, les réseaux de neurones artificiels extrêmement superficiels, comportant une unique couche cachée dotée de deux ou trois unités de calcul non linéaires et bridés par un arrêt précoce violent, ont été employés avec succès dans certaines variantes d’AdaBoost.
Toutefois, ces alternatives se heurtent fréquemment à des écueils opérationnels : les réseaux de neurones superficiels sont instables sous repondération dynamique et requièrent une normalisation continue des variables, tandis que les répresseurs linéaires peinent à isoler des non-linéarités locales sans adjonction artificielle de bases polynomiales. Les estimateurs à base d’arbres, par leur insensibilité naturelle aux transformations monotones des données et leur faculté innée à sélectionner des variables informatives de façon discontinue, demeurent le standard empirique indéboulonnable du boosting contemporain.
5. Le mécanisme fondamental du boosting : intuition et séquentialité
5.1 L’analogie de l’apprentissage humain et de la correction des erreurs
Pour forger une intuition robuste du fonctionnement du boosting, une analogie épistémologique avec les processus d’acquisition de connaissances chez l’être humain s’avère particulièrement éclairante. Considérons la trajectoire cognitive d’un étudiant préparant une épreuve académique complexe à l’aide d’une série successive d’examens blancs. Lors de la première tentative, l’apprenant mobilise ses connaissances initiales de manière générale et homogène. La correction de cette première épreuve met inévitablement en lumière des disparités de maîtrise : certains concepts sont acquis avec certitude, tandis que d’autres font l’objet d’erreurs systématiques d’interprétation.
Un étudiant rationnel ne choisira pas de réviser l’ensemble du corpus de façon uniforme lors de la session suivante. Au contraire, il opérera une réallocation de son budget d’attention temporelle et cognitive : les chapitres parfaitement compris seront mis en veilleuse, tandis que les exercices ayant conduit à un échec cuisant deviendront la priorité d’étude immédiate. Lors du second examen blanc, l’effort analytique portera spécifiquement sur la résolution de ces écueils préalablement identifiés.
Ce processus de rétroaction adaptative se poursuit d’itération en itération. Le profil d’expertise final de l’étudiant n’est pas le résultat d’une récitation mécanique d’un manuel appris par cœur (qui s’apparenterait à du surapprentissage par mémorisation pure), mais bien d’une sédimentation d’ajustements correctifs graduels. Chaque cycle d’évaluation génère un gradient d’effort proportionnel aux faiblesses constatées. C’est précisément cette dialectique entre observation des dysfonctionnements locaux et mobilisation ciblée des ressources prédictives qui structure l’algorithmique du boosting.
5.2 La dynamique séquentielle d’entraînement
D’un point de vue mécanique, l’exécution d’un algorithme de boosting obéit à un protocole itératif rigoureux au fil d’une succession de pas temporels discrets $m = 1, dots, M$. Soit un jeu de données d’apprentissage $\mathcal{S} = {(x_1, y_1), (x_2, y_2), dots, (x_N, y_N)}$ où chaque paire associe un vecteur d’observations à sa classe ou valeur cible réelle.
À l’origine du protocole ($m = 1$), une condition d’indifférence bayésienne est posée : un poids d’échantillonnage uniforme est attribué à chaque instance, soit $w_i^{(1)} = \frac{1}{N}$ pour tout $i in {1, dots, N}$. Le premier apprenant faible $h_1$ est entraîné sur cette distribution équilibrée afin de minimiser le taux d’erreur moyen standard. Dès l’achèvement de cette première passe, l’algorithme évalue quantitativement l’écart entre la réalité $y_i$ et la prédiction $h_1(x_i)$ pour chaque observation individuelle.
Cette confrontation génère une redistribution immédiate de la masse de probabilité sur le jeu de données pour l’itération $m = 2$. Les observations dont la prédiction est exacte voient leur pondération $w_i$ comprimée, devenant virtuellement transparentes pour l’étape suivante. À l’opposé, les instances erronées subissent une pénalisation multiplicative qui amplifie considérablement leur poids relatif. Le second estimateur $h_2$ est subséquemment entraîné sur ce jeu de données déformé : son optimisation est mathématiquement contrainte d’accorder la priorité absolue aux cas d’échec de $h_1$. Cette séquence de rééquilibrage se réitère jusqu’à l’atteinte d’un critère d’arrêt déterminé, chaque estimateur se voyant confier la responsabilité exclusive des résidus accumulés par ses prédécesseurs.
5.3 La construction de la décision agrégée
L’étape terminale du boosting réside dans la synthèse des connaissances éparses acquises par la lignée d’estimateurs faibles au sein d’une décision unifiée. Contrairement au bagging qui octroie à chaque modèle une voix strictement identique lors du dépouillement final, le boosting met en place une méritocratie statistique rigoureuse.
À chaque itération $m$, l’algorithme attribue à l’estimateur $h_m$ un coefficient d’influence scalaire, traditionnellement désigné par la lettre grecque $\alpha_m$. Ce coefficient constitue une mesure directe de la confiance épistémique que le système accorde à ce prédicteur particulier. Un apprenant ayant démontré une exactitude globale remarquable sur sa distribution d’entraînement héritera d’un coefficient $\alpha_m$ élevé, pesant lourdement dans le scrutin final. Inversement, un modèle dont la performance n’aura dépassé que de manière infime le seuil aléatoire se verra relégué à un rôle marginal par le biais d’un poids proche de zéro.
Pour un problème de classification binaire où les labels appartiennent à ${-1, +1}$, la décision collective globale $H(x)$ pour une nouvelle observation $x$ s’exprime comme le signe d’une combinaison linéaire pondérée :
$$H(x) = \text{sign}\left(\sum_{m=1}^M \alpha_m h_m(x)\right)$$
Dans un contexte de régression continue, l’agrégation finale s’affranchit de la fonction signe pour sommer directement les contributions rééchelonnées des modèles successifs. L’architecture finale n’est donc pas un vote démocratique uniforme, mais un arbitrage géométrique hautement structuré où les certitudes de chaque maillon compensent précisément les défaillances des autres.
6. AdaBoost (Adaptive Boosting) : l’algorithme fondateur
6.1 Architecture et formalisme de l’algorithme de Freund et Schapire
Présenté lors de la prestigieuse conférence EuroCOLT en 1995 et publié formellement en 1997 par Yoav Freund et Robert Schapire, l’algorithme AdaBoost (pour Adaptive Boosting) a constitué une véritable onde de choc au sein de la communauté statistique, récompensé ultérieurement par le prestigieux prix Gödel. AdaBoost incarne la première implémentation pratique totalement réussie du concept de boosting pour la classification binaire.
L’élégance d’AdaBoost repose sur sa nature déterministe et auto-adaptative : il ne requiert aucune connaissance a priori sur le niveau de précision des apprenants faibles, calibrant automatiquement la dynamique d’entraînement à partir des taux d’erreur mesurés empiriquement. Le formalisme de l’algorithme se déploie selon la séquence suivante :
- Soit une base d’apprentissage $\mathcal{S} = {(x_i, y_i)}_{i=1}^N$ avec $x_i in \mathcal{X}$ et $y_i in {-1, +1}$.
- Initialisation du vecteur de poids distributionnel : $w_i^{(1)} = \frac{1}{N}$ pour $i = 1, dots, N$.
- Pour chaque itération de boosting $m = 1, dots, M$ :
- Ajuster un classifieur faible $h_m : \mathcal{X} to {-1, +1}$ en minimisant l’erreur pondérée sur les données régies par les poids $w^{(m)}$.
- Calculer l’erreur pondérée normalisée $\epsilon_m$ de ce classifieur :
$$\epsilon_m = \sum_{i=1}^N w_i^{(m)} \mathbb{I}(y_i \neq h_m(x_i))$$
où $\mathbb{I}(\cdot)$ représente la fonction indicatrice booléenne. - Si $\epsilon_m \geq 0,5$, le processus s’interrompt ou l’hypothèse est inversée pour garantir $\epsilon_m < 0,5$.
- Calculer le poids d’influence $\alpha_m$ du classifieur :
$$\alpha_m = \frac{1}{2} \ln\left(\frac{1 – \epsilon_m}{\epsilon_m}\right)$$ - Mettre à jour le profil de distribution des poids pour chaque instance $i$ :
$$w_i^{(m+1)} = \frac{w_i^{(m)} \exp\left(-\alpha_m y_i h_m(x_i)\right)}{Z_m}$$
où $Z_m$ est une constante de normalisation assurant que $\sum_{i=1}^N w_i^{(m+1)} = 1$.
- Restitution du classifieur fort final : $H(x) = \text{sign}\left(\sum_{m=1}^M \alpha_m h_m(x)\right)$.
Schapire et Freund ont établi une borne théorique fondamentale : si chaque classifieur faible présente une marge d’avantage $\gamma_m = 0,5 – \epsilon_m > 0$, l’erreur de classification sur l’échantillon d’apprentissage décroît de façon strictement exponentielle avec le nombre d’itérations, vérifiant $\text{Erreur}_{\text{train}} \leq \exp\left(-2 \sum_{m=1}^M \gamma_m^2\right)$.
6.2 Mise à jour mathématique des poids d’échantillons
Le cœur opératoire d’AdaBoost réside dans la mécanique exponentielle qui régit la mise à jour vectorielle des pondérations d’échantillons. Analysons en profondeur le terme multiplicatif central : $\exp\left(-\alpha_m y_i h_m(x_i)\right)$.
Puisque les étiquettes réelles $y_i$ et les prédictions $h_m(x_i)$ n’adoptent que les valeurs canoniques $-1$ ou $+1$, le produit algébrique $y_i h_m(x_i)$ constitue un indicateur scalaire de concordance :
- Si la prédiction est conforme à la réalité ($h_m(x_i) = y_i$), le produit est égal à $+1$. L’exposant devient négatif : $\exp(-\alpha_m)$. Étant donné que $\alpha_m > 0$, ce facteur multiplicatif est strictement compris entre 0 et 1, ce qui induit une réduction de la pondération de l’observation $i$.
- Si le classifieur commet une erreur ($h_m(x_i) \neq y_i$), le produit devient $-1$. L’exposant se transforme en une quantité positive : $\exp(+\alpha_m)$. Comme $\exp(\alpha_m) > 1$, la pondération de cette instance subit une amplification exponentielle proportionnelle à la confiance accordée au modèle.
Le dénominateur $Z_m = \sum_{i=1}^N w_i^{(m)} \exp(-\alpha_m y_i h_m(x_i))$ agit comme une fonction de partition issue de la mécanique statistique, maintenant les poids au sein du simplexe de probabilité $\Delta^{N-1}$. Sur le plan géométrique, cette transformation déforme continuellement la métrique de l’espace d’apprentissage : les instances systématiquement réfractaires migrent vers des régions de densité artificielle extrême, contraignant l’espace des paramètres des estimateurs futurs à se focaliser presque exclusivement sur leur résolution.
6.3 Calcul de l’importance des classifieurs (Alpha)
La dérivation analytique de la formulation du coefficient $\alpha_m = \frac{1}{2} \ln\left(\frac{1 – \epsilon_m}{\epsilon_m}\right)$ n’est en rien arbitraire : elle émane directement de la volonté de minimiser la constante de normalisation $Z_m$ considérée comme une fonctionnelle de $\alpha$. En dérivant $Z_m$ par rapport à $\alpha$ et en annulant cette dérivée, on isole rigoureusement cette valeur optimale.
L’examen des propriétés limites de cette fonction logarithmique éclaire le comportement du système :
- Lorsque le taux d’erreur $\epsilon_m$ converge vers 0 (performance quasi parfaite), le ratio $\frac{1 – \epsilon_m}{\epsilon_m}$ tend vers $+\infty$, conduisant $\alpha_m$ à diverger vers l’infini positif. Ce modèle exceptionnel se voit conférer une prépondérance absolue, pouvant à lui seul verrouiller la décision globale du collège.
- Lorsque $\epsilon_m$ s’approche de 0,5 (le niveau de bruit aléatoire complet), le quotient tend vers 1, ce qui annule son logarithme naturel : $\alpha_m to 0$. Ce modèle, n’apportant aucune information discriminante réelle, est purement et simplement neutralisé lors du vote final.
- Si un apprenant venait à présenter un taux d’erreur pire que le hasard ($\epsilon_m > 0,5$), $\alpha_m$ adopterait une valeur négative. Le boosting inverse alors automatiquement sa prédiction : un système systématiquement défaillant devient un informateur fiable dès lors que l’on prend le contre-pied systématique de ses assertions.
Cette régularité mathématique garantit la cohérence asymptotique du processus d’agrégation, protégeant l’ensemble de la contamination par des prédicteurs inconsistants.
6.4 Forces et vulnérabilités pratiques d’AdaBoost
L’avènement d’AdaBoost a doté la science des données d’un outil prédictif remarquable, caractérisé par une étonnante simplicité d’implémentation et une quasi-absence d’hyperparamètres de réglage critiques en dehors du nombre d’itérations $M$. Sur une vaste variété de jeux de données tabulaires bien conditionnés, AdaBoost a démontré une résistance surprenante au surapprentissage, continuant souvent d’améliorer la marge de séparation sur les données de test bien après que l’erreur d’entraînement a atteint le plancher théorique de zéro.
Néanmoins, la contrepartie de cette mécanique exponentielle réside dans une hypersensibilité pathologique aux valeurs aberrantes (outliers) et au bruit d’étiquetage aléatoire. Si un jeu de données contient des observations corrompues (par exemple, une étiquette positive attribuée par erreur à un profil typiquement négatif), AdaBoost tentera avec obstination de corriger ces anomalies insolubles.
Au fil des itérations, le poids affecté à ces points discordants croît de manière exponentielle, jusqu’à cannibaliser l’intégralité de la masse de probabilité $Z_m$. L’algorithme se retrouve alors pris au piège, consacrant la quasi-totalité de sa capacité d’apprentissage à construire des frontières de décision aberrantes pour isoler quelques observations corrompues, ce qui entraîne un effondrement brutal de la performance de généralisation hors échantillon. Cette vulnérabilité intrinsèque a motivé les statisticiens à reformuler le boosting dans un cadre d’optimisation plus résilient et généralisable.
7. Gradient Boosting : l’optimisation par descente de gradient
7.1 Formulation du boosting dans l’espace des fonctions
À la fin des années 1990, une avancée conceptuelle majeure orchestrée par Jerome Friedman, Trevor Hastie et Robert Tibshirani a permis de s’extraire de l’interprétation purement probabiliste d’AdaBoost pour la refonder dans le cadre élégant de l’optimisation numérique en dimension infinie. Dans son article fondateur de 2001 intitulé Greedy Function Approximation: A Gradient Boosting Machine, Jerome Friedman a démontré que le boosting pouvait être conceptualisé comme une méthode de descente de gradient appliquée directement dans l’espace des fonctions mathématiques.
Considérons la tâche consistant à minimiser l’espérance empirique d’une fonction de perte différentiable arbitraire $L(y, F(x))$ sur un jeu d’entraînement :
$$\mathcal{L}(F) = \sum_{i=1}^N L(y_i, F(x_i))$$
Dans la descente de gradient traditionnelle en apprentissage profond, les vecteurs de paramètres d’un modèle statique sont mis à jour en soustrayant le gradient de la perte évalué par rapport à ces paramètres. Dans le Gradient Boosting, le modèle global $F_M(x)$ est lui-même constitué par l’addition séquentielle d’un ensemble de fonctions d’approximation : $F_M(x) = \sum_{m=0}^M f_m(x)$.
L’apprentissage ne consiste plus à modifier les poids internes d’une fonction figée, mais à progresser pas à pas dans l’espace de Hilbert des fonctions prédictives. À chaque étape $m$, on cherche à ajouter la fonction $h_m(x)$ qui pointe au plus près dans la direction opposée au gradient de la perte globale. Le passage de la repondération explicite des données propres à AdaBoost à l’optimisation différentiable d’une perte quelconque unifie sous un même paradigme l’ensemble des tâches statistiques, qu’il s’agisse de classification binaire, multi-classe, de régression continue ou d’ordonnancement.
7.2 Le concept de pseudo-résidus
La pierre angulaire opérationnelle du Gradient Boosting repose sur la notion mathématique de pseudo-résidus. Si l’on évalue la fonction de perte au point courant de l’itération, soit $F_{m-1}(x_i)$, la variation de l’erreur causée par une modification infinitésimale de la prédiction au point $x_i$ est donnée par la dérivée partielle de la perte par rapport à son second argument. Le gradient négatif, représentant la direction de plus grande descente locale, s’écrit pour chaque observation $i in {1, dots, N}$ :
$$r_{im} = -\left[ \frac{\partial L(y_i, F(x_i))}{\partial F(x_i)} \right]_{F(x) = F_{m-1}(x)}$$
Ces quantités $r_{im}$ sont appelées pseudo-résidus car elles jouent exactement le même rôle opérationnel que les résidus arithmétiques classiques en régression. Pour illustrer cette parenté, examinons le cas de la perte quadratique standard $L(y, F(x)) = \frac{1}{2}(y – F(x))^2$ :
$$r_{im} = -\left[ -(y_i – F_{m-1}(x_i)) \right] = y_i – F_{m-1}(x_i)$$
Sous la perte quadratique, le pseudo-résidu coïncide rigoureusement avec l’erreur résiduelle standard. Toutefois, la force monumentale du Gradient Boosting est que cette équivalence se décline pour n’importe quelle perte différentiable :
- Perte absolue (L1) pour une régression robuste : $L(y, F) = |y – F|$, les pseudo-résidus deviennent $r_{im} = \text{sign}(y_i – F_{m-1}(x_i))$, rendant le système totalement insensible aux valeurs extrêmes aberrantes.
- Perte logistique (déviances binaires) : $L(y, F) = ln(1 + exp(-2yF))$, reliant élégamment le gradient boosting à la régression logistique pénalisée.
- Perte de Poisson : Utilisée pour modéliser des variables de dénombrement ou de fréquence d’événements rares.
À l’itération $m$, l’algorithme n’ajuste plus un modèle faible sur les étiquettes initiales $y_i$ au moyen de poids artificiels, mais régresse directement un nouvel arbre de décision sur la cible continue que forment les pseudo-résidus $r_{im}$. L’arbre capture ainsi le gradient de descente empirique.
7.3 Le pas d’apprentissage (Learning Rate ou Shrinkage)
L’adjonction directe et intégrale du modèle d’approximation $h_m(x)$ à la fonction cumulative $F_{m-1}(x)$ conduirait fréquemment à une progression trop brutale dans l’espace fonctionnel, précipitant l’ensemble vers un surapprentissage précoce. Pour stabiliser la trajectoire de convergence, Jerome Friedman a introduit un paramètre de modération fondamental désigné sous les termes de taux d’apprentissage (learning rate) ou rétrécissement fonctionnel (shrinkage), noté $eta$ (ou $\nu$) avec $eta in ]0, 1]$ :
$$F_m(x) = F_{m-1}(x) + \eta \cdot \gamma_m h_m(x)$$
où $\gamma_m$ est un facteur d’échelle scalaire obtenu par recherche linéaire (line search) pour optimiser le pas global le long de la direction de descente choisie.
L’action du paramètre $eta$ s’apparente à une régularisation par friction continue. En réduisant arbitrairement la contribution individuelle de chaque arbre (par exemple en fixant $eta = 0,05$ ou $eta = 0,01$), le modèle est contraint de diluer l’effort d’ajustement à travers un nombre considérablement plus élevé d’arbres prédictifs successifs. Ce ralentissement délibéré offre deux bénéfices statistiques majeurs :
- Il empêche un arbre isolé d’accaparer prématurément une part excessive de l’explication de la variance, laissant les résidus disponibles pour que d’autres configurations de variables puissent être exploitées par les arbres ultérieurs.
- Il lisse la surface de séparation multidimensionnelle globale, réduisant de manière spectaculaire la variance de l’ensemble et renforçant sa robustesse lors du déploiement en inférence hors échantillon.
Cette régularisation implique un arbitrage computationnel direct : plus le taux d’apprentissage $eta$ est configuré à une valeur infinitésimale, plus le nombre total d’itérations $M$ requis pour atteindre la convergence théorique doit être revu à la hausse, augmentant proportionnellement le coût en temps de calcul.
8. Variantes modernes et haute performance : XGBoost, LightGBM et CatBoost
8.1 XGBoost : l’ingénierie extrême et le développement de Taylor
Développé à l’origine en 2014 par Tianqi Chen à l’Université de Washington, XGBoost (pour eXtreme Gradient Boosting) a métamorphosé la scène de l’apprentissage automatique compétitif en s’imposant comme la solution prédominante dans les défis d’analyse prédictive sur données tabulaires. Cette suprématie repose sur une synthèse d’avancées théoriques formelles et d’optimisations matérielles poussées à l’extrême.
Sur le plan mathématique, la première innovation d’XGBoost consiste à substituer à la classique approximation de gradient au premier ordre une expansion de Taylor au second ordre de la fonction de perte. La fonctionnelle d’objectif à minimiser lors de l’adjonction du $m$-ième arbre $f_m$ s’exprime sous la forme :
$$\tilde{\mathcal{L}}^{(m)} simeq \sum_{i=1}^N \left[ L(y_i, F_{m-1}(x_i)) + g_i f_m(x_i) + \frac{1}{2} h_i f_m^2(x_i) \right] + \Omega(f_m)$$
où $g_i = \frac{\partial L(y_i, F_{m-1}(x_i))}{\partial F_{m-1}(x_i)}$ représente le gradient de premier ordre classique et $h_i = \frac{\partial^2 L(y_i, F_{m-1}(x_i))}{\partial F_{m-1}(x_i)^2}$ correspond à la courbure hessienne locale (second ordre). L’intégration explicite de cette courbure fournit à l’algorithme une indication précieuse sur la vitesse d’inflexion de la perte, accélérant drastiquement la convergence géométrique vers les minima locaux.
Parallèlement, XGBoost introduit une régularisation structurelle explicite directement intégrée dans le terme de pénalité de l’arbre $\Omega(f_m)$ :
$$\Omega(f_m) = \gamma T + \frac{1}{2} \lambda \sum_{j=1}^T w_j^2 + \alpha \sum_{j=1}^T |w_j|$$
où $T$ désigne le nombre total de feuilles terminales de l’arbre, $w_j$ le poids de prédiction scalaire attribué à la feuille $j$, et $\gamma, \lambda, \alpha$ des hyperparamètres régulant respectivement la parcimonie du nombre de feuilles (coût de complexité par nœud) et des pénalisations de type Ridge (L2) et Lasso (L1) sur les amplitudes des sorties de chaque feuille.
Sur le plan de l’ingénierie logicielle, XGBoost intègre un algorithme d’énumération par quantiles pondérés pour le partitionnement rapide de variables à valeurs continues, une gestion automatique des valeurs manquantes qui oriente ces dernières vers la branche minimisant empiriquement la perte, et une exploitation avancée de la parallélisation sur architectures multi-cœurs via le stockage des données par blocs compressés en colonnes (Compressed Sparse Columns).
8.2 LightGBM : accélération par histogrammes et croissance verticale
Face aux contraintes d’échelle imposées par des ensembles de données comprenant des dizaines de millions de lignes, Microsoft Research a dévoilé en 2017 LightGBM (Light Gradient Boosting Machine). L’ambition déclarée de ce cadriciel était de surmonter le goulet d’étranglement temporel et spatial induit par la recherche de partitions optimales dans les arbres continus, tout en conservant une exactitude statistique rigoureuse.
La première rupture conceptuelle de LightGBM réside dans le remplacement des algorithmes de balayage de tri continu par une approche à base d’histogrammes discrets. Les variables continues sont préalablement quantifiées dans un ensemble restreint de compartiments discrets (typiquement 256 bins, codables sur un seul octet). Au lieu d’évaluer la fonction de fractionnement sur chaque point d’observation distinct, l’algorithme n’évalue les gains de séparation que sur les frontières de ces compartiments. Cela réduit la complexité computationnelle de la recherche de partitions de $\mathcal{O}(N \times \text{features})$ à $\mathcal{O}(\text{bins} \times \text{features})$, générant un gain de vitesse monumental et une réduction drastique de l’empreinte mémoire vive.
La seconde innovation majeure est le mode de croissance de l’arbre décisionnel. Alors que les algorithmes traditionnels (dont la majorité des versions d’XGBoost originel) adoptent une stratégie horizontale niveau par niveau (depth-wise ou level-wise), LightGBM emploie une croissance verticale feuille par feuille (leaf-wise). À chaque division structurelle, l’algorithme examine l’ensemble des feuilles terminales existantes et sélectionne uniquement celle qui promet la plus importante réduction de perte absolue, sans obligation de maintenir l’arbre équilibré :
- Croissance Depth-wise : Génère des arbres symétriques, faciles à réguler mais gaspillant de la capacité computationnelle sur des sous-arbres peu informatifs.
- Croissance Leaf-wise : Maximise la diminution de la perte à chaque fractionnement, produisant des arbres asymétriques très profonds capables de modéliser des interactions non linéaires locales avec une efficience supérieure, bien qu’exigeant une surveillance accrue de l’hyperparamètre
max_depthpour juguler le surapprentissage.
Enfin, LightGBM enrichit son moteur de deux techniques stochastiques brevetées : GOSS (Gradient-based One-Side Sampling), qui conserve l’intégralité des observations dotées de gradients élevés tout en sous-échantillonnant aléatoirement les instances à faibles résidus pour alléger le calcul sans fausser la distribution, et EFB (Exclusive Feature Bundling), qui fusionne au sein d’une métavariable unique les attributs parcimonieux qui s’excluent mutuellement (qui ne prennent presque jamais de valeurs non nulles simultanément).
8.3 CatBoost : traitement natif des données catégorielles et réduction des biais
Conçu par le géant technologique Yandex et mis à disposition en open-source en 2017, CatBoost (contraction de Categorical Boosting) s’est attaqué à deux des angles morts les plus persistants des architectures de gradient boosting traditionnelles : la dégradation statistique causée par l’encodage classique des variables qualitatives (catégorielles) et les biais d’estimation inhérents au réemploi des données lors du calcul des résidus successifs.
Dans la plupart des algorithmes, les variables catégorielles à haute cardinalité (comme les codes postaux, les identifiants de produits ou les catégories professionnelles) sont soit éclatées en centaines de colonnes binaires via l’encodage disjonctif complet (one-hot encoding), ce qui dilate l’espace vectoriel et ralentit l’apprentissage, soit remplacées par la moyenne de la variable cible conditionnée à chaque catégorie (target encoding). Cependant, un encodage cible naïf induit une fuite d’information dévastatrice : la valeur prédictive d’une ligne intègre la réalisation de sa propre étiquette cible, conduisant à un surapprentissage structurel immédiat.
CatBoost résout cette difficulté par le déploiement d’un encodage cible ordonné (Ordered Target Statistics). L’ensemble d’apprentissage subit une permutation aléatoire temporelle fictive. Pour chaque observation donnée, l’estimation statistique de la moyenne catégorielle n’est calculée qu’en exploitant strictement les instances qui la précèdent chronologiquement dans cette séquence permutée :
$$\hat{x}_{k}^i = \frac{\sum_{j=1}^{p-1} [x_{\sigma(j), k} = x_{\sigma(p), k}] \cdot y_{\sigma(j)} + a \cdot P}{\sum_{j=1}^{p-1} [x_{\sigma(j), k} = x_{\sigma(p), k}] + a}$$
où $\sigma$ est une permutation aléatoire, $P$ une constante a priori et $a$ un paramètre de lissage. Cette démarche supprime toute contamination rétrospective de l’information.
Par ailleurs, CatBoost introduit le concept d’Ordered Boosting pour contrer le biais d’optimisation (le fait que le calcul du pseudo-résidu d’une observation s’effectue sur un modèle $F_{m-1}$ dont l’apprentissage a précisément intégré cette observation). Enfin, CatBoost utilise exclusivement des arbres de décision symétriques ou oblitérés (oblivious trees). Dans un arbre symétrique, le même critère de partition (même variable, même seuil) est imposé à l’ensemble des nœuds appartenant à une même profondeur d’arbre. Cette topologie très rigide agit comme une puissante régularisation naturelle et permet une vectorisation ultra-rapide de l’inférence prédictive via des instructions CPU bit à bit.
9. Régularisation et contrôle du surapprentissage dans le boosting
9.1 Manifestations du surajustement dans les algorithmes itératifs
Le surapprentissage (overfitting) constitue la vulnérabilité théorique majeure du boosting. Par construction, chaque itération du système a pour mandat formel d’éradiquer les résidus non résolus par les modèles antérieurs. Si le processus n’est pas borné par des contraintes mathématiques et méthodologiques fermes, l’algorithme finira inexorablement par interpréter le bruit stochastique irréductible $varepsilon$, les incohérences de labellisation et les artefacts d’échantillonnage comme des signaux fonctionnels légitimes.
Cette dérive se manifeste empiriquement par une divergence pathologique des courbes de perte. Sur le jeu de données d’apprentissage, la fonction de coût continue sa décroissance asymptotique monotone, se rapprochant de zéro à mesure que de nouveaux arbres s’ajoutent à la combinaison. En revanche, sur un échantillon de validation indépendant représentatif de la population sous-jacente, la courbe de perte atteint un extremum local (le point d’optimalité empirique) avant d’amorcer une remontée progressive et continue. La capacité de généralisation s’étiole à mesure que le modèle accumule des micro-décisions de plus en plus complexes pour tenter d’accommoder les données résiduelles isolées.
Les partitions géométriques finales deviennent excessivement fragmentées : l’espace de décision se hérisse d’îlots minuscules et de frontières tourmentées, traduisant une perte d’extrapolation fondamentale. L’enjeu de la régularisation consiste précisément à inhiber cette mémorisation stochastique sans étouffer la puissance d’approximation du modèle.
9.2 L’arrêt précoce (Early Stopping)
Parmi les protocoles opérationnels de contrôle de la complexité, l’arrêt précoce (early stopping) s’impose comme une heuristique de régularisation élégante, universelle et d’une efficacité remarquable dans les modèles itératifs. Son postulat fondamental repose sur l’exploitation du temps d’apprentissage — c’est-à-dire le nombre total d’itérations $M$ — comme un hyperparamètre de régularisation continue à part entière.
Le protocole opératoire se déroule selon une surveillance en temps réel de la performance hors échantillon :
- Une fraction représentative du jeu de données disponible (typiquement 15 à 20 %, ou les plis d’une validation croisée) est sanctuarisée sous forme de jeu de validation et totalement soustraite à l’optimisation des arbres de gradient.
- À chaque itération $m$, consécutivement à l’adjonction du nouvel apprenant $h_m$, la métrique d’évaluation cible (perte logarithmique, aire sous la courbe ROC, erreur quadratique, etc.) est calculée sur ce jeu de validation.
- Un paramètre de tolérance, désigné sous le terme de patience, est assigné à l’algorithme. Si la performance sur le jeu de validation stagne ou se dégrade pendant un nombre consécutif de $k$ itérations (par exemple $k = 50$), le calcul est interrompu préventivement.
- L’état final du modèle composite retenu pour le déploiement opérationnel n’est pas celui de la dernière itération calculée, mais l’état précis correspondant au point d’inflexion optimal enregistré sur le jeu de validation au cours de l’historique du calcul.
Cette approche neutralise les itérations superflues, réduisant le temps d’entraînement tout en préservant le compromis biais-variance optimal.
9.3 Pénalisation structurelle et sous-échantillonnage
Au-delà du contrôle strict du nombre d’estimateurs, la prévention de l’hypertrophie prédictive exige le déploiement d’un arsenal complet de contraintes structurelles et de perturbations stochastiques à l’échelle de chaque arbre élémentaire.
La première ligne de défense réside dans la pénalisation explicite de l’architecture des arbres :
- Contrainte de profondeur (
max_depth) et de cardinalité des feuilles (max_leaf_nodes) : Limite drastiquement l’ordre des interactions non linéaires capturées au sein d’une même composante. - Poids minimal par feuille (
min_child_weight) : Impose un seuil minimal d’échantillons ou de couverture hessienne locale sous lequel aucune division supplémentaire n’est autorisée, interdisant l’isolement d’observations uniques. - Régularisation analytique L1/L2 sur les feuilles : Comme formalisé dans XGBoost, l’imposition d’un coût quadratique sur l’amplitude des prédictions émises par les feuilles comprime les valeurs extrêmes vers zéro, évitant les sur-réactions locales face à des gradients instables.
La seconde ligne de défense s’inspire directement des vertus de décorrélation du bagging à travers le Stochastic Gradient Boosting, formalisé par Jerome Friedman en 1999. À chaque nouvelle itération, l’arbre $h_m$ n’est pas ajusté sur l’intégralité du corpus d’apprentissage, mais sur un sous-échantillon tiré uniformément sans remise selon une proportion définie (typiquement 50 à 80 % des lignes). Ce tirage injecte un bruit protecteur salutaire qui prévient le verrouillage des arbres sur les singularités de l’échantillon complet.
De surcroît, le sous-échantillonnage aléatoire des colonnes (feature subsampling), appliqué soit au niveau de l’arbre global (à la manière des forêts aléatoires), soit au niveau de chaque division de nœud individuelle, empêche un prédicteur dominant d’occulter structurellement les variables prédictives secondaires, assurant une diversification salutaire de l’information exploitée par le collectif.
10. Hyperparamètres critiques et protocoles de réglage (Tuning)
10.1 Paramètres régissant la structure de l’arbre
Le calibrage des hyperparamètres régissant la morphologie individuelle des arbres constitue l’étape fondatrice du paramétrage d’un système de boosting. Ces paramètres fixent la frontière entre l’expressivité locale de chaque apprenant et sa propension à l’instabilité statistique.
Le paramètre de profondeur maximale (max_depth) impose une borne absolue sur le chemin le plus long reliant la racine d’un arbre à ses feuilles. En pratique, là où une forêt aléatoire nécessite des profondeurs oscillant entre 15 et 30 niveaux pour réduire son biais individuel, les modèles de gradient boosting prospèrent typiquement avec des profondeurs restreintes : des valeurs comprises entre 3 et 8 sont la norme sur les données tabulaires standards. Un arbre de profondeur 3 capture des interactions jusqu’à trois variables distinctes, ce qui suffit à appréhender l’immense majorité des couplages prédictifs du monde réel sans dilater inutilement la variance.
Dans les architectures comme LightGBM privilégiant la croissance par feuille, le nombre maximal de feuilles terminales (num_leaves) supplante la profondeur en tant que levier de contrôle principal. Un lien heuristique essentiel lie ces deux notions : pour un arbre binaire complet, $\text{num_leaves} = 2^{\text{\max_depth}}$. Afin de prémunir LightGBM contre un surapprentissage sévère, il est conventionnel de fixer num_leaves à une valeur strictement inférieure à $2^{\text{\max_depth}}$, limitant la dissymétrie tout en permettant une liberté d’ajustement ciblée.
Enfin, le paramètre min_child_weight (dans XGBoost) ou min_data_in_leaf (dans LightGBM) détermine la masse statistique requise pour valider une scission. Dans les contextes de données hautement bruitées, augmenter ce seuil contraint l’arbre à ignorer les micro-agrégats pour ne retenir que les macro-tendances corroborées par un volume d’observations robuste.
10.2 Paramètres régissant la convergence globale
Le second volet du réglage hyperparamétrique concerne la dynamique cinétique d’agrégation de la suite d’estimateurs, gouvernée par l’interaction intime entre le nombre d’arbres (n_estimators ou $M$) et le taux d’apprentissage (learning_rate ou $eta$).
Ces deux hyperparamètres entretiennent une relation de compensation inversement proportionnelle quasi parfaite : diviser le taux d’apprentissage par deux nécessite généralement de doubler le nombre total d’arbres pour atteindre un niveau de convergence similaire le long de la variété fonctionnelle. La pratique recommandée en modélisation industrielle consiste à découpler leur réglage :
- Fixer temporairement un taux d’apprentissage modérément conservateur (par exemple $eta = 0,05$ ou $eta = 0,1$) pour maintenir des temps de calcul raisonnables.
- Associer un nombre d’estimateurs généreux (par exemple
n_estimators = 2000) et activer systématiquement le mécanisme d’arrêt précoce (early_stopping_rounds = 50) pour déterminer dynamiquement le nombre optimal d’itérations $M^*$. - Une fois les autres paramètres structurels et de sous-échantillonnage calibrés, réduire le taux d’apprentissage (par exemple $eta = 0,01$) et laisser l’arrêt précoce réajuster à la hausse le volume final d’arbres pour extraire les ultimes gains de généralisation.
Dans les contextes de classification fortement déséquilibrée (détection de fraude, diagnostic de maladies orphelines), le paramètre scale_pos_weight (ou is_unbalance) devient capital. Il permet d’amplifier artificiellement le gradient des erreurs commises sur la classe minoritaire, évitant que le modèle ne converge vers une solution triviale consistant à assigner systématiquement la classe majoritaire à l’ensemble du domaine d’entrée.
10.3 Stratégies méthodologiques d’optimisation
L’espace combinatoire défini par l’intersection des hyperparamètres structurels, d’échantillonnage et de convergence rend toute exploration exhaustive par balayage systématique sur grille (Grid Search) mathématiquement impraticable dès lors que les données excèdent quelques dizaines de milliers de lignes. Si l’on considère 6 paramètres dotés chacun de 4 valeurs candidates, le coût computationnel implique l’entraînement de $4^6 = 4096$ modèles complets, une charge incompatible avec les cycles de développement modernes.
La recherche aléatoire (Random Search) constitue une première alternative éprouvée. Comme l’ont démontré Bergstra et Bengio en 2012, échantillonner uniformément des points dans l’espace hyperparamétrique surpasse structurellement la recherche par grille à budget computationnel constant. Cela s’explique par le fait que certains hyperparamètres exercent un impact déterminant sur la variance de sortie tandis que d’autres s’avèrent marginaux : la grille teste inutilement des répétitions sur les axes inactifs, tandis que l’échantillonnage aléatoire explore un éventail continu de configurations uniques sur chaque dimension critique.
Cependant, l’état de l’art méthodologique réside dans le déploiement de l’optimisation bayésienne (via des bibliothèques spécialisées comme Optuna ou Hyperopt). L’optimisation bayésienne modélise la fonction objectif inconnue (la perte de validation croisée en fonction des hyperparamètres) à l’aide d’un processus gaussien ou d’un estimateur par arbre de Parzen (TPE). En équilibrant continuellement l’exploration des régions inexplorées de l’espace et l’exploitation des combinaisons performantes identifiées, le système converge vers l’optimum global en une fraction des itérations exigées par les approches stochastiques naïves, le tout sous le contrôle d’une validation croisée stratifiée à $K$ plis garantissant l’indépendance statistique des estimations.
11. Domaines d’application et analogies cognitives et comportementales
11.1 Applications pratiques dans les sciences prédictives
Le gradient boosting et ses implémentations contemporaines sont devenus la référence absolue pour le traitement des données structurées et tabulaires au sein de l’écosystème industriel et de la recherche appliquée. Si l’apprentissage profond (Deep Learning) règne sans partage sur les données non structurées (images, flux audio, vidéo et texte brut), le boosting surpasse presque systématiquement les architectures neuronales dès lors que l’information se présente sous la forme de tables relationnelles aux variables fortement hétérogènes, mêlant mesures continues, dénombrements et modalités catégorielles discrètes.
Dans l’industrie financière, le boosting régit la majorité des systèmes d’octroi de crédit bancaire (credit scoring) et des infrastructures de surveillance des transactions en temps réel pour la détection des fraudes par carte de paiement. La capacité de l’algorithme à détecter des interactions non linéaires complexes entre des montants d’achat, des localisations géographiques et des historiques de dépenses lui confère un avantage déterminant face aux régressions logistiques classiques.
En médecine translationnelle et en bio-informatique, les variantes de gradient boosting sont déployées pour la prédiction de survie des patients en oncologie à partir de signatures d’expression génétique à haute dimension, ainsi que pour l’identification de biomarqueurs sanguins associés aux stades précoces de pathologies neurodégénératives. Parallèlement, dans le secteur des technologies de l’information, les moteurs de recherche et les plateformes de commerce électronique exploitent le boosting pour les algorithmes d’ordonnancement prédictif (Learning to Rank), où il s’agit d’ajuster dynamiquement l’ordre de présentation des résultats en fonction de signaux utilisateurs multivariés.
11.2 Parallèles épistémologiques avec la cognition humaine
L’architecture opérationnelle du boosting ne se borne pas à être une prouesse d’ingénierie mathématique ; elle entretient des résonances épistémologiques profondes avec les modèles contemporains décrivant le fonctionnement cognitif du cerveau humain. Les sciences de la décision et les neurosciences computationnelles ont depuis longtemps mis en évidence que la rationalité humaine ne procède pas d’une analyse déductive pure et monolithique, mais d’une sédimentation d’heuristiques partielles, souvent simplistes et spécialisées.
Ce fonctionnement s’apparente étroitement à la théorie du double processus cognitif formalisée par Daniel Kahneman, distinguant le Système 1 (rapide, automatique, heuristique et générateur d’erreurs d’évaluation systématiques) du Système 2 (lent, analytique, réflexif et mobilisé spécifiquement pour corriger les biais et les failles de perception du premier). Le boosting formalise mathématiquement ce dialogue : le premier modèle faible agit comme une heuristique de surface du Système 1, capturant les macro-patterns évidents de l’environnement au prix d’erreurs grossières. Les modèles ultérieurs interviennent comme des modules de contrôle cognitif de plus en plus spécialisés, mobilisés sélectivement pour réprimer et rectifier les réponses erronées induites par les couches antérieures.
De même, sur le plan de la théorie perceptive de la Gestalt, la reconnaissance globale d’une forme ou d’un concept abstrait n’est pas la simple somme d’éléments isolés, mais l’intégration dynamique de micro-indices perceptifs faibles. Chaque caractéristique visuelle élémentaire (une orientation de ligne, un contraste de teinte, une discontinuité spatiale) ne possède individuellement qu’une valeur discriminante marginale. C’est l’agencement hiérarchique et la pondération séquentielle de ces signaux élémentaires au sein des cortex associatifs qui engendre la perception unifiée et robuste d’une scène complexe.
11.3 Interprétabilité et explicabilité des décisions d’ensemble
L’essor de la régulation algorithmique (à l’image du Règlement Général sur la Protection des Données – RGPD en Europe et de l’IA Act) a placé l’explicabilité au rang d’exigence éthique et juridique impérieuse. Un modèle prédictif d’ensemble, constitué de l’empilement de plusieurs centaines d’arbres asymétriques scindant continuellement l’espace multidimensionnel, ne peut prétendre à l’interprétabilité intrinsèque directe propre à une régression linéaire ou à un arbre décisionnel unitaire unique.
Historiquement, les praticiens se sont appuyés sur des mesures d’importance globale des variables issues des arbres de décision, à l’instar de l’importance basée sur le gain moyen (la réduction totale de la fonction de perte attribuable aux scissions opérées sur une variable donnée) ou l’importance de fréquence (le nombre de fois où une variable est mobilisée dans la construction de l’ensemble). Cependant, ces métriques empiriques présentent des biais structurels notoires : elles surestiment systématiquement l’importance des variables continues ou catégorielles à haute cardinalité au détriment des variables binaires, et échouent à rendre compte de l’orientation positive ou négative de l’effet prédictif.
Pour surmonter ces lacunes, la science des données s’est ralliée à la théorie des jeux coopératifs à travers le formalisme des valeurs de SHAP (Shapley Additive exPlanations), développé par Scott Lundberg et Su-In Lee en 2017. L’algorithme spécialisé TreeSHAP permet d’évaluer en un temps polynomial la contribution marginale exacte de chaque variable à la décision d’un modèle d’arbres pour une observation individuelle :
$$\phi_i(x) = \sum_{S \subseteq F setminus {i}} \frac{|S|!(|F| – |S| – 1)!}{|F|!} \left( f_x(S \cup {i}) – f_x(S) \right)$$
En décomposant la prédiction finale en une somme additive d’effets imputables à chaque descripteur, SHAP transforme le boosting en une architecture parfaitement auditable, réconciliant puissance d’approximation statistique et transparence décisionnelle exigée par les applications critiques.
12. Perspectives d’avenir, limites et bonnes pratiques méthodologiques
12.1 Limites intrinsèques et cas de non-pertinence du boosting
En dépit de sa remarquable suprématie sur les données structurées, le boosting ne saurait être érigé en panacée universelle pour l’apprentissage statistique. La reconnaissance lucide de ses limites intrinsèques constitue le prérequis d’une démarche d’ingénierie rigoureuse. La première de ces frontières réside dans son inaptitude structurelle à traiter les données brutes non structurées caractérisées par une haute dimensionnalité et une forte invariance par translation ou composition, à l’instar des flux d’images haute définition ou des corpus textuels massifs. Sur ces modalités, les architectures de réseaux neuronaux profonds convolutionnels ou à base de Transformers surpassent sans conteste le boosting grâce à leur faculté d’apprendre des représentations hiérarchiques continues à partir de primitives de bas niveau.
Une seconde limite concerne le comportement du boosting en extrapolation hors support. Les modèles d’ensemble basés sur des arbres partitionnent l’espace géométrique en une collection finie de pavés orthogonaux constants par morceaux. Par conséquent, pour toute nouvelle observation dont les coordonnées vectorielles se situent en dehors de l’enveloppe convexe délimitée par les bornes minimales et maximales du jeu d’entraînement, le modèle sera structurellement incapable de prédire une tendance continue ascendante ou descendante : sa réponse sera désespérément bornée par la valeur moyenne de la feuille périphérique la plus proche. Le boosting n’est donc pas adapté aux tâches prédictives de séries temporelles avec forte dérive tendancielle (trend) sans une phase préalable rigoureuse de stationnarisation ou de décomposition de la composante tendancielle.
Enfin, la nature séquentielle fondamentale de l’algorithme constitue un verrou computationnel incompressible. Contrairement au bagging ou à l’entraînement de couches neuronales sur accélérateurs graphiques hautement parallélisables, l’arbre $m$ ne peut mathématiquement être instancié tant que l’arbre $m-1$ n’a pas finalisé ses prédictions et projeté ses résidus sur l’espace d’entraînement. Même si le partitionnement à l’intérieur de chaque arbre est massivement parallélisé par des bibliothèques modernes, la dimension temporelle de l’apprentissage séquentiel demeure fondamentalement récursive, interdisant une scalabilité horizontale infinie.
12.2 Tendances contemporaines et recherche hybride
Les frontières traditionnelles séparant l’apprentissage statistique tabulaire et le deep learning font aujourd’hui l’objet d’une convergence méthodologique féconde au sein de la recherche académique. L’une des directions les plus prometteuses concerne les architectures d’arbres décisionnels différentiables de bout en bout intégrés dans des graphes de calcul computationnels rétro-propageables.
Des travaux précurseurs tels que NODE (Neural Oblivious Decision Ensembles) ont formalisé la traduction d’arbres symétriques similaires à ceux de CatBoost sous la forme d’opérateurs neuronaux exploitant la fonction d’activation sparsemax pour émuler des choix de division discrets. Cette synthèse ouvre la possibilité d’entraîner conjointement des représentations continues via des réseaux de neurones complexes et des comités d’arbres boostés optimisés par une unique descente de gradient stochastique globale.
Une seconde ligne de front concerne la compression algorithmique et l’optimisation pour l’inférence ultra-rapide sur systèmes embarqués (Edge AI). Des compilateurs spécialisés comme Treelite transforment des ensembles massifs d’arbres hétérogènes en structures de code C optimisées et dénuées de structures de pointeurs superflues, réduisant le temps d’inférence d’une décision à quelques microsecondes par vecteur, ce qui permet l’embarquement direct d’algorithmes de gradient boosting au sein de capteurs industriels autonomes et de dispositifs médicaux portables.
12.3 Guide pratique pour le praticien moderne
Pour clore ce panorama exhaustif, il convient de synthétiser les meilleures pratiques méthodologiques destinées à guider le praticien dans l’implémentation opérationnelle de modèles de boosting durables et performants :
- Le choix circonstancié de la variante algorithmique :
- Privilégier CatBoost face à des jeux de données contenant une multitude de variables catégorielles à haute cardinalité, ou lorsqu’un étalonnage rapide avec un minimum de réglage d’hyperparamètres est requis.
- Adopter LightGBM lors du traitement de volumétries massives de données tabulaires (au-delà de quelques millions de lignes), où l’accélération par histogrammes et la croissance leaf-wise procurent un gain d’ordre de grandeur en temps de calcul et en mémoire vive.
- Recourir à XGBoost pour les jeux de données tabulaires de dimensions modérées à élevées exigeant un contrôle chirurgical de la régularisation analytique (L1/L2) et une robustesse éprouvée sur les fonctions d’objectif personnalisées hautement non linéaires.
- La check-list de prétraitement rigoureuse : Bien que les arbres tolèrent les valeurs manquantes et ne nécessitent aucune normalisation d’échelle des variables continues, il demeure impératif d’identifier et d’isoler en amont les valeurs aberrantes manifestes sur la cible en régression, d’éliminer les variables quasi constantes sans variance informative et de sanctuariser un jeu de test final strictement vierge de toute influence analytique.
- La discipline de validation croisée : Ne jamais calibrer les hyperparamètres sur le jeu de test final. Mettre systématiquement en place une validation croisée à $K$ plis stratifiée (pour la classification) ou temporelle (pour les données de séries chronologiques ou d’événements ordonnés) afin d’assurer l’étanchéité statistique absolue entre phase d’apprentissage, ajustement des seuils de l’arrêt précoce et évaluation finale de la généralisation.
En abordant le boosting non comme un automate opaque mais comme une machinerie analytique séquentielle modulant rigoureusement le compromis biais-variance au fil d’une descente fonctionnelle continue, le concepteur de solutions statistiques accède à un niveau de maîtrise algorithmique d’une exceptionnelle efficacité, à la hauteur des défis prédictifs les plus exigeants de la science des données contemporaine.
Références
Bergstra, J., & Bengio, Y. (2012). Random search for hyper-parameter optimization. Journal of Machine Learning Research, 13(2), 281–305. https://jmlr.org/papers/v13/bergstra12a.html
Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123–140. https://doi.org/10.1007/BF00058655
Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 785–794). ACM. https://doi.org/10.1145/2939672.2939785
Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
Freund, Y., & Schapire, R. E. (1997). A decision-theoretic generalization of on-line learning and an application to boosting. Journal of Computer and System Sciences, 55(1), 119–139. https://doi.org/10.1006/jcss.1997.1504
Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189–1232. https://doi.org/10.1214/aos/1013203451
Friedman, J. H. (2002). Stochastic gradient boosting. Computational Statistics & Data Analysis, 38(4), 367–378. https://doi.org/10.1016/S0167-9473(01)00065-2
Kearns, M., & Valiant, L. (1994). Cryptographic limitations on learning Boolean formulae and finite automata. Journal of the ACM, 41(1), 67–95. https://doi.org/10.1145/174644.174647
Ke, G., Meng, Q., Finley, T., Wang, T., Chen, W., Ma, W., Ye, Q., & Liu, T. Y. (2017). LightGBM: A highly efficient gradient boosting decision tree. In Advances in Neural Information Processing Systems (Vol. 30, pp. 3146–3154). Curran Associates, Inc. https://proceedings.neurips.cc/paper/2017/hash/6449f44a102fde848669bdd9eb6b76fa-Abstract.html
Lundberg, S. M., & Lee, S.-I. (2017). A unified approach to interpreting model predictions. In Advances in Neural Information Processing Systems (Vol. 30, pp. 4765–4774). Curran Associates, Inc. https://proceedings.neurips.cc/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html
Prokhorenkova, L., Gusev, G., Vorobev, A., Dorogush, A. V., & Gulin, A. (2018). CatBoost: Unbiased boosting with categorical features. In Advances in Neural Information Processing Systems (Vol. 31, pp. 6638–6648). Curran Associates, Inc. https://proceedings.neurips.cc/paper/2018/hash/14491b756b3a51daac41c24863285549-Abstract.html
Schapire, R. E. (1990). The strength of weak learnability. Machine Learning, 5(2), 197–227. https://doi.org/10.1007/BF00116037
Valiant, L. G. (1984). A theory of the learnable. Communications of the ACM, 27(11), 1134–1142. https://doi.org/10.1145/1968.1972