
Dans le paysage des probabilités appliquées et de l’analyse stochastique, la modélisation de l’aléa se heurte fréquemment à une aporie fondamentale : l’indigence ou l’absence totale de données empiriques historiques. Alors que les méthodes statistiques inférentielles classiques présupposent des corpus d’observations suffisamment volumineux pour calibrer des lois paramétriques complexes à queues infinies, telles que la distribution gaussienne ou la loi log-normale, les praticiens de l’ingénierie des systèmes, de la gestion prévisionnelle des risques et des sciences de la décision opèrent couramment dans des régimes d’information incomplète. Face à cette incertitude épistémique radicale, le recours aveugle à des fonctions de densité sophistiquées engendre un biais de sur-paramétrisation trompeur, conférant une illusion de précision mathématique à des conjectures empiriquement fragiles.
C’est précisément au sein de cette brèche méthodologique que s’impose la distribution triangulaire. Qualifiée parfois de distribution de l’estimation subjective par excellence, cette loi de probabilité continue à support compact incarne le principe de parcimonie analytique formulé par Guillaume d’Ockham : maximiser l’information structurante disponible sans introduire d’hypothèses asymptotiques injustifiables. En ne requérant que trois jalons cognitifs immédiatement appréhendables par l’intellect humain — une borne inférieure pessimiste, une borne supérieure optimiste et une valeur modale correspondant au scénario le plus plausible —, elle érige une géométrie fonctionnelle d’une remarquable élégance, combinant accessibilité heuristique et rigueur formelle.
Le présent article propose une exploration exhaustive et multidisciplinaire de la distribution triangulaire. De ses fondements topologiques aux subtilités de sa fonction de répartition, de l’anatomie de ses moments statistiques jusqu’à ses manifestations dans la psychométrie, la recherche opérationnelle et l’évaluation des risques technologiques majeurs, nous disséquerons les propriétés analytiques qui font de cet objet géométrique élémentaire l’un des piliers les plus résilients de la modélisation probabiliste moderne. En confrontant ses vertus algorithmiques à ses limites théoriques intrinsèques, nous mettrons en lumière la manière dont une simple triangulation de l’incertitude permet de formaliser mathématiquement le jugement humain face à l’impondérable.
1. Fondements théoriques et définition mathématique de la distribution triangulaire
1.1 Genèse et formalisation de la variable aléatoire continue
La notion de variable aléatoire continue constitue le socle sur lequel repose l’ensemble de la théorie moderne des probabilités, telle qu’axiomatPointisée par le mathématicien soviétique Andreï Kolmogorov dans les années 1930. Dans ce cadre formel, une variable aléatoire continue est une application mesurable définie sur un espace de probabilité fondamental et prenant ses valeurs dans le corps des nombres réels, pour laquelle la probabilité d’occurrence d’un point isolé est rigoureusement nulle. La distribution triangulaire se distingue d’emblée par la nature restreinte de son espace d’état : contrairement aux distributions classiques non bornées dont le support coïncide avec la droite réelle complète ou le demi-axe positif, elle est définie exclusivement sur un intervalle fini et fermé du corps réel. Cette contrainte de support compact reflète une volonté explicite d’ancrer la modélisation dans des frontières physiques ou logiques indépassables.
Historiquement, l’émergence de la distribution triangulaire ne découle pas d’une spéculation purement académique sur les espaces abstraits de mesure, mais plutôt des impératifs opérationnels apparus au milieu du vingtième siècle, notamment au sein des laboratoires de la RAND Corporation et lors du déploiement du programme balistique Polaris. Confrontés à l’obligation de modéliser des temps d’achèvement de tâches technologiques inédites pour lesquelles aucune archive statistique n’existait, les ingénieurs durent substituer à la complexité des équations différentielles stochastiques des approximations géométriques intuitives. La distribution triangulaire s’est ainsi imposée comme une alternative pragmatique aux lois continues traditionnelles, offrant une modélisation continue par morceaux capable de capturer l’asymétrie fondamentale des estimations prévisionnelles sans mobiliser l’appareillage calculatoire prohibitif des fonctions eulériennes ou hypergéométriques.
L’importance de la géométrie fonctionnelle dans l’intuition probabiliste élémentaire trouve ici son illustration la plus frappante. En substituant aux courbures asymptotiques une morphologie linéaire par morceaux, la distribution triangulaire établit une passerelle immédiate entre le calcul d’aires géométriques classiques (triangles et trapèzes) et le calcul intégral propre à la théorie de la mesure. Pour l’analyste, appréhender une probabilité sous la forme d’un segment de surface triangulaire permet de désamorcer les écueils de l’abstraction statistique. Le domaine de définition restreint répond en outre à des conditions de régularité mathématique strictes : la fonction de densité associée doit être intégrable au sens de Riemann, positive ou nulle sur l’intervalle fermé considéré, et s’annuler identiquement sur l’ensemble de son complémentaire topologique, garantissant une étanchéité probabiliste totale vis-à-vis des valeurs jugées physiquement ou logiquement impossibles.
1.2 Les trois paramètres fondamentaux : a, b et c
L’architecture entière de la distribution triangulaire est gouvernée par un triplet ordonné de paramètres scalaires réels, conventionnellement désignés par les lettres a, b et c. Chacun de ces paramètres possède une sémantique probabiliste et décisionnelle rigoureuse qui transcende la simple caractérisation algébrique. Le premier paramètre, noté a, définit la borne inférieure absolue de la distribution. Il représente le minimum irréductible en deçà duquel la probabilité de réalisation du phénomène est strictement nulle. Dans le contexte de l’élicitation d’expert, cette valeur correspond au scénario ultra-optimiste (ou ultra-pessimiste selon la métrique analysée), incarnant l’état du monde où l’ensemble des contingences favorables se conjuguent sans la moindre friction.
À l’autre extrémité du support spatial se trouve le paramètre b, qui caractérise la borne supérieure maximale envisageable. De façon symétrique à la borne inférieure, toute valeur supérieure à b possède une densité d’apparition nulle, ce qui exclut catégoriquement l’existence de queues de distribution infinies ou d’événements aberrants non bornés. Ce paramètre formalise le plafond théorique de la variable aléatoire, matérialisant l’agrégation de l’ensemble des contraintes capacitaires, des saturations de réseau ou des dégradations systémiques maximales. L’intervalle fermé délimité par ces deux valeurs extrêmes constitue le domaine d’existence exclusif de la variable aléatoire sous-jacente.
Le troisième paramètre, désigné par c, incarne le mode de la distribution. Il s’agit du point où la fonction de densité de probabilité atteint son sommet géométrique, ce qui en fait la valeur la plus probable ou la plus plausible au sens de la vraisemblance statistique. Contrairement aux lois paramétriques symétriques où le centre de gravité coïncide nécessairement avec le point de convergence moyen, le paramètre c peut glisser librement sur la totalité de l’intervalle fermé délimité par les bornes extrêmes. Cette mobilité confère à la distribution une grande souplesse morphologique. Il existe toutefois une contrainte structurelle d’ordonnancement stricte et non négociable : l’inégalité large a ≤ c ≤ b doit être impérativement satisfaite pour préserver l’intégrité topologique de la figure géométrique. Si l’une de ces relations venait à être violée, le support spatial s’effondrerait et la condition de normalisation unitaire ne pourrait plus être mathématiquement garantie.
1.3 Représentation géométrique de la distribution de probabilité
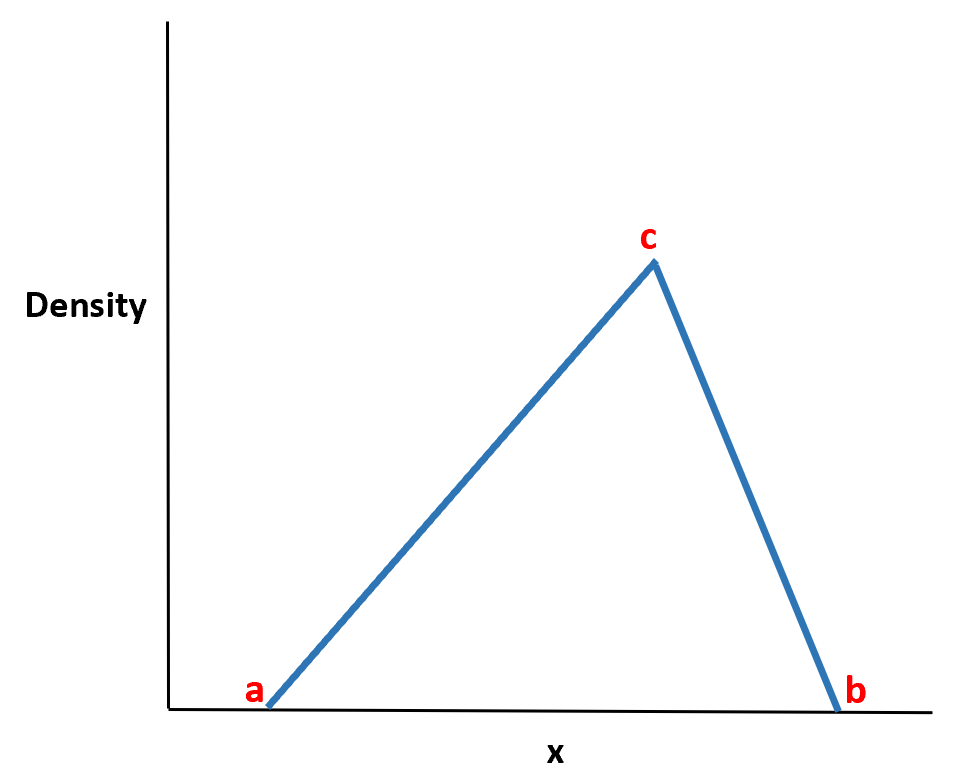
La représentation géométrique de la distribution triangulaire fournit une métaphore visuelle d’une limpidité remarquable pour l’analyse probabiliste. Dans le repère cartésien standard, le graphe de la fonction de densité dessine un triangle fermé reposant sur l’axe des abscisses, dont la base s’étend du point de coordonnées (a, 0) jusqu’au point (b, 0), avec un sommet culminant au point d’abscisse c. L’axiome fondamental de normalisation des probabilités stipule que la mesure de Lebesgue totale sous la courbe de densité doit être rigoureusement égale à l’unité. Par conséquent, l’aire géométrique de ce triangle unitaire, définie classiquement par la formule élémentaire du demi-produit de la base par la hauteur, doit satisfaire l’équation fondamentale : Aire = (Base × Hauteur) / 2 = 1.
La base du triangle correspondant à l’amplitude totale de l’intervalle de définition, sa longueur algébrique s’exprime directement par la différence (b – a). En substituant cette grandeur dans l’équation de normalisation, on en déduit immédiatement la hauteur maximale de la fonction de densité, atteinte de manière unique à l’abscisse modale c. Cette ordonnée sommitale, que nous désignerons par la variable h, est ainsi irrévocablement fixée par la relation : h = 2 / (b – a). Cette formulation algébrique révèle une propriété mécanique fondamentale : la hauteur de la densité ne dépend absolument pas de la position interne du mode c, mais exclusivement de l’étalement spatial entre les bornes extrêmes. Plus l’intervalle est resserré, plus la hauteur sommitale s’élève, traduisant une concentration accrue de la masse de probabilité.
Du point de vue de l’analyse spatiale, le triangle global se décompose naturellement en deux sous-triangles contigus séparés par l’axe vertical passant par l’abscisse modale c. Le triangle de gauche, de nature strictement ascendante, repose sur une sous-base de longueur (c – a), tandis que le triangle de droite, strictement descendant, s’articule autour d’une sous-base de longueur (b – c). La sommation des aires respectives de ces deux figures géométriques triangulaires, ou l’évaluation d’aires tronquées sous la forme de trapèzes partiels pour des intervalles internes, permet de calculer n’importe quelle probabilité élémentaire sans avoir recours aux formalismes avancés de l’analyse complexe. Cette parfaite congruence entre les axiomes de probabilité d’Andreï Kolmogorov et les théorèmes fondamentaux de la géométrie euclidienne confère à la loi triangulaire une robustesse analytique immédiate, où toute proposition probabiliste correspond physiquement à une portion mesurable de surface plane.
2. La fonction de densité de probabilité (PDF)
2.1 Formulation analytique sur le segment ascendant [a, c]
La fonction de densité de probabilité (PDF, pour Probability Density Function) d’une variable aléatoire continue caractérise la densité locale de probabilité en chaque point du support. Pour la distribution triangulaire, cette fonction est une application affine par morceaux, continue sur l’ensemble de la droite réelle mais fragmentée en plusieurs sous-domaines analytiques distincts. Sur le premier sous-intervalle fermé, correspondant au segment ascendant où la variable x évolue entre la borne minimale a et la valeur modale c (sous l’hypothèse structurelle où a < c), la densité trace le segment de droite joignant l’origine du support (a, 0) au sommet géométrique (c, h).
L’équation cartésienne d’un segment de droite passant par deux points distincts s’obtient classiquement en déterminant son coefficient directeur. La pente de cette branche ascendante est définie par le rapport entre l’élévation verticale et la distance horizontale, soit h / (c – a). En substituant à la hauteur h sa valeur d’équilibre unitaire démontrée précédemment, à savoir 2 / (b – a), le coefficient directeur de la droite s’établit rigoureusement à la valeur 2 / ((b – a)(c – a)). Étant donné que la fonction s’annule précisément au point d’abscisse a, l’expression algébrique exacte de la fonction de densité sur ce premier intervalle prend la forme canonique :
f(x) = 2(x – a) / ((b – a)(c – a)) pour tout x appartenant à l’intervalle [a, c].
L’interprétation probabiliste de cette formulation linéaire ascendante est d’une grande clarté conceptuelle : à mesure que la variable aléatoire x s’éloigne de son point de départ a pour progresser vers le mode c, la densité d’apparition des observations croît de manière strictement proportionnelle à la distance parcourue. Le processus de densification des états possibles est continu et constant en accélération première, ce qui traduit une intensification régulière de la plausibilité de l’événement. Au voisinage immédiat de la valeur modale c, le comportement asymptotique local converge vers le pic de probabilité maximal sans aucune oscillation ni discontinuité spatiale, atteignant exactement le plafond théorique 2 / (b – a) lorsque x devient indiscernable de c.
2.2 Formulation analytique sur le segment descendant [c, b]
Une fois franchi le seuil modal c, le profil de probabilité de la distribution triangulaire bascule dans sa seconde phase fonctionnelle, matérialisée par un segment linéaire descendant reliant le sommet sommital (c, h) à l’extrémité finale du support (b, 0). Sur ce sous-intervalle fermé, où la variable x est strictement comprise entre c et b (en supposant la condition c < b vérifiée), la densité de probabilité diminue de manière constante au fur et à mesure que l’on s’approche de la limite supérieure des réalisations admissibles.
Le coefficient directeur de cette seconde droite est négatif, traduisant une décroissance structurelle de la vraisemblance. En calculant le rapport entre la variation d’ordonnée (passant de h à 0) et la variation d’abscisse correspondante (passant de c à b), la pente s’établit algébriquement à la valeur -h / (b – c). En injectant à nouveau la valeur normalisée de la hauteur sommitale h = 2 / (b – a) et en exploitant la propriété d’annulation de la fonction au point d’abscisse terminale b, l’équation algébrique de la fonction de densité sur ce segment descendant se condense sous l’expression :
f(x) = 2(b – x) / ((b – a)(b – c)) pour tout x appartenant à l’intervalle [c, b].
Cette décroissance linéaire formalise la rareté croissante des observations empiriques au fur et à mesure que la variable s’enfonce dans le domaine des valeurs exceptionnellement élevées. À l’instar de la phase ascendante, l’affaiblissement de la densité est rigoureusement constant dans son rythme géométrique. Un aspect analytique fondamental de cette formulation réside dans la continuité globale de la fonction f(x) au point critique de transition x = c. En évaluant la limite de la branche ascendante lorsque x tend vers c par valeurs inférieures, on obtient la valeur 2 / (b – a). En évaluant simultanément la limite de la branche descendante lorsque x tend vers c par valeurs supérieures, on retrouve rigoureusement la même grandeur 2 / (b – a). La distribution triangulaire garantit ainsi une continuité topologique de classe C-zéro sur l’intégralité du corps des réels.
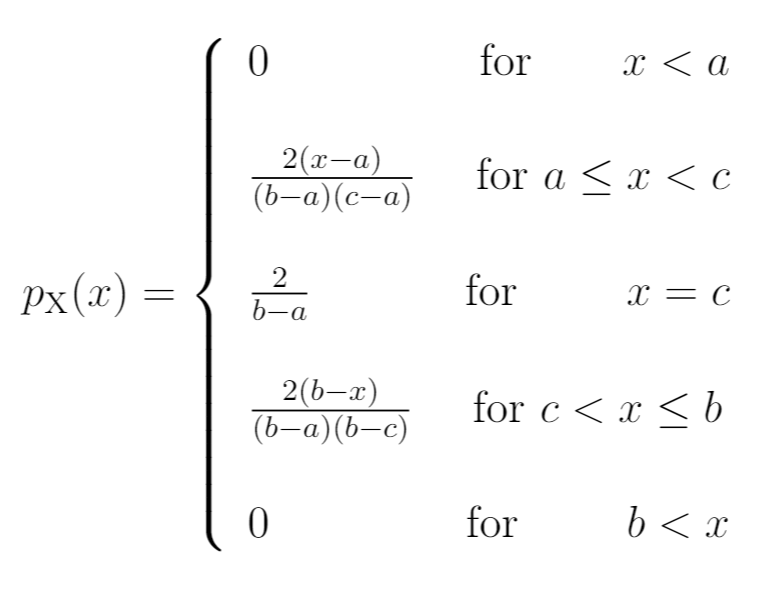
2.3 Propriétés topologiques et condition de normalisation
La démonstration de l’intégrale unitaire de la fonction de densité constitue l’étape fondamentale de sa validation probabiliste au regard de la théorie de l’intégration. Pour attester que f(x) définit une mesure de probabilité valide, il convient de vérifier que l’intégrale de Lebesgue de la fonction sur la droite réelle tout entière est strictement égale à un. En dehors du segment fermé compact [a, b], la fonction de densité est posée comme étant identiquement nulle : f(x) = 0 pour tout x < a et pour tout x > b. L’intégrale généralisée se réduit donc au calcul de deux intégrales de Riemann consécutives :
Intégrale de a à b de f(x) dx = Intégrale de a à c de [2(x – a) / ((b – a)(c – a))] dx + Intégrale de c à b de [2(b – x) / ((b – a)(b – c))] dx.
Le calcul de la primitive du premier terme donne [(x – a)² / ((b – a)(c – a))], évalué entre a et c, ce qui produit le quotient scalaire (c – a) / (b – a). Le calcul de la primitive du second terme donne quant à lui [- (b – x)² / ((b – a)(b – c))], évalué entre c et b, ce qui génère le quotient complémentaire (b – c) / (b – a). La sommation algébrique directe de ces deux résultats intermédiaires produit (c – a + b – c) / (b – a) = (b – a) / (b – a) = 1. La condition de normalisation unitaire est ainsi démontrée avec une rigueur absolue, confirmant la validité fondamentale de la distribution.
Toutefois, la morphologie de la distribution triangulaire révèle une singularité topologique majeure qui la sépare nettement des lois analytiques lisses. Au point modal x = c, la dérivée première de la fonction de densité subit un saut de discontinuité franc. La dérivée à gauche au sommet vaut 2 / ((b – a)(c – a)), tandis que la dérivée à droite s’établit à -2 / ((b – a)(b – c)). Cette inversion brutale de pente engendre un point anguleux au sommet : la fonction de densité n’est donc pas différentiable au sens standard au point modal x = c. Cette absence de différentiabilité d’ordre un contraste fortement avec la régularité mathématique des distributions traditionnelles comme la loi normale de Carl Friedrich Gauss, qui appartient à la classe des fonctions C-infini (infiniment différentiables sur l’ensemble de la droite réelle). Ce comportement anguleux, bien qu’extrêmement commode pour le calcul géométrique direct, impose des précautions méthodologiques spécifiques lors de l’application d’algorithmes d’optimisation numérique fondés sur le calcul des gradients locaux.
3. La fonction de répartition cumulative (CDF)
3.1 Intégration et comportement sur la branche ascendante
La fonction de répartition cumulative (désignée sous l’acronyme CDF pour Cumulative Distribution Function), traditionnellement notée F(x), représente la probabilité qu’une variable aléatoire X prenne une valeur inférieure ou égale à un seuil réel déterminé x. Mathématiquement, elle correspond à la primitive de la fonction de densité de probabilité s’annulant en moins l’infini. Sur le segment initial s’étendant de la borne inférieure a jusqu’au mode structurel c, l’intégration de la première branche linéaire s’effectue directement par l’intégration d’un polynôme de degré un, donnant lieu à une fonction quadratique d’ordre deux.
En intégrant l’expression f(t) = 2(t – a) / ((b – a)(c – a)) pour une borne variable t comprise entre a et x, on obtient de manière exacte la formule close de la fonction de répartition sur la première branche :
F(x) = (x – a)² / ((b – a)(c – a)) pour tout x satisfaisant la relation a ≤ x ≤ c.
D’un point de vue analytique, la présence du terme quadratique au numérateur confère à la courbe de probabilité cumulée une concavité résolument tournée vers le haut (dérivée seconde strictement positive). Cela indique une accélération continue de l’accumulation de la probabilité à mesure que l’on se rapproche du centre de masse de la distribution. Plus l’on s’approche de c, plus le gain marginal de probabilité cumulée par unité de déplacement sur l’axe des abscisses s’accroît. Un jalon probabiliste central apparaît lorsque l’on évalue la valeur cumulée critique précisément atteinte au point modal x = c. En remplaçant x par c dans l’équation quadratique, le facteur (c – a) se simplifie partiellement, produisant la relation canonique :
F(c) = (c – a) / (b – a).
Ce résultat remarquable démontre que la probabilité cumulée accumulée jusqu’au mode de la distribution est rigoureusement équivalente au ratio de longueur entre le sous-intervalle ascendant et l’intervalle global du support spatial. Si le mode est situé précisément au tiers de l’intervalle total, la probabilité que la variable aléatoire prenne une valeur inférieure au mode sera mathématiquement fixée à un tiers, indépendamment de toute autre considération d’échelle.
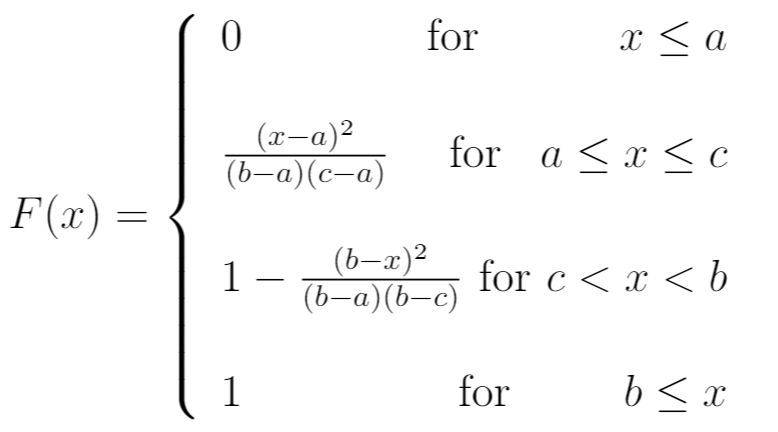
3.2 Intégration et comportement sur la branche descendante
Pour des valeurs de l’abscisse x situées au-delà du sommet modal, c’est-à-dire dans le sous-intervalle fermé délimité par c et la borne supérieure b, la fonction de répartition cumulative doit sommer la probabilité totale accumulée sur le premier segment, soit F(c), avec l’intégrale de la branche descendante de la densité évaluée entre la borne c et la variable x. Ce calcul intégral, impliquant la fonction affine décroissante f(t) = 2(b – t) / ((b – a)(b – c)), peut être résolu de manière élégante en observant que la probabilité restante au-delà de x, notée 1 – F(x), correspond à l’aire du triangle résiduel s’étendant de x jusqu’à la borne finale b.
En exploitant cette approche géométrique complémentaire, la surface du triangle résiduel supérieur se calcule directement comme le produit de sa base (b – x) par sa hauteur locale f(x), le tout divisé par deux. En substituant l’expression analytique de f(x) sur le segment descendant, l’expression intégrale de la fonction de répartition prend sa forme définitive :
F(x) = 1 – (b – x)² / ((b – a)(b – c)) pour tout x satisfaisant la relation c ≤ x ≤ b.
Sur ce second segment, la fonction de répartition change radicalement de profil dynamique : la dérivée seconde devenant strictement négative, la concavité est désormais orientée vers le bas. Le point modal x = c constitue ainsi un point d’inflexion morphologique où le taux d’accumulation de la probabilité passe d’un régime d’accélération à un régime de décélération progressive. Lorsque x converge vers la borne supérieure b, le terme soustractif s’annihile totalement, garantissant la convergence stricte vers l’unité : F(b) = 1. Pour toute valeur de x strictement supérieure à b, la fonction de répartition demeure invariablement égale à l’unité. Il convient de souligner que, bien que la fonction de densité présente un angle saillant en c, la fonction de répartition F(x) est quant à elle strictement dérivable en tout point de son domaine, y compris en x = c. Elle appartient de ce fait à la classe de régularité C1 sur l’ensemble de l’espace des réels, assurant une transition parfaitement lisse de la probabilité cumulée.
3.3 Inversion analytique de la fonction de répartition
L’inversion analytique de la fonction de répartition cumulative constitue l’un des mécanismes les plus puissants de la théorie probabiliste appliquée, car elle permet d’établir la fonction quantile, généralement notée Q(p) ou F-1(p), où la variable p représente une probabilité cumulative appartenant au segment fermé [0, 1]. Cette opération consiste à déterminer la valeur unique de x satisfaisant l’équation F(x) = p. Grâce à la structure polynomiale par morceaux de degré deux de la loi triangulaire, cette équation s’inverse de manière totalement déterministe et exacte par simple résolution de radicaux algébriques, éliminant tout recours à des approximations numériques complexes.
La résolution de cette fonction inverse exige un traitement algorithmique conditionnel scindé en deux branches, dont la frontière d’activation dépend de la comparaison entre le niveau de probabilité p et la valeur charnière F(c) = (c – a) / (b – a). Si le niveau de probabilité requis est inférieur ou égal à ce seuil critique, la variable recherchée se situe sur la branche ascendante. En inversant l’équation p = (x – a)² / ((b – a)(c – a)), on isole directement la racine positive :
x = Q(p) = a + √[ p (b – a) (c – a) ] pour tout p ≤ (c – a) / (b – a).
Dans la configuration inverse où le quantile recherché dépasse la valeur seuil F(c), la solution algébrique se déploie sur la branche descendante. En procédant à l’inversion de l’expression p = 1 – (b – x)² / ((b – a)(b – c)), on isole la grandeur recherchée sous la forme :
x = Q(p) = b – √[ (1 – p) (b – a) (b – c) ] pour tout p > (c – a) / (b – a).
Cette formulation analytique close confère à la distribution triangulaire une supériorité computationnelle majeure pour la méthode de transformation inverse, abondamment utilisée dans l’échantillonnage de Monte-Carlo. Par ailleurs, elle permet d’étudier la sensibilité de la médiane probabiliste (définie par le quantile p = 0,5) face aux déformations des paramètres. Si le mode c est décalé vers la droite de manière à ce que F(c) > 0,5, la médiane sera obligatoirement contrainte dans le premier segment quadratique ; à l’inverse, si le sommet penche vers la gauche avec F(c) < 0,5, la médiane se trouvera projetée sur le second segment. Cette souplesse de reparamétrage illustre l’extrême réactivité des quantiles face aux asymétries imposées par les experts du domaine lors du processus de modélisation.
4. Moments statistiques et propriétés descriptives fondamentales
4.1 Espérance mathématique et barycentre de la distribution
L’espérance mathématique d’une variable aléatoire continue constitue son premier moment ordinaire, traduisant le centre de gravité probabiliste autour duquel s’équilibre l’ensemble de la masse de probabilité. Pour une variable aléatoire X gouvernée par une distribution triangulaire définie sur le support [a, b] avec un mode c, le calcul de l’espérance s’effectue en évaluant l’intégrale de Riemann du produit de la variable par sa densité sur les deux sous-intervalles caractéristiques : E(X) = ∫ x f(x) dx.
En développant l’intégration par parties des deux polynômes d’ordre un composant la fonction de densité, les termes quadratiques et cubiques se regroupent et se simplifient pour aboutir à une formule synthétique d’une remarquable simplicité géométrique :
E(X) = (a + b + c) / 3.
Cette formulation possède une résonance physique immédiate et profonde : l’espérance mathématique de la distribution triangulaire est rigoureusement identique au barycentre (ou centre d’inertie mécanique) d’une plaque plane triangulaire d’épaisseur et de densité surfacique homogènes dans un espace à deux dimensions. Les coordonnées cartésiennes des trois sommets étant situées aux points (a, 0), (b, 0) et (c, h), l’abscisse barycentrique correspond exactement à la moyenne arithmétique des abscisses des trois sommets. Chaque paramètre fondamental contribue ainsi avec un poids rigoureusement symétrique et égal d’un tiers à la détermination de la tendance centrale moyenne.
Ce résultat théorique met en lumière une distinction critique, trop souvent ignorée dans la pratique opérationnelle, entre la moyenne mathématique et la valeur la plus probable. Alors que le mode c indique le sommet ponctuel de vraisemblance, l’espérance E(X) absorbe l’ensemble du volume délimité par les bornes extrêmes a et b. Dès lors que la morphologie de la distribution devient asymétrique (lorsque c ne coïncide pas avec le milieu exact du segment reliant a à b), l’espérance mathématique se détache mécaniquement du mode pour glisser vers le centre du support, reflétant l’inertie globale imposée par la branche la plus allongée.
4.2 Mode et médiane : dynamique de divergence
L’analyse comparée des trois mesures classiques de tendance centrale — le mode, la médiane et l’espérance mathématique — révèle les dynamiques de distorsion interne propres à la géométrie de la distribution triangulaire. Le mode, par définition paramétrique intrinsèque, est fixé de manière invariable au point d’inflexion c. Il représente le point focal de l’estimation, le repère empirique autour duquel se cristallise la plus haute densité de probabilité locale. À l’opposé, la médiane, notée m, divise l’espace probabiliste en deux masses d’aires rigoureusement équivalentes à 50 % (soit F(m) = 0,5).
L’expression analytique de la médiane présente une complexité non linéaire dépendante de la position relative du mode c par rapport au centre arithmétique de l’intervalle global, défini par le point médian spatial (a + b) / 2. En exploitant les fonctions quantiles dérivées précédemment, la valeur explicite de la médiane se scinde selon les deux cas de figure suivants :
- Si le mode c ≥ (a + b) / 2, ce qui équivaut à F(c) ≥ 0,5, la médiane est localisée sur le segment ascendant et s’exprime par la relation : m = a + √[ (b – a)(c – a) / 2 ].
- Si le mode c ≤ (a + b) / 2, ce qui correspond à F(c) ≤ 0,5, la médiane bascule sur le segment descendant et répond à l’équation : m = b – √[ (b – a)(b – c) / 2 ].
Dans la configuration singulière de symétrie parfaite, où le mode est placé exactement au centre du domaine d’étude de telle sorte que c = (a + b) / 2, les trois indicateurs s’effondrent en un point unique d’harmonie totale : E(X) = m = c = (a + b) / 2. Cependant, dès qu’une déformation morphologique asymétrique est introduite, une dynamique de divergence sépare inexorablement ces trois grandeurs. Lorsque la distribution présente une asymétrie positive (étalement vers les valeurs élevées, le mode c étant proche de la borne inférieure a), l’ordre hiérarchique strict des valeurs devient systématiquement : Mode < Médiane < Espérance. À l’inverse, en régime d’asymétrie négative (le mode c étant repoussé vers la borne supérieure b), l’ordre hiérarchique s’inverse rigoureusement pour établir la séquence : Espérance < Médiane < Mode. La médiane préserve en toute circonstance sa position régulatrice d’équilibre, s’intercalant systématiquement entre le mode géométrique et l’espérance barycentrique.
4.3 Variance, écart-type et quantification de la dispersion
La variance d’une variable aléatoire continue constitue son second moment centré, quantifiant l’amplitude moyenne de la dispersion quadratique des réalisations potentielles autour de leur espérance mathématique : Var(X) = E[(X – E(X))²] = E(X²) – [E(X)]². Pour la distribution triangulaire, le calcul de l’espérance du carré de la variable, soit le second moment ordinaire E(X²), requiert l’intégration de monômes de degré deux appliqués aux équations affines de la fonction de densité de probabilité.
À l’issue d’un développement algébrique rigoureux et de la factorisation des polynômes symétriques aux trois variables a, b et c, l’expression de la variance se condense sous la formulation élégante :
Var(X) = (a² + b² + c² – ab – ac – bc) / 18.
Il est possible de restructurer cette expression sous une forme factorisée mettant en lumière les écarts quadratiques internes entre les trois paramètres :
Var(X) = [ (b – a)² + (c – a)(c – b) ] / 18 = [ (a – c)² + (b – c)² + (b – a)² ] / 36.
L’écart-type, noté σ, s’obtient directement en extrayant la racine carrée positive de cette grandeur scalaire. L’analyse de cette formule met en évidence la sensibilité de la variance face à l’écartement des bornes extrêmes par rapport au mode. La présence du dénominateur constant fixé à 18 — à comparer au dénominateur 12 qui régit la variance d’une distribution uniforme continue sur un intervalle identique — illustre l’impact réducteur de l’émergence d’une pointe centrale. La concentration pyramidale de la probabilité autour de c restreint substantiellement l’inertie globale du système par rapport à une répartition plate sans mode privilégié.
D’un point de vue topologique, la variance demeure remarquablement stable face à des variations infinitésimales des paramètres d’entrée. En dérivant partiellement la variance par rapport au mode c, on constate que la dispersion maximale est atteinte lorsque le mode est positionné exactement au centre du segment, c’est-à-dire dans la configuration symétrique où c = (a + b) / 2. Dans ce cas précis, la variance se simplifie sous la forme Var(X) = (b – a)² / 24. À l’inverse, lorsque le mode est repoussé aux frontières extrêmes du support (dans les configurations de triangles rectangles où c = a ou c = b), la variance se contracte pour atteindre sa borne inférieure théorique, soit Var(X) = (b – a)² / 18. Cette relative stabilité face aux déplacements internes du mode atteste de la résilience du modèle face aux fluctuations d’estimation ponctuelle de la valeur la plus probable.
4.4 Moments d’ordre supérieur : asymétrie et kurtosis
Les moments statistiques d’ordre supérieur complètent l’analyse de la morphologie distributionnelle en évaluant la dissymétrie des fluctuations et l’épaisseur structurelle de ses flancs. Le troisième moment centré normalisé, traditionnellement formalisé par le coefficient d’asymétrie de Fisher-Pearson (noté γ1 ou Skewness), mesure l’écart à la symétrie axiale parfaite. Ce coefficient s’obtient en divisant le troisième moment centré par le cube de l’écart-type : γ1 = E[(X – E(X))³] / σ³.
Pour la distribution triangulaire, le calcul analytique de cette grandeur aboutit à une formule close où le dénominateur et le numérateur révèlent une dépendance directe et exclusive à la position relative du mode à l’intérieur du support compact :
γ1 = [ √2 (a + b – 2c) (2a – b – c) (a – 2b + c) ] / [ 5 (a² + b² + c² – ab – ac – bc)3/2 ].
L’analyse du signe de ce coefficient renseigne instantanément sur l’orientation de la queue distributionnelle :
- Lorsque le mode est rigoureusement équidistant des bornes extrêmes, c’est-à-dire quand c = (a + b) / 2, le facteur (a + b – 2c) s’annule immédiatement, induisant un coefficient d’asymétrie strictement nul (γ1 = 0). La distribution est alors parfaitement symétrique.
- Lorsque le mode glisse vers la borne inférieure (c < (a + b) / 2), le coefficient γ1 devient strictement positif, matérialisant une asymétrie droite avec un flanc allongé vers les valeurs positives.
- Inversement, lorsque le mode se rapproche de la borne supérieure (c > (a + b) / 2), le coefficient devient strictement négatif, traduisant une asymétrie gauche où le flanc s’étire vers les valeurs négatives.
Le quatrième moment centré normalisé, ou coefficient d’aplatissement de Fisher (noté β2 ou Kurtosis), évalue la propension de la distribution à concentrer sa masse dans ses flancs plutôt que dans sa zone intermédiaire : β2 = E[(X – E(X))4] / σ4. Un résultat analytique d’une portée théorique fondamentale réside dans l’invariance absolue de ce paramètre : pour toute distribution triangulaire, quelles que soient les valeurs attribuées aux paramètres a, b et c, le coefficient d’aplatissement brut est rigoureusement constant et invariant, fixé à la valeur théorique exacte de β2 = 12 / 5 = 2,4. L’excès de kurtosis (mesuré par rapport à la valeur gaussienne étalon de 3) est ainsi perpétuellement négatif, s’établissant à -0,6.
Cette propriété établit de manière irréfutable la nature platykurtique de la distribution triangulaire. Une distribution platykurtique se caractérise par des flancs relativement étroits et une absence totale de queues lourdes ou semi-lourdes. Pour les gestionnaires du risque et les théoriciens de la décision, cette caractéristique mathématique revêt une importance capitale : la distribution triangulaire exclut par nature la possibilité d’engendrer des événements aberrants ou des « cygnes noirs » au-delà des frontières a et b. Si cette étanchéité préserve les modèles stochastiques des dérives d’instabilité infinie, elle constitue également un point de vulnérabilité majeur lorsqu’elle est appliquée à des systèmes physiques ou économiques régis par des lois de puissance ou des dynamiques critiques non bornées.
5. Typologies et configurations morphologiques de la loi triangulaire
5.1 La distribution triangulaire symétrique
La configuration symétrique de la distribution triangulaire représente le cas d’équilibre géométrique parfait. Cette morphologie d’exception émerge dès lors que le paramètre modal c coïncide rigoureusement avec le centre géométrique de l’intervalle spatial support, formalisé par la relation déterministe : c = (a + b) / 2. Sous cette contrainte paramétrique, la distribution présente un profil en chapeau pointu isocèle dont les deux versants affichent des pentes rigoureusement opposées en valeur absolue mais égales en module, soit +4 / (b – a)² pour le versant ascendant et -4 / (b – a)² pour le versant descendant.
L’alignement structurel des indicateurs de tendance centrale atteint dans ce cadre une parfaite superposition : l’espérance mathématique, la médiane et le mode se confondent identiquement sur la valeur d’équilibre (a + b) / 2. La distribution bénéficie en outre de la propriété d’invariance par réflexion axiale : la densité de probabilité au point ((a + b) / 2 – Δ) est strictement identique à la densité au point ((a + b) / 2 + Δ) pour tout écart scalaire Δ compris entre 0 et (b – a) / 2.
Un intérêt théorique majeur de la distribution triangulaire symétrique réside dans son équivalence fonctionnelle directe avec le produit de convolution de deux variables aléatoires indépendantes et identiquement distribuées suivant une loi uniforme continue. Soient deux variables indépendantes U1 et U2 distribuées de manière uniforme sur le segment compact [-1/2, 1/2]. La variable somme S = U1 + U2 suit rigoureusement une loi triangulaire symétrique centrée en zéro, reposant sur l’intervalle [-1, 1]. Cette propriété d’addition fait de la distribution triangulaire le premier échelon fondamental de l’application progressive du théorème central limite : en sommant seulement deux briques uniformes sans courbure, le modèle probabiliste engendre instantanément une émergence polygonale continue qui préfigure la cloche gaussienne.
5.2 Configurations fortement asymétriques
À l’opposé de l’équilibre isocèle, la distribution triangulaire peut être poussée dans des configurations limites hautement dyssymétriques, désignées sous le vocable de configurations en triangle rectangle. Ces géométries extrêmes surviennent lorsque le mode s’effondre directement sur l’une des deux frontières délimitant le domaine de définition de la variable aléatoire.
Le premier cas limite correspond à l’asymétrie droite maximale, où le mode se superpose exactement à la borne inférieure, instaurant l’égalité structurelle c = a. La branche ascendante s’annihile totalement, et la fonction de densité se résume à une décroissance linéaire abrupte débutant à l’ordonnée maximale h = 2 / (b – a) dès le point d’abscisse a pour plonger vers zéro au point b. Cette morphologie, formalisée par l’équation f(x) = 2(b – x) / (b – a)², sert de cadre de modélisation idéal pour les phénomènes d’effet plancher, où la survenue d’un phénomène est maximale à son étiage le plus bas et se raréfie de manière purement linéaire à mesure que l’intensité s’accroît. L’espérance mathématique migre alors vers son point le plus bas admissible, soit E(X) = (2a + b) / 3, tandis que le coefficient d’asymétrie atteint son plafond d’inflexion positive.
De façon symétrique, la seconde frontière morphologique correspond à l’asymétrie gauche maximale, déclenchée par l’alignement du mode sur la borne supérieure avec c = b. Dans cette configuration en triangle rectangle orienté vers la droite, la fonction de densité s’exprime exclusivement par sa composante ascendante : f(x) = 2(x – a) / (b – a)². La densité d’occurrence est rigoureusement nulle en a et s’intensifie de manière continue jusqu’à culminer à la frontière terminale b. Ce profil dynamique s’avère particulièrement fécond pour modéliser les situations de blocage supérieur ou les mécanismes de saturation capacitaires, où un système est soumis à une force d’attraction vers sa limite de rupture opérationnelle. L’espérance barycentrique s’élève alors à (a + 2b) / 3, et la probabilité cumulée se concentre massivement dans le dernier tiers du spectre spatial.
5.3 La distribution triangulaire standardisée
À l’instar de la distribution normale centrée réduite qui s’affranchit des contingences d’échelle en fixant arbitrairement sa moyenne à zéro et sa variance à l’unité, la distribution triangulaire peut être normalisée sur un domaine géométrique canonique afin de simplifier les analyses comparatives et les architectures logicielles. Cette standardisation consiste à restreindre l’intervalle spatial de définition au segment unitaire fermé [0, 1]. Dans ce cadre normalisé, les bornes extrêmes sont figées par convention sur les constantes a = 0 et b = 1.
Sous cette projection canonique, l’ensemble de la distribution ne dépend plus que d’un paramètre scalaire unique de forme, généralement désigné par la variable c’, qui matérialise la position relative du mode à l’intérieur du segment unité : c’ = (c – a) / (b – a), avec la contrainte 0 ≤ c’ ≤ 1. L’amplitude du support étant égale à l’unité, la hauteur sommitale de la fonction de densité standardisée se fige immuablement sur la constante entière h = 2. La formulation analytique de la densité standardisée se réduit alors à :
- f(x) = 2x / c’ pour tout x appartenant à [0, c’] (si c’ > 0).
- f(x) = 2(1 – x) / (1 – c’) pour tout x appartenant à [c’, 1] (si c’ < 1).
Cette forme adimensionnelle simplifie considérablement les démonstrations théoriques en théorie de l’échantillonnage et accélère les calculs stochastiques dans les bibliothèques logicielles. Pour rétablir la distribution générale sur un support physique quelconque délimité par des valeurs concrètes a et b, il suffit de lui appliquer la transformation affine directe : X = a + (b – a) Xstd, où Xstd est la variable aléatoire triangulaire standardisée. La préservation intégrale des propriétés géométriques sous l’effet de cette transformation linéaire atteste du caractère invariant d’échelle de la famille des distributions triangulaires.
6. Rôle de la distribution triangulaire dans la psychologie de l’estimation cognitive
6.1 Heuristiques cognitives et elicitation d’experts en trois points
L’un des apports les plus considérables de la distribution triangulaire réside dans son adéquation remarquable avec l’architecture cognitive de l’esprit humain lorsqu’il est confronté au jugement probabiliste en contexte de rationalité limitée. Comme l’ont amplement démontré les travaux pionniers des psychologues Daniel Kahneman et Amos Tversky, l’appareil cognitif traite avec d’immenses difficultés les paramètres d’abstraction statistique de second ordre, tels que la variance, l’écart-type, les moments d’asymétrie ou les covariances matricielles. Solliciter d’un ingénieur aéronautique ou d’un gestionnaire financier l’estimation directe de l’écart-type de la durée de développement d’un sous-système constitue une aberration méthodologique qui génère fréquemment des réponses arbitraires dénuées de toute consistance empirique.
À l’inverse, l’esprit humain excelle dans l’évaluation heuristique par scénarios contrastés, une démarche cognitivement naturelle fondée sur l’élicitation en trois points. Cette méthode consiste à interroger les experts selon trois prismes narratifs distincts :
- Le pire scénario concevable, traduisant la borne pessimiste absolue (a) où surviennent l’ensemble des défaillances et frictions opérationnelles.
- Le meilleur scénario envisageable, incarnant la borne optimiste (b) où toutes les conditions de fluidité et de succès sont réunies.
- Le scénario nominal ou de référence, désignant la valeur modale la plus plausible (c) que l’expert observe couramment dans l’exercice de sa pratique.
En ancrant la formalisation mathématique dans ces trois repères immédiatement tangibles, la distribution triangulaire réduit considérablement la charge cognitive requise pour convertir le savoir tacite ou qualitatif d’un praticien en une mesure de probabilité exploitable par les outils de simulation. Elle constitue de ce fait un instrument de cartographie cognitive de premier ordre, permettant de capter fidèlement les représentations mentales de l’incertain sans imposer un carcan formel abstrait inaccessible aux non-statisticiens.
6.2 Biais d’ancrage et d’optimisme dans la fixation des bornes
Bien que la distribution triangulaire s’adapte avec souplesse aux processus de pensée humains, elle n’est pas exempte des biais cognitifs systématiques qui polluent l’évaluation subjective des grandeurs numériques. Le premier écueil d’envergure réside dans le biais de surconfiance (overconfidence bias), qui pousse de manière quasi universelle les évaluateurs à sous-estimer la largeur réelle de l’intervalle des possibles. En affirmant catégoriquement qu’un paramètre ne pourra jamais chuter sous le seuil a ou excéder la limite b, les experts restreignent artificiellement le support spatial, omettant d’intégrer les chocs exogènes majeurs non vécus dans leur histoire immédiate.
Ce rétrécissement des bornes est fréquemment exacerbé par l’action conjointe du biais d’ancrage et de l’optimisme comparatif non réaliste. Le biais d’ancrage intervient dès lors que l’analyste formule ou sollicite la valeur nominale la plus probable (c) avant de calibrer les valeurs extrêmes. Cette valeur centrale opère comme un ancrage psychologique magnétique, incitant le sujet interrogé à déployer ses bornes a et b de manière symétrique et trop resserrée autour de ce pivot initial. Simultanément, le biais d’optimisme tend à comprimer de manière disproportionnée le pire scénario envisageable, l’évaluateur refusant inconsciemment de contempler l’accumulation concomitante de multiples défaillances systémiques.
Pour neutraliser ces dérives cognitives documentées, les protocoles de calibration métacognitive imposent aujourd’hui des séquences d’interrogation strictes lors des ateliers d’élicitation d’experts. Il est impératif de contraindre l’expert à verbaliser et documenter en premier lieu les scénarios de catastrophes systémiques justifiant la fixation d’une borne supérieure b très éloignée, puis de déterminer de manière totalement découplée le scénario d’alignement parfait des conditions pour la borne a, avant d’aborder en dernier ressort l’estimation de la valeur modale c. Ce protocole inversé permet d’élargir le support géométrique du triangle et de prévenir l’écrasement artificiel des variances prévisionnelles.
6.3 Modélisation de l’incertitude épistémique versus aléatoire
L’intégration de la distribution triangulaire dans les architectures décisionnelles exige une clarification fondamentale quant à la nature de l’incertitude traitée. La théorie de la décision moderne scinde rigoureusement l’incertain en deux catégories ontologiques distinctes :
- L’incertitude aléatoire (ou stochastique), qui caractérise la variabilité intrinsèque, objective et irréductible d’un système physique (comme la désintégration radioactive d’un atome ou la turbulence aérodynamique locale).
- L’incertitude épistémique, qui reflète quant à elle le déficit temporaire d’information, la méconnaissance ou l’ignorance partielle de l’évaluateur quant à l’état réel d’un paramètre déterministe sous-jacent.
La distribution triangulaire ne prétend pas modéliser un mécanisme de génération de variabilité physique pure ; elle s’affirme avant tout comme une traductrice mathématique de l’incertitude épistémique. Elle ne décrit pas comment la nature se comporte en soi, mais formalise l’état de croyance rationnelle d’un observateur disposant d’un faisceau d’indices partiels. En ce sens, son utilisation s’inscrit pleinement dans la filiation de l’épistémologie bayésienne subjective et de la théorie de la décision en univers incertain développée par Leonard Savage.
Cette dimension épistémique explique l’immense acceptabilité psychologique dont jouit la loi triangulaire auprès des comités de direction et des décideurs non-mathématiciens. Contrairement aux lois asymptotiques qui exigent l’adhésion à des abstractions conceptuelles intimidantes (telles que des intégrales sans bornes ou des queues de probabilité infinitésimales s’étirant jusqu’à l’infini), la distribution triangulaire préserve un langage de clarté géométrique absolue. Pour un responsable opérationnel, la visualisation d’un polygone délimité par des barrières physiques concrètes permet d’exercer un contrôle critique immédiat sur les hypothèses d’entrée, évitant ainsi le piège des modèles « boîte noire » dont la sophistication mathématique masque souvent la fragilité des prémisses.
7. Méthodes de génération de nombres aléatoires et simulation stochastique
7.1 Mise en œuvre de la méthode de transformation inverse
La simulation stochastique et les calculs de type Monte-Carlo reposent fondamentalement sur la capacité des processeurs à générer des flux massifs de variables pseudo-aléatoires conformes à une distribution cible. Pour la distribution triangulaire, la méthode algorithmique de référence est la méthode de transformation inverse (Inverse Transform Sampling), dont la base théorique s’appuie sur le théorème fondamental de la transformation intégrale des probabilités. Ce théorème stipule que si une variable continue U suit une loi uniforme standard sur l’intervalle [0, 1], alors la variable aléatoire X = F-1(U) = Q(U) suit rigoureusement la distribution cible caractérisée par la fonction de répartition F.
L’implémentation logicielle de cette inversion s’articule autour d’une structure conditionnelle élémentaire extrêmement rapide à exécuter, ne mobilisant qu’un tirage uniforme standard par valeur simulée. L’algorithme se résume aux étapes suivantes :
- Étape 1 : Générer un nombre pseudo-aléatoire u issu d’une distribution uniforme U(0, 1).
- Étape 2 : Évaluer la position relative de u par rapport au seuil critique de probabilité cumulée au mode, défini par le ratio pcritique = (c – a) / (b – a).
- Étape 3 : Si u < pcritique, calculer la valeur échantillonnée sur la branche quadratique ascendante par la formule déterministe :
x = a + √[ u (b – a) (c – a) ]. - Étape 4 : Si u ≥ pcritique, calculer la valeur échantillonnée sur la branche quadratique descendante par la formule symétrique :
x = b – √[ (1 – u) (b – a) (b – c) ].
D’un point de vue de la complexité algorithmique, ce générateur présente une efficacité computationnelle optimale de classe O(1). Contrairement aux méthodes d’acceptation-rejet (rejection sampling) qui gaspillent une fraction substantielle des cycles de calcul en rejetant les tirages aléatoires tombant en dehors d’une enveloppe de test, l’inversion par transformée directe pour la distribution triangulaire garantit une génération sans aucun rejet : chaque tirage uniforme produit instantanément et exactement une observation valide, préservant ainsi les ressources mémoire lors de simulations industrielles à grande échelle.
7.2 Méthode de sommation de variables uniformes
Une approche alternative pour engendrer des nombres aléatoires distribués selon une loi triangulaire repose sur l’exploitation des propriétés de convolution de la somme de variables uniformes indépendantes. Comme explicité dans l’étude de la typologie symétrique, la somme arithmétique de deux variables aléatoires continues U1 et U2, mutuellement indépendantes et uniformément réparties sur l’intervalle unitaire [0, 1], engendre de manière déterministe une variable composite S = U1 + U2 dont la distribution géométrique trace un triangle isocèle parfait sur le support compact [0, 2], avec un mode culminant exactement en 1.
Pour généraliser cette propriété géométrique à un intervalle symétrique arbitraire délimité par des bornes a et b, avec un mode positionné au centre c = (a + b) / 2, l’algorithme de calcul se condense en une opération vectorielle d’une remarquable concision n’exigeant aucune extraction de racine carrée :
Xsymétrique = a + ((b – a) / 2) × (U1 + U2).
Bien que cette technique d’addition directe s’avère particulièrement élégante et rapide pour les configurations symétriques, sa généralisation à des configurations asymétriques arbitraires (où c ≠ (a + b) / 2) requiert l’application de combinaisons linéaires pondérées de variables uniformes ou l’usage de mélanges conditionnels qui alourdissent substantiellement le graphe d’exécution algorithmique. En pratique logicielle contemporaine, l’extraction directe de radicaux via la méthode d’inversion par transformée (décrite en section 7.1) demeure nettement privilégiée en raison de son universalité et de sa capacité à absorber instantanément n’importe quel degré d’asymétrie sans modification de la structure du code.
7.3 Intégration au sein des simulations de Monte-Carlo
Dans l’écosystème de la modélisation prévisionnelle contemporaine, la méthode de Monte-Carlo constitue le vecteur privilégié de propagation des incertitudes décisionnelles. Qu’il s’agisse d’évaluer le risque de dépassement de budget d’une infrastructure ferroviaire ou de modéliser la marge de sécurité thermique d’un réacteur chimique, le protocole consiste à injecter des distributions de probabilité à l’entrée d’un système déterministe non linéaire, pour en observer le comportement statistique agrégé à la sortie après plusieurs dizaines ou centaines de milliers d’itérations stochastiques.
Au sein de cette méthodologie, la distribution triangulaire joue le rôle de pivot de propagation pour toutes les variables d’entrée dépourvues de séries de données historiques consolidées. En vertu de la loi forte des grands nombres, la moyenne empirique issue de l’échantillonnage de flux triangulaires converge asymptotiquement avec une certitude absolue vers l’espérance mathématique théorique (a + b + c) / 3, tandis que la variance des moyennes d’échantillons décroît selon un rythme proportionnel à l’inverse de la racine carrée de la taille d’échantillon N. Cette stabilité asymptotique garantit une robustesse totale des estimateurs numériques.
L’intégration de la distribution triangulaire dans les moteurs de simulation permet en outre de conduire des analyses de sensibilité paramétrique globales d’une grande acuité. En faisant varier systématiquement les bornes extrêmes a et b ou le degré de dissymétrie imposé par c, l’analyste peut quantifier l’élasticité de la sortie du modèle vis-à-vis de chacune des hypothèses cognitives formulées par les experts. La validation du bon comportement numérique des générateurs triangulaires s’opère couramment par des diagnostics graphiques avancés, tels que la superposition d’histogrammes de fréquence haute résolution avec la courbe théorique de la densité, ou le tracé de diagrammes Quantile-Quantile (Q-Q plots) confrontant les quantiles empiriques simulés aux quantiles théoriques issus de la fonction Q(p).
8. Analyse comparative : distribution triangulaire et autres lois continues
8.1 Confrontation avec la loi Bêta et la méthode PERT
Dans le domaine de l’ordonnancement de projets et de la gestion de l’ingénierie, la distribution triangulaire entre en concurrence directe avec la distribution Bêta, notamment à travers la méthodologie PERT (Program Evaluation and Review Technique). Ces deux familles de distributions partagent un cahier des charges fonctionnel similaire : elles s’articulent toutes deux autour de trois données d’entrée cognitives explicites fournies par l’évaluateur, à savoir l’estimation optimiste a, la valeur la plus probable c (ou m), et l’estimation pessimiste b. Cependant, les topologies mathématiques qui sous-tendent leur formulation révèlent des divergences conceptuelles fondamentales.
La distinction la plus immédiate réside dans la pondération accordée au mode lors de la détermination de l’espérance mathématique. Alors que la distribution triangulaire attribue un poids symétrique équitable d’un tiers à chaque paramètre avec E(X) = (a + b + c) / 3, la méthode PERT historique, reposant sur une paramétrisation spécifique de la loi Bêta, écrase les valeurs extrêmes en affectant un coefficient de pondération quadruple au mode :
E(X)PERT = (a + 4c + b) / 6.
Cette divergence structurelle se traduit sur le plan géométrique par une opposition marquée : la loi Bêta engendre une courbe lisse de classe C-infini, dont les raccordements aux bornes a et b épousent des tangentes douces sans aucune aspérité anguleuse. À l’opposé, la distribution triangulaire présente des parois planes linéaires et une rupture de pente franche au point modal. Si la loi Bêta offre un réalisme physique supérieur pour modéliser des cinétiques naturelles régulières, la distribution triangulaire conserve une supériorité incontestable en termes de transparence arithmétique, de calculabilité immédiate sur tableur sans mobiliser de fonctions eulériennes complexes, et d’indépendance vis-à-vis d’hypothèses statistiques implicites invérifiables.
8.2 Distinction avec la loi normale et la loi normale tronquée
La confrontation de la distribution triangulaire avec la loi normale de Gauss met en lumière le dilemme classique entre le confort analytique du formalisme probabiliste standard et les impératifs de la réalité opérationnelle bornée. La distribution normale repose sur un support spatial infini s’étirant de moins l’infini à plus l’infini. Dans les applications pratiques d’ingénierie, cette infinité des queues de distribution constitue une faille de réalisme majeure, car elle attribue une probabilité résiduelle non nulle à des événements physiquement impossibles, tels que des durées de tâches négatives, des coûts de construction inférieurs à zéro ou des résistances de matériaux infinies.
Pour neutraliser ces aberrations asymptotiques, les modélisateurs ont parfois recours à la loi normale tronquée, qui sectionne artificiellement la cloche gaussienne à l’intérieur d’un intervalle compact [a, b]. Toutefois, cette troncature mathématique détruit la simplicité algébrique du modèle : elle impose une recalibration lourde de la constante de normalisation, complexifie considérablement le calcul analytique de l’espérance et de la variance réelles, et altère la convergence des algorithmes d’estimation. La distribution triangulaire s’affranchit d’emblée de ces artifices compensatoires : son support est naturellement et strictement borné par essence, éliminant par construction tout risque de fuite de probabilité vers des territoires physiques interdits.
Par ailleurs, si le théorème central limite justifie amplement l’usage de la loi normale lorsque le phénomène observé résulte de la sommation d’une myriade de perturbations infinitésimales indépendantes, cette hypothèse asymptotique s’effondre dans les contextes de forte contrainte opérationnelle régis par des contraintes mécaniques ou organisationnelles dominantes. Dans ces régimes où l’aléa est contraint à l’intérieur d’une enveloppe de tolérance stricte sans comportement d’agrégation massive, la géométrie bornée et accessible de la loi triangulaire s’avère infiniment plus adaptée et disciplinée que l’inadéquation structurelle des distributions à support infini.
8.3 Comparaison avec la loi uniforme continue
La comparaison entre la distribution triangulaire et la loi uniforme continue éclaire le passage progressif de l’ignorance totale à la structuration de l’information statistique. La loi uniforme, définie sur l’intervalle [a, b], incarne l’état d’ignorance maximale au sens du principe de raison insuffisante formulé par Pierre-Simon de Laplace : n’ayant aucun motif rationnel de privilégier un sous-ensemble du domaine par rapport à un autre, l’analyste affecte une densité rigoureusement plate et constante f(x) = 1 / (b – a) sur l’ensemble du support.
La valeur ajoutée fondamentale de la distribution triangulaire réside dans l’injection d’un point d’ancrage qualitatif décisif : la valeur modale c. Dès l’instant où un évaluateur est en mesure d’affirmer qu’une zone interne du domaine d’incertitude est marginalement plus plausible qu’une autre, l’hypothèse d’uniformité s’effondre. La distribution triangulaire canalise cette information émergente en brisant la platitude de la densité pour ériger un pic de probabilité proportionnel au niveau de certitude disponible. La transition continue entre la loi uniforme et la loi triangulaire peut s’interpréter géométriquement comme le passage d’un plateau rectangulaire à un profil en coin : à mesure que le sommet du triangle s’aplatit pour se transformer en un plateau trapézoïdal, le modèle se rapproche de l’indifférenciation uniforme.
Sur le plan de la théorie de l’information développée par Claude Shannon, cette structuration morphologique se traduit par une baisse mesurable de l’entropie informationnelle relative. L’entropie d’une distribution continue, qui quantifie le degré d’incertitude ou de désordre inhérent à la densité, atteint son maximum absolu pour le support compact [a, b] avec la distribution uniforme. En intégrant un mode c et en adoptant une morphologie triangulaire, l’entropie différentielle diminue strictement, attestant de l’apport informationnel concret fourni par l’expertise humaine.
9. Applications en psychométrie et sciences comportementales
9.1 Modélisation des temps de réponse et latences cognitives
Dans les disciplines de la neuropsychologie expérimentale et de la psychométrie chronométrique, l’analyse des temps de réponse (Reaction Times, RT) face à des stimuli visuels ou auditifs fournit une fenêtre d’observation critique sur l’architecture du traitement cérébral de l’information. L’ajustement empirique des séries chronométriques se heurte systématiquement à deux contraintes physiologiques incontournables : l’existence d’une limite de vitesse neuromusculaire absolue en deçà de laquelle aucun influx nerveux ne peut se propager, et une asymétrie marquée caractérisée par un regroupement massif des latences autour d’une valeur optimale, suivi d’un étalement résiduel des réponses ralenties par la fatigue ou l’inattention.
La distribution triangulaire s’adapte avec précision à cette réalité biomécanique :
- La borne inférieure a capture la latence physiologique minimale irréductible, correspondant au délai incompressible de transduction rétinienne, de conduction axonale et d’activation synaptique des unités motrices.
- Le mode c modélise le temps de latence nominal dans l’exécution de la tâche cognitive, c’est-à-dire le pic de vitesse de croisière optimal du sujet en état de veille active.
- La borne supérieure b délimite le temps d’attente maximum toléré avant l’abandon ou la réinitialisation de l’essai expérimental.
Contrairement aux modèles fondés sur des distributions log-normales ou des lois de Weibull qui projettent théoriquement des queues de probabilité infinies, incompatibles avec les protocoles de laboratoire bornés par des fenêtres de déclenchement (timeouts), la distribution triangulaire contient rigoureusement les valeurs extrêmes sans introduire d’artifices non biologiques. Son ajustement sur des distributions empiriques de latence motrice fournit des paramètres immédiatement transposables en indicateurs cliniques pour évaluer les déficits attentionnels ou les gains d’apprentissage psychomoteur.
9.2 Quantification de l’incertitude dans les échelles d’attitudes subjectives
La collecte de données subjectives en sciences sociales et comportementales s’effectue massivement au moyen d’échelles de Likert ou de continuums sémantiques différentiels. Traditionnellement, les sujets sont contraints de figer leur degré d’adhésion à une proposition sous la forme d’une valeur discrète unique (par exemple, un entier positionné entre 1 et 7). Ce format de recueil classique souffre d’une réduction d’information sévère : il ignore l’hésitation interne, l’ambivalence cognitive et la marge d’ambiguïté inhérente au jugement humain.
Pour surmonter cette faiblesse méthodologique, les protocoles psychométriques avancés déploient des interfaces numériques sur lesquelles les participants ne sélectionnent plus un point fixe, mais étirent un curseur triangulaire interactif. Cette démarche transforme chaque score individuel en un nombre flou triangulaire (Triangular Fuzzy Number) :
- Le sommet c représente la conviction centrale ou le point d’accord préférentiel du sujet.
- Les extrémités a et b matérialisent les frontières de plausibilité de son adhésion, révélant son degré d’hésitation ou de tolérance sémantique.
L’exploitation statistique de ces réponses s’effectue ensuite par l’agrégation collective des perceptions individuelles sous la forme de mélanges de distributions triangulaires continues. Cette approche permet de distinguer avec une grande netteté deux individus ayant formulé le même score modal mais affichant des niveaux d’incertitude diamétralement opposés. La mesure de la divergence intra-individuelle et de la cohérence interne des jugements acquiert ainsi une granularité mathématique sans précédent, réconciliant la théorie de la mesure psychologique avec la logique floue et l’analyse stochastique continue.
9.3 Évaluation de la calibration métacognitive
La métacognition désigne la capacité réflexive d’un individu à évaluer avec lucidité l’exactitude de ses propres connaissances et la précision de ses processus cognitifs. L’un des protocoles expérimentaux les plus réputés pour quantifier la calibration métacognitive consiste à soumettre des participants à des questionnaires de culture générale ou de prospective opérationnelle, en exigeant pour chaque question l’élicitation d’un intervalle de plausibilité triangulaire [a, b] centré sur leur meilleure estimation c, avec un niveau de confiance assigné (par exemple, 90 %).
L’analyse des distributions triangulaires déclarées permet de calculer des indices de calibration et de surconfiance d’une grande rigueur diagnostique. Si les réalisations factuelles objectives tombent en dehors de l’intervalle [a, b] dans une proportion de tests significativement supérieure aux 10 % théoriquement tolérés, le sujet manifeste un biais de surconfiance sévère, traduisant une constriction anormale de son support d’estimation. À l’inverse, des intervalles disproportionnellement étalés révèlent une sous-confiance pathologique ou une incapacité à structurer le champ des connaissances disponibles.
Dans les programmes d’entraînement cognitif destinés aux décideurs stratégiques ou aux opérateurs de systèmes critiques (tels que les contrôleurs aériens ou les gestionnaires de crise nucléaire), le protocole d’élicitation triangulaire est employé comme instrument d’apprentissage guidé. En confrontant de manière itérative les distributions subjectives déclarées avec les retours d’expérience empiriques, l’apprentissage vise à réduire l’étalement inutile de la distribution tout en réalignant les bornes extrêmes sur les distributions réelles de l’aléa, améliorant ainsi durablement la résilience cognitive des équipes décisionnelles.
10. Applications appliquées à la gestion des risques et aux organisations
10.1 Estimation prévisionnelle des coûts et des calendriers de projet
Dans le domaine de l’ingénierie des méga-projets industriels, des infrastructures civiles et du développement logiciel complexe, le dépassement des enveloppes budgétaires et le glissement calendaire constituent un phénomène systémique documenté sous le concept d’illusion de planification (Planning Fallacy). Pour neutraliser ce biais organisationnel majeur, les standards internationaux d’ingénierie de projet prescrivent l’abandon des prévisions déterministes à point unique au profit de l’estimation probabiliste à trois points adossée à la distribution triangulaire.
Dans ce cadre opérationnel, chaque tâche critique d’un réseau d’activités (diagramme PERT ou graphe de précédence) se voit attribuer une durée ou un coût modélisé par une variable triangulaire indépendante. L’expert en ingénierie chiffre :
- Une durée minimale d’exécution absolue a, postulant une absence totale d’aléa défavorable et un rendement productif parfait.
- Une durée nominale la plus fréquente c, intégrant les frictions opérationnelles habituelles observées sur les chantiers analogues.
- Une durée maximale dégradée b, incorporant l’impact des aléas climatiques sévères, des défaillances de sous-traitance ou des retards d’approvisionnement logistique.
En agrégeant ces multiples variables au sein d’une simulation stochastique de chemin critique, les organisations dépassent la simple addition de moyennes déterministes. Le modèle permet de générer des courbes de probabilité de complétion globale du projet en fonction du temps (courbes en S), identifiant les goulots d’étranglement dynamiques où l’asymétrie des distributions triangulaires menace d’engendrer des retards cumulatifs par effet de chaîne. Cette visibilité quantitative offre aux comités de pilotage la possibilité de dimensionner les réserves pour contingences budgétaires et temporelles sur des bases rationnelles adossées à des percentiles contractuels précis.
10.2 Évaluation de l’exposition financière et des pertes potentielles
Le secteur de l’ingénierie financière et de la gestion du risque d’entreprise mobilise la distribution triangulaire pour quantifier des expositions aux pertes potentielles dans des contextes marqués par une rareté historique des événements dommageables. Dans le champ du risque opérationnel bancaire (accords prudentiels de Bâle) ou de l’assurance des risques industriels atypiques, la quantification de la Valeur en Risque Opérationnelle (Operational Value at Risk, OpVaR) se heurte fréquemment à l’inexistence de séries chronologiques de sinistres suffisamment denses pour autoriser une modélisation par la théorie des valeurs extrêmes.
La distribution triangulaire s’affirme alors comme le modèle de repli méthodologique le plus robuste. Elle est employée pour modéliser la sévérité des pertes unitaires découlant de défaillances de conformité, de cyberattaques massives ou d’interruptions d’activité d’origine tellurique. En calibrant la borne pessimiste b sur l’exposition financière maximale calculée lors de scénarios de stress tests extrêmes, l’institution s’assure d’une modélisation rigoureuse de son besoin de fonds propres sans introduire d’instabilités numériques infinies propres aux lois non bornées.
Dans le secteur de la réassurance et de la tarification de risques non standards (tels que la couverture d’événements climatiques exceptionnels pour des infrastructures off-shore), l’arbitrage décisionnel s’opère directement par l’évaluation des percentiles de la fonction quantile triangulaire. Les primes pures d’assurance sont calculées à partir de l’espérance barycentrique majorée d’un chargement de sécurité directement proportionnel à l’écart-type dérivé de la formule fermée Var(X). Cette approche garantit une traçabilité intégrale des calculs actuariels, hautement appréciée par les autorités de régulation financière soucieuses d’auditer la plausibilité des modèles internes de capital économique.
10.3 Gestion des stocks et planification de la demande sous incertitude
L’optimisation des chaînes d’approvisionnement (Supply Chain Management) exige une conciliation permanente entre deux impératifs financiers antinomiques : minimiser les coûts d’immobilisation du capital associés au surstockage et éradiquer le risque d’indisponibilité commerciale matérialisé par les ruptures d’approvisionnement. Lorsque le lancement d’une référence produit inédite empêche tout ajustement par des modèles autorégressifs classiques de séries temporelles, la demande future sur le cycle de réapprovisionnement est modélisée au moyen d’une distribution triangulaire.
Cette paramétrisation permet aux planificateurs de formaliser avec finesse les asymétries de la demande prévisionnelle. Si le marché présente un profil d’adoption explosive potentiel, la borne supérieure b sera fixée très haut par rapport au mode nominal c. À partir de cette distribution d’entrée, les équations classiques du modèle du vendeur de journaux (Newsvendor Problem) s’ajustent par inversion de la fonction de répartition cumulative triangulaire :
Le ratio critique de rentabilité CR = Cu / (Cu + Co) — où Cu désigne le coût unitaire de rupture de stock et Co le coût unitaire d’obsolescence ou de possession — est directement injecté dans la fonction quantile Q(p) démontrée en section 3.3. Le stock de commande optimal S* s’obtient instantanément par la résolution : S* = Q(CR). Si le ratio critique tombe sur le segment ascendant, la commande optimale se calculera à partir de l’expression quadratique basse ; s’il commande une disponibilité élevée (comme dans l’approvisionnement de pièces détachées aéronautiques où le coût de rupture est écrasant), la commande bascule sur la formule de la branche supérieure :
S* = b – √[ (1 – CR) (b – a) (b – c) ].
Ce dimensionnement mathématique des stocks de sécurité garantit une résilience opérationnelle totale face aux ruptures d’approvisionnement, tout en adaptant dynamiquement l’engagement financier aux asymétries structurelles du profil commercial envisagé.
11. Implémentation computationnelle et programmation statistique
11.1 Modélisation numérique avec l’environnement R
L’environnement de programmation statistique R intègre la distribution triangulaire à travers plusieurs bibliothèques spécialisées de référence, au premier rang desquelles figure le package d’analyse environnementale et stochastique EnvStats, ainsi que le package extraDistr. Conformément aux conventions idiomatiques de R régissant les lois de probabilité, la manipulation de la distribution s’effectue au moyen d’un quatuor fonctionnel standardisé composé des primitives dtriang, ptriang, qtriang et rtriang, acceptant pour paramètres formels les grandeurs scalaires min (a), max (b) et mode (c).
L’estimation des paramètres de la distribution triangulaire à partir d’un échantillon empirique vectorisé s’exécute dans R selon deux méthodologies distinctes : l’ajustement par la méthode des moments et l’estimation par maximisation de vraisemblance (MLE, pour Maximum Likelihood Estimation). Si la méthode des moments résout analytiquement le système d’équations non linéaires liant la moyenne empirique, la variance et l’asymétrie calculées aux expressions théoriques E(X) et Var(X), l’ajustement par maximisation de vraisemblance exige le déploiement d’optimiseurs numériques spécialisés capables de contourner la singularité de non-différentiabilité au point modal.
La représentation graphique haute fidélité des densités de probabilité et des quantiles cumulés s’articule élégamment avec l’écosystème graphique ggplot2. Grâce à la vectorisation native du langage R, l’utilisateur peut superposer de manière limpide les densités empiriques issues de tracés de type geom_density avec la courbe géométrique théorique tracée via stat_function, en configurant rigoureusement les trois paramètres a, b et c. La validation de la conformité d’un échantillon de données empiriques vis-à-vis d’un modèle triangulaire théorique s’achève par la réalisation de diagnostics de résidus et de tests formels d’adéquation de type Kolmogorov-Smirnov (en exploitant la fonction ks.test couplée à la fonction cumulative ptriang), garantissant le contrôle de l’erreur statistique de première espèce.
11.2 Implémentation en Python via l’écosystème SciPy et NumPy
Dans l’écosystème Python orienté vers la science des données et l’apprentissage automatique, le traitement de la distribution triangulaire est principalement orchestré par le module spécialisé scipy.stats, via la classe triang. Toutefois, l’architecture logicielle de la bibliothèque SciPy adopte une convention de paramétrisation spécifique qui diffère subtilement de la notation conventionnelle tripartite (a, b, c). Les développeurs doivent faire preuve d’une grande rigueur d’implémentation pour éviter les erreurs d’échelle.
Dans SciPy, la classe triang est définie par trois arguments formels :
- Le paramètre de forme obligatoire c (qui correspond en réalité au ratio adimensionnel c’ = (c – a) / (b – a)).
- L’argument de translation loc (qui correspond à la borne inférieure a).
- L’argument d’échelle scale (qui correspond à l’amplitude totale de l’intervalle (b – a)).
Dès lors, pour modéliser une variable aléatoire triangulaire définie sur l’intervalle [10, 50] avec un mode fixé à 20, l’analyste Python devra obligatoirement paramétrer l’objet statistique sous la syntaxe : triang(c=(20-10)/(50-10), loc=10, scale=40). Une fois l’objet correctement instancié, l’ensemble des méthodes vectorisées deviennent accessibles : .pdf() pour la fonction de densité, .cdf() pour la fonction de répartition cumulative, .ppf() (Percent Point Function) pour la fonction quantile inverse, et .rvs() pour l’échantillonnage de vecteurs massifs de variables pseudo-aléatoires.
Pour des simulations stochastiques à haute performance exigeant le traitement de dizaines de millions d’itérations, la vectorisation native via la bibliothèque NumPy permet d’accélérer drastiquement les calculs en s’affranchissant du surcoût des objets de haut niveau de SciPy. En implémentant directement l’algorithme d’inversion par transformée sous forme de masques booléens NumPy vectorisés (np.where), les cycles de génération de nombres pseudo-aléatoires s’exécutent au plus près du processeur avec une efficacité optimale. La restitution graphique interactive des profils probabilistes s’effectue ensuite au moyen des bibliothèques Matplotlib et Seaborn, permettant une exploration visuelle fine de la propagation des densités.
11.3 Déploiement sous tableurs et outils décisionnels bureautiques
Malgré la puissance des langages de programmation scientifique de pointe, une proportion écrasante des modèles de décision financière, d’évaluation de projets et d’audit des risques continue d’être opérée au sein de tableurs bureautiques tels que Microsoft Excel ou Google Sheets. L’un des atouts déterminants de la distribution triangulaire réside précisément dans sa capacité à être intégralement déployée au sein de feuilles de calcul sans exiger l’installation de macros VBA complexes ou d’add-ins tiers payants.
Pour calculer la densité de probabilité f(x) ou la distribution cumulée F(x) d’une valeur x saisie dans une cellule, il suffit d’imbriquer la fonction logique conditionnelle SI selon la position de x par rapport aux paramètres a, b et c saisis dans des cellules dédiées. Par exemple, le calcul de la fonction de répartition cumulative F(x) s’implémente directement par une syntaxe conditionnelle matricielle répliquant fidèlement la formulation théorique démontrée en section 3 : si x ≤ a renvoyer 0 ; si a < x ≤ c renvoyer (x-a)^2/((b-a)*(c-a)) ; si c < x ≤ b renvoyer 1-(b-x)^2/((b-a)*(b-c)) ; sinon renvoyer 1.
L’implémentation d’un moteur de simulation de Monte-Carlo léger s’effectue avec la même aisance pour la génération stochastique, en combinant la fonction aléatoire standard ALEA() (qui génère un tirage uniforme standard U(0, 1) à chaque recalcul de la feuille) avec la structure de l’algorithme d’inversion. En inscrivant la formule dans une colonne étirée sur plusieurs milliers de lignes, le tableur génère instantanément un échantillon empirique complet :
=SI(ALEA() < (c-a)/(b-a) ; a + RACINE(ALEA() * (b-a) * (c-a)) ; b – RACINE((1 – ALEA()) * (b-a) * (b-c))).
Il convient toutefois de souligner une erreur courante d’implémentation algorithmique au sein des tableurs qui fausse lourdement la structure probabiliste des simulations : l’appel répété de la fonction ALEA() au sein d’une même ligne de formule conditionnelle. Si la fonction ALEA() est appelée deux fois distinctement (une fois pour le test logique de condition et une seconde fois à l’intérieur du radical de calcul), le processeur du tableur effectue deux tirages stochastiques indépendants au lieu d’un seul, violant ainsi le principe fondamental de la méthode d’inversion par transformée. Les bonnes pratiques d’audit numérique imposent de dédier une première colonne technique au stockage figé du tirage uniforme u = ALEA(), avant d’appliquer dans une colonne contiguë la logique de transformation géométrique.
12. Limites structurelles, controverses méthodologiques et extensions avancées
12.1 Critique de la non-différentiabilité au point modal
Malgré son élégance et son universalité pratique, la distribution triangulaire fait l’objet de réserves théoriques substantielles de la part de l’école des mathématiques appliquées. La critique la plus vive se focalise sur la rupture de pente brutale qui caractérise son sommet au point modal x = c. Dans la modélisation de la quasi-totalité des phénomènes physiques, biologiques, chimiques ou macroéconomiques, les processus de transition dynamique s’opèrent selon des courbures continues et différentiables. L’émergence d’un point anguleux aigu au sommet de la fonction de densité de probabilité constitue une simplification géométrique artificielle qui heurte le réalisme phénoménologique.
Sur le plan de l’analyse numérique avancée, cette non-différentiabilité d’ordre un engendre des complications sévères lors de l’application d’algorithmes d’optimisation mathématique fondés sur le calcul différentiel, tels que les méthodes de descente de gradient, les algorithmes de quasi-Newton (comme le protocole BFGS) ou les échantillonneurs de Monte-Carlo par chaînes de Markov hamiltoniennes (HMC). L’absence de dérivée seconde continue et le saut de discontinuité de la dérivée première au point c peuvent provoquer des oscillations numériques parasites, des blocages de convergence algorithmique ou des instabilités dans le calcul des matrices hessiennes nécessaires à l’évaluation des intervalles de confiance asymptotiques.
Pour contourner ces écueils de régularité sans sacrifier l’intelligibilité des paramètres d’entrée en trois points, des approches alternatives de lissage ont été développées. Celles-ci consistent à substituer à la jonction anguleuse des raccords de splines cubiques lissées ou des approximations par des polynômes régularisés de classe C2 au voisinage du sommet modal. Toutefois, si ces raffinements géométriques satisfont l’exigence formelle de différentiabilité, leur impact quantitatif sur les intégrales cumulées de risque et sur le calcul des quantiles globaux s’avère dans la grande majorité des cas rigoureusement négligeable, cantonnant souvent ces extensions à des niches académiques ultra-spécialisées.
12.2 Hyper-sensibilité aux erreurs d’estimation des valeurs extrêmes
Une seconde controverse d’ordre épistémologique et méthodologique réside dans la vulnérabilité structurelle de la distribution triangulaire face à l’arbitraire du choix de ses bornes extrêmes a et b. Dans la mesure où la distribution s’interdit catégoriquement d’exister en deçà de a et au-delà de b, ces deux valeurs cessent d’opérer comme de simples indicateurs de tendance pour devenir des barrières absolues infranchissables.
Or, dans la pratique de l’expertise cognitive humaine, l’estimation des bornes extrêmes est précisément la zone où la marge d’erreur subjective est la plus dévastatrice. Une variation infinitésimale de l’appréciation d’un scénario pessimiste peut conduire un évaluateur à modifier substantiellement la valeur de la borne b. En raison de la présence du terme quadratique (b – a)² dans les formules analytiques de dispersion, l’écart-type et la variance de la distribution réagissent avec une hyper-sensibilité immédiate face à toute modification des frontières extrêmes. Une surestimation unilatérale du pire scénario gonfle artificiellement l’incertitude globale du modèle, ce qui peut paralyser la prise de décision stratégique ou imposer des surcoûts d’assurance prohibitifs.
Cette sensibilité paramétrique soulève des problématiques éthiques et managériales de premier plan, notamment le risque de manipulation délibérée des bornes lors des revues de projet. Un chef de département désireux de faire approuver un investissement risqué peut être tenté de contracter subtilement la borne supérieure b pour afficher une variance rassurante et dissimuler l’ampleur des pertes potentielles. Pour immuniser les modèles contre ces dérives d’ajustement opportuniste, les architectures de gouvernance du risque modernes mettent en place des protocoles de rétroaction dynamique (feedback loops), où les bornes déclarées sont continuellement réévaluées à l’aune des données émergentes au moyen de règles de mise à jour bayésienne calibrées.
12.3 Extensions multivariées et distributions généralisées
Pour repousser les frontières dimensionnelles et fonctionnelles de la loi triangulaire univariée élémentaire, la recherche contemporaine s’est orientée vers le développement d’architectures stochastiques multivariées et de généralisations morphologiques avancées. Dans les systèmes complexes où les variables d’entrée ne sont pas indépendantes mais manifestent des couplages stochastiques prononcés, la modélisation de distributions triangulaires bivariées ou multivariées devient impérative.
La méthode la plus féconde pour coupler plusieurs variables triangulaires sans dénaturer leurs distributions marginales respectives repose sur l’application de la théorie des copules, formalisée par le théorème d’Abe Sklar. En employant des copules elliptiques (comme la copule gaussienne ou la copule de Student) ou des copules archimédiennes (telles que les copules de Clayton ou de Gumbel), l’ingénieur peut coupler des marges strictement triangulaires tout en modélisant avec fidélité des structures de dépendance complexes non linéaires, incluant des phénomènes de corrélation de queue ou de contagion stochastique asymétrique.
Parallèlement aux extensions de dimension, la distribution triangulaire a engendré une descendance morphologique directe à travers la distribution trapézoïdale. Cette généralisation structurelle émerge en scindant le sommet modal ponctuel en un plateau continu délimité par deux points intérieurs ordonnés, notés c et d, transformant le triplet de paramètres initial en un quadruplet canonique : a ≤ c ≤ d ≤ b. La fonction de densité adopte alors une forme trapézoïdale, où la phase ascendante sur [a, c] débouche sur un plateau de probabilité uniforme constante sur le sous-intervalle modal [c, d], avant de plonger selon la branche descendante sur [d, b].
Cette extension trapézoïdale offre une réponse méthodologique remarquable aux situations où l’expert refuse de s’engager sur une valeur modale unique, préférant désigner une plage d’équiprobabilité nominale à l’intérieur de laquelle son discernement demeure indifférencié. Dans les architectures contemporaines de l’intelligence artificielle, du traitement du langage naturel et de la commande de systèmes mécatroniques complexes fondées sur les systèmes d’inférence floue de type Mamdani ou Sugeno, ces fonctions d’appartenance triangulaires et trapézoïdales continuent de former le substrat formel le plus universellement déployé, prouvant ainsi la pérennité conceptuelle d’une modélisation géométrique de l’incertain amorcée il y a plus de six décennies.
Références
Johnson, N. L., Kotz, S., & Balakrishnan, N. (1995). Continuous Univariate Distributions, Volume 2 (2nd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Continuous+Univariate+Distributions%2C+Volume+2%2C+2nd+Edition-p-9780471584940
Kahneman, D., Slovic, S. P., & Tversky, A. (Eds.). (1982). Judgment under Uncertainty: Heuristics and Biases. Cambridge University Press. https://doi.org/10.1017/CBO9780511809477
Kolmogorov, A. N. (1956). Foundations of the Theory of Probability (N. Morrison, Trans.; 2nd ed.). Chelsea Publishing Company. (Original work published 1933)
Kotz, S., & van Dorp, J. R. (2004). Beyond Beta: Other Continuous Families of Distributions with Bounded Support and Applications. World Scientific Publishing. https://doi.org/10.1142/5565
Malcolm, D. G., Roseboom, J. H., Clark, C. E., & Fazar, W. (1959). Application of a Technique for Research and Development Program Evaluation. Operations Research, 7(5), 646–669. https://doi.org/10.1287/opre.7.5.646
Nelsen, R. B. (2006). An Introduction to Copulas (2nd ed.). Springer. https://doi.org/10.1007/0-387-28678-0
Project Management Institute. (2021). A Guide to the Project Management Body of Knowledge (PMBOK Guide) (7th ed.). Project Management Institute.
Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
Tversky, A., & Kahneman, D. (1974). Judgment under Uncertainty: Heuristics and Biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
van Dorp, J. R., & Kotz, S. (2002). A Novel Extension of the Triangular Distribution and Its Parameter Estimation. The American Statistician, 56(2), 90–99. https://doi.org/10.1198/000313002317572753
Vose, D. (2008). Risk Analysis: A Quantitative Guide (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Risk+Analysis%3A+A+Quantitative+Guide%2C+3rd+Edition-p-9780470512845
Zadeh, L. A. (1965). Fuzzy Sets. Information and Control, 8(3), 338–353. https://doi.org/10.1016/S0019-9958(65)90241-X