
L’analyse de variance factorielle à deux facteurs, communément désignée sous l’acronyme anglo-saxon d’ANOVA à deux voies (Two-Way ANOVA), constitue l’un des piliers méthodologiques les plus robustes et les plus universellement déployés dans les sciences du comportement, la neurobiologie cognitive et la psychologie expérimentale. Élaborée initialement par le statisticien et généticien britannique Ronald Aylmer Fisher dans les années 1920, cette technique inférentielle transcende la simple comparaison bivariée en permettant d’examiner simultanément l’influence conjointe et interactive de deux variables indépendantes catégorielles sur une variable dépendante quantitative continue. Dans le champ de la psychologie, où les phénomènes mentaux et comportementaux résultent invariablement de déterminismes pluriels et d’interactions complexes entre dispositions individuelles et contraintes environnementales, l’ANOVA factorielle offre un cadre mathématique d’une élégance conceptuelle et d’une rigueur diagnostique inégalées.
Si des progiciels spécialisés tels que SPSS, R, SAS ou JASP dominent fréquemment les laboratoires de recherche de pointe, Microsoft Excel demeure une plateforme d’une omniprésence indéniable, souvent sous-estimée quant à ses capacités d’analyse computationnelle avancée. Doté du complément natif intitulé Utilitaire d’analyse (Analysis ToolPak), le tableur d’Open Office ou de la suite Microsoft 365 recèle un moteur d’inférence statistique parfaitement capable d’exécuter des plans factoriels orthogonaux avec réplication. Cependant, l’utilisation rigoureuse d’Excel pour l’ANOVA factorielle requiert une compréhension chirurgicale de ses spécificités ergonomiques, de ses contraintes d’agencement matriciel et de ses limites inhérentes, notamment face aux plans déséquilibrés ou aux violations d’homoscédasticité.
Ce guide exhaustif a été conçu pour guider les chercheurs, psychologues, statisticiens et étudiants avancés à travers l’ensemble des étapes requises pour concevoir, implémenter, interpréter et publier une ANOVA à deux facteurs sous Microsoft Excel selon les standards académiques les plus exigeants de l’American Psychological Association (normes APA, 7e édition). De la décomposition formelle des sommes de carrés au tracé géométrique des profils d’interaction, en passant par le calcul de l’éta-carré partiel et la détection d’observations aberrantes, ce manuel opératoire détaille l’intégralité du processus méthodologique avec une minutie scientifique absolue.
1. Fondements théoriques de l’ANOVA à deux facteurs en recherche psychologique
L’architecture épistémologique de la recherche expérimentale repose sur le contrôle rigoureux des variables parasites et l’observation systématique des variations induites sur le comportement humain. Alors que le test t de Student pour échantillons indépendants ou l’ANOVA univariée à un facteur ne peuvent évaluer qu’une seule dimension causale à la fois, la réalité psychologique est fondamentalement multivariée. Isoler une variable indépendante du contexte écologique dans lequel elle s’exprime expose le chercheur à des biais d’omission sévères, masquant la manière dont certains facteurs modulent, amplifient ou annulent les effets d’autres déterminants.
L’ANOVA factorielle à deux facteurs apporte une réponse méthodologique directe à ce défi en partitionnant la variance globale observée en composantes additives distinctes. Elle permet ainsi d’explorer non seulement les effets dits « principaux » de chaque variable prédictive, mais également l’effet d’interaction, concept fondamental qui capture la non-additivité des influences environnementales ou cognitives.
2. Définition et principes fondamentaux du modèle linéaire général
L’ANOVA factorielle s’inscrit formellement au sein de la théorie du modèle linéaire général (GLM), un paradigme statistique unificateur qui postule que toute observation quantitative peut être décomposée en une somme pondérée d’effets fixes déterministes et d’un résidu stochastique non observable. Pour un plan factoriel à deux facteurs inter-sujets comportant un facteur A à I niveaux et un facteur B à J niveaux, chaque observation individuelle Yijk (représentant la mesure du k-ième sujet au sein du niveau i du facteur A et du niveau j du facteur B) s’exprime selon l’équation structurelle suivante :
Yijk = μ + αi + βj + (αβ)ij + εijk
Dans ce formalisme, le paramètre μ représente la moyenne générale théorique (le grand mean) de l’ensemble de la population parente sous-jacente. Le terme αi désigne l’effet différentiel principal du niveau i du premier facteur, contraint par convention d’orthogonalité à la somme nulle (∑ αi = 0). De façon analogue, βj quantifie l’effet principal du niveau j du second facteur (∑ βj = 0). Le terme combiné (αβ)ij incarne l’effet d’interaction spécifique résultant de la conjonction des modalités i et j, lui aussi astreint à une sommation nulle sur chaque ligne et chaque colonne. Enfin, le composant résiduel εijk capture l’erreur expérimentale aléatoire propre à l’individu k, supposée identiquement, indépendamment et normalement distribuée avec une espérance nulle et une variance constante σ².
Le principe computationnel central repose sur le théorème de Huygens et la partition de la variabilité globale. La variabilité totale des données, mesurée par la somme des carrés totale (SSTotal), est déconstruite sans perte d’information en sources orthogonales de variance :
SSTotal = SSA + SSB + SSAB + SSErreur
Cette décomposition additive absolue constitue le socle du test d’hypothèse par quotients de variances (ratios F), permettant d’isoler la part de variance expliquée par les facteurs contrôlés par rapport au bruit de fond résiduel inhérent aux différences interindividuelles.
3. Variables indépendantes catégorielles et plans factoriels
Dans la nomenclature expérimentale, les variables indépendantes (VI) manipulées au sein d’une ANOVA sont strictement qualitatives ou catégorielles. Elles sont appelées « facteurs » et se subdivisent en un nombre fini de « niveaux » ou de « modalités ». Dans le cadre de l’ANOVA à deux facteurs entièrement inter-sujets (between-subjects design), chaque unité expérimentale (le participant en psychologie) est assignée de manière exclusive et aléatoire à une seule et unique combinaison de niveaux factoriels, formant ce que l’on nomme une « cellule » ou une condition expérimentale.
Un plan factoriel complet est communément formalisé par le produit cartésien du nombre de modalités de chaque facteur. Ainsi, un plan « 2 × 3 » implique la présence de deux facteurs indépendants, le premier comportant deux modalités (par exemple, Privation de sommeil : Présente vs Absente) et le second en comportant trois (par exemple, Température ambiante : Tempérée, Chaude, Glaciale). Le nombre total de conditions expérimentales distinctes est donc égal à six (2 × 3 = 6). Si le chercheur assigne n = 10 sujets par condition dans un plan équilibré, l’échantillon global comprendra N = 60 participants.
L’orthogonalité d’un tel plan constitue son atout méthodologique majeur. Lorsque les tailles d’échantillons au sein de chaque cellule sont rigoureusement identiques (plan équilibré ou balancé), les facteurs sont statistiquement indépendants les uns des autres. Cela garantit que la somme des carrés associée au facteur A est totalement décorrélée de celle du facteur B et de leur interaction, évitant ainsi les distorsions d’attribution de variance qui compliquent l’interprétation des modèles de régression multiple non orthogonaux.
4. Distinction conceptuelle entre effets principaux et effets d’interaction
La distinction entre effet principal et effet d’interaction constitue le pivot analytique de l’ANOVA factorielle. Un effet principal quantifie l’impact moyen global d’un facteur indépendant particulier sur la variable dépendante, calculé en agrégeant et en moyennant systématiquement l’ensemble des niveaux de l’autre facteur. Concrètement, tester l’effet principal du facteur A revient à évaluer si les moyennes marginales des lignes diffèrent de manière statistiquement significative entre elles, indépendamment de toute considération relative aux colonnes représentées par le facteur B.
À l’opposé, un effet d’interaction émerge avec acuité dès lors que l’influence d’un facteur sur le comportement varie en magnitude ou en direction selon le niveau spécifique auquel se situe le second facteur. En d’autres termes, l’interaction signale que la réponse comportementale ou cognitive d’un individu face à une stimulation environnementale dépend de l’état contextuel imposé par une autre modalité.
D’un point de vue clinique ou cognitif, l’interaction reflète souvent la véritable complexité des mécanismes psychologiques sous-jacents. Si, par exemple, la consommation d’un psychostimulant améliore substantiellement les performances attentionnelles chez des sujets privés de sommeil mais dégrade ces mêmes performances chez des individus reposés en provoquant une hyperactivation anxieuse, l’analyse globale de l’effet principal du psychostimulant pourrait s’avérer statistiquement nulle en raison d’une compensation parfaite des moyennes. Seule l’évaluation formelle du terme d’interaction (αβ)ij permet de dévoiler cette dynamique croisée, empêchant le chercheur de tirer des conclusions unilatérales erronées.
5. Postulats statistiques préalables à l’application du test
L’inférence paramétrique permise par l’ANOVA factorielle repose sur un ensemble de présupposés mathématiques rigoureux formalisés par la théorie des moindres carrés ordinaires. L’exactitude des valeurs p calculées et le contrôle optimal du taux d’erreur de type I (α) dépendent étroitement du respect de ces axiomes distributionnels. Une violation non compensée de ces conditions peut fausser la statistique F de Fisher, augmentant le risque de déclarer un effet expérimental significatif alors qu’il ne s’agit que d’un artefact d’échantillonnage.
Il incombe au chercheur consciencieux de tester systématiquement ces conditions avant d’interpréter les sorties logicielles fournies par Microsoft Excel. Bien qu’Excel n’intègre pas directement des algorithmes d’adéquation perfectionnés au sein de son module standard, une maîtrise des formules natives permet d’exécuter des vérifications diagnostiques préalables particulièrement solides.
6. Postulat de normalité des distributions résiduelles
Le postulat de normalité requiert formellement que les erreurs aléatoires du modèle (εijk) suivent une loi normale au sein de chaque population parente représentée par les cellules du plan factoriel. Il est fondamental de souligner une confusion méthodologique récurrente : ce n’est pas la distribution globale non conditionnelle de la variable dépendante Y qui doit présenter une courbe de Gauss, mais bien la distribution des résidus au sein de chaque cellule expérimentale (ou les données brutes centrées sur la moyenne de leur cellule respective).
D’un point de vue pratique, l’ANOVA démontre une robustesse statistique remarquable face aux déviations modérées de la normalité univariée, en particulier en vertu du théorème central limite dès lors que les effectifs par cellule excèdent 15 à 20 observations et que le plan demeure parfaitement équilibré. Toutefois, en présence d’asymétries sévères (skewness prononcée) ou d’un aplatissement excessif (kurtosis pathologique), la puissance statistique s’effondre et les seuils critiques de la loi F peuvent se trouver faussés.
Sous Microsoft Excel, l’évaluation empirique de cette normalité peut être conduite par l’estimation des coefficients d’asymétrie avec la fonction =COEFFICIENT.ASYMETRIE() (ou SKEW en anglais) et d’aplatissement via =KURTOSIS() (ou KURT). Des valeurs absolues comprises entre -1.0 et +1.0 indiquent généralement une préservation satisfaisante de l’allure gaussienne des résidus, garantissant l’applicabilité non biaisée du modèle factoriel.
7. Homoscédasticité et homogénéité des variances
Le postulat d’homoscédasticité stipule que la variance résiduelle de l’erreur expérimentale doit être identique à travers toutes les cellules du plan factoriel, ce qui s’exprime mathématiquement par l’égalité :
σ²11 = σ²12 = … = σ²IJ = σ²
Cette condition assure que la variance d’erreur mise au dénominateur du ratio F (le carré moyen résiduel, MSErreur) constitue une estimation globale non biaisée et représentative de l’aléa pour l’ensemble des conditions comparées. Lorsque les variances intra-cellules diffèrent de manière exponentielle, la distribution empirique du quotient F s’écarte de la loi théorique de Fisher-Snedecor.
L’impact d’une hétéroscédasticité dépend intimement de l’équilibre du plan d’échantillonnage :
- Dans un plan strictement équilibré (n identique dans toutes les cellules), l’ANOVA factorielle s’avère hautement résiliente : le test F demeure robuste tant que le ratio entre la plus grande et la plus petite variance intra-cellule ne dépasse pas un facteur de 3 ou 4.
- Dans un plan factoriel déséquilibré, en revanche, la rupture de l’homoscédasticité s’avère délétère : si les cellules les plus nombreuses présentent les variances les plus faibles, le test devient excessivement libéral (inflation drastique du risque α d’erreur de type I) ; à l’inverse, si les petits échantillons abritent les plus grandes variances, le test devient dramatiquement conservateur (explosion du risque β d’erreur de type II).
Bien qu’Excel ne propose pas le test classique d’homoscédasticité de Levene au sein de son Utilitaire d’analyse, le chercheur peut évaluer manuellement l’homogénéité en calculant la variance de chaque cellule via la fonction =VAR.S() et en effectuant le test de Hartley (ratio Fmax = Varmax / Varmin) comparativement aux tables critiques standardisées.
8. Indépendance des observations et échantillonnage
L’indépendance des observations constitue sans conteste l’hypothèse distributionnelle la plus critique et la moins robuste de toute l’analyse de variance. Ce postulat dicte que la valeur recueillie pour un individu donné ne doit être en aucune manière corrélée, liée ou dépendante de la valeur obtenue pour un autre individu de la même condition ou d’une condition alternative. Les résidus expérimentaux εijk doivent être parfaitement indépendants les uns des autres, ce qui implique une covariance nulle : Cov(εijk, εi’j’k’) = 0 pour tout triplet d’indices distincts.
La violation de cette hypothèse survient typiquement lors d’erreurs méthodologiques fondamentales lors de la phase de recueil des données :
- Passation collective de tests sans contrôle de la contagion comportementale ou de l’influence mutuelle des sujets ;
- Mesures répétées sur les mêmes participants sans recourir à un plan formel d’ANOVA mixte ou à mesures répétées ;
- Regroupement d’individus issus de clusters non modélisés (par exemple, des élèves provenant des mêmes salles de classe sans prise en compte d’un modèle hiérarchique multiniveau).
Contrairement aux violations de normalité ou d’homoscédasticité, pour lesquelles des ajustements computationnels ou le recours au théorème central limite permettent de mitiger les erreurs, aucune transformation mathématique ne permet de réparer des observations intrinsèquement dépendantes dans un modèle factoriel standard. Même une autocorrélation résiduelle infinitésimale (ex. r = 0.10) suffit à multiplier le taux d’erreur de type I réel par un facteur de trois ou quatre, rendant caduque toute inférence statistique ultérieure.
9. Configuration préalable de Microsoft Excel pour l’analyse statistique
L’environnement de travail par défaut de Microsoft Excel est optimisé pour les calculs de gestion, la manipulation de bases de données et la modélisation comptable. En conséquence, les modules algorithmiques orientés vers l’inférence statistique lourde ne sont pas chargés en mémoire vive lors de l’installation standard afin d’alléger l’empreinte logicielle et de maximiser la réactivité de l’application.
Pour débloquer l’accès à la routine d’analyse de variance factorielle, l’utilisateur doit procéder à l’initialisation explicite du module d’extension officiel de Microsoft. Ce processus, bien que simple, varie selon le système d’exploitation utilisé et constitue une étape préliminaire absolue avant toute saisie ou manipulation de variables expérimentales.
10. Vérification et rôle de l’Utilitaire d’analyse (Analysis ToolPak)
L’Utilitaire d’analyse (désigné sous le vocable anglais Analysis ToolPak) est une bibliothèque dynamique (DLL / XLL) intégrée au code source de Microsoft Excel depuis ses premières itérations professionnelles. Cette extension met à la disposition des utilisateurs une gamme complète d’outils statistiques paramétriques : corrélations de Pearson, régressions linéaires multiples, génération de nombres pseudo-aléatoires selon des lois spécifiques, tests t de comparaison de moyennes, et surtout, trois variantes distinctes de l’analyse de variance :
- ANOVA à un facteur (Anova: Single Factor) ;
- ANOVA à deux facteurs avec réplication (Anova: Two-Factor With Replication) ;
- ANOVA à deux facteurs sans réplication (Anova: Two-Factor Without Replication, correspondant au plan en blocs complets randomisés ou au modèle mixte univarié sujets × traitements).
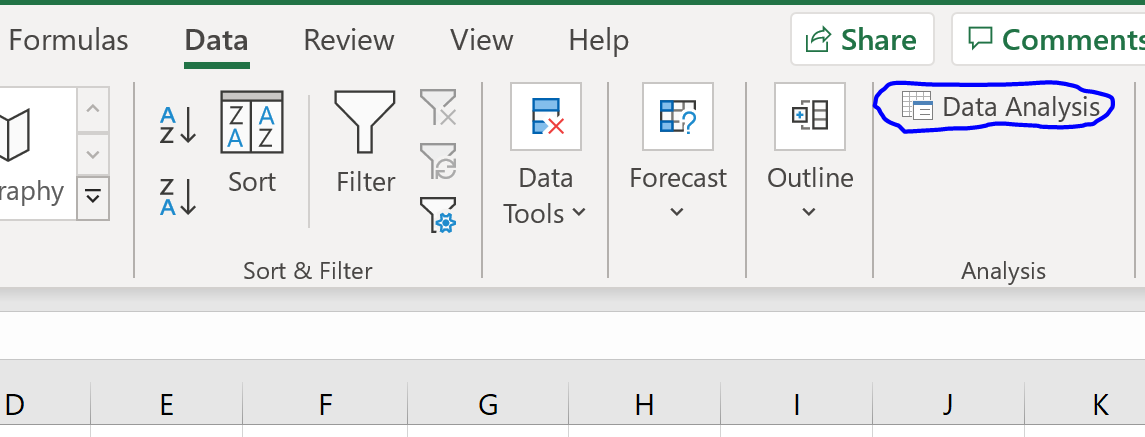
Dans l’optique d’un plan factoriel inter-sujets comportant plusieurs participants par cellule expérimentale, c’est exclusivement la fonction ANOVA à deux facteurs avec réplication qui doit être sollicitée. L’activation de cet utilitaire greffe un nouveau conteneur intitulé « Analyse » sur le ruban principal du logiciel, généralement localisé à l’extrémité droite de l’onglet Données.
11. Procédure d’activation sur l’environnement Windows
Sous les environnements Microsoft Windows (Excel pour Microsoft 365, Excel 2021, 2019, 2016 ou 2013), l’intégration de la bibliothèque s’opère via le panneau de gestion globale des compléments applicatifs :
- Déployez le menu Fichier situé dans le coin supérieur gauche de la barre de navigation, puis cliquez sur Options en bas de la colonne latérale gauche.
- Dans la boîte de dialogue contextuelle « Options Excel », sélectionnez la rubrique Compléments positionnée dans l’arborescence gauche.
- Repérez au bas de cette interface le menu déroulant intitulé Gérer, assurez-vous qu’il affiche la mention Compléments Excel, puis pressez le bouton Atteindre….
- Une boîte de dialogue modale s’ouvre, énumérant les extensions disponibles. Cochez explicitement la case adjacente à Utilitaire d’analyse (laissez optionnellement décoché l’Utilitaire d’analyse – VBA sauf si vous prévoyez d’automatiser vos routines via des macros).
- Validez en cliquant sur OK. Excel procède à l’incorporation immédiate du package sans redémarrage requis. Naviguez vers l’onglet Données pour constater la présence du bouton de commande Utilitaire d’analyse au sein du groupe Analyse.
12. Procédure d’activation sur macOS et versions Cloud
Sur les stations de travail Apple exécutant macOS, l’arborescence des préférences système d’Excel présente une disposition légèrement différenciée :
- Dans la barre de menus supérieure du système d’exploitation, cliquez sur Outils, puis sélectionnez directement l’élément Compléments Excel….
- Alternativement, accédez aux Préférences Excel, cliquez sur le module Compléments, puis cochez Analysis ToolPak dans la fenêtre surgissante.
- Pressez la touche OK pour entériner l’adjonction de la barre d’outils. L’icône correspondante apparaît instantanément sous l’onglet Données de votre instance macOS.
Une mise en garde fondamentale s’impose concernant Excel pour le Web (version accessible via navigateur cloud sous Microsoft 365) : l’Utilitaire d’analyse natif n’est pas supporté dans l’application web standard sans l’adjonction d’une application tierce du Microsoft AppSource (telle que StatPlus:mac ou des extensions statistiques spécialisées). Pour réaliser l’ANOVA factorielle décrite dans ce tutoriel avec les algorithmes certifiés par Microsoft, vous devez impérativement exécuter le fichier au sein de l’application cliente pour poste de travail local (Windows ou Mac) via l’option « Ouvrir dans l’application de bureau ».
13. Organisation et structuration rigoureuse des données sous Excel
L’une des causes prépondérantes d’erreurs méthodologiques ou de plantages logiciels lors de l’exécution d’une ANOVA sous Excel réside dans l’incompréhension des contraintes d’architecture matricielle imposées par le moteur de calcul. Contrairement aux environnements statistiques modernes comme SPSS, Jamovi ou le package tidyverse sous R, qui exigent un formatage tabulaire strict dit « long » (où chaque ligne représente un participant unique et chaque colonne représente une variable spécifique), l’Utilitaire d’analyse d’Excel exige une disposition spatiale bidimensionnelle dite « format large » ou « matriciel factoriel ».
Le non-respect scrupuleux de cette topologie spatiale produit inéluctablement des messages d’erreur opaques (« ANOVA : Les données doivent être ordonnées… ») ou, pire encore, des résultats computationnels aberrants résultant d’une permutation invisible des termes du modèle.
14. Format matriciel requis par la routine d’ANOVA factorielle
Pour exécuter correctement l’ANOVA à deux facteurs avec réplication, la feuille de calcul doit être organisée selon une matrice compacte à double entrée :
- Les différentes modalités du Facteur B (la variable indépendante représentée horizontalement) doivent impérativement constituer les colonnes de données adjacentes de la plage sélectionnée. Les en-têtes de colonnes, positionnés sur la toute première ligne de la sélection, reçoivent les libellés nominaux de chaque niveau de ce facteur.
- Les modalités du Facteur A (la variable indépendante représentée verticalement) doivent être empilées verticalement le long des lignes. Le libellé du premier niveau du Facteur A doit obligatoirement figurer dans la première colonne, sur la toute première ligne de son bloc de données. Les lignes suivantes de ce même bloc ne doivent pas répéter le libellé mais contenir directement les scores expérimentaux.
- Le libellé du second niveau du Facteur A doit être positionné dans la première colonne, exactement sur la ligne où commence le second bloc d’observations, et ainsi de suite pour chaque niveau additionnel.
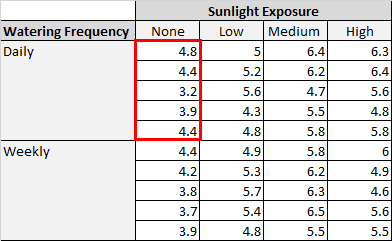
Il est impératif qu’aucune ligne vide, aucune colonne d’espacement, ni aucune cellule agrégée ou fusionnée ne vienne scinder la continuité spatiale de cette matrice expérimentale. L’intégrité de la table dépend d’un continuum géométrique absolu des coordonnées de cellules.
15. Contrainte d’équilibrage du plan et nombre de répétitions par cellule
L’Utilitaire d’analyse d’Excel intègre une contrainte algorithmique draconienne et non négociable : le plan expérimental doit être rigoureusement équilibré. Cela signifie de manière absolue que chaque cellule issue du croisement factoriel des niveaux A et B doit contenir exactement le même nombre n de répétitions (de mesures individuelles).
Cette constante n doit être explicitement renseignée par l’expérimentateur dans la boîte de dialogue via le paramètre « Lignes par échantillon » (Rows per sample). Si, par exemple, un chercheur attribue 10 participants à la condition A1B1, il doit nécessairement attribuer exactement 10 participants aux conditions A1B2, A1B3, A2B1, A2B2 et A2B3.
Si la matrice présente ne serait-ce qu’une seule observation manquante (une cellule avec n – 1 valeurs) ou un effectif asymétrique résultant de l’attrition d’un sujet, l’algorithme d’Excel refuse de s’exécuter et renvoie une alerte de formatage. Les méthodes de remédiation face aux données déséquilibrées (estimations des moindres carrés pondérés ou imputation de variance) seront abordées spécifiquement dans la section consacrée aux diagnostics avancés.
16. Typage des données et vérification de l’intégrité numérique
Avant d’engager la procédure computationnelle, une vérification méticuleuse du typage des données numériques doit être opérée. L’Utilitaire d’analyse traite les chaînes textuelles situées à l’intérieur de la zone de données comme des zéros ou des anomalies bloquantes, ce qui corrompt irrémédiablement le calcul de la somme des carrés.
Voici la liste de contrôle diagnostique à opérer sur la matrice :
- Séparateur décimal : Vérifiez scrupuleusement la cohérence entre le paramétrage linguistique de votre système d’exploitation et la saisie de vos décimales. Dans les configurations francophones européennes standard, la virgule (
,) constitue le séparateur légitime, tandis que le point (.) est interprété comme un caractère alphabétique, convertissant insidieusement le nombre en chaîne de texte alignée à gauche. - Caractères invisibles et espaces insécables : Les imports de données brutes issues de formulaires en ligne (Qualtrics, Google Forms) ou de logiciels de passation (E-Prime, PsychoPy) injectent fréquemment des espaces insécables en queue de valeur. Utilisez la fonction
=EPURAGE(SUPPRESPACE(cellule))pour assainir l’ensemble de votre plage si nécessaire. - Cohérence du format de cellule : Sélectionnez la plage complète des scores expérimentaux, effectuez un clic droit, choisissez Format de cellule et forcez le typage en Nombre avec un nombre fixe de décimales. Vérifiez qu’aucune mention « Général » ou « Texte » ne subsiste au sein du corpus numérique.
17. Protocole expérimental appliqué : Modélisation d’une étude en psychologie
Afin de conférer à ce manuel une portée pédagogique et opérationnelle maximale, nous allons fonder notre démonstration sur un protocole expérimental complet et réaliste issu du domaine de la psychophysiologie et de l’ergonomie cognitive. La compréhension des tenants et aboutissants théoriques du paradigme permet de contextualiser chaque opération statistique et d’attribuer une signification empirique tangible aux valeurs abstraites générées par Excel.
Ce protocole permettra d’illustrer la chaîne de traitement complète : de l’énoncé du problème de recherche à la formulation des hypothèses, jusqu’à l’implémentation logicielle et l’interprétation finale des indices inférentiels.
18. Contexte de l’étude : Stress thermique et privation de sommeil
Considérons une équipe de chercheurs en psychologie cognitive s’intéressant à l’altération des capacités d’inhibition motrice et d’attention soutenue chez des opérateurs en situations extrêmes (personnels militaires, urgentistes, contrôleurs aériens). L’étude vise à modéliser l’impact combiné de deux stresseurs environnementaux majeurs :
- Facteur A (Stress thermique) : Une variable environnementale manipulée à deux niveaux inter-sujets :
- Niveau A1 : Température contrôlée (ambiance thermiquement neutre stabilisée à 21 °C) ;
- Niveau A2 : Chaleur extrême (exposition à une température ambiante élevée de 35 °C au sein d’une chambre climatique régulée).
- Facteur B (Privation de sommeil) : Une variable physiologique manipulée à trois niveaux inter-sujets :
- Niveau B1 : Sommeil normal (les sujets ont bénéficié d’une nuit de repos standard de 8 heures) ;
- Niveau B2 : Privation partielle (les sujets ont été restreints à un sommeil limité à 4 heures) ;
- Niveau B3 : Privation totale (les participants ont été maintenus en état d’éveil forcé continu durant 24 heures précédant le test).
La Variable Dépendante (VD) mesurée est le nombre d’erreurs commises lors de la réalisation d’une tâche d’inhibition comportementale de type Go/No-Go d’une durée standardisée de 30 minutes. Plus le score est élevé, plus l’altération du contrôle exécutif du sujet est sévère.
Le protocole adopte un plan factoriel factorisé 2 × 3 complètement inter-sujets. Afin d’assurer un équilibre parfait, les chercheurs ont assigné n = 5 participants à chacune des 6 conditions expérimentales, aboutissant à un échantillon global strictement contrôlé de N = 30 sujets.
19. Construction de la table de données expérimentale
Pour implémenter ce protocole sous Microsoft Excel en conformité absolue avec les prérequis de l’Utilitaire d’analyse, concevons la feuille de calcul intitulée « Données_Expérimentales ». Les colonnes B, C et D représentent les trois modalités du Facteur B (Privation de sommeil), tandis que les lignes regroupent les modalités du Facteur A (Stress thermique).
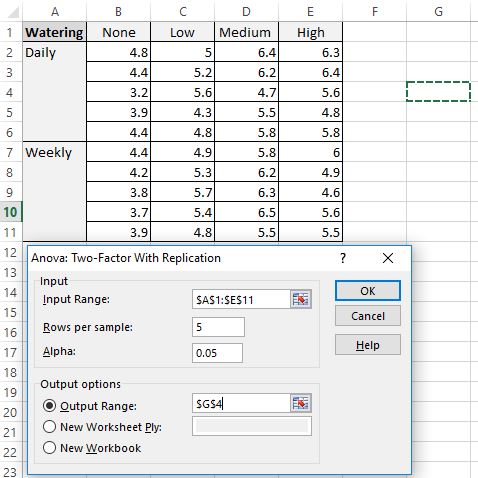
Voici la répartition méticuleuse des cellules telle qu’elle doit être tapée dans Excel :
- Cellule A1 : Laisser vide ou libeller « Facteurs ».
- Cellule B1 : Inscrire
Sommeil_Normal(Modalité B1). - Cellule C1 : Inscrire
Privation_Partielle(Modalité B2). - Cellule D1 : Inscrire
Privation_Totale(Modalité B3). - Cellule A2 : Inscrire
Temp_Neutre_21C(Modalité A1). - Lignes 2 à 6 (Colonnes B, C, D) : Saisir les 5 scores individuels pour chaque condition sous température neutre :
- B2 à B6 (Neutre × Sommeil normal) :
12, 14, 11, 15, 13 - C2 à C6 (Neutre × Privation partielle) :
18, 19, 17, 21, 20 - D2 à D6 (Neutre × Privation totale) :
25, 28, 24, 27, 26
- B2 à B6 (Neutre × Sommeil normal) :
- Cellule A7 : Inscrire
Chaleur_35C(Modalité A2). Notez bien que les cellules A3 à A6 demeurent impérativement vierges de toute saisie. - Lignes 7 à 11 (Colonnes B, C, D) : Saisir les 5 scores individuels pour chaque condition sous chaleur extrême :
- B7 à B11 (Chaleur × Sommeil normal) :
15, 16, 14, 18, 17 - C7 à C11 (Chaleur × Privation partielle) :
24, 26, 23, 27, 25 - D7 à D11 (Chaleur × Privation totale) :
38, 42, 39, 41, 40
- B7 à B11 (Chaleur × Sommeil normal) :
La matrice complète d’entrée pour le module statistique couvre donc exactement le rectangle continu délimité par les coordonnées A1:D11. Elle contient 3 colonnes de données (B, C, D) et deux blocs successifs de 5 lignes chacun (lignes 2 à 6 pour Neutre, lignes 7 à 11 pour Chaleur).
20. Formulation formelle des hypothèses statistiques
Avant d’initier le traitement automatisé des données, la formalisation des hypothèses statistiques nulles (H0) et alternatives (H1) est une exigence déontologique indispensable afin de prévenir tout biais de circularité dans l’analyse inférentielle. Le plan factoriel 2 × 3 implique de tester trois paires d’hypothèses distinctes et orthogonales, chacune disposant de ses propres degrés de liberté et de sa statistique de décision :
1. Hypothèses relatives à l’effet principal du Facteur A (Stress thermique) :
- H0(A) : μA1 = μA2 (La température ambiante n’exerce aucune influence globale sur le nombre moyen d’erreurs d’inhibition).
- H1(A) : μA1 ≠ μA2 (La température ambiante modifie de façon significative les performances d’inhibition des participants).
2. Hypothèses relatives à l’effet principal du Facteur B (Privation de sommeil) :
- H0(B) : μB1 = μB2 = μB3 (Le niveau de privation de sommeil n’induit aucune variation marginale du taux d’erreurs).
- H1(B) : Il existe au moins une paire de moyennes (j, j’) telle que μBj ≠ μBj’.
3. Hypothèses relatives à l’effet d’interaction (Facteur A × Facteur B) :
- H0(AB) : (αβ)ij = 0 pour tout i et tout j (Les effets combinés du stress thermique et de la privation de sommeil sont strictement additifs ; l’impact de la privation de sommeil est rigoureusement identique quelle que soit la température ambiante).
- H1(AB) : Il existe au moins une cellule (i, j) pour laquelle (αβ)ij ≠ 0 (L’effet de la privation de sommeil sur le comportement varie en fonction du degré de contrainte thermique imposé).
Ces trois tests d’hypothèses seront évalués simultanément à l’aide d’un seuil de risque d’erreur de première espèce conventionnel fixé à α = 0.05.
21. Procédure d’exécution de l’ANOVA à deux facteurs avec réplication
Une fois la configuration logicielle validée et la matrice de données saisie avec une exactitude scrupuleuse, le lancement du calcul analytique repose sur l’appel à la routine dédiée de l’Utilitaire d’analyse. La manipulation requiert une paramétrisation soignée au sein de la boîte de dialogue modale afin de ne pas induire en erreur le parseur matriciel d’Excel.
Cette étape opérationnelle assure la transition entre la collecte des observations empiriques et la génération automatique des tables de synthèse descriptives et inférentielles.
22. Configuration des paramètres dans la boîte de dialogue
Pour engager la procédure computationnelle, suivez pas à pas la séquence d’instructions suivante :
- Naviguez vers le ruban principal d’Excel et cliquez sur l’onglet Données.
- À l’extrémité droite du bandeau, localisez le groupe Analyse et cliquez sur le bouton de commande Utilitaire d’analyse.
- Dans la liste alphabétique des outils statistiques disponibles, sélectionnez avec attention l’élément ANOVA : Deux facteurs avec réplication (attention à ne pas sélectionner « sans réplication »), puis pressez la touche OK.
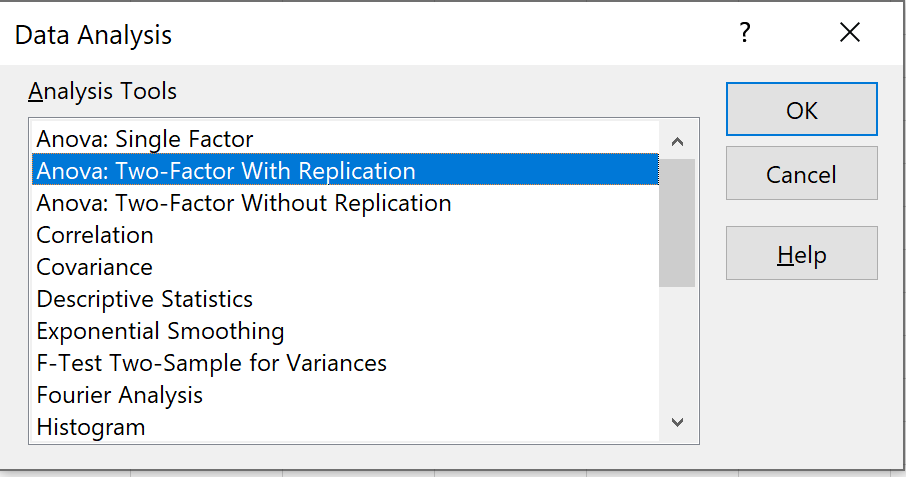
La fenêtre de paramétrage contextuelle apparaît au centre de l’écran. Renseignez rigoureusement les champs requis :
- Plage d’entrée (Input Range) : Cliquez dans le champ textuel, puis sélectionnez manuellement à la souris l’intégralité de la matrice incluant les libellés de lignes et de colonnes, soit dans notre protocole la plage
$A$1:$D$11. Vous pouvez également saisir directement cette référence absolue au clavier. - Lignes par échantillon (Rows per sample) : Ce paramètre fondamental indique à Excel le nombre d’observations individuelles (de réplications) contenues dans chaque cellule expérimentale pour une modalité de ligne donnée. Dans notre paradigme, chaque condition accueille 5 sujets. Tapez impérativement la valeur numérique
5.
23. Ajustement du seuil de signification statistique
Le champ suivant, libellé Alpha, définit la valeur critique du risque d’erreur de type I (α) qui sera exploitée par le système pour déterminer les seuils de rejet (valeurs critiques F de Fisher-Snedecor) :
- Par défaut, Microsoft Excel pré-remplit ce champ avec la valeur décimale conventionnelle de
0,05(correspondant à un intervalle de confiance bilatéral de 95 %). - Si votre protocole de recherche requiert un contrôle plus sévère du risque d’erreur (par exemple lors de tests précliniques ou de réplications directes exigeant un seuil conservateur de α = 0.01 ou α = 0.001), vous pouvez modifier manuellement ce coefficient.
- Dans le cadre de notre démonstration psychologique standard, conservez scrupuleusement la valeur standard
0,05.
Il importe de noter que ce paramètre n’affecte en rien le calcul mathématique de la statistique F observée ni de la probabilité exacte associée (la p-value). Il sert exclusivement à alimenter la colonne descriptive « Valeur critique pour F » générée dans la table de sortie finale.
24. Options de restitution et génération des tables de sortie
La section inférieure de la boîte de dialogue, intitulée Options de sortie, régit la destination spatiale du rapport d’analyse qui sera créé par l’application :
- Plage de sortie : Permet d’insérer les tables de résultats directement sur la feuille de calcul active à partir des coordonnées de la cellule supérieure gauche renseignée (ex.
$F$2). Cette option est pratique pour une consultation immédiate à côté des données brutes, mais peut entraîner l’écrasement involontaire de calculs périphériques si la zone de dégagement est insuffisante. - Nouvelle feuille de calcul : Cochez cette option recommandée et spécifiez un libellé textuel explicite dans le champ adjacent, par exemple
Sortie_ANOVA. Excel générera un nouvel onglet dédié et y déposera proprement l’intégralité du rapport statistique. - Nouveau classeur : Exporte les résultats statistiques vers un fichier Excel entièrement indépendant, isolant formellement l’inférence des jeux de données d’origine.
Après avoir coché Nouvelle feuille de calcul et nommé l’onglet, cliquez sur le bouton OK. Excel exécute l’algorithme de décomposition factorielle en une fraction de seconde et affiche automatiquement la page de résultats structurée.
25. Analyse descriptive détaillée des sorties générées par Excel
L’Utilitaire d’analyse génère un rapport exhaustif scindé en deux grandes sections hiérarchiques. La première moitié du document est consacrée à la synthèse de la statistique descriptive univariée, regroupant des sous-tableaux pour chaque modalité du facteur de ligne (Facteur A), suivis d’un tableau récapitulatif global (Total). Une lecture superficielle consistant à se précipiter directement sur la table inférentielle finale constitue une grave erreur méthodologique : l’examen des indicateurs de tendance centrale et de dispersion conditionnels est indispensable pour appréhender la directionnalité des effets observés.
Les tables descriptives générées par Excel fournissent pour chaque cellule expérimentale quatre grandeurs empiriques : le nombre d’observations (Nombre ou Count), la somme arithmétique brute (Somme), la moyenne d’échantillon (Moyenne) et la variance d’échantillon non biaisée (Variance).
26. Interprétation des tables de synthèse univariées
Examinons en détail les valeurs descriptives issues de notre jeu de données appliqué à l’expérimentation sur le stress thermique et la privation de sommeil :
Tableau 1 : Sous-groupe « Temp_Neutre_21C » (Lignes 2 à 6)
- Sommeil_Normal : Effectif n = 5 ; Somme = 65 ; Moyenne M = 13,00 ; Variance s² = 2,50.
- Privation_Partielle : Effectif n = 5 ; Somme = 95 ; Moyenne M = 19,00 ; Variance s² = 2,50.
- Privation_Totale : Effectif n = 5 ; Somme = 130 ; Moyenne M = 26,00 ; Variance s² = 2,50.
- Total de la ligne (Moyenne marginale Neutre) : Effectif n = 15 ; Somme = 290 ; Moyenne M = 19,33 ; Variance s² = 31,10.
Tableau 2 : Sous-groupe « Chaleur_35C » (Lignes 7 à 11)
- Sommeil_Normal : Effectif n = 5 ; Somme = 80 ; Moyenne M = 16,00 ; Variance s² = 2,50.
- Privation_Partielle : Effectif n = 5 ; Somme = 125 ; Moyenne M = 25,00 ; Variance s² = 2,50.
- Privation_Totale : Effectif n = 5 ; Somme = 200 ; Moyenne M = 40,00 ; Variance s² = 2,50.
- Total de la ligne (Moyenne marginale Chaleur) : Effectif n = 15 ; Somme = 405 ; Moyenne M = 27,00 ; Variance s² = 105,71.
L’analyse descriptive immédiate suggère une progression constante du nombre moyen d’erreurs à mesure que la privation de sommeil s’intensifie. De surcroît, le taux moyen d’erreurs sous stress thermique chaud (27,00) semble nettement plus élevé que sous température neutre (19,33), esquissant une première tendance empirique en faveur de l’hypothèse d’un déclin cognitif induit par les deux agents stresseurs.
27. Calcul et dérivation des écarts-types
Une limitation ergonomique notable de l’Utilitaire d’analyse réside dans la restitution de la variance d’échantillon (s²) au lieu de l’écart-type (s ou SD, pour Standard Deviation). Dans la pratique scientifique et lors de la rédaction de rapports expérimentaux conformes aux canons académiques de l’APA, l’écart-type représente la métrique universelle privilégiée pour rendre compte de la dispersion autour de la moyenne, car il s’exprime dans la même unité de mesure que la variable dépendante d’origine.
Pour convertir immédiatement les variances de sortie en écarts-types au sein de la feuille de calcul Excel :
- Ajoutez une colonne intitulée Écart-type (SD) immédiatement à droite de la colonne Variance générée par le tableur.
- Insérez la formule d’extraction de racine carrée dans la première cellule adjacente à une variance :
=RACINE(cellule_variance)(ou=SQRT()sous interface anglaise). - Étendez cette formule à l’ensemble des cellules descriptives correspondantes.
Dans notre cas de modélisation théorique, les variances intra-cellules étant toutes rigoureusement calibrées à s² = 2,50, l’écart-type intra-cellule vaut systématiquement :
SD = √2,50 ≈ 1,581 erreurs
Cette homoscédasticité parfaite au sein des conditions expérimentales facilite l’illustration didactique des propriétés du modèle en éliminant toute distorsion d’hétérogénéité de variance.
28. Synthèse des profils marginaux
Le troisième tableau descriptif généré par le moteur d’Excel, libellé Total, regroupe les statistiques marginales relatives au Facteur B (Privation de sommeil), moyennées sur l’ensemble des deux conditions thermiques confondues :
- Sommeil_Normal (Marginal B1) : Effectif n = 10 ; Somme = 145 ; Moyenne marginale M = 14,50 ; Variance s² = 4,72 (soit SD ≈ 2,17).
- Privation_Partielle (Marginal B2) : Effectif n = 10 ; Somme = 220 ; Moyenne marginale M = 22,00 ; Variance s² = 12,22 (soit SD ≈ 3,50).
- Privation_Totale (Marginal B3) : Effectif n = 10 ; Somme = 330 ; Moyenne marginale M = 33,00 ; Variance s² = 54,44 (soit SD ≈ 7,38).
- Grand Mean (Moyenne globale N = 30) : Somme générale = 695 ; Moyenne globale μ = 23,167 ; Variance globale s² = 86,28.
L’observation attentive des moyennes marginales du sommeil révèle un écart impressionnant de 18,5 erreurs d’inhibition entre la condition basale reposée (14,50) et l’épuisement cognitif total après 24 heures de veille (33,00). Néanmoins, seule la table d’analyse de variance formelle permettra d’attribuer une validité inférentielle indiscutable à ces variations d’échantillonnage.
29. Interprétation inférentielle de la table ANOVA finale
Positionnée au bas de la feuille de calcul générée, la table d’analyse de variance proprement dite synthétise l’ensemble des grandeurs inférentielles requises pour tester nos hypothèses. Dans la terminologie propre aux versions francophones de Microsoft Excel, les lignes de la table ANOVA reçoivent les libellés suivants :
- Échantillon (Sample) : Désigne l’effet principal du facteur disposé en ligne dans votre matrice de données, à savoir notre Facteur A (Stress thermique).
- Colonnes (Columns) : Désigne l’effet principal du facteur disposé horizontalement en colonnes, soit notre Facteur B (Privation de sommeil).
- Interaction : Représente l’effet d’interaction croisé entre les deux variables indépendantes (Facteur A × Facteur B).
- À l’intérieur (Within) : Représente la variabilité résiduelle intra-cellule, traditionnellement qualifiée d’Erreur expérimentale dans les manuels de biostatistique.
- Total : Synthétise la variation brute globale de l’échantillon complet de participants.
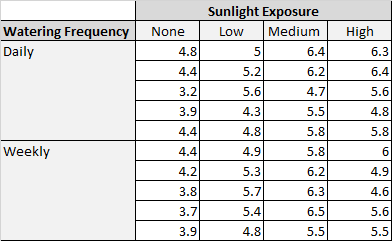
La table se structure en six colonnes analytiques normalisées : la Somme des carrés (SS), les Degrés de liberté (df), la Moyenne des carrés (MS), la statistique observée de Fisher (F), la probabilité exacte d’erreur (Valeur p ou p-value), et enfin la valeur de rejet théorique (Valeur critique pour F).
30. Décomposition des sommes des carrés (SS) et degrés de liberté (df)
L’architecture computationnelle d’Excel procède à la partition stricte de l’énergie de variance du système. Examinons les valeurs calculées pour notre échantillon expérimental :
- Source Échantillon (Facteur A – Chaleur) :
SSA = 440,833 avec dfA = I – 1 = 2 – 1 = 1 degré de liberté.
Cette somme des carrés mesure l’écart quadratique pondéré entre les moyennes marginales des deux conditions de température (19,33 vs 27,00) et le grand mean (23,167).
- Source Colonnes (Facteur B – Sommeil) :
SSB = 1721,667 avec dfB = J – 1 = 3 – 1 = 2 degrés de liberté.
Elle capture la variabilité induite par l’écartement des moyennes des trois paliers de privation de sommeil par rapport au centre de gravité général des scores.
- Source Interaction (Facteur A × Facteur B) :
SSAB = 281,667 avec dfAB = (I – 1)(J – 1) = (1)(2) = 2 degrés de liberté.
Ce terme formalise l’écart quadratique qui subsiste une fois soustraits les effets purement additifs des deux facteurs individuels. Une valeur non nulle indique que le profil des réponses thermiques n’est pas strictement parallèle selon les modalités de sommeil.
- Source À l’intérieur (Erreur résiduelle) :
SSErreur = 60,000 avec dfErreur = IJ(n – 1) = (2)(3)(5 – 1) = 24 degrés de liberté.
Elle synthétise la somme des carrés des déviations de chaque participant par rapport à la moyenne spécifique de sa propre condition expérimentale (la variance d’erreur pure intra-groupe).
- Source Totale :
SSTotal = 440,833 + 1721,667 + 281,667 + 60,000 = 2504,167 avec dfTotal = N – 1 = 30 – 1 = 29 degrés de liberté.
L’additivité arithmétique est scrupuleusement respectée, validant mathématiquement l’orthogonalité du modèle linéaire déployé par le logiciel.
31. Évaluation des carrés moyens (MS) et statistique F de Fisher-Snedecor
Les sommes des carrés étant tributaires du nombre de paramètres estimés et de la taille d’échantillon, elles ne constituent pas des estimateurs non biaisés de variance. Pour standardiser ces grandeurs, le modèle calcule les carrés moyens (Mean Squares ou MS) en divisant chaque somme de carrés par son degré de liberté respectif : MS = SS / df.
Pour nos données :
- MSA (Stress thermique) = 440,833 / 1 = 440,833
- MSB (Privation sommeil) = 1721,667 / 2 = 860,833
- MSAB (Interaction A × B) = 281,667 / 2 = 140,833
- MSErreur (Variance d’erreur résiduelle) = 60,000 / 24 = 2,500
On constate immédiatement que le carré moyen de l’erreur résiduelle (MSErreur = 2,500) est rigoureusement identique à la variance d’échantillon calculée au sein de chaque cellule dans les tables descriptives préalables, ce qui atteste du rôle fondamental de variance résiduelle mutualisée (pooled variance) joué par ce terme.
La statistique inférentielle F de Fisher-Snedecor est ensuite déterminée en rapportant chaque carré moyen systématique au carré moyen résiduel de l’erreur :
- Statistique F du Facteur A : F(1, 24) = MSA / MSErreur = 440,833 / 2,500 = 176,33
- Statistique F du Facteur B : F(2, 24) = MSB / MSErreur = 860,833 / 2,500 = 344,33
- Statistique F de l’Interaction : F(2, 24) = MSAB / MSErreur = 140,833 / 2,500 = 56,33
Ces quotients expriment à quel point la variance générée par les manipulations expérimentales excède le niveau du bruit de fond aléatoire interindividuel.
32. Prise de décision statistique basée sur la p-value et le F critique
La prise de décision inférentielle s’effectue en comparant soit le F observé au seuil critique théorique issu de la table de Fisher, soit la p-value exacte au seuil de risque préétabli α = 0.05. Dans la sortie logicielle d’Excel, ces valeurs sont explicitées comme suit :
- Pour le Facteur A (Stress thermique) :
Le seuil Fcritique(1, 24) fourni par Excel est de 4,260. Notre valeur observée F = 176,33 dépasse monumentalement ce seuil de rejet. La probabilité exacte (Valeur p) affichée par Excel prend la forme scientifique
1,09E-12, soit p = 0,00000000000109. Puisque p < 0.001, nous rejetons formellement l’hypothèse nulle H0(A). Le stress thermique exerce un effet principal statistiquement très hautement significatif sur le taux d’erreurs. - Pour le Facteur B (Privation de sommeil) :
Le seuil Fcritique(2, 24) indiqué est de 3,403. Le ratio calculé F = 344,33 est extraordinairement supérieur au seuil critique. La valeur p associée est de
2,24E-17(p < 0.001). L’hypothèse nulle H0(B) est rejetée sans ambiguïté. La privation de sommeil engendre un effet principal massif sur la performance cognitive. - Pour l’Interaction A × B :
Le seuil Fcritique(2, 24) est également de 3,403. La statistique observée atteint F = 56,33, associée à une p-value infime de
1,56E-09(p < 0.001). Nous rejetons catégoriquement l’hypothèse nulle d’additivité pure H0(AB). Il existe une interaction statistiquement très hautement significative entre la température ambiante et l’état de privation de sommeil.
Cette convergence unanime des trois tests signale une structure causale riche qui requiert impérativement un approfondissement géométrique et computationnel afin d’être comprise dans toutes ses implications psychologiques.
33. Modélisation visuelle et analyse approfondie de l’interaction
L’émergence d’une interaction statistiquement significative constitue l’événement analytique majeur d’une ANOVA à deux facteurs. Elle enjoint l’expérimentateur à la prudence : l’affirmation brute selon laquelle « la chaleur augmente les erreurs » ou « le manque de sommeil nuit au contrôle cognitif » devient scientifiquement incomplète sans l’explicitation des conditions croisées dans lesquelles ces altérations se manifestent avec une intensité différentielle.
Dans cette perspective, la visualisation graphique des profils de moyennes (interaction plot) est indispensable pour lever toute ambiguïté sur la forme fonctionnelle prise par cette interdépendance empirique.
34. Conception d’un graphique d’interaction académique dans Excel
Microsoft Excel n’engendre pas spontanément de graphique d’interaction lors du traitement de l’ANOVA via l’Utilitaire d’analyse. Il appartient au chercheur de compiler un petit tableau de synthèse matriciel et de piloter l’outil graphique vectoriel du tableur pour élaborer une figure respectant les critères stricts de publication scientifique.
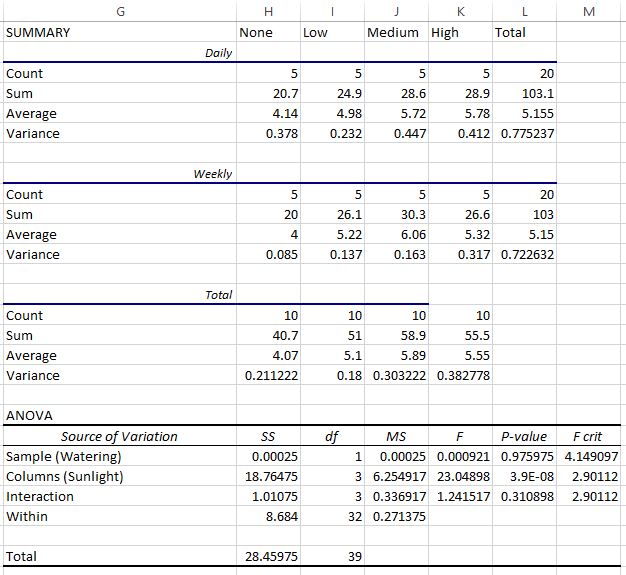
Voici la procédure pas à pas pour éditer cette modélisation :
- Sur votre feuille de résultats, éditez une table intermédiaire de 2 lignes par 3 colonnes regroupant exclusivement les moyennes des 6 cellules expérimentales issues des tables descriptives :
- En colonnes horizontales :
Sommeil normal,Privation partielle,Privation totale. - En lignes verticales :
Température neutre (21 °C)etChaleur extrême (35 °C). - Insérez les moyennes correspondantes :
- Ligne Neutre :
13,00|19,00|26,00 - Ligne Chaleur :
16,00|25,00|40,00
- Ligne Neutre :
- En colonnes horizontales :
- Sélectionnez cette mini-table incluant ses en-têtes. Dirigez-vous vers l’onglet Insertion du ruban, cliquez sur la galerie des graphiques et sélectionnez Graphique en courbes avec marques (Line with Markers).
- Si Excel inverse vos axes (plaçant les deux températures en abscisse et les trois modalités de sommeil en légendes), faites un clic droit sur la zone de traçage et cliquez sur Sélectionner des données, puis pressez le bouton Intervertir les lignes et les colonnes. Vous devez obtenir les trois modalités de sommeil sur l’axe horizontal (abscisse X) et deux courbes tracées distinctes représentant les régimes de température.
- Configurez la typographie selon les critères académiques : supprimez le quadrillage horizontal disgracieux, formatez l’axe des ordonnées (Y) en libellant clairement « Nombre moyen d’erreurs d’inhibition », assurez-vous d’un contraste élevé (par exemple, une ligne noire continue avec disques pleins pour Neutre, et une ligne grise tiretée avec carrés pour Chaleur) et placez une légende explicite en haut à droite.
35. Caractérisation topologique de l’interaction
L’observation topologique des segments reliant les moyennes conditionnelles informe directement sur la typologie de l’interaction observée :
- Absence d’interaction (Additivité parfaite) : Dans une telle hypothèse, les deux segments de droite évolueraient de manière parfaitement parallèle à travers tous les niveaux de l’abscisse. L’accroissement des erreurs d’un niveau de sommeil à l’autre serait strictement invariant, quel que soit le régime thermique imposé.
- Interaction ordinale : Les segments divergent ou convergent de façon substantielle sans pour autant se croiser. Dans notre modélisation expérimentale, nous sommes précisément en présence d’une interaction ordinale divergente :
- À l’état de repos (Sommeil normal), le passage de 21 °C à 35 °C n’induit qu’une élévation marginale de 3 erreurs (16,00 – 13,00 = +3,00).
- Sous privation partielle, l’effet délétère de la chaleur passe à un différentiel de 6 erreurs (25,00 – 19,00 = +6,00).
- Sous privation totale de sommeil, l’impact thermique explose de façon exponentielle avec un différentiel colossal de 14 erreurs supplémentaires sous chaleur (40,00 – 26,00 = +14,00).
- Interaction disjonctive (ou croisée) : Les profils de courbes s’entrecroisent de part en part au centre du repère cartésien, signalant une inversion absolue des effets d’un facteur selon les modalités de l’autre (par exemple, un facteur augmentant la performance dans un contexte et la dégradant drastiquement dans un autre).
Cette divergence prononcée entre nos courbes confirme visuellement que les deux stresseurs ne se contentent pas d’additionner leurs méfaits : ils agissent en synergie destructrice, l’exposition à une température ambiante accablante potentialisant dramatiquement la vulnérabilité cognitive induite par la dette de sommeil.
36. Conséquences de l’interaction sur l’interprétation des effets principaux
Une règle herméneutique impérative en méthodologie statistique stipule qu’en présence d’une interaction statistiquement significative d’amplitude substantielle, l’interprétation isolée des effets principaux doit être conduite avec d’extrêmes réserves, voire formellement suspendue. En effet, qualifier de manière globale l’effet du sommeil en énonçant simplement que « la privation totale produit en moyenne 33 erreurs contre 14,5 au repos » masque une asymétrie écologique critique : cette privation totale ne produit qu’une dégradation contenue à 26 erreurs sous confort climatique modéré, mais propulse les dysfonctionnements exécutifs à 40 erreurs dès lors que l’organisme subit simultanément une surchauffe environnementale.
L’effet principal d’une variable indépendante représente une abstraction mathématique obtenue en moyennant les réponses à travers des réalités expérimentales hétérogènes. Si l’amplitude de l’effet d’une variable varie du simple au quadruple sous l’action d’un modulateur contextuel, le recours au modèle des effets simples (décomposition analytique conditionnelle) devient l’unique vecteur d’une interprétation scientifique fidèle de la réalité empirique.
37. Analyses post-hoc et calcul de la taille d’effet
Si la statistique F de Fisher établit avec rigueur que le modèle factoriel explique une part non négligeable de variabilité et que certaines conditions diffèrent entre elles, elle demeure incapable d’isoler précisément quelles paires de modalités sont statistiquement dissociables lorsque le facteur compte plus de deux niveaux (comme notre facteur sommeil à 3 niveaux). De surcroît, le seuil de significativité p informe exclusivement sur l’existence d’une différence, mais aucunement sur son ampleur substantielle ou son utilité clinique.
Pour parachever l’examen inférentiel, le chercheur doit obligatoirement déployer des procédures de comparaisons multiples a posteriori (tests post-hoc), quantifier les effets conditionnels simples et dériver les coefficients de taille d’effet standardisés.
38. Mise en œuvre des tests de comparaison multiple sous Excel
Microsoft Excel n’implémente pas de routine automatisée pour les tests post-hoc classiques tels que le test HSD de Tukey, le test de Scheffé ou la procédure de Newman-Keuls. Face à cette contrainte logicielle, deux stratégies calculatoires s’offrent au praticien :
1. L’ajustement de Bonferroni via les tests t de Student :
Cette méthode, universellement reconnue pour sa rigueur et sa simplicité, consiste à exécuter des tests t bivariés de comparaison de moyennes pour chaque paire d’intérêt tout en divisant le seuil alpha nominal par le nombre total k de contrastes appariés réalisés :
αajusté = α / k
Pour le facteur sommeil qui comporte 3 modalités, nous avons k = 3(3 – 1) / 2 = 3 comparaisons possibles (Normal vs Partiel, Normal vs Total, Partiel vs Total). Le seuil critique corrigé pour déclarer une différence statistiquement significative s’établit donc à :
αBonferroni = 0,05 / 3 ≈ 0,0167
Sous Excel, vous pouvez mobiliser directement la fonction de probabilité du test t pour échantillons indépendants :
=TEST.T(plage_groupe_1; plage_groupe_2; 2; 2)
(les paramètres 2; 2 spécifiant un test bilatéral avec présupposé de variances égales fondé sur le carré moyen résiduel de l’ANOVA).
2. Le calcul manuel de la différence minimale significative de Tukey (HSD) :
La statistique HSD (Honestly Significant Difference) de Tukey s’évalue au moyen de la formule mathématique :
HSD = q(α, k, df_Erreur) × √(MSErreur / n)
Où q représente la valeur critique issue de la distribution de l’étendue studentisée (Studentized Range Distribution) pour k groupes et les degrés de liberté résiduels, MSErreur est directement extrait de la table ANOVA (2,50), et n est l’effectif des cellules comparées. Toute différence brute entre deux moyennes dépassant le seuil critique HSD est déclarée statistiquement significative à p < 0.05.
39. Décomposition des effets simples en présence d’interaction
Puisque notre interaction A × B s’avère hautement significative (p < 0.001), la décomposition des effets simples (simple main effects) s’impose pour disséquer l’impact de la privation de sommeil au sein de chaque niveau de température individuellement considéré :
Effet simple du sommeil à Température Neutre (21 °C) :
Il s’agit d’évaluer la variation des trois moyennes (13, 19, 26). La somme des carrés associée à cet effet conditionnel se calcule selon :
SSB à A1 = n × ∑(M1j – M1.)² = 5 × [(13 – 19,33)² + (19 – 19,33)² + (26 – 19,33)²] = 5 × [40,07 + 0,11 + 44,49] = 423,33
Avec df = 2, le carré moyen vaut MS = 423,33 / 2 = 211,67. En utilisant la variance d’erreur globale mutualisée de notre grand modèle (MSErreur = 2,50 avec 24 df), la statistique F de cet effet simple atteint :
F(2, 24) = 211,67 / 2,50 = 84,67 (p < 0.001)
Effet simple du sommeil sous Chaleur Extrême (35 °C) :
On évalue ici la divergence des moyennes (16, 25, 40) dont la moyenne conditionnelle est de 27,00 :
SSB à A2 = 5 × [(16 – 27)² + (25 – 27)² + (40 – 27)²] = 5 × [121 + 4 + 169] = 5 × 294 = 1470,00
Le carré moyen s’élève à MS = 1470,00 / 2 = 735,00. Le test du ratio F donne :
F(2, 24) = 735,00 / 2,50 = 294,00 (p < 0.001)
Bien que la privation de sommeil dégrade la performance dans les deux environnements, la force de l’effet sous contrainte thermique est plus de trois fois plus puissante (F = 294,00 contre F = 84,67), fournissant la quantification analytique exacte de la synergie observée graphiquement.
40. Calcul de la taille d’effet : Éta-carré partiel (ηp²)
La déclaration de la taille d’effet est une obligation prescrite par la 7e édition du manuel de l’APA. Dans le cadre des plans factoriels, l’éta-carré partiel (ηp² ou partial eta squared) constitue l’indice métrique de référence. Il quantifie la proportion de variance attribuable à une source expérimentale donnée, une fois évacuée l’influence des autres effets systématiques du modèle :
ηp² = SSEffet / (SSEffet + SSErreur)
Cet indice se calcule avec une facilité déconcertante dans Excel en exploitant directement les cellules de la table d’analyse de variance :
- Éta-carré partiel du Facteur A (Stress thermique) :
ηp(A)² = SSA / (SSA + SSErreur) = 440,833 / (440,833 + 60,000) = 440,833 / 500,833 ≈ 0,880
Sous Excel, tapez la formule :
=B13/(B13+B16)(en adaptant les coordonnées de cellules à votre table). - Éta-carré partiel du Facteur B (Privation de sommeil) :
ηp(B)² = SSB / (SSB + SSErreur) = 1721,667 / (1721,667 + 60,000) = 1721,667 / 1781,667 ≈ 0,966
- Éta-carré partiel de l’Interaction A × B :
ηp(AB)² = SSAB / (SSAB + SSErreur) = 281,667 / (281,667 + 60,000) = 281,667 / 341,667 ≈ 0,824
Selon les conventions d’interprétation empirique universellement admises établies par Jacob Cohen (1988), un ηp² de 0,01 signale un effet faible, 0,06 correspond à un effet modéré, et toute valeur excédant 0,14 traduit un effet fort. Dans notre protocole expérimental, toutes les composantes affichent un ηp² > 0,80, ce qui dénote des tailles d’effet spectaculaires : 82,4 % de la variance non expliquée par les facteurs principaux est directement capturée par leur interaction synergique.
41. Diagnostics des anomalies et procédures de remédiation
L’analyse de données expérimentales réelles se heurte inévitablement à des imperfections distributionnelles absentes des manuels théoriques : valeurs aberrantes résultant d’un décrochage d’attention d’un sujet, distributions asymétriques provoquées par des effets plancher ou plafond, et pertes accidentelles de sujets compromettant l’équilibrage du plan factoriel.
L’Utilitaire d’analyse d’Excel étant particulièrement sensible à ces perturbations, le chercheur doit maîtriser l’arsenal des techniques de diagnostic et de remédiation analytique au sein du tableur.
42. Détection et traitement des valeurs aberrantes (outliers)
Une observation aberrante (outlier) peut distordre artificiellement la moyenne d’une cellule et gonfler le carré moyen de l’erreur (MSErreur), annihilant la puissance statistique du test F. La détection des anomalies doit s’opérer de façon conditionnelle, c’est-à-dire au sein de chaque condition expérimentale prise isolément.
La méthode de diagnostic la plus standardisée repose sur la standardisation en scores Z résiduels ou sur l’intervalle interquartile de John Tukey :
- Méthode des scores Z : Pour chaque cellule, calculez la moyenne et l’écart-type. Dans une colonne dédiée, calculez pour chaque score :
Z = (X - Moyenne) / Ecart_Typevia la formule=CENTREE.REDUITE(cellule; moyenne_cellule; ecart_type_cellule). Tout participant affichant un score |Z| > 2,5 (pour les petits échantillons) ou |Z| > 3,0 (pour les cohortes plus larges) doit être qualifié d’aberrant. - Règle de Tukey : Un score est identifié comme aberrant s’il se situe au-delà des clôtures :
Q1 - 1,5 × IQRouQ3 + 1,5 × IQR, où IQR représente l’écart interquartile calculable sous Excel par=QUARTILE.INC(plage; 3) - QUARTILE.INC(plage; 1).
Face à un outlier avéré, le chercheur doit examiner s’il procède d’une erreur de saisie ou de transcription matérielle (qui doit être corrigée). S’il s’agit d’une observation authentique mais divergente, des procédures de winsorisation (remplacement de la valeur extrême par le score valide le plus proche) ou de troncature documentée peuvent être envisagées, sous réserve de déclaration explicite dans le rapport méthodologique.
43. Transformations mathématiques pour restaurer la normalité
Lorsque les distributions résiduelles au sein des cellules manifestent des asymétries positives prononcées ou que la variance croît proportionnellement à la magnitude des moyennes (hétéroscédasticité hétérogène), le recours à des transformations mathématiques univariées constitue la réponse classique préconisée par la littérature méthodologique.
Excel intègre toutes les primitives computationnelles pour opérer ces redressements distributionnels :
- Transformation Logarithmique : Idéale pour corriger une asymétrie positive sévère (temps de réaction en millisecondes). Utilisez la fonction
=LN(cellule)pour le logarithme népérien ou=LOG10(cellule). Si les données contiennent des zéros absolus, appliquez la translation classique :=LN(cellule + 1). - Transformation Racine Carrée : Particulièrement préconisée pour les données de dénombrement ou de fréquences d’événements discrets (comme notre nombre d’erreurs d’inhibition) :
=RACINE(cellule)ou=RACINE(cellule + 0,5). - Transformation Inverse : Pour les déviations extrêmes :
=1 / cellule.
Une fois la transformation appliquée à la totalité de la matrice, l’ANOVA à deux facteurs avec réplication est de nouveau exécutée sur les données transformées. Il est impératif de souligner que si les tests inférentiels (valeurs F et p) sont rapportés sur la base des données transformées, les statistiques descriptives de tendance centrale (moyennes et écarts-types) doivent être présentées dans leurs unités métriques originelles lors de la restitution rédactionnelle.
44. Gestion des plans factoriels déséquilibrés
Comme énoncé précédemment, l’Utilitaire d’analyse de Microsoft Excel est strictement incapable d’exécuter son algorithme si le nombre d’observations par cellule n’est pas rigoureusement invariant. Dans l’éventualité où un participant aurait dû être exclu pour non-respect des critères d’inclusion (aboutissant par exemple à une cellule à n = 4 tandis que les autres comptent n = 5), l’outil affichera une fin de non-recevoir logicielle.
Trois voies de résolution sont envisageables sous Excel :
- Imputation par la moyenne de cellule (Technique de substitution conservatrice) :
Le chercheur peut imputer la valeur manquante en insérant exactement la moyenne arithmétique de la cellule concernée, ramenant artificiellement son effectif à n = 5. Cette technique permet de préserver l’équilibre parfait du plan sans altérer la moyenne du groupe ni les sommes des carrés systématiques. Néanmoins, pour ne pas biaiser l’inférence, il est impératif de soustraire manuellement 1 degré de liberté au dénominateur de l’erreur dans la table ANOVA finale (dfErreur devenant 23 au lieu de 24) et de recalculer le MSErreur et les ratios F correspondants.
- Sous-échantillonnage aléatoire (Random Pruning) :
Si la taille des cellules est modérément inégale (par exemple 12 vs 11 sujets), une suppression aléatoire d’un sujet dans la cellule majoritaire au moyen d’un tirage pseudo-aléatoire via
=ALEA()permet de rétablir l’orthogonalité exacte. - Régression linéaire multiple avec variables muettes (Modèle GLM de type III) :
Pour un traitement rigoureux d’un déséquilibre substantiel sans perte d’information, le chercheur doit abandonner l’Utilitaire d’analyse de base et structurer ses données sous forme vectorielle longue en recourant au complément de régression linéaire multiple d’Excel. En codant les facteurs sous forme de contrastes orthogonaux sum-to-zero (effect coding), la méthode des moindres carrés pondérés permet de dériver une ANOVA de Type III formellement exacte.
45. Rédaction scientifique des résultats selon les normes APA et pièges fréquents
L’aboutissement ultime de la démarche scientifique réside dans la transmission fidèle, concise et universellement intelligible des résultats statistiques au sein de la littérature spécialisée. L’American Psychological Association a instauré des normes de typographie et d’agencement stylistique d’une rigueur absolue dans son manuel officiel (APA 7e édition).
Un rapport d’analyse statistique ne doit jamais se limiter à un collage brut de captures d’écran d’Excel. Il doit orchestrer une narration scientifique articulant rigoureusement les indicateurs descriptifs, les paramètres inférentiels et les implications théoriques du comportement observé.
46. Normes de présentation typographique APA (7e édition)
La restitution académique d’une ANOVA à deux facteurs selon les canons de l’APA Style Guide exige le respect scrupuleux des conventions formelles suivantes :
- Mise en italique des symboles statistiques : Toutes les lettres latines symbolisant des grandeurs statistiques doivent être composées en italique : F, p, M, SD, t, n, N, R². Les lettres grecques (ηp², α, β) demeurent en revanche en typographie romaine droite régulière.
- Degrés de liberté : Les degrés de liberté associés au test doivent impérativement être accolés entre parenthèses immédiatement après la statistique F, séparés par une virgule et une espace : F(dfEffet, dfErreur). Exemple : F(1, 24) ou F(2, 24).
- Formatage des décimales : Les statistiques F, les moyennes (M) et les écarts-types (SD) sont systématiquement arrondis à deux décimales après la virgule (ex. F = 176,33). L’éta-carré partiel (ηp²) est traditionnellement rapporté à deux ou trois décimales (ex. ηp² = 0,82).
- Règles de présentation de la p-value :
- Dans les normes anglophones de l’APA, le zéro précédant le séparateur décimal est formellement omis pour les probabilités bornées entre 0 et 1 (ex. p = .034 et non p = 0.034). Dans les rédactions francophones strictes, l’usage autorise le maintien du zéro : p = 0,034.
- Si la probabilité calculée par Excel est infinitésimale (ex.
1,09E-12), il est formellement interdit d’écrire p = 0,000. Il convient d’écrire obligatoirement : p < .001 (ou p < 0,001 en français).
- Association systématique de la taille d’effet : Aucune statistique F ne doit être rapportée de manière isolée sans être immédiatement accompagnée de son indice d’amplitude standardisé (ηp²).
47. Exemple de paragraphe rédactionnel pour publication académique
Voici le modèle exemplaire de rédaction scientifique, conforme aux exigences de l’APA 7e édition, restituant l’analyse intégrale de notre étude expérimentale sur le stress thermique et la privation de sommeil :
« Une analyse de variance (ANOVA) factorielle 2 × 3 inter-sujets a été réalisée afin d’examiner l’incidence conjointe du stress thermique (Neutre [21 °C] vs Chaleur [35 °C]) et de la privation de sommeil (Sommeil normal vs Privation partielle [4 h] vs Privation totale [24 h]) sur le nombre d’erreurs commises lors d’une tâche d’inhibition comportementale Go/No-Go.
L’analyse révèle un effet principal hautement significatif du stress thermique, F(1, 24) = 176,33, p < 0,001, ηp² = 0,88, indiquant que les participants exposés à une température extrême de 35 °C ont commis substantiellement plus d’erreurs d’inhibition (M = 27,00, SD = 10,28) que ceux placés dans un environnement thermiquement contrôlé à 21 °C (M = 19,33, SD = 5,58). De même, l’effet principal de la privation de sommeil s’avère particulièrement robuste, F(2, 24) = 344,33, p < 0,001, ηp² = 0,97. Des analyses post-hoc assorties d’une correction de Bonferroni indiquent que le groupe soumis à une privation totale (M = 33,00, SD = 7,38) commet significativement plus d’erreurs que le groupe restreint à 4 h de sommeil (M = 22,00, SD = 3,50, p < 0,001), ce dernier commettant lui-même significativement plus d’erreurs que le groupe témoin reposé (M = 14,50, SD = 2,17, p < 0,001).
De façon cruciale, ces effets principaux sont modulés par une interaction bidirectionnelle hautement significative entre le stress thermique et la privation de sommeil, F(2, 24) = 56,33, p < 0,001, ηp² = 0,82. L’analyse des effets simples confirme que si la dette de sommeil dégrade la performance dans des conditions de température neutre, F(2, 24) = 84,67, p < 0,001, cette altération se trouve décuplée sous exposition à une chaleur accablante, F(2, 24) = 294,00, p < 0,001. En particulier, la combinaison d’une privation totale de sommeil et d’un stress thermique extrême entraîne un effondrement catastrophique de la précision motrice (M = 40,00, SD = 1,58), mettant en évidence une vulnérabilité neurocognitive accrue lors de l’action synergique de stresseurs environnementaux cumulés. »
48. Erreurs méthodologiques et pièges courants sous Excel
Pour parfaire la formation méthodologique du praticien, nous synthétisons ci-dessous les écueils les plus récurrents identifiés lors de l’exécution d’ANOVA factorielles sous Microsoft Excel, accompagnés de leurs remèdes immédiats :
- Inversion du paramètre « Lignes par échantillon » : Il s’agit de l’erreur computationnelle la plus dévastatrice. Si vous saisissez un chiffre incorrect dans ce champ (par exemple inscrire 3 au lieu de 5 sous prétexte qu’il y a 3 colonnes), Excel tronçonnera votre matrice à des coordonnées erronées, mélangeant allègrement des groupes de sujets différents au sein des mêmes cellules. Vérifiez systématiquement que ce chiffre correspond scrupuleusement au nombre de participants par cellule.
- Confusion entre modèles avec et sans réplication : Lancer accidentellement la routine « ANOVA : Deux facteurs sans réplication » sur une table contenant plusieurs sujets par cellule est une faute fréquente. Cette fonction spécifique est réservée au modèle dans lequel il n’existe qu’une seule observation unique par cellule factorielle (modèle en blocs randomisés). L’appliquer sur des données avec réplications produit une erreur de calcul immédiate sur les degrés de liberté.
- Omission des libellés dans la plage d’entrée : Si vous sélectionnez la matrice de données sans inclure la ligne d’en-tête (ligne 1) ou la colonne d’en-tête de gauche (colonne A), Excel interprétera vos premières lignes de données comme des chaînes de caractères de libellés, éjectant ainsi le premier sujet de chaque groupe hors de l’analyse inférentielle.
- Traitement inadapté d’un plan à mesures répétées (intra-sujets) : L’Utilitaire d’analyse de base d’Excel ne sait pas traiter nativement une ANOVA à deux facteurs mixtes (split-plot ANOVA comportant un facteur inter-sujets et un facteur intra-sujets) ou une ANOVA factorielle entièrement à mesures répétées. Tenter d’utiliser la routine inter-sujets décrite dans ce guide pour des mesures temporelles longitudinales recueillies sur les mêmes participants constitue une violation grossière du postulat d’indépendance des observations, invalidant catégoriquement les résultats d’inférence.
En observant une discipline rigoureuse dans la préparation matricielle de vos données et en appliquant méthodiquement l’ensemble des protocoles diagnostiques exposés dans ce traité, Microsoft Excel se révèle être un instrument statistique d’une précision analytique irréprochable, parfaitement apte à soutenir des projets de recherche expérimentale de niveau académique international.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2017). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Microsoft Corporation. (2024). Utiliser les outils d’analyse pour effectuer des analyses de données complexes. Support Microsoft 365. https://support.microsoft.com/
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.