
L’analyse empirique contemporaine repose fondamentalement sur la capacité du chercheur et du praticien des données à synthétiser visuellement des relations bivariées complexes avant d’en inférer des lois mathématiques. Dans le vaste répertoire de la sémiotique graphique, le nuage de points (scatterplot) combiné à une droite d’ajustement constitue sans conteste l’archétype fondamental de l’exploration statistique. Cette représentation bivariée offre un pont cognitif irremplaçable entre l’observation brute de phénomènes stochastiques et l’abstraction formelle des modèles linéaires, matérialisant d’un seul regard la dispersion des observations empiriques, la tendance centrale de leur trajectoire conjointe ainsi que la plausibilité des postulats probabilistes sous-jacents.
Au sein de l’environnement scientifique contemporain, le langage de programmation Python s’est imposé comme la lingua franca de l’ingénierie mathématique et du traitement analytique des données. Grâce à une architecture modulaire associant le calcul matriciel de haute performance à des moteurs de rendu graphique d’une flexibilité chirurgicale, Python permet non seulement d’automatiser le traçage géométrique, mais surtout de calibrer avec une rigueur statistique absolue chaque composante de la modélisation. Comprendre comment articuler harmonieusement un nuage de points avec une droite de régression dans cet écosystème ne relève pas d’une simple habileté syntaxique ; il s’agit d’une compétence épistémologique centrale, conditionnant la validité des inférences déduites de données quantitatives en sciences sociales, biomédicales ou technologiques.
Ce guide exhaustif a pour vocation de déconstruire méthodiquement l’ensemble des protocoles théoriques, computationnels et esthétiques nécessaires à l’élaboration de graphiques bivariés de niveau publication internationale. En parcourant les fondements de l’optimisation par les moindres carrés, l’implémentation algorithmique élémentaire via NumPy et Matplotlib, l’abstraction élégante offerte par Seaborn, ainsi que la quantification inférentielle rigoureuse procurée par Statsmodels, nous dresserons un panorama intégral des meilleures pratiques contemporaines. L’objectif ultime consiste à doter le lecteur d’un cadre méthodologique pérenne, garantissant une fidélité sémiotique irréprochable et une parfaite conformité aux standards académiques les plus exigeants.
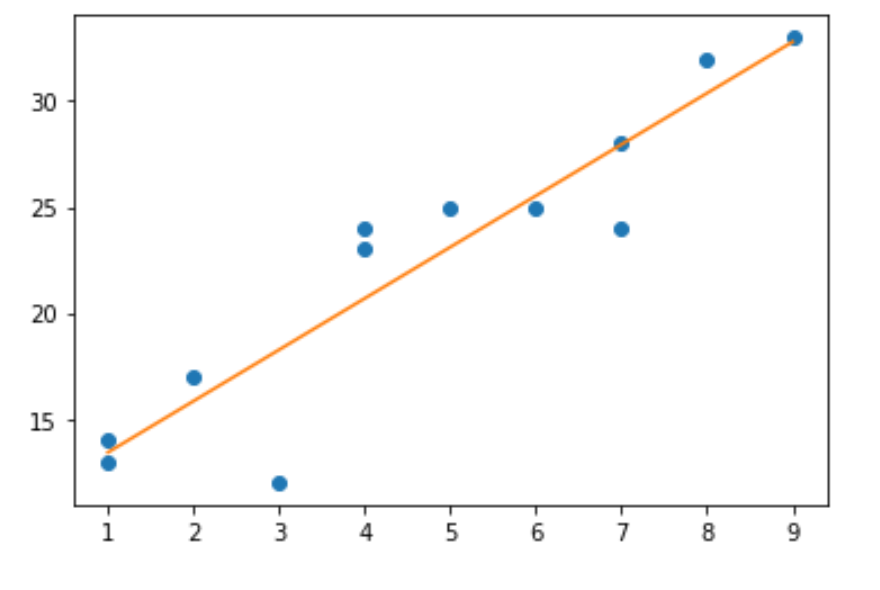
1. 1. Introduction à la régression linéaire et à la visualisation bivariée en Python
1.1 Rôle de la visualisation dans l’analyse quantitative exploratoire
L’analyse quantitative exploratoire (Exploratory Data Analysis, ou EDA), théorisée initialement par le statisticien John Tukey à la fin des années 1970, postule que la compréhension intime d’une structure de données précède impérativement toute formalisation mathématique close. Dans ce cadre épistémologique, la visualisation graphique n’est pas un simple artifice d’illustration destiné à vulgariser des résultats préexistants ; elle représente un instrument d’investigation cognitif à part entière. Face à une matrice de données bivariées, les descripteurs numériques conventionnels — tels que la moyenne arithmétique, la variance marginale et même le coefficient de corrélation linéaire de Pearson — s’avèrent structurellement insuffisants pour capturer la morphologie sous-jacente des distributions observées.
L’argument le plus saisissant en faveur de la primauté exploratoire demeure le célèbre quartet d’Anscombe, conçu en 1973, où quatre ensembles de données partagent des propriétés statistiques synthétiques rigoureusement identiques (mêmes moyennes pour les variables explicative et expliquée, mêmes variances, même équation de régression et même coefficient de détermination) tout en affichant des structures géométriques diamétralement hétérogènes. Seul le tracé du nuage de points couplé à la trajectoire d’ajustement permet de révéler instantanément que le premier ensemble illustre une relation linéaire pure, le second une courbure parabolique non linéaire, le troisième une droite parfaite corrompue par un point aberrant isolé, et le quatrième une absence totale de covariation couplée à une valeur charnière artificielle. L’inspection visuelle prévient ainsi l’analyste contre l’application aveugle de calculs d’inférence sur des distributions dont les postulats d’application sont manifestement violés.
Dans la pratique scientifique moderne, le déploiement d’un graphique bivarié permet en outre de guider le diagnostic préliminaire d’hétéroscédasticité, d’identifier la présence de sous-populations masquées au sein de l’échantillon global et d’apprécier la pertinence des transformations d’échelle (telles que les passages au logarithme ou les normalisations par les racines carrées). Ainsi, la visualisation bivariée agit comme un filtre de validation empirique garantissant que le modèle de régression linéaire appliqué reflète fidèlement la mécanique génératrice des données réelles, protégeant le chercheur contre les biais de confirmation et les artefacts de modélisation mathématique hâtive.
1.2 Principes fondamentaux du nuage de points en psychométrie et sciences empiriques
Le nuage de points constitue la concrétisation graphique du produit cartésien de deux variables aléatoires continues ou pseudo-continues. En psychométrie, en économétrie et dans les sciences du comportement, son élaboration obéit à des conventions sémiotiques immuables destinées à minimiser la charge cognitive du lecteur tout en maximisant le transfert d’information quantitative. Chaque observation individuelle de l’échantillon d’étude est projetée au sein d’un repère orthogonal à deux dimensions sous la forme d’un glyphe géométrique ponctuel dont les coordonnées spatiales correspondent scrupuleusement aux mesures quantifiées des variables analysées.
Par convention épistémologique, l’axe des abscisses (l’axe horizontal, usuellement noté X) est réservé à la variable indépendante, explicative, prédictrice ou exogène. Ce choix directionnel traduit graphiquement l’hypothèse de causalité ou d’antériorité temporelle postulée par le chercheur : il matérialise le stimulus, l’intervention expérimentale, le trait psychologique latent ou le facteur environnemental dont on cherche à évaluer l’impact. Corrélativement, l’axe des ordonnées (l’axe vertical, traditionnellement noté Y) accueille la variable dépendante, expliquée ou endogène, représentant la réponse comportementale, le score de performance cognitive, le symptôme clinique ou la grandeur économique censée varier consécutivement aux fluctuations de la variable prédictrice.
La morphologie globale adoptée par l’agrégation de ces points révèle la nature et l’intensité de la dépendance stochastique unissant les deux dimensions d’analyse. Une dispersion circonscrite le long d’une bande diagonale ascendante signale une corrélation empirique positive robuste, traduisant une covariation conjointe des grandeurs, tandis qu’une orientation descendante manifeste une relation antagoniste. Inversement, une configuration circulaire amorphe ou diffuse dénonce une indépendance statistique marginale. En psychométrie, où la fidélité des instruments de mesure est constamment mise à l’épreuve des erreurs d’échantillonnage et des fluctuations psychologiques non systématiques, le nuage de points permet d’apprécier immédiatement la consistance interne des échelles de mesure, la validité convergente entre construits théoriques et la présence éventuelle de plafonnements ou d’effets de plancher susceptibles de biaiser les estimations paramétriques.
1.3 Vue d’ensemble de l’écosystème Python pour la science des données
L’hégémonie contemporaine de Python dans le champ de la statistique computationnelle et de l’apprentissage automatique découle de la cohésion organique d’un ensemble de bibliothèques tierces hautement optimisées, regroupées sous la bannière informelle de la suite SciPy. Au cœur de cette architecture se trouve NumPy (Numerical Python), qui dote le langage d’une structure de données matricielle multidimensionnelle contiguë en mémoire (l’objet ndarray) écrite en langage C. Cette abstraction vectorisée permet d’exécuter des calculs d’algèbre linéaire complexes avec une efficacité temporelle sans commune mesure avec les structures itératives natives de Python, fournissant ainsi la base arithmétique indispensable à l’ajustement polynomial et à la résolution des systèmes d’équations normales.
Au-dessus de cette couche d’abstraction purement numérique se greffe Pandas, un cadriciel dédié à la manipulation et à l’ingestion de données structurées. En introduisant la notion de DataFrame, Pandas permet aux chercheurs d’indexer, d’aligner, de nettoyer et de requêter des jeux de données hétérogènes mêlant variables quantitatives continues et métadonnées qualitatives catégorielles. C’est à partir de ces structures tabulaires que les modules graphiques extraient les vecteurs de coordonnées destinés aux moteurs de rendu. Le socle universel de la visualisation scientifique en Python est incarné par Matplotlib, créé originellement par John D. Hunter pour émuler les capacités d’affichage de MATLAB. Matplotlib offre un contrôle atomique et programmatique sur la totalité des éléments de l’espace graphique (axes, graduations, limites, sélecteurs d’échelle, annotations textuelles et moteurs typographiques).
Pour affranchir l’utilisateur de la verbosité parfois pesante de Matplotlib tout en intégrant nativement la formalisation des modèles statistiques, la bibliothèque Seaborn opère comme une surcouche de haut niveau. Elle encapsule les procédures d’échantillonnage, le calcul automatisé des intervalles de confiance par rééchantillonnage (bootstrapping) et le mappage colorimétrique selon les principes contemporains de la perception humaine. Enfin, Statsmodels complète cet ensemble en apportant la rigueur inférentielle traditionnellement associée au langage R : il fournit des résumés statistiques exhaustifs, incluant tests d’hypothèses, valeurs de probabilité critique (valeurs p), erreurs-types robustes et critères d’information. Cet écosystème polyvalent et cohérent permet au data scientist de naviguer sans discontinuité logique depuis la donnée brute jusqu’à la publication académique de haut niveau.
2. Fondements mathématiques et statistiques de la droite d’ajustement
2.1 La méthode des moindres carrés ordinaires (MCO)
L’estimation d’une droite de régression repose conceptuellement sur la minimisation formelle d’une fonction de perte géométrique quantifiant l’écart entre le modèle théorique et la réalité empirique observée. Dans le cas de la régression linéaire simple univariée, nous postulons que la variable dépendante scalaire Y est liée à la variable prédictive X par une relation structurelle de la forme : y_i = β_0 + β_1 * x_i + ε_i, où β_0 représente la constante (ordonnée à l’origine), β_1 le coefficient directeur (pente d’ajustement), et ε_i une composante d’erreur stochastique inobservable. La valeur ajustée par le modèle pour chaque point s’exprime sous la forme y_chapeau_i = b_0 + b_1 * x_i, où b_0 et b_1 désignent les estimateurs d’échantillon des paramètres de la population.
Le résidu individuel, noté e_i, est défini par la différence algébrique stricte entre la mesure observée et la projection théorique correspondante : e_i = y_i – y_chapeau_i = y_i – (b_0 + b_1 * x_i). La méthode des moindres carrés ordinaires (MCO, ou OLS pour Ordinary Least Squares) consiste à identifier le couple unique d’estimateurs (b_0, b_1) qui minimise la somme des carrés des résidus (SCR, ou Residual Sum of Squares, RSS) :
S(b_0, b_1) = ∑ [y_i – (b_0 + b_1 * x_i)]²
L’élévation au carré de chaque écart individuel remplit une double mission : d’une part, elle empêche que les résidus positifs et négatifs ne s’annulent mutuellement lors de la sommation globale ; d’autre part, elle pénalise de manière quadratique les écarts importants, conférant une sensibilité accrue du modèle aux observations fortement éloignées du barycentre des données. En différentiant partiellement la fonction objective S par rapport à b_0 et à b_1, et en annulant ces dérivées partielles pour obtenir les conditions du premier ordre, nous obtenons le système classique des équations normales. La résolution analytique de ce système conduit aux estimateurs universels des moindres carrés ordinaires :
b_1 = Cov(X, Y) / Var(X) = [∑ (x_i – x_barre)(y_i – y_barre)] / [∑ (x_i – x_barre)²]
b_0 = y_barre – b_1 * x_barre
où x_barre et y_barre représentent respectivement les moyennes arithmétiques empiriques des variables d’analyse. Ces formules révèlent que la pente d’ajustement dépend directement de la covariance empirique conjointe normalisée par la variance observée de la variable indépendante.
2.2 Interprétation des paramètres géométriques et statistiques
L’interprétation des coefficients issus des moindres carrés ordinaires doit être articulée avec une méticulosité extrême, en distinguant la dimension purement spatiale du graphique de sa signification substantive au sein du domaine scientifique investigué. Le coefficient b_1, mesurant la pente de la droite de régression, traduit le taux marginal de variation de la variable expliquée Y consécutif à une augmentation unitaire infinitésimale de la variable explicative X. Sur le plan des unités dimensionnelles, b_1 s’exprime dans le ratio direct des unités de mesure (unités de Y par unité de X). Un coefficient positif indique une relation directement proportionnelle, alors qu’une valeur négative formalise une décroissance systématique. Lorsque les variables ont été préalablement centrées et réduites (standardisation en scores Z), la pente de régression simple devient rigoureusement équivalente au coefficient de corrélation linéaire de Bravais-Pearson (noté r), borné conventionnellement entre -1 et +1.
Le paramètre b_0, ou constante de régression, correspond géométriquement à l’ordonnée du point d’intersection précis entre la droite modélisée et l’axe vertical d’équation X = 0. Sa portée interprétative dépend entièrement de la plausibilité théorique et physique d’une valeur nulle pour la variable prédictive au sein du système étudié. Si la valeur zéro se situe en dehors du domaine de définition expérimental (par exemple, lors de la modélisation du quotient intellectuel, de la pression artérielle systolique ou de la température corporelle chez l’être humain), l’ordonnée à l’origine constitue un simple ancrage mathématique dépourvu de signification empirique directe, garantissant uniquement que la droite traverse le centre de gravité ou barycentre des observations, défini par le point cartésien (x_barre, y_barre).
Sur le plan inférentiel, la qualité d’ajustement globale du modèle est quantifiée par le coefficient de détermination, noté R². Mathématiquement, ce paramètre correspond au rapport entre la somme des carrés expliquée par le modèle (SCE) et la somme des carrés totale des variations de la variable endogène (SCT) : R² = SCE / SCT = 1 – (SCR / SCT). Dans le cadre univarié, le coefficient de détermination coïncide exactement avec le carré du coefficient de corrélation de Pearson (r²). Il quantifie la proportion de la variance totale de la variable de réponse qui se trouve structurellement capturée et prédite par la variation linéaire de la variable prédictive, fournissant ainsi une métrique normalisée de l’adéquation empirique de la droite d’ajustement.
2.3 Conditions d’application et postulats de Gauss-Markov
L’optimalité statistique des estimateurs des moindres carrés ordinaires repose sur un ensemble de conditions formelles connues sous le nom de théorème de Gauss-Markov. Ce théorème stipule que, sous réserve de la validation stricte de ces hypothèses fondamentales, les estimateurs b_0 et b_1 constituent les meilleurs estimateurs linéaires sans biais (Best Linear Unbiased Estimators, ou BLUE), garantissant une variance minimale parmi l’ensemble des estimateurs non biaisés possibles de la classe linéaire. La méconnaissance de ces postulats expose l’analyste à des inférences totalement erronées et à une surconfiance injustifiée dans les intervalles de prédiction générés visuellement.
Les postulats de base peuvent être formalisés synthétiquement comme suit :
- Linéarité des paramètres : Le modèle sous-jacent doit pouvoir s’écrire sous forme linéaire par rapport à ses coefficients, même si les variables indépendantes font l’objet de transformations préalables.
- Exogénéité stricte : L’espérance conditionnelle du terme d’erreur stochastique par rapport aux variables explicatives est identiquement nulle, c’est-à-dire E(ε_i | x_i) = 0. Cette condition implique l’absence totale de corrélation entre les résidus et la variable explicative, excluant l’omission de variables confondantes majeures.
- Homoscédasticité : La variance conditionnelle du terme d’erreur demeure rigoureusement constante pour chaque niveau de la variable indépendante : Var(ε_i | x_i) = σ². Si la variance des erreurs s’accroît ou décroît de façon monotone le long de l’axe des abscisses, le phénomène d’hétéroscédasticité invalide le calcul conventionnel des erreurs-types standards.
- Absence d’autocorrélation : Les termes d’erreur associés à deux observations distinctes ne présentent aucune corrélation mutuelle : Cov(ε_i, ε_j) = 0 pour tout i ≠ j. Cette indépendance stochastique est cruciale lors de l’analyse de séries temporelles ou spatiales.
- Normalité des erreurs : Pour que les tests de significativité statistique (tests de Student et de Fisher) et les intervalles de confiance soient rigoureusement exacts à taille d’échantillon finie, les perturbations doivent suivre une distribution normale multivariée : ε ~ N(0, σ² * I).
L’évaluation visuelle du nuage de points et de ses résidus constitue le moyen empirique par excellence pour sonder le respect effectif de ces postulats fondamentaux avant d’entamer toute communication formelle de résultats de recherche.
3. Configuration de l’environnement Python et structuration des données
3.1 Mise en place de l’environnement de travail scientifique
Pour garantir la reproductibilité intégrale des analyses computationnelles présentées dans ce guide, la configuration rigoureuse d’un environnement de développement dédié est indispensable. Il est fortement recommandé d’isoler les dépendances logicielles au sein d’un environnement virtuel standardisé, évitant ainsi tout conflit de versions entre bibliothèques tierces. L’utilisation d’outils tels que venv, virtualenv ou le gestionnaire multiplateforme conda permet d’encapsuler précisément la version de l’interpréteur Python ainsi que l’ensemble des modules mathématiques requis pour nos protocoles de visualisation bivariée.
La séquence fondamentale d’installation via l’utilitaire d’empaquetage standard de Python implique l’exécution des commandes d’environnement suivantes au sein de votre terminal :
python -m venv env_statistique
source env_statistique/bin/activate (ou env_statistiqueScriptsactivate sous Windows)
pip install numpy scipy pandas matplotlib seaborn statsmodels
Cette pile technologique couvre l’intégralité du spectre analytique : manipulation matricielle avec NumPy, calculs inférentiels avancés avec SciPy, structuration tabulaire via Pandas, rendu graphique vectoriel atomique avec Matplotlib, modélisation statistique élégante avec Seaborn et validation économétrique paramétrique poussée via Statsmodels. Une fois l’environnement initialisé, les sessions de programmation interactive peuvent être conduites soit au cœur d’un carnet interactif Jupyter (Jupyter Notebook / JupyterLab), particulièrement adapté à la phase exploratoire visuelle, soit au moyen de scripts autonomes destinés à l’intégration dans des pipelines d’intégration continue de production scientifique.
3.2 Structuration des vecteurs de données avec NumPy et Pandas
Une rigueur méthodologique absolue s’impose quant au formatage et à l’alignement des collections de données destinées au traçage graphique. Les structures de données primaires exploitées pour l’ajustement bivarié sont les vecteurs unidimensionnels continus. Dans NumPy, ces vecteurs s’incarnent sous la forme de tableaux contigus à une dimension (numpy.ndarray) caractérisés par un type de donnée uniforme, usuellement des nombres à virgule flottante en double précision (float64). L’homogénéité du type de donnée est cruciale pour garantir des opérations vectorisées instantanées lors de la soustraction des moyennes ou du calcul des produits scalaires.
Cependant, dans la majorité des scénarios d’analyse appliquée, les données d’observation proviennent d’enquêtes ou de relevés instrumentaux comportant des données manquantes, des identifiants et des libellés de facteurs. L’encapsulation de ces vecteurs au sein d’un DataFrame de Pandas offre une flexibilité indispensable. Les séries Pandas (pandas.Series) gèrent de manière cohérente l’indexation temporelle ou individuelle ainsi que les valeurs manquantes (représentées par le marqueur numpy.nan). Avant d’exécuter la moindre routine graphique ou d’ajustement linéaire, il est impératif d’assainir structurellement les vecteurs en vérifiant leur parfaite concordance de longueur et en éliminant explicitement les paires d’observations incomplètes au moyen des méthodes de filtrage vectorisé telles que dropna().
La structuration rigoureuse implique également l’assignation explicite des types : une colonne quantitative destinée à figurer sur les axes cartésiens ne doit en aucun cas être interprétée comme une chaîne de caractères ou un type générique (object), sous peine de fausser l’échelle continue du graphique au profit d’un espacement catégoriel arbitraire. Cette discipline de typage strict prévient les anomalies de rendu spatial où les intervalles entre valeurs mesurées ne respectent pas la distance euclidienne réelle du phénomène observé.
3.3 Génération d’un jeu de données expérimental étalon
Afin d’illustrer de manière transparente et reproductible les différentes approches méthodologiques sans dépendre de fichiers de données externes potentiellement volatils, nous concevons un générateur synthétique de données contrôlées. Cette stratégie permet de fixer délibérément les paramètres de la population théorique (la pente réelle, la constante et l’écart-type de l’erreur) afin de confronter directement les estimations graphiques et computationnelles à la vérité terrain du modèle génératif stochastique.
Considérons une situation expérimentale en psychologie cognitive évaluant la relation entre le nombre d’heures d’entraînement sur un simulateur perceptif (variable indépendante X) et le score de précision obtenu lors d’une tâche d’attention divisée (variable dépendante Y). Nous fixons arbitrairement la taille de l’échantillon à N = 100 observations. Nous initialisons la graine du générateur de nombres pseudo-aléatoires de NumPy (np.random.seed(42)) afin de garantir la constance stochastique absolue des tracés générés au cours des sections suivantes.
Le protocole de simulation mathématique s’établit ainsi :
- La variable prédictive X est échantillonnée selon une loi uniforme continue comprise entre 2 et 20 heures d’apprentissage : X ~ U(2, 20).
- Le bruit expérimental stochastique ε est tiré d’une distribution normale gaussienne de moyenne nulle et d’écart-type égal à 4 unités : ε ~ N(0, 16).
- La relation théorique sous-jacente est calibrée selon l’équation de population : Y = 15.0 + 2.5 * X + ε, conférant une pente théorique β_1 = 2.5 et une ordonnée d’origine β_0 = 15.0.
Cette formalisation algorithmique produit un jeu de données bivarié idéal : il exhibe une tendance linéaire prépondérante tout en conservant une variabilité aléatoire réaliste, autorisant ainsi une démonstration exhaustive de l’ensemble des techniques de visualisation et d’inférence statistique disponibles sous Python.
4. Méthode 1 : Construction pas à pas avec Matplotlib et NumPy
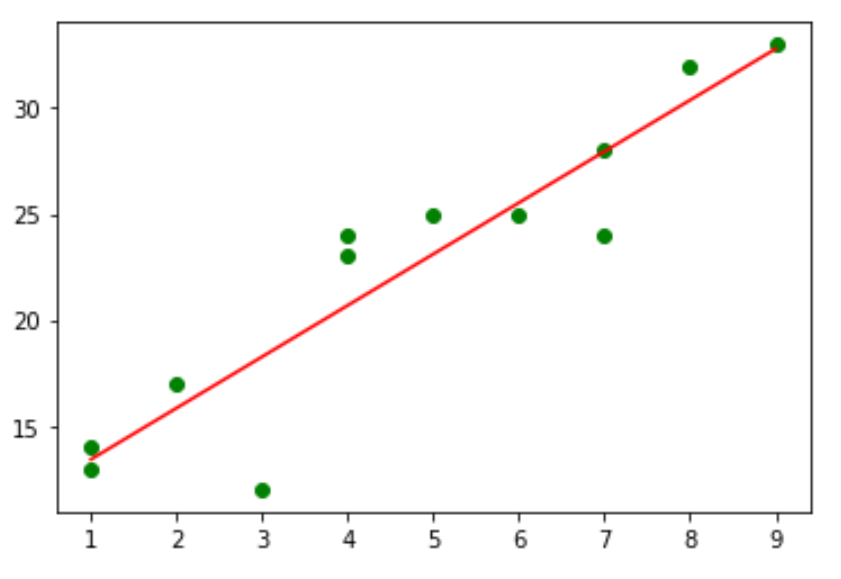
4.1 Tracé du nuage de points primaire avec plt.plot et plt.scatter
La décomposition programmatique de l’affichage commence par la création de l’ossature géométrique élémentaire à l’aide de l’API orientée objet de Matplotlib. Bien que l’interface procédurale basée sur matplotlib.pyplot offre une grande accessibilité pour des opérations rapides, l’approche professionnelle exige l’instanciation explicite des objets Figure et Axes (au moyen de la fabrique plt.subplots()). Cette méthode garantit une gouvernance totale sur chaque élément du canevas, condition indispensable à l’élaboration de figures destinées à l’édition scientifique.
Deux fonctions distinctes permettent de générer un nuage de points sous Matplotlib : Axes.plot() et Axes.scatter(). Bien qu’elles puissent sembler redondantes en première approche, elles répondent à des paradigmes computationnels foncièrement différents. La méthode Axes.plot(), lorsqu’on lui passe un format de marqueur sans trait de liaison (par exemple marker='o', linestyle=''), trace des points identiques à très haute performance. Elle traite l’ensemble des marqueurs comme un tracé graphique unique, ce qui la rend considérablement plus véloce pour manipuler des échantillons denses excédant plusieurs dizaines de milliers d’observations.
À l’opposé, la méthode Axes.scatter() instancie une collection géométrique complète (une PathCollection). Cette architecture plus lourde offre une flexibilité incomparable : elle permet de faire varier individuellement la taille des points, leur couleur de remplissage, la teinte de leur bordure ou leur degré d’opacité en fonction de vecteurs d’observations tiers. Dans notre contexte d’analyse bivariée standard, Axes.scatter() constitue l’outil privilégié en permettant de moduler l’opacité (paramètre alpha) afin de désamorcer l’occultation visuelle en cas de chevauchement dense des coordonnées cartésiennes.
4.2 Calcul des coefficients d’ajustement avec numpy.polyfit
Une fois le nuage d’observations empiriques projeté sur la grille orthogonale, l’étape subséquente consiste à dériver les paramètres mathématiques de la droite d’ajustement sans recourir à un moteur d’inférence lourd. La bibliothèque NumPy fournit pour cet usage une routine d’ajustement polynomial particulièrement robuste et universelle : la fonction numpy.polyfit(). Cette méthode implémente la résolution des moindres carrés ordinaires par l’intermédiaire d’une factorisation en valeurs singulières (SVD) de la matrice de Vandermonde associée aux observations, garantissant une remarquable stabilité numérique même en présence de matrices mal conditionnées.
Pour ajuster un modèle linéaire du premier ordre, la fonction prend comme arguments les vecteurs coordonnés des abscisses et des ordonnées, ainsi que le degré polynomial cible fixé à deg=1. L’appel fonctionnel s’articule comme suit :
pente, intercept = np.polyfit(x, y, deg=1)
La fonction retourne un tableau de scalaires correspondant aux coefficients du polynôme ordonnés par puissances décroissantes, isolant ainsi la pente empirique b_1 en premier élément et la constante b_0 en second. NumPy propose également le module modernisé numpy.polynomial.polynomial dont la classe Polynomial.fit() évite les instabilités liées à l’ordre des paramètres en adaptant dynamiquement l’échelle du domaine. Ces coefficients permettent de dériver immédiatement l’expression analytique de la trajectoire d’ajustement.
Il importe de souligner que numpy.polyfit() opère purement sur le plan géométrique et déterministe : il ne calcule pas intrinsèquement les erreurs-types des estimateurs, ni les valeurs p de significativité statistique associées aux coefficients, ni les résidus standardisés. Son utilité réside dans sa vitesse d’exécution chirurgicale et son absence de dépendance envers des bibliothèques externes complexes, en faisant la méthode de prédilection pour l’affichage visuel direct au sein d’environnements computationnels contraints.
4.3 Superposition de la droite de régression sur le graphique
L’intégration graphique de la droite d’ajustement calculée sur le nuage de points préexistant s’opère par la superposition ordonnée d’un tracé vectoriel continu au moyen de la méthode Axes.plot(). Il convient de prêter une attention rigoureuse à la discrétisation spatiale de la variable indépendante pour générer ce tracé. Une erreur fréquente consiste à injecter directement le vecteur x d’origine non trié dans le calcul de projection, ce qui, dans le cas d’ajustements d’ordre supérieur, produit des tracés en dents de scie désordonnés en raison de l’interconnexion linéaire des points dans leur ordre séquentiel d’apparition.
La bonne pratique académique impose la construction d’un vecteur synthétique équi-réparti s’étendant exactement entre les valeurs minimale et maximale du domaine observé au moyen de la fonction numpy.linspace(). Par exemple :
x_modele = np.linspace(x.min(), x.max(), 200)
y_modele = pente * x_modele + intercept
Ce vecteur synthétique de 200 points garantit une régularité de tracé parfaite sans aucune rupture de pente perceptible. La projection de cette droite sur l’axe s’exécute ensuite en spécifiant des paramètres graphiques explicites : une largeur de ligne substantielle (linewidth=2), une couleur contrastant franchement avec la teinte des points (comme un rouge cramoisi opposé à un bleu ardoise), ainsi qu’un label informatif au sein de la légende reportant l’équation mathématique du modèle et le coefficient de détermination R² préalablement calculé.
Cette construction manuelle pas à pas Matplotlib/NumPy assure une maîtrise architecturale totale : le praticien contrôle précisément la hiérarchie visuelle, l’ordre d’empilement spatial des calques de rendu via le paramètre zorder (garantissant que la droite se situe au-dessus des marqueurs ou inversement), ainsi que l’ancrage spatial exact des métadonnées analytiques.
5. Méthode 2 : Approche automatisée et statistique avec Seaborn
5.1 Utilisation de seaborn.regplot pour une implémentation rapide
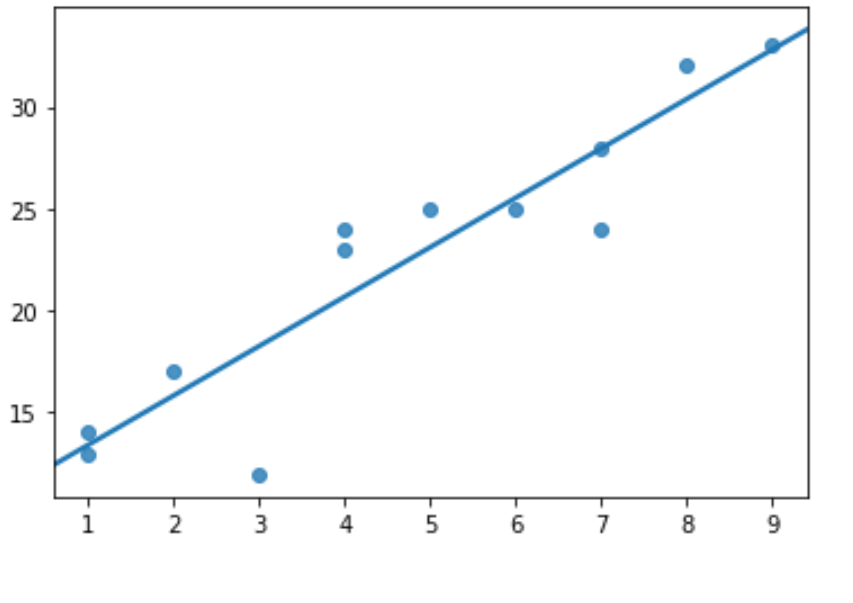
Pour les analyses exploratoires rapides et l’élaboration de visualisations statistiques prêtes pour la communication de résultats, la bibliothèque Seaborn offre des abstractions de très haut niveau qui automatisent la totalité du flux de travail arithmétique et graphique. Au centre de ce dispositif d’analyse bivariée se trouve la fonction seaborn.regplot(). Conçue spécifiquement pour fusionner le nuage de points et la modélisation linéaire en un appel fonctionnel unique et compact, cette fonction encapsule l’ajustement numérique, l’inférence des marges d’erreur et le rendu graphique au sein d’une interface syntaxique fluide.
La commande fondamentale s’exprime sous la forme paradigmatique suivante :
sns.regplot(x='heures_apprentissage', y='score_precision', data=df, ax=ax, scatter_kws={'alpha':0.6}, line_kws={'color':'firebrick'})
En acceptant directement un objet DataFrame de Pandas conjointement avec les identifiants textuels de colonnes, regplot() décharge le programmeur de toute extraction vectorielle préliminaire. La fonction prend en charge automatiquement le filtrage des valeurs manquantes par paire (pairwise deletion), garantissant qu’aucune anomalie de calcul ne vienne corrompre l’inférence des moindres carrés ordinaires.
Par ailleurs, la fonction offre une séparation élégante entre la personnalisation esthétique du nuage de points primaire et celle de la trajectoire linéaire modélisée grâce aux dictionnaires d’arguments scatter_kws et line_kws. Cette souplesse permet de modifier simultanément la morphologie géométrique des marqueurs (taille, couleur de bordure, transparence) et la signature visuelle de la droite d’ajustement (épaisseur du trait, motif pointillé, teinte colorimétrique), préservant la compatibilité intégrale avec l’écosystème de styles de Matplotlib sur lequel repose le moteur de rendu interne de Seaborn.
5.2 Tracé et interprétation de l’intervalle de confiance
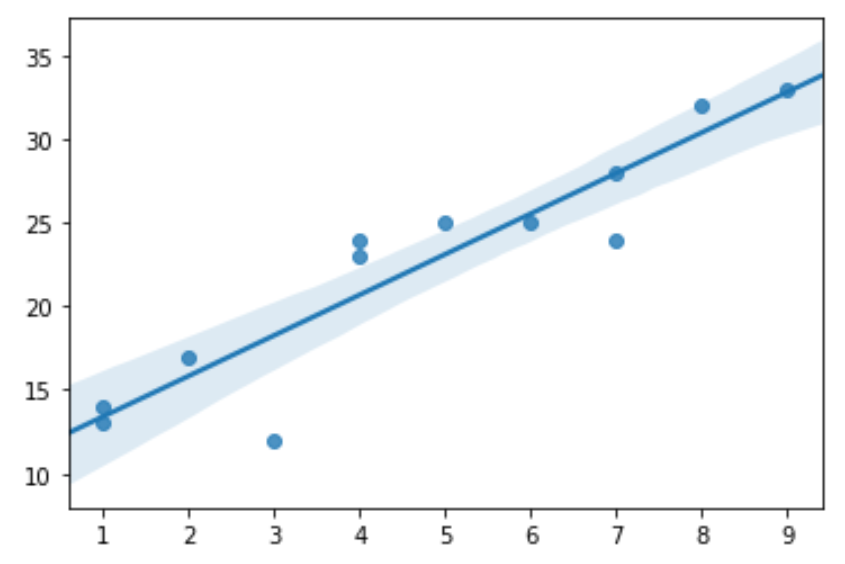
L’apport méthodologique majeur de Seaborn réside dans sa capacité à enrichir immédiatement la droite d’ajustement d’un intervalle de confiance statistique, représenté graphiquement sous la forme d’un ruban translucide englobant la trajectoire de régression. Par défaut, seaborn.regplot() paramètre cet intervalle à un niveau de confiance de 95 % (argument ci=95). Il est crucial de comprendre que ce ruban ombré ne reflète pas l’intervalle de prédiction individuel des futures observations empiriques, mais bien l’intervalle de confiance encadrant la valeur attendue de la moyenne conditionnelle de la population (l’espérance mathématique conditionnelle E(Y|X)).
Sur le plan algorithmique, Seaborn calcule cet intervalle au moyen d’un rééchantillonnage avec remise (bootstrap non paramétrique). Cette approche empirique présente l’immense avantage théorique de ne pas reposer sur l’hypothèse stricte de normalité gaussienne des résidus d’échantillonnage : le jeu de données est rééchantillonné de multiples fois (typiquement 1 000 itérations) afin de générer une distribution empirique des pentes et des ordonnées à l’origine possibles, délimitant ainsi les percentiles supérieur (97,5 %) et inférieur (2,5 %) de la droite estimée.
Morphologiquement, ce ruban adopte une silhouette caractéristique en diabolo ou en sablier, manifestant un étranglement prononcé au niveau du barycentre des coordonnées (x_barre, y_barre) et un évasement progressif à mesure que l’on s’écarte vers les extrémités de la distribution observée. Cette géométrie traduit directement l’incertitude épistémique inhérente à l’échantillonnage : l’estimation de la moyenne conditionnelle bénéficie d’une densité d’information maximale au cœur du nuage de données, tandis que la trajectoire des pentes plausibles diverge structurellement aux marges de l’espace empirique.
5.3 Comparaison fonctionnelle entre regplot et lmplot
Au sein de la bibliothèque Seaborn, il existe une dualité architecturale fondamentale entre les fonctions d’ajustement regplot() et lmplot(), source fréquente de confusion pour les utilisateurs intermédiaires. Bien que ces deux procédures partagent le même moteur computationnel sous-jacent pour l’ajustement linéaire et le rééchantillonnage des intervalles de confiance, elles occupent des niveaux d’abstraction diamétralement distincts au sein de la hiérarchie logicielle.
La fonction seaborn.regplot() est une fonction dite de niveau axe (axes-level function). Cela signifie qu’elle dessine exclusivement au sein de l’objet matplotlib.axes.Axes qui lui est explicitement alloué via le paramètre ax. En conséquence, regplot() s’intègre avec une flexibilité totale dans des configurations matricielles complexes générées manuellement par plt.subplots(), permettant de juxtaposer au sein d’une même figure globale un nuage de points de régression, un histogramme marginal et une boîte à moustaches.
À l’inverse, seaborn.lmplot() est une fonction de niveau figure (figure-level function), bâtie au sommet de la classe FacetGrid. L’invocation de lmplot() instancie et gouverne de manière autonome sa propre structure de fenêtrage multi-axes. La finalité prioritaire de lmplot() réside dans la stratification multidimensionnelle des données : en utilisant des arguments de partitionnement sémantique tels que hue, col et row, lmplot() déploie instantanément un réseau orthogonal de sous-graphiques bivariés distincts conditionnés par les modalités de variables qualitatives catégorielles d’intérêt. Pour des tracés bivariés isolés nécessitant une intégration fine dans des sous-figures Matplotlib complexes, regplot() est le choix architectural adéquat ; pour une exploration multivariée stratifiée par facteurs, lmplot() s’avère considérablement plus puissant et direct.
6. Méthode 3 : Modélisation formelle et inférentielle avec Statsmodels
6.1 Estimation rigoureuse du modèle OLS (Ordinary Least Squares)
Lorsque la finalité de l’étude analytique dépasse la simple exploration graphique pour s’inscrire dans le cadre formel de la validation d’hypothèses statistiques et de l’économétrie appliquée, la bibliothèque Statsmodels constitue le standard de rigueur méthodologique. Contrairement à Matplotlib ou Seaborn, dont la vocation principale demeure visuelle, Statsmodels se concentre sur l’estimation mathématique intégrale des matrices de covariance, le calcul de la statistique de Student, des p-valeurs exactes, des critères d’information (AIC, BIC) et des diagnostics d’hétéroscédasticité.
L’estimation formelle d’un modèle de moindres carrés ordinaires sous Statsmodels s’opère usuellement via le module statsmodels.api. Un impératif structurel propre à cette approche réside dans l’adjonction explicite du terme constant. En effet, par convention d’algèbre matricielle, Statsmodels ne postule pas a priori l’existence d’une ordonnée à l’origine afin de préserver la possibilité d’ajuster des modèles contraints passant rigoureusement par le point d’origine cartésien. Il est donc obligatoire de transformer le vecteur indépendant x en une matrice d’expérience à deux colonnes incorporant un vecteur unitaire via la fonction sm.add_constant() :
X_avec_constante = sm.add_constant(x)
modele = sm.OLS(y, X_avec_constante)
resultats = modele.fit()
L’invocation de la méthode summary() sur l’objet de résultats génère alors une table académique standardisée consignant l’ensemble des grandeurs statistiques du modèle : coefficients estimés (coef), erreurs-types associées (std err), statistiques de Student (t), probabilités critiques bilatérales (P>|t|), intervalles de confiance paramétriques à 95 %, ainsi que les statistiques globales du modèle telles que le F-statistic et les diagnostics d’asymétrie (Skewness) et d’aplatissement (Kurtosis) des résidus.
6.2 Visualisation graphique intégrant les intervalles de prédiction
L’un des avantages fondamentaux de l’estimation formelle via Statsmodels réside dans la dissociation mathématique rigoureuse entre l’intervalle de confiance de la droite de régression et l’intervalle de prédiction des observations individuelles. Tandis que l’intervalle de confiance quantifie l’incertitude relative à la position moyenne de la droite théorique dans la population, l’intervalle de prédiction incorpore simultanément cette incertitude paramétrique et la variance stochastique inhérente au phénomène aléatoire (l’aléa σ² des résidus individuels). En conséquence, l’intervalle de prédiction est structurellement beaucoup plus large que l’intervalle de confiance moyen.
Pour calculer et représenter graphiquement ces deux faisceaux probabilistes distincts, on recourt à la méthode get_prediction() appliquée à une grille dense de valeurs indépendantes :
predictions = resultats.get_prediction(X_grille)
cadre_predictions = predictions.summary_frame(alpha=0.05)
Le DataFrame résultant fournit directement les bornes analytiques nécessaires :
mean: la valeur attendue ponctuelle (trajectoire centrale de la droite d’ajustement).mean_ci_loweretmean_ci_upper: les bornes inférieure et supérieure de l’intervalle de confiance à 95 % de la moyenne conditionnelle.obs_ci_loweretobs_ci_upper: les bornes inférieure et supérieure de l’intervalle de prédiction à 95 % pour une observation individuelle future.
Sur le canevas graphique de Matplotlib, ces grandeurs sont superposées au nuage de points d’origine au moyen de la méthode Axes.fill_between(). L’analyste projette d’abord le faisceau de confiance moyen sous une opacité modérée, puis englobe l’ensemble dans le ruban de prédiction individuel sous une opacité plus faible ou délimité par des lignes discontinues. Cette double stratification sémiotique offre au lecteur une compréhension instantanée et exhaustive de la précision du modèle : environ 95 % des observations réelles doivent s’inscrire à l’intérieur du fuseau de prédiction externe, tandis que l’étroitesse du fuseau interne renseigne sur la solidité de l’estimation de la pente globale.
6.3 Incorporation des métriques statistiques sur le graphique
La valeur démonstrative d’une visualisation académique est considérablement renforcée lorsque les métriques inférentielles fondamentales sont incrustées directement dans le champ graphique, évitant ainsi au lecteur d’avoir à rechercher ces valeurs critiques au sein du texte narratif ou des tableaux annexes. L’incorporation programmatique de ces indices requiert l’extraction sélective des valeurs numériques stockées dans l’objet de résultats de Statsmodels, suivie de leur formatage typographique au sein d’une boîte d’annotation textuelle.
Les métriques indispensables à faire figurer dans ce cadre contextuel sont le coefficient de détermination R² (ou le R² ajusté), la statistique de significativité globale F associée à sa p-valeur correspondante, ainsi que la valeur estimée de la pente accompagnée de son erreur-type standard. Le formatage de ces chaînes de caractères obéit aux normes de précision de la discipline (usuellement trois décimales significatives pour les coefficients et notation exponentielle ou seuil standardisé tel que p < 0.001 pour les probabilités infimes).
L’affichage s’exécute à l’aide de la méthode Axes.text() de Matplotlib, en privilégiant l’utilisation des coordonnées relatives aux axes plutôt que des coordonnées brutes des données :
ax.text(0.05, 0.95, texte_statistiques, transform=ax.transAxes, verticalalignment='top', bbox=dict(boxstyle='round,pad=0.5', facecolor='white', alpha=0.8, edgecolor='gray'))
L’utilisation de transform=ax.transAxes lie l’ancrage spatial du bloc textuel aux limites relatives du panneau de traçage (le point (0, 0) représentant le coin inférieur gauche et (1, 1) le coin supérieur droit), assurant que l’encadré d’information demeure parfaitement positionné quelles que soient les modifications ultérieures apportées aux échelles ou aux bornes des axes empiriques.
7. Personnalisation esthétique et sémiotique pour les revues académiques
7.1 Typographie, étiquetage précis et normes éditoriales (APA)
La conversion d’une ébauche graphique exploratoire en une figure digne des plus prestigieuses revues scientifiques internationales (telles que les publications de l’American Psychological Association, ou APA) obéit à des règles éditoriales rigides de clarté, de sobriété et de typographie. Le postulat fondamental de ces normes prescrit l’élimination scrupuleuse de tout bruit visuel parasite (chartjunk), au profit d’un ratio données/encre maximal, théorisé par Edward Tufte. Chaque marque typographique, chaque graduation et chaque ligne directrice doivent apporter une valeur informative irremplaçable.
Sur le plan typographique, les normes académiques proscrivent l’usage de polices décoratives ou fantaisistes, préconisant l’emploi strict de polices sans empattement hautement lisibles à petite échelle (comme Arial, Helvetica ou Computer Modern Sans Serif) ou de polices à empattement canoniques pour les manuscrits de sciences humaines (Times New Roman). L’implémentation sous Matplotlib s’effectue globalement via la modification des paramètres d’exécution runtime (matplotlib.rcParams) :
plt.rcParams['font.sans-serif'] = 'Helvetica'
plt.rcParams['font.family'] = 'sans-serif'
plt.rcParams['font.size'] = 10
L’étiquetage des axes cartésiens doit être d’une précision chirurgicale. Il est impératif de stipuler explicitement le nom complet de la variable conceptuelle, accompagné impérativement entre parenthèses de son unité de mesure dimensionnelle standardisée (par exemple : Temps de réponse perceptif (ms) et non simplement TR). L’orientation typographique du label de l’axe vertical doit être maintenue horizontale ou pivoter selon un angle rigoureux de 90 degrés pour faciliter la lecture. Conformément aux directives APA (7e édition), les figures ne doivent pas comporter de titre graphique redondant massif incrusté au sommet du canevas ; la désignation ordonnée de la figure ainsi que son titre descriptif en italique doivent être déportés dans la légende textuelle du manuscrit sous-jacent.
7.2 Choix des palettes de couleurs et accessibilité visuelle
La conception sémiotique moderne impose une vigilance accrue envers l’accessibilité visuelle des productions scientifiques. Une proportion substantielle de la population scientifique — notamment masculine — présente des anomalies de la vision trichromatique (daltonisme, deutéranopie, protanopie). En outre, nombre de tirages académiques continuent d’être reproduits ou imprimés en nuances de gris physiques. L’utilisation naïve de combinaisons chromatiques binaires traditionnelles (telles que le vert et le rouge pour signaler des contrastes directionnels) constitue un manquement méthodologique disqualifiant.
L’analyste veillera à adopter des échelles de couleurs perceptuellement uniformes développées scientifiquement pour pallier ces déficiences, telles que les palettes Viridis, Cividis ou les dégradés sélectifs de ColorBrewer. Pour la superposition d’un nuage univarié et de sa régression, l’usage d’une teinte neutre à saturation modérée pour les observations empiriques (comme un gris ardoise ou un bleu marine atténué) contrastée par une couleur vive univoque pour la droite d’ajustement (telle qu’une nuance vermillon ou ambre foncé) garantit une lisibilité maximale.
Cette distinction chromatique doit s’accompagner d’une redondance sémiotique par la géométrie et la texture :
- Différenciation de la trajectoire centrale par un tracé plein contrastant avec les intervalles de confiance délimités par des traits tiretés ou des hachures vectorielles.
- Application d’un léger contour sombre ou blanc (paramètre
edgecolor) autour des marqueurs ponctuels du nuage de points pour préserver leur intelligibilité géométrique individuelle même en présence d’agrégations locales denses. - Calibration minutieuse de la transparence alpha (comprise usuellement entre 0.4 et 0.7) afin que la superposition spatiale des points ne masque pas la trajectoire de la droite de régression sous-jacente.
7.3 Structuration fine des axes, graduations et grilles
L’architecture spatiale du cadre de référence (les axes et leurs graduations) conditionne la perception quantitative du lecteur. Un graphique académique ne doit jamais laisser ses limites de projection s’ajuster de manière aveugle aux bornes extrêmes des données brutes, au risque d’écraser des marqueurs contre les bordures extérieures du cadre. Il convient d’introduire un espace respiratoire contrôlé — typiquement une marge de 5 à 10 % au-delà des observations extrêmes — en calibrant manuellement les méthodes set_xlim() et set_ylim().
La standardisation contemporaine recommande la suppression des bordures supérieures et droites superflues (appelées « spines » dans Matplotlib), qui enferment inutilement la figure dans un cadre étouffant sans véhiculer la moindre graduation informationnelle. Cette désactivation s’opère élégamment via la commande sns.despine() ou manuellement par la désactivation de la visibilité des bordures correspondantes :
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
Les graduations principales (major ticks) doivent être dirigées vers l’extérieur de l’axe (tick_params(direction='out')) afin d’éviter qu’elles n’empiètent sur les points situés à proximité immédiate des lignes d’axes. Concernant l’intégration d’une grille cartésienne d’arrière-plan, la parcimonie est de rigueur : si une grille s’avère indispensable pour faciliter l’interpolation mentale des coordonnées de points spécifiques, elle doit être reléguée au second plan sémiotique au moyen d’un tracé très discret (couleur gris très clair, motif pointillé fin et indice zorder=0 plaçant la grille en dessous de l’ensemble des éléments de données).
8. Diagnostic visuel et analyse des résidus associés au modèle
8.1 Visualisation des distances résiduelles individuelles
Bien que la droite d’ajustement matérialise la tendance centrale du modèle, la validité interne de la régression linéaire se jauge avant tout à travers l’inspection des écarts qui séparent chaque observation empirique de sa projection théorique. Pour rendre palpable la notion géométrique fondamentale de minimisation des moindres carrés, il est particulièrement instructif de tracer visuellement les segments de résidus reliant directement les coordonnées réelles (x_i, y_i) à leurs coordonnées prédites correspondantes (x_i, y_chapeau_i).
Dans Matplotlib, cette visualisation s’élabore à l’aide de la méthode Axes.vlines() (vertical lines) :
ax.vlines(x, y, y_ajuste, color='gray', linestyle=':', alpha=0.6, linewidth=1)
Ce procédé graphique trace instantanément l’ensemble des tiges d’écart vertical. L’impact didactique et analytique de cette représentation est immédiat : elle concrétise visuellement la fonction objective des moindres carrés — c’est la somme des carrés de la longueur de l’ensemble de ces micro-segments verticaux que l’algorithme a minimisée de manière absolue. Cette vue permet d’isoler au premier coup d’œil les observations pour lesquelles l’erreur d’ajustement est disproportionnée, offrant un point de départ qualitatif pour l’inspection des points atypiques.
8.2 Tracé du graphique des résidus par rapport aux valeurs ajustées
L’outil diagnostique le plus important dans l’arsenal de l’analyste demeure sans conteste le graphique des résidus en fonction des valeurs ajustées (Residuals vs Fitted plot). La projection du nuage de points brut peut fréquemment masquer des violations insidieuses des postulats de Gauss-Markov, car l’œil humain a tendance à se focaliser sur l’inclinaison dominante de la droite plutôt que sur la structure fine de la dispersion orthogonale. En opérant une rotation de l’espace pour projeter les résidus e_i sur l’axe vertical en fonction des valeurs prédites y_chapeau_i sur l’axe horizontal, on élimine la pente globale pour examiner exclusivement le signal d’erreur stochastique.
Dans un modèle parfaitement spécifié et validant l’ensemble des hypothèses statistiques fondamentales, le nuage des résidus doit adopter l’apparence d’une « bande horizontale amorphe » exempte de toute configuration discernable, uniformément distribuée de part et d’autre de la ligne d’ordonnée zéro (e = 0). Deux pathologies classiques se détectent immédiatement sur ce tracé :
- Présence d’une non-linéarité : Si le nuage des résidus dessine une courbure systématique (en forme de parabole concave ou convexe), la relation sous-jacente entre les variables est structurellement curviligne et l’ajustement linéaire du premier ordre constitue une sous-spécification du modèle théorique.
- Hétéroscédasticité caractérisée : Si la dispersion verticale des résidus s’évase ou se resserre le long de l’axe des valeurs ajustées, dessinant une silhouette d’entonnoir (funnel shape) ou de mégaphone, le postulat d’homoscédasticité est formellement réfuté, indiquant que l’incertitude du modèle n’est pas stationnaire.
L’ajout d’une ligne de lissage non paramétrique de type LOESS (Locally Estimated Scatterplot Smoothing) en surimpression sur ce graphique diagnostique constitue un moyen extrêmement efficace de matérialiser visuellement toute déviation de l’espérance locale résiduelle par rapport au zéro théorique.
8.3 Représentation combinée : nuage principal et panneau diagnostique
Pour atteindre un niveau de synthèse éditoriale optimal, il est hautement recommandé d’assembler, au sein d’une figure multi-panneaux intégrée, le graphique bivarié d’origine et son panneau diagnostique de résidus associé. Cette disposition synoptique permet à l’examinateur ou au relecteur académique de confronter instantanément la trajectoire d’ajustement brute à l’examen critique de ses perturbations.
La structuration géométrique de cette figure composite se réalise avec précision via le gestionnaire de disposition GridSpec de Matplotlib :
fig = plt.figure(figsize=(10, 8))
gs = fig.add_gridspec(2, 1, height_ratios=[3, 1], hspace=0.15)
ax_primaire = fig.add_subplot(gs[0])
ax_residus = fig.add_subplot(gs[1], sharex=ax_primaire)
Cette articulation technique offre des avantages ergonomiques considérables : en assignant un ratio de hauteur dissymétrique (par exemple 3 pour 1), le panneau supérieur conserve la prépondérance visuelle consacrée aux données empiriques brutes et à la droite de régression formelle. Le panneau inférieur, de dimensions plus resserrées, accueille le tracé des résidus individuels projetés le long du même axe d’abscisse grâce au paramètre sharex=ax_primaire. Ainsi, chaque point du graphique d’origine se trouve rigoureusement aligné verticalement avec son résidu d’ajustement correspondant, facilitant une inspection visuelle directe et chirurgicale de la fidélité locale du modèle.
9. Gestion des cas complexes : non-linéarité, hétéroscédasticité et aberrations
9.1 Détection et pondération des points aberrants et influents
La vulnérabilité majeure de la méthode des moindres carrés ordinaires découle directement de sa fonction objective quadratique : un unique point d’observation anormalement déporté peut à lui seul faire pivoter artificiellement la droite de régression, dégradant l’exactitude du modèle pour l’ensemble des données légitimes. Il convient toutefois de distinguer rigoureusement sur le plan conceptuel un point aberrant d’un point influent.
Un point aberrant (outlier) correspond à une observation dont l’ordonnée empirique y_i s’écarte radicalement de la valeur prédite par le modèle, générant un résidu standardisé exceptionnellement élevé en valeur absolue (usuellement supérieur à 3 écarts-types). Un point à fort levier (high leverage point), quant à lui, est caractérisé par une valeur extrême sur la variable indépendante x_i, se situant très loin du barycentre des prédicteurs. Une observation ne devient formellement influente que si elle combine un résidu non nul avec un levier substantiel, altérant significativement la valeur des paramètres estimés lorsqu’on l’omet du processus d’ajustement.
La quantification de cette influence s’opère au moyen de la Distance de Cook. Sous Python, cette distance d’influence peut être extraite directement via l’objet OLSInfluence de Statsmodels :
influence = resultats.get_influence()
distances_cook = influence.cooks_distance[0]
Pour représenter graphiquement cette dimension au sein du nuage de points, une technique sémiotique élégante consiste à moduler la surface des marqueurs géométriques proportionnellement à leur distance de Cook respective (paramètre s=distances_cook * facteur_echelle dans Axes.scatter()). Les observations exerçant une traction disproportionnée sur la droite d’ajustement apparaissent alors sous forme de cercles dilatés, alertant immédiatement l’analyste sur la nécessité d’enquêter sur l’intégrité de ces mesures ou d’opter pour des méthodes d’ajustement robustes (telles que la régression de Huber ou les M-estimateurs de RLM dans Statsmodels).
9.2 Modélisation et visualisation des relations curvilignes
Lorsque le diagnostic des résidus démontre sans ambiguïté une trajectoire non linéaire, contraindre les données dans le carcan d’une droite de régression du premier degré constitue une faute méthodologique grave. Le modèle linéaire peut être aisément étendu pour capturer des relations curvilinéaires en incorporant des puissances polynomiales de la variable explicative tout en demeurant strictement linéaire par rapport à ses paramètres.
Sous Seaborn, l’exploration d’un ajustement polynomial d’ordre supérieur s’exécute de manière totalement transparente au moyen de l’argument order au sein de seaborn.regplot() :
sns.regplot(x='x', y='y', data=df, order=2, ax=ax, scatter_kws={'alpha':0.5})
En fixant order=2, la fonction procède automatiquement à l’estimation d’une parabole quadratique de type y = b_0 + b_1 * x + b_2 * x² et recalcule le ruban d’intervalle de confiance bootstrappé autour de cette trajectoire curviligne continue. Si le phénomène suggère une saturation progressive plutôt qu’une inflexion parabolique symétrique, Seaborn permet également d’ajuster une régression logistique bivariée (argument logistic=True si la variable dépendante est binaire) ou un modèle à lissage non paramétrique robuste via LOESS (argument lowess=True).
L’utilisation de lowess=True affranchit totalement l’analyse de tout postulat paramétrique préalable : la courbe d’ajustement est construite point par point par des régressions locales pondérées en fonction de la proximité spatiale des voisins, matérialisant visuellement la tendance empirique pure sans la contraindre à épouser une formule mathématique globale fermée.
9.3 Prise en compte des transformations de variables
Une alternative élégante à l’introduction de polynômes explicites consiste à stabiliser la variance ou à linéariser la relation structurelle par le biais de transformations mathématiques univariées appliquées en amont sur les séries de données. Dans de nombreuses disciplines empiriques, les grandeurs économiques, démographiques ou biologiques suivent des lois de puissance ou des dynamiques exponentielles où l’effet marginal d’une variation n’est pas additif mais multiplicatif.
La transformation la plus universelle est la transformation logarithmique népérienne. Deux approches conceptuelles distinctes s’offrent alors pour la représentation graphique :
- Transformation des données brutes : On calcule au préalable
np.log(x)et/ounp.log(y)dans le DataFrame, puis on trace un graphique cartésien standard dont les axes représentent les grandeurs transformées. Bien que mathématiquement directe, cette méthode détériore l’interprétabilité intuitive, car les échelles numériques affichent des valeurs logarithmiques déconnectées des unités de mesure concrètes du domaine étudié. - Transformation de l’échelle des axes : L’approche méthodologiquement supérieure consiste à conserver les valeurs empiriques brutes au sein des vecteurs de données, mais à paramétrer le moteur de rendu de Matplotlib pour projeter l’espace selon une échelle logarithmique (au moyen de
Axes.set_xscale('log')ouAxes.set_yscale('log')).
Dans ce cadre géométrique non euclidien, la droite de régression calculée selon le modèle log-linéaire ou log-log doit être projetée de façon continue en adaptant la discrétisation vectorielle avec numpy.geomspace() ou numpy.logspace() au lieu de linspace(), assurant une densité d’évaluation géométrique homogène le long des cycles de puissances de 10 de l’axe transformé.
10. Comparaison de plusieurs groupes : régressions multiples et modération
10.1 Nuages de points catégorisés avec droites d’ajustement stratifiées
Dans les protocoles de recherche quasi-expérimentaux ou observationnels, il est rare qu’une relation bivariée opère en vase clos au sein d’un échantillon parfaitement homogène. La population étudiée se subdivise fréquemment en sous-groupes discrets — tels que le groupe clinique expérimental face au groupe contrôle placebo, ou différentes cohortes d’âge. Superposer aveuglément l’ensemble de ces sous-populations au sein d’une droite de régression unique expose l’analyste au redoutable paradoxe de Simpson, où une corrélation globale agrégée peut s’avérer diamétralement inverse aux corrélations partielles observées au sein de chaque strate sous-jacente.
Pour prévenir cet écueil épistémologique, il convient d’exécuter des régressions stratifiées par classe catégorielle, associant à chaque modalité factorielle une palette chromatique et un style géométrique dédiés. La fonction seaborn.lmplot() excelle dans cette tâche en exploitant son paramètre sémantique hue :
sns.lmplot(x='heures_apprentissage', y='score_precision', hue='groupe_traitement', data=df, palette='Set2', aspect=1.3, markers=['o', 's'])
Cette instruction déploie automatiquement un partitionnement stratifié de l’espace graphique :
- Les observations empiriques sont dissociées par des marqueurs géométriques et des codes chromatiques contrastés.
- Une estimation des moindres carrés distincte est menée indépendamment sur chaque sous-échantillon.
- Chaque droite d’ajustement est superposée avec son faisceau d’intervalle de confiance bootstrappé respectif.
- Une légende contextuelle unifiée est générée en périphérie immédiate du panneau de projection.
Cette approche permet d’évaluer visuellement en un coup d’œil si les sous-groupes partagent une même ordonnée à l’origine (effet principal de groupe) tout en conservant une trajectoire conjointe parallèle.
10.2 Illustration graphique de l’effet modérateur (interaction)
L’extension analytique directe de la régression stratifiée correspond, dans le vocabulaire statistique des sciences comportementales, à l’analyse de modération ou d’interaction statistique. Une modération se matérialise mathématiquement lorsque l’intensité ou la direction de la relation linéaire unissant la variable indépendante X à la variable dépendante Y fluctue conditionnellement en fonction de la magnitude d’une troisième variable modératrice Z.
Sur le plan géométrique, l’existence d’une interaction statistiquement significative entre deux variables quantitatives continues se traduit sans ambiguïté par un non-parallélisme des droites d’ajustement conditionnelles. Si les droites associées aux différents niveaux du modérateur s’avèrent rigoureusement parallèles, l’effet est purement additif (absence d’interaction). Si, en revanche, les droites se croisent ou exhibent des angles d’inclinaison divergents (des pentes statistiquement hétérogènes), l’effet modérateur est manifeste.
Pour rendre compte visuellement d’un effet d’interaction impliquant une variable modératrice continue, la convention méthodologique standard (popularisée par Aiken et West) consiste à discrétiser synthétiquement le modérateur en trois strates fonctionnelles d’évaluation :
- La moyenne de la variable modératrice : Z_barre.
- Le niveau modérateur bas, positionné à un écart-type en dessous de la moyenne : Z_barre – 1 * SD.
- Le niveau modérateur haut, positionné à un écart-type au-dessus de la moyenne : Z_barre + 1 * SD.
En projetant ensuite les trois droites de régression conditionnelles correspondantes (générées via un modèle interactif sous Statsmodels intégrant le terme de produit X * Z) sur le nuage de points global, le chercheur offre une transcription spatiale accessible des effets conditionnels simples (simple slopes), dégageant avec une netteté totale les régimes de fonctionnement différentiels du phénomène sous observation.
10.3 Gestion de l’encombrement graphique et lisibilité multi-groupes
Dès lors qu’une analyse bivariée implique la superposition de trois sous-groupes ou davantage au sein d’un même repère cartésien, le phénomène d’occultation visuelle (overplotting) menace la lisibilité globale. L’entrecroisement désordonné des droites de régression couplé au chevauchement massif des marqueurs de données engendre une saturation perceptive rendant l’extraction d’information pratiquement impossible.
Plusieurs stratégies de remédiation sémiotique doivent être déployées pour préserver l’élégance et la clarté du manuscrit :
- Le partitionnement en facettes (Small Multiples) : Plutôt que de superposer l’ensemble des groupes au sein d’un canevas unique surchargé, il est nettement plus judicieux de décomposer la figure en une matrice de sous-graphiques partageant une échelle commune d’axes au moyen de l’argument
col='categorie'dansseaborn.lmplot(). Chaque sous-groupe bénéficie ainsi de son propre panneau dédié, permettant une comparaison transversale immédiate sans aucune interférence de tracés. - L’atténuation de l’arrière-plan contextuel : Si la superposition sur un axe unique demeure requise pour des raisons éditoriales, une technique redoutablement efficace consiste à projeter l’intégralité de l’échantillon complet sous la forme d’un nuage de points grisés très discrets en arrière-plan de chaque panneau, tout en mettant en exergue au premier plan uniquement les points et la droite d’ajustement du sous-groupe focal.
- L’ajustement du tremblement stochastique (Jittering) : Lorsque les données empiriques proviennent d’échelles d’évaluation discrètes (telles que des échelles de Likert en psychométrie), de multiples observations partagent des coordonnées spatiales parfaitement identiques. L’injection d’une translation aléatoire infinitésimale sur les coordonnées de projection (via l’argument
x_jitterdansseaborn.regplot()) permet d’éclater visuellement les grappes de points sans corrompre le calcul de la droite d’ajustement sous-jacente.
11. Exportation haute résolution et intégration documentaire
11.1 Paramétrage des formats vectoriels et matriciels
L’ultime étape méthodologique de la production d’une figure statistique réside dans son exportation numérique depuis l’environnement d’exécution Python vers le système de fichiers local. Une erreur récurrente consiste à exporter indistinctement des représentations bivariées sous des formats compressés destructifs (tels que le format JPEG standard), ce qui génère des artefacts de compression flous autour des lignes de tracé fines et des étiquettes typographiques lors de la phase de composition prépresse.
Une distinction fondamentale doit être opérée entre les deux grandes familles de formats d’exportation graphique :
- Les formats vectoriels (PDF, EPS, SVG) : Les formats vectoriels encodent les composants graphiques sous forme d’instructions géométriques et mathématiques closes (primitives de courbes de Bézier, coordonnées de points et glyphes de polices intégrées). En conséquence, une figure vectorielle jouit d’une indépendance d’échelle absolue : elle peut être agrandie ou réduite à l’infini sans la moindre dégradation de netteté. Le format PDF (Portable Document Format) et le format EPS (Encapsulated PostScript) représentent les standards incontournables pour la soumission d’articles aux revues académiques de premier rang.
- Les formats matriciels ou raster (PNG, TIFF) : Ces formats décomposent l’espace en une matrice fixe de pixels colorés. Lorsqu’un format matriciel est exigé par un comité éditorial, l’utilisation exclusive du format sans perte PNG (Portable Network Graphics) ou TIFF non compressé est impérative. La résolution d’échantillonnage spatiale doit être explicitement verrouillée à un minimum strict de 300 points par pouce (DPI), voire 600 ou 1 200 DPI pour les dessins au trait au noir pur.
L’instruction d’exportation sous Matplotlib doit systématiquement mobiliser les paramètres de configuration avancés suivants :
fig.savefig('figure_bivariee.pdf', format='pdf', dpi=300, bbox_inches='tight', pad_inches=0.05, transparent=False)
L’argument bbox_inches='tight' s’avère particulièrement crucial : il ordonne au moteur de rendu de recalculer dynamiquement la boîte englobante de la figure afin de tronquer les marges blanches excédentaires tout en garantissant qu’aucune étiquette d’axe déportée ne soit rognée lors de l’enregistrement sur disque.
11.2 Intégration transparente dans les manuscrits LaTeX et typographie mathématique
Pour les rédactions scientifiques exigeantes conduites sous l’environnement de composition typographique LaTeX, la cohérence visuelle d’un document exige une homogénéité totale entre la typographie du texte narratif et celle des annotations intégrées aux graphiques Python. Matplotlib intègre un moteur de rendu interne capable d’émuler la syntaxe mathématique de base au moyen d’un sous-ensemble TeX (en encadrant les chaînes de caractères de symboles dollar : ax.set_xlabel(r'$\beta_{\text{percept}} \times \Delta t$')).
Cependant, pour atteindre une intégration documentaire d’une perfection absolue, il est possible de déléguer l’intégralité du traitement typographique de la figure à l’interpréteur LaTeX du système hôte via la directive de configuration suivante :
plt.rcParams.update({'text.usetex': True, 'font.family': 'serif', 'font.serif': ['Computer Modern']})
Lorsque cette option est activée, chaque fragment de texte, graduation numérique ou libellé d’axe présent sur le graphique est directement composé par le moteur LaTeX local de la machine, garantissant une reproduction rigoureusement identique des polices, des graisses et du crénage des symboles mathématiques par rapport au reste de votre manuscrit. Lors de l’incorporation finale du fichier exporté au sein du document source TeX, l’utilisation du paquetage standard usepackage{graphicx} couplée à la directive includegraphics[width=columnwidth]{figure_bivariee.pdf} garantit un dimensionnement géométrique proportionnel irréprochable au sein des colonnes de texte du modèle éditorial.
11.3 Automatisation de rapports dynamiques
Dans les contextes d’analyse à haut débit, d’essais cliniques ou d’ingénierie prédictive, le traçage manuel d’un nuage de points et de sa régression devient rapidement contre-productif face à des dizaines de paires de variables à investiguer. L’élaboration de pipelines automatisés de production de rapports visuels s’impose alors comme une nécessité organisationnelle. Cette démarche repose sur la conception de fonctions d’encapsulation génériques acceptant en paramètres d’entrée le DataFrame, les étiquettes des variables à corréler, ainsi que les chemins de sortie des fichiers.
Ces modules peuvent être harmonieusement orchestrés au sein de carnets interactifs couplés à des outils de compilation dynamique tels que Quarto, JupyterBook ou les moteurs de génération de rapports automatisés basés sur Jinja2. L’encapsulation de ces routines au sein d’une architecture orientée objet permet d’itérer de façon systématique sur des centaines de covariables tout en garantissant l’application stricte d’une charte graphique immuable (palette de couleurs institutionnelle, seuils de significativité uniformes et formats d’exportation conformes).
En couplant ce dispositif à des frameworks de surveillance de modèles de données, il devient possible d’archiver de manière versionnée les instantanés graphiques bivariés de distributions à mesure que de nouveaux volumes de données empiriques sont ingérés dans les bases transactionnelles, prévenant la dérive conceptuelle (data drift) par un contrôle visuel et statistique continu.
12. Synthèse méthodologique, bonnes pratiques et erreurs critiques à éviter
12.1 Écueils fréquents d’extrapolation et d’interprétation causale
L’aisance avec laquelle les bibliothèques contemporaines de Python permettent de tracer une élégante droite d’ajustement au travers d’un nuage de points peut induire un sentiment trompeur de sécurité analytique. Le premier piège méthodologique majeur réside dans l’erreur d’extrapolation abusive en dehors du domaine de validité empirique. Une équation de régression ordinaire n’est formellement calibrée que sur l’intervalle spatial délimité par les valeurs minimale et maximale observées sur la variable explicative [x_min, x_max]. Projeter la droite d’ajustement au-delà de ces frontières empiriques pour prédire des comportements dans des régimes inexplorés postule de manière totalement gratuite que la linéarité locale observée perdure indéfiniment, méconnaissant les seuils de saturation, les ruptures structurelles ou les contraintes physiques des systèmes réels.
Le second écueil, immensément plus destructeur sur le plan épistémologique, consiste à confondre la corrélation statistique avec la causalité mécanique. L’existence d’une régression linéaire hautement significative dotée d’un R² proche de l’unité n’atteste en rien que la variable X gouverne causalement les fluctuations de la variable Y. Cette relation conjointe peut résulter de multiples mécanismes alternatifs :
- Une causalité inverse, où Y est le moteur effectif influençant X.
- La présence d’une variable confondante latente omise (third-variable problem), agissant simultanément sur X et Y et engendrant une corrélation fallacieuse (spurious correlation).
- Le biais de sélection de l’échantillon ou le conditionnement sur un collisionneur (collider bias), créant artificiellement une association linéaire au sein de l’échantillon alors que les variables sont parfaitement indépendantes dans la population globale.
L’analyste veillera scrupuleusement à modérer ses conclusions narratives en proscrivant les verbes à vocation strictement causale (tels que « provoque », « induit » ou « détermine ») au profit de tournures épistémiques décrivant l’association covariationnelle (comme « s’associe de manière monotone à » ou « est prédictif de »), à moins que le dispositif méthodologique ne s’appuie sur un essai randomisé contrôlé formel.
12.2 Liste de contrôle de conformité graphique et empirique
Avant d’intégrer définitivement une visualisation bivariée au sein d’un manuscrit soumis à relecture par les pairs ou d’un rapport décisionnel stratégique, il est impératif de confronter la figure à une grille de validation méthodologique rigoureuse. Cette liste de contrôle résume les exigences incontournables garantes d’une intégrité scientifique absolue :
- Validation formelle des distributions : L’inspection visuelle préalable a-t-elle confirmé l’absence de non-linéarité prononcée et l’absence de regroupements multimodaux artificiels ?
- Examen approfondi des résidus : Un graphique diagnostique des résidus a-t-il été tracé pour certifier l’absence d’hétéroscédasticité caractérisée et la conformité à l’hypothèse d’homoscédasticité ?
- Typographie et étiquetage dimensionnel : Les deux axes portent-ils des libellés informatifs complets précisant sans ambiguïté les unités de mesure physiques ou psychométriques entre parenthèses ?
- Sémiotique et contraste chromatique : La palette de couleurs retenue est-elle vérifiée pour les personnes daltoniennes et conserve-t-elle sa pleine lisibilité contrastive lors d’un tirage en niveaux de gris ?
- Clarification de la nature de l’intervalle : Si une zone ombragée englobe la droite, sa légende explicite-t-elle formellement s’il s’agit d’un intervalle de confiance sur la moyenne conditionnelle (typiquement à 95 %) ou d’un intervalle de prédiction individuel ?
- Révélation transparente des données d’origine : Le nuage de points est-il visible avec une opacité judicieusement calibrée pour permettre d’apprécier la densité réelle de l’échantillon sans masquer la droite de modélisation ?
- Absence de bruit graphique : Les bordures supérieure et droite inutiles ont-elles été éliminées, et les lignes de grille ont-elles été subordonnées visuellement en arrière-plan ?
- Résolution et format d’exportation : L’exportation finale a-t-elle été effectuée dans un format vectoriel (PDF/EPS) ou matriciel haute définition (PNG ≥ 300 DPI) exempt d’artéfacts de compression ?
12.3 Tableau comparatif des approches et arbre de décision programmatique
Pour guider le praticien dans le choix de l’outil informatique le plus pertinent face à un défi d’analyse spécifique, le tableau synthétique ci-dessous compare les trois approches fondamentales documentées au fil de ce guide :
| Caractéristique / Bibliothèque | NumPy & Matplotlib | Seaborn (regplot / lmplot) | Statsmodels & Matplotlib |
|---|---|---|---|
| Niveau d’abstraction | Bas niveau (atomique et manuel) | Haut niveau (statistique déclarative) | Intermédiaire (inférentiel formel) |
| Calcul des coefficients | Direct via polyfit (matriciel SVD) |
Automatisé en interne | Modèle formel sm.OLS complet |
| Intervalle de confiance | Non automatisé (formules manuelles requises) | Automatisé par défaut (Bootstrapping) | Analytique exact (Student / Fisher) |
| Intervalle de prédiction | Manuel (calculs de variance d’erreur) | Non disponible nativement | Direct via get_prediction() |
| Stratification multivariée | Boucles itératives manuelles | Natif via hue, col et row |
Manuel ou via l’interface formula |
| Contrôle esthétique fin | Illimité et absolu | Élégant par défaut, personnalisable | Délégué entièrement à Matplotlib |
| Tableau récapitulatif complet | Non | Non | Oui (results.summary()) |
Pour opérer un choix programmatique cohérent lors du démarrage d’une session d’investigation de données sous Python, l’analyste se conformera à la logique décisionnelle suivante :
- Si la priorité exclusive réside dans l’exploration visuelle ultra-rapide, la stratification multidimensionnelle selon plusieurs catégories d’échantillonnage et la communication préliminaire d’une tendance : optez sans hésitation pour Seaborn (
regplotoulmplot). - Si la finalité scientifique requiert une modélisation économétrique ou psychométrique stricte, avec communication des erreurs-types robustes, tests d’hypothèses sur la pente, analyse fine des leviers d’influence (Cook) et tracé rigoureux des intervalles de prédiction individuels : optez pour le couplage Statsmodels et Matplotlib.
- Si le projet s’inscrit au sein d’un pipeline logiciel contraint exigeant une empreinte de dépendance minimale, une exécution temps réel à ultra-haute vitesse sur de volumineuses matrices de calcul, ou l’imbrication dans une interface graphique sur mesure : déployez la construction pas à pas directe associant NumPy et Matplotlib.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (pp. 92–96). https://doi.org/10.25080/Majora-92bf1922-011
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22–30. https://doi.org/10.1109/MCSE.2011.37
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0