
Dans le domaine des sciences comportementales, de la psychologie cognitive et de la recherche biomédicale, la démarche expérimentale repose sur la comparaison rigoureuse de conditions empiriques pour tester des modèles théoriques complexes. Lorsqu’un chercheur souhaite évaluer l’effet d’une variable indépendante catégorielle comportant plusieurs modalités sur une variable dépendante continue, l’analyse de variance (ANOVA) constitue la méthode inférentielle de référence. Conçue initialement par Sir Ronald Fisher, cette approche permet de déterminer s’il existe une variation globale systématique entre les groupes qui dépasse ce que le simple hasard de l’échantillonnage pourrait produire.
Toutefois, la confirmation d’un effet statistiquement significatif à l’issue d’une ANOVA soulève un défi analytique immédiat : le test F omnibus indique qu’au moins deux moyennes diffèrent au sein de la population étudiée, mais demeure intrinsèquement muet quant à la localisation exacte de ces divergences. L’analyste se trouve alors confronté à une énigme d’attribution statistique. Est-ce le groupe clinique innovant qui surpasse le placebo standard, ou s’agit-il d’une divergence entre deux thérapies actives, ou encore d’un effet conjugué ? Tenter de répondre à ces interrogations par une cascade d’analyses non contrôlées expose le chercheur à un piège méthodologique majeur : l’inflation exponentielle du risque d’erreur de type I, couramment désignée sous le terme de prolifération des faux positifs.
Ce guide exhaustif a pour vocation d’explorer l’univers mathématique, méthodologique et pratique des tests post hoc appliqués à l’ANOVA. En abordant les fondements de la distribution de l’étendue studentisée, les subtilités des ajustements séquentiels, les corrections robustes face à l’hétéroscédasticité et les protocoles de rédaction conformes aux standards de l’American Psychological Association (APA 7e édition), cet article offre une feuille de route avancée pour les chercheurs, statisticiens et étudiants exigeants souhaitant allier puissance statistique, contrôle du risque familial et transparence empirique.
1. Introduction aux tests post hoc dans le cadre de l’ANOVA en psychologie
1.1 Rôle de l’analyse de variance dans la recherche expérimentale
L’analyse de variance unidirectionnelle ou factorielle constitue la pierre angulaire de l’évaluation quantitative des protocoles expérimentaux en psychologie. Son mécanisme opérationnel repose sur la décomposition mathématique de la variance totale observée au sein des données en deux composantes fondamentales : la variance intergroupes, qui capture les écarts entre les moyennes des différentes conditions expérimentales sous l’effet du traitement et de l’erreur, et la variance intragroupe (ou variance résiduelle), qui reflète la variabilité naturelle, biologique ou psychométrique existant entre des individus soumis à une condition strictement identique. En comparant le ratio de ces deux variances par le biais de la statistique F de Fisher-Snedecor, le chercheur évalue si les fluctuations constatées d’un groupe à l’autre excèdent raisonnablement le bruit de fond inhérent à l’échantillonnage aléatoire.
Historiquement, les praticiens recouraient de manière itérative au test t de Student pour comparer des paires de conditions. Cependant, dès que le devis expérimental intègre trois groupes ou plus, cette approche bilatérale isolée devient conceptuellement et statistiquement déficiente. Prenons l’exemple concret d’une étude clinique évaluant l’efficacité de différentes modalités de prise en charge du trouble dépressif majeur : un protocole assignant des patients de manière aléatoire soit à une thérapie cognitivo-comportementale (TCC), soit à une psychothérapie interpersonnelle (PIP), soit à une molécule pharmacologique de référence (ISRS), soit à un groupe témoin sur liste d’attente. L’ANOVA apporte une réponse globale à la question : « Le facteur Modalité Thérapeutique exerce-t-il une influence systématique sur l’évolution du score à l’échelle de dépression de Hamilton ? » Cette démarche protège l’analyse contre la dispersion méthodologique en testant l’homogénéité globale du modèle avant d’autoriser toute partition plus granulaire.
1.2 Le test F global et ses restrictions intrinsèques
La statistique F omnibus constitue un filtre inférentiel global. Lorsque la valeur calculée de F franchit le seuil critique pour les degrés de liberté associés au facteur et à l’erreur, l’analyste rejette l’hypothèse nulle générale selon laquelle toutes les moyennes de population seraient mutuellement identiques. Ce rejet atteste de l’existence d’une hétérogénéité significative dans les données. Pour autant, l’ANOVA omnibus ne fournit aucune information directionnelle ni structurelle sur les relations unilatérales ou différentielles liant les conditions expérimentales prises deux à deux. Le test F ne spécifie aucunement quelles moyennes se détachent du lot, ni si cette disparité émane d’un seul groupe atypique ou d’une séparation graduelle de l’ensemble des conditions le long d’un continuum psychologique.
Cette cécité topologique de la statistique F crée une asymétrie entre la détection globale d’un effet expérimental et l’explication théorique des mécanismes causaux sous-jacents. Dans notre évaluation clinique des dépressions, obtenir une valeur F hautement significative (par exemple, p < 0,001) confirme sans équivoque que les quatre conditions ne génèrent pas des trajectoires de rémission interchangeables. Pourtant, ce résultat ne permet pas d’affirmer si la TCC surpasse significativement la psychothérapie interpersonnelle, ni si l’un de ces protocoles psychothérapeutiques se distingue statistiquement du groupe sous antidépresseur pharmacologique. Les chercheurs ne peuvent fonder des préconisations cliniques sur une statistique non localisée. C’est précisément cette insuffisance intrinsèque du test F global qui rend impérative l’ouverture d’une seconde phase d’investigation statistique focalisée sur les contrastes locaux.
1.3 Définition et objectifs fondamentaux des analyses post hoc
L’expression latine post hoc, signifiant littéralement « après cela », qualifie une classe de procédures inférentielles conçues pour être exécutées après la prise de connaissance des résultats de l’ANOVA globale, en l’absence d’hypothèses directionnelles strictes formulées avant la collecte empirique des données. L’objectif fondamental des analyses post hoc est d’explorer l’ensemble exhaustif des combinaisons possibles de paires de moyennes — ou parfois de combinaisons linéaires complexes — tout en garantissant le respect scrupuleux du cadre probabiliste régissant l’inférence statistique. Les tests post hoc constituent un rempart mathématique contre les biais d’interprétation opportunistes qui émergent inévitablement lorsque l’analyste examine visuellement ses distributions avant de décider quelles comparaisons méritent d’être testées.
Il convient de distinguer formellement la démarche confirmatoire, régie par des contrastes planifiés a priori, de la démarche exploratoire encadrée par les tests a posteriori. Tandis que la première teste des prédictions théoriques rigides déduites de la littérature préalable au moyen d’un nombre restreint de contrastes orthogonaux, la seconde sonde l’intégralité du champ factoriel pour cartographier les régularités inattendues, les effets d’entraînement ou les neutralisations mutuelles entre traitements. Les analyses post hoc permettent ainsi de mener une fouille méthodique des données sans compromettre la rigueur déductive, transformant un signal omnibus brut en un ensemble d’assertions précises, vérifiables et reproductibles au sein de la communauté scientifique internationale.
2. Fondements théoriques de l’ANOVA et limites inférentielles
2.1 Formalisation des hypothèses statistiques
L’édifice mathématique de l’analyse de variance à un facteur repose sur la confrontation formelle de deux hypothèses probabilistes mutuellement exclusives. L’hypothèse nulle, notée H0, postule l’égalité parfaite des paramètres de position centrale au sein des k populations dont sont extraits les échantillons expérimentaux :
H0 : μ1 = μ2 = μ3 = … = μk
Sous cette hypothèse, toute fluctuation observée entre les moyennes empiriques d’échantillon est traitée comme une déviation stochastique pure, imputable aux seules fluctuations d’échantillonnage aléatoire au sein d’une méta-population homogène présentant une variance commune notée σ2.
À l’opposé, l’hypothèse alternative, formalisée par H1, ne stipule pas que toutes les moyennes diffèrent uniformément les unes des autres, mais affirme de façon non directionnelle qu’il existe au moins une paire de moyennes populationnelles dissemblables :
H1 : ∃ (i, j) tel que μi ≠ μj pour i ≠ j
En fixant le seuil de significativité conventionnel α à 0,05 (soit un niveau de confiance bilatéral de 95 %), la communauté scientifique accepte un taux nominal de 5 % de déclarer à tort une divergence dans la population alors que l’hypothèse nulle d’homogénéité stricte est vérifiée. La nature asymétrique et non directionnelle de H1 implique qu’un rejet formel de H0 ne valide en rien une hiérarchie précise entre les conditions, imposant une étape analytique supplémentaire pour qualifier la nature géométrique de l’espace des moyennes.
2.2 Les postulats paramétriques sous-jacents
La validité probabiliste de l’ANOVA et des procédures d’inférence ultérieures repose sur trois postulats distributionnels fondamentaux dont le non-respect altère considérablement les propriétés asymptotiques du modèle :
- La normalité des résidus : Les écarts individuels par rapport à la moyenne du groupe auquel appartient le participant doivent suivre une loi normale au sein de chaque population parente. Dans les devis comportementaux, cette hypothèse est vérifiée par l’analyse des diagrammes quantile-quantile (Q-Q plots) et par des tests formels tels que le test de Shapiro-Wilk. Si le théorème central limite confère à l’ANOVA une robustesse appréciable face aux écarts modérés de symétrie lorsque les tailles d’échantillon sont importantes (n ≥ 30 par condition), une asymétrie sévère combinée à de faibles effectifs compromet gravement le calcul des probabilités critiques.
- L’homogénéité des variances (homoscédasticité) : Les variances résiduelles des k populations doivent être rigoureusement équivalentes (σ12 = σ22 = … = σk2). Ce postulat conditionne la mise en commun valide des sommes de carrés au sein de la variance résiduelle globale (carré moyen de l’erreur, noté CME). En présence d’hétéroscédasticité — fréquemment objectivée par le test de Levene —, les statistiques de test s’écartent drastiquement de la distribution théorique de Fisher, provoquant soit une augmentation incontrôlée du risque d’erreur de type I, soit une chute dramatique de la puissance statistique.
- L’indépendance des observations : Chaque mesure collectée doit être statistiquement indépendante de toutes les autres. Cela implique que l’assignation aléatoire des sujets à chaque modalité doit s’accompagner d’une absence d’interactions directes ou d’effets de contamination sérielle durant la phase de recueil des réponses. La violation de l’indépendance constitue le manquement méthodologique le plus dommageable, car elle biaise directement le dénominateur de la statistique de test et invalide l’ensemble des théorèmes limites sous-jacents.
2.3 La transition logique du résultat global aux comparaisons multiples
L’enchaînement logique reliant le test omnibus aux analyses post hoc est régi par une convention méthodologique stricte issue des travaux de Fisher sur le test de la plus petite différence significative protégée (Fisher’s Protected LSD) : l’exécution des tests post hoc non planifiés est conditionnée par l’obtention préalable d’un test F global statistiquement significatif au seuil prédéterminé (α = 0,05). Conduire des comparaisons multiples tous azimuts à la suite d’une ANOVA non significative constitue une infraction déontologique et statistique majeure, assimilable à une opération de braconnage de données (« data dredging » ou « p-hacking »), visant à extraire des fluctuations marginales dépourvues de validité dans la population générale.
Cette transition logique requiert également de distinguer avec netteté la taille de l’effet omnibus de l’ampleur des contrastes locaux. L’indicateur êta-carré partiel (ηp2) ou l’oméga-carré (ω2) quantify la proportion de variance globale attribuable au facteur manipulé par rapport à l’inertie totale du modèle. Un effet omnibus d’ampleur moyenne (ηp2 ≈ 0,06) peut masquer des contrastes bilatéraux de très forte magnitude côtoyant des contrastes strictement nuls. Sur le plan mathématique, le partitionnement de la somme des carrés intergroupes (SCInter) en un ensemble de sous-composantes indépendantes illustre cette distribution d’énergie inférentielle : les tests post hoc agissent comme un prisme séparant les photons d’un spectre blanc pour en quantifier les longueurs d’onde isolées.
3. Le problème de l’inflation de l’erreur de type I
3.1 Mécanisme mathématique de l’accumulation du risque alpha
L’argumentaire justifiant le recours impératif aux tests post hoc corrigés réside dans la mécanique combinatoire de l’accumulation du risque d’erreur de type I, couramment qualifié de faux positif. Lorsqu’un chercheur réalise une comparaison isolée entre deux moyennes au seuil α = 0,05, la probabilité d’accepter à bon droit l’hypothèse nulle sous condition qu’elle soit vraie s’élève à 1 – α = 0,95 (soit 95 % de chances de ne pas commettre d’erreur de faux rejet). Dès lors que l’expérience comprend k groupes indépendants, le nombre total de combinaisons possibles de paires de moyennes est donné par le coefficient binomial :
c = k(k – 1) / 2
Si ces c comparaisons étaient strictement indépendantes les unes des autres sur le plan stochastique, la probabilité conjointe de ne commettre aucune erreur de type I sur l’ensemble de la série de tests serait formulée par la multiplication des probabilités élémentaires, soit (1 – α)c. Par conséquent, la probabilité complémentaire de commettre au moins une erreur de type I sur l’ensemble de la famille de comparaisons — désignée sous le terme de taux d’erreur familial (en anglais, Family-Wise Error Rate ou FWER) — est régie par l’expression mathématique suivante :
αFWER = 1 – (1 – α)c
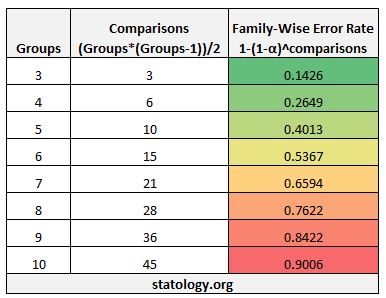
L’explosion exponentielle de ce risque devient alarmante au fur et à mesure que le plan expérimental s’étoffe. Pour un plan expérimental simple à trois conditions (k = 3), le nombre de paires est c = 3, portant le risque FWER cumulé théorique à 1 – (0,95)3 ≈ 0,1426 (14,26 %). Dans un devis comportant 5 groupes (c = 10 paires), ce risque grimpe à 1 – (0,95)10 ≈ 0,4013 (40,13 %). Pour un devis à 10 groupes (c = 45 paires), le FWER atteint le chiffre vertigineux de 1 – (0,95)45 ≈ 0,9006, soit plus de 90 % de probabilité d’observer au moins une différence déclarée à tort statistiquement significative. Cette dynamique destructrice ruine la reproductibilité expérimentale en inondant la littérature psychologique d’artefacts d’échantillonnage érigés en découvertes théoriques factices.
3.2 Taux d’erreur par comparaison versus taux d’erreur par famille
Pour clarifier les règles de décision statistique, la théorie distingue rigoureusement le taux d’erreur par comparaison (Per-Comparison Error Rate ou PCER) et le taux d’erreur par famille (Family-Wise Error Rate ou FWER). Le PCER représente le risque α alloué de manière unitaire à chaque test individuel pris isolément, traditionnellement calibré à 0,05. Sous ce paradigme libéral, chaque test s’exécute comme si les autres comparaisons n’existaient pas au sein de l’univers expérimental. Cette approche maximise la puissance statistique locale au détriment de l’intégrité globale du protocole expérimental.
À l’inverse, le FWER appréhende l’ensemble des inférences générées par l’analyse factorielle comme un système unitaire indivisible. L’objectif méthodologique devient alors de borner la probabilité totale d’émettre au moins une fausse alerte sur l’ensemble de l’étude à un seuil nominal strict (généralement 5 %). Il s’agit d’un arbitrage inférentiel crucial entre la rigueur du contrôle contre les faux positifs (spécificité) et la sensibilité du test face aux effets réels (puissance statistique). Le consensus méthodologique contemporain en sciences comportementales exige la protection rigide du FWER pour toutes les analyses exploratoires non planifiées, garantissant ainsi que l’ensemble des conclusions publiées dans un article respecte le standard d’incertitude consenti par la communauté des pairs.
3.3 Les risques de l’utilisation non corrigée de tests t multiples
Face à la complexité des ajustements post-hoc, une tentation persistante consiste à segmenter le modèle omnibus en une suite de tests t de Student à deux échantillons indépendants, menés chacun au seuil α = 0,05 standard. Cette pratique, unanimement proscrite par les comités de rédaction des revues à comité de lecture, engendre un double préjudice méthodologique aux conséquences dévastatrices pour l’accumulation des connaissances empiriques.
D’une part, cette démarche démultiplie les faux rejets de l’hypothèse nulle et active un biais de confirmation majeur. L’expérimentateur parcourt la matrice des résultats empiriques pour isoler les contrastes dont la valeur de p passe opportunément sous la barre des 0,05, en ignorant superbement la masse des comparaisons non significatives. Cette instrumentalisation du hasard génère une distorsion sélective qui contamine ultérieurement les méta-analyses et les revues systématiques en gonflant artificiellement les tailles d’effet rapportées dans la littérature. D’autre part, le test t classique calcule sa variance d’erreur uniquement à partir des données issues des deux échantillons comparés, négligeant l’estimation globale de l’erreur résiduelle fournie par l’ensemble de l’échantillon de l’ANOVA (le CME). Ce faisant, le chercheur se prive d’un gain substantiel en degrés de liberté pour estimer l’erreur, réduisant paradoxalement la fiabilité métrique de sa statistique de décision.
4. Comparaisons planifiées a priori versus tests post hoc a posteriori
4.1 Fondements des contrastes planifiés guidés par la théorie
Dans la taxonomie de l’analyse factorielle, les comparaisons planifiées — communément appelées contrastes a priori — occupent une place épistémologique privilégiée. Elles se distinguent fondamentalement des tests post hoc en ce qu’elles sont déduites de manière purement hypothético-déductive à partir d’un modèle théorique préalable, avant même l’enregistrement de la première observation empirique. La pertinence d’un contraste planifié ne dépend pas de l’existence d’une significativité sur le test F global ; il est théoriquement légitime de tester un contraste planifié même si le F omnibus échoue à atteindre le seuil de 5 %, à la condition formelle que le contraste ait été scrupuleusement consigné dans un protocole pré-enregistré (sur des plateformes d’Open Science telles que l’Open Science Framework).
Sur le plan calculatoire, les contrastes planifiés utilisent des vecteurs de coefficients numériques λi dont la somme algébrique est rigoureusement égale à zéro (∑λi = 0). Deux contrastes sont dits orthogonaux lorsque la somme des produits de leurs coefficients respectifs est nulle (∑λ1iλ2i = 0), ce qui implique qu’ils capturent des composantes de variance totalement décorrélées et non redondantes. Cette orthogonalité confère aux contrastes une économie substantielle de puissance statistique, autorisant leur évaluation au seuil nominal α sans application de pénalités correctives démesurées. Le chercheur formule ainsi des questions hautement ciblées, maximisant l’élégance inférentielle et l’adéquation au modèle conceptuel.
4.2 Nature exploratoire des tests post hoc non planifiés
À l’extrême opposé du spectre déductif, les tests post hoc incarnent une logique d’exploration exhaustive sans préjugé structural. Ils s’imposent dès lors que le chercheur ne dispose pas de bases théoriques suffisamment établies pour postuler quelles conditions précises produiront des divergences comportementales, ou lorsque le devis expérimental inclut de nombreuses variantes de dosage, d’interventions ergonomiques ou de protocoles d’apprentissage dont les effets mutuels sont inconnus ex ante.
La nature exhaustive de cette procédure impose de tester la totalité des paires ou des combinaisons possibles au sein de la matrice expérimentale. Cette absence de directionnalité préalable expose directement le modèle aux fluctuations de la variance d’échantillonnage. En conséquence, les procédures post hoc appliquent une pénalisation statistique compensatoire, soit en gonflant la différence critique nécessaire pour déclarer un effet significatif, soit en majorant algorithmiquement la valeur de la probabilité empirique associée (p-valeur ajustée). Bien que cette contrainte réduise la sensibilité du test, elle remplit une mission scientifique fondamentale : servir de filtre de criblage rigoureux pour générer de nouvelles hypothèses plausibles, destinées à être testées ultérieurement de manière strictement confirmatoire au cours d’expérimentations indépendantes.
4.3 Critères décisionnels entre démarche a priori et démarche a posteriori
Le choix stratégique entre la mise en œuvre de contrastes planifiés a priori et l’adoption d’un protocole post hoc a posteriori dépend d’un ensemble de critères méthodologiques que l’analyste doit évaluer avec une parfaite probité intellectuelle :
- Le degré de maturation théorique du domaine : Lorsque la littérature fournit des prédictions directionnelles quantitatives stables (par exemple, affirmer qu’une exposition à la lumière bleue à 22h dégrade la latence d’endormissement comparativement à une lumière rouge et à un groupe obscurité totale), les contrastes orthogonaux représentent le choix le plus robuste et le plus économe en puissance statistique. Si l’expérience intègre de nouvelles conditions jamais testées, l’approche post hoc s’impose d’emblée.
- Le volume des questions analytiques posées : Les contrastes planifiés ne peuvent excéder le nombre de degrés de liberté accordés au facteur expérimental (soit k – 1 contrastes mutuellement orthogonaux). Si le plan de recherche exige d’interroger davantage de relations ou de vérifier toutes les permutations deux à deux sans hiérarchie préalable, seule la boîte à outils post hoc permet de couvrir ce périmètre sans violer les théorèmes de probabilité.
- La régulation de la puissance face au risque bêta : Si le nombre de comparaisons exploratoires est très élevé, la pénalité imposée par les tests post hoc les plus stricts fait chuter la puissance statistique, augmentant drastiquement le risque de commettre une erreur de type II (ne pas détecter une différence réelle entre deux modalités). Le chercheur doit calibrer le protocole pour s’assurer que ses effectifs autorisent le maintien d’une puissance acceptable (1 – β ≥ 0,80).
- Les contraintes de publication et de pré-enregistrement : Les revues à fort facteur d’impact exigent désormais la traçabilité intégrale du protocole expérimental. Tenter de maquiller une recherche post hoc exploratoire en un ensemble de contrastes faussement présentés comme planifiés a priori relève d’une pratique scientifique contestable qualifiée de HARKing (Hypothesizing After the Results are Known).
5. Le test HSD de Tukey : La méthode de référence
5.1 Fondements et distribution de l’étendue studentisée
Conçu par le mathématicien et statisticien John Wilder Tukey, le test de la différence honnêtement significative (Honestly Significant Difference ou HSD) s’impose comme la méthode étalon pour comparer simultanément toutes les paires possibles de moyennes issues d’un plan factoriel à échantillons indépendants. Contrairement aux tests bâtis sur la loi t de Student classique, le test HSD repose sur la loi de distribution de l’étendue studentisée, couramment désignée par la variable aléatoire q.
L’étendue studentisée modélise spécifiquement la distribution statistique du ratio de la différence maximale entre la plus grande et la plus petite moyenne d’un ensemble de k échantillons aléatoires indépendants, normalisée par l’erreur type de l’ensemble du dispositif factoriel. En calibrant la statistique de référence non pas sur deux moyennes isolées, mais sur l’écart maximal potentiel susceptible d’émerger parmi k conditions sous l’hypothèse nulle, le test de Tukey contrôle rigoureusement le FWER à la valeur nominale exacte α = 0,05 pour l’ensemble exhaustif des comparaisons par paires. Ses hypothèses d’application exigent la normalité de la distribution des résidus et une stricte homogénéité des variances populationnelles à travers les conditions du plan.
5.2 Calcul de la différence minimale significative
La mise en œuvre mathématique du test HSD de Tukey consiste à déterminer un seuil critique unique d’écart absolu entre moyennes, désigné sous le terme de Différence Honnêtement Significative (HSD). Pour des groupes présentant des effectifs strictement équilibrés (n participants par condition), la formule d’estimation s’énonce comme suit :
HSD = q(α, k, ddlerreur) × √( CME / n )
Dans cette équation, q représente la valeur critique issue de la table de l’étendue studentisée paramétrée par le risque global α, le nombre total de groupes k composant l’expérience, et les degrés de liberté résiduels de l’ANOVA (ddlerreur = N – k). Le terme CME désigne le Carré Moyen de l’Erreur intragroupe issu de la table globale de l’ANOVA, servant d’estimateur non biaisé de la variance résiduelle commune σ2, et n représente la taille d’échantillon unitaire de chaque groupe.
Dès lors que la différence empirique absolue entre deux moyennes observées quelconques (|Mi – Mj|) dépasse cette valeur seuil HSD, le contraste est formellement déclaré statistiquement significatif au niveau α choisi. Sur le plan géométrique, cette procédure permet de construire des intervalles de confiance simultanés pour l’ensemble des paires de moyennes. Ces intervalles possèdent la propriété formelle suivante : la probabilité conjointe que l’intégralité des c intervalles contienne simultanément les vraies différences de moyennes populationnelles (μi – μj) est exactement égale à 1 – α (soit 95 %).
5.3 Adaptation aux effectifs inégaux : La variante Tukey-Kramer
Dans les investigations empiriques en sciences humaines, il est très fréquent que les effectifs finaux divergent d’un groupe à un autre en raison de défections de participants, de données inexploitables ou de contraintes d’échantillonnage asymétriques. L’application directe de la formule classique du HSD de Tukey est alors mathématiquement invalide, car le terme √(CME / n) suppose un effectif uniforme.
Pour surmonter cette restriction structurelle, Clyde Kramer a proposé en 1956 une généralisation élégante connue sous l’appellation de procédure de Tukey-Kramer. Cette variante adapte l’erreur type locale de chaque paire spécifique en calculant la moyenne harmonique des effectifs respectifs des deux conditions comparées (ni et nj). La formule révisée de la valeur critique propre à la paire (i, j) s’écrit :
HSDij = q(α, k, ddlerreur) × √[ (CME / 2) × ( (1 / ni) + (1 / nj) ) ]
La démonstration théorique a prouvé que la procédure de Tukey-Kramer préserve scrupuleusement le taux nominal d’erreur FWER en deçà du seuil α. Elle s’avère légèrement conservatrice dans certaines configurations asymétriques, garantissant que le risque d’erreur de type I ne dépasse jamais les 5 % conventionnels. En raison de cette robustesse analytique, la modification de Tukey-Kramer constitue l’algorithme par défaut exécuté par les principaux progiciels d’analyse statistique dès lors qu’un déséquilibre dans les effectifs est détecté.
5.4 Limites et conditions inappropriées d’application
En dépit de son statut d’outil de référence au sein de la psychologie empirique, le test HSD de Tukey souffre de vulnérabilités méthodologiques qu’il est indispensable d’identifier afin d’éviter des déductions inférentielles erronées :
- Sensibilité à la rupture d’homoscédasticité : Dès que le postulat d’égalité des variances est violé (hétéroscédasticité significative) — particulièrement lorsque les tailles d’échantillons sont concomitamment déséquilibrées —, le test HSD devient instable. Si le groupe ayant le plus faible effectif présente la variance la plus forte, le taux réel de faux positifs peut grimper bien au-delà de 10 %, invalidant la prétention du test à contrôler le risque familial.
- Incapacité à évaluer des contrastes complexes : Le formalisme de l’étendue studentisée est exclusivement calibré pour des comparaisons bilatérales simples de moyennes deux à deux (|Mi – Mj|). Il est structurellement incapable d’évaluer des contrastes combinés plus complexes, tels que la comparaison de la moyenne d’un groupe expérimental novateur à la moyenne pondérée de deux groupes de contrôle standard.
- Sur-pénalisation pour des contrastes partiels restreints : Si le plan de recherche ne s’intéresse en définitive qu’à un sous-ensemble restreint de comparaisons par paires (par exemple, confronter seulement quatre paires clés au sein d’une expérience impliquant six modalités), le test de Tukey applique la pénalité dimensionnée pour l’intégralité des 15 paires virtuelles, entraînant une chute inutile de la puissance statistique.
- Impact des asymétries distributionnelles sévères : En présence de distributions lourdement leptokurtiques ou affectées par des valeurs aberrantes marquées, l’estimation conjointe du CME au dénominateur est altérée, ce qui nuit à l’exactitude de l’intervalle de décision.
6. Les corrections de Bonferroni, Šidák et l’approche séquentielle de Holm
6.1 La méthode classique d’ajustement de Bonferroni
La procédure d’ajustement de Bonferroni repose sur un résultat fondamental de la théorie des probabilités connu sous le nom d’inégalité de Boole-Fréchet. Cette inégalité établit que la probabilité de l’union d’un ensemble d’événements stochastiques ne peut en aucun cas excéder la somme algébrique des probabilités individuelles de chacun de ces événements pris isolément :
P(∪ Ai) ≤ ∑ P(Ai)
En transposant ce théorème à la problématique des comparaisons multiples, Carlo Emilio Bonferroni a formalisé une règle de décision universelle d’une simplicité mathématique désarmante : pour maintenir le taux d’erreur familial global (FWER) à un niveau cible α (typiquement 0,05) au long d’une série de c tests statistiques indépendants ou dépendants, il suffit d’assigner à chaque comparaison individuelle un seuil de significativité corrigé αcorrigé défini par la division arithmétique :
αcorrigé = α / c
Réciproquement, cette opération peut s’effectuer en multipliant la valeur de probabilité empirique observée (p-valeur brute) par le nombre total de comparaisons planifiées ou exécutées (pajustée = p × c). L’universalité constitue le triomphe méthodologique de la correction de Bonferroni : elle ne requiert aucun postulat particulier quant à la forme de la distribution sous-jacente ni quant au statut d’indépendance des variables.
Cependant, cette universalité se paie par un conservatisme méthodologique extrême. En supposant implicitement le cas le plus défavorable — une orthogonalité et une disjonction parfaites des événements —, la méthode de Bonferroni applique une pénalisation disproportionnée dès lors que le nombre de comparaisons augmente. Pour une matrice de 20 comparaisons, le seuil de décision individuel tombe à 0,05 / 20 = 0,0025. Cette sévérité entraîne une réduction drastique de la puissance statistique locale, induisant une explosion du risque d’erreur de type II (β). De nombreux effets comportementaux légitimes sont ainsi occultés et rejetés par excès de frilosité probabiliste.
6.2 L’inégalité exacte de Šidák
Afin d’atténuer le conservatisme linéaire inhérent au redressement de Bonferroni, le mathématicien Zbyněk Šidák a élaboré en 1967 un raffinement probabiliste reposant sur l’hypothèse de l’indépendance mutuelle — ou du moins de la dépendance positive — entre les statistiques de test. Partant de l’identité exacte liant le risque familial au taux par comparaison αPC sous condition d’indépendance :
1 – αFWER = (1 – αPC)c
Šidák en a déduit, par inversion algébrique rigoureuse, la formule de calibration du seuil de significativité unitaire requis pour neutraliser l’accumulation des erreurs :
αŠidák = 1 – (1 – αFWER)1 / c
Sur le plan calculatoire, la correction de Šidák alloue un seuil individuel systématiquement plus permissif que la division arithmétique brute de Bonferroni (αŠidák > αBonferroni). Prenons l’exemple d’un protocole comportant 10 comparaisons au risque global de 5 % : le seuil unitaire de Bonferroni est fixé à 0,0050, tandis que l’inégalité de Šidák établit le seuil de tolérance à 1 – (0,95)0,1 ≈ 0,005116. Bien que le gain en puissance statistique demeure marginal sur de petits volumes de contrastes, l’écart mathématique se creuse en faveur de Šidák lorsque c s’élève. Cependant, à l’instar de Bonferroni, la procédure de Šidák perd rapidement de son attrait dès que le nombre de paires analysées devient très grand, incitant les chercheurs à délaisser ces procédures statiques à palier unique au profit d’architectures décisionnelles séquentielles dynamiques.
6.3 La procédure séquentielle descendante de Holm-Bonferroni
Publiée en 1979 par Sture Holm, la méthode séquentielle descendante dite de Holm-Bonferroni constitue une avancée majeure dans la théorie du contrôle des erreurs multiples. Holm a démontré qu’il est mathématiquement possible d’accroître substantiellement la puissance statistique globale par rapport à l’ajustement classique de Bonferroni tout en maintenant un contrôle tout aussi infaillible du FWER au seuil nominal α.
L’algorithme de Holm-Bonferroni ne recourt pas à un seuil critique fixe pour l’ensemble des contrastes, mais procède par étapes dynamiques successives conformément au protocole suivant :
- L’ensemble des c valeurs de probabilité brutes issues des tests bilatéraux (valeurs de p empiriques) est trié par ordre croissant d’amplitude : p(1) ≤ p(2) ≤ p(3) ≤ … ≤ p(c). Chaque valeur est associée à son hypothèse nulle respective H0(i).
- L’analyse débute par l’évaluation de la plus petite valeur de p observée, p(1). Celle-ci est comparée au seuil le plus strict de la série, équivalent au seuil classique de Bonferroni :
α1 = α / c
Si p(1) > α1, la procédure s’interrompt immédiatement : aucune hypothèse nulle n’est rejetée, et l’ensemble des tests est déclaré non significatif. - Si p(1) ≤ α1, l’hypothèse nulle H0(1) est formellement rejetée au bénéfice de l’alternative. L’algorithme passe alors à l’évaluation de la seconde plus petite probabilité, p(2). Le seuil de décision est dynamiquement recalculé en retranchant l’hypothèse déjà écartée du dénominateur :
α2 = α / (c – 1) - De façon générale, à la i-ème étape du processus séquentiel, la valeur p(i) est confrontée au seuil dynamique réajusté :
αi = α / (c – i + 1) - Le processus se poursuit pas à pas tant que la condition p(i) ≤ αi est satisfaite. Dès qu’une valeur p échoue à franchir le seuil local qui lui est assigné, l’évaluation s’arrête de manière définitive (« step-down ») ; l’hypothèse correspondante ainsi que toutes les hypothèses subséquentes de la chaîne ordonnée sont irrévocablement conservées.
Cette logique d’élimination séquentielle garantit une supériorité systématique en termes de puissance statistique par rapport à l’ajustement statique de Bonferroni. Les contrastes évalués aux étapes intermédiaires et finales bénéficient de seuils critiques de plus en plus accommodants (α / 2, puis α / 1 pour la dernière hypothèse restante). Pour cette raison, la communauté méthodologique contemporaine recommande unanimement d’abandonner l’application classique de Bonferroni au profit de la procédure de Holm-Bonferroni pour les investigations post hoc à effectif modéré de comparaisons.
7. Le test de Scheffé pour les contrastes complexes
7.1 Mécanisme théorique fondé sur la distribution F globale
Développé par le mathématicien Henry Scheffé en 1953, le test de Scheffé occupe une place d’exception dans l’arsenal des méthodes d’inférence statistique. Contrairement aux procédures de Tukey ou de Bonferroni dimensionnées pour des comparaisons linéaires simples par paires, le test de Scheffé dérive directement de la région de confiance conjointe multidimensionnelle de l’ANOVA globale, géométriquement représentée par un ellipsoïde dans l’espace euclidien des moyennes.
Cette assise théorique confère au test de Scheffé une propriété mathématique unique : il garantit le maintien absolu du risque d’erreur de type I au seuil nominal α pour l’infinité des contrastes linéaires concevables au sein du plan expérimental, qu’ils soient simples ou arbitrairement complexes. Sur le plan opérationnel, la valeur critique d’un contraste de Scheffé ne s’obtient pas à partir d’une distribution de Student ou de l’étendue studentisée, mais procède d’une transformation directe du seuil critique F de l’ANOVA globale. La valeur critique de la somme des carrés du contraste (notée S) s’établit selon la formule :
Fcritique, Scheffé = (k – 1) × F(α, k – 1, ddlerreur)
Toute estimation de contraste dont la statistique F locale — ou le carré de la statistique t — dépasse ce seuil majoré est déclarée statistiquement significative. Cette formulation engendre une cohérence mathématique absolue avec le test F de l’ANOVA : le test omnibus est statistiquement significatif au seuil α si et seulement si il existe au moins un contraste linéaire possible au sein de l’espace factoriel qui se révèle significatif selon la règle de décision de Scheffé.
7.2 Exploration des contrastes non linéaires et combinaisons de moyennes
L’immense valeur heuristique du test de Scheffé réside dans sa flexibilité analytique, inégalée par les autres méthodes post hoc. Alors que le test HSD de Tukey est mathématiquement restreint aux oppositions directes de type Mi – Mj, la procédure de Scheffé autorise le chercheur à tester a posteriori, sans aucune planification préalable, des regroupements structurels complexes de conditions expérimentales guidés par l’observation brute des données.
Considérons une recherche en psychophysiologie évaluant la charge cognitive sous différentes interfaces de commande : un groupe témoin utilisant un système analogique classique (M1) et trois groupes expérimentaux soumis à des déclinaisons technologiques numériques novatrices (M2, M3, M4). Après observation des graphiques, le chercheur souhaite évaluer si la performance cognitive moyenne des trois interfaces numériques combinées se démarque significativement de la modalité analogique standard. Le contraste linéaire s’écrit formellement :
Ψ = M1 – (1/3 × M2 + 1/3 × M3 + 1/3 × M4)
De même, Scheffé permet de tester des tendances polynomiales exploratoires — telles que la présence d’une composante quadratique (en U inversé) ou cubique au sein d’une échelle ordinale de privation de sommeil — sans craindre une quelconque inflation du risque d’erreur de faux positif. Cette universalité géométrique en fait l’outil d’investigation post-expérimentale par excellence pour le data mining rigoureux et l’élaboration de nouveaux paradigmes expérimentaux.
7.3 Le coût en puissance statistique et la question du conservatisme
La contrepartie inévitable de cette protection omnidirectionnelle contre le risque de type I est un coût exorbitant en puissance statistique locale. En protégeant simultanément l’univers infini de tous les contrastes spatiaux possibles, le test de Scheffé s’avère considérablement plus conservateur que toutes les techniques concurrentes lorsqu’il est restreint à l’évaluation de simples comparaisons deux à deux.
Si un analyste commet l’erreur de mobiliser le test de Scheffé pour exécuter de banales confrontations de paires de moyennes, le seuil critique Fcritique, Scheffé sera artificiellement surélevé. Cela engendre une probabilité dramatiquement élevée de commettre une erreur de type II (β), c’est-à-dire d’échouer à détecter des différences réelles d’amplitude modérée entre deux groupes. Pour cette raison formelle, la doctrine méthodologique en sciences du comportement proscrit formellement l’usage du test de Scheffé pour l’analyse exclusive des comparaisons simples par paires, le réservant impérativement aux contextes de recherche où des contrastes complexes multifactoriels ou des regroupements exploratoires non structurés sont mobilisés.
8. La méthode de Dunnett pour les comparaisons avec un groupe témoin
8.1 Architecture des comparaisons un-à-plusieurs
Dans un nombre considérable de protocoles expérimentaux en psychologie clinique, en neuropsychopharmacologie et en ergonomie, la problématique de recherche ne requiert nullement la confrontation exhaustive de l’ensemble des conditions expérimentales entre elles. Au lieu d’explorer toutes les bifurcations de l’espace factoriel, le devis s’organise autour d’une architecture relationnelle asymétrique dite de type « un-à-plusieurs » (many-to-one comparisons).
Dans cette architecture conceptuelle formalisée par Charles Dunnett en 1955, un groupe de référence spécifique — typiquement un groupe placebo, une condition contrôle sur liste d’attente ou un groupe témoin sous véhicule neutre — est systématiquement confronté à chacun des k – 1 groupes de traitement actif. Les comparaisons reliant les traitements expérimentaux entre eux (par exemple, confronter la Thérapie A à la Thérapie B) sont délibérément exclues du champ d’investigation. Ce recentrage stratégique réduit drastiquement le nombre total de confrontations statistiques nécessaires :
c = k – 1
Alors qu’un devis factoriel à 6 groupes imposerait 15 comparaisons bilatérales pour une exploration toutes paires confondues (éligible au Tukey HSD), la démarche de Dunnett n’en mobilise que 5. Cette économie de tests autorise une allocation beaucoup plus avantageuse de la puissance statistique, garantissant une acuité supérieure pour identifier l’émergence d’une efficacité thérapeutique par rapport à l’état de référence neutre.
8.2 Distribution statistique multivariée de Dunnett
L’évaluation statistique d’un devis de Dunnett ne peut être traitée par un découpage naïf en tests t classiques de Student, ni par une simple correction de Bonferroni. En effet, les différentes statistiques de contraste partagent toutes un dénominateur commun : les données du groupe témoin entrent dans le calcul de chacune des k – 1 différences de moyennes (Mj – Mcontrôle). Il en résulte une corrélation stochastique positive structurelle et non nulle entre l’ensemble des comparaisons menées.
Charles Dunnett a brillamment résolu ce problème en intégrant cette matrice de dépendance interne dans une distribution multivariée spécifique de Student. La statistique de Dunnett s’exprime sous la forme canonique :
d = (Mj – Mcontrôle) / √[ CME × ( (1 / nj) + (1 / ncontrôle) ) ]
Cette valeur empirique d est alors confrontée aux bornes d’une table spécialisée fournissant les valeurs critiques dcritique calibrées en fonction du risque global α, du nombre total de groupes k (témoin inclus), et des degrés de liberté de la variance résiduelle de l’ANOVA (CME). De surcroît, la procédure de Dunnett offre l’immense avantage de permettre la formulation d’hypothèses unilatérales rigoureusement protégées (par exemple, tester uniquement si un traitement novateur est supérieur au témoin, en ignorant la zone de rejet d’infériorité). Cela permet d’abaisser le seuil critique et d’optimiser considérablement la sensibilité de détection de l’effet clinique.
8.3 Allocation optimale des tailles d’échantillons
Un apport majeur de la formalisation mathématique de Dunnett réside dans l’optimisation économique et méthodologique de l’échantillonnage expérimental. Puisque le groupe témoin sert de pivot référentiel à l’intégralité des contrastes formulés, toute incertitude de mesure ou fluctuation stochastique affectant ce groupe spécifique se propage inévitablement à l’ensemble des k – 1 inférences de l’étude.
Pour maximiser la puissance statistique globale à coût d’échantillonnage constant (c’est-à-dire pour un effectif global total N prédéterminé), Dunnett a établi une règle mathématique d’allocation asymétrique des participants. L’effectif idéal à allouer au groupe contrôle (ncontrôle) par rapport à l’effectif alloué à chacun des groupes expérimentaux actifs (nexp, supposés équilibrés) doit être proportionnel à la racine carrée du nombre de conditions actives :
ncontrôle / nexp ≈ √(k – 1)
Ainsi, dans une expérimentation clinique évaluant 4 nouveaux traitements cognitifs face à un unique groupe contrôle (k = 5 conditions au total), le ratio optimal est de √(5 – 1) = √4 = 2. Le chercheur maximisera la puissance de son protocole en recrutant deux fois plus de participants dans le groupe témoin que dans chacun des groupes sous traitement expérimental isolé. Cette disposition méthodologique confère au paradigme de Dunnett une efficience organisationnelle remarquable dans les contextes biomédicaux et psychologiques où les coûts d’implémentation des thérapeutiques actives sont nettement plus onéreux que l’observation du groupe témoin.
9. Gestion de l’hétéroscédasticité : Procédures de Games-Howell et Dunnett T3
9.1 Diagnostic de la violation de l’homoscédasticité
L’ensemble des procédures d’analyse post hoc examinées jusqu’ici — qu’il s’agisse du HSD de Tukey, des corrections de Bonferroni ou du formalisme de Scheffé — reposent sur un postulat structural immuable : l’homoscédasticité, c’est-à-dire l’égalité rigoureuse des variances d’erreur au sein de toutes les populations sous-jacentes. En pratique empirique, ce postulat est régulièrement mis en défaut par la nature même des phénomènes psychologiques étudiés (effets plancher ou plafond, sensibilité différentielle à l’intervention, réactance comportementale hétérogène).
L’évaluation de cette propriété repose classiquement sur le test d’homogénéité des variances de Levene, ou sa déclinaison plus robuste centrée sur la médiane (test de Brown-Forsythe). Lorsque ce test atteint le seuil de significativité statistique (p < 0,05), l’hypothèse nulle d’homogénéité des variances est formellement rejetée. L’analyste se trouve alors dans une situation critique : le Carré Moyen de l’Erreur (CME) de l’ANOVA ne reflète plus une estimation neutre de la variabilité résiduelle, mais constitue une moyenne pondérée d’entités divergentes.
Ce dysfonctionnement s’avère particulièrement toxique lorsque les variances inégales sont associées à des tailles d’échantillons asymétriques. Si les effectifs les plus réduits coïncident avec les variances les plus importantes — une configuration fréquente en psychopathologie clinique —, les statistiques de test classiques gonflent artificiellement, multipliant de manière silencieuse les rejets injustifiés de H0. Dans un tel contexte, le recours aux tests post hoc paramétriques conventionnels s’apparente à une faute méthodologique grave, imposant une bifurcation obligatoire vers des algorithmes résilients face à l’hétéroscédasticité.
9.2 Le test de Games-Howell : Fondements et mise en œuvre
Pour affronter sereinement la violation conjointe de l’homogénéité des variances et de l’équilibre des effectifs, Paul Games et John Howell ont développé en 1976 une extension hautement sophistiquée du principe de Tukey-Kramer : le test de Games-Howell. Cette procédure constitue l’équivalent direct pour comparaisons multiples de la célèbre correction de Welch-Satterthwaite appliquée au test t pour variances inégales.
La singularité du test de Games-Howell s’articule autour de deux ruptures calculatoires majeures avec le cadre de l’ANOVA classique :
- Le refus de mutualiser la variance résiduelle : Games-Howell abandonne le calcul du CME global. L’erreur type n’est plus dérivée de l’ensemble du dispositif factoriel, mais est recalculée de manière autonome pour chaque paire spécifique de groupes (i, j) sur la base exclusive de leurs variances empiriques d’échantillon respectives (si2 et sj2) et de leurs effectifs propres (ni et nj) :
SEGH = √[ (si2 / ni) + (sj2 / nj) ] - L’ajustement local des degrés de liberté selon Welch-Satterthwaite : Puisque les variances sont inégales, les degrés de liberté associés à la distribution de la statistique de décision ne correspondent plus aux degrés résiduels de l’ANOVA globale. Games-Howell détermine des degrés de liberté virtuels ajustés (notés df‘) spécifiques à chaque confrontation locale par l’équation :
df‘ij = [ (si2 / ni) + (sj2 / nj) ]2 / [ ( (si2 / ni)2 / (ni – 1) ) + ( (sj2 / nj)2 / (nj – 1) ) ]
La statistique de décision ainsi pondérée est comparée aux valeurs de la distribution de l’étendue studentisée q indexées sur les degrés de liberté fractionnaires df‘ij. Des études empiriques par simulations de Monte Carlo ont largement démontré que le test de Games-Howell assure un contrôle exceptionnellement stable du taux d’erreur familial (FWER) même face à de sévères discordances de variances, tout en délivrant une puissance statistique remarquable. Pour ces motifs, Games-Howell est universellement préconisé comme la méthode post hoc de référence par défaut dès lors que l’homogénéité des variances ne peut être fermement certifiée.
9.3 Les alternatives : Dunnett T3 et C de Tamhane
En marge de Games-Howell, la littérature biométrique et statistique propose d’autres alternatives conçues pour les scénarios d’hétéroscédasticité aiguë, au premier rang desquelles figurent la procédure Dunnett T3 et le test C de Tamhane.
Le test Dunnett T3 — mis au point par Charles Dunnett en 1980 — ne doit pas être confondu avec le test de Dunnett classique pour groupe contrôle. Il s’agit d’une procédure de comparaison par paires toutes conditions confondues adaptée aux variances hétérogènes. Son formalisme méthodologique substitue la distribution de l’étendue studentisée au profit direct de l’inégalité de Šidák, appliquée à des statistiques t locales dotées des degrés de liberté ajustés de Welch-Satterthwaite. Sur le plan de son profil opérationnel, le test Dunnett T3 s’avère nettement plus conservateur que Games-Howell, en particulier lorsque les tailles d’échantillons sont très modestes (n < 15 par modalité). Alors que Games-Howell peut occasionnellement présenter une très légère déflation du contrôle FWER sur de tout petits échantillons très asymétriques, Dunnett T3 verrouille absolument le risque en deçà du seuil nominal de 5 % au détriment de quelques fractions de puissance statistique.
Le test C de Tamhane, quant à lui, met en œuvre une démarche conservative similaire reposant sur l’ajustement arithmétique de Bonferroni appliqué aux degrés de liberté de Welch. De multiples investigations comparatives indiquent que sur des échantillons d’ampleur moyenne à large (n ≥ 30 par groupe), Games-Howell et Dunnett T3 fournissent des inférences rigoureusement équivalentes. Toutefois, si le chercheur opère dans un cadre de recherche clinique hautement sensible où le risque de faux positif doit être jugulé avec une sévérité implacable, le choix délibéré du Dunnett T3 s’impose comme une précaution épistémologique défendable et reconnue.
10. Arbre décisionnel pour la sélection du test post hoc optimal
10.1 Critères structurants de la matrice décisionnelle
Face à la diversité des algorithmes disponibles au sein des progiciels modernes, l’expérimentateur doit structurer son choix analytique non pas en fonction des résultats empiriques observés, mais en application d’un arbre décisionnel fondé sur les caractéristiques formelles de son plan d’expérience et le comportement de ses distributions.
Cette matrice décisionnelle s’articule autour de quatre interrogations cardinales ordonnées de façon hiérarchique :
- Le diagnostic de la variance (Homoscédasticité) : Les variances des populations parentes sont-elles statistiquement homogènes au regard du test de Levene (p ≥ 0,05) et de l’inspection graphique des résidus ? Si la réponse est négative, les portes des tests classiques de Tukey et Scheffé se ferment immédiatement, orientant l’analyste vers Games-Howell ou Dunnett T3.
- L’architecture relationnelle des contrastes : Le questionnement de recherche exige-t-il d’évaluer la totalité des combinaisons de paires envisageables (toutes paires confondues), ou se restreint-il de manière stricte à l’opposition de conditions expérimentales face à une condition de référence unique (un-à-plusieurs) ? La seconde éventualité désigne immédiatement la procédure de Dunnett.
- La géométrie des comparaisons (Simples vs Complexes) : L’analyse se limite-t-elle à des confrontations bivariées standard (Mi contre Mj), ou implique-t-elle la mise à l’épreuve de combinaisons linéaires multidimensionnelles (moyennes de sous-groupes fusionnés, décompositions polynomiales exploratoires) ? La présence de contrastes complexes requiert le recours exclusif au test de Scheffé.
- L’équilibre des effectifs (Balance du design) : Les tailles d’échantillons sont-elles rigoureusement symétriques au sein de toutes les cellules (n identique) ou présentent-elles des décalages numériques ? Ce critère guide le choix entre la formulation standard de Tukey et l’algorithme d’harmonisation de Tukey-Kramer.
10.2 Synthèse comparative des performances relatives
Pour éclairer l’arbitrage méthodologique entre le contrôle strict de l’erreur de première espèce (α) et la préservation de la puissance de détection empirique (1 – β), le tableau synoptique suivant récapitule les caractéristiques opérationnelles des méthodes post hoc majeures abordées dans ce guide :
| Méthode Post Hoc | Hypothèse de Variance | Objectif & Type de Contrastes | Niveau de Conservatisme | Puissance Statistique Relative | Recommandation d’Usage |
|---|---|---|---|---|---|
| Tukey HSD / Tukey-Kramer | Homoscédasticité requise | Toutes les paires simples possibles | Optimal / Équilibré | Très élevée sur les paires simples | Choix par défaut si les variances sont égales |
| Holm-Bonferroni | Homoscédasticité requise (ANOVA) | Sous-ensemble défini de paires | Rigoureux séquentiel | Élevée si le nombre de paires est modéré | Idéal pour explorer un nombre ciblé de paires |
| Bonferroni classique | Robuste / Non paramétrique | Tout type de contrastes prédéterminés | Extrêmement conservateur | Très faible dès que le nombre de tests croît | À proscrire en post hoc large ; limiter à 2-3 tests |
| Dunnett | Homoscédasticité requise | Comparaisons face à un témoin unique | Ajusté aux corrélations | Maximale pour les schémas un-à-plusieurs | Standard en clinique (Traitements vs Placebo) |
| Scheffé | Homoscédasticité requise | Contrastes complexes et non linéaires | Ultra-conservateur sur les paires simples | Très faible sur paires ; maximale sur le complexe | Réservé à l’exploration de combinaisons de groupes |
| Games-Howell | Variances inégales tolérées | Toutes les paires simples possibles | Modéré / Robuste | Optimale sous conditions d’hétérogénéité | Choix par défaut en cas d’hétéroscédasticité |
| Dunnett T3 | Variances inégales tolérées | Toutes les paires simples possibles | Élevé / Très strict | Légèrement inférieure à Games-Howell | Recommandé si N très faible et hétéroscédastique |
10.3 Cas particuliers des devis à mesures répétées et factoriels
L’implémentation de tests post hoc dans le cadre de devis à mesures répétées (intra-sujets) ou de designs factoriels multivariés (ANOVA à deux ou trois facteurs) introduit des contraintes méthodologiques spécifiques qui transcendent le simple cadre de l’analyse unidirectionnelle classique.
Dans les plans à mesures répétées, l’indépendance des observations est caduque par construction, puisque chaque sujet traverse l’ensemble des conditions factorielles. Le postulat crucial devient ici la sphéricité de la matrice de covariance — évaluée par le test de sphéricité de Mauchly —, stipulant l’égalité des variances des différences calculées entre toutes les paires possibles de conditions. Lorsque la sphéricité est violée, les degrés de liberté résiduels subissent une minoration correctrice via les coefficients d’épsilon de Greenhouse-Geisser ou de Huynh-Feldt. Pour les analyses post hoc intra-sujets, la méthode HSD de Tukey conventionnelle est inapplicable sans ajustement formel ; la recommandation prévalente consiste à recourir à des tests t appariés locaux protégés par l’algorithme séquentiel de Holm-Bonferroni, ou à exploiter les modèles linéaires mixtes contemporains.
Dans les plans factoriels (par exemple, un design 2 × 3 croisant Genre et Type d’Entraînement), l’analyste fait face à l’émergence d’effets principaux et d’effets d’interaction. Si l’interaction entre deux facteurs s’avère statistiquement significative (p < 0,05), l’interprétation isolée des effets principaux devient méthodologiquement caduque et fallacieuse. La démarche post hoc requiert alors une décomposition ordonnée en « effets simples » (simple effects analysis), consistant à examiner l’impact du Facteur A à chaque niveau spécifique du Facteur B pris isolément. Cette batterie de tests engendre une multiplication fulgurante du nombre d’inférences statistiques menées en parallèle, imposant une discipline de correction sans faille (typiquement via des contrastes emmeans ajustés par Holm ou Tukey) sous peine de dissoudre l’interprétation théorique sous une cascade d’artefacts stochastiques.
11. Mise en application pratique sous logiciels statistiques : R, SPSS et Jamovi
11.1 Exécution et analyse sous l’environnement R
L’environnement open-source de programmation statistique R fournit l’écosystème le plus puissant et le plus versatile pour modéliser l’ANOVA et piloter des procédures post hoc hautement calibrées. L’approche standard mobilise le paquet de base combiné aux extensions spécialisées que sont emmeans (Estimated Marginal Means) et rstatix.
Après avoir ajusté un modèle linéaire univarié via la commande canonique modele <- aov(Score ~ Groupe, data = donnees), l’analyste peut solliciter la fonction native TukeyHSD(modele) pour extraire instantanément la matrice des contrastes par paires équilibrés ou déséquilibrés. Cette routine retourne la différence moyenne estimée, les bornes inférieures et supérieures de l’intervalle de confiance à 95 % ajusté selon la distribution de l’étendue studentisée, ainsi que la valeur de p ajustée exacte.
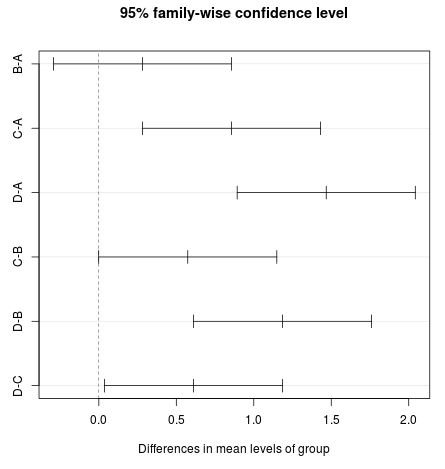
Pour un contrôle analytique avancé — notamment en présence de covariables ou de facteurs multiples —, le paquet emmeans représente le standard professionnel absolu. La syntaxe repose sur le calcul préalable des moyennes marginales estimées par moyennes_ajustees <- emmeans(modele, ~ Groupe), suivi par l’appel de la fonction de contraste : pairs(moyennes_ajustees, adjust = "tukey") ou pairs(moyennes_ajustees, adjust = "holm"). Si le diagnostic révèle une rupture d’homogénéité des variances, l’analyste bascule avec agilité vers le paquet rstatix pour déclencher un test de Games-Howell autonome au moyen de la commande directe : games_howell_test(donnees, Score ~ Groupe). Cette commande extrait automatiquement la statistique de Welch-Satterthwaite et génère les intervalles robustes adaptés aux devis hétéroscédastiques.
11.2 Paramétrage pas à pas dans le logiciel SPSS
Le logiciel commercial IBM SPSS Statistics demeure largement implanté dans les laboratoires de recherche en psychologie institutionnelle et en sciences de l’éducation. L’implémentation des tests post hoc y bénéficie d’une interface graphique dédiée, accessible via le menu déroulant : Analyser > Comparer les moyennes > ANOVA à un facteur (ou via le module Modèle Linéaire Général > Univarié).
Au sein de la boîte de dialogue principale, le bouton latéral intitulé Post Hoc… déploie un panneau structurant scindé en deux compartiments théoriques majeurs :
- Le compartiment supérieur (« Variances égales supposées ») : Il rassemble les procédures paramétriques standards. Le chercheur coche préférentiellement la case Tukey pour les devis exhaustifs sans a priori, Dunnett pour confronter ses groupes à un témoin prédéfini via le menu déroulant associé, ou Bonferroni si l’objectif se focalise sur un nombre très circonscrit de comparaisons d’effets simples.
- Le compartiment inférieur (« Variances égales non supposées ») : Conçu pour parer aux situations d’hétérogénéité des variances identifiées par le test de Levene, cet espace offre un accès direct aux procédures de Games-Howell, Dunnett T3 et C de Tamhane.
Lors de l’édition des résultats dans la fenêtre de sortie, SPSS produit une volumineuse matrice intitulée Comparaisons multiples. Cette grille affiche, pour chaque paire de conditions, la différence de moyennes (marquée d’un astérisque lorsqu’elle franchit le seuil de 5 %), l’erreur type locale, la valeur de p ajustée exacte (colonne Signification), ainsi que l’intervalle de confiance bilatéral simultané. Un second tableau complémentaire, intitulé Sous-ensembles homogènes, regroupe visuellement les conditions dont les moyennes ne divergent pas statistiquement au sein de colonnes identifiées. Bien que séduisant pour une inspection visuelle rapide, ce format en sous-ensembles doit être interprété avec prudence, car il occulte les valeurs de probabilité exactes exigées pour la publication savante.
11.3 Utilisation de l’interface Jamovi pour les sciences comportementales
Conçu par et pour des chercheurs en sciences humaines dans une perspective de science ouverte, le logiciel libre Jamovi (construit sur un moteur R natif) propose une ergonomie d’analyse remarquable pour les tests post hoc. Son architecture dynamique permet la mise à jour instantanée des tableaux d’inférence en fonction des paramètres sélectionnés par l’analyste.
Au sein du module ANOVA, la sélection d’une ANOVA unidirectionnelle déploie un volet d’options repliable nommé Tests Post-Hoc. L’utilisateur glisse la variable factorielle dans le champ de sélection actif, ce qui enclenche automatiquement la génération de la matrice de comparaisons. Jamovi permet alors de basculer instantanément entre les modes de correction via de simples cases à cocher : Tukey, Bonferroni, Holm ou Scheffé. De plus, une case dédiée permet d’activer la correction pour variances inégales (Games-Howell) sans quitter l’environnement de modélisation univarié.
L’atout distinctif majeur de Jamovi réside dans la clarté typographique de ses tableaux de sortie, nativement pré-formatés selon les normes de publication de l’APA. Les matrices incluent directement les différences moyennes, les erreurs types, les statistiques de test (t de Student ajusté ou q de Tukey), les degrés de liberté, ainsi que les intervalles de confiance à 95 %. De surcroît, le module autorise la création instantanée d’un tracé graphique d’estimation des moyennes (Descriptive Plots) enrichi des barres d’erreur basées sur les intervalles ajustés post hoc, offrant ainsi un continuum immédiat entre le traitement algorithmique et l’élaboration de supports visuels pour la diffusion scientifique.
12. Rédaction scientifique et présentation des résultats selon les normes APA
12.1 Structure canonique du paragraphe de résultats
La restitution écrite d’une expérimentation psychologique au sein d’un article soumis aux normes de l’American Psychological Association (manuel de publication de l’APA, 7e édition) doit obéir à une architecture rhétorique rigoureusement codifiée, fluide et exempte de redondance. L’insertion de la phase post hoc s’opère toujours en subordination directe au compte-rendu du test F global de l’ANOVA.
La structure canonique séquentielle comprend quatre jalons textuels incontournables :
- L’énonciation du résultat omnibus : Il convient de rapporter formellement la statistique F, ses deux paramètres de degrés de liberté (intergroupes et résiduels), la valeur exacte de p et l’indicateur de taille d’effet standardisé (ηp2 ou ω2).
- La désignation et la justification du test post hoc mobilisé : L’auteur explicite la technique d’ajustement sélectionnée en motivant brièvement son choix au regard des postulats de distribution (par exemple, la mention du respect ou du non-respect de l’homoscédasticité via le test de Levene).
- L’exposé des contrastes pertinents avec leurs statistiques descriptives : Chaque paire discriminante doit être étayée par la présentation de ses moyennes ajustées (M), de ses écarts-types (ET) ou erreurs types (SE), de l’amplitude de sa différence moyenne, de son intervalle de confiance à 95 %, ainsi que de la valeur exacte de p corrigée associée.
- L’interprétation sémantique directionnelle : Le texte ne se contente pas d’aligner des métriques mathématiques ; il conclut explicitement sur le sens conceptuel de l’effet dans le champ comportemental (quelle modalité s’avère supérieure ou équivalente à quelle autre).
12.2 Typographie statistique et conventions de notation
Le formalisme éditorial de l’APA impose des règles typographiques millimétrées qu’il est capital de respecter pour garantir la crédibilité académique du manuscrit :
- L’usage de l’italique : Tous les symboles statistiques désignés par des lettres latines sont impérativement composés en italique (M, ET, F, t, q, p, n, N). À l’inverse, les lettres grecques (α, β, ηp2, ω2) et les abréviations d’opérateurs ou de tests (CME, HSD, ANOVA) demeurent en caractères romains droits standard.
- La gestion des décimales et des zéros non significatifs : Les statistiques empiriques (F, t, M, ET) sont systématiquement arrondies à deux décimales après la virgule (ou le point décimal selon les conventions éditoriales anglophones). En revanche, les valeurs de probabilité (p) sont exprimées avec trois décimales. Conformément à la norme APA, si une statistique ne peut théoriquement jamais dépasser la valeur absolue de 1 (ce qui est le cas des probabilités p, des corrélations r et des proportions η2), le zéro initial avant le séparateur décimal doit être omis dans les publications en anglais (noter p = .024 et non p = 0.024 ; en français académique, l’usage autorise p = 0,024).
- La précision des probabilités : Les formules vagues du type « p < 0,05 » doivent être proscrites au bénéfice de l’affichage de la valeur exacte de probabilité (par exemple, pajusté = 0,018). Seules les probabilités infimes inférieures à un millième sont formatées sous la borne conventionnelle p < 0,001.
Voici un gabarit textuel d’excellence illustrant la mise en forme de ces directives pour notre étude psychothérapeutique :
« Une analyse de variance unidirectionnelle a révélé un effet principal significatif du protocole de prise en charge sur la réduction des symptômes dépressifs, F(3, 116) = 8,42, p < 0,001, ηp2 = 0,18. Le test de Levene n’ayant pas indiqué d’infraction au postulat d’homogénéité des variances, F(3, 116) = 1,14, p = 0,336, des comparaisons post hoc ont été menées à l’aide de la procédure HSD de Tukey pour explorer l’ensemble des paires de moyennes. Ces analyses indiquent que les participants assignés à la thérapie cognitivo-comportementale ont présenté une réduction des scores significativement plus marquée (M = 14,20, ET = 3,12) que ceux placés sur liste d’attente (M = 6,80, ET = 2,95), Différence Moyenne = 7,40, IC à 95 % [4,62, 10,18], p < 0,001. En revanche, aucune divergence statistiquement significative n’a été détectée entre le groupe TCC et le groupe sous ISRS (M = 12,90, ET = 3,40), Différence Moyenne = 1,30, IC à 95 % [-1,48, 4,08], p = 0,612, ni entre le protocole TCC et la psychothérapie interpersonnelle (M = 13,10, ET = 3,05), p = 0,485. »
12.3 Conception de tableaux et graphiques informatifs
L’adjonction de supports visuels informatifs s’avère indispensable pour décharger le texte narratif lorsque le devis factoriel comporte un grand nombre de comparaisons. Selon les canons de l’APA 7, un tableau de données doit faire l’économie de tout quadrillage vertical interne et limiter ses lignes de démarcation horizontales à trois traits principaux : sous l’en-tête de colonne, sous les titres de catégories et à la base terminale du tableau.
Pour matérialiser visuellement les sous-ensembles issus d’analyses post hoc au sein d’un tableau récapitulatif de moyennes, la méthode standard consiste à utiliser des lettres exposantes distinctes (système des lettres de Tukey ou compact letter display). Deux moyennes partageant une lettre identique en exposant (par exemple, 14,20a et 13,10a) ne diffèrent pas significativement entre elles au seuil ajusté de 5 % ; inversement, l’assignation de lettres totalement disjointes (par exemple, 14,20a contre 6,80b) dénote l’existence d’une divergence statistiquement significative selon le test post hoc sélectionné. Cette convention offre une lisibilité instantanée et compacte des structures d’homogénéité.
Sur le plan iconographique, la représentation graphique de choix pour les comparaisons multiples réside dans le diagramme en barres avec intervalles d’erreur ou le tracé de moyennes avec distribution des données sous-jacentes (raincloud plot ou diagramme de dispersion superposé). Les barres d’erreur doivent impérativement être explicitées dans la légende de la figure : s’agit-il d’écarts-types (reflétant la dispersion brute des sujets), d’erreurs types (reflétant la précision de l’échantillonnage) ou d’intervalles de confiance à 95 % ajustés selon Tukey ?
Pour indiquer formellement la significativité des contrastes locaux sur le graphique, l’usage préconise l’emploi d’accolades ou de barres horizontales suspendues coiffant les deux conditions comparées, surmontées d’annotations typographiques standardisées : * p < 0,05, ** p < 0,01, *** p < 0,001, ou de l’acronyme ns (non significatif). La légende de la figure doit être entièrement autonome, fournissant au lecteur l’ensemble des clés méthodologiques requises : taille de l’échantillon par cellule, nature exacte de l’ajustement post hoc mobilisé (par exemple : « Les valeurs de probabilité indiquées au-dessus des barres de contraste ont été ajustées selon l’algorithme séquentiel de Holm-Bonferroni ») et définition exhaustive de tous les symboles employés.
Références
- Bonferroni, C. E. (1936). Teoria statistica delle classi e calcolo delle probabilità. Pubblicazioni del R Istituto Superiore di Scienze Economiche e Commerciali di Firenze, 8, 3-62.
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096-1121. https://doi.org/10.1080/01621459.1955.10501294
- Dunnett, C. W. (1980). Pairwise multiple comparisons in the unequal variance case. Journal of the American Statistical Association, 75(372), 796-800. https://doi.org/10.1080/01621459.1980.10477552
- Fisher, R. A. (1935). The Design of Experiments. Oliver and Boyd.
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal n’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113-125. https://doi.org/10.3102/10769986001002113
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65-70. https://www.jstor.org/stable/4615733
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307-310. https://doi.org/10.2307/3001466
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2017). Designing Experiments and Analyzing Data: A Model Comparison Perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Scheffé, H. (1953). A method for judging all contrasts in the analysis of variance. Biometrika, 40(1-2), 87-110. https://doi.org/10.1093/biomet/40.1-2.87
- Šidák, Z. (1967). Rectangular confidence regions for the means of multivariate normal distributions. Journal of the American Statistical Association, 62(318), 626-633. https://doi.org/10.1080/01621459.1967.10482935
- Tamhane, A. C. (1979). A comparison of procedures for multiple comparisons of means with unequal variances. Journal of the American Statistical Association, 74(366a), 471-480. https://doi.org/10.1080/01621459.1979.10482541
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99-114. https://doi.org/10.2307/3001913