
L’analyse statistique contemporaine repose sur des piliers mathématiques dont l’un des plus illustres et fondamentaux est sans conteste la distribution normale, communément appelée distribution gaussienne ou loi de Laplace-Gauss. Au sein de l’environnement de programmation et de calcul statistique R, la manipulation de cette loi de probabilité continue est régie par un ensemble cohérent, élégant et hautement optimisé de quatre fonctions élémentaires : dnorm, pnorm, qnorm et rnorm. Conçues pour répondre respectivement aux impératifs de calcul de densité, de cumul de probabilité, d’inversion quantile et d’échantillonnage stochastique, ces routines constituent le socle technique indispensable à tout praticien des données, qu’il s’agisse de modéliser des phénomènes psychométriques complexes, de calibrer des modèles économétriques ou d’exécuter des simulations bayésiennes de grande envergure.
La compréhension approfondie de ces quatre briques logicielles transcende la simple mémorisation de leur syntaxe de base. Elle exige une appréhension minutieuse des concepts probabilistes sous-jacents, une vigilance algorithmique quant à la précision de l’arithmétique en virgule flottante et une maîtrise des paramètres structurels qui gouvernent le comportement numérique de ces fonctions dans des régimes asymptotiques ou extrêmes. L’environnement R offre une implémentation native exceptionnellement robuste de ces outils, exploitant des algorithmes de calcul numérique éprouvés et codés directement en langage C ou Fortran pour maximiser la vélocité sans sacrifier la précision infinitésimale requise par l’inférence moderne.
Ce guide exhaustif a pour vocation de disséquer de manière méthodique et académique l’architecture, la théorie, la programmation et les applications de ce quatuor canonique. En parcourant les aspects fondamentaux de la densité avec dnorm, l’intégration cumulative avec pnorm, la réciprocité quantile avec qnorm, et la génération pseudo-aléatoire avec rnorm, le chercheur ou l’analyste découvrira les subtilités calculatoires et empiriques nécessaires pour mener des analyses rigoureuses, reproductibles et exemptes d’écueils méthodologiques.
1. Introduction aux fondements de la loi normale dans l’environnement R
1.1 Importance théorique de la distribution gaussienne en statistique
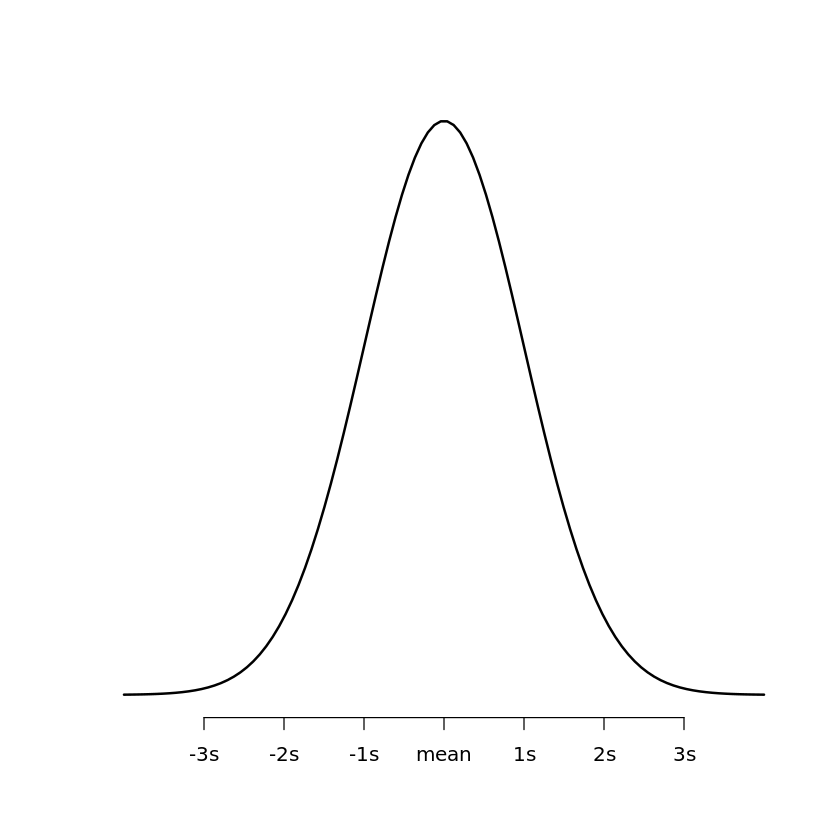
La distribution gaussienne occupe une place quasi hégémonique dans l’histoire et la pratique des sciences quantitatives. Sa morphologie en cloche, parfaitement symétrique autour de son espérance mathématique, est caractérisée par une annulation de son coefficient d’asymétrie statistique (skewness de Fisher égal à zéro) et un coefficient d’aplatissement (kurtosis de Pearson) rigoureusement égal à trois, soit un excès de kurtosis nul. Ces propriétés de symétrie axiale impliquent que la moyenne, la médiane et le mode d’une variable aléatoire continue suivant une loi normale sont rigoureusement confondus au sommet de la courbe de densité. Les asymptotes horizontales de la fonction de densité, se prolongeant indéfiniment vers l’infini positif et l’infini négatif, traduisent le fait que l’espace des réalisations possibles s’étend sur la droite réelle tout entière, quand bien même la masse de probabilité se concentre quasi intégralement dans un intervalle restreint autour de la moyenne.
Sur le plan fondamental de la théorie probabiliste et de la théorie de la mesure, la suprématie de la loi normale découle directement du théorème central limite. Selon ce théorème cardinal énoncé sous diverses hypothèses par Pierre-Simon de Laplace, Carl Friedrich Gauss et consolidé par Aleksandr Lyapunov, la somme normalisée d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées, pourvu qu’elles possèdent une variance finie, converge en loi vers une distribution normale standard, indépendamment de la forme de la distribution sous-jacente d’origine. Cette propriété d’attraction universelle confère à la loi normale un statut central dans l’inférence statistique classique : elle légitime l’hypothèse de normalité asymptotique pour une vaste classe d’estimateurs, tels que les moyennes d’échantillons et les estimateurs du maximum de vraisemblance.
Dans les disciplines empiriques, notamment l’évaluation psychométrique et la psychologie quantitative, la loi normale sert de modèle paradigmatique pour quantifier les traits latents, l’intelligence générale ou les traits de personnalité. L’accumulation de multiples déterminants génétiques et environnementaux infinitésimaux s’additionnant pour forger le phénotype comportemental justifie conceptuellement l’émergence d’une distribution normale des scores observés au sein de la population. Il demeure néanmoins impératif d’opérer une distinction ontologique stricte entre la distribution théorique continue, définie sur un continuum non borné avec une précision mathématique infinie, et les distributions empiriques collectées sur le terrain, qui sont inévitablement discrétisées, tronquées aux bornes des instruments d’évaluation et sujettes aux fluctuations d’échantillonnage.
1.2 Présentation du quatuor fonctionnel de base dans R
Pour interagir avec les lois de probabilités continues et discrètes, les concepteurs du langage R ont formalisé une convention de préfixage d’une cohérence remarquable. Ce système attribue à chaque famille de distributions un radical mnémotechnique, associé à quatre préfixes unificateurs : le préfixe d renvoie à la densité de probabilité (density), le préfixe p correspond à la fonction de répartition ou probabilité cumulative (probability), le préfixe q calcule les quantiles théoriques par inversion de la fonction de répartition (quantile), et le préfixe r procède à l’échantillonnage ou à la génération de nombres pseudo-aléatoires (random). Pour la loi normale, le radical générique est « norm », engendrant ainsi le quatuor fondamental composé de dnorm, pnorm, qnorm et rnorm.
Ces quatre fonctions sont indissolublement unies par les deux mêmes paramètres régulateurs fondamentaux : la moyenne arithmétique de la distribution, notée usuellement mu (μ), et l’écart-type, noté sigma (σ). La convergence mathématique liant ces routines assure une transition sans faille de l’une à l’autre : l’intégrale de dnorm produit les valeurs calculées par pnorm ; la fonction qnorm prend en entrée les probabilités produites par pnorm pour restituer les abscisses d’origine ; et rnorm tire des réalisations individuelles dont la distribution de fréquence empirique converge au sens asymptotique vers la densité calculée par dnorm.
Sur le plan architectural, l’implémentation de ces fonctions au cœur du moteur natif de R (« base R ») garantit une efficacité computationnelle optimale. Développées en code C optimisé au plus bas niveau du runtime, ces routines évitent les surcoûts d’interprétation inhérents au code vectoriel R de haut niveau. Dans les protocoles de recherche expérimentale, de la psychométrie à la biostatistique, cette architecture permet l’évaluation quasi instantanée de millions de points de calcul, qu’il s’agisse de calculer des niveaux de signification empiriques dans des modèles de régression multiple ou de simuler des chaînes de Markov à convergence continue.
1.3 Gestion des paramètres par défaut et spécification des arguments
L’une des commodités fondamentales des fonctions statistiques de R réside dans l’utilisation de valeurs par défaut pour les paramètres distributionnels. Si l’utilisateur omet de spécifier explicitement les composantes d’échelle et de localisation, R postule de facto l’utilisation de la loi normale centrée réduite, également dite standardisée, en affectant au paramètre mean la valeur 0 et au paramètre sd (écart-type) la valeur 1. Par conséquent, l’invocation de dnorm(0) évalue implicitement la hauteur de la distribution gaussienne standardisée à son origine, un automatisme qui allège substantiellement la syntaxe dans les travaux théoriques standardisés.
La rigueur statistique requiert toutefois une attention soutenue à la contrainte de positivité stricte qui pèse sur le paramètre de dispersion sd. L’écart-type mesurant l’amplitude moyenne de la déviation quadratique autour de la moyenne, une valeur strictement négative représente une aberration théorique. Lorsque l’analyste transmet par inadvertance un argument sd < 0, l’interpréteur R interrompt le calcul normal en générant un avertissement explicite (NaNs produced) et renvoie la valeur indéfinie NaN (Not a Number). En revanche, la valeur limite sd = 0 correspond à une distribution dégénérée concentrée en un point unique (la mesure de Dirac), ce qui induit une divergence de la densité à la moyenne et l’inversion discontinue de la fonction de répartition.
La gestion des données manquantes et la stabilité numérique du système reposent sur une politique rigoureuse de propagation des valeurs spéciales. Dès lors qu’un vecteur d’entrée comporte des éléments non renseignés de type NA (Not Available) ou des entités arithmétiques invalides telles que NaN, les quatre fonctions de la famille gaussienne préservent l’intégrité de l’indicateur d’absence en renvoyant directement NA ou NaN aux indices correspondants. De surcroît, le typage strict des vecteurs en arithmétique flottante à double précision (standard IEEE 754) empêche les erreurs de troncature prématurées, assurant ainsi une régularité et une fiabilité analytique indispensables au traitement automatique de larges bases de données scientifiques.
2. Comprendre et maîtriser la fonction dnorm : Densité de probabilité
2.1 Définition mathématique et formulation sous R
La fonction dnorm constitue la transposition algorithmique directe de la fonction de densité de probabilité (PDF, pour Probability Density Function) de la loi normale continue. Sur le plan analytique, pour une variable aléatoire réelle X gouvernée par les paramètres d’espérance μ et d’écart-type σ strictement positif, l’expression formelle de cette fonction s’énonce comme suit :
f(x; μ, σ) = (1 / (σ √(2π))) × exp( – (x – μ)2 / (2σ2) )
Dans l’écosystème R, la signature complète de la commande s’établit sous la forme : dnorm(x, mean = 0, sd = 1, log = FALSE). Le premier argument, x, accepte un scalaire unique ou un vecteur numérique arbitrairement long représentant les abscisses auxquelles la hauteur de la densité doit être quantifiée. Les arguments mean et sd assignent respectivement le centre et l’échelle de dispersion du profil gaussien.
Une distinction épistémologique cruciale, particulièrement pour les praticiens habitués aux modèles discrets, réside dans la nature même de la densité. Dans le cadre d’une distribution continue, la probabilité ponctuelle exacte associée à une valeur isolée x est strictement nulle : P(X = x) = 0. Dès lors, la valeur renvoyée par dnorm(x) ne représente en aucune circonstance une probabilité, mais bien une ordonnée mathématique mesurant une densité locale de probabilité par unité de mesure. L’évaluation de l’ordonnée maximale de la courbe s’observe au centre géométrique de la distribution, c’est-à-dire en x = μ. Pour la loi centrée réduite (μ = 0, σ = 1), cette ordonnée maximale culmine à la valeur théorique exacte 1 / √(2π), soit approximativement 0,3989423.
2.2 Utilisation du paramètre logarithmique log = TRUE
L’argument logique log = FALSE, présent dans la signature de dnorm, constitue une passerelle capitale vers la stabilité numérique en statistique inférentielle computationnelle. Lorsqu’il est configuré sur log = TRUE, la fonction calcule directement le logarithme népérien de la densité théorique, c’est-à-dire ln(f(x; μ, σ)), au lieu d’évaluer d’abord la densité f(x) pour ensuite en prendre le logarithme via une instruction externe comme log(dnorm(x)).
Cette approche native présente un avantage numérique déterminant pour pallier les effets dévastateurs du sous-dépassement arithmétique (arithmetic underflow). Dans les machines numériques fonctionnant selon la norme de représentation à virgule flottante double précision, le plus petit nombre positif non dénormalisé pouvant être représenté est de l’ordre de 2,22 × 10-308. Si une observation x se situe à une distance importante de la moyenne (par exemple, à six ou sept écarts-types), la densité f(x) devient infinitésimale et plonge sous le seuil de précision machine, étant brutalement arrondie à zéro. L’exécution subséquente de log(0) renvoie alors la valeur -Inf, anéantissant toute possibilité de poursuivre le calcul analytique.
En mobilisant dnorm(x, log = TRUE), l’interpréteur contourne l’exponentiation initiale en calculant analytiquement l’expression simplifiée :
ln(f(x; μ, σ)) = – ln(σ) – (1/2) ln(2π) – (x – μ)2 / (2σ2)
Cette formulation transforme les opérations de multiplication de probabilités indépendantes — omniprésentes dans l’estimation du maximum de vraisemblance (MLE) — en de simples sommes de termes algébriques stables. L’optimisation algorithmique d’une log-vraisemblance conjointe à l’aide de fonctions comme optim() ou nlm() gagne ainsi en rapidité d’exécution et évite les instabilités numériques provoquées par les valeurs résiduelles aberrantes.
2.3 Exemples numériques appliqués et interprétation des ordonnées
Pour appréhender concrètement la manipulation de dnorm, examinons l’évaluation numérique de la densité à l’origine dans le cadre standardisé. Lorsque l’on évalue dnorm(0, mean = 0, sd = 1), le résultat obtenu s’établit exactement à 0,3989423. Si l’on modifie la dispersion pour considérer une distribution plus étalée avec un écart-type σ = 2, la densité maximale au centre dnorm(0, mean = 0, sd = 2) décroît de moitié pour atteindre 0,1994711. Cette diminution mécanique découle directement du principe de conservation de l’aire sous la courbe : l’intégrale totale de la densité sur l’ensemble des réels devant impérativement demeurer égale à 1, tout étalement latéral de la masse probabiliste entraîne un affaissement proportionnel de son sommet.
En psychologie expérimentale et dans les sciences du comportement, l’ordonnée de la courbe de densité sert fréquemment d’indicateur relatif de plausibilité locale. Bien qu’elle ne quantifie pas directement un risque ou une probabilité de survenue discrète, la hauteur de densité permet de calculer des ratios de vraisemblance (likelihood ratios) pour comparer l’ajustement d’un score empirique sous deux hypothèses concurrentes. Par exemple, comparer dnorm(x_obs, mean = 100, sd = 15) et dnorm(x_obs, mean = 115, sd = 15) permet d’évaluer la plausibilité relative qu’un participant provienne d’une population neurotypique versus un groupe clinique ciblé.
Enfin, l’observation du comportement asymptotique aux queues de distribution démontre l’extrême sensibilité de la décroissance gaussienne. Lorsque l’on évalue dnorm(4, mean = 0, sd = 1), l’ordonnée descend à 0,0001338, tandis qu’à x = 6, dnorm(6) ne vaut plus que 6,075883 × 10⁻⁹. Cette chute vertigineuse souligne l’incroyable rareté théorique des événements distants sous l’hypothèse de normalité, un fait qui doit inciter l’analyste à la plus grande prudence lorsque des valeurs empiriques extrêmes se manifestent de manière récurrente dans ses échantillons.
3. Applications graphiques de dnorm pour la modélisation visuelle
3.1 Tracé de la cloche de Gauss avec le moteur graphique de base
L’exploitation graphique de la fonction dnorm offre un support pédagogique et analytique puissant pour représenter le comportement théorique de variables continues. Avec le moteur graphique intégré nativement dans le système R, la première étape opérationnelle consiste à générer un continuum d’abscisses régulières couvrant l’intervalle d’intérêt. On utilise à cette fin la fonction seq(), en bornant typiquement l’intervalle entre quatre écarts-types en deçà et au-delà de la moyenne théorique (μ ± 4σ) avec un pas incrémental fin pour préserver une continuité visuelle fluide.
Une fois cette séquence d’abscisses établie dans un vecteur, l’instruction plot() combinée avec l’argument type = 'l' (pour le traçage linéaire) et l’appel vectorisé de dnorm() permet de dessiner instantanément la célèbre cloche de Gauss. L’enrichissement de la figure peut être parachevé par l’invocation de la routine abline(), laquelle permet d’insérer des repères verticaux discontinus marquant les positions stratégiques de la moyenne et des écarts-types remarquables (±1σ, ±2σ, ±3σ). Les fonctions textuelles associées à l’argument d’expression mathématique expression() permettent quant à elles d’inclure des symboles grecs formels au sein des étiquettes des axes et des titres de graphiques.
Cette approche bas niveau demeure particulièrement efficiente dans le cadre de diagnostics exploratoires rapides ou de la génération de scripts automatisés légers, ne requérant aucune dépendance logicielle externe. La personnalisation complète des paramètres graphiques globaux via la fonction par() confère un contrôle minutieux sur les marges, les épaisseurs de traits (lwd) et les couleurs (col), garantissant des tracés d’une grande rigueur formelle.
3.2 Représentation avancée et superposition avec ggplot2
Dans l’écosystème contemporain de visualisation de données articulé autour du package de référence ggplot2, fondé sur les concepts de la grammaire des graphiques de Leland Wilkinson, la fonction dnorm s’intègre avec une flexibilité structurelle accrue. Plutôt que de contraindre l’utilisateur à créer manuellement des tables de valeurs denses, le module propose la commande stat_function(), qui automatise l’évaluation mathématique de toute fonction continue sur la plage d’abscisses définie dans le canevas graphique.
L’une des opérations diagnostiques les plus cruciales en analyse de données consiste à superposer une courbe théorique de densité gaussienne sur un histogramme empirique de scores observés. Pour que la confrontation graphique soit mathématiquement valide, il est indispensable de veiller à ce que l’axe vertical de l’histogramme n’affiche pas des fréquences d’effectifs absolus (comptages discrets), mais bien une densité empirique. Dans ggplot2, cette mise à l’échelle s’obtient élégamment en spécifiant aes(y = after_stat(density)) au sein de la couche geom_histogram().
Cette méthodologie permet ensuite d’ajouter un tracé stat_function(fun = dnorm, args = list(mean = mean(scores), sd = sd(scores))) venant délicatement envelopper la distribution expérimentale. L’application d’esthétiques chromatiques subtiles, telles que le remplissage translucide des zones critiques de rejet ou des intervalles de confiance au moyen d’échelles de couleurs perceptuellement uniformes (comme la palette viridis), permet d’obtenir des figures conformes aux exigences strictes de publication des revues scientifiques internationales.
3.3 Visualisation de comparaisons inter-groupes sous différentes variances
L’analyse comparative de cohortes ou de conditions expérimentales distinctes requiert fréquemment l’évaluation simultanée de plusieurs distributions théoriques différant par leurs paramètres de position ou de dispersion. Lorsque deux groupes expérimentaux présentent des moyennes divergentes et, surtout, des variances non homogènes (hétéroscédasticité), la confrontation de leurs courbes de densité respectives met immédiatement en exergue l’ampleur du chevauchement distributionnel (overlapping) et l’asymétrie potentielle de leur pouvoir de discrimination.
Sur le plan technique, la visualisation simultanée de ces profils est accomplie sous le moteur graphique de base en initialisant le graphique avec le premier groupe, puis en employant la commande lines() pour surimposer le second profil gaussien avec des paramètres mean et sd différenciés. Pour accentuer visuellement la masse probabiliste contenue sous une section spécifique d’une courbe, on fait couramment appel à la routine polygon(), qui génère des aplats de couleurs polygonaux délimités par des coordonnées cartésiennes précises. Dans le cadre de ggplot2, l’homologue fonctionnel est représenté par la couche geom_ribbon() ou des sélections conditionnelles dans geom_area().
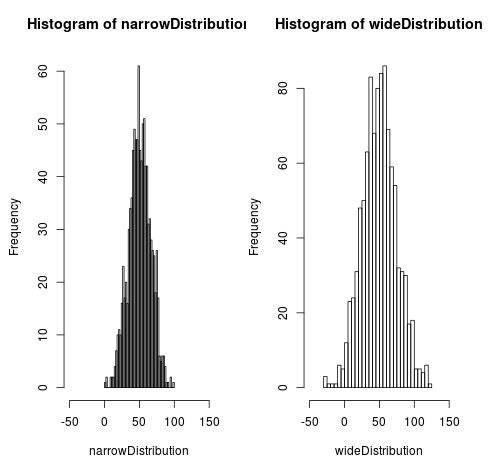
La structuration rigoureuse de ces figures comparatives exige enfin l’insertion d’une légende sans ambiguïté précisant explicitement les paramètres de chaque distribution tracée. Cela permet aux évaluateurs de saisir instantanément l’impact de l’hétérogénéité des variances : une distribution dotée d’un écart-type restreint se manifestera sous la forme d’un pic très étroit et étiré verticalement (leptocurtique en apparence relative), tandis qu’un groupe hautement dispersé présentera une voûte affaissée et largement étendue le long de l’axe horizontal.
4. La fonction pnorm : Calcul des probabilités cumulées
4.1 Fonction de répartition cumulative (CDF) et syntaxe
La fonction pnorm constitue l’outil par excellence de quantification probabiliste sous la loi normale, matérialisant la fonction de répartition cumulative (connue sous l’acronyme anglophone CDF pour Cumulative Distribution Function). Sur le plan infinitésimal, la valeur renvoyée par cette fonction correspond à l’intégrale définie de la fonction de densité gaussienne depuis l’infini négatif jusqu’à une valeur seuil spécifique notée q :
F(q; μ, σ) = P(X ≤ q) = ∫-∞q f(t; μ, σ) dt
La signature opérationnelle complète de la fonction s’articule comme suit : pnorm(q, mean = 0, sd = 1, lower.tail = TRUE, log.p = FALSE). Le premier argument, q, désigne le quantile empirique ou la borne supérieure d’intégration considérée. Les paramètres mean et sd définissent les propriétés de localisation et d’échelle de la distribution, conservant leurs valeurs standardisées par défaut de 0 et 1.
La distinction méthodologique entre dnorm et pnorm est fondamentale : alors que dnorm détermine la hauteur instantanée de la courbe (l’ordonnée de densité sans interprétation probabiliste absolue), pnorm mesure une surface géométrique sous la courbe, c’est-à-dire une probabilité réelle et directement interprétable comprise de manière axiomatique entre 0 et 1. Aux limites mathématiques du support continu, la fonction de répartition présente un comportement strictement asymptotique : lorsque q tend vers -∞, F(q) tend vers 0, et lorsque q progresse vers +∞, F(q) tend vers 1, la médiane théorique vérifiant scrupuleusement F(μ) = 0,5.
4.2 Rôle et manipulation de l’argument lower.tail
L’argument logique lower.tail, activé par défaut sur TRUE, contrôle la directionnalité de l’intégration probabiliste. Dans sa configuration nominale, pnorm(q, lower.tail = TRUE) renvoie la masse cumulée située dans la queue inférieure de la distribution, c’est-à-dire P(X ≤ q). À l’inverse, dès lors que le praticien bascule cet argument sur lower.tail = FALSE, la routine calcule la probabilité de survie ou masse de la queue supérieure, définie formellement par P(X > q) = 1 – P(X ≤ q).
D’un point de vue analytique naïf, il semblerait équivalent d’exécuter l’instruction algébrique 1 - pnorm(q) pour obtenir la masse supérieure. Cependant, cette pratique informelle induit des périls algorithmiques majeurs désignés sous le terme d’annulation catastrophique (catastrophic cancellation). En arithmétique flottante, soustraire de la valeur entière 1 un nombre extrêmement proche de 1 (ce qui se produit invariablement lorsque q dépasse quatre ou cinq écarts-types) conduit inéluctablement à l’annihilation des chiffres significatifs de mantisse et à une perte irrémédiable de précision numérique.
L’argument lower.tail = FALSE déploie des approximations rationnelles spécifiques conçues pour évaluer directement l’intégrale de queue supérieure sans jamais passer par le complément arithmétique de 1. Ce mécanisme algorithmique interne préserve l’intégrité de la précision machine en virgule flottante double précision même lorsque l’on explore des zones distantes correspondant à des événements rarissimes d’une probabilité inférieure à 10-15.
4.3 Calculs de probabilités par intervalles
L’une des manipulations les plus récurrentes de la fonction pnorm réside dans la détermination de la probabilité qu’une observation gaussienne appartienne à un intervalle continu borné par deux valeurs réelles arbitraires [a, b], sous la condition a < b. En vertu des axiomes fondamentaux de Kolmogorov régissant les mesures de probabilité cumulées, cette grandeur s’obtient directement par la différence de potentiel probabiliste :
P(a ≤ X ≤ b) = P(X ≤ b) – P(X ≤ a) = pnorm(b, mean, sd) – pnorm(a, mean, sd)
Cette formulation permet de formaliser et de démontrer empiriquement la célèbre règle empirique 68-95-99.7 régissant la distribution normale standard. En exécutant l’instruction pnorm(1) - pnorm(-1), le système renvoie immédiatement 0,6826895, confirmant qu’environ 68,27 % de la population s’inscrit dans un rayon d’un écart-type autour de la moyenne. Pour deux écarts-types, l’instruction pnorm(2) - pnorm(-2) fournit 0,9544997 (approximativement 95,45 %), tandis que l’évaluation à trois écarts-types pnorm(3) - pnorm(-3) atteint 0,9973002, laissant une fraction résiduelle d’à peine 0,27 % au-delà des bornes ±3σ.
L’évaluation des probabilités bilatérales au-delà d’un seuil de déviation absolue critique |z| peut être facilement systématisée. En raison de la symétrie axiale parfaite de la courbe autour de zéro, la masse totale située dans les deux queues extrêmes combinées s’exprime par la simple multiplication 2 * pnorm(z, lower.tail = FALSE) (pour un score z positif). La vectorisation inhérente au moteur R permet en outre de transmettre un vecteur complet de seuils multiples à pnorm, renvoyant sans boucle explicite la matrice des probabilités cumulées correspondantes.
5. Applications inférentielles et psychométriques de pnorm
5.1 Calcul de z-scores et positionnement relatif de scores psychologiques
En psychométrie et en psychologie quantitative, la standardisation des observations empiriques constitue un prérequis incontournable pour conférer une signification clinique à des métriques issues d’échelles variées. Le calcul élémentaire d’un score centré réduit z = (x – μ) / σ permet d’ancrer la performance d’un individu par rapport à un échantillon normatif d’étalonnage. Une fois ce z-score dérivé, la fonction pnorm(z) transforme instantanément cette position relative en un rang centile précis, traduisant le pourcentage exact de la population de référence obtenant un score inférieur ou égal au participant testé.
Considérons par exemple les tests d’intelligence standardisés à l’instar des échelles de Wechsler (WAIS ou WISC), traditionnellement calibrées sur une distribution normale de moyenne μ = 100 et d’écart-type σ = 15. Un individu affichant un quotient intellectuel de 130 présente un score z = (130 – 100) / 15 = +2,00. L’évaluation de pnorm(130, mean = 100, sd = 15) renvoie 0,9772499, révélant que cet individu surpasse 97,72 % de ses pairs au sein de la population générale.
L’utilisation diagnostique de la fonction cumulative s’avère particulièrement discriminante pour caractériser les zones critiques situées au-delà de deux écarts-types, seuil conventionnel délimitant la douance cognitive supérieure (QI ≥ 130) ou, à l’opposé du continuum, le retard ou déficit intellectuel (QI ≤ 70 correspondant à pnorm(70, 100, 15) ≈ 2,28 %). De surcroît, le recours systématique à la distribution cumulative théorique permet de modéliser et de corriger les distorsions provoquées par les effets de plancher et de plafond inhérents aux batteries d’évaluations standardisées comportant un nombre fini d’items.
5.2 Détermination des valeurs p dans les tests d’hypothèses
Dans le cadre de l’inférence statistique fréquentiste et du paradigme d’invalidation d’hypothèses de Neyman-Pearson, la fonction pnorm incarne le moteur calculatoire central pour dériver les valeurs p (p-values) associées aux statistiques de test qui suivent asymptotiquement une loi normale, telles que les tests Z sur proportions ou grands échantillons. La valeur p quantifie formellement la probabilité d’obtenir, sous l’hypothèse nulle (H0), une statistique au moins aussi extrême que celle effectivement observée dans les données d’échantillonnage.
La formulation algorithmique de la valeur p dépend impérativement du dessein expérimental et de l’orientation formulée dans les hypothèses de recherche. Pour un test unilatéral supérieur stipulant que le paramètre d’intérêt dépasse la valeur d’ancrage nulle, la valeur p se calcule par l’instruction :
p_val_sup <- pnorm(z_obs, lower.tail = FALSE)
Pour un test bilatéral non orienté, susceptible de déceler une divergence dans les deux directions, la masse probabiliste des deux queues extrêmes doit être sommée symétriquement :
p_val_bilat <- 2 * pnorm(abs(z_obs), lower.tail = FALSE)
Cette capacité à déterminer avec une précision machine les niveaux de signification exacts a rendu définitivement obsolètes les tables statistiques sur support papier imprimées en annexe des traités manuels d’antan. Le chercheur s’affranchit ainsi des approximations par interpolation linéaire et maîtrise parfaitement le contrôle de son erreur de première espèce alpha (α), traditionnellement fixée à 0,05 ou 0,01.
5.3 Gestion des queues de distribution extrêmes avec log.p = TRUE
Avec l’avènement des analyses quantitatives massives contemporaines, telles que les études d’association pangénomique (GWAS) corrélant des millions de polymorphismes nucléotidiques à des traits psychologiques ou phénotypiques, les seuils de significativité statistique sont abaissés de manière drastique par des corrections de tests multiples (e.g., seuil de Bonferroni de 5 × 10⁻⁸). Dans ces contextes extrêmes, les statistiques de test atteignent des valeurs de z-scores considérables (dépassant fréquemment 8 ou 10), plongeant la queue de probabilité dans des zones infinitésimales inaccessibles à l’évaluation standard.
C’est ici que l’argument log.p = TRUE révèle toute son indispensabilité méthodologique. Conjointement mobilisé avec lower.tail = FALSE, il permet d’évaluer directement le logarithme de la probabilité de dépassement sans subir l’effondrement numérique qui survient lorsque l’interpréteur tente d’instancier un nombre flottant en deçà de 10-324. La commande s’énonce ainsi :
log_p <- pnorm(z_extreme, lower.tail = FALSE, log.p = TRUE)
Pour convertir ce résultat sur une échelle d’interprétation conventionnelle telle que le -log10(p-value) systématiquement projeté sur les graphiques de Manhattan en génomique comportementale, il suffit d’effectuer une simple conversion de base logarithmique en divisant le résultat précédent par le logarithme népérien de dix : - log_p / log(10). Cette robustesse opérationnelle protège les algorithmes de criblage automatisé contre les fausses anomalies découlant de valeurs p indéterminées ou arrondies abusivement à zéro pur.
6. La fonction qnorm : Calcul des quantiles et fonctions réciproques
6.1 Définition théorique de la fonction quantile ou probit
La fonction qnorm matérialise l’opération réciproque (inversion fonctionnelle) de la fonction de répartition cumulative pnorm. Connue dans la littérature mathématique sous l’appellation de fonction quantile ou de fonction probit, elle opère une bijection stricte reliant l’espace des probabilités continues à la droite réelle des valeurs de la variable aléatoire. Formellement, pour une probabilité cumulée p donnée, le quantile x = qnorm(p) vérifie l’équivalence :
qnorm(p; μ, σ) = F-1(p; μ, σ) = { x ∈ ℜ : P(X ≤ x) = p }
La syntaxe de programmation sous R s’exécute selon les arguments suivants : qnorm(p, mean = 0, sd = 1, lower.tail = TRUE, log.p = FALSE). Le premier argument, p, doit impérativement être alimenté par des valeurs de probabilités appartenant au domaine de définition strict de l’intervalle réel [0, 1].
Une vigilance rigoureuse s’impose quant au comportement de la fonction à ses frontières singulières. En vertu du prolongement infini de la distribution normale sur l’ensemble de la droite des réels, le quantile théorique correspondant à une probabilité nulle qnorm(0) renvoie la limite mathématique -Inf, tandis que l’évaluation à la certitude absolue qnorm(1) renvoie asymptotiquement +Inf. Toute tentative de spécifier une valeur en dehors de ces bornes axiologiques, telle que p = -0.05 ou p = 1.05, se solde immédiatement par un avertissement d’erreur d’exécution numérique (NaNs produced) et l’affectation d’un résultat indéfini NaN.
6.2 Récupération des scores bruts à partir de pourcentages cumulés
L’utilisation canonique de qnorm intervient dès lors qu’il convient de rétro-traduire une cible probabiliste ou un rang centile donné en une valeur brute ou standardisée sur l’échelle de mesure d’origine. Si un système éducatif ou une organisation professionnelle souhaite octroyer une bourse d’excellence aux 5 % des étudiants les plus brillants à une épreuve étalonnée selon une loi normale standard, le score de coupure z-score nécessaire s’obtient instantanément par l’inversion de la masse cumulée inférieure de 95 % : qnorm(0.95, mean = 0, sd = 1), ce qui restitue la valeur critique de 1,644853.
L’argument lower.tail = FALSE autorise une approche alternative conceptuellement plus limpide lorsqu’il s’agit de raisonner directement sur les pourcentages supérieurs d’exclusion. Évaluer qnorm(0.05, lower.tail = FALSE) renvoie exactement la même frontière critique de +1,644853, tout en évitant à l’analyste l’étape mentale de soustraction préalable de la probabilité par rapport à l’unité.
Cette mécanique d’inversion s’avère particulièrement précieuse dans la mise en œuvre de la méthode de la transformée inverse (inverse transform sampling). Cette technique fondamentale en simulation statistique démontre que si une variable aléatoire U suit une loi uniforme continue sur l’intervalle ]0, 1[, alors la variable transformée X = qnorm(U, mean, sd) suivra scrupuleusement une loi normale exacte de paramètres moyenne et écart-type spécifiés. En combinant la fonction génératrice uniforme runif() avec qnorm(), on dispose ainsi d’une voie directe pour bâtir des simulateurs stochastiques déterministes sur mesure.
6.3 Précision numérique pour les probabilités extrêmes
Sur le plan algorithmique interne, la fonction qnorm ne repose pas sur une intégration numérique directe au moment de l’exécution, ce qui se révélerait prohibitif en temps de calcul, mais sur des développements d’approximations rationnelles hautement sophistiqués. Historiquement conçue à partir des travaux pionniers de Wichura (notamment l’algorithme AS 241 de l’Applied Statistics Series), l’implémentation de R garantit une précision pouvant atteindre 16 décimales significatives pour la quasi-totalité de l’intervalle des probabilités standards.
Néanmoins, lorsque l’on manipule des probabilités situées aux confins de la distribution (par exemple, des seuils de p ≤ 10-20), l’argument log.p = TRUE doit impérativement être adjoint. En transmettant directement le logarithme naturel de la probabilité, qnorm déploie des formules asymptotiques spécifiques prévenant l’écrasement du quantile vers l’infini non informatif. L’analyste peut ainsi manipuler des critères d’exclusion extrêmement sévères, sans craindre les artefacts de l’arithmétique flottante.
La confirmation empirique de l’intégrité numérique du moteur mathématique de R réside dans l’exactitude de la bijection identitaire : pour toute valeur réelle x, l’instruction composée qnorm(pnorm(x)) doit restituer x, aux limites infinitésimales de l’erreur d’arrondi machine près (généralement inférieure à 10-15). Cette réciprocité absolue témoigne de l’exceptionnelle robustesse des polynômes d’approximation rationnelle déployés sous le capot de base R.
7. Cas pratiques de qnorm dans l’étalonnage psychométrique et la décision
7.1 Établissement des seuils critiques de rejet dans les tests statistiques
En statistique décisionnelle inférentielle, qnorm constitue l’instrument direct permettant de calibrer les frontières d’acceptation et de rejet de l’hypothèse nulle. Lors de la construction d’un test Z bilatéral sous un niveau d’erreur de première espèce fixé conventionnellement à α = 0,05, la masse d’invalidation est divisée équitablement en deux tranches de 2,5 % réparties sur chaque extrémité de la courbe. L’invocation de :
z_critique <- qnorm(1 - 0.05 / 2)
renvoie précisément la célèbre valeur de référence 1,959964, arrondie canoniquement à 1,96 dans la quasi-totalité des publications empiriques. Si l’évaluation s’oriente vers un protocole plus conservateur à α = 0,01, l’instruction analogue qnorm(1 - 0.01 / 2) génère le seuil de 2,575829 (soit 2,58).
Cette extraction automatisée des seuils critiques via des scripts dynamiques permet d’éliminer définitivement le codage en dur (hardcoding) de valeurs fixes au sein des programmes statistiques. L’intervalle de confiance asymptotique à 95 % pour un paramètre estimé theta (θ) s’écrit de manière systématique sous la forme analytique : IC95 = est ± qnorm(0.975) * Erreur_Standard, assurant une adaptabilité universelle et une parfaite reproductibilité du code statistique.
7.2 Création d’échelles de notation normalisées
Dans l’ingénierie des tests psychologiques et des inventaires de personnalité, l’étalonnage des scores bruts vers des échelles de notation standardisées normalisées représente une tâche prépondérante. Les échelles les plus notoires comprennent l’échelle des Stanines (Standard Nines, moyenne = 5, écart-type = 2, discrétisée de 1 à 9), l’échelle des Stens (Standard Tens, moyenne = 5,5, écart-type = 2, découpée en 10 classes régulières) ou encore les célèbres échelles de T-scores (moyenne = 50, écart-type = 10).
La fonction qnorm permet de dériver de manière mathématiquement rigoureuse les bornes de coupure de ces catégories d’étalonnage. Si l’on prend l’exemple d’une catégorisation en quintiles de performance normalisés — où chaque classe doit enfermer scrupuleusement 20 % de la masse de probabilité théorique —, les bornes d’abscisses correspondantes sur une échelle de distribution normale centrée réduite s’obtiennent par un appel vectorisé direct :
bornes <- qnorm(c(0.2, 0.4, 0.6, 0.8))
Ces valeurs (-0,8416 ; -0,2533 ; +0,2533 ; +0,8416) définissent les limites exactes auxquelles les scores empiriques bruts doivent être comparés pour affecter les participants aux cinq catégories standardisées de manière équitable. Cette méthodologie garantit une normalisation non linéaire de rangs empiriques (normal score transformation), technique fréquemment indispensable pour corriger les asymétries modérées des distributions de notes scolaires ou professionnelles.
7.3 Définition de scores seuils cliniques dans les bilans diagnostiques
La pratique clinique neuropsychologique et diagnostique impose régulièrement de trancher entre un profil cognitif préservé et un déficit avéré sur la base d’un score d’évaluation seuil. Dans de multiples nomenclatures internationales, un trouble neuropsychologique significatif est diagnostiqué dès lors que les aptitudes du patient chutent sous le seuil du cinquième percentile ou à une distance d’au moins deux écarts-types sous la moyenne d’un groupe normatif apparié selon l’âge et le niveau d’éducation.
Considérons un test de mémoire épisodique standardisé dont la moyenne chez les seniors normatifs est de 75 points avec un écart-type de 12 points. Pour identifier le score clinique d’exclusion en dessous duquel un patient se situe au 5e percentile inférieur, l’analyste formule l’appel :
score_seuil <- qnorm(0.05, mean = 75, sd = 12)
Le résultat obtenu (55,26 points) établit la ligne de démarcation diagnostique avec une clarté absolue. Le recours à qnorm pour calibrer ces seuils prévient les erreurs de catégorisation induites par des règles empiriques approximatives, minimisant d’un même élan les risques éthiquement préjudiciables de faux positifs diagnostiques (sur-pathologisation) ou de faux négatifs (défauts de détection précoce de troubles neurodégénératifs).
8. La fonction rnorm : Génération de variables aléatoires gaussiennes
8.1 Principes de génération pseudo-aléatoire sous R
La génération de nombres aléatoires constitue le moteur fondamental de l’échantillonnage moderne, de la simulation stochastique et des approches inférentielles de rééchantillonnage. La fonction rnorm assure la production de réalisations pseudo-aléatoires distribuées selon une loi normale spécifiée, par le biais de la syntaxe élémentaire suivante : rnorm(n, mean = 0, sd = 1). L’argument central n spécifie le nombre scalaire entier de tirages indépendants souhaités.
Il est fondamental de rappeler que les calculateurs numériques déterministes sont intrinsèquement incapables de concevoir un aléa ontologique pur. Ils génèrent par conséquent des séquences de nombres pseudo-aléatoires via des algorithmes récursifs complexes qui miment à la perfection les propriétés statistiques du hasard. Par défaut, les versions récentes de R exploitent le générateur Mersenne-Twister (développé par Makoto Matsumoto et Takuji Nishimura), reconnu internationalement pour sa formidable période de récurrence colossale (219937 – 1) et son absence de corrélation dimensionnelle jusqu’à l’ordre 623. La transformation de ces nombres uniformes en écarts gaussiens repose par défaut sur l’inversion précise d’inversion directe ou la méthode révisée de Box-Muller.
La fidélité de l’échantillon généré vis-à-vis des paramètres théoriques cibles (μ et σ) est directement asservie à la taille d’échantillon n, conformément à la loi des grands nombres. Si l’on génère n = 10 observations, la moyenne et la variance empiriques divergeront sensiblement des valeurs 0 et 1 en raison de l’erreur d’échantillonnage aléatoire. En revanche, dès lors que n franchit les seuils de 100 000 ou 1 000 000 d’itérations, la distribution empirique générée s’aligne de manière quasi parfaite sur le modèle théorique sous-jacent.
8.2 Garantir la reproductibilité scientifique avec set.seed
Dans toute démarche scientifique quantitative rigoureuse, la reproductibilité expérimentale constitue une exigence déontologique et méthodologique absolue. Si un chercheur publie un protocole de simulation statistique fondé sur des réalisations aléatoires générées par rnorm sans fixer l’état initial du générateur, ses pairs seront incapables de reproduire à l’identique les estimations chiffrées, les graphiques d’illustration ou les valeurs exactes des tests de simulation.
Pour neutraliser cette variabilité stochastique inter-sessions, R intègre la fonction déterminante set.seed(). Cette commande prend en argument un entier arbitraire qui sert à initialiser le germe (la « graine ») de l’algorithme générateur. Deux sessions R indépendantes, ou deux ordinateurs distincts exécutant la même version de l’interpréteur, produiront une suite de nombres générés par rnorm rigoureusement identique bit à bit si la commande set.seed() a été préalablement exécutée avec la même valeur de graine :
set.seed(42)
tirage_1 <- rnorm(5)
set.seed(42)
tirage_2 <- rnorm(5) # tirage_2 sera rigoureusement identique à tirage_1
L’omission de cette étape cardinale dans les scripts de simulation constitue un défaut majeur de gouvernance logicielle dans la recherche scientifique. Il convient en outre d’observer une vigilance accrue dans le cadre de calculs parallélisés (distribués sur de multiples cœurs de processeur via des packages tels que parallel ou future), où la synchronisation standard de set.seed ne suffit plus et nécessite le recours à des générateurs spécifiques pour flux indépendants, tels que l’algorithme de L’Ecuyer.
8.3 Génération conditionnelle et vecteurs paramétriques
L’une des plus remarquables forces d’ingénierie du langage R réside dans sa philosophie de vectorisation intégrale. La fonction rnorm ne se restreint pas à l’utilisation d’arguments scalaires uniques pour mean et sd ; elle accepte des vecteurs numériques de longueurs arbitraires pour définir ces paramètres.
Cette caractéristique permet d’échantillonner d’un seul bloc des cohortes stratifiées ou des sous-populations aux propriétés distinctes sans recourir à la moindre structure itérative de type boucle for. Par exemple, si l’on souhaite simuler une cohorte composite comportant 500 individus issus d’un groupe témoin (μ = 100, σ = 15) et 500 individus issus d’un groupe expérimental (μ = 115, σ = 20), on peut spécifier un vecteur de moyennes de longueur 1000 et un vecteur d’écarts-types correspondant, permettant à rnorm de tirer chaque observation individuelle avec ses paramètres propres :
moyennes <- rep(c(100, 115), each = 500)
dispersions <- rep(c(15, 20), each = 500)
donnees_simulees <- rnorm(1000, mean = moyennes, sd = dispersions)
Cette flexibilité trouve un écho immédiat dans la simulation de plans pré-test / post-test à variances hétérogènes. Dans les configurations où les valeurs simulées doivent respecter des bornes physiques infranchissables (par exemple, des temps de réaction psychomoteurs strictement positifs ou des scores d’auto-questionnaires bornés entre 0 et 100), le chercheur devra associer le générateur rnorm à des règles d’exclusion par ré-échantillonnage ou recourir à des distributions normales tronquées (implémentées dans des extensions comme truncnorm) pour interdire toute émergence de valeurs aberrantes impossibles dans la réalité empirique.
9. Simulations de Monte-Carlo et protocoles expérimentaux avec rnorm
9.1 Illustration empirique du Théorème Central Limite
La puissance conceptuelle des méthodes de Monte-Carlo réside dans leur capacité à démontrer empiriquement des théorèmes analytiques abstraits par la force de l’itération informatique massive. L’illustration par excellence de ce paradigme est la modélisation du théorème central limite au départ de populations non normales hautement asymétriques ou discontinues, telles qu’une loi exponentielle ou une distribution uniforme.
En générant à l’aide d’une fonction stochastique appropriée des milliers d’échantillons indépendants de taille fixe N, puis en calculant la moyenne arithmétique de chacun de ces échantillons, on crée une distribution de moyennes d’échantillonnage. En confrontant ensuite cette distribution empirique aux prédictions théoriques issues de dnorm (en calibrant la moyenne globale théorique et l’erreur standard théorique σX̄ = σ / √N), la superposition visuelle confirme la fulgurance de la convergence gaussienne, même sous des tailles d’échantillons très modestes (e.g., N = 30).
Ce protocole permet en outre d’évaluer concrètement l’amenuisement de la variance d’échantillonnage à mesure que la taille N progresse. En observant la distribution des moyennes simulées se resserrer inexorablement autour de l’espérance mathématique de la population mère, l’étudiant et le chercheur saisissent intuitivement pourquoi l’accroissement des effectifs expérimentaux constitue le rempart statistique le plus infaillible contre l’incertitude métrologique et la dispersion aléatoire des résultats.
9.2 Estimation de la puissance statistique par simulation
La planification d’une étude expérimentale rigoureuse exige impérativement une analyse de puissance a priori afin de minimiser le risque de commettre une erreur de deuxième espèce (β), c’est-à-dire l’échec de détection d’un effet pourtant réel au sein de la population. Si des formulations analytiques directes existent pour des plans factoriels élémentaires (via le package pwr), les protocoles complexes, déséquilibrés ou multivariés échappent fréquemment aux solutions fermées.
L’exploitation conjointe de rnorm et des itérations Monte-Carlo offre une méthodologie universelle d’estimation de la puissance statistique (1 – β). Le protocole se formalise comme suit :
- Définir la taille d’effet théorique attendue (e.g., un d de Cohen de 0,5 correspondant à un écart de 0,5 écart-type entre deux groupes).
- Itérer un nombre massif de réplications indépendantes (typiquement 10 000 cycles).
- À chaque itération, générer deux échantillons de taille N via
rnormavec des moyennes décalées correspondant à l’effet postulé. - Exécuter le test statistique d’inférence (e.g., un test t de Student avec
t.test()) et extraire la valeur p résultante. - Quantifier la puissance empirique en calculant la proportion de simulations où la valeur p s’est révélée strictement inférieure au seuil alpha fixé (généralement 0,05).
En faisant varier progressivement la taille N au sein d’une grille de simulation, le chercheur génère une courbe de puissance sur mesure d’une fidélité irréprochable. Cette démarche permet d’identifier avec exactitude le point de bascule statistique garantissant une puissance cible de 80 % ou 90 %, évitant ainsi tout investissement humain et financier disproportionné dans des cohortes surdimensionnées ou le risque d’avorter une recherche pour sous-effectif critique.
9.3 Modélisation de données psychométriques avec bruit gaussien
Dans la validation empirique de nouveaux modèles de mesure psychométrique ou d’algorithmes d’apprentissage automatique, il est indispensable de disposer de jeux de données dont les paramètres générateurs sont parfaitement contrôlés par l’expérimentateur (ground truth). La fonction rnorm intervient alors pour insuffler un bruit expérimental stochastique dans des équations linéaires structurelles.
Pour synthétiser un modèle de régression psychologique simple où une variable explicative X (par exemple, le temps de révision hebdomadaire) influence une variable de performance académique Y selon l’équation théorique Y = β0 + β1 X + ε, on génère les termes d’erreur résiduelle ε par une instruction telle que epsilon <- rnorm(N, mean = 0, sd = sigma_erreur). L’ajustement subséquent d’un modèle par les moindres carrés ordinaires via la fonction lm() permet d’évaluer la fidélité de récupération des coefficients régressifs sous divers régimes de pollution de mesure.
Cette approche par simulation autorise l’exploration systématique de la robustesse des estimateurs statistiques face à la violation des hypothèses de modélisation classique : introduction de colinéarité, déséquilibres sévères d’effectifs dans les plans factoriels, ou contamination par des valeurs aberrantes générées par un mélange de lois normales (mixture distributions) incorporant une faible proportion de tirages stochastiques à très forte variance.
10. Analyse comparative et interconnexions mathématiques du quatuor
10.1 Dualité théorique et opérationnelle entre pnorm et qnorm
L’interconnexion entre pnorm et qnorm représente une illustration parfaite du théorème de la bijection en analyse mathématique. Ces deux routines sont unies par une relation de réciprocité fonctionnelle stricte, formalisée par les identités composées :
pnorm(qnorm(p)) = p, ∀ p ∈ ]0, 1[
qnorm(pnorm(x)) = x, ∀ x ∈ ℜ
L’exécution de ces identités dans la console R met en exergue la fluidité de la passerelle entre l’espace continu des probabilités [0, 1] et l’espace infini de la variable d’observation ]-∞, +∞[. Sur le plan graphique, cette dualité se traduit par une inversion géométrique des axes cartésiens : la courbe sigmoïde de la fonction de répartition pnorm trace l’évolution de la probabilité cumulée sur l’axe vertical en fonction de l’abscisse z, tandis que la courbe de la fonction quantile qnorm inverse symétriquement ce tracé en projetant le quantile z sur l’axe vertical en fonction de la probabilité p portée sur l’axe horizontal.
Cette complémentarité opérationnelle est intensivement mobilisée lors des protocoles d’appariement statistique de cohortes et de standardisation non paramétrique. Lorsqu’une cohorte clinique hétérogène doit être calibrée sur une cohorte saine, le passage des scores bruts en probabilités cumulées empiriques via pnorm, suivi de leur re-projection via qnorm sur une nouvelle échelle paramétrique cible, permet d’opérer des déstandardisations et des recalibrages d’une rigueur absolue. L’observation minutieuse des résidus machine lors de l’enchaînement de ces deux fonctions confirme que l’écart entre la valeur initiale et la valeur recalculée reste cantonné au plancher microscopique des fluctuations de précision de l’arithmétique IEEE 754.
10.2 Dérivation empirique de dnorm à partir de pnorm
L’articulation entre la fonction de densité et la fonction de répartition cumulative repose sur le théorème fondamental de l’analyse infinitésimale : la densité de probabilité f(x) n’est autre que la dérivée première de la fonction de répartition F(x) par rapport à la variable x :
f(x) = d/dx [ F(x) ] = limh → 0 [ (F(x + h) – F(x – h)) / (2h) ]
Cette relation fondamentale peut être implémentée et vérifiée sous R à l’aide d’une approximation numérique par différences finies centrées. En choisissant un pas d’incrémentation infinitésimal arbitrairement faible, par exemple h = 10-5, on peut estimer la pente locale de pnorm en un point d’évaluation x quelconque :
x <- 1.5
h <- 1e-5
derivee_empirique <- (pnorm(x + h) - pnorm(x - h)) / (2 * h)
densite_theorique <- dnorm(x)
La confrontation des deux scalaires révèle une concordance rigoureuse atteignant plus de dix chiffres significatifs après la virgule. Cet exercice pédagogique éclaire la nature de la fonction dnorm : elle n’est rien d’autre que le taux de variation instantané de la masse de probabilité cumulée. Sur le plan computationnel, l’analyste choisira invariablement la formule analytique fermée de dnorm, qui s’exécute à des vitesses algorithmiques nettement supérieures à toute approximation différentielle tout en s’affranchissant des erreurs résiduelles de troncature inhérentes aux choix du pas h.
10.3 Validation de la génération rnorm à travers les métriques théoriques
Le contrôle de conformité des routines de simulation stochastique impose de vérifier que les réalisations issues de rnorm respectent rigoureusement les propriétés théoriques dictées par les trois autres composantes du quatuor. Pour procéder à cette validation croisée empirique, un protocole d’adéquation en trois dimensions peut être formalisé :
Premièrement, la superposition d’un histogramme de données empiriques issues d’un tirage massif (e.g., n = 100 000) de rnorm avec la courbe de densité théorique modélisée par dnorm fournit une vérification visuelle immédiate de l’ajustement distributionnel.
Deuxièmement, la construction de la fonction de distribution cumulative empirique (via l’instruction native ecdf() appliquée au vecteur aléatoire) confrontée point par point à la courbe de probabilité sigmoïde générée par pnorm permet de mesurer l’écart suprême vertical (la statistique de distance de Kolmogorov-Smirnov).
Troisièmement, l’évaluation des quantiles empiriques de l’échantillon (obtenus via quantile(donnees, probs = p)) face aux quantiles théoriques issus de qnorm(p) pour une grille dense de centiles valide de manière bidirectionnelle la fidélité de l’échantillonneur aléatoire sur l’ensemble du domaine de validité. L’alignement quasi parfait de ces métriques théoriques et empiriques certifie la convergence algorithmique totale de l’écosystème R dans la manipulation de la distribution gaussienne.
11. Diagnostic de normalité et validation empirique des postulats
11.1 Construction mathématique et interprétation du diagramme Quantile-Quantile
Le diagramme Quantile-Quantile normal, universellement désigné sous l’acronyme de QQ-plot, constitue l’outil diagnostique graphique le plus sensible, robuste et universellement plébiscité pour auditer la conformité d’une série de données empiriques vis-à-vis de l’hypothèse de normalité. Sa construction géométrique repose directement sur la mécanique fonctionnelle de qnorm.
Pour élaborer un diagramme QQ-plot sans boîte noire logicielle, la série d’observations de taille n est dans un premier temps ordonnée selon une suite croissante de statistiques d’ordre x(1) ≤ x(2) ≤ … ≤ x(n). Pour chaque observation de rang k, une probabilité théorique de positionnement empirique pk lui est assignée (par exemple pk = (k – 0,5) / n). La coordonnée d’ordonnée empirique x(k) est ensuite projetée contre le quantile théorique correspondant issu de la fonction d’inversion :
zk = qnorm(pk)
Dans l’environnement de base R, les commandes canoniques qqnorm(donnees) et qqline(donnees) tracent instantanément ce nuage de points et superposent la ligne droite idéale de référence reliant le premier et le troisième quartile. Si la distribution observée est rigoureusement gaussienne, les points expérimentaux s’alignent fidèlement sur cette bissectrice théorique.
L’interprétation qualitative des distorsions du tracé informe avec une remarquable acuité sur la nature des déviations :
- Une courbure concave ou convexe systématique traduit une asymétrie marquée (présence d’une queue droite étirée ou d’une compression unilatérale).
- Une morphologie caractéristique en « S » ou en sigmoïde inversée trahit une anomalie d’aplatissement (kurtosis) : des extrémités qui s’écartent vers l’extérieur dénotent des queues lourdes (distribution leptocurtique avec prolifération de valeurs extrêmes), tandis qu’un aplatissement vers l’axe révèle des queues courtes (distribution platycurtique).
L’utilisation de packages spécialisés tels que car (avec qqPlot()) ou les extensions de ggplot2 enrichit ce tracé d’enveloppes de confiance à 95 % dérivées par rééchantillonnage de Kolmogorov-Smirnov, fournissant un repère objectif pour déterminer si les déviations observées excèdent les simples fluctuations d’échantillonnage stochastique.
11.2 Tests d’adéquation statistiques formels
Bien que l’évaluation graphique via le QQ-plot doive systématiquement primer dans l’analyse exploratoire, la confirmation formelle par des tests d’hypothèses statistiques est souvent exigée dans les protocoles de publication académique. Le test statistique le plus puissant et le plus robuste pour évaluer l’hypothèse nulle d’appartenance à une population normale est sans conteste le test de Shapiro-Wilk, disponible nativement sous R via la routine shapiro.test().
Ce test statistique évalue la corrélation linéaire au carré entre les statistiques d’ordre observées et les poids optimaux théoriques attendus sous la loi normale, renvoyant une statistique de test W comprise entre 0 et 1. Une valeur de W s’effondrant significativement en deçà de l’unité conduit au rejet de l’hypothèse de normalité à un seuil alpha donné. En complément, le test de Kolmogorov-Smirnov à un échantillon, accessible via la commande ks.test(donnees, "pnorm", mean(donnees), sd(donnees)), confronte la fonction cumulative empirique à la loi théorique pnorm, bien que sa puissance statistique soit substantiellement inférieure à celle du test de Shapiro-Wilk dès lors que les paramètres μ et σ sont estimés à partir des données mêmes.
Il est impératif d’émettre une mise en garde méthodologique fondamentale sur la sensibilité dimensionnelle de ces tests formels. Dans les très grands échantillons (n > 1 000 ou 5 000 participants), la puissance statistique du test de Shapiro-Wilk devient colossale : la moindre déviation infinitésimale et sans aucune incidence pratique par rapport à la normalité idéale produit mécaniquement une valeur p ultra-significative (p < 0,001), conduisant à un rejet injustifié du modèle gaussien. À l’inverse, dans les petits échantillons (n < 30), le test souffre d’un manque criant de puissance, incapable de déceler des asymétries pourtant tangibles. Par conséquent, l’évaluation de la normalité ne doit jamais être déléguée aveuglément à une valeur p unique, mais doit procéder d’une synthèse équilibrée combinant inspection visuelle du QQ-plot, calcul des coefficients de Skewness et Kurtosis standardisés, et tests formels d’ajustement.
11.3 Impact des violations de la normalité en psychométrie
L’infraction au postulat de normalité des résidus ou des variables d’observation n’est pas sans conséquence sur la validité interne des inférences quantitatives. Dans le cadre du modèle linéaire général (régressions multiples, analyses de variance ANOVA, modélisations par équations structurelles), la non-normalité sévère compromet l’exactitude des calculs de variance résiduelle et peut induire une distorsion des erreurs-types, perturbant le contrôle nominal du taux d’erreur de première espèce (α) et amoindrissant la puissance statistique des tests de significativité des paramètres.
En psychométrie, certaines variables sont intrinsèquement et ontologiquement non normales. C’est le cas emblématique des temps de réaction à des stimuli attentionnels, dont les distributions exhibent systématiquement une asymétrie positive prononcée due à un plancher physiologique infranchissable et une longue traînée de latence attentionnelle (souvent mieux modélisée par une loi ex-Gaussienne ou une loi Gamma). Tenter de contraindre arbitrairement de telles mesures sous un prisme gaussien classique sans traitement préalable constitue une faute méthodologique caractérisée.
Face à une infraction constatée de normalité, trois avenues correctives principales s’offrent au praticien :
- Les transformations mathématiques de données : l’application de la transformation logarithmique népérienne
log(x)pour compresser les asymétries positives, de la racine carréesqrt(x)pour les données de comptage, ou de la famille paramétrique des transformations de Box-Cox via le packageMASSpour identifier la puissance λ optimale qui maximise l’adéquation gaussienne. - Les statistiques non paramétriques : le recours à des tests fondés sur les rangs (test U de Mann-Whitney-Wilcoxon avec
wilcox.test(), test de Kruskal-Wallis aveckruskal.test()) qui s’affranchissent de toute contrainte distributionnelle paramétrique. - L’inférence robuste et le rééchantillonnage : l’estimation d’intervalles de confiance par bootstrap (via le package
boot) ou l’application d’estimateurs à erreurs-types sandwich hétéroscédastiques et non normales, préservant la validité des conclusions scientifiques indépendamment de la morphologie de la distribution d’origine.
12. Bonnes pratiques, erreurs fréquentes et optimisation computationnelle
12.1 Confusion classique entre écart-type et variance dans l’appel des fonctions
L’une des erreurs les plus ubiquitaires et insidieuses commises par les étudiants et les analystes, y compris parfois chevronnés, réside dans la confusion entre l’écart-type et la variance au moment de renseigner l’argument de dispersion au sein des quatre fonctions gaussiennes de R. En formalisme mathématique traditionnel, la distribution normale est universellement notée Ν(μ, σ2), où le second terme désigne la variance scalaire. Or, dans l’architecture fonctionnelle de R, l’argument de dispersion est invariablement nommé sd et requiert l’écart-type σ (la racine carrée positive de la variance).
Considérons une étude clinique déclarant un indice cognitif calibré sur une distribution de moyenne 100 et de variance 225. Si l’analyste écrit naïvement sous R :
pnorm(115, mean = 100, sd = 225) # ERREUR CRITIQUE
la fonction considérera que l’écart-type vaut 225 points (correspondant à une variance de 50 625 !), aplatissant de manière démesurée la courbe de densité théorique et générant une probabilité cumulée aberrante (0,5266 au lieu de la véritable valeur 0,8413 issue d’un écart-type réel √225 = 15). Cette méprise produit des conclusions totalement erronées lors des décisions diagnostiques ou de l’évaluation des seuils de puissance.
Pour prévenir ces écueils de programmation, une technique défensive recommandée dans les environnements de recherche collaborative consiste à formaliser explicitement l’extraction de l’écart-type ou à concevoir des fonctions d’encapsulation (wrappers) rigoureuses validant formellement leurs entrées :
pnorm_variance <- function(q, mean = 0, var = 1) {
if (var < 0) stop("La variance doit être strictement positive.")
pnorm(q, mean = mean, sd = sqrt(var))
}
L’intégration de telles vérifications préalables au sein des bibliothèques d’analyse internes des équipes de recherche constitue un garde-fou décisif contre la propagation silencieuse de bogues statistiques dans les chaînes de traitement de données.
12.2 Gestion rigoureuse des cas limites et vectorisation performante
L’optimisation des flux de traitement analytique sous R impose d’exploiter sans concession la puissance de la vectorisation. L’écriture d’itérations explicites basées sur des boucles for pour évaluer séquentiellement la densité ou la probabilité sur un vecteur de milliers de scores constitue une hérésie en matière de performances sous R. Les quatre routines d/p/q/rnorm sont nativement implémentées pour opérer directement sur des structures vectorielles et matricielles massives avec des gains de vélocité pouvant atteindre plusieurs ordres de grandeur.
Une vigilance impérieuse s’impose cependant quant au mécanisme interne de recyclage des vecteurs propre à l’interpréteur R. Lorsque des arguments de longueurs différentes sont transmis simultanément (par exemple, un vecteur de quantiles de longueur 10 confronté à un vecteur de moyennes de longueur 3), R recycle cycliquement le vecteur le plus court pour l’aligner sur la dimension du plus long. Si la longueur du plus long n’est pas un multiple exact de celle du plus court, le système émet un avertissement formel : longer object length is not a multiple of shorter object length. Cette situation est fréquemment le symptôme d’un désalignement accidentel de colonnes au sein d’un tableau de données, susceptible de corrompre silencieusement les assignations de paramètres individuels si l’avertissement n’est pas traité avec la plus grande rigueur.
Pour auditer la vélocité et l’empreinte mémoire de calculs statistiques massifs, l’utilisation de packages de benchmarking professionnels tels que microbenchmark permet d’évaluer avec une précision microscopique le temps d’exécution des routines gaussiennes. Les benchmarks confirment invariablement que la gestion native des paramètres (tels que log = TRUE ou lower.tail = FALSE) offre non seulement une stabilité mathématique absolue, mais réduit également de façon drastique les temps de calcul machine en évitant l’instanciation intermédiaire de vecteurs temporaires au sein de la mémoire vive.
12.3 Guide synthétique de décision pour choisir la fonction adéquate
Face à une problématique analytique concrète impliquant la distribution normale sous R, la sélection de la routine adéquate parmi le quatuor fondamental obéit à un arbre de décision logique parfaitement structuré. L’analyste doit simplement identifier la nature exacte de son point d’entrée informationnel et la finalité mathématique de sa requête :
- Vous disposez d’une valeur d’abscisse x et souhaitez évaluer la plausibilité relative, la hauteur de la courbe ou calculer une log-vraisemblance ?
→ Sélectionnezdnorm(Densité). Argument clé :log = TRUEpour la stabilité en modélisation MLE. - Vous disposez d’un seuil critique q et souhaitez calculer un pourcentage cumulé, un rang centile, un risque de dépassement ou une p-value ?
→ Sélectionnezpnorm(Probabilité). Argument clé :lower.tail = FALSEpour quantifier directement les queues supérieures sans perte de précision. - Vous disposez d’une probabilité cumulée p (ou d’un rang centile cible) et cherchez à retrouver la note brute, le score standardisé z ou la frontière clinique d’exclusion ?
→ Sélectionnezqnorm(Quantile). Argument clé :lower.tail = FALSEpour les quantiles d’excellence supérieurs. - Vous devez simuler une cohorte expérimentale synthétique, générer du bruit de mesure stochastique ou mener une étude de puissance statistique par Monte-Carlo ?
→ Sélectionnezrnorm(Aléatoire). Règle d’or absolue : toujours faire précéder vos simulations deset.seed()pour garantir la reproductibilité intégrale de vos résultats.
Le tableau analytique récapitulatif ci-dessous synthétise de manière synoptique les propriétés architecturales fondamentales des quatre composantes de la boîte à outils gaussienne sous R :
| Fonction | Rôle fondamental | Type d’entrée principale | Type de sortie générée | Arguments discriminants |
|---|---|---|---|---|
| dnorm | Densité locale de probabilité f(x) | Abscisses réelles x (]-∞, +∞[) | Hauteurs de densité locales (ordonnées ≥ 0) | log = FALSE / TRUE |
| pnorm | Probabilité cumulée F(q) = P(X ≤ q) | Quantiles ou seuils réels q | Probabilités p intégrées ([0, 1]) | lower.tail, log.p |
| qnorm | Quantile théorique F-1(p) | Probabilités p (]0, 1[) | Scores réels ou quantiles x | lower.tail, log.p |
| rnorm | Échantillonnage pseudo-aléatoire | Taille scalaire entière n | Vecteur stochastique de n réalisations | Sensible à set.seed() |
Préalablement à toute publication de résultats statistiques s’appuyant sur l’une de ces routines, l’analyste scrupuleux veillera à vérifier la check-list méthodologique suivante : la dispersion a-t-elle été spécifiée sous forme d’écart-type et non de variance ? Le générateur stochastique a-t-il été rigoureusement ancré par une graine reproductible ? Les diagnostics de normalité via les QQ-plots corroborent-ils la légitimité de l’inférence paramétrique ? La consultation de la documentation interne native de R demeure toujours accessible en saisissant l’instruction de référence ?rnorm dans la console logicielle, offrant un aperçu exhaustif des fondations mathématiques et algorithmiques de ce quatuor d’exception.
Références
Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://ggplot2.tidyverse.org
Wichura, M. J. (1988). Algorithm AS 241: The percentage points of the normal distribution. Applied Statistics, 37(3), 477–484. https://doi.org/10.2307/2347330
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0