
L’analyse quantitative contemporaine repose sur la capacité fondamentale d’extraire des structures intelligibles au sein d’ensembles de données tabulaires massifs et hétérogènes. Dans les environnements infonuagiques tels que Google Sheets, l’opération consistant à additionner des grandeurs scalaires selon des modalités qualitatives distinctes représente bien plus qu’une simple commodité arithmétique : elle constitue la première étape de la réduction dimensionnelle et de la modélisation statistique. Qu’il s’agisse de traiter des métriques financières, des scores psychométriques ou des relevés expérimentaux en écologie comportementale, la sommation catégorielle transforme le bruit des micro-enregistrements individuels en indicateurs macroscopiques directement interprétables par le chercheur ou le gestionnaire décisionnel.
Toutefois, la mise en œuvre de cette opération élémentaire en apparence dissimule une complexité méthodologique et calculatoire substantielle. Entre les contraintes de normalisation typologique des chaînes de caractères, les pièges de l’arithmétique à virgule flottante, les spécificités structurelles du moteur de calcul vectoriel de Google et les exigences de reproductibilité scientifique, la maîtrise des fonctions conditionnelles requiert une rigueur d’ingénierie logicielle. Un protocole analytique déficient à ce stade introductif induit des biais de calcul imperceptibles mais cumulatifs, susceptibles de compromettre l’intégrité inférentielle de l’ensemble d’un programme d’investigation empirique.
Ce guide exhaustif propose une exploration théorique et empirique de la sommation par catégorie au sein de l’écosystème Google Sheets. À travers l’examen méthodique des fonctions matricielles natives, du langage d’interrogation déclaratif, des structures de pivotement dynamique et des algorithmes d’assainissement lexical, nous établirons les standards optimaux de traitement automatisé des données. L’objectif est de doter l’analyste d’une boîte à outils algorithmique et cognitive lui permettant d’ériger des architectures de calcul robustes, évolutives et exemptes d’artefacts méthodologiques.
1. Introduction théorique à l’agrégation catégorielle dans Google Sheets
1.1 Définition et importance de la sommation conditionnelle
La sommation conditionnelle constitue une opération fondamentale de l’algèbre relationnelle appliquée aux bases de données tabulaires. Sur le plan mathématique, elle s’exprime comme l’application d’un opérateur de projection et de réduction sur un ensemble de n-uplets structurés. Soit un ensemble d’observations défini dans un espace multidimensionnel où chaque ligne combine des variables qualitatives, discrètes ou catégorielles, et des variables quantitatives continues. La sommation conditionnelle partitionne l’ensemble de départ en classes d’équivalence disjointes en fonction des modalités d’une ou plusieurs variables nominales, puis applique la fonction de mesure additive exclusivement aux éléments scalaires appartenant à chaque classe respective. Ce processus mathématique réduit la dimensionnalité intrinsèque des observations initiales tout en préservant l’invariance de la masse globale de la grandeur mesurée.
Dans la recherche contemporaine, qu’il s’agisse de psychométrie, d’épidémiologie ou d’économétrie appliquée, la nécessité de segmenter les données brutes en sous-groupes homogènes est un impératif épistémologique. L’agrégation catégorielle permet de tester des hypothèses différentielles en isolant les effets de groupe des fluctuations aléatoires interindividuelles. Par exemple, lors de l’évaluation de protocoles d’intervention comportementale, l’analyse ne peut se satisfaire d’un score cumulé global ; elle exige la décomposition des métriques de performance selon le bras expérimental, la cohorte démographique ou la temporalité d’exposition au stimulus, sous peine d’induire un paradoxe de Simpson masquant les dynamiques sous-jacentes réelles.
Il importe de distinguer formellement la sommation globale de la sommation catégorisée. La première applique un opérateur de réduction scalaire indifférencié sur un vecteur univarié, annihilant toute structure interne au profit d’un invariant d’échelle unique. La seconde préserve la distribution inter-classes et permet d’étudier la variance entre groupes par rapport à la variance intra-groupe. Cette séparation conceptuelle conditionne la sélection des outils computationnels dans Google Sheets, dictant l’abandon des fonctions scalaires pures au profit de primitives conditionnelles capables de réévaluer dynamiquement les prédicats logiques associés à chaque partition de l’espace d’échantillonnage.
1.2 Structure des données tabulaires et classification catégorielle
L’efficacité de tout calcul d’agrégation conditionnelle dépend étroitement de la conformation de l’architecture tabulaire sous-jacente. Selon les principes fondamentaux du paradigme Tidy Data formalisés par Hadley Wickham, un jeu de données est rigoureusement ordonné si et seulement si chaque variable correspond à une colonne dédiée, chaque observation distincte à une ligne unique, et chaque unité observationnelle forme une table autonome. L’organisation optimale des variables qualitatives exige qu’elles soient consignées dans des colonnes atomiques où chaque cellule contient une modalité d’état univoque, qu’elle relève d’une échelle nominale pure ou d’une échelle ordinale hiérarchisée.
L’alignement des variables quantitatives continues ou discrètes doit respecter un parallélisme dimensionnel strict vis-à-vis des facteurs de classification. Dans Google Sheets, toute tentative d’effectuer une sommation catégorielle sur une structure dénormalisée — par exemple, un tableau où les catégories sont distribuées horizontalement sur les en-têtes de colonnes tandis que les valeurs scalaires se déploient dans le corps de la matrice — complique exponentiellement la syntaxe des formules et accroît le risque d’erreur d’adressage. La forme longue, où les enregistrements se succèdent verticalement, constitue l’unique agencement garantissant une extensibilité computationnelle pérenne et une compatibilité native avec les fonctions matricielles.
L’architecture tabulaire exerce un impact déterminant sur l’efficacité algorithmique du moteur de feuille de calcul. Google Sheets traite les opérations vectorielles en optimisant les accès contigus en mémoire vive. Lorsque les données respectent les postulats du schéma relationnel en première forme normale, les fonctions d’agrégation conditionnelle exécutent des balayages linéaires à haute performance sans nécessiter de transpositions matricielles intermédiaires. Une structure désorganisée, à l’inverse, force l’interpréteur à instancier des tampons de mémoire éphémères, multipliant la latence de traitement lors du recalcul automatique de classeurs volumineux.
1.3 Enjeux cognitifs et méthodologiques de la réduction de données
L’agrégation de données tabulaires répond à une contrainte fondamentale formulée par la théorie de la charge cognitive : l’incapacité de la mémoire de travail humaine à appréhender simultanément plus de quelques segments discrets d’information. Face à un jeu de données comportant plusieurs dizaines de milliers d’enregistrements granulaires, l’analyste se trouve confronté à une surcharge perceptive neutralisant tout discernement inductif. La sommation par catégorie opère une synthèse sémiotique qui transforme un volume ingérable de micro-données en un tableau synoptique condensé, favorisant l’extraction de régularités statistiques et la détection d’anomalies structurelles.
Cette condensation informationnelle ne doit cependant pas s’opérer au détriment de la fidélité méthodologique. Toute réduction dimensionnelle implique intrinsèquement une perte irréversible de variance locale au sein de chaque classe d’équivalence. Il est dès lors impératif de conserver des synthèses intermédiaires auditables garantissant que les agrégats macroscopiques n’occultent pas des déviations extrêmes ou des erreurs systématiques de saisie. Dans un contexte expérimental ou décisionnel rigoureux, l’analyste doit concevoir son flux de travail afin de pouvoir naviguer sans rupture entre la vue sommée et les éléments unitaires constitutifs.
La reproductibilité et la traçabilité des transformations numériques conditionnent la validité épistémique des résultats obtenus. L’utilisation d’opérations manuelles, telles que la sélection discontinue de plages disjointes au moyen de la souris ou la saisie en dur de totaux intermédiaires, constitue une faute méthodologique critique. Dans Google Sheets, la formulation explicite et déclarative de l’agrégation conditionnelle via des fonctions formelles documentées assure que n’importe quel évaluateur indépendant pourra réexécuter la chaîne de traitement, de l’état brut à la distribution factorielle finale, sans ambiguïté interprétative.
2. Préparation et assainissement préalable du jeu de données
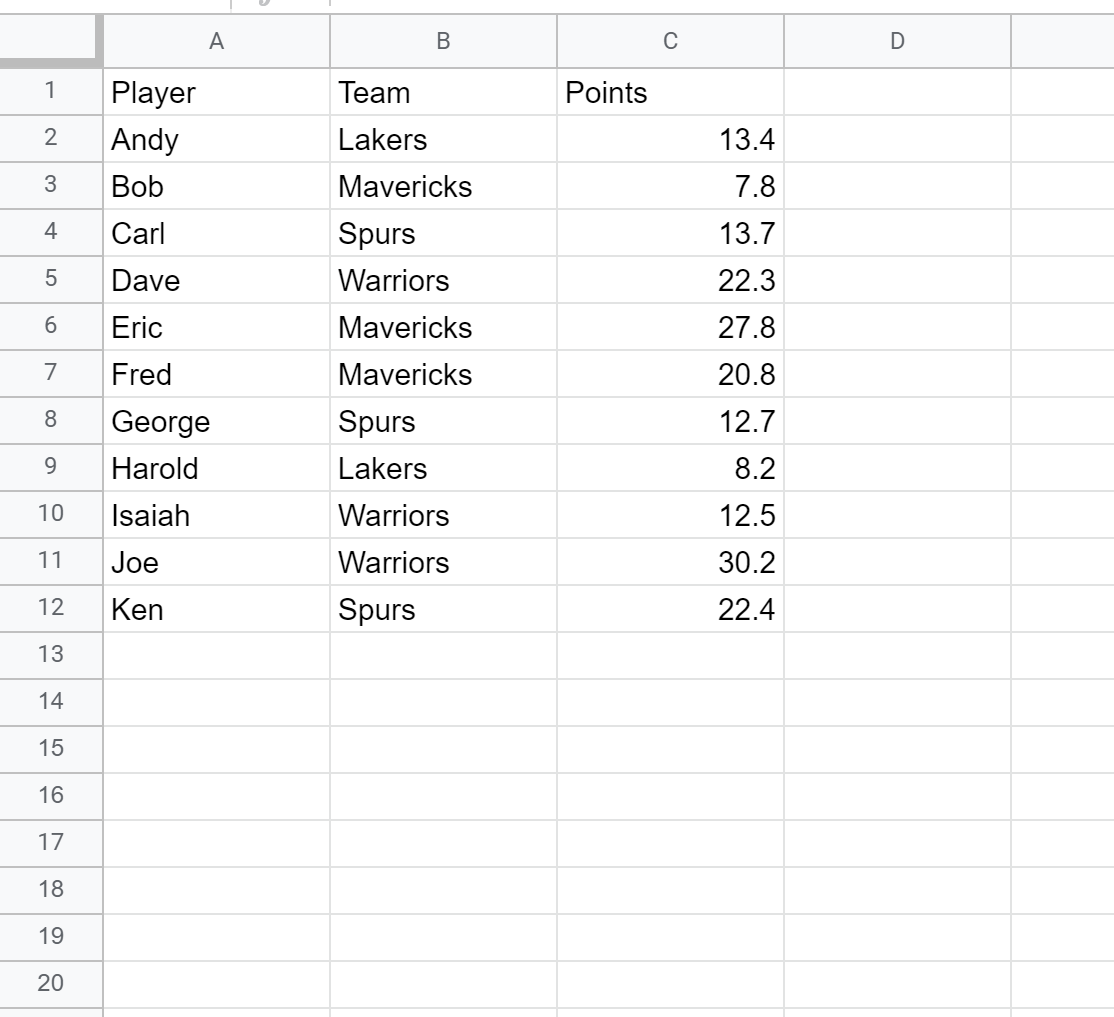
2.1 Normalisation et nettoyage des données textuelles
L’exécution rigoureuse d’une sommation catégorielle repose sur l’intégrité lexicale absolue de la colonne de groupement. Les fonctions conditionnelles de Google Sheets procèdent à des correspondances par égalité de chaînes ; par conséquent, la moindre divergence typographique entraîne la scission artificielle d’une catégorie unique en plusieurs sous-groupes fantômes. La source d’erreur la plus prévalente réside dans la présence d’espaces insécables ou résiduels situés avant, après ou entre les termes descriptifs. L’implémentation de la fonction SUPPRESPACE s’avère indispensable pour assainir systématiquement le vecteur textuel en éliminant les espaces de début et de fin tout en réduisant les espaces internes multiples à un séparateur unitaire standard.
Parallèlement à l’élimination des espaces parasites, l’analyste doit uniformiser la casse typographique des données qualitatives. Bien que certaines fonctions comme SOMME.SI soient insensibles à la casse par défaut, l’utilisation ultérieure de filtres matriciels ou d’expressions rationnelles strictes exige une harmonisation préventive. L’application des fonctions MAJUSCULE, MINUSCULE ou NOMPROPRE permet de contraindre l’ensemble des étiquettes textuelles à un format invariant, prévenant ainsi les ruptures d’association lexicale lors des croisements de tables.
Enfin, la résolution des doublons lexicaux imputables à des variations orthographiques ou des fautes de frappe réclame un protocole de standardisation explicite. L’analyste doit substituer aux libellés divergents une nomenclature normalisée contrôlée au moyen de tables de correspondance exploitant la fonction RECHERCHEV ou d’imbrications conditionnelles précises. L’objectif ultime de cette phase d’assainissement préliminaire est d’aboutir à un vecteur de catégories où chaque modalité distincte correspond strictement et exclusivement au concept nominal qu’elle est censée représenter dans le modèle d’analyse.
2.2 Typage rigoureux des données numériques et textuelles
L’une des anomalies les plus pernicieuses au sein des tableurs infonuagiques découle de la confusion typologique entre grandeurs scalaires et chaînes de caractères numériques. Lorsqu’un nombre est importé ou saisi avec des préfixes invisibles, des apostrophes ou un formatage textuel forcé, Google Sheets l’interprète comme un littéral non sommable. Dans ce scénario, les fonctions d’agrégation conditionnelle ignorent silencieusement ces entrées factices, conduisant à des sous-estimations massives des totaux sans qu’aucun message d’erreur explicite ne soit notifié à l’utilisateur.
Pour diagnostiquer et pallier cette pathologie structurelle, il convient de soumettre les colonnes quantitatives à des fonctions de vérification et de conversion systématiques. L’opérateur ESTNUM permet d’identifier immédiatement la présence d’éléments scalaires corrompus au sein du vecteur de mesure. Pour réhabiliter ces valeurs sans dénaturer la matrice originelle, l’application de la fonction CNUM force l’interpréteur à réévaluer les chaînes de chiffres selon leur valeur arithmétique réelle, rétablissant ainsi leur exploitabilité immédiate par les moteurs d’agrégation.
Les paramètres régionaux du classeur exercent également une influence prépondérante sur la ségrégation typologique des données. La divergence entre le point décimal anglo-saxon et la virgule décimale européenne constitue une source fréquente de dysfonctionnement lors des processus d’importation automatisée de fichiers CSV. L’analyste doit impérativement aligner la configuration régionale de son document (accessible via les paramètres du fichier) sur la convention typographique des données sources, ou appliquer des formules de substitution textuelle combinant SUBSTITUE et CNUM pour garantir que chaque séparateur soit conforme à la grammaire de calcul active.
2.3 Traitement des valeurs manquantes et aberrantes
La manipulation rigoureuse d’un jeu de données quantitatives exige une distinction conceptuelle nette entre une valeur manquante au sens de l’absence totale d’observation et une valeur mesurée égale à zéro. Confondre une omission avec un état nul altère fondamentalement les propriétés distributionnelles des sous-groupes lors des analyses secondaires de variance ou de tendance centrale. Lors d’une sommation par catégorie, une cellule vide n’impacte pas arithmétiquement le cumul scalaire, mais elle peut vicier l’évaluation des effectifs associés si l’analyste dérive ultérieurement des moyennes catégorielles à partir de ces totaux partiels.
Le filtrage préliminaire des entrées corrompues ou incomplètes doit s’effectuer selon un protocole transparent et documenté. Si une observation présente une catégorie valide mais une métrique quantitative corrompue par une valeur d’erreur telle que #VALEUR! ou #DIV/0!, la fonction de sommation risque d’interrompre son calcul matriciel ou de propager l’état d’erreur à l’ensemble du cumul catégoriel. L’encapsulation préventive des plages numériques dans des structures d’assainissement conditionnel de type SIERREUR ou ESTERREUR assure l’isolement des anomalies avant l’exécution du processus d’agrégation.
Face aux valeurs aberrantes avérées — qu’elles résultent d’erreurs de mesure instrumentale ou de saisies manuelles aberrantes —, l’analyste doit arbitrer entre des stratégies d’exclusion motivée et des protocoles d’imputation formels. Si l’exclusion est retenue, elle doit être opérée en amont de la sommation par l’application de filtres booléens précis, plutôt que par l’altération destructive des cellules brutes. Cette approche garantit la traçabilité absolue des choix méthodologiques et préserve l’intégrité de la piste d’audit scientifique.
3. Extraction automatisée des catégories uniques avec UNIQUE
3.1 Syntaxe formelle et fonctionnement matriciel de la fonction UNIQUE
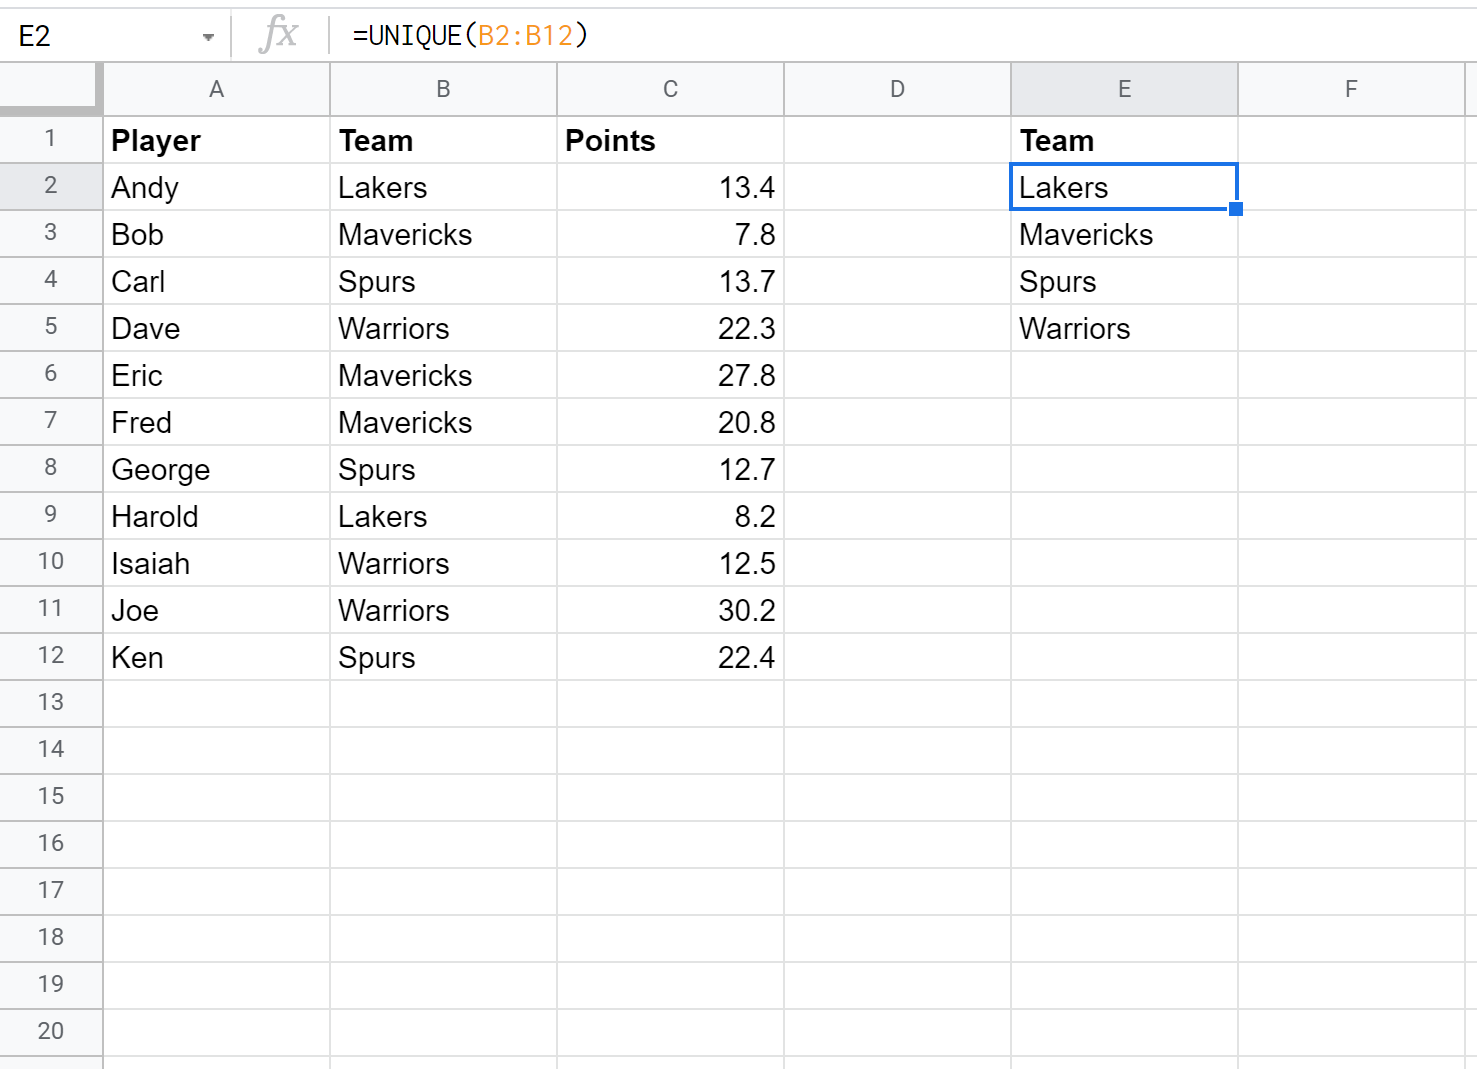
L’automatisation moderne de l’agrégation catégorielle dans Google Sheets repose sur l’abandon des saisies manuelles d’étiquettes au profit de l’extraction dynamique d’inventaires nominaux exhaustifs. La fonction matricielle UNIQUE matérialise cette approche en isolant les valeurs distinctes présentes au sein d’une plage de données univariée ou multivariée. Sa syntaxe canonique se formalise comme suit : =UNIQUE(plage; [par_colonne]; [exactement_une_fois]). Dans le cadre usuel de la sommation par catégorie, seul le premier argument désignant le vecteur source est mobilisé, les paramètres optionnels conservant leurs assignations par défaut.
Le fonctionnement interne de UNIQUE repose sur le concept fondamental de propagation matricielle (array spilling). Lorsque la fonction est instanciée dans une cellule racine, elle s’étend dynamiquement vers le bas pour occuper autant de cellules contiguës que le vecteur comporte de modalités uniques distinctes. Cette projection vectorielle requiert impérativement que la zone de destination soit exempte de tout contenu textuel ou numérique résiduel ; la moindre interférence spatiale provoque l’émission immédiate d’une erreur d’extension matricielle de type #REF!, bloquant la restitution du résultat.
Sur le plan algorithmique, la fonction UNIQUE évalue l’identité stricte des chaînes de caractères en tenant compte des espaces résiduels mais en observant une insensibilité native à la casse typographique. Si deux occurrences diffèrent uniquement par des lettres minuscules et majuscules, UNIQUE ne retiendra que la première occurrence rencontrée dans l’ordre séquentiel de lecture de la plage source. Dès lors, l’étape préalable d’assainissement lexical décrite précédemment s’avère déterminante pour éviter que l’extraction ne produise un échantillonnage aléatoire de styles typographiques au sein de la liste des catégories maîtresses.
3.2 Application empirique à l’extraction de catégories distinctes
Pour illustrer empiriquement la mise en œuvre de cette primitive, considérons un protocole expérimental répartissant plusieurs centaines de sujets au sein de diverses équipes ou cohortes d’intervention, consignées dans la colonne A2:A. En saisissant la formule =UNIQUE(A2:A100) au sein de la cellule D2, Google Sheets génère instantanément la liste exhaustive des groupes expérimentaux distincts sans redondance. Ce procédé élimine toute marge d’erreur humaine inhérente au recopiage manuel des identifiants catégoriels.
L’exhaustivité de la liste générée automatiquement peut être vérifiée en confrontant le cardinal du vecteur projeté au résultat d’une fonction de dénombrement conditionnel. Afin d’optimiser l’intelligibilité de la restitution et d’harmoniser la présentation visuelle des résultats, il est fortement recommandé d’adjoindre à l’extraction un opérateur de mise en ordre séquentielle. L’imbrication de la fonction TRIER transforme l’expression comme suit : =TRIER(UNIQUE(A2:A100)). L’analyste obtient ainsi une nomenclature catégorielle rigoureusement ordonnée par ordre alphabétique ou numérique, facilitant les lectures comparatives ultérieures.
Cette approche combinée garantit l’intégrité de la taxonomie de référence. Dès lors que de nouvelles données sont injectées dans la zone source, la formule matricielle réévalue dynamiquement l’ensemble des n-uplets et intègre instantanément toute nouvelle modalité émergente au sein de la liste ordonnée, sans nécessiter la moindre reconfiguration structurelle de la feuille de travail.
3.3 Gestion des plages dynamiques ouvertes pour pérenniser l’extraction
Dans un contexte d’acquisition de données en temps réel ou de flux continus, figer la plage source au moyen de coordonnées finies telles que A2:A100 engendre une dette technique majeure. Pour conférer une pérennité absolue à l’extraction catégorielle, il convient d’adopter des notations de plages dynamiques ouvertes, désignées par la syntaxe A2:A. Cette notation ordonne au moteur de calcul de balayer la colonne depuis la deuxième ligne jusqu’à la limite inférieure absolue de la feuille de calcul, absorbant de facto tout flux entrant futur.
L’adoption d’une plage ouverte introduit toutefois un écueil structurel : l’inclusion systématique des cellules vierges situées en bas de tableau au sein de l’inventaire catégoriel, matérialisée par une cellule vide occupant le sommet ou la base de la matrice projetée. Pour neutraliser cet artefact indésirable, l’analyste doit intégrer un prédicat de filtrage préalable à l’extraction. La combinaison des fonctions UNIQUE et FILTER permet d’éliminer élégamment les enregistrements nuls : =TRIER(UNIQUE(FILTER(A2:A; A2:A""))).
Cette architecture computationnelle stabilise la liste des catégories uniques face à n’importe quelle séquence de mise à jour, de suppression ou d’adjonction de données brutes. L’expression renvoie un vecteur dense, débarrassé de tout élément vide, prêt à servir d’ancrage logique pour les formules de sommation conditionnelle déployées dans les colonnes adjacentes.
4. Maîtrise fondamentale de la fonction SOMME.SI (SUMIF)
4.1 Anatomie de la syntaxe SOMME.SI
La fonction SOMME.SI représente l’opérateur univarié standard pour l’agrégation conditionnelle dans Google Sheets. Sa signature formelle s’établit selon la triade d’arguments suivante : =SOMME.SI(plage; critère; [plage_somme]). La maîtrise de cet outil exige une compréhension chirurgicale du rôle dévolu à chaque composant au sein du pipeline d’exécution arithmétique de la feuille de calcul.
Le premier argument, plage, définit le domaine spatial d’évaluation contenant les occurrences de la variable qualitative ou nominale. Le second argument, critère, matérialise l’expression logique, la constante littérale ou la référence scalaire qui doit être testée par rapport à chaque cellule du domaine d’évaluation. Ce critère peut s’exprimer sous forme de correspondance exacte ou d’opérateurs relationnels. Enfin, le troisième argument optionnel, plage_somme, spécifie le domaine spatial contenant les grandeurs quantitatives scalaires à additionner lorsque le test logique unitaire renvoie la valeur booléenne VRAI.
Une attention méthodologique extrême doit être accordée aux conséquences de l’omission du troisième argument. Lorsque plage_somme n’est pas explicité, Google Sheets traite par convention l’argument plage comme étant simultanément la zone d’évaluation et la zone de sommation arithmétique. Si cette omission est pertinente pour additionner des nombres supérieurs à un certain seuil scalaire au sein d’une colonne univariée, elle s’avère catastrophique dans le cadre de la sommation catégorielle où la colonne de test contient des étiquettes textuelles non sommables, aboutissant irrémédiablement à un résultat nul.
4.2 Implémentation pas à pas sur les catégories isolées
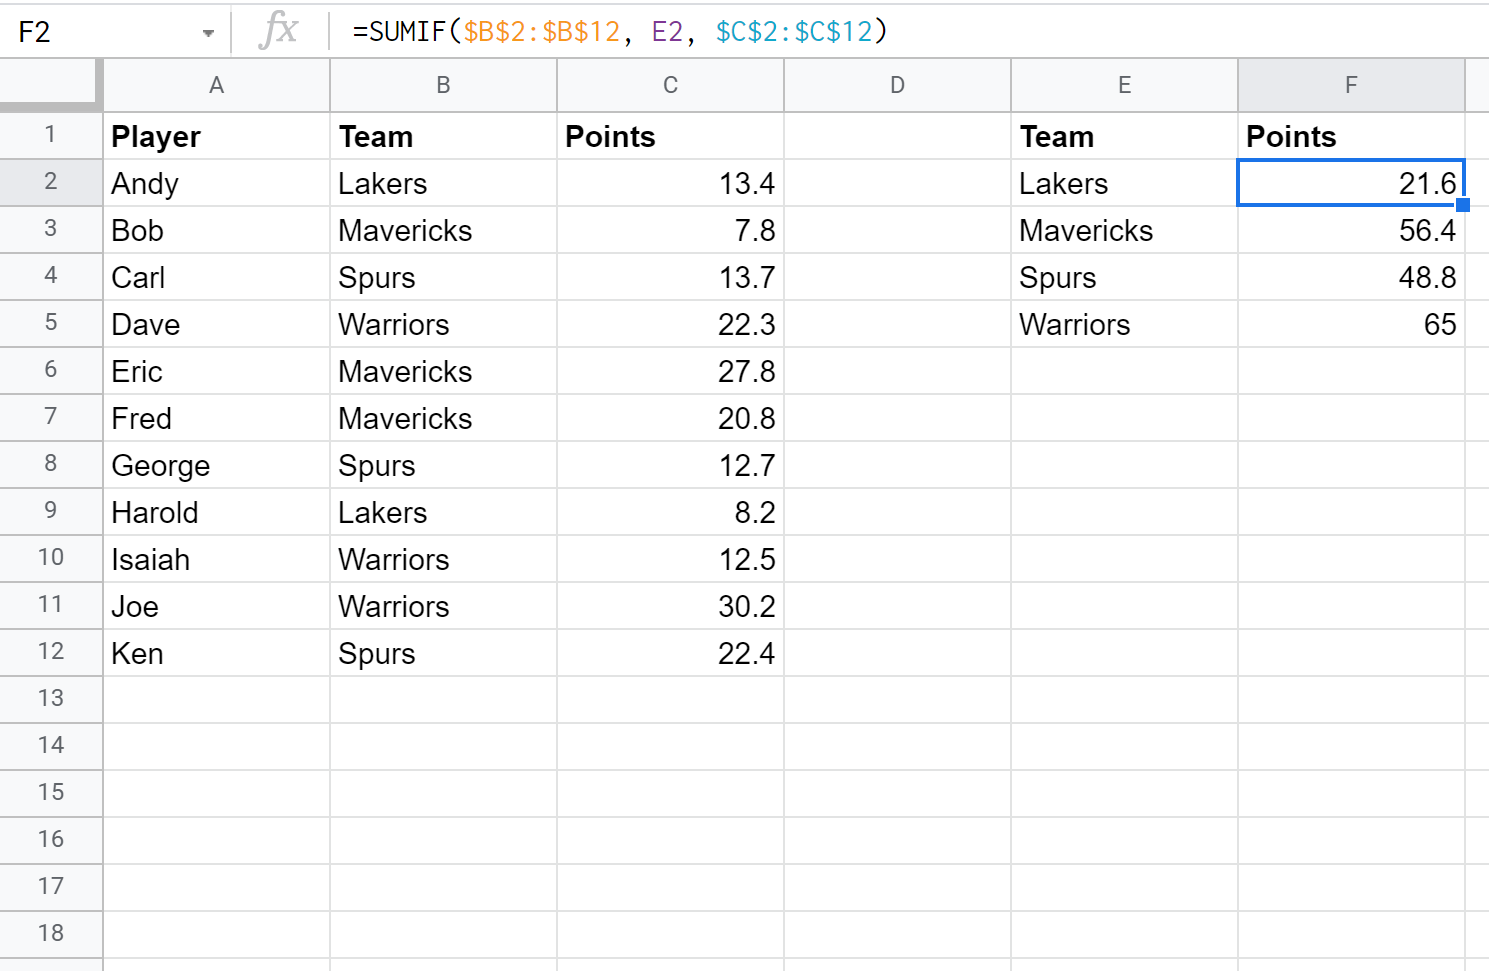
L’implémentation rigoureuse de SOMME.SI débute par la liaison du critère de sélection à la cellule contenant la première catégorie unique extraite par la méthode décrite dans la section précédente. Supposons que les données brutes résident dans les colonnes A2:B100 (colonne A contenant la catégorie, colonne B la métrique continue), et que la liste ordonnée des catégories uniques ait été projetée en D2:D10. Au sein de la cellule E2, la syntaxe d’appel s’articule comme suit : =SOMME.SI($A$2:$A$100; D2; $B$2:$B$100).
L’utilisation des références absolues matérialisées par le symbole du dollar ($) revêt une importance capitale. L’ancrage rigide des plages $A$2:$A$100 et $B$2:$B$100 garantit que lors de la propagation verticale de la formule de la ligne 2 à la ligne 10 le long du vecteur catégoriel, le cadre spatial d’analyse demeure rigoureusement invariant. Seule la référence relative D2 se transmute séquentiellement en D3, D4, jusqu’à D10, assurant une concordance univoque entre chaque modalité et son cumul respectif.
Dès la propagation achevée, un protocole de validation arithmétique élémentaire mais fondamental doit être immédiatement exécuté. L’analyste doit comparer la somme des totaux catégoriels calculés en colonne E avec la somme globale directe appliquée au vecteur source d’origine via la formule =SOMME($B$2:$B$100). Une identité arithmétique stricte confirme la parfaite conservation de la masse scalaire et atteste qu’aucune observation granulaire n’a été omise ou dupliquée au cours de la procédure d’agrégation.
4.3 Interprétation et validation des résultats agrégés
La validation d’un vecteur de résultats agrégés ne se cantonne pas à l’égalité arithmétique globale ; elle exige une lecture critique de la distribution inter-groupes. La première étape consiste à déceler d’éventuelles disparités aberrantes dans la répartition de la masse sommée. Une catégorie affichant un résultat anormalement marginal ou excessivement disproportionné par rapport aux anticipations théoriques peut signaler un glissement sémantique dans la codification originelle des observations plutôt qu’une réalité sous-jacente propre au phénomène mesuré.
La présence de valeurs nulles (0) au sein du vecteur agrégé nécessite une investigation ciblée. Il convient d’établir formellement si ce résultat traduit l’existence de valeurs intrinsèquement nulles au sein de la cohorte considérée, une annulation exacte par sommation d’éléments de signes opposés, ou plus communément une absence totale d’occurrences de la modalité suite à une altération typographique non captée lors de l’extraction. L’adjonction concomitante d’une colonne de dénombrement utilisant la fonction NB.SI permet de lever immédiatement cette ambiguïté en documentant l’effectif associé à chaque cumul.
Enfin, la cohérence mathématique globale doit intégrer l’évaluation des erreurs d’arrondi imputables au standard IEEE 754 régissant l’arithmétique à virgule flottante au sein des moteurs informatiques modernes. Lors de l’addition répétée de nombres décimaux étendus, des résidus infimes peuvent émerger, créant des disparités apparentes de l’ordre de 10⁻¹⁴ entre la somme globale et la somme des parties. La fonction ARRONDI doit être mobilisée au besoin pour normaliser les résultats au degré de granularité pertinent pour la recherche.
5. Extension multicritère avec la fonction SOMME.SI.ENS (SUMIFS)
5.1 Distinction syntaxique et structurelle avec SOMME.SI
Dès lors que l’analyse factorielle s’affine, la réduction univariée offerte par SOMME.SI devient insuffisante pour modéliser des interactions complexes. La fonction SOMME.SI.ENS intervient pour permettre l’agrégation conditionnelle soumise à une pluralité de prédicats logiques simultanés. Cette transition s’accompagne d’une rupture fondamentale dans l’agencement structural des arguments de la formule, rupture qui constitue l’une des sources de bogues les plus récurrentes chez les utilisateurs habitués à la fonction univariée.
Contrairement à SOMME.SI où la zone de calcul scalaire est reléguée en position terminale optionnelle, SOMME.SI.ENS impose le positionnement prioritaire et obligatoire de plage_somme en premier argument. Sa signature formelle s’établit comme suit : =SOMME.SI.ENS(plage_somme; plage_critères1; critère1; [plage_critères2; critère2; ...]). Cette architecture permet au moteur d’évaluation d’instancier immédiatement le tampon arithmétique avant de soumettre les coordonnées vectorielles aux filtres logiques successifs ordonnés par paires alternées.
Sur le plan de la théorie des ensembles, SOMME.SI.ENS applique une logique d’intersection cumulative, équivalente à l’opérateur booléen ET. Une ligne donnée ne voit sa valeur scalaire intégrée à la masse sommée que si et seulement si elle satisfait simultanément et sans exception l’intégralité des prédicats formulés dans les couples plage_critères / critère. Cette caractéristique confère à la fonction une puissance analytique remarquable pour isoler des sous-populations hautement spécifiées au sein d’architectures tabulaires multidimensionnelles.
5.2 Application à des sous-groupes multidimensionnels
L’application de SOMME.SI.ENS s’illustre idéalement dans les protocoles de recherche nécessitant le croisement d’un facteur expérimental principal avec une variable contextuelle ou temporelle secondaire. Supposons une étude clinique où la colonne A répertorie la cohorte d’appartenance du patient, la colonne B consigne la phase temporelle de l’évaluation (par exemple : « Pré-test », « Post-test »), et la colonne C enregistre le score psychométrique continu mesuré.
Pour calculer le cumul des scores associés exclusivement à la cohorte « Groupe_Alpha » durant la phase « Post-test », la formule se formule avec une précision rigoureuse : =SOMME.SI.ENS($C$2:$C$1000; $A$2:$A$1000; "Groupe_Alpha"; $B$2:$B$1000; "Post-test"). Bien entendu, dans une optique de modélisation dynamique, les chaînes littérales doivent être substituées par des références directes aux cellules constitutives d’un tableau à double entrée préalablement agencé, maximisant l’extensibilité du dispositif.
La polyvalence de SOMME.SI.ENS s’exprime également par sa capacité à intégrer des critères quantitatifs relationnels au sein du croisement catégoriel. Il est parfaitement possible d’ajouter une condition d’exclusion relative à un seuil d’intensité en insérant une troisième paire : $C$2:$C$1000; ">50". L’analyste combine ainsi dans une unique structure déclarative la stratification nominale inter-groupes et le filtrage scalaire intra-groupe, sans recourir à des colonnes techniques de calcul intermédiaires.
5.3 Résolution des paradoxes d’agrégation multicritère
Le raffinement multicritère confronte fréquemment l’analyste à des paradoxes d’agrégation structurels, au premier rang desquels figure le problème des sous-ensembles vides. Lorsqu’une intersection de critères ne correspond à aucune observation empirique au sein du jeu de données brutes, SOMME.SI.ENS renvoie la valeur scalaire 0. Il devient alors indispensable de discriminer s’il s’agit d’un zéro résultant de mesures empiriques effectives ou de la simple inexistence d’individus présentant cette combinaison factorielle. Le recours couplé à NB.SI.ENS permet d’attester sans équivoque la complétude ou la vacuité de la cellule factorielle considérée.
Un autre défi méthodologique majeur réside dans la prévention des doubles comptages lors du croisement de variables interdépendantes. Si les dimensions intégrées dans SOMME.SI.ENS ne sont pas strictement orthogonales — c’est-à-dire si une appartenance à la catégorie X influence mécaniquement la distribution de la variable Y —, l’analyste risque de dériver des conclusions erronées quant à l’impact additif de chaque modalité. L’indépendance logique des axes de segmentation doit être théoriquement validée en amont de toute manipulation quantitative.
Enfin, la complétude factorielle impose de s’assurer que la somme de l’ensemble des intersections multicritères reconstitue rigoureusement la somme marginale de la catégorie principale correspondante. Si la somme des sous-groupes « Pré-test » et « Post-test » du « Groupe_Alpha » ne coïncide pas exactement avec le résultat univarié délivré par SOMME.SI pour ce même « Groupe_Alpha », l’anomalie signale infailliblement la présence de valeurs non renseignées ou corrompues au sein de la colonne secondaire, rompant l’exhaustivité de la partition factorielle.
6. Vectorisation des calculs avec ARRAYFORMULA et SOMME.SI
6.1 Principe de la vectorisation dans Google Sheets
Dans l’ingénierie traditionnelle des feuilles de calcul, la duplication des formules le long d’un vecteur repose sur l’opération physique de glissement ou de recopiage vers le bas. Cette pratique, bien qu’universellement répandue, introduit une dette technique substantielle : elle alourdit le fichier, multiplie les risques de rupture de continuité accidentelle des formules lors des tris manuels, et oblige à une maintenance récurrente lors de l’insertion de nouveaux enregistrements. La vectorisation des calculs, rendue possible par la directive ARRAYFORMULA, émancipe le classeur de ces contingences mécaniques.
Le moteur d’exécution de Google Sheets intègre un sous-système de calcul vectoriel capable d’appliquer un opérateur scalaire ou conditionnel à un tenseur univarié complet en une seule passe opérationnelle. Lorsqu’une expression est encapsulée au sein de ARRAYFORMULA, l’interpréteur transmute les arguments scalaires de la fonction cible en vecteurs de dimension n. Le calcul s’exécute dès lors en mémoire centrale de manière atomique, projetant le vecteur de résultats dans la colonne sous-jacente sans qu’aucune formule ne soit inscrite physiquement dans les cellules réceptrices inférieures.
Cette approche garantit une intégrité algorithmique absolue sur l’ensemble de la dimension considérée. Il devient impossible pour un collaborateur ou un opérateur de données de modifier accidentellement une cellule intermédiaire du tableau d’agrégation : la formule matricielle réside exclusivement dans la cellule supérieure de tête, toute tentative d’altération locale des cellules dérivées étant automatiquement rejetée ou neutralisée par le moteur sous forme d’erreur de collision.
6.2 Combinaison technique de SOMME.SI et ARRAYFORMULA
Bien que la fonction multicritère SOMME.SI.ENS oppose une résistance architecturale structurelle à la vectorisation via ARRAYFORMULA — son moteur interne refusant d’itérer nativement sur des plages de critères multiples au sein d’un contexte matriciel —, la fonction univariée SOMME.SI se prête admirablement à cette technique d’optimisation vectorielle. Pour propager automatiquement la sommation sur l’intégralité d’une liste de catégories uniques situées en D2:D, la syntaxe se structure de la manière suivante : =ARRAYFORMULA(SOMME.SI(A2:A; D2:D; B2:B)).
L’évaluation immédiate de cette expression sur une plage ouverte génère toutefois un effet collatéral indésirable : le calcul s’exécute sur l’infinité des cellules vierges situées au-delà des catégories effectives, affichant une suite interminable de valeurs nulles (0) jusqu’au terme de la feuille. Pour juguler cette prolifération inutile et préserver la clarté visuelle du rapport, il convient d’adjoindre une structure conditionnelle matricielle préliminaire vérifiant la complétude de la colonne de référence : =ARRAYFORMULA(SI(D2:D=""; ""; SOMME.SI(A2:A; D2:D; B2:B))).
Grâce à cette formulation hautement élégante, le tableau d’agrégation adapte sa hauteur de projection de façon totalement dynamique et autonome. Si l’extraction de la colonne D passe de cinq à cinquante modalités par l’adjonction de données brutes nouvelles en colonne A, la formule vectorisée en E2 déploie instantanément les quarante-cinq nouvelles sommations correspondantes sans qu’aucune intervention humaine ne soit requise.
6.3 Performance et limites des calculs matriciels étendus
L’adoption systématique des structures vectorisées matricielles impose une compréhension aiguë de leurs compromis algorithmiques. Bien que la vectorisation réduise la taille du document XML sous-jacent en évitant la redondance textuelle des formules sur des milliers de lignes, elle induit une charge computationnelle substantielle lors de la phase de réévaluation globale. Si des plages infinies de type A:A sont mobilisées sans discernement au sein d’arborescences de calculs complexes, Google Sheets est contraint d’allouer des segments de mémoire pour analyser des centaines de milliers de cellules vierges potentielles.
Cette mobilisation excessive de ressources se traduit par une latence perceptible lors de l’ouverture du classeur, voire par des interruptions d’exécution matérialisées par des dépassements de temps de calcul autorisé (time-out). De surcroît, la mémoire vive allouée à l’environnement d’exécution du navigateur web client constitue une limite physique infranchissable lors du traitement de jeux de données massifs excédant les dizaines de milliers d’enregistrements vectorisés simultanément.
Il relève donc des bonnes pratiques d’ingénierie de circonscrire les matrices vectorielles aux zones spatiales rigoureusement nécessaires. L’utilisation de plages dynamiques fermées mais adaptatives au moyen de fonctions de dimensionnement indirect, ou le recours à des filtres préliminaires réduisant la taille des vecteurs transmis à ARRAYFORMULA, assure un équilibre optimal entre automatisation architecturale et réactivité opérationnelle du tableur.
7. Agrégation par catégorie via le langage SQL avec QUERY
7.1 Architecture fondamentale de la fonction QUERY
Parmi l’arsenal fonctionnel de Google Sheets, la fonction QUERY se distingue radicalement par son paradigme déclaratif issu du monde des bases de données relationnelles. Au lieu de combiner et d’imbriquer une pluralité de fonctions mathématiques et de filtres matriciels, l’analyste interagit directement avec le moteur sous-jacent via le langage d’interrogation de l’API Google Visualization, fortement inspiré du standard SQL (Structured Query Language). Sa signature formelle s’énonce simplement : =QUERY(données; requête; [en_têtes]).
Le premier argument, données, encapsule la table brute intégrale soumise à l’investigation, incluant facultativement ses en-têtes descriptifs. Le second argument, requête, constitue une chaîne de caractères formalisant les opérations de sélection, de projection, de filtrage et d’agrégation selon une grammaire rigoureusement normalisée. Le troisième argument précise le cardinal des lignes dévolues aux étiquettes structurales supérieures, permettant à l’interpréteur de dissocier les métadonnées de l’espace d’échantillonnage réel.
La puissance intrinsèque de QUERY réside dans sa compacité architecturale et sa modularité expressive. Alors qu’une chaîne de traitement conventionnelle impose de séquencer l’extraction des identifiants uniques, leur ordonnancement séquentiel, le calcul conditionnel univarié, puis le filtrage d’affichage au moyen de multiples formules distribuées sur plusieurs colonnes techniques, une unique instruction QUERY exécute l’intégralité de ces opérations en un point nodal unique du classeur.
7.2 Formulation des clauses SELECT, GROUP BY et SUM()
L’exécution d’une sommation par catégorie via le langage déclaratif mobilise la conjonction impérative des clauses SELECT, SUM() et GROUP BY. Considérons une matrice de données s’étendant de A1 à B100, où la première colonne correspond au facteur catégoriel et la seconde aux valeurs quantitatives scalaires. L’instruction fondamentale s’articule comme suit : =QUERY(A1:B100; "SELECT A, SUM(B) GROUP BY A"; 1).
L’analyse structurelle de cette requête met en lumière son élégance logique. La clause SELECT A, SUM(B) ordonne la projection conjointe de la variable catégorielle nominale et de l’agrégat arithmétique de la métrique quantitative. L’opérateur GROUP BY A commande au moteur relationnel de partitionner la table selon les modalités uniques de la colonne A, appliquant la fonction d’agrégation SUM() à chaque partition de manière strictement isolée, conformément au modèle formel du partitionnement relationnel.
Pour parfaire la présentation du tableau d’agrégation résultant sans altérer la requête structurelle, il est loisible d’annexer la clause LABEL. Par défaut, QUERY génère des en-têtes techniques automatiques tels que « sum Variable ». En complétant la chaîne d’interrogation : =QUERY(A1:B100; "SELECT A, SUM(B) GROUP BY A LABEL SUM(B) 'Total Mesuré'"; 1), l’analyste redéfinit instantanément l’étiquette de restitution avec une rigueur éditoriale absolue.
7.3 Avantages comparatifs de QUERY face à UNIQUE et SOMME.SI
La confrontation méthodologique entre l’architecture QUERY et l’association modulaire UNIQUE / SOMME.SI met en évidence des profils d’efficience différenciés selon les cas d’usage analytiques. Le bénéfice cardinal de la fonction QUERY réside dans son atomicité transactionnelle : l’intégralité de la table de synthèse — identifiants catégoriels, agrégats numériques et libellés d’en-tête — est matérialisée à partir d’une seule formule maîtresse, éliminant tout risque de désynchronisation spatiale ou de référence brisée entre colonnes indépendantes.
Par ailleurs, QUERY intègre nativement des mécanismes sophistiqués d’ordonnancement et d’élagage des données au sein de la même clause expressive. L’adjonction de ORDER BY SUM(B) DESC classe instantanément les catégories sommées par ordre décroissant de magnitude scalaire, tandis que l’incorporation de conditions WHERE A IS NOT NULL neutralise automatiquement les lignes orphelines sans exiger l’imbrication de primitives secondaires comme FILTER ou TRIER. Cette concision syntaxique simplifie considérablement la documentation et l’auditabilité des modèles complexes.
En contrepartie de cette suprématie expressive, QUERY impose une contrainte typologique intransigeante : elle exige une stricte homogénéité des types de données au sein de chaque colonne analysée. Si une colonne contient une distribution composite de valeurs numériques et de mentions textuelles, l’API Google Visualization applique un seuil majoritaire et convertit arbitrairement les éléments minoritaires en valeurs nulles, introduisant un biais silencieux sévère. Dans de telles configurations hétérogènes, l’association traditionnelle de SOMME.SI et UNIQUE demeure plus tolérante et robuste.
8. Tableaux croisés dynamiques comme alternative analytique interactive
8.1 Conception d’un tableau croisé dynamique pour la sommation
Outre les fonctions algorithmiques et déclaratives inscrites dans les cellules, Google Sheets propose une couche d’abstraction supérieure hautement interactive dédiée à la synthèse multidimensionnelle : les tableaux croisés dynamiques (Pivot Tables). Conçus pour explorer rapidement de volumineux répertoires de micro-données sans requérir l’écriture d’expressions syntaxiques complexes, ils constituent l’outil privilégié de l’exploration de données heuristique et de la présentation exécutive immédiate.
La genèse d’un tableau croisé dynamique s’opère en sélectionnant la matrice de données brutes, puis en activant la commande correspondante depuis le menu contextuel Insertion. Dès cette étape liminaire, un choix structurel déterminant s’impose à l’analyste concernant la définition de la zone source. Définir une plage rigide (ex. A1:C500) expose la synthèse à l’obsolescence lors de l’adjonction de données ultérieures, tandis qu’une sélection de plage dynamique ouverte (ex. A1:C) garantit la prise en compte pérenne des extensions de volume, au prix d’une éventuelle ligne résiduelle vide qu’il conviendra de neutraliser par filtrage structurel.
L’environnement invite ensuite l’analyste à déterminer l’emplacement spatial de la table de restitution, soit au sein d’une nouvelle feuille de calcul dédiée — recommandation méthodologique standard garantissant l’absence d’interférences visuelles et de collisions spatiales —, soit sur une zone réservée de la feuille active. Une fois instancié, le panneau latéral de configuration devient l’interface nodale de paramétrage dimensionnel.
8.2 Configuration des dimensions qualitatives et des métriques
Le paramétrage méthodique d’un tableau croisé dynamique obéit à la cartographie spatiale des variables en jeu. Pour réaliser une sommation par catégorie, l’analyste assigne la variable qualitative ou nominale au compartiment des Lignes (Rows). Cette action équivaut fonctionnellement à l’exécution de la primitive UNIQUE : le moteur de pivotement isole instantanément l’inventaire des modalités discrètes et les aligne verticalement en tête de structure.
La seconde phase consiste à assigner la variable quantitative continue au compartiment des Valeurs (Values). Par défaut, l’environnement peut assigner une métrique d’occurrence (NB) ou de somme ; il importe de s’assurer expressément que l’opérateur de réduction sélectionné dans le menu déroulant est bien SOMME. Instantanément, l’infrastructure calcule et restitue le cumul arithmétique rigoureusement associé à chaque modalité catégorielle affichée.
Pour démultiplier la portée analytique de la synthèse sans multiplier les calculs dérivés manuels, le compartiment des valeurs permet de moduler la typologie de restitution. Au-delà de la valeur absolue brute de la somme, l’analyste peut sélectionner un affichage exprimé en Pourcentage du total de la colonne. Cette fonctionnalité transforme instantanément une grandeur scalaire extensive en une métrique de contribution fractionnaire relative, permettant d’appréhender d’un coup d’œil la structure de dominance au sein de la distribution catégorielle globale.
8.3 Évaluation comparative : Tableaux croisés contre Formules natives
L’arbitrage entre l’usage d’un tableau croisé dynamique et le déploiement de formules formelles (telles que SOMME.SI, ARRAYFORMULA ou QUERY) repose sur une tension dialectique fondamentale entre ergonomie exploratoire et rigueur programmatique. Le tableau croisé dynamique brille par son élasticité interactive : il autorise le chercheur à modifier à la volée les dimensions de regroupement, à imbriquer des hiérarchies qualitatives secondaires en sous-niveaux visuels rétractables, et à segmenter les populations via des commandes de filtrage graphique sans réécrire une ligne de logique relationnelle.
En revanche, sur le plan de l’intégration dans des pipelines d’analyse complexes et automatisés, les tableaux croisés dynamiques souffrent de rigidités rédhibitoires. Leurs dimensions spatiales fluctuantes rendent extrêmement précaire la liaison de formules référençant directement leurs cellules internes : tout changement dans le cardinal des catégories déplace physiquement les totaux, rompant les dépendances arithmétiques établies en aval. De plus, leur recalcul automatique peut s’avérer plus lourd en ressources graphiques et en mémoire vive du navigateur que l’exécution de primitives natives optimisées.
Les formules natives, en particulier les requêtes QUERY ou les vecteurs ARRAYFORMULA, conservent une supériorité incontestable pour l’édification de tableaux de bord figés, normalisés et destinés à une alimentation automatisée continue. L’analyste rigoureux privilégiera ainsi les tableaux croisés dynamiques pour la phase de découverte et d’exploration informelle des données, avant de cristalliser les calculs pérennes au moyen de formules matricielles déclaratives dans la version de production de son classeur.
9. Traitement des critères avancés : Caractères génériques et expressions régulières
9.1 Exploitation des caractères génériques dans SOMME.SI
Dans de multiples contextes d’analyse empirique, les catégories nominales ne se présentent pas sous la forme de termes atomiques parfaits, mais plutôt sous la forme d’arborescences codifiées, d’acronymes composés ou de descriptions lexicales hétérogènes. La fonction SOMME.SI dispose d’une flexibilité intrinsèque majeure grâce à sa compatibilité historique avec les caractères génériques (wildcards), permettant d’agréger des classes de valeurs partageant une racine textuelle commune sans exiger la normalisation exhaustive préalable de chaque enregistrement.
Le premier caractère générique fondamental est l’astérisque (*), qui se substitue à une séquence arbitraire de zéro, un ou plusieurs caractères typographiques. Si l’on souhaite agréger l’ensemble des métriques associées aux comptes budgétaires de recherche débutant par le préfixe « LAB », la formulation du critère prendra la forme "LAB*" au sein de SOMME.SI. Cette syntaxe inclura indistinctement « LAB_BIO », « LAB_PHYS » ou « LAB_01 ». Placée de part et d’autre d’un mot-clé (ex. "*URGENT*"), elle permet d’isoler toute ligne dont la description contextuelle encapsule ce terme spécifique, quelle que soit sa position séquentielle dans la chaîne de texte.
Le second métacaractère opératoire est le point d’interrogation (?), qui correspond strictement à un unique caractère unitaire indéfini. Cette granularité fine est précieuse pour traiter des codes de référence normalisés où une lettre pivot signale une sous-catégorie méthodologique. Par exemple, la chaîne "EXP-?2" agrégera les occurrences de « EXP-A2 » et « EXP-B2 », mais ignorera formellement « EXP-AA2 ». Lorsque l’analyste doit impérativement rechercher un astérisque ou un point d’interrogation littéral au sein du texte brut, il doit neutraliser son comportement générique en le faisant précéder d’un tilde d’échappement (~* ou ~?).
9.2 Gestion de la sensibilité à la casse et des délimitations strictes
L’un des angles morts les plus critiques de la fonction SOMME.SI réside dans son insensibilité native et irrévocable à la casse typographique. Si un protocole d’encodage de données expérimentales utilise la majuscule et la minuscule pour différentier des états expérimentaux distincts — par exemple « Ctrl » pour un groupe témoin et « CTRL » pour une ligne d’expression génétique surexprimée —, SOMME.SI assimilera aveuglément ces deux modalités en un seul agrégat amalgamé, faussant irrémédiablement l’interprétation des données.
Pour instaurer une ségrégation catégorielle rigoureuse sensible à la casse, il est nécessaire de s’émanciper de SOMME.SI et de recourir à la fonction SOMMEPROD couplée à la primitive EXACT. La fonction EXACT procède à une comparaison binaire littérale exacte entre deux chaînes de caractères et renvoie VRAI exclusivement en cas d’identité orthographique et typologique stricte. L’expression se formalise dès lors sous la structure matricielle suivante : =SOMMEPROD(EXACT(A2:A100; "CTRL") * B2:B100).
L’analyse opérationnelle de cette formule met en évidence l’élégance de l’algèbre booléenne appliquée au tableur. Le test EXACT(A2:A100; "CTRL") génère un vecteur colonnaire de valeurs booléennes VRAI et FAUX. L’opérateur de multiplication arithmétique (*) contraint ce vecteur booléen à se convertir en un vecteur binaire d’entiers 1 et 0. Ce vecteur binaire est ensuite multiplié élément par élément par le vecteur de valeurs quantitatives B2:B100, avant que la fonction SOMMEPROD n’exécute la sommation finale des produits. Seules les valeurs associées au critère sensible à la casse survivent à la mise à zéro scalaire.
9.3 Expressions régulières combinées à la sommation
Lorsque les critères de segmentation reposent sur des motifs syntaxiques non linéaires hautement sophistiqués, ni les caractères génériques élémentaires ni la comparaison exacte ne suffisent. L’arsenal de Google Sheets s’illustre par son support natif des expressions régulières (regex) selon le standard RE2 développé par Google. La fonction REGEXMATCH constitue le vecteur privilégié d’intégration de cette puissance expressive dans les calculs d’agrégation quantitative.
La primitive REGEXMATCH évalue si une chaîne de texte correspond à un motif structural défini, supportant des classes de caractères, des ancres de début et de fin de chaîne, des quantificateurs et des alternatives conditionnelles. Pour exécuter une sommation reposant sur un filtre d’expression régulière, on combine REGEXMATCH avec SOMME et FILTER, ou au sein d’une structure SOMMEPROD matricielle. Par exemple, pour additionner toutes les valeurs de la colonne B dont l’identifiant en colonne A se termine par une séquence de trois chiffres pairs : =SOMME(FILTER(B2:B; REGEXMATCH(A2:A; "d*[02468]{3}$"))).
Cette méthodologie d’agrégation par motifs offre une résilience incomparable lors du traitement de nomenclatures composites complexes, telles que les identifiants d’échantillons de bio-banques, les codes de transaction financière transnationaux ou les nomenclatures d’inventaire logistique. L’analyste formalise des règles de sélection catégorielle abstraites et puissantes, affranchissant l’architecture tabulaire d’infinies opérations intermédiaires de décomposition lexicale de colonnes.
10. Diagnostic, audit et résolution des anomalies de sommation
10.1 Résolution des décalages de dimension de plages
L’erreur structurelle la plus sournoise au sein des formules d’agrégation conditionnelle découle de l’asymétrie dimensionnelle entre la plage de test des critères et la plage de sommation scalaire. Les fonctions SOMME.SI et SOMME.SI.ENS exigent un parallélisme géométrique strict entre les domaines spatiaux qu’elles manipulent. Si un analyste configure par inattention une formule de type =SOMME.SI(A2:A100; "Alpha"; B2:B90), il introduit une anomalie de bornage matriciel critique.
Le comportement de Google Sheets face à cette dissemblance varie de manière déconcertante selon la fonction mobilisée. Tandis que SOMME.SI.ENS interrompt son exécution en renvoyant une erreur explicite d’incompatibilité d’arguments de type #VALEUR! dès que les dimensions matricielles divergent, la fonction historique SOMME.SI tente fréquemment d’ajuster silencieusement la taille de la plage de sommation pour la calquer sur la dimension de la plage de critères. Cet ajustement implicite redimensionne arbitrairement la zone de calcul en mémoire, pouvant intégrer des cellules non désirées situées en dessous de la sélection visible.
Pour prévenir ces comportements indéterminés, l’analyste doit instaurer une règle d’or architecturale : imposer un synchronisme dimensionnel absolu à l’ensemble des coordonnées vectorielles d’une même formule. Le recours systématique aux notations ouvertes normalisées (telles que A2:A et B2:B) ou la définition de plages nommées dynamiques garantit qu’aucun décalage de fin de table ne pourra altérer la cohérence d’évaluation des prédicats arithmétiques.
10.2 Détection des caractères non imprimables et espaces fantômes
Lorsqu’une formule SOMME.SI syntaxiquement parfaite renvoie un résultat nul ou substantiellement inférieur aux attentes théoriques alors même que les catégories semblent visuellement correspondre au jeu de données brutes, l’origine du bogue réside presque invariablement dans la présence de caractères invisibles ou d’espaces fantômes. Le plus dévastateur d’entre eux est l’espace insécable, identifié par le code ASCII 160 (ou code hexadécimal / u00A0), massivement généré lors de copier-coller depuis des interfaces web ou des progiciels de gestion intégrés (ERP).
L’espace insécable se distingue visuellement de l’espace standard (code ASCII 32) par une imperceptibilité totale pour l’œil humain, mais constitue pour le moteur de Google Sheets un caractère typographique entièrement distinct. Par conséquent, la chaîne « Groupe A » avec un espace insécable ne sera jamais considérée comme égale à « Groupe A » doté d’un espace standard. Pire encore : la fonction SUPPRESPACE conventionnelle de Google Sheets est historiquement programmée pour éliminer l’espace ASCII 32, laissant souvent subsister l’espace ASCII 160 sans le purger.
Pour neutraliser cette pathologie cryptique, l’analyste doit employer des protocoles d’assainissement radical combinant les fonctions CAR et SUBSTITUE. La formule suivante force la conversion systématique des espaces insécables en espaces standards avant tout traitement d’agrégation : =SUBSTITUE(A2; CAR(160); " "). Pour auditer formellement la présence de telles anomalies lors d’une session de débogage, l’application ponctuelle de la fonction CODE ou NBCAR comparée sur les chaînes litigieuses permet de révéler instantanément la présence de ces octets parasites masqués.
10.3 Audit des références circulaires et des écrasements matriciels
Le déploiement des formules de sommation catégorielle, particulièrement lorsqu’elles intègrent des mécanismes d’extension matricielle ou de projection automatique, expose le classeur à deux pathologies d’exécution redoutables : la référence circulaire et l’écrasement matriciel (spill collision). La référence circulaire émerge lorsqu’une formule d’agrégation inclut, directement ou par le biais d’une cascade de cellules dépendantes intermédiaires, sa propre coordonnée au sein de son domaine d’investigation ou de sommation. Cet état interdit toute convergence mathématique et plonge l’interpréteur dans une boucle infinie sanctionnée par une alerte #REF!.
L’écrasement matriciel constitue quant à lui le tribut payé à la puissance des fonctions dynamiques modernes telles que UNIQUE, SORT ou ARRAYFORMULA. Dès lors que la zone d’expansion physique requise par la projection matricielle rencontre une cellule non vierge — fût-ce un espace blanc résiduel, une constante oubliée ou une formule préexistante —, le moteur de calcul interrompt la restitution et déclenche une erreur d’expansion matricielle explicite. La résolution impose un nettoyage physique rigoureux du couloir de projection sous-jacent.
Pour pérenniser la robustesse d’un classeur analytique institutionnel, il est impératif d’en documenter l’architecture interne. L’adjonction d’une feuille de métadonnées détaillant le rôle des plages nodales, l’usage délibéré d’annotations de cellules documentant les constructions conditionnelles sophistiquées et l’utilisation rigoureuse de la fonctionnalité Afficher les formules (Ctrl + `) lors des phases de recette garantissent que le classeur pourra être maintenu, audité et transféré sans rupture d’intelligibilité méthodologique.
11. Visualisation et communication académique des résultats agrégés
11.1 Construction de diagrammes synthétiques conformes aux normes
La sommation par catégorie ne constitue que rarement le terme ultime du processus d’analyse ; elle sert généralement de matrice d’alimentation pour la production de représentations visuelles synthétiques destinées à la dissémination des résultats. Pour traduire graphiquement une série de totaux catégoriels, le diagramme en barres horizontales ou en colonnes verticales constitue l’étalon d’or méthodologique de la sémiologie graphique. Contrairement aux diagrammes circulaires (dits « camemberts ») dont l’évaluation cognitive des angles est hautement faillible pour l’esprit humain, les barres alignées mobilisent le cortex visuel sur une tâche d’estimation de longueurs rectilignes le long d’une échelle commune, tâche pour laquelle la perception humaine offre une acuité maximale.
La conformité méthodologique de ces représentations exige le respect scrupuleux des principes fondateurs de visualisation scientifique formalisés par Edward Tufte, notamment l’optimisation du ratio encre-données (data-ink ratio). Tout élément graphique non porteur d’information mathématique — bordures lourdes, quadrillages d’arrière-plan hyperdenses, effets de perspective tridimensionnels fallacieux ou ombrages décoratifs — doit être rigoureusement éliminé de l’espace de restitution visuelle.
Enfin, l’axe quantitatif portant la mesure scalaire agrégée doit impérativement trouver son origine au point zéro absolu. Tronquer l’axe des ordonnées pour amplifier artificiellement les disparités relatives entre catégories constitue un biais de communication sévère, déformant la perception de la magnitude relative des totaux. Les échelles, graduations et étiquettes d’unités doivent être explicitement renseignées, garantissant l’autonomie sémantique complète de la figure en dehors du corps de texte principal.
11.2 Optimisation cognitive de la présentation des agrégats
L’efficacité communicationnelle d’un tableau ou d’une visualisation de données sommées dépend étroitement de l’ordonnancement structurel des informations présentées. Classer arbitrairement des catégories par ordre chronologique de collecte ou selon l’apparition erratique des données brutes contraint le lecteur à un balayage oculaire fastidieux et désordonné pour identifier les éléments dominants. Deux logiques d’ordonnancement méthodologiques s’imposent : le tri méthodique par magnitude scalaire décroissante (ou croissante selon l’objet de recherche), ou le classement selon une logique nominale ordinale intrinsèque (telle que des cohortes d’âge ou des strates de dosage clinique).
L’utilisation de la couleur doit répondre à une intentionnalité sémiotique stricte plutôt qu’à un impératif esthétique. Une palette chromatique sobre et neutre (composée de nuances de gris ou de teintes sourdes) doit constituer la trame de fond standard de la restitution. L’usage d’une couleur d’accentuation vive unique doit être réservé à la mise en exergue contextuelle d’une catégorie pivot, par exemple le groupe expérimental cible par opposition aux différentes strates de référence ou de contrôle.
Cette économie cognitive du design visuel s’étend à la typographie et à la tabularisation des données numériques résumées. Les valeurs sommées présentées au sein d’un tableau synthétique doivent être systématiquement alignées à droite pour permettre une comparaison verticale instantanée des ordres de grandeur de chiffres, et présentées avec un nombre de décimales constant et strictement congruent avec la précision instrumentale réelle des mesures d’origine.
11.3 Exportation et intégration des données sommées dans des rapports de recherche
L’insertion des résultats d’agrégation catégorielle au sein de manuscrits académiques ou de rapports techniques exige une standardisation rigoureuse conforme aux protocoles éditoriaux reconnus, tels que les normes de l’American Psychological Association (APA). Un tableau de synthèse aux normes APA prohibe formellement les quadrillages verticaux et restreint l’usage des bordures horizontales à trois délimitations fondamentales : au-dessus et en-dessous de la rangée d’en-tête, et sous la rangée terminale des totaux marginaux.
Pour assurer la fluidité de la rédaction scientifique, l’intégration des tableaux agrégés depuis Google Sheets vers des traitements de texte contemporains (tels que Google Docs ou des éditeurs LaTeX) doit préserver l’interactivité ou la fidélité typographique. La fonctionnalité de liaison dynamique entre Google Sheets et Google Docs permet d’actualiser d’un simple clic les tableaux et figures inclus dans le manuscrit dès lors que de nouvelles données sources sont intégrées et recalculées dans le tableur hôte, éradiquant les erreurs humaines de recopie manuelle lors des phases d’édition itératives.
Pour les environnements de composition typographique rigoureuse comme LaTeX, l’analyste peut mobiliser des fonctions de concaténation matricielle au sein de Google Sheets pour générer directement le code source d’environnement tabulaire. En assemblant les cellules agrégées avec des séparateurs d’esperluette (&) et des fins de ligne en double antislash () via la fonction JOINDRE.TEXTE, l’analyste crée une passerelle programmatique garantissant une reproductibilité numérique absolue entre le moteur de calcul infonuagique et le document imprimable final.
12. Prolongements analytiques : Vers des analyses statistiques approfondies
12.1 Articuler la sommation catégorielle avec le résumé à cinq nombres
Bien que la sommation conditionnelle constitue une opération fondamentale d’évaluation macroscopique, elle ne saurait à elle seule caractériser pleinement la distribution des grandeurs sous-jacentes. Réduire une catégorie à sa masse totale sommée dissimule des phénomènes cruciaux de dispersion, d’aplatissement ou d’asymétrie statistique. Dès lors, l’analyste rigoureux doit articuler systématiquement l’analyse des totaux catégoriels avec le déploiement du résumé à cinq nombres formalisé par John Tukey : la valeur minimale, le premier quartile (Q1), la médiane (Q2), le troisième quartile (Q3) et la valeur maximale.
Dans Google Sheets, cette caractérisation distributionnelle s’implémente en conjuguant les fonctions QUARTILE ou MEDIANE avec la structure FILTER pour chaque modalité catégorielle isolée. Par exemple, pour extraire la médiane de la catégorie ciblée en D2 : =MEDIANE(FILTER($B$2:$B$1000; $A$2:$A$1000 = D2)). Cette confrontation révèle instantanément si un total catégoriel impressionnant résulte d’une magnitude scalaire uniformément élevée au sein des individus du groupe, ou s’il est artificiellement distordu par une poignée d’observations asymétriques atypiques.
L’évaluation de la représentativité de la somme face aux distributions asymétriques constitue un impératif méthodologique. Lorsque la distribution intra-groupe suit une loi fortement asymétrique (comme une distribution de Pareto ou une loi log-normale), la somme globale demeure pertinente pour estimer la consommation totale d’une ressource ou la masse financière cumulée, mais s’avère trompeuse si l’on cherche à induire le comportement d’un individu médian du sous-groupe. L’articulation méthodique entre indicateurs de masse (la somme) et indicateurs de position (la médiane) garantit une lucidité inférentielle indispensable.
12.2 Intégration de l’intervalle interquartile (IQR) par groupe
En complément immédiat du résumé à cinq nombres, la quantification de la dispersion interne des catégories sommées s’avère déterminante pour attester la stabilité des métriques agrégées. L’écart-type paramétrique conventionnel étant excessivement sensible aux valeurs extrêmes, le recours à l’intervalle interquartile (IQR), défini comme la différence arithmétique stricte entre le troisième et le premier quartile (IQR = Q3 - Q1), offre une mesure de dispersion hautement robuste et non paramétrique.
L’intégration de l’IQR au sein du tableau d’agrégation permet d’ériger un filtre diagnostique rigoureux pour identifier les observations aberrantes qui influencent indûment les totaux sommé. Selon la règle empirique de Tukey, toute observation située au-delà de 1,5 * IQR au-dessus du troisième quartile ou en-dessous du premier quartile doit être formellement qualifiée de valeur atypique (outlier). L’analyste peut concevoir des formules matricielles automatisées signalant les catégories où la contribution scalaire de ces valeurs extrêmes excède une fraction critique de la somme totale.
Cette approche comparée permet de hiérarchiser la robustesse méthodologique des agrégats. Si une catégorie présente une somme massive mais que son intervalle interquartile est infinitésimalement resserré autour de valeurs basses à l’exception d’un unique événement titanesque, la validité inductive de la somme doit être questionnée. L’adjonction de colonnes documentant simultanément la moyenne, la médiane, l’écart-type et l’intervalle interquartile aux côtés de la somme catégorielle fondamentale garantit une transparence analytique intégrale.
12.3 Normalisation et pondération des valeurs sommées
L’étape finale de l’exploitation analytique avancée réside dans la standardisation des agrégats bruts afin de rendre possibles des comparaisons inter-catégorielles équitables, particulièrement lorsque les effectifs constitutifs des différents groupes sont substantiellement déséquilibrés. Une catégorie comportant mille observations produira presque mécaniquement une somme scalaire supérieure à une catégorie n’en dénombrant que cinquante, sans que cela n’implique une intensité supérieure du phénomène mesuré par unité d’échantillonnage.
La première technique de normalisation consiste à dériver les poids relatifs et les contributions fractionnaires de chaque modalité par rapport à la masse totale absolue du système, opération formalisée par le ratio Somme_Catégorie / Somme_Totale. Parallèlement, le calcul de la valeur sommée normalisée par tête (équivalente à la moyenne pondérée de la classe) rétablit la commensurabilité des groupes en neutralisant l’effet d’échelle imputable aux disparités d’effectifs.
Pour aller plus loin dans la préparation des données en vue de leur intégration dans des modèles statistiques multivariés (tels que des régressions hiérarchiques ou des classifications ascendante hiérarchiques), les totaux catégoriels peuvent être soumis à une normalisation Min-Max (recalant les totaux sur un continuum invariant de 0 à 1) ou à une standardisation en score standardisé Z (centrage-réduction par rapport à la moyenne et à l’écart-type de l’ensemble des totaux catégoriels) :
Z = (Somme_Catégorie - Moyenne_des_Sommes) / Ecart_Type_des_Sommes
Cette normalisation avancée convertit la distribution des totaux catégoriels en une échelle sans dimension unifiée. L’analyste se trouve dès lors idéalement positionné pour intégrer ces métriques au sein de méta-modèles explicatifs, concluant ainsi avec une rigueur mathématique irréprochable le continuum méthodologique allant du nettoyage initial du tableur jusqu’à la modélisation statistique avancée.
Références
- Google. (s. d.). Fonction SOMME.SI. Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3093583
- Google. (s. d.). Fonction SOMME.SI.ENS. Centre d’aide Google Docs. Consulté le 24 mai 2024, à l’adresse https://support.google.com/docs/answer/3238496
- Google. (s. d.). Google Visualization API Query Language. Google Developers. Consulté le 24 mai 2024, à l’adresse https://developers.google.com/chart/interactive/docs/querylanguage
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10