
La modélisation des phénomènes stochastiques constitue l’un des piliers fondamentaux de la science computationnelle contemporaine. Qu’il s’agisse de capturer les fluctuations infinitésimales des marchés financiers, de calibrer les signaux électrophysiologiques en neurosciences ou d’étalonner les instruments de mesure des aptitudes cognitives en psychométrie, la loi normale — souvent désignée sous l’appellation de distribution gaussienne — s’impose comme la référence paradigmatique incontournable. Sa présence omniprésente découle non pas d’un simple caprice empirique, mais d’une propriété mathématique fondamentale ancrée dans les théorèmes limites qui régissent les agrégations de variables aléatoires indépendantes.
Dans le cadre de la recherche quantitative et de l’ingénierie des données, la capacité à synthétiser des cohortes artificielles suivant fidèlement une distribution normale est devenue une compétence technique indispensable. Le langage de programmation Python, enrichi de son écosystème d’outils scientifiques de haute performance, offre un cadre d’une expressivité et d’une puissance remarquables pour orchestrer de telles simulations. Loin de se limiter à de simples appels de fonctions boîte-noire, la génération rigoureuse de pseudo-aléa gaussien exige une maîtrise fine des algorithmes sous-jacents, de la gestion de la mémoire, de la reproductibilité expérimentale et de la validation inférentielle.
Le présent traité propose une exploration exhaustive, théorique et opérationnelle, de la génération de distributions normales en Python. À travers un parcours didactique rigoureux, nous disséquerons les fondements mathématiques de la densité gaussienne, l’architecture logicielle des générateurs pseudo-aléatoires modernes, les méthodes de validation empirique et graphique, ainsi que les extensions multivariées appliquées aux sciences du comportement. Ce guide s’adresse aux chercheurs, analystes et développeurs désireux d’allier rigueur méthodologique et excellence technique dans leurs protocoles de simulation stochastique.
1. 1. Introduction aux distributions normales et à leur simulation en Python
1.1 Fondements mathématiques de la loi normale
La distribution normale univariée, formalisée initialement par Abraham de Moivre et sublimée ultérieurement par Carl Friedrich Gauss et Pierre-Simon de Laplace, est une loi de probabilité absolument continue dont la densité est définie sur l’ensemble de la droite réelle. Mathématiquement, pour une variable aléatoire continue notée $X$, la fonction de densité de probabilité (FDP) s’énonce selon l’équation canonique :
$$f(x; \mu, \sigma) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^{!2} \right)$$
Dans cette formulation, deux paramètres directeurs gouvernent l’intégralité du profil distributionnel. Le premier paramètre, $\mu in \mathbb{R}$, représente la moyenne arithmétique et correspond simultanément à l’espérance mathématique, à la médiane et au mode de la distribution. Il détermine le positionnement du centre de gravité de la courbe sur l’axe des abscisses. Le second paramètre, $\sigma in \mathbb{R}_+^*$, désigne l’écart-type de la population, dont le carré, $\sigma^2$, constitue la variance. Ce paramètre quantifie l’échelle de dispersion des valeurs autour de l’axe central. Plus $\sigma$ est restreint, plus la masse de probabilité se concentre autour de $\mu$, conférant à la courbe un profil leptokurtique aigu ; inversement, un $\sigma$ élevé induit un aplatissement platykurtique et un étalement latéral significatif.
La structure géométrique de cette fonction présente des propriétés analytiques remarquables. D’une part, la courbe jouit d’une symétrie axiale parfaite par rapport à la droite d’équation $x = \mu$, ce qui implique formellement que le moment centré d’ordre 3 (et plus généralement tout moment centré d’ordre impair) est rigoureusement nul. D’autre part, la fonction admet deux points d’inflexion situés exactement aux coordonnées $x = \mu – \sigma$ et $x = \mu + \sigma$, marquant la transition où la dérivée seconde de la densité change de signe, passant d’un régime concave à un régime convexe. Les branches latérales de la courbe décroissent selon une allure exponentielle quadratique, tendant asymptotiquement vers zéro lorsque $x$ diverge vers l’infini positif ou négatif, sans jamais intersecter l’axe horizontal.
La prééminence universelle de la loi normale trouve sa justification ultime dans le théorème central limite (TCL). Ce résultat magistral de la théorie des probabilités établit que la somme — ou la moyenne — d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées (i.i.d.), dotées d’une variance finie, converge en loi vers une distribution gaussienne, indépendamment de la loi de probabilité originelle des composantes individuelles. Dans les sciences quantitatives, ce théorème fournit une explication mécanique élégante : dès lors qu’un phénomène mesurable résulte de la résultante additive d’une multitude de perturbations microscopiques infinitésimales et non corrélées, sa distribution macroscopique adopte spontanément une morphologie gaussienne.
1.2 Pertinence de la simulation stochastique en psychométrie
Dans les sciences du comportement et la psychométrie contemporaine, la modélisation des traits latents repose très largement sur des postulats gaussiens. Les aptitudes cognitives générales, telles que mesurées par l’échelle de Wechsler, ou encore les dimensions fondamentales de la personnalité issues du modèle en cinq facteurs (Big Five), sont traditionnellement conceptualisées comme des variables continues non observables réparties selon une distribution normale au sein de la population générale de référence. Cette hypothèse n’est pas purement arbitraire ; elle s’enracine dans la théorie des tests classiques et les modèles de réponse à l’item (Item Response Theory), postulant que l’expression phénotypique d’une aptitude résulte de la sommation d’influences polygéniques et environnementales complexes.
Cependant, la collecte empirique de données psychométriques se heurte fréquemment à des obstacles méthodologiques majeurs : contraintes logistiques, attrition des participants, biais de désirabilité sociale ou coûts prohibitifs d’administration d’épreuves standardisées. C’est ici que la simulation stochastique révèle toute son utilité clinique et méthodologique. En générant des cohortes synthétiques de sujets virtuels dont les scores latents sont calibrés sur des distributions normales spécifiques, les psychométriciens peuvent évaluer la robustesse structurelle de nouveaux instruments de mesure, vérifier la validité de construit d’échelles composites et simuler l’impact théorique d’erreurs de mesure systématiques sur les indices de fidélité comme le coefficient alpha de Cronbach ou l’oméga de McDonald.
De surcroît, les protocoles computationnels fondés sur les méthodes de Monte-Carlo constituent le moyen de prédilection pour investiguer le comportement des estimateurs statistiques face aux distorsions d’échantillonnage. Dans les situations où les échantillons cliniques réels souffrent d’une taille d’observation réduite ($N < 30$), la simulation de milliers de réplications gaussiennes permet d'étudier la dérive de l'erreur-type, de cartographier la puissance statistique des tests d'hypothèses et d'établir des tables empiriques de valeurs critiques adaptées aux particularités expérimentales.
1.3 Aperçu de l’écosystème Python pour le calcul scientifique
L’ascension de Python en tant qu’environnement de référence pour l’analyse stochastique et la modélisation mathématique repose sur une pile logicielle modulaire hautement optimisée. Au cœur de cet écosystème se trouve NumPy (Numerical Python), une bibliothèque fondamentale qui introduit le concept de tableau multidimensionnel homogène (`ndarray`). Développé en langage C et interfacé nativement avec les bibliothèques d’algèbre linéaire de bas niveau telles que BLAS (Basic Linear Algebra Subprograms) et LAPACK, NumPy permet d’exécuter des calculs vectorisés avec une vélocité comparable à celle des langages compilés traditionnels, tout en préservant l’élégance syntaxique de Python.
En superposition à cette couche matricielle de base, la bibliothèque SciPy enrichit l’arsenal computationnel en proposant des sous-modules spécialisés dans l’analyse numérique avancée. En particulier, le module `scipy.stats` renferme une collection exhaustive de distributions de probabilités continues et discrètes, dotées de méthodes analytiques rigoureuses pour l’évaluation des fonctions de répartition, le calcul des quantiles exacts, l’estimation par maximum de vraisemblance et la réalisation de tests d’adéquation inférentiels sophistiqués.
Enfin, la dimension exploratoire et diagnostique de la modélisation statistique ne saurait être dissociée de la restitution visuelle. Les bibliothèques Matplotlib et Seaborn s’intègrent intimement avec les structures de données NumPy pour matérialiser instantanément les distributions synthétisées. Alors que Matplotlib offre un contrôle granulaire de bas niveau sur l’ensemble des éléments géométriques et graphiques, Seaborn fournit des abstractions de haut niveau conçues spécifiquement pour la visualisation statistique, facilitant le tracé direct d’estimations de densité par noyau, de nuages de points enrichis et de graphiques diagnostiques indispensables à l’analyse rigoureuse des simulations stochastiques.
2. 2. Architecture et syntaxe de la fonction numpy.random.normal
2.1 Décomposition des paramètres formels de la fonction
Au sein de l’infrastructure logicielle fournie par NumPy, la génération de réalisations pseudo-aléatoires issues d’une loi gaussienne s’articule historiquement autour de la fonction numpy.random.normal. La signature canonique de cette fonction expose trois arguments principaux :
numpy.random.normal(loc=0.0, scale=1.0, size=None)
Une compréhension minutieuse de chacun de ces paramètres formels est indispensable pour garantir l’intégrité de la simulation computationnelle :
loc(flottant ou tableau de flottants) : Ce paramètre assigne la moyenne arithmétique ($\mu$) de la distribution cible. Sa valeur par défaut est fixée à0.0, correspondant à une distribution centrée. Il détermine l’ancrage central du processus stochastique. Il est à noter que l’argument peut également accepter une structure vectorielle, permettant ainsi d’effectuer des tirages où chaque coordonnée répond à une espérance mathématique distincte par le biais du mécanisme de diffusion (broadcasting) de NumPy.scale(flottant ou tableau de flottants) : Cet argument spécifie l’écart-type ($\sigma$) de la distribution, régissant l’amplitude de dispersion des réalisations autour de la moyenne. Sa valeur par défaut s’élève à1.0. Une exigence mathématique stricte régit ce paramètre : il doit impérativement être strictement positif ($\sigma > 0$). La transmission d’une valeur négative provoque la levée immédiate d’une exception de typeValueErrorpar l’interpréteur, tandis qu’une valeur nulle constitue un cas dégénéré théoriquement non conforme aux postulats de continuité de la densité.size(entier ou tuple d’entiers, optionnel) : Ce paramètre dicte la topologie dimensionnelle de l’objet produit en sortie. Si l’argument est omis ou valorisé àNone(état par défaut), la fonction extrait une unique observation scalaire sous la forme d’un flottant standard Python. À l’inverse, si un entier scalaire $N$ est renseigné, la fonction alloue un vecteur unidimensionnel de longueur $N$. Lorsqu’un tuple d’entiers tel que(n_lignes, n_colonnes)est transmis, la fonction instancie un tenseur multidimensionnel dont la géométrie coïncide rigoureusement avec les dimensions spécifiées.
L’omission complète d’arguments lors de l’appel — exécuté simplement sous la forme numpy.random.normal() — tire parti des valeurs implicites documentées : le moteur produit alors un unique échantillon scalaire issu de la loi normale standard $\mathcal{N}(0, 1)$, caractérisée par une moyenne nulle et une variance unitaire.
2.2 Types de retour et structure des données produites
L’invocation de la fonction numpy.random.normal aboutit, dès lors que l’argument size est explicitement configuré sous forme vectorielle ou matricielle, à l’instanciation d’une structure de données de type numpy.ndarray. Cet objet ne constitue pas une simple liste d’éléments encapsulés selon les conventions de haut niveau de Python, mais représente un bloc contigu de mémoire physique alloué au sein de l’espace d’adressage du processus, géré directement par le runtime C sous-jacent de NumPy.
Par défaut sur la quasi-totalité des architectures informatiques contemporaines (x86-64 et ARM64), les composantes numériques hébergées au sein de ce tableau adoptent le type de données scalaire numpy.float64 (flottant double précision selon la norme standard IEEE 754). Chaque tirage stochastique mobilise par conséquent 8 octets de mémoire vive. Ce format offre une précision de 53 bits de mantisse (soit environ 15 à 17 chiffres décimaux significatifs) et une plage dynamique d’exposants allant de $10^{-308}$ à $10^{308}$, garantissant une résolution amplement suffisante pour préserver l’intégrité numérique des queues de distribution les plus extrêmes.
Sur le plan de l’ingénierie logicielle, l’allocation dynamique de tableaux gaussiens de grande taille exige une vigilance accrue quant à l’empreinte mémoire volumétrique. À titre d’illustration, la génération d’une matrice synthétique comptabilisant cent millions d’observations ($10^8$) requiert instantanément l’allocation continue d’environ 800 mégaoctets de mémoire vive vive non compressée. Si les contraintes matérielles deviennent prégnantes — par exemple lors du déploiement de calculs distribués sur des processeurs graphiques (GPU) —, il devient impératif de rationaliser cette empreinte en procédant à un transtypage explicite vers une représentation en simple précision (numpy.float32), réduisant de moitié la charge pondérale du tenseur au détriment d’une troncature minime de la précision fractionnaire.
3. 3. Configuration de l’environnement et maîtrise de la reproductibilité
3.1 Configuration technique de l’espace de travail
La mise en place d’un espace de travail rigoureux et hermétique constitue le prérequis méthodologique indispensable à toute entreprise de calcul computationnel reproductible. L’usage direct de l’environnement d’exécution système global est formellement proscrit en milieu académique et industriel afin d’éviter toute collision de dépendances ou instabilité logicielle. L’approche d’excellence consiste à isoler l’analyse au sein d’un environnement virtuel autonome via les utilitaires venv ou le gestionnaire de paquets conda.
L’installation des bibliothèques nécessaires s’opère usuellement à l’aide de l’outil pip en exécutant dans le terminal la commande déclarative suivante :
pip install numpy scipy matplotlib seaborn
Une fois les binaires déployés dans l’environnement virtuel cible, l’organisation syntaxique du script d’analyse doit respecter les normes PEP 8 relatives aux importations de modules. La convention unanime au sein de la communauté scientifique préconise l’usage d’alias normalisés pour simplifier la lisibilité du code tout en évitant la pollution de l’espace de nommage global :
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt
import seaborn as sns
Cette structuration modulaire garantit que chaque routine appelée conserve son identifiant contextuel explicite (par exemple np.mean ou stats.shapiro), assurant une traçabilité sans équivoque pour tout lecteur tiers analysant la chaîne de traitement statistique.
3.2 Importance critique de l’initialisation du générateur aléatoire
Il est fondamental de rappeler qu’en informatique déterministe conventionnelle, les processeurs sont incapables de produire du hasard pur au sens ontologique du terme. Les valeurs générées résultent d’algorithmes mathématiques récursifs hautement sophistiqués qualifiés de générateurs de nombres pseudo-aléatoires (PRNG pour Pseudorandom Number Generators). Ces algorithmes calculent une séquence déterministe de nombres qui émulent à la perfection les propriétés d’indépendance et de dispersion statistique d’un bruit stochastique idéal, partant d’un état interne initial dénommé « graine » (ou seed).
Durant plusieurs décennies, l’écosystème NumPy a reposé principalement sur l’algorithme Mersenne Twister (MT19937). Dans l’ancienne API de NumPy, la fixation de l’état interne s’effectuait par le truchement de la fonction globale np.random.seed(valeur_entiere). Bien que cette formulation demeure omniprésente dans la littérature pédagogique, elle présente des vulnérabilités méthodologiques notoires : elle modifie un état global partagé par l’ensemble des modules, ce qui peut engendrer des effets de bord imprévisibles dans les systèmes multithreads ou au sein de programmes modulaires complexes.
Afin de pallier ces limitations architecturales, NumPy a introduit depuis sa version 1.17 une API moderne articulée autour de la classe explicite Generator et du moteur d’aléatisation PCG64 (Permuted Congruential Generator). La fixation de la reproductibilité s’opère désormais de façon modulaire et encapsulée en instanciant un générateur via l’instruction :
rng = np.random.default_rng(seed=42)L’entier transmis en paramètre (ici arbitrairement fixé à 42) ancre le point de départ de la trajectoire pseudo-aléatoire. Toute simulation exécutée à partir de cette instance générera une série strictement identique d’observations sur n’importe quelle machine dotée de la même architecture, conférant ainsi au protocole de recherche une reproductibilité scientifique absolue.
4. 4. Génération pratique pas à pas d’un échantillon gaussien
4.1 Implémentation pas à pas du premier script de simulation
Afin de concrétiser les principes théoriques précédemment exposés, construisons un script élémentaire visant à extraire un échantillon représentatif de $N = 200$ observations issues d’une distribution normale. Pour illustrer cette manipulation, nous définissons une population théorique simulant un score psychométrique continu doté d’une moyenne $\mu = 100.0$ et d’un écart-type $\sigma = 15.0$, caractéristiques typiques de l’étalonnage standard des échelles d’intelligence générale.
Le protocole d’implémentation débute par l’initialisation du générateur moderne, suivie de la sollicitation de la méthode normal() :
import numpy as np

# Initialisation rigoureuse du générateur avec graine fixée
rng = np.random.default_rng(seed=12345)

# Paramètres de la population théorique
mu = 100.0
sigma = 15.0
taille_echantillon = 200

# Tirage stochastique de l'échantillon
scores_qi = rng.normal(loc=mu, scale=sigma, size=taille_echantillon)
Dès l’exécution de ces lignes, le tableau vectoriel scores_qi est intégralement instancié en mémoire. Afin de valider la conformité de l’objet produit, l’analyste doit procéder à l’inspection de ses caractéristiques topologiques par le truchement des attributs intrinsèques de l’objet ndarray :
# Inspection structurelle et vectorielle
print("Type de l'objet :", type(scores_qi))
print("Dimensions géométriques :", scores_qi.shape)
print("Type des scalaires :", scores_qi.dtype)
print("Cinq premières observations :", scores_qi[:5])
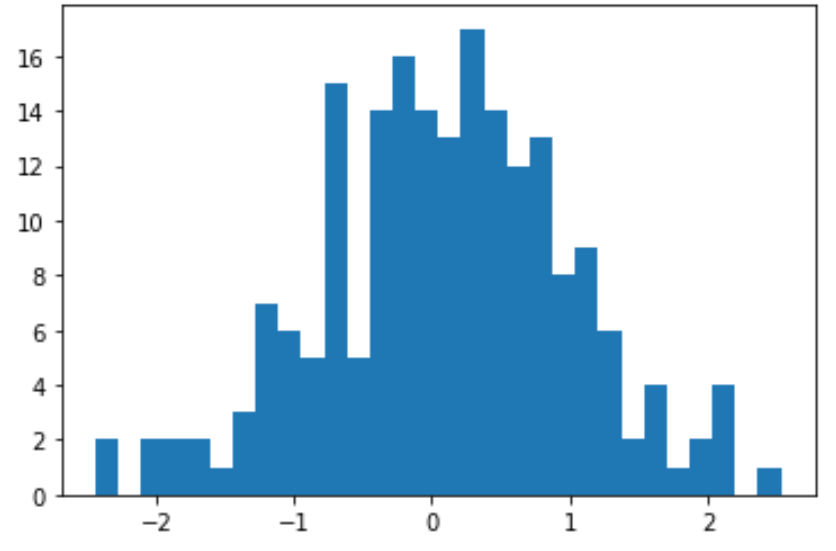
L’attribut shape renvoie le tuple (200,), attestant qu’il s’agit d’un vecteur continu d’exactement deux cents composantes numériques unidimensionnelles. La technique de découpage vectoriel (slicing) scores_qi[:5] permet d’extraire les premières valeurs générées sans saturer la console d’affichage, révélant des valeurs flottantes oscillant autour du centre théorique 100.0, réparties selon les fluctuations naturelles dictées par l’échelle de 15.0.
4.2 Variations paramétriques élémentaires
L’avantage opérationnel de la paramétrisation offerte par NumPy réside dans la flexibilité absolue de translation et de dilatation morphologique appliquée au tenseur aléatoire. Considérons en premier lieu la distribution normale centrée réduite standard, notée $\mathcal{N}(0, 1)$, qui joue le rôle d’étalon mathématique universel. Sa génération s’opère instantanément en annulant le centre de gravité et en unifiant la dispersion :
echantillon_standard = rng.normal(loc=0.0, scale=1.0, size=1000)À partir de cette distribution fondamentale, toute translation linéaire du paramètre loc provoque un glissement rigide de l’intégralité de la masse de probabilité sur la droite réelle, sans altérer d’aucune façon la forme intrinsèque de la cloche ni la dispersion relative de ses composantes. Ainsi, attribuer loc=-25.0 déplace l’espérance mathématique vers le domaine négatif, ancrant le sommet de la distribution sur cette coordonnée spécifique.
Inversement, la modification du paramètre scale applique une transformation affine de dilatation ou de contraction. Si nous configurons un scale=0.5, l’éventail des réalisations se contracte dramatiquement autour du centre de gravité, induisant une concentration accrue des probabilités dans un intervalle étroit. À l’inverse, l’attribution d’un scale=50.0 aplatit considérablement la densité, autorisant l’émergence de valeurs s’éloignant substantiellement de la moyenne. Il convient de souligner que cette transformation peut également s’obtenir analytiquement par l’algèbre des variables aléatoires : si $Z \sim \mathcal{N}(0, 1)$, alors la variable transformée $X = \mu + \sigma Z$ obéit rigoureusement à la loi $\mathcal{N}(\mu, \sigma^2)$, une équivalence fonctionnelle exploitée nativement au sein des routines compilées de bas niveau.
5. 5. Validation empirique des paramètres statistiques de l’échantillon
5.1 Calcul et interprétation de la moyenne d’échantillonnage
Lorsqu’un échantillon fini d’observations est extrait d’une population gaussienne théorique, les paramètres statistiques calculés a posteriori sur l’échantillon empirique ne coïncident presque jamais rigoureusement avec les paramètres théoriques assignés au générateur. Cet écart ne traduit nullement une défaillance de l’algorithme pseudo-aléatoire, mais illustre le concept fondamental d’erreur d’échantillonnage stochastique.
L’estimation ponctuelle de la tendance centrale s’effectue via la fonction numpy.mean(), qui calcule la moyenne arithmétique empirique définie par :
$$\bar{x} = \frac{1}{N} \sum_{i=1}^{N} x_i$$
moyenne_empirique = np.mean(scores_qi)
print(f"Moyenne théorique : {mu} | Moyenne empirique : {moyenne_empirique:.4f}")
L’écart observé $|\bar{x} – mu|$ est gouverné par l’erreur standard de la moyenne (SEM, pour Standard Error of the Mean), modélisée théoriquement par le ratio $\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{N}}$. Cette relation met en exergue le rôle critique de la taille d’échantillon $N$ : la précision de l’estimation empirique croît proportionnellement à la racine carrée de la taille de la cohorte. Pour un échantillon modeste de 200 individus doté d’un $\sigma = 15$, l’erreur-type théorique avoisine $\approx 1.06$ point de QI. Par conséquent, observer une moyenne empirique de 99.2 ou 101.1 demeure parfaitement compatible avec le modèle génératif sous-jacent, l’intervalle de confiance à 95 % entourant $\bar{x}$ englobant rigoureusement la valeur nominale 100.0.
5.2 Estimation sans biais de la dispersion de l’échantillon
L’évaluation empirique de la dispersion requiert une attention méthodologique particulière quant au choix du dénominateur arithmétique. Si l’on applique naïvement la formule de la variance en divisant la somme des carrés des écarts par la taille totale de l’échantillon $N$, l’estimateur obtenu est affecté d’un biais systématique : il tend à sous-estimer légèrement la variance réelle de la population parente, car les écarts sont mesurés par rapport à la moyenne empirique $\bar{x}$ et non par rapport à la véritable espérance $\mu$.
Pour neutraliser ce biais mathématique, il est impératif d’incorporer la correction de Bessel, consistant à soustraire un degré de liberté au dénominateur, divisant ainsi la somme par $N – 1$. Au sein de la bibliothèque NumPy, ce comportement est gouverné par l’argument formel ddof (Delta Degrees of Freedom). Par défaut, NumPy assigne ddof=0 (estimateur biaisé du maximum de vraisemblance), contrairement au langage R ou aux conventions canoniques des sciences humaines qui appliquent systématiquement ddof=1 :
# Calcul rigoureux avec correction de Bessel (ddof=1)
variance_sans_biais = np.var(scores_qi, ddof=1)
ecart_type_sans_biais = np.std(scores_qi, ddof=1)

print(f"Écart-type théorique : {sigma}")
print(f"Écart-type empirique corrigé : {ecart_type_sans_biais:.4f}")
L’omission de l’argument ddof=1 sur de petits échantillons ($N < 30$) fausse significativement les analyses de puissance et la calibration d'indices standardisés. En appliquant systématiquement cette correction, le statisticien s'assure d'obtenir une estimation ponctuelle non biaisée de la variance paramétrique $\sigma^2$.
5.3 Statistiques d’ordre et moments supérieurs
Au-delà de la moyenne et de la variance, la qualification exhaustive d’une distribution générée implique l’analyse des moments statistiques d’ordres supérieurs, principalement l’asymétrie (skewness) et l’aplatissement (kurtosis). Pour une distribution normale théorique pure, l’asymétrie est rigoureusement égale à zéro en raison de la symétrie axiale parfaite, et le coefficient d’aplatissement de Pearson s’élève précisément à 3.0 (ou un excès de kurtosis égal à 0.0 selon la convention de Fisher) :
asymetrie = stats.skew(scores_qi)
kurtosis_fisher = stats.kurtosis(scores_qi, fisher=True)

print(f"Coefficient d'asymétrie (skewness) : {asymetrie:.4f}")
print(f"Excès de kurtosis (Fisher) : {kurtosis_fisher:.4f}")
Dans un échantillon simulé de taille finie, ces coefficients fluctuent naturellement autour de zéro. Une déviation substantielle (par exemple, une asymétrie excédant $\pm 0.5$) indiquerait que la séquence générée s’écarte transitoirement de l’idéal théorique en raison de fluctuations stochastiques d’échantillonnage.
Parallèlement aux moments, l’inspection des statistiques d’ordre — concrétisées par les percentiles — permet de vérifier la validité de la célèbre règle empirique 68-95-99.7. Selon ce principe, environ 68.27 % des valeurs doivent se situer dans l’intervalle $[\mu – \sigma, \mu + \sigma]$, 95.45 % dans $[\mu – 2\sigma, \mu + 2\sigma]$, et 99.73 % dans $[\mu – 3\sigma, \mu + 3\sigma]$. L’interrogation des percentiles empiriques via la fonction numpy.percentile() permet de corroborer cette conformité distributionnelle :
p16, p50, p84 = np.percentile(scores_qi, [15.87, 50.0, 84.13])
print(f"Médiane empirique (théorique ~ 100) : {p50:.2f}")
print(f"Intervalle central 68% : [{p16:.2f}, {p84:.2f}]")
6. 6. Représentation graphique élémentaire avec Matplotlib
6.1 Construction et paramétrage d’un histogramme de fréquences
La transcription visuelle d’un vecteur stochastique constitue la première étape incontournable du diagnostic distributionnel. L’outil graphique fondamental demeure l’histogramme, dont le principe repose sur la discrétisation de l’intervalle continu des valeurs observées en une suite d’intervalles contigus adjacents appelés classes (ou bins), au sein desquels sont décomptées les fréquences d’occurrence.
Le choix du nombre de classes exerce une influence prépondérante sur la restitution perceptuelle de la distribution. Un découpage trop grossier (sous-lissage) masque les singularités morphologiques, tandis qu’un découpage excessivement fin (sur-lissage) morcelle la cloche sous l’effet du bruit stochastique. Si la littérature basique propose la règle simpliste de Sturges ($k = 1 + \log_2 N$), celle-ci s’avère notoirement inadaptée aux distributions continues denses. On privilégiera impérativement la règle de Freedman-Diaconis, qui calibre la largeur des classes sur l’écart interquartile (IQR) selon la formule $h = 2 \cdot \text{IQR} \cdot N^{-1/3}$, ou la règle de Scott reposant sur l’écart-type :
import matplotlib.pyplot as plt

plt.figure(figsize=(9, 5), dpi=100)

# Construction de l'histogramme normalisé en densité
n, bins, patches = plt.hist(
    scores_qi,
    bins='freedman-diaconis',
    density=True,
    color='#3498db',
    edgecolor='white',
    alpha=0.7,
    label="Fréquences empiriques"
)

plt.title("Distribution empirique des scores simulés (N=200)", fontsize=13, fontweight='bold')
plt.xlabel("Score standardisé (Quotient Intellectuel)", fontsize=11)
plt.ylabel("Densité de probabilité", fontsize=11)
plt.grid(axis='y', linestyle='--', alpha=0.5)
L’argument formel density=True est ici d’une importance capitale : il normalise la hauteur des rectangles de telle manière que la surface totale de l’histogramme soit rigoureusement égale à 1.0. Cette mise à l’échelle transforme l’histogramme de simples effectifs discrets en une véritable fonction de densité empirique, rendant possible la superposition directe d’une courbe de probabilité mathématique continue.
6.2 Superposition de la fonction de densité théorique
Pour évaluer l’adéquation entre l’échantillon simulé et le modèle mathématique sous-jacent, il convient de tracer sur le même repère cartésien la fonction de densité de probabilité théorique continue. Cette confrontation visuelle immédiate permet d’attester que le centre de symétrie et l’étalement des données générées épousent la courbe analytique en cloche.
La méthode rigoureuse consiste à échantillonner un continuum d’abscisses sur la plage des valeurs observées via numpy.linspace(), puis à évaluer analytiquement l’équation gaussienne, soit par formulation arithmétique manuelle, soit par le truchement de la méthode optimisée scipy.stats.norm.pdf() :
# Continuum d'abscisses pour le tracé théorique
x_continu = np.linspace(scores_qi.min() - 5, scores_qi.max() + 5, 500)

# Évaluation de la densité théorique N(100, 15^2)
densite_theorique = stats.norm.pdf(x_continu, loc=mu, scale=sigma)

# Tracé de la courbe théorique
plt.plot(x_continu, densite_theorique, color='#e74c3c', linewidth=2.5, label="Densité théorique $\mathcal{N}(100, 15^2)$")

# Enrichissement cosmétique et légende
plt.legend(frameon=True, facecolor='white', framealpha=0.9, fontsize=10)
plt.tight_layout()
plt.show()
La ligne continue rouge ainsi obtenue matérialise l’idéal asymptotique vers lequel tendrait l’histogramme empirique si la taille de l’échantillon $N$ croissait vers l’infini. La proximité visuelle entre les sommets des rectangles et l’enveloppe théorique permet de valider qualitativement la calibration du générateur stochastique.
7. 7. Visualisations diagnostiques avancées de la normalité
7.1 Tracé de densité par noyau (KDE) avec Seaborn
Bien que l’histogramme normalisé constitue un instrument diagnostique élémentaire, il présente le désavantage structurel d’introduire des discontinuités artificielles dictées par les frontières arbitraires des classes d’intervalles. L’estimation de la densité par noyau (KDE pour Kernel Density Estimation) surmonte cette limitation en substituant à chaque point discret de l’échantillon une petite fonction continue de pondération — typiquement un noyau gaussien infinitésimal —, dont la sommation produit une courbe d’estimation parfaitement lisse et différentiable.
La bibliothèque Seaborn automatise ce calcul mathématique complexe par le biais de sa fonction d’interface sns.histplot ou sns.kdeplot :
import seaborn as sns

plt.figure(figsize=(9, 5))

# Combinaison de l'histogramme et du lissage par noyau
sns.histplot(
    scores_qi,
    kde=True,
    stat="density",
    color="#2ecc71",
    line_kws={"linewidth": 2, "color": "#27ae60"},
    label="KDE empirique"
)

plt.title("Estimation non paramétrique de la densité par noyau (KDE)", fontsize=13)
plt.xlabel("Valeurs observées")
plt.ylabel("Densité estimée")
plt.show()
Le paramètre gouvernant la finesse de cette estimation est la largeur de bande (bandwidth). Une largeur trop étroite induit un sous-lissage parasité par chaque fluctuation ponctuelle d’échantillonnage, alors qu’une largeur excessive efface les spécificités morphologiques réelles. L’intérêt clinique et méthodologique du tracé KDE réside dans son aptitude à dévoiler sans ambiguïté la présence éventuelle de sous-populations cachées au sein de l’échantillon, telles qu’une bimodalité subtile traduisant le mélange non maîtrisé de deux groupes distincts.
7.2 Construction et analyse du diagramme quantile-quantile (Q-Q Plot)
Le diagramme quantile-quantile, universellement désigné sous le terme de Q-Q Plot, représente le dispositif graphique diagnostique le plus puissant et le plus sensible pour statuer sur la normalité d’une série distributionnelle. Son principe mathématique consiste à ordonner l’ensemble des observations empiriques de la cohorte et à confronter chaque quantile d’échantillonnage observé au quantile théorique exact qui serait attendu sous l’hypothèse d’une distribution normale pure de même moyenne et de même variance.
La fonction scipy.stats.probplot matérialise ce diagnostic inférentiel en appariant les points sur un plan cartésien et en traçant la droite de référence théorique d’équation $y = ax + b$ :
plt.figure(figsize=(7, 7))

# Génération du graphique Quantile-Quantile
stats.probplot(scores_qi, dist="norm", plot=plt)

# Personnalisation des éléments graphiques
plt.title("Diagramme Quantile-Quantile (Normal Q-Q Plot)", fontsize=13, fontweight='bold')
plt.xlabel("Quantiles théoriques gaussiens", fontsize=11)
plt.ylabel("Quantiles empiriques observés", fontsize=11)
plt.grid(True, linestyle=':', alpha=0.6)
plt.show()
L’interprétation analytique de ce diagramme repose sur l’alignement géométrique des points par rapport à la droite diagonale rouge :
- Conformité idéale : Lorsque les points s’alignent fidèlement sur la droite d’un bout à l’autre de l’axe, la distribution empirique est en adéquation parfaite avec la loi gaussienne théorique.
- Queues lourdes (leptokurtose) : Si les extrémités du tracé s’écartent de la droite en adoptant une forme sigmoïdale incurvée vers le bas à gauche et vers le haut à droite, l’échantillon comporte une surreprésentation d’observations extrêmes par rapport à la norme théorique.
- Queues légères (platykurtose) : Un tracé en forme de « S » inversé signale un déficit de valeurs extrêmes et une troncature artificielle des bords de la distribution.
- Asymétrie positive ou négative : Une courbure convexe ou concave unilatérale de l’ensemble des points signale la présence d’un biais d’étalement vers les valeurs hautes ou basses.
En contexte psychométrique, le Q-Q Plot s’avère particulièrement révélateur pour diagnostiquer les effets de plancher (accumulation de scores minimaux impossibles à départager) ou les effets de plafond sur les épreuves chronométrées ou de puissance cognitive.
8. 8. Tests d’hypothèse formels pour évaluer la normalité
8.1 Application rigoureuse du test de Shapiro-Wilk
Bien que les approches visuelles soient indispensables à l’appréhension globale des données, la confirmation objective de la conformité distributionnelle requiert fréquemment la mise en œuvre de tests d’hypothèse inférentiels formels. Parmi l’arsenal méthodologique disponible, le test de Shapiro-Wilk est unanimement reconnu par les biostatisticiens comme l’un des tests les plus puissants pour détecter les déviations par rapport à la loi normale univariée.
Le cadre inférentiel s’articule autour de deux hypothèses statistiques mutuellement exclusives :
- Hypothèse nulle ($H_0$) : L’échantillon empirique est extrait d’une population parente distribuée selon une loi normale.
- Hypothèse alternative ($H_1$) : La population parente ne suit pas une loi de distribution normale.
La mise en œuvre pratique de ce protocole s’effectue via l’appel de la fonction scipy.stats.shapiro() :
statistique_w, p_valeur = stats.shapiro(scores_qi)

print(f"Statistique de test W : {statistique_w:.5f}")
print(f"P-valeur associée : {p_valeur:.5f}")

seuil_alpha = 0.05
if p_valeur > seuil_alpha:
    print("Conclusion : Non-rejet de H0. L'échantillon est compatible avec une loi normale.")
else:
    print("Conclusion : Rejet de H0. Déviation significative par rapport à la normalité.")
La statistique de test, désignée par la lettre $W$, est bornée théoriquement entre 0 et 1. Plus $W$ est proche de l’unité, plus l’adéquation aux données est parfaite. L’interprétation décisionnelle découle directement de la confrontation de la p-valeur au seuil de significativité conventionnel $\alpha$ (ordinairement fixé à 0.05). Dès lors que $p > 0.05$, l’analyste conclut à l’absence de preuves statistiques suffisantes pour réfuter l’hypothèse de normalité.
Cependant, une réserve méthodologique d’importance capitale doit être soulignée : le test de Shapiro-Wilk est intrinsèquement calibré pour des échantillons de taille modérée ($N le 5000$). Pour des cohortes volumineuses, sa sensibilité mathématique devient telle qu’il détecte des micro-déviations infinitésimales sans aucune pertinence substantielle, aboutissant à des rejets systématiques injustifiés de $H_0$.
8.2 Approches inférentielles complémentaires
Face aux limites d’applicabilité de Shapiro-Wilk sur les cohortes étendues, d’autres paradigmes de test statistique ont été conceptualisés. Le test d’omno-normalité de D’Agostino-Pearson constitue l’une des alternatives les plus robustes. Ce test évalue simultanément les coefficients d’asymétrie et d’aplatissement de l’échantillon, calculant une statistique composite $K^2$ qui obéit asymptotiquement à une loi du $\chi^2$ à deux degrés de liberté :
k2_stat, d_agostino_p = stats.normaltest(scores_qi)
print(f"Test de D'Agostino-Pearson : Statistique={k2_stat:.4f}, p-valeur={d_agostino_p:.4f}")
Parallèlement, le test d’adéquation non paramétrique de Kolmogorov-Smirnov (KS) peut être convoqué via la fonction scipy.stats.kstest. Il mesure l’écart maximal absolu suprenum $D$ entre la fonction de répartition empirique $F_n(x)$ et la fonction de répartition cumulative théorique $F_0(x)$ du modèle ciblé :
ks_stat, ks_p = stats.kstest(scores_qi, 'norm', args=(np.mean(scores_qi), np.std(scores_qi, ddof=1)))
print(f"Test de Kolmogorov-Smirnov : D={ks_stat:.4f}, p-valeur={ks_p:.4f}")
Il importe de rappeler une règle d’or en statistique computationnelle : dans les très grands échantillons ($N > 10,000$), aucun test formel d’hypothèse ne devrait être utilisé isolément pour certifier la normalité. Dans ce régime asymptotique, l’inévitable dérive de puissance rend tout test hyper-sensible au moindre arrondi numérique. Le jugement analytique éclairé du statisticien doit impérativement privilégier l’inspection diagnostique combinée du Q-Q Plot, des coefficients d’asymétrie et du kurtosis standardisé.
9. 9. Simulation de distributions normales multivariées
9.1 Extension au cadre multidimensionnel
Dans la complexité des systèmes naturels et comportementaux, les variables n’évoluent que rarement de manière cloisonnée et isolée. La caractérisation conjointe de plusieurs grandeurs stochastiques interdépendantes impose le recours à la distribution normale multivariée (ou distribution gaussienne multidimensionnelle). Pour un vecteur aléatoire $boldsymbol{X} = [X_1, X_2, dots, X_p]^T$ de dimension $p$, la densité conjointe s’exprime sous la forme matricielle généralisée :
$$f(boldsymbol{x}; boldsymbol{\mu}, boldsymbol{\Sigma}) = \frac{1}{(2\pi)^{p/2} |boldsymbol{\Sigma}|^{1/2}} \exp\left( -\frac{1}{2} (boldsymbol{x} – boldsymbol{\mu})^T boldsymbol{\Sigma}^{-1} (boldsymbol{x} – boldsymbol{\mu}) \right)$$
Dans cette équation, $boldsymbol{\mu} in \mathbb{R}^p$ désigne le vecteur des moyennes théoriques associées à chacune des dimensions scalaires, tandis que $boldsymbol{\Sigma} in \mathbb{R}^{p \times p}$ symbolise la matrice de variance-covariance de la population. Cette matrice carrée satisfait obligatoirement à deux contraintes structurales fondamentales :
- Elle est strictement symétrique ($boldsymbol{\Sigma} = boldsymbol{\Sigma}^T$).
- Elle est semi-définie positive (ou strictement définie positive), ce qui garantit que pour tout vecteur non nul $boldsymbol{v}$, le produit quadratique satisfait $boldsymbol{v}^T boldsymbol{\Sigma} boldsymbol{v} ge 0$, assurant l’existence et la positivité de son déterminant $|boldsymbol{\Sigma}|$.
NumPy intègre cette formulation multidimensionnelle complexe au sein de son générateur via la fonction dédiée rng.multivariate_normal(), exploitant la décomposition de Cholesky ($boldsymbol{\Sigma} = boldsymbol{L}boldsymbol{L}^T$) ou la décomposition en valeurs singulières (SVD) pour instancier des tenseurs corrélés de haute fidélité stochastique.
9.2 Applications psychologiques des lois bivariées
Pour matérialiser ce cadre conceptuel au sein d’une problématique appliquée aux sciences comportementales, considérons la simulation d’une cohorte clinique mesurant conjointement l’anxiété-trait ($X_1$) et la sévérité des symptômes dépressifs ($X_2$). La littérature clinique établit une forte corrélation linéaire positive entre ces deux construits psychopathologiques, documentée classiquement autour de $r = 0.65$.
Supposons que nos échelles de mesure soient étalonnées selon les métriques suivantes :
- Anxiété ($X_1$) : Moyenne $\mu_1 = 50.0$, Écart-type $\sigma_1 = 10.0$ (Variance $\sigma_1^2 = 100$).
- Dépression ($X_2$) : Moyenne $\mu_2 = 45.0$, Écart-type $\sigma_2 = 12.0$ (Variance $\sigma_2^2 = 144$).
La covariance théorique unissant ces deux dimensions est directement dictée par la formule mathématique $\text{Cov}(X_1, X_2) = r \cdot \sigma_1 \cdot \sigma_2$. Dans notre cas : $\text{Cov}(X_1, X_2) = 0.65 \times 10.0 \times 12.0 = 78.0$. La construction scripturale de la matrice et l’extraction de l’échantillon bivarié se déploient comme suit :
# Paramètres multivariés
vecteur_mu = np.array([50.0, 45.0])
matrice_sigma = np.array([
    [100.0,  78.0],  # Variance anxiété et covariance
    [ 78.0, 144.0]   # Covariance et variance dépression
])

# Tirage stochastique multivarié de 500 participants
observations_psy = rng.multivariate_normal(mean=vecteur_mu, cov=matrice_sigma, size=500)

anxiete = observations_psy[:, 0]
depression = observations_psy[:, 1]

# Calcul du coefficient de Pearson empirique
corr_empirique = np.corrcoef(anxiete, depression)[0, 1]
print(f"Corrélation empirique obtenue : {corr_empirique:.3f}")
La représentation conjointe de cette distribution bivariée s’effectue optimalement sous la forme d’un nuage de points agrémenté d’une estimation de contour par noyau bidimensionnel, ou via l’inscription géométrique d’ellipses de confiance correspondant aux contours d’isodensité de la loi conjointe :
plt.figure(figsize=(7, 6))
sns.scatterplot(x=anxiete, y=depression, color="#8e44ad", alpha=0.6, edgecolor='none')
sns.kdeplot(x=anxiete, y=depression, levels=5, color="#2c3e50", linewidths=1.5)

plt.title("Loi normale bivariée : Anxiété vs Dépression (r = 0.65)", fontsize=12)
plt.xlabel("Score d'anxiété-trait ($X_1$)")
plt.ylabel("Score de dépression ($X_2$)")
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
L’ellipse allongée formée par les courbes d’isodensité atteste graphiquement de la force et de la directionnalité de l’interdépendance linéaire unissant les deux variables comportementales simulées.
10. 10. Méthodes alternatives de génération de variables normales
10.1 Utilisation du module scipy.stats.norm
Bien que NumPy demeure la référence incontournable en matière d’efficacité brute et de calcul matriciel, le module scipy.stats propose une abstraction orientée objet hautement sophistiquée pour la manipulation des lois de probabilité via la classe spécialisée scipy.stats.norm. Contrairement aux fonctions autonomes de NumPy, cette classe encapsule l’intégralité des outils mathématiques attachés à la distribution gaussienne au sein d’une structure logicielle cohérente.
La génération d’échantillons stochastiques s’effectue alors via la méthode rvs() (Random Variates Simulation) :
import scipy.stats as stats

# Tirage stochastique via SciPy
echantillon_scipy = stats.norm.rvs(loc=0.0, scale=1.0, size=1000, random_state=42)
L’argument formel random_state permet de spécifier un entier ou une instance de générateur pour garantir la reproductibilité. Mais la supériorité opérationnelle de scipy.stats.norm réside dans l’accessibilité immédiate de l’ensemble de ses méthodes analytiques associées :
pdf(x, loc, scale): Fonction de densité de probabilité (FDP).cdf(x, loc, scale): Fonction de répartition cumulative, calculant $P(X le x)$.ppf(q, loc, scale): Fonction quantile (Percent Point Function), calculant l’inverse de la fonction de répartition ($x$ tel que $F(x) = q$).fit(data): Estimation des paramètres $\mu$ et $\sigma$ par le principe d’optimisation du maximum de vraisemblance à partir d’un ensemble de données empiriques.
En contrepartie de cette richesse fonctionnelle, les benchmarks d’exécution démontrent que stats.norm.rvs() affiche une surcharge computationnelle (overhead) substantiellement supérieure à celle de rng.normal(), due à de multiples contrôles de validation dimensionnelle et d’encapsulation. Pour des simulations de Monte-Carlo massives impliquant des dizaines de millions d’itérations, l’emploi direct de NumPy s’impose pour des considérations d’économie de cycles processeur.
10.2 Modules standards et algorithmes historiques
Il est instructif de noter que Python intègre nativement, au sein de sa bibliothèque standard distribuée par défaut, des outils élémentaires de génération stochastique sans nécessiter l’installation de dépendances tierces, par le canal du module random. Deux fonctions spécialisées permettent de synthétiser des observations scalaires univariées :
random.gauss(mu, sigma): Implémentation historiquement optimisée tirant parti d’algorithmes de factorisation trigonométrique.random.normalvariate(mu, sigma): Variante algorithmique reposant généralement sur la méthode polaire de Marsaglia-Bray.
Sur le plan fondamental de l’histoire du calcul scientifique, le procédé mathématique d’élection pour transformer des variables aléatoires uniformes — faciles à extraire computationnellement — en variables normales est la transformation de Box-Muller. Formulé en 1958, cet algorithme exploite le fait que si $U_1, U_2 \sim \mathcal{U}(0, 1)$ sont deux variables aléatoires uniformément réparties et indépendantes, alors les deux variables suivantes sont rigoureusement normales centrées réduites et indépendantes :
$$Z_0 = \sqrt{-2\ln U_1} \cos(2\pi U_2)$$
$$Z_1 = \sqrt{-2\ln U_1} \sin(2\pi U_2)$$
Bien qu’élégante sur le plan analytique, la programmation manuelle de cette transformation via des boucles itératives pures en Python (`for` ou `while`) aboutit à des ralentissements d’exécution catastrophiques par rapport aux méthodes vectorisées de NumPy, souffrant du coût d’interprétation dynamique inhérent au bytecode Python. Les générateurs contemporains de NumPy abandonnent d’ailleurs Box-Muller au profit de l’algorithme du Ziggurat, une méthode par rejet étagé beaucoup plus rapide, minimisant le recours aux coûteuses fonctions transcendantes (logarithmes et cosinus).
11. 11. Études de cas appliquées aux sciences du comportement
11.1 Simulation d’échelles psychométriques standardisées
Dans la pratique de la psychométrie appliquée et de l’évaluation neuropsychologique, les scores bruts sont presque toujours convertis en échelles étalonnées standards afin de situer les performances individuelles par rapport à une cohorte de normalisation représentative. Les deux étalonnages les plus fréquemment mobilisés sont le Quotient Intellectuel standardisé (QI de Wechsler, $\mu = 100, \sigma = 15$) et les scores T utilisés dans les questionnaires de personnalité comme le MMPI ($\mu = 50, \sigma = 10$).
Cependant, dans la réalité clinique, les tests psychométriques ne génèrent jamais de nombres réels infinis dotés de décimales arbitraires. Les épreuves comportent des nombres entiers d’items, et les scores composites font l’objet d’une discrétisation stricte ainsi que d’une troncature imposée par les bornes théoriques de l’instrument de mesure (effet plancher et effet plafond). Pour simuler une cohorte d’évaluation cliniquement réaliste, le chercheur doit encapsuler le tirage gaussien continu dans une séquence d’arrondi et d’écrêtage :
rng = np.random.default_rng(seed=777)

# Tirage gaussien continu sous-jacent (N = 1000)
scores_bruts_continus = rng.normal(loc=100.0, scale=15.0, size=1000)

# Discrétisation à l'entier le plus proche
scores_discretises = np.round(scores_bruts_continus)

# Troncature aux bornes réelles de l'instrument clinique (ex. QI entre 40 et 160)
scores_qi_reels = np.clip(scores_discretises, a_min=40, a_max=160).astype(int)

# Identification des profils cliniquement atypiques (QI = 130)
deficience_intellectuelle = np.sum(scores_qi_reels = 130)

print(f"Proportion 'Déficience' observée (=130) : {haut_potentiel / 1000 * 100:.2f}% (théorique: ~2.27%)")
Cette approche permet d’étudier l’impact de la granularité de discrétisation sur la sensibilité diagnostique des instruments et de valider la conformité des prévalences simulées par rapport aux prédictions épidémiologiques théoriques.
11.2 Modélisation du bruit expérimental et des temps de réaction
L’investigation expérimentale en chronométrie mentale — l’étude de la latence temporelle requise pour traiter une information cognitive — fournit une illustration passionnante de la puissance mais aussi des limites de la modélisation gaussienne pure. Dans les paradigmes expérimentaux d’électrophysiologie ou d’oculométrie, les signaux temporels enregistrés sont inévitablement pollués par un bruit de fond physiologique et instrumental modélisé usuellement par un bruit blanc gaussien additif, doté d’une moyenne nulle et d’une variance stationnaire :
t = np.linspace(0, 1, 1000)  # Chronologie d'une seconde
signal_potentiel_evoque = 5.0 * np.sin(2 * np.pi * 5 * t)  # Onde cérébrale théorique 5 Hz
bruit_gaussien = rng.normal(loc=0.0, scale=1.5, size=1000)  # Bruit de fond instrumental

signal_bruite = signal_potentiel_evoque + bruit_gaussien
Toutefois, lorsqu’on s’intéresse à la distribution des temps de réaction (TR) humains eux-mêmes, l’hypothèse d’une stricte normalité échoue de façon critique. Les distributions chronométriques réelles présentent une asymétrie positive systématique et irréductible : il existe une barrière temporelle infranchissable liée aux limites de conduction axonale motrice (aucun TR ne peut être inférieur à ~150 ms), couplée à une longue traîne de latences élevées causées par des lapses attentionnels épisodiques.
Pour capturer cette dynamique empirique avec réalisme, les psychologues computationnels délaissent la loi normale pure au profit de la distribution normale modifiée exponentiellement (loi ex-Gaussienne). Cette loi stochastique modélise le temps de réaction comme la somme indépendante de deux processus physiologiques additifs : une composante gaussienne $\mathcal{N}(\mu, \sigma^2)$ capturant la variabilité des processus perceptifs et moteurs de base, convoluée avec une composante exponentielle $\mathcal{E}(\tau)$ traduisant les fluctuations de l’attention centrale :
# Paramètres du modèle ex-Gaussien
mu_moteur = 300.0       # Moyenne de la composante motrice (ms)
sigma_moteur = 25.0     # Dispersion motrice (ms)
tau_attention = 80.0    # Échelle de la traîne attentionnelle exponentielle (ms)

# Simulation des deux processus sous-jacents
composante_normale = rng.normal(loc=mu_moteur, scale=sigma_moteur, size=2000)
composante_exponentielle = rng.exponential(scale=tau_attention, size=2000)

# Temps de réaction total observable
temps_reaction_ex_gauss = composante_normale + composante_exponentielle

# Validation visuelle de l'asymétrie
plt.figure(figsize=(8, 4.5))
sns.histplot(temps_reaction_ex_gauss, kde=True, color="#e67e22", bins=40)
plt.title("Modélisation computationnelle des temps de réaction (Loi ex-Gaussienne)", fontsize=12)
plt.xlabel("Temps de réaction (millisecondes)")
plt.ylabel("Densité d'occurrences")
plt.show()
12. 12. Bonnes pratiques méthodologiques et optimisation computationnelle
12.1 Adoption des standards modernes de l’API NumPy
L’évolution continue de la bibliothèque NumPy a conduit à une refonte architecturale majeure de son sous-système de calcul stochastique. L’emploi de l’ancienne interface globale incarnée par numpy.random.seed() et numpy.random.normal() doit aujourd’hui être formellement abandonné dans toute nouvelle publication scientifique ou développement d’ingénierie logicielle au profit de l’API introduite dans NumPy 1.17.
Cette transition se justifie par des impératifs conceptuels et de sécurité algorithmique majeurs. L’algorithme Mersenne Twister historique (MT19937), qui sous-tendait l’ancienne interface, présente des faiblesses statistiques documentées : il échoue à certains tests modernes de la suite TestU01 Crush, et son état interne volumineux (624 entiers de 32 bits) le rend inadapté à la dérivation de flux parallèles d’aléas indépendants. À l’inverse, le générateur par défaut de l’API moderne, le PCG64, est un algorithme à congruence permutée d’une vitesse remarquable, doté d’un état interne compact (128 bits), surpassant rigoureusement l’ensemble des batteries de tests de non-corrélation et garantissant une période gigantissime de $2^{128}$ tirages sans répétition de cycle.
La règle d’or consiste à instancier un objet générateur dédié localement et à solliciter exclusivement ses méthodes :
# Syntaxe moderne et recommandée
from numpy.random import default_rng

rng = default_rng(seed=123456789)
donnees_valides = rng.normal(loc=0.0, scale=1.0, size=10000)
Cette syntaxe garantit une totale indépendance des flux stochastiques au sein des architectures logicielles concurrentes, éliminant tout risque de pollution mutuelle des états internes de tirage.
12.2 Optimisation des performances et gestion de la mémoire
Dans le domaine des simulations de Monte-Carlo à grande échelle ou lors de l’entraînement d’algorithmes d’apprentissage profond, l’efficacité d’exécution et l’empreinte en mémoire vive deviennent des goulots d’étranglement déterminants. Deux axes stratégiques d’optimisation méritent une attention prioritaire :
En premier lieu, la gestion de la précision numérique des flottants. Par défaut, les tirages sont effectués en double précision (float64), nécessitant 8 octets par valeur. Dans de très nombreuses applications de simulation stochastique où une résolution de 6 décimales significatives est amplement suffisante, il est avantageux de forcer la production de flottants en simple précision 32 bits (float32). Cette simple décision technique divise instantanément par deux la quantité de mémoire vive mobilisée et accélère les transferts vers les mémoires caches des processeurs :
# Réduction de 50% de l'empreinte mémoire par float32
echantillon_leger = rng.normal(loc=0.0, scale=1.0, size=10_000_000).astype(np.float32)
En second lieu, il est absolument impératif d’adopter une programmation vectorisée pure. Le recours à des itérations séquentielles à l’aide de boucles natives Python (`for i in range(…)`) pour concaténer des observations aléatoires constitue une hérésie computationnelle majeure menant à des pénalités d’exécution d’un à deux ordres de grandeur. L’analyste doit impérativement allouer l’intégralité des dimensions scalaires cibles via l’argument size en un unique appel unifié.
Enfin, lorsque l’exploration stochastique impose d’exécuter des milliards de réplications distribuées, la stratégie d’excellence réside dans la parallélisation explicite. Grâce à la conception modulaire de l’API PCG64, il est aisé de dériver des générateurs indépendants via la méthode rng.spawn(), permettant d’exécuter des simulations de Monte-Carlo concurrentes sur l’ensemble des cœurs physiques du processeur sans le moindre verrouillage de mémoire et sans corrélation d’état stochastique.
Références
- Box, G. E. P., & Muller, M. E. (1958). A note on the generation of random normal deviates. The Annals of Mathematical Statistics, 29(2), 610–611. https://doi.org/10.1214/aoms/1177706645
- D’Agostino, R. B., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of $b_2$ and $\sqrt{b_1}$. Biometrika, 60(3), 613–622. https://doi.org/10.1093/biomet/60.3.613
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- O’Neill, M. E. (2014). PCG: A family of simple fast space-efficient statistically good algorithms for random number generation (HMC-CS-2014-0905). Harvey Mudd College.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021