
Dans le vaste univers de la théorie des probabilités et de l’inférence statistique, la transition analytique entre le monde discret du dénombrement et le monde continu de la mesure physique représente l’une des passerelles conceptuelles les plus fascinantes et délicates. Lorsqu’un chercheur observe un phénomène reposant sur des événements binaires — qu’il s’agisse de la réussite ou de l’échec à un item psychométrique, de la présence ou de l’absence d’un symptôme clinique, ou de choix dans une tâche décisionnelle —, les variables sous-jacentes sont fondamentalement discontinues, progressant par sauts discrets sur l’ensemble des entiers naturels. Pourtant, depuis les travaux pionniers d’Abraham de Moivre au XVIIIe siècle, prolongés avec génie par Pierre-Simon de Laplace, la statistique mathématique a appris à modéliser ces distributions granulaires à l’aide d’une courbe continue, lisse et infiniment dérivable : la courbe de Gauss, ou distribution normale.
Cette substitution fonctionnelle, bien que d’une élégance mathématique indéniable et d’une puissance computationnelle remarquable, soulève un dilemme géométrique fondamental. Comment peut-on légitimement évaluer la probabilité qu’une variable discrète prenne une valeur entière exacte, ou se situe à l’intérieur d’un intervalle borné, en utilisant une fonction dont l’intégrale sur un point unique est rigoureusement nulle ? C’est précisément pour résoudre ce paradoxe dimensionnel et combler le décalage géométrique entre une sommation finie de rectangles unitaires et une intégration sous une courbe continue qu’a été introduite la correction de continuité. Souvent résumée de façon pratique par la règle de l’ajustement de ± 0,5, cette technique est bien plus qu’une simple astuce arithmétique : elle constitue un pontage théorique rigoureux garantissant la fidélité de l’approximation asymptotique.
Le présent article propose une analyse approfondie, exhaustive et accessible de ce mécanisme fondamental. Destiné aux statisticiens, psychométriciens, data scientists et chercheurs en sciences du comportement, ce guide explore la genèse historique du concept, ses justifications topologiques et géométriques, sa mise en œuvre calculatoire dans les approximations binomiales et les tests du Chi-deux de Yates, ainsi que les débats contemporains relatifs à sa pertinence à l’ère du calcul numérique de haute précision. En articulant rigueur mathématique et contextualisation empirique, nous mettrons en lumière les conditions exactes sous lesquelles cette correction doit être impérativement appliquée, et celles où les approches exactes modernes lui sont préférables.
1. Introduction aux fondements de la correction de continuité
1.1 Définition formelle et genèse théorique du concept
D’un point de vue formel, la correction de continuité se définit comme un ajustement arithmétique appliqué aux bornes d’une variable aléatoire discrète lorsque la fonction de répartition de cette dernière est approchée au moyen d’une fonction de répartition issue d’une variable aléatoire continue. L’objectif premier de cette opération est de minimiser l’erreur systématique d’approximation inhérente au remplacement d’une série finie de probabilités ponctuelles discrètes par une intégrale définie sur un continuum réel. Dans son acception la plus canonique, cet ajustement consiste à étendre ou restreindre l’intervalle d’évaluation d’une demi-unité (généralement 0,5 pour les distributions à pas entier), permettant ainsi à chaque valeur discrète d’être représentée non pas par un point sans épaisseur, mais par un segment continu de largeur unitaire centré sur cet entier.
L’émergence historique de cette méthode trouve ses racines dans les contraintes de calcul analytique qui prévalaient bien avant l’avènement de l’informatique moderne. Dès le début des années 1730, le mathématicien français exilé à Londres, Abraham de Moivre, cherchait à simplifier le calcul des probabilités combinatoires associées aux jeux de hasard répétés, spécifiquement les tirages à pile ou face décrits par la loi binomiale. Calculer manuellement la somme de centaines de coefficients binomiaux factoriels représentait une tâche d’une lourdeur prohibitive, souvent hors de portée des calculateurs humains de l’époque. De Moivre découvrit que la distribution binomiale symétrique pouvait être remarquablement approchée par une courbe exponentielle d’allure campaniforme, préfigurant la distribution normale que Laplace généralisera en 1812 dans sa monumentale Théorie analytique des probabilités.
Toutefois, les premiers théoriciens de la probabilité ont immédiatement identifié une divergence structurelle : l’application directe de la fonction continue sans réalignement géométrique produisait des erreurs d’estimation substantielles, particulièrement pour les probabilités cumulées proches de l’espérance ou dans les queues de distribution. La formalisation de la correction de continuité a ainsi constitué un progrès décisif dans l’optimisation de la convergence asymptotique. En alignant précisément l’aire des rectangles discrets de l’histogramme de probabilité sur la surface sous la fonction de densité gaussienne, les mathématiciens ont forgé un outil analytique d’une précision remarquable, transformant une heuristique approximative en un standard de calcul rigoureux adopté par toute la communauté scientifique internationale.
1.2 La transition fonctionnelle entre espaces discrets et continus
Pour appréhender la nécessité ontologique de la correction de continuité, il convient d’examiner attentivement la nature de la transition fonctionnelle entre les espaces probabilisés discrets et continus. Dans le cas d’une variable aléatoire discrète, l’espace des événements élémentaires observables est constitué d’un ensemble dénombrable de valeurs isolées, le plus souvent les entiers naturels. La mesure de probabilité est assignée directement à chacun de ces points au travers d’une fonction de masse. Par conséquent, la probabilité d’un intervalle ou d’un ensemble d’événements s’obtient par une simple sommation algébrique discrète de ces masses individuelles. L’espace mathématique est intrinsèquement granulaire : entre deux valeurs consécutives, disons 14 et 15 succès, il n’existe aucune réalité probabiliste mesurable dans le modèle.
À l’inverse, l’univers des variables aléatoires continues opère sur un corps non dénombrable, typiquement l’ensemble des nombres réels ou un intervalle de celui-ci. Dans ce cadre, la probabilité n’est plus attribuée à des points singuliers, mais est définie par une fonction de densité de probabilité via l’intégrale de Riemann ou de Lebesgue. En analyse réelle élémentaire, un point géométrique isolé possède une mesure de Lebesgue nulle ; il est dépourvu de longueur, de largeur et de volume. Dès lors, si l’on tente d’interroger un modèle continu sur la probabilité ponctuelle d’une valeur exacte, la réponse mathématique rigoureuse est inéluctablement égale à zéro. Il est formellement impossible de sommer des probabilités ponctuelles nulles pour reconstruire la probabilité d’un événement global continu.
Cette divergence crée une fracture lors du passage d’une sommation discrète à une intégrale continue. Lorsque l’on cherche à approximer la somme d’une fonction de masse discrète entre les entiers a et b, on ne peut pas simplement poser l’intégrale de la fonction de densité entre ces deux mêmes bornes sans commettre une erreur de troncature spatiale. En procédant ainsi, on omettrait la moitié géométrique du premier pavé de masse centré en a ainsi que la moitié géométrique du dernier pavé de masse centré en b. L’ajustement systématique des bornes d’intégration — en soustrayant une demi-unité à la borne inférieure et en ajoutant une demi-unité à la borne supérieure — permet de rétablir l’équivalence volumique entre le cumul discret des masses et la surface sous la courbe continue.
1.3 Pertinence épistémologique en psychométrie et sciences du comportement
L’utilisation de la correction de continuité revêt une importance épistémologique capitale dans les sciences empiriques humaines, tout particulièrement en psychométrie, en neuropsychologie et dans l’étude expérimentale du comportement. Dans ces disciplines, les chercheurs sont constamment confrontés au défi de quantifier des construits latents non directement observables — tels que l’anxiété, la mémoire de travail, l’intelligence fluide ou les biais cognitifs — à travers des instruments de mesure qui produisent quasi exclusivement des variables discrètes. Qu’il s’agisse du nombre de réponses correctes à un test de performance cognitive, du nombre d’items validés sur une échelle de dépistage ou d’orientations spatiales dichotomiques dans un labyrinthe comportemental, les données brutes sont constituées de comptages d’événements élémentaires.
Or, pour inférer des propriétés sur la population générale ou pour tester des hypothèses de causalité, les méthodologues s’appuient massivement sur des modèles statistiques paramétriques ou non paramétriques reposant sur l’hypothèse de distributions d’échantillonnage continues. Les tailles d’échantillon disponibles dans les protocoles cliniques ou les paradigmes de neuro-imagerie sont fréquemment modérées, oscillant souvent entre 20 et 80 participants en raison de contraintes matérielles ou éthiques. Dans cette zone critique d’effectifs modérés, le théorème central limite ne déploie pas encore toute sa puissance asymptotique brute, et les erreurs d’approximation résultant de la négligence de la granularité des données peuvent fausser significativement les valeurs de p (p-values) calculées.
L’omission d’une correction de continuité sur un échantillon clinique de taille réduite peut conduire à une sous-estimation systématique de la variance d’échantillonnage ou à un décalage artificiel de la statistique de test vers la région critique de rejet. Cela accroît substantiellement le risque de commettre une erreur de type I, consistant à rejeter à tort l’hypothèse nulle d’absence d’effet ou de différence inter-groupes. Préserver la rigueur mathématique par l’ajustement de continuité constitue ainsi un garde-fou méthodologique indispensable. Il garantit que les conclusions théoriques tirées de protocoles expérimentaux complexes reposent sur une inférence probabiliste exempte d’artefacts calculatoires, conférant une validité interne robuste aux modèles psychométriques modernes.
2. Distinctions fondamentales entre variables discrètes et variables continues
2.1 Caractéristiques intrinsèques des distributions discrètes
Pour maîtriser l’architecture de la correction de continuité, il est indispensable de poser avec une clarté absolue les frontières qui séparent les deux grandes familles de variables probabilistes. Une distribution est dite discrète lorsque la variable aléatoire qui la génère ne peut prendre que des valeurs distinctes, isolées et dénombrables au sein de son espace d’échantillonnage. Ce support mathématique peut être fini, comme l’ensemble des résultats possibles lors d’un test composé de 10 questions à choix multiples (allant de 0 à 10), ou dénombrable infini, comme dans le cas du nombre d’appels reçus par un standard téléphonique d’urgence au cours d’une heure donnée, modélisé par une distribution de Poisson.
Le comportement stochastique d’une variable discrète est intégralement décrit par sa fonction de masse de probabilité (notée habituellement P(X = x) ou p(x)). Cette fonction assigne à chaque valeur ponctuelle admissible une probabilité positive non nulle, comprise strictement ou largement entre 0 et 1. La somme totale de ces probabilités ponctuelles sur l’ensemble du support est obligatoirement égale à l’unité :
∑ P(X = xi) = 1
Graphiquement, la distribution discrète se matérialise par une succession de barres verticales ou de bâtons discontinus, séparés par des zones de vide probabiliste où la probabilité d’occurrence est strictement nulle. Des exemples canoniques illustrent cette réalité au quotidien : le nombre de succès dans une série d’épreuves répétées (loi binomiale), le nombre de tentatives requises avant l’obtention du premier succès (loi géométrique), ou encore les scores attribués sur des échelles ordinales d’attitudes de type Likert en psychologie sociale.
2.2 Propriétés topologiques des distributions continues
À l’autre extrémité du spectre analytique se déploient les distributions continues. Une variable aléatoire est qualifiée de continue lorsque son support n’est plus dénombrable, mais correspond à un sous-ensemble indénombrable de la droite réelle ℝ, tel qu’un intervalle ouvert ou fermé, ou encore la totalité de l’axe réel de moins l’infini à plus l’infini. Ces variables représentent traditionnellement des grandeurs physiques mesurables en continu : le temps de réaction à un stimulus sensoriel exprimé en millisecondes, la taille d’un individu en centimètres, la température corporelle, ou encore la concentration sérique d’une hormone dans le plasma sanguin.
Puisque l’ensemble des valeurs possibles est indénombrable, la probabilité ne peut plus être distribuée sous forme de masses isolées sur des points discrets. Elle est décrite par une fonction de densité de probabilité, traditionnellement notée f(x). Cette fonction présente des caractéristiques topologiques radicalement différentes : elle n’exprime pas directement une probabilité, mais une intensité locale ou une densité surfacique. Ses seules contraintes sont d’être partout positive ou nulle (f(x) ≥ 0) et de posséder une intégrale totale sur son domaine de définition strictement égale à 1 :
∫-∞+∞ f(x) dx = 1
Dans ce modèle continu, l’évaluation d’une probabilité s’effectue exclusivement par le calcul de l’aire géométrique sous la courbe de la densité entre deux bornes déterminées. Cela conduit au paradoxe apparent, mais fondamental, de l’analyse réelle : pour toute valeur ponctuelle isolée c, la probabilité que la variable X prenne exactement cette valeur est strictement nulle :
P(X = c) = ∫cc f(x) dx = 0
Par conséquent, dans une distribution continue rigoureuse, la distinction entre inégalités strictes et inégalités larges devient formellement caduque : P(X ≤ c) est rigoureusement identique à P(X < c), une propriété qui n’a absolument aucun équivalent dans le monde discret.
2.3 L’incompatibilité conceptuelle du calcul ponctuel
C’est précisément cette divergence sur le traitement de la probabilité ponctuelle qui engendre une incompatibilité conceptuelle majeure lorsqu’on cherche à approximer une loi discrète par une loi continue. Imaginons un protocole psychologique où l’on dénombre le nombre de réussites X à une batterie de tests cognitifs. La variable X est strictement discrète. Le chercheur peut parfaitement s’interroger sur la probabilité empirique d’observer exactement 50 réussites, ce qui s’écrit P(X = 50). Dans le modèle discret d’origine (par exemple une loi binomiale), cette probabilité possède une valeur numérique parfaitement définie, positive et calculable via des formules combinatoires.
Si l’analyste décide d’utiliser une approximation normale continue sans précaution méthodologique et tente d’évaluer directement la probabilité de cette valeur ponctuelle 50 à l’aide de la loi normale, le formalisme de l’intégrale continue lui renverra instantanément la valeur 0. L’application brute du modèle continu détruit ainsi l’information recherchée. Pour surmonter ce blocage analytique, il devient épistémologiquement indispensable de procéder à un changement de représentation géométrique : chaque événement unitaire discret doit être dilaté pour occuper un espace géométrique continu.
La justification épistémique de cette opération réside dans la notion d’intervalle de tolérance unitaire. On postule que la valeur entière observée, par exemple 50, n’est en réalité que le représentant central d’une tranche continue s’étendant de la demi-unité inférieure à la demi-unité supérieure, soit l’intervalle réel [49,5 ; 50,5]. Sous cette convention, l’événement discret ponctuel {X = 50} est mathématiquement traduit dans l’espace continu par l’événement d’intervalle {49,5 < X < 50,5}. Dès cet instant, l’incompatibilité analytique s’évanouit : l’intégrale de la fonction de densité gaussienne sur ce segment unitaire produit une aire positive non nulle, offrant une estimation extraordinairement fidèle de la masse discrète originelle.
3. La loi binomiale et son comportement asymptotique
3.1 Paramétrage mathématique et combinatoire binomiale
La distribution binomiale constitue le terrain d’élection historique et pédagogique de la correction de continuité. Elle modélise le nombre total de succès obtenus au cours d’une suite de n épreuves de Bernoulli identiques et mutuellement indépendantes, où chaque essai individuel ne présente que deux issues exclusives : le succès, avec une probabilité constante notée p, et l’échec, survenant avec une probabilité complémentaire q = 1 – p. La variable aléatoire X, représentant le nombre total de succès enregistrés sur les n répétitions, peut prendre n’importe quelle valeur entière comprise dans l’ensemble discret {0, 1, 2, …, n}.
La probabilité exacte d’observer précisément k succès parmi les n essais est régie par la formule combinatoire binomiale classique :
P(X = k) = Cnk pk (1 – p)n – k = [n! / (k! (n – k)!)] pk (1 – p)n – k
Cette expression fait intervenir le coefficient binomial, qui quantifie le nombre distinct d’agencements ou de séquences temporelles menant à l’obtention de k succès au cours des n tirages. À partir de cette fonction de masse, le calcul des moments statistiques fondamentaux de la loi binomiale permet d’établir formellement son espérance mathématique μ et sa variance σ² :
- Espérance mathématique : μ = E(X) = n p
- Variance théorique : σ² = Var(X) = n p (1 – p)
- Écart-type : σ = √[n p (1 – p)]
L’espérance indique le centre de gravité de la distribution, tandis que la variance mesure l’ampleur de la dispersion des observations autour de ce barycentre théorique. Lorsque p = 0,5, la distribution présente une symétrie axiale parfaite autour de sa moyenne. Lorsque p ≠ 0,5, la loi affiche une asymétrie plus ou moins marquée qui s’atténue progressivement à mesure que le nombre total d’essais n augmente considérablement.
3.2 Le théorème de De Moivre-Laplace et la convergence normale
Le fondement mathématique autorisant la substitution de la loi binomiale par la loi normale repose sur un résultat fondamental de l’analyse stochastique : le théorème de De Moivre-Laplace, qui constitue une déclinaison spécifique du théorème central limite appliqué aux sommes de variables aléatoires indicatrices de Bernoulli indépendantes et de même loi. Cet énoncé démontre que lorsque la taille de l’échantillon n croît vers l’infini, la distribution standardisée de la variable binomiale converge en loi vers la distribution normale standard N(0, 1).
Sur le plan morphologique, si l’on construit un diagramme en barres représentant les probabilités de la loi binomiale pour une valeur de n de plus en plus élevée, les contours de ces barres se fondent visuellement dans une enveloppe continue dont la silhouette reproduit avec une fidélité troublante la célèbre courbe en cloche de Gauss. Les oscillations discrètes se lissent, et la concentration de la masse probabiliste autour de l’espérance np s’organise selon une symétrie progressive. Dès lors que n atteint des valeurs suffisamment imposantes, on peut poser l’équivalence d’approximation suivante :
X ~ B(n, p) ⇒ Xapprox ~ N(μ = np, σ² = np(1 – p))
Toutefois, cette convergence vers la normalité n’est qu’asymptotique : elle n’est mathématiquement exacte qu’à la limite infinie. Pour des échantillons réels de dimensions finies, la structure de la loi binomiale conserve des singularités intrinsèques, à commencer par son caractère étagé et granulaire. C’est dans cet interstice entre la réalité discrète d’un échantillon fini et l’idéalisation asymptotique de l’infini gaussien que la correction de continuité trouve sa justification mathématique la plus éclatante.
3.3 Complexité calculatoire historique versus calcul contemporain
Pour mesurer pleinement la valeur historique de cette approximation gaussienne, il est salutaire de se replacer dans le contexte computationnel des XVIIIe, XIXe et du début du XXe siècle. En l’absence totale de calculateurs électroniques, évaluer une probabilité cumulée telle que la probabilité d’obtenir au plus 450 succès au cours de 1 000 tirages sous l’hypothèse d’une pièce équilibrée nécessitait de calculer et de sommer manuellement 451 termes combinatoires distincts, chacun impliquant des factorielles de nombres gigantesques (comme 1 000 !).
Cette tâche titanesque était virtuellement impossible sans simplifications analytiques d’envergure. L’apport du théorème de De Moivre-Laplace, associé à l’utilisation systématique des tables pré-calculées de la loi normale centrée réduite, a représenté une véritable révolution scientifique. En convertissant une somme combinatoire impossible en un simple score standardisé z pouvant être lu instantanément dans une table numérique, les statisticiens ont ouvert la voie à l’inférence moderne dans des domaines aussi variés que la génétique, l’agronomie, l’économie et la psychophysique naissante.
À l’ère contemporaine, la démocratisation des ordinateurs et l’avènement de langages de programmation statistique tels que R ou Python ont rendu le calcul exact des factorielles et des distributions cumulées instantané, même pour des tailles d’échantillon considérables. On pourrait donc être tenté de reléguer l’approximation normale et sa correction de continuité au rang de curiosités archéologiques de l’histoire des sciences. Ce serait méconnaître leur rôle fondamental dans la compréhension conceptuelle des tests asymptotiques. Les approximations normales demeurent omniprésentes dans l’infrastructure de nombreux algorithmes modernes, dans les calculs de puissance statistique a priori, ainsi que dans la modélisation asymptotique des grands modèles d’équations structurelles et des méta-analyses.
4. Le mécanisme mathématique de la correction de continuité : la règle de ± 0,5
4.1 La justification géométrique de l’ajustement de demi-unité
Le cœur opératoire de la correction de continuité repose sur une justification géométrique d’une remarquable simplicité, illustrée par la construction d’un histogramme de probabilité unitaire. Considérons la distribution d’une variable discrète X. Sur un repère cartésien, chaque événement élémentaire X = k (où k est un entier relatif) peut être visualisé sous la forme d’un rectangle dont la hauteur est rigoureusement égale à la probabilité ponctuelle P(X = k). Pour que la surface géométrique de ce rectangle soit exactement égale à sa probabilité, il suffit de lui attribuer une base de largeur égale à 1.
Puisque ce pavé géométrique de largeur 1 doit être parfaitement équilibré autour de la valeur entière k, sa base doit impérativement s’étendre sur l’axe réel continu depuis la borne inférieure k – 0,5 jusqu’à la borne supérieure k + 0,5. L’aire surfacique du rectangle s’exprime alors comme :
Aire = Largeur × Hauteur = [ (k + 0,5) – (k – 0,5) ] × P(X = k) = 1 × P(X = k) = P(X = k)
Lorsque l’on cherche à évaluer la probabilité cumulée d’obtenir un ensemble de réalisations contiguës — par exemple toutes les valeurs comprises entre deux entiers a et b inclus —, la probabilité discrète globale correspond à l’addition de tous les rectangles unitaires juxtaposés. Visuellement, le domaine couvert par cette série de rectangles ne démarre pas précisément en a et ne s’arrête pas précisément en b : il commence à la limite extérieure gauche du premier pavé, soit en a – 0,5, et se termine à la limite extérieure droite du dernier pavé, soit en b + 0,5. Ignorer cette expansion géométrique de demi-unité reviendrait à sectionner arbitrairement la moitié des rectangles d’extrémité, amputant le calcul d’une portion significative de sa masse de probabilité.
4.2 Intégration de l’aire sous la courbe normale
L’opération d’approximation consiste à superposer la fonction de densité continue de Gauss f(x), paramétrée avec la moyenne μ = np et la variance σ² = np(1-p), directement sur cet ensemble de rectangles disjoints. La courbe gaussienne ondule au-dessus des pavés : à certains endroits, elle coupe le sommet du rectangle, laissant une petite surface rectangulaire hors de son périmètre ; à d’autres endroits, elle englobe une portion d’espace vide non couverte par le rectangle discret.
L’élégance de la correction de continuité réside dans le principe de compensation géométrique. En intégrant la fonction de densité continue sur l’intervalle étendu [k – 0,5 ; k + 0,5], les petites excroissances où la courbe passe en dessous du rectangle sont quasi parfaitement compensées par les zones triangulaires supérieures où la courbe englobe du volume additionnel. Cette compensation différentielle permet d’annuler les termes d’erreur du premier ordre dans le développement asymptotique de la série d’Euler-Maclaurin, qui relie formellement les sommes discrètes aux intégrales continues.
En minimisant ainsi l’erreur quadratique absolue entre la sommation discrète des masses et l’intégrale définie de la densité normale, l’analyste garantit que la surface sous la cloche de Gauss reproduit fidèlement le volume cumulé des rectangles de probabilité. Sans cet ajustement de ± 0,5, l’intégrale tronquée générerait une erreur systématique d’ordre O(1/√n), dégradant considérablement l’exactitude de l’inférence probabiliste, particulièrement au voisinage du centre de la distribution où la pente de la densité est la plus abrupte.
4.3 Traduction standardisée en scores z
Pour exploiter concrètement cette correction dans les calculs manuels ou informatiques standards, la variable continue d’approximation doit être convertie selon la métrique de la loi normale centrée réduite N(0, 1) au moyen du score standardisé z. Dans le cadre d’une approximation classique non corrigée, le score z s’obtient simplement en retranchant l’espérance μ à la valeur brute k observée, puis en divisant le résultat par l’écart-type théorique σ :
zbrut = (k – np) / √[np(1 – p)]
L’introduction formelle de la correction de continuité impose de modifier directement le numérateur de cette fraction standardisée afin d’y incorporer le décalage de demi-unité (+0,5 ou -0,5 selon l’orientation analytique de l’inégalité traitée). La structure fondamentale du dénominateur demeure quant à elle rigoureusement inchangée, conservant l’écart-type théorique exact √[np(1-p)]. Le score standardisé corrigé s’exprime donc sous l’une des formes suivantes :
zcorrigé = [ (k ± 0,5) – np ] / √[np(1 – p)]
Ce léger déplacement de 0,5 au numérateur produit une translation infinitésimale mais déterminante de la position du score z sur l’axe standardisé. Une fois ce score zcorrigé obtenu, la probabilité cumulée recherchée se déduit par simple lecture de la fonction de répartition cumulative normale standard, traditionnellement notée Φ(z). Ce décalage a pour effet mécanique d’ajuster la probabilité de queue calculée, évitant les sous-estimations ou surestimations chroniques inhérentes à l’évaluation non corrigée.
5. Guide systématique des conversions d’inégalités
5.1 Traitement de l’égalité stricte : P(X = k)
L’évaluation probabiliste d’une valeur ponctuelle isolée, notée formellement P(X = k), constitue le cas le plus emblématique de la nécessité opérationnelle de la correction de continuité. Comme nous l’avons théoriquement explicité, attribuer cette valeur ponctuelle directement à une loi continue se solderait mathématiquement par une probabilité nulle, puisque l’intégrale d’une densité sur un ensemble de mesure nulle est égale à zéro (Pcont(X = k) = 0).
Pour contourner cette aporie, la règle géométrique impose d’envelopper l’entier k dans son pavé unitaire d’origine. L’égalité stricte discrète est donc obligatoirement transmutée en un intervalle bilatéral symétrique fermé d’une largeur totale de 1 unité :
P(X = k) ⇒ P(k – 0,5 < Xcontinu < k + 0,5)
La procédure d’inférence s’effectue alors en calculant les deux scores z standardisés associés respectivement à chacune des deux bornes spatiales :
- Borne inférieure : zinf = [(k – 0,5) – np] / √[np(1 – p)]
- Borne supérieure : zsup = [(k + 0,5) – np] / √[np(1 – p)]
La probabilité estimée de l’événement ponctuel s’obtient enfin en effectuant la soustraction arithmétique entre les deux valeurs cumulées lues dans la table de la loi normale standard :
P(X = k) ≈ Φ(zsup) – Φ(zinf)
Cette approche transforme une impasse analytique en une estimation extraordinairement fine de la hauteur du bâton de masse binomial d’origine.
5.2 Traitement des inégalités cumulées inférieures : P(X ≤ k) et P(X < k)
Le traitement des inégalités cumulées inférieures exige une vigilance rigoureuse quant à la formulation de la borne : il convient de distinguer impérativement l’inégalité large (au plus k succès) de l’inégalité stricte (strictement moins de k succès).
Considérons en premier lieu l’inégalité large P(X ≤ k). Cet énoncé probabiliste signifie que l’on souhaite cumuler tous les résultats entiers possibles depuis 0 jusqu’à k inclus. Dans la perspective de l’histogramme de probabilité, le rectangle centré en k doit être intégralement englobé dans la zone d’intégration. Puisque la limite extérieure droite de ce pavé s’étend jusqu’à k + 0,5, l’intégration continue doit obligatoirement pousser sa frontière supérieure jusqu’à cette valeur étendue :
P(X ≤ k) ⇒ P(Xcontinu < k + 0,5)
Le score standardisé correspondant sera donc : z = [(k + 0,5) – np] / σ, et la probabilité recherchée sera simplement Φ(z).
Considérons à présent l’inégalité stricte P(X < k). Dans l’espace discret des entiers, l’événement « strictement inférieur à k » signifie formellement que la valeur maximale admissible est l’entier immédiatement inférieur, soit k – 1. On peut donc formuler l’équivalence logique : P(X < k) = P(X ≤ k – 1). Dès lors, le pavé centré sur l’entier k est expressément exclu du champ probabiliste. Le dernier rectangle à incorporer est celui centré en k – 1, dont la frontière supérieure s’arrête en (k – 1) + 0,5 = k – 0,5. La conversion s’écrit donc :
P(X < k) ⇒ P(Xcontinu < k – 0,5)
Une erreur pédagogique classique consiste à appliquer mécaniquement un signe négatif ou positif sans avoir préalablement vérifié si la valeur limite fait ou non partie intégrante de l’ensemble d’événements admis.
5.3 Traitement des inégalités cumulées supérieures : P(X ≥ k) et P(X > k)
Une logique géométrique symétrique s’applique au traitement des queues de distribution supérieures. Analysons d’abord l’inégalité large P(X ≥ k), correspondant à l’obtention d’au moins k succès. Dans ce scénario, le rectangle centré sur la valeur k représente la porte d’entrée de la région critique ; il doit impérativement être absorbé en totalité dans le cumul probabiliste. La limite extérieure gauche de ce rectangle débute à la coordonnée continue k – 0,5. L’intégration de la queue supérieure de la distribution continue doit donc démarrer à cette borne inférieure reculée :
P(X ≥ k) ⇒ P(Xcontinu > k – 0,5)
En exploitant la propriété de complémentarité de la fonction de répartition normale, le calcul effectif se traduit par l’expression suivante :
P(X ≥ k) ≈ 1 – Φ( [ (k – 0,5) – np ] / σ )
À l’opposé, examinons le cas de l’inégalité stricte P(X > k), traduisant l’événement « strictement plus de k succès ». Sur le domaine des entiers discrets, cet énoncé est rigoureusement équivalent à déclarer que le premier résultat valide est l’entier consécutif k + 1 (soit P(X ≥ k + 1)). Le rectangle centré en k est ainsi totalement exclu de l’évaluation. La zone probabiliste continue ne doit débuter qu’à la frontière gauche du rectangle k + 1, laquelle est située précisément en (k + 1) – 0,5 = k + 0,5 :
P(X > k) ⇒ P(Xcontinu > k + 0,5) = 1 – Φ( [ (k + 0,5) – np ] / σ )
Le respect méticuleux de ce décalage garantit une exactitude optimale lors des tests unilatéraux orientés vers la droite.
5.4 Traitement des intervalles bornés : P(a ≤ X ≤ b)
Dans la pratique de la modélisation statistique, les chercheurs sont fréquemment amenés à quantifier la probabilité qu’une variable discrète s’inscrive à l’intérieur d’un corridor borné par deux valeurs entières distinctes. Le cas de référence le plus courant est celui de l’intervalle bilatéralement inclusif, noté formellement P(a ≤ X ≤ b), où les deux entiers extrêmes a et b (avec a < b) font explicitement partie des réalisations admissibles.
En combinant méthodiquement les règles géométriques établies précédemment pour chaque extrémité du segment, on constate que la région continue doit impérativement s’étirer des deux côtés à la fois : elle doit descendre jusqu’à la limite extérieure gauche du pavé a (soit a – 0,5) et pousser son extension jusqu’à la frontière extérieure droite du pavé b (soit b + 0,5). La transcription analytique continue prend ainsi la forme :
P(a ≤ X ≤ b) ⇒ P(a – 0,5 < Xcontinu < b + 0,5)
Le calcul concret passe par la standardisation successive des deux frontières géométriques :
- z1 = [(a – 0,5) – np] / √[np(1 – p)]
- z2 = [(b + 0,5) – np] / √[np(1 – p)]
La probabilité d’encadrement s’obtient alors instantanément par la soustraction : P(a ≤ X ≤ b) ≈ Φ(z2) – Φ(z1).
Dans l’éventualité où certaines bornes seraient définies par des inégalités strictes, il suffit de réécrire préalablement l’intervalle sous sa forme inclusive équivalente sur les entiers avant d’appliquer la règle de ± 0,5 :
- Pour P(a < X ≤ b) : équivalent discret à P(a + 1 ≤ X ≤ b) ⇒ P(a + 0,5 < Xcontinu < b + 0,5)
- Pour P(a ≤ X < b) : équivalent discret à P(a ≤ X ≤ b – 1) ⇒ P(a – 0,5 < Xcontinu < b – 0,5)
- Pour P(a < X < b) : équivalent discret à P(a + 1 ≤ X ≤ b – 1) ⇒ P(a + 0,5 < Xcontinu < b – 0,5)
6. Conditions d’application et critères de validité empirique
6.1 Les critères empiriques classiques d’admissibilité
L’utilisation de la loi normale pour approximer une distribution discrète — même avec le secours méthodique de la correction de continuité — n’est jamais une opération inconditionnelle. La théorie asymptotique exige que la distribution binomiale d’origine présente un profil suffisamment étalé et symétrique pour que l’erreur d’ajustement globale ne compromette pas la validité des conclusions statistiques. Au fil des décennies, les statisticiens théoriciens et appliqués ont formalisé plusieurs règles empiriques fondamentales régissant l’admissibilité de cette approximation.
La règle empirique la plus universellement enseignée et admise dans la littérature méthodologique anglo-saxonne et francophone impose que les effectifs attendus dans chaque catégorie d’événements élémentaires soient au moins égaux à 5. Formellement, cette double contrainte s’énonce :
n p ≥ 5 et n (1 – p) ≥ 5
Ces deux inégalités garantissent simultanément que le nombre moyen théorique de succès attendus (np) et le nombre moyen d’échecs attendus (n(1-p)) sont suffisamment éloignés des frontières rigides de l’espace d’échantillonnage (respectivement 0 et n). Si l’une de ces quantités s’avère inférieure à 5, la distribution réelle est écrasée contre l’une des bordures, induisant une troncature abrupte totalement incompatible avec la courbe gaussienne dont les queues s’étendent à l’infini.
Cependant, de nombreux auteurs contemporains et comités de rédaction psychométriques adoptent des préconisations plus conservatrices. Ils recommandent de porter ce seuil minimal de sécurité à 10, voire 15 (exigeant np ≥ 10 et n(1-p) ≥ 10). Cette élévation du seuil est particulièrement impérative dès lors que le statisticien envisage de calculer des probabilités dans les queues extrêmes de distribution (au-delà de deux écarts-types de la moyenne), zones géométriques où la convergence asymptotique s’avère nettement plus lente et capricieuse qu’au centre de la distribution.
6.2 L’impact de l’asymétrie de la distribution binomiale
L’un des pièges conceptuels les plus récurrents consiste à croire que la correction de continuité possède la vertu miraculeuse de compenser l’asymétrie intrinsèque d’une distribution. Il s’agit d’une confusion théorique majeure : la correction de continuité compense exclusivement l’erreur de granularité (la discrétisation en pavés de largeur unitaire) ; elle est totalement impuissante à redresser un biais causé par une asymétrie de forme fondamentale.
La morphologie de la loi binomiale dépend crucialement de la proximité du paramètre p avec la valeur d’équilibre symétrique 0,5. Le coefficient d’asymétrie théorique (noté γ1 ou skewness) de la loi binomiale s’exprime par la formule analytique suivante :
γ1 = (1 – 2p) / √[n p (1 – p)]
L’analyse de cette équation révèle immédiatement deux vérités mathématiques :
- Si p = 0,5, le numérateur (1 – 2p) s’annule rigoureusement : la distribution binomiale est parfaitement symétrique pour toute valeur de n, ce qui offre les conditions idéales pour une approximation normale dès que n dépasse 15 ou 20.
- Si p s’éloigne drastiquement de 0,5 (par exemple pour des événements rares où p = 0,05 ou p = 0,95), le coefficient d’asymétrie prend une valeur élevée non nulle. La distribution s’étire en une longue traîne d’un côté et présente un sommet déporté.
Bien que le dénominateur montre que l’asymétrie décroît au rythme de 1/√n à mesure que l’échantillon grossit, cette convergence est d’une grande lenteur. Si p est très asymétrique et que n est modéré, superposer une courbe gaussienne — qui est rigoureusement symétrique par nature — sur une distribution discrète asymétrique constitue une faute méthodologique grave. La correction de continuité étendra fidèlement les intervalles de demi-unité, mais l’intégrale résultante sera biaisée, surestimant massivement une queue et sous-estimant l’autre.
6.3 Seuils critiques d’échantillonnage et alternatives computationnelles
Lorsque les critères d’admissibilité (np ≥ 10 et n(1-p) ≥ 10) ne sont manifestement pas satisfaits par le dispositif expérimental, le recours à l’approximation normale — même corrigée pour la continuité — doit être formellement proscrit. Les taux d’erreur relative sur l’évaluation des probabilités de dépassement peuvent alors excéder 50 % ou 100 %, entraînant des décisions inférentielles totalement biaisées.
Face à une telle rupture de validité empirique, deux alternatives mathématiques préférentielles s’imposent :
- L’approximation par la loi de Poisson : Si l’effectif n est important (n ≥ 30, voire n ≥ 100) mais que la probabilité de succès p est extrêmement faible (p < 0,05), avec un produit λ = np modéré et stable (np < 10), la distribution binomiale converge vers la loi de Poisson de paramètre λ. Cette loi étant elle-même discrète, elle conserve la granularité entière et intègre structurellement l’asymétrie prononcée des événements rares sans nécessiter d’artifice de continuité.
- Le calcul exact direct basé sur la distribution binomiale : Dans tout contexte expérimental informatisé contemporain, dès lors que les effectifs sont réduits (n < 30), il n’existe aucune justification valable pour délaisser le calcul exact au profit d’une approximation. La sommation directe des probabilités binomiales élémentaires via des bibliothèques algorithmiques éprouvées fournit la valeur P exacte sans la moindre erreur d’arrondi ni biais asymptotique.
7. Exemple pratique détaillé : Modélisation d’une épreuve psychologique binaire
7.1 Contexte expérimental et modélisation du problème
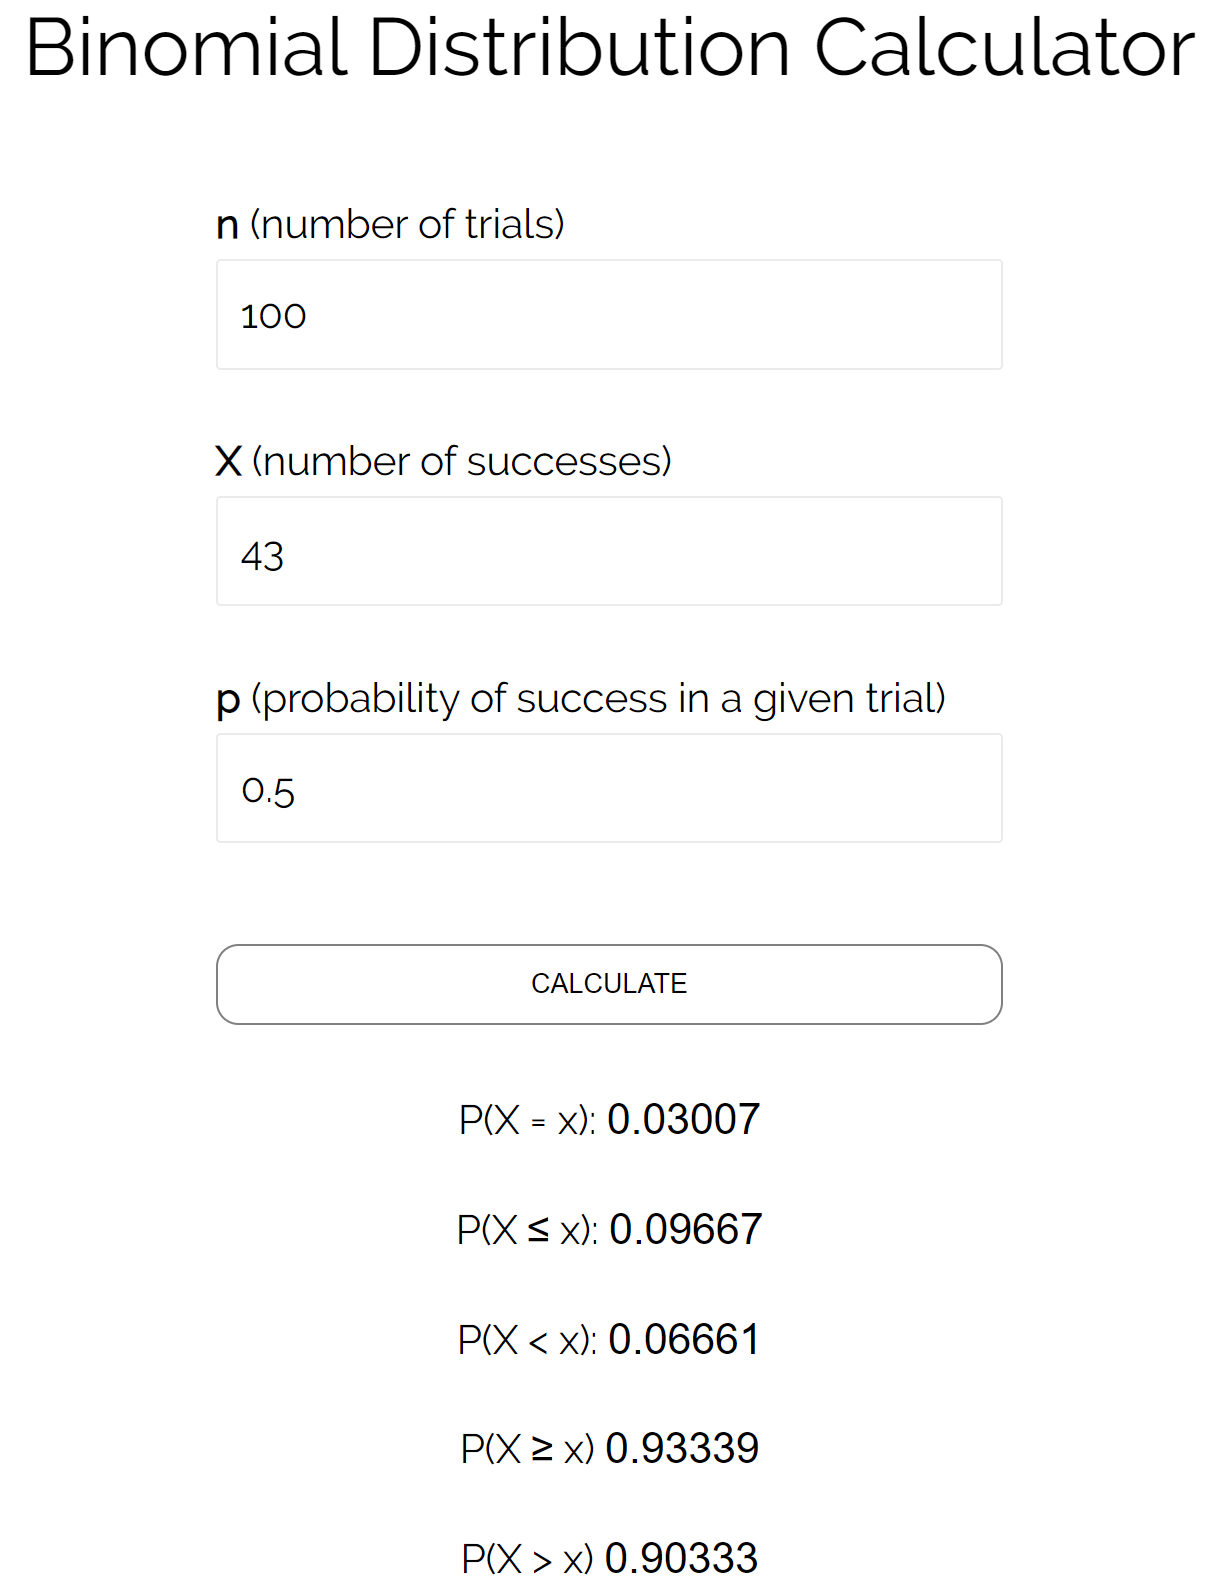
Afin d’illustrer la mécanique mathématique et d’apprécier la précision comparée de la correction de continuité, étudions un protocole expérimental classique issu de la neuropsychologie cognitive. Un laboratoire s’intéresse à la détection de micro-signaux visuels sous le seuil de conscience explicite (paradigme de perception subliminale). Un participant est soumis à une séquence standardisée comprenant exactement n = 100 essais indépendants. À chaque essai, un stimulus directionnel imperceptible est affiché, et le sujet doit choisir entre deux réponses motrices alternatives (gauche ou droite).
L’hypothèse nulle (H0) postule l’absence totale de perception consciente ou inconsciente : le sujet répondrait au hasard pur, ce qui correspond à une probabilité de réussite théorique de p = 0,5. La variable aléatoire X dénombrant le nombre total de réussites enregistrées suit donc, sous H0, une distribution binomiale canonique :
X ~ B(n = 100, p = 0,5)
À l’issue de la passation expérimentale, le participant n’obtient que 45 succès sur les 100 essais présentés. L’équipe de recherche souhaite tester l’hypothèse d’une performance anormalement faible (éventuelle inhibition cognitive ou stratégie d’évitement) et cherche à déterminer avec une rigueur statistique maximale la probabilité cumulative unilatérale d’observer un résultat aussi modeste ou inférieur sous l’effet exclusif de la chance. La grandeur d’intérêt formelle est donc la probabilité discrète :
P(X ≤ 45)
7.2 Résolution analytique par la distribution binomiale exacte
L’étalon de mesure absolu permettant de quantifier l’erreur de nos approximations successives est fourni par le calcul combinatoire exact de la somme des 46 probabilités de masse binomiales, de 0 succès jusqu’à 45 succès inclus :
P(X ≤ 45) = ∑k=045 [ 100! / (k! (100 – k)!) ] (0,5)k (0,5)100 – k = (0,5)100 ∑k=045 C100k
L’exécution de cette sommation algorithmique exacte (réalisable en quelques microsecondes sous un environnement computationnel moderne) produit la valeur de référence suivante :
Pexacte(X ≤ 45) = 0,184100808… ≈ 0,1841 (soit 18,41 %)
Cette valeur de 18,41 % constitue la vérité mathématique indiscutable de notre problème expérimental. Si le seuil de significativité nominal de l’étude a été fixé à α = 0,05, le chercheur constate immédiatement que cette probabilité d’occurrence (0,1841) est largement supérieure à 0,05, ce qui impose de conserver l’hypothèse nulle : un score de 45 réussites sur 100 n’a absolument rien d’exceptionnel sous l’effet du seul hasard.
7.3 Résolution par approximation normale non corrigée
Imaginons désormais qu’un chercheur applique de façon naïve et mécanique l’approximation par la loi normale, en omettant délibérément la correction de continuité. Les paramètres distributionnels théoriques de la loi gaussienne associée sont préalablement établis :
- Moyenne théorique : μ = np = 100 × 0,5 = 50
- Variance théorique : σ² = np(1 – p) = 100 × 0,5 × 0,5 = 25
- Écart-type théorique : σ = √25 = 5
Puisque les conditions d’admissibilité sont largement satisfaites (np = 50 ≥ 10 et n(1-p) = 50 ≥ 10), le chercheur procède à la standardisation brute de la valeur observée 45 :
zbrut = (45 – 50) / 5 = -5 / 5 = -1,0000
En consultant la table de la loi normale centrée réduite standard pour la valeur critique z = -1,00, on extrait la probabilité cumulée non corrigée :
Papprox_brute(X ≤ 45) ≈ Φ(-1,00) = 0,158655… ≈ 0,1587 (soit 15,87 %)
Comparons ce résultat avec la probabilité exacte d’origine :
- Erreur absolue : |0,1587 – 0,1841| = 0,0254 (un décalage de plus de 2,5 points de pourcentage)
- Erreur relative : |0,1587 – 0,1841| / 0,1841 ≈ 13,8 %
Cette erreur de près de 14 % est colossale pour une taille d’échantillon réputée confortable de 100 essais. L’omission de la correction produit un biais systématique agressif, sous-estimant la p-valeur réelle et rapprochant artificiellement la statistique du seuil de rejet alpha.
7.4 Résolution par approximation normale avec correction de continuité
Mettons à présent en œuvre la méthode rigoureuse incorporant la correction de continuité. L’énoncé probabiliste discret recherché est P(X ≤ 45). Comme nous l’avons théorisé au chapitre 5.2, l’inégalité large impose d’englober intégralement le pavé unitaire centré en 45. La frontière d’intégration de la loi normale continue doit donc être repoussée jusqu’à sa limite supérieure externe, soit :
kajusté = 45 + 0,5 = 45,5
Le calcul du score standardisé corrigé zcorrigé s’exécute avec les mêmes paramètres μ = 50 et σ = 5 :
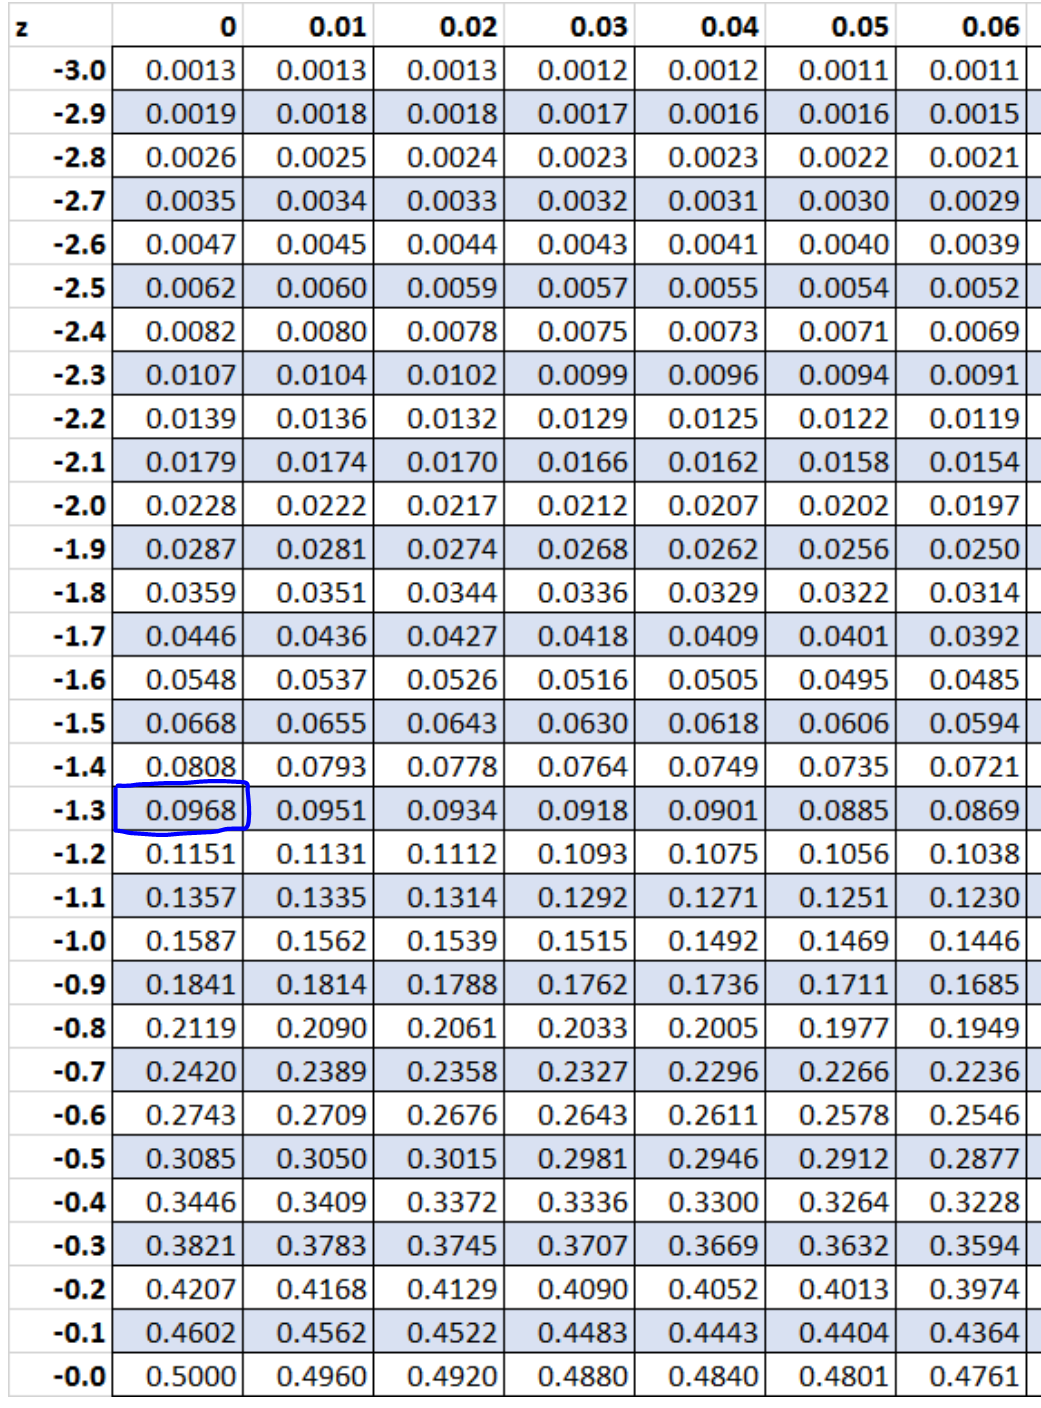
zcorrigé = (45,5 – 50) / 5 = -4,5 / 5 = -0,9000
En interrogeant la fonction de répartition cumulative normale standardisée pour ce nouveau score z = -0,90, nous obtenons :
Papprox_corrigée(X ≤ 45) ≈ Φ(-0,90) = 0,184060… ≈ 0,1841 (soit 18,41 %)
La confrontation des grandeurs chiffrées est saisissante :
- Probabilité binomiale exacte : 0,184101
- Probabilité normale avec correction : 0,184060
- Erreur absolue résiduelle : |0,184060 – 0,184101| = 0,000041 (soit 4 centièmes de millième de pourcent !)
- Erreur relative résiduelle : 0,022 %
Par la simple application du décalage d’une demi-unité géométrique, l’erreur d’approximation relative a été divisée par plus de 600, passant de 13,8 % à 0,02 %. La démonstration est limpide : la correction de continuité a presque intégralement éliminé le biais structurel d’approximation.
8. La correction de continuité dans le test du Chi-deux de Yates
8.1 Genèse et formulation du test de Yates pour tableaux 2×2
Si la correction de continuité trouve sa genèse dans l’approximation de la loi binomiale, son application la plus célèbre — et historiquement la plus controversée — se situe dans le champ des analyses de contingence via le test du Chi-deux d’indépendance de Karl Pearson. En 1934, le statisticien britannique Frank Yates publie un article séminal dans le supplément du Journal of the Royal Statistical Society, intitulé Contingency table technique involving small numbers and the χ² test.
Yates y met en évidence une vulnérabilité théorique structurelle du test du Chi-deux classique de Pearson lorsqu’il est appliqué à des tableaux croisés d’effectifs à deux lignes et deux colonnes (tableaux dits 2×2). Dans une table de contingence 2×2, le nombre de degrés de liberté (ddl), donné par la formule classique (lignes – 1) × (colonnes – 1), est exactement égal à 1 :
ddl = (2 – 1) × (2 – 1) = 1
Or, sous l’hypothèse de marges fixes conditionnelles, les fréquences cellulaires observées dans le tableau ne peuvent fluctuer que selon des incréments discrets entiers, régis fondamentalement par une loi hypergéométrique. Superposer à cette grille discontinue la loi théorique du Chi-deux — qui est une distribution rigoureusement continue découlant du carré d’une variable normale centrée réduite — génère le même biais spatial d’incompatibilité dimensionnelle que celui observé pour la loi binomiale. Yates démontra que le test standard de Pearson surestime systématiquement la significativité statistique en présence de faibles effectifs globaux, produisant un taux anormalement élevé de faux positifs.
8.2 Expression mathématique de la statistique modifiée
Pour neutraliser ce biais et réaligner la statistique discrète sur l’intégrale continue de la distribution théorique du Chi-deux à 1 degré de liberté, Frank Yates introduisit une modification arithmétique consistant à retrancher une demi-unité (0,5) à la valeur absolue de chaque écart entre effectif observé et effectif théorique attendu avant de l’élever au carré. La formule générale de la statistique du Chi-deux de Yates prend la forme suivante :
χ²Yates = ∑ [ (|Oi – Ei| – 0,5)² / Ei ]
Dans cette équation, Oi désigne l’effectif empirique concrètement observé dans la i-ème cellule du tableau, et Ei représente l’effectif théorique attendu sous l’hypothèse nulle d’indépendance stochastique, calculé classiquement par le produit marginal divisé par l’effectif total N.
Pour un tableau de contingence 2×2 dont les cellules intérieures sont conventionnellement notées [a, b ; c, d] avec un effectif total N = a + b + c + d, la formule de Yates bénéficie d’une expression analytique condensée particulièrement rapide à exécuter manuellement :
χ²Yates = [ N (|ad – bc| – N/2)² ] / [ (a + b)(c + d)(a + c)(b + d) ]
L’observation de cette structure algébrique met en relief l’impact direct de la correction : la soustraction du terme 0,5 (ou du facteur d’échelle N/2) a pour conséquence mathématique inéluctable de comprimer le numérateur. Par construction, la statistique de test calculée χ²Yates sera donc toujours rigoureusement inférieure à la statistique de Pearson standard non corrigée.
8.3 Influence sur le taux d’erreur de première espèce
La réduction mécanique de la valeur numérique de la statistique de test entraîne une translation immédiate de la p-valeur associée vers des grandeurs plus élevées. En d’autres termes, pour un même tableau d’observations croisées, le test de Yates renverra systématiquement une valeur p supérieure à celle calculée par le test du Chi-deux conventionnel de Pearson.
Cette propriété a été spécifiquement conçue par Yates pour constituer un bouclier protecteur contre l’inflation du taux d’erreur de première espèce (le risque α). Lorsque les effectifs d’échantillon sont modestes (par exemple N < 40 ou lorsque certaines cellules présentent des effectifs attendus inférieurs à 5), le Chi-deux classique a une fâcheuse propension à afficher des p-valeurs artificiellement basses (par exemple p = 0,038), incitant à tort l’expérimentateur à déclarer une dépendance significative alors que les variations observées relèvent de simples fluctuations d’échantillonnage discret.
En pénalisant la statistique de test, la correction de Yates rétablit le niveau de confiance nominal, garantissant que la probabilité réelle de rejeter l’hypothèse nulle à tort ne dépasse pas le seuil critique α = 0,05 convenu au protocole. Durant plus d’un demi-siècle, son inclusion systématique dans les analyses de tables 2×2 est devenue le standard méthodologique dominant exigé par les relecteurs des revues biomédicales et psychologiques.
9. Controverses méthodologiques et débats contemporains
9.1 Le risque de sur-correction conservatrice de Yates
En dépit de son adoption massive au XXe siècle, la correction de continuité de Yates a fait l’objet de vives contestations théoriques dès les années 1950, alimentant l’un des débats méthodologiques les plus persistants de la statistique appliquée. Le reproche fondamental articulé par de nombreux biométriciens et statisticiens mathématiques (notamment E. S. Pearson, Berkson, ou plus tard Camilli et Hopkins) réside dans le fait que la correction de Yates « corrige trop fort » : elle est excessivement conservatrice.
Plusieurs études de simulation de Monte-Carlo à grande échelle ont démontré que si la statistique classique de Pearson surestime parfois le risque α, l’application de la correction de Yates abaisse fréquemment le taux d’erreur de type I réel très en dessous du niveau nominal α = 0,05, le cantonnant souvent autour de 0,02 ou 0,01. Or, en statistique inférentielle, toute baisse artificielle du risque α sous son niveau consenti se paie directement par une dégradation drastique de la puissance statistique du test (une augmentation corrélative de l’erreur de type II, β).
En appliquant la correction de continuité de Yates de façon indiscriminée, les chercheurs courent un risque majeur : celui d’échouer à détecter des associations expérimentales ou des effets thérapeutiques parfaitement réels, la statistique de test étant indûment étouffée par le retranchement conservateur de la demi-unité. Sur des cohortes cliniques où les effets sont subtils, cette perte de puissance méthodologique peut conduire à l’abandon prématuré de pistes de recherche biomédicales prometteuses.
9.2 La position des théoriciens face aux tests asymptotiques
Pour comprendre la genèse de cette sur-correction conservatrice, il est nécessaire d’examiner les hypothèses probabilistes sous-jacentes. La correction de Yates a été formellement dérivée sous l’hypothèse rigide que les totaux marginaux du tableau 2×2 (les sommes des lignes et des colonnes) sont fixés par avance par le protocole expérimental (plan d’échantillonnage doublement conditionnel). C’est précisément sous cette condition de double conditionnement que la distribution d’échantillonnage exacte est strictement régie par la loi hypergéométrique.
Or, dans l’immense majorité des recherches empiriques réelles en sciences sociales ou en médecine, les marges ne sont absolument pas fixées à l’avance. Fréquemment, seule la taille globale de l’échantillon N est déterminée (échantillonnage multinomial), voire aucune marge n’est contrainte (échantillonnage de Poisson pur, où les sujets sont simplement classés au fil de leur recrutement). Des théoriciens comme Campbell (2007) ou Ian Gordon ont souligné que lorsque les marges sont libres de fluctuer stochastiquement, la statistique non corrigée de Pearson offre en réalité une approximation du taux d’erreur α bien plus proche de 0,05 que la statistique de Yates, qui s’avère inutilement punitive.
De nombreux statisticiens contemporains préconisent par conséquent de dissocier clairement l’approximation des lois univariées (comme la binomiale, où l’ajustement de ± 0,5 demeure mathématiquement irréprochable) de l’analyse des tables de contingence bidimensionnelles, où l’interaction des contraintes marginales rend l’ajustement de Yates sous-optimal par rapport à d’autres alternatives méthodologiques.
9.3 Alternatives computationnelles : le test exact de Fisher
Le coup de grâce porté à l’obligation systématique d’utiliser la correction de continuité de Yates provient de la puissance computationnelle moderne, incarnée par le test exact de Fisher (Fisher’s exact test). Formulé par Ronald A. Fisher en 1935, ce test ne repose sur aucun développement asymptotique et ne fait appel à aucune courbe continue approximative : il calcule directement la probabilité exacte d’observer la table de contingence obtenue (et de toutes les tables plus extrêmes) en évaluant de façon exhaustive les probabilités combinatoires de la distribution hypergéométrique.
Autrefois cantonné aux très petits échantillons en raison de la complexité astronomique des factorielles combinatoires à manipuler à la main, le test exact de Fisher s’exécute aujourd’hui instantanément sur n’importe quel ordinateur portable pour des tableaux comportant des centaines ou des milliers de sujets. Dès lors, le consensus contemporain au sein des revues scientifiques de premier plan (notamment en épidémiologie, génétique et psychologie cognitive) peut se résumer ainsi :
- Si les effectifs cellulaires attendus sont tous confortables (typiquement Ei ≥ 5 pour toutes les cellules), le test du Chi-deux classique de Pearson non corrigé est largement privilégié en raison de son respect optimal du niveau α et de sa puissance supérieure.
- Si l’un des effectifs théoriques attendus est faible (Ei < 5) ou si la taille totale N est modeste, on délaisse totalement les approximations continues pour exécuter directement le test exact de Fisher (ou des tests de randomisation exacte).
Dans ce paysage computationnel moderne, la correction de Yates apparaît de plus en plus comme une technique de transition historique, bien qu’elle demeure implémentée par défaut dans de multiples progiciels statistiques commerciaux.
10. Applications dans les tests non paramétriques en psychologie
10.1 Le test des rangs signés de Wilcoxon
L’utilité méthodologique de la correction de continuité ne s’arrête pas aux distributions binomiales ou aux tables de contingence : elle joue un rôle prépondérant dans la mise en œuvre des tests statistiques non paramétriques basés sur les rangs, très largement employés en psychologie expérimentale lorsque les postulats de normalité des distributions sous-jacentes sont violés.
Le test des rangs signés de Wilcoxon est classiquement utilisé pour comparer deux mesures répétées ou appariées issues des mêmes participants. Le principe analytique consiste à calculer la différence entre chaque paire de scores, à classer ces différences absolues par ordre croissant de rangs, puis à sommer séparément les rangs affectés d’un signe positif et ceux affectés d’un signe négatif. La statistique de test, notée W (ou T), est par construction une variable discrète : elle ne progresse que par sauts entiers en fonction des permutations combinatoires finies des attributions de rangs.
Lorsque le nombre de paires analysées dépasse un seuil conventionnel (généralement n ≥ 20), la distribution d’échantillonnage exacte de la somme des rangs sous l’hypothèse nulle converge vers une distribution normale d’espérance μW = [n(n + 1)] / 4 et de variance σ²W = [n(n + 1)(2n + 1)] / 24. Pour évaluer la statistique standardisée z associée à cette somme de rangs discrète, l’application d’une correction de continuité au numérateur s’avère indispensable :
z = [ |W – μW| – 0,5 ] / σW
Ce retranchement de 0,5 compense la structure étagée des sommes de rangs, évitant un gonflement artificiel de la valeur standardisée z et garantissant que l’inférence non paramétrique sur des échantillons moyens conserve son intégrité probabiliste.
10.2 Le test U de Mann-Whitney
Un mécanisme rigoureusement analogue s’applique au test U de Mann-Whitney (également connu sous l’appellation de test de la somme des rangs de Wilcoxon pour échantillons indépendants). Cet outil méthodologique fondamental sert d’alternative directe au test t de Student pour la comparaison de deux groupes indépendants ne respectant pas le postulat de normalité gaussienne.
La statistique U quantifie le nombre d’occurrences où un score tiré du premier groupe surpasse un score issu du second groupe lors de comparaisons paire à paire. Là encore, la statistique U est fondamentalement entière et discrète. Sous l’hypothèse nulle d’équivalence stochastique, la distribution d’échantillonnage de U converge rapidement vers la normalité dès que les tailles des deux groupes respectifs (n1 et n2) dépassent une dizaine d’unités, avec pour paramètres théoriques :
- Moyenne théorique : μU = (n1 n2) / 2
- Variance théorique : σ²U = [n1 n2 (n1 + n2 + 1)] / 12
Lors de la conversion asymptotique vers le score standardisé z, l’intégration de la correction de continuité de demi-unité s’effectue au moyen de la formulation absolue :
z = [ |U – μU| – 0,5 ] / σU
Cette correction permet de lisser la granularité combinatoire des rangs, fournissant une p-valeur bilatérale asymptotique d’une grande conformité avec les calculs de permutations exacts permis par les algorithmes modernes.
10.3 Gestion des ex-aequo et complexification structurelle
L’application concrète de la correction de continuité dans les tests de rangs se complexifie substantiellement lorsque les données empiriques comportent des valeurs identiques (appelées ex-aequo ou ties). La présence de scores identiques oblige le statisticien à attribuer aux observations concernées des rangs moyens fractionnaires (par exemple des rangs valant 4,5 ou 7,33).
L’apparition de ces fractions rompt la granularité entière régulière de la distribution d’échantillonnage discrète sous-jacente. Le pas entre deux sommes de rangs consécutives n’est plus rigoureusement constant ni égal à 1. Dans cette configuration, deux modifications analytiques doivent impérativement être gérées de concert :
- Correction de la variance pour ex-aequo : La formule de la variance théorique doit être déflatée en y soustrayant un facteur correctif calculé à partir de la somme des cubes des tailles des groupes d’ex-aequo : ∑ (ti³ – ti).
- Ajustement de la continuité géométrique : Certains algorithmes avancés réduisent le terme correcteur de continuité pour refléter la diminution du pas discret minimum effectif induit par les rangs fractionnaires.
Les chercheurs doivent faire preuve d’une prudence méthodologique extrême lorsqu’ils examinent les sorties des progiciels statistiques : certains logiciels (comme R ou SAS) désactivent automatiquement la correction de continuité dès lors que des ex-aequo sont détectés, tandis que d’autres (comme SPSS) maintiennent aveuglément le décalage de 0,5, créant d’infimes divergences numériques entre les résultats rapportés dans différentes publications.
11. Mise en œuvre computationnelle et syntaxe logicielle
11.1 Programmation et exécution sous l’environnement R
L’environnement statistique libre R offre un contrôle d’une granularité totale sur l’activation, la désactivation ou la comparaison des corrections de continuité dans l’ensemble de ses routines analytiques fondamentales.
Pour l’analyse de conformité d’une proportion ou d’un test binomial asymptotique, la fonction standard prop.test() implémente nativement un argument booléen intitulé correct. Par défaut, R active systématiquement la correction de continuité (correct = TRUE). Si le chercheur souhaite comparer la statistique corrigée avec la statistique de Pearson brute, il lui suffit de modifier cet opérateur syntaxique :
Pour exécuter un test avec correction :
prop.test(x = 45, n = 100, p = 0.5, correct = TRUE)
Pour exécuter un test sans correction asymptotique :
prop.test(x = 45, n = 100, p = 0.5, correct = FALSE)
Pour obtenir la probabilité exacte absolue sans recourir au modèle continu asymptotique, l’utilisateur sollicitera la commande dédiée :
binom.test(x = 45, n = 100, p = 0.5)
De façon rigoureusement analogue, pour l’analyse des tables de contingence via la commande chisq.test(), l’argument correct = TRUE force l’implémentation de la correction de continuité de Yates pour les tables 2×2. Si l’utilisateur passe cet argument à FALSE, la fonction retourne le Chi-deux d’indépendance de Pearson conventionnel sans altération d’écart.
11.2 Procédures sous langage Python avec SciPy et Statsmodels
Dans l’écosystème Python orienté vers la science des données et l’apprentissage statistique, les bibliothèques scipy.stats et statsmodels constituent les piliers de référence pour la mise en œuvre de ces procédures d’inférence.
Au sein de la bibliothèque scipy.stats, l’analyse des tableaux de contingence s’opère au moyen de la fonction chi2_contingency. Tout comme sous R, un paramètre booléen explicite correction gouverne l’application de la règle de Yates :
Pour appliquer la correction de Yates sur une matrice 2×2 :
scipy.stats.chi2_contingency(table_observee, correction=True)
Pour solliciter l’algorithme standard sans décalage :
scipy.stats.chi2_contingency(table_observee, correction=False)
Lorsqu’on souhaite programmer manuellement l’évaluation cumulative d’une distribution binomiale avec correction de continuité à l’aide des objets de densité de SciPy, on recourt directement à la fonction de répartition cumulative norm.cdf :
Calcul standardisé de la borne avec translation de demi-unité :
z = ((k + 0.5) - n * p) / math.sqrt(n * p * (1 - p))
probabilite = scipy.stats.norm.cdf(z)
L’accès aux calculs exacts s’effectue avec la même concision via la commande scipy.stats.binom.cdf(k, n, p) pour la distribution binomiale cumulative ou scipy.stats.fisher_exact(table_observee) pour le test exact de Fisher, garantissant une flexibilité d’analyse absolue pour les développeurs d’algorithmes statistiques.
11.3 Paramétrage dans les logiciels SPSS et Jamovi
Pour les chercheurs utilisant des environnements dotés d’une interface graphique interactive, tels qu’IBM SPSS Statistics ou Jamovi, la gestion de la correction de continuité obéit à des règles de restitution automatisées qu’il convient de savoir interpréter.
Dans le logiciel SPSS, lors de l’exécution d’une analyse de contingence via le menu Statistiques Descriptives > Tableaux Croisés en cochant l’option Chi-deux, le logiciel ne demande pas à l’utilisateur s’il désire ou non activer la correction. Dans sa fenêtre de résultats, le tableau Tests du Chi-deux génère automatiquement plusieurs lignes de calcul simultanées dès lors que le tableau soumis est de dimension 2×2 :
- La ligne Chi-carré de Pearson (la statistique conventionnelle brute non corrigée).
- La ligne Correction de continuité : c’est précisément ici qu’est affichée la statistique du Chi-deux de Yates modifiée avec le retranchement de 0,5 et sa p-valeur associée.
- La ligne Test exact de Fisher, affichant les p-valeurs unilatérales et bilatérales exactes basées sur la distribution hypergéométrique.
Dans le logiciel open-source Jamovi, réputé pour sa clarté pédagogique et son moteur R sous-jacent, le module Tableaux de Contingence offre des cases à cocher distinctes : l’utilisateur peut cocher indépendamment Chi-deux, Correction de continuité de Yates, ou Exact de Fisher. La bonne pratique dans ces interfaces graphiques consiste à ne jamais rapporter les résultats de la ligne de Yates de façon automatique sans justification méthodologique préalable, mais à arbitrer scrupuleusement entre la statistique de Pearson et le test exact de Fisher en fonction de la taille globale de l’échantillon et des effectifs attendus par cellule.
12. Synthèse méthodologique et recommandations pour les chercheurs
12.1 Arbre décisionnel pour l’analyse de variables discrètes
Afin de guider rationnellement les chercheurs, praticiens et analystes de données dans la sélection de leurs outils inférentiels face à des variables discrètes, nous proposons l’arbre décisionnel méthodologique suivant :
- Évaluation initiale de l’outil disponible : Dispose-t-on d’un environnement computationnel moderne (R, Python, logiciel statistique complet) permettant le calcul exact instantané ?
- Si OUI : Pour toute analyse univariée de proportions binomiales ou pour toute table 2×2 avec effectifs modérés, privilégier prioritairement les méthodes combinatoires exactes (test binomial exact via la loi binomiale, test exact de Fisher). La question de la correction de continuité devient alors caduque.
- Si NON (calcul manuel, grandes tables imposantes, ou contrainte de modèle asymptotique paramétrique) : Poursuivre vers l’étape 2.
- Vérification des critères d’admissibilité de l’approximation normale : Évaluer les conditions d’effectif attendu : np ≥ 10 et n(1 – p) ≥ 10.
- Si les conditions NE SONT PAS satisfaites : Rejeter formellement l’approximation normale. Se tourner vers la loi de Poisson (si les événements sont très rares et n grand) ou recourir impérativement à des méthodes non paramétriques exactes.
- Si les conditions SONT satisfaites : L’approximation continue est formellement légitime. Passer à l’étape 3.
- Application de la correction de continuité :
- Dans le cadre de l’approximation de la distribution binomiale (ou de Poisson) par la distribution normale : appliquer systématiquement et obligatoirement la règle d’ajustement géométrique de ± 0,5. Son apport analytique est indiscutable et réduit massivement le biais d’approximation sans générer d’inconvénient méthodologique.
- Dans le cadre d’un test du Chi-deux pour tableau 2×2 : ne pas appliquer la correction de Yates par défaut si les marges ne sont pas expérimentalement contraintes et que les effectifs attendus sont confortables (Ei ≥ 5), afin de ne pas détruire artificiellement la puissance statistique du test.
- Dans le cadre des tests non paramétriques de rangs (Wilcoxon, Mann-Whitney) sur de grands échantillons : activer la correction de demi-unité au numérateur du score z dès lors que le nombre d’ex-aequo est nul ou très marginal.
12.2 Normes de rédaction et de transparence empirique selon l’APA
L’American Psychological Association (normes APA, 7e édition) impose une transparence absolue dans la déclaration des protocoles statistiques et des résultats empiriques afin de garantir la réplicabilité de la science du comportement. Lorsqu’un statisticien rapporte les résultats d’un test impliquant ou non une correction de continuité, les directives de rédaction exigent le respect scrupuleux des préceptes suivants :
- Mention explicite de la procédure : La section Analyses statistiques doit stipuler de façon non ambiguë si une correction de continuité a été appliquée ou non. Il convient d’écrire par exemple : « Une analyse du Chi-deux d’indépendance de Pearson sans correction de continuité de Yates a été menée… » ou « Une approximation normale avec correction de continuité de ± 0,5 a été utilisée pour évaluer le score z… ».
- Précision de la statistique de test et de ses paramètres : Rapporter rigoureusement la lettre symbolique de la statistique, les degrés de liberté entre parenthèses, la valeur numérique exacte de la statistique arrondie à deux décimales, et la valeur p précise arrondie à trois décimales (sans écrire arbitrairement p < 0,05 sauf si p < 0,001). Par exemple : χ²(1, N = 80) = 4,25 ; p = 0,039.
- Cohérence de la déclaration de taille d’effet : Si une statistique de test corrigée pour la continuité est utilisée, la mesure de taille d’effet associée (comme le coefficient phi φ, le V de Cramér ou le rapport de cotes odds ratio) doit être explicitement définie, accompagnée systématiquement de son intervalle de confiance à 95 %.
Cette rigueur de déclaration permet aux futurs méta-analystes de recalculer précisément les tailles d’effet brutes sans se heurter aux distorsions causées par des corrections non mentionnées dans le corps du texte publié.
12.3 Récapitulatif des pièges conceptuels récurrents
Pour clore ce panorama méthodologique, récapitulons les trois pièges conceptuels les plus fréquemment observés dans les travaux de recherche et les mémoires d’étudiants :
- L’inversion du sens de l’ajustement arithmétique : Il s’agit de l’erreur la plus banale lors des calculs manuels ou de la programmation d’algorithmes sur mesure. Soustraire 0,5 au lieu de l’ajouter (ou inversement) lors de l’évaluation d’une inégalité stricte dégrade considérablement l’estimation, produisant une erreur pire que si aucune correction n’avait été tentée. Il est indispensable de matérialiser systématiquement l’histogramme de probabilité sur un brouillon pour visualiser si la frontière doit inclure ou exclure le pavé unitaire considéré.
- L’application indue à des variables nativement continues mais arrondies : Certains praticiens croient à tort devoir appliquer la correction de continuité à des grandeurs réelles — telles que le temps de réaction en millisecondes, le poids en kilogrammes ou la tension artérielle en millimètres de mercure — sous prétexte que les instruments de mesure n’enregistrent que des nombres entiers arrondis. C’est une faute théorique : ces variables sont ontologiquement continues dans la nature ; leur distribution d’échantillonnage théorique ne présente aucun saut discret et ne nécessite en aucun cas un ajustement de ± 0,5. La correction de continuité est strictement et exclusivement réservée aux variables générées par un processus de comptage discret (dénombrement d’occurrences).
- L’oubli de la vérification de l’asymétrie : Appliquer scrupuleusement la règle de ± 0,5 sur un échantillon binomial où p = 0,02 et n = 50 relève d’une illusion méthodologique. La précision géométrique de l’ajustement de demi-unité ne sauvera jamais une distribution violemment asymétrique de l’inadéquation structurelle du modèle gaussien. Les conditions préalables d’effectifs minimaux (np ≥ 10 et n(1-p) ≥ 10) demeurent la clé de voûte indispensable sur laquelle repose l’édifice mathématique de la correction de continuité.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Campbell, I. (2007). Chi-squared and Fisher-Irwin tests of two-by-two tables with small expected frequencies. Statistics in Medicine, 26(19), 3661-3675. https://doi.org/10.1002/sim.2832
- De Moivre, A. (1738). The Doctrine of Chances: Or, A Method of Calculating the Probabilities of Events in Play (2nd ed.). H. Woodfall.
- Fisher, R. A. (1935). The logic of inductive inference. Journal of the Royal Statistical Society, 98(1), 39-82. https://doi.org/10.2307/2342435
- Haviland, M. G. (1990). Yates’s correction for continuity and the analysis of 2 × 2 contingency tables. Statistics in Medicine, 9(4), 363-367. https://doi.org/10.1002/sim.4780090403
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier.
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50-60. https://doi.org/10.1214/aoms/1177730491
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968
- Yates, F. (1934). Contingency table technique involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217-235. https://doi.org/10.2307/2983604