
L’inférence statistique au sein des sciences contemporaines repose sur un postulat fondamental que l’on qualifie souvent, avec une désinvolture trompeuse, d’hypothèse d’indépendance et d’identique distribution des erreurs. Pourtant, lorsque les chercheurs en psychologie, en éducation ou en économie comportementale collectent des données empiriques, la réalité du terrain s’avère infiniment plus intriquée. Les individus ne constituent que rarement des entités isolées évoluant dans un vide social ou institutionnel ; ils s’inscrivent dans des classes scolaires, des unités hospitalières, des cellules familiales, des organisations professionnelles ou des zones géographiques définies. Ignorer ces architectures sociales et méthodologiques revient à commettre une erreur épistémologique majeure, dont la sanction mathématique immédiate est l’illusion de la précision statistique.
Au cœur de cette problématique se loge l’erreur type, véritable boussole guidant le rejet ou le maintien de l’hypothèse nulle. Lorsqu’un modèle de régression standard traite des observations corrélées comme si elles étaient mutuellement indépendantes, il surestime grossièrement la quantité réelle d’information apportée par l’échantillon. Cette défaillance conceptuelle engendre une contraction artificielle des erreurs types, propulsant les statistiques de test vers des sommets trompeurs et faisant s’effondrer les valeurs p bien en dessous des seuils d’acceptabilité conventionnels. Le résultat en est une prolifération de faux positifs, menaçant directement la réplicabilité des découvertes scientifiques et conduisant les praticiens à accorder du crédit à des interventions dépourvues d’efficacité réelle.
Face à ce péril méthodologique, le recours aux erreurs types regroupées (connues en anglais sous l’appellation de clustered standard errors) s’est imposé comme une réponse incontournable. Cette approche non paramétrique d’ajustement de la variance permet de corriger les statistiques inférentielles sans modifier les coefficients de régression estimés, autorisant ainsi une structure de corrélation arbitraire entre les résidus des observations appartenant à une même grappe. Le présent guide a pour vocation de décortiquer en profondeur la genèse, la théorie mathématique, les applications concrètes et les limites de cet outil fondamental, offrant aux chercheurs et aux analystes un cadre rigoureux pour préserver l’intégrité de leurs conclusions empiriques.
1. Introduction aux modèles de régression et rôle fondamental des erreurs types
1.1 Fondements de l’analyse de régression en recherche psychologique
L’analyse de régression linéaire représente l’un des piliers méthodologiques les plus mobilisés au sein de la recherche psychologique quantitative. Son but premier consiste à formaliser et à quantifier la relation fonctionnelle unissant une ou plusieurs variables explicatives indépendantes à une variable dépendante continue, qu’il s’agisse de mesurer la réduction de symptômes anxieux, les scores d’engagement académique ou la rapidité du traitement cognitif. En formulant un modèle statistique linéaire, le chercheur postule que l’espérance mathématique de la réponse observée peut être approchée par une combinaison pondérée des covariables, modulée par un terme d’erreur stochastique résumant l’ensemble des déterminants non observés ou aléatoires du comportement humain.
L’estimation des coefficients de régression, communément désignés sous le terme de coefficients bêta, permet d’isoler l’ampleur de l’effet marginal exercé par chaque régresseur, toutes choses étant égales par ailleurs. Dans une perspective clinique ou appliquée, ces paramètres fournissent une mesure concrète de l’ampleur de l’impact associé à une unité supplémentaire sur l’échelle prédictive. Néanmoins, l’obtention d’un coefficient ponctuel n’est qu’une première étape : un estimateur calculé sur un échantillon donné demeure une variable aléatoire soumise aux aléas de l’échantillonnage probabiliste. C’est ici qu’intervient l’évaluation de l’incertitude, sans laquelle aucune déduction scientifique pérenne ne saurait être validée.
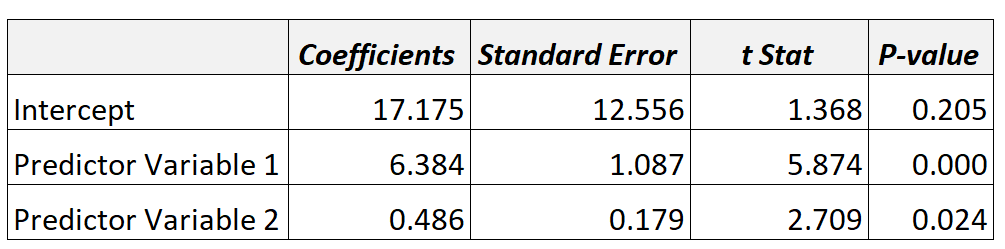
Dans la structure conventionnelle d’un tableau de régression linéaire tel que présenté dans les publications scientifiques soumises aux normes de l’American Psychological Association, chaque coefficient ponctuel est systématiquement flanqué de son erreur type, de sa statistique de test associée et de sa valeur p. Ce tableau formalise le passage délicat entre la simple description des données collectées et l’inférence théorique généralisable à une population cible. Si le coefficient ponctuel nous renseigne sur la direction et la force de la relation étudiée, c’est l’erreur type qui dicte le degré de confiance que la communauté scientifique peut accorder à cette observation, agissant ainsi comme le garant de la prudence méthodologique.
1.2 Comprendre l’erreur type : métrique de la précision de l’estimateur
D’un point de vue strictement mathématique, l’erreur type d’un estimateur correspond à l’écart-type de sa distribution d’échantillonnage théorique. Si un protocole d’expérimentation était répliqué une infinité de fois sous des conditions strictement identiques à partir de la même population parente, chaque tirage d’échantillon produirait une estimation légèrement différente du vecteur de paramètres par la méthode des moindres carrés ordinaires. L’erreur type quantifie précisément la dispersion attendue de ces estimations répétées autour de la véritable valeur populationnelle inconnue, constituant de fait l’étalon universel de la précision ou de la volatilité de la mesure statistique.
Il existe un lien analytique direct entre la taille de l’échantillon, la dispersion des résidus et la magnitude de l’erreur type. Dans le cadre canonique des moindres carrés ordinaires, la variance asymptotique de l’estimateur s’exprime comme le rapport entre la variance des termes d’erreur résiduels et la somme des carrés des écarts de la variable prédictive. Dès lors, plus le volume d’observations indépendantes augmente, plus le dénominateur s’accroît, resserrant la distribution d’échantillonnage et réduisant mécaniquement l’erreur type. Inversement, une forte dispersion résiduelle non expliquée par les régresseurs augmente le numérateur et dilate l’incertitude entourant l’estimation du paramètre.
Ce calcul exerce une influence déterminante sur le test d’hypothèse nulle. La statistique de Student se définit explicitement comme le ratio du coefficient estimé divisé par son erreur type associée. Ce ratio confronte l’amplitude observée de l’effet à l’incertitude inhérente à sa mesure. Par voie de conséquence directe, la valeur p (p-value), qui découle de la comparaison de cette statistique t avec la distribution théorique sous l’hypothèse nulle, dépend intimement de l’erreur type. Toute altération, minimisation ou distorsion de l’erreur type modifie de manière exponentielle la valeur p, guidant ainsi de façon binaire la décision d’accepter ou de rejeter l’hypothèse nulle de recherche.
1.3 Le piège de la fausse précision en inférence statistique
Le piège méthodologique le plus insidieux en modélisation statistique réside dans le phénomène de sous-estimation systématique de l’erreur type. Lorsqu’un algorithme d’estimation suppose à tort que chaque observation apporte une quantité d’information totalement indépendante des autres, il calcule une erreur type artificiellement comprimée. Ce rétrécissement illégitime a pour répercussion immédiate la constriction des intervalles de confiance à 95 %, donnant au chercheur l’impression erronée que son estimation est circonscrite dans une fourchette étroite et stable, alors même que la variabilité réelle du phénomène exploré est considérablement plus vaste.
La conséquence statistique la plus dévastatrice de cette sous-estimation réside dans l’inflation spectaculaire du taux d’erreur de type I, couramment qualifié de taux de faux positifs. Alors que le cadre néo-fisherien ou de Neyman-Pearson fixe conventionnellement le risque d’erreur de première espèce à un seuil alpha de 5 %, l’omission d’une structure de corrélation peut propulser ce taux d’erreur réel à 20 %, 40 % voire plus de 80 % dans certains contextes extrêmes. Les chercheurs se retrouvent dès lors à proclamer la significativité statistique d’interventions thérapeutiques, de disparités cognitives ou d’effets éducatifs qui ne sont en réalité que de purs artefacts imputables au bruit d’échantillonnage.
Ce phénomène met en lumière la vulnérabilité intrinsèque du cadre inférentiel aux violations des hypothèses sous-jacentes du modèle linéaire général. Trop souvent, l’attention des analystes se focalise de manière exclusive sur l’absence de biais des coefficients ponctuels, oubliant qu’un coefficient sans biais assorti d’une erreur type erronée constitue une base tout aussi défaillante pour l’établissement d’une science cumulative. La fausse précision nourrit l’illusion de la certitude, fausse les méta-analyses futures et contribue directement à la crise de la reproductibilité qui secoue les sciences du comportement depuis plus d’une décennie.
2. L’hypothèse d’indépendance des observations et ses violations structurelles
2.1 Le postulat d’indépendance et distribution des résidus (i.i.d.)
Le théorème de Gauss-Markov, qui consacre l’optimalité des moindres carrés ordinaires en tant que meilleur estimateur linéaire non biaisé (BLUE), repose sur une série d’axiomes stricts concernant la distribution des perturbations stochastiques. Parmi ceux-ci figure l’hypothèse d’indépendance et d’identique distribution des erreurs, souvent abrégée sous l’acronyme i.i.d. Cette condition exige non seulement que chaque résidu possède une espérance mathématique conditionnelle nulle et une variance constante (homoscédasticité), mais surtout que la covariance entre les termes d’erreur individuels de deux unités quelconques soit rigoureusement nulle :
$$\text{cov}(e_i, e_j) = 0 \quad \forall ; i \neq j$$
Dans la pratique de la recherche psychologique et sociale, cette condition d’absence totale de corrélation croisée est quasi systématiquement violée dès lors que les données sont recueillies au sein d’environnements naturels. Qu’il s’agisse de protocoles expérimentaux randomisés en grappes ou d’enquêtes observationnelles transversales, la réalité humaine se caractérise par des dépendances contextuelles multiples. L’environnement physique, institutionnel ou relationnel partagé par plusieurs sujets induit des similitudes comportementales et psychologiques profondes qui ne peuvent être capturées dans leur intégralité par les seules covariables introduites dans l’équation de régression.
Lorsque cette indépendance fait défaut, l’information apportée par chaque sujet additionnel n’est plus entièrement novatrice. Le second sujet interrogé au sein d’un même contexte reproduit en partie l’information déjà fournie par le premier, créant une redondance observationnelle que le modèle linéaire conventionnel ignore totalement. Traiter ces observations dépendantes comme si elles provenaient de tirages indépendants dans une urne théorique infinie constitue la racine première des dérives inférentielles observées dans la littérature quantitative moderne.
2.2 Origine des dépendances intraclasses en psychologie
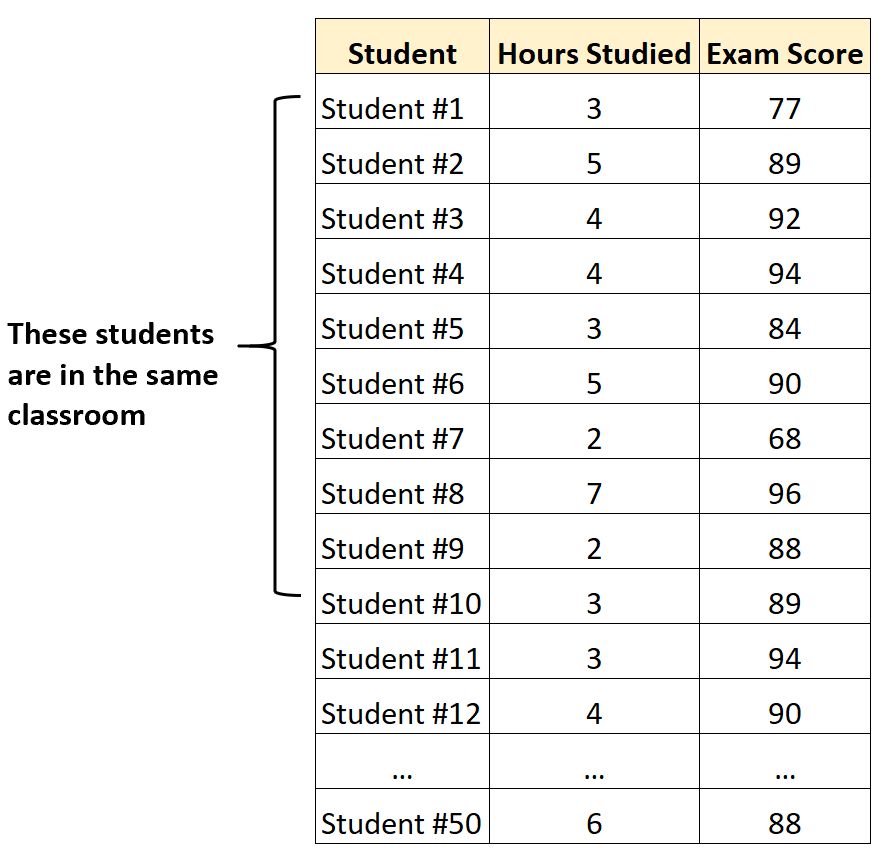
Les sources de dépendance intraclasse en psychologie sont intrinsèquement liées aux processus de socialisation et aux dynamiques écologiques. Les individus regroupés au sein d’entités sociales partagées—telles que les familles, les unités de soins psychiatriques, les groupes d’entraide ou les classes d’école—sont soumis à des stimuli environnementaux uniformes. Dans une classe primaire, par exemple, le style pédagogique de l’enseignant, la luminosité de la pièce, le niveau moyen d’agitation des élèves et les politiques de l’établissement constituent un cadre d’expérience commun qui module simultanément le profil de réponse de chaque enfant du groupe.
Au-delà des influences environnementales directes, l’homogénéité accrue au sein des grappes découle fréquemment de mécanismes d’auto-sélection ou d’assignation différentielle. Les couples conjugaux partagent des habitudes alimentaires, des routines de sommeil et des stresseurs financiers communs ; les résidents d’un même quartier partagent des niveaux d’exposition comparables à la pollution sonore ou à l’insécurité ; les patients d’une même clinique psychiatrique ont été triés en fonction de la sévérité de leurs troubles ou de leur couverture géographique. Ces phénomènes créent une ressemblance phénotypique et psychologique bien supérieure à celle attendue par simple tirage aléatoire dans la population générale.
Cette proximité se traduit analytiquement par la présence de facteurs latents non observés par l’expérimentateur. Même lorsque le chercheur prend soin de contrôler des variables individuelles classiques telles que l’âge, le genre ou le statut socio-économique, il subsiste une part résiduelle substantielle de variance partagée au niveau du groupe. Cette variance latente non modélisée se déverse directement dans les termes d’erreur résiduels du modèle, induisant une corrélation systématique positive entre les résidus d’individus partageant la même appartenance contextuelle, violant sans équivoque le postulat standard d’orthogonalité des résidus.
2.3 Mesures répétées et données longitudinales au niveau individuel
Les structures de grappes ne se limitent nullement aux regroupements sociaux ou institutionnels d’individus distincts ; elles émergent de manière tout aussi prégnante au sein des trajectoires temporelles individuelles. Dans les protocoles de mesures répétées, les études longitudinales à panels ou les méthodologies contemporaines d’évaluation écologique momentanée (Ecological Momentary Assessment), un même participant est évalué à de multiples reprises à travers le temps, générant une cascade d’observations imbriquées au niveau intra-individuel.
Dans cette architecture empirique, la personne devient elle-même la grappe d’observations multiples. L’état d’humeur, la réactivité physiologique ou la performance cognitive d’un individu à un instant donné sont inévitablement corrélés avec ses mesures aux points temporels précédents ou ultérieurs. L’architecture biologique, les traits de personnalité stables, le capital génétique et l’histoire personnelle d’un sujet constituent un socle invariant qui ancre ses observations dans un registre spécifique, distinct de celui des autres participants de l’échantillon.
L’utilisation de modèles de moindres carrés classiques pour analyser de telles données longitudinales sans ajustement spécifique s’avère particulièrement préjudiciable. Les autocorrélations temporelles intra-sujet violent frontalement le postulat d’indépendance. Si un chercheur recueille cinquante mesures journalières auprès de cent sujets, il ne dispose pas d’un échantillon de 5000 observations véritablement autonomes, mais d’une structure groupée de cent unités complexes. Assimiler cette matrice à un vecteur de 5000 unités indépendantes aboutit à une déformation massive des statistiques inférentielles et à une confiance aveugle en des résultats instables.
3. Définition conceptuelle des erreurs types regroupées (Clustered Standard Errors)
3.1 Définition mathématique et principe intuitif du regroupement
Les erreurs types regroupées, également documentées dans la littérature économétrique et biostatistique sous l’appellation d’erreurs types robustes aux grappes, constituent une généralisation de l’estimateur de variance robuste développé à l’origine par Huber et popularisé par White pour pallier l’hétéroscédasticité des erreurs. Alors que l’estimateur de White standard traite l’hétéroscédasticité tout en préservant l’hypothèse d’indépendance mutuelle des observations individuelles, l’approche par regroupement autorise explicitement l’existence d’une structure de corrélation arbitraire, flexible et non spécifiée entre les termes d’erreur des observations appartenant à une même entité collective.
Le principe intuitif sous-jacent repose sur une partition méthodologique claire : le chercheur s’abstient d’imposer une forme fonctionnelle stricte ou une paramétrisation contraignante à la corrélation intra-grappe. Les erreurs des sujets d’un même groupe peuvent présenter des variances dissemblables et des covariances croisées arbitrairement élevées. En revanche, l’indépendance stricte continue d’être postulée entre les différentes grappes. Ainsi, si la classe A et la classe B sont mutuellement indépendantes, toute la dépendance interne à l’intérieur de la classe A est intégralement prise en compte lors du calcul de la variance de l’estimateur.
Un atout épistémologique capital de cette démarche réside dans sa neutralité vis-à-vis de l’estimation ponctuelle. L’application des erreurs types regroupées ne modifie en aucune manière la valeur des coefficients bêta calculés par les moindres carrés ordinaires. Les estimations des effets marginaux demeurent strictement inchangées, conservant leur propriété de non-biais sous l’hypothèse d’exogénéité conditionnelle des régresseurs. C’est uniquement la matrice de variance-covariance de ces coefficients qui est recalculée, ajustant l’incertitude sans forcer une ré-estimation des pentes de régression.
3.2 Fonctionnement de l’estimateur de variance en sandwich pour grappes
L’architecture algébrique de cette méthode repose sur la structure dite en « sandwich », omniprésente dans la théorie asymptotique moderne des modèles quasi-paramétriques. Dans cette configuration, la matrice de variance-covariance estimée de l’estimateur vectoriel des coefficients de régression s’exprime comme le produit matriciel de trois termes distincts : une composante centrale désignée métaphoriquement comme la « viande », enserrée entre deux matrices identiques figurant le « pain » :
$$V_{\text{CRSE}} = (X’X)^{-1} \left( \sum_{g=1}^G X_g’ u_g u_g’ X_g \right) (X’X)^{-1}$$
Le « pain » extérieur, $(X’X)^{-1}$, découle directement de la formulation conventionnelle des moindres carrés ordinaires et reflète la structure globale de dispersion des variables explicatives de l’échantillon. La modification essentielle réside dans la « viande » centrale du sandwich. Au lieu de sommer les carrés des résidus individuels multipliés par les covariables correspondantes, l’estimateur de variance robuste aux grappes procède à une sommation sur les grappes. Pour chaque grappe $g$, les résidus individuels sont agrégés sous la forme d’un vecteur de dimension $n_g \times 1$, permettant de capturer non seulement la variance propre à chaque sujet, mais également l’intégralité des produits croisés des résidus entre tous les membres de cette même unité.
Cette sommation intra-groupe transforme les scores individuels en un score agrégé par grappe. Si les résidus d’individus partageant la même grappe ont tendance à être de même signe et de magnitude corrélée, le produit extérieur $u_g u_g’$ intègre directement ces covariances positives, augmentant mécaniquement la magnitude globale de la « viande » matricielle. Par la suite, des corrections de degrés de liberté adaptées aux petits échantillons sont introduites pour compenser le biais inhérent à l’utilisation des résidus estimés à la place des erreurs théoriques non observables.
3.3 Terminologie et synonymes dans la littérature statistique
La littérature quantitative contemporaine présente une pluralité terminologique susceptible d’engendrer des confusions chez les praticiens. L’appellation canonique d’erreurs types robustes aux grappes (Cluster-Robust Standard Errors, ou CRSE) coexiste fréquemment avec les désignations historiques de variance de Huber-White ajustée pour grappes, d’estimateur de Rogers, ou encore d’erreurs types en grappes de Liang-Zeger. Ces dénominations renvoient pour l’essentiel à un socle mathématique unifié, bien que leurs contextes d’introduction historique aient varié entre l’économétrie générale et l’épidémiologie clinique.
Dans le domaine biostatistique et médical, cette formulation est intimement liée aux équations d’estimation généralisées (Generalized Estimating Equations, ou GEE), introduites par Liang et Zeger en 1986. Dans ce paradigme, l’estimateur est souvent qualifié d’estimateur de variance empirique ou robuste, par opposition à l’estimateur de variance basé sur le modèle (model-based). Quelle que soit l’étiquette sémantique choisie, l’objectif opérationnel demeure identique : extraire une inférence valide sans exiger que la matrice de corrélation de travail spécifiée a priori par l’analyste soit rigoureusement exacte.
Enfin, dans les sciences de l’éducation et les enquêtes sociologiques à large échelle, ces ajustements sont couramment décrits comme des corrections pour effets de plan ou effets de structure d’échantillonnage (survey design-adjusted standard errors). Les logiciels spécialisés tels que SUDAAN, Survey sous Stata ou le package survey sous R mobilisent ces concepts pour tenir compte des plans d’échantillonnage complexes à plusieurs degrés, où les unités primaires d’échantillonnage correspondent mathématiquement aux grappes de l’économétrie appliquée.
4. Typologie des structures de regroupement en sciences psychologiques
4.1 Le clustering hiérarchique institutionnel et social
L’organisation de la société humaine présente une structure fondamentalement hiérarchique et imbriquée, ce qui se reflète directement dans la morphologie des données collectées en recherche psychologique. L’exemple paradigmatique en recherche évaluative clinique concerne « l’effet thérapeute ». Lorsque des patients souffrant de troubles dépressifs majeurs participent à un essai clinique contrôlé, ils sont assignés à des psychothérapeutes spécifiques. Même si le protocole thérapeutique est rigoureusement standardisé au moyen d’un manuel d’intervention, les compétences d’alliance thérapeutique, la voix, la personnalité et l’expérience propre de chaque clinicien introduisent une corrélation substantielle entre les issues thérapeutiques de l’ensemble des patients traités par ce même praticien.
De manière analogue, la psychologie de l’éducation et les neurosciences du développement opèrent au sein d’environnements scolaires hautement structurés. Les élèves sont imbriqués au sein de classes scolaires spécifiques, elles-mêmes nichées au sein d’établissements éducatifs régis par des directions distinctes et implantés dans des zones socio-démographiques singulières. Les apprentissages, l’auto-efficacité perçue ou les comportements d’indiscipline partagent une part de variance propre à la classe et une part propre à l’école. Négliger le fait que deux élèves partagent la même salle de classe équivaut à postuler que l’environnement didactique n’exerce aucune empreinte globale sur leur fonctionnement psychologique.
En psychologie du travail et des organisations, les salariés sont groupés en équipes de projet opérationnelles, placées sous la supervision directe de gestionnaires communs. Le micro-climat organisationnel instauré par un supérieur hiérarchique—qu’il s’agisse de sécurité psychologique, de pression temporelle ou de justice organisationnelle procédurale—diffuse à travers toute l’unité de travail. Les indicateurs individuels de burnout, d’engagement au travail ou de citoyenneté organisationnelle manifestent ainsi une dépendance intraclasse marquée, conditionnée par le leadership et la cohésion interne de l’équipe.
4.2 Le clustering temporel et méthodologique
Au-delà de la topographie spatiale et institutionnelle, les protocoles méthodologiques modernes génèrent de puissantes structures de regroupement temporel. L’avènement des technologies mobiles a démocratisé les études par journal de bord quotidien (Daily Diary Studies) et la méthode d’échantillonnage des expériences (Experience Sampling Method). Dans ces designs, les participants reçoivent entre trois et dix notifications par jour sur leurs smartphones durant plusieurs semaines consécutives pour auto-évaluer leur anxiété, leur concentration ou leurs interactions interpersonnelles en situation écologique.
Ces protocoles créent une imbrication à deux, voire trois niveaux : les évaluations instantanées sont regroupées au sein des journées d’un individu, et ces journées sont regroupées au sein de l’individu lui-même. Deux évaluations émotionnelles conduites à deux heures d’intervalle au cours d’un même après-midi partagent un contexte situationnel et un état d’activation neurobiologique immédiats qui ne sauraient être observés entre deux mesures prises à deux semaines d’intervalle. L’omission de cette dépendance intra-journalière et intra-sujet biaise drastiquement les tests d’association entre stresseurs et humeur.
Un autre vecteur méthodologique fréquent de regroupement en laboratoire expérimental découle des vagues de passation et de l’effet de l’expérimentateur. Lorsque des centaines de participants réalisent une tâche cognitive sur plusieurs mois, ils sont accueillis par des assistants de recherche successifs au cours de sessions collectives ou individuelles. L’attitude de l’expérimentateur, la calibration périodique des appareils de mesure, ou même les variations thermiques du laboratoire au fil des saisons peuvent créer de subtiles dépendances au niveau des sessions de test, rompant le postulat d’indépendance inter-sujets.
4.3 Le clustering spatial et culturel
Les investigations psychologiques contemporaines s’étendent de plus en plus au-delà des frontières des laboratoires universitaires occidentaux pour embrasser des designs transculturels et populationnels à large échelle. Les comparaisons internationales évaluant l’universalité des dimensions de la personnalité, des valeurs morales ou des biais cognitifs impliquent des dizaines de nations, chaque pays représentant une grappe au sein de laquelle résident des milliers de citoyens. Les normes culturelles, les institutions juridiques, la langue vernaculaire et l’histoire politique partagée créent une corrélation intragroupe profonde pour l’ensemble des réponses psychométriques recueillies au sein d’une même nation.
À une échelle géographique plus fine, la psychologie communautaire et la santé mentale publique s’intéressent à l’impact des caractéristiques urbaines sur la détresse psychologique des populations. Les résidents d’un même quartier ou d’un même îlot de recensement partagent une exposition commune à des facteurs de stress environnementaux tels que la proximité d’artères routières bruyantes, l’absence d’espaces verts réparateurs ou la densité des débits de boissons alcoolisées. Ces déterminants spatiaux créent une convergence des trajectoires psychologiques au niveau local.
En outre, les mécanismes de contagion comportementale et émotionnelle au sein de réseaux sociaux territorialement denses renforcent cette dépendance spatiale. L’adoption de comportements à risque à l’adolescence, la prévalence du tabagisme ou la diffusion d’affects dépressifs se transmettent par capillarité relationnelle entre voisins et pairs d’une même zone d’habitation. Considérer chaque répondant urbain comme une unité purement aléatoire et indépendante de ses voisins géographiques revient à ignorer les fondements mêmes de l’écologie du comportement humain.
5. Conséquences statistiques de l’ignorance du regroupement des données
5.1 L’illusion de la puissance statistique et la taille d’échantillon effective
L’ignorance délibérée ou accidentelle d’une structure de regroupement engendre une confusion majeure entre la taille nominale d’un échantillon et sa taille d’échantillon effective (souvent notée $N_{\text{eff}}$). La taille nominale correspond au simple décompte brut des observations collectées ($N = \sum n_g$). Les logiciels statistiques traitent par défaut ce chiffre comme le volume d’unités autonomes d’information. Or, dès lors que les résidus au sein des groupes présentent une corrélation non nulle, chaque observation successive au sein d’un groupe apporte une quantité d’information marginale décroissante sur le phénomène étudié.
La théorie de l’échantillonnage par grappes formalise cette perte d’information à travers le concept de facteur d’effet de plan (design effect, ou $VIF_{\text{cluster}}$), lequel permet d’établir l’équivalence entre la taille nominale et la taille effective via la formule fondamentale :
$$N_{\text{eff}} = \frac{N}{1 + (m – 1) \rho}$$
Dans cette équation élégante, $m$ représente la taille moyenne de chaque grappe et $rho$ symbolise le coefficient de corrélation intraclasse (ICC). Cette relation mathématique illustre une réalité brutale : la réduction de l’information effective est une fonction multiplicative de la taille des grappes. Même en présence d’une corrélation intraclasse d’apparence dérisoire—par exemple $\rho = 0{,}02$—si la taille moyenne des grappes est importante ($m = 100$), le dénominateur devient $1 + (99 \times 0{,}02) = 2{,}98$. Dans cette situation, un échantillon nominal de 3000 observations ne fournit en réalité que l’équivalent informationnel d’environ 1000 observations rigoureusement indépendantes.
Cette divergence crée une illusion pernicieuse de puissance statistique. Le chercheur planifie son protocole en estimant que son imposant effectif d’observations individuelles lui conférera la capacité de détecter des effets de taille ténue avec une certitude absolue. En réalité, le modèle souffre d’une sous-alimentation dramatique en termes d’unités informatives primaires, gonflant la volatilité réelle de l’estimateur sans que cette incertitude ne transparaisse dans les diagnostics du modèle naïf.
5.2 L’explosion du taux d’erreur de type I démontrée par Moulton
La démonstration théorique la plus retentissante de la défaillance des moindres carrés en présence de données groupées a été apportée par l’économètre Brent Moulton dans ses travaux fondateurs de 1986 et 1990. Moulton a formalisé le facteur d’inflation de la variance qui frappe spécifiquement les régressions où la variable explicative principale est mesurée au niveau de la grappe (par exemple, l’évaluation d’un programme pédagogique déployé au niveau de la classe, ou d’une loi promulguée au niveau d’un État).
Dans cette configuration critique, Moulton a démontré que le ratio de la variance véritable de l’estimateur des moindres carrés ordinaires sur la variance naïvement calculée par la formule standard s’exprime approximativement comme :
$$\frac{\text{Var}(\hat{\beta})_{\text{réelle}}}{\text{Var}(\hat{\beta})_{\text{MCO}}} \approx 1 + \left[ \frac{\text{Var}(m)}{\bar{m}} + \bar{m} – 1 \right] \rho_x \rho_e$$
où $\rho_x$ est la corrélation intraclasse de la variable explicative et $\rho_e$ est la corrélation intraclasse des résidus non observés. Lorsque le traitement est assigné uniformément à l’échelle de la grappe, $\rho_x = 1$. Dans un tel scénario, l’erreur type standard issue d’un MCO conventionnel peut être divisée par un facteur de deux, trois, voire cinq par rapport à sa valeur véritable. La statistique t de Student se retrouve multipliée par ce même facteur multiplicateur artificiel.
Ce phénomène explique l’effondrement spectaculaire des valeurs p sous le seuil critique de 0,05. Une statistique t calculée de manière naïve à 3,20 (correspondant à une valeur p hautement significative de 0,0014 sous les lois de Student conventionnelles) peut se réduire à une statistique t réelle de 1,40 après correction robuste pour grappes, affichant une valeur p corrigée de 0,16 totalement non significative. Moulton a ainsi mis en évidence que de vastes pans de la littérature économique et sociologique avaient proclamé avec une certitude absolue des causalités purement artefactuelles, issues d’une grossière sous-estimation de la variance.
5.3 Distorsion des intervalles de confiance et mauvaise réplicabilité
L’inflation du taux de faux positifs s’accompagne d’une distorsion symétrique des intervalles de confiance à 95 %. Sous le régime des moindres carrés naïfs, l’intervalle de confiance est calculé selon la formule standard $\hat{\beta} \pm t_{\text{crit}} \times \text{SE}(\hat{\beta})$. Dès lors que l’erreur type estimée est artificiellement resserrée, l’intervalle résultant présente une largeur démesurément étroite. Il échoue à couvrir la valeur réelle du paramètre populationnel avec le taux de couverture nominal de 95 % promis par la théorie mathématique, tombant parfois à un taux de couverture réel de 60 % ou 70 %.
Cette constriction anormale des marges d’incertitude a des répercussions désastreuses sur la dynamique de la réplicabilité scientifique en psychologie expérimentale et clinique. Lorsqu’une équipe de recherche réplique ultérieurement le protocole dans un nouvel échantillon de grappes, l’estimation ponctuelle obtenue se situe fréquemment bien en dehors de l’intervalle de confiance ultra-étroit publié par les auteurs initiaux. Ce décalage est alors interprété à tort comme un échec de réplication ou l’existence de modérateurs inconnus, alors qu’il ne reflète que la dispersion normale et prévisible d’un phénomène dont l’erreur type initiale avait été sous-évaluée de moitié.
En recherche translationnelle et en psychothérapie, ce biais d’inférence conduit au rejet erroné et prématuré de l’hypothèse nulle d’absence d’effet. Des politiques publiques coûteuses ou des programmes d’interventions thérapeutiques de groupe sont alors massivement adoptés et financés sur la base de résultats statistiques « hautement significatifs », pour se révéler ultérieurement dénués d’efficacité lors de déploiements pragmatiques rigoureusement contrôlés. La robustesse inférentielle n’est donc pas une simple coquetterie de théoricien des probabilités, mais une condition sine qua non de l’intégrité de l’application scientifique dans la société.
6. Formulation mathématique et coefficients de corrélation intraclasse
6.1 Le coefficient de corrélation intraclasse (ICC / Rho)
Pour appréhender quantitativement la nature et la sévérité du regroupement au sein d’une base de données, la métrique maîtresse demeure le coefficient de corrélation intraclasse, universellement désigné par l’acronyme ICC ou la lettre grecque $rho$. Ce coefficient trouve son origine dans la décomposition de la variance d’un modèle linéaire à effets aléatoires simples (souvent qualifié de modèle nul ou modèle à composantes de variance). Dans ce modèle, l’observation individuelle $Y_{ig}$ est décomposée selon l’équation :
$$Y_{ig} = \mu + u_g + \epsilon_{ig}$$
où $\mu$ représente le grand intercept populationnel, $u_g \sim \mathcal{N}(0, \sigma_u^2)$ symbolise l’écart spécifique de la grappe $g$ par rapport à la moyenne globale, et $\epsilon_{ig} \sim \mathcal{N}(0, \sigma_\epsilon^2)$ représente la déviation individuelle idiosyncratique. Le coefficient de corrélation intraclasse se définit formellement comme le ratio de la variance inter-grappes sur la variance phénotypique totale :
$$\text{ICC} = \rho = \frac{\sigma_u^2}{\sigma_u^2 + \sigma_\epsilon^2}$$
L’interprétation théorique et clinique de ce ratio est fondamentale. Un ICC de 0,02 signifie que 2 % seulement de la variabilité globale de la variable de réponse réside entre les différentes grappes, tandis que 98 % de la variance se déploie à l’échelle intra-grappe, entre les sujets d’un même groupe. Inversement, un ICC de 0,25 indique une remarquable homogénéité interne : un quart de l’hétérogénéité globale des scores est directement imputable à l’appartenance collective. Dans les études scolaires ou organisationnelles, les valeurs typiques d’ICC oscillent habituellement entre 0,05 et 0,20.
Il est indispensable de souligner un écueil cognitif récurrent chez les chercheurs : juger un ICC de 0,01 ou 0,02 comme négligeable. Comme l’a révélé l’examen de la taille d’échantillon effective et de la formule de Moulton, la gravité de la distorsion inférentielle dépend du produit de l’ICC par la taille moyenne des grappes. Dans une étude portant sur des cohortes d’entreprises où $m = 500$, un ICC apparemment minuscule de 0,01 produit un facteur multiplicatif d’effet de plan égal à $1 + (499 \times 0{,}01) = 5{,}99$. Dans ce contexte, ignorer le regroupement sous prétexte que l’ICC est « cliniquement proche de zéro » engendre une sous-estimation vertigineuse des erreurs types de près de 60 %.
6.2 Structure de la matrice de covariance résiduelle non diagonale
L’hypothèse classique des moindres carrés ordinaires postule que la matrice de variance-covariance des résidus, notée conventionnellement $\Omega$, est une matrice diagonale scalaire de dimension $N \times N$. Sous ce postulat i.i.d., chaque terme diagonal est égal à $\sigma^2$ (variance résiduelle constante) et l’intégralité des éléments hors-diagonale est strictement égale à zéro : $\Omega = \sigma^2 I_N$. Cette structure mathématique épurée incarne l’absence complète de corrélation entre les observations prises deux à deux.
En présence d’une structure de regroupement où la base de données est partitionnée en $G$ grappes indépendantes, la morphologie matricielle subit une reconfiguration géométrique profonde. La matrice $\Omega$ adopte alors une forme diagonale par blocs (block-diagonal matrix) :
$$\Omega = \begin{\bmatrix} \Sigma_1 &a\mp; 0 &a\mp; \cdots &a\mp; 0 0 &a\mp; \Sigma_2 &a\mp; \cdots &a\mp; 0 \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots 0 &a\mp; 0 &a\mp; \cdots &a\mp; \Sigma_G \end{\bmatrix}$$
Les blocs extra-diagonaux constitués de zéros reflètent la préservation de l’hypothèse d’indépendance mutuelle entre les différentes grappes. En revanche, chaque bloc diagonal $\Sigma_g$, de dimension $n_g \times n_g$, représente la matrice de covariance interne propre à la grappe $g$. Les éléments diagonaux internes de ce sous-bloc correspondent aux variances spécifiques des résidus individuels des membres de cette grappe, tandis que les éléments hors-diagonale internes représentent les covariances résiduelles intra-grappes :
$$\text{cov}(e_{ig}, e_{jg}) = \sigma_{ij,g} \neq 0 \quad \text{pour} ; i \neq j$$
Dans l’approche des erreurs types regroupées, aucune contrainte paramétrique d’équicorrélation ou d’homoscédasticité n’est imposée à ces blocs diagonaux $\Sigma_g$. La matrice résiduelle interne à chaque groupe est autorisée à adopter une forme générale quelconque, permettant des variances hétérogènes entre sujets et des covariances croisées asymétriques. L’objectif mathématique de l’inférence cluster-robuste est précisément d’estimer la variance globale des coefficients sans devoir expliciter ou paramétrer préalablement la forme précise de chaque bloc $\Sigma_g$.
6.3 Calcul explicite de l’estimateur sandwich cluster-robuste
L’estimation algébrique de la matrice de variance-covariance de l’estimateur des coefficients des moindres carrés ordinaires, sous la formulation cluster-robuste, s’effectue en substituant à la véritable matrice inconnue $\Omega$ une estimation empirique construite à partir des résidus observés au niveau de chaque groupe. Soit le modèle linéaire sous forme matricielle standard $Y = X\beta + e$, où $X$ est la matrice d’expérience de dimension $N \times K$. L’estimateur ponctuel reste l’estimateur ordinaire $\hat{\beta} = (X’X)^{-1}X’Y$. La matrice de variance cluster-robuste $V_{\text{CR}}$ s’exprime rigoureusement comme :
$$V_{\text{CR}} = (X’X)^{-1} \left[ \sum_{g=1}^G X_g’ \hat{e}_g \hat{e}_g’ X_g \right] (X’X)^{-1}$$
où $X_g$ est la sous-matrice des régresseurs pour l’ensemble des individus de la grappe $g$ (de dimension $n_g \times K$), et $\hat{e}_g = Y_g – X_g \hat{\beta}$ est le vecteur de dimension $n_g \times 1$ des résidus empiriques estimés par MCO pour cette même grappe. Le produit vectoriel $u_g = X_g’ \hat{e}_g$ représente le vecteur de score résiduel agrégé de dimension $K \times 1$. La « viande » centrale du sandwich se condense ainsi en une sommation élégante sur les $G$ unités primaires : $\sum_{g=1}^G u_g u_g’$.
Cependant, dans les échantillons finis, cette formulation asymptotique présente un biais vers le bas systématique, tendant à sous-estimer légèrement la variance en raison du fait que les résidus estimés $\hat{e}_g$ sont structurellement plus resserrés que les véritables perturbations inobservées. Pour neutraliser ce biais, un facteur de correction d’échantillon fini est systématiquement appliqué par les algorithmes statistiques avancés :
$$q_c = \left( \frac{G}{G – 1} \right) \times \left( \frac{N – 1}{N – K} \right)$$
Le premier terme du multiplicateur, $\frac{G}{G-1}$, ajuste l’estimation pour le nombre de grappes indépendantes disponibles, tandis que le second terme, $\frac{N-1}{N-K}$, compense le nombre de paramètres estimés dans le modèle linéaire. L’erreur type regroupée associée au $k$-ième régresseur est ensuite simplement extraite en prenant la racine carrée du $k$-ième élément situé sur la diagonale principale de la matrice finale ajustée $q_c \times V_{\text{CR}}$.
7. Exemple empirique détaillé : Évaluation d’une intervention psychologique en milieu scolaire
7.1 Présentation du cadre d’étude et structure des données
Afin d’illustrer de façon concrète et opérationnelle le fonctionnement des erreurs types regroupées, examinons un essai contrôlé randomisé par grappes conduit en milieu scolaire, typique des recherches translationnelles en psychologie clinique de l’enfant et de l’adolescent. Imaginons une équipe de chercheurs cherchant à évaluer l’efficacité d’un programme novateur de réduction du stress basé sur la pleine conscience (Mindfulness-Based Stress Reduction adapté aux contextes éducatifs). L’hypothèse générale stipule que les adolescents bénéficiant de huit semaines de formation structurée présenteront une baisse statistiquement significative de leur niveau d’anxiété par rapport à leurs pairs placés sur liste d’attente.
L’échantillon empirique est composé de $N = 600$ adolescents âgés de 14 à 16 ans, scolarisés au sein de $G = 20$ classes distinctes de troisième et de seconde réparties dans cinq collèges et lycées partenaires. Chaque classe compte exactement $m = 30$ élèves. Pour des raisons évidentes de logistique et afin de prévenir la contamination expérimentale au sein d’une même salle de cours, la randomisation est opérée au niveau de la classe entière : 10 classes sont assignées de manière aléatoire au protocole expérimental de pleine conscience, tandis que les 10 autres classes poursuivent les activités d’éducation physique et civique habituelles sans intervention ciblée.
La variable dépendante continue ($Y$) est le score post-intervention obtenu par chaque élève à l’Inventaire d’Anxiété Trait-État de Spielberger pour adolescents (STAI-Y), où un score élevé reflète un niveau d’anxiété symptomatique prononcé. Le modèle de régression multivarié intègre comme variable explicative pivot l’indicateur binaire d’assignation au traitement ($T_g = 1$ pour les classes expérimentales, $T_g = 0$ pour les classes témoins), tout en contrôlant rigoureusement pour le niveau d’anxiété initial mesuré avant le début du programme ($X_{1,ig}$) ainsi que le genre de l’élève ($X_{2,ig}$).
7.2 Estimation par régression classique (MCO standards) : Résultats trompeurs
Dans un premier temps, le chercheur applique un modèle de régression linéaire classique par la méthode des moindres carrés ordinaires, en omettant d’indiquer au logiciel statistique que les données sont hiérarchiquement organisées en vingt classes scolaires indépendantes. L’algorithme traite alors le fichier comme une suite de six cents observations parfaitement autonomes. Les résultats bruts de cette estimation naïve sont présentés dans le tableau synthétique ci-dessous :
| Variable prédictive | Coefficient ($\beta$) | Erreur Type (Standard) | Statistique $t$ | Valeur $p$ | IC à 95 % |
|---|---|---|---|---|---|
| Constante | 24,15 | 1,82 | 13,27 | < 0,001 | [20,57 ; 27,73] |
| Programme Pleine Conscience ($T$) | -3,45 | 1,30 | -2,65 | 0,008 | [-6,01 ; -0,89] |
| Anxiété Pré-intervention ($X_1$) | 0,58 | 0,04 | 14,50 | < 0,001 | [0,50 ; 0,66] |
| Genre Féminin ($X_2$) | 1,85 | 0,75 | 2,47 | 0,014 | [0,38 ; 3,32] |
Sous ce prisme analytique conventionnel, les conclusions paraissent indiscutables. Le coefficient associé au programme de pleine conscience affiche une magnitude de $-3{,}45$ points avec une erreur type estimée à seulement $1{,}30$. La statistique de Student correspondante est de $t = -2{,}65$, ce qui se traduit par une valeur p de $0{,}008$. Ce chiffre se positionnant largement sous le seuil symbolique de $\alpha = 0{,}01$, le chercheur serait conventionnellement fondé à rejeter l’hypothèse nulle et à conclure à un impact significatif et hautement bénéfique du programme pour juguler la détresse psychologique en milieu scolaire.
L’intervalle de confiance à 95 %, s’étendant de $-6{,}01$ à $-0{,}89$, renforce cette assurance en suggérant que l’intervention induit de façon fiable un allègement de la charge anxieuse chez les élèves. Fort de ces résultats, l’expérimentateur pourrait être tenté de recommander sans délai l’adoption généralisée de ce module de formation auprès des décideurs des politiques éducatives régionales, persuadé que le risque de commettre une erreur de type I est inférieur à un sur cent.
7.3 Application des erreurs types regroupées au niveau de la classe : Rectification
Supposons désormais que l’analyste procède à une vérification rigoureuse et identifie une corrélation intraclasse modérée au sein des résidus des classes scolaires : $\text{ICC} = \rho = 0{,}08$. Cette valeur indique que 8 % de la variance résiduelle des scores de détresse anxieuse est partagée entre les pairs d’une même salle de classe, sous l’influence du climat relationnel, du tempérament des enseignants ou de dynamiques de groupe locales. En appliquant la formule de l’estimateur en sandwich cluster-robuste agrégé sur les 20 identifiants de classes, le tableau d’estimation est profondément révisé :
| Variable prédictive | Coefficient ($\beta$) | Erreur Type (CRSE) | Statistique $t$ | Valeur $p$ | IC à 95 % |
|---|---|---|---|---|---|
| Constante | 24,15 | 2,65 | 9,11 | < 0,001 | [18,60 ; 29,70] |
| Programme Pleine Conscience ($T$) | -3,45 | 1,96 | -1,76 | 0,094 | [-7,55 ; 0,65] |
| Anxiété Pré-intervention ($X_1$) | 0,58 | 0,05 | 11,60 | < 0,001 | [0,47 ; 0,69] |
| Genre Féminin ($X_2$) | 1,85 | 0,78 | 2,37 | 0,028 | [0,22 ; 3,48] |
La comparaison rigoureuse entre ces deux tableaux révèle un contraste méthodologique frappant. Conformément aux propriétés mathématiques établies précédemment, l’estimation ponctuelle du coefficient de traitement demeure strictement inchangée à $\beta = -3{,}45$. En revanche, l’erreur type associée au programme subit une augmentation substantielle, passant de $1{,}30$ à $1{,}96$, soit une hausse d’environ 51 %. En appliquant la statistique de test sur les 19 degrés de liberté réels accordés par les 20 grappes indépendantes ($G – 1$), la statistique t s’effondre à $t = -1{,}76$, et la valeur p correspondante s’élève désormais à $0{,}094$.
Au seuil décisionnel canonique de $\alpha = 0{,}05$, l’effet du programme n’est plus statistiquement significatif. L’intervalle de confiance corrigé à 95 % s’est considérablement élargi, couvrant désormais la plage allant de $-7{,}55$ à $+0{,}65$. La traversée de la valeur zéro par cet intervalle indique sans ambiguïté que les données disponibles ne permettent pas d’écarter l’hypothèse d’une absence d’impact réel de l’intervention. L’illusion d’une démonstration scientifique incontestable s’évanouit au profit d’un constat plus modeste : l’échantillon de 20 classes manquait de puissance effective pour statuer sur l’efficacité du protocole avec le niveau de certitude requis.
8. Erreurs types regroupées versus Modèles Mixtes Linéaires (HLM / LMM)
8.1 Deux philosophies distinctes face aux structures imbriquées
Face à la violation du postulat d’indépendance par des données hiérarchiques, les statisticiens disposent de deux grandes stratégies analytiques incarnant deux postures épistémologiques radicalement divergentes : l’approche par les erreurs types regroupées (ou modèles à effets marginaux/populationnels) et l’approche par la modélisation multiniveau (modèles mixtes linéaires, HLM ou LMM, représentant les modèles à effets conditionnels). Comprendre les fondements théoriques séparant ces deux paradigmes est indispensable pour orienter judicieusement le choix méthodologique.
L’approche par erreurs types regroupées privilégie une perspective strictement populationnelle (population-averaged). Le chercheur s’intéresse exclusivement à l’effet moyen global des covariables sur l’ensemble de la population cible, traitant la dépendance intra-grappe comme un paramètre de nuisance technique qu’il convient de purger des calculs de variance sans chercher à l’interpréter substantivement. On ne cherche pas à décomposer la trajectoire individuelle de chaque entité collective, mais à obtenir un estimateur ponctuel robuste de l’effet marginal moyen, tout en calculant une incertitude valide.
À l’inverse, les modèles mixtes linéaires adoptent une approche paramétrique explicite et conditionnelle. Dans un cadre HLM, la corrélation intra-grappe n’est pas considérée comme une simple anomalie stochastique à corriger, mais comme un phénomène théorique digne d’intérêt scientifique en soi. Les modèles multiniveaux estiment simultanément des paramètres d’effets fixes et des composantes de variance aléatoire (intercepts aléatoires et pentes aléatoires). L’objectif inférentiel se déplace : il ne s’agit plus seulement de connaître l’effet moyen global, mais de quantifier précisément dans quelle mesure cet effet varie d’une école à l’autre, ou d’un thérapeute à l’autre.
8.2 Robustesse aux erreurs de spécification de la distribution
Le principal avantage comparatif des erreurs types regroupées réside dans leur remarquable robustesse non paramétrique face aux potentielles erreurs de spécification des distributions sous-jacentes. L’estimateur sandwich cluster-robuste ne requiert aucune hypothèse distributionnelle restrictive sur la forme géométrique de la corrélation intra-grappe : celle-ci peut résulter d’un processus autorégressif, d’une variance inégale entre unités, ou de structures de covariance hautement asymétriques. L’inférence demeure asymptotiquement valide quelle que soit la morphologie intime de la matrice d’erreur interne.
En contrepartie, les modèles mixtes linéaires reposent traditionnellement sur des postulats paramétriques nettement plus exigeants. Dans la formulation canonique des LMM, les effets aléatoires au niveau du groupe sont postulés suivre une distribution normale multidimensionnelle conjointe, avec une matrice d’homoscédasticité constante entre les niveaux. Si cette distribution s’avère lourdement asymétrique, leptokurtique, ou contaminée par des valeurs extrêmes multivariées, les estimateurs du maximum de vraisemblance restreint (REML) peuvent générer des estimations de variance biaisées, compromettant la précision des tests de significativité des effets fixes associés.
De surcroît, la charge computationnelle et les problèmes de non-convergence constituent un obstacle récurrent dans le déploiement des modèles multiniveaux hautement paramétrés. Lorsqu’un modèle HLM tente d’estimer simultanément plusieurs pentes aléatoires corrélées sur des bases de données complexes ou déséquilibrées, les algorithmes itératifs d’optimisation (tels que Newton-Raphson ou l’algorithme EM) butent fréquemment sur des matrices de covariance singulières ou échouent purement à converger. Les erreurs types regroupées contournent intégralement cet écueil : le calcul matriciel des moindres carrés couplé au sandwich est analytique, direct, instantané et imperméable aux difficultés d’optimisation numérique.
8.3 Critères décisionnels pour le chercheur en psychologie
Le choix entre l’estimation par moindres carrés assortie de CRSE et le recours à une modélisation multiniveau dépend intimement de la question de recherche fondamentale et de la configuration des variables explicatives disponibles. Si la question théorique implique de tester des interactions inter-niveaux (cross-level interactions)—par exemple, examiner si l’effet de l’anxiété individuelle sur la performance scolaire est modéré par le niveau de cohésion de la classe entière—, les modèles multiniveaux s’avèrent irremplaçables. Ils permettent de modéliser directement les prédicteurs de niveau 2 et de partitionner formellement la variance entre ses composantes micro et macro.
En revanche, lorsque l’investigation empirique se focalise sur l’effet principal d’une covariable mesurée au niveau individuel (par exemple, le temps de réaction dans une tâche cognitive informatisée ou l’impact d’un trait de personnalité) et que la structure de grappe n’est qu’un artefact d’échantillonnage logistique (les étudiants ayant passé le test par sessions de 15 sujets), l’application des erreurs types regroupées représente l’option méthodologique la plus sobre, la plus robuste et la plus transparente. Elle évite d’introduire des hypothèses distributionnelles superflues et préserve le chercheur de toute sur-interprétation des variances aléatoires.
De nos jours, une saine pratique méthodologique consiste à ne pas envisager ces deux outils comme mutuellement exclusifs, mais comme de puissants instruments de triangulation au sein d’analyses de sensibilité pré-enregistrées. Un résultat substantiel dont la significativité dépend exclusivement du choix arbitraire entre une régression MCO avec CRSE et un modèle HLM à intercept aléatoire doit être accueilli avec un sain scepticisme scientifique. La convergence des déductions inférentielles issues de ces deux philosophies statistiques renforce considérablement la crédibilité écologique et interne des conclusions publiées.
9. Le problème du faible nombre de grappes (Small Cluster Problem) et ses remèdes
9.1 Risques statistiques associés à un nombre insuffisant de groupes (G < 30-50)
Si la formule de l’estimateur de variance robuste aux grappes est mathématiquement irréprochable dans son abstraction théorique, sa validité opératoire repose sur un socle asymptotique rigide. Les démonstrations attestant de la non-distorsion et de la convergence de l’estimateur sandwich postulent formellement que le nombre de grappes ($G$) tend vers l’infini. Dans les contextes où ce nombre est substantiel—typiquement supérieur à 50 ou 100 grappes indépendantes—, les propriétés de l’inférence sont remarquablement préservées.
Le problème émerge brutalement dans la réalité quotidienne de la recherche expérimentale et translationnelle, où les contraintes de coût et de logistique restreignent drastiquement le nombre d’unités collectives mobilisables. Il est très fréquent qu’un essai thérapeutique randomisé ne puisse recruter que 8 à 15 hôpitaux, qu’une étude scolaire ne dispose que de 12 classes, ou qu’une expérience sociale compare des politiques publiques menées à l’échelle de 6 à 10 cantons ou régions administratives. Dans de telles configurations ($G < 30$), l’estimateur sandwich standard s’effondre.
Lorsque le nombre de grappes est restreint, l’estimateur de variance souffre d’un biais vers le bas substantiel : il sous-estime systématiquement la variance véritable des coefficients. Cette déficience est particulièrement marquée lorsque la taille des grappes est fortement déséquilibrée. Par conséquent, loin de protéger le chercheur contre les faux positifs, l’application naïve des erreurs types regroupées en présence d’un faible nombre de grappes réintroduit l’inflation du taux d’erreur de type I, pouvant atteindre 10 % à 25 % pour un seuil nominal théorique fixé à 5 %. Croire être protégé par une correction robuste dans ces conditions relève d’une pure illusion statistique.
9.2 La méthode du Wild Cluster Bootstrap
Face à l’échec de la théorie asymptotique pour les petits échantillons de grappes, la méthodologie contemporaine a développé des approches de rééchantillonnage par réinjection computationnelle d’une remarquable efficacité. Parmi celles-ci, le Wild Cluster Bootstrap (ou bootstrap sauvage pour grappes), théorisé et validé de manière extensive par Cameron, Gelbach et Miller (2008), s’est imposé comme l’étalon-or pour restaurer des déductions inférentielles fiables.
Le fonctionnement du Wild Cluster Bootstrap se distingue fondamentalement du bootstrap naïf à deux égards majeurs : il opère le rééchantillonnage au niveau de la grappe entière (et non des individus isolés), et il préserve la structure de la matrice d’expérience $X$ sans la rééchantillonner directement. À chaque itération de bootstrap, le vecteur complet des résidus estimés de chaque grappe $g$ est multiplié dans son intégralité par un poids aléatoire scalaire $v_g$ tiré d’une distribution symétrique spécifique, le plus souvent la distribution binaire de Rademacher ($v_g in {-1, +1}$ avec des probabilités égales de 0,5) ou la distribution de Webb à six points :
$$Y_g^* = X_g \hat{\beta}_{\text{restre\int}} + v_g \hat{e}_g$$
En inversant ou conservant de manière aléatoire et uniforme le signe des résidus de l’ensemble des membres d’une même grappe, cette technique simule la distribution d’échantillonnage théorique de la statistique de test sous l’hypothèse nulle, tout en préservant fidèlement l’intégralité de la structure d’hétéroscédasticité et de corrélation interne arbitraire qui lie les sujets de chaque groupe. Les simulations de Monte Carlo ont démontré avec constance que le Wild Cluster Bootstrap parvient à maintenir un taux d’erreur de première espèce rigoureusement fixé à 5 %, même lorsque l’analyse repose sur un effectif aussi réduit que 6 à 12 grappes indépendantes.
9.3 Corrections analytiques pour petits échantillons : Approches de Bell-McCaffrey
Parallèlement aux démarches computationnelles intensives par rééchantillonnage bootstrap, des statisticiens ont élaboré des corrections analytiques déterministes directes de l’estimateur sandwich. Ces travaux, amorcés par MacKinnon et White pour le cas non groupé, ont été transposés avec brio aux structures de grappes par Bell et McCaffrey (2002), formulant ce que la littérature nomme aujourd’hui les ajustements par linéarisation à biais réduit (Bias-Reduced Linearization, ou BRL), classifiés sous les labels de corrections CR2 et CR3.
L’estimateur corrigé CR2 procède à une transformation structurelle des vecteurs de résidus empiriques de chaque grappe avant d’injecter ces derniers dans la matrice centrale en sandwich. Plus précisément, le vecteur de résidus $\hat{e}_g$ est prémultiplié par la racine carrée inverse de la matrice chapeau résiduelle $(I – H_{gg})^{-1/2}$, où $H_{gg} = X_g(X’X)^{-1}X_g’$ représente le bloc diagonal correspondant à la grappe au sein de la matrice de projection globale des moindres carrés. Cette opération mathématique a pour effet de ré-étalonner les résidus en annulant exactement le biais fini qui découle du calcul des paramètres estimés :
$$\tilde{e}_g = (I – H_{gg})^{-1/2} \hat{e}_g$$
De surcroît, les travaux de Bell-McCaffrey introduisent un calcul novateur des degrés de liberté effectifs pour l’inférence par la loi de Student, fondé sur une approximation de type Welch-Satterthwaite. Au lieu de postuler naïvement que les degrés de liberté sont égaux à $G – 1$, la formule de Satterthwaite évalue le degré de déséquilibre entre les grappes et le levier spécifique exercé par certains groupes influents. Si deux grappes concentrent à elles seules l’essentiel de la variabilité des données, les degrés de liberté effectifs peuvent s’effondrer de $G – 1 = 19$ à seulement 4 ou 5 degrés de liberté réels. L’intégration conjointe de la correction CR2 et des degrés de liberté ajustés de Satterthwaite assure un contrôle quasi parfait des marges d’erreur, faisant de cette correction analytique une alternative directe et élégante au bootstrap sauvage.
10. Regroupement bidirectionnel et multidirectionnel (Multi-Way Clustering)
10.1 Structures non hiérarchiques et regroupements croisés en psychologie
Dans de nombreuses configurations expérimentales en sciences cognitives, la morphologie des données ne s’organise pas selon un schéma strictement arborescent ou hiérarchique où chaque niveau s’emboîte sagement dans le précédent. La recherche psychologique recourt de manière intensive à des protocoles dits à facteurs croisés (Crossed-Random Effects Designs). Dans ce type d’architecture, les observations résultent de la conjonction de deux ou plusieurs dimensions collectives indépendantes qui se croisent intégralement sans s’imbriquer.
L’exemple par excellence se déploie dans les protocoles d’évaluation cognitive et de perception sociale : un panel d’évaluateurs humains évalue un ensemble standardisé d’items ou de stimuli visuels. Considérons une tâche où 50 participants ($S$) jugent l’expression émotionnelle, l’attractivité ou le degré de menace perçu sur un ensemble de 40 visages humains photographiés ($F$). Chaque observation unitaire est le résultat de l’interaction entre un sujet spécifique $i$ et un stimulus facial particulier $j$. Cette matrice compte 2000 points d’évaluation croisés.
Dans ce design, il existe deux sources de dépendance stochastique simultanées et non hiérarchisées : les réponses d’un même participant pour différents visages sont corrélées (clustering au niveau des Sujets), et les évaluations d’un même visage par différents participants sont également corrélées sous l’effet des caractéristiques morphologiques objectives de ce stimulus (clustering au niveau des Visages). Ignorer l’une de ces deux dimensions—par exemple, regrouper les erreurs uniquement sur les sujets tout en traitant les stimuli comme des unités indépendantes et interchangeables—expose le modèle à une sous-estimation substantielle de la variance, faisant courir le risque de généraliser à l’ensemble des stimuli de la population des effets qui ne sont le fruit que d’un biais d’échantillonnage des items.
10.2 Mécanisme mathématique de l’estimateur de Cameron-Gelbach-Miller
Pour résoudre cette complexité structurelle sans contraindre les analystes à développer des modèles mixtes croisés excessivement lourds en temps de calcul, Cameron, Gelbach et Miller (2011) ont mis au point une formulation analytique révolutionnaire permettant d’estimer des erreurs types regroupées multidirectionnelles (Multi-Way Clustering).
Leur démarche exploite avec ingéniosité le principe de la théorie ensembliste d’inclusion-exclusion. Soient deux dimensions indépendantes de regroupement désignées par $1$ (les sujets) et $2$ (les stimuli). L’estimateur de variance robuste croisé pour ces deux voies se calcule à travers la combinaison linéaire suivante :
$$V_{\text{2-way}} = V_{\text{cluster}_1} + V_{\text{cluster}_2} – V_{\text{intersection}_{(1,2)}}$$
Le calcul s’articule en trois temps : l’analyste calcule d’abord la matrice de variance sandwich $V_{\text{cluster}_1}$ en regroupant les données exclusivement sur la première dimension (les sujets). Il calcule ensuite indépendamment la matrice de variance $V_{\text{cluster}_2}$ en regroupant les observations exclusivement sur la seconde dimension (les stimuli). Cependant, l’addition de ces deux matrices génère une double comptabilisation de la variance propre aux observations partageant simultanément le même sujet et le même stimulus. Pour éliminer cette redondance, l’algorithme soustrait la matrice de variance $V_{\text{intersection}_{(1,2)}}$, calculée en regroupant les erreurs sur les cellules d’intersection entre les deux dimensions (dans notre cas, la cellule sujet-visage individuelle).
Cette approche élégante résout avec maestria le célèbre dilemme identifié dès 1973 par le psycholinguiste Herbert Clark sous l’appellation de Language-as-Fixed-Effect Fallacy. Clark avait démontré que les études en sciences du langage concluaient massivement à de faux effets de traitement en traitant les listes de mots présentées dans les expériences comme des effets fixes sans modéliser l’incertitude liée à l’échantillonnage de ces termes. L’estimateur à double voie de Cameron-Gelbach-Miller résout simultanément l’incertitude liée aux sujets et celle relative aux stimuli, garantissant une inférence robuste sans calcul itératif complexe.
10.3 Applications directes en cognition sociale et perception
L’implémentation du regroupement bidirectionnel trouve des champs d’application majeurs dans la recherche empirique sur les préjugés et la cognition sociale stéréotypée. Imaginons une expérience analysant les biais implicites de genre dans les processus de recrutement professionnel. Des évaluateurs masculins et féminins notent des curriculum vitæ fictifs contenant des indices subtils de trajectoire de vie. Dans ce protocole, chaque recruteur examine plusieurs dizaines de profils, et chaque profil standardisé est évalué par plusieurs recruteurs. Le déploiement d’un regroupement bidirectionnel sur les évaluateurs et sur les profils de candidats immunise l’analyste contre le risque de sur-significativité causé par l’attractivité idiosyncratique de certains profils particuliers.
Un cas d’usage tout aussi probant réside dans l’expertise psychiatrique et le jugement clinique. Lorsque des récits de cas cliniques (vignettes de patients) décrivant des épisodes psychotiques ou des troubles de la personnalité sont présentés à un échantillon national de psychiatres pour évaluer la justesse diagnostique ou l’indication d’hospitalisation sous contrainte, les observations sont croisées entre les praticiens et les récits de cas. L’estimateur à double sens isole scrupuleusement la part d’incertitude imputable à l’hétérogénéité d’interprétation des praticiens de celle relative à la formulation sémantique des vignettes narratives.
Enfin, en économie comportementale et dans les études sur les dynamiques de négociation, les expériences mettent en scène des dyades d’individus qui interagissent au sein de marchés simulés à travers des rounds temporels successifs. Les données recueillies présentent à la fois un regroupement par agent économique et un regroupement par marché ou session de négociation. Le calcul d’erreurs types regroupées multidirectionnelles offre une solution méthodologique optimale, permettant aux auteurs de préserver toute la puissance statistique des tests marginaux tout en modélisant avec une fidélité absolue la non-indépendance croisée des décisions d’échange.
11. Mise en pratique pas à pas dans les logiciels statistiques (R, Stata et Python)
11.1 Implémentation complète sous R
L’environnement open source R offre un écosystème particulièrement riche pour le calcul des erreurs types regroupées et le déploiement du Wild Cluster Bootstrap. Historiquement, la démarche standard mobilisait conjointement le package stats pour l’estimation du modèle linéaire de base via la fonction lm(), couplé au package sandwich développé par Achim Zeileis et ses collaborateurs. Dans ce flux de travail conventionnel, le calcul de la matrice de variance robuste aux grappes s’exécute à travers la fonction vcovCL(), en renseignant explicitement l’argument cluster sous la forme d’un vecteur ou d’une formule indiquant l’identifiant de groupe :
Dans les pratiques contemporaines, le package fixest (développé par Laurent Bergé) s’est imposé comme l’alternative la plus performante et ergonomique pour les modèles à effets fixes et l’estimation robuste en grande dimension. À travers sa fonction phare feols(), l’utilisateur peut estimer une régression linéaire tout en spécifiant directement la structure de regroupement au sein même de la commande grâce à l’argument cluster = ~classe_id. Les calculs sont exécutés en langage compilé C++, offrant une accélération spectaculaire par rapport aux fonctions natives tout en calculant automatiquement les degrés de liberté corrigés pour petits échantillons.
Lorsque le nombre de grappes est particulièrement modeste ($G < 30$), il est impératif d’exécuter un rééchantillonnage par bootstrap sauvage. Le package spécialisé fwildclusterboot (conçu par Alexander Fischer) fournit à la communauté la fonction boottest(). Cette fonction s’applique directement sur l’objet retourné par feols() ou lm(), et exécute en quelques fractions de seconde des milliers de réplications avec poids de Rademacher ou de Webb. Pour la restitution formelle des résultats sous forme de tableaux prêts pour la soumission académique, le package modelsummary permet de cartographier et de juxtaposer aisément les colonnes d’erreurs types conventionnelles, robustes simples et robustes aux grappes, garantissant une transparence totale de l’analyse empirique.
11.2 Syntaxe et options sous Stata
Dans le logiciel Stata, couramment exploité en économétrie appliquée et en sociologie quantitative, la prise en compte des structures en grappes bénéficie d’une intégration native historique extrêmement fluide. L’instruction fondamentale s’articule autour de la commande de régression canonique regress, à laquelle s’adjoint simplement l’option de variance-covariance vce(cluster varname). La syntaxe élémentaire s’écrit de la façon suivante :
regress anxiete programme_mindfulness anxiete_pre genre, vce(cluster classe_id)
Dès lors que cette option est validée, Stata ré-estime la matrice de variance-covariance des estimateurs en appliquant scrupuleusement la formule de l’estimateur sandwich avec correction de taille finie $q_c$. Il convient de prêter une attention rigoureuse à la console de sortie : Stata affiche en haut à droite du tableau de régression le nombre effectif de grappes identifiées (Number of clusters). Les degrés de liberté utilisés pour calculer les valeurs p et les intervalles de confiance sont automatiquement fixés à $G – 1$, rappelant visuellement à l’utilisateur que la puissance inférentielle repose asymptotiquement sur le nombre de grappes et non sur l’effectif brut d’individus.
Pour la gestion avancée des clusters bidirectionnels ou des modèles comportant des absorptions multiples d’effets fixes, la communauté Stata utilise très largement la commande reghdfe développée par Sergio Correia. Cette commande permet de spécifier plusieurs voies de regroupement simultanées au sein de l’option vce(cluster varname1 varname2). Enfin, pour exécuter un Wild Cluster Bootstrap face à un nombre restreint de grappes, le module communautaire incontournable boottest (développé par David Roodman) fournit une syntaxe simple post-estimation permettant d’obtenir des valeurs p et des intervalles de confiance bootstrappés sans biais d’échantillon fini.
11.3 Déploiement sous Python avec Statsmodels
Dans l’écosystème de la science des données et de l’intelligence artificielle sous Python, l’estimation des erreurs types regroupées est assurée principalement par la bibliothèque d’économétrie et de statistiques appliquées statsmodels. À travers le module statsmodels.formula.api, les praticiens peuvent modéliser leurs relations fonctionnelles à l’aide d’une syntaxe déclarative similaire aux formules de régression traditionnelles de R.
Après avoir instancié un modèle de moindres carrés ordinaires au moyen de la méthode ols(formula, data), l’ajustement robuste aux grappes est activé lors de l’appel de la méthode .fit(). Pour ce faire, il est nécessaire de renseigner le paramètre cov_type=’cluster’ et de fournir conjointement le dictionnaire d’arguments cov_kwds={‘groups’: df[‘cluster_id’]}. L’algorithme interne de Statsmodels procède alors à la transformation matricielle des résidus agrégés par groupe et substitue la matrice de covariance cluster-robuste à la matrice de covariance standard.
Les chercheurs utilisant Python doivent veiller à comparer de manière systématique l’objet de résultats standard .fit() avec son homologue regroupé. La bibliothèque permet d’extraire directement les erreurs types issues de l’attribut .bse et de construire des tableaux comparatifs structurés sous forme de DataFrames pandas. Cette étape d’exploration diagnostique met en lumière l’amplitude de l’inflation de l’erreur type consécutive à la prise en compte de la covariance intra-grappe, prémunissant l’analyste contre toute interprétation hâtive des statistiques t générées par les modèles standards.
12. Normes de publication, reporting APA et recommandations méthodologiques
12.1 Transparence du reporting selon les standards de l’APA (7e édition)
L’intégrité de la communication scientifique en psychologie exige une transparence absolue dans la description des démarches d’inférence statistique. Les recommandations méthodologiques énoncées dans la 7e édition du manuel de publication de l’American Psychological Association imposent aux auteurs de ne plus se borner à la simple mention « des erreurs types robustes ont été calculées ». Il est désormais requis de fournir une justification théorique et empirique explicite présidant au choix du niveau de regroupement retenu dans les analyses.
Le manuscrit doit documenter formellement les caractéristiques écologiques de la structure de grappes sous-jacente. Il est indispensable d’indiquer de manière claire le nombre total de grappes indépendantes ($G$), la taille moyenne des grappes ($\bar{m}$), ainsi que leur degré de dispersion ou de déséquilibre (taille minimale et maximale observée). Lorsque cela s’avère pertinent, la publication du coefficient de corrélation intraclasse estimé ($rho$) pour la variable dépendante ainsi que pour les prédicteurs principaux apporte un éclairage indispensable permettant aux évaluateurs d’apprécier la magnitude de l’effet de plan.
Dans la formalisation des tableaux de régression, la rigueur exige que les notes de bas de tableau décrivent sans ambiguïté la nature de l’ajustement opéré. Une note standardisée rigoureuse prendra la forme suivante : « Note. Les erreurs types entre parenthèses sont des erreurs types robustes aux grappes (CRSE), corrigées pour l’hétéroscédasticité et la dépendance résiduelle au niveau des classes scolaires (G = 20 grappes indépendantes). Les valeurs de t et de p sont évaluées sur la base de G – 1 = 19 degrés de liberté réels. » Une telle formulation témoigne d’une maîtrise des contraintes inférentielles et préserve les lecteurs de toute méprise quant à la puissance statistique effective du design.
12.2 Erreurs fréquentes et mauvaises pratiques à proscrire
Le déploiement des erreurs types regroupées n’est pas exempt de dérives méthodologiques majeures qu’il convient de dénoncer fermement. La mauvaise pratique la plus pernicieuse consiste en ce que l’on peut qualifier de « cluster hunting » (la chasse opportuniste au regroupement). Cette dérive consiste pour un chercheur à exécuter successivement des régressions en testant différents niveaux de regroupement arbitraires (par exemple, par séance, puis par thérapeute, puis par clinique) non pas sur la base d’une hypothèse sur la nature du processus causal, mais dans l’unique but de sélectionner a posteriori le niveau d’agrégation qui permet à la valeur p de franchir le seuil fatidique de significativité statistique ($p < 0{,}05$). Cette pratique constitue une forme caractérisée de p-hacking qui détruit toute validité déductive.
Une autre erreur récurrente consiste à regrouper les erreurs sur une variable qui n’induit aucune dépendance résiduelle plausible dans le mécanisme générateur de données, ou à l’inverse, à regrouper sur une dimension beaucoup trop granulaire. Si les résidus d’individus partagent une corrélation au niveau régional, regrouper les erreurs au niveau du quartier d’habitation est totalement insuffisant : la dépendance macro-régionale non modélisée continuera d’infiltrer la « viande » du sandwich et de biaiser l’erreur type vers le bas. La règle directrice fondamentale de l’économétrie stipule qu’il faut toujours regrouper au niveau d’agrégation le plus élevé où l’on suspecte raisonnablement l’existence d’une corrélation résiduelle partagée.
Enfin, il demeure crucial de dissiper la confusion entretenue entre l’ajustement simple pour hétéroscédasticité de White (parfois nommé HC0, HC1 ou HC3) et l’ajustement pour grappes (CRSE / CR2). Utiliser un estimateur de White standard traite l’inégalité des variances individuelles mais postule avec force que toutes les covariances croisées entre sujets sont rigoureusement nulles. Face à des données imbriquées, l’estimateur de White est totalement inopérant pour corriger la sous-estimation de l’erreur type causée par la corrélation intra-grappe. Seule la prise en compte intégrale de la matrice par blocs via l’estimateur en sandwich cluster-robuste apporte la réponse mathématique adéquate.
12.3 Grille d’évaluation pour les relecteurs et chercheurs
Afin de guider les évaluateurs pairs, les directeurs de revues et les analystes préalablement à la soumission ou à l’approbation d’un manuscrit quantitatif comportant des données susceptibles d’être imbriquées, nous proposons une grille séquentielle de contrôle méthodologique articulée autour de six questions clés :
- Identification contextuelle : La structure de collecte des données comporte-t-elle des regroupements spatiaux, institutionnels, temporels ou méthodologiques évidents (classes, centres, équipes, sessions de passation, sujets dans un protocole répété) ?
- Adéquation de l’estimateur : Les auteurs ont-ils explicitement corrigé les erreurs types pour la dépendance intra-grappe, ou justifié de manière exhaustive l’application d’un modèle multiniveau concurrent ?
- Suffisance du nombre de grappes ($G$) : L’analyse repose-t-elle sur un effectif de grappes suffisant ($G ge 40-50$) pour garantir les propriétés asymptotiques de l’estimateur sandwich ? En présence d’un nombre restreint ($G < 30$), les auteurs ont-ils implémenté un Wild Cluster Bootstrap ou une correction de type CR2 de Bell-McCaffrey ?
- Définition du niveau de regroupement : Le niveau d’agrégation choisi correspond-il au mécanisme d’assignation du traitement ou à l’unité de variance commune la plus haute (par exemple, au niveau de l’école plutôt qu’au simple niveau de la classe) ?
- Transparence descriptive : Le manuscrit documente-t-il clairement la taille moyenne des grappes, la valeur estimée de la corrélation intraclasse ($rho$), et les degrés de liberté effectivement utilisés pour les inférences par la loi de Student ?
- Triangulation analytique : Les conclusions majeures résistent-elles à des analyses de sensibilité pré-enregistrées contrastant les erreurs types regroupées avec des modélisations hiérarchiques à composantes de variance ?
En adoptant cette discipline méthodologique et en intégrant systématiquement le calcul des erreurs types regroupées au rang des standards minimaux de rigueur quantitative, la communauté des sciences psychologiques s’arme efficacement contre les illusions d’optique statistique. Préserver la justesse de l’erreur type, c’est respecter la véritable incertitude qui entoure l’exploration du comportement humain, et garantir que les savoirs accumulés reposent sur des fondations empiriques solides, réplicables et dignes de confiance.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Bell, R. M., & McCaffrey, D. F. (2002). Bias reduction in standard errors for linear regression with multi-stage samples. Survey Methodology, 28(2), 169–181.
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. The Review of Economics and Statistics, 90(3), 414–427. https://doi.org/10.1162/rest.90.3.414
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2011). Robust inference with multiway clustering. Journal of Business & Economic Statistics, 29(2), 238–249. https://doi.org/10.1198/jbes.2010.07136
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Clark, H. H. (1973). The language-as-fixed-effect fallacy: A critique of language statistics in psychological research. Journal of Verbal Learning and Verbal Behavior, 12(4), 335–359. https://doi.org/10.1016/S0022-5371(73)80014-3
- Huber, P. J. (1967). The behavior of maximum likelihood estimates under nonstandard conditions. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, 1, 221–233. https://projecteuclid.org/journals/berkeley-symposium-on-mathematical-statistics-and-probability/volume-1/issue-none/On-the-Theory-of-Linear-Statistical-Inference/bsmsp/1200512985.full
- Liang, K. Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305–325. https://doi.org/10.1016/0304-4076(85)90158-7
- Moulton, B. R. (1986). Random group effects and the precision of regression estimates. Journal of Econometrics, 32(3), 385–397. https://doi.org/10.1016/0304-4076(86)90021-7
- Moulton, B. R. (1990). An illustration of a pitfall in estimating common random effects in aggregated data. The Review of Economics and Statistics, 72(2), 334–338. https://doi.org/10.2307/1912014
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage Publications.
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wooldridge, J. M. (2003). Cluster-sample methods in applied econometrics. American Economic Review, 93(2), 133–138. https://doi.org/10.1257/000282803321946930