
Dans le domaine des sciences sociales, de la recherche biomédicale et de la statistique inférentielle, la collecte de données constitue la pierre angulaire de toute prétention à l’intelligibilité du réel. L’ambition fondamentale du statisticien consiste à extraire, à partir d’une fraction restreinte d’individus, des propriétés vérifiables et généralisables à l’ensemble d’une population cible. Cependant, la validité de ce saut inductif — de l’échantillon vers la population — repose entièrement sur les fondements probabilistes et méthodologiques qui régissent le recrutement des sujets d’étude. Lorsque ce processus échappe au contrôle systématique du chercheur pour être délégué à l’initiative individuelle des participants, l’édifice méthodologique vacille, confronté à l’un des phénomènes les plus pernicieux de la recherche empirique : l’échantillonnage à réponse volontaire.
L’échantillon à réponse volontaire, omniprésent dans le paysage médiatique contemporain, les sondages d’opinion sur Internet, les plateformes d’évaluation commerciale et même certains pans de la recherche académique participative, représente un défi épistémologique majeur. Contrairement aux plans d’échantillonnage probabilistes élaborés par des pionniers de la statistique comme Jerzy Neyman, Ronald Fisher ou Harold Hotelling, cette approche abandonne délibérément le principe d’équiprobabilité d’inclusion au profit d’une dynamique d’auto-sélection. Il en résulte une fracture béante entre la facilité logistique de la collecte des données et la fiabilité scientifique des conclusions qu’il est légitime d’en tirer.
Comprendre la nature, les mécanismes psychologiques, les distorsions mathématiques et les conséquences inférentielles de l’échantillon à réponse volontaire ne relève pas d’une simple querelle académique ; c’est un impératif méthodologique pour quiconque souhaite naviguer avec discernement dans l’ère de la surabondance informationnelle. Cet article propose une dissection exhaustive de ce dispositif d’enquête, explorant ses origines conceptuelles, sa structure statistique, ses manifestations quotidiennes, ainsi que les protocoles d’atténuation et de redressement développés pour tenter d’en corriger les tares inhérentes.
1. Introduction conceptuelle : Définition de l’échantillon à réponse volontaire
L’échantillonnage à réponse volontaire occupe une place singulière dans la panoplie des outils de recherche empirique. Souvent perçu par le grand public comme une forme démocratique et ouverte d’expression de l’opinion, il constitue pour le statisticien rigoureux une source majeure d’inquiétude épistémologique. Pour analyser ses répercussions, il convient avant tout d’en poser les définitions canoniques et d’en préciser la genèse historique au sein des sciences de l’observation.
1.1 Définition formelle et principes fondamentaux
Un échantillon à réponse volontaire (ou échantillon auto-sélectionné) se définit formellement comme une méthode d’échantillonnage non probabiliste dans laquelle les individus composant l’échantillon ont délibérément pris l’initiative de participer à l’étude, plutôt que d’avoir été sélectionnés par le chercheur selon un protocole aléatoire ou systématique préétabli. Dans ce paradigme, le filtre d’inclusion ne résulte pas d’une fonction de tirage probabiliste opérée sur une base de sondage, mais dépend entièrement d’une décision individuelle, souvent motivée par un intérêt personnel, une réaction émotionnelle ou une disposition psychologique particulière à l’égard de la thématique investiguée.
Il existe une distinction opérationnelle essentielle entre la sollicitation passive et le recrutement actif des sujets. Dans le recrutement actif, le chercheur circonscrit une population cible, extrait une liste de membres identifiables, et déploie des efforts soutenus pour entrer en contact avec les personnes spécifiquement désignées, en minimisant les refus par des incitations ou des relances. À l’inverse, la sollicitation passive propre à l’échantillon à réponse volontaire consiste à émettre un stimulus général — qu’il s’agisse d’un appel radiophonique, d’un formulaire mis en ligne sur les réseaux sociaux, d’une affiche dans une salle d’attente ou d’un encart dans un journal — et à attendre que les répondants se manifestent spontanément. L’auto-sélection devient ainsi le mécanisme exclusif de constitution de la base empirique.
Historiquement, cette méthode a vu son apogée populaire dans les débuts des sondages d’opinion publique à la fin du XIXe et au début du XXe siècle, notamment à travers les fameux « straw polls » ou votes de paille organisés par des organes de presse écrite aux États-Unis. Ces médias imprimaient des coupons-réponses que les lecteurs devaient découper, remplir et renvoyer par voie postale à leurs frais. Si ces initiatives ont longtemps fasciné par le volume impressionnant de données accumulées, elles portaient déjà en elles les germes d’une instabilité inférentielle que les crises politiques et électorales du XXe siècle allaient brutalement révéler.
1.2 Typologie statistique : L’échantillonnage non probabiliste
Au sein de la théorie moderne des sondages, la ligne de démarcation fondamentale sépare les méthodes probabilistes des méthodes non probabilistes. L’échantillon à réponse volontaire se range sans ambiguïté dans la seconde catégorie. Sa caractéristique discriminante majeure réside dans l’inégalité fondamentale et indéterminée des probabilités d’inclusion de chaque élément au sein de la population cible. Dans un plan de sondage probabiliste, chaque unité statistique dispose d’une probabilité d’inclusion strictement positive et connue a priori (notée $\pi_i > 0$). Cette condition mathématique indispensable permet de pondérer les observations par l’inverse de leur probabilité de sélection (estimateur de Horvitz-Thompson) et de garantir l’absence de biais des estimateurs.
Dans un contexte de réponse volontaire, il est mathématiquement impossible d’attribuer une telle probabilité non nulle et mesurable à chaque individu. Quelle était la probabilité qu’un individu quelconque, résidant dans une région donnée et n’ayant pas accès au canal de diffusion du sondage, puisse faire partie de l’échantillon ? Cette probabilité est soit nulle, soit rigoureusement indéterminable. L’absence de distribution d’échantillonnage connue anéantit les fondements théoriques nécessaires au calcul standard de la marge d’erreur, des intervalles de confiance et des tests d’hypothèses statistiques usuels.
Cette approche diverge radicalement des protocoles d’échantillonnage aléatoire simple, où chaque individu possède une probabilité rigoureusement identique d’être choisi ($1/N$), ou d’échantillonnage stratifié, où la population est préalablement segmentée en sous-groupes homogènes avant qu’un tirage au sort ne soit exécuté au sein de chaque strate. L’échantillonnage volontaire opère en totale contradiction avec ces principes : la structure démographique finale de l’échantillon ne reflète pas la composition de la population d’origine, mais l’interaction complexe entre la visibilité du canal de diffusion et la propension psychologique des individus à s’auto-désigner comme répondants.
1.3 Le rôle du chercheur face à la passivité du protocole
L’adoption d’un protocole à réponse volontaire engendre une mutation profonde de la posture épistémologique du chercheur. Ce dernier abandonne son rôle traditionnel d’architecte du plan d’échantillonnage pour devenir un récepteur passif de flux informationnels. Cette perte de contrôle méthodologique sur la composition finale de l’échantillon constitue une concession critique qui fragilise la robustesse interne et externe des investigations scientifiques. Le chercheur ne décide plus de qui est interrogé ; il observe simplement qui a souhaité s’exprimer.
La diffusion large de l’instrument de mesure (questionnaires dématérialisés, liens hypertextes partagés en accès public, formulaires en libre-service) sans ciblage contrôlé des répondants répond souvent à des impératifs d’économie de moyens ou d’urgence temporelle. Cela pose un véritable dilemme éthique et pratique au sein de la communauté scientifique : le compromis entre la facilité d’accès à des cohortes massives à coût quasi nul et la rigueur d’un dispositif contrôlé qui requiert des ressources logistiques considérables. Face à la pression académique de publication rapide (« publish or perish »), la tentation de recourir à l’auto-sélection est constante, bien que ses périls soient universellement documentés.
Par ailleurs, ce protocole passif modifie structurellement la gestion de la non-réponse. Dans un échantillonnage classique, le taux de non-réponse est un indicateur quantifiable (nombre de refus divisé par le nombre de sollicitations directes), permettant la mise en œuvre de relances dirigées pour tenter d’enrayer le biais d’attrition. Dans le cas de la réponse volontaire, la notion même de taux de non-réponse perd toute consistance arithmétique : le dénominateur — c’est-à-dire le nombre total d’individus ayant été exposés au stimulus de l’enquête mais ayant choisi de l’ignorer — demeure à jamais inconnu. Le chercheur se trouve donc privé de l’outil diagnostique élémentaire permettant d’évaluer l’ampleur de la déperdition d’information.
2. Les fondements théoriques : Échantillonnage non probabiliste versus probabiliste
Pour mesurer la dérive épistémologique induite par la réponse volontaire, il est impératif de revisiter les fondements mathématiques qui confèrent à l’échantillonnage probabiliste sa force démonstrative, et de comprendre comment l’auto-sélection en subvertit les théorèmes les plus cardinaux.
2.1 Les postulats de l’échantillonnage probabiliste
L’inférence statistique moderne repose sur le paradigme probabiliste établi au cours de la première moitié du XXe siècle. Le principe fondateur du tirage aléatoire stipule que la représentativité théorique d’un échantillon n’est pas garantie par une quelconque ressemblance photographique instantanée avec la population, mais par la nature stochastique du processus de sélection. Lorsque le hasard pur, orchestré par un générateur de nombres pseudo-aléatoires ou des urnes de tirage contrôlées, préside au choix des unités, les lois de la probabilité garantissent que les estimateurs empiriques convergent en probabilité vers les paramètres populationnels réels au fur et à mesure que la taille de l’échantillon croît.
Ce mécanisme autorise le calcul rigoureux de la variance d’échantillonnage et la construction d’intervalles de confiance précis. Selon les postulats du théorème central limite et de la loi des grands nombres, la distribution des moyennes d’échantillonnage répétées autour de la véritable moyenne populationnelle $\mu$ suit une distribution asymptotiquement normale de variance $\sigma^2 / n$. Cette propriété mathématique élégante et robuste permet d’énoncer des affirmations probabilistes sur l’erreur maximale d’estimation à un seuil de confiance déterminé (par exemple, 95 %).
Ces garanties théoriques assurent la double préservation de la validité interne (le fait que la relation observée au sein de l’échantillon ne soit pas un pur artéfact méthodologique) et de la validité externe (la légitimité d’extrapoler cette relation à l’ensemble de la population de référence). L’échantillonnage probabiliste constitue ainsi le pont mathématique reliant l’observation fragmentaire du particulier à la loi générale qui gouverne le tout.
2.2 La rupture épistémologique induite par la réponse volontaire
L’échantillonnage à réponse volontaire consomme une rupture radicale avec cette architecture axiomatique. En premier lieu, il viole délibérément les conditions d’indépendance et d’équiprobabilité qui sous-tendent les théorèmes asymptotiques. Les observations collectées ne peuvent plus être modélisées comme des variables aléatoires indépendantes et identiquement distribuées (i.i.d.). Chaque unité statistique entre dans l’échantillon par le truchement d’une décision intentionnelle dépendante de variables cognitives, affectives et contextuelles propres à l’individu.
Dès lors, le processus de sélection n’est plus un mécanisme neutre et exogène piloté par le statisticien ; il se transforme en une variable dépendante psychologique interne au système étudié. La probabilité d’inclusion d’un sujet devient fonction directe de la valeur qu’il porte à l’égard de la variable mesurée. Par exemple, si l’étude porte sur le niveau de satisfaction professionnelle, la probabilité d’auto-sélection sera corrélée de manière non linéaire au niveau de mécontentement ou d’exaltation de l’employé. Cette endogénéité fondamentale contamine l’ensemble des estimateurs statistiques.
À cette défaillance s’ajoute l’absence de base de sondage délimitée (sampling frame). Faute de pouvoir circonscrire mathématiquement l’univers des répondants potentiels, le chercheur se trouve face à un ensemble d’individus dont les caractéristiques structurelles échappent à toute modélisation probabiliste rigoureuse. Les limites axiomatiques interdisent alors formellement toute généralisation directe des données empiriques vers une population élargie, réduisant les données obtenues au statut de simples anecdotes agrégées, privées de puissance inférentielle universelle.
2.3 Taxonomie comparative des méthodes de collecte
Afin de situer l’échantillon à réponse volontaire dans le spectre des pratiques empiriques, il convient de le comparer à d’autres méthodes non probabilistes couramment employées en sciences sociales et en marketing. Le tableau conceptuel suivant permet de distinguer leurs logiques de fonctionnement respectives :
- L’échantillonnage par quotas : Bien que non probabiliste, cette méthode impose des contraintes démographiques préalables (âge, genre, profession) visant à forcer l’échantillon final à reproduire la structure marginale de la population parente, généralement issue des recensements nationaux. Contrairement à la réponse volontaire pure, le chercheur sélectionne activement des participants pour remplir des cellules démographiques strictes, limitant ainsi les dérives les plus flagrantes, bien que le biais d’auto-sélection résiduel persiste au sein des strates.
- Les échantillons de convenance : Souvent confondus avec les échantillons volontaires, ils partagent une absence de fondement probabiliste mais diffèrent par le point de départ du contact. L’échantillon de convenance repose sur la facilité géographique ou logistique d’accès pour le chercheur (par exemple, interroger les passants à un coin de rue ou les étudiants inscrits à son propre cours magistral). Le sujet y est souvent passif dans l’initialisation du contact, là où l’échantillon à réponse volontaire exige une démarche motrice et spontanée du répondant.
- La méthode de la boule de neige (snowball sampling) : Utilisée pour accéder à des populations cachées ou difficiles d’accès (personnes séropositives, usagers de drogues dures, élites financières), cette méthode s’appuie sur les réseaux sociaux des premiers répondants pour recruter les suivants. Bien qu’elle dépende de la bonne volonté des participants, elle est régulée par les liens d’interconnaissance et les sociogrammes, contrairement à la réponse volontaire qui s’adresse de façon impersonnelle et indifférenciée à un public anonyme.
La démarcation entre ces approches doit être évaluée à l’aune de la finalité de l’étude. Si une méthode exploratoire ou qualitative peut s’accommoder de l’absence de représentativité probabiliste pour identifier des concepts émergents, une visée descriptive, prédictive ou étiologique souffrira irrémédiablement de la distorsion engendrée par l’auto-sélection pure.
3. Mécanismes psychologiques sous-jacents à l’auto-sélection
Le biais de réponse volontaire ne provient pas d’un défaut des machines de calcul, mais de la psychologie humaine. La décision d’un individu de consacrer du temps, de l’énergie et de l’attention à un questionnaire non rémunéré ou spontanément accessible dépend d’une constellation de déterminants psychologiques bien répertoriés par les sciences du comportement.
3.1 L’intensité de l’attitude et l’engagement émotionnel
L’un des postulats cardinaux de la psychologie sociale réside dans la relation entre l’intensité d’une attitude et la propension au passage à l’action. Dans les années 1960, la théorie de l’implication personnelle (Ego-Involvement Theory) développée par Muzafer Sherif et Carl Hovland a brillamment démontré que les individus possédant une position extrême sur un sujet donné manifestent une « latitude de rejet » exceptionnellement large à l’égard des positions alternatives, couplée à une activation émotionnelle intense dès que le thème est évoqué. Ce sont précisément ces individus fortement investis qui se mobilisent lorsqu’une opportunité d’expression s’offre à eux.
À l’opposé, les personnes dont les opinions sont modérées, nuancées ou qui perçoivent le sujet avec indifférence présentent une apathie comportementale prévisible. L’utilité perçue de consacrer quelques minutes à remplir un formulaire est largement inférieure aux coûts d’opportunité cognitifs liés à l’effort de concentration. Il en découle un phénomène mécanique de polarisation des réponses : l’enquête n’enregistre pas la distribution de l’opinion dans la société, mais la distribution de la passion dans la société. Les cohortes aux avis mitigés disparaissent purement et simplement de la métrique observée.
Cette asymétrie d’engagement est encore exacerbée par la valence de l’émotion ressentie. Les travaux contemporains en neurosciences affectives confirment que les états émotionnels à haute valence négative (colère, indignation, sentiment d’injustice) constituent de bien plus puissants catalyseurs comportementaux que les émotions positives douces (satisfaction passive, contentement routinier). Dès lors, les questionnaires d’évaluation ou d’opinion collectés de manière volontaire deviennent des amplificateurs du ressentiment et de l’exaspération, le besoin de rétroaction négative fonctionnant comme une catharsis pour le répondant frustré.
3.2 Motivation intrinsèque, altruisme et civisme scientifique
L’analyse des répondants volontaires peut également être abordée par le prisme de la théorie de l’autodétermination formulée par Edward Deci et Richard Ryan. En l’absence de rétribution monétaire ou d’obligation institutionnelle, la participation relève d’une motivation intrinsèque autonome. Deux profils psychologiques distincts émergent fréquemment au sein de ces panels spontanés : les individus motivés par un comportement prosocial ou civique, et ceux animés par un fort sentiment d’efficacité personnelle.
Le désir d’aider la recherche académique, de participer au progrès de la science médicale ou de manifester une solidarité envers un projet d’utilité publique constitue un puissant biais de sélection bienveillant. Les personnes qui répondent spontanément à de telles sollicitations affichent des scores systématiquement plus élevés sur les traits de personnalité du modèle des Big Five, notamment l’Agréabilité (altruisme, empathie, coopération) et la Conscience (sens du devoir, rigueur morale). Ce filtre sélectif crée une distorsion pernicieuse : les sujets étudiés sont psychologiquement plus coopératifs, plus altruistes et plus confiants dans les institutions que la moyenne de la population générale qu’ils sont censés représenter.
De surcroît, le sentiment d’auto-efficacité (self-efficacy théorisé par Albert Bandura) joue un rôle filtrant déterminant. Les individus convaincus de la valeur de leur voix et persuadés que leur contribution singulière peut peser sur l’orientation d’une politique publique ou sur le développement d’une solution commerciale sont infiniment plus enclins à cliquer sur un questionnaire. Ceux qui éprouvent un sentiment d’impuissance politique, de relégation sociale ou d’incompétence intellectuelle s’auto-excluent spontanément de la démarche, privant l’enquête des perspectives des segments de population les plus vulnérables ou marginalisés.
3.3 Biais de confirmation et validation de l’identité sociale
Participer à une consultation ouverte n’est que rarement un acte neutre de transmission d’information objective ; c’est fréquemment un acte performatif d’affirmation identitaire. À l’ère de l’individualisme expressif et des réseaux socionumériques, les individus mobilisent l’enquête d’opinion comme une arène où réaffirmer leur appartenance à un « endogroupe » valorisé face à un « exogroupe » antagoniste, selon les axiomes de la théorie de l’identité sociale d’Henri Tajfel.
Le biais de confirmation pousse les militants, qu’ils soient politiques, idéologiques ou consuméristes, à guetter les sondages en accès libre pour faire triompher leur narratif. L’acte de répondre devient une opportunité stratégique de faire pencher la balance statistique en faveur de leur communauté, créant de véritables dynamiques de mobilisation collective coordonnées (phénomène de « brigading » numérique où des groupes d’intérêt partagent massivement les liens d’un sondage pour en fausser délibérément l’issue). Le sondage à réponse volontaire se transforme alors en caisse de résonance militante.
Enfin, la manifestation de la dissonance cognitive (Leon Festinger) explique pourquoi les sujets ayant vécu une expérience dissonante ou traumatisante avec un service ou une entité ressentent un besoin irrépressible d’externaliser leur malaise en répondant à des enquêtes d’évaluation. L’effort consenti pour répondre sert à réduire la tension psychologique interne en punissant le prestataire ou en tentant d’aligner la réalité perçue avec leur ressenti intérieur, accentuant encore la déformation de l’échantillon final au détriment des profils psychologiquement stables.
4. Exemples classiques et contemporains d’échantillons à réponse volontaire
Pour appréhender l’impact concret de ces distorsions psychologiques et méthodologiques, il est instructif d’examiner des cas d’école récurrents où l’échantillonnage à réponse volontaire a produit des illusions de masse ou des erreurs systématiques d’interprétation.
4.1 L’exemple paradigmatique : Le sondage radiophonique ou télévisuel
Le format du débat radiophonique ou télévisuel invitant les auditeurs à « voter par SMS ou sur l’application mobile » pour répondre à une question binaire du type : « Êtes-vous favorable au rétablissement de la peine de mort ? » ou « Faut-il interdire immédiatement le glyphosate ? » constitue l’illustration la plus archétypale de la réponse volontaire et de ses ravages méthodologiques.
Dans ce scénario, la base d’auditeurs exposés est déjà soumise à un premier filtre de sélection structurel (l’affinité politique ou stylistique avec la station ou la chaîne). Mais au sein même de ce public ciblé, seuls les individus en état d’excitation psychologique ou d’indignation morale aiguë prendront leur téléphone pour envoyer un message ou se rendre sur le site web de l’émission. Les auditeurs estimant que le sujet est complexe, qu’il exige des arbitrages délicats ou qui n’ont pas d’avis arrêté s’abstiendront rigoureusement. Le résultat affiché à l’écran — par exemple un tonitruant « 87 % de OUI » — ne renseigne en rien sur l’opinion de la population nationale, ni même sur celle de l’ensemble des auditeurs du programme.
Ce résultat n’est que la mesure de la taille relative de deux factions militantes auto-sélectionnées au sein d’une tranche horaire particulière. Lorsque de tels chiffres sont mis en scène par les présentateurs comme une « photographie de l’opinion », il y a tromperie épistémologique majeure : la majorité silencieuse, tempérée et médiane, a été gommée de l’équation statistique, remplacée par les franges les plus bruyantes et radicales du spectre idéologique.
4.2 Les revues de consommateurs et avis en ligne
L’économie numérique contemporaine repose en grande partie sur les mécanismes de réputation électronique matérialisés par les étoiles d’évaluation sur des plateformes comme TripAdvisor, Amazon, Google Maps ou Trustpilot. Ces dispositifs sont les héritiers directs du modèle de la réponse volontaire généralisée à l’échelle planétaire.
L’analyse statistique de la distribution des notes sur ces plateformes révèle une régularité mathématique stupéfiante : l’extrême rareté de la distribution normale (courbe de Gauss) en cloche centrée sur une note moyenne de 3/5. À la place, les chercheurs observent quasi systématiquement une distribution bimodale en « U » ou dissymétrique en « J ». Les clients qui prennent le temps de rédiger un avis sont soit des clients euphoriques ayant vécu une expérience extraordinaire (notations 5 étoiles), soit des usagers excédés par une défaillance de service majeure (notations 1 étoile).
Le consommateur lambda ayant consommé un café correct pour un prix normal ne ressent aucune impulsion motivationnelle suffisante pour se connecter à une application et rédiger une critique. Dès lors, la note moyenne observée souffre d’une instabilité structurelle qui fausse l’appréciation globale de la qualité réelle d’un produit. Cet artefact méthodologique engendre ensuite des effets de cascade informationnelle : les futurs acheteurs fondent leurs choix sur des avis qui reflètent des anomalies statistiques marginales plutôt que l’expérience médiane des cohortes d’utilisateurs ordinaires.
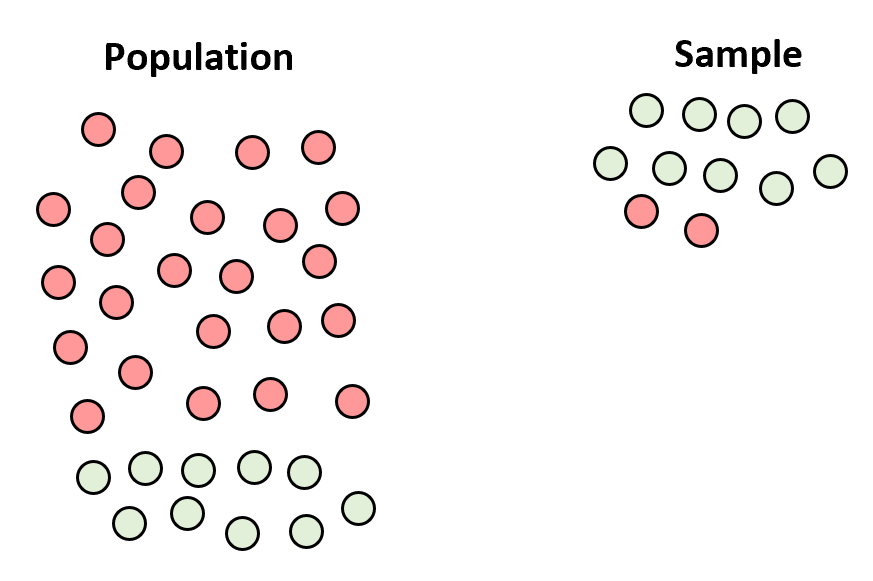
4.3 Les études de santé publique et questionnaires ouverts sur les réseaux sociaux
Avec la démocratisation des outils de création de formulaires en ligne (Google Forms, SurveyMonkey, Qualtrics) et leur viralisation sur les plateformes comme X (anciennement Twitter), Instagram, LinkedIn ou Reddit, un nombre croissant d’initiatives prétendant relever de la santé publique ou de la sociologie médicale recourt à des échantillons auto-sélectionnés.
Un cas d’école fréquemment observé concerne les sondages ouverts évaluant les effets secondaires perçus d’un traitement pharmaceutique, la prévalence auto-déclarée du Covid long, ou encore le niveau de détresse psychologique durant une période de confinement. Les individus souffrant physiquement ou psychologiquement, ceux qui sont activement en quête de sens face à leurs symptômes, ou les militants regroupés au sein d’associations de patients hyperconnectées partagent frénétiquement ces liens au sein de leurs bulles algorithmiques. À l’inverse, les personnes ayant reçu le traitement ou traversé la crise sans le moindre encombrement somatique n’ont aucune raison de s’attarder sur un tel questionnaire, si tant est qu’il leur soit un jour proposé.
Les taux de prévalence calculés à partir de ces corpus sont systématiquement surévalués de plusieurs ordres de grandeur. Dans de nombreuses publications pré-imprimées durant les crises épidémiques récentes, des auteurs ont affirmé observer des incidences alarmantes de complications diverses en oubliant l’axiome fondamental : la probabilité d’accéder au formulaire et d’y répondre était positivement conditionnée par la présence même du trouble investigué. Ces erreurs d’estimation polluent le débat médical et instillent des craintes disproportionnées au sein de l’opinion publique.
5. Le biais de réponse volontaire (Voluntary Response Bias) et ses impacts statistiques
Pour le théoricien de la mesure statistique, le biais de réponse volontaire n’est pas une simple imprécision cosmétique ; c’est une déformation mathématique structurée qui rend inopérantes les propriétés analytiques conventionnelles de la statistique descriptive et décisionnelle.
5.1 Définition et structure mathématique du biais
D’un point de vue formel, le biais d’un estimateur statistique $\hat{\theta}$ par rapport au paramètre réel $\theta$ de la population est défini comme l’espérance mathématique de la différence entre cet estimateur et la valeur vraie :
$$\text{Biais}(\hat{\theta}) = \mathbb{E}[\hat{\theta}] – \theta$$
Dans le cas d’un échantillon probabiliste sans biais, $\mathbb{E}[\hat{\theta}] = \theta$, ce qui signifie que si l’on répétait l’échantillonnage une infinité de fois, la moyenne des estimations convergerait exactement vers le paramètre inconnu de la population. Dans le cadre de la réponse volontaire, ce terme de biais est rigoureusement non nul ($\text{Biais}(\hat{\theta}) \neq 0$) en raison d’une erreur systématique de mesure ancrée dans le protocole de sélection lui-même.
L’erreur la plus répandue chez les praticiens novices consiste à penser que l’augmentation spectaculaire de la taille de l’échantillon ($N$) permettrait d’estomper ou de résorber ce biais. Il s’agit là du fameux « paradoxe du grand échantillon non représentatif ». L’erreur quadratique moyenne (EQM ou Mean Squared Error en anglais) d’un estimateur se décompose canoniquement en la somme de sa variance et du carré de son biais :
$$\text{EQM}(\hat{\theta}) = \text{Var}(\hat{\theta}) + [\text{Biais}(\hat{\theta})]^2$$
Lorsque la taille de l’échantillon $N$ tend vers l’infini, la variance d’échantillonnage $\text{Var}(\hat{\theta}) propto \frac{\sigma^2}{N}$ décroît inexorablement vers zéro. En revanche, le terme de biais systématique $[\text{Biais}(\hat{\theta})]^2$, lui, demeure parfaitement invariant par rapport à la volumétrie des données ! Par conséquent, un échantillon auto-sélectionné portant sur un million d’individus n’a pas pour effet de se rapprocher de la réalité : il a simplement pour effet d’estimer avec une précision absolue et une variance infinitésimale une grandeur totalement fausse. Le chercheur dispose d’une certitude mathématique inébranlable quant à la valeur d’une erreur systématique.
5.2 La bimodalité artificielle des résultats empiriques
L’une des conséquences graphiques et structurales les plus frappantes du biais d’auto-sélection est la genèse d’une bimodalité artificielle dans les jeux de données empiriques. Si l’on postule qu’une opinion ou qu’un trait psychologique sous-jacent est distribué dans la population globale selon une loi normale standard $\mathcal{N}(\mu, \sigma^2)$, la majorité des individus se regroupe autour de la médiane et des valeurs moyennes, les positions tranchées constituant les queues minoritaires de la distribution gaussienne.
L’auto-sélection opère comme un filtre de transformation non linéaire qui modifie la fonction de densité observée. En pénalisant drastiquement la probabilité de participation des individus proches de la moyenne (frappés par l’indifférence cognitive) et en favorisant exponentiellement l’inclusion des individus situés aux extrêmes ($x ll \mu$ ou $x gg \mu$), le processus d’échantillonnage écrase le centre de la distribution au profit exclusif de ses queues. La distribution observée dans l’échantillon volontaire perd son allure de cloche pour adopter un profil en « selle de cheval » ou en « U » présentant deux modes distincts et antagonistes.
Ce phénomène crée une illusion sociologique extrêmement délétère : il donne le sentiment trompeur d’un consensus conflictuel ou d’une société irrémédiablement fracturée en deux camps irréconciliables, alors même que le corps social réel demeure massivement ancré dans un consensus modéré. Sur le plan descriptif, les métriques usuelles de tendance centrale sont vidées de leur sens : la moyenne arithmétique devient un non-sens absolu puisqu’elle tombe précisément dans le creux de la distribution où aucun répondant ne se situe véritablement, et l’écart-type est artificiellement boursouflé.
5.3 Erreurs d’inférence statistique et risques de conclusions fallacieuses
Lorsque des chercheurs appliquent naïvement les techniques de l’inférence statistique classique (tests t de Student, analyses de variance ANOVA, régressions linéaires moindres carrés) à des données issues de réponses volontaires, les conclusions analytiques sont structurellement invalidées. En ignorant le mécanisme de sélection endogène, les modèles statistiques sous-estiment radicalement l’erreur type réelle de leurs paramètres, ce qui engendre une explosion catastrophique des taux d’erreur de Type I (rejet à tort de l’hypothèse nulle d’absence d’effet, c’est-à-dire détection de faux positifs).
Dans une régression linéaire standard $Y = \beta_0 + \beta_1 X + \epsilon$, l’hypothèse d’exogénéité stricte requiert que le terme d’erreur soit indépendant des variables explicatives ($\mathbb{E}[\epsilon | X] = 0$). Or, dès lors que la probabilité d’inclusion dans l’échantillon dépend à la fois de $Y$ (par exemple, la détresse psychologique) et de $X$ (par exemple, le temps passé sur les écrans numériques), une corrélation fallacieuse est mécaniquement induite entre le résidu et le régresseur au sein de l’échantillon conditionné. Ce piège méthodologique, connu sous le nom de biais du collisionneur (collider bias ou paradoxe de Berkson dans l’analyse causale moderne), peut inverser mathématiquement le signe de la véritable relation ou faire apparaître des associations causales entièrement illusoires.
Le danger s’avère critique lorsque de telles extrapolations fallacieuses franchissent les portes des cercles décisionnels. Qu’il s’agisse de déployer des politiques économiques erronées, d’interdire un dispositif thérapeutique sur la base de remontées d’effets secondaires auto-sélectionnées ou de légiférer sous la panique morale provoquée par un micro-trottoir numérique, les artéfacts statistiques d’un échantillon à réponse volontaire se transforment trop souvent en préjudices réels pour la collectivité.
6. Comparaison avec d’autres méthodes d’échantillonnage non probabilistes
Bien que regroupées sous la bannière commune des approches non probabilistes en raison de l’absence de tirage au sort certifié, les différentes stratégies de collecte empirique ne se valent pas et ne mobilisent pas les mêmes leviers méthodologiques.
6.1 Échantillonnage à réponse volontaire versus échantillonnage de convenance
L’échantillonnage de convenance et l’échantillonnage à réponse volontaire sont fréquemment traités de manière interchangeable dans les manuels de méthodologie simplifiés. Il existe pourtant entre eux une divergence conceptuelle et praxéologique majeure portant sur l’initiative du contact initial.
Dans l’échantillonnage de convenance, l’initiative repose sur le chercheur. C’est l’enquêteur qui, pour des motifs de réduction de coûts logistiques ou d’accessibilité immédiate, déploie son protocole au sein d’une unité géographique ou sociale aisément disponible : les étudiants de sa propre université, les patients hospitalisés dans le service où il exerce, ou les passants déambulant dans un centre commercial un mardi après-midi. Le sujet abordé ne s’est pas réveillé avec l’intention expresse d’alimenter une base de données ; il est intercepté et sollicité directement par l’observateur. Bien que non représentatif de la nation entière, cet échantillon conserve une certaine forme de passivité de la part du participant lors de la sélection initiale.
À l’inverse, dans l’échantillon à réponse volontaire, l’initiative est intégralement transférée au répondant. L’enquêteur est statique ; il a simplement déposé son piège informationnel dans l’espace public (physique ou numérique). C’est le répondant qui, mu par une tension psychologique interne, décide d’accomplir la démarche motrice d’interagir avec l’instrument. Le filtre d’entrée n’est plus l’accessibilité géographique pour le scientifique, mais l’hyper-réactivité cognitive et affective du participant. Les deux méthodes partagent cependant une zone de chevauchement toxique dans la recherche contemporaine en ligne : lorsque des chercheurs postent un questionnaire sur un forum public fréquenté par commodité, le protocole fusionne l’arbitraire du choix du canal (convenance) et l’extrémisme de l’auto-désignation (volontariat).
6.2 Échantillonnage par quotas : Une tentative de régulation structurelle
Face aux dérives manifestes de l’auto-sélection brute, les instituts de sondage professionnels ont développé dès les années 1930 l’échantillonnage par quotas, sous l’impulsion notable de George Gallup et d’Elmo Roper. Cette méthode consiste à imposer une grille de contraintes morphologiques exogènes : l’échantillon final doit comporter rigoureusement, par exemple, 52 % de femmes, 15 % de cadres supérieurs, 22 % de retraités et 30 % de résidents de communes rurales, afin de calquer les distributions marginales d’un recensement officiel.
L’échantillonnage par quotas parvient ainsi à masquer les déséquilibres sociodémographiques les plus visibles qui défigurent les échantillons volontaires purs. Cependant, il ne résout en aucun cas la tare de l’auto-sélection : il ne fait que la compartimenter au sein de chaque cellule démographique. Les 150 ouvriers masculins de moins de trente ans qui acceptent spontanément de répondre pour remplir la case vacante du quota ne sont en rien équivalents aux millions d’autres ouvriers qui ignorent la sollicitation. Ils présentent des traits de personnalité, des niveaux d’acculturation et des intérêts politiques atypiques par rapport à leurs pairs non répondants.
Sur le plan prédictif, l’échantillonnage par quotas affiche historiquement des performances très supérieures à la réponse volontaire brute lors des consultations électorales, précisément parce que la stratification forcée neutralise les corrélations majeures liant le vote à la classe d’âge ou au statut socio-économique. Néanmoins, cette performance accrue a un coût d’exécution sans commune mesure avec la gratuité illusoire d’une collecte ouverte sur Internet, et conserve une fragilité théorique intrinsèque qui resurgit brutalement dès lors que les clivages d’opinion s’émancipent des variables démographiques classiques.
6.3 Échantillonnage ciblé ou au jugé (Purposive Sampling)
Une autre distinction épistémologique majeure doit être opérée avec l’échantillonnage au jugé, raisonné ou intentionnel (purposive sampling). Dans cette méthodologie, fréquente dans les designs qualitatifs et les études de cas approfondies, l’inclusion d’une unité statistique n’est ni le fruit du hasard probabiliste, ni la conséquence de l’auto-désignation spontanée du sujet : elle est dictée par l’expertise théorique préalable du chercheur.
Le scientifique identifie délibérément des cas précis en fonction de critères de pertinence conceptuelle rigoureux. Il peut s’agir de la recherche de cas extrêmes ou déviants pour éprouver les limites d’un modèle (par exemple, étudier les survivants exceptionnels d’une pathologie létale), de cas critiques permettant une falsification poppérienne (« si le phénomène n’est pas vérifié dans cette entreprise modèle, il ne le sera nulle part »), ou d’un panel d’experts détenteurs d’un savoir technique très circonscrit. Contrairement à l’accueil passif des répondants extrêmes dans l’échantillon volontaire, la quête des cas dans l’échantillonnage au jugé est intentionnelle, maîtrisée, documentée et adossée à un cadre théorique transparent.
La démarcation dépend donc de la visée de l’investigation. L’échantillonnage au jugé ne prétend généralement pas à une estimation généralisable de paramètres au sens fréquentiste, mais poursuit un objectif de théorisation ancrée et de conceptualisation locale. L’échantillonnage à réponse volontaire, à l’inverse, pèche par son ambiguïté téléologique : ses utilisateurs prétendent fréquemment mesurer l’ensemble d’une communauté alors que leur protocole n’est qu’un entonnoir à singularités.
7. Implications méthodologiques en psychologie et en sciences comportementales
C’est sans doute en psychologie expérimentale et dans les sciences du comportement que l’échantillon à réponse volontaire a suscité les analyses critiques les plus méticuleuses, révélant que le profil même du « volontaire » constitue une variable confondante majeure.
7.1 Le profil psychologique distinctif des participants volontaires
Dans un ouvrage fondateur qui a marqué l’histoire de la méthodologie expérimentale (The Volunteer Subject, 1975), les psychologues Robert Rosenthal et Ralph L. Rosnow ont dressé le portrait psychométrique détaillé de l’individu qui se propose spontanément pour des recherches scientifiques. Leurs synthèses méta-analytiques ont permis de dresser une liste robuste de caractéristiques qui distinguent de manière statistiquement significative les sujets volontaires des non-volontaires.
Comparé à la moyenne de la population, le sujet volontaire présente en moyenne :
- Un niveau d’éducation formelle plus élevé ;
- Un statut socio-économique plus favorisé ;
- Un besoin d’approbation sociale plus marqué ;
- Un score aux tests d’intelligence générale et verbale supérieur ;
- Une moindre adhésion au conventionnalisme autoritaire ;
- Une tendance plus marquée à l’extraversion, à l’ouverture aux expériences nouvelles et à la sociabilité.
Ces différentiels systématiques introduisent ce que les méthodologistes appellent le « biais du sujet volontaire ». Si un chercheur en psychologie sociale tente d’étudier les mécanismes de la soumission à l’autorité ou de la conformité de groupe en s’appuyant uniquement sur des individus ayant levé la main pour participer, il étudie par définition une population atypique, structurellement moins encline à l’obéissance aveugle que la moyenne de ses concitoyens. De même, dans les études longitudinales, ces volontaires affichent des comportements d’attrition et de persévérance spécifiques, faussant l’évaluation des trajectoires de développement ou de rétention cognitive au fil des années.
7.2 La crise de la reproductibilité et l’auto-sélection
Depuis le début des années 2010, les sciences comportementales traversent une sévère crise de la reproductibilité (replication crisis), de nombreuses expériences princeps s’avérant impossibles à reproduire dans des laboratoires indépendants. L’une des racines structurelles de cette fragilité réside dans la mutation des modalités de recrutement des cohortes expérimentales, notamment à travers l’usage massif des plateformes de micro-travail et de crowdsourcing en ligne telles qu’Amazon Mechanical Turk (MTurk), Prolific ou CloudResearch.
Sur ces plateformes, des centaines de milliers d’études académiques reposent sur un modèle d’auto-sélection rémunérée. Les participants parcourent des tableaux de bord listant les tâches disponibles et s’auto-désignent pour participer aux protocoles en fonction du titre de l’étude, de sa durée apparente et du montant de la récompense monétaire. Ce modèle a engendré une « professionnalisation » pernicieuse des répondants : une sous-population hyper-expérimentée de répondants réalise des dizaines de protocoles par jour. Cette pratique entraîne l’épuisement complet de la naïveté expérimentale des sujets.
Ces « professionnels » de la réponse volontaire ont décrypté les paradigmes classiques de la psychologie (dilemme du tramway, tâche de Stroop, amorçage sémantique, ancrage cognitif). Ils anticipent les hypothèses du chercheur et adaptent consciemment ou inconsciemment leurs comportements pour satisfaire les attentes perçues de l’investigateur, amplifiant le biais des caractéristiques de la demande (demand characteristics d’Orne). L’effet mesuré ne correspond plus au fonctionnement cognitif spontané de l’esprit humain, mais à la performance théâtrale d’un panel d’utilisateurs hautement conditionnés par l’auto-sélection algorithmique.
7.3 Conséquences sur les études psychopathologiques et cliniques
Le champ de la recherche clinique et de la psychopathologie expérimentale n’est pas épargné par les distorsions de l’auto-sélection. Lorsqu’un essai clinique préliminaire ou une enquête épidémiologique recrute ses sujets par voie d’annonces publiques ouvertes, la composition clinique de la cohorte finale subit un biais de sélection diagnostique aigu.
D’un côté, les formes les plus sévères de dépression caractérisée, associées à un état d’anhédonie profonde, d’aboulie et de retrait social complet, sont presque totalement exclues de l’échantillon. Un patient incapable de quitter son lit ne naviguera pas sur Internet pour remplir un formulaire de cinquante questions sur son humeur. À l’opposé, les personnes en recherche effrénée d’un diagnostic, animées d’une inquiétude hypocondriaque ou souffrant de troubles fonctionnels non encore étiquetés, se ruent sur les questionnaires d’évaluation pour tenter d’obtenir une écoute ou une confirmation médicale de leur souffrance. La cohorte est ainsi vidée de ses cas cliniques les plus graves et submergée de profils anxieux à forte labilité symptomatique.
Dans l’évaluation des thérapies non médicamenteuses (psychothérapies cognitivo-comportementales, méditation de pleine conscience, remédiation cognitive), l’auto-sélection magnifie artificiellement l’effet placebo et les taux d’efficacité brute. Les volontaires qui acceptent d’intégrer un protocole thérapeutique contraignant de douze semaines possèdent un niveau initial d’espérance de guérison et d’alliance thérapeutique potentielle sans commune mesure avec un échantillon randomisé de patients tout-venant. L’estimation des bénéfices de l’intervention en situation réelle s’en trouve lourdement biaisée à la hausse.
8. La représentativité et la validité externe compromises
L’argument central opposé à l’usage de l’échantillon à réponse volontaire réside dans l’anéantissement de la représentativité statistique et l’effondrement corollaire de la validité externe de la recherche.
8.1 Validité interne versus validité externe
Il importe d’opérer une distinction méthodologique rigoureuse entre validité interne et validité externe, concept formalisé par Donald T. Campbell. Un protocole expérimental mené sur un échantillon à réponse volontaire peut parfaitement afficher une excellente validité interne. Si, au sein du groupe de volontaires recrutés, le chercheur procède à une véritable randomisation stochastique assignant les individus de manière aléatoire au groupe contrôle ou au groupe expérimental sous double insu, il est mathématiquement fondé à inférer un lien causal direct entre le traitement et la variable de résultat au sein de ce groupe précis.
Le drame méthodologique réside dans l’effondrement total de la validité écologique et externe. L’inférence causale locale ne peut pas être étendue à la population générale sans faire le postulat héroïque — et presque toujours faux — qu’il n’existe aucune interaction statistique entre le traitement expérimenté et les caractéristiques latentes qui ont conduit ces sujets particuliers à se porter volontaires. Si, par exemple, un programme d’entraînement cognitif fonctionne uniquement sur des sujets dotés d’une forte motivation intrinsèque préalable (qui les a précisément conduits à répondre à l’annonce), l’effet sera totalement nul s’il est appliqué à grande échelle dans un cadre scolaire obligatoire.
La validité externe mesure la transférabilité des conclusions d’une étude au-delà de son cadre expérimental immédiat : vers d’autres populations, d’autres contextes géographiques et d’autres horizons temporels. En confisquant le contrôle de l’échantillonnage, la réponse volontaire cantonne la science à la production de savoirs insulaires, valides uniquement pour la micro-culture des individus ayant choisi d’en faire partie.
8.2 La fracture numérique et les biais sociodémographiques d’accès
À l’ère où la majorité écrasante des collectes à réponse volontaire s’opère via des plateformes numériques, des formulaires web ou des applications pour smartphones, le biais de sélection se double d’une exclusion structurelle liée à l’accessibilité technique.
La fracture numérique de premier degré (l’absence matérielle d’accès à une connexion haut débit ou à un équipement informatique adapté) et de second degré (l’illectronisme ou le déficit de compétences d’usage pour naviguer confortablement sur des interfaces interactives) écartent de facto des segments colossaux de la société humaine. Les personnes très âgées dépendantes, les ménages vivant sous le seuil d’extrême pauvreté, les populations rurales non raccordées aux réseaux de fibre optique ou de téléphonie mobile, ainsi que les personnes en situation de handicap cognitif ou visuel sévère sont réduites au silence statistique absolu dans tout protocole numérique ouvert.
Ce canal induit une distorsion générationnelle et culturelle massive favorisant systématiquement les cohortes jeunes, hautement technophiles, urbaines et instruites. Par ailleurs, l’existence même de l’enquête n’atteint que les individus inscrits dans certains flux d’information spécifiques. L’illusion que « tout le monde est sur Internet » méconnaît la balkanisation algorithmique des réseaux sociaux contemporains, où les informations ne circulent qu’au sein de bulles de filtrage hermétiques les unes aux autres. Diffuser un lien d’enquête sur un réseau n’est jamais un appel au monde entier ; c’est un appel aux abonnés d’une bulle particulière.
8.3 L’illusion de la représentativité par la volumétrie des ‘Big Data’
L’avènement des mégadonnées (Big Data) a vu resurgir une illusion positiviste naïve selon laquelle la quantité brute d’informations collectées pourrait se substituer à la qualité du plan expérimental. Nombre d’analystes suggèrent implicitement ou explicitement qu’en réunissant un demi-million de tweets, un million de clics ou trois cent mille réponses à une consultation en ligne, l’échantillon deviendrait « naturellement » représentatif par pure masse critique.
L’histoire de la statistique a pourtant administré la démonstration définitive de l’inanité de cette croyance lors de l’élection présidentielle américaine de 1936. Le célèbre magazine Literary Digest organisa un sondage de paille d’une envergure colossale en envoyant plus de dix millions de cartes-réponses postales, et en recueillant le chiffre astronomique de 2,27 millions de bulletins retournés volontairement par les électeurs. Le magazine prédit avec une certitude absolue l’écrasante victoire du républicain Alf Landon avec 57 % des voix face au président démocrate sortant Franklin D. Roosevelt. Le résultat réel de l’élection fut l’un des plus grands raz-de-marée de l’histoire américaine : Roosevelt fut réélu triomphalement avec 60,8 % des suffrages populaires !
Comment une étude portant sur plus de deux millions de personnes a-t-elle pu commettre une erreur de prédiction de près de 18 points de pourcentage ? La réponse réside dans la combinaison fatale de deux biais d’auto-sélection : d’une part, les listes de distribution du magazine étaient constituées à partir d’annuaires téléphoniques et de registres de cartes grises, sélectionnant une frange fortunée de la population en pleine Grande Dépression ; d’autre part et surtout, parmi ces destinataires privilégiés, seuls ceux qui haïssaient viscéralement les réformes économiques du New Deal de Roosevelt prirent la peine de renvoyer leur coupon par la poste. Au même moment, un jeune statisticien du nom de George Gallup, opérant sur un échantillon probabiliste rigoureux de seulement 50 000 individus, prédisait avec exactitude la victoire éclatante de Roosevelt. La règle d’or de la statistique demeure immuable : la qualité du plan d’échantillonnage prime toujours, absolument et irréversiblement, sur la taille brute de l’échantillon.
9. Analyse mathématique et déviation des distributions dans les réponses volontaires
Pour formaliser la défaillance des échantillons volontaires, il est nécessaire de recourir aux outils de l’économétrie et de la théorie de la mesure, qui modélisent mathématiquement le mécanisme stochastique par lequel une donnée est observée ou perdue.
9.1 Modélisation formelle du processus de sélection
Considérons une population d’individus indicés par $i = 1, dots, N$. On s’intéresse à la distribution d’une variable aléatoire $Y_i$ (par exemple, le salaire, l’adhésion à une politique vaccinale ou le niveau d’anxiété), de moyenne théorique $\mu = \mathbb{E}[Y_i]$. Définissons une variable indicatrice de sélection binaire $S_i in {0, 1}$, telle que $S_i = 1$ si l’individu $i$ choisit activement de répondre à l’enquête, et $S_i = 0$ s’il s’abstient.
Dans un plan probabiliste idéal, l’événement de sélection est totalement indépendant de la variable d’intérêt conditionnellement aux covariables observables $X_i$, ce qui s’écrit formellement sous la forme :
$$P(S_i = 1 mid Y_i, X_i) = P(S_i = 1 mid X_i)$$
Dans un échantillon à réponse volontaire, cette condition d’indépendance conditionnelle est systématiquement violée. La probabilité d’inclusion dépend directement et non linéairement de la valeur même de $Y_i$ :
$$P(S_i = 1 mid Y_i, X_i) = f(Y_i, X_i, U_i)$$
où $U_i$ représente un ensemble de variables latentes psychologiques inobservables (l’intérêt personnel, la colère, l’engagement moral). Dès lors, la moyenne empirique observée sur l’échantillon des répondants volontaires, notée $\bar{Y}_{\text{obs}}$, s’écrit mathématiquement comme l’espérance conditionnelle :
$$\mathbb{E}[\bar{Y}_{\text{obs}}] = \mathbb{E}[Y_i mid S_i = 1]$$
Par application de la formule de décomposition de la covariance, nous avons :
$$\mathbb{E}[Y_i mid S_i = 1] = \mathbb{E}[Y_i] + \frac{\text{Cov}(Y_i, S_i)}{\mathbb{E}[S_i]}$$
Cette formulation démontre avec élégance la nature de l’asymétrie induite. L’espérance de l’estimateur empirique n’est égale à la moyenne populationnelle $\mathbb{E}[Y_i]$ que si et seulement si la covariance entre la variable d’intérêt et l’indicatrice de participation est rigoureusement nulle ($\text{Cov}(Y_i, S_i) = 0$). Dans tout protocole à réponse volontaire, cette covariance est substantiellement positive ou négative, induisant un écart permanent et incompressible proportionnel à l’intensité de la corrélation entre la variable étudiée et la propension à s’exprimer.
9.2 Comparaison des fonctions de densité de probabilité
L’effet géométrique du mécanisme d’auto-sélection sur la distribution des données peut être visualisé à travers l’altération de la fonction de densité de probabilité $f(y)$. Si la population parente suit une densité normale $f(y) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left(-\frac{(y-\mu)^2}{2\sigma^2}\right)$, la densité conditionnelle observée $g(y mid S=1)$ se formalise par le théorème de Bayes appliqué aux fonctions de densité :
$$g(y mid S=1) = \frac{P(S=1 mid Y=y) f(y)}{\int_{-\infty}^{+\infty} P(S=1 mid Y=t) f(t) , dt}$$
Lorsque la fonction de réponse $P(S=1 mid Y=y)$ adopte une allure convexe ou en forme de bol — reflétant la forte participation des valeurs extrêmes tant positives que négatives —, le numérateur gonfle symétriquement ou asymétriquement les valeurs distantes de $\mu$. Cela engendre des perturbations structurales majeures des moments d’ordre supérieur de la distribution :
- La skewness (coefficient d’asymétrie) : Si le sujet est polarisé de manière dissymétrique (par exemple, les insatisfaits réagissent plus vigoureusement que les satisfaits), la distribution observée subit une torsion abrupte vers la gauche ou la droite, ruinant l’hypothèse de symétrie sous-jacente à la majorité des tests paramétriques.
- La kurtosis (coefficient d’aplatissement) : Le creusement du centre modal transforme des distributions originellement mésokurtiques en distributions platikurtiques extrêmes, voire en profils multimodaux singuliers, augmentant dramatiquement la dispersion apparente des résidus dans les modèles d’ajustement.
Face à de telles distorsions géométriques, l’utilisation d’estimateurs non paramétriques (comme la médiane ou les rangs de Wilcoxon) ne résout en rien l’impasse : le rang des individus étant lui-même conditionné par leur présence dans l’échantillon, le déplacement de la masse de probabilité fausse identiquement les centiles observés.
9.3 Le concept statistique de Missing Not At Random (MNAR)
Dans la théorie canonique du traitement des données manquantes formalisée par Donald Rubin et Roderick Little, les mécanismes générateurs de non-réponse sont classés en trois régimes fondamentaux :
- MCAR (Missing Completely At Random) : Les données manquent de manière totalement aléatoire. La probabilité d’omission est indépendante tant des variables observées que des variables non observées. L’échantillon restant demeure une réduction homothétique non biaisée de la population.
- MAR (Missing At Random) : La probabilité qu’une valeur manque dépend des variables observables enregistrées par ailleurs dans le questionnaire, mais ne dépend pas de la valeur manquante elle-même. Les techniques de régression ou d’imputation multiple permettent dans ce cas d’annihiler le biais.
- MNAR (Missing Not At Random) : La probabilité de manquer dépend intrinsèquement de la valeur même de la variable non observée, ou de facteurs latents non mesurés liés à cette variable.
Le statut épistémologique de l’échantillon à réponse volontaire relève sans équivoque du mécanisme MNAR. L’absence de réponse de l’immense cohorte des silencieux est directement corrélée à la nature même de leur position sur l’objet de la recherche (leur manque d’enthousiasme, leur modération ou leur rejet de l’instrument). Il s’agit du régime de données manquantes le plus redoutable et le plus intraitable en statistique appliquée.
Dans un contexte MNAR, le processus générateur de données ne peut pas être qualifié « d’ignorable » (ignorable missing data mechanism). Il est mathématiquement impossible d’ignorer la dynamique de non-réponse sans contaminer irrémédiablement l’ensemble des inférences. Toute tentative d’analyse exige la spécification d’un méta-modèle joint intégrant conjointement l’équation d’intérêt substantielle et l’équation comportementale d’accès à l’enquête.
10. Stratégies de détection et d’évaluation du biais d’auto-sélection
Lorsqu’un chercheur se trouve contraint d’analyser un jeu de données issu d’une réponse volontaire, ou lorsqu’il examine la littérature existante avec un œil critique, plusieurs démarches diagnostiques permettent de quantifier l’étendue des dommages méthodologiques.
10.1 Comparaison avec les données de référence populationnelles (Benchmarks)
La première stratégie diagnostique, conceptuellement intuitive mais d’une grande puissance analytique, consiste à confronter les caractéristiques marginales de l’échantillon volontaire avec des données de référence institutionnelles certifiées et hautement fiables (recensements démographiques de l’INSEE en France, de l’U.S. Census Bureau, ou registres administratifs de sécurité sociale).
Le chercheur compare les distributions de variables sociodémographiques stables qui ne devraient théoriquement pas être affectées par l’objet de l’enquête : la pyramide des âges, la parité de genre, le niveau d’instruction diplômante, la répartition par catégories socioprofessionnelles (CSP) et le découpage par régions d’habitation. Pour mesurer rigoureusement l’écart géométrique global entre les deux structures de distribution, on utilise des outils quantitatifs tels que la distance de Hellinger ou l’indice de dissimilarité de Duncan :
$$D = \frac{1}{2} \sum_{k=1}^K |p_k – q_k|$$
où $p_k$ représente la proportion de la strate $k$ dans l’échantillon volontaire et $q_k$ sa proportion dans la population de référence. Un indice $D$ substantiellement élevé révèle une distorsion structurelle aiguë.
Toutefois, cette méthode présente une limite méthodologique intrinsèque majeure : une conformité démographique apparente peut parfaitement masquer des divergences psychologiques profondes. Si un échantillon volontaire affiche miraculeusement 50 % d’hommes et 50 % de femmes avec un âge moyen parfait, les volontaires au sein de ces tranches d’âge peuvent néanmoins différer radicalement de leurs homologues populationnels en matière de névrosisme, d’appartenance politique ou d’hygiène de vie. Le calage démographique est une condition nécessaire, mais absolument jamais suffisante pour postuler la représentativité.
10.2 L’analyse des répondants tardifs (Wave Analysis)
Une méthodologie d’évaluation ingénieuse, développée à l’origine par Leslie Kish et perfectionnée pour les enquêtes par courrier ou par Internet, repose sur le postulat continuiste de la propension à répondre : l’analyse des vagues temporelles (wave analysis).
Ce protocole postule que les participants qui répondent tardivement à une sollicitation — par exemple après deux semaines de diffusion, ou après plusieurs rappels publics — ressemblent psychologiquement et comportementalement bien davantage aux non-répondants définitifs qu’aux individus qui se sont précipités sur le formulaire dans les premières heures de sa mise en ligne. Le chercheur segmente donc son échantillon chronologiquement en plusieurs cohortes : les répondants immédiats (vague 1), les répondants intermédiaires (vague 2) et les répondants tardifs (vague 3).
On procède ensuite à un test de tendance linéaire ou monotone sur les variables d’intérêt $Y$ à travers ces différentes vagues chronologiques. Si l’on constate, par exemple, que le degré de mécontentement exprimé chute de manière continue et statistiquement significative entre la vague 1 et la vague 3, il est extrêmement plausible que l’immense masse des silencieux qui n’ont jamais répondu présente un niveau de mécontentement encore plus faible. Cette technique permet, par extrapolation asymptotique, d’estimer la direction et l’amplitude minimale du biais d’auto-sélection qui contamine l’ensemble de l’échantillon.
10.3 L’utilisation de sous-échantillons d’audit contrôlés
L’approche la plus rigoureuse — bien que la plus onéreuse sur le plan logistique — pour certifier la présence et l’ampleur d’un biais d’auto-sélection consiste à mener simultanément un échantillon d’audit probabiliste en parallèle de la collecte ouverte.
Le chercheur alloue une fraction de son budget de recherche au tirage au sort probabiliste strict d’un sous-échantillon de taille modeste issu de la même population cible (par exemple, 500 individus contactés par composition téléphonique aléatoire RDD ou par courrier nominatif avec incitation financière garantie). L’équipe de recherche consacre des efforts considérables à relancer ce sous-échantillon pour atteindre un taux de complétion élevé (supérieur à 70-80 %), assurant ainsi sa représentativité réelle.
On confronte ensuite directement les résultats obtenus sur la variable d’intérêt entre l’échantillon d’audit probabiliste contrôlé et la base de données massive issue de la réponse volontaire. L’écart statistique observé entre les deux moyennes fournit une estimation empirique non biaisée de l’erreur d’auto-sélection. Si cette démarche valide scientifiquement l’ampleur de la dérive, elle révèle souvent une vérité cruelle : les millions de réponses collectées gratuitement n’apportent aucune valeur ajoutée inférentielle par rapport aux 500 réponses rigoureusement auditées par méthode probabiliste.
11. Méthodes pour corriger ou atténuer les biais dans les données collectées
Lorsqu’un chercheur hérite d’une base de données à réponse volontaire sans pouvoir réitérer la collecte, plusieurs techniques statistiques avancées peuvent être mobilisées pour tenter de réduire — sans jamais pouvoir l’éliminer totalement — l’impact des distorsions constatées.
11.1 Techniques de pondération post-stratification et calage sur marges
La méthode la plus traditionnellement appliquée dans l’industrie du sondage pour corriger les asymétries structurelles est la pondération par post-stratification, complétée par les algorithmes de calage sur marges (méthode de Deming-Stephan ou algorithme de *Raking*).
Le principe fondamental consiste à réattribuer à chaque répondant individuel un poids statistique correcteur $w_i$, de sorte que la somme pondérée des caractéristiques démographiques de l’échantillon coïncide rigoureusement avec les marges de la population cible connue. Si les jeunes hommes de 18 à 25 ans sous-diplômés ne représentent que 2 % de l’échantillon volontaire alors qu’ils composent 8 % du recensement général, l’algorithme leur assignera un coefficient multiplicateur élevé ($w_i \approx 4$), tandis que les catégories surreprésentées (par exemple, les femmes cadres de 40 ans) verront leur poids réduit ($w_i \approx 0,3$).
Cependant, cette alchimie mathématique se heurte à des limites sévères :
- L’inflation de la variance : L’application de poids extrêmes dégrade considérablement la précision des estimations, gonflant artificiellement l’erreur-type des métriques (phénomène mesuré par l’effet de plan ou *design effect* de Kish). Quelques répondants marginaux finissent par peser de manière disproportionnée sur le résultat final.
- L’aveuglement aux variables non observées : Le calage sur marges opère sous l’hypothèse héroïque que l’individu sous-représenté qui a répondu volontairement pense exactement de la même manière que ses pairs démographiques qui n’ont pas répondu. Si les 2 % de jeunes interrogés sont des militants écologistes, leur attribuer un poids de 4 ne fera qu’amplifier l’erreur d’estimation politique en octroyant un mégaphone statistique à des profils hautement atypiques.
11.2 Le score de propension appliqué à l’ajustement d’échantillon
Inspirée des travaux de Paul Rosenbaum et Donald Rubin dans le champ de l’inférence causale observationnelle, la méthode d’ajustement par score de propension (Propensity Score Adjustment ou PSA) tente de modéliser explicitement le mécanisme d’auto-sélection pour en compenser les effets.
Le protocole nécessite l’accès à une enquête de référence probabiliste de haute qualité mesurant des variables sociodémographiques et attitudinales communes. Le statisticien fusionne la base de données volontaire et l’échantillon de référence, puis estime la probabilité conditionnelle d’appartenir à la base volontaire ($S=1$) par rapport à la base de référence ($S=0$) à l’aide d’un modèle de régression logistique multivarié :
$$e(X_i) = P(S_i = 1 mid X_i) = \frac{1}{1 + \exp(-X_i \beta)}$$
Une fois ce « score de propension » calculé pour chaque individu, deux approches sont envisageables :
- La pondération par l’inverse de la propension (IPW – Inverse Probability Weighting) : Chaque unité de la base volontaire est pondérée par $w_i = \frac{1 – e(X_i)}{e(X_i)}$, ce qui a pour effet mathématique de dégonfler le poids des profils ayant une forte propension naturelle à s’auto-sélectionner et de survaloriser les profils qui se sont exprimés en dépit d’une très faible probabilité prédite de le faire.
- L’appariement sur score de propension (Propensity Score Matching) : On associe à chaque participant volontaire un jumeau statistique issu de l’enquête probabiliste présentant un score de propension rigoureusement identique, écartant les observations volontaires ne trouvant aucun équivalent dans la distribution de référence (absence de support commun).
Bien que plus puissante que le simple calage sociodémographique, cette technique dépend elle aussi de l’hypothèse de forte ignorabilité conditionnelle : elle postule qu’aucune variable non mesurée n’explique simultanément la sélection et la variable de résultat, une exigence rarement satisfaite dans les dynamiques d’auto-sélection émotionnelle.
11.3 Modélisation de sélection de Heckman (Heckit)
Couronnée par le prix de la Banque de Suède en sciences économiques en mémoire d’Alfred Nobel en 2000, la méthode de correction en deux étapes développée par James Heckman (le modèle Heckit) offre le cadre économétrique le plus élégant pour affronter les données sélectionnées de manière non aléatoire.
Le modèle conceptualise la réalité sous la forme d’un système à deux équations structurelles dépendantes :
- L’équation substantielle d’intérêt : $Y_i^* = X_i \beta + \epsilon_i$, où la variable dépendante d’intérêt $Y_i^*$ n’est observée que si une variable latente de sélection franchit un certain seuil.
- L’équation de sélection : $Z_i^* = W_i \gamma + u_i$, où l’individu choisit de participer ($S_i = 1$) si $Z_i^* > 0$, et s’abstient ($S_i = 0$) sinon.
Les termes d’erreur $\epsilon_i$ et $u_i$ suivent une loi normale bivariée de moyenne nulle, de variances respectives $\sigma_\epsilon^2$ et 1, et de corrélation $rho$. Si $\rho \neq 0$, nous sommes en présence d’un biais de sélection endogène : les facteurs inobservables qui poussent un individu à s’exprimer sont corrélés aux facteurs inobservables qui déterminent sa réponse substantielle.
La première étape de la méthode consiste à estimer l’équation de sélection sur l’ensemble de la population via un modèle Probit, permettant de calculer pour chaque individu observé le ratio inverse de Mills ($\lambda_i$) :
$$\lambda_i = \frac{\phi(W_i \hat{\gamma})}{\Phi(W_i \hat{\gamma})}$$
où $\phi(\cdot)$ représente la densité normale standard et $\Phi(\cdot)$ la fonction de répartition cumulative. Dans la seconde étape, ce ratio inverse de Mills est inséré comme variable explicative supplémentaire dans l’équation substantielle de régression linéaire :
$$Y_i = X_i \beta + \beta_\lambda \lambda_i + \nu_i$$
L’introduction du régresseur $\lambda_i$ capture et purge l’effet du terme d’erreur corrélé. Si le coefficient associé $\beta_\lambda = \rho \sigma_\epsilon$ est statistiquement différent de zéro, la présence du biais d’auto-sélection est empiriquement prouvée et les coefficients structurels $\beta$ sont corrigés de cette contamination endogène. L’immense défi pratique de cette procédure réside toutefois dans la nécessité de trouver une variable instrumentale valide : une variable présente dans le vecteur $W_i$ (expliquant le choix de répondre) mais rigoureusement absente du vecteur $X_i$ (n’ayant aucun lien direct avec la variable d’intérêt elle-même), condition d’exclusion souvent difficile à défendre sur le plan théorique.
12. Bonnes pratiques méthodologiques et recommandations pour les chercheurs
Face à l’ensemble de ces contraintes, l’échantillon à réponse volontaire ne doit pas être diabolisé comme un péché scientifique absolu, mais circonscrit avec une lucidité critique absolue quant à ses domaines de validité et ses limites indépassables.
12.1 Quand et comment utiliser l’échantillon à réponse volontaire à bon escient
Il existe des contextes d’investigation scientifique où le recours à un échantillon à réponse volontaire est non seulement légitime, mais parfois la seule option méthodologique humainement ou éthiquement envisageable.
En premier lieu, les phases exploratoires d’une recherche bénéficient grandement de la collecte spontanée. Lorsqu’un scientifique aborde un champ thématique vierge, qu’il cherche à défricher de nouvelles hypothèses conceptuelles ou à cartographier la diversité sémantique des discours sociaux, l’auto-sélection ouverte constitue un accélérateur d’idées remarquable. Le recueil de témoignages ouverts d’individus passionnés permet d’élaborer une théorisation ancrée qui sera ultérieurement testée de manière formalisée. De même, lors du développement d’échelles psychométriques ou de questionnaires d’évaluation, la phase de pré-test technique — visant à vérifier la clarté syntaxique des items, la variance des temps de réponse ou la structure factorielle exploratoire préliminaire — peut parfaitement s’accommoder de panels volontaires.
En second lieu, l’accès à des populations cliniques rares, marginalisées, stigmatisées ou criminalisées (personnes vivant avec une maladie génétique orpheline, travailleurs du sexe clandestins, transfuges de sectes) rend l’échantillonnage probabiliste impossible en raison de l’absence de base de sondage et des impératifs de confidentialité. Dans ces cas, l’appel ouvert à des volontaires s’impose comme une nécessité de terrain incontournable. Toutefois, l’impératif méthodologique catégorique qui incombe au chercheur consiste à abandonner toute prétention à l’estimation prévalente : il est épistémologiquement acceptable de décrire la dynamique psychologique interne d’un groupe de volontaires atypiques, mais il est rigoureusement proscrit d’affirmer que ce groupe représente la prévalence globale du phénomène dans la société.
12.2 Transparence rédactionnelle et standards de publication
La déontologie scientifique et la rigueur académique exigent une transparence sans compromis lors de la rédaction des rapports de recherche et des articles soumis à évaluation par les pairs (peer-reviewing). L’utilisation d’un échantillon auto-sélectionné doit être déclarée sans fard dès le résumé introductif et développée exhaustivement dans la section « Méthode ».
Les chercheurs sont instamment invités à se conformer aux standards méthodologiques internationaux régissant la publication scientifique, tels que les directives de l’American Psychological Association (APA), la déclaration STROBE (Strengthening the Reporting of Observational Studies in Epidemiology) pour les études biomédicales, ou la grille CHERRIES (Checklist for Reporting Results of Internet E-Surveys) spécifiquement dédiée aux enquêtes dématérialisées. Ces protocoles imposent de documenter avec une précision chirurgicale :
- Le canal exact de diffusion des sollicitations et les métriques de visibilité disponibles ;
- La formulation précise de l’appel à participants (les termes employés conditionnant l’auto-sélection) ;
- L’absence de base de sondage et l’impossibilité de quantifier le taux de non-réponse ;
- La présence éventuelle d’incitations matérielles ou financières et leur nature ;
- Les caractéristiques sociodémographiques comparées avec les registres officiels de population.
Dans la section « Discussion », le chercheur doit consacrer un paragraphe substantiel à l’exposition des limites méthodologiques induites par la sélection endogène, en proscrivant les termes trompeurs tels que « représentatif de la population », « panel national » ou « les citoyens estiment que… ». Il convient d’adopter une prose modeste et précautionneuse qui restreint la portée des conclusions au périmètre strict des répondants ayant participé à l’étude.
12.3 Vers des protocoles mixtes et innovants
Pour dépasser l’impasse historique opposant les coûts prohibitifs de l’échantillonnage probabiliste pur et les dérives scientifiques de la réponse volontaire brute, la méthodologie contemporaine s’oriente vers des architectures de collecte hybrides et des protocoles novateurs.
L’une des pistes les plus prometteuses réside dans l’intégration de panels probabilistes étalons associés à des collectes ouvertes enrichies par apprentissage automatique. Des institutions comme le Pew Research Center ou des consortiums universitaires européens déploient des cohortes de référence tirées aléatoirement avec équipement technologique fourni aux foyers non connectés (panels hors ligne recrutés par voie postale), tout en utilisant des flux de données volontaires massives redressées de manière non linéaire par des modèles d’arbres de décision ou de réseaux neuronaux calibrés sur le noyau probabiliste.
Une autre alternative féconde pour l’accès aux populations sensibles est l’échantillonnage dirigé par les répondants (Respondent-Driven Sampling ou RDS). Développé par Douglas Heckathorn, ce protocole mathématisé hybride le bouche-à-oreille et les chaînes de Markov. Les participants initiaux (les « graines ») reçoivent un nombre strictement limité de coupons de recrutement qu’ils transmettent à leurs pairs. En modélisant mathématiquement la structure du réseau social d’interconnaissance et en pondérant les observations par l’inverse du degré de connectivité de chaque individu dans le graphe relationnel, le RDS parvient à produire des estimateurs asymptotiquement sans biais à partir d’un recrutement fondé initialement sur la bonne volonté des participants.
En dernière analyse, l’échantillon à réponse volontaire rappelle avec force que les données numériques ne possèdent aucune magie intrinsèque. En science comme dans le débat citoyen, le respect scrupuleux des lois mathématiques du hasard demeure le seul rempart authentique contre les mirages de l’intuition, les pièges de l’auto-illusion et la tyrannie des voix les plus assourdissantes.
Références
Bandura, A. (1997). Self-efficacy: The exercise of control. W. H. Freeman and Company.
Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally.
Deci, E. L., & Ryan, R. M. (2000). The « what » and « why » of goal pursuits: Human needs and the self-determination of behavior. Psychological Inquiry, 11(4), 227-268. https://doi.org/10.1207/S15327965PLI1104_01
Eysenbach, G. (2004). Improving the quality of Web surveys: The Checklist for Reporting Results of Internet E-Surveys (CHERRIES). Journal of Medical Internet Research, 6(3), e34. https://doi.org/10.2196/jmir.6.3.e34
Festinger, L. (1957). A theory of cognitive dissonance. Stanford University Press.
Gallup, G., & Rae, S. F. (1940). The pulse of democracy: The public-opinion poll and how it works. Simon and Schuster.
Heckathorn, D. D. (1997). Respondent-driven sampling: A new approach to the study of hidden populations. Social Problems, 44(2), 174-199. https://doi.org/10.2307/3096941
Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153-161. https://doi.org/10.2307/1912352
Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663-685. https://doi.org/10.1080/01621459.1952.10483446
Kish, L. (1965). Survey sampling. John Wiley & Sons.
Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons.
Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558-625. https://doi.org/10.2307/2342192
Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
Orne, M. T. (1962). On the social psychology of the psychological experiment: With particular reference to demand characteristics and their implications. American Psychologist, 17(11), 776-783. https://doi.org/10.1037/h0043424
Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41-55. https://doi.org/10.1093/biomet/70.1.41
Rosenthal, R., & Rosnow, R. L. (1975). The volunteer subject. John Wiley & Sons.
Sherif, M., & Hovland, C. I. (1961). Social judgment: Assimilation and contrast effects in communication and attitude change. Yale University Press.
Tajfel, H., & Turner, J. C. (1979). An integrative theory of intergroup conflict. In W. G. Austin & S. Worchel (Eds.), The social psychology of intergroup relations (pp. 33-47). Brooks/Cole.
von dem Knesebeck, O. (2020). Epidemiological work in times of COVID-19: A plea for representative sampling. International Journal of Public Health, 65(5), 519-520. https://doi.org/10.1007/s00038-020-01416-8