
L’analyse de régression linéaire constitue sans conteste l’un des piliers méthodologiques les plus omniprésents au sein des sciences contemporaines, qu’il s’agisse de la psychologie, de l’économétrie, de l’épidémiologie ou de la biologie computationnelle. Pourtant, une asymétrie d’attention frappante persiste dans la pratique de la recherche : alors que les analystes scrutent avec une ferveur quasi obsessionnelle l’amplitude de la pente estimée — ce fameux coefficient qui quantifierait la force d’une relation causale ou prédictive —, ils relèguent trop souvent l’erreur type de cette même pente au rang de simple formalité calculatoire ou d’étape intermédiaire vers la p-valeur. Cette négligence épistémologique constitue une source majeure d’erreurs d’interprétation, de fausses découvertes et de crises de réplicabilité à travers la littérature académique.
L’erreur type de la pente de régression n’est pas un simple artefact algorithmique ; elle est l’incarnation mathématique même de l’incertitude scientifique. Elle synthétise la tension inhérente entre la réalité sous-jacente d’une population inaccessible dans son ensemble et la nature parcellaire, fluctuante et bruitée des échantillons empiriques que nous sommes en mesure d’observer. Comprendre les tenants et aboutissants de cette métrique, c’est acquérir une lucidité méthodologique indispensable pour quiconque souhaite naviguer entre les écueils de la surconfiance inductive et ceux du scepticisme stérile. Sans une appréhension rigoureuse de l’erreur type, toute affirmation relative à l’intensité ou à la directionnalité d’un effet demeure fondamentalement incomplète, voire dangereusement fallacieuse.
Ce guide exhaustif a pour vocation d’analyser en profondeur chaque facette de l’erreur type de la pente de régression linéaire. Des fondements conceptuels de l’échantillonnage stochastique à sa formulation mathématique matricielle et scalaire, des facteurs mécaniques qui gouvernent son amplitude aux distorsions induites par la violation des postulats classiques de Gauss-Markov, cet article dissèque la mécanique intime de l’incertitude paramétrique. En explorant ses implications inférentielles, ses corrections contemporaines et ses manifestations empiriques à travers des cas concrets issus des sciences comportementales, nous fournirons au chercheur, au statisticien et à l’étudiant avancé les clés cognitives et techniques nécessaires pour interpréter, communiquer et valoriser cette statistique avec un niveau d’exigence académique irréprochable.
1. Fondements conceptuels de la pente de régression et de son incertitude
1.1 Définition de la pente de régression dans les modèles linéaires
Dans le cadre fondamental du modèle de régression linéaire simple univarié, formalisé historiquement par des figures pionnières telles que Francis Galton et Karl Pearson, l’objectif analytique consiste à modéliser la dépendance fonctionnelle d’une variable réponse continue, notée Y, en fonction des fluctuations d’une variable explicative ou prédictive, notée X. Au sein de cette formalisation, la relation déterministe sous-jacente s’exprime par une fonction affine où le paramètre d’ordonnée à l’origine intercepte l’axe vertical, tandis que le coefficient de pente, conventionnellement désigné par la lettre grecque bêta (β) dans la population et par la lettre latine b ou β chapeau (ˆβ) dans l’échantillon, quantifie le taux marginal de variation de Y induit par une modification unitaire de X. Mathématiquement, ce paramètre correspond à la dérivée première de la fonction d’espérance conditionnelle :
E(Y | X) = β0 + β1X
Dès lors, β1 incarne la vitesse et la direction du changement attendu. Si la pente est positive, chaque incrément unitaire sur l’échelle de mesure du prédicteur se traduit mécaniquement par une élévation moyenne proportionnelle sur l’échelle de la variable dépendante. À l’inverse, une valeur négative signale une dynamique d’atténuation ou de réduction réciproque. Sur le plan structural, il est crucial d’établir une ligne de démarcation imperméable entre le paramètre structurel de la population — une constante théorique inconnue, immuable sous les hypothèses du modèle — et l’estimateur calculé sur une fraction empirique de cette même population. L’estimateur de la pente obtenu par la méthode des moindres carrés ordinaires (MCO) n’est jamais la réalité omnisciente de la population : il s’agit d’une réalisation ponctuelle, contingente et variable dans un univers probabiliste d’échantillons potentiels.
1.2 La nature stochastique des données et variabilité d’échantillonnage
La collecte de données empiriques s’inscrit invariablement dans un processus de génération stochastique. Même lorsque le protocole de recueil est standardisé avec une minutie maniaque, des forces perturbatrices non mesurées, des fluctuations biologiques, des erreurs instrumentales résiduelles ou des influences environnementales aléatoires viennent se greffer sur la composante systématique du modèle pour engendrer un terme d’erreur composite, noté ε. Par conséquent, si un investigateur procédait à la répétition rigoureusement identique de son protocole d’échantillonnage à l’infini — en tirant de façon indépendante des sous-ensembles de taille N au sein d’une même population parente —, la constellation des points de données observés fluctuerait d’un essai à l’autre. Cette instabilité physique des observations entraîne une conséquence mathématique directe : la droite d’ajustement empirique oscille, pivote et se déplace dans le plan cartésien.
Cette oscillation systématique donne naissance au concept central de distribution d’échantillonnage de la pente de régression. Le coefficient estimé ˆβ1 n’est pas une constante, mais une variable aléatoire dotée de ses propres propriétés probabilistes, notamment une espérance mathématique et une dispersion propre. L’espérance de cette distribution coïncide, sous des conditions d’échantillonnage aléatoire simple et d’exogénéité stricte, avec la véritable pente de la population β1, conférant à l’estimateur la vertu essentielle de non-biais. Néanmoins, d’une réplication à la suivante, les valeurs numériques de ˆβ1 afficheront des fluctuations inévitables autour de cette cible centrale. L’ampleur de cette danse stochastique autour du barycentre théorique constitue l’incertitude fondamentale d’échantillonnage que la théorie statistique se donne pour mandat d’évaluer et de maîtriser.
1.3 Distinction essentielle entre écart type et erreur type
Dans l’arsenal terminologique de la métrologie statistique, aucune confusion conceptuelle n’est aussi tenace ni aussi pernicieuse que l’assimilation hâtive de l’écart type (standard deviation) à l’erreur type (standard error). Ces deux métriques partagent certes une grammaire calculatoire analogue — reposant sur des racines carrées de variances —, mais leurs référents ontologiques et leurs échelles d’application sont fondamentalement étanches. L’écart type mesure l’hétérogénéité, la dispersion ou l’étalement des entités individuelles concrètes au sein d’une distribution d’observations brutes. Lorsque l’on rapporte l’écart type d’une variable Y ou celui des résidus du modèle, on décrit fidèlement la variabilité substantielle qui sépare les sujets expérimentaux ou les unités écologiques les uns des autres dans le monde réel.
L’erreur type, quant à elle, opère à un niveau d’abstraction conceptuelle supérieur : elle représente l’écart type d’une distribution théorique de statistiques d’échantillons répliqués. Elle ne quantifie nullement la dispersion des individus, mais bien la précision métrologique avec laquelle un macro-paramètre statistique — ici, le coefficient de régression ˆβ1 — est appréhendé par l’échantillon disponible. L’erreur type de la pente constitue donc l’étalon d’imprécision inhérent à notre appareil d’estimation. Une erreur type substantielle indique que notre instrument empirique est excessivement flottant et qu’un nouvel échantillon tiré dans des conditions identiques pourrait générer une inclinaison radicalement différente, tandis qu’une erreur type ténue certifie la stabilité géométrique et l’ancrage rigide du coefficient face aux aléas du renouvellement d’échantillonnage.
2. Formulation mathématique et décomposition de l’erreur type
2.1 Analyse du numérateur : la variance résiduelle des erreurs
Pour disséquer la mécanique intime gouvernant l’incertitude de la pente, il est impératif d’examiner la structure algébrique de sa formule sous l’angle de ses deux composantes antinomiques : le numérateur et le dénominateur. Au sommet de cette architecture trône l’estimation de l’écart type des perturbations stochastiques non captées par le modèle, universellement désignée sous l’appellation d’erreur type de l’estimation ou racine carrée de la variance résiduelle, symbolisée par se ou σˆ. Cette grandeur dérive de la somme des carrés des résidus (SCR ou residual sum of squares), qui agrège l’ensemble des écarts quadratiques séparant les points empiriques réels yi de leurs prédictions théoriques correspondantes générées par l’équation :
ˆyi = ˆβ0 + ˆβ1xi
La somme des carrés des résidus est formalisée par l’expression :
SCR = Σ (yi – ˆyi)2
Afin de transformer cette accumulation brute d’erreurs en un estimateur non biaisé de la variance résiduelle de la population, il convient de diviser la SCR par ses degrés de liberté résiduels appropriés, soit N – 2 dans le cas d’une régression univariée (où N représente l’effectif total et où 2 retranche les degrés de liberté mobilisés par l’estimation conjointe de la constante et de la pente). La formule s’établit ainsi :
se2 = SCR / (N – 2)
L’impact de ce terme sur la précision de la pente est immédiat et direct : se opère comme un multiplicateur de bruit au numérateur de l’erreur type. Plus les observations s’écartent avec violence de la droite de régression — traduisant une part prépondérante de variance inexpliquée, un phénomène complexe mal spécifié ou un bruit métrologique massif —, plus la valeur de se enfle. En conséquence géométrique inévitable, ce gonflement du numérateur vient directement élargir l’erreur type de la pente, altérant drastiquement la fiabilité du coefficient directeur calculé.
2.2 Analyse du dénominateur : la somme des carrés des écarts du prédicteur
Si le numérateur concentre les sources d’imprécision et d’aléa résiduel, le dénominateur de l’erreur type agit comme un puissant stabilisateur géométrique. Il est constitué par la somme des carrés des écarts du prédicteur par rapport à sa propre moyenne arithmétique, couramment notée SCX ou SSX (pour Sum of Squares of X). Cette métrique se définit mathématiquement comme suit :
SCX = Σ (xi – x̄)2 = (N – 1) × sX2
où sX2 correspond à la variance échantillonnale observée de la variable indépendante X. Sur le plan mécanique, la présence de la racine carrée de cette somme au dénominateur confère aux valeurs de X un rôle de bras de levier stabilisateur face aux perturbations stochastiques du modèle.
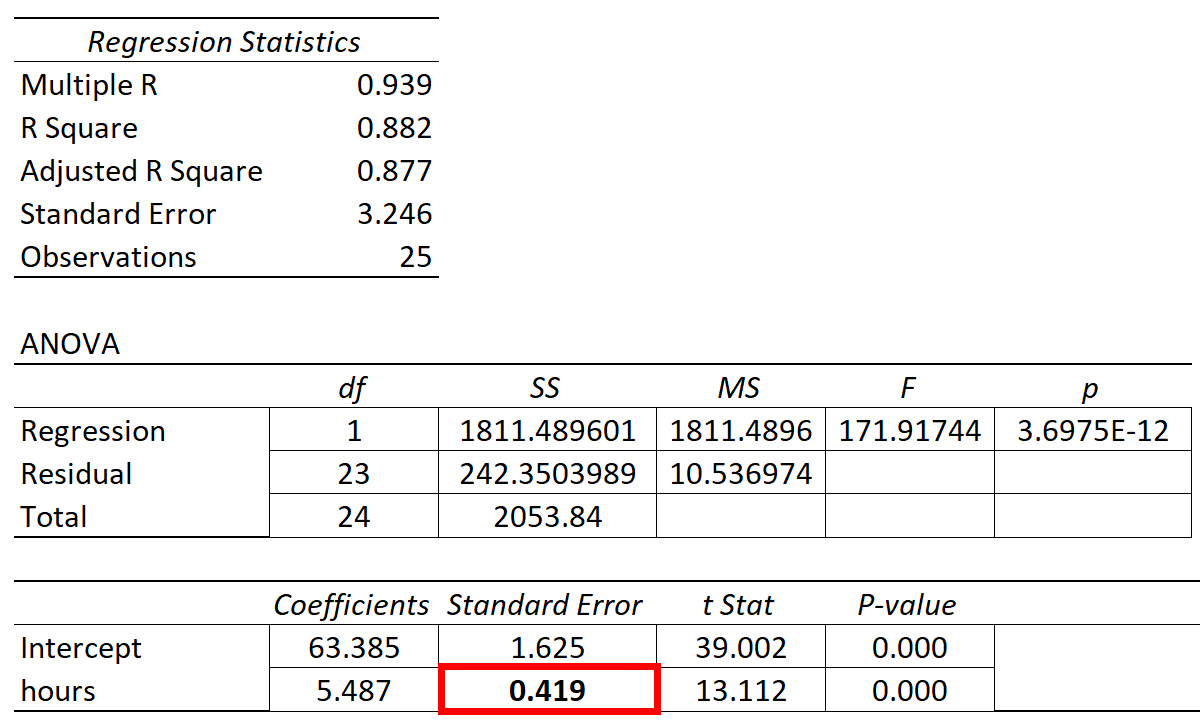
Considérons intuitivement une réglette rigide soumise à des oscillations induites par des forces extérieures. Si l’on tente d’ajuster l’orientation d’une droite en concentrant l’ensemble des points d’ancrage empiriques au sein d’un corridor excessivement restreint le long de l’axe horizontal, la moindre fluctuation aléatoire sur l’axe vertical d’un seul point induira une bascule chaotique de l’inclinaison générale du segment. À l’opposé, si les points d’appui sont disséminés sur une vaste amplitude d’étalement le long de l’axe des abscisses, les valeurs extrêmes exercent une résistance inertielle formidable contre les torsions aléatoires des résidus. Par voie de conséquence, un étalement restreint de la variable X réduit dramatiquement le dénominateur, provoquant une explosion mécanique de l’erreur type de la pente, tandis qu’une forte dispersion de X dilate le dénominateur et comprime l’incertitude entourant le coefficient estimé.
2.3 Dérivation mathématique complète sous les hypothèses des moindres carrés
La synthèse formelle de ces deux composantes antagonistes aboutit à la formule analytique universelle de l’erreur type de la pente empirique, formalisée canoniquement comme suit :
SE(ˆβ1) = se / √( Σ (xi – x̄)2 )
Pour comprendre la dérivation rigoureuse de cette équation maîtresse, il convient de rappeler la représentation linéaire de l’estimateur MCO sous forme d’une somme pondérée des observations de la variable dépendante :
ˆβ1 = Σ wi yi
où les poids analytiques wi sont strictement déterministes (en conditionnant sur les valeurs observées du prédicteur X) et définis par le rapport d’étalement :
wi = (xi – x̄) / Σ (xk – x̄)2
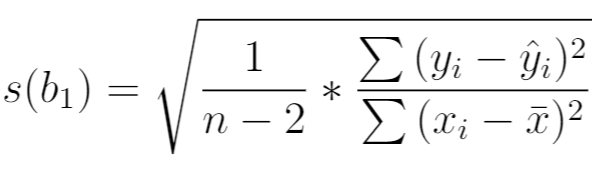
En vertu des règles fondamentales régissant la variance d’une combinaison linéaire de variables aléatoires mutuellement indépendantes, la variance théorique de l’estimateur de pente équivaut à la somme pondérée des variances individuelles :
Var(ˆβ1 | X) = Σ wi2 × Var(yi | X)
Sous les célèbres postulats du théorème de Gauss-Markov — qui énoncent l’homoscédasticité stricte de la variance résiduelle conditionnelle de sorte que Var(yi | X) = σ2 pour tout i, et l’absence totale de corrélation sérielle entre les termes d’erreur tels que Cov(εi, εj) = 0 pour tout i ≠ j —, la variance constante σ2 peut être factorisée hors de la sommation :
Var(ˆβ1 | X) = σ2 × Σ wi2
En substituant la définition de wi et en simplifiant le développement algébrique de Σ wi2, on constate que le terme de sommation quadratique au numérateur s’annule partiellement avec le dénominateur au carré, laissant l’expression élégante :
Σ wi2 = [ Σ (xi – x̄)2 ] / [ Σ (xi – x̄)2 ]2 = 1 / Σ (xi – x̄)2
Il en résulte sans équivoque que la variance théorique de l’estimateur est égale à σ2 divisé par la somme des carrés des écarts de X. En extrayant la racine carrée de cette variance et en remplaçant la variance inconnue de la population σ2 par son estimateur convergent sans biais se2 issu de l’échantillon, on dérive infailliblement la formule opérationnelle de l’erreur type de la pente. Cette démonstration démontre avec éclat que la précision de l’estimateur découle directement de la fidélité aux axiomes classiques des moindres carrés.
3. Facteurs déterminants influençant la magnitude de l’erreur type
3.1 L’impact critique de la taille de l’échantillon
Le premier levier structurel gouvernant l’amplitude de l’erreur type réside dans l’effectif global des observations collectées, désigné par N. Une lecture superficielle de la formule de l’erreur type pourrait laisser penser que N n’intervient que marginalement au dénominateur des degrés de liberté du numérateur. En réalité, son impact le plus décisif opère au dénominateur par le biais de la somme des carrés des écarts de X. Puisque SCX s’exprime comme le produit de la taille d’échantillon (décrémentée d’une unité) par la variance empirique de X, la formule de l’erreur type peut être reformulée pour mettre en évidence la trajectoire asymptotique :
SE(ˆβ1) = se / [ sX × √(N – 1) ]
Cette relation établit formellement que l’erreur type décroît à un rythme inversement proportionnel à la racine carrée de la taille de l’échantillon, soit un ordre de convergence en O(N-1/2). Ce comportement mathématique engendre une dynamique de rendements marginaux décroissants bien connue des méthodologistes. Pour réduire de moitié l’erreur type d’une pente — et donc doubler la précision métrique de l’effet —, il ne suffit pas de doubler l’échantillon ; il est indispensable de le quadrupler. Pour diviser l’imprécision par un facteur de dix, il faut multiplier l’effort d’échantillonnage par cent. Cette loi de puissance explique pourquoi les études à effectifs restreints (par exemple N = 20 ou 30) souffrent d’une instabilité chronique : sur ces segments, chaque observation additionnelle apporte un gain substantiel de stabilisation géométrique, tandis qu’au-delà de plusieurs centaines de sujets, l’erreur type tend vers une zone de saturation relative où les gains métrologiques marginaux deviennent infiniment plus coûteux à acquérir.
3.2 L’étendue et la variabilité de la variable indépendante
Le second levier fondamental relève de l’architecture d’échantillonnage de la variable explicative X elle-même. Comme le démontre le terme sX figurant au dénominateur, plus la variance empirique du prédicteur est vaste, plus l’erreur type de la pente est comprimée. Lorsque des chercheurs restreignent involontairement ou par commodité méthodologique la portée de leurs observations à une sous-population trop homogène — par exemple en évaluant l’impact du quotient intellectuel uniquement sur des étudiants universitaires d’élite, ou l’effet du revenu uniquement au sein d’une classe moyenne supérieure —, ils induisent un phénomène délétère de restriction d’étendue (range restriction).
Cette constriction de la variabilité de X comprime drastiquement la somme des carrés des écarts au dénominateur. En conséquence directe, l’erreur type de la pente explose, masquant potentiellement des relations causales robustes sous une chape d’imprécision artificielle. Dans les paradigmes expérimentaux ou quasi-expérimentaux où l’expérimentateur dispose de la liberté d’assigner ou de cibler les valeurs du prédicteur, une planification optimale consiste à échantillonner délibérément des observations réparties de manière uniforme sur l’ensemble de l’éventail théorique du phénomène, voire de sur-échantillonner les extrémités de la distribution tout en veillant à préserver l’hypothèse de linéarité globale de la relation sous-jacente.
3.3 L’ampleur du bruit de mesure et des variables non contrôlées
Le troisième axe déterminant concerne la pureté métrologique et la complétude fonctionnelle du modèle, qui conditionnent directement la magnitude de l’erreur type de l’estimation se au numérateur. Dans les sciences empiriques, l’erreur résiduelle agrège deux composantes épistémologiques distinctes mais indémêlables dans le calcul brut : d’une part, les erreurs de mesure aléatoires inhérentes aux instruments psychométriques, biologiques ou électroniques mobilisés pour enregistrer la variable dépendante Y ; d’autre part, l’omission dans la spécification du modèle de facteurs explicatifs orthogonaux dotés d’un pouvoir prédictif substantiel.
Chaque fois qu’un instrument de mesure souffre d’une faible fidélité test-retest ou d’une cohérence interne médiocre, cette variance d’erreur instrumentale vient contaminer le terme résiduel ε, gonflant mécaniquement la somme des carrés des résidus. De même, si des variables modératrices ou explicatives majeures ne sont ni contrôlées ni intégrées au modèle, leurs contributions déterministes sont reléguées au statut d’aléa stochastique résiduel. En assainissant la chaîne de mesure et en intégrant des covariables pertinentes dans le cadre d’une régression multiple, le statisticien parvient à purger une part considérable de cette variance parasite, comprimant le numérateur se et conférant à la pente une précision d’estimation considérablement accrue.
4. Interprétation pratique de la grandeur de l’erreur type
4.1 Scénario d’une erreur type faible : précision et certitude
Sur le plan géométrique et phénoménologique, une situation caractérisée par une erreur type exceptionnellement ténue se traduit visuellement par un alignement d’une régularité cristalline des données empiriques le long de la droite d’ajustement structurelle. Les résidus individuels sont resserrés autour de la trajectoire modélisée, et l’étalement du prédicteur offre une assise inébranlable à la fonction de projection. Une telle configuration octroie à l’analyste un niveau de certitude statistique supérieur : l’inclinaison calculée ˆβ1 n’est plus une conjecture fragile mais un reflet fidèle, stable et hautement reproductible de la dynamique populationnelle sous-jacente.
Dans un contexte d’application pratique, qu’il s’agisse de déployer un protocole d’intervention pharmacologique ou d’implanter une politique publique d’ingénierie comportementale, une erreur type minime garantit que les prévisions de rentabilité ou d’efficacité marginale ne s’effondreront pas sous le coup des fluctuations d’échantillonnage. L’investigateur peut affirmer avec autorité qu’une variation unitaire de X produit un effet quantifié avec une marge d’incertitude négligeable. Le coefficient de pente devient ainsi un instrument décisionnel d’une grande rigueur prédictive.
4.2 Scénario d’une erreur type élevée : imprécision et aléa
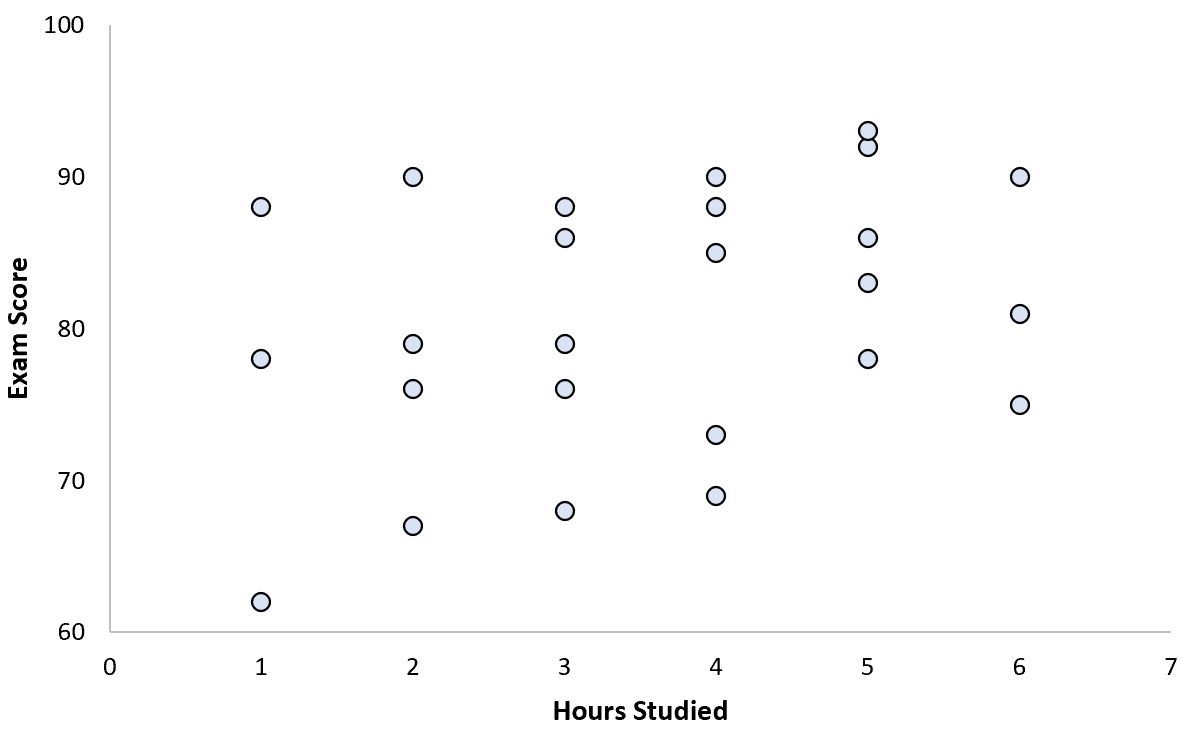
À l’opposé du spectre méthodologique, la manifestation d’une erreur type hypertrophiée signale une vulnérabilité critique de l’inférence paramétrique. Graphiquement, cette configuration se matérialise par un nuage de dispersion diffus, nébuleux, où la trajectoire de la droite des moindres carrés semble n’être qu’un compromis précaire au milieu d’un chaos d’observations désordonnées. Dans ce contexte d’amorphousité empirique, la magnitude observée du coefficient de pente est éminemment volatile et friable.
La dangerosité épistémologique d’une telle situation réside dans l’instabilité potentielle du signe même de la relation : un coefficient estimé à +0,45 affublé d’une erreur type de 0,38 n’offre aucune garantie robuste que la relation sous-jacente au sein de la population parente ne soit pas en réalité neutre ou rigoureusement négative. Dans un tel paysage d’aléa, toute tentative d’isoler l’effet propre du prédicteur relève de l’illusion projective. L’analyste se trouve dans l’incapacité d’établir si le résultat découle d’une force générative structurée ou d’un simple mirage mathématique produit par la convergence fortuite de perturbations d’échantillonnage défavorables.
4.3 Interprétation contextualisée selon l’échelle de mesure
L’une des méprises les plus insidieuses consiste à porter un jugement de valeur sur la magnitude brute d’une erreur type sans la contextualiser immédiatement au regard de l’échelle métrique des variables engagées et de la valeur absolue du coefficient de pente estimé. Une erreur type dont la valeur absolue équivaut à 0,002 peut sembler infinitésimale au regard de l’intuition profane ; pourtant, si la pente brute associée s’élève à 0,001, cette erreur type représente le double du coefficient, révélant une imprécision métrologique monumentale. Inversement, une erreur type de 1500 peut s’avérer d’une précision chirurgicale si le coefficient de pente s’élève à 250 000 unités monétaires.
Pour s’émanciper des illusions d’optique liées aux unités de mesure physiques (millimètres, milligrammes, scores sur une échelle de Likert ou PIB par habitant), il est fréquemment enrichissant de recourir à l’erreur type du coefficient standardisé β* (souvent symbolisé par b* ou pente standardisée), où X et Y sont préalablement réduits à des distributions d’écart type unitaire :
ˆβ* = ˆβ1 × (sX / sY)
Cette transposition permet de juger immédiatement la précision relative de la dynamique d’association indépendamment des artefacts de calibrage d’échelle. Dès lors, l’évaluation de la grandeur de l’erreur type doit être subordonnée à une analyse de ratio relatif, dont la formalisation par excellence s’incarne dans la statistique inférentielle de Student.
5. Rôle de l’erreur type dans l’inférence statistique et les tests d’hypothèses
5.1 Construction de la statistique de test t de Student
L’erreur type constitue la clé de voûte de toute l’architecture de l’inférence classique fréquentiste, car elle fournit l’unité métrique permettant de normaliser la distance séparant un résultat empirique de son attente sous une hypothèse nulle conventionnelle. Dans le test de significativité bilatéral standard visant à éprouver l’hypothèse nulle d’absence de relation linéaire dans la population, formalisée par H0 : β1 = 0, face à l’hypothèse alternative H1 : β1 ≠ 0, l’analyste construit le ratio statistique t de Student en divisant l’estimation ponctuelle par son erreur type :
t = (ˆβ1 – β1,hypothétisé) / SE(ˆβ1) = ˆβ1 / SE(ˆβ1)
Ce ratio statistique exprime littéralement le nombre d’erreurs types qui séparent le coefficient empirique observé de la valeur nulle d’absence d’effet. Plus cette distance standardisée est vaste, moins l’écart constaté peut être raisonnablement imputé aux seules tribulations de la fluctuation d’échantillonnage. Sous la conjonction des hypothèses de normalité des résidus de Gauss-Markov et sous la validité de l’hypothèse nulle, cette statistique t suit rigoureusement une distribution théorique de Student paramétrée par N – 2 degrés de liberté. L’erreur type opère donc ici comme le dénominateur fondamental qui convertit un écart dimensionnel brut en une métrique adimensionnelle universelle gouvernée par les lois probabilistes de la décision statistique.
5.2 Calcul de la p-valeur et seuils de décision académiques
Une fois le ratio t empirique calculé à l’aide de l’erreur type, la machinerie inférentielle procède à l’évaluation de la probabilité conditionnelle d’observer une statistique de test au moins aussi extrême en valeur absolue sous la condition stricte où l’hypothèse nulle H0 serait vraie dans la nature. Cette grandeur probabiliste constitue la célèbre p-valeur (ou valeur de probabilité). Pour une régression linéaire affichant k degrés de liberté résiduels (k = N – 2), cette probabilité se formalise par l’intégrale de la densité de Student sur les queues de distribution :
p = 2 × P(Tk ≥ |t|)
Cette dérivation met en exergue l’asservissement mathématique complet de la p-valeur envers l’erreur type : pour un coefficient de régression brut strictement identique (ˆβ1 = 2,50 par exemple), une variation marginale de l’erreur type peut faire basculer le résultat d’un triomphe statistique (t = 5,00 ; p < 0,0001 avec SE = 0,50) à un rejet académique cuisant (t = 1,47 ; p = 0,14 avec SE = 1,70). Ce mécanisme met en garde le chercheur contre le piège consistant à confondre une faible p-valeur avec une grande magnitude d’effet substantiel : une erreur type artificiellement comprimée par un échantillon gigantesque garantit l’atteinte des seuils canoniques (α = 0,05 ou 0,01) même pour des pentes infinitésimales et dénuées de toute pertinence pratique ou clinique.
5.3 Équilibre entre erreurs de type I et de type II
La précision de l’erreur type gouverne l’équilibre fondamental entre les deux périls de la décision inférentielle : l’erreur de type I (rejeter à tort une hypothèse nulle authentiquement vraie, matérialisée par le taux d’erreur α) et l’erreur de type II (échouer à rejeter l’hypothèse nulle alors qu’une relation bien réelle existe dans la population, quantifiée par le coefficient β du test d’hypothèse). Si, en raison d’artefacts méthodologiques ou de violations d’hypothèses, l’erreur type calculée par le logiciel sous-estime l’incertitude réelle de la pente, le ratio t se trouve gonflé de façon fallacieuse. Ce phénomène catapulte le taux effectif d’erreur de type I bien au-delà du seuil nominal de 5 %, inondant la littérature de faux positifs dévastateurs.
Inversement, si l’erreur type est anormalement hypertrophiée — en raison d’un manque d’échantillonnage, d’une variance excessive de l’erreur résiduelle ou d’une restriction d’amplitude du prédicteur —, la puissance statistique globale de l’étude (1 – β) subit une érosion dramatique. Le test devient incapable d’extraire le signal au-delà du bruit d’échantillonnage, condamnant l’investigateur à commettre une erreur de type II en concluant prématurément à l’absence d’effet. Dès lors, le calibrage a priori de la taille d’échantillon par des analyses de puissance rigoureuses repose intrinsèquement sur la projection de l’erreur type minimale requise pour discerner la pente attendue des turbulences résiduelles de la mesure.
6. Construction et analyse des intervalles de confiance de la pente
6.1 Dérivation formelle des bornes inférieure et supérieure
Bien que les tests de significativité basés sur la p-valeur occupent une place hégémonique dans les habitudes des chercheurs, la construction d’un intervalle de confiance entourant la pente constitue une approche infiniment plus informative, transparente et rigoureuse pour communiquer l’incertitude paramétrique. L’intervalle de confiance dérive directement du produit de l’erreur type par la valeur critique théorique issue de la distribution t de Student pour un niveau de confiance désiré (généralement 1 – α = 0,95 ou 0,99) et pour N – 2 degrés de liberté :
IC1 – α(β1) = [ ˆβ1 – tcritique × SE(ˆβ1) ; ˆβ1 + tcritique × SE(ˆβ1) ]
Le produit du quantile critique et de l’erreur type forme ce que la métrologie nomme la marge d’erreur paramétrique. Par exemple, pour un échantillon de taille raisonnable (où tcritique pour α = 0,05 converge vers la valeur de Gauss 1,96), la borne inférieure et la borne supérieure de l’intervalle à 95 % se déploient de façon symétrique sur environ deux erreurs types de part et d’autre de l’estimation ponctuelle ˆβ1. Si l’on requiert une certitude accrue, comme un intervalle à 99 %, la valeur critique s’élève à approximativement 2,58, dilatant l’enveloppe de tolérance pour absorber l’exigence de couverture stochastique supérieure.
6.2 Interprétation rigoureuse de la couverture probabiliste
L’interprétation théorique de cet intervalle est le théâtre de glissements sémantiques récurrents. Il est formellement erroné, dans une optique fréquentiste classique, d’affirmer qu’« il y a 95 % de chances que la véritable pente de la population se trouve à l’intérieur de l’intervalle de confiance calculé sur mon échantillon empirique spécifique ». Dans la réalité objective sous-jacente, le paramètre populationnel β1 est une constante non aléatoire : il est soit entièrement contenu, soit totalement absent de l’intervalle calculé. La probabilité attachée à cet intervalle concret et fixe est donc binaire : 0 ou 1.
L’assertion probabiliste de 95 % s’applique exclusivement à la procédure d’échantillonnage et de construction de l’intervalle à long terme. La définition méthodologiquement irréprochable s’énonce comme suit : si nous répliquions cette expérience à l’identique un nombre infini de fois, en générant à chaque itération un échantillon aléatoire de taille N et en calculant l’intervalle de confiance spécifique à cet échantillon, exactement 95 % de ces myriades d’intervalles distincts captureraient avec succès la véritable pente β1 de la population parente, tandis que 5 % manqueraient la cible. L’intervalle de confiance calculé n’est qu’une occurrence singulière issue de cette famille d’intervalles stochastiques. Sa largeur, régie sans partage par l’ampleur de l’erreur type, fournit au lecteur une métrique sans fard de la netteté de notre champ de vision statistique.
6.3 Évaluation de la plausibilité théorique selon l’étendue de l’intervalle
L’utilité scientifique majeure de l’intervalle de confiance réside dans sa capacité à exposer crûment la plausibilité théorique des modèles en concurrence. Tout d’abord, il sert de test visuel immédiat pour l’hypothèse nulle : si l’intervalle de confiance à 95 % inclut la valeur zéro entre sa borne inférieure et sa borne supérieure (par exemple [-0,12 ; +0,68]), l’investigateur déduit instantanément que la pente n’est pas statistiquement significative au seuil de 5 %, éliminant le besoin de consulter une table statistique.
Cependant, l’intervalle de confiance transcende la logique réductrice du tout-ou-rien inhérente au test de significativité. Même face à un coefficient qualifié de « hautement significatif » (p < 0,01), la contemplation d’un intervalle de confiance démesurément large — par exemple un coefficient de pente de +2,10 assorti d’un intervalle de confiance s’étendant de +0,08 à +4,12 — révèle une imprécision colossale. Un tel étalement indique que le phénomène étudié pourrait être presque trivial et négligeable (+0,08) ou au contraire extraordinairement puissant et déterminant (+4,12). En exposant explicitement le continuum des valeurs du paramètre pleinement compatibles avec les données d’observation, l’intervalle calibré par l’erreur type force l’analyste à une honnêteté intellectuelle indispensable, immunisant la communauté scientifique contre l’illusion de certitude conférée par les seules étoiles de significativité.
7. Lecture et décryptage des sorties logicielles statistiques
7.1 Identification des colonnes clés dans SPSS, SAS et JASP
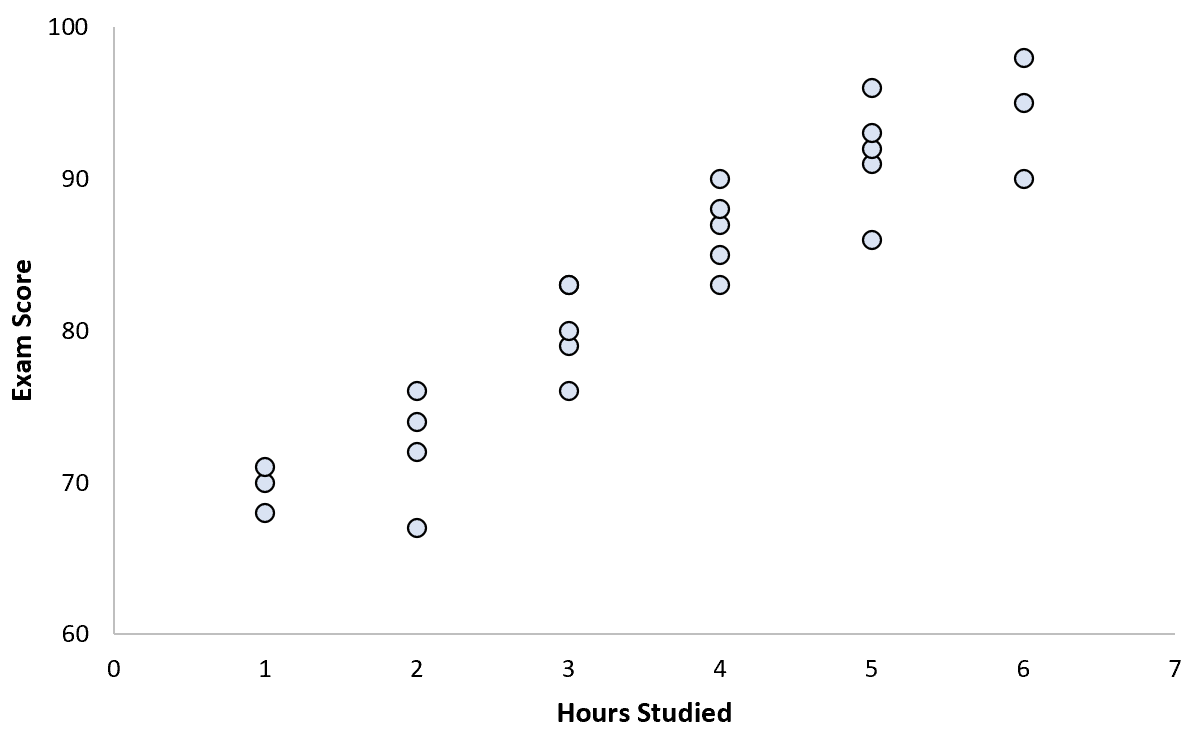
Dans l’écosystème des progiciels statistiques munis d’interfaces graphiques — tels qu’IBM SPSS Statistics, SAS ou le logiciel libre JASP —, les résultats d’une régression linéaire sont invariablement synthétisés dans un tableau matriciel canonique intitulé « Coefficients ». Pour l’analyste, la première étape méthodologique consiste à naviguer avec discernement parmi ces sorties standardisées sans céder à la tentation de ne fixer que la colonne finale dédiée à la significativité bilatérale.
Au sein de ce tableau, la première colonne présente les coefficients non standardisés, généralement désignés par B ou Estimate. La ligne supérieure correspond au terme d’interception (la constante), tandis que la ligne sous-jacente affiche la pente associée au prédicteur. Immédiatement adjacente à cette estimation se déploie la colonne critique, universellement libellée Std. Error (Erreur standard ou Erreur type). C’est précisément cette valeur numérique qui quantifie l’imprécision d’échantillonnage de la pente. Il est impératif de ne pas confondre cette métrique avec l’erreur type de l’estimation du modèle global (Standard Error of the Estimate), qui figure dans le tableau récapitulatif du modèle (Model Summary) et qui correspond à se, le numérateur de notre équation maîtresse. Le ratio entre la valeur de la colonne B et celle de la colonne Std. Error alimente directement la colonne adjacente dédiée à la statistique t, confirmant l’imbrication géométrique de ces mesures au cœur de l’algorithme d’inférence.
7.2 Interprétation des résultats textuels en environnement R
Dans l’écosystème computationnel du langage R, l’exécution d’une régression linéaire par l’intermédiaire de la primitive lm() produit un objet structuré dont la consultation détaillée s’opère canoniquement via la fonction d’interrogation summary(). L’affichage textuel console qui en résulte s’articule autour d’un bloc matriciel épuré sous l’en-tête explicite Coefficients:. Ce bloc structurel organise l’information selon quatre colonnes mathématiques fondamentales :
Estimate | Std. Error | t value | Pr(>|t|)
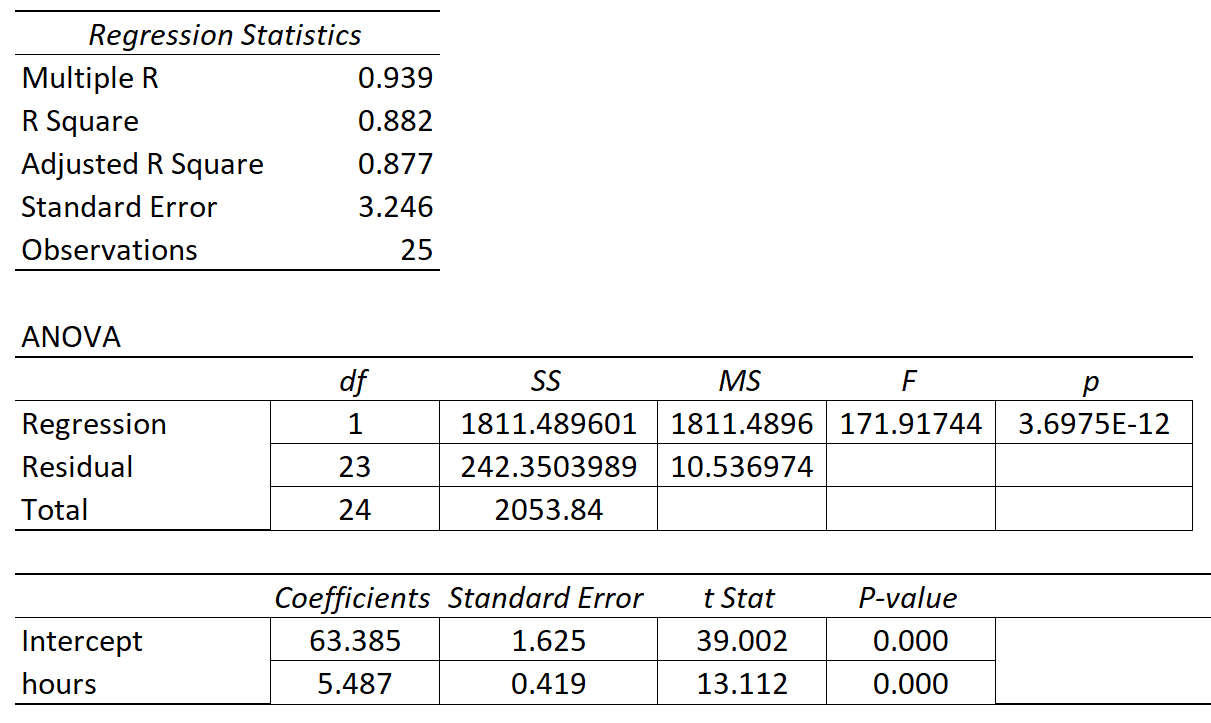
Dans cet agencement algorithmique, la valeur numérique située à l’intersection de la ligne assignée au régresseur et de la colonne Std. Error constitue fidèlement l’erreur type de la pente. R assure l’alignement mécanique strict entre les colonnes : la valeur de t value équivaut au quotient exact de Estimate par Std. Error, tandis que la colonne Pr(>|t|) consigne la p-valeur déduite de la fonction de répartition symétrique de la loi de Student. Sur le plan de la programmation avancée, l’utilisateur peut extraire ces valeurs avec une précision sans arrondi via l’instruction d’accès aux composantes de variance :
sqrt(diag(vcov(modele)))[2]
Cette commande extrait directement la racine carrée du second élément diagonal de la matrice de variance-covariance des coefficients, illustrant l’identité profonde liant les dérivations matricielles abstraites aux vecteurs de sortie textuels des consoles informatiques modernes.
7.3 Vérification de cohérence interne des données produites
Le chercheur scrupuleux ne saurait accorder une foi aveugle aux sorties logicielles sans procéder à une rapide vérification de plausibilité et de cohérence interne des métriques tabulées. En premier lieu, il est toujours salutaire de recalculer manuellement la valeur de la statistique t en divisant le coefficient non standardisé de pente par son erreur type affichée. Si le ratio obtenu diverge sensiblement de la valeur t consignée dans le tableau — au-delà des tolérances normales d’arrondi décimal —, cette discordance trahit fréquemment une instabilité de calcul, des singularités d’échelle entre les variables engagées ou une convergence compromise de l’algorithme d’inversion matricielle.
En second lieu, une vigilance impérative s’impose lorsque l’erreur type affichée prend des proportions extravagantes : une erreur type anormalement minuscule (exprimée par exemple sous la notation scientifique 2.34e-17) ou au contraire gigantesque (plusieurs ordres de grandeur supérieurs au coefficient lui-même) signale presque invariablement un problème de quasi-séparation des données, une colinéarité fonctionnelle quasi parfaite avec une autre covariable, ou une erreur majeure de codage dans l’encodage des valeurs manquantes. La vérification manuelle de ces ratios constitue le premier rempart méthodologique contre les aberrations algorithmiques que des analyses purement automatisées risquent de propager insidieusement dans les rapports d’études.
8. Violations des postulats classiques et distorsions de l’erreur type
8.1 L’hétéroscédasticité et l’invalidation des formules classiques
L’édifice mathématique classique des moindres carrés ordinaires repose sur l’assomption formelle d’homoscédasticité, selon laquelle la variance conditionnelle des termes d’erreur résiduels ε demeure strictement constante pour toute valeur prise par la variable indépendante X dans le domaine d’observation : Var(εi | X = xi) = σ2. Lorsque cette condition d’uniformité est violée — une anomalie courante désignée sous le terme d’hétéroscédasticité —, la variance résiduelle se met à enfler ou à se contracter systématiquement le long de l’axe de progression du prédicteur, prenant classiquement la forme d’un entonnoir ou d’un pavillon de trompette sur les graphiques de dispersion.
Sous la présence d’hétéroscédasticité, une conséquence mathématique redoutable survient : bien que l’estimateur de pente des moindres carrés ordinaires demeure théoriquement sans biais (sa valeur moyenne converge toujours vers la cible populationnelle), l’estimateur conventionnel de son erreur type, SE(ˆβ1), devient quant à lui totalement biaisé, inconsistant et structurellement faux. Dans la vaste majorité des configurations empiriques où la dispersion des erreurs croît avec les valeurs élevées de X, la formule standard MCO sous-estime systématiquement la variabilité réelle de l’estimateur d’échantillonnage. En conséquence directe, le dénominateur des ratios t se trouve artificiellement tassé, provoquant une explosion incontrôlée du taux d’erreurs de type I : le chercheur rejette l’hypothèse nulle avec une fausse confiance jubilatoire, dupé par une erreur type corrompue par l’instabilité de la variance résiduelle.
8.2 Autocorrélation des résidus dans les mesures répétées
Une seconde hypothèse cardinale du théorème de Gauss-Markov postule l’indépendance statistique mutuelle de l’ensemble des termes de perturbation stochastique : Cov(εi, εj) = 0 pour tout i distinct de j. Cette clause d’orthogonalité sérielle est pourtant violemment bafouée dès lors que les données procèdent d’un échantillonnage longitudinal, de séries chronologiques ou d’observations écologiques spatialement agrégées où des mesures consécutives sont recueillies sur les mêmes unités expérimentales ou au sein des mêmes grappes institutionnelles. Dans ces circonstances, les résidus temporels ou spatiaux s’enchaînent avec une dépendance inertielle : un résidu positif tend statistiquement à être immédiatement suivi d’un autre résidu positif.
L’effet de cette autocorrélation positive des erreurs sur l’erreur type de la pente est proprement dévastateur. En ignorant la redondance informationnelle inhérente aux observations dépendantes, l’algorithme conventionnel des MCO présume que chaque ligne de la base de données apporte un incrément d’information totalement indépendant. En réalité, le volume d’information effectif — la taille d’échantillon effective Neff — est substantiellement inférieur à l’effectif nominal comptabilisé dans le fichier. L’erreur type classique traite les observations comme des entités vierges, comprimant de façon totalement fallacieuse son résultat final. L’inflation de la significativité statistique apparente qui en découle est spectaculaire : des coefficients de pente totalement fallacieux peuvent exhiber des valeurs de t démesurées et des p-valeurs inférieures à 0,001, alors que le signal substantiel réel n’est qu’un artefact généré par l’inertie de la mémoire sérielle du processus d’erreur.
8.3 Influence des valeurs extrêmes et des points de levier
L’architecture des moindres carrés ordinaires étant intrinsèquement minimisatrice d’écarts quadratiques, elle confère aux observations marginales ou atypiques un pouvoir d’interférence disproportionné sur les paramètres du modèle. Deux typologies de singularités observationnelles doivent être scrupuleusement distinguées quant à leur impact sur l’erreur type : les valeurs aberrantes (outliers) et les points à fort levier (high leverage points). Une valeur aberrante verticale — un sujet possédant une valeur de Y extraordinairement dissemblable de la prédiction du modèle au milieu de la distribution de X — va générer un résidu d’une amplitude colossale. Ce résidu géant gonfle de façon immédiate la somme des carrés des résidus (SCR), dilatant le numérateur se et provoquant l’élargissement soudain de l’erreur type de la pente, ce qui atténue la puissance du test statistique.
À l’opposé, une observation située à une distance extrême sur l’axe horizontal du prédicteur constitue un point à fort levier géométrique. Si ce point s’aligne fidèlement avec la pente générale tracée par les autres observations, sa présence va accroître de façon vertigineuse la somme des carrés des écarts de X au dénominateur (Σ (xi – x̄)2), tout en introduisant un résidu proche de zéro. Le résultat mécanique est une contraction spectaculaire et artificielle de l’erreur type de la pente : le modèle semble tout à coup d’une précision exemplaire, alors que cette apparente solidité ne repose que sur le poids solitaire d’une observation unique excentrée. Les diagnostics d’influence — reposant sur la distance de Cook, le levier (hat values) et les résidus studentisés — constituent les instruments impératifs pour identifier et neutraliser ces distorsions avant toute interprétation de l’incertitude paramétrique.
9. Méthodes de correction et alternatives robustes d’estimation
9.1 Erreurs types robustes à l’hétéroscédasticité
Face à la vulnérabilité démontrée des formules classiques en présence de variances non uniformes, l’économétrie moderne et les sciences statistiques contemporaines ont développé des estimateurs correctifs de la variance d’échantillonnage, universellement regroupés sous le vocable d’estimateurs sandwich ou estimateurs de White-Huber. L’appellation imagée de matrice sandwich s’explique par sa structure analytique matricielle, où l’estimateur de la variance-covariance des coefficients empiriques prend la forme structurelle suivante :
Vsandwich = (X’X)-1 × (X’ΩX) × (X’X)-1
Dans cette architecture fondamentale, les matrices extérieures (X’X)-1 représentent le pain du sandwich — dicté par la structure du prédicteur —, tandis que la matrice centrale (X’ΩX) incarne la garniture d’erreur, modélisée directement à partir de la distribution empirique des résidus observés au lieu d’assumer une variance scalaire constante σ2.
Plusieurs déclinaisons opérationnelles de cet estimateur robuste ont été successivement perfectionnées : la formule originale de Halbert White (désignée par le sigle HC0) souffrait d’un biais non négligeable en présence d’échantillons de taille modeste. Des variantes correctrices successives ont ainsi vu le jour : la variante HC1 intègre un ajustement élémentaire par les degrés de liberté résiduels ; la version HC2 modère l’impact des points d’observation en pondérant les résidus par les valeurs de levier diagonalisées (1 – hii) ; enfin, l’estimateur HC3 procède à une division des carrés des résidus par le facteur quadratique (1 – hii)2. Les simulations de Monte-Carlo ont indiscutablement démontré la supériorité de l’estimateur HC3 pour maintenir un taux d’erreur de type I irréprochable face à de fortes structures d’hétéroscédasticité dans des échantillons de taille modeste ou intermédiaire (N < 250). De nombreux méthodologistes recommandent d’ailleurs d’adopter systématiquement les erreurs types robustes HC3 ou HC4 par défaut dans toute analyse inférentielle moderne.
9.2 Approches non paramétriques par rééchantillonnage de type bootstrap
Lorsque les postulats distributionnels des résidus s’effondrent — notamment face à des asymétries prononcées, des kurtosis extrêmes ou des déviations majeures par rapport à la normalité gaussienne —, l’inférence asymptotique paramétrique peut être avantageusement supplantée par les techniques de rééchantillonnage computationnel non paramétrique, au premier rang desquelles figure le bootstrap initié par Bradley Efron. La méthodologie du bootstrap par paires (case resampling bootstrap) aborde l’échantillon empirique observé de taille N comme une pseudo-population représentative du monde réel. L’algorithme tire aléatoirement avec remise N observations au sein de cette matrice empirique pour forger un échantillon pseudo-répliqué, sur lequel le modèle de régression linéaire est estimé afin d’enregistrer la pente spécifique obtenue.
Ce cycle computationnel est itéré un grand nombre de fois — typiquement B = 2 000 ou 5 000 réplications. La dispersion empirique des milliers de pentes rééchantillonnées ainsi générées constitue la distribution d’échantillonnage empirique bootstrap du coefficient. L’erreur type bootstrap de la pente s’obtient alors en calculant simplement l’écart type arithmétique de cette constellation de réplications :
SEboot(ˆβ1) = √ [ (1 / (B – 1)) × Σ (ˆβ1,b* – ˆβ̄1*)2 ]
Cette approche présente l’avantage inestimable de ne requérir aucun postulat restrictif sur la distribution probabiliste des termes d’erreur, s’adaptant organiquement aux asymétries et aux hétéroscédasticités complexes. De surcroît, elle permet de dériver des intervalles de confiance non linéaires corrigés pour le biais et accélérés (intervalles BCa), garantissant une précision inférentielle d’une robustesse inégalée face aux données rétives aux formalismes paramétriques.
9.3 Modélisation des erreurs groupées pour données hiérarchiques
Dans de multiples configurations empiriques — telles que des élèves imbriqués au sein de classes scolaires, des patients recrutés dans différents centres hospitaliers ou des citoyens regroupés par régions administratives —, les observations ne sont plus indépendantes les unes des autres, mais partagent des facteurs de confusion latents propres à leur sous-groupe ou grappe d’appartenance. Pour préserver la validité de l’erreur type face à cette violation flagrante de l’indépendance d’échantillonnage, la méthode d’ajustement par erreurs types en grappes (clustered standard errors ou estimateurs sandwich en grappes) doit impérativement supplanter les calculs classiques.
Cette méthodologie d’agrégation regroupe les résidus par blocs intra-grappes avant d’estimer la matrice centrale sandwich. Elle autorise une corrélation intra-classe et une hétéroscédasticité totalement arbitraires à l’intérieur des grappes définies, sous la seule condition que les différentes grappes demeurent indépendantes les unes des autres. Lorsque la hiérarchie des données présente une complexité structurelle prononcée ou que l’on s’intéresse à la variation de la pente elle-même d’un groupe à l’autre (pentes aléatoires ou random slopes), la transition vers les modèles multiniveaux (modèles linéaires mixtes) s’impose comme la solution intégrée par excellence. En modélisant explicitement les composantes de variance fixes et aléatoires au sein d’une structure de vraisemblance unifiée, le modèle multiniveau réajuste l’erreur type de la pente avec une justesse rigoureuse, immunisant l’analyste contre les conclusions fallacieuses engendrées par l’illusion de puissance propre aux agrégations d’observations dépendantes.
10. Extensions : régression multiple et interférence de la multicolinéarité
10.1 Formulation de l’erreur type pour une pente partielle
Dès lors que l’on s’émancipe du cadre univarié pour aborder la modélisation à prédicteurs multiples — où la variable réponse Y est régressée simultanément sur une constellation de p covariables X1, X2, …, Xp —, le coefficient associé à chaque prédicteur acquiert le statut de pente partielle. Cette pente partielle quantifie le taux de variation espéré de Y pour un incrément unitaire du prédicteur cible lorsque l’ensemble des autres variables indépendantes du modèle sont maintenues statiques à un niveau constant. La formulation mathématique de l’erreur type de cette pente partielle ˆβj incorpore alors un paramètre additionnel majeur : le coefficient de détermination multiple partiel découlant de la régression auxiliaire de Xj sur toutes les autres covariables présentes, noté Rj2 :
SE(ˆβj) = se / [ √( Σ (xji – x̄j)2 ) × √(1 – Rj2) ]
Cette expression démontre avec clarté que la variance résiduelle de la variable Y, se2, prend désormais en compte le pouvoir explicatif cumulé de l’intégralité des variables introduites dans l’équation. Ainsi, l’inclusion de covariables pertinentes et hautement prédictives de Y permet souvent de réduire substantiellement se. Toutefois, l’élément novateur et potentiellement déstabilisateur réside dans le terme correctif (1 – Rj2) au dénominateur : ce facteur capture directement l’interférence informationnelle et le degré d’association liant la variable explicative d’intérêt à ses homologues dans le modèle.
10.2 Gonflement de l’erreur type par la multicolinéarité
La décomposition précédente met en lumière le danger méthodologique suprême de l’analyse multivariée : le phénomène de multicolinéarité. Le terme inverse du facteur de conditionnement du dénominateur définit formellement le facteur d’inflation de la variance (FIV ou Variance Inflation Factor) propre au prédicteur j :
VIFj = 1 / (1 – Rj2)
La formule de l’erreur type d’une pente partielle peut donc s’écrire de manière équivalente sous la forme :
SE(ˆβj) = [ se / √( Σ (xji – x̄j)2 ) ] × √(VIFj)
Cette formulation rend transparent le fait que la racine carrée du VIF agit comme un multiplicateur direct de l’erreur type de la pente. Lorsque deux prédicteurs ou plus partagent une corrélation linéaire étouffante au sein de la base de données empirique — par exemple si Rj2 atteint 0,90 —, le VIF bondit à la valeur de 10, ce qui se traduit par un triplement immédiat de l’erreur type de la pente partielle (√10 ≈ 3,16). Le mécanisme sous-jacent est intuitif : lorsque deux variables mesurent presque exactement le même concept théorique, le modèle est incapable de démêler quelle part de la variance de Y doit être attribuée à l’une plutôt qu’à l’autre. Dans cette situation d’ambiguïté informationnelle, les estimations ponctuelles des pentes deviennent hyper-sensibles à la moindre fluctuation de l’échantillon, oscillant de façon erratique, tandis que leurs erreurs types explosent. Ce phénomène conduit fréquemment à une situation paradoxale : un modèle global doté d’un R2 global prodigieux et hautement significatif lors du test F, mais au sein duquel aucune des pentes partielles n’atteint le seuil de significativité individuelle en raison du gonflement destructeur de leurs erreurs types respectives.
10.3 Solutions analytiques face au problème d’inflation de l’erreur
Pour juguler cette explosion pathologique de l’erreur type induite par la colinéarité, l’analyste dispose d’un panel de stratégies méthodologiques préventives et curatives. La démarche la plus élémentaire sur le plan théorique consiste à réexaminer la spécification du modèle à la lumière de la parcimonie conceptuelle : si deux prédicteurs redondants partagent une corrélation bivariée massive (par exemple r > 0,85), il est souvent judicieux d’éliminer le régresseur le moins fiable ou de fusionner les indicateurs redondants en un indice composite agrégé, stabilisant immédiatement le VIF de l’équation.
Lorsque la conservation intégrale de l’ensemble des régresseurs est impérative, le recours aux méthodes de régularisation mathématique pénalisée, telles que la régression Ridge (qui applique une pénalité quadratique L2 sur les coefficients) ou la régression Lasso (qui mobilise une pénalité en valeur absolue L1), s’avère particulièrement efficace. En introduisant délibérément une infime dose de biais déterministe dans l’estimation des pentes, la régression pénalisée comprime drastiquement la variance d’échantillonnage de ces coefficients, réduisant massivement l’erreur quadratique moyenne globale du modèle :
EQM(ˆβ) = Biais(ˆβ)2 + Var(ˆβ)
Enfin, les approches de réduction de dimensionnalité non supervisée — telles que l’analyse en composantes principales (ACP) ou l’analyse factorielle exploratoire préliminaire — permettent de projeter le bloc de prédicteurs colinéaires sur un ensemble d’axes factoriels strictement orthogonaux entre eux, restaurant une indépendance géométrique parfaite qui annule tout gonflement du VIF et ramène les erreurs types des pentes à des proportions maîtrisées.
11. Applications empiriques et études de cas en psychologie
11.1 Étude 1 : Relation entre le stress perçu et les fonctions exécutives
Afin de concrétiser les principes théoriques exposés précédemment, examinons une première étude de cas empirique issue du champ de la neuropsychologie clinique et des sciences cognitives comportementales. Une équipe de recherche s’intéresse à l’impact du niveau de stress chronique perçu (évalué via le questionnaire standardisé Perceived Stress Scale, noté X) sur l’efficience des fonctions exécutives, opérationnalisée par le temps d’inhibition cognitive mesuré en millisecondes sur la tâche de Stroop (variable Y). Le protocole de recherche mobilise un échantillon probabiliste moyen de N = 120 adultes jeunes et d’âge intermédiaire, indemnes de troubles neurologiques avérés. Les instruments psychométriques et chronométriques mobilisés bénéficient d’une fidélité test-retest élevée, maintenant la variance résiduelle de l’erreur à un niveau modéré.
L’estimation des paramètres du modèle par la méthode des moindres carrés ordinaires produit l’équation de régression suivante :
ˆY = 412,50 + 14,80 × X
L’erreur type de l’estimation du modèle s’établit à se = 38,20 millisecondes, tandis que l’étalement du prédicteur affiche une somme des carrés des écarts de SCX = 2 850 unités quadratiques. L’application directe de notre formule maîtresse permet de dériver l’erreur type de la pente de régression :
SE(ˆβ1) = 38,20 / √2850 = 38,20 / 53,385 ≈ 0,7156 milliseconde par unité de stress
Ce résultat quantifie une précision métrologique remarquable. Le ratio de Student correspondant atteint une amplitude considérable :
t = 14,80 / 0,7156 ≈ 20,68
Avec 118 degrés de liberté, la probabilité d’erreur associée s’effondre à p < 0,00001. La dérivation de l’intervalle de confiance à 95 % (pour tcritique ≈ 1,98) livre l’enveloppe suivante :
IC95 %(β1) = [ 14,80 ± 1,98 × 0,7156 ] = [ 13,38 ; 16,22 ]
Cette marge d’incertitude ténue assure aux cliniciens une validité écologique et prospective exceptionnelle : chaque point de stress additionnel allonge le temps d’inhibition cognitive de façon inébranlable entre 13,4 et 16,2 millisecondes. L’erreur type minime confère ici à la conclusion scientifique une reproductibilité et un ancrage métrologique de premier ordre.
11.2 Étude 2 : Effet du temps d’exposition aux écrans sur les symptômes dépressifs
Examinons à présent un second paradigme empirique, représentatif d’une grande partie des recherches contemporaines en psychologie sociale et en psychiatrie préventive, où les données se heurtent à une variabilité résiduelle massive. Une étude épidémiologique transversale cherche à modéliser la sévérité des symptômes dépressifs (mesurée par le score total au questionnaire PHQ-9, s’étendant de 0 à 27 points, variable Y) en fonction du nombre d’heures d’exposition quotidienne aux écrans et aux réseaux sociaux (variable X). L’étude porte sur un échantillon restreint de N = 45 adolescents recrutés via des annonces en ligne. En raison de facteurs contextuels non mesurés (dynamiques familiales, vulnérabilités génétiques, harcèlement scolaire, qualité du sommeil), la dispersion des scores individuels autour de la tendance générale est particulièrement hétérogène et asymétrique.
L’analyse par régression linéaire livre les coefficients empiriques suivants :
ˆY = 4,10 + 0,65 × X
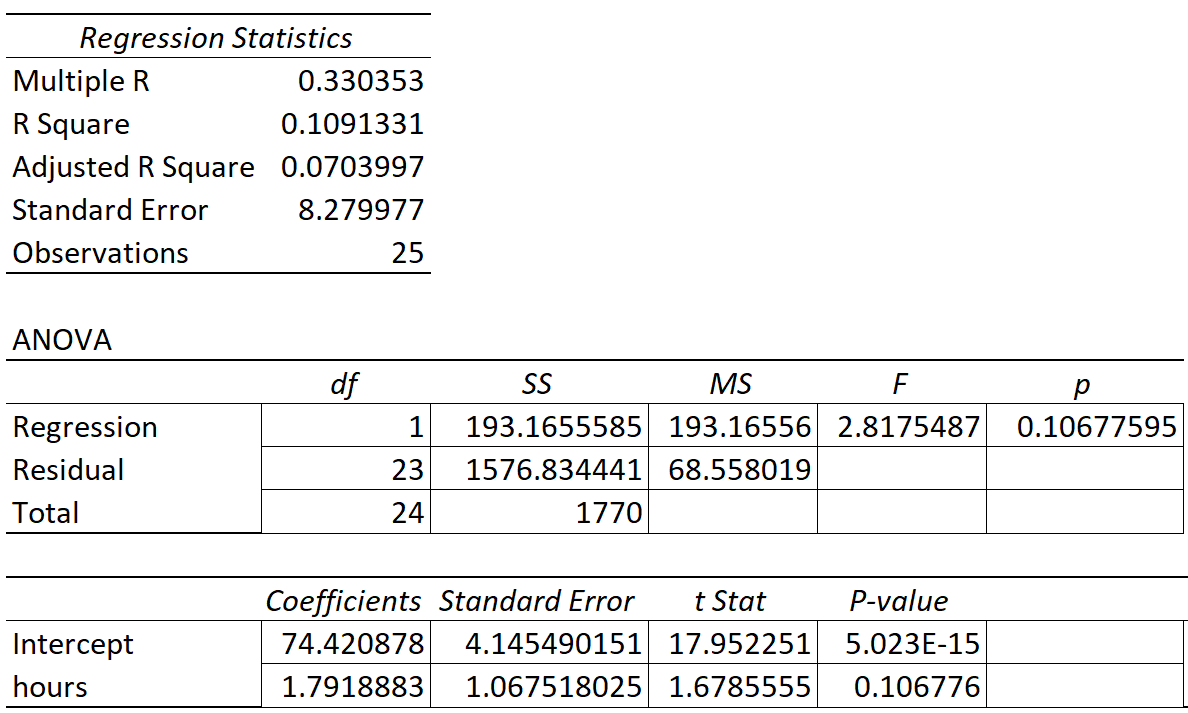
Le chercheur constate superficiellement que la pente brute est positive : chaque heure d’écran semble majorer le score de dépression de 0,65 point. Néanmoins, l’examen de l’erreur résiduelle révèle une somme des carrés des résidus considérable, conduisant à une erreur type de l’estimation de se = 5,40 points. Parallèlement, en raison d’une forte concentration des sujets autour de 3 à 5 heures d’écran par jour, la variabilité du prédicteur est comprimée, affichant une somme des carrés des écarts de seulement SCX = 215. L’erreur type de la pente qui en résulte s’établit à :
SE(ˆβ1) = 5,40 / √215 = 5,40 / 14,663 ≈ 0,3682
La statistique t associée s’élève à :
t = 0,65 / 0,3682 ≈ 1,765
Face aux 43 degrés de liberté résiduels, la valeur critique requise au seuil de 5 % est de t0,05 ≈ 2,017, ce qui génère une p-valeur bilatérale de p ≈ 0,0846. La pente échoue donc à franchir le seuil canonique de la significativité statistique conventionnelle. Plus parlant encore, l’intervalle de confiance à 95 % s’étend de façon désordonnée de -0,09 à +1,39 point par heure d’écran. Cette étude de cas illustre magistralement comment une erreur type hypertrophiée — nourrie par la double malédiction d’un faible échantillon et d’une variance résiduelle disproportionnée — prive le chercheur de toute conclusion définitive, démontrant que l’affirmation hâtive d’un impact délétère des écrans repose ici sur une incertitude métrologique rédhibitoire.
11.3 Synthèse comparative de la sensibilité décisionnelle
La mise en regard comparative de ces deux études de cas met en exergue la dépendance absolue de la validité inférentielle envers l’architecture de capture du signal et du bruit. Dans la première étude, la conjonction d’un instrument cognitif aux propriétés chronométriques objectives et d’un échantillon calibré garantit la compression de l’erreur type, permettant de dégager un signal franc et reproductible. Dans la seconde étude, la subjectivité inhérente aux auto-questionnaires rétrospectifs, la présence de déterminants majeurs non contrôlés et la restriction de variance du prédicteur concourent à une dilution complète du pouvoir métrologique du modèle.
Cette comparaison met en évidence un impératif méthodologique pour la recherche translationnelle : la quête de la significativité statistique ne doit pas être abordée comme une chasse opportuniste aux petites p-valeurs par l’accumulation aveugle de cohortes gigantesques, mais bien comme une démarche rigoureuse d’ingénierie métrologique visant à réduire l’erreur type de la pente par la source. En améliorant la fidélité des instruments d’évaluation psychologique, en déployant des plans d’échantillonnage maximisant la variance du prédicteur et en isolant les variables parasites par un contrôle expérimental rigoureux, le chercheur préserve la précision intrinsèque de son modèle, assurant une interprétation paramétrique saine, réplicable et véritablement informative pour la communauté scientifique.
12. Normes académiques de publication et communication des résultats
12.1 Règles formelles de présentation des résultats selon le format APA
La transmission rigoureuse des résultats d’une analyse de régression linéaire dans la littérature internationale est encadrée par des exigences éditoriales strictes, au premier rang desquelles figurent les normes prescrites par l’American Psychological Association (APA 7e édition). Ces standards stipulent impérativement que tout compte-rendu inférentiel textuel d’une pente de régression doit articuler de façon séquentielle le coefficient non standardisé, son erreur type associée, la statistique du test d’hypothèse avec ses degrés de liberté, la p-valeur exacte et l’intervalle de confiance à 95 %.
La syntaxe canonique recommandée au sein du corps du texte prend la forme rédactionnelle suivante :
La régression linéaire simple a indiqué que le stress perçu prédisait de manière significative le temps d’inhibition cognitive, B = 14,80, SE = 0,72, t(118) = 20,68, p < ,001, IC à 95 % [13,38, 16,22].
L’APA insiste avec une fermeté croissante sur l’interdiction formelle de tronquer la restitution en ne publiant que le coefficient bêta standardisé ou la seule p-valeur : l’erreur type (SE) doit figurer explicitement, car elle constitue le seul paramètre permettant aux méta-analystes de recalculer les tailles d’effet brutes, de synthétiser les précisions métriques et d’agréger ultérieurement les études au sein de méta-régressions quantitatives. Dans les tableaux récapitulatifs de régressions multivariées, les normes éditoriales exigent la disposition en colonnes contiguës de B et de SE(B), garantissant aux relecteurs une lecture visuelle immédiate du ratio de stabilité de chaque coefficient.
12.2 Visualisation graphique rigoureuse de l’incertitude du modèle
La communication scientifique moderne ne saurait se cantonner à la publication de métriques tabulaires austères ; elle requiert une transcription graphique transparente et intuitive de l’incertitude paramétrique. Le standard par excellence consiste à superposer à la droite de régression des moindres carrés ses bandes de confiance à 95 %. Ces bandes de confiance ne se matérialisent pas sous la forme d’un corridor rectiligne parallèle, mais sous celle d’une hyperbole concave dont l’étranglement le plus serré s’observe exactement au barycentre des données — c’est-à-dire aux coordonnées conjointes des moyennes arithmétiques (x̄, ȳ).
Cette géométrie hyperbolique découle directement de la dérivation mathématique de l’erreur type de l’espérance conditionnelle pour une valeur spécifique donnée X0 :
SE(ˆY0) = se × √ [ (1 / N) + ( (x0 – x̄)2 / Σ (xi – x̄)2 ) ]
Ce formalisme démontre avec force que plus l’on s’éloigne du centre de gravité des données vers les marges du domaine d’observation, plus le second terme sous le radical prend de l’ampleur sous l’effet du bras de levier, évasant les bandes de confiance vers le haut et vers le bas. Il est primordial, dans les légendes des figures académiques, de distinguer formellement ces bandes de confiance de l’espérance (qui illustrent l’incertitude entourant l’emplacement moyen de la droite elle-même) des bandes de prédiction individuelle (qui intègrent en sus la variance résiduelle individuelle se2 et sont par conséquent considérablement plus larges). L’emploi d’affichages contemporains fondés sur les densités de distribution postérieures ou les tracés d’échantillonnage d’équations plausibles (spaghetti plots bootstrap) enrichit encore cette communication, dépeignant l’erreur type non comme un intervalle figé, mais comme un gradient continu de vraisemblance.
12.3 Pièges d’interprétation fréquents à éviter dans les manuscrits scientifiques
Pour parachever une formation méthodologique de haut niveau, il convient d’exposer les trois pièges rhétoriques et conceptuels qui grèvent avec une fréquence alarmante les sections « Discussion » des manuscrits soumis aux revues à comité de lecture. Le premier écueil réside dans l’erreur d’omission qui consiste à ne discuter que la significativité statistique en occultant l’ampleur absolue de l’erreur type. Cette faille conduit à célébrer triomphalement des coefficients dotés d’une marge d’incertitude si vaste qu’ils s’avèrent scientifiquement inexploitables pour tout guidage décisionnel concret.
Le deuxième écueil consiste en l’attribution erronée d’une causalité basée sur la seule petitesse de l’erreur type. Une erreur type minuscule atteste d’une grande régularité statistique et d’une précision géométrique indéniable ; en aucun cas elle ne garantit que la variable indépendante X est la cause générative directe des fluctuations de Y. La confusion entre précision métrologique et validité causale demeure l’une des sources majeures de désinformation épidémiologique et comportementale, une relation hautement précise pouvant n’être que la manifestation parfaite d’une corrélation fallacieuse régie par un facteur de confusion non mesuré.
Le troisième écueil, symétrique du précédent, s’incarne dans la confusion délétère entre l’absence d’effet démontré et l’imprécision du dispositif d’observation. Face à une pente affichant une p-valeur non significative de p = 0,22, de trop nombreux auteurs concluent avec témérité à « l’absence d’effet du prédicteur sur le critère ». Or, l’examen de l’erreur type montre souvent que le modèle souffrait d’un déficit d’échantillonnage si flagrant que l’intervalle de confiance n’exclut aucunement des effets de grande ampleur. Comme le formulait le célèbre aphorisme statistique d’Altman et Bland, « l’absence de preuve n’est pas la preuve de l’absence ». La publication scrupuleuse, lucide et exhaustive de l’erreur type de la pente de régression demeure, en définitive, le rempart épistémologique ultime garantissant que l’incertitude inhérente à toute quête de savoir empirique demeure pleinement mesurée, comprise et partagée avec la communauté scientifique.
Références
- Altman, D. G., & Bland, J. M. (1995). Absence of evidence is not evidence of absence. BMJ, 311(7003), 485. https://doi.org/10.1136/bmj.311.7003.485
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Efron, B., & Hastie, T. (2016). Computer age statistical inference: Algorithms, evidence, and data science. Cambridge University Press. https://doi.org/10.1017/CBO9781316576533
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/BF03192961
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Neter, J., Kutner, M. H., Nachtsheim, C. J., & Wasserman, W. (1996). Applied linear statistical models (4th ed.). Irwin.
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.