
Dans l’écosystème du traitement analytique et de l’ingénierie des données volumineuses, le logiciel SAS (Statistical Analysis System) demeure une référence institutionnelle majeure au sein des banques, des compagnies d’assurance, de la recherche clinique et des organismes statistiques gouvernementaux. Au cœur de cette infrastructure réside l’étape DATA, un environnement d’exécution procédural optimisé pour la manipulation ligne par ligne de structures tabulaires complexes. La maîtrise des mécanismes de décision séquentielle au sein de cette étape conditionne directement la fiabilité métrique, la robustesse algorithmique et la performance computationnelle de l’ensemble des pipelines d’analyse statistique.
La prise de décision algorithmique sous SAS s’articule autour d’évaluations booléennes régissant le flux d’exécution. Si l’instruction conditionnelle élémentaire permet d’assigner une valeur isolée selon la véracité d’un prédicat, les architectures de données contemporaines exigent des transformations bien plus complexes, impliquant des mises à jour concomitantes de variables scalaires, l’application de fonctions de transformation vectorielle, et la redirection dynamique des flux d’enregistrements. Dès lors que plusieurs opérations interdépendantes doivent être déclenchées par une seule et même conjoncture logique, l’utilisation de structures en blocs devient indispensable.
Le bloc conditionnel délimité par les mots-clés IF-THEN-DO constitue la pierre angulaire de cette programmation modulaire dans le langage SAS de base. En encapsulant une séquence arbitraire d’instructions exécutables entre les bornes lexicales formées par le groupe DO et l’instruction de clôture END, le programmeur s’affranchit des limitations de la syntaxe unitaire. Ce guide exhaustif explore l’ensemble des dimensions théoriques, syntaxiques, architecturales et matérielles de cette construction fondamentale, illustrant chaque concept par des cas d’usage industriels approfondis.
1. Introduction aux structures conditionnelles dans SAS
1.1 Fondements de l’évaluation logique dans l’étape DATA
L’étape DATA de SAS fonctionne selon un paradigme itératif implicite fondamentalement différent de la plupart des langages procéduraux traditionnels comme le langage C ou Python. Lors de l’exécution, SAS instancie une zone de mémoire intermédiaire désignée sous le terme de vecteur de données du programme, ou Program Data Vector (PDV). Ce vecteur alloue statiquement des emplacements contigus de mémoire pour stocker l’ensemble des variables déclarées ou lues à partir des tables d’entrée via des instructions telles que SET, MERGE ou INPUT. L’étape DATA parcourt le jeu d’enregistrements sous-jacent en appliquant séquentiellement l’intégralité du script compilé à chaque ligne individuelle, avant de restituer le résultat vers une table de sortie et de réinitialiser le PDV pour l’observation suivante.
Dans ce cycle de traitement continuel, l’évaluation des prédicats logiques repose sur une sémantique booléenne stricte où le processeur d’évaluation SAS interprète tout résultat d’expression numérique comme une valeur de vérité binaire. Contrairement à des environnements disposant d’un type booléen primitif dédié, SAS associe la valeur numérique un (1) à la vérité logique, et la valeur numérique zéro (0) à la fausseté. Cependant, une particularité critique réside dans la gestion des valeurs manquantes : toute donnée absente numérique, représentée en mémoire par un point ou un caractère spécial d’absence, est évaluée comme logiquement fausse lorsqu’elle est soumise à un test direct d’affirmation, mais se comporte comme la plus petite valeur possible lors des opérations de comparaison d’ordre de grandeur.
Le contrôle de flux offert par les instructions conditionnelles permet d’intercepter cette exécution linéaire ligne par ligne. Sans structures décisionnelles, l’étape DATA appliquerait uniformément les mêmes formules algébriques et les mêmes réassignations de variables à l’ensemble du fichier plat. L’intégration des prédicats conditionnels introduit des embranchements déterministes, garantissant que certaines portions de code ne soient activées que si et seulement si l’état des variables de l’observation courante satisfait des critères algébriques, typologiques ou temporels prédéterminés par l’ingénieur de données.
1.2 Nécessité des blocs d’instructions groupées
L’instruction conditionnelle élémentaire de SAS, formulée sous le paradigme simple d’une condition suivie immédiatement d’une unique action, présente une restriction opérationnelle majeure : elle ne peut légalement lier qu’une seule et unique instruction exécutable à l’évaluation positive de son prédicat logique. Dans les environnements réels d’ingénierie statistique, les exigences de transformation de données dépassent très largement le cadre de la réassignation unitaire. L’identification d’une sous-population clinique atypique, par exemple, nécessite simultanément l’incrémentation de compteurs de contrôle, le recodage d’indicateurs de risque, la conversion d’unités de mesure physiologiques et la génération de messages d’audit dans le journal d’exécution.
Si le programmeur devait s’en tenir aux constructions unitaires, il serait contraint de répéter la même expression conditionnelle pour chaque variable devant subir une modification. Cette duplication textuelle induit une dette technique considérable. Non seulement elle dégrade la lisibilité globale de l’algorithme, mais elle engendre également une inefficacité computationnelle manifeste, puisque le moteur d’évaluation interne de SAS est forcé de réévaluer le même test logique autant de fois qu’il y a d’instructions d’assignation dépendantes, consommant inutilement des cycles processeur sur des volumes massifs de téraoctets.
Le concept de bloc d’instructions conditionnelles résout cette impasse architecturale en autorisant le regroupement hermétique d’une séquence quelconque d’ordres SAS au sein d’une unité logique atomique. Une fois que la condition principale est validée au sommet de la structure, le fil d’exécution pénètre dans le bloc et exécute séquentiellement l’intégralité des instructions internes sans jamais réévaluer le prédicat initial. Cette encapsulation garantit l’intégrité transactionnelle des transformations : soit l’ensemble des variables interdépendantes est recalculé de concert, soit aucune d’entre elles ne l’est, prévenant ainsi toute incohérence d’état au sein du vecteur de données.
1.3 Applications types en analyse de données
L’utilisation des blocs d’instructions groupées s’impose dans de multiples contextes méthodologiques liés à la préparation et au nettoyage rigoureux des bases de données de recherche. En premier lieu figure le recodage multidimensionnel de données cliniques ou démographiques. Lorsqu’un sujet d’étude change de cohorte en raison du franchissement d’un seuil biologique, il est impératif de modifier concomitamment son libellé de statut, la variable quantitative représentant son dosage recommandé, ainsi que la date d’entrée en vigueur de ce nouveau protocole.
En second lieu, l’imputation conditionnelle de données d’enquêtes ou psychométriques requiert fréquemment l’exécution conjointe de calculs mathématiques et d’indicateurs d’état. Par exemple, si une valeur est détectée comme manquante au sein d’une échelle de Likert, un algorithme d’imputation déterministe peut calculer la moyenne des items résiduels du sous-domaine pour cette observation, assigner cette valeur estimée à la case vide, et immédiatement positionner un drapeau binaire (flag d’imputation) à un pour avertir les modélisateurs économétriques en aval que cette donnée résulte d’un traitement synthétique.
Enfin, le filtrage sélectif et la standardisation de données transactionnelles issues de systèmes hétérogènes mobilisent systématiquement des blocs conditionnels étendus. Dans le traitement des flux bancaires transfrontaliers, la détection d’une devise étrangère spécifique commande l’application d’un taux de change dynamique, le calcul de frais de compensation proportionnels, la conversion des montants dans la monnaie de référence comptable, et la transcription d’un code pays normalisé selon la norme ISO 3166-1. L’atomicité procurée par le bloc conditionnel garantit que ces quatre opérations s’exécutent de façon synchrone et infaillible.
2. Distinction syntaxique et logique entre IF-THEN et IF-THEN-DO
2.1 L’instruction unitaire IF-THEN : Mécanismes et restrictions
L’instruction unitaire conditionnelle fondamentale obéit à la grammaire rigoureuse suivante : le mot-clé IF est suivi d’une expression dont la résolution produit une valeur scalaire numérique, immédiatement suivie du mot-clé THEN, lequel introduit la commande d’action unique. Cette commande peut consister en une affectation arithmétique élémentaire, un appel de fonction système ou une instruction de contrôle telle que DELETE. Le compilateur SAS interprète cette structure en associant le saut conditionnel directement à l’adresse mémoire de l’instruction qui suit la première ponctuation de terminaison rencontrée, à savoir le point-virgule.
Cette conception syntaxique impose une restriction stricte : il est rigoureusement impossible d’insérer deux instructions séparées par des points-virgules sous la tutelle d’un seul mot-clé THEN sans faire appel à un conteneur lexical. Si un développeur débutant tente d’écrire une suite d’affectations séparées par des points-virgules après THEN, seule la toute première affectation sera soumise à la condition logique. L’instruction suivante, bien qu’indentée visuellement sous la condition, sera interprétée par le compilateur comme une instruction inconditionnelle indépendante, exécutée systématiquement pour chaque observation traversant l’étape DATA, provoquant une corruption immédiate et silencieuse des données.
Pour contourner cette limitation sans utiliser de blocs groupés, le programmeur se trouverait contraint de répéter laborieusement la structure :
- Évaluation de la condition pour la première variable cible et affectation du résultat ;
- Réévaluation stricte de la même condition logique pour la deuxième variable cible et affectation du second résultat ;
- Multiplication proportionnelle des blocs de contrôle pour chaque attribut subsidiaire devant être synchronisé.
Ce schéma répétitif encombre inutilement le fichier source et augmente dramatiquement le risque d’introduire des discordances si l’un des prédicats vient à être modifié ultérieurement sans que les copies conformes réparties sur les lignes subséquentes ne soient rigoureusement actualisées.
2.2 Le groupe d’instructions conditionnel : L’apport de la clause DO
L’introduction du mot-clé DO en aval direct de la particule THEN transforme radicalement la portée syntaxique de la structure conditionnelle. Sur le plan lexical, le terme DO n’exécute pas une opération arithmétique en soi ; il agit comme un opérateur d’ouverture de bloc d’instructions, signalant au compilateur SAS qu’une séquence d’instructions hétérogènes va suivre et qu’elle doit être considérée conceptuellement comme une instruction composée unique. La clôture de cette séquence est formellement actée par l’instruction terminale END, qui rétablit le flux séquentiel ordinaire de l’étape DATA.
Grâce à ce mécanisme d’encapsulation, l’ensemble des instructions comprises entre le mot DO; et le mot END; partage un sort d’exécution rigoureusement identique. Si l’expression logique formulée après le IF s’évalue comme vraie (différente de zéro et non manquante), le pointeur d’instruction pénètre dans le bloc et déroule séquentiellement chaque ligne interne : calculs mathématiques, manipulation de chaînes de caractères, appels de routines système via l’instruction CALL, et même instructions d’écriture physique ou d’abandon d’observation. À l’inverse, si la condition s’évalue comme fausse, le moteur d’exécution opère un branchement direct vers l’instruction située immédiatement après le mot-clé END;, sautant d’un seul bloc toutes les opérations intermédiaires.
Ce mode opératoire rationalise considérablement l’arbre décisionnel du programme. Les dépendances fonctionnelles entre variables sont explicitées de manière claire et non équivoque. Le compilateur n’a plus à réanalyser la validité d’une condition pour chaque membre d’un groupe d’actions solidaires, ce qui réduit considérablement le nombre total de comparaisons binaires exécutées à l’échelle d’une table contenant des dizaines de millions de lignes.
2.3 Comparaison structurelle des approches
Pour mesurer précisément le gouffre qualitatif qui sépare l’emploi de conditions unitaires multiples de l’utilisation d’un bloc conditionnel consolidé, il convient d’analyser leurs comportements respectifs sous l’angle de la performance matérielle et de la maintenance logicielle. Sur le plan du coût de traitement computationnel, la multiplication de clauses conditionnelles unitaires oblige l’unité centrale à charger les registres de mémoire, à vérifier les comparateurs d’égalité ou d’inégalité, et à gérer les prédictions de branchement pour chaque ligne de code isolée. Lorsque ces mêmes instructions sont rassemblées dans un bloc DO-END, la logique décisionnelle est évaluée une seule et unique fois par enregistrement, optimisant le pipeline d’exécution des microprocesseurs modernes et réduisant l’empreinte thermique globale des calculs lourds.
Sur le plan du génie logiciel et de la lisibilité algorithmique, le regroupement au sein d’un bloc structuré facilite grandement l’audit de code, en particulier dans les secteurs hautement réglementés soumis aux directives de la Food and Drug Administration (FDA) ou des accords prudentiels bancaires de Bâle III. La maintenance d’un script SAS comportant des centaines d’instructions conditionnelles éparses devient rapidement ingérable en cas de rotation des équipes statistiques. Un bloc bien délimité permet d’isoler visuellement la portée exacte d’une règle métier, rendant immédiatement évidentes les corrélations fonctionnelles entre les différentes variables créées.
En somme, la directive IF-THEN unitaire doit être réservée exclusivement aux modifications scalaires isolées et strictement indépendantes de tout autre paramètre d’état du système. Dès lors qu’une décision logique implique la modification conjointe de deux attributs ou plus, ou requiert l’exécution séquentielle d’un traitement complexe, le recours au paradigme IF-THEN-DO s’impose comme un impératif d’ingénierie non négociable.
3. Syntaxe formelle et anatomie du bloc IF-THEN-DO
3.1 Décomposition de la règle syntaxique standard
La grammaire officielle du langage SAS spécifie une architecture rigoureuse pour l’implémentation d’un bloc conditionnel groupé standard. L’ossature fondamentale repose sur un enchaînement déterministe de jetons lexicaux, débutant par le mot-clé d’amorce conditionnelle, intégrant le corps fonctionnel des instructions exécutables, et se concluant par la balise d’extinction de portée. Cette syntaxe canonique se structure formellement de la manière suivante :
IF expression-logique THEN DO;
instruction-exécutable-1;
instruction-exécutable-2;
…
instruction-exécutable-n;
END;
L’expression logique située entre IF et THEN peut adopter un niveau de complexité arbitraire, combinant des identifiants de colonnes, des constantes littérales, des fonctions mathématiques scalaires et des opérateurs de conjonction booléenne. L’élément déterminant réside dans la liaison indissociable entre le mot-clé THEN et l’instruction DO;. Contrairement à des structures itératives où le mot DO est complété par une variable d’indexation numérique et des bornes de boucle, il s’agit ici d’un DO dit simple ou déclaratif de bloc, dont l’unique raison d’être consiste à suspendre la clôture de la portée conditionnelle jusqu’à ce que son homologue lexical END; soit formellement intercepté par l’analyseur syntaxique.
3.2 Types d’instructions admises au sein du bloc DO
L’espace syntaxique circonscrit entre les bornes DO; et END; ne subit pratiquement aucune restriction quant à la nature fonctionnelle des instructions SAS exécutables pouvant y être intégrées. Cette permissivité structurelle autorise des opérations hautement diversifiées répondant aux besoins les plus pointus du traitement de données :
- Les assignations arithmétiques classiques et les évaluations trigonométriques, logarithmiques ou exponentielles calculées à partir des valeurs instantanées du PDV ;
- L’invocation de fonctions intégrées spécialisées dans le nettoyage ou l’altération de chaînes de caractères, telles que SUBSTR, SCAN, COMPBL ou les fonctions d’expression régulière de la famille PRXPARSE ;
- L’appel de routines systèmes précompilées via le mot-clé CALL, incluant par exemple des générateurs de nombres pseudo-aléatoires ou des procédures de tri vectoriel sur tableaux mémoire ;
- Le déploiement d’instructions impératives de contrôle de flux, à l’instar de l’instruction OUTPUT pour forcer l’écriture physique immédiate d’une ligne, de l’instruction DELETE pour éliminer sans délai l’observation du traitement courant, ou encore de l’ordre STOP pour interrompre définitivement l’étape DATA ;
- La manipulation de structures de données vectorielles à travers l’indexation de tableaux dynamiques déclarés via l’instruction ARRAY.
Il est en revanche crucial de souligner que les instructions purement déclaratives et non exécutables, telles que les définitions de structure LABEL, FORMAT, INFORMAT ou LENGTH, bien qu’elles puissent techniquement être placées physiquement à l’intérieur d’un bloc sans provoquer d’erreur bloquante de compilation, ne sont aucunement soumises à la logique conditionnelle du IF. Le compilateur les évalue lors de sa passe préparatoire préliminaire et leur assignation de métadonnées s’applique de façon immuable à l’intégralité de la table, indépendamment du statut d’exécution du bloc.
3.3 Gestion de la ponctuation et du point-virgule
En programmation SAS, le point-virgule constitue le délimiteur d’instruction universel et irremplaçable. L’un des écueils syntaxiques les plus récurrents et les plus destructeurs rencontrés par les praticiens de données réside dans l’insertion prématurée ou erronée d’un point-virgule au sein de la ligne de déclaration conditionnelle. Si l’on écrit par inadvertance l’expression conditionnelle en plaçant un point-virgule immédiatement après le mot-clé THEN, le compilateur interprète ce signe comme une instruction nulle, c’est-à-dire une action valide qui consiste à ne rien faire du tout. Conséquemment, l’instruction DO; située immédiatement après est comprise comme une ouverture inconditionnelle de bloc, rompant tout lien avec le test initial et provoquant l’exécution systématique de toutes les opérations du bloc pour chaque observation.
De même, la séquence d’ouverture impose que le point-virgule soit positionné immédiatement après le mot DO (formulé ainsi : THEN DO;). L’absence de ce point-virgule provoque l’agrégation erronée du mot DO avec la première instruction de la ligne suivante, générant une erreur d’arrêt de compilation de type « statement is not valid » dans le journal SAS. Chaque instruction contenue à l’intérieur du bloc doit rigoureusement se terminer par son propre point-virgule terminal, respectant les règles syntaxiques ordinaires du langage.
Enfin, l’instruction de terminaison END requiert son propre point-virgule de clôture (formulé ainsi : END;). Toute omission de ce symbole final maintient le bloc conditionnel artificiellement ouvert dans la table des symboles du compilateur, provoquant une cascade d’erreurs d’interprétation sur l’ensemble des lignes de code sous-jacentes, et aboutissant à un échec global de l’étape DATA lors de la tentative de soumission du script.
4. Exemple pratique pas à pas : Création et assignation de variables
4.1 Définition du jeu de données source
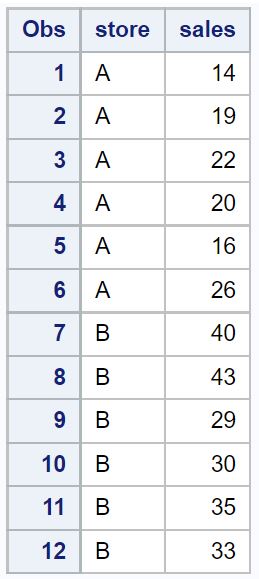
Pour illustrer de façon empirique et reproductible le déploiement opérationnel d’un bloc conditionnel IF-THEN-DO, considérons une base de données de gestion commerciale modélisant les performances de vente de différents établissements de distribution. Le fichier d’origine contient des enregistrements caractérisés par un identifiant d’établissement sous forme de chaîne de caractères, un volume quantitatif brut de transactions exprimé en euros, ainsi qu’un volume de retours de marchandises enregistrés au cours de la période d’exercice comptable.
Nous instancions ce jeu de données expérimental au moyen de l’instruction DATALINES intégrée au sein d’une première étape DATA dénommée donnees_magasins. Cette démarche permet de simuler un environnement de production contrôlé tout en rendant le code entièrement autonome et exécutable sur toute instance SAS active. Les variables quantitatives présentent des distributions hétérogènes réparties entre différents points de vente régionaux, certains enregistrant un chiffre d’affaires particulièrement dynamique tandis que d’autres affichent des volumes modestes couplés à des taux de retour anormalement élevés.
Avant d’engager toute transformation conditionnelle approfondie, la validation de la structure de base est systématiquement effectuée via l’invocation de la procédure PROC PRINT, permettant à l’analyste de s’assurer de la conformité du chargement brut des enregistrements, de l’absence de décalage dans la lecture des colonnes au niveau du tampon d’entrée, et de l’intégrité globale du jeu de données de référence.
4.2 Implémentation du bloc IF-THEN-DO
L’objectif fonctionnel assigné à notre étape de transformation consiste à identifier de manière ciblée les établissements situés dans la métropole bordelaise afin de leur appliquer un ensemble concerté de règles de gestion fiscale et de labellisation géographique. Pour chaque point de vente satisfaisant la condition d’égalité sur la variable Magasin, le script doit simultanément créer une variable catégorielle Region contenant la mention « Nouvelle-Aquitaine », une variable Pays fixée à « France », calculer un montant de taxe régionale spécifique indexé à 8,5 % du volume net des ventes (ventes brutes diminuées des retours), et attribuer un score de priorité opérationnelle sous forme d’une constante textuelle qualifiée de « Haute ».
L’architecture algorithmique mise en œuvre repose sur une étape DATA dénommée donnees_transformees lisant la table initiale par l’ordre SET donnees_magasins;. Immédiatement après cette lecture séquentielle, l’évaluation conditionnelle s’énonce ainsi : le mot IF compare la variable Magasin à la chaîne littérale ‘Bordeaux’. Dès lors que cette égalité stricte est validée par l’évaluateur logique interne, la directive THEN DO; engage l’exécution de la séquence d’instructions. Les affectations s’enchaînent alors rigoureusement : calcul de la variable de taxe arithmétique nette, assignation des constantes géographiques et marquage de l’indicateur de priorité. La séquence se clôt de façon hermétique grâce à la directive impérative END;.
Cette construction méthodique garantit qu’aucune des variables descriptives associées à la juridiction bordelaise n’est instanciée de manière désordonnée ou partielle. L’intégrité transactionnelle au niveau de chaque ligne analysée dans le vecteur de mémoire est parfaitement respectée.
4.3 Validation des résultats et inspection des sorties
La validation empirique du programme s’opère par la soumission conjointe d’un affichage tabulaire via PROC PRINT et d’un examen approfondi du journal d’exécution (le SAS Log). L’inspection du journal constitue une étape méthodologique cruciale : elle permet d’attester que le volume de lignes lues depuis la table source concorde rigoureusement avec le volume de lignes insérées dans la table de destination, tout en vérifiant l’absence absolue de messages d’avertissement de type « uninitialized variable » ou d’erreurs de troncature de chaîne.
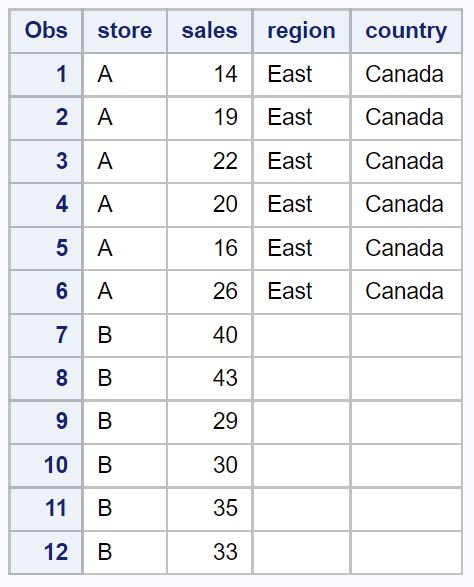
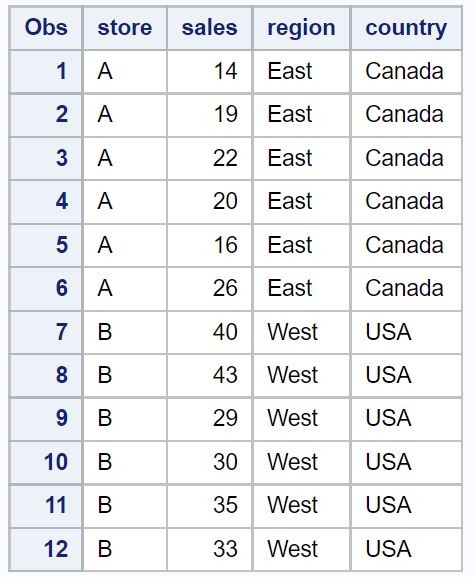
L’analyse visuelle et analytique du tableau de sortie met en exergue une dichotomie parfaite entre les enregistrements. Les lignes correspondant aux magasins bordelais affichent avec exactitude les valeurs assignées au sein du bloc : la région est renseignée, le pays est correctement identifié, la taxe nette correspond parfaitement au résultat du modèle algébrique, et le statut prioritaire est arboré. Pour les établissements situés dans d’autres agglomérations (comme Lyon, Lille ou Marseille), le comportement par défaut de l’étape DATA se manifeste pleinement : n’ayant pas satisfait la condition logique, ces lignes ont contourné le bloc DO-END dans son intégralité.
Par conséquent, pour ces observations dissidentes, les variables calculées et textuelles créées exclusivement à l’intérieur du bloc reçoivent automatiquement la valeur manquante par défaut du système SAS, à savoir un espace vide pour les variables alphanumériques et un point décimal pour les variables numériques. Ce constat illustre avec une clarté totale la dynamique du vecteur de données et souligne la nécessité, dans les architectures industrielles, d’anticiper le traitement de ces valeurs résiduelles au moyen d’alternatives conditionnelles complètes.
5. Gestion rigoureuse des attributs et dimensionnement avec LENGTH
5.1 Le mécanisme de troncature automatique dans SAS
L’un des pièges les plus insidieux et les plus destructeurs de l’étape DATA réside dans le mécanisme par lequel le compilateur SAS détermine la longueur d’allocation mémoire des nouvelles variables de type caractère. Contrairement aux environnements modernes à typage dynamique qui redimensionnent continuellement les zones tampons en mémoire selon la longueur du texte assigné, SAS applique un modèle statique fondé sur le principe de la première occurrence textuelle rencontrée lors de la phase de compilation initiale du script.
Lorsque le compilateur analyse séquentiellement le code source de haut en bas, la toute première fois qu’il intercepte l’assignation d’une variable qui n’a pas été formellement déclarée au préalable dans le dictionnaire du PDV, il examine la longueur physique exacte de la constante littérale présente à la droite de l’opérateur d’égalité. Si cette première instanciation survient dans une branche conditionnelle attribuant une chaîne très courte, par exemple le mot « Nord » comportant quatre caractères, le compilateur fige irrévocablement la longueur de cette variable à quatre octets pour l’ensemble du cycle de vie de l’étape DATA.
Si, plus loin dans le flux d’exécution ou au sein d’une seconde branche conditionnelle alternative, une observation satisfait un critère imposant l’attribution d’une chaîne plus longue, par exemple l’appellation « Ile-de-France » totalisant treize caractères, SAS ne procèdera à aucun réajustement d’allocation. La valeur sera silencieusement tronquée pour tenir dans le gabarit initial de quatre octets, produisant l’aberration lexicale « Ile- ». Cette perte d’information se produit sans nécessairement générer d’erreur fatale dans le journal, faussant irrémédiablement les agrégations catégorielles ultérieures et les analyses statistiques de cohorte.
5.2 Utilisation explicite de l’instruction LENGTH
Pour éliminer tout risque de troncature silencieuse et garantir une reproductibilité absolue des transformations de données, la bonne pratique méthodologique universelle consiste à déclarer explicitement la taille de chaque variable alphanumérique en amont immédiat de toute structure conditionnelle. Cette déclaration anticipée s’effectue au moyen de l’instruction déclarative non exécutable LENGTH.
L’instruction LENGTH obéit à une syntaxe concise où le nom de la variable cible est immédiatement suivi du symbole dollar ($) désignant la typologie caractère, lui-même suivi d’un entier numérique spécifiant le nombre précis d’octets que le vecteur de données (PDV) doit réserver de manière permanente pour cette colonne. En plaçant par exemple l’énoncé déclarant que la variable Region dispose d’une longueur allouée de vingt octets et la variable Statut d’une longueur de quinze octets tout au début de l’étape DATA, l’ingénieur de données neutralise l’heuristique de déduction automatique du compilateur.
Dès lors que le compilateur rencontre cette directive d’amont, il dimensionne immédiatement les emplacements de mémoire correspondants dans la table de structure interne. Lorsque le fil d’exécution pénètre ultérieurement dans les différents blocs IF-THEN-DO, chaque valeur textuelle assignée, qu’elle comporte deux caractères ou dix-huit caractères, s’insère harmonieusement dans l’espace alloué, les positions excédentaires étant naturellement complétées par des espaces de remplissage standard. Cette rigueur déclarative constitue le fondement d’une architecture de données robuste et pérenne.
5.3 Attribution de formats et libellés au sein de la structure
Au-delà de la stricte allocation d’espace physique garantie par l’instruction LENGTH, la gestion exhaustive du cycle de vie des variables dérivées générées au sein de blocs conditionnels exige une contextualisation descriptive au moyen des instructions LABEL et FORMAT. Dans l’écosystème SAS, la séparation fonctionnelle entre la représentation interne des données en mémoire machine et leur représentation visuelle externe constitue un principe d’architecture fondamental.
L’instruction LABEL permet d’associer à une variable nouvellement calculée une chaîne descriptive textuelle enrichie pouvant atteindre deux cent cinquante-six caractères. Cette étiquette sémantique est stockée de manière indélébile dans les métadonnées de la table SAS. Elle sera automatiquement mobilisée par les procédures analytiques avancées, telles que PROC MEANS, PROC TABULATE ou PROC REPORT, garantissant que les sorties graphiques ou tabulaires soient immédiatement compréhensibles pour les décideurs métiers sans exiger de post-traitement typographique.
Parallèlement, l’instruction FORMAT gouverne le masque d’affichage des valeurs scalaires, qu’elles soient temporelles, monétaires ou catégorielles. Si un bloc IF-THEN-DO calcule un montant d’indemnité d’assurance ou une pénalité financière, l’assignation anticipée d’un format monétaire adéquat (tel que EURO12.2 ou DOLLAR14.2) garantit que les nombres flottants en double précision stockés dans le PDV soient restitués sous une présentation standardisée incluant séparateurs de milliers, décimales calibrées et symbole monétaire adéquat. Tout comme l’instruction LENGTH, ces directives doivent impérativement être positionnées au sommet déclaratif de l’étape DATA afin de clarifier la distinction entre la modélisation des schémas de données et la logique conditionnelle procédurale.
6. Formulation de conditions complexes avec opérateurs logiques
6.1 Opérateurs relationnels et conjonctions booléennes
L’évaluation des prédicats gouvernant l’entrée dans un bloc IF-THEN-DO ne se limite que très rarement à des comparaisons scalaires simples. Dans les environnements statistiques avancés, la décision d’exécuter un traitement groupé dépend couramment de la combinaison algébrique d’une multitude de critères simultanés. SAS fournit un catalogue complet d’opérateurs de comparaison relationnels, disponibles sous forme de mnémoniques textuels alphabétiques ou de symboles mathématiques standards :
- Égalité stricte : EQ ou symbole d’égalité (=) ;
- Non-égalité ou exclusion : NE ou symbole de négation de l’égalité (^= ou ~=) ;
- Supériorité stricte et supériorité large : GT (>) et GE (>=) ;
- Infériorité stricte et infériorité large : LT (<) et LE (<=) ;
- Appartenance à une liste discrète d’éléments : l’opérateur ensembliste IN.
Ces comparaisons atomiques sont agrégées sous forme d’arborescences logiques complexes au moyen des conjonctions booléennes AND (intersection stricte) et OR (union inclusive), appuyées au besoin par l’opérateur d’inversion NOT. La rigueur de formulation impose une maîtrise absolue des règles de préséance opératoire établies par le compilateur SAS : les comparaisons arithmétiques sont résolues en premier lieu, suivies des opérateurs relationnels, puis de la conjonction AND, et enfin de la conjonction OR.
Afin de prévenir tout biais d’évaluation découlant de cette hiérarchie implicite, il est impératif d’utiliser des parenthèses de groupement pour expliciter sans ambiguïté les priorités d’évaluation. Une expression conditionnelle non parenthésée combinant des AND et des OR successifs constitue l’une des sources majeures d’erreurs logiques non détectées en programmation statistique, conduisant à l’activation accidentelle de blocs conditionnels pour des sous-populations qui auraient dû être formellement exclues du traitement.
6.2 Gestion des valeurs manquantes dans les tests logiques
La gestion des valeurs manquantes (missing values) au sein des prédicats conditionnels constitue sans conteste la spécificité la plus critique et la plus dangereuse du langage SAS. Sur le plan de l’architecture binaire interne, SAS traite les valeurs manquantes numériques ordinaires (représentées par un point) ainsi que les vingt-sept valeurs manquantes spéciales (représentées par un point suivi d’une lettre de A à Z ou d’un caractère de soulignement) comme des nombres réels dont la grandeur est arbitrairement fixée comme étant inférieure à n’importe quel nombre réel négatif imaginable. En substance, pour le compilateur SAS, une valeur numérique manquante représente l’équivalent mathématique de l’infini négatif.
Par conséquent, si un analyste rédige une instruction conditionnelle formulée sous la forme :
IF Montant_Ventes < 50000 THEN DO;
cette condition sera évaluée comme strictement VRAIE pour chaque enregistrement dont la variable Montant_Ventes est manquante ou non renseignée dans le fichier source. Le bloc conditionnel s’exécutera donc pour ces observations, appliquant indûment des formules de remise, de reclassement ou de calcul de pénalité à des entités pour lesquelles l’information est fondamentalement inconnue, introduisant ainsi une distorsion méthodologique majeure dans les modèles économétriques finaux.
Pour immuniser le code contre cet effet pervers, il est indispensable de faire appel à la fonction système précompilée MISSING(), ou d’encadrer explicitement la comparaison par des bornes inférieures valides. La formulation d’un test robuste doit obligatoirement s’écrire :
IF NOT MISSING(Montant_Ventes) AND Montant_Ventes < 50000 THEN DO;
Alternativement, l’expression peut recourir à la comparaison d’exclusion :
IF . < Montant_Ventes < 50000 THEN DO;
Cette seconde notation exploite la capacité unique de SAS à chaîner les comparaisons d’inégalité continue, garantissant de façon irréfutable que seules les observations présentant une valeur numérique strictement supérieure au point d’absence et inférieure au seuil limite ne pénètrent à l’intérieur du bloc DO-END.
6.3 Conditions textuelles et sensibilité à la casse
L’évaluation des prédicats portant sur des chaînes de caractères impose des précautions méthodologiques symétriques à celles requises pour les grandeurs numériques, principalement en raison de la stricte sensibilité à la casse (case sensitivity) régissant les comparaisons de chaînes en environnement SAS standard. Par défaut, la chaîne littérale ‘Paris’ n’est aucunement équivalente à la chaîne ‘PARIS’, ni à la variante ‘paris’. Une condition IF formulée naïvement sur une chaîne brute échouera à identifier les enregistrements valides dès lors que la saisie présente la moindre variation de casse orthographique.
La neutralisation de cette instabilité s’opère par l’adjonction systématique de fonctions de normalisation textuelle au niveau de l’expression conditionnelle elle-même. Les fonctions intégrées UPCASE() et LOWCASE() convertissent dynamiquement la variable en mémoire vers un registre typographique uniforme lors de la phase d’évaluation, sans pour autant altérer la valeur originelle conservée dans la variable source si celle-ci ne fait pas l’objet d’une réassignation. Ainsi, le prédicat :
IF UPCASE(Nom_Ville) = ‘PARIS’ THEN DO;
validera avec une exactitude absolue n’importe quelle déclinaison morphologique de la graphie du mot.
De surcroît, les variables textuelles issues de fichiers plats ou de transferts relationnels d’anciennes architectures contiennent fréquemment des espaces résiduels invisibles, qu’ils soient positionnés en tête ou en queue de chaîne. Ces caractères d’espacement modifient la valeur binaire de la chaîne et bloquent les tests d’égalité. L’application des fonctions STRIP() (qui élimine simultanément les espaces initiaux et terminaux) ou COMPBL() (qui réduit les espaces consécutifs internes à un unique intervalle blanc) combinée à l’opérateur ensembliste IN permet de construire des prédicats à l’épreuve des corruptions de saisie, garantissant l’activation légitime des blocs DO-END associés.
7. L’alternative structurelle : Intégration de ELSE DO et DO-END
7.1 Architecture d’une structure conditionnelle exhaustive
Dans la théorie générale des systèmes et de l’ingénierie algorithmique, un système d’aiguillage n’atteint la robustesse déterministe que s’il couvre de façon exhaustive l’intégralité de l’espace d’états d’un phénomène donné. Se contenter d’une instruction isolée IF-THEN-DO laisse les observations ne satisfaisant pas la condition dans un état de traitement non explicité par le code source, ce qui engendre des valeurs manquantes imprévues ou la persistance involontaire d’états antérieurs. Pour remédier à cette faille structurelle, le langage SAS met à disposition la clause alternative ELSE DO.
L’architecture conditionnelle exhaustive s’articule autour d’une symétrie rigoureuse : à chaque bloc d’affirmation IF-THEN-DO répond un bloc de négation ou de dérivation complémentaire ouvert par les mots ELSE DO; et clos par son propre délimiteur END;. Cette syntaxe se matérialise de la sorte :
IF condition-principale THEN DO;
actions-du-cas-positif;
END;
ELSE DO;
actions-du-cas-alternatif;
END;
Dans cette configuration canonique, l’étanchéité logique est absolue. Chaque observation traversant l’étape DATA est obligatoirement dirigée vers l’un des deux compartiments d’exécution. Il n’existe aucun état intermédiaire non contrôlé : si le prédicat s’évalue comme vrai, les actions du bloc positif sont exécutées et le bloc ELSE DO est totalement ignoré ; dans le cas rigoureusement inverse, le processeur enjambe le premier bloc pour consacrer l’intégralité des ressources au bloc alternatif.
7.2 Chaînes de décisions multiniveaux avec ELSE IF-THEN-DO
Dès lors que la segmentation logique d’un portefeuille de données requiert une partition en plus de deux états mutuellement exclusifs, l’assemblage linéaire de blocs distincts s’opère par l’entremise de cascades décisionnelles formulées avec la clause ELSE IF-THEN-DO. Cette chaîne d’évaluation séquentielle hiérarchisée constitue l’équivalent procédural le plus efficient pour formaliser des règles métier à seuils d’activation échelonnés.
L’avantage computationnel fondamental de la structure ELSE IF par rapport à une succession naïve de plusieurs blocs IF simples réside dans l’interruption précoce du cycle d’évaluation. Lorsqu’une observation valide le premier test conditionnel, SAS exécute le premier bloc DO-END, puis contourne purement et simplement l’ensemble des clauses ELSE IF et ELSE subséquentes jusqu’à la fin de la chaîne hiérarchique. L’unité centrale n’exécute donc jamais de tests logiques superflus sur des conditions que l’on sait par définition mutuellement exclusives avec les étapes antérieures.
Une bonne pratique de programmation industrielle consiste à clore systématiquement ces chaînes de décision multiniveaux par une clause ELSE DO; … END; terminale dépourvue de condition explicite. Cette branche résiduelle finale agit comme une trappe de sécurité (catch-all), recueillant tous les enregistrements aux profils atypiques, aberrants ou non anticipés par les modélisateurs. On peut y consigner des assignations d’alerte, incrémenter des variables de rejet ou insérer des messages d’erreur tracés au moyen de l’instruction PUTLOG, prévenant ainsi toute contamination de la base finale par des observations non traitées.
7.3 Comparaison avec la clause SELECT-WHEN
Le langage SAS propose une structure conditionnelle concurrente pour la prise en charge des ramifications décisionnelles étendues : le bloc SELECT-WHEN. Il apparaît dès lors indispensable d’établir les critères méthodologiques guidant l’arbitrage entre une architecture fondée sur des blocs ELSE IF-THEN-DO et une architecture articulée autour de directives SELECT-WHEN.
L’instruction SELECT excelle tout particulièrement dans les contextes où l’arbre de décision dépend de l’évaluation discrète d’une unique variable pivot, notamment lorsqu’il s’agit de transposer des codes de typologie d’enregistrements en catégories explicites. Dans ce scénario précis, la syntaxe SELECT(variable_pivot); WHEN(valeur_1) DO; … END; OTHERWISE DO; … END; END; offre une clarté typographique incomparable et réduit la redondance lexicale en évitant d’avoir à réécrire continuellement le nom de la variable testée.
En revanche, dès que la logique décisionnelle mobilise des prédicats hétérogènes faisant intervenir simultanément de multiples colonnes distinctes, des opérations arithmétiques comparées à des seuils glissants, ou des conjonctions booléennes asymétriques mêlant variables de texte et grandeurs temporelles, la construction ELSE IF-THEN-DO retrouve une supériorité opérationnelle éclatante. Elle offre une flexibilité totale dans la modélisation des conditions, sans obliger le processeur à forcer la comparaison contre un sélecteur centralisé, conférant au développeur une liberté algorithmique intégrale dans la formulation des règles métier hautement complexes.
8. Imbrication avancée des blocs conditionnels
8.1 Conception d’arbres décisionnels hiérarchisés
La modélisation de processus industriels ou cliniques complexes impose fréquemment d’évaluer des conditions subordonnées qui n’ont de sens algorithmique que si et seulement si une condition maîtresse préliminaire a été préalablement validée. L’imbrication hiérarchique de blocs conditionnels consiste à intégrer un ou plusieurs blocs IF-THEN-DO … END complets à l’intérieur du corps syntaxique d’un bloc parent préexistant.
Dans cette architecture en poupées russes, le flux logique procède par raffinements successifs. L’analyseur du moteur SAS valide d’abord le macro-critère délimitant la cohorte d’intérêt globale. Une fois le pointeur de traitement engagé à l’intérieur du bloc DO de premier rang, il rencontre un sous-prédicat régissant un sous-bloc interne. Ce second niveau affine la segmentation, par exemple en distinguant les sous-groupes posologiques au sein de la seule population des patients ayant validé le protocole initial. Si la condition parente échoue, l’ensemble de la sous-arborescence interne est intégralement enjambé, économisant un temps de calcul substantiel.
La règle d’or régissant l’intégrité de ces édifices algorithmiques réside dans le respect absolu de la parité stricte entre les instructions d’ouverture DO et les instructions de clôture END. Pour chaque mot-clé DO introduit au niveau supérieur ou dans les sous-branches, un mot-clé END rigoureusement homologue doit être implanté pour refermer le sous-ensemble avant que la branche parente ne puisse elle-même être scellée. Toute asymétrie dans ce décompte provoque une rupture fatale de structure dès l’étape de compilation.
8.2 Contrôle d’exécution fine avec DO séquentiel et conditionnel
L’utilisation de blocs DO sous la tutelle d’une instruction IF ne se cantonne pas aux simples blocs d’encapsulation non itératifs. Un pan extrêmement puissant de la programmation SAS réside dans la capacité à fusionner des boucles itératives réelles avec des conditions préalables, déclenchant des itérations complexes uniquement lorsque certaines caractéristiques de données sont réunies à l’échelle de l’observation courante.
Il est parfaitement valide d’implanter des boucles indicées indexées par des bornes numériques entières sous une clause conditionnelle, sous la forme générale :
IF Critere_Activation = 1 THEN DO i = 1 TO dim(Tableau_Mesures);
calculs-sur-tableau-i;
END;
Dans cette configuration, l’initialisation de l’indice de boucle et le parcours itératif des dimensions du vecteur ne se matérialisent que si la variable d’activation a préalablement certifié la pertinence de l’opération, épargnant ainsi des millions d’itérations stériles sur les lignes de données non concernées.
De surcroît, le développeur peut introduire des boucles à terminaison conditionnelle dynamique pilotées par les clauses DO WHILE (évaluation du prédicat d’itération en tête de boucle) ou DO UNTIL (évaluation du prédicat de sortie en queue de boucle) au sein d’un bloc conditionnel primaire. Pour orchestrer les sorties d’urgence lorsque des convergences asymptotiques ou des seuils de rupture analytique sont prématurément atteints à l’intérieur de ces sous-boucles imbriquées, l’instruction impérative LEAVE force le saut immédiat hors de la boucle itérative la plus interne, tandis que l’instruction CONTINUE commande le passage instantané à l’itération indicée suivante sans exécuter le reste du bloc.
8.3 Limites et risques de la sur-imbrication
Bien que le compilateur SAS autorise théoriquement des niveaux d’imbrication d’une profondeur considérable, la prolifération incontrôlée de blocs conditionnels superposés engendre des risques majeurs pour la gouvernance des systèmes d’information statistique. Le phénomène dit de sur-imbrication (ou code spaghetti) dégrade dramatiquement l’indice de maintenabilité logicielle et accroît exponentiellement la probabilité d’introduire des régressions lors des phases d’évolution des règles métier.
Lorsqu’un arbre décisionnel franchit le seuil critique de quatre à cinq niveaux d’imbrications successives, la charge cognitive requise pour appréhender l’ensemble des ramifications devient prohibitive pour les équipes d’audit et de contrôle qualité. Les stratégies modernes d’ingénierie des données recommandent alors formellement d’adopter des modèles architecturaux alternatifs :
- La décomposition du problème par modularisation, consistant à segmenter un script monolithique en une succession de plusieurs étapes DATA distinctes reliées par des tables intermédiaires légères (staging datasets) ;
- Le recours aux tables de transcodage de paramètres gérées via des étapes d’appariement relationnel optimisé sous PROC SQL ou par des jointures en mémoire par hachage (hash objects) ;
- La factorisation de segments récurrents d’instructions conditionnelles au sein de macro-fonctions SAS paramétrables compilées dans le catalogue central de l’environnement de production.
9. Traitement dynamique des flux de données : OUTPUT conditionnel
9.1 Règles d’écriture implicite vs explicite dans l’étape DATA
Par défaut, l’étape DATA obéit à un mécanisme d’écriture entièrement automatique et implicite. À chaque cycle d’itération, lorsque le pointeur d’exécution atteint la dernière instruction textuelle formalisant le périmètre de l’étape DATA (symbolisée par la ligne RUN;), le moteur SAS transfère spontanément l’intégralité du contenu instantané des variables du Program Data Vector vers le fichier de données de sortie physique sur disque, avant de purger les mémoires volatiles et d’engager la lecture de l’observation suivante.
Cependant, l’introduction d’une seule instruction explicite OUTPUT à n’importe quel endroit du code source modifie radicalement et irréversiblement ce comportement par défaut. Dès lors que le compilateur identifie la présence d’une commande OUTPUT, il désactive de manière permanente le mécanisme de vidage automatique en queue de boucle. Dès lors, plus aucune observation n’est inscrite dans la table finale à moins que le fil d’exécution ne franchisse physiquement une instruction OUTPUT formulée de manière explicite.
Cette mutation paradigmatique trouve son expression la plus puissante lorsqu’elle est encapsulée à l’intérieur d’un bloc conditionnel IF-THEN-DO. L’analyste s’arroge ainsi un contrôle chirurgical sur la génération des enregistrements physiques. Il devient possible de décider non seulement si une ligne donnée doit être matérialisée dans la table finale, mais également de dupliquer dynamiquement une observation d’entrée en plusieurs observations de sortie différenciées en multipliant l’appel à des ordres OUTPUT au gré de transformations de variables cadencées au sein du même bloc décisionnel.
9.2 Ventilation conditionnelle vers plusieurs tables cibles
L’une des architectures les plus efficaces permises par le couplage de IF-THEN-DO et d’instructions d’écriture explicite réside dans le routage dynamique et simultané d’un flux de données brut unique vers une multiplicité de tables analytiques spécialisées. Cette opération de ventilation multidirectionnelle s’opère en déclarant l’ensemble des tables de sortie cibles au sein de l’instruction d’en-tête de l’étape DATA, séparées par de simples espaces :
DATA table_actifs table_dormants table_contentieux table_rejets;
Au cœur du script procédural, une cascade de blocs conditionnels IF-THEN-DO segmentant la patientèle ou la clientèle oriente chaque observation vers sa destination idoine. L’instruction OUTPUT s’enrichit alors d’un argument spécifiant expressément le nom de la table cible sur laquelle l’écriture doit immédiatement être déversée :
IF Solde > 0 AND Statut = ‘ACT’ THEN DO;
Date_Derniere_Activite = today();
OUTPUT table_actifs;
END;
ELSE IF Solde = 0 THEN DO;
Duree_Inactivite = today() – Date_Cloture;
OUTPUT table_dormants;
END;
ELSE IF Solde < 0 THEN DO;
Niveau_Risque = ‘Critique’;
OUTPUT table_contentieux;
END;
Ce patron d’architecture offre un gain de performance matériel monumental par rapport aux méthodologies naïves consistant à exécuter plusieurs étapes DATA consécutives appliquant des filtres WHERE successifs sur la même table de base volumineuse. L’intégralité du processus d’aiguillage s’effectue ici en une seule passe de lecture des disques de stockage, divisant drastiquement les opérations d’entrées/sorties physiques (I/O throughput).
9.3 Filtrage et suppression d’enregistrements avec DELETE
À l’exact opposé de l’action constructive matérialisée par l’instruction OUTPUT, la directive DELETE permet de purger instantanément les observations non conformes ou polluantes au sein d’un pipeline de prétraitement. L’intégration de l’instruction DELETE à l’intérieur d’un bloc IF-THEN-DO répond généralement à des critères de rejet multicritères associant des vérifications de cohérence arithmétique et des alertes de corruption de format.
Lorsque le fil d’exécution pénètre dans un bloc conditionnel comportant l’instruction DELETE;, SAS interrompt sans délai l’évaluation du reste de l’étape DATA pour l’observation courante. Le PDV ne fait l’objet d’aucune écriture dans aucune table de sortie, l’exécution saute immédiatement par-dessus toutes les instructions résiduelles situées en aval, et le pointeur système se repositionne au sommet de l’étape DATA pour appeler l’enregistrement suivant depuis le fichier source.
Sur le plan méthodologique, l’usage de DELETE à l’intérieur de blocs conditionnels doit être manié avec une prudence extrême. L’élimination précoce de lignes peut altérer silencieusement la représentativité d’un échantillon d’inférence statistique. Les standards d’audit contemporains recommandent de privilégier, dans la mesure des ressources de stockage disponibles, la redirection vers une table de quarantaine dédiée (au moyen d’un OUTPUT vers une table d’anomalies) plutôt qu’une suppression brute par DELETE, préservant ainsi la traçabilité intégrale de l’ensemble des données écartées pour les revues de validation des modèles.
10. Erreurs syntaxiques, diagnostics et débogage
10.1 Omission ou déséquilibre de l’instruction END
L’anomalie de programmation la plus fréquente lors de la mise en œuvre de structures conditionnelles étendues réside dans la rupture d’équilibre entre l’amorce d’un bloc par la directive DO et sa fermeture par l’instruction END. Cette omission survient régulièrement lors de sessions de refactorisation logicielle, lorsqu’un analyste déplace des pans d’instructions ou imbrique de nouvelles règles sans vérifier scrupuleusement la balance des délimiteurs.
Lorsque le compilateur SAS atteint le terme formel de l’étape DATA (marqué par l’instruction RUN;) alors qu’un ou plusieurs blocs DO demeurent ouverts dans la pile des instructions, il stoppe net la procédure de compilation et consigne dans le journal SAS une erreur explicite généralement libellée :
ERROR: Statement is not valid or it is used out of proper order, ou encore :
ERROR: The DO statement was not matched by an END statement.
Cette interruption prévient l’exécution d’un code corrompu, mais le diagnostic peut s’avérer laborieux sur des scripts étalés sur plusieurs milliers de lignes.
L’effet de cascade provoqué par un END manquant déstabilise totalement l’arbre syntaxique : toutes les instructions situées en dessous du bloc incriminé sont subordonnées par erreur à la condition initiale, altérant la portée fonctionnelle de pans entiers du programme. Pour neutraliser rapidement ces dysfonctionnements, les environnements intégrés de développement SAS modernes (tels que SAS Enterprise Guide ou SAS Studio) intègrent des mécanismes d’analyse lexicale statique et de mise en surbrillance automatique des blocs appariés, permettant d’identifier immédiatement la ligne exacte où la parité structurelle a été rompue.
10.2 Gestion des conflits d’assignation et initialisations involontaires
Une problématique conceptuelle majeure fréquemment rencontrée lors du recours aux blocs IF-THEN-DO concerne la gestion du statut d’initialisation des variables calculées au fil des itérations du PDV. Dans le cycle standard de l’étape DATA, toute variable créée par une formule d’affectation interne (contrairement à celles lues directement depuis une table via l’ordre SET) est réinitialisée à sa valeur manquante (. ou espace) au tout début de chaque nouvelle itération de lecture.
Si une variable cible n’est alimentée qu’au sein d’un bloc IF-THEN-DO activé de façon sporadique, elle prendra sa valeur assignée pour les observations qui remplissent la condition, mais retournera instantanément à la valeur manquante pour toutes les observations suivantes qui échouent au test conditionnel. Si le dessein du programmeur était en réalité de conserver la dernière valeur calculée valide pour l’appliquer par propagation descendante aux observations intercalaires, l’étape DATA produira un résultat totalement erroné constitué d’îlots de valeurs entourés de vides statistiques.
La résolution de cette anomalie de persistance impose l’utilisation concertée de l’instruction déclarative RETAIN. En déclarant la variable concernée au sein d’une directive RETAIN, le programmeur ordonne formellement au moteur SAS de suspendre la purge automatique de la mémoire du PDV pour cette colonne spécifique lors du passage d’une observation à la suivante. Dès lors, la variable conserve sa valeur issue de la dernière exécution valide du bloc IF-THEN-DO jusqu’à ce qu’une nouvelle observation satisfasse de nouveau la condition et vienne écraser le contenu de l’emplacement mémoire avec une nouvelle estimation actualisée.
10.3 Outils de diagnostic dans le journal SAS
Lorsque le comportement observé d’un algorithme conditionnel diverge des prédictions théoriques de l’analyste, le recours aux outils d’instrumentation interne et de traçage temps réel s’impose pour diagnostiquer les anomalies de flux au sein du PDV. L’instruction la plus fondamentale et la plus immédiatement accessible demeure l’ordre PUT combiné ou non avec la variante contemporaine PUTLOG.
L’insertion stratégique d’instructions d’impression dans le journal à l’intérieur même du corps d’un bloc conditionnel permet de valider empiriquement si et quand la condition est franchie lors de l’exécution :
IF Anomalie_Detectee = 1 THEN DO;
PUTLOG ‘ATTENTION : Condition franchie pour l observation numéro ‘ _N_ ‘ Identifiant = ‘ Identifiant_Client;
actions-de-traitement;
END;
L’utilisation de la variable automatique du système _N_ (qui dénombre les itérations successives de l’étape DATA) couplée à la variable automatique _ERROR_ fournit une visibilité absolue sur l’état instantané du vecteur mémoire au moment précis du déclenchement du bloc. Enfin, pour les architectures critiques requérant un débogage pas à pas interactif avec inspection dynamique de la mémoire, les praticiens chevronnés peuvent solliciter le module DATA Step Debugger en ajoutant l’option /DEBUG à l’énoncé de l’instruction DATA, offrant ainsi un environnement d’exécution sous contrôle total avec points d’arrêt (breakpoints) et surveillance de variables (watchers).
11. Mécanique interne du vecteur de mémoire (PDV) et optimisation
11.1 Cycle de vie des variables au sein du Program Data Vector
Pour appréhender l’efficience intime des blocs conditionnels, il est impératif d’analyser la cinématique des micro-opérations qui se déroulent dans les registres physiques de la mémoire vive au gré de l’étape DATA. Le Program Data Vector (PDV) constitue l’interface tampon fondamentale dressée entre les sources de stockage physique persistant et la logique procédurale compilée. Lors de la phase de chargement initial, SAS dimensionne les blocs de mémoire du PDV pour accueillir rigoureusement toutes les variables déclarées ou inférées du code.
Le cycle de vie d’une observation s’articule selon une chorégraphie invariante :
- Initialisation des zones de mémoire : les variables internes calculées sont remises à leur valeur manquante primitive par défaut, tandis que les variables issues de tables persistantes via l’instruction SET conservent temporairement leur état résiduel jusqu’au chargement physique du flux ;
- Lecture de l’enregistrement externe : les données brutes sont aspirées et inscrites dans les emplacements correspondants du PDV ;
- Déroulement séquentiel des instructions procédurales : l’unité centrale exécute les calculs de haut en bas selon la topologie compilée du script ;
- Traversée des structures conditionnelles : dès qu’un prédicat IF est validé, les adresses des variables ciblées au sein du bloc DO-END sont sollicitées en écriture, écrasant les valeurs résiduelles antérieures du PDV avec les nouveaux scalaires calculés ;
- Vidage ou écriture : les données du PDV sont projetées vers la mémoire tampon de sortie si un ordre d’écriture (implicite ou explicite) est déclenché.
Cette chronologie souligne que l’ordre physique dans lequel les blocs IF-THEN-DO sont positionnés dans le fichier source conditionne directement l’état transactionnel des variables à chaque point d’étape. L’utilisation d’une variable au sein d’un calcul intervenant dans un sous-bloc situé plus bas dans le script exploitera impérativement la valeur mutée par le bloc conditionnel amont, illustrant la séquentialité absolue du processus de mutation dans le PDV.
11.2 Optimisation des performances computationnelles
À l’ère du traitement massif de données volumineuses (Big Data) portant sur des téraoctets d’archives transactionnelles ou des milliards d’enregistrements d’objets connectés, l’architecture des tests logiques conditionnels exerce un impact direct et massif sur les temps d’occupation processeur et la consommation énergétique des serveurs d’entreprise. L’optimisation algorithmique d’une chaîne de décision conditionnelle repose sur des principes fondamentaux d’évaluation probabiliste.
La règle d’or pour la conception de chaînes conditionnelles multiniveaux structurées en IF-THEN-DO … ELSE IF-THEN-DO consiste à ordonner systématiquement les conditions de test par ordre de probabilité décroissante d’occurrence empirique. Si une règle métier s’applique statistiquement à 80 % des observations d’un échantillon, tandis que deux autres règles alternatives ne concernent respectivement que 15 % et 5 % des individus, il est impératif d’implanter la condition couvrant les 80 % au tout début de la structure hiérarchique.
En procédant de la sorte, huit fois sur dix, le compilateur validera le tout premier prédicat rencontré, exécutera le bloc DO associé, et contournera instantanément l’intégralité des dizaines d’autres tests logiques subordonnés via le branchement direct vers la sortie de chaîne. À l’inverse, positionner une condition rare en tête de structure contraint le processeur à évaluer inutilement des expressions relationnelles coûteuses sur la quasi-totalité de la base de données avant d’atteindre le bloc légitime, dilapidant des milliards de cycles d’horloge machine de manière purement stérile.
11.3 Impact mémoire des instructions déclaratives dans le bloc
Une incompréhension fréquente chez les développeurs SAS concerne la distinction conceptuelle entre les instructions exécutables au moment du runtime et les instructions déclaratives interprétées exclusivement lors de la phase de compilation préliminaire. Cette confusion conduit régulièrement à des maladresses de conception, comme l’insertion inutile d’instructions de métadonnées à l’intérieur de blocs conditionnels IF-THEN-DO.
Des instructions telles que KEEP, DROP, RENAME, LABEL, FORMAT, INFORMAT ou LENGTH ne sont jamais soumises à la cinématique d’exécution séquentielle régie par le prédicat IF. Le compilateur les extrait de façon prioritaire lors de sa lecture syntaxique préliminaire du code pour configurer définitivement la structure statique du PDV et la structure du dictionnaire de métadonnées du fichier SAS final.
Placer par exemple une instruction DROP Variable_X; à l’intérieur d’un bloc conditionnel n’aura jamais pour effet d’éliminer la colonne uniquement pour les observations remplissant la condition. L’instruction déclarative s’appliquera universellement et aveuglément à la table tout entière, et la variable sera irrémédiablement absente de l’ensemble du jeu de données final pour toutes les observations sans exception. L’ingénieur doit donc rigoureusement bannir toute instruction de schéma déclaratif de l’intérieur des blocs DO-END, et regrouper méthodiquement l’intégralité de ces déclarations au sommet absolu de l’étape DATA afin de refléter fidèlement la réalité de la mécanique de compilation sous-jacente.
12. Bonnes pratiques de programmation et standards de documentation
12.1 Conventions de mise en page et indentation
La lisibilité visuelle d’un algorithme constitue le premier rempart contre les anomalies conceptuelles et la dette technique. Dans la mesure où le compilateur SAS ignore totalement les retours à la ligne, les tabulations et les espaces blancs surnuméraires (considérant uniquement le point-virgule comme frontière lexicale), l’analyste dispose d’une liberté totale de mise en page. Cependant, l’absence de discipline formelle débouche inexorablement sur un code compact, indéchiffrable et propice aux régressions lors des revues de code entre pairs.
Les standards de programmation industrielle préconisent l’adoption uniforme d’un modèle d’indentation strict et standardisé pour l’ensemble des structures conditionnelles :
- Alignement vertical des mots-clés d’amorce et d’extinction : le mot-clé END; fermant un bloc conditionnel doit impérativement être indenté sur la même colonne typographique que le mot-clé IF ou la clause ELSE DO qui lui a donné naissance ;
- Retrait systématique des instructions internes : l’ensemble des instructions exécutables contenues entre DO; et END; doit faire l’objet d’un décalage vers la droite d’au minimum deux à quatre espaces standardisés (l’usage des tabulations brutes étant proscrit en raison de leur variabilité de rendu selon les éditeurs de texte) ;
- Décalage proportionnel des niveaux d’imbrication : chaque sous-bloc conditionnel imbriqué dans une structure parente doit accroître son niveau de retrait d’un palier d’indentation supplémentaire, rendant immédiatement apparente la hiérarchie des dépendances logiques pour quiconque parcourt le script ;
- Consistance typographique : l’adoption d’une convention invariable quant à la casse des mots-clés du système SAS (conventionnellement en majuscules pour les commandes syntaxiques natives telles que IF, THEN, DO, END, ELSE) et des identifiants de variables (en notation CamelCase ou séparés par des traits de soulignement) confère au code une clarté immédiate.
12.2 Stratégies de documentation interne du code
L’intégration de blocs conditionnels étendus reflète systématiquement la transcription informatique de règles de gestion ou de choix méthodologiques statistiques cruciaux. Par conséquent, l’insertion rigoureuse de commentaires explicatifs au sein même du script constitue une composante indissociable de la documentation projet, particulièrement dans les contextes de recherche médicale ou de modélisation financière soumis aux audits des régulateurs de marché.
Le langage SAS supporte deux syntaxes de commentaires : les commentaires de bloc délimités par les séquences de caractères /* et */ (qui présentent l’avantage de pouvoir être insérés n’importe où, y compris au milieu d’une ligne d’instructions, et d’englober plusieurs paragraphes sans nécessiter de terminaison par point-virgule) et les commentaires d’instruction débutant par un astérisque (*) et s’achevant impérativement par un point-virgule (;).
La règle méthodologique fondamentale consiste à documenter non pas l’évidence technique (inutile de commenter qu’un bloc DO-END regroupe des assignations), mais bien la justification fonctionnelle sous-jacente. Il est impératif de consigner en amont direct de chaque macro-bloc décisionnel : la référence exacte de la clause du cahier des charges métier ou du protocole clinique d’essai validé, l’explication théorique guidant le choix des seuils numériques appliqués aux prédicats, ainsi que la date et l’auteur de la dernière modification structurelle apportée à l’arbre conditionnel.
12.3 Synthèse et guide de référence rapide
Pour parachever l’élaboration de scripts d’ingénierie statistique sans faille, il apparaît hautement bénéfique de soumettre chaque étape DATA conditionnelle à une liste de contrôle d’audit préalable (checklist) avant toute transmission en environnement de pré-production ou de production industrielle. Cette démarche préventive systématisée permet d’éradiquer la grande majorité des anomalies logiques et matérielles avant la phase de calcul intensif :
- Vérification formelle de la parité lexicale : le nombre d’instructions d’ouverture DO concorde-t-il rigoureusement avec le nombre d’instructions de clôture END au sein de l’étape DATA ?
- Dimensionnement préventif des chaînes : toutes les variables catégoriques de type caractère assignées au sein des différents embranchements ont-elles fait l’objet d’une déclaration explicite préalable via l’instruction LENGTH pour prévenir toute troncature silencieuse ?
- Neutralisation des valeurs manquantes : les conditions d’inégalité stricte ou large vérifient-elles l’absence préalable de données manquantes numériques via la fonction MISSING() ou des bornes d’exclusion explicites ?
- Normalisation de la casse textuelle : les prédicats portant sur des identifiants textuels mobilisent-ils des fonctions d’harmonisation de casse telles que UPCASE() ou LOWCASE() et d’épuration d’espaces via STRIP() ?
- Couverture exhaustive de l’espace d’états : la structure conditionnelle prend-elle en charge l’ensemble des éventualités au moyen d’une clause terminale ELSE DO agissant comme réceptacle de sécurité pour les valeurs inattendues ?
- Gestion explicite des flux de sortie : si l’instruction OUTPUT ou l’ordre DELETE est invoqué dans un bloc, le comportement sur le reste du flux d’enregistrements a-t-il été soigneusement anticipé et testé sur un échantillon réduit ?
L’exécution systématique de tests unitaires préliminaires sur des sous-échantillons d’enregistrements de contrôle, adossée à une inspection rigoureuse des lignes du journal d’exécution SAS, permet d’attester de la conformité intégrale des structures logiques développées, scellant ainsi l’alliance entre rigueur mathématique et excellence en génie logiciel.
Références
Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute.
Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute.
Horstman, D. W. (2017). Data Step vs. PROC SQL: What’s a Programmer to Do? SAS Global Forum Proceedings. SAS Institute. https://support.sas.com/resources/papers/proceedings17/0212-2017.pdf
SAS Institute. (2020). SAS(R) 9.4 Statements: Reference, Fifth Edition. SAS Documentation. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lestmtsref/titlepage.htm
SAS Institute. (2021). Base SAS Procedures Guide: Statistical Procedures. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/proc/titlepage.htm
Whitlock, I. (2007). Categorizing Data in the DATA Step: Techniques and Comparison. Lex Jansen SAS Papers Archive. https://www.lexjansen.com/pharmasug/2007/cc/CC08.pdf