
Dans le champ foisonnant de l’analyse empirique contemporaine, la pureté métrologique d’un ensemble de données constitue la condition sine qua non de toute inférence scientifique valide. Que l’on évolue au sein des sciences psychologiques, de la neurobiologie computationnelle, de la sociométrie quantitative ou de l’économétrie appliquée, le chercheur ou l’analyste de données se heurte inéluctablement à l’irruption de mesures hétérodoxes qui dévient radicalement du patron distributionnel attendu. Ces singularités statistiques, communément désignées sous le vocable de « valeurs aberrantes » ou d’outliers, incarnent simultanément une menace pour la robustesse des modèles mathématiques et une opportunité heuristique d’élucidation des phénomènes sous-jacents.
L’avènement des suites logicielles infonuagiques, et plus particulièrement de Google Sheets, a démocratisé de manière spectaculaire le traitement interactif et collaboratif des séries de données massives. Néanmoins, la simplicité d’accès apparente de cet environnement tabulaire ne doit en aucun cas occulter l’exigence méthodologique requise lors de la phase de prétraitement et de diagnostic anomalique. L’identification rigoureuse d’une déviance quantitative ne relève pas d’une intuition impressionniste ; elle s’ancre dans des théorèmes formels et des algorithmes de statistique robuste éprouvés, dont l’implémentation requiert une maîtrise approfondie des fonctions matricielles et logiques offertes par la plateforme en nuage.
Le présent traité méthodologique se propose de guider le praticien et le chercheur à travers les méandres théoriques, mathématiques et techniques de la détection des valeurs aberrantes au sein de Google Sheets. De l’élucidation épistémologique du concept d’aberration statistique jusqu’à la mise en place de flux d’automatisation scriptés sous Google Apps Script, chaque jalon analytique sera méthodiquement exploré. En conjuguant les fondements de la statistique exploratoire de John Tukey, l’analyse paramétrique standardisée et les techniques visuelles de criblage dynamique, ce guide fournit l’ensemble des clés opérationnelles pour préserver la validité de vos conclusions empiriques sans jamais corrompre l’intégrité de votre recueil expérimental.
1. Fondements conceptuels des valeurs aberrantes en psychologie et en science des données
1.1 Définition épistémologique et mathématique de l’aberration statistique
Sur le plan épistémologique, une valeur aberrante se définit comme une observation singulière qui s’écarte de manière si substantielle des autres éléments de la série qu’elle suscite un soupçon légitime quant au mécanisme générateur sous-jacent. Dans l’architecture formelle des probabilités, une observation est qualifiée de déviante lorsqu’elle occupe les régions de densité asymptotiquement quasi nulles au sein de la fonction de répartition postulée. Cette caractérisation géométrique repose traditionnellement sur le calcul d’une distance métrique, qu’il s’agisse de la simple distance euclidienne unidimensionnelle par rapport à l’espérance mathématique ou, dans des espaces multidimensionnels plus complexes, de la distance de Mahalanobis qui tient compte des covariances structurelles.
L’évaluation de la déviance dépend intrinsèquement des mesures de tendance centrale adoptées par l’investigateur. Lorsque l’on recourt à la moyenne arithmétique comme point d’ancrage, celle-ci subit une attraction proportionnelle à l’amplitude de l’écart, créant un phénomène de circularité vicieuse où le paramètre de référence se trouve lui-même contaminé par l’entité qu’il est censé évaluer. À l’inverse, l’ancrage sur des estimateurs de position non paramétriques, tels que la médiane ou les quantiles tronqués, offre une invariance relative face aux perturbations exogènes, conférant à la définition de l’aberration une assise formelle beaucoup plus stable et reproductible.
D’un point de vue téléologique, il est crucial d’établir une ligne de démarcation nette entre une valeur extrême appartenant légitimement à la queue d’une loi de probabilité à queue lourde (telle qu’une distribution de Cauchy, de Pareto ou de Weibull) et une aberration née d’un artefact méthodologique. L’extrême probabiliste traduit la réalité d’un état rare mais plausible du système modélisé, tandis que l’erreur d’échantillonnage constitue une scorie informationnelle résultant de la captation d’un individu n’appartenant pas à la population cible. Les origines de cette préoccupation méthodologique remontent aux travaux précurseurs d’astronomes et de géodésiens du dix-neuvième siècle, à l’instar de Daniel Bernoulli, Benjamin Peirce ou Francis Edgeworth, qui s’interrogeaient déjà sur la légitimité d’écarter unilatéralement des observations télescopiques divergentes afin de stabiliser le calcul des trajectoires célestes.
1.2 Typologie des valeurs aberrantes en recherche comportementale
Dans le domaine des sciences comportementales et de la psychologie cognitive ou différentielle, les sources génératrices d’aberrations sont éminemment variées et nécessitent une taxonomie rigoureuse. La première catégorie, la plus banale mais également la plus fréquente, regroupe les erreurs instrumentales et mécaniques. Il s’agit typiquement de coquilles typographiques survenues lors de la saisie manuelle au clavier (par exemple, la transcription d’un temps de réaction sous la forme de 4500 millisecondes au lieu de 450 millisecondes), d’une défaillance logicielle du chronomètre de présentation des stimuli, ou encore d’une corruption de l’encodage des caractères au sein du formulaire d’acquisition en ligne.
La deuxième catégorie englobe la variabilité biologique et cognitive intrinsèque. Dans tout paradigme psychométrique, l’hétérogénéité des cohortes humaines génère des profils idiosyncrasiques : un participant doté d’un potentiel intellectuel exceptionnel, ou à l’opposé un individu présentant des troubles spécifiques de l’attention ou de l’appareil perceptif, fournira des réponses dont la métrique s’éloignera de la normalité sans qu’aucune défaillance technique ne soit en cause. L’exclusion aveugle de telles données risque alors d’appauvrir drastiquement la portée écologique de l’investigation en oblitérant la neurodiversité constitutive de la population générale.
Enfin, la troisième catégorie découle de biais motivationnels et stratégiques chez les répondants. Dans les protocoles fondés sur des questionnaires auto-rapportés ou des plateformes de crowdsourcing en ligne, certains sujets adoptent une posture de non-coopération caractérisée par le remplissage aléatoire accéléré (speeding), la sélection systématique d’une même modalité de réponse (straightlining), ou des tentatives délibérées de manipulation expérimentale. Ces comportements parasitaires injectent un bruit statistique massif qui altère gravement tant la validité interne du dispositif — en induisant des corrélations illusoires ou en masquant les véritables liens de causalité — que sa validité externe, interdisant toute généralisation légitime des inférences théoriques tirées de l’échantillon.
1.3 Conséquences statistiques sur la distribution et les tests paramétriques
L’intrusion d’observations aberrantes au sein d’un échantillon empirique exerce une influence délétère sur la géométrie de la distribution des données. Le premier moment centré (la moyenne) et le deuxième moment centré (la variance, et par extension son extrapolation quadratique, l’écart-type) se caractérisent par un point de rupture (breakdown point) égal à zéro. Cela implique mathématiquement qu’une seule observation infinitésimale ou infiniment grande suffit à faire basculer la moyenne ou à gonfler artificiellement la variance vers des grandeurs arbitraires, ruinant ainsi toute représentativité des paramètres calculés.
Sur le plan inférentiel, ces perturbations ont pour corollaire une inflation incontrôlée des risques d’erreur de première espèce (alpha) et de deuxième espèce (bêta). Dans le cadre d’un test paramétrique standard tel que le test t de Student pour échantillons indépendants ou l’analyse de variance univariée (ANOVA), la présence d’une valeur aberrante dans un groupe expérimental va démesurément accroître la somme des carrés résiduels au dénominateur du ratio de Fisher. En conséquence, la statistique F se trouve artificiellement diminuée, ce qui réduit la puissance statistique et conduit fréquemment à l’acceptation erronée de l’hypothèse nulle (erreur de type II), dissimulant un effet expérimental pourtant réel.
De surcroît, les hypothèses fondamentales sous-tendant la théorie linéaire générale — à savoir la normalité multivariée des erreurs résiduelles et l’homoscédasticité (l’homogénéité de la variance à travers les différentes conditions de traitement) — se trouvent formellement violées. Dès lors que les résidus exhibent une asymétrie marquée (skewness) ou un aplatissement excessif (kurtosis), les valeurs p associées aux tests de significativité cessent d’être exactes et deviennent totalement fallacieuses. Ce constat impose au chercheur une démarche méthodique d’assainissement préalable, garantissant que les propriétés structurales des séries collectées répondent sans ambiguïté aux réquisits formels des estimateurs mathématiques mobilisés.
2. La règle de l’écart interquartile (IQR) selon la statistique robuste
2.1 Principes fondamentaux du premier et troisième quartiles
Face à la fragilité structurelle des estimateurs gaussiens traditionnels, la statistique robuste propose de s’affranchir de la dépendance à la moyenne en s’appuyant sur des statistiques d’ordre. Le concept cardinal repose sur la fragmentation ordonnée de la distribution empirique. Lorsque l’ensemble des observations d’un échantillon de taille n est préalablement trié par ordre croissant de magnitude, il devient possible de découper la série en quantiles réguliers insensibles à la position relative des bornes extrêmes.
Le premier quartile, universellement noté Q1, correspond au vingt-cinquième percentile de la population échantillonnée. Il constitue la valeur en deçà de laquelle se situe exactement un quart (25 %) des données observées, tandis que les trois quarts restants (75 %) lui sont supérieurs. À l’autre extrémité de la structure médiane, le troisième quartile, désigné par Q3, incarne le soixante-quinzième percentile, délimitant le seuil sous lequel sont contenues 75 % des observations et au-delà duquel ne subsiste que le quart supérieur le plus élevé de la distribution.
Ces deux métriques fondamentales découpent la masse distributionnelle en quatre segments équiprobables. Contrairement à la moyenne qui réagit violemment à tout glissement marginal d’un score vers l’infini, Q1 et Q3 possèdent un point de rupture de 0,25. Cela signifie qu’il faudrait falsifier ou déplacer arbitrairement au moins un quart de l’échantillon complet avant que la valeur absolue de ces quantiles ne perde son ancrage représentatif au cœur du corpus étudié, assurant ainsi une résistance remarquable face aux perturbations extrêmes.
2.2 Définition et propriétés de l’intervalle interquartile
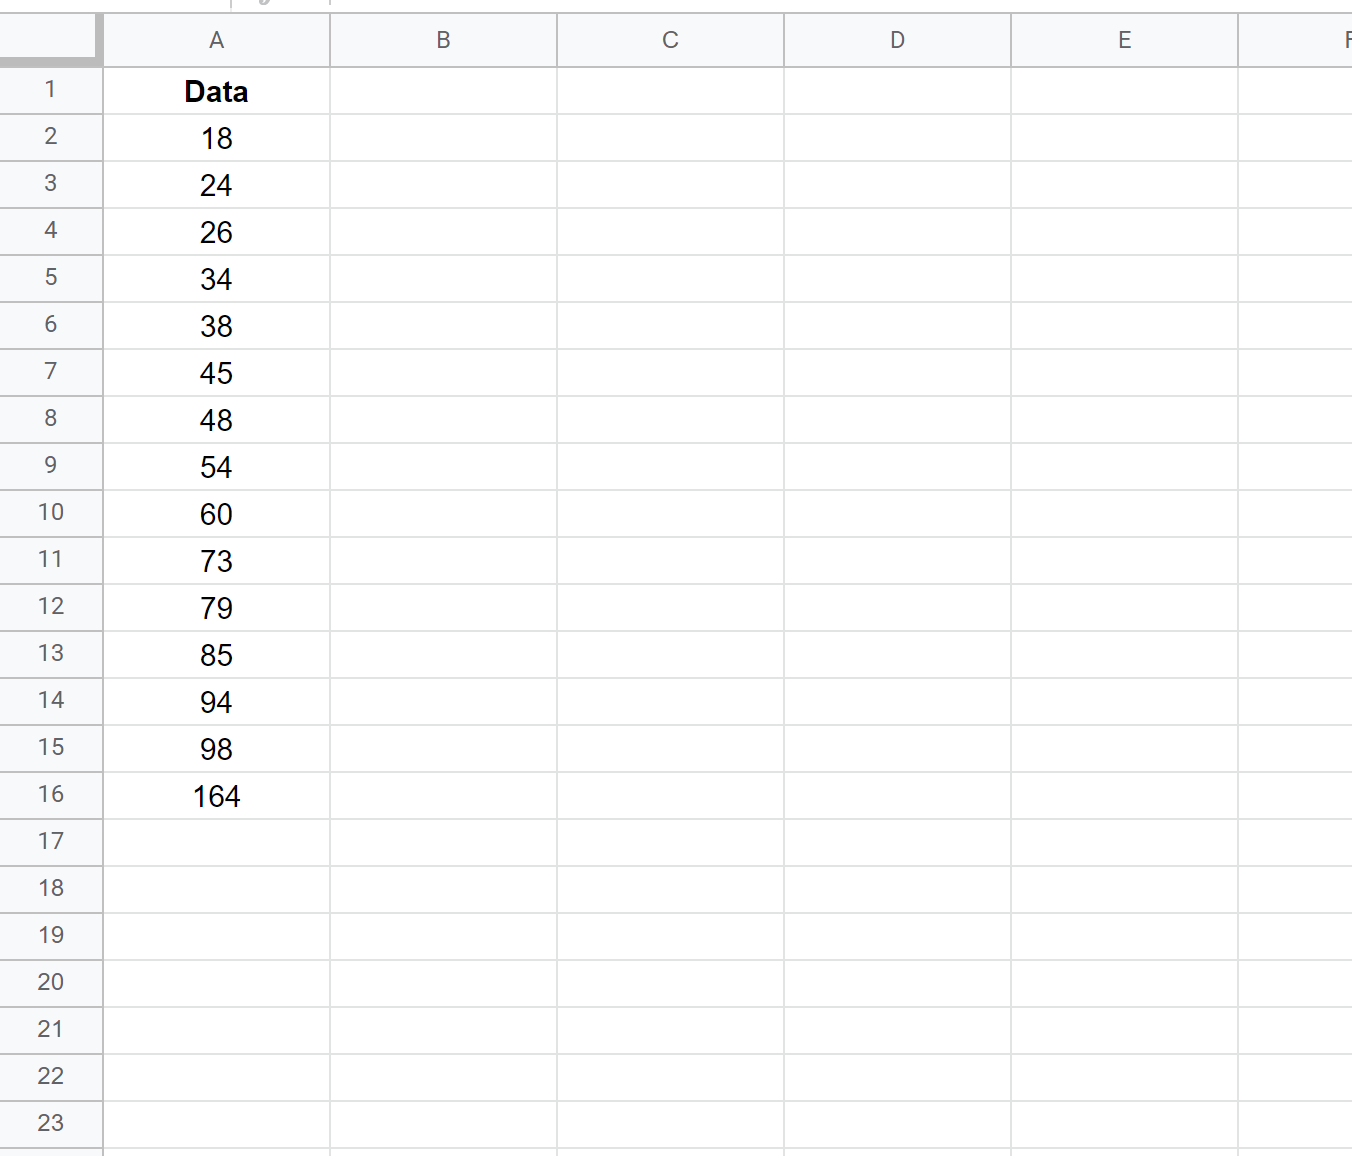
L’écart interquartile, désigné internationalement par l’acronyme IQR (pour Interquartile Range), se définit algébriquement comme la différence scalaire stricte séparant le troisième quartile du premier quartile, soit :
IQR = Q3 – Q1
Cette grandeur unidimensionnelle matérialise l’étendue de l’intervalle au sein duquel se concentrent exactement les 50 % centraux de l’échantillon analysé. Par sa conception même, l’IQR ignore totalement la dispersion des deux tranches marginales de 25 % situées aux antipodes de la médiane, éradiquant dès lors l’impact délétère que pourraient exercer des artéfacts d’échantillonnage disséminés dans les queues de distribution.
Sur le plan comparatif, l’IQR surpasse incontestablement l’étendue simple (différence brute entre le maximum et le minimum), laquelle constitue la mesure de dispersion la plus versatile et la moins robuste qui soit, assujettie au moindre score divergent. L’écart interquartile manifeste en outre une stabilité mathématique remarquable lors de l’étude de distributions asymétriques (telles que les temps de réaction modélisés par des distributions Ex-Gaussiennes ou de Wald) ou de distributions tronquées par des effets de plancher ou de plafond. Il restitue une métrique fidèle de la dispersion intrinsèque du phénomène sans requérir l’hypothèse restrictive d’une symétrie parfaite autour du barycentre statistique.
2.3 Justification théorique du coefficient multiplicateur de Tukey
Dans son ouvrage fondateur consacré à l’analyse exploratoire des données, le statisticien américain John Wilder Tukey a formalisé un critère algorithmique d’une remarquable élégance pour baliser les frontières de l’acceptabilité statistique sans présumer de la normalité stricte de la population d’origine. Tukey a postulé qu’une observation pouvait être qualifiée de déviante ou suspecte si elle s’éloignait du bloc central des quartiles d’une distance supérieure à 1,5 fois la valeur de l’écart interquartile.
Ce coefficient multiplicateur k = 1,5 n’est pas issu d’un pur arbitraire empirique. Dans l’hypothèse d’une loi normale centrée et réduite théorique, la distance séparant la médiane (0) de Q1 ou Q3 est d’approximativement 0,6745 écart-type (σ), ce qui confère à l’IQR une valeur théorique équivalente à 1,349 σ. En retranchant 1,5 fois l’IQR à Q1 et en l’ajoutant à Q3, on obtient des clôtures mathématiques situées précisément à :
± (0,6745 + 1,5 × 1,349) σ ≈ ± 2,698 σ
Sous l’empire d’une distribution gaussienne parfaite, l’intervale [Q1 – 1,5×IQR ; Q3 + 1,5×IQR] englobe approximativement 99,3 % de la population globale. Dès lors, la probabilité théorique d’observer par pur hasard une valeur en dehors de ces clôtures est restreinte à seulement 0,007 (soit 0,7 % de l’échantillon). Tukey a également formalisé la distinction cruciale entre les « valeurs aberrantes mineures » (outside values, basées sur un facteur k = 1,5) et les « valeurs aberrantes extrêmes » (far out values), qui adoptent un coefficient conservateur de k = 3,0, correspondant à un écart équivalent à plus de 4,7 σ, où la probabilité stochastique d’occurrence aléatoire chute à moins de 0,000002. Les clôtures inférieure et supérieure s’établissent ainsi formellement :
- Clôture inférieure (Lower Fence) : Q1 – (1,5 × IQR)
- Clôture supérieure (Upper Fence) : Q3 + (1,5 × IQR)
3. Structuration et préparation des données expérimentales dans Google Sheets
3.1 Organisation tabulaire rigoureuse de la feuille de calcul
L’application rigoureuse d’algorithmes de détection sous Google Sheets présuppose une architecture de données conforme aux préceptes du tidy data popularisés par la communauté des sciences de l’information. Dans ce paradigme, une feuille de calcul dédiée à l’analyse ne doit jamais être assimilée à un support de mise en page visuelle. Chaque ligne physique doit représenter de manière stricte et invariable une unité d’observation unique (par exemple, une passation expérimentale ou un participant singulier), tandis que chaque colonne verticale est assignée à une variable empirique spécifique mesurée selon univoque métrique.
La première colonne du classeur gagne toujours à être réservée à l’attribution d’un identifiant numérique ou alphanumérique unique et parfaitement anonymisé pour chaque sujet (ex. : SUBJ_001, SUBJ_002). Cette précaution garantit la traçabilité intégrale des enregistrements lors des manipulations de tri ou d’isolation ultérieures. De surcroît, la première ligne du tableau doit impérativement être réservée aux en-têtes de colonnes, dont la nomenclature se voudra explicite, sans espaces complexes ni caractères diacritiques problématiques pour les scripts futurs.
Une règle d’or consiste à préserver une frontière étanche entre le bloc de données sources brutes et les zones de diagnostic analytique. Il est formellement déconseillé d’insérer des cellules de synthèse ou des totaux statistiques à l’intérieur même du vecteur de variables. Les descripteurs globaux et les seuils de coupure doivent être externalisés, soit au sein d’un panneau de contrôle latéral dédié, soit idéalement sur un onglet secondaire explicitement nommé, évitant ainsi toute pollution des plages d’analyse par des valeurs agrégées qui fausseraient dramatiquement le calcul des quantiles.
3.2 Contrôle typologique et assainissement préliminaire
Google Sheets procède à une analyse heuristique automatique du type de contenu lors de la saisie ou de l’importation de fichiers CSV. Toutefois, ce mécanisme implicite est fréquemment source d’aberrations purement computationnelles. Il advient couramment que des valeurs perçues comme numériques par le chercheur soient interprétées comme des chaînes de caractères (strings) par le moteur d’exécution en raison de la présence d’une espace insécable résiduelle, d’une apostrophe introductive ou de l’utilisation erronée d’un séparateur décimal non conforme à la locale du classeur. Dans ce contexte, toute fonction quantitative telle que QUARTILE ignorera purement et simplement ces cellules textuelles, faussant la taille d’échantillon nominale.
L’assainissement préalable requiert donc une phase de standardisation typologique. Le recours aux fonctions natives de nettoyage s’avère ici incontournable. L’analyste peut déployer la fonction SUPPRESPACE (ou TRIM en syntaxe anglo-saxonne) pour éliminer les espaces parasites de tête ou de queue, combinée le cas échéant à EPURAGE (CLEAN) afin de débarrasser les chaînes des caractères ASCII non imprimables issus des transferts web. Pour forcer la coercition d’une plage en données numériques sans modifier la nature intrinsèque des réels, l’application de la fonction CNUM (VALUE) garantit la réévaluation syntaxique immédiate.
Enfin, la gestion des valeurs manquantes doit être verrouillée avant toute opération. Il convient d’éviter scrupuleusement de laisser des cellules vides non étiquetées qui pourraient, dans certaines formules arithmétiques, être assimilées par inadvertance à la valeur zéro. L’emploi d’un codage explicite et réservé (par exemple la convention #N/A ou l’utilisation d’une étiquette textuelle unifiée comme NULL) permet d’isoler délibérément les non-réponses au moyen des clauses conditionnelles de test, écartant de facto toute interférence avec le calcul robuste de l’IQR.
3.3 Gestion de l’intégrité référentielle du classeur
Dans un contexte expérimental collaboratif ou d’examen approfondi, l’altération involontaire de la feuille source représente un risque épistémique majeur. Afin d’immuniser l’environnement de calcul contre les erreurs d’inattention, Google Sheets intègre des mécanismes robustes de verrouillage granulaire. Dès la finalisation de l’importation des données brutes, il est impératif de mobiliser la commande de « Protection des feuilles et des plages » accessible via le menu Données, permettant de restreindre les droits d’écriture aux seuls superviseurs du protocole de recherche.
Une bonne pratique de laboratoire consiste à dupliquer systématiquement la matrice originale pour travailler exclusivement sur une feuille miroir ou dérivée. Dans cette perspective, la fonction IMPORTRANGE ou la simple liaison dynamique vectorielle (par exemple en utilisant la syntaxe ={FeuilleBrute!A:Z}) assure une synchronisation en lecture seule avec le socle expérimental immuable, garantissant que les protocoles de détection et de marquage n’écraseront jamais la source empirique native.
Par ailleurs, la rigueur métrologique impose la création d’un onglet spécifiquement assigné au journal d’audit (audit trail). Cet espace documente de manière transparente chaque phase de préparation : date de téléchargement, nombre de cas bruts recensés, anomalies typographiques corrigées et justification méthodologique des filtres préalables. Il est enfin critique de vérifier les paramètres régionaux du classeur (accessibles dans Fichier > Paramètres) afin d’assurer que la virgule ou le point décimal utilisé par le protocole expérimental s’accorde rigoureusement avec la configuration linguistique de l’instance Google Sheets.
4. Calcul de l’écart interquartile avec les fonctions natives de Google Sheets
4.1 Utilisation différentielle de QUARTILE, QUARTILE.INC et QUARTILE.EXC
Le moteur d’évaluation numérique de Google Sheets propose trois implémentations distinctes pour calculer les quartiles d’une série statistique, et le choix entre ces fonctions exerce une influence technique subtile mais réelle sur les seuils d’exclusion obtenus. La fonction historique et générique QUARTILE(plage; quartile) calcule le quartile spécifié (de 0 pour le minimum à 4 pour le maximum). Sur le plan algorithmique, cette fonction historique constitue un équivalent direct et un calque de compatibilité avec la formule QUARTILE.INC(plage; quartile).
La fonction QUARTILE.INC repose sur le principe de l’inclusion des percentiles (inclusive percentile method). Dans cette approche mathématique, les percentiles 0 et 100 coïncident strictement avec les valeurs minimale et maximale de l’échantillon. L’algorithme opère une interpolation linéaire continue entre les rangs k = p × (n – 1) + 1, où p est la fraction percentile visée et n la cardinalité du groupe. Cette méthode est celle traditionnellement adoptée par la majorité des tableurs grand public et s’avère particulièrement résiliente pour les échantillons de taille modeste ou lorsque l’ensemble des valeurs possibles est borné par construction.
À l’opposé, la fonction QUARTILE.EXC(plage; quartile) met en œuvre la méthode exclusive (exclusive percentile method), très prisée dans certains départements de recherche académique et au sein de logiciels de statistique avancée. Ici, le percentile 0 et le percentile 100 sont formellement exclus du domaine de définition observable ; les rangs sont calculés selon l’interpolation k = p × (n + 1). Par conséquent, cette fonction exige au minimum une taille d’échantillon n > 3 pour calculer Q1 et Q3. Sur les petits volumes de données, QUARTILE.EXC génère des écarts interquartiles mécaniquement plus larges que QUARTILE.INC, déplaçant légèrement les clôtures de Tukey vers l’extérieur. Le tableau ci-dessous explicite ces divergences opérationnelles :
- =QUARTILE.INC(A2:A100; 1) : Calcule Q1 inclusif (25e percentile). Compatible avec tous les historiques de calculs standards.
- =QUARTILE.INC(A2:A100; 3) : Calcule Q3 inclusif (75e percentile). Base recommandée pour la règle classique de Tukey.
- =QUARTILE.EXC(A2:A100; 1) : Calcule Q1 exclusif. Recommandé pour l’inférence formelle sur variables continues non tronquées.
- =QUARTILE.EXC(A2:A100; 3) : Calcule Q3 exclusif. Réduit légèrement le taux de faux positifs sur petits échantillons.
4.2 Calcul algorithmique de l’intervalle interquartile (IQR)
L’implémentation opérationnelle de l’IQR dans Google Sheets requiert une formulation dépourvue de toute ambiguïté syntaxique. La méthode la plus pédagogique et la plus facile à auditer consiste à décomposer les étapes du calcul au sein de cellules dédiées de la feuille de diagnostic. Si la série expérimentale étudiée (par exemple des temps de réponse mesurés en millisecondes) est logée dans la plage continue B2:B150, le chercheur instanciera :
En cellule E2 (Premier quartile Q1) : =QUARTILE.INC(B$2:B$150; 1)
En cellule E3 (Troisième quartile Q3) : =QUARTILE.INC(B$2:B$150; 3)
En cellule E4 (Écart interquartile) : =E3 – E2
Pour les environnements de production ou les feuilles de traitement automatisé où la concision structurelle est privilégiée, il est tout à fait loisible de condenser l’ensemble du calcul en une formule unifiée et autonome. La cellule hébergeant l’IQR condensé recevra alors la syntaxe directe :
=QUARTILE.INC(B2:B150; 3) – QUARTILE.INC(B2:B150; 1)
Il est impératif de procéder à un contrôle d’intégrité sur la cellule résultante. L’IQR étant par définition une différence scalaire ordonnée (Q3 étant nécessairement supérieur ou égal à Q1 dans une série triée ou non), le résultat doit obligatoirement être un nombre réel positif ou strictement nul. Un résultat négatif dénoterait une inversion d’arguments dans la formule. Dans l’éventualité où l’IQR ressort à zéro (ce qui survient lorsque plus de 50 % des observations d’un échantillon présentent une valeur parfaitement identique), la règle standard de Tukey ne peut plus être appliquée telle quelle, car elle écraserait toutes les bornes sur la valeur de la médiane, qualifiant à tort toute nuance de déviance aberrante.
4.3 Automatisation du calcul pour des séries volumineuses
Dans les contextes réels d’acquisition de données expérimentales — telles que les études longitudinales ou les protocoles de tests psychologiques continus —, la taille de l’échantillon s’accroît de façon dynamique à mesure que de nouveaux sujets complètent l’évaluation. L’utilisation de plages rigides fermées (comme B2:B150) oblige à une réécriture manuelle constante des formules, source inévitable d’omissions. Pour pallier cette contrainte, Google Sheets autorise la désignation de plages ouvertes illimitées.
En configurant la plage sous la forme B2:B, l’algorithme parcourt l’intégralité de la colonne à partir de la ligne 2 jusqu’à la frontière terminale de la grille. Les fonctions QUARTILE.INC et QUARTILE.EXC ignorent par défaut les cellules vides situées dans la plage ouverte, calculant dynamiquement les quantiles exacts sur le volume d’entrées réelles :
=QUARTILE.INC(B2:B; 3) – QUARTILE.INC(B2:B; 1)
Pour les architectures analytiques complexes distribuant les mesures sur plusieurs dizaines d’onglets expérimentaux, le recours conjoint à la fonction INDIRECT offre une flexibilité décuplée. En stockant le nom de l’onglet cible dans une cellule paramétrique (par exemple en D1 le texte Session_Printemps), la formule de calcul de l’IQR s’articule comme suit :
=QUARTILE.INC(INDIRECT(« ‘ » & D1 & « ‘!B2:B »); 3) – QUARTILE.INC(INDIRECT(« ‘ » & D1 & « ‘!B2:B »); 1)
Il conviendra toutefois de surveiller l’empreinte computationnelle de telles fonctions volatiles lors du passage à des séries volumineuses excédant plusieurs dizaines de milliers de lignes. Google Sheets recalculant les fonctions volatiles à chaque modification de la grille, la centralisation des calculs d’IQR au sein d’une table de synthèse dédiée garantira la fluidité d’exécution et préviendra les latences indésirables du navigateur.
5. Mise en œuvre de la formule logique d’étiquetage des valeurs aberrantes
5.1 Établissement des bornes critiques inférieure et supérieure
Une fois les grandeurs fondamentales Q1, Q3 et IQR calculées et stockées dans l’espace de diagnostic, l’étape consécutive consiste à matérialiser les bornes critiques d’acceptabilité statistique définies par la règle de Tukey. Ces bornes définissent l’enveloppe à l’intérieur de laquelle une mesure comportementale ou cognitive est déclarée conforme à la variabilité normale attendue de la cohorte.
Supposons que nos descripteurs occupent les cellules E2 (Q1), E3 (Q3) et E4 (IQR). La formalisation des clôtures s’exécute à travers deux équations arithmétiques limpides :
Pour la clôture inférieure (Lower Threshold) en cellule E5 : =E2 – (1,5 * E4)
Pour la clôture supérieure (Upper Threshold) en cellule E6 : =E3 + (1,5 * E4)
D’un point de vue clinique ou diagnostique, toute observation individuelle dont la magnitude numérique s’avère strictement inférieure à la valeur calculée en E5 sera qualifiée d’aberration par le bas (ex. : temps de réponse irréaliste de 80 millisecondes trahissant une anticipation motrice avant l’affichage du stimulus). Réciproquement, tout score strictement supérieur à la valeur de E6 constituera une aberration par le haut (ex. : temps d’action de 15 000 millisecondes trahissant une distraction totale du sujet ou une interruption externe). L’espace continu délimité par [E5 ; E6] circonscrit la zone de validité expérimentale nominale.
5.2 Implémentation de l’instruction conditionnelle SI imbriquée
Pour conférer au tableur une fonction d’arbitrage automatisé, on déploie au sein d’une colonne adjacente à la variable brute une structure logique conditionnelle. Celle-ci va comparer unitairement chaque observation aux bornes critiques fixées et lui attribuer un statut diagnostique explicite.
La formulation conventionnelle repose sur l’imbrication de la fonction SI (IF). Si la première observation brute se situe en cellule B2, et que nos bornes sont ancrées en E5 et E6, la formule s’écrit :
=SI(B2<$E$5; « Aberrant Bas »; SI(B2>$E$6; « Aberrant Haut »; « Conforme »))
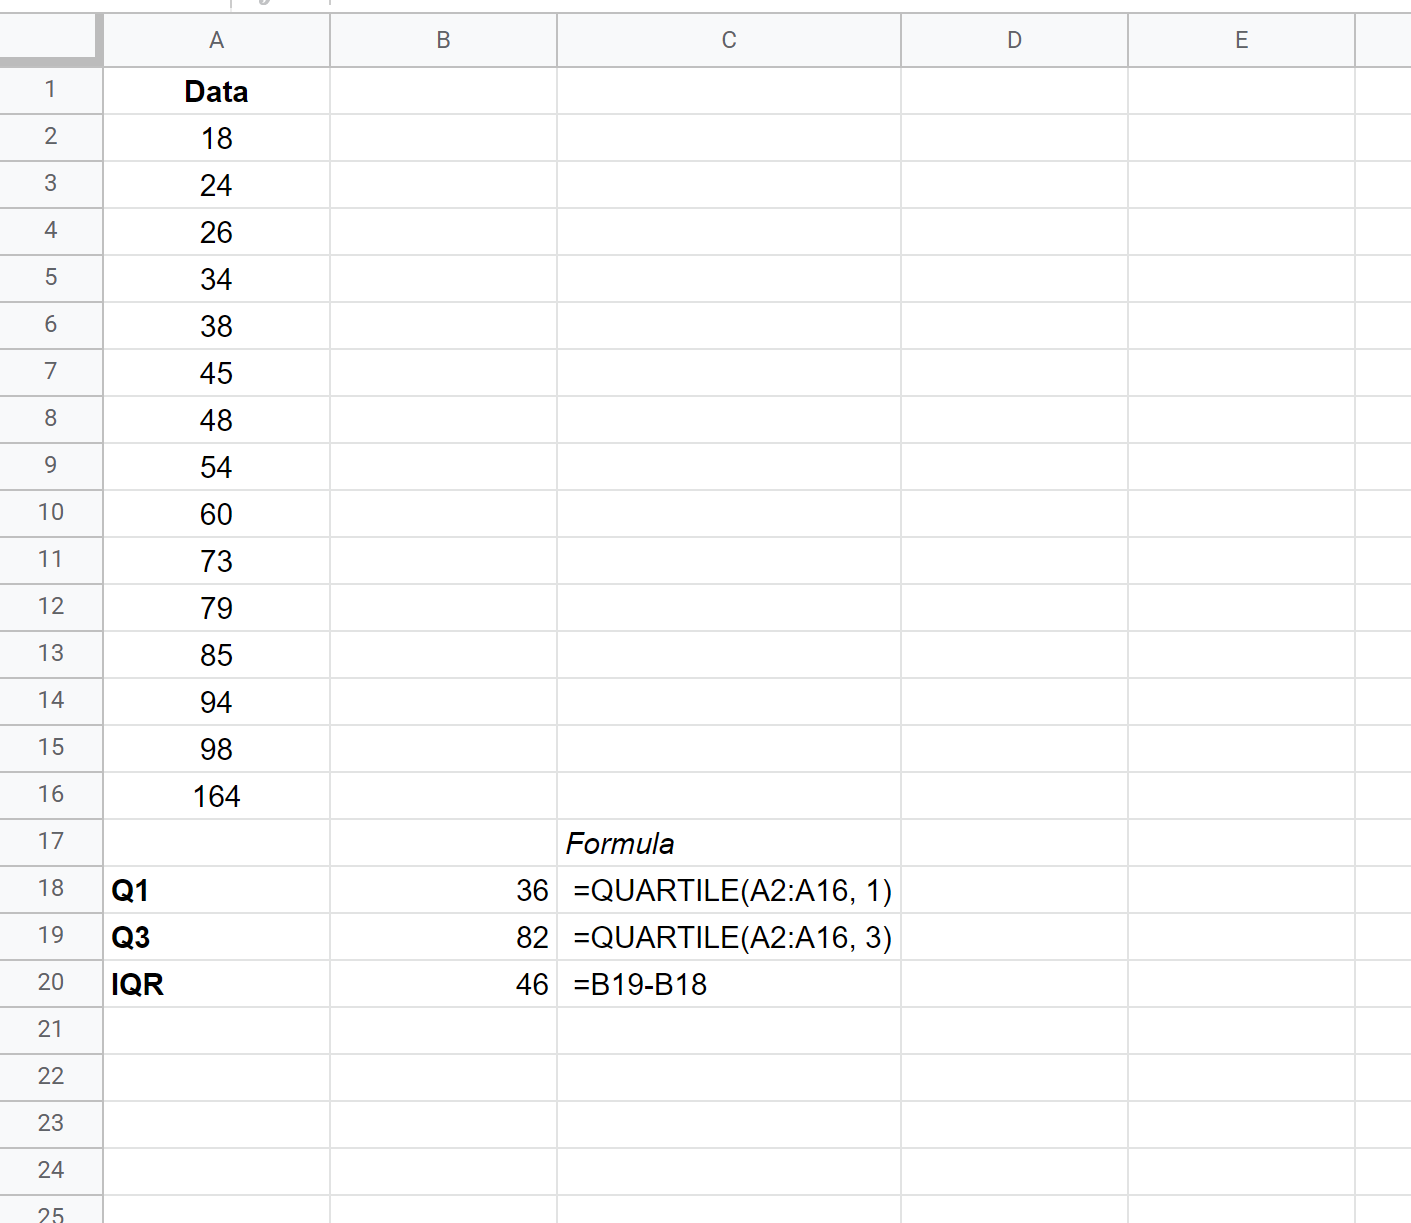
Dans une perspective de traitement algorithmique ultérieur ou de modélisation économétrique, un renvoi sous forme d’indicateur booléen binaire (0 ou 1) est souvent préférable aux étiquettes textuelles. La codification binaire facilite en effet les opérations de sommation directe pour dénombrer instantanément le volume total d’anomalies recensées. La formulation peut alors être allégée et optimisée en recourant à la fonction disjonctive OU (OR) :
=SI(OU(B2<$E$5; B2>$E$6); 1; 0)
Dans ce schéma opérationnel, la formule renvoie immédiatement la valeur numérique 1 dès lors que la valeur de la cellule B2 franchit l’une des clôtures de Tukey, et renvoie la valeur 0 si l’observation se loge sereinement dans l’intervalle d’acceptabilité. Cette standardisation binaire offre une base idéale pour calculer le taux de contamination de l’échantillon par une simple moyenne arithmétique sur la colonne d’étiquetage.
5.3 Maîtrise du référencement absolu par le symbole dollar
L’une des sources d’erreurs les plus pernicieuses et les plus récurrentes lors de l’implémentation de formules sous tableur réside dans la mauvaise manipulation du mode d’adressage des cellules. Par défaut, Google Sheets applique un référencement relatif : lorsqu’une formule écrite en C2 est copiée et étirée verticalement vers C3, C4, puis C100, les coordonnées matricielles des opérandes glissent d’autant de lignes vers le bas.
Si ce comportement dynamique est précisément recherché pour la cellule contenant la donnée individuelle (qui doit passer de B2 à B3 puis B4), il s’avère catastrophique s’il s’applique aux cellules hébergeant les clôtures critiques calculées (E5 et E6). Sans précaution, la condition logique évaluerait B3 par rapport à E6 et E7, puis B4 par rapport à E7 et E8, comparant ainsi les données à des cellules vides ou incohérentes.
Il est donc rigoureusement indispensable de verrouiller l’ancrage des cellules de référence en mobilisant le signe typographique dollar $ devant l’identifiant de la colonne et le numéro de la ligne, transformant l’adresse en référence absolue : $E$5 et $E$6. L’analyste s’assure ainsi d’une invariance totale des seuils de comparaison sur toute la profondeur de la cohorte analysée. Un contrôle visuel pas à pas via la barre de formule ou l’activation de l’affichage des dépendances garantit l’imperméabilité du système face à toute dérive de recopie.
6. Vectorisation du calcul à l’aide de la fonction ARRAYFORMULA
6.1 Principes du traitement matriciel dans les tableurs infonuagiques
Dans l’ingénierie logicielle appliquée aux classeurs contemporains, l’étirement mécanique manuel d’une formule sur des milliers de lignes appartient à une pratique obsolète, vulnérable et consommatrice de mémoire. Lorsqu’une formule est répliquée individuellement sur dix mille rangées, le moteur de calcul du navigateur web doit allouer des structures d’arbres de dépendance pour chaque cellule distincte, ce qui provoque une dégradation notable de la réactivité de l’interface utilisateur.
Pour transcender ces limitations structurelles, Google Sheets propose une fonctionnalité native de très haute volée : la fonction matricielle ARRAYFORMULA. Ce constructeur vectoriel permet d’appliquer un opérateur mathématique ou logique unifié sur l’ensemble d’une plage de données en une seule instruction d’évaluation. Une unique formule instanciée en tête de colonne prend en charge le traitement de toute la profondeur tabulaire, propageant instantanément les résultats vers le bas sans qu’aucune formule ne soit inscrite physiquement dans les cellules subordonnées.
Outre un gain substantiel en matière d’efficacité computationnelle, la vectorisation garantit l’inviolabilité du processus d’analyse : il devient rigoureusement impossible pour un collaborateur de rompre la chaîne de calcul en supprimant par inadvertance une ligne au milieu de la feuille. En outre, lors de l’adjonction de nouvelles lignes d’observations à la base expérimentale, celles-ci sont prises en compte de manière totalement automatique sans nécessiter la moindre intervention de maintenance technique.
6.2 Adaptation des conditions logiques pour le mode matriciel
L’exploitation de ARRAYFORMULA impose une adaptation syntaxique majeure relative aux opérations booléennes. Au sein du moteur d’exécution matriciel de Google Sheets, les fonctions logiques scalaires traditionnelles telles que ET (AND) ou OU (OR) échouent systématiquement : au lieu d’évaluer chaque ligne de manière séquentielle, elles agrègent l’ensemble des valeurs de la matrice en un seul résultat logique global vrai ou faux, détruisant la vectorisation attendue.
Pour contourner cette limitation fondamentale et implémenter une disjonction logique (« valeur inférieure à la borne basse OU supérieure à la borne haute ») en mode matriciel, le chercheur doit substituer aux fonctions verbales l’algèbre booléenne arithmétique. Dans ce formalisme formel, l’opérateur logique OU équivaut à l’addition arithmétique (+) de deux conditions, tandis que l’opérateur ET équivaut à leur multiplication (*). Dès lors que l’une des deux conditions est vraie (valeur logique 1), la somme arithmétique devient strictement supérieure à zéro.
En intégrant une clause de protection préalable pour ignorer les lignes dépourvues de données dans une plage ouverte B2:B, la syntaxe vectorielle complète d’étiquetage des valeurs aberrantes s’établit avec une remarquable pureté mathématique :
=ARRAYFORMULA(SI(B2:B= » »; « »; SI((B2:B<$E$5) + (B2:B>$E$6); « Outlier »; « Normal »)))
Cette instruction unique, insérée exclusivement dans la cellule C2, analyse instantanément l’intégralité du vecteur B2:B, renvoyant une chaîne vide sur les lignes vierges, l’étiquette textuelle « Outlier » pour toute observation franchissant l’une des clôtures de Tukey, et la mention « Normal » dans le cas contraire, assurant un déploiement parfait sur toute la verticalité du classeur.
6.3 Surveillance et maintenance des formules matricielles
Bien que d’une efficience remarquable, l’utilisation de matrices dynamiques via ARRAYFORMULA requiert une vigilance rigoureuse quant à l’espace de déploiement disponible au sein de la grille tabulaire. L’erreur la plus emblématique rencontrée par les utilisateurs s’incarne dans la notification d’erreur #REF! accompagnée de l’avertissement explicite d’écrasement (spill error) : « La formule matricielle n’a pas pu être développée, car elle écraserait les données de la cellule… ».
Cette obstruction survient inévitablement dès lors qu’une cellule située sur la trajectoire d’expansion vectorielle (par exemple la cellule C45 dans notre colonne de diagnostic) contient la moindre bribe d’information, fût-ce une simple espace typographique résiduelle ou une ancienne valeur statique non purgée. La résolution impose de vider intégralement la totalité des cellules sous-jacentes à la formule mère pour permettre au vecteur de s’épanouir sans entrave sur l’axe vertical.
Par ailleurs, dans la perspective de l’archivage ou de la réplication de la recherche au sein d’autres environnements de calcul (comme l’exportation vers Microsoft Excel, GNU R ou Python Pandas), il convient de documenter méticuleusement ces formules matricielles dans le protocole technique. En effet, certaines fonctions matricielles hautement spécifiques de Google Sheets peuvent subir des altérations syntaxiques ou des pertes d’évaluation lors de conversions aveugles vers des formats de tableurs propriétaires concurrents.
7. Identification visuelle par mise en forme conditionnelle dynamique
7.1 Paramétrage d’une règle de surbrillance personnalisée
L’exploration sémiotique et visuelle des anomalies constitue un complément cognitif précieux aux étiquetages textuels ou binaires. La mise en forme conditionnelle permet d’altérer dynamiquement les attributs chromatiques et typographiques d’une cellule en fonction de la valeur scalaire qu’elle héberge, attirant immédiatement l’attention du chercheur sur les déviances majeures lors du défilement des protocoles.
Pour concevoir cette règle d’interception visuelle au sein de Google Sheets, la procédure s’organise selon les étapes suivantes :
- Sélectionner à la souris la plage de données empiriques brutes à cribler (par exemple la plage B2:B150).
- Accéder au ruban supérieur et déployer le menu Format, puis sélectionner l’entrée Mise en forme conditionnelle pour faire surgir le panneau de configuration latéral.
- Sous l’onglet « Règle unique », repérer la section intitulée « Règles de mise en forme » et ouvrir le menu déroulant pour délaisser les conditions prédéfinies au profit de la sélection La formule personnalisée est.
- Dans le champ de saisie textuel qui apparaît, introduire l’équation logique d’exclusion en prenant soin de désigner la cellule sommitale de la sélection avec un adressage relatif pour la variable et absolu pour les seuils de Tukey : =OU(B2<$E$5; B2>$E$6).
- Définir les styles de mise en valeur visuelle au sein de la section « Style de mise en forme ».
Dans un souci d’accessibilité et d’ergonomie cognitive, il est fortement recommandé d’abandonner les tons rouges saturés criards qui fatiguent l’appareil oculaire et induisent un biais anxiogène dans l’interprétation. Le recours à des teintes pastel douces (par exemple un fond rouge ambré clair #FCE8E6 couplé à une typographie rouge bordeaux profond #C5221F, enrichie d’une graisse Gras) garantit une lisibilité optimale tout en respectant les standards graphiques d’accessibilité pour les personnes souffrant de déficits de la vision des couleurs (daltonisme).
7.2 Création d’une échelle de criticité chromatique
La statistique robuste de Tukey formalisant l’existence de deux paliers de divergence — les anomalies modérées (au-delà de 1,5 IQR) et les anomalies extrêmes ou sévères (au-delà de 3,0 IQR) —, il est particulièrement judicieux de traduire cette gradation théorique sous la forme d’une double hiérarchie de formatage conditionnel. Cette stratification permet d’isoler au premier coup d’œil les légers glissements comportementaux des ruptures métrologiques monumentales.
À cet effet, l’analyste superpose deux règles de formatage personnalisées distinctes sur la même plage cible B2:B150, en exploitant l’ordonnancement séquentiel des règles proposé par l’interface de Google Sheets :
- Règle prioritaire supérieure (Anomalies Sévères) : La formule personnalisée est =OU(B2<($E$2 – 3*$E$4); B2>($E$3 + 3*$E$4)). On lui assigne une coloration d’alerte prononcée, par exemple un remplissage corail soutenu avec texte sombre contrasté.
- Règle subordonnée (Anomalies Modérées) : La formule personnalisée est =OU(B2<$E$5; B2>$E$6). On lui attribue un ton plus discret, tel qu’un jaune ambré pastel.
L’ordre de superposition au sein du panneau de gestion des règles s’avère absolument déterminant. Google Sheets évaluant les conditions de haut en bas, la règle d’anomalie extrême (3 IQR) doit impérativement trôner au sommet de la liste. Ainsi, une observation immensément déviante déclenchera immédiatement la coloration corail sans être interceptée prématurément par la règle de 1,5 IQR, offrant une cartographie visuelle d’une remarquable finesse sémiologique.
7.3 Intégration sans colonne intermédiaire de calcul
Bien que la disposition des clôtures critiques au sein de cellules annexes (E5 et E6) constitue une architecture limpide, certaines situations de travail collaboratif restreint interdisent la modification structurelle de la feuille de calcul ou l’insertion de tables diagnostiques auxiliaires. Google Sheets offre la plasticité algorithmique requise pour compacter l’intégralité du calcul de l’IQR directement à l’intérieur de la règle de mise en forme conditionnelle.
En exploitant les formules natives imbriquées, la formule personnalisée appliquée à la cellule B2 s’exprime sous une forme autosuffisante :
=OU(B2 < (QUARTILE.INC($B$2:$B$150; 1) – 1,5*(QUARTILE.INC($B$2:$B$150; 3) – QUARTILE.INC($B$2:$B$150; 1))); B2 > (QUARTILE.INC($B$2:$B$150; 3) + 1,5*(QUARTILE.INC($B$2:$B$150; 3) – QUARTILE.INC($B$2:$B$150; 1))))
Dans ce schéma opératoire, le moteur de rendu calcule à la volée les percentiles globaux de la plage de référence pour chaque cellule inspectée, sans qu’aucune colonne tierce ne vienne encombrer l’espace tabulaire d’origine. Cette technique garantit une sobriété visuelle exemplaire pour les tableaux destinés à la publication directe.
Il importe néanmoins de souligner l’impact de ce choix sur les performances graphiques. L’évaluation directe à la volée de quartiles itérés sur des sélections dépassant plusieurs dizaines de milliers de lignes induit une consommation significative de cycles processeur au niveau du navigateur client, pouvant se manifester par des micro-saccades lors du défilement vertical rapide de la feuille de données.
8. Représentation graphique : Visualisation par diagrammes de dispersion et boîtes à moustaches
8.1 Conception et réglage d’une boîte à moustaches (Box Plot)
La boîte à moustaches, ou box plot, conceptualisée initialement par John Tukey, incarne la traduction graphique canonique et indissociable de la méthode de l’écart interquartile. Cette géométrie statistique synthétise au sein d’une figure unique la médiane, le premier et le troisième quartiles, tout en déployant des appendices linéaires (« moustaches ») dont l’extrémité cartographie précisément la frontière des clôtures de Tukey.
Google Sheets dispose d’un moteur de rendu natif permettant de générer des diagrammes en boîte. Pour élaborer cette visualisation, l’analyste sélectionne la colonne de données empiriques (incluant l’en-tête), navigue vers l’onglet Insertion, puis active l’option Graphique. Dans le volet de configuration de droite, il convient de sélectionner le type de graphique et de faire défiler les options jusqu’à la section « Autre », où figure l’icône caractéristique de la Boîte à moustaches.
L’examen clinique du graphique renseigne instantanément sur les propriétés de la distribution. Le corps rectangulaire central matérialise l’intervalle interquartile (contenant 50 % de l’échantillon), barré par le trait horizontal de la médiane. Les moustaches s’étirent jusqu’à la valeur la plus éloignée ne dépassant pas 1,5 fois l’IQR. Toute observation franchissant ces frontières est matérialisée graphiquement sous la forme d’un point isolé flottant au-delà des segments de clôture. Cette sémiologie spatiale permet de détecter en une fraction de seconde la sévérité et la polarité de l’asymétrie (présence préférentielle d’anomalies vers le haut ou vers le bas).
Il convient néanmoins de garder à l’esprit certaines contraintes techniques du moteur graphique de Google Sheets. Contrairement à des environnements scientifiques spécialisés comme R (paquet ggplot2) ou Python (Seaborn), le box plot de Google Sheets offre des capacités de personnalisation parfois frustrantes concernant le traitement individuel des points déviants et peut, selon la configuration choisie pour l’agrégation des données, exiger un pré-formatage rigoureux en colonnes d’intervalles (minimum, quartile inférieur, quartile supérieur, maximum).
8.2 Exploitation du nuage de points pour la détection multidimensionnelle
Si la boîte à moustaches excelle dans l’analyse distributionnelle univariée, l’investigation empirique confronte régulièrement le statisticien à des anomalies qui ne se révèlent qu’à l’intersection croisée de deux variables continues corrélées. Une observation peut tout à fait s’inscrire dans les limites acceptables univariées de la variable X et de la variable Y prises isolément, tout en constituant une anomalie flagrante au sein de l’espace bivarié (ex. : une capacité crânienne moyenne associée à une taille corporelle infinitésimale).
Pour démasquer ces ruptures relationnelles, le nuage de points (scatter plot) constitue un outil d’inspection incontournable. Dans Google Sheets, la génération s’opère en sélectionnant conjointement les deux colonnes de variables métriques (ex. : Âge et Temps d’apprentissage) puis en choisissant le type de graphique Graphique à nuage de points.
Au sein des paramètres de personnalisation du graphique (sous l’onglet « Série »), le chercheur gagne à cocher l’option Ligne de tendance (modèle linéaire, polynomial ou exponentiel selon la théorie sous-jacente) et à afficher le coefficient de détermination R². L’inspection visuelle vise alors à repérer les points singuliers qui s’écartent perpendiculairement de manière vertigineuse du couloir de régression global. Ces observations exercent un effet de levier disproportionné sur la pente de régression de Pearson, menaçant la significativité et la stabilité des extrapolations prédictives.
8.3 Visualisation par histogramme de distribution
L’histogramme de distribution constitue le troisième pilier de la panoplie d’investigation visuelle. Son objet fondamental est de segmenter l’étendue continue d’une variable en classes contiguës (bins) et de dénombrer la fréquence empirique des observations s’agrégeant au sein de chaque tranche, fournissant une approximation directe de la fonction de densité de probabilité empirique.
L’instanciation de l’histogramme sous Google Sheets s’effectue via le menu d’insertion graphique en sélectionnant la modalité Graphique d’histogramme. L’étape analytique cruciale réside dans le calibrage chirurgical de la largeur des classes, accessible via Personnaliser > Histogramme > Taille de l’élément. Par défaut, l’algorithme tente d’estimer une largeur automatique, mais celle-ci s’avère souvent trop large pour déceler les petites excroissances isolées dans les queues distributionnelles.
En réduisant judicieusement la granularité de la taille des classes, le chercheur met en exergue l’existence d’observations esseulées qui émergent sous la forme de barres isolées d’amplitude 1, séparées du corps principal de la distribution par un gouffre de classes totalement vides d’effectifs (fréquence zéro). Cette déconnexion topologique signale la présence irréfutable d’aberrations qui tirent artificiellement la moyenne vers la droite ou la gauche, fournissant une indication immédiate de la violation du postulat de normalité symétrique.
9. Approche alternative complémentaire : La méthode du score Z standardisé
9.1 Fondements mathématiques et calcul du score Z
Bien que la méthode de l’écart interquartile s’impose comme l’étalon-or en statistique non paramétrique robuste, la méthodologie du score Z (ou centrage-réduction standardisé) conserve une pertinence fondamentale au sein de corpus statistiques dont on sait formellement qu’ils sont issus d’un processus générateur gaussien sous-jacent. Le score Z quantifie la distance exacte séparant une observation brute de la moyenne arithmétique globale, exprimée en unités universelles d’écarts-types.
Sur le plan mathématique, l’équation s’énonce selon la formule séculaire :
Z = (X – μ) / σ
Où X représente la valeur individuelle observée, μ l’espérance mathématique (approchée empiriquement par la moyenne d’échantillon) et σ l’écart-type de la population (estimé par l’écart-type d’échantillon sans biais).
Au sein de Google Sheets, l’analyste peut procéder à cette standardisation en déployant la fonction dédiée CENTREE.REDUITE (ou STANDARDIZE en version anglaise). Si la valeur observée réside en B2 et que la série complète occupe la plage $B$2:$B$150, l’implémentation de la fonction s’écrit :
=CENTREE.REDUITE(B2; MOYENNE($B$2:$B$150); ECARTYPE.STAB($B$2:$B$150))
Il est capital de souligner l’emploi scrupuleux de la fonction ECARTYPE.STAB (équivalent de STDEV.S) plutôt que de ECARTYPE.STANDARD (ou STDEV.P). La première intègre la correction de Bessel au dénominateur (division par n – 1 au lieu de n), fournissant un estimateur sans biais de la variance de la population générale à partir des données de l’échantillon expérimental.
9.2 Seuils critiques d’exclusion selon la loi normale
L’utilisation des scores Z pour la classification des déviances repose sur les propriétés probabilistes déduites de l’intégrale de Gauss. Dans une distribution normale standardisée parfaite :
- Environ 68,27 % des valeurs résident à l’intérieur de l’intervalle [-1 ; +1] score Z.
- Environ 95,45 % des valeurs résident à l’intérieur de l’intervalle [-2 ; +2] score Z.
- Environ 99,73 % des valeurs résident à l’intérieur de l’intervalle [-3 ; +3] score Z.
La convention académique la plus répandue consiste à fixer le seuil critique d’exclusion à une valeur absolue de score Z égale à 3,0 (parfois assouplie à 2,5 dans le cadre d’études exploratoires ou de petits échantillons en psychologie différentielle). Sous cette heuristique, une valeur dont le score Z calculé franchit la barre de +3,0 ou s’effondre en deçà de -3,0 possède une probabilité stochastique théorique d’apparition spontanée inférieure à 0,27 % (p < 0,0027), autorisant sa catégorisation comme anomalie statistique.
Au sein de Google Sheets, le marquage automatisé s’obtient élégamment en conjuguant la fonction de valeur absolue ABSOLUE (ABS) à une condition logique. En supposant que le score standardisé calculé par CENTREE.REDUITE repose dans la colonne C (cellule C2), la formule de détection s’écrit :
=SI(ABS(C2) >= 3; « Aberrant Z »; « Conforme »)
Ce formalisme direct offre un filtrage binaire immédiat, simplifiant grandement le reporting des observations s’écartant du canon probabiliste gaussien.
9.3 Analyse comparative : Écart interquartile contre Z-Score
Le choix épistémologique entre l’algorithme de l’IQR et la métrique du Z-score ne relève aucunement d’une convenance stylistique ; il conditionne radicalement la sensibilité et la spécificité du protocole de détection. Le principal talon d’Achille de la méthode du score Z réside dans sa vulnérabilité intrinsèque à l’effet de masque (masking effect) et à l’effet d’engloutissement (swamping effect).
Lorsqu’un échantillon intègre plusieurs valeurs extrêmement aberrantes de grande amplitude, celles-ci gonflent mécaniquement la moyenne arithmétique et exercent un impact exponentiel démesuré sur l’écart-type (du fait de l’élévation des écarts au carré). En gonflant artificiellement σ, ces anomalies élargissent le dénominateur de l’équation : les scores Z de toutes les observations se trouvent contractés vers zéro. Paradoxalement, des valeurs manifestement déviantes peuvent ainsi afficher un score Z de 2,6 et échapper au couperet critique de 3,0, masquées par leur propre contamination de l’estimateur de dispersion.
À l’opposé, l’IQR selon la règle de Tukey utilise des quantiles qui demeurent totalement insensibles à la magnitude précise des extrêmes, échappant ainsi à ce piège méthodologique. Le tableau synthétique ci-dessous balise les critères d’arbitrage à destination du praticien :
- Distribution asymétrique, bimodale ou à queue lourde : Privilégier formellement la méthode de l’IQR. Le score Z générerait un taux intolérable de faux positifs dans la queue étirée.
- Distribution théoriquement gaussienne prouvée : L’approche par le score Z offre une interprétation probabiliste directe standardisée.
- Présence d’anomalies multiples et groupées : Employer l’IQR pour neutraliser l’effet de masque sur la variance.
- Taille de l’échantillon réduite (N < 30) : L’estimation de l’écart-type est instable ; l’IQR (calculé via QUARTILE.INC) fournit un diagnostic structurellement plus robuste.
10. Filtrage, extraction et isolation systématique des observations suspectes
10.1 Isolement par la fonction FILTER dans un onglet dédié
L’assainissement d’une base empirique ne saurait se solder par l’effacement destructeur direct des lignes suspectes sur le tableau original. La rigueur scientifique impose de préserver l’intégrité intégrale de l’enregistrement source tout en procédant à l’isolation systématique des cas déviants vers un espace d’examen dédié afin d’en comprendre les déterminants psychologiques ou instrumentaux.
Google Sheets propose pour cet office une fonction d’une puissance algorithmique exceptionnelle : la fonction FILTER. Cet outil permet d’extraire dynamiquement toutes les lignes répondant à un ensemble de conditions booléennes et de les injecter sous forme d’une table dérivée au sein d’un nouvel onglet.
Imaginons que nous ayons créé un onglet baptisé Diagnostic_Anomalies. Dans la cellule A2 de cet onglet, le chercheur instancie la fonction suivante pour aspirer l’intégralité des observations brutes (colonnes A à D de la feuille Données) dont la variable mesurée en colonne B excède les clôtures de Tukey précalculées :
=FILTER(Données!A2:D; (Données!B2:B < Paramètres!$E$5) + (Données!B2:B > Paramètres!$E$6))
Dans cette formulation, l’opérateur arithmétique (+) assure la disjonction logique inclusive. Dès qu’une valeur de la colonne B franchit la clôture inférieure ou supérieure, l’intégralité des métadonnées du participant (identifiant, genre, âge, scores annexes) est instantanément dupliquée dans le tableau d’audit. Ce tableau dynamique demeure en liaison vivante permanente : toute modification ou réévaluation au sein de la feuille mère actualise en temps réel la liste des observations isolées, sans jamais compromettre le fichier source.
10.2 Requêtes statistiques avancées avec la fonction QUERY
Pour les architectes de données habitués à la puissance déclarative du langage relationnel SQL, la fonction native QUERY de Google Sheets représente l’instrument d’extraction et d’agrégation analytique le plus sophistiqué de la plateforme. Elle permet d’exécuter des requêtes combinant sélections d’attributs, filtrages logiques complexes, ordonnancements pondérés et groupements statistiques au moyen d’une chaîne de commande textuelle concise.
Supposons que nous souhaitions extraire non seulement les valeurs aberrantes de temps de réaction (colonne B), mais que nous souhaitions restreindre cette extraction aux participants d’un groupe expérimental spécifique (« Condition_Contrôle » stockée en colonne C), tout en ordonnant les résultats de l’anomalie la plus vertigineuse à la plus modeste. La syntaxe prend la forme suivante :
=QUERY(Données!A2:E; « SELECT A, B, C, D WHERE (B < » & Paramètres!E5 & » OR B > » & Paramètres!E6 & « ) AND C = ‘Condition_Contrôle’ ORDER BY B DESC »; 0)
La concision de la syntaxe permet d’effectuer un diagnostic d’une redoutable acuité sans devoir concevoir des chaînes interminables de colonnes de calcul intermédiaires. L’injection dynamique des références cellulaires au sein de la clause textuelle SQL via la concaténation assure une adaptabilité absolue : toute variation des seuils de Tukey modifie instantanément le flux de données restitué par la requête.
La clause de regroupement GROUP BY peut également être adjointe pour quantifier en temps réel la distribution des valeurs aberrantes à travers différentes sous-populations démographiques (par exemple en dénombrant les anomalies ventilées par site de collecte expérimental), facilitant le repérage d’un éventuel biais systématique propre à un laboratoire d’acquisition particulier.
10.3 Emploi des vues filtrées collaboratives
Dans les contextes de recherche contemporains, les classeurs Google Sheets sont quasi systématiquement manipulés par des équipes multidisciplinaires travaillant en temps partagé simultané. L’application d’un filtre standard ordinaire (via l’icône d’entonnoir générique) constitue alors une source majeure de perturbation : l’activation d’un filtre sur une colonne masque instantanément les lignes correspondantes pour tous les autres collaborateurs connectés à l’instant présent sur la feuille, interrompant dramatiquement leur travail de saisie ou d’inspection.
Pour résoudre cette friction collaborative, Google Sheets intègre la technologie des Vues filtrées (Filter Views). Accessible via Données > Vues filtrées > Créer une vue filtrée, cette fonctionnalité permet à un chercheur d’appliquer des filtres d’exclusion et des tris complexes au sein d’un calque virtuel strictement personnel. La bordure des cellules se pare d’un liseré sombre caractéristique, signalant que les modifications d’affichage n’altèrent en rien la vue par défaut des collègues connectés.
Chaque vue filtrée peut être explicitement nommée (par exemple « Anomalies_TempsReaction_IQR ») et sauvegardée de manière permanente dans la mémoire du classeur. Elle génère une adresse URL unique comportant un identifiant de vue (paramètre fvid=…). Cette propriété s’avère providentielle pour la recherche scientifique : le statisticien peut copier ce lien hypertexte direct et l’insérer dans le cahier de laboratoire électronique ou le transmettre par messagerie à un évaluateur, lui permettant d’atterrir directement sur la vue tamisée des données sans qu’aucune ligne physique n’ait été altérée ni déplacée.
11. Prise de décision épistémologique et éthique face aux données atypiques
11.1 Taxonomie des stratégies de traitement de l’anomalie
L’identification formelle d’une valeur aberrante dans Google Sheets ne constitue que le préambule d’un arbitrage méthodologique beaucoup plus complexe : le choix du destin réservé à cette observation au sein du pipeline d’analyse inférentielle. Il existe quatre postures théoriques majeures, chacune engageant la responsabilité épistémologique du chercheur :
- La rétention intégrale argumentée : Cette stratégie consiste à maintenir scrupuleusement la totalité des observations aberrantes au sein du corpus d’analyse, tout en délaissant les tests paramétriques vulnérables au profit d’alternatives non paramétriques (comme le test U de Mann-Whitney ou le test de Kruskal-Wallis) ou de modélisations robustes basées sur le rééchantillonnage par bootstrap.
- La suppression unilatérale : Cette voie radique évince purement et simplement les lignes déviantes de la base de données analysée. Si elle se justifie sans réserve en présence d’une erreur mécanique ou d’une tricherie manifeste dûment documentée, elle s’avère hautement périlleuse lorsqu’elle frappe des sujets humains authentiques, au risque d’amputer artificiellement la variance biologique naturelle.
- La Winsorisation (Winsorizing) : Conceptualisée par le biostatisticien Charles P. Winsor, cette technique hybride consiste non pas à expulser l’observation, mais à recoder sa magnitude numérique pour la ramener au niveau du percentile acceptable le plus proche (par exemple la borne de Tukey ou le 95e percentile).
- La transformation mathématique : L’application d’une fonction logarithmique (log(X)), racine carrée (SQRT(X)) ou inverse (1/X) permet de contracter sélectivement les queues de distribution étirées vers la droite, normalisant l’asymétrie globale sans exiger l’amputation de données.
La règle d’or éthique face à ce choix réside dans la réalisation systématique d’une analyse de sensibilité (sensitivity analysis). Le statisticien doit conduire son inférence selon deux scénarios parallèles : une fois avec l’ensemble du corpus non épuré, et une fois après traitement ou éviction des valeurs aberrantes. Si les conclusions substantielles et le sens des effets expérimentaux demeurent rigoureusement identiques à travers les deux approches, le modèle est qualifié de robuste. Dans l’éventualité où la significativité statistique bascule exclusivement du fait de l’exclusion de deux ou trois observations marginales, le devoir déontologique impose de déclarer cette extrême fragilité dans le rapport de recherche, prévenant toute surinterprétation téméraire.
11.2 Mise en œuvre pratique de la Winsorisation sous Google Sheets
La Winsorisation présente le vertige mathématique de stabiliser l’influence des queues de distribution tout en préservant intacte la taille de l’échantillon nominal (N), évitant ainsi la dégradation de la puissance statistique inhérente à la suppression pure et simple d’enregistrements. Au lieu d’éliminer un score temps de réponse de 4 800 ms, l’algorithme le ramène exactement à la clôture supérieure de Tukey, disons 1 850 ms.
Dans Google Sheets, l’implémentation algorithmique d’une Winsorisation bornée par les seuils de Tukey s’opère avec une remarquable fluidité technique en combinant les fonctions extrêmes MAX et MIN. Si la donnée empirique brute est localisée en cellule B2, et que les bornes inférieure et supérieure sont figées en $E$5 et $E$6, la transformation s’exécute selon la syntaxe :
=MAX($E$5; MIN(B2; $E$6))
L’analyse logique démontre la perfection du mécanisme : la fonction intérieure MIN(B2; $E$6) compare l’observation à la borne haute ; si la valeur est supérieure, elle est immédiatement écrêtée et ramenée au plafond $E$6. La fonction extérieure MAX prend ensuite le relais en comparant ce résultat à la borne basse $E$5 ; si la valeur s’avère plus faible, elle est rehaussée au plancher $E$5. Toute valeur comprise entre les deux seuils traverse l’équation sans subir la moindre modification.
En étendant ce traitement vectoriel à l’aide de ARRAYFORMULA sur l’intégralité d’une colonne, le chercheur engendre en une fraction de seconde une série expérimentale assainie, parfaitement immunisée contre les déformations asymptotiques et prête à alimenter les modèles linéaires de variance sans violer leurs postulats fondateurs.
11.3 Exigences de transparence et reproductibilité scientifique
À l’ère de la crise de la reproductibilité qui secoue l’ensemble des disciplines expérimentales, la gestion occulte des valeurs aberrantes constitue l’un des vecteurs majeurs de biais cognitif et de fraude méthodologique passive, regroupés sous le terme de questionable research practices (QRP) ou de p-hacking. Il est trop aisé pour un analyste de manipuler arbitrairement les seuils de détection (en basculant opportunément d’un k=1,5 à un k=2,0 ou en alternant entre score Z et IQR) dans l’unique but de franchir le seuil fatidique de significativité p < 0,05 indispensable à la publication académique.
Pour immuniser son protocole contre ces dérives déontologiques, le chercheur doit se conformer aux standards de la science ouverte (Open Science). Les critères d’exclusion des données doivent impérativement faire l’objet d’un pré-enregistrement formel (pre-registration) sur des registres publics indépendants tels que l’Open Science Framework (OSF) avant même la phase d’acquisition du premier sujet expérimental. Le protocole pré-enregistré doit stipuler sans équivoque la métrique retenue (ex. : clôture externe de Tukey basée sur QUARTILE.INC), les conditions logiques appliquées et le sort précis réservé aux données déviantes.
De surcroît, lors de la rédaction finale du manuscrit scientifique, les directives de reporting institutionnelles (telles que les normes de l’APA) imposent une transparence absolue. Le chercheur doit déclarer le nombre précis d’observations écartées, la justification mécanique de chaque éviction, ainsi que la matrice comparative des résultats statistiques avant et après assainissement. Le dépôt ouvert des feuilles de calcul Google Sheets préalablement anonymisées et rigoureusement auditées au sein d’entrepôts de données pérennes (Zenodo, Dataverse) scelle la probité intellectuelle de la recherche, garantissant une réplicabilité computationnelle totale par les pairs.
12. Automatisation et extension : Vers un flux d’analyse reproductible
12.1 Conception d’une macro Google Apps Script pour l’étiquetage rapide
Bien que les formules natives et les règles matricielles de Google Sheets suffisent amplement au traitement ordinaire, la répétition quotidienne de protocoles de criblage sur des dizaines de classeurs distincts peut justifier une automatisation procédurale complète. Google Sheets intègre un environnement de développement infonuagique puissant adossé au langage JavaScript : Google Apps Script.
En accédant au menu Extensions > Apps Script, le développeur peut insérer une routine algorithmique dédiée au traitement automatisé de la détection des valeurs aberrantes. Le script ci-dessous illustre l’implémentation robuste du calcul de Tukey et l’application directe d’une surbrillance sur la colonne active sélectionnée par l’utilisateur :
L’algorithme lit l’intégralité des données numériques de la plage ciblée, calcule par interpolation linéaire ordonnée les valeurs exactes de Q1 et Q3, en déduit le produit 1,5 * IQR, puis itère sur les cellules pour appliquer un arrière-plan coloré d’alerte sur chaque observation franchissant les frontières statistiques. Cette routine peut ensuite être reliée à un élément de menu personnalisé ou à un bouton graphique cliquable disposé sur la feuille de calcul, transformant le tableur en un véritable instrument de diagnostic automatisé en un clic.
Cette approche scriptée présente l’avantage décisif d’alléger drastiquement la charge computationnelle de la feuille : les calculs étant exécutés côté serveur sur l’infrastructure Google puis figés sous forme d’attributs visuels directs, le classeur ne subit aucun ralentissement lié à l’évaluation perpétuelle de formules matricielles complexes.
12.2 Interfaçage et exportation vers des environnements spécialisés
Google Sheets ne saurait se substituer intégralement aux environnements de calcul statistique de pointe lorsqu’il s’agit de modéliser des équations structurales complexes ou des modèles mixtes à effets aléatoires. Sa véritable vocation réside dans le recueil, la structuration collaborative et le premier niveau d’assainissement métrologique. Dès lors, l’interfaçage harmonieux du tableur avec des écosystèmes analytiques dédiés s’impose comme une nécessité technique.
La passerelle la plus immédiate repose sur l’exportation au format standardisé CSV (valeurs séparées par des virgules). Toutefois, avant de déclencher l’exportation, l’analyste doit veiller à figer les colonnes dérivées en valeurs statiques (via la commande Copier > Collage spécial > Valeurs uniquement) afin d’éviter la propagation d’erreurs de référence ou de formules résiduelles au sein du fichier texte plat.
Pour un flux de travail professionnel automatisé, l’écosystème open-source GNU R propose le paquetage spécialisé googlesheets4. Cet outil permet d’interroger directement l’API de Google Sheets sans aucune exportation intermédiaire de fichiers statiques :
Le script R authentifie la session de recherche, aspire la feuille Google Sheets directement dans un conteneur de données (tibble), et permet de vérifier la conformité stricte des seuils calculés dans le tableur avec les bibliothèques d’analyse statistique avancée (comme le paquet car ou outliers). Des interconnexions similaires peuvent être établies sans heurts vers des logiciels open source comme JASP ou des solutions propriétaires telles que SPSS, assurant une traçabilité numérique sans rupture depuis la saisie sur le terrain jusqu’aux modèles finaux.
12.3 Synthèse des bonnes pratiques et grille d’audit du tableur
Au terme de ce parcours méthodologique, il apparaît clairement que la traque et la gestion des valeurs aberrantes au sein de Google Sheets ne tolèrent aucune improvisation. Pour garantir l’infaillibilité de vos flux de données et la validité inébranlable de vos inférences ultérieures, il est vivement recommandé d’auditer systématiquement vos classeurs à l’aune de la liste de vérification ci-dessous :
- Intégrité originelle : Les données sources brutes sont-elles préservées dans un onglet sanctuarisé, protégé en écriture contre toute altération accidentelle ?
- Contrôle typologique : Toutes les cellules de mesures quantitatives ont-elles été nettoyées des espaces parasites et formellement validées sous un format numérique pur ?
- Justification de la métrique : Le choix entre l’écart interquartile (statistique robuste) et le score Z (statistique gaussienne) repose-t-il sur une inspection rigoureuse de la normalité de la distribution ?
- Cohérence des ancrages : Les formules de condition logique mobilisent-elles scrupuleusement le référencement absolu ($) pour interdire toute dérive de cellule lors des recopies ?
- Fluidité de calcul : Les formules matricielles de type ARRAYFORMULA ont-elles été nettoyées de tout risque de conflit d’écrasement ou d’obstruction par des cellules résiduelles ?
- Transparence éthique : Les règles de décision appliquées ont-elles fait l’objet d’une analyse de sensibilité comparant les modèles avec et sans valeurs atypiques ?
En incorporant ces principes directeurs au sein de vos protocoles réguliers d’expérimentation et d’analyse, vous conférerez à vos classeurs Google Sheets une rigueur analytique égale à celle des logiciels de calcul les plus austères, tout en préservant la flexibilité, la fluidité collaborative et la puissance de visualisation qui font la force unique des architectures infonuagiques modernes.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Barnett, V., & Lewis, T. (1994). Outliers in statistical data (3rd ed.). John Wiley & Sons.
Bakker, M., & Wicherts, J. M. (2014). Outlier removal, data transforms, and the plausibility of results: High degrees of freedom in data analysis jeopardize research findings. Computers in Human Behavior, 34, 1-8. https://doi.org/10.1016/j.chb.2014.01.028
Hoaglin, D. C., Mosteller, F., & Tukey, J. W. (Eds.). (2000). Understanding robust and exploratory data analysis. John Wiley & Sons. https://doi.org/10.1002/9781118150702
Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764-766. https://doi.org/10.1016/j.jesp.2013.03.013
Maronna, R. A., Martin, R. D., Yohai, V. J., & Salibián-Barrera, M. (2019). Robust statistics: Theory and methods (with R) (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119214656
Osborne, J. W., & Overbay, A. (2004). The power of outliers (and why researchers should ALWAYS check for them). Practical Assessment, Research, and Evaluation, 9(1), Article 6. https://doi.org/10.7275/q71v-hn44
Rousseeuw, P. J., & Hubert, M. (2011). Robust statistics for outlier detection. WIREs Data Mining and Knowledge Discovery, 1(1), 73-79. https://doi.org/10.1002/widm.2
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/B978-0-12-804566-4.00001-9