
Dans le champ foisonnant de l’analyse exploratoire de données, la représentation graphique constitue bien souvent le premier contact du chercheur avec la réalité empirique de son échantillon. Face à l’inflation contemporaine des volumes de données massives, les praticiens et les scientifiques ont parfois tendance à négliger les micro-jeux de données issus de protocoles expérimentaux hautement contrôlés, de cohortes cliniques rares ou d’études pilotes préliminaires. C’est précisément au sein de ces contextes où chaque observation individuelle porte un poids heuristique déterminant que le graphique à points, ou dot plot dans la littérature anglo-saxonne, déploie toute sa pertinence méthodologique et sa puissance descriptive.
Conçu à l’origine pour pallier les approximations inhérentes aux représentations agrégées, le graphique à points permet une inspection sans filtre de la géométrie distributionnelle. Contrairement à des résumés purement numériques qui masquent les singularités sous des indices synthétiques, cette approche visuelle univariée conserve l’intégrité de chaque mesure élémentaire. Néanmoins, la simple observation brute d’un nuage de points demeure insuffisante pour asseoir une inférence statistique robuste ou pour communiquer de manière rigoureuse des conclusions scientifiques. L’observateur doit être capable d’extraire avec méthode les deux piliers jumeaux de la statistique descriptive : la tendance centrale, qui incarne le point d’ancrage typique du phénomène étudié, et la dispersion, qui en quantifie l’hétérogénéité et l’étalement spatial.
L’objectif de cet article est de vous guider pas à pas dans la caractérisation mathématique et visuelle du centre et de la dispersion sur un graphique à points. En abordant successivement les fondements théoriques, les algorithmes manuels de repérage, le traitement des distributions asymétriques et l’impact critique des valeurs aberrantes, nous explorerons les protocoles formels nécessaires à une lecture analytique approfondie. Que vous soyez statisticien, chercheur en psychologie expérimentale, étudiant en sciences biomédicales ou analyste de données, la maîtrise de ces techniques garantit une interprétation rigoureuse, exempte de biais perceptifs et parfaitement alignée sur les standards les plus exigeants de la communication scientifique.
1. Introduction aux graphiques à points et à l’analyse exploratoire de données
1.1 Définition et structure fondamentale du graphique à points
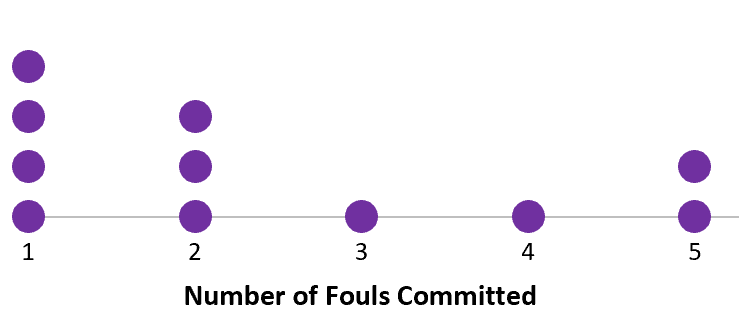
Le graphique à points est un dispositif graphique univarié qui projette une série d’observations quantitatives le long d’un axe horizontal gradué unique, représentant l’échelle continue ou discrète de la variable mesurée. Chaque observation individuelle y est matérialisée par un symbole ponctuel distinct, le plus souvent un point plein ou un disque de rayon constant. Lorsque plusieurs entités statistiques partagent une valeur numérique identique ou se situent dans un intervalle de quantification indistinct, les points correspondants s’empilent verticalement au-dessus de la graduation considérée. Cette disposition orthogonale confère au graphique une seconde dimension implicite, où la hauteur de chaque colonne reflète la fréquence absolue exacte de l’occurrence observée.
Cette structure unitaire offre un avantage considérable sur les formes concurrentes de visualisation de données, telles que les histogrammes et les boîtes à moustaches (boxplots). En effet, l’histogramme impose une discrétisation arbitraire de l’espace par le choix de la largeur des classes (ou bins), ce qui engendre un lissage potentiellement trompeur de la distribution lorsque les effectifs sont modestes. Une largeur de classe mal calibrée peut aisément masquer une bimodalité latente ou suggérer une continuité illusoire. De son côté, la boîte à moustaches synthétise les données selon un résumé à cinq nombres (valeur minimale, premier quartile, médiane, troisième quartile, valeur maximale) qui, bien qu’élégant, efface complètement les concentrations locales, les zones de vide et les configurations particulières au sein des intervalles interquartiles.
Dans le domaine des sciences du comportement, de la neurobiologie ou de la psychologie cognitive, les expérimentateurs travaillent régulièrement sur des échantillons restreints, souvent compris entre dix et quarante sujets par condition, en raison de contraintes logistiques, éthiques ou budgétaires. Dans ce cadre précis, le graphique à points préserve l’intégrité intégrale de l’échantillon : aucune information n’est sacrifiée sur l’autel de la synthèse prématurée. L’analyste conserve la possibilité de retracer l’origine exacte de chaque point, facilitant ainsi la détection immédiate des artefacts de mesure, des effets de plancher ou de plafond, ainsi que des particularités morphologiques du jeu de données.
1.2 L’importance conjointe du centre et de la dispersion dans la description statistique
L’exploration statistique univariée repose fondamentalement sur le couplage indissociable d’un indice de position centrale et d’un indice de variabilité. Isoler l’un de ces deux paramètres au détriment de l’autre conduit inéluctablement à une représentation déformée ou stérile du phénomène étudié. Affirmer, par exemple, qu’un groupe de participants soumis à un paradigme de privation de sommeil présente un score moyen de vingt erreurs à une tâche de vigilance psychomotrice ne fournit qu’une indication partielle : cette moyenne peut résulter d’un ensemble de scores étroitement regroupés autour de vingt, ou au contraire d’une distribution hautement polarisée où la moitié des sujets ne commet aucune erreur tandis que l’autre moitié en commet quarante.
Sur le plan épistémologique, l’évaluation de la tendance centrale a pour vocation de résumer l’information en identifiant la valeur qui minimise l’erreur globale de prédiction sous une fonction de perte déterminée. Elle recherche le « représentant canonique » de la série statistique. Toutefois, la validité de ce représentant dépend étroitement de l’homogénéité de la cohorte, mesure assurée par les indices de dispersion. La variabilité rend compte de la propension des données à s’éloigner de leur point d’ancrage, témoignant des variations interindividuelles réelles, du bruit expérimental ou des fluctuations d’échantillonnage aléatoires. Sans quantification de cette dispersion, le centre statistique n’est qu’une abstraction désincarnée.
L’examen direct d’un graphique à points permet de court-circuiter les illusions cognitives induites par les seuls tableaux de chiffres. L’œil humain est capable de balayer simultanément l’étendue totale des données et la compacité des agglomérations de points, ce qui aide à formuler sans attendre des hypothèses scientifiques quantitatives. Dans le cadre de cohortes cliniques de taille réduite — par exemple lors de l’étude des temps d’accès lexical chez des patients aphasiques post-accident vasculaire cérébral —, cette double lecture visuelle permet de déterminer si la réponse d’un sous-groupe se singularise par un glissement global de la performance ou par un éclatement de sa variance, ouvrant la voie à des interprétations physiopathologiques nuancées.
2. Fondements conceptuels de la tendance centrale sur un graphique à points
2.1 La médiane comme métrique de référence de la valeur centrale
D’un point de vue formel, la médiane statistique se définit comme le cinquantième centile d’une série ordonnée d’observations. Elle constitue la valeur charnière qui sépare l’ensemble des données ordonnées en deux sous-ensembles d’effectifs rigoureusement identiques : 50 % des observations lui sont inférieures ou égales, et 50 % lui sont supérieures ou égales. Sur le plan de la théorie statistique de l’estimation, la médiane représente la valeur $M$ qui minimise la somme des écarts absolus par rapport aux observations, soit la fonction de perte $L_1$ définie par :
$$\sum_{i=1}^{n} |x_i – M|$$
Cette propriété mathématique lui confère une insensibilité totale — qualifiée de robustesse — face aux observations atypiques situées aux confins de la distribution. Contrairement aux indices qui intègrent la grandeur métrique brute de chaque observation dans leur calcul, la médiane ne dépend que du rang des valeurs une fois celles-ci triées le long de l’axe horizontal. Qu’un point extrême s’éloigne de dix ou de dix mille unités sur l’axe des abscisses, la position de la médiane demeure absolument inchangée tant que son rang au sein de l’effectif ordonné est préservé. Cette résistance aux distorsions asymétriques en fait la métrique d’élection pour évaluer le centre d’un graphique à points, où les asymétries et les points distants sautent immédiatement aux yeux de l’observateur.
Conceptuellement, la médiane incarne le centre de gravité des rangs plutôt que le centre de masse physique des valeurs. Sur le graphique à points, elle s’interprète comme une ligne de partage spatiale : si l’on comptabilise les symboles ponctuels d’un côté et de l’autre de la ligne médiane, on obtient une parité parfaite. Cette propriété géométrique intuitive facilite grandement son extraction directe, évitant à l’analyste de devoir effectuer des calculs mentaux fastidieux de sommation et de division sur des échelles numériques parfois complexes.
2.2 La moyenne arithmétique : calcul, barycentre et vulnérabilités
La moyenne arithmétique constitue l’indicateur de tendance centrale le plus conventionnel en statistique paramétrique. Mathématiquement, elle correspond à la somme arithmétique de toutes les valeurs individuelles divisée par l’effectif total de l’échantillon ($n$). D’un point de vue mécanique, la moyenne représente le centre de gravité physique (ou barycentre) du graphique à points. Si l’on imaginait l’axe horizontal comme une réglette rigide d’épaisseur négligeable et d’une masse parfaitement homogène, et chaque point comme une bille d’un poids unitaire fixe posée sur cette réglette, la moyenne arithmétique correspondrait très exactement au point d’appui unique sur lequel l’ensemble du système demeurerait en équilibre gravitationnel horizontal sans basculer.
Cette équivalence physique met immédiatement en lumière la vulnérabilité intrinsèque de la moyenne. Tout comme une bille placée à une extrémité d’un levier exerce un moment de force proportionnel à son éloignement du pivot, un point isolé situé très loin sur l’axe horizontal tire irrésistiblement la moyenne arithmétique vers lui, loin de la zone où se concentre la majorité de l’effectif. Formellement, la moyenne minimise la somme des carrés des écarts (fonction de perte $L_2$), ce qui amplifie de manière quadratique le poids des écarts importants :
$$\sum_{i=1}^{n} (x_i – \bar{x})^2$$
Sur un graphique à points, la comparaison de la position spatiale de la moyenne par rapport à celle de la médiane constitue un indicateur diagnostique fondamental de la morphologie des données. Lorsque la distribution est parfaitement équilibrée, la moyenne et la médiane se superposent fidèlement au même point de l’axe. En revanche, dès qu’apparaît un étalement asymétrique vers la droite ou vers la gauche, la moyenne s’échappe en direction de la traîne, tandis que la médiane reste fermement ancrée au milieu des points les plus denses. Dans ces conditions de dissymétrie prononcée, la moyenne arithmétique perd sa pertinence descriptive en tant qu’indice du cas typique, son adoption au détriment de la médiane devant alors être écartée.
2.3 Le mode et la détection visuelle des zones de forte densité
Le mode se définit comme la valeur nominale ou la classe discrète qui apparaît avec la fréquence la plus élevée au sein de l’échantillon. Sur un graphique à points, son repérage relève de la simple inspection géométrique : le mode correspond directement à l’abscisse de la colonne de points qui atteint la hauteur verticale maximale. Cette caractéristique en fait l’indice de tendance centrale le plus élémentaire et le plus immédiatement accessible à la perception humaine, ne réclamant ni calcul arithmétique ni opérations de dénombrement itératif préalable.
Toutefois, la portée analytique du mode présente d’importantes limites théoriques. Dans les variables continues caractérisées par une précision de mesure élevée, il est fréquent que chaque valeur observée ne soit relevée qu’une seule fois ; dans cette situation, la distribution ne comporte aucun mode ou, à l’inverse, chaque point constitue un mode trivial. De plus, le mode est insensible à la disposition d’ensemble du nuage de points : une colonne massive peut culminer à une extrémité de l’axe tandis que le reste des observations s’étale à l’opposé, conduisant le mode à désigner une région périphérique comme le « centre » de la distribution.
En revanche, le mode acquiert une valeur diagnostique précieuse pour déceler la structure globale d’un échantillon. L’identification d’une distribution unimodale (un seul sommet prédominant) suggère une population d’origine homogène. À l’opposé, l’émergence d’une structure bimodale ou multimodale — reconnaissable à la présence de deux ou plusieurs colonnes distinctes surélevées, séparées par une dépression — signale la superposition de sous-populations hétérogènes au sein du groupe étudié. Le mode permet également de mettre en évidence des effets expérimentaux de plafond (accumulation massive de points sur la borne maximale autorisée du test) ou de plancher (empilement sur le score zéro), avertissant le chercheur d’un possible manque de sensibilité de son instrument de mesure.
3. Méthodes algorithmiques pour localiser le centre sur un graphique à points
3.1 Protocole de dénombrement séquentiel pour déterminer la médiane
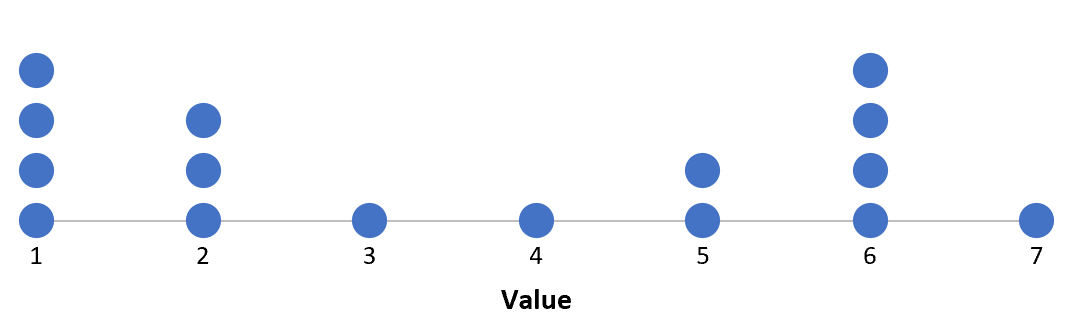
Pour déterminer la médiane sur un graphique à points sans commettre d’erreur d’omission, il convient d’appliquer un protocole algorithmique déterministe. La première étape consiste à recenser l’effectif total de l’échantillon, noté $n$, en procédant à un comptage exhaustif de tous les points tracés sur le graphique, colonne après colonne, en balayant l’axe des abscisses de la gauche vers la droite. Il est conseillé de consigner ce total par écrit pour éviter d’avoir à recommencer l’opération au cours des étapes ultérieures.
Une fois $n$ établi, deux cas de figure se présentent en fonction de la parité arithmétique de la taille de l’échantillon :
- Cas d’un effectif impair ($n = 2k + 1$) : La médiane occupe une position physique unique au sein de la série ordonnée. Le rang du point médian se calcule à l’aide de la formule standard de position :
$$P_M = \frac{n + 1}{2}$$
Il suffit alors de reprendre le balayage du graphique de gauche à droite, en comptant les points un à un (de bas en haut au sein de chaque colonne), jusqu’à atteindre le point dont le numéro d’ordre correspond exactement à $P_M$. La valeur projetée de ce point sur l’axe horizontal indique la médiane exacte. - Cas d’un effectif pair ($n = 2k$) : Il n’existe pas de point unique partageant l’échantillon en deux parties égales. La médiane se situe théoriquement à mi-chemin entre les deux observations centrales, c’est-à-dire les rangs :
$$R_1 = \frac{n}{2} \quad \text{et} \quad R_2 = \left(\frac{n}{2}\right) + 1$$
L’opérateur dénombre les points jusqu’à identifier la valeur de l’observation $R_1$ puis celle de l’observation $R_2$. Si ces deux points appartiennent à la même colonne verticale, la médiane est égale à cette graduation. S’ils se trouvent sur deux colonnes distinctes $x_1$ et $x_2$, la médiane s’obtient par interpolation linéaire moyenne :
$$M = \frac{x_1 + x_2}{2}$$
3.2 Technique visuelle de cancellation symétrique des points extrêmes
Lorsque l’on travaille directement sur un support imprimé ou sur un écran interactif et que l’effectif $n$ demeure modeste (typiquement inférieur à trente observations), la technique dite de cancellation symétrique — ou élimination appariée des bornes — offre une alternative visuelle particulièrement rapide et intuitive. Cette méthode émule graphiquement l’algorithme sous-jacent à la réduction progressive d’une liste triée sans nécessiter de calcul arithmétique préalable.
Le procédé se déroule selon une séquence itérative rigoureuse :
- L’observateur repère simultanément le point situé le plus à gauche sur l’axe (la valeur minimale) et le point situé le plus à droite (la valeur maximale), puis les élimine virtuellement de l’analyse (par un léger trait de crayon ou un pointage visuel).
- L’itération se poursuit en supprimant le deuxième point le plus bas et le deuxième le plus haut. Lorsque plusieurs points sont empilés sur une même valeur, on consomme la colonne de haut en bas pour l’extrémité supérieure et de bas en haut pour l’extrémité inférieure, garantissant ainsi un traitement systématique.
- Ce processus d’élimination symétrique de paires d’extrémités se répète de manière centripète jusqu’à ce qu’il ne reste plus qu’un point isolé (dans le cas d’un effectif impair) ou une paire finale de points (dans le cas d’un effectif pair).
Si la paire finale réside sur la même coordonnée d’abscisse, cette valeur constitue immédiatement la médiane. Si les deux points ultimes reposent sur deux graduations adjacentes ou disjointes, la médiane correspond au milieu arithmétique de cet intervalle résiduel. Bien que très directe, cette méthode heuristique exige une attention soutenue pour ne pas désynchroniser l’élimination des paires ; un contrôle croisé par dénombrement direct demeure toujours recommandé dans un cadre d’analyse de données formel.
3.3 Extraction mathématique complète de la liste des valeurs ordonnées
Pour éliminer tout risque d’erreur d’interprétation visuelle, la démarche méthodologique la plus formelle consiste à transcrire le contenu du graphique à points sous forme d’une série numérique discrète ordonnée. Cette opération de rétro-ingénierie graphique convertit les arrangements géométriques en un vecteur mathématique exploitable par des calculs numériques rigoureux ou par des progiciels de traitement de données.
L’opérateur parcourt l’axe horizontal dans l’ordre croissant des graduations. Chaque fois qu’une colonne de points est rencontrée, la coordonnée numérique de l’abscisse est recopiée autant de fois qu’il y a de points empilés verticalement dans cette colonne. Par exemple, si l’on relève deux points à l’abscisse 12, cinq points à 14 et un point à 15, la transcription génère le vecteur :
$$\mathbf{x} = {12, 12, 14, 14, 14, 14, 14, 15}$$
À l’issue de cette transcription, il est impératif de valider la concordance numérique en vérifiant que la longueur du vecteur obtenu est scrupuleusement égale au nombre total de points visibles sur le graphique original. À partir de cette liste séquentielle ordonnée, le calcul de la moyenne arithmétique devient direct et systématique :
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$$
Cette formalisation algébrique permet non seulement de calculer la moyenne et d’isoler la médiane avec une précision infaillible, mais également de quantifier précisément l’écart absolu $|\bar{x} – M|$. Cet écart fournit une mesure objective de la distorsion causée par la forme de la distribution, documentant avec clarté le degré d’asymétrie auquel les données sont soumises.
4. Concepts théoriques de la dispersion appliqués aux graphiques à points
4.1 L’étendue globale : portée et sensibilité extrême
L’étendue globale (souvent désignée par le terme anglophone range) constitue la métrique de dispersion la plus élémentaire en statistique descriptive. Elle se définit mathématiquement comme la différence arithmétique simple séparant la valeur maximale observée ($x_{\max}$) de la valeur minimale observée ($x_{\min}$) au sein de la distribution :
$$E = x_{\max} – x_{\min}$$
Sur un graphique à points, l’étendue se traduit géométriquement par la largeur totale occupée par le nuage de points le long de l’axe des abscisses. Elle offre une délimitation immédiate de l’intervalle au sein duquel s’inscrit l’intégralité des mesures recueillies, permettant à l’analyste de saisir d’un seul coup d’œil l’espace de variation maximal du phénomène étudié.
Cependant, cette simplicité de calcul s’accompagne d’une fragilité méthodologique majeure. L’étendue ne prend en compte que les deux valeurs les plus périphériques du jeu de données, ignorant totalement l’agencement, la densité et la dispersion des $n – 2$ points situés à l’intérieur de ces bornes. Par conséquent, l’étendue est extrêmement vulnérable aux fluctuations d’échantillonnage aléatoires et aux observations atypiques : la simple apparition d’un point aberré ou d’une erreur d’enregistrement à une extrémité suffit à doubler ou tripler l’étendue globale, sans que la variabilité intrinsèque de la majorité de l’échantillon n’ait changé d’un iota. Pour cette raison, l’étendue ne doit être considérée que comme un indicateur grossier, utile lors d’un premier tri visuel, mais inapte à résumer fidèlement la dispersion d’une distribution complexe.
4.2 L’écart interquartile (IQR) comme mesure robuste d’étalement
Pour remédier à la vulnérabilité de l’étendue globale, les statisticiens ont développé une alternative robuste : l’écart interquartile (noté IQR, pour Interquartile Range). L’écart interquartile correspond à la différence arithmétique entre le troisième quartile ($Q_3$ ou soixante-quinzième centile) et le premier quartile ($Q_1$ ou vingt-cinquième centile) de la série ordonnée :
$$\text{IQR} = Q_3 – Q_1$$
D’un point de vue conceptuel, l’IQR circonscrit l’empan horizontal occupé par les 50 % centraux des données. En éliminant délibérément les 25 % des observations les plus faibles et les 25 % des observations les plus fortes, l’écart interquartile s’affranchit entièrement des perturbations provoquées par d’éventuelles valeurs aberrantes ou par l’effilochage asymétrique des queues de distribution. Tout comme la médiane est la contrepartie robuste de la moyenne arithmétique, l’écart interquartile constitue la contrepartie robuste de l’étendue et de l’écart-type.
Sur un graphique à points, l’IQR s’illustre visuellement comme la largeur de la zone de forte condensation des observations. Une distribution dont l’étendue globale est très large en raison de quelques points isolés mais dont l’IQR reste étroit reflète un phénomène hautement homogène pour l’immense majorité des sujets, avec quelques trajectoires atypiques marginales. En analyse exploratoire, le couplage de la médiane et de l’écart interquartile est systématiquement préconisé dès lors que la disposition des points sur l’axe s’écarte de la symétrie idéale ou que des points isolés se manifestent aux extrémités.
4.3 L’écart-type et la variance dans un contexte visuel
La variance ($s^2$) et son corollaire direct, l’écart-type ($s$), forment le socle de la dispersion dans le paradigme de l’inférence paramétrique classique. L’écart-type quantifie l’amplitude moyenne de la déviation des observations individuelles par rapport à la moyenne arithmétique de la distribution. Formellement, pour un échantillon de taille $n$, il est donné par l’estimateur sans biais :
$$s = \sqrt{\frac{1}{n – 1} \sum_{i=1}^{n} (x_i – \bar{x})^2}$$
Bien que l’extraction exacte de l’écart-type ne puisse se faire directement sans calcul mathématique complet, la morphologie d’un graphique à points permet une approximation heuristique remarquablement utile. Lorsque la distribution présente une allure globalement symétrique et unimodale (qui évoque une loi normale), on peut mobiliser la règle empirique (ou règle des trois sigmas). Selon cette propriété, environ 68 % des observations sont comprises dans l’intervalle $[\bar{x} – s, \bar{x} + s]$, et environ 95 % s’inscrivent dans l’intervalle $[\bar{x} – 2s, \bar{x} + 2s]$.
Par conséquent, pour un jeu de données raisonnablement gaussien dont l’effectif approche une trentaine de points, l’étendue globale couvre approximativement une largeur équivalente à quatre à six écarts-types ($x_{\max} – x_{\min} \approx 4s \text{ à } 6s$). L’analyste peut ainsi estimer visuellement l’ordre de grandeur de $s$ en divisant l’étendue apparente par quatre ou cinq. En revanche, cette estimation heuristique devient totalement caduque dès lors que le graphique à points présente une asymétrie marquée, des vides internes substantiels ou des valeurs isolées extrêmes, conditions dans lesquelles seule la dispersion interquartile conserve toute sa validité descriptive.
5. Techniques pratiques pour quantifier la dispersion sur un graphique
5.1 Calcul pas à pas de l’étendue à partir des bornes visuelles
L’évaluation pratique de l’étendue globale à partir d’un graphique à points ne requiert que quelques opérations visuelles élémentaires, à condition d’observer une vigilance rigoureuse sur la lecture des graduations de l’axe :
- Identification de la borne inférieure : L’observateur scrute l’extrémité gauche du graphique et repère le tout premier point tracé sur l’axe. Il projette perpendiculairement ce point sur l’axe gradué pour relever avec exactitude sa coordonnée numérique, notée $x_{\min}$. Si la colonne la plus à gauche comprend plusieurs points verticaux, c’est bien la valeur d’abscisse de cette colonne qui est retenue.
- Identification de la borne supérieure : De manière analogue, l’observateur porte son regard sur l’extrémité droite du graphique pour identifier le point ou la colonne de points le plus éloigné le long de la direction positive de l’axe, notant cette coordonnée $x_{\max}$.
- Calcul arithmétique de la portée : L’étendue est calculée par la soustraction directe :
$$E = x_{\max} – x_{\min}$$
Une source fréquente d’erreur réside dans la confusion entre l’étendue des données et l’étendue de l’axe physique représenté. Les progiciels de visualisation fixent souvent les limites minimale et maximale de l’axe au-delà des valeurs observées pour éviter que les points de bordure ne soient tronqués par le cadre graphique. Il convient donc de mesurer l’étendue stricte entre les points extrêmes réels, et non entre les bornes géométriques du cadre de traçage. De surcroît, l’analyste doit vérifier l’absence d’interruptions d’échelle ou de sauts non linéaires qui fausseraient la lecture directe de l’intervalle.
5.2 Localisation des quartiles Q1 et Q3 par division d’effectifs
La détermination manuelle des quartiles sur un graphique à points repose sur la partition ordonnée de l’effectif total $n$ en quatre sous-groupes d’effectifs égaux, opération articulée autour de la médiane préalablement isolée. Bien qu’il existe plusieurs conventions de calcul pour les centiles dans les logiciels d’analyse de données (notamment les variantes proposées par Hyndman et Fan), la méthode dite « méthode de Tukey » (ou méthode des charnières) s’impose comme la plus naturelle pour l’extraction graphique manuelle :
- Division du jeu de points : Une fois la médiane $M$ identifiée, l’ensemble des observations est scindé en deux moitiés égales : la moitié inférieure (contenant toutes les observations situées strictement à gauche de la médiane) et la moitié supérieure (contenant toutes les observations situées strictement à droite). Si la médiane correspondait à un point matériel unique issu d’un effectif impair, ce point pivot est généralement exclu des deux sous-ensembles pour l’analyse des quartiles.
- Calcul du premier quartile ($Q_1$) : Le premier quartile s’obtient en appliquant l’algorithme de la médiane exclusivement à la moitié inférieure des données. Il correspond au point central de cette sous-série ordonnée, marquant le seuil sous lequel se trouvent 25 % des observations de l’ensemble de l’échantillon.
- Calcul du troisième quartile ($Q_3$) : De façon symétrique, le troisième quartile s’obtient en déterminant la valeur médiane de la moitié supérieure des données. Il marque le seuil sous lequel se situent 75 % de l’ensemble des points.
- Formalisation de l’écart interquartile : La dispersion robuste est enfin obtenue en opérant la différence :
$$\text{IQR} = Q_3 – Q_1$$
Cette approche systématique garantit que l’écart interquartile résultant représente très exactement la largeur de l’empan spatial dans lequel se concentre le cœur de l’échantillon.
5.3 Évaluation de la densité relative et des zones de vide (gaps)
L’un des apports majeurs du graphique à points par rapport aux résumés numériques est sa capacité à révéler sans artifice la texture interne de la distribution, notamment la présence de zones de vide (qualifiées de gaps dans la littérature spécialisée) et de zones de forte condensation locale. Une dispersion globale ne se manifeste pas nécessairement par un étalement continu et régulier des mesures sur l’axe : elle peut résulter d’agglomérations distinctes séparées par des étendues désertes.
Une zone de vide s’identifie visuellement par un intervalle horizontal horizontalement étendu sur l’axe des abscisses le long duquel aucun point n’est tracé, alors même que des observations existent en amont et en aval de cette coupure. L’existence d’un tel vide indique une discontinuité fondamentale dans le processus générateur de données. Dans un protocole expérimental, cela peut révéler un seuil critique d’activation, une dichotomie inattendue au sein des profils de réponse des sujets, ou un défaut d’échantillonnage n’ayant pas capturé les états intermédiaires de la variable.
L’évaluation conjointe de la densité relative (le rapport entre le nombre de points empilés dans une colonne et la largeur occupée) et des zones de vide permet de pondérer l’interprétation de la dispersion. Si deux groupes d’individus affichent une étendue brute identique de vingt unités, mais que le premier groupe présente une distribution continue homogène tandis que le second se compose de deux amas étanches séparés par un vide de quinze unités, l’analyste conclura à des dynamiques de variabilité radicalement différentes. La simple lecture des paramètres numériques traditionnels aurait occulté cette distinction morphologique majeure.
6. Étude de cas détaillée : scores comportementaux et temps de réaction
6.1 Contextualisation expérimentale et présentation du graphique à points
Pour illustrer de manière concrète l’application de ces démarches méthodologiques, examinons une étude de cas inspirée des paradigmes classiques de neuropsychologie expérimentale. Une équipe de chercheurs étudie l’impact d’une tâche d’attention divisée complexe sur la précision de la réponse motrice chez un groupe de vingt-cinq volontaires adultes sains ($N = 25$). La variable d’intérêt dépendante est le nombre d’erreurs commises lors d’une session standardisée d’une durée de dix minutes. Les scores possibles s’étendent sur une échelle discrète théorique allant de 0 à 20 erreurs.
Le protocole expérimental a produit la distribution de points suivante sur l’axe horizontal gradué :
- À l’abscisse 2 : 1 point
- À l’abscisse 3 : 2 points empilés
- À l’abscisse 4 : 3 points empilés
- À l’abscisse 5 : 5 points empilés
- À l’abscisse 6 : 4 points empilés
- À l’abscisse 7 : 3 points empilés
- À l’abscisse 8 : 2 points empilés
- À l’abscisse 9 : 1 point
- À l’abscisse 11 : 1 point
- À l’abscisse 12 : 1 point
- À l’abscisse 16 : 2 points empilés
Les questions de recherche visent à déterminer le niveau de performance typique des participants confrontés à ce protocole cognitif éprouvant (tendance centrale) et à caractériser le degré d’homogénéité ou d’hétérogénéité des profils individuels au sein de ce groupe (dispersion).
6.2 Identification guidée du centre : calculs de la médiane et de la moyenne
Engageons le calcul du centre à partir des données structurées de l’expérience :
- Vérification de l’effectif total :
$$n = 1 + 2 + 3 + 5 + 4 + 3 + 2 + 1 + 1 + 1 + 2 = 25 \text{ points}$$
L’effectif étant impair ($n = 25$), la médiane occupe un rang physique unique délimité par :
$$P_M = \frac{n + 1}{2} = \frac{25 + 1}{2} = 13\text{e position}$$ - Localisation séquentielle de la médiane : Nous comptons les points de gauche à droite le long de l’axe :
- Abscisse 2 : 1 point cumulé
- Abscisse 3 : 1 + 2 = 3 points cumulés
- Abscisse 4 : 3 + 3 = 6 points cumulés
- Abscisse 5 : 6 + 5 = 11 points cumulés
- Abscisse 6 : les points cumulés couvrent les rangs 12, 13, 14 et 15.
Le treizième point de la distribution se situe donc indubitablement dans la colonne érigée au-dessus de la valeur 6. La médiane empirique de notre échantillon est par conséquent :
$$\text{Mdn} = 6\text{ erreurs}$$ - Calcul de la moyenne arithmétique : Procédons à l’extraction de la somme pondérée de toutes les observations :
$$\sum x_i = (1 \times 2) + (2 \times 3) + (3 \times 4) + (5 \times 5) + (4 \times 6) + (3 \times 7) + (2 \times 8) + (1 \times 9) + (1 \times 11) + (1 \times 12) + (2 \times 16)$$
$$\sum x_i = 2 + 6 + 12 + 25 + 24 + 21 + 16 + 9 + 11 + 12 + 32 = 170$$
La moyenne s’établit dès lors à :
$$\bar{x} = \frac{170}{25} = 6{,}80\text{ erreurs}$$
L’analyse comparative de ces deux valeurs révèle un décalage instructif : la moyenne arithmétique (6,80) se trouve surélevée de près d’une unité par rapport à la médiane (6,00). Ce déplacement vers les valeurs supérieures résulte de l’attraction barycentrique exercée par les observations marginales situées à 11, 12 et surtout à 16 erreurs. Pour rendre compte de la performance centrale typique d’un participant standard, la médiane à 6 erreurs s’avère indiscutablement plus représentative que la moyenne.
6.3 Quantification rigoureuse de la dispersion : étendue et quartiles
Passons à présent à la formalisation de la dispersion de ce même échantillon :
- Calcul de l’étendue globale : Le point le plus à gauche correspond à $x_{\min} = 2$, et le point le plus à droite correspond à $x_{\max} = 16$. L’étendue brute s’élève ainsi à :
$$E = 16 – 2 = 14\text{ erreurs}$$
Cette amplitude de 14 unités suggère au premier abord une dispersion très substantielle au sein du groupe expérimental. - Partitionnement pour l’écart interquartile : La médiane étant la treizième valeur, la moitié inférieure de l’échantillon regroupe les douze premières observations (du rang 1 au rang 12), tandis que la moitié supérieure regroupe les douze dernières observations (du rang 14 au rang 25).
- Pour la moitié inférieure ($n_{\text{\inf}} = 12$), la médiane de ce sous-groupe correspond au point médian entre les rangs 6 et 7. En consultant notre décompte cumulé, le rang 6 se trouve à la valeur 4, et le rang 7 se situe au début de la colonne 5. Le premier quartile vaut donc :
$$Q_1 = \frac{4 + 5}{2} = 4{,}5\text{ erreurs}$$ - Pour la moitié supérieure ($n_{\text{\sup}} = 12$), la médiane correspond à l’intervalle entre les rangs 19 et 20 de la série globale ($12 + 6 = 18$ et $12 + 7 = 19$, soit le sixième et le septième élément du sous-ensemble supérieur). Vérifions les rangs cumulés : les rangs 12 à 15 sont à la valeur 6 ; les rangs 16, 17, 18 sont à la valeur 7 ; les rangs 19 et 20 tombent tous les deux sur la valeur 8. Par conséquent :
$$Q_3 = \frac{8 + 8}{2} = 8\text{ erreurs}$$
- Pour la moitié inférieure ($n_{\text{\inf}} = 12$), la médiane de ce sous-groupe correspond au point médian entre les rangs 6 et 7. En consultant notre décompte cumulé, le rang 6 se trouve à la valeur 4, et le rang 7 se situe au début de la colonne 5. Le premier quartile vaut donc :
- Calcul de l’IQR :
$$\text{IQR} = Q_3 – Q_1 = 8 – 4{,}5 = 3{,}5\text{ erreurs}$$
Cette quantification éclaire la structure du groupe : alors que l’étendue globale est de 14 erreurs, 50 % des participants se trouvent concentrés dans un intervalle étroit de seulement 3,5 erreurs autour du centre. L’hétérogénéité apparente de l’échantillon est donc principalement le fait de quelques individus isolés, la majorité de la cohorte faisant preuve d’une homogénéité comportementale remarquable.
7. Impact de la forme de la distribution sur le centre et la dispersion
7.1 Distributions symétriques et concordance des paramètres
La forme géométrique dessinée par les colonnes de points sur l’axe horizontal conditionne directement la relation entre les indicateurs de position et de dispersion. Une distribution est dite parfaitement symétrique s’il existe un axe vertical de symétrie tel que la disposition des points situés à gauche de cet axe est le reflet exact de celle des points situés à droite. Sur un graphique à points, cette configuration prend l’aspect d’une cloche équilibrée ou d’une pyramide centrée, les colonnes s’élevant progressivement vers un pic unique médian pour redescendre de manière homogène vers les deux extrémités.
En présence d’une symétrie rigoureuse, on assiste à un alignement spatial idéal des trois paramètres de tendance centrale :
$$\text{Mode} = \text{Médiane} = \text{Moyenne arithmétique}$$
Dans ce contexte, le choix entre la moyenne et la médiane cesse d’être conflictuel sur le plan descriptif, chacune convergeant vers la même coordonnée d’abscisse. Il est alors d’usage de privilégier la moyenne arithmétique et l’écart-type, car ces métriques bénéficient d’une efficacité statistique optimale (variance d’échantillonnage minimale) sous hypothèse de quasi-normalité. L’écart interquartile et l’étendue maintiennent des relations fixes prévisibles avec l’écart-type : l’IQR équivaut approximativement à $1{,}349 \times s$, permettant une modélisation paramétrique harmonieuse de l’ensemble des données.
7.2 Asymétrie positive (étalement à droite) : distorsion des indicateurs
L’asymétrie positive, communément appelée étalement à droite (ou right-skewed distribution), représente la morphologie non symétrique la plus couramment rencontrée dans la pratique expérimentale, notamment lors du recueil de grandeurs physiques strictement positives comme les temps de réaction, les taux sanguins d’hormones ou le nombre d’erreurs commises. Sur le graphique à points, cette configuration se caractérise par une forte concentration de colonnes denses dans la partie gauche de l’axe (vers les valeurs faibles), suivie d’une longue traîne effilée de points épars s’étirant vers la droite.
Cette morphologie entraîne une distorsion systématique et prévisible de la hiérarchie des mesures de tendance centrale, obéissant à l’inégalité classique :
$$\text{Mode} < \text{Médiane} < \text{Moyenne arithmétique}$$
Sous l’influence gravitationnelle des quelques points éloignés sur la droite, la moyenne est littéralement aspirée vers les valeurs élevées, au point d’atterrir dans une zone horizontale où les points sont rares, voire absents. Elle ne représente plus du tout la performance standard d’un individu de l’échantillon. La médiane, en revanche, résiste à cette attraction et demeure positionnée au sein du massif principal d’observations. Quant à la dispersion, l’étendue globale subit une inflation disproportionnée sous l’effet de la traîne, tandis que l’écart interquartile préserve une mesure fidèle de l’étalement du cœur du groupe. C’est le cas type où l’adoption du couple Médiane-IQR s’impose impérativement.
7.3 Asymétrie négative (étalement à gauche) et multimodalité
À l’opposé, l’asymétrie négative — ou étalement à gauche (left-skewed distribution) — se manifeste par une masse de points concentrée sur les valeurs élevées de l’échelle, bordée par une queue d’observations peu nombreuses s’effilochant vers la gauche, en direction des valeurs faibles ou négatives. On l’observe typiquement lors d’examens universitaires faciles ou dans des tâches psychologiques routinières où la plupart des participants frôlent le score maximal. Dans ce cas, la relation d’ordre s’inverse de façon symétrique :
$$\text{Moyenne arithmétique} < \text{Médiane} < \text{Mode}$$
La présence d’une multimodalité engendre une complexité analytique encore supérieure. Lorsqu’un graphique à points fait apparaître deux ou trois amas denses distincts séparés par des zones de vide intermédiaire, l’analyste se trouve confronté à une faillite descriptive des résumés à valeur centrale unique. Calculer une médiane ou une moyenne sur une distribution bimodale revient à situer le « centre » de l’échantillon en plein cœur de la zone de vide, c’est-à-dire précisément à un endroit où aucune observation n’a été enregistrée.
Face à une distribution multimodale sur un graphique à points, la rigueur méthodologique proscrit l’application d’un paramètre central global unifié. L’analyste doit reconnaître l’existence de sous-populations sous-jacentes (par exemple, des répondeurs et des non-répondeurs à une molécule pharmacologique, ou des profils débutants versus experts) et procéder à une segmentation conditionnelle de son échantillon, en décrivant le centre et la dispersion de chaque grappe de points de manière indépendante.
8. Identification et traitement des valeurs aberrantes (outliers)
8.1 Critères géométriques et visuels d’isolement sur le graphique
L’un des atouts diagnostiques majeurs du graphique à points réside dans sa capacité à exposer immédiatement les valeurs aberrantes (ou outliers) sans qu’aucun calcul préalable ne soit nécessaire. Sur le plan géométrique, une valeur aberrante se repère visuellement comme un point solitaire relégué à une extrémité de l’axe, séparé du reste du nuage de points par une zone de vide horizontal particulièrement vaste et disproportionnée par rapport aux espacements inter-points observés au sein du groupe central.
Toutefois, l’analyste doit se garder de confondre une véritable valeur aberrante avec la variabilité naturelle d’une distribution à queue lourde. Une observation isolée peut résulter de trois causes distinctes :
- Une erreur de mesure ou d’encodage : Dysfonctionnement d’un capteur électronique, frappe erronée lors de la saisie d’un résultat, ou non-respect flagrant des consignes de l’expérience par un participant.
- Une contamination de l’échantillon : Inclusion involontaire d’un individu n’appartenant pas à la population cible (par exemple, un participant ayant consommé un psychotrope avant un test d’attention).
- Une variation biologique ou comportementale réelle : Trajectoire idiosyncrasique mais parfaitement authentique d’un individu exceptionnel (par exemple, un temps de réaction phénoménal chez un athlète d’élite).
L’observation du point sur le graphique déclenche l’investigation méthodologique, mais ne suffit pas à justifier son exclusion sommaire. Le graphique à points préserve ce signal d’alerte, empêchant que l’anomalie ne passe inaperçue sous un voile d’agrégation statistique.
8.2 Application de la règle standard de Tukey sur le graphique à points
Pour dépasser l’appréciation purement subjective de l’isolement visuel, on applique la règle formelle d’identification des clôtures de Tukey, élaborée par le statisticien John Tukey. Cette méthode standardise le seuillage des valeurs aberrantes en exploitant les quartiles et l’écart interquartile :
- Calcul des clôtures internes (seuil de modération) :
- Clôture inférieure modérée : $\text{CI} = Q_1 – 1{,}5 \times \text{IQR}$
- Clôture supérieure modérée : $\text{CS} = Q_3 + 1{,}5 \times \text{IQR}$
Tout point tracé sur le graphique au-delà de ces clôtures est formellement catégorisé comme une valeur aberrante modérée.
- Calcul des clôtures externes (seuil de sévérité) :
- Clôture inférieure extrême : $\text{CEI} = Q_1 – 3{,}0 \times \text{IQR}$
- Clôture supérieure extrême : $\text{CES} = Q_3 + 3{,}0 \times \text{IQR}$
Tout point situé au-delà de ces clôtures externes constitue une valeur aberrante extrême (ou sévère).
Prenons un exemple concret : si notre calcul sur un graphique à points a établi que $Q_1 = 10$, $Q_3 = 20$ (d’où $\text{IQR} = 10$), les clôtures internes s’établiront à :
$$\text{CI} = 10 – (1{,}5 \times 10) = -5 \quad \text{et} \quad \text{CS} = 20 + (1{,}5 \times 10) = 35$$
Un point tracé à la position 38 sur l’axe des abscisses franchit la clôture supérieure (38 > 35) : il est mathématiquement déclaré valeur aberrante. Cette standardisation algorithmique permet d’objectiver les décisions de reporting scientifique et d’éviter les biais de confirmation lors de l’épuration des micro-fichiers de données.
8.3 Stratégies méthodologiques d’analyse avec et sans valeurs aberrantes
Lorsqu’une ou plusieurs valeurs aberrantes sont identifiées sur un graphique à points, la tentation immédiate du chercheur débutant est de les supprimer purement et simplement afin de resserrer la distribution et de faire converger la moyenne vers la médiane. Cette pratique de censure des données sans justification causale démontrée enfreint les règles déontologiques les plus élémentaires de la démarche scientifique.
La doctrine méthodologique moderne préconise la stratégie du « double rapport » (ou analyse de sensibilité) :
- L’analyste consigne les paramètres descriptifs complets (moyenne, médiane, étendue, IQR) calculés sur l’intégralité de l’échantillon incluant les points extrêmes.
- Il recalcule ensuite ces mêmes métriques après neutralisation ciblée de la ou des valeurs aberrantes avérées.
- Il évalue la divergence entre les deux états : si la médiane et l’IQR restent quasiment immobiles tandis que la moyenne et l’étendue s’effondrent, l’analyste apporte la preuve empirique que la dynamique du phénomène central n’est pas modifiée par ces singularités, tout en documentant en toute transparence la présence d’individus atypiques.
Dans le texte scientifique accompagnant le graphique, chaque point exclu doit faire l’objet d’une justification explicite (par exemple : « un participant a été retiré de l’analyse en raison d’un score de 19 erreurs excédant de plus de trois écarts-types la limite supérieure de Tukey, imputable à une interruption technique pendant la tâche »). Cette rigueur confère à l’évaluation du centre et de la dispersion une fiabilité méthodologique irréprochable.
9. Comparaison de plusieurs graphiques à points : analyses de groupes
9.1 Alignement vertical de graphiques parallèles pour groupes indépendants
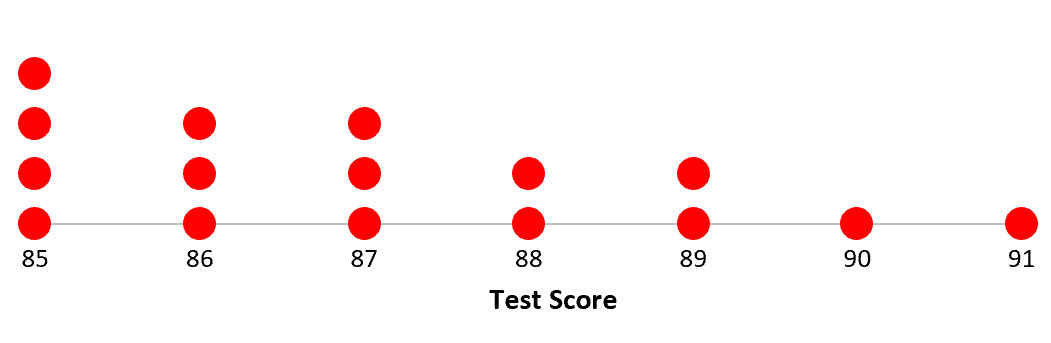
L’un des usages les plus féconds du graphique à points en analyse expérimentale est la comparaison directe de deux ou plusieurs conditions de traitement par l’entremise de graphiques à points parallèles empilés verticalement. Dans cette configuration, chaque groupe expérimental ou cohorte clinique dispose de sa propre ligne horizontale de points, les différents axes étant disposés les uns au-dessus des autres dans un même repère graphique.
La règle d’or architecturale de ce type de visualisation réside dans le partage strict d’une échelle d’abscisse rigoureusement identique en termes d’origine, d’étendue et de pas d’incrémentation. Sous cette condition impérative, l’observateur peut procéder à une comparaison visuelle immédiate des distributions :
- Alignement des centres : En abaissant mentalement ou matériellement une ligne verticale depuis la médiane du groupe contrôle vers celle du groupe expérimental, on apprécie instantanément l’amplitude de l’effet du traitement. Tout décalage horizontal vers la droite ou la gauche matérialise un glissement de la tendance centrale.
- Comparaison des largeurs : La comparaison visuelle directe de la distance séparant les points extrêmes de chaque ligne permet d’évaluer si une condition expérimentale a eu pour effet d’homogénéiser les réponses des sujets (resserrement horizontal) ou, au contraire, d’induire une dispersion accrue (élargissement latéral de la ligne de points).
9.2 Mesure du chevauchement et de la séparation des distributions
Au-delà de la seule comparaison de leurs centres respectifs, l’efficacité différentielle de deux conditions expérimentales se mesure à l’intensité du chevauchement (ou overlap) géométrique de leurs nuages de points sur l’axe partagé. Si le graphique à points d’un groupe traité se trouve intégralement déporté sur la droite de celui du groupe contrôle, sans qu’aucun point ne partage une coordonnée commune, la séparation des distributions est dite totale, signalant une taille d’effet expérimentale considérable.
À l’inverse, si les médianes diffèrent de quelques unités mais que la grande majorité des points des deux cohortes s’inscrivent dans une plage de valeurs partagée, le chevauchement est massif. Cela avertit le chercheur que, malgré une possible significativité statistique issue d’un test formel sur grand échantillon, la pertinence clinique individuelle de la différence observée reste modeste : un sujet pris au hasard dans le groupe traité a de fortes probabilités d’afficher un score comparable à celui d’un individu du groupe témoin.
Ce diagnostic visuel intuitif constitue une approximation qualitative du concept statistique de taille d’effet (notamment le $d$ de Cohen ou le coefficient de non-recouvrement de Grissom et Kim). Le graphique à points protège ainsi l’analyste contre l’écueil classique consistant à déclarer une intervention expérimentale probante sur la foi d’un décalage de moyenne, alors même que l’hétérogénéité des deux groupes rend les distributions largement indissociables sur le terrain.
9.3 Identification de l’hétéroscédasticité entre plusieurs cohortes
L’hétéroscédasticité — c’est-à-dire l’inégalité de la dispersion ou de la variance entre plusieurs groupes d’échantillonnage — constitue une violation majeure des postulats régissant la plupart des méthodes d’inférence statistique paramétrique, telles que le test $t$ de Student ou l’analyse de variance (ANOVA). L’examen de graphiques à points parallèles offre un outil diagnostique visuel remarquablement sensible pour intercepter ce problème avant d’engager des modélisations mathématiques formelles.
Si la ligne de points du groupe A présente un regroupement très compact autour de sa médiane (IQR réduit, points fortement empilés verticalement sur trois graduations), tandis que la ligne de points du groupe B s’étire de façon diffuse sur l’ensemble de la portée de l’axe (faibles empilements, dispersion horizontale très large), l’analyste pose un diagnostic immédiat d’hétérogénéité des variances. Ce constat visuel a d’importantes conséquences méthodologiques :
- L’application d’un test $t$ classique sans correction conduirait à un taux d’erreur de type I incontrôlé.
- L’analyste est averti qu’il doit s’orienter vers des alternatives robustes, telles que le test de Welch pour variances inégales ou des tests non paramétriques basés sur les rangs (test $U$ de Mann-Whitney).
- Sur le plan théorique, l’augmentation spectaculaire de la dispersion au sein d’un groupe expérimental peut signifier que le traitement appliqué ne produit pas un effet uniforme, mais engendre des réactions divergentes selon les caractéristiques individuelles des participants, ouvrant de nouvelles pistes d’investigation.
10. Erreurs méthodologiques courantes et biais de lecture
10.1 Confusions relatives à l’échelle et aux pas d’incrémentation
L’interprétation visuelle de la dispersion et du centre sur un graphique à points est tributaire des choix de conception graphique retenus lors de l’élaboration de l’axe horizontal. Une première source récurrente d’erreur réside dans la manipulation des bornes de l’échelle et la troncature arbitraire de son point d’origine. Si l’axe d’une variable qui s’étend théoriquement de 0 à 100 est tronqué pour ne débuter qu’à 85 et s’achever à 95, un nuage de points dont l’étendue réelle n’est que de 8 unités paraîtra visuellement occuper la quasi-totalité de l’espace graphique disponible, induisant le lecteur en erreur quant à l’importance de sa dispersion.
Une seconde distorsion découle du ratio d’aspect géométrique (la largeur totale du graphique divisée par sa hauteur). En étirant démesurément l’axe horizontal, on projette une illusion de forte dispersion : les points semblent s’éloigner les uns des autres. À l’inverse, une compression horizontale excessive resserre artificiellement les colonnes de points, donnant le sentiment trompeur d’une compacité et d’une homogénéité extrêmes. L’analyste doit s’assurer que les pas d’incrémentation (les graduations) sont réguliers, linéaires et clairement annotés par des chiffres lisibles.
Enfin, une erreur technique fréquente survient lorsque le diamètre des points est mal ajusté à la résolution de l’échelle. Si les symboles ponctuels sont disproportionnellement larges, ils peuvent fusionner ou se chevaucher horizontalement, empêchant de discerner si deux observations occupent des valeurs adjacentes distinctes ou une même coordonnée, ruinant ainsi la précision du dénombrement séquentiel nécessaire au calcul de la médiane.
10.2 Biais d’estimation visuelle de la moyenne au lieu de la médiane
La cognition visuelle humaine souffre d’un biais d’estimation spontané lorsqu’elle est sollicitée pour situer le « milieu » d’un nuage de points sur une surface graphique. Face à un graphique à points, notre système perceptif a une tendance naturelle à rechercher le centre géométrique de l’empan visuel total, c’est-à-dire le milieu exact séparant le point le plus à gauche du point le plus à droite (le milieu de l’étendue, ou mid-range) :
$$\text{Centre perçu} \approx \frac{x_{\min} + x_{\max}}{2}$$
Ce raccourci cognitif s’avère particulièrement trompeur en présence de distributions asymétriques ou de valeurs aberrantes. Prenons un jeu de données de dix observations où huit points s’empilent sur la valeur 5, un point se trouve à 10 et un point est isolé à 25. Le centre géométrique apparent de l’étendue se situe à :
$$\frac{5 + 25}{2} = 15$$
Pourtant, la médiane réelle de cette distribution est de 5, et sa moyenne arithmétique est de :
$$\frac{(8 \times 5) + 10 + 25}{10} = \frac{75}{10} = 7{,}5$$
L’œil a tendance à sous-estimer massivement le poids statistique des colonnes composées de points superposés, le cerveau accordant un poids attentionnel disproportionné aux espaces vides et aux points extrêmes isolés. Pour se prémunir contre ce piège perceptif, l’analyste ne doit jamais se fier à son intuition visuelle globale pour déterminer le centre : il doit impérativement formaliser le processus de comptage séquentiel ou de cancellation symétrique décrit précédemment.
10.3 Interprétation abusive de petits échantillons
Bien que le graphique à points constitue l’outil par excellence pour l’analyse des jeux de micro-données, sa transparence même peut conduire à un écueil interprétatif inverse : la surinterprétation des singularités aléatoires sur des échantillons de très petite taille ($N < 10$). Dans un groupe de six ou sept sujets, la topologie des points est intrinsèquement instable et hautement volatile.
Sur un si faible effectif, l’apparition d’un vide horizontal (gap) entre deux colonnes ou d’une asymétrie apparente résulte le plus souvent du simple bruit d’échantillonnage stochastique plutôt que d’une véritable structure sous-jacente au sein de la population parente. De même, l’ajout ou le retrait d’une seule observation peut entraîner un saut brutal de la médiane et doubler instantanément l’étendue globale de la série.
L’analyste doit donc faire preuve de tempérance méthodologique. L’extraction du centre et de la dispersion sur un micro-graphique à points sert avant tout à synthétiser fidèlement l’échantillon présent sous ses yeux ; elle ne saurait autoriser des inférences généralisatrices catégoriques vers des populations globales sans l’appui de réplications expérimentales indépendantes ou d’intervalles de confiance calculés par des techniques de rééchantillonnage robustes (telles que le bootstrap).
11. Outils numériques et logiciels pour générer et analyser un graphique à points
11.1 Implémentation sous l’environnement statistique R
L’environnement statistique open source R offre des capacités computationnelles de premier ordre pour produire des graphiques à points d’une grande rigueur formelle. Dans le système de graphisme de base, la commande native stripchart() permet de générer instantanément un tracé univarié avec empilement vertical précis des points concordants :
L’argument method = "stack" assure l’empilement vertical des observations partageant des valeurs identiques, évitant la superposition opaque. Pour des besoins de publication académique avancée, l’écosystème ggplot2 constitue le standard incontournable grâce à sa fonction dédiée geom_dotplot(). Cette méthode permet de paramétrer finement le diamètre des points (dotsize), la méthode de groupement par classe (binwidth) et l’axe d’empilement (stackdir).
L’avantage décisif d’un environnement scripté comme R réside dans l’intégration programmatique des métriques de centre et de dispersion directement sur la figure. À l’aide de fonctions comme stat_summary() ou de couches vectorielles geom_segment(), l’analyste peut superposer sur le graphique une barre verticale matérialisant la médiane exacte, encadrée par un bandeau ou des moustaches représentant l’intervalle interquartile ($Q_1$ et $Q_3$). L’extraction conjointe des valeurs numériques par les fonctions median() et IQR() garantit une parfaite synchronisation entre le support visuel et les statistiques rapportées dans le texte.
11.2 Génération via Python et les bibliothèques scientifiques
Au sein de l’écosystème Python, l’analyse exploratoire de graphiques à points s’appuie principalement sur la conjonction des bibliothèques matplotlib et seaborn. Bien que seaborn ne propose pas de géométrie d’empilement vertical rigoureusement déterministe identique à celle de R pour les variables continues pures, il offre la fonction stripplot() qui permet d’afficher les observations individuelles le long d’un axe avec un contrôle précis de la dispersion horizontale :
L’activation mesurée du paramètre de dispersion aléatoire (jitter=True) introduit un léger décalage spatial orthogonal qui prévient le recouvrement complet des points partageant la même coordonnée sans altérer en rien leur positionnement critique sur l’axe métrique de la variable. Pour une disposition strictement empilée de données discrètes, l’analyste peut implémenter une boucle algorithmique élémentaire sous matplotlib calculant les fréquences cumulées à l’aide des structures vectorisées de pandas ou numpy.
Le couplage avec les méthodes analytiques de numpy (notamment numpy.median() et numpy.percentile()) permet d’automatiser le calcul des bornes de Tukey et de tracer dynamiquement les clôtures de dispersion sur l’axe horizontal. Cette approche computationnelle garantit la production de figures vectorielles haute résolution (aux formats SVG ou PDF) directement intégrables dans des manuscrits scientifiques soumis aux revues à comité de lecture.
11.3 Solutions interactives et logithèques dédiées à l’enseignement
Pour l’apprentissage méthodologique ou l’exploration rapide de données sans programmation, plusieurs interfaces logicielles graphiques se distinguent par leur pertinence ergonomique :
- GeoGebra : Cette plateforme mathématique dynamique est particulièrement adaptée à la démonstration pédagogique. Elle permet de construire des graphiques à points au sein desquels chaque point peut être glissé individuellement le long de l’axe à l’aide de la souris. L’utilisateur visualise en temps réel les répercussions immédiates de ce déplacement sur une jauge affichant la moyenne, la médiane et l’étendue, concrétisant de manière éclatante la sensibilité barycentrique de la première et la robustesse de la seconde.
- JASP et Jamovi : Développés par et pour la communauté universitaire des chercheurs en sciences humaines et biomédicales, ces progiciels open source intègrent des modules complets d’analyse descriptive visuelle. D’un simple clic, l’utilisateur génère des graphiques à points parallèles superposés à des diagrammes en boîte ou à des tracés de violon (violin plots), tout en extrayant automatiquement des tableaux récapitulatifs exhaustifs intégrant médiane, moyenne, écart-type, IQR et clôtures de Tukey selon les standards de l’APA.
12. Synthèse et recommandations pour le reporting scientifique selon l’APA
12.1 Normes de présentation textuelle des métriques extraites
Dans le corps d’un article scientifique rédigé selon les normes de l’American Psychological Association (APA, 7e édition), la restitution des indices de tendance centrale et de dispersion extraits d’un graphique à points obéit à des conventions typographiques et structurelles strictes. Les symboles statistiques doivent être composés en italique, et les valeurs numériques arrondies avec une rigueur constante (généralement deux décimales) :
- Signalement de la médiane et de l’écart interquartile : Lorsque la distribution des points présente une asymétrie ou héberge des valeurs atypiques, la médiane et l’écart interquartile sont prioritairement mobilisés. L’abréviation officielle pour la médiane est Mdn, et celle pour l’écart interquartile est IQR. La formulation textuelle standard prend la forme suivante :
« Le nombre médian d’erreurs relevées au cours de la tâche comportementale s’établit à 6,00 (IQR = 3,50), témoignant d’une concentration étroite de la majorité des participants en dépit d’une étendue globale substantielle (Min = 2, Max = 16). » - Signalement de la moyenne et de l’écart-type : Si la disposition des points sur le graphique s’avère parfaitement symétrique et dépourvue d’anomalies, le rapport privilégie la moyenne arithmétique (notée M) et l’écart-type (noté SD) :
« Les scores moyens de vigilance affichent une symétrie satisfaisante (M = 14,20, SD = 2,15, N = 25). »
Il est impératif d’expliciter systématiquement la taille totale de l’échantillon (notée N ou n selon qu’il s’agit de la population parente ou d’un sous-groupe) et de justifier le choix de métriques robustes face aux indices paramétriques en s’appuyant sur les propriétés morphologiques observées lors de l’inspection du graphique.
12.2 Conception graphique optimale et légendes explicatives
Un graphique à points destiné à la publication académique doit respecter le principe d’auto-suffisance informative : le lecteur doit pouvoir en décrypter l’intégralité du contenu sans avoir nécessairement à se référer au corps du texte de l’article. Cette exigence impose des règles graphiques strictes :
- Étiquetage de l’axe : L’axe horizontal doit comporter un intitulé précis mentionnant explicitement le nom de la variable mesurée, accompagné de son unité de mesure normalisée entre parenthèses (par exemple : « Temps de latence motrice (ms) » ou « Nombre de réponses correctes »).
- Clarté de la légende unitaire : La légende de la figure doit obligatoirement stipuler la signification unitaire d’un symbole ponctuel (par exemple : « Note. Chaque point plein représente les performances d’un participant unique ($N = 25$). La ligne verticale discontinue indique la médiane de l’échantillon, et les segments horizontaux délimitent l’intervalle interquartile ($Q_1 – Q_3$). »).
- Accessibilité visuelle : Pour satisfaire aux exigences contemporaines d’accessibilité universelle, les graphiques doivent préserver un contraste élevé (points noirs ou gris foncé sur fond blanc uni) et proscrire le recours exclusif à des nuances de couleur pour différencier des sous-groupes sur des axes parallèles, préférant l’emploi de symboles morphologiquement distincts (disques pleins, carrés, triangles évidés).
12.3 Arbre décisionnel récapitulatif pour l’analyse d’un graphique à points
Pour conclure cette exploration méthodologique, voici la synthèse de la démarche intégrée d’analyse d’un graphique à points sous la forme d’un arbre décisionnel séquentiel en quatre phases :
- Phase 1 : Recensement et intégrité structurelle :
- Dénombrer exhaustivement les points pour établir la taille d’échantillon $n$.
- Vérifier la continuité et la linéarité des graduations de l’axe des abscisses.
- Identifier d’éventuels effets de plancher ou de plafond expérimentaux (colonnes disproportionnées aux bornes).
- Phase 2 : Évaluation morphologique de la distribution :
- Évaluer visuellement la symétrie : la distribution est-elle équilibrée, étalée vers la droite ou vers la gauche ?
- Vérifier la modalité : repérer si le graphique comporte un sommet unique ou des grappes disjointes suggérant une multimodalité.
- Identifier les zones de vide notables (gaps) et isoler géométriquement les points atypiques marginaux.
- Phase 3 : Sélection et extraction de la tendance centrale :
- Si la distribution est asymétrique ou comporte des valeurs aberrantes : appliquer l’algorithme de la médiane via le rang $(n + 1) / 2$ ou la cancellation symétrique. Déclarer Mdn.
- Si la distribution est strictement symétrique et unimodale : calculer la moyenne arithmétique $\bar{x}$ en sommant les valeurs ordonnées. Déclarer M.
- Si la distribution est nettement multimodale : segmenter les sous-groupes et calculer les centres conditionnels distincts.
- Phase 4 : Sélection et quantification de la dispersion :
- Mesurer systématiquement l’étendue globale brute ($x_{\max} – x_{\min}$) pour délimiter l’espace total des variations observées.
- Localiser les quartiles $Q_1$ et $Q_3$ par partition d’effectifs et déduire l’écart interquartile $\text{IQR} = Q_3 – Q_1$.
- Calculer les clôtures de Tukey ($Q_1 – 1{,}5 \times \text{IQR}$ et $Q_3 + 1{,}5 \times \text{IQR}$) pour objectiver le statut de tout point suspect.
- Si l’hypothèse de quasi-normalité est confirmée : intégrer l’estimation de l’écart-type ($s$) pour formaliser les modèles paramétriques ultérieurs.
En observant scrupuleusement ces étapes analytiques, le chercheur ou le praticien extrait la quintessence informative contenue dans la géométrie de ses micro-jeux de données, articulant la rigueur du calcul mathématique à la pertinence visuelle de l’exploration graphique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Grissom, R. J., & Kim, J. J. (2012). Effect sizes for research: Univariate and multivariate applications (2nd ed.). Routledge. https://doi.org/10.4324/9780203803004
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- National Institute of Standards and Technology. (2012). e-Handbook of statistical methods. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (1999). Dot plots. The American Statistician, 53(3), 276–283. https://doi.org/10.1080/00031305.1999.10474474