
La représentation graphique des données constitue l’un des piliers fondamentaux de la démarche scientifique contemporaine et de l’ingénierie analytique. Lorsqu’un chercheur ou un praticien manipule des ensembles de mesures expérimentales discrètes, l’objectif visuel premier consiste fréquemment à traduire la dynamique continue sous-jacente du phénomène observé. Dans l’écosystème du langage Python, la bibliothèque Matplotlib s’est imposée comme le standard pour la production de figures destinées aux revues académiques et aux rapports techniques. Toutefois, par conception algorithmique intrinsèque, les fonctions de base de cette bibliothèque relient les observations par de simples segments de droite. Cette modélisation linéaire par morceaux produit inévitablement des représentations anguleuses qui, loin d’être neutres, peuvent introduire des distorsions perceptives sévères, masquer la nature physique des processus différentiables ou susciter des biais d’interprétation chez le lecteur.
Pour dépasser les limites de cette discrétisation visuelle sans corrompre l’intégrité quantitative des mesures, le recours à des méthodologies d’interpolation et de lissage mathématique s’avère incontournable. L’intégration harmonieuse des structures de calcul vectoriel issues de NumPy et des algorithmes d’analyse numérique avancés hébergés au sein du sous-module d’interpolation de SciPy permet de transformer une séquence éparse de points empiriques en une trajectoire continue d’une régularité géométrique irréprochable. Cette transformation n’est pas un simple artifice esthétique ; elle relève d’une discipline méthodologique exigeante où le choix du degré polynomial, la distribution des nœuds et la gestion des conditions aux limites déterminent la validité scientifique de la visualisation finale.
Ce guide exhaustif a pour ambition d’explorer de manière approfondie les fondements théoriques, les mécanismes algorithmiques et les protocoles d’implémentation logicielle nécessaires au traçage de courbes lisses dans Matplotlib. En naviguant à travers les subtilités mathématiques des fonctions splines et B-splines, en disséquant la syntaxe des outils spécialisés tels que l’interpolateur spline de SciPy et en confrontant ces techniques aux pièges d’oscillations pathologiques comme le phénomène de Runge, cet article fournit une référence complète pour les chercheurs, analystes et ingénieurs soucieux d’allier rigueur analytique et excellence graphique.
1. Fondements et enjeux de la visualisation de courbes lisses dans Matplotlib
1.1 Limites du tracé linéaire par morceaux par défaut
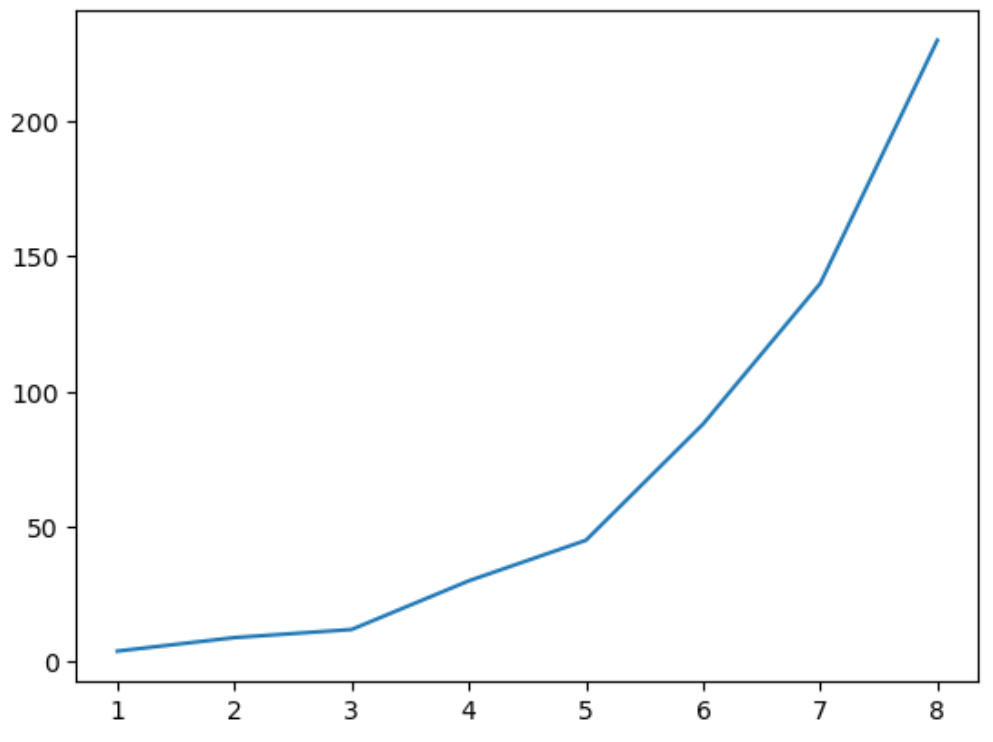
Le comportement standard de la commande de tracé fondamentale de Matplotlib repose sur un principe déterministe élémentaire : l’interconnexion linéaire point par point. Lorsque l’utilisateur soumet deux vecteurs unidimensionnels représentant les coordonnées cartésiennes d’un échantillon, le moteur graphique applique une interpolation affine par morceaux. Dans ce paradigme, chaque paire d’abscisses adjacentes est raccordée par un segment de droite unique. Si cette approche garantit une fidélité absolue à l’emplacement géométrique des données enregistrées sans nécessiter de calcul intermédiaire, elle révèle rapidement ses faiblesses dès lors que l’échantillonnage expérimental est restreint ou asymétriquement distribué le long du domaine d’étude.
Cette discrétisation grossière engendre des artefacts visuels hautement préjudiciables à la lecture des données. Les ruptures brutales de direction aux nœuds de mesure créent des sommets anguleux et des creux en biseau qui n’ont aucune correspondance dans les systèmes physiques, biologiques ou psychométriques réels, lesquels obéissent généralement à des lois de transition fluides régies par des équations différentielles. Ces arêtes vives induisent un bruit perceptif parasitaire qui capte indûment l’attention visuelle de l’observateur au détriment de la tendance globale du signal. Il devient alors ardu de distinguer ce qui relève d’une réelle perturbation expérimentale de ce qui n’est qu’un artefact graphique induit par l’insuffisance du taux d’échantillonnage temporel ou spatial.
Au-delà de la dégradation esthétique, la discontinuité de la dérivée première aux points de jonction modifie profondément la perception des variations dynamiques. En physique ou en cinétique chimique, la pente d’une courbe traduit une vitesse instantanée, tandis que sa variation d’inclinaison représente une accélération ou une force motrice. Une représentation linéaire par morceaux suggère implicitement que la vitesse demeure parfaitement constante entre deux observations puis subit une accélération infinie et instantanée lors du passage sur le point mesuré. Cette aberration mathématique désoriente l’interprétation scientifique et souligne la nécessité de mobiliser des modèles d’interpolation d’ordre supérieur garantissant la continuité des dérivées successives.
1.2 Différence fondamentale entre interpolation, régression et lissage
L’élaboration d’une courbe continue à partir d’un ensemble de mesures nécessite une clarification épistémologique préalable des concepts d’interpolation, de régression et de lissage, termes fréquemment confondus dans la pratique du développement informatique. L’interpolation désigne une procédure mathématique exacte imposant à la fonction continue résultante de passer rigoureusement par chacun des points de données observés. L’erreur résiduelle aux points d’ancrage est par définition strictement nulle. Cette approche est parfaitement légitime lorsque les données sources proviennent de calculs théoriques déterministes, de tables trigonométriques ou de mesures instrumentales de très haute précision où l’incertitude aléatoire peut être tenue pour négligeable.
À l’opposé, la régression statistique paramétrique postule l’existence d’une loi structurelle sous-jacente, formulée sous la forme d’un modèle fonctionnel prédéterminé dont les paramètres libres sont ajustés de manière à minimiser une fonction de coût, traditionnellement la somme des carrés des écarts. La courbe de régression n’a pas pour vocation d’intercepter chaque observation ; elle vise à capturer la composante déterministe d’un phénomène en s’affranchissant du bruit d’observation. Cette stratégie est indispensable lorsque le phénomène étudié répond à un cadre théorique robuste, comme une cinétique enzymatique de Michaelis-Menten ou une décroissance radioactive exponentielle, mais elle devient contraignante lorsqu’aucune forme fonctionnelle analytique globale ne s’impose a priori.
Le lissage non paramétrique, souvent matérialisé par des splines d’ajustement ou des filtres convolutifs, occupe une position médiane privilégiée. Il recherche un compromis formel entre deux exigences contradictoires : l’adhérence minimale aux points mesurés et la régularité intrinsèque de la trajectoire, mesurée à travers l’intégrale de sa courbure. Le praticien ne cherche plus à contraindre la courbe à traverser des valeurs aberrantes ou parasitées par un bruit stochastique, mais module un paramètre de pénalisation pour obtenir une forme continue traduisant fidèlement la tendance morphologique. Le choix éclairé entre ces trois approches conditionne directement la rigueur de l’analyse visuelle et dépend intimement du rapport signal sur bruit caractérisant l’expérience.
1.3 Rôle des représentations continues en psychométrie et sciences quantitatives
Dans les disciplines quantitatives traitant du comportement humain, telles que la psychologie expérimentale, les neurosciences cognitives et la psychométrie, la transition visuelle vers la continuité répond à des impératifs méthodologiques cruciaux. L’étude des courbes d’apprentissage, de l’évolution temporelle de la charge mentale ou des cinétiques d’habituation perceptive confronte régulièrement le chercheur à des protocoles où les données sont collectées à des intervalles discrets, par exemple au terme de sessions d’entraînement successives. Une modélisation continue permet d’appréhender le processus sous la forme d’une dynamique cognitive sous-jacente, reflétant la plasticité synaptique ou la réorganisation stratégique du sujet expérimental.
La visualisation des chronométries mentales et des distributions de temps de réaction illustre avec acuité la pertinence de cette approche. L’utilisation d’une courbe lisse facilite l’identification immédiate des régimes de transition, tels que l’amorce d’une phase de saturation cognitive, l’émergence d’un plateau de performance ou la survenue d’un fléchissement attentionnel. Ces zones critiques se caractérisent par des modifications subtiles de la courbure et des points d’inflexion que les tracés polygonaux traditionnels ont tendance à masquer ou à découper artificiellement. Une courbe dotée d’une continuité différentiable rend ces propriétés morphologiques immédiatement discernables à l’œil averti du statisticien.
En outre, la psychologie de la forme (théorie de la Gestalt) enseigne que le système visuel humain possède une propension naturelle à interpréter les angles aigus comme des ruptures qualitatives majeures ou des changements de régime causal. En présentant un tracé anguleux, le concepteur du graphique induit inconsciemment chez ses pairs des interprétations biaisées, poussant le lecteur à postuler des événements critiques à des instants arbitraires où seule une prise de mesure a eu lieu. Adopter une courbe lisse et régulière restaure la neutralité perceptive du document, à condition que cette opération soit explicitée dans le protocole méthodologique de la publication et adossée à une formulation mathématique irréprochable.
2. Théorie mathématique des fonctions splines et B-splines
2.1 Définition formelle des fonctions splines
Sur le plan de l’analyse numérique, une fonction spline est une fonction polynomiale par morceaux définie sur un intervalle réel fermé subdivisé en sous-intervalles distincts. Soit une partition d’un domaine délimitée par une suite strictement croissante de nœuds réels. Une fonction est qualifiée de spline de degré polynomial k si, sur chacun des sous-intervalles délimités par deux nœuds consécutifs, elle coïncide avec un polynôme algébrique de degré inférieur ou égal à k, et si elle présente une régularité globale assurée par la continuité de ses dérivées successives jusqu’à l’ordre k-1 sur l’ensemble du domaine d’interpolation.
Cette condition de raccordement différentiable constitue le cœur structurel des splines. Elle impose que les segments polynomiaux adjacents ne se contentent pas de se toucher à leurs extrémités communes, mais qu’ils partagent également les mêmes valeurs de pente (dérivée première), de concavité (dérivée seconde) et potentiellement de dérivées supérieures selon l’ordre sélectionné. Pour une spline de degré trois, universellement désignée sous le nom de spline cubique, la fonction appartient à l’espace des fonctions deux fois continûment différentiables, garantissant une absence totale de cassure dans la trajectoire ainsi qu’une évolution continue du rayon de courbure.
L’avantage fondamental de cette décomposition par morceaux réside dans sa formidable stabilité numérique comparativement à l’interpolation polynomiale globale de Lagrange. Dans cette dernière, l’accroissement du nombre de points d’échantillonnage impose une élévation concomitante du degré de l’unique polynôme d’ajustement, ce qui conduit inévitablement à un mauvais conditionnement du système matriciel de Vandermonde sous-jacent. Les fonctions splines s’affranchissent radicalement de cette impasse en conservant un degré polynomial modéré tout en augmentant la flexibilité du modèle par l’adjonction méthodique de nœuds d’interpolation locaux.
2.2 Fondements des B-splines (Basis Splines)
Les B-splines, ou splines de base, forment une base vectorielle particulièrement élégante et stable pour l’espace vectoriel des fonctions splines d’un degré donné sur une grille de nœuds prescrite. Développées formellement à travers les travaux fondamentaux de théoriciens de l’analyse numérique tels que Carl de Boor et Maurice Cox, les B-splines permettent d’exprimer toute courbe spline comme une combinaison linéaire de fonctions de base élémentaires pondérées par des coefficients scalaires de contrôle. Cette formulation paramétrique confère aux B-splines des propriétés mathématiques exceptionnelles adaptées à l’informatique graphique.
La construction des fonctions de base B-spline s’effectue traditionnellement par le biais de la relation de récurrence de Cox-de Boor. Au degré zéro, la fonction de base se réduit à une fonction indicatrice valant un sur son intervalle nodal élémentaire et zéro ailleurs. Pour les degrés supérieurs, chaque fonction de base d’ordre k est calculée par une combinaison convexe normalisée de deux fonctions de base d’ordre k-1 adjacentes. Cette définition itérative confère directement aux fonctions de base deux propriétés analytiques majeures : la positivité stricte sur leur domaine d’activation et la propriété de partition de l’unité, signifiant que la somme de toutes les fonctions de base en tout point du domaine est rigoureusement égale à un.
L’atout prépondérant des B-splines réside dans leur support compact. Contrairement aux polynômes classiques dont l’évaluation en un point dépend intrinsèquement de l’ensemble des données distantes, une fonction de base B-spline de degré k s’annule strictement en dehors d’un voisinage immédiat délimité par k+2 nœuds consécutifs. Il en résulte un contrôle géométrique strictement local : la modification d’un coefficient ou le déplacement d’un point expérimental n’entraîne une déformation de la courbe que dans sa proximité immédiate, laissant le reste du tracé parfaitement inchangé. Cette découplabilité spatiale assure une immunité remarquable contre les instabilités numériques globales.
2.3 Le phénomène de Runge et l’avantage des splines d’ordre modéré
Pour appréhender la supériorité opérationnelle des splines dans Matplotlib, il est impératif d’examiner les défaillances notoires de l’interpolation polynomiale globale mises en lumière par le mathématicien allemand Carl Runge au début du vingtième siècle. Lorsque l’on cherche à interpoler une fonction continue sur une grille de nœuds régulièrement espacés à l’aide d’un polynôme unique dont le degré augmente avec la taille de l’échantillon, on observe une dégradation catastrophique de l’approximation aux marges extérieures du domaine. Ce comportement pathologique se traduit par des oscillations d’amplitude exponentiellement croissante près des bornes de l’intervalle.
Le phénomène de Runge découle directement de la croissance démesurée de la constante de Lebesgue associée aux nœuds équidistants. Les dérivées d’ordres supérieurs des polynômes de degré élevé adoptent des valeurs colossales, induisant des courbures parasites qui dénaturent totalement l’allure physique de la grandeur représentée. Tenter de tracer une courbe lisse dans Matplotlib en recourant aveuglément à des fonctions de régression polynomiale de degré supérieur à quatre expose immédiatement l’analyste à ces oscillations fictives, qui peuvent introduire des valeurs aberrantes là où les observations expérimentales indiquaient une trajectoire stable et monotone.
Les splines cubiques (degré k=3) résolvent ce dilemme par une minimisation variationnelle naturelle de la courbure. Il est mathématiquement démontré que parmi toutes les fonctions deux fois continûment différentiables interpolant un ensemble de points donnés, la spline cubique naturelle est celle qui minimise l’intégrale du carré de sa dérivée seconde sur le domaine. Cette formulation est l’analogue direct de l’énergie de déformation élastique emmagasinée par une fine tige métallique ou une règle souple en bois — historiquement appelée *spline* dans la construction navale — contrainte de passer par des points d’appui mécaniques. Les splines d’ordre modéré offrent ainsi le compromis physique parfait entre souplesse morphologique et sobriété géométrique.
3. Configuration de l’environnement Python et préparation des données
3.1 Bibliothèques requises et architecture logicielle
L’élaboration d’un pipeline robuste pour la génération de tracés lisses s’appuie sur une pile logicielle standardisée et hautement optimisée au sein du panorama scientifique Python. Le socle de cette architecture repose sur la trilogie formée par NumPy, SciPy et Matplotlib. NumPy assure le stockage contigu en mémoire vive des vecteurs de coordonnées à travers son objet tableau multidimensionnel, permettant l’exécution d’opérations vectorisées hautement performantes écrites en C et en Fortran. Cette efficacité est primordiale lorsque l’évaluation de la courbe continue implique la densification de milliers de points intermédiaires.
Le sous-module d’interpolation de SciPy constitue le moteur algorithmique central du traitement. Il héberge les structures de données avancées et les solveurs de systèmes linéaires nécessaires à la résolution des équations de raccordement des splines. Les classes et fonctions spécialisées telles que la fabrique d’interpolation spline et la structure B-spline dédiée sont interfacées de manière transparente avec les tableaux NumPy, garantissant un flux de transformation de données sans surcoût de conversion. Par-dessus cette couche de calcul, le module de dessin de Matplotlib assure la traduction des coordonnées lissées en primitives graphiques vectorielles ou matricielles.
Pour garantir la reproductibilité intégrale des calculs dans le cadre de publications scientifiques, il est fortement préconisé d’isoler l’exécution au sein d’un environnement virtuel dédié, piloté par des gestionnaires tels que Conda ou Virtualenv. L’explicitation rigoureuse des numéros de version des bibliothèques déployées prévient les disparités d’arrondi numérique ou les évolutions fonctionnelles de l’API SciPy. Une discipline d’importation claire et conventionnelle, associant des alias standards aux modules NumPy et Matplotlib et ciblant précisément les sous-fonctions d’interpolation, constitue le premier jalon d’un script scientifique maintenable et auditable.
3.2 Préparation et contraintes sur les tableaux de données
Avant d’engager tout calcul d’interpolation géométrique, une préparation rigoureuse des données sources s’impose afin de respecter les préconditions mathématiques requises par les solveurs sous-jacents. La contrainte la plus impérieuse concerne la monotonicité stricte du vecteur d’abscisses. Les algorithmes d’interpolation spline imposent que chaque valeur d’abscisse soit strictement supérieure à la précédente. Une séquence désordonnée ou décroissante déclenche irrémédiablement une exception logicielle bloquante au niveau du solveur, car elle empêche la construction cohérente des intervalles nodaux.
Lorsque les données expérimentales proviennent de capteurs asynchrones ou de processus d’acquisition automatisés, il est fréquent que les observations soient enregistrées dans un ordre chronologique erratique ou spatialement dispersé. Il convient alors de procéder à un tri préalable automatisé. L’analyste doit extraire le vecteur des indices de tri à partir du tableau des abscisses, puis réorganiser simultanément les abscisses et les ordonnées selon cette séquence d’indices. Cette opération vectorisée garantit le maintien strict de la correspondance biunivoque entre chaque observation et sa coordonnée temporelle ou spatiale tout en satisfaisant aux réquisits de monotonicité.
Un autre écueil classique réside dans la présence de doublons stricts sur l’axe des abscisses. La coexistence de deux mesures distinctes pour une même valeur indépendante génère un intervalle nodal de longueur nulle, ce qui conduit à une division par zéro lors du calcul des différences finies ou à une matrice d’interpolation singulière non inversible. Il est impératif de nettoyer le jeu de données en amont en appliquant soit une méthode d’agrégation statistique locale, comme le remplacement des doublons par leur valeur moyenne arithmétique ou médiane, soit un filtrage éliminatoire des redondances. De même, les valeurs manquantes ou infinies doivent être formellement purgées avant toute tentative de résolution.
3.3 Génération d’un jeu de données synthétique de référence
Afin d’illustrer de manière pragmatique les mécanismes de transformation d’une trajectoire brute en courbe fluide, il est méthodologiquement judicieux de concevoir un jeu de données synthétique contrôlé. Ce jeu d’essai doit simuler les propriétés morphologiques récurrentes des observations empiriques réelles : la présence de montées rapides, de zones de saturation asymptotique et d’oscillations amorties, le tout échantillonné de manière clairsemée pour mettre en exergue l’effet des artefacts visuels linéaires.
Considérons par exemple une série de dix coordonnées discrètes régulièrement ou irrégulièrement distribuées sur un intervalle spatial donné. Lorsqu’on transmet directement ces coordonnées au gestionnaire de tracé conventionnel de Matplotlib sans traitement préalable, le résultat graphique se matérialise sous la forme d’un ensemble de facettes rectilignes successives. L’inspection détaillée de cette figure initiale permet d’identifier visuellement les ruptures d’angles qui dénaturent la fluidité du profil théorique. Ces zones anguleuses constituent précisément le point d’application ciblé des algorithmes de reconstruction continue par splines.
Ce jeu de données de référence permet également d’instaurer un banc d’essai comparatif rigoureux. En disposant à la fois des coordonnées des points de contrôle discrets et de l’allure souhaitée du phénomène physique sous-jacent, l’analyste peut évaluer objectivement dans quelle mesure chaque paramètre d’interpolation parvient à reconstituer la dynamique continue initiale sans introduire de déviations aberrantes. Cette étape préparatoire scelle le contrat méthodologique unissant la modélisation mathématique du signal à son exécution logicielle sur les canevas de Matplotlib.
4. Mise en œuvre pratique avec scipy.interpolate.make_interp_spline
4.1 Principe et syntaxe de make_interp_spline
Au sein de la bibliothèque SciPy, la fonction constructrice de spline d’interpolation s’affirme comme l’instrument contemporain le plus puissant et le plus élégant pour transformer un nuage de points discret en une fonction continue différentiable. Conçue pour remplacer progressivement les anciennes interfaces d’interpolation unidimensionnelle, cette fonction fabrique directement une instance de la classe B-spline hautement optimisée. Sa signature canonique requiert au minimum les tableaux de coordonnées d’entrée et propose un paramètre optionnel déterminant l’ordre polynomial de la spline désirée.
Lors de son exécution, la fonction inspecte les dimensions des tableaux d’entrée, vérifie l’absence de non-monotonicité et génère de manière entièrement automatisée le vecteur de nœuds sous-jacent. Elle configure un vecteur de nœuds étendu de telle sorte que les points extrêmes du jeu de données bénéficient d’une multiplicité nodale appropriée, assurant ainsi un calage géométrique rigoureux sur les frontières du domaine d’étude. Simultanément, la fonction formule et résout le système linéaire tridiagonal ou bandé permettant de calculer les coefficients scalaires de la base B-spline qui garantissent le passage exact par l’ensemble des coordonnées fournies.
Le résultat renvoyé par cette fonction constructrice n’est pas un simple ensemble de nouvelles coordonnées statiques, mais un véritable objet fonctionnel appelable. Cette caractéristique architecturale offre une commodité de développement remarquable : l’objet résultant peut être sollicité ultérieurement comme une fonction mathématique standard, capable d’évaluer la valeur prédite en n’importe quelle abscisse continue comprise dans le domaine de définition. L’instanciation de l’interpolateur et l’évaluation de la trajectoire se trouvent ainsi nettement découplées, ce qui optimise substantiellement les temps de calcul lors de visualisations dynamiques ou d’itérations multiples.
4.2 Densification du domaine avec numpy.linspace
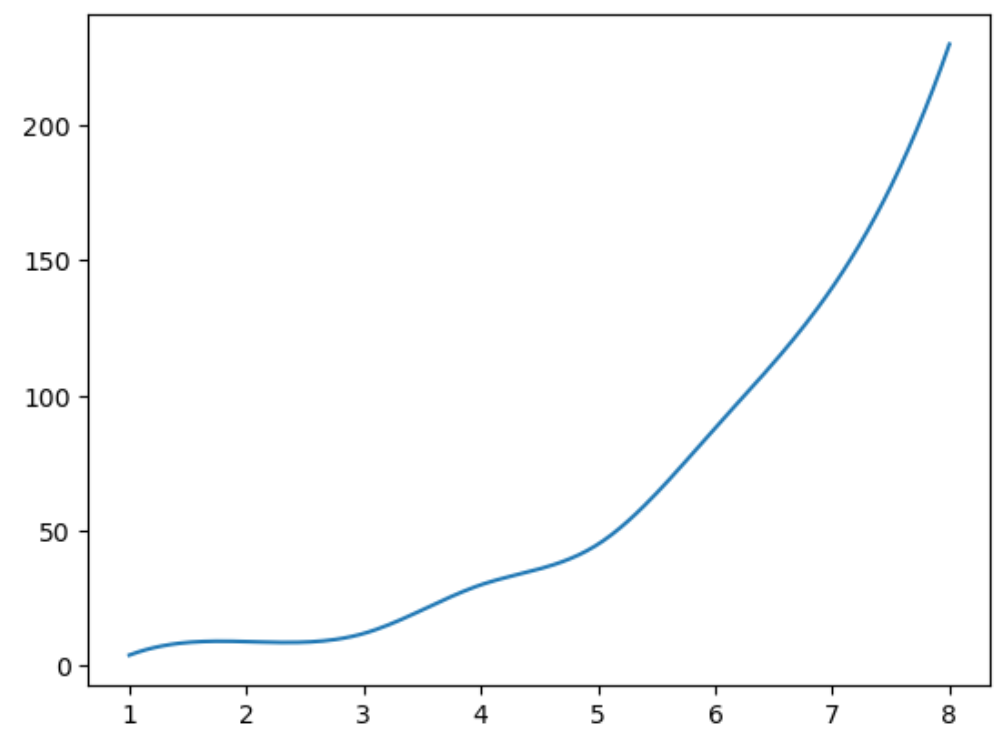
L’obtention concrète d’une courbe visuellement lisse sur un écran d’ordinateur ou sur une planche d’impression vectorielle repose sur une illusion de continuité permise par la densification du maillage d’évaluation. Puisque le moteur de rendu de Matplotlib continue techniquement de relier des points par de minuscules segments, la stratégie consiste à accroître considérablement la densité de ces points jusqu’à ce que la longueur des segments devienne strictement inférieure à la taille physique du pixel ou à la limite de résolution du système visuel humain.
Pour accomplir cette densification, la fonction d’échantillonnage régulier de NumPy s’impose comme la méthode de référence. Elle permet de générer un vecteur d’abscisses hautement résolu délimité très exactement par les valeurs minimale et maximale du jeu de données d’origine. Le choix du nombre de points intermédiaires constitue un paramètre d’arbitrage fondamental : un partitionnement comprenant entre deux cents et cinq cents points s’avère généralement optimal pour la quasi-totalité des figures scientifiques standard. Ce niveau de discrétisation confère une courbure perçue comme infiniment fluide sans grever la mémoire vive ni ralentir le tracé vectoriel.
Il convient toutefois de veiller scrupuleusement au respect des bornes de définition de la spline. Si l’utilisateur tente d’évaluer le modèle en deçà de la valeur minimale ou au-delà de la valeur maximale des données d’origine sans avoir explicitement configuré un protocole d’extrapolation, la fonction génératrice renverra des valeurs indéterminées ou soulèvera une exception d’incompatibilité de domaine. Une formulation rigoureuse consiste donc à extraire dynamiquement les extrêmes du vecteur d’abscisses d’origine pour alimenter les bornes du générateur de maillage dense, assurant ainsi une parfaite congruence spatiale.
4.3 Tracé de la courbe continue résultante
Une fois le maillage dense d’abscisses synthétisé et l’objet interpolant instancié, la génération des ordonnées continues correspondantes s’effectue par une simple invocation vectorisée. L’évaluation de l’objet B-spline sur le maillage dense produit un nouveau vecteur de valeurs d’ordonnées doté d’une résolution identique. Cette opération met en œuvre les routines compilées de bas niveau de SciPy, réalisant le calcul de la combinaison linéaire des fonctions de base avec une célérité temporelle de l’ordre de la milliseconde pour des grilles usuelles.
Le tracé proprement dit s’articule au sein de l’interface graphique de Matplotlib en transmettant ces deux vecteurs à haute résolution aux méthodes de dessin de l’objet d’axe. Parallèlement à cette trajectoire fluide, les préceptes de la visualisation scientifique recommandent vivement de superposer les points de données discrets initiaux au moyen d’un tracé de nuage de points distinct. Cette juxtaposition permet au lecteur d’évaluer instantanément la performance de l’interpolation en constatant visuellement que la courbe continue passe avec une exactitude mathématique absolue par le centre géométrique de chacun des marqueurs expérimentaux.
La comparaison directe entre la courbe brute linéaire et la courbe résultant de l’interpolation par spline cubique permet de mesurer immédiatement le gain de lisibilité scientifique. Les angles agressifs sont résorbés au profit d’arches et d’inflexions harmonieuses qui traduisent l’inertie du phénomène mesuré. En ajustant soigneusement la couleur, l’épaisseur du trait continu et le contraste des points d’ancrage, l’analyste obtient un document graphique répondant aux critères d’exigence éditoriale les plus élevés du monde académique.
5. Analyse approfondie du paramètre de degré polynomial (k)
5.1 Splines de degré un (k=1) : L’interpolation linéaire
Dans la signature de la fonction d’interpolation spline, l’argument formel k régit le degré polynomial des morceaux de fonctions assemblés entre chaque nœud. L’assignation de la valeur k=1 configure l’algorithme pour opérer une interpolation spline de degré un. Sur le plan mathématique, cette configuration se réduit très exactement au modèle linéaire par morceaux traditionnel. Chaque sous-intervalle nodal est alors régi par une équation affine de degré un dont les deux coefficients sont déterminés par les coordonnées des deux points délimitant la section.
Dans ce mode opératoire, la continuité de la fonction elle-même (continuité de classe C0) est rigoureusement respectée à chaque point de jonction, mais la dérivée première présente des discontinuités de première espèce (sauts finis de pente) à chaque nœud expérimental. La dérivée seconde, quant à elle, s’annule sur chaque segment ouvert et adopte un comportement distributionnel impulsionnel indéfini au droit des nœuds. Ce diagnostic formel met en lumière la nature discontinue de la variation locale de trajectoire, confirmant visuellement la persistance d’angles vifs indésirables.
L’utilisation délibérée de la valeur k=1 présente néanmoins un intérêt didactique et technique non négligeable. D’une part, elle permet de vérifier l’intégrité de la chaîne de traitement logicielle en superposant la sortie de l’algorithme spline au tracé natif de Matplotlib, les deux représentations devant coïncider rigoureusement au pixel près. D’autre part, elle est requise dans les domaines où les principes physiques sous-jacents imposent formellement des lois d’évolution en dents de scie ou des cinétiques par seuils de commutation rapide interdisant toute dérivabilité aux transitions.
5.2 Splines quadratiques (k=2) et cubiques (k=3)
L’élévation du paramètre à la valeur k=2 introduit les splines quadratiques, composées de paraboles raccordées aux nœuds de telle manière que la courbe présente une continuité de classe C1. Sous ce régime, la fonction d’interpolation et sa dérivée première sont strictement continues sur l’intégralité du domaine. L’élimination des discontinuités de pente supprime instantanément toute apparence anguleuse sur le tracé de Matplotlib, conférant à la courbe un aspect visuel de rondeur satisfaisant pour l’œil humain.
Toutefois, la dérivée seconde d’une spline quadratique demeure une fonction en escalier, présentant des sauts discontinus à chaque point nodal. Bien que cette discontinuité de courbure soit difficilement perceptible à l’œil nu sur un tracé statique simple, elle induit des déformations dynamiques indésirables lorsque l’on s’intéresse aux taux d’accélération ou à l’évolution géométrique des rayons de courbure. C’est la raison fondamentale pour laquelle le degré k=3, correspondant à la spline cubique, s’impose comme le standard universel et indétrônable en visualisation de données et en ingénierie numérique.
La spline cubique garantit une régularité de classe C2, ce qui implique la continuité ininterrompue de la fonction, de sa dérivée première et de sa dérivée seconde. Cette double différentiabilité assure que le rayon de courbure varie de manière parfaitement graduelle le long de la trajectoire, éliminant tout artefact d’inflexion abrupte. Ce degré offre l’équilibre mathématique optimal : il est suffisamment élevé pour absorber harmonieusement les variations géométriques complexes sans induire de déphasage spatial, tout en demeurant suffisamment bas pour prévenir les instabilités de calcul inhérentes aux polynômes d’ordre supérieur.
5.3 Dépasser le degré trois : Risques et dégradations géométriques
Face à la tentation intuitive de conférer une régularité encore plus poussée au tracé en configurant le paramètre sur des valeurs telles que k=4 (splines quartiques) ou k=5 (splines quintiques), l’analyse numérique invite à la plus grande circonspection. Si ces degrés élevés assurent formellement une continuité de classe C3 ou C4, leur utilisation pour une simple tâche d’interpolation visuelle produit quasi systématiquement des effets contre-productifs sévères.
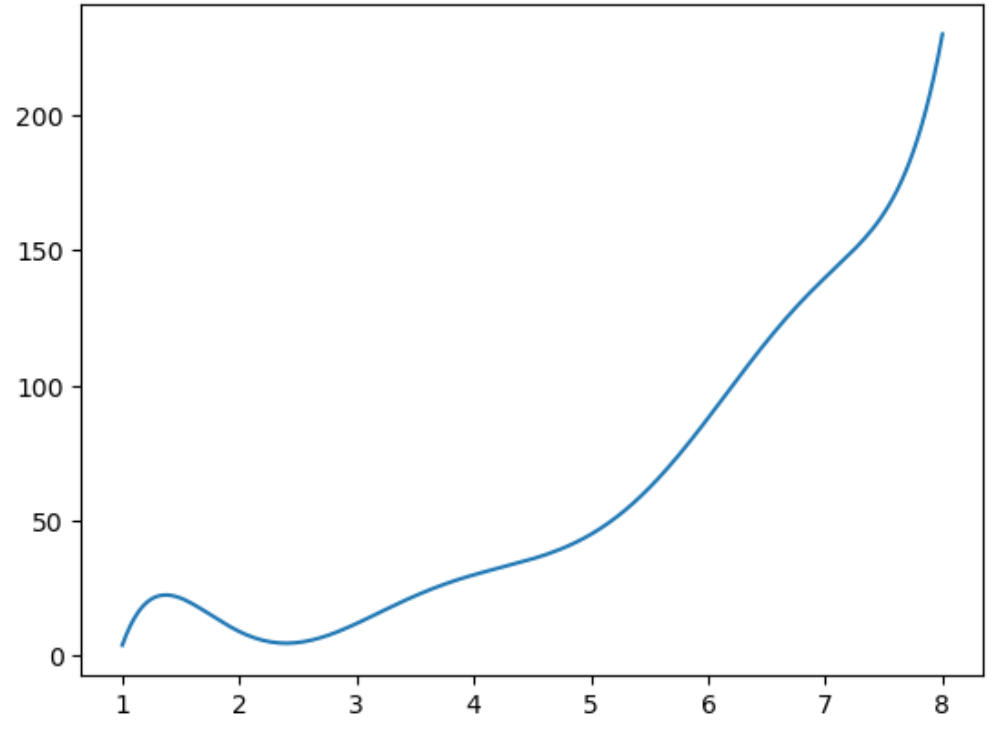
L’élévation du degré polynomial élargit le support d’influence des fonctions de base B-spline, ce qui signifie que chaque point de contrôle exerce une contrainte géométrique sur une portion considérablement plus vaste du domaine. Il en résulte une perte progressive du contrôle local de la forme. De surcroît, les splines de degré élevé manifestent une tendance fâcheuse à répliquer localement les pathologies du phénomène de Runge : elles produisent des dépassements d’amplitude (overshoots) considérables et introduisent des ondulations parasites dans les intervalles où les données empiriques décrivent pourtant une progression parfaitement étale.
Sur le plan computationnel, le conditionnement du système linéaire à résoudre pour déterminer les coefficients de la spline se dégrade exponentiellement avec l’augmentation du degré k. Cette instabilité numérique peut conduire à des erreurs d’arrondi machine perceptibles sous la forme de micro-oscillations aberrantes sur le graphique final, particulièrement lorsque les points de mesure sont rapprochés. Par conséquent, il est formellement recommandé dans la pratique scientifique de proscrire les valeurs de k supérieures à trois pour le tracé de courbes d’interpolation, sauf impératif analytique très spécifique requérant des dérivées troisièmes ou quatrièmes rigoureusement continues.
6. Utilisation experte de la classe scipy.interpolate.BSpline
6.1 Structure interne de l’objet BSpline
Pour exploiter pleinement la puissance des représentations splines dans l’environnement Python, il est essentiel de dépasser les simples fonctions d’assistance pour appréhender l’architecture interne de la classe générique B-spline de SciPy. Cet objet fondamental encapsule l’intégralité des paramètres définissant la fonction selon le formalisme matriciel contemporain : le vecteur de nœuds réels, le tableau multidimensionnel des coefficients de pondération et le degré polynomial du système.
Le vecteur de nœuds constitue l’ossature géométrique de l’espace d’interpolation. Pour une spline de degré k comportant un nombre n de coefficients de contrôle, ce vecteur doit obligatoirement présenter une dimension égale à n + k + 1. La disposition des nœuds détermine la répartition des points d’ancrage et la localisation des zones de continuité différentiable. Une propriété remarquable réside dans la notion de multiplicité des nœuds : si une même valeur d’abscisse est répétée plusieurs fois consécutivement dans le vecteur, la régularité différentiable de la spline en ce point diminue d’autant d’ordres que le degré de multiplicité, permettant si nécessaire de modéliser des ruptures de pente contrôlées.
Lorsqu’un modèle est initialisé par une routine de haut niveau, il est possible de désencapsuler ces composants en interrogeant directement les attributs publics de l’objet généré. L’extraction du vecteur de nœuds et du vecteur de coefficients permet d’inspecter mathématiquement la structure de l’approximation, de stocker ces descripteurs compacts dans des bases de données de métadonnées ou de les réinjecter dans des solveurs externes indépendants, conférant une interopérabilité logicielle totale aux résultats visuels produits dans Matplotlib.
6.2 Instanciation manuelle d’une BSpline personnalisée
L’instanciation manuelle d’un objet B-spline ouvre des perspectives de modélisation géométrique d’une flexibilité incomparable, particulièrement pour la conception de courbes de lissage paramétriques s’inspirant des courbes de Bézier utilisées en conception assistée par ordinateur. Dans ce paradigme de travail, le praticien ne cherche pas nécessairement à résoudre un problème d’interpolation inverse pour passer par des points de données, mais définit arbitrairement un polygone de contrôle composé de points directeurs guidant l’allure globale de la trajectoire.
Pour construire une B-spline manuelle valide, il convient d’édifier un vecteur de nœuds dit « borné » ou « calé » (clamped knot vector). Cette configuration impose que les k+1 premiers nœuds soient rigoureusement identiques à la borne inférieure du domaine, et que les k+1 derniers nœuds soient identiques à la borne supérieure. Cette répétition aux frontières force la courbe continue à intercepter exactement le premier et le dernier point de contrôle géométrique, tout en garantissant que la tangente de départ et la tangente d’arrivée soient colinéaires aux premiers et derniers segments du polygone de contrôle.
En évaluant cette instance vectoriellement sur une grille continue générée par la commande de linspace, l’analyste obtient une courbe d’une régularité absolue qui oscille harmonieusement à l’intérieur de l’enveloppe convexe délimitée par les points de contrôle. Cette technique s’avère particulièrement précieuse en visualisation infographique pour dessiner des trajectoires théoriques schématiques, des couloirs de guidage ou des frontières de décision dans des espaces de classification, sans subir les contraintes d’ajustement point par point de l’interpolation stricte.
6.3 Calcul analytique des dérivées et primitives avec BSpline
L’un des avantages déterminants de la représentation par B-spline réside dans le fait qu’elle constitue une description analytique fermée de la fonction continue sous-jacente. Par conséquent, les opérations de dérivation et d’intégration ne nécessitent nullement l’application d’approximations par différences finies ou de méthodes de quadrature numérique discrètes sujettes aux erreurs d’arrondi : elles peuvent être exécutées de manière formelle et exacte directement sur la structure des coefficients et des nœuds.
L’objet B-spline intègre des méthodes natives permettant de dériver analytiquement le modèle d’interpolation. L’appel à la méthode de dérivation engendre instantanément une nouvelle instance de B-spline, dont le degré se trouve décrémenté d’une unité et dont les coefficients ont été recalculés selon les relations exactes d’analyse différentielle de Cox-de Boor. Cette nouvelle fonction peut alors être tracée sur un axe secondaire de Matplotlib pour représenter l’évolution temporelle du taux de variation, de la vitesse de réaction ou du gradient spatial du signal mesuré, offrant une perspective diagnostique d’une rigueur absolue.
Réciproquement, la méthode d’antidérivation permet de calculer la primitive continue exacte de la courbe. Cette fonctionnalité s’avère providentielle pour la quantification de grandeurs intégrales telles que l’aire sous la courbe (par exemple dans le calcul de la biodisponibilité pharmacocinétique ou de l’énergie mécanique dissipée), ou encore pour estimer les taux d’apprentissage cumulés dans les protocoles psychométriques. L’intégration directe de ces dérivées et primitives au sein de la même figure Matplotlib confère à la production scientifique un niveau d’achèvement et de cohérence formelle inégalable.
7. Gestion des conditions aux limites et contrôle des extrêmes
7.1 Typologie des conditions aux limites (bc_type)
Le système linéaire sous-jacent à la résolution d’une spline cubique comporte un degré de liberté mathématique aux deux extrémités du domaine. Pour obtenir un système algébrique déterminé admettant une solution unique et stable, il est formellement requis d’imposer deux contraintes supplémentaires, traditionnellement nommées conditions aux limites. Le choix de ces conditions, piloté par l’argument d’ajustement des bornes dans les outils modernes de SciPy, exerce une influence majeure sur le comportement graphique de la courbe aux abords immédiats des marges extérieures.
La condition par défaut universellement déployée est la condition dite de « non-a-knot » (sans nœud supplémentaire). Cette approche impose que la dérivée troisième de la spline soit continue au niveau du deuxième nœud et de l’avant-dernier nœud. Cela revient à fusionner les deux premiers segments polynomiaux en un seul et unique polynôme cubique, et de faire de même pour les deux derniers segments. Cette condition présente l’avantage exceptionnel de ne nécessiter aucune hypothèse physique préalable sur les valeurs des dérivées aux frontières et offre une excellente convergence asymptotique.
À cette condition s’ajoute la célèbre condition de spline « naturelle », qui force la dérivée seconde de la fonction à s’annuler identiquement sur les deux extrémités du domaine. Géométriquement, cela contraint la courbe à adopter un comportement rectiligne d’inflexion nulle lorsqu’elle atteint les bornes, éliminant toute courbure artificielle aux frontières. Enfin, les conditions de type « fixé » (clamped) permettent à l’analyste de prescrire manuellement une valeur numérique exacte pour la dérivée première au départ et à l’arrivée, tandis que les conditions périodiques imposent l’égalité stricte de la fonction et de ses deux premières dérivées entre la borne initiale et la borne terminale pour les signaux cycliques.
7.2 Impact des conditions aux limites sur l’allure des extrémités
L’incidence visuelle des conditions aux limites se manifeste de manière spectaculaire sur les portions marginales du tracé Matplotlib. L’adoption irréfléchie d’une condition inadaptée à la nature des données peut engendrer des flexions aberrantes et hautement déceptives. Par exemple, l’application d’une spline naturelle à un jeu de données décrivant une trajectoire parabolique ou sinusoïdale au sommet d’une arche provoquera un aplatissement forcé et factice de la courbe aux extrémités, dégradant la fidélité de la modélisation.
Inversement, la condition de non-a-knot, bien que généralement robuste, peut occasionner des dépassements excessifs (overshoots) si les points extrêmes présentent un fort gradient couplé à un espacement nodal asymétrique. Dans ces situations délicates, la courbe semble « s’échapper » verticalement vers des valeurs irréalistes avant de revenir intercepter le point final. Une inspection visuelle méthodique des marges du graphique permet d’identifier ces divergences locales et d’ajuster le paramètre de condition aux limites pour restaurer un profil morphologiquement cohérent.
Le traitement des extrapolations au-delà du domaine expérimental constitue un danger corollaire majeur. Par défaut, tenter de prolonger l’évaluation d’une spline cubique en dehors de ses bornes mène à des divergences polynomiales cubiques vertigineuses qui ne possèdent aucune pertinence empirique. Les préceptes de la visualisation de données rigoureuse imposent soit de restreindre formellement le tracé lissé à l’enveloppe convective des observations mesurées, soit d’indiquer explicitement par un tracé discontinu et une annotation textuelle que la courbe relève d’une projection extrapolée incertaine.
7.3 Contrôle de la positivité et prévention des dépassements
Un problème récurrent et critique rencontré lors de l’interpolation par splines cubiques concerne la violation de contraintes physiques d’admissibilité des grandeurs représentées, en particulier la positivité stricte. Dans de nombreuses applications scientifiques — telles que la mesure de concentrations biochimiques, de temps de réaction en psychologie ou de densités de probabilité —, une valeur négative est dépourvue de sens physique. Or, en raison de son inertie différentiable, une spline cubique standard oscillant à proximité immédiate de l’axe zéro peut aisément plonger en territoire négatif entre deux points d’ancrage positifs.
Pour parer à cette défaillance sans renoncer à la fluidité de la trajectoire, l’analyste doit se tourner vers des algorithmes d’interpolation préservant la monotonicité et la concavité locale. L’interpolateur d’Hermite cubique par morceaux préservant la monotonicité (Pchip), disponible au sein du module d’interpolation de SciPy, apporte une réponse mathématique parfaite à cette exigence. Contrairement à la spline cubique classique qui garantit la continuité de la dérivée seconde au prix d’ondulations libres, l’interpolateur Pchip limite le calcul des dérivées de manière à empêcher tout dépassement au-delà des extremums locaux des données brutes.
La comparaison graphique dans Matplotlib entre une spline cubique non contrainte et une interpolation de type Pchip met en lumière des divergences qualitatives fondamentales. Si les données sous-jacentes présentent un palier d’invariance ou une décroissance monotone, la courbe Pchip épousera rigoureusement cette monotonicité sans jamais générer de vagues artificielles ni franchir les seuils critiques de positivité. Cette rigueur structurelle en fait l’outil d’élection pour le traitement de cinétiques saturables ou de grandeurs strictement non négatives.
8. Méthodes alternatives de lissage dans l’écosystème Python
8.1 Utilisation de scipy.interpolate.interp1d et CubicSpline
L’écosystème SciPy héberge plusieurs générations d’outils d’interpolation, et la clarté méthodologique exige de comprendre leur articulation historique et fonctionnelle. Pendant de nombreuses années, la fonction générique d’interpolation unidimensionnelle interp1d a constitué le point d’entrée prédominant pour le calcul de trajectoires continues, en permettant de basculer entre des modes linéaires, quadratiques ou cubiques via un simple argument textuel. Toutefois, cette fonction est aujourd’hui considérée comme une interface patrimoniale (legacy) dont l’utilisation est déconseillée dans les développements contemporains en raison de son manque de flexibilité algorithmique et de ses performances sous-optimales.
À sa place, la classe spécialisée CubicSpline représente l’implémentation de référence moderne dédiée exclusivement aux splines cubiques C2. Construite sur des structures de matrices tridiagonales résolues de manière ultra-optimisée, elle partage avec la fabrique de spline d’interpolation une rapidité d’exécution remarquable tout en offrant une interface particulièrement intuitive pour la spécification des conditions aux limites complexes. Elle supporte nativement des conditions personnalisées définies de manière indépendante pour la frontière gauche et la frontière droite, ce qui simplifie grandement l’intégration de contraintes physiques asymétriques.
En termes de benchmarking de performance, CubicSpline et la fonction génératrice make_interp_spline affichent des métriques d’efficacité temporelle équivalentes, toutes deux exploitant en sous-main les mêmes routines compilées de bas niveau. Le choix entre ces deux instruments repose essentiellement sur la nature du projet : make_interp_spline est à privilégier lorsque l’on souhaite manipuler formellement des B-splines et faire varier dynamiquement le degré k, tandis que CubicSpline offre une concision syntaxique inégalée lorsque le cadre du travail est strictement cantonné aux splines cubiques classiques.
8.2 Lissage avec tolérance d’erreur via UnivariateSpline
Dans de multiples contextes expérimentaux, les observations collectées ne constituent pas des valeurs déterministes absolues, mais sont corrompues par un bruit stochastique instrumental ou biologique. Forcer une courbe à passer exactement par chaque coordonnée expérimentale au moyen d’une interpolation stricte constitue alors une erreur méthodologique patente, qui conduit au surajustement visuel (overfitting) en retranscrivant fidèlement les fluctuations aléatoires du bruit sous la forme de méandres incohérents.
Pour résoudre cette difficulté, la classe UnivariateSpline de SciPy propose un modèle de lissage variationnel par spline doté d’une tolérance d’erreur paramétrable. Ce modèle cherche la fonction qui minimise un critère mixte combinant l’intégrale de la courbure au carré (garante de la douceur géométrique de la courbe) et la somme pondérée des carrés des écarts aux points expérimentaux. Ce compromis est quantifié par un facteur de lissage scalaire fondamental, usuellement noté s.
Lorsque le paramètre s est assigné à zéro, l’algorithme annule la tolérance d’écart et retombe exactement sur le cas d’une interpolation cubique stricte passant par tous les points. À mesure que l’analyste augmente la valeur numérique de s, la tolérance s’élargit, permettant à la trajectoire continue de s’écarter des observations individuelles pour privilégier la rectitude et la fluidité géométrique globale. À l’extrême, pour une valeur de s tendant vers l’infini, la courbe converge vers une droite de régression linéaire par moindres carrés. Le réglage méthodique de ce paramètre permet d’extraire la substantifique moelle d’un signal fortement bruité sans subir la rigidité d’un modèle paramétrique.
8.3 Filtrage de Savitzky-Golay (scipy.signal.savgol_filter)
Issu du traitement du signal et de la spectroscopie analytique, le filtre de Savitzky-Golay, accessible au sein du sous-module de traitement du signal de SciPy, constitue une alternative algorithmique de premier plan à l’interpolation par splines pour le lissage de séries temporelles denses mais bruitées. Contrairement aux approches par splines qui construisent une base fonctionnelle globale sur l’ensemble du domaine, le filtrage de Savitzky-Golay repose sur un principe de convolution locale par régression polynomiale glissante.
L’algorithme fait glisser une fenêtre temporelle symétrique d’une largeur impaire déterminée le long des données et ajuste, à l’intérieur de cette fenêtre mobile, un polynôme de faible degré par la méthode des moindres carrés. La valeur centrale de la fenêtre est alors remplacée par l’évaluation de ce polynôme local. L’atout majeur de cette formulation réside dans sa capacité unique à préserver avec une fidélité stupéfiante les caractéristiques de haute fréquence du signal d’origine, telles que la hauteur relative des pics d’amplitude et la finesse des largeurs à mi-hauteur, là où les moyennes mobiles ou les splines trop fortement pénalisées ont tendance à écraser et à étaler les extremums.
L’application d’un filtre de Savitzky-Golay requiert toutefois que les données soient échantillonnées à des intervalles d’abscisses rigoureusement uniformes. Une fois le filtrage opéré, le vecteur lissé résultant conserve la dimension originelle du jeu de données. Pour obtenir une courbe parfaitement fluide dans Matplotlib, il est alors courant et élégant de chaîner ces méthodes : on applique d’abord un filtrage de Savitzky-Golay pour déparasiter le signal tout en préservant ses singularités morphologiques, puis l’on injecte les points filtrés dans un interpolateur spline cubique pour densifier le maillage et assurer un rendu graphique d’une absolue continuité.
9. Personnalisation esthétique et scientifique des tracés dans Matplotlib
9.1 Superposition élégante des points observés et de la courbe
L’élaboration d’une figure destinée à une revue scientifique internationale ne saurait se borner au simple tracé d’une ligne continue ; elle exige une scénographie visuelle rigoureuse explicitant la relation entre les données empiriques brutes et le modèle d’interpolation sous-jacent. L’articulation harmonieuse entre les marqueurs discrets et la trajectoire lissée repose sur la maîtrise fine des hiérarchies de rendu dans le moteur d’affichage de Matplotlib.
Pour garantir une lisibilité optimale, les points observés doivent être matérialisés par des symboles discrets via la commande de nuage de points ou d’affichage de marqueurs, en configurant judicieusement leur taille, leur couleur de remplissage et leur bordure. Une technique graphique de haut niveau consiste à appliquer un contour blanc ou d’un gris très clair aux marqueurs, tout en leur conférant une priorité d’affichage supérieure grâce au paramètre d’ordonnancement des couches (zorder). De cette manière, les points expérimentaux apparaissent nettement détachés au premier plan, superposés sans ambiguïté à la courbe continue qui s’écoule en arrière-plan sans les masquer ni être interrompue.
La typologie de la ligne elle-même doit faire l’objet d’un arbitrage minutieux. Une épaisseur de trait modérée, associée à une teinte chromatique saturée contrastant avec la tonalité des marqueurs, permet de guider le regard de l’observateur le long du flux fonctionnel. Enfin, la légende graphique se doit d’être d’une transparence absolue : elle doit comporter deux entrées distinctes, l’une associant le glyphe ponctuel aux « Données expérimentales observées », l’autre associant le segment linéaire à la « Trajectoire interpolée par spline cubique », bannissant toute ambiguïté sur la nature algorithmique du tracé.
9.2 Représentation des bandes de variabilité et intervalles d’erreur
En recherche quantitative, une mesure isolée de sa variance n’a qu’une valeur scientifique tronquée. Dès lors qu’un jeu de données comporte des incertitudes de mesure ou des déviations standards inter-sujets, la courbe de tendance lissée doit obligatoirement être accompagnée de son enveloppe de dispersion statistique. La tentative naïve consistant à tracer des barres d’erreur verticales classiques sur une courbe lisse recrée paradoxalement la rigidité anguleuse que l’on cherchait à éliminer.
Une démarche infiniment plus rigoureuse et esthétique réside dans l’interpolation séparée des bornes d’incertitude. L’analyste procède en ajustant une spline cubique ou un modèle Pchip sur la moyenne empirique, mais également sur le vecteur de la borne inférieure (moyenne moins une déviation standard) et sur le vecteur de la borne supérieure (moyenne plus une déviation standard), tous préalablement évalués sur le même maillage dense de linspace. Il convient ensuite de mobiliser la fonction de remplissage surfacique entre courbes de Matplotlib (fill_between) pour matérialiser un ruban d’incertitude continu.
Pour prévenir tout écrasement visuel de l’information, ce ruban de variabilité doit être teinté de la même nuance chromatique que la courbe centrale moyenne, mais modulé par un coefficient de transparence alpha compris entre 0,15 et 0,30. Cette technique confère à la figure une profondeur visuelle remarquable : l’œil identifie instantanément la trajectoire centrale comme l’estimateur de tendance le plus probable, tout en intégrant immédiatement l’élargissement ou le rétrécissement des couloirs de confiance spatio-temporels le long du domaine d’observation.
9.3 Stylisation typographique et chromatique pour revues académiques
L’optimisation finale d’un graphique scientifique implique une mise en conformité stricte avec les chartes graphiques des éditeurs académiques de référence. Cette exigence débute par la configuration typographique de l’environnement Matplotlib via la gestion de ses dictionnaires de paramètres par défaut (rcParams). Les polices génériques sans empattement de faible lisibilité doivent être substituées par des polices de haute facture, ou harmonisées avec la typographie du corps de texte du manuscrit grâce à l’activation du compilateur de rendu typographique LaTeX de Matplotlib.
Le choix de la palette de couleurs constitue un enjeu méthodologique et éthique majeur. Les couleurs primaires saturées historiques (bleu pur, rouge vif, vert saturé) doivent être formellement proscrites au profit de palettes perceptuellement uniformes et universellement accessibles aux personnes atteintes de déficiences de la vision chromatique (daltonisme). Les cartographies chromatiques standardisées telles que Viridis, Cividis ou les palettes issues de ColorBrewer offrent des contrastes de luminance parfaitement linéaires qui garantissent que l’information demeure intégralement interprétable, y compris lors d’une impression en niveaux de gris.
Enfin, l’exportation du fichier graphique doit être paramétrée pour délivrer des documents de résolution optimale. Pour les revues imprimées et les manuscrits électroniques vectoriels, l’export sous des formats vectoriels indépendants de la résolution (PDF ou SVG) est impératif afin de préserver la pureté mathématique des splines lors des agrandissements à la mise en page. Si un format matriciel de type PNG est requis, il est primordial de forcer la résolution de rastérisation à une valeur d’au moins 300 points par pouce (DPI), assurant ainsi une netteté cristalline à la figure finale.
10. Pièges courants, anomalies numériques et solutions pratiques
10.1 Gestion des données non ordonnées et exceptions logicielles
Parmi les écueils opérationnels les plus fréquemment rencontrés par les développeurs Python lors de l’intégration de splines d’interpolation, l’exception logicielle signalant que le vecteur d’abscisses doit impérativement être strictement croissant occupe la première place. Cette erreur survient généralement lors de l’automatisation de scripts traitant des fichiers de journalisation externes, des bases de données SQL non triées ou des résultats d’expérimentations menées en parallèle où l’ordre des lignes dans la table de données n’est pas corrélé à l’axe des temps ou des espaces.
Pour immuniser définitivement le code contre cette anomalie sans introduire de lourdeur algorithmique, il est recommandé de mettre en place une fonction de tri défensif systématique en amont de l’appel à la fonction d’interpolation. En s’appuyant sur la fonction argsort de NumPy, l’ingénieur extrait en une seule opération vectorisée les indices ordonnés du vecteur d’abscisses, puis réordonne les deux dimensions simultanément. Cette opération n’introduit aucun surcoût mesurable sur les jeux de données usuels et garantit la robustesse structurelle du pipeline face à toute permutation aléatoire des mesures sources.
Un problème corollaire réside dans la présence de points d’abscisse identiques ou excessivement rapprochés, séparés par un écart inférieur à la précision de la virgule flottante de la machine. Cette situation génère des dérivées locales tendant vers l’infini et provoque l’échec de la décomposition matricielle du solveur spline. Le traitement défensif doit donc intégrer une vérification des différences finies adjacentes et appliquer, le cas échéant, une routine d’unicité (par exemple via numpy.unique) couplée à une règle d’agrégation statistique pour substituer aux réplicats leur moyenne arithmétique.
10.2 Phénomène de sur-oscillation (overshoot) et artéfacts d’inflexion
L’écueil géométrique le plus insidieux des splines cubiques réside dans le phénomène de dépassement incontrôlé, fréquemment désigné sous le terme anglo-saxon d’overshoot. Ce comportement survient typiquement lorsque les données expérimentales présentent une variation brusque d’amplitude — comme un front de montée raide ou un palier en échelon — suivi d’une phase de stabilité horizontale. En raison de sa haute classe de différentiabilité, la spline cubique accumule une importante quantité d’énergie de courbure lors de la transition abrupte, ce qui la conduit à dépasser largement le niveau de palier avant d’osciller pour venir se recaler sur les points ultérieurs.
Ces ondulations parasites créent des sommets et des vallées artificiels qui n’ont aucune réalité expérimentale et peuvent conduire à des interprétations scientifiques désastreuses, en laissant croire à l’existence de résonances, de rebonds physiologiques ou d’instabilités mécaniques imaginaires. Dès lors qu’une inspection visuelle du graphique révèle une courbure convexe non justifiée au-dessus d’un palier empirique, le diagnostic de sur-oscillation par rigidité de spline cubique est formellement établi.
La solution méthodologique la plus élégante et rigoureuse face à ce problème consiste à substituer à la spline cubique l’interpolateur Akima unidimensionnel (Akima1DInterpolator) disponible dans SciPy. Conçu spécifiquement par Hiroshi Akima pour remédier aux dépassements pathologiques des splines classiques, cet algorithme calcule les pentes aux nœuds par une moyenne géométrique pondérée des différences finies locales d’ordre un. La courbe d’Akima qui en résulte s’adapte avec une plasticité exceptionnelle aux variations brutales sans jamais engendrer d’oscillations résiduelles parasites, tout en garantissant une régularité de classe C1 visuellement parfaite sur les tracés Matplotlib.
10.3 Considérations éthiques sur l’illusion de continuité
Au-delà de la virtuosité technique et de la perfection géométrique, le tracé d’une courbe lisse dans un support académique engage la responsabilité éthique et déontologique de l’auteur. Le lissage n’est jamais une opération scientifiquement neutre : il consiste fondamentalement à fabriquer des données interpolées qui n’ont jamais été observées dans la réalité expérimentale. Présenter une courbe continue immaculée sans faire figurer les marqueurs discrets d’acquisition relève d’une dissimulation méthodologique condamnable, car cela masque délibérément l’incertitude, la rareté de l’échantillonnage ou la dispersion statistique du protocole.
L’illusion de continuité induite par un tracé spline peut inciter le lecteur à déduire des extrapolations fallacieuses ou à considérer comme prouvé un comportement dynamique sur des intervalles de temps où aucune mesure n’a pourtant été collectée. Il existe des contextes où le tracé lisse doit être formellement proscrit : c’est notamment le cas lorsque le phénomène sous-jacent est fondamentalement discret (comme le nombre d’erreurs commises par un sujet ou un décompte d’occurrences entières), ou lorsque les données sont affectées par un niveau de bruit stochastique tel que la recherche d’une trajectoire continue précise relève de la surinterprétation pure.
Pour garantir la transparence et l’intégrité de la communication scientifique, la légende du graphique ainsi que le texte de la section méthodologique du manuscrit doivent expliciter sans ambiguïté les outils mathématiques mis en œuvre. Il est impératif d’y faire figurer la classe de lissage employée, le degré du polynôme, la valeur du facteur de tolérance ou la méthode de régularisation retenue. Cette discipline garantit que la figure demeure un instrument de démonstration rigoureux et reproductible, et non un artifice purement décoratif.
11. Études de cas appliquées à l’analyse de données expérimentales
11.1 Cas n°1 : Traçage d’une courbe d’apprentissage psychométrique
Considérons une investigation psychométrique longitudinale évaluant l’acquisition d’une compétence visuo-motrice complexe auprès d’une cohorte d’apprenants. Le protocole expérimental consiste à mesurer le pourcentage de succès lors d’épreuves standardisées réparties sur huit sessions d’entraînement discontinues. Les données empiriques brutes décrivent une progression typique, caractérisée par une forte phase d’accélération cognitive initiale suivie d’un ralentissement graduel traduisant la convergence vers un plateau asymptotique de performance motrice.
Pour mettre en valeur cette dynamique au sein d’une planche graphique de publication, l’analyste déploie un script exploitant la fonction de construction de spline d’interpolation de SciPy. Après avoir structuré les sessions sous la forme d’un tableau NumPy d’abscisses et les pourcentages de réussite sous la forme d’un tableau d’ordonnées, le domaine temporel est densifié sur un maillage de trois cents points via linspace. L’instanciation d’une spline cubique naturelle permet d’évaluer la trajectoire continue attendue.
Le tracé final dans Matplotlib juxtapose avec une élégance sobre les données de performance moyenne sous la forme de disques sombres cerclés de blanc et la trajectoire lissée d’une teinte bleu nuit profonde. Une ligne horizontale en tiretés discrets matérialise le plafond théorique asymptotique de l’épreuve. Grâce à la régularité C2 de la spline, le lecteur perçoit avec une acuité immédiate la décélération graduelle du taux d’acquisition du geste moteur sans que cette interprétation ne soit perturbée par les cassures géométriques du tracé linéaire par morceaux originel.
11.2 Cas n°2 : Modélisation d’une réponse physiologique en série temporelle
Dans cette seconde étude de cas, nous analysons l’enregistrement chronologique continu d’un indice physiologique autonome, à l’instar de la conductance cutanée ou de la fréquence cardiaque instantanée d’un sujet soumis à un stimulus émotionnel aigu au cours d’un test neurophysiologique. La série chronologique acquise par les capteurs biomédicaux se compose d’une cinquantaine d’échantillons affectés par un bruit de haute fréquence induit par des micro-mouvements musculaires et des perturbations thermiques de l’électrode.
Une interpolation stricte passant rigoureusement par chacune de ces cinquante coordonnées produirait un tracé frénétique d’une confusion visuelle absolue. L’analyste recourt donc à la classe UnivariateSpline afin d’opérer un lissage d’ajustement par minimisation de courbure. Le facteur de lissage scalaire est ajusté de manière itérative afin de filtrer le tremblement stochastique tout en capturant très fidèlement l’amplitude et la latence du pic de décharge sympathique survenant immédiatement après la délivrance du stimulus expérimental.
La figure produite sous Matplotlib intègre une mise en valeur contextuelle avancée. Les données brutes bruitées sont représentées avec une discrétion délibérée sous la forme de minuscules croix grises semi-transparentes, tandis que la trajectoire lissée par la spline d’ajustement est tracée sous la forme d’un trait rouge carmin affirmé. Une zone verticale légèrement ombrée matérialise l’intervalle d’application du stimulus externe, et une flèche d’annotation pointe mathématiquement le sommet exact de la réponse physiologique, identifié par la recherche de la racine de la dérivée première analytique de la spline.
11.3 Cas n°3 : Tracé d’une courbe dose-réponse sigmoïdale
L’analyse toxicologique et pharmacologique repose quasi universellement sur l’évaluation de courbes dose-réponse, où l’on observe la cytotoxicité ou l’inhibition métabolique induite par des concentrations chimiques croissantes administrées à des cultures cellulaires. En raison de la dynamique exponentielle des concentrations explorées, l’axe expérimental des abscisses s’échelonne sur plusieurs ordres de grandeur, imposant une représentation sur échelle logarithmique.
L’application naïve d’une interpolation spline linéaire dans l’espace arithmétique classique avant d’activer l’échelle logarithmique dans Matplotlib engendre une distorsion géométrique sévère, car la distribution spatiale des nœuds sur le canevas devient asymétriquement concentrée vers l’extrémité droite du graphique. Pour préserver la symétrie centrale caractéristique de la transition sigmoïde, l’analyste doit impérativement effectuer la transformation logarithmique de ses abscisses en amont dans NumPy, interpoler la relation par spline cubique ou Pchip dans ce domaine logarithmique transformé, puis évaluer son maillage dense avant de transmettre les coordonnées aux axes de Matplotlib configurés en échelle logarithmique.
Le résultat visuel est irréprochable : la courbe de transition sigmoïdale épouse harmonieusement les points expérimentaux espacés de manière équidistante sur l’échelle en puissances de dix. Il convient toutefois de discuter dans la légende les limites inhérentes à l’interpolation pure par rapport à un ajustement paramétrique explicite basé sur l’équation de Hill à quatre paramètres. Si la spline restitue impeccablement l’allure graphique de la relation, seul le modèle paramétrique permet de déduire formellement des paramètres biophysiques interprétables tels que la concentration inhibitrice médiane (IC50).
12. Synthèse méthodologique et recommandations de mise en production
12.1 Arbre de décision pour le choix de la méthode de lissage
Face à la diversité des bibliothèques et des algorithmes hébergés au sein de l’écosystème Python, le chercheur ou l’ingénieur de données doit disposer d’un cadre méthodologique rigoureux pour guider son arbitrage algorithmique. Le choix de la fonction d’interpolation ou de lissage ne doit jamais reposer sur des considérations empiriques hasardeuses, mais résulter d’une analyse systématique des propriétés structurelles des données et des contraintes théoriques de l’expérience.
La première dichotomie fondamentale oppose les jeux de données déterministes dénués de bruit aux ensembles de mesures expérimentales stochastiques. Si les données sont exactes et doivent être rigoureusement interceptées, l’interpolation stricte s’impose : on privilégiera l’interpolateur Pchip si le respect strict de la monotonicité et de la positivité physique est impératif (absence absolue d’overshoot), l’interpolateur d’Akima si les données présentent des transitions abruptes sans palier strict, ou la spline cubique via make_interp_spline ou CubicSpline si la priorité réside dans la continuité de classe C2 de la courbure.
Si, au contraire, les données expérimentales sont affectées par un niveau de variance et de bruit de mesure sensible, l’interpolation exacte doit être bannie au profit du lissage. Lorsque les abscisses sont régulièrement espacées et que l’objectif est de filtrer un bruit de haute fréquence tout en préservant scrupuleusement la hauteur des extremums locaux, le filtrage de Savitzky-Golay représente l’instrument d’élection. En revanche, si l’échantillonnage spatial est asymétrique ou irrégulièrement distribué, l’utilisation de la classe UnivariateSpline modulée par un facteur de pénalisation s permet d’obtenir une approximation continue d’une sobriété géométrique optimale.
12.2 Optimisation des performances pour les flux de données massives
L’intégration de procédures d’interpolation et de lissage au sein de pipelines de production industrielle ou de systèmes de traitement par lots impliquant des dizaines de milliers de séries temporelles impose une attention rigoureuse à l’efficacité algorithmique et à la consommation des ressources de calcul. Bien que les routines sous-jacentes de SciPy soient compilées en code machine optimisé, une mauvaise orchestration des appels de fonctions en Python peut engendrer des goulets d’étranglement sévères.
L’optimisation première repose sur la minimisation de la redondance d’instanciation. Lorsqu’une même géométrie de nœuds est partagée par une multitude de séries de données distinctes (comme dans le cas d’une matrice de capteurs échantillonnant tous aux mêmes instants discrets), il est considérablement plus efficace de factoriser la décomposition matricielle du système spline en amont plutôt que de réinstancier l’intégralité du solveur pour chaque canal d’acquisition. De même, la dimension du maillage de densification généré par linspace doit être dimensionnée avec justesse : allouer dix mille points d’évaluation pour une figure destinée à être affichée dans un encart de cinq cents pixels sur une page web constitue un gaspillage computationnel stérile sans aucun bénéfice perceptible pour l’utilisateur.
Pour les analyses de données massives nécessitant des millions d’évaluations dynamiques, le recours à des profileurs de code déterministes intégrés à Python permet d’auditer avec précision la proportion du temps d’exécution captée par les fonctions d’interpolation comparativement aux routines de rastérisation graphique de Matplotlib. L’élimination des allocations mémoire intermédiaires et l’exploitation systématique des opérations in-place sur les tableaux NumPy garantissent un débit de traitement maximal compatible avec les exigences du traitement de données en temps réel.
12.3 Modèle de script Python réutilisable et standardisé
La pérennité et la reproductibilité des travaux de visualisation scientifique reposent sur l’élaboration de modules logiciels réutilisables, modulaires et documentés selon les standards de l’ingénierie du logiciel. Il est hautement souhaitable de structurer les opérations abordées tout au long de cet article sous la forme d’une fonction Python générique d’assistance au tracé, encapsulant l’intégralité du pipeline de vérification et de rendu.
Cette fonction type doit accepter en arguments obligatoires les tableaux de coordonnées d’abscisses et d’ordonnées, ainsi qu’un ensemble de paramètres optionnels configurant l’objet d’axe de Matplotlib sur lequel opérer, le degré de la spline, le choix de la méthode d’interpolation ou de lissage, le nombre de points d’échantillonnage de la grille dense, et les métadonnées de style typographique. En interne, la fonction doit exécuter de manière transparente et défensive le tri préalable des données via les indices ordonnés, la détection et l’élimination des doublons, la vérification de la monotonicité et l’instanciation du modèle d’interpolation adéquat.
En renvoyant à l’utilisateur à la fois l’objet de ligne de tracé de Matplotlib et l’instance fonctionnelle de la spline interpolante, un tel module concilie l’immédiateté graphique requise pour l’exploration de données préliminaire et la rigueur formelle nécessaire à l’extraction ultérieure de métriques quantitatives (dérivées, intégrales, extrema). En définitive, la maîtrise du tracé de courbes lisses dans Matplotlib transcende la simple recherche d’une élégance visuelle superficielle : elle constitue l’expression achevée d’une rigueur méthodologique qui met la puissance de l’analyse numérique et de la géométrie différentielle au service d’une communication scientifique limpide, fidèle et irréprochable.
Références
- Akima, H. (1970). A new method of interpolation and smooth curve fitting based on local procedures. Journal of the ACM, 17(4), 589-602. https://doi.org/10.1145/321607.321609
- Boor, C. de. (1978). A Practical Guide to Splines. Springer-Verlag. https://doi.org/10.1007/978-1-4612-6333-3
- Cox, M. G. (1972). The numerical evaluation of B-splines. Journal of the Institute of Mathematics and Its Applications, 10(2), 134-149. https://doi.org/10.1093/imamat/10.2.134
- Dierckx, P. (1993). Curve and Surface Fitting with Splines. Oxford University Press.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Runge, C. (1901). Über empirische Funktionen und die Interpolation zwischen äquidistanten Ordinaten. Zeitschrift für Mathematik und Physik, 46, 224-243.
- Savitzky, A., & Golay, M. J. (1964). Smoothing and differentiation of data by simplified least squares procedures. Analytical Chemistry, 36(8), 1627-1639. https://doi.org/10.1021/ac60214a047
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2