
Dans le domaine de l’analyse exploratoire et de la modélisation statistique appliquée aux sciences empiriques, la visualisation graphique constitue une étape charnière pour appréhender la structure sous-jacente des données observées. Parmi l’ensemble des instruments sémiotiques et graphiques à la disposition du chercheur, la droite de meilleur ajustement, communément qualifiée de droite de régression, occupe une place fondamentale. Cet artéfact géométrique permet de résumer la tendance centrale d’une relation bivariée, de quantifier la force ainsi que la direction d’une dépendance fonctionnelle, et d’offrir un support visuel direct aux démarches inférentielles. L’objectif premier d’une telle représentation réside dans la capacité à condenser la dispersion empirique au sein d’une trajectoire déterministe univoque, facilitant ainsi l’interprétation théorique des phénomènes quantitatifs.
Le langage de programmation Python s’est imposé au fil des deux dernières décennies comme le standard de référence pour le calcul scientifique, l’analyse biométrique et l’apprentissage automatique, principalement grâce à son écosystème modulaire riche et cohérent. La flexibilité offerte par des bibliothèques telles que NumPy, Matplotlib, SciPy, Statsmodels et Seaborn permet d’aborder la construction de la droite d’ajustement sous des angles complémentaires. Qu’il s’agisse d’une simple projection géométrique destinée à éclairer un nuage de points ou d’une modélisation inférentielle rigoureuse nécessitant le calcul précis d’intervalles de confiance et le diagnostic des résidus, Python met à disposition des chercheurs des primitives algorithmiques optimisées pour traduire fidèlement les concepts de la statistique classique.
Le présent traité propose une exploration méthodique et exhaustive des méthodologies permettant d’estimer, de tracer, de personnaliser et d’évaluer la droite de meilleur ajustement au sein de l’environnement Python. À travers un parcours alliant formalisation mathématique rigoureuse, considérations algorithmiques et études de cas appliquées à l’analyse du comportement et des données psychométriques, cet article a pour vocation de fournir aux analystes, doctorants et chercheurs un guide de référence complet. En adoptant les meilleures pratiques de programmation et les standards de publication scientifique, ce document détaille chaque étape du processus, depuis le traitement vectoriel des signaux bruités jusqu’à la vérification des hypothèses distributionnelles indispensables à la validité des conclusions empiriques.
1. Fondements théoriques de la droite d’ajustement et régression linéaire
1.1 Principe de la méthode des moindres carrés ordinaires (MCO)
La recherche d’une droite d’ajustement optimal au sein d’un ensemble de données bidimensionnelles repose historiquement sur le principe variationnel formalisé par Adrien-Marie Legendre et Carl Friedrich Gauss au tournant du dix-neuvième siècle : la méthode des moindres carrés ordinaires. D’un point de vue mathématique, considérons un échantillon constitué de n paires d’observations numériques désignées par (x_i, y_i) pour i variant de 1 à n. L’objectif consiste à déterminer les paramètres scalaires a, représentant la pente ou le coefficient directeur, et b, désignant l’ordonnée à l’origine, définissant la fonction affine y_chapeau = a * x + b. Cette fonction a pour vocation de prédire au mieux la valeur de la réponse observée en minimisant la grandeur des erreurs commises.
L’écart vertical entre l’observation empirique y_i et l’estimation correspondante issue du modèle linéaire constitue le résidu empirique, formellement défini par la quantité e_i = y_i – (a * x_i + b). L’approche des moindres carrés postule que la solution optimale correspond à la minimisation globale de la somme des carrés de ces résidus, souvent abrégée sous le sigle SCE. En formulant cette grandeur sous la forme d’une fonction convexe dépendant des deux variables a et b, l’annulation conjointe de ses dérivées partielles premières par rapport à a et à b conduit à un système de deux équations linéaires à deux inconnues, universellement nommées les équations normales de Gauss. La résolution de ce système linéaire aboutit à des expressions analytiques explicites pour les estimateurs de la pente et de l’ordonnée à l’origine.
L’expression analytique de l’estimateur de la pente s’établit comme le rapport entre la covariance empirique des variables x et y et la variance empirique de la variable explicative x. Parallèlement, l’ordonnée à l’origine s’obtient en soustrayant à la moyenne arithmétique de la variable dépendante le produit de la pente estimée par la moyenne arithmétique de la variable indépendante. Cette formulation garantit sur le plan géométrique que la droite de régression résultante passe impérativement par le centre de gravité du nuage de points, défini par le couple des moyennes arithmétiques des deux variables considérées.
Sur le plan des propriétés statistiques théoriques, le théorème de Gauss-Markov confère à ces estimateurs une position privilégiée au sein de la classe des méthodes linéaires. En vertu de ce théorème, sous réserve que les conditions classiques relatives à l’espérance nulle, à l’homoscédasticité et à l’absence d’autocorrélation des perturbations soient formellement satisfaites, les estimateurs issus des moindres carrés ordinaires constituent les meilleurs estimateurs linéaires sans biais, une propriété couramment désignée par l’acronyme anglais BLUE (Best Linear Unbiased Estimator). Cela signifie qu’aucun autre estimateur linéaire non biaisé ne possède une variance d’échantillonnage inférieure à celle fournie par les équations des moindres carrés, conférant à la droite ainsi calculée une robustesse et une efficience théoriques remarquables.
1.2 Pertinence de la régression linéaire dans l’analyse comportementale et quantitative
L’application du modèle linéaire univarié au sein des disciplines quantitatives, notamment en psychométrie, en neurosciences cognitives et en sociologie computationnelle, répond à l’exigence fondamentale de modéliser des relations fonctionnelles plausibles au sein d’environnements intrinsèquement bruités. Dans les protocoles expérimentaux, le chercheur manipule fréquemment une variable indépendante contrôlée, telle que l’intensité d’un stimulus perceptif, la dose d’une substance pharmacologique ou la durée d’une tâche d’apprentissage, et mesure consécutivement les fluctuations d’une variable de réponse dépendante, comme le temps de latence motrice, le taux d’erreurs ou l’amplitude d’un potentiel évoqué. L’ajustement linéaire fournit alors un cadre analytique direct pour quantifier la sensibilité du système biologique ou comportemental étudié.
Il demeure néanmoins crucial de distinguer sur le plan épistémologique et méthodologique la simple corrélation linéaire bivariée de Pearson de la régression linéaire prédictive. Tandis que le coefficient de corrélation r évalue de manière symétrique le degré de covariation standardisée entre deux dimensions sans présumer d’une asymétrie fonctionnelle, la régression linéaire introduit délibérément une structure causale ou directionnelle explicite. Dans ce dernier cadre, la variable x est postulée comme prédicteur déterministe ou exogène, tandis que la variable y est envisagée comme un réceptacle stochastique intégrant la composante déterministe et une perturbation aléatoire indécomposable.
En sciences du comportement, les mesures empiriques sont invariablement contaminées par des sources d’hétérogénéité multiples, incluant la variabilité interindividuelle liée aux traits intrinsèques des sujets et l’erreur instrumentale de mesure. L’usage de la droite d’ajustement permet de filtrer ces fluctuations microscopiques pour extraire la tendance macroscopique dominante. Dès lors, la pente estimée traduit directement le taux de variation moyen attendu de la réponse comportementale par unité d’accroissement de la variable explicative, offrant une interprétation directement exploitable pour la théorisation psychologique et la validation d’hypothèses quantitatives.
1.3 Hypothèses sous-jacentes du modèle linéaire classique
La validité des inférences statistiques et des intervalles d’incertitude construits autour de la droite de meilleur ajustement repose sur le respect scrupuleux d’un ensemble de postulats fondamentaux régissant la nature du terme d’erreur aléatoire. Le premier de ces postulats concerne la linéarité intrinsèque de la fonction de régression : l’espérance conditionnelle de la variable dépendante y sachant la variable explicative x doit être une fonction rigoureusement affine des paramètres du modèle. Une méconnaissance de cette hypothèse face à un processus biologique sous-jacent non linéaire, tel qu’une dynamique exponentielle ou sigmoïdale, engendre des distorsions prédictives sévères et un biais systématique d’estimation.
Le second postulat majeur stipule l’indépendance mutuelle des termes d’erreur ainsi que la nullité de leur espérance mathématique conditionnelle par rapport à la variable explicative. Cette condition d’exogénéité stricte garantit que les perturbations stochastiques ne véhiculent aucune information systématique corrélée avec la variable prédictive. Lorsque les données sont issues d’échantillonnages longitudinaux ou de mesures répétées sur un même sujet, le phénomène d’autocorrélation résiduelle peut émerger, conduisant à une sous-estimation substantielle des erreurs-types des coefficients et, par voie de conséquence, à une inflation artificielle des taux de faux positifs lors des tests d’hypothèses.
Enfin, la théorie classique requiert la satisfaction conjointe de l’homoscédasticité et de la normalité des perturbations. L’homoscédasticité impose que la variance des termes d’erreur demeure rigoureusement constante sur l’ensemble de l’espace défini par la variable prédictive. La violation de cette invariance structurelle, désignée sous le terme d’hétéroscédasticité, se traduit fréquemment par un élargissement en entonnoir de la dispersion des points à mesure que x croît. Bien que les estimateurs des moindres carrés conservent leur caractère non biaisé en présence d’hétéroscédasticité, ils perdent leur statut d’efficience minimale, rendant caducs les tests de Student usuels s’ils ne sont pas assortis de corrections robustes pour la matrice de covariance.
2. Configuration de l’environnement Python et préparation des données
2.1 Écosystème scientifique : installation et importation des modules
La mise en œuvre pratique de la régression linéaire et la génération de visualisations graphiques de haute tenue méthodologique nécessitent l’agencement structuré d’un ensemble de bibliothèques tierces éprouvées. Au cœur de cette infrastructure numérique figure NumPy, le socle fondamental pour le calcul vectoriel et matriciel à haute performance en Python. En fournissant des structures de tableaux homogènes multidimensionnels hautement optimisées et exécutées au niveau binaire en langage C, NumPy élimine la surcharge temporelle inhérente aux boucles dynamiques natives de Python et permet l’évaluation vectorisée instantanée des formules des moindres carrés.
En superposition à ce moteur computationnel, le module Matplotlib, et plus particulièrement son interface procédurale standardisée pyplot, constitue l’ossature primaire pour la restitution visuelle des données. Conçu initialement pour reproduire la syntaxe et les capacités graphiques de l’environnement MATLAB, Matplotlib offre un contrôle déterministe absolu sur chaque élément graphique de la scène : limites dimensionnelles, système de coordonnées cartésiennes, propriétés typographiques des axes et mécanismes de projection vectorielle. Il permet d’échafauder des figures complexes combinant des marqueurs discrets et des lignes continues d’ajustement au moyen d’appels de bas niveau particulièrement stables.
Pour compléter cet ensemble instrumental, le recours à la suite SciPy s’avère indispensable dès lors que l’analyste souhaite accéder à des primitives statistiques avancées, à l’instar de tests inférentiels univariés ou de modules d’optimisation non linéaire. Parallèlement, l’environnement Statsmodels enrichit la panoplie analytique en proposant une formalisation orientée vers la modélisation économétrique et biostatistique, caractérisée par l’émission de tables de synthèse exhaustives détaillant l’ensemble des diagnostics statistiques. Enfin, la bibliothèque Pandas offre des structures tabulaires étiquetées de type DataFrame, facilitant l’ingestion, le nettoyage et l’alignement préliminaire des cohortes de données empiriques issues des laboratoires.
2.2 Formatage et structuration des vecteurs de données
L’estimation rigoureuse d’une droite de meilleur ajustement implique une attention minutieuse portée à la topologie et au typage des structures de données manipulées en mémoire. Les séries de mesures collectées, qu’elles proviennent de fichiers délimités par des virgules (CSV), de protocoles de capture automatisés ou de dictionnaires Python hétérogènes, doivent impérativement être converties en tableaux unidimensionnels NumPy conformes au type flottant standard à double précision, couramment désigné par la signature float64. Cette uniformisation prévient tout comportement imprévu ou dégradation de précision numérique lors de la multiplication matricielle et des sommes pondérées.
La conformité dimensionnelle constitue une source fréquente de dysfonctionnements algorithmiques. Les fonctions statistiques requièrent usuellement que les vecteurs correspondant à la variable explicative x et à la variable de réponse y possèdent rigoureusement la même longueur n. Toute divergence dans le nombre d’éléments observés déclenche l’interruption des procédures de calcul par levée d’exceptions de forme. De surcroît, il convient d’assurer une distinction formelle entre les tenseurs unidimensionnels de forme (n,) exploités par les interfaces fonctionnelles simples et les matrices colonnes bidimensionnelles de forme (n, 1) exigées par les moteurs d’estimation matricielle tels que Scikit-Learn ou certains modules de Statsmodels.
Une étape méthodologique indispensable réside dans le filtrage scrupuleux des valeurs manquantes, désignées conventionnellement par le symbole NaN (Not a Number), ainsi que des grandeurs infinies susceptibles de corrompre les séries empiriques à la suite d’erreurs de capteurs ou de divisions par zéro. L’existence d’une unique valeur non définie au sein d’un vecteur de données induit, en vertu des règles de propagation arithmétique IEEE 754, la contamination intégrale des sommes de carrés et l’obtention de coefficients de régression nuls ou invalides. L’analyste doit dès lors appliquer un masquage booléen rigoureux ou mobiliser les méthodes de suppression des enregistrements incomplets afin de garantir l’intégrité numérique des vecteurs injectés dans l’algorithme d’ajustement.
2.3 Génération de jeux de données synthétiques pour validation
Avant d’appliquer des algorithmes d’estimation à des données biologiques ou comportementales dont les paramètres sous-jacents demeurent par nature incertains, il est méthodologiquement recommandé d’éprouver la chaîne de traitement sur des jeux de données synthétiques parfaitement contrôlés. La génération de telles structures s’appuie sur l’instanciation préalable d’un générateur d’états pseudo-aléatoires au moyen du sous-module random de NumPy. La fixation délibérée d’une graine d’initialisation numérique garantit la reproductibilité intégrale des simulations expérimentales à travers différentes sessions d’exécution logicielle.
Le protocole de génération consiste à formaliser un signal linéaire déterministe en appliquant l’équation affine fondamentale à une grille discrète de valeurs régulièrement espacées le long du continuum de la variable indépendante x. Les paramètres théoriques réels de la simulation, à savoir la pente vraie et l’ordonnée vraie, sont explicitement assignés par le programmeur, créant ainsi un étalon de référence absolu pour mesurer la fidélité de l’estimation algorithmique ultérieure.
Pour reproduire le réalisme stochastique propre aux observations empiriques de laboratoire, ce vecteur théorique est ensuite altéré par l’adjonction d’un vecteur de bruit blanc gaussien centré. Ce terme perturbateur est produit en échantillonnant une distribution normale de moyenne nulle et d’écart-type calibré, ce dernier paramètre gouvernant directement l’amplitude de la dispersion des points autour de la trajectoire d’équilibre. En faisant varier systématiquement cet écart-type lors d’analyses de sensibilité, l’expérimentateur peut quantifier la résilience de l’algorithme de minimisation face à des niveaux croissants de contamination stochastique.
3. Implémentation fondamentale : la méthode numpy.polyfit
3.1 Mécanique algorithmique de la fonction numpy.polyfit
Au sein de l’écosystème NumPy, la fonction polyfit constitue l’outil le plus accessible et le plus direct pour déterminer les paramètres optimaux d’un ajustement polynomial par la méthode des moindres carrés. Pour l’ajustement d’une droite linéaire canonique, l’utilisateur sollicite la fonction en spécifiant en entrée le vecteur des abscisses x, le vecteur des ordonnées y, ainsi que l’entier scalaire un, désignant le degré polynomial ciblé. En retour, l’algorithme renvoie un tableau unidimensionnel composé de deux scalaires décrivant le modèle : le premier élément correspond rigoureusement à la pente calculée de la droite, tandis que le second désigne l’ordonnée à l’origine.
La mécanique interne sous-jacente à la fonction numpy.polyfit ne repose pas sur une résolution naïve du système matriciel des équations normales via l’inversion directe de la matrice de covariance empirique. Une telle inversion explicite s’avère en effet numériquement instable et particulièrement sensible aux erreurs d’arrondi machine lorsque les valeurs de la variable explicative possèdent des ordres de grandeur disparates ou présentent une quasi-colinéarité. Au lieu de cela, l’algorithme sous-jacent formule le problème sous la forme d’un système linéaire de Vandermonde et résout les équations au moyen d’une décomposition en valeurs singulières (SVD) hautement vectorisée.
Cette décomposition orthogonale garantit une robustesse arithmétique maximale, même en présence de matrices mal conditionnées. Les valeurs singulières associées aux vecteurs d’observation sont évaluées, et les directions spectrales dont l’amplitude tombe en deçà d’un seuil de tolérance machine sont tronquées afin de prévenir l’explosion des variances d’estimation. Il en découle que le résultat produit par numpy.polyfit constitue l’estimateur numériquement le plus fiable de la trajectoire des moindres carrés atteignable avec la précision arithmétique flottante matérielle disponible sur le système hôte.
3.2 Construction du tracé de base avec matplotlib.pyplot
L’orchestration graphique de la droite de meilleur ajustement via le module matplotlib.pyplot s’articule traditionnellement autour de la superposition de deux entités visuelles distinctes : un nuage de points matérialisant les données brutes observées et une ligne continue représentant la trajectoire mathématique déduite de la modélisation. La première étape implique l’appel à la commande plt.scatter, laquelle projette chaque paire d’observations issues des vecteurs x et y sous la forme d’un marqueur géométrique discret au sein de l’espace cartésien préalablement instancié.
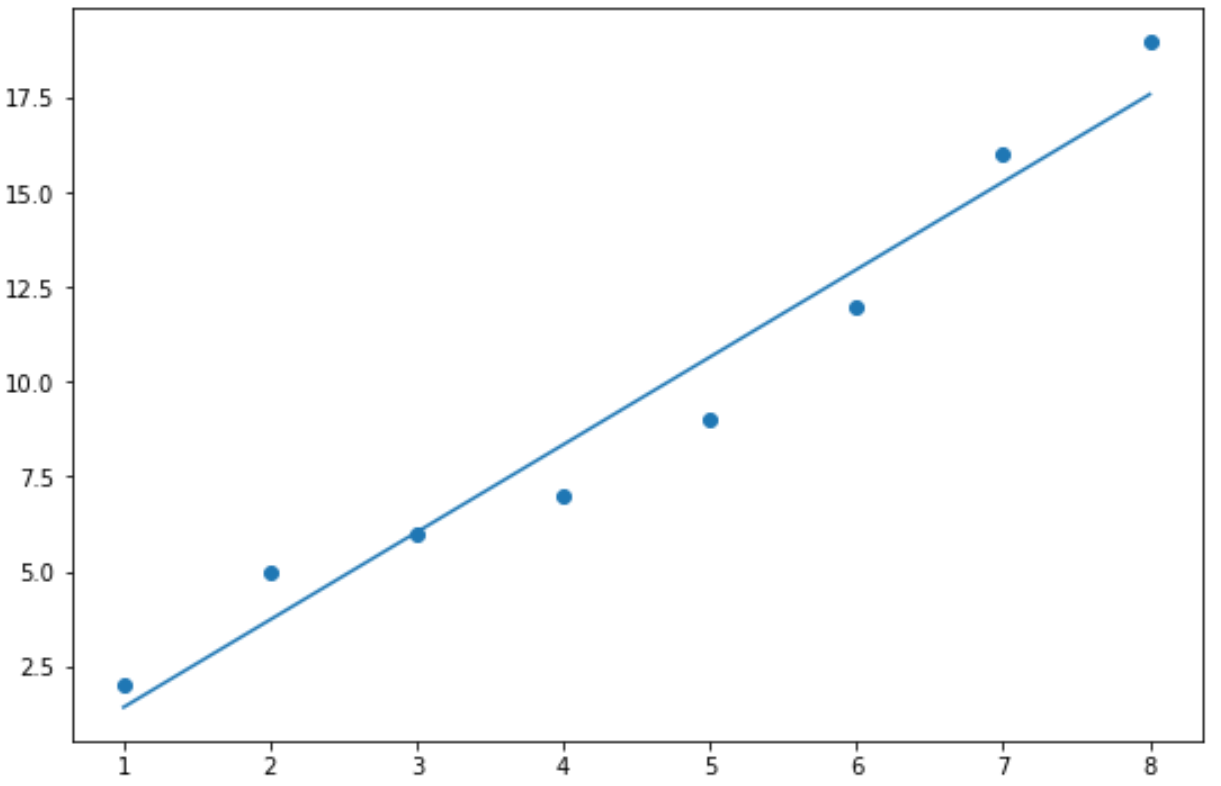
Dans un second temps, il convient de générer les coordonnées fonctionnelles requises pour tracer la droite d’ajustement continue. Pour préserver l’efficacité computationnelle et éviter toute interpolation erronée, il est courant d’appliquer directement les coefficients extraits de la fonction polyfit aux éléments du vecteur d’entrée x afin de synthétiser le vecteur des ordonnées estimées. La commande plt.plot reçoit consécutivement les abscisses d’origine et ces nouvelles ordonnées prédites pour tracer le segment ou la droite représentative unissant l’ensemble des prédictions linéaires.
Le script s’achève formellement par l’invocation de l’instruction plt.show, qui ordonne au moteur graphique d’effectuer le rendu matriciel ou vectoriel de la figure complète, d’ouvrir l’interface de visualisation interactive sur le système d’exploitation et de libérer consécutivement les descripteurs de mémoire alloués aux objets géométriques. L’intégration de ces primitives au sein d’un script structuré fournit en moins d’une dizaine de lignes de code une représentation claire et explicite de la corrélation étudiée.
3.3 Alternative vectorielle avec numpy.poly1d
Bien que la manipulation directe des coefficients scalaires a et b issus de polyfit soit intuitive pour un modèle univarié basique, l’utilisation de la classe utilitaire poly1d intégrée au module NumPy offre une abstraction fonctionnelle substantiellement plus élégante et modulaire pour le calcul de prédictions. En encapsulant le tableau de coefficients renvoyé par polyfit au sein de l’objet poly1d, l’interpréteur génère une entité appelable qui se comporte d’un point de vue programmatique comme une fonction mathématique polynomiale standard.
Cette encapsulation vectorielle élimine l’écriture explicite de formules affines lors de la phase de prédiction. Il suffit en effet de transmettre en argument à cet objet polynomial une nouvelle grille de valeurs continues générées par la fonction linspace pour obtenir instantanément, et sans boucle algorithmique explicite, le vecteur complet des valeurs ajustées correspondantes. Cette commodité syntaxique se révèle particulièrement précieuse lorsque l’analyste désire extrapoler ou interpoler le modèle sur un maillage spatial dense afin d’obtenir un rendu visuel parfaitement exempt de toute discontinuité angulaire.
D’un point de vue de l’ingénierie logicielle et des performances comparées, la surcharge introduite par l’objet poly1d demeure infinitésimale et n’altère en rien la vitesse d’exécution sur de larges volumes de données. La logique d’évaluation sous-jacente s’appuie en effet sur la règle de Horner vectorisée, garantissant un nombre minimal d’opérations d’addition et de multiplication au niveau machine. De plus, cette approche normalisée facilite grandement la transition vers des modèles de complexité polynomiale supérieure sans nécessiter de réécriture de la logique de calcul prédictif.
4. Personnalisation esthétique et stylistique du graphique
4.1 Paramétrage visuel de la droite d’ajustement
L’efficacité communicative d’une figure scientifique repose pour une part substantielle sur la différenciation visuelle et la clarté hiérarchique de ses composantes vectorielles. La ligne de meilleur ajustement, en tant qu’incarnation de la modélisation mathématique abstraite, doit impérativement se détacher avec netteté de la dispersion des observations empiriques. La bibliothèque Matplotlib propose à cet effet un répertoire étendu d’arguments de configuration au sein de l’instruction plot permettant d’ajuster avec minutie la chromie, l’épaisseur et la texture géométrique du tracé.
L’argument color autorise la spécification de palettes graphiques avancées, qu’il s’agisse de chaînes de caractères littérales reconnues, de codes hexadécimaux précis issus de chartes éditoriales professionnelles ou de tuples normalisés selon l’espace colorimétrique RVB. Pour éviter toute confusion perceptuelle avec les points de données, il est d’usage dans la littérature académique d’attribuer à la droite de régression une teinte saturée et contrastante, tel qu’un rouge écarlate profond, un bleu nuit ou un ton carmin distinctif.
Parallèlement, le contrôle de l’épaisseur du trait au moyen du paramètre linewidth s’avère indispensable pour garantir la lisibilité de la figure lors de sa réduction dimensionnelle dans le cadre d’une mise en page d’article ou d’un tirage imprimé. Une valeur comprise généralement entre 1.5 et 2.5 points typographiques offre un équilibre optimal entre visibilité et finesse d’analyse. Enfin, l’argument linestyle permet de modifier la nature continue du tracé en lui substituant une géométrie tiretée ou en pointillés réguliers, ce qui constitue une convention efficace pour signaler immédiatement au lecteur le statut d’estimation statistique conféré à cette trajectoire.
4.2 Optimisation de la représentation des points expérimentaux
Le nuage de points expérimentaux traduit la réalité matérielle de l’échantillonnage et doit être traité avec une vigilance particulière afin de restituer fidèlement la structure de la dispersion sans introduire d’artéfacts d’occlusion visuelle. L’instruction scatter met à disposition des paramètres spécialisés pour réguler la morphologie des marqueurs. Le paramètre s gouverne directement l’aire géométrique occupée par chaque observation, permettant d’adapter l’échelle des points en fonction de la taille globale de l’échantillon analysé : des cohortes volumineuses commandent l’emploi de marqueurs compacts pour prévenir l’illisibilité du graphique.
Un écueil méthodologique fréquent lors de la visualisation de jeux de données denses réside dans la surimposition opaque de multiples observations partageant des coordonnées spatiales contiguës, un écueil désigné sous le terme de sur-traçage ou overplotting. Pour contourner cette limitation perceptive, l’application d’un coefficient de transparence alpha, gradué continûment entre zéro et un, s’avère extrêmement bénéfique. L’accumulation optique de marqueurs semi-transparents génère naturellement un dégradé d’intensité chromatique révélant les foyers d’accumulation et la densité locale de la distribution multivariée.
En complément de la transparence, la définition des bordures de chaque marqueur via les arguments edgecolors et linewidths renforce substantiellement la différenciation individuelle des observations lorsque celles-ci se chevauchent partiellement. L’association d’un cœur de marqueur coloré semi-transparent ceint d’un liseré opaque plus sombre confère au graphique une profondeur visuelle conforme aux standards typographiques des publications scientifiques de premier rang.
4.3 Harmonisation globale selon les standards académiques
La transformation d’un schéma préliminaire en une figure publiable répondant aux normes édictées par les comités de lecture académiques requiert une harmonisation contextuelle rigoureuse du cadre graphique environnant. Le premier impératif méthodologique concerne l’étiquetage exhaustif et sans équivoque des axes cartésiens au moyen des fonctions plt.xlabel et plt.ylabel. Chaque étiquette doit consigner expressément le nom de la variable mesurée, son acronyme scientifique le cas échéant, ainsi que son unité physique ou psychométrique de référence placée entre parenthèses ou crochets standardisés.
Le calibrage typographique de l’ensemble des éléments textuels participe directement au confort de lecture. L’ajustement des arguments fontsize garantit une proportionnalité harmonieuse entre les titres d’axes, la graduation numérique des repères (ticks) et les annotations annexes. Un titre descriptif concis, formalisé par plt.title, peut être adjoint au sommet du repère afin d’expliciter le paradigme d’évaluation ou la nature de l’échantillon analysé, bien que dans le cadre formel des articles scientifiques, cette description textuelle soit majoritairement dévolue à la légende typographique sous-jacente de la figure.
L’introduction d’un quadrillage orthogonal discret, régulée par la fonction plt.grid, procure à l’observateur des repères géométriques facilitant l’estimation visuelle des ordonnées prédites associées à des abscisses précises. Pour maintenir une hiérarchie visuelle préservant la primauté du signal expérimental, ce quadrillage doit adopter un style de tracé allégé, matérialisé par des lignes pointillées fines et une tonalité grise estompée, prévenant toute interférence disruptive avec la droite d’ajustement.
5. Intégration des métriques statistiques et équations formelles
5.1 Formatage dynamique de l’équation de régression
L’adjonction formelle de l’équation de régression au sein même du canevas graphique évite à l’observateur d’avoir à compulser le corps du texte pour extraire les paramètres quantitatifs régissant la droite tracée. Dans un environnement Python automatisé, cette intégration gagne à être totalement dynamique, garantissant que toute modification de la cohorte d’entrée répercute instantanément la mise à jour des paramètres textuels affichés. Cela s’opère par l’intermédiaire des chaînes de caractères formatées modernes introduites dans le langage, permettant l’interpolation directe des variables scalaires issues de l’algorithme d’estimation.
Pour assurer une présentation formelle irréprochable, l’analyste doit formater les nombres réels représentant la pente et l’ordonnée à l’origine avec une précision décimale strictement calibrée, généralement bornée à deux ou trois chiffres significatifs après la virgule selon la précision métrologique des instruments de capture. De plus, il est fondamental de gérer l’affichage conditionnel du signe arithmétique de l’ordonnée à l’origine, prévenant ainsi l’apparition disgracieuse d’une double négation visuelle ou d’un opérateur positif superflu lorsque le paramètre b adopte une valeur négative.
Matplotlib se distingue par son moteur de rendu typographique capable d’interpréter nativement les expressions mathématiques complexes formulées selon la syntaxe standard du système LaTeX. En encapsulant le corps de la chaîne de caractères entre des symboles de dollar et en préfixant la chaîne par un modificateur brut (chaîne brute), le moteur convertit les commandes mathématiques en glyphes vectoriels parfaits. Les variables théoriques s’affichent alors en italique standardisé tandis que les indices, exposants et symboles de chapeaux mathématiques s’intègrent avec une rigueur géométrique identique aux ouvrages universitaires spécialisés.
5.2 Calcul et affichage du coefficient de détermination R²
Le coefficient de détermination, universellement désigné par le symbole R², représente une métrique statistique essentielle pour juger de la qualité intrinsèque de l’ajustement linéaire réalisé. Conceptuellement, il formalise la proportion de la variance totale observée au sein de la variable dépendante y qui se trouve mathématiquement expliquée ou capturée par la droite de régression linéaire. Dans le cadre univarié simple de la méthode des moindres carrés, cette statistique équivaut rigoureusement au carré du coefficient de corrélation linéaire de Bravais-Pearson.
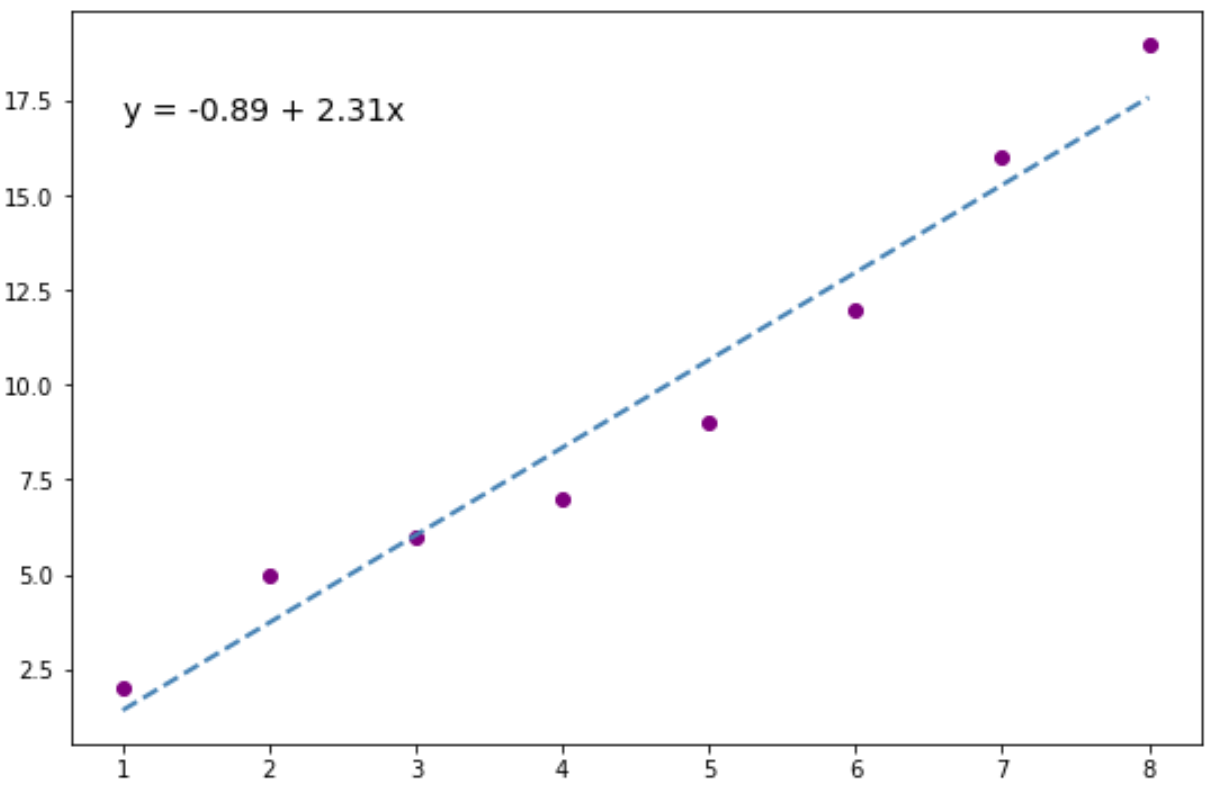
La dérivation computationnelle de cette métrique en Python s’exécute avec une grande simplicité vectorielle sous NumPy. Elle implique la sommation des carrés des résidus, obtenue en soustrayant le vecteur des valeurs ajustées du vecteur des données observées, divisée par la somme totale des carrés des écarts de la variable dépendante par rapport à sa propre moyenne arithmétique globale. La soustraction de ce ratio unitaire fournit la valeur de R², une grandeur sans dimension systématiquement confinée entre zéro, traduisant une inefficacité explicative complète du modèle linéaire, et un, matérialisant un alignement déterministe parfait de l’ensemble des points le long de la droite.
L’intégration de cette valeur chiffrée sur la figure s’avère indispensable pour renseigner l’observateur sur l’ampleur de la dispersion résiduelle non captée par la modélisation. En combinant la chaîne typographique de l’équation affine et l’affichage du coefficient de détermination au sein d’un même bloc textuel, l’expérimentateur confère à son graphique une autonomie sémiotique complète, permettant à tout évaluateur externe de statuer instantanément sur la pertinence prédictive de la liaison fonctionnelle proposée.
5.3 Positionnement stratégique des annotations textuelles
L’incrustation spatiale d’une légende mathématique ou statistique au moyen de l’instruction plt.text nécessite une planification géométrique rigoureuse afin d’éviter tout chevauchement disruptif avec le nuage de points ou la droite d’ajustement. Deux systèmes de coordonnées distincts peuvent être mobilisés : les coordonnées absolues des données, qui calent l’annotation sur les unités réelles des axes cartésiens, et les coordonnées relatives à l’axe (transformées entre zéro et un), qui positionnent le texte à un emplacement invariable indépendamment de l’amplitude numérique des séries temporelles ou spatiales étudiées.
Pour détacher optiquement l’annotation textuelle de la complexité visuelle sous-jacente, il est fortement recommandé d’adjoindre un encadré stylisé en renseignant le paramètre optionnel bbox de la fonction plt.text. Cet argument prend en entrée un dictionnaire de propriétés stylistiques autorisant la spécification d’une couleur d’arrière-plan claire, d’une opacité contrôlée, d’une marge intérieure (padding) protectrice et de contours arrondis discrets. Ce dispositif confère à l’encart statistique une lisibilité irréprochable quel que soit l’environnement géométrique immédiat.
Dans le cadre de chaînes de traitement automatisées appliquées à des centaines de jeux de données sériels distincts, l’ancrage spatial de l’annotation doit être optimisé par des règles programmatiques dynamiques. Une convention éprouvée consiste à localiser l’encadré d’information dans le coin supérieur gauche de la boîte de traçage si la pente du modèle est négative, ou dans le coin supérieur droit si la tendance est positive, préservant ainsi systématiquement un espace vierge suffisant au sein de la zone graphique utile.
6. Approche statistique inférentielle avec scipy.stats.linregress
6.1 Exécution de la régression linéaire univariée complète
Tandis que la commande numpy.polyfit se cantonne à une résolution géométrique et algébrique stricte sans produire d’indicateurs probabilistes sur la dispersion, la fonction linregress, hébergée au sein du sous-module stats de la bibliothèque scientifique SciPy, a été spécifiquement développée pour satisfaire les impératifs de la statistique inférentielle. Son invocation requiert le passage des deux vecteurs d’observations x et y, et engendre en retour un objet de résultats composite structuré regroupant l’ensemble des métriques descriptives et probabilistes canoniques.
L’objet renvoyé par cette procédure permet d’accéder via des attributs nommés explicites à la pente du modèle, à l’ordonnée à l’origine, au coefficient de corrélation bivariée r, à la p-valeur associée au test de significativité bilatéral, ainsi qu’à l’erreur-type estimée de la pente. Les versions contemporaines de la bibliothèque fournissent également l’erreur-type relative à l’ordonnée à l’origine, comblant ainsi un manque historique et permettant une quantification intégrale des incertitudes pesant sur l’ensemble de la structure de l’équation affine.
La supériorité opérationnelle de cette approche pour le praticien réside dans l’unification algorithmique : en un appel fonctionnel unique, l’utilisateur obtient à la fois la trajectoire requise pour la construction graphique et les tests de validation probabilistes indispensables à la rédaction du protocole scientifique. Cette concentration méthodologique élimine les risques d’incohérence numérique susceptibles d’apparaître lorsque le calcul des coefficients et la dérivation des tests d’hypothèses sont conduits au moyen de modules logiciels disjoints.
6.2 Interprétation des tests de significativité statistique
L’intégration de la fonction linregress permet de dépasser le cadre purement descriptif de la droite de meilleur ajustement pour aborder la théorie de la décision statistique. Le test d’hypothèse nulle sous-jacent postule l’absence totale d’association linéaire au sein de la population générale dont est extrait l’échantillon, ce qui se traduit par l’hypothèse H0 : bêta = 0, où bêta désigne la pente théorique inconnue. Le rejet de cette hypothèse nulle conditionne directement la légitimité du chercheur à affirmer l’existence d’une relation fonctionnelle non fortuite entre les grandeurs examinées.
La décision repose formellement sur le calcul d’une statistique de Student t, obtenue en divisant la pente empirique par son erreur-type d’échantillonnage, cette grandeur suivant une loi de Student à n – 2 degrés de liberté. La p-valeur générée exprime la probabilité d’observer un écart d’au moins cette magnitude sous l’hypothèse d’une absence d’effet réel. Conformément aux conventions de recherche en vigueur, une valeur de p inférieure au seuil critique de 0,05 ou 0,01 permet de rejeter H0 et d’attester de la significativité statistique du modèle linéaire déduit.
L’évaluation de l’erreur-type associée à la pente fournit en outre une mesure directe de la précision de l’ajustement. Une erreur-type restreinte atteste d’une localisation étroite de l’estimateur autour de son espérance mathématique, conférant à la droite tracée un statut de modèle hautement représentatif. À l’inverse, une dispersion résiduelle élevée doublée d’un échantillon clairsemé se traduira par une inflation de cette incertitude, signalant graphiquement et analytiquement que l’orientation angulaire de la droite demeure soumise à une forte volatilité stochastique.
6.3 Automatisation du tracé basé sur les résultats de SciPy
L’exploitation programmatique des sorties d’un objet linregress autorise le développement de pipelines graphiques entièrement automatisés et robustes. Grâce à l’attribut de pente et à celui d’ordonnée à l’origine, la modélisation s’intègre harmonieusement dans les directives de traçage de Matplotlib, dispensant l’utilisateur de recourir à des calculs intermédiaires manuels. La droite peut ainsi être projetée directement sur le graphique en évaluant l’expression vectorielle dérivée sur l’ensemble de la plage d’intérêt.
Cette approche systématique facilite la génération automatisée d’annotations statistiques standardisées au sein des légendes de figures. Il devient trivial de concevoir une fonction générique assemblant au sein d’une chaîne typographique unique la valeur numérique de la statistique t, le nombre de degrés de liberté sous-jacents, l’erreur-type associée ainsi que la mention du degré de significativité de la p-valeur. Ce formalisme garantit que les figures produites incorporent l’intégralité des informations requises par les revues scientifiques internationales sans intervention manuelle ultérieure.
L’incorporation de ces routines au sein d’architectures de traitement par lots permet d’analyser et de visualiser séquentiellement des dizaines de cohortes expérimentales indépendantes. Le script peut être paramétré pour adapter dynamiquement la couleur de la droite de meilleur ajustement en fonction de la significativité statistique calculée, appliquant par exemple une teinte soutenue pour les ajustements confirmés à p < 0,01 et une texture estompée pour les tendances n'atteignant pas le seuil critique d'acceptation, optimisant ainsi le tri exploratoire visuel.
7. Modélisation robuste et rapports détaillés avec Statsmodels
7.1 Spécification formelle du modèle linéaire par moindres carrés
Pour les contextes analytiques exigeant une formalisation méthodologique poussée et un ancrage affirmé dans les paradigmes de la modélisation statistique avancée, la bibliothèque Statsmodels offre un environnement rigoureux fondé sur une formulation matricielle explicite. À la différence des routines simplifiées qui supposent implicitement la présence d’une ordonnée à l’origine, la classe OLS (Ordinary Least Squares) de Statsmodels impose une spécification formelle de la matrice de conception, désignée universellement sous le vocable de matrice d’expérience.
Cette exigence architecturale se concrétise par l’application préalable de la fonction sm.add_constant au vecteur ou à la matrice des prédicteurs empiriques x. Cette instruction adjoindra une colonne de uns scalaires contiguë aux variables explicatives, ce qui permet d’estimer formellement le paramètre de constante représentant l’ordonnée à l’origine. L’omission délibérée ou accidentelle de cette étape forcerait la droite d’ajustement à transiter obligatoirement par l’origine cartésienne (0, 0), une contrainte structurelle sévère qui induit généralement un biais massif d’estimation dans les contextes comportementaux où la réponse basale est naturellement non nulle.
L’instanciation de la classe sm.OLS requiert de spécifier en premier paramètre le vecteur de la variable dépendante y, suivi de la matrice de conception enrichie. L’application consécutive de la méthode fit sur l’objet modèle exécute la minimisation des moindres carrés en s’appuyant sur des solveurs de décomposition QR ou SVD particulièrement optimisés. Le modèle ajusté encapsule une quantité exhaustive de données statistiques prêtes à être disséquées et visualisées.
7.2 Exploitation du tableau récapitulatif complet
L’atout prépondérant de la bibliothèque Statsmodels réside dans la restitution d’un rapport synthétique complet accessible par la méthode summary. Cette table structurée condense l’ensemble des grandeurs analytiques indispensables à l’audit du modèle et dépasse largement le cadre restreint des métriques de pente et de corrélation. En tête de ce récapitulatif figurent le coefficient de détermination R², sa variante corrigée prenant en compte les degrés de liberté, ainsi que la statistique globale de Fisher (F-test), qui éprouve la pertinence globale de la modélisation par rapport à un modèle trivial réduit à sa seule moyenne.
La section centrale du rapport décline pour chaque paramètre estimé son coefficient numérique, son erreur-type asymptotique, la statistique de Student associée ainsi que l’intervalle de confiance bilatéral calculé au seuil par défaut de 95 %. Ces éléments permettent de quantifier avec précision l’incertitude pesant individuellement sur l’estimation de l’ordonnée et de la pente d’ajustement.
Enfin, la partition inférieure du tableau de synthèse propose un ensemble d’indicateurs diagnostiques avancés permettant de scruter la validité des hypothèses d’homoscédasticité et de normalité. Les métriques d’asymétrie (skewness) et d’aplatissement (kurtosis) renseignent sur la conformité de la distribution des erreurs empiriques à la loi normale, tandis que le test de Durbin-Watson permet de détecter l’émergence d’une autocorrélation résiduelle de premier ordre. Ce diagnostic multidimensionnel confère au chercheur l’assurance statistique nécessaire avant de valider la représentation graphique finale de sa droite d’ajustement.
7.3 Tracé graphique des prédictions du modèle OLS
La passerelle entre la modélisation statistique avancée sous Statsmodels et la restitution visuelle via Matplotlib s’établit par l’interrogation directe des attributs de l’objet de résultats issu de la méthode fit. L’attribut fittedvalues contient le vecteur dimensionné de l’ensemble des ordonnées ajustées correspondant rigoureusement aux observations de l’échantillon. En triant les valeurs de la variable explicative et en leur associant ces estimations séquentielles, le tracé de la droite de meilleur ajustement s’opère de façon transparente et rigoureuse.
Pour dépasser l’évaluation discrète bornée aux points observés, l’objet de résultats offre la méthode predict, capable d’ingérer une nouvelle grille matricielle de valeurs continues, préalablement pourvue de la constante unitaire requise. Cela autorise la génération d’une droite d’ajustement parfaitement lisse et uniformément résolue, franchissant l’ensemble du domaine de mesure sélectionné par l’expérimentateur.
De surcroît, le sous-module statsmodels.graphics met à disposition des fonctions graphiques spécialisées, à l’instar de plot_fit ou abline_plot, conçues spécifiquement pour automatiser la superposition du modèle linéaire et des données empiriques. Ces utilitaires allègent substantiellement le volume de code d’infrastructure nécessaire pour générer des visualisations rigoureuses, tout en garantissant une adéquation mathématique parfaite entre les diagnostics tabulés et le tracé géométrique restitué.
8. Visualisation avancée et modélisation directe avec Seaborn
8.1 Utilisation de seaborn.regplot pour des tracés immédiats
La bibliothèque de visualisation statistique Seaborn a profondément transformé les pratiques d’analyse de données en Python en fournissant une couche d’abstraction déclarative de haut niveau reposant sur Matplotlib. Plutôt que de requérir la dérivation explicite des coefficients mathématiques et l’agencement procédural pas à pas des éléments géométriques, Seaborn unifie la modélisation sous-jacente et le rendu visuel au sein de commandes holistiques. La fonction seaborn.regplot constitue l’incarnation canonique de cette approche pour l’ajustement linéaire univarié.
Cette fonction accepte nativement des structures de données organisées, telles que des DataFrames Pandas, permettant de désigner les variables d’abscisse et d’ordonnée par leurs simples étiquettes de colonnes textuelles. En une seule instruction fonctionnelle, seaborn.regplot exécute le calcul interne de la régression par moindres carrés, trace le nuage de points empiriques, dessine la droite de meilleur ajustement correspondante et calcule puis projette automatiquement une bande translucide délimitant l’intervalle de confiance de la moyenne estimée à 95 % via des techniques de rééchantillonnage bootstrap ou de dérivation analytique.
La flexibilité de la fonction se manifeste également à travers ses arguments d’ajustement géométrique, tels que le paramètre truncate. Par défaut, la droite tracée est confinée strictement à l’intervalle empirique des données observées pour prévenir les visualisations extrapolées indues. Cependant, l’analyste peut choisir de désactiver cette troncature afin d’étendre la trajectoire de la droite jusqu’aux confins des limites cartésiennes fixées pour la figure, facilitant ainsi l’appréciation visuelle des prolongements théoriques du modèle.
8.2 Différenciation de sous-populations expérimentales via lmplot
Dans la recherche empirique contemporaine, l’investigation des interactions et la comparaison des trajectoires fonctionnelles à travers différentes sous-populations constituent une exigence fréquente. La fonction seaborn.lmplot répond à ce défi méthodologique en conjuguant les capacités d’estimation de regplot avec la flexibilité architecturale des grilles multidimensionnelles FacetGrid. Cette fonction de niveau figure permet de conditionner l’ajustement linéaire à des facteurs catégoriels discrets.
Par l’entremise de l’argument hue, l’analyste peut spécifier une variable de stratification expérimentale, comme la partition entre un groupe clinique et un groupe contrôle, ou la différenciation selon des cohortes d’âge. Seaborn segmente alors automatiquement le jeu de données, ajuste une droite de régression indépendante pour chaque sous-ensemble d’observations, applique une palette chromatique différenciée et engendre une légende synthétique intégrée. Cette approche permet de déceler d’un simple coup d’œil d’éventuelles différences d’inclinaison entre les sous-groupes, traduisant graphiquement des effets d’interaction statistique modérateurs.
Au-delà de la modulation chromatique, lmplot autorise la décomposition spatiale de la scène en une matrice de sous-graphiques distincts par le biais des arguments col et row. Chaque case de la grille expose alors de façon isolée le nuage de points et la droite d’ajustement propre à une modalité factorielle particulière. Cette compartimentation graphique élimine l’encombrement visuel inhérent aux nuages de points denses tout en conservant une mise à l’échelle uniformisée des axes permettant la comparaison visuelle directe des pentes de régression à travers les conditions expérimentales.
8.3 Harmonisation esthétique avec le style académique
L’un des avantages déterminants de l’écosystème Seaborn réside dans la sophistication typographique et thématique de ses styles par défaut, conçus pour transcender la rudesse brute des tracés élémentaires. L’instruction seaborn.set_theme permet d’instaurer instantanément un univers esthétique cohérent à l’échelle de l’ensemble de la session d’analyse. Pour les publications savantes soumises à des contraintes d’impression monochromes ou d’austérité visuelle, le style dénommé ticks ou whitegrid s’impose comme une référence méthodologique particulièrement adaptée.
L’élégance de la restitution graphique est complétée par la fonction seaborn.despine, qui a pour vocation d’élaguer les segments superflus de la boîte de traçage cartésienne. En supprimant les arêtes supérieure et droite de l’encadrement, elle allège la charge d’encre non informative et focalise l’attention de l’évaluateur sur la dynamique des axes fondamentaux d’abscisse et d’ordonnée, respectant ainsi scrupuleusement les principes fondamentaux du design graphique théorisé par Edward Tufte pour la transmission visuelle d’informations scientifiques.
Enfin, Seaborn s’intègre avec les moteurs d’exportation vectorielle de Matplotlib, garantissant la sauvegarde des figures générées dans des formats de compression sans perte tels que le PDF vectoriel ou le SVG à haute définition. Cette préservation de l’intégrité géométrique autorise des agrandissements typographiques infinis sans aucune pixellisation, satisfaisant ainsi aux exigences techniques les plus draconiennes formulées par les comités d’édition des revues de rang international.
9. Calcul et visualisation des intervalles d’incertitude
9.1 Distinction entre intervalle de confiance et intervalle de prédiction
Une interprétation rigoureuse de la droite de meilleur ajustement commande de ne point appréhender cette dernière comme une certitude déterministe absolue, mais bien comme l’espérance mathématique conditionnelle d’un processus stochastique entaché d’incertitude d’échantillonnage. Dans ce cadre épistémologique, il est impératif de distinguer avec une précision formelle l’intervalle de confiance appliqué à la droite de régression de l’intervalle de prédiction associé aux futures observations individuelles.
L’intervalle de confiance évalue exclusivement la variabilité de la moyenne estimée de la réponse pour une valeur fixée de la variable prédictive x. Il quantifie l’incertitude inhérente à l’échantillonnage fini : si l’expérimentateur devait réitérer son protocole un nombre infini de fois et dériver une multitude de droites de régression empiriques, une proportion calibrée de ces trajectoires (traditionnellement 95 %) se trouverait circonscrite à l’intérieur de cette enveloppe. Sa géométrie présente un étranglement caractéristique au niveau du centre de gravité des données, traduisant le fait que l’estimation de la moyenne gagne en précision à proximité des valeurs moyennes observées de x.
À l’opposé, l’intervalle de prédiction incorpore non seulement cette incertitude pesant sur la localisation de la droite d’ajustement, mais y adjoint également la variance irréductible propre aux perturbations aléatoires individuelles e_i. Il délimite la zone au sein de laquelle une observation singulière isolée, prélevée ultérieurement sur la population, a une probabilité définie de s’établir. En conséquence de l’intégration de cette variance résiduelle propre, l’intervalle de prédiction s’avère considérablement plus large que l’intervalle de confiance de la moyenne, une nuance conceptuelle critique que tout chercheur doit impérativement expliciter graphiquement sous peine d’induire le lecteur en erreur quant à la dispersion réelle des comportements individuels.
9.2 Calcul analytique des bandes de confiance en Python
La formalisation analytique des bandes de confiance le long d’un continuum d’abscisses requiert le déploiement de formules matricielles rigoureuses au moyen de NumPy et SciPy. L’ingrédient fondamental de cette modélisation réside dans l’estimation sans biais de la variance résiduelle du modèle, obtenue en divisant la somme des carrés des résidus empiriques par le nombre de degrés de liberté résiduels n – 2. Cette grandeur permet de déduire l’écart-type résiduel fondamental de la régression.
Pour chaque coordonnée x_0 située sur la grille continue d’évaluation, l’erreur-type de la prédiction de la réponse moyenne s’obtient en combinant l’erreur d’échantillonnage globale inversement proportionnelle à la taille de l’échantillon n et une composante quadratique pondérée par la somme des écarts au carré de la variable explicative d’origine. Cette formulation analytique reflète mathématiquement l’accroissement progressif de l’incertitude à mesure que l’on s’écarte de la moyenne arithmétique de la variable d’entraînement.
La borne d’incertitude marginale s’obtient alors en multipliant cette erreur-type locale par le quantile critique approprié issu de la distribution t de Student bilatérale, calculé précisément via la fonction de survie inverse scipy.stats.t.ppf pour un niveau de confiance fixé, usuellement à 0,975 pour un intervalle bilatéral à 95 %. L’addition et la soustraction de cette marge à la valeur moyenne ajustée délimitent les bornes supérieure et inférieure de la bande de confiance continue.
9.3 Rendu visuel par zones d’ombre avec matplotlib.pyplot.fill_between
Une fois les vecteurs des limites inférieure et supérieure formellement dérivés sur l’ensemble de la grille d’évaluation, la restitution de l’enveloppe d’incertitude s’exécute avec fluidité au moyen de l’instruction matplotlib.pyplot.fill_between. Cette fonction spécialisée génère un polygone continu d’ombrage remplissant intégralement l’espace bidimensionnel borné verticalement par les deux courbes asymptotiques fournies.
L’utilisation judicieuse du paramètre alpha s’avère capitale lors de cette opération : une translucidité prononcée, calibrée typiquement entre 0,15 et 0,25, permet d’ombrer la région d’incertitude statistique sans occulter les points expérimentaux qui y transitent ou la trajectoire centrale de la droite de régression tracée par-dessus. Il convient généralement de synchroniser la couleur de ce remplissage avec celle de la droite d’ajustement afin de maintenir une harmonie visuelle évidente au sein de la figure.
Cette approche manuelle permet à l’expérimentateur d’exercer un contrôle déterministe absolu sur la nature des bandes représentées. Il lui devient aisé de tracer simultanément sur un même graphique une zone d’ombre étroite figurant l’intervalle de confiance à 95 % de la trajectoire moyenne et une seconde zone plus étendue et plus pâle représentant l’intervalle de prédiction des observations individuelles, offrant ainsi au lecteur une radiographie méthodologique intégrale de la structure de dépendance et de dispersion des données.
10. Analyse graphique des résidus et vérification diagnostique
10.1 Visualisation du graphique des résidus par rapport aux valeurs ajustées
L’acceptation scientifique d’une droite de meilleur ajustement ne saurait reposer exclusivement sur l’attractivité visuelle de son tracé ou sur la magnitude de son coefficient de détermination R². Une étape diagnostique impérative consiste à inspecter scrupuleusement le comportement des résidus au moyen d’un graphique dédié confrontant les résidus empiriques e_i aux valeurs prédites correspondantes y_chapeau. Ce schéma de contrôle diagnostique permet de détecter d’éventuelles violations flagrantes des postulats fondamentaux régissant les moindres carrés.
Dans le cas d’un modèle linéaire rigoureusement valide, le nuage de résidus ainsi visualisé doit former une constellation aléatoire, homogène et exempte de toute organisation structurelle, oscillant de façon symétrique autour de la ligne horizontale d’ordonnée nulle. L’émergence d’une tendance curviligne, telle qu’une allure parabolique ou sinusoïdale au sein de ce tracé, constitue l’indice probant d’une spécification erronée du modèle fonctionnel, révélant que la relation sous-jacente relève d’une dynamique non linéaire ignorée par l’ajustement affine.
Parallèlement, la morphologie globale du nuage permet de tester visuellement l’hypothèse d’homoscédasticité. Si l’amplitude verticale de dispersion des résidus s’élargit ou se contracte systématiquement le long de l’axe des abscisses, dessinant un motif caractéristique d’entonnoir ou de pavillon de trompette, l’analyste se trouve en présence d’une hétéroscédasticité manifeste. Un tel constat commande d’abandonner les inférences standard de Student au profit de procédures de régression pondérée par la variance locale ou d’estimateurs de covariance robustes à l’hétéroscédasticité de type White ou Huber-White.
10.2 Contrôle de la normalité des erreurs d’ajustement
L’exactitude des valeurs critiques p et la représentativité des bandes de confiance calculées reposent théoriquement sur l’hypothèse d’une distribution normale des perturbations résiduelles au sein de la population parente. L’instrument graphique canonique pour apprécier cette conformité distributionnelle réside dans le diagramme quantile-quantile normal, universellement désigné par l’appellation Q-Q plot. Ce diagramme confronte les quantiles empiriques extraits des résidus standardisés aux quantiles théoriques d’une distribution normale unitaire.
La génération de cette représentation s’opère commodément en Python au moyen de la fonction probplot incluse dans le sous-module stats de SciPy. En spécifiant l’option de traçage direct, la fonction ordonne les erreurs résiduelles et les projette graphiquement sous forme de coordonnées confrontées à la diagonale théorique d’alignement parfait. Lorsque les résidus sont rigoureusement gaussiens, l’ensemble des points d’observation s’agrège de manière rectiligne le long de cette trajectoire de référence.
Les déviations systématiques observées aux extrémités du diagramme revêtent une signification diagnostique capitale pour le chercheur. Une courbure affectant les queues de distribution signale la présence de distributions à queues lourdes (leptokurtiques) ou d’asymétries structurelles sévères. Ces altérations indiquent une vulnérabilité accrue du modèle aux valeurs atypiques extrêmes, suggérant que l’ajustement par moindres carrés ordinaires pourrait fournir des inférences exagérément optimistes et justifiant l’application conjointe de tests d’adéquation formels à l’image du test de Shapiro-Wilk ou du test de D’Agostino-Pearson.
10.3 Repérage des observations influentes et des points de levier
La méthode des moindres carrés ordinaires présente une vulnérabilité structurelle notoire à l’endroit des observations extrêmes en raison de la pénalisation quadratique appliquée aux résidus verticaux. Au sein d’un échantillon expérimental, une observation isolée peut exercer une influence disproportionnée sur l’orientation angulaire de la droite de meilleur ajustement au point de masquer la dynamique réelle régissant le reste de la cohorte. Deux dimensions analytiques complémentaires permettent de qualifier cette influence : l’effet de levier et la distance de Cook.
L’effet de levier mesure l’éloignement d’une observation par rapport au centre de gravité de la variable explicative x au sein de l’espace de conception. Une observation possédant une abscisse singulière extrêmement distante des autres points dispose d’un potentiel de levier géométrique considérable pour faire pivoter la droite d’ajustement. Toutefois, un point de levier n’altère substantiellement les paramètres du modèle que s’il est également associé à un résidu empirique conséquent par rapport à la tendance dominante.
La distance de Cook synthétise l’impact unitaire global de chaque observation en calculant la variation globale induite sur l’ensemble des valeurs ajustées lorsque ladite observation est temporairement exclue du jeu d’entraînement. La bibliothèque Statsmodels permet de dériver instantanément les distances de Cook associées à chaque point d’une régression OLS via la classe OLSInfluence. L’analyste peut alors tracer un diagramme d’influence affichant ces grandeurs, conventionnellement adossées à un seuil critique empirique tel que 4 / (n – k – 1), permettant d’isoler visuellement les données susceptibles de vicier l’intégrité de la droite d’ajustement.
11. Études de cas appliquées à l’analyse de données empiriques
11.1 Étude 1 : Relation entre privation de sommeil et temps de réaction cognitif
Pour illustrer la mise en œuvre pratique de ces concepts méthodologiques dans un paradigme expérimental concret, considérons une recherche menée en neurobiologie comportementale étudiant l’impact de la privation de sommeil prolongée sur l’efficience psychomotrice. Dans ce protocole, un échantillon de sujets volontaires est soumis à des durées de veille continue calibrées s’étendant de zéro à quarante-huit heures, la variable dépendante mesurée étant le temps de réaction moyen consigné lors d’une tâche d’attention soutenue standardisée (Psychomotor Vigilance Task).
Après l’ingestion des séries de mesures via un DataFrame Pandas et l’élimination préliminaire des artefacts de capture par filtrage vectoriel, le chercheur applique la modélisation des moindres carrés à l’aide de SciPy et Matplotlib. L’estimation produit une droite d’ajustement exhibant une pente positive robuste, chiffrée par exemple à une augmentation moyenne de 6,4 millisecondes de latence par heure de veille continue accumulée. Le tracé superpose le nuage de points semi-transparents, la droite de meilleur ajustement continue et l’intervalle de confiance à 95 % déduit analytiquement.
L’intégration textuelle des métriques renseigne un coefficient de détermination substantiel, attestant qu’une fraction majeure de la dégradation de la latence motrice est strictement attribuable à la dette de vigilance imposée par le protocole expérimental. La vérification diagnostique consécutive sur le graphique des résidus confirme l’absence d’hétéroscédasticité majeure le long du continuum temporel, autorisant le chercheur à conclure avec une rigueur statistique irréprochable sur l’impact fonctionnel délétère de la privation de sommeil au sein de la cohorte évaluée.
11.2 Étude 2 : Corrélation entre anxiété perçue et performance mnésique
La seconde étude de cas relève de la psychologie différentielle et porte sur l’interaction entre les scores d’anxiété perçue, quantifiés au moyen d’un inventaire psychométrique validé de type Spielberger (STAI), et la performance d’encodage lors d’une épreuve de mémoire de travail verbale. Contrairement aux grandeurs physiques temporelles, les scores psychométriques se caractérisent par une variabilité intrinsèque marquée et une dispersion substantielle due à la composante subjective des auto-évaluations.
La droite d’ajustement, modélisée sous Statsmodels et visualisée via Seaborn, met en évidence une tendance déclinante modérée : à mesure que le score d’anxiété déclarée s’élève le long de l’axe horizontal, le volume d’items correctement restitués diminue de façon statistiquement significative. Cependant, la dispersion imposante des observations autour de la trajectoire se traduit par un coefficient de détermination R² d’amplitude plus modeste, fréquemment situé aux alentours de 0,25 dans ce type de protocole comportemental.
Cette modélisation visuelle ouvre la voie à une discussion épistémologique essentielle quant aux limites du paradigme linéaire classique. En intégrant une analyse soignée des résidus, l’analyste peut éprouver la loi de Yerkes-Dodson, qui postule historiquement une relation curvilinéaire en U inversé entre l’éveil émotionnel et l’efficience cognitive. La constatation visuelle d’une concavité résiduelle systématique aux niveaux d’anxiété extrêmes signale à l’expérimentateur l’impérieuse nécessité de substituer à la droite de meilleur ajustement un polynôme de degré deux ou une régression spline pénalisée pour refléter avec fidélité la nature non linéaire du processus mnésique sous-jacent.
11.3 Étude 3 : Modélisation longitudinale de l’acquisition d’une habileté motrice
La troisième application empirique concerne l’apprentissage moteur au cours d’un entraînement longitudinal consistant en la répétition séquentielle d’une tâche de dextérité fine sur plusieurs dizaines d’essais consécutifs. La variable explicative correspond ici au rang de l’essai d’apprentissage, tandis que la variable de réponse quantifie la précision gestuelle ou la vitesse d’exécution de la trajectoire biomécanique.
Dans ce scénario d’apprentissage, l’expérimentateur utilise les capacités de traçage groupé offertes par Matplotlib et Seaborn pour projeter simultanément deux niveaux de réalité empirique : d’une part, les trajectoires d’apprentissage individuelles de chaque sujet matérialisées par des lignes fines et semi-transparentes de couleur neutre, et d’autre part, la droite de meilleur ajustement globale représentative de la cohorte tracée avec une épaisseur typographique dominante et une chromie vibrante.
Cette double représentation permet de concilier la réalité de l’hétérogénéité interindividuelle, visible à travers les décalages d’ordonnées à l’origine traduisant les aptitudes basales hétérogènes des apprenants, et la loi de progression moyenne formalisée par la pente positive de la droite d’ajustement. L’analyse inférentielle adossée aux diagnostics de Statsmodels permet d’attester de la significativité de l’effet d’apprentissage global, tout en conservant une traçabilité visuelle immédiate des sujets atypiques dont le profil d’acquisition diverge radicalement de la moyenne générale.
12. Bonnes pratiques, gestion des valeurs aberrantes et limites
12.1 Techniques de régression robuste face aux données contaminées
Lorsque des données expérimentales intègrent des valeurs aberrantes ou contaminées résultant d’artéfacts techniques ou d’inattentions comportementales majeures de la part des participants, l’utilisation aveugle de la méthode des moindres carrés ordinaires peut conduire à des errements inférentiels dramatiques. La sensibilité quadratique de la minimisation de la somme des résidus confère à tout point aberrant une capacité disproportionnée à dévier la droite de sa trajectoire centrale, menant à une mauvaise représentation de l’ensemble de la distribution.
Pour parer à cette défaillance méthodologique sans recourir à une élimination arbitraire et controversée des observations distantes, l’analyste peut mobiliser les estimateurs de régression robuste implémentés au sein de bibliothèques spécialisées telles que Scikit-Learn. Parmi ces méthodologies, l’algorithme RANSAC (Random Sample Consensus) s’illustre particulièrement : il procède par ajustements itératifs sur des sous-ensembles aléatoires d’observations pour discriminer formellement les données conformes (inliers) de la contamination périphérique (outliers).
Une seconde approche éprouvée repose sur les M-estimateurs de Huber, qui substituent à la fonction de coût quadratique classique une fonction linéaire dès lors que les résidus dépassent un seuil de déviation paramétré. Sur le plan graphique, il est d’un grand intérêt pédagogique de tracer de façon conjointe sur une même figure la droite fragile issue des moindres carrés ordinaires et la droite d’ajustement robuste déduite de l’estimateur de Huber. Cette superposition révèle instantanément au lecteur la résilience de l’approche robuste face aux distorsions aberrantes et préserve la validité descriptive de la modélisation empirique.
12.2 Les dangers méthodologiques de l’extrapolation hors échantillon
L’une des dérives analytiques les plus répandues consiste à assigner à la droite de meilleur ajustement une portée universelle au-delà des frontières strictes délimitées par l’échantillonnage empirique initial. La délimitation entre interpolation, consistant à estimer la réponse à l’intérieur du domaine d’observation de la variable explicative, et extrapolation prospective, qui projette le modèle en dehors de cet intervalle, constitue une frontière méthodologique fondamentale que tout chercheur rigoureux doit préserver.
Une droite d’ajustement linéaire ne représente qu’une approximation asymptotique locale valide dans le domaine expérimental spécifié. En dehors de cette enveloppe de mesure, les contraintes physiques, physiologiques ou psychologiques des systèmes étudiés engendrent fréquemment des effets de seuil, des saturations ou des retournements de tendance. Par exemple, une relation parfaitement affine établie entre la dose d’un composé neurochimique et une capacité de mémorisation peut basculer dans une toxicité létale ou une perte de réponse totale lorsque la concentration excède le domaine initialement administré.
Pour prévenir toute confusion chez l’observateur lors de la diffusion des résultats, il est hautement recommandé de délimiter graphiquement le domaine de validité empirique. L’analyste doit s’abstenir de prolonger la droite de régression jusqu’aux confins arbitraires des axes géométriques si aucune observation n’y réside. À défaut, la trajectoire extrapolée doit adopter un traitement visuel explicitement distinct, matérialisé par un style en pointillés allégé complété par une note d’avertissement dans la légende précisant la nature hypothétique de la projection.
12.3 Synthèse et recommandations pour la publication scientifique
L’élaboration d’une visualisation de droite d’ajustement destinée à l’édition savante et à l’examen par les pairs requiert la satisfaction d’un ensemble de critères de qualité technique, méthodologique et déontologique. La reproductibilité computationnelle intégrale constitue le premier de ces piliers : l’ensemble des scripts Python ayant généré la figure doit être rigoureusement commenté, versionné et rendu accessible, accompagné des matrices de données brutes ou de protocoles de génération synthétique permettant la réplication exacte des résultats chiffrés.
Sur le plan de l’architecture graphique, la figure finale doit comporter l’ensemble des éléments descriptifs minimaux exigés par les comités de lecture internationaux : étiquetage précis des axes cartésiens incluant les unités physiques, échelle de proportionnalité typographique respectée, contraste chromatique suffisant pour les lecteurs présentant des déficits de perception des couleurs (utilisation préférentielle de palettes universelles de type Viridis ou Cividis), et affichage contextuel explicite des métriques de significativité statistique fondamentales (pente, erreur-type, coefficient R² et p-valeur).
Enfin, la phase d’exportation matérielle de la figure doit s’affranchir impérativement des formats matriciels destructeurs à basse résolution comme le format JPEG standard. L’analyste privilégiera l’exportation au format vectoriel pur (PDF, EPS ou SVG) ou, si les directives éditoriales imposent un rendu matriciel, veillera à configurer une densité typographique minimale de 300 à 600 points par pouce (DPI) via l’argument dpi de la fonction plt.savefig. Cette rigueur garantit que la droite de meilleur ajustement, symbole de la synthèse entre le modèle théorique abstrait et le fait expérimental concret, apparaîtra avec une netteté visuelle parfaite au sein du corpus pérenne de la recherche scientifique.
Références
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Legendre, A. M. (1805). Nouvelles méthodes pour la détermination des orbites des comètes. F. Didot.
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1928-042
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (pp. 92–96). https://doi.org/10.25080/Majora-92bf1928-011
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Van Rossum, G., & Drake, F. L. (2009). Python 3 reference manual. CreateSpace.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021