
L’analyse de régression linéaire et la modélisation des relations bivariées constituent l’un des piliers fondamentaux de la démarche scientifique moderne, qu’il s’agisse des sciences computationnelles, des sciences économiques, de la physique expérimentale ou de la psychométrie quantitative. Au cœur de cette démarche réside la droite d’ajustement, communément désignée sous le terme de droite des moindres carrés ordinaires ou droite de meilleur ajustement. Ce vecteur graphique et analytique ne se limite pas à relier visuellement des observations éparses au sein d’un repère cartésien ; il formalise une tentative rigoureuse d’extraire un signal structurel pertinent et déterministe au milieu d’un bruit stochastique inhérent à toute mesure empirique. La droite matérialise ainsi une fonction prédictive continue, optimisée pour minimiser l’écart global entre les postulats théoriques du chercheur et la variabilité intrinsèque des phénomènes observés dans le monde réel.
Dans l’écosystème contemporain du calcul scientifique et de la science des données, le langage de programmation Python s’est imposé comme l’environnement hégémonique pour formaliser, estimer et visualiser ces modèles mathématiques. Grâce à une synergie sans équivalent entre des bibliothèques matricielles optimisées à bas niveau comme NumPy, des moteurs de rendu graphique granulaires tels que Matplotlib, des extensions statistiques spécialisées à l’instar de SciPy, et des abstractions déclaratives de haut niveau comme Seaborn, les analystes disposent d’un continuum méthodologique complet. Ce spectre programmatique permet de transiter sans friction de l’algèbre linéaire fondamentale à la publication de visualisations rigoureuses conformes aux exigences éditoriales académiques les plus strictes, notamment celles prescrites par l’American Psychological Association.
Toutefois, la relative simplicité syntaxique avec laquelle une droite d’ajustement peut être projetée sur un écran dissimule fréquemment des simplifications conceptuelles téméraires et des écueils interprétatifs profonds. Tracer une régression exige une maîtrise conjointe des fondations statistiques sous-jacentes, des hypothèses de distribution des résidus, de la sensibilité aux points d’inflexion, ainsi que des spécificités computationnelles relatives à la précision numérique et à la gestion vectorielle des structures de données. Le présent traité méthodologique propose une exploration exhaustive des techniques permettant de construire, personnaliser, diagnostiquer et interpréter une droite d’ajustement en Python, en adoptant une perspective académique où la rigueur mathématique guide chaque choix d’implémentation logicielle.
1. Fondements théoriques de la droite d’ajustement linéaire
1.1 Définition mathématique et méthode des moindres carrés
La formalisation algébrique d’une relation fonctionnelle linéaire entre une variable explicative indépendante, conventionnellement notée x, et une variable dépendante ou réponse, notée y, s’établit traditionnellement sous l’expression canonique y = ax + b, où a représente le coefficient directeur ou la pente de la trajectoire, et b désigne l’ordonnée à l’origine, correspondant à la valeur prédite lorsque la variable exogène s’annule. Dans le cadre de l’échantillonnage empirique, chaque observation individuelle indicée par i dévie de cette trajectoire idéale en raison d’une composante d’erreur stochastique, notée εi, conduisant au modèle génératif yi = axi + b + εi. L’estimation paramétrique des coefficients optimaux repose sur le principe de la méthode des moindres carrés ordinaires, conceptualisée indépendamment par Carl Friedrich Gauss et Adrien-Marie Legendre.
Cette approche analytique stipule que la meilleure approximation linéaire d’un ensemble de points consiste à déterminer le couple de paramètres réels (a, b) qui minimise de façon globale la somme quadratique des écarts verticaux entre les valeurs observées réelles et les valeurs théoriques prédites par le modèle linéaire. Mathématiquement, l’objectif consiste à trouver le minimum global de la fonction de coût résiduelle S(a, b) = ∑ (yi – (axi + b))2. La minimisation analytique de cette surface convexe différentiable s’opère par le calcul des dérivées partielles par rapport à a et b, puis par leur annulation simultanée, aboutissant au système des équations normales de Gauss. La résolution de ce système linéaire permet d’isoler l’estimateur de la pente sous la forme du ratio de la covariance empirique entre x et y sur la variance empirique de x, tandis que l’ordonnée à l’origine s’obtient directement en soustrayant le produit de la pente et de la moyenne arithmétique de x à la moyenne arithmétique de y.
L’optimalité statistique des estimateurs des moindres carrés découle directement du théorème de Gauss-Markov. Selon ce dernier, au sein de la classe des estimateurs linéaires sans biais, les estimateurs issus des moindres carrés ordinaires possèdent la variance d’échantillonnage minimale, leur conférant le statut d’estimateurs BLU (Best Linear Unbiased Estimators). Cette propriété mathématique requiert néanmoins le respect strict de plusieurs hypothèses fondamentales relatives à la structure probabiliste des résidus : l’espérance conditionnelle des perturbations doit être strictement nulle, la variance des erreurs doit demeurer constante sur l’ensemble du domaine de mesure (condition impérative d’homoscédasticité), et les erreurs associées à deux observations distinctes doivent afficher une covariance nulle, garantissant leur indépendance statistique mutuelle. L’estimation ponctuelle de la trajectoire linéaire offre alors un résumé synthétique optimal de la tendance générale qui sous-tend la dispersion empirique.
1.2 Pertinence épistémologique dans l’analyse de données quantitatives
Sur le plan épistémologique, l’ajustement linéaire opère une réduction délibérée et parcimonieuse de l’infinie complexité du réel observé. Face à un ensemble massif d’enregistrements quantitatifs caractérisés par une dispersion apparente, l’esprit scientifique cherche à discriminer le signal invariant des fluctuations aléatoires de mesure. En traduisant un phénomène multidimensionnel complexe en une relation fonctionnelle gouvernée par seulement deux scalaires fondamentaux — un taux de variation moyen et un niveau de base —, le chercheur formalise une abstraction intelligible. Cette modélisation des régularités empiriques sert de pont entre l’induction basée sur les données d’observation et la déduction dérivée de théories hypothético-déductives.
Dans des disciplines empiriques telles que la psychométrie, les sciences cognitives, la sociologie quantitative ou l’économétrie, la droite d’ajustement constitue le socle opérationnel sur lequel s’érigent les paradigmes explicatifs. Par exemple, lorsqu’il s’agit d’évaluer la dynamique de l’apprentissage en fonction du temps d’exposition ou de quantifier l’évolution du stress perçu face à une charge cognitive progressive, l’ajustement linéaire fournit un étalon de mesure standardisé. L’inclinaison de la droite quantifie directement la sensibilité du système sous examen aux variations de l’intrant expérimental, autorisant ainsi des comparaisons inter-individuelles ou inter-groupes d’une grande rigueur métrologique.
Il importe toutefois de discriminer avec précision la finalité descriptive d’une droite d’ajustement de sa vocation prédictive. Dans une perspective purement géométrique ou descriptive, la droite se contente de synthétiser la direction médiane de la distribution bivariée pour l’échantillon clos ayant servi à son calcul. En revanche, lorsqu’elle est investie d’une ambition prédictive, la droite prétend anticiper la valeur numérique qu’adopterait la variable dépendante si une nouvelle observation de la variable explicative venait à être réalisée en dehors de l’échantillon originel. Cette transition conceptuelle suppose la stabilité temporelle et contextuelle du processus sous-jacent, conférant ainsi à l’outil une responsabilité méthodologique qui dépasse la simple synthèse visuelle.
1.3 Distinction fondamentale entre corrélation et causalité
L’une des dérives analytiques les plus répandues lors de la mise en œuvre d’une droite d’ajustement réside dans la confusion pernicieuse entre l’existence d’une corrélation statistique et l’affirmation d’une relation de causalité unidirectionnelle. Le coefficient de corrélation linéaire de Pearson, désigné par la lettre r, mesure le degré de covariation linéaire normalisé entre deux variables et oscille rigoureusement dans l’intervalle [-1, 1]. Bien que la pente de la droite des moindres carrés ordinaires soit intimement liée à ce coefficient — partageant invariablement son signe et son niveau d’annulation statistique —, elle n’établit en aucune manière que les variations de la variable x constituent la cause motrice des variations observées chez la variable y.
L’ajustement d’une trajectoire linéaire demeure aveugle à la présence de variables confondantes, ou variables tierces non observées dans le protocole expérimental. Deux grandeurs physiques ou sociales peuvent présenter un alignement linéaire quasi parfait uniquement en raison de leur dépendance simultanée et synchrone vis-à-vis d’une cause sous-jacente commune. Par exemple, une corrélation positive marquée entre la vente de crèmes solaires et le nombre de noyades répertoriées ne procède d’aucun lien de cause à effet direct, mais reflète l’action régulatrice de la température ambiante estivale. Omettre d’incorporer ces facteurs exogènes dans la chaîne explicative expose l’analyste au risque majeur de formaliser une régression fallacieuse ou spécieuse.
L’inférence causale valide ne peut être postulée à partir d’un simple ajustement bivarié. Elle requiert impérativement un plan d’échantillonnage expérimental rigoureux fondé sur l’assignation aléatoire, l’isolation active des stimuli environnementaux ou, dans le cadre observationnel non interventionnel, le recours à des approches économétriques avancées telles que la méthode des variables instrumentales ou les modèles d’équations structurelles. Par conséquent, la visualisation d’une droite d’ajustement doit être systématiquement interprétée comme le constat géométrique d’une association linéaire empirique, et non comme la preuve expérimentale irréfutable d’un mécanisme de transmission causal.
2. Configuration de l’environnement de développement Python
2.1 Installation et gestion des dépendances scientifiques
La mise en place d’un écosystème de calcul et d’analyse statistique stable, pérenne et rigoureusement reproductible constitue la condition préalable indispensable à toute investigation numérique en Python. L’utilisation anarchique du gestionnaire d’installation global du système d’exploitation engendre fréquemment des conflits de versions irréconciliables entre bibliothèques tierces, compromettant la validité des scripts analytiques à moyen terme. Il est donc impératif de compartimenter l’espace de travail au moyen d’environnements virtuels isolés, déployés soit via le module natif venv, soit par l’intermédiaire de la distribution scientifique Conda, particulièrement réputée pour sa gestion robuste des liaisons dynamiques d’algèbre linéaire compilées en C et Fortran.
L’initialisation d’un tel environnement dédié garantit que les versions spécifiques de Python, de la couche de calcul tensoriel NumPy et de la suite graphique Matplotlib demeurent immuables durant toute la durée de l’étude. L’installation standardisée s’exécute traditionnellement au moyen de l’utilitaire pip ou de la commande conda install, en veillant à interroger les registres officiels pour obtenir des binaires optimisés compatibles avec l’architecture matérielle sous-jacente. Pour préserver l’intégrité computationnelle du projet, la fixation exhaustive des dépendances au sein d’un fichier manifeste nommé requirements.txt ou environment.yml s’impose comme une norme éthique incontournable, permettant à tout évaluateur externe de dupliquer fidèlement l’état exact des modules exécutés lors de la production initiale des graphiques.
Il convient également de vérifier méticuleusement la compatibilité des versions de l’interpréteur Python lui-même. Bien que les versions récentes garantissent des gains notables en termes d’efficacité d’exécution générale, certaines fonctions de modélisation mathématique fine requièrent des sous-dépendances compilées dont la compatibilité n’est parfois assurée que sur des versions stables désignées (LTS). Une vérification systématique dans le terminal au moyen des commandes de contrôle de version permet d’éliminer en amont toute incertitude quant au comportement des algorithmes numériques de résolution matricielle.
2.2 Importation conventionnelle des modules fondamentaux
La communauté scientifique internationale s’est accordée sur un ensemble de conventions d’importation canoniques qui régissent l’écriture du code Python dédié à l’analyse de données. Le non-respect de ces conventions nuit à la lisibilité universelle des programmes et complexifie la relecture critique par les pairs. Ainsi, la bibliothèque fondamentale de calcul numérique vectoriel NumPy s’importe invariablement sous le pseudonyme abrégé np, tandis que l’interface de traçage graphique déclaratif procédural Matplotlib Pyplot s’appelle universellement sous l’alias plt. Ces conventions mnémotechniques standardisent l’accès aux classes et aux méthodes de bas niveau, rendant le flux algorithmique limpide pour tout observateur averti.
Au-delà de l’appel aux modules eux-mêmes, la configuration sous-jacente du moteur de rendu graphique — le backend — requiert une attention méthodologique soutenue. Selon que l’environnement d’exécution s’articule autour d’un serveur d’automatisation sans tête (headless), d’une invite de commande interactive ou d’un calepin numérique de type Jupyter Notebook, la restitution visuelle de la droite d’ajustement exige un backend adapté. Pour des sorties interactives nécessitant un zoom dynamique et une manipulation de repère, les backends basés sur Qt ou Tkinter s’avèrent optimaux, tandis que l’exportation vers des formats vectoriels statiques haute résolution destinés à l’impression privilégiera des moteurs non interactifs comme Agg ou Cairo.
Dans le contexte spécifique des environnements interactifs sur navigateur web, l’activation des directives magiques régissant l’intégration directe des figures dans le flux du document garantit une cohérence visuelle immédiate. L’appel explicite aux paramètres de configuration globale de Matplotlib via le dictionnaire plt.rcParams permet de figer en amont les standards esthétiques de la publication, qu’il s’agisse de la résolution exprimée en points par pouce (dpi), de la typographie générale ou des dimensions par défaut des canevas de dessin, instaurant dès l’importation une rigueur géométrique absolue.
2.3 Structuration des notebooks et scripts reproductibles
L’écriture d’un script destiné à la formalisation d’une droite de meilleur ajustement obéit à une architecture modulaire et compartimentée, articulée de manière à dissocier la génération ou l’ingestion des flux de données, le traitement statistique algorithmique, et la phase terminale de stylisation graphique. Entremêler confusément le calcul des moindres carrés et les instructions de rendu chromatique engendre une dette technique pénalisante et accroît considérablement le risque d’introduire des erreurs d’arrondi ou de manipulation d’index non reproductibles.
Un impératif catégorique de la programmation scientifique réside dans la fixation explicite des graines aléatoires (random seeds) lorsque les jeux de données expérimentaux font l’objet de simulations synthétiques, de perturbations stochastiques ou de procédures de rééchantillonnage. L’assignation d’une valeur entière fixe au générateur de nombres pseudo-aléatoires de NumPy permet de figer l’aléa mathématique dans un état déterministe rigoureusement reproductible sur n’importe quelle machine tierce. Sans cette précaution technique élémentaire, deux exécutions consécutives du même script de démonstration produiraient des nuages de points subtilement divergents et, par corollaire, des pentes d’ajustement oscillantes.
Enfin, la standardisation du code passe par l’implémentation de commentaires structurés, de chaînes de documentation (docstrings) explicites et de typages statiques indicatifs sur les fonctions d’ajustement. Déclarer explicitement que les arguments d’entrée attendus doivent posséder la signature d’un tableau à une dimension d’éléments à virgule flottante participe activement à la robustesse du protocole computationnel, prévenant les erreurs silencieuses induites par la coercition de types inattendue au sein du compilateur sous-jacent.
3. Implémentation élémentaire avec NumPy et Matplotlib
3.1 Définition vectorielle des variables explicatives et dépendantes
L’amorce de la procédure d’ajustement linéaire requiert la construction et l’initialisation de structures de données aptes à subir des calculs matriciels hautement performants. Contrairement aux listes natives fournies par Python, qui souffrent d’une dispersion spatiale dans la mémoire vive et d’une surcharge d’encapsulation dynamique pour chaque objet individuel, les tableaux unidimensionnels créés via np.array allouent un bloc contigu de mémoire physique dédié à un type de donnée homogène — généralement des flottants sur 64 bits (float64). Cette architecture matérielle optimise drastiquement le franchissement des registres processeurs grâce aux instructions de vectorisation SIMD (Single Instruction, Multiple Data).
Avant d’engager le moindre calcul numérique d’ajustement, l’analyste doit impérativement auditer la stricte équivalence dimensionnelle entre le vecteur de variables indépendantes x et le vecteur de réponses observées y. L’interrogation de l’attribut de forme des tableaux vectoriels permet de s’assurer formellement qu’aucun déphasage structurel n’existe entre les deux grandeurs ; une asymétrie élémentaire dans les dimensions engendrerait immédiatement une interruption brutale de la routine de calcul ou, pire encore, un comportement de diffusion (broadcasting) erratique susceptible de déformer silencieusement la géométrie des données sous-jacentes.
Les propriétés vectorisées de NumPy autorisent en outre des opérations algébriques coordonnées sur l’ensemble de la série sans recourir aux boucles itératives interprétées, particulièrement lentes. L’application d’un décalage d’échelle, d’une soustraction par la moyenne ou d’une normalisation univariée s’opère instantanément à l’aide d’opérateurs mathématiques standards surchargés, préservant la fluidité conceptuelle de la chaîne d’instructions tout en garantissant un coût d’exécution algorithmique minimal.
3.2 Calcul des coefficients de régression via np.polyfit
Pour déterminer les coefficients de la droite optimale au sens des moindres carrés, la bibliothèque NumPy offre la fonction historique np.polyfit, spécialement conçue pour approcher un nuage de points par une courbe polynomiale de degré arbitraire. Dans le cas spécifique et fondamental de la régression linéaire affine, le degré spécifié en argument doit être impérativement restreint à la valeur entière 1. L’appel fonctionnel standard prend alors la forme canonique de l’injection simultanée du vecteur des abscisses, du vecteur des ordonnées et de la constante de degré scalaire.
L’exécution de cette fonction retourne un tableau unidimensionnel contenant les coefficients ordonnés selon les puissances décroissantes de la variable indépendante. Ainsi, le premier élément du vecteur résultant correspond rigoureusement à la pente ou coefficient directeur a, tandis que le second élément isole le terme constant ou ordonnée à l’origine b. L’affectation simultanée par déballage de tuple permet d’assigner ces valeurs directement à des variables nommées, facilitant l’intégration ultérieure de ces scalaires dans des équations prédictives ou des chaînes de formatage textuel destinées à l’annotation cartographique.
Sur le plan algorithmique sous-jacent, np.polyfit ne résout pas naïvement le système des équations normales par inversion de la matrice de covariance — opération notoirement sensible aux erreurs d’arrondis numériques et instable face aux problèmes de quasi-colinéarité. La fonction s’appuie en réalité sur les routines LAPACK de décomposition en valeurs singulières (SVD) ou de factorisation QR de la matrice de Vandermonde associée aux données observées. Ce choix d’implémentation garantit une résilience computationnelle maximale, même lorsque les données sont soumises à un mauvais conditionnement mathématique préliminaire.
3.3 Génération du nuage de points et superposition graphique
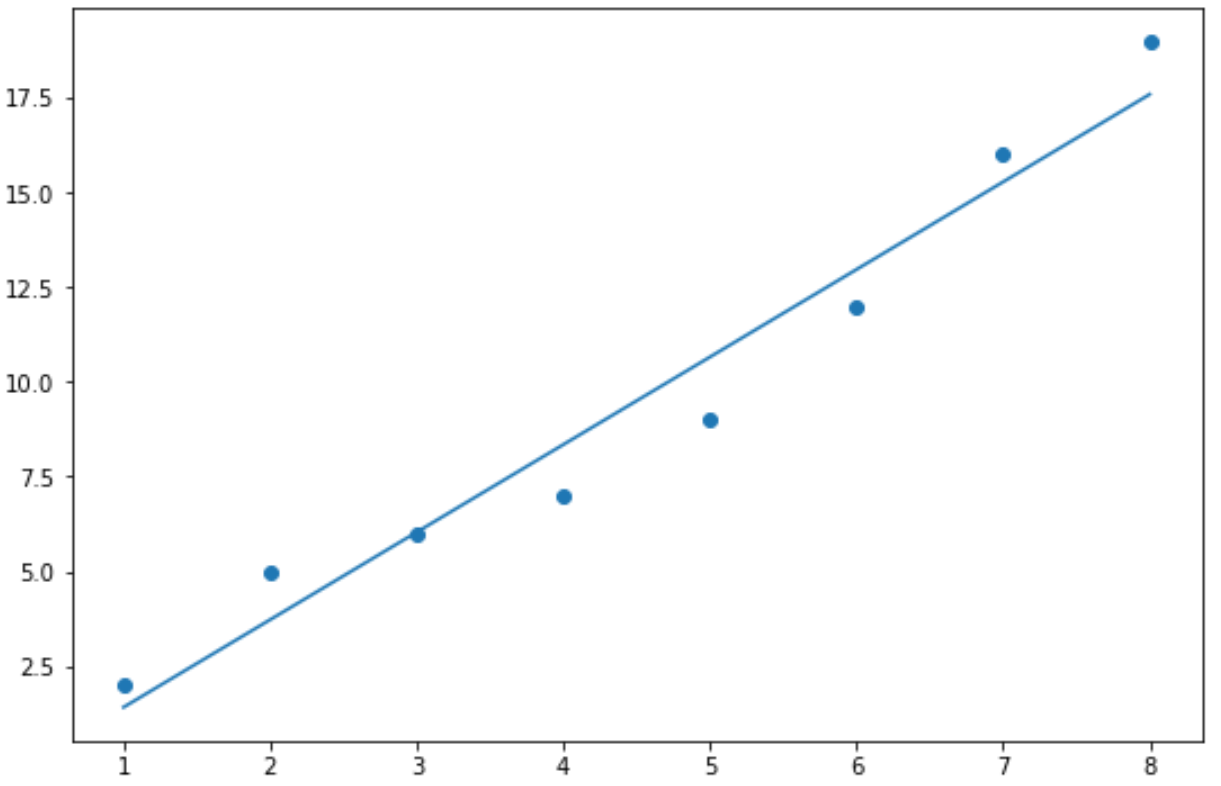
L’étape de matérialisation graphique de l’ajustement linéaire mobilise l’interface Pyplot de Matplotlib pour juxtaposer les observations brutes et la tendance mathématique estimée. La projection de la dispersion empirique s’articule autour de la commande plt.scatter, qui instancie une collection de glyphes bidimensionnels positionnés à l’intersection exacte des coordonnées fournies par les vecteurs x et y. Ce tracé ponctuel permet d’apprécier visuellement l’homogénéité de la dispersion, l’épaisseur du nuage ainsi que la présence éventuelle de trajectoires courbes échappant au modèle linéaire.
Sur ce même système de coordonnées cartésiennes, la droite d’ajustement est superposée au moyen de la méthode continue plt.plot. Pour générer un rendu net et exempt de toute discontinuité géométrique, il n’est pas nécessaire de recalculer la prédiction pour l’ensemble des points d’observation. Il suffit d’évaluer la fonction affine y_pred = a * x + b sur un domaine vectoriel couvrant l’amplitude minimale et maximale des abscisses. La méthode plt.plot trace ensuite une ligne continue unissant ces bornes de projection, illustrant sans ambiguïté la direction moyenne capturée par l’optimisation des moindres carrés.
Le processus de restitution visuelle se conclut classiquement par l’adjonction d’éléments typographiques structurants — titres institutionnels, labels explicatifs sur les axes d’abscisse et d’ordonnée incluant les unités métrologiques — suivis de l’instruction d’affichage terminale plt.show. Cette méthode prend en charge la compilation du canevas par le backend actif, la restitution sur l’écran d’affichage, et opère simultanément la libération de l’allocation mémoire tampon réservée à la structure de données de la figure en cours, évitant ainsi l’accumulation silencieuse de structures graphiques orphelines dans la mémoire vive du système.
4. Personnalisation visuelle et esthétique du graphique
4.1 Propriétés chromatiques et morphologie des marqueurs
L’optimisation esthétique et fonctionnelle d’un graphique ne constitue pas une coquetterie périphérique ; elle détermine la capacité d’assimilation cognitive de l’information statistique par le lecteur scientifique. Le premier niveau de paramétrage concerne la morphologie et le rendu chromatique du nuage de points généré via plt.scatter. L’utilisation des teintes par défaut du framework graphique est formellement déconseillée au profit de palettes standardisées, conçues pour préserver la lisibilité universelle y compris pour les lecteurs présentant des déficiences de la vision des couleurs, telles que les palettes perceptuellement uniformes Viridis, Cividis ou les normes chromatiques édictées par les revues académiques internationales.
La gestion de la superposition des observations — phénomène récurrent lorsque la volumétrie d’échantillonnage excède plusieurs centaines d’enregistrements — requiert l’ajustement impératif du coefficient de transparence alpha, dont la valeur s’échelonne continuement de 0 (translucidité absolue) à 1 (opacité totale). En abaissant le niveau de ce paramètre, les zones de haute densité observationnelle se révèlent visuellement par saturation chromatique progressive, fournissant une indication immédiate sur la répartition probabiliste sous-jacente de l’échantillon, que des marqueurs rigoureusement opaques masqueraient sous un masque d’occlusion uniforme.
De surcroît, la géométrie des marqueurs peut être modulée à l’aide de l’argument marker pour transcrire des typologies catégorielles au sein des données empiriques. Des cercles évidés, des losanges fins ou des croix orthogonales peuvent être appliqués sélectivement. L’attribution d’un contour chromatique distinct — par exemple une bordure sombre ceinturant un point clair — accentue le contraste individuel de chaque mesure sans altérer la perception d’ensemble, permettant d’identifier sans ambiguïté les singularités ou les observations périphériques disséminées aux marges du repère orthogonal.
4.2 Paramétrage géométrique de la droite d’ajustement
La droite des moindres carrés ordinaires doit s’affirmer visuellement au premier regard sans pour autant oblitérer la distribution spatiale des points empiriques dont elle émane. Cette hiérarchie perceptuelle s’obtient principalement par le contrôle de l’épaisseur du trait, régie par l’argument scalaire linewidth au sein de la commande plt.plot. Une largeur comprise entre 1.5 et 2.5 points typographiques offre habituellement un compromis parfait, conférant une présence structurelle affirmée sans occulter les marqueurs sous-jacents qui croisent son tracé.
Le style de trait — contrôlé par l’instruction linestyle — permet d’enrichir la sémantique de la figure. Si le trait plein continu demeure la norme pour matérialiser la relation linéaire principale, les tracés tiretés (dashed) ou pointillés (dotted) s’avèrent indispensables dès lors que l’on superpose simultanément des modèles concurrents, des trajectoires théoriques a priori, ou des enveloppes d’incertitude marginales. L’emploi réfléchi de ces modulations géométriques évite toute confusion taxonomique chez l’observateur lors de l’analyse conjointe de plusieurs vecteurs statistiques.
Un levier technique fondamental mais souvent négligé pour ordonner la restitution visuelle réside dans la manipulation explicite de la profondeur de plan au moyen du paramètre zorder. Par défaut, Matplotlib applique un ordre séquentiel basé sur l’ordre chronologique d’appel des fonctions de dessin. En assignant délibérément une valeur de zorder supérieure à la droite d’ajustement par rapport aux éléments du nuage de points, l’analyste s’assure que la trajectoire linéaire transversale apparaîtra toujours en avant-plan, empêchant qu’un amas dense de données d’observation ne vienne noyer ou tronquer la lisibilité de la pente mathématique de synthèse.
4.3 Intégration textuelle de l’équation sur le canevas
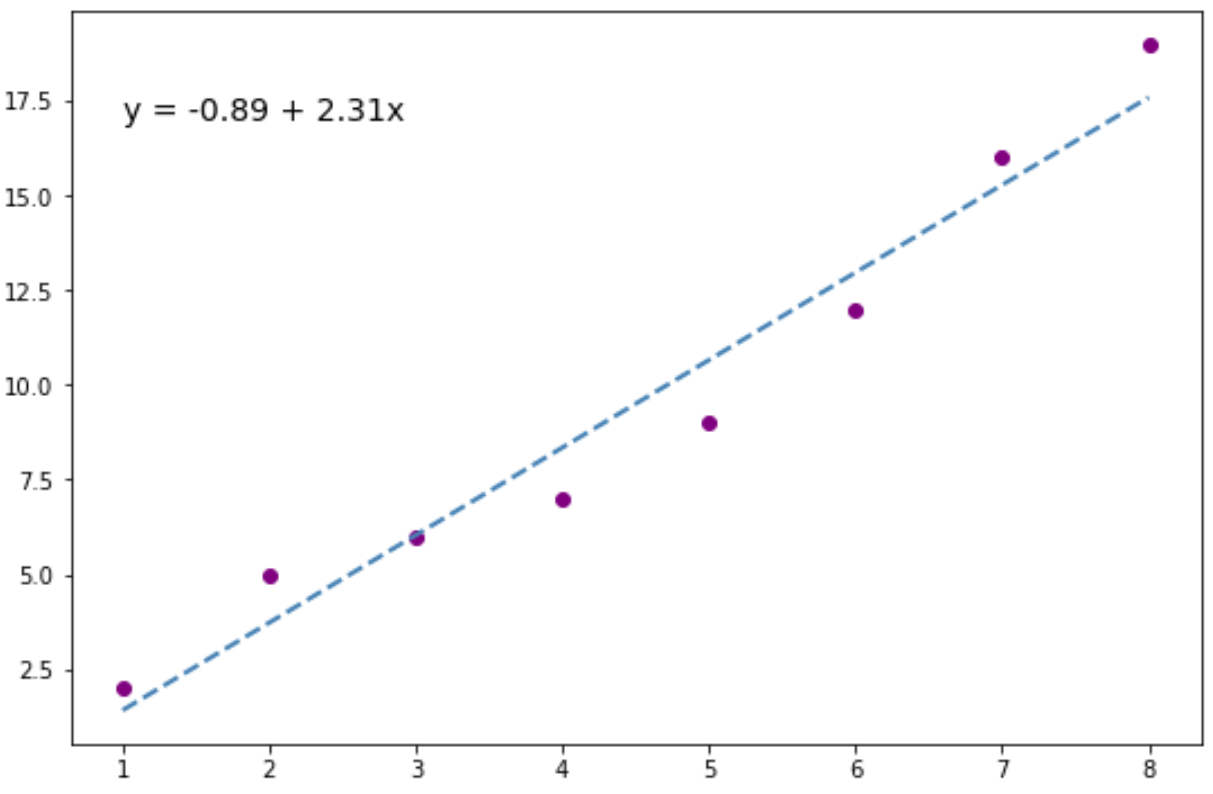
Pour qu’un graphique de régression constitue une figure scientifique autonome et pleinement informatif sans exiger la consultation permanente du corps de texte annexe, l’expression formelle de son équation analytique doit être directement inscrite sur le canevas d’affichage. L’assemblage de cette étiquette s’effectue dynamiquement en Python grâce aux littéraux de chaînes de caractères formatées (f-strings). Cette syntaxe permet d’extraire la pente a et l’ordonnée à l’origine b issues de l’optimisation numérique et de les formater selon une troncature décimale rigoureuse, par exemple en restreignant l’affichage à deux ou trois chiffres significatifs après la virgule.
Le positionnement spatial de ce bloc descriptif s’exécute à l’aide de la commande plt.text. Il est fortement recommandé d’éviter l’ancrage fondé sur les coordonnées absolues des données, qui contraint l’utilisateur à recalculer manuellement les positions à chaque modification d’échelle. L’adoption d’un système de coordonnées transformées relatives aux axes (transform=ax.transAxes), où l’origine (0, 0) correspond à l’angle inférieur gauche et le point (1, 1) à l’angle supérieur droit du cadre de tracé, garantit que l’annotation textuelle conservera une localisation stable et élégante, immunisée contre toute fluctuation d’amplitude des variables mesurées.
L’intégration d’un rendu typographique mathématique de qualité professionnelle est rendue possible par le moteur interne mathtext de Matplotlib, qui interprète nativement un sous-ensemble du langage de composition LaTeX. En encadrant l’équation de symboles dollar au sein d’une chaîne brute (raw string préfixée par la lettre r), les symboles grecs, les indices, les exposants et les opérateurs d’égalité s’affichent avec une perfection calligraphique irréprochable. L’encapsulation supplémentaire de l’annotation dans un boîtier rectangulaire semi-transparent doté de coins arrondis (bbox) assure un détachement optique optimal sur fond de données, éliminant tout conflit de superposition avec les marqueurs du nuage.
5. Diagnostic statistique et évaluation de la qualité de l’ajustement
5.1 Calcul et interprétation du coefficient de détermination R²
L’évaluation quantitative de la pertinence d’une droite d’ajustement repose historiquement sur le calcul du coefficient de détermination, universellement désigné par la métrique R². Ce scalaire synthétique mesure la proportion de la variance empirique totale observée chez la variable dépendante qui se trouve formellement expliquée et capturée par le modèle linéaire proposé. La formalisation statistique de cette métrique s’articule autour de la décomposition canonique de la somme des carrés : la somme totale des carrés (SST), qui quantifie la dispersion intrinsèque des observations par rapport à leur moyenne arithmétique globale, est rigoureusement égale à la somme de la variance expliquée par la régression (SSR) et de la variance des erreurs résiduelles inexpliquées (SSE).
Dans l’écosystème de programmation NumPy, la transcription de cette identité s’opère par des opérations vectorielles directes. La somme totale des carrés s’obtient en élevant au carré les déviations des données y par rapport à leur moyenne empirique, puis en sommant l’ensemble du vecteur via np.sum. De manière analogue, la somme résiduelle s’évalue en calculant la différence quadratique entre les observations initiales et le vecteur des prédictions linéaires associées. Le coefficient s’établit alors formellement par le ratio unitaire complémentaire R² = 1 – (SSE / SST). Dans le cadre exclusif de la régression linéaire simple par moindres carrés ordinaires, ce coefficient correspond exactement au carré du coefficient de corrélation linéaire de Pearson entre les deux grandeurs.
Bien que le R² offre une lecture intuitive échelonnée de 0 (incapacité totale du modèle linéaire à expliquer la variabilité) à 1 (ajustement géométrique parfait sans le moindre résidu), son interprétation commande une retenue épistémologique stricte. Une valeur élevée de R² n’atteste en rien de la validité substantielle du modèle ni de la linéarité intrinsèque du phénomène sous-jacent ; une relation non linéaire mal ajustée par une droite peut afficher un R² artificiellement élevé si l’étendue des données est vaste. De surcroît, au sein d’échantillons de taille très réduite, le coefficient de détermination présente un biais mécanique d’optimisme, nécessitant l’utilisation d’une version ajustée pénalisant le nombre de degrés de liberté consommés par les paramètres du modèle.
5.2 Analyse géométrique des résidus et homoscédasticité
L’inspection du coefficient de détermination global ne dispense jamais l’analyste d’une investigation méticuleuse de la structure géométrique des résidus individuels, définis formellement comme la différence verticale arithmétique ei = yi – ŷi pour chaque enregistrement. Si le modèle linéaire capture fidèlement la dynamique génératrice des données d’observation, les erreurs résiduelles doivent se manifester sous la forme d’un bruit blanc strictement stochastique, dépourvu de tout agencement ordonné, de périodicité ou de dissymétrie systématique le long du continuum de mesure.
La construction graphique d’un diagramme de résidus consiste à projeter les écarts résiduels verticaux sur l’axe des ordonnées en fonction des valeurs prédites par la droite ou des valeurs de la variable explicative sur l’axe des abscisses, complété par une droite horizontale de référence tracée à l’ordonnée zéro. La présence d’une courbure en forme de cloche, de parabole ou de sinusoïde au sein de cette projection résiduelle trahit immédiatement une spécification fonctionnelle erronée : le processus sous-jacent est fondamentalement non linéaire et le modèle linéaire tente de forcer une approximation plate inadaptée, générant des biais d’estimation localisés.
Cette visualisation graphique constitue également l’outil diagnostique par excellence de l’homoscédasticité, condition sine qua non de la validité de l’inférence des moindres carrés ordinaires. L’hétéroscédasticité — caractérisée par une variance des erreurs non constante — se matérialise visuellement sur le graphique des résidus par un motif géométrique conique ou en entonnoir, où la dispersion verticale des points s’évase ou se resserre continûment à mesure que l’on progresse sur l’axe horizontal. Lorsque ce comportement est détecté, les intervalles de confiance et les tests de significativité associés aux coefficients de la droite deviennent mathématiquement caducs et imposent des corrections matricielles robustes.
5.3 Détection des points leviers et valeurs aberrantes
L’algorithme de minimisation quadratique des moindres carrés présente une vulnérabilité mathématique intrinsèque : en élevant au carré les distances verticales résiduelles avant d’en opérer la sommation, il confère un poids disproportionné aux observations qui s’écartent sensiblement de la majorité du nuage de points. Il est par conséquent vital de repérer avec précision les valeurs aberrantes (outliers) et les points présentant un bras de levier spatial important, susceptibles d’attirer artificiellement la droite vers leur propre position géométrique et de fausser irrémédiablement l’estimation de la pente globale.
Un point levier se caractérise par une valeur de la variable explicative x extraordinairement éloignée du barycentre ou de la moyenne générale du vecteur des abscisses. Même si son résidu vertical demeure faible, ce point possède une capacité mécanique considérable à infléchir l’orientation angulaire de la droite d’ajustement. À l’inverse, une valeur aberrante se définit par un résidu vertical anormalement vaste vis-à-vis du plan de tendance moyen, indiquant un comportement d’observation atypique potentiellement généré par une erreur de transcription métrologique ou une rupture d’homogénéité de l’échantillon.
Pour évaluer l’influence combinée de ces anomalies sur la trajectoire finale de la droite, des métriques scalaires rigoureuses, telles que la distance de Cook ou les résidus studentisés, peuvent être calculées numériquement et projetées sous forme d’encodage visuel contextuel. En faisant varier le diamètre ou la teinte des marqueurs dans le diagramme de dispersion en proportion directe de leur distance de Cook, l’analyste identifie immédiatement les points singuliers exerçant une force d’attraction excessive sur l’estimation des paramètres de la régression, ouvrant la voie à des analyses de robustesse par exclusion ciblée ou à l’application de régressions pénalisées.
6. Approche alternative avec la bibliothèque SciPy
6.1 Exploitation de scipy.stats.linregress pour un bilan complet
Tandis que la routine np.polyfit de NumPy se focalise prioritairement sur la résolution matricielle algébrique des coefficients polynomiaux sans déployer d’infrastructure statistique attenante, le sous-module scipy.stats propose une alternative dédiée spécifiquement à la régression linéaire univariée par le biais de la fonction scipy.stats.linregress. Cette fonction constitue un instrument privilégié pour les chercheurs en ce qu’elle synthétise en un appel algorithmique unique l’ensemble des métriques descriptives et probabilistes indispensables à l’établissement d’un bilan d’ajustement scientifique rigoureux.
La signature d’exécution de linregress accepte les deux vecteurs de données continues sous forme de tableaux ou de séquences compatibles et retourne un objet structuré encapsulant cinq métriques déterminantes : le coefficient directeur de la pente (slope), l’ordonnée à l’origine (intercept), le coefficient de corrélation linéaire de Pearson (rvalue), la valeur de probabilité critique de significativité bilatérale (pvalue), ainsi que l’erreur type asymptotique associée à l’estimation de la pente (stderr). Dans les versions contemporaines de la bibliothèque, une estimation de l’erreur type relative à l’ordonnée à l’origine (intercept_stderr) est également adjointe à cette structure de données exhaustive.
En matière d’optimisation computationnelle et de stabilité d’exécution, scipy.stats.linregress déploie des routines d’algèbre sous-jacentes hautement optimisées, capables de traiter des séries de données d’envergure tout en maintenant une décrue infinitésimale des erreurs d’arrondis. Le gain de productivité pour le chercheur est considérable : il n’est plus nécessaire d’échafauder manuellement le calcul de la somme résiduelle des carrés, de la variance d’échantillonnage ou de la distribution de Student pour appréhender la significativité de l’ajustement géométrique ainsi projeté sur le graphique.
6.2 Interprétation probabiliste et tests d’hypothèses
L’intégration de scipy.stats.linregress permet de sortir du cadre purement géométrique de la droite d’ajustement pour aborder le domaine fondamental de l’inférence statistique formalisée. La valeur de probabilité (p-valeur) retournée par la fonction évalue directement l’hypothèse nulle fondamentale H0 : a = 0, selon laquelle la pente véritable de la population parente est rigoureusement nulle, ce qui dénoterait une absence totale de relation linéaire déterministe entre le stimulus explicatif et la réponse observée.
Lorsque cette valeur de probabilité s’avère inférieure au seuil de risque critique prédéterminé dans le protocole de recherche — conventionnellement fixé dans la littérature académique à des niveaux α de 0.05, 0.01 ou 0.001 —, le chercheur se trouve fondé à rejeter formellement l’hypothèse nulle d’indépendance linéaire. Cette décision atteste que la pente calculée par la méthode des moindres carrés présente une déviation non fortuite vis-à-vis d’une trajectoire parfaitement horizontale, conférant ainsi une légitimité probabiliste robuste au tracé graphique de la droite sur le canevas d’observation.
L’erreur type de l’estimation de la pente (stderr) mesure quant à elle l’ampleur de la fluctuation d’échantillonnage attendue si l’expérience devait être répliquée un nombre infini de fois dans des conditions méthodologiques identiques. Un ratio élevé entre l’amplitude absolue du coefficient directeur et son erreur type associée génère une statistique de Student t élevée, traduisant une stabilité remarquable de l’orientation angulaire de la droite d’ajustement. Cette métrique constitue également le matériau de base nécessaire à la construction des intervalles de confiance paramétriques bordant la droite observée.
6.3 Visualisation enrichie des métriques statistiques
Disposer d’un ensemble complet de métriques probabilistes issues de scipy.stats.linregress permet d’enrichir visuellement la cartouche d’identification ou la légende du graphique sans alourdir la lecture cognitive de la scène géométrique. Plutôt que de confiner ces informations dans une légende textuelle séparée, l’incorporation dynamique de ces paramètres dans la métadonnée d’étiquette (label) de l’instruction plt.plot garantit leur liaison indéfectible lors de la restitution du cartouche par plt.legend.
La formulation syntaxique de cette étiquette peut être automatisée de façon conditionnelle en adaptant le rendu typographique de la p-valeur selon les canons traditionnels de la communication scientifique. Si la p-valeur s’avère infinitésimale (par exemple inférieure à 0.001), le texte formatera l’affichage sous la forme classique p < 0.001 plutôt que d’imprimer une notation scientifique brute peu esthétique. La légende combinera ainsi harmonieusement la valeur de la pente assortie de son erreur type, l’expression de l’ordonnée à l’origine, le coefficient de détermination R² calculé par élévation au carré du paramètre rvalue, et le degré de significativité statistique atteint.
Cette méthodologie d’annotation unifiée garantit une communication scientifique d’une transparence exemplaire. Les observateurs disposent immédiatement, au sein de l’espace de la figure, non seulement de la trajectoire mathématique médiane ajustée aux données, mais également de tous les critères d’évaluation critique nécessaires pour juger de la pertinence, de la force et de la solidité méthodologique de l’association statistique mise en scène par la visualisation graphique.
7. Visualisation automatisée et avancée avec Seaborn
7.1 Utilisation pragmatique de sns.regplot
Tandis que la construction d’une régression linéaire sous Matplotlib pur requiert l’enchaînement successif de multiples étapes procédurales — extraction matricielle, optimisation par moindres carrés, évaluation d’un vecteur continu de prédiction et tracés superposés —, la bibliothèque de visualisation statistique Seaborn simplifie radicalement cette démarche opérationnelle. Conçue comme une interface déclarative de haut niveau bâtie sur les fondations de Matplotlib, Seaborn automatise l’ensemble de cette chaîne technique par l’entremise de sa fonction phare sns.regplot.
L’exécution de la méthode sns.regplot prend nativement en charge la double opération géométrique : d’une part, la projection du nuage de dispersion des observations empiriques, et d’autre part, le calcul instantané et le tracé de la droite d’ajustement linéaire correspondante, le tout condensé en une seule instruction de code concise. Cette commande interagit directement avec les vecteurs de données ou accepte des références par noms de colonnes couplées à une source tabulaire structurée, déchargeant ainsi l’analyste de la manipulation manuelle des coordonnées cartésiennes élémentaires.
En outre, Seaborn applique par défaut des normes esthétiques raffinées issues des préceptes de design graphique contemporain, atténuant la saturation agressive des encres, ajustant harmonieusement la taille des marqueurs et intégrant un repère quadrillé discret favorable à une lecture métrologique rapide. Cette immédiateté syntaxique ne se fait pas au détriment de la granularité de configuration, puisque la fonction offre des passerelles d’arguments dédiées (scatter_kws et line_kws) permettant d’injecter des dictionnaires de personnalisation fine directement vers les sous-couches primitives d’exécution de Matplotlib.
7.2 Estimation et tracé automatique des bandes de confiance
L’un des apports majeurs de la fonction sns.regplot réside dans sa capacité intrinsèque à évaluer et matérialiser graphiquement, sans paramétrage computationnel complexe, une bande de confiance entourant fidèlement la droite d’ajustement. Cette zone translucide, paramétrée par défaut à un seuil de certitude de 95 % via l’argument ci=95, figure l’enveloppe probabiliste à l’intérieur de laquelle la droite de régression de la population théorique parente a de très fortes chances de se situer réellement.
Sur le plan algorithmique sous-jacent, Seaborn ne s’enferme pas obligatoirement dans des postulats de normalité asymptotique pour dériver cette marge d’incertitude ; elle déploie de façon standardisée une procédure de rééchantillonnage statistique non paramétrique par bootstrap. L’algorithme tire itérativement avec remise des centaines d’échantillons au sein des données empiriques disponibles, calcule pour chacun d’entre eux une nouvelle trajectoire de moindres carrés, et extrait les quantiles empiriques de cette distribution de droites pour délimiter les contours inférieur et supérieur de l’enveloppe de projection.
Cette approche computationally intensive produit une visualisation instructive où l’on observe visuellement l’évasement systématique des bandes de confiance à mesure que l’on s’éloigne du barycentre de l’échantillon pour converger vers les bornes extrêmes du domaine d’observation. Ce phénomène géométrique illustre de manière saisissante la perte de précision mécanique inhérente aux estimations linéaires lorsque l’on s’écarte de la zone de densité informative maximale, rappelant visuellement à tout observateur la précarité croissante des inférences conduites aux frontières de l’échantillonnage empirique.
7.3 Facettage catégoriel avec sns.lmplot
Lorsque la structure du jeu de données implique des sous-populations distinctes ou que l’analyste cherche à évaluer la stabilité d’une relation bivariée à travers plusieurs facteurs de groupement catégoriels, l’utilisation de la fonction sns.lmplot s’avère particulièrement puissante. Bâtie sur l’architecture multidimensionnelle FacetGrid de Seaborn, cette méthode combine les capacités de régression linéaire de regplot avec un moteur d’orchestration de sous-graphiques en treillis matriciel.
L’injection d’un facteur qualitatif au sein du paramètre chromatique hue permet de scinder instantanément le nuage de points et d’engager des régressions d’ajustement indépendantes pour chaque modalité du groupe au sein d’un repère unique, chaque catégorie bénéficiant d’un codage couleur spécifique et de sa propre droite d’ajustement accompagnée de son enveloppe de confiance bootstrap. Cette fonctionnalité s’avère cruciale dans la mise en évidence d’effets de modération, où la trajectoire linéaire subit une altération sensible de sa pente selon le statut catégoriel des observations examinées.
De surcroît, les arguments de facettage horizontal (col) et vertical (row) autorisent la décomposition automatique de la scène graphique en une grille ordonnée de panneaux orthogonaux indépendants mais partageant des axes d’échelles rigoureusement harmonisés. En une seule instruction fonctionnelle déclarative, le chercheur génère une planche d’analyse bivariée comparative d’une densité informationnelle remarquable, parfaitement dimensionnée pour des publications comparatives de cohortes cliniques, de panels psychométriques segmentés ou de sous-systèmes industriels distincts.
8. Intégration fluide avec les structures de données Pandas
8.1 Extraction directe à partir de DataFrames
Dans la pratique contemporaine de l’ingénierie des données et de l’analyse statistique sous Python, les observations brutes ne se présentent que très exceptionnellement sous la forme de vecteurs NumPy isolés et décontextualisés ; elles sont quasi systématiquement agrégées au sein de structures tabulaires complexes manipulées via la bibliothèque Pandas. Les structures matricielles nommées DataFrame et les séries unidimensionnelles Series constituent ainsi l’interface d’entrée standard de tout pipeline de traitement contemporain.
L’extraction des séries quantitatives destinées à alimenter les routines d’ajustement linéaire s’exécute avec une extrême fluidité. Les séries Pandas héritant de manière native des interfaces de mémoire tampon de NumPy, elles peuvent être injectées directement en tant qu’arguments d’entrée au sein de np.polyfit, de scipy.stats.linregress ou des méthodes de tracé graphique de Matplotlib, sans exiger de conversion explicite préalable. Les moteurs algorithmiques accèdent directement aux tableaux C-contigus sous-jacents, préservant la vitesse d’exécution et prévenant les surallocations mémoires superflues.
Il demeure néanmoins primordial d’exercer une surveillance rigoureuse sur l’alignement des indexations et sur l’homogénéité des types de données enregistrés au sein des colonnes sélectionnées. La présence inopinée de valeurs sérialisées sous forme de chaînes de caractères (strings) ou d’objets hybrides au sein d’une colonne de mesures numériques génère inévitablement des exceptions bloquantes lors du calcul matriciel de la pente. Un contrôle typologique préliminaire, opéré via la méthode de coercition pd.to_numeric, garantit la pureté arithmétique indispensable au bon fonctionnement des algorithmes des moindres carrés.
8.2 Traitement préalable des données manquantes
L’un des périls majeurs menaçant la validité d’une chaîne de modélisation linéaire réside dans la gestion des données manquantes, classiquement formalisées sous la valeur sentinelle NaN (Not a Number) au sein des écosystèmes informatiques. Les algorithmes d’ajustement de régression fondés sur l’algèbre linéaire sont intrinsèquement incapables de composer avec des valeurs indéterminées : l’injection d’un seul élément NaN au sein d’un vecteur explicatif ou dépendant contamine l’ensemble de la sommation quadratique et aboutit fatalement à la restitution de coefficients de régression indéterminés.
Face à cet écueil, le chercheur doit adopter une stratégie méthodologique rigoureuse et concertée. L’approche la plus usuelle et la plus conservatrice consiste en l’application d’une suppression par observation complète (listwise deletion) au moyen de la méthode native dropna de Pandas, ciblée strictement sur le sous-ensemble constitué de la paire de colonnes impliquées dans la régression bivariée. Cette synchronisation du filtrage est vitale : éliminer les valeurs aberrantes ou manquantes de manière découplée sur x et sur y briserait l’appariement bijectif des paires d’observation et ruinerait toute tentative d’ajustement cohérent.
Toutefois, l’amputation aveugle d’observations incomplètes peut introduire un biais de sélection dramatique si le mécanisme de disparition des données n’est pas strictement aléatoire (mécanisme MCAR : Missing Completely At Random). Lorsque des pans entiers de mesures manquent de façon corrélée avec la réponse elle-même, l’analyste doit envisager des méthodes de substitution statistique avancées, telles que l’imputation par la moyenne conditionnelle ou des algorithmes d’imputation multiple par équations chaînées, sous peine de voir la pente de sa droite de meilleur ajustement subir une distorsion systématique qui altérera l’ensemble des conclusions substantives du travail de recherche.
8.3 Pipeline complet de traitement et de rendu graphique
Pour garantir la maintenabilité et la reproductibilité des analyses statistiques, il est hautement recommandé d’encapsuler l’intégralité du processus de traitement — allant de la sélection des variables brutes jusqu’à la restitution du tracé final haute fidélité — au sein d’une fonction réutilisable hautement paramétrable. Une telle architecture fonctionnelle prévient la duplication anarchique de code source au sein des calepins de recherche et assure une uniformité stylistique exemplaire à l’échelle de l’ensemble d’une institution ou d’un laboratoire expérimental.
Une fonction de pipeline canonique accepte en entrée un objet DataFrame, les identifiants textuels des colonnes représentatives des variables x et y, ainsi que divers indicateurs optionnels gouvernant les options esthétiques et les répertoires d’exportation. La fonction opère alors automatiquement l’assainissement des données par élimination des enregistrements non valides, calcule les coefficients optimaux des moindres carrés, détermine la significativité statistique via SciPy, instancie la figure Matplotlib, projette les données combinées et intègre les annotations textuelles calibrées au millimètre.
Ce pipeline s’achève traditionnellement par l’automatisation de l’exportation vers le disque dur au moyen de la fonction plt.savefig. L’utilisation d’arguments stricts, tels qu’un seuil de résolution de 300 points par pouce (dpi=300) et le rognage automatisé des marges extérieures blanches (bbox_inches='tight'), garantit que le rendu vectoriel ou matriciel produit répond instantanément aux normes de résolution les plus exigeantes imposées par les comités éditoriaux des grandes revues savantes internationales, sans nécessiter la moindre retouche manuelle postérieure au moyen de logiciels d’édition graphique tiers.
9. Calcul et représentation graphique des intervalles d’incertitude
9.1 Fondements mathématiques de l’intervalle de prédiction
Dans la communication des résultats de modélisation linéaire, une confusion fréquente et dommageable persiste entre l’intervalle de confiance encadrant la droite de régression et l’intervalle de prédiction associé à de futures observations individuelles. L’intervalle de confiance quantifie l’incertitude épistémique entourant l’estimation de l’espérance conditionnelle moyenne ; il reflète le fait que la vraie droite théorique de la population parente peut fluctuer légèrement en raison de la variance intrinsèque d’échantillonnage qui affecte simultanément le calcul de la pente et de l’ordonnée à l’origine.
À l’opposé, l’intervalle de prédiction incorpore non seulement cette incertitude paramétrique relative à la trajectoire moyenne de la droite, mais intègre en surplus la variance stochastique individuelle inhérente à chaque observation singulière, formalisée par l’écart type des résidus du modèle. Par conséquent, pour un niveau de confiance rigoureusement identique (par exemple 95 %), la bande de prédiction individuelle s’avère considérablement plus large et évasée que la bande de confiance moyenne, car prédire le comportement spécifique d’une unité expérimentale isolée comporte un niveau d’aléa incompressible bien supérieur à l’estimation d’une tendance centroïde globale.
La dérivation analytique de l’écart type d’une prédiction individuelle ponctuelle pour une abscisse arbitraire x0 fait intervenir la racine carrée de la somme de trois composantes fondamentales : la variance résiduelle unitaire, la pénalité liée à la taille finie de l’échantillon global, et une pénalité géométrique proportionnelle au carré de la distance séparant l’abscisse x0 de la moyenne arithmétique de la variable explicative. Cette structure mathématique éclaire formellement la morphologie hyperbolique des enveloppes d’incertitude, qui s’évasent de manière quadratique au fur et à mesure que l’on s’aventure vers les limites extrêmes de l’espace empirique observé.
9.2 Tracé vectoriel des enveloppes d’incertitude avec Matplotlib
La matérialisation graphique de ces corridors d’incertitude dans l’environnement Matplotlib s’opère magistralement par le truchement de la fonction plt.fill_between. Cette méthode polygonale vectorielle projette une surface continue ombrée délimitée par une courbe frontière inférieure et une courbe frontière supérieure le long d’un maillage régulier et dense de coordonnées d’abscisses, généralement généré via l’instruction np.linspace s’étendant sur l’amplitude complète des mesures observées.
Pour assurer une intégration visuelle harmonieuse qui ne détériore pas la perception des marqueurs empiriques individuels disséminés dans le plan, l’analyste doit impérativement doser avec précaution le coefficient de transparence (alpha) de cette nappe ombrée, en privilégiant des valeurs diaphanes situées entre 0.15 et 0.25. L’harmonisation chromatique — en veillant à ce que l’enveloppe d’incertitude adopte une nuance rigoureusement identique à celle de la droite d’ajustement centrale — permet d’unifier visuellement le concept de modèle et son halo de probabilité attenant.
Il est en outre hautement formateur de superposer conjointement, sur un repère unique, l’étroit fuseau de l’intervalle de confiance moyen et les larges frontières hyperboliques de l’intervalle de prédiction individuel, ces dernières pouvant être soulignées par de fins tracés en tiretés discrets. Cette mise en scène visuelle explicite avec éclat la distinction fondamentale entre la stabilité de la loi statistique globale estimée à l’échelle du groupe et l’irréductible dispersion probabiliste qui subsiste au niveau de chaque trajectoire individuelle spécifique.
9.3 Cas d’usage : communication rigoureuse de la marge d’erreur
La représentation exclusive d’une droite d’ajustement linéaire nue, dépourvue de toute contextualisation métrologique de son incertitude statistique, est de plus en plus proscrite par les comités éditoriaux des revues scientifiques de premier rang. Présenter une simple trajectoire déterministe induit insidieusement le lecteur en erreur en suggérant une précision d’estimation absolue et universelle, masquant commodément la fragilité inhérente aux échantillons clairsemés ou fortement bruités.
La transparence méthodologique impose de communiquer graphiquement et textuellement l’amplitude de l’erreur type et des bornes de confiance. Dans des domaines appliqués aux conséquences sociétales directes — tels que les essais cliniques pharmacologiques, l’évaluation de l’impact de politiques éducatives ou la prévision climatologique —, occulter les marges d’erreur expose les décideurs à des anticipations fallacieuses basées sur une foi excessive dans la valeur ponctuelle centrale de la droite de régression.
L’intégration visuelle soignée des intervalles d’incertitude répond scrupuleusement aux standards méthodologiques les plus rigoureux, tels que ceux édictés par l’American Psychological Association dans son manuel de publication. Elle rappelle de façon continue et explicite la frontière ténue qui sépare le modèle mathématique épuré de la réalité empirique fondamentale, éduquant le regard critique de l’observateur face aux inévitables variations stochastiques qui gouvernent le recueil des données dans le monde réel.
10. Extensions non linéaires et modélisation polynomiale
10.1 Ajustement polynomial d’ordre supérieur avec np.polyfit et np.poly1d
Dans de nombreuses configurations expérimentales, l’hypothèse d’une relation strictement rectiligne entre deux grandeurs s’avère empiriquement insoutenable : les processus de saturation biologique, les dynamiques d’accélération physique ou les phénomènes d’épuisement cognitif épousent naturellement des profils curvilignes prononcés. Face à de telles distributions, forcer l’application d’une droite d’ajustement de degré 1 constitue une erreur de spécification majeure qui dégrade sévèrement la validité interne de la modélisation.
Pour surmonter cette limitation géométrique sans quitter la commodité calculatoire de l’optimisation linéaire des moindres carrés, il est tout à fait loisible d’étendre le modèle vers des formulations polynomiales d’ordre supérieur. La fonction np.polyfit gère cette extension de manière parfaitement transparente : il suffit de substituer au degré unitaire scalaire une valeur entière supérieure, telle que 2 pour un ajustement parabolique quadratique ou 3 pour une trajectoire cubique infléchie, résolvant instantanément le système matriciel associé.
Pour manipuler confortablement l’objet polynomial ainsi estimé et faciliter l’évaluation de ses valeurs continues sans avoir à réécrire laborieusement l’expansion algébrique de chaque terme de puissance, la classe np.poly1d offre une abstraction logicielle remarquable. En encapsulant le vecteur de coefficients retourné par np.polyfit au sein d’une instance np.poly1d, l’analyste obtient un objet directement appelable à la manière d’une fonction mathématique classique. L’injection d’un maillage dense généré par np.linspace permet alors d’obtenir immédiatement le profil courbé lisse optimal, prêt à être superposé au nuage de points via plt.plot.
10.2 Le risque critique de surapprentissage (overfitting)
L’accès aisé à des ajustements polynomiaux d’ordre arbitraire confronte immédiatement l’analyste au dilemme méthodologique universel du compromis entre le biais statistique et la variance d’estimation, plus communément désigné sous le terme de surapprentissage ou surajustement (overfitting). En augmentant inconsidérément le degré polynomial de l’ajustement — par exemple en déployant un polynôme de degré 15 sur un échantillon d’une vingtaine de points —, la courbe mathématique parvient artificiellement à réduire la somme des carrés des résidus à une valeur proche de zéro, passant servilement par chaque point empirique.
Cette adéquation descriptive apparemment irréprochable constitue en réalité un désastre épistémologique absolu. Le modèle cesse d’extraire la tendance structurelle du phénomène pour se mettre à modéliser servilement le bruit stochastique propre à cet échantillon particulier. La courbe polynomiale résultante affiche alors des oscillations sauvages et incontrôlées — phénomène mathématique connu sous le nom de phénomène de Runge —, particulièrement dévastatrices aux abords des frontières du domaine expérimental.
La capacité de généralisation prédictive d’un tel modèle sur de nouvelles observations issues de la même population parente s’effondre dramatiquement, générant des erreurs quadratiques moyennes colossales. La sélection du degré d’ajustement optimal doit impérativement être guidée par des critères de parcimonie scientifique rigoureux, tels que le critère d’information d’Akaike (AIC), le critère d’information bayésien (BIC), ou validée de façon indépendante par des procédures de validation croisée étanches (k-fold cross-validation), privilégiant invariablement le modèle le plus simple capable de rendre compte adéquatement des données.
10.3 Transformation de variables pour linéariser les relations
Une stratégie alternative particulièrement élégante et robuste face aux relations non linéaires consiste à opérer des transformations mathématiques univariées ciblées sur l’un ou l’autre des axes cartésiens avant de procéder à l’application conventionnelle de l’ajustement par les moindres carrés ordinaires. L’objectif consiste à projeter les données au sein d’un espace topologique transformé où la géométrie de la relation se redresse pour devenir rigoureusement linéaire.
Parmi les transformations les plus fécondes figurent la compression logarithmique — particulièrement idoine lorsque l’amplitude des données s’étale sur plusieurs ordres de grandeur ou que le phénomène exhibe des propriétés d’accroissement exponentiel —, ainsi que les transformations en puissance, les racines carrées ou les inversions réciproques. Par exemple, si une relation sous-jacente suit une loi de puissance régie par y = α xβ, l’application d’un logarithme naturel aux deux membres de l’égalité convertit l’expression en une droite formelle ln(y) = ln(α) + β ln(x), dont la pente correspond directement à l’exposant d’échelle recherché.
Une fois les coefficients linéaires estimés sur les variables transformées, il est crucial de maîtriser la rétro-projection graphique. Deux approches se présentent à l’analyste : la première consiste à conserver un repère cartésien linéaire conventionnel et à tracer la fonction puissance courbée rétro-transformée ; la seconde, souvent plus informative d’un point de vue diagnostique, consiste à paramétrer les axes de Matplotlib en échelles logarithmiques via les instructions ax.set_xscale('log') et ax.set_yscale('log'), transformant visuellement la relation de puissance originelle en une parfaite droite géométrique sur le canevas d’observation.
11. Applications pratiques en sciences comportementales et psychologie
11.1 Modélisation du temps de réaction face à la charge cognitive
Dans le champ de la psychologie expérimentale et des neurosciences cognitives, l’analyse bivariée par droite d’ajustement constitue le dispositif fondamental permettant de valider empiriquement les modèles théoriques régissant le traitement de l’information par l’architecture cérébrale humaine. Une illustration paradigmatique réside dans l’application de la célèbre loi de Hick, qui postule une relation fonctionnelle linéaire directe entre le temps de réaction d’un participant et la quantité d’information transmise par le stimulus, mesurée en bits logarithmiques selon le nombre d’alternatives décisionnelles offertes.
Dans un tel paradigme expérimental, la formalisation de la droite d’ajustement prend une signification substantielle fondamentale qui transcende la pure géométrie descriptive. L’ordonnée à l’origine b synthétise le temps de latence neuromotrice incompressible — correspondant à la conduction de l’influx nerveux afférent depuis la rétine jusqu’aux aires visuelles primaires, couplée au délai mécanique d’exécution motrice sur l’organe effecteur. La pente a de la droite quantifie quant à elle la vitesse de traitement mental centrale du sujet, exprimant le coût temporel cognitif marginal induit par chaque bit d’information additionnel à intégrer avant d’émettre la réponse motrice.
La transcription graphique sous Python de cette architecture cognitive mobilise l’ensemble des techniques abordées. Le repère cartésien juxtapose le temps de réaction moyen exprimé en millisecondes sur l’axe des ordonnées et l’indice de complexité de la tâche cognitive sur l’axe des abscisses. La projection de la droite des moindres carrés permet d’isoler immédiatement les variations inter-individuelles : une pente anormalement raide reflétera une vulnérabilité prononcée à la saturation cognitive, fournissant aux cliniciens un biomarqueur comportemental objectif d’une grande valeur diagnostique.
11.2 Ajustement linéaire entre scores psychométriques et stress perçu
L’investigation des interactions émotionnelles et de leur impact sur le fonctionnement intellectuel constitue un autre terrain privilégié pour le déploiement de régressions linéaires sous Python. Considérons l’analyse corrélationnelle standard explorant l’influence des scores d’anxiété état — évalués par des échelles standardisées telles que l’inventaire STAI — sur les performances d’attention soutenue ou de mémoire de travail au sein d’une cohorte clinique sous pression évaluative.
Le tracé du nuage de dispersion empirique révèle fréquemment une hétérogénéité substantielle entre les individus, requérant un diagnostic statistique particulièrement aiguisé de la droite d’ajustement. L’évaluation de l’homoscédasticité des résidus s’avère ici capitale : les individus affichant un faible niveau de stress perçu ont tendance à manifester des performances attentionnelles homogènes et resserrées, tandis que les profils caractérisés par un stress extrême développent des stratégies cognitives divergentes, engendrant un évasement spectaculaire de la dispersion aux bornes supérieures de l’échelle d’anxiété.
La matérialisation graphique rigoureuse de ces résultats implique l’adjonction systématique d’intervalles de confiance bootstrap via Seaborn ou la projection manuelle d’enveloppes d’incertitude sur Matplotlib. Cette démarche prévient toute généralisation hâtive en illustrant sans fard la variabilité intrinsèque des réponses humaines face au stress psychologique, rappelant que la droite d’ajustement n’incarne qu’une trajectoire moyenne probabiliste au sein d’un espace phénotypique éminemment diversifié.
11.3 Mise aux normes graphiques de l’APA (American Psychological Association)
La rédaction de manuscrits scientifiques soumis à des revues académiques internationales affiliées aux sciences sociales, comportementales ou médicales exige une conformité absolue avec les directives typographiques et visuelles édictées par l’American Psychological Association (normes APA, 7e édition). Les rendus graphiques par défaut fournis par Matplotlib s’écartent sensiblement de ces standards exigeants, imposant une reconfiguration programmatique systématique de l’environnement de tracé.
Les normes APA imposent une épuration visuelle radicale destinée à éliminer toute encre non informative (le fameux chartjunk théorisé par Edward Tufte). Les cadres d’encadrement rectangulaires complets doivent être proscrits : seules les épines inférieure (axe des abscisses) et gauche (axe des ordonnées) doivent subsister, tandis que les bordures supérieure et droite sont impérativement masquées via ax.spines['top'].set_visible(False) et ax.spines['right'].set_visible(False). De surcroît, le quadrillage interne lourd doit être entièrement aboli ou réduit à une trame d’une extrême discrétion chromatique.
Sur le plan typographique, les normes préconisent l’emploi exclusif de polices claires et universelles, avec ou sans empattement (telles que Arial, Calibri ou Times New Roman), appliquées selon une hiérarchie scalaire rigoureusement proportionnée. Les titres de figures ne sont traditionnellement pas gravés en tête de graphique sur le canevas lui-même, mais intégrés dans la légende textuelle extérieure normalisée qui accompagne la planche. Enfin, l’utilisation de la couleur doit être pensée pour conserver son intégralité sémantique et son contraste même en cas d’impression en niveaux de gris, consacrant la droite d’ajustement comme un instrument d’élégance et de sobriété scientifique absolue.
12. Bonnes pratiques, erreurs fréquentes et optimisation algorithmique
12.1 Écueils méthodologiques de l’extrapolation abusive
L’un des égarements analytiques les plus pernicieux dans l’utilisation pratique de la droite d’ajustement consiste en l’extrapolation téméraire des valeurs prédictives bien au-delà de l’intervalle spatial délimité par les observations empiriques réelles. L’ajustement mathématique par la méthode des moindres carrés ordinaires n’est valide et robuste qu’à l’intérieur du strict domaine de définition couvert par l’échantillon d’origine — pratique désignée sous le terme d’interpolation légitime.
Projeter la droite au-delà des bornes expérimentales observées repose sur l’hypothèse invérifiable et souvent fallacieuse que la dynamique génératrice sous-jacente conserve indéfiniment une structure linéaire invariable. Or, dans l’immense majorité des phénomènes naturels, physiques ou comportementaux, des effets de seuil critique, des phénomènes d’asymptote, de saturation ou de rupture d’équilibre systémique interviennent inévitablement hors du champ de vision immédiat, transformant toute extrapolation linéaire en une pure fiction spéculative dénuée de fondement scientifique.
Pour prémunir le lecteur contre cette illusion cognitive, la bonne pratique de programmation consiste à brider délibérément l’étendue vectorielle du tracé de la droite aux valeurs minimale et maximale du vecteur des abscisses d’observation (x.min() et x.max()). Si des projections extrapolées s’avèrent impérieusement requises par la problématique de recherche, elles doivent impérativement être signalées visuellement par une rupture de style géométrique — par exemple une transition franche d’un trait plein continu vers une ligne en pointillés —, avertissant l’observateur qu’il franchit le seuil de l’observation avérée pour s’aventurer dans l’espace de la conjecture mathématique théorique.
12.2 Piège du paradoxe de Simpson dans l’analyse globale
Une régression linéaire appliquée aveuglément à un ensemble de données agrégées sans partitionnement analytique préalable peut engendrer des contresens épistémologiques majeurs, dont la manifestation la plus spectaculaire est le paradoxe de Simpson. Ce phénomène statistique se produit lorsqu’une tendance linéaire observée au sein de plusieurs sous-groupes homogènes s’inverse de façon stupéfiante — passant par exemple d’une pente résolument positive à une pente globalement négative — dès lors que l’ensemble des observations sont fusionnées au sein d’une analyse univariée globale.
Ce paradoxe découle de l’existence d’une variable de confusion catégorielle latente, non prise en considération dans la régression simple, qui régule simultanément le positionnement spatial des sous-groupes sur les deux axes de mesure. L’analyste qui se contenterait de tracer une unique droite de meilleur ajustement sur la totalité de l’échantillon conclurait à tort à l’existence d’un lien inverse entre les deux variables, alors même que pour chaque catégorie individuelle considérée isolément, l’effet s’avère rigoureusement opposé.
La prévention de cet écueil méthodologique requiert une rigueur d’exploration préliminaire systématique. Il est impératif de stratifier les données selon les facteurs contextuels majeurs avant d’arrêter le choix d’un modèle d’ajustement. Sur le plan visuel en Python, le déploiement de facettages catégoriels ou l’attribution de palettes chromatiques distinctes aux sous-groupes au sein de Seaborn permet de déceler instantanément ces discordances de pente intra-groupes, immunisant le chercheur contre les conclusions fallacieuses dictées par une agrégation statistique hâtive et simplificatrice.
12.3 Optimisation computationnelle pour données à haute fréquence
À l’ère des mégadonnées (Big Data), de l’enregistrement continu de signaux physiologiques haute fréquence ou du traçage de flux financiers, les jeux de données bivariés à traiter peuvent fréquemment englober des millions d’enregistrements individuels. Dans ces conditions volumétriques extrêmes, les scripts élémentaires de tracé sous Matplotlib subissent un effondrement dramatique de leurs performances temporelles et peuvent provoquer un épuisement catastrophique de la mémoire vive disponible.
Si le calcul algébrique des coefficients de régression par np.polyfit demeure exceptionnellement rapide — ne nécessitant que quelques fractions de seconde pour agréger plusieurs millions de points grâce aux routines optimisées du processeur —, la tentative de projeter un nuage de dispersion composé de millions de marqueurs vectoriels via plt.scatter s’avère absurde et inopérante. Le canevas graphique devient un magma d’encre illisible, saturant inutilement les moteurs de rastérisation et générant des fichiers de sortie au poids prohibitif.
La parade architecturale consiste à dissocier la masse des calculs statistiques de la finesse de restitution graphique. Pour le rendu visuel de densités massives, il convient de substituer aux marqueurs individuels des représentations de densité bivariée continue, telles que les histogrammes bidimensionnels hexagonaux (plt.hexbin) ou l’estimation de densité par noyau, sur lesquels la droite d’ajustement linéaire peut alors être superposée avec une lisibilité parfaite. Enfin, pour l’exportation des figures terminales, le choix du format de fichier doit être dicté par la nature des données : les formats vectoriels (PDF, SVG) garantissent une netteté infinie pour les tracés géométriques épurés, tandis que les formats matriciels compressés sans perte (PNG haute densité) s’imposent dès lors que la figure intègre des trames de pixels complexes, assurant un équilibre idéal entre fidélité visuelle et légèreté computationnelle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, F. A., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Legendre, A. M. (1805). Nouvelles méthodes pour la détermination des orbites des comètes. F. Didot.
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021