
Dans l’écosystème contemporain de l’ingénierie des données et de l’analyse décisionnelle, les tableurs infonuagiques occupent une place prépondérante au sein des infrastructures informationnelles des organisations. Parmi ces solutions, l’application Google Sheets s’est imposée comme un standard collaboratif incontournable, permettant l’ingestion, la modélisation et la diffusion de volumétries de données toujours plus substantielles. Toutefois, la valeur heuristique et prédictive d’un modèle quantitatif dépend intrinsèquement de la pureté des données sous-jacentes. Les données qualitatives et textuelles, par leur nature discursive, polymorphe et souvent manuelle, constituent le foyer principal des anomalies, des disparités typographiques et des incohérences syntaxiques qui compromettent la validité des analyses ultérieures.
Le traitement, la standardisation et la substitution de chaînes de caractères au sein de feuilles de calcul ne relèvent pas simplement de considérations esthétiques ou cosmétiques. Il s’agit d’une exigence méthodologique fondamentale qui conditionne le bon fonctionnement des algorithmes de hachage, des fonctions d’agrégation conditionnelle, des liaisons relationnelles par clés primaires ou étrangères, ainsi que des scripts d’automatisation transactionnels. Qu’il s’agisse de corriger des libellés catégoriels obsolètes, de normaliser des codes de nomenclature internationale, de purger des séquences de caractères invisibles ou d’extraire des sous-chaînes critiques au moyen de motifs complexes, la maîtrise des mécanismes de remplacement textuel constitue une compétence cardinale pour tout gestionnaire de données, statisticien ou analyste des systèmes d’information.
Le présent traité propose une analyse exhaustive et rigoureuse des méthodologies de substitution textuelle disponibles dans Google Sheets. De l’utilisation élémentaire des interfaces graphiques interactives aux architectures algorithmiques avancées exploitant les expressions régulières et l’écosystème Google Apps Script, cette étude détaille les fondements théoriques, les implications pratiques et les risques d’intégrité systémique inhérents à chaque approche. À travers des protocoles expérimentaux documentés pas à pas et des démonstrations empiriques approfondies, ce guide vise à doter les praticiens des grilles de décision et des compétences techniques requises pour transformer des corpus textuels hétérogènes en jeux de données normalisés, reproductibles et pérennes.
1. 1. Fondements et typologie de la manipulation textuelle dans Google Sheets
1.1 1.1 Enjeux de la standardisation des données textuelles
La cohérence sémantique constitue le socle épistémologique de toute modélisation analytique rigoureuse. Au sein d’une base de données ou d’un tableau à double entrée, l’identité formelle d’une modalité catégorielle garantit son unicité logique. Dès lors qu’un même concept métier est consigné sous des formes lexicales divergentes — par exemple par l’introduction fortuite de variations orthographiques, d’abréviations non concertées, de variations d’accents ou de divergences de casse —, le système d’information fragmente la réalité empirique en catégories disjointes et artificielles. Cette entropie lexicale altère l’intégrité des tables de contingence, fausse les distributions de fréquences et biaise irrémédiablement les estimations statistiques descriptives ou inférentielles qui en découlent.
Sur le plan opérationnel, l’absence de normalisation textuelle engendre des dysfonctionnements immédiats au sein des moteurs d’interrogation de Google Sheets. Les fonctions classiques de recherche et de correspondance matricielle, telles que les fonctions standard de consultation par index ou les fonctions logiques de type recherche verticale, reposent par défaut sur des critères d’égalité stricte entre la clé d’interrogation et le vecteur de destination. Un écart d’un seul caractère, fût-il un espace typographique insécable ou un symbole de ponctuation adventice, induit un échec d’appariement et déclenche la propagation d’erreurs en cascade dans l’ensemble des dépendances de la feuille de calcul. De surcroît, les mécanismes de tri alphanumérique deviennent imprévisibles, séparant arbitrairement des enregistrements fonctionnellement jumeaux et complexifiant l’analyse humaine autant que computationnelle.
Face à ces défis, il convient d’opérer une distinction fondamentale entre les opérations de modification textuelle statique et les processus de transformation dynamique. La modification statique intervient de manière destructive ou définitive sur la cellule hôte en altérant physiquement la chaîne de caractères enregistrée dans la mémoire du classeur. À l’inverse, la transformation dynamique opère par l’intermédiaire de formules et de fonctions qui prennent en entrée la chaîne brute pour instancier, dans un espace cellulaire distinct ou dans un cache d’exécution temporaire, une version purifiée sans altérer l’enregistrement originel. Cette dialectique entre immuabilité des sources primaires et ductilité des représentations secondaires structure l’ensemble des arbitrages d’architecture de données dans les environnements de bureautique décisionnelle.
1.2 1.2 Vue d’ensemble des méthodes disponibles
L’environnement Google Sheets déploie une panoplie diversifiée d’outils dédiés à la substitution et à la réorganisation textuelle, chacun répondant à des exigences techniques, spatiales et fonctionnelles spécifiques. Au premier niveau d’intervention se situe l’interface modale native « Rechercher et remplacer », accessible directement via le ruban de commande de l’interface utilisateur. Cet outil interactif permet de scanner rapidement les plages cellulaires sélectionnées, les onglets actifs ou la totalité d’un classeur afin de substituer des chaînes de caractères littérales ou des motifs syntaxiques simples. Son exécution, directe et définitive, modifie le contenu des cellules sans nécessiter la mise en place de colonnes de calcul auxiliaires, ce qui en fait l’instrument privilégié pour les opérations ponctuelles de correction de masse.
Pour les contextes exigeant une non-destructivité absolue, une reproductibilité automatisée ou une mise à jour en temps réel des données ingérées, Google Sheets propose une bibliothèque de fonctions de feuille de calcul hautement spécialisées. La fonction SUBSTITUE se consacre au remplacement ciblé de sous-chaînes de caractères déterminées au sein d’un texte, offrant en outre la possibilité de discriminer précisément les occurrences à modifier. En parallèle, la fonction REMPLACER s’appuie sur une logique de repérage spatial et d’indexation numérique, opérant la substitution non pas sur la base du contenu sémantique, mais selon la position séquentielle et la longueur de la chaîne à évincer. Enfin, la fonction algorithmique REGEXREPLACE transcende les limitations des fonctions textuelles conventionnelles en mobilisant la puissance computationnelle des expressions régulières, autorisant des opérations complexes de filtrage par motifs, de purge de métacaractères et de réordonnancement par groupes de capture.
Au sommet de cette hiérarchie méthodologique s’articule l’automatisation programmée via la plateforme Google Apps Script. Reposant sur un moteur d’exécution JavaScript optimisé côté serveur, ce paradigme permet de scripter des routines de nettoyage complexes, exécutables de manière événementielle, planifiée ou asynchrone. Par l’entremise des classes documentaires intégrées, les scripts peuvent parcourir de manière itérative des architectures multi-onglets complexes, appliquer des dictionnaires de correspondances exhaustifs, valider la conformité des chaînes contre des référentiels externes et journaliser avec une précision chirurgicale l’ensemble des transformations effectuées, garantissant ainsi une traçabilité intégrale au sein des flux de travail professionnels.
1.3 1.3 Critères de sélection de la méthode appropriée
La sélection d’une méthode d’altération textuelle optimale ne saurait résulter d’une habitude arbitraire ; elle doit découler d’un arbitrage rigoureux fondé sur des contraintes techniques explicites. Le premier paramètre déterminant réside dans la volumétrie et la structure dimensionnelle du jeu de données. Pour un jeu de données restreint et statique, l’interface graphique offre une efficacité temporelle immédiate sans surcharge cognitive. En revanche, face à des tables massives comportant des dizaines de milliers de lignes enrichies en continu par des formulaires en ligne ou des flux d’ingestion automatisés (API), l’usage de fonctions matricielles ou de routines Apps Script s’avère indispensable pour garantir la pérennité du traitement sans intervention manuelle répétée.
Le second critère décisionnel réside dans l’impératif de préservation des données sources par rapport à la tolérance à l’écrasement physique. Dans les secteurs régulés tels que la recherche biomédicale, l’audit financier ou l’analyse actuarielle, la traçabilité des modifications impose souvent la conservation intégrale de l’état brut des données (audit trail). Dans cette perspective, les méthodes de remplacement statique doivent être formellement proscrites au bénéfice de fonctions dérivées non destructives, permettant d’exposer simultanément la chaîne brute originelle et la chaîne transformée dans une colonne de standardisation adjacente. Cet agencement autorise un contrôle a posteriori permanent et la vérification des règles de dérivation sans risque d’altération irréversible de la matière première informationnelle.
Enfin, la complexité intrinsèque du motif textuel constitue le troisième pilier de l’arbre décisionnel. Si la substitution implique une chaîne de caractères parfaitement constante, invariante et de longueur fixe (par exemple convertir l’abréviation « Dept » en « Département »), les fonctions littérales classiques ou le menu natif répondent parfaitement au besoin. Toutefois, dès lors que le motif implique une variabilité structurelle — telle que la détection d’adresses de courriel hétérogènes, l’isolation de numéros de téléphone aux séparateurs anarchiques ou l’harmonisation de dates encodées sous de multiples formats —, le recours exclusif aux expressions rationnelles via REGEXREPLACE ou à la programmation procédurale devient une exigence algorithmique incontournable pour éviter les faux positifs et préserver la complétude du corpus.
2. 2. L’outil natif « Rechercher et remplacer » : Architecture et fonctionnalités
2.1 2.1 Accès et ergonomie de l’interface modale
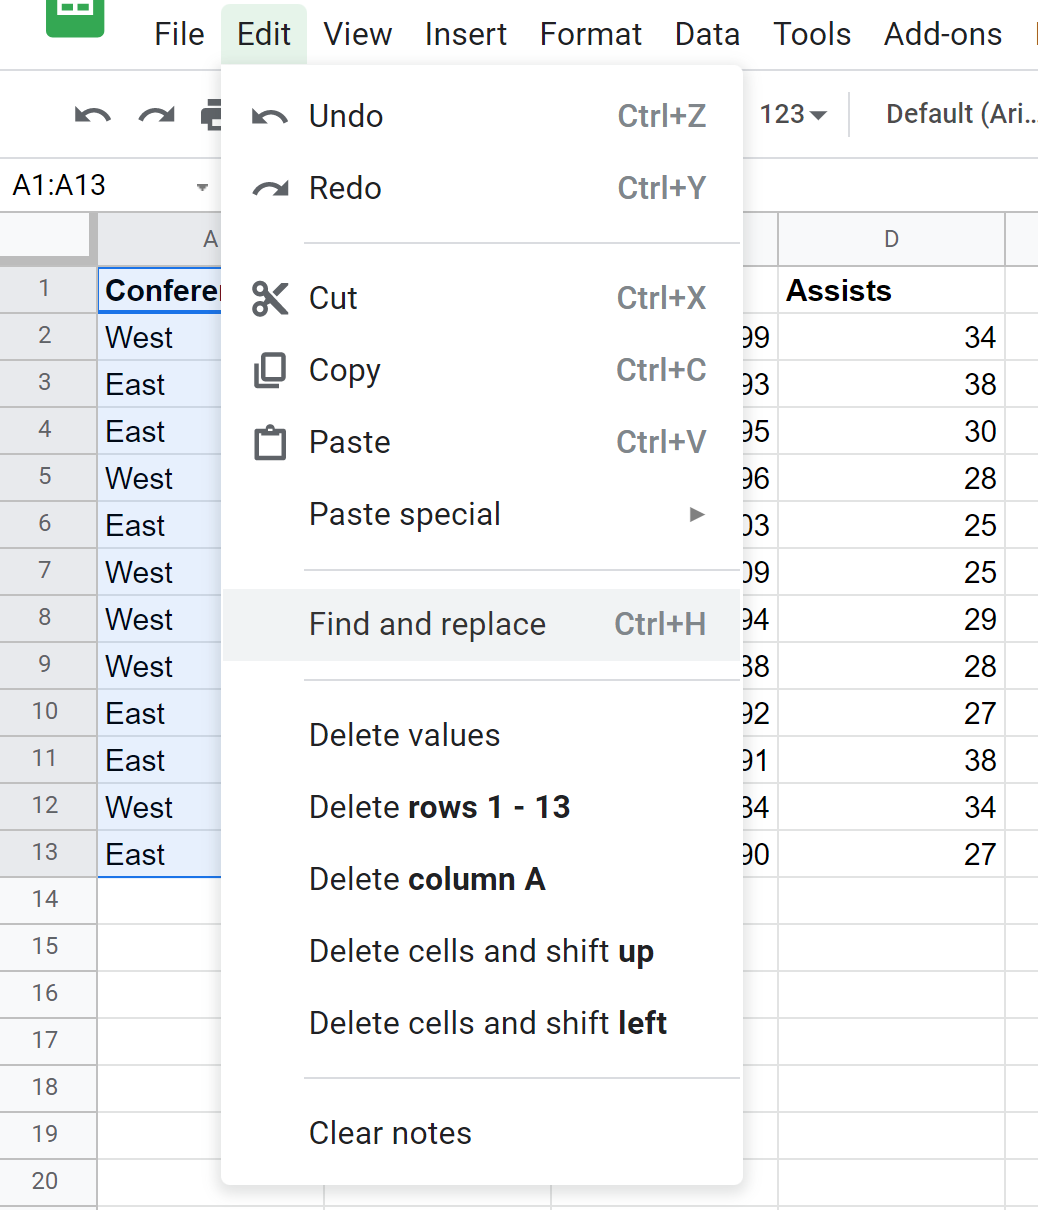
L’utilitaire « Rechercher et remplacer » intégré nativement à Google Sheets constitue la réponse d’ingénierie logicielle directe aux besoins de transformation lexicale immédiate. Conçu selon les standards ergonomiques des applications web modernes, il se matérialise sous la forme d’une fenêtre modale flottante venant s’ancrer au-dessus de la grille cellulaire active sans bloquer la perception visuelle globale du document sous-jacent. L’accès à ce module s’effectue traditionnellement par le ruban supérieur en déployant le menu déroulant Édition, puis en sélectionnant la rubrique spécifique Rechercher et remplacer. Cette trajectoire visuelle, bien qu’intuitive pour l’utilisateur novice, s’efface généralement devant l’utilisation des commandes mnémoniques au clavier.
Afin d’optimiser l’efficacité opérationnelle des opérateurs de saisie et des analystes, Google Sheets implémente des combinaisons de touches standardisées adaptées aux différents environnements d’exploitation. Sous le système d’exploitation Windows et la majorité des distributions Linux, la commande canonique s’exécute par l’enfoncement simultané des touches Ctrl + H. Sur les plateformes macOS d’Apple, cette action est dévolue à la combinaison combinatoire Cmd + Shift + H (la simple association Cmd + F étant exclusivement réservée au panneau de recherche unilatérale restreinte). Cette distinction matérielle assure une continuité fonctionnelle rigoureuse avec les standards historiques du traitement de texte et des interfaces graphiques de bureau.
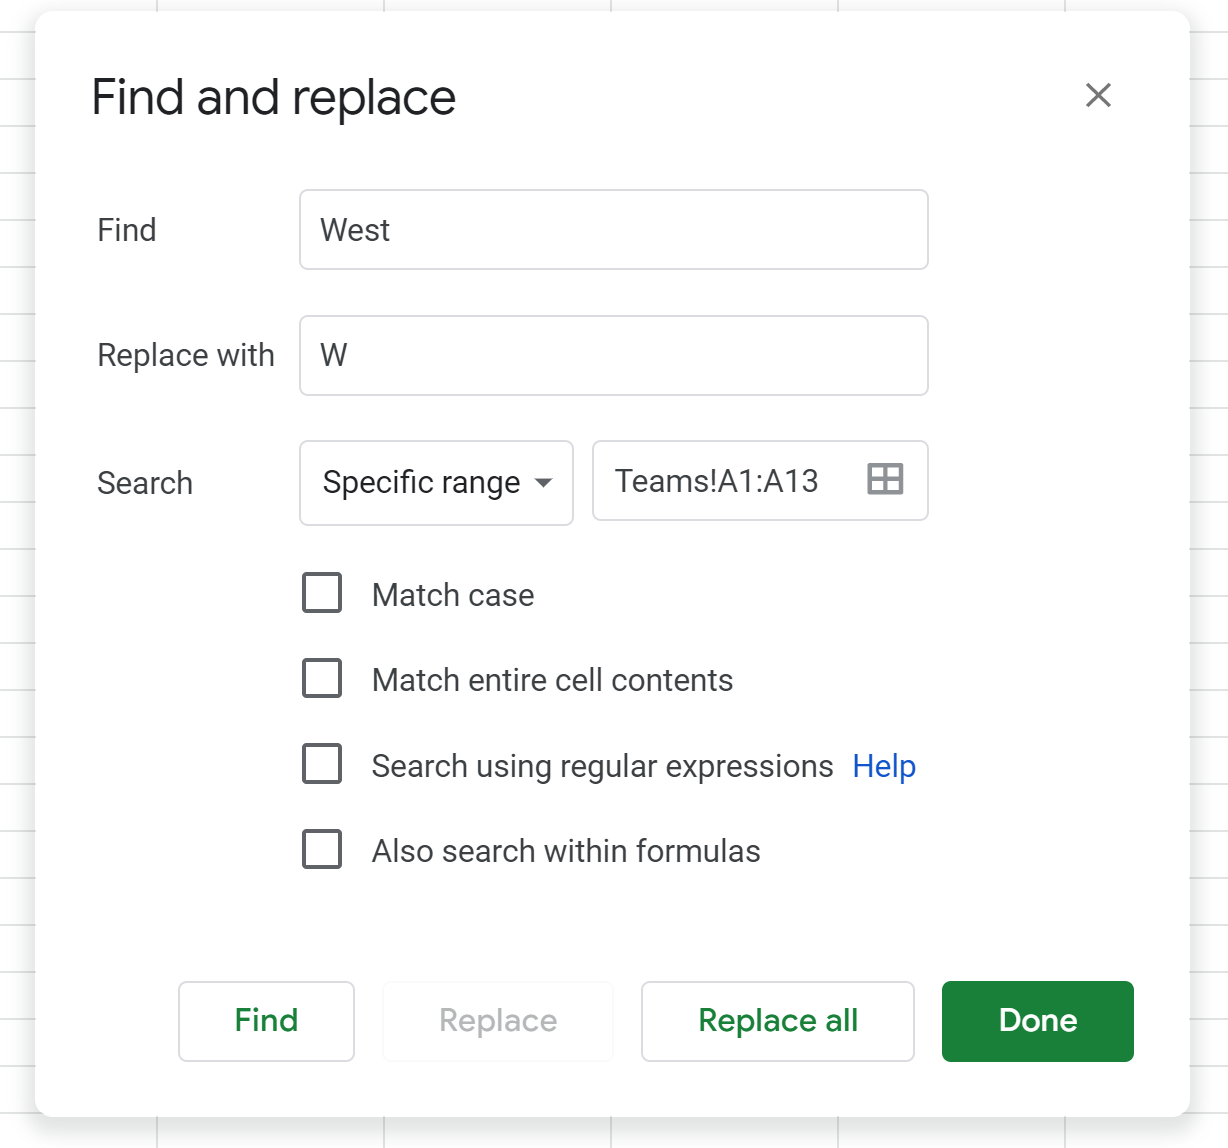
L’anatomie interne de la boîte de dialogue révèle une organisation fonctionnelle optimisée pour la précision chirurgicale des modifications. Elle comporte deux zones de saisie textuelle textuelle primordiales : le champ « Rechercher », dévolu à la définition du terme, de la séquence d’octets ou de l’expression rationnelle cible, et le champ « Remplacer par », destiné à recevoir la chaîne d’incorporation finale (qui peut être délibérément laissée vierge dans le cas d’une opération de purge ou d’amputation textuelle). Sous ces champs d’entrée se déploient un sélecteur de périmètre contextuel ainsi qu’une série de cases à cocher déterminant les conditions booléennes d’évaluation, complétés à la base par les boutons d’action transactionnels : « Rechercher », « Remplacer », « Tout remplacer » et « OK ».
2.2 2.2 Paramétrage du périmètre d’exécution
La précision spatiale d’une intervention de substitution est conditionnée par le paramétrage rigoureux de son périmètre d’application. Google Sheets offre une granularité tridimensionnelle permettant d’isoler avec exactitude les cellules assujetties au balayage algorithmique. Par défaut, la fenêtre modale s’initialise sur l’option Cette feuille, restreignant l’inspection et la mutation des valeurs à l’onglet présentement actif à l’écran. Cette configuration de base prévient les altérations fortuites qui pourraient survenir dans d’autres partitions du classeur masquées à la vue immédiate de l’utilisateur, confinant ainsi le risque d’erreur au contexte de travail courant.
Néanmoins, l’analyste a la faculté d’élargir ou de restreindre ce champ d’action par le biais d’un menu déroulant dédié. L’option la plus prudente consiste à contraindre l’opération à une Plage spécifique. Dans ce scénario, seules les cellules préalablement surlignées par le curseur — ou explicitement définies dans le champ de saisie sous la forme d’une notation matricielle standard de type A2:A500 — subiront le traitement. Cette approche compartimentée est hautement recommandée lors du travail sur des feuilles polymorphes où différentes colonnes partagent des lexiques communs mais répondent à des sémantiques distinctes, évitant ainsi la réécriture accidentelle de métadonnées ou d’en-têtes de colonnes adjacents.
À l’autre extrémité du spectre se trouve la modalité Toutes les feuilles. Cette option déploie la recherche et la modification sur l’intégralité des onglets composant le document, sans considération de leur état d’affichage ou de masquage. Si cette approche s’avère particulièrement puissante pour appliquer une révision terminologique globale à l’échelle d’un projet d’entreprise — comme le changement d’une raison sociale ou l’actualisation d’une devise comptable —, elle exige une vigilance extrême. L’exécution d’une commande globale non maîtrisée au sein d’un classeur volumineux comportant des dizaines d’onglets interconnectés peut détruire silencieusement l’intégrité de tables satellites non vérifiées immédiatement par l’opérateur.
2.3 2.3 Analyse comparative : Remplacer unitairement versus Tout remplacer
L’arbitrage entre l’exécution unitaire et le remplacement global constitue une problématique centrale de la sûreté des données opérationnelles. Le bouton d’action Remplacer opère selon une mécanique itérative pas à pas : à chaque activation, le moteur identifie l’occurrence la plus proche répondant aux critères, place la cellule correspondante en surbrillance visuelle et applique la modification textuelle. Ce processus oblige l’utilisateur à une validation cognitive individuelle de chaque transformation. Cette approche granulaire est fortement préconisée lorsque le terme de recherche présente des risques élevés de polysémie contextuelle ou lorsque la régularité du jeu de données n’a pas été préalablement attestée par un audit statistique.
À l’inverse, l’activation de la commande Tout remplacer déclenche un balayage algorithmique exhaustif et quasi instantané sur l’ensemble de la plage définie. Le moteur transactionnel applique la substitution de façon inconditionnelle à toutes les correspondances détectées, puis retourne un message système informant du nombre total d’occurrences modifiées. Cette méthode offre une scalabilité optimale pour le traitement de volumes industriels comprenant des milliers d’occurrences. Elle élimine la fatigue décisionnelle de l’opérateur et garantit une harmonisation totale en une fraction de seconde, optimisant ainsi substantiellement les temps d’ingénierie préparatoire.
Cependant, cette puissance exécutive s’accompagne d’un risque structurel majeur : l’irréversibilité fonctionnelle des modifications de masse. Bien que Google Sheets implémente un système robuste d’annulation (accessible par le raccourci classique Ctrl + Z) et un historique complet des versions via les serveurs d’infonuagique de Google, une fausse manipulation exécutée via Tout remplacer peut passer inaperçue lors d’une session collaborative. Si d’autres intervenants continuent d’insérer des données par-dessus une feuille corrompue, la restauration ultérieure d’un point de sauvegarde historique détruira l’ensemble des travaux intercalaires. Une analyse rigoureuse des chaînes cibles et une vérification préalable sur un échantillon restreint doivent donc impérativement précéder l’emploi de cette commande globale.
3. 3. Application pratique : Remplacement standard au sein d’un jeu de données sportives
3.1 3.1 Présentation du modèle de données expérimental
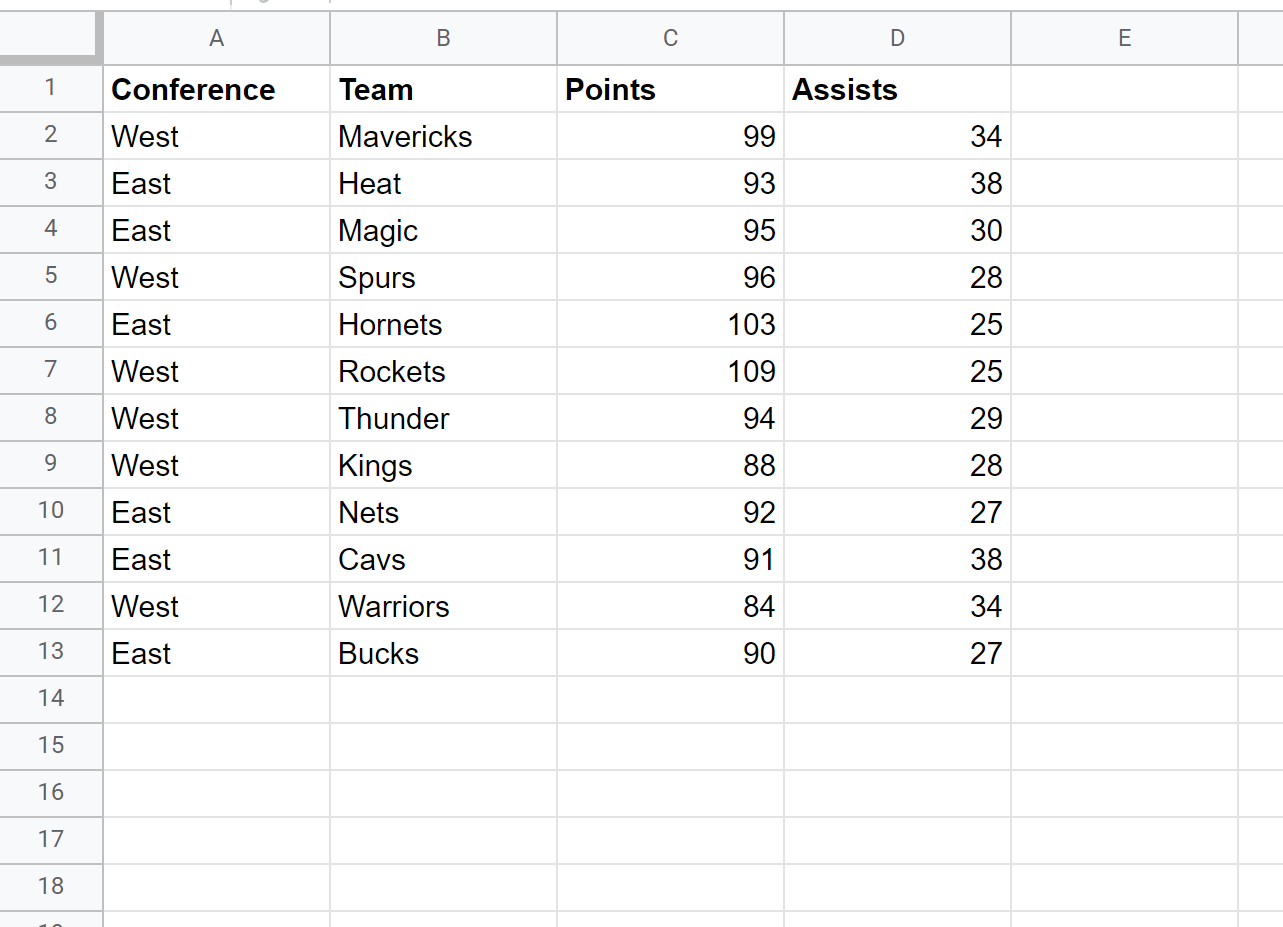
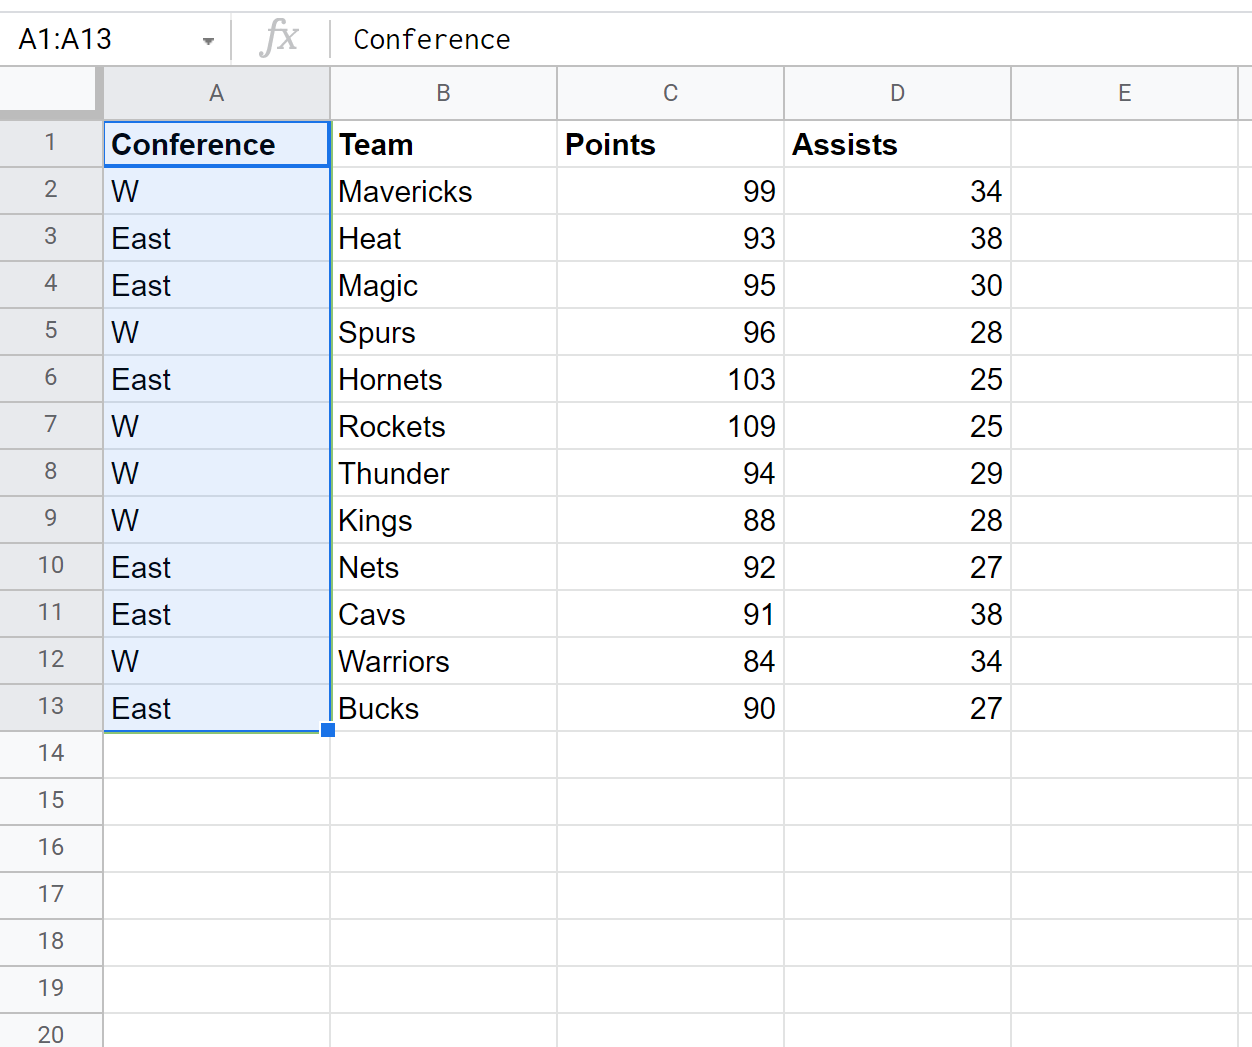
Afin de concrétiser ces principes théoriques au sein d’un environnement de calcul réaliste, nous mobiliserons un jeu de données canonique relatif aux statistiques opérationnelles d’une ligue professionnelle de basketball. Dans cette modélisation, chaque ligne représente une entité sportive distincte, qualifiée par un identifiant textuel, une localisation urbaine, une dénomination de franchise, une catégorisation par conférence géographique et divers indicateurs métriques de performance quantitative. La colonne désignant l’appartenance régionale, intitulée « Conférence », présente des entrées qualitatives brutes rédigées sous leur forme lexicale complète en langue anglaise, à savoir les modalités verbales « West » et « East ».
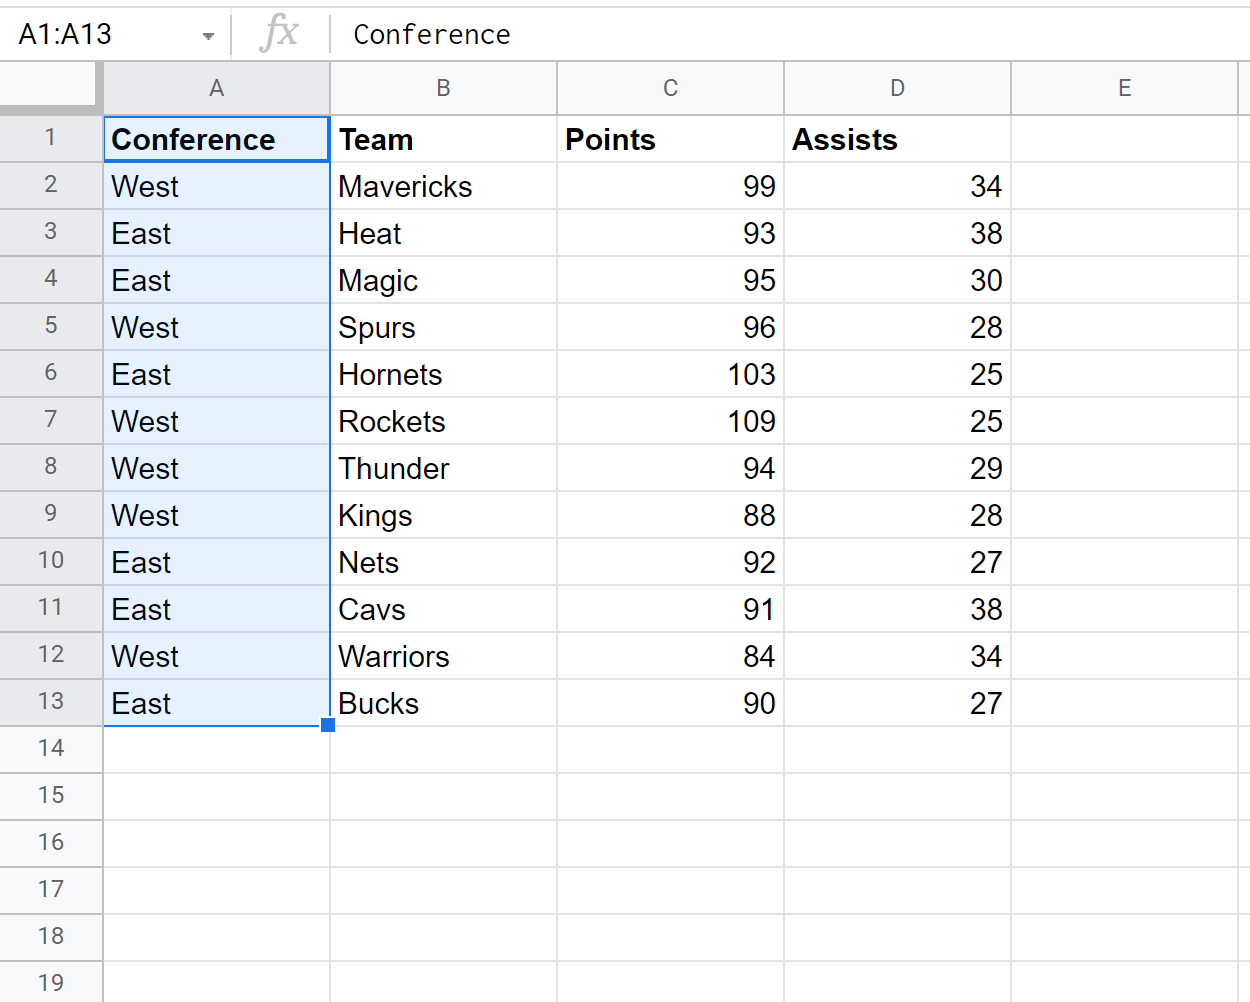
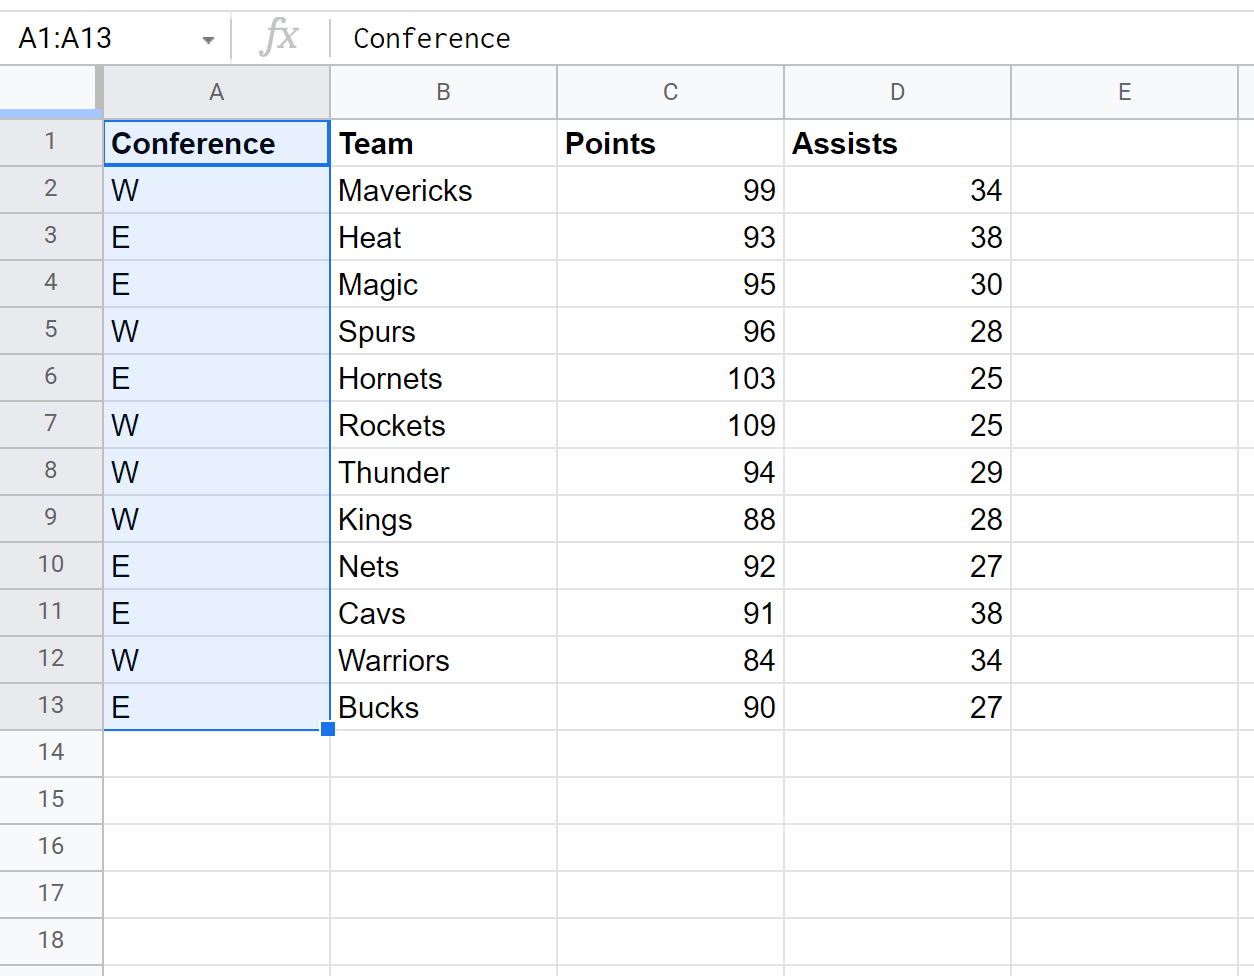
L’objectif de cette étude de cas pratique consiste à standardiser formellement cette variable catégorielle afin de préparer la table pour une intégration harmonieuse au sein d’un tableau de bord de business intelligence ou d’une modélisation économétrique. Les protocoles de publication et les impératifs d’espace graphique dans les représentations visuelles (tels que les diagrammes de dispersion ou les cartographies de données) exigent une concision typographique maximale. Il a donc été déterminé que les désignations régionales complètes devront être abrégées selon une convention stricte : la chaîne de caractères « West » doit être systématiquement condensée sous la forme de l’initiale majuscule « W », tandis que le terme « East » doit être rigoureusement transcrit sous le glyphe unique « E ».
Cette typologie de normalisation représente l’archétype des interventions de nettoyage rencontrées quotidiennement par les professionnels de la gestion de bases de données. Bien que conceptuellement triviale, cette opération nécessite le respect scrupuleux d’une méthodologie opératoire afin d’éviter tout dommage collatéral sur les colonnes adjacentes contenant éventuellement des segments lexicaux analogues (comme les noms d’équipes ou les patronymes de joueurs contenant les sous-chaînes « west » ou « east », à l’instar de « Golden State Warriors » ou de joueurs nommés « West »). L’application d’un confinement vectoriel strict est donc le prérequis fondamental de la démonstration qui suit.
3.2 3.2 Procédure détaillée pour la modalité « West » vers « W »
Le protocole d’exécution débute par le bornage spatial de la zone d’intervention. Dans la feuille de calcul active, l’opérateur commence par sélectionner méticuleusement le vecteur correspondant à la conférence géographique, par exemple la plage linéaire allant de la cellule D2 à la cellule D100. En isolant exclusivement cette colonne, on érige une barrière logique infranchissable pour l’algorithme, préservant ainsi d’emblée la colonne des franchises où l’apparition du mot « West » ne doit en aucun cas être tronquée en un simple « W » isolé.
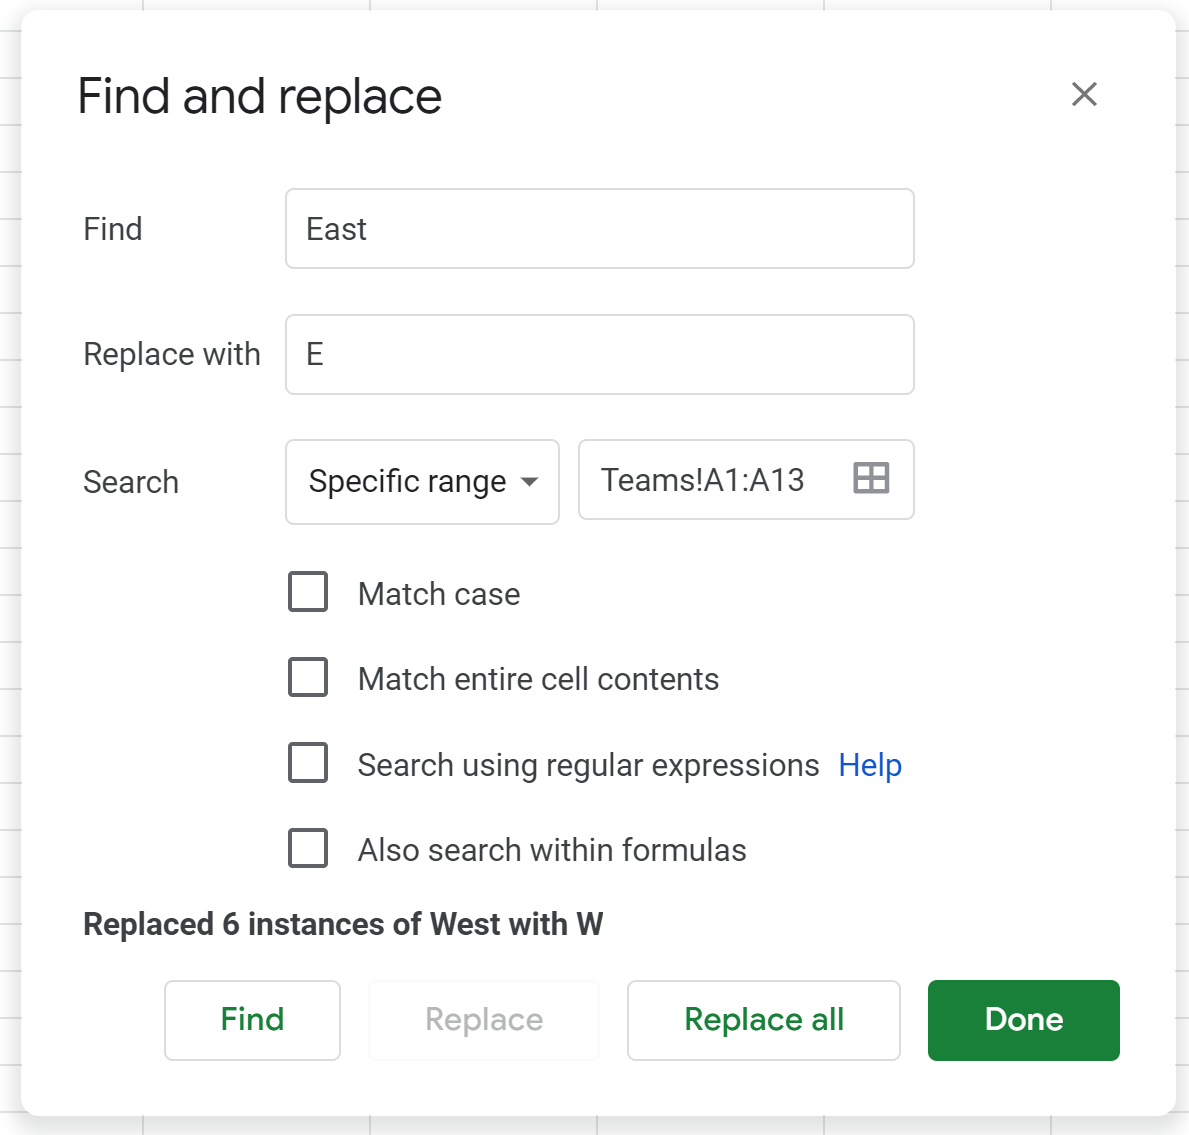
La sélection étant stabilisée, l’interface de substitution est appelée par le raccourci Ctrl + H (ou Cmd + Shift + H sur macOS). Dans la fenêtre modale qui apparaît en surimpression, l’analyste renseigne le champ Rechercher avec la chaîne littérale exacte : West. Immédiatement en dessous, dans le champ Remplacer par, il saisit la nouvelle valeur normalisée : W. Il convient à ce stade de s’assurer dans le sélecteur de portée que le périmètre indique précisément Cette feuille ou Plage spécifique: D2:D100, matérialisant ainsi la restriction opératoire préalablement définie.
L’étape finale de cette première phase consiste à valider le remplacement. L’opérateur peut opérer un contrôle de plausibilité en cliquant une première fois sur le bouton Rechercher pour vérifier que le pointeur se positionne effectivement sur la première cellule contenant la valeur « West ». Une fois la correspondance validée, l’activation du bouton Tout remplacer exécute la mutation vectorielle. Le système affiche alors instantanément une notification confirmant le nombre exact de transformations effectuées (par exemple : « 50 instances de ‘West’ ont été remplacées par ‘W’ »). Un audit visuel rapide de la colonne cible permet de constater la transformation uniforme des désignations occidentales.
3.3 3.3 Procédure séquentielle pour la modalité « East » vers « E »
Une fois la branche occidentale de la catégorisation standardisée, l’analyste procède immédiatement au traitement de la modalité orientale complémentaire. Pour maintenir une efficience maximale et éviter des manipulations d’interface superflues, il est recommandé de ne pas refermer la boîte de dialogue modale ni de désélectionner la colonne d’intérêt. La plage D2:D100 demeurant en surbrillance sous la fenêtre flottante, le contexte spatial d’exécution reste parfaitement verrouillé et immunisé contre les erreurs de ciblage.
L’opérateur repositionne le curseur textuel au sein du formulaire et modifie les paramètres d’interrogation. Le champ Rechercher est actualisé avec la chaîne de caractères East, tandis que le champ Remplacer par est configuré avec l’abréviation E. Les paramètres structurels et les options conditionnelles préalablement cochées demeurent inchangés, assurant une parfaite cohérence opérationnelle entre les deux cycles de nettoyage consécutifs. Ce traitement séquentiel garantit la reproductibilité de l’approche algorithmique au sein d’une même session de travail.
L’exécution de la commande s’effectue par un nouveau clic sur le bouton Tout remplacer. Le moteur Google Sheets parcourt à nouveau le sous-ensemble cellulaire restreint, identifie les occurrences résiduelles correspondant au terme « East » et procède à leur substitution atomique par l’identifiant « E ». À l’issue de cette seconde passe, la fenêtre indique le bilan des modifications (par exemple : « 50 instances de ‘East’ ont été remplacées par ‘E’ »). La fermeture de la boîte modale via le bouton OK ou Terminé laisse place à un tableau parfaitement normalisé, où la variable « Conférence » ne présente plus que les deux modalités synthétiques et canoniques requises par les impératifs analytiques contemporains.
4. 4. Paramètres avancés de l’outil natif de substitution
4.1 4.1 Sensibilité à la casse (respect des majuscules et minuscules)
Par défaut, le moteur de recherche de Google Sheets adopte un comportement insensible à la casse (case-insensitive). Cette tolérance algorithmique implique que la saisie du terme « west » identifiera indifféremment les instances graphiques « West », « WEST », « west » ou même des formes idiosyncratiques telles que « wEsT ». Bien que cette flexibilité soit hautement désirable lors de recherches exploratoires informelles, elle s’avère extrêmement périlleuse dans le contexte de protocoles d’ingénierie de données stricts, où la typographie porteuse de minuscules ou de majuscules véhicule une valeur sémantique distinctive.
L’activation de la case à cocher Respecter la casse modifie fondamentalement l’algorithme sous-jacent. Le système abandonne la normalisation typologique préalable pour effectuer une comparaison binaire directe, bit à bit, des codes de points de code des caractères dans la norme Unicode ou ASCII. Sous ce régime strict, la chaîne de caractères « W » est rigoureusement dissociée du caractère minuscule « w ». Ce niveau de discrimination est impératif, par exemple, lors de la manipulation d’acronymes de nomenclature chimique, de codes boursiers internationaux ou de clés de chiffrement et d’identification sensibles à la capitalisation.
Considérons à titre d’illustration une colonne renfermant des codes d’inventaire combinant des indicateurs d’état en minuscules et des localisations d’entrepôt en majuscules, comme « p-PARIS » versus « P-PARIS », où le préfixe minuscule désigne un produit en attente et la majuscule un produit validé. Un remplacement aveugle du caractère « p » par « V » sans respect de la casse détruirait instantanément la taxonomie sous-jacente en convertissant indistinctement les deux enregistrements en « V-PARIS ». L’enclenchement raisonné de la sensibilité à la casse prémunit le jeu de données contre ces corruptions lexicales invisibles et préserve l’intégrité classificatoire des variables discrètes.
4.2 4.2 Correspondance avec le contenu intégral de la cellule
L’un des pièges les plus dévastateurs de la manipulation textuelle automatisée réside dans la substitution accidentelle de fragments de mots enchâssés au sein de structures lexicales plus complexes. Par défaut, le moteur de recherche analyse le contenu de chaque cellule comme une chaîne continue au sein de laquelle il tente de localiser n’importe quel segment correspondant au motif recherché. Ainsi, ordonner le remplacement de la sous-chaîne « car » par « bus » provoquera non seulement la transformation du mot isolé « car », mais corrompra également les termes composites, transformant « carton » en « buston », « encart » en « enbust » ou « écart » en « ébust ».
Pour immuniser les traitements contre cet effet destructeur de chevauchement sous-chaîne, l’interface propose l’option critique Faire correspondre avec le contenu intégral de la cellule. Lorsque cette condition booléenne est validée, l’algorithme impose une contrainte de démarcation absolue : la correspondance n’est déclarée positive que si et seulement si l’intégralité du contenu de la cellule est rigoureusement identique au motif spécifié dans le champ de recherche, du premier au dernier caractère. La cellule ne doit comporter aucun préfixe, suffixe ou espace adjacent supplémentaire par rapport à la chaîne cible.
Cette fonctionnalité est particulièrement cruciale dans la standardisation des systèmes de codification catégorielle et des identifiants métiers. Par exemple, au sein d’une nomenclature où coexistent les codes « 10 », « 101 », « 102 » et « A10 », l’application d’un remplacement visant à convertir le code « 10 » en « 99 » doit impérativement s’effectuer sous cette contrainte d’intégralité. À défaut, les codes dépendants seraient altérés par ricochet en « 991 », « 992 » et « A99 », annihilant la cohérence structurelle de l’arbre taxonomique. Ce paramètre constitue donc la barrière de confinement indispensable lors de toute manipulation de modalités discrètes homogènes.
4.3 4.3 Recherche au sein des formules mathématiques et logiques
L’utilitaire natif de Google Sheets ne restreint pas ses capacités d’introspection aux seules valeurs textuelles statiques affichées à l’écran ; il possède la capacité de pénétrer la couche logique sous-jacente du classeur via l’option Rechercher également dans les formules. Par défaut, le moteur ignore la syntaxe interne des instructions programmées pour n’évaluer que le résultat final produit et rendu dans la cellule. L’activation de cette option spécifique renverse ce paradigme et expose directement le code source des formules aux opérations de balayage et de modification textuelle.
Cette fonctionnalité confère une puissance d’intervention remarquable lors des opérations de restructuration d’architecture logicielle au sein de classeurs complexes. Elle permet par exemple de procéder à des modifications massives de références de plages, de modifier l’adresse absolue d’un onglet externe ou de renommer un argument logique sur des centaines de cellules dépendantes en une seule action (par exemple substituer globalement l’appel de fonction RECHERCHEV par la fonction moderne XLOOKUP ou modifier le nom d’une feuille source 'Données 2023'! en 'Données 2024'!). Cette faculté évite à l’architecte de données de devoir réécrire ou étirer manuellement des formules complexes à travers des structures tabulaires hétérogènes.
Néanmoins, l’usage de cette option requiert une rigueur technique absolue. Une substitution textuelle indiscriminée au sein d’une formule peut corrompre irrémédiablement la syntaxe de calcul et induire des ruptures logiques majeures. Par exemple, si l’on cherche à remplacer le terme « OR » dans un classeur financier pour mettre à jour un intitulé monétaire tout en incluant les formules, on court le risque critique d’altérer la fonction logique standard OU (qui s’écrit OR dans l’interpréteur interne de Google Sheets), transformant des conditions mathématiques saines en erreurs de syntaxe bloquantes de type #ERROR!. L’inspection des formules doit par conséquent toujours être conduite avec des motifs ultra-spécifiques et un contrôle de casse draconien.
5. 5. Approche fonctionnelle non destructive : La formule SUBSTITUE
5.1 5.1 Syntaxe fondamentale et taxonomie des arguments
Pour répondre aux exigences de traçabilité, de non-destructivité et de réactivité dynamique inhérentes à la science des données moderne, Google Sheets intègre la fonction canonique SUBSTITUE. Contrairement à l’outil modale interactif, cette fonction opère de manière purement fonctionnelle : elle ingère une chaîne de référence en mémoire, applique les règles de dérivation textuelle programmées, et projette le résultat transformé au sein d’une cellule réceptrice indépendante. La donnée source demeure physiquement intouchée et préservée de toute dégradation, autorisant des comparaisons immédiates de cohérence et respectant les impératifs déontologiques de conservation de l’audit trail.
La taxonomie formelle de la fonction s’articule autour de trois arguments obligatoires, rigoureusement ordonnés selon l’écriture normalisée : SUBSTITUE(texte_à_analyser, texte_recherché, nouveau_texte, [numéro_occurrence]). Le premier paramètre, texte_à_analyser, désigne la source primaire de données, qui peut s’incarner sous la forme d’une chaîne littérale encapsulée entre guillemets droits ou, plus conventionnellement, d’une référence cellulaire matricielle (telle que A2). Le deuxième argument, texte_recherché, définit explicitement le segment textuel ou la séquence de glyphes à localiser. Enfin, le troisième argument, nouveau_texte, explicite la chaîne de substitution qui viendra oblitérer et remplacer le fragment identifié.
Il est capital de souligner que la fonction SUBSTITUE opère intrinsèquement sous un régime de stricte sensibilité à la casse. Contrairement au comportement par défaut de l’interface graphique modale, l’évaluation de la chaîne de recherche est discriminante au regard des minuscules et des majuscules. Par voie de conséquence, l’instruction =SUBSTITUE(A2; "Paris"; "Lyon") n’aura strictement aucun impact sur une cellule A2 hébergeant la séquence textuelle « paris » en minuscules, retournant alors la chaîne primitive sans la moindre modification. Cette rigueur typographique inaltérable impose une uniformisation préalable des chaînes ou la composition stratégique de fonctions auxiliaires lors du traitement de corpus textuels fortement bruités.
5.2 5.2 Gestion des occurrences via le quatrième argument optionnel
L’un des atouts différentiels majeurs de la fonction SUBSTITUE réside dans l’intégration de son quatrième argument facultatif : le paramètre numérique numéro_occurrence. Par défaut, lorsque cet argument est omis par le praticien, l’algorithme adopte une politique d’exhaustivité absolue : chaque occurrence du texte_recherché détectée dans la chaîne analysée est systématiquement éradiquée et remplacée par le nouveau_texte. Cette configuration standard est idéale pour purger des séparateurs omniprésents, comme remplacer l’ensemble des traits d’union d’un numéro d’enregistrement par des barres obliques.
Toutefois, de nombreuses structures syntaxiques métier exigent une sélectivité chirurgicale. L’adjonction d’une valeur entière positive au sein du paramètre numéro_occurrence contraint la fonction à focaliser son action modificatrice exclusivement sur l’itération dont l’index ordinal correspond très exactement au nombre spécifié, laissant l’intégralité des autres occurrences similaires parfaitement intactes. Par exemple, face à une séquence d’horodatage ou de traçabilité réseau telle que « 192.168.1.1 », la formulation =SUBSTITUE(A2; "."; "-"; 3) n’altérera que le troisième et dernier point de séparation, générant la chaîne « 192.168.1-1 » tout en préservant l’intégrité des deux premiers délimiteurs d’octets.
Cette granularité fonctionnelle ouvre des perspectives remarquables pour le traitement des données semi-structurées, telles que des chaînes de logistique d’expédition où le premier caractère de délimitation sépare un code pays et les suivants définissent des numéros de série internes. Elle permet de s’affranchir de découpages complexes et d’extractions séquentielles via des fonctions de tronquage, en résolvant au moyen d’une unique déclaration mathématique des problèmes de substitution sélective qui nécessiteraient autrement de lourdes combinaisons d’indexation algorithmique.
5.3 5.3 Exemples de formules combinées et imbrications multiples
Dans la pratique opérationnelle de la science des données, les anomalies textuelles se présentent rarement sous une forme unitaire isolée. Un même enregistrement brut peut accumuler des scories typographiques divergentes, des préfixes désuets et des suffixes discordants nécessitant des interventions d’épuration multiples et simultanées. La nature fonctionnelle de la formule SUBSTITUE permet de répondre à cette complexité par le paradigme de l’imbrication récursive, où le flux de sortie d’une instance sert directement de flux d’entrée à l’instance suivante.
Considérons à titre d’illustration une table d’adresses d’entreprises hébergeant des données saisies manuellement avec des abréviations routières hétérogènes. Si l’on souhaite standardiser au sein d’une même cellule les occurrences « Bd » en « Boulevard », « Av. » en « Avenue » et « R. » en « Rue », il suffit d’agencer une structure imbriquée en cascade selon l’architecture suivante :
=SUBSTITUE(SUBSTITUE(SUBSTITUE(A2; "Bd"; "Boulevard"); "Av."; "Avenue"); "R."; "Rue")
Dans cette architecture computationnelle, l’interpréteur de Google Sheets procède à l’évaluation en partant de la strate la plus interne (le remplacement de « Bd » sur la cellule A2), produit une chaîne intermédiaire non affichée, applique sur cette dernière la substitution de « Av. », puis transfère le flux résultant à la fonction terminale qui convertit « R. ». Cette dérivation continue garantit une vectorisation élégante du processus de normalisation sans qu’aucune modification ne soit apportée au référentiel originel en colonne A.
Toutefois, l’usage extensif des imbrications multiples soulève des défis substantiels en matière de maintenabilité et de lisibilité du code applicatif. Au-delà de quatre à cinq niveaux d’imbrication, la formule devient visuellement opaque, complexe à déboguer et particulièrement vulnérable aux erreurs de parenthésage. Dans de tels contextes de polymorphisme élevé, le concepteur devra arbitrer entre l’élégance théorique de la fonction unifiée et la mise en œuvre de tables de transcodage associées à des boucles de substitution par script ou à l’usage d’expressions régulières consolidées.
6. 6. Substitution ciblée par indexation spatiale : La formule REMPLACER
6.1 6.1 Décomposition mécanique de la fonction REMPLACER
Alors que la fonction SUBSTITUE conditionne son exécution à l’identification d’une sous-chaîne sémantique préalablement connue, la fonction REMPLACER (désignée par l’anglicisme REPLACE dans la nomenclature internationale) relève d’une rationalité opératoire fondamentalement distincte : l’indexation spatiale absolue. Elle ne se préoccupe nullement de la valeur textuelle résidant dans la cellule cible, mais agit selon un découpage topologique strict fondé sur l’adresse et l’amplitude séquentielle des caractères au sein du vecteur d’octets.
L’ordonnancement de ses paramètres obligatoires illustre cette logique mécanique : REMPLACER(texte, position, longueur, nouveau_texte). L’argument texte définit la chaîne primitive assujettie à la transformation. Le paramètre position, sous la forme d’un nombre entier strictement positif, établit l’index de départ du traitement (la numérotation débutant invariablement à 1 pour le premier caractère d’en-tête de chaîne dans l’environnement Google Sheets). L’argument longueur spécifie la quantité quantitative exacte de caractères consécutifs qui doivent être retranchés à compter de cette position ordinale. Enfin, le paramètre nouveau_texte stipule la séquence de caractères destinée à être greffée au point de rupture ainsi ménagé.
Cette approche mécanique dissocie l’action de substitution du sens lexical. Elle permet d’opérer des transformations chirurgicales avec une certitude déterministe totale, là où les variations morphologiques des termes sous-jacents mettraient en défaut les algorithmes basés sur la concordance lexicale. Elle est l’instrument de prédilection dès lors que la structure géométrique du jeu de données prime sur son contenu narratif.
6.2 6.2 Applications pratiques sur les chaînes de longueur fixe
Le champ d’excellence de la fonction REMPLACER s’exprime pleinement dans la standardisation des séquences de données normalisées à longueur fixe, couramment rencontrées dans les secteurs de la bancassurance, de la logistique industrielle ou des ressources humaines. Parmi ces données hautement structurées figurent les numéros de sécurité sociale, les codes d’identification bancaire (IBAN), les numéros de suivi de colis ou les clés d’inventaire d’équipements informatiques.
Une première application critique concerne l’anonymisation et le masquage de données hautement sensibles, en stricte conformité avec les réglementations sur la protection des données personnelles (telles que le RGPD de l’Union européenne). Considérons un jeu de données contenant des numéros d’identification fiscale à douze chiffres en cellule A2. Afin de permettre la diffusion de la base à des équipes de recherche sans compromettre la vie privée des assujettis, l’analyste peut masquer les huit chiffres centraux par une chaîne d’astérisques via la formule suivante :
=REMPLACER(A2; 3; 8; "********")
Dans ce schéma, la fonction préserve intacts les deux premiers caractères (index 1 et 2), excise impitoyablement les huit caractères suivants (du 3e au 10e inclus), et insère la séquence de masquage avant de restituer les deux derniers chiffres de contrôle terminaux. L’opération s’exécute avec une vitesse computationnelle optimale et garantit une uniformité visuelle parfaite à l’échelle de millions d’enregistrements.
Une seconde utilisation pratique réside dans l’insertion dynamique de caractères de séparation au sein de chaînes continues. Si un identifiant produit se présente sous la forme monolithique « PROD2024V01 », la formule =REMPLACER(A2; 5; 0; "-") illustre une propriété remarquable de la fonction : en configurant l’argument longueur à la valeur zéro, l’algorithme n’oblitère aucun caractère existant, mais intercale purement et simplement le caractère spécifié à la position désignée, convertissant instantanément la chaîne en « PROD-2024V01 ».
6.3 6.3 Synergie avec les fonctions de repérage dynamique
Bien que la fonction REMPLACER brille par son efficacité sur des formats de géométrie constante, son potentiel analytique se décuple lorsqu’elle est combinée avec des fonctions d’inspection spatiale dynamique, à l’instar de CHERCHE (insensible à la casse), TROUVE (sensible à la casse) et NBCAR (calculant le nombre total de glyphes composant une chaîne). Cette hybridation permet de traiter avec une rigueur absolue des architectures textuelles semi-régulières dont la délimitation interne varie d’une observation à l’autre.
Supposons que nous devions traiter une colonne répertoriant des adresses électroniques professionnelles hétérogènes en cellule A2 (par exemple « [email protected] » ou « [email protected] ») et que l’impératif technique consiste à remplacer l’intégralité du domaine institutionnel par un suffixe générique « @archive.org ». La longueur des identifiants nominatifs étant intrinsèquement variable, un index de position statique mènerait à une corruption immédiate des données. La solution consiste à calculer la position d’ancrage dynamiquement grâce à la fonction TROUVE en ciblant le séparateur structurel « @ » :
=REMPLACER(A2; TROUVE("@"; A2); NBCAR(A2) - TROUVE("@"; A2) + 1; "@archive.org")
Dans cet agencement d’ingénierie avancée, TROUVE("@"; A2) détermine avec une précision mathématique la position ordinale absolue du caractère arobase. Simultanément, l’expression NBCAR(A2) - TROUVE("@"; A2) + 1 évalue en temps réel la longueur exacte résiduelle de la chaîne depuis ce séparateur jusqu’au point terminal. La fonction REMPLACER dispose dès lors de coordonnées adaptatives parfaites pour exciser la portion de domaine obsolète et y greffer la nouvelle extension, neutralisant ainsi les variations de longueur des patronymes sans nécessiter de fastidieux découpages préalables.
7. 7. Algorithmique avancée : Expressions régulières avec REGEXREPLACE
7.1 7.1 Fondements de la syntaxe REGEX dans Google Sheets
Les expressions régulières (communément abrégées sous l’acronyme REGEX ou expressions rationnelles) représentent l’un des accomplissements les plus puissants de l’informatique théorique et de la linguistique computationnelle moderne. Conçues initialement dans le cadre de la théorie des automates par le mathématicien Stephen Cole Kleene, elles offrent un formalisme déclaratif ultra-condensé permettant de décrire, d’identifier et de manipuler des motifs textuels complexes selon des règles algébriques précises. Dans Google Sheets, cette puissance est encapsulée au sein de la fonction spécialisée REGEXREPLACE.
La syntaxe fondamentale de l’instruction s’énonce comme suit : REGEXREPLACE(texte, expression_régulière, remplacement). Le premier argument désigne le texte source ou la cellule cible. Le deuxième paramètre introduit le motif rationnel codifié sous la forme d’une chaîne de métacaractères interprétée par le moteur PCRE/RE2 sous-jacent. Le troisième paramètre représente le schéma de substitution. Contrairement aux fonctions textuelles conventionnelles qui évaluent les caractères pour leur valeur littérale unitaire, le moteur de REGEXREPLACE analyse les classes de caractères (comme d pour n’importe quel chiffre de 0 à 9, ou w pour tout caractère alphanumérique), les quantificateurs (tels que + pour une ou plusieurs occurrences, ou * pour zéro ou plusieurs) ainsi que les ancrages directionnels (comme ^ pour le début de chaîne et $ pour la terminaison).
L’avantage comparatif de cette approche est incommensurable face aux limites des fonctions élémentaires. Là où une substitution standard requerrait des dizaines d’imbrications récursives de la fonction SUBSTITUE pour traquer des variations de saisie (par exemple détecter les différentes graphies d’un numéro de téléphone combinant parenthèses, espaces, points et tirets), une expression régulière unique de quelques caractères suffit à encapsuler l’ensemble des permutations topologiques possibles. Elle dote ainsi l’analyste d’un scalpel algorithmique capable de purifier des architectures informationnelles hautement bruitées.
7.2 7.2 Cas d’usage : Extraction, neutralisation et reformatage
L’un des cas d’usage industriels les plus classiques réside dans la purge radicale de scories non numériques au sein de colonnes destinées à être converties en métriques quantitatives. Il est fréquent que des imports de données intègrent des valeurs monétaires ou de poids polluées par des symboles alphabétiques ou des devises textuelles disparates (ex. « 1 250 € », « Env. 4500$ », « Ref:890kg »). La formule suivante permet de désinfecter instantanément la cellule A2 en éliminant sans discrimination tout caractère qui ne relève pas de la classe des entiers numériques :
=REGEXREPLACE(A2; "[^d]"; "")
Dans ce motif, les crochets définissent une classe personnalisée, le métacaractère accent circonflexe ^ agit comme opérateur de négation logique, et d représente la série des chiffres décimaux. Ainsi, l’expression cible universellement tout glyphe n’étant pas un chiffre pour le remplacer par une chaîne vide (longueur nulle), ce qui a pour effet direct de l’oblitérer totalement. Le résultat obtenu est un résidu numérique pur, immédiatement convertible en format numérique calculable.
Un autre déploiement spectaculaire de REGEXREPLACE réside dans la réorganisation structurelle de dates ou d’identifiants composites par l’entremise des groupes de capture. Supposons une série chronologique importée au format anglo-saxon « AAAA-MM-JJ » que l’on doit transposer au format continental « JJ/MM/AAAA ». L’utilisation de parenthèses de capture au sein de l’expression régulière permet d’isoler les composantes temporelles et de les réordonner arbitrairement via les variables de rétro-référence $1, $2 et $3 :
=REGEXREPLACE(A2; "(d{4})-(d{2})-(d{2})"; "$3/$2/$1")
Le moteur segmente la chaîne en trois blocs distincts répondant aux contraintes quantitatives définies entre accolades, puis réassemble ces entités selon l’architecture spécifiée dans le troisième argument. Cette technique transcende la simple substitution : elle opère une véritable métamorphose géométrique de l’information sans solliciter la moindre fonction de calcul matriciel externe.
7.3 7.3 Validation et tests de robustesse des expressions rationnelles
En dépit de sa puissance intrinsèque, l’ingénierie des expressions rationnelles comporte des risques d’effets secondaires non négligeables en raison de la nature générique de ses motifs d’interrogation. Une expression mal calibrée peut engendrer des faux positifs désastreux en interceptant des séquences informationnelles légitimes qui partagent fortuitement un patron abstrait similaire. Par exemple, une regex conçue pour neutraliser les codes postaux à cinq chiffres peut accidentellement amputer des fragments de montants transactionnels ou des numéros de série internes si les conditions d’ancrage contextuel font défaut.
La robustesse algorithmique d’une formule REGEXREPLACE repose donc sur une délimitation rigoureuse des frontières lexicales. L’utilisation du métacaractère b (marquant la bordure d’un mot) ou l’adjonction systématique d’ancres de début de ligne ^ et de fin de chaîne $ garantissent que l’évaluation s’exécute dans un cadre géométrique parfaitement circonscrit. De surcroît, la complexité calculatoire des expressions comportant de multiples quantificateurs imbriqués doit être surveillée : des formulations ambiguës peuvent déclencher des mécanismes de rétro-traçage catastrophique (catastrophic backtracking), saturant le moteur JavaScript du navigateur et provoquant des gels temporaires de l’application lors du traitement de feuilles volumineuses.
Il est donc impératif de soumettre toute nouvelle expression rationnelle à un protocole de test formel sur un échantillon témoin avant son déploiement à large échelle. Cet audit empirique doit inclure des jeux d’épreuve comprenant des cas nominaux idéaux, mais surtout des cas limites et pervers : chaînes nulles, cellules ne comportant que des espaces, caractères typographiques étendus, accents diacritiques ou formats mixtes inattendus. La documentation explicite de la logique sous-jacente au sein des métadonnées du classeur constitue enfin une exigence de reproductibilité indispensable pour assurer la transférabilité du projet à d’autres équipes d’analystes.
8. 8. Traitement matriciel et automatisation sur colonnes entières
8.1 8.1 Déploiement à large échelle via ARRAYFORMULA
L’une des limitations historiques majeures des tableurs traditionnels réside dans la nécessité d’étirer manuellement les formules textuelles le long des colonnes ou de les copier-coller sur des plages verticales étendues. Cette approche présente des tares structurelles sévères : elle alourdit le volume mémoire du classeur, augmente le temps de calcul lors des recalculs globaux, et s’avère particulièrement instable lors de l’insertion ultérieure de nouvelles lignes au sein de la table. Pour surmonter ces contraintes, Google Sheets met à disposition le concept d’évaluation vectorielle unifiée via la commande ARRAYFORMULA.
Le principe fondamental de la vectorisation textuelle consiste à encapsuler une fonction de substitution standard — telle que SUBSTITUE ou REGEXREPLACE — au sein d’une enveloppe matricielle matricielle. Au lieu de transmettre en argument une référence cellulaire scalaire unique (par exemple A2), l’analyste déclare un vecteur unidimensionnel ouvert (par exemple A2:A). La structure s’exprime selon le modèle formel :
=ARRAYFORMULA(SUBSTITUE(A2:A; "Ancien"; "Nouveau"))
Sous cette instruction unique logée en tête de colonne, le moteur de calcul instancie dynamiquement un tableau virtuel et projette instantanément les résultats de la substitution sur l’ensemble de la dimension verticale, descendant de manière autonome jusqu’à la dernière ligne physique du classeur. Aucun étirement manuel n’est requis. L’intégrité algorithmique de la colonne est ainsi centralisée en un point d’ancrage unique : la cellule hébergeant la formule matricielle matricielle, ce qui simplifie radicalement les opérations de maintenance logicielle.
8.2 8.2 Gestion des plages dynamiques ouvertes et évitement des cellules vides
Si la déclaration d’une plage vectorielle ouverte de type A2:A confère une scalabilité parfaite au traitement, elle soulève immédiatement un problème de pollution visuelle et structurelle. Par défaut, la fonction matricielle traite l’ensemble des cellules vierges situées au bas du tableau comme des chaînes de caractères vides, leur appliquant aveuglément les règles de dérivation et générant des centaines de lignes de valeurs parasites ou de zéros qui gonflent artificiellement la zone active de la feuille et perturbent les mécanismes de détection de fin de données.
Pour immuniser l’architecture matricielle contre ce comportement indésirable, il est indispensable de coupler l’instruction de remplacement avec une barrière conditionnelle logique via la fonction SI. La formule d’ingénierie type s’articule comme suit :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); ""; SUBSTITUE(A2:A; "West"; "W")))
Cette formulation procède à une évaluation préalable rigoureuse : si la cellule de la colonne source est dénuée de contenu textuel (ESTVIDE(A2:A) validé), l’algorithme retourne une chaîne strictement nulle "", inhibant l’exécution du processus de substitution. Seuls les enregistrements effectivement pourvus d’une valeur textuelle mobilisent les ressources du moteur d’évaluation textuelle. Cette optimisation rationnelle préserve la propreté graphique des tableaux de bord, réduit la consommation de mémoire d’exécution et prévient le ralentissement progressif des interactions utilisateur.
8.3 8.3 Combinaison matricielle avec REGEXREPLACE
L’alliance computationnelle de la vectorisation par ARRAYFORMULA et de la puissance algorithmique de REGEXREPLACE constitue le pinacle de l’ingénierie textuelle déclarative au sein de Google Sheets. Cette symbiose permet de déployer des règles de normalisation phonétique, syntaxique ou structurelle de très haute complexité sur des cohortes entières de données en n’inscrivant qu’une seule formule modélisatrice dans l’en-tête de la colonne réceptrice.
Considérons le scénario d’une plateforme de commerce électronique collectant des milliers d’identifiants de commandes hétérogènes générés par des canaux tiers. Ces identifiants comportent des préfixes parasites (« CMD- », « ORD: », « REF_ ») suivis d’espaces instables et de codes variables. La mise en place de la formule vectorielle suivante en cellule B2 résout de manière unifiée la totalité des déviances structurelles sur l’ensemble de la colonne A active et future :
=ARRAYFORMULA(SI(A2:A=""; ""; REGEXREPLACE(A2:A; "^(CMD|ORD|REF)[-_:s]+"; "")))
Dès lors qu’une nouvelle ligne est injectée dans le classeur via l’API de commande ou un formulaire connecté, le moteur matriciel capture immédiatement l’événement, filtre les préfixes hétérogènes via l’expression rationnelle et restitue l’identifiant purifié en colonne B, sans nécessiter la moindre intervention humaine. Cette architecture déclarative vectorielle offre une robustesse comparable aux meilleurs pipelines d’extraction, transformation et chargement (ETL) industriels, tout en demeurant intégralement opérable au sein d’une interface bureautique collaborative légère.
9. 9. Protocoles de nettoyage pour cas particuliers et caractères non imprimables
9.1 9.1 Élimination des espaces superflus et insécables
L’une des causes les plus insidieuses d’échec dans les opérations de réconciliation de données réside dans la présence d’espaces typographiques polymorphes. Si l’espace standard — codé sous la valeur hexadécimale 0x20 ou le point de code décimal 32 dans la table ASCII — est généralement bien pris en charge par les fonctions de nettoyage de base telles que SUPPRESPACE (qui élimine les espaces initiaux, terminaux et redondants), les données issues du web ou de documents bureautiques formatés recèlent fréquemment des espaces insécables.
L’espace insécable, identifié sous le point de code 160 (Unicode U+00A0 ou entité HTML ), constitue un glyphe totalement étanche aux algorithmes conventionnels de la fonction SUPPRESPACE. Aux yeux du moteur d’évaluation, deux chaînes textuelles visuellement identiques comme « France » et « France » constituent des entités logiques distinctes si l’une d’elles comporte un caractère 160 résiduel. Pour éradiquer définitivement cette anomalie, l’analyste doit orchestrer une substitution binaire explicite en mobilisant la fonction CAR (retournant un caractère à partir de son code numérique) :
=SUPPRESPACE(SUBSTITUE(A2; CAR(160); " "))
Dans ce protocole en deux temps, la fonction SUBSTITUE transcode d’abord méthodiquement chaque espace insécable rencontré en un espace standard standard de rang 32. Dans un second temps, la fonction englobante SUPPRESPACE purge les résidus d’espacement superflus ainsi créés aux extrémités de la chaîne. L’application systématique de ce protocole sur les imports de données brutes assainit le corpus et prévient les échecs cryptiques de recherche d’équivalence.
9.2 9.2 Gestion des retours à la ligne et séparateurs invisibles
La présence de retours chariots et de sauts de ligne intempestifs au sein de cellules de texte libre constitue une source majeure de perturbation lors de l’exportation de classeurs vers des formats plats délimités tels que le CSV (Comma-Separated Values) ou lors de la transmission vers des bases de données relationnelles SQL. Ces sauts de ligne internes corrompent la structure des enregistrements en scindant artificiellement une même ligne d’observation en plusieurs fragments disjoints au sein des fichiers de destination.
Sous les systèmes d’exploitation Unix, Linux et macOS contemporains, le saut de ligne standard (Line Feed) est encodé par la valeur décimale 10, accessible dans Google Sheets via l’expression CAR(10) (sur les environnements Windows historiques, il peut être précédé d’un retour chariot Carriage Return de rang 13, soit CAR(13)). Pour aplanir un texte multi-lignes et transformer une séquence narrative en une chaîne continue homogène propice à l’analyse computationnelle, on mettra en œuvre une substitution ciblée de ces délimiteurs d’invisibles :
=SUBSTITUE(SUBSTITUE(A2; CAR(13); ""); CAR(10); " - ")
Ce double passage éradique d’abord les retours chariots résiduels, puis transmute l’ensemble des sauts de ligne verticaux en une séquence typographique horizontale stable (« – » ou une simple virgule). L’opération rétablit l’horizontalité absolue de chaque enregistrement, garantissant une intégration sans heurts dans les pipelines automatisés de traitement du langage naturel ou d’analyse statistique multivariée.
9.3 9.3 Substitution des cellules vides par des valeurs par défaut
Dans le paradigme du traitement quantitatif, les cellules vides — ou valeurs manquantes — introduisent un degré d’ambiguïté épistémologique dommageable : le vide traduit-il une absence d’observation, une impossibilité technique de mesure, un refus de réponse ou une valeur nulle ? Afin de lever ces incertitudes, la standardisation d’une colonne exige souvent la substitution systématique des cellules vierges par un marqueur sémantique explicite, tel que le libellé « Non renseigné », la valeur d’imputation « N/A » ou la constante numérique « 0 ».
L’outil modale « Rechercher et remplacer » permet de réaliser cette opération de manière statique avec une ingéniosité particulière : en cochant impérativement l’option Faire correspondre avec le contenu intégral de la cellule et en activant l’option Rechercher à l’aide des expressions régulières, il suffit de renseigner le champ Rechercher avec le motif ^$ (qui matérialise l’absence absolue de tout caractère entre le début et la fin de chaîne) et d’inscrire la valeur de substitution souhaitée (par exemple « Inconnu ») dans le champ de destination. L’exécution de la commande comble instantanément l’ensemble des vides de la plage sélectionnée.
Sur le plan dynamique, cette substitution préventive s’orchestre par la composition de fonctions logiques de détection, telles que SI combinée à ESTVIDE, ou par l’intermédiaire de la fonction spécialisée SI.NON.DISP lors du traitement des erreurs d’interrogation. Cette politique de remplissage standardisé conditionne la justesse des calculs ultérieurs : elle évite par exemple que les fonctions de comptage ou de moyenne n’excluent arbitrairement des observations sous prétexte de nullité de cellule, assurant une stricte comparabilité des dénominateurs statistiques.
10. 10. Automatisation avancée par scripts : Google Apps Script
10.1 10.1 Environnement Apps Script et modèle d’objet SpreadsheetApp
Lorsque les exigences de transformation textuelle dépassent le cadre des fonctions de feuille de calcul — notamment lors de traitements multi-documents, de dépendances asynchrones à des API externes ou de protocoles de nettoyage conditionnels nécessitant des structures de contrôle itératives sophistiquées —, l’écosystème Google Apps Script constitue l’infrastructure d’exécution privilégiée. Intégré nativement dans Google Workspace, cet environnement de script permet de manipuler par programmation le modèle d’objet de Google Sheets au moyen du service centralisé SpreadsheetApp.
L’exécution de ces procédures s’effectue côté serveur au sein de l’infrastructure infonuagique de Google, ce qui découple entièrement la charge computationnelle du navigateur client de l’utilisateur. Pour manipuler le texte d’un classeur avec une efficience maximale, l’API fournit la classe spécialisée TextFinder, accessible directement depuis les instances d’objets de type feuille (Sheet) ou plage (Range) via la méthode native createTextFinder(findText). Cette classe expose un jeu de méthodes avancées permettant de configurer la sensibilité à la casse (matchCase()), la correspondance intégrale (matchEntireCell()) ou l’activation des expressions régulières (useRegularExpression()).
L’appel final de la méthode d’exécution replaceAllWith(replaceText) applique les substitutions directement dans la structure mémoire du document avec une vélocité supérieure aux itérations manuelles sur des tableaux bidimensionnels de valeurs. Ce paradigme algorithmique permet de construire des architectures de traitement déterministes, industrialisables et auditables, prêtes à être déployées sur des parcs documentaires d’entreprise massifs.
10.2 10.2 Script type de substitution automatisée sur plusieurs onglets
L’un des apports majeurs de la programmation scriptée réside dans sa capacité à opérer des nettoyages terminologiques transversaux à travers des dizaines d’onglets au sein d’un même classeur, éliminant ainsi les manipulations humaines récurrentes et les risques d’omission. Le script documenté ci-dessous illustre l’implémentation d’une routine itérative appliquant un dictionnaire de correspondances lexicales prédéfinies à l’ensemble des feuilles actives :
Dans l’éditeur de scripts Google Apps Script (accessible via le menu Extensions > Apps Script), l’analyste peut implémenter la logique procédurale suivante :
On définit d’abord un objet JavaScript structuré contenant les couples clé-valeur de substitution, par exemple associer les acronymes « DEV » à « Développement », « MKT » à « Marketing » et « RH » à « Ressources Humaines ». Le script instancie le classeur actif via SpreadsheetApp.getActiveSpreadsheet(), puis extrait la collection exhaustive de ses feuilles au moyen de la méthode getSheets(). À travers une boucle itérative de type forEach, le programme examine chaque onglet séquentiellement. Pour chaque terme du dictionnaire de correspondances, un TextFinder dédié est instancié sur la feuille en cours, paramétré pour imposer le respect absolu de la casse et la correspondance de cellule entière, puis la substitution globale est exécutée via replaceAllWith().
Ce protocole automatisé intègre avantageusement des mécanismes de journalisation via la classe Logger.log(), permettant d’enregistrer avec précision l’identifiant de chaque feuille traitée et le volume des opérations réalisées. Cette trace d’exécution garantit une traçabilité scientifique complète des transformations appliquées sur les données patrimoniales de l’organisation.
10.3 10.3 Déclencheurs temporels et événements à l’ouverture
La puissance d’une solution Apps Script s’exprime pleinement lorsqu’elle est affranchie de toute intervention humaine directe grâce à l’activation des déclencheurs événementiels (triggers). L’environnement Google Sheets propose deux grandes catégories de déclencheurs : les déclencheurs simples basés sur les conventions de nommage d’événements systèmes et les déclencheurs installables configurables via le tableau de bord d’administration du projet.
Le déclencheur simple onOpen() permet d’exécuter une routine de contrôle et de normalisation textuelle au moment précis où un utilisateur initialise l’ouverture du classeur dans son interface. Plus pertinent encore dans les architectures d’ingestion continue, le déclencheur d’événement de soumission de formulaire (onFormSubmit) permet d’intercepter en temps réel toute nouvelle ligne de données injectée par un formulaire Google Forms connecté. Le script peut immédiatement analyser les réponses textuelles brutes saisies par l’utilisateur, purger les espaces invisibles, harmoniser la casse et substituer les valeurs déviantes avant même que les analystes métier n’accèdent à l’enregistrement.
Enfin, les déclencheurs temporels planifiés (time-driven triggers) autorisent l’orchestration de routines de maintenance périodiques — exécutables par exemple chaque nuit à heure fixe ou selon un cycle hebdomadaire déterminé. Cette automatisation récurrente garantit que des corpus documentaires partagés entre des centaines de collaborateurs restent continuellement conformes aux normes taxonomiques de l’entreprise, sans qu’aucun opérateur n’ait à renouveler manuellement les procédures de nettoyage.
11. 11. Erreurs méthodologiques courantes, pièges et intégrité des données
11.1 11.1 Risque d’altération collatérale par chevauchement lexical
L’écueil le plus fréquent et le plus dévastateur lors de la manipulation textuelle réside dans le phénomène de chevauchement lexical non anticipé, souvent désigné en ingénierie logicielle sous le nom de « problème de Scunthorpe » (altération accidentelle de mots innocents contenant une sous-chaîne interdite). Cette défaillance survient inévitablement lorsqu’une opération de remplacement de sous-chaîne est exécutée sans imposer de frontières lexicales strictes sur un vocabulaire partageant des racines morphologiques communes.
Considérons le cas d’école d’un gestionnaire de données cherchant à standardiser les mentions de pays au sein d’une table d’adresses en substituant l’abréviation « US » par le libellé complet « United States ». Si cette commande est exécutée sans activer l’option Faire correspondre avec le contenu intégral de la cellule ou sans délimiter les frontières de mot b dans une expression rationnelle, la sous-chaîne « US » sera impitoyablement remplacée au cœur de mots communs. Des noms de villes ou de tiers deviendront grotesquement corrompus : « TOULOUSE » se mutera en « TOULUnited StatesE », l’adjectif « BONUS » deviendra « BONUnited States », et le patronyme « RUST » sera défiguré en « RUnited StatesT ».
Pour juguler ces corruptions collatérales, il convient d’appliquer deux règles méthodologiques cardinales : premièrement, toujours vérifier la distribution fréquentielle du terme cible avant toute opération de masse afin d’identifier ses éventuelles inclusions lexicales ; deuxièmement, lorsque plusieurs remplacements interdépendants doivent être conduits séquentiellement, ordonner impérativement les opérations de la chaîne la plus longue vers la chaîne la plus courte. Ainsi, substituer « Directeur Général » avant de substituer « Directeur » évite que la première entité ne soit partiellement détruite avant d’avoir pu être traitée dans son intégralité.
11.2 11.2 Rupture involontaire des liaisons et dépendances de formules
Un danger majeur de l’utilisation non maîtrisée des outils de substitution réside dans la destruction silencieuse du réseau de dépendances mathématiques et logiques qui structure un classeur professionnel. Lorsque l’option de recherche dans les formules est activée, ou lorsqu’un remplacement textuel direct altère des valeurs littérales servant de clés de recherche dans des fonctions d’appariement externe (telles que RECHERCHEV, INDEX/EQUIV ou XLOOKUP), les mécanismes de liaison relationnelle s’effondrent instantanément.
Supposons qu’un modèle financier calcule des consolidations budgétaires en recherchant le terme exact « Salaire Brut » au sein d’une table de référence. Si un analyste procède à une standardisation unilatérale de cette étiquette en la remplaçant par « Rémunération Brute » sans mettre simultanément à jour les paramètres textuels codés en dur dans les formules dépendantes, l’ensemble des requêtes de consultation échouera, propageant des erreurs fatales de type #N/A ou #REF! à travers tous les états financiers du modèle. De manière analogue, modifier par inadvertance le nom d’un onglet au sein d’une chaîne peut briser irrémédiablement les liaisons inter-feuilles.
Pour conjurer ces risques systémiques, tout protocole de nettoyage textuel doit être précédé de la création d’un instantané de version dans l’historique des versions de Google Sheets (menu Fichier > Historique des versions > Nommer la version actuelle). Cette pratique garantit la possibilité d’un retour arrière instantané et sans perte de données en cas de rupture imprévue de la chaîne de calcul. De plus, l’adoption de plages nommées et de références par variables indirectes est fortement encouragée pour découper la logique de calcul de la couche de libellés textuels interchangeables.
11.3 11.3 Conversion implicite de types après substitution
Le moteur d’inférence de types de Google Sheets analyse continuellement les entrées de données pour leur assigner automatiquement un type scalaire : texte, nombre, date ou booléen. Si cette flexibilité dynamique est séduisante au quotidien, elle constitue une source fréquente de corruption silencieuse lors des opérations de substitution textuelle. Lorsqu’une chaîne textuelle est modifiée de telle sorte que sa nouvelle configuration morphologique ressemble à un nombre ou à une date, Google Sheets opère fréquemment une conversion implicite de type non sollicitée.
L’illustration la plus critique de ce phénomène concerne la gestion des identifiants numériques codés avec des zéros initiaux significatifs, tels que les codes postaux, les numéros de sécurité sociale ou les identifiants d’articles de catalogue (SKU). Si l’on applique une formule de remplacement sur la chaîne « REF-00123 » pour purger le préfixe « REF- », la chaîne résultante « 00123 » sera fréquemment réinterprétée par l’interpréteur comme l’entier numérique 123, éradiquant irrémédiablement les zéros d’en-tête indispensables à l’intégrité de la codification.
Pour prémunir les jeux de données contre cette transformation destructrice, l’ingénieur de données doit forcer explicitement le typage textuel du réceptacle. Cela s’opère soit en configurant préalablement le format de la colonne cible sur le mode Texte brut (menu Format > Nombre > Texte brut), soit en injectant un caractère d’échappement apostrophe ' au début de la chaîne de substitution, soit encore en encapsulant l’opération de remplacement dans la fonction de conversion explicite TEXTE(valeur; "@"). Cette précaution neutralise l’inférence automatique et maintient l’intégrité physique de la chaîne de caractères originelle.
12. 12. Matrice d’aide à la décision et bonnes pratiques d’ingénierie de données
12.1 12.1 Tableau comparatif des approches de remplacement
Afin de synthétiser les enseignements techniques développés tout au long de ce traité et de guider les architectes de données dans leurs arbitrages méthodologiques quotidiens, le tableau analytique ci-dessous structure les caractéristiques opérationnelles, les forces et les vulnérabilités de chaque solution examinée :
| Méthode | Destructivité | Réactivité | Scalabilité | Complexité de mise en œuvre | Scénario d’adéquation optimale |
|---|---|---|---|---|---|
| Rechercher & Remplacer (Natif) | Destructive (Écrasement physique direct) | Statique (Nécessite une exécution manuelle) | Moyenne (Limitée aux volumes interactifs) | Faible (Interface graphique conviviale) | Corrections ponctuelles rapides, harmonisations typographiques globales non récurrentes. |
| Fonction SUBSTITUE | Non destructive (Génération d’une dérivation) | Dynamique (Recalcul temps réel à la modification) | Élevée (Vectorisable via ARRAYFORMULA) | Faible à Moyenne (Syntaxe mathématique accessible) | Standardisation de termes invariables connus, remplacements sélectifs d’occurrences ordinales. |
| Fonction REMPLACER | Non destructive (Conservation de la source) | Dynamique (Mise à jour instantanée) | Élevée (Compatible traitement matriciel) | Moyenne (Exige la maîtrise des index spatiaux) | Masquage RGPD, reformatage de codes de longueur fixe (IBAN, numéros de série industriels). |
| Fonction REGEXREPLACE | Non destructive (Respect du référentiel brut) | Dynamique (Calculée en mémoire d’exécution) | Maximale (Vectorisation universelle élégante) | Élevée (Maîtrise indispensable des motifs rationnels) | Purge de scories hétérogènes, inversion structurale complexe, extraction de patrons variables. |
| Google Apps Script | Configurable (Destructive ou Non destructive) | Événementielle (Planification, triggers, onOpen) | Industrielle (Traitement automatisé multi-classeurs) | Très Élevée (Requiert des compétences JavaScript) | Pipelines ETL complexes, synchronisation avec des API externes, gouvernance multi-onglets. |
Cette matrice met en exergue l’absence de solution universellement supérieure : l’excellence opérationnelle réside dans l’adéquation rigoureuse entre la technique mobilisée et les contraintes de gouvernance, de reproductibilité et de performance propres à chaque écosystème informationnel.
12.2 12.2 Protocole standard de validation avant et après traitement
L’application d’un protocole de standardisation textuelle ne saurait être considérée comme achevée dès l’exécution de la formule ou de la commande native ; elle exige la mise en œuvre d’un cadre d’assurance qualité méthodique destiné à valider l’intégrité du corpus résultant. Le premier jalon de ce protocole consiste systématiquement à instancier un instantané de version dans l’historique du classeur ou à dupliquer l’onglet source dans un état d’archivage temporaire isolé.
Le second jalon repose sur le déploiement d’outils statistiques de dénombrement avant et après le traitement. L’utilisation conjointe de la fonction UNIQUE ou la construction d’une table de contingence via un tableau croisé dynamique permet d’exposer instantanément le spectre complet des modalités distinctes au sein de la colonne cible. En comparant le décompte des modalités uniques avant l’opération (par exemple 45 libellés hétérogènes) et après celle-ci (par exemple exactement 2 catégories canoniques normalisées), l’analyste obtient la preuve empirique irréfutable de la convergence sémantique de son jeu de données.
Enfin, le troisième jalon mobilise des assertions logiques pour traquer les valeurs résiduelles anormales. L’adjonction temporaire d’une colonne de contrôle exploitant la fonction NB.SI ou des règles de mise en forme conditionnelle permet d’allumer une alerte visuelle sur toute cellule dont le contenu ne se conformerait pas strictement au dictionnaire des termes autorisés. Ce n’est qu’une fois cet audit de conformité validé que la colonne standardisée peut être définitivement promue au statut de référentiel de production pour les tableaux de bord et modèles décisionnels aval.
12.3 12.3 Perspectives d’évolution vers des flux de travail pérennes
Au-delà des techniques curatives de nettoyage et de substitution textuelle a posteriori, la maturité d’une organisation en matière d’ingénierie de données se mesure à sa capacité à tarir l’apparition des anomalies à la source même du flux informationnel. La correction perpétuelle de scories lexicales traduit bien souvent un défaut d’architecture en amont dans les processus de saisie et de capture des événements métier.
L’implantation de règles de Validation des données rigoureuses (accessible via le menu Données > Validation des données) constitue le rempart fondamental contre l’entropie textuelle. En contraignant les utilisateurs à sélectionner exclusivement leurs entrées au sein d’une liste déroulante prédéfinie et verrouillée, on élimine de facto les fautes de frappe, les variations de casse et les abréviations sauvages. La donnée ingérée est intrinsèquement conforme dès sa création, rendant caduques les lourdes opérations de substitution ultérieures.
À une échelle plus vaste, l’intégration de Google Sheets au sein d’architectures d’ingénierie modernes impose d’adosser le tableur à des bases de données relationnelles consolidées (via BigQuery ou des connecteurs de bases SQL) et d’automatiser les transformations par l’entremise d’outils de transformation déclaratifs (comme dbt) ou de pipelines de données éprouvés. En articulant harmonieusement la ductilité collaborative de Google Sheets pour la restitution analytique et la rigueur des protocoles de gouvernance industrielle pour le traitement textuel, les organisations s’assurent d’exploiter des données pérennes, hautement qualitatives et immédiatement actionnables pour la prise de décision stratégique.
Références
Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377-387. https://doi.org/10.1145/362384.362685
Friedl, J. E. (2006). Mastering regular expressions (3e éd.). O’Reilly Media.
Google Workspace Developers. (2024). Class SpreadsheetApp and Class TextFinder reference documentation. Google Developers. https://developers.google.com/apps-script/reference/spreadsheet
Google Support. (2024). Rechercher et remplacer du texte et des nombres dans Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/62754
Kleene, S. C. (1956). Representation of events in nerve nets and finite automata. Automata Studies, Annals of Mathematics Studies, 34, 3-41. Princeton University Press.
Unicode Consortium. (2023). The Unicode Standard, Version 15.1.0. Unicode Consortium. https://www.unicode.org/versions/Unicode15.1.0/
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10