
Dans l’ingénierie contemporaine des données et la modélisation financière, la feuille de calcul s’est imposée comme un vecteur pivot de transformation décisionnelle. Toutefois, la manipulation de matrices volumineuses au sein d’environnements infonuagiques tels que Google Sheets confronte invariablement l’analyste à un dilemme technique récurrent : le statut logique et arithmétique de la cellule non renseignée. Loin d’être une simple commodité cosmétique visant à uniformiser les tableaux de bord, le remplacement délibéré des cellules vides par le chiffre zéro constitue une opération d’imputation structurelle qui modifie en profondeur la sémantique de l’information sous-jacente, la dynamique du moteur d’exécution et les résultats des calculs agrégés.
Le tableur conçoit l’espace tabulaire comme une grille matricielle discrète au sein de laquelle coexistent des états computationnels distincts. Entre l’absence ontologique de saisie, la chaîne textuelle de longueur nulle générée par des embranchements conditionnels, et l’entité arithmétique scalaire zéro, s’étend un gradient d’effets collatéraux susceptibles de fausser les estimateurs statistiques fondamentaux ou de provoquer des ruptures critiques dans les pipelines de données automatisés. La substitution aveugle d’un vide par un zéro sans maîtrise méthodologique préalable représente l’un des facteurs prépondérants d’introduction de biais au sein des modèles prédictifs et des bilans comptables institutionnels.
Ce traité exhaustif expose l’ensemble des paradigmes, protocoles et architectures logiques permettant d’identifier, d’auditer et de remplacer les cellules vides par la valeur zéro dans Google Sheets. De l’utilisation granulaire du moteur d’expressions régulières jusqu’aux déploiements matriciels dynamiques non destructifs et à l’automatisation procédurale via Google Apps Script, cette étude détaille les implications mathématiques, cognitives et computationnelles de chaque approche afin de doter les praticiens de données d’un cadre opératoire rigoureux et pérenne.
1. Cadre théorique et enjeux des cellules vides dans Google Sheets
1.1 Distinction ontologique entre absence de valeur et valeur nulle
L’architecture fondamentale des moteurs de calcul tabulaire repose sur une distinction conceptuelle majeure entre le néant informationnel et la valeur scalaire neutre. Dans le formalisme informatique régissant les bases de données et les tableurs, le vide sémantique — souvent assimilé au concept de valeur null issu de la théorie relationnelle de Codd — désigne l’inconnu, l’inapplicable ou l’absence formelle de mesure empirique. À l’opposé, le zéro mathématique (0) représente une quantité numérique déterminée, un état d’équilibre ou une quantification effective d’une magnitude nulle au sein de l’espace des réels. Confondre ces deux états revient à assimiler une température non relevée par un capteur défaillant à une température mesurée de zéro degré Celsius.
Au sein du moteur d’évaluation de Google Sheets, cette frontière s’avère particulièrement subtile en raison des mécanismes internes de coercition de type. Lorsqu’une cellule strictement vide est injectée dans une opération arithmétique élémentaire d’addition ou de soustraction, le moteur applique une conversion implicite vers la valeur zéro, permettant au calcul de converger sans générer d’erreur syntaxique. En revanche, dès lors que l’évaluation bascule dans l’ordre logique et booléen, le comportement diverge : une cellule vide comparée à une chaîne vide retournera une valeur vraie, alors que sa comparaison stricte au chiffre zéro dans un contexte d’égalité logique directe générera une assertion fausse, révélant la persistance d’une divergence d’état en mémoire.
Dans la modélisation des variables quantitatives continues et discrètes, substituer prématurément le vide par le zéro altère irrémédiablement la distribution sous-jacente des observations. Pour une variable discrète représentant un volume de transactions, l’absence de transaction documentée ne signifie pas systématiquement l’existence d’une transaction d’un montant nul ; il peut s’agir d’une omission de collecte, d’une période de fermeture ou d’une perte d’information technique. Dès lors que l’analyste procède à une imputation systématique sans modélisation bayésienne ou paramétrique préalable, il contamine l’échantillon en convertissant une incertitude épistémique en une certitude quantitative erronée, induisant un biais de survie ou d’attrition au sein des séries temporelles.
1.2 Typologie des cellules non renseignées dans les feuilles de calcul
L’observation visuelle d’une grille blanche au sein de l’interface graphique masque une hétérogénéité technique profonde. Il convient d’établir une typologie rigoureuse des états d’inoccupation au sein de Google Sheets afin de calibrer adéquatement les algorithmes de nettoyage. La première catégorie correspond à la cellule vierge au sens strict : une coordonnée matricielle n’ayant jamais été initialisée, dépourvue de métadonnées de formatage, de formule et de contenu en mémoire vive. Ces cellules occupent une empreinte minimale au sein de l’arbre syntaxique du document et sont interprétées nativement par l’API comme des nœuds non instanciés.
La deuxième catégorie englobe les chaînes de caractères de longueur nulle, universellement désignées par l’expression syntaxique "". Celles-ci sont le plus souvent le produit dérivé de formules conditionnelles antérieures ayant renvoyé un résultat textuel vide pour masquer des sorties indésirables. Bien que ces cellules apparaissent totalement dégagées pour l’opérateur humain, elles abritent un type de données textuel résiduel. Ce statut textuel empêche leur traitement transparent par certaines fonctions d’agrégation numérique et bloque l’application des filtres conçus exclusivement pour cibler le vide structurel.
Une troisième classe de non-valeurs regroupe les artefacts invisibles résultant d’opérations d’importation depuis des systèmes externes (fichiers CSV mal formatés, extractions ERP ou requêtes SQL brutes). Il s’agit des espaces standards (code ASCII 32), des tabulations horizontales (ASCII 9), des retours à la ligne résiduels (ASCII 10 et 13), et surtout du redoutable espace insécable (code ASCII 160 ou Unicode U+00A0). Ces entités graphiquement imperceptibles confèrent à la cellule une longueur scalaire non nulle, empêchant toute fonction d’identification standard telle que ESTVIDE() de reconnaître la vacuité de la cellule.
Enfin, la quatrième catégorie concerne les cellules présentant des erreurs d’évaluation masquées par des artifices typographiques ou des règles de mise en forme conditionnelle appliquant une police blanche sur fond blanc. De telles cellules conservent un statut d’erreur système bloquant (ex. #N/A, #VALEUR!, #DIV/0!) qui paralyse les chaînes de dépendance logique en aval, tout en mimant superficiellement l’apparence du vide documentaire.
1.3 Répercussions des vides sur le calcul statistique et fonctionnel
L’asymétrie de traitement algorithmique réservée aux cellules vides au sein de la bibliothèque de fonctions natives de Google Sheets engendre des distorsions mathématiques majeures. La disparité fonctionnelle la plus documentée s’observe lors de l’application de la triade d’agrégation élémentaire : SOMME, MOYENNE et NB. La fonction SOMME traite par défaut les cellules vides comme des zéros opérationnels sans altérer son résultat arithmétique. En revanche, la fonction NB dénombre exclusivement les cellules contenant des valeurs numériques formelles, ignorant délibérément les cellules vides et les chaînes de longueur nulle.
Par voie de conséquence directe, la fonction MOYENNE calcule son ratio fondamental en divisant la somme arithmétique par le décompte issu de la logique de NB. Si un échantillon de cinq observations comporte les valeurs [10, 20, vide, 30, vide], le calcul de la moyenne ignore les deux vides et s’effectue sur un dénominateur égal à trois, produisant une moyenne de 20. Si l’opérateur impute la valeur zéro à ces deux cellules sans discernement méthodologique, l’échantillon devient [10, 20, 0, 30, 0], projetant instantanément le dénominateur à cinq et la moyenne résultante à 12. Cette chute vertigineuse de 40 % de l’indicateur illustre la vulnérabilité mathématique des calculs face à la mauvaise gestion des vides.
Ce phénomène de distorsion s’amplifie exponentiellement lors de l’évaluation des moments d’ordre supérieur tels que la variance (VAR.S) et l’écart-type (ECARTYPE.STANDARD). En augmentant la cardinalité de l’échantillon par des zéros situés à une distance significative de la moyenne empirique initiale, l’analyste accroît artificiellement la somme des déviations quadratiques, faussant la largeur des intervalles de confiance et invalidant les tests de significativité statistique subséquents.
Au-delà de la métrologie descriptive, les structures de recherche tabulaire subissent des dysfonctionnements critiques. Une fonction d’indexation telle que RECHERCHEV ou le binôme INDEX/EQUIV, configurée pour localiser une correspondance exacte, renvoie une valeur zéro lorsqu’elle pointe vers une cellule cible vierge de tout contenu, créant un artefact où le récepteur hérite d’une valeur arithmétique inexistante chez l’émetteur. À l’inverse, si la valeur recherchée est elle-même un zéro et que la matrice source comporte des blancs combinés à des espaces insécables, la procédure de liaison échouera, soulevant des erreurs d’incompatibilité de type au sein des processus ETL (Extract-Transform-Load) interconnectés.
2. La méthode fondamentale : La commande Rechercher et remplacer
2.1 Accès ergonomique et paramétrage du panneau dédié
Pour intervenir de façon chirurgicale sur des ensembles de données structurés sans mobiliser de moteurs de script externes, Google Sheets intègre une interface native de manipulation de chaînes et de structures scalaires via la commande Rechercher et remplacer. Accessible depuis le ruban horizontal supérieur sous le menu contextuel Édition, cet outil condense l’essentiel de la logique de balayage de la grille. Les praticiens exigeants privilégient systématiquement l’invocation par combinaisons de touches canoniques, à savoir la séquence universelle Ctrl + H sous les systèmes d’exploitation Windows et Linux, ou Cmd + Shift + H au sein de l’environnement macOS.
L’ouverture de cette interface modale déploie un panneau d’options critiques régissant la portée spatiale de l’inspection syntaxique. Le champ de sélection Rechercher dans autorise trois topologies opérationnelles : la totalité des feuilles composant le classeur, la feuille de calcul activement affichée à l’écran, ou une plage de coordonnées géographiques strictement délimitée par la notation alphanumérique standard (ex. Feuille1!C2:G500). L’affectation d’une portée globale sans restriction préalable représente un risque critique pour l’intégrité de la structure tabulaire, car l’opération est susceptible de propager des valeurs zéros au sein de zones d’annotations textuelles, de zones de respiration typographique ou de marges de mise en page intentionnellement vierges.
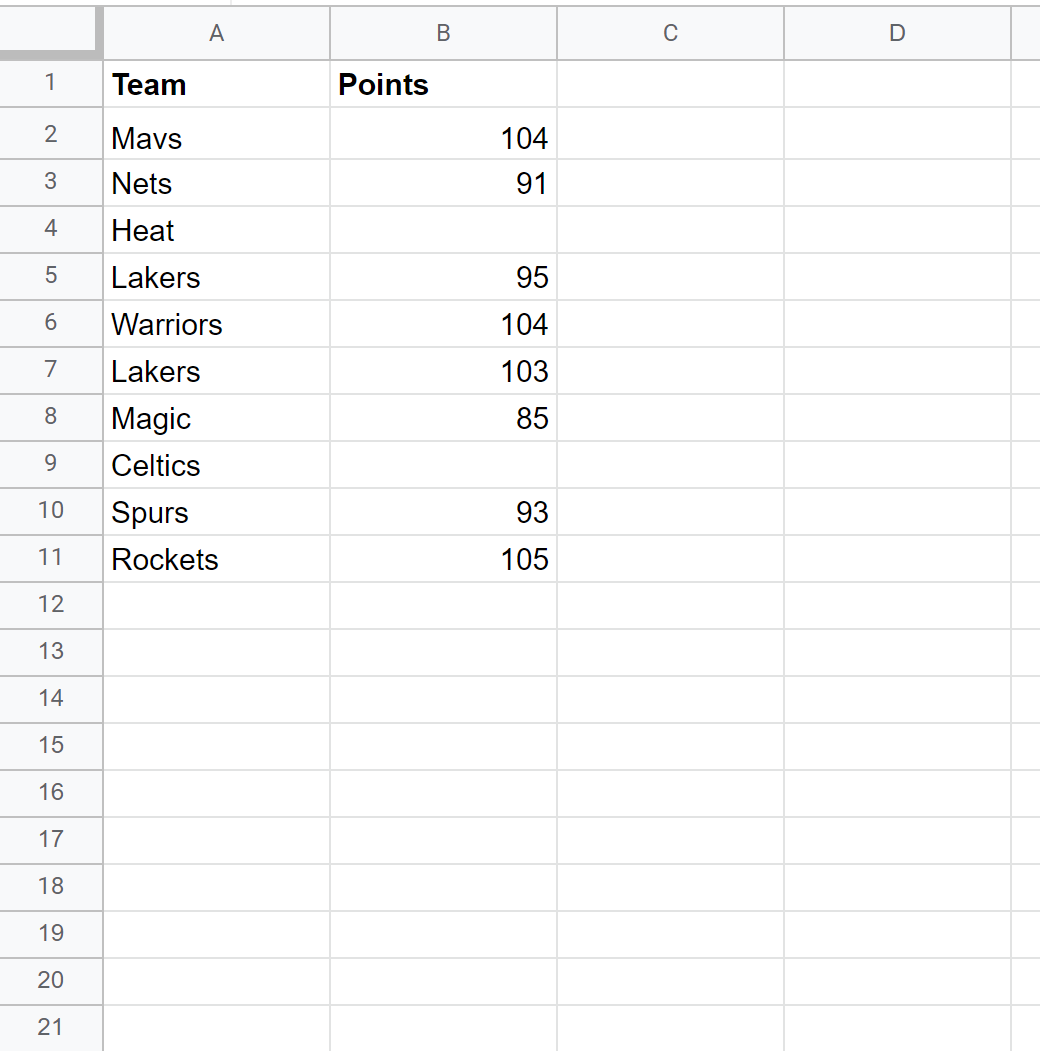
Avant d’engager toute configuration de chaîne au sein de la boîte de dialogue, l’analyste doit impérativement cartographier les métadonnées de son classeur. La préservation de la structure tabulaire commande de verrouiller visuellement les colonnes contenant des formules actives afin de ne pas altérer les arguments textuels internes ou les opérateurs logiques imbriqués lors des passes de substitution globale.
2.2 Configuration des paramètres de substitution standard
La substitution standard des cellules vides via le panneau natif impose une rigueur d’exécution sans faille. Une erreur opérationnelle classique consiste à laisser le champ Rechercher rigoureusement vide tout en saisissant la valeur numérique 0 dans le champ Remplacer par. Dans les versions historiques des tableurs bureautiques, cette approche heuristique pouvait combler l’intégralité de la grille jusqu’à ses limites périphériques extrêmes, provoquant la création de plusieurs centaines de milliers de cellules actives inutiles et la saturation instantanée des capacités mémoires du navigateur client.
Pour endiguer ce phénomène, Google Sheets impose l’adjonction de critères de filtrage contextuel via une série de cases à cocher déterminantes situées sous les champs de saisie principaux. La sélection préalable de la plage géographique cible s’avère ici la condition sine qua non. En isolant exclusivement le segment vectoriel ou matriciel nécessitant l’imputation, l’utilisateur dresse une frontière d’exécution étanche protégeant le reste du classeur.
L’activation concomitante de l’option Faire correspondre la cellule entière s’avère indispensable lorsque l’on utilise des expressions spécifiques pour désigner le vide. Sans cette précaution, le moteur de recherche analyse les sous-chaînes au sein des cellules occupées, risquant d’insérer le zéro à l’intérieur de chaînes textuelles existantes ou de nombres décimaux préétablis. Les conséquences d’un remplacement aveugle sans délimitation géographique stricte se traduisent immanquablement par la pollution des cellules périphériques situées au-delà des dernières lignes utiles du tableau, entraînant l’expansion artificielle du fichier et la dégradation substantielle des temps de recalcul du document hébergé dans le cloud.
2.3 Validation et contrôle d’exécution des modifications
L’exécution finale de la commande requiert une analyse méthodique du dialogue de confirmation généré par le moteur logiciel. Lors du clic sur la commande Remplacer tout, l’interface utilisateur de Google Sheets présente un rapport de traitement synthétique matérialisé par une notification temporaire indiquant le volume exact d’occurrences modifiées (ex. « 142 instances remplacées sur la plage sélectionnée »). Ce décompte constitue le premier indicateur d’audit : si le nombre d’occurrences excède drastiquement les prévisions issues de l’inspection exploratoire initiale, l’analyste doit suspecter une propagation incontrôlée de la substitution dans les marges matricielles.
L’audit visuel immédiat doit être complété par l’échantillonnage de cellules témoins situées aux extrémités de la plage ciblée (première ligne, dernière ligne, colonnes de démarcation). L’utilisation du journal de révision (accessible via le menu Fichier > Historique des versions) permet d’inspecter l’instantané structurel précédant l’opération et d’isoler avec exactitude le périmètre des cellules touchées par le processus de modification séquentielle.
Dans un contexte de production collaborative synchronisée, l’impact d’une telle opération de masse est décuplé. Chaque modification de cellule génère des événements au sein de la couche de synchronisation WebSockets de Google Sheets. Une substitution massive déclenche l’invalidation simultanée des caches locaux de tous les collaborateurs connectés au même instant, pouvant induire des latences de rendu graphique, des suspensions temporaires de calcul et des conflits de versions si des coéditeurs travaillent sur les mêmes plages vectorielles. Par conséquent, il demeure impératif d’exécuter ces nettoyages en dehors des pics de collaboration active ou d’isoler préalablement la feuille de travail au sein d’une copie de développement fermée.
3. L’usage des expressions régulières pour cibler le vide absolu
3.1 Fondements de la syntaxe Regex au sein de Google Sheets
L’intégration des expressions régulières (Regex) au cœur du moteur de recherche de Google Sheets confère à l’analyste une puissance de ciblage syntaxique inaccessible aux méthodes de substitution textuelle littérale. En cochant l’option Rechercher à l’aide d’expressions régulières au sein du panneau de configuration de recherche, l’utilisateur bascule le moteur d’appariement d’un mode de comparaison scalaire classique vers l’analyseur déterministe RE2 développé par Google. Ce moteur traite les chaînes de caractères selon une logique d’automates finis non déterministes, garantissant un temps d’exécution linéaire proportionnel à la taille de l’entrée et éliminant tout risque d’explosion combinatoire.
Dans cette architecture, les métacaractères d’ancrage structurel jouent un rôle fondamental pour identifier l’absence totale de matière graphique. Le symbole circonflexe (^) impose un point d’ancrage au début absolu de la chaîne contenue dans la mémoire tampon de la cellule, tandis que le symbole dollar ($) marque son ancrage de fin. Dès lors qu’une expression combine ces deux bornes sans insérer de caractère littéral intermédiaire, elle formalise la détection rigoureuse d’un intervalle textuel d’une amplitude strictement nulle.
Cependant, une limite inhérente réside dans la manière dont le moteur RE2 interprète les cellules purement numériques par rapport aux chaînes textuelles. Lorsqu’une cellule héberge déjà une valeur numérique valide, le moteur la coerce virtuellement en chaîne pour évaluer la correspondance regex. Dès lors, le maniement des ancrages doit être articulé avec une rigueur absolue afin de ne cibler que les cellules dont l’état initial ne contient ni flux de caractères visibles ni valeurs scalaires non nulles masquées par des formats de rendu spécifiques.
3.2 Décomposition structurelle de l’expression régulatrice ^s*$
L’expression régulière universellement reconnue comme le canon de l’ingénierie de nettoyage de données au sein des tableurs modernes est la formulation ^s*$. La décomposition morphologique de ce pattern révèle son élégance et sa polyvalence technique. Le jeton ^ verrouille l’amorce de la chaîne. Le métacaractère d’échappement s désigne la classe de caractères générique des séparateurs d’espacement, incluant indifféremment l’espace typographique ordinaire (U+0020), la tabulation horizontale (U+0009), la tabulation verticale (U+000B), le saut de page (U+000C) et les retours chariot (U+000A et U+000D).
L’adjonction immédiate de l’opérateur quantificateur astérisque (*) modifie profondément la sémantique de l’évaluation : il stipule que l’élément d’espacement qui le précède peut apparaître zéro fois, une fois ou un nombre arbitrairement grand de fois consécutives. Enfin, le caractère $ clôt l’évaluation en affirmant la fin immédiate de la chaîne analysée. Par conséquent, cette formule matricielle possède la propriété remarquable de valider simultanément deux états physiologiques distincts : le vide absolu (où le quantificateur astérisque valide la répétition nulle de l’espace entre ^ et $) et le vide parasité (où la cellule ne contient qu’une séquence d’un ou plusieurs espaces ou retours à la ligne sans aucun caractère alphanumérique).
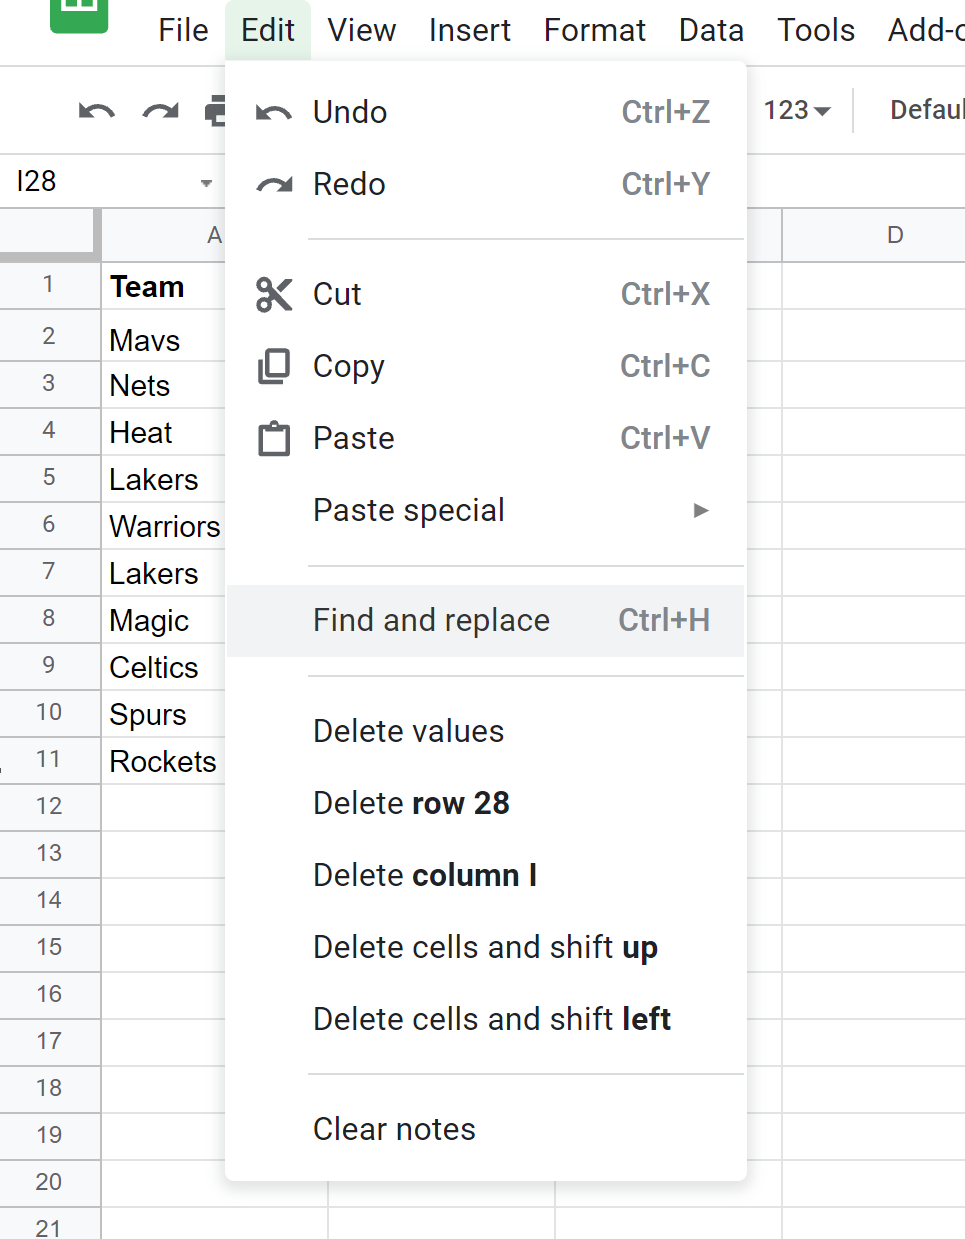
En comparaison analytique, l’expression minimaliste ^$ correspond au vide strict : elle échouera systématiquement face à une cellule contenant un simple espace résiduel inséré par mégarde lors d’une saisie manuelle. À l’inverse, ^s*$ constitue une formulation tolérante et réparatrice qui neutralise en une seule passe logique l’ensemble des artefacts d’inoccupation, purifiant la grille des résidus de saisie avant d’y inscrire la valeur zéro stabilisatrice.
3.3 Sensibilité à la casse et critères d’exclusion associés
L’activation de l’option Respecter la casse peut paraître contre-intuitive lors de l’utilisation d’une expression telle que ^s*$, laquelle ne comporte aucun caractère alphabétique soumis à une déclinaison en majuscule ou minuscule. Pourtant, sur le plan de l’architecture logicielle de Google Sheets, l’activation de ce drapeau contraint le moteur RE2 à appliquer une évaluation binaire stricte sans déployer les tables d’équivalence typographique universelles de Unicode (case-folding tables).
Cette rigueur computationnelle prévient les comportements erratiques et accélère le temps de traitement sur les volumes massifs. Plus critique encore, elle évite les faux positifs au sein de colonnes adjacentes contenant des acronymes ou des codes d’inventaire spéciaux dont certaines représentations internes pourraient, dans de rares cas de corruption de page de code, correspondre à des masques d’échappement mal formés.
Concernant les cellules incorporant des retours à la ligne multiples générés par la combinaison de touches Alt + Entrée, l’expression ^s*$ conserve son universalité d’interception, car le métacaractère s intègre le code saut de ligne sous son ombrelle de capture. Afin de garantir l’immunité structurelle des jeux de données critiques, la méthode scientifique impose de dupliquer la colonne cible sur un onglet de test isolé, d’y déployer l’expression régulière avec les drapeaux activés, et de valider par des fonctions de contrôle que le taux d’interception correspond scrupuleusement aux cellules identifiées comme inoccupées par l’audit structurel préalable.
4. Protocole opératoire pas à pas : Imputation par expressions régulières
4.1 Étape préparatoire : Isolation de la série de données
La mise en œuvre d’une transformation structurelle destructrice requiert une phase d’isolation préalable standardisée selon les normes de la gouvernance de données. L’analyste doit d’abord circonscrire formellement le vecteur cible. Dans le cas d’une colonne de données quantitatives située dans la plage A2:A5000, la sélection manuelle par défilement à la souris est proscrite au profit des commandes de navigation rapide : se positionner en A2, puis exécuter la séquence Ctrl + Shift + Flèche Bas (ou Cmd + Shift + Flèche Bas sous macOS) pour étendre la sélection jusqu’à la rupture logique de la continuité des données, ou saisir explicitement l’intervalle dans la zone de nom située à gauche de la barre de formules.
L’étape subséquente impose le gel immédiat de la ligne d’en-tête (menu Affichage > Figer > 1 ligne) afin de prémunir le libellé descriptif de la variable contre toute altération accidentelle. Les colonnes connexes non impliquées dans le protocole doivent être temporairement masquées ou protégées en écriture via la commande Données > Feuilles et plages protégées, érigeant une barrière logique contre tout débordement matriciel involontaire.
Il est impératif de s’assurer de l’absence totale de filtres actifs au sein de la feuille. L’application d’un filtre textuel ou conditionnel masque une partie des lignes sans les extraire de la feuille. L’exécution d’une commande de remplacement sur une sélection discontinue peut provoquer des comportements asymétriques où seules les lignes visibles sont modifiées, brisant la cohérence relationnelle entre les lignes affichées et les lignes occultées. Enfin, la duplication de l’onglet source par clic droit puis Dupliquer constitue la sauvegarde incrémentale de sécurité obligatoire avant tout traitement irréversible.
4.2 Étape d’exécution : Paramétrage précis de la boîte de dialogue
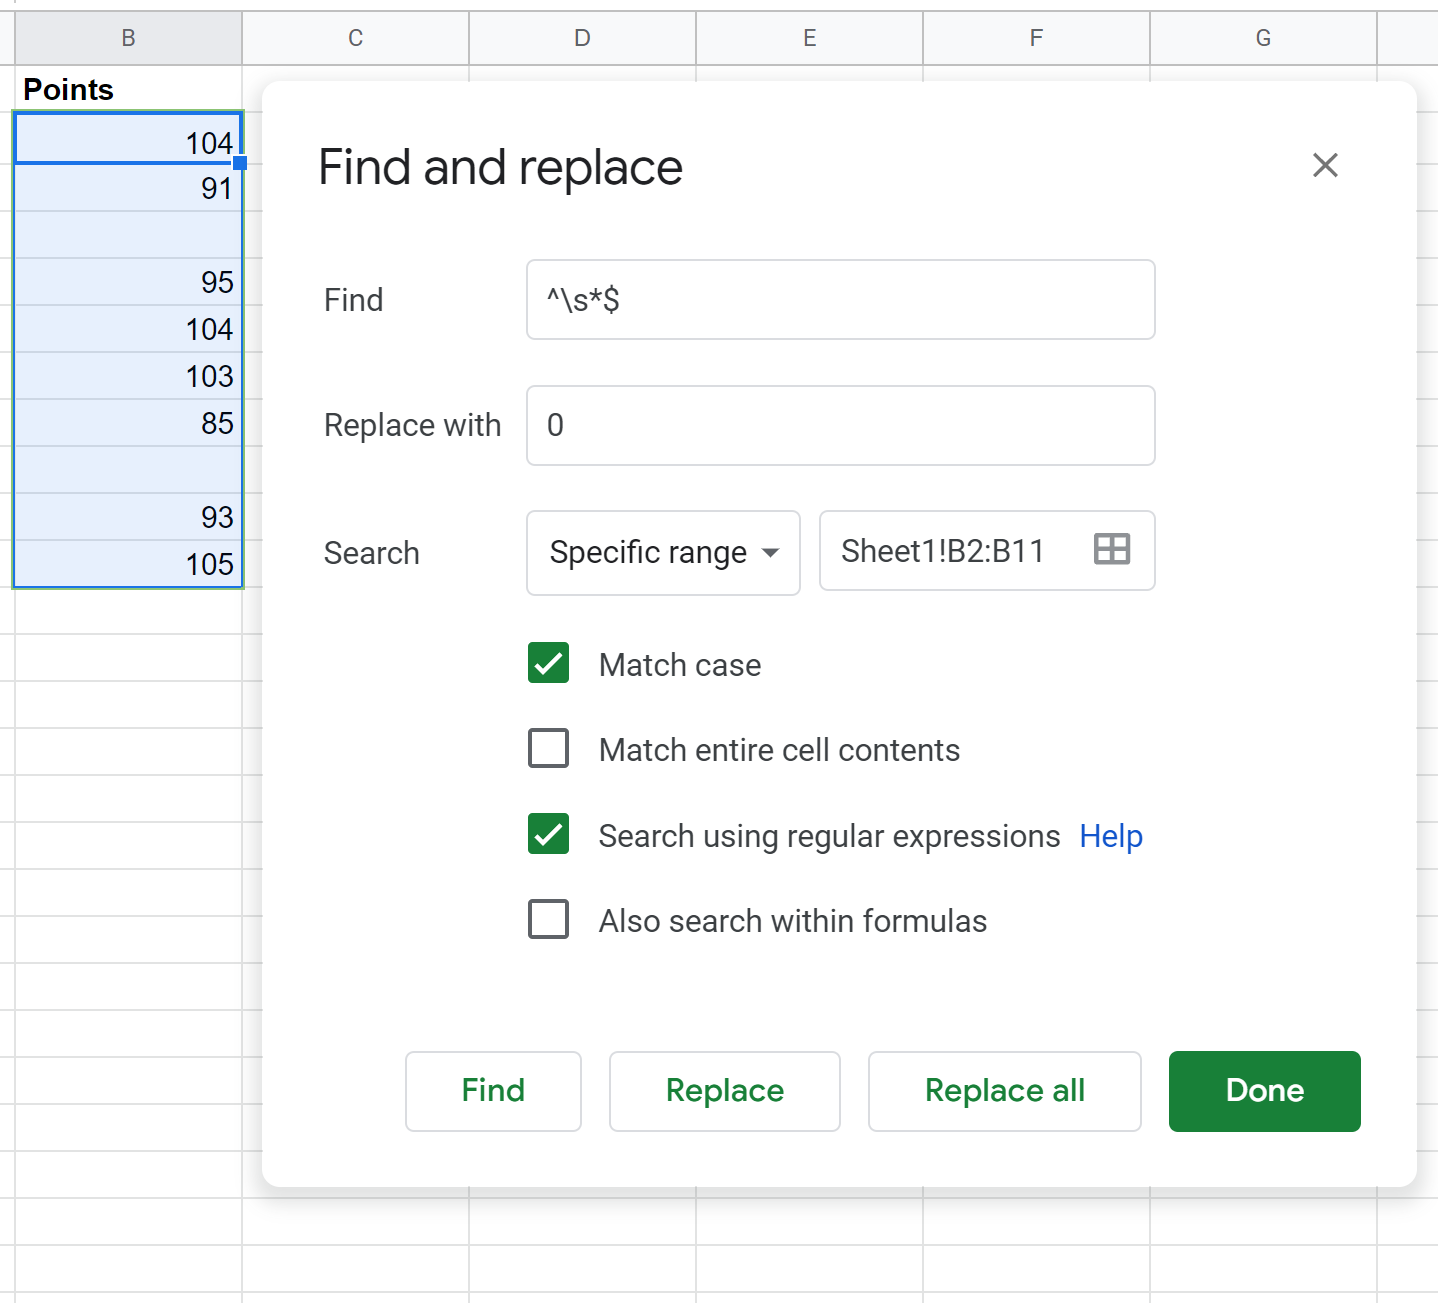
Une fois la plage rigoureusement sélectionnée, l’opérateur appelle la boîte de dialogue par le raccourci Ctrl + H. Les paramètres d’exécution doivent être scrupuleusement renseignés selon l’ordonnancement algorithmique suivant :
- Champ « Rechercher » : Saisir manuellement la chaîne d’ancrage
^s*$sans aucun espace périphérique adventice. - Champ « Remplacer par » : Saisir le caractère numérique scalaire unique
0. Il convient de proscrire l’adjonction d’apostrophes d’échappement (comme'0), car celles-ci transformeraient le zéro en chaîne de texte, détruisant son potentiel de calcul arithmétique ultérieur. - Champ « Rechercher dans » : Sélectionner impérativement l’option Plage spécifique et confirmer que les coordonnées affichées coïncident au millimètre matriciel près avec l’intervalle isolé (par exemple
Feuille1!A2:A5000). - Cases à cocher contextuelles :
- Cocher Rechercher à l’aide d’expressions régulières : instruction requise pour activer le compilateur RE2.
- Cocher Respecter la casse : optimise l’évaluation computationnelle binaire.
- Cocher Faire correspondre la cellule entière : impose l’équivalence entre l’intégralité du contenu cellulaire et le motif défini, neutralisant toute substitution partielle.
L’analyste doit vérifier une dernière fois qu’aucune formule critique ne réside au sein de la plage sélectionnée avant de valider l’amorce de la commande de substitution.
4.3 Étape de finalisation : Exécution et confirmation systémique
L’engagement opérationnel s’effectue par un clic franc sur le bouton Remplacer tout. À cet instant, le thread d’exécution de Google Sheets suspend temporairement les mises à jour graphiques du DOM (Document Object Model) du navigateur pour appliquer le batch de modification sur la représentation matricielle en mémoire vive, avant de synchroniser les modifications avec les serveurs distants.
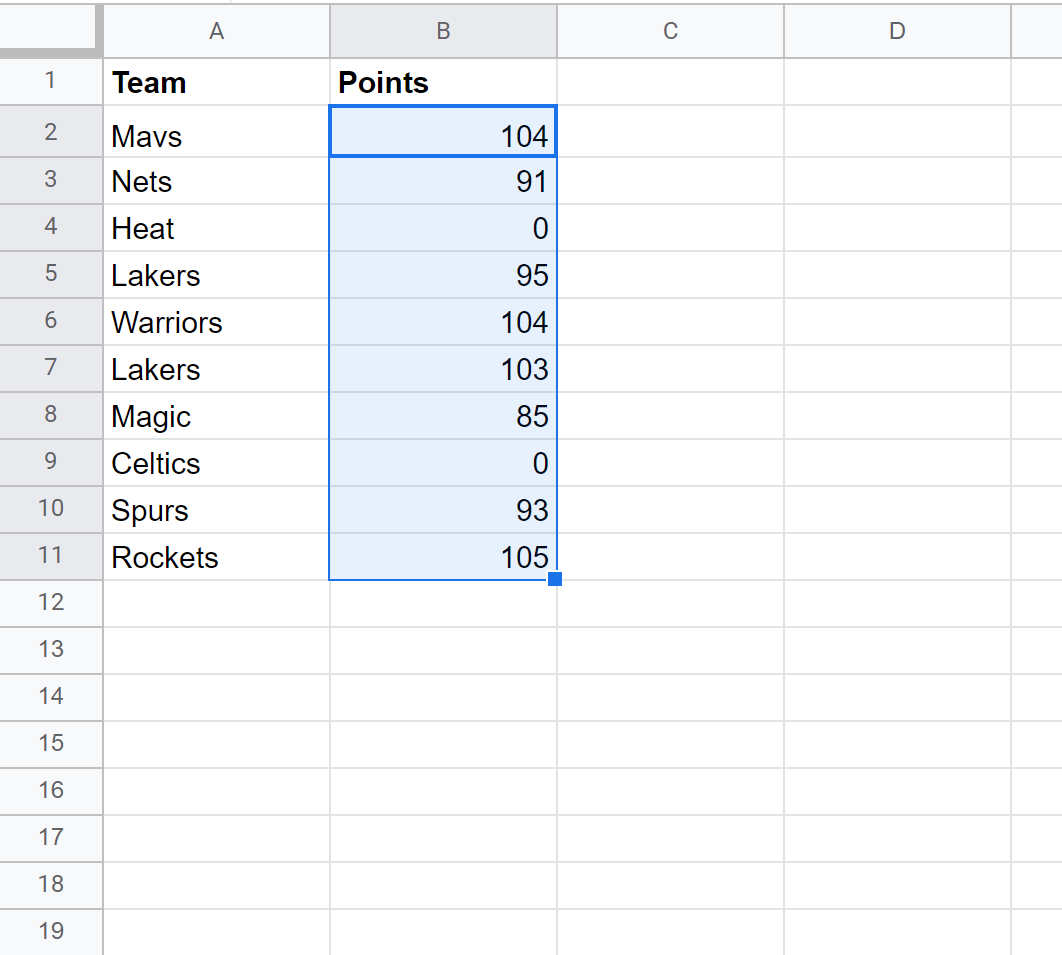
Dès l’apparition de l’infobulle quantitative indiquant le volume des instances remplacées, l’analyste consigne cette valeur numérique dans son registre d’audit. La fermeture de l’interface modale s’opère par le clic sur le bouton Terminé. Une phase d’inspection métrologique directe doit succéder immédiatement à la clôture de la fenêtre :
L’analyste doit appliquer une fonction de comptage logique sur la plage traitée pour attester de l’extinction complète des cellules non renseignées. La formule =NB.VIDE(A2:A5000) doit désormais retourner impérativement la valeur 0. Parallèlement, la formule =NB.SI(A2:A5000; 0) doit restituer une valeur strictement égale au nombre d’imputations notifiées par le panneau de remplacement, augmentée des éventuels zéros déjà présents dans l’échantillon initial. Dès lors que cette égalité arithmétique est vérifiée, la série temporelle ou transversale est déclarée conforme et intègre le cycle d’exploitation analytique aval.
5. Remplacement dynamique et non destructif via les formules logiques
5.1 Utilisation de la structure conditionnelle SI et ESTVIDE
L’altération directe des données primaires au sein de leur plage d’hébergement originelle contrevient souvent aux normes modernes de traçabilité et d’auditabilité des systèmes d’information. Les architectures de données résilientes préconisent l’usage de transformations fonctionnelles non destructives : les valeurs brutes demeurent immuables dans leur colonne source, tandis qu’un flux vectoriel parallèle accueille les données assainies et imputées par calcul dynamique. La structure canonique élémentaire mobilisée pour cette fin repose sur la conjonction des fonctions SI et ESTVIDE.
Dans sa modélisation standard pour une cellule source unitaire localisée en A2, la formule s’énonce :
=SI(ESTVIDE(A2); 0; A2)
Cette écriture ordonne au moteur logique d’évaluer le prédicat booléen d’inoccupation via ESTVIDE. Si le nœud mémoire sous-jacent est vierge de tout enregistrement, l’embranchement conditionnel retourne la constante numérique 0 ; dans la situation inverse, il répercute fidèlement la valeur scalaire ou textuelle préexistante. Néanmoins, cette formule présente une vulnérabilité opérationnelle majeure face aux chaînes de caractères de longueur nulle : si la cellule A2 contient le produit invisible d’une formule antérieure matérialisé par "", la fonction ESTVIDE renverra l’évaluation FAUX, échouant ainsi à imputer le zéro attendu.
Pour parer à cette déficience structurelle, les ingénieurs de données privilégient la syntaxe comparative universelle :
=SI(A2=""; 0; A2)
Dans l’évaluation de Google Sheets, l’opérateur de comparaison d’égalité appliqué à une chaîne vide (="") possède la propriété de retourner VRAI aussi bien face à une cellule vierge au sens strict que face à une chaîne de longueur nulle ou un espace logique sans contenu matériel. Cette formulation assure une couverture d’imputation exhaustive tout en maintenant une lisibilité syntaxique parfaite pour les relecteurs du modèle.
5.2 Substitution élégante avec la fonction SI.NON.DISP et détection d’erreur
Dans les pipelines d’intégration complexes faisant intervenir des calculs de recherche tabulaire, l’absence de valeur résulte fréquemment de l’échec structurel d’une formule d’appariement. L’interception et la conversion directe de ces états défaillants en zéros opérationnels s’effectuent classiquement via les fonctions d’encapsulation d’erreurs. La fonction SIERREUR permet de capturer n’importe quel code d’anomalie pour le contraindre vers une valeur nulle :
=SIERREUR(RECHERCHEV(D2; Source!A:B; 2; FAUX); 0)
Toutefois, cette tolérance absolue de SIERREUR constitue une faiblesse méthodologique, car elle masque indistinctement les erreurs d’absence de référence (#N/A) et les corruptions graves de syntaxe (telles que #REF! ou #NOM?). Dès lors, la bonne pratique commande de restreindre l’interception au seul échec d’appariement par l’emploi de SI.NON.DISP, garantissant que seules les entités non localisées se voient assigner la valeur zéro, les anomalies d’architecture restant visibles pour l’analyste.
Parallèlement, Google Sheets propose la fonction scalaire N(), conçue historiquement pour assurer la rétrocompatibilité des types numériques :
=N(A2)
La fonction N() applique une coercition immédiate : elle convertit une cellule vide en 0, une valeur booléenne VRAI en 1, FAUX en 0, et transmet les nombres de manière transparente. Cependant, son comportement face aux chaînes de texte s’avère drastique : elle convertit arbitrairement tout texte non convertible en zéro. Par conséquent, l’utilisation de N() doit être strictement proscrite sur les colonnes de nature mixte ou alphanumérique, sous peine d’écraser des libellés nominatifs textuels en zéros computationnels sans émettre d’avertissement. Une approche robuste combinera systématiquement la vérification de type :
=SI(ESTNUM(A2); A2; SI(A2=""; 0; "Erreur_Type"))
5.3 La fonction CHOISIRCOLS et transformations matricielles modernes
L’introduction récente des fonctions matricielles dynamiques et du moteur d’abstraction LAMBDA dans Google Sheets permet de concevoir des architectures d’assainissement de flux modulaires et élégantes. Les fonctions matricielles avancées telles que CHOISIRCOLS permettent d’isoler des sous-ensembles géométriques au sein d’une table maîtresse, pour leur appliquer instantanément un patron d’imputation sans jamais manipuler manuellement les cellules une par une.
En associant CHOISIRCOLS avec une fonction de transformation logique d’ordre supérieur, on encapsule l’intégralité du traitement de substitution des vides par zéro au sein d’une unique cellule de contrôle située en haut d’un tableau de bord de restitution :
=LAMBDA(matrice; MAP(matrice; LAMBDA(cellule; SI(cellule=""; 0; cellule))))(CHOISIRCOLS(A2:E500; 3; 5))
Cette construction algorithmique extrait les colonnes 3 et 5 de la table brute A2:E500, puis applique récursivement à chaque coordonnée matricielle un test de vacuité logique, réinjectant un zéro pur à la volée dès qu’un blanc est détecté. La matrice transformée se déverse dynamiquement (phénomène de spill) dans la feuille réceptrice sans qu’aucun enregistrement originel ne subisse la moindre altération irréversible.
Cette architecture confère une traçabilité intégrale indispensable aux flux de données scientifiques et d’enquêtes sociologiques. Les auditeurs peuvent à tout instant comparer le tableau d’ingestion primaire avec le flux d’analyse secondaire, attestant de la fidélité des calculs et documentant les règles d’imputation dans le cadre d’audits de conformité réglementaire.
6. Déploiement à grande échelle grâce aux formules matricielles
6.1 La puissance de la fonction ARRAYFORMULA pour colonnes entières
L’étirement manuel d’une formule scalaire sur des dizaines de milliers de lignes est une hérésie en ingénierie de données. Non seulement cette pratique accroît exponentiellement la taille du DOM et la mémoire tampon du navigateur, mais elle introduit également des risques de désynchronisation structurelle dès lors qu’un opérateur insère de nouvelles lignes au milieu de la plage existante. L’infrastructure de Google Sheets offre une solution native : la fonction d’encapsulation ARRAYFORMULA.
Pour convertir de façon dynamique et permanente toute cellule vide d’une colonne vectorielle A en zéro, la première itération matricielle s’articule ainsi :
=ARRAYFORMULA(SI(ESTVIDE(A2:A); 0; A2:A))
Néanmoins, le déploiement brut de cette formule met en lumière un effet indésirable sévère : en ciblant la plage ouverte A2:A, la formule s’évalue jusqu’à la limite physique absolue de la feuille de calcul (souvent la millième ou la cinquante-millième ligne). En conséquence, des milliers de zéros s’impriment dans le vide sous le tableau de données utiles, polluant visuellement la feuille et saturant les ressources de traitement.
Il est donc impératif de conditionner l’exécution de la formule matricielle à la présence d’une ligne d’enregistrement active matérialisée par une colonne identifiante (telle qu’une clé primaire ID ou une référence chronologique non vide située en colonne B) :
=ARRAYFORMULA(SI(LIGNE(A2:A)>MAX(SI(B2:B""; LIGNE(B2:B); 0)); ""; SI(A2:A=""; 0; A2:A)))
Ou, dans une syntaxe plus concise et ergonomique :
=ARRAYFORMULA(SI(B2:B=""; ""; SI(A2:A=""; 0; A2:A)))
Cette structure conditionnelle double garantit que l’imputation du zéro ne s’exécute que pour les lignes matérialisant une transaction réelle en colonne B, laissant les lignes situées sous le tableau dans un état vierge absolu, assurant une hygiène matricielle irréprochable.
6.2 Combinaison avec MAP et les fonctions LAMBDA
Bien qu’ARRAYFORMULA demeure un pilier éprouvé, l’introduction de l’itérateur matriciel vectoriel MAP adossé aux fonctions LAMBDA constitue l’état de l’art du développement fonctionnel au sein de Google Sheets. MAP résout élégamment certaines limites d’interprétation contextuelle rencontrées par ARRAYFORMULA face à des fonctions imbriquées complexes.
L’implémentation canonique d’une substitution de vides par MAP se structure selon la formulation suivante :
=MAP(A2:A; B2:B; LAMBDA(valeur; cle; SI(cle=""; ""; SI(valeur=""; 0; valeur))))
Dans ce schéma déclaratif, MAP capture en parallèle les deux vecteurs ouverts A2:A et B2:B, puis injecte séquentiellement chaque couple scalaire dans les variables locales valeur et cle d’une fonction LAMBDA anonyme. L’empreinte mémoire d’un tel traitement s’avère optimisée grâce à l’allocation dynamique de registres unifiés au sein de la machine virtuelle de Google Sheets.
Sur le plan de la maintenance applicative en entreprise, cette approche offre une lisibilité algorithmique remarquable pour les développeurs tiers et analystes quantitatifs familiers des paradigmes du calcul fonctionnel moderne (similaires aux structures map() de Python, R ou JavaScript). Les benchmarks de performance démontrent que sur des volumes excédant 100 000 cellules, MAP gère la libération des allocations temporaires avec une efficacité supérieure à ARRAYFORMULA, évitant le figeage de l’interface client lors de modifications en cascade.
6.3 Transformation matricielle en mémoire via les fonctions LET
La complexification croissante des modèles financiers et prédictifs engendre fréquemment des formules massives au sein desquelles les mêmes références de plages ou les mêmes calculs intermédiaires sont répétés de façon redondante. Ce schéma génère un coût computationnel indu en forçant le moteur à relire plusieurs fois les mêmes segments de mémoire. La fonction LET permet d’éradiquer cette inefficience par la déclaration de variables lexicales en mémoire locale.
Considérons l’assainissement d’une matrice financière bidimensionnelle où l’on souhaite capturer les cellules vides pour leur assigner la valeur zéro, tout en neutralisant simultanément les valeurs d’erreurs potentielles. L’architecture optimisée s’articule ainsi :
=LET(

  plageSource; A2:C500;

  indicateurActivite; INDEX(plageSource; ; 1);

  MAP(plageSource; LAMBDA(cellule;

    SI(cellule=""; 0;

      SIERREUR(cellule * 1; 0)

    )

  ))

)
Dans cette architecture, la variable plageSource n’est requêtée qu’une seule fois dans la mémoire tampon du graphe d’évaluation. L’attribution ultérieure s’exécute à l’intérieur du scope local sans requêtes I/O supplémentaires sur la grille du document. Ce découpage facilite la documentation interne des modèles : chaque bloc de code porte une sémantique claire, ce qui simplifie grandement les revues de code critiques et la certification des modèles au sein des institutions financières.
7. Automatisation procédurale par Google Apps Script
7.1 Conception d’un script élémentaire de substitution directe
Lorsque la maintenance de formules matricielles dynamiques devient une charge excessive pour les utilisateurs finaux, ou que l’on désire imputer le zéro de façon structurelle et atomique au sein de tables brutes sans passer par le panneau graphique manuel, l’ingénierie logicielle s’en remet à l’environnement d’exécution Google Apps Script. Cet écosystème offre un runtime JavaScript hébergé côté serveur interagissant directement avec l’API Document Object Model de Google Workspace.
L’accès à cet environnement s’effectue depuis le menu Extensions > Apps Script. La règle d’or d’ingénierie pour tout traitement matriciel par script réside dans la minimisation absolue des appels d’interface applicative : les lectures et écritures unitaires via getValue() et setValue() au sein d’une boucle d’itération doivent être formellement proscrites sous peine d’épuiser prématurément le quota de temps d’exécution maximal alloué par Google (fixé à 6 minutes par exécution pour les comptes Workspace standards).
L’algorithme de substitution par traitement matriciel en mémoire globale s’implémente selon le patron de conception suivant :
function remplacerVidesParZeroDirect() {

  var feuille = SpreadsheetApp.getActiveSpreadsheet().getActiveSheet();

  var plage = feuille.getDataRange();

  var valeurs = plage.getValues();

  var mutations = 0;
for (var r = 0; r < valeurs.length; r++) {
for (var c = 0; c < valeurs[r].length; c++) {
var v = valeurs[r][c];
if (v === "" || v === null || (typeof v === "string" && v.trim() === "")) {
valeurs[r][c] = 0;
mutations++;
}
}
}
if (mutations > 0) {
plage.setValues(valeurs);
}
Logger.log("Audit : " + mutations + " cellules imputées avec succès.");
}
Ce script extrait l’intégralité de la matrice dans un tableau JavaScript bidimensionnel en un appel API unique (getValues()), applique l’évaluation de vacuité strictement typée en mémoire RAM, puis réinjecte l’intégralité du bloc transformé en une écriture atomique unique (setValues()). Une opération portant sur 50 000 cellules s’exécute ainsi en une fraction de seconde, là où un algorithme itératif unitaire traditionnel aurait nécessité plusieurs minutes avant de planter pour dépassement de quota.
7.2 Création d’un macro-programme rattaché à un déclencheur
L’automatisation continue du nettoyage de données requiert l’intégration de mécanismes déclencheurs écoutant les événements d’ingestion. Pour les équipes opérationnelles ne maîtrisant pas le code natif, l’enregistreur de macros (menu Extensions > Macros > Enregistrer une macro) offre une approche visuelle de génération de code scripté, qu’il convient toutefois de nettoyer et d’encadrer par des routines professionnelles.
Pour garantir que toute nouvelle ligne insérée manuellement ou importée par une intégration tierce soit immédiatement assainie, l’ingénieur déploie un déclencheur événementiel simple baptisé onEdit(e). Ce gestionnaire capture le contexte événementiel de chaque modification individuelle :
function onEdit(e) {

  if (!e) return;

  var plageModifiee = e.range;

  var feuille = plageModifiee.getSheet();

  if (feuille.getName() !== "DonneesSources") return;

  if (plageModifiee.getColumn() === 3 && e.value === undefined) {

    plageModifiee.setValue(0);

  }

}
Pour les traitements asynchrones de masse, la planification temporelle représente la solution de référence. En accédant à la console des déclencheurs du projet Apps Script (icône d’horloge dans l’éditeur de script), l’administrateur peut programmer l’exécution périodique d’une fonction de balayage toutes les nuits à une heure précise. Cette routine de maintenance purifie la grille en dehors des heures ouvrées, éliminant tout impact sur les utilisateurs en production et régularisant les données issues des flux automatisés quotidiens.
7.3 Implémentation de fonctions personnalisées JavaScript (UDF)
Google Apps Script permet d’étendre la grammaire native des calculs de Google Sheets par la création de fonctions personnalisées (User Defined Functions ou UDF), directement utilisables par les analystes au sein des cellules au même titre que les fonctions standards. La conception d’une fonction d’imputation universelle dédiée s’avère particulièrement utile lorsque l’on souhaite appliquer une logique de nettoyage hybride à l’échelle d’une cellule isolée ou d’une plage arbitraire.
L’implémentation rigoureuse d’une telle fonction doit intégrer la gestion polymorphique des arguments (scalaires ou matriciels) et une documentation formalisée au format JSDoc pour activer l’autocomplétion native au sein de la barre de formules :
/**

 * Évalue une valeur ou une plage et convertit toute cellule vide ou textuellement vierge en zéro.

 * @param {any} donnee Entrée scalaire ou plage matricielle de cellules.

 * @return {any} Donnée assainie contenant 0 à la place des vides.

 * @customfunction

 */

function REMPLACER_VIDES_PAR_ZERO(donnee) {

  if (!Array.isArray(donnee)) {

    return (donnee === "" || donnee === null || donnee === undefined) ? 0 : donnee;

  }

  return donnee.map(function(ligne) {

    return ligne.map(function(cellule) {

      return (cellule === "" || cellule === null || cellule === undefined) ? 0 : cellule;

    });

  });

}
L’intégration de l’étiquette @customfunction au sein du bloc documentaire ordonne au moteur de Google Sheets d’indexer la fonction dans son catalogue public. L’utilisateur peut dès lors saisir dans sa feuille =REMPLACER_VIDES_PAR_ZERO(B2:D100) et bénéficier d’une expansion matricielle dynamique transparente. Néanmoins, l’analyste gardera à l’esprit que les fonctions personnalisées UDF s’exécutent dans un conteneur sandboxé distinct, ce qui engendre une latence de calcul marginalement supérieure aux fonctions compilées en C++ du cœur de Google Sheets.
8. Impacts analytiques et statistiques du remplacement du vide par zéro
8.1 Distorsion des indicateurs de tendance centrale
L’imputation arbitraire de zéros au sein d’une distribution statistique de données quantitatives continues ou discrètes ne relève jamais d’une opération méthodologiquement neutre. La première victime arithmétique de cette pratique est la moyenne arithmétique. L’injection massive de zéros dans un jeu de données provoque un glissement mécanique irréversible de la moyenne vers la borne inférieure de l’intervalle de définition. Dans les domaines du pricing, de l’évaluation médicale ou du dimensionnement d’actifs, un tel abaissement fallacieux du niveau moyen conduit à des sous-estimations critiques des capacités de charge ou des rendements attendus.
En contrepoint, la médiane offre une résistance notable face à l’afflux de valeurs nulles, en raison de son statut d’indicateur d’ordre robuste. Toutefois, si la proportion de cellules vides imputées outrepasse la rupture des 50 % de la masse de l’échantillon, la médiane s’effondre à son tour pour se fixer précisément sur le point d’ancrage zéro, détruisant tout pouvoir d’information discriminante sur la population étudiée.
Dans l’ingénierie de la régression linéaire élémentaire ou multiple, l’impact se révèle encore plus insidieux. L’introduction d’un essaim de points artificiellement positionnés sur l’axe des ordonnées en $y=0$ distord la pente des moindres carrés ordinaires (OLS). Le coefficient directeur subit une rotation non naturelle pour compenser la traction exercée par ces résidus exogènes, ce qui réduit drastiquement le coefficient de détermination ($R^2$) et conduit à l’acceptation fallacieuse de l’hypothèse nulle quant à l’absence de corrélation entre les variables explicatives et la variable cible.
8.2 Altération des mesures de dispersion et d’asymétrie
L’incidence sur les statistiques de second ordre et les moments distributionnels supérieurs exige une vigilance épistémologique accrue. Selon la position de la moyenne empirique originelle par rapport à zéro, l’adjonction de valeurs nulles peut engendrer un gonflement artificiel de l’écart-type et de la variance si les données authentiques sont situées loin de l’origine, ou au contraire une contraction factice de la dispersion apparente si la distribution originelle gravitait déjà autour de zéro.
Plus déterminant encore est l’effet induit sur le coefficient d’asymétrie de Pearson (skewness). L’adjonction unilatérale d’un pôle d’accumulation à zéro étire l’une des queues de distribution, projetant la distribution dans une asymétrie positive prononcée si toutes les données mesurées étaient strictement positives. Ce phénomène invalide immédiatement l’hypothèse de normalité gaussienne requise par les tests statistiques paramétriques fondamentaux tels que le test $t$ de Student pour échantillons appariés ou l’analyse de variance (ANOVA).
Pour attester de la robustesse des modélisations conduites sur des jeux de données ayant subi une imputation de zéros, les protocoles scientifiques de pointe imposent l’exécution systématique d’une analyse de sensibilité. Celle-ci consiste à exécuter le pipeline d’estimation sous trois régimes d’hypothèses distincts : suppression pure et simple des observations incomplètes (listwise deletion), imputation déterministe de la valeur zéro, et imputation stochastique par les méthodes de chaînes de Markov (MICE). La stabilité des coefficients à travers ces différents régimes permet seule d’attester de la validité empirique des conclusions tirées.
8.3 Conséquences sur le partitionnement et l’apprentissage automatique
Dans les applications modernes d’apprentissage automatique supervisé et non supervisé alimentées en amont par des extractions depuis Google Sheets, l’imputation de zéros perturbe la structure de l’espace métrique vectoriel. Les algorithmes de classification non supervisée basés sur la distance géométrique, à l’instar du partitionnement par les $k$-moyennes (k-means) ou des cartes auto-adaptatives de Kohonen, calculent les similarités d’instances selon des métriques de distance euclidienne ou de Manhattan :
$$d(x, y) = \sqrt{\sum_{i=1}^{n} (x_i – y_i)^2}$$
Lorsqu’une dimension d’un vecteur d’observation passe arbitrairement du statut de vide non considéré à la valeur absolue zéro, sa distance euclidienne par rapport aux centres de gravité de clusters préétablis est artificiellement majorée. Il en résulte un phénomène pernicieux de polarisation : les entités comportant des données absentes se retrouvent artificiellement agrégées au sein d’un méta-groupe parasite caractérisé non pas par une affinité structurelle latente, mais exclusivement par la signature de leur manque d’information originel.
De surcroît, les étapes de mise à l’échelle indispensables telles que la normalisation min-max :
$$X_{norm} = \frac{X – X_{\min}}{X_{\max} – X_{\min}}$$
se retrouvent lourdement biaisées si le minimum authentique de la variable empirique était strictement supérieur à zéro (par exemple des pressions barométriques oscillant entre 980 et 1040 hPa). L’inclusion d’un zéro imputé abaisse instantanément $X_{\min}$ à zéro, écrasant l’ensemble de la véritable dynamique de variation du signal physique dans un intervalle réduit de quelques pourcents de l’espace d’encodage normalisé, dégradant substantiellement la convergence des réseaux de neurones ou des classificateurs à vecteurs de support (SVM).
9. Biais cognitifs et perception psychologique de la vacuité numérique
9.1 L’inconfort psychologique face au vide dans les interfaces de données
L’impulsion menant les gestionnaires de bases de données et les contrôleurs de gestion à remplacer frénétiquement les cellules vierges par des zéros trouve son origine dans des mécanismes psychologiques et ergonomiques profonds. Au sein des théories cognitives de l’attention visuelle, le concept d’horror vacui — la terreur du vide — s’applique avec une acuité particulière à la lecture des matrices de données. Pour le système visuel humain, une cellule tabulaire vierge génère une rupture inattendue dans la continuité de la grille de lecture, suscitant une incertitude immédiate : s’agit-il d’un oubli de saisie, d’une erreur d’affichage logicielle, d’une suppression malencontreuse ou d’une véritable absence de phénomène ?
Cette incertitude mobilise l’attention de travail de l’utilisateur et brise le principe de clôture visuelle modélisé par la psychologie de la Gestalt. Pour rétablir l’équilibre psychologique du tableau, l’analyste a tendance à vouloir remplir la case pour attester que l’observation a été effectivement évaluée et classée. L’inscription du caractère zéro matérialise physiquement cette clôture.
Néanmoins, cet apaisement visuel immédiat opère un transfert pernicieux du doute vers le domaine de l’interprétation. En éliminant le vide, l’opérateur active l’effet d’ancrage cognitif décrit par Tversky et Kahneman : l’œil du décideur enregistre le zéro comme une valeur de référence ferme, effaçant toute conscience du fait qu’il s’agissait initialement d’une absence d’observation. L’analyste se retrouve ainsi piégé par son propre besoin d’ordre visuel au détriment de la fidélité épistémologique du modèle.
9.2 Lisibilité visuelle et charge mentale de l’utilisateur
Paradoxalement, si le vide déroute l’opérateur non averti, la prolifération excessive de zéros imprimés au sein d’une grille de données denses détériore gravement la lisibilité globale et accroît la charge mentale de traitement cognitif. La répétition uniforme du glyphe circulaire 0 crée un bruit typographique dense qui sature la perception périphérique. Il devient alors extrêmement ardu pour l’analyste de repérer au premier regard les valeurs saillantes, les ruptures de tendance ou les signaux faibles émergents au sein du tableau.
Les canons de l’ergonomie visuelle moderne recommandent de s’appuyer sur la puissance du blanc typographique pour guider le regard. Google Sheets propose une solution technique permettant de concilier la présence mathématique du zéro en mémoire vive et sa discrétion visuelle à l’écran : le format de nombre personnalisé. En accédant au menu Format > Nombre > Format de nombre personnalisé, l’utilisateur peut appliquer une structure de formatage séquentielle à trois segments séparés par des points-virgules, obéissant à la syntaxe :
#,##0.00; -#,##0.00; ""
Le premier segment régit l’affichage des nombres positifs, le deuxième celui des nombres négatifs, et le troisième celui des zéros scalaires. En laissant le troisième segment vide de tout masque d’affichage, Google Sheets conserve la valeur numérique exacte 0 dans la mémoire sous-jacente du moteur de calcul (préservant ainsi l’intégrité de la logique fonctionnelle et des pipelines de liaison), tout en masquant graphiquement le chiffre pour laisser apparaître une cellule blanche et apaisée. Cette approche dissipe la tension ergonomique en dissociant rigoureusement la vérité arithmétique de sa représentation visuelle.
9.3 Biais d’interprétation chez les décideurs et parties prenantes
L’impact de l’imputation du zéro dépasse les frontières du bureau de l’analyste technique pour contaminer les comités de direction et les instances de gouvernance stratégique. Les parties prenantes et dirigeants non rompus aux subtilités de l’ingénierie des données appliquent systématiquement une lecture binaire : un indicateur de performance affichant zéro est quasi invariablement perçu comme un signal de contre-performance opérationnelle, d’échec commercial ou de défaillance d’activité.
Par exemple, si un reporting commercial affiche un chiffre d’affaires de 0 € pour une nouvelle filiale internationale lors d’un trimestre donné, le comité d’audit interprétera ce chiffre comme l’incapacité de l’équipe locale à générer des ventes. Si la réalité technique sous-jacente était en vérité un blanc méthodologique signifiant que la filiale n’avait pas encore ouvert ses systèmes d’encaissement et que la mesure n’était pas applicable, l’analyste ayant forcé l’imputation de zéros a induit une distorsion décisionnelle majeure, susceptible d’entraîner des sanctions managériales injustifiées ou un retrait prématuré de capitaux.
La responsabilité déontologique de l’ingénieur de données exige par conséquent d’expliciter sans ambiguïté les conventions de saisie retenues au moyen de légendes d’audit et de notes méthodologiques attachées aux cellules maîtresses (via le menu Insérer > Note ou Commentaire). Il est formellement requis de distinguer dans les restitutions finales la notion de « Non Applicable » (N/A), celle de « Non Mesuré » (NM) et celle de « Valeur Mesurée Nulle » (0,00).
10. Dépannage avancé et résolution des anomalies de substitution
10.1 Échec de détection des cellules apparemment vides
L’un des scénarios d’anomalie les plus déroutants lors des opérations de nettoyage matriciel sous Google Sheets réside dans l’échec silencieux des filtres de vacuité : la cellule apparaît vierge, les expressions de détection de base ne l’interceptent pas, et la commande Rechercher et remplacer l’ignore souverainement. Dans plus de 90 % des cas documentés, cette pathologie trouve son origine dans la présence d’espaces insécables invisibles hérités d’extractions web ou de tables de bases de données formatées en encodage ISO-8859-1.
L’espace insécable possède le point de code décimal ASCII 160 (correspondant à l’entité HTML ou à l’encodage hexadécimal 0xA0). Or, la fonction standard de Google Sheets SUPPRESPACE ne nettoie par défaut que l’espace standard d’espacement (ASCII 32). Pour éradiquer ces artefacts tenaces avant d’appliquer le protocole de substitution par zéro, l’analyste doit appliquer une chaîne de purification fonctionnelle robuste :
=SUBSTITUE(A2; CARCL(160); "")
La combinaison de cette fonction avec EPURAGE permet de purger simultanément les 32 premiers caractères de contrôle non imprimables du code ASCII (tels que les débuts de transmission ou les sauts de page résiduels) :
=EPURAGE(SUBSTITUE(A2; CARCL(160); ""))
Pour diagnostiquer rigoureusement la nature du caractère invisible parasitant une cellule récalcitrante située en A2, on utilisera une formule d’inspection anatomique renvoyant le code décimal du premier caractère suspect :
=CODE(GAUCHE(A2; 1))
Si la formule retourne la valeur numérique 160, le diagnostic d’infection par espace insécable est irréfutablement posé. Enfin, une attention particulière doit être portée aux cellules dont le contenu apparent est vierge mais qui abritent en préfixe une apostrophe d’échappement simple ('). Cette apostrophe, invisible en affichage standard mais persistante dans la barre de formule, force le type de la cellule en chaîne de caractères pure. Pour la neutraliser, il est nécessaire de réinitialiser la cellule par collage spécial de valeurs ou de forcer son évaluation par une expression régulière ciblant explicitement la coercition de chaîne.
10.2 Problèmes de formatage et persistance du format texte
Une anomalie critique post-remplacement se matérialise lorsque le chiffre 0 inséré refuse obstinément d’être pris en compte dans les fonctions d’agrégation numérique telles que SOMME ou MOYENNE. Cet incident survient lorsque la colonne cible avait été préalablement configurée au format Texte brut au niveau de l’interface de Google Sheets, ou que le zéro a été injecté sous forme d’une chaîne scalaire ("0") par une routine de script mal typée. Ce zéro textuel s’affiche alors aligné par défaut sur le bord gauche de la cellule, trahissant son statut typologique d’entité alphanumérique.
Pour résoudre cette incohérence structurelle, la première approche corrective consiste à forcer la réaffectation du formatage matriciel : sélectionner la plage incriminée, naviguer vers Format > Nombre, et sélectionner explicitement l’option Automatique ou Nombre. Cependant, si le format texte a été incrusté en dur avec une apostrophe sous-jacente, le changement d’option graphique via le menu peut demeurer inopérant.
L’artifice de secours le plus véloce consiste alors à mobiliser l’opération mathématique de coercition unaire. En copiant une cellule quelconque contenant le chiffre 1, puis en sélectionnant la plage polluée et en exécutant la commande Édition > Collage spécial > Coller avec multiplication, le moteur de Google Sheets est contraint de multiplier chaque cellule par un, convertissant instantanément les zéros textuels en véritables zéros scalaires intégrables dans les calculs arithmétiques. L’audit d’intégrité finale s’effectue au moyen de la fonction de validation booléenne :
=ESTNUM(A2)
Cette formule doit impérativement retourner la valeur VRAI pour certifier la navigabilité arithmétique de la cellule imputée.
10.3 Gestion des dépendances et bris de chaînes de formules
L’exécution d’un protocole de remplacement de masse au sein d’une feuille de travail comportant des arborescences de dépendances interconnectées peut déclencher la propagation fulgurante de ruptures de chaînes référentielles. L’erreur la plus redoutée est l’apparition intempestive du drapeau d’erreur #REF!. Cette situation catastrophique survient lorsque la commande de remplacement a été paramétrée de manière imprudente sans délimitation géographique stricte, venant écraser des cellules sources sur lesquelles reposaient des formules matricielles dynamiques en expansion (phénomène de collision de spill).
Lorsqu’une cellule vierge située au sein de l’espace d’expansion naturel d’une fonction FILTER, SORT ou UNIQUE est soudainement occupée par la constante numérique 0, le moteur d’évaluation matriciel se trouve dans l’impossibilité physique de déverser ses données et interrompt immédiatement l’évaluation en affichant l’erreur critique : « Le résultat développé n’a pas été développé, car il écraserait les données de [Coordonnée] ».
Pour juguler immédiatement la crise lors d’une fausse manœuvre, l’analyste doit déclencher sans attendre l’opération d’annulation atomique par le raccourci Ctrl + Z (ou Cmd + Z), qui rétablit fidèlement l’état de la pile d’exécution antérieure. Si l’opération a été validée trop tôt et que le tampon d’annulation est purgé, le recours immédiat au module Fichier > Historique des versions > Afficher l’historique des versions permet de restaurer l’instantané du classeur généré juste avant l’exécution du script ou de la commande de remplacement, préservant ainsi des heures d’architecture décisionnelle contre la corruption accidentelle.
11. Optimisation des performances sur les grands ensembles de données
11.1 Gestion de la latence du moteur de calcul de Google Sheets
L’exécution d’opérations d’imputation et de calcul sur des ensembles de données massifs approchant les limites structurelles de Google Sheets (établies à 10 millions de cellules par classeur) confronte le praticien aux goulets d’étranglement de la machine d’exécution cloud et de la couche de rendu client JavaScript. Lorsque des expressions régulières complexes sont appliquées sur des matrices comptant plus de 100 000 enregistrements, le temps de compilation des expressions et le balayage itératif du graphe de dépendance peuvent saturer le thread principal du navigateur, entraînant l’apparition d’un écran gris ou le gel prolongé de l’onglet de travail.
Pour prévenir cette dégradation sévère, il convient d’adopter une stratégie de partitionnement horizontal (chunking). Au lieu de soumettre la table complète à une commande globale de substitution, l’opérateur partitionne l’intervention par blocs opérationnels homogènes de 20 000 à 30 000 lignes maximum. Cette segmentation permet au ramasse-miettes (garbage collector) du moteur JavaScript d’évacuer périodiquement les contextes d’exécution obsolètes et de maintenir un débit de synchronisation fluide avec les clusters de serveurs de Google.
Sur le plan du coût computationnel comparé, il est capital de noter que la commande native Rechercher et remplacer s’avère nettement moins vorace en cycles CPU récurrents que les formules matricielles dynamiques. En effet, une fois la substitution effectuée par l’interface native, les zéros sont inscrits sous forme de valeurs scalaires statiques : le moteur de calcul n’a plus jamais besoin de les réévaluer. À l’inverse, l’usage d’une formule matricielle extensive (ex. ARRAYFORMULA ou MAP) impose au moteur de réévaluer le prédicat conditionnel de chaque cellule à chaque fois qu’une modification quelconque survient sur l’ensemble de la feuille, créant une latence de fond perpétuelle pénalisant l’expérience utilisateur.
11.2 Traitement par lots (Batch Processing) via API et scripts
Pour les infrastructures de données industrialisées où les volumes dépassent le cadre de la manipulation humaine interactive, l’ingénierie moderne déporte le traitement d’imputation hors du navigateur client via l’utilisation de l’API REST Google Sheets v4. Cette interface de bas niveau autorise des interventions directes sur la représentation JSON sous-jacente du classeur hébergé dans le cloud, sans requérir l’instanciation de l’interface graphique consommatrice de ressources.
Le paradigme fondamental d’optimisation via l’API réside dans le protocole de traitement par lots unifié, orchestré par la méthode spreadsheets.batchUpdate. Au lieu de transmettre des requêtes de mise à jour atomiques cellule par cellule sur le réseau HTTPS — ce qui saturerait rapidement les quotas de requêtes par minute et induirait une latence réseau prohibitive —, l’ingénieur encapsule l’intégralité des substitutions requises au sein d’une seule charge utile (payload) contenant des requêtes de type FindReplaceRequest :
{

  "findReplace": {

    "find": "^s*$",

    "replacement": "0",

    "matchCase": true,

    "matchEntireCell": true,

    "searchByRegex": true,

    "range": {

      "sheetId": 0,

      "startRowIndex": 1,

      "endRowIndex": 100000,

      "startColumnIndex": 0,

      "endColumnIndex": 5

    }

  }

}
Cette requête est compilée et exécutée directement au sein de l’infrastructure serveurs de Google avec des performances optimales, affranchissant le poste client de toute charge de traitement et autorisant un assainissement instantané des données en amont de leur exploitation collaborative.
11.3 Bonnes pratiques de dimensionnement de la feuille de calcul
L’optimisation des performances d’un classeur Google Sheets implique une gestion stricte des dimensions physiques de sa grille matricielle. Par défaut, lors de la création d’une nouvelle feuille, le système initialise une matrice de 26 colonnes (de A à Z) et de 1 000 lignes, générant d’emblée 26 000 coordonnées cellulaires. Lorsque l’analyste importe des tables massives, la tentation est grande d’étendre la grille jusqu’à des dimensions pléthoriques sans jamais purger les espaces excédentaires.
Or, la présence de dizaines de colonnes et de milliers de lignes vierges périphériques grève lourdement les performances du moteur logiciel : lors de l’exécution d’une recherche par expressions régulières ou de l’application de formules matricielles ouvertes, le moteur doit allouer des structures de contrôle pour inspecter ces zones fantômes. La suppression préventive de toutes les lignes et colonnes non occupées au-delà du périmètre utile du tableau constitue une règle d’hygiène impérative.
Pour élaguer ces espaces superflus, il suffit de sélectionner la première colonne vierge située immédiatement à droite du tableau utile, d’exécuter Ctrl + Shift + Flèche Droite pour englober la totalité des colonnes périphériques jusqu’à la limite de la grille, d’effectuer un clic droit et de sélectionner Supprimer les colonnes. Le même protocole s’applique rigoureusement pour les lignes situées sous le tableau (via Ctrl + Shift + Flèche Bas). En réduisant la géométrie de la feuille au strict volume utile, la vitesse de balayage des expressions régulières est démultipliée et l’empreinte mémoire du fichier au sein du cloud de Google Drive est allégée de façon pérenne.
12. Gouvernance des données et protocoles de validation méthodologique
12.1 Établissement d’une charte de saisie et de standardisation
L’excellence opérationnelle dans la gestion des flux de données tabulaires commence bien avant l’étape de nettoyage : elle s’enracine dans la standardisation des protocoles de collecte et de saisie. Au sein des organisations modernes, l’ingénierie des données doit formaliser une charte d’architecture stipulant sans ambiguïté les conventions de typage applicables aux tables analytiques. Cette normalisation institutionnelle prévient les disparités d’interprétation entre les opérateurs et uniformise la représentation des données manquantes.
La charte doit délimiter explicitement les typologies de variables pour lesquelles l’imputation d’un zéro est formellement autorisée, et celles pour lesquelles elle est strictement prohibée. Par exemple, pour des variables de flux comptables ou des décomptes d’unités physiques produites, le zéro possède une légitimité arithmétique incontestable dès lors que l’absence d’événement équivaut à une magnitude nulle avérée. En revanche, pour des variables d’évaluation sensorielle, des ratios financiers de valorisation ou des indicateurs biomédicaux, la charte doit imposer la conservation du vide ou l’utilisation d’un identifiant textuel normé tel que NA (Not Available), interdisant formellement l’écrasement par zéro sous peine de vicier la chaîne de responsabilité légale.
Pour sanctuariser ces directives à la source, l’administrateur déploie des règles de validation de données (menu Données > Validation des données). En assignant des critères d’admissibilité stricts (ex. autoriser exclusivement des nombres supérieurs ou égaux à zéro et rejeter systématiquement les cellules vides lors de la soumission de formulaires), l’organisation élimine la prolifération de la vacuité à la racine du système, dispensant les équipes de maintenance de fastidieuses opérations de nettoyage a posteriori.
12.2 Documentation systématique des opérations de prétraitement
L’assainissement de données par substitution matricielle ne doit jamais constituer un processus opaque et non documenté. Conformément aux principes directeurs de l’intégrité scientifique et des audits de conformité réglementaire (tels que la réglementation financière Sarbanes-Oxley ou les standards pharmaceutiques de la FDA), chaque transformation structurelle affectant les données brutes doit s’accompagner d’un journal d’audit transparent et reproductible.
Il est recommandé de consacrer systématiquement un onglet spécifique au sein du classeur, baptisé conventionnellement _Journal_Audit ou METADONNEES, consignant l’historique exhaustif des manipulations conduites sur la matrice principale. Ce registre doit comporter a minima :
- L’horodatage précis (date, heure et fuseau) de l’exécution du nettoyage.
- L’identité de l’opérateur ou du script automatisé ayant déclenché l’opération.
- Les coordonnées géographiques précises de la plage matricielle concernée (ex.
DonneesBrutes!C2:E5000). - La méthode technique déployée (commande native, regex
^s*$, script Apps Script ou formule matricielle). - Le volume quantitatif exact des cellules modifiées et la justification métier formelle de l’imputation.
Cette rigueur documentaire assure la reproductibilité intégrale des protocoles pour les auditeurs externes ou les pairs académiques. Elle protège l’organisation contre les accusations de manipulation d’indicateurs et permet, en cas de découverte ultérieure d’une distorsion de calcul, de reconstituer précisément la séquence d’événements ayant mené à l’état courant de la base de données.
12.3 Audit qualité et contrôle continu post-remplacement
La dernière étape du cycle de vie du traitement de données consiste en l’institution de garde-fous automatisés attestant en continu de la conformité du classeur. L’analyste déploie un bloc de cellules de contrôle métrologique dans un espace sécurisé de la feuille, compilant des assertions logiques instantanées via la fonction native ET :
=ET(NB.VIDE(Donnees!A2:A5000)=0; NB.SI(Donnees!A2:A5000; "<0")=0)
Cette formule vérifie simultanément l’absence totale de cellules résiduelles vides et la conformité des bornes de validité du domaine numérique cible. Si l’une des conditions vient à être violée suite à une mauvaise manipulation ultérieure, la cellule d’audit bascule instantanément à FAUX.
Pour amplifier l’impact visuel de ces alertes, l’ingénieur couple cette cellule de contrôle à une règle de mise en forme conditionnelle (menu Format > Mise en forme conditionnelle). En appliquant une mise en évidence en rouge vif sur le bandeau d’en-tête du tableau de bord dès lors que le test de vacuité échoue, l’équipe d’exploitation est immédiatement alertée de la dégradation de l’hygiène des données avant même que les synthèses ne soient transmises aux décideurs finaux. L’intégration de ce jalon de revue critique garantit la pérennité, la robustesse et l’infaillibilité fonctionnelle des architectures d’analyse bâties sous Google Sheets.
Références
Codd, E. F. (1979). Extending the database relational model to capture more meaning. ACM Transactions on Database Systems (TODS), 4(4), 397-434. https://doi.org/10.1145/320107.320109
Cox, D. R. (1958). The analysis of exponentially distributed life-times with two types of failure. Journal of the Royal Statistical Society: Series B (Methodological), 20(2), 371-382. https://doi.org/10.1111/j.2517-6161.1958.tb00306.x
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Google Workspace Developers. (2024). Google Apps Script: Spreadsheet service documentation. Google Developers. https://developers.google.com/apps-script/reference/spreadsheet
Google Workspace Support. (2024). Fonction GOOGLE SHEETS: ESTVIDE et ARRAYFORMULA. Centre d’aide Google. https://support.google.com/docs/answer/3093290
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2e éd.). Springer. https://doi.org/10.1007/978-0-387-84858-7
Little, R. J., & Rubin, D. B. (2019). Statistical analysis with missing data (3e éd.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
MacQueen, J. (1967). Some methods for classification and analysis of multivariate observations. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, 1(14), 281-297.
Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124-1131. https://doi.org/10.1126/science.185.4157.1124
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10