
Dans le domaine du traitement analytique avancé et de l’économétrie appliquée, la manipulation rigoureuse des données quantitatives constitue le socle indispensable sur lequel repose la validité de toute inférence scientifique. Lorsque des variables continues issues d’environnements expérimentaux hétérogènes, d’enquêtes psychométriques ou de capteurs biométriques sont agrégées au sein d’une même architecture analytique, leurs disparités d’échelle, d’amplitude et d’unités physiques risquent d’induire des distorsions sévères. Sans un étalonnage préalable rigoureux, les algorithmes multivariés fondés sur l’optimisation des distances géométriques ou sur la décomposition spectrale des matrices de covariance accordent un poids démesuré aux variables affichant les variances numériques les plus élevées, reléguant au second plan des dimensions explicatives tout aussi déterminantes mais mesurées sur des échelles restreintes.
Le système SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme la référence académique et industrielle pour la manipulation statistique à grande échelle, offrant des procédures natives d’une efficacité computationnelle et d’une robustesse mathématique incomparables. Parmi cet arsenal, la standardisation et la normalisation des données occupent une position névralgique, faisant le pont entre la collecte brute et la modélisation prédictive ou factorielle. La maîtrise des mécanismes internes de SAS, notamment à travers des procédures spécialisées telles que PROC STDIZE, PROC MEANS ou PROC UNIVARIATE, permet non seulement de transformer adéquatement les distributions, mais également de préserver l’intégrité métrologique des observations sans altérer la structure latente des covariations.
Cet article propose une exploration encyclopédique et méthodologique de la normalisation des données sous SAS. En articulant les fondements théoriques de l’algèbre matricielle et de la psychométrie aux réalités de la programmation SAS, nous examinerons en détail les démarches algorithmiques, les options de paramétrage avancées, l’imputation conjointe des données manquantes, ainsi que l’impact critique de ces transformations sur l’apprentissage automatique et la modélisation statistique avancée. L’objectif consiste à fournir aux chercheurs, biostatisticiens et analystes de données un cadre de référence opérationnel et conceptuel garantissant une reproductibilité sans faille selon les standards académiques les plus stricts.
1. Fondements théoriques de la normalisation des données dans SAS
1.1 Définition mathématique et conceptuelle du centrage et de la réduction
La transformation statistique communément désignée sous le terme de centrage-réduction ou transformation en score z (z-score) repose sur une opération linéaire élémentaire mais aux répercussions analytiques fondamentales. Mathématiquement, pour une variable aléatoire continue $X$ observée sur un échantillon de taille $n$, chaque observation individuelle $x_i$ est soumise à une translation suivie d’un changement d’échelle. L’opération s’énonce selon l’équation canonique $z_i = (x_i – \mu) / \sigma$, où $\mu$ représente l’espérance mathématique (estimée empiriquement par la moyenne arithmétique $\bar{x}$) et $\sigma$ désigne l’écart-type de la distribution dans la population parente. L’effet algébrique immédiat de cette double opération est la translation du centre de gravité de la distribution vers l’origine du repère euclidien, fixant la nouvelle espérance à zéro, et la contraction ou dilatation de l’espace des données de manière à ce que la variance empirique finale soit rigoureusement égale à un.
Sur le plan métrologique, le centrage-réduction réalise la suppression pure et simple de l’artéfact dimensionnel et des unités de mesure physiques. Qu’une grandeur initiale soit exprimée en millimètres de mercure, en milligrammes par décilitre ou en scores composites sur une échelle de Likert, sa conversion en variable centrée-réduite la transmute en une quantité adimensionnelle. Cette suppression dimensionnelle est cruciale dans les environnements de modélisation multivariée, car elle empêche qu’une variable pourvue d’un ordre de grandeur numérique massif (par exemple, le revenu annuel en unités monétaires) n’écrase artificiellement une variable mesurée sur une étendue restreinte (comme le nombre d’années de scolarité), alors même que leur pertinence théorique respective peut être inversement proportionnelle à leur dispersion brute.
Il importe de souligner avec une grande rigueur épistémologique que la normalisation univariée par score z ne constitue en aucun cas une opération de « normalisation gaussienne » au sens où elle ne force nullement une distribution empirique arbitraire à épouser la loi normale de Laplace-Gauss. Si la distribution parente de $X$ présente une asymétrie marquée (skewness non nulle) ou un aplatissement prononcé (kurtosis atypique), la variable transformée $Z$ conservera strictement ces propriétés distributionnelles intrinsèques. La transformation en score z est une transformation affine strictement croissante qui préserve scrupuleusement la forme relative de la densité de probabilité, les ratios de distances relatives entre observations consécutives et les rangs percentiles originaux, tout en modifiant exclusivement les deux premiers moments de la distribution.
1.2 Nécessité méthodologique dans l’analyse de données psychologiques et comportementales
Dans les sciences comportementales, la psychométrie et la psychiatrie computationnelle, les données quantitatives proviennent quasi systématiquement d’instruments de mesure composites, tels que des inventaires d’auto-évaluation, des tests d’aptitude cognitive ou des échelles d’évaluation clinique standardisées. Ces outils emploient fréquemment des structures de réponses ordinales graduées selon le modèle de Likert, comptant de quatre à sept modalités par item, dont la sommation ou le moyennage génère des scores totaux hétérogènes. Par exemple, l’inventaire de dépression de Beck (BDI) produit un score s’étalant de 0 à 63, tandis que l’échelle d’anxiété état-trait de Spielberger (STAI) génère des scores oscillant entre 20 et 80. Confronter ou agréger directement ces scores bruts sans ajustement métrique constitue une faute méthodologique majeure, car les écarts numériques ne reflètent pas des intensités phénoménologiques comparables.
L’élimination des biais d’amplitude représente le premier impératif clinique et psychométrique justifiant la standardisation dans SAS. En l’absence de centrage-réduction, l’évaluation psychométrique multidimensionnelle devient captive des échelles de notation les plus dispersées. Les variances d’items variables introduisent des surpondérations implicites au sein des scores factoriels, biaisant les modèles d’équations structurelles ou les analyses factorielles exploratoires. En soumettant les vecteurs d’items ou les scores composites à une standardisation préalable au sein du pipeline de données SAS, le chercheur neutralise ces artéfacts de construction instrumentale, garantissant que chaque facette psychologique contribue à la variance totale en stricte proportion de sa fidélité et de sa validité de construit, et non en fonction du nombre arbitraire d’échelons de son échelle de réponse.
Enfin, la standardisation assure une comparabilité statistique directe entre des cohortes cliniques soumises à des protocoles de recueil discordants. Dans le cadre de méta-analyses sur données individuelles ou de registres hospitaliers multicentriques, différents centres peuvent administrer des versions révisées ou concurrentes d’un même paradigme diagnostique. Dès lors que les propriétés métrologiques de base des instruments sont établies, le recours aux scores standardisés permet d’ancrer les profils pathologiques individuels sur un continuum universel exprimé en déviations par rapport au groupe de référence, assurant une harmonisation indispensable avant toute tentative d’inférence transversale ou longitudinale.
1.3 Propriétés métrologiques des scores standardisés résultants
L’interprétation métrologique d’un score z s’effectue directement en unités d’écart-type, offrant une grille de lecture standardisée hautement informative tant pour le clinicien que pour le statisticien. Un score de $z = +1{,}50$ signifie sans ambiguïté que l’observation considérée se situe précisément à un écart-type et demi au-dessus de la moyenne de l’échantillon ou de la population d’étalonnage. Cette propriété universelle permet de situer instantanément un sujet au sein de la hiérarchie distributionnelle, indépendamment des spécificités du système métrique originel. En contexte diagnostique, cela autorise la définition de seuils d’intervention cliniques universels : un écart de deux unités standard ($|z| ge 2{,}00$) signale une déviation observée chez moins de 5 % des individus d’une population gaussienne, servant couramment de critère d’atypie ou de sévérité symptomatique.
Cette propriété métrique constitue le fondement de l’identification formelle des valeurs aberrantes ou extrêmes (outliers) dans les procédures d’assurance qualité des données sous SAS. En isolant systématiquement les observations dont la valeur absolue du score standardisé franchit des bornes prédéterminées (typiquement $|z| > 3{,}00$ ou $|z| > 3{,}29$, ce dernier seuil correspondant aux centiles 0,05 % et 99,95 % d’une loi normale théorique), les analystes disposent d’un filtre statistique objectif. Contrairement à l’examen subjectif des histogrammes bruts, le recours aux scores z opérationnalise la détection d’anomalies de saisie ou de cas cliniques singuliers au moyen de règles conditionnelles automatisables au sein des étapes de programmation SAS.
Sur le plan de l’association statistique, la transformation affine propre au calcul des scores z présente l’immense avantage de maintenir rigoureusement invariants les coefficients de corrélation linéaire de Pearson entre variables continues. Soient deux variables $X$ et $Y$, dont la covariance est dénotée $\mathrm{Cov}(X, Y)$ et le coefficient de corrélation $r_{XY}$. La standardisation linéaire produit de nouvelles variables $Z_X$ et $Z_Y$ telles que la covariance empirique calculée entre ces vecteurs transformés devient strictement identique à leur coefficient de corrélation d’origine : $\mathrm{Cov}(Z_X, Z_Y) = r_{XY}$. Cette identité mathématique fondamentale garantit que l’architecture des relations bivariées et multivariées au sein d’une matrice de données n’est en rien déformée par le centrage et la réduction, assurant la parfaite fidélité des analyses statistiques subséquentes.
2. Distinction systématique entre normalisation, standardisation et mise à l’échelle
2.1 Standardisation z-score versus normalisation Min-Max
Dans la littérature méthodologique contemporaine et dans la terminologie anglo-saxonne souvent adoptée sans précaution, les termes « normalisation » et « standardisation » sont fréquemment employés de manière interchangeable, générant une confusion préjudiciable à la rigueur de l’analyse empirique. Il convient de distinguer formellement la standardisation par score z de la normalisation par bornage min-max, également appelée mise à l’échelle unitaire (feature scaling). Tandis que la standardisation projette les données sur un intervalle non borné théoriquement centré sur zéro avec une dispersion unitaire, la normalisation min-max applique une fonction de transfert linéaire projetant l’ensemble des valeurs observées dans un intervalle fermé et strictement délimité, généralement $[0, 1]$ ou $[-1, 1]$. L’équation de cette transformation s’écrit $x_{\text{scaled}} = (x_i – x_{\min}) / (x_{\max} – x_{\min})$, où $x_{\min}$ et $x_{\max}$ représentent respectivement les bornes empiriques minimale et maximale de la série observée.
Cette divergence fonctionnelle entraîne des propriétés opérationnelles radicalement distinctes face à la contamination de l’échantillon par des valeurs atypiques. La normalisation min-max est extrêmement vulnérable à la présence de valeurs extrêmes. Si un échantillon comporte une unique valeur aberrante anormalement élevée, cette observation isolée va s’approprier la valeur 1, tandis que l’immense majorité des observations régulières se trouvera comprimée dans un sous-intervalle infinitésimal proche de 0, anéantissant ainsi le pouvoir discriminant de la variable. En revanche, bien que la moyenne arithmétique et l’écart-type employés dans le score z soient également sensibles aux valeurs extrêmes, la standardisation ne comprime pas artificiellement le reste de la distribution dans un espace métrique étriqué et préserve la hiérarchie proportionnelle globale des distances interindividuelles.
Ces divergences de comportement mathématique exercent des répercussions directes sur les métriques de proximité spatiale employées dans les analyses multidimensionnelles. Le calcul de la distance euclidienne canonique entre deux vecteurs d’observations $u$ et $v$, défini par $d(u, v) = \sqrt{\sum (u_k – v_k)^2}$, est tributaire de l’échelle d’encadrement des dimensions. Dans un schéma min-max, chaque variable est mathématiquement contrainte à évoluer dans un hypercube unitaire, conférant à chaque dimension un potentiel théorique de contribution équivalent à la distance maximale observable. En standardisation z, l’espace métrique demeure ouvert et certaines dimensions aux queues de distribution épaisses peuvent continuer à générer des écarts euclidiens substantiels, ce qui s’avère avantageux lorsque la variabilité extrême porte une information substantielle sur le phénomène étudié.
2.2 Transformations non linéaires pour corriger la non-normalité
Une confusion épistémologique particulièrement récurrente chez les praticiens de l’analyse de données consiste à assimiler la normalisation des variables à la gaussianisation de leurs distributions. Centrer et réduire une variable asymétrique ne modifie aucunement la courbure de sa fonction de répartition. Lorsque les hypothèses des modèles statistiques sous-jacents exigent impérativement l’adhésion à une loi de distribution normale — comme dans le cas de l’inférence par régression des moindres carrés ordinaires ou de l’analyse discriminante linéaire paramétrique —, le recours à des transformations non linéaires de la variable originelle s’impose en amont de toute démarche de centrage ou de standardisation.
Ces transformations non linéaires modifient structurellement les distances relatives entre les points de données afin d’atténuer ou de corriger les asymétries positives ou négatives. Pour des distributions asymétriques à droite (étalées vers les valeurs positives), la transformation logarithmique népérienne $y = ln(x)$ ou décimale $y = \log_{10}(x)$ comprime l’espace des valeurs élevées tout en dilatant l’espace des valeurs faibles, réduisant ainsi drastiquement la queue de distribution. La famille des transformations de Box-Cox, introduite par George Box et David Cox (1964), généralise cette démarche via une transformation paramétrique continue définie par $y = (x^\lambda – 1) / \lambda$ pour $lambda ne 0$ et $y = ln(x)$ pour $lambda = 0$, où le paramètre $lambda$ est optimisé par la méthode du maximum de vraisemblance afin de maximiser la conformité de la série résiduelle avec la loi normale gaussienne.
Il est donc crucial de distinguer méthodologiquement l’action de rendre une variable symétrique et homoscédastique de celle consistant à lui conférer une moyenne nulle et une variance unitaire. Le séquençage approprié des étapes de prétraitement au sein des procédures SAS requiert une hiérarchie stricte : la transformation non linéaire correctrice de forme (Box-Cox, logarithmique, racine carrée) doit impérativement précéder l’application de la standardisation linéaire. Procéder dans le sens inverse anéantirait immédiatement les propriétés du centrage : appliquer un logarithme à une variable préalablement centrée sur zéro serait d’une part mathématiquement impossible pour toutes les observations négatives, et d’autre part détruirait l’espérance nulle et la variance unitaire chèrement acquises.
3. Initialisation de l’environnement et structuration des données initiales dans SAS
3.1 Création du jeu de données expérimental via l’étape DATA
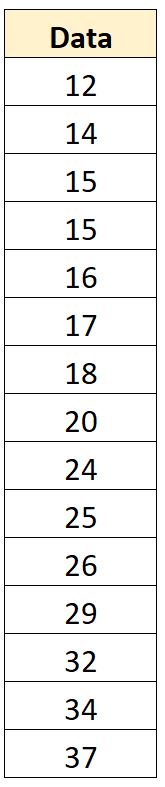
L’opérationnalisation de tout protocole d’analyse sous SAS débute par l’orchestration rigoureuse de l’étape DATA, cellule computationnelle fondamentale permettant la lecture, l’attribution des types métrologiques et la structuration physique des tables de travail. Afin d’ancrer notre démonstration dans un cadre empirique réaliste et reproductible, nous créons un jeu de données simulant une batterie d’évaluations psychométriques administrées à une cohorte clinique de participants. Ce contexte expérimental requiert la capture de plusieurs dimensions comportementales continues associées à des identifiants univoques et des variables d’assignation catégorielle.
L’étape DATA utilise la syntaxe canonique articulée autour de l’instruction INPUT, qui spécifie l’ordre, la dénomination et le format des variables lues, ainsi que de l’instruction DATALINES (ou CARDS) permettant d’injecter directement le flux des observations empiriques au sein du corps du programme. La commande instancie une table temporaire au sein de la bibliothèque de travail SAS WORK, garantissant un traitement rapide en mémoire vive sans altération des référentiels physiques distants. Lors de cette phase, il convient de veiller à ce que les variables d’intérêt continu soient typées en virgule flottante double précision, standard numérique par défaut sous l’architecture SAS garantissant une résolution sur 8 octets, indispensable pour prévenir l’accumulation de biais d’arrondi lors des calculs de variance subséquents.
La validation de l’intégrité de la structure tabulaire constitue un prérequis incontournable avant toute tentative de modélisation. Dès la compilation et l’exécution du bloc DATA par le compilateur SAS, le journal d’exécution (SAS Log) doit être rigoureusement examiné afin de vérifier l’absence d’erreurs de syntaxe, d’avertissements relatifs à des conversions implicites de type de variable ou de messages signalant la lecture tronquée d’enregistrements. Le descripteur de la table ainsi créé dans la bibliothèque WORK contient non seulement le vecteur physique des valeurs brutes mais également les métadonnées structurelles indispensables qui serviront d’intrants aux procédures de standardisation statistique automatisées.
3.2 Exploration descriptive préliminaire au moyen de PROC MEANS
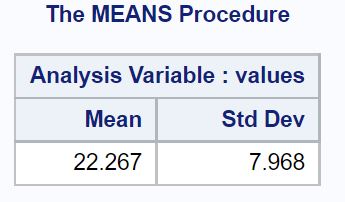
L’exploration descriptive des données brutes représente une étape d’assurance qualité statistique fondamentale, interdisant toute modification aveugle des métriques d’origine. La procédure PROC MEANS fournit le cadre computationnel le plus adapté et efficient pour extraire les paramètres de tendance centrale et de dispersion régissant les variables d’intérêt. En spécifiant l’instruction VAR suivie des colonnes quantitatives continues à analyser, l’analyste délimite précisément le champ d’investigation de la procédure, évitant ainsi le traitement inutile de colonnes d’identification ou de variables de contrôle catégorielles non destinées à la standardisation.
L’évaluation des moments empiriques de référence exige une finesse d’affichage adaptée aux exigences académiques les plus strictes. L’option NDEC= intégrée à l’instruction d’en-tête de PROC MEANS permet de calibrer formellement le nombre de décimales affichées au sein du rapport de sortie ODS (Output Delivery System), prévenant à la fois les arrondis prématurés masquant de légères asymétries et la surcharge cognitive induite par l’étalage inutile de décimales superflues. Les statistiques requises incluent obligatoirement l’effectif valide ($N$), la moyenne arithmétique ($Mean$), l’écart-type d’échantillon ($Std Dev$), la valeur minimale ($Min$) et la valeur maximale ($Max$). Ces estimateurs serviront de repères analytiques fixes contre lesquels la précision des algorithmes de normalisation ultérieurs sera rigoureusement confrontée.
La documentation de ces paramètres d’échelle initiaux joue un rôle métrologique fondamental dans les publications scientifiques et les dossiers d’homologation clinique. Sans une traçabilité intégrale des moyennes brutes et des dispersions de départ, il s’avère impossible pour des examinateurs externes ou des équipes indépendantes de déstandardiser ultérieurement les coefficients d’un modèle pour les transposer à des contextes opérationnels concrets. La table de sortie générée par PROC MEANS via une instruction conditionnelle OUTPUT OUT= peut ainsi être archivée de façon pérenne, cristallisant l’état métrique initial de la cohorte d’étude avant toute manipulation de transformation matricielle.
3.3 Inspection de la distribution des données psychométriques avec PROC UNIVARIATE
Si la procédure PROC MEANS dresse le bilan synthétique des deux premiers moments d’une distribution, l’exploration approfondie de la morphologie distributionnelle requiert la puissance analytique de la procédure PROC UNIVARIATE. Cette procédure est indispensable pour inspecter les troisième et quatrième moments de la distribution, à savoir le coefficient d’asymétrie (skewness) de Fisher-Pearson et le coefficient d’aplatissement ou d’acuité des queues de distribution (kurtosis). Ces indices statistiques renseignent l’expérimentateur sur l’écart de ses données empiriques par rapport aux postulats de la courbe en cloche de Gauss.
Une asymétrie substantielle (classiquement définie par un coefficient excédant la valeur absolue de 1,0 ou 2,0 selon les critères retenus) indique que la moyenne arithmétique subit l’attraction disproportionnée d’un pan de la distribution, ce qui altère sa représentativité en tant que paramètre de centrage dans la normalisation par score z. De même, un aplatissement excessif signale la présence d’une leptokurticité caractérisée par des queues de distribution lourdes, propices à l’émergence d’observations extrêmes susceptibles de déstabiliser le calcul de l’écart-type d’échantillon. L’examen des quantiles empiriques, notamment la médiane, l’écart interquartile ($IQR = Q_3 – Q_1$) et les 1er et 99e centiles calculés par PROC UNIVARIATE, permet de documenter les déviances structurales que la simple lecture de la moyenne et de l’écart-type masquerait irrémédiablement.
L’intégration de visualisations graphiques avancées enrichit l’analyse descriptive au sein de cette même procédure. L’instruction HISTOGRAM, associée à la sous-instruction NORMAL, instruit le moteur graphique ODS de générer un histogramme paramétrique précis sur lequel est superposée la courbe de densité théorique normale paramétrée par la moyenne et la variance empiriques du jeu de données. Cette confrontation optique directe permet de statuer en toute rigueur sur l’adéquation d’une standardisation classique fondée sur les moments gaussiens ou sur la nécessité de basculer vers des estimateurs d’échelle non paramétriques ou des procédures robustes résistantes aux distorsions distributionnelles.
4. Mise en œuvre fondamentale de la procédure PROC STDIZE
4.1 Architecture et syntaxe de base de l’instruction PROC STDIZE
Dans l’architecture logicielle de SAS, la procédure PROC STDIZE constitue le module algorithmique spécifiquement dédié aux transformations d’échelle, au centrage et à la standardisation des matrices numériques. Contrairement à une croyance répandue incitant les programmeurs novices à coder manuellement la transformation au sein d’une étape DATA via une double passe de lecture mobilisant des variables macroscopiques préalablement stockées par PROC MEANS, PROC STDIZE optimise nativement l’ensemble des accès disques et de la gestion vectorielle en mémoire. Elle condense l’ensemble de la chaîne opérationnelle en une syntaxe déclarative concise, robuste et totalement exempte de risques d’erreurs algorithmiques de programmation.
La syntaxe canonique repose sur l’appel fondamental de l’instruction PROC STDIZE, au sein de laquelle la spécification de deux arguments cardinaux est requise pour assurer la rigueur du flux de traitement : l’option DATA=, désignant la table source hébergeant les séries empiriques brutes, et l’argument impératif OUT=, désignant la nouvelle table de données SAS qui recevra le résultat des calculs transformés. L’omission délibérée ou accidentelle de l’option OUT= contraindrait le moteur SAS à réécrire directement les résultats sur la table source spécifiée dans l’argument DATA=, entraînant l’écrasement irréversible des valeurs brutes originales — une transgression méthodologique absolue compromettant l’auditabilité et la reproductibilité du traitement.
Au sein du bloc d’instructions encadré par PROC STDIZE et son instruction de fermeture RUN;, l’instruction VAR détermine le sous-ensemble strict des variables quantitatives continues assujetties à la transformation métrique. Toutes les variables hébergées dans la table source mais omises de l’instruction VAR — telles que les identifiants textuels de sujets, les indices temporels de suivi ou les assignations de groupes cliniques — sont automatiquement préservées dans leur intégralité et recopiées de manière isotrope dans la table de destination spécifiée par OUT=. Ce mécanisme évite le recours à des jointures manuelles post-transformation souvent lourdes et sources de désynchronisation de données.
4.2 Paramétrage par défaut et transformation z-score
L’une des grandes forces de l’ingénierie logicielle présidant à la conception de PROC STDIZE réside dans la rationalité de ses choix de paramétrage par défaut. Lorsque la procédure est invoquée sans spécification explicite de méthode via des paramètres auxiliaires, l’algorithme sous-jacent exécute automatiquement et rigoureusement la standardisation en score z canonique. De manière implicite, le moteur computationnel effectue une lecture optimisée de la série afin de dériver les moments statistiques nécessaires, soustrayant à chaque valeur observée la moyenne arithmétique de sa colonne respective, puis divisant le résultat de cette différence par l’écart-type d’échantillon calculé avec $n – 1$ degrés de liberté au dénominateur.
Sur le plan algorithmique, cette exécution tire parti des optimisations mathématiques développées par SAS Institute pour minimiser le coût computationnel sur des tables massives (Big Data) ou des matrices hautement dimensionnelles issues d’études génomiques ou neuro-imageries. PROC STDIZE évite la réallocation dynamique répétitive de mémoire en dimensionnant d’emblée des registres optimisés pour le calcul cumulatif parallèle des sommes simples et des sommes des carrés des écarts, prévenant l’apparition de débordements arithmétiques ou de dégradations de performances sur de très larges volumétries.
Ce traitement par défaut applique avec une constance absolue la même règle mathématique sur chaque variable déclarée dans la liste de l’instruction VAR. L’analyste se trouve ainsi déchargé du calcul préliminaire des constantes d’ajustement : la procédure calcule dynamiquement le couple de paramètres $(\bar{x}_j, s_j)$ propre à chaque dimension $j$, stocke temporairement ces scalaires dans sa mémoire de travail et applique la transformation vectorielle en assurant une cohérence métrique globale sur l’intégralité de la cohorte analysée.
4.3 Exportation et affichage des observations transformées
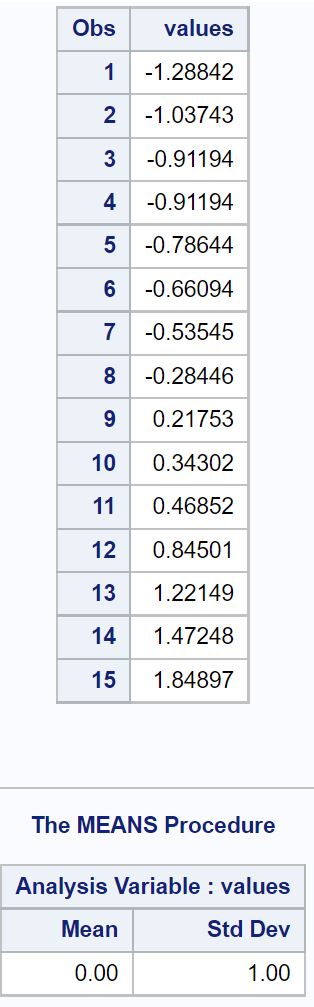
Une fois le traitement de transformation exécuté au sein de la table de sortie désignée, la validation visuelle et structurelle des données normalisées s’effectue généralement par le déploiement de la procédure PROC PRINT. Cette étape d’inspection élémentaire permet de contrôler la bonne matérialisation des scores z au niveau individuel. L’utilisation d’options de restriction d’affichage, telles que (OBS=10) accolée au nom du jeu de données dans l’instruction PROC PRINT, assure une revue rapide des premières lignes de la table sans encombrer la mémoire de l’interpréteur ni saturer le visualiseur de résultats.
Cette inspection visuelle initiale confirme que les variables d’identification non quantitatives ont été rigoureusement conservées et que les valeurs des colonnes cibles oscillent désormais autour de zéro, affichant des valeurs positives et négatives compatibles avec une échelle standardisée typique. C’est également à ce stade que l’intégrité référentielle peut être formellement auditée : la persistance des clés primaires individuelles garantit qu’aucune désynchronisation de lignes ou de permutation involontaire d’observations n’est intervenue lors de la traversée de la mémoire vectorielle de PROC STDIZE.
Dans un contexte de recherche translationnelle ou de collaboration interdisciplinaire, les tables résultantes issues de PROC STDIZE sont fréquemment exportées vers des formats analytiques tiers ou des progiciels académiques partenaires (fichiers plats délimités, bases relationnelles SQL ou structures matricielles R et Python). Grâce aux moteurs d’exportation standardisés de SAS, tels que PROC EXPORT, les séries standardisées peuvent être transférées avec une précision numérique intégrale, fournissant des intrants immaculés pour la rédaction de rapports d’essais cliniques ou la mise en commun de consortiums de recherche internationaux.
5. Validation statistique des résultats de la normalisation
5.1 Vérification empirique des nouveaux moments statistiques
L’exécution aveugle d’un traitement statistique, aussi éprouvé soit le logiciel employé, contrevient aux principes déontologiques fondamentaux de la pratique de la science des données. Tout traitement de standardisation doit impérativement faire l’objet d’une validation empirique formelle visant à s’assurer que les nouvelles séries numériques respectent rigoureusement les propriétés théoriques assignées par la formulation mathématique du score z. La démarche canonique consiste à soumettre immédiatement la table de sortie générée par PROC STDIZE à une nouvelle exécution de la procédure PROC MEANS.
L’inspection des résultats générés par cette seconde passe de PROC MEANS sur les variables standardisées permet de vérifier l’exactitude de la convergence numérique. La moyenne arithmétique de chaque variable traitée doit afficher une valeur rigoureusement égale à zéro, attestant du parfait centrage du centre de gravité de la distribution sur l’origine métrique. Conjointement, l’écart-type d’échantillon ($Std Dev$) ainsi que la variance empirique calculée doivent afficher de façon irréfutable la valeur 1,000, confirmant la réduction d’échelle souhaitée.
Le contrôle s’étend également à l’examen de l’amplitude totale et de la disposition relative des extrema. La différence absolue entre la nouvelle valeur maximale et la nouvelle valeur minimale doit refléter fidèlement le ratio d’amplitude de la série originelle divisé par l’écart-type initial ($[x_{\max} – x_{\min}] / s_x$). La validation simultanée de ces propriétés confirme que la transformation s’est opérée sans distorsion géométrique et que l’échelle des données est désormais harmonisée sur un étalon universel.
5.2 Gestion des imprécisions de virgule flottante dans SAS
Lors de l’examen minutieux des rapports statistiques émis par PROC MEANS ou d’autres procédures descriptives sur des séries standardisées, l’analyste attentif relèvera fréquemment une curiosité numérique propre au calcul informatisé : la moyenne arithmétique post-standardisation ne s’affiche pas toujours sous la forme du chiffre 0 absolu, mais sous celle d’une notation scientifique exponentielle extrêmement proche de zéro, telle que $-1{,}2479E-16$ ou $+2{,}1103E-17$. Une telle manifestation numérique suscite parfois l’inquiétude infondée de chercheurs non avertis, qui y suspectent l’intrusion d’une anomalie algorithmique.
Ce phénomène découle inéluctablement de la norme IEEE 754 régissant l’arithmétique en virgule flottante double précision au sein des architectures informatiques modernes, standard scrupuleusement implémenté par le moteur SAS. Dans la mesure où les nombres réels continus sont représentés en base binaire sur une allocation fixe de 64 bits, certains fractions décimales ne peuvent être encodées de manière infiniment exacte, induisant des erreurs d’arrondi infinitésimales lors des cycles successifs d’accumulations et de divisions d’agrégats statistiques. Ces résidus d’une magnitude de $10^{-16}$ ne traduisent pas un biais empirique mais représentent le zéro absolu de la machine sous les contraintes physiques du calcul sur silicium.
Afin de gérer ces artefacts computationnels dans le cadre de la rédaction de publications scientifiques ou de tableaux destinés à des instances réglementaires, il convient d’instruire SAS de contrôler formellement l’arrondi statistique de sortie. L’utilisation rigoureuse de l’option de formatage NDEC=2 ou NDEC=3 dans l’instruction d’appel de PROC MEANS ou l’application explicite de formats d’affichage SAS tels que FORMAT var 8.3; neutralise l’affichage de ces résidus infinitésimaux, restituant la valeur 0,00 requise par les normes éditoriales académiques sans corrompre la haute précision binaire interne préservée au niveau de la table de données sous-jacente.
5.3 Contrôle graphique de l’invariance distributionnelle
Au-delà de la confirmation tabulaire des moments statistiques scalaires, la validation qualitative de la normalisation exige une vérification visuelle rigoureuse de la géométrie de distribution. L’objectif est de s’assurer de l’invariance absolue de la forme de la distribution avant et après standardisation. Pour ce faire, les procédures graphiques modernes de la suite SAS Statistical Graphics, principalement la procédure PROC SGPLOT, offrent l’environnement idéal pour concevoir des superpositions de distributions comparatives.
En traçant des tracés de densité par noyau lissé (instructions DENSITY avec estimation paramétrique et non paramétrique de type KERNEL) ou des diagrammes de dispersion bivariés reliant deux variables avant et après leur standardisation, l’analyste peut vérifier de visu l’absence de toute déformation topologique. L’histogramme de la variable centrée-réduite présente une silhouette strictement identique à celle de la variable brute, subissant uniquement une translation horizontale de son axe d’abscisse (décalant son pic médian vers 0) et une contraction de son emprise transversale, les graduations horizontales s’exprimant désormais en déviations d’écart-type.
Sur un diagramme de dispersion bivarié confrontant deux mesures psychométriques, la structure géométrique du nuage de points doit être rigoureusement préservée dans ses moindres détails morphologiques. Les alignements de points, les conglomérats denses, les vides spatiaux et la dispersion des cas isolés restent parfaitement homotopes. Cette invariance visuelle matérialise pour le chercheur la neutralité métrologique de la transformation affine : les relations fonctionnelles sous-jacentes au sein du collectif d’observations n’ont subi aucune distorsion artificielle, validant l’adéquation de la table standardisée pour les étapes ultérieures d’inférence statistique ou de modélisation mathématique avancée.
6. Méthodes alternatives de mise à l’échelle via l’option METHOD=
6.1 Normalisation Min-Max avec l’option METHOD=RANGE
Bien que la standardisation par score z demeure la démarche par défaut au sein de PROC STDIZE, la procédure offre une grande souplesse algorithmique grâce à l’argument de sélection d’échelle METHOD=. Lorsque les objectifs d’analyse s’écartent des postulats gaussiens pour converger vers les impératifs opérationnels de l’apprentissage automatique (machine learning) ou des architectures de réseaux de neurones artificiels, la projection des données sur un intervalle unitaire délimité devient prépondérante. Cette mise à l’échelle s’exécute sous SAS en configurant l’instruction sous la forme explicite METHOD=RANGE.
La formalisation mathématique sous-jacente à METHOD=RANGE calcule pour chaque observation la fonction linéaire $z_i = (x_i – x_{\min}) / (x_{\max} – x_{\min})$. Par défaut, cette opération projette strictement l’ensemble des données numériques au sein du domaine compact $[0, 1]$, assignant obligatoirement la valeur zéro à l’observation originellement la plus faible et la valeur un à l’observation culminante. Toutefois, l’environnement SAS autorise une personnalisation poussée de ces bornes de projection via l’instruction complémentaire RANGE=, permettant par exemple de délimiter l’intervalle entre $[-1, 1]$, format fréquemment requis par les fonctions d’activation neuronales de type tangente hyperbolique ($tanh$).
L’utilisation de cette méthode s’avère particulièrement pertinente lors de la préparation de tenseurs de données pour des algorithmes d’apprentissage profond ou des séparateurs à vaste marge (SVM), où des variables aux étendues divergentes perturbent gravement le calcul du gradient de descente stochastique. L’option FUZZ= peut être associée à cette configuration afin d’absorber de légères fluctuations numériques autour des seuils limites et d’éviter que des observations infiniment proches des extrema ne génèrent des instabilités numériques ou des divisions par zéro lors du traitement de sous-échantillons à dispersion quasi nulle.
6.2 Normalisation robuste basée sur la médiane et les quantiles
L’inconvénient structurel majeur de la moyenne arithmétique et de l’écart-type réside dans leur vulnérabilité métrologique face aux données atypiques : leur point de rupture asymptotique est mathématiquement nul ($\epsilon^* = 0$). Cela implique qu’une seule observation contaminée arbitrairement élevée ou erronée au sein d’une série suffit à entraîner la moyenne et l’écart-type vers l’infini, biaisant l’ensemble de la standardisation z pour l’ensemble des observations saines. Pour pallier cette faiblesse dans les cohortes cliniques instables ou asymétriques, PROC STDIZE propose une panoplie d’estimateurs résistants de haut niveau par le biais des options METHOD=MEDIAN, METHOD=MAD et METHOD=IQR.
L’argument METHOD=MAD substitue à l’écart-type classique la déviation médiane absolue (Median Absolute Deviation), définie par la relation robuste $\mathrm{MAD} = \mathrm{médiane}(|x_i – \mathrm{médiane}(X)|)$. Normalisée par un facteur de correction d’échelle asymptotique égal à $1{,}4826$ sous hypothèse gaussienne, la MAD fournit un estimateur d’échelle hautement résistant, doté d’un point de rupture élevé de 50 %, ce qui signifie que près de la moitié de l’échantillon peut être sévèrement corrompue sans que l’indicateur d’échelle ne s’effondre. De son côté, la commande METHOD=IQR mobilise l’écart interquartile ($Q_3 – Q_1$) normalisé comme diviseur d’échelle après soustraction de la médiane empirique, offrant un ancrage quantile intermédiaire d’une grande rigueur métrologique.
Ces méthodologies robustes trouvent un champ d’application direct dans l’analyse de données psychométriques ou comportementales issues de populations psychiatriques sévères. Dans ces populations, des comportements atypiques ou des temps de réaction extrêmement retardés peuvent générer des observations hautement aberrantes sans pour autant relever d’erreurs de mesure. Standardiser ces profils avec des estimateurs robustes permet de replacer les sujets au sein de métriques universelles non influencées par les cas limites, évitant ainsi d’atténuer artificiellement les scores standardisés des individus réguliers.
6.3 Mise à l’échelle basée sur les normes géométriques
Dans les applications analytiques spécialisées exploitant l’algèbre vectorielle et la topologie spatiale, la transformation des variables quantitatives ne vise plus obligatoirement l’homogénéisation des deux premiers moments statistiques univariés, mais plutôt la contrainte géométrique des vecteurs d’observations sur des hypersurfaces spécifiques au sein d’un espace à $p$ dimensions. PROC STDIZE permet de répondre avec précision à ces exigences matricielles avancées grâce à ses options de normalisation fondées sur les normes géométriques de Minkowski, paramétrables via les options METHOD=L1 et METHOD=L2.
L’implémentation de la commande METHOD=L1 (ou norme de Manhattan) contraint la somme des valeurs absolues de chaque vecteur dimensionnel à être strictement égale à l’unité ($\sum |z_{ij}| = 1$). Sur le plan fonctionnel, cette approche s’apparente à une projection sur un simplexe unitaire, transformant les observations en proportions relatives d’allocation globale, ce qui s’avère particulièrement utile lors du traitement de données compositionnelles, d’analyses de profils budgétaires de temps comportemental ou de profils d’expression métabolique. Chaque coordonnée reflète dès lors la contribution fractionnaire d’une modalité donnée à l’énergie totale du vecteur analysé.
À l’inverse, l’option METHOD=L2 applique la norme euclidienne canonique, contraignant la somme des carrés des coordonnées scalaires à l’unité ($\sum z_{ij}^2 = 1$). Géométriquement, l’ensemble des vecteurs de données ainsi transformés se trouve projeté sur la surface d’une hypersphère unitaire centrée sur l’origine au sein de l’espace métrique euclidien. Cette mise à l’échelle géométrique est fondamentale en text-mining pour le calcul de similarités cosinus ou dans l’élaboration de typologies comportementales de profils psychologiques comparés. Elle assure que deux profils manifestant des proportions identiques à travers une batterie d’items partagent des coordonnées spatiales identiques, neutralisant l’effet d’intensité globale ou de volume d’activité absolue du sujet.
7. Normalisation multivariée simultanée de profils de variables
7.1 Traitement de batteries d’évaluations psychométriques complexes
L’exploitation empirique de protocoles de recherche en neurosciences cognitives et en psychométrie clinique implique rarement l’analyse isolée d’un trait univarié unique. Les expérimentateurs sont couramment confrontés au recueil simultané de batteries composites combinant des dizaines de dimensions comportementales, neuropsychologiques et biologiques hétérogènes. Déployer des cycles d’instructions élémentaires répétitifs pour chaque variable au sein de programmes d’analyse fragilise la maintenabilité du code et multiplie les risques d’omissions accidentelles. PROC STDIZE résout cette complexité structurelle en autorisant la déclaration groupée de vecteurs multivariés complexes au sein d’une clause VAR unique.
La syntaxe de l’instruction VAR admet les notations abrégées vectorielles de SAS, autorisant la saisie de listes de variables indexées par des tirets numériques consécutifs (par exemple, Item1-Item50) ou l’usage de caractères génériques et d’intervalles de variables contiguës (VAR Score_Cognitif -- Mesure_Biologique;). Lors de cette exécution multivariée conjointe, PROC STDIZE garantit une totale indépendance opérationnelle dans le traitement de chaque colonne. Le moteur itère à travers les colonnes matricielles en recalculant de manière hermétique les paramètres de localisation et d’échelle propres à chaque trait, sans aucune interférence ou contamination croisée entre les estimateurs marginaux respectifs.
Ce traitement unifié produit un résultat capital sur la structure relationnelle interne de la matrice de données : la préservation intégrale et parfaite de la matrice de corrélation linéaire originale. Dès lors que chaque dimension subit une transformation affine rigoureusement univariée, l’angle cosinus spatial séparant chaque couple de vecteurs de variables demeure immuable. Par conséquent, la nouvelle matrice de variance-covariance calculée sur l’ensemble des variables centrées et réduites devient strictement et formellement identique à la matrice de corrélation de Pearson originelle des données brutes, condition préalable indispensable pour l’engagement de procédures d’analyse factorielle ou de modélisation causale ultérieures.
7.2 Gestion de la dénomination des variables en sortie
L’exécution d’une standardisation multivariée massive soulève un défi d’architecture de données concernant l’identification des séries transformées au sein de la table de sortie. Par défaut, PROC STDIZE conserve dans la table OUT= les dénominations d’origine pour les colonnes standardisées. Bien que cette substitution de valeurs soit parfaitement lisible, elle présente l’inconvénient méthodologique de masquer le statut d’échelle de la variable et interdit la présence simultanée des mesures brutes et des scores standardisés au sein du même enregistrement analytique, contraignant les analystes à multiplier les jointures pour de simples vérifications.
Pour prévenir toute ambiguïté de nomenclature au sein des banques de données partagées, il convient d’associer à PROC STDIZE ou aux étapes de manipulation connexes des stratégies précises de renommage dynamique. L’utilisation conjointe de l’instruction RENAME= au sein de la table de sortie (par exemple, PROC STDIZE DATA=Source OUT=Target(RENAME=(Anxiete=z_Anxiete Depression=z_Depression));) garantit une traçabilité visuelle immédiate dans le dictionnaire des variables de SAS. L’incorporation de préfixes distinctifs tels que z_ ou std_ documente explicitement la nature métrologique de la colonne pour tous les utilisateurs ultérieurs de la table.
Conjointement au renommage formel des identifiants de colonnes, la préservation des métadonnées de variables s’effectue via l’instruction d’attribution de labels explicatifs (instruction LABEL). PROC STDIZE autorise la mise à jour dynamique des étiquettes descriptives associées aux colonnes traitées. L’attribution d’un label précisant formellement l’ancrage algorithmique (par exemple, LABEL z_Depression="Score BDI Centré et Réduit (Moyenne=0, Écart-Type=1)";) ancre de manière indélébile la traçabilité des opérations directement au sein du dictionnaire des métadonnées du fichier de données SAS, satisfaisant ainsi aux exigences de transparence méthodologique des consortiums scientifiques internationaux.
7.3 Sauvegarde des vecteurs de localisation et d’échelle
L’un des apports majeurs de la procédure PROC STDIZE sur le plan de la rigueur scientifique et de l’ingénierie logicielle réside dans sa capacité native à archiver l’intégralité des paramètres numériques mobilisés lors du calcul de mise à l’échelle. Dans le cadre d’un protocole expérimental rigoureux, il ne suffit pas de générer une table d’observations transformées ; il est impératif d’enregistrer de manière permanente les scalaires exacts de centrage (les moyennes ou médianes empiriques) et de réduction (les écarts-types ou écarts interquartiles) ayant servi à normaliser chaque dimension. Cette extraction s’opère au moyen de l’option OUTSTAT= ajoutée dans l’en-tête de la procédure.
L’instruction OUTSTAT=Table_Parametres ordonne à SAS de générer une table relationnelle structurée qui répertorie de façon systématique, sous forme de lignes indexées par une variable discriminante _TYPE_, les paramètres statistiques clés calculés pour chaque variable soumise à normalisation. La table héberge ainsi des lignes formelles documentant l’effectif valide (N), la moyenne ou le paramètre de localisation (LOCATION) et l’écart-type ou le paramètre d’échelle (SCALE). Cet inventaire numérique dresse une photographie exacte de l’état métrique de la cohorte ayant servi de base à l’étalonnage du système de mesure.
Cette sauvegarde systématique des scalaires de localisation et d’échelle est primordiale pour la reproductibilité computationnelle exigée par les revues à comité de lecture et les agences d’évaluation du médicament (telles que la FDA ou l’EMA). Elle fournit une traçabilité intégrale permettant de reconstituer les séries de données initiales à partir des scores standardisés selon la relation inverse $x_i = (z_i \times \mathrm{SCALE}) + \mathrm{LOCATION}$. De surcroît, elle fournit l’intrant fondamental nécessaire au scoring prospectif de nouvelles cohortes de sujets, évitant ainsi le risque fatal de contamination des bases de test par recalcul instable d’estimateurs marginaux.
8. Traitement rigoureux des valeurs manquantes et imputation conjointe
8.1 Comportement natif de PROC STDIZE face aux valeurs manquantes
La présence de valeurs manquantes (représentées par un point d’interrogation ou point décimal simple . dans les tables SAS numériques) est une contingence quasi inévitable dans les recherches cliniques, les cohortes épidémiologiques et les collectes de données écologiques longitudinales. Dans ce contexte, l’intégrité de l’algorithme de normalisation dépend de sa capacité à traiter ces lacunes sans introduire de biais d’estimation au niveau des paramètres de centrage et de dispersion. Par défaut, PROC STDIZE adopte une stratégie d’exclusion marginale rigoureuse conforme aux standards de l’analyse exploratoire univariée.
Lors de la phase d’estimation préliminaire, PROC STDIZE calcule la moyenne arithmétique et l’écart-type d’une colonne donnée en se fondant exclusivement sur le sous-ensemble effectif des observations renseignées pour cette variable précise, ignorant purement et simplement les valeurs manquantes. Contrairement à certaines procédures multivariées qui procèdent par suppression de la liste complète des observations incomplètes (listwise deletion) dès lors qu’une seule case est vide, PROC STDIZE calcule les statistiques d’échelle pour chaque dimension de manière univariée, maximisant ainsi la puissance statistique de chaque estimation d’échelle en utilisant l’intégralité des données disponibles.
Toutefois, ce comportement par défaut dicte également le sort de la valeur manquante dans la table finale transformée spécifiée par l’argument OUT=. Si une cellule comporte une valeur manquante dans la table source, la cellule homologue dans la table transformée demeurera strictement une valeur manquante. Cette rigueur algorithmique préserve l’analyste de toute falsification involontaire des données en amont, mais elle transfère l’obligation de traiter ces absences aux étapes analytiques ultérieures, de nombreux modèles statistiques multivariés (comme les modèles factoriels ou certaines régressions pénalisées) ne tolérant aucun manque au sein de leur matrice de prédicteurs.
8.2 Imputation simultanée au cours de la normalisation
Conscients de la nécessité fonctionnelle de combler les lacunes d’observation au sein des chaînes de traitement automatisées, les concepteurs de SAS ont intégré à PROC STDIZE un moteur d’imputation univariée simple extrêmement performant. Ce dispositif permet de fusionner en une passe algorithmique unique les opérations de traitement des données manquantes et de standardisation d’échelle, éliminant ainsi le recours à des macro-programmes de substitution complexes. Cette fonctionnalité s’active par l’association de l’option REPONLY et du paramètre de sélection de valeur MISSING=.
L’argument REPONLY modifie le comportement par défaut de la procédure en indiquant au compilateur qu’aucune standardisation métrique ne doit être appliquée aux observations valides, la procédure devant se focaliser exclusivement sur le remplacement des données manquantes par une valeur cible. Lorsqu’elle est utilisée sans l’option REPONLY, PROC STDIZE standardise d’abord les valeurs renseignées puis substitue instantanément les valeurs manquantes par la métrique spécifiée via MISSING=. L’analyste peut ainsi spécifier MISSING=METHOD pour ordonner le remplacement automatique des cases vides par la moyenne empirique (ou par la médiane selon la clause METHOD= choisie) calculée sur les cas valides de la colonne.
L’utilisation de cette méthode d’imputation déterministe univariée soulève néanmoins d’importantes questions méthodologiques et psychométriques. Bien qu’elle permette de maintenir l’effectif complet des lignes de la table d’analyse sans supprimer les cas partiellement renseignés, l’imputation par la moyenne engendre une réduction artificielle de la variance empirique de la variable et dilue l’intensité des corrélations observées avec les autres dimensions mesurées. Dès lors, cette stratégie d’imputation directe au sein de PROC STDIZE doit être réservée à des variables présentant un taux de données manquantes résiduel (typiquement inférieur à 3 ou 5 %) ou appliquée dans des cadres d’ingénierie prédictive opérationnelle où la continuité computationnelle prime sur l’inférence des paramètres d’échantillonnage.
8.3 Diagnostic comparatif avant et après traitement d’absence
L’application d’un traitement d’imputation conjointe impose un diagnostic métrologique rigoureux afin d’évaluer la distorsion résiduelle introduite dans la structure des données. Un protocole analytique professionnel requiert l’évaluation de la matrice d’écart-type et des coefficients de corrélation avant et après la phase d’imputation-standardisation. L’altération significative des quantiles ou un affaissement marqué de l’écart-type témoignent d’une surreprésentation artificielle de la valeur centrale imputée, qui risque de fausser les tests d’hypothèses ultérieurs en réduisant artificiellement les erreurs-types associées.
Pour des jeux de données caractérisés par une attrition plus prononcée ou des patrons d’absence non aléatoires (Missing at Random ou Missing Not at Random selon la typologie de Rubin), la méthodologie académique proscrit l’imputation simple par PROC STDIZE au profit d’approches par imputation multiple, orchestrées sous SAS via la procédure PROC MI. Cette dernière génère plusieurs jeux de données imputés complétés par modélisation stochastique (par régression logistique, chaîne de Markov Monte Carlo ou modèle de prédiction conditionnelle pleinement spécifiée), reflétant ainsi l’incertitude liée au processus de perte de données.
Les normes de transparence méthodologique contemporaines exigent que les rapports de recherche quantitatifs documentent explicitement la méthode employée pour gérer les absences de données. Lorsqu’une normalisation avec imputation univariée via PROC STDIZE est retenue, le pourcentage exact de cellules imputées par variable, la justification statistique du seuil d’admissibilité et l’impact comparé sur les moments de distribution doivent être formellement consignés dans le protocole expérimental ou dans les annexes méthodologiques de la publication.
9. Normalisation stratifiée par sous-groupes via l’instruction BY
9.1 Standardisation intragroupe pour études différentielles
Dans de nombreuses applications cliniques, épidémiologiques et sociodémographiques, postuler l’existence d’une distribution unique et homogène au sein de la cohorte d’étude constitue une simplification abusive. Des sous-populations distinctes au sein d’un même échantillon peuvent manifester des variations physiologiques, développementales ou cognitives systématiques. Par exemple, la vitesse de traitement de l’information varie fortement selon les tranches d’âge, tandis que la capacité vitale pulmonaire dépend de la taille et du sexe biologique. Standardiser de telles variables de façon globale écraserait les variations spécifiques à chaque sous-groupe, pénalisant systématiquement certains profils par un centrage inadapté.
La normalisation stratifiée, ou standardisation intragroupe, vise à remédier à cet écueil en calibrant le centrage et la réduction de manière autonome au sein de chaque strate démographique ou expérimentale identifiée. Au lieu d’utiliser la moyenne globale de la cohorte, l’algorithme dérive des paramètres $(\bar{x}_k, s_k)$ spécifiques à chaque sous-groupe $k$. Chaque observation individuelle est ensuite évaluée exclusivement par rapport à la distribution de son groupe de référence fonctionnel. En psychologie différentielle, cette approche permet d’établir des normes d’évaluation cliniques étalonnées, garantissant qu’un score z exprime une déviation réelle par rapport aux pairs de même tranche d’âge plutôt qu’un écart systématique lié au vieillissement.
Sur le plan expérimental, cette standardisation partitionnée permet également d’annuler les écarts systématiques de ligne de base existant entre des cohortes expérimentales et des groupes témoins avant l’administration d’un traitement thérapeutique. En fixant la moyenne de chaque condition d’essai à zéro au temps de référence, les analyses longitudinales subséquentes (comme les analyses de variance à mesures répétées ou les modèles mixtes) peuvent isoler l’effet spécifique de l’intervention sans interférence des disparités préexistantes.
9.2 Exécution séquentielle avec tri préalable via PROC SORT
L’implémentation de la normalisation stratifiée au sein de l’architecture SAS repose sur l’intégration de la clause BY au sein de la procédure PROC STDIZE. Cette instruction ordonne au compilateur d’exécuter l’algorithme de façon séquentielle et hermétique pour chaque modalité de la variable de stratification désignée. Toutefois, cette souplesse syntaxique impose une contrainte opérationnelle fondamentale propre au moteur interne de traitement séquentiel de SAS : les données en entrée doivent impérativement être triées au préalable selon l’ordre strict des variables déclarées dans la clause BY.
La soumission d’une instruction BY sur une table non indexée ou non triée interrompt immédiatement l’exécution de la procédure, générant une erreur bloquante au journal de session (ERROR: Data set WORK.DATA is not sorted in order of the BY variables). L’étape préliminaire requiert donc systématiquement l’appel préalable de la procédure de tri optimisé PROC SORT. Cette procédure réorganise physiquement les enregistrements du jeu de données en mémoire ou sur disque selon les variables de regroupement catégorielles choisies (par exemple, PROC SORT DATA=Cohorte; BY Sexe Tranche_Age; RUN;).
Une fois le tri complété avec succès, la clause BY intégrée à PROC STDIZE opère le découpage algorithmique sans rupture de flux. La procédure calcule successivement les scalaires d’échelle propres à chaque strate, applique la transformation correspondante et consolide l’ensemble des enregistrements standardisés au sein de la table finale désignée par OUT=. L’analyste peut vérifier la rigueur de l’exécution en observant, via un PROC MEANS combiné à cette même clause BY, que la moyenne empirique converge précisément vers zéro et que l’écart-type se calibre à l’unité au sein de chaque strate démographique.
9.3 Comparaison entre normalisation globale et normalisation segmentée
Le choix entre une approche de standardisation globale et une démarche segmentée par sous-groupes ne relève pas d’une simple préférence computationnelle mais d’une décision méthodologique engageante qui façonne la structure des données analysées. Une normalisation globale préserve les contrastes absolus et les décalages de niveau moyens existant entre les différents groupes de l’échantillon. Par exemple, si un groupe clinique pathologique affiche un niveau moyen de biomarqueur systématiquement supérieur à celui du groupe témoin, la standardisation globale conservera cet écart de moyenne intergroupe intact au sein des scores standardisés résultants.
À l’inverse, l’application d’une normalisation stratifiée par sous-groupe neutralise délibérément ces contrastes intergroupes globaux. En forçant la moyenne de chaque strate à s’aligner sur zéro et sa variance sur l’unité, cette approche supprime la variance intergroupe pour ne conserver que la variance intragroupe résiduelle. Ce traitement peut s’avérer néfaste si l’objectif de l’analyste consiste à prédire l’appartenance au groupe pathologique à partir des scores standardisés, car le signal discriminant lié aux différences de moyenne entre groupes aura été involontairement éliminé par la procédure de centrage partitionné.
Il appartient donc au statisticien d’évaluer la pertinence de cette segmentation au regard de son modèle théorique d’investigation. Si la question de recherche porte sur l’identification d’anomalies relatives par rapport à un étalonnage normatif spécifique à une strate (normes d’aptitude selon l’âge ou normes biologiques ajustées au sexe), la standardisation par BY est indispensable. Si la finalité réside en revanche dans l’évaluation de la performance prédictive globale ou la détection de contrastes diagnostiques intermédiaires, la normalisation globale non segmentée doit être maintenue afin de préserver l’information portée par les écarts systématiques entre sous-populations.
10. Automatisation et intégration dans des macro-programmes SAS
10.1 Conception d’une macro polyvalente de standardisation
Dans les environnements d’analyse de données d’entreprise et les centres de coordination biostatistiques, la reproductibilité et la rentabilité du code requièrent l’automatisation des opérations récurrentes de préparation de données. L’écriture manuelle répétitive de blocs de procédures pour chaque nouvelle table ou sélection de variables est source d’hétérogénéités programmatiques et d’erreurs de maintenance. L’encapsulation de la procédure PROC STDIZE au sein d’une macro SAS paramétrable (%MACRO) fournit une solution élégante et industrielle pour standardiser dynamiquement des matrices de données de configurations variables.
Une macro de standardisation robuste doit accepter des arguments flexibles permettant de spécifier la table source (dsin), la table cible (dsout), la liste exhaustive des variables continues cibles (varlist), la méthode de standardisation souhaitée (method=STD) et le préfixe textuel à accoler aux variables en sortie. La structure interne de la macro peut intégrer des vérifications d’intégrité préalables en interrogeant les tables de métadonnées du système SAS hébergées dans la bibliothèque de métadonnées SASHELP, en particulier la vue SASHELP.VCOLUMN. Ce dictionnaire permet de contrôler dynamiquement si les colonnes soumises existent réellement dans la table d’entrée et si leur typage est bien de nature numérique, interrompant l’exécution de la macro par un message d’erreur explicite dans le journal SAS (SAS Log) en cas d’anomalie.
Cette approche modulaire standardise les protocoles de préparation de données au sein d’une organisation de recherche. L’appel concis d’une seule commande unifiée (par exemple, %NormaliserDonnees(dsin=Clinique, dsout=Clinique_Std, varlist=Age Pression Glycemie, method=RANGE);) remplace des dizaines de lignes de code statique, assurant la traçabilité des transformations et réduisant les risques d’erreur humaine lors de l’intégration dans des pipelines d’analyses périodiques complexes.
10.2 Réapplication de paramètres de centrage sur de nouvelles observations
L’un des écueils majeurs de la modélisation prédictive en apprentissage automatique et en analyse biométrique réside dans la fuite d’information statistique, désignée dans la littérature sous le concept de data leakage. Ce phénomène invalidant se produit lorsqu’une étape de prétraitement (telle que le calcul de la moyenne et de l’écart-type d’une variable) est exécutée de façon globale sur l’intégralité du jeu de données agrégé avant d’opérer la scission entre échantillon d’apprentissage (training set) et échantillon de validation (test set). Dans ce cas, les paramètres descriptifs du jeu d’apprentissage sont contaminés par l’information issue des cas de test, produisant des évaluations de performance prédictive trop optimistes et impossibles à reproduire sur le terrain.
Pour prévenir cette contamination sous SAS, les paramètres de localisation et d’échelle doivent être calculés exclusivement sur l’échantillon d’apprentissage, archivés dans une table de métadonnées via l’option OUTSTAT= de PROC STDIZE, puis réappliqués de manière déterministe sur les nouvelles observations de validation ou les cohortes de déploiement ultérieures. Cette transposition d’ancrage métrique sans recalcul d’estimateurs marginaux s’opère de façon optimale grâce à la procédure PROC SCORE, conçue spécifiquement pour projeter une table d’observations brutes selon une matrice de coefficients et de paramètres de centrage fixes générée en amont.
Alternativement, le mode scoring de PROC STDIZE lui-même peut être mobilisé pour accomplir cette projection en spécifiant l’option METHOD=IN=, qui instruit la procédure de puiser ses scalaires de transformation directement au sein d’une table d’étalonnage préalablement générée par OUTSTAT=. Cette rigueur méthodologique garantit que les observations de test sont évaluées à l’aune stricte des paramètres statistiques établis sur le jeu d’entraînement, préservant la validité du protocole de validation croisée et garantissant l’indépendance de l’évaluation prédictive.
10.3 Optimisation des performances sur des volumétries massives
Lorsque la normalisation s’applique à des bases de données massives — telles que des séries de données d’assurance, des registres de télémétrie ou des génotypages exhaustifs comptant plusieurs dizaines de millions d’enregistrements et plusieurs centaines de colonnes —, l’optimisation des performances d’exécution machine devient un enjeu opérationnel critique. L’accumulation des entrées-sorties sur disque (I/O) et les contentions de bande passante mémoire peuvent rapidement dégrader les temps de traitement si les paramètres de configuration du système SAS ne sont pas minutieusement ajustés.
L’exploitation de l’option système BUFFSIZE= et du paramètre de mémoire tampon BUFNO= permet d’accroître substantiellement l’efficacité des transferts de données en chargeant des blocs volumineux d’enregistrements directement en mémoire cache, minimisant ainsi les accès physiques au disque dur. De même, lorsque l’architecture matérielle le permet, l’affectation temporaire de la bibliothèque de travail WORK au sein d’un disque virtuel en mémoire vive (RAM-Disk) via le paramètre MEMLIB accélère de manière spectaculaire les étapes intermédiaires de lecture et de réécriture matricielle exécutées par PROC STDIZE.
Enfin, l’audit méthodique des temps de traitement d’horloge (real time) et de temps processeur (CPU time), consigné au sein du journal d’exécution grâce à l’activation préalable des options d’environnement globales OPTIONS FULLSTIMER;, fournit aux bio-informaticiens et aux architectes de données des métriques de diagnostic précises. Cet audit des ressources computationnelles permet d’identifier d’éventuels goulets d’étranglement structurels, d’ajuster l’allocation de la mémoire vive partagée et de rationaliser les flux d’instructions avant de lancer des campagnes de modélisation à très grande échelle.
11. Impact de la normalisation sur les analyses statistiques multivariées avancées
11.1 Influence déterminante sur l’Analyse en Composantes Principales (PROC PRINCOMP)
L’Analyse en Composantes Principales (ACP) constitue l’une des techniques de réduction dimensionnelle les plus répandues en analyse exploratoire multivariée. Son algorithme repose sur la diagonalisation d’une matrice symétrique de dispersion : soit la matrice de covariance brute $boldsymbol{\Sigma}$, soit la matrice de corrélation linéaire $\mathbf{R}$. L’exécution de cette technique sous SAS via la procédure PROC PRINCOMP illustre parfaitement le rôle décisif de la normalisation préalable des variables quantitatives continues.
Lorsque PROC PRINCOMP est appliquée sur des données brutes hétérogènes sans spécification particulière, la procédure opère par défaut la diagonalisation de la matrice de covariance. Les variables affichant les variances numériques les plus massives captent artificiellement l’essentiel de l’inertie globale du nuage de points, monopolisant les premiers vecteurs propres associés aux plus grandes valeurs propres. Le premier axe factoriel extrait ne reflétera alors pas une combinaison causale latente fondamentale, mais simplement la projection géométrique de la variable la plus dispersée du jeu de données, masquant les relations de covariance plus subtiles entre les variables de plus faible amplitude.
Pour neutraliser ce biais dimensionnel, il est nécessaire de réaliser l’ACP sur la matrice de corrélation ou, de façon strictement équivalente, d’exécuter l’ACP sur une matrice de données préalablement standardisée via PROC STDIZE. Dans ce cadre, chaque variable normalisée se voit attribuer une variance unitaire strictly égale à 1, garantissant que chaque dimension dispose d’un potentiel équivalent de contribution à la variance globale totale ($p$, correspondant au nombre de variables analysées). L’interprétation des valeurs propres, des pourcentages de variance expliquée et du diagramme d’éboulis (scree plot) reflète dès lors de véritables associations dimensionnelles, offrant une modélisation factorielle saine exempte de tout biais d’échelle.
11.2 Applications en classification non supervisée (PROC FASTCLUS et PROC CLUSTER)
Les algorithmes de classification non supervisée ou de typologie automatique (clustering), tels que l’algorithme des $k$-moyennes implémenté dans PROC FASTCLUS ou les méthodes de classification hiérarchique ascendante intégrées dans PROC CLUSTER, reposent fondamentalement sur le calcul d’indices de dissimilarité spatiale interindividuelle. Dans l’immense majorité des applications, la proximité entre deux profils d’observations s’évalue par le calcul direct de la distance euclidienne canonique au sein de l’espace vectoriel formé par les variables descriptives sélectionnées.
En l’absence d’une normalisation préalable rigoureuse, la topologie spatiale des données se trouve déformée de manière disproportionnée au profit de la variable caractérisée par l’étendue numérique la plus vaste. Une variation de 50 unités sur une variable d’échelle large (comme le revenu ou le score total d’un test étendu) générera une distance spatiale quadratique $(50)^2 = 2500$, tandis qu’une variation d’une unité sur une variable restreinte (comme le nombre d’enfants à charge ou un ratio clinique) n’induira qu’un écart marginal de $(1)^2 = 1$. L’algorithme de partitionnement regroupera dès lors les individus quasi exclusivement en fonction de leur proximité sur la première dimension, rendant les autres dimensions totalement inopérantes dans la formation des classes d’individus.
La mise en œuvre systématique de PROC STDIZE en amont de PROC FASTCLUS garantit une métrique euclidienne non biaisée au sein de laquelle chaque dimension comportementale ou clinique intervient avec une dispersion normalisée équivalente. Cette isotropie d’échelle stabilise de manière spectaculaire la convergence des centroïdes de clusters, améliore la reproductibilité empirique des partitions obtenues et prévient l’émergence de regroupements artificiels dictés par de simples disparités d’unités de mesure.
11.3 Régularisation dans les modèles prédictifs et régressions pénalisées
L’essor de la modélisation statistique moderne en contexte de haute dimensionnalité a popularisé les techniques de régression pénalisée, principalement les estimateurs Lasso (pénalité $L_1$), Ridge (pénalité $L_2$) et Elastic Net (combinaison linéaire des pénalités $L_1$ et $L_2$). Ces approches, implémentées dans SAS au sein de la procédure PROC GLMSELECT, contraignent la fonction de vraisemblance en infligeant une pénalité financière mathématique sur la magnitude des coefficients de régression estimée $\sum |\beta_j|$ ou $\sum \beta_j^2$ afin de prévenir le surapprentissage (overfitting) et d’opérer une sélection parcimonieuse de prédicteurs.
Cette imposition d’une contrainte d’amplitude globale sur les coefficients de régression exige impérativement que l’ensemble des prédicteurs candidats soit calibré sur une échelle de mesure strictement standardisée. La pénalité s’appliquant uniformément aux grandeurs numériques brutes des coefficients $\beta_j$, un prédicteur associé à une unité de mesure infinitésimale présentera naturellement un coefficient numérique massif pour compenser son échelle, et subira ainsi une pénalisation disproportionnée conduisant à son exclusion erronée du modèle. Inversement, un prédicteur mesuré sur une échelle numérique immense verra son coefficient artificiellement comprimé vers zéro et échappera indûment à la régularisation.
Bien que PROC GLMSELECT intègre des routines internes de standardisation automatique de ses prédicteurs au cours du calcul d’optimisation par pénalisation, la maîtrise explicite de cette transformation au sein du pipeline en amont via PROC STDIZE garantit une transparence totale sur les données injectées. Une fois les prédicteurs sélectionnés et les coefficients optimisés, les paramètres peuvent être rétablis sur leur échelle de mesure d’origine via les constantes d’échelle archivées dans la table OUTSTAT=, condition indispensable pour que les coefficients finaux du modèle soient interprétables sur le plan clinique ou opérationnel par les praticiens du domaine.
12. Erreurs fréquentes, validation empirique et recommandations académiques
12.1 Pièges computationnels et méconnaissances syntaxiques courantes
L’application pratique de la normalisation sous SAS est fréquemment émaillée d’approximations conceptuelles et d’erreurs d’implémentation logicielle qui peuvent compromettre la validité des analyses ultérieures. Le premier piège méthodologique, récurrent chez les utilisateurs juniors, repose sur la confusion fondamentale entre la standardisation linéaire par score z et l’ajustement formel à une loi de distribution normale. Standardiser une variable distribuée selon une loi bimodale ou exponentielle ne modifie en rien son asymétrie sous-jacente. Conclure à la normalité gaussienne d’une série au seul motif qu’elle affiche une moyenne nulle et un écart-type unitaire après passage par PROC STDIZE constitue une grave erreur d’inférence statistique.
Sur le plan programmatique, l’erreur la plus préjudiciable consiste en l’omission de l’argument de destination OUT= lors de l’appel de PROC STDIZE. Dans un tel scénario, l’architecture SAS exécute la transformation directement sur la table source déclarée dans DATA=, écrasant définitivement les données brutes par les valeurs standardisées. Si l’analyste n’a pas préalablement constitué une copie de sauvegarde immuable de ses données sources, cette inadvertance entraîne la destruction irréversible de l’historique métrologique originel, interdisant tout retour aux valeurs brutes et invalidant les audits de reproductibilité exigés par les comités d’examen scientifique.
Enfin, une autre erreur classique réside dans la standardisation conjointe et indistincte des variables prédictives et de la variable dépendante (ou variable cible) au sein des modèles prédictifs supervisés. Si la standardisation des prédicteurs d’entrée est essentielle dans les analyses régularisées ou multivariées, transformer sans précaution la variable cible peut altérer l’interprétabilité des métriques résiduelles (telles que la moyenne des erreurs quadratiques, RMSE) et compliquer l’estimation des probabilités d’événements dans le cadre de modèles de régression logistique binaire ou polytomique.
12.2 Critères méthodologiques pour le choix entre moyenne-écart type et alternatives robustes
Le choix raisonné de la méthode de standardisation à déployer au sein de PROC STDIZE ne doit pas s’effectuer au hasard mais découler d’un protocole de diagnostic distributionnel rigoureux. Face à un jeu de données quantitatives continues, l’analyste doit articuler son arbre de décision autour de deux facteurs majeurs : le degré d’asymétrie structurelle de la distribution et le taux de contamination présumé par des valeurs extrêmes ou aberrantes.
Lorsque les données empiriques présentent une distribution approximativement symétrique (coefficient d’asymétrie compris entre $-0{,}5$ et $+0{,}5$) et que les tests d’adéquation ne révèlent aucune queue de distribution lourde, la méthode par défaut (moyenne arithmétique et écart-type canonique) demeure l’approche optimale. Elle maximise l’efficacité statistique des estimateurs en exploitant l’ensemble de l’information échantillonnale sous des postulats d’échantillonnage asymptotiquement gaussiens.
En revanche, dès lors que l’échantillon présente une contamination sévère par des valeurs atypiques ou des asymétries prononcées, le maintien des estimateurs classiques expose l’analyste à des biais métrologiques majeurs. L’arbre décisionnel impose alors le basculement vers des alternatives robustes. Si l’objectif consiste à préserver la métrique d’écart-type tout en protégeant le système contre l’influence des queues de distribution, l’option METHOD=MAD doit être privilégiée. Si la métrique d’intérêt relève de la logique d’ordre des quantiles, la standardisation par l’intervalle interquartile via METHOD=IQR offre une résistance supérieure. Enfin, si les données sont destinées à alimenter des algorithmes d’apprentissage automatique requérant des tenseurs bornés compacts, la sélection de METHOD=RANGE s’impose comme le choix fonctionnel le plus pertinent.
12.3 Normes de rigueur pour la restitution des résultats dans les publications scientifiques
La communication des protocoles de normalisation au sein des manuscrits académiques soumis aux revues internationales à comité de lecture est assujettie à des exigences de transparence méthodologique strictes, formulées notamment par l’American Psychological Association (APA, 7e édition) et le consortium EQUATOR Network via les lignes directrices STROBE et CONSORT. Il est scientifiquement inacceptable de se borner à mentionner dans la section méthodologique que « les données ont été normalisées » sans fournir le détail exhaustif de l’opérationnalisation statistique retenue.
Le chercheur doit obligatoirement expliciter la formulation mathématique employée (standardisation par score z canonique, mise à l’échelle min-max sur intervalle fermé, ou recours à des estimateurs robustes de type médiane et MAD), en citant expressément le logiciel utilisé, le module d’exécution et sa version exacte (par exemple, SAS System version 9.4, procédure PROC STDIZE, SAS Institute Inc., Cary, NC). Lorsque des transformations non linéaires préalables (comme des corrections logarithmiques ou de Box-Cox) ont été appliquées pour pallier une asymétrie de distribution, le paramètre de transformation d’échelle (par exemple, la valeur optimale du coefficient $lambda$) doit être formellement documenté.
Enfin, la rigueur éditoriale impose de ne pas occulter les métriques empiriques originelles. Les tableaux de synthèse descriptive présentés dans le corps de l’article ou insérés au sein des annexes documentaires doivent systématiquement consigner les moyennes arithmétiques brutes, les écarts-types initiaux, ainsi que les valeurs minimales et maximales observées avant toute manipulation mathématique. Cette double communication permet aux lecteurs d’apprécier la morphologie réelle de l’échantillon tout en évaluant la pertinence de la standardisation retenue, garantissant la reproductibilité analytique de l’étude et son intégration fiable au sein de futures synthèses méta-analytiques internationales.
Références
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://www.jstor.org/stable/2984418
- IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://ieeexplore.ieee.org/document/8766229
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1-55. https://www.jstor.org/stable/2268305
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273-1283. https://doi.org/10.1080/01621459.1993.10476408
- SAS Institute Inc. (2021). SAS/STAT 15.2 User’s Guide: The STDIZE Procedure. SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2021). Base SAS 9.4 Procedures Guide: Statistical Procedures. SAS Institute Inc. https://support.sas.com
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.