
Dans le domaine des sciences statistiques contemporaines, de l’économétrie appliquée, de l’épidémiologie et de la recherche en sciences sociales, la gestion efficace et rigoureuse des corpus de données constitue le socle indispensable à toute inférence robuste. Pendant plusieurs décennies, le Statistical Analysis System (SAS), développé à l’origine par l’Université d’État de Caroline du Nord et commercialisé par le SAS Institute, a régné en maître incontesté sur les infrastructures d’analyse des institutions publiques, des agences de régulation pharmaceutique et des grands groupes industriels. Sa robustesse transactionnelle, sa capacité historique à traiter de volumineuses banques de données sans solliciter excessivement la mémoire vive et ses procédures hautement standardisées lui ont conféré une légitimité institutionnelle quasi universelle.
Toutefois, l’avènement et la maturation spectaculaire de l’environnement open-source R Project for Statistical Computing, catalysés par l’expansion de l’écosystème Tidyverse, ont profondément bouleversé ce paradigme informatique. Les chercheurs et les analystes quantitatifs sont aujourd’hui très fréquemment confrontés à des archives documentaires patrimoniales, des cohortes cliniques longitudinales ou des enquêtes sociologiques massives encapsulées dans des formats propriétaires SAS, tout en devant déployer des modélisations statistiques novatrices, des algorithmes d’apprentissage automatique ou des protocoles de visualisation dynamique au sein de R. Ce transfert méthodologique n’est pas un simple exercice d’ingénierie logicielle ; il conditionne la reproductibilité computationnelle et la validité scientifique des analyses ultérieures.
Le présent guide a pour vocation de détailler, de manière exhaustive et rigoureuse, l’ensemble des mécanismes théoriques, méthodologiques et programmatiques nécessaires à l’importation sans perte de données issues des formats SAS vers R. En explorant l’architecture interne des fichiers binaires, les divergences sémantiques entre structures tabulaires, la préservation minutieuse des dictionnaires de métadonnées et la résolution des problématiques d’encodage de caractères, cet article offre un protocole pas-à-pas à l’attention des chercheurs méthodologues, des biostatisticiens et des scientifiques des données soucieux d’atteindre une intégrité analytique sans faille.
1. Introduction à l’interopérabilité entre SAS et R dans la recherche empirique
1.1 Contexte de la transition logicielle en analyse de données
L’évolution des pratiques computationnelles au cours des deux dernières décennies se caractérise par un mouvement de transition massif des logiciels statistiques propriétaires et compilés vers des langages interprétés, modulaires et distribués sous licences libres. Longtemps, SAS s’est imposé comme l’étalon-or, particulièrement dans les contextes où la traçabilité des opérations logicielles devait satisfaire aux exigences drastiques de directives institutionnelles telles que le titre 21 du Code of Federal Regulations (Partie 11) de la Food and Drug Administration (FDA) aux États-Unis. Ce statut privilégié a conduit à la sédimentation d’immenses entrepôts de données au format propriétaire au sein d’instituts de sondage, de laboratoires pharmaceutiques et d’organismes de statistiques publiques tels que l’INSEE en France ou Statistique Canada.
Parallèlement, la montée en puissance de la science ouverte (Open Science) a souligné l’urgence d’une reproductibilité intégrale des chaînes de traitement statistique, depuis la collecte brute jusqu’à la publication des résultats. R s’est imposé comme le véhicule privilégié de cette transformation grâce à son système de packages évalués par les pairs via le Comprehensive R Archive Network (CRAN), sa flexibilité syntaxique et son intégration transparente avec des outils de rédaction scientifique reproductible tels que Quarto et R Markdown. Cependant, cette transition ne saurait s’opérer par une rupture brutale avec le passé ; l’exigence méthodologique impose de garantir que la migration d’un système à un autre préserve l’intégrité numérique stricte des vecteurs de données, sans altération des arrondis flottants, des horodatages ni des structures classificatoires préexistantes.
En outre, l’écosystème R offre des capacités d’extension analytique sans commune mesure avec les cycles de mise à jour traditionnels des logiciels commerciaux. Qu’il s’agisse de déployer des modèles mixtes généralisés non linéaires, des méthodes de bootstrap non paramétrique ou des inférences bayésiennes via Stan, R offre aux méthodologues un terrain d’investigation d’une richesse exceptionnelle. Par conséquent, assurer une passerelle computationnelle fluide entre les bases SAS historiques et l’environnement R contemporain ne relève pas du simple confort technique, mais d’une impérieuse nécessité académique et professionnelle.
1.2 Défis structurels du format propriétaire SAS
L’extraction de données depuis un format propriétaire vers un environnement ouvert se heurte d’emblée à la nature fermée des spécifications d’ingénierie sous-jacentes. Les fichiers de tables de données SAS, portant traditionnellement l’extension .sas7bdat, reposent sur une architecture binaire propriétaire spécifiquement optimisée pour le moteur d’exécution séquentiel de SAS. Contrairement aux formats textuels délimités tels que le CSV (Comma-Separated Values), un fichier binaire SAS encapsule dans un même conteneur physique les données matricielles brutes, la définition des types de colonnes, des pointeurs internes d’alignement mémoire, des drapeaux d’état d’indexation, ainsi que d’éventuels algorithmes de compression propriétaires, à l’instar des algorithmes RLE (Run-Length Encoding) ou Ross Data Compression (RDC).
L’un des défis majeurs réside dans la séparation fonctionnelle qu’opère SAS entre la donnée purement numérique ou textuelle et sa représentation sémiotique. Dans la philosophie SAS, une variable numérique codée sous la forme d’un entier scalaire peut être reliée à un dictionnaire externe d’étiquettes de format (User-Defined Formats), ce qui permet à l’utilisateur de visualiser une modalité catégorielle descriptive (par exemple « Fortement en désaccord ») alors que le disque ne stocke fondamentalement que la valeur arithmétique sous-jacente. Si le transfert vers R se contente d’extraire la matrice brute sans reconstituer cette topologie de métadonnées, la sémantique de l’étude s’en trouve instantanément amputée, compromettant la validité des inférences futures.
Cette problématique devient particulièrement aiguë dans le champ des enquêtes psychosociales, des observatoires longitudinaux et des essais cliniques randomisés. Dans ces contextes, la perte d’un dictionnaire de variables ou l’interprétation erronée d’un schéma de codage des valeurs manquantes peut invalider des mois de travail empirique. La traçabilité scientifique impose donc que le parseur employé dans R soit capable de lire avec une exactitude mathématique la charge utile du fichier binaire, d’interpréter les métadonnées intégrées aux segments d’en-tête et de réconcilier, le cas échéant, les catalogues de formats externes pour reconstituer la richesse d’origine du dispositif d’observation.
2. Comprendre les spécificités des formats de fichiers SAS
2.1 Structure interne du fichier .sas7bdat
Pour appréhender les mécanismes d’ingénierie inverse mis en œuvre lors de l’importation dans R, il convient de disséquer l’anatomie d’un fichier .sas7bdat. Ce dernier est segmenté en unités de taille fixe appelées pages de données (data pages), dont la dimension est déterminée lors de la création de la table sous SAS (couramment 4 Ko, 8 Ko, 16 Ko, voire 64 Ko selon les architectures matérielles). La première section du fichier est constituée par la page d’en-tête (header page), qui renferme les signatures binaires identifiant la version de SAS exploitée lors de l’écriture, le système d’exploitation d’origine (architecture 32 bits versus 64 bits), le boutisme (endianness, ordonnancement des octets de poids fort et faible en mémoire), l’horodatage précis de création et de modification, ainsi que l’encodage textuel déclaré.
Au-delà de cette page de préambule, le fichier organise les observations sous une forme matricielle paginée. Chaque page contient un en-tête de contrôle local suivi par les enregistrements d’observations. Dans l’architecture SAS native, il n’existe fondamentalement que deux types de données primitifs : le type numérique et le type caractère. Les variables numériques sont invariablement stockées par défaut sous forme de nombres à virgule flottante en double précision, conformes à la norme IEEE 754 sur 8 octets (bien que des compressions de longueur puissent être spécifiées pour réduire la taille à 3, 4, 5, 6 ou 7 octets au prix d’une perte de précision mantissique). Les variables de type caractère sont stockées sous forme de chaînes de longueur fixe, complétées par des espaces d’espacement (trailing spaces) jusqu’à concurrence de la longueur déclarée lors de l’étape de compilation SAS.
L’extraction programmatique de ces blocs nécessite une compréhension rigoureuse des descripteurs de sous-en-têtes (subheader descriptors). Ces structures binaires indiquent l’emplacement exact de chaque colonne dans l’enregistrement physique, sa longueur en octets, son décalage (offset) par rapport au début de la ligne, ainsi que les pointeurs vers les noms de variables et leurs attributs descriptifs. Toute corruption de cette cartographie binaire ou toute mauvaise interprétation de l’alignement architectural entraîne inévitablement un décalage en cascade de la lecture des observations, générant des valeurs aberrantes ou des erreurs critiques de terminaison de flux.
2.2 Rôle des fichiers de formats catalogues (.sas7bcat)
L’une des singularités architecturales les plus déroutantes pour les praticiens découvrant l’écosystème SAS réside dans l’externalisation fréquente des dictionnaires de libellés. Alors qu’un fichier .sas7bdat peut contenir les noms de variables et leurs étiquettes descriptives immédiates (variable labels), les correspondances entre les codes numériques bruts et leurs dénominations textuelles détaillées (value labels) sont très souvent compilées séparément dans un fichier catalogue portant l’extension .sas7bcat, généralement dénommé formats.sas7bcat.
Ce mécanisme repose sur l’utilisation de la procédure SAS PROC FORMAT, qui génère des tables de consultation binaires indépendantes. Par exemple, une variable modélisant le statut tabagique d’un patient pourra être encodée numériquement sous les valeurs discrètes 0, 1 ou 2 au sein de la table principale cohorte.sas7bdat. L’affichage textuel « Non-fumeur », « Ancien fumeur » et « Fumeur actif » n’existe alors nulle part au sein de ce fichier principal : il est encapsulé dans le catalogue de formats associé via un format utilisateur désigné, par exemple, sous le nom de format TABACFMT..
Lors de l’extraction vers l’environnement R, si l’analyste se contente d’importer isolément le fichier .sas7bdat, le moteur d’ingestion lira fidèlement les nombres 0, 1 et 2, mais sera totalement incapable d’assigner les significations sémantiques correspondantes. Pour surmonter cette limitation structurelle, les parseurs R modernes doivent impérativement proposer des arguments permettant de spécifier conjointement le chemin vers le fichier de données et le chemin vers le catalogue de formats correspondant. Cette opération permet de fusionner dynamiquement en mémoire vive la valeur mathématique et son enveloppe conceptuelle au sein d’une structure vectorielle adaptée.
2.3 Formats de transport et d’échange SAS (.xpt)
Face à la complexité et à la non-portabilité intrinsèque des fichiers binaires compilés sur différentes plateformes matérielles (notamment entre les architectures Unix, Mainframe IBM et Windows x86/x64), SAS a introduit très tôt un format d’échange normalisé : le format de transport SAS, universellement identifié par l’extension .xpt. Régie par la norme de transport SAS XPORT, cette spécification technique a été conçue pour garantir que les données puissent transiter entre des systèmes aux architectures de processeurs divergentes sans altération binaire.
Le format XPORT classique, couramment désigné sous le vocable de Version 5 (V5), repose sur un encodage strict des caractères au format ASCII et impose des restrictions drastiques : les noms de variables ne peuvent excéder huit caractères, les étiquettes de variables sont limitées à 40 octets, et les données textuelles ne peuvent dépasser 200 octets par champ. Malgré son archaïsme technique apparent, le format XPORT V5 demeure à ce jour un standard réglementaire d’une importance capitale, prescrit notamment par la FDA américaine et l’Agence européenne des médicaments (EMA) pour la transmission formelle des jeux de données d’essais cliniques selon les standards du consortium CDISC (Clinical Data Interchange Standards Consortium), notamment les modèles SDTM et ADaM.
Une révision plus moderne, le format XPORT Version 8 (V8), a ultérieurement levé certaines de ces contraintes en autorisant des noms de variables jusqu’à 32 caractères et des chaînes plus longues. Sur le plan computationnel dans R, la lecture des fichiers .xpt requiert des algorithmes distincts de ceux employés pour les tables binaires .sas7bdat, car la structure de sérialisation des blocs XPORT obéit à un enregistrement séquentiel de cardinalité fixe (généralement des blocs de 80 octets réminiscent de l’époque des cartes perforées), nécessitant une routine de désérialisation spécifique pour convertir les représentations à virgule flottante IBM en représentations compatibles IEEE 754.
3. Configuration de l’environnement R et écosystème Tidyverse
3.1 Présentation et rôle du package haven
Dans l’écosystème R moderne, le package haven s’affirme comme la référence hégémonique pour l’ingestion et l’exportation des formats de fichiers issus des suites logicielles commerciales traditionnelles, incluant SAS, SPSS et Stata. Maintenu activement par Posit (anciennement RStudio) et intégré au noyau étendu du Tidyverse, haven a été conçu pour abolir les frictions historiques qui entravaient la collaboration entre les équipes d’analystes utilisant des outils hétérogènes.
La puissance et la vélocité remarquables de haven reposent sur son architecture logicielle sous-jacente. Plutôt que de réimplémenter un moteur de lecture intégralement en langage R interprété, haven s’appuie sur la bibliothèque C open-source ReadStat, initiée par Matthew Shotwell et activement développée au sein de la communauté du génie logiciel. En déléguant l’analyse syntaxique binaire bas niveau (parsing), la gestion des pages mémoire et le décodage des primitives numériques à du code C hautement optimisé et compilé, haven atteint des vitesses d’exécution exceptionnelles tout en limitant au strict minimum la surcharge mémoire.
Par ailleurs, haven ne se limite pas à extraire des matrices de données ; il a été pensé dès sa conception pour s’intégrer harmonieusement avec la philosophie du Tidyverse. Les structures générées par ses fonctions de lecture ne sont pas de simples tables de données basiques (data.frame), mais des tables enrichies (tibble). Ces dernières garantissent un affichage console tronqué et ergonomique, préservent strictement les types de données sans conversion implicite indésirable (refusant notamment la conversion historique automatique des chaînes de caractères en facteurs arbitraires), et encapsulent les métadonnées complexes sous forme d’attributs vectoriels standardisés.
3.2 Procédure d’installation et de chargement
L’installation du package haven s’effectue directement depuis les serveurs officiels du CRAN, garantissant l’obtention de binaires précompilés stables adaptés au système d’exploitation de l’hôte (Windows, macOS ou distributions Linux). Bien que haven soit inclus par défaut lors de l’installation globale du méta-package tidyverse, il est vivement recommandé dans les contextes de production analytique et de recherche reproductible de l’installer et de le charger explicitement en tant que composant isolé afin de minimiser les dépendances superflues et de documenter avec exactitude l’environnement d’exécution.
La commande d’installation s’exécute de manière canonique au sein de la console R :
install.packages("haven")
Il est impératif de s’assurer que la version de l’interpréteur R sous-jacent est tenue à jour. Le package haven bénéficie d’évolutions régulières visant à corriger d’éventuelles failles de sécurité liées au traitement de binaires malformés au niveau de la bibliothèque C ReadStat, tout en optimisant la compatibilité avec les architectures matérielles récentes (notamment les processeurs Apple Silicon ARM64 et les plateformes x86_64 multi-cœurs). Une fois le processus d’installation achevé avec succès, l’initialisation de la bibliothèque au début de chaque session ou script de calcul est réalisée au moyen de l’instruction standard :
library(haven)
Cette commande rend immédiatement disponibles l’ensemble des fonctions d’ingestion spécialisées, en particulier read_sas() pour les fichiers .sas7bdat et .sas7bcat, ainsi que read_xpt() pour les formats de transport réglementaires.
3.3 Paramétrage du répertoire de travail et des chemins d’accès
La gestion rigoureuse des chemins d’accès sur le système de fichiers constitue l’une des pierres angulaires de l’informatique reproductible. Une proportion substantielle des dysfonctionnements rencontrés par les praticiens lors de l’étape d’importation ne découle pas d’une défaillance du moteur de lecture, mais d’une mauvaise résolution des adresses physiques de stockage des fichiers. Sous les environnements d’exploitation de type Windows, l’utilisation traditionnelle de la barre oblique inverse (backslash, ) représente une source chronique d’erreurs d’échappement au sein des chaînes de caractères R, où la barre oblique inverse agit comme un préfixe de séquence spéciale (par exemple n ou t).
Pour prévenir ces ambiguïtés, la règle méthodologique absolue consiste à normaliser l’ensemble des chemins d’accès au moyen de barres obliques simples (forward slashes, /), universellement reconnues par le moteur d’exécution R indépendamment du système hôte. De surcroît, le recours à des chemins d’accès absolus rigides (par exemple C:/Utilisateurs/Chercheur/Projet/donnees.sas7bdat) doit être proscrit dans le cadre de la recherche scientifique : il anéantit toute possibilité d’exécution sans reconfiguration sur une machine tierce, un serveur de calcul distant ou une infrastructure d’intégration continue.
La solution méthodologique d’excellence repose sur l’adoption conjointe des projets RStudio (fichiers .Rproj) et du package here. Ce dernier permet d’ancrer le répertoire racine de travail au niveau de l’arborescence du projet et de construire des chemins relatifs dynamiques résilients aux variations d’environnement d’exécution. L’arborescence recommandée pour un projet d’analyse intégrant des sources de données SAS se structure typiquement de la façon suivante :
racine_du_projet/projet.Rproj: Fichier de configuration de projet RStudio.scripts/: Dossier réservé aux programmes de nettoyage, de modélisation et de visualisation.donnees_brutes/: Répertoire dédié au stockage immuable des fichiers SAS sources (.sas7bdatet.sas7bcat).donnees_derivees/: Espace de sauvegarde des tables nettoyées et sérialisées au format natif R.sorties/: Répertoire de destination des graphiques vectoriels et des tableaux de résultats.
4. Syntaxe fondamentale et paramètres de la fonction read_sas()
4.1 Anatomie de l’appel de base
L’accès aux tables binaires SAS s’opère dans haven par l’intermédiaire de la fonction read_sas(). Cette dernière encapsule l’ensemble de la tuyauterie de décodage sous une signature programmatique claire et épurée. L’appel le plus élémentaire se présente sous la forme suivante :
objet_donnees <- read_sas(data_file = "chemin/vers/fichier.sas7bdat")
Dans cette configuration fondamentale, la fonction prend pour argument principal data_file, qui correspond à la chaîne de caractères désignant l’emplacement physique du fichier de données sur le disque. Le comportement par défaut de la fonction déclenche une inspection préalable de l’en-tête binaire, alloue la mémoire nécessaire, procède au désarchivage des pages séquentiellement, instancie les vecteurs atomiques correspondants dans R et renvoie une structure de type tibble assignée dans l’environnement global à l’objet désigné.
Toutefois, la signature formelle de la fonction révèle un ensemble de paramètres optionnels d’une importance stratégique pour le contrôle de l’importation :
read_sas(data_file, catalog_file = NULL, encoding = NULL, col_select = NULL, skip = 0L, n_max = Inf, .name_repair = "unique")
Lorsque des catalogues de formats utilisateur ont été élaborés lors de la phase SAS, l’argument catalog_file permet de renseigner le chemin d’accès vers le fichier .sas7bcat afférent. En combinant ces deux sources lors du parsing initial, haven est capable de greffer automatiquement les définitions de formats catégoriels aux valeurs numériques sous-jacentes, évitant ainsi des étapes manuelles de recodage laborieuses et sujettes aux erreurs d’inattention.
4.2 Paramètres d’encodage des caractères
La gestion de l’encodage textuel représente sans conteste l’un des points de friction les plus critiques lors du traitement de fichiers créés dans des environnements SAS anciens ou configurés selon des paramètres régionaux spécifiques. Historiquement, SAS stockait les chaînes de caractères en fonction de la table de pages de codes (code page) de la session active du système d’exploitation d’origine. Ainsi, une base SAS générée sous un système Windows francophone d’Europe occidentale utilisait fréquemment l’encodage Windows-1252 (CP1252) ou ISO-8859-1 (Latin1), tandis que les environnements modernes privilégient quasi universellement le format universel Unicode UTF-8.
Bien que les versions récentes de SAS intègrent un indicateur d’encodage au sein de l’en-tête binaire du fichier .sas7bdat, il arrive fréquemment que cet indicateur soit inexistant, imprécis ou mal renseigné par les procédures d’exportation d’origine. Si haven tente d’interpréter un flux binaire codé en CP1252 sous une session R configurée par défaut en UTF-8 sans directive explicite, il en résultera l’apparition de séquences de caractères altérées (phénomène connu sous le nom de mojibake, transformant par exemple « élève » en « élève ») ou des erreurs bloquantes de transcription binaire rendant l’importation impossible.
L’argument encoding de la fonction read_sas() permet de neutraliser rigoureusement cette difficulté en spécifiant explicitement la table de décodage à appliquer aux segments textuels. En déclarant par exemple encoding = "CP1252" ou encoding = "latin1", l’analyste contraint le parseur ReadStat à traduire correctement chaque octet de chaîne de caractères vers l’encodage natif UTF-8 utilisé par le moteur R moderne. Cette précaution garantit l’exactitude typographique absolue des libellés de variables, des noms d’items et des réponses qualitatives ouvertes.
4.3 Filtrage et sélection sélective à l’importation
Dans le contexte du traitement de mégadonnées ou de cohortes épidémiologiques comportant plusieurs milliers de colonnes et des millions d’individus, charger la totalité d’un fichier SAS en mémoire vive constitue une pratique inefficace, susceptible de saturer la RAM et de dégrader drastiquement la réactivité de la station de travail. Le package haven intègre des mécanismes d’optimisation en amont, permettant de filtrer sélectivement les structures de données dès l’étape de décodage binaire.
Le paramètre col_select fournit un levier d’optimisation d’une extrême élégance. En exploitant la syntaxe d’évaluation ordonnée (tidyselect), il permet de ne lire que les colonnes strictement indispensables à la modélisation projetée. L’analyste peut spécifier un vecteur de noms de variables (ex. col_select = c(identifiant, age, statut_vital)), utiliser des sélecteurs contextuels (ex. col_select = starts_with("item_")) ou appliquer des exclusions délibérées (ex. col_select = -c(adresse, telephone)). Le moteur ReadStat contourne alors les octets correspondant aux colonnes délaissées, accélérant notablement le temps d’ingestion.
Complémentairement, les paramètres n_max et skip offrent un contrôle granulaire sur la dimension verticale du jeu de données :
n_max: Spécifie le plafond maximal d’observations à importer (par exemplen_max = 1000pour extraire un échantillon pilote d’amorçage destiné au prototypage d’un algorithme).skip: Commande au parseur d’ignorer un nombre déterminé de lignes au début de la table d’observations avant d’initier la capture des données.
Ces mécanismes d’extraction sélective permettent d’auditer des banques d’informations monumentales de manière chirurgicale, sans jamais engorger l’architecture mémoire du système hôte.
5. Guide étape par étape : Importation pratique d’un fichier SAS
5.1 Étape 1 : Téléchargement et localisation de la source de données
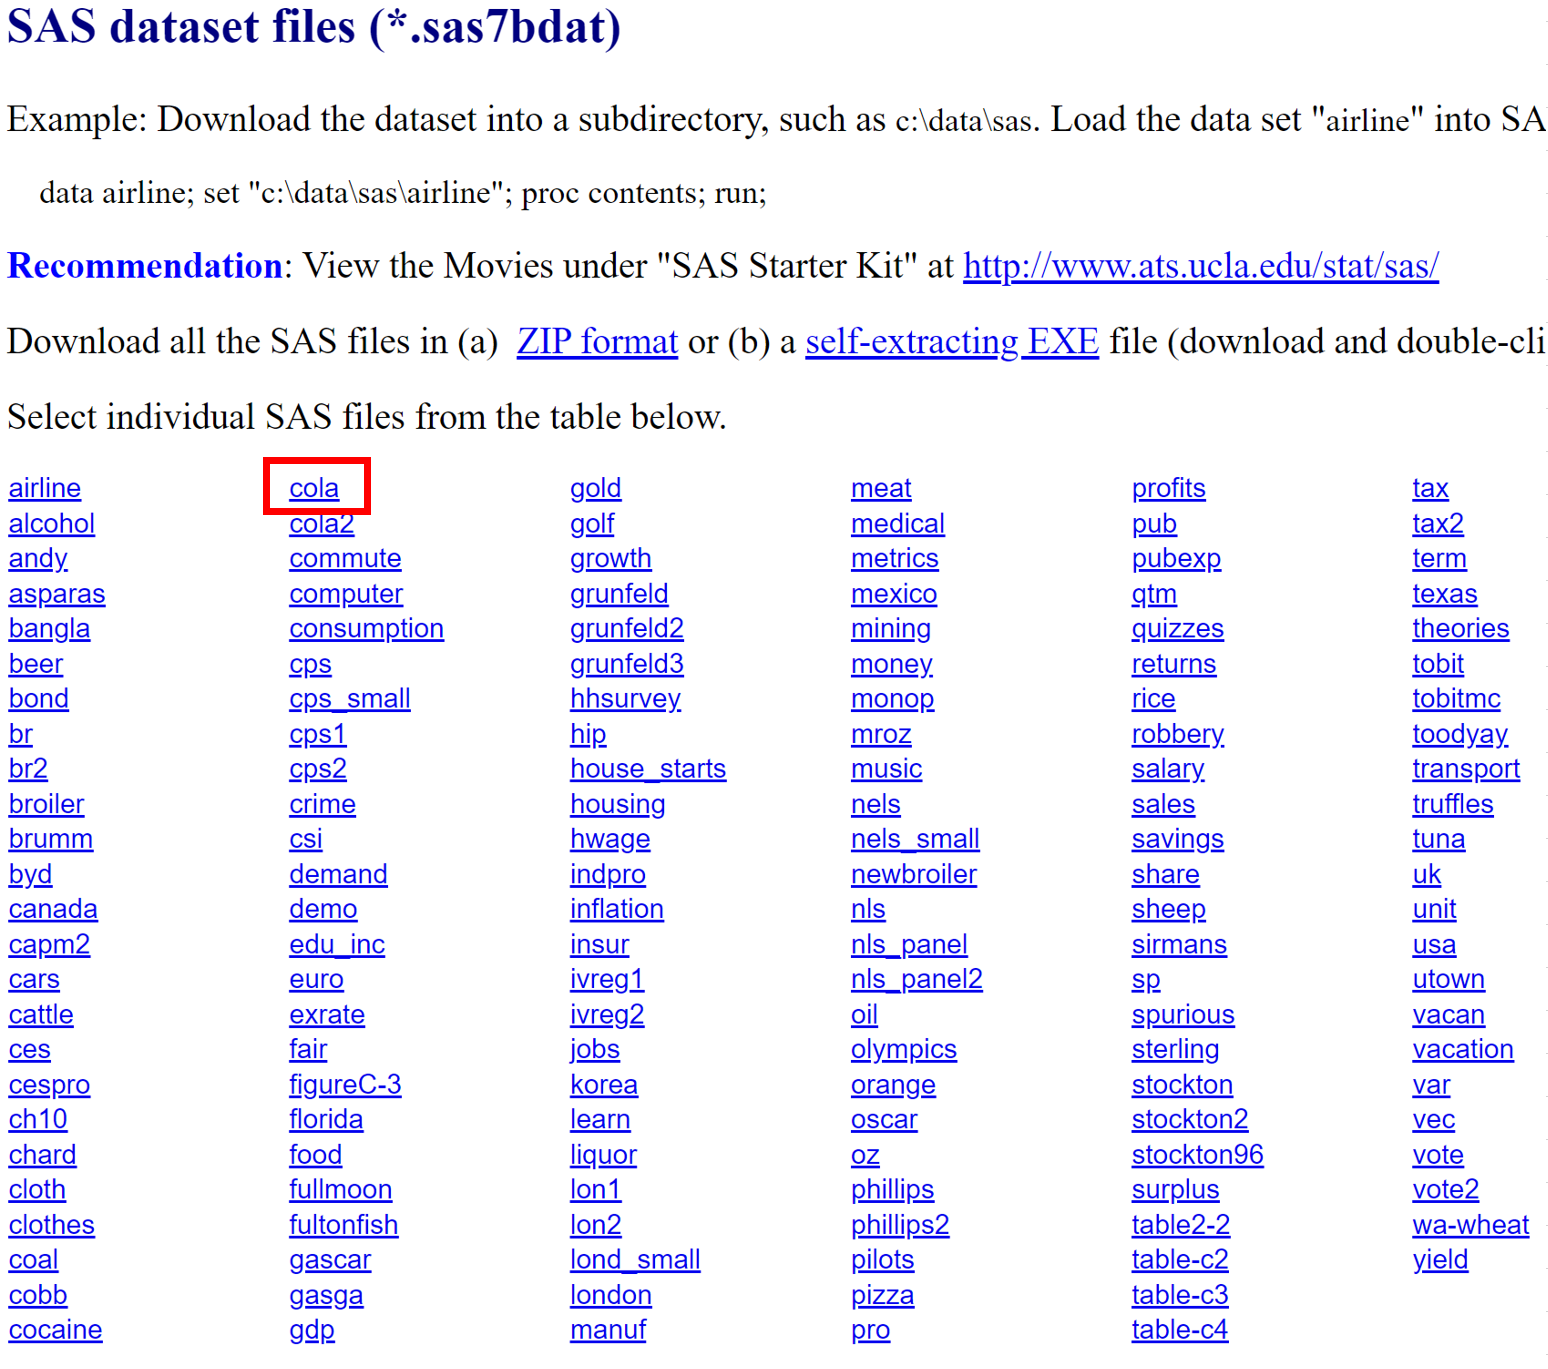
Pour illustrer de manière concrète et didactique le déroulement opératoire d’une importation, considérons un scénario empirique canonique : l’analyse d’une base de données d’évaluation de préférences de consommateurs, consignée dans le fichier d’exemple classique cola.sas7bdat. La première démarche consiste à s’assurer de l’intégrité physique du fichier et de son positionnement rationnel au sein de l’arborescence du projet informatique.
Le fichier binaire doit être déposé au sein du sous-répertoire dédié aux données sources non modifiées, conventionnellement nommé data/ ou donnees_brutes/. L’analyste doit impérativement s’abstenir de toute manipulation manuelle de renommage d’extension ou d’ouverture via des éditeurs de texte tiers qui risqueraient d’insérer des caractères de contrôle invisibles ou d’altérer la structure binaire des pages d’en-tête. Il convient également de vérifier les autorisations du système d’exploitation pour garantir que l’utilisateur exécutant la session R dispose des privilèges de lecture (read permissions) sur le fichier ciblé.
Une bonne pratique de gouvernance des données consiste à documenter dès cette étape la provenance du fichier au moyen d’une somme de contrôle cryptographique (couramment un condensat MD5 ou SHA-256). Cette mesure garantit que l’objet binaire présent sur le disque correspond trait pour trait à la version archivée dans le référentiel institutionnel, scellant ainsi la chaîne de traçabilité dès le point d’entrée computationnel.
5.2 Étape 2 : Initialisation du script et chargement de la bibliothèque
L’amorce de la procédure d’analyse impose la rédaction d’un script R rigoureusement structuré. Ce fichier de commandes, enregistré par exemple sous la désignation 01_importation_donnees.R, doit s’ouvrir par un en-tête documentaire mentionnant l’intitulé du projet, le nom du chercheur ou analyste responsable, la date de création et la version de R employée. Afin de garantir l’étanchéité de l’exécution, il est fortement déconseillé de compter sur des objets préexistants en mémoire vive.
Le chargement des bibliothèques nécessaires constitue l’étape subséquente. Dans le cadre d’un flux de travail respectant les meilleures pratiques, nous mobilisons le package haven pour l’ingestion binaire, le package here pour la gestion dynamique des chemins, et l’écosystème dplyr pour les opérations subséquentes de validation structurelle :
# Initialisation des dépendances logicielles

library(haven)

library(here)

library(dplyr)
L’exécution de ces instructions ne doit lever aucun avertissement bloquant. La commande library(haven) s’exécute silencieusement, rendant les primitives de lecture disponibles pour l’ensemble des étapes analytiques du pipeline.
5.3 Étape 3 : Exécution de la commande d’importation
Une fois les préliminaires structurels accomplis, l’importation de la table de données s’effectue par l’appel formel à read_sas(), en imbriquant la fonction here() pour garantir la parfaite résolution du chemin relatif :
# Construction du chemin et ingestion des donnees binaires

chemin_fichier <- here("donnees_brutes", "cola.sas7bdat")

donnees_cola <- read_sas(data_file = chemin_fichier)
Lors de l’évaluation de cette ligne de code, l’interpréteur R communique le chemin d’accès à la bibliothèque ReadStat en sous-main. ReadStat ouvre le fichier binaire, analyse l’en-tête, vérifie l’intégrité de la table, détermine le nombre d’observations et de variables, puis alloue directement les vecteurs atomiques au sein de la mémoire vive de R. À la complétion de la routine, la console restitue la main à l’utilisateur sans générer d’affichage verbeux superflu.
Dans l’interface de développement RStudio, le panneau d’environnement (Environment pane) s’enrichit instantanément d’une nouvelle entité baptisée donnees_cola. Cette mention confirme que la base matricielle SAS a été désérialisée avec succès et réside désormais sous forme d’objet natif en mémoire, prête à être inspectée, nettoyée et modélisée.
6. Inspection structurelle et vérification de l’intégrité des données
6.1 Évaluation de la classe et de la structure de l’objet
L’acquisition d’un jeu de données ne saurait être considérée comme valide sans un audit métrologique rigoureux destiné à vérifier la fidélité de l’importation. La première inspection porte sur la classe intrinsèque de l’objet nouvellement généré. L’application de la fonction class() renvoie un diagnostic structurel sans équivoque :
class(donnees_cola)
Le résultat typique renvoyé atteste de la nature composite de la structure : "tbl_df", "tbl" et "data.frame". Cette hiérarchie d’héritage objet confirme que la table bénéficie des méthodes enrichies du format tibble tout en demeurant strictement rétrocompatible avec les fonctions exigeant un data.frame conventionnel de R de base.
Pour disséquer la morphologie détaillée des colonnes, la commande classique str(donnees_cola) ou, plus élégamment, la fonction glimpse(donnees_cola) issue de dplyr, offre une vue synoptique exceptionnelle. Cette fonction synthétise sur quelques lignes le nombre total de lignes et de colonnes, liste l’ensemble des identifiants de variables, expose leur type atomique immédiat (numérique double précision <dbl>, chaîne de caractères <chr>, date <date>) et affiche les premières valeurs observées, tout en révélant la présence d’attributs de métadonnées spécifiques sur lesquels nous reviendrons en détail.
6.2 Vérification des dimensions métriques
L’étape de validation métrique fondamentale consiste à confronter les dimensions physiques de l’objet R obtenu avec la documentation de gestion de projet SAS d’origine. Cette vérification prévient toute troncature accidentelle imputable à une saturation de l’espace de stockage temporaire ou à une interruption prématurée du flux de lecture.
La commande dim(donnees_cola) restitue un vecteur de longueur deux, dont le premier élément quantifie le volume des observations et le second dénombre les variables recensées. De manière complémentaire et unitaire, les fonctions spécialisées permettent d’extraire ces scalaires :
nb_lignes <- nrow(donnees_cola)

nb_colonnes <- ncol(donnees_cola)
Dans un cadre de travail automatisé ou au sein d’un pipeline de validation continue, il est fortement conseillé d’intégrer des tests d’assertion formels à l’aide de packages dédiés comme testthat ou assertr :
stopifnot(nb_lignes == 500)

stopifnot(nb_colonnes == 12)
Ce protocole garantit qu’en cas d’évolution imprévue du fichier source sur le disque (par exemple une extraction partielle ou corrompue), l’ensemble de la chaîne de scripts s’interrompra immédiatement, protégeant le chercheur contre la formulation de conclusions erronées établies sur des données tronquées.
6.3 Inspection visuelle des premières et dernières observations
La confirmation de la validité de l’ingestion exige un examen direct des bornes matricielles. L’exécution de la fonction head(donnees_cola, n = 6) permet d’afficher les premiers enregistrements de la table pour contrôler le bon positionnement des noms de colonnes et l’absence d’interversion de champs textuels ou numériques.
De manière tout aussi cruciale, l’inspection des queues de distribution via tail(donnees_cola, n = 6) permet de vérifier que la terminaison du fichier a été lue conformément aux spécifications. Dans certains fichiers binaires SAS corrompus ou générés par des ponts logiciels défaillants, les dernières pages de données peuvent héberger des blocs résiduels nuls ou des enregistrements parasites non purgés. L’examen des dernières lignes confirme la cohérence des indicateurs d’observation jusqu’à la fermeture du fichier.
Par ailleurs, cette inspection visuelle rapide facilite la détection précoce d’éventuels décalages d’alignement horizontal qui auraient pu survenir si un délimiteur de chaîne non protégé avait induit en erreur le moteur ReadStat (bien que cette anomalie soit rarissime avec les fichiers binaires .sas7bdat par rapport aux fichiers textuels plats).
7. Traitement approfondi des étiquettes et des métadonnées
7.1 Compréhension de la classe haven_labelled
L’une des contributions conceptuelles les plus remarquables du package haven réside dans sa gestion novatrice des étiquettes descriptives SAS au travers de la classe d’objet haven_labelled. Historiquement, les analystes effectuant une migration depuis SAS vers R étaient confrontés à un dilemme insoluble : soit convertir immédiatement les variables catégorielles codées en facteurs R (factors), perdant ainsi la valeur numérique brute d’origine et compliquant l’exécution de certaines opérations arithmétiques, soit ne conserver que la valeur numérique pure, éliminant totalement l’étiquette contextuelle indispensable à la rédaction des rapports.
Pour résoudre cette antinomie, haven encapsule ces données au sein d’un vecteur numérique atomique sous-jacent, enrichi de deux attributs de métadonnées spécifiques :
label: Une chaîne de caractères descriptive définissant le sens sémantique de la variable dans son ensemble (l’équivalent du variable label de SAS).labels: Un vecteur numérique nommé répertoriant la correspondance biunivoque entre chaque modalité numérique discrète et son étiquette textuelle associée (l’équivalent des value labels de SAS).
Si cette approche hybride offre une fidélité d’archivage exceptionnelle, elle présente l’inconvénient d’une compatibilité limitée avec certaines fonctions statistiques traditionnelles de R de base (telles que lm(), glm() ou certaines fonctions graphiques de base), qui ne reconnaissent pas la classe haven_labelled et refusent d’effectuer des calculs sur ces structures inhabituelles. Il incombe donc à l’analyste de piloter délibérément la transformation de ces vecteurs vers des types R conventionnels selon les nécessités de l’investigation empirique.
7.2 Extraction et manipulation des étiquettes de variables
L’exploration des attributs de métadonnées peut s’effectuer au moyen des fonctions primitives de R ou en exploitant les utilitaires spécialisés du package labelled, un compagnon indispensable de haven. Pour extraire le libellé descriptif global d’une colonne spécifique, la commande de base s’articule comme suit :
libelle_variable <- attr(donnees_cola$preference, "label")
Pour auditer de manière exhaustive l’ensemble des étiquettes de variables d’une table et générer un dictionnaire de données automatisé, le package labelled simplifie considérablement la démarche :
library(labelled)

dictionnaire_variables <- var_label(donnees_cola)
Cette instruction renvoie une liste nommée associant chaque identifiant de colonne à sa description textuelle. Ces métadonnées s’avèrent inestimables lors de l’intégration des tableaux de bord interactifs ou de l’édition automatique de graphiques avec ggplot2, où le libellé d’origine peut être injecté de manière programmatique sur les axes de coordonnées plutôt que de réécrire manuellement des étiquettes textuelles éphémères :
library(ggplot2)

ggplot(donnees_cola, aes(x = preference)) +

  geom_bar() +

  labs(x = var_label(donnees_cola$preference), y = "Frequence absolue")
7.3 Conversion en facteurs R standards
Pour intégrer des variables étiquetées au sein de modèles économétriques, de régressions logistiques ou de tables de contingence bivariées, la conversion vers la classe factor de R s’impose comme une nécessité méthodologique. Haven propose à cet effet la fonction spécialisée as_factor(), qui diffère fondamentalement de la fonction de base as.factor() par sa capacité à substituer intelligemment les valeurs numériques sous-jacentes par leurs étiquettes descriptives textuelles :
donnees_nettoyees <- donnees_cola %>%

  mutate(preference_facteur = as_factor(preference))
Dans certains cas de figure, notamment lors de l’estimation de modèles psychométriques ou de modèles à équations structurelles, le statisticien souhaite au contraire conserver exclusivement les entiers purs pour traiter une échelle de Likert comme un continuum quantitatif, tout en éliminant les attributs résiduels pour alléger la structure mémoire. La fonction zap_labels() permet d’éradiquer chirurgicalement l’ensemble des étiquettes de modalités tout en préservant le vecteur atomique originel :
donnees_numeriques_pures <- donnees_cola %>%

  zap_labels()
Il existe également la fonction zap_label() (au singulier), dédiée à la suppression de l’étiquette globale de la variable, offrant ainsi une latitude de normalisation absolue sur le jeu de données.
8. Méthodes alternatives d’importation de fichiers SAS
8.1 Utilisation historique du package foreign
Avant l’avènement de haven et de la bibliothèque ReadStat, les utilisateurs de R recouraient de manière quasi exclusive au package foreign, composante historique distribuée avec l’installation de base du logiciel. Le package foreign renferme une fonction dédiée aux transferts de fichiers SAS, intitulée read.xport().
Toutefois, cette fonction souffre d’une limitation rédhibitoire dans le cadre de l’ingénierie moderne des données : elle est strictement incapable d’ingérer les fichiers de tables natives .sas7bdat. Son champ d’application se limite exclusivement aux fichiers au format de transport SAS XPORT V5. De surcroît, sa gestion des métadonnées demeure rudimentaire, convertissant brutalement certaines colonnes sans préserver les topologies de formats utilisateur complexes ni gérer de manière fluide les encodages textuels internationaux.
Bien que le package foreign conserve un intérêt indéniable pour la maintenance de systèmes patrimoniaux ou l’exécution de scripts anciens sans dépendance externe, son usage pour le développement de nouveaux pipelines analytiques est aujourd’hui universellement déconseillé au profit de haven.
8.2 L’approche du package sas7bdat
Pour répondre à l’incapacité historique de foreign à lire les formats compilés natifs, le chercheur Matthew Shotwell a développé le package autonome sas7bdat, disponible sur le CRAN. L’intérêt méthodologique de cette contribution réside dans le fait qu’il s’agissait de la toute première tentative d’ingénierie inverse open-source documentée permettant de lire nativement les fichiers .sas7bdat sans exiger la présence d’une licence SAS sur la machine hôte.
La syntaxe de mise en œuvre est élémentaire :
library(sas7bdat)

table_donnees <- read.sas7bdat("chemin/vers/fichier.sas7bdat")
Néanmoins, le package sas7bdat présente des limitations techniques sensibles comparé à haven. Étant principalement codé en langage R avec des routines de désérialisation non optimisées en C pour les structures mémoires complexes, sa vitesse d’ingestion s’avère considérablement plus lente sur des fichiers volumineux excédant quelques dizaines de mégaoctets. En outre, il échoue fréquemment à décoder les fichiers SAS ayant subi une compression binaire avancée (RDC) et ne propose pas de mécanisme robuste pour réconcilier les catalogues .sas7bcat. Par conséquent, il demeure cantonné à un rôle de solution de secours lorsque des contraintes d’infrastructure empêchent la compilation de dépendances C externes.
8.3 Connexions directes via ODBC et interfaces SAS
Dans les architectures d’entreprise ou les environnements hospitaliers hautement sécurisés, l’analyste n’a pas nécessairement la permission d’extraire des fichiers statiques volumineux sur son poste de travail local. Dans ces configurations, l’accès direct aux données SAS s’opère par l’intermédiaire d’une liaison client-serveur dynamique exploitant la norme Open Database Connectivity (ODBC) ou des connecteurs propriétaires dédiés.
En mobilisant conjointement les packages DBI et odbc, il est possible d’établir une liaison avec un serveur SAS exécutant le moteur SAS Share ou un serveur relationnel exposant des tables SAS via des pilotes officiels :
library(DBI)

con <- dbConnect(odbc::odbc(),

                 Driver = "SAS Server Driver",

                 Server = "serveur_sas.institution.fr",

                 Port = 8561,

                 UID = "identifiant",

                 PWD = "mot_de_passe")
Une fois le pont relationnel établi, l’extraction s’opère au moyen de requêtes SQL standardisées via la commande dbGetQuery(), déléguant au serveur SAS la charge computationnelle du filtrage, de l’agrégation et de la jointure des tables. L’interrogation à distance permet de rapatrier vers la session R locale uniquement la matrice d’analyse condensée, contournant élégamment les goulets d’étranglement de bande passante réseau et de stockage local.
9. Gestion des jeux de données volumineux et optimisation des performances
9.1 Traitement par blocs (chunking) avec haven
Lorsque la taille physique d’un fichier .sas7bdat excède la capacité de la mémoire vive disponible (par exemple un registre médico-économique de 40 gigaoctets sur une station dotée de 16 Go de RAM), la tentative d’importation unitaire au moyen de read_sas() provoque inévitablement une erreur d’épuisement mémoire (vector memory exhausted). La stratégie de contournement standard réside dans le traitement par blocs séquentiels, communément désigné sous le terme de chunking.
Haven propose à cet effet une classe de fonctions hautement efficientes reposant sur le mécanisme des fonctions de rappel (callback functions), articulées autour de read_sas_chunked() :
# Definition d'une routine de filtrage itératif

filtrer_patients_actifs <- function(morceau, index) {

  morceau %>%

    filter(statut_vital == 1) %>%

    select(id_patient, date_inclusion, score_clinique)

}
# Execution du flux d'importation par blocs de 100 000 observations
donnees_filtrees <- read_sas_chunked(
data_file = "registre_massif.sas7bdat",
callback = DataFrameCallback$new(filtrer_patients_actifs),
chunk_size = 100000
)
Dans ce paradigme séquentiel, le moteur ReadStat lit exactement 100 000 enregistrements depuis le disque, applique immédiatement la fonction R spécifiée pour élaguer les variables et filtrer les observations non pertinentes, empile le résultat compacté au sein d’un accumulateur mémoire, puis libère les pages brutes avant de procéder à la lecture du bloc suivant. Cette approche permet de traiter des corpus monumentaux sur du matériel informatique standard sans jamais saturer la RAM.
9.2 Stratégies d’optimisation de la mémoire vive (RAM)
Au-delà de la technique du traitement par morceaux, l’optimisation de l’empreinte mémoire d’un jeu de données SAS requiert une vigilance rigoureuse quant au typage des colonnes. Par construction, SAS alloue 8 octets de précision en virgule flottante pour chaque champ numérique, y compris pour des variables n’hébergeant que des indicateurs booléens (0 ou 1) ou des entiers courts (codes postaux, classes d’âge). Une fois importées dans R, ces colonnes consomment inutilement des volumes colossaux d’espace mémoire.
Après l’ingestion initiale, l’application systématique de conversions de type permet de diviser fréquemment l’occupation mémoire par un facteur 2 à 4 :
- Conversion des identifiants et chaînes textuelles à faible cardinalité en facteurs ou en entiers compacts.
- Transformation des variables flottantes sans composante décimale en entiers natifs R au moyen de
as.integer()(4 octets par valeur au lieu de 8). - Suppression définitive des objets intermédiaires à l’aide de l’instruction
rm(objet), suivie d’un appel explicite au ramasse-miettes viagc()pour forcer le système d’exploitation à récupérer la mémoire libérée.
De surcroît, pour les étapes ultérieures du projet, il est particulièrement avantageux de sérialiser immédiatement la table nettoyée vers des formats de stockage colonnaires ultra-rapides tels qu’Apache Parquet (via le package arrow). Le format Parquet assure une compression disque exceptionnelle, des vitesses de réouverture jusqu’à vingt fois supérieures à celles d’un fichier SAS natif et une préservation scrupuleuse des types de données modernes.
9.3 Parallélisation et benchmarking des méthodes
L’optimisation des flux de données exige une évaluation empirique rigoureuse au moyen de protocoles de profilage et de micro-évaluation comparative (benchmarking). L’emploi du package microbenchmark permet de quantifier avec une précision microsecondaire les performances temporelles des différentes approches d’importation :
library(microbenchmark)

comparaison <- microbenchmark(

  haven_complet = read_sas("echantillon.sas7bdat"),

  haven_select = read_sas("echantillon.sas7bdat", col_select = c("id", "score")),

  times = 10

)
Les résultats empiriques démontrent invariablement que la vitesse d’ingestion est majoritairement conditionnée par la bande passante des opérations d’entrée/sortie (I/O) du disque de stockage. L’exécution de routines d’importation depuis un disque à semi-conducteurs NVMe (Solid-State Drive) surclasse les disques durs magnétiques traditionnels par plusieurs ordres de grandeur.
Cependant, il convient de souligner une contrainte architecturale structurelle : la lecture binaire séquentielle d’un fichier .sas7bdat ne se prête pas aisément à une parallélisation multi-cœurs naïve. Contrairement à des formats textuels partitionnables ou à des tables partitionnées en colonnes, l’interdépendance des pages compressées impose une décompression strictement linéaire. Dès lors, le levier de performance le plus déterminant ne réside pas dans la multiplication artificielle des processus R parallèles, mais dans la restriction drastique du volume d’octets transférés depuis le support physique grâce au filtrage ciblé par col_select.
10. Gestion des valeurs manquantes et anomalies de codage
10.1 Valeurs manquantes spéciales propres à SAS
L’un des écueils méthodologiques les plus insidieux lors de la transition de SAS vers R concerne le traitement des données non renseignées. Dans l’écosystème R, la notion d’absence de données est modélisée par une constante scalaire universelle : la valeur NA (Not Available), typée selon le vecteur hôte. En revanche, SAS intègre un système beaucoup plus granulaire autorisant jusqu’à 27 codes distincts de valeurs manquantes pour les variables numériques : le point standard (.) et 26 valeurs manquantes spéciales représentées par un point immédiatement suivi d’une lettre majuscule (.A à .Z), complétées par le caractère de soulignement (._).
Ces codes spécifiques jouent un rôle analytique crucial dans la recherche institutionnelle : ils permettent de qualifier la raison épistémologique ou technique motivant l’absence de l’information. Par exemple, au sein d’une enquête sociologique, un code .A peut signifier « Refus de répondre », un code .B « Non applicable compte tenu du filtre de question précédent », et un code .C « Donnée détruite ou illisible ».
Par défaut, l’instruction read_sas() de haven unifie brutalement l’ensemble de ces codes distincts sous un unique NA générique, annihilant toute la subtilité du schéma d’enquête d’origine. Pour préserver cette information primordiale, haven propose la structure avancée des valeurs manquantes étiquetées (tagged NA) :
# Préservation de la taxonomie des motifs d'absence

donnees_qualifiees <- read_sas("enquete.sas7bdat")

valeur_taggee <- haven::tagged_na("A")

# Vérification de la présence du code d'absence spécifique

is_na_specifique <- haven::is_tagged_na(donnees_qualifiees$item_salaire, "A")
Cette fonctionnalité confère à l’analyste une rigueur méthodologique absolue, lui permettant de documenter précisément l’attrition des cohortes et d’appliquer des stratégies d’imputation multiple adaptées aux motifs déclarés de non-réponse.
10.2 Détection et recodage des valeurs aberrantes
Dans de nombreuses bases de données patrimoniales élaborées sous SAS, les concepteurs d’enquêtes ont contourné l’usage formel des valeurs manquantes SAS en recourant à des conventions empiriques de codage arbitraire, consistant à consigner des entiers extrêmes négatifs ou positifs pour signaler l’anomalie (par exemple -99, -999, 9999 pour exprimer le refus de réponse ou l’erreur de saisie).
Si ces vecteurs sont importés dans R sans neutralisation préalable, l’interpréteur les considérera comme des valeurs quantitatives valides. L’impact sur les métriques synthétiques élémentaires sera dévastateur : le calcul d’une moyenne arithmétique ou l’estimation d’une variance empirique sera totalement biaisé par la présence de ces sentinelles numériques. L’analyste doit donc déployer des procédures systématiques de recodage post-importation :
donnees_corrigees <- donnees_qualifiees %>%

  mutate(across(

    where(is.numeric),

    ~ na_if(na_if(.x, -99), 999)

  ))
L’application rigoureuse de la fonction na_if() de dplyr substitue chirurgicalement les codes d’anomalies connus par de véritables NA exploités par les algorithmes statistiques de R, restituant la validité des estimations paramétriques.
10.3 Gestion des dates et horodatages SAS
L’alignement temporel constitue une autre divergence fondamentale entre les deux architectures. Dans le système SAS, les dates calendaires sont stockées sous la forme d’un nombre entier représentant le nombre de jours écoulés depuis le 1er janvier 1960 (les dates antérieures étant modélisées par des entiers négatifs). Les horodatages complets (datetimes) quantifient quant à eux le nombre de secondes écoulées depuis minuit le 1er janvier 1960.
À l’opposé, la convention informatique standard adoptée par R, conforme au standard temporel POSIX, prend pour point d’origine computationnel l’époque Unix, soit le 1er janvier 1970. Il existe donc un décalage structurel constant de 3 653 jours (incluant le décompte des années bissextiles intervenues entre 1960 et 1970) entre ces deux référentiels temporels.
Fort heureusement, la fonction read_sas() de haven prend automatiquement en charge cette translation mathématique dès lors que les colonnes SAS possèdent un format de date déclaré (tel que DATE9., YYMMDD10. ou DATETIME20.). Le moteur ReadStat applique la correction d’époque et instancie directement des objets de classe native R Date ou POSIXct. Toutefois, si la base SAS initiale a consigné des dates dans de simples colonnes numériques brutes sans leur assigner de format d’affichage temporel explicite, R importera un entier anonyme. L’analyste devra alors redresser manuellement le référentiel :
# Redressement manuel d'un scalaire temporel SAS sans format

donnees_dates <- donnees_cola %>%

  mutate(date_convertie = as.Date(date_brute_sas, origin = "1960-01-01"))
Cette rigueur de conversion garantit l’alignement calendaire parfait des séries chronologiques, des calculs de durées de survie et des analyses d’événements récurrents.
11. Application concrète : Importation et traitement de données psychométriques
11.1 Modélisation d’une enquête comportementale sous SAS
Afin de synthétiser l’ensemble de ces préceptes méthodologiques au sein d’un cas d’école réaliste, nous allons déployer un pipeline de traitement complet appliqué à une enquête comportementale fictive mais représentative des dispositifs de recherche en sciences humaines. Imaginons une base de données de santé au travail, consignée dans les fichiers climat_social.sas7bdat et formats.sas7bcat.
Ce corpus comprend des variables sociodémographiques (identifiant du travailleur, genre, ancienneté en années) et une batterie d’items psychométriques mesurant le sentiment d’épuisement professionnel à l’aide d’échelles de Likert en 5 points (de 1 = « Jamais » à 5 = « Quotidiennement »). Au sein de l’environnement SAS source, les items sont codés numériquement sous les variables burnout_1, burnout_2, burnout_3, et sont reliés à un catalogue de formats externe définissant les intitulés complets des questions et les libellés de chaque modalité de réponse.
11.2 Pipeline complet d’importation et de nettoyage
Le script d’ingestion et de prétraitement exploite la synergie entre haven, dplyr et le package psychométrique psych. L’objectif est d’importer le fichier en liant son catalogue, de valider sa structure, de transformer les étiquettes et de calculer un indice de consistance interne de l’échelle (alpha de Cronbach) :
# 1. Chargement des bibliothèques spécialisées

library(haven)

library(here)

library(dplyr)

library(labelled)

library(psych)
# 2. Définition des chemins vers les binaires et le catalogue
fichier_donnees <- here("donnees_brutes", "climat_social.sas7bdat")
fichier_catalogue <- here("donnees_brutes", "formats.sas7bcat")
# 3. Importation synchronisée des données et de leurs formats
enquete_brute <- read_sas(
data_file = fichier_donnees,
catalog_file = fichier_catalogue,
encoding = "UTF-8"
)
# 4. Pipeline de nettoyage, transformation et audit
enquete_propre <- enquete_brute %>%
# Filtrage des enregistrements invalides
filter(!is.na(id_salarie)) %>%
# Conversion du genre en facteur nominal avec libellés descriptifs
mutate(genre = as_factor(genre)) %>%
# Recodage d'éventuelles valeurs sentinelles d'anomalies
mutate(across(starts_with("burnout_"), ~ na_if(.x, 99)))
# 5. Extraction de la matrice numérique d'items pour analyse de consistance
matrice_items <- enquete_propre %>%
select(starts_with("burnout_")) %>%
zap_labels()
# 6. Évaluation psychométrique de l'échelle (Alpha de Cronbach)
resultat_fiabilite <- psych::alpha(matrice_items)
score_alpha <- resultat_fiabilite$total$raw_alpha
Grâce à la préservation des métadonnées lors de la phase read_sas(), le chercheur dispose à la fois d’une table analytique propre pour l’évaluation psychométrique et d’un inventaire complet des intitulés originels de questions pour l’interprétation théorique des facteurs.
11.3 Documentation et export du jeu de données finalisé
L’aboutissement de la démarche méthodologique consiste à figer le corpus nettoyé dans un conteneur pérenne, hautement documenté et facilement partageable au sein de la communauté scientifique. La première étape consiste à générer un livre de codes (codebook) condensant les descripteurs de variables :
# Génération du dictionnaire de métadonnées

livre_de_codes <- tibble(

  variable = names(enquete_propre),

  description = unlist(var_label(enquete_propre)),

  type = sapply(enquete_propre, typeof)

)
Pour l’archivage pérenne au sein de l’environnement R, le recours à la fonction native de sérialisation d’objet unique saveRDS() s’impose comme la solution de référence :
saveRDS(enquete_propre, file = here("donnees_derivees", "climat_social_consolide.rds"))
Contrairement aux archives binaires externes, un fichier .rds encapsule l’intégralité des classes R modernes, compresse efficacement le volume de stockage et garantit une restitution instantanée de l’environnement computationnel lors des sessions ultérieures via l’instruction symétrique readRDS(), scellant ainsi l’idéal de reproductibilité scientifique.
12. Dépannage systématique des erreurs courantes d’importation
12.1 Erreurs de chemin d’accès et permissions de fichiers
Parmi la typologie des incidents techniques répertoriés lors des flux d’importation, l’exception Error: '...' does not exist in current working directory représente l’anomalie la plus récurrente. Cette défaillance procède presque invariablement d’une mauvaise appréciation du répertoire de travail actif ou d’une coquille orthographique dans l’extension du fichier (par exemple confondre un zéro avec la lettre O, ou omettre le chiffre 7 dans .sas7bdat).
Le premier geste diagnostique consiste à interroger le répertoire courant au moyen de l’instruction getwd() et à vérifier la visibilité physique du fichier ciblé via la fonction d’inspection système :
file.exists("chemin/vers/fichier.sas7bdat")
Si cette commande renvoie FALSE, il convient de passer en revue la présence d’espaces insécables, de caractères accentués dans les noms de répertoires parents, ou de s’assurer que le fichier n’est pas verrouillé exclusivement par une instance SAS concurrente ouverte en arrière-plan sur la même station. Sous Windows, une table ouverte en mode édition exclusive sous l’interface SAS bloque tout accès en lecture partagée aux parseurs externes ; la fermeture de la session SAS libère instantanément le verrou de fichier (file lock) et autorise la lecture sans encombre par ReadStat.
12.2 Conflits d’encodage et corruptions de caractères
Les erreurs de décodage textuel se manifestent typiquement par l’émission d’avertissements explicites du type Warning: Failed to parse string using encoding 'UTF-8', accompagnés de troncatures inattendues de chaînes de caractères ou de l’apparition de symboles de remplacement (tels que le losange d’interrogation ?). Ce phénomène traduit une incompatibilité entre la page de codes déclarée dans l’en-tête du fichier SAS et la séquence d’octets réellement gravée sur le disque.
Pour diagnostiquer l’encodage réel d’un fichier en situation d’échec, l’analyste peut mobiliser la commande de détection heuristique du package readr :
readr::guess_encoding("chemin/vers/fichier.sas7bdat")
Bien que les fichiers binaires perturbent parfois les analyseurs heuristiques conçus pour le texte pur, cette inspection donne une indication précieuse sur les tables de codes potentielles (telles que ISO-8859-1, Windows-1252 ou Shift-JIS). Une fois l’encodage probable identifié, il suffit de contraindre la lecture en surchargeant l’argument dédié au sein de haven :
donnees <- read_sas("fichier.sas7bdat", encoding = "WINDOWS-1252")
Cette directive ordonne au convertisseur interne d’interpréter fidèlement la table d’octets selon les tables régionales historiques, éliminant radicalement toute corruption des chaînes de caractères.
12.3 Échecs de parsing et incompatibilité de versions SAS
Dans des contextes d’investigation sur des archives historiques, l’analyste peut se trouver confronté à des tables issues de versions obsolètes du système SAS (telles que SAS Version 6, reconnaissables à l’extension .sd2). Le parseur read_sas() de haven a été spécifiquement conçu pour les architectures modernes de la Version 7 à la Version 9.4 (fichiers .sas7bdat) et refusera de traiter ces structures binaires primitives, levant une exception de type Invalid file, or file has unsupported features.
Face à une telle obsolescence, la solution la plus robuste consiste à convertir préalablement l’archive au format de transport normalisé .xpt depuis une instance SAS d’émulation à l’aide de la procédure PROC COPY ou du moteur de transport CPORT, avant d’importer le vecteur résultant dans R via read_xpt().
Un autre cas de blocage critique concerne les fichiers protégés par un chiffrement cryptographique interne (fonctionnalité ENCRYPT=AES de SAS) ou verrouillés par un mot de passe de table (options READ= ou PW=). La bibliothèque ReadStat ne disposant pas des mécanismes de rétro-ingénierie permettant de casser les algorithmes de chiffrement symétrique du SAS Institute, ces tables chiffrées ne peuvent être désérialisées directement dans R. Elles nécessitent impérativement un déverrouillage préalable au sein de l’environnement SAS agréé afin de produire une extraction binaire non protégée ou un export intermédiaire sécurisé.
Références
- Food and Drug Administration. (2003). Guidance for industry: Part 11, Electronic records; electronic signatures — Scope and application. U.S. Department of Health and Human Services. https://www.fda.gov/regulatory-information/search-fda-guidance-documents/part-11-electronic-records-electronic-signatures-scope-and-application
- Müller, K., & Wickham, H. (2023). tibble: Simple Data Frames (Version 3.2.1) [Logiciel R]. CRAN. https://cran.r-project.org/package=tibble
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienne, Autriche. https://www.r-project.org/
- Revelle, W. (2024). psych: Procedures for Psychological, Psychometric, and Personality Research (Version 2.4.3) [Logiciel R]. Northwestern University, Evanston, Illinois. https://cran.r-project.org/package=psych
- SAS Institute Inc. (2018). SAS 9.4 Language Reference: Concepts, Sixth Edition. SAS Institute Inc., Cary, Caroline du Nord. https://documentation.sas.com/
- Shotwell, M. S. (2020). ReadStat: A command-line tool and C library for reading files from popular stats packages [Logiciel informatique]. GitHub. https://github.com/WizardMac/ReadStat
- Wickham, H., & Grolemund, G. (2017). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data. O’Reilly Media. https://r4ds.had.co.nz/
- Wickham, H., Hester, J., & Bryan, J. (2024). haven: Import and Export ‘SPSS’, ‘Stata’ and ‘SAS’ Files (Version 2.5.4) [Logiciel R]. CRAN. https://cran.r-project.org/package=haven