
Dans le domaine de l’analyse de données empiriques et de l’économétrie moderne, la collecte initiale des observations s’effectue encore massivement au moyen de tableurs grand public tels que Microsoft Excel. Outil d’une polyvalence indéniable, le tableur s’est imposé au fil des décennies comme la matrice universelle de saisie, d’organisation tabulaire et de partage rapide d’informations au sein des laboratoires universitaires, des administrations publiques et des entreprises privées. Néanmoins, l’émergence des exigences contemporaines de la science ouverte et la crise de la reproductibilité ont mis en lumière les limites structurelles inhérentes à ces interfaces graphiques interactives. La manipulation directe des cellules à la souris, la non-traçabilité des transformations manuelles et les conversions automatiques silencieuses constituent des vulnérabilités méthodologiques majeures, incompatibles avec la rigueur attendue dans les protocoles quantitatifs de pointe.
Face à ces écueils, le basculement vers des environnements de calcul statistique scriptés et programmatiques représente une mutation méthodologique essentielle. L’écosystème The R Project for Statistical Computing s’affirme comme une référence internationale pour le traitement, la modélisation et la restitution graphique des données complexes. En dissociant rigoureusement le jeu de données source du code exécutable chargé de son analyse, R garantit une traçabilité intégrale de chaque étape analytique, depuis le chargement des données brutes jusqu’à la compilation des rapports scientifiques finaux. Cette architecture scriptée permet non seulement d’automatiser des flux de travail récurrents, mais offre également aux chercheurs la possibilité d’auditer avec une exactitude absolue la moindre altération infligée aux variables observées.
Toutefois, la phase initiale d’ingestion des classeurs Excel dans l’espace de travail de R constitue une étape charnière, souvent jalonnée de difficultés techniques sous-estimées. La nature hybride des fichiers propriétaires de Microsoft, combinant données binaires compressées, métadonnées stylistiques, formules dynamiques et structures d’onglets multiples, impose l’adoption d’un protocole d’extraction méthodique et robuste. Le présent traité analytique a pour objectif d’exposer de manière exhaustive, systématique et didactique les principes théoriques et les applications pratiques indispensables pour réussir l’importation de classeurs Excel dans l’environnement R, en s’appuyant sur les outils les plus fiables de la science des données moderne.
1. Introduction méthodologique à l’intégration des données Excel dans l’écosystème R
1.1 Importance de la transition d’Excel vers R dans la recherche quantitative
L’utilisation de tableurs WYSIWYG (What You See Is What You Get) dans le cadre de la recherche quantitative expérimentale et psychométrique soulève des problématiques épistémologiques et techniques fondamentales. Au cœur de ces vulnérabilités réside l’absence quasi-totale de séparation étanche entre le stockage des données brutes, leur présentation visuelle et la logique de calcul. Lorsqu’un utilisateur effectue un tri manuel, colore des rangées ou modifie accidentellement la formule d’une cellule isolée dans un classeur Microsoft Excel, aucune trace exploitable de cette altération n’est conservée de façon programmable. En psychométrie, où les batteries d’évaluation impliquent fréquemment des matrices de réponses multidimensionnelles et des codages d’échelles d’attitude complexes, de telles interventions manuelles introduisent un biais d’erreur humaine difficilement détectable lors des audits méthodologiques.
Les publications scientifiques ont documenté de manière alarmante les répercussions de cette plasticité des tableurs. Des études génomiques de grande envergure ont révélé que des milliers d’articles indexés dans des revues de premier plan présentaient des erreurs de nomenclature génétique imputables à la conversion automatique non sollicitée de symboles géniques en formats temporels (par exemple, le gène SEPT2 systématiquement converti en date du 2 septembre). Ce phénomène illustre l’inaptitude structurelle d’Excel à maintenir une rigueur de typage sans intervention coercitive. À l’inverse, le langage R impose une séparation stricte entre les données immuables résidant sur le disque et les structures vectorielles instanciées dans la mémoire vive de la session. Chaque recodage, chaque imputation de valeur manquante ou chaque transformation d’échelle fait l’objet d’un énoncé algorithmique explicite, garantissant ainsi l’entière reproductibilité de la chaîne de traitement scientifique.
Au-delà de cette préservation de l’intégrité informationnelle, la transition d’Excel vers R répond à des contraintes dimensionnelles et algorithmiques incontournables. Alors qu’un classeur moderne demeure circonscrit à une limite théorique de 1 048 576 lignes et 16 384 colonnes, R, en exploitant l’architecture de la mémoire adressable 64 bits, permet de manipuler des tables de contingence et des matrices longitudinales d’une envergure considérablement plus vaste. L’évolution historique des formats de stockage de Microsoft ajoute une couche de complexité analytique : le passage du format binaire propriétaire .xls (spécifique aux versions Excel 97 à 2003, reposant sur le format de fichier BIFF) au format conteneur compressé .xlsx (introduit avec la norme Office Open XML basée sur une archive ZIP renfermant des fichiers XML) a profondément redéfini les protocoles d’accès aux flux de données sous-jacents.
1.2 Vue d’ensemble de l’écosystème de lecture de données dans R
L’histoire de l’interfaçage entre les données tabulaires externes et le moteur d’exécution de R témoigne d’un effort d’ingénierie logicielle continu pour s’affranchir des contraintes imposées par les formats fermés. Durant les premières décennies de l’écosystème GNU R, l’importation de fichiers issus de suites bureautiques nécessitait fréquemment l’intermédiation de pilotes de bases de données génériques tels que ODBC (via le package RODBC) ou l’appel à des sous-systèmes tiers complexes. Ces approches imposaient des dépendances système fragiles et souffraient d’instabilités chroniques liées aux architectures hétérogènes des systèmes d’exploitation hôtes, tout en introduisant des goulets d’étranglement de performance significatifs lors du traitement de volumes importants.
Dans ce contexte historique, la pratique dominante a longtemps consisté à exporter manuellement les classeurs au format texte délimité, à l’instar des fichiers .csv (Comma-Separated Values) ou .tsv (Tab-Separated Values). Si cette solution textuelle présente l’avantage de la simplicité universelle et d’une prise en charge native par les fonctions canoniques de base de R telles que read.table() ou read.csv(), elle engendre une dégradation notable de l’information contextuelle. La conversion en texte brut élimine irrémédiablement le cloisonnement par onglets multiples au sein d’un même document, force l’aplatissement des représentations temporelles et risque d’altérer les encodages de caractères internationaux lors de l’ouverture sur des plateformes linguistiques divergentes (notamment la divergence séculaire entre le point décimal anglo-saxon et la virgule décimale francophone).
Afin de concilier la persistance des structures natives d’Excel et les exigences de rapidité computationnelle contemporaines, la communauté R s’est enrichie de bibliothèques spécialisées dans le décodage direct des spécifications binaires et XML. Au premier rang de cette évolution figure le package readxl, développé sous l’égide du consortium Tidyverse. Conçu pour s’intégrer de manière transparente aux pipelines de manipulation de données modernes, readxl extrait fidèlement la typologie native des cellules de classeurs .xls et .xlsx sans requérir l’installation de logiciels tiers ou de moteurs d’exécution lourds, matérialisant ainsi un pont idéal entre les pratiques de collecte courantes et la rigueur de l’analyse computationnelle.
2. Configuration préalable de l’environnement de travail et gestion des répertoires
2.1 Définition et vérification du répertoire de travail actif
Toute entreprise d’ingestion programmatique de données doit débuter par une clarification rigoureuse de l’environnement spatial de la session R. Le concept fondamental de « répertoire de travail actif » (current working directory) représente le point d’ancrage contextuel au sein duquel le moteur d’exécution cherche prioritairement à résoudre les références aux chemins de fichiers relatifs. L’interrogation de ce paramètre s’effectue via l’invocation de la fonction getwd(), qui renvoie une chaîne de caractères spécifiant le chemin absolu du dossier hôte. À l’inverse, l’ajustement dynamique de cet emplacement d’exécution peut être réalisé au moyen de la commande setwd(), bien que cette approche doive être employée avec une grande parcimonie dans les protocoles automatisés.
Pour assurer la pérennité d’une recherche quantitative, l’arborescence des dossiers doit obéir à une hiérarchisation standardisée et prévisible. Il est hautement recommandé d’adopter une organisation structurée en sous-répertoires hermétiques : un dossier racine hébergeant la documentation méthodologique, un sous-dossier data/raw/ sanctuarisé pour la réception des classeurs Excel originaux protégés en écriture, un sous-dossier data/processed/ pour les extraits standardisés, et un dossier scripts/ réservé aux instructions logicielles. L’avènement des projets RStudio, caractérisés par la présence d’un fichier descripteur d’extension .Rproj à la racine du répertoire de travail, permet d’automatiser l’attribution de cet ancrage contextuel sans jamais coder en dur des chemins absolus propres à une machine physique spécifique.
Dans un flux d’analyse défensif, il est par ailleurs impératif de valider formellement la présence physique du fichier cible avant d’initier toute tentative de décodage par le parseur. La commande native file.exists() remplit précisément cette fonction de diagnostic préventif en retournant un vecteur logique booléen (TRUE ou FALSE). L’intégration de cette vérification au sein d’une clause conditionnelle permet d’interrompre gracieusement l’exécution du script ou de déclencher un message d’alerte explicite si le classeur attendu a été déplacé, corrompu ou renommé de façon inappropriée, évitant ainsi le déclenchement d’erreurs d’exécution génériques et peu descriptives.
2.2 Bonnes pratiques pour la nomenclature des fichiers et la cohérence du système
La pérennité des flux d’importation dépend étroitement de la discipline appliquée lors de la dénomination des fichiers de données. L’écueil le plus fréquent réside dans l’utilisation d’espaces typographiques, de caractères accentués, de trémas ou de symboles diacritiques propres aux langues latines. Si ces glyphes sont correctement interprétés par les interfaces graphiques des systèmes d’exploitation contemporains, ils constituent une source constante de vulnérabilités lors de leur transmission à travers des bibliothèques compilées en langage C ou C++ sous-jacentes. L’adoption stricte de la convention snake_case (mots en minuscules séparés par des tirets bas) ou du standard kebab-case (mots séparés par des traits d’union), restreinte exclusivement aux caractères alphanumériques ASCII de base, représente le premier rempart contre les échecs de résolution d’adresses de stockage.
Une autre source majeure de dysfonctionnement en milieu professionnel réside dans les conflits d’accès concurrentiel aux classeurs. Lorsqu’un chercheur ou un collaborateur conserve un fichier Excel ouvert au sein de l’application Microsoft Office, le système d’exploitation applique fréquemment un verrou exclusif sur le fichier et génère un fichier temporaire masqué dont le nom débute par le préfixe tilde-dollar (par exemple ~$protocole_mesures.xlsx). Ce mécanisme de verrouillage peut, selon les configurations réseau et les droits d’accès au système de fichiers partagé, bloquer net les routines de lecture en lecture seule de R ou induire l’analyse involontaire d’une version transitoire désynchronisée. Il convient donc d’établir pour règle formelle la clôture complète des instances de tableurs avant toute exécution de pipeline analytique.
Enfin, la rigueur méthodologique impose de considérer la sensibilité à la casse (case sensitivity) différentielle selon les plateformes informatiques. Alors que le système de fichiers NTFS de Microsoft Windows et, par défaut, le système APFS de macOS se comportent de manière insensible à la casse (considérant que DONNEES.xlsx et donnees.xlsx désignent une entité identique), les systèmes basés sur le noyau Linux, massivement exploités sur les clusters de calcul haute performance et les serveurs d’intégration continue, appliquent une distinction stricte et binaire. Un script développé sous Windows comportant une discordance de capitalisation échouera inévitablement lors de son déploiement sur un serveur scientifique Linux, compromettant l’interopérabilité globale du projet de recherche.
3. Installation et chargement rigoureux des packages spécialisés
3.1 Procédure d’installation et de déploiement du package readxl
L’intégration de capacités avancées de lecture des classeurs Microsoft nécessite l’adjonction de bibliothèques tierces distribuées par le Comprehensive R Archive Network (CRAN). La référence consensuelle pour cette opération est le package readxl, conçu expressément pour extraire les données de formats tabulaires propriétaires sans mobiliser de dépendances logicielles externes encombrantes. L’installation s’effectue via l’exécution en console de la commande standard install.packages("readxl"), qui télécharge et compile, si nécessaire, les bibliothèques C et C++ qui constituent le moteur interne du module.
Le déploiement du package au sein d’un script scientifique requiert une déclaration rigoureuse en tête de document à travers l’instruction library(readxl). Cette démarche rend disponibles les fonctions spécialisées dans l’espace de noms global de la session active. Toutefois, dans les environnements collaboratifs denses où plusieurs bibliothèques manipulant des concepts identiques sont chargées simultanément, des collisions d’espaces de noms (namespace masking) peuvent survenir. Bien que readxl présente une signature de fonctions hautement spécifique minimisant ce danger, l’utilisation de l’opérateur de résolution explicite readxl::read_excel() demeure une pratique d’excellence dans le cadre de scripts de production critique, garantissant l’origine absolue de la fonction appelée sans ambiguïté interprétative.
L’avantage technique prééminent de readxl réside dans son architecture interne totalement découplée de l’environnement d’exécution Java (Java Runtime Environment ou JRE). Historiquement, les bibliothèques de manipulation de classeurs sous R dépendaient massivement du pont logiciel rJava pour interagir avec des bibliothèques Java open source comme Apache POI. Ces configurations antérieures provoquaient de récurrents problèmes d’incompatibilité de versions entre les architectures 32 bits et 64 bits, des erreurs complexes de variables d’environnement JAVA_HOME, et des blocages liés au dépassement de la mémoire tampon (heap memory). En intégrant directement les analyseurs natifs C++ rapidxml (pour le format .xlsx) et libxls écrit en C (pour le format binaire hérité .xls), readxl garantit des performances d’exécution véloces et une portabilité immédiate sur l’ensemble des systèmes d’exploitation modernes.
3.2 Vérification des versions et maintien de l’environnement logiciel
Dans une perspective de reproductibilité scientifique pérenne, la maîtrise des versions logicielles constitue une contrainte méthodologique incontournable. Les algorithmes d’inférence de types et les mécanismes de lecture de bas niveau évoluant au gré des itérations de maintenance des bibliothèques, un comportement de parsing observé à un instant t peut subtilement diverger lors d’une mise à jour logicielle ultérieure. Il est donc indispensable d’interroger la configuration logicielle déployée via la fonction packageVersion("readxl") afin d’indexer formellement la sous-version exacte exploitée lors de la phase de collecte.
Au-delà du package unitaire, l’interaction de la bibliothèque avec l’architecture globale de R (notamment la compatibilité avec la branche majeure R 4.x) doit faire l’objet d’un audit de session régulier. L’appel à la fonction native sessionInfo() compile instantanément la configuration exhaustive du système hôte : version du compilateur, chaîne d’encodage par défaut de l’OS, micro-versions des packages chargés et des dépendances indirectes associées. L’adjonction de cette synthèse en annexe technique des publications quantitatives permet à tout évaluateur indépendant de reconstituer fidèlement l’écosystème computationnel d’origine.
Pour immuniser définitivement les pipelines de recherche contre l’entropie logicielle et les ruptures de compatibilité ascendante, l’intégration d’outils de gestion de dépendances déterministes tels que le gestionnaire d’environnements virtuels renv est fortement recommandée. En consignant la signature cryptographique et la provenance précise de l’ensemble des modules logiciels dans un fichier de verrouillage structuré (renv.lock), le chercheur prévient tout risque de dysfonctionnement ultérieur lié à une modification impromptue de l’arbre des dépendances du système hôte.
4. Syntaxe fondamentale et premier import avec read_excel()
4.1 Décomposition de la signature de la fonction read_excel()
La commande pivot du package readxl s’incarne dans la fonction polymorphique read_excel(). Cette routine se charge d’analyser l’en-tête du fichier cible afin d’en identifier la signature binaire intrinsèque (le magic number), opérant ainsi une délégation automatique vers les sous-fonctions spécialisées read_xls() pour les formats anciens ou read_xlsx() pour les classeurs XML modernes. L’argument central obligatoire, désigné par le paramètre formel path, attend une chaîne de caractères spécifiant le chemin physique ou relatif menant au classeur d’intérêt.
Contrairement aux fonctions historiques du package de base utils qui convertissent d’office les matrices tabulaires en structures classiques de type data.frame, read_excel() renvoie par conception un objet de classe étendue tbl_df, communément désigné sous le terme de tibble. Cette structure conserve toutes les propriétés fondamentales du data.frame standard, tout en y adjoignant des comportements préventifs hautement vertueux : suppression de l’affichage console involontaire de dizaines de milliers de lignes, interdiction stricte du fractionnement partiel des noms de colonnes et préservation rigoureuse de la typologie des chaînes de caractères sans conversion insidieuse en facteurs statistiques non désirés.
L’affectation de la structure résultante dans l’environnement global de travail s’exécute par l’intermédiaire de l’opérateur d’assignation standardisé <-. La signature complète de la fonction offre une panoplie de paramètres optionnels finement calibrés pour contrôler le comportement du parseur, tels que la sélection de sous-partitions d’onglets, la définition de seuils heuristiques de typage ou encore la configuration de filtres géométriques de cellules. L’appropriation progressive de ces arguments permet d’adapter l’ingestion aux structures tabulaires les plus hétérodoxes.
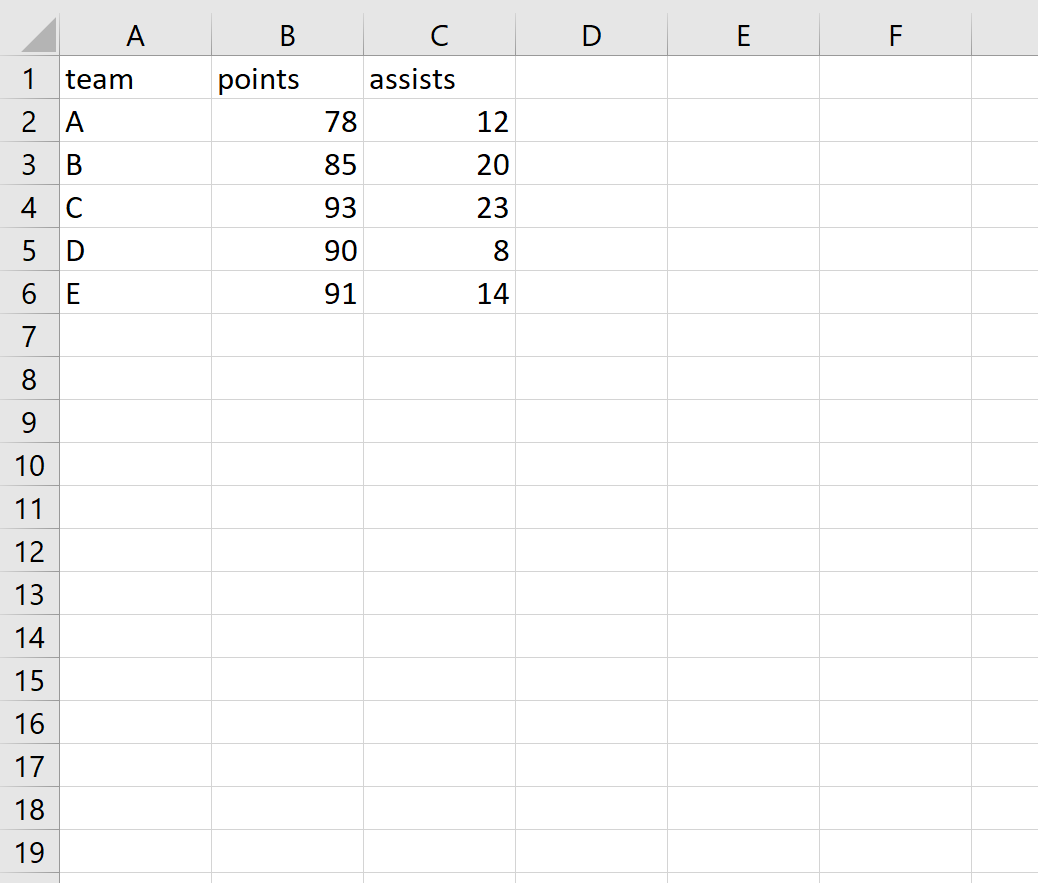
4.2 Exécution d’un exemple concret d’importation basique
Considérons à titre d’illustration méthodologique une matrice de recueil psychologique standard, hébergée dans un classeur nommé observations_cliniques.xlsx situé dans le sous-répertoire actif des données. L’écriture du code minimaliste pour rapatrier ces observations s’articule comme suit :
Le script débute par l’appel à la bibliothèque : library(readxl). L’assignation formelle s’opère ensuite par l’instruction : donnees_cliniques <- read_excel("data/observations_cliniques.xlsx"). Dès l’exécution de cet énoncé, le parseur C++ parcourt la structure zippée de l’archive XML, analyse la première feuille disponible du classeur, infère la typologie des variables présentes et compile l’ensemble dans la mémoire de R sous la forme d’un tibble structuré accessible immédiatement via la variable donnees_cliniques.
L’inspection initiale de l’objet matérialisé s’effectue directement en invoquant le nom de la variable dans la console ou par l’intermédiaire de fonctions d’évaluation dimensionnelle. L’appel à dim(donnees_cliniques) renvoie immédiatement un vecteur d’entiers informant sur la volumétrie globale : le premier élément documente le nombre total de lignes observées (observations ou individus statistiques), tandis que le second spécifie le nombre de colonnes (attributs ou indicateurs psychométriques). L’utilisation conjointe des fonctions nrow() et ncol() permet de ventiler isolément ces paramètres au sein de routines de vérification ultérieures.
Enfin, l’évaluation de l’empreinte mémoire initiale du jeu de données constitue une étape de salubrité computationnelle essentielle, particulièrement lors de l’exécution d’analyses sur des postes de travail aux ressources restreintes. La commande native object.size(donnees_cliniques), ou plus rigoureusement la fonction lobstr::obj_size(donnees_cliniques), délivre une quantification précise du volume d’octets mobilisés par la structure en mémoire vive. Cette analyse préliminaire permet d’anticiper les éventuels besoins d’optimisation mémoire avant d’engager des modélisations statistiques gourmandes en calcul matriciel.
5. Gestion experte des chemins de fichiers et écueils syntaxiques
5.1 Résolution de l’erreur d’échappement sous l’environnement Windows
L’une des pierres d’achoppement les plus universelles rencontrées par les utilisateurs de R évoluant sous l’environnement d’exploitation Microsoft Windows réside dans l’incompatibilité de la notation conventionnelle des répertoires de disques avec la syntaxe des chaînes de caractères de R. Dans l’écosystème Windows, la délimitation des sous-dossiers s’effectue historiquement à l’aide de la barre oblique inversée, ou antislash (). Un chemin typique copié depuis l’explorateur de fichiers se présente sous la forme : C:UsersChercheurDocumentsProjetdonnees.xlsx.
Or, dans la grammaire formelle du langage R (partagée avec le langage C et la grande majorité des langages de programmation modernes), l’antislash est réservé en tant que métacaractère d’échappement. Il sert à conférer une signification particulière au caractère qui lui succède immédiatement, comme le saut de ligne (n), la tabulation (t), ou encore l’introduction d’un identifiant hexadécimal ou Unicode (u ou U). Dès lors, lorsque le moteur de lecture de R tente d’analyser une chaîne telle que "C:Users...", il interprète la séquence U comme le préfixe annonçant un caractère Unicode étendu mal formé. Cette méprise lexicale déclenche instantanément une erreur syntaxique bloquante : « unrecognized escape sequence » ou « ‘path’ does not exist ».
Pour neutraliser cette anomalie structurelle, deux solutions programmatiques s’offrent à l’analyste. La première consiste à doubler chaque barre oblique inversée afin d’échapper le métacaractère lui-même (par exemple : "C:UsersChercheurDocumentsProjetdonnees.xlsx"). Cependant, la pratique la plus élégante, pérenne et recommandée sur le plan méthodologique consiste à substituer universellement les antislashs par des barres obliques standards (slashes, /), sous la forme : "C:/Users/Chercheur/Documents/Projet/donnees.xlsx". Bien qu’exécuté sous Windows, le système d’entrée-sortie de R gère parfaitement cette notation forward-slash. Pour les chemins complexes déjà existants, l’emploi de la fonction de commodité normalizePath() permet d’automatiser cette régularisation syntaxique de manière programmable.
5.2 Exploitation du package here pour une robustesse multiplateforme
Bien que la rectification des délimiteurs de répertoires résolve les dysfonctionnements syntaxiques immédiats, l’inscription de chemins d’accès absolus (débutant par une lettre de lecteur telle que C:/ ou la racine globale /home/) constitue une hérésie méthodologique majeure en matière de reproductibilité computationnelle. Un script contenant un chemin absolu codé en dur est intrinsèquement voué à l’échec dès lors qu’il est exécuté sur l’ordinateur d’un pair évaluateur, sur un serveur distant ou simplement sur la même machine si l’utilisateur modifie l’arborescence de son propre système de stockage.
Pour éliminer définitivement cette fragilité, l’adoption du package here constitue la norme méthodologique d’excellence. Le principe d’action de here repose sur la détection heuristique intelligente de la racine du projet analytique. Dès son chargement, la bibliothèque inspecte l’arborescence des dossiers parents jusqu’à localiser un marqueur univoque d’ancrage, tel qu’un fichier de projet RStudio (.Rproj), un dossier de contrôle de version décentralisé .git, ou un fichier d’environnement .here.
L’utilisation combinée de read_excel() et de la syntaxe de composition dynamique de chemins délivrée par here() confère une robustesse absolue aux flux d’ingestion. Au lieu de spécifier une chaîne de texte composite sujette aux erreurs, l’analyste segmente l’arborescence sous la forme d’arguments successifs indépendants du système d’exploitation : read_excel(here::here("data", "experimental", "classeur_recherche.xlsx")). Le module compile dynamiquement la séquence en intercalant les délimiteurs conformes aux spécifications du système d’exploitation hôte (Windows, macOS ou distributions GNU/Linux). Cette abstraction garantit l’interopérabilité sans couture du script au travers d’équipes de recherche distribuées et d’environnements d’intégration continue hétérogènes.
6. Ciblage et navigation au sein des feuilles de calcul multiples
6.1 Inspection préalable des métadonnées du classeur
Une caractéristique fondamentale distinguant les classeurs Microsoft Excel des fichiers de données plats réside dans leur capacité à héberger une pluralité de tables partitionnées au sein d’onglets distincts (les feuilles de calcul ou worksheets). Dans les dispositifs d’expérimentation longitudinale ou les enquêtes transversales à grande échelle, il est fréquent que les administrateurs de données consacrent une feuille individuelle à chaque phase temporelle (par exemple : « Pré-test », « Post-test », « Suivi_6mois ») ou à chaque sous-population d’échantillonnage. Tenter d’importer aveuglément un tel document sans un examen programmatique préliminaire expose l’analyste à tronquer substantiellement ses analyses.
Le package readxl met à disposition un instrument dédié à la cartographie structurelle préalable : la fonction excel_sheets(). En lui transmettant le chemin d’accès vers le fichier sans procéder au parsing intégral des matrices numériques sous-jacentes, cette commande interroge le manifeste XML du classeur pour extraire instantanément un vecteur de chaînes de caractères énumérant de manière exhaustive la dénomination exacte de l’ensemble des onglets disponibles :
L’exploitation programmatique de ce vecteur offre des perspectives avancées de sécurisation des flux de travail. Par le biais de fonctions d’algèbre relationnelle ou de tests logiques basiques (à l’instar de l’opérateur d’appartenance vectorielle %in%), l’analyste peut implémenter une routine de validation défensive. Il est ainsi aisé de vérifier automatiquement si une feuille critique — nommée par exemple « Metriques_Finales » — figure bien dans l’inventaire avant d’amorcer les traitements computationnels lourds. Si l’assertion échoue, l’exécution peut être interrompue préventivement au moyen d’un appel explicite à stop(), prévenant toute propagation silencieuse d’erreurs structurelles en aval de la chaîne analytique.
6.2 Extraction de feuilles spécifiques via l’argument sheet
Par défaut, l’instruction read_excel() n’analyse et ne rapatrie que la première feuille physique contenue dans le classeur cible, occultant totalement les données hébergées sur les onglets subséquents. Pour sélectionner un onglet alternatif, le concepteur du script doit expressément solliciter le paramètre sheet. Ce dernier accepte deux modes d’adressage distincts : l’indexation numérique ordinale ou la désignation littérale par chaîne de caractères nominative.
L’indexation numérique s’effectue en fournissant un entier correspondant à la position spatiale de la feuille dans le classeur (par exemple : read_excel("protocole.xlsx", sheet = 2) pour la deuxième feuille). Bien que concise, cette méthode souffre d’une fragilité majeure dans les contextes collaboratifs : si un opérateur tiers ouvre manuellement le fichier Excel et déplace l’ordre visuel des onglets par glisser-déposer sans en altérer les contenus, le script lira la mauvaise sous-population lors de son exécution suivante sans soulever d’erreur explicite. L’indexation ordinale doit donc être réservée à des flux de données strictement normalisés ou à des routines d’itération mathématique aveugle.
L’adressage nominatif, formulé par la transmission de l’intitulé textuel précis de l’onglet (par exemple : read_excel("protocole.xlsx", sheet = "Post_Test_2023")), s’impose comme la méthodologie d’extraction la plus sûre et la plus lisible. Cette approche immunise l’analyse contre les réorganisations spatiales des onglets au sein de la suite bureautique. Une vigilance particulière s’impose néanmoins quant au respect strict de la casse, des espaces superflus involontairement intercalés en fin d’intitulé par le saisisseur initial, ainsi que des caractères diacritiques. Si l’intitulé cible comporte des particularités syntaxiques, il est souvent judicieux d’extraire d’abord le vecteur via excel_sheets() et de cibler dynamiquement l’élément souhaité par filtrage régulier.
7. Contrôle strict de la typologie des variables et des colonnes
7.1 Mécanisme d’inférence automatique des types par read_excel()
Dans la théorie des bases de données et des architectures de stockage, la détermination du type de données (data typing) conditionne la validité des calculs algébriques et l’intégrité de la mémoire. À la différence des systèmes de bases de données relationnelles stricts (comme PostgreSQL ou MySQL) qui imposent un schéma rigide en amont de toute persistance, les tableurs Excel autorisent une permissivité quasi absolue : une même colonne peut héberger sans avertissement préalable un mélange d’entiers, de chaînes textuelles explicatives, de représentations temporelles et de codes d’erreur de formules (tels que #VALEUR! ou #DIV/0!).
Pour transcrire ce chaos potentiel en vecteurs atomiques homogènes propres à R, la fonction read_excel() applique un algorithme d’inférence statistique supervisé par l’argument heuristique guess_max. Par défaut, la bibliothèque analyse les premières $N = 1000$ lignes du fichier pour déterminer le dénominateur commun le plus adapté à chaque colonne : si les mille premières cellules contiennent exclusivement des chiffres, la colonne sera catégorisée comme numérique (numeric ou double) ; si des chaînes textuelles sont interceptées, la colonne bascule irréversiblement vers le type textuel générique (text ou character).
Ce mécanisme d’inférence, bien que salvateur dans la majorité des cas standards, induit des défaillances pernicieuses face à des variables comportementales éparses ou des identifiants administratifs. Si une modalité clinique rare n’apparaît que pour la première fois à la millième deuxième ligne d’une table d’observations et que toutes les entrées antérieures contenaient des codes chiffrés ou des cellules vacantes, read_excel() typifie la colonne en vecteur purement numérique. Lors du passage sur cette valeur textuelle tardive, le parseur C++ se trouve dans l’incapacité de convertir la chaîne en valeur décimale, génère un avertissement de parsing de type « parsing issue: expected numeric, got text » et substitue unilatéralement la donnée originale par une valeur manquante NA. L’ajustement du paramètre guess_max = Inf ou à une borne supérieure garantit l’analyse préalable de l’intégralité du tableau, au détriment d’une légère dégradation de la vitesse de chargement initial.
7.2 Forçage explicite des types via le paramètre col_types
Dans le cadre de protocoles scientifiques formels, s’en remettre à des mécanismes de divination heuristique constitue une faiblesse méthodologique évitable. Le standard d’excellence préconise l’assignation explicite et déterministe de la nature de chaque variable dès la phase d’ingestion. Cette maîtrise absolue est garantie par l’argument formel col_types de la fonction read_excel(), qui permet de stipuler la spécification typologique exacte attendue pour chacune des colonnes du tableau sous la forme d’un vecteur de chaînes de caractères.
Le package readxl reconnaît un répertoire fini de typologies atomiques :
"numeric": force la conversion en nombres à virgule flottante double précision (y compris pour les entiers) ;"text": contraint le stockage sous forme de chaînes de caractères (indispensable pour les champs qualitatifs) ;"date": parse les informations sous l’architecture temporelle POSIXct de R ;"logical": interprète les booléens binaires (vrai/faux) ;"skip": indique au moteur de décodage d’ignorer purement et simplement la colonne lors de la lecture physique du classeur ;"guess": délègue ponctuellement la détermination du type à l’algorithme d’inférence pour la variable concernée.
L’utilisation de la directive "skip" s’avère particulièrement puissante en matière d’ingénierie de la mémoire : en excluant immédiatement les colonnes redondantes, les commentaires annexes ou les identifiants techniques non pertinents pour l’analyse, l’empreinte de la structure en mémoire vive se trouve drastiquement allégée. Par ailleurs, le forçage systématique des identifiants d’échantillons (tels que les numéros d’inclusion des patients ou les codes postaux) vers le type "text" prévient l’effacement désastreux des zéros non significatifs initiaux (par exemple, le code administratif "01234" irréversiblement tronqué en valeur arithmétique 1234 si la variable est classifiée par inadvertance en format numérique).
8. Traitement avancé des valeurs manquantes et anomalies de saisie
8.1 Standardisation des valeurs manquantes à l’aide de l’argument na
La complétude parfaite des données expérimentales relève d’une fiction statistique rarement observée dans la recherche empirique. Les protocoles psychométriques, cliniques ou sociologiques sont constamment confrontés à l’absence fortuite ou systématique de réponses, aux abandons de participants ou aux défaillances instrumentales. Cependant, les modalités de consignation de ces vides analytiques dans les tableurs souffrent d’une anarchie notoire : certains opérateurs laissent la cellule visuellement vide, d’autres inscrivent textuellement des mentions telles que « Absent », « Non-renseigné », « N/A », « Refus », ou attribuent des conventions numériques sentinelles issues de traditions logicielles antérieures, à l’image du célèbre code -99, 999 ou ..
Si aucune précaution n’est adoptée lors de la lecture dans R, une colonne numérique contenant la mention explicative textuelle « Non-répondu » verra l’ensemble de ses composantes arithmétiques converties d’office en vecteurs de chaînes de caractères pour préserver la cohérence apparente du tableau, annihilant immédiatement la possibilité d’appliquer des estimateurs statistiques basiques comme la moyenne ou l’écart-type. Le paramètre formel na de read_excel() offre une arme de neutralisation massive contre cette corruption. Il permet de soumettre un vecteur de chaînes de caractères stipulant exhaustivement les motifs littéraux ou numériques devant être uniformément assimilés au marqueur universel d’incomplétude de R : la constante NA (Not Available).
En configurant l’appel sous la forme : read_excel("donnees.xlsx", na = c("", "NA", "N/A", "-99", "Refus", "ND")), l’analyste assainit l’importation à la source. Toutes les occurrences détectées concordant avec l’une de ces valeurs sentinelles sont converties de manière transparente en valeurs manquantes natives lors du décodage bas-niveau. Cette conversion préventive garantit que les colonnes numériques conservent rigoureusement leur statut de vecteurs quantitatifs continus, tout en permettant aux algorithmes de modélisation ultérieurs d’appliquer leurs routines spécifiques d’imputation multiple ou de gestion de l’incomplétude (via les arguments conventionnels na.rm = TRUE).
8.2 Gestion des cellules corrompues et des commentaires textuels parasites
En dépit d’une paramétrisation rigoureuse des types et des valeurs sentinelles, l’analyse de fichiers de terrain volumineux peut se heurter à des dysfonctionnements locaux de conversion de cellules. Le parseur de readxl est conçu selon une logique de résilience : lorsqu’une anomalie insurmontable est détectée (par exemple une date formulée dans un format corrompu impossible à désérialiser), la fonction ne bloque pas brutalement l’ensemble du processus de lecture. Elle émet à la place un avertissement d’exécution (warning message) signalant l’émergence d’une ou plusieurs « parsing issues ».
Pour auditer avec précision ces occurrences d’échec sans devoir inspecter manuellement des millions de cellules, la bibliothèque met à disposition la fonction d’inspection problems(). En appliquant cette instruction à la structure tibble importée (par exemple : problems(donnees_cliniques)), l’analyste obtient instantanément un tableau d’audit exhaustif spécifiant les coordonnées cartésiennes précises (numéro de ligne, numéro de colonne), la valeur brute incriminée interceptée dans le fichier Excel et la typologie théorique attendue par le moteur de parsing. Cet outil de diagnostic permet de remonter directement à la source de l’anomalie pour la documenter ou programmer une routine de redressement ciblé.
Une autre menace invisible perturbant régulièrement l’intégrité des données textuelles réside dans la présence de caractères d’espacement non conventionnels issus de copier-coller depuis des plateformes Web ou des traitements de texte, au premier rang desquels figure l’espace insécable Unicode (codé u00A0 ou ). Pour l’œil humain, ce caractère est indiscernable d’un espace standard ; pour un interpréteur R, il constitue un octet distinct empêchant l’appariement strict de facteurs ou l’identification de clés primaires lors des jointures relationnelles. L’application systématique de routines de nettoyage sur les colonnes textuelles à l’aide de fonctions vectorielles comme stringr::str_squish() ou stringi::stri_enc_toutf8() en post-importation achève de purifier les distributions de ces artefacts invisibles.
9. Importation ciblée de plages cellulaires et gestion des en-têtes
9.1 Extraction géométrique de sous-ensembles via le paramètre range
L’une des déviances structurelles les plus répandues dans l’élaboration de classeurs au sein des institutions consiste à employer la feuille de calcul non pas comme une table de base de données standardisée (où chaque ligne représente une unité d’observation et chaque colonne une variable unique), mais comme un support de mise en page visuel complexe. Il est fréquent d’observer des classeurs dont les premières lignes sont saturées de métadonnées décoratives (logos institutionnels, titres en gras, coordonnées des enquêteurs), ou qui comportent des blocs de calculs de synthèse marginaux adjacents au tableau de données principal.
Si read_excel() tente d’analyser globalement une telle feuille, il interprète les cellules de titre fusionnées comme des noms de colonnes et agrège les notes de bas de page dans le corps des observations statistiques, provoquant une distorsion structurelle majeure. Pour pallier cette anomalie sans contraindre l’analyste à altérer manuellement le classeur original — action proscrite par les normes de traçabilité —, le paramètre range offre un mécanisme de sélection géométrique d’une précision chirurgicale. Ce paramètre autorise l’usage direct de la syntaxe de notation cartésienne universelle propre à Microsoft Excel :
En formulant la requête sous la forme : read_excel("rapport_financier.xlsx", range = "B5:H120"), le moteur d’extraction isole exclusivement le parallélogramme cellulaire délimité par l’intersection de la colonne B ligne 5 et de la colonne H ligne 120, ignorant superbement les artefacts décoratifs périphériques. La notation permet également de spécifier l’onglet cible au sein de la même chaîne d’adressage en préfixant la plage par l’intitulé de la feuille suivi d’un point d’exclamation (par exemple : range = "Suivi_Clinique!C10:N250").
Pour les scénarios complexes où les coordonnées extrêmes d’une matrice doivent être définies dynamiquement par programmation, readxl propose les fonctions utilitaires auxiliaires de la famille cell_limits(). Les opérateurs de commodité cell_rows() et cell_cols() permettent d’assigner des contraintes unidirectionnelles, par exemple en ciblant exclusivement un intervalle continu de rangées sans prédéterminer le nombre total de colonnes (range = cell_rows(10:500)), offrant ainsi une flexibilité d’ingestion inégalée face à des tableaux d’envergure variable.
9.2 Configuration des noms de colonnes et saut de lignes préliminaires
Lorsque les anomalies de mise en page d’un classeur se cantonnent à la présence de quelques lignes d’en-tête informatives situées au-dessus du tableau effectif, la mobilisation d’une plage géométrique fermée peut s’avérer inutilement rigide. L’argument de commodité skip délivre une réponse procédurale simplifiée en ordonnant au parseur d’omettre un nombre cardinal déterminé de lignes physiques avant d’initier la lecture de la structure tabulaire (par exemple : read_excel("enquete.xlsx", skip = 4)).
Une fois ces lignes parasites contournées, la configuration des libellés de colonnes est régie par l’argument logique ou vectoriel col_names. Par défaut, ce paramètre est configuré sur TRUE, ce qui implique que la première ligne utile interceptée par le parseur est systématiquement promue au rang d’en-tête de variables. Cependant, si le tableau source est totalement dépourvu de ligne descriptive et débute directement par les valeurs observées du premier individu statistique, l’assignation col_names = FALSE enjoint R de ne pas absorber ces observations initiales comme étiquettes. Le système attribue alors automatiquement une nomenclature technique standardisée aux vecteurs créés (..1, ..2, ..3, etc.), prévenant la troncation accidentelle de la première observation du corpus.
Au-delà du simple choix binaire, le paramètre col_names offre la capacité substantielle d’accueillir un vecteur de chaînes de caractères fournissant une nomenclature de remplacement sur mesure. En transmettant un vecteur de noms formels (par exemple : col_names = c("id", "age", "score_anxiete", "date_inclusion")), l’analyste renomme de façon déterministe les attributs dès la phase de bas niveau. Pour parachever cette standardisation et se conformer aux préconisations d’analyse de données modernes, l’application immédiate de la fonction janitor::clean_names() sur le tibble obtenu permet de convertir l’ensemble des libellés de variables selon une convention programmatique unifiée (suppression des espaces résiduels, minusculisation intégrale, substitution des ponctuations par des tirets bas), assurant une fluidité ergonomique totale lors des manipulations ultérieures avec les verbes de dplyr.
10. Alternatives analytiques : comparaison des packages openxlsx et XLConnect
10.1 Cas d’usage et fonctionnalités du package openxlsx
Si la bibliothèque readxl constitue la composante de référence du Tidyverse pour la lecture pure de classeurs en raison de sa légèreté et de sa rapidité d’exécution, certains contextes de production analytique exigent des capacités fonctionnelles plus étendues que la simple ingestion passive. C’est précisément pour répondre aux impératifs d’interactivité bidirectionnelle qu’a été conçu le package openxlsx. Tout comme readxl, cette bibliothèque présente l’atout capital de s’affranchir entièrement de la machine virtuelle Java, reposant sur une implémentation C++ native via Rcpp qui assure d’excellentes performances computationnelles.
L’atout distinctif majeur d’openxlsx réside dans sa maîtrise globale de l’objet classeur (workbook object). Alors que readxl est strictement cantonné à des opérations de lecture en lecture seule, openxlsx (au travers de sa fonction principale read.xlsx()) permet simultanément d’importer des matrices tabulaires, de modifier par script le contenu de cellules isolées, d’injecter des styles typographiques et de couleurs, de créer des formules de calculs dynamiques Excel, et de sérialiser le résultat final dans de nouveaux fichiers .xlsx sans jamais quitter l’environnement interactif de R. Cette polyvalence en fait le moteur de prédilection pour l’automatisation de rapports d’activité d’entreprise récurrents où la mise en forme conditionnelle finale doit impérativement obéir à des chartes graphiques institutionnelles prédéfinies.
En matière de benchmarks temporels d’ingestion de données pures, les deux bibliothèques affichent des comportements compétitifs mais contrastés selon la configuration structurelle du classeur. readxl démontre généralement une vélocité supérieure lors de l’analyse de fichiers monolithiques contenant un nombre massif de lignes numériques simples grâce à l’optimisation extrême de ses parseurs C natifs. En contrepartie, openxlsx s’avère parfois plus tolérant face à des classeurs XML dont les structures internes respectent imparfaitement les schémas stricts OpenXML, tout en délivrant des options avancées de parsing telles que la conversion automatique des formats de nombres comptables personnalisés.
10.2 Présentation du package XLConnect et arbitrages techniques
À l’autre extrémité du spectre des bibliothèques de traitement de classeurs se trouve le package historique XLConnect. Reposant structurellement sur le pont applicatif rJava et l’infrastructure open source Apache POI de la fondation Apache, XLConnect fournit une interface d’une exhaustivité fonctionnelle remarquable. Il permet de manipuler les moindres recoins de l’architecture d’un classeur : évaluation dynamique du moteur de calcul interne d’Excel (permettant à R de forcer le recalcul des formules matricielles complexes avant d’extraire la valeur résultante), injection d’objets graphiques vectoriels, manipulation des plages nommées (named ranges) complexes et gestion fine des commentaires de cellules.
Néanmoins, cette richesse fonctionnelle s’accompagne d’un coût opérationnel extrêmement lourd qui restreint drastiquement son adoption dans les architectures d’analyse modernes. La dépendance impérative envers la machine virtuelle Java (JVM) introduit des frictions d’installation chroniques, particulièrement lors de déploiements conteneurisés (Docker) ou sur des systèmes d’exploitation dotés de configurations Java 32/64 bits hétérogènes. Par ailleurs, la gestion de l’allocation mémoire impose d’assigner manuellement des paramètres de machine virtuelle via l’instruction options(java.parameters = "-Xmx4g") impérativement avant le chargement du package, sous peine de déclencher des erreurs catastrophiques de saturation de mémoire du tas (Java heap space OutOfMemoryError) dès que le fichier dépasse quelques dizaines de mégaoctets.
Le tableau d’arbitrage méthodologique entre ces trois solutions s’articule ainsi de manière univoque en fonction des finalités assignées au pipeline de traitement :
- Privilégier systématiquement
readxlpour toutes les opérations d’ingestion scientifique pure en lecture seule : il offre la vitesse maximale, une intégration parfaite au Tidyverse, une indépendance complète vis-à-vis de Java et une empreinte mémoire maîtrisée ; - Adopter
openxlsxlorsque le projet impose de générer, enrichir ou styliser des classeurs Excel de sortie de manière programmable sans dépendre d’un environnement Java lourd ; - Réserver l’emploi d’
XLConnectaux cas de figure résiduels complexes nécessitant l’évaluation en direct de formules imbriquées complexes via le moteur Apache POI ou la manipulation avancée de structures historiques.xlsavec graphiques intégrés.
11. Automatisation de l’importation par lots de plusieurs classeurs
11.1 Inventaire programmatique de fichiers par motifs d’expression
L’un des apports méthodologiques les plus considérables de la programmation statistique réside dans sa capacité à abolir les tâches répétitives fastidieuses d’agrégation de données. Dans de multiples dispositifs expérimentaux, la collecte ne produit pas un classeur consolidé unique, mais génère une dispersion de centaines de fichiers sectoriels : un classeur par sujet psychométrique testé, par laboratoire satellite participant, ou par journée d’échantillonnage calendaire. Entreprendre la lecture séquentielle et la fusion manuelle de telles masses de documents expose inévitablement l’analyste à des erreurs d’inattention fatales.
L’automatisation du flux débute par l’inventaire dynamique et exhaustif des cibles présentes sur le support de stockage via la commande native de navigation list.files(). Pour conférer une efficacité maximale à cette étape d’exploration, l’utilisation conjointe d’expressions régulières (regex) au travers du paramètre formel pattern est indispensable. L’expression ".xlsx$" assure ainsi l’identification sélective de tous les fichiers dont le suffixe correspond rigoureusement à l’extension d’un classeur moderne, écartant les documents texte ou PDF cohabitant dans le même répertoire :
Cette routine d’inventaire doit obligatoirement être immunisée contre l’interception involontaire des fichiers de verrouillage temporaires mentionnés précédemment. En formulant une clause de filtrage excluant tout fichier dont le libellé débute par le caractère tilde (^~$), l’analyste s’assure de ne pas transmettre des fragments corrompus au moteur de parsing. Enfin, la spécification du paramètre full.names = TRUE est impérative : elle ordonne à R de renvoyer non pas simplement le nom d’affichage du fichier, mais son chemin d’accès relatif ou absolu complet, indispensable pour alimenter consécutivement les itérateurs de lecture.
11.2 Itération et consolidation avec le framework fonctionnel purrr
Une fois le vecteur de chemins d’accès consolidé et ordonné, l’époque consistant à employer des boucles séquentielles itératives for lentes et consommatrices de mémoire est révolue. L’ingénierie contemporaine de R s’appuie sur les paradigmes de la programmation fonctionnelle, magistralement encapsulés au sein du package purrr. Ce framework permet de vectoriser l’application d’une fonction de transformation arbitraire sur chaque élément d’une collection sans générer de variables d’incrémentation globales polluantes.
L’instruction reine pour opérer cette fusion massive s’incarne dans la fonction map_dfr() (ou dans les versions contemporaines de purrr, l’association de map() et list_rbind(), ou encore l’application conjointe avec dplyr::bind_rows()). La logique de fonctionnement est limpide : le système applique de manière séquentielle l’instruction read_excel à chacun des fichiers répertoriés dans le vecteur d’adresses, recueille les tibbles générés sous la forme d’une liste en mémoire, puis procède à leur empilement vertical immédiat en une structure tabulaire unifiée :
L’argument formel .id délivre une fonctionnalité méthodologique d’une valeur inestimable pour la traçabilité des données. En renseignant par exemple .id = "source_fichier", le système injecte automatiquement une colonne catégorielle liminaire au sein du tableau final consolidé. Cette variable consigne explicitement l’identifiant exact ou le chemin du fichier d’où provient chaque rangée d’observations. L’analyste dispose ainsi d’un moyen immédiat de décomposer ultérieurement la variance par centre d’investigation ou d’auditer instantanément l’origine précise d’une valeur atypique détectée dans la distribution globale.
Cette phase d’agrégation automatique requiert néanmoins une condition structurelle préalable incontournable : la compatibilité d’alignement des schémas de données (schema alignment). Si les classeurs individuels présentent des dénominations de colonnes discordantes (par exemple « Réponse » dans un fichier et « Reponse_1 » dans un autre) ou des typologies intrinsèquement incompatibles sur une même colonne (numérique dans un classeur, textuelle dans le suivant), l’opération de liaison verticale échouera ou introduira des colonnes fantômes dupliquées. L’adjonction d’une routine de standardisation préalable au sein de la boucle fonctionnelle de lecture constitue le gage d’une robustesse opérationnelle totale.
12. Validation post-importation, diagnostics d’intégrité et reproductibilité
12.1 Outils de diagnostic rapide de l’intégrité du jeu de données
L’obtention d’un objet en mémoire sans interruption d’exécution par un message d’erreur ne garantit en aucun cas que la fidélité de l’information originelle a été préservée. L’analyste rigoureux doit systématiquement déployer un protocole d’audit post-importation visant à certifier l’intégrité structurelle, typologique et sémantique de la table matérialisée avant d’engager la moindre inférence mathématique.
Ce diagnostic rapide s’articule autour d’une trilogie de commandes complémentaires du dialecte R :
str()et son équivalent moderne enrichidplyr::glimpse(): fournissent une vue synthétique compacte de l’architecture du tibble, exposant simultanément le volume total d’observations, le compte de colonnes, la typologie formelle de chaque vecteur atomique (<dbl>,<chr>,<date>) et un échantillon représentatif des premières valeurs sérialisées ;summary(): délivre une batterie instantanée d’indicateurs de position et de dispersion pour les variables quantitatives (minimum, quartiles, médiane, moyenne, maximum), permettant de repérer d’emblée des valeurs extrêmes physiologiquement ou psychologiquement aberrantes (par exemple un score d’âge négatif ou une valeur d’échelle de Likert excédant les bornes autorisées) imputables à des erreurs de frappe originales ;- Le recensement exhaustif des données manquantes : l’évaluation par la formule matricielle
colSums(is.na(donnees))quantifie sans ambiguïté le taux d’attrition de chaque indicateur, alertant le chercheur sur l’émergence inattendue de valeursNAinduites par un échec silencieux de conversion de type lors de la phase de lecture.
Enfin, l’audit doit impérativement porter sur la conformité de l’encodage des chaînes textuelles. Sous l’effet des transferts de fichiers entre systèmes hétérogènes, des corruptions de caractères linguistiques diacritiques (connues sous le terme technique de mojibake, transformant par exemple « Résultat » en « Résultat ») peuvent contaminer les variables qualitatives. L’application de fonctions d’inspection d’encodage telles que tools::showNonASCII() permet d’intercepter ces artefacts de translitération et d’ordonner leur régularisation immédiate vers le standard universel de fait qu’est le jeu de caractères UTF-8.
12.2 Standardisation d’un pipeline d’importation pérenne pour les publications
L’étape ultime de la méthodologie quantitative consiste à affranchir le script d’importation de son statut de code d’exploration ad hoc pour le muer en un composant logiciel pérenne, documenté et immédiatement réutilisable. Cette transition exige la modularisation du processus au sein d’une fonction encapsulée sur mesure. En rassemblant les étapes de validation des chemins, de contrôle d’existence, de lecture paramétrée, de nettoyage des libellés et d’imputation des valeurs manquantes au sein d’une unité algorithmique cohérente (par exemple : charger_et_valider_cohorte(chemin_fichier)), l’analyste applique les préceptes cardinaux de l’ingénierie logicielle (principe DRY : Don’t Repeat Yourself).
Dans un contexte de publication scientifique, la conservation de volumineux classeurs Microsoft Excel complexes comme format de stockage à long terme est vivement déconseillée. Ces structures propriétaires vieillissent mal et demeurent sensibles à l’obsolescence programmée des suites logicielles privatives. Il est infiniment plus sage, sitôt le nettoyage d’importation finalisé, de sérialiser l’objet R purifié au sein d’un format binaire performant et optimisé pour la science des données :
- Le format sérialisé natif de R via
saveRDS(donnees, file = "data/processed/donnees.rds"), garantissant une conservation intégrale des classes de variables, des attributs spécifiques et des facteurs ordonnés, tout en offrant des taux de compression substantiels ; - Le format ouvert orienté colonnes Apache Parquet via la bibliothèque
arrow(arrow::write_parquet()), qui s’impose aujourd’hui comme le standard international absolu pour l’interopérabilité multilangage (permettant une relecture instantanée et ultrarapide depuis R, Python, Julia ou des moteurs SQL sans perte de métadonnées de typage).
Pour assurer la reproductibilité intégrale exigée lors de la soumission d’articles aux comités d’évaluation par les pairs, le chercheur veillera à adjoindre à son dépôt d’archive publique (sur des plateformes de science ouverte telles que Zenodo ou l’Open Science Framework) une check-list de contrôle rigoureuse : sanctuarisation en lecture seule des classeurs Excel originaux bruts sans altération manuelle post-collecte, script R d’ingestion totalement déterministe s’exécutant de façon linéaire sans dépendance externe interactive, fixation univoque des versions logicielles via un environnement virtuel documenté, et génération d’un journal d’audit (log) attestant de l’adéquation parfaite entre les dimensions de la matrice collectée et les volumes intégrés dans les modèles statistiques finaux.
Références
- Bryan, J. (2017). Project-oriented workflow. Tidyverse Software Design Essays. https://www.tidyverse.org/blog/2017/12/workflow-vs-script/
- Müller, K. (2020). here: A Simpler Way to Find Your Files (R package version 1.0.1). https://CRAN.R-project.org/package=here
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Schauberger, P., & Walker, A. (2023). openxlsx: Read, Write and Edit xlsx Files (R package version 4.2.5.2). https://CRAN.R-project.org/package=openxlsx
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2019). Advanced R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351201315
- Wickham, H., & Bryan, J. (2023). readxl: Read Excel Files (R package version 1.4.3). https://CRAN.R-project.org/package=readxl
- Wickham, H., & Grolemund, G. (2017). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data. O’Reilly Media. https://r4ds.had.co.nz/
- Ziemann, M., Eren, Y., & El-Osta, A. (2016). Gene name errors are widespread in the scientific literature. Genome Biology, 17(1), 177. https://doi.org/10.1186/s13059-016-1044-7