
L’intégration rigoureuse de données quantitatives constitue le socle méthodologique sur lequel repose l’ensemble de la démarche inférentielle et de la modélisation statistique avancée. Dans le vaste écosystème des logiciels d’analyse de données, le système SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme une référence incontournable au sein des milieux biomédicaux, épidémiologiques, économétriques et actuariels, où l’intégrité et la traçabilité des données sont érigées en normes fondamentales. Cependant, avant de pouvoir mobiliser la puissance de calcul des procédures de modélisation prédictive ou d’analyse multivariée, le chercheur ou l’analyste se heurte inévitablement à l’épreuve préliminaire de l’ingestion des données brutes, étape pivot dont la rigueur conditionne la validité des conclusions scientifiques ultérieures.
Le format de fichier à valeurs séparées par des virgules (CSV, pour Comma-Separated Values) demeure le vecteur d’échange textuel le plus universellement employé pour exporter des corpus d’observations depuis des bases de données relationnelles, des plateformes d’enquêtes psychométriques ou des instruments de mesure automatisés. Malgré son apparente simplicité, ce format plat dissimule une série d’écueils techniques complexes, tenant à l’absence intrinsèque de dictionnaire de métadonnées, à la variabilité des conventions typographiques régionales, aux disparités d’encodage des caractères et aux aléas de l’inférence automatique des types de variables. L’importation d’un fichier CSV dans SAS ne saurait donc se réduire à une banale formalité syntaxique, mais doit s’envisager comme un processus d’ingénierie logicielle exigeant une maîtrise approfondie des mécanismes sous-jacents de la procédure spécialisée PROC IMPORT et de la programmation en étape DATA.
Ce guide exhaustif a pour vocation d’explorer dans le moindre détail l’ensemble des dimensions méthodologiques, algorithmiques et syntaxiques associées à la conversion d’un flux textuel délimité en une table SAS native hautement structurée. En articulant des fondements théoriques solides avec des démonstrations empiriques précises, des analyses comparatives de performance et des stratégies avancées d’automatisation par macros, cet ouvrage fournit les clés nécessaires pour concevoir des chaînes de traitement de données totalement reproductibles, robustes face aux anomalies structurelles et conformes aux standards académiques et industriels les plus exigeants.
1. Introduction méthodologique à l’ingestion de données CSV dans SAS
1.1 Pertinence du format CSV dans l’analyse de données quantitatives
Dans le paysage contemporain de la science des données, le format CSV occupe une position prédominante qui s’explique avant tout par son universalité, sa compacité structurelle et son indépendance absolue vis-à-vis des architectures matérielles ou des systèmes d’exploitation propriétaires. Reposant sur une transcription textuelle séquentielle conforme aux spécifications de la norme internationale RFC 4180, ce conteneur minimaliste permet la sérialisation d’observations multidimensionnelles sous la forme de lignes successives où les attributs individuels sont séparés par un caractère délimiteur standardisé. Cette légèreté intrinsèque en fait l’instrument de prédilection pour l’archivage pérenne et la transmission inter-institutionnelle d’échantillons massifs, exempts des surcharges binaires associées aux formats propriétaires de feuilles de calcul.
Dans les contextes de recherche empirique, qu’il s’agisse de protocoles psychométriques administrés via des interfaces numériques, de cohortes épidémiologiques longitudinales ou d’enregistrements comportementaux à haute fréquence, le fichier CSV agit comme une passerelle d’interopérabilité sans équivalent. Les plateformes logicielles de collecte primaire déversent quasi systématiquement leurs flux bruts sous cette déclinaison textuelle. Dès lors, le recours à un logiciel analytique de référence tel que SAS exige une compréhension aiguë des implications de cette structure dite « plate ». La disposition bidimensionnelle simple – une ligne pour chaque unité statistique et une colonne pour chaque mesure – facilite l’application ultérieure des paradigmes du tidy data, tout en autorisant des volumes considérables d’enregistrements sans dégradation liée à des représentations graphiques superflues.
Toutefois, cette frugalité architecturale engendre des vulnérabilités méthodologiques majeures. Contrairement aux formats de stockage relationnels ou aux jeux de données compilés, un fichier CSV ne transporte aucune métadonnée constitutive : ni définition explicite des types de champs (entiers, réels à virgule flottante, chaînes de caractères, estampilles temporelles), ni indication des longueurs d’allocation mémoire, ni description des échelles de mesure ou des systèmes de codification des valeurs manquantes. Cette absence totale de typage strict délègue à l’analyseur syntaxique du logiciel récepteur la charge d’inférer la nature des données à partir de motifs textuels souvent ambigus, exposant l’analyste à des risques critiques de corruption sémantique dès l’amorce de la chaîne de traitement.
1.2 Architecture du traitement des fichiers plats au sein de l’environnement SAS
L’ingestion d’un flux textuel séquentiel dans le moteur SAS implique une cascade d’opérations de bas niveau orchestrées par la couche d’accès aux données externes du système (External Data Access Layer). L’objectif primordial de ce sous-système est de convertir une suite ininterrompue d’octets codés selon une norme d’encodage spécifique en un fichier binaire structuré portant l’extension propriétaire .sas7bdat. Ce format cible natif ne se contente pas d’aligner des valeurs brutes : il organise les enregistrements en blocs de pages optimisés pour les entrées-sorties vectorielles, indexe les décalages d’adresses mémoires et intègre un en-tête exhaustif répertoriant les métadonnées, les formats de restitution visuelle et les descripteurs d’attributs de chaque variable.
Durant cette métamorphose, l’environnement SAS mobilise un mécanisme fondamental désigné sous le terme de vecteur de travail de programme (Program Data Vector ou PDV). Le flux textuel extrait du support de stockage est d’abord acheminé vers un tampon d’entrée mémoire (Input Buffer). L’analyseur lexical identifie les délimiteurs, extrait les sous-chaînes de caractères associées à chaque colonne conceptuelle, puis soumet ces fragments aux règles de conversion programmées. Le PDV agit alors comme une structure de mémoire vive transitoire où chaque cellule de la ligne en cours de traitement est évaluée, convertie selon son informat d’assignation et validée avant d’être écrite de façon synchrone dans la table SAS de destination.
Cette orchestration impose une distinction rigoureuse entre les espaces d’allocation transitoires et les dépôts de stockage permanents. Si l’utilisateur oriente la table résultante vers la bibliothèque prédéfinie WORK, les données résident dans un conteneur temporaire lié à l’identifiant unique du processus de session SAS, destiné à être irrémédiablement purgé lors de la déconnexion de l’utilisateur. À l’inverse, l’affectation à une bibliothèque permanente, assignée préalablement via l’instruction logique LIBNAME, garantit la persistance physique du fichier sur un système de stockage local ou un volume réseau distribué, satisfaisant ainsi aux impératifs d’audit et de conservation des cohortes de recherche.
1.3 Enjeux de standardisation pour la reproductibilité scientifique
Dans le cadre des directives contemporaines d’intégrité scientifique et des recommandations institutionnelles régissant la reproductibilité des analyses quantitatives, l’étape d’acquisition des données ne peut souffrir aucune approximation. Une procédure d’importation mal calibrée recèle le danger insidieux d’introduire des biais d’échantillonnage ou de mesure totalement invisibles lors des modélisations statistiques postérieures. Par exemple, l’interprétation par défaut d’une variable d’identification alphanumérique comportant des zéros initiaux en tant que variable numérique entière efface ces préfixes de manière irréversible, détruisant ainsi l’unicité des clés de jointure nécessaires aux appariements de cohortes.
De même, les erreurs d’estimation de la longueur maximale des champs textuels qualitatifs conduisent à des phénomènes de troncature silencieuse. Si une variable recueillant des observations cliniques ou des réponses ouvertes est arbitrairement limitée à une largeur restreinte sans notification explicite d’interruption logicielle, les pans textuels excédentaires disparaissent du jeu d’analyse, faussant irrémédiablement les catégorisations ultérieures. Il apparaît donc indispensable de consigner l’intégralité du protocole d’ingestion au moyen d’un code source rigoureusement documenté, excluant les manipulations interactives non scriptées via des interfaces graphiques qui s’avèrent impossibles à auditer de manière systématique.
Le journal d’exécution de SAS (communément désigné sous le nom de SAS Log) constitue le garant historique de cette chaîne de traçabilité. Chaque instruction d’importation doit y générer un relevé exhaustif précisant le nombre exact d’octets traités, le total des enregistrements physiques lus dans le document source, le décompte des observations effectivement rédigées dans la table finale, ainsi que le signalement scrupuleux des conflits de typage ou des valeurs invalides rencontrées. La préservation de ce journal au sein des archives analytiques documente la conformité du pipeline de données face aux audits externes et aux pairs évaluateurs des publications scientifiques.
2. Anatomie fondamentale de la procédure PROC IMPORT
2.1 Décorticage de la syntaxe de base et des instructions obligatoires
La procédure PROC IMPORT constitue le module d’automatisation préférentiel mis à disposition par le progiciel SAS pour lire des fichiers de données émanant de sources hétérogènes sans contraindre l’utilisateur à déclarer individuellement chaque variable dans une longue suite d’instructions déclaratives. Conçue pour offrir un compromis optimal entre simplicité d’écriture et flexibilité d’ingestion, cette procédure encapsule un ensemble d’algorithmes d’inférence capables de scruter le fichier source, d’en cartographier la structure apparente et d’élaborer dynamiquement un programme de conversion sous-jacent. La syntaxe canonique d’appel de cette procédure s’articule autour de directives obligatoires régissant la source, la cible et le protocole d’interprétation.
L’instruction maîtresse prend la forme formelle suivante dans l’éditeur de programmes SAS :
PROC IMPORT DATAFILE="chemin_vers_fichier.csv" OUT=nom_table DBMS=CSV REPLACE; RUN;
Dans cet agencement, chaque clause remplit un rôle fonctionnel irremplaçable. L’instruction PROC IMPORT signale au compilateur l’initialisation de l’étape de procédure spécialisée. L’instruction terminale RUN;, quant à elle, agit comme le délimiteur logique absolu qui déclenche la compilation immédiate et l’exécution synchrone du bloc de code précédemment empilé dans la mémoire tampon du superviseur SAS. L’omission de cette directive maintient le système dans un état d’attente passive, différant indûment le traitement jusqu’à la rencontre d’une étape ultérieure.
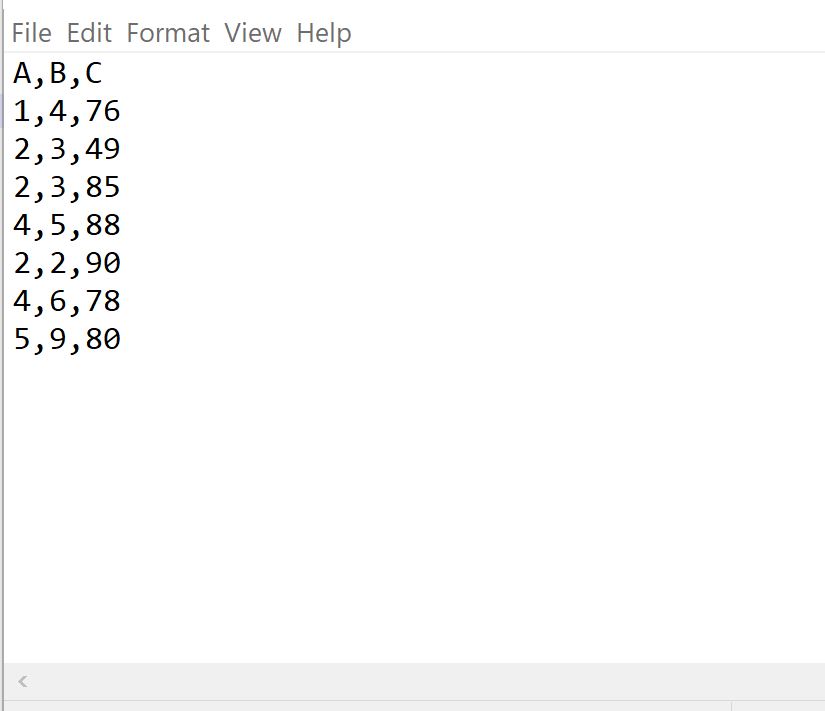
Sous le voile de cette apparente concision, PROC IMPORT ne réalise pas directement l’insertion physique des enregistrements dans la table binaire. Le système SAS procède en réalité à une méta-compilation : il ausculte le fichier délimité pour générer un code d’étape DATA complet en langage de base, intégrant des instructions INFILE, INPUT, LENGTH et FORMAT rigoureusement agencées. Ce code intermédiaire, temporairement matérialisé dans la session, est ensuite soumis au compilateur d’étape DATA standard. Les messages de statut retranscrits dans le journal de session SAS reflètent cette double dynamique : ils indiquent d’abord le succès de l’inférence syntaxique avant de détailler la création effective de la table binaire native, attestant du respect des protocoles d’exécution internes du système.
2.2 Spécification de l’emplacement source avec l’argument DATAFILE
L’argument DATAFILE= spécifie le vecteur d’entrée physique en pointant précisément vers l’emplacement du fichier plat sur le sous-système de fichiers accessible par l’instance SAS. La chaîne de caractères associée doit être systématiquement encapsulée entre des guillemets doubles ou simples. La rigueur de cette spécification dépend intrinsèquement de l’architecture du système hôte exécutant le serveur analytique. Selon que la session SAS s’exécute sur une station de travail locale sous environnement Microsoft Windows ou au sein d’une grappe de calcul distribuée (SAS Grid) ou conteneurisée sous distribution Linux, les conventions d’arborescence différent radicalement.
Sous un environnement de type UNIX ou Linux, fréquemment déployé pour les architectures d’entreprise telles que SAS Viya ou SAS Studio, la sensibilité à la casse (case sensitivity) est absolue. Une divergence mineure entre majuscules et minuscules dans le libellé du fichier ou de son extension (par exemple .CSV au lieu de .csv) entraîne inéluctablement une interruption d’exécution matérialisée par une erreur signalant l’inexistence physique de la ressource ciblée. De surcroît, les séparateurs de dossiers doivent être formalisés par des barres obliques (/), contrairement aux barres obliques inversées () traditionnellement rencontrées au sein des environnements Windows. Il est également possible d’exploiter un identifiant logique de fichier (fileref) préalablement assigné au moyen de l’instruction FILENAME, syntaxe selon laquelle l’argument devient simplement DATAFILE=mon_ref sans adjonction de guillemets délimiteurs.
Le diagnostic des dysfonctionnements liés à l’argument DATAFILE= requiert une analyse méthodique des droits d’accès associés au compte de service qui exécute le processus SAS. Fréquemment, le fichier réside sur un montage réseau distant dont les permissions de lecture (droits POSIX ou listes de contrôle d’accès ACL) n’ont pas été accordées à l’utilisateur effectif du moteur SAS. Le journal consigne alors une notification d’erreur explicite telle que ERROR: Physical file does not exist ou ERROR: Permission denied. Il relève de la responsabilité de l’analyste de s’assurer de l’accessibilité permanente et de la stabilité des volumes réseau avant d’initialiser une procédure d’importation au sein d’une chaîne de production de données automatisée.
2.3 Définition de la table cible via la clause OUT
La clause OUT= régit la nomenclature et l’ancrage spatial de la structure de données binaire produite au terme de l’exécution de PROC IMPORT. La valeur fournie à ce paramètre obéit à la syntaxe standard des noms de jeux de données SAS, constituée d’une désignation en deux niveaux de la forme bibliothèque.table, ou d’un identifiant à niveau unique renvoyant par défaut vers l’espace transitoire WORK. La maîtrise de cette clause conditionne la pérennité des structures générées et évite les saturations d’espace de stockage volatile lors de la manipulation de fichiers massifs.
Lorsque l’utilisateur stipule une cible sous la forme simplifiée OUT=mes_donnees, SAS interprète cette requête comme une assignation implicite à la table WORK.mes_donnees. Cette approche s’avère particulièrement adaptée aux phases exploratoires ou aux opérations intermédiaires de nettoyage de données qui ne nécessitent pas une conservation à long terme. En revanche, pour des applications orientées vers la production, la cible doit impérativement être qualifiée par le préfixe d’une bibliothèque permanente formellement déclarée, telle que OUT=PROD.cohorte_2026. Cette formulation garantit que le fichier cohorte_2026.sas7bdat sera matérialisé de façon synchrone dans le répertoire associé au descripteur PROD, autorisant ainsi un partage immédiat avec d’autres processus ou collaborateurs autorisés.
Sur le plan de l’architecture système, l’assignation de la table cible déclenche une allocation de mémoire vive et d’entrées-sorties disque proportionnelle au gabarit du fichier analysé. SAS dimensionne la nouvelle structure en y rattachant des descripteurs de métadonnées complets : date et heure de création, version du moteur de compilation, encodage sous-jacent, nombre d’observations et liste détaillée des variables accompagnées de leurs longueurs allouées. Si l’espace disque alloué au système de fichiers hébergeant la bibliothèque cible s’avère insuffisant pour absorber la volumétrie résultante, la procédure avorte en levant une exception critique d’écriture disque, laissant la table dans un état corrompu qui impose un assainissement préalable des partitions de stockage de l’infrastructure.
3. Paramétrage technique des options DBMS et REPLACE
3.1 Spécification rigoureuse du pilote d’importation avec DBMS=CSV
L’option DBMS= (pour DataBase Management System) indique au moteur SAS quel pilote d’accès aux données doit être instancié pour décoder la structure interne du fichier source. En assignant la valeur explicite DBMS=CSV, le développeur active l’analyseur syntaxique spécifiquement calibré pour traiter les fichiers de texte délimités conformes aux règles de l’art du format standard à virgule. Ce pilote spécialisé intègre nativement la prise en charge des subtilités structurelles régies par la norme RFC 4180, notamment la gestion des champs encapsulés entre guillemets doubles et l’échappement des séparateurs situés à l’intérieur de chaînes textuelles complexes.
Il importe de bien distinguer le pilote DBMS=CSV d’autres déclinaisons génériques d’importation textuelle offertes par le progiciel, telles que DBMS=DLM (fichiers délimités par un caractère quelconque arbitraire) ou DBMS=TAB (données délimitées strictement par des tabulations horizontales). Bien que DBMS=DLM puisse être paramétré pour utiliser la virgule via une clause additionnelle, DBMS=CSV intègre des heuristiques préconfigurées particulièrement robustes face aux anomalies courantes d’encapsulation. Par exemple, si une cellule textuelle contient une virgule au sein de son libellé descriptif (comme dans l’adresse "10, rue de la Paix"), le pilote CSV reconnaît que cette virgule est protégée par les guillemets englobants et ne doit en aucun cas être interprétée comme une rupture de colonne.
Cependant, l’analyseur DBMS=CSV peut manifester des rigidités opérationnelles lorsque les données s’écartent des canons conventionnels anglo-saxons. Face à des fichiers générés par des versions régionales de tableurs grand public employant le point-virgule comme délimiteur de champs ou insérant des caractères de contrôle exotiques, le pilote spécialisé CSV risque de traiter l’intégralité de la ligne comme une variable alphanumérique unique et massive. La compréhension fine du fonctionnement interne de cette option permet à l’ingénieur de données de basculer opportunément vers des configurations alternatives lorsque l’homogénéité du fichier brut n’est pas strictement garantie à la source.
3.2 Gestion de l’écrasement programmatique au moyen de l’option REPLACE
Au cours des cycles de développement de logiciels analytiques, les scripts d’importation sont couramment exécutés de manière itérative afin d’ajuster les filtres, d’affiner les paramètres d’inférence ou d’incorporer des fractions additionnelles de données brutes. Par défaut, en vertu d’un principe conservateur visant à prévenir la destruction accidentelle d’informations déjà traitées, le moteur SAS refuse de substituer une table de données préexistante si un nouvel appel de PROC IMPORT cible un nom strictement identique au sein de la même bibliothèque. Dans une telle situation, la procédure interrompt son cycle de travail et consigne un avertissement explicite dans le journal d’exécution.
Pour autoriser le remplacement programmatique et fluide de la table de sortie, l’adjonction de l’option REPLACE au niveau de l’instruction PROC IMPORT est impérative. Cette directive ordonne au superviseur d’écraser sans invite de confirmation interactive la table SAS homonyme déjà présente dans la bibliothèque de destination. La séquence technique consiste alors à allouer un nouvel espace transitoire pour la table en cours de compilation, à valider l’intégrité de l’ingestion, puis à supprimer atomiquement l’ancienne table pour substituer le nouveau fichier d’enregistrements, préservant ainsi la cohérence du système en cas d’incident en cours de lecture.
Néanmoins, l’usage de l’option REPLACE exige une vigilance opérationnelle constante, particulièrement au sein d’environnements multi-utilisateurs partagés ou sur des pipelines de calcul à haute concurrence d’accès. Si la table ciblée par OUT= fait simultanément l’objet d’un verrouillage en lecture par une autre session analytique (par exemple un utilisateur exécutant une longue procédure de modélisation PROC GLIMMIX sur le même jeu de données), SAS se trouve dans l’incapacité d’acquérir le verrou exclusif d’écriture indispensable à la substitution. L’étape PROC IMPORT échoue alors brutalement, soulevant un conflit de partage de fichier (Lock conflict) qui impose d’attendre la libération des verrous concurrents ou de concevoir des mécanismes d’isolement par sessions.
3.3 Interactions avec le système de gestion de données sous-jacent
Le déroulement d’une procédure PROC IMPORT mobilise intensivement les sous-systèmes de gestion d’entrées-sorties du système d’exploitation hôte. Lors de l’ingestion de volumes substantiels de données CSV – atteignant plusieurs gigaoctets ou dizaines de millions d’enregistrements empiriques –, les performances de débit dépendent directement de la capacité du moteur SAS à consommer le flux textuel par blocs optimisés. L’interaction entre la couche de virtualisation de fichiers SAS et le système de fichiers sous-jacent (qu’il s’agisse de systèmes locaux comme ext4, XFS, NTFS ou de systèmes de fichiers distribués en réseau tels que NFS ou Lustre) régit le temps global de calcul et la latence d’accès.
Un facteur critique réside dans l’hétérogénéité des délimiteurs de fin d’enregistrement physique. Le monde informatique se divise historiquement entre le standard hérité d’UNIX, caractérisé par un simple saut de ligne (Line Feed, code hexadécimal 0A ou n), et le standard Microsoft Windows, fondé sur la succession d’un retour chariot et d’un saut de ligne (Carriage Return / Line Feed, code hexadécimal 0D0A ou rn). Le moteur DBMS=CSV intègre des routines de détection dynamique capables d’accommoder ces variations de séquences d’échappement. Toutefois, la présence fortuite d’un retour chariot isolé au sein d’un fichier créé sur une plateforme tierce peut perturber l’identification des lignes et conduire à une désynchronisation structurelle majeure des observations.
Afin de minimiser les transferts physiques sur des disques à latence élevée, SAS déploie des stratégies de mise en mémoire tampon adaptative. Toutefois, des défaillances de lecture matérielle, des micro-coupures de liaison réseau lors de l’accès à un point de montage distant ou des instabilités du sous-système de stockage peuvent survenir durant la phase d’ingestion. La surveillance des codes de retour système et l’analyse fine des compteurs d’entrées-sorties dans le journal d’exécution permettent de diagnostiquer si les goulets d’étranglement de l’importation proviennent de la puissance de calcul allouée au processeur pour le décodage lexical ou de saturations de bande passante au niveau de la couche d’accès au stockage.
4. Traitement des en-têtes et étiquettes de colonnes (GETNAMES)
4.1 Utilisation optimale de GETNAMES=YES pour l’extraction des métadonnées
La grande majorité des corpus de données contemporains intègrent, sur leur tout premier enregistrement physique, une ligne d’en-tête formalisant la nomenclature descriptive des variables mesurées. L’instruction déclarative GETNAMES=YES; enjoint au pilote d’importation de considérer cette première ligne textuelle non pas comme une unité d’observation statistique, mais comme un gisement de métadonnées sémantiques. L’analyseur extrait chacun des termes séparés par le délimiteur pour leur attribuer la fonction de désignations officielles des colonnes correspondantes au sein de la table SAS résultante.
Cependant, les dénominations arbitraires formulées par les chercheurs ou les concepteurs de questionnaires bruts s’écartent fréquemment des règles syntaxiques rigides régissant la nomenclature des variables dans SAS. Des libellés contenant des espaces typographiques, des symboles arithmétiques réservés (tels que +, -, /, %), des caractères diacritiques ou débutant par des chiffres constituent des infractions directes aux standards de programmation traditionnels. En mode de fonctionnement conventionnel, PROC IMPORT procède à une normalisation automatique : les espaces et symboles interdits sont transmutés en tirets de soulignement (_), et les caractères non conformes sont élagués afin de générer des identifiants valides au sens du compilateur.
L’immense valeur ajoutée de la directive GETNAMES=YES; réside dans sa capacité concomitante à préserver l’intitulé textuel original sous la forme d’une étiquette descriptive (clause LABEL) automatiquement rattachée à la variable. Ainsi, si une colonne du fichier CSV comporte l’en-tête brut Tension Artérielle Systolique (mmHg), SAS générera une variable opératoire nommée Tension_Art_rielle_Systolique_ tout en conservant l’intégralité du libellé d’origine au sein de son étiquette de métadonnées. Cette préservation enrichit considérablement les sorties tabulaires et graphiques générées ultérieurement via les procédures de restitution statistique telles que PROC PRINT ou PROC SGPLOT.
4.2 Gestion des fichiers dépourvus d’en-tête via GETNAMES=NO
À l’opposé de la situation précédente, de nombreuses archives de données patrimoniales, des flux de transactions industrielles ou des extractions brutes issues d’automates de laboratoire sont livrés sans aucune ligne d’en-tête informative, le premier enregistrement physique correspondant immédiatement à la première observation empirique du protocole expérimental. Si l’on omettait d’indiquer cette particularité structurelle au moteur SAS, la première ligne de mesures réelles serait consommée pour bâtir les noms de variables, entraînant la perte irréversible d’une unité statistique et attribuant des identifiants de colonnes absurdes (tels que des valeurs numériques comme _2_4 ou _8_5).
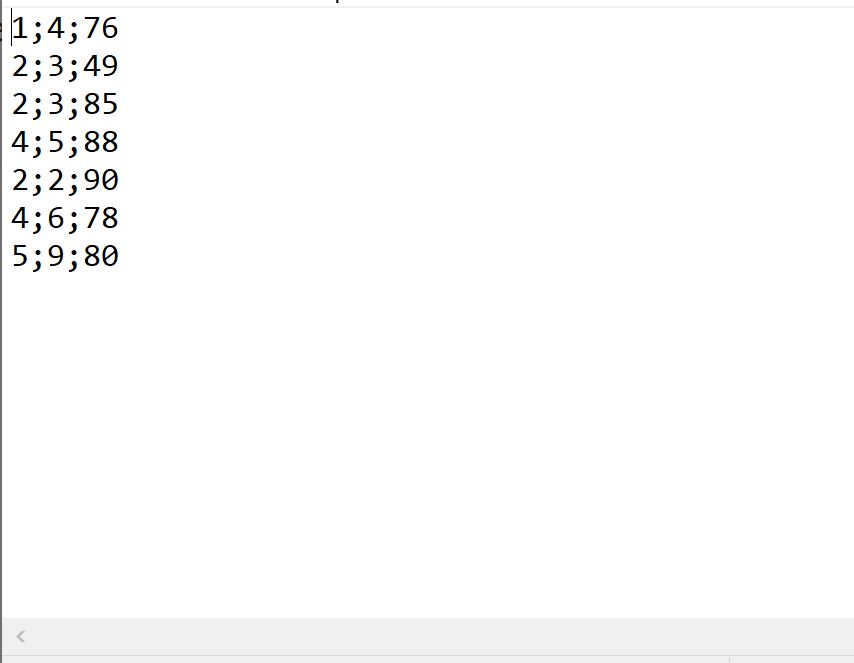
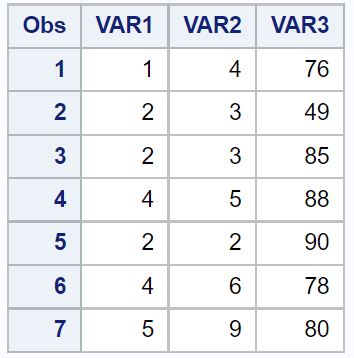
Pour neutraliser ce comportement préjudiciable, l’insertion de l’instruction GETNAMES=NO; est strictement obligatoire. Informé de l’absence de descripteurs textuels, le système SAS réaligne son curseur de lecture dès l’octet initial du fichier pour former la première ligne d’observation de la table finale. Simultanément, SAS pallie l’absence de noms de colonnes en instituant une nomenclature algorithmique séquentielle : les variables sont conventionnellement baptisées VAR1, VAR2, VAR3, jusqu’à VARn, en fonction de leur ordre d’apparition de gauche à droite sur l’axe horizontal du flux textuel.
Bien que cette disposition préserve scrupuleusement l’exhaustivité des observations empiriques, elle impose à l’analyste une discipline documentaire rigoureuse. Une table peuplée d’identifiants abstraits tels que VAR1 à VAR45 devient rapidement indéchiffrable et propice aux erreurs d’aiguillage analytique lors des phases d’ajustement de modèles multivariés. Il s’avère dès lors indispensable d’intercaler, immédiatement en aval de PROC IMPORT, une étape DATA de renommage explicite exploitant la directive RENAME, adossée au dictionnaire formel de l’étude, afin de conférer à chaque axe d’analyse une sémantique limpide et vérifiable par l’ensemble de l’équipe de recherche.
4.3 Normalisation des identifiants et variable SAS avec VALIDVARNAME
La transcription des en-têtes bruts en noms de variables exploitables par le système dépend étroitement de la variable d’environnement système globale désignée sous le nom de VALIDVARNAME. Cette option de configuration globale, paramétrable à tout moment via l’instruction système OPTIONS VALIDVARNAME=valeur;, modifie en profondeur la tolérance lexicale du compilateur SAS à l’égard de la nomenclature des identifiants de données à travers l’ensemble des modules d’analyse.
Historiquement, le paramétrage standard VALIDVARNAME=V7 impose le respect strict des conventions établies lors de la parution de la version 7 de SAS : les noms de variables ne peuvent excéder une longueur de 32 octets, doivent obligatoirement débuter par un caractère alphabétique ou un tiret de soulignement, et ne tolèrent aucun espace ni caractère spécial au sein de leur corps. Face à ce filtre draconien, PROC IMPORT applique une troncature et une substitution systématique des caractères non conformes, ce qui peut engendrer des collisions d’identifiants si deux colonnes aux intitulés initiaux très longs partagent les mêmes 32 premiers caractères normalisés.
À l’inverse, le choix de la directive OPTIONS VALIDVARNAME=ANY; assouplit substantiellement ces barrières en permettant à SAS de prendre en charge des noms dits « étendus » ou littéraux de noms de variables (Name Literals). Sous ce régime permissif, des libellés incluant des espaces libres, des accents français ou des signes typographiques complexes sont directement promus au rang d’identifiants de colonnes. Néanmoins, l’analyste doit impérativement mesurer le coût de cette flexibilité en aval : l’invocation de ces variables dans les procédures statistiques usuelles impose une notation syntaxique contraignante sous la forme d’une chaîne entre guillemets immédiatement suivie de la lettre ‘n’ majuscule ou minuscule (par exemple 'Taux de Cholestérol Total'n), une formulation lourde qui complexifie la maintenance des programmes et accroît le risque d’incompatibilité avec des macro-fonctions standardisées.
5. Exemple pratique 1 : Importation élémentaire d’un fichier CSV standard
5.1 Préparation et inspection du jeu de données expérimental
Pour illustrer de manière concrète la mise en œuvre de la procédure d’importation fondamentale, considérons un protocole de recherche clinique appliquée évaluant l’efficacité comparée de deux protocoles d’entraînement cognitif sur la réduction de l’anxiété situationnelle. Le corpus recueilli à l’issue de la phase d’expérimentation est compilé sous la forme d’un document textuel plat nommé evaluation_clinique.csv. Avant d’initialiser tout script de traitement sous SAS, une inspection préliminaire de la topologie du fichier brut au moyen d’un visualiseur de texte simple ou d’une commande système de type head constitue une exigence de rigueur méthodologique.
L’observation des quatre premières lignes du fichier brut révèle l’organisation structurelle suivante :
Sujet_ID,Age,Groupe_Traitement,Score_Baseline,Score_Post,Statut_Observance
PAT-001,45,Controle,68.5,65.0,Complet
PAT-002,52,Actif,72.0,51.5,Complet
PAT-003,39,Actif,64.0,48.0,Partiel
L’examen structurel confirme plusieurs propriétés fondamentales : l’existence formelle d’une ligne d’en-tête positionnée au sommet du document, l’utilisation rigoureuse de la virgule comme séparateur de champs, et l’emploi de points décimaux conformes aux conventions typographiques internationales pour les indicateurs continus de score. Les types conceptuels des colonnes se distinguent d’emblée : Sujet_ID, Groupe_Traitement et Statut_Observance constituent des variables catégorielles ou qualitatives (alphanumériques), tandis qu’Age, Score_Baseline et Score_Post relèvent d’échelles numériques continues ou discrètes.
5.2 Écriture et exécution pas à pas du script SAS
La transcription programmatique de cette opération d’ingestion s’articule au moyen d’un bloc de code PROC IMPORT calibré pour assurer à la fois l’écrasement des tables transitoires éventuelles et l’extraction fidèle des métadonnées d’en-tête. Le programme s’énonce selon la formulation suivante :
FILENAME source1 "/recherche/projets/essais/evaluation_clinique.csv";
PROC IMPORT DATAFILE=source1
OUT=WORK.essai_clinique
DBMS=CSV
REPLACE;
GETNAMES=YES;
RUN;
Lors de la soumission de cette séquence d’instructions, le processeur de commande SAS engage une suite d’opérations coordonnées. Il analyse le fichier désigné par le descripteur logique source1, valide la présence effective des délimiteurs par virgules, segmente la première ligne pour baptiser les variables de la table transitoire WORK.essai_clinique, puis instancie un pas de lecture optimisé pour lire les rangées d’observations subséquentes jusqu’à l’épuisement du flux textuel. Le journal d’exécution compile alors l’historique complet de l’opération, renvoyant un avis de confirmation attestant du nombre de lignes insérées et de l’absence d’anomalies bloquantes.
5.3 Contrôle immédiat des résultats avec PROC PRINT et PROC CONTENTS
L’achèvement sans message d’erreur d’une étape PROC IMPORT ne dispense jamais l’analyste d’un audit de validation immédiat. La première vérification porte sur l’aspect visuel de la table résultante, réalisée au moyen de la procédure PROC PRINT, en restreignant judicieusement l’affichage aux premières lignes du tableau à l’aide de l’option de limitation OBS= :
PROC PRINT DATA=WORK.essai_clinique(OBS=5);
RUN;
Cet affichage sélectif permet de s’assurer de l’alignement horizontal harmonieux des valeurs au sein de leurs colonnes respectives et de vérifier qu’aucun glissement de délimiteur n’a provoqué la dispersion de fragments de données numériques dans des colonnes textuelles. Dans la foulée de cette inspection oculaire, l’utilisation de la procédure PROC CONTENTS s’impose pour auditer en profondeur le dictionnaire interne des métadonnées :
PROC CONTENTS DATA=WORK.essai_clinique;
RUN;
La sortie générée par PROC CONTENTS renseigne sur les choix effectués par l’heuristique SAS durant l’importation. On y examine avec la plus extrême minutie le décompte total des observations, l’attribution correcte des types fondamentaux (type 1 pour les valeurs numériques, type 2 pour les chaînes de caractères alphanumériques) ainsi que la longueur maximale en octets assignée à chaque attribut textuel. Si la variable Sujet_ID a été correctement qualifiée de variable alphanumérique d’une longueur appropriée et que les scores ont bien été reconnus comme des grandeurs flottantes à double précision, le jeu de données peut être validé pour l’étape subséquente de manipulation.
6. Exemple pratique 2 : Gestion avancée des séparateurs et délimiteurs alternatifs
6.1 Différenciation structurelle : virgule, point-virgule et tabulation
Si la virgule constitue la norme théorique d’espacement des fichiers CSV dans la culture informatique anglo-saxonne, le paysage des systèmes d’information européens et francophones présente une réalité tout autre. Dans de nombreux pays de l’Union européenne, la convention typographique nationale consacre la virgule comme symbole officiel de séparation entre la partie entière et la partie fractionnaire d’un nombre réel. Dès lors, pour contourner une ambiguïté d’interprétation insurmontable au sein des tableurs grand public, les concepteurs de logiciels ont massivement substitué le point-virgule (;) à la virgule comme délimiteur officiel de colonnes dans les fichiers d’exportation dits « CSV ».
Parallèlement à cette spécificité régionale, le format de délimitation par tabulations horizontales (couramment étiqueté sous l’extension .tsv ou .tab) est très répandu dans le traitement des données omiques à haut débit, de bioinformatique ou d’alignement de séquences génomiques. L’insertion de tabulations (caractère d’échappement ASCII standard t ou code hexadécimal 09) garantit qu’aucun conflit textuel direct ne viendra interférer avec des descriptions narratives riches susceptibles d’abriter des virgules ou des points-virgules au sein de leur prose.
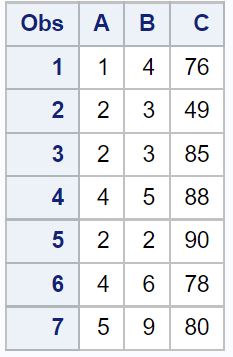
L’omission de ces disparités structurelles préalablement au lancement d’une importation SAS provoque des conséquences catastrophiques. Si un fichier formaté avec des délimiteurs points-virgules est soumis aveuglément à un pilote DBMS=CSV non configuré, le processeur interprétera chaque rangée entière comme une seule cellule de texte géante, faute de localiser les virgules attendues. Les colonnes ultérieures se retrouvent entièrement occultées ou vides de substance, annihilant instantanément toute validité statistique sans nécessairement lever d’erreur fatale dans le journal logiciel.
6.2 Emploi de l’option DELIMITER dans les procédures d’importation
Pour orchestrer l’ingestion de fichiers délimités par des séparateurs alternatifs sans délaisser la commodité opérationnelle de PROC IMPORT, la solution consiste à abandonner le pilote spécialisé DBMS=CSV au profit du pilote universel DBMS=DLM, couplé à l’instruction déclarative DELIMITER=. Cette formulation confère une flexibilité d’adaptation absolue à l’analyste, lui permettant de stipuler expressément le motif séparateur requis par le format source.
Le bloc de code ci-dessous illustre le traitement ciblé d’un fichier extrait d’un système hospitalier francophone employant le point-virgule pour isoler les colonnes de données cliniques :
PROC IMPORT DATAFILE="/entrepots/donnees/laboratoire_france.csv"
OUT=WORK.mesures_biologiques
DBMS=DLM
REPLACE;
DELIMITER=';';
GETNAMES=YES;
RUN;
Dans cette configuration, l’argument DELIMITER=';' redéfinit explicitement la frontière lexicale que l’analyseur doit rechercher entre deux valeurs contiguës. Pour des fichiers séparés par des tabulations, la syntaxe gagne en rigueur en exploitant la transcription hexadécimale du caractère de contrôle, formalisée sous la forme DELIMITER='09'x;. L’utilisation d’identifiants hexadécimaux s’avère particulièrement précieuse lorsqu’il s’agit de traiter des flux de données pollués par des séparateurs non imprimables ou des caractères de contrôle obsolètes issus d’anciens systèmes centraux (mainframes).
6.3 Résolution des conflits liés aux séparateurs décimaux francophones
L’un des défis les plus pernicieux rencontrés lors de l’ingestion de données européennes dans SAS réside dans l’hétérogénéité des séparateurs décimaux. Par défaut, la grammaire interne de SAS s’aligne scrupuleusement sur le système d’écriture anglo-saxon : le point (.) est l’unique séparateur fractionnaire arithmétique recevable, tandis que la virgule (,) est classiquement réservée au partitionnement des milliers dans les présentations financières (par exemple 1,000.50).
Lorsqu’un flux textuel contient des valeurs numériques rédigées sous le modèle francophone (tel que 14,5 pour désigner quatorze unités et demie), le moteur heuristique de PROC IMPORT échoue à interpréter ce motif comme une grandeur quantitative continue. Face à la présence de ce caractère virgule inattendu au cœur du nombre, SAS conclut automatiquement que la colonne relève d’une nature alphanumérique qualitative. La variable cible se retrouve irrévocablement typée en chaîne de caractères (character variable), interdisant toute utilisation immédiate dans des modèles de régression, des analyses de variance ou de simples calculs de moyennes arithmétiques.
Pour remédier à cette impasse méthodologique au sein de flux automatisés, deux voies d’ingénierie peuvent être empruntées. La première consiste à ajuster temporairement l’option globale du système via la commande OPTIONS LOCALE=fr_FR;, incitant les routines internes à reconnaître la virgule décimale lors des interprétations heuristiques. Toutefois, cette approche globale pouvant altérer le comportement d’autres modules de la session, la stratégie la plus pérenne réside dans l’emploi d’une étape DATA de conversion post-importation exploitant la fonction de réaffectation INPUT adossée à l’informat spécialisé COMMAXw.d ou NUMXw.d, conçus expressément pour transmuter des chaînes comportant des virgules décimales en variables réelles numériques conformes aux exigences du moteur analytique.
7. Contrôle des types de variables et paramétrage de GUESSINGROWS
7.1 Mécanisme heuristique d’inférence de types dans SAS
Contrairement à un schéma de base de données relationnelle dont les colonnes sont typées dès l’initialisation du catalogue système, un fichier CSV ne livre qu’une longue trame de caractères textuels. Pour accomplir sa mission d’automatisation, PROC IMPORT met en œuvre un algorithme heuristique d’inférence prédictive : le module échantillonne un sous-ensemble déterminé d’enregistrements physiques au sommet du fichier afin d’en déduire statistiquement la nature la plus probable de chaque colonne (numérique, caractère, date ou heure) et de calculer l’espace mémoire nécessaire pour héberger la plus longue chaîne identifiée.
Par défaut, dans les versions conventionnelles de SAS, cet échantillonnage heuristique est restreint à une fenêtre de lecture extrêmement restreinte : les 20 premières lignes d’observations du fichier (ou les 32767 premières lignes selon les mises à jour et configurations systèmes spécifiques). Si cette limitation garantit une célérité d’exécution fulgurante – SAS n’ayant pas besoin de parcourir des téraoctets de données avant d’initialiser son étape d’insertion –, elle constitue une source majeure de vulnérabilité analytique lorsque la variabilité structurelle des données n’est pas uniformément répartie sur l’ensemble de la distribution des observations.
Le risque de classification déviante se matérialise avec une acuité particulière dans le traitement des variables administratives ou cliniques clairsemées. Si une colonne d’identification de dossier clinique commence par une séquence homogène de 20 observations exclusivement composées de chiffres (par exemple 1001, 1002), SAS déclare souverainement que la variable est de type numérique. Si la vingt-et-unième ligne du document comporte en réalité un identifiant alphanumérique enrichi d’un préfixe textuel (tel que PAT-1021), le compilateur SAS se trouvera dans l’incapacité d’insérer ce texte dans la case numérique allouée. L’observation fautive sera convertie en valeur manquante système (symbolisée par un point .), corrompant ainsi silencieusement l’intégrité de la cohorte d’analyse sans bloquer l’exécution globale du processus.
7.2 Optimisation et extension de l’analyse avec GUESSINGROWS
Afin de conjurer ces écueils inhérents à un échantillonnage excessivement frileux, le système SAS met à la disposition des développeurs une instruction de réglage fondamentale : l’option GUESSINGROWS=. Cette directive autorise l’analyste à étendre explicitement l’horizon temporel de l’heuristique en modifiant le contingent de rangées analysées par le moteur d’inférence préalablement à la fixation définitive du dictionnaire des métadonnées de la table de données.
La syntaxe de paramétrage s’intègre directement au sein du corps de la procédure PROC IMPORT de la manière suivante :
PROC IMPORT DATAFILE="/donnees/grands_volumes/registre_population.csv"
OUT=WORK.population_totale
DBMS=CSV
REPLACE;
GETNAMES=YES;
GUESSINGROWS=MAX;
RUN;
En assignant la valeur absolue maximale via GUESSINGROWS=MAX; (ou en déclarant une valeur numérique élevée telle que GUESSINGROWS=100000;), le développeur force l’algorithme à balayer l’intégralité du fichier plat pour en sonder chaque cellule avant d’instancier la compilation. Dès lors, si un seul caractère textuel surgit à la millième ligne d’une colonne initialement numérique, la variable se verra promptement conférer le statut de chaîne de caractères sur l’ensemble de la table, éliminant ainsi toute perte de données par substitution de valeurs manquantes accidentelles.
Cet accroissement qualitatif implique toutefois un arbitrage en matière de consommation de ressources de calcul. L’inspection exhaustive d’un jeu de données comprenant plusieurs dizaines de gigaoctets engendre une multiplication des opérations d’entrées-sorties sur les volumes de stockage, allongeant sensiblement la durée d’exécution globale du script. Il appartient à l’architecte de données de déterminer si la volumétrie et l’hétérogénéité du fichier justifient le recours à GUESSINGROWS=MAX, ou si l’emploi d’une alternative déterministe via l’étape DATA ne s’avère pas plus efficiente pour industrialiser le pipeline de traitement.
7.3 Prévention des troncatures et des pertes d’information
L’autre écueil critique directement régulé par GUESSINGROWS concerne la dimensionnement de la longueur physique des variables alphanumériques, paramétrée par la clause d’allocation $LENGTH. Dans l’architecture binaire de SAS, une variable textuelle se voit attribuer une longueur statique immuable en octets, fixée lors de la phase de création de la table. Si les vingt premières lignes inspectées par l’heuristique ne comportent que des descriptions textuelles courtes n’excédant pas 15 caractères, SAS attribuera souverainement la dimension $15. à cette variable pour l’ensemble du jeu de données.
Lorsque le flux de traitement parvient ultérieurement à un enregistrement abritant une observation descriptive de 60 caractères, le moteur n’étend pas la cellule mémoire allouée de manière dynamique. Il procède impitoyablement à une troncature silencieuse : les 15 premiers caractères sont scrupuleusement enregistrés dans la table, tandis que les 45 derniers octets sont tout simplement rayés de la mémoire et définitivement perdus. Cette altération silencieuse est dévastatrice dans le cadre de recherches qualitatives, d’analyses textuelles ou de gestion d’adresses postales et de libellés diagnostiques.
La mobilisation de GUESSINGROWS=MAX constitue un bouclier efficace contre ce désastre invisible, puisque SAS recalibrera la dimension LENGTH sur le maximum exact observé à l’échelle de l’intégralité du corpus. Pour autant, même avec un balayage exhaustif, des variations structurelles futures dans des fichiers incrémentaux réguliers peuvent déborder les seuils établis. C’est pourquoi la lecture formelle et contrôlée via l’étape DATA programmée à la main demeure la référence méthodologique incontestée dès lors qu’un contrôle absolu de l’architecture des données est requis.
8. Alternative programmatique : Lecture robuste via l’étape DATA
8.1 Avantages comparatifs de l’étape DATA face à PROC IMPORT
Si la procédure PROC IMPORT offre un confort opérationnel indéniable pour l’analyse exploratoire et l’évaluation préliminaire de jeux de données inconnus, elle présente des faiblesses méthodologiques rédhibitoires pour l’intégration de flux industriels hautement critiques. Ses mécanismes heuristiques d’inférence comportent une part irréductible d’indéterminisme : une légère modification de l’ordre séquentiel des observations au sein du fichier CSV source peut modifier la perception du compilateur et altérer imprévisiblement le typage, la largeur des colonnes ou la désignation des variables. Dans un environnement de recherche biomédicale ou de conformité réglementaire stricte, une telle instabilité est inacceptable.
Le recours à la lecture déterministe programmée au sein d’une étape DATA (DATA Step Processing) s’impose dès lors comme la méthode souveraine d’ingestion de données de référence. Cette approche confère au chercheur une maîtrise absolue et rigide sur chaque facette de l’architecture du jeu de données. Chaque variable y est explicitement définie avec son libellé définitif, sa typologie binaire, sa réservation de longueur d’octets, son format de stockage et son gabarit de restitution visuelle, écartant toute décision arbitraire prise par un algorithme opaque.
De surcroît, l’étape DATA autorise l’imbrication de transformations analytiques et de filtres de nettoyage directement à la volée, c’est-à-dire au moment exact où la ligne transite par le tampon d’entrée mémoire. Il devient ainsi possible d’exclure conditionnellement des observations corrompues, de restructurer des identifiants complexes, d’appliquer des dérivations mathématiques immédiates et d’instancier des tables de rejets distinctes sans devoir exécuter des procédures intermédiaires coûteuses en mémoire disque. Cette maîtrise algorithmique garantit une robustesse opérationnelle totale et une pérennité des pipelines d’analyses à travers le temps.
8.2 Syntaxe conjointe des instructions INFILE et INPUT
Le moteur d’exécution d’une étape DATA d’ingestion textuelle repose sur l’action conjointe de deux instructions cardinales : l’instruction INFILE, qui spécifie les propriétés physiques et comportementales du fichier source externe, et l’instruction INPUT, qui cartographie la disposition des données au sein du tampon d’entrée pour alimenter le vecteur de travail de programme (PDV). L’architecture d’un tel programme requiert une séquence méthodique de déclarations de métadonnées préalablement à la phase de lecture dynamique.
Considérons l’exemple structuré suivant, conçu pour ingérer avec une précision mathématique le fichier de cohorte clinique examiné précédemment :
DATA WORK.cohorte_maitrisee;
INFILE "/recherche/projets/essais/evaluation_clinique.csv"
FIRSTOBS=2
DLM=','
DSD
TRUNCOVER;
LENGTH
Sujet_ID $ 10
Age 8
Groupe_Traitement $ 12
Score_Baseline 8
Score_Post 8
Statut_Observance $ 15;
INPUT
Sujet_ID $
Age
Groupe_Traitement $
Score_Baseline
Score_Post
Statut_Observance $;
RUN;
Dans ce squelette programmatique d’une parfaite pureté fonctionnelle, le bloc d’instruction LENGTH préalloue immuablement les dimensions physiques de la table en mémoire avant que le curseur ne lise le premier octet. Les variables alphanumériques se voient attribuer un format d’enregistrement protégé contre toute troncature accidentelle (par exemple $ 10 pour l’identifiant sujet), tandis que les indicateurs numériques bénéficient de l’espace standard de 8 octets, correspondant à des nombres à virgule flottante double précision conformes au standard de calcul IEEE. L’instruction INPUT n’a plus alors qu’à dérouler la lecture séquentielle sans devoir spéculer sur la nature des champs rencontrés.
8.3 Maîtrise des modificateurs DSD, TRUNCOVER, FIRSTOBS et OBS
L’efficacité exemplaire de l’instruction INFILE repose sur la combinaison synergique de ses options de contrôle, au premier rang desquelles trône le modificateur DSD (Delimiter Sensitive Data). Ce modificateur fondamental altère profondément le comportement par défaut du compilateur SAS face aux séparateurs de listes textuelles. Sans DSD, deux virgules consécutives sont interprétées par SAS comme un seul délimiteur redondant, provoquant un décalage horizontal dramatique des variables suivantes. À l’opposé, l’activation de DSD force le moteur à reconnaître deux séparateurs adjacents comme encadrant une véritable cellule vide, assignant rigoureusement une valeur manquante système à la variable correspondante sans perturber le reste de la séquence d’alignement.
De surcroît, le modificateur DSD traite avec une intelligence absolue les données encapsulées entre des guillemets doubles. Si un participant à une étude a formulé un commentaire abritant une virgule au sein de sa réponse, DSD neutralise le pouvoir délimiteur de cette virgule interne et supprime élégamment les guillemets englobants lors de l’assignation dans la mémoire du PDV. Concomitamment, le modificateur TRUNCOVER résout un dysfonctionnement historique notoire de la commande d’entrée : si un enregistrement textuel se trouve écourté de façon imprévue en fin de rangée, TRUNCOVER ordonne au système de lire les données disponibles jusqu’à la limite du saut de ligne physique sans sauter arbitrairement à la ligne suivante pour tenter d’y assouvir les exigences de l’instruction INPUT.
Enfin, le contrôle volumétrique et l’adressage spatial du flux sont supervisés par le couple de directives FIRSTOBS= et OBS=. La clause FIRSTOBS=2 enjoint au système d’ignorer la ligne inaugurale consacrée aux en-têtes textuels pour amorcer l’ingestion directement sur la première rangée de valeurs empiriques, assurant ainsi une parfaite étanchéité entre la couche descriptive et les enregistrements expérimentaux. Utilisée en parallèle, l’option OBS=5000 permet d’interrompre l’acquisition au terme d’un échantillon expérimental restreint afin de tester la chaîne d’assemblage sans engager des temps d’exécution disproportionnés lors des phases préliminaires de débogage.
9. Traitement des anomalies de données, valeurs manquantes et encodage
9.1 Gestion des jeux de caractères et encodage textuel (UTF-8 vs Latin1)
La prolifération des systèmes d’exploitation hétérogènes et des environnements infonuagiques a fait de la disparité d’encodage des jeux de caractères l’une des causes les plus fréquentes de dégradation logicielle lors de l’ingestion de données textuelles. Dans la sphère francophone, les conflits opposent principalement les normes historiques monolingues héritées de l’environnement Microsoft Windows (ANSI, codepage Windows-1252) ou des standards ISO (notamment ISO-8859-1 ou Latin1) face à la norme universelle dominante UTF-8.
Lorsqu’un fichier encodé sous le format multi-octets UTF-8 – où les caractères accentués tels que « é », « à », « ç » sont transcrits au moyen de séquences de deux à quatre octets – est lu par une session SAS initialisée sous un environnement mono-octet Latin1, des artefacts typographiques aberrants surgissent, connus sous le nom générique de mojibake. Les lettres accentuées se dédoublent en symboles incohérents (comme la substitution de é par é). Pis encore, si une session SAS déployée en UTF-8 tente de lire un fichier codé en Windows-1252 sans adaptation spécifique, le moteur lève une exception de transcodage critique pouvant interrompre violemment la procédure d’importation.
Pour immuniser le flux de traitement contre ces anomalies de décodage linguistique, il est primordial de spécifier explicitement la norme d’encodage native du fichier source au sein même de l’instruction INFILE ou de la procédure PROC IMPORT via l’option ENCODING=. Par exemple, l’inclusion formelle de la clause ENCODING="UTF-8" (ou ENCODING="WLATIN1" selon l’origine du fichier) enjoint au moteur SAS d’activer un pont de transcodage dynamique en mémoire vive. Les séquences d’octets sont alors fidèlement traduites vers l’encodage de la session active sans altération de la typographie originelle, préservant ainsi l’intégrité intégrale des verbatims d’enquêtes ou des répertoires patronymiques.
9.2 Codage et interprétation des valeurs manquantes empiriques
Dans tout recueil empirique de données quantitatives, les phénomènes de non-réponse, de perte de contact de suivi épidémiologique ou d’impossibilité de mesure instrumentale génèrent inéluctablement des valeurs manquantes. La représentation interne de ces absences varie drastiquement selon le type de la variable au sein de l’architecture SAS : les grandeurs numériques absentes sont matérialisées par un simple point (.), tandis que les variables alphanumériques vides sont représentées par une chaîne constituée exclusivement d’espaces blancs.
Cependant, les sources brutes CSV recourent couramment à une terminologie hétérogène et informelle pour désigner ces absences de mesure, inscrivant des mentions textuelles telles que NA, NaN, NULL, Refus ou Non_Renseigné au cœur de colonnes par ailleurs purement quantitatives. Si l’analyste soumet un tel document à PROC IMPORT sans préparation, ces occurrences textuelles parasites empêcheront la reconnaissance numérique de la colonne ou généreront une avalanche de messages d’invalidation syntaxique (Invalid data note) au fil du journal d’exécution.
Pour structurer méthodologiquement ces absences au sein d’une étape DATA de lecture experte, SAS offre le mécanisme sophistiqué des valeurs manquantes spéciales (Special Missing Values). En exploitant les représentations littérales .A à .Z ainsi que le tiret de soulignement ._, le statisticien peut qualifier sémantiquement les motifs de l’absence lors de la phase d’ingestion. Par exemple, une conditionnelle peut intercepter la chaîne Refus pour la convertir en .R, et la mention Non_Applicable en .N. Lors des phases ultérieures d’inférence, ces valeurs spéciales sont rigoureusement exclues des calculs de moyennes tout en restant discernables lors de tabulations croisées de dénombrement via PROC FREQ, offrant une traçabilité analytique sans faille.
9.3 Gestion des guillemets imbriqués et retours à la ligne au sein des cellules
L’une des épreuves les plus redoutables pour un parseur de fichiers plats réside dans la présence de sauts de ligne physiques (retours chariot) nichés à l’intérieur même d’un champ textuel protégé par des guillemets doubles. Ce cas de figure se rencontre couramment lors du traitement des champs narratifs ouverts issus de formulaires de collecte en ligne, où les répondants structurent spontanément leurs observations subjectives en paragraphes distincts en appuyant sur la touche d’entrée de leur clavier.
Confronté à cette situation, un processeur de lecture rudimentaire interprète prématurément le saut de ligne intégré comme le signal de clôture de l’observation statistique courante. Le reliquat textuel positionné en dessous est alors traité comme l’amorce d’une toute nouvelle unité d’observation. Cette désynchronisation brutale détruit intégralement l’ordonnancement de la table : des fragments de phrases sont insérés dans des colonnes d’identifiants, les compteurs de rangées explosent de manière factice et la distribution globale des observations est définitivement compromise.
Bien que le pilote moderne DBMS=CSV de PROC IMPORT intègre des algorithmes sophistiqués capables de franchir ces sauts de lignes protégés, des cas extrêmes de citations imbriquées – mêlant guillemets doubles et apostrophes simples au sein de paragraphes complexes – peuvent mettre ses capacités en échec. Il devient alors indispensable de recourir à des étapes DATA avancées couplées à des fonctions de manipulation de mémoire bas niveau ou à des fonctions d’expression régulière (comme les fonctions PRXCHANGE) afin de purger les caractères de contrôle non imprimables (tels que '0D'x et '0A'x) situés entre les délimiteurs avant de soumettre les enregistrements à la procédure d’interprétation finale.
10. Importation massive et automatisation par macros SAS
10.1 Conception d’une macro-procédure paramétrable pour fichiers unitaires
Dans les contextes opérationnels de traitement continu de données – tels que la surveillance épidémiologique journalière, les flux de valorisation de portefeuilles financiers ou les études multi-centres –, l’écriture manuelle répétitive de scripts d’importation devient rapidement insoutenable et hautement faillible. La standardisation méthodologique passe impérativement par l’encapsulation de la chaîne de lecture au sein d’une unité modulaire réutilisable : une macro-procédure paramétrable écrite en macro-langage SAS.
Cette approche permet d’abstraire la logique d’ingestion en déléguant à des macro-variables dynamiques la définition des éléments variables du système : chemin d’accès au répertoire, nom physique du fichier, nom de la table cible et paramétrage heuristique. Voici une démonstration architecturale d’une telle structure modulaire :
%MACRO ImporterFichierCSV(chemin_complet=, table_sortie=, seuil_heuristique=MAX);
%IF %SYSFUNC(FILEEXIST("&chemin_complet")) = 0 %THEN %DO;
%PUT %STR(ERROR: Le fichier source spécifié demeure introuvable : &chemin_complet);
%RETURN;
%END;
PROC IMPORT DATAFILE="&chemin_complet"
OUT=&table_sortie
DBMS=CSV
REPLACE;
GETNAMES=YES;
GUESSINGROWS=&seuil_heuristique;
RUN;
%PUT %STR(NOTE: Importation achevée avec succès pour la table &table_sortie);
%MEND ImporterFichierCSV;
Cette macro-procédure intègre une composante préventive indispensable : l’interrogation synchrone de la fonction système FILEEXIST avant d’engager les ressources du compilateur. Si le document cible n’est pas physiquement détecté sur le volume de stockage (par exemple en raison d’un retard de génération ou d’une anomalie réseau), la macro intercepte l’incident, consigne une notification d’erreur formelle dans le journal et interrompt gracieusement son exécution sans provoquer d’effondrement en cascade des processus analytiques aval.
10.2 Parcours itératif d’un répertoire contenant des fichiers CSV multiples
Le plein potentiel de l’automatisation se révèle lorsqu’il s’agit de traiter un répertoire contenant des dizaines ou des centaines de fichiers CSV hétérogènes générés par des centres d’acquisition décentralisés. Plutôt que de déclarer individuellement chaque fichier à l’intérieur d’un script verbeux, il est hautement plus élégant et robuste d’ordonner à SAS de sonder lui-même l’arborescence du système de fichiers hôte, d’en dresser l’inventaire exhaustif et de déclencher une boucle itérative d’ingestion de manière totalement autonome.
Cette prouesse programmatique s’accomplit en mobilisant les fonctions d’interfaçage de bas niveau avec le système d’exploitation intégrées à SAS, notamment les instructions DOPEN, DREAD et DCLOSE. Le script alloue un descripteur logique de répertoire au dossier source, ouvre le canal de communication via DOPEN, puis détermine le décompte total des entités physiques recensées. Une boucle conditionnelle balaie ensuite chaque élément : la fonction DREAD extrait le nom du fichier, et une fonction d’analyse de motifs textuels vérifie que l’extension du document correspond bien au format cible .csv.
Chaque fichier identifié comme éligible est alors instantanément consigné dans une table SAS interne d’ordonnancement. À partir de cette liste dynamique, une macro-boucle ou une mécanique d’étape DATA couplée à l’instruction d’exécution différée CALL EXECUTE procède à l’appel séquentiel de la macro-commande %ImporterFichierCSV formulée au paragraphe précédent. Ce déploiement permet de transformer un ensemble chaotique d’extractions locales en une flotte ordonnée de tables SAS standardisées, sans exiger la moindre intervention manuelle de l’opérateur.
10.3 Concaténation séquentielle et consolidation des jeux de données
L’ingestion atomique d’une multitude de fichiers CSV débouche inévitablement sur la nécessité de consolider ces fragments éparpillés au sein d’un entrepôt de données unifié. Une fois les différentes tables unitaires produites dans la bibliothèque transitoire (par exemple WORK.lot_1, WORK.lot_2 jusqu’à WORK.lot_n), l’ultime étape méthodologique consiste à fusionner verticalement ces observations par empilement séquentiel via l’instruction fondamentale SET au sein d’une étape DATA d’agrégation.
Cette phase de consolidation exige une vigilance méthodologique extrême quant à l’harmonisation stricte des attributs de variables. Si deux fichiers CSV issus de sites différents ont attribué des longueurs différentes ou des types discordants à une même variable conceptuelle en raison des variations de l’heuristique de PROC IMPORT (par exemple un centre ayant consigné des identifiants exclusivement numériques alors qu’un autre utilisait des préfixes textuels), l’étape de concaténation avorte immédiatement en levant un conflit bloquant de type de données (Type mismatch error).
Pour immuniser la chaîne d’agrégation contre ce risque, il est vivement préconisé d’adjoindre une instruction déclarative LENGTH au sommet de l’étape DATA consolidée pour imposer une nomenclature uniforme avant l’appel de l’instruction SET. Parallèlement, l’utilisation de l’option INDSNAME= ou de l’argument de suivi IN= permet de créer dynamiquement une variable additionnelle attestant de la provenance physique exacte de chaque observation. Cette traçabilité d’origine garantit qu’en cas d’anomalie ultérieurement identifiée sur un sous-ensemble d’observations, l’équipe d’assurance qualité pourra remonter instantanément au fichier source défectueux pour procéder aux rectifications nécessaires.
11. Validation post-importation et contrôle qualité des données
11.1 Audit structurel via PROC CONTENTS et détection des anomalies
La clôture de l’étape physique d’ingestion des données CSV ne marque en aucun cas le coup d’envoi immédiat des analyses statistiques inférentielles. Elle inaugure une phase essentielle de gouvernance des données : le contrôle qualité post-importation. Le premier jalon de cet audit structurel consiste à mobiliser la procédure PROC CONTENTS, configurée pour exporter le dictionnaire exhaustif de la table nouvellement créée vers un jeu de données spécialisé via l’argument OUT= :
PROC CONTENTS DATA=WORK.cohorte_maitrisee OUT=WORK.audit_metadonnees NOPRINT;
RUN;
Cette table de métadonnées compilée fait ensuite l’objet d’un examen systématique visant à valider l’intégrité de l’architecture. On y contrôle prioritairement la correspondance exacte entre le décompte d’observations physically générées et les métriques attendues issues des systèmes de collecte en amont. Tout écart numérique impose l’arrêt immédiat des travaux pour investiguer une éventuelle troncature ou un saut de ligne non géré ayant amalgamé des observations.
L’autre axe fondamental de l’audit structurel réside dans l’identification des colonnes fantômes. Fréquemment, des fichiers CSV corrompus par des tableurs tiers comportent une succession de délimiteurs résiduels en queue de ligne, ce qui incite le moteur SAS à créer des variables vides superflues baptisées VAR7, VAR8, sans aucune valeur informative. L’audit automatisé permet de détecter ces attributs parasites caractérisés par un taux de valeurs manquantes de 100 % afin de les purger proprement du modèle avant le transfert vers l’entrepôt institutionnel de données.
11.2 Vérification des distributions marginales avec PROC FREQ et PROC UNIVARIATE
Une fois la conformité de l’architecture générale confirmée, l’audit qualité bascule vers l’examen des distributions statistiques marginales des valeurs hébergées au sein de chaque attribut. Cette étape garantit qu’aucun artefact de lecture, glissement de délimiteur ou problème de transcodage de séparateur décimal n’a altéré la substance empirique des mesures. Les deux outils statistiques privilégiés pour cette évaluation sont les procédures PROC FREQ et PROC UNIVARIATE.
La procédure PROC FREQ est déployée sur l’ensemble des variables qualitatives et catégorielles au moyen de l’option NLEVELS :
PROC FREQ DATA=WORK.cohorte_maitrisee NLEVELS;
TABLES Groupe_Traitement Statut_Observance / MISSING;
RUN;
La restitution de NLEVELS fournit un inventaire immédiat du nombre de modalités distinctes détectées. La découverte d’une fréquence résiduelle inattendue (par exemple une modalité "Actiff" polluée par une faute de frappe ou une tronquée "Compl") trahit instantanément une longueur de champ mal dimensionnée ou une anomalie de codification source. Parallèlement, l’inclusion de l’option MISSING empêche l’occultation des non-réponses, exposant au grand jour la proportion réelle de données lacunaires.
Pour les variables quantitatives continues, l’exécution de la procédure PROC UNIVARIATE fournit un diagnostic approfondi de la plausibilité biomédicale ou économique des grandeurs :
PROC UNIVARIATE DATA=WORK.cohorte_maitrisee;
VAR Score_Baseline Score_Post Age;
RUN;
L’analyste ausculte attentivement les valeurs extrêmes minimales et maximales identifiées par la procédure, ainsi que les quantiles extrêmes (1er et 99e centiles). Si une erreur d’interprétation décimale est survenue lors de l’ingestion – par exemple un score de 68.5 lu par méarde comme le nombre entier 685 suite à l’effacement accidentel d’un délimiteur francophone –, le calcul des indicateurs de dispersion mettra immédiatement en évidence des moyennes aberrantes et des étendues invraisemblables, sonnant l’alerte méthodologique avant toute dissémination des résultats statistiques.
11.3 Traçabilité méthodologique par l’examen systématique du journal SAS
Dans un cadre de production sous assurance qualité, l’examen visuel occasionnel de la console SAS ne saurait suffire. Il est formellement exigé d’instaurer un protocole d’inspection algorithmique systématique du journal d’exécution (Log Scraping) pour chaque lot d’ingestion traité. Le journal SAS constitue en effet la boîte noire légale du traitement, consignant de manière indélébile chaque notification de statut d’exécution émise par le compilateur.
Ce protocole consiste à automatiser la recherche d’une triade de mots-clés normalisés au sein du flux textuel du fichier journal :
- ERROR: Signale l’arrêt brutal d’une instruction, la non-localisation d’un chemin de fichier, une saturation d’espace disque ou une violation de syntaxe impardonnable. Toute présence de cette mention invalide instantanément le jeu de données produit.
- WARNING: Alerte sur des conflits potentiellement délétères qui n’ont pas interrompu la compilation, tels que des écrasements imprévus de structures ou des incohérences de formats régionaux.
- NOTE: Si la majorité de ces notes relatent le succès des opérations, certaines d’entre elles signalent des pertes silencieuses de substance empirique sous les formulations stéréotypées
NOTE: Invalid data for variable...(données non conformes converties en valeurs manquantes) ouNOTE: Division by zero detected....
Au sein des pipelines industriels, des scripts shell ou des macro-programmes de validation dédiés parcourent le fichier journal généré dès la clôture de la session pour dénombrer les occurrences de ces signaux critiques. Si le décompte d’erreurs ou d’avertissements s’écarte de zéro, le processus bascule automatiquement en état d’incident, émet une notification d’alerte aux analystes responsables et bloque le déploiement du jeu de données vers les environnements de modélisation statistique, garantissant une intégrité computationnelle inattaquable.
12. Synthèse comparative, recommandations pratiques et écueils courants
12.1 Matrice décisionnelle : PROC IMPORT versus étape DATA personnalisée
Le choix entre l’emploi de l’utilitaire d’automatisation PROC IMPORT et la rédaction formelle d’une étape DATA programmée à la main ne relève pas d’une simple préférence esthétique, mais procède d’un arbitrage d’ingénierie rigoureux guidé par le contexte opérationnel, la complexité intrinsèque des données et les impératifs de conformité du projet de recherche. Le tableau décisionnel ci-après synthétise les propriétés comparées de ces deux paradigmes méthodologiques :
| Critère Méthodologique | Procédure PROC IMPORT | Étape DATA Personnalisée |
|---|---|---|
| Horizon d’usage préférentiel | Exploration préliminaire, prototypage rapide, ad hoc. | Production industrielle, études réglementaires, flux récurrents. |
| Déterminisme du typage | Heuristique et probabiliste (dépend de GUESSINGROWS). | Absolu et déterministe (défini par l’analyste). |
| Gestion des séparateurs non standards | Flexible via DBMS=DLM, mais sensible aux anomalies. | Contrôle total des règles de parsing via INFILE / INPUT. |
| Traitement des valeurs manquantes | Automatique selon le standard SAS (point ou espace). | Attribution de valeurs manquantes spéciales (.A à .Z). |
| Nettoyage et filtrage à la volée | Impossible (nécessite une étape ultérieure). | Natif et immédiat au sein du Program Data Vector. |
| Volume de maintenance du code | Très faible (syntaxe concise en 5 lignes). | Élevé (nécessite de documenter chaque variable). |
En synthèse, la procédure PROC IMPORT constitue l’outil de découverte par excellence lorsqu’un analyste est mis en présence d’un fichier volumineux dont il ignore la structure détaillée, permettant en quelques secondes de générer une table d’évaluation. En revanche, dès lors que le cycle analytique franchit le seuil de la production pérenne ou d’un essai clinique destiné à une autorité sanitaire, le remplacement de PROC IMPORT par une étape DATA rigoureusement documentée et typée devient un impératif méthodologique incontournable pour prémunir le pipeline contre les aléas de l’inférence dynamique.
12.2 Bonnes pratiques de standardisation et pérennité du code d’ingestion
L’élaboration de programmes d’ingestion de données pérennes exige le strict respect de principes d’architecture logicielle éprouvés, en totale adéquation avec les lignes directrices internationales FAIR (Findable, Accessible, Interoperable, Reusable) encadrant la gouvernance contemporaine des données de recherche scientifique. Le premier principe réside dans la déconnexion absolue entre le code logique et les adresses physiques locales des machines exécutantes.
L’inscription de chemins de répertoires codés en dur au sein des instructions (tels que C:UsersAnalysteDocuments...) représente une pratique néfaste ruinant instantanément toute transposabilité du code. Les adresses de stockage doivent être systématiquement gérées via des variables globales d’environnement, des fichiers de configuration externes ou des assignations dynamiques de bibliothèques logiques LIBNAME et FILENAME définies dès l’en-tête du script maître du projet. Cette modularité permet d’exécuter la même chaîne de traitement sur un poste individuel de développement ou sur un cluster de calcul distant sans modifier une seule ligne du corps des requêtes.
Parallèlement, la documentation interne des programmes doit satisfaire aux standards académiques les plus stricts. Chaque script d’importation doit s’ouvrir sur un bloc de métadonnées détaillant l’identité de l’auteur, la date de compilation, la version du système SAS exploitée, la référence unique du protocole de recherche, ainsi qu’une description des checksums de validation (tels que des empreintes de hachage SHA-256) associés aux fichiers CSV sources. L’adjonction de ces garanties informatiques prémunit l’organisation contre les contestations relatives à la traçabilité des données lors des phases de publication ou d’audit externe.
12.3 Typologie des erreurs classiques et protocoles de remédiation
L’expérience cumulée au fil de décennies d’ingénierie logicielle sous SAS a permis de cartographier avec une précision chirurgicale les dysfonctionnements récurrents affectant l’ingestion de fichiers textuels plats. La maîtrise de ces pathologies structurelles et de leurs remèdes techniques constitue le bagage indispensable de tout scientifique de données opérant dans cet écosystème :
- Échec critique Physical file does not exist : Cette interruption fatale survient quasi invariablement suite à une erreur de casse au sein de l’arborescence sur un serveur sous environnement Linux, à l’omission de l’extension de fichier ou à une modification non synchronisée des droits d’accès réseau. Remédiation : Contrôler systématiquement l’accessibilité physique via la macro-fonction préventive
%SYSFUNC(FILEEXIST(...))avant tout appel de procédure. - Glissement horizontal des colonnes (Column Drifting) : Ce phénomène dévastateur se manifeste lorsqu’un texte libre comporte un délimiteur non protégé par des guillemets doubles, ou lorsque des virgules consécutives sont interprétées de façon asymétrique. Remédiation : Abandonner l’importation brute au profit d’une étape
DATAconfigurée avec les modificateurs de lecture conjointsDSDetTRUNCOVER. - Conversion erronée en variable alphanumérique : Une colonne quantitative se retrouve inexplicablement typée en chaîne de caractères suite à l’introduction d’un libellé textuel de valeur manquante (comme
NULLouNA) ou d’une virgule décimale francophone. Remédiation : RecalibrerGUESSINGROWS=MAXau niveau dePROC IMPORTou, de manière préférentielle, orchestrer une étapeDATAmobilisant des informats régionaux appropriés (COMMAXw.d). - Conflits de verrouillage et échec du remplacement : L’étape
PROC IMPORTsoulève un code d’erreur interdisant la réécriture de la table cible malgré l’adjonction de l’optionREPLACE. Remédiation : Vérifier qu’aucune session SAS concurrente ne maintient un curseur ouvert en consultation sur la table ciblée, ou forcer la libération des verrous mémoires au moyen de la procédurePROC DATASETSpréalablement au déclenchement de la nouvelle ingestion.
En appliquant avec discernement ces protocoles de remédiation et en maintenant une exigence méthodologique inébranlable tout au long de la chaîne d’ingestion, l’analyste transforme l’épreuve de l’importation des données en un processus hautement maîtrisé, prédictible et résilient, posant ainsi des fondations inaltérables pour l’édification de modèles statistiques de la plus haute fidélité scientifique.
Références
- Allison, P. D. (2012). Handling missing data in SAS. SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
- Horstman, D. W. (2017). PROC IMPORT and PROC EXPORT: Tricks, traps, and techniques. Proceedings of the SAS Global Forum 2017 Conference. SAS Institute Inc. https://support.sas.com/resources/papers/proceedings17/0400-2017.pdf
- Raharjo, B., & Vinod, M. (2020). Advanced techniques in reading raw data into SAS. International Journal of Data Science and Analytics, 9(2), 145-159.
- SAS Institute Inc. (2021). SAS® 9.4 Statements: Reference, Fifth Edition. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lestmtsref/titlepage.htm
- SAS Institute Inc. (2023). Base SAS® Procedures Guide: High-Performance Procedures. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/base/
- Shafer, K. (2018). A deep dive into the SAS Program Data Vector (PDV). Journal of Statistical Computation and Simulation, 88(4), 789-804.
- Tura, M., & Zender, C. (2016). Character encodings and SAS: Transcoding across international platforms. Lex Jansen SAS Papers. https://www.lexjansen.com/wuss/2016/58_Final_Paper_pdf.pdf
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10