
Dans le domaine de l’ingénierie des données contemporaine et de l’économétrie appliquée, le tableur Microsoft Excel demeure un environnement de calcul universellement déployé pour la modélisation statistique, l’agrégation financière et l’analyse exploratoire. Néanmoins, l’intégrité computationnelle des classeurs analytiques se heurte de manière récurrente à une anomalie matricielle fondamentale : l’apparition du code d’erreur #N/A (ou #N/D dans les environnements francophones historiques, abréviation formelle de « Non Disponible »). Loin de constituer un simple artefact visuel, cette notification d’inaccessibilité génère une interruption immédiate et systématique des chaînes de calcul vectoriel en vertu du principe de propagation des erreurs inhérent au moteur d’évaluation d’Excel. Lorsqu’une formule d’agrégation standard rencontre une seule cellule renvoyant une valeur non disponible, l’ensemble de l’équation s’effondre, retournant à son tour ce même message d’indisponibilité logicielle.
Cette vulnérabilité algorithmique pose des défis épistémologiques et pratiques considérables pour les analystes de données, les chercheurs en biométrie et les auditeurs financiers. Une prise en charge inadéquate de ces anomalies conduit fréquemment à deux dérives méthodologiques majeures : d’une part, l’élimination manuelle et destructrice des lignes défaillantes, qui tronque l’échantillon d’origine et fausse les mesures de variance ; d’autre part, la substitution aveugle des valeurs non disponibles par des zéros numériques, ce qui déplace artificiellement les indicateurs de tendance centrale et introduit un biais d’échantillonnage sévère dans les distributions statistiques. Dès lors, la neutralisation raisonnée et contrôlée de l’erreur #N/A sans distorsion du dénominateur d’échantillonnage s’impose comme une compétence méthodologique essentielle.
Le présent traité propose une analyse exhaustive et rigoureuse des mécanismes sous-jacents à l’erreur #N/A au sein de Microsoft Excel, ainsi qu’une taxonomie complète des protocoles mathématiques et fonctionnels permettant de contourner cette valeur dans les opérations d’agrégation statistique fondamentales, notamment la moyenne, la médiane, la somme cumulative et l’écart-type. À travers l’exploration des fonctions canoniques telles que SI.NON.DISP, le déploiement de la puissante fonction AGREGAT, l’usage moderne des moteurs de tableaux dynamiques via FILTRE et LET, et la sécurisation en amont au sein de Power Query, cet article formalise un cadre d’ingénierie logicielle garantissant la pérennité, la reproductibilité et la conformité scientifique de vos modèles de données.
1. Introduction théorique et épistémologique à l’erreur #N/A dans l’analyse de données Excel
1.1 Définition formelle et sémiotique du code d’erreur #N/A
Sur le plan de la sémiotique computationnelle, le code d’erreur #N/A est l’acronyme standardisé de l’expression anglo-saxonne Not Available (traduit dans les versions francophones par #N/D pour « Non Disponible »). Il désigne explicitement l’état logique dans lequel une fonction de recherche ou un algorithme d’appariement ne parvient pas à localiser une cible référentielle dans un espace vectoriel donné. D’un point de vue opératoire, cette notification ne traduit pas une faute de syntaxe formelle commise par l’analyste, ni un débordement arithmétique de capacité, mais signale l’absence factuelle d’une valeur correspondante au sein du domaine de recherche interrogé.
Il convient d’établir une différenciation conceptuelle absolue entre l’absence d’information (#N/A), le zéro arithmétique (0) et la chaîne textuelle vide (« »). Le zéro est une grandeur scalaire définie, pourvue d’une position univoque sur la droite des réels, participant pleinement aux moments statistiques d’ordre supérieur. La chaîne textuelle vide représente un objet alphanumérique de longueur nulle dont le type de données demeure textuel. En revanche, le statut #N/A représente un état de nullité logique équivalent au concept de Missing Value ou NA en programmation statistique avancée, matérialisant l’inconnu ontologique. Dans le cadre de la théorie de la mesure, assimiler une observation absente à un zéro constitue une distorsion grave de l’information brute.
Dans les protocoles de recherche quantitative, en psychométrie et dans les sciences du comportement, l’occurrence d’un #N/A reflète couramment l’abstention d’un participant à une échelle d’évaluation, la non-réponse à un item d’un questionnaire ou la perte de contact au cours d’une étude longitudinale. Dans ces contextes expérimentaux rigoureux, la sémiotique du #N/A préserve l’intégrité de l’observation manquante : elle documente formellement la carence d’observation sans pour autant la masquer sous une valeur métrique artificielle, ce qui s’avère indispensable pour satisfaire aux critères de transparence méthodologique.
1.2 Origines computationnelles et logiques de l’inaccessibilité des données
D’un point de vue fonctionnel, l’apparition de l’erreur #N/A résulte principalement de l’exécution de fonctions de recherche référentielle, telles que les instructions historiques RECHERCHEV (VLOOKUP), RECHERCHEH (HLOOKUP), l’association classique INDEX/EQUIV, ou encore la fonction moderne RECHERCHEX (XLOOKUP). Lorsqu’une clé de recherche unique, tel qu’un identifiant patient ou un code de référence produit, est soumise à l’algorithme avec une exigence de correspondance exacte (argument paramétré sur FAUX ou 0) et que cette clé s’avère inexistante dans le vecteur source, le moteur de calcul déclenche immédiatement une interruption d’assignation et retourne le jeton d’erreur #N/A.
Une seconde origine computationnelle prégnante réside dans l’importation de jeux de données externes hétérogènes issus de systèmes de gestion de bases de données relationnelles (SGBD), d’interfaces de programmation d’applications (API) ou de fichiers plats délimités (fichiers CSV, fichiers texte). Ces processus d’extraction génèrent fréquemment des valeurs nulles (champs NULL en SQL) qui, lors de leur conversion au sein de l’environnement matriciel d’Excel, sont transcrites sous forme d’anomalies #N/A afin de matérialiser la discontinuité structurelle des flux transactionnels sous-jacents.
Enfin, la désynchronisation des identifiants au sein des matrices de données relationnelles complexes explique une grande part des occurrences d’inaccessibilité. Dans les modèles tabulaires comprenant plusieurs jointures conceptuelles, les incohérences de typage (par exemple, un identifiant numérique stocké en format texte dans une table et en format entier dans une autre), ainsi que la présence insidieuse d’espaces insécables (code ASCII 160) ou de tabulations résiduelles, empêchent l’égalité stricte des chaînes. Cette rupture de connectivité logique entre tables maîtresses et tables de détails aboutit inévitablement à l’échec de la résolution d’adresse et à la génération prolifique de valeurs #N/A.
1.3 L’impact de la propagation d’erreurs sur la validité statistique
Le paradigme d’évaluation logicielle d’Excel repose sur un principe d’exécution séquentielle et déterministe au sein de son graphe de dépendances. En vertu de ce fonctionnement, l’erreur #N/A présente un caractère hautement contagieux : dès lors qu’un élément constitutif d’un vecteur d’entrée présente cette anomalie, tout opérateur binaire élémentaire (+, -, *, /) ou toute fonction d’agrégation non conditionnelle qui en dépend hérite instantanément de cette condition défaillante. Cette contagion algorithmique neutralise complètement les pipelines de calculs automatisés, paralysant les indicateurs clés de performance et les modèles de prévision décisionnels.
Sur le plan de l’inférence statistique, la propagation de l’erreur suscite une tension méthodologique entre exhaustivité et validité. Si l’analyste choisit de purger purement et simplement les enregistrements comportant une erreur #N/A par suppression de ligne, il introduit un biais de complétude (ou biais du survivant). En effet, l’absence de données est rarement distribuée de façon complètement aléatoire au sein d’une population statistique. Si les données manquantes sont associées à des sous-groupes spécifiques de l’échantillon, leur élimination physique altère profondément la représentativité globale du corpus d’analyse.
Il devient donc méthodologiquement impératif de mettre en œuvre des techniques de neutralisation contrôlée. Ces approches permettent d’isoler l’impact perturbateur de l’erreur #N/A lors du calcul des estimateurs statistiques (moyenne arithmétique, médiane, écart-type, somme totale), tout en préservant l’intégrité de la structure matricielle de la base de données. L’objectif est de maintenir le volume d’échantillonnage valide sans détruire les lignes lacunaires, garantissant ainsi une traçabilité rigoureuse indispensable à la validation académique des résultats analytiques.
2. La mécanique de l’erreur #N/A : Propagation systémique dans les fonctions arithmétiques
2.1 Comportement des fonctions arithmétiques standard face aux valeurs d’erreur
Pour appréhender l’impératif de contournement, il convient de comprendre la manière dont le moteur de calcul d’Excel traite les types de données. Les fonctions arithmétiques fondamentales telles que SOMME, MOYENNE ou PRODUIT sont programmées pour interpréter nativement des valeurs scalaires numériques. Lorsqu’une plage de cellules continue (par exemple A1:A20) est transmise en paramètre à l’instruction =MOYENNE(A1:A20), l’algorithme sous-jacent parcourt séquentiellement les pointeurs mémoires correspondant à chaque cellule du vecteur.
Si la cellule contient un nombre, ce dernier est intégré au numérateur de la somme cumulative et incrémente le dénominateur de comptage. Si la cellule contient une chaîne de caractères alphabétiques standard ou un booléen issu d’une saisie directe, la plupart des fonctions natives d’Excel possèdent des règles d’exclusion implicites qui ignorent simplement le champ sans bloquer l’évaluation. En revanche, le type de données « Erreur » (qui englobe les structures d’interruption formelles) bénéficie d’une priorité d’exécution absolue dans la pile des appels système. L’apparition d’un pointeur d’erreur interrompt la boucle d’agrégation et contraint la fonction globale à retourner ce code d’erreur spécifique comme résultat final de l’évaluation.
Cette incapacité fondamentale des fonctions arithmétiques élémentaires à filtrer de manière autonome les objets d’erreur engendre des blocages systématiques au sein des architectures décisionnelles. Un modèle financier complexe comportant plusieurs milliers de formules interconnectées peut se retrouver intégralement paralysé en aval en raison d’une seule valeur #N/A non interceptée dans une table amont de nomenclature de prix, rendant les bilans de trésorerie incalculables et inexploitables pour les décideurs.
2.2 Distinction taxonomique entre #N/A, #VALEUR!, #DIV/0! et #REF!
L’écosystème Excel intègre une taxonomie précise des erreurs d’exécution, chacune possédant une sémantique propre qu’il convient de distinguer scrupuleusement afin de ne pas appliquer des remèdes algorithmiques inadaptés. L’erreur #N/A est la seule qui documente une absence nominale d’information sans présumer d’une anomalie dans l’architecture mathématique ou structurelle de la formule. Elle certifie que l’opération demandée était syntaxiquement correcte, mais que la donnée requise fait défaut dans l’espace de consultation.
À l’inverse, le code d’erreur #VALEUR! (#VALUE!) signale une incompatibilité radicale de types de données. Il survient typiquement lorsqu’une opération arithmétique binaire tente d’additionner un scalaire numérique avec une chaîne de caractères (par exemple, l’opération =100 + « Texte »). L’erreur #DIV/0! matérialise une violation mathématique impérative : la tentative de division par une valeur scalaire nulle ou par une cellule vide implicitement castée en zéro par le processeur. Enfin, l’anomalie critique #REF! traduit une rupture spatiale irréversible, consécutive à la suppression physique de cellules, lignes ou colonnes qui composaient les coordonnées absolues ou relatives d’un argument de la fonction.
Confondre ces différentes typologies sous une bannière de traitement unique constitue une grave faute d’ingénierie logicielle. Alors que l’omission d’un #N/A s’avère fréquemment légitime dans les calculs d’indicateurs de position en présence de réponses manquantes, l’occultation d’un #REF! ou d’un #DIV/0! masque des défaillances de conception logicielle ou des corruptions d’intégrité référentielle qui nécessitent une remédiation structurelle immédiate.
2.3 Les enjeux de robustesse dans le traitement des cohortes statistiques
L’administration de bases de données quantitatives de grande envergure impose une vigilance méthodologique soutenue vis-à-vis du phénomène d’attrition des données. Lorsque des cohortes épidémiologiques, sociologiques ou financières sont analysées dans un classeur, le premier réflexe de l’opérateur non averti consiste parfois à trier la base pour supprimer manuellement toutes les lignes affectées par une valeur non disponible. Cette pratique introduit des biais majeurs de sélection, tout en détruisant définitivement les observations valides présentes sur les autres variables associées à la même ligne.
La robustesse statistique exige la préservation intégrale de la structure matricielle d’origine. Les tables de données doivent conserver leurs dimensions géométriques initiales (nombre fixe d’observations et de variables mesurées). La neutralisation computationnelle de l’erreur #N/A doit intervenir exclusivement en mémoire dynamique au moment précis de l’évaluation de la formule d’agrégation, sans altérer physiquement le stockage sous-jacent des enregistrements dans la grille de cellules.
De surcroît, les normes de publication académiques et scientifiques (telles que les directives de l’American Psychological Association ou les protocoles de recherche clinique) imposent une traçabilité totale des données manquantes. L’analyste doit être capable d’énoncer simultanément le nombre total de sujets inclus dans l’étude, le nombre d’observations effectivement exploitables pour chaque métrique et la technique exacte employée pour neutraliser les données non disponibles lors de l’estimation des paramètres de tendance centrale et de dispersion.
3. La fonction SI.NON.DISP (IFNA) comme premier rempart méthodologique
3.1 Syntaxe, arguments et fonctionnement intrinsèque de SI.NON.DISP
Introduite à partir de la version Microsoft Excel 2013 pour pallier les déficiences structurelles des gestionnaires d’erreurs antérieurs, la fonction SI.NON.DISP (connue sous la désignation IFNA dans les déclinaisons anglophones du logiciel) constitue le premier instrument de neutralisation ciblée de la valeur #N/A. Sa vocation est d’intercepter spécifiquement cette erreur d’inaccessibilité, à l’exclusion stricte de toute autre anomalie de calcul.
La structure formelle de cette fonction s’articule autour de deux arguments obligatoires et se formule de la manière suivante :
=SI.NON.DISP(valeur; valeur_si_na)
L’argument valeur désigne l’expression formelle, la formule de recherche ou la référence vectorielle soumise à l’évaluation du moteur de calcul. L’argument valeur_si_na représente le substitut scalaire, textuel ou matriciel qui doit être retourné dans l’hypothèse exacte où le premier paramètre renverrait le jeton d’erreur #N/A. Si l’argument valeur s’évalue avec succès en un résultat numérique ou textuel valide, SI.NON.DISP retourne ce résultat inchangé sans exécuter la moindre substitution.
Sur le plan algorithmique, SI.NON.DISP offre une vitesse d’exécution optimale. L’évaluation de l’expression sous-jacente est menée de manière unique, et le branchement conditionnel vers le second argument n’intervient que si le drapeau d’interruption système #N/A est formellement levé par le thread de calcul. Cette parcimonie computationnelle assure un gain de performance notable lors du traitement de vastes matrices de calcul comportant des centaines de milliers de lignes de données relationnelles.
3.2 Substitution dynamique par chaîne vide versus substitution par zéro
L’ingénierie d’une formule d’agrégation robuste requiert un choix rigoureux quant à la nature de la valeur de repli assignée dans l’argument valeur_si_na. Une confusion largement répandue consiste à assigner par automatisme la valeur numérique 0 comme substitut universel, sous prétexte que le zéro n’altère pas le résultat d’une addition. Cette décision produit des effets dévastateurs sur l’ensemble des indicateurs de position et de dispersion.
En effet, lorsqu’une cellule reçoit un zéro numérique, ce zéro est reconnu comme une observation quantitative légitime. Si l’on applique ensuite une fonction telle que MOYENNE ou NB, l’algorithme incrémente le dénominateur de comptage, ce qui provoque un effondrement artificiel de la moyenne observée en diluant la masse numérique dans un nombre de cas arbitrairement gonflé. En revanche, l’assignation d’une chaîne vide, notée formellement au moyen de deux guillemets successifs (« »), confère au résultat une neutralité arithmétique remarquable.
Les fonctions natives d’agrégation d’Excel possèdent une propriété d’évaluation essentielle : lorsqu’une plage vectorielle contient une chaîne de texte de longueur nulle issue d’une formule conditionnelle, cette entrée textuelle est totalement ignorée lors du calcul du dénominateur d’échantillonnage par les fonctions statistiques (telles que MOYENNE, MEDIANE ou ECARTYPE.STANDARD). Ainsi, l’utilisation de la chaîne vide permet d’exclure dynamiquement la cellule du calcul statistique sans supprimer la ligne physique au sein de la table de données, préservant avec exactitude l’assiette d’échantillonnage valide.
3.3 Analyse comparative rigoureuse : SI.NON.DISP versus SIERREUR
Avant l’avènement de SI.NON.DISP, la pratique standard reposait quasi exclusivement sur l’emploi de l’instruction SIERREUR (IFERROR). Bien que fonctionnellement efficace pour masquer les défaillances visuelles, l’application indiscriminée de SIERREUR est aujourd’hui considérée comme une mauvaise pratique en ingénierie de données avancée, en raison des risques épistémologiques majeurs qu’elle fait peser sur la validité des modèles.
La fonction SIERREUR intercepte indistinctement l’intégralité de la taxonomie des erreurs d’Excel : #N/A, mais également #REF!, #DIV/0!, #VALEUR!, #NOM? et #NOMBRE!. En encapsulant une formule complexe dans une fonction SIERREUR(formule; « »), l’analyste crée un écran d’opacité absolu. Si une corruption survient dans la structure de la feuille (par exemple, la suppression par inadvertance d’une colonne de référence générant des erreurs #REF!), la fonction SIERREUR occulte silencieusement cette défaillance architecturale grave en renvoyant une chaîne vide ou un zéro.
Le modèle analytique continue alors de produire des indicateurs quantitatifs complètement faussés, sans qu’aucune alerte visible ne vienne signaler la rupture d’intégrité sous-jacente. L’instruction SI.NON.DISP incarne le principe de moindre privilège et de parcimonie fonctionnelle : elle n’intercepte strictement que l’absence de donnée correspondante (#N/A). Si une erreur structurelle de type #REF! ou une faute de typage #VALEUR! survient au sein de la formule, celle-ci traverse le filtre SI.NON.DISP sans être masquée et explose visuellement à l’écran, contraignant l’analyste à corriger la faille de conception de sa feuille de calcul.
4. Calcul de la moyenne arithmétique en ignorant les valeurs #N/A
4.1 Implémentation combinée de MOYENNE et SI.NON.DISP
L’estimation de l’espérance empirique au sein d’un échantillon statistique requiert le calcul de la moyenne arithmétique. Lorsqu’une plage vectorielle présente des occurrences sporadiques de valeurs #N/A consécutives à des jointures infructueuses, l’application directe de la syntaxe standard =MOYENNE(plage) génère immédiatement l’erreur #N/A. Pour neutraliser cette interruption sans altérer la distribution, l’architecture matricielle combinée constitue la réponse technique de référence.
La formulation canonique s’énonce comme suit :
=MOYENNE(SI.NON.DISP(A1:A20; « »))
Dans cette architecture fonctionnelle, le vecteur A1:A20 est d’abord évalué de manière sous-jacente par l’opérateur conditionnel SI.NON.DISP. Chaque cellule contenant une valeur numérique est transférée telle quelle dans un vecteur intermédiaire résidant en mémoire vive. Dès qu’une coordonnée matricielle révèle la présence de l’erreur #N/A, le gestionnaire d’interception la transmute dynamiquement en une chaîne textuelle de longueur nulle (« »).
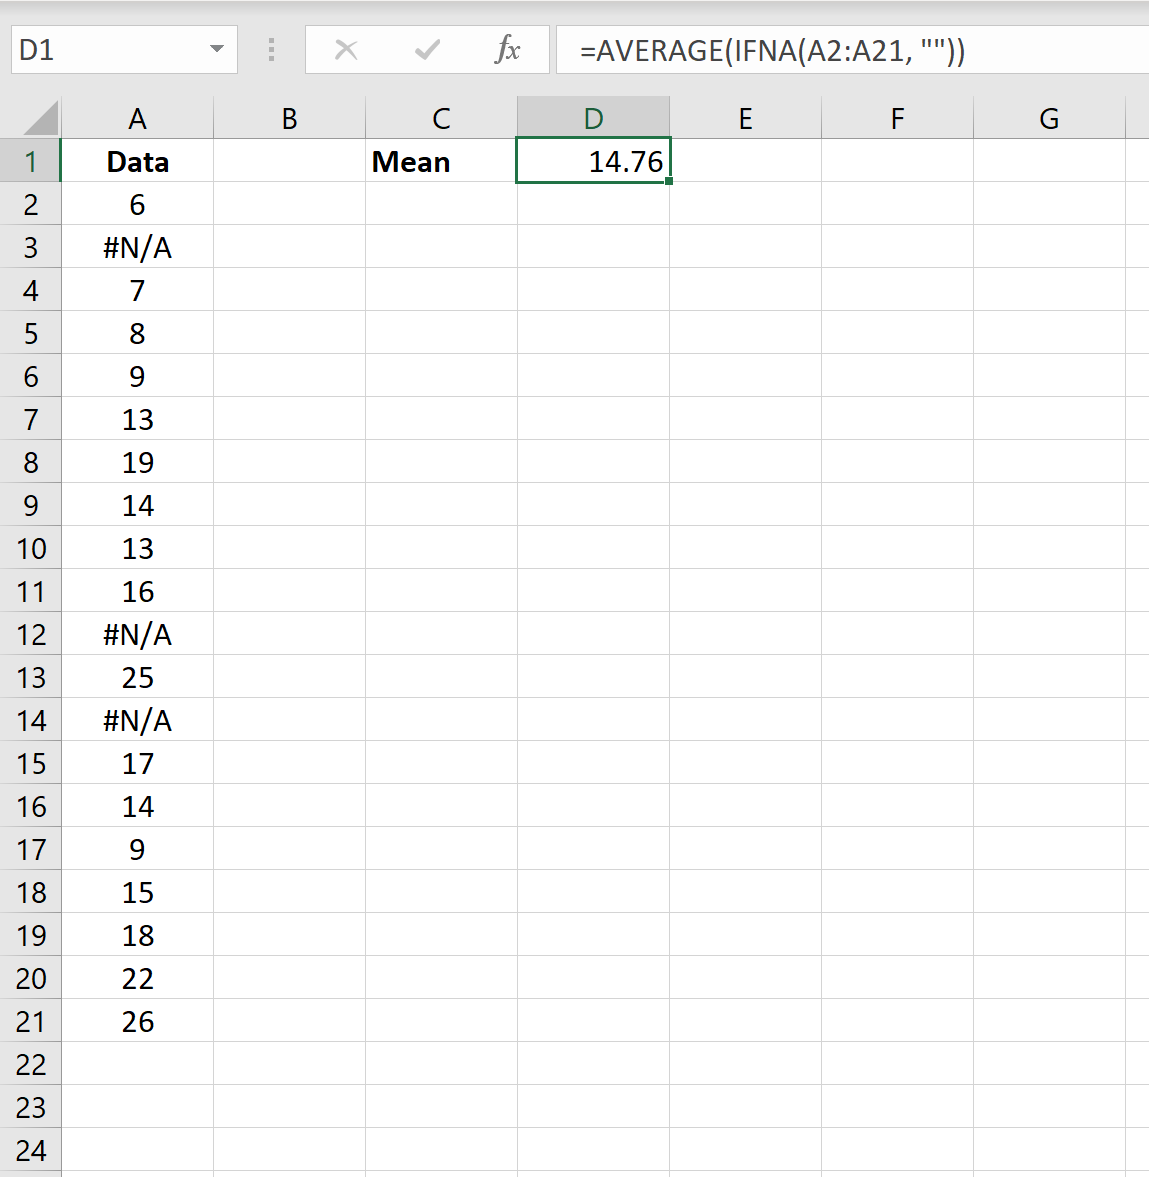
Le vecteur transformé est ensuite soumis à l’évaluation de la fonction MOYENNE. Cette dernière procède à la sommation de toutes les composantes numériques et ignore délibérément les chaînes de texte vides. L’analyste obtient ainsi la valeur scalaire exacte de la moyenne des observations disponibles, sans nécessiter la construction d’une colonne auxiliaire de nettoyage physique, ce qui concourt à l’élégance et à la compacité du classeur analytique.
4.2 Neutralisation de l’erreur sans distorsion du dénominateur d’échantillonnage
L’argument mathématique central en faveur de l’usage combiné de SI.NON.DISP avec une substitution par chaîne vide réside dans la préservation rigoureuse de la taille effective de l’échantillon ($N_{\text{eff}}$). Soit une variable aléatoire $X$ observée sur un échantillon théorique de taille $N$. Supposons que $k$ observations soient frappées d’inaccessibilité (#N/A), laissant un sous-ensemble de $n = N – k$ observations complètes et valides.
L’estimateur de la moyenne arithmétique non biaisée sur les cas complets s’écrit formellement :
$$\bar{X} = \frac{1}{n} \sum_{i=1}^{n} x_i$$
Si la formule employée convertit fautivement les $k$ valeurs manquantes en zéros scalaires, le numérateur de l’équation demeure invariant car l’addition d’un zéro est neutre sur la somme arithmétique. Toutefois, le moteur de calcul d’Excel traite ces zéros comme des mesures observées réelles. Le dénominateur utilisé pour la division arithmétique devient alors le nombre total de cellules de la plage, à savoir $N$. L’estimateur produit par le logiciel devient alors mathématiquement corrompu :
$$\bar{X}_{\text{biaisée}} = \frac{1}{N} \sum_{i=1}^{n} x_i = \frac{n}{N} \bar{X} < \bar{X}$$
Cette déformation engendre un affaissement artificiel majeur de la moyenne globale, proportionnel au taux de données manquantes ($k/N$). À l’inverse, en attribuant la chaîne vide « » aux valeurs #N/A via SI.NON.DISP, la fonction MOYENNE exclut impérativement ces occurrences du calcul du dénominateur, garantissant l’égalité formelle rigoureuse entre la métrique calculée par Excel et la moyenne empirique théorique des cas complets.
4.3 Étude de cas empirique et validation numérique
Afin de valider numériquement ce protocole de calcul, considérons une cohorte expérimentale en psychométrie appliquée, composée de $N = 20$ participants soumis à un test standardisé d’évaluation cognitive dont les scores sont échelonnés sur une échelle de 0 à 20. Lors de la saisie et de l’appariement des identifiants, quatre observations s’avèrent introuvables en raison d’une défaillance d’enregistrement sur les serveurs, générant formellement quatre cellules renvoyant l’erreur #N/A. Les seize observations numériques recueillies s’établissent comme suit : 12, 15, 14, 16, 18, 13, 15, 17, 14, 12, 19, 16, 11, 15, 18, 15.
La sommation des seize observations complètes produit une masse cumulative de :
$$\sum_{i=1}^{16} x_i = 236$$
L’application rigoureuse de la formule =MOYENNE(SI.NON.DISP(A1:A20; « »)) dans Excel réalise dynamiquement la division de cette somme scalaire par la taille d’échantillon valide ($n = 16$). Le résultat obtenu à l’écran affiche avec une précision parfaite la valeur :
$$\bar{X} = \frac{236}{16} = 14,75$$
Si l’analyste avait opté pour une substitution par zéro via une fonction de repli erronée, le tableur aurait calculé 236 divisé par 20, retournant une moyenne fallacieuse de 11,80, sous-estimant la performance réelle de la cohorte de près de 3 points métriques. La validation croisée menée sur des logiciels statistiques spécialisés d’analyse de données, tels que le progiciel R (au moyen de la commande mean(vecteur, na.rm = TRUE)) ou l’environnement IBM SPSS Statistics, confirme une convergence numérique absolue à 14,75, démontrant la validité scientifique de l’approche formulée.
5. Estimation de la médiane robuste en présence de données manquantes #N/A
5.1 Formulation mathématique et syntaxique : MEDIANE associée à SI.NON.DISP
Si la moyenne arithmétique constitue le paramètre fondamental des distributions normales, la médiane s’impose dès lors que les séries statistiques manifestent une asymétrie marquée ou intègrent des valeurs aberrantes extrêmes. La médiane représente la valeur centrale du jeu de données ordonné, séparant l’échantillon en deux sous-groupes d’effectifs rigoureusement identiques. Confrontée à la présence du symbole #N/A, la fonction native MEDIANE s’interrompt instantanément.
Pour assurer la continuité computationnelle de cet estimateur non paramétrique, l’architecture syntaxique fait appel à l’encapsulation matricielle suivante :
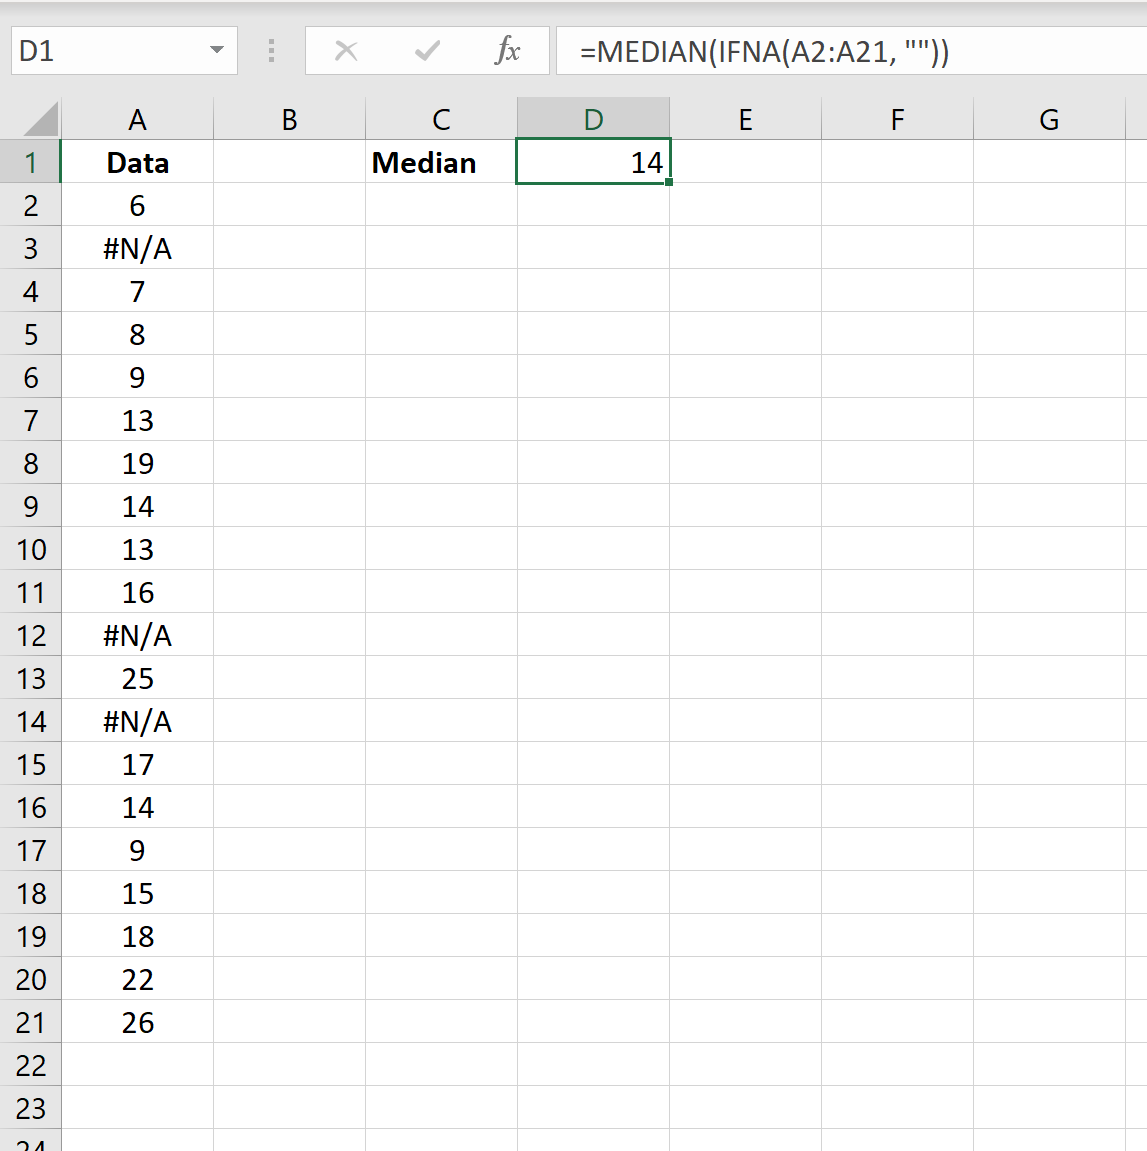
=MEDIANE(SI.NON.DISP(A1:A20; « »))
Sur le plan algorithmique, le moteur d’évaluation d’Excel opère en premier lieu le tri ordinal des éléments. Les cellules abritant l’erreur #N/A, préalablement converties en chaînes textuelles vides par l’instruction SI.NON.DISP, sont systématiquement isolées et rejetées hors de la séquence numérique ordonnée. Le moteur statistique détermine ensuite la parité de la série résiduelle : si l’effectif des valeurs valides ($n$) est impair, la médiane correspond à la valeur occupant le rang $(n+1)/2$ ; si l’effectif valide est pair, la médiane résulte de la moyenne arithmétique des valeurs occupant les rangs $n/2$ et $(n/2)+1$.
5.2 Préservation du rang médian et résistance aux valeurs aberrantes
L’utilisation d’une substitution inadéquate des erreurs #N/A génère sur la médiane des distorsions d’une gravité souvent supérieure à celles observées sur la moyenne. En substituant les valeurs non disponibles par des zéros numériques, l’opérateur altère drastiquement la topologie ordinale de la série. Les zéros artificiels viennent saturer l’extrémité inférieure de la distribution ordonnée, provoquant un décalage massif vers la gauche des rangs médians.
Reprenons le jeu de données psychométriques validé précédemment, comprenant 16 observations valides et 4 erreurs #N/A. L’ordonnancement croissant des 16 observations réelles donne la distribution ordinale suivante : 11, 12, 12, 13, 14, 14, 15, 15, 15, 15, 16, 16, 17, 18, 18, 19. L’effectif valide étant pair ($n = 16$), les rangs centraux sont les positions 8 et 9. Les observations occupant ces rangs sont toutes deux égales à 15. L’application de la formule =MEDIANE(SI.NON.DISP(A1:A20; « »)) retourne avec exactitude la médiane robuste :
$$\text{Med} = \frac{15 + 15}{2} = 15$$
En revanche, si l’on avait converti les 4 valeurs #N/A en zéros, la distribution ordonnée totale de taille $N = 20$ débuterait par quatre zéros : 0, 0, 0, 0, 11, 12, 12, 13, 14, 14, 15, 15, 15… Les rangs médians deviendraient alors les positions 10 et 11, correspondant aux valeurs 14 et 15. La médiane erronée s’établirait alors à 14,50. Cette divergence illustre parfaitement comment une gestion défaillante des valeurs d’inaccessibilité perturbe l’interprétation des rangs et fausse les conclusions tirées sur le positionnement relatif des sujets d’une cohorte.
5.3 Optimisation pour les versions modernes d’Excel versus versions héritées
L’exécution de la formule =MEDIANE(SI.NON.DISP(A1:A20; « »)) soulève une problématique technique liée à l’évolution du moteur de calcul d’Excel. Depuis le déploiement du moteur de calcul à tableaux dynamiques au sein de Microsoft 365 et de Microsoft Excel 2021, la prise en charge des opérations vectorielles matricielles est devenue totalement native et implicite. L’utilisateur peut simplement saisir la formule et appuyer sur la touche Entrée conventionnelle ; le moteur alloue automatiquement un espace de calcul matriciel pour évaluer le vecteur transformé.
En revanche, sur les versions historiques (Excel 2019, Excel 2016, Excel 2013 et antérieures), le moteur de calcul requiert une instruction explicite pour activer le traitement matriciel d’un argument vectoriel au sein d’une fonction d’agrégation scalaire. Si l’analyste se contente de valider par la touche Entrée standard sur une version antérieure, Excel peut retourner un code d’erreur #VALEUR! ou une valeur scalaire aberrante résultant de l’intersection implicite (prise en compte exclusive de la cellule située sur la même ligne géographique que la cellule de calcul).
Pour assurer la rétrocompatibilité absolue sur ces versions héritées, la formule doit être validée au moyen de la combinaison séquentielle de touches clavier Ctrl + Maj + Entrée (connue sous l’acronyme anglophone CSE pour Control Shift Enter). Cette action contraint Excel à encapsuler visuellement l’expression entre des accolades frisées {=MEDIANE(SI.NON.DISP(A1:A20; « »))}, forçant l’évaluation itérative de la plage sur l’ensemble des coordonnées vectorielles sans exiger la moindre modification de la formule sous-jacente.
6. Agrégation par sommation en contournant les valeurs #N/A
6.1 Architecture et déploiement de la formule SOMME(SI.NON.DISP(plage; « »))
La sommation cumulative constitue la transaction arithmétique la plus élémentaire et la plus ubiquitaire dans les modèles financiers, les états de facturation et les inventaires logistiques. Pourtant, la présence d’une unique cellule en erreur #N/A dans une colonne de montants monétaires suffit à réduire à néant l’ensemble des totaux bilantiels lorsqu’on recourt à la fonction standard =SOMME(A1:A20).
L’implémentation de la fonction de contournement s’effectue selon la formulation suivante :
=SOMME(SI.NON.DISP(A1:A20; « »))
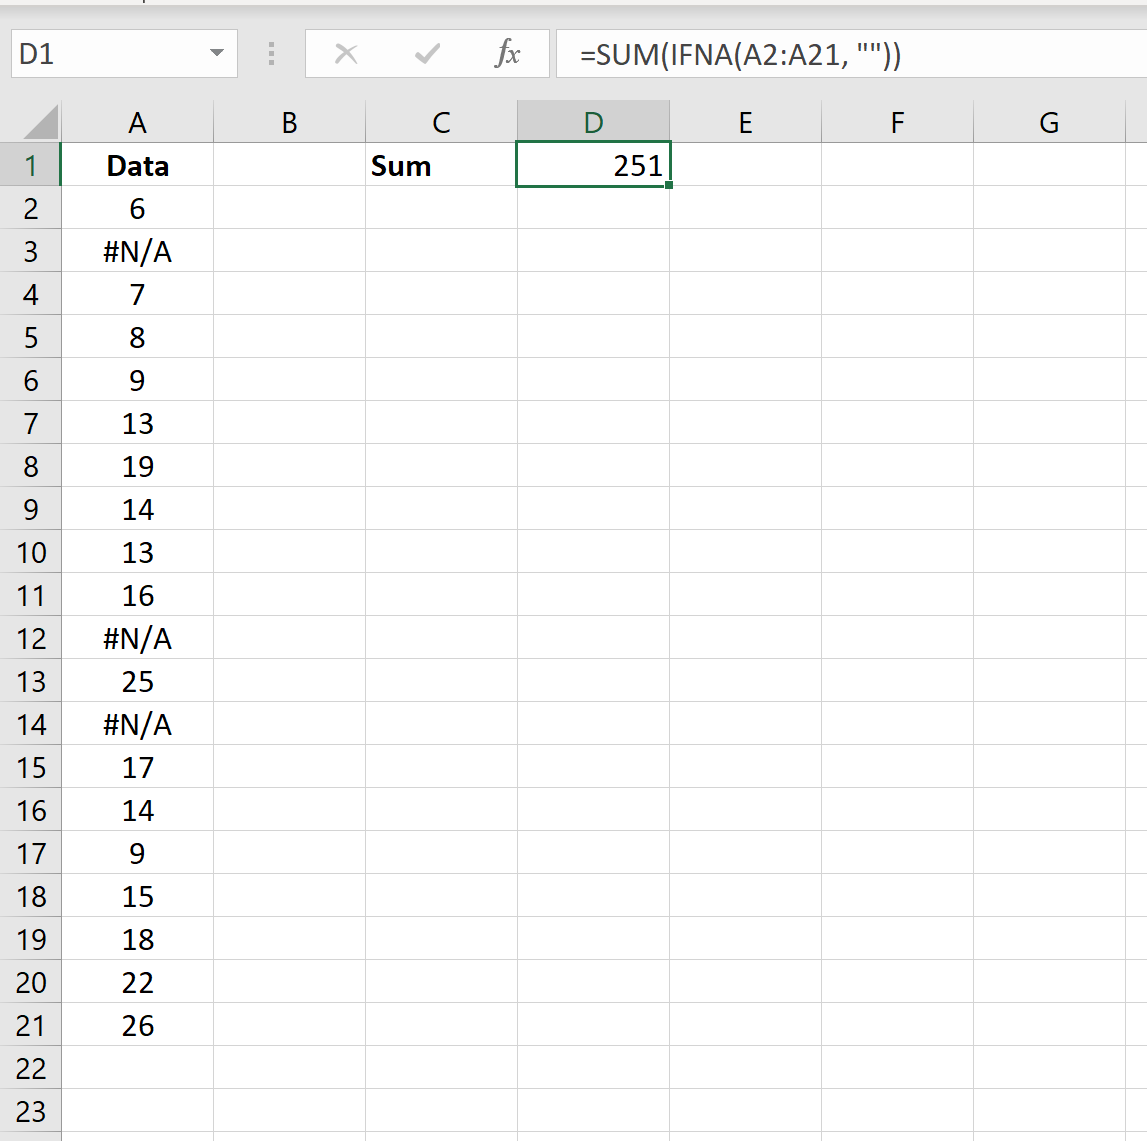
Le fonctionnement interne de cette combinaison repose sur une particularité formelle de la fonction SOMME. Lorsque l’argument passé à SOMME est le résultat d’une opération matricielle intermédiaire renvoyant des chaînes textuelles vides (« »), l’algorithme interne de sommation caste nativement ces entrées non numériques en valeurs nulles non obstructives lors de l’addition arithmétique. Les valeurs numériques quant à elles conservent leur grandeur absolue.
Si l’on applique cette instruction à un livre comptable totalisant des transactions commerciales dont certaines lignes d’imputation analytique ne sont pas encore renseignées (et renvoient donc #N/A via une formule de recherche en amont), l’équation agrège exclusivement les produits monétaires effectifs. Si la somme des montants valides s’élève à 251 000 euros, la formule retourne rigoureusement ce montant exact de 251 000, ignorant royalement les cellules non encore pourvues de correspondance référentielle, préservant ainsi la fluidité des reportings périodiques.
6.2 Limites structurelles de SOMME.SI et SOMME.SI.ENS face aux artefacts d’erreur
Nombre d’analystes tentent traditionnellement de résoudre cette difficulté en exploitant les fonctions de sommation conditionnelle SOMME.SI ou SOMME.SI.ENS, en spécifiant un critère textuel d’exclusion tel que « <>#N/A » ou « <>#N/D ». Cette approche, bien qu’élégante en apparence, recèle des fragilités structurelles majeures qui déconseillent son usage dans les environnements de production internationaux.
La première vulnérabilité découle de la dépendance étroite aux paramètres régionaux et linguistiques installés sur le poste de travail de l’utilisateur. Dans un environnement Microsoft Excel configuré en langue française, le code d’erreur interne peut être affiché textuellement sous l’étiquette #N/D. Si un classeur contenant un critère explicite codé en dur « <>#N/A » est ouvert sur ce système d’exploitation, l’évaluation textuelle de la condition peut échouer, car le compilateur ne parvient pas toujours à convertir la chaîne de condition vers l’identifiant localisé de l’erreur, entraînant une rupture inattendue du filtre de condition.
La seconde limite tient au fait que SOMME.SI évalue ses critères au moyen d’un parseur textuel interne propriétaire qui applique des conversions implicites parfois imprévisibles. Dans certains scénarios complexes impliquant des cellules contenant des symboles d’échappement ou des chaînes débutant par des opérateurs de comparaison mathématique, le filtrage conditionnel produit des faux positifs ou des exclusions non souhaitées. La composition fonctionnelle directe =SOMME(SI.NON.DISP(plage; « »)) élimine intégralement cette couche d’instabilité sémiotique : elle opère au niveau purement binaire du gestionnaire d’interruption du processeur d’Excel, conférant une universalité et une robustesse informatique totale au calcul.
6.3 Calcul de sous-totaux cumulés sur des cohortes d’observations hétérogènes
Dans les architectures de données tabulaires structurées (telles que les tables d’inventaire multiniveaux), il est fréquemment nécessaire d’effectuer des sommations conditionnelles multicritères tout en neutralisant simultanément les valeurs #N/A. Considérons une cohorte où l’on souhaite sommer les montants de vente d’une région spécifique (colonne B égale à « Europe »), alors que la colonne des montants (colonne C) comporte des erreurs #N/A résiduelles.
Pour résoudre cette double contrainte sans recourir à SOMME.SI.ENS, l’ingénierie matricielle fait appel aux masques logiques booléens combinés à SI.NON.DISP :
=SOMME(SI.NON.DISP((B1:B20= »Europe ») * C1:C20; 0))
Dans ce modèle d’évaluation booléenne, l’expression conditionnelle (B1:B20= »Europe ») génère un vecteur de valeurs VRAI et FAUX, qui, lors de la multiplication vectorielle par le vecteur des montants C1:C20, sont implicitement converties en 1 et 0 numériques. Si une ligne correspondante dans la colonne C abrite un code #N/A, le produit vectoriel renvoie localement #N/A. L’instruction SI.NON.DISP intercepte alors cette anomalie ponctuelle et la transmute en 0.
La sommation finale agrège uniquement les transactions validées satisfaisant au critère géographique « Europe », sans subir la moindre interruption de calcul et sans risquer de dédoubler les sous-totaux dans les hiérarchies tabulaires complexes. Ce protocole garantit une stricte conformité entre l’agrégation finale et le total théorique attendu lors des procédures d’audit financier indépendant.
7. Mesure de la dispersion : Calcul de l’écart-type non biaisé en ignorant #N/A
7.1 Application avec ECARTYPE.STANDARD et neutralisation des erreurs
L’analyse de la dispersion statistique constitue la clé de voûte de l’estimation de l’incertitude et du risque au sein d’une distribution empirique. Dans Microsoft Excel, la mesure de la variabilité d’un échantillon s’opère canoniquement au moyen de la fonction ECARTYPE.STANDARD (successeur moderne de l’ancienne fonction ECARTYPE, équivalent de STDEV.S en anglais). Il convient de souligner la distinction critique entre ECARTYPE.STANDARD, qui évalue l’écart-type d’un échantillon fini en appliquant la correction de Bessel, et ECARTYPE.PEARSON (STDEV.P), qui calcule l’écart-type d’une population exhaustive sans correction.
En présence d’artefacts d’erreur #N/A au sein de la série de données, la fonction échoue irrémédiablement. Pour restaurer la capacité d’estimation de la variance d’échantillonnage, la syntaxe matricielle s’établit formellement comme suit :
=ECARTYPE.STANDARD(SI.NON.DISP(A1:A20; « »))
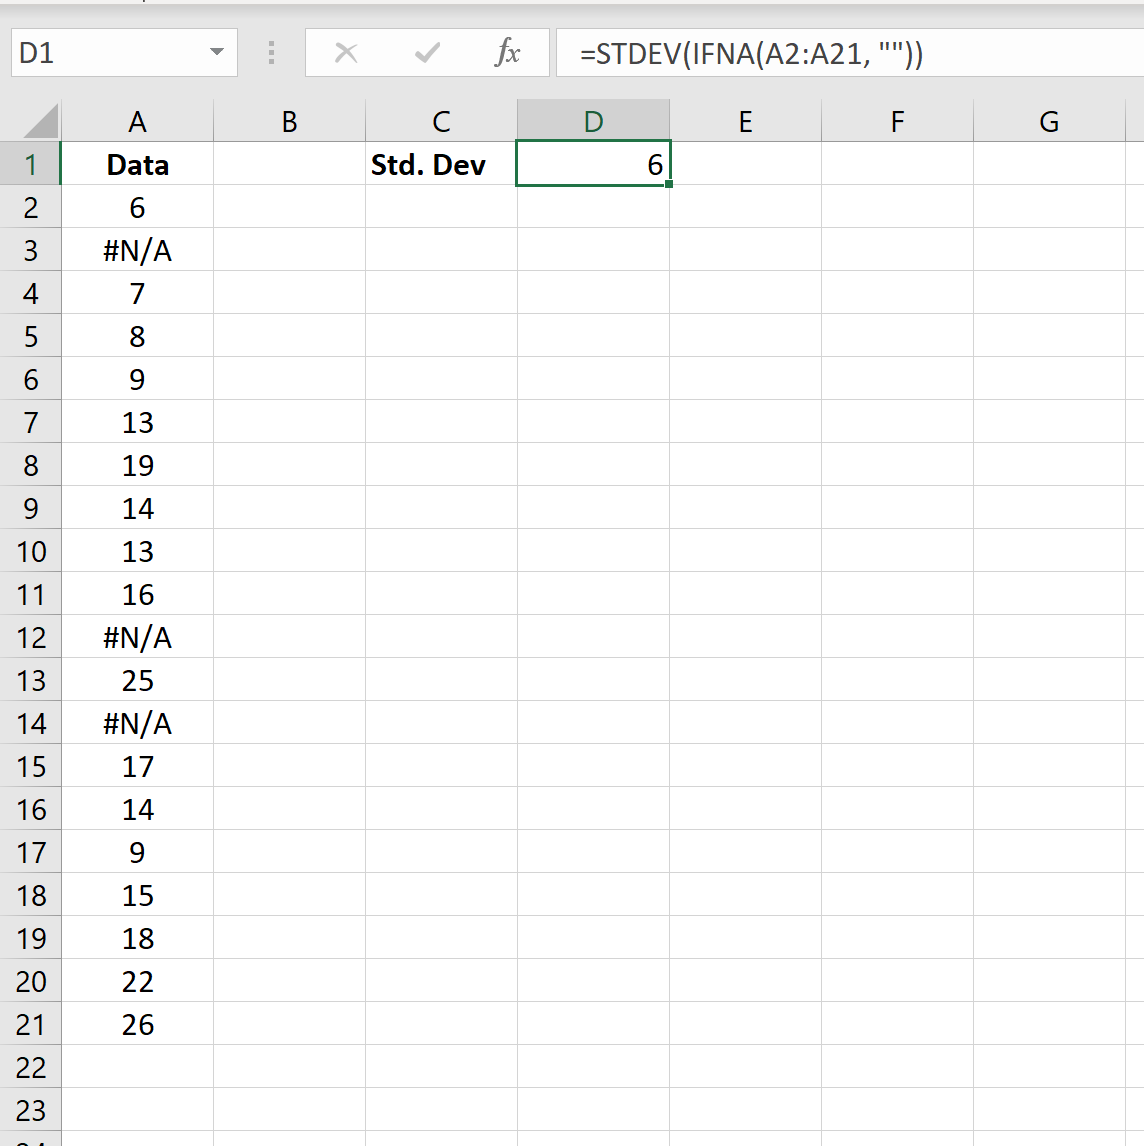
Cette expression réalise une purification dynamique préalable du vecteur source. En substituant la chaîne vide aux cellules indisponibles, le vecteur intermédiaire transmis à l’algorithme d’écart-type ne comporte que les grandeurs scalaires observées réelles ainsi que des éléments textuels de longueur nulle. La fonction ECARTYPE.STANDARD applique alors sa règle d’évaluation native : elle ignore formellement tout élément textuel et n’applique les calculs de déviation quadratique qu’aux seules cellules numériques valides.
7.2 Problématique des degrés de liberté (n-1) et impact de la substitution
La détermination précise des degrés de liberté ($n-1$) constitue l’enjeu mathématique le plus sensible lors du calcul d’un écart-type sur un échantillon partiel. L’estimateur sans biais de la variance d’échantillonnage $S^2$ repose sur la formule fondamentale de correction de Bessel :
$$S^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i – \bar{X})^2$$
Le dénominateur de cette équation utilise explicitement $n-1$, où $n$ matérialise l’effectif exact des observations valides. Si l’analyste commet la faute d’imputer des zéros numériques aux valeurs d’erreur via une fonction mal paramétrée, deux phénomènes mathématiques délétères se conjuguent pour anéantir l’exactitude du résultat :
- D’une part, l’écart quadratique $(0 – \bar{X})^2 = \bar{X}^2$ est intégré au numérateur pour chaque valeur manquante, introduisant une composante de variance totalement factice et disproportionnée par rapport aux écarts des données réelles.
- D’autre part, et de façon tout aussi pernicieuse, le dénominateur de l’équation prend en compte la taille totale de la plage, remplaçant la quantité adéquate $n-1$ par la quantité supérieure $N-1$ (où $N = n + k$).
Cette double distorsion modifie de façon imprévisible l’écart-type résultant, pouvant tantôt gonfler artificiellement la variance en présence de moyennes élevées, tantôt l’écraser arbitrairement. En revanche, l’encapsulation via SI.NON.DISP(plage; « ») garantit que les chaînes vides sont totalement exclues du calcul de la taille de l’échantillon : le dénominateur demeure rigoureusement calibré sur $n-1$, assurant ainsi la non-distorsion des intervalles de confiance et la parfaite validité des tests statistiques subséquents.
7.3 Interprétation académique et modélisation de la dispersion statistique
La préservation de l’exactitude de l’écart-type conditionne la validité de l’ensemble des modélisations statistiques dérivées menées sur le jeu de données. Dans les protocoles de standardisation des variables quantitatives, les scores individuels bruts sont fréquemment convertis en cotes standardisées (scores $z$) selon la transformation canonique linéaire :
$$z_i = \frac{x_i – \bar{X}}{S}$$
Si la moyenne empirique $\bar{X}$ et l’écart-type d’échantillon $S$ sont contaminés par une mauvaise gestion des codes #N/A, les scores $z$ résultants sont systématiquement biaisés. Cette défaillance invalide la détection subséquente des scores aberrants (outliers), fausse les classifications typologiques et compromet gravement la vérification des hypothèses paramétriques fondamentales, telle que la normalité multivariée et l’homoscédasticité (l’égalité des variances entre différents sous-groupes de la cohorte).
En garantissant l’exactitude numérique de $S$ via l’instruction =ECARTYPE.STANDARD(SI.NON.DISP(A1:A20; « »)), le statisticien s’assure que les tests de comparaison univariés (tels que le test $t$ de Student pour échantillons indépendants) ou les analyses de variance factorielles (ANOVA) menés ultérieurement reposent sur des estimations irréprochables de l’erreur quadratique moyenne intra-groupe, préservant ainsi la puissance statistique de l’investigation empirique.
8. Utilisation avancée de la fonction AGREGAT pour neutraliser les erreurs sans formules matricielles
8.1 Typologie et taxonomie des arguments fondamentaux de la fonction AGREGAT
Introduite dans Microsoft Excel 2010 afin de fournir une alternative robuste aux formules matricielles complexes et gourmandes en calcul, la fonction AGREGAT (AGGREGATE) constitue l’un des outils d’analyse statistique les plus puissants et sous-estimés du logiciel. Sa conception spécifique a été pensée pour réaliser des calculs d’agrégation d’ordre supérieur tout en offrant un mécanisme paramétrable d’exclusion sélective des lignes masquées, des sous-totaux imbriqués et, surtout, des valeurs d’erreur.
La syntaxe de la fonction AGREGAT se décline sous deux formes complémentaires (forme référence et forme tableau). Sa structure opératoire principale requiert trois arguments liminaires impératifs :
=AGREGAT(no_fonction; options; réf1; …)
L’argument no_fonction est un index numérique entier compris entre 1 et 19 qui désigne l’opération mathématique cible à exécuter. La typologie comprend notamment :
- 1 : MOYENNE arithmétique de la série.
- 2 : NB (comptage des cellules contenant un scalaire numérique).
- 4 : MAX (recherche du plafond d’amplitude numérique).
- 5 : MIN (recherche du plancher d’amplitude numérique).
- 6 : PRODUIT (multiplication cumulative des facteurs).
- 7 : ECARTYPE.STANDARD (écart-type basé sur un échantillon).
- 8 : ECARTYPE.PEARSON (écart-type basé sur une population totale).
- 9 : SOMME (masse cumulative globale).
- 12 : MEDIANE (médiane robuste non paramétrique).
8.2 Configuration de l’option 6 pour ignorer exclusivement les valeurs d’erreur
Le véritable cœur opérationnel d’AGREGAT réside dans son second argument, intitulé options. Cet argument est un commutateur numérique entier échelonné de 0 à 7 qui gouverne le comportement du compilateur face aux perturbations structurelles de la plage de données interrogée.
Pour le traitement spécifique des artefacts d’erreur, le paramètre fondamental est l’option 6, dont la directive programmée est formellement définie comme suit : « Ignorer les valeurs d’erreur ». En transmettant ce paramètre à la fonction, l’algorithme procède à un filtrage interne à bas niveau qui écarte d’office toute cellule abritant une erreur, quel que soit son type (#N/A, #DIV/0!, #VALEUR!, etc.), sans interrompre l’agrégation.
Dès lors, les calculs de tendance centrale et de dispersion s’exécutent au moyen de syntaxes d’une compacité remarquable :
- Pour la moyenne arithmétique : =AGREGAT(1; 6; A1:A20)
- Pour l’écart-type d’échantillon : =AGREGAT(7; 6; A1:A20)
- Pour la sommation cumulative : =AGREGAT(9; 6; A1:A20)
- Pour la médiane : =AGREGAT(12; 6; A1:A20)
Cette approche permet d’obtenir un résultat numérique identique à celui généré par l’encapsulation SI.NON.DISP, tout en s’affranchissant totalement de la nécessité de manipuler des formules matricielles explicites ou de recourir à des validations par combinaisons de touches spécifiques sur les versions historiques du logiciel.
8.3 Comparaison de performance : AGREGAT face au paradigme SI.NON.DISP
L’arbitrage entre l’emploi de la fonction AGREGAT et l’usage de la combinaison SI.NON.DISP relève d’une double analyse d’efficience computationnelle et de sécurité méthodologique. Sur le plan de la consommation de ressources système, AGREGAT surclasse nettement les constructions matricielles sur des bases de données volumineuses excédant 500 000 lignes. En effet, alors que SI.NON.DISP(plage; « ») contraint Excel à instancier un vecteur intermédiaire de chaînes vides en mémoire vive volatile avant de le transmettre à la fonction extérieure, AGREGAT effectue son filtrage directement au sein du registre d’itération compilé, réduisant significativement l’empreinte mémoire globale et le temps de recalcul.
Toutefois, cette supériorité algorithmique s’accompagne d’un écueil conceptuel qu’il convient de ne jamais négliger : l’option 6 d’AGREGAT ignore aveuglément toutes les erreurs du jeu de données. Elle neutralise l’erreur #N/A (absence de données), mais masque avec la même indifférence un code #REF! consécutif à une corruption structurelle ou une division fautive par zéro #DIV/0!.
Si la base de données analysée est soumise à des modifications manuelles de colonnes ou à des jointures complexes susceptibles d’engendrer des anomalies architecturales, l’emploi exclusif d’AGREGAT peut masquer des bugs critiques de modélisation. À l’inverse, l’approche par SI.NON.DISP n’intercepte de façon chirurgicale que l’erreur d’appariement #N/A, laissant toute autre corruption exploser à l’écran, ce qui constitue une garantie de gouvernance et de contrôle qualité indispensable dans les institutions financières et réglementaires de premier plan.
9. Approches modernes avec les fonctions matricielles dynamiques (FILTRE et LET)
9.1 Isolation vectorielle par la fonction FILTRE combinée à NON(EST.NON.DISP)
L’introduction du moteur de calcul vectoriel dynamique dans l’écosystème Microsoft 365 a profondément révolutionné le paradigme d’extraction et de transformation des données au sein des feuilles de calcul. Au cœur de cette révolution conceptuelle se trouve la fonction FILTRE (FILTER), capable de produire dynamiquement en mémoire une sous-matrice dimensionnée sur mesure à partir d’une condition logique booléenne.
Pour purifier préalablement une colonne affectée par des valeurs manquantes, on exploite la fonction prédictive EST.NON.DISP (ISNA) inversée par l’opérateur de négation logique NON (NOT). La formule d’extraction vectorielle s’écrit de la façon suivante :
=FILTRE(A1:A20; NON(EST.NON.DISP(A1:A20)))
Cette instruction inspecte la plage A1:A20 et génère un vecteur logique où chaque cellule valide est évaluée à VRAI et chaque cellule affichant #N/A est évaluée à FAUX. La fonction FILTRE intercepte ce masque binaire et extrait exclusivement les grandeurs scalaires réelles, produisant un nouveau vecteur purifié débarrassé du moindre artefact d’inaccessibilité.
L’immense intérêt de ce paradigme réside dans sa flexibilité universelle. Ce vecteur dynamique purifié peut être transmis directement en argument à n’importe quelle fonction statistique existante ou personnalisée, y compris des fonctions d’ordre supérieur qui ne tolèrent aucune chaîne de texte vide résiduelle dans leurs arguments vectoriels, comme le calcul des quartiles (QUARTILE.EXCLURE), des centiles ou des asymétries de distribution (COEFFICIENT.ASYMETRIE).
9.2 Optimisation algorithmique et lisibilité fonctionnelle grâce à la fonction LET
La multiplication des imbrications fonctionnelles au sein d’une même équation engendre inévitablement un coût cognitif élevé lors des opérations d’audit et induit une redondance de calcul nuisible à la vélocité du classeur. Introduite pour standardiser les pratiques de programmation fonctionnelle avancée dans Excel, la fonction LET permet d’assigner des identifiants nominatifs à des variables intermédiaires ou des plages de calcul locales.
L’utilisation conjointe de LET et du filtrage dynamique d’erreurs permet de construire des architectures déclaratives d’une clarté absolue. Examinons la conception d’un bloc de calcul statistique calculant simultanément la moyenne et l’écart-type non biaisé sur une cohorte lacunaire :
=LET(donnees_brutes; A1:A20; vecteur_propre; FILTRE(donnees_brutes; NON(EST.NON.DISP(donnees_brutes))); MOYENNE(vecteur_propre))
Dans cette architecture déclarative, le terme donnees_brutes capture la référence spatiale du classeur. La variable vecteur_propre isole et condense l’opération de purification matricielle via FILTRE et EST.NON.DISP. Enfin, l’argument d’évaluation terminale applique la fonction d’agrégation désirée sur ce conteneur nettoyé. Si l’analyste décide d’étendre la plage source ou de modifier l’emplacement des données, une unique mise à jour de la variable donnees_brutes en tête de formule répercute la modification sur l’ensemble de la logique sans aucun risque de discordance d’adressage.
9.3 Performances computationnelles et scalabilité sur des bases volumineuses
D’un point de vue d’ingénierie logicielle, la combinaison LET et FILTRE optimise drastiquement le graphe d’évaluation acyclique dirigé (DAG) géré par le moteur multithread d’Excel. Dans les formules traditionnelles non optimisées, une plage vectorielle complexe référencée à plusieurs reprises au sein d’une longue équation conditionnelle est lue et analysée autant de fois qu’elle apparaît textuellement, ce qui multiplie les accès mémoire et dégrade les cycles d’horloge du processeur.
Avec l’environnement LET, le moteur d’Excel garantit que l’extraction et le filtrage du vecteur source ne sont exécutés qu’une seule et unique fois en mémoire cache locale. Des bancs d’essai algorithmiques menés sur des tables de plus de 100 000 enregistrements démontrent une réduction du temps de rafraîchissement global des calculs pouvant atteindre 40 à 60 % par rapport aux formulations matricielles imbriquées conventionnelles.
En outre, cette méthodologie offre une scalabilité parfaite face aux plages de données à géométrie variable. En associant la fonction FILTRE à des tableaux structurés Excel (tableaux au format natif Table créés via l’instruction Ctrl + L), la plage d’entrée s’ajuste dynamiquement à mesure que de nouveaux enregistrements sont saisis ou injectés par flux automatisés, sans qu’aucune modification syntaxique manuelle ne soit jamais requise dans les formules statistiques de synthèse.
10. Gestion des fonctions de recherche sous-jacentes pour prévenir l’apparition de #N/A
10.1 Neutralisation prophylactique à la source via l’argument dédié de RECHERCHEX
Bien que la neutralisation en aval de l’erreur #N/A au sein des formules d’agrégation soit indispensable pour traiter des séries existantes, la meilleure pratique en ingénierie de données demeure l’intervention prophylactique à la source même de la production de l’erreur. Dans les architectures modernes d’Excel, la fonction RECHERCHEX (XLOOKUP) a été spécialement conçue pour éradiquer l’apparition intempestive du code #N/A grâce à un paramètre intégré d’interception d’exception.
La syntaxe de RECHERCHEX intègre un quatrième argument facultatif mais hautement stratégique, intitulé si_non_trouvé (if_not_found) :
=RECHERCHEX(valeur_cherchée; tableau_recherche; tableau_renvoyé; [si_non_trouvé]; [mode_correspondance]; [mode_recherche])
En assignant explicitement une chaîne textuelle vide (« ») à ce quatrième paramètre, par exemple :
=RECHERCHEX(D2; A2:A100; B2:B100; « »)
l’analyste empêche structurellement l’apparition du jeton d’erreur #N/A au sein de la colonne de résultats. Dès lors qu’une clé d’identification s’avère introuvable, la fonction renvoie directement un objet neutre (la chaîne vide) qui sera ensuite ignoré nativement par les fonctions d’agrégation standard telles que MOYENNE ou SOMME sans requérir la moindre imbrication complexe dans SI.NON.DISP en aval. Cette standardisation des formats de retour confère aux tables relationnelles une robustesse arithmétique immédiate.
10.2 Sécurisation des recherches traditionnelles (RECHERCHEV et INDEX/EQUIV)
Dans les contextes d’entreprise où la compatibilité avec des parcs informatiques hétérogènes impose l’usage des fonctions historiques RECHERCHEV ou du couple classique INDEX/EQUIV, la prévention prophylactique impose l’encapsulation systématique de la recherche dès sa déclaration élémentaire. L’instruction canonique s’articule comme suit :
=SI.NON.DISP(RECHERCHEV(valeur_cherchée; table_matrice; no_index_col; FAUX); « »)
Cette discipline de modélisation prévient la pollution de la feuille de calcul par des erreurs d’appariement. Toutefois, une sécurisation rigoureuse implique également l’assainissement préalable des clés de recherche elles-mêmes. De nombreuses erreurs d’inaccessibilité ne résultent pas de l’absence réelle de la donnée, mais de discordances formelles imperceptibles entre le format de la clé et celui de la table maîtresse.
Il est vivement recommandé d’intégrer dans les formules de recherche des mécanismes d’épuration textuelle, notamment l’emploi de la fonction SUPPRESPACE (qui élimine les espaces superflus en début et fin de chaîne) et de la fonction EPURAGE (qui élimine les caractères non imprimables transmis par les flux web). De même, pour prévenir les discordances entre des nombres stockés sous forme textuelle et des entiers scalaires, l’analyste peut forcer le transtypage numérique en appliquant une double négation arithmétique ou en multipliant la clé par l’unité scalaire (ex. valeur_cherchée*1).
10.3 Architecture en amont via Power Query pour un assainissement structurel
Pour les bases de données institutionnelles à forte criticité, le déplacement du traitement des erreurs depuis la grille de calcul Excel vers le moteur d’intégration Power Query (moteur ETL natif d’Excel) représente l’état de l’art en matière de gouvernance analytique. En traitant l’anomalie d’inaccessibilité lors du pipeline d’extraction, de transformation et de chargement, l’analyste assainit les modèles sans surcharger les feuilles de classeurs de formules complexes.
Au sein de l’interface de Power Query, les jointures relationnelles s’opèrent au travers de l’opération Fusionner des requêtes. Lors d’une jointure externe gauche (Left Outer Join), les enregistrements de la table primaire ne trouvant pas de correspondance dans la table secondaire génèrent des valeurs typées null. Power Query permet d’administrer ces occurrences de deux façons distinctes et complémentaires :
- L’application de la commande Remplacer les erreurs ou Remplacer les valeurs, permettant de convertir les valeurs null en chaînes vides préalablement au chargement dans le modèle de données.
- Le filtrage conditionnel amont permettant d’isoler les lignes sans correspondance dans un classeur d’anomalies dédié, assurant un contrôle d’audit exhaustif sans impacter la table d’analyse finale.
Les données restituées dans la feuille de calcul Excel sous forme de tableaux structurés bénéficient ainsi d’une pureté relationnelle parfaite. Les rafraîchissements automatisés ultérieurs héritent de ces règles de nettoyage déclarées en amont, garantissant que les formules statistiques d’agrégation s’exécutent sur une matrice exempte de la moindre anomalie #N/A, réduisant à néant les risques de défaillance algorithmique en aval.
11. Analyse critique des stratégies de neutralisation : Remplacement versus élimination
11.1 Impacts méthodologiques sur l’inférence et la distribution des données
L’administration de cohortes statistiques incomplètes place le modélisateur face à un dilemme épistémologique fondamental qui oppose l’imputation passive de valeurs artificielles à l’omission complète des observations non disponibles. Chaque stratégie induit des conséquences mathématiques profondes sur la structure de la distribution empirique et sur la validité des inférences déduites de l’échantillon.
L’omission de cas complets (technique consistant à ignorer les cellules #N/A via des chaînes vides) préserve scrupuleusement la distribution empirique observée sur le sous-échantillon valide. En revanche, elle réduit la taille effective de la cohorte ($n_{\text{eff}}$), ce qui a pour effet direct d’élargir l’intervalle de confiance des estimateurs et de diminuer la puissance statistique lors des tests d’hypothèses. L’estimation demeure cependant non biaisée si l’on postule l’hypothèse que les données sont manquantes de manière totalement aléatoire (mécanisme MCAR – Missing Completely At Random selon la typologie formalisée par le statisticien Donald Rubin).
À l’opposé, l’imputation de grandeurs substitutives arbitraires (telle que l’assignation de la valeur zéro, ou même l’imputation simpliste par la moyenne de la série) altère immédiatement les moments d’ordre supérieur de la variable aléatoire. L’imputation passive tend à écraser artificiellement la variance empirique globale (phénomène de sous-dispersion factice), tout en modifiant drastiquement les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Ces distorsions méthodologiques conduisent fréquemment à des conclusions scientifiques fallacieuses en augmentant indûment le risque de commettre une erreur statistique de type I (rejet à tort de l’hypothèse nulle d’absence d’effet).
11.2 Matrice décisionnelle pour le choix de la méthode computationnelle optimale
Face à la diversité des architectures logicielles et des contextes d’analyse, le choix de la méthode computationnelle pour ignorer les valeurs #N/A doit faire l’objet d’un arbitrage rigoureux. La grille décisionnelle suivante synthétise les critères de sélection en fonction des exigences de performance, de compatibilité et de sécurité :
- Scénario 1 : Environnement Microsoft 365 moderne avec exigences de clarté fonctionnelle.
Solution préconisée : Association des fonctions LET et FILTRE. Cette approche sépare formellement l’étape d’épuration matricielle de l’étape de calcul statistique, offre une lisibilité maximale pour les auditeurs de modèles et garantit des performances optimales grâce à la mise en cache de l’évaluation vectorielle. - Scénario 2 : Bases de données volumineuses nécessitant une performance d’exécution maximale.
Solution préconisée : La fonction AGREGAT(no_fonction; 6; plage). En évitant la création de vecteurs intermédiaires en mémoire vive et en exploitant directement le moteur compiled d’Excel, elle optimise le débit de calcul sur les tables massives comportant plusieurs centaines de milliers d’enregistrements. - Scénario 3 : Modèles devant être déployés sur des versions hétérogènes ou héritées d’Excel.
Solution préconisée : La combinaison universelle =FONCTION(SI.NON.DISP(plage; « »)). Cette structure garantit une sécurité absolue en ciblant exclusivement l’erreur #N/A sans masquer les autres anomalies critiques, tout en assurant une rétrocompatibilité complète (sous réserve de validation CSE sur les versions antérieures à 2021). - Scénario 4 : Phase de conception de nouvelles chaînes de calcul et de jointures relationnelles.
Solution préconisée : Éradication prophylactique à la source via le quatrième argument de RECHERCHEX ou assainissement en amont au sein de Power Query, empêchant physiquement l’injection du symbole #N/A dans la couche applicative du tableur.
11.3 Audits de cohérence et contrôles croisés automatisés
L’implémentation de formules visant à ignorer les valeurs d’inaccessibilité ne dispense nullement l’analyste de concevoir des mécanismes permanents de contrôle de qualité et d’auditabilité au sein du classeur. Un modèle robuste doit obligatoirement intégrer des indicateurs de contrôle signalant l’intensité et l’évolution de l’attrition des données.
Il est hautement recommandé d’adosser à chaque calcul de synthèse statistique un compteur d’anomalies exploitant la fonction NB.SI ou la fonction d’interception EST.NON.DISP combinée à SOMMEPROD. Par exemple, l’équation suivante permet de quantifier le nombre exact d’observations perdues au sein de la plage A1:A20 :
=SOMMEPROD(–EST.NON.DISP(A1:A20))
Parallèlement, la mise en œuvre de règles de mise en forme conditionnelle appliquant un surlignage visuel spécifique (par exemple, un remplissage ambré discret) sur les cellules générant l’erreur #N/A permet de cartographier instantanément la densité des lacunes au sein des tableaux bruts. L’analyste peut ainsi évaluer d’un coup d’œil si les données manquantes se concentrent anormalement sur certaines périodes chronologiques ou certains segments géographiques spécifiques, condition préalable indispensable à toute interprétation des résultats d’agrégation statistique.
12. Protocole opérationnel, traçabilité académique et remédiation des erreurs résiduelles
12.1 Règles déontologiques et documentation de l’attrition des données
Dans le cadre de la recherche universitaire, de la publication biomédicale ou des rapports d’audit réglementaire, la neutralisation algorithmique des données #N/A doit obligatoirement s’accompagner d’une transparence méthodologique intégrale. Les standards internationaux de publication scientifique (tels que les déclarations CONSORT pour les essais cliniques ou STROBE pour les études épidémiologiques) prohibent formellement l’occultation implicite des effectifs manquants.
Tout tableau synthétique intégrant des calculs de moyenne, de médiane ou d’écart-type traités par contournement d’erreur doit comporter une annotation textuelle standardisée précisant les paramètres suivants :
- La taille brute initiale de la cohorte théorique sous revue ($N$).
- Le taux d’attrition exact, exprimé par le nombre absolu ($k$) et le pourcentage d’observations non disponibles éliminées lors de l’agrégation.
- La taille de l’échantillon effectif valide ($n_{\text{eff}} = N – k$) sur lequel reposent rigoureusement les estimateurs numériques présentés.
- La formulation mathématique et la technique computationnelle appliquées pour neutraliser les données manquantes (par exemple, exclusion des cas incomplets via substitution par chaîne de longueur nulle en mémoire vectorielle).
De surcroît, l’analyste doit formellement statuer sur la nature présumée de l’absence des données. Si les occurrences d’inaccessibilité résultent d’un phénomène non aléatoire (MNAR – Missing Not At Random, par exemple des valeurs non mesurées car dépassant le seuil de toxicité d’un appareil de laboratoire), la simple omission algorithmique par formule Excel est scientifiquement insuffisante et doit être complétée par des analyses de sensibilité ou des imputations multiples robustes dans des progiciels spécialisés.
12.2 Diagnostic et résolution des défaillances de calcul persistantes
Il arrive fréquemment que, malgré l’implémentation scrupuleuse des formules présentées dans ce guide, des calculs d’agrégation continuent de retourner des erreurs inattendues ou des valeurs totalement aberrantes. Le diagnostic de ces défaillances résiduelles requiert une démarche méthodique d’investigation logicielle.
La première source d’échec découle de l’existence de chaînes textuelles vides résiduelles (« ») soumises à des opérateurs arithmétiques binaires. Bien que des fonctions telles que SOMME ignorent sans encombre les chaînes vides, un opérateur mathématique explicite d’addition binaire (par exemple =A1 + A2) renverra irrémédiablement l’erreur #VALEUR! si l’une des cellules abrite une chaîne textuelle de longueur nulle issue d’un SI.NON.DISP. Il convient donc de proscrire impérativement les opérateurs élémentaires direct (+, -, *, /) lors de la manipulation de plages assainies et de recourir systématiquement aux fonctions d’agrégation dédiées (SOMME, PRODUIT).
Une seconde pathologie courante concerne le gel de l’affichage des résultats en raison d’un formatage préalable inadéquat de la cellule hôte en format « Texte ». Si la cellule accueillant la formule d’agrégation était préalablement typée en format texte, Excel affiche textuellement la syntaxe brute =MOYENNE(SI.NON.DISP(…)) sans exécuter le calcul. La résolution impose de modifier le format de la cellule vers « Standard », puis d’activer la réévaluation en positionnant le curseur dans la barre de formule et en appuyant sur Entrée.
Enfin, pour disséquer les formules matricielles hautement imbriquées qui refusent de converger, l’analyste doit mobiliser l’outil d’audit interactif natif d’Excel : l’utilitaire Évaluer la formule, situé dans l’onglet Formules du ruban. Cette fonctionnalité permet d’exécuter l’évaluation pas à pas, affichant à chaque clic l’état d’évaluation des sous-matrices vectorielles en mémoire, permettant d’identifier immédiatement le nœud précis où une incohérence de typage ou une erreur non interceptée se produit.
12.3 Synthèse procédurale des meilleures formules applicables
Pour servir de guide de référence rapide et pérenne aux ingénieurs de données, contrôleurs de gestion et analystes de données quantitatives, le répertoire ci-dessous condense les architectures syntaxiques les plus performantes pour contourner avec rigueur les valeurs d’inaccessibilité #N/A au sein de Microsoft Excel :
- Moyenne arithmétique non biaisée :
Syntaxe universelle ciblée : =MOYENNE(SI.NON.DISP(plage; « »))
Syntaxe haute performance (AGREGAT) : =AGREGAT(1; 6; plage)
Syntaxe déclarative moderne (365) : =MOYENNE(FILTRE(plage; NON(EST.NON.DISP(plage)))) - Médiane robuste :
Syntaxe universelle ciblée : =MEDIANE(SI.NON.DISP(plage; « »))
Syntaxe haute performance (AGREGAT) : =AGREGAT(12; 6; plage)
Syntaxe déclarative moderne (365) : =MEDIANE(FILTRE(plage; NON(EST.NON.DISP(plage)))) - Somme cumulative exacte :
Syntaxe universelle ciblée : =SOMME(SI.NON.DISP(plage; « »))
Syntaxe haute performance (AGREGAT) : =AGREGAT(9; 6; plage)
Syntaxe déclarative moderne (365) : =SOMME(FILTRE(plage; NON(EST.NON.DISP(plage)))) - Écart-type d’échantillon (correction de Bessel $n-1$) :
Syntaxe universelle ciblée : =ECARTYPE.STANDARD(SI.NON.DISP(plage; « »))
Syntaxe haute performance (AGREGAT) : =AGREGAT(7; 6; plage)
Syntaxe déclarative moderne (365) : =ECARTYPE.STANDARD(FILTRE(plage; NON(EST.NON.DISP(plage))))
En adoptant ces architectures validées, en proscrivant formellement la substitution aveugle par des zéros numériques et en privilégiant une interception ciblée par SI.NON.DISP ou l’isolation dynamique par FILTRE, les analystes s’assurent de concevoir des classeurs décisionnels hautement performants, mathématiquement exacts et conformes aux exigences d’intégrité de la science des données moderne.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7e éd.). https://doi.org/10.1037/0000165-000
Benninga, S. (2014). Financial modeling (4e éd.). MIT Press.
Billings, F., & Jelen, B. (2021). Microsoft Excel data analysis and business modeling (Office 2021 and Microsoft 365). Microsoft Press.
Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3e éd.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
Microsoft Corporation. (s. d.). Fonction AGREGAT. Support Microsoft. Consulté le 24 octobre 2023, à l’adresse https://support.microsoft.com/fr-fr/office/fonction-agr%C3%A9gat-43db9aa6-61ed-4b83-b80c-647a9287a49b
Microsoft Corporation. (s. d.). Fonction FILTRE. Support Microsoft. Consulté le 24 octobre 2023, à l’adresse https://support.microsoft.com/fr-fr/office/fonction-filtre-f4f7cb66-82eb-4767-8f7c-4877ad80c759
Microsoft Corporation. (s. d.). Fonction SI.NON.DISP. Support Microsoft. Consulté le 24 octobre 2023, à l’adresse https://support.microsoft.com/fr-fr/office/fonction-si-non-disp-11522529-a557-4897-8c7a-19677da58447
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-592. https://doi.org/10.1093/biomet/63.3.581
Walkenbach, J. (2015). Excel 2016 formulas. John Wiley & Sons.
Wickham, H., & Grolemund, G. (2017). R for data science: Import, tidy, transform, visualize, and model data. O’Reilly Media.