
Dans le domaine de la visualisation scientifique des données et de l’ingénierie logicielle computationnelle, la couleur ne constitue pas un simple artifice esthétique, mais un vecteur fondamental d’encodage informationnel. Au sein de l’écosystème scientifique Python, la bibliothèque Matplotlib s’est imposée comme la référence fondamentale pour la production de représentations graphiques bidimensionnelles et tridimensionnelles rigoureuses. Pourtant, lorsqu’un analyste est confronté à des jeux de données hautement dynamiques, à des regroupements non supervisés de cardinalité imprévisible ou à des flux de données synthétiques requérant une démarcation immédiate, la sélection déterministe manuelle des palettes de couleurs atteint rapidement ses limites opérationnelles. L’automatisation chromatique devient alors un impératif méthodologique incontournable.
La génération stochastique de couleurs, loin d’être un processus trivial consistant à appeler de manière désordonnée une fonction aléatoire élémentaire, repose sur des fondations mathématiques, physiques et psychophysiques complexes. L’attribution probabiliste de valeurs chromatiques nécessite une compréhension approfondie de la façon dont le moteur graphique interprète les canaux de luminance, des topologies dimensionnelles des espaces de couleurs sous-jacents, ainsi que des particularités du système visuel humain. Une mauvaise implémentation stochastique risque d’engendrer des artefacts perceptuels majeurs, tels que des regroupements illusoires fondés sur des saillances involontaires, une perte totale de contraste par rapport à l’arrière-plan, ou une illisibilité complète pour les observateurs souffrant de dyschromatopsies.
Le présent traité propose une analyse exhaustive et rigoureuse des mécanismes permettant de synthétiser, moduler et attribuer des couleurs aléatoires dans l’infrastructure de traçage de Matplotlib. À travers une progression méthodique articulée autour de la théorie de la couleur, du calcul matriciel vectorisé avec NumPy, de la manipulation des espaces perceptuels et des techniques d’optimisation pour le traitement de volumétries massives de données, cet article explore les meilleures pratiques d’ingénierie logicielle garantissant à la fois l’indépendance statistique des tirages et la reproductibilité expérimentale absolue exigée par la démarche scientifique contemporaine.
1. Fondements théoriques de la représentation des couleurs dans Matplotlib
1.1 L’espace chromatique RVB normalisé dans l’écosystème Python
Au cœur de l’architecture logicielle de Matplotlib se trouve le modèle additif de couleurs fondé sur les composantes Rouge, Vert et Bleu (RVB ou RGB en nomenclature anglo-saxonne). Contrairement aux environnements de développement web conventionnels ou aux formats de stockage matriciel d’images qui quantifient traditionnellement chaque canal sur une échelle discrète d’entiers non signés de 8 bits s’étendant de zéro à deux cent cinquante-cinq, Matplotlib adopte un formalisme mathématique rigoureux reposant sur l’analyse continue. Dans ce cadre, chaque composante spectrale est représentée par un nombre flottant à double ou simple précision confiné dans l’intervalle fermé unité [0.0, 1.0].
Cette normalisation unitaire découle directement de la physique théorique du rayonnement lumineux et du traitement numérique du signal. La valeur zéro indique l’absence totale de stimulation radiométrique du canal considéré, tandis que la valeur un représente la saturation énergétique maximale admissible par le périphérique de restitution visuelle. Par exemple, le triplet (0.0, 0.0, 0.0) modélise l’obscurité absolue (le noir profond), tandis que le triplet (1.0, 1.0, 1.0) traduit l’émission conjointe et équilibrée des trois longueurs d’onde fondamentales, générant le blanc de référence.
D’un point de vue matriciel, le moteur graphique de bas niveau de Matplotlib, souvent interfacé avec des moteurs de rendu vectoriel comme Agg, PDF ou SVG, traite ces triplets non pas comme de simples étiquettes typographiques, mais comme des tenseurs ou des vecteurs de luminance projetés sur les couches de pixellisation. La transition continue au sein de l’intervalle [0.0, 1.0] offre une résolution chromatique théoriquement infinie, limitée uniquement par la mantisse des représentations en virgule flottante conformes à la norme IEEE 754, évitant ainsi les artefacts de quantification et d’arrondi lors des calculs d’interpolation lumineuse ou de fusion alpha.
1.2 La structure des arguments de couleur dans l’API pyplot
L’interface de programmation applicative (API) de Matplotlib, principalement structurée autour du sous-module pyplot et de la hiérarchie orientée objet des classes Artist, dispose d’une flexibilité remarquable mais parfois déroutante concernant la spécification des couleurs. Deux paramètres majeurs gouvernent ces interactions : le paramètre explicite color et son alias raccourci c, fréquemment employé dans les signatures de méthodes telles que plt.scatter ou plt.plot.
Bien que ces arguments puissent sembler interchangeables au premier abord, leur comportement sous-jacent dépend intimement de la nature structurelle des données transmises. Le paramètre color accepte généralement une spécification scalaire univoque, telle qu’une chaîne de caractères désignant une couleur nommée du standard CSS4, un code hexadécimal rigoureusement formaté, ou un tuple de trois à quatre flottants. En revanche, le paramètre c de la méthode de dispersion scatter a été spécifiquement conçu pour accepter aussi bien des spécifications chromatiques directes que des séquences de scalaires destinés à être cartographiés via une table de couleurs (colormap) couplée à un objet de normalisation (Normalize).
Lorsqu’un développeur injecte un conteneur itérable dans ces paramètres, le parseur interne de Matplotlib initie une cascade de vérifications dimensionnelles via la fonction utilitaire matplotlib.colors.to_rgba_array. Cette routine interne inspecte la forme géométrique du tenseur d’entrée : s’il s’agit d’un tableau à deux dimensions de taille N par trois ou N par quatre, chaque ligne est rigoureusement assignée à la primitive géométrique correspondante. Toute ambiguïté dimensionnelle, telle qu’un vecteur unidimensionnel de longueur trois passé par erreur à une collection attendant N éléments scalaires, peut déclencher des comportements heuristiques inattendus où le vecteur est interprété soit comme une série de trois données à normaliser, soit comme un unique triplet chromatique RVB appliqué uniformément à l’ensemble du jeu de données.
2. Principes probabilistes et génération stochastique avec NumPy
2.1 Utilisation des distributions uniformes pour l’échantillonnage chromatique
La génération de couleurs aléatoires dans un espace vectoriel continu exige une formulation probabiliste adéquate. L’approche fondamentale repose sur le déploiement de distributions statistiques uniformes continues, modélisées par la densité de probabilité constante sur le domaine de définition considéré. Dans le contexte de l’espace RVB normalisé, le domaine d’intérêt est l’hypercube unitaire tridimensionnel [0, 1]³, défini par le produit cartésien des trois intervalles indépendants.
L’utilisation de la fonction numpy.random.random ou de ses équivalents modernes permet d’effectuer un échantillonnage pseudo-aléatoire où chaque coordonnée chromatique possède une probabilité rigoureusement identique d’être sélectionnée sur l’ensemble du spectre continu. L’équirépartition spatiale au sein de cet hypercube garantit, d’un point de vue théorique, qu’aucune zone du volume chromatique n’est favorisée a priori. Ainsi, l’espérance mathématique de chaque canal converge invariablement vers la valeur médiane de 0.5, conférant au système une neutralité stochastique théorique.
Toutefois, le comportement asymptotique lors de tirages itératifs successifs révèle une propriété essentielle de la théorie des probabilités : l’indépendance mutuelle des variables aléatoires n’implique nullement une dispersion visuellement harmonieuse. En vertu de la loi des grands nombres et du phénomène de regroupement poissonnien, un échantillonnage purement uniforme génère inévitablement des agglomérations locales dans l’espace des couleurs. Deux tirages consécutifs peuvent ainsi se retrouver arbitrairement proches l’un de l’autre selon la métrique euclidienne usuelle, produisant des couleurs visuellement indiscernables pour l’œil humain malgré la perfection probabiliste du générateur sous-jacent.
2.2 Différences fondamentales entre random.random, random.rand et default_rng
L’écosystème NumPy a connu une évolution architecturale majeure concernant la gestion de l’aléatoire, marquée par la transition entre l’ancienne infrastructure héritée du générateur de Mersenne Twister (MT19937) et le nouveau sous-système modulaire introduit avec NumPy 1.17, centré sur la classe Generator et l’algorithme PCG64 (Permuted Congruential Generator).
Les fonctions historiques telles que numpy.random.random et numpy.random.rand reposent sur un état global mutable partagé au sein du processus Python. La fonction rand hérite d’une convention syntaxique inspirée de MATLAB, acceptant des dimensions séparées par des virgules pour définir la forme du tableau résultat, tandis que random requiert un tuple dimensionnel explicite. Outre cette divergence d’interface, ces interfaces classiques souffrent de lacunes statistiques intrinsèques au MT19937, notamment une sensibilité accrue aux corrélations linéaires dans les hypercubes de grande dimension et une impossibilité native de parallélisation rigoureuse sans risque de collision d’états.
À l’inverse, l’instanciation moderne via numpy.random.default_rng() encapsule le générateur dans un objet distinct doté d’une meilleure complexité algorithmique, d’un débit computationnel supérieur et d’une distribution statistique exempte de défauts de dimensionalité. Pour la synthèse de tableaux chromatiques volumineux, l’emploi de rng.random((N, 3)) surpasse les anciennes méthodes tant sur le plan de la consommation mémoire que de la vélocité d’exécution, tout en garantissant des propriétés cryptographiques et statistiques hautement supérieures pour les applications scientifiques rigoureuses.
3. Génération d’une couleur aléatoire unique pour les tracés linéaires
3.1 Implémentation syntaxique via un triplet de flottants aléatoires
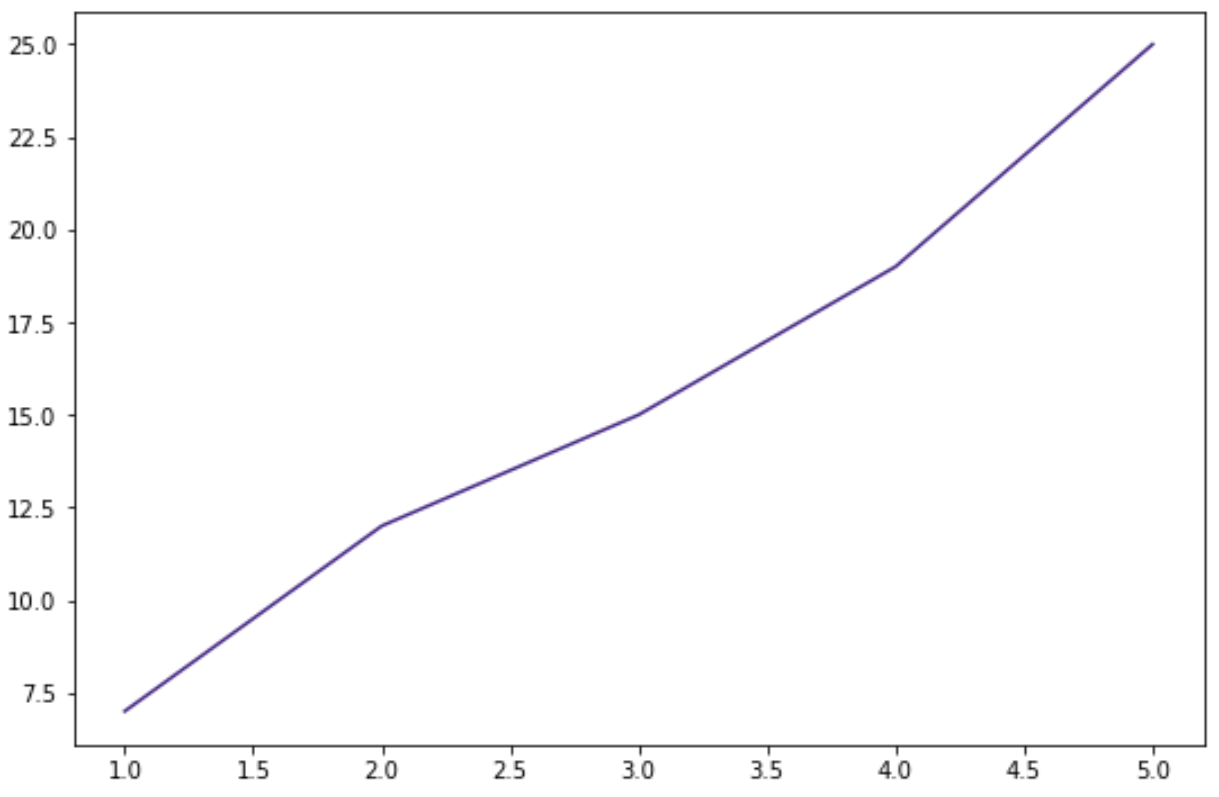
L’application la plus élémentaire de la génération stochastique de couleurs concerne l’individualisation d’un tracé géométrique unique, modélisé par une ligne polygonale continue via l’instruction plt.plot. Pour attribuer de manière dynamique une identité chromatique à cette série sans recourir aux palettes prédéfinies de Matplotlib, la méthode canonique consiste à formuler un triplet de scalaires pseudo-aléatoires encapsulé sous la forme d’un tuple ou d’un tableau unidimensionnel.
Sur le plan algorithmique, cette opération s’articule autour de l’échantillonnage de trois variables aléatoires uniformes indépendantes et identiquement distribuées sur le domaine unitaire. Le vecteur obtenu, de forme géométrique (3,), est ensuite directement assigné au paramètre color ou au paramètre c de la signature d’appel. Lors de chaque invocation de l’interpréteur graphique, la primitive de ligne hérite de ce profil chromatique exclusif. La variabilité visuelle observée lors d’exécutions successives reflète fidèlement la trajectoire stochastique du générateur.
Cette approche présente toutefois une limite inhérente à l’absence de contraintes spectrales : le tirage purement aléatoire peut engendrer des valeurs simultanément très faibles sur les trois canaux, résultant en une teinte extrêmement sombre difficilement discernable sur un fond d’affichage noir, ou à l’inverse, des valeurs excessivement élevées proches de l’unité, causant la quasi-invisibilité du tracé sur un canevas blanc immaculé conventionnel. Il est donc fréquemment nécessaire de contraindre l’intervalle d’échantillonnage ou de rejeter conditionnellement les vecteurs dont la norme s’écarte trop des seuils de visibilité optimaux.
3.2 Gestion de multiples séries temporelles avec couleurs individualisées
L’intérêt de la synthèse chromatique automatisée se manifeste pleinement lorsque l’infrastructure de calcul doit orchestrer l’affichage simultané d’une multiplicité de séries temporelles ou de trajectoires physiques expérimentales. Dans ce scénario, une itération déterministe sur les données multivariées est couplée à une génération dynamique de triplets chromatiques à chaque étape de la boucle de tracé.
Pour maintenir une traçabilité rigoureuse au sein du graphique, chaque série doit être associée de façon univoque à son identifiant stochastique. L’ingénierie du pipeline graphique impose alors de consigner explicitement le vecteur généré dans une structure de métadonnées accompagnant le tracé. Cela garantit une synchronisation parfaite avec les éléments de la légende contextuelle, générée par la commande plt.legend(). En l’absence d’une telle association explicite, les routines internes de Matplotlib appliqueraient leur cycle de couleurs cyclique par défaut (le fameux cycle de dix couleurs de la palette standard tab10), ce qui provoquerait une répétition indésirable dès que le nombre de séries excéderait la cardinalité de la table interne.
L’affectation itérative peut être formalisée de manière élégante au moyen de compréhensions de listes ou de générateurs Python. Il demeure cependant crucial de veiller à ce que l’espacement visuel entre les courbes soit suffisant pour prévenir la confusion cognitive de l’analyste. Si deux courbes adjacentes reçoivent par simple coïncidence probabiliste des nuances spectrales quasi-identiques, la différenciation analytique des dynamiques temporelles sous-jacentes devient compromise, ce qui justifie l’application de filtres de séparation minimale que nous aborderons dans les sections subséquentes.
4. Attribution stochastique de couleurs dans les nuages de points
4.1 Génération matricielle multidimensionnelle pour plt.scatter
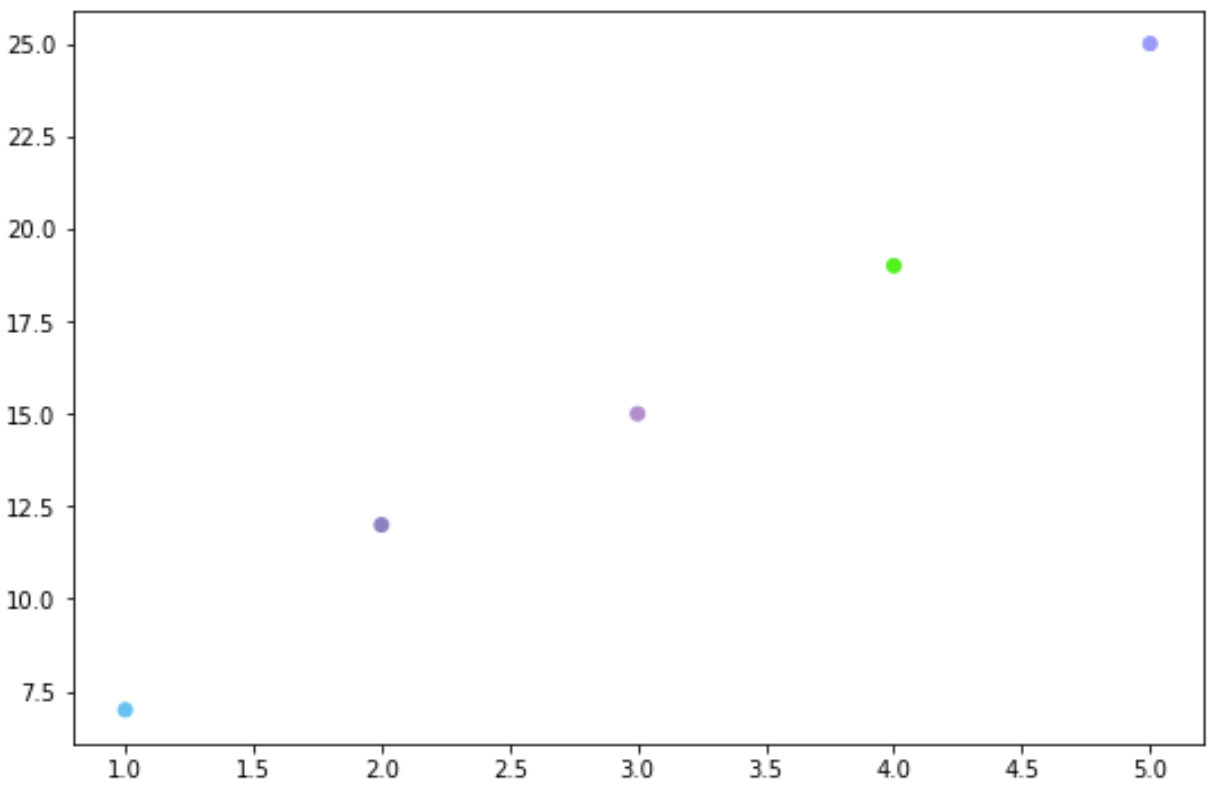
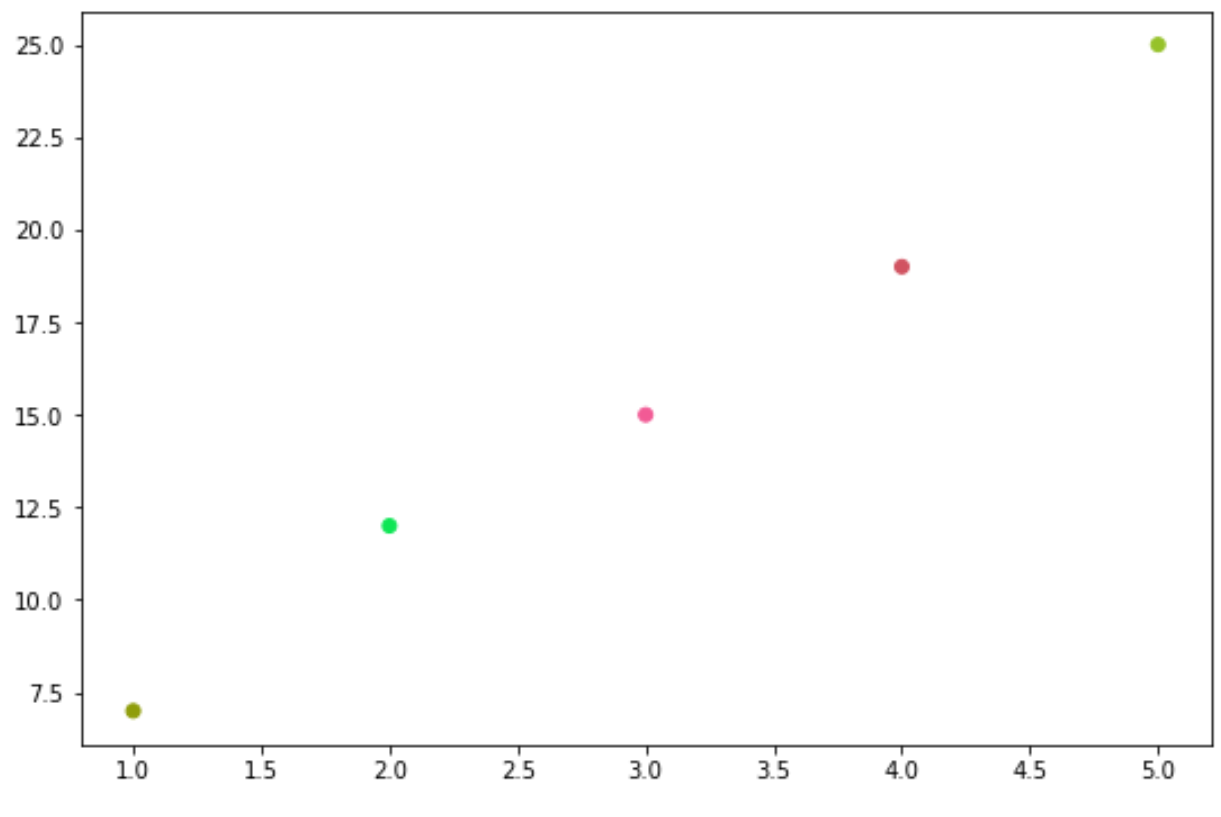
Contrairement aux tracés linéaires où une couleur unique est traditionnellement assignée à l’ensemble d’une courbe continue, les diagrammes de dispersion ou nuages de points (implémentés via la primitive plt.scatter) autorisent une granularité d’encodage infiniment plus fine. Dans ce paradigme, chaque particule ou observation individuelle peut se voir attribuer une signature chromatique spécifique, transformant ainsi le graphique en un champ multidimensionnel d’informations visuelles.
Pour atteindre une efficacité computationnelle optimale, il convient de proscrire rigoureusement toute boucle itérative native en Python au profit des mécanismes d’allocation matricielle vectorisée offerts par la bibliothèque NumPy. La construction d’une matrice bidimensionnelle de dimensions N par trois, où N désigne le cardinal total des observations géométriques cartésiennes, s’effectue en une unique opération optimisée au niveau du compilateur sous-jacent. Chaque ligne i de cette matrice de tenseurs correspond de façon bijective aux coordonnées cartésiennes (x_i, y_i) de l’élément géométrique homologue.
Cette approche vectorisée présente des gains d’échelle considérables en matière d’empreinte mémoire et de temps de calcul. Le moteur graphique interne de Matplotlib, via la classe PathCollection, est conçu pour ingérer directement ces blocs contigus de mémoire C, éliminant l’ensemble des surcoûts d’encapsulation (boxing et unboxing) inhérents aux objets scalaires du langage Python. L’échantillonnage globalisé d’un million de points colorés de manière stochastique s’exécute ainsi en une fraction de seconde, assurant une fluidité essentielle lors des analyses exploratoires de mégadonnées.
4.2 Différenciation structurelle entre dispersion 2D et 3D
L’extension de ces principes stochastiques à l’espace tridimensionnel, rendue possible par le module d’extension mpl_toolkits.mplot3d et sa classe d’axes Axes3D, introduit des défis conceptuels et géométriques supplémentaires. Lorsque l’analyste projette un nuage de points dans un repère cartésien à trois dimensions (X, Y, Z), la perception des distances et de la position spatiale des données est intrinsèquement modulée par les calculs d’illumination, d’ombrage et de perspective fuyante.
Dans un tracé de dispersion 2D standard, le mélange additif de couleurs arbitraires ne dépend que de la superposition relative des marqueurs le long de l’axe z-order virtuel du plan de projection. En revanche, dans un rendu 3D, le moteur graphique applique un tri dynamique des primitives en fonction de la distance relative séparant chaque point de la caméra virtuelle de l’observateur. L’attribution stochastique de couleurs non contraintes peut perturber l’interprétation de la profondeur : des teintes excessivement claires ou saturées situées en arrière-plan peuvent erronément sembler plus proches que des particules sombres localisées au premier plan, un artefact psychophysique causé par le phénomène d’avancement et de recul des couleurs (chromostéréopsis).
Il s’avère par conséquent impératif d’ajuster rigoureusement les matrices chromatiques stochastiques appliquées aux axes tridimensionnels. Une stratégie méthodologique efficace consiste à lier l’un des canaux chromatiques à l’une des coordonnées spatiales ou à contraindre la variance de la luminance, de manière à préserver la cohérence visuelle face aux rotations interactives et aux modifications continues de l’angle d’observation (azimut et élévation) de la scène graphique.
5. Intégration du canal alpha pour la transparence stochastique
5.1 Modélisation de l’espace chromatique RVBA à quatre dimensions
L’enrichissement du modèle additif tridimensionnel par l’adjonction d’un quatrième canal de contrôle conduit à l’espace RVBA (Rouge, Vert, Bleu, Alpha). La composante alpha régit de façon unitaire le degré d’opacité ou de transparence optique associé à la primitive graphique. Tout comme ses homologues chromatiques, le canal alpha est formalisé dans Matplotlib par une grandeur flottante continue normalisée sur l’intervalle [0.0, 1.0], où zéro représente une translucidité absolue (invisibilité complète de l’objet) et l’unité caractérise une opacité parfaite occultant intégralement les strates sous-jacentes.
La synthèse stochastique d’une matrice RVBA requiert l’échantillonnage d’un tenseur de dimensions N par quatre. Cependant, l’application d’une distribution uniforme non contrainte sur le quatrième canal constitue un piège méthodologique majeur. L’attribution aléatoire de valeurs alpha proches de zéro génère des points totalement évanescents, conduisant à une déperdition nette d’information scientifique. À l’opposé, une saturation systématique vers l’unité annule tous les bénéfices de la composition translucide.
Une modélisation stochastique rigoureuse impose par conséquent d’ajuster les bornes de l’intervalle d’échantillonnage de la composante alpha au moyen d’une transformation affine de la variable aléatoire uniforme, ou via l’emploi d’une distribution bêta paramétrée. La définition d’un seuil minimal de visibilité garantit que chaque entité graphique contribue de manière perceptible au signal visuel, tout en modulant sa présence optique au sein du canevas analytique global.
5.2 Résolution des phénomènes de chevauchement dans les nuages de points denses
L’un des défis les plus redoutables de la visualisation de mégadonnées quantitatives réside dans le phénomène d’occlusion mutuelle ou d’encombrement visuel (overplotting). Lorsqu’un diagramme de dispersion intègre des centaines de milliers, voire des millions de primitives géométriques au sein d’un espace de projection restreint, les points se superposent massivement, formant des agglomérats opaques indifférenciés qui dissimulent la véritable topologie de la distribution statistique sous-jacente.
L’incorporation délibérée d’une transparence stochastique ou homogène couplée à des variations chromatiques aléatoires résout ce problème d’occlusion par le mécanisme de composition alpha additive (l’algorithme de mélange standard de Porter-Duff). Lorsque plusieurs marqueurs semi-transparents se chevauchent dans le plan de restitution, leurs flux lumineux respectifs s’additionnent de manière progressive sur la grille de pixels. L’intensité colorimétrique cumulée résultante devient alors une fonction monotone croissante de la densité locale d’observations empiriques.
Cette approche permet à l’observateur de distinguer instantanément les régions isolées à faible densité, où les teintes individuelles conservent leur transparence éthérée, des centres névralgiques de forte concentration statistique, où la confluence des marqueurs engendre une luminance saturée et un mélange spectral complexe. La transparence probabiliste transforme ainsi un graphique statique saturé en une carte de densité perceptive hautement informative.
6. Conversion et manipulation sous format hexadécimal
6.1 Traduction algorithmique de vecteurs numériques en chaînes hexadécimales
Bien que le formalisme matriciel unitaire flottant [0.0, 1.0] soit l’étalon mathématique au sein du noyau de calcul de Matplotlib, les standards industriels du génie logiciel, de l’intégration web et de la conception graphique exploitent de manière quasi-universelle la notation hexadécimale. Cette dernière encode les canaux de couleur sous la forme d’une chaîne alphanumérique préfixée par un croisillon, suivie de six caractères hexadécimaux représentant respectivement le Rouge, le Vert et le Bleu sur une base de seize chiffres (de 0 à F), soit deux symboles par canal correspondant à la plage discrète de 0 à 255.
La conversion rigoureuse d’un vecteur de trois flottants normalisés vers cette représentation typographique implique une séquence d’opérations élémentaires : mise à l’échelle par multiplication scalaire par la constante deux cent cinquante-cinq, troncature ou arrondissement vers l’entier le plus proche, puis formatage textuel avec remplissage systématique par des zéros à gauche pour préserver la structure invariante à deux positions par composante. La fonction spécialisée matplotlib.colors.to_hex encapsule ces étapes avec une robustesse mathématique absolue, gérant les éventuels dépassements de capacité aux frontières du domaine.
Il est également envisageable de générer directement des identifiants hexadécimaux stochastiques sans transiter formellement par le domaine flottant, en synthétisant un nombre entier aléatoire compris entre zéro et seize millions sept cent soixante-dix-sept mille deux cent quinze (2²⁴ – 1), puis en le traduisant dans sa base hexadécimale via les spécificateurs de format de chaîne de Python. Cette technique s’avère particulièrement véloce lorsqu’il s’agit d’interfacer les moteurs graphiques scientifiques avec des couches de restitution front-end ou des feuilles de style externes.
6.2 Intégration des identifiants hexadécimaux dans les graphiques complexes
L’emploi d’identifiants hexadécimaux au sein de Matplotlib dépasse le simple cadre de l’esthétique syntaxique : il garantit une interopérabilité logicielle totale lors de l’exportation et de la sérialisation des configurations graphiques. Dans les architectures logicielles distribuées de science des données, les paramètres de rendu visuel doivent fréquemment transiter sous forme de documents textuels structurés (tels que JSON ou YAML) vers des interfaces de programmation ou des tableaux de bord interactifs basés sur des moteurs JavaScript comme D3.js ou Plotly.
L’utilisation de chaînes hexadécimales standardisées protège les attributs graphiques contre les dérives de précision induites par les opérations de sérialisation et désérialisation de nombres à virgule flottante entre différents environnements informatiques. De plus, les moteurs d’interprétation de Matplotlib intègrent des analyseurs syntaxiques rigoureux capables de valider instantanément la conformité structurelle de ces chaînes. Si un code hexadécimal tronqué ou corrompu est injecté dans une méthode de tracé, le sous-système matplotlib.colors lève immédiatement une exception explicite, prévenant l’apparition d’états graphiques silencieusement indéterminés.
Cette standardisation textuelle facilite également le stockage persistant de palettes stochastiques au sein de bases de données relationnelles ou de magasins de métadonnées d’expériences scientifiques (tels que MLflow ou Weights & Biases), assurant une concordance visuelle parfaite entre les figures statiques générées lors de la phase d’entraînement et les restitutions interactives visualisées en production.
7. Échantillonnage aléatoire discret à partir de cartes de couleurs prédéfinies
7.1 Sélection stochastique d’indices au sein des colormaps Matplotlib
L’échantillonnage aléatoire dans l’hypercube RVB continu présente l’inconvénient majeur de produire un « bruit blanc chromatique », où la disparité esthétique et la variabilité de la luminance perçue nuisent à l’élégance et à la lisibilité scientifique des figures. Pour pallier cet écueil, une méthodologie sophistiquée consiste à contraindre le tirage stochastique le long d’une trajectoire géométrique prédéfinie au sein de l’espace des couleurs, c’est-à-dire en échantillonnant de manière probabiliste une table de couleurs continue (colormap).
Matplotlib met à disposition des dizaines de palettes continues hautement raffinées, scientifiquement étalonnées pour assurer une uniformité séquentielle, telles que Viridis, Plasma, Inferno, Magma, ou encore les cartes divergentes comme Spectral ou Coolwarm. Une table de couleurs continue peut être modélisée mathématiquement comme une fonction vectorielle continue C(t), qui projette le segment unitaire scalaire [0, 1] vers l’espace quadridimensionnel RVBA.
L’échantillonnage stochastique se ramène alors au tirage d’une variable aléatoire uniforme scalaire u sur [0, 1], laquelle est ensuite fournie en paramètre d’évaluation à l’objet colormap : plt.cm.viridis(u). Cette démarche présente un avantage fondamental : bien que les couleurs obtenues demeurent stochastiquement distribuées, elles partagent toutes la signature harmonique, la cohérence stylistique et le profil de luminance scientifiquement validé de la palette mère, évitant les heurts spectraux discordants du hasard non régulé.
7.2 Création de listes d’échantillons discrets via ListedColormap
Dans de nombreux cas d’usage, notamment la classification supervisée ou la segmentation catégorielle, le problème visuel ne requiert pas un spectre continu, mais un ensemble discret fini de nuances chromatiques bien différenciées. L’objet matplotlib.colors.ListedColormap permet de cristalliser une collection finie de couleurs sous forme d’une table d’accès indicée.
La génération d’une sous-palette stochastique discrète s’orchestre alors en deux étapes computationnelles distinctes. Premièrement, une discrétisation systématique d’une colormap maîtresse continue est opérée pour extraire un réservoir étendu de candidats spectraux. Deuxièmement, la méthode de tirage vectorisé numpy.random.choice est déployée pour extraire un sous-ensemble de cardinalité K à partir de ce réservoir de référence.
L’analyste dispose du contrôle total sur la stratégie d’échantillonnage : un tirage avec remise permet de modéliser des processus purement poissoniens, tandis qu’un tirage sans remise garantit l’unicité stricte de chaque nuance au sein de la figure résultante. Une fois la liste discrète finalisée, elle est encapsulée dans une instance de ListedColormap, qui peut ensuite être assignée aux objets de traçage et couplée à un séparateur de bornes BoundaryNorm, produisant des légendes catégorielles rigoureuses et exemptes d’ambiguïté interprétative.
8. Reproductibilité scientifique et contrôle du générateur pseudo-aléatoire
8.1 Fixation de la graine stochastique pour la recherche expérimentale
L’un des axiomes directeurs de la publication scientifique réside dans la reproductibilité computationnelle absolue des résultats empiriques et de leurs représentations graphiques associées. Une figure scientifique ne saurait changer de topologie colorimétrique au gré des réexécutions du code source par les pairs académiques chargés de l’évaluation ou par la communauté scientifique au sens large.
Dans les algorithmes déterministes qui sous-tendent les générateurs de nombres pseudo-aléatoires modernes, la suite de valeurs apparemment chaotiques est intégralement déterminée par une condition initiale unique appelée graine stochastique (seed). Historiquement, la commande globale numpy.random.seed(valeur) était universellement employée. Toutefois, les standards actuels de l’ingénierie logicielle proscrivent cette pratique en raison de son impact global et de la possibilité de collisions d’états collatérales au sein de programmes modulaires complexes ou d’architectures asynchrones.
La méthodologie contemporaine impose l’instanciation d’un générateur d’états isolé et étanche au moyen de la fabrique numpy.random.default_rng(graine). En fixant explicitement un entier arbitraire immuable lors de l’initialisation de cet objet, le chercheur sanctuarise le comportement probabiliste de l’ensemble de son pipeline graphique. Chaque exécution subséquente du script produira rigoureusement, au bit près, les mêmes vecteurs chromatiques stochastiques, assurant une conformité exemplaire avec les exigences de la science ouverte et de la publication académique rigoureuse.
8.2 Sauvegarde et restauration des configurations chromatiques
Au-delà de la simple fixation de la graine du générateur, la robustesse opérationnelle exige fréquemment la persistance matérielle des matrices chromatiques effectives associées aux tracés. Dans les cycles de révision d’articles scientifiques ou lors de la modification incrémentale de figures vectorielles complexes, l’ajout de nouvelles annotations ou le réajustement des échelles d’axes ne doit en aucun cas altérer les couleurs déjà validées par le comité éditorial.
La sauvegarde de ces matrices s’accomplit avec une fidélité absolue au moyen des formats d’échange sérialisés de NumPy, tels que les archives compressées binaires .npz, ou via des fichiers tabulaires à délimitation stricte. En liant explicitement l’index d’identification des variables empiriques aux triplets RVBA sauvegardés, l’analyste se dote d’un mécanisme de restauration déterministe indépendant de l’état du système d’exploitation ou de la version de la bibliothèque d’échantillonnage.
De surcroît, lors de l’exportation des figures vers des formats graphiques vectoriels normalisés comme le PDF ou le SVG, Matplotlib intègre nativement les définitions de couleurs directement au cœur de l’arborescence DOM vectorielle ou des instructions de flux de données PostScript. Cela garantit que la reproduction typographique sur papier ou la visualisation à des résolutions microscopiques préserve scrupuleusement les nuances chromatiques calculées lors de la phase de calcul initial.
9. Considérations psychophysiques et perception visuelle des couleurs aléatoires
9.1 Biais de perception induits par le hasard chromatique
L’attribution de couleurs purement stochastiques dans un graphique scientifique soulève d’importantes problématiques psychophysiques liées aux mécanismes de la perception visuelle humaine. Le système visuel n’agit pas comme un spectrophotomètre linéaire objectif : il amplifie, pondère et distord activement les stimuli lumineux en fonction de leur longueur d’onde, de leur luminance relative et du contexte géométrique environnant.
L’échantillonnage aléatoire uniforme dans l’espace RVB souffre d’un défaut conceptuel flagrant : l’hypercube unitaire physique ne présente aucune homogénéité perceptive. Ainsi, une variation numérique de 0.1 sur le canal vert engendre un contraste perçu infiniment plus puissant qu’une variation identique sur le canal bleu, en raison de la prépondérance évolutive des photorécepteurs de type M et L dans la rétine humaine. Ce phénomène induit une saillance visuelle asymétrique : certains points ou courbes générés aléatoirement vont capter arbitrairement l’attention cognitive de l’observateur au détriment d’autres éléments analytiquement plus pertinents.
De surcroît, les principes d’organisation perceptive énoncés par la théorie de la Gestalt démontrent que l’esprit humain regroupe spontanément les objets présentant des caractéristiques visuelles similaires (loi de similarité). Dès lors, si le hasard stochastique attribue par accident des teintes spectralement proches à des catégories sémantiquement indépendantes, l’observateur inférera inconsciemment l’existence d’une corrélation, d’un regroupement ou d’un lien fonctionnel parfaitement inexistant, introduisant un biais interprétatif majeur dans la lecture des données expérimentales.
9.2 Accessibilité visuelle et prise en compte du daltonisme
L’éthique scientifique et les directives contemporaines d’accessibilité numérique imposent que les figures publiées demeurent parfaitement déchiffrables par l’ensemble des membres de la communauté, y compris les personnes présentant des déficiences de la vision chromatique (dyschromatopsies), lesquelles affectent approximativement huit pour cent de la population masculine mondiale.
Les formes les plus répandues de dyschromatopsie, telles que la deutéranopie (déficience des récepteurs rétiniens au vert) et la protanopie (déficience des récepteurs au rouge), réduisent l’espace tridimensionnel des couleurs perçues à un espace dégénéré à deux dimensions. Lors d’une génération purement aléatoire de triplets RVB, la probabilité d’engendrer des paires de couleurs se projetant sur une ligne de confusion chromatique identique pour un individu dyschromate est extraordinairement élevée. Deux séries temporelles visualisées avec fierté par un chercheur trichromate normal peuvent ainsi devenir strictement indiscernables pour un relecteur deutéranope.
Pour contrer cette exclusion perceptuelle involontaire, il est fondamental d’intégrer des routines de simulation algorithmique des dyschromatopsies (à l’instar des matrices de transformation de Brettel ou de Machado) au sein des scripts de visualisation exploratoire, ou de contraindre le tirage stochastique à des axes de luminance et de saturation garantissant un contraste résiduel suffisant, même en l’absence totale de discrimination spectrale rouge-vert.
10. Techniques avancées : Nuances aléatoires contraintes et espaces perceptuels
10.1 Génération stochastique dans l’espace HSV et conversion en RVB
Afin de concilier la variété chromatique offerte par les méthodes stochastiques et l’indispensable équilibre perceptuel requis par la rigueur scientifique, la transition depuis l’espace géométrique RVB vers des modèles colorimétriques cylindriques orientés vers la perception humaine, tels que l’espace TSV (Teinte, Saturation, Valeur ou HSV en nomenclature internationale), s’impose comme une stratégie d’ingénierie élégante et puissante.
Dans le cylindre unitaire HSV, l’angle de teinte (Hue) décrit la nature spectrale de la couleur sur un cercle continu de 0 à 360 degrés (normalisé entre 0.0 et 1.0 dans les algorithmes logiciels), tandis que la saturation (Saturation) contrôle la pureté chromatique et la valeur (Value) quantifie la luminance énergétique brute de l’émission. Pour neutraliser les écarts brutaux de clarté qui polluent les tirages RVB directs, il suffit de figer la saturation et la valeur à des constantes scrupuleusement sélectionnées (par exemple, une saturation à 0.7 et une valeur à 0.95 pour obtenir des nuances vives et lumineuses) et de confiner l’aléa stochastique à la seule variable de teinte.
Le vecteur résultant, généré sous la forme (teinte_aléatoire, saturation_fixe, valeur_fixe), est subséquemment transmuté vers l’espace matriciel RVB sous-jacent au moyen de la routine hautement optimisée matplotlib.colors.hsv_to_rgb. Les couleurs ainsi produites jouissent d’une diversité spectrale totale tout en conservant une intensité lumineuse rigoureusement uniforme, éradiquant les disparités de contraste et offrant une harmonie visuelle exemplaire.
10.2 Algorithmes de rejet pour assurer un seuil de distance euclidienne minimale
Lorsque la cardinalité des catégories ou des séries graphiques demeure modérée (typiquement entre cinq et vingt entités distinctes), la méthode la plus rigoureuse sur le plan computationnel consiste à déployer un algorithme de tirage stochastique sous contrainte spatiale, fondé sur la méthode de rejet (ou échantillonnage de Monte-Carlo par rejet).
L’objectif algorithmique est de garantir qu’aucune paire de couleurs au sein de l’échantillon ne présente une proximité perceptive inférieure à un seuil critique préétabli, désigné conventionnellement par la variable epsilon. Pour ce faire, les candidats spectraux sont synthétisés séquentiellement de manière probabiliste. Chaque nouveau triplet candidat fait l’objet d’un calcul de distance matricielle euclidienne (ou d’une distance perceptuelle dans l’espace uniforme CIELAB via les formules d’écart de couleur Delta E) par rapport à l’ensemble des éléments déjà validés et insérés dans la liste d’attente.
Si la distance minimale séparant le candidat du point le plus proche de la collection est supérieure ou égale au seuil de démarcation géométrique requis, le candidat est définitivement accepté ; dans le cas contraire, il est instantanément rejeté et un nouveau tirage est exécuté. Cette boucle itérative se poursuit jusqu’à ce que le quota de nuances requis soit rigoureusement comblé. Ce mécanisme élimine mathématiquement tout risque de collisions chromatiques ou de quasi-doublons visuels, garantissant une séparabilité catégorielle optimale pour l’observateur final.
11. Optimisation des performances computationnelles pour le Big Data
11.1 Gestion de l’empreinte mémoire pour des nuages de très grande taille
Le traitement contemporain de jeux de données massifs en astrophysique, en génomique ou en apprentissage profond confronte régulièrement les ingénieurs à des nuages de points comptant plusieurs dizaines de millions d’enregistrements individuels. Dans ce contexte d’échelle critique, l’allocation naïve de matrices de couleurs stochastiques peut saturer de façon dramatique la mémoire vive (RAM) du système et dégrader catastrophiquement les performances d’exécution.
Par défaut, l’interpréteur Python et les générateurs de tableaux NumPy allouent les nombres à virgule flottante sous la forme de structures float64 (double précision IEEE 754), chaque scalaire mobilisant huit octets consécutifs. Pour une matrice RVBA de dix millions de lignes par quatre colonnes, cette convention impose une consommation brute de trois cent vingt mégaoctets de mémoire vive uniquement dédiée aux propriétés chromatiques, sans compter les coordonnées spatiales et les structures de rendu graphique sous-jacentes. En contraignant explicitement le type de données (dtype) à la simple précision float32, voire à des entiers non signés sur 8 bits uint8 combinés avec des représentations compressées, l’empreinte mémoire est instantanément divisée par deux ou par huit sans la moindre dégradation visuelle perceptible sur un écran conventionnel.
De surcroît, pour des volumétries atteignant des seuils asymptotiques extrêmes, les techniques de rendu par lots (chunking) permettent de fractionner la génération et la projection des flux chromatiques stochastiques, limitant l’empreinte mémoire instantanée et évitant le déclenchement de défaillances de pagination mémoire (swapping) fatales à la fluidité du calcul.
11.2 Comparaison de vitesse d’exécution entre approches vectorielles et boucles
L’architecture interne de l’interpréteur standard CPython est pénalisée par des pénalités temporelles significatives lors de l’exécution de boucles itératives pures, en raison de l’évaluation dynamique des types et de l’overhead syntaxique de l’interpréteur à chaque itération. La comparaison méthodique des performances temporelles entre une approche itérative artisanale et une implémentation purement vectorisée avec NumPy met en évidence des disparités monumentales.
L’utilisation d’une compréhension de liste combinée avec le module natif random de Python pour synthétiser un million de triplets chromatiques et les assigner individuellement à des primitives Matplotlib requiert un temps computationnel de plusieurs secondes, immobilisant l’unité centrale de traitement. À l’opposé, l’appel à la primitive unifiée rng.random((N, 3), dtype=np.float32) délègue l’intégralité du cycle d’échantillonnage à des sous-routines de bas niveau compilées en langage C et optimisées pour les architectures matérielles à instructions vectorielles SIMD (AVX-512 ou ARM Neon).
Le temps de traitement est ainsi réduit à quelques millisecondes, autorisant des cadences d’affichage compatibles avec la visualisation interactive en temps réel. Par ailleurs, l’injection directe de ce tenseur contigu au sein des collections graphiques spécialisées de Matplotlib, telles que PolyCollection ou PathCollection, contourne l’instanciation de millions d’objets Artist individuels, optimisant drastiquement le pipeline de tramage et de rendu raster vers le serveur graphique.
12. Guide méthodologique et synthèse des meilleures pratiques d’ingénierie
12.1 Encapsulation dans des fonctions utilitaires réutilisables
L’adoption des meilleures pratiques en matière d’ingénierie logicielle appliquée à la science des données impose de rejeter la duplication de code ad hoc au profit de la conception de bibliothèques utilitaires modulaires, testables et rigoureusement typées. Une fonction génératrice de couleurs stochastiques pour Matplotlib doit idéalement masquer la complexité algorithmique sous-jacente tout en exposant une interface programmatique paramétrable.
Une implémentation robuste doit prendre en charge la validation des assertions d’entrée, la gestion explicite des graines pseudo-aléatoires, le choix du modèle d’espace chromatique (RVB direct, espace cylindrique HSV ou extraction de colormaps), ainsi que le formatage du tenseur de sortie selon les exigences de l’API appelante (scalaires individuels, matrices pour nuages de points ou chaînes hexadécimales). Les annotations de type (type hints) conformes au standard PEP 484 et la documentation structurée selon les conventions académiques permettent d’intégrer harmonieusement ces modules au sein de grands pipelines logiciels de production.
L’interfaçage de telles fonctions utilitaires assure une cohérence stylistique transversale sur l’ensemble des figures d’une organisation de recherche, tout en diminuant substantiellement les risques de régression logicielle et d’incohérence visuelle au fil des itérations expérimentales.
12.2 Matrice décisionnelle pour le choix de la méthode stochastique
Le choix de la stratégie probabiliste de génération chromatique ne doit jamais être abandonné au hasard de la programmation impulsive ; il doit résulter d’une analyse systématique des contraintes fonctionnelles et perceptuelles du projet de recherche. Le tableau suivant synthétise les compromis structurels régissant les différentes approches méthodologiques examinées tout au long de ce traité.
- Échantillonnage uniforme direct dans [0, 1]³ (RVB) : Recommandé prioritairement pour les tests de charge computationnelle rapide et le prototypage d’ingénierie logicielle. Il offre une vitesse de calcul maximale mais souffre d’un encombrement perceptuel élevé et d’une esthétique médiocre.
- Échantillonnage angulaire sous contrainte dans l’espace HSV : Solution optimale pour la différenciation catégorielle de tracés linéaires multiples ou de séries temporelles non ordonnées. Il assure une luminance parfaitement constante et une esthétique soignée, au prix d’un coût de conversion trigonométrique mineur.
- Tirage stochastique indicé sur Colormaps continues : Recommandé formellement pour les visualisations destinées à la publication dans des revues internationales à comité de lecture. Il garantit une préservation totale des principes d’harmonie spectrale et de lisibilité séquentielle.
- Échantillonnage par rejet sous distance euclidienne minimale (Monte-Carlo) : Impératif absolu lorsque les graphiques intègrent un nombre restreint de classes (5 à 15) dont la distinction sans équivoque conditionne la validation scientifique des hypothèses expérimentales.
- Matrices RVBA avec alpha probabiliste : Recommandé sans réserve pour les diagrammes de dispersion massifs (Big Data) caractérisés par un taux d’occlusion géométrique important, permettant de substituer la densité optique à la saturation aveugle.
En alignant méticuleusement la méthode de génération chromatique sur les exigences cognitives de l’observateur et les contraintes computationnelles de l’architecture logicielle, le scientifique ou l’ingénieur transforme le hasard probabiliste en un instrument d’amplification visuelle d’une rigueur absolue.
Références
- Brettel, H., Viénot, F., & Mollon, J. D. (1997). Computerized simulation of color appearance for dichromats. Journal of the Optical Society of America A, 14(10), 2647-2655. https://doi.org/10.1364/JOSAA.14.002647
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Machado, G. M., Oliveira, M. M., & Fernandes, L. A. (2009). A physiologically-based model for simulation of color vision deficiency. IEEE Transactions on Visualization and Computer Graphics, 15(6), 1291-1298. https://doi.org/10.1109/TVCG.2009.113
- O’Donoghue, S. I., Baldi, B. F., Clark, S. J., Darling, A. E., Hogan, J. M., Kaur, S., … & Procter, J. B. (2018). Visualization of biological data: strategies for library selection and design. Nature Methods, 15(4), 277-290. https://doi.org/10.1038/nmeth.4607
- Porter, T., & Duff, T. (1984). Compositing digital images. ACM SIGGRAPH Computer Graphics, 18(3), 253-259. https://doi.org/10.1145/800031.808606
- Rouline, N. P. (2018). Scientific Visualization: Python & Matplotlib. Eurographics Association. https://inria.hal.science/hal-03427242
- Ware, C. (2019). Information Visualization: Perception for Design (4th ed.). Morgan Kaufmann. https://www.sciencedirect.com/book/9780128128275/information-visualization