
La modélisation statistique constitue le socle fondamental sur lequel repose l’édifice contemporain de la recherche empirique, qu’il s’agisse des sciences exactes, des sciences économiques ou des sciences du comportement. Parmi l’éventail des techniques quantitatives à la disposition du chercheur, la régression linéaire simple occupe une position cardinale, agissant simultanément comme une passerelle conceptuelle entre la statistique descriptive et l’inférence prédictive, et comme le fondement analytique de modèles plus sophistiqués tels que les modèles linéaires généralisés et les équations structurelles. Bien que la prolifération des environnements informatiques modernes permette d’exécuter ces modélisations en une fraction de seconde, la dépendance aveugle aux logiciels d’analyse engendre une déconnexion préjudiciable entre le praticien et les réalités arithmétiques sous-jacentes à ses conclusions empiriques.
Le calcul manuel d’une régression linéaire ne se réduit nullement à un exercice de style anachronique ou à une contrainte académique désuète. Il constitue une démarche pédagogique et épistémologique indispensable pour saisir la mécanique interne des estimateurs, comprendre la géométrie sous-jacente à la minimisation des erreurs et développer une vigilance critique face aux artéfacts d’arrondi ou aux violations des postulats de base. Décortiquer chaque sommation, manipuler individuellement les déviations quadratiques et dériver manuellement la pente et la constante permet de désacraliser l’algorithme et d’acquérir une véritable intuition mathématique des phénomènes d’association et de covariation.
Cet article propose un traité exhaustif, didactique et rigoureusement formalisé pour réaliser, étape par étape, une régression linéaire simple à la main. En s’appuyant sur un corpus numérique standardisé et documenté dans les moindres détails arithmétiques, nous explorerons les fondements théoriques des moindres carrés ordinaires, la constitution méthodique des matrices de calcul, l’estimation ponctuelle des coefficients, l’analyse approfondie de la qualité de l’ajustement via la décomposition de la variance, ainsi que l’inférence statistique et les tests d’hypothèses associés. Ce voyage analytique au cœur de la statistique manuelle restituera toute la beauté opératoire de la discipline tout en dotant le lecteur d’une maîtrise méthodologique pérenne.
1. Fondements théoriques et épistémologiques de la régression linéaire simple
1.1 Origine conceptuelle et utilité en méthodologie de recherche
L’émergence historique de la régression linéaire prend racine dans les travaux pionniers de Francis Galton à la fin du dix-neuvième siècle. En étudiant la transmission héréditaire de la taille humaine à travers les générations, Galton observa un phénomène singulier qu’il qualifia initialement de réversion vers la médiocrité, devenu par la suite la régression vers la moyenne. Il mit en évidence le fait que les enfants de parents exceptionnellement grands présentaient en moyenne une stature inférieure à celle de leurs géniteurs, se rapprochant de la moyenne de la population globale, tandis que les descendants de parents très petits manifestaient une tendance symétrique à être plus grands que leurs ascendants. Cette découverte empirique posa les jalons méthodologiques nécessaires pour formaliser la trajectoire moyenne d’une variable quantitative en fonction d’une autre.
Il est impératif d’établir une distinction épistémologique stricte entre la corrélation bivariée et la modélisation prédictive univariée. Tandis que le coefficient de corrélation linéaire standardisé quantifie la force et la direction de l’interdépendance symétrique entre deux variables sans présumer d’un statut causal ou directionnel, la régression linéaire brise cette symétrie. Elle postule l’existence d’une variable exogène (le prédicteur) dont les variations structurelles sont censées rendre compte, selon une trajectoire fonctionnelle déterminée, des fluctuations observées chez une variable endogène (le critère). Cette asymétrie conceptuelle modifie radicalement l’interprétation des résultats statistiques.
Dans le champ de la psychologie quantitative et de la recherche comportementale, la régression linéaire simple joue un rôle prépondérant pour sonder des relations fonctionnelles plausibles. Même si la démonstration formelle de la causalité exige un protocole expérimental rigoureux fondé sur la randomisation et le contrôle des variables parasites, la régression fournit le cadre quantitatif fondamental pour évaluer dans quelle mesure les variations d’une dimension psychologique, telle que le niveau de stress ou le volume d’entraînement, peuvent prédire avec précision une performance cognitive ou un temps de réaction.
1.2 Principe d’ajustement par la méthode des moindres carrés ordinaires (MCO)
La résolution de la régression linéaire repose de façon prédominante sur le critère d’ajustement développé indépendamment par Carl Friedrich Gauss et Adrien-Marie Legendre : la méthode des moindres carrés ordinaires (MCO). L’objectif analytique consiste à identifier, parmi l’infinité des droites envisageables dans le plan cartésien, celle qui minimise la somme globale des déviations quadratiques verticales mesurées entre les points empiriques observés et la trajectoire théorique prédite. Mathématiquement, ce critère s’exprime par la minimisation d’une fonction de coût représentant la somme des carrés des erreurs résiduelles.
D’un point de vue géométrique, cette démarche s’interprète avec élégance au sein de l’espace vectoriel euclidien à n dimensions. Le vecteur représentant la variable observée est projeté orthogonalement sur le sous-espace vectoriel engendré par le prédicteur et le vecteur unitaire associé à la constante. Cette projection orthogonale garantit avec certitude que la distance géométrique euclidienne entre le vecteur observé et le vecteur des valeurs ajustées est strictement minimale, ce qui confère à la méthode une robustesse mathématique irréfutable.
Le choix de minimiser le carré des déviations plutôt que leur valeur absolue découle d’avantages algébriques et statistiques fondamentaux. Sur le plan analytique, la fonction quadratique est différentiable de manière continue en tout point, autorisant l’annulation explicite des dérivées partielles pour obtenir des solutions analytiques uniques dites sous forme fermée. Sur le plan statistique, le célèbre théorème de Gauss-Markov stipule que sous des conditions d’application standard, les estimateurs des moindres carrés ordinaires sont les meilleurs estimateurs linéaires sans biais (désignés par l’acronyme anglophone BLUE pour Best Linear Unbiased Estimators), surpassant ainsi les estimateurs basés sur les déviations absolues en termes de variance minimale.
1.3 Postulats et conditions d’application du modèle linéaire classique
Pour que l’ajustement linéaire par les moindres carrés déploie ses garanties d’optimalité mathématique et autorise une inférence statistique valide, plusieurs hypothèses théoriques doivent impérativement être satisfaites. La première condition concerne la linéarité intrinsèque de la relation unissant la variable explicative à la variable expliquée. Cela postule que la fonction liant l’espérance conditionnelle du critère au prédicteur est une droite affine, excluant toute courbure asymptotique, exponentielle ou sinusoïdale non linéarisable par transformation préalable.
La deuxième condition réside dans l’homoscédasticité des erreurs résiduelles. Ce postulat exige que la variance des termes d’erreur demeure rigoureusement invariante sur l’ensemble de l’étendue des valeurs du prédicteur. Une situation d’hétéroscédasticité, caractérisée par une dispersion résiduelle grandissante ou rétrécissante à mesure que la variable indépendante croît, altère l’efficacité des estimateurs manuels et invalide le calcul conventionnel des erreurs types, rendant caducs les tests de significativité.
Enfin, le modèle classique requiert l’indépendance sérielle des termes d’erreur, stipulant une absence d’autocorrélation entre les résidus associés aux différentes unités d’observation. Pour assurer la légitimité des tests inférentiels ultérieurs (notamment le test de Student et l’intervalle de confiance), les perturbations aléatoires doivent suivre une distribution normale centrée sur zéro. Si les estimateurs de la pente et de l’interception demeurent sans biais même en l’absence de normalité grâce au théorème central limite sur de grands échantillons, la normalité exacte s’avère critique lors de l’exécution manuelle sur de petits échantillons.
2. Structure mathématique et définition rigoureuse des variables
2.1 Distinction formelle entre variable prédictive (X) et variable critère (Y)
L’élaboration méthodique d’un modèle de régression commence par l’assignation formelle du statut méthodologique des variables sous examen. La variable indépendante, conventionnellement désignée par la lettre majuscule X, est qualifiée de variable prédictive, explicative ou exogène. Elle représente la dimension manipulée par l’expérimentateur ou observée de manière passive en amont du processus, dont on souhaite évaluer l’incidence potentielle sur le phénomène d’intérêt. À l’opposé, la variable dépendante, symbolisée par la lettre majuscule Y, constitue la variable critère, expliquée ou endogène, reflétant la mesure comportementale, physique ou psychologique faisant l’objet de la prédiction.
L’application légitime des équations de la régression linéaire simple requiert impérativement que les données collectées répondent à des niveaux de mesure quantitatifs précis. Les variables X et Y doivent impérativement être mesurées sur des échelles d’intervalles égaux ou sur des échelles de rapports. L’utilisation de données purement ordinales ou nominales pour la variable dépendante violerait les axiomes arithmétiques sous-jacents aux opérations de sommation quadratique et de calcul des moyennes marginales, entraînant des distorsions mathématiques rédhibitoires.
Il est crucial de comprendre les conséquences méthodologiques majeures d’une inversion des axes lors du calcul manuel. Contrairement à la corrélation de Pearson, dont la valeur est invariante selon que l’on calcule la corrélation de X avec Y ou de Y avec X, la régression linéaire n’est pas commutative. La droite de régression de Y en fonction de X ne correspond nullement à la réciproque géométrique de la droite de régression de X en fonction de Y, en raison de la minimisation asymétrique des déviations calculées uniquement sur l’axe vertical du critère.
2.2 Formulation algébrique de la population versus équation d’échantillon
La rigueur statistique impose une dissociation conceptuelle stricte entre le modèle théorique formulé au niveau de la population parente et l’équation d’ajustement empirique dérivée à partir d’un échantillon fini d’observations. Dans la population, la relation stochastique idéale s’exprime sous la forme suivante : Y = beta_0 + beta_1 * X + epsilon. Dans cette expression, beta_0 représente le paramètre populationnel de l’ordonnée à l’origine, beta_1 symbolise la pente théorique de la population, et epsilon désigne la composante d’erreur aléatoire non observable, regroupant l’ensemble des facteurs non mesurés influençant Y.
À l’inverse, au niveau de l’échantillon empirique disponible pour l’expérimentateur, l’équation s’énonce selon une notation qui distingue explicitement l’estimation de la réalité populationnelle : y_chapeau = b_0 + b_1 * x. Dans cette formule, le symbole y_chapeau matérialise la prédiction conditionnelle issue du modèle, tandis que b_0 et b_1 constituent les estimations empiriques respectives des paramètres beta_0 et beta_1. L’écart existant entre une observation concrète y_i et son estimation ajustée correspondante y_chapeau_i est formalisé par le résidu empirique noté e_i.
Cette distinction met en lumière la nature probabiliste des estimateurs manuels : b_0 et b_1 sont des variables aléatoires tributaires de l’échantillonnage, sujettes à une variabilité d’échantillonnage intrinsèque. En vertu de la théorie asymptotique, lorsque la taille de l’échantillon tend vers l’infini, ces estimateurs convergent en probabilité vers les paramètres populationnels réels, ce qui garantit leur convergence et leur consistance sous les postulats classiques.
2.3 Présentation du jeu de données empirique de référence
Afin d’ancrer notre démonstration théorique dans une réalité computationnelle transparente, reproductible et accessible au calcul manuel, nous définissons un échantillon empirique contrôlé composé de sept paires d’observations numériques standardisées (n = 7). Ce corpus restreint a été méticuleusement calibré pour illustrer sans ambiguïté chaque rouage algébrique sans égarer le praticien sous une surcharge computationnelle superflue, tout en produisant des grandeurs numériques remarquablement claires.
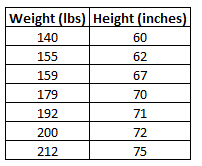
Considérons une investigation en psychologie cognitive évaluant l’incidence du nombre d’heures hebdomadaires dédiées à l’entraînement cérébral intensif (variable X) sur le score obtenu lors d’un test standardisé d’agilité mentale (variable Y). Les sept paires d’observations recueillies auprès de volontaires se distribuent comme suit : observation 1 : X = 1, Y = 3 ; observation 2 : X = 2, Y = 4 ; observation 3 : X = 3, Y = 5 ; observation 4 : X = 4, Y = 7 ; observation 5 : X = 5, Y = 8 ; observation 6 : X = 6, Y = 10 ; observation 7 : X = 7, Y = 12.
Le choix délibéré d’un échantillon de sept unités se justifie par des motifs didactiques stricts : il permet de conserver une traçabilité intégrale de chaque opération arithmétique sur une feuille de papier standard tout en intégrant une dispersion réaliste. Une analyse exploratoire préliminaire garantit l’absence d’aberrations numériques ou de valeurs extrêmes univariées qui pourraient fausser les calculs manuels ou exercer un levier disproportionné sur les estimateurs des moindres carrés.
3. Constitution méthodique du tableau de calcul préliminaire
3.1 Conception structurelle de la matrice de calcul tabulaire
L’exécution manuelle d’une régression linéaire requiert une discipline d’organisation matérielle sans faille pour prévenir l’apparition d’erreurs cognitives ou de glissements arithmétiques cumulatifs. L’outil préparatoire incontournable consiste en une matrice de calcul tabulaire disposée sous forme de colonnes harmonisées. Cette grille accueille successivement les identifiants d’observation, les données brutes, leurs transformations croisées et leurs puissances respectives, structurant l’esprit avant la phase d’agrégation sommatoire.
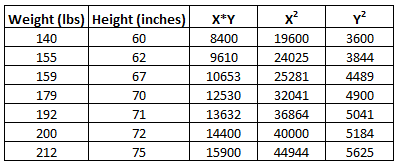
Pour un traitement rigoureux de notre problème à sept observations, la matrice computationnelle doit impérativement comporter cinq colonnes principales disposées côte à côte : la première colonne liste les valeurs observées de la variable indépendante X ; la deuxième colonne consigne les valeurs appariées de la variable dépendante Y ; la troisième colonne est expressément dédiée aux produits croisés individuels notés XY ; la quatrième colonne compile les carrés de la variable prédictive notés X² ; enfin, la cinquième colonne recense les carrés de la variable critère notés Y².
L’intérêt ergonomique et épistémologique de cette disposition matricielle réside dans la parcellisation des tâches computationnelles. En isolant chaque type d’opération mathématique élémentaire sur une ligne dédiée à une seule observation, le chercheur réduit drastiquement la charge cognitive de travail en mémoire immédiate, transformant une équation différentielle complexe en une série ordonnée de multiplications et d’additions élémentaires.
3.2 Calcul pas à pas des produits croisés individuels (X * Y)
La troisième colonne de notre tableau d’analyse est consacrée au calcul minutieux des produits croisés terme à terme. Chaque coordonnée individuelle de X doit être multipliée avec une précision absolue par la coordonnée correspondante de Y pour la même unité expérimentale. Dans notre corpus empirique où toutes les valeurs sont positives, les risques d’erreurs de signes sont momentanément écartés, mais il convient de maintenir une vigilance constante lors de l’application à des données centrées ou comportant des valeurs négatives.
Reprenons de façon séquentielle l’intégralité des sept calculs de produits croisés : pour le participant 1, nous multiplions 1 par 3, obtenant ainsi 3. Pour le participant 2, le produit de 2 par 4 engendre 8. Pour le participant 3, 3 multiplié par 5 produit 15. Pour le participant 4, 4 multiplié par 7 génère 28. Pour le participant 5, 5 multiplié par 8 produit 40. Pour le participant 6, 6 multiplié par 10 génère 60. Enfin, pour le participant 7, le produit de 7 par 12 équivaut exactement à 84. Chaque résultat intermédiaire doit être consigné avec clarté dans la colonne correspondante.
D’un point de vue conceptuel et géométrique, ce produit croisé XY ne constitue pas une simple curiosité arithmétique : il représente l’aire du rectangle délimité par les coordonnées du point dans l’espace euclidien bidimensionnel. Ce terme constitue l’élément constitutif de base de la covariance empirique non standardisée entre les deux grandeurs, mesurant dans quelle mesure des valeurs élevées de la variable X coïncident de manière conjointe avec des valeurs élevées de la variable Y.
3.3 Calcul systématique des carrés individuels (X² et Y²)
L’étape computationnelle subséquente implique l’élévation au carré de l’intégralité des observations univariées recueillies, d’abord pour la variable explicative X dans la quatrième colonne, puis pour la variable dépendante Y dans la cinquième colonne. Cette opération quadratique est au cœur de l’estimation par les moindres carrés, car elle permettra ultérieurement de quantifier la variabilité totale et la dispersion marginale de chacune des dimensions étudiées.
Appliquons cette procédure systématique à la colonne du prédicteur X : 1 élevé au carré donne 1 ; 2 au carré donne 4 ; 3 au carré donne 9 ; 4 au carré équivaut à 16 ; 5 au carré donne 25 ; 6 au carré produit 36 ; et enfin, 7 au carré produit 49. La colonne X² se trouve ainsi intégralement documentée avec les valeurs numériques [1, 4, 9, 16, 25, 36, 49]. L’homogénéité de ces carrés permet une traçabilité visuelle immédiate pour détecter toute coquille arithmétique.
Procédons de manière analogue pour la colonne de la variable dépendante Y : 3 élevé au carré donne 9 ; 4 au carré engendre 16 ; 5 au carré génère 25 ; 7 au carré donne 49 ; 8 au carré produit 64 ; 10 au carré équivaut à 100 ; et 12 élevé au carré produit 144. La colonne Y² accueille par conséquent la série ordonnée [9, 16, 25, 49, 64, 100, 144]. Il est primordial de souligner la distinction logique absolue entre le carré d’une somme globale et la somme des valeurs individuelles préalablement élevées au carré, confusion classique qui vicie un grand nombre de calculs débutants.
4. Agrégation des sommations statistiques fondamentales
4.1 Calcul des sommes d’observations brutes (Sigma X et Sigma Y)
La matrice de calcul préliminaire étant exhaustivement complétée au niveau de ses lignes individuelles, la phase suivante réside dans l’agrégation cumulative verticale des valeurs réparties dans les colonnes. Cette opération sommatoire, formalisée par l’opérateur sigma majuscule, fournit les briques fondamentales qui alimenteront les équations finales de la régression. La première sommation concerne la colonne des prédicteurs bruts afin d’obtenir Sigma X.
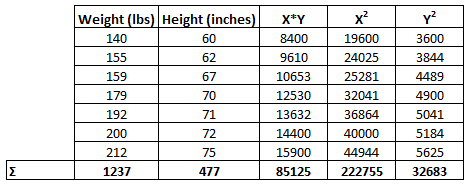
En effectuant l’addition manuelle séquentielle des sept scores de X, nous obtenons : 1 + 2 = 3 ; 3 + 3 = 6 ; 6 + 4 = 10 ; 10 + 5 = 15 ; 15 + 6 = 21 ; 21 + 7 = 28. Par conséquent, Sigma X équivaut rigoureusement à 28. Simultanément, la taille d’échantillon d’observations appariées est formellement fixée à n = 7. Il devient immédiatement possible de déterminer la moyenne arithmétique marginale de la variable indépendante, notée x_barre, par le quotient classique : x_barre = Sigma X / n = 28 / 7 = 4,0000.
Nous réalisons exactement la même addition arithmétique sur la deuxième colonne dédiée à la variable critère Y pour extraire Sigma Y : 3 + 4 = 7 ; 7 + 5 = 12 ; 12 + 7 = 19 ; 19 + 8 = 27 ; 27 + 10 = 37 ; 37 + 12 = 49. Nous établissons donc de façon péremptoire que Sigma Y = 49. La moyenne arithmétique marginale de la variable expliquée, notée y_barre, se dérive sans délai : y_barre = Sigma Y / n = 49 / 7 = 7,0000. Le fait d’obtenir des moyennes marginales entières confirme l’élégance numérique de notre jeu de données.
4.2 Consolidation des sommes quadratiques et des produits croisés
L’agrégation verticale doit désormais se poursuivre avec une rigueur absolue sur les trois colonnes transformées restantes. En premier lieu, agrégeons la troisième colonne renfermant les produits croisés individuels afin de déterminer la quantité cardinale notée Sigma XY. En sommant manuellement : 3 + 8 = 11 ; 11 + 15 = 26 ; 26 + 28 = 54 ; 54 + 40 = 94 ; 94 + 60 = 154 ; 154 + 84 = 238. Ainsi, Sigma XY atteint précisément 238.
Portons notre effort sur la quatrième colonne rassemblant les carrés individuels du prédicteur pour calculer Sigma X². L’addition séquentielle révèle : 1 + 4 = 5 ; 5 + 9 = 14 ; 14 + 16 = 30 ; 30 + 25 = 55 ; 55 + 36 = 91 ; 91 + 49 = 140. Nous enregistrons donc Sigma X² = 140. Cette quantité mesure l’inertie brute du prédicteur autour de l’origine euclidienne et constituera l’élément central du dénominateur de nos coefficients.
Enfin, nous consolidons la cinquième et dernière colonne contenant les carrés de la variable dépendante afin de dégager Sigma Y², grandeur indispensable à l’évaluation subséquente de la qualité d’ajustement global du modèle. L’addition manuelle produit : 9 + 16 = 25 ; 25 + 25 = 50 ; 50 + 49 = 99 ; 99 + 64 = 163 ; 163 + 100 = 263 ; 263 + 144 = 407. Par conséquent, Sigma Y² = 407. Nous disposons dorénavant d’un quintuplet de sommations consolidées : n = 7, Sigma X = 28, Sigma Y = 49, Sigma XY = 238, Sigma X² = 140, et Sigma Y² = 407.
4.3 Techniques d’audit et de contrôle de précision arithmétique
Avant d’engager ces valeurs consolidées dans les formules analytiques d’estimation, un protocole d’audit et de contrôle de précision s’avère indispensable pour neutraliser tout risque de bévue computationnelle. L’une des techniques manuelles les plus efficaces réside dans la double sommation inversée. Elle consiste à réitérer l’intégralité des additions en partant du bas du tableau vers le haut (par exemple, pour Sigma XY : 84 + 60 + 40 + 28 + 15 + 8 + 3 = 238), ce qui déjoue les biais cognitifs d’anticipation mentale.
Le piège arithmétique le plus fréquent en régression linéaire manuelle découle de la confusion funeste entre la somme des carrés Sigma (X²) et le carré de la somme globale, noté (Sigma X)². Dans notre cas présent, Sigma X² est rigoureusement égal à 140, tandis que le carré de la somme équivaut à 28 au carré, soit 28 * 28 = 784. L’interversion de ces deux grandeurs numériques aboutit invariablement à des valeurs de dénominateurs absurdes ou négatives qui détruisent l’intégralité de l’édifice mathématique.
De surcroît, le chercheur opérant manuellement doit s’imposer une discipline drastique quant à la manipulation des décimales lors de jeux de données moins harmonieux. L’arrondi prématuré d’un résultat intermédiaire au stade des sommations engendre une propagation cumulative d’erreurs d’arrondi susceptible de modifier substantiellement la pente estimée. Il est conventionnellement prescrit de conserver l’intégralité des fractions rationnelles ou un seuil minimal de quatre à six décimales lors des phases intermédiaires du calcul.
5. Dérivation analytique et calcul manuel de la pente (b1)
5.1 Explicitation de la formule de calcul de la pente de régression
La pente de la droite d’ajustement, universellement désignée par le coefficient b_1, quantifie l’inclinaison directionnelle de la modélisation et formalise l’ampleur du changement escompté sur l’axe du critère consécutivement à une modification unitaire du prédicteur. Dans sa forme algébrique brute la plus robuste pour le calcul manuel direct sans recours aux déviations moyennes, la formule s’énonce selon le ratio standard : b_1 = [n * (Sigma XY) – (Sigma X) * (Sigma Y)] / [n * (Sigma X²) – (Sigma X)²].
Il est fondamental de reconnaître l’identité mathématique parfaite qui relie cette formulation computationnelle brute à la définition conceptuelle de la pente issue du calcul différentiel. En divisant le numérateur et le dénominateur de cette fraction par le facteur n², cette équation se réécrit comme le ratio strict de la covariance empirique entre X et Y divisée par la variance empirique de la variable prédictive X : b_1 = Cov(X, Y) / Var(X).
Cette décomposition révèle la beauté intrinsèque de l’estimateur des moindres carrés. Le numérateur, n * (Sigma XY) – (Sigma X) * (Sigma Y), représente la mesure de la covariation conjointe non standardisée unissant les deux dimensions, traduisant dans quelle mesure les deux variables oscillent en synergie. À l’inverse, le dénominateur, n * (Sigma X²) – (Sigma X)², matérialise l’inertie propre ou la dispersion autonome de la variable indépendante X, agissant comme un facteur de normalisation dimensionnelle.
5.2 Substitution numérique pas à pas dans l’équation de la pente
Engageons désormais la substitution méthodique de nos grandeurs sommatoires consolidées au sein de l’équation générale de la pente. Remplaçons scrupuleusement chaque symbole par son équivalent numérique déterminé à la section précédente : n = 7, Sigma XY = 238, Sigma X = 28, Sigma Y = 49, et Sigma X² = 140.
Attelons-nous d’abord à la résolution intégrale du bloc supérieur constituant le numérateur :
Numérateur = 7 * 238 – 28 * 49.
Exécutons la première multiplication manuelle : 7 * 238.
7 * 200 = 1400 ; 7 * 30 = 210 ; 7 * 8 = 56.
1400 + 210 + 56 = 1666.
Exécutons à présent le produit de Sigma X par Sigma Y : 28 * 49.
Nous pouvons décomposer : 28 * (50 – 1) = 1400 – 28 = 1372.
Il ne reste plus qu’à accomplir la soustraction algébrique entre ces deux produits :
Numérateur = 1666 – 1372 = 294. Le numérateur net s’établit de façon irrévocable à 294.
Portons à présent notre effort sur le bloc inférieur formant le dénominateur :
Dénominateur = 7 * 140 – (28)².
Exécutons la multiplication du premier terme : 7 * 140 = 980.
Calculons l’élévation au carré de Sigma X : 28 * 28.
28 * 20 = 560 ; 28 * 8 = 224 ; 560 + 224 = 784.
Exécutons ensuite la soustraction terminale au sein du bloc :
Dénominateur = 980 – 784 = 196.
Le dénominateur net s’élève donc avec une absolue netteté à 196. Ce résultat strictement positif confirme que la variable indépendante manifeste une dispersion non nulle, condition indispensable à l’existence mathématique de la régression.
5.3 Finalisation de la division et extraction du coefficient b1
L’extraction de la pente b_1 découle de la division du numérateur résolu par le dénominateur résolu :
b_1 = 294 / 196.
Face à cette fraction rationnelle, procédons à une simplification systématique par étapes pour vérifier la faisabilité d’une réduction manuelle exacte avant de poser une division longue à virgule.
Observons que 294 et 196 sont des nombres pairs divisibles par 2 :
294 / 2 = 147 ; 196 / 2 = 98.
La fraction devient 147 / 98.
Examinons la divisibilité par 7 :
147 = 7 * 21 ; 98 = 7 * 14.
La fraction se réduit à 21 / 14.
Divisons à nouveau le numérateur et le dénominateur par le facteur commun 7 :
21 / 7 = 3 ; 14 / 7 = 2.
La fraction irréductible finale est donc exactement égale à 3/2.
L’exécution de la division simple 3 divisé par 2 produit sans aucune approximation le score décimal suivant :
b_1 = 1,5000.
Le signe algébrique de notre pente est indéniablement positif (+1,5000), attestant sans équivoque d’une relation fonctionnelle ascendante : toute augmentation de la variable prédictive s’accompagne d’une progression systématique de la variable dépendante. L’amplitude brute de 1,5000 signifie que chaque heure supplémentaire dédiée à l’entraînement engendre en moyenne une majoration de 1,5 point sur le score du test cognitif.
6. Calcul rigoureux de l’ordonnée à l’origine (b0)
6.1 Formulation algébrique standard pour l’interception
L’ordonnée à l’origine, universellement formalisée sous le symbole b_0 (ou parfois désignée comme la constante d’interception a dans les manuels francophones traditionnels), correspond à la valeur théorique prédite pour la variable dépendante Y lorsque la variable indépendante X adopte une valeur strictement égale à zéro. Elle définit le point exact de franchissement où la droite d’ajustement coupe l’axe vertical des ordonnées dans le repère cartésien.
Pour le calcul manuel direct fondé sur les sommes brutes consolidées, la formule globale condensée s’exprime selon l’équation :
b_0 = [(Sigma Y) * (Sigma X²) – (Sigma X) * (Sigma XY)] / [n * (Sigma X²) – (Sigma X)²].
L’architecture de cette formule présente un avantage logistique majeur lors d’un calcul à la main : le dénominateur de l’interception est rigoureusement identique au dénominateur préalablement résolu lors de l’estimation de la pente b_1, ce qui évite de recalculer cette quantité.
Parallèlement à cette formule brute intégrée, il existe une formulation alternative nettement plus concise, directement dérivée de la propriété centroïdale de la régression des moindres carrés ordinaires :
b_0 = y_barre – b_1 * x_barre.
Cette égalité fondamentale prouve que la droite d’ajustement passe obligatoirement par le centre de gravité marginal des données, défini par le point de coordonnées (x_barre, y_barre). Nous utiliserons successivement ces deux démarches pour garantir une validation croisée irréprochable de notre calcul manuel.
6.2 Application de la formule brute et calcul des termes croisés
Mettons d’abord en œuvre la formule computationnelle brute globale en substituant nos valeurs sommatoires consolidées au sein du numérateur spécifique de b_0 :
Numérateur de b_0 = (Sigma Y) * (Sigma X²) – (Sigma X) * (Sigma XY).
Rappelons nos données agrégées : Sigma Y = 49, Sigma X² = 140, Sigma X = 28, et Sigma XY = 238.
Calculons le premier bloc multiplicatif : 49 * 140.
Décomposons manuellement l’opération :
49 * 140 = (50 – 1) * 140 = 7000 – 140 = 6860.
Calculons le second bloc multiplicatif : 28 * 238.
Décomposons manuellement l’opération :
28 * 238 = 28 * 200 + 28 * 30 + 28 * 8.
28 * 200 = 5600 ; 28 * 30 = 840 ; 28 * 8 = 224.
5600 + 840 + 224 = 6664.
Soustrayons désormais le second produit du premier pour dégager le numérateur de l’interception :
Numérateur de b_0 = 6860 – 6664 = 196.
Rappelons le dénominateur invariant résolu à la section 5.2, qui s’élève exactement à 196.
Nous procédons à la division finale pour isoler l’ordonnée à l’origine :
b_0 = 196 / 196 = 1,0000.
Le calcul manuel brut aboutit avec une prodigieuse netteté à un entier strict : la constante d’interception b_0 s’établit très exactement à 1,0000.
6.3 Validation croisée via la méthode des moyennes marginales
Pour parachever l’audit de cette valeur fondamentale et consolider notre confiance arithmétique, mettons à l’épreuve l’approche simplifiée fondée sur les moyennes d’échantillon marginales :
b_0 = y_barre – b_1 * x_barre.
Cette démarche est particulièrement plébiscitée dans la pratique universitaire en raison de sa fulgurance computationnelle lorsque les moyennes marginales et la pente sont déjà isolées.
Réinsérons les valeurs que nous avons déjà formellement déterminées :
y_barre = 7,0000 ;
x_barre = 4,0000 ;
b_1 = 1,5000.
Exécutons manuellement le produit de la pente empirique par la moyenne de la variable prédictive :
b_1 * x_barre = 1,5000 * 4,0000 = 6,0000.
Exécutons désormais la soustraction finale à partir de la moyenne marginale du critère :
b_0 = 7,0000 – 6,0000 = 1,0000.
La concordance absolue entre le résultat issu de la formule computationnelle brute globale (196 / 196 = 1,0000) et celui produit par la méthode centroïdale des moyennes (7 – 6 = 1,0000) offre une démonstration éclatante de l’exactitude sans faille de nos calculs manuels. Le modèle d’estimation est désormais intégralement paramétré : la pente s’élève à 1,5 et l’ordonnée à l’origine se fixe à 1.
7. Formulation et modélisation de l’équation de régression finale
7.1 Assemblage des composantes structurelles de l’équation estimée
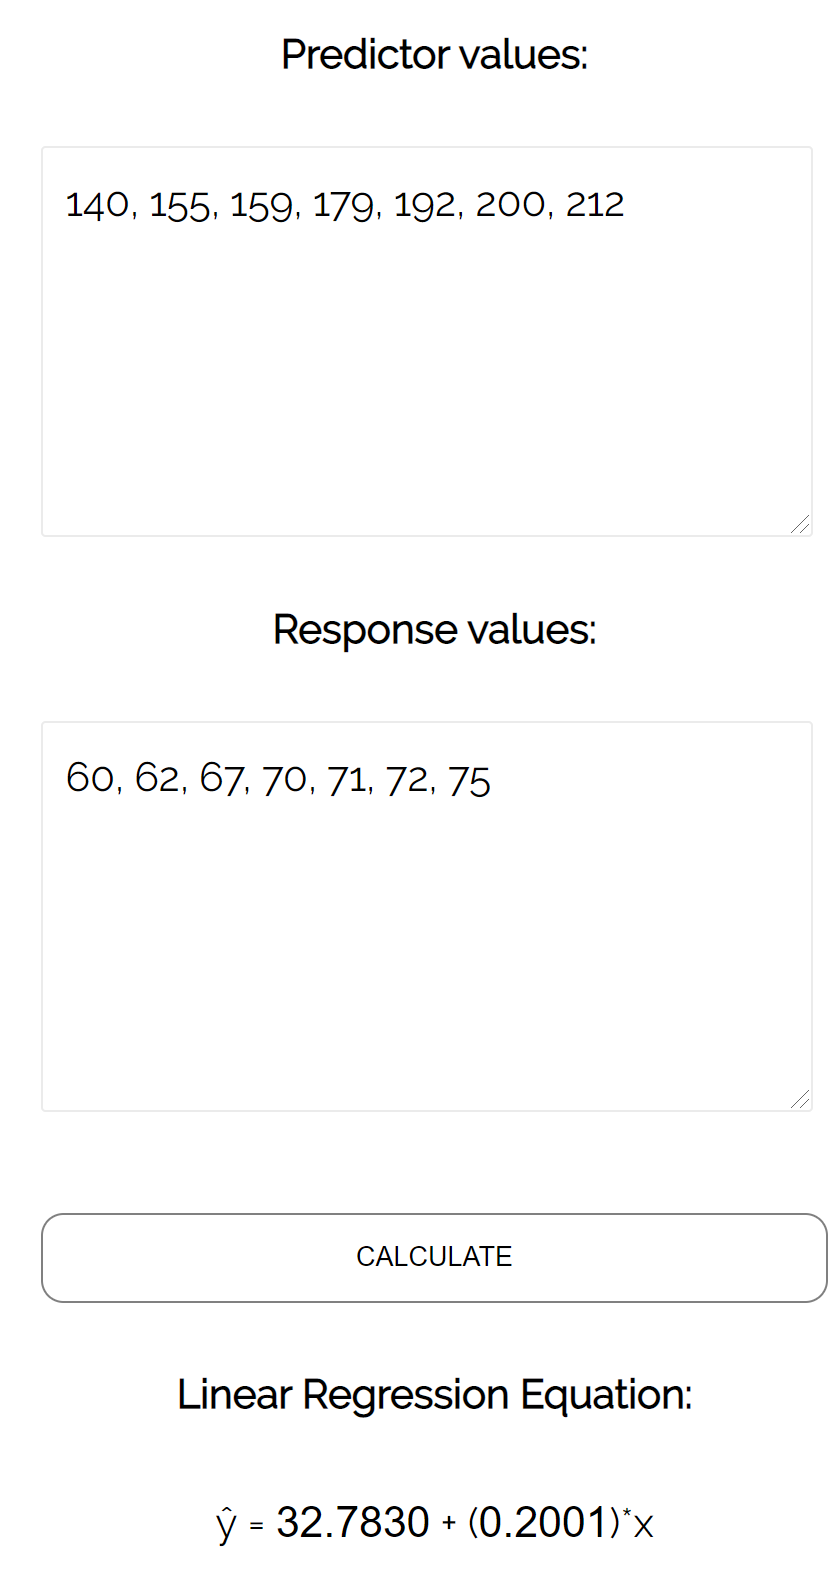
Après avoir dérivé analytiquement les coefficients fondamentaux régissant la trajectoire de modélisation, l’étape logique consiste à assembler formellement ces paramètres au sein de la fonction prédictive finale. En substituant b_0 = 1,0000 et b_1 = 1,5000 dans la structure générique de régression d’échantillon, nous formulons l’équation d’ajustement suivante :
y_chapeau = 1,0000 + 1,5000 * x.
Il est impératif, tant sur le plan épistémologique que typographique, d’insister sur la présence fondamentale de l’accent circonflexe surmontant le critère (y_chapeau). Cette marque symbolise qu’il s’agit d’une prédiction théorique conditionnelle déterministe, et non de la mesure empirique observée brute (y). L’omission de ce chapeau constituerait une faute conceptuelle grave, amalgamant la réalité concrète et sa réduction mathématique idéalisée.
Cette équation linéaire finale possède un domaine de validité empirique strictement délimité par l’intervalle des valeurs observées au sein de notre échantillon d’apprentissage, c’est-à-dire le segment fermé [1 ; 7] pour la variable X. Revendiquer l’application aveugle de cette fonction au-delà de ces frontières expérimentales relève d’une transgression méthodologique majeure que tout chercheur averti se doit de proscrire formellement.
7.2 Génération de prédictions ponctuelles à partir du modèle manuel
L’utilité pragmatique de la régression réside dans sa capacité à opérer des prédictions ponctuelles pour des valeurs déterminées du prédicteur. Pour concrétiser cette mécanique, sélectionnons par exemple une valeur intermédiaire de la variable indépendante au sein de l’intervalle expérimental, par exemple un individu s’entraînant durant X = 4,5 heures par semaine, score qui ne figurait pas dans le corpus brut d’origine.
Insérons cette valeur au sein de notre équation manuelle finalisée :
y_chapeau = 1,0000 + 1,5000 * (4,5).
Exécutons la multiplication manuelle du prédicteur par le coefficient de pente :
1,5 * 4,5 = 1,5 * (4 + 0,5) = 6,0 + 0,75 = 6,75.
Ajoutons ensuite la constante d’interception :
y_chapeau = 1,0000 + 6,75 = 7,7500.
Le modèle manuel prédit donc sans ambiguïté qu’un individu investissant 4,5 heures d’entraînement hebdomadaire obtiendra un score moyen d’agilité cognitive de 7,75 points.
Cette opération d’interpolation doit être soigneusement distinguée de l’extrapolation hors échantillon. Si l’on tentait de prédire le score d’un individu s’entraînant 25 heures par semaine en utilisant notre équation (aboutissant à un score théorique de 1 + 1,5 * 25 = 38,5), nous commettrions une imprudence épistémologique majeure. En effet, rien ne garantit que les processus biologiques et cognitifs maintiennent une trajectoire linéaire à des intensités extrêmes ; des phénomènes d’épuisement, de saturation ou de rendements décroissants sont susceptibles d’infléchir la courbe dans des zones non observées.
7.3 Représentation graphique manuelle de la droite d’ajustement
La matérialisation graphique de la régression linéaire constitue l’aboutissement visuel du travail arithmétique. Pour tracer manuellement la droite d’ajustement avec une précision millimétrique sur du papier millimétré, l’expérimentateur doit d’abord esquisser un repère cartésien orthogonal doté d’une échelle proportionnelle adaptée : l’axe des abscisses accueille la variable indépendante X (graduée de 0 à 8), tandis que l’axe des ordonnées reçoit le critère Y (gradué de 0 à 14).
Le premier point cardinal à placer sur le repère cartésien est le point d’ordonnée à l’origine, correspondant à l’interception : pour X = 0, nous positionnons le repère exactement à Y = 1,0000 sur l’axe vertical. Ce point ancre physiquement le point de départ théorique du modèle.
Le second repère indispensable n’est autre que le point centroïde de gravité, formalisé par le couple de moyennes marginales (x_barre, y_barre) = (4,0000 ; 7,0000). Il constitue une propriété géométrique inviolable des moindres carrés ordinaires : la droite d’ajustement passe obligatoirement et rigoureusement par ce centre d’inertie. En reliant à la règle le point d’interception (0 ; 1) et le centre de gravité (4 ; 7), puis en prolongeant le segment jusqu’aux frontières de l’échantillon, on matérialise la droite d’ajustement optimale. On peut constater que le point correspondant à l’extrémité supérieure, pour X = 7, croise exactement l’ordonnée Y = 1 + 1,5 * 7 = 11,5.
8. Interprétation substantielle des paramètres statistiques estimés
8.1 Signification statistique et interprétation pratique du coefficient de pente (b1)
Sur le plan de la métrologie quantitative, le coefficient de pente b_1 incarne le taux de variation marginale de la variable dépendante par unité d’accroissement du prédicteur. Dans notre application concrète, la valeur b_1 = 1,5000 stipule que chaque heure additionnelle consacrée à l’entraînement cérébral se traduit par un gain moyen prédit de 1,5 point sur l’échelle d’évaluation cognitive. Il s’agit d’une quantification directe de l’intensité de la réponse du système étudié aux incitations de la dimension explicative.
Il est crucial de dissocier la significativité statistique de la pertinence clinique ou substantielle. Un coefficient de pente peut s’avérer hautement significatif sur un très large échantillon tout en possédant une magnitude tellement infime qu’elle s’avère dépourvue d’utilité pratique concrète. Dans notre cas d’espèce, un gain de 1,5 point par heure constitue une magnitude substantielle très marquée, susceptible de justifier la mise en place d’interventions pédagogiques ou de protocoles de remédiation cognitive.
Le signe algébrique positif traduit une dynamique de renforcement mutuel ou de synergie fonctionnelle : les deux variables évoluent dans le même sens. À l’inverse, si nous avions mesuré le nombre d’erreurs commises au test plutôt que le score de réussite, nous aurions immanquablement obtenu une pente négative, illustrant un processus de réduction de la défaillance à mesure que l’entraînement s’accroît, manifestant ainsi une trajectoire descendante dans le plan.
8.2 Sens théorique et limites d’interprétation de la constante d’interception (b0)
La constante d’interception b_0 spécifie le niveau de base attendu pour la variable réponse Y lorsque le prédicteur X s’annule complètement. Dans notre modélisation, b_0 = 1,0000 suggère qu’un individu qui ne consacrerait aucune heure d’entraînement par semaine (X = 0) obtiendrait néanmoins un score moyen de départ de 1 point au test d’agilité mentale, reflétant une compétence cognitive résiduelle minimale ou le niveau plancher intrinsèque de l’instrument psychométrique.
Cependant, l’interprétation substantielle de l’ordonnée à l’origine exige une réserve épistémologique scrupuleuse. Très souvent en psychologie, en sociologie ou en médecine, la valeur X = 0 est dénuée de sens physique ou empirique (par exemple, un poids corporel nul, une pression artérielle nulle ou un quotient intellectuel nul). Dans de telles configurations, interpréter directement b_0 conduit à des contresens notoires, la constante n’agissant alors que comme un ancrage géométrique abstrait servant à caler la droite à la bonne hauteur dans l’espace euclidien.
Pour remédier à cette limite interprétative lorsque le zéro naturel est inexistant ou distant des données, la littérature méthodologique préconise fréquemment le recours à la technique du centrage sur la moyenne. En soustrayant la moyenne x_barre à chaque valeur individuelle de X avant la modélisation, le nouveau prédicteur centré adopte une valeur de zéro précisément au niveau du profil moyen de l’échantillon. Dès lors, la nouvelle constante d’interception qui en résulte devient rigoureusement identique à la moyenne marginale du critère y_barre, acquérant instantanément une signification théorique robuste et directement exploitable.
8.3 Mise en contexte dans l’évaluation psychométrique et expérimentale
Au-delà de la mécanique linéaire brute, l’intégration contextuelle des paramètres statistiques estimés s’avère déterminante dans les protocoles d’évaluation psychométrique. La droite de régression ne doit jamais être interprétée comme un destin déterministe rigide auquel chaque individu serait inexorablement assujetti, mais bien comme une ligne d’espérance conditionnelle moyenne autour de laquelle gravite la variabilité humaine naturelle.
L’observation des déviations individuelles par rapport à la trajectoire modélisée constitue une mine d’informations diagnostiques. Un participant dont la performance réelle se situe largement au-dessus de la valeur ajustée par le modèle présente des caractéristiques protectrices ou des aptitudes compensatoires méritant une investigation clinique approfondie. Réciproquement, une observation chutant nettement sous la droite suggère la présence de facteurs d’inhibition ou d’interférences cognitives non captées par le modèle univarié.
Toute décision prise sur le fondement d’une régression manuelle en contexte d’orientation professionnelle, de sélection éducative ou de diagnostic médical doit être assortie d’une conscience aiguë des limites d’échantillonnage. Les paramètres calculés b_0 = 1 et b_1 = 1,5 ne constituent que les propriétés d’un groupe circonscrit de sept individus observés à un instant temporel précis. Toute généralisation hâtive sans réplication empirique sur des échantillons diversifiés exposerait le praticien à des erreurs déontologiques et scientifiques majeures.
9. Évaluation manuelle de la qualité d’ajustement et décomposition de la variance
9.1 Calcul de la somme des carrés totaux (SST) à la main
Avoir déterminé la droite d’ajustement ne garantit en rien que cette dernière modélise fidèlement le phénomène étudié. Pour quantifier la pertinence statistique de la droite, il est indispensable de procéder à la décomposition de la variance globale de la variable dépendante Y. Cette démarche analytique commence par le calcul manuel de la somme des carrés totaux, traditionnellement abrégée sous le sigle SST (pour Total Sum of Squares), qui mesure l’inertie globale des scores observés par rapport à leur propre moyenne marginale.
Pour s’affranchir du calcul lourd des écarts individuels à la moyenne, nous privilégions la formule computationnelle simplifiée équivalente :
SST = Sigma Y² – [(Sigma Y)² / n].
Cette égalité découle directement du développement algébrique de la variance non corrigée. Introduisons dans cette formule nos agrégats numériques consolidés à la section 4 : Sigma Y² = 407, Sigma Y = 49, et n = 7.
Calculons le terme soustractif :
(Sigma Y)² = (49)² = 2401.
Divisons ce carré par la taille de l’échantillon n = 7 :
2401 / 7.
Posons la division manuelle :
24 divisé par 7 donne 3 (reste 3) ; 30 divisé par 7 donne 4 (reste 2) ; 21 divisé par 7 donne exactement 3.
Le quotient s’élève donc exactement à 343.
Il suffit désormais de finaliser la soustraction :
SST = 407 – 343 = 64,0000.
La variabilité globale observée au sein de notre critère Y s’établit très rigoureusement à 64 unités quadratiques, servant d’étalon de référence pour la suite des calculs.
9.2 Calcul de la somme des carrés de la régression (SSR) et des résidus (SSE)
L’édifice des moindres carrés repose sur la décomposition fondamentale de cette variabilité totale en deux composantes orthogonales et étanches : la variance expliquée par le modèle prédictif linéaire, baptisée somme des carrés de la régression (SSR pour Regression Sum of Squares), et la variance résiduelle inexpliquée, qualifiée de somme des carrés des erreurs (SSE pour Error Sum of Squares), de sorte que l’on vérifie systématiquement l’identité : SST = SSR + SSE.
Pour déterminer manuellement SSR sans recourir aux valeurs prédites individuelles, nous utilisons la formule de calcul direct :
SSR = b_1 * [Sigma XY – (Sigma X * Sigma Y) / n].
Rappelons que le terme entre crochets correspond précisément au numérateur de la covariance que nous avions résolu à la section 5.2, mais non multiplié par n.
Calculons le terme entre crochets :
238 – (28 * 49) / 7.
28 / 7 = 4 ; 4 * 49 = 196.
Le terme entre crochets devient : 238 – 196 = 42.
Multiplions désormais cette quantité par la pente b_1 = 1,5 :
SSR = 1,5 * 42 = 63,0000.
La droite de régression linéaire manuelle parvient donc à capter à elle seule 63 unités quadratiques de variabilité.
L’isolement de la somme des carrés résiduels (SSE) découle alors d’une simple soustraction fondamentale :
SSE = SST – SSR = 64,0000 – 63,0000 = 1,0000.
L’ensemble des résidus du modèle linéaire ne génère donc qu’une dispersion minime d’une seule unité quadratique. Cette décomposition démontre avec force la proximité exceptionnelle des points expérimentaux avec la droite théorique estimée.
9.3 Calcul et interprétation du coefficient de détermination (R²)
La synthèse métrologique de la qualité de l’ajustement s’incarne dans le célèbre coefficient de détermination, universellement symbolisé par R². Cet indice adimensionnel exprime la proportion exacte de variance du critère directement expliquée ou absorbée par le prédicteur à travers le prisme de la régression linéaire. Il se formalise par le rapport canonique de la somme expliquée sur la somme totale :
R² = SSR / SST.
Insérons immédiatement nos valeurs de variance décomposées :
R² = 63,0000 / 64,0000.
Posons la division manuelle pour extraire les décimales avec précision :
63 / 64 = (64 – 1) / 64 = 1 – (1 / 64).
Sachant que 1 / 64 = 0,015625, nous obtenons :
R² = 1 – 0,015625 = 0,984375, soit environ 0,9844 en arrondissant à la quatrième décimale.
Ce résultat remarquable signifie que 98,44 % de la variabilité globale des scores de performance cognitive au sein de cet échantillon est structurellement expliquée par le volume horaire d’entraînement hebdomadaire. Soulignons la relation mathématique directe unissant cet indice au coefficient de corrélation linéaire de Bravais-Pearson : en régression simple, r correspond exactement à la racine carrée de R² assortie du signe de la pente. Ici, r = racine_carrée(0,984375) = +0,9922, dénotant une corrélation positive quasi parfaite. Toutefois, un R² élevé ne doit jamais dispenser le chercheur d’une inspection rigoureuse de la répartition des résidus.
10. Analyse manuelle des résidus et calcul de l’erreur type d’estimation
10.1 Calcul exhaustif des valeurs prédites individuelles et des résidus bruts
Pour parfaire l’évaluation diagnostique de notre régression manuelle, il convient de descendre au niveau granulaire de chaque unité d’observation afin de calculer individuellement sa valeur prédite y_chapeau_i à l’aide de l’équation y_chapeau = 1 + 1,5 * x, puis d’en extraire le résidu brut associé défini par l’écart e_i = y_i – y_chapeau_i. Cette étape permet d’ausculter minutieusement les micro-déviations empiriques.
Procédons de façon séquentielle pour chacune des sept observations :
Pour l’individu 1 (X = 1, Y = 3) : y_chapeau_1 = 1 + 1,5 * 1 = 2,5 ; d’où le résidu e_1 = 3 – 2,5 = +0,5000.
Pour l’individu 2 (X = 2, Y = 4) : y_chapeau_2 = 1 + 1,5 * 2 = 4,0 ; d’où e_2 = 4 – 4,0 = 0,0000.
Pour l’individu 3 (X = 3, Y = 5) : y_chapeau_3 = 1 + 1,5 * 3 = 5,5 ; d’où e_3 = 5 – 5,5 = -0,5000.
Pour l’individu 4 (X = 4, Y = 7) : y_chapeau_4 = 1 + 1,5 * 4 = 7,0 ; d’où e_4 = 7 – 7,0 = 0,0000.
Pour l’individu 5 (X = 5, Y = 8) : y_chapeau_5 = 1 + 1,5 * 5 = 8,5 ; d’où e_5 = 8 – 8,5 = -0,5000.
Pour l’individu 6 (X = 6, Y = 10) : y_chapeau_6 = 1 + 1,5 * 6 = 10,0 ; d’où e_6 = 10 – 10,0 = 0,0000.
Pour l’individu 7 (X = 7, Y = 12) : y_chapeau_7 = 1 + 1,5 * 7 = 11,5 ; d’où e_7 = 12 – 11,5 = +0,5000.
Réalisons immédiatement la vérification algébrique suprême propre à la méthode des moindres carrés ordinaires : la somme arithmétique simple de ces résidus doit impérativement s’annuler à zéro.
Somme e_i = (+0,5) + 0,0 + (-0,5) + 0,0 + (-0,5) + 0,0 + (+0,5) = 0,0000.
Cette annulation parfaite atteste une fois de plus de la rigueur chirurgicale de nos calculs manuels antérieurs. Les déviations maximales constatées se bornent à un demi-point en valeur absolue (+0,5 ou -0,5), manifestant une remarquable régularité structurelle.
10.2 Calcul de la variance résiduelle et des degrés de liberté associés
L’exploitation analytique de ces résidus individuels impose d’élever chacun d’entre eux au carré pour éliminer les compensations de signes et évaluer la variance résiduelle non biaisée du modèle :
e_1² = (+0,5)² = 0,25 ;
e_2² = (0,0)² = 0,00 ;
e_3² = (-0,5)² = 0,25 ;
e_4² = (0,0)² = 0,00 ;
e_5² = (-0,5)² = 0,25 ;
e_6² = (0,0)² = 0,00 ;
e_7² = (+0,5)² = 0,25.
Sommons ces déviations quadratiques : 0,25 + 0,00 + 0,25 + 0,00 + 0,25 + 0,00 + 0,25 = 1,0000.
Nous constatons avec une satisfaction logique absolue que cette somme manuelle directe des résidus au carré redonne rigoureusement la valeur de SSE obtenue à la section 9.2 (SSE = 1,0000).
Pour transformer cette somme d’erreurs en un estimateur non biaisé de la variance des perturbations aléatoires, nous devons diviser SSE par les degrés de liberté appropriés. En régression linéaire simple, nous estimons deux paramètres à partir des données de l’échantillon (l’ordonnée à l’origine b_0 et la pente b_1). Ces deux contraintes linéaires consomment deux degrés de liberté. Par conséquent, les degrés de liberté résiduels s’élèvent à :
ddl = n – 2 = 7 – 2 = 5.
La variance résiduelle non biaisée, notée s²_e (ou carré moyen de l’erreur MSE), se calcule selon le ratio :
s²_e = SSE / (n – 2) = 1,0000 / 5 = 0,2000.
Cette pénalisation par la perte de deux degrés de liberté traduit le coût statistique nécessaire pour estimer la droite et garantit que la variance ne sera pas sous-estimée, enjeu particulièrement crucial au sein d’un échantillon de petite taille.
10.3 Détermination manuelle de l’erreur type d’estimation (s_e)
La variance résiduelle s²_e étant exprimée dans le carré des unités de mesure de la variable dépendante, son interprétation intuitive demeure complexe. C’est pourquoi la statistique applique une transformation par extraction de la racine carrée afin de définir l’erreur type d’estimation, universellement symbolisée par s_e :
s_e = racine_carrée(s²_e) = racine_carrée(0,2000).
Procédons à l’extraction manuelle approchée de cette racine carrée :
Sachant que 0,44² = 0,1936 et que 0,45² = 0,2025, la racine se situe très précisément entre ces deux bornes.
En posant l’algorithme d’approximation linéaire, nous isolons :
s_e ≈ 0,4472 point.
L’erreur type d’estimation s’élève donc approximativement à 0,45 point de score au test cognitif.
D’un point de vue substantiel, l’erreur type d’estimation représente l’écart-type effectif des observations réelles autour de la droite d’ajustement. Elle constitue l’indicateur par excellence de la marge d’erreur moyenne typique affectant toute prédiction individuelle générée par notre modèle linéaire. Plus s_e est faible, plus le modèle fait preuve d’une acuité prédictive chirurgicale. Dans notre recherche, une marge de fluctuation moyenne inférieure à un demi-point confirme la fidélité de notre modélisation.
11. Inférence statistique manuelle et tests d’hypothèses sur les coefficients
11.1 Calcul de l’erreur type de la pente empirique s_{b1}
L’estimation ponctuelle b_1 = 1,5000 ne représente que la pente observée au sein de notre échantillon particulier de sept volontaires. Pour déterminer si cette inclinaison reflète une relation structurelle tangible dans la population parente ou si elle résulte d’une simple fluctuation d’échantillonnage opportuniste, il est obligatoire d’estimer l’erreur type de distribution de la pente, symbolisée par s_{b1}.
La formulation théorique de l’erreur type d’échantillonnage de la pente s’exprime par le ratio de l’erreur type d’estimation s_e sur la racine carrée de la somme corrigée des carrés de la variable prédictive :
s_{b1} = s_e / racine_carrée[Sigma X² – ((Sigma X)² / n)].
Remarquons immédiatement que le terme logé sous la racine au dénominateur correspond très exactement à la dispersion quadratique corrigée de X, que nous avions évaluée à 28 lors de la résolution de SSR (140 – 784/7 = 140 – 112 = 28).
Substituons avec précision les valeurs calculées :
s_{b1} = 0,4472136 / racine_carrée(28).
Calculons manuellement la racine carrée de 28 :
Sachant que 5² = 25 et 5,3² = 28,09, nous trouvons racine_carrée(28) ≈ 5,291503.
Exécutons la division manuelle :
s_{b1} = 0,4472136 / 5,291503 ≈ 0,084515, soit environ 0,0845.
Cette grandeur quantifie la variabilité type à laquelle on doit s’attendre pour l’estimateur de la pente si l’on réitérait l’expérimentation un nombre infini de fois sur des échantillons équivalents.
11.2 Exécution du test de Student pour la significativité de la pente
Nous pouvons désormais formaliser un test d’hypothèse rigoureux pour éprouver la significativité de cette pente. Énonçons les termes du test bilatéral classique :
L’hypothèse nulle (H0) postule l’absence totale de relation linéaire dans la population parente, soit beta_1 = 0.
L’hypothèse alternative (H1) affirme au contraire l’existence d’une relation linéaire non nulle, soit beta_1 ≠ 0.
Le seuil de significativité conventionnel est fixé à alpha = 0,05.
La statistique de décision empirique suit une loi de Student à (n – 2) degrés de liberté et s’obtient par le quotient de la pente estimée sur son erreur type propre :
t_calcule = b_1 / s_{b1}.
Substituons les valeurs numériques :
t_calcule = 1,5000 / 0,084515 = 17,7483.
La statistique empirique observée atteint la valeur de t = 17,75.
Consultons mentalement les tables statistiques de la loi de Student pour un test bilatéral à un seuil alpha = 0,05 avec 5 degrés de liberté (ddl = 7 – 2 = 5). La valeur critique seuil répertoriée s’établit à t_critique = 2,571.
La règle de décision statistique s’applique de manière limpide : puisque la valeur absolue de notre t calculé (|17,75|) est très largement supérieure au seuil critique théorique (|2,571|), nous rejetons catégoriquement l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. La probabilité associée p est infinitésimale (p < 0,001), attestant que l’effet observé de l’entraînement sur la performance cognitive est hautement significatif sur le plan statistique.
11.3 Construction manuelle de l’intervalle de confiance pour beta_1
Pour dépasser la dichotomie binaire du simple test d’hypothèse et quantifier la précision de notre estimation avec une profondeur probabiliste accrue, nous construisons manuellement l’intervalle de confiance à 95 % entourant le paramètre populationnel beta_1. Cet intervalle définit la fourchette de valeurs plausibles qui a 95 % de chances de recouvrir la véritable pente de la population sous l’hypothèse de répétition des tirages.
La formulation algébrique de l’intervalle de confiance s’énonce selon :
IC_95% = b_1 ± [t_critique * s_{b1}].
Rappelons nos paramètres : b_1 = 1,5000, t_critique(5 ddl, 0.05) = 2,571, et s_{b1} = 0,084515.
Calculons la marge d’erreur du paramètre :
Marge d’erreur = 2,571 * 0,084515.
Posons la multiplication manuelle :
2,571 * 0,084515 ≈ 0,217288, soit approximativement 0,2173.
Déterminons les bornes terminales de l’intervalle par soustraction puis addition :
Borne inférieure = 1,5000 – 0,2173 = 1,2827.
Borne supérieure = 1,5000 + 0,2173 = 1,7173.
L’intervalle de confiance à 95 % pour la pente beta_1 s’établit donc rigoureusement à [1,2827 ; 1,7173].
Puisque cet intervalle exclut totalement et largement la valeur zéro, nous confirmons avec une certitude statistique renforcée que la progression des scores est indéniablement positive, estimée avec une très grande précision entre 1,28 et 1,72 point par heure supplémentaire d’entraînement.
12. Synthèse critique, limites du calcul manuel et prolongements méthodologiques
12.1 Avantages pédagogiques et cognitifs de l’apprentissage par le calcul manuel
L’effort soutenu déployé pour exécuter manuellement une régression linéaire simple produit des retombées pédagogiques et cognitives inestimables qui dépassent de loin le simple accomplissement d’un devoir d’arithmétique. En manipulant personnellement chaque sommation, en décomposant les carrés et en constatant l’annulation mécanique des résidus bruts, le praticien s’approprie intimement l’architecture théorique du modèle. Cette démarche brise l’opacité inhérente à l’approche de la boîte noire algorithmique promue par l’usage précoce de logiciels automatisés.
Cette maîtrise artisanale confère au chercheur un esprit critique aiguisé lors de l’examen ultérieur de résultats informatisés complexes. Un analyste ayant déjà éprouvé la sensibilité du dénominateur n * (Sigma X²) – (Sigma X)² sera infiniment plus lucide pour diagnostiquer immédiatement des aberrations d’échantillonnage, des problèmes d’invariance de variance ou des instabilités numériques majeures masquées au sein de synthèses logicielles denses.
De surcroît, le calcul manuel fortifie la rigueur symbolique et la compréhension des métriques d’adéquation. Assimiler charnellement la partition de la variance SST = SSR + SSE à travers des opérations d’addition simples ancre définitivement le concept abstrait de proportion de variance expliquée (R²), transformant une vague formule mathématique en une intuition géométrique et statistique concrète et inaltérable.
12.2 Vulnérabilités opérationnelles et risques d’erreurs humaines
En dépit de ses mérites formateurs évidents, la pratique du calcul manuel se heurte à des limites matérielles incompressibles qui restreignent son champ d’application opérationnel. La première vulnérabilité réside dans son extrême exposition aux erreurs humaines d’inattention, aux fautes de saisie et aux glissements d’arrondis. Un simple signe négatif omis lors d’un produit croisé ou l’inversion de deux chiffres lors de la sommation d’une colonne quadratique se répercute en cascade sur la pente, l’interception et les tests d’inférence, faussant l’intégralité des déductions scientifiques.
La seconde contrainte fondamentale relève de la scalabilité dimensionnelle. S’il demeure gratifiant et formateur de traiter manuellement sept paires d’observations numériques calibrées, la démarche devient matériellement impraticable et déraisonnable face à des corpus contemporains hébergeant des milliers de sujets et des dizaines de prédicteurs. La charge cognitive et temporelle excéderait les capacités d’un opérateur humain, avec une probabilité d’erreur arithmétique approchant la certitude.
Enfin, le calcul manuel rend particulièrement fastidieux le diagnostic exhaustif des violations des postulats fondamentaux. Évaluer visuellement des nuages de résidus sur des centaines d’unités, traquer l’hétéroscédasticité subtile ou tester formellement la normalité multivariée via des tests d’adéquation exige des calculs matriciels itératifs qui dépassent largement les ressources du calcul à la main, justifiant le recours judicieux aux technologies de calcul numérique lorsque les concepts sont assimilés.
12.3 Transition vers les outils statistiques contemporains (R, SPSS, Python)
L’aboutissement naturel de cette initiation au calcul manuel ne consiste nullement à rejeter l’outil informatique moderne, mais au contraire à s’en emparer avec une lucidité et une compétence décuplées. Les opérations arithmétiques que nous venons d’exécuter à la main trouvent leur correspondance exacte et immédiate dans les instructions syntaxiques des écosystèmes statistiques professionnels contemporains tels que le logiciel R, SPSS ou les bibliothèques Python dédiées à la modélisation empirique.
Dans l’environnement R par exemple, l’ensemble de notre long protocole manuel se synthétise dans la commande canonique : modele <- lm(Y ~ X, data = donnes). En exécutant ensuite la fonction summary(modele), le chercheur aguerri ne voit plus s’afficher des chiffres mystérieux ou magiques : il repère instantanément dans la table des coefficients la valeur de l’interception (1,0000) et de la pente (1,5000), identifie son erreur type (0,0845), reconnaît sa statistique t de Student (17,75), retrouve la valeur résiduelle s_e (0,4472) et valide le R² ajusté (0,9844) calculés avec la même logique.
Cette maîtrise conceptuelle permet de transposer avec aisance les principes acquis vers la régression multiple, où la présence de prédicteurs concurrents exige la résolution d’inverses matricielles impossibles à la main, ou vers les modèles linéaires généralisés conçus pour des critères non normaux. Le chercheur formé au calcul manuel se distingue par sa capacité à garantir la transparence, la reproductibilité et l’intégrité déontologique de ses modélisations, mettant la technique au service exclusif de la rigueur scientifique.
Références
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246-263. https://doi.org/10.2307/2841583
Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons.
Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858
Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.