
Dans le domaine de l’analyse numérique et du traitement des données expérimentales, la modélisation des transitions continues à partir d’observations discrètes constitue une problématique fondamentale. Les dispositifs de mesure physiques, qu’ils soient issus de capteurs industriels, d’enregistrements physiologiques ou d’instruments astronomiques, collectent des informations à des intervalles finis et discontinus. Pourtant, les processus naturels sous-jacents se déploient majoritairement dans un continuum spatial ou temporel. L’estimation des états intermédiaires, indispensable pour la simulation, le rééchantillonnage de signaux ou le comblement de données manquantes, requiert ainsi des stratégies d’inférence déterministes et computationnellement soutenables.
L’interpolation linéaire s’impose historiquement et pratiquement comme la solution paradigmatique de premier ordre pour résoudre ce défi. Fondée sur le postulat d’une variation proportionnelle locale entre deux coordonnées connues, elle établit un compromis optimal entre simplicité algorithmique, robustesse conceptuelle et efficacité de calcul. Contrairement aux approximations polynomiales d’ordre supérieur qui risquent d’induire des oscillations parasites, l’interpolation linéaire affine préserve la monotonicité locale et offre une interprétabilité géométrique directe, ce qui en fait un outil de référence incontournable en métrologie et en ingénierie logicielle.
L’écosystème open-source Python, propulsé par des bibliothèques scientifiques de premier plan telles que NumPy, SciPy et Pandas, offre un cadre idéal pour l’implémentation industrielle et académique de ces techniques. Ce présent traité méthodologique expose les fondements théoriques, les mécanismes analytiques, l’implémentation programmatique native et les cas d’usage avancés de l’interpolation linéaire en Python, en guidant le praticien depuis les postulats mathématiques jusqu’au diagnostic d’anomalies de calcul à grande échelle.
1. Fondements théoriques et mathématiques de l’interpolation linéaire
1.1 Définition et principe fondamental de l’approximation par morceaux
L’interpolation se définit rigoureusement comme une méthode mathématique permettant de déterminer la valeur d’une fonction inconnue en un point cible arbitraire, situé strictement à l’intérieur d’un intervalle défini par un ensemble fini de données tabulées ou expérimentales. Contrairement aux méthodes prédictives exploratoires, l’interpolateur est contraint par une condition fondamentale d’exactitude nodale : la fonction interpolante construite doit reproduire scrupuleusement les valeurs observées en chacun des points pivots, nommés nœuds ou points d’échantillonnage. En d’autres termes, si l’on dispose d’un ensemble discret de couples ordonnés (x_k, y_k), la courbe d’interpolation passe nécessairement et exactement par chacun de ces points au sein de l’espace euclidien.
Le principe fondamental de l’approximation affine par morceaux repose sur une hypothèse de continuité locale et de variation proportionnelle. L’espace global entre la borne initiale et la borne terminale du jeu de données n’est pas appréhendé par un polynôme global complexe, mais subdivisé en une succession de sous-intervalles contigus. Au sein de chaque sous-intervalle élémentaire borné par deux observations consécutives, l’évolution du phénomène est postulée comme étant strictement linéaire. Cette restriction locale garantit que l’approximation s’affranchit des comportements asymptotiques divergents ou des ondulations indésirables souvent provoquées par les ajustements globaux sur des maillages non uniformes.
Le domaine de validité géométrique de cette technique demeure confiné à l’intervalle fermé délimité par l’abscisse minimale et l’abscisse maximale du jeu de données expérimentales. Dès lors que l’on tente d’évaluer la fonction en dehors de ces limites, l’opération cesse d’être une interpolation pour devenir une extrapolation, laquelle engage des risques épistémologiques et statistiques substantiels. La distinction entre un comportement linéaire global — qui impliquerait qu’une droite unique régisse l’ensemble des observations — et une approximation linéaire par morceaux réside précisément dans cette flexibilité segmentée : chaque segment de droite possède son propre coefficient directeur, déterminé exclusivement par le couple de nœuds qui l’encadre directement.
1.2 Formulation analytique de l’équation d’interpolation
D’un point de vue analytique, la dérivation de l’équation d’interpolation linéaire procède directement de la géométrie de la droite sécante reliant deux points nodaux successifs, notés (x1, y1) et (x2, y2), sous la condition impérative que x1 soit strictement distinct de x2. Le coefficient directeur (ou pente) de cette sécante représente le taux d’accroissement moyen de la variable dépendante par rapport à la variable indépendante sur l’intervalle considéré. En exprimant l’égalité des pentes entre le segment reliant (x1, y1) au point intermédiaire inconnu (x, y) et le segment reliant (x1, y1) à (x2, y2), on obtient la relation d’homothétie élémentaire :
(y – y1) / (x – x1) = (y2 – y1) / (x2 – x1)
En isolant la variable y, nous obtenons l’expression algébrique canonique de l’interpolation linéaire, couramment exploitée par les algorithmes de calcul numérique :
y = y1 + (x – x1) * (y2 – y1) / (x2 – x1)
Cette formulation analytique peut être décomposée de manière pédagogique en deux opérateurs distincts : un ratio de distance relative sans dimension, noté alpha = (x – x1) / (x2 – x1), et un incrément d’amplitude scalaire défini par (y2 – y1). Le facteur alpha quantifie la position normalisée de l’abscisse x au sein de son sous-intervalle, variant continûment de 0 (lorsque x coïncide avec x1) à 1 (lorsque x atteint x2). L’évaluation de y apparaît alors comme une combinaison convexe barycentrique des ordonnées environnantes, réductible à l’expression pondérée y = (1 – alpha) * y1 + alpha * y2.
Cette écriture met en lumière les propriétés d’invariance d’échelle et d’exactitude absolue aux bornes. Lorsque le point d’évaluation converge vers l’abscisse initiale x1, le terme correctif s’annule, garantissant l’identité y = y1. Réciproquement, lorsque x converge vers l’abscisse finale x2, le ratio alpha tend vers l’unité, conférant à y la valeur exacte y2. L’interpolation linéaire garantit ainsi une transition sans discontinuité spatiale (continuité de classe C0) à travers chaque nœud, bien qu’elle n’assure pas la dérivabilité aux points de jonction, où les pentes subissent un saut discret.
1.3 Différenciation épistémologique : interpolation, extrapolation et régression
Il est scientifiquement primordial de dissocier rigoureusement l’interpolation linéaire de deux autres paradigmes d’ajustement fréquemment employés en analyse quantitative : l’extrapolation et la régression. L’interpolation opère strictement au sein de l’enveloppe convexe des observations empiriques existantes. Elle ne postule rien au-delà des bornes connues et se contente d’établir une continuité géométrique locale entre des états mesurés. À l’inverse, l’extrapolation consiste à projeter une relation mathématique hors de la plage des abscisses observées, ce qui présuppose une pérennité invariante des mécanismes sous-jacents, exposant l’analyste à des divergences massives dès lors que le système physique entre dans des régimes non linéaires ou saturants.
La distinction méthodologique avec la régression linéaire s’avère tout aussi déterminante. La régression repose sur un paradigme statistique stochastique : elle postule que les données mesurées sont corrompues par un bruit aléatoire et cherche à identifier une tendance globale unique capable de minimiser une fonction de coût, généralement la somme des carrés des écarts (résidus des moindres carrés ordinaires). En conséquence, la droite de régression ne passe que très rarement par les points expérimentaux individuels ; elle sacrifie la précision nodale au profit d’une synthèse structurelle de l’ensemble du nuage de points.
L’interpolation linéaire relève pour sa part d’une approche purement géométrique et déterministe. Elle accorde une confiance absolue à la véracité des coordonnées collectées, considérant chaque nœud comme une vérité de terrain intangible par laquelle la courbe interpolée doit rigoureusement transiter. Dès lors, le choix entre interpolation et régression dépend intrinsèquement de la nature des données : des mesures de haute précision requérant une reconstruction exacte entre des pas temporels denses justifieront une interpolation, tandis que des mesures fortement bruitées imposent un lissage statistique par régression pour éviter de sur-ajuster le bruit expérimental.
2. Pertinence de l’interpolation linéaire dans l’analyse de données expérimentales
2.1 Traitement des données manquantes dans les séries temporelles et comportementales
Dans l’acquisition de données expérimentales en temps réel, la survenue de valeurs manquantes (valeurs nulles ou « Not a Number », abrégé NaN) constitue un écueil quasi inévitable. Dans le cadre de protocoles biométriques, neurophysiologiques ou de monitorage de signaux environnementaux, des pertes d’échantillons surviennent fréquemment à la suite de déconnexions transitoires de capteurs, d’artéfacts de mouvement ou de micro-coupures de transmission télémétrique. Face à ces lacunes ponctuelles, la suppression brute des enregistrements corrompus entraîne une perte substantielle de puissance statistique et déstructure l’alignement temporel des flux multicanaux.
L’interpolation linéaire fournit un mécanisme d’imputation particulièrement parcimonieux et adapté aux trous de faible amplitude. En reliant le dernier échantillon valide précédant la coupure au premier échantillon validé consécutif à la reprise du signal, elle reconstitue une dynamique de transition plausible qui préserve la tendance moyenne locale. Cette méthode présente l’avantage majeur de ne pas introduire de composantes fréquentielles parasites d’ordre élevé, écueil fréquent des interpolations oscillatoires complexes lorsque l’intervalle manquant est restreint.
Néanmoins, la validité cognitive et physiologique d’une telle imputation demeure tributaire de l’échelle temporelle de la coupure par rapport à la constante de temps du système biologique étudié. Si un capteur cardiaque perd le signal durant un laps de temps inférieur à la fraction d’un intervalle R-R, l’interpolation affine offre une approximation acceptable. Si la lacune excède la durée moyenne d’un cycle cardiaque, l’interpolation linéaire masque la variabilité physiologique fondamentale et projette une fausse dynamique homéostatique linéaire, ce qui fausse potentiellement les analyses spectrales subséquentes.
2.2 Rééchantillonnage uniforme des signaux discrets
L’hétérogénéité des fréquences d’échantillonnage représente un verrou récurrent lors de l’intégration de flux instrumentaux asynchrones. Dans une chaîne de capture multimodale associant, par exemple, un capteur de positionnement géospatial cadencé à 10 Hz et une centrale inertielle délivrant des accélérations à 128 Hz, la fusion sensorielle exige une harmonisation sur une base temporelle commune et strictement équidistante. L’application d’algorithmes de traitement du signal tels que la transformée de Fourier rapide (FFT) requiert expressément un pas temporel constant entre chaque observation consécutive.
L’interpolation linéaire permet d’exécuter ce rééchantillonnage de manière déterministe en projetant le signal asynchrone sur une grille temporelle artificielle uniformément espacée. Chaque nouveau point de la grille est calculé par combinaison linéaire des deux mesures asynchrones les plus proches dans le temps. Cette transformation linéaire par morceaux opère sans imposer d’hypothèse globale sur la périodicité du phénomène, préservant scrupuleusement la topologie temporelle des chroniques sans nécessiter l’apprentissage statistique d’un modèle génératif lourd.
Cette standardisation de la fréquence d’échantillonnage simplifie la concaténation matricielle et le calcul différentiel direct. En évitant les instabilités asymptotiques associées aux méthodes globales de rééchantillonnage par séries de Fourier tronquées, l’approche affine par morceaux conserve les limites extrêmes du signal d’origine sans provoquer de dépassements artificiels d’amplitude, garantissant le respect des contraintes physiques du capteur (seuils de saturation des voltages, par exemple).
2.3 Hypothèses sous-jacentes et limites de validité de la linéarité locale
L’adoption de l’interpolation linéaire repose implicitement sur un postulat mathématique majeur : la courbure locale du phénomène physique sous-jacent doit être négligeable à l’échelle de l’intervalle séparant deux observations successives. Conformément au théorème de Taylor, toute fonction deux fois continûment différentiable peut être approchée au premier ordre par son segment de tangente, le terme d’erreur résiduel dépendant directement du carré du pas d’échantillonnage et de la dérivée seconde de la fonction. Par conséquent, l’interpolation linéaire n’est valide que si la densité du maillage initial est suffisamment élevée pour capturer les plus hautes fréquences du signal.
Lorsque cette densité est insuffisante, l’erreur géométrique commise augmente drastiquement. L’approximation affine transforme des transitions sinusoïdales lisses en une trajectoire polygonale anguleuse, créant des « points de rebroussement » mathématiques artificiels aux nœuds d’échantillonnage. En ces coordonnées précises, la dérivée première de la fonction reconstruite présente une discontinuité de première espèce (un saut fini), tandis que la dérivée seconde devient indéterminée ou infinie au sens des distributions (impulsions de Dirac).
Cette rupture de différentiabilité supérieure s’avère particulièrement pénalisante si les données interpolées sont destinées à alimenter des équations différentielles physiques exigeant une continuité de vitesse ou d’accélération (lois de la dynamique newtonienne, hydrodynamique). Dans ces cas critiques, l’introduction de discontinuités de pente dégrade l’énergie cinétique du système simulé et injecte du bruit haute fréquence dans les dérivées numériques, bornant ainsi le champ d’application de l’interpolation linéaire aux situations où la continuité de classe C0 est jugée opérationnellement suffisante.
3. Écosystème Python pour le calcul scientifique et l’interpolation
3.1 Rôle central de NumPy dans la manipulation vectorielle
La mise en œuvre performante de calculs numériques en Python repose sur la bibliothèque fondamentale NumPy. L’interpréteur standard CPython souffre d’une lenteur structurelle lorsqu’il manipule des boucles itératives massives appliquées à des listes dynamiques d’objets hétérogènes, principalement en raison de la surcharge liée au typage dynamique et au mécanisme de gestion de la mémoire. NumPy contourne cette contrainte en introduisant la structure de données ndarray, qui alloue des blocs de mémoire contigus pour des collections d’éléments de type homogène.
Cette contiguïté en mémoire permet de tirer profit des optimisations matérielles modernes, notamment la vectorisation SIMD (Single Instruction, Multiple Data) et l’utilisation optimale de la mémoire cache du processeur. Dans le cadre de l’interpolation, la manipulation des vecteurs de coordonnées discrètes s’exécute à des vitesses comparables à celles de codes compilés en C ou en Fortran. L’interopérabilité de NumPy avec les bibliothèques d’algèbre linéaire de bas niveau (LAPACK et BLAS) assure une stabilité numérique maximale lors du calcul simultané de milliers de points intermédiaires.
Par ailleurs, les mécanismes de diffusion vectorielle (broadcasting) inhérents à NumPy permettent d’exprimer des calculs algébriques complexes sur des tenseurs multidimensionnels sans recourir à des itérations manuelles. Les opérations arithmétiques requises par la formule d’interpolation linéaire peuvent ainsi s’exécuter de façon vectorisée sur des grilles d’abscisses comprenant plusieurs millions d’éléments en une seule ligne d’instruction Python, libérant le développeur de la gestion complexe des pointeurs et des indices mémoires.
3.2 Le module scipy.interpolate de la suite SciPy
Bâtie directement au-dessus des fondations vectorielles de NumPy, la suite SciPy regroupe un vaste ensemble d’algorithmes dédiés au calcul scientifique avancé, à l’optimisation, à l’intégration et au traitement du signal. Au sein de cette architecture, le sous-module scipy.interpolate concentre les classes et fonctions spécialisées dans l’approximation fonctionnelle unidimensionnelle et multidimensionnelle, allant des méthodes affines les plus basiques jusqu’aux splines B-splines et interpolations radiales (RBF).
Historiquement, la classe interp1d a constitué la méthode standard pour la réalisation d’interpolations unidimensionnelles dans SciPy. Son architecture repose sur une approche objet élégante : plutôt que d’exécuter un calcul éphémère et de détruire les structures intermédiaires, elle génère un objet appelable (callable object) agissant comme une fonction mathématique synthétique. Cet objet encapsule les tableaux d’abscisses et d’ordonnées initiaux, conserve en mémoire les conditions aux limites et permet des interrogations scalaires ou vectorielles répétées sans réinitialisation algorithmique.
Cette approche fonctionnelle dissocie nettement la phase d’apprentissage ou de paramétrage de la phase d’évaluation. Bien que SciPy évolue continuellement vers des interfaces plus modulaires (telles que make_interp_spline avec un ordre k=1 pour la linéarité), interp1d conserve une popularité majeure dans le milieu académique et industriel en raison de sa clarté syntaxique, de sa robustesse éprouvée et de sa compatibilité étendue avec les bases de code historiques.
3.3 Configuration de l’environnement de travail et dépendances
Pour garantir la reproductibilité absolue des expérimentations numériques présentées dans ce guide, il convient d’instancier un environnement virtuel Python rigoureusement configuré. L’isolation des dépendances logicielles prévient les conflits de versions entre paquets fondamentaux et sécurise l’exécution des scripts de calcul. En utilisant l’utilitaire standard venv ou le gestionnaire d’environnements conda, le praticien s’assure d’un écosystème maîtrisé.
L’installation des bibliothèques nécessaires s’effectue via l’installateur officiel de paquets à l’aide de la commande terminal suivante :
pip install numpy scipy matplotlib pandas
Il est recommandé d’utiliser une version de Python égale ou supérieure à 3.9, associée à des versions modernes de NumPy (≥ 1.22), de SciPy (≥ 1.8) et de Matplotlib (≥ 3.5). La vérification programmatique de l’intégrité de l’environnement peut être réalisée au moyen d’un script d’amorçage contrôlant les attributs __version__ de chaque module importé. Cette rigueur méthodologique élimine les risques de comportements divergents liés à des dépréciations de paramètres (comme l’évolution récente des arguments de gestion des limites dans SciPy) et garantit la conformité stricte du code source déployé.
4. Formulation algorithmique et implémentation Python sans dépendance externe
4.1 Développement de l’algorithme manuel de recherche d’intervalle
Pour appréhender la mécanique interne des bibliothèques scientifiques de haut niveau, il est formateur de concevoir manuellement un algorithme d’interpolation linéaire en Python pur, sans faire appel à NumPy ou SciPy. La première étape conceptuelle réside dans la résolution du problème de localisation spatiale : étant donné un point cible x_cible et une série ordonnée de nœuds d’abscisses x_points, comment identifier de façon fiable le sous-intervalle fermé [x_i, x_{i+1}] tel que x_i ≤ x_cible ≤ x_{i+1} ?
Une approche naïve consiste à parcourir séquentiellement la liste des abscisses à l’aide d’une boucle for. Bien que conceptuellement simple, cette traversée présente une complexité temporelle linéaire qui dégrade les performances sur de grands volumes de données. Dans un vecteur strictement ordonné de manière croissante, la stratégie optimale exploite la recherche dichotomique (bisection binaire). Le module standard bisect de Python implémente précisément cette logique de partitionnement binaire hautement optimisée en C, permettant de localiser l’indice du sous-intervalle en un temps logarithmique.
Une fois l’indice structurel i localisé, l’algorithme extrait les quatre scalaires cardinaux caractérisant la cellule : l’abscisse inférieure x1, l’ordonnée inférieure y1, l’abscisse supérieure x2 et l’ordonnée correspondante y2. Il est impératif d’incorporer un contrôle de validité pour s’assurer que l’abscisse cible ne se situe pas strictement en amont de la première valeur disponible ou en aval de la dernière, afin de ne pas déclencher d’erreurs d’accès aux index mémoires (IndexError) et de prévenir toute extrapolation non consentie.
4.2 Écriture d’une fonction native en Python pur
La matérialisation logicielle de cette logique prend la forme d’une fonction réutilisable, encapsulant la vérification dimensionnelle des listes d’entrées, le test de monotonicité croissante, le repérage de l’intervalle et l’évaluation algébrique standard. La structure du code s’articule comme suit :
L’implémentation débute par la validation de la concordance de taille entre la collection des abscisses et celle des ordonnées. Toute asymétrie dimensionnelle doit impérativement lever une exception de type ValueError. De même, la présence d’au moins deux points est mathématiquement indispensable pour pouvoir définir une corde géométrique d’interpolation. La gestion du cas pathologique où deux abscisses consécutives seraient rigoureusement identiques doit être anticipée pour empêcher une division par zéro lors du calcul du coefficient directeur.
Dans le corps de la fonction native, le ratio d’avancement est calculé via la formule alpha = (x_cible - x1) / (x2 - x1). L’ordonnée recherchée découle immédiatement de l’opération y_cible = y1 + alpha * (y2 - y1). L’intérêt didactique de cette fonction purement Python réside dans sa lisibilité algorithmique totale : chaque étape du raisonnement mathématique s’exprime de manière explicite sans l’abstraction apportée par les wrappers C sous-jacents des bibliothèques scientifiques, facilitant ainsi l’apprentissage académique et le débogage sur des architectures embarquées dépourvues de compilateur C.
4.3 Analyse de la complexité computationnelle
L’analyse formelle des performances de cette implémentation native requiert l’évaluation de deux composantes distinctes : la complexité temporelle relative au temps processeur requis pour une estimation, et la complexité spatiale relative à l’allocation mémoire dynamique. En exploitant la recherche dichotomique via bisect, la phase de repérage de l’encadrement au sein d’une séquence ordonnée comportant n nœuds présente une complexité temporelle asymptotique de l’ordre de O(log n). L’évaluation arithmétique subséquente s’exécutant en temps constant O(1), le coût unitaire d’une interpolation scalaire demeure strictement contraint par le coût de la bisection binaire.
Cependant, si l’on tente d’évaluer m points cibles indépendants par des appels réitérés à cette fonction native, la complexité globale devient O(m * log n). En Python pur, la surcharge inhérente à l’allocation dynamique d’entiers et de flottants boxed (objets PyObject) et à la vérification continue des types lors de l’exécution de la boucle entraîne un surcoût temporel massif par rapport à une boucle compilée statiquement. L’occupation mémoire présente une complexité de O(1) au-delà du stockage initial des tableaux de données, car l’opération ne génère aucune duplication de structure en mémoire vive.
Cette implémentation native révèle toutefois ses limites critiques dès lors que le volume de points à interpoler dépasse quelques dizaines de milliers d’éléments. La lenteur intrinsèque de la boucle interprétée par CPython crée un goulet d’étranglement qui rend cette approche purement algorithmique inadaptée aux pipelines de production de données volumineuses (Big Data) ou aux flux de calcul scientifique intensif, justifiant pleinement la transition vers des bibliothèques optimisées au niveau machine comme SciPy et NumPy.
5. Utilisation de scipy.interpolate.interp1d : Méthodologie standard
5.1 Syntaxe générale et signature de la classe interp1d
La classe scipy.interpolate.interp1d constitue l’outil historique le plus standardisé pour mener à bien une interpolation unidimensionnelle au sein de l’écosystème Python. Sa conception repose sur une signature flexible acceptant de multiples arguments de contrôle pour configurer finement le comportement numérique de l’opérateur. La signature fondamentale s’articule autour de deux paramètres positionnels obligatoires suivis de directives de modélisation :
scipy.interpolate.interp1d(x, y, kind='linear', axis=-1, copy=True, bounds_error=None, fill_value=nan, assume_sorted=False)
Le paramètre kind régit directement le modèle mathématique sous-jacent. Bien que la classe permette d’exécuter des interpolations de type ‘nearest’, ‘zero’, ‘slinear’, ‘quadratic’ ou ‘cubic’, la spécification explicite de kind='linear' garantit l’activation du modèle affine par morceaux de degré 1. Les arguments x et y doivent être des structures de données assimilables à des tableaux NumPy (array-like), unidimensionnelles et de longueurs strictement identiques selon l’axe d’interpolation désigné par le paramètre axis.
L’argument assume_sorted mérite une attention méthodologique particulière. Par défaut, sa valeur est fixée à False, ce qui contraint SciPy à vérifier au préalable la stricte croissance monotone des abscisses du tableau x et à les trier le cas échéant, induisant un surcoût computationnel modéré en O(n log n). Si le praticien garantit en amont que ses mesures expérimentales sont déjà rigoureusement ordonnées par ordre chronologique ou spatial croissant, basculer cet indicateur à True optimise l’instanciation de l’objet en évitant cette passe de vérification et de tri interne.
5.2 Instanciation et génération de l’objet fonctionnel
L’appel à la classe interp1d ne retourne pas immédiatement une valeur numérique scalaire interpolée, mais un objet fonctionnel d’instance (couramment désigné comme un « callable » en programmation orientée objet). Ce mécanisme d’instanciation sépare distinctement la phase d’ingestion et de préconditionnement des données de la phase d’évaluation effective. L’objet ainsi généré encapsule les tableaux d’origine et maintient un état interne cohérent contenant les métadonnées géométriques des segments.
Sur le plan conceptuel, cet objet se comporte exactement comme une fonction mathématique standard définie par morceaux. Lorsqu’une instance est assignée à une variable, par exemple f_modele = interp1d(x_data, y_data, kind='linear'), la variable f_modele peut être sollicitée ultérieurement à n’importe quel stade du pipeline logiciel au moyen de l’opérateur parenthèse f_modele(...). Ce paradigme autorise le passage de l’interpolateur en tant qu’argument à des intégrateurs numériques (comme scipy.integrate.quad) ou à des optimiseurs scalaires (comme scipy.optimize.minimize).
Cette persistance structurelle implique que l’objet retient une référence vers les données sources. Selon la valeur assignée au paramètre copy (qui vaut True par défaut), SciPy crée une copie défensive complète des tableaux x et y ou conserve une vue mémoire directe pointant vers les structures originales. Il appartient à l’ingénieur système de peser ce choix : la copie défensive immunise l’interpolateur contre les modifications extérieures involontaires des données d’origine mais double l’empreinte mémoire, tandis que la désactivation de la copie réduit l’usage de la mémoire vive au prix d’un risque accru d’effets de bord par mutation de pointeurs.
5.3 Évaluation scalaire et vectorielle sur de nouvelles coordonnées
Une fois l’objet fonctionnel instancié, son exécution peut être sollicitée de façon scalaire ou vectorielle avec une flexibilité syntaxique remarquable. Si l’on transmet un scalaire unique (un entier ou un nombre à virgule flottante) en argument à l’objet, celui-ci localise le segment adéquat et renvoie un tableau NumPy unidimensionnel contenant la valeur interpolée scalaire correspondante. Le retour est presque systématiquement converti sous la forme d’un conteneur NumPy, même pour une coordonnée unique, afin de préserver l’uniformité des types dans les flux de données en aval.
L’atout majeur de interp1d réside dans sa capacité à traiter simultanément des tableaux complets de nouvelles coordonnées d’interrogation. Si un vecteur NumPy dense comprenant des dizaines de milliers d’abscisses cibles est passé en argument, l’objet déploie des routines C sous-jacentes hautement optimisées basées sur des bibliothèques de recherche d’intervalles contigus. Les calculs arithmétiques de ratio et de proportionnalité sont alors intégralement vectorisés, contournant le verrou global de l’interpréteur Python (GIL) et maximisant le débit de calcul numérique.
Le tableau résultant adopte scrupuleusement la topologie dimensionnelle du tableau d’entrée. Si l’on fournit une matrice bidimensionnelle ou un tenseur tridimensionnel de points cibles, l’interpolateur restitue une structure tensorielle congruente contenant les valeurs estimées correspondantes. Cette stabilité structurelle assure une intégration fluide au sein des architectures logicielles complexes, telles que les chaînes de traitement d’images médicales ou les moteurs d’apprentissage automatique où la conservation de la forme des tenseurs est capitale.
6. Exemple pratique pas à pas : De l’échantillon à l’estimation
6.1 Définition du jeu de données et configuration de l’expérience
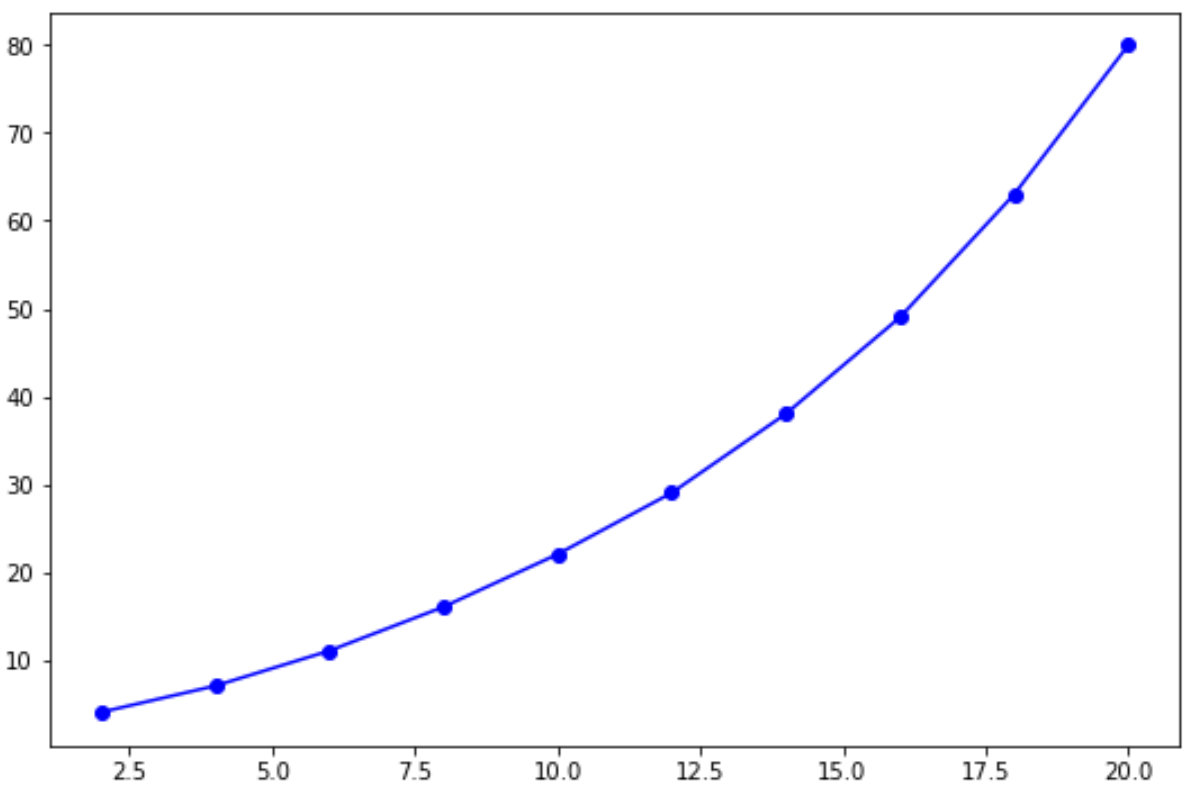
Pour ancrer ces concepts dans un cadre expérimental tangible, nous concevons un cas d’étude complet représentatif d’une mesure physique non linéaire discrétisée. Considérons une série d’échantillons mesurés à des abscisses équidistantes, où la relation sous-jacente présente une courbure quadratique progressive. Les vecteurs de données expérimentales sont configurés avec les coordonnées entières suivantes :
x = [2, 4, 6, 8, 10, 12, 14, 16, 18, 20]
y = [4, 7, 11, 16, 22, 29, 38, 49, 63, 80]
L’observation du gradient de variation de y (les incréments successifs valant 3, 4, 5, 6, 7, 9, 11, 14, 17) met en évidence que le profil global ne répond pas à une cinématique rectiligne unique, mais reflète une dynamique d’accélération continue. Cette non-linéarité générale constitue le cadre parfait pour illustrer le comportement d’une approximation affine par morceaux, chaque segment capturant localement l’augmentation graduelle de la pente.
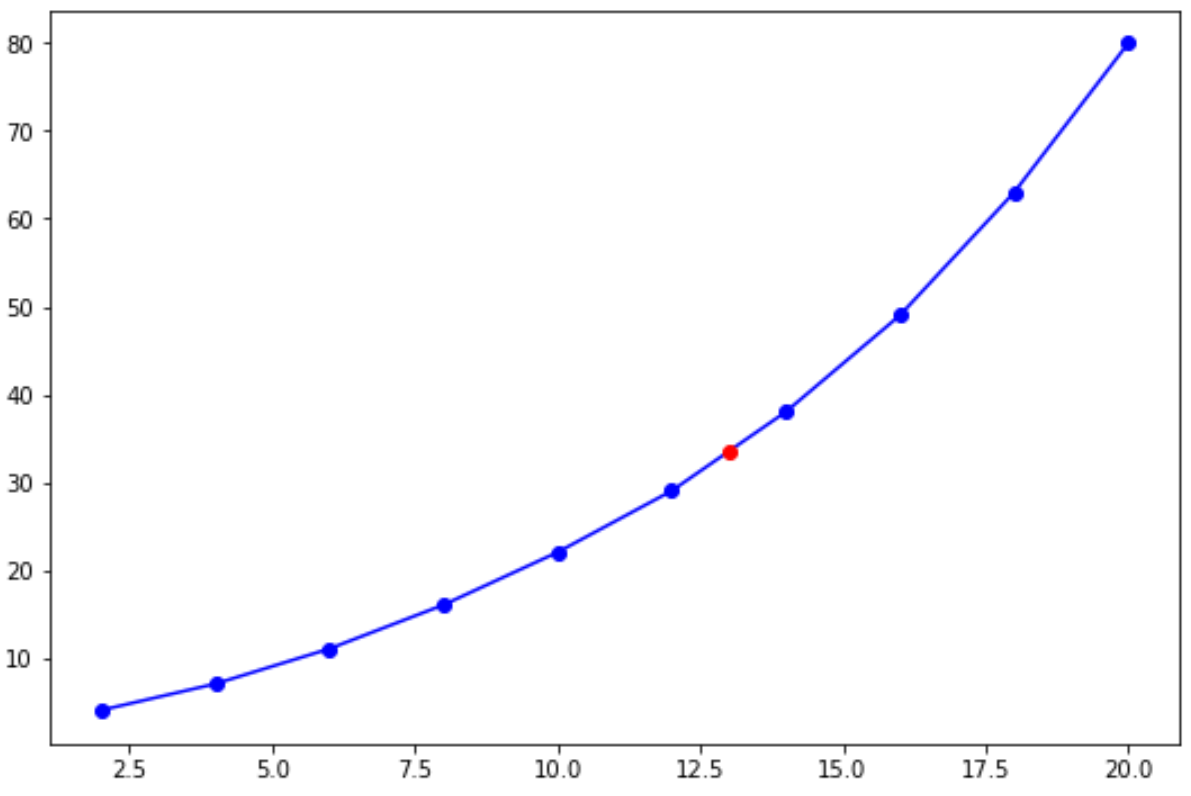
Nous fixons pour objectif pratique l’estimation rigoureuse de la coordonnée dépendante y associée à une abscisse cible x = 13. Cette valeur d’abscisse n’existe pas dans le jeu d’observations primitives, mais elle est strictement enclose entre le nœud x_5 = 12 (associé à y_5 = 29) et le nœud x_6 = 14 (associé à y_6 = 38). L’estimation de ce point intermédiaire nécessite donc l’évaluation de la corde reliant spécifiquement ces deux observations locales.
6.2 Exécution séquentielle du code avec scipy.interpolate
La mise en œuvre séquentielle sous Python de cette estimation s’articule en quelques instructions canoniques. Le protocole programmatique complet s’organise selon la séquence d’instructions suivante :
En premier lieu, les modules spécialisés sont importés dans l’espace de noms : NumPy pour l’instanciation des structures de tableaux contigus et interp1d issu de scipy.interpolate pour la modélisation mathématique. Les listes d’observations discrètes sont converties en tableaux typés numpy.float64 afin de garantir une précision en virgule flottante conforme au standard IEEE 754 à double précision :
import numpy as np
from scipy.interpolate import interp1d
x_obs = np.array([2, 4, 6, 8, 10, 12, 14, 16, 18, 20], dtype=np.float64)
y_obs = np.array([4, 7, 11, 16, 22, 29, 38, 49, 63, 80], dtype=np.float64)
L’interpolateur linéaire est ensuite instancié en spécifiant expressément le modèle affine par morceaux :
interpolateur = interp1d(x_obs, y_obs, kind='linear')
L’objet fonctionnel ainsi créé est interrogé avec la coordonnée cible x = 13 :
x_cible = 13.0
y_estime = interpolateur(x_cible)
print(f"Valeur interpolée en x = {x_cible} : {y_estime}")
L’exécution de cette séquence affiche immédiatement dans le terminal le résultat numérique scalaire encapsulé : Valeur interpolée en x = 13.0 : 33.5. L’opération a été exécutée par SciPy en allouant dynamiquement les structures nécessaires, en identifiant l’encadrement nodal et en évaluant la droite locale correspondante.
6.3 Vérification manuelle et validation mathématique du résultat
Afin de valider la robustesse scientifique du résultat fourni par la bibliothèque logicielle et d’exclure tout artefact computationnel, il convient de procéder à la résolution analytique manuelle de l’équation d’interpolation sur le sous-intervalle considéré. Les bornes d’encadrement identifiées pour l’abscisse x = 13 sont formellement :
(x1, y1) = (12.0, 29.0)
(x2, y2) = (14.0, 38.0)
Le calcul du taux d’accroissement local (le coefficient directeur de la droite sécante sur cet intervalle spécifique) donne :
Pente = (y2 – y1) / (x2 – x1) = (38.0 – 29.0) / (14.0 – 12.0) = 9.0 / 2.0 = 4.5
La distance relative séparant l’abscisse cible de la borne inférieure est :
Delta_x = x – x1 = 13.0 – 12.0 = 1.0
En substituant ces scalaires dans la formule d’interpolation canonique, l’ordonnée estimée se calcule selon :
y = y1 + Delta_x * Pente = 29.0 + (1.0 * 4.5) = 33.5
Cette démonstration algébrique établit une correspondance absolue entre l’évaluation manuelle théorique et la valeur calculée par la classe interp1d de SciPy. La valeur 33.5 représente le milieu exact du segment reliant 29 à 38, ce qui est géométriquement parfait puisque l’abscisse 13 se trouve précisément à mi-chemin entre 12 et 14. Cette confirmation manuelle conforte la fiabilité des algorithmes vectoriels de la bibliothèque.
7. Visualisation graphique des données et des résultats avec Matplotlib
7.1 Tracé du jeu de données discrètes original
La validation d’un processus d’interpolation en milieu scientifique ne saurait être complète sans une représentation visuelle rigoureuse. La bibliothèque Matplotlib s’impose comme la référence méthodologique pour concevoir des figures répondant aux critères de publication académique. La première composante visuelle à instaurer est la matérialisation claire des points d’échantillonnage originaux, qui constituent les ancres déterministes du modèle.
Pour représenter graphiquement ces observations sans masquer leur nature intrinsèquement discontinue, il est préconisé d’utiliser des marqueurs circulaires proéminents reliés par des traits pointillés ou discrets. La fonction plt.plot(x_obs, y_obs, 'o', color='#1f77b4', markersize=8, label='Données observées') permet de fixer visuellement la topologie des nœuds. L’application d’une couleur contrastée et d’un dimensionnement suffisant pour les marqueurs évite toute ambiguïté lors de la lecture d’ensembles de données denses.
Il est indispensable d’adjoindre à cette représentation une configuration complète du système de coordonnées : libellés précis des axes incluant les unités physiques de mesure via plt.xlabel() et plt.ylabel(), titre explicite définissant l’expérience via plt.title(), et affichage d’une grille de référence en arrière-plan à l’aide de plt.grid(True, linestyle='--', alpha=0.6). Cette grille facilite l’estimation visuelle immédiate des coordonnées sans surcharge cognitive.
7.2 Représentation spécifique du point interpolé
L’étape graphique suivante réside dans la mise en évidence contrastée du résultat estimé à l’abscisse cible. Le point virtuel (13.0, 33.5) doit se distinguer sans équivoque des données empiriques observées afin d’indiquer clairement à l’observateur qu’il s’agit d’un point synthétique déduit par calcul et non d’une mesure directe.
Cette distinction s’opère couramment en superposant un marqueur géométrique différencié (un losange, une étoile ou un carré de couleur écarlate ou vermillon) au moyen de l’instruction plt.plot(13.0, 33.5, 's', color='#d62728', markersize=10, label='Point interpolé (x=13)'). L’utilisation d’une couleur saturée différente de celle de la série initiale focalise immédiatement le regard sur l’inférence.
Pour renforcer la rigueur de la figure, il est recommandé de tracer des lignes de projection orthogonales (ou lignes de rappel) reliant le point interpolé aux deux axes du repère cartésien. L’utilisation de plt.vlines(x=13.0, ymin=0, ymax=33.5, color='#d62728', linestyle=':') et de plt.hlines(y=33.5, xmin=0, xmax=13.0, color='#d62728', linestyle=':') matérialise le mécanisme de projection géométrique et démontre sans ambiguïté la correspondance projective du calcul.
7.3 Représentation d’une grille continue interpolée
Pour visualiser la totalité de la trajectoire reconstruite par l’interpolateur linéaire, il convient d’évaluer l’objet interpolateur sur un continuum dense d’abscisses recouvrant l’intégralité du domaine expérimental [2, 20]. Cette grille d’évaluation continue est générée au moyen de la fonction numpy.linspace(start=2, stop=20, num=500), créant un vecteur uniformément espacé de cinq cents points.
L’évaluation vectorisée y_dense = interpolateur(x_dense) produit la courbe continue par morceaux. En traçant cette série avec plt.plot(x_dense, y_dense, '-', color='#2ca02c', linewidth=1.5, label='Interpolation linéaire'), on fait émerger la silhouette polygonale caractéristique de l’approximation du premier ordre. Cette représentation met en lumière la nature anguleuse des raccordements au niveau des nœuds expérimentaux, attestant graphiquement de la continuité C0 et de la non-dérivabilité aux points pivots.
La figure finale s’achève par l’intégration d’une légende ordonnée via plt.legend(loc='best', frameon=True) et la sauvegarde du canevas sous un format vectoriel non destructif (comme le format SVG ou PDF) via plt.savefig('interpolation_lineaire.svg', dpi=300, bbox_inches='tight'). Cette méthodologie garantit une lisibilité maximale pour les rapports techniques et les mémoires de recherche scientifique.
8. Alternative haute performance : L’approche numpy.interp
8.1 Architecture et principes de numpy.interp
Bien que la classe scipy.interpolate.interp1d offre un modèle orienté objet d’une grande modularité, la bibliothèque NumPy intègre sa propre fonction d’interpolation linéaire native optimisée : numpy.interp. Contrairement à SciPy qui privilégie un paradigme fonctionnel en deux étapes (instanciation d’un objet appelable puis évaluation), l’approche de NumPy est purement impérative et procédurale, exécutant le calcul de manière directe et immédiate.
La signature standard de cette fonction se structure de la façon suivante :
numpy.interp(x, xp, fp, left=None, right=None, period=None)
Dans ce formalisme, x représente les coordonnées cibles où l’évaluation est sollicitée, xp correspond aux abscisses des données observées (qui doivent impérativement être strictement monotones croissantes), et fp représente les valeurs observées de la fonction aux points xp. La fonction retourne immédiatement un tableau NumPy de dimension équivalente à x, peuplé des ordonnées calculées.
L’architecture interne de numpy.interp est intégralement codée en langage C sous la forme d’une boucle compilée hautement optimisée, évitant la moindre allocation d’objets Python intermédiaires. La recherche des intervalles s’appuie sur un algorithme de recherche binaire interne exempt de toute surcharge d’évaluation de type au moment de l’exécution, ce qui confère à cette routine une vélocité maximale pour les tâches répétitives en temps réel.
8.2 Comparaison de performance : numpy.interp versus scipy interp1d
Sur le plan des performances informatiques pures, la confrontation empirique entre numpy.interp et scipy.interpolate.interp1d tourne systématiquement à l’avantage de la première solution lorsqu’il s’agit d’exécuter des interpolations affines unidimensionnelles. Des tests de performance normalisés (benchmarking via le module timeit) démontrent que numpy.interp s’avère fréquemment cinq à vingt fois plus rapide que interp1d(kind='linear') pour le traitement de tableaux massifs comprenant plusieurs millions de coordonnées.
Cette disparité d’efficacité s’explique par deux facteurs techniques fondamentaux. D’une part, l’instanciation de l’objet interp1d requiert la configuration de multiples attributs internes de validation, l’analyse d’arguments sous forme de dictionnaires et la création de wrappers de compatibilité, ce qui introduit une latence structurelle considérable si la fonction est recréée à l’intérieur d’une boucle itérative. D’autre part, la machinerie interne de SciPy est conçue pour gérer des familles de splines d’ordres arbitraires, ce qui induit des embranchements conditionnels supplémentaires dont est exempte la routine ultra-dédiée de NumPy.
En matière d’empreinte mémoire, numpy.interp alloue uniquement le bloc contigu requis pour héberger le tableau des résultats, tandis que interp1d maintient des références persistantes vers les jeux de données d’entrée et crée des structures d’objets Python volumineuses. Par conséquent, dans les environnements de production soumis à des contraintes de mémoire vive ou de latence stricte (systèmes embarqués, analyse boursière haute fréquence), numpy.interp doit être formellement privilégiée pour toute interpolation strictement linéaire.
8.3 Traitement automatique des limites hors bornes dans NumPy
Une divergence comportementale majeure entre NumPy et SciPy réside dans le traitement des coordonnées d’évaluation situées en dehors du domaine de définition expérimental [xp[0], xp[-1]]. Alors que la configuration par défaut de SciPy lève immédiatement une exception d’interruption du flux d’exécution, numpy.interp adopte par défaut une stratégie d’extrapolation constante par les bornes, couramment désignée sous le terme de plafonnement ou clamping.
Concrètement, si une abscisse cible x est strictement inférieure à la première borne xp[0], numpy.interp lui assigne invariablement la première ordonnée observée fp[0]. Symétriquement, si l’abscisse cible excède la borne supérieure xp[-1], le résultat est plafonné à la dernière ordonnée fp[-1]. Cette approche prévient les crashs inopinés des pipelines de données industriels face à des artéfacts transitoires hors limites, mais elle aplatit artificiellement la dynamique du signal sur les queues de distribution.
Les paramètres optionnels left et right permettent de réguler ce comportement avec précision. Le développeur peut ainsi spécifier explicitement des valeurs sentinelles de substitution :
y_traite = np.interp(x_cibles, xp_connus, fp_connus, left=np.nan, right=-9999.0)
Dans cette configuration, tout point d’évaluation situé en deçà du domaine nominal se voit attribuer la constante np.nan, matérialisant son invalidité physique, tandis que les points supérieurs reçoivent le code sentinelle désigné. Cette souplesse de paramétrage natif permet d’isoler immédiatement les requêtes hors limites sans pénaliser la performance vectorielle par des blocs de capture d’exceptions conditionnels.
9. Gestion des conditions aux limites et de l’extrapolation
9.1 Le danger épistémologique de l’extrapolation linéaire
L’évaluation d’un modèle d’interpolation au-delà des frontières fermées de son échantillonnage initial engage la responsabilité méthodologique du chercheur. D’un point de vue épistémologique, l’extrapolation consiste à affirmer arbitrairement que la tendance affine observée sur le segment terminal d’un jeu de données expérimental se poursuit indéfiniment avec un coefficient directeur rigoureusement identique dans l’espace inconnu. Une telle assertion viole fréquemment les principes de conservation physique, les lois de saturation thermodynamique ou les régulations homéostatiques propres aux systèmes réels.
Si l’on considère un système biologique mesurant la cinétique enzymatique en fonction de la concentration de substrat, la relation locale observée à concentration moyenne peut sembler quasi linéaire. Projeter cette droite vers des concentrations infinies prédit une vitesse de réaction arbitrairement élevée, alors que le phénomène réel plafonne selon une cinétique michaélienne sous l’effet de la saturation des sites actifs de l’enzyme. L’extrapolation linéaire induit dans ce cas des erreurs quantitatives massives pouvant fausser complètement les conclusions d’une étude.
Il est donc essentiel de poser comme règle méthodologique que l’extrapolation ne doit être activée qu’en toute connaissance de cause, sur des plages très restreintes adjacentes aux bornes d’échantillonnage, et uniquement lorsqu’une théorie mécanistique solide valide la continuité du comportement asymptotique. En l’absence de telles garanties théoriques, toute tentative d’évaluation externe relève de l’artefact statistique et doit être proscrite ou formellement signalée comme une conjecture hypothétique non observée.
9.2 Gestion des exceptions dans scipy.interpolate.interp1d
Conscients de ce péril épistémologique, les concepteurs de SciPy ont adopté une posture défensive par défaut au sein de la classe interp1d. Si l’on sollicite l’évaluation de l’objet fonctionnel avec une coordonnée x située strictement en dehors de l’intervalle fermé [x_min, x_max], l’interpréteur interrompt immédiatement l’opération et lève une exception critique de type ValueError: A value in x_new is above the interpolation range.
Ce verrouillage structurel protège les chaînes de traitement automatisées contre la contamination invisible de données non étayées. Toutefois, pour les flux opérationnels où les dépassements de bornes sont prévisibles et ne doivent pas paralyser l’exécution globale, SciPy propose une régulation fine au moyen du couple de paramètres bounds_error et fill_value. En stipulant bounds_error=False, l’utilisateur désactive explicitement la levée systématique de l’exception bloquante :
f_securisee = interp1d(x, y, kind='linear', bounds_error=False, fill_value=np.nan)
Sous cette configuration, l’évaluation de f_securisee sur des abscisses en dehors des limites n’interrompt plus le programme : elle insère de manière contrôlée la valeur NaN en chaque coordonnée fautive. Ce comportement permet de consigner proprement l’invalidité locale du résultat tout en préservant l’intégrité du traitement vectoriel pour toutes les autres coordonnées valides, facilitant ainsi les filtrages ultérieurs dans les bibliothèques d’analyse comme Pandas.
9.3 Activation raisonnée de l’extrapolation linéaire
Dans des configurations spécifiques où l’extrapolation physique ou cinématique s’avère formellement requise et mathématiquement justifiée, la classe interp1d autorise le prolongement continu des segments terminaux. Ce comportement s’enclenche en affectant la chaîne de caractères littérale "extrapolate" à l’argument fill_value :
f_extrapolante = interp1d(x, y, kind='linear', fill_value='extrapolate')
Sous ce régime d’exécution, pour toute abscisse d’interrogation x > x_max, SciPy évalue l’équation de la droite issue des deux ultimes nœuds du jeu de données, prolongeant indéfiniment la pente finale (y_n – y_{n-1}) / (x_n – x_{n-1}). Symétriquement, pour toute abscisse inférieure à la borne de départ, la pente du segment initial reliant le premier au second nœud est prolongée vers la gauche.
L’application de ce mécanisme engendre une divergence linéaire rapide si les abscisses s’éloignent substantiellement du cœur d’échantillonnage. Dans tout rapport scientifique ou documentation logicielle, l’utilisation de l’option fill_value='extrapolate' doit faire l’objet d’une mention explicite dans la section méthodologique. Il est recommandé de quantifier systématiquement l’éloignement des points extrapolés par rapport à la plus proche frontière empirique afin d’assortir ces valeurs d’un intervalle de confiance dégradé proportionnellement à la distance d’extrapolation.
10. Interpolation linéaire sur structures de données Pandas
10.1 Application directe avec la méthode Series.interpolate()
Dans les pipelines modernes de science des données, la manipulation des données expérimentales et financières s’effectue majoritairement au moyen de structures de données tabulaires fournies par la bibliothèque Pandas. Les chroniques temporelles y sont formalisées sous la forme d’objets Series dont l’axe des indices représente la dimension chronologique ou spatiale. Pour pallier les coupures d’acquisition et imputer élégamment les cellules manquantes matérialisées par des indicateurs NaN, Pandas intègre directement une méthode native hautement optimisée : Series.interpolate().
L’invocation la plus fondamentale s’exprime selon l’instruction serie_nettoyee = serie_brute.interpolate(method='linear'). Par défaut, cette méthode identifie automatiquement les segments contigus de valeurs manquantes, repère les observations valides qui les encadrent immédiatement, et résout l’interpolation linéaire pour chacune des lacunes. La continuité des séries s’en trouve restaurée sans qu’il soit nécessaire d’écrire des boucles ou d’extraire manuellement les coordonnées vers NumPy :
Un paramètre déterminant de Series.interpolate() réside dans le choix de la méthode sous-jacente en relation avec l’indexation. Si l’index de la série représente un maillage équidistant continu (index numérique incrémental par défaut), method='linear' traite chaque palier d’indice comme un intervalle géométrique équivalent. Si, en revanche, les données sont collectées à des pas de temps irréguliers matérialisés par un DatetimeIndex, l’activation de method='time' commande à Pandas de pondérer l’accroissement proportionnel en fonction de la distance chronologique exacte séparant les horodatages, assurant une modélisation affine temporellement rigoureuse.
10.2 Interpolation au sein de DataFrames multidimensionnels
L’extension de cette mécanique aux tableaux multidimensionnels représentés par les DataFrame de Pandas permet d’imputer simultanément des dizaines de colonnes de capteurs en une seule instruction vectorisée. La méthode DataFrame.interpolate() itère sur l’ensemble des séries univariées constituantes en appliquant de manière uniforme les postulats géométriques choisis.
La méthode propose des mécanismes de régulation directionnelle et de limitation de portée via des paramètres dédiés :
limit: entier spécifiant le nombre maximal de valeursNaNconsécutives autorisées à être comblées par l’algorithme. Cette contrainte empêche le comblement de larges plages d’absence prolongée de signal qui fausseraient la statistique globale du phénomène.limit_direction: accepte les options'forward','backward'ou'both', déterminant si l’imputation doit se propager exclusivement vers l’avant, vers l’arrière ou de manière bidirectionnelle depuis les points valides.limit_area: permet de restreindre l’interpolation aux seules zones intérieures ('inside'), excluant expressément les lacunes situées au tout début ou à la toute fin de la table de données pour interdire l’extrapolation accidentelle aux bornes.
Le contrôle rigoureux de ces paramètres garantit que l’intégrité des séries chronologiques multidimensionnelles est préservée. À l’issue de l’imputation, l’intégrité de la structure est généralement vérifiée par l’évaluation booléenne assert df.isna().sum().sum() == 0, confirmant la résorption intégrale des valeurs manquantes admissibles avant la transmission des matrices aux couches d’apprentissage automatique ou d’analyse spectrale.
10.3 Précautions méthodologiques lors du nettoyage de données
Si l’imputation par interpolation linéaire au sein de Pandas s’avère d’une grande commodité algorithmique, son application aveugle présente des risques statistiques substantiels qu’il importe de maîtriser. Le premier effet collatéral réside dans la réduction artificielle de la variance des variables imputées. En forçant les valeurs de remplacement à s’aligner rigoureusement sur une trajectoire rectiligne déterministe entre deux nœuds distants, on supprime la variabilité stochastique naturelle inhérente au processus de mesure, ce qui entraîne une sous-estimation systématique de l’écart-type et de l’incertitude globale du signal.
Le second écueil concerne la taille des fenêtres de données manquantes. Lorsqu’un capteur subit une panne prolongée générant une séquence continue de centaines de valeurs NaN, tracer une corde linéaire unique entre le début et la fin de l’interruption constitue une approximation grossière dénuée de sens physique. Durant cet intervalle de temps étendu, le phénomène réel a pu traverser des régimes transitoires, des inversions de cycle ou des paliers d’état que la droite sécante occulte intégralement.
Une bonne pratique d’ingénierie des données consiste à coupler systématiquement l’interpolation linéaire à une phase de diagnostic exploratoire préalable. Il convient d’établir un masque booléen identifiant les longueurs de séquences corrompues consécutives, de réserver l’interpolation affine aux fenêtres ne dépassant pas trois à cinq pas d’échantillonnage consécutifs, et de classer les lacunes plus étendues comme des ruptures de régime exigeant des modèles génératifs plus sophistiqués (modèles autorégressifs ARIMA, processus gaussiens) ou un partitionnement de la série chronologique.
11. Comparaison méthodologique : Interpolation linéaire contre approches d’ordre supérieur
11.1 L’interpolation par splines cubiques (CubicSpline)
Face aux limites de différentiabilité inhérentes à l’interpolation linéaire affine, l’interpolation par splines cubiques (accessible via scipy.interpolate.CubicSpline) représente l’alternative classique d’ordre supérieur la plus fréquemment mobilisée. Au lieu d’ajuster des polynômes de degré 1 sur chaque sous-intervalle, l’algorithme des splines cubiques calibre des polynômes de degré 3 en imposant une contrainte de régularité mathématique supplémentaire : l’égalité stricte des dérivées premières et des dérivées secondes de part et d’autre de chaque nœud d’observation.
Cette formulation assure une continuité de classe C2 sur l’ensemble du domaine de modélisation. La courbe résultante adopte un profil lisse et harmonieux, idéal pour modéliser des trajectoires robotiques, des profils aérodynamiques ou des phénomènes oscillatoires fluides où toute discontinuité d’accélération entraînerait des contraintes mécaniques infinies destructrices. L’absence d’angles vifs permet également de différentier analytiquement la spline pour extraire des gradients ou des courbures avec une excellente précision mathématique.
Cependant, cette élégance géométrique se paie au prix d’une vulnérabilité accrue aux instabilités oscillatoires. Lorsqu’un signal présente des variations brutales ou des transitions en échelon, les splines cubiques ont tendance à générer des dépassements d’amplitude parasites (overshoot et undershoot) connus sous le nom de phénomène d’ondulation ou phénomène de Runge localisé. Dans ces configurations discontinues, l’interpolation linéaire affine, en vertu de sa stricte monotonicité locale, se révèle paradoxalement plus fidèle à la physique sous-jacente que les courbes d’ordre supérieur.
11.2 Interpolation par plus proche voisin et fonctions en escalier
À l’opposé des méthodes cubiques dans l’échelle de régularité mathématique se trouve l’interpolation par plus proche voisin (configurée via kind='nearest' dans interp1d ou par la fonction scipy.interpolate.NearestNDInterpolator). Cette approche d’ordre zéro ne postule aucune variation affine intermédiaire : pour toute coordonnée cible x, elle lui assigne invariablement l’ordonnée du nœud d’observation le plus proche spatialement ou temporellement. La courbe qui en découle présente une géométrie en escalier, discontinuant brutalement à mi-chemin de chaque sous-intervalle.
Cette approche, bien que mathématiquement discontinue (non C0 aux points de bascule), s’avère irremplaçable pour le traitement de grandeurs physiques discrètes, d’états d’actionneurs binaires (marche/arrêt, électrovannes ouvertes/fermées) ou de variables qualitatives catégorielles encodées numériquement (classes taxonomiques). Tenter d’appliquer une interpolation linéaire sur un identifiant de modalité binaire produirait des valeurs décimales intermédiaires dépourvues de réalité fonctionnelle (comme un état 0.73 entre l’état inactif 0 et actif 1).
L’interpolation par plus proche voisin est également mobilisée dans les approches causales strictes en temps réel sous la forme d’un bloqueur d’ordre zéro (Zero-Order Hold, ou interpolation ‘zero’ / ‘previous’ dans SciPy). Le signal est maintenu rigoureusement constant à sa dernière valeur mesurée jusqu’à l’arrivée de la mesure suivante. Contrairement à l’interpolation linéaire standard qui nécessite de connaître l’observation future x2 pour imputer le point intermédiaire x (introduisant un retard de phase égal à la durée d’échantillonnage), le maintien d’ordre zéro n’introduit aucun temps de latence prédictif.
11.3 Arbre de décision méthodologique pour le choix de l’interpolateur
Le choix de l’opérateur d’interpolation optimal ne relève pas d’une préférence subjective, mais de l’analyse conjointe de la dynamique du système, de la nature de la variable et de la finalité algorithmique du traitement. L’arbre de décision méthodologique suivant synthétise les critères de sélection technique face à un problème d’estimation numérique :
- Nature discrète ou catégorielle de la variable : Opter impérativement pour l’interpolation par plus proche voisin (
kind='nearest') ou le maintien d’état précédent (kind='previous') pour interdire toute synthèse de fausses modalités intermédiaires. - Système causal temps réel sans tolérance au retard : Déployer un bloqueur d’ordre zéro (
kind='previous') garantissant une absence totale de dépendance envers les horizons temporels futurs. - Signal continu à fort niveau de bruit instrumental : Proscrire l’interpolation exacte. Orienter le pipeline vers une régression statistique (moindres carrés polynomiaux) ou un lissage par spline pénalisée (
scipy.interpolate.UnivariateSplineavec un paramètre de lissage s non nul). - Système mécanique, trajectoire physique fluide exigeant des dérivées secondes continues : Sélectionner les splines cubiques régulières (
scipy.interpolate.CubicSpline), en surveillant activement les dépassements d’amplitude au voisinage des gradients abrupts. - Données déterministes à profil monotone, maillage dense, ou volumétrie massive requérant une efficacité computationnelle maximale : Choisir l’interpolation linéaire affine de premier ordre, mise en œuvre via
numpy.interppour la performance pure ouscipy.interpolate.interp1d(kind='linear')pour l’intégration modulaire.
Ce protocole systématique immunise l’analyste contre les erreurs de sélection d’outils et garantit que l’approximation fonctionnelle adoptée reflète fidèlement les contraintes phénoménologiques du problème étudié.
12. Diagnostic des anomalies, pièges fréquents et recommandations scientifiques
12.1 Exigence de monotonicité stricte des abscisses
L’un des pièges les plus récurrents lors du déploiement d’algorithmes d’interpolation en Python réside dans l’introduction de tableaux d’abscisses non triés ou corrompus par des doublons stricts. Les moteurs computationnels de NumPy et de SciPy reposent sur le postulat formel que l’axe des x constitue un ensemble strictement croissant (x_0 < x_1 < … < x_n). Le non-respect de cette contrainte engendre des comportements aberrants sans nécessairement déclencher d’erreur explicite d’interruption.
Si un vecteur d’abscisses désordonné est fourni à numpy.interp, l’algorithme interne de bisection binaire échoue silencieusement à localiser les véritables cellules d’encadrement, renvoyant des ordonnées interpolées incohérentes qui défigurent complètement le signal traité. De surcroît, la présence de doublons d’abscisses consécutifs (deux mesures distinctes partageant la même coordonnée x) génère un sous-intervalle d’amplitude spatiale nulle (x2 – x1 = 0), provoquant une division par zéro lors du calcul du coefficient directeur, laquelle engendre l’apparition de valeurs inf ou NaN qui contaminent les flux de données subséquents.
Pour immuniser les scripts scientifiques contre cette classe d’anomalies, il est impératif d’intégrer un bloc de sanitisation en amont du calcul d’interpolation :
indices_tries = np.argsort(x_brut)
x_trie = x_brut[indices_tries]
y_trie = y_brut[indices_tries]
x_unique, indices_uniques = np.unique(x_trie, return_index=True)
y_unique = y_trie[indices_uniques]
Cette séquence préventive garantit le tri ascendant universel et l’élimination stricte de toute redondance nodale, assurant l’exécution nominale des routines de calcul de NumPy et SciPy.
12.2 Impact du bruit de mesure et propagation des erreurs
Une limitation méthodologique critique de l’interpolation linéaire réside dans son absence totale de tolérance face au bruit stochastique de mesure. Puisque l’interpolateur est contraint de passer rigoureusement par chacun des nœuds empiriques enregistrés, toute déviation aléatoire (bruit gaussien haute fréquence, saut quantique de mesure d’un convertisseur analogique-numérique) affecte directement la pente locale des segments de raccordement.
Si une observation isolée y_i subit une fluctuation positive anormale sous l’effet du bruit instrumental, les deux segments adjacents [x_{i-1}, x_i] et [x_i, x_{i+1}] voient leurs coefficients directeurs basculer artificiellement vers le haut puis vers le bas. L’ensemble des points virtuels interpolés à l’intérieur de ces deux intervalles se trouve systématiquement biaisé par cette perturbation locale, amplifiant l’énergie du bruit au lieu de la dissiper.
En présence de données hautement bruitées, il est méthodologiquement erroné d’appliquer directement une interpolation affine brute. Le protocole scientifique impose d’intercaler une étape de filtrage préalable ou de débruitage : application d’un filtre à moyenne mobile, d’un filtre de Savitzky-Golay (via scipy.signal.savgol_filter) ou d’un filtrage passe-bas de Butterworth. L’interpolation linéaire ne doit être exécutée que sur les coordonnées lissées résultantes afin d’empêcher la propagation non amortie des résidus expérimentaux vers les valeurs reconstruites.
12.3 Protocole pour un code scientifique robuste et reproductible
Pour élever l’implémentation de l’interpolation linéaire aux normes de qualité logicielles requises par les revues académiques et les industries de pointe, il est primordial de structurer le pipeline sous la forme de modules défensifs testables. Un code scientifique robuste ne se limite pas à l’évaluation des équations mathématiques : il vérifie ses propres hypothèses avant l’exécution et documente ses décisions de calcul.
Ce protocole d’ingénierie s’articule autour de cinq directives cardinales :
- Assertions d’entrée explicites : Utiliser des instructions d’assertion ou des exceptions typées pour valider que les tableaux d’entrée sont unidimensionnels, qu’ils possèdent la même longueur et qu’ils contiennent au moins deux coordonnées distinctes.
- Typage strict des données : Forcer la conversion des vecteurs de données vers des formats à virgule flottante homogènes (
np.float64) pour éviter les phénomènes d’arrondi de la division entière propre aux versions anciennes ou aux types d’entiers non signés. - Gestion hermétique des limites d’extrapolation : Définir systématiquement des paramètres de confinement (
bounds_error=Trueou configuration explicite defill_valueavec des sentinellesnp.nan) pour proscrire toute projection non autorisée hors du maillage certifié. - Encapsulation fonctionnelle : Bannir les scripts monolithiques procéduraux. Réunir la logique de préparation, de validation et d’interpolation au sein de fonctions documentées respectant la convention des docstrings scientifiques (format NumPy ou Google), explicitant les préconditions, les types de retour et les garanties algorithmiques.
- Documentation systématique des paramètres : Consigner dans les métadonnées de sortie ou les fichiers journaux (logs) la version exacte des bibliothèques employées ainsi que l’ensemble des choix méthodologiques retenus (modèle d’interpolation, méthode de tri, tolérance aux bornes), garantissant la parfaite réplicabilité des résultats sur d’autres plateformes de calcul.
En observant scrupuleusement ces standards méthodologiques et logiciels, le chercheur ou l’ingénieur convertit un calcul d’interpolation élémentaire en un composant algorithmique robuste, pérenne et scientifiquement irréprochable au sein de ses écosystèmes d’analyse numérique en langage Python.
Références
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, F. A., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1923-00a
- Press, W. H., Teukolsky, S. A., Vetterling, W. T., & Flannery, B. P. (2007). Numerical recipes: The art of scientific computing (3rd ed.). Cambridge University Press.
- Quarteroni, A., Sacco, R., & Saleri, F. (2007). Numerical mathematics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b98885
- Stoer, J., & Bulirsch, R. (2002). Introduction to numerical analysis (3rd ed.). Springer-Verlag. https://doi.org/10.1007/978-0-387-21738-3
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2