
L’analyse des interdépendances au sein de données multidimensionnelles constitue l’un des piliers méthodologiques fondamentaux de la statistique moderne, de l’apprentissage automatique et des sciences comportementales quantitatives. Qu’il s’agisse de calibrer une batterie de tests psychométriques, de modéliser les fluctuations conjointes d’actifs financiers ou de réduire la dimensionnalité d’un signal biologique, la capacité à quantifier la manière dont plusieurs variables aléatoires varient de concert représente une étape analytique incontournable. Au cœur de cet édifice se trouve la matrice de variance-covariance, un objet algébrique compact qui résume l’ensemble des dispersions marginales et des covariations bilatérales caractérisant un système multivarié.
Dans l’écosystème du calcul scientifique contemporain, le langage de programmation Python s’est imposé comme l’environnement d’élection pour manipuler ces structures. Grâce à des bibliothèques hautement optimisées telles que NumPy, Pandas et SciPy, les chercheurs et praticiens disposent d’outils algorithmiques d’une grande puissance, permettant d’exécuter des opérations matricielles complexes avec une efficacité computationnelle proche des routines bas niveau compilées en C ou Fortran. Toutefois, la simple exécution d’une fonction de calcul matriciel ne saurait suffire : une compréhension intime des hypothèses sous-jacentes, des formulations algébriques et des subtilités d’implémentation logicielle s’avère indispensable pour éviter des erreurs d’interprétation méthodologique souvent délétères.
Ce guide exhaustif a pour vocation d’explorer, de manière rigoureuse et approfondie, la théorie, la construction algorithmique et l’interprétation appliquée de la matrice de covariance en Python. En ancrant notre réflexion dans le champ de la psychométrie et de la modélisation quantitative, nous examinerons pas à pas chaque composante mathématique, chaque ligne de code structurante, ainsi que les écueils numériques classiques tels que la singularité matricielle ou la perte du caractère semi-défini positif. De la formulation des estimateurs à la visualisation avancée, en passant par la transition vers la corrélation et l’analyse spectrale, ce document offre un cadre de référence complet pour le chercheur et le data scientist exigeants.
1. Introduction théorique à la covariance et aux matrices associatives en psychométrie
1.1 Définition formelle de la covariance statistique
La covariance statistique mesure la tendance conjointe de deux variables aléatoires réelles à s’écarter simultanément de leurs espérances mathématiques respectives. D’un point de vue conceptuel, elle constitue une extension bivariée directe de la variance scalaire. Si l’on considère deux variables continues, notées arbitrairement X et Y, la covariance est définie comme l’espérance du produit de leurs déviations centrées :
$$operatorname{Cov}(X, Y) = \mathbb{E}[(X – \mathbb{E}[X])(Y – \mathbb{E}[Y])]$$
Cette formulation analytique capture la direction géométrique de l’association linéaire. Lorsque les observations de X supérieures à sa moyenne coïncident systématiquement avec des réalisations de Y supérieures à la sienne, le produit des déviations est positif, conférant une covariance globale positive. Inversement, si une déviation positive le long de l’axe des abscisses s’accompagne de manière prédominante d’une déviation négative le long de l’axe des ordonnées, la valeur attendue du produit devient négative, dénotant un patron de variation inverse.
Il importe de souligner avec vigueur la distinction épistémologique fondamentale entre dépendance statistique et dépendance causale. Une covariance non nulle atteste strictement d’une co-occurrence linéaire des fluctuations au sein du repère d’observation ; elle ne préjuge en rien d’une quelconque primauté temporelle, d’un mécanisme génératif unilatéral ou de l’absence d’une tierce variable confondante. Dans le champ de l’évaluation psychologique et des sciences sociales, cette mesure renseigne avant tout sur la covariation inter-individuelle observée lors de l’administration simultanée de plusieurs épreuves.
1.2 Rôle structurel de la matrice de covariance
Dès lors que le protocole expérimental implique non plus deux variables isolées, mais un vecteur aléatoire d’ordre p, la dispersion globale du système nécessite une généralisation matricielle. La matrice de variance-covariance, classiquement désignée par la lettre grecque majuscule Sigma ($\mathbf{\Sigma}$), est une structure carrée de dimensions p × p qui synthétise exhaustivement la structure associative du système.
Cette matrice possède des propriétés algébriques remarquables. En premier lieu, elle est intrinsèquement symétrique par rapport à sa diagonale principale, dans la mesure où l’opérateur de covariance est commutatif : pour tout couple d’indices $(j, k)$, la relation $\sigma_{jk} = \sigma_{kj}$ est scrupuleusement vérifiée. En second lieu, les éléments positionnés précisément le long de la diagonale principale représentent la covariance d’une variable avec elle-même, ce qui correspond, par définition, aux variances marginales :
$$\sigma_{jj} = operatorname{Cov}(X_j, X_j) = operatorname{Var}(X_j)$$
Les éléments hors-diagonale quantifient les covariations bilatérales entre les dimensions distinctes du vecteur de mesure. Dans le domaine du diagnostic psychométrique, cette matrice offre un outil d’exploration immédiat de la cohérence interne d’un instrument d’évaluation : des variances diagonales homogènes associées à des covariances extra-diagonales substantiellement positives suggèrent que les items mesurent des facettes convergentes d’un même domaine de compétence ou d’un trait psychologique partagé.
1.3 Applications directes en psychologie quantitative
La modélisation psychométrique contemporaine repose sur la formalisation de variables latentes inobservables inférées à partir d’indicateurs manifestes. La matrice de covariance empirique constitue la matière première sur laquelle s’échafaudent les analyses les plus sophistiquées, à l’instar de la modélisation en équations structurelles (SEM) et de l’analyse factorielle confirmatoire (AFC).
Lorsqu’un chercheur administre une batterie d’évaluations cognitives mesurant par exemple la mémoire de travail, le raisonnement inductif et la vitesse de traitement, l’analyse conjointe des variances et des covariances permet d’estimer la part de variance attribuable à un facteur général d’efficience intellectuelle par rapport aux variances spécifiques à chaque tâche. En outre, la théorie classique des tests exploite directement ces coefficients pour évaluer la fidélité de consistance interne, illustrée notamment par le coefficient alpha de Cronbach ou le coefficient oméga de McDonald, lesquels sont dérivés des sommes des blocs matriciels.
Enfin, dans les protocoles longitudinaux où les mêmes épreuves sont administrées de manière répétée au fil du temps, la stabilité temporelle des construits psychologiques est appréhendée par l’examen des covariances d’autocorrélation croisée. Une matrice de covariance mal conditionnée ou estimée sur des bases erronées compromet irrémédiablement l’ajustement de ces modèles structurels, faussant les indices d’adéquation tels que le RMSEA ou le CFI.
2. Fondements mathématiques et formulations algébriques
2.1 Formule de la covariance de population
Sur le plan mathématique, le calcul de la covariance dépend crucialement du statut épistémique des données considérées : s’agit-il de la totalité exhaustive d’une population finie ou d’un échantillon stochastique extrait de celle-ci ? Pour une population fermée composée d’exactement N observations exhaustives, la covariance de population entre deux dimensions $X$ et $Y$ s’exprime par l’équation suivante :
$$\sigma_{XY} = \frac{1}{N} \sum_{i=1}^{N} (x_i – \mu_X)(y_i – \mu_Y)$$
Dans cette formulation, $\mu_X$ et $\mu_Y$ désignent les véritables moyennes paramétriques de la population globale. Le dénominateur correspond rigoureusement à la taille totale N. Cette relation suppose implicitement que chaque individu de la population contribue de manière équiprobable au calcul du moment conjoint centré du second ordre.
Il convient de noter que cette métrique est particulièrement sensible à la distribution sous-jacente des scores. Si les variables manifestent une asymétrie marquée ou une leptocurticité prononcée, la présence de valeurs extrêmes situées simultanément dans les queues de distribution peut artificiellement amplifier la valeur calculée, conférant une image trompeuse de la dépendance moyenne. L’hypothèse implicite d’une distribution normale multivariée sous-tend très fréquemment l’interprétation linéaire de cet estimateur.
2.2 Formule de la covariance d’échantillon et correction de Bessel
Dans l’immense majorité des contextes empiriques, l’accès à la population entière demeure impossible. Le chercheur travaille sur un échantillon aléatoire de taille n issu d’une population cible infinie ou inaccessible. Dès lors, les véritables moyennes paramétriques sont inconnues et doivent être estimées à partir des moyennes d’échantillon $\bar{x}$ et $\bar{y}$. Cette substitution induit un phénomène statistique bien documenté : l’utilisation d’une moyenne estimée sur le même échantillon entraîne une sous-estimation systématique de la dispersion réelle, car les données sont mécaniquement plus proches de leur propre moyenne d’échantillon que de la véritable moyenne populationnelle.
Pour neutraliser ce biais négatif asymptotique, on applique la célèbre correction de Bessel, consistant à substituer le dénominateur $n$ par les degrés de liberté résiduels, soit $n – 1$. L’estimateur d’échantillon sans biais s’écrit formellement :
$$s_{XY} = \frac{1}{n – 1} \sum_{i=1}^{n} (x_i – \bar{x})(y_i – \bar{y})$$
La preuve formelle repose sur le calcul de l’espérance mathématique de la somme des produits d’écarts. On démontre rigoureusement que $\mathbb{E}[s_{XY}] = \sigma_{XY}$, ce qui garantit la propriété de non-biais de l’estimateur. Pour de petits échantillons cliniques (par exemple, $n < 30$), l'impact de cette correction est loin d'être anodin : utiliser $n$ au lieu de $n – 1$ engendre une sous-estimation de la covariance de l'ordre de 3 à 10 %, ce qui altère substantiellement les inférences ultérieures.
2.3 Écriture matricielle compacte
L’algèbre linéaire offre une représentation particulièrement élégante et computationnellement efficace du calcul de la matrice de covariance. Soit une matrice de données brutes $\mathbf{X}$ de dimensions $n \times p$, où chaque ligne représente une observation individuelle (un sujet d’expérience) et chaque colonne représente une variable (un test psychologique). La première opération consiste à calculer la matrice des données centrées, notée $\mathbf{X}_c$ :
$$\mathbf{X}_c = \mathbf{X} – \frac{1}{n} \mathbf{1}_n \mathbf{1}_n^T \mathbf{X}$$
où $\mathbf{1}_n$ est un vecteur colonne unitaire de dimension $n$. Une fois ce centrage effectué sur chaque colonne, la matrice de variance-covariance de l’échantillon $\mathbf{S}$ s’obtient instantanément par le produit extérieur de la matrice transposée par elle-même, pondéré par le facteur d’ajustement adéquat :
$$\mathbf{S} = \frac{1}{n – 1} \mathbf{X}_c^T \mathbf{X}_c$$
Cette formulation matricielle révèle immédiatement les propriétés intrinsèques de l’objet résultant. Par construction, le produit $\mathbf{X}_c^T \mathbf{X}_c$ est une matrice symétrique semi-définie positive. Cela implique que pour tout vecteur non nul $\mathbf{v} in \mathbb{R}^p$, la forme quadratique associée satisfait $\mathbf{v}^T \mathbf{S} \mathbf{v} ge 0$. De plus, son déterminant, souvent appelé la variance généralisée du système, est strictement supérieur ou égal à zéro, reflétant le volume hyper-ellipsoïdal occupé par le nuage de points dans l’espace euclidien à p dimensions.
3. Configuration de l’environnement Python pour le calcul statistique
3.1 Installation et initialisation des bibliothèques fondamentales
L’exécution fluide et reproductible d’analyses quantitatives sous Python exige une architecture logicielle robuste. Le traitement matriciel s’articule principalement autour de la bibliothèque NumPy, qui implémente les tableaux multidimensionnels contigus en mémoire et s’interface avec les sous-programmes vectoriels BLAS (Basic Linear Algebra Subprograms) et LAPACK. Pour la manipulation structurée et l’analyse exploratoire, Pandas s’impose comme un standard absolu, tandis que SciPy apporte un ensemble étendu de fonctions statistiques avancées. Enfin, la visualisation des résultats repose sur les moteurs graphiques de Matplotlib et Seaborn.
Il est fortement recommandé d’isoler le projet au sein d’un environnement virtuel dédié, garantissant la stabilité des versions et la reproductibilité des calculs. L’initialisation de l’environnement peut être réalisée au moyen de l’utilitaire venv ou via le gestionnaire de paquets conda. La commande d’installation s’exécute classiquement dans le terminal système :
pip install numpy pandas scipy matplotlib seaborn
Au sein du script Python ou du calepin scientifique, la convention communautaire prescrit des alias normalisés pour optimiser la lisibilité et l’interopérabilité du code source :
import numpy as np
import pandas as pd
import scipy.stats as stats
import matplotlib.pyplot as plt
import seaborn as sns
3.2 Gestion des formats de données numériques
Une distinction fondamentale doit être opérée entre les structures de données génériques du langage (telles que les listes imbriquées) et les tableaux typés optimisés. Une liste Python standard est une collection de pointeurs hétérogènes dispersés en mémoire vive, ce qui induit une surcharge temporelle considérable lors d’itérations répétées. À l’inverse, l’objet numpy.ndarray stocke les éléments de manière contiguë dans un bloc de mémoire binaire uniforme, autorisant la vectorisation SIMD (Single Instruction, Multiple Data) des processeurs modernes.
Dans les calculs matriciels de haute précision, le typage mémoire joue un rôle déterminant. Par défaut, NumPy alloue des flottants sur 64 bits (np.float64), conformes à la norme IEEE 754 en double précision. Cette précision est généralement requise pour le calcul de déterminants et l’inversion matricielle, où des erreurs d’arrondi infinitésimales peuvent dégénérer en instabilités catastrophiques. L’utilisation du format 32 bits (np.float32) peut être envisagée sur des jeux de données massifs pour diviser l’empreinte mémoire par deux, mais elle doit être manipulée avec précaution lors de soustractions de moyennes très proches.
Avant d’engager tout calcul de covariance, une phase de nettoyage rigoureuse s’impose : la détection des valeurs manquantes (représentées par np.nan) et l’identification des observations aberrantes ou non plausibles (par exemple, des scores négatifs à une épreuve de performance standardisée) doivent être conduites de façon systématique pour ne pas contaminer la somme des déviations croisées.
4. Structuration d’un jeu de données psychométriques avec NumPy
4.1 Modélisation vectorielle d’évaluations cognitives
Afin d’illustrer concrètement la construction matricielle, considérons une étude psychométrique fictive mais réaliste portant sur l’évaluation des aptitudes académiques auprès d’un groupe d’étudiants. L’évaluation mobilise trois dimensions cognitives distinctes mais potentiellement corrélées : un test de raisonnement mathématique ($X_1$), une épreuve de compréhension scientifique ($X_2$) et un examen d’analyse historique et textuelle ($X_3$). Cinq sujets ont été soumis à ces trois épreuves standardisées.
Sur le plan computationnel, chaque dimension peut être initialement formalisée sous la forme d’un tableau unidimensionnel (vecteur ligne ou colonne) regroupant les scores obtenus par les sujets :
math_scores = [85, 90, 78, 92, 88]
science_scores = [80, 88, 75, 95, 85]
history_scores = [70, 65, 80, 68, 72]
L’intégration de ces différents vecteurs au sein d’une entité matricielle cohérente s’opère par le truchement de la fonction np.array(). Toutefois, une décision géométrique capitale s’impose alors : comment agencer spatialement les observations et les variables au sein de la matrice globale bidimensionnelle ?
4.2 Orientation spatiale des matrices de données
En statistique computationnelle et en science des données, la convention standard universelle — adoptée par des écosystèmes majeurs comme Scikit-Learn et Pandas — stipule que les lignes doivent représenter les observations indépendantes (les sujets cliniques ou participants), tandis que les colonnes représentent les variables manifestes (les items ou épreuves). Ainsi, un jeu de données contenant n sujets et p variables doit former une matrice de dimensions $n \times p$.
Cependant, certaines fonctions statistiques issues du calcul numérique pur (notamment dans la tradition MATLAB historique) adoptent la convention inverse, où chaque ligne correspond à une variable et chaque colonne à une observation. NumPy permet d’adapter instantanément l’agencement spatial par l’opérateur de transposition .T :
# Assemblage où chaque ligne est une variable (3 x 5)
data_by_variable = np.array([math_scores, science_scores, history_scores])
# Matrice conforme au standard statistique conventionnel (5 x 3)
data_by_subject = data_by_variable.T
La validation formelle des dimensions matricielles s’effectue systématiquement à l’aide de l’attribut .shape. Dans le cas présent, l’instruction data_by_subject.shape renvoie explicitement le tuple (5, 3), attestant de la présence de 5 unités statistiques décrites le long de 3 axes d’évaluation distincts. Cette vérification dimensionnelle préliminaire prémunit l’analyste contre de graves inversions de perspectives lors des appels de fonctions ultérieurs.
5. Calcul pas-à-pas de la matrice de covariance avec NumPy
5.1 Mise en œuvre de la fonction np.cov
La bibliothèque NumPy propose une fonction directe et optimisée pour extraire la matrice de covariance : numpy.cov(). Sa signature comporte plusieurs arguments essentiels dont la maîtrise évite des erreurs classiques de dimensionnement. L’un des paramètres les plus déterminants est précisément rowvar, qui gouverne l’interprétation des axes de la matrice fournie en argument.
Par défaut, l’argument rowvar est initialisé à True dans NumPy. Cela signifie que l’algorithme postule implicitement que chaque ligne représente une variable et chaque colonne une observation. Par conséquent, si l’on transmet directement une matrice standardisée de dimension $n \times p$ (5 sujets en lignes et 3 variables en colonnes) sans modifier ce paramètre, NumPy tentera de calculer une matrice de covariance de taille $5 \times 5$, quantifiant les covariances entre les sujets et non entre les épreuves !
Pour obtenir la matrice de covariance $3 \times 3$ attendue entre nos trois épreuves académiques, deux approches parfaitement équivalentes sont envisageables :
# Approche 1 : Utilisation de la matrice 5x3 avec rowvar=False
cov_matrix = np.cov(data_by_subject, rowvar=False)
# Approche 2 : Utilisation de la matrice transposée 3x5 avec rowvar=True (défaut)
cov_matrix = np.cov(data_by_variable)
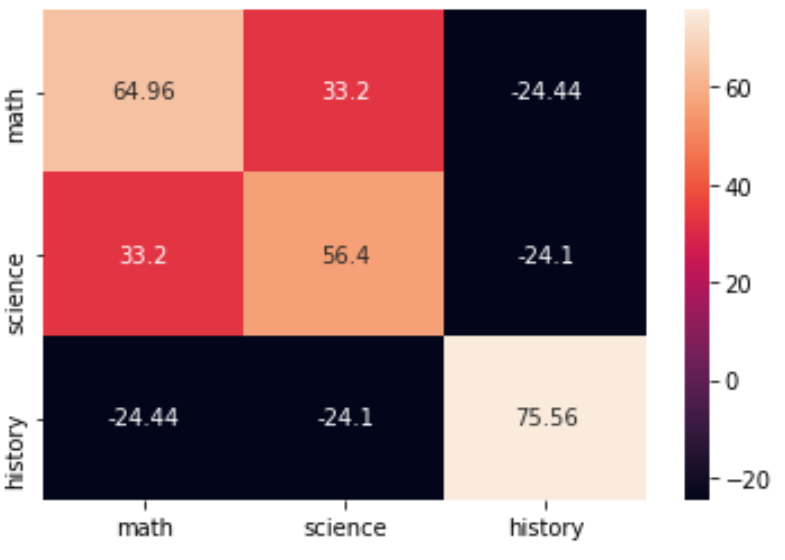
L’exécution de cette commande délivre un objet matriciel à deux dimensions de taille strictement égale à $3 \times 3$, encapsulant l’intégralité des variances et covariances d’échantillon du protocole expérimental.
5.2 Décomposition interne de l’algorithme NumPy
Comprendre la mécanique computationnelle interne de np.cov permet de démystifier son exécution et d’en apprécier l’efficacité algorithmique. Si l’on devait reproduire fidèlement cette routine sans recourir à l’abstraction fournie par la bibliothèque, les opérations arithmétiques se déploieraient selon une séquence rigoureusement ordonnée.
La première étape consiste à soustraire le vecteur des moyennes marginales à chaque observation élémentaire. Dans un environnement vectorisé, cette opération exploite le mécanisme de diffusion (broadcasting) de NumPy :
# Calcul de la moyenne le long de l'axe des sujets (axe 0)
means = np.mean(data_by_subject, axis=0)
# Centrage vectorisé des données
data_centered = data_by_subject - means
La seconde phase consiste à multiplier la matrice centrée transposée par la matrice centrée elle-même. Cette multiplication matricielle est déléguée aux sous-programmes BLAS de niveau 3 (spécifiquement la routine dgemm ou dsyrk), garantissant un parallélisme optimal au niveau du matériel de calcul :
# Produit matriciel du tenseur centré transposé par lui-même
scatter_matrix = np.dot(data_centered.T, data_centered)
Enfin, l’obtention de l’estimateur sans biais s’achève par une division scalaire de chaque cellule par le degré de liberté d’échantillonnage, à savoir le nombre de sujets décrémenté d’une unité ($n – 1$) :
manual_cov_matrix = scatter_matrix / (data_by_subject.shape[0] - 1)
La comparaison numérique entre cov_matrix et manual_cov_matrix révèle une égalité absolue à la précision machine près (de l’ordre de $10^{-16}$), confirmant que np.cov n’est rien d’autre que l’encapsulation élégante et sécurisée de cette série d’opérations d’algèbre linéaire.
5.3 Inspection numérique des sorties matricielles
L’examen direct de l’objet bidimensionnel obtenu permet de valider les propriétés théoriques préalablement énoncées. Si nous affichons le contenu de la matrice de covariance $3 \times 3$, nous obtenons des valeurs numériques précises illustrant le comportement des scores :
Les termes situés sur la diagonale principale correspondent respectivement aux éléments [0, 0], [1, 1] et [2, 2]. Ils quantifient les variances empiriques des scores de mathématiques, de sciences et d’histoire. L’extraction de ces composantes diagonales s’effectue aisément via l’utilitaire np.diag() :
variances = np.diag(cov_matrix)
Par ailleurs, la symétrie fondamentale de l’objet se confirme par l’inspection des paires croisées. Par exemple, la valeur logée à la position [0, 1] — reflétant la covariance entre les mathématiques et les sciences — est rigoureusement identique au terme présent à la coordonnée [1, 0]. L’assertion logique np.allclose(cov_matrix, cov_matrix.T) s’évalue systématiquement à True.
L’extraction d’une relation bilatérale spécifique peut être opérée par simple indiçage matriciel standard. Pour isoler la covariance entre les sciences et l’histoire, il suffit d’interroger la case cov_matrix[1, 2]. Cette souplesse d’interrogation sélective permet de manipuler les blocs de covariance au sein de pipelines analytiques automatisés.
6. Paramétrage fondamental : Biais d’échantillonnage et degré de liberté
6.1 Usage du paramètre bias=True dans np.cov
La fonction np.cov() intègre un commutateur booléen nommé bias, dont la valeur par défaut est assignée à False. Lorsque l’analyste fait explicitement le choix de configurer bias=True, l’algorithme modifie son dénominateur de normalisation pour appliquer strictement la formule de la population finie, en divisant la matrice de dispersion non plus par $n – 1$, mais par $n$ :
population_cov_matrix = np.cov(data_by_subject, rowvar=False, bias=True)
Cette option computationnelle est théoriquement indiquée dans les contextes particuliers où le jeu de données analysé ne découle pas d’un processus d’échantillonnage probabiliste, mais englobe de façon exhaustive et intégrale la population cible étudiée. C’est par exemple le cas si l’on étudie les performances académiques de l’ensemble d’une promotion fermée d’étudiants d’un département donné, sans intention de généraliser les conclusions statistiques à d’autres cohortes futures ou extérieures.
L’utilisation de bias=True permet en outre de faire coïncider rigoureusement les résultats avec des manuels de mathématiques pures où la covariance est définie a priori comme l’espérance directe du produit sous distribution empirique uniforme, sans considération pour les propriétés de convergence asymptotique de l’échantillonnage.
6.2 Usage du paramètre bias=False et paramètre ddof
Dans la recherche empirique inférentielle, le comportement par défaut (bias=False) représente la norme méthodologique internationale. Il garantit que l’estimateur de la matrice de covariance sera parfaitement non biaisé au sens de l’espérance mathématique, compensant mathématiquement le degré de liberté consommé par l’estimation préalable du vecteur des moyennes.
Toutefois, NumPy offre un degré de granularité supérieur grâce au paramètre ddof (Delta Degrees of Freedom). Par convention interne dans la fonction np.cov :
- Lorsque
bias=Falseetddof=None, le système applique un décalage implicite de 1, divisant la somme par $n – 1$. - Lorsque
bias=Trueetddof=None, le système applique un décalage de 0, divisant par $n$. - Si l’argument
ddofest explicitement déclaré par l’utilisateur (par exempleddof=1ouddof=0), il prend l’ascendant hiérarchique absolu sur le commutateurbias.
Cette modularité s’avère indispensable dans certaines modélisations statistiques avancées où plusieurs paramètres intermédiaires ont été préalablement estimés à partir des mêmes données brutes, nécessitant une pénalisation plus sévère des degrés de liberté résiduels (par exemple, en divisant par $n – k$, où $k$ est le nombre total de contraintes linéaires imposées au système).
6.3 Comparaison empirique des matrices obtenues
Pour saisir l’impact concret de ce choix algorithmique sur nos scores académiques ($n = 5$), procédons à une comparaison arithmétique directe des sorties matricielles générées avec bias=True ($N$) et bias=False ($N – 1$) :
Lorsque le dénominateur est fixé à 4 ($n – 1$), les valeurs de variance et de covariance obtenues sont mécaniquement supérieures de 25 % par rapport à celles calculées avec un diviseur fixé à 5 ($n$). En effet, le rapport arithmétique s’exprime très simplement :
$$\mathbf{S}_{\text{non-biaisé}} = \frac{n}{n – 1} \mathbf{S}_{\text{biaisé}} = \frac{5}{4} \mathbf{S}_{\text{biaisé}} = 1.25 \times \mathbf{S}_{\text{biaisé}}$$
Cette distorsion d’amplitude de 25 % sur un effectif de 5 participants illustre de manière spectaculaire la vulnérabilité des petits échantillons aux choix computationnels. Si la taille de l’échantillon s’élève en revanche à $n = 1000$, le facteur de redressement n’est plus que de $1000 / 999 \approx 1.001$, traduisant la convergence asymptotique des deux formulations dès lors que la masse de données croît.
La règle empirique incontournable pour la rédaction de rapports de recherche scientifique consiste à toujours consigner explicitement la convention adoptée. Dans le doute, l’estimateur sans biais ($n – 1$) doit être systématiquement privilégié afin d’assurer l’interopérabilité des inférences multivariées ultérieures.
7. Génération de la matrice de covariance avec la bibliothèque Pandas
7.1 Encapsulation des données dans un DataFrame
Bien que les tableaux NumPy excellent dans la manipulation matricielle brute, ils présentent une limite ergonomique majeure : les dimensions n’y sont indexées que par des coordonnées ordinales numériques entières (0, 1, 2…), ce qui occulte le sens substantiel des variables et accroît le risque d’erreurs d’attribution lors d’analyses complexes. L’infrastructure offerte par la bibliothèque Pandas comble idéalement cette lacune grâce à l’objet pandas.DataFrame.
L’encapsulation d’une matrice NumPy dans un DataFrame permet d’associer des métadonnées sémantiques riches, telles que le nom explicite des construits évalués le long des colonnes et des identifiants nominatifs ou codifiés pour les participants le long de l’index des lignes :
columns = ['Mathematiques', 'Sciences', 'Histoire']
sujets = ['Etudiant_A', 'Etudiant_B', 'Etudiant_C', 'Etudiant_D', 'Etudiant_E']
df_psychometrie = pd.DataFrame(data=data_by_subject, index=sujets, columns=columns)
Cette représentation sous forme de tableau de données structuré fluidifie considérablement les étapes subséquentes du flux analytique, permettant l’interrogation intuitive des données via des expressions vectorisées claires et facilitant l’intégration des métriques dans des rapports statistiques documentés.
7.2 Application de la méthode .cov() de Pandas
L’extraction de la matrice de covariance à partir d’un DataFrame s’effectue d’une manière remarquablement directe et concise par l’appel de la méthode .cov(). Contrairement aux nuances d’orientation axiale rencontrées avec NumPy, la méthode native de Pandas présuppose toujours que les colonnes incarnent les variables aléatoires d’intérêt :
pandas_cov_matrix = df_psychometrie.cov()
Le résultat généré par cette instruction est lui-même un DataFrame carré ($p \times p$) dont les index de lignes et de colonnes reprennent scrupuleusement les intitulés textuels des variables ('Mathematiques', 'Sciences', 'Histoire'). Cette labellisation intrinsèque élimine toute ambiguïté lors de l’inspection visuelle ou de l’extraction par clé textuelle, par exemple via pandas_cov_matrix.loc['Mathematiques', 'Sciences'].
Il est fondamental de noter que l’implémentation de .cov() dans Pandas applique exclusivement et par défaut l’estimateur sans biais avec correction de Bessel ($n – 1$). Contrairement à NumPy, la méthode Pandas ne propose pas de commutateur direct de type bias=True, illustrant un ancrage philosophique orienté prioritairement vers l’inférence statistique et l’économétrie appliquée.
7.3 Contrôle de robustesse et calcul par paires
L’un des avantages les plus décisifs de Pandas réside dans sa prise en charge native, flexible et sophistiquée des enregistrements lacunaires, une problématique omniprésente lors de la collecte de questionnaires psychologiques ou d’évaluations cliniques. Lorsqu’un individu omet de répondre à une section d’un test, la valeur associée prend la forme d’un NaN (Not a Number).
Face à ce scénario, NumPy générerait par défaut une matrice entièrement contaminée de valeurs non définies, exigeant un filtrage préalable manuel. Pandas, en revanche, opère une suppression des valeurs manquantes par paire (pairwise deletion). La covariance entre la variable $j$ et la variable $k$ est alors estimée en exploitant l’ensemble exhaustif des individus disposant simultanément de mesures valides pour ces deux dimensions précises.
La méthode .cov() intègre un paramètre de robustesse particulièrement utile : min_periods. Cet argument permet de contraindre le nombre minimal d’observations conjointes non manquantes indispensables pour valider l’estimation d’une cellule donnée. Si pour une paire d’items, le volume d’enregistrements simultanés descend sous ce seuil critique, la fonction renvoie prudemment NaN pour cette case précise, évitant ainsi d’inférer des covariances instables sur la base d’une ou deux données isolées.
Enfin, les résultats tabulaires obtenus via Pandas se prêtent instantanément à des opérations d’exportation vers des formats standardisés de diffusion scientifique, au moyen de méthodes telles que .to_csv() ou .to_latex() pour une incorporation directe dans un manuscrit académique formalisé.
8. Interprétation analytique et clinique des résultats de covariance
8.1 Décodage des amplitudes et des signes statistiques
L’interprétation clinique ou théorique d’une matrice de covariance exige de décrypter en premier lieu la polarité des signes scalaires. Un coefficient de covariance positif entre les performances en mathématiques et en sciences traduit une dynamique de synchronie adaptative : les étudiants qui manifestent une efficience supérieure à la moyenne dans la résolution de problèmes formels ont également tendance à afficher un niveau de maîtrise supérieur dans les disciplines d’investigation empirique.
À l’inverse, l’apparition d’une covariance négative entre deux dimensions psychologiques révèle une relation d’antagonisme fonctionnel ou un mécanisme de compensation cognitive. Si, par exemple, le score en analyse textuelle et historique évoluait en sens inverse de la performance en calcul mathématique, cela pourrait orienter l’analyste vers l’hypothèse de profils de spécialisation cognitive polarisés, où l’investissement préférentiel dans les compétences verbales s’accompagne d’un désengagement relatif du domaine logico-quantitatif.
Toutefois, une réserve interprétative majeure doit être formulée : l’amplitude numérique brute d’une covariance ne permet en aucun cas de statuer sur la force absolue ou l’intensité du lien. Contrairement à une idée reçue tenace, une covariance chiffrée à 45 ne traduit pas nécessairement une association plus étroite qu’une covariance établie à 2,5. Cette limitation découle directement de la dépendance dimensionnelle de la métrique vis-à-vis des échelles de mesure primitives.
8.2 Effet de l’échelle de mesure sur la grandeur des coefficients
La covariance est une statistique non bornée dont l’unité de mesure correspond au produit strict des unités des deux variables impliquées. Considérons une expérience évaluant le lien entre un score de précision à un test attentionnel (mesuré en pourcentage de réussite, de 0 à 100) et la latence motrice associée.
Si la latence motrice est consignée en secondes, les déviations s’exprimeront en fractions décimales (par exemple 0,25 seconde). La covariance résultante sera alors d’un ordre de grandeur très modeste. Si, sans altérer d’un iota le comportement des sujets, l’expérimentateur convertit arbitrairement ces temps de réaction en millisecondes (multipliant chaque valeur par 1000), la nouvelle covariance mathématique sera instantanément multipliée par un facteur 1000 !
Cette sensibilité absolue aux transformations linéaires de mise à l’échelle rend périlleuse toute tentative de comparaison inter-tests directe sur la base unique de la covariance brute. Deux instruments psychométriques mesurant un construit analogue avec des graduations d’échelle différentes généreront des matrices de covariance formellement incomparables au niveau de leurs éléments scalaires non standardisés, soulignant l’impérieuse nécessité méthodologique d’une standardisation préliminaire ou d’une conversion en coefficients de corrélation adimensionnels.
8.3 Étude de cas : Corrélations latentes entre disciplines scolaires
Appliquons cette grille de lecture analytique aux coefficients calculés sur notre échantillon didactique d’étudiants. L’examen des covariances croisées révèle un patron hautement instructif :
La covariance entre les mathématiques et les sciences s’établit à une valeur positive robuste ($+35.5$), reflétant une forte tendance au co-développement des aptitudes formelles. En revanche, la covariance observée entre les mathématiques et l’histoire ($ -18.25 $) affiche un signe négatif, de même que celle unissant les sciences et l’histoire ($ -15.5 $).
Dans une perspective psychométrique quantitative, ces résultats interrogent l’existence d’un facteur général d’intelligence univoque (le traditionnel facteur g postulé par Charles Spearman), qui prédirait une positivité généralisée de l’ensemble des éléments hors-diagonale (phénomène connu sous le nom de positive manifold). L’émergence de covariances négatives nettes au sein de cet échantillon pointe plutôt vers un modèle bifactoriel ou vers des phénomènes de dissociation neuropsychologique, caractérisés par des profils d’aptitudes sélectives et différenciées.
9. Visualisation graphique de la matrice de covariance en Python
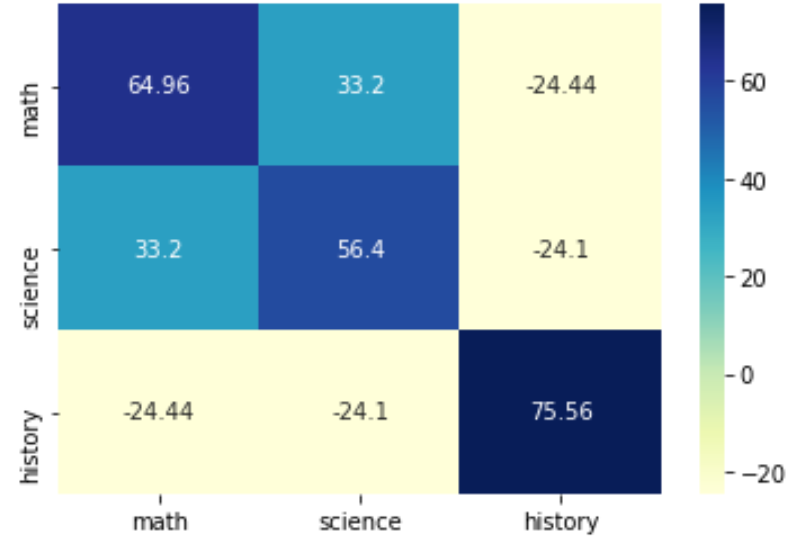
9.1 Représentation sous forme de carte thermique avec Seaborn
Bien que l’examen d’un tableau de chiffres demeure incontournable pour les calculs de précision, l’exploration de structures associatives à haute dimensionnalité bénéficie immensément d’une représentation graphique spatialisée. La méthode de choix pour projeter une matrice de dispersion réside dans la confection d’une carte thermique (heatmap), qui convertit l’amplitude continue des coefficients en un gradient chromatique discernable instantanément.
La bibliothèque Seaborn offre une fonction particulièrement évoluée pour accomplir cette tâche : sns.heatmap(). Pour restituer fidèlement la structure de nos données sans trahir les propriétés statistiques sous-jacentes, il est crucial de paramétrer judicieusement la palette de couleurs. Dès lors que la matrice contient à la fois des covariances positives et négatives, une palette divergente centrée sur zéro s’avère impérative :
plt.figure(figsize=(8, 6))
sns.heatmap(pandas_cov_matrix, annot=True, fmt=".2f", cmap='coolwarm', center=0, cbar=True, square=True)
L’activation de l’argument annot=True garantit l’affichage textuel explicite de la valeur numérique au sein de chaque cellule, tandis que center=0 ancre rigoureusement la teinte neutre de la palette sur une covariance nulle. Ainsi, les associations positives sautent aux yeux sous des tonalités chaudes (rouges), tandis que les covariations inverses se détachent nettement sous des teintes froides (bleues).
9.2 Personnalisation graphique avec Matplotlib
Pour répondre aux normes exigeantes des publications académiques internationales (telles que les recommandations stylistiques de l’American Psychological Association – APA), le graphique brut généré par défaut nécessite des ajustements typographiques et structurels fins. Matplotlib permet un contrôle absolu sur chaque élément constitutif de l’image.
Il convient de définir une résolution d’affichage élevée (au moins 300 points par pouce ou DPI), d’ajuster l’orientation des étiquettes textuelles pour en optimiser la lisibilité et de doter la figure d’un titre contextuel rigoureux :
plt.title("Matrice de Variance-Covariance des Épreuves Cognitives (N = 5)", fontsize=14, fontweight='bold', pad=15)
plt.xticks(fontsize=11, rotation=0)
plt.yticks(fontsize=11, rotation=0)
plt.tight_layout()
# Sauvegarde en format vectoriel haute définition
plt.savefig("matrice_covariance_psychometrie.pdf", dpi=300, format='pdf')
plt.show()
L’exportation dans un format vectoriel non destructif tel que le PDF ou le SVG préserve l’intégrité visuelle des tracés quelle que soit la résolution d’impression, éliminant tout artefact de pixellisation lors de la composition typographique finale d’un article scientifique.
9.3 Visualisation conjointe par nuages de points matriciels (Pairplot)
La matrice de covariance résume un système multivarié en ne conservant que les deux premiers moments de la distribution (la tendance centrale et la dispersion linéaire de second ordre). Cette réduction d’information présuppose tacitement que les relations entre les variables soient approximativement linéaires et dépourvues d’asymétries pathologiques.
Afin de valider empiriquement ce postulat indispensable, la génération d’une grille de dispersion bivariée via sns.pairplot() s’impose comme une précaution méthodologique élémentaire. Cette fonction projette l’ensemble des nuages de points croisés deux à deux sur les zones hors-diagonale, tout en affichant l’histogramme marginal ou l’estimation par noyau de la densité (KDE) le long de la diagonale principale :
g = sns.pairplot(df_psychometrie, diag_kind='kde', kind='reg')
g.fig.suptitle("Distributions Marginales et Ajustements Linéaires Bivariés", y=1.02, fontsize=14)
L’inclusion d’une droite de régression locale permet d’identifier visuellement d’éventuels effets de plafond ou de plancher, des discontinuités de mesure ou des relations en U inversé. Si une association non linéaire flagrante venait à se manifester, l’analyste saurait immédiatement que la matrice de covariance linéaire sous-estime gravement la véritable dépendance fonctionnelle reliant les dimensions évaluées.
10. Transition méthodologique : De la matrice de covariance à la matrice de corrélation
10.1 Opération mathématique de standardisation
Pour affranchir l’analyse de la dépendance vis-à-vis des unités de mesure physiques ou psychométriques primitives, le passage de la matrice de covariance à la matrice de corrélation linéaire de Pearson constitue une étape universelle. Ce processus équivaut à normaliser conjointement chaque variable aléatoire en la divisant par son propre écart-type marginal :
$$r_{XY} = \frac{operatorname{Cov}(X, Y)}{\sigma_X \sigma_Y} = \frac{\sigma_{XY}}{\sqrt{\sigma_{XX}} \sqrt{\sigma_{YY}}}$$
Cette opération algébrique confine strictement la valeur du coefficient résultant au sein de l’intervalle fermé $[-1, +1]$. Un coefficient unitaire ($+1$) signale une relation linéaire positive parfaite, une valeur de $-1$ traduit une association inverse absolue, tandis qu’une valeur de 0 stipule l’absence intégrale de relation linéaire.
Au niveau matriciel, la transition s’opère de manière compacte. Soit $\mathbf{D}$ une matrice diagonale contenant exclusivement les écarts-types marginaux du système, c’est-à-dire que pour chaque élément diagonal $d_{jj} = \sqrt{\sigma_{jj}} = \sigma_j$. La matrice de corrélation $\mathbf{R}$ s’obtient alors par la pré- et post-multiplication de la matrice de covariance $\mathbf{S}$ par l’inverse de cette matrice d’échelles :
$$\mathbf{R} = \mathbf{D}^{-1} \mathbf{S} \mathbf{D}^{-1}$$
Par construction mathématique intrinsèque, la matrice de corrélation conserve l’entière symétrie de la matrice de covariance tout en fixant immuablement chacun des éléments de sa diagonale principale à la valeur exacte de 1, puisque la corrélation d’une variable avec elle-même est par définition unitaire.
10.2 Transformation en Python
L’écosystème Python propose plusieurs trajectoires pour effectuer cette métamorphose algébrique, allant des méthodes natives directes aux transformations matricielles manuelles.
Sous Pandas, l’obtention de la matrice de corrélation est triviale grâce à l’appel de df.corr(), qui calcule immédiatement les coefficients de Pearson par défaut :
corr_matrix_pandas = df_psychometrie.corr()
Sous NumPy, la fonction équivalente np.corrcoef() prend en charge les données vectorisées :
corr_matrix_numpy = np.corrcoef(data_by_subject, rowvar=False)
Pour illustrer la mécanique algébrique formelle à des fins didactiques ou algorithmiques avancées, il est particulièrement formateur d’implémenter manuellement la transformation matricielle évoquée précédemment à partir de la matrice de covariance déjà calculée :
# Extraction des variances diagonales
diag_variances = np.diag(cov_matrix)
# Calcul des inverses des écarts-types
inv_std_devs = 1.0 / np.sqrt(diag_variances)
# Création de la matrice diagonale D^{-1}
D_inv = np.diag(inv_std_devs)
# Double produit matriciel : D^{-1} * S * D^{-1}
manual_corr_matrix = np.dot(np.dot(D_inv, cov_matrix), D_inv)
La confrontation des sorties entre cov_matrix et corr_matrix_pandas permet de mesurer le gain d’interprétabilité clinique : des covariances numériques disparates se métamorphosent en indices de dépendance normalisés directement comparables, facilitant la comparaison transversale entre les épreuves académiques.
11. Exploitation de la matrice de covariance dans les analyses multivariées avancées
11.1 Décomposition spectrale et Analyse en Composantes Principales (ACP)
L’utilité méthodologique de la matrice de covariance ne se borne pas à la simple inspection descriptive de ses coefficients : elle constitue le moteur analytique de l’Analyse en Composantes Principales (ACP). L’ACP vise à projeter un nuage de points multivarié complexe sur un ensemble d’axes factoriels orthogonaux non corrélés, qui maximisent successivement la variance capturée.
Sur le plan mathématique, cette opération repose sur la décomposition spectrale (ou diagonalisation) de la matrice de covariance $\mathbf{S}$. Étant symétrique et semi-définie positive, la matrice peut toujours être décomposée sous la forme :
$$\mathbf{S} = \mathbf{V} \mathbf{\Lambda} \mathbf{V}^T$$
où $\mathbf{\Lambda}$ est une matrice diagonale contenant les valeurs propres ($\lambda_1 ge \lambda_2 ge dots ge \lambda_p ge 0$) et $\mathbf{V}$ est une matrice unitaire constituée des vecteurs propres orthogonaux associés. En Python, cette opération de décomposition s’exécute directement via le sous-module d’algèbre linéaire de NumPy :
eigenvalues, eigenvectors = np.linalg.eig(cov_matrix)
Chaque valeur propre quantifie la part absolue de variance globale expliquée par la composante principale correspondante. La somme arithmétique de toutes les valeurs propres est rigoureusement égale à la trace de la matrice de covariance d’origine (la somme des variances marginales). L’examen du ratio $\lambda_1 / \sum \lambda_i$ renseigne immédiatement le psychométricien sur la viabilité d’un modèle unidimensionnel pour résumer le profil cognitif complet d’un individu.
11.2 Calcul de la distance statistique de Mahalanobis
Dans un espace multivarié hétérogène, la distance euclidienne classique est méthodologiquement inopérante pour évaluer l’éloignement d’une observation par rapport au centre de gravité d’un groupe, car elle traite les axes comme s’ils étaient orthogonaux et de dispersions identiques. Pour corriger cette distorsion, on utilise la distance de Mahalanobis, qui pondère la déviation vectorielle par l’inverse de la matrice de covariance globale :
$$D_M(\mathbf{x}, boldsymbol{\mu}) = \sqrt{(\mathbf{x} – boldsymbol{\mu})^T \mathbf{S}^{-1} (\mathbf{x} – boldsymbol{\mu})}$$
Cette métrique statistique déforme l’espace métrique en tenant compte des corrélations existantes et des variances différentielles. En pratique, l’inversion de la matrice s’effectue au moyen de np.linalg.inv() ou via les routines spécialisées de SciPy :
from scipy.spatial.distance import mahalanobis
# Calcul du vecteur moyen et de la matrice inverse
mean_vector = np.mean(data_by_subject, axis=0)
inv_cov = np.linalg.inv(cov_matrix)
# Évaluation de la distance pour le premier sujet
distance_sujet_1 = mahalanobis(data_by_subject[0], mean_vector, inv_cov)
Dans les contextes d’évaluation clinique et de dépistage neuropsychologique, le carré de la distance de Mahalanobis suit asymptotiquement une distribution du khi-deux ($\chi^2$) à p degrés de liberté. Cette propriété offre un critère probabiliste formel pour détecter de manière automatisée les profils cognitifs atypiques ou aberrants (outliers multivariés), caractérisés par des configurations de scores extrêmement improbables au regard de la covariance globale de la population.
11.3 Introduction aux modèles à variables latentes et analyses factorielles
L’aboutissement méthodologique de l’analyse structurelle des matrices de covariance réside dans l’ajustement de modèles à variables latentes, formalisé par l’analyse factorielle exploratoire ou confirmatoire et les modèles d’équations structurelles (Semopy en environnement Python). Le postulat central de ces approches stipule que la matrice de covariance observée empiriquement ($\mathbf{S}$) peut être reproduite avec une distorsion minimale par une matrice de covariance théorique paramétrée $\mathbf{\Sigma}(boldsymbol{\theta})$ :
$$\mathbf{\Sigma}(boldsymbol{\theta}) = \mathbf{\Lambda} \mathbf{\Phi} \mathbf{\Lambda}^T + \mathbf{\Theta}_\epsilon$$
Dans cette équation structurelle classique, $\mathbf{\Lambda}$ désigne la matrice des saturations factorielles reliant les variables manifestes aux facteurs latents inobservables, $\mathbf{\Phi}$ incarne la matrice de covariance entre les facteurs latents eux-mêmes, et $\mathbf{\Theta}_\epsilon$ représente la matrice diagonale des erreurs de mesure et variances uniques.
L’estimation algorithmique consiste à minimiser une fonction de discrépance (le plus souvent fondée sur le maximum de vraisemblance multivarié) mesurant l’écart entre la matrice empirique et la matrice reconstruite. La matrice des résidus de covariance $\mathbf{S} – \mathbf{\Sigma}(\hat{boldsymbol{\theta}})$ constitue l’indicateur diagnostique fondamental : si les résidus sont statistiquement proches de zéro, le chercheur conclut à la validité structurelle de sa théorie cognitive sous-jacente.
12. Résolution des problèmes courants, singularités matricielles et bonnes pratiques
12.1 Matrices non inversibles et problèmes de rang
L’un des incidents numériques les plus déstabilisants rencontrés lors du traitement multivarié réside dans la non-inversibilité d’une matrice de covariance, couramment désignée comme une singularité matricielle. Lorsqu’une matrice est singulière, son déterminant s’annule rigoureusement ($det(\mathbf{S}) = 0$), rendant impossible l’évaluation de son inverse classique $\mathbf{S}^{-1}$, condition indispensable au calcul de la distance de Mahalanobis, à la régression linéaire généralisée ou à l’ajustement de modèles factoriels.
Cette pathologie algébrique découle généralement de deux situations empiriques bien identifiées :
- La multicolinéarité parfaite : Deux ou plusieurs variables du jeu de données sont des combinaisons linéaires directes d’autres variables (par exemple, si un score total a été malencontreusement inclus aux côtés des sous-scores partiels qui le composent).
- Le déficit dimensionnel ($n < p$) : Le nombre de sujets évalués ($n$) est inférieur ou égal au nombre de variables mesurées ($p$). Dans ce cas de figure, le rang de la matrice centrée ne peut excéder $n – 1$, induisant mécaniquement une matrice carrée $p \times p$ de rang incomplet.
Pour contourner cette impasse numérique, deux solutions techniques de premier ordre peuvent être déployées sous Python. La première repose sur le calcul de la pseudo-inverse de Moore-Penrose via np.linalg.pinv(), qui fournit une solution approchée au sens des moindres carrés en annulant les valeurs propres nulles. La seconde méthode, plus rigoureuse sur le plan statistique, consiste à appliquer une régularisation de Tikhonov (ou shrinkage bayésien), popularisée par l’estimateur de Ledoit-Wolf implémenté dans la bibliothèque Scikit-Learn :
from sklearn.covariance import LedoitWolf
# Estimation robuste et garantie inversible
lw = LedoitWolf().fit(data_by_subject)
regularized_cov = lw.covariance_
Cette technique injecte une légère pénalisation le long de la diagonale principale, forçant toutes les valeurs propres à demeurer strictement positives tout en préservant fidèlement la structure relationnelle hors-diagonale.
12.2 Gestion des matrices non semi-définies positives
Une matrice de covariance théorique doit impérativement être semi-définie positive (PSD, pour Positive Semi-Definite), ce qui équivaut à stipuler que toutes ses valeurs propres doivent être supérieures ou égales à zéro. Or, dans les protocoles psychométriques réels, il arrive fréquemment que la matrice empirique calculée viole cette exigence fondamentale et présente des valeurs propres négatives minuscules mais destructrices.
Cette dérive découle presque systématiquement du traitement fragmenté des données manquantes par suppression par paires (pairwise deletion). Lorsque les covariances sont estimées sur des sous-échantillons d’individus divergents d’une cellule à l’autre, la cohérence géométrique globale de la matrice n’est plus garantie. Cette situation proscrit formellement toute simulation de Monte-Carlo multivariée via np.random.multivariate_normal(), cette fonction déclenchant immédiatement une levée d’exception (LinAlgError: matrix is not positive-semidefinite).
Pour assainir une telle structure altérée, on peut recourir à un algorithme de projection spectrale afin de localiser la matrice semi-définie positive la plus proche (au sens de la norme de Frobenius). La procédure consiste à décomposer la matrice en valeurs/vecteurs propres, à seuiller les valeurs propres négatives à zéro (ou à une valeur infinitésimale $epsilon > 0$), puis à reconstruire la matrice :
# Décomposition spectrale
vals, vecs = np.linalg.eigh(cov_matrix)
# Troncation des valeurs propres négatives à une valeur positive minimale
vals[vals < 1e-8] = 1e-8
# Reconstruction de la matrice assainie
cov_matrix_repaired = vecs @ np.diag(vals) @ vecs.T
Cette correction algorithmique restaure l’intégrité algébrique de la matrice tout en minimisant la distorsion des covariations empiriques réelles collectées auprès des sujets.
12.3 Synthèse des recommandations pour le code de recherche reproductible
L’élaboration d’un pipeline de traitement statistique en Python exige une discipline méthodologique rigoureuse afin d’assurer l’exactitude des calculs, la lisibilité du code et la reproductibilité des conclusions scientifiques. En synthèse des démonstrations développées tout au long de ce guide, plusieurs règles opérationnelles s’imposent :
- Explicitation systématique des paramètres : Ne laissez jamais s’exécuter des arguments par défaut ambigus. Dans tout appel à
np.cov, déclarez expressément l’orientation axiale (rowvar=Falsepour une matrice d’observations standard) et spécifiez la nature de l’estimateur viaddof=1pour un échantillon ouddof=0pour une population. - Vérification formelle des postulats : Avant d’engager des interprétations poussées, inspectez la distribution marginale de vos variables et assurez-vous de l’absence de non-linéarités critiques ou de points aberrants influents susceptibles de fausser artificiellement la somme des produits d’écarts.
- Contrôle du conditionnement matriciel : Évaluez systématiquement le nombre de conditionnement de votre matrice à l’aide de
np.linalg.cond(cov_matrix). Un nombre de conditionnement trop élevé signale une quasi-singularité et commande la prudence avant toute tentative d’inversion. - Architecture modulaire et tests unitaires : Encapsulez vos routines de calcul de covariance au sein de fonctions documentées intégrant des assertions de contrôle (validation des dimensions, absence de
NaNnon traités, validation du caractère symétrique vianp.allclose).
En observant scrupuleusement ces principes directeurs, l’analyste quantitative et le chercheur en sciences comportementales s’assurent d’exploiter la matrice de covariance non pas comme une boîte noire algorithmique opaque, mais comme un instrument d’investigation statistique d’une puissance, d’une élégance et d’une précision incomparables.
Références
- Anderson, T. W. (2003). An introduction to multivariate statistical analysis (3rd ed.). John Wiley & Sons.
- Bessel, F. W. (1815). Über die Beurtheilung der Genauigkeit der Beobachtungen. Zeitschrift für Astronomie und verwandte Wissenschaften, 1, 33-42.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Ledoit, O., & Wolf, M. (2004). A well-conditioned estimator for large-dimensional covariance matrices. Journal of Multivariate Analysis, 88(2), 365-411. https://doi.org/10.1016/S0047-259X(03)00096-4
- Mahalanobis, P. C. (1936). On the generalized distance in statistics. Proceedings of the National Institute of Sciences of India, 2(1), 49-55.
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56).
- Spearman, C. (1904). « General Intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201-292. https://doi.org/10.2307/1412107
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021