
Dans le champ de l’analyse exploratoire des données et de la statistique descriptive inférentielle, la représentation graphique de la distribution d’une variable quantitative constitue une étape fondamentale pour appréhender la structure sous-jacente d’un échantillon. Si l’histogramme classique et le diagramme en boîte demeurent des instruments privilégiés pour évaluer la forme globale d’une densité empirique, ils présentent des limites intrinsèques lorsqu’il s’agit d’estimer avec précision des proportions cumulées, des seuils décisionnels ou des quantiles. C’est précisément au sein de cet espace méthodologique que s’impose le tracé de la distribution cumulative polygonale, traditionnellement désignée sous le terme d’ogive statistique. Cette courbe continue par morceaux permet de lier directement les valeurs prises par une variable à leur fréquence cumulée, offrant une lisibilité remarquable pour la modélisation des probabilités empiriques.
Le langage de programmation Python s’est imposé comme l’environnement computationnel de référence pour l’analyse scientifique des données et l’apprentissage automatique. Grâce à la synergie d’outils numériques hautement performants comme NumPy, conçue pour les opérations vectorisées et matricielles, et Matplotlib, bibliothèque pionnière pour la restitution cartésienne de données, la formalisation algorithmique d’une ogive s’effectue avec une rigueur mathématique et une flexibilité esthétique exceptionnelles. Néanmoins, la construction d’un tel graphique exige une compréhension approfondie des mécanismes de discrétisation, du calcul vectorisé des sommes cumulées et du calage rigoureux des frontières d’intervalles de classes, sous peine d’introduire des décalages d’indices susceptibles de biaiser l’estimation des percentiles.
Le présent traité propose une déconstruction exhaustive, à la fois théorique, mathématique et computationnelle, de la courbe ogivale appliquée aux sciences des données. Depuis les racines épistémologiques du concept et sa relation étroite avec la fonction de répartition empirique, jusqu’à son implémentation paramétrée en production logicielle pour les revues académiques, cet article détaille chaque étape méthodologique. À travers des études de cas cliniques et psychométriques, des comparaisons d’algorithmes de découpage et des stratégies avancées d’interpolation, ce guide procure aux chercheurs, ingénieurs et analystes l’ensemble des clés techniques nécessaires pour concevoir des visualisations cumulatives rigoureuses, élégantes et conformes aux exigences les plus strictes de la recherche contemporaine.
1. Introduction théorique au concept d’ogive statistique
1.1 Définition et origines de la courbe en ogive
Le vocable « ogive » trouve son origine dans l’architecture médiévale gothique, où il désigne l’arc diagonal en plein cintre ou brisé qui se croise avec un autre pour former la membrure d’une voûte. Cette forme courbée élégante, caractérisée par une montée progressive s’adoucissant au sommet d’une nervure, a été transposée dans le vocabulaire statistique au cours du XIXe siècle par l’érudit britannique Sir Francis Galton. Constatant que la fonction de répartition cumulée d’une variable suivant une distribution normale engendre une forme en S aplati, Galton introduisit ce terme descriptif pour illustrer le comportement géométrique des distributions cumulatives régulières issues de variables biométriques et sociales continues.
Sur le plan de la statistique descriptive, l’ogive est définie comme un polygone de fréquences cumulées représentant graphiquement la proportion ou l’effectif d’observations situées en deçà ou au-delà d’une frontière de classe déterminée. Contrairement à une variable discrète pour laquelle les sauts de probabilité sont isolés, la variable quantitative continue requiert une partition de son espace de support en intervalles contigus. L’ogive relie par des segments linéaires successifs les points dont l’abscisse correspond à la borne d’un intervalle et l’ordonnée au total cumulé des fréquences des observations associées.
Il existe une distinction épistémologique majeure entre l’histogramme des fréquences simples et la courbe ogivale. L’histogramme cherche à estimer la fonction de densité de probabilité sous-jacente par l’intermédiaire de surfaces rectangulaires proportionnelles au nombre de réalisations tombant dans un intervalle donné. Cette approche met l’accent sur les concentrations locales d’événements et sur les modes de la distribution. En revanche, l’ogive statistique abandonne la focalisation sur la masse de probabilité locale au profit d’une perspective intégrale, matérialisant l’accumulation continue de la matière statistique. Cette transposition de la dérivée vers l’intégrale offre une stabilité visuelle accrue, réduisant l’impact du bruit d’échantillonnage aléatoire présent sur les densités brutes.
1.2 Lien avec la fonction de répartition empirique (ECDF)
L’ogive statistique constitue une variante continue par morceaux de la fonction de répartition empirique, classiquement formalisée dans la littérature mathématique sous l’abréviation ECDF (Empirical Cumulative Distribution Function). Soit un échantillon de variables aléatoires indépendantes et identiquement distribuées noté X₁, X₂, …, Xₙ, la fonction de répartition empirique Fₙ(x) attribue à tout réel x la proportion d’observations qui lui sont inférieures ou égales. Elle est rigoureusement définie comme la somme pondérée de la fonction indicatrice associée à chaque observation : Fₙ(x) = (1/n) ∑ 𝕀(Xᵢ ≤ x). Cette formulation analytique engendre une fonction en escalier, monotone non décroissante, présentant des discontinuités de première espèce à chaque point de données observé.
La nuance structurelle qui sépare l’ECDF exacte de l’ogive traditionnelle réside dans l’opération d’agrégation préliminaire et le processus d’interpolation linéaire subséquent. Dans l’ogive binnée, les données ne sont pas traitées individuellement, mais regroupées en classes ou réceptacles discrets. L’ogive procède ensuite à une interpolation linéaire entre la valeur cumulée à la borne inférieure et celle à la borne supérieure de l’intervalle. Alors que l’ECDF exacte présente une allure discontinue en gradins, l’ogive construit un cheminement continu polygonisé, reposant sur l’hypothèse simplificatrice d’une répartition uniforme des observations à l’intérieur de chaque classe spécifique.
Cette interpolation confère à l’ogive une propriété de monotonie globale non décroissante sur l’ensemble de son domaine de définition : pour tout couple de réels (x₁, x₂) tel que x₁ < x₂, nous observons systématiquement F(x₁) ≤ F(x₂). Lorsque les fréquences relatives sont normalisées entre 0 et 1, ou exprimées en pourcentages de 0 % à 100 %, l’ogive converge asymptotiquement vers l’unité à sa borne supérieure. Cette monotonicité garantit l’inversibilité locale de la fonction par morceaux, autorisant l’estimation continue des percentiles par simple interpolation algébrique, sans avoir à gérer les sauts d’indétermination propres aux fonctions en escalier des petits échantillons.
1.3 Pertinence méthodologique dans l’analyse des données
Sur le plan de l’analyse exploratoire et de l’inférence statistique, l’ogive remplit des fonctions diagnostiques indispensables qu’aucun autre outil graphique univarié ne peut suppléer avec une efficacité comparable. Sa première vertu réside dans l’identification immédiate des seuils critiques et la quantification intuitive des paramètres de dispersion. En observant l’axe des ordonnées, un praticien peut instantanément abaisser un regard perpendiculaire vers l’abscisse pour extraire la médiane empirique, le premier décile ou le quatre-vingt-quinzième percentile. Cette lecture directe dispense d’un recalcul algébrique complexe lors des présentations de synthèse ou des revues de contrôle de qualité industrielle.
Dans un contexte expérimental comparatif, l’ogive permet d’évaluer avec une grande netteté la domination stochastique d’une condition sur une autre. Lorsque l’on superpose les ogives de deux cohortes d’individus soumises à des traitements thérapeutiques ou pédagogiques distincts, la translation horizontale intégrale d’une courbe par rapport à l’autre démontre formellement qu’une condition surpasse systématiquement l’autre à tous les niveaux d’occurrence probabiliste. Cette clarté géométrique préfigure les résultats des tests non paramétriques formels, tels que le test des rangs de Wilcoxon-Mann-Whitney ou le critère d’homogénéité de Kolmogorov-Smirnov.
Enfin, l’allure morphologique de l’ogive autorise une évaluation préliminaire de la normalité et des asymétries distributionnelles. Une variable parfaitement gaussienne générera une ogive symétrique présentant une courbure sigmoïdale exemplaire : une pente initiale modérée traduisant la rareté des faibles valeurs, une accélération marquée autour de la moyenne arithmétique où la densité est maximale, suivie d’une décélération progressive symétrique vers l’asymptote unitaire. Toute déviation par rapport à cette sigmoïde trahit une asymétrie positive si le point de basculement est déporté à gauche, une asymétrie négative si la pente s’affole aux valeurs élevées, ou un kurtosis atypique matérialisé par des ruptures abruptes du gradient de croissance.
2. Fondements mathématiques et typologie des ogives
2.1 L’ogive ascendante ou courbe « moins que »
L’ogive ascendante, couramment désignée sous l’appellation d’ogive « moins que » (less than ogive), constitue la transcription graphique directe de la fonction de répartition empirique cumulative. Son protocole constructif repose sur un processus d’agrégation séquentielle et ascendante de la masse des observations, depuis la frontière inférieure de la première classe jusqu’à la frontière supérieure de la dernière classe recensée. Pour une série ordonnée de k intervalles contigus définis par leurs bornes [b₀, b₁], [b₁, b₂], …, [bₖ₋₁, bₖ], l’ogive ascendante attribue à chaque borne bᵢ l’effectif total d’observations qui lui sont strictement inférieures ou égales.
Sur le plan analytique, si l’on désigne par nᵢ l’effectif absolu dénombré au sein du i-ème intervalle [bᵢ₋₁, bᵢ], l’effectif cumulé ascendant Nᵢ associé à la borne bᵢ est formalisé par la sommation finie Nᵢ = ∑ₘ₌₁ⁱ nₘ. Dans le cas où l’analyse exige une standardisation unitaire, la fréquence relative cumulée fᵢ est obtenue en divisant Nᵢ par la taille totale de l’échantillon N = ∑ₘ₌₁ᵏ nₘ, soit fᵢ = Nᵢ / N. L’ogive ascendante est formellement ancrée au point d’origine cartésien (b₀, 0), signifiant de manière indiscutable qu’aucune observation ne peut être strictement inférieure à la borne minimale de l’échantillon analysé.
L’utilité primordiale de l’ogive ascendante réside dans sa capacité à résoudre instantanément des interrogations portant sur le respect de normes minimales ou maximales. Elle permet de quantifier avec précision la proportion de sujets échouant sous une note couperet lors d’une sélection académique, ou la fraction de pièces manufacturées dont la dimension mécanique ne franchit pas une tolérance d’usinage prédéterminée. Grâce à la convexité initiale suivie de la concavité terminale propres aux distributions unimodales régulières, la courbe ascendante offre une vision synthétique de l’épuisement progressif de la variabilité expérimentale.
2.2 L’ogive descendante ou courbe « plus que »
Symétrique conceptuelle de l’ogive ascendante, l’ogive descendante, traditionnellement qualifiée d’ogive « plus que » (more than ogive ou greater than ogive), adopte une logique de décrémentation continue à partir de la masse totale de la population étudiée. Son principe opératoire consiste à quantifier, pour chaque frontière de classe donnée, le volume d’observations dont la valeur mesurée excède strictement ou égale ce seuil d’évaluation. La courbe prend donc son départ à l’ordonnée maximale (soit un effectif total N, ou une proportion de 100 %) au niveau de la borne inférieure initiale b₀, pour s’annuler inéluctablement à la borne supérieure terminale bₖ.
La formulation mathématique de la fréquence résiduelle cumulée descendante, notée Sᵢ pour la borne bᵢ₋₁, repose sur la soustraction progressive des effectifs déjà franchis ou sur la sommation des effectifs restants : Sᵢ = ∑ₘ₌ᵢᵏ nₘ. En vertu du principe de conservation des effectifs marginaux, il existe une complémentarité arithmétique rigide et absolue entre la fonction de répartition cumulative ascendante F(x) et son pendant descendant S(x). Pour toute valeur x du continuum des observations, la relation fondamentale S(x) = 1 – F(x) s’applique sans exception, faisant de l’ogive descendante l’analogue empirique direct de la fonction de survie (survival function) ou fonction de fiabilité R(t) formalisée dans les modèles probabilistes avancés.
Cette typologie d’ogive descendante s’avère particulièrement féconde dans les disciplines traitant des durées de vie, de la résistance des matériaux et de l’ingénierie de la fiabilité logicielle. Elle permet d’illustrer la proportion de composants matériels demeurant opérationnels après un nombre d’heures de sollicitation donné, ou le pourcentage de candidats conservant un score supérieur à un barème d’excellence. Son tracé descendant présente une dérivée première négative sur tout son support, offrant une lecture immédiate du déclin probabiliste au fur et à mesure que les seuils de sévérité s’élèvent.
2.3 Le point d’intersection et l’estimation de la médiane
La conjonction simultanée de l’ogive ascendante (« moins que ») et de l’ogive descendante (« plus que ») au sein d’un même repère cartésien produit une configuration géométrique d’un intérêt statistique exceptionnel. Puisque la première courbe est une fonction continue monotone croissante reliant 0 à 1 (ou 0 % à 100 %), et que la seconde constitue une fonction continue monotone décroissante reliant 1 à 0, le théorème des valeurs intermédiaires postule l’existence obligatoire d’un point d’intersection unique, noté (x*, y*), au sein de l’intervalle spatial délimité par les bornes extrêmes de la distribution.
La démonstration analytique de la localisation de cette intersection découle directement de la complémentarité des deux courbes. À l’intersection des deux fonctions, l’égalité structurelle impose que F(x*) = S(x*). Sachant que par définition théorique S(x*) = 1 – F(x*), la substitution immédiate engendre l’équation F(x*) = 1 – F(x*), ce qui conduit irrémédiablement à 2F(x*) = 1, et par conséquent à F(x*) = 0,5, soit exactement 50 % de la masse cumulative globale. Dès lors, l’ordonnée d’intersection y* est universellement figée au seuil de 0,5 (ou 50 % des effectifs totaux), tandis que l’abscisse correspondante x* constitue, par définition mathématique stricte, l’estimation graphique de la médiane empirique de la variable étudiée.
Toutefois, la précision de cette estimation graphique dépend étroitement de la finesse de l’interpolation linéaire sous-jacente. Si le maillage des intervalles de discrétisation est trop large, l’hypothèse d’uniformité intra-classe risque d’introduire un biais géométrique systématique par rapport à la médiane calculée sur données brutes non groupées. L’ogive approche la médiane réelle avec une marge d’erreur proportionnelle au carré de la largeur des classes si la distribution présente une courbure locale prononcée. Les data scientists doivent être conscients de cette sensibilité afin d’ajuster judicieusement leurs stratégies de binning lorsqu’ils exploitent cette propriété géométrique singulière.
3. Configuration de l’environnement de développement Python
3.1 Sélection et installation des bibliothèques fondamentales
La mise en œuvre computationnelle rigoureuse d’un tracé d’ogive en Python nécessite un écosystème logiciel stabilisé et hautement optimisé pour l’algèbre numérique et la visualisation cartésienne. Le socle de cette architecture repose sur la bibliothèque standard de calcul scientifique NumPy. Cette dernière fournit les structures de données fondamentales sous la forme de tableaux multidimensionnels homogènes (ndarray) ainsi que les primitives vectorisées indispensables pour exécuter le partitionnement des classes et le cumul additif des masses de données sans recourir à des boucles explicites particulièrement lentes.
Le second pilier de cet agencement est incarné par le module matplotlib.pyplot, sous-système de dessin vectoriel 2D issu du projet open source Matplotlib. Ce moteur graphique prend en charge la conversion des tableaux numériques en entités géométriques cartésiennes, gère la projection projective sur les axes d’affichage, orchestre la typographie des étiquettes et assure le rendu pixel ou vectoriel selon les normes industrielles en vigueur. En parallèle, l’adjonction de bibliothèques tierces telles que Pandas pour la manipulation tabulaire de données et SciPy pour l’accès aux routines statistiques avancées confère une robustesse accrue à l’ensemble du pipeline expérimental.
Pour garantir la reproductibilité absolue des calculs et préserver le système d’exploitation hôte de toute pollution de dépendances, il est impératif d’isoler l’environnement de travail. Cette isolation s’opère usuellement via l’utilitaire standard venv disponible nativement dans les distributions modernes de Python, ou par l’intermédiaire du gestionnaire d’environnements binaires Conda. L’installation des paquets requis s’exécute traditionnellement via l’outil d’empaquetage pip en invoquant l’instruction d’installation conjointe pour NumPy, Matplotlib, SciPy et Pandas, garantissant ainsi l’alignement des versions des bibliothèques dynamiques sous-jacentes écrites en langage C et Fortran.
3.2 Optimisation des paramètres graphiques globaux
Avant d’initier la moindre commande de tracé géométrique, il convient de calibrer l’environnement de rendu graphique de manière globale afin de répondre aux critères typographiques imposés par les revues académiques et les directions techniques d’entreprise. Matplotlib embarque un dictionnaire global de configuration nommé rcParams, accessible via le module pyplot, qui régit l’intégralité des attributs visuels par défaut, allant de la taille des polices de caractères à la densité des lignes du maillage cartésien. La modification programmatique de ce dictionnaire permet de standardiser immédiatement l’ensemble des figures générées au cours d’une session de travail.
Un des paramètres cruciaux concerne la résolution spatiale du tracé, déterminée par la densité de pixels par pouce ou dots per inch (DPI). Pour un affichage interactif sur écran standard, une valeur de 100 DPI s’avère suffisante, mais toute projection destinée à une publication scientifique imprimée ou insérée dans un rapport PDF formel exige un paramétrage minimal fixé à 300 DPI, assurant une netteté absolue des glyphes typographiques et des segments polygonaux. De surcroît, le choix d’un thème stylistique épuré, tel que le style seaborn-v0_8-whitegrid ou une feuille de style personnalisée instaurant une typographie sans empattement robuste (comme DejaVu Sans ou Helvetica), épure la visualisation en éliminant les artifices décoratifs non informatifs susceptibles de saturer la charge cognitive de l’observateur.
L’utilisation de carnets interactifs tels que Jupyter Notebook ou l’interface JupyterLab commande l’insertion préalable de directives d’affichage spécifiques, notamment l’instruction magique déclarant le moteur graphique en ligne, afin que les objets figures soient restitués directement sous les cellules de code avec un support vectoriel natif. Cette configuration en amont garantit que les tracés d’ogives intégreront harmonieusement les proportions de toiles adaptées, évitant les chevauchements disgracieux entre les labels d’axes, les valeurs d’intervalles et les titres de distribution.
4. Génération et modélisation de jeux de données synthétiques
4.1 Création d’échantillons aléatoires avec NumPy
Dans l’optique d’illustrer la construction d’une ogive sans dépendre initialement d’aléas de captation de données empiriques réelles, le recours à l’échantillonnage stochastique contrôlé constitue la démarche méthodologique la plus rigoureuse. Le module numpy.random offre des générateurs d’états pseudo-aléatoires basés sur des algorithmes de pointe tels que le générateur Permuted Congruential Generator (PCG-64). La fixation explicite d’une graine aléatoire (random seed) par l’instanciation formelle d’un générateur via la méthode default_rng est obligatoire pour assurer l’immuabilité et la reproductibilité des séries synthétiques générées lors de chaque exécution du script.
Pour explorer les différentes morphologies distributionnelles et tester la capacité de l’ogive à traduire fidèlement des dynamiques variées, il est judicieux de synthétiser des variables continues suivant une loi normale gaussienne canonique. En fixant une espérance mathématique théorique (moyenne µ = 100) et une variance connue (écart-type σ = 15), simulant par exemple la distribution standardisée des quotients intellectuels d’une cohorte, la fonction d’échantillonnage normale permet d’engendrer un vecteur unidimensionnel contenant un nombre substantiel d’observations, couramment fixé à N = 1 000 ou N = 10 000 individus simulés.
Parallèlement, la simulation peut être étendue à des variables continues asymétriques, telles que celles dérivant de distributions log-normales, exponentielles ou de Weibull, afin d’observer la distorsion subséquente des courbures sigmoïdales de l’ogive. L’instanciation de ces jeux de données synthétiques fournit un matériel expérimental exhaustif, exempt d’imperfections initiales, permettant d’éprouver la précision algorithmique des fonctions de discrétisation et de cumul sans subir l’influence de données manquantes ou de perturbations instrumentales imprévues.
4.2 Inspection et diagnostic de la structure des données
Une fois le vecteur de données synthétiques instancié dans la mémoire de travail, une phase de diagnostic structurel est indispensable pour valider son adéquation avec les prérequis du tracé de l’ogive. Cette étape implique en premier lieu la vérification des dimensions spatiales de l’objet via la propriété dimensionnelle du tableau NumPy, s’assurant qu’il s’agit bien d’une structure linéaire plate unidimensionnelle. L’évaluation du type de données (dtype) doit certifier la présence de réels en virgule flottante (généralement float64), format requis pour prévenir tout risque de troncature numérique inhérent aux représentations entières lors des calculs d’intervalles contigus.
L’exploration descriptive se poursuit par l’extraction des indicateurs synthétiques centraux : calcul de la moyenne empirique observée, de l’écart-type d’échantillon, de la valeur minimale absolue et du maximum observable. La différence entre ces deux bornes extrêmes établit l’étendue globale (range) de la série statistique, grandeur fondamentale qui conditionnera directement la largeur des fenêtres de partitionnement lors de la phase ultérieure de discrétisation. L’alignement de ces statistiques empiriques avec les paramètres théoriques injectés dans le générateur pseudo-aléatoire confirme la fidélité de l’échantillon créé.
Enfin, le diagnostic doit impérativement certifier l’absence de valeurs singulières néfastes. L’exécution de masques booléens vérifiant l’inexistence de données manquantes (NaN pour Not a Number) ou de grandeurs infinies positives et négatives constitue une précaution technique indispensable. En environnement de production, la présence non purgée d’un seul élément indéterminé au sein du tableau de données entraînerait la propagation systématique d’indéterminations arithmétiques tout au long de la chaîne d’évaluation cumulative, neutralisant l’intégrité de la figure finale.
5. Construction pas à pas d’une ogive avec NumPy et Matplotlib
5.1 Discrétisation et extraction des classes via np.histogram
L’ossature fondamentale d’une ogive réside dans l’opération de partitionnement de la variable continue en un ensemble ordonné de sous-intervalles disjoints, également qualifiés de classes ou de boîtes (bins). Au sein de l’environnement Python, cette tâche est exécutée de manière optimale par la fonction numpy.histogram. Cette fonction ne se borne pas à préparer une visualisation, mais effectue un calcul matriciel pur : elle prend en entrée le vecteur brut des observations quantitatives et un paramètre spécifiant le nombre souhaité d’intervalles ou les valeurs frontières explicites des intervalles.
En sortie, la fonction numpy.histogram retourne un tuple de deux tableaux unidimensionnels distincts qu’il convient de découpler soigneusement. Le premier tableau renferme les effectifs absolus dénombrés au sein de chaque classe, c’est-à-dire le compte exhaustif des observations comprises entre les frontières successives. Le second tableau contient la séquence ordonnée des limites de classes (bin edges). Il est fondamental de souligner la dissymétrie dimensionnelle inhérente à ce retour : si l’on paramètre la fonction pour segmenter les données en k classes, le tableau des effectifs comptera exactement k éléments, tandis que le tableau des frontières en comportera systématiquement k + 1, incluant la borne inférieure minimale et la borne supérieure terminale.
Cet écart dimensionnel unitaire (k par rapport à k + 1) représente le nœud méthodologique principal de la construction d’une ogive. Tout alignement cartésien hâtif associant directement le vecteur des effectifs avec le vecteur des bornes provoquerait une incohérence mathématique et une exception d’exécution logicielle en raison de l’incompatibilité des dimensions des matrices. Il est donc indispensable d’élaborer une stratégie algorithmique claire pour associer sans ambiguïté chaque valeur de fréquence cumulée à la borne supérieure d’intervalle correspondante.
5.2 Calcul vectorisé des fréquences cumulées avec np.cumsum
Une fois les effectifs discrets extraits pour chaque intervalle de la partition, l’étape suivante consiste à calculer l’accumulation successive des masses d’observations. Ce calcul s’effectue avec une efficacité maximale grâce à la fonction vectorisée numpy.cumsum. Cette primitive opère une sommation cumulative le long de l’axe spécifié, retournant un tableau de même taille k où chaque élément d’indice i représente la somme rigoureuse de tous les effectifs précédents et de l’effectif courant. L’emploi de cette routine compilée en C surpasse drastiquement en performance n’importe quelle itération fondée sur des boucles natives de haut niveau en Python.
Pour convertir ces effectifs cumulés bruts en fréquences relatives ou en pourcentages lisibles, il suffit de diviser l’ensemble du tableau résultant par la taille totale de l’échantillon N (qui correspond d’ailleurs exactement à la dernière valeur issue de np.cumsum), puis de multiplier le vecteur par le facteur scalaire 100 si l’on souhaite graduer l’axe vertical de 0 à 100 %. Cette normalisation vectorielle préserve l’intégrité de la structure dimensionnelle tout en conférant à la métrique une comparabilité universelle, indépendante du volume brut d’individus auscultés.
Cependant, pour satisfaire aux exigences théoriques de l’ogive ascendante décrites précédemment, la courbe ne peut débuter abruptement à la borne supérieure du premier intervalle avec une valeur déjà strictement positive. Il est impératif d’intégrer manuellement le point de calage initial : à la borne inférieure absolue du premier intervalle, la fréquence cumulée est rigoureusement égale à zéro. Algorithmiquement, cela implique de concaténer la valeur scalaire 0 en tête du vecteur des fréquences cumulées à l’aide de la fonction numpy.insert ou numpy.concatenate. Par cette opération d’adjonction élémentaire, le vecteur de l’ordonnée cumulative acquiert désormais une dimension de k + 1 éléments, s’harmonisant de manière parfaite avec la longueur du tableau des frontières de classes.
5.3 Génération du tracé linéaire à l’aide de plt.plot
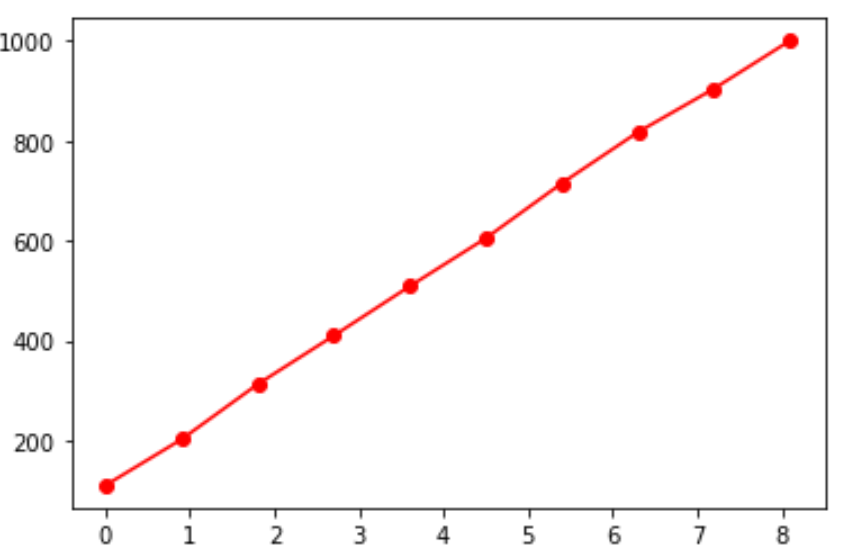
L’harmonisation dimensionnelle étant rigoureusement établie, l’orchestration du tracé s’opère par le biais de la fonction matplotlib.pyplot.plot. Le couple de coordonnées cartésiennes se déploie sans ambiguïté : le tableau complet des k + 1 bornes d’intervalles est transmis pour régir l’axe des abscisses (X), tandis que le tableau étendu des k + 1 fréquences relatives cumulées (débutant par le point d’ancrage zéro) pilote l’axe des ordonnées (Y). La fonction relie chaque couple séquentiel par un segment de droite continu, matérialisant visuellement l’interpolation linéaire polygonale propre à l’ogive.
Pour parfaire la lisibilité de la géométrie polygonale, il est d’usage d’adjoindre des marqueurs discrets sur chaque sommet de classe reliant les segments de droite. L’adjonction de l’argument stylistique spécifiant des marqueurs circulaires pleins, rehaussés d’une couleur de remplissage contrastée et d’un liseré périphérique distinct, permet au lecteur de discriminer immédiatement les frontières effectives de partitionnement par rapport aux portions purement interpolées de la ligne brisée. L’épaisseur du trait (linewidth) doit être ajustée pour conférer une assise visuelle solide sans pour autant masquer la position exacte des coordonnées nodales.
La finalisation de l’affichage élémentaire s’articule autour des primitives de gestion de repère cartésien. L’appel explicite de la méthode gérant les limites spatiales permet de verrouiller l’ordonnée strictement entre le seuil zéro et l’asymptote de 100 %, interdisant toute troncature intempestive ou débordement automatique généré par les marges intempestives de Matplotlib. Enfin, l’invocation de matplotlib.pyplot.show déclenche l’interprétation par le backend graphique et la restitution immédiate de la figure vectorielle au sein de la fenêtre de visualisation ou du carnet interactif.
6. Influence de la discrétisation (binning) sur la forme de l’ogive
6.1 Sous-ajustement et sur-ajustement par le choix du nombre de classes
La sélection du nombre d’intervalles de découpage k exerce une influence déterminante sur la morphologie de l’ogive et sur la validité des inférences subséquentes. Dans le domaine de l’apprentissage automatique et de la statistique non paramétrique, cette problématique s’inscrit au cœur du dilemme classique entre le biais et la variance. Un découpage outrageusement sommaire, consistant par exemple à segmenter un échantillon de plusieurs milliers de valeurs en seulement 4 ou 5 classes très larges, induit un phénomène aigu de sous-ajustement (under-smoothing). L’ogive se déforme alors en une série de rares segments rectilignes massifs qui gomment la subtilité des courbures locales, anéantissant l’information relative à l’asymétrie ou à la bimodalité potentielle de la distribution sous-jacente.
À l’inverse, l’écueil du sur-ajustement (over-smoothing ou hyper-binning) émerge dès lors que le nombre d’intervalles devient disproportionné par rapport à l’effectif disponible, par exemple en fixant 100 classes sur un échantillon restreint de 150 observations. Dans cette configuration pathologique, de nombreuses classes ne contiendront aucun individu ou seulement une unité sporadique. L’ogive perd alors son allure sigmoïdale fluide pour adopter une succession erratique de paliers horizontaux plats entrecoupés d’escalades verticales aiguës. Le tracé ne reflète plus la structure probabiliste générale de la variable, mais matérialise le bruit d’échantillonnage et les fluctuations stochastiques propres à ce micro-échantillon.
La comparaison expérimentale simultanée de quatre variantes d’une même distribution simulée découpée successivement en 5, 10, 30 et 50 intervalles met en évidence cette sensibilité géométrique. Alors qu’un maillage à 5 classes simplifie à l’excès la zone médiane en sous-estimant la pente centrale, un maillage à 50 classes introduit des ondulations instables sur les ailes de la distribution. Il existe par conséquent une zone de résolution optimale où la courbure de l’ogive traduit avec fidélité l’intégrale de la fonction génératrice sous-jacente, sans altération géométrique outrancière.
6.2 Critères heuristiques formels pour déterminer le binning optimal
Afin de s’extraire de l’arbitraire empirique du choix subjectif de la granularité des intervalles, la statistique théorique a développé plusieurs règles heuristiques fondées sur des critères d’optimisation de l’erreur quadratique intégrée moyenne. La formulation la plus historiquement ancrée est la règle d’Herbert Sturges, établie en 1926. Dérivée de l’expansion binomiale symétrique, la règle de Sturges stipule que le nombre optimal de classes k doit être proportionnel au logarithme binaire de la taille de l’échantillon : k = 1 + ⌈log₂(N)⌉. Cette règle s’avère particulièrement adaptée et performante pour des échantillons de taille modérée (N < 200) issus de distributions unimodales approximativement gaussiennes, mais tend à sous-estimer notablement le nombre de classes nécessaires pour de volumineux jeux de données.
Pour pallier les insuffisances de l’approche de Sturges face à des cohortes plus larges, David Scott a introduit en 1979 un critère fondé sur la minimisation de l’erreur d’estimation de la densité par l’intermédiaire de la variance d’échantillon. La règle de Scott spécifie directement la largeur idéale de l’intervalle d’intégration h par la formule h = (3,49 · s) / ∛N, où s représente l’écart-type de l’échantillon et N l’effectif global. Le nombre de classes s’obtient ensuite simplement en divisant l’étendue globale des données par la largeur optimale h. En intégrant explicitement la dispersion réelle des données, la règle de Scott évite les biais de partitionnement sur des séries fortement étalées.
Une alternative encore plus robuste, conçue expressément pour résister à l’influence perturbatrice des valeurs aberrantes ou extrêmes, a été formalisée par David Freedman et Persi Diaconis en 1981. L’estimateur de Freedman-Diaconis substitue l’écart-type paramétrique par une métrique non paramétrique hautement résiliente : l’écart interquartile (IQR). La largeur optimale d’intervalle est régie par la relation analytique h = (2 · IQR(X)) / ∛N. Dès lors que la série statistique présente une asymétrie marquée ou une contamination par des valeurs singulières isolées, la règle de Freedman-Diaconis s’impose comme le standard méthodologique par excellence pour configurer la discrétisation préalable à l’ogive.
6.3 Algorithmes automatiques intégrés dans NumPy
L’un des avantages majeurs de l’implémentation moderne de NumPy réside dans l’intégration native de ces formulations d’optimisation au sein même du paramètre d’intervalles de la fonction numpy.histogram. Plutôt que de forcer le programmeur à calculer manuellement les équations de Sturges, Scott ou Freedman-Diaconis, NumPy permet de transmettre une chaîne de caractères descriptive désignant directement l’algorithme désiré au paramètre bins. L’assignation de la valeur textuelle 'sturges', 'scott' ou 'fd' (pour Freedman-Diaconis) délègue l’intégralité du calcul préparatoire au moteur C sous-jacent.
En outre, NumPy propose une option particulièrement robuste baptisée 'auto'. Lorsqu’elle est activée, cette directive orchestre un arbitrage intelligent : elle calcule simultanément la largeur de classe prescrite par la règle de Sturges et celle prescrite par la règle de Freedman-Diaconis, puis sélectionne automatiquement l’estimateur qui génère les classes les plus fines (soit h = min(h_sturges, h_fd)). Cet ajustement adaptatif garantit que pour les petits échantillons, la règle de Sturges préviendra le morcellement excessif, tandis que pour les grands jeux de données ou les séries asymétriques, l’estimateur de Freedman-Diaconis prendra le relais pour préserver la structure fine de la distribution cumulée.
Le choix de l’algorithme automatique n’est pas anodin sur le plan computationnel et statistique. Il conditionne directement la finesse d’estimation des percentiles qui seront ultérieurement extraits le long de l’ogive polygonale. Un recours systématique au paramètre bins='auto' confère au code une portabilité maximale, lui permettant de s’ajuster avec une résilience parfaite à des échantillons de taille variable sans nécessiter de recalibration manuelle des pas d’intégration.
7. Implémentation technique de l’ogive descendante
7.1 Algorithme de calcul inverse des fréquences résiduelles
L’implémentation logicielle de l’ogive descendante (« plus que ») requiert une modification structurelle de l’ordre d’accumulation arithmétique. Alors que l’ogive ascendante cumule les fréquences de gauche à droite le long de l’axe des grandeurs croissantes, l’ogive descendante quantifie le volume résiduel restant. Pour coder cet algorithme à l’aide de NumPy sans dégrader la vélocité vectorielle, deux approches computationnelles s’offrent au concepteur logiciel : la décrémentation soustractive à partir du volume global total ou l’inversion directionnelle du vecteur de fréquences simples préalablement à la sommation.
L’approche par inversion directionnelle se révèle particulièrement élégante et rapide. Elle consiste à prendre le vecteur des effectifs simples par classe issu de np.histogram, à inverser l’ordre de ses composantes vectorielles à l’aide de la syntaxe d’indexation inversée propre à Python (ou via la fonction native numpy.flip), à exécuter la fonction numpy.cumsum sur cette séquence renversée, puis à renverser de nouveau le vecteur résultant pour restaurer le sens ordinal naturel de l’abscisse. Cette séquence d’opérations vectorisées génère instantanément la somme résiduelle exacte sans encourir les imprécisions d’arrondi soustractif en virgule flottante sur de grands volumes.
Sur le plan cartésien, l’alignement géométrique exige une vigilance accrue quant au choix des bornes d’intervalles associées. Pour l’ogive descendante, le point d’origine maximale (où la fréquence résiduelle est égale à 100 %) ne se situe pas à la borne supérieure du premier intervalle, mais rigoureusement à sa borne inférieure absolue : la totalité des observations de l’échantillon possède en effet une valeur supérieure ou égale au seuil minimal. Par symétrie, la fréquence résiduelle s’annule complètement à la borne supérieure du dernier intervalle d’échantillonnage. En concaténant un zéro scalaire à la fin du vecteur résiduel calculé, la dimension de k + 1 points est rigoureusement rétablie, assurant une parfaite concordance géométrique avec le vecteur global des frontières de partitionnement.
7.2 Superposition simultanée des deux courbes ogivales
La conjonction des deux dynamiques d’accumulation au sein d’une unique interface visuelle permet de tirer parti de toute la puissance sémiologique de l’ogive. Pour superposer avec netteté l’ogive ascendante et l’ogive descendante sur le même repère cartésien, il convient d’exécuter deux appels successifs à la fonction matplotlib.pyplot.plot au sein du même bloc de dessin, en ciblant le même conteneur d’axes (axes instance). La différenciation chromatique et stylistique constitue ici un impératif de lisibilité indiscutable.
Une bonne pratique de conception consiste à attribuer à la courbe ascendante une teinte dominante franche, par exemple un bleu profond (comme la couleur institutionnelle de Matplotlib ou un ton cobalt), symbolisant la construction cumulative positive. En contrepoint, l’ogive descendante se pare avantageusement d’une teinte contrastée chaude, tel qu’un pourpre cuivré ou un rouge vermillon sombre, évoquant l’amenuisement de la matière résiduelle. Pour renforcer l’accessibilité aux observateurs atteints de dyschromatopsies, il est fortement préconisé de différencier également le style des traits, en conservant un segment plein pour l’ogive ascendante et en assignant un motif en tirets réguliers ou en pointillés denses pour l’ogive descendante.
Cette superposition simultanée rend immédiatement visible le phénomène d’intersection géométrique explicité théoriquement dans la section 2.3. Le croisement des deux tracés polygonaux brisés saute aux yeux de l’analyste, focalisant l’attention sur la région centrale de la distribution. Cette visualisation conjointe sert de soubassement visuel pour implémenter des annotations automatiques venant matérialiser la convergence des deux courbes vers la valeur médiane de la population étudiée.
8. Personnalisation graphique avancée et standardisation de publication
8.1 Enrichissement typographique et annotatif des axes
Un tracé statistique ne possède de valeur scientifique que si son appareillage annotatif dissipe toute ambiguïté quant à la nature des unités physiques, métriques ou psychométriques projetées dans l’espace cartésien. L’enrichissement des axes commence par la spécification formelle des libellés d’axes (labels) via les méthodes plt.xlabel et plt.ylabel. L’axe des abscisses doit expliciter le nom complet de la variable quantitative mesurée ainsi que son unité de mesure entre parenthèses, tandis que l’axe des ordonnées doit stipuler sans équivoque s’il s’agit d’effectifs absolus dénombrés, de fréquences relatives normalisées unitairement ou de pourcentages cumulés de la population analysée.
Le paramétrage des graduations d’axes (ticks) doit s’affranchir des automatismes de Matplotlib pour adopter un maillage en adéquation stricte avec la théorie statistique. À l’aide de la fonction plt.yticks, il est pertinent de positionner des graduations spécifiques sur l’axe vertical aux hauteurs décisives correspondant aux fractions quantiles : 0 %, 25 % (premier quartile), 50 % (médiane), 75 % (troisième quartile) et 100 % (saturation de l’échantillon). L’adjonction de symboles de pourcentages explicites dans le formatage textuel des étiquettes d’ordonnées élimine toute méprise interprétative pour les lecteurs peu familiarisés avec les notations décimales univalentes.
Enfin, la figure doit être coiffée d’un titre scientifique structuré à l’aide de la méthode plt.title. Un titre rigoureux ne se contente pas d’une dénomination lapidaire, mais renseigne sur la population statistique ciblée, la taille totale de l’échantillon étudié (notée conventionnellement sous la forme N = …) ainsi que le type d’ogive déployé. L’ajustement de la taille de la police de titre, de sa graisse typographique (semi-bold) et de son dégagement vertical (pad) confère à l’ensemble un équilibre visuel conforme aux normes éditoriales des revues internationales à comité de lecture.
8.2 Intégration d’un quadrillage et de guides de lecture visuels
En raison de sa vocation géométrique fondamentale qui consiste à projeter mentalement ou graphiquement une fréquence cumulée vers une valeur observée, l’ogive requiert la présence d’une armature de repérage cartésien irréprochable. L’activation d’un quadrillage régulier via la primitive plt.grid constitue une exigence fonctionnelle majeure. Toutefois, ce quadrillage ne doit jamais saturer visuellement le dessin : l’ajustement du coefficient de transparence alpha à une valeur modérée (typiquement entre 0,3 et 0,5), combiné à l’adoption d’un tracé pointillé d’épaisseur fine, assure son rôle de guide sans concurrencer la primauté perceptive des courbes d’ogive.
Pour décupler l’efficacité analytique du tracé, il est particulièrement pertinent de matérialiser directement les corridors de référence associés aux statistiques d’ordre. L’emploi de la fonction plt.axhline permet d’insérer des segments horizontaux traversant l’intégralité du graphique à des ordonnées stratégiques, notamment à Y = 50 % pour la ligne médiane, ou à Y = 25 % et Y = 75 % pour les bornes interquartiles. Ces lignes directrices, tracées avec un ton neutre (gris ardoise) et un motif discontinu discret, attirent instantanément l’œil vers les seuils de référence probabilistes.
De manière complémentaire, l’analyste chevronné exploitera les fonctions de projection ciblée plt.vlines et plt.hlines pour former des segments de guidage orthogonaux s’arrêtant précisément à la courbe ogivale. Lorsqu’une valeur d’abscisse remarquable ou un seuil critique réglementaire est analysé, ce système de projections tronquées permet de visualiser d’un seul coup d’œil le pourcentage exact d’individus exclus ou inclus par ce seuil, constituant un instrument de communication décisionnelle d’une limpidité incomparable au sein des rapports techniques.
8.3 Lissage de la courbe ogivale par interpolation polynomiale ou spline
Dans un contexte de communication grand public ou de publication de prestige, l’allure brisée polygonale de l’ogive standard peut être jugée visuellement austère. Les praticiens sont alors tentés d’adoucir le tracé par des techniques d’interpolation numérique continue, notamment à l’aide des fonctions de lissage par B-splines disponibles dans le module scipy.interpolate (en particulier via la classe make_interp_spline). Cette procédure génère une courbe fluide de classe C² dont le gradient varie de manière continue sans aucune rupture angulaire sur les nœuds d’intervalles.
Néanmoins, cette recherche esthétique soulève de redoutables questions théoriques et méthodologiques. L’application d’une spline cubique standard sur un polygone de fréquences cumulées comporte un risque majeur : la violation locale de la condition de monotonicité non décroissante. En raison du phénomène de sur-oscillation mathématique (analogue au phénomène de Runge dans l’interpolation polynomiale), une spline cubique mal contrainte peut présenter de légères concavités négatives locales ou des ondulations régressives, suggérant de manière absurde qu’une augmentation de la valeur mesurée sur l’axe X pourrait se traduire par une baisse locale de la probabilité cumulée sur l’axe Y.
Pour concilier rigueur probabiliste et élégance visuelle, il est par conséquent formellement proscrit d’employer des splines conventionnelles non régularisées. Le statisticien avisé doit obligatoirement recourir à des algorithmes d’interpolation préservant la monotonicité par morceaux, tels que l’interpolateur cubique monotone de Fritsch et Carlson implémenté dans SciPy sous le nom PchipInterpolator (Piecewise Cubic Hermite Interpolating Polynomial). Cet algorithme sophistiqué garantit de façon absolue que la dérivée première de la courbe interpolée demeure strictement positive ou nulle sur tout son domaine, empêchant toute aberration logique tout en offrant une courbure sigmoïdale parfaitement lissée.
9. Méthodes alternatives de tracé avec Pandas, SciPy et Seaborn
9.1 Exploitation de la structure de données Pandas Series
Lorsque le flux de traitement s’inscrit au sein d’une architecture d’ingénierie des données exploitant massivement l’écosystème Pandas, la construction d’une ogive peut être rationalisée en utilisant les structures de colonnes étiquetées (Series). La première phase consiste à opérer la discrétisation vectorisée de la série numérique à l’aide de la fonction pandas.cut. Cette dernière prend en argument la colonne de données brutes et le nombre d’intervalles requis, retournant une série catégorielle ordonnée dont chaque modalité représente l’intervalle exact d’appartenance avec la notation classique des crochets fermés et ouverts.
L’agrégation s’effectue ensuite par l’enchaînement fluide de deux méthodes natives hautement performantes : la méthode value_counts(sort=False) qui compile les effectifs associés à chaque catégorie dans l’ordre spatial des intervalles, immédiatement suivie de la méthode cumsum() qui calcule le cumul additif des effectifs. En une seule ligne d’instruction chaînée, l’analyste obtient une nouvelle série Pandas dont l’index est formé par les intervalles de découpage et les valeurs par la masse cumulée croissante. Pour normaliser cette série en pourcentages, il suffit d’appliquer une division vectorielle directe par la dernière valeur de la série cumulée.
Bien que Pandas propose un moteur de tracé interne accessible via la méthode Series.plot(), son utilisation directe pour une ogive requiert une manipulation préliminaire des index pour extraire les bornes supérieures sous forme de valeurs numériques pures. En effet, l’index résultant de pd.cut étant composé d’objets de type Interval, Matplotlib les interpréterait par défaut comme des labels catégoriels discrets équidistants sur l’axe horizontal, détruisant l’échelle métrique continue de la variable. L’extraction programmatique des propriétés Interval.right de l’index Pandas résout cette limitation et rétablit la justesse spatiale du tracé cartésien.
9.2 Construction de la fonction ECDF exacte avec SciPy et Statsmodels
La statistique inférentielle moderne privilégie fréquemment l’abandon délibéré de la discrétisation en classes au profit du tracé de la fonction de répartition empirique exacte non groupée. Cette méthodologie évite tout arbitraire lié au choix du nombre d’intervalles ou de leurs frontières. La bibliothèque de modélisation économétrique et statistique Statsmodels fournit une implémentation de référence à travers la classe ECDF, logée dans son module de distributions empiriques.
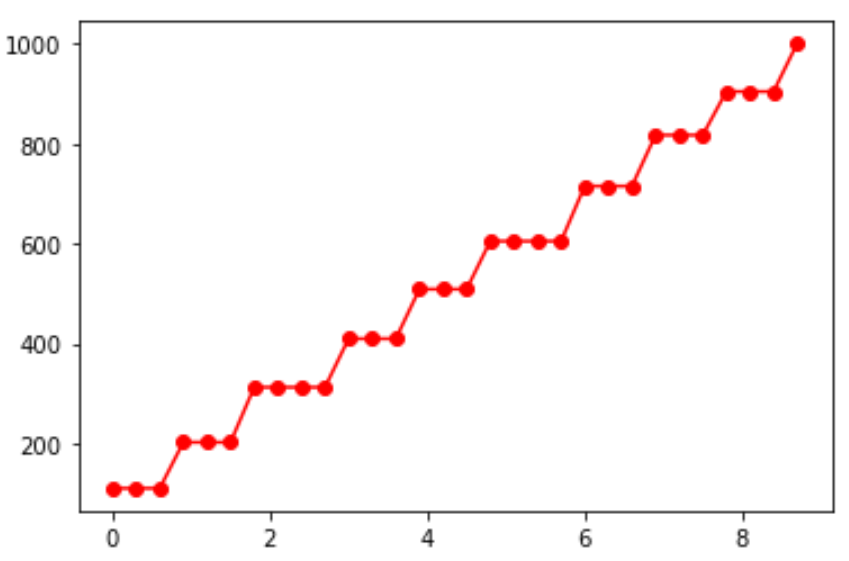
L’instanciation de l’objet ECDF avec le tableau des observations brutes génère instantanément un objet fonctionnel exécutable. Cet objet encapsule le tableau trié des valeurs réelles de l’échantillon ainsi que leurs rangs percentiles normalisés respectifs sans regrouper les données en boîtes artificielles. L’évaluation de cette instance sur un continuum de points scalaires retourne la probabilité empirique exacte F(x) = k / N. Contrairement à l’ogive qui relie les bornes de classes par des segments inclinés continus, le tracé direct d’un objet ECDF via Matplotlib matérialise la nature fondamentalement discrète d’un échantillon fini en dessinant un escalier constitué de paliers horizontaux et de sauts verticaux discrets.
Le recours à la bibliothèque SciPy offre une alternative computationnelle puissante depuis ses versions récentes avec l’introduction de la fonction scipy.stats.ecdf. Cette fonction optimise l’évaluation asymptotique et fournit directement les méthodes pour calculer des intervalles de confiance non paramétriques (bandes de confiance de Dvoretzky-Kiefer-Wolfowitz) entourant la distribution cumulative empirique. Pour des volumétries massives comprenant plusieurs millions d’enregistrements, cette méthode surpasse les calculs d’histogrammes en évitant les surcoûts d’allocation de mémoire liés au partitionnement itératif.
9.3 Visualisation de distributions cumulatives avec Seaborn
La bibliothèque de haut niveau Seaborn, conçue sur les fondations de Matplotlib pour enrichir les représentations statistiques exploratoires, propose des abstractions déclaratives particulièrement élégantes. Pour cartographier une distribution cumulative empirique, Seaborn met à disposition la fonction spécialisée seaborn.ecdfplot. Cette commande accepte directement des tableaux NumPy, des séries Pandas ou des DataFrames entiers tout en gérant automatiquement l’intégralité du calcul de cumul et de normalisation unitaire en coulisses.
L’immense force de Seaborn réside dans sa capacité à traiter de façon transparente la stratification par groupes ou catégories expérimentales via l’argument syntaxique hue. En transmettant une colonne catégorielle à cet argument, ecdfplot partitionne instantanément le jeu de données, calcule les fonctions cumulatives distinctes pour chaque sous-population et génère des courbes de couleurs différenciées assorties d’une légende automatique parfaitement positionnée. Cette concision syntaxique en fait l’outil d’exploration préliminaire le plus rapide et le plus fiable pour comparer visuellement la distribution de cohortes multiples (par exemple hommes versus femmes, ou groupe contrôle versus groupe traité).
Il importe toutefois de souligner une distinction épistémologique cruciale : par défaut, seaborn.ecdfplot trace rigoureusement la fonction en escalier exacte de l’échantillon non binné, et non une ogive polygonale fermée et interpolée au sens académique classique du terme. Bien qu’il soit possible d’ajuster certains paramètres pour émuler un comportement lissé ou de combiner la fonction avec kdeplot(cumulative=True) pour obtenir une intégrale de noyau de densité, Seaborn s’éloigne de la tradition scolaire du polygone des fréquences cumulées ancré sur des frontières de classes strictes. Les deux approches demeurent complémentaires, l’ogive restant irremplaçable lorsqu’il s’agit de restituer des données déjà tabulées en classes par des organismes de statistiques publiques.
10. Extraction quantitative et interpolation des percentiles
10.1 Localisation visuelle et analytique de la médiane (Q2)
L’un des apports majeurs de la construction d’une ogive réside dans l’extraction continue des métriques de position centrale, au premier rang desquelles figure la médiane (ou deuxième quartile Q2). Sur le plan visuel, la localisation de la médiane consiste à tracer une droite horizontale issue de l’axe des ordonnées au niveau du percentile 50 % (ou de la fréquence relative 0,5), à repérer géométriquement son point d’impact sur le tracé de l’ogive ascendante, puis à projeter ce point orthogonalement vers le bas pour lire l’abscisse correspondante sur l’axe des grandeurs de la variable.
Sur le plan analytique et computationnel, cette lecture graphique est automatisée en inversant localement la fonction d’interpolation linéaire par morceaux à l’aide de la fonction numpy.interp. Cette fonction standard d’interpolation unidimensionnelle prend pour arguments la cible quantile recherchée (ici la valeur scalaire 0,5 ou 50), le tableau des ordonnées cumulées connues (les fréquences cumulées aux bornes), et le tableau des abscisses correspondantes (les limites d’intervalles). En exécutant cet appel, NumPy identifie automatiquement l’intervalle encadrant [Fᵢ₋₁, Fᵢ] qui contient la valeur 0,5 et applique la formule mathématique classique de l’interpolation proportionnelle :
Médiane_estimée = bᵢ₋₁ + ((0,5 – Fᵢ₋₁) / (Fᵢ – Fᵢ₋₁)) · (bᵢ – bᵢ₋₁)
La valeur médiane extraite par cette interpolation sur l’ogive binnée s’avère remarquablement proche de la médiane calculée de manière exacte sur l’échantillon brut non groupé via numpy.median. L’écart marginal résiduel entre ces deux grandeurs constitue un indicateur précieux du degré d’asymétrie locale intra-classe. Pour des échantillons de grande taille convenablement discrétisés, cette erreur d’interpolation devient asymptotiquement négligeable, validant l’ogive comme un instrument computationnel robuste d’inférence non paramétrique.
10.2 Calcul de l’écart interquartile (IQR) sur l’ogive
L’analyse de la dispersion d’une distribution échappant à la symétrie gaussienne ne peut se satisfaire de l’écart-type arithmétique, excessivement sensible aux queues de distribution et aux valeurs atypiques. L’écart interquartile (Interquartile Range ou IQR), défini comme la distance séparant le troisième quartile Q3 (75e percentile) du premier quartile Q1 (25e percentile), s’impose comme la mesure de variabilité robuste privilégiée. L’ogive constitue un outil d’une remarquable efficacité pour extraire et spatialiser simultanément ces deux grandeurs fondamentales.
Le protocole computationnel déploie de nouveau la puissance de la fonction numpy.interp, cette fois-ci en lui transmettant un vecteur de deux cibles quantiles conjointes : les valeurs 0,25 et 0,75 (ou 25 % et 75 %). L’algorithme retourne quasi instantanément les deux abscisses correspondantes, notées respectivement x_Q1 et x_Q3. L’écart interquartile interpolé s’obtient alors par la simple différence arithmétique : IQR = x_Q3 – x_Q1. Cette emprise centrale englobe par définition mathématique rigoureuse exactement 50 % de la masse statistique totale des observations de l’échantillon.
La matérialisation de l’écart interquartile sur le graphique enrichit considérablement l’interprétabilité de la figure. En traçant deux lignes de projection verticales descendantes depuis les ordonnées 25 % et 75 % jusqu’à l’axe des abscisses, et en reliant ces deux bornes sur l’axe horizontal par un bandeau ombré ou une flèche bidirectionnelle annotée, l’analyste illustre visuellement la concentration du cœur de distribution. Une zone interquartile resserrée horizontalement trahira une ogive à forte pente centrale caractéristique d’une distribution leptokurtique très concentrée, tandis qu’un étalement spacieux révélera une variabilité prononcée ou une distribution platykurtique aplatie.
10.3 Détermination des rangs percentiles pour des scores spécifiques
L’opération inverse de l’extraction des quantiles présente une utilité pratique tout aussi fondamentale : étant donné un score brut observé x_cible (par exemple la note obtenue par un individu à une évaluation psychologique ou le niveau de charge d’un composant), quelle fraction de la population se situe sous cette performance ? Ce calcul revient à projeter une abscisse donnée verticalement vers la courbe ogivale, puis horizontalement vers l’axe des ordonnées pour en extraire le rang centile (percentile rank) correspondant.
La transposition algorithmique s’opère toujours via la fonction vectorisée numpy.interp, mais en inversant la polarité de ses paramètres directeurs. Pour déterminer le rang centile d’un score donné, le premier argument devient la valeur scalaire x_cible, le second argument est formé par le vecteur des bornes d’intervalles (abscisses de l’ogive), et le troisième argument correspond au vecteur des fréquences cumulées (ordonnées de l’ogive). La fonction interpole linéairement la position exacte du score cible entre les deux limites de classe qui le bornent et retourne immédiatement la proportion cumulée correspondante, qu’il suffit de multiplier par 100 pour obtenir le rang centile.
Cette approche brille particulièrement par son extensibilité computationnelle. Grâce aux propriétés de vectorisation intrinsèques de NumPy, il n’est nullement nécessaire de traiter les scores un par un : on peut injecter un tableau complet comprenant des milliers de scores individuels bruts en un unique appel de fonction. En une fraction de milliseconde, le programme convertit l’ensemble des scores bruts en une série normalisée de rangs centiles étalonnés sur l’ogive de référence. Cette métrique standardisée est universellement comprise, permettant de situer immédiatement un individu ou une mesure au sein de sa population de référence.
11. Étude de cas appliquée : Évaluation de métriques psychologiques
11.1 Normalisation et étalonnage de tests psychométriques
Le champ de la psychométrie et de l’évaluation neuropsychologique constitue historiquement et méthodologiquement le domaine de prédilection de la courbe ogivale. Lorsqu’un nouvel instrument psychométrique est développé (qu’il s’agisse d’un test d’aptitudes cognitives générales, d’une échelle d’anxiété clinique ou d’un inventaire d’évaluation de la personnalité), les résultats bruts obtenus par les participants correspondent à des sommes de points discrets qui ne possèdent aucun sens métrique intrinsèque universel. Un score brut de 42 points à une échelle de dépression n’indique en rien le degré de sévérité de l’affection si l’on ignore comment se distribuent les scores au sein de la population générale saine et clinique.
Pour conférer à ce score une valeur diagnostique indiscutable, les psychomètres procèdent à un protocole d’étalonnage sur un échantillon normatif représentatif de plusieurs milliers d’individus. La construction de l’ogive ascendante de cet échantillon normatif permet de cartographier la fonction de distribution cumulative de référence. Grâce aux mécanismes d’interpolation polygonale de l’ogive, le score brut de chaque sujet est automatiquement converti en son rang centile équivalent. Un praticien hospitalier observant qu’un score brut de 42 correspond à l’ordonnée cumulative 98,5 % sur l’ogive normative en conclut immédiatement et rigoureusement que le patient surpasse 98,5 % des individus de référence, attestant ainsi d’une symptomatologie clinique d’une sévérité critique nécessitant une intervention thérapeutique immédiate.
De plus, cette standardisation ogivale permet d’affranchir l’évaluation des déformations distributionnelles fréquentes dans les tests psychologiques, où les scores bruts sont rarement parfaitement gaussiens en raison d’effets de plafond (saturation vers les scores hauts) ou d’effets de plancher (accumulation sur les scores minimaux). L’ogive absorbe ces asymétries en adaptant la pente de son profil, assurant une conversion en centiles rigoureusement fidèle à la réalité empirique du terrain expérimental.
11.2 Analyse chronométrique des temps de réaction cognitive
L’analyse des temps de réaction (TR) au sein des paradigmes d’attention visuelle ou de décision motrice en sciences cognitives fournit une autre illustration éclatante de la pertinence de l’ogive. La cinétique des temps de latence cognitive ne suit jamais une distribution normale : elle est caractérisée de façon universelle par une distribution fortement asymétrique positive, modélisée mathématiquement par la loi ex-gaussienne (conjonction d’une composante gaussienne centrale et d’une queue exponentielle droite très étirée, générée par des épisodes sporadiques d’inattention mentale).
Dans ce contexte particulier, l’ogive ascendante révèle sa suprématie visuelle sur l’histogramme classique. Pour ausculter les processus cognitifs ultra-rapides, les chercheurs s’intéressent prioritairement à la latence minimale des réponses motrices, située entre le premier centile et le dixième centile. Sur un histogramme standard, cette zone critique est écrasée par la masse du mode central et se résume à une ou deux barres minuscules difficilement discriminables. Sur l’ogive, la dynamique de démarrage de la courbe offre une résolution visuelle spectaculaire : l’abscisse exacte où la courbe décolle de l’axe horizontal marque le temps physiologique incompressible de conduction sensorielle périphérique, tandis que la raideur de l’accélération initiale traduit la vivacité de l’intégration corticale centrale.
Lorsque deux conditions expérimentales distinctes sont comparées (par exemple une condition de contrôle sans distraction par rapport à une condition avec charge mentale accrue induite par une tâche concurrente), la superposition des deux ogives permet de localiser instantanément où s’exerce l’impact de la charge cognitive. Si la seconde courbe est uniformément translatée vers la droite dès son origine, cela démontre un ralentissement moteur global ; en revanche, si les deux ogives coïncident parfaitement sur les 20 premiers pourcents avant de diverger fortement sur la portion supérieure, le chercheur déduit formellement que la charge mentale n’affecte pas les réponses automatiques rapides, mais dégrade uniquement la stabilité attentionnelle sur les essais complexes.
11.3 Interprétation clinique des fractures de pente sur l’ogive
L’une des propriétés les plus remarquables de l’ogive statistique réside dans sa sensibilité géométrique aux hétérogénéités sous-jacentes d’une population, révélée par la présence de fractures de pente ou de points d’inflexion multiples le long de sa trajectoire. Dans une distribution unimodale régulière, l’ogive ne possède qu’un seul point d’inflexion majeur, correspondant au mode de la distribution (le point où la pente de la tangente est maximale, traduisant la densité de probabilité la plus élevée). Dès lors que l’on observe visuellement une rupture angulaire ou une alternance de ralentissements et de ré-accélérations de la pente, l’analyste se trouve confronté à l’indice diagnostique patent d’une distribution multimodale.
En contexte clinique hospitalier, la mise en évidence de telles fractures de pente sur une ogive d’évaluation de biomarqueurs ou de scores psychopathologiques possède des implications majeures. Supposons qu’une équipe médicale ausculte une cohorte de 500 patients admis pour un trouble neurologique indéterminé. Si l’ogive cumulative des scores d’atteinte motrice présente une ascension initiale rapide se stabilisant autour de 40 %, suivie d’un palier horizontal prolongé puis d’une nouvelle ascension brutale à partir du score 60 pour atteindre l’asymptote terminale, cette morphologie en double sigmoïde prouve de manière éclatante que l’échantillon ne constitue pas une population pathologique homogène.
Cette fracture de pente signale l’amalgame clinique de deux sous-groupes nosographiques distincts dissimulés sous une même étiquette diagnostique : un premier sous-ensemble d’individus atteints d’une forme bénigne ou modérée (formant le premier massif modal) et un second groupe d’individus souffrant d’une dégénérescence massive hautement symptomatique (formant le second mode). L’identification de ce palier intermédiaire sur l’ogive permet aux épidémiologistes de fixer une frontière de découpage phénotypique objective, permettant d’isoler les profils pathologiques atypiques afin de leur attribuer des protocoles de prise en charge pharmacologique différenciés.
12. Bonnes pratiques, erreurs courantes et optimisation logicielle
12.1 Pièges fréquents dans la gestion des bornes et décalages d’indices
L’implémentation algorithmique d’une ogive sous Python recèle un ensemble de pièges classiques liés à l’arithmétique des indexages et à la sémantique mathématique des intervalles. L’erreur la plus répandue chez les développeurs débutants réside dans la confusion sur l’alignement des k effectifs cumulés issus de numpy.cumsum avec les k + 1 frontières retournées par numpy.histogram. Une pratique fautive fréquente consiste à éliminer arbitrairement la dernière frontière de classe pour égaliser artificiellement les dimensions matricielles. Cette faute grave a pour conséquence d’associer la masse cumulative maximale à l’avant-dernière borne, induisant un décalage systématique de la courbe vers la gauche et introduisant un biais d’estimation majeur sur l’ensemble des percentiles extraits.
Le second écueil réside dans la gestion des conventions d’inclusion des bornes d’intervalles (intervalles semi-ouverts à gauche ou à droite). Par défaut, la fonction numpy.histogram traite tous les intervalles comme semi-ouverts à droite [a, b), à l’exception impérative de la dernière classe qui inclut exceptionnellement sa borne supérieure [a, b]. Cette asymétrie de conception logicielle peut engendrer de subtiles incohérences lors du traitement de variables discrétisées à forte concentration sur les valeurs extrêmes. Si une analyse requiert une stricte convention d’intervalles fermés à droite (a, b], comme c’est classiquement le cas dans la définition théorique de la fonction de répartition cumulative probabiliste F(x) = P(X ≤ x), le développeur doit être conscient de ce comportement pour ajuster les paramètres de discrétisation en conséquence.
Il est enfin fondamental de s’assurer de l’insertion systématique du point de masse nulle (b₀, 0) à la base de l’ogive ascendante, tel que formalisé dans notre section 5.2. L’omission de cette origine tronque le premier segment polygonal et donne l’illusion fausse que des observations existent en dessous de la borne minimale de l’échantillon, faussant radicalement l’estimation du premier décile ou du percentile 5 % lors de l’interpolation numérique inverse.
12.2 Gestion des distributions extrêmes et des valeurs aberrantes
La présence de valeurs extrêmes ou aberrantes (outliers), issues d’erreurs de captation sensorielle ou représentatives de phénomènes à queues lourdes (distributions de Cauchy ou de Pareto), constitue une menace sévère pour la lisibilité cartésienne de l’ogive. Lorsqu’une poignée de valeurs démesurément élevées coexiste avec un corps principal d’observations concentrées, l’échelle linéaire de l’axe des abscisses s’étire de manière disproportionnée. L’ogive se déforme alors en une ligne quasi verticale collée à gauche, suivie d’un immense plateau horizontal plat s’étirant sur la quasi-totalité de l’espace graphique jusqu’à l’observation maximale isolée, détruisant tout intérêt diagnostique pour la fraction centrale de la population.
Pour remédier à cette distorsion sans altérer frauduleusement les données, plusieurs démarches méthodologiques s’offrent au concepteur. La première consiste à opérer une transformation mathématique non linéaire préalable de la variable, telle qu’une transformation logarithmique standard ou une transformation de Box-Cox stabilisatrice de variance. Le tracé de l’ogive sur la variable transformée log(X) restaure une courbure sigmoïdale équilibrée, permettant de scruter la dynamique cumulative interne tout en intégrant rigoureusement l’ensemble des observations extrêmes au sein d’une échelle logarithmique explicitée sur le label d’axe.
Une approche alternative, particulièrement préconisée dans le cadre du reporting industriel ou opérationnel, repose sur la troncature contrôlée ou la winsorisation des extrêmes. Cette technique consiste à fixer des bornes de découpage manuelles englobant par exemple 99 % des observations centrales, en regroupant les observations résiduelles dans une classe supérieure ouverte étiquetée de manière spécifique. Dans ce cas de figure, l’ogive conserve une lisibilité optimale sur son corps principal, mais le cartouche annotatif doit impérativement stipuler le pourcentage exact d’individus exclus de la fenêtre d’observation géométrique afin de préserver l’intégrité déontologique de la publication statistique.
12.3 Modularité et création d’une fonction réutilisable en production
Dans un contexte d’ingénierie logicielle pérenne ou d’intégration au sein d’une chaîne de traitement continu (CI/CD pipeline), la génération d’un tracé graphique ne doit jamais reposer sur des scripts ad hoc monolithiques et désorganisés. Il est impératif d’encapsuler la logique computationnelle et graphique de l’ogive au sein d’une fonction modulaire, rigoureusement typée à l’aide des annotations de type statique de Python (type hinting via le module typing), et minutieusement documentée selon les standards reconnus de la communauté scientifique (tels que le format de docstrings NumPy ou Google).
Cette fonction hautement factorisée doit accepter en entrée obligatoire le vecteur brut des données unidimensionnelles (sous forme de tableau NumPy ou de structure compatible), ainsi qu’un ensemble de paramètres optionnels flexibles dotés de valeurs par défaut raisonnables : la stratégie de découpage d’intervalles (par défaut configurée sur 'auto'), la typologie d’ogive désirée (ascendante, descendante ou double croisée simultanée), les arguments de normalisation unitaire ou centésimale, ainsi qu’une référence optionnelle vers une instance d’axe Matplotlib préexistante. Cette dernière disposition autorise l’intégration fluide de la fonction au sein de grilles de sous-graphiques complexes (subplots) sans forcer la création d’une nouvelle fenêtre d’affichage isolée.
Enfin, la fonction doit intégrer les directives d’exportation vers des formats vectoriels haute définition. Alors que les formats matriciels comme le PNG sont assujettis aux artéfacts de pixellisation lors des agrandissements d’impression, l’exportation au format SVG (Scalable Vector Graphics) ou PDF vectoriel encapsulé préserve la perfection géométrique absolue des tracés de lignes, des marqueurs et des polices de caractères, quelle que soit l’échelle d’agrandissement typographique finale imposée par l’éditeur scientifique ou le support de présentation institutionnelle.
Références
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L₂ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
- Galton, F. (1875). Statistics by intercomparison, with remarks on the law of frequency of error. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 49(322), 33-46. https://doi.org/10.1080/14786447508641179
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. Dans Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). Austin, TX. https://doi.org/10.25080/Majora-92bf1927-005
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605-610. https://doi.org/10.1093/biomet/66.3.605
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65-66. https://doi.org/10.1080/01621459.1926.10502161
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021