
Dans le domaine de l’analyse quantitative des données, de l’évaluation psychométrique et des sciences comportementales, la représentation visuelle des distributions de fréquences constitue un levier analytique fondamental. Alors que les histogrammes traditionnels et les diagrammes en boîte fournissent un aperçu immédiat de la tendance centrale et de la dispersion, ils peinent souvent à révéler avec précision la progression cumulative des scores au sein d’une population de référence. C’est précisément dans ce contexte épistémologique et méthodologique que s’impose le polygone des fréquences cumulées, historiquement et communément désigné sous le terme d’ogive. Cet outil graphique séculaire, dont les fondements remontent aux travaux pionniers de Sir Francis Galton sur l’hérédité et la biométrie, offre une perspective continue et intégrée sur la manière dont les observations s’accumulent le long du continuum de mesure.
L’essor contemporain de l’écosystème Python dans le champ de la recherche scientifique et de la science des données confère une pertinence nouvelle à cette technique classique. Grâce à des bibliothèques matricielles et graphiques hautement optimisées telles que NumPy et Matplotlib, la génération d’ogives ne relève plus du tracé manuel laborieux sur papier millimétré, mais d’une modélisation algorithmique rigoureuse, reproductible et personnalisable. Pour le psychologue clinicien, le chercheur en neurosciences cognitives ou l’analyste de données, maîtriser la construction programmatique d’une ogive en Python permet d’opérationnaliser instantanément des concepts statistiques cruciaux tels que les rangs centiles, les seuils diagnostiques, la dominance stochastique ou encore l’étalonnage normatif d’instruments psychométriques complexes.
Ce guide exhaustif propose une immersion théorique, mathématique et pratique dans la création, l’optimisation et l’interprétation des graphiques en ogive sous Python. Conçu selon les standards d’exigence de la recherche académique, il détaille pas à pas la chaîne de traitement complète : depuis la formalisation des fréquences cumulées et la discrétisation par partitionnement d’intervalles jusqu’au rendu graphique avancé conforme aux normes de publication internationales. À travers des cas d’études concrets appliqués aux sciences cognitives et à la psychologie différentielle, cet ouvrage de référence démontre comment concilier la rigueur conceptuelle de la statistique inférentielle avec la puissance expressive de la programmation scientifique moderne.
1. Introduction théorique à la courbe ogive en psychométrie et statistiques
1.1 Définition formelle du polygone des fréquences cumulées
Le polygone des fréquences cumulées, universellement désigné sous le vocable d’ogive en référence à la forme architecturale ogivale des voûtes gothiques esquissant une double courbure en S, représente la traduction géométrique de la distribution cumulative d’une variable statistique quantitative. Sur le plan mathématique, l’ogive associe à chaque limite supérieure de classe la somme cumulée des effectifs ou des fréquences relatives observées depuis la borne inférieure de la distribution jusqu’à cette limite. Contrairement aux représentations différentielles qui s’attachent à mesurer la densité locale des observations, l’ogive incarne une approche intégrale où chaque coordonnée d’ordonnée reflète l’état global du système statistique pour une valeur d’abscisse donnée.
La différenciation structurelle entre un histogramme de fréquences simples et une courbe ogive réside dans la nature même de l’information transmise. Tandis que l’histogramme segmente l’espace des données en barres disjointes dont l’aire est proportionnelle à la fréquence locale de chaque intervalle, l’ogive synthétise cette information sous la forme d’une ligne polygonale continue et strictement non décroissante dans sa configuration standard. L’histogramme met en lumière la modalité, la symétrie locale et l’aplatissement de la distribution, mais il impose une charge cognitive importante lorsqu’il s’agit d’estimer mentalement la proportion d’individus situés sous un score déterminé. L’ogive compense cette limite en offrant une lecture directe et intuitive de l’accumulation statistique, transformant l’analyse de fréquence en une évaluation de position relative.
Sur le plan géométrique, l’ogive se caractérise par des propriétés fondamentales qui régissent sa morphologie. La première propriété est la monotonie croissante, signifiant formellement que pour toute paire de valeurs telle que la première est inférieure ou égale à la seconde, la fréquence cumulée associée à la première borne est nécessairement inférieure ou égale à celle de la seconde. La seconde propriété concerne la présence d’asymptotes empiriques horizontales. Dans le cas d’une ogive exprimée en pourcentages cumulés, la courbe prend naissance à l’ordonnée zéro au niveau de la borne inférieure de la première classe et culmine invariablement à l’ordonnée cent pour cent au niveau de la limite supérieure de la dernière classe, décrivant ainsi une trajectoire sigmoïde caractéristique lorsque la distribution sous-jacente approche la normalité.
1.2 Importance de l’ogive dans l’évaluation psychologique et comportementale
Dans le domaine de l’évaluation psychologique et de la psychométrie différentielle, l’étalonnage des tests standardisés constitue une étape méthodologique indispensable pour conférer une signification clinique ou diagnostique aux scores bruts obtenus par les sujets. Un score brut isolé, qu’il s’agisse du nombre de réponses correctes à un test de raisonnement fluide ou de la somme des points sur une échelle d’évaluation de la symptomatologie dépressive, ne possède aucune signification intrinsèque. L’ogive intervient alors comme l’instrument privilégié de l’étalonnage normatif, permettant de convertir les scores bruts en rangs centiles au moyen d’une fonction de transfert continue reliant les performances individuelles à la distribution d’un échantillon représentatif de standardisation.
Le positionnement relatif d’un individu au sein d’une population de référence s’effectue avec une remarquable aisance visuelle sur un graphique en ogive. En projetant le score brut obtenu par un patient sur l’axe des abscisses, puis en traçant mentalement ou graphiquement une perpendiculaire jusqu’à l’intersection avec l’ogive, le praticien identifie instantanément sur l’axe des ordonnées le pourcentage précis de la population normative ayant obtenu un score inférieur ou égal à ce niveau. Cette métrique, universellement comprise au-delà des cercles d’experts en statistiques, prévient les erreurs d’interprétation inhérentes aux scores d’écart réduit lorsque les distributions empiriques s’écartent substantiellement du modèle gaussien théorique.
Au-delà de la simple conversion en centiles, l’ogive joue un rôle déterminant dans l’évaluation des seuils diagnostiques et la fixation des points de coupure clinique. Dans le cadre de la validation d’échelles de dépistage psychopathologique, les cliniciens doivent fréquemment établir des valeurs limites permettant de maximiser conjointement la sensibilité et la spécificité de l’outil. L’ogive permet d’appréhender d’un seul regard l’impact d’une modification du point de coupure sur la proportion de la population catégorisée comme étant à risque, facilitant ainsi la prise de décision éthique et médicale lors de l’implémentation de politiques de santé publique ou d’interventions thérapeutiques ciblées.
1.3 Typologie des ogives : formes ascendantes et descendantes
L’analyse distributionnelle distingue deux architectures fondamentales de polygones cumulatifs : l’ogive ascendante, dite courbe du type « moins de », et l’ogive descendante, désignée sous l’appellation de courbe du type « plus de ». L’ogive ascendante constitue la déclinaison canonique la plus répandue dans la littérature académique. Sa structure repose sur le cumul progressif des effectifs ou des fréquences relatifs à l’ensemble des valeurs inférieures ou égales à une borne supérieure spécifiée. Elle répond rigoureusement à la question clinique ou expérimentale : quelle est la proportion de sujets dont la performance ne dépasse pas un niveau de référence donné ?
À l’inverse, l’ogive descendante adopte une logique de décompte inversée, associant à chaque borne inférieure de classe le volume d’observations dont la valeur est strictement supérieure ou égale à cette limite. Sa trajectoire géométrique débute donc à la valeur maximale de cent pour cent pour décroître de manière monotone jusqu’à atteindre l’ordonnée zéro au terme du domaine de définition. Bien que moins fréquemment employée dans les bilans psychométriques d’aptitude générale, l’ogive descendante s’avère particulièrement pertinente pour modéliser des phénomènes d’attrition, de survie cognitive ou de persistance comportementale, où l’accent méthodologique porte sur la capacité des sujets à maintenir une performance au-delà de contraintes temporelles ou d’interférences distractives croissantes.
L’utilité comparative de ces deux approches atteint son paroxysme lors de l’investigation des temps de latence cognitive au sein de protocoles expérimentaux chronométriques. Dans les tâches de temps de réaction simple ou de choix multiple, l’analyse conjointe de l’ogive ascendante et de l’ogive descendante permet de dissocier les processus d’initiation motrice rapide des mécanismes de ralentissement pathologique liés à des défaillances attentionnelles transitoires. L’intersection précise entre la courbe ascendante et la courbe descendante matérialise géométriquement la médiane empirique de la distribution, offrant une vérification visuelle immédiate de la tendance centrale robuste sans subir l’influence perturbatrice des valeurs extrêmes qui polluent fréquemment les distributions de temps de réponse.
2. Fondements mathématiques et statistiques de la distribution cumulée
2.1 Calcul analytique des effectifs et fréquences cumulés
La dérivation formelle d’une distribution cumulée repose initialement sur une opération de discrétisation de l’espace continu ou quasi-continu des observations. Soit un échantillon de taille N composé de réalisations indépendantes d’une variable aléatoire quantitative X. La première étape consiste à définir une partition de l’espace des données en K classes contiguës, mutuellement exclusives et collectivement exhaustives. Chaque classe k, pour k variant de 1 à K, est délimitée par une borne inférieure notée L_k et une borne supérieure notée U_k, avec la contrainte structurelle de continuité stipulant que la borne supérieure d’un intervalle coïncide rigoureusement avec la borne inférieure de l’intervalle immédiatement consécutif.
À chaque intervalle ainsi circonscrit est associé son effectif simple n_k, représentant le dénombrement cardinal des observations tombant dans les limites de la classe considérée. La formulation de la sommation séquentielle permettant d’établir l’effectif absolu cumulé N_k au terme de la k-ième classe s’écrit comme la somme de tous les effectifs n_j pour j variant de 1 à k. Cette relation récursive implique que l’effectif cumulé d’une classe s’obtient en ajoutant l’effectif propre de cette classe à l’effectif cumulé de la classe précédente. Au terme du processus, lorsque k est égal à K, l’effectif cumulé total N_K est rigoureusement identique à la taille totale N de l’échantillon analysé.
Pour s’affranchir de la dépendance à la taille brute de la cohorte et autoriser des comparaisons inter-échantillons valides, la conversion des fréquences absolues cumulées en fréquences relatives cumulées F_k ou en pourcentages cumulés P_k s’avère indispensable. La fréquence relative s’obtient en divisant l’effectif cumulé N_k par la taille totale N, générant un ratio borné sur l’intervalle fermé [0, 1]. Le pourcentage cumulé s’en déduit par une multiplication scalaire par cent. Cette normalisation confère aux ordonnées de l’ogive une interprétation probabiliste directe, assimilant chaque point de la courbe à une estimation ponctuelle de la fonction de répartition empirique de la population parente.
2.2 Lien entre ogive empirique et fonction de répartition continue
L’ogive empirique entretient une filiation mathématique intime avec le concept théorique de fonction de répartition continue, classiquement notée F(x), qui exprime pour toute variable continue la probabilité formelle que la variable aléatoire sous-jacente prenne une valeur inférieure ou égale à un réel x donné. En vertu du théorème de Glivenko-Cantelli, souvent qualifié de théorème fondamental de la statistique mathématique, la fonction de répartition empirique converge uniformément et presque sûrement vers la fonction de répartition théorique de la loi parente lorsque la taille de l’échantillon tend vers l’infini, que celle-ci suive une loi normale, log-normale ou une loi gamma.
Il importe toutefois d’opérer une distinction conceptuelle rigoureuse entre la fonction de distribution empirique discrète (désignée dans la littérature anglophone par l’acronyme ECDF) et l’ogive discrétisée par classes. L’ECDF se présente comme une fonction en escalier, non paramétrique, discontinue à droite, présentant un saut vertical d’amplitude 1/N à l’emplacement exact de chaque observation individuelle de l’échantillon. En revanche, l’ogive opère une agrégation préliminaire des données au sein d’intervalles prédéfinis et remplace les discontinuités en escalier par des segments linéaires joignant les points nodaux situés aux bornes supérieures de chaque classe.
Cette interpolation linéaire entre les limites de classes exerce un impact déterminant sur l’approximation continue de la distribution sous-jacente. En reliant le point de coordonnées (U_{k-1}, F_{k-1}) au point (U_k, F_k) par une droite affine, l’ogive pose implicitement l’hypothèse d’une distribution uniforme des observations à l’intérieur de chaque intervalle spécifique. Ce lissage géométrique régularise la trajectoire empirique en éliminant les micro-fluctuations d’échantillonnage, fournissant ainsi une approximation visuelle et numérique particulièrement fidèle de l’intégrale de la fonction de densité de probabilité, tout en réduisant substantiellement la charge computationnelle lors du traitement de volumétries massives de données.
2.3 Extraction directe des quantiles, déciles et percentiles
L’une des propriétés opérationnelles les plus puissantes du graphique en ogive réside dans sa réversibilité fonctionnelle, autorisant l’extraction graphique et analytique directe des paramètres de position non paramétriques sans nécessiter le recalcul des rangs sur la série brute. La recherche de la médiane, correspondant par définition au 50e percentile ou au deuxième quartile, s’effectue en projetant horizontalement la valeur d’ordonnée 50 % jusqu’à sa rencontre avec le segment de l’ogive, puis en abaissant une ligne orthogonale vers l’axe des abscisses pour lire le score équivalent. Cette technique d’interpolation linéaire intra-classe permet d’estimer avec une remarquable précision la tendance centrale d’une distribution même lorsque celle-ci présente une asymétrie marquée.
Le même algorithme géométrique s’applique à la détermination des intervalles interquartiles, définis par la différence entre le troisième quartile (75e percentile) et le premier quartile (25e percentile). En psychométrie clinique, l’intervalle interquartile constitue un indicateur robuste de la dispersion des scores, totalement insensible aux fluctuations sporadiques des valeurs aberrantes ou aux déformations induites par des réponses atypiques. L’ogive matérialise l’intervalle interquartile sous la forme de la distance horizontale séparant les projections sur l’abscisse des seuils d’ordonnée 25 % et 75 %, offrant une évaluation spatiale immédiate de l’homogénéité du groupe évalué.
Dans le domaine de la psychologie différentielle et de la neuropsychologie, l’exploitation analytique de l’ogive facilite le calibrage conjoint des scores standardisés Z et des rangs centiles. En exploitant la relation fonctionnelle biunivoque établie par la courbe cumulée, il devient possible de dresser des abaques d’étalonnage automatisées associant à chaque niveau de performance son centile exact, puis de projeter ces rangs sur une échelle gaussienne standardisée d’espérance nulle et de variance unitaire. Cette démarche standardise l’interprétation des profils cognitifs complexes en permettant la comparaison directe de performances issues d’épreuves hétérogènes mesurées sur des échelles métriques disparates.
3. Environnement de travail et configuration logicielle en Python
3.1 Sélection et justification de la pile technologique
La construction computationnelle d’une ogive statistique au sein de l’écosystème Python exige une architecture logicielle alliant performance de calcul vectoriel, robustesse algorithmique et précision de rendu vectoriel. Au cœur de cette pile technologique se trouve la bibliothèque NumPy, qui s’impose comme le moteur matriciel fondamental. Grâce à ses structures de tableaux multidimensionnels contigus en mémoire et à ses routines compilées en C, NumPy permet de réaliser les opérations de partitionnement numérique (binning) et de sommation cumulative avec une efficacité temporelle d’ordre algorithmique optimal, évitant les surcoûts d’interprétation inhérents aux boucles itératives standard de Python.
Pour la composante visuelle et graphique, la bibliothèque Matplotlib, et plus spécifiquement son sous-module pyplot, constitue la norme académique prédominante. Matplotlib fournit une interface cartésienne de bas niveau conférant un contrôle granulaire absolu sur l’intégralité des éléments typographiques, géométriques et structurels du graphique. Contrairement à des bibliothèques de plus haut niveau qui automatisent entièrement le rendu au détriment de la flexibilité paramétrique, Matplotlib permet de piloter précisément les coordonnées nodales de l’ogive, d’ajuster l’ancrage au zéro absolu et de synchroniser de multiples échelles d’axes coordonnées.
En complément de ce socle fondamental, les bibliothèques SciPy et Pandas s’avèrent particulièrement précieuses dans les étapes préliminaires de manipulation et de validation des séries psychométriques. Pandas apporte des structures de données labellisées (DataFrame) facilitant l’ingestion, le nettoyage et le filtrage des cohortes cliniques complexes comportant des métadonnées sociodémographiques. Parallèlement, le module de statistiques de SciPy offre une batterie complète de tests distributionnels et de fonctions de répartition théoriques continues permettant de confronter l’ogive empirique générée avec des modèles prédictifs asymptotiques.
3.2 Installation et initialisation des bibliothèques scientifiques
L’établissement d’un environnement de calcul rigoureux et reproductible débute par l’installation contrôlée des dépendances logicielles au sein d’un environnement virtuel isolé, garantissant l’absence de conflits de versions entre les bibliothèques. Les gestionnaires de paquets conventionnels, qu’il s’agisse de pip ou de l’écosystème Conda préconisé pour le calcul scientifique lourd, permettent de déployer les versions stables de l’interpréteur Python et des bibliothèques associées. L’intégration harmonieuse des modules requiert la spécification formelle de leurs identifiants de version afin de pérenniser la reproductibilité des scripts d’analyse sur le long terme.
L’initialisation programmatique dans les scripts d’analyse s’effectue via les conventions d’importation idiomatiques universellement reconnues par la communauté scientifique. Ainsi, NumPy est systématiquement importé sous l’alias compact np, et Matplotlib.pyplot est chargé sous le préfixe plt. Cette standardisation syntaxique favorise la lisibilité du code source et simplifie les processus de relecture par les pairs lors de la soumission de protocoles de recherche à des revues académiques. L’inclusion éventuelle de Pandas sous l’alias pd et de SciPy.stats complète l’initialisation du pipeline computationnel.
Un impératif méthodologique souvent négligé mais absolument crucial concerne la gestion des générateurs de nombres pseudo-aléatoires. Lorsqu’un protocole implique la simulation de cohortes statistiques ou le rééchantillonnage par bootstrap, la fixation explicite d’une graine aléatoire (seed) via le sous-module random de NumPy s’avère indispensable. Cette instruction préliminaire garantit que la séquence stochastique générée demeure rigoureusement déterministe et identique sur toute machine exécutant le script, assurant ainsi la reproductibilité intégrale des graphiques, des valeurs numériques calculées et des seuils quantiles dérivés.
3.3 Normes de configuration graphique pour publications académiques
La préparation d’illustrations destinées à l’édition scientifique et aux revues à comité de lecture obéit à des directives typographiques et visuelles extrêmement strictes. Matplotlib dispose d’un système global de gestion des paramètres graphiques dénommé rcParams, qui permet de redéfinir en amont de toute instruction de tracé la résolution d’exportation, les familles de polices de caractères, les épaisseurs de traits et les marges d’encadrement. L’ajustement de la résolution spatiale à une valeur minimale de 300 points par pouce (DPI) pour les sorties matricielles, ou l’exportation directe sous des formats vectoriels pérennes tels que le SVG ou le PDF, garantit une netteté absolue des tracés quelle que soit l’échelle finale de reproduction sur papier ou support numérique.
Le choix typographique doit privilégier la lisibilité et l’harmonie avec le corps de texte des articles de recherche. Les directives de publication de référence, à l’instar des normes édictées par l’American Psychological Association (APA), préconisent le recours à des polices sans empattement universelles telles que Arial ou Helvetica, ou à des polices sérifées académiques comme Times New Roman pour les environnements de composition formelle. La configuration de Matplotlib permet de contraindre le moteur de rendu textuel à utiliser ces familles de polices spécifiques, tout en calibrant uniformément la taille des caractères des titres, des légendes et des graduations d’axes afin de préserver une hiérarchie visuelle parfaitement proportionnée.
Enfin, la gestion des palettes chromatiques engage la responsabilité éthique et scientifique des auteurs quant à l’accessibilité universelle des données. L’utilisation de contrastes de couleurs inadaptés ou de dégradés arc-en-ciel traditionnels peut gravement compromettre la compréhension des graphiques pour les lecteurs présentant des déficiences de la vision des couleurs (daltonisme). Le recours à des palettes de couleurs perceptuellement uniformes et testées pour l’accessibilité, telles que Viridis, Cividis ou des camaïeux de gris rigoureusement contrastés, assure une transmission optimale de l’information statistique sans perte de signal visuel, même en cas de reprographie monochrome.
4. Génération et structuration des jeux de données d’évaluation
4.1 Simulation de distributions psychométriques contrôlées
Dans une perspective de démonstration didactique et de validation méthodologique des algorithmes, la génération contrôlée de données synthétiques présente l’avantage inestimable de connaître a priori les véritables paramètres de la population parente. L’ingénierie statistique en Python permet de simuler avec une fidélité mathématique totale deux grands types de distributions psychométriques : les épreuves discrètes constituées d’items dichotomiques ou polytomiques, et les variables dimensionnelles continues reflétant des construits psychologiques latents.
Pour modéliser des scores discrets résultant de l’addition d’items individuels, l’emploi de fonctions génératrices de variables aléatoires entières, telles que celles fournies par le module d’échantillonnage discret de NumPy, permet de simuler l’agrégation de réponses soumises à des échelles de Likert. À un niveau plus sophistiqué, la modélisation de traits psychologiques continus, tels que l’intelligence fluide, l’extraversion ou la vitesse de traitement perceptif, s’opère préférentiellement via l’échantillonnage de variables aléatoires continues suivant une loi normale d’espérance et d’écart-type prédéterminés. L’instruction permet de spécifier la moyenne théorique du test ainsi que son échelle de dispersion empirique sur un échantillon virtuel de plusieurs milliers de sujets.
Dès l’achèvement de la phase de génération stochastique, un contrôle systématique de la conformité dimensionnelle et de la nature des types de données doit être entrepris. Il convient de vérifier formellement que les tableaux NumPy ainsi structurés constituent des vecteurs unidimensionnels continus, débarrassés de dimensions résiduelles susceptibles d’induire des comportements de diffusion vectorielle (broadcasting) erronés lors des étapes ultérieures de discrétisation et de sommation cumulative.
4.2 Modélisation de scores psychologiques réels ou simulés
Les données psychométriques collectées sur le terrain expérimental ou clinique s’écartent fréquemment de la symétrie idéale de la courbe de Gauss. Pour illustrer la robustesse de l’ogive face à ces spécificités empiriques, il est crucial de modéliser des scénarios d’évaluation psychologique représentatifs des réalités cliniques. Considérons, à titre d’exemple paradigmatique, la simulation d’un inventaire d’anxiété ou de dépression dont les scores bruts sont contraints sur un intervalle fermé de 0 à 100 points. Dans une population générale saine, une telle échelle présentera structurellement une asymétrie positive marquée, la grande majorité des participants se concentrant sur des valeurs basses tandis qu’une minorité clinique étire la queue supérieure de la distribution.
Un autre cas d’usage hautement représentatif concerne la modélisation des temps de réaction dans des paradigmes d’attention visuelle ou d’inhibition cognitive. Ces latences, exprimées en millisecondes, ne peuvent jamais être négatives et sont bornées inférieurement par le délai incompressible de conduction neuromusculaire, généralement situé autour de 150 à 200 millisecondes. Les distributions de temps de réaction adoptent typiquement une allure asymétrique modélisable par une loi log-normale ou une loi ex-gaussienne, caractérisée par une forte concentration initiale suivie d’une longue queue d’étirement vers les latences élevées correspondant aux lapsus attentionnels.
La prise en compte programmatique des artefacts de mesure inclut également le traitement simulé des effets de plancher et de plafond. Un effet de plancher se manifeste lorsqu’un test s’avère trop difficile pour une cohorte, provoquant une accumulation artificielle d’observations au score minimal possible, tandis qu’un effet de plafond caractérise un outil trop aisé où une part excessive de l’échantillon sature la borne maximale. L’ogive constitue précisément l’outil visuel le plus pertinent pour diagnostiquer ces artefacts, se traduisant par un décollage vertical brutal dès l’origine dans le premier cas, ou par un plateau prolongé précoce sous la borne asymptotique supérieure dans le second.
4.3 Contrôle d’intégrité et exploration initiale des données
Avant d’engager le moteur de calcul dans la phase d’agrégation cumulative, un protocole strict de vérification d’intégrité des vecteurs de données doit être déployé. Cette inspection exploratoire préliminaire débute par la visualisation des premiers éléments de la structure matricielle via des opérations d’indexation ciblées. Ce contrôle visuel direct permet de confirmer la cohérence de l’ordre de grandeur des valeurs numériques simulées ou importées et d’identifier immédiatement d’éventuelles anomalies de parsing liées au formatage des décimales ou des séparateurs de colonnes.
L’étape suivante consiste à calculer les descripteurs statistiques primaires résumant la série de mesures. Le calcul systématique de la moyenne arithmétique, de l’écart-type d’échantillon, du minimum, du maximum et de l’étendue globale permet de valider le calibrage de l’échantillon au regard des limites théoriques du protocole psychométrique considéré. Cette formalisation descriptive préliminaire fixe les repères quantitatifs indispensables à la validation croisée des estimations qui seront ultérieurement lues de manière graphique sur la courbe ogive finalisée.
Enfin, l’éradication des valeurs manquantes ou indéterminées, conventionnellement codées sous la forme de constantes non numériques (NaN pour Not a Number), s’impose comme un impératif algorithmique absolu. La présence d’une seule valeur manquante au sein d’un vecteur brut est susceptible de corrompre l’ensemble des opérations cumulatives consécutives, propageant des valeurs indéfinies sur l’ensemble de la série cumulée. L’application de filtres booléens vectorisés de nettoyage permet d’isoler et de supprimer rigoureusement ces enregistrements défaillants ou de procéder à des imputations contrôlées préalablement à toute phase de binning.
5. Discrétisation des données et partitionnement avec NumPy
5.1 Fonctionnement détaillé de l’algorithme numpy.histogram
Le socle algorithmique de la construction de l’ogive en Python réside dans la discrétisation partitionnelle des données, opérée de manière native par la fonction de calcul de distribution de fréquences intégrée à NumPy. Cette routine analytique assure la conversion d’un vecteur continu non structuré en une table de fréquences groupées selon une grille d’intervalles contigus. La fonction requiert au minimum deux arguments d’entrée fondamentaux : la série unidimensionnelle des observations brutes et la spécification de la structure de partitionnement, qui peut être définie soit par un nombre entier désignant la quantité totale de classes souhaitée, soit par une séquence explicite ordonnant les limites d’intervalles.
Le résultat délivré par l’exécution de cet algorithme se compose d’un tuple contenant deux tableaux distincts d’une importance capitale. Le premier élément est un vecteur unidimensionnel d’entiers contenant le décompte absolu des effectifs pour chaque classe successive. Le second élément est un vecteur numérique dont la dimension excède systématiquement celle du premier tableau d’une unité, recensant les coordonnées complètes des bornes d’intervalles depuis la limite inférieure de la première classe jusqu’à la limite supérieure de l’ultime intervalle.
La compréhension de la nature topologique des intervalles générés par NumPy est essentielle pour prévenir les erreurs de classification aux frontières de classe. Par défaut, la fonction opère sur des intervalles semi-ouverts à droite, de la forme semi-fermée à gauche [L_k, U_k[, ce qui signifie qu’une observation coïncidant exactement avec la borne inférieure d’un intervalle est incorporée dans celui-ci, tandis qu’une valeur égale à la borne supérieure est basculée dans la classe suivante. Une exception mathématique est toutefois introduite pour la toute dernière classe de la série, qui est délibérément fermée à droite [L_K, U_K] afin de garantir l’inclusion intégrale de la valeur maximale absolue observée dans l’échantillon.
5.2 Détermination des limites supérieures de classe
Dans la théorie géométrique de l’ogive ascendante, l’accumulation statistique ne s’effectue pas au centre de classe (contrairement au polygone de fréquences simples), mais s’ancre obligatoirement sur les bornes supérieures des intervalles. En effet, par définition même d’une fréquence cumulée « inférieure ou égale à », la totalité des observations d’un intervalle n’a été entièrement dépassée qu’une fois atteint le point terminal droit de cet intervalle. L’analyste doit donc extraire avec une rigueur absolue le sous-vecteur des limites supérieures en appliquant un découpage matriciel approprié sur le tableau des bornes issues de l’algorithme de partitionnement.
Cette extraction s’opère en éliminant la première coordonnée du tableau des limites, qui correspond à la borne inférieure de la toute première classe. Le vecteur résultant, débutant à la fin de la première classe et s’achevant à la borne finale de l’échantillon, présente alors une longueur rigoureusement identique au vecteur des effectifs simples calculés par classe. Cette stricte parité dimensionnelle constitue la condition sine qua non de la synchronisation vectorielle entre les abscisses métriques et les ordonnées cumulées.
Cependant, une modélisation mathématiquement parfaite de l’ogive impose de traiter avec une attention égale le point de départ absolu de la trajectoire. À la limite inférieure de la première classe, par définition statistique, aucun individu de l’échantillon n’a encore été recensé ; l’effectif cumulé y est donc rigoureusement nul. L’omission de ce point d’ancrage fondamental à effectif zéro produit une ogive visuellement « flottante », débutant arbitrairement à une altitude positive dès la première borne supérieure, ce qui tronque la dynamique initiale d’accumulation et fausse l’interpolation géométrique des déciles les plus bas de la distribution.
5.3 Stratégies de découpage : classes d’égales amplitudes vs quantiles
Le choix de la stratégie de discrétisation conditionne profondément la structure de l’ogive et sa sensibilité analytique. La méthode la plus courante, adoptée par défaut dans la quasi-totalité des logiciels, repose sur un partitionnement en classes d’égales amplitudes géométriques. L’étendue totale des données est alors divisée en sous-intervalles de largeur uniforme constante. Cette approche offre l’avantage indéniable de la simplicité conceptuelle et préserve l’intuitivité de l’axe des abscisses, mais elle présente une vulnérabilité majeure : dans les queues de distributions fortement asymétriques ou leptokurtiques, de nombreux intervalles peuvent se révéler totalement vides, induisant des paliers horizontaux artificiels sur le tracé de l’ogive.
Une stratégie alternative particulièrement puissante en psychométrie avancée consiste à opérer un découpage basé sur les quantiles de la distribution, conduisant à des classes d’amplitudes variables mais d’effectifs rigoureusement équivalents. Dans cette configuration, chaque intervalle renferme une fraction constante de la population totale (par exemple 5 % ou 10 % des sujets). Les intervalles sont extrêmement resserrés dans les zones de forte densité modale et s’élargissent considérablement dans les queues de distribution clairsemées.
Le choix entre ces deux paradigmes de discrétisation dépend intrinsèquement des objectifs de l’investigation. Si la finalité première est de fournir une table d’étalonnage psychométrique continue pour un instrument clinique standardisé, le découpage en classes d’égales amplitudes métriques s’impose afin de respecter l’échelle de mesure originale du test. En revanche, si la recherche cible la détection fine d’anomalies de distribution au sein de sous-populations spécifiques ou la comparaison de modèles théoriques complexes, l’analyse de sensibilité via un partitionnement quantile apporte un éclairage structurel complémentaire d’une grande valeur heuristique.
6. Calcul de la série cumulée avec la fonction cumsum
6.1 Mécanisme de la somme cumulative vectorisée
Une fois les effectifs simples discrétisés par classe, l’opération mathématique centrale présidant à la genèse de l’ogive réside dans l’intégration discrète de cette série de fréquences. En programmation Python scientifique, cette sommation cumulative est exécutée de manière hautement optimisée par la fonction de calcul de somme cumulée intégrée au cœur de NumPy. L’application de cet opérateur vectorisé sur le vecteur des effectifs simples génère instantanément une nouvelle séquence de même longueur dans laquelle chaque élément d’indice k est égal à la somme algébrique de l’ensemble des composantes vectorielles de rang inférieur ou égal à k.
Sur le plan de l’architecture logicielle et de l’ingénierie algorithmique, le recours à la fonction de somme cumulée vectorisée surpasse radicalement l’utilisation de boucles itératives séquentielles conventionnelles. Traitée directement au niveau de la mémoire contiguë compilée, l’opération s’exécute avec une complexité temporelle linéaire strictement proportionnelle au nombre de classes de la partition, tout en présentant une empreinte mémoire négligeable. Cette vélocité algorithmique autorise l’intégration fluide du tracé d’ogives au sein de procédures de rééchantillonnage intensives ou de boucles de simulation de Monte-Carlo impliquant plusieurs dizaines de milliers d’itérations récursives.
La validation formelle du calcul cumulé implique un test d’intégrité numérique élémentaire mais décisif : le dernier élément du vecteur cumulé ainsi généré doit impérativement coïncider avec l’effectif global de l’échantillon initial. Toute divergence arithmétique, même infinitésimale, signalerait une corruption du vecteur source, l’omission d’observations situées sur les bornes extérieures de la partition ou une mauvaise prise en compte des valeurs manquantes lors de la phase de préparation des données.
6.2 Normalisation pour obtenir l’ogive des pourcentages cumulés
Bien que l’ogive des effectifs absolus cumulés offre une vue fidèle du dénombrement brut d’une cohorte spécifique, la pratique psychométrique et statistique exige très largement une standardisation relative de la courbe sous la forme de pourcentages cumulés. L’intérêt méthodologique de cette transformation est immédiat : elle affranchit la lecture du graphique du volume total de l’échantillon de test, permettant ainsi de comparer directement des protocoles expérimentaux menés sur des cohortes de tailles hétérogènes ou de projeter des profils individuels sur des tables normatives unifiées.
La normalisation s’opère sur le plan arithmétique par une division vectorielle élémentaire. Le vecteur des effectifs cumulés est divisé par la constante scalaire représentant la taille totale de l’échantillon N, puis multiplié par la valeur cent pour convertir les fréquences relatives en pourcentages stricts. Grâce aux mécanismes de diffusion automatique des scalaires au sein de NumPy, cette instruction s’exécute de manière totalement atomique et instantanée, garantissant une précision numérique maximale sur l’ensemble des décimales à virgule flottante.
Dans certains cadres de modélisation probabiliste avancée ou de confrontation avec des fonctions de distribution cumulative théoriques, il est préférable de maintenir la série normalisée sur l’intervalle unitaire standard [0, 1] sans appliquer le multiplicateur cent. Cette formulation en fréquences relatives normalisées assimile rigoureusement l’axe des ordonnées à une échelle d’évaluation de la probabilité d’occurrence, facilitant le calcul direct des métriques de divergence distributionnelle et l’interfaçage avec les algorithmes d’estimation du maximum de vraisemblance.
6.3 Synchronisation dimensionnelle des coordonnées d’abscisse et d’ordonnée
L’écueil méthodologique et programmatique le plus fréquent lors de l’implémentation manuelle d’une ogive sous Matplotlib réside dans le décalage dimensionnel inhérent aux sorties de discrétisation. Si l’on dénombre K classes, l’algorithme de partitionnement fournit un vecteur de limites d’intervalles comprenant exactement K + 1 valeurs, tandis que le vecteur des effectifs ou des pourcentages cumulés ne comporte intrinsèquement que K éléments. La tentative de tracer directement ces deux structures brutes aboutit inévitablement à une erreur d’exécution bloquante relative à l’incompatibilité dimensionnelle des axes cartésiens.
Pour résoudre cette asymétrie avec une rigueur statistique sans faille, il est impératif d’intégrer formellement le point d’origine à coordonnées (borne inférieure de la première classe, zéro). Sur le plan programmatique, cette synchronisation s’effectue par une opération de concaténation vectorielle : on insère la valeur scalaire zéro en tête du vecteur des ordonnées cumulées, obtenant ainsi un nouveau vecteur d’ordonnées de longueur K + 1, désormais en parfaite adéquation dimensionnelle avec le vecteur exhaustif des bornes d’intervalles.
Cette harmonisation structurelle garantit que chaque coordonnée d’abscisse se voit apparier son ordonnée théorique exacte. Le premier point du tracé s’ancre avec exactitude sur la borne inférieure initiale avec une ordonnée de zéro pour cent, chaque point nodal intermédiaire marque la limite supérieure de sa classe avec le cumul correspondant, et l’ultime point s’achève sur la borne supérieure maximale avec une ordonnée rigoureusement égale à cent pour cent. Cette architecture cartésienne fermée est la seule qui satisfasse aux exigences de validité formelle du polygone des fréquences cumulées.
7. Construction pas à pas du graphique en ogive avec Matplotlib
7.1 Initialisation du système de coordonnées cartésiennes
L’implémentation graphique de l’ogive débute par la configuration formelle de l’espace de rendu au moyen de l’architecture orientée objet de Matplotlib. Contrairement à l’approche procédurale reposant sur des appels séquentiels globaux, l’instanciation explicite d’une figure parente et d’un conteneur d’axes via l’environnement dédié confère un contrôle matriciel complet sur la topologie du tracé. Cette méthodologie garantit une modularité optimale et simplifie l’intégration subséquente de sous-graphiques, d’annotations ou d’échelles jumelées indispensables aux publications scientifiques.
Dès l’instanciation des axes, le chercheur doit calibrer les bornes géométriques extrêmes de la surface cartésienne. Pour l’axe des ordonnées, il est impératif de fixer manuellement les limites entre zéro et cent pour cent (ou entre zéro et un pour une échelle probabiliste unitaire). Laisser le moteur graphique déterminer automatiquement l’ajustement vertical conduirait fréquemment à un rognage inopportun de la ligne d’origine ou à un dépassement esthétiquement disgracieux au-delà du seuil de cent pour cent. Pour l’axe des abscisses, un léger élargissement des bornes minimales et maximales par rapport aux valeurs extrêmes de la partition permet d’aérer visuellement le tracé sans altérer la rigueur de lecture des seuils nodaux.
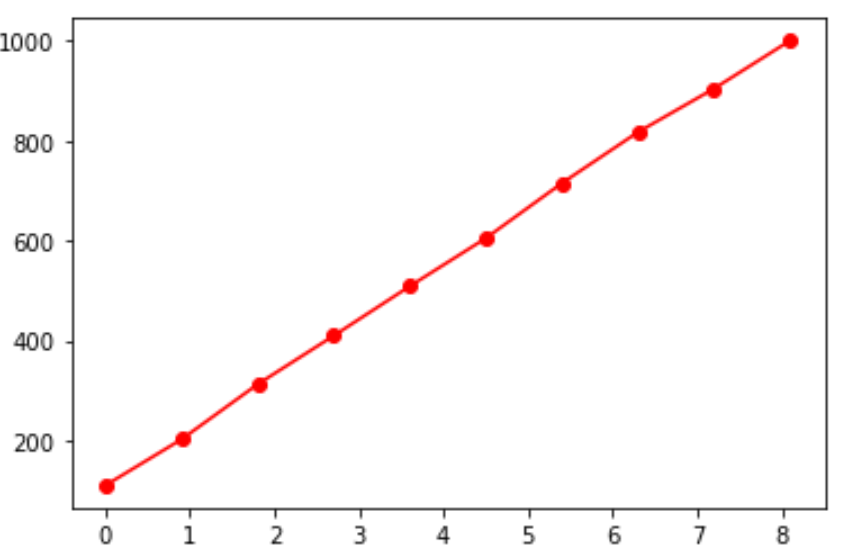
L’instruction de traçage fondamentale mobilise ensuite la méthode de tracé linéaire cartésien sur l’objet d’axes configuré. En lui injectant le vecteur synchronisé des bornes d’intervalles en abscisse et le vecteur complété des pourcentages cumulés en ordonnée, le moteur génère la ligne polygonale caractéristique de l’ogive. L’activation des marqueurs ponctuels sur chaque point nodal assure la visibilité explicite des frontières de classe utilisées pour le calcul, permettant au lecteur d’identifier instantanément le niveau de résolution du partitionnement sous-jacent.
7.2 Habillage descriptif et étiquetage scientifique des axes
La valeur informative d’une illustration statistique en contexte de recherche dépend fondamentalement de la précision et de l’exhaustivité de son appareil textuel descriptif. Un graphique scientifique ne doit laisser subsister aucune ambiguïté quant à la nature des grandeurs physiques, psychologiques ou comportementales représentées. L’assignation d’un titre de graphique conforme aux normes académiques requiert la mention explicite de la variable investiguée, de la nature cumulative du traitement appliqué et de l’échantillon ou de la condition expérimentale sous-jacente.
L’étiquetage de l’axe horizontal des abscisses doit spécifier sans équivoque la métrique psychométrique mesurée, l’unité physique ou conventionnelle de quantification ainsi que le sens de progression de la performance (par exemple : Score global au test d’inhibition exécutive, en points d’échelle standardisée). L’omission de l’unité de mesure ou l’usage d’abréviations informatiques hermétiques constitue une faute méthodologique récurrente qui pénalise la diffusion des résultats empiriques.
Sur l’axe vertical des ordonnées, la formulation de l’étiquette doit préciser s’il s’agit d’un effectif absolu cumulé, d’une fréquence relative cumulée ou d’un pourcentage cumulé (équivalent au rang centile). L’adjonction de la mention formelle du rang centile simplifie considérablement la restitution clinique des bilans individuels auprès de professionnels non statisticiens ou des participants eux-mêmes, en explicitant le fait que l’ordonnée mesure le pourcentage de sujets ayant obtenu un résultat égal ou inférieur à la valeur lue en abscisse.
7.3 Intégration d’un quadrillage structural pour la lecture directe
La fonction première d’une ogive étant de faciliter l’interpolation visuelle et géométrique des paramètres de position sans recourir aux équations brutes, l’adjonction d’un quadrillage structural cartésien s’avère absolument indispensable. Sans repères orthonormés denses et précis, l’estimation oculaire d’un centile ou d’une médiane sur une courbe continue demeure approximative et sujette à d’importants biais de parallaxe visuelle.
L’implémentation de la grille de lecture via l’interface de contrôle des axes de Matplotlib doit être menée avec une grande subtilité visuelle pour éviter de saturer l’espace graphique d’éléments parasites (ce que le théoricien de l’information graphique Edward Tufte qualifie de « chartjunk »). Le quadrillage majeur doit être configuré avec un style de ligne discret, de préférence en pointillés légers ou en tirets fins, assorti d’une valeur de transparence alpha modérée et d’une teinte neutre telle qu’un gris moyen. Cette discrétion esthétique permet à la grille de remplir son office d’aide à la projection spatiale tout en s’effaçant visuellement derrière le tracé principal de l’ogive.
Pour une rigueur accrue, l’activation conjointe d’un quadrillage mineur découpant l’axe des ordonnées par tranches déciles (tous les dix centiles) ou quartiles (tous les vingt-cinq centiles) permet au praticien d’effectuer une lecture quasi-analytique instantanée. Cette architecture réticulaire fournit le cadre optimal pour projeter les scores limites d’une batterie neuropsychologique et délimiter les zones de normalité, de fragilité et de déficit clinique sévère.
8. Optimisation et impact du choix du nombre d’intervalles (bins)
8.1 Conséquences du sur-lissage et du sous-lissage de la courbe
L’un des défis méthodologiques les plus critiques lors de la discrétisation statistique réside dans le calibrage optimal du nombre de classes de la partition. Ce choix paramétrique arbitre un compromis fondamental entre le biais d’estimation et la variance d’échantillonnage, déterminant directement le degré de lissage appliqué à la distribution cumulative empirique. Une sélection erronée de la granularité temporelle ou métrique peut masquer des structures psychométriques vitales ou, à l’inverse, ériger de simples bruits de mesure en pseudo-effets expérimentaux.
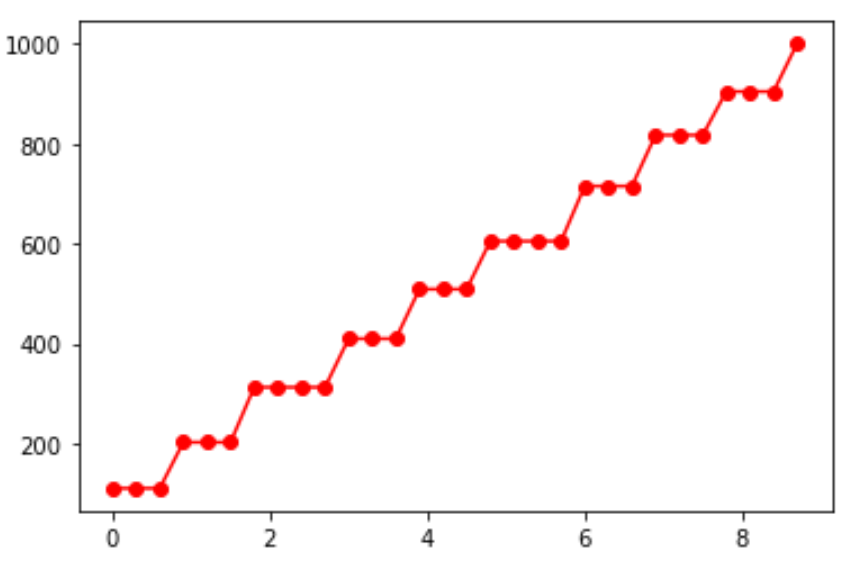
L’écueil du sous-lissage, résultant du choix d’un nombre excessif de classes (par exemple cinquante ou cent intervalles pour un échantillon modeste), fragmente excessivement la distribution. L’ogive perd alors son allure sigmoïde harmonieuse pour afficher une succession erratique de paliers verticaux abrupts entrecoupés de longs plateaux horizontaux dus aux classes désertes. Cette instabilité graphique reflète la sensibilité excessive de l’échantillon aux aléas stochastiques locaux et empêche l’extraction fiable des centiles théoriques par interpolation linéaire.
À l’opposé, le piège du sur-lissage, provoqué par un nombre d’intervalles démesurément faible (tel qu’un découpage en trois ou quatre classes seulement), oblitère brutalement la morphologie fine de la distribution. En moyennant grossièrement les observations sur de trop vastes étendues métriques, le sur-lissage supprime la capacité de l’ogive à révéler la bimodalité d’une cohorte (signe potentiel d’un sous-groupe clinique distinct), aplatit les zones de transition rapide de densité et introduit un biais systématique substantiel dans le calcul géométrique des quartiles et de la médiane.
8.2 Application des règles heuristiques statistiques de discrétisation
Pour s’affranchir de la subjectivité d’un choix empirique aléatoire du nombre de classes, la littérature statistique a formulé plusieurs heuristiques mathématiques rigoureuses établissant le partitionnement optimal en fonction des propriétés intrinsèques de l’échantillon analysé. La règle historique la plus connue est la formule de Sturges, qui calibre le nombre de classes proportionnellement au logarithme en base deux de la taille totale de l’échantillon. Bien qu’extrêmement populaire et implémentée par défaut dans de nombreux logiciels généralistes, la règle de Sturges repose sur l’hypothèse sous-jacente d’une normalité stricte des données et tend à sous-estimer sévèrement le nombre de classes requis lorsque la taille de l’échantillon excède quelques centaines d’observations.
Une alternative beaucoup plus puissante pour les distributions asymptotiquement normales est la règle de Scott, qui fonde la largeur idéale de classe sur l’écart-type de l’échantillon et sur la racine cubique de sa taille. En intégrant directement la dispersion empirique du phénomène étudié, l’algorithme de Scott optimise formellement l’erreur quadratique intégrée de la densité de fréquence, assurant une transition douce et continue de l’ogive résultante sans écraser les particularités locales de la distribution.
Dans le domaine psychologique où les distributions empiriques manifestent fréquemment de fortes asymétries et la présence de valeurs extrêmes résiduelles, la règle de Freedman-Diaconis s’impose comme la méthodologie de référence la plus robuste. Cette formulation substitue à l’écart-type l’intervalle interquartile, neutralisant ainsi totalement l’influence perturbatrice des observations atypiques dans le dimensionnement des classes. L’application de la règle de Freedman-Diaconis garantit un partitionnement équilibré, évitant que l’étendue démesurée générée par quelques valeurs isolées ne vienne dilater excessivement la largeur de toutes les classes centrales du continuum.
8.3 Validation de la stabilité de l’ogive selon les partitions
La validation de la robustesse méthodologique d’un étalonnage psychométrique exige la conduite d’une analyse de sensibilité évaluant formellement la stabilité des tracés en fonction de variations contrôlées du nombre d’intervalles de partitionnement. Un instrument d’évaluation fiable ne saurait voir ses estimations de centiles fluctuer substantiellement au gré de modifications mineures apportées à la grille de découpage de son échantillon normatif.
Cette validation s’opère sur le plan computationnel en comparant quantitativement les percentiles interpolés dérivés d’ogives générées selon différentes granularités (par exemple 10, 20 et 30 classes, ou via la comparaison croisée des heuristiques de Sturges et de Freedman-Diaconis). L’enregistrement des écarts absolus constatés sur l’estimation des premier, deuxième et troisième quartiles permet de quantifier l’erreur de discrétisation. Si ces écarts demeurent inférieurs à l’erreur type de mesure intrinsèque de l’épreuve psychologique, la stabilité de l’étalonnage est réputée statistiquement acquise.
En programmation Python, l’automatisation de cette sélection optimale s’effectue en passant simplement des chaînes de caractères prédéfinies à l’argument de partitionnement de la fonction de partitionnement de NumPy. Le moteur interne évalue alors dynamiquement les caractéristiques dimensionnelles et distributionnelles du tableau de données fourni et applique instantanément l’algorithme d’optimisation sélectionné, déchargeant le chercheur des calculs préliminaires tout en garantissant une rigueur méthodologique reproductible.
9. Personnalisation graphique avancée selon les standards académiques
9.1 Esthétique du tracé : marqueurs, typographie et palette
L’élévation d’un graphique en ogive basique au rang d’illustration prête pour la publication académique implique un travail minutieux d’optimisation sémiotique et esthétique, respectant les chartes graphiques des sociétés savantes telles que l’APA. La différenciation nette de la courbe cumulée par rapport aux éléments d’arrière-plan requiert un réglage approprié de l’épaisseur de ligne (linewidth), généralement calibrée entre 2 et 2.5 points typographiques, conférant au tracé une présence visuelle indiscutable sans alourdir la perception de la trajectoire.
La sélection des marqueurs géométriques ancrés sur chaque limite supérieure de classe doit faire l’objet d’un arbitrage réfléchi. L’usage de disques circulaires pleins, de triangles discrets ou de losanges de dimension modérée permet d’identifier sans ambiguïté les points d’interpolation empiriques réels sans créer d’amas opaques dans les zones de forte densité de classes. La coloration personnalisée du contour des marqueurs, associée à une teinte de remplissage harmonisée avec le fond de la figure, renforce la lisibilité spatiale de la séquence discrète.
La cohérence chromatique globale doit privilégier des palettes institutionnelles sobres, exploitant des contrastes binaires marqués (tels que le bleu nuit profond, l’anthracite ardoise ou le bordeaux académique) pour la ligne principale, tout en réservant les teintes secondaires plus douces aux axes de référence et aux grilles sous-jacentes. L’harmonisation stricte de la typographie textuelle sur l’ensemble de la figure, imposant une parité absolue entre les polices du corps de texte du manuscrit et les labels graphiques, parachève l’intégration esthétique de la figure dans la production scientifique finale.
9.2 Annotation interactive des valeurs de référence (médiane et quartiles)
Pour transcender le statut de simple courbe descriptive et devenir un véritable instrument de diagnostic analytique, l’ogive doit matérialiser visuellement les repères psychométriques fondamentaux que constituent la médiane et les quartiles. Cette valorisation s’accomplit par l’adjonction de lignes de projection orthogonales reliant les ordonnées critiques aux valeurs de scores correspondantes sur l’abscisse métrique.
L’implémentation de ces projections géométriques mobilise les instructions de tracé de lignes de référence horizontales et verticales disponibles dans l’interface de contrôle des axes de Matplotlib. En traçant un segment horizontal interrompu depuis l’axe vertical au niveau de l’ordonnée cinquante pour cent jusqu’à l’intersection avec l’ogive, relayé par un segment vertical descendant vers l’axe horizontal, le chercheur offre une lecture décomposée et immédiate de la valeur médiane estimée de l’échantillon. Le même procédé s’applique élégamment aux premier et troisième quartiles, délimitant visuellement la zone centrale regroupant cinquante pour cent de la cohorte.
L’enrichissement explicatif se complète par l’insertion de boîtes de texte annotatives dotées de flèches indicatrices pointant avec précision vers les intersections structurelles remarquables. La méthode d’annotation de Matplotlib permet de spécifier conjointement les coordonnées cartésiennes de la cible d’intérêt et l’emplacement relatif de l’étiquette textuelle explicative. Ce dispositif permet de consigner directement sur la figure la valeur numérique interpolée exacte de la médiane (par exemple : Médiane = 48.5 points) et l’écart interquartile associé, rendant l’illustration entièrement autonome et auto-explicative pour le lecteur.
9.3 Affichage simultané des échelles absolues et relatives (double axe y)
Dans de nombreuses configurations expérimentales ou rapports de standardisation psychologique, il s’avère hautement profitable de présenter simultanément l’échelle des effectifs bruts (nombre absolu de participants) et l’échelle des fréquences relatives (pourcentages cumulés). Cette double lecture informe d’un seul coup d’œil sur la puissance statistique de l’échantillon tout en fournissant les repères universels des rangs centiles.
Matplotlib permet de résoudre cette exigence typographique grâce à la création d’axes jumeaux via la méthode dédiée du système cartésien. Cette technique permet de superposer à l’espace graphique initial un second système d’ordonnées, partageant rigoureusement le même axe horizontal d’abscisse mais disposant d’une graduation verticale indépendante sur le flanc droit de la figure. L’axe de gauche est alors configuré pour refléter les pourcentages cumulés standardisés de 0 à 100 %, tandis que l’axe de droite est précisément gradué de 0 jusqu’à la taille totale N de la population de standardisation.
L’écueil absolu de cette architecture bi-axiale réside dans le risque de désynchronisation visuelle si les deux échelles d’ordonnées ne sont pas mathématiquement verrouillées dans un rapport strictement proportionnel. L’ajustement impératif des limites d’axes impose de veiller à ce que le sommet de l’échelle des effectifs coïncide à la décimale près avec le seuil cent pour cent de l’échelle relative. Une fois cette précaution algorithmique scellée, l’harmonisation des couleurs de graduation entre les axes et les étiquettes textuelles respectives garantit une intelligibilité parfaite sans risque de confusion cognitive pour l’analyste.
10. Tracé comparatif d’ogives et analyse de sous-groupes cliniques
10.1 Construction conjointe de l’ogive ascendante et descendante
L’investigation clinique approfondie d’un instrument d’évaluation psychologique bénéficie grandement de la superposition simultanée, sur un même repère orthonormé, de l’ogive ascendante (« moins de ») et de l’ogive descendante (« plus de »). Cette confrontation géométrique offre une vision bidirectionnelle de la distribution des compétences ou des symptômes, explicitant conjointement la dynamique d’accumulation des performances faibles et la rétention des performances exceptionnelles.
L’algorithme de génération de l’ogive descendante se déduit directement de la série cumulée ascendante par l’application d’une opération de complémentation algébrique. Pour chaque classe k de la partition, le pourcentage d’individus obtenant un score strictement supérieur ou égal à la borne d’intervalle s’obtient en soustrayant le pourcentage cumulé ascendant correspondant de la valeur totale cent pour cent (ou de l’effectif maximal N dans le cas de séries brutes). Ce calcul vectorisé instantané produit une séquence symétriquement décroissante débutant à cent pour cent pour s’annuler au terme de l’échelle métrique.
La propriété géométrique la plus remarquable de cette double construction réside dans le fait que les deux courbes polygonales se croisent obligatoirement à l’altitude exacte de cinquante pour cent. L’abscisse de ce point d’intersection singulier identifie sans aucune ambiguïté la médiane empirique de l’échantillon. Cette dualité visuelle constitue un moyen de diagnostic extrêmement élégant pour mettre en évidence la symétrie ou les déséquilibres d’étalement d’une distribution : toute asymétrie de la population parente se traduit par un décalage spatial immédiat du point de croisement par rapport au centre géométrique du graphique.
10.2 Comparaison de deux cohortes (groupe contrôle vs groupe clinique)
L’une des applications les plus fécondes du graphique en ogive en psychopathologie cognitive et en neuropsychologie réside dans la comparaison directe de deux cohortes indépendantes soumises au même protocole d’évaluation, classiquement un groupe témoin sain et une population de patients diagnostiqués avec une pathologie spécifique. L’évaluation comparative par ogives surpasse souvent la simple confrontation de moyennes via des tests de Student en dévoilant l’ensemble de la réorganisation distributionnelle induite par l’état clinique.
Sur le plan de la programmation scientifique, ce protocole implique la conduite de chaînes de discrétisation séparées pour chaque sous-échantillon, tout en contraignant formellement les deux procédures à adopter une grille de bornes d’intervalles strictement commune et synchronisée. Si les deux cohortes étaient découpées selon des limites de classes divergentes, toute comparaison géométrique directe sur le même axe deviendrait caduque et fallacieuse. Une fois les pourcentages cumulés dérivés sur cette trame commune, les deux séries sont tracées conjointement au moyen de styles de traits distinctifs (par exemple, une ligne continue pleine pour le groupe contrôle et une ligne interrompue pour le groupe pathologique) associés à des teintes contrastées.
L’analyse visuelle de l’écartement spatial séparant les deux ogives fournit une mesure directe de l’ampleur de l’effet clinique. Un glissement global et uniforme de l’ogive du groupe pathologique vers la gauche ou vers la droite atteste d’une altération systématique de la performance touchant l’ensemble de la cohorte clinique. En revanche, une divergence qui ne se manifeste que sur les centiles supérieurs ou inférieurs met en évidence un effet d’interaction touchant sélectivement les individus les plus vulnérables ou les plus résilients, information que la moyenne arithmétique globale échoue irrémédiablement à capturer.
10.3 Évaluation de la dominance stochastique entre distributions
Sur le plan de l’inférence non paramétrique théorique, la comparaison conjointe de deux ogives constitue l’expression visuelle exacte du concept de dominance stochastique au premier ordre. On dit formellement qu’une variable aléatoire A domine stochastiquement au premier ordre une variable aléatoire B si, pour tout niveau de score x, la fonction de répartition de A est inférieure ou égale à celle de B. Sur le graphique cartésien, cette propriété mathématique se traduit par une configuration sans croisement où l’ogive de la cohorte A se situe rigoureusement et en tout point à droite (ou en dessous) de celle de la cohorte B.
L’identification d’une dominance stochastique possède des implications diagnostiques et théoriques majeures en psychologie différentielle. Elle démontre que quelle que soit la sévérité du seuil clinique envisagé, la proportion de sujets atteignant ce niveau de performance dans le groupe A est systématiquement supérieure à celle observée dans le groupe B. Cette invariance d’ordre élimine toute ambiguïté quant à l’efficacité globale d’une prise en charge thérapeutique ou quant à la supériorité structurelle d’une méthode d’apprentissage pédagogique sur une cohorte expérimentale.
Ce paradigme géométrique s’articule de manière directe avec le formalisme mathématique du test non paramétrique de Kolmogorov-Smirnov à deux échantillons. La statistique de test D de Kolmogorov-Smirnov correspond très exactement à la distance verticale maximale séparant les deux fonctions de distribution cumulée empiriques le long de l’axe des abscisses. L’ogive comparative permet ainsi d’identifier immédiatement la zone critique de l’échelle de mesure où la divergence inter-groupes atteint son paroxysme statistique, guidant le clinicien vers les seuils de scores les plus discriminants pour la pratique diagnostique.
11. Applications empiriques : Études de cas en sciences du comportement
11.1 Cas pratique 1 : Étalonnage d’une échelle d’anxiété de Spielberger (STAI)
Pour ancrer ces développements théoriques dans la réalité clinique quotidienne, examinons le protocole de standardisation psychométrique de l’Inventaire d’Anxiété État-Trait de Spielberger (STAI-Y). Cette épreuve d’auto-évaluation mondialement validée comporte 20 items cotés de 1 à 4, générant un score brut total variant de façon discrète entre 20 (absence complète d’anxiété perceptible) et 80 points (anxiété paroxystique majeure). Dans le cadre de l’étalonnage d’une version nationale sur une cohorte représentative de 1 500 jeunes adultes, l’ogive s’impose pour transformer ces scores d’échelle en abaques centiles utilisables par les praticiens hospitaliers.
Le pipeline computationnel en Python procède à l’ingestion des scores bruts, élimine les dossiers incomplets puis applique un partitionnement en classes de deux points d’amplitude afin de respecter la finesse métrique de l’instrument. Le tracé de l’ogive des pourcentages cumulés révèle une courbure sigmoïde asymétrique, caractéristique d’un phénomène émotionnel où les scores très élevés demeurent l’apanage d’une fraction restreinte de la population générale. L’adjonction de lignes de repère orthogonales aux centiles 10, 25, 50, 75 et 90 permet de matérialiser spatialement les zones de vulnérabilité émotionnelle croissante.
L’exploitation finale de ce traitement algorithmique aboutit à la génération automatisée d’une table d’étalonnage unifiée. En interrogeant la série cumulée synchronisée par des techniques d’interpolation linéaire, le script Python exporte directement une matrice de correspondance assignant à chaque score brut entier de 20 à 80 son rang centile normé exact. Cette automatisation sécurise le processus de publication des manuels de tests cliniques en éliminant les risques d’erreurs matérielles de transcription inhérents aux méthodes d’étalonnage manuelles d’autrefois.
11.2 Cas pratique 2 : Analyse des temps de réponse dans une tâche de Stroop
Le second cas pratique relève du champ de la neuropsychologie expérimentale et s’intéresse à la célèbre tâche d’interférence attentionnelle de Stroop. Les participants sont confrontés à des stimuli colorés dont la dénomination s’effectue sous deux conditions expérimentales distinctes : une condition congruente (le mot « VERT » imprimé en encre verte) et une condition incongruente déclenchant un conflit cognitif majeur (le mot « ROUGE » imprimé en encre bleue). Les variables recueillies sont les temps de latence verbale exprimés en millisecondes sur plusieurs centaines d’essais répétés.
La distribution des temps de réaction dans la condition incongruente présente une longue traîne asymétrique traduisant les épisodes d’interférence exécutive sévère. La construction de deux ogives superposées sur le même graphique cartésien — l’une modélisant la condition congruente et l’autre la condition incongruente — met en évidence la translation massive de la distribution cumulative provoquée par l’effort d’inhibition cognitive. Alors que 80 % des réponses de la condition congruente sont émises sous la barre temporelle critique des 650 millisecondes, cette proportion s’effondre à moins de 35 % lors de la condition de conflit attentionnel.
L’ogive permet également d’isoler avec une acuité particulière la fraction des réponses ultra-rapides situées sous le seuil des 300 millisecondes, conventionnellement assimilées à des réponses impulsives anticipatoires dépourvues de contrôle exécutif réel. L’identification visuelle de l’ancrage au zéro et du décollage différentiel des deux courbes à ce seuil physiologique incompressible fournit aux chercheurs un indicateur diagnostique pur de la régulation de l’impulsivité motrice, confirmant la polyvalence analytique de l’ogive au-delà des simples tests psychométriques papier-crayon.
11.3 Cas pratique 3 : Identification de profils atypiques dans un test de mémoire
Le troisième scénario empirique explore le dépistage précoce des troubles neurocognitifs légers (MCI) au moyen d’une épreuve de mémoire épisodique verbale (rappel libre différé de listes de mots). Dans cette épreuve étalonnée sur une cohorte de personnes âgées saines de 70 à 85 ans, le score maximal théorique est de 16 mots rappelés. En pratique clinique gériatrique, la définition du déficit mnésique pathologique s’établit conventionnellement à partir d’un seuil de performance situé strictement en deçà du 5e percentile de la distribution normative des sujets témoins de même tranche d’âge et de même niveau socioculturel.
Le tracé de l’ogive de l’échantillon normatif permet d’isoler géométriquement ce seuil critique d’alerte diagnostique. En pointant l’ordonnée 5 % et en projetant l’abscisse correspondante, le script met en exergue le score limite de rappel (en l’espèce, un score brut inférieur ou égal à 6 mots) marquant la frontière de la normalité statistique. Tout score individuel s’inscrivant dans cette zone résiduelle inférieure déclenche l’orientation du patient vers un bilan neuropsychologique et d’imagerie cérébrale approfondi.
L’intégration de la performance d’un patient singulier sur ce graphique normatif fournit un support de médiation visuelle particulièrement éclairant lors de la restitution du bilan au patient et à ses aidants. En visualisant l’ogive de la cohorte générale et la projection singularisée de son propre score dans la queue inférieure de la courbe, le patient saisit intuitivement l’ampleur de son décalage adaptatif par rapport aux personnes de son âge, démystifiant ainsi les notions statistiques abstraites au profit d’une communication clinique transparente et objective.
12. Architecture logicielle, modularisation et approches alternatives en Python
12.1 Développement d’une fonction Python modulaire et documentée
L’industrialisation et la pérennisation des flux de traitement statistique imposent de dépasser l’écriture de scripts séquentiels ad hoc au profit d’une architecture logicielle modulaire, réutilisable et rigoureusement documentée. La factorisation de l’ensemble de la chaîne de traitement menant du vecteur de scores bruts à la restitution graphique finalisée doit être encapsulée au sein d’une fonction autonome acceptant des arguments de paramétrage flexibles.
Cette fonction experte doit accepter en entrée obligatoire le vecteur numérique des observations sous forme de tableau NumPy ou de série Pandas, complété par une collection d’arguments optionnels régissant la finesse du binning (nombre entier de classes ou sélection heuristique de Sturges, Scott ou Freedman-Diaconis), le mode de normalisation souhaité (effectifs absolus, fréquences relatives [0, 1] ou pourcentages [0, 100]), l’orientation de l’ogive (ascendante ou descendante) et les conteneurs d’axes Matplotlib cibles pour une composition personnalisée de figures complexes.
Sur le plan du génie logiciel, le respect strict des recommandations de typage statique (type hints introduits par la PEP 484) et des normes de documentation technique (docstrings conformes à la PEP 257 ou au standard NumPy/SciPy) garantit l’interopérabilité et la maintenabilité du code source au sein des équipes de recherche pluridisciplinaires. La fonction documente exhaustivement la nature dimensionnelle des entrées, la structure des sorties délivrées (retournant typiquement l’objet d’axes configuré et les vecteurs de coordonnées discrétisées calculées) ainsi que la liste formelle des exceptions levées en cas d’anomalies de distribution.
12.2 Pièges fréquents et gestion des anomalies numériques
La mise en œuvre computationnelle de distributions cumulées recèle plusieurs pièges algorithmiques subtils susceptibles d’engendrer des erreurs d’interprétation insidieuses si des mécanismes de contrôle défensifs ne sont pas intégrés au cœur du code. Le premier écueil concerne la gestion des distributions à variance nulle ou quasi-nulle, cas de figure pathologique où l’ensemble des participants d’un échantillon expérimental obtiennent rigoureusement le même score. Dans cette circonstance, l’algorithme de calcul des largeurs de classes se heurte à une division par zéro, générant des bornes indéterminées et bloquant l’exécution graphique. La fonction modulaire doit impérativement intercepter ce cas limite en amont et lever un avertissement statistique explicite.
Le second piège fréquent, d’ordre dimensionnel, réside dans l’omission involontaire du point d’ancrage initial à zéro pour cent ou dans l’appariement erroné des effectifs cumulés avec les bornes inférieures plutôt qu’avec les limites supérieures des intervalles. Une telle interversion géométrique applique à l’ogive une translation artificielle vers la gauche d’une amplitude égale à la largeur d’une classe complète, surestimant systématiquement le rang centile réel des participants et faussant gravement toute conclusion diagnostique ultérieure.
Enfin, la présence de valeurs infinies ou de valeurs aberrantes extrêmes résultant d’erreurs de saisie manuelle dans les bases de données psychométriques exige un filtrage rigoureux. L’intégration d’assertions programmatiques préliminaires vérifiant que la totalité des données d’entrée s’inscrit à l’intérieur des limites théoriques admissibles du test évite que l’étendue géométrique globale ne soit démesurément distendue, préservant ainsi la lisibilité de la zone centrale d’intérêt clinique de l’ogive.
12.3 Comparaison méthodologique avec statsmodels et Seaborn
Pour parfaire cette étude méthodologique, il est instructif de situer l’ogive construite sous Matplotlib au sein de l’écosystème plus vaste des outils graphiques de Python, en la comparant avec les fonctionnalités offertes par des bibliothèques de haut niveau telles que Seaborn et Statsmodels. Ces bibliothèques proposent des routines natives hautement automatisées dédiées à la génération de fonctions de répartition empiriques, à l’instar du tracé ECDF de Seaborn ou de la classe de distribution empirique de Statsmodels.
L’approche ECDF continue déployée par Seaborn calcule et affiche un saut vertical infinitésimal à chaque occurrence de score observée, sans procéder à aucun partitionnement préalable par intervalles de classes. Cette méthodologie présente l’avantage indéniable de ne faire dépendre le tracé d’aucun choix arbitraire de largeur de classe et de conserver la totalité de l’information statistique brute contenue dans l’échantillon. Toutefois, cette fidélité microscopique produit un tracé visuellement lourd et discontinu dès lors que l’échantillon atteint plusieurs milliers d’observations, générant des artefacts visuels en escalier peu adaptés à la lecture globale simplifiée exigée par les praticiens cliniques.
La synthèse comparative révèle que le polygone des fréquences cumulées par classes de Matplotlib et l’ECDF continue de Seaborn ne s’excluent pas mais répondent à des finalités complémentaires dans la démarche scientifique. L’ogive discrétisée par classes demeure l’instrument roi pour l’étalonnage psychométrique normatif, la construction d’abaques d’évaluation, la restitution pédagogique aux participants et l’estimation linéaire rapide de quantiles sur des échelles de mesure bornées. L’ECDF non groupée s’impose préférentiellement dans les phases de recherche fondamentale exploratoire, lors de l’application de tests d’adéquation non paramétriques stricts ou lorsque la taille restreinte de cohortes très spécifiques exclut toute tentative de découpage partitionnel sans perte critique d’information.
Références
- Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Galton, F. (1875). Statistics by intercomparison, with remarks on the law of frequency of error. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 49(322), 33–46. https://doi.org/10.1080/14786447508641179
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Kolmogorov, A. (1933). Sulla determinazione empirica di una legge di distribuzione. Giornale dell’Istituto Italiano degli Attuari, 4, 83–91.
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22–30. https://doi.org/10.1109/MCSE.2011.37
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021