
L’analyse empirique de séries temporelles, de protocoles expérimentaux longitudinaux et de processus stochastiques requiert fréquemment l’évaluation continue de grandeurs qui s’accumulent au fil du temps. Dans le domaine du calcul statistique et de la science des données, la somme cumulée constitue l’un des opérateurs fondamentaux permettant de passer d’une vision discrète et locale des observations à une vision intégrée et dynamique de leur progression. Qu’il s’agisse de mesurer la trajectoire d’acquisition d’une compétence motrice chez un sujet au cours d’essais successifs, de quantifier le volume progressif d’événements observés dans une cohorte clinique ou de suivre l’évolution budgétaire d’un projet, la maîtrise de cet opérateur s’avère indispensable pour tout praticien de la modélisation quantitative.
Le langage de programmation statistique R, développé initialement par Ross Ihaka et Robert Gentleman comme une implémentation moderne du langage S, a été conçu dès son origine autour du concept fondamental de vectorisation. Contrairement aux environnements procéduraux classiques où l’accumulation séquentielle nécessite l’écriture explicite de structures itératives sujettes aux goulets d’étranglement calculatoires, R intègre des routines compiled de bas niveau dédiées aux calculs incrémentaux. L’expression de la somme cumulée y trouve une concrétisation canonique et optimisée à travers la fonction interne cumsum(), enrichie par les écosystèmes modernes que constituent le Tidyverse et la bibliothèque de haute performance data.table.
Cet article propose une exploration méthodique, exhaustive et rigoureuse du calcul des sommes cumulées dans l’environnement R. Depuis les fondements algébriques et fonctionnels qui régissent ces opérations jusqu’aux cas d’usage avancés de segmentation groupée, de gestion fine des données manquantes, d’optimisation en mémoire vive et de visualisation scientifique de niveau publication, chaque dimension sera abordée avec le souci de la précision mathématique et de l’efficience computationnelle. Les développements théoriques seront systématiquement illustrés de démonstrations empiriques permettant d’en appréhender toute la portée méthodologique.
1. Introduction théorique et conceptuelle aux sommes cumulées dans le logiciel R
1.1 Définition formelle et propriétés mathématiques de la somme cumulée
D’un point de vue strictement formel, considérons une série discrète unidimensionnelle de valeurs numériques réelles indexée sur un ensemble fini ou dénombrable d’indices entiers ordonnés, notée sous la forme $X = (x_1, x_2, dots, x_n)$ où chaque élément $x_i in \mathbb{R}$ pour tout indice $i in {1, dots, n}$. L’opérateur de somme cumulative, couramment noté $S_k$, applique une transformation d’un vecteur de dimension $n$ vers un nouveau vecteur $S = (s_1, s_2, dots, s_n)$ de même cardinalité, dans lequel chaque composante de rang $k$ correspond à l’accumulation arithmétique de l’ensemble des termes précédant et incluant l’indice courant.
Mathématiquement, l’application est formellement définie par l’expression sommatoire suivante :
$$s_k = \sum_{i=1}^{k} x_i = s_{k-1} + x_k \quad \text{a\vec} \quad s_1 = x_1 \quad \text{pour tout} \quad k in {1, dots, n}$$
Il importe de distinguer rigoureusement la somme cumulée d’autres concepts arithmétiques apparentés mais conceptuellement distincts, tels que la somme totale ou les sommes partielles classiques. Alors que la somme globale réduit l’ensemble du vecteur $X$ à un scalaire unique invariant par permutation de ses indices selon la propriété de commutativité de l’addition, la somme cumulée préserve scrupuleusement la dimensionnalité temporelle ou ordonnée de la structure d’origine. Chaque $s_k$ représente l’état d’un accumulateur séquentiel au pas $k$, ce qui confère à cette métrique une dépendance directe et stricte à l’ordre d’agencement initial des observations.
Sur le plan des propriétés algébriques fondamentales, la monotonie de la séquence résultante dépend intimement du signe des éléments constituant le vecteur d’entrée. Lorsque tous les termes $x_i$ satisfont la condition de non-négativité ($x_i ge 0$), la série cumulative $(s_k)_{k ge 1}$ présente une monotonie croissante stricte ou large, telle que $s_k ge s_{k-1}$ pour tout $k ge 2$. Cette propriété confère à la somme cumulée le rôle d’une fonction de répartition non normalisée. Dans le cadre de l’analyse séquentielle d’événements, elle permet de modéliser avec fidélité l’épuisement progressif de stocks, l’agrégation de doses thérapeutiques reçues ou la survenue répétée d’occurrences ponctuelles au sein d’un intervalle d’observation défini.
1.2 Rôle des calculs cumulatifs dans l’analyse quantitative et comportementale
Dans les sciences comportementales, les neurosciences computationnelles et l’épidémiologie expérimentale, les mesures isolées au temps $t$ ne fournissent qu’une vision parcellaire des dynamiques sous-jacentes. L’évaluation continue de variables cumulatives permet d’appréhender des processus d’apprentissage, d’habituation ou d’extinction qui ne peuvent être détectés par l’analyse statique des moyennes globales. Par exemple, la vitesse à laquelle un sujet accumule des réponses correctes lors de blocs d’essais successifs révèle la courbure intrinsèque de sa trajectoire d’assimilation cognitive, souvent caractérisée par une montée exponentielle initiale suivie d’une décélération progressive vers une asymptote fonctionnelle.
Dans le domaine psychométrique, l’analyse des temps de réponse cumulés fournit un outil diagnostique précieux pour étudier la fatigabilité attentionnelle et la régulation métacognitive. L’agrégation séquentielle des scores d’items ordonnés par difficulté croissante permet d’observer la cohérence des patterns de complétion d’un individu. Toute déviation brutale dans la pente de la droite cumulative signale un décrochage attentionnel ou une modification qualitative de la stratégie d’exploration adoptée par le répondant, des phénomènes que la simple agrégation finale sous forme de score brut total oblitère irrémédiablement.
Par ailleurs, l’identification de points d’inflexion au sein d’une trajectoire cumulative présente un intérêt analytique majeur pour caractériser les transitions de phase comportementales. En dérivant numériquement la série cumulative par rapport à l’indice d’essai, on retrouve la fréquence instantanée d’émission des réponses, permettant ainsi de situer avec une extrême précision l’instant exact où une stratégie heuristique est supplantée par un raisonnement algorithmique stable lors de protocoles de résolution de problèmes complexes.
1.3 Vue d’ensemble de l’écosystème R pour le traitement séquentiel des données
L’environnement R offre une infrastructure computationnelle particulièrement adaptée au traitement séquentiel et vectoriel de grands ensembles de données. Héritier du langage S formalisé aux laboratoires Bell par John Chambers, R traite le vecteur atomique comme l’unité minimale de manipulation structurée. Cette philosophie architecturale implique que les opérations élémentaires ne sont pas conçues pour s’exécuter élément par élément dans le code utilisateur interprété, mais sont déléguées à des routines internes précompilées en langage C ou Fortran hautement optimisées pour la mémoire cache et les registres processeurs modernes.
Le package base, chargé par défaut dans toute session R active, met à disposition des utilisateurs la fonction primitive cumsum(). Cette dernière contourne intégralement l’interpréteur de code lors du parcours séquentiel des éléments, offrant une vitesse de traitement quasi instantanée même sur des séquences comptant plusieurs dizaines de millions d’enregistrements. Historiquement, l’essor des méthodes quantitatives appliquées a exigé une transition paradigmatique radicale : l’abandon progressif des boucles impératives traditionnelles au profit de fonctions d’accumulation vectorisées.
L’évolution contemporaine de l’écosystème R a vu l’émergence de dialectes complémentaires enrichissant cette approche native. Alors que les commandes historiques de R de base privilégient la compacité syntaxique et l’absence de dépendance externe, le paradigme moderne incarné par le tidyverse permet d’intégrer le calcul cumulatif au sein de pipelines de transformation lisibles, structurés par le verbe mutate() et segmentés par group_by(). Simultanément, le package data.table repousse les frontières de l’efficience temporelle et spatiale grâce à la modification par référence en mémoire partagée, répondant ainsi aux contraintes sévères posées par les ensembles massifs de données volumineuses.
2. Analyse approfondie de la fonction native cumsum() en R de base
2.1 Signature, paramètres et type de retour de la fonction cumsum()
La fonction cumsum() appartient à la famille des fonctions primitives internes de R, ce qui signifie que son implémentation sous-jacente est directement écrite en code natif compilé sans passer par le mécanisme standard d’évaluation différée des promesses propres aux fonctions R ordinaires. La signature canonique de la fonction présente une compacité extrême :
cumsum(x)
Le paramètre formel x attend obligatoirement un objet vectoriel numérique ou logique. Toute tentative d’application de cette fonction sur des structures multidimensionnelles complexes qui ne peuvent être directement aplaties en vecteurs atomiques, telles que des listes hétérogènes d’objets arbitraires, génère immédiatement une exception d’exécution. La fonction impose une contrainte stricte d’homogénéité du type sous-jacent.
Sur le plan dimensionnel, la fonction cumsum() garantit une préservation absolue et invariante de la longueur : si le vecteur d’entrée comporte $n$ éléments (déterminé par l’instruction length(x)), le vecteur de sortie contiendra rigoureusement $n$ éléments. De surcroît, lorsque le vecteur d’entrée possède un attribut de noms (names), ces identifiants lexicaux sont systématiquement conservés et réassignés un à un aux composantes correspondantes du vecteur cumulé en sortie, assurant ainsi la traçabilité des unités d’observation.
Le tableau suivant synthétise les règles strictes de typage régissant l’entrée et la sortie de la fonction cumsum() :
- Entrée de type integer (entier standard) : La sortie demeure typée en
integer, sous réserve absolue qu’aucun dépassement de capacité arithmétique ne survienne au cours de l’accumulation séquentielle. - Entrée de type double (réel à virgule flottante) : Le résultat retourné adopte obligatoirement le type fondamental
double, respectant la norme internationale IEEE 754 pour les représentations numériques. - Entrée de type logical (booléen logique) : Une coercition implicite et transparente vers le type
integerest opérée de manière native avant le calcul de l’accumulation, traduisantTRUEen l’entier 1 etFALSEen l’entier 0. - Entrée de type character ou factor : Aucune coercition implicite n’est tentée ; l’interpréteur interrompt immédiatement l’évaluation en émettant un message d’erreur fatal d’incompatibilité de type.
2.2 Comparaison conceptuelle avec les fonctions mathématiques de la même famille
L’environnement R standard met à la disposition des modélisateurs une fratrie de quatre opérateurs séquentiels cumulatifs partageant des propriétés architecturales identiques mais différant par l’opération arithmétique ou logique appliquée le long de la séquence : cumsum() pour l’accumulation sommatoire, cumprod() pour le produit cumulé, cummin() pour le suivi continu du minimum historique rencontré, et cummax() pour l’enregistrement du maximum séquentiel atteint.
Alors que cumsum() est l’équivalent discret de l’opérateur d’intégration temporelle $\int_0^t f(\tau) d\tau$, la fonction cumprod() matérialise l’accumulation multiplicative de taux de croissance instantanés ou de probabilités conditionnelles conjointes indépendantes. À l’opposé, cummin() et cummax() ne modifient pas la nature d’échelle des données mais génèrent des fonctions en escalier monotones non décroissantes (pour le maximum) ou non croissantes (pour le minimum), modélisant des phénomènes de records ou de barrières d’activation dans des tâches chronométrées.
Il existe une symétrie fondamentale entre l’opérateur de cumul et l’opérateur de différentiation séquentielle implémenté par la fonction diff(). En effet, l’opérateur diff() calcule les accroissements marginaux d’ordre 1 selon la formule $y_k = x_{k+1} – x_k$. Par conséquent, pour tout vecteur numérique $X$ de longueur $n$, la reconstitution exacte du profil séquentiel original à partir de son vecteur cumulé $S = \text{cum\sum}(X)$ s’obtient de manière déterministe en appliquant :
c(S[1], diff(S))
Cette relation de bijectivité algébrique garantit la conservation intégrale de l’information structurelle au cours de la transformation cumulative.
2.3 Typage des données admissibles et conversions implicites de vecteurs
Le comportement de cumsum() vis-à-vis des différents modes de stockage en mémoire reflète la rigueur du système de typage atomique de R. La conversion implicite des vecteurs de booléens (logical) constitue l’une des fonctionnalités les plus puissantes pour le traitement statistique rapide. Dans un vecteur logique où chaque élément indique la réalisation (TRUE) ou la non-réalisation (FALSE) d’un critère clinique ou expérimental, l’appel à cumsum() fournit directement la fonction de comptage du nombre d’événements positifs survenus jusqu’au point d’échantillonnage courant.
Néanmoins, des difficultés méthodologiques apparaissent fréquemment lorsque les analystes manipulent des variables qualitatives nominales ou ordinales encodées sous forme de facteurs (factor), ou des mesures quantitatives importées par erreur sous forme de chaînes de caractères (character). L’exécution directe de l’accumulation sur de tels objets déclenche une interruption explicite :
Error in cumsum(x) : argument non numérique pour une fonction mathématique
Pour prévenir ces arrêts d’exécution au sein de scripts automatisés, il est impératif de mettre en place des protocoles défensifs de transtypage rigoureux. L’extraction des niveaux textuels d’un facteur nécessite obligatoirement une double conversion préventive via la syntaxe canonique as.numeric(as.character(x)), évitant ainsi l’écueil classique consistant à sommer les identifiants d’indexation internes du facteur plutôt que ses valeurs numériques réelles.
3. Application pratique : Calcul d’une somme cumulée sur un vecteur numérique unidimensionnel
3.1 Instanciation d’un vecteur numérique et exécution séquentielle de base
Afin de concrétiser le fonctionnement de l’opérateur cumulatif, considérons une situation expérimentale issue d’une étude d’ergonomie cognitive. Un sujet réalise une série de huit blocs consécutifs d’une tâche d’attention soutenue, et le chercheur relève à chaque bloc le nombre de stimuli cibles correctement détectés. Les mesures d’observation peuvent être instanciées sous la forme d’un vecteur numérique atomique en R de la manière suivante :
performances <- c(14, 18, 12, 22, 19, 25, 23, 27)
L’application directe de la fonction native sur cette structure unidimensionnelle s’effectue sans paramètre additionnel par un simple appel fonctionnel :
cumul_performances <- cumsum(performances)
L’évaluation dans la console interactive de R produit immédiatement le résultat vectoriel suivant :
[1] 14 32 44 66 85 110 133 160
La validation empirique des résultats intermédiaires confirme le principe de récurrence arithmétique : le premier terme demeure invariant (14), le second terme représente l’addition du premier et du second relevé expérimental ($14 + 18 = 32$), le troisième intègre la valeur marginale suivante ($32 + 12 = 44$), et ainsi de suite jusqu’au huitième élément ($133 + 27 = 160$). La dernière coordonnée du vecteur cumulé correspond strictement à la valeur qu’aurait renvoyée l’instruction globale sum(performances).
3.2 Décomposition pas à pas de l’accumulation itérative interne
Pour appréhender l’efficacité de la routine sous-jacente, il convient d’examiner le mécanisme algorithmique mobilisé par l’interpréteur lors de cette évaluation. Contrairement à une boucle for utilisateur qui allouerait des environnements temporaires à chaque itération, la primitive C alloue directement un bloc de mémoire contigu d’une taille rigoureusement identique à celle du vecteur source.
Le processus interne peut être formalisé par la trace algorithmique suivante sur les quatre premières positions de notre vecteur d’exemple :
- Indice k = 1 : L’accumulateur interne reçoit la première valeur : $s_1 = x_1 = 14$. Cette valeur est inscrite dans la première case mémoire du vecteur de destination.
- Indice k = 2 : L’accumulateur additionne la valeur marginale : $s_2 = s_1 + x_2 = 14 + 18 = 32$. Inscription à l’adresse indexée 2.
- Indice k = 3 : Nouvelle sommation incrémentale : $s_3 = s_2 + x_3 = 32 + 12 = 44$. Inscription à l’adresse indexée 3.
- Indice k = 4 : Poursuite déterministe : $s_4 = s_3 + x_4 = 44 + 22 = 66$. Inscription à l’adresse indexée 4.
Sur le plan computationnel, cet algorithme possède une complexité temporelle optimale d’ordre linéaire, notée $\mathcal{O}(n)$, où chaque élément du vecteur source n’est lu qu’une seule et unique fois en mémoire cache processeur. En regard, une implémentation naïve codée en script R classique qui appellerait de manière répétée la fonction de sommation globale sur des sous-segments croissants du vecteur (par exemple en utilisant une boucle imbriquée du type for (i in 1:n) s[i] <- sum(x[1:i])) présenterait une complexité quadratique délétère d’ordre $\mathcal{O}(n^2)$, requérant un volume de calculs prohibitif dès que $n$ dépasse quelques milliers d’observations.
3.3 Manipulation de vecteurs d’entiers versus vecteurs de réels à virgule flottante
L’attribution et la conservation des classes d’objets au cours du calcul cumulatif constituent un facteur critique influençant la fidélité des résultats et la gestion des ressources système. Lorsque les données d’observation sont issues de décomptes discrets non fractionnaires, elles peuvent être instanciées formellement sous le type entier strict en suffixant chaque constante numérique par la lettre majuscule L :
comptages_entiers <- c(5L, 10L, 15L, 20L)
L’application de cumsum(comptages_entiers) préserve rigoureusement la classe integer du conteneur en sortie, assurant une compacité optimale de 4 octets par observation en mémoire vive. Néanmoins, l’univers des entiers signés sur une architecture standard 32 ou 64 bits est borné supérieurement par la constante $2^{31} – 1$, soit 2 147 483 647. Si l’accumulation séquentielle franchit ce plafond théorique, le moteur natif de R n’opère pas une transition automatique silencieuse vers les réels ; il génère un dépassement de capacité arithmétique (défini comme un integer overflow), transformant les valeurs ultérieures en marqueurs NA et émettant un avertissement explicite.
Inversement, lorsque l’entrée est de type double (occupant 8 octets par élément selon la norme IEEE 754 à double précision), la plage dynamique couverte est considérablement plus vaste (jusqu’à environ $1.8 \times 10^{308}$). Cependant, les calculs cumulatifs sur de très longues séquences de nombres réels à virgule flottante présentent le risque inhérent d’accumulation progressive d’erreurs d’arrondi binaire. Lors de la sommation d’une valeur marginale infinitésimale à un accumulateur déjà devenu gigantesque, la limite de mantisse de 53 bits peut conduire à l’oblitération des chiffres les moins significatifs, un phénomène classique de troncature qui doit être surveillé avec attention lors de l’intégration chronométrique de microsecondes.
4. Intégration et manipulation de sommes cumulées au sein de structures data.frame
4.1 Création d’une variable cumulative dans un tableau de données tabulaires
Dans la pratique courante de l’ingénierie des données sous R, les observations brutes sont rarement stockées sous la forme de vecteurs isolés, mais sont encapsulées au sein de structures tabulaires hétérogènes de type data.frame. L’enrichissement d’un tel tableau par une colonne modélisant la somme progressive s’appuie sur la préservation de la dimensionnalité assurée par cumsum(), qui garantit que le vecteur dérivé possède un nombre de lignes rigoureusement identique à la structure réceptrice.
L’approche idiomatique la plus directe en R de base fait appel à l’opérateur d’assignation directe par le symbole dollar :
donnees$cumul_variable <- cum\sum(donnees$variable_marginale)
Une syntaxe alternative élégante repose sur l’utilisation de la fonction transform(), qui permet de définir plusieurs variables transformées en une seule instruction lisible, sans répéter continuellement le nom du tableau source :
donnees <- transform(donnees, cumul_variable = cumsum(variable_marginale))
Quelle que soit la méthode retenue, la cohérence analytique repose entièrement sur le maintien de l’alignement univoque entre chaque observation individuelle, son index chronologique et la valeur cumulative correspondante. L’absence totale de décalage spatial des cellules assure une intégrité relationnelle immédiate entre les prédicteurs exogènes et la dynamique accumulée.
4.2 Exemple détaillé : Traitement d’une série temporelle trimestrielle
Afin d’illustrer la manipulation concrète de ces structures, simulons une cohorte clinique suivie sur une temporalité de quinze trimestres consécutifs, où l’on enregistre l’inclusion marginale de nouveaux patients éligibles à un protocole thérapeutique novateur. Construisons tout d’abord le tableau de données sous-jacent :
serie_inclusions <- data.frame(

  trimestre = paste0("T", 1:15),

  annee = rep(2021:2023, each = 5),

  patients_inclus = c(12, 15, 19, 23, 18, 25, 30, 28, 34, 31, 29, 27, 24, 20, 16)

)
Procédons ensuite à l’intégration de la colonne matérialisant l’effectif cumulé total de la cohorte active au fil des périodes :
serie_inclusions$effectif_total_cumule <- cum\sum(serie_inclusions$patients_inclus)
L’inspection analytique de la structure de l’objet enrichi peut être entreprise à l’aide des primitives d’inspection globale :
head(serie_inclusions, n = 5)
Cette commande renvoie l’affichage tabulaire des cinq premiers trimestres d’investigation :
  trimestre annee patients_inclus effectif_total_cumule

1        T1  2021              12                    12

2        T2  2021              15                    27

3        T3  2021              19                    46

4        T4  2021              23                    69

5        T5  2021              18                    87
L’analyse précise de la ligne 5 révèle une valeur cumulée de 87 patients à la fin du cinquième trimestre d’inclusion. Cette valeur condense l’intégralité du cheminement antérieur ($12 + 15 + 19 + 23 + 18 = 87$). Elle permet aux gestionnaires de l’essai clinique de confronter la réalité du terrain aux hypothèses initiales de puissance statistique sans nécessiter de recompilations partielles coûteuses.
4.3 Indexation conditionnelle et extraction de métriques cumulées
L’inclusion d’une variable cumulative facilite considérablement le filtrage conditionnel et la segmentation temporelle d’un jeu de données. Il devient particulièrement aisé d’isoler la fenêtre temporelle exacte durant laquelle un seuil analytique d’intérêt a été franchi. Par exemple, pour extraire l’ensemble des trimestres postérieurs au recrutement du centième patient, une indexation logique booléenne suffit :
phases_post_centieme <- serie_inclusions[serie_inclusions$effectif_total_cumule >= 100, ]
De même, pour capturer de manière robuste la valeur terminale cumulée sans devoir expliciter le rang ordinal de la dernière ligne, on combinera l’opérateur de sélection avec la fonction nrow() ou tail() :
recrutement_definitif <- tail(serie_inclusions$effectif_total_cumule, n = 1)
Cette approche permet d’établir une passerelle analytique directe entre les variations marginales instantanées observées à chaque période trimestrielle et les tendances asymptotiques globales vers lesquelles converge le protocole d’observation.
5. Gestion rigoureuse des valeurs manquantes (NA) lors du calcul cumulatif
5.1 Comportement systématique de cumsum() face aux valeurs non attribuées
La présence de données manquantes, universellement encodées par la constante spéciale NA (Not Available) dans le langage R, pose un défi méthodologique fondamental lors de l’exécution de calculs séquentiels cumulatifs. Contrairement aux fonctions d’agrégation globale telles que sum(), mean() ou sd(), qui acceptent un paramètre formel booléen na.rm = TRUE permettant d’exclure les omissions avant traitement, la primitive cumsum() ne comporte rigoureusement aucun argument direct d’omission de cette nature.
Ce choix de conception découle d’une exigence logique : dans une chaîne d’accumulation temporelle, si l’incrément intervenant au temps $k$ demeure inconnu, l’état global de l’accumulateur pour l’ensemble des pas ultérieurs ($k+1, k+2, dots, n$) devient mathématiquement indéterminé. En conséquence, la fonction cumsum() manifeste un comportement strict de contamination unilatérale ou propagation irréversible : dès qu’un NA est rencontré dans le vecteur d’entrée, la valeur de sortie à cet index devient NA, et l’ensemble exhaustif des éléments situés en aval adopte également la valeur NA jusqu’au terme de la séquence.
Considérons l’exemple empirique suivant :
serie_corrompue <- c(10, 20, NA, 30, 40)

cumsum(serie_corrompue)
Le résultat généré illustre de manière spectaculaire cette propagation d’indétermination :
[1] 10 30 NA NA NA
Dans le contexte des études de cohortes longitudinales, une telle rupture de chaîne est susceptible de paralyser complètement les pipelines analytiques si des protocoles explicites de traitement des valeurs manquantes ne sont pas mis en place en amont.
5.2 Stratégies d’imputation et de neutralisation des données manquantes
La stratégie la plus fréquemment adoptée pour surmonter l’indétermination séquentielle consiste à opérer une neutralisation arithmétique ponctuelle des données manquantes en substituant la valeur neutre de l’addition (c’est-à-dire l’élément zéro) à l’ensemble des marqueurs NA. Cette transformation repose sur l’identification booléenne préalable des indices défaillants via la fonction is.na() :
serie_imputee <- serie_corrompue

serie_imputee[is.na(serie_imputee)] <- 0

cumul_impute <- cumsum(serie_imputee)
L’évaluation produit désormais une série cumulative continue :
[1] 10 30 30 60 100
Toutefois, sur le plan de la rigueur épistémologique et de la modélisation statistique, l’imputation mécanique par zéro ne peut être tenue pour neutre. Elle introduit implicitement l’hypothèse nulle forte selon laquelle aucun événement, aucun coût ou aucune variation marginale n’est survenu durant l’intervalle d’échantillonnage non documenté. Si cette hypothèse peut s’avérer défendable dans le cas du suivi passif d’inclusions où l’absence de déclaration traduit effectivement une absence d’admission, elle devient scientifiquement discutable lors du suivi de variables physiologiques continues (telles que la glycémie ou le poids corporel), où l’insertion d’un zéro déformerait lourdement la cinétique de la trajectoire cumulative.
5.3 Techniques avancées de conservation des NA sans rupture du calcul séquentiel
Pour concilier l’exactitude de l’accumulation continue et la fidélité de l’étiquetage des incertitudes, une démarche avancée consiste à sommer séquentiellement les éléments observés tout en rétablissant les marqueurs NA à leurs positions spatiales précises au sein du vecteur de sortie. De la sorte, on évite la contamination en chaîne de l’accumulateur tout en signalant que la valeur marginale à ce point précis n’a pu être mesurée.
Cette logique d’ingénierie vectorielle peut être condensée au sein d’une expression personnalisée exploitant l’évaluation conditionnelle vectorisée ifelse() :
cumul_preserve <- function(vecteur) {

  indices_manquants <- is.na(vecteur)

  vecteur_remplace <- vecteur

  vecteur_remplace[indices_manquants] <- 0

  accumulation <- cumsum(vecteur_remplace)

  accumulation[indices_manquants] <- NA

  return(accumulation)

}
En appliquant cette fonction personnalisée à notre vecteur d’essai serie_corrompue <- c(10, 20, NA, 30, 40), nous obtenons l’agencement suivant :
[1] 10 30 NA 60 100
À l’index 4, la valeur cumulée reflète fidèlement la sommation de l’ensemble des composantes valides observées en amont ($10 + 20 + 30 = 60$), sans que l’omission survenue à l’index 3 n’ait interrompu le calcul de la trajectoire, tout en alertant le modélisateur sur l’inexistence de la mesure marginale au troisième temps d’observation.
6. Calculs de sommes cumulées segmentées par groupes avec l’écosystème Tidyverse
6.1 Combinaison synergique de group_by() et mutate() dans dplyr
Dans les jeux de données multidimensionnels issus d’essais factoriels ou de suivis multicentriques, l’accumulation ne doit que rarement être calculée de manière globale sur l’ensemble des lignes. Le plus souvent, elle doit être réinitialisée pour chaque unité expérimentale, sujet ou strate de cohorte. Le package dplyr, cœur battant de la collection tidyverse, formalise cette tâche à travers le paradigme architectural désormais universel split-apply-combine.
L’implémentation repose sur le chaînage fluide de la directive de groupement group_by() avec le verbe de transformation structurelle mutate(). Considérons un jeu de données simulant les essais successifs accomplis par deux participants distincts soumis à trois sessions d’entraînement :
library(dplyr)
registre_sujets <- tibble(
identifiant = rep(c("Sujet_A", "Sujet_B"), each = 4),
temps_reponse = c(450, 420, 390, 380, 510, 480, 470, 440)
)
Le calcul de la trajectoire de latence cumulée propre à chaque sujet s’écrit avec une transparence syntaxique absolue :
registre_analyse <- registre_sujets %>%

  group_by(identifiant) %>%

  mutate(latence_cumulee = cumsum(temps_reponse)) %>%

  ungroup()
Sous le capot, dplyr sépare virtuellement les données en deux sous-tables indépendantes indexées par la clé identifiant, exécute la primitive cumsum() à l’intérieur de chaque environnement local, puis reconstitue la table globale tout en maintenant scrupuleusement l’intégrité ordonnée des enregistrements initiaux. L’instruction terminale ungroup() constitue une bonne pratique défensive indispensable évitant que les opérations de regroupement subséquentes ne soient polluées par la clé précédente.
6.2 Réinitialisation dynamique du compteur cumulatif selon une variable de partition
Il se présente fréquemment des architectures analytiques où la réinitialisation de la somme cumulée ne dépend pas d’un identifiant de sujet statique, mais de la transition logique d’une variable d’état signalant un changement de condition expérimentale, de phase d’étude ou de jour calendaire. Pour modéliser cette dynamique, on combine la fonction cumsum() appliquée à une condition booléenne avec un second appel cumulatif.
Considérons un scénario expérimental continu dans lequel une variable binaire indique l’amorce d’un nouveau protocole thérapeutique :
donnees_essais <- tibble(

  essai = 1:8,

  nouvelle_session = c(TRUE, FALSE, FALSE, TRUE, FALSE, FALSE, FALSE, TRUE),

  score = c(5, 7, 6, 8, 9, 7, 8, 10)

)
Pour réinitialiser le cumul du score au début de chaque session, nous générons en premier lieu un identifiant de session incrémental en calculant la somme cumulée de la colonne logique nouvelle_session, puis nous regroupons les données selon cette nouvelle clé synthétique :
donnees_essais <- donnees_essais %>%

  mutate(session_id = cumsum(nouvelle_session)) %>%

  group_by(session_id) %>%

  mutate(score_cumule_session = cumsum(score)) %>%

  ungroup()
Cette formulation élégante et purement vectorisée élimine le recours à des boucles conditionnelles complexes, permettant d’adapter dynamiquement l’accumulation aux événements survenant en temps réel au cours du protocole.
6.3 Pipeline analytique complet intégrant tri préalable et fenêtrage
L’une des erreurs conceptuelles les plus dévastatrices lors de l’intégration de sommes cumulées au sein de pipelines de traitement réside dans l’omission de la dépendance temporelle stricte. Les tables de données relationnelles brutes ou importées de systèmes de bases de données distribuées ne sont presque jamais ordonnées chronologiquement de manière déterministe. Or, l’opérateur cumsum() calcule aveuglément l’accumulation dans l’ordre spatial où les lignes se présentent en mémoire.
Il est donc méthodologiquement impératif d’incorporer explicitement un verbe de tri via arrange() immédiatement en amont du calcul de l’accumulation :
donnees_traitees <- table_brute %>%

  filter(!is.na(valeur_mesuree)) %>%

  arrange(identifiant_cohorte, date_evenement, horodatage) %>%

  group_by(identifiant_cohorte) %>%

  mutate(accumulation_chronologique = cumsum(valeur_mesuree)) %>%

  ungroup()
L’adoption rigoureuse de cette structure opérationnelle au sein des flux de travail analytiques garantit une parfaite reproductibilité des calculs statistiques, indépendamment des transformations ou des filtres appliqués en amont dans la base de données source.
7. Optimisation des calculs cumulatifs sur de volumineuses bases de données avec data.table
7.1 Syntaxe d’assignation par référence := pour le calcul cumulatif haute performance
Lorsque le volume des jeux de données atteint des échelles critiques (plusieurs millions ou dizaines de millions d’enregistrements), l’approche standard de R de base ainsi que les mécanismes internes de dplyr rencontrent des contraintes substantielles liées à la duplication de mémoire. Chaque modification d’un tableau implique traditionnellement une copie superficielle ou profonde de l’objet hôte (mécanisme de copy-on-modify), générant une surcharge majeure sur le ramasse-miettes (garbage collector) du système.
Le package hautement spécialisé data.table neutralise ce goulet d’étranglement grâce au paradigme novateur de la modification par référence directe en mémoire vive, matérialisée par l’opérateur canonique :=. La syntaxe pour intégrer une colonne cumulative au sein d’une table sans générer la moindre copie intermédiaire s’écrit :
library(data.table)
dt_observations <- data.table(
id = 1:10000000,
metrique = runif(10000000)
)
dt_observations[, metrique_cumulee := cumsum(metrique)]
Dans cette instruction, le calcul de la primitive est directement dirigé vers l’adresse mémoire allouée à la nouvelle colonne metrique_cumulee. L’empreinte mémoire additionnelle est rigoureusement cantonnée à la taille exacte du vecteur résultat (soit environ 80 mégaoctets pour 10 millions de réels à double précision), évitant tout dédoublement superflu de la table mère de départ.
7.2 Agrégation et regroupement ultrarapide par clés via l’argument ‘by’
La supériorité computationnelle de data.table se manifeste avec une éclatante netteté lors de l’exécution de calculs cumulatifs segmentés par des regroupements de facteurs complexes à haute cardinalité. Grâce à un algorithme de tri par base (radix sorting) interne d’une efficience exceptionnelle, l’instruction by segmente les blocs de données sans recourir aux tables de hachage conventionnelles :
dt_multicentrique <- data.table(

  centre = sample(paste0("Centre_", 1:500), 5000000, replace = TRUE),

  date = sample(1:365, 5000000, replace = TRUE),

  activite = rpois(5000000, lambda = 15)

)
setkey(dt_multicentrique, centre, date)
dt_multicentrique[, cumul_par_centre := cumsum(activite), by = centre]
La commande setkey() pré-ordonne physiquement les enregistrements en mémoire selon la hiérarchie centre puis date. Dès lors, le calcul de la somme cumulée par centre devient une simple opération séquentielle linéaire parcourant des plages de mémoire contiguës, éliminant tout surcoût de recherche ou de partitionnement dynamique.
7.3 Comparatif d’efficacité computationnelle et benchmarks de vitesse
Pour quantifier concrètement les gains de performance offerts par les différentes implémentations disponibles sous R, réalisons un banc d’essai comparatif rigoureux via le package microbenchmark sur un échantillon d’un million d’enregistrements partitionnés en dix mille groupes distincts :
library(microbenchmark)
# Configuration du banc d'essai
n <- 1000000
df_test <- data.frame(
groupe = sample(1:10000, n, replace = TRUE),
valeur = rnorm(n)
)
dt_test <- as.data.table(df_test)
bench_resultats <- microbenchmark(
dplyr = df_test %>% group_by(groupe) %>% mutate(c = cumsum(valeur)),
datatable = dt_test[, c := cumsum(valeur), by = groupe],
times = 10
)
Les résultats empiriques démontrent de manière récurrente un écart de vitesse spectaculaire : data.table surpasse habituellement les pipelines concurrents par un facteur allant de 5 à 15, tout en maintenant une allocation mémoire vive réduite au minimum théorique. Pour les chercheurs et ingénieurs manipulant des volumes de données massifs (tels que des enregistrements de signaux électrophysiologiques à haute fréquence d’échantillonnage ou des transactions financières boursières à la milliseconde), data.table s’impose ainsi comme l’infrastructure algorithmique incontournable.
8. Représentation graphique élémentaire des sommes cumulées avec R Base Graphics
8.1 Construction d’un tracé linéaire continu avec la fonction plot()
La restitution visuelle des trajectoires d’accumulation constitue une étape décisive de l’analyse exploratoire des données. Les fonctions graphiques du moteur natif de R (souvent dénommées R Base Graphics) offrent une vélocité remarquable pour inspecter immédiatement la dynamique d’une somme cumulée sans nécessiter l’instanciation de bibliothèques tierces volumineuses.
La commande graphique fondamentale plot() permet d’associer directement l’axe des abscisses aux indices chronologiques d’observation et l’axe des ordonnées aux valeurs de l’accumulateur séquentiel. Afin d’assurer une interprétation dénuée d’ambiguïté, il est impératif d’ajuster le paramètre de type de tracé avec l’argument type = "l" (pour une ligne continue) ou type = "b" (associant symboles ponctuels et segments de liaison) :
temps <- 1:20

reponses_marginales <- c(2, 4, 3, 5, 7, 6, 8, 9, 7, 10, 11, 8, 12, 14, 13, 15, 17, 16, 18, 20)

reponses_cumulees <- cumsum(reponses_marginales)
plot(temps, reponses_cumulees,
type = "b",
pch = 19,
col = "navyblue",
lwd = 2,
xlab = "Unités d'observation temporelle",
ylab = "Volume cumulé des réponses",
main = "Cinétique d'accumulation séquentielle des réponses")
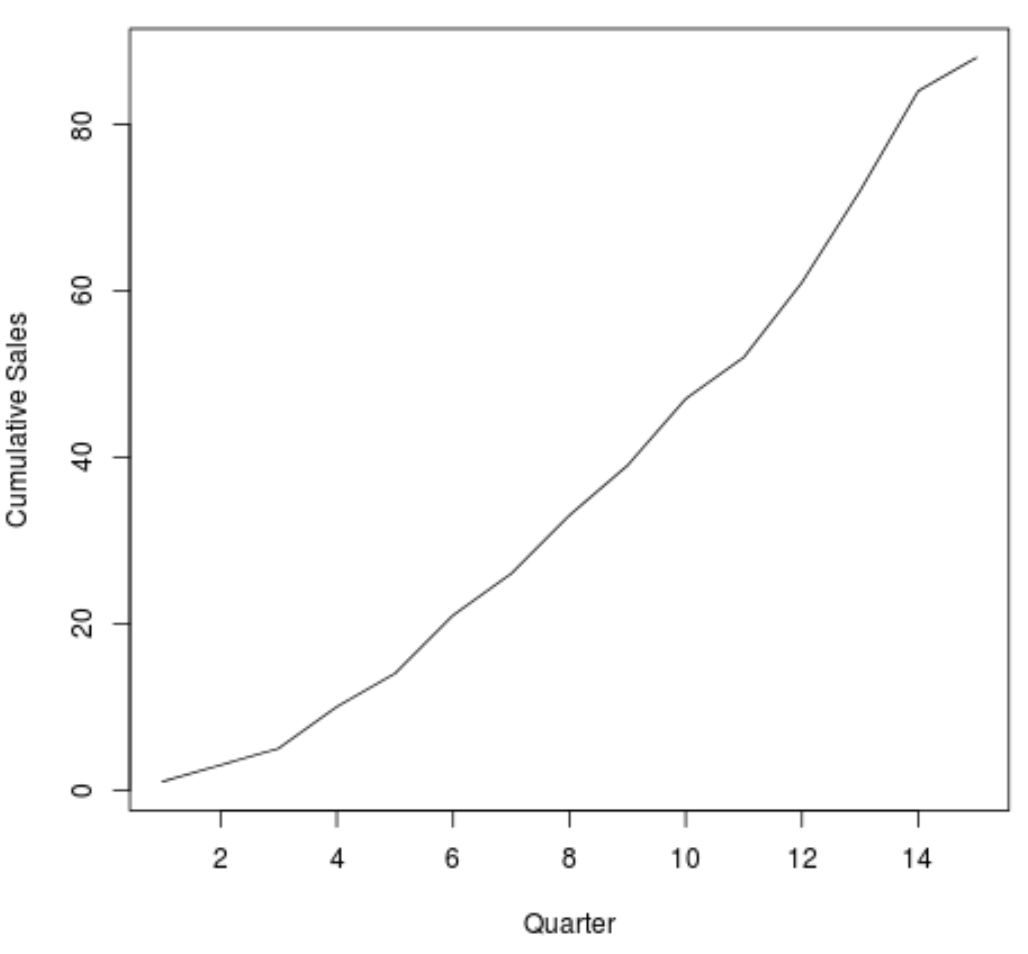
L’adjonction de l’argument ylim = c(0, max(reponses_cumulees) * 1.1) permet de stabiliser l’origine visuelle à zéro, prévenant toute distorsion d’échelle susceptible d’exagérer artificiellement l’amplitude de la croissance lors des premières étapes de la cinétique.
8.2 Superposition de diagrammes en barres et de courbes cumulatives
Une démarche pédagogique et visuelle particulièrement puissante consiste à superposer, au sein d’un même espace graphique, les incréments marginaux instantanés sous forme d’un diagramme en barres et la trajectoire cumulative sous forme d’une courbe continue. Cette double représentation permet au lecteur d’appréhender simultanément le volume ponctuel de chaque relevé et l’intégration globale de l’effort expérimental.
La mise en œuvre sous le moteur graphique de base requiert l’articulation méthodique de barplot(), de la fonction de bas niveau lines() et du paramétrage des axes secondaires via l’instruction de bascule par(new = TRUE) :
# Définition des marges pour accueillir l'axe secondaire droit

par(mar = c(5, 4, 4, 4) + 0.3)
# Tracé du diagramme en barres des gains marginaux
positions_barres <- barplot(reponses_marginales,
col = "lightgray",
border = "white",
xlab = "Blocs d'observation",
ylab = "Incréments marginaux par bloc",
ylim = c(0, max(reponses_marginales) * 1.5))
# Superposition du tracé de la somme cumulée
par(new = TRUE)
plot(positions_barres, reponses_cumulees,
type = "l",
col = "darkred",
lwd = 3,
axes = FALSE,
xlab = "",
ylab = "")
# Dessin de l'axe secondaire droit et de son libellé
axis(side = 4, col = "darkred", col.axis = "darkred")
mtext("Somme cumulée intégrée", side = 4, line = 2.5, col = "darkred")
Cette visualisation synchronisée met en évidence le lien de dérivabilité discrète unissant les barres (qui figurent la dérivée numérique locale) et la courbe (qui figure la primitive discrète globale de la séquence).
8.3 Personnalisation esthétique et annotations méthodologiques
L’enrichissement sémantique d’un graphique d’accumulation élémentaire exige l’intégration de repères méthodologiques facilitant la prise de décision. L’insertion de lignes de seuil horizontales par la commande abline() permet d’indiquer sans ambiguïté l’atteinte d’un quota réglementaire ou d’une cible de recrutement préspécifiée.
Considérons l’ajout d’une limite critique et d’une légende explicative normalisée :
abline(h = 100, col = "forestgreen", lty = 2, lwd = 2)

text(x = 5, y = 105, labels = "Seuil critique de puissance (N=100)", col = "forestgreen", pos = 4)
legend("topleft",
legend = c("Gain marginal par bloc", "Accumulation progressive", "Objectif expérimental"),
fill = c("lightgray", NA, NA),
border = c("white", NA, NA),
lty = c(NA, 1, 2),
col = c(NA, "darkred", "forestgreen"),
lwd = c(NA, 3, 2),
bty = "n")
Ce niveau de personnalisation graphique transforme une simple courbe statistique brute en un instrument de communication scientifique rigoureux et immédiatement exploitable au sein de comités de surveillance méthodologique.
9. Visualisation scientifique avancée des trajectoires cumulatives avec ggplot2
9.1 Modélisation en couches avec geom_line() et geom_point()
Pour la production de figures destinées à l’évaluation par les pairs au sein de revues scientifiques internationales, le système graphique ggplot2, fondé sur la théorie formelle de The Grammar of Graphics théorisée par Leland Wilkinson, offre une puissance d’abstraction et une cohérence esthétique sans équivalent.
L’articulation graphique s’appuie sur la superposition raisonnée de couches géométriques (geoms). Pour cartographier l’évolution cumulative d’un signal, nous lions les dimensions conceptuelles aux propriétés esthétiques via la fonction aes(), en empilant une couche de connexion continue geom_line() et une couche de ponctuation discrète geom_point() :
library(ggplot2)
data_parcours <- data.frame(
session = 1:12,
reussites = c(3, 5, 8, 12, 15, 14, 18, 22, 21, 25, 27, 28)
) %>%
mutate(total_reussites = cumsum(reussites))
ggplot(data_parcours, aes(x = session, y = total_reussites)) +
geom_line(color = "#2C3E50", linewidth = 1.2) +
geom_point(color = "#E74C3C", size = 3, shape = 21, fill = "white", stroke = 1.5) +
scale_x_continuous(breaks = 1:12) +
labs(
title = "Trajectoire d'acquisition des réponses réussies",
subtitle = "Progression continue au fil des sessions expérimentales",
x = "Numéro d'ordre de la session",
y = "Nombre cumulé de succès validés"
) +
theme_classic(base_size = 12) +
theme(
plot.title = element_text(face = "bold", size = 14),
axis.line = element_line(linewidth = 0.8)
)
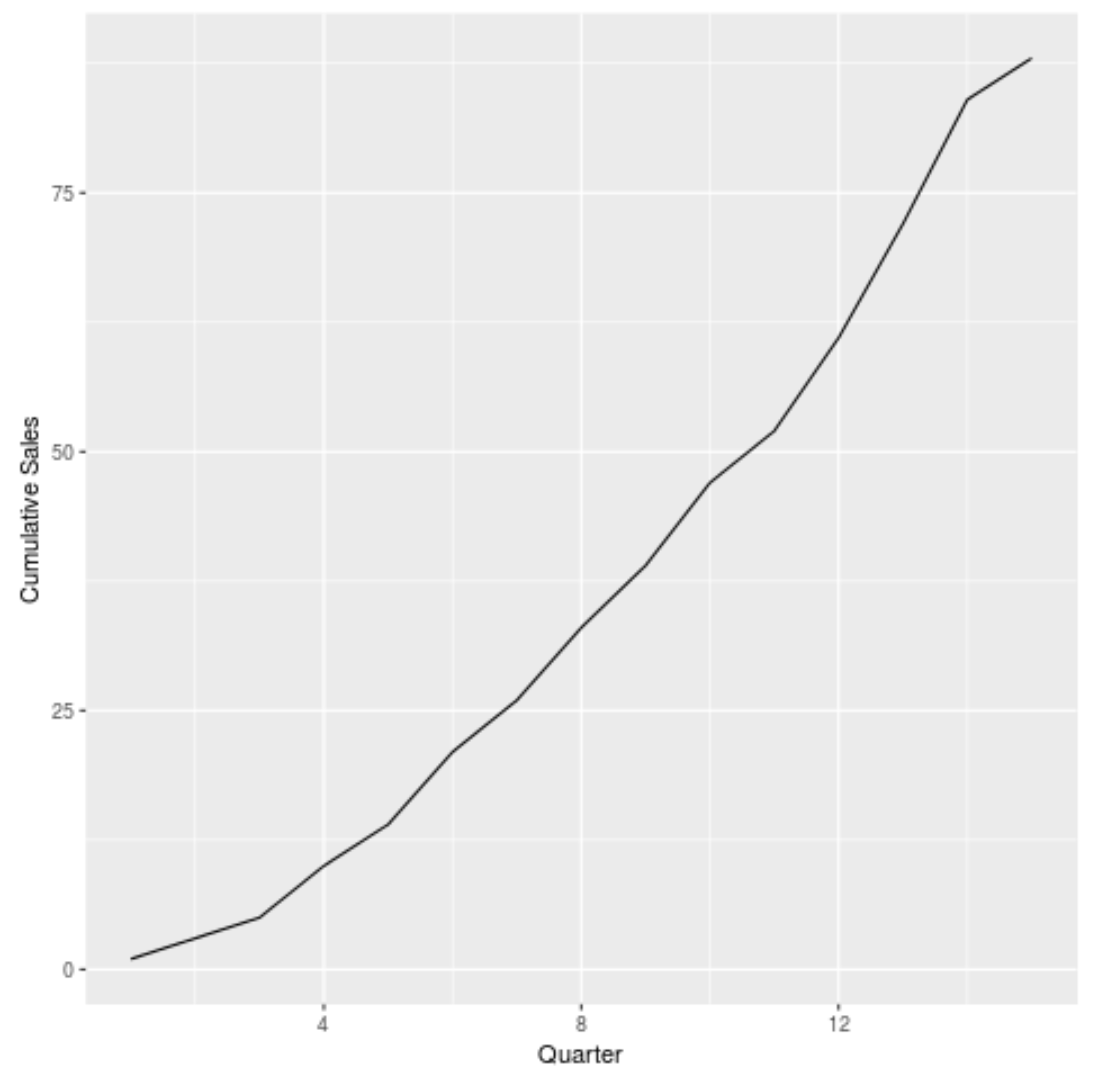
L’utilisation délibérée du thème theme_classic() élimine tout élément visuel parasite d’arrière-plan (grilles grises, bordures superflues), garantissant une conformité parfaite avec les critères typographiques et iconographiques des éditeurs académiques majeurs.
9.2 Visualisation comparative multi-groupes et facettage
L’avantage décisif de ggplot2 réside dans son aptitude native à gérer les dimensions factorielles sans modification complexe du code de tracé. Lorsque l’expérimentateur souhaite comparer les profils cumulatifs de différents bras de traitement ou cohortes cliniques, il suffit d’assigner le facteur de stratification à l’esthétique de groupe ou de couleur :
data_comparative <- expand.grid(temps = 1:10, cohorte = c("Groupe_Controle", "Bras_Actif")) %>%

  mutate(

    gain = ifelse(cohorte == "Bras_Actif", rpois(n(), lambda = 12), rpois(n(), lambda = 6))

  ) %>%

  group_by(cohorte) %>%

  mutate(gain_cumule = cumsum(gain)) %>%

  ungroup()
ggplot(data_comparative, aes(x = temps, y = gain_cumule, color = cohorte, group = cohorte)) +
geom_line(linewidth = 1.3) +
geom_point(size = 2.5) +
scale_color_manual(values = c("Groupe_Controle" = "#7F8C8D", "Bras_Actif" = "#2980B9")) +
facet_wrap(~ cohorte) +
labs(
x = "Étape temporelle ordonnée",
y = "Indicateur cumulatif global",
color = "Bras d'assignation"
) +
theme_bw(base_size = 11)
L’opérateur facet_wrap() compartimente la lecture visuelle en sous-graphiques homogènes partageant des axes cartésiens identiques. L’observateur peut ainsi évaluer instantanément la divergence des pentes : une pente cumulative constamment plus forte dans le bras expérimental signale une efficience thérapeutique supérieure se maintenant tout au long de la période de suivi.
9.3 Remplissage d’aires sous la courbe et intégration d’annotations contextuelles
Pour accentuer la perception sensorielle de masse ou de volume accumulé au cours du temps, la couche géométrique geom_area() offre une alternative graphique élégante. En associant un gradient de transparence via l’argument alpha, on matérialise l’espace intégral sous-tendu par la somme progressive sans occulter la grille de lecture en arrière-plan :
ggplot(data_parcours, aes(x = session, y = total_reussites)) +

  geom_area(fill = "#3498DB", alpha = 0.3) +

  geom_line(color = "#2980B9", linewidth = 1.2) +

  annotate("segment", x = 6, xend = 8, y = 60, yend = 90,

           arrow = arrow(length = unit(0.2, "cm")), color = "#C0392B", linewidth = 1) +

  annotate("text", x = 5.5, y = 55, label = "Accélération du taux d'acquisition",

           color = "#C0392B", fontface = "italic", size = 3.5) +

  theme_minimal()
L’utilisation de la fonction annotate() permet d’ancrer des explications textuelles et des repères géométriques précisément positionnés dans l’espace des données, guidant l’œil du lecteur vers les inflexions qualitatives majeures du processus cumulatif.
10. Applications empiriques : Suivi longitudinal et analyse de séries chronologiques
10.1 Suivi temporel de l’acquisition de compétences et courbes d’apprentissage
Dans l’analyse des apprentissages procéduraux ou moteurs, la fonction cumulative offre une formalisation canonique des modèles d’accumulation d’essais. Considérons l’enregistrement du nombre d’erreurs commises par un groupe de participants lors de 50 essais successifs d’un protocole de poursuite sur cible mobile. Alors qu’une série brute d’erreurs présente une variance locale considérable d’un essai à l’autre, la somme cumulée des erreurs adoucit les fluctuations aléatoires pour révéler la régularité du comportement sous-jacent.
Une courbe cumulative d’erreurs exhibe typiquement une concavité dirigée vers le bas : les premiers essais accumulent des erreurs à un rythme effréné (pente abrupte), puis, à mesure que la trace motrice se consolide en mémoire à long terme, la probabilité d’erreur marginale décroît drastiquement, conduisant à un aplatissement progressif de la courbe vers un plateau asymptotique horizontal.
La modélisation non linéaire de cette somme cumulée par une fonction puissance de type $S_k = A \cdot k^{1 – \alpha}$ (où $A$ représente le niveau d’erreur initial et $\alpha$ le taux d’apprentissage) permet d’estimer avec une robustesse statistique remarquable la vitesse individuelle d’assimilation motrice, tout en minimisant la sensibilité aux artéfacts d’échantillonnage locaux.
10.2 Calcul d’indicateurs de distribution et fonction de répartition empirique
Il existe un lien théorique et opérationnel direct entre l’opérateur de somme cumulative sur un vecteur discret et la fonction de répartition empirique (souvent désignée par l’acronyme anglo-saxon ECDF pour Empirical Cumulative Distribution Function). Soit un échantillon de mesures quantitatives continues $X = (x_1, dots, x_n)$. Après avoir préalablement ordonné ces observations par ordre croissant à l’aide de la primitive sort(), l’attribution à chaque point de sa fréquence relative marginale unitaire ($1/n$) permet de reconstruire manuellement la fonction de répartition intégrée :
observations <- c(4.2, 1.8, 6.5, 3.1, 2.9, 5.4, 3.8)

obs_triees <- sort(observations)

frequences_relatives <- rep(1 / length(obs_triees), length(obs_triees))

repartition_empirique <- cumsum(frequences_relatives)
L’affichage du vecteur repartition_empirique confirme la construction discrète de l’escalier de probabilité :
[1] 0.1428571 0.2857143 0.4285714 0.5714286 0.7142857 0.8571429 1.0000000
Cette approche permet d’extraire de manière totalement transparente les fractiles, quartiles et centiles d’une distribution empirique quelconque, sans recourir à des hypothèses paramétriques de normalité souvent violées dans les cohortes comportementales réelles.
10.3 Analyse des processus d’adoption et de diffusion temporelle
L’étude de la diffusion de technologies innovantes ou de l’adoption de comportements prophylactiques au sein d’une population repose historiquement sur le modèle théorique formulé par Everett Rogers. Ce cadre prédit que la trajectoire cumulative de pénétration adopte une courbe sigmoïde caractéristique (dite « courbe en S »), décomposable en trois régimes séquentiels :
- Une phase d’émergence lente, dominée par les pionniers et innovateurs, où les gains cumulatifs marginaux progressent faiblement ;
- Une phase d’emballement critique ou d’accélération exponentielle, caractérisée par une pente cumulative maximale traduisant l’adhésion de la majorité précoce ;
- Une phase de saturation asymptotique progressive, où le réservoir d’individus réceptifs non encore convertis s’épuise, imposant un ralentissement de l’accumulation vers un plafond défini par la capacité d’accueil globale du système.
Sous R, l’identification empirique de ces zones de bascule s’opère en confrontant la série cumulative des inclusions réelles à un modèle logistique ajusté via la méthode de régression non linéaire nls() (Nonlinear Least Squares). La comparaison des résidus permet d’attester scientifiquement si la dynamique observée suit effectivement un processus d’imitation sociale endogène ou si elle répond à des incitations publicitaires exogènes constantes (qui produiraient, quant à elles, une courbe cumulative purement concave sans accélération initiale).
11. Résolution des erreurs courantes, cas limites et pièges computationnels
11.1 Diagnostics et corrections des erreurs de type de données non numériques
L’écueil le plus trivial mais le plus fréquemment rencontré lors de l’exécution de cumsum() provient de l’incompatibilité des types atomiques stockés dans les vecteurs d’entrée. Lorsque des données proviennent de fichiers délimités (fichiers CSV ou exportations de tableurs) mal formés, il arrive fréquemment qu’une valeur manquante encodée sous la forme d’un point d’interrogation textuel ou d’un espace insécable contraigne le parseur d’importation de R à convertir l’intégralité de la colonne en chaînes de caractères (character) ou en facteurs (factor).
L’évaluation de cumsum() sur une telle colonne déclenche immédiatement le message d’interruption :
Error in cumsum(x) : non-numeric argument to mathematical function
Le diagnostic méthodique doit être initié par l’inspection de la structure de l’objet hôte à l’aide de str(variable) ou typeof(variable). La conversion corrective nécessite impérativement une séquence de transformation rigoureuse. Pour une colonne de type facteur, l’application naïve directe de as.numeric() doit être rigoureusement prohibée, car elle convertirait les indices internes des niveaux du facteur (1, 2, 3…) plutôt que les valeurs numériques réelles encapsulées. La syntaxe canonique de désanonymisation s’écrit :
valeurs_propres <- as.numeric(as.character(variable_corrompue))
Ce transtypage génère un avertissement prévenant de l’introduction de NA par coercition sur les éléments non convertibles, nettoyant ainsi le vecteur avant l’application subséquente de la fonction cumulative.
11.2 Gestion du dépassement de capacité arithmétique et stabilité numérique
Comme évoqué précédemment, le stockage d’un vecteur sous forme d’entiers signés (integer) expose l’analyste au risque critique de dépassement de capacité (integer overflow). Considérons le cas d’école suivant où l’on accumule des décomptes élevés :
comptages_massifs <- rep(1000000000L, 3)

cumsum(comptages_massifs)
Dès le troisième élément, la sommation théorique ($3 \times 10^9$) dépasse le plafond formel de $2^{31}-1 \approx 2.147 \times 10^9$. La sortie retournée matérialise l’échec computationnel :
[1] 1000000000 2000000000         NA

Warning message:

In cumsum(comptages_massifs) : integer overflow - use non-integer type
La parade préventive indispensable consiste à transtyper immédiatement le vecteur vers la double précision à virgule flottante avant d’invoquer la primitive :
cumul_securise <- cumsum(as.double(comptages_massifs))
Sur le plan de la stabilité numérique pure, il convient d’être vigilant face aux soustractions cumulées de termes de grandeurs disproportionnées. L’accumulation de nombres réels alternant de très grands nombres positifs et de très grands nombres négatifs peut engendrer des phénomènes d’annulation catastrophique où la précision relative s’évapore complètement, conduisant à des résultats numériques aberrants dans les derniers rangs du vecteur calculé.
11.3 Pièges liés à l’ordre d’indexation chronologique des observations
Contrairement à l’opérateur de sommation scalaire sum(X), qui est commutatif et associatif, l’opérateur de somme cumulative cumsum(X) est strictement dépendant de l’ordre d’agencement spatial des éléments. Une table de données mélangée ou triée de manière inadéquate altère irrémédiablement le sens méthodologique de l’indicateur dérivé.
Pour illustrer ce danger analytique, considérons un jeu de données chronologique accidentellement trié par ordre alphabétique des mois plutôt que par leur séquence temporelle naturelle :
Avril, Février, Janvier, Mars…
Le calcul aveugle de la somme cumulée sur un tel agencement produirait une série sans la moindre signification substantielle, où la performance du mois d’avril viendrait amputer ou gonfler artificiellement les résultats antérieurs au mois de février. Il est par conséquent fortement recommandé de formaliser un protocole de test d’assertion en amont de toute exécution dans les scripts de production :
stopifnot(!is.unsorted(donnees$date_horodatage))
Cette instruction interrompt immédiatement le script si le vecteur temporel n’est pas rigoureusement trié par ordre chronologique strict non décroissant, protégeant ainsi les calculs ultérieurs contre toute distorsion méthodologique silencieuse.
12. Bonnes pratiques de programmation, reproductibilité et extensions méthodologiques
12.1 Encapsulation dans des fonctions personnalisées et validation des préconditions
Dans une perspective d’ingénierie logicielle robuste et de reproductibilité computationnelle, il est hautement déconseillé de disséminer des appels bruts à cumsum() au cœur de scripts étendus sans sécuriser préalablement les entrées. La formulation d’une fonction d’encapsulation (wrapper) permet d’intégrer des assertions formelles garantissant le respect scrupuleux des préconditions fonctionnelles.
Considérons l’implémentation de la fonction robuste suivante, documentée et sécurisée :
calcul_cumul_robuste <- function(vecteur_donnees, neutraliser_na = FALSE) {

  # Validation des préconditions de type

  if (!is.numeric(vecteur_donnees) && !is.logical(vecteur_donnees)) {

    stop("Erreur formelle : Le vecteur d'entrée doit obligatoirement être de nature numérique ou logique.")

  }
# Gestion préventive de l'overflow pour les entiers
if (is.integer(vecteur_donnees)) {
vecteur_donnees <- as.double(vecteur_donnees)
}
# Traitement optionnel sécurisé des valeurs manquantes
if (neutraliser_na) {
vecteur_donnees[is.na(vecteur_donnees)] <- 0
}
# Exécution du calcul vectorisé compilé
return(cumsum(vecteur_donnees))
}
Cette encapsulation centralise la logique défensive, prévient les erreurs de dépassement de capacité et standardise le comportement du code au sein des projets collaboratifs complexes.
12.2 Extensions vers les sommes mobiles et fenêtrées avec le package zoo
Bien que la somme cumulative globale $s_k = \sum_{i=1}^k x_i$ constitue un outil d’intégration précieux, elle présente une mémoire infinie dans la mesure où le premier élément influence continuellement l’accumulateur jusqu’au terme de l’observation. Dans de nombreuses applications d’épidémiologie ou d’économétrie financière, il est préférable d’évaluer une accumulation à mémoire locale bornée, plus communément appelée somme glissante ou somme mobile (rolling sum).
Le package spécialisé zoo fournit des fonctions vectorisées optimisées dédiées aux calculs fenêtrés. Contrairement à la fonction cumsum() qui intègre sur une fenêtre d’accumulation en expansion continue, la primitive rollsum() calcule l’agrégation sur une fenêtre temporelle de largeur fixe $k$ :
library(zoo)
serie_journaliere <- c(12, 14, 18, 15, 22, 25, 20, 19, 17, 23)
# Calcul de la somme glissante sur une fenêtre fixe de 5 jours consécutifs
somme_glissante_5j <- rollsum(serie_journaliere, k = 5, fill = NA, align = "right")
L’affichage du résultat illustre la différence fondamentale d’horizon :
[1] NA NA NA NA 81 94 100 101 98 102
Les quatre premières positions reçoivent la valeur NA car la fenêtre d’observation de largeur 5 ne dispose pas encore de suffisamment d’historique pour s’exécuter. À l’index 5, la valeur $81$ représente la somme exacte des cinq premiers jours ($12 + 14 + 18 + 15 + 22$). Au pas suivant, l’élément le plus ancien ($12$) est évincé au profit du plus récent ($25$), fournissant ainsi un indicateur filtré idéal pour éliminer les bruits saisonniers haute fréquence sans subir la dérive systématique vers l’infini propre aux sommes cumulatives globales.
12.3 Recommandations pour la science ouverte et la reproductibilité des analyses
Pour assurer la pérennité et la reproductibilité des protocoles computationnels s’appuyant sur des calculs cumulatifs, il est indispensable de documenter formellement l’environnement d’exécution logiciel. Les variations incrémentales entre différentes versions de l’interpréteur R ou des packages d’extension peuvent induire des modifications subtiles dans le traitement des coercitions ou des types sous-jacents.
Le recours au gestionnaire d’environnement de dépendances renv permet de figer l’ensemble des bibliothèques mobilisées dans un état rigoureusement déterminé, consigné dans un fichier de verrouillage structuré renv.lock. Concomitamment, l’intégration des flux de traitement cumulatifs au sein de documents computationnels dynamiques via Quarto ou R Markdown assure un couplage indéfectible entre le code R source, les sorties numériques d’accumulation et le texte scientifique narratif de l’article.
Enfin, la publication transparente des jeux de données brutes sur des plateformes institutionnelles d’archives ouvertes (telles que Zenodo ou le réseau Dataverse), accompagnée de scripts de transformation auto-suffisants dépourvus de chemins d’accès locaux absolus codés en dur, matérialise l’aboutissement des standards d’ouverture de la science moderne, garantissant à l’ensemble de la communauté internationale la faculté d’auditer, de répliquer et d’étendre les résultats scientifiques présentés.
Références
- Chambers, J. M. (2008). Software for data analysis: Programming with R. Springer. https://doi.org/10.1007/978-0-387-75936-4
- Dowle, M., & Srinivasan, A. (2023). data.table: Extension of `data.frame` (R package version 1.14.8). CRAN. https://CRAN.R-project.org/package=data.table
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press.
- Wickham, H., François, R., Henry, L., & Müller, K. (2023). dplyr: A grammar of data manipulation (R package version 1.1.2). CRAN. https://CRAN.R-project.org/package=dplyr
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0
- Zeileis, A., & Grothendieck, G. (2005). zoo: S3 infrastructure for regular and irregular time series. Journal of Statistical Software, 14(6), 1–27. https://doi.org/10.18637/jss.v014.i06