
L’analyse exploratoire de données contemporaine exige des outils méthodologiques et computationnels capables de synthétiser des volumes d’informations croissants sans sacrifier la précision ni la traçabilité scientifique. Au cœur de cette démarche d’investigation quantitative, le tableau croisé dynamique — historiquement popularisé par les interfaces graphiques des tableurs de bureau — demeure une modalité fondamentale pour condenser, réorganiser et interroger les relations multidimensionnelles entre variables catégorielles et continues. Dans les écosystèmes modernes de la science des données, et plus particulièrement au sein de l’environnement statistique R, cette technique transcende la simple manipulation interactive à la souris pour s’ancrer dans des paradigmes de programmation rigoureux, scriptés et reproductibles.
Le passage d’une manipulation manuelle des données à une structuration programmatique répond à un impératif épistémologique : garantir que chaque étape de transformation, de la donnée brute à la métrique agrégée, puisse être auditée, reproduite et automatisée à travers des pipelines analytiques formalisés. Le langage R offre une diversité d’approches pour accomplir ces synthèses croisées, allant des fonctions canoniques de manipulation vectorielle du métapackage tidyverse jusqu’aux architectures à haute performance algorithmique incarnées par data.table, sans omettre les bibliothèques dédiées à l’interactivité web et à la mise en page typographique de niveau éditorial.
Ce traité exhaustif explore les fondements théoriques, les mécanismes algorithmiques et les protocoles d’implémentation pratique des tableaux croisés dynamiques dans R. À travers l’examen détaillé des modèles de fractionnement et de recombinaison, la gestion des formes matricielles, l’évaluation des métriques d’inférence statistique et le traitement des cas limites, ce guide a pour vocation de fournir aux analystes, chercheurs et data scientists une référence méthodologique complète pour intégrer ces architectures tabulaires dans des travaux d’envergure académique ou industrielle.
1. Fondements méthodologiques du tableau croisé dynamique en analyse de données
1.1 Origine conceptuelle et utilité analytique
L’émergence des métriques tabulaires croisées s’inscrit dans l’histoire de la mécanographie et de l’automatisation du calcul commercial et scientifique. Bien avant l’avènement de l’informatique moderne, la nécessité de croiser plusieurs critères nominaux pour agréger des variables de flux ou de stock constituait déjà un défi pour les statisticiens du recensement. Avec l’apparition des premiers tableurs électroniques à la fin des années 1970 et durant la décennie 1980, le concept de pivot table a formalisé la capacité d’intervertir dynamiquement les lignes, les colonnes et les couches de synthèse afin de restructurer instantanément la perspective analytique sur un jeu d’observations.
Dans les sciences empiriques, l’utilité analytique du tableau croisé dynamique réside principalement dans sa faculté à réduire la dimensionnalité d’une matrice de données. Face à une population observée selon des dizaines d’attributs, l’investigateur doit isoler des invariants, quantifier des écarts typologiques et révéler d’éventuelles interactions statistiques entre facteurs. La synthèse croisée opère un partitionnement de l’espace d’échantillonnage, projetant la distribution conjointe de deux ou plusieurs variables catégorielles contre un ensemble de métriques centrales telles que l’espérance, la dispersion ou les fréquences relatives d’apparition.
Toutefois, la divergence structurelle entre les interfaces de tableurs classiques de type Microsoft Excel et les environnements de programmation vectorielle comme R soulève des questions méthodologiques cruciales. Alors que l’agrégation interactive sur tableur repose sur des gestes visuels non documentés dans un flux textuel — exposant l’analyste au risque permanent d’erreurs de pointage ou d’omissions invisibles —, la manipulation programmatique matérialise chaque transformation sous forme d’instructions exécutables. Cette approche algorithmique garantit la traçabilité absolue des calculs, condition sine qua non de la reproductibilité scientifique et de la maintenance logicielle des études statistiques contemporaines.
En inscrivant la création du tableau croisé au sein d’un script formel, l’analyste s’assure que toute actualisation des données sources mettra à jour l’intégralité des agrégats sans intervention manuelle. Ce changement de paradigme transforme le tableau croisé dynamique : d’un objet visuel éphémère et manipulé à la main, il devient le résultat déterministe d’une séquence d’opérations relationnelles rigoureusement calibrées sur une structure de données pérenne.
1.2 Paradigme split-apply-combine appliqué aux jeux de données
D’un point de vue algorithmique et conceptuel, la construction d’un tableau croisé dynamique s’articule autour d’une abstraction fondamentale théorisée par Hadley Wickham sous l’appellation du paradigme split-apply-combine. Cette modélisation unifie l’ensemble des tâches de manipulation de données complexes en décomposant une opération globale en trois phases successives et logiquement indépendantes, facilitant à la fois la conception du code et son optimisation computationnelle.
La première phase, le partitionnement (split), consiste à segmenter la structure initiale de données en une multiplicité de sous-ensembles homogènes, déterminés par les combinaisons uniques des modalités des variables de groupement choisies. Dans un cadre multidimensionnel, cette opération segmente la population totale selon le produit cartésien des facteurs retenus. Cette division abstraite prépare le terrain pour l’intervention ciblée des fonctions statistiques sur des groupes d’observations strictement délimités.
La seconde phase, l’application (apply), applique une fonction de réduction ou de transformation à chacun de ces sous-ensembles de manière indépendante. Cette étape évalue les métriques numériques ciblées : calcul d’une moyenne arithmétique pondérée, évaluation d’un écart-type d’échantillon, extraction d’une médiane ou dénombrement strict des occurrences. L’orthogonalité des sous-groupes permet d’envisager ces calculs de façon isolée, posant les bases conceptuelles de l’exécution vectorisée ou du calcul distribué et parallèle.
Enfin, la troisième phase, la recombinaison (combine), rassemble l’ensemble des résultats individuels générés par la phase précédente au sein d’une structure de données unifiée. Cette recomposition doit préserver l’intégrité relationnelle des métadonnées de groupe tout en présentant les estimateurs agrégés sous une forme exploitable. Cette approche influence considérablement la complexité algorithmique temporelle et spatiale, dans la mesure où l’efficacité de la gestion des index et de la mémoire vive durant le partitionnement conditionne directement la vitesse globale d’exécution sur de larges bases de données.
Il s’établit dès lors une convergence naturelle entre ces représentations tabulaires croisées et les structures matricielles de données. Si le résultat du split-apply-combine est initialement produit sous un format relationnel normalisé, sa finalité visuelle requiert souvent une disposition bidimensionnelle où les modalités d’un facteur s’étalent sur les lignes tandis que celles d’un second facteur gouvernent les colonnes, réalisant ainsi une synthèse matricielle immédiate pour la lecture humaine.
2. Préparation et structuration de l’environnement de données dans R
2.1 Instanciation du jeu de données expérimental
Afin d’étudier rigoureusement les différentes méthodes d’agrégation tabulaire sans dépendre de sources externes fluctuantes, il convient d’instancier un jeu de données expérimental contrôlé au sein de l’environnement R. Ce corpus servira de fil conducteur tout au long de nos démonstrations. Nous concevons une structure de données modélisant des transactions commerciales réparties sur plusieurs territoires géographiques, impliquant divers types de dispositifs technologiques, des volumes de ventes quantitatifs, des scores de satisfaction client et des horodatages distincts.
La génération programmatique repose sur la fonction d’instanciation de data frame en R de base, combinée à l’utilisation d’échantillonnages aléatoires reproductibles contrôlés par l’initialisation du générateur de nombres pseudo-aléatoires. Fixer une graine aléatoire via l’instruction dédiée garantit que chaque utilisateur exécutant le protocole obtiendra des vecteurs strictement identiques. Les variables catégorielles sont construites à l’aide de répétitions de modalités textuelles couvrant plusieurs régions géographiques (telles que Nord, Sud, Est, Ouest) et des catégories de dispositifs matériels (Ordinateurs, Mobiles, Tablettes, Accessoires).
Une attention méticuleuse doit être portée à la typologie intrinsèque de chaque variable composant cette structure. Les colonnes d’identification textuelle doivent être examinées pour déterminer s’il est préférable de les traiter sous forme de chaînes de caractères brutes ou de facteurs statistiques formels dotés de niveaux ordonnés ou nominaux. Les variables quantitatives, quant à elles, doivent être converties sous des types numériques adéquats : entiers stricts pour les comptages et nombres décimaux à virgule flottante double précision pour les montants financiers et les métriques d’évaluation continues.
L’inspection préliminaire de ce jeu de données s’effectue au moyen des fonctions d’exploration natives de R, telles que l’affichage de la structure interne des objets, la visualisation des six premières lignes du tableau et le calcul d’un résumé statistique univarié des distributions empiriques. Conjointement, le paramétrage initial des options globales de l’interpréteur R — notamment le contrôle du nombre de chiffres après la virgule pour les sorties console et la désactivation de l’encodage automatique des chaînes en facteurs — assure un environnement de calcul rigoureux, stable et immunisé contre les disparités de configuration matérielle.
2.2 Normes de propreté des données (Tidy Data)
L’efficience de la construction d’un tableau croisé dans l’écosystème moderne de R repose sur l’adhésion stricte aux principes des données ordonnées (Tidy Data), formalisés dans la littérature de la statistique computationnelle. Ces préceptes reposent sur trois axiomes cardinaux : chaque variable doit constituer une colonne distincte, chaque observation unitaire doit occuper une ligne unique, et chaque type d’unité d’observation doit être consigné au sein d’une table dédiée. Le respect de cette morphologie garantit une interopérabilité sans friction avec l’ensemble des bibliothèques d’analyse et de visualisation.
Une distinction fondamentale doit être opérée entre le format long (ou empilé) et le format large (ou dénormalisé). Dans le format long, chaque ligne représente une mesure ou un événement particulier, les descripteurs catégoriels étant répétés autant de fois que nécessaire. Cette structure offre une flexibilité maximale pour l’application des algorithmes de partitionnement et de calcul vectoriel, car les relations géométriques entre colonnes demeurent rigoureusement uniformes, quelle que soit la quantité de facteurs intégrés à l’étude.
À l’inverse, le format large utilise les modalités d’une variable qualitative pour nommer les colonnes elles-mêmes, disposant les mesures correspondantes aux intersections des cellules. Si ce format correspond précisément à la restitution visuelle classique du tableau croisé dynamique recherchée par les analystes pour la lecture séquentielle et la mise en page de synthèses, il s’avère particulièrement inadapté à la plupart des modélisations statistiques avancées et à la manipulation automatisée par flux.
L’évaluation rigoureuse du format des données d’entrée constitue donc une phase préliminaire incontournable. Toute velléité d’appliquer des fonctions de croisement sur un jeu de données initialement structuré de manière disparate conduit inéluctablement à une surcharge syntaxique et à des instabilités d’exécution. Par ailleurs, cette étape préparatoire exige d’anticiper les biais introduits par les valeurs manquantes structurelles : une combinaison de facteurs non observée dans la réalité du terrain doit être formellement distinguée d’une observation enregistrée dont la valeur quantitative demeure inconnue, évitant ainsi des erreurs d’interprétation mathématique dans les proportions et totaux calculés ultérieurement.
3. L’approche fondamentale avec dplyr : utilisation conjointe de group_by() et summarize()
3.1 Syntaxe canonique et logique d’enchaînement avec l’opérateur pipe
Le package dplyr constitue le socle contemporain de la manipulation relationnelle de données dans R. Sa philosophie repose sur une grammaire explicite d’actions fondées sur des verbes statistiques. L’articulation de ces opérations est orchestrée par l’opérateur de redirection de flux (pipe), disponible historiquement via le symbole d’enchaînement de magrittr et désormais intégré nativement dans le langage R standard par une notation fonctionnelle épurée. Ce dispositif permet de lier séquentiellement les transformations de gauche à droite sans stocker de variables intermédiaires superflues dans la mémoire de travail.
La mécanique canonique pour générer l’ossature d’un tableau croisé dynamique repose sur l’association méthodique du verbe de regroupement virtuel et du verbe de réduction agrégée. L’instruction de groupement assigne des métadonnées invisibles à la structure de données sous-jacente, segmentant virtuellement l’échantillon sans altérer l’apparence immédiate des lignes. Cette indexation interne configure l’environnement d’exécution pour les verbes ultérieurs, spécifiant que toute opération statistique devra être exécutée indépendamment sur chacune des strates ainsi isolées.
Le verbe de résumé statistique prend ensuite le relais en absorbant la structure groupée pour instancier un nouveau tableau d’agrégats. Pour chaque strate identifiée par les variables catégorielles, la commande applique les fonctions d’estimation déclarées par l’utilisateur et renvoie une ligne unique par combinaison de groupes. Cette opération réduit drastiquement la granularité du jeu de données, passant du niveau de l’observation individuelle au niveau de la cellule synthétique.
Une pratique fondamentale de rigueur logicielle consiste à dégroupeler systématiquement la structure résultante à la fin du pipeline de transformation. En l’absence de cette instruction explicite de réinitialisation des métadonnées, le tableau produit conserve son comportement groupé pour les opérations en aval. Ce maintien résiduel peut introduire des comportements inattendus et des biais computationnels dissimulés lors de calculs ultérieurs portant sur des mutations de colonnes ou des filtrages de rang.
3.2 Agrégation univariée : calcul de sommes et de moyennes globales
L’agrégation univariée constitue la configuration la plus directe du tableau croisé, dans laquelle une unique dimension catégorielle gouverne la décomposition d’une ou plusieurs variables quantitatives. Considérons le cas d’une analyse des performances de ventes réparties selon les différentes zones géographiques de notre jeu expérimental. La première étape analytique consiste à quantifier le volume d’affaires global généré au sein de chaque entité territoriale par le calcul de la somme arithmétique de la variable financière d’intérêt.
Conjointement à la masse totale des transactions, l’analyste cherche à cerner le comportement moyen des observations au sein de chaque secteur. L’estimation de l’espérance empirique des ventes s’obtient par l’intégration de la fonction moyenne à l’intérieur du verbe de résumé. Cette confrontation simultanée de la somme globale et de la moyenne arithmétique renseigne l’investigateur à la fois sur le poids macroéconomique de la région et sur la valeur attendue d’une transaction unitaire au sein de ce groupe d’appartenance.
Cependant, une analyse statistique rigoureuse ne saurait s’en tenir aux seuls indicateurs de tendance centrale. L’évaluation conjointe de la dispersion s’avère indispensable pour juger de la représentativité de la moyenne observée. L’introduction du calcul de la variance d’échantillon et de l’écart-type permet d’objectiver l’hétérogénéité des montants de vente au sein de chaque strate géographique. Deux régions affichant une moyenne de vente rigoureusement identique peuvent masquer des réalités opérationnelles divergentes : l’une caractérisée par une régularité extrême des flux de transaction, l’autre polarisée par de rares transactions monumentales masquant un volume d’achats marginaux de faible envergure.
Enfin, la robustesse statistique de chaque strate doit être mesurée par le dénombrement effectif des observations qui la composent. L’emploi de la fonction de comptage interne fournit le dénominateur fondamental garantissant que les moyennes calculées ne reposent pas sur un effectif dérisoire, susceptible de fragiliser les conclusions par un manque de puissance statistique.
3.3 Regroupement factoriel multiple
La pleine puissance du tableau croisé dynamique se manifeste lorsque l’on croise simultanément deux ou plusieurs variables explicatives qualitatives. En insérant dans l’instruction de groupement à la fois la variable territoriale et la typologie des appareils commercialisés, l’analyste force l’algorithme à partitionner la base d’observations selon les intersections du plan factoriel complet. Le jeu de données se fragmente alors en sous-populations définies par le couple associant une région déterminée et une famille technologique spécifique.
L’ordre de déclaration des variables au sein de l’instruction de partitionnement joue un rôle déterminant dans la hiérarchie logique de la structure résultante. Si l’on déclare la région avant la typologie des dispositifs, le tableau restituera les résultats en regroupant d’abord l’ensemble des catégories de matériel propres à la première région, avant de basculer sur la seconde. Cette disposition hiérarchique gouverne également le comportement de réduction progressive du groupement : par défaut, chaque passage du verbe de résumé élimine le dernier niveau de regroupement déclaré, laissant le tableau intermédiaire groupé par la variable primaire.
Cette approche permet d’observer directement les interactions statistiques entre facteurs. Par exemple, une famille d’appareils peut s’avérer largement prédominante en volume au sein des zones septentrionales tout en enregistrant des performances marginales dans les territoires méridionaux. De tels écarts d’homogénéité ne peuvent être décelés par des analyses univariées isolées, ces dernières masquant la covariance structurelle liant le type de dispositif au contexte spatial d’acquisition.
Une vigilance particulière doit être portée à l’exhaustivité des intersections factorielles. Dans le cas où certaines combinaisons théoriques entre modalités n’ont fait l’objet d’aucun enregistrement dans les données brutes, l’agrégation dplyr standard omettra purement et simplement ces cellules non observées dans la table restituée. Bien que cette élimination corresponde à la réalité de la base d’entraînement, elle nécessite des adaptations ultérieures lorsque l’on souhaite représenter formellement l’espace complet des possibilités au sein d’un plan d’expérience exhaustif.
4. Transformation bidimensionnelle de format avec tidyr : pivot_wider()
4.1 Restructuration du format long vers la matrice croisée
Bien que l’enchaînement des fonctions de groupement et d’agrégation de dplyr génère l’ensemble des synthèses numériques nécessaires, le tableau obtenu demeure confiné dans une architecture longue. Pour transformer cette structure en une véritable table bidimensionnelle assimilable visuellement au tableau croisé dynamique conventionnel, il est indispensable de faire appel aux algorithmes de restructuration morphologique fournis par le package tidyr, et plus particulièrement à la fonction de déploiement en largeur.
L’opération de pivotement vers le format large nécessite la spécification explicite de deux paramètres cardinaux. D’une part, l’argument dictant la provenance des en-têtes détermine quelle variable catégorielle verra ses modalités projetées horizontalement pour former les nouveaux noms de colonnes du tableau d’arrivée. D’autre part, l’argument renvoyant aux valeurs identifie la colonne numérique compilée dont le contenu viendra peupler l’intersection de chaque ligne et de chaque nouvelle colonne générée.
Cette réorganisation spatiale soulève la problématique des cellules vides correspondant à des combinaisons factorielles inexistantes dans le jeu agrégé de départ. Si aucune vente de tablettes n’a été répertoriée dans la région Sud, l’algorithme insérera par défaut une valeur manquante non définie au sein de la cellule d’intersection. Pour rétablir la rigueur comptable et mathématique de la synthèse, l’argument de remplissage permet d’assigner une constante numérique — le plus souvent la valeur zéro — à l’ensemble de ces absences d’observation.
Le résultat final de cette transition structurelle rapproche visuellement les données de la disposition tabulaire matricielle familière aux utilisateurs d’outils bureautiques. Les différentes régions conservent leur ancrage vertical sur l’axe des ordonnées, tandis que les catégories technologiques s’échelonnent sur l’abscisse horizontale, chaque cellule de la grille fournissant la lecture immédiate du volume d’affaires unifié.
4.2 Agrégation directe au sein de la fonction de pivot
Une fonctionnalité puissante et souvent sous-estimée de la commande de déploiement en largeur réside dans sa capacité à opérer des agrégations statistiques directes sans exiger le passage préalable par un pipeline de groupement et de résumé explicite. Ce mécanisme s’active dès lors que le tableau source présente plusieurs observations distinctes pour une même combinaison des variables d’index et de colonnes cibles, situation qui engendre normalement un conflit d’unicité morphologique.
Dans sa configuration de base, la présence de doublons d’indexation conduit la fonction à générer des colonnes sous forme de listes d’éléments non scalaires, chaque cellule accueillant le vecteur de l’ensemble des réalisations correspondantes. Pour surmonter cet écueil et synthétiser directement les informations, l’argument d’assignation de fonction d’agrégation permet de déclarer formellement l’opérateur mathématique qui doit être appliqué pour réduire ces vecteurs de doublons à un scalaire unique lors du déploiement matriciel.
Il devient ainsi envisageable de lui transmettre directement des opérateurs statistiques canoniques, tels que la somme arithmétique ou la moyenne, ou même des fonctions anonymes et des estimateurs personnalisés incorporant des contraintes de troncature ou des règles d’exclusion conditionnelle. L’évaluation se produit alors de manière synchrone durant la phase de transposition spatiale, économisant la rédaction de lignes de code intermédiaires.
Néanmoins, l’analyste rigoureux doit soupeser le compromis computationnel inhérent à cette stratégie. Si le pivotement avec agrégation intégrée offre une concision syntaxique indéniable, les bancs d’essai temporels démontrent que pour des jeux de données d’une volumétrie substantielle, la séquence explicite combinant le partitionnement préalable puis la réduction via les verbes de dplyr conserve une efficacité algorithmique et une vélocité de traitement nettement supérieures, en raison de l’optimisation interne des indexations de groupes dans son moteur compilé en C++.
5. Calculs avancés et métriques conditionnelles au sein des tableaux croisés
5.1 Calcul de proportions relatives et de fréquences marginales
L’estimation des grandeurs absolues au sein d’un tableau croisé dynamique ne constitue souvent que la première étape de l’investigation empirique. Pour dégager la structure sous-jacente des données, le calcul de grandeurs relatives, de pourcentages et de distributions marginales conditionnelles s’avère indispensable. Dans le cadre d’un tableau croisé, ces métriques peuvent s’envisager selon trois perspectives : la proportion par rapport à la masse totale de la population, la proportion relative conditionnelle calculée le long des lignes (profils-lignes), et la proportion relative évaluée verticalement le long des colonnes (profils-colonnes).
Pour dériver des profils-lignes, l’analyste exploite les fonctions de fenêtrage statistique au sein d’une mutation de données. Lorsque le tableau est conservé dans son état long groupé par la dimension spatiale, toute division d’un montant de vente catégoriel par la somme des ventes de la région produit instantanément le ratio unitaire d’apport de chaque famille de produits au chiffre d’affaires local. La somme de ces coefficients sur une même entité régionale converge alors strictement vers la valeur unitaire ou cent pour cent.
À l’inverse, l’évaluation des profils-colonnes exige d’inverser la hiérarchie du regroupement pour conditionner le calcul par la typologie des appareils. Dans ce cas de figure, l’analyste mesure l’attractivité territoriale relative d’une technologie donnée : on calcule la part d’un secteur géographique dans l’absorption globale du marché d’un équipement spécifique, révélant les zones géographiques motrices pour chaque ligne de production.
La formalisation des marges horizontales et verticales — représentant les totaux d’ensemble projetés sur les bordures du tableau — requiert une gymnastique algorithmique particulière. Si les tableurs bureautiques automatisent ces marges sans discernement, leur instanciation en R doit être exécutée avec une précision arithmétique totale, en veillant à conserver la précision numérique en virgule flottante tout au long des étapes de division avant toute opération d’arrondi typographique destiné à la restitution finale.
5.2 Agrégations multi-métriques simultanées
L’analyse approfondie d’un jeu de données multidimensionnel impose fréquemment d’examiner conjointement plusieurs indicateurs statistiques pour une même cellule factorielle. Limiter la description d’une sous-population à son espérance arithmétique constitue une approximation risquée, particulièrement face à des distributions asymétriques ou affectées par des valeurs extrêmes. L’incorporation simultanée de métriques de tendance centrale, d’indices d’hétérogénéité et de paramètres de forme au sein d’une seule exécution tabulaire répond à cette exigence de complétude.
Le package dplyr résout cette complexité via le modificateur d’action globale appliqué sur une sélection de colonnes numériques. Cette instruction vectorisée permet d’exécuter une collection nommée de fonctions d’estimation sur l’ensemble des attributs quantitatifs ciblés. L’analyste peut ainsi requérir, au sein d’une même clause d’agrégation, l’évaluation synchrone de la moyenne arithmétique, de la médiane empirique, de l’écart-type, ainsi que de percentiles précis tels que le premier et le neuvième décile.
Le paramétrage du nommage dynamique des colonnes agrégées générées s’effectue au moyen de gabarits textuels configurables. Ce mécanisme associe systématiquement le label de la variable d’origine au nom de la métrique mathématique correspondante, produisant des intitulés de colonnes clairs et explicites pour l’exploitation en aval. Cette rigueur dans la nomenclature prévient toute ambiguïté sémantique lors des manipulations ultérieures.
Cette multiplicité d’indicateurs offre une profondeur d’interprétation immédiate. La comparaison directe entre la médiane et la moyenne calculées au sein d’une même intersection factorielle éclaire l’asymétrie de la distribution locale : une moyenne significativement plus élevée que la médiane dénonce sans ambiguïté un étirement de la queue de distribution vers les valeurs positives, induit par quelques transactions exceptionnelles. Une telle observation alerte immédiatement le statisticien sur la nécessité de privilégier des estimateurs non paramétriques robustes pour modéliser cette sous-population.
6. Production interactive de tableaux croisés dynamiques avec rpivotTable
6.1 Intégration de composants htmlwidgets pour l’exploration visuelle
Si la manipulation scriptée via dplyr et tidyr offre une rigueur méthodologique optimale pour les pipelines d’automatisation, la phase d’exploration inductive initiale gagne grandement à s’appuyer sur des dispositifs visuels interactifs. Dans cette optique, le package rpivotTable comble le fossé entre la souplesse ergonomique des interfaces graphiques de tableurs et la puissance de traitement de l’environnement R, en adaptant la célèbre bibliothèque JavaScript PivotTable.js au travers du canevas des composants web autonomes (htmlwidgets).
L’initialisation de ce composant s’exécute avec une remarquable économie de moyens. Il suffit de transmettre un tableau de données brut, sans agrégation préalable, à la fonction d’instanciation du package pour voir s’ouvrir, au sein de l’afficheur graphique de RStudio ou dans un navigateur internet, une interface utilisateur complète et réactive. L’utilisateur se trouve alors face à une arène interactive dotée de zones de dépôt pour les lignes, les colonnes et les filtres factoriels.
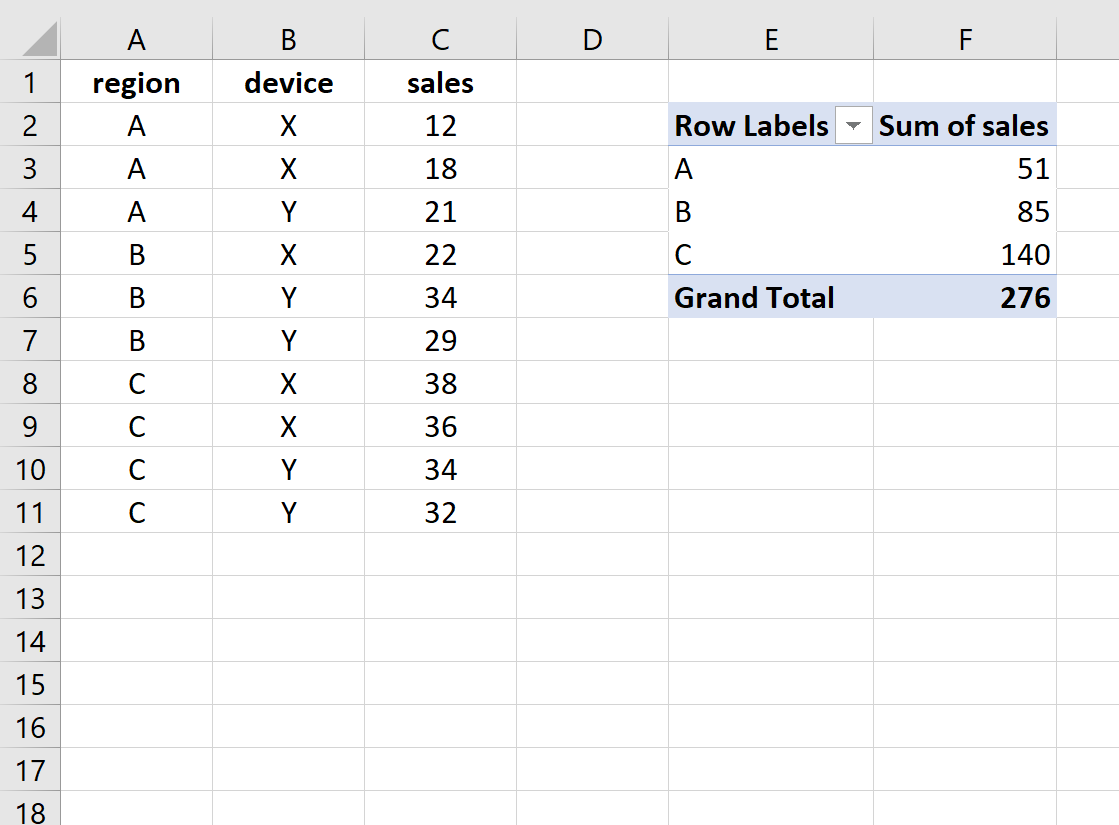
Cette approche permet une exploration multidimensionnelle par glisser-déposer sans réécriture de code. L’analyste peut permuter instantanément les dimensions spatiales et typologiques, injecter des sous-stratifications supplémentaires, ou restreindre la population observée en modulant dynamiquement les curseurs de filtrage catégoriel. Parallèlement, l’interface propose un menu déroulant complet de fonctions d’agrégation, autorisant le basculement immédiat du dénombrement brut vers des sommes, des moyennes, des variances, ou des calculs de ratios fractionnaires rapportés aux totaux marginaux.
Au-delà de la restitution tabulaire textuelle, le composant encapsule nativement des moteurs de rendu graphique interactifs. En un clic, le tableau croisé se convertit en un diagramme en barres empilées, en une carte thermique de densité colorimétrique ou en un nuage de points synthétique, offrant ainsi une compréhension sensorielle rapide des patterns et singularités logés dans la distribution conjointe des facteurs.
6.2 Exportation et insertion dans des rapports reproductibles
L’intérêt de la bibliothèque rpivotTable dépasse le cadre d’un usage purement exploratoire sur le poste du chercheur ; son architecture s’intègre harmonieusement dans les formats de publication scientifique moderne tels que R Markdown et les environnements de documentation computationnelle Quarto. Cette compatibilité permet de concevoir des rapports d’audit ou des synthèses de recherche interactives destinées à des décideurs ou à des pairs désireux de manipuler eux-mêmes la structure agrégée.
Pour pérenniser une configuration analytique spécifique au sein d’un document compilé, la fonction d’instanciation accepte des arguments de paramétrage prédéfinis. L’auteur d’un rapport peut ainsi figer à l’avance quelles variables doivent occuper les axes des abscisses et des ordonnées lors du premier affichage du document, quel opérateur statistique doit gouverner l’intersection des cellules, et quelle typologie de visualisation doit s’activer à l’ouverture, tout en préservant la liberté pour le lecteur final de modifier ces choix à volonté au sein du document HTML généré.
Toutefois, l’intégration de widgets interactifs implique des contraintes techniques qui doivent être évaluées avec discernement. L’insertion d’un objet htmlwidget autonome nécessite l’intégration conjointe de l’intégralité du jeu de données source ainsi que des dépendances logicielles JavaScript sous-jacentes au sein du document final. Cela entraîne un gonflement substantiel de la taille du fichier généré, ce qui peut nuire à sa fluidité de transmission et de rendu si la base sous-jacente contient des dizaines de milliers d’enregistrements.
Par ailleurs, cette approche interactive montre ses limites dès lors que le livrable final doit être converti en un format de publication statique et figé, à l’instar des tirages au format PDF ou des manuscrits imprimés conformes aux standards éditoriaux académiques. Dans ce contexte, l’interactivité devient caduque et l’analyste doit impérativement se réorienter vers des générateurs de tableaux statiques à haute exigence typographique pour garantir l’élégance et la lisibilité de ses restitutions scientifiques.
7. Optimisation computationnelle avec le package data.table
7.1 Syntaxe condensée et opérateur [i, j, by]
Lorsque la volumétrie des données atteint des centaines de milliers ou des dizaines de millions d’enregistrements, les mécanismes internes d’allocation de mémoire du tidyverse peuvent présenter des limites de débit computationnel. Dans ce contexte de haute performance, le package data.table s’impose comme la référence absolue de l’ingénierie statistique sous R. Son architecture repose sur une extension radicale du data frame standard, optimisée au niveau du compilateur en langage C pour maximiser l’efficacité du cache processeur et minimiser les copies d’objets en mémoire vive.
L’accès et la manipulation des objets se structurent autour d’une syntaxe condensée matricielle universelle articulée selon trois composantes formelles. Le premier élément sélectionne les sous-ensembles d’enregistrements selon des conditions logiques équivalentes à un filtrage horizontal. Le second élément désigne les opérations de projection, de mutation ou d’agrégation à accomplir verticalement sur les colonnes. Le troisième élément formalise le partitionnement analytique en regroupant les données selon les variables factorielles choisies.
L’exécution d’un tableau croisé dynamique univarié ou multivarié s’effectue ainsi au moyen d’une concision syntaxique extrême. L’analyste renseigne dans le troisième composant la liste des attributs gouvernant la stratification catégorielle, tandis que le second accueille les fonctions d’évaluation statistique encapsulées au sein d’une liste nommée. L’agrégation s’opère instantanément à l’intérieur des structures d’indexation natives sans générer la moindre table intermédiaire superflue.
L’atout prépondérant de data.table réside dans son principe de modification par référence, symbolisé par un opérateur d’assignation dédié. Contrairement aux approches fonctionnelles pures qui dupliquent systématiquement les structures lors de chaque transformation, data.table modifie les blocs de données directement à l’emplacement mémoire alloué. Il en résulte un gain de vitesse qui peut atteindre un ou deux ordres de grandeur lors de l’exécution de calculs de croisement intensifs sur des matrices volumineuses.
7.2 Tableaux croisés volumineux via dcast.data.table
Pour projeter une volumétrie massive de données agrégées dans une matrice bidimensionnelle croisée, data.table déploie une fonction spécialisée de transposition en largeur, conçue pour opérer à très haute vitesse sur des structures d’envergure industrielle. Cette commande utilise une interface syntaxique fondée sur la notation par formule, offrant une distinction claire entre les variables gouvernant l’ancrage vertical des lignes et celles dictant le déploiement horizontal des colonnes.
La formulation place à la gauche d’un opérateur tilde les attributs factoriels destinés à composer l’identifiant unique des rangées du tableau croisé, tandis que la partie droite accueille les dimensions appelées à se déployer en en-têtes de colonnes. Les variables quantitatives contenant les observations numériques sont renseignées au sein d’un paramètre dédié. La fonction prend alors en charge la réorganisation spatiale avec une vélocité sans commune mesure avec les méthodes interprétées classiques.
À l’instar de ce que propose tidyr, la transposition de data.table intègre nativement un argument dédié aux fonctions d’agrégation. Si la base de départ contient des occurrences multiples pour une même coordonnée de grille, la fonction applique l’opérateur arithmétique de réduction de façon synchrone durant l’étape de remodelage spatial. Cette capacité à condenser et pivoter en un seul cycle machine garantit un temps d’exécution minimal et préserve l’intégrité de la mémoire vive face à des tables massives.
L’évaluation comparative des temps d’exécution confirme l’hégémonie de data.table dès lors que le volume de la table franchit le cap de plusieurs gigaoctets. L’exploitation rigoureuse d’algorithmes de tri par base (radix sort) permet à son moteur de construire les tables de contingence et les tableaux croisés à des vitesses proches des limites matérielles d’accès au bus mémoire. Ce composant est donc vivement recommandé pour tout projet traitant des flux d’événements continus, des données de télémétrie ou des registres transactionnels de grande ampleur.
8. Application spécifique aux analyses psychométriques et comportementales
8.1 Structuration de tables de contingence pour scores psychologiques
Dans le domaine des sciences psychologiques, de la psychométrie et des études comportementales, le tableau croisé dynamique constitue la cheville ouvrière du traitement des variables qualitatives ordonnées, telles que les réponses récoltées sur des échelles d’évaluation de Likert. L’évaluation de traits de personnalité, d’indices d’anxiété ou de niveaux de satisfaction requiert méthodologiquement de croiser les profils diagnostiques des sujets avec l’intensité catégorisée de leurs réponses à des batteries d’items standardisés.
L’objectif de cette synthèse croisée consiste à mesurer la distribution empirique des choix de réponses conditionnellement à l’appartenance à des sous-cohortes spécifiques — segmentées, par exemple, selon des critères de vulnérabilité clinique ou des assignations à des protocoles thérapeutiques distincts. L’analyste structure alors le tableau croisé de manière à positionner les paliers d’intensité de la réponse ordonnée en colonnes et les groupes cliniques en lignes, révélant la morphologie de la distribution des réponses pour chaque strate expérimentale.
Une configuration similaire s’applique à l’analyse des temps de réaction psychomoteurs enregistrés au cours de tâches attentionnelles informatisées. Les latences de réponse, bien que continues à l’origine, sont fréquemment découpées en classes d’intervalles temporels ou soumises à un double croisement catégoriel combinant la nature de la stimulation sensorielle et la condition de congruence cognitive. Le tableau croisé synthétise alors les latences médianes et les dispersions interquartiles observées dans chaque condition expérimentale.
L’examen minutieux des patterns numériques distribués au sein des cellules du tableau croisé permet d’isoler des dynamiques cliniques significatives. Une distorsion frappante de la répartition des scores d’auto-évaluation entre un groupe expérimental et un groupe témoin renseigne immédiatement le chercheur sur l’impact potentiel d’une manipulation psychologique, guidant l’élaboration d’hypothèses causales raffinées avant l’engagement de procédures d’inférence multidimensionnelle plus lourdes.
8.2 Couplage avec les tests d’indépendance statistique
Au-delà de la description morphologique des effectifs observés, la table croisée dynamique représente la matrice d’alimentation directe des tests d’hypothèse portant sur l’indépendance de deux distributions catégorielles. Le protocole canonique repose sur l’extraction directe des fréquences observées pour nourrir l’évaluation du Chi-carré de Pearson, procédure statistique visant à infirmer l’hypothèse nulle d’indépendance stochastique entre les deux facteurs croisés.
Dans un pipeline d’analyse R rigoureux, les effectifs conjoints condensés au sein du tableau croisé sont transmis à la fonction d’évaluation d’indépendance. Cet algorithme calcule mathématiquement les effectifs théoriques attendus sous l’hypothèse de stricte indépendance, quantifie les divergences quadratiques locales cellule par cellule, et détermine la statistique globale de déviation par rapport à la distribution théorique du Chi-carré au degré de liberté approprié.
Toutefois, la simple obtention d’une valeur de significativité statistique ne suffit pas à clore l’investigation empirique. Pour identifier précisément quelles cellules factorielles contribuent le plus à l’éventuel rejet de l’hypothèse d’indépendance, l’analyste extrait de la structure du test les résidus standardisés ajustés. Ces métriques, comparables à des scores centrés réduits, permettent de repérer les combinaisons de facteurs caractérisées par une surreprésentation ou une sous-représentation pathologique par rapport aux espérances marginales.
Enfin, pour compléter cette analyse d’indépendance, l’intensité intrinsèque de l’association statistique liant les deux variables doit être évaluée au moyen d’indices d’effet normalisés affranchis de la taille brute de l’échantillon, tels que le coefficient V de Cramér dérivé des marges tabulaires. Ce processus séquentiel positionne le tableau croisé dynamique comme une passerelle analytique indispensable, servant de socle méthodologique préparatoire à l’ajustement de modèles log-linéaires ou de régressions logistiques multinomiales.
9. Mise en forme typographique et publication académique des tableaux
9.1 Formatage professionnel avec knitr::kable et kableExtra
L’obtention d’un tableau croisé numérique rigoureux ne constitue que la moitié du travail de restitution de l’analyste ; la diffusion académique et l’édition professionnelle exigent une mise en forme typographique irréprochable répondant aux normes éditoriales les plus strictes. La combinaison de la fonction de base issue du package knitr avec les fonctionnalités avancées de la bibliothèque kableExtra offre un environnement de composition de premier ordre pour sublimer les matrices agrégées.
La commande d’origine convertit instantanément un data frame restructuré en une table de balisage prête pour l’incorporation dans des documents compilés. L’intervention des extensions de kableExtra enrichit ensuite cette ossature en permettant de définir des alignements décimaux micrométriques, de moduler les graisses typographiques et d’ajuster l’espacement interligne afin d’assurer un confort de lecture optimal sur les écrans comme sur les supports imprimés.
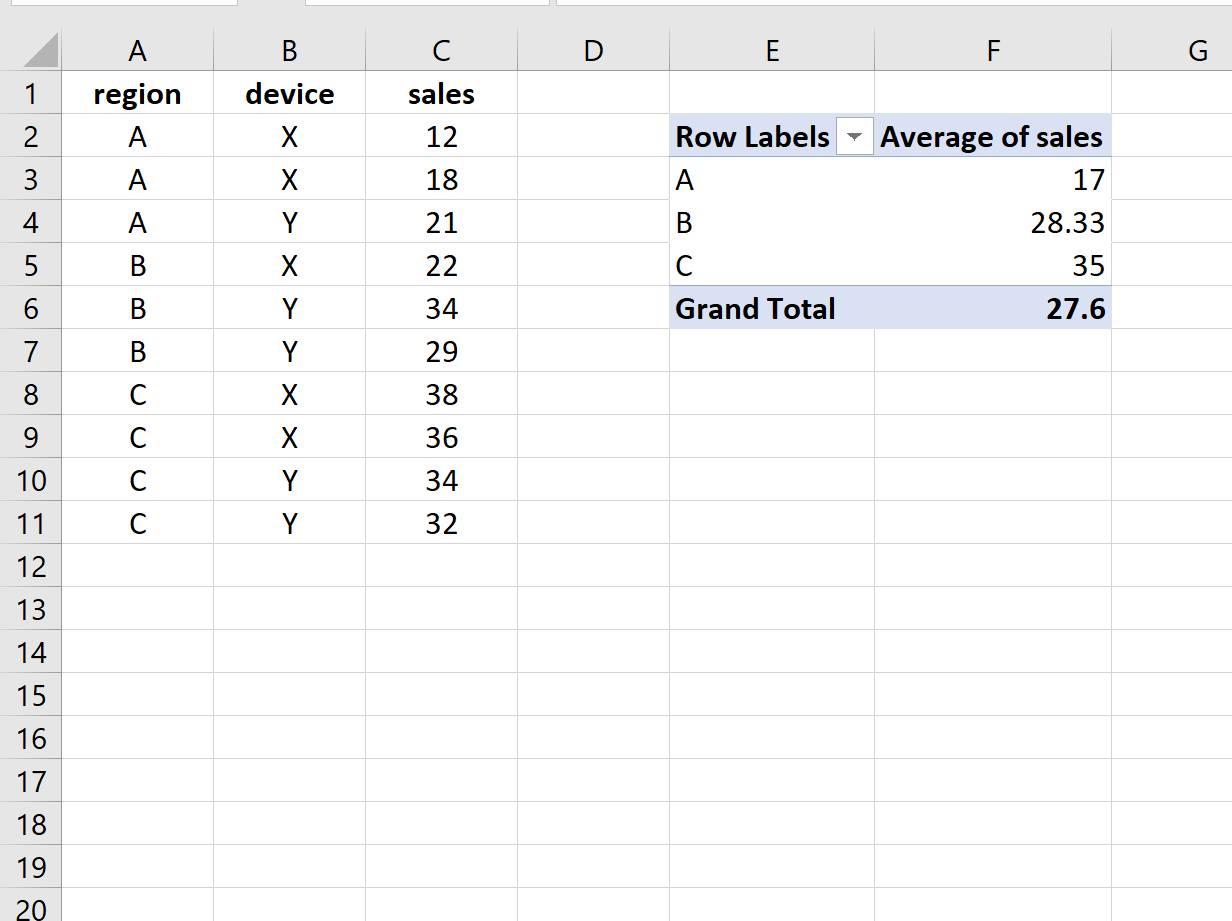
Une des capacités remarquables de ce dispositif réside dans l’adjonction d’en-têtes hiérarchiques fusionnés sur plusieurs niveaux verticaux. Si un tableau croisé dynamique segmente les ventes de différentes catégories d’équipements à travers de multiples territoires géographiques eux-mêmes regroupés en macro-continents, il devient aisé de surmonter les colonnes primaires par une ligne de métadonnées visuelles unifiant les strates continentales, facilitant ainsi la décomposition analytique pour le lecteur.
De surcroît, le respect scrupuleux des normes de publication scientifique — telles que les préconisations stylistiques de l’American Psychological Association (normes APA) ou les standards médicaux de Vancouver — s’obtient par l’application de thèmes de mise en page prédéfinis. Ces styles suppriment toute grille verticale inutile, épurent les bordures horizontales pour ne conserver que les séparateurs méthodologiques indispensables, et intègrent proprement les annotations et légendes marginales au pied du tableau édité.
9.2 Création de présentations avancées via le package gt
Pour aller plus loin dans la sophistication graphique et l’expressivité visuelle des restitutions, le package gt introduit une véritable philosophie de la composition tabulaire, bâtie sur le modèle de la grammaire des graphiques chère à l’écosystème R. L’architecture de gt décompose le tableau en régions anatomiques formalisées : le bandeau de titre et de sous-titre, les en-têtes de colonnes, le corps central des données, les séparateurs de groupes de rangées, et les sections de notes de bas de page et de sources bibliographiques.
Cette approche s’adapte remarquablement aux synthèses croisées dynamiques issues des manipulations tidyr et dplyr. Une fois le tableau déployé en largeur, son passage dans la chaîne fonctionnelle de gt permet de formater avec une grande rigueur le rendu des cellules : conversion instantanée des fractions en pourcentages stylisés, alignement des chiffres monétaires avec leurs symboles d’unité légaux, ou encore arrondi sélectif des valeurs numériques en fonction de la précision empirique autorisée par la métrologie des mesures initiales.
Un atout distinctif majeur réside dans l’aptitude à mettre en œuvre une colorimétrie différentielle conditionnelle directement indexée sur les valeurs numériques. L’analyste peut instancier des dégradés de teintes continus ou discrets pour teinter le fond des cellules à l’image d’une matrice thermique (heatmap). Cette mise en valeur chromatique permet de révéler instantanément les pôles de rentabilité maximale ou les anomalies statistiques au sein d’une grille de croisement complexe comportant des centaines d’intersections.
Enfin, la polyvalence de gt repose sur sa remarquable neutralité technologique vis-à-vis des formats de restitution finale. Une unique séquence de code génère, sans la moindre modification structurelle, un tableau interactif parfaitement stylisé pour le web au standard HTML, une composition vectorielle en LaTeX calibrée pour l’impression haute définition d’un mémoire de thèse, ou une table brute destinée à être insérée dans un classeur bureautique ou un document de traitement de texte standardisé.
10. Traitement rigoureux des valeurs aberrantes et des données manquantes
10.1 Gestion de la non-réponse et des données manquantes
L’intégrité inférentielle d’un tableau croisé dynamique dépend directement de la rigueur avec laquelle sont traitées les données manquantes et les non-réponses au sein des collectes d’échantillons. Dans le fonctionnement standard de R, la présence d’une valeur indéfinie au sein d’un vecteur numérique contamine systématiquement toute fonction d’estimation conventionnelle : une somme ou une moyenne appliquée à une série comportant une seule entrée non renseignée renverra invariablement un résultat non défini.
Pour contourner cette règle de sécurité du langage, l’analyste fait souvent usage de l’argument d’omission des valeurs manquantes directement dans les fonctions de calcul. Toutefois, si cette instruction rétablit la production d’un scalaire numérique, son application aveugle présente de sérieux risques d’invalidation méthodologique. Elle réduit silencieusement l’effectif effectif de la strate sans que le lecteur de la table ne soit averti de l’attrition de l’échantillon, créant ainsi une illusion trompeuse de précision statistique.
Deux stratégies concurrentes s’offrent alors à l’analyste face à ce défi. La première consiste à appliquer des algorithmes d’imputation en amont de toute phase de partitionnement et de synthèse croisée, en modélisant les cellules absentes par des valeurs plausibles issues de régressions multiples ou de méthodes fondées sur les plus proches voisins. La seconde stratégie, plus prudente et conservatrice, privilégie le traitement au fil de l’eau en documentant explicitement, pour chaque intersection factorielle, le volume précis d’enregistrements exclus du calcul statistique via une colonne de dénombrement dédiée.
Il est par ailleurs indispensable de tester formellement l’hypothèse de données manquantes complètement aléatoires (MCAR, Missing Completely At Random). Si les données manquantes résultent d’un phénomène de censure systématique — par exemple, des participants refusant systématiquement de dévoiler leurs revenus au sein d’une classe d’âge spécifique —, le tableau croisé dynamique restituera une distribution structurellement biaisée. Identifier la typologie des données manquantes est donc un prérequis méthodologique absolu avant d’entamer la moindre lecture inférentielle des cellules du tableau.
10.2 Robustesse face aux valeurs extrêmes et distributions asymétriques
L’estimation des paramètres de tendance centrale au sein des cellules d’un tableau croisé dynamique est particulièrement vulnérable aux valeurs aberrantes (outliers) ou aux distributions hautement asymétriques. L’emploi non critique de la moyenne arithmétique comme unique métrique d’agrégation d’une sous-population expose le tableau à des distorsions majeures : l’apparition d’une seule mesure hors norme, induite par une erreur de transcription métrologique ou par un événement exceptionnel rarissime, peut doubler artificiellement le niveau central apparent de toute une catégorie de données.
Pour immuniser les conclusions de l’étude contre cette fragilité empirique, l’analyste doit intégrer des estimateurs de position robustes. La substitution systématique ou conjointe de la moyenne par la médiane empirique constitue la première ligne de défense méthodologique, la médiane présentant un point de rupture de cinquante pour cent face aux contaminations extrêmes. Alternativement, le recours à la moyenne tronquée ou à la moyenne winsorisée offre un compromis mathématique élégant, en neutralisant l’influence disproportionnée des pourcentages extrêmes de la distribution sans sacrifier l’information contenue dans les observations régulières.
De façon corollaire, les mesures de variabilité doivent également être choisies avec discernement. L’écart-type d’échantillon, étant fondé sur le carré des déviations à la moyenne, amplifie démesurément l’impact des valeurs éloignées. L’insertion de l’écart interquartile (IQR) ou de la déviation absolue médiane (MAD) au sein de la clause d’agrégation confère au tableau croisé un niveau de résilience analytique nettement supérieur pour documenter la réelle dispersion locale des données.
Enfin, une attention préventive rigoureuse doit être accordée au diagnostic des cellules à très faible effectif. Une intersection factorielle regroupant seulement une ou deux observations ne dispose pas d’une base empirique suffisante pour supporter une estimation statistique pérenne. L’analyste doit prévoir des règles d’exclusion automatique ou de regroupement dynamique de modalités en amont de la construction du tableau, afin de consolider les strates d’échantillonnage et de préserver la validité conceptuelle des conclusions de son investigation.
11. Automatisation et encapsulation dans des fonctions personnalisées
11.1 Programmation non standard avec rlang et tidy evaluation
Le passage d’un script d’analyse ponctuel à un pipeline d’ingénierie logicielle pérenne requiert la capacité d’encapsuler la construction des tableaux croisés dynamiques au sein de fonctions génériques réutilisables. Cependant, l’intégration des fonctions du tidyverse à l’intérieur de routines personnalisées se heurte à une spécificité conceptuelle du langage R : le mécanisme d’évaluation non standard (NSE). Au sein de dplyr, les noms de colonnes sont passés directement sous forme de symboles littéraux non évalués, ce qui empêche une fonction personnalisée conventionnelle d’interpréter dynamiquement les arguments passés sans déclencher d’erreurs d’évaluation.
Pour résoudre cette difficulté, le package rlang fournit le cadre théorique et technique de la tidy evaluation. Ce modèle repose sur la distinction formelle entre la citation d’une expression — qui suspend son évaluation immédiate — et son défigeage ou injection dans l’environnement d’exécution de la bibliothèque cible. Dans la syntaxe moderne de R, ce mécanisme d’injection est grandement simplifié par l’usage de l’opérateur d’embrassement (symbolisé par une double accolade syntaxique).
En encapsulant les variables de groupement et la variable de mesure au sein de cette syntaxe d’embrassement, l’analyste conçoit une fonction universelle de tabulation croisée. Cette fonction reçoit en entrée le data frame source, les symboles non cités des dimensions qualitatives à croiser, la métrique quantitative à condenser et la nature de la fonction mathématique d’agrégation souhaitée, exécutant l’ensemble de la séquence partitionnement-réduction-pivotement sans rupture d’évaluation de contexte.
Une telle architecture de programmation modulaire exige également l’intégration d’instructions de validation défensive des types d’arguments d’entrée. Avant de lancer le pipeline d’agrégation, la fonction personnalisée doit s’assurer, par des assertions formelles, que l’objet transmis constitue bien une structure de données valide, que les colonnes déclarées existent au sein de la table d’entrée, et que les variables numériques désignées répondent aux exigences computationnelles des fonctions d’estimation sollicitées.
11.2 Génération modulaire de tableaux de bord analytiques
L’encapsulation fonctionnelle des tableaux croisés dynamiques constitue le socle indispensable pour automatiser la génération en série de rapports d’activité, de bilans périodiques et de tableaux de bord analytiques. Plutôt que de dupliquer des centaines de lignes de code pour chaque nouvelle variable ou découpage territorial à étudier, l’analyste déploie sa fonction personnalisée au sein de boucles vectorisées en exploitant la programmation fonctionnelle avancée offerte par le package purrr.
Cette approche permet d’itérer élégamment sur des listes complètes d’indicateurs de performance. Par exemple, en associant une liste de variables de ciblage à une fonction d’itération fonctionnelle, l’analyste peut générer de façon entièrement automatisée une série de dix tableaux croisés dynamiques distincts, chacun décortiquant une facette spécifique du modèle comportemental étudié, tout en conservant une structure de code compacte, modulaire et exempte de toute redondance manuelle.
Les structures tabulaires résultantes peuvent ensuite faire l’objet d’un export systématique vers des destinations multiples : sérialisation directe sous forme de classeurs multisheets au format Microsoft Excel via les bibliothèques openxlsx ou writexl, déversement automatisé dans des tables au sein d’une base de données relationnelle SQL via les pilotes DBI, ou assemblage dans un conteneur réactif destiné à nourrir une application d’aide à la décision codée sous R Shiny.
Pour garantir la conformité scientifique absolue de ces chaînes de traitement automatisées, l’écriture de tests unitaires à l’aide de la bibliothèque testthat s’avère indispensable. Ces tests vérifient rigoureusement que les totaux agrégés par la fonction modulaire correspondent précisément aux sommes théoriques des données brutes, qu’aucune ligne n’est mystérieusement écartée lors des phases de pivotement, et que la cohérence sémantique des nomenclatures de variables demeure rigoureusement préservée à travers l’ensemble des modules du système analytique.
12. Synthèse méthodologique et recommandations pour l’analyse reproductible
12.1 Arbre décisionnel pour le choix du package approprié
Face à la richesse des extensions logicielles disponibles dans l’écosystème R pour concevoir des tableaux croisés dynamiques, l’analyste de données doit adopter une stratégie de sélection méthodique guidée par les contraintes spécifiques de son projet. Le choix entre R de base, la galaxie tidyverse, le moteur haute performance data.table ou les bibliothèques d’interactivité web ne relève pas d’une préférence dogmatique, mais d’une adéquation raisonnée entre la volumétrie des données, les impératifs de vitesse, la lisibilité du code et la destination finale des livrables.
Lorsque la base d’observations demeure d’une taille modérée — typiquement inférieure au million de lignes — et que l’objectif principal réside dans la maintenance collaborative, l’enseignement ou l’insertion au sein de pipelines analytiques clairs et documentés, la combinaison éprouvée de dplyr et tidyr représente le standard incontournable. Sa syntaxe explicite et sa parfaite intégration avec les outils de modélisation en font l’environnement idéal pour concevoir des études méthodologiques rigoureuses et aisément lisibles par des tiers.
En revanche, dès lors que l’analyste fait face à des ensembles de données massifs excédant plusieurs millions d’enregistrements, ou lorsque les opérations de partitionnement doivent être répétées des milliers de fois dans le cadre de simulations de Monte-Carlo, le recours à data.table devient un impératif d’ingénierie logicielle. Ses gains d’efficacité sur l’allocation de mémoire et sa rapidité d’exécution le rendent incontournable pour le traitement de mégadonnées en milieu industriel ou dans les infrastructures de calcul distribué à haute performance.
Enfin, pour les phases exploratoires informelles où la découverte visuelle prime sur la formalisation, rpivotTable constitue l’outil idéal pour sonder rapidement les structures empiriques conjointes. Une fois les patterns découverts, cette interactivité éphémère doit néanmoins s’effacer au profit de fonctions scriptées pérennes couplées à des générateurs typographiques de pointe comme gt ou kableExtra, dès lors qu’il s’agit de produire un manuscrit scientifique soumis à évaluation par les pairs ou une publication institutionnelle à forte visibilité.
12.2 Principes de science ouverte et reproductibilité computationnelle
L’abandon des manipulations sur tableur de bureau au profit de la modélisation sous forme de scripts en langage R constitue une avancée méthodologique décisive pour l’élévation des standards de rigueur statistique. La propension documentée des interfaces graphiques manuelles à introduire des erreurs silencieuses — qu’il s’agisse de décalages de plages de sélection, d’écrasements de formules ou de conversions automatiques abusives — représente une menace permanente pour la fiabilité des résultats empiriques dans tous les domaines scientifiques.
L’adhésion aux principes de la science ouverte implique de documenter l’intégralité du cheminement computationnel ayant permis de transformer les données brutes initiales en tableaux de synthèse finaux. Cela suppose non seulement le partage transparent du code source R régissant chaque partitionnement et chaque calcul d’agrégation, mais également la stabilisation de l’ensemble de l’environnement d’exécution logiciel.
L’utilisation de gestionnaires de paquets avancés, tels que la bibliothèque renv, s’avère indispensable pour consigner formellement les versions exactes de R et de l’ensemble des extensions mobilisées lors de l’étude. Cette traçabilité logicielle garantit qu’un script de tableau croisé exécuté plusieurs années plus tard produira rigoureusement le même résultat arithmétique et la même disposition matricielle, à l’abri des dépréciations d’arguments ou des mutations d’API inhérentes au cycle de vie des bibliothèques de calcul.
En archivant de concert les données brutes ouvertes, les scripts d’orchestration dûment documentés et les tables finales au sein d’entrepôts de recherche certifiés, la communauté scientifique franchit un palier de qualité déterminant. Le tableau croisé dynamique, autrefois simple synthèse bureautique opaque et périssable, devient ainsi un composant analytique ouvert, auditable et parfaitement reproductible, au service d’une modélisation empirique rigoureuse et vérifiable.
Références
Barret, M., Dowle, M., Srinivasan, A., Gorecki, J., Chirico, M., & Hocking, T. (2023). data.table: Extension of `data.frame` (R package version 1.14.8). Comprehensive R Archive Network. https://CRAN.R-project.org/package=data.table
Iannone, R., Cheng, J., Schloerke, B., Hughes, E., Lauer, A., & Seo, J. (2024). gt: Easily Create Presentation-Ready Display Tables (R package version 0.10.1). Comprehensive R Archive Network. https://CRAN.R-project.org/package=gt
Muller, K., & Wickham, H. (2023). tibble: Simple Data Frames (R package version 3.2.1). Comprehensive R Archive Network. https://CRAN.R-project.org/package=tibble
R Core Team. (2024). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Wickham, H. (2011). The Split-Apply-Combine Strategy for Data Analysis. Journal of Statistical Software, 40(1), 1–29. https://doi.org/10.18637/jss.v040.i01
Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686
Wickham, H., & Grolemund, G. (2017). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data. O’Reilly Media. https://r4ds.had.co.nz/
Xie, Y. (2023). knitr: A General-Purpose Package for Dynamic Report Generation in R (R package version 1.45). Comprehensive R Archive Network. https://CRAN.R-project.org/package=knitr
Zhu, H. (2024). kableExtra: Construct Complex Table with ‘kable’ and Pipe Syntax (R package version 1.4.0). Comprehensive R Archive Network. https://CRAN.R-project.org/package=kableExtra