
L’estimation des paramètres au sein des modèles de régression linéaire par la méthode des moindres carrés ordinaires repose sur l’hypothèse fondamentale selon laquelle chaque unité statistique contribue de façon proportionnée et équilibrée à l’établissement de la droite ou de l’hyperplan de régression. Toutefois, dans la pratique empirique des sciences comportementales, économiques, médicales et sociales, cette condition idéale se heurte fréquemment à la présence d’observations singulières. Ces données atypiques possèdent le potentiel d’exercer une force d’attraction disproportionnée sur l’estimation des coefficients vectoriels, faussant ainsi l’interprétation substantielle des relations causales ou associatives théorisées par le chercheur.
Face à cette vulnérabilité intrinsèque des estimateurs linéaires, l’économétrie et la statistique moderne ont développé un éventail sophistiqué d’outils diagnostiques d’influence. Parmi ces métriques, les DFBETAS (différence standardisée des bêtas) occupent une place prépondérante en permettant une décomposition granulaire et paramètre par paramètre de l’impact individuel de chaque point d’échantillonnage. Contrairement aux indicateurs d’agrégation globale qui résument la perturbation globale d’un modèle en une valeur scalaire unique, les DFBETAS offrent une radiographie ciblée de la stabilité de chaque pente partielle, isolant avec une précision chirurgicale les observations qui modifient significativement la trajectoire d’un régresseur donné.
Ce guide exhaustif a pour vocation d’exposer la théorie statistique, la formulation mathématique et l’implémentation algorithmique rigoureuse du calcul des DFBETAS dans l’environnement informatique R. En parcourant les étapes successives menant de la modélisation fondamentale aux visualisations graphiques avancées, en passant par l’interprétation substantive des cas critiques et l’application des régressions robustes, les chercheurs et analystes quantitatifs disposeront d’un protocole d’audit méthodologique complet garantissant l’intégrité, la robustesse et la reproductibilité de leurs inférences empiriques.
1. Introduction aux mesures d’influence et fondements théoriques des DFBETAS
1.1 Définition et rôle des DFBETAS en régression linéaire
Dans le cadre de l’ajustement d’un modèle de régression linéaire multiple par les moindres carrés ordinaires, la sensibilité des estimateurs face à des perturbations localisées constitue une préoccupation méthodologique majeure. Les DFBETAS, acronyme désignant la différence standardisée des coefficients de régression (Difference in Betas Standardized), représentent une métrique diagnostique conçue pour quantifier précisément l’impact exercé par une observation individuelle sur l’estimation de chacun des paramètres du modèle. Fondamentalement, cette statistique évalue la variation standardisée que subirait l’estimateur d’une pente partielle ou de l’ordonnée à l’origine si l’observation indicée i venait à être intégralement retranchée de l’échantillon d’analyse.
Il est conceptuellement impératif de dissocier les DFBETAS d’autres anomalies distributionnelles courantes, notamment les points de levier statistiques et les résidus aberrants. Un point de levier désigne une observation affichant une configuration extrême ou atypique dans l’espace multidimensionnel des variables explicatives indépendantes, mesurée conventionnellement par les valeurs diagonales de la matrice de projection chapeau. En revanche, un résidu aberrant ou une valeur aberrante se caractérise par un écart substantiel entre la valeur observée de la variable dépendante et la valeur prédite par le modèle, traduisant un échec local de l’ajustement. Une observation peut ainsi présenter un effet de levier considérable sans pour autant être influente si elle se situe exactement dans l’alignement de la tendance générale. Inversement, une observation influente, détectée par les DFBETAS, conjugue généralement un levier non négligeable et un résidu marqué, modifiant substantiellement l’angle de la droite de régression.
Cette distinction revêt une importance critique pour la validité interne des modèles psychométriques, sociologiques et biomédicaux, où des sous-groupes cliniques ou des profils atypiques peuvent induire des biais de modélisation invisibles lors des diagnostics d’adéquation globale. L’architecture algorithmique des DFBETAS repose sur le mécanisme rigoureux d’exclusion unitaire, également qualifié de procédure leave-one-out ou jackknife. Ce principe consiste à réestimer itérativement les paramètres du modèle sur n sous-échantillons de taille n moins un, afin d’observer directement la réactivité de chaque coefficient vectoriel face à la troncature systématique de chaque unité statistique.
1.2 Distinction entre DFBETAS, DFFITS et la distance de Cook
L’arsenal des statistiques d’influence développées dans la littérature économétrique et statistique comprend principalement trois métriques fondamentales : la distance de Cook, le DFFITS et les DFBETAS. Bien que ces mesures partagent une racine conceptuelle commune basée sur la suppression unitaire d’observations, leurs vocations analytiques et leurs granularités diffèrent fondamentalement. La distance de Cook est un indicateur synthétique agrégé qui évalue le déplacement global du vecteur des prédictions ou, de manière équivalente, le glissement de l’ensemble du vecteur des coefficients dans l’espace paramétrique multidimensionnel. Elle fournit ainsi un signal d’alerte global informant le chercheur qu’une observation perturbe la structure générale du modèle, sans toutefois préciser quel paramètre spécifique subit cette altération.
De manière similaire, le DFFITS (Difference in Fits Standardized) mesure la variation standardisée induite par une observation sur sa propre valeur prédite. Il s’agit d’une métrique centrée sur la réponse ajustée individuelle, très sensible aux déviations prédictives ponctuelles, mais qui condense à nouveau l’information sous une forme scalaire unique par observation. Les DFBETAS, quant à eux, offrent une résolution analytique supérieure en se déployant non pas sous la forme d’un vecteur unidimensionnel de longueur n, mais sous la forme d’une matrice complète de dimensions n lignes par k plus un colonnes, où k représente le nombre de régresseurs indépendants augmentés du terme d’interception.
Cette structure matricielle confère aux DFBETAS une capacité diagnostique unique : chaque coefficient vectoriel individuel fait l’objet d’un examen dédié. Grâce à leurs propriétés de standardisation par une estimation appropriée de l’erreur type tronquée, les DFBETAS permettent des comparaisons rigoureuses entre variables mesurées sur des échelles hétérogènes, neutralisant les effets d’unités de mesure divergentes. Pour mener un audit complet et irréprochable des données empiriques, les recommandations méthodologiques préconisent d’articuler ces outils de manière séquentielle : utiliser la distance de Cook et le DFFITS pour cartographier les perturbations globales du système d’estimation, puis mobiliser immédiatement les DFBETAS afin d’identifier avec précision quel mécanisme explicatif particulier ou quelle pente marginale se trouve déformée par les observations suspectes.
1.3 Enjeux méthodologiques pour la recherche quantitative
La recherche quantitative moderne, soumise à des exigences accrues d’intégrité et de reproductibilité empirique, fait face à des risques épistémologiques majeurs lorsque l’étape des diagnostics d’influence est négligée. Les inférences statistiques, qu’il s’agisse des tests de signification d’hypothèses nulles de Student ou des intervalles de confiance associés aux pentes partielles, sont extrêmement vulnérables dans les échantillons de taille petite à modérée. Une unique observation influente peut suffire à faire basculer une p-valeur de part et d’autre du seuil conventionnel de cinq pour cent, transformant une relation empirique statistiquement non significative en une découverte illusoire, ou inversement, masquant une association théorique pourtant robuste par inflation artificielle de l’erreur type.
Dans ce contexte, le recours systématique aux DFBETAS protège le chercheur contre le biais de confirmation cognitif qui menace l’épuration des données. Sans métrique standardisée et objective, l’expérimentateur pourrait être tenté d’éliminer de façon discrétionnaire des points singuliers au seul motif qu’ils contredisent les hypothèses de recherche initialement formulées. L’adoption d’un critère formel d’influence paramétrique contraint le processus de validation à reposer sur des bases mathématiques transparentes, documentées et reproductibles.
L’intégration des diagnostics de DFBETAS répond directement à la crise de la reproductibilité qui traverse les sciences empiriques contemporaines. Un modèle économétrique ou psychométrique dont les conclusions fondamentales reposent exclusivement sur la présence contingente de deux ou trois unités d’échantillonnage ne saurait prétendre à la généralisabilité scientifique. La mise en œuvre rigoureuse des diagnostics d’influence permet ainsi d’établir la stabilité structurelle des inférences paramétriques et d’apporter la preuve que les conclusions publiées reflètent fidèlement les dynamiques de la population cible plutôt que les idiosyncrasies accidentelles de cas extrêmes.
2. Formulation mathématique et mécanisme statistique sous-jacent
2.1 Formule mathématique de base des DFBETAS
La dérivation mathématique des DFBETAS s’articule autour de l’algèbre matricielle de la régression linéaire multiple. Soit un modèle spécifié sous la forme vectorielle standard Y = X beta + epsilon, où Y est le vecteur des n réponses observées, X la matrice de plan de dimensions n par p (avec p = k + 1 incluant la colonne unitaire d’interception), beta le vecteur des p coefficients à estimer, et epsilon le vecteur des erreurs résiduelles indépendantes et identiquement distribuées. L’estimateur conventionnel des moindres carrés ordinaires s’exprime par le vecteur beta chapeau = (X^T X)^(-1) X^T Y.
Considérons maintenant l’estimateur tronqué noté beta chapeau entre parenthèses indice i, obtenu en réestimant le modèle après avoir exclu la i-ième ligne de la matrice X et le i-ième élément du vecteur Y. La variation vectorielle brute induite par ce retrait s’écrit beta chapeau moins beta chapeau entre parenthèses indice i. Pour isoler le j-ième coefficient de ce vecteur et le normaliser afin de s’affranchir des unités de mesure de la variable associée, la formule analytique du DFBETAS pour le j-ième paramètre et la i-ième observation s’énonce comme le rapport entre la différence brute du coefficient et une mesure standardisée de sa variabilité :
DFBETAS_j(i) = [beta_chapeau_j – beta_chapeau_j(i)] / [s_(i) * sqrt(c_jj)]
Dans cette formulation algébrique fondamentale, s_(i) représente l’estimation de l’écart-type de l’erreur résiduelle obtenue après exclusion de la i-ième observation, assurant une stricte indépendance vis-à-vis du point évalué. Le terme c_jj correspond au j-ième élément diagonal de la matrice inverse des covariances des régresseurs, c’est-à-dire le j-ième scalaire diagonal de la matrice (X^T X)^(-1). Par ailleurs, l’algèbre matricielle démontre, grâce à l’application du lemme d’inversion matricielle de Sherman-Morrison-Woodbury, qu’il n’est pas nécessaire de réajuster manuellement n régressions distinctes pour calculer ces valeurs. Le terme de variation s’exprime directement à l’aide des résidus studentisés externes et des éléments de la matrice de projection chapeau H = X (X^T X)^(-1) X^T, liant intimement l’effet de levier h_ii et le résidu standardisé à la déviation paramétrique observée.
L’interprétation du signe algébrique du DFBETAS est immédiate : un score positif indique que l’inclusion de l’observation i dans l’échantillon tire l’estimation du coefficient beta_j vers le haut, c’est-à-dire qu’elle accroît sa magnitude positive ou réduit sa négativité. Réciproquement, un score DFBETAS négatif signale que l’observation i exerce une pression à la baisse sur le coefficient j, diminuant sa valeur estimée globale. La magnitude absolue renseigne quant à elle directement sur l’amplitude de ce déplacement, exprimée en unités d’écart-type de l’estimateur.
2.2 Différence fondamentale entre dfbeta et dfbetas
L’environnement statistique R fournit deux fonctions distinctes aux désignations très proches mais dont la portée analytique diffère radicalement : la fonction dfbeta() d’une part, et la fonction dfbetas() d’autre part. Cette terminaison par un s minuscule marque le passage d’une métrique dimensionnelle brute à une métrique adimensionnelle strictement standardisée. La fonction dfbeta() calcule l’écart direct non standardisé, correspondant simplement au numérateur de la formule statistique :
dfbeta_j(i) = beta_chapeau_j – beta_chapeau_j(i)
Par conséquent, la grandeur numérique générée par dfbeta() s’exprime exactement dans l’unité de mesure d’origine de la variable dépendante Y divisée par l’unité de mesure du régresseur explicatif X_j. Par exemple, si la variable dépendante représente un salaire annuel mesuré en euros et que le régresseur modélise le niveau d’éducation exprimé en années d’études, la valeur retournée par dfbeta() s’interprétera directement en euros par année supplémentaire de scolarité. Si cette quantification brute offre une interprétabilité financière ou physique immédiate pour le praticien spécialiste du domaine concerné, elle présente un inconvénient majeur : elle interdit formellement toute comparaison d’influence entre régresseurs au sein d’un même modèle, ainsi que toute comparaison entre modèles portant sur des variables distinctes.
À l’opposé, la fonction dfbetas() incorpore la division par le dénominateur standardisé comprenant l’erreur type de l’estimateur sans l’observation i. Il en résulte un nombre pur, adimensionnel, représentant le déplacement du coefficient en fractions d’erreurs types. Lors des procédures de contrôle de qualité des données et des audits diagnostiques comparatifs, il est impératif de privilégier l’usage des DFBETAS standardisés. Cette standardisation permet d’appliquer des règles de décision universelles et d’identifier avec la même sévérité relative les perturbations affectant des variables aux variances disparates.
2.3 Seuils théoriques et heuristiques de coupure
L’exploitation pratique des DFBETAS requiert l’établissement de règles de décision formelles afin de distinguer les fluctuations d’échantillonnage aléatoires ordinaires des cas d’influence paramétrique anormale. Dans leur ouvrage de référence sur les diagnostics de régression, Belsley, Kuh et Welsch (1980) ont établi deux heuristiques de coupure canoniques qui font aujourd’hui autorité dans la littérature méthodologique.
La première règle, dite seuil dépendant de la taille de l’échantillon ou critère ajusté, stipule qu’une observation doit être considérée comme suspecte et soumise à un examen minutieux si la valeur absolue de son DFBETAS dépasse le seuil critique calculé selon la formule :
Seuil_BKW = 2 / sqrt(n)
Ce seuil adaptatif découle de considérations théoriques sur la distribution asymptotique des statistiques d’influence. Dans un échantillon de taille n, la contribution moyenne théorique d’une observation individuelle à la variance d’un coefficient décroît proportionnellement à l’inverse de la racine carrée de n. Par conséquent, l’heuristique deux divisé par la racine carrée de n ajuste dynamiquement le degré de sévérité du filtre diagnostique en fonction du volume d’observations collectées. Plus l’échantillon est volumineux, plus le seuil devient strict en valeur absolue, empêchant des observations marginales d’échapper à la détection dans les grandes bases de données.
La seconde heuristique, de nature absolue et conservatrice, retient un seuil fixe égal à l’unité :
Seuil_Absolu = 1.0
Le franchissement d’un seuil absolu unitaire indique qu’à elle seule, une observation déplace l’estimation du coefficient de plus d’un écart-type entier. Une telle distorsion constitue un événement statistique exceptionnel, capable de transformer radicalement la significativité ou le signe de la pente. Cependant, dans les contextes contemporains de mégadonnées ou de cohortes massives comprenant des dizaines de milliers d’individus, l’application aveugle du seuil ajusté 2/sqrt(n) peut conduire à une sur-détection pathologique en qualifiant d’influentes des centaines de données dont l’impact substantiel reste pourtant négligeable. Il est donc fondamental de rejeter tout automatisme binaire dénué de discernement méthodologique, et d’ajuster l’arbitrage entre seuils relatifs et seuils absolus selon la taille du collectif et les finalités épistémiques de la modélisation.
3. Préparation de l’environnement de travail et des données dans R
3.1 Configuration des bibliothèques nécessaires
L’implémentation rigoureuse des diagnostics d’influence sous le langage R tire parti de l’écosystème modulaire et extensible propre à cet environnement logiciel. Si les fonctions statistiques de base requises pour l’estimation paramétrique et le calcul matriciel des DFBETAS sont nativement intégrées au package standard stats préinstallé dans R, l’approfondissement des analyses et la sophistication visuelle nécessitent l’appel à des bibliothèques spécialisées développées par la communauté biométrique et économétrique.
Au premier rang de ces extensions figure le package car (Companion to Applied Regression), développé initialement par John Fox et Sanford Weisberg. Cette bibliothèque constitue la référence méthodologique incontournable pour les tests d’hypothèses linéaires, l’examen de la colinéarité et la génération automatisée de graphiques de diagnostic combinés. Conjointement, le package olsrr (OLS Regression Diagnostics and Tools) fournit une interface analytique contemporaine dédiée exclusivement à l’évaluation méthodique des modèles linéaires gaussiens, offrant des sorties tabulaires structurées et des fonctions graphiques prêtes à l’emploi pour l’inspection des DFBETAS.
Pour l’ingénierie des données et la restitution graphique selon les standards graphiques les plus élevés, l’environnement tidyverse, structuré autour de packages tels que dplyr pour la manipulation de données, tidyr pour le remodelage vectoriel et ggplot2 pour la grammaire graphique stratifiée, s’avère indispensable. Enfin, la configuration des options globales de la session RStudio, notamment le réglage de l’affichage numérique via l’instruction d’options de scipen fixée à une valeur adéquate pour éviter une notation scientifique prématurée, garantit une lisibilité maximale des sorties console lors du calcul des valeurs critiques d’échantillonnage.
3.2 Sélection et inspection exploratoire du jeu de données
Pour assurer la transférabilité pédagogique et la reproductibilité absolue des procédures présentées, la démarche analytique s’appuiera sur des jeux de données d’accès direct au sein de l’environnement R, tels que le célèbre jeu de données mtcars, issu des essais de performances automobiles documentés par Motor Trend en 1974, ou des sous-ensembles psychométriques représentatifs de dimensions continues. Le choix d’un jeu de données canonique tel que mtcars présente un avantage diagnostique considérable : cet échantillon modéré comprenant 32 observations pour 11 attributs mécaniques et structurels contient des véhicules aux caractéristiques particulièrement contrastées, offrant un terrain d’exercice idéal pour illustrer le comportement des cas influents.
Avant d’ajuster le moindre modèle mathématique, une inspection exploratoire méthodique s’impose. Cette étape initiale débute par l’examen minutieux des types de variables via la fonction str() ou glimpse(), confirmant la nature continue des grandeurs destinées à figurer comme régresseurs et variable dépendante. La présence éventuelle d’enregistrements manquants (valeurs NA) doit être systématiquement décomptée et traitée, car l’omission non planifiée d’observations en cours d’ajustement perturberait l’indexation séquentielle nécessaire à la traçabilité des DFBETAS.
L’évaluation des statistiques descriptives fondamentales (moyennes, écarts-types, médianes, quartiles et étendues) permet de repérer en amont les asymétries distributionnelles sévères qui présagent fréquemment l’émergence de points de levier statistiques. Dans le cadre de notre modélisation de référence, nous définirons la consommation de carburant, mesurée en miles par gallon (mpg), comme variable dépendante continue, tandis que la masse du véhicule (wt), la cylindrée du moteur (disp) et la puissance brute (hp) feront office de prédicteurs continus au sein du système explicatif.
3.3 Vérification des hypothèses préalables de la régression
L’interprétation valide des mesures d’influence requiert impérativement que le modèle de régression linéaire sous-jacent soit structurellement et théoriquement adéquat. Calculer des DFBETAS sur une spécification économétrique corrompue par une violation massive des hypothèses de Gauss-Markov conduirait à imputer à quelques observations isolées ce qui relève en réalité d’un défaut systémique de paramétrisation mathématique.
La première hypothèse à examiner concerne la multicolinéarité entre les variables explicatives. La présence de corrélations linéaires intenses entre prédicteurs a pour conséquence directe de dilater artificiellement les variances des estimateurs, ce qui modifie substantiellement les éléments diagonaux c_jj de la matrice (X^T X)^(-1). L’évaluation des facteurs d’inflation de la variance (VIF) constitue à cet égard une précaution essentielle : des valeurs de VIF supérieures aux seuils conventionnels de 5 ou 10 signalent une instabilité colinéaire qui viendrait exacerber de manière fallacieuse les scores de DFBETAS calculés pour les variables concernées.
De surcroît, l’inspection préalable de la linéarité fonctionnelle et de l’homoscédasticité des perturbations résiduelles s’opère conventionnellement par l’examen des graphiques de résidus contre valeurs prédites et par l’application de tests formels tels que le test de Breusch-Pagan. Enfin, la détection précoce des effets de levier structurels s’accomplit par l’extraction des éléments diagonaux h_ii de la matrice chapeau, couramment dénommés hatvalues. L’identification des points de données dépassant le seuil classique de levier fixé à deux ou trois fois le levier moyen (p divisé par n) attire d’emblée l’attention de l’analyste sur les unités statistiques possédant le potentiel théorique maximal de distorsion paramétrique, préparant ainsi l’étape d’évaluation ciblée des DFBETAS.
4. Ajustement du modèle de régression linéaire multiple
4.1 Construction du modèle avec la fonction lm()
La formulation empirique de la relation linéaire s’opère dans R par l’intermédiaire de la fonction fondamentale lm(), qui implémente numériquement l’algorithme des moindres carrés ordinaires au moyen d’une décomposition matricielle QR hautement optimisée. Cette méthode de factorisation garantit une remarquable stabilité numérique lors de l’inversion des matrices, minimisant les erreurs d’arrondi computationnelles inhérentes aux systèmes linéaires comportant des prédicteurs corrélés.
La syntaxe de base consiste à expliciter la formule symbolique reliant la variable réponse aux variables explicatives continues, séparées par l’opérateur d’addition. L’affectation de cette opération à un objet spécifique au sein de l’environnement R conserve en mémoire la totalité des structures de données associées au modèle :
modele_cars <- lm(mpg ~ wt + disp + hp, data = mtcars)
Cette déclaration spécifie un modèle complet comprenant trois pentes partielles associées respectivement à la masse, à la cylindrée et à la puissance, ainsi qu’un terme constant d’interception modélisant la consommation théorique attendue pour des valeurs nulles de l’ensemble des prédicteurs. L’algorithme des moindres carrés traite simultanément l’ensemble des coefficients vectoriels en minimisant la somme des carrés des erreurs résiduelles. Il est capital de s’assurer, avant de poursuivre, que la convergence computationnelle s’est opérée sans émission d’avertissements relatifs à des singularités matricielles ou à des coefficients indéterminés en raison d’une redondance d’information stricte.
4.2 Extraction et analyse du sommaire statistique
L’exécution de la méthode polymorphe summary() sur l’objet de régression modele_cars génère le panorama statistique complet nécessaire à l’évaluation de la performance globale et locale du modèle estimé. La console R restitue alors l’estimation des coefficients non standardisés, leurs erreurs types asymptotiques respectives, les valeurs des statistiques de test t de Student associées ainsi que les p-valeurs correspondantes calculées sous l’hypothèse de nullité des paramètres.
Dans ce sommaire, l’attention du chercheur doit se porter tant sur l’ampleur absolue des coefficients estimés que sur leur niveau d’incertitude. L’examen attentif du coefficient de détermination global R-carré et de sa version corrigée (R-carré ajusté) permet de déterminer la proportion de variance de la consommation mécanique expliquée par les trois variables indépendantes. Cependant, l’apparition de variables présentant une signification statistique marginale ou fragile, caractérisée par des p-valeurs situées à proximité immédiate du seuil alpha de 0,05, constitue une alerte méthodologique majeure. Ce sont précisément ces prédicteurs à la limite de la significativité statistique qui s’avèrent les plus vulnérables à l’influence de points d’échantillonnage singuliers : l’exclusion d’une seule observation pourrait entraîner le basculement de ces coefficients dans la zone de non-significativité ou, inversement, masquer une contribution explicative authentique.
4.3 Sauvegarde des métadonnées du modèle
Afin de structurer le flux de travail analytique et de préparer les calculs ultérieurs de détection sans réexécuter inutilement les fonctions d’estimation, il est recommandé d’extraire systématiquement les métadonnées clés associées à l’objet de régression et de les stocker au sein d’un environnement de données consolidé. Les paramètres dimensionnels fondamentaux du modèle s’obtiennent par programmation élémentaire : la taille de l’échantillon n correspond au nombre de lignes résiduelles ou d’observations actives, tandis que le nombre total de paramètres p s’extrait par la longueur du vecteur des coefficients.
De manière complémentaire, les résidus ordinaires, les résidus standardisés calculés par rstandard() et les résidus studentisés externes obtenus via rstudent() doivent être archivés dans un même tableau de données récapitulatif. Le résidu studentisé externe s’avère particulièrement précieux car il intègre déjà le mécanisme d’exclusion unitaire au niveau de la variance d’ajustement résiduelle, constituant une composante essentielle de la mécanique interne des DFBETAS. En adjoignant à ce tableau les valeurs diagonales de levier statistique extraites par hatvalues(), l’analyste pose les fondations quantitatives indispensables à l’audit croisé de l’influence locale.
5. Calcul pas à pas des DFBETAS avec les fonctions natives de R
5.1 Exécution de la fonction dfbetas()
Le calcul des DFBETAS standardisés s’effectue dans l’environnement R au moyen d’un appel direct à la fonction native dfbetas() issue de la bibliothèque de base stats. Cette fonction prend pour argument principal l’objet de régression issu de la fonction lm() et restitue instantanément la matrice d’influence complète sans exiger de l’utilisateur la programmation manuelle de la boucle d’itération jackknife :
matrice_dfbetas <- dfbetas(modele_cars)
L’objet résultant se matérialise sous la forme d’une matrice numérique à deux dimensions dont la structure formelle reflète rigoureusement l’espace d’échantillonnage et l’espace paramétrique. Le nombre de lignes de cette matrice équivaut strictement à la taille n de l’échantillon d’analyse (soit 32 lignes pour le modèle mtcars), tandis que le nombre de colonnes correspond au nombre de coefficients p du modèle, intégrant l’ordonnée à l’origine (soit 4 colonnes : (Intercept), wt, disp et hp). Chaque cellule située à l’intersection de la ligne i et de la colonne j quantifie de manière exacte la valeur prise par DFBETAS_j(i).
Une étape de vérification d’intégrité computationnelle s’impose dès l’obtention de cette matrice. L’analyste doit s’assurer de l’absence totale de valeurs manquantes (NA) ou de grandeurs infinies (Inf), qui témoigneraient d’une singularité géométrique locale ou d’un point de levier absolu ayant absorbé l’intégralité des degrés de liberté résiduels. La validation de la conformité dimensionnelle de la matrice garantit que la bijection entre les identifiants d’observations et les scores d’impact paramétrique est rigoureusement préservée.
5.2 Extraction ciblée pour des prédicteurs spécifiques
Bien que la matrice globale fournisse une vue exhaustive des dynamiques d’influence au sein du modèle, l’investigation empirique cible fréquemment des coefficients spécifiques présentant un intérêt théorique central pour les hypothèses de recherche. L’isolement des DFBETAS associés à un prédicteur particulier s’opère par indexation matricielle standard en désignant la colonne d’intérêt par son étiquette textuelle ou son indice de position.
Afin de fluidifier les étapes subséquentes de manipulation statistique et de visualisation graphique, il est vivement recommandé de convertir la matrice brute en un tableau de données rectangulaire moderne de type data.frame ou tibble. Les identifiants textuels des unités statistiques, initialement stockés dans les attributs de noms de lignes (rownames), doivent être expressément promus au statut de colonne explicite d’identification au sein du tableau :
dfbetas_structure <- as.data.frame(matrice_dfbetas)
dfbetas_structure$identifiant <- rownames(dfbetas_structure)
Cette transformation garantit que chaque mesure d’impact individuel demeure indissolublement liée à l’unité statistique dont elle dérive. Il devient dès lors aisé de renommer explicitement les colonnes pour écarter toute ambiguïté sémantique, par exemple en préfixant le nom de chaque variable par la mention dfb_, et d’effectuer des opérations de fusion ou de jointure avec le jeu de données d’origine contenant les caractéristiques descriptives complètes des observations analysées.
5.3 Calcul alternatif avec la fonction dfbeta() brute
L’exécution conjointe de la fonction dfbeta() permet d’extraire les variations brutes non standardisées beta_chapeau_j moins beta_chapeau_j(i), offrant une perspective complémentaire précieuse pour éclairer l’ampleur substantielle des déplacements paramétriques :
matrice_dfbeta_brute <- dfbeta(modele_cars)
La comparaison terme à terme entre la sortie de dfbeta() et celle de dfbetas() illustre empiriquement le mécanisme de standardisation théorisé à la section 2. Pour une observation et un régresseur donnés, la division de la valeur brute dfbeta par le produit de l’écart-type résiduel sans l’observation i (noté s_(i)) et de la racine carrée du terme diagonal c_jj de la matrice (X^T X)^(-1) restitue rigoureusement la valeur issue de dfbetas().
Cette approche désagrégée s’avère particulièrement instructive dans les contextes industriels, cliniques ou managériaux, où les décideurs s’avèrent souvent plus réceptifs à une variation mesurée directement dans l’échelle d’origine des phénomènes qu’à une unité standardisée abstraite. Par exemple, observer qu’un modèle particulier de voiture modifie à lui seul la sensibilité de la consommation au poids de 0,5 mile par gallon par tonne confère une intuition opérationnelle tangible que le score d’écart-type ne communique pas immédiatement. Toutefois, la vigilance s’impose : seule la métrique standardisée DFBETAS issue de dfbetas() possède la neutralité mathématique requise pour identifier objectivement les anomalies statistiques prioritaires.
6. Application rigoureuse des seuils d’identification des cas influents
6.1 Calcul programmable du seuil spécifique 2/sqrt(n)
La détection rigoureuse des observations anormalement influentes requiert la formalisation algorithmique des critères théoriques évoqués précédemment. Pour automatiser ce processus sans recourir à des calculs manuels sources d’erreurs, le seuil ajusté de Belsley, Kuh et Welsch doit être déterminé dynamiquement au sein du script R en extrayant la dimension d’échantillonnage directement depuis le modèle ajusté :
taille_echantillon <- nobs(modele_cars)
seuil_critique <- 2 / sqrt(taille_echantillon)
Pour l’échantillon mtcars comportant 32 unités statistiques, le calcul numérique attribue au seuil critique la valeur de 2 divisé par la racine carrée de 32, soit environ 0,3535. Toute observation pour laquelle la valeur absolue du DFBETAS excède cette limite seuil sera classée comme statistiquement influente sur le coefficient considéré.
L’implémentation programmatique tire profit des vecteurs logiques booléens générés par l’opérateur de comparaison. En appliquant la condition d’inégalité stricte à l’ensemble de la matrice des DFBETAS prise en valeur absolue, R génère une structure matricielle d’indicatrices booléennes (TRUE ou FALSE) signalant instantanément les dépassements de tolérance pour chaque cellule du modèle. Cette démarche garantit une totale reproductibilité et neutralise les risques d’omission lors du dépouillement diagnostique.
6.2 Filtrage et classement des observations critiques
L’exploitation de l’infrastructure logicielle fournie par le package dplyr permet d’extraire, de filtrer et de sérier les observations problématiques avec une remarquable clarté syntaxique. En associant les fonctions filter() et arrange(), l’analyste peut ordonner les cas suspects selon l’ampleur absolue de leur influence sur un régresseur donné :
cas_influents_poids <- dfbetas_structure %>%
filter(abs(wt) > seuil_critique) %>%
arrange(desc(abs(wt)))
Cette routine d’extraction isole immédiatement les unités statistiques qui exercent une traction démesurée sur le paramètre de masse du véhicule. Il est fréquent que certaines observations s’illustrent par une influence généralisée, franchissant simultanément le seuil critique pour l’ensemble des prédicteurs du modèle, tandis que d’autres ciblent exclusivement un régresseur unique en raison d’une localisation atypique limitée à un seul sous-espace orthogonal.
Le résultat de cette filtration systématique peut être mis en forme sous la forme d’un tableau récapitulatif publiable, consignant pour chaque cas signalé son identifiant d’échantillonnage, la valeur exacte de ses DFBETAS par prédicteur, ainsi que le rapport proportionnel entre l’influence constatée et le seuil critique d’alerte. Cette synthèse tabulaire constitue la base documentaire indispensable pour toute discussion méthodologique ultérieure portant sur la stabilité du modèle.
6.3 Analyse différentielle selon le type de prédicteur
L’évaluation des scores DFBETAS ne doit pas être menée de manière uniforme sans tenir compte de la nature mathématique et géométrique des différents régresseurs introduits dans la formule linéaire. L’ordonnée à l’origine (terme constant ou Intercept) affiche structurellement une vulnérabilité diagnostique supérieure face aux DFBETAS par rapport aux pentes partielles centrées. En effet, la colonne vectorielle associée à l’interception n’étant constituée que de valeurs unitaires invariantes, toute observation dont les valeurs explicatives se situent à une distance considérable du point d’origine théorique exercera une force de bascule massive sur la constante, générant des scores de DFBETAS particulièrement élevés sans que les pentes associées aux variables d’intérêt n’en soient nécessairement déstabilisées.
Le comportement des DFBETAS face aux variables catégorielles ou indicatrices binaires (variables muettes ou dummy variables) mérite une vigilance tout aussi pointue. Dans le cas d’une indicatrice marquant une catégorie minoritaire qui ne regroupe qu’une infime fraction de l’échantillon total, chaque unité appartenant à ce sous-groupe rare détient un effet de levier intrinsèquement élevé. Il s’ensuit que les DFBETAS associés à ce coefficient binaire franchiront couramment les seuils statistiques théoriques sous l’effet de la seule rareté de la modalité, sans que cela n’indique la présence d’une pathologie d’échantillonnage ou d’une anomalie substantielle.
Enfin, pour les régresseurs continus présentant une faible dispersion ou variance, l’analyste doit se prémunir contre le risque de sur-détection consécutif à l’application aveugle du critère 2/sqrt(n) au sein de petits collectifs. La prise en compte de la structure sous-jacente des données permet de contextualiser la signification de chaque alerte diagnostique et d’éviter des interprétations alarmistes injustifiées.
7. Visualisation graphique fondamentale des DFBETAS dans R de base
7.1 Génération de graphiques d’indices simples
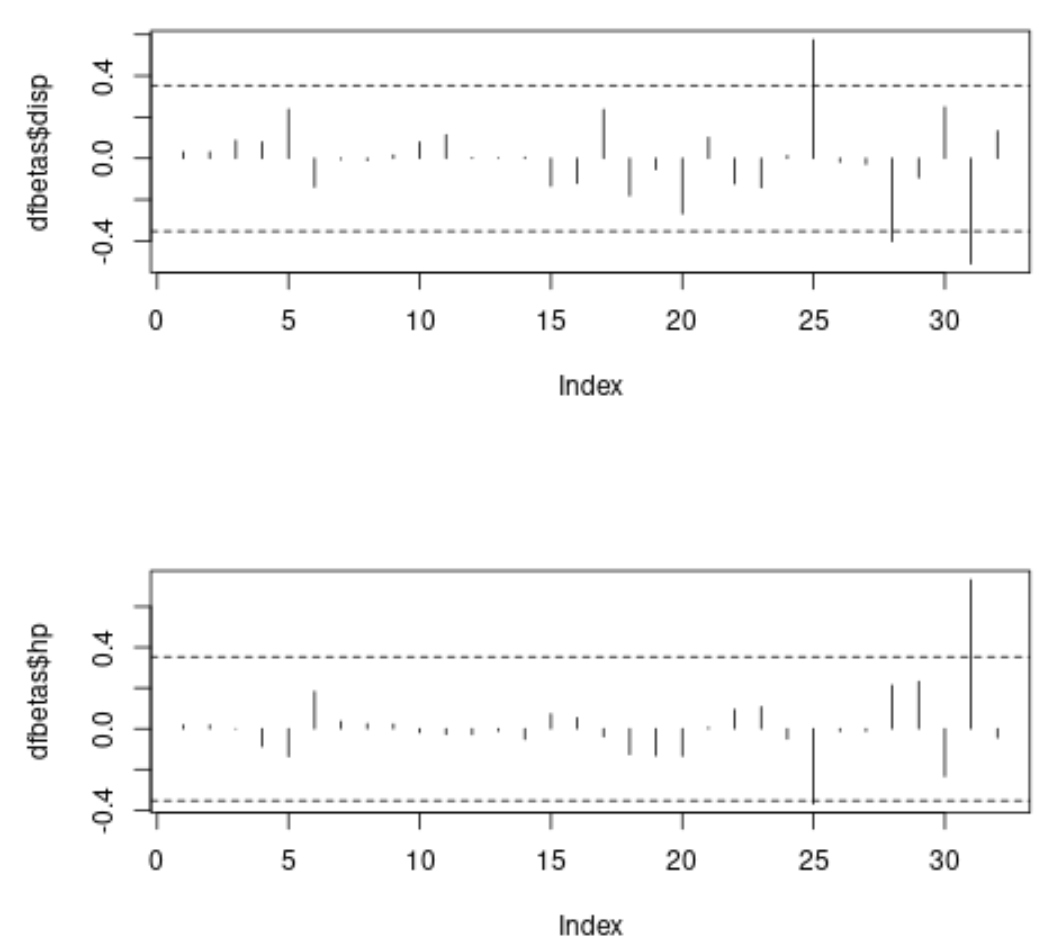
La visualisation graphique constitue un prolongement indispensable de l’analyse tabulaire en permettant une appréhension spatiale immédiate de la dispersion des mesures d’influence à travers l’échantillon. Les outils graphiques natifs fournis par l’environnement de base de R permettent d’élaborer rapidement des diagrammes d’indices (index plots) d’une grande efficacité diagnostique sans nécessiter le chargement de packages externes.
La construction d’un graphique d’indice repose sur la projection séquentielle des valeurs de DFBETAS calculées pour un coefficient donné sur l’axe des ordonnées, en correspondance avec le rang d’indexation ou l’ordre chronologique des observations positionné sur l’axe des abscisses. La fonction générique plot() combinée à l’adjonction de droites de référence via abline() permet de circonscrire l’espace d’acceptabilité statistique :
plot(matrice_dfbetas[, « wt »], type = « h », main = « DFBETAS pour la variable Poids », ylab = « DFBETAS Standardisés », xlab = « Index des observations », ylim = c(-1.2, 1.2))
abline(h = 0, lty = 1, col = « black »)
abline(h = c(-seuil_critique, seuil_critique), lty = 2, col = « red »)
Dans cette configuration, l’emploi de l’argument de type en bâtons (type = « h ») matérialise verticalement l’éloignement de chaque point par rapport à la ligne de flottaison neutre d’impact zéro. Les lignes discontinues horizontales tracées en rouge figurent avec précision les limites d’alerte théoriques. Le chercheur perçoit instantanément les observations dont les tiges verticales percent les frontières de tolérance critique, se détachant visiblement de la rumeur de fond des variations aléatoires standard.
7.2 Étiquetage textuel des points extrêmes
Un tracé graphique d’indices ne livre toute sa puissance analytique que s’il permet l’identification nominale directe des unités statistiques problématiques, évitant à l’expérimentateur des allers-retours fastidieux entre la fenêtre graphique et les vecteurs de la console. L’enrichissement textuel d’un tracé graphique sous le moteur natif de R s’opère par la mobilisation de la fonction d’annotation text().
Pour prévenir la surcharge visuelle et la superposition anarchique d’étiquettes, il est capital de conditionner l’affichage textuel aux seuls points qui transgressent le seuil statistique fixé. Cette discrimination s’accomplit en sélectionnant dynamiquement les coordonnées spatiales des cas aberrants via des vecteurs logiques d’indexation :
indices_suspects <- which(abs(matrice_dfbetas[, « wt »]) > seuil_critique)
text(x = indices_suspects, y = matrice_dfbetas[indices_suspects, « wt »], labels = rownames(matrice_dfbetas)[indices_suspects], pos = 3, cex = 0.8, col = « blue »)
L’argument pos fixé à trois commande l’inscription des étiquettes typographiques immédiatement au-dessus des coordonnées des points identifiés, tandis que le paramètre d’échelle cex module la taille des caractères pour assurer une lecture confortable. Par ce dispositif automatisé, les identifiants d’échantillons singuliers, tels que les modèles spécifiques d’automobiles affichant des caractéristiques aberrantes, apparaissent nettement en surbrillance chromatique, offrant un support visuel directement exploitable pour les rapports d’expertise ou les manuscrits scientifiques.
7.3 Multi-panneaux graphiques pour l’ensemble des prédicteurs
Limiter l’inspection visuelle à un prédicteur unique ferait courir le risque de négliger des distorsions majeures affectant d’autres composantes du modèle linéaire. Afin de dresser un panorama diagnostique exhaustif et synoptique, il est nécessaire de juxtaposer les profils d’influence de l’intégralité des coefficients au sein d’une même planche multi-panneaux.
Cette orchestration graphique s’articule nativement dans R par le paramétrage de l’environnement d’affichage au moyen de l’instruction par(mfrow = c(lignes, colonnes)). En définissant une grille adaptée à la dimensionnalité du modèle (par exemple une matrice 2×2 pour accueillir les quatre coefficients de notre régression de démonstration), une simple structure itérative de boucle for exécute la série séquentielle des tracés graphiques avec un alignement rigoureux des échelles verticales :
par(mfrow = c(2, 2), mar = c(4, 4, 2, 1))
for(nom_colonne in colnames(matrice_dfbetas)) {
plot(matrice_dfbetas[, nom_colonne], type = « h », main = nom_colonne, ylab = « DFBETAS », xlab = « Index », ylim = c(-1.5, 1.5))
abline(h = c(-seuil_critique, 0, seuil_critique), lty = c(2, 1, 2), col = c(« red », « gray », « red »))
}
Cette planche intégrée permet une lecture comparée instantanée : l’observateur distingue d’un seul regard si une observation spécifique déstabilise de concert l’ensemble des paramètres structurels du système ou si son empreinte d’influence demeure circonscrite à une pente partielle singulière. L’exportation de ce dispositif au format vectoriel haute définition (PDF ou EPS) fournit une archive d’audit graphique de référence pour l’évaluation empirique.
8. Visualisation graphique avancée avec ggplot2
8.1 Structuration des données au format long
Si les graphiques natifs de R s’avèrent irremplaçables pour une inspection exploratoire immédiate, la production d’illustrations sophistiquées répondant aux standards éditoriaux contemporains des revues scientifiques de premier rang s’appuie préférentiellement sur la bibliothèque ggplot2. Ce paradigme repose sur la formalisation théorique d’une grammaire des graphiques qui exige que les structures de données adoptent un format rectangulaire unifié dit format long (tidy data).
Dans ce format optimalisé, chaque ligne du tableau de données représente une mesure unique d’influence pour une unité statistique et un coefficient donnés. Le passage de la matrice rectangulaire large des DFBETAS à ce format vertical s’opère élégamment à l’aide de la fonction pivot_longer() issue du package tidyr :
dfbetas_long <- dfbetas_structure %>%
pivot_longer(cols = -identifiant, names_to = « Parametre », values_to = « Valeur_DFBETAS ») %>%
mutate(Est_Influent = abs(Valeur_DFBETAS) > seuil_critique)
Cette opération transforme la table d’origine en un tableau de données comportant trois attributs essentiels : l’identifiant de l’observation, le nom du paramètre sous-jacent et le score numérique de DFBETAS. La création conjointe de la variable indicatrice booléenne Est_Influent intègre directement la règle de décision au sein de la structure de données, préparant l’assignation dynamique de propriétés esthétiques différentielles (couleurs, formes, transparences) lors de la construction des couches graphiques vectorielles.
8.2 Création de graphiques lollipop et diagrammes à barres
Le diagramme de type lollipop (graphique en sucette) constitue l’alternative visuelle contemporaine la plus élégante et informative pour représenter les mesures d’influence à la place des graphiques à barres traditionnels. Moins dense visuellement que des barres pleines massives, le tracé lollipop associe une ligne fine reliant l’origine au point d’estimation et un point terminal accentué, focalisant l’attention de l’œil sur la dispersion des coordonnées critiques.
La matérialisation de ce tracé sous ggplot2 s’articule par la superposition méthodique de couches géométriques combinant geom_segment() pour les tiges verticales et geom_point() pour les marqueurs sommitaux. La couleur des marqueurs est liée à l’attribut logique de dépassement de seuil, tandis que des lignes de référence horizontales sont introduites via geom_hline() :
ggplot(dfbetas_long, aes(x = identifiant, y = Valeur_DFBETAS)) +
geom_segment(aes(x = identifiant, xend = identifiant, y = 0, yend = Valeur_DFBETAS), color = « gray70 ») +
geom_point(aes(color = Est_Influent), size = 2) +
geom_hline(yintercept = c(-seuil_critique, seuil_critique), linetype = « dashed », color = « firebrick ») +
scale_color_manual(values = c(« FALSE » = « steelblue », « TRUE » = « firebrick »)) +
theme_minimal() +
theme(axis.text.x = element_blank(), axis.ticks.x = element_blank())
Ce formalisme esthétique offre un contraste percutant : les observations ordinaires s’affichent sous une tonalité discrète tandis que les points pathologiques émergent avec netteté en teinte pourpre, guidant immédiatement l’attention du lecteur sur les anomalies prioritaires tout en maintenant un dépouillement graphique optimal conforme aux règles de conception de Tufte.
8.3 Facettage et interactivité graphique
L’un des atouts déterminants de l’écosystème ggplot2 réside dans sa capacité native à déployer des décompositions visuelles multi-dimensionnelles au moyen de l’opérateur de facettage facet_wrap(). En découpant la structure de données unifiée dfbetas_long selon la modalité catégorielle Parametre, l’analyste génère une matrice coordonnée de tracés diagnostiques distincts, harmonisés sur une grille commune :
graphique_facette <- ggplot(dfbetas_long, aes(x = identifiant, y = Valeur_DFBETAS)) +
geom_segment(aes(x = identifiant, xend = identifiant, y = 0, yend = Valeur_DFBETAS), color = « gray75 ») +
geom_point(aes(color = Est_Influent), size = 1.5) +
geom_hline(yintercept = c(-seuil_critique, seuil_critique), linetype = « dashed », color = « firebrick ») +
facet_wrap(~ Parametre, scales = « free_y ») +
scale_color_manual(values = c(« FALSE » = « grey40 », « TRUE » = « darkred »)) +
theme_bw()
Pour parachever l’identification nominative sans provoquer d’enchevêtrements typographiques, l’intégration des fonctionnalités de la bibliothèque ggrepel permet d’implanter la fonction geom_text_repel(), qui projette des étiquettes répulsives automatiquement repoussées hors des zones de densité de points. Enfin, dans le cadre de rapports électroniques ou d’environnements d’analyse décisionnelle interactifs, ce rendu ggplot2 peut être converti dynamiquement en une interface d’exploration interactive par un simple appel à la fonction ggplotly() de la bibliothèque plotly, autorisant l’inspection au survol des métadonnées de chaque observation influente.
9. Utilisation de packages spécialisés : car et olsrr
9.1 Exploitation de la fonction influenceIndexPlot() du package car
Bien que la manipulation matricielle directe sous R de base et tidyverse confère une flexibilité totale de mise en forme, le recours aux packages méthodologiques spécialisés optimise la productivité de l’analyste en automatisant les routines d’audit diagnostique. Le package car de John Fox propose à cet effet la fonction de haut niveau influenceIndexPlot(), qui regroupe sur un graphique coordonné l’ensemble des métriques d’influence fondamentales dérivées du modèle linéaire :
library(car)
influenceIndexPlot(modele_cars, vars = c(« dfbetas », « Cook », « hat »), id = list(n = 3))
L’exécution de cette commande produit une mise en page verticale multi-échelles intégrant simultanément les tracés des DFBETAS pour chaque régresseur, les distances de Cook et les valeurs de levier hatvalues. Le paramètre id = list(n = 3) commande l’identification automatique et l’étiquetage textuel direct des trois observations affichant les scores d’anomalie les plus sévères pour chaque panneau respectif.
L’avantage prépondérant de cette fonction réside dans sa robustesse algorithmique et son intégration harmonieuse au flux de travail éprouvé de l’école statistique de Fox. Elle permet à l’investigateur de confronter immédiatement la localisation d’un point au sein du spectre des DFBETAS avec son positionnement au regard de la distance globale de Cook et de sa coordonnée d’effet de levier, scellant ainsi un diagnostic triangulé rapide et rigoureux.
9.2 Diagnostics graphiques dédiés avec le package olsrr
Le package moderne olsrr propose une approche diagnostique résolument contemporaine en fournissant des procédures d’évaluation exclusivement calibrées pour la régression par les moindres carrés ordinaires. Sa fonction dédiée à l’inspection des DFBETAS, désignée par ols_plot_dfbetas(), se distingue par une prise en charge intégrale de la production graphique et tabulaire :
library(olsrr)
ols_plot_dfbetas(modele_cars)
Cette commande génère sans paramétrage complexe préalable une séquence ordonnée de graphiques esthétiquement aboutis, appliquant d’office le seuil théorique dépendant de l’échantillon 2/sqrt(n) tracé sous la forme de lignes horizontales d’avertissement. Le moteur graphique d’olsrr colore automatiquement les observations en fonction de leur statut, isolant en tonalité vive toute unité franchissant les bornes d’admissibilité statistique.
Au-delà de la restitution visuelle, l’objet retourné par les fonctions d’olsrr encapsule en son sein les tables de données sous-jacentes contenant les identifiants exacts des cas problématiques, leurs valeurs numériques d’influence ainsi que le rang de sévérité de chaque observation. Cette double dimension visuelle et tabulaire confère à la bibliothèque olsrr une ergonomie particulièrement appréciable lors de la rédaction de bilans méthodologiques d’étape ou d’audits statistiques préliminaires.
9.3 Synthèse des diagnostics d’influence avec influence.measures()
Pour conduire une validation exhaustive selon les critères canoniques de l’économétrie sans déployer de bibliothèques tierces, R intègre nativement la fonction d’audit global influence.measures(). Cette routine exécute en un unique appel l’évaluation simultanée de la totalité des statistiques d’exclusion unitaire : DFBETAS pour chaque paramètre, DFFITS, distances de Cook, ratios de covariance du déterminant matriciel (covratio) et valeurs de levier diagonal :
audit_global <- influence.measures(modele_cars)
summary(audit_global)
La commande summary() appliquée à cet objet d’audit applique les heuristiques théoriques de Belsley, Kuh et Welsch à l’ensemble des dimensions statistiques calculées. La console R n’affiche alors que les observations franchissant au moins l’un des seuils d’alerte prédéfinis, en apposant un astérisque typographique distinctif en regard de chaque métrique jugée critique pour l’observation concernée.
L’analyste dispose ainsi d’une matrice booléenne condensée permettant d’apprécier la transversalité de l’influence exercée par chaque point singulier. Une observation signalée par des astérisques multiples couvrant conjointement le DFFITS, la distance de Cook et plusieurs colonnes de DFBETAS s’impose sans équivoque comme une unité statistique pivot modifiant en profondeur l’équilibre du modèle. L’intégration de la sortie consolidée d’influence.measures() au sein des annexes d’un mémoire ou d’une publication académique atteste de la rigueur déontologique de la validation empirique.
10. Interprétation substantive des cas influents identifiés
10.1 Détermination du mécanisme de distorsion sur les coefficients
L’identification numérique et visuelle d’un score DFBETAS anormal ne constitue pas l’aboutissement de la démarche diagnostique, mais marque au contraire le point de départ d’une réflexion substantive approfondie sur la dynamique causale du modèle. L’analyste doit impérativement démonter le mécanisme statistique par lequel l’observation suspecte altère la géométrie de la régression.
Deux mécanismes fondamentaux de distorsion paramétrique s’observent en pratique. Dans le premier scénario, l’observation atypique amplifie artificiellement une relation statistique. Cela se produit lorsqu’un cas cumule un effet de levier élevé dans le sens présumé de l’association théorique et une valeur dépendante extrême, tendant la droite des moindres carrés vers lui et créant une pente apparente fortement statistiquement significative qui s’effondre dès lors que ce point unique est soustrait de l’échantillon. Le second scénario, plus pernicieux encore, correspond à l’effet de masquage statistique (masking effect) ou d’atténuation : l’observation influente s’oppose frontalement au schéma structural général porté par l’ensemble des autres unités statistiques. En tirant la pente vers l’horizontale ou en gonflant considérablement la variance résiduelle de l’ajustement, ce cas singulier peut neutraliser la significativité statistique d’un prédicteur dont l’impact substantiel est pourtant avéré sur le reste de la population.
Dans des configurations extrêmes, l’exclusion d’une seule observation affichant un DFBETAS excédant l’unité peut induire une inversion pure et simple du signe algébrique de l’estimateur. Un tel basculement transforme par exemple une association supposée protectrice en facteur de risque apparent, soulignant la précarité épistémologique de toute déduction substantielle établie sans vérification préalable de la stabilité locale des moindres carrés.
10.2 Comparaison du modèle avant et après suppression des observations
L’investigation concrète des conséquences d’une observation influente requiert la conduite d’un réajustement comparatif. L’environnement R facilite grandement cette expérience contrefactuelle grâce à la fonction polymorphe update(), qui réestime le modèle mathématique en lui adjoignant un argument de filtrage des sous-ensembles sans exiger la réécriture complète de la formule de régression :
modele_tronque <- update(modele_cars, subset = (rownames(mtcars) != « Maserati Bora »))
La confrontation rigoureuse des sorties statistiques issues des deux modèles permet de calculer avec exactitude le pourcentage d’évolution de chaque pente partielle, l’amplitude de déplacement des erreurs types et la trajectoire des p-valeurs associées. Si l’exclusion du point influent transforme un coefficient statistiquement significatif au seuil de 1 % en un paramètre non significatif dont la p-valeur dépasse 0,10, l’analyste se trouve dans l’obligation méthodologique de reconnaître que l’effet empirique documenté est tributaire d’un profil singulier unique et ne peut être généralisé avec assurance.
Parallèlement à l’examen des pentes, il convient de quantifier l’impact de cette troncature sur les grandeurs synthétiques de modélisation : le coefficient de détermination global R-carré et la variance de l’erreur résiduelle standard. Fréquemment, la neutralisation d’un point influent atypique engendre une contraction marquée de l’erreur quadratique moyenne globale, se traduisant par un gain substantiel d’efficience et de précision estimative pour l’ensemble des autres paramètres maintenus au sein du système.
10.3 Évaluation de la nature des anomalies : erreur de saisie ou profil atypique
La confirmation mathématique de l’influence déstabilisatrice d’une unité statistique impose de mener une enquête factuelle rigoureuse quant à l’origine substantielle de cette singularité. L’attitude méthodologique appropriée commande de catégoriser l’anomalie au sein d’une typologie d’erreurs clairement différenciée avant de décider de son sort au sein de l’analyse.
La première catégorie regroupe les erreurs pures de saisie typographique, d’encodage numérique ou de dysfonctionnement technique des instruments de mesure (par exemple, un âge renseigné à 300 ans ou une masse de véhicule décalée d’un facteur 10 suite à un séparateur décimal corrompu). Dans ce contexte d’invalidité matérielle indiscutable, la correction immédiate de la valeur erronée sur la base des archives originales ou, à défaut, son exclusion de l’échantillon d’analyse constitue une obligation déontologique élémentaire.
La seconde catégorie, conceptuellement bien plus délicate, concerne les observations véridiques mais intrinsèquement rares ou exceptionnelles (par exemple, un individu aux revenus hors normes au sein d’une enquête salariale ou une voiture de sport d’exception dans une cohorte de véhicules conventionnels). Ces points de données appartiennent légitimement à la population étudiée, et leur retrait sélectif constitue une falsification insidieuse de la variabilité naturelle du monde empirique. L’exclusion opportuniste d’observations sous le seul prétexte qu’elles contrarient les seuils de DFBETAS expose la recherche au reproche de manipulation de données (data trimming abusif). L’éthique scientifique exige donc de documenter avec une parfaite transparence tout retrait de données, d’en expliciter les justifications théoriques et d’exposer publiquement les analyses parallèles attestant de l’impact de ces décisions sur les conclusions présentées.
11. Stratégies méthodologiques face aux DFBETAS excessifs
11.1 Analyses de sensibilité et modélisation parallèle
Face à la détection d’observations affichant des DFBETAS excessifs qui ne relèvent pas d’erreurs matérielles manifestes, la recommandation méthodologique prédominante dans les guides de rédaction scientifique (notamment les normes méthodologiques de l’American Psychological Association – APA) consiste à exécuter une analyse de sensibilité formelle adossée à une modélisation parallèle transparente.
Cette approche consiste à consigner et présenter conjointement dans les rapports finaux les résultats issus du modèle complet incluant l’intégralité des données d’échantillonnage et les estimations dérivées du modèle ajusté après neutralisation des cas influents. En juxtaposant les estimations ponctuelles, les erreurs types et les niveaux de signification statistique au sein d’un même tableau comparatif, l’auteur démontre une parfaite probité scientifique et permet à la communauté des pairs d’évaluer de façon indépendante la résilience des inférences empiriques face aux variations locales de l’échantillon.
Si la trajectoire substantielle des relations d’intérêt demeure inchangée entre les deux spécifications, l’hypothèse de robustesse théorique est confirmée avec force : les conclusions formulées transcendent les contingences locales d’échantillonnage. En revanche, si la suppression de deux cas influents anéantit l’effet mesuré ou renverse son orientation, le chercheur doit tempérer ses prétentions causales et formuler explicitement les réserves qui s’imposent quant à la dépendance étroite du phénomène à l’égard de conditions particulières ou de profils exceptionnels.
11.2 Recours aux régressions robustes dans R
Lorsque le modèle linéaire traditionnel par les moindres carrés ordinaires s’avère manifestement trop vulnérable aux perturbations causées par des observations influentes et que leur exclusion sèche ne peut être théoriquement justifiée, l’alternative méthodologique de premier choix consiste à abandonner l’estimateur conventionnel au profit des méthodes d’estimation linéaire robuste. Ces algorithmes alternatifs sont spécifiquement conçus pour minimiser l’impact déstabilisateur des données atypiques sans contraindre l’analyste à des suppressions binaires radicales.
L’implémentation de la régression robuste sous R s’opère couramment via la fonction rlm() (Robust Linear Model) fournie par le package de référence MASS. Cette procédure implémente typiquement l’estimation par M-estimateurs ou MM-estimateurs, articulée autour de fonctions de pondération itératives telles que la fonction de perte bi-carrée de Tukey ou la fonction de Huber :
library(MASS)
modele_robuste <- rlm(mpg ~ wt + disp + hp, data = mtcars, method = « MM »)
summary(modele_robuste)
Le mécanisme computationnel sous-jacent évalue itérativement les résidus de chaque observation et leur attribue un poids d’ajustement dynamique compris entre zéro et un. Les observations ordinaires au cœur de la distribution reçoivent une pondération maximale de un, tandis que les cas périphériques pourvoyeurs de DFBETAS colossaux voient leur contribution mathématique progressivement étouffée ou annulée. La confrontation directe entre les coefficients de la régression robuste et les estimations MCO renseigne immédiatement sur la distorsion globale subie par le modèle conventionnel et offre une alternative d’inférence d’une remarquable stabilité statistique.
11.3 Transformations de variables et révision du modèle structurel
L’apparition récurrente d’observations hautement influentes au sein d’un modèle linéaire standard constitue bien souvent le symptôme d’un défaut sous-jacent de spécification fonctionnelle plutôt qu’une pathologie propre aux données elles-mêmes. L’ajustement forcé d’une droite rigide sur un phénomène régulateur non linéaire concentre inévitablement aux extrémités de l’espace géométrique une traction disproportionnée matérialisée par des DFBETAS exorbitants.
Dans cette perspective, l’exploration de transformations mathématiques des variables explicatives ou de la variable dépendante représente une stratégie d’assainissement particulièrement féconde. L’application d’une transformation logarithmique, d’une racine carrée ou d’une transformation de puissance paramétrique selon la famille de transformations de Box-Cox permet de compresser l’échelle des prédicteurs très asymétriques, rapprochant ainsi les valeurs extrêmes de la masse distributionnelle principale et réduisant mécaniquement leur effet de levier structurel.
De manière complémentaire, l’analyste doit réexaminer la structure théorique de son modèle : l’émergence d’une influence anormale peut traduire l’omission malencontreuse d’un terme d’interaction multiplicatif ou d’une composante polynomiale quadratique capable d’épouser naturellement la courbure des données. De même, la présence de points influents isolés peut révéler l’existence d’une sous-population hétérogène dissimulée au sein du collectif expérimental, réclamant l’introduction d’un facteur de stratification catégoriel adapté. Une fois la forme structurelle correctement réalignée sur les réalités distributionnelles des variables, la réévaluation des DFBETAS témoigne généralement d’une sédation spectaculaire des scores d’anomalie.
12. Automatisation, bonnes pratiques et reproductibilité dans R
12.1 Création d’une fonction R personnalisée de diagnostic complet
Pour assurer la pérennité et l’efficience des contrôles de qualité des données au fil des projets de recherche quantitatifs, l’assemblage des routines diagnostiques sous la forme d’une fonction R modulaire, documentée et reproductible constitue une pratique de programmation statistique exemplaire. Cette fonction personnalisée doit recevoir en entrée un objet de régression générique issu de lm(), calculer dynamiquement les seuils spécifiques à l’échantillon, dépouiller la matrice des DFBETAS et restituer une structure de résultats ordonnée prête à l’emploi :
diagnostiquer_dfbetas <- function(modele, seuil_manuel = NULL) {
n <- nobs(modele)
seuil <- ifelse(is.null(seuil_manuel), 2 / sqrt(n), seuil_manuel)
mat_dfb <- dfbetas(modele)
depassements <- abs(mat_dfb) > seuil
lignes_suspectes <- which(apply(depassements, 1, any))
resume_anomalies <- as.data.frame(mat_dfb[lignes_suspectes, , drop = FALSE])
return(list(seuil_utilise = seuil, nb_anomalies = length(lignes_suspectes), cas_critiques = resume_anomalies))
}
Cette architecture fonctionnelle encapsule l’intégralité du processus décisionnel dans un conteneur algorithmique unifié. En renvoyant une liste structurée associant le seuil théorique employé, le décompte absolu des observations transgressives et le sous-ensemble tabulaire des scores critiques, la fonction simplifie considérablement les protocoles d’audit dans les pipelines d’analyse complexes. L’adjonction optionnelle de sauvegardes graphiques automatiques exportées directement sur le disque dur parachève l’automatisation intégrale du contrôle statistique de l’influence.
12.2 Intégration dans des flux de travail automatisés Quarto et R Markdown
L’excellence méthodologique contemporaine est indissociable des impératifs de reproductibilité computationnelle portés par les environnements de publication scientifique automatisés tels que Quarto et R Markdown. L’insertion d’une section dédiée au diagnostic des DFBETAS au sein du flux de génération documentaire assure la traçabilité intégrale de la chaîne analytique, reliant sans discontinuité les données brutes aux inférences paramétriques publiées.
Au sein de ces documents reproductibles, l’exploitation des bibliothèques de mise en forme tabulaire telles que kableExtra ou gt permet de sublimer la restitution des tables de DFBETAS filtrées. Il devient possible de programmer un formatage conditionnel automatisant la colorisation en surbrillance rouge des cellules de la table dont les valeurs numériques excèdent les bornes théoriques de 2/sqrt(n), offrant un confort de lecture optimal lors de l’évaluation par les pairs ou de la diffusion interne des résultats.
De surcroît, la standardisation absolue des environnements d’exécution computationnelle implique la fixation déterministe des graines aléatoires (au moyen de l’instruction set.seed()) lorsque des procédures d’échantillonnage, de rééchantillonnage par bootstrap ou de validations croisées complètent l’évaluation de la stabilité des paramètres. Ce niveau d’exigence garantit que tout auditeur indépendant réexécutant le code source obtiendra rigoureusement à l’identique les mêmes mesures matricielles de DFBETAS et les mêmes délimitations de cas influents.
12.3 Synthèse des pièges fréquents et recommandations pour le chercheur
Au terme de ce parcours approfondi dédié à l’évaluation méthodique de l’influence locale en régression linéaire multiple, il convient de dresser un inventaire synthétique des écueils méthodologiques majeurs qui guettent l’analyste de données, ainsi qu’une grille de contrôle définitive à observer scrupuleusement avant la soumission ou la dissémination de toute analyse quantitative :
- L’automatisme de suppression binaire : L’erreur méthodologique la plus dommageable consiste à transformer l’identification diagnostique d’un score de DFBETAS élevé en un motif automatique d’expulsion de la donnée. L’influence statistique n’est pas synonyme d’invalidité matérielle ; elle témoigne simplement d’une sensibilité locale de l’ajustement qui exige une investigation substantive approfondie et une analyse de robustesse transparente.
- La confusion entre résidu d’ajustement et influence paramétrique : Un résidu résolument volumineux n’induit pas obligatoirement un DFBETAS substantiel si le point correspondant est dépourvu de levier statistique (c’est-à-dire situé à proximité étroite du barycentre des prédicteurs). Réciproquement, une observation à fort levier dotée d’un résidu modeste peut exercer une distorsion majeure sur les pentes. Les diagnostics doivent impérativement s’articuler autour des DFBETAS standardisés et non des seuls résidus simples.
- L’omission de la multicolinéarité préexistante : Une structure de corrélation exacerbée entre variables explicatives dilate artificiellement les variances de dispersion matricielles (c_jj élevés), ce qui fausse la mécanique interne des dénominateurs de DFBETAS et amplifie l’instabilité perçue des coefficients. Le contrôle préalable rigoureux des VIF doit obligatoirement précéder l’audit des mesures d’influence.
- La rigidité face aux tailles d’échantillons massives : L’application littérale et non critique du seuil de Belsley, Kuh et Welsch 2/sqrt(n) sur des échantillons comprenant plusieurs dizaines de milliers d’enregistrements aboutit inévitablement à qualifier de façon illusoire une fraction considérable de données ordinaires de points influents, en raison de l’extrême sévérité asymptotique de ce seuil. Dans les cohortes de grande envergure, l’analyste doit privilégier les seuils absolus et apprécier avant tout l’amplitude pratique des variations paramétriques observées.
En respectant rigoureusement ce protocole diagnostique et en mobilisant les potentialités algorithmiques de l’environnement R, le chercheur consolide l’intégrité de son dispositif d’inférence, s’assurant que ses découvertes empiriques reposent sur des fondations statistiques inattaquables et parfaitement reproductibles.
Références
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression Diagnostics: Identifying Influential Data and Sources of Collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Fox, J., & Weisberg, S. (2019). An R Companion to Applied Regression (3rd ed.). Sage Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
Hebbali, A. (2020). olsrr: Tools for building OLS regression models (R package version 0.5.3). https://cran.r-project.org/package=olsrr
Venables, W. N., & Ripley, B. D. (2002). Modern Applied Statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., Takahashi, K., Vaughan, D., Wilke, C., Woo, K., & Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686