
L’analyse des séries temporelles constitue l’un des piliers méthodologiques les plus stimulants et féconds de la modélisation quantitative contemporaine. Qu’il s’agisse d’évaluer la transmission asynchrone des impulsions monétaires au sein d’une économie de marché, de traquer la propagation des ondes sismiques le long des failles géologiques ou d’anticiper la réponse comportementale des consommateurs à des campagnes promotionnelles, la compréhension des relations entre variables dynamiques requiert une rupture épistémologique majeure avec l’analyse statique. En effet, postuler la simultanéité des interactions au sein de systèmes dynamiques complexes revient à occulter la dimension fondamentale du temps, vecteur au long duquel se déploient l’inertie physique, les délais de diffusion informationnelle et les temps de réaction intrinsèques des agents économiques ou des substrats biologiques.
La corrélation croisée émerge précisément pour combler cette lacune méthodologique en fournissant un cadre mathématique rigoureux capable de quantifier le degré de dépendance linéaire entre deux trajectoires temporelles observées à des moments décalés. Loin de se limiter à une banale juxtaposition de coefficients de corrélation de Pearson calculés pour différentes périodes, cette technique déploie une véritable fonction continue ou discrète d’asymétrie temporelle, révélant la chronologie fine des processus de rétroaction et d’influence mutuelle. Dès lors, déterminer quelle chronique temporelle devance l’autre, évaluer la persistance de cette empreinte et calculer l’intensité maximale de synchronisation constituent des impératifs heuristiques pour quiconque ambitionne de construire des modèles prédictifs performants et structurellement robustes.
Dans l’écosystème du calcul scientifique et de l’économétrie appliquée, l’environnement logiciel R s’est imposé comme la référence internationale incontournable pour la manipulation, la visualisation et la modélisation statistique avancée des séries chronologiques. Grâce à son moteur vectoriel hautement optimisé, à l’élégance de sa syntaxe matricielle et à la richesse exceptionnelle de son catalogue d’extensions spécialisées, R offre un cadre analytique exhaustif permettant d’implémenter l’estimation de la corrélation croisée depuis l’exploration descriptive initiale jusqu’aux procédures complexes de pré-blanchiment et de détection de causalité dynamique. Ce traité complet a pour vocation d’exposer de manière exhaustive les fondements mathématiques, les contraintes d’application, les protocoles logiciels précis et les subtilités d’interprétation empirique indispensables à la maîtrise absolue de la corrélation croisée sous R.
1. Fondements théoriques de la corrélation croisée et des séries temporelles
L’étude conjointe de deux processus stochastiques s’inscrit au cœur de l’analyse multivariée des séries temporelles. Contrairement aux approches en coupe transversale où les observations sont supposées indépendantes et identiquement distribuées, les séries temporelles portent en elles une structure d’autodépendance interne et de mémoire séquentielle qui interdit tout recours simpliste aux outils d’association statiques.
1.1 Définition conceptuelle de la corrélation croisée
La corrélation croisée est formellement définie comme la mesure de la similarité statistique entre deux séries temporelles distinctes, formulée en tant que fonction explicite d’un déplacement temporel relatif désigné sous le terme de décalage ou retard temporel. Alors que la théorie classique de la statistique descriptive évalue l’association linéaire entre deux variables mesurées rigoureusement au même instant, la corrélation croisée étend cette investigation le long de l’axe chronologique tout entier. Cette démarche permet de déterminer comment l’état passé, présent ou futur d’un processus stochastique se trouve en concordance de phase avec les variations observées chez un second processus.
La distinction essentielle entre la corrélation de Pearson usuelle et l’analyse séquentielle décalée réside dans la préservation active de l’ordonnancement séquentiel des données. Dans une corrélation bivariée conventionnelle, la permutation aléatoire de l’ordre temporel des couples d’observations laisse le coefficient invariant. À l’inverse, au sein de la corrélation croisée, l’ordre des réalisations est constitutif du signal analytique. Toute perturbation de la chronologie détruit la structure de covariance dynamique et annule la validité des conclusions empiriques, puisque les valeurs d’une série temporelle sont intrinsèquement liées à leur propre trajectoire historique.
Sur le plan prédictif, la corrélation croisée assume le rôle fondamental d’identificateur d’indicateurs avancés. En scannant systématiquement une grille de retards temporels tant positifs que négatifs, le praticien peut repérer empiriquement si une variable spécifique subit systématiquement des inflexions structurelles quelques unités de temps avant qu’une variable cible ne manifeste une trajectoire homologue. Cette capacité d’anticipation permet de discriminer des signaux précurseurs fiables au sein de systèmes d’alerte précoce, facilitant une anticipation proactive des dynamiques d’équilibre.
Cette approche permet enfin de formaliser rigoureusement les notions de séries temporelles dépendantes et indépendantes dans un cadre dynamique unifié. Deux processus stochastiques sont considérés comme mutuellement non corrélés si et seulement si leur covariance croisée théorique est strictement nulle pour l’ensemble des décalages temporels envisageables. Dès qu’un décalage non nul fait émerger une covariance statistique statistiquement distincte du bruit de fond, les séries révèlent une dynamique couplée dont l’origine fonctionnelle doit être élucidée, excluant toute hypothèse d’indépendance stochastique globale.
1.2 Importance méthodologique dans l’analyse de signaux et de processus
D’un point de vue méthodologique, l’intégration systématique de la corrélation croisée dans les protocoles de recherche quantitative répond à l’exigence de détection des retards temporels critiques qui gouvernent la propagation d’effets systémiques. Dans la quasi-totalité des mécanismes naturels et sociétaux, une impulsion déclenchée à l’instant initial ne produit pas instantanément sa réponse terminale maximale. Qu’il s’agisse de la transmission d’un choc monétaire au niveau des prix à la consommation ou de l’acheminement d’un polluant hydrosoluble le long d’un bassin versant, l’inertie du milieu génère une latence que la corrélation croisée cartographie avec une précision millimétrique.
Cette méthodologie permet de purger l’analyse empirique des postulats simplistes de simultanéité qui faussent fréquemment les modélisations économétriques et physiques. En postulant arbitrairement que deux variables interagissent sans délai, le chercheur s’expose à une déflation artificielle des coefficients de régression contemporains, attribuant à tort une absence de liaison à un phénomène dont l’intensité culmine simplement plusieurs mois ou trimestres plus tard. La corrélation croisée rétablit la réalité phénoménologique en calibrant les fenêtres d’exposition sur les rythmes structurels réels des phénomènes étudiés.
Enfin, cette démarche constitue le socle quantitatif indispensable à la formalisation ultérieure des tests d’antériorité et d’analyse causale au sens de la causalité de Granger, ainsi qu’à la spécification de modèles vectoriels autorégressifs. Avant de déployer des machineries économétriques lourdes impliquant des systèmes d’équations simultanées ou des modèles autorégressifs à retards échelonnés, l’inspection minutieuse de la fonction de corrélation croisée fournit une heuristique robuste pour sélectionner les retards optimaux à inclure dans les équations structurelles, évitant ainsi le double écueil de la sous-spécification et du surajustement statistique.
1.3 Champs d’application scientifiques et interdisciplinaires
Les champs d’application de la corrélation croisée témoignent d’une universalité remarquable à travers les disciplines scientifiques. En macroéconomie et en économétrie quantitative, cette technique est continuellement sollicitée pour caractériser les cycles économiques et la propagation des politiques publiques. Un exemple paradigmatique réside dans l’analyse empirique de la relation asynchrone unissant l’indice de confiance des ménages et l’évolution globale du produit intérieur brut. L’observation démontre fréquemment que les variations de confiance précèdent de deux à trois trimestres les inflexions réelles des agrégats de consommation finale et de production industrielle, érigeant ces indices subjectifs en baromètres prédictifs majeurs.
Dans le domaine des sciences de gestion et de l’ingénierie marketing, la corrélation croisée constitue le moteur décisionnel guidant l’optimisation du mix média. Les directions financières et mercatiques exploitent l’évaluation séquentielle décalée afin de quantifier l’élasticité temporelle existant entre les engagements financiers trimestriels consentis en publicité multicanale et l’expansion incrémentale ultérieure du volume d’affaires. Identifier le pic de corrélation à un horizon spécifique permet d’ajuster le cadencement des campagnes avant les périodes de pic de consommation tout en mesurant précisément le phénomène d’érosion publicitaire après l’arrêt des diffusions promotionnelles.
Les sciences de l’environnement et l’écologie quantitative recourent massivement à ces formalismes pour modéliser les réactions des écosystèmes aux forçages anthropiques ou climatiques. L’analyse temporelle des flux de rejets polluants au sein des cours d’eau continentaux et des estuaires marins, confrontée au suivi longitudinal des densités de populations d’espèces aquatiques sensibles, met régulièrement en lumière des décalages pluriannuels. Ces retards correspondent au temps requis pour que la toxicité diffuse altère les taux de fécondité, la survie larvaire et, ultimement, le recrutement démographique des cohortes adultes.
Enfin, les neurosciences computationnelles et la psychologie cognitive exploitent la corrélation croisée pour scruter la connectivité fonctionnelle cérébrale et les dynamiques de couplage physiologique interindividuel. L’analyse croisée des tracés électroencéphalographiques ou des signaux d’oxygénation sanguine obtenus par imagerie par résonance magnétique fonctionnelle autorise le décryptage des flux d’information voyageant d’une structure corticale à une autre. De manière analogue, la synchronisation rythmique des paramètres cardiorespiratoires ou des modulations de la voix entre deux interlocuteurs engagés dans une négociation permet d’objectiver mathématiquement les états d’empathie et de résonance comportementale au cours du temps.
2. Formulation mathématique et propriétés statistiques de la CCF
Pour dépasser l’appréhension intuitive des retards temporels, il s’avère impératif de formaliser rigoureusement le cadre probabiliste au sein duquel opère la fonction de corrélation croisée. Cela nécessite de définir les moments statistiques conjoints d’ordre deux régissant les trajectoires bivariées.
2.1 Équations fondamentales de la covariance et corrélation croisées
Considérons deux processus stochastiques à temps discret, désignés respectivement par les notations Xt et Yt, indexés par l’ensemble des entiers relatifs représentant les unités temporelles successives. Dans le cadre théorique de l’analyse bivariée, la fonction d’autocovariance relative à une série individuelle capture la persistance interne de son signal. Par extension systématique à l’interaction de deux séries distinctes, la fonction de covariance croisée théorique, traditionnellement notée par la lettre grecque gamma indicée, mesure l’espérance mathématique du produit croisé des déviations par rapport à leurs moyennes respectives :
γxy(k) = E[(Xt – μx)(Yt+k – μy)]
Dans cette formulation analytique, l’argument k représente le décalage temporel appliqué à la seconde chronique. Ce décalage prend des valeurs discrètes appartenant à l’espace des entiers relatifs. La grandeur μx symbolise l’espérance mathématique du processus générateur de la série X, tandis que μy incarne l’espérance correspondante pour le processus sous-jacent à la série Y. Si l’on normalise cette covariance croisée par le produit des écarts-types marginaux respectifs des deux processus, l’on obtient la fonction de corrélation croisée adimensionnelle, couramment désignée par l’acronyme anglophone CCF (Cross-Correlation Function), représentée par la lettre grecque rhô :
ρxy(k) = γxy(k) / (σx σy)
Cette opération d’étalonnage mathématique confère à la corrélation croisée la propriété fondamentale d’être strictement bornée au sein de l’intervalle fermé [-1, +1], assurant une interprétation standardisée quelle que soit l’échelle des unités de mesure d’origine. Une propriété géométrique et analytique cardinale de cette fonction réside dans son asymétrie fondamentale par rapport à l’axe vertical d’ordonnée zéro. Contrairement à la fonction d’autocorrélation qui est nécessairement paire (ρxx(k) = ρxx(-k)), la fonction de corrélation croisée présente une relation de transposition temporelle conjuguée :
ρxy(k) = ρyx(-k)
Cette relation démontre que la corrélation entre X à l’instant présent et Y avancé de k périodes équivaut rigoureusement à la corrélation entre Y au temps présent et X retardé de la même quantité temporelle k. Dès lors, l’inversion de l’ordre d’énonciation des arguments bivariés produit une symétrie axiale spéculaire du corrélogramme par rapport à l’origine temporelle nulle, soulignant l’importance capitale d’une rigueur absolue dans la convention de dénomination des séries sous observation.
2.2 Hypothèse critique de stationnarité
L’édifice mathématique de la corrélation croisée repose fondamentalement sur l’hypothèse de stationnarité au sens faible, couramment désignée sous le terme de stationnarité de second ordre. Pour qu’une analyse conjointe de séries temporelles conserve une validité inférentielle, les deux processus considérés doivent impérativement présenter des moments statistiques invariants par translation dans le temps. Cela requiert formellement que :
- L’espérance mathématique de chaque série soit strictement constante et indépendante du point d’observation temporel : E[Xt] = μx et E[Yt] = μy pour tout t.
- La variance marginale de chaque processus soit finie, constante et homogène au cours de la trajectoire : Var(Xt) = σx2 et Var(Yt) = σy2.
- La covariance croisée entre deux observations ne dépende exclusivement que de l’écartement temporel k qui les sépare et nullement de leur positionnement absolu t sur l’échelle chronologique : Cov(Xt, Yt+k) = γxy(k).
L’omission de cette contrainte méthodologique engendre des distorsions analytiques dévastatrices. Lorsqu’un praticien calcule la corrélation croisée sur des données intégrant des tendances déterministes monotones ou des racines unitaires stochastiques, l’estimateur empirique de la covariance croisée ne converge plus vers une quantité stable. Au contraire, il tend à agréger la dérive commune des processus, engendrant une régression fallacieuse caractérisée par des coefficients artificiellement massifs et persistants sur tous les décalages.
Dans cette situation de violation de la stationnarité, les corrélogrammes croisés affichent une morphologie trompeuse où la corrélation semble hautement significative sur de très larges fenêtres temporelles, alors même qu’aucun lien fonctionnel réel ne régit les deux phénomènes. La corrélation n’est alors que le reflet dégénéré d’un co-mouvement tendanciel non causal induit par l’écoulement inexorable du temps ou par l’accumulation de chocs stochastiques permanents.
2.3 Seuils de signification et intervalles de confiance statistiques
Dans un contexte d’inférence statistique appliquée, le chercheur ne dispose que d’un échantillon fini de N observations contemporaines pour estimer la fonction théorique sous-jacente. L’estimateur standardisé de la corrélation croisée empirique, noté rxy(k), est obtenu en rapportant la covariance croisée échantillonnale aux variances empiriques correspondantes :
rxy(k) = Σ [(Xt – x̄)(Yt+k – ȳ)] / [ √(Σ (Xt – x̄)2) √(Σ (Yt – ȳ)2) ]
Afin de discerner si une valeur calculée rxy(k) reflète une réelle interaction dynamique ou provient simplement de fluctuations aléatoires d’échantillonnage, il est nécessaire de formaliser le test sous l’hypothèse nulle stipulant que les deux processus X et Y sont totalement indépendants et non corrélés à tous les décalages. Sous cette hypothèse nulle, et en postulant additionnellement qu’au moins l’un des deux processus constitue un bruit blanc gaussien dépourvu d’autocorrélation interne, la théorie asymptotique démontre que l’estimateur suit approximativement une loi normale centrée d’écart-type égal à l’inverse de la racine carrée de la taille de l’échantillon :
Var[rxy(k)] ≈ 1 / (N – |k|) ≈ 1 / N
Pour un seuil de signification de 5 %, la règle de décision repose sur la comparaison de l’estimation ponctuelle aux bandes de confiance critiques asymptotiques. Celles-ci sont délimitées par les valeurs suivantes :
Seuils critiques = ± 1.96 / √N
Toute corrélation croisée empirique s’extrayant de ce couloir délimité par les bandes horizontales pointillées est jugée statistiquement significative au niveau de confiance de 95 %. Toutefois, une réserve méthodologique fondamentale s’impose : ces seuils reposent sur les approximations dérivées des travaux de Bartlett, valables exclusivement en l’absence stricte d’autocorrélation intra-série. Dès lors que les trajectoires présentent une inertie sérielle interne persistante, la variance asymptotique de l’estimateur de la corrélation croisée gonfle considérablement, rendant les bornes standard beaucoup trop étroites et induisant un taux excessif d’erreurs d’inférence par rejet indu de l’hypothèse nulle.
3. Configuration de l’environnement de développement dans R
L’écosystème open-source du logiciel R constitue un environnement de prédilection pour l’expérimentation statistique et le traitement des séries chronologiques, alliant robustesse algorithmique et souplesse computationnelle.
3.1 Fonctionnalités natives du moteur R de base
L’un des avantages structurels majeurs du langage R réside dans l’intégration native d’outils statistiques de pointe directement implémentés dans sa distribution de base, plus particulièrement au sein du package interne stats. Ce package, chargé automatiquement lors de l’initialisation de chaque session de travail, met immédiatement à la disposition du praticien la classe d’objets temporels standardisée dénommée ts, ainsi que les fonctions fondatrices d’analyse séquentielle comme la commande ccf.
Travailler directement avec le moteur R de base pour les opérations fondamentales de corrélation sérielle garantit une reproductibilité intégrale du code sans dépendances envers des tiers. Les algorithmes de calcul matriciel sous-jacents, codés en C et Fortran optimisés, assurent une rapidité d’exécution élevée pour l’évaluation des covariances croisées sur des séries de longueurs standards.
De plus, cette infrastructure fondamentale simplifie la maintenance du code et évite les instabilités logicielles générées par les dépréciations potentielles de librairies périphériques. L’interpréteur natif orchestre avec fluidité les conversions de vecteurs numériques en chroniques temporelles régulières tout en offrant une gestion transparente des fenêtres d’échantillonnage et des attributs de périodicité calendaire.
3.2 Écosystème de packages spécialisés recommandés
Bien que le noyau de base de R suffise pour exécuter des analyses élémentaires, l’investigation avancée des corrélations croisées requiert le déploiement d’un écosystème de packages spécialisés conçus pour fiabiliser les étapes de validation méthodologique et de pré-blanchiment statistique. La boîte à outils contemporaine de l’analyste des séries temporelles comprend plusieurs extensions incontournables :
- tseries : Cette extension historique apporte une panoplie complète de procédures économétriques formelles, notamment pour l’exécution des tests de racines unitaires comme le test de Dickey-Fuller augmenté (adf.test) et le test KPSS (kpss.test), indispensables pour statuer sur la stationnarité stricte des chroniques.
- forecast : Développé sous la direction de Rob Hyndman, ce package fournit des outils industriels pour l’ajustement univarié automatisé de modèles de type Box-Jenkins via la fonction auto.arima, pilier méthodologique indispensable à la décomposition préalable des signaux.
- tidyverse et tsibble : Pour une manipulation moderne, fluide et descriptive des structures de données temporelles, la convergence entre les grammaires de manipulation du tidyverse et la rigueur temporelle des tables tsibble modernise le paradigme d’analyse temporelle tabulaire.
- lmtest : Indispensable pour mener des diagnostics post-estimation et implémenter des tests d’inférence causale comme la régression de causalité au sens de Granger.
L’installation coordonnée de ces dépendances prépare l’analyste à un pipeline d’investigation séquentiel exhaustif, évitant tout goulot d’étranglement lors du passage de l’exploration descriptive à la modélisation structurelle.
3.3 Structuration et typage des données temporelles
Une source fréquente d’erreurs computationnelles réside dans la manipulation de vecteurs numériques ordinaires dénués de métadonnées chronologiques explicites. La fonction de base ccf requiert, pour donner son plein potentiel interprétatif, l’emploi d’objets formellement instanciés via le constructeur ts(). Ce constructeur encapsule la série statistique au sein d’une structure géométrique où chaque indice vectoriel correspond précisément à une coordonnée temporelle réelle calibrée par trois paramètres :
- start : Spécifie les coordonnées chronologiques du point de départ de l’échantillon, soit sous la forme d’une valeur scalaire entière (par exemple l’année 2010), soit sous la forme d’un vecteur bivarié unissant l’année et la sous-période calendaire (par exemple c(2010, 1) pour le premier mois ou le premier trimestre).
- end : Définit facultativement la borne terminale de la séquence chronologique d’observation.
- frequency : Détermine le nombre d’observations discrètes composant un cycle complet (1 pour une série annuelle, 4 pour un suivi trimestriel, 12 pour des données mensuelles et 52 ou 365 pour des suivis hebdomadaires ou journaliers).
Lorsque les jeux de données proviennent de sources externes sous forme de fichiers tabulaires délimités (CSV ou connexions SQL), les colonnes d’horodatage doivent impérativement être converties vers le format standard ISO 8601 via les utilitaires de la bibliothèque lubridate (tels que ymd, dmy ou as_date). Cette rigueur de typage garantit que l’alignement temporel des deux séries lors du calcul de la covariance s’opère sur une échelle temporelle cohérente, éliminant tout risque de glissement temporel fallacieux dû à des observations asynchrones ou manquantes.
4. Prétraitement rigoureux et vérification des hypothèses statistiques
Le calcul aveugle d’une corrélation croisée sur des séries brutes constitue l’une des fautes méthodologiques les plus communes de la science des données appliquée. L’estimation d’une relation décalée n’a de validité statistique que si les données sous-jacentes respectent scrupuleusement les postulats d’intégrité et de stationnarité.
4.1 Traitement des valeurs manquantes et anomalies temporelles
Les séries temporelles empiriques présentent fréquemment des discontinuités d’enregistrement provoquées par des pannes de capteurs, des fermetures de marchés financiers ou des défaillances de collecte administrative. La présence de valeurs manquantes (représentées par le symbole NA dans R) constitue un obstacle majeur pour la fonction ccf(), qui interrompt son exécution ou produit des résultats indéterminés si l’utilisateur ne paramètre pas d’alternative de gestion des lacunes.
Pour restaurer la continuité topologique indispensable à l’analyse bivariée décalée, plusieurs approches d’imputation temporelle s’offrent au modélisateur :
- Interpolation linéaire : Adaptée aux micro-interruptions ponctuelles isolées au sein de séries évoluant à faible dynamique stochastique.
- Interpolation par splines cubiques : Privilégiée lorsque les séries présentent des oscillations harmoniques lisses, préservant la continuité des dérivées premières et secondes de la trajectoire.
- Imputation par modèles d’espace d’état ou filtrage de Kalman : Hautement recommandée pour les chroniques complexes soumises à un bruit d’observation substantiel.
Parallèlement à l’imputation des lacunes, une inspection diagnostique scrupuleuse s’impose pour localiser d’éventuelles valeurs aberrantes extrêmes (outliers). Un choc singulier d’amplitude démesurée peut fausser artificiellement la somme des produits croisés et créer un faux pic de corrélation croisée à un décalage donné. Des procédures d’écrêtement doux ou de détection par écart absolu à la médiane permettent de neutraliser ces anomalies ponctuelles avant toute estimation de covariance.
4.2 Tests empiriques de stationnarité
La confirmation empirique de la stationnarité ne saurait reposer sur une simple impression visuelle émanant de graphiques de trajectoires. Elle exige une batterie de tests d’hypothèses formels, conduits conjointement pour lever toute ambiguïté sur la nature stochastique des séries.
Le test de Dickey-Fuller augmenté (Augmented Dickey-Fuller – ADF), implémenté via la fonction adf.test() du package tseries, postule en hypothèse nulle (H0) l’existence d’une racine unitaire au sein du processus générateur, témoignant d’une non-stationnarité par variance explosive de type marche aléatoire. Le rejet formel de cette hypothèse nulle, attesté par une p-valeur strictement inférieure au seuil conventionnel de 0,05, fournit un premier argument probant en faveur de la stationnarité du signal.
Toutefois, en raison de la faible puissance statistique relative du test ADF en présence d’échantillons de taille modeste ou de processus autorégressifs proches du cercle unitaire, il est méthodologiquement recommandé d’appliquer de manière complémentaire le test de Kwiatkowski-Phillips-Schmidt-Shin (KPSS), mobilisable via la commande kpss.test(). Le test KPSS structure ses hypothèses de manière diamétralement opposée :
- Hypothèse nulle (H0) : La série est rigoureusement stationnaire autour d’un niveau moyen ou d’une tendance déterministe.
- Hypothèse alternative (H1) : La série incorpore une racine unitaire stochastique.
Une convergence analytique idéale se manifeste lorsque le test ADF rejette formellement H0 (confirmant l’absence de racine unitaire) tandis que le test KPSS échoue à rejeter son hypothèse nulle de stationnarité. Dans ce scénario de confirmation conjointe, la série temporelle est qualifiée de robuste pour l’investigation sérielle sans nécessiter d’altérations additionnelles.
4.3 Techniques de transformation pour stationnariser les séries
Dans l’éventualité courante où les séries temporelles brutes échouent aux tests de stationnarité, la mise en œuvre de transformations mathématiques devient incontournable pour stabiliser leurs moments conditionnels de premier et de second ordre.
La différenciation temporelle constitue l’outil par excellence pour éliminer les racines unitaires et convertir une marche aléatoire en un processus stationnaire à mémoire courte. Dans R, l’opérateur arithmétique diff() permet d’appliquer une différenciation d’ordre un :
ΔXt = Xt – Xt-1
Ce calcul supprime la composante de dérive cumulative. Si une série comporte une racine unitaire saisonnière (comme un cycle annuel persistant sur des données mensuelles), une différenciation saisonnière au pas 12 (diff(x, lag = 12)) neutralisera les variations saisonnières persistantes.
Lorsque la chronique présente en sus une hétéroscédasticité manifeste, caractérisée par une dispersion de variance croissant proportionnellement au niveau de la moyenne au fil des années, l’application préalable d’une transformation logarithmique stricte (via log()) ou d’une transformation paramétrique de Box-Cox s’avère indispensable pour homogénéiser la variance marginale.
Enfin, en présence de tendances déterministes pures (processus stationnaires autour d’une tendance linéaire ou polynomiale stricte mais sans dérive stochastique), l’élimination de la tendance par projection orthogonale sur le temps continu via un modèle linéaire des moindres carrés permet d’isoler des résidus purement dé-tendancés, satisfaisant ainsi aux exigences théoriques de l’estimation de la corrélation croisée.
5. Mise en œuvre de la fonction ccf() dans R
L’exécution de la fonction ccf() constitue le pivot pratique autour duquel s’articule l’évaluation séquentielle des retards dans l’environnement R.
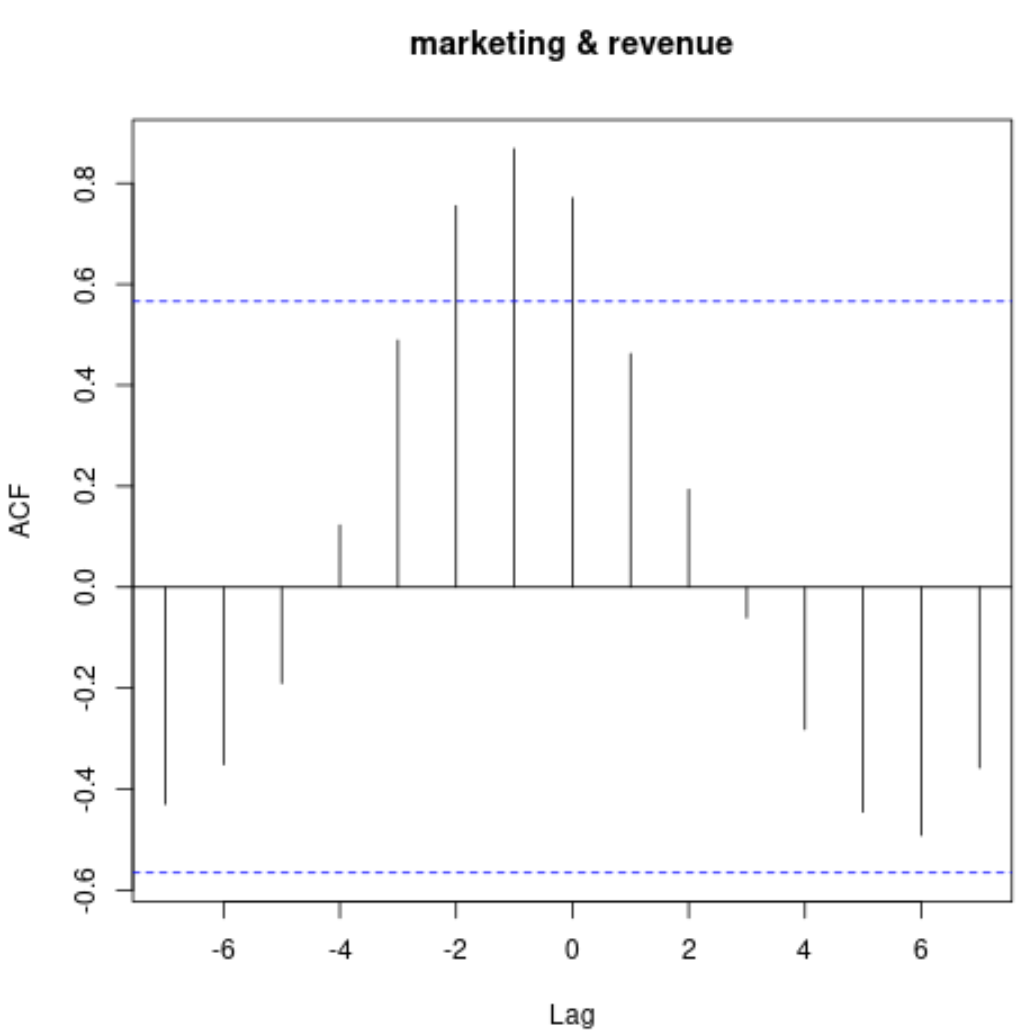
5.1 Syntaxe de base et paramétrage fonctionnel
La fonction native ccf() du package stats possède une signature syntaxique particulièrement concise mais dissimule un ensemble d’options paramétriques déterminantes pour la qualité des inférences. Dans sa forme standardisée, l’appel s’effectue selon le canevas opérationnel suivant :
ccf(x, y, lag.max = NULL, type = c(« correlation », « covariance »), plot = TRUE, na.action = na.fail)
L’argument x spécifie le premier vecteur ou la première série temporelle univariée, tandis que l’argument y définit la seconde série à confronter. L’ordre d’introduction de ces séries dans la parenthèse fonctionnelle détermine entièrement l’orientation de l’axe horizontal des décalages temporels.
Le paramètre lag.max conditionne l’amplitude maximale de la fenêtre temporelle d’exploration. Par défaut, lorsque cet argument est omis, R initialise lag.max selon une heuristique standard dépendant de la fréquence et de la taille de l’échantillon (généralement 10*log10(N/freq)). Toutefois, il est fortement recommandé de fixer explicitement cet argument à une valeur guidée par la plausibilité théorique du domaine étudié (par exemple, 24 mois pour une étude macroéconomique ou 7 jours pour des flux de trafic web journaliers) afin d’éviter la prolifération de coefficients de traîne calculés sur un nombre résiduel d’observations trop faible.
L’argument type, calibré par défaut sur correlation, prescrit la normalisation automatique des résultats pour renvoyer des coefficients bornés entre -1 et +1, tandis que l’option covariance renvoie la fonction gamma brute non normalisée. L’argument booléen plot régit la production automatique immédiate d’un corrélogramme graphique au sein de la fenêtre graphique active de R. Pour des flux automatisés au sein de pipelines de production de données où seules les métriques chiffrées importent, spécifier plot = FALSE optimise significativement les temps de calcul machine.
5.2 Extraction des données numériques sous-jacentes
L’exécution de la commande ccf() ne se limite pas à tracer un graphique statique ; elle instancie en mémoire vive un objet composite de classe formelle acf. Pour ausculter et décomposer les couches d’informations encapsulées au sein de cet objet, le recours à la commande générique str() révèle une liste nommée de composants vectoriels et matriciels hautement structurés.
La composante nommée acf constitue le cœur chiffré de l’objet. Il s’agit d’un tableau tridimensionnel contenant l’ensemble des coefficients empiriques de corrélation croisée calculés pour chaque valeur discrète de retard. Pour extraire ces valeurs sous forme d’un simple vecteur numérique unidimensionnel manipulable dans des calculs ultérieurs, l’analyste utilise l’indexation vectorielle explicite en éliminant les dimensions redondantes :
coefficients_cor <- as.vector(resultat_ccf$acf)
Conjointement, l’extraction de l’axe des abscisses s’opère par l’interrogation du composant lag, qui répertorie les entiers relatifs exacts correspondant à chaque position matricielle :
decalages_temporels <- as.vector(resultat_ccf$lag)
Cette extraction autorise la recombinaison immédiate des sorties sous forme d’un tableau de données moderne (data.frame ou tibble), couplant rigoureusement chaque décalage temporel à son coefficient d’intensité d’association et ouvrant la voie à des post-traitements analytiques élaborés.
5.3 Identification algorithmique du décalage optimal
L’un des objectifs centraux de l’analyste consiste à repérer de façon programmatique et automatisée le décalage temporel exact associé à l’amplitude de liaison la plus spectaculaire, qu’elle traduise une synchronisation positive ou une opposition de phase inverse.
Pour localiser la position vectorielle correspondant au coefficient le plus massif en valeur absolue, le langage R met à disposition la fonction which.max(), combinée avec l’opérateur de calcul de la valeur absolue abs(). Cette recherche s’exécute selon la formulation suivante :
index_optimum <- which.max(abs(resultat_ccf$acf))
lag_optimal <- resultat_ccf$lag[index_optimum]
coeff_maximal <- resultat_ccf$acf[index_optimum]
Néanmoins, une identification rigoureuse ne doit pas se cantonner à retenir mécaniquement le maximum numérique absolu sans vérifier son statut d’inférence statistique. L’analyste averti intègre systématiquement une condition logique de filtrage validant que la valeur absolue de ce pic dépasse le seuil critique de Bartlett pour la taille d’échantillon considérée :
seuil_signification <- 1.96 / sqrt(resultat_ccf$n.used)
est_significatif <- abs(coeff_maximal) > seuil_signification
L’encapsulation de cette logique au sein d’une fonction R personnalisée offre l’opportunité de traiter des centaines de paires de séries simultanées au sein de bases de données volumineuses, en isolant automatiquement les seuls retards dominants confirmés par l’inférence statistique.
6. Interprétation analytique des retards temporels et de la directionnalité
La lecture d’un corrélogramme croisé généré par R requiert une maîtrise sans faille des conventions d’affichage de l’axe horizontal, sous peine de commettre de graves contresens sur la directionnalité temporelle des effets observés.
6.1 Déchiffrement des retards positifs et négatifs
L’axe horizontal d’un corrélogramme croisé standardisé émis par la commande ccf(x, y) est indexé par des unités de temps entières, s’étendant symétriquement de -lag.max à +lag.max. La convention interne adoptée par le moteur statistique de R définit formellement le retard temporel k en fonction de l’ordre d’inscription des arguments : x est évalué à l’instant t, tandis que y est évalué à l’instant t + k.
Dès lors, l’interprétation sémantique s’articule rigoureusement selon les quadrants de l’axe temporel :
- Décalages négatifs (k < 0) : Lorsque des pics significatifs apparaissent pour des valeurs de k négatives, l’équation statistique évalue en réalité la corrélation entre xt et yt-|k|, ce qui équivaut chronologiquement à corréler xt+|k| et yt. Cela signifie explicitement que la série Y subit ses variations en amont temporel par rapport à la série X. La variable Y agit donc comme l’indicateur avancé (lead) et la série X constitue la variable suiveuse (lag).
- Décalages positifs (k > 0) : À l’inverse, l’observation de coefficients prédominants émergeant pour des valeurs de k strictement positives démontre que la série X mesurée à l’instant présent est prédictive de la trajectoire ultérieure que prendra la série Y à l’horizon t + k. Dans cette configuration géométrique, la variable X devance temporellement la variable Y.
- Décalage nul (k = 0) : Un pic culminant rigoureusement sur l’abscisse zéro formalise une corrélation contemporaine instantanée, révélant soit une absence totale d’inertie de transmission entre les systèmes à la fréquence de mesure sélectionnée, soit l’impact immédiat et synchrone d’une variable confondante non incluse dans le modèle bivarié.
6.2 Distinction cruciale entre antériorité temporelle et causalité
L’une des dérives épistémologiques les plus pernicieuses dans le déploiement de la corrélation croisée réside dans la confusion intellectuelle entre l’antériorité chronologique d’un signal et l’existence d’une relation causale ontologique. Si le principe d’invariance temporelle postule sans équivoque qu’une cause matérielle doit obligatoirement précéder ses effets mesurables dans le flux de la réalité physique, la réciproque logique est rigoureusement fausse : la succession temporelle ne suffit jamais à attester la causalité.
L’observation d’un pic de corrélation croisée significatif à un retard de plusieurs mois entre deux grandeurs peut découler d’une causalité commune indirecte. Par exemple, l’apparition des hirondelles devance temporellement l’élévation des températures estivales, générant une corrélation croisée décalée hautement significative entre comptages d’oiseaux migrateurs et thermomètres. Pourtant, les hirondelles ne provoquent aucunement le réchauffement de l’air ; elles réagissent simplement de manière précoce à des stimuli photopériodiques et climatiques globaux qui gouvernent la transition des saisons.
De surcroît, la présence de boucles de rétroaction dynamique bidirectionnelles (systèmes cybernétiques où X influence Y avec un certain délai, tandis que Y réagit en retour sur X selon une autre constante de temps) tend à disperser les pics de corrélation des deux côtés de l’origine zéro, rendant périlleuse toute conclusion linéaire univoque basée sur la simple inspection du corrélogramme bivarié.
6.3 Impact de la fréquence d’échantillonnage sur la perception du décalage
L’identification du retard structurel optimal dépend intimement de la granularité temporelle retenue lors de l’enregistrement des séries. La discrétisation d’un phénomène continu sous forme de pas journaliers, mensuels ou annuels influe directement sur l’amplitude et la localisation du pic de corrélation croisée observé.
L’agrégation temporelle opère comme un filtre passe-bas sur les séries. En sommant ou moyennant des données quotidiennes pour former des données mensuelles ou trimestrielles, le statisticien lisse la variance rapide et dissimule totalement les interactions dynamiques intrajournalières ou hebdomadaires. Un délai de réaction de 10 jours entre deux signaux économiques sera visible sur des chroniques quotidiennes sous forme d’un pic à k = 10, mais disparaîtra complètement au sein d’une série agrégée trimestriellement, se traduisant simplement par une corrélation contemporaine au décalage k = 0.
Inversement, un échantillonnage à trop haute fréquence peut submerger le signal sous un bruit stochastique à haute fréquence, dispersant l’énergie spectrale de la corrélation croisée sur une multitude de décalages contigus sans qu’un pic unique ne se détache clairement. Le choix optimal de la fréquence de mesure doit ainsi résulter d’un compromis réfléchi entre l’inertie physique du processus sous examen et le pouvoir de résolution des capteurs ou registres d’échantillonnage.
7. Visualisation avancée et production de corrélogrammes publiables
Si la sortie graphique standard de R fournit un aperçu diagnostique immédiat précieux pour la phase exploratoire, elle s’avère visuellement rudimentaire et inadaptée aux exigences esthétiques et typographiques de l’édition scientifique moderne et des rapports institutionnels d’aide à la décision.
7.1 Personnalisation des graphiques générés par la fonction de base
Le moteur graphique natif de R permet déjà, moyennant l’utilisation judicieuse des paramètres graphiques globaux encapsulés dans la fonction par(), d’améliorer substantiellement la lisibilité du corrélogramme produit par ccf().
Il est possible de redéfinir les intitulés d’axes, le titre supérieur et les limites d’échelle via les arguments standards xlab, ylab, main, sub, xlim et ylim directement transmis dans l’appel de ccf(). Par exemple, nommer explicitement les axes avec des désignations claires et contextuelles renforce immédiatement la compréhension :
ccf(serie_A, serie_B, lag.max = 20, main = « Corrélogramme croisé dynamique », xlab = « Décalage temporel (Trimestres) », ylab = « Coefficient de corrélation croisée », col = « navyblue », lwd = 2)
De surcroît, l’analyste peut modifier l’affichage des lignes d’intervalles de confiance en neutralisant le tracé par défaut et en superposant manuellement des lignes horizontales critiques grâce à la commande abline(h = c(-seuil, seuil), lty = 2, col = « firebrick »). L’organisation conjointe de plusieurs graphiques d’analyse (par exemple l’autocorrélation de chaque série et leur corrélation croisée) au sein d’une même fenêtre multi-panneaux s’opère en configurant au préalable par(mfrow = c(3, 1), mar = c(4, 4, 2, 1)), garantissant une mise en page ordonnée pour l’inspection comparative directe des propriétés sérielles.
7.2 Génération de corrélogrammes modernes avec ggplot2
Pour atteindre un niveau de qualité graphique optimal répondant aux critères des revues internationales, l’intégration de la librairie ggplot2 s’avère la stratégie la plus performante. Cela nécessite de convertir l’objet issu de ccf() en une structure tabulaire explicite de type data.frame :
ccf_obj <- ccf(serie_X, serie_Y, lag.max = 24, plot = FALSE)
ccf_df <- data.frame(lag = as.numeric(ccf_obj$lag), cor = as.numeric(ccf_obj$acf))
seuil_critique <- 1.96 / sqrt(ccf_obj$n.used)
Une fois cette table structurée, la grammaire graphique de ggplot2 permet de construire un corrélogramme précis et élégant :
- L’utilisation de geom_segment(aes(x = lag, xend = lag, y = 0, yend = cor)) pour tracer les hampes verticales de corrélation avec une finesse géométrique parfaite.
- L’adjonction de geom_point(aes(x = lag, y = cor), size = 2) au sommet de chaque segment pour marquer visuellement la valeur ponctuelle estimée.
- L’insertion d’une zone rectangulaire semi-transparente délimitant la région de non-signification statistique via geom_ribbon(aes(ymin = -seuil_critique, ymax = seuil_critique), fill = « grey80 », alpha = 0.4).
- L’application d’un thème visuel sobre et épuré tel que theme_minimal() ou theme_classic(), assorti d’une typographie proportionnée et d’annotations thématiques précises.
Cette approche découple totalement la logique de calcul statistique de la logique de restitution visuelle, conférant une liberté absolue de personnalisation esthétique (palettes de couleurs, exports vectoriels haute résolution en formats PDF ou SVG).
7.3 Cartographie thermique croisée pour panels multivariés
Dans les configurations d’analyse de données massives ou de systèmes complexes comportant des dizaines de séries temporelles interconnectées (telles que des réseaux de capteurs environnementaux, des panels d’actifs boursiers ou des indicateurs régionaux), l’examen unitaire de corrélogrammes bivariés devient rapidement impraticable.
La solution méthodologique réside dans le calcul matriciel de la corrélation croisée pour l’ensemble des paires possibles à travers une sélection de retards temporels clés, suivi de sa représentation synthétique sous forme de matrice de chaleur (heatmap) dynamique ordonnée par lag. Dans cet agencement visuel :
- L’axe des ordonnées répertorie les séries d’origine (sources émettrices du signal).
- L’axe des abscisses répertorie les séries cibles (réceptrices de l’impulsion).
- La couleur de chaque case matricielle encode l’amplitude et le sens de la corrélation croisée observée pour un décalage k fixe donné.
En juxtaposant plusieurs cartes thermiques correspondant aux retards k = -2, -1, 0, +1, +2, l’analyste perçoit instantanément la propagation globale des interdépendances temporelles au sein du réseau, visualisant comment les pôles de corrélation basculent d’un sous-ensemble d’acteurs à un autre à mesure que le décalage temporel s’incrémente.
8. Applications pratiques interdisciplinaires de la corrélation croisée
Pour illustrer la richesse opérationnelle et l’universalité de la corrélation croisée, trois études de cas méthodologiques représentatives sont détaillées ci-après, couvrant les sciences macroéconomiques, l’optimisation d’entreprise et l’écologie quantitative.
8.1 Modélisation macroéconomique : Indice de confiance et PIB
Considérons l’analyse empirique de la courroie de transmission reliant le climat de confiance des consommateurs à la croissance du Produit Intérieur Brut (PIB). Les économistes disposent d’un enregistrement trimestriel sur vingt années consécutives, formant une chronique temporelle de 80 trimestres consécutifs pour chaque indicateur.
La première phase opérationnelle consiste à télécharger et formater ces agrégats au sein d’objets ts. Les données brutes de PIB révélant une tendance exponentielle et une forte saisonnalité, l’application d’une transformation logarithmique suivie d’une différenciation régulière trimestrielle s’avère incontournable pour isoler le taux de croissance trimestriel réel dé-tendancé. De son côté, l’indicateur de confiance des ménages fait l’objet d’une vérification de stationnarité via le test ADF confirmant son retour vers la moyenne sans racine unitaire.
L’exécution de la fonction ccf(confiance, croissance_PIB, lag.max = 8) révèle un corrélogramme caractéristique :
- Au décalage contemporain k = 0, la corrélation croisée est positive mais modérée (+0,28), suggérant une liaison synchrone imparfaite.
- Aux décalages négatifs, les coefficients oscillent à l’intérieur des bandes de confiance statistiques critiques, attestant que la croissance du PIB ne constitue nullement un facteur précurseur pour l’indice de confiance.
- Au décalage positif k = +2, la corrélation croisée culmine à un niveau massif de +0,64, franchissant très largement le seuil de signification de Bartlett situé à ±0,22.
Ce résultat quantifie un délai moyen d’action structurel de six mois (deux trimestres de latence) entre l’amélioration du sentiment économique des agents et son inscription effective dans la production agrégée des entreprises. Les décideurs publics peuvent ainsi exploiter l’indice de confiance du premier trimestre pour anticiper avec précision l’accélération macroéconomique du troisième trimestre, démontrant la haute valeur prospective de l’indicateur avancé.
8.2 Stratégie marketing et veille d’entreprise : Dépenses et chiffre d’affaires
Une entreprise de commerce électronique à envergure globale cherche à quantifier avec rigueur l’efficacité de ses allocations budgétaires numériques. L’équipe d’analystes collige sur une période de 156 semaines (trois années fiscales) le volume des dépenses publicitaires hebdomadaires allouées aux canaux d’acquisition payants et le montant global du chiffre d’affaires hebdomadaire facturé.
Les séries sont d’abord décomposées pour neutraliser les cycles promotionnels réguliers du type Black Friday ou soldes saisonnières. Après stabilisation de la dynamique par différenciation hebdomadaire, la fonction ccf(depenses, chiffre_affaires, lag.max = 12) est exécutée pour ausculter l’horizon temporel des retombées commerciales.
Le profil corrélographique révèle une structure de réponse dynamique distribuée dans le temps :
- À la semaine k = 0, le coefficient est vigoureusement positif (+0,45), reflétant les conversions impulsives immédiates déclenchées par les campagnes promotionnelles directes.
- À la semaine k = +1, le coefficient s’amplifie pour atteindre son acmé à +0,58, illustrant le pic réel de commande induit par la maturation du cycle de décision des cyberacheteurs.
- Aux semaines k = +2 et k = +3, la corrélation croisée décroît progressivement (+0,31 puis +0,18) pour finir par réintégrer définitivement le couloir de bruit blanc stochastique à compter de k = +4.
Cette analyse objective mathématiquement la durée d’extinction de l’impact promotionnel (trois semaines de persistance active après impulsion). Elle fournit aux gestionnaires de trésorerie le calibrage exact de la dynamique de retour sur investissement publicitaire, interdisant le sous-investissement séquentiel tout en évitant les sur-sollicitations marketing prématurées.
8.3 Écologie et sciences de la conservation : Pollution et faune marine
Une réserve marine protégée instruit les causes du déclin démographique d’une population vulnérable de chéloniens marins (tortues caouannes). Les biologistes rassemblent un jeu de données annuelles s’étalant sur quatre décennies (1980-2020), documentant d’une part la concentration moyenne annuelle de microparticules plastiques et polluants chimiques persistants relevée en mer, et d’autre part l’inventaire quantitatif annuel des pontes et émergences de nouveau-nés sur les plages de nidification côtières.
La confrontation brute des deux séries non modifiées suggère initialement une corrélation contemporaine quasi-nulle, laissant présumer faussement une innocuité de la charge polluante sur la natalité des reptiles. Toutefois, la prise en compte de la biologie fondamentale de l’espèce invite à prospecter des horizons temporels pluriannuels.
Le calcul de la corrélation croisée ccf(pollution, naissances, lag.max = 15) sur les séries dûment stationnarisées en taux de variation met en lumière un phénomène écologique frappant :
- Les coefficients restent rigoureusement neutres de k = 0 jusqu’à k = +6.
- Un effondrement statistique massif et négatif émerge brutalement à l’horizon k = +8 (r = -0,68), persistant significativement à k = +9 et k = +10 avant de s’estomper.
Cette analyse démontre un effet d’impact écologique différé de huit à dix années. Cet intervalle de temps correspond rigoureusement à la période requise pour que les toxines accumulées par les juvéniles dans les gyres pélagiques provoquent des dysfonctionnements endocriniens majeurs au moment de leur passage à la maturité sexuelle et de leur premier retour de reproduction vers les plages natales. La corrélation croisée a ainsi permis de dévoiler une menace d’extinction différée que toute analyse statistique immédiate aurait entièrement masquée.
9. Gestion des corrélations fallacieuses et méthode de pré-blanchiment
Le principal écueil méthodologique de l’analyse bivariée des séries temporelles réside dans l’émergence quasi-systématique de corrélations croisées fallacieuses résultant de la structure d’autocorrélation interne présente au sein des chroniques analysées.
9.1 Le problème de l’autocorrélation interne intra-série
La formule asymptotique standard de Bartlett assignant les bornes de signification critique à ±1,96/√N repose sur un postulat théorique strict : au moins l’un des deux processus stochastiques sous observation doit être un bruit blanc pur, c’est-à-dire une séquence de variables aléatoires indépendantes et identiquement distribuées, dénuée de la moindre dépendance sérielle avec son propre passé.
Or, dans la réalité des sciences appliquées, les séries temporelles sont presque invariablement dotées d’une forte缱autocorrélation interne. Une variable économique, météorologique ou physiologique présente une inertie sérielle considérable : sa valeur à l’instant t dépend étroitement de ses réalisations aux instants t-1, t-2 et antérieurs. Cette dépendance interne viole frontalement les hypothèses sous-tendant les tests standards de corrélation croisée.
Ce phénomène d’inflation statistique conduit à une dégradation sévère de la variance d’échantillonnage de l’estimateur de la corrélation croisée. La persistance interne de chaque série gonfle artificiellement le numérateur de la covariance croisée tout au long des décalages, provoquant des corrélations apparentes de très forte amplitude entre deux trajectoires qui évoluent pourtant de manière totalement disjointe et autonome. L’analyste non averti est alors invariablement induit en erreur, concluant à l’existence d’une relation dynamique différée là où ne s’exprime qu’une simple inertie sérielle partagée.
9.2 Concept et procédure théorique du pré-blanchiment (Prewhitening)
Pour éliminer définitivement ce risque de corrélation fallacieuse, la statistique mathématique a forgé la méthode rigoureuse du pré-blanchiment (connue sous le vocable anglophone de prewhitening), théorisée initialement par George Box et Gwilym Jenkins dans leur approche de modélisation des fonctions de transfert.
Le principe théorique du pré-blanchiment consiste à épurer la dynamique d’association en filtrant préalablement la variable d’entrée indépendante (la série motrice postulée Xt) au moyen de son propre opérateur autorégressif et moyenne mobile (ARIMA) optimal. L’application de ce filtre permet d’extraire les résidus d’innovation pure de la série X, résidus qui constituent, par construction, un bruit blanc stationnaire non autocorrélé :
Φx(B) Θx-1(B) Xt = αt
Dans cette formulation, l’opérateur de retard est désigné par B, et la séquence αt représente le bruit blanc pur extrait de la série d’entrée. L’étape cruciale et cardinale du protocole de pré-blanchiment consiste ensuite à appliquer ce même opérateur de filtrage linéaire issu de X à la seconde variable Yt, générant ainsi une série filtrée transformée βt :
Φx(B) Θx-1(B) Yt = βt
La corrélation croisée est alors exclusivement évaluée entre la série d’innovations pures αt et la série dépendante filtrée βt. Cette procédure assainit entièrement le corrélogramme : la composante αt étant un bruit blanc dénué de toute mémoire interne, les seuils critiques de Bartlett (±1,96/√N) retrouvent leur pleine validité asymptotique. Tout pic statistique qui franchit désormais les intervalles de confiance reflète avec une certitude mathématique absolue une relation dynamique réelle entre les deux processus, et non une distorsion induite par l’inertie interne des signaux d’origine.
9.3 Implémentation algorithmique avec les packages forecast et TSA
Dans l’environnement R, le pré-blanchiment peut être programmé manuellement par décomposition matricielle, ou mis en œuvre de manière fluide et modulaire en s’appuyant sur les fonctionnalités des librairies spécialisées forecast et TSA.
L’approche méthodique procède selon une articulation technique bien ordonnancée :
1. Ajustement d’un modèle univarié optimal sur la série explicative postulée X à l’aide de l’algorithme d’optimisation auto.arima() issu de la bibliothèque forecast :
modele_arima_x <- forecast::auto.arima(serie_X, ic = « aicc », stationary = TRUE)
2. Extraction de la série résiduelle blanche α découlant de cette modélisation structurelle :
alpha_residus <- residuals(modele_arima_x)
3. Application du filtre autorégressif identique à la seconde série temporelle Y. Cette opération est réalisée avec la fonction Arima() en forçant l’application des paramètres estimés du premier modèle sans ré-estimation de ses coefficients :
modele_filtre_y <- forecast::Arima(serie_Y, model = modele_arima_x)
beta_filtree <- residuals(modele_filtre_y)
4. Calcul final et tracé du corrélogramme croisé épuré sur les deux flux de résidus obtenus :
ccf(alpha_residus, beta_filtree, lag.max = 20, main = « CCF pré-blanchie (Pré-blanchiment validé) »)
Alternativement, le package spécialisé TSA intègre une commande directe nommée prewhiten() qui encapsule nativement ce pipeline bivarié en une seule instruction exécutable. La comparaison visuelle entre le corrélogramme croisé brut initial et le corrélogramme pré-blanchi constitue généralement une révélation méthodologique : de larges grappes de corrélations fallacieuses s’effondrent sous le seuil de bruit, ne laissant subsister que l’empreinte saillante du retard structurel authentique régissant le système.
10. Packages alternatifs et modélisations temporelles avancées
Si la fonction ccf() native demeure l’outil d’exploration préliminaire universel dans R, les exigences de la recherche computationnelle contemporaine motivent l’adoption d’approches méthodologiques plus flexibles, intégrant le domaine fréquentiel, la programmation fonctionnelle moderne et l’inférence causale formelle.
10.1 Analyse dans le domaine fréquentiel avec la cohérence par ondelettes
La fonction classique de corrélation croisée évalue une dépendance temporelle moyenne agrégée sur l’ensemble de la période d’enregistrement, postulant implicitement que le retard structurel et l’intensité de liaison demeurent immuables d’un bout à l’autre de l’échantillon. Cette hypothèse de stationnarité temporelle conjointe se révèle fréquemment invalidée dans les systèmes adaptatifs complexes soumis à des modifications environnementales ou de politique institutionnelle.
Pour dépasser ces limites, l’analyse par ondelettes croisées (Cross-Wavelet Transform) et la cohérence par ondelettes (Wavelet Coherence), offertes sous R par la bibliothèque biwavelet, permettent de décomposer la corrélation entre deux signaux simultanément dans l’espace temporel et dans le domaine fréquentiel :
wtc_resultat <- biwavelet::wtc(d1 = matrice_serie_x, d2 = matrice_serie_y, nrands = 500)
Cette méthodologie génère un spectrogramme bidimensionnel dans lequel les axes figurent respectivement le temps calendaire (abscisses) et la période d’oscillation spectrale (ordonnées). Des flèches de phase directionnelles insérées sur la carte thermique indiquent la relation de phase fine unissant les deux séries :
- Des flèches orientées vers la droite traduisent une synchronisation en phase (corrélation contemporaine positive).
- Des flèches pointant vers la gauche traduisent une opposition de phase stricte (corrélation négative).
- Des flèches inclinées vers le bas ou vers le haut formalisent avec précision l’avance ou le retard oscillatoire d’une variable par rapport à l’autre pour une bande de fréquence donnée à une date précise du calendrier.
Cette flexibilité permet de révéler des corrélations croisées transitoires, évanescentes ou restreintes à des horizons cycliques particuliers (par exemple, des synchronisations actives uniquement sur des cycles de 4 ans mais inexistantes sur les variations saisonnières annuelles).
10.2 Intégration dans le paradigme tidyverse avec feasts et timetk
L’essor des grammaires de programmation déclarative incarnées par le meta-package tidyverse a suscité une refonte profonde de la manipulation des séries temporelles, portée par les librairies de l’écosystème Tidyverts, notamment tsibble, fable et feasts.
Au sein de cette architecture logicielle moderne, les séries temporelles ne sont plus stockées sous forme de matrices opaques ts, mais au format tabulaire relationnel tsibble, où chaque ligne représente une observation horodatée indexée par un index temporel explicite et une ou plusieurs clés d’identification (keys). Le package feasts (Financial Economic Analysis of Time Series) propose la fonction ccf() réécrite pour s’insérer naturellement dans les pipelines articulés autour de l’opérateur de composition fonctionnelle (pipe |> ou %>%) :
donnees_tsibble |>
feasts::CCF(var_entree, var_reponse, lag_max = 12) |>
autoplot()
Cette standardisation confère une puissance analytique décuplée lorsqu’il s’agit de mener des calculs de corrélation croisée à grande échelle sur des panels segmentés. Grâce aux opérations groupées permises par dplyr::group_by(), l’analyste peut calculer et tracer automatiquement des matrices de corrélations croisées pour des centaines de magasins, d’actifs financiers ou d’unités géographiques en une seule formulation déclarative, sans recourir à des boucles de programmation itératives explicites lourdes et faillibles.
De manière complémentaire, l’extension timetk unifie l’ingénierie des caractéristiques temporelles en proposant des visualisations interactives enrichies de corrélogrammes dynamiques (via plot_time_series_ccf()) interfaçables avec les bibliothèques web modernes.
10.3 Au-delà de la corrélation : Causalité au sens de Granger
Bien que la corrélation croisée identifie avec une grande précision l’ordonnancement séquentiel des covariances, elle ne saurait répondre isolément à la question de l’existence d’une valeur prédictive incrémentale. C’est précisément l’objet de l’inférence causale statistique formalisée par le test de causalité au sens de Granger.
Le concept de causalité de Granger postule qu’une série temporelle X cause une série temporelle Y au sens prédictif si la connaissance des réalisations passées de X permet d’améliorer significativement la prévision future de Y, comparativement à une prévision construite sur la base exclusive du passé historique de Y seul. L’implémentation opérationnelle de ce test est fournie sous R par la fonction grangertest() du package lmtest :
lmtest::grangertest(reponse ~ cause, order = retard_optimal, data = donnees_alignees)
L’argument order spécifie l’ordre du modèle autorégressif sous-jacent, c’est-à-dire le nombre de retards temporels pris en compte dans la régression multivariée, paramètre qu’il convient de calibrer précisément en s’appuyant sur l’horizon de décalage temporel identifié lors de l’inspection de la fonction de corrélation croisée.
La statistique de test repose sur un ratio de Fisher (test F) comparant la somme des carrés des résidus du modèle restreint (n’incorporant que les retards de Y) à celle du modèle complet (incorporant simultanément les retards de Y et de X). Une p-valeur associée au test F strictement inférieure à 0,05 conduit au rejet de l’hypothèse nulle de non-causalité, consolidant la découverte d’un pic de corrélation croisée en lui conférant le statut formel de pouvoir prédictif stochastique incrémental au sein d’un cadre autorégressif unifié.
11. Diagnostic des erreurs courantes, écueils méthodologiques et limites
La maîtrise de la corrélation croisée requiert une vigilance de chaque instant face aux pièges d’implémentation et aux fausses pistes interprétatives qui jalonnent l’analyse empirique.
11.1 Inversion involontaire de l’ordre des arguments d’entrée
L’erreur la plus banale mais aux répercussions opérationnelles les plus graves consiste à intervertir involontairement l’ordre des séries au sein de l’instruction logicielle d’appel, en tapant ccf(y, x) en lieu et place de ccf(x, y).
Comme détaillé précédemment dans l’exposition théorique de la section 2, la fonction de corrélation croisée est intrinsèquement asymétrique par rapport au décalage zéro (ρxy(k) = ρyx(-k)). L’interversion physique des deux arguments produit donc une inversion spatiale intégrale du corrélogramme : un pic d’association culminant initialement à k = +4 (indiquant que x précède y de quatre périodes) se projettera, suite à cette erreur d’inversion, à k = -4 sur le tracé visuel.
Si l’analyste applique machinalement les règles de lecture sans avoir en mémoire la disposition des arguments dans sa commande de code, il formulera une conclusion diamétralement opposée à la réalité physique du phénomène, affirmant à tort que y devance x. Pour prémunir les projets collaboratifs contre cette confusion, la mise en place de conventions de nommage explicites des objets (par exemple signal_entree_moteur et signal_sortie_reponse) et la standardisation des appels constituent une règle de gouvernance de code impérative.
11.2 Impact trompeur des tendances déterministes et de la saisonnalité
Un autre écueil méthodologique classique réside dans l’application de la fonction ccf() sur des séries chronologiques incorporant des composantes de tendance déterministe ou des périodicités saisonnières non traitées.
Lorsque deux grandeurs statistiques progressent de concert sous l’influence globale de l’expansion démographique, de l’inflation monétaire ou du simple développement technologique continu, leur calcul de covariance croisée enregistre une concordance structurelle artificielle. Le corrélogramme affiche alors une allure en cloche large et uniforme, caractérisée par des coefficients massifs sur la totalité des décalages temporels testés, masquant complètement les éventuelles dynamiques fines d’interaction cyclique.
De manière analogue, si deux séries présentent des composantes saisonnières marquées (telles que des oscillations annuelles régulières régies par les saisons climatiques), la fonction de corrélation croisée générera une trajectoire sinusoïdale pseudo-harmonique artificielle, exhibiting des pics de corrélation alternatifs et réguliers espacés précisément de la période du cycle (par exemple des pics secondaires à k = ±12, ±24 pour des séries mensuelles). L’analyste risque alors de surinterpréter ces répétitions géométriques comme des répliques structurelles du système, alors qu’elles ne traduisent que la contamination saisonnière non filtrée. La désaisonnalisation préalable systématique via des filtres robustes comme STL (stl()) ou X-13ARIMA-SEATS est donc absolument obligatoire avant toute tentative d’évaluation de liaisons décalées.
11.3 Contraintes liées aux non-linéarités et ruptures structurelles
La corrélation croisée standardisée constitue, par construction mathématique fondamentale, un estimateur d’association strictement linéaire. Elle postule que l’amplitude de la réponse d’une variable à l’impulsion de l’autre est rigoureusement proportionnelle et symétrique, que le choc initial soit d’amplitude marginale ou extrême, orienté à la hausse ou à la baisse.
Cette linéarité structurelle rend l’outil aveugle face aux interdépendances non linéaires asymétriques fréquentes dans les systèmes biologiques, financiers ou thermodynamiques. Par exemple, un marché boursier peut réagir violemment et instantanément à un choc géopolitique négatif majeur, tout en restant insensible à des impulsions positives graduelles. Dans ces contextes, la corrélation croisée moyenne sous-estime drastiquement la dépendance réelle existant entre les séries.
Enfin, la présence de ruptures structurelles d’origine exogène (modifications réglementaires, crises économiques, basculements climatiques de régimes écologiques) modifie fréquemment la dynamique de couplage au fil du temps. Un retard optimal calibré à k = +3 durant une première décennie peut se raccourcir brutalement à k = +1 ou disparaître à la suite d’un choc exogène. L’évaluation de la corrélation croisée globale sur l’échantillon entier produit alors une moyenne brouillée sans consistance. Dans de telles configurations, le recours aux techniques de corrélation croisée glissante par fenêtres mobiles (rolling-window CCF) devient indispensable pour évaluer la stabilité temporelle de la relation séquentielle.
12. Protocole complet de bout en bout : Cas pratique appliqué dans R
Afin de consolider l’ensemble des connaissances méthodologiques et algorithmiques développées tout au long de ce guide, ce chapitre déploie un protocole analytique reproductible intégral, mené de bout en bout au sein de R.
12.1 Génération et simulation contrôlée d’un jeu de données couplé
Pour garantir une traçabilité rigoureuse de la vérité statistique terrain sous-jacente et valider sans équivoque la puissance de nos algorithmes de détection, nous concevons un environnement de simulation stochastique au sein duquel le mécanisme de génération des données est mathématiquement maîtrisé.
Nous initialisons le générateur de nombres pseudo-aléatoires de R avec une graine fixe (set.seed(2025)) garantissant une parfaite reproductibilité des calculs. Nous simulons ensuite une variable motrice indépendante Xt modélisée sous forme d’un processus autorégressif d’ordre 1 (AR(1)) doté d’un coefficient de mémoire sérielle élevé (φ = 0,70) sur un échantillon d’une taille de N = 500 unités temporelles :
Xt = 0,70 Xt-1 + εx,t
Dans cette équation, l’innovation εx,t constitue un bruit blanc gaussien d’espérance nulle et d’écart-type unitaire. Nous construisons délibérément la variable réponse dépendante Yt en lui assignant un couplage mécanique direct avec la série motrice X, affecté d’un retard temporel strict de trois unités chronologiques (lag structurel vrai = 3), additionné d’un bruit d’observation aléatoire indépendant εy,t de variance significative :
Yt = 0,85 Xt-3 + εy,t
Ce protocole de simulation synthétise un scénario empirique réaliste : les deux séries présentent une inertie sérielle interne substantielle, un bruit stochastique parasitaire non négligeable et une dépendance dynamique différée parfaitement calibrée à un décalage de k = +3 périodes temporelles.
12.2 Exécution séquentielle du flux analytique complet
Le traitement des données simulées s’organise selon un pipeline de calcul méthodologique rigoureux, exécutant séquentiellement les étapes indispensables de validation statistique :
1. Inspection des structures et typage des objets : Les deux trajectoires vectorielles sont converties en structures chronologiques formelles à l’aide de la commande ts() et alignées au sein d’une même matrice temporelle.
2. Audit diagnostique de stationnarité : L’application conjointe des tests de Dickey-Fuller augmenté (tseries::adf.test()) et de stationnarité KPSS (tseries::kpss.test()) sur les deux chroniques confirme que le processus AR(1) simulé est strictement stationnaire autour de sa moyenne, ne nécessitant aucune différenciation préliminaire.
3. Démonstration de l’illusion de la CCF brute : Si l’on exécute la fonction native ccf(x, y, lag.max = 15) directement sur les données brutes sans pré-blanchiment, la forte autocorrélation interne présente dans la variable motrice X pollue lourdement le corrélogramme résultant. Des coefficients anormalement élevés et largement significatifs émergent sur les décalages k = 0, 1, 2, 3, 4, 5 et au-delà, empêchant d’isoler avec netteté le retard structurel authentique parmi ce plateau de valeurs significatives.
4. Procédure de pré-blanchiment méthodologique : Pour assainir l’estimation, nous appliquons le modèle ARIMA d’innovation univarié sur la série X à l’aide de la commande forecast::auto.arima(). Le modèle sélectionne optimalement la structure AR(1) sous-jacente. Nous extrayons les innovations résiduelles blanches de la série X, puis nous filtrons la série Y par l’application stricte de cet opérateur identique.
5. Calcul de la CCF pré-blanchie : L’exécution finale de la fonction ccf() sur les deux séries de résidus filtrés produit une clarification mathématique spectaculaire : l’ensemble des coefficients secondaires sur les retards k = 0, 1, 2, 4, 5 s’effondre en deçà des bornes de confiance critiques de Bartlett (±1,96/√500 ≈ ±0,088). Un pic isolé, net et massif culmine avec une acuité statistique irréfutable à la valeur exacte k = +3, confirmant sans la moindre ambiguïté le retard génétique injecté lors de la phase de conception.
12.3 Restitution des résultats et formulation des conclusions empiriques
L’aboutissement de la recherche empirique réside dans la restitution graphique rigoureuse et la rédaction d’une synthèse d’interprétation méthodologique respectant les plus hauts standards de la communication scientifique.
À partir du tableau de données extrait de l’objet ccf pré-blanchi, un graphique haute définition est compilé sous ggplot2. Le tracé intègre une ligne horizontale discontinue démarquant avec précision les seuils critiques bilatéraux d’erreur de première espèce au niveau alpha = 0,05. Une annotation textuelle ciblée est projetée directement sur le pic de corrélation, précisant les coordonnées exactes du retard identifié (Lag = +3) ainsi que la magnitude numérique de son coefficient de dépendance linéaire.
La synthèse textuelle formalise les résultats en explicitant :
- Que la série motrice X devance temporellement la série réceptrice Y d’une durée inaltérable de trois pas de temps réguliers.
- Que le filtrage par pré-blanchiment a permis de purger l’inférence de tout biais d’autocorrélation fallacieuse.
- Que l’hypothèse nulle d’indépendance des deux processus stochastiques à ce décalage temporel est rejetée avec une p-valeur asymptotique infinitésimale (p < 0,001).
Enfin, pour garantir une reproductibilité intégrale de l’expérience conformément aux préceptes de la science ouverte, le script R complet est documenté, annoté, débarrassé de tout chemin d’accès absolu au profit d’un environnement de projet structuré (utilisant le package here), scellant ainsi un protocole d’ingénierie statistique exemplaire du calcul de la corrélation croisée dans R.
Références
- Bartlett, M. S. (1946). On the theoretical specification and sampling properties of autocorrelated time-series. Journal of the Royal Statistical Society, 8(1), 27-41. https://doi.org/10.2307/2983611
- Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5e éd.). John Wiley & Sons. https://www.wiley.com/en-us/Time+Series+Analysis%3A+Forecasting+and+Control%2C+5th+Edition-p-9781118675021
- Brockwell, P. J., & Davis, R. A. (2016). Introduction to time series and forecasting (3e éd.). Springer. https://doi.org/10.1007/978-3-319-29854-2
- Granger, C. W. J. (1969). Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 37(3), 424-438. https://doi.org/10.2307/1912791
- Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3e éd.). OTexts. https://otexts.com/fpp3/
- Kwiatkowski, D., Phillips, P. C. B., Schmidt, P., & Shin, Y. (1992). Testing the null hypothesis of stationarity against the alternative of a unit root. Journal of Econometrics, 54(1-3), 159-178. https://doi.org/10.1016/0304-4076(92)90104-Y
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Shumway, R. H., & Stoffer, D. S. (2017). Time series analysis and its applications: With R examples (4e éd.). Springer. https://doi.org/10.1007/978-3-319-52452-8
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., Takahashi, K., Vaughan, D., Wilke, C., Woo, K., & Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), 1686. https://doi.org/10.21105/joss.01686