
Le traitement des données quantitatives contemporaines repose de manière fondamentale sur l’algèbre linéaire, dont le produit scalaire constitue l’une des pierres angulaires. Qu’il s’agisse de mesurer la corrélation entre des profils d’évaluation psychométrique, d’évaluer la proximité sémantique au sein de corpus textuels numérisés, d’optimiser des portefeuilles d’actifs financiers ou d’implémenter des algorithmes élémentaires d’apprentissage automatique, la capacité à projeter et comparer des vecteurs multidimensionnels s’avère indispensable. Dans les environnements professionnels et académiques, le tableur Microsoft Excel demeure l’un des outils de calcul les plus universellement déployés, offrant un pont remarquable entre l’abstraction mathématique et la manipulation empirique des données.
Toutefois, la transposition d’un concept vectoriel abstrait au sein de la grille bidimensionnelle d’une feuille de calcul requiert une compréhension rigoureuse tant des structures mathématiques sous-jacentes que des spécificités du moteur de calcul d’Excel. Si la notion géométrique de projection orthogonale semble intuitive sur un plan cartésien à deux dimensions, son calcul efficace sur des séries comprenant des dizaines, voire des centaines de composantes, exige de maîtriser les fonctions natives adaptées, à l’instar de SOMMEPROD, ou les combinaisons matricielles sophistiquées comme l’association de PRODUITMAT et TRANSPOSE.
Le présent traité propose une exploration exhaustive des méthodologies permettant de calculer le produit scalaire dans Excel, depuis les fondements de la géométrie euclidienne jusqu’aux applications complexes en modélisation psychométrique et textuelle. En articulant théorie vectorielle, ergonomie des feuilles de calcul, diagnostic des erreurs de précision machine et optimisation computationnelle, ce guide vise à doter les analystes, chercheurs et praticiens des compétences indispensables pour transformer leurs classeurs en puissants moteurs d’analyse vectorielle.
1. Fondements théoriques et définition mathématique du produit scalaire
1.1 Définition algébrique et formulation vectorielle
D’un point de vue purement algébrique, le produit scalaire de deux vecteurs s’inscrit dans le cadre formel des espaces préhilbertiens réels, et plus particulièrement des espaces euclidiens de dimension finie notés R^n. Soit deux vecteurs u et v appartenant à cet espace, chacun étant défini par un ensemble ordonné de composantes numériques réelles telles que u = (u₁, u₂, …, uₙ) et v = (v₁, v₂, …, vₙ). L’opération de produit scalaire, traditionnellement symbolisée par un point médian ou par la notation entre crochets angulaires, associe à ce couple de vecteurs un nombre réel unique issu de la somme des produits de leurs composantes homologues respectives.
L’expression mathématique standard s’énonce comme la sommation discrète pour l’indice i variant de 1 à n du produit uᵢ par vᵢ. Ce processus computationnel se décompose de manière séquentielle : chaque élément d’un vecteur est apparié de manière stricte avec l’élément occupant la même position ordinale dans le second vecteur, subit une multiplication arithmétique unitaire, puis l’ensemble de ces résultats intermédiaires est agrégé au sein d’un accumulateur global. Il est impératif de souligner que cette opération contracte les dimensions spatiales : deux structures de rang n s’annihilent mutuellement pour engendrer un scalaire de dimension 1, ce qui constitue une différence fondamentale avec d’autres opérations vectorielles.
À cet égard, une distinction conceptuelle rigoureuse doit être établie entre plusieurs formes de multiplications opérant sur des structures linéaires. La multiplication scalaire, tout d’abord, désigne le produit d’un vecteur par un nombre réel unique, opération qui dilate ou contracte le vecteur sans en altérer la dimensionnalité intrinsèque. Le produit vectoriel, en second lieu, n’est défini que dans l’espace tridimensionnel R³ et génère un nouveau vecteur qui est orthogonal au plan sous-tendu par les deux vecteurs initiaux. Enfin, le produit matriciel généralise cette approche en appliquant le produit scalaire entre les lignes d’une première matrice et les colonnes d’une seconde, produisant un tenseur d’ordre deux. Le produit scalaire euclidien classique représente ainsi le cas particulier élémentaire d’un produit matriciel entre une matrice ligne de taille 1×n et une matrice colonne de taille n×1.
1.2 Propriétés mathématiques structurales
L’étude des propriétés structurales du produit scalaire permet d’en appréhender la stabilité opératoire et la cohérence au sein des systèmes de calcul formel. La première propriété essentielle réside dans la commutativité absolue de l’opération, stipulant que pour tout couple de vecteurs u et v, le produit scalaire de u par v est rigoureusement identique au produit scalaire de v par u. Cette invariance par permutation découle directement de la commutativité fondamentale de la multiplication dans le corps des nombres réels. Dans le cadre d’un modèle d’analyse sous tableur, cette propriété garantit à l’analyste une liberté totale quant à l’ordre d’attribution des plages de cellules au sein des arguments de fonction.
La deuxième propriété structurale majeure est la distributivité par rapport à l’addition vectorielle. Si l’on considère un troisième vecteur w appartenant au même espace vectoriel, le produit scalaire du vecteur u avec la somme (v + w) équivaut exactement à la somme arithmétique du produit scalaire de u par v et du produit scalaire de u par w. Cette distributivité confère à l’opérateur une linéarité à droite qui, combinée à la commutativité, établit la bilinéarité de l’application. La bilinéarité implique qu’une variation proportionnelle appliquée à l’un des vecteurs se répercute de façon strictement linéaire sur la valeur finale du scalaire généré.
En corollaire, l’homogénéité du produit scalaire régit le comportement de l’opération lorsqu’un ou plusieurs vecteurs sont multipliés par un scalaire lambda. L’expression indique que multiplier préalablement un vecteur par une constante réelle revient à multiplier le produit scalaire final par cette même constante. Enfin, le produit scalaire euclidien est strictement défini positif : le produit scalaire d’un vecteur u par lui-même est toujours supérieur ou égal à zéro, et ne s’annule si et seulement si le vecteur u est le vecteur nul. Cette propriété de positivité s’avère indispensable pour conférer à l’espace vectoriel une métrique cohérente et autoriser le calcul de distances et de normes physiques ou psychométriques.
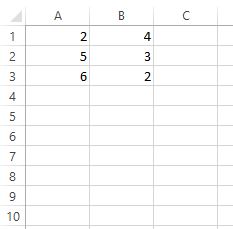
1.3 Interprétation géométrique et projection
Au-delà de sa formalisation algébrique en composantes discrètes, le produit scalaire possède une interprétation géométrique d’une richesse conceptuelle considérable. Dans l’espace géométrique euclidien standard, le produit scalaire entre u et v peut être formulé de manière équivalente comme le produit de la norme euclidienne de u, de la norme euclidienne de v, et du cosinus de l’angle non orienté thêta formé par les directions spatiales de ces deux entités. Cette relation trigonométrique fondamentale relie directement la magnitude brute des grandeurs mesurées à leur orientation relative au sein du repère d’observation.
Cette formulation géométrique met en exergue le critère universel d’orthogonalité. En effet, lorsque deux vecteurs non nuls forment un angle droit de 90 degrés (ou pi sur deux radians), le cosinus de cet angle s’annule rigoureusement. Par voie de conséquence, leur produit scalaire devient égal à zéro. Cette propriété fait du produit scalaire un détecteur algébrique d’orthogonalité ou d’indépendance directionnelle d’une efficacité redoutable. Dans les modèles d’analyse multivariée ou d’analyse en composantes principales, l’annulation du produit scalaire entre deux vecteurs de scores indique une absence totale de redondance linéaire ou une indépendance statistique lorsque les variables sont préalablement centrées.
Enfin, l’opération se prête à une visualisation intuitive par le prisme de la projection orthogonale. Calculer le produit scalaire de u par v revient géométriquement à déterminer la longueur algébrique de la projection orthogonale du vecteur u sur la droite vectorielle soutenue par le vecteur v, cette longueur étant ensuite pondérée par la norme de ce dernier. Si v est un vecteur unitaire de norme égale à un, le produit scalaire mesure précisément l’ombre portée par u le long de cet axe unitaire. Cette perspective est omniprésente dans les algorithmes de réduction dimensionnelle, où un jeu volumineux de données multidimensionnelles est projeté sur des axes optimaux afin d’en extraire la variance dominante sans déformation de la structure relationnelle globale.
2. Préparation et structuration des données vectorielles dans Excel
2.1 Organisation des vecteurs en colonnes individuelles
L’implantation rigoureuse d’un calcul vectoriel au sein du tableur Microsoft Excel débute obligatoirement par une réflexion approfondie sur la disposition spatiale des données dans la grille de calcul. La configuration la plus naturelle et la plus conforme aux normes de la modélisation statistique consiste à ordonner les composantes des vecteurs le long de colonnes verticales distinctes. Dans cette optique, chaque colonne représente un vecteur spécifique, tandis que chaque ligne correspond à une dimension, un axe de coordonnées spatiales, un item d’évaluation ou un pas temporel particulier.
Une bonne gouvernance de la feuille de calcul impose d’attribuer une ligne d’en-tête explicite et standardisée au sommet de chaque colonne vectorielle, généralement sur la première ligne de la feuille ou du tableau structuré. Ces étiquettes textuelles, telles que « Vecteur_U » ou « Vecteur_V », doivent désigner sans ambiguïté la nature des grandeurs quantifiées. En dessous de cet en-tête, les composantes numériques s’égrènent de manière séquentielle et ininterrompue, occupant une plage contiguë telle que A2:A101 pour un vecteur de dimension 100.
Un impératif architectural absolu réside dans l’alignement dimensionnel strict des colonnes destinées à faire l’objet d’un produit scalaire. Les deux plages doivent impérativement posséder une cardinalité identique, c’est-à-dire inclure un nombre exactement égal de cellules sur la dimension verticale. Si le vecteur source est localisé dans la plage A2:A101, le vecteur cible doit obligatoirement s’étendre sur une hauteur identique, par exemple B2:B101. Tout décalage vertical ou toute discordance dans la borne inférieure ou supérieure rompt l’isomorphisme des coordonnées, introduisant des biais d’indexation majeurs ou des erreurs de traitement que les fonctions natives ne sont pas toujours en mesure de signaler explicitement.
2.2 Organisation horizontale des vecteurs en lignes
Bien que la disposition verticale soit privilégiée pour les séries temporelles et les jeux de données tabulaires classiques, la configuration horizontale des vecteurs le long des lignes de la feuille de calcul demeure extrêmement fréquente, notamment dans les matrices de données psychométriques ou les relevés d’enquêtes où chaque ligne matérialise un individu statistique et chaque colonne une variable observée. Dans ce paradigme horizontal, les composantes d’un vecteur u s’étirent le long d’une plage horizontale, par exemple de la cellule B2 à la cellule CW2 pour une structure à 100 dimensions.
Cette approche ergonomique présente des avantages indéniables lors de l’analyse simultanée de multiples échantillons ou sujets d’étude, car elle autorise l’empilement vertical de centaines de profils vectoriels comparables. Toutefois, elle impose une discipline d’analyse accrue. L’utilisateur doit s’assurer que l’ordre des colonnes respecte scrupuleusement la même séquence pour tous les vecteurs considérés. Une permutation involontaire entre deux colonnes adjacentes dans l’une des lignes fausserait irrémédiablement l’appariement des composantes homologues lors de l’exécution du produit scalaire, sans pour autant déclencher de message d’erreur au niveau de l’interpréteur de calcul d’Excel.
Par ailleurs, il convient de veiller à l’uniformité du sens de lecture au sein du classeur. Mixer arbitrairement des vecteurs orientés horizontalement avec des vecteurs orientés verticalement sans recourir à des opérateurs de transposition formels constitue une source fréquente de dysfonctionnements computationnels. Les fonctions matricielles d’Excel requièrent en effet une compatibilité d’orientation géométrique spécifique pour exécuter des multiplications terme à terme, sous peine de transformer involontairement un calcul de produit scalaire scalaire en une table de multiplication bidimensionnelle non désirée.
2.3 Validation des formats et nettoyage des données
L’intégrité du calcul du produit scalaire dépend de manière critique de la pureté numérique des valeurs inscrites dans les cellules matricielles. L’une des anomalies les plus pernicieuses rencontrées dans les feuilles de calcul provient de la présence de nombres enregistrés sous format textuel, souvent issus d’extractions de bases de données relationnelles ou d’imports de fichiers au format délimité (CSV). Un chiffre stocké en format texte peut visuellement paraître valide, mais sera évalué comme un zéro arithmétique ou générera une interruption d’exécution lors de l’appel de certaines fonctions analytiques strictes.
Pour parer à cette défaillance, il est vivement recommandé d’appliquer une validation systématique des données en exploitant des fonctions d’inspection telles que ESTNUM ou en forçant la conversion explicite par le biais de l’outil de conversion textuelle en colonnes d’Excel. Les espaces insécables (dont le code ASCII correspond au caractère 160) souvent injectés lors des copier-coller depuis des interfaces web doivent être impérativement éradiqués à l’aide de la fonction combinée SUBSTITUE, car ils interdisent toute conversion automatique des données en réels à virgule flottante.
La gestion des cellules vides et des données manquantes constitue le second volet critique du nettoyage préparatoire. Dans la logique du produit scalaire, une cellule vide est généralement interprétée comme un zéro par les fonctions de sommation matricielle native. Cependant, d’un point de vue statistique et méthodologique, l’absence de mesure ne doit pas être assimilée systématiquement à une valeur nulle sans justification théorique. L’analyste doit déterminer au préalable si les lacunes informationnelles doivent faire l’objet d’une imputation statistique (par exemple par la moyenne de la composante considérée) ou si la paire de composantes concernée doit être purement et simplement exclue du calcul afin de ne pas biaiser artificiellement la métrique résultante.
3. Méthode standard : Utilisation de la fonction SOMMEPROD
3.1 Syntaxe formelle et mécanisme d’exécution de SOMMEPROD
Au sein de la bibliothèque de fonctions mathématiques natives de Microsoft Excel, la fonction SOMMEPROD (ou SUMPRODUCT en version anglophone) représente l’instrument paradigmatique et optimal pour évaluer le produit scalaire de deux vecteurs. Sa syntaxe fondamentale s’articule autour de la transmission d’arguments matriciels séquentiels : la fonction accepte une série de matrices ou de plages cellulaires, désignées sous les vocables matrice1, matrice2, et ainsi de suite jusqu’à un maximum de 255 tableaux d’arguments.
Le mécanisme interne d’exécution de SOMMEPROD s’opère selon un processus computationnel rigoureusement isomorphe à la définition mathématique du produit scalaire. Dès son instanciation, la fonction parcourt simultanément et de manière synchronisée les plages spécifiées. Pour chaque position indicielle, elle extrait la valeur correspondante dans la première matrice et la multiplie par la valeur occupant l’emplacement homothétique dans la seconde matrice. Cette phase de multiplication élément par élément génère une matrice transitoire en mémoire vive, matrice qui n’est jamais affichée directement sur la grille de calcul, mais dont tous les constituants sont immédiatement agrégés par l’accumulateur interne de sommation.
L’avantage prépondérant de la fonction SOMMEPROD, qui justifie son statut de méthode de référence absolue dans l’écosystème Excel, réside dans sa nature intrinsèquement matricielle ne nécessitant aucune manipulation complexe de saisie. Contrairement aux anciennes formules matricielles historiques d’Excel qui exigeaient une validation cryptique par combinaison de touches, SOMMEPROD gère de façon entièrement native et transparente les tableaux sous-jacents, garantissant une exécution immédiate, intuitive et particulièrement fluide pour l’utilisateur final.
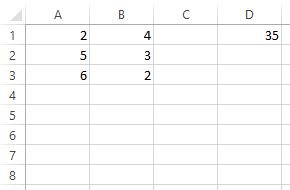
3.2 Procédure d’implémentation pratique pas à pas
Pour mettre en œuvre concrètement le calcul du produit scalaire à l’aide de la fonction SOMMEPROD sur une feuille de calcul opérationnelle, la procédure se déploie selon une séquence d’actions particulièrement simple. Considérons à titre d’illustration didactique deux vecteurs numériques de dimension 5, dont les composantes respectives sont logées dans les cellules verticales A2:A6 pour le vecteur u, et dans les cellules B2:B6 pour le vecteur v.
La première démarche consiste à sélectionner une cellule de destination totalement vierge, par exemple la cellule C2, destinée à héberger le résultat scalaire final. Dans la barre de formule de cette cellule, l’utilisateur entame la saisie de l’expression en écrivant le signe d’égalité conventionnel, suivi de l’opérateur fonctionnel et de la parenthèse ouvrante : =SOMMEPROD(. À ce stade, il convient de spécifier la première plage de coordonnées en sélectionnant directement à l’aide du curseur ou en saisissant au clavier la référence A2:A6.
L’étape suivante requiert l’insertion du séparateur syntaxique approprié, lequel correspond au point-virgule dans la localisation linguistique française d’Excel (ou à la virgule dans les versions anglo-saxonnes). Immédiatement après ce délimiteur, la seconde plage vectorielle B2:B6 est introduite, avant de clore l’instruction par la parenthèse fermante, aboutissant à la formule complète =SOMMEPROD(A2:A6; B2:B6). Une simple validation par la touche Entrée déclenche l’évaluation instantanée. Excel multiplie alors A2 par B2, A3 par B3, et ainsi de suite, pour restituer en cellule C2 le scalaire unique représentant la somme de ces cinq produits élémentaires.
3.3 Robustesse et compatibilité interversionnelle de SOMMEPROD
L’un des arguments les plus décisifs en faveur de l’adoption institutionnelle de SOMMEPROD dans les classeurs critiques d’entreprise réside dans sa rétrocompatibilité absolue. Présente depuis les premières déclinaisons de Microsoft Excel apparues dans les années 1990, cette fonction conserve un comportement rigoureusement invariant à travers l’ensemble des itérations historiques et multiplateformes du logiciel, qu’il s’agisse de versions patrimoniales comme Excel 2003, de suites d’entreprise sous Windows ou Mac, ou des solutions contemporaines basées sur le cloud telles qu’Office 365 et Excel Online.
Sur le plan de la robustesse computationnelle, SOMMEPROD fait preuve d’une remarquable résilience face à la diversité des typologies de données. En présence de cellules contenant des valeurs booléennes comme VRAI ou FAUX intégrées au sein des arguments matriciels purs, la fonction les traite de manière standard comme des valeurs nulles à moins qu’un opérateur unaire de double négation ne soit explicitement spécifié pour les convertir en entiers binaires (1 et 0). De même, les cellules textuelles intégrées accidentellement sont le plus souvent ignorées ou assimilées à des zéros, protégeant l’utilisateur contre des blocages inopinés lors du traitement de jeux de données imparfaits.
En matière d’allocation de ressources informatiques, SOMMEPROD a bénéficié de décennies d’optimisation au niveau du code machine C++ compilé au cœur du moteur de calcul d’Excel. Pour des vecteurs de taille petite à modérée (comportant de quelques unités à plusieurs dizaines de milliers de lignes), la fonction démontre une vitesse d’exécution quasi-instantanée et une empreinte mémoire négligeable, ce qui la rend infiniment plus performante et sécurisante que des implémentations décentralisées reposant sur des boucles itératives manuelles ou des macro-commandes non compilées.
4. Méthode matricielle avancée : L’association de PRODUITMAT et TRANSPOSE
4.1 Principes de la multiplication matricielle appliquée aux vecteurs
Dans le paradigme formel de l’algèbre linéaire, un vecteur est conceptuellement assimilé à une matrice unicolonne ou uniligne. Le calcul du produit scalaire entre deux vecteurs colonnes de taille n×1 ne peut pas être opéré directement par un produit matriciel simple, car la condition fondamentale de conformabilité des dimensions matricielles ne serait pas satisfaite : le produit d’une matrice n×1 par une matrice n×1 est indéfini sur le plan mathématique.
Pour contourner cette contrainte dimensionnelle, il est impératif d’appliquer l’opération de transposition au premier vecteur de la chaîne de calcul. La transposition d’un vecteur colonne de dimensions n×1 réorganise ses composantes sous la forme d’un vecteur ligne dont les dimensions deviennent rigoureusement 1×n. Dès cet instant, la règle d’associativité matricielle stipulant que le nombre de colonnes de la première matrice doit correspondre scrupuleusement au nombre de lignes de la seconde matrice se trouve validée, les dimensions internes s’accordant sur la valeur n.
L’opération matricielle qui en découle multiplie ainsi la matrice ligne 1×n par la matrice colonne n×1. L’application de la règle générale des dimensions matricielles produit inévitablement une matrice résultante dont la structure finale correspond aux dimensions extrêmes, à savoir précisément une ligne et une colonne (1×1). Cette matrice d’ordre unitaire ne contient qu’une seule composante scalaire, laquelle est l’expression mathématique et numérique rigoureuse du produit scalaire des deux vecteurs considérés.
4.2 Construction de la formule matricielle combinée
Pour traduire cette élégance théorique au sein de la syntaxe d’Excel, il est nécessaire d’emboîter harmonieusement deux fonctions de calcul matriciel avancées : la fonction PRODUITMAT, qui effectue la multiplication de deux tableaux compatibles, et la fonction TRANSPOSE, qui bascule l’orientation spatiale de la matrice transmise en argument.
En reprenant l’exemple concret de deux vecteurs verticaux ordonnés dans les plages A2:A100 et B2:B100, la formulation de l’expression s’établit en imbriquant TRANSPOSE au sein du premier argument de la fonction PRODUITMAT. La syntaxe complète s’écrit formellement sous la forme : =PRODUITMAT(TRANSPOSE(A2:A100); B2:B100). Lors de l’évaluation, l’interpréteur d’Excel commence par exécuter la fonction interne TRANSPOSE, transformant virtuellement la colonne A2:A100 en une ligne horizontale fictive de dimensions 1×99, avant de déclencher PRODUITMAT qui multiplie cette structure par la colonne B2:B100.
La validation de cette formule varie considérablement selon la génération du moteur de calcul d’Excel employée. Dans les versions contemporaines équipées du moteur de tableaux dynamiques (introduit à partir d’Office 365 et Excel 2021), une simple pression sur la touche Entrée suffit à finaliser le calcul. En revanche, sur les éditions patrimoniales d’Excel antérieures à ces évolutions, la formule doit impérativement être saisie selon le protocole historique des formules matricielles, requérant la frappe conjointe des touches Contrôle, Majuscule et Entrée (CSE), sous peine d’obtenir une valeur d’erreur typologique ou un résultat tronqué.
4.3 Gestion des tableaux dynamiques et combinaison matricielle
L’avènement de l’architecture des tableaux dynamiques au sein des versions modernes de Microsoft Excel a profondément remodelé l’interaction avec les opérations matricielles. Désormais, le concept de déversement (ou spill en langue anglaise) permet à une fonction renvoyant des dimensions multiples de propager automatiquement ses résultats dans les cellules environnantes adjacentes sans qu’il soit nécessaire de prédéfinir ou de figer la plage de réception.
Dans le cas spécifique de l’association PRODUITMAT et TRANSPOSE appliquée à deux vecteurs conformes, le résultat final étant strictement scalaire de taille 1×1, aucun phénomène de déversement étendu ne se produit sur la feuille : la valeur unique s’établit paisiblement dans la cellule hôte, évitant ainsi toute collision accidentelle avec des données préexistantes susceptibles de déclencher l’erreur #EPARS!. Cette fluidité conceptuelle confère à l’alliance PRODUITMAT/TRANSPOSE une légitimité nouvelle auprès des analystes quantitatifs chevronnés.
Toutefois, lorsqu’il s’agit d’analyser l’efficacité computationnelle brute, une comparaison objective s’impose face à SOMMEPROD. Bien que PRODUITMAT soit extrêmement optimisée pour le calcul de tenseurs volumineux, l’étape préalable de transposition imposée par l’encapsulation de TRANSPOSE induit une allocation transitoire de mémoire vive pour réordonner les pointeurs d’adresses. Sur des ensembles vectoriels massifs comportant plusieurs centaines de milliers d’éléments, cette manipulation de transposition interne peut introduire une latence infinitésimale mais mesurable par rapport à SOMMEPROD, qui lit directement les éléments sans réagencer leur géométrie mémoire sous-jacente.
5. Méthode élémentaire par décomposition pas à pas
5.1 Création d’une colonne intermédiaire de produits termes à termes
Bien que les fonctions sophistiquées comme SOMMEPROD ou l’imbrication matricielle PRODUITMAT procurent une concision syntaxique indéniable, l’approche élémentaire par décomposition pas à pas conserve une pertinence pédagogique et opérationnelle considérable. Cette méthodologie consiste à matérialiser explicitement sur la grille du tableur l’ensemble des calculs intermédiaires avant d’en effectuer la synthèse définitive.
Concrètement, si le premier vecteur réside dans la colonne A (de A2 à A100) et le second dans la colonne B (de B2 à B100), l’analyste alloue la colonne adjacente C pour y générer un vecteur résultat transitoire. Dans la cellule C2, une formule arithmétique élémentaire est inscrite : =A2*B2. Cette relation exécute de manière explicite et unitaire le produit de la première composante du vecteur u par la première composante homologue du vecteur v.
En s’appuyant sur le système ingénieux des références relatives intrinsèque à la mécanique d’Excel, il suffit d’étendre cette formule vers le bas, soit par un double-clic sur la poignée de recopie située à l’angle inférieur droit de la cellule C2, soit par un étirement manuel jusqu’à la cellule C100. Excel incrémente automatiquement les numéros d’indices de ligne, produisant instantanément une série de 99 produits élémentaires, parfaitement visibles et audités individuellement. Chaque ligne de cette colonne intermédiaire reflète la contribution arithmétique partielle de la dimension correspondante au produit scalaire global.
5.2 Sommation terminale des produits intermédiaires
La seconde phase de cette démarche élémentaire consiste à agréger cette collection de résultats partiels en faisant appel à la fonction d’addition la plus basique du logiciel. Au pied de la colonne intermédiaire, par exemple au sein de la cellule C101, ou dans une case récapitulative dédiée sur un tableau de bord, l’utilisateur insère la commande de sommation standard : =SOMME(C2:C100).
Cette sommation terminale compile l’ensemble des composantes du vecteur intermédiaire généré lors de la phase précédente. Sur le plan de la rigueur mathématique, le résultat numérique obtenu dans cette cellule est rigoureusement identique, au bit de précision près, à celui calculé instantanément par une fonction globale comme SOMMEPROD. L’égalité structurelle entre l’évaluation condensée et la sommation éclatée permet de valider le fonctionnement des algorithmes sous-jacents.
L’intérêt didactique majeur de cette décomposition réside dans l’accessibilité immédiate du processus analytique pour des interlocuteurs non spécialistes de l’algèbre vectorielle. Dans un rapport de conformité financière ou un audit réglementaire d’ingénierie, dévoiler l’intégralité de la chaîne d’engendrement du nombre rassure les évaluateurs et simplifie grandement l’inspection visuelle globale de la cohérence des calculs.
5.3 Diagnostic visuel et identification ciblée des anomalies
L’incontestable valeur ajoutée de la méthode décomposée repose sur la puissance de diagnostic immédiat qu’elle confère à l’opérateur. Lorsqu’une formule condensée comme SOMMEPROD renvoie une valeur surprenante, aberrante ou une erreur d’exécution, la boîte noire algorithmique ne fournit aucun indice direct quant à la localisation précise de la défaillance au sein des centaines de composantes analysées.
À l’inverse, en observant la colonne intermédiaire des produits terme à terme, l’analyste repère instantanément toute rupture de cohérence. Si une cellule spécifique affiche l’erreur #VALEUR!, le regard se porte sans délai sur la ligne incriminée, révélant la présence inattendue d’un caractère textuel ou d’un espace insécable dans les cellules sources correspondantes. De surcroît, cette visibilité granulaire permet de détecter sans difficulté les valeurs extrêmes ou aberrantes : un produit partiel disproportionné par rapport aux grandeurs moyennes environnantes met en évidence une erreur potentielle d’échelle, d’unité de mesure ou de saisie décimale.
Enfin, sur le plan de l’apprentissage des sciences de l’ingénieur, des mathématiques appliquées et de la psychométrie expérimentale, cette méthode pas à pas constitue un levier pédagogique irremplaçable. Elle matérialise visuellement la façon dont l’accumulation de micro-variations individuelles engendre une grandeur scalaire synthétique, facilitant l’assimilation intuitive de concepts abstraits tels que la variance partagée, la covariance ou la distance de projection euclidienne.
6. Calcul du produit scalaire dans des espaces vectoriels de haute dimension
6.1 Extension aux vecteurs de dimension n arbitraire
Alors que les exercices théoriques d’initiation restreignent généralement leurs démonstrations à des espaces tridimensionnels ou quadridimensionnels aisément appréhendables, la pratique moderne de l’analyse de données confronte régulièrement les utilisateurs d’Excel à des espaces vectoriels de haute dimension, où n peut aisément atteindre plusieurs milliers, voire plusieurs centaines de milliers d’éléments. Qu’il s’agisse de spectrogrammes physiques haute résolution, de séries temporelles financières complexes ou de vecteurs d’encastrement textuel, la méthodologie doit s’adapter sans perte de performance.
Face à de telles échelles, le respect scrupuleux de la continuité spatiale des plages cellulaires s’impose comme une condition de survie pour les modèles analytiques. Une rupture accidentelle de séquence causée par l’insertion malencontreuse de lignes de sous-totaux textuels au sein du flux de données compromettrait instantanément la validité du produit scalaire en altérant le calcul de SOMMEPROD. Les plages passées en argument doivent être parfaitement continues, homogènes et exemptes de toute interruption structurelle.
De surcroît, la lisibilité des formules dans la barre d’édition devient critique lorsque les plages s’étendent sur des milliers de lignes, par exemple =SOMMEPROD(A2:A50000; B2:B50000). La maintenance manuelle de telles coordonnées est source d’erreurs d’inattention, particulièrement lorsqu’il s’agit de recalibrer les modèles à la suite de l’adjonction de nouvelles données expérimentales. Il convient alors de recourir à des mécanismes d’abstraction supérieurs pour sanctuariser la structure des calculs.
6.2 Utilisation des plages nommées pour optimiser la clarté
L’attribution de noms mnémotechniques standardisés par le biais du Gestionnaire de noms de Microsoft Excel représente l’une des meilleures pratiques de gouvernance pour l’analyse vectorielle en haute dimension. Plutôt que de manipuler des références alphanumériques opaques et vulnérables aux décalages de sélection, l’analyste associe une désignation textuelle explicite et invariable aux plages de données hébergeant les composantes vectorielles.
Par exemple, en sélectionnant la plage A2:A50000 et en lui assignant l’identifiant Vecteur_Observation, puis en nommant la plage B2:B50000 sous le libellé Vecteur_Ponderation, l’instruction syntaxique du produit scalaire se transforme de manière spectaculaire : =SOMMEPROD(Vecteur_Observation; Vecteur_Ponderation). La formule gagne instantanément une clarté sémantique absolue, devenant immédiatement compréhensible pour tout relecteur externe sans nécessiter d’investigation préalable sur l’organisation spatiale de la feuille.
Cette approche réduit de façon draconienne les risques de régression lors des opérations d’extension du modèle. En intégrant des formules de plages dynamiques fondées sur la fonction DECALER ou, plus avantageusement, en convertissant les séries en Tableaux Structurés Excel (objets ListObject), les noms de champs s’ajustent automatiquement au fur et à mesure que de nouvelles observations sont injectées dans la table, dispensant l’utilisateur de toute réécriture manuelle des bornes d’évaluation au sein de ses formules de produit scalaire.
6.3 Traitement spécifique des vecteurs épars à forte proportion de zéros
Dans de nombreuses applications scientifiques contemporaines, telles que l’analyse des réseaux sociaux, les modèles de sacs de mots en linguistique computationnelle ou les matrices de consommation de biens, les vecteurs manipulés présentent une nature dite « éparse » ou creuse (sparse vectors), caractérisée par une proportion écrasante de valeurs nulles (zéros) et un nombre infime de composantes non nulles.
Sur le plan mathématique pur, le zéro étant l’élément absorbant de la multiplication, tout produit partiel impliquant une composante nulle s’annule obligatoirement (0 * vᵢ = 0). Ainsi, le produit scalaire dépend exclusivement de l’intersection des composantes non nulles au sein des deux vecteurs. Si cette neutralité garantit la justesse du résultat numérique fourni par SOMMEPROD, elle engendre en revanche une inefficacité computationnelle flagrante : le processeur passe la quasi-totalité de ses cycles d’horloge à multiplier inutilement des zéros entre eux.
Lorsque la volumétrie atteint les limites de capacité du tableur, l’analyste averti peut mettre en œuvre des techniques de filtrage préalable ou recourir à des tables d’indexation éparse. En restructurant les données sous la forme de listes de coordonnées constituées uniquement de paires clé-valeur pour les dimensions actives, le produit scalaire peut être reformulé par une combinaison de fonctions de recherche avancées (telles que RECHERCHEX) et de sommes conditionnelles, évitant ainsi le balayage exhaustif de millions de cellules silencieuses et optimisant de manière drastique l’usage de la mémoire vive.
7. Applications géométriques : Norme euclidienne et similarité cosinus
7.1 Calcul de la norme euclidienne d’un vecteur avec SOMMEPROD
L’une des manifestations les plus remarquables de la fécondité théorique du produit scalaire réside dans sa capacité à engendrer directement la norme euclidienne, qui matérialise la magnitude géométrique, la longueur absolue ou l’intensité métrique d’un vecteur au sein d’un espace multidimensionnel. En vertu de la définition euclidienne standard, la norme d’un vecteur u, conventionnellement notée entre doubles barres verticales, est rigoureusement égale à la racine carrée du produit scalaire de ce vecteur avec lui-même.
Cette relation fondamentale s’implémente dans Excel avec une économie de moyens et une concision formelle remarquables en associant la fonction RACINE (ou SQRT en anglais) à la fonction SOMMEPROD. Pour évaluer la magnitude d’un vecteur logé dans la plage cellulaire A2:A100, il suffit de formuler l’instruction : =RACINE(SOMMEPROD(A2:A100; A2:A100)). Le moteur de calcul évalue le produit scalaire d’autoréférence, élevant implicitement chaque composante à sa puissance carrée avant d’en effectuer la sommation, puis en extrait instantanément le radical.
Cette mesure de longueur multidimensionnelle constitue un jalon analytique essentiel. Sans elle, il serait impossible d’appréhender l’échelle réelle des phénomènes modélisés, qu’il s’agisse de mesurer la dispersion d’une série d’erreurs expérimentales, de calculer une distance cartésienne entre deux observations physiques, ou de calibrer des forces en mécanique théorique. La maîtrise conjointe du produit scalaire et de la norme euclidienne pose les fondations de toute analyse géométrique rigoureuse au sein d’Excel.
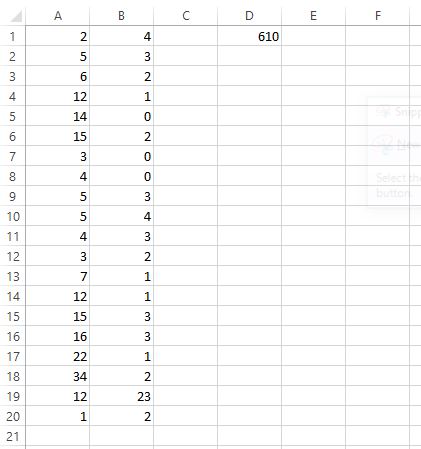
7.2 Formulation complète de la similarité cosinus dans Excel
L’exploitation conjointe du produit scalaire et des normes euclidiennes trouve son apogée analytique dans la métrique de similarité cosinus. Cette mesure géométrique standardisée évalue la proximité angulaire entre deux vecteurs, indépendamment de leurs amplitudes ou de leurs longueurs respectives. Elle est universellement mobilisée en intelligence artificielle, en fouille de textes, en bio-informatique et en psychométrie pour déterminer à quel point deux profils directionnels convergent.
Mathématiquement, le cosinus de l’angle formé par deux vecteurs u et v équivaut au rapport de leur produit scalaire sur le produit de leurs normes euclidiennes individuelles. Pour traduire cette architecture au sein d’une unique cellule de calcul sous Excel pour deux vecteurs situés en A2:A50 et B2:B50, l’analyste déploie une formule synthétique unifiée : =SOMMEPROD(A2:A50; B2:B50) / (RACINE(SOMMEPROD(A2:A50; A2:A50)) * RACINE(SOMMEPROD(B2:B50; B2:B50))).
Le coefficient obtenu à l’issue de cette division s’inscrit rigoureusement au sein d’un intervalle théorique borné entre -1 et +1. Une valeur de +1 signale un alignement directionnel absolu (vecteurs colinéaires de même sens, indiquant une concordance parfaite de forme entre les deux profils). Une valeur égale à 0 témoigne d’une stricte orthogonalité (indépendance angulaire totale), tandis qu’un score de -1 dénote une opposition diamétrale rigoureuse. L’intégration de cette formule permet de concevoir des systèmes de comparaison avancés directement au cœur du tableur.
7.3 Normalisation unitaire préalable des données vectorielles
Bien que la formule consolidée de similarité cosinus détaillée précédemment offre une parfaite autonomie opératoire, elle nécessite de recalculer les normes euclidiennes à chaque nouvelle tentative de croisement. Lorsque l’objectif est de comparer un vecteur cible avec des dizaines ou des centaines d’autres séries vectorielles, cette redondance computationnelle pèse lourdement sur les capacités de rafraîchissement d’Excel. Une alternative méthodologique infiniment plus élégante et performante réside dans la normalisation unitaire préalable des données.
Normaliser un vecteur consiste à diviser chacune de ses composantes initiales par sa propre norme euclidienne, transformant ainsi le vecteur d’origine en un vecteur dit « unitaire », dont la norme géométrique finale est rigoureusement égale à 1. Dans la feuille de calcul, cette opération s’effectue en dédiant une colonne auxiliaire où chaque cellule de la plage initiale est divisée par la valeur scalaire de sa magnitude globale (calculée au préalable via la combinaison RACINE et SOMMEPROD en référence absolue).
La beauté mathématique de cette approche réside dans le théorème d’équivalence : le produit scalaire direct de deux vecteurs préalablement normalisés correspond exactement, sans aucune division subséquente, à leur similarité cosinus. Dès lors que l’ensemble du corpus de vecteurs a été converti à la dimension unitaire, l’analyste peut déployer une simple fonction =SOMMEPROD(Norm_U; Norm_V) pour obtenir instantanément le degré d’alignement angulaire. Cette simplification accélère considérablement l’exécution des modèles volumineux et fluidifie les classeurs d’analyse comparative.
8. Résolution des erreurs récurrentes et diagnostic technique
8.1 Gestion de l’erreur #VALEUR! liée à la discordance dimensionnelle
L’apparition brutale du code d’anomalie #VALEUR! constitue sans conteste l’incident technique le plus fréquemment rencontré lors de la manipulation des fonctions vectorielles sous Microsoft Excel. Dans le contexte opérationnel de la fonction SOMMEPROD, ce message d’alerte signale de façon quasi univoque une violation du postulat d’isomorphisme dimensionnel entre les matrices spécifiées.
La règle d’or régissant l’algorithme interne de SOMMEPROD impose que l’ensemble des plages d’arguments possède une géométrie strictement identique. Si le premier argument cible une colonne comprenant 50 cellules (par exemple A2:A51) alors que le second argument en englobe 51 par suite d’une inadvertance de pointage (par exemple B2:B52), le processus de multiplication par paires ne parvient pas à apparier la composante terminale. Incapable d’inférer de manière probabiliste la valeur d’une coordonnée absente, la fonction s’interrompt brutalement et renvoie l’erreur #VALEUR! pour préserver l’analyste contre un calcul faussé.
Pour résoudre méthodiquement cette rupture, l’utilisateur doit inspecter les coordonnées de la formule via la barre d’édition ou faire appel à la fonction LIGNES appliquée à chacune des plages pour en auditer la hauteur réelle : =LIGNES(Plage1) = LIGNES(Plage2). Si le test logique retourne FAUX, un réalignement manuel des bornes supérieures et inférieures des plages de sélection ou le recours aux Tableaux Structurés garantissant l’équivalence dimensionnelle automatique éliminera définitivement l’anomalie.
8.2 Traitement de l’erreur #N/A et des cellules non numériques
Une autre catégorie majeure de dysfonctionnements computationnels se matérialise sous la forme du code d’erreur #N/A (non disponible), particulièrement récurrent lorsque les données vectorielles sont issues de fonctions d’appariement dynamique en cascade telles que RECHERCHEV, EQUIV ou RECHERCHEX. Lorsqu’une recherche de correspondance échoue à localiser une composante spécifique dans un référentiel externe, elle propage l’indicateur d’absence #N/A au sein du vecteur.
Contrairement aux cellules purement vides que SOMMEPROD convertit docilement en zéros sans générer d’interruption logicielle, la présence d’une seule valeur d’erreur telle que #N/A au sein de n’importe quelle composante vectorielle « empoisonne » immédiatement l’ensemble de la chaîne de calcul, contraignant SOMMEPROD à restituer à son tour cette valeur d’erreur terminale. Pour prémunir le modèle contre cette propagation délétère, il convient d’assainir en amont les formules d’extraction en les encapsulant dans des structures de protection logique telles que SIERREUR ou SI.NON.DISP, en forçant une valeur d’échappement par défaut (généralement zéro) : =SIERREUR(RECHERCHEX(…); 0).
Parallèlement, la présence de chaînes textuelles explicites injectées au sein des cellules constitue un risque insidieux. Si l’opérateur utilise l’opérateur arithmétique astérisque direct au sein de SOMMEPROD plutôt que le séparateur point-virgule conventionnel (c’est-à-dire =SOMMEPROD(A2:A10 * B2:B10) au lieu de =SOMMEPROD(A2:A10; B2:B10)), la présence du moindre mot ou espace textuel déclenchera irrévocablement une erreur de typologie #VALEUR!, car l’astérisque force une conversion coercitive que le moteur de calcul ne peut accomplir sur des caractères alphabétiques.
8.3 Précision numérique et anomalies de calcul en virgule flottante
L’évaluation du produit scalaire dans un tableur informatique n’évolue pas dans l’univers parfait des mathématiques continues, mais se trouve soumise aux contraintes matérielles de la représentation des nombres réels selon la norme internationale IEEE 754 relative à l’arithmétique en virgule flottante en double précision. Microsoft Excel alloue 64 bits de mémoire pour stocker chaque valeur numérique, ce qui assure une précision intrinsèque limitée à environ 15 chiffres décimaux significatifs.
Cette limitation architecturale engendre des phénomènes contre-intuitifs mais fondamentaux lors du diagnostic d’orthogonalité entre vecteurs. Supposons deux vecteurs théoriquement orthogonaux dont le produit scalaire continu s’annule rigoureusement à zéro. En raison des inévitables approximations de troncature binaire survenues lors des multiplications successives de nombres décimaux fractionnaires, Excel peut renvoyer un résultat résiduel infinitésimal mais non strictement nul, par exemple de l’ordre de 1,4210854715202E-14.
Si l’analyste implémente un test d’orthogonalité booléen direct sous la forme simpliste =SI(SOMMEPROD(U; V) = 0; « Orthogonal »; « Non orthogonal »), le test échouera invariablement, concluant de façon erronée à l’absence d’orthogonalité géométrique. Pour stabiliser durablement ces évaluations de conformité logique, il est impératif d’intégrer une marge de tolérance numérique en encapsulant le produit scalaire dans la fonction ARRONDI (par exemple =ARRONDI(SOMMEPROD(U; V); 8) = 0) ou en vérifiant que la valeur absolue de la déviation reste inférieure à un seuil critique d’imprécision prédéfini.
9. Automatisation du calcul par le biais de fonctions personnalisées en VBA
9.1 Écriture d’une fonction personnalisée (UDF) de produit scalaire
Bien que les fonctionnalités natives de Microsoft Excel satisfassent l’immense majorité des exigences d’analyse de données standard, la programmation d’une fonction personnalisée via l’environnement Visual Basic for Applications (VBA), désignée sous le terme d’UDF (User Defined Function), apporte une plus-value ergonomique remarquable lors de la conception de classeurs complexes destinés à des opérateurs non experts en syntaxe matricielle.
Pour concevoir cette procédure, le développeur accède à l’éditeur de code intégré (via le raccourci Alt + F11) et insère un nouveau module de code standard au sein du classeur actif. La fonction, baptisée de manière intuitive ProduitScalaire, est programmée pour accueillir en paramètres deux arguments obligatoires typés sous la forme d’objets Excel spécifiques : PlageA As Range et PlageB As Range. La fonction est elle-même déclarée comme renvoyant une valeur de type numérique Double afin de garantir la préservation maximale de la précision décimale.
Le corps algorithmique de la fonction initialise une variable d’accumulation locale à zéro, puis met en œuvre une boucle d’itération contrôlée qui balaie de manière synchronisée chaque élément unitaire des deux plages transmises. À chaque itération de la séquence, l’algorithme extrait les valeurs respectives des cellules homologues, calcule leur produit multiplicatif direct, et incrémente l’accumulateur. Une fois le parcours achevé, la valeur cumulée est affectée au nom même de la fonction personnalisée. Dès cet instant, la nouvelle fonction apparaît directement dans le catalogue des formules d’Excel et peut être appelée en toute simplicité : =ProduitScalaire(A2:A100; B2:B100).
9.2 Contrôle des types et validation rigoureuse des entrées en VBA
L’atout prépondérant du développement procédural en VBA réside dans la capacité à bâtir des garde-fous algorithmiques personnalisés capables d’intercepter les erreurs de saisie en amont et de retourner des diagnostics explicites et immédiatement exploitables pour l’utilisateur de la feuille de calcul.
Dès l’entame de l’exécution de la macro-fonction, le code procède à une vérification dimensionnelle préalable en interrogeant la propriété de comptage des cellules de chaque plage : PlageA.CountLarge et PlageB.CountLarge. Si le nombre d’éléments hébergés dans la première sélection diverge de celui de la seconde, l’exécution s’interrompt instantanément et assigne une valeur d’erreur standardisée d’Excel au résultat, évitant tout dépassement de tableau en mémoire vive ou tout décalage d’indexation catastrophique.
En outre, une couche de validation typologique avancée peut être déployée à l’intérieur de la boucle de calcul. En exploitant la fonction native VBA IsNumeric sur chaque cellule examinée, l’algorithme s’assure que la composante ne contient aucun caractère textuel indésirable. Si une chaîne textuelle est découverte, le script peut soit la convertir implicitement en zéro conformément à une règle méthodologique choisie, soit déclencher l’arrêt du calcul avec émission d’une alerte personnalisée, offrant un contrôle que les formules de grille fermées ne permettent pas toujours de personnaliser avec autant de granularité.
9.3 Comparaison de performance : VBA versus fonctions natives
Lors de l’arbitrage entre l’emploi d’une fonction personnalisée programmée en VBA et l’usage des formules natives intégrées comme SOMMEPROD, la dimension de l’efficience algorithmique et de la vitesse computationnelle doit faire l’objet d’une analyse critique sans concession.
Le moteur d’exécution de Visual Basic for Applications fonctionne selon un modèle interprété qui induit un surcoût temporel non négligeable lors de la communication interfacée avec la grille de cellules. Chaque appel individuel d’une propriété d’objet cellule (telle que .Value) génère des micro-pénalités de traitement au niveau du pont d’échange de données interne d’Excel. À l’inverse, la fonction SOMMEPROD est compilée en langage bas niveau (C++ natif) et interagit directement avec les blocs de mémoire vive sous-jacents via des instructions optimisées pour les registres vectoriels des microprocesseurs modernes.
Des analyses comparatives de métrologie informatique (benchmarking) démontrent sans équivoque que pour des vecteurs de taille substantielle ou sur des feuilles recalculant des dizaines de milliers de produits scalaires simultanément, la fonction native SOMMEPROD s’avère entre 10 et 50 fois plus véloce qu’une boucle UDF VBA classique. Par conséquent, l’usage du VBA doit être expressément circonscrit à des scénarios d’automatisation globale de processus ou à des classeurs nécessitant une validation syntaxique rigide, tandis que le cœur des calculs intensifs doit toujours être confié aux moteurs algorithmiques natifs d’Excel.
10. Calcul de matrices de produits scalaires pour ensembles vectoriels multiples
10.1 Génération de la matrice de Gram dans une feuille de calcul
Lorsque les investigations analytiques dépassent la simple confrontation bivariée entre deux vecteurs isolés pour embrasser l’exploration systématique d’un ensemble complet de k vecteurs de dimension n, le calcul individuel de chaque produit scalaire devient rapidement impraticable. Il s’avère alors nécessaire de générer la matrice de Gram, structure matricielle carrée d’ordre k×k répertoriant de façon exhaustive l’ensemble des produits scalaires croisés envisageables entre tous les couples possibles de la collection.
Dans l’architecture de cette table carrée, l’élément situé à l’intersection de la ligne i et de la colonne j correspond précisément au produit scalaire du i-ème vecteur avec le j-ème vecteur de l’ensemble. Cette disposition globale confère à la matrice de Gram des propriétés algébriques remarquables : elle est invariablement symétrique par rapport à sa diagonale principale (en vertu de la commutativité absolue du produit scalaire euclidien) et possède la qualité fondamentale d’être semi-définie positive.
Par ailleurs, les éléments occupant la diagonale principale de cette grille matricielle correspondent au produit scalaire de chaque vecteur avec lui-même, ce qui équivaut, comme démontré précédemment, au carré exact de leur norme euclidienne respective. La matrice de Gram compile ainsi au sein d’un espace géométrique unifié l’intégralité des informations relatives aux longueurs absolues des vecteurs et à leurs orientations angulaires mutuelles, servant de tremplin vers des analyses multivariées de pointe.
10.2 Combinaison matricielle massive via PRODUITMAT et TRANSPOSE
L’élaboration manuelle d’une matrice de Gram en insérant une multitude de formules SOMMEPROD individuelles dans chaque cellule de la grille réceptrice constitue une démarche fastidieuse, hautement redondante et particulièrement inefficace sur le plan computationnel. Grâce à la puissance de calcul matriciel d’Excel, l’intégralité de cette matrice complexe peut être générée en un éclair au moyen d’une seule formule unifiée.
Supposons que nos k vecteurs d’observations soient disposés sous la forme d’un tableau rectangulaire compact occupant une plage de dimensions n×k (où chaque colonne représente un vecteur spécifique comportant n lignes d’enregistrements), désignée sous la plage globale A2:E101 pour un jeu de 5 vecteurs à 100 dimensions. Pour déployer la matrice de Gram 5×5 associée, il suffit de sélectionner une cellule libre et d’y inscrire l’instruction matricielle universelle : =PRODUITMAT(TRANSPOSE(A2:E101); A2:E101).
Le mécanisme opératoire est saisissant de virtuosité mathématique : la fonction TRANSPOSE réoriente la matrice initiale de 100×5 en une matrice horizontale temporaire de 5×100. La fonction PRODUITMAT multiplie ensuite cette matrice de dimensions 5×100 par la matrice source de 100×5. Les dimensions intérieures de 100 s’annulant mutuellement, le produit vectoriel résultant déverse instantanément une magnifique grille carrée de 5 lignes et 5 colonnes. Cette formulation compacte mobilise de manière optimale le moteur de calcul matriciel d’Office 365, recalculant l’ensemble de la structure relationnelle avec une vélocité sans précédent.
10.3 Mise en forme conditionnelle et interprétation visuelle
La génération brute d’une matrice de produits scalaires dense produit un tableau de nombres qui, à l’œil nu, peut sembler difficile à interpréter sur le plan qualitatif. Afin d’en optimiser l’exploitation opérationnelle et de transformer cette grille en un outil d’exploration analytique performant, le déploiement d’une mise en forme conditionnelle graphique est vivement recommandé.
En sélectionnant l’ensemble de la matrice de Gram résultante et en activant l’outil de nuances de couleurs (échelles thermiques) depuis le ruban d’accueil d’Excel, l’utilisateur convertit la grille de calcul en une carte de chaleur visuelle (heatmap). Il est judicieux de paramétrer une échelle chromatique à trois couleurs : une teinte sombre ou froide (comme le bleu profond) pour les valeurs les plus basses ou négatives, une nuance intermédiaire neutre (comme le blanc ou le gris clair) pour les valeurs proches de zéro, et une coloration vive ou chaude (comme le rouge intense) pour les amplitudes scalaires maximales.
Cette visualisation synthétique autorise un diagnostic structurel immédiat. Les blocs de cellules arborant des tonalités chaudes révèlent instantanément des grappes (clusters) de vecteurs fortement alignés et redondants, partageant une variance commune considérable. À l’opposé, les zones blanches indiquent des constellations vectorielles quasiment orthogonales, signalant une indépendance informative absolue entre les séries de données observées, ce qui facilite grandement le travail d’exploration préliminaire de structures de corrélation complexes.
11. Applications concrètes en modélisation quantitative et psychométrie
11.1 Pondération indicielle et calcul de scores composites
Dans l’univers des sciences comportementales, des ressources humaines et de la psychométrie appliquée, l’évaluation standardisée d’aptitudes cognitives ou de dimensions de la personnalité s’appuie très rarement sur l’analyse de questions isolées. Les praticiens conçoivent plutôt des « scores composites » synthétiques, issus de l’agrégation ordonnée de multiples items pondérés individuellement en fonction de leur contribution respective au trait latent théorique mesuré.
Cette architecture computationnelle correspond exactement à un calcul de produit scalaire. Si un participant à une batterie d’évaluation psychométrique répond à une série de 20 questions quantifiées sur une échelle d’évaluation continue (formant un vecteur individuel de réponses r localisé en B5:U5), et que les psychomètres ont assigné des poids factoriels empiriques à chacun de ces items (constituant un vecteur fixe de pondérations w assigné dans la plage B2:U2), le score composite brut s’évalue en une fraction de seconde grâce à la fonction : =SOMMEPROD(B5:U5; B2:U2).
Cette formule condensée supplante avantageusement les calculs rébarbatifs consistant à additionner manuellement chaque produit (B5*B2 + C5*C2 + …). De surcroît, elle autorise une adaptabilité immédiate du modèle : si l’équipe de recherche décide d’affiner ultérieurement la structure de pondération en recalilbrant les poids factoriels de la plage B2:U2 à la suite d’une nouvelle étude de validité, l’ensemble des scores composites de milliers de candidats enregistrés dans le classeur s’ajuste dynamiquement en temps réel, garantissant une flexibilité exemplaire.
11.2 Comparaison de profils psychologiques et indices de concordance
Au-delà de la simple évaluation unidimensionnelle de scores composites, le produit scalaire et ses extensions trigonométriques constituent le socle de l’analyse comparative de profils psychologiques globaux. Dans les contextes de recrutement prédictif ou d’orientation professionnelle spécialisée, les psychologues définissent fréquemment un profil de compétences idéal cible (représenté sous la forme d’un vecteur de référence regroupant les niveaux optimaux attendus sur diverses facettes comportementales).
Pour mesurer à quel point le profil empirique d’un candidat réel s’aligne harmonieusement sur ce profil idéal normatif, le calcul de la similarité cosinus via la combinaison de SOMMEPROD et RACINE fournit un indice de congruence vectorielle remarquable, souvent désigné en psychométrie sous le vocable de coefficient de congruence de Tucker. Cet indicateur invariant à l’échelle évalue l’homologie formelle des configurations de traits : deux profils présentant rigoureusement les mêmes creux et les mêmes pics comportementaux recevront un indice proche de l’unité, attestant d’une excellente adéquation directionnelle.
L’utilisation de cette métrique permet de formaliser objectivement les processus de sélection et de validation d’instruments de mesure. Au lieu de s’en remettre à des appréciations subjectives ou à de simples écarts absolus moyens qui écrasent la structure globale des traits, les professionnels disposent d’un indicateur de cohérence géométrique irréfutable, parfaitement calculable au sein d’une feuille de travail conventionnelle sans recourir à des suites logicielles statistiques tierces coûteuses.
11.3 Analyse sémantique vectorielle et modèles d’espace sémantique
L’avènement des technologies d’intelligence artificielle et du traitement automatique du langage naturel (TALN) a popularisé l’usage des encastrements lexicaux (ou plongements de mots, connus internationalement sous le vocable d’embeddings). Ces techniques mathématiques convertissent des mots, des phrases ou des concepts textuels en de longs vecteurs denses de nombres réels (comportant généralement de 50 à plus de 1500 dimensions), où la proximité spatiale au sein de l’espace vectoriel reflète la proximité du sens sémantique.
Grâce aux capacités de calcul matriciel d’Excel, il devient parfaitement envisageable d’implémenter un moteur de recherche par similarité lexicale miniature directement sur une feuille de calcul. En important dans le tableur une base de vecteurs d’encastrement textuel associés à différents concepts ou descriptions de postes, et en y insérant le vecteur correspondant à une requête rédigée par un utilisateur, le calcul systématique du produit scalaire entre le vecteur de la requête et chaque vecteur du dictionnaire identifie immédiatement les unités linguistiques les plus proches conceptuellement.
Dans ces modèles d’espace sémantique, si les vecteurs textuels sont préalablement normalisés pour posséder une norme unitaire égale à 1, le produit scalaire direct délivre instantanément le coefficient de proximité sémantique. L’analyste peut alors coupler cette fonction SOMMEPROD avec les formules GRANDE.VALEUR et INDEX/EQUIV pour extraire dynamiquement les termes les plus pertinents par rapport au concept interrogé, matérialisant de manière frappante la convergence entre l’algèbre linéaire élémentaire sous tableur et les applications d’intelligence artificielle les plus actuelles.
12. Bonnes pratiques, gouvernance des classeurs et optimisation
12.1 Stratégies d’audit et de traçabilité des calculs
L’élaboration de classeurs décisionnels fondés sur des calculs vectoriels intensifs exige la mise en œuvre d’une gouvernance rigoureuse afin d’assurer la pérennité, la robustesse et l’auditabilité des formules de calcul. La première bonne pratique en matière d’assurance qualité consiste à exploiter systématiquement les outils d’audit natifs intégrés au ruban Formules d’Excel, tels que le repérage graphique des antécédents et la fenêtre d’évaluation progressive de formule.
Le visualisateur d’antécédents trace des flèches directionnelles sur la grille, permettant de vérifier d’un seul coup d’œil que les plages vectorielles pointées par la fonction SOMMEPROD ne capturent pas involontairement des cellules parasites situées au-delà des limites structurelles du tableau de données. De son côté, l’outil d’évaluation de formule permet de décomposer l’exécution interne de la formule étape par étape, visualisant les tableaux d’éléments transitoires avant leur réduction scalaire finale, ce qui simplifie grandement l’isolement de valeurs erronées.
Parallèlement, la mise en place de zones de tests unitaires automatisés constitue une stratégie d’ingénierie logicielle transposable avec profit aux feuilles de calcul. Dans un volet technique dédié, l’analyste implémente des vérifications de cohérence fondamentales fondées sur les théorèmes d’algèbre vectorielle (par exemple en vérifiant par un test logique que le produit scalaire commutatif de u par v est rigoureusement égal à celui de v par u, ou que le produit scalaire d’un vecteur avec lui-même n’est jamais négatif). Si l’un de ces tests de contrôle échoue à la suite d’une manipulation de données, une alerte visuelle se déclenche immédiatement pour inviter à une révision structurelle.
12.2 Optimisation des performances sur les classeurs à calcul intensif
Lorsque la taille des jeux de données s’accroît et que les calculs de produits scalaires se dénombrent par centaines de milliers, le maintien d’une expérience utilisateur réactive impose de calibrer judicieusement les paramètres de recalcul et la structure des références de plages au sein du classeur.
L’une des erreurs les plus néfastes pour les performances d’Excel réside dans l’utilisation paresseuse de références englobant des colonnes complètes, à l’image d’une syntaxe telle que =SOMMEPROD(A:A; B:B). Bien que le moteur de calcul moderne d’Excel tente de restreindre dynamiquement l’évaluation à la plage réellement utilisée (used range), cette syntaxe oblige le gestionnaire de mémoire à inspecter potentiellement plus d’un million de lignes, ce qui induit une surcharge critique de l’allocation mémoire et un ralentissement sensible de l’interactivité globale. Les plages doivent impérativement être bornées de manière stricte ou être encapsulées au sein de Tableaux Structurés dynamiques (objets ListObject) qui adaptent leur empreinte spatiale au volume exact d’enregistrements actifs.
Dans les classeurs volumineux hébergeant de massives matrices de Gram déployées par PRODUITMAT, il s’avère fréquemment judicieux de modifier le mode de recalcul d’Excel en le faisant basculer d’Automatique à Manuel (accessible via le menu Options > Formules). Cette configuration suspend les cycles de calcul à chaque modification d’une cellule isolée, permettant à l’opérateur d’effectuer ses saisies de manière fluide, avant de déclencher sur commande l’actualisation globale de la feuille par l’activation ciblée de la touche de fonction F9.
12.3 Synthèse comparative et arbre décisionnel pour le choix de la méthode
Pour parachever cette étude exhaustive, il convient de formaliser un cadre d’arbitrage méthodologique clair guidant le choix de la technique de calcul la plus appropriée en fonction des contraintes de l’environnement de production, de la volumétrie des données et des objectifs qualitatifs visés.
La fonction SOMMEPROD doit être considérée comme le choix d’excellence par défaut pour tout calcul unitaire de produit scalaire ou de similarité angulaire entre deux vecteurs identifiés. Sa syntaxe compacte, sa robustesse face aux variations dimensionnelles raisonnables et sa rétrocompatibilité universelle avec l’ensemble des générations du tableur en font l’outil standard incontournable de l’analyste.
La combinaison matricielle PRODUITMAT et TRANSPOSE est à privilégier expressément dès lors que la modélisation requiert le traitement simultané d’ensembles vectoriels multiples sous forme de matrices de Gram, ou lorsque l’analyste évolue dans un environnement moderne exploitant pleinement les tableaux dynamiques déversés d’Office 365. Elle procure alors un gain d’espace de modélisation et une concision algorithmique sans équivalent.
La décomposition pas à pas par colonne intermédiaire conserve une supériorité absolue pour toutes les phases d’audit préliminaire, de débogage d’anomalies de données complexes ou d’enseignement didactique où la transparence du calcul prévaut sur la compacité du classeur. Enfin, le recours aux fonctions personnalisées en VBA doit être strictement réservé aux scénarios d’industrialisation nécessitant une validation syntaxique procédurale imperméable et un guidage rigoureux pour des opérateurs novices, tout en assumant le surcoût de performance inhérent aux macros interprétées.
Références
- Blyth, T. S., & Robertson, E. F. (2002). Basic Linear Algebra (2nd ed.). Springer. https://doi.org/10.1007/978-1-4471-0661-6
- Deisenroth, M. P., Faisal, A. A., & Ong, C. S. (2020). Mathematics for Machine Learning. Cambridge University Press. https://doi.org/10.1017/9781108679930
- Goldberg, D. (1991). What every computer scientist should know about floating-point arithmetic. ACM Computing Surveys, 23(1), 5–48. https://doi.org/10.1145/103162.103163
- Lay, D. C., Lay, S. R., & McDonald, J. J. (2016). Linear Algebra and Its Applications (5th ed.). Pearson.
- Microsoft Support. (2024). Fonction SOMMEPROD – Support Microsoft. Consulté le 15 mai 2024, à l’adresse https://support.microsoft.com/fr-fr/office/sommeprod-fonction-sommeprod-167b14d5-b3ef-45b6-803a-ad279cf36047
- Microsoft Support. (2024). PRODUITMAT (Fonction PRODUITMAT) – Support Microsoft. Consulté le 15 mai 2024, à l’adresse https://support.microsoft.com/fr-fr/office/produitmat-fonction-produitmat-dd5532d0-611c-470b-8147-94f9d5c19616
- Strang, G. (2016). Introduction to Linear Algebra (5th ed.). Wellesley-Cambridge Press.
- Tucker, L. R. (1951). A method for synthesis of factor analysis studies (Personnel Research Section Report No. 984). Department of the Army.