
Dans l’analyse quantitative moderne, la modélisation probabiliste constitue le socle sur lequel reposent la gestion des risques, l’ingénierie financière, l’économétrie et l’aide à la décision stratégique. Au cœur de cet édifice conceptuel se trouve l’espérance mathématique, une grandeur fondamentale qui synthétise le comportement asymptotique d’une variable aléatoire en un scalaire déterministe unique. Bien que son formalisme théorique découle de la théorie de la mesure et du calcul stochastique formalisé par Andreï Kolmogorov, sa mise en application concrète exige des outils informatiques capables de manipuler avec rigueur des distributions de données empiriques ou théoriques.
Le tableur Microsoft Excel s’est imposé, au fil des décennies, comme l’environnement d’analyse numérique universellement adopté dans les milieux universitaires, industriels et financiers. La convergence entre la théorie des probabilités et l’architecture matricielle d’Excel offre un cadre d’expérimentation et d’implémentation remarquable. Calculer une espérance mathématique au sein d’une feuille de calcul ne se résume pas à l’exécution mécanique d’une formule arithmétique élémentaire ; cela requiert une compréhension aiguë de la structuration des vecteurs de données, de la gestion de la précision numérique en virgule flottante et du contrôle axiomatique des distributions stochastiques.
Ce traité méthodique a pour dessein d’explorer de manière exhaustive le calcul, l’optimisation, l’audit et l’interprétation de l’espérance mathématique sous Microsoft Excel. En associant rigueur analytique, formalisation statistique et démonstrations opérationnelles pas-à-pas, cet article constitue un guide de référence destiné aux analystes, chercheurs, ingénieurs et étudiants désireux de maîtriser la modélisation stochastique appliquée dans les environnements de calcul tabulaire modernes.
1. Fondements théoriques de l’espérance mathématique et variables aléatoires
1.1 Définition stochastique de l’espérance mathématique
L’espérance mathématique, traditionnellement notée E(X) ou désignée par la lettre grecque μ, représente la valeur théorique moyenne attendue d’une variable aléatoire lorsque l’expérience sous-jacente est itérée un nombre infini de fois dans des conditions strictement identiques. D’un point de vue stochastique, une variable aléatoire discrète X est une application mesurable définie sur un espace probabilisable et prenant un ensemble fini ou dénombrable de valeurs réelles. L’espérance se définit alors formellement comme la somme, pondérée par leurs probabilités d’occurrence respectives, de l’ensemble des réalisations possibles de cette variable.
Sur le plan conceptuel, ce paramètre correspond au centre de gravité d’une distribution de probabilités. De la même manière qu’en mécanique classique le centre d’inertie d’un solide matérialise le point d’équilibre géométrique où s’annule le moment résultant des forces de pesanteur, l’espérance mathématique constitue le barycentre des masses de probabilité réparties sur la droite réelle. Toute déviation par rapport à ce centre de masse probabiliste induit une asymétrie informationnelle que les moments d’ordre supérieur, notamment le coefficient d’asymétrie, chercheront ultérieurement à quantifier.
Il est épistémologiquement indispensable d’établir une distinction catégorique entre l’espérance mathématique et la moyenne empirique observée au sein d’un échantillon fini. Alors que la moyenne d’échantillon est une statistique descriptive intrinsèquement fluctuante, soumise à l’aléa de l’échantillonnage et contingente aux données collectées a posteriori, l’espérance mathématique est une constante ontologique déterministe, invariante et intrinsèque à la loi de probabilité gouvernant le phénomène. Confondre ces deux entités relève d’une erreur de catégorie que la statistique inférentielle s’attache précisément à dissiper.
1.2 Propriétés mathématiques fondamentales
L’une des propriétés structurales les plus puissantes de l’espérance mathématique réside dans sa linéarité. Soient deux variables aléatoires X et Y définies sur un même espace de probabilité, et soient a et b deux constantes réelles scalaires. L’opérateur espérance satisfait rigoureusement l’identité E(aX + bY) = aE(X) + bE(Y). Cette relation d’homomorphisme vectoriel s’applique sans restriction aucune quant à la nature de la dépendance stochastique liant les variables considérées ; qu’elles soient parfaitement indépendantes, corrélées ou liées par des structures de copules non linéaires complexes, la linéarité demeure absolue et inviolable.
En revanche, le comportement de l’opérateur espérance face au produit de deux variables aléatoires est tributaire de leur indépendance stochastique mutuelle. Si et seulement si les variables X et Y sont stochastiquement indépendantes (ou, au minimum, non corrélées au sens de la covariance nulle), nous vérifions l’égalité multiplicative E(XY) = E(X) × E(Y). En présence d’une interdépendance statistique, le produit croisé fait émerger le terme de covariance sous la forme E(XY) = E(X)E(Y) + Cov(X,Y), ce qui complexifie significativement la transposition algorithmique des modèles financiers ou actuariels au sein des tableurs.
Le comportement asymptotique de ces grandeurs est formellement encadré par le théorème fondamental de la loi des grands nombres, énoncée sous ses formes faible et forte par Borel, Cantelli et Kolmogorov. Cette loi stipule que lorsque la taille d’un échantillon de variables aléatoires indépendantes et identiquement distribuées tend vers l’infini, la moyenne empirique converge presque sûrement vers l’espérance mathématique théorique de la distribution sous-jacente. Cette convergence asymptotique justifie l’utilisation des simulations de Monte-Carlo dans les feuilles de calcul Excel pour valider et approximer numériquement des valeurs attendues analytiquement insolubles.
1.3 Distinction entre lois discrètes et distributions continues
La formalisation mathématique de l’espérance diffère radicalement selon la topologie de l’ensemble des valeurs admissibles. Pour une variable aléatoire discrète, le calcul s’opère par une sommation discrète finie ou dénombrable. L’opérateur somme est alors directement transposable dans l’environnement informatique sous forme de vecteurs de coordonnées discrètes. À l’inverse, pour une variable aléatoire continue dotée d’une densité de probabilité f(x) définie sur un intervalle continu de la droite réelle, l’espérance nécessite le calcul d’une intégrale de Lebesgue s’étendant sur l’ensemble du domaine de définition.
L’existence formelle de l’espérance mathématique est subordonnée à une condition de sommabilité absolue. Dans le cas discret, la série formée par la somme des produits de la valeur absolue de chaque réalisation par sa probabilité associée doit impérativement être convergente. Si cette condition fait défaut, l’espérance est dite indéfinie ou divergente. L’exemple paradigmatique de la loi de Cauchy, dont la densité symétrique engendre des intégrales divergentes en valeur absolue, rappelle la nécessité d’une vigilance théorique constante avant d’engager tout calcul automatisé dans un tableur, car l’obtention d’une valeur arithmétique artificielle masquerait une impossibilité mathématique sous-jacente.
Dans le cadre applicatif d’un logiciel comme Excel, les distributions continues ne peuvent pas être intégrées symboliquement de façon native sans recourir à des moteurs de calcul formel. Par conséquent, la modélisation de phénomènes continus exige soit le recours à des approximations numériques discrétisées, en découpant le continuum en un maillage d’intervalles élémentaires fermés, soit l’exploitation des fonctions de répartition intégrées natives qui délivrent la probabilité cumulée sur un segment donné. Cette transposition numérique implique une réflexion méthodologique sur l’erreur de discrétisation et la densité du maillage adopté.
2. La formulation mathématique et sa transcription algorithmique
2.1 Analyse structurelle de l’équation standard
L’équation fondamentale de l’espérance mathématique pour une variable aléatoire discrète s’articule autour d’une formulation universelle d’une grande élégance : l’espérance μ est égale à la sommation de chaque réalisation possible x multipliée par la probabilité ponctuelle associée P(X = x). Cette formule synthétique gouverne l’ensemble des opérations que nous serons amenés à concevoir dans l’espace bidimensionnel des grilles de calcul matricielles.
Les valeurs nodales, couramment désignées par les éléments scalaires xi, représentent l’éventail exhaustif et exclusif des réalisations numériques envisageables pour le système étudié. Ces valeurs peuvent correspondre à des grandeurs économiques, des unités monétaires, des décomptes physiques de pièces défectueuses ou des scores sportifs. Il importe que ces réalisations soient des grandeurs scalaires réelles non équivoques, dépourvues d’incertitude quant à leur mesure intrinsèque.
Les coefficients de pondération P(xi) incarnent la mesure de probabilité assignée à chaque état de la nature. Ils sont contraints par les axiomes de la théorie de la probabilité, formulés par Kolmogorov, qui imposent que chaque probabilité élémentaire soit comprise entre zéro et un inclusivement, et que leur somme sur l’ensemble de l’univers des événements possibles soit rigoureusement égale à un. Toute déviation par rapport à cette clôture probabiliste invalide l’interprétation stochastique du résultat final et traduit une anomalie de spécification du modèle.
2.2 Traduction logique vers l’environnement matriciel d’Excel
Dans l’environnement de calcul d’une feuille Excel, l’univers stochastique unidimensionnel se traduit immédiatement sous la forme de structures de données colinéaires. La liste ordonnée des états possibles xi est transcrite dans un premier vecteur colonne continu, tandis que la mesure de probabilité correspondante P(X = xi) est implémentée dans un vecteur colonne parallèle de dimensions strictement identiques. Cette disposition orthogonale garantit une correspondance biunivoque entre chaque nœud de valeur et son poids probabiliste associé.
Sur le plan de l’exécution algorithmique, le tableur permet deux approches distinctes pour opérer cette transformation linéaire. La première approche, dite analytique ou intermédiaire, mobilise l’adressage relatif des cellules pour exécuter un produit arithmétique scalaire ligne par ligne le long d’une colonne tierce, avant de consolider la somme globale via une commande terminale. La seconde approche, d’ordre vectoriel et matriciel, court-circuite le stockage intermédiaire en effectuant directement le produit scalaire des deux vecteurs en mémoire vive, offrant une compacité algorithmique et une maintenabilité conceptuelle bien supérieures.
L’évaluation du coût computationnel et de l’efficience algorithmique au sein d’Excel devient primordiale dès lors que les distributions s’étendent sur plusieurs dizaines de milliers de lignes ou s’inscrivent dans des classeurs financiers recalculés dynamiquement. Alors que les calculs intermédiaires dispersés sur de multiples cellules sollicitent l’arbre de dépendance du moteur de recalcul et encombrent la mémoire cache, l’exploitation native des primitives vectorielles optimise le pipeline d’instructions en tirant parti des optimisations vectorielles du processeur. Choisir la formulation algorithmique idoine nécessite ainsi de concilier lisibilité pédagogique et performance computationnelle.
3. Structuration et mise en forme du jeu de données dans la feuille de calcul
3.1 Conception d’une architecture tabulaire normalisée
La viabilité et l’auditabilité de tout calcul actuariel ou stochastique dans Excel reposent en premier lieu sur une hygiène rigoureuse de la structure tabulaire. Les données doivent être agencées sous forme d’une table bidimensionnelle stricte dans laquelle chaque ligne représente une réalisation unique et mutuellement exclusive de l’événement aléatoire, et chaque colonne correspond à un attribut mathématique invariable. Cette ségrégation fonctionnelle prévient tout risque de confusion entre variables aléatoires indépendantes et garantit l’intégrité référentielle des plages de calcul.
La normalisation sémantique des en-têtes de colonnes est un impératif méthodologique. Des désignations explicites telles que « Valeur de la réalisation (x) », « Probabilité élémentaire P(X=x) » ou « Pondération unitaire x*P(x) » doivent systématiquement remplacer des dénominations ambiguës ou génériques. Cette discipline typographique facilite non seulement la relecture humaine par des auditeurs tiers, mais s’avère également indispensable lorsque les formules utilisent des références structurées dans les versions modernes d’Excel.
L’utilisation de la fonctionnalité native de « Tableau structuré » (accessible via le raccourci clavier Contrôle + L ou la commande Insérer un tableau) transforme radicalement la robustesse du modèle. Contrairement aux plages de cellules statiques, un tableau structuré ajuste automatiquement ses dimensions lors de l’adjonction de nouvelles réalisations stochastiques à la base de la distribution. Les formules qui s’y réfèrent adaptent instantanément leurs bornes de sommation, éliminant de facto l’un des vecteurs d’erreur les plus fréquents dans la modélisation sous tableur : la non-prise en compte des queues de distribution ajoutées ultérieurement.
3.2 Typage des cellules et rigueur des formats numériques
La précision intrinsèque des calculs probabilistes impose un paramétrage strict du typage numérique au sein de la feuille de travail. Les cellules hébergeant les valeurs de la variable aléatoire doivent être configurées au format « Nombre » avec un nombre de décimales suffisant, ou au format « Monétaire » si les réalisations traduisent des flux financiers. Pour les probabilités, le choix entre un format décimal pur (par exemple avec une précision fixée à quatre ou six décimales) et un format « Pourcentage » doit être uniforme sur l’ensemble de la série afin d’éviter toute distorsion cognitive lors de la lecture des résultats.
Une vigilance particulière doit être portée à l’éradication des chaînes textuelles dissimulées sous une apparence numérique. L’importation de distributions depuis des bases de données externes ou des fichiers plats génère fréquemment des caractères résiduels, tels que des espaces insécables ou des apostrophes initiales invisibles, qui forcent Excel à traiter les probabilités comme du texte brut. Dans un tel scénario, les fonctions d’agrégation arithmétique ignoreront silencieusement ces cellules ou généreront des erreurs bloquantes, corrompant irrémédiablement le calcul du barycentre stochastique.
Il est par ailleurs fondamental de dissocier la précision de l’affichage visuel de la précision computationnelle conservée dans les registres du processeur. Excel applique la norme internationale IEEE 754 relative à l’arithmétique en virgule flottante double précision, offrant une résolution interne d’environ quinze chiffres significatifs. Une probabilité affichée visuellement comme valant 0,05 peut ainsi correspondre en mémoire à la valeur 0,050000000000004. Cette distinction prend une importance capitale lors des tests d’assertion de clôture unitaire de la distribution.
3.3 Audit de complétude et validation des données d’entrée
Avant d’engager le moindre calcul d’espérance, un protocole d’audit de complétude doit être appliqué au jeu de données stochastiques. Le mécanisme de « Validation des données » d’Excel fournit un premier rempart préventif : il convient de circonscrire impérativement la plage des probabilités à l’intervalle fermé [0, 1]. Toute tentative de saisie accidentelle d’une probabilité négative ou d’une valeur supérieure à l’unité peut ainsi être interceptée à la source par une boîte de dialogue d’interdiction bloquante.
La détection automatisée d’éventuels doublons parmi les réalisations élémentaires constitue la seconde étape de cette validation structurelle. Une variable aléatoire discrète requiert que l’ensemble de ses états possibles soit formulé de manière disjointe. L’apparition redondante d’une même valeur xi sur plusieurs lignes disloquerait la cohérence du modèle, à moins qu’une routine de consolidation par tableau croisé dynamique ne vienne agréger les probabilités associées à ces occurrences identiques en amont du calcul final.
Enfin, le traitement des valeurs absentes ou nulles doit être standardisé. Une cellule laissée vide dans la colonne des probabilités ne doit jamais être assimilée par défaut à un zéro implicite sans documentation explicite, car elle traduit le plus souvent une omission lors de la collecte des données empiriques. De même, les événements dont la probabilité théorique est strictement nulle peuvent être conservés pour préserver la symétrie conceptuelle d’un espace d’échantillonnage, mais leur présence ne doit en aucun cas introduire des erreurs de division ou d’indétermination dans les calculs corrélatifs subséquents.
4. Méthode analytique pas-à-pas : Le calcul par colonne intermédiaire
4.1 Saisie des données et agencement des colonnes primaires
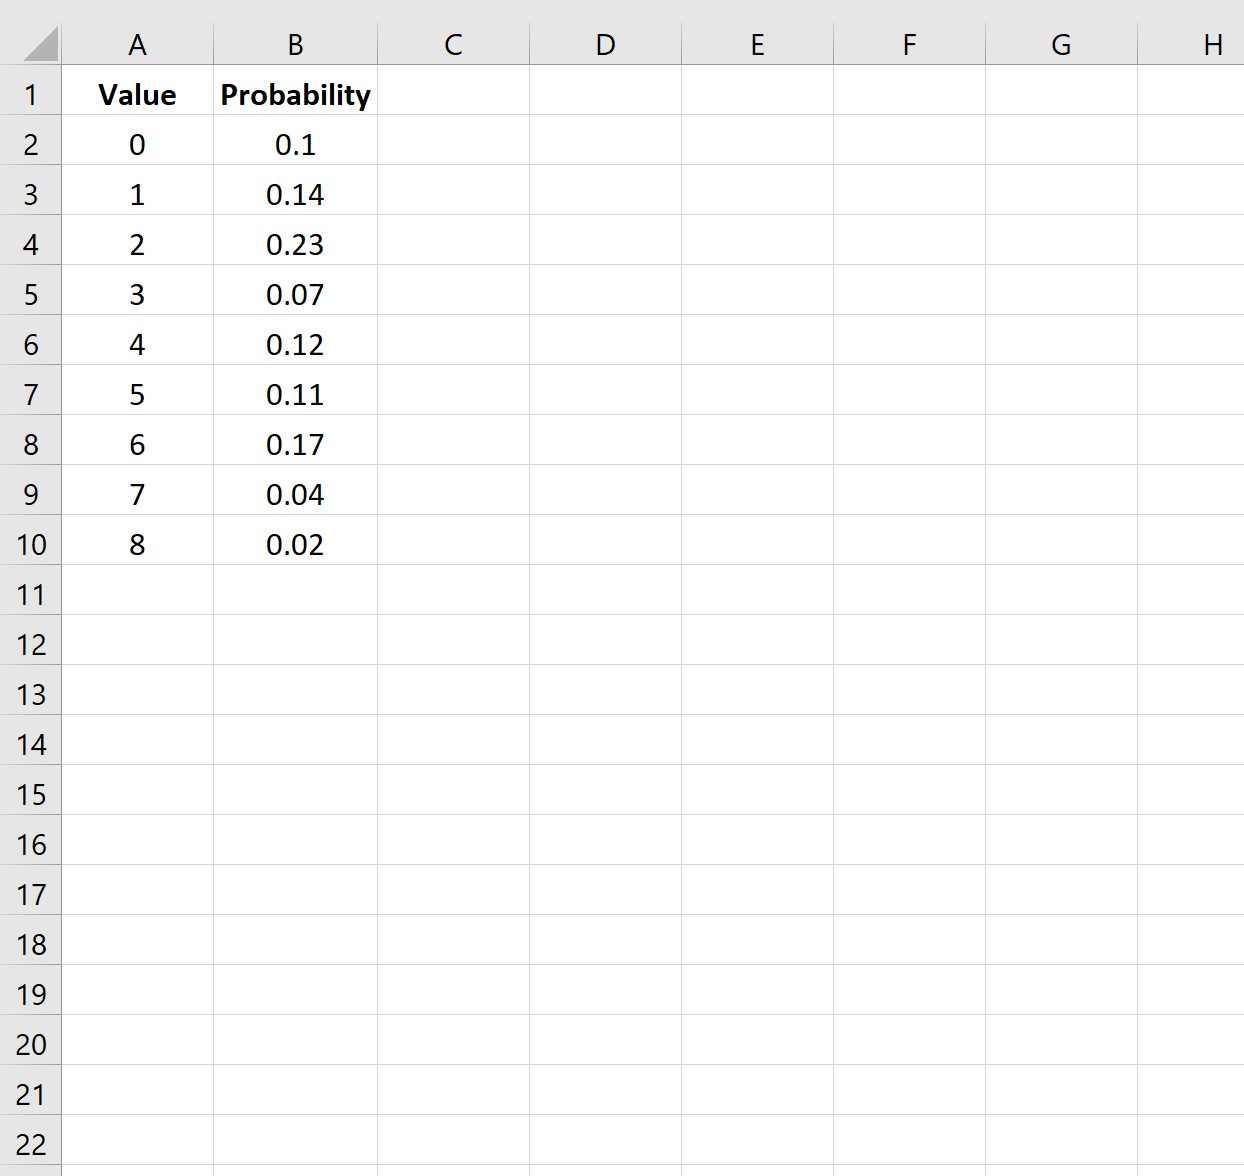
La méthode analytique décomposée constitue l’approche pédagogique de référence pour appréhender la mécanique computationnelle de l’espérance mathématique. Elle présente l’avantage inestimable d’offrir une visibilité absolue sur chacun des termes contribuant à la somme finale. Pour initier cette démarche, réservons la colonne A d’une feuille vierge à la variable aléatoire. Dans la cellule A1, inscrivons l’étiquette sémantique « x_i », puis saisissons verticalement les réalisations de la variable à partir de la ligne 2, par exemple de A2 jusqu’à A11 pour un ensemble de dix états possibles.
Dans la colonne contiguë B, saisissons l’en-tête « P(X = x_i) » en cellule B1. Les cellules B2 à B11 accueilleront les mesures de probabilité rigoureusement associées aux réalisations situées sur la même ligne horizontale. Il est absolument fondamental de vérifier la correspondance univoque de chaque couple ligne par ligne : l’événement décrit en A5 doit impérativement avoir sa probabilité mathématique d’occurrence renseignée en B5. Tout décalage vertical provoqué par une inadvertance de tri anéantirait l’intégrité de la structure sous-jacente.
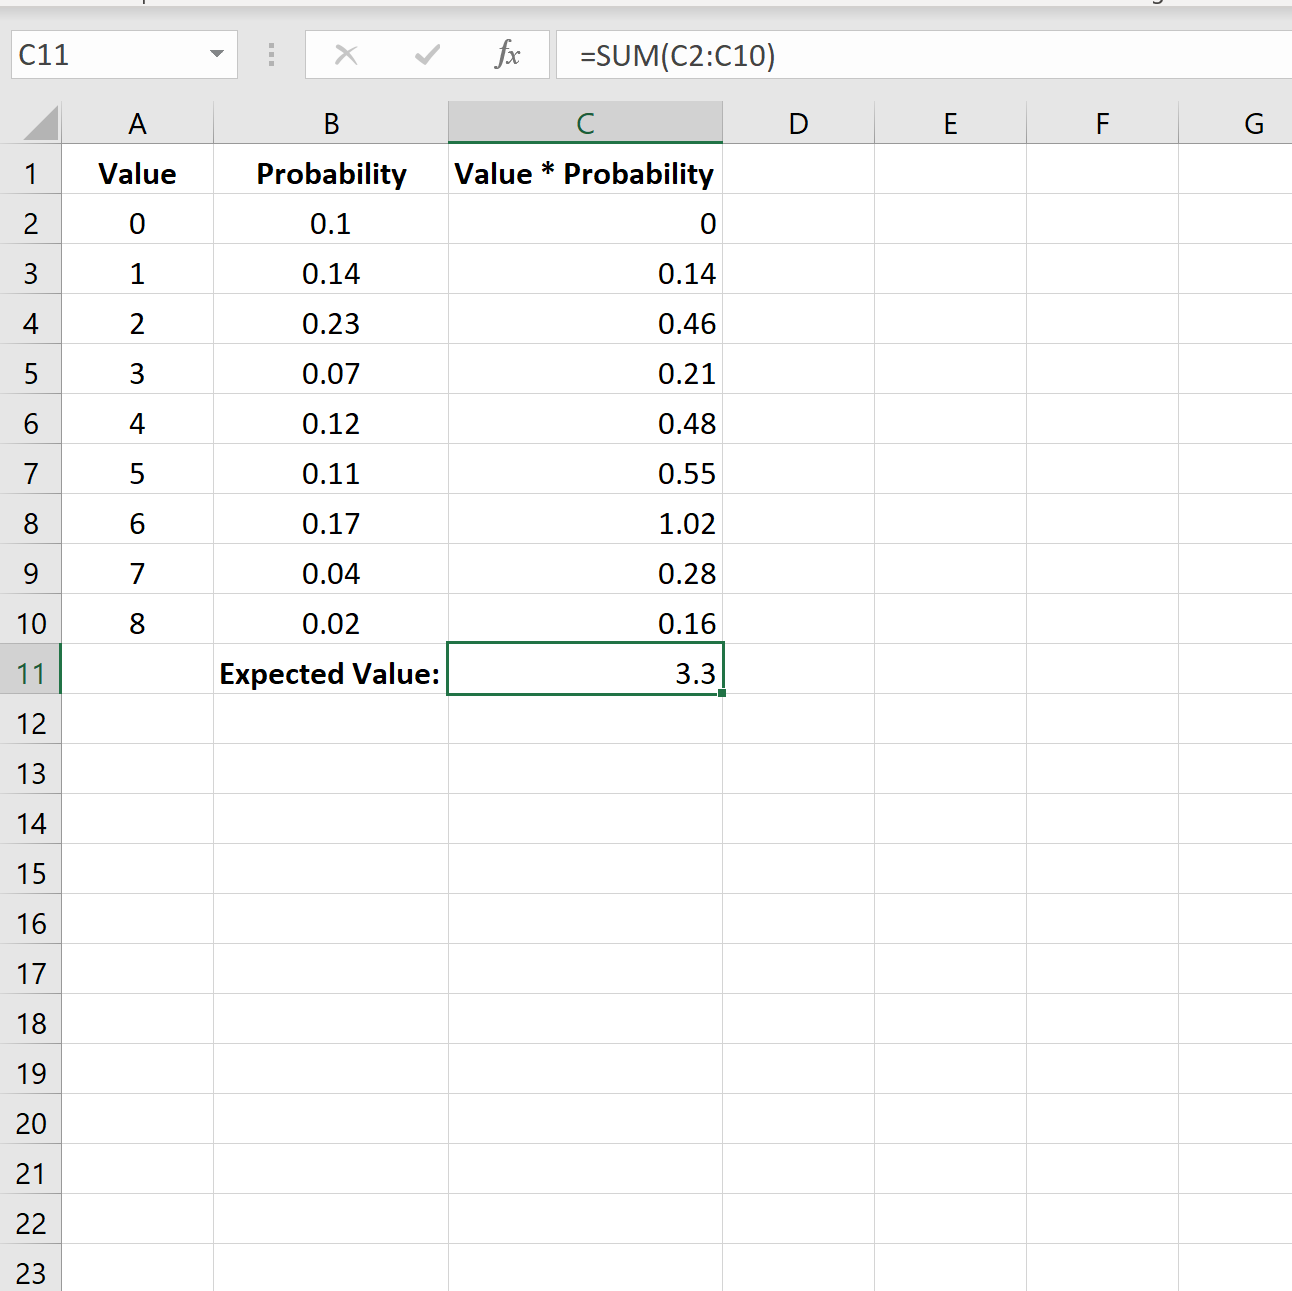
Nous configurons ensuite la colonne C comme notre espace de décomposition analytique unitaire. En cellule C1, inscrivons l’en-tête « x_i * P(X = x_i) ». Cette colonne intermédiaire aura pour mission d’isoler le produit arithmétique de chaque événement pondéré par sa fréquence relative théorique. Cette disposition en triptyque constitue l’architecture classique préconisée par les manuels de statistique actuarielle pour auditer visuellement la contribution pondérée de chaque segment de la distribution.
4.2 Formulation du produit unitaire et propagation verticale
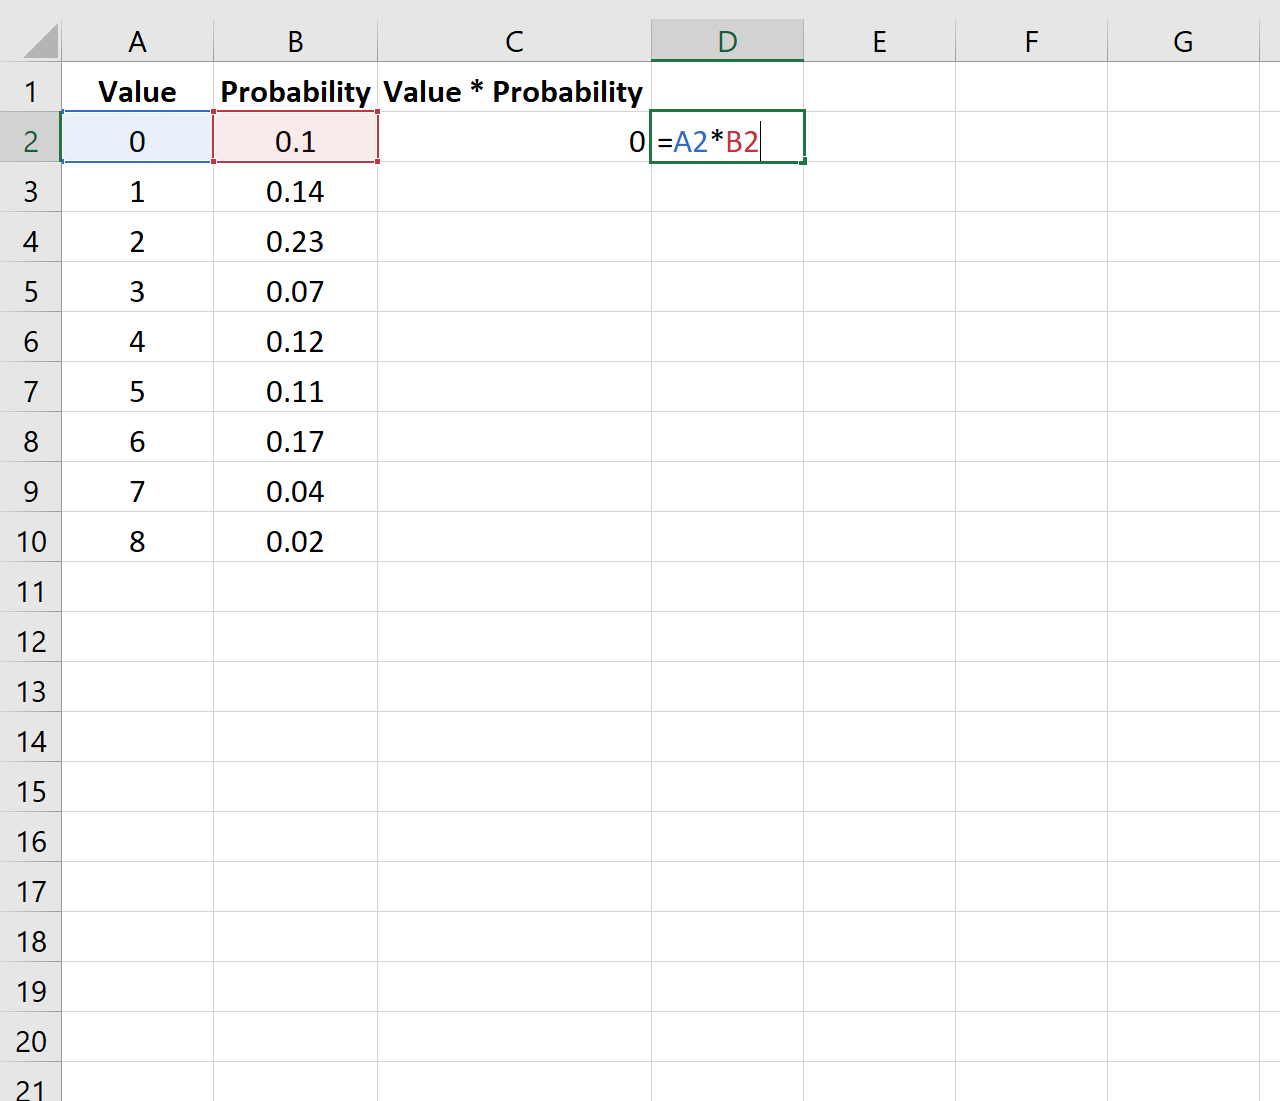
L’implémentation opérationnelle du calcul unitaire débute par la sélection de la première cellule de données de notre colonne intermédiaire, à savoir la cellule C2. Nous y introduisons l’opérateur d’assignation d’égalité suivi du produit scalaire des deux cellules adjacentes : =A2*B2. Dès la validation de cette instruction, Excel calcule instantanément la fraction de l’espérance globale imputable au premier état de la nature de la distribution probabiliste.
Pour propager ce calcul élémentaire à l’ensemble du domaine de définition de notre variable, nous exploitons le mécanisme fondamental de l’adressage relatif. En saisissant la poignée de recopie située dans le coin inférieur droit de la cellule C2 et en l’étirant verticalement jusqu’à la cellule C11 (ou en exécutant un double-clic gauche sur cette même poignée), la formule se duplique automatiquement le long de l’axe vertical. Excel adapte dynamiquement les indices de lignes : la cellule C3 intègre =A3*B3, la cellule C4 évalue =A4*B4, et ainsi de suite jusqu’à la borne finale C11.
Une revue d’assurance qualité s’impose à ce stade. Il convient de scruter attentivement la colonne C pour s’assurer qu’aucune valeur aberrante n’a émergé du processus de recopie. Une anomalie telle que l’apparition du code d’erreur #VALEUR! trahirait immédiatement la présence d’un caractère non numérique dans l’une des cellules sources, tandis qu’un résultat inattendu de zéro pourrait indiquer une mauvaise référence de cellule ou une probabilité malencontreusement écrasée.
4.3 Agrégation finale par la fonction SOMME
L’étape conclusive de la méthode analytique réside dans l’intégration globale des produits élémentaires précédemment calculés. Pour ce faire, positionnons-nous dans une cellule libre dédiée à la restitution des résultats synthétiques, par exemple la cellule C12, située immédiatement en dessous de notre colonne de décomposition. Nous inscrivons dans cette cellule la formule d’agrégation standard du tableur : =SOMME(C2:C11).
Lors de l’évaluation de cette fonction, le moteur de calcul d’Excel procède à l’accumulation arithmétique exhaustive des valeurs intermédiaires hébergées au sein du vecteur C2:C11. Cette opération réalise matériellement la sommation de l’opérateur sigma de la formulation mathématique théorique. La valeur scalaire qui s’affiche alors dans la cellule C12 représente précisément l’espérance mathématique E(X) de notre variable aléatoire discrète.
L’interprétation académique de ce résultat requiert une attention intellectuelle particulière : la valeur obtenue en C12 ne désigne pas un événement susceptible de se produire de manière certaine lors d’un tirage unitaire isolé, mais bien la moyenne pondérée à long terme vers laquelle convergerait irrémédiablement la somme cumulée des réalisations divisée par le nombre d’essais, si cette expérience était perpétuée à l’infini. Cette grandeur constitue le repère invariant autour duquel oscilleront toutes les instanciations futures du système stochastique modélisé.
5. Optimisation vectorielle avancée : L’exploitation de la fonction SOMMEPROD
5.1 Syntaxe formelle et mécanisme interne de SOMMEPROD
Si la méthode analytique par colonne intermédiaire se révèle pédagogique, elle présente l’inconvénient d’encombrer l’espace de la feuille de calcul et d’augmenter inutilement la surface d’audit du classeur. Pour pallier ces limites, Excel met à la disposition des modélisateurs une fonction native d’une efficacité mathématique exceptionnelle : la fonction SOMMEPROD. Sa syntaxe standardisée s’articule comme suit : SOMMEPROD(matrice1; [matrice2]; [matrice3]; ...). Cette primitive est spécifiquement conçue pour multiplier entre eux les éléments homologues de plusieurs matrices de dimensions identiques, avant de sommer l’ensemble des produits scalaires obtenus.
Le fonctionnement interne de SOMMEPROD s’apparente à une opération d’algèbre linéaire exécutée directement au niveau de la mémoire de travail sans allouer de cellules intermédiaires sur la grille de calcul. Les arguments transmis doivent être des tableaux rectangulaires de tailles strictement congruentes. Si le premier argument correspond à une plage verticale de dimension n × 1, le second argument doit obligatoirement présenter cette même dimension sous peine d’engendrer une discordance structurelle que le moteur rejettera.
L’avantage computationnel de cette fonction réside dans son intégration bas niveau. Contrairement aux approches traditionnelles qui obligent le tableur à instancier des centaines ou des milliers de nœuds de formules intermédiaires dans son graphe de dépendance acyclique, SOMMEPROD gère la boucle d’itération et l’accumulation scalaire au sein d’une routine compilée unique et compacte. Cette optimisation réduit considérablement l’empreinte mémoire du classeur et accélère les cycles de recalcul lors de modèles à grande échelle.
5.2 Mise en œuvre pratique sur une distribution discrète
L’application de la fonction SOMMEPROD pour dériver l’espérance mathématique d’une variable aléatoire constitue l’étalon d’or de la modélisation sous Excel. En reprenant l’architecture de données établie précédemment, où les réalisations xi sont localisées dans la plage A2:A11 et les probabilités P(X = xi) dans la plage B2:B11, le calcul complet de l’espérance s’effectue au sein d’une seule et unique cellule via l’instruction suivante : =SOMMEPROD(A2:A11; B2:B11).
Cette formulation condensée réalise simultanément deux opérations distinctes. Dans un premier temps, elle effectue le produit élément par élément des vecteurs passés en paramètres : elle multiplie la valeur A2 par la valeur B2, la valeur A3 par la valeur B3, et ainsi de suite jusqu’au terme final A11 multiplié par B11. Dans un second temps, elle procède à la sommation globale immédiate de ces dix composantes résultantes, restituant avec une rigueur absolue la valeur exacte de l’espérance mathématique.
La validation de l’équivalence arithmétique stricte entre cette fonction vectorielle et la méthode analytique par colonne intermédiaire est systématique : les deux résultats sont rigoureusement identiques au bit près, conformément aux principes de l’associativité et de la commutativité de l’addition et de la multiplication dans le corps des réels. Néanmoins, la compacité syntaxique de SOMMEPROD immunise le classeur contre les altérations accidentelles de cellules intermédiaires et simplifie drastiquement les procédures de vérification du code de calcul.
5.3 Gestion des matrices dynamiques et formules matricielles modernes
L’introduction du moteur de calcul à matrices dynamiques dans les versions contemporaines d’Excel (notamment Microsoft 365 et Office 2021) a redéfini le paradigme de manipulation des vecteurs stochastiques. Historiquement, l’exécution d’un produit matriciel direct sans recourir à SOMMEPROD exigeait la validation manuelle de formules matricielles héritées complexes via la combinaison contraignante de touches Ctrl + Maj + Entrée (CSE), matérialisée par l’apparition d’accolades entourant la formule.
Désormais, le moteur moderne gère nativement le déversement vectoriel et l’algèbre matricielle. Il est ainsi parfaitement envisageable de calculer l’espérance mathématique en employant simplement la fonction SOMME associée à une multiplication matricielle explicite : =SOMME(A2:A11 * B2:B11). Dans ce contexte, l’expression A2:A11 * B2:B11 génère en mémoire tampon un vecteur dynamique transitoire contenant les produits pondérés, vecteur qui est instantanément agrégé par la fonction SOMME sans qu’il soit nécessaire d’utiliser la syntaxe CSE historique.
De surcroît, l’emploi de l’opérateur de propagation dièse (noté #) permet de référencer dynamiquement des plages de données dont la dimension est variable ou générée par d’autres formules matricielles telles que FILTRE ou TRIER. Si la liste des réalisations est le fruit d’une formule matricielle déployée à partir de la cellule A2, le calcul de l’espérance s’ajuste instantanément via la syntaxe =SOMMEPROD(A2#; B2#). Cette avancée technique confère aux modèles probabilistes une souplesse et une adaptabilité inédites face aux flux de données stochastiques changeants.
6. Vérification axiomatique : Le contrôle de cohérence probabiliste
6.1 Validation du premier axiome de Kolmogorov
L’édifice du calcul des probabilités repose sur le corpus axiomatique formulé par Kolmogorov en 1933. Le premier axiome d’admissibilité stochastique impose une condition stricte et incontournable : la mesure de probabilité assignée à l’univers tout entier doit être égale à un. En d’autres termes, la somme algébrique des probabilités élémentaires associées à l’ensemble des événements disjoints constitutifs d’une variable aléatoire discrète doit vérifier rigoureusement l’équation : ∑ P(X = xi) = 1.
Dans un environnement de modélisation sur tableur, l’omission d’une cellule de contrôle d’intégrité probabiliste constitue une faute méthodologique critique. Il est impératif d’intégrer, à proximité immédiate de la colonne des probabilités, une cellule sentinelle totalisant la mesure de masse stochastique via la formule =SOMME(B2:B11). Si cette cellule affiche un résultat divergent de l’unité, le modèle se trouve dans un état de distorsion axiomatique : soit certains événements possibles ont été omis (somme inférieure à 1), soit des événements redondants se chevauchent mutuellement (somme supérieure à 1).
Pour automatiser la surveillance de cette clôture stochastique, il est recommandé de mettre en place une règle de « Mise en forme conditionnelle ». En appliquant une coloration d’alerte rouge sur la cellule de totalisation dès lors que sa valeur dévie de l’unité, le modélisateur garantit une détection visuelle immédiate des anomalies. Il est également judicieux d’imbriquer le calcul de l’espérance dans un test d’assertion logique de la forme : =SI(SOMME(B2:B11)=1; SOMMEPROD(A2:A11; B2:B11); "ERREUR: Distribution non clôturée") afin d’interdire tout affichage d’une espérance mathématique frelatée.
6.2 Gestion de l’imprécision arithmétique en virgule flottante
La transcription informatique du contrôle d’égalité mathématique SOMME(B2:B11) = 1 se heurte fréquemment à une limitation matérielle fondamentale : l’imprécision inhérente à la représentation binaire des nombres décimaux en virgule flottante sous la norme IEEE 754. Dans cette norme, des fractions décimales élémentaires comme 0,1 ou 0,2 ne possèdent pas de développement binaire fini, se transformant en nombres périodiques infinis tronqués à la 53e position binaire. Par conséquent, la sommation d’une série de probabilités en apparence parfaitement calée peut produire en mémoire un résultat machine microscopiquement différent de l’unité, tel que 0,9999999999999996 ou 1,0000000000000004.
Si l’analyste utilise un test d’égalité logique stricte SOMME(B2:B11) = 1, la formule peut échouer et renvoyer la valeur FAUX, bloquant injustement le modèle alors même que la somme des probabilités est théoriquement exacte. Ce phénomène d’erreur d’arrondi machine nécessite une prise en charge algorithmique spécifique pour fiabiliser les tests d’intégrité au sein des feuilles de calcul.
La solution méthodologique la plus robuste consiste à encadrer la vérification stochastique au moyen de la fonction ARRONDI ou d’une tolérance différentielle infinitésimale communément désignée sous le symbole grec epsilon (ε). La formulation rigoureuse du contrôle d’intégrité doit être formulée ainsi : =ARRONDI(SOMME(B2:B11); 6) = 1, limitant l’appréciation de l’égalité aux six premières décimales. De façon encore plus académique, on pourra employer la conditionnelle basée sur la valeur absolue : =ABS(SOMME(B2:B11) - 1) < 1E-9. Cette précaution garantit une résilience totale face aux artefacts numériques binaires du processeur.
6.3 Normalisation automatique des distributions non clôturées
Dans de nombreuses applications empiriques, les données collectées ne se présentent pas sous forme de probabilités théoriques rigoureusement closes, mais sous la forme de fréquences absolues d’occurrences, de décomptes bruts ou de coefficients de pondération empiriques dont la somme est arbitraire (par exemple, des effectifs observés lors d’une étude d’échantillonnage). Avant de pouvoir déterminer l’espérance mathématique, il est alors nécessaire de procéder à la normalisation du vecteur des poids pour le convertir en une mesure de probabilité admissible.
Sur le plan algorithmique dans Excel, cette opération de normalisation s’intègre de façon dynamique au sein même de la formule de l’espérance mathématique, sans qu’il soit impératif de reconstruire manuellement une colonne de probabilités relatives intermédiaires. La formule prend alors la structure vectorielle suivante : =SOMMEPROD(A2:A11; B2:B11) / SOMME(B2:B11). Dans cette configuration, le terme au numérateur calcule la somme brute pondérée par les effectifs, tandis que le dénominateur divise l’ensemble par l’effectif global cumulé, rétablissant ainsi mécaniquement la clôture stochastique unitaire.
Il importe toutefois de souligner les implications théoriques d’une telle normalisation a posteriori. Si cette technique s’avère parfaitement légitime lorsqu’on manipule des poids relatifs ou des fréquences observées, elle peut s’avérer pernicieuse si elle est appliquée aveuglément pour pallier une distribution de probabilités tronquée ou corrompue. Forcer artificiellement la somme à valoir un par division stochastique revient à redistribuer proportionnellement la masse manquante sur les états connus, une hypothèse épistémologique forte qui suppose que les événements omis se répartissent selon un profil d’homothétie parfaite vis-à-vis des événements mesurés.
7. Étude de cas empirique : Modélisation des réalisations d’un événement sportif
7.1 Présentation du modèle et distribution des occurrences de buts
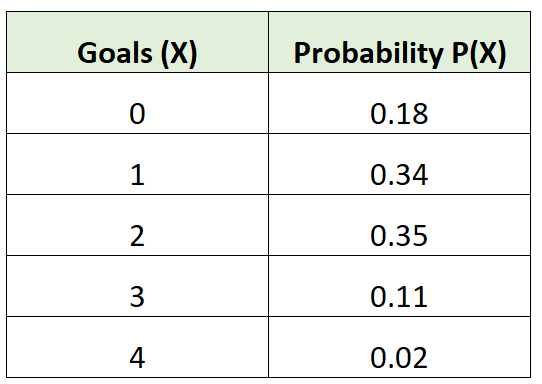
Afin de concrétiser le déploiement opérationnel des concepts exposés, examinons une étude de cas empirique issue de l’ingénierie statistique du sport : la modélisation probabiliste du nombre de buts inscrits par une équipe de football professionnelle lors d’une confrontation officielle. Dans ce modèle, la variable aléatoire discrète, notée X, représente le décompte des buts marqués au terme du temps réglementaire. Par hypothèse et observation empirique sur un échantillon longitudinal de plusieurs championnats, nous restreignons ici l’espace fondamental aux réalisations entières comprises entre zéro et quatre buts inclusivement, la probabilité d’inscrire cinq buts ou davantage étant considérée comme négligeable dans ce modèle simplifié.
Les données stochastiques du système sont issues d’une calibration statistique basée sur les fréquences historiques observées et ajustées selon une loi d’intensité offensive. La distribution de probabilité théorique retenue s’articule comme suit :
la réalisation X = 0 est dotée d’une probabilité P(X = 0) = 0,20 ;
la réalisation X = 1 est associée à une probabilité P(X = 1) = 0,35 ;
la réalisation X = 2 présente une probabilité P(X = 2) = 0,30 ;
la réalisation X = 3 affiche une probabilité P(X = 3) = 0,10 ;
enfin, la réalisation X = 4 possède une probabilité P(X = 4) = 0,05.
Avant d’engager la moindre saisie dans le tableur, nous validons mentalement la clôture stochastique du système : 0,20 + 0,35 + 0,30 + 0,10 + 0,05 = 1,00. La condition axiomatique d’admissibilité kolmogorovienne étant scrupuleusement respectée, le modèle présente une parfaite cohérence stochastique. L’hypothèse fondamentale sous-jacente est que ce processus générateur est stationnaire et que le match considéré se déroule dans des conditions climatiques, tactiques et physiologiques analogues à celles ayant présidé à l’étalonnage des coefficients de pondération.
7.2 Exécution numérique pas-à-pas sous Excel
Procédons à l’implémentation rigoureuse de cette étude de cas dans une feuille de calcul Excel. En cellules A1, B1 et C1, inscrivons respectivement les en-têtes structurés « Buts marqués (k) », « Probabilité P(X=k) » et « Contribution pondérée ». Dans la plage A2:A6, saisissons verticalement les entiers discrets de 0 à 4. Dans la plage parallèle B2:B6, renseignons avec exactitude les valeurs décimales correspondantes : 0,20 en B2, 0,35 en B3, 0,30 en B4, 0,10 en B5 et 0,05 en B6.
En cellule C2, nous introduisons la formule arithmétique élémentaire =A2*B2, renvoyant la valeur 0,00 (puisque zéro but multiplié par une probabilité quelconque produit une contribution nulle à l’espérance). En étirant cette formule jusqu’en cellule C6, nous obtenons les produits partiels suivants : 0,35 pour un but (1 * 0,35), 0,60 pour deux buts (2 * 0,30), 0,30 pour trois buts (3 * 0,10), et enfin 0,20 pour quatre buts (4 * 0,05).
Pour parachever l’analyse, plaçons-nous en cellule C7 et introduisons l’agrégation globale via =SOMME(C2:C6). Le tableur renvoie avec exactitude le scalaire 1,45. Concomitamment, pour vérifier la supériorité vectorielle de l’approche directe, positionnons-nous en cellule E2 et saisissons =SOMMEPROD(A2:A6; B2:B6). Le résultat restitué est immédiatement et rigoureusement égal à 1,45, confirmant de manière empirique la parfaite concordance computationnelle des deux méthodologies.
7.3 Interprétation contextuelle et limites décisionnelles
La valeur de l’espérance mathématique ainsi dérivée, fixée à E(X) = 1,45 but par match, exige une analyse critique approfondie afin d’éviter tout écueil d’interprétation. En premier lieu, il saute aux yeux qu’aucune équipe de football ne saurait marquer 1,45 but au cours d’une confrontation réelle, les réalisations physiques d’un tel processus étant strictement restreintes à l’ensemble des entiers naturels. L’espérance mathématique d’une variable aléatoire discrète n’est pas une réalisation candidate, mais une moyenne pondérée théorique asymptotique.
Il est capital de différencier rigoureusement l’espérance mathématique du mode statistique de la distribution. Dans notre cas empirique, la réalisation la plus fréquente, caractérisée par la probabilité ponctuelle la plus élevée (35 %), correspond au score d’un but marqué (X = 1). L’espérance mathématique se situe au-delà de ce mode (à 1,45), précisément parce que la distribution présente une asymétrie positive à droite : la possibilité d’inscrire deux, trois ou quatre buts tire le barycentre de la distribution vers le haut, quand bien même ces événements extrêmes sont dotés de probabilités unitaires décroissantes.
Dans une optique décisionnelle ou de modélisation prédictive, ce paramètre de 1,45 but attendu constitue la métrique pivot pour calibrer un processus de Poisson sous-jacent ou pour tarifer des contrats sur les marchés de paris sportifs ou d’assurance événementielle. Si un bookmaker propose une cote sur l’événement « Plus de 1,5 but » dans la rencontre, l’analyste quantitativement outillé utilisera cette espérance calibrée pour évaluer si la tarification implicite du marché présente une sous-évaluation ou une surévaluation par rapport à la distribution stochastique réelle modélisée sous Excel.
8. L’espérance mathématique en sciences cognitives et psychologie de la décision
8.1 Modélisation de l’espérance d’utilité versus espérance mathématique
L’application brute de l’espérance mathématique aux choix humains en univers risqué révèle des contradictions empiriques documentées dès le XVIIIe siècle, notamment à travers le célèbre paradoxe de Saint-Pétersbourg exposé par Daniel Bernoulli. Ce décalage historique entre le gain monétaire objectif attendu et la satisfaction subjective éprouvée par l’agent économique a conduit au développement de la théorie de l’espérance d’utilité, ultérieurement axiomatisée par John von Neumann et Oskar Morgenstern en 1944. Cette théorie postule que les individus ne maximisent pas l’espérance mathématique de la richesse objective E(X), mais l’espérance mathématique de l’utilité subjective de cette richesse, notée E[U(X)].
L’environnement matriciel d’Excel se prête remarquablement bien à cette distinction cardinale. Pour implémenter un modèle von Neumann-Morgenstern, il suffit d’adjoindre à la distribution de probabilité une colonne transformant la variable objective xi via une fonction d’utilité concave, traduisant l’aversion au risque de l’agent. Une fonction d’utilité logarithmique de type U(x) = LN(x) ou une fonction puissance de type isoélastique U(x) = x^(1 – γ) / (1 – γ) peut ainsi être formulée directement dans les cellules du tableur.
Une fois les utilités individuelles U(xi) calculées dans une colonne dédiée, l’espérance d’utilité s’obtient instantanément en combinant la fonction vectorielle : =SOMMEPROD(U_i; P_i). La comparaison systématique entre l’espérance monétaire brute issue de SOMMEPROD(X_i; P_i) et l’espérance d’utilité calculée met immédiatement en lumière pourquoi un décideur rationnel averse au risque est prêt à refuser une loterie dont l’espérance mathématique monétaire est strictement positive, éclairant ainsi la rationalité sous-jacente aux marchés de l’assurance.
8.2 Biais cognitifs et distorsion des probabilités objectives
L’économie comportementale et les sciences cognitives ont démontré que l’esprit humain ne traite pas les probabilités objectives de façon linéaire. Dans leurs travaux fondateurs sur la théorie des perspectives (Prospect Theory), les psychologues Daniel Kahneman et Amos Tversky ont mis en évidence l’existence d’une fonction de pondération non linéaire des probabilités, traditionnellement notée w(p). Selon cette modélisation empirique, les agents surpondèrent systématiquement les probabilités infinitésimales (ce qui explique l’attrait irrationnel pour les billets de loterie) et sous-pondèrent les probabilités modérées à élevées.
Pour transposer cette réalité psychologique au sein d’Excel, il convient d’insérer une colonne modifiant les probabilités objectives pi par la fonction de distorsion de Kahneman-Tversky, formulée classiquement par : w(p) = p^γ / (p^γ + (1 – p)^γ)^(1/γ), où le paramètre empirique γ oscille fréquemment autour de 0,65. Dans le tableur, cette transformation se transcrit au sein de la ligne 2 par : =B2^0,65 / (B2^0,65 + (1 - B2)^0,65)^(1/0,65).
En recalculant ensuite l’espérance pondérée par ces poids psychologiques déformés au moyen de la syntaxe =SOMMEPROD(A2:A11; C2:C11), le modélisateur met en relief l’espérance subjective perçue par le sujet économique. Cet écart quantifié entre l’espérance mathématique rationnelle et la valeur attendue comportementale constitue un outil d’analyse puissant pour comprendre les anomalies d’évaluation d’actifs sur les marchés financiers ou les erreurs d’appréciation des risques industriels majeurs.
8.3 Simulations expérimentales de dilemmes décisionnels
L’instrumentation sous tableur permet également de construire des simulateurs de dilemmes décisionnels confrontant des options certaines à des loteries stochastiques aléatoires. Considérons par exemple le choix canonique entre une option A garantissant un gain certain de 500 euros et une option B offrant 50 % de chances de décrocher 1 000 euros et 50 % de chances de n’obtenir aucun gain. Alors que les deux stratégies possèdent une espérance mathématique strictement identique de 500 euros, les comportements humains divergent massivement en faveur de l’option A.
Sous Excel, ce dilemme peut être modélisé en introduisant le concept d’« équivalent certain », défini comme la somme certaine dont l’utilité équivaut rigoureusement à l’espérance d’utilité de la loterie risquée. En inversant mathématiquement la fonction d’utilité via la formule =EXP(Esperance_Utilite) (dans l’hypothèse d’une fonction logarithmique), le tableur calcule automatiquement le montant déterministe seuil que l’individu exige pour accepter d’abandonner la loterie aléatoire.
La différence mathématique entre l’espérance monétaire brute et cet équivalent certain représente la « prime de risque ». Dans notre feuille de calcul, la formalisation de cette prime sous forme de cellule dynamique met en évidence la proportion de capital que l’agent est prêt à sacrifier pour se prémunir de la volatilité stochastique. En associant des curseurs de formulaires interactifs pour faire varier le coefficient d’aversion au risque, l’analyste peut visualiser en temps réel la contraction ou l’expansion de l’espace de décision sous-jacent.
9. Modélisation dynamique et automatisation via les outils avancés d’Excel
9.1 Exploitation des tableaux structurés et références explicites
L’élévation de la robustesse des modèles probabilistes passe impérativement par l’abandon des coordonnées de plages statiques au profit des objets Tableaux structurés d’Excel. En convertissant une matrice de données stochastiques en un tableau nommé, par exemple Tbl_Distribution, les colonnes reçoivent des étiquettes pérennes et immuables. L’espérance mathématique ne se calcule plus à partir d’adresses cryptiques mais au moyen de références textuelles explicites : =SOMMEPROD(Tbl_Distribution[Valeurs]; Tbl_Distribution[Probabilites]).
Cette approche élimine tout risque d’erreur lors de l’insertion ou de la suppression de réalisations au sein de l’univers aléatoire. Si de nouveaux états de la nature doivent être incorporés pour affiner la discrétisation d’un phénomène probabiliste, il suffit de les saisir directement à la ligne suivant la dernière observation du tableau. Le tableau structuré s’étend automatiquement vers le bas, incorporant instantanément ces nouvelles lignes dans son périmètre formel, provoquant une réévaluation immédiate et sans intervention humaine de l’espérance mathématique globale.
Par ailleurs, la lisibilité documentaire du modèle s’en trouve décuplée. Tout auditeur financier ou scientifique parcourant le classeur est à même de déchiffrer instantanément l’intention logique présidant à la formule, sans avoir à remonter manuellement le tracé des plages de cellules pour vérifier si des données ont été tronquées ou omises. Les références structurées garantissent ainsi la totale transparence méthodologique des algorithmes déployés.
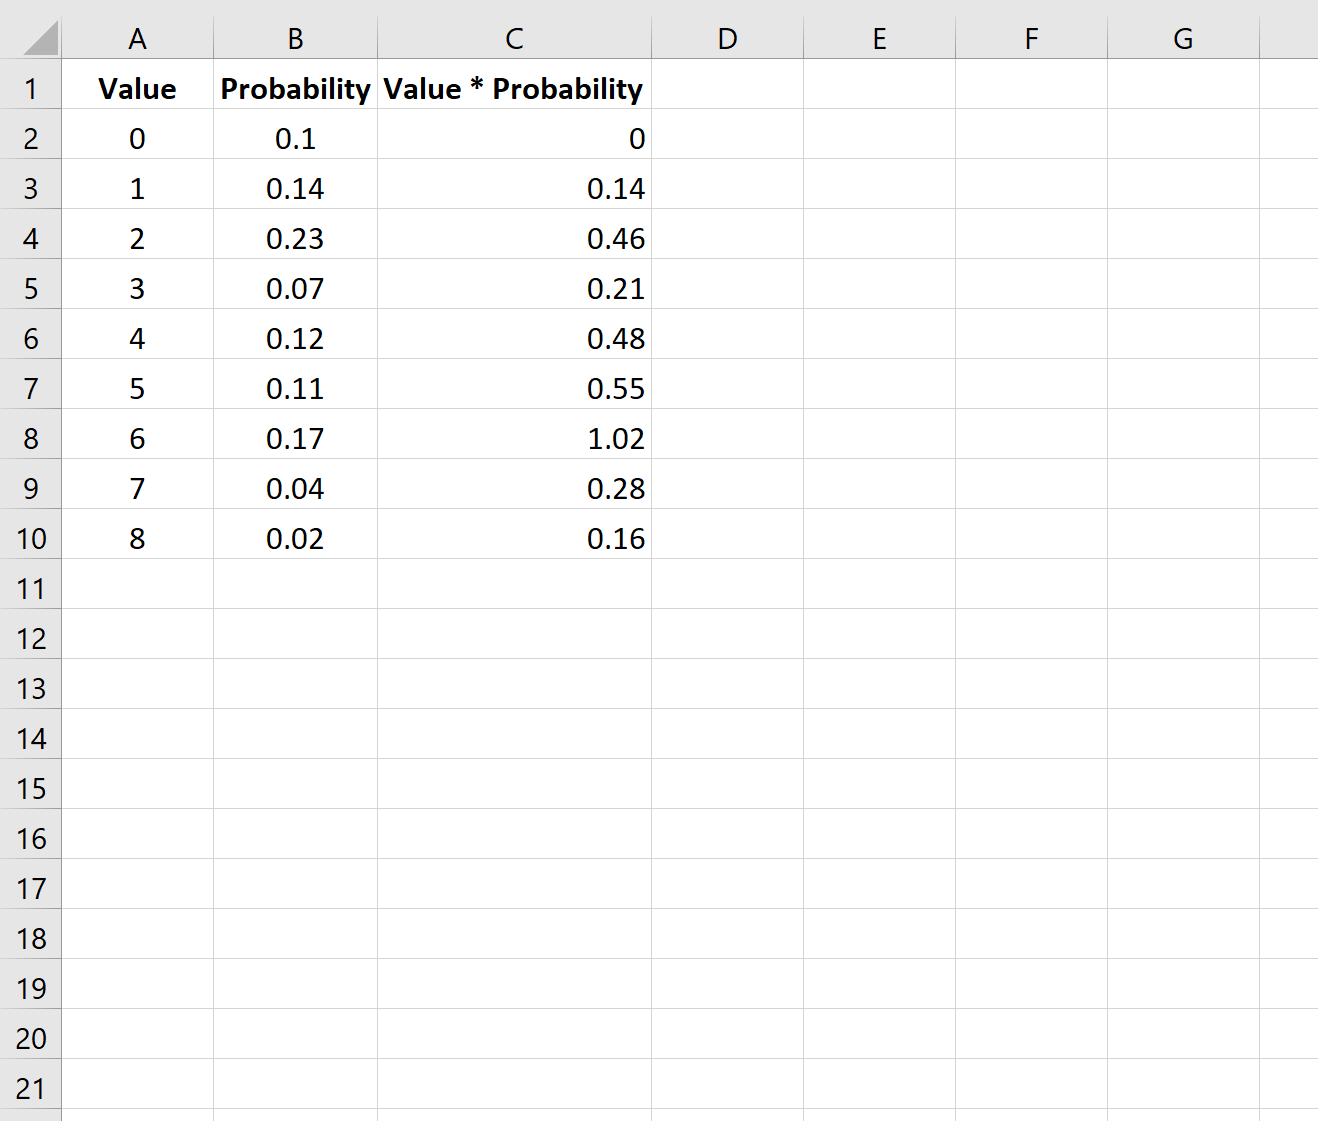
9.2 Gestion des scénarios stochastiques avec les fonctions LAMBDA et LET
L’intégration récente des fonctions de programmation fonctionnelle avancée au sein du moteur Excel, tout particulièrement LET et LAMBDA, permet de s’affranchir définitivement du code VBA pour concevoir des algorithmes probabilistes sophistiqués, hautement performants et nativement portables sur toutes les plateformes, y compris Excel pour le web.
La fonction LET permet d’assigner des noms à des expressions ou à des sous-calculs intermédiaires au sein d’une même formule, évitant ainsi la réévaluation redondante de termes coûteux. Nous pouvons ainsi encapsuler le contrôle d’intégrité et le calcul de l’espérance au sein d’une formule auto-contenue unique :
=LET(X; A2:A11; P; B2:B11; SommeP; SOMME(P); SI(ABS(SommeP - 1) > 1E-6; "Distribution Invalide"; SOMMEPROD(X; P)))
Dans cette structure, les vecteurs de valeurs et de probabilités sont instanciés une fois pour toutes sous les variables X et P, rendant la formule élégante, modulaire et remarquablement véloce.
Pour pousser l’automatisation à son paroxysme, la fonction LAMBDA offre la capacité de concevoir des fonctions personnalisées réutilisables dans l’ensemble du classeur sans la moindre ligne de macro. En déclarant dans le Gestionnaire de noms une fonction nommée ESPERANCE(VecteurX; VecteurP) définie par l’expression =LAMBDA(x; p; SOMMEPROD(x; p) / SOMME(p)), l’utilisateur dote son environnement de travail d’une primitive personnalisée de calcul d’espérance stochastique, applicable dynamiquement à n’importe quel couple de plages de données au gré de ses analyses quantitatives.
9.3 Sensibilisation aux variations paramétriques via la Table de données
L’espérance mathématique est fréquemment soumise à une incertitude paramétrique, tout particulièrement lorsque les probabilités d’occurrence reposent sur des estimations sujettes à caution ou des hypothèses macroéconomiques volatiles. Pour évaluer la sensibilité de la valeur attendue aux fluctuations d’un paramètre nodal, Excel intègre un puissant moteur d’analyse de scénarios : la « Table de données » (accessible via l’onglet Données > Analyse de scénarios > Table de données).
Pour construire une table de sensibilité unidirectionnelle, il convient de définir une séquence de variations paramétriques (par exemple, faire osciller la probabilité d’un choc de marché de 1 % à 15 % par pas de 1 %) le long d’une colonne. La tête de la colonne adjacente est liée à la cellule de calcul de notre espérance mathématique. En sélectionnant la plage globale et en déclarant la cellule source de la probabilité comme variable d’entrée de la table, le moteur d’Excel exécute automatiquement une boucle de simulation vectorielle recalculant l’espérance pour chacune des hypothèses testées.
Cette approche peut être étendue à une table bidimensionnelle permettant de croiser simultanément la variation de deux paramètres indépendants, tels que l’impact financier d’un sinistre et sa fréquence de survenance. La matrice résultante génère une cartographie exhaustive de l’espace de décision, permettant de visualiser les points de bascule critique où l’espérance mathématique bascule d’une zone de profitabilité vers une zone de déficit structurel.
10. Calcul de l’espérance pour les lois théoriques discrètes usuelles
10.1 Loi binomiale et modélisation par fonctions natives
La loi binomiale régit le nombre de succès observés lors de la répétition indépendante de n épreuves de Bernoulli identiques, chacune présentant une probabilité élémentaire de succès p. Si la théorie statistique démontre par factorisation combinatoire que l’espérance mathématique fermée d’une telle variable s’établit simplement selon l’identité analytique E(X) = n × p, il est particulièrement instructif de reconstituer cette distribution exhaustivement dans Excel pour valider la convergence de nos méthodes matricielles.
Pour modéliser une loi binomiale de paramètres n = 10 et p = 0,3, nous listons dans la plage A2:A12 les réalisations entières de succès possibles allant de 0 à 10. Dans la colonne B contiguë, nous générons la densité de probabilité discrète associée en faisant appel à la fonction native d’Excel : =LOI.BINOMIALE.N(A2; 10; 0,3; FAUX), le paramètre logique FAUX ordonnant au moteur de renvoyer la probabilité ponctuelle exacte et non la distribution cumulative.
En appliquant ensuite notre fonction vectorielle =SOMMEPROD(A2:A12; B2:B12) sur cette distribution générée synthétiquement, le tableur restitue avec une rigueur absolue la valeur 3,0. Ce résultat coïncide parfaitement avec la formule théorique fermée 10 × 0,3 = 3. Cet exercice confirme la fiabilité des primitives du tableur pour approximer ou recalculer des barycentres stochastiques à partir de lois de probabilité paramétrées.
10.2 Loi de Poisson pour les événements rares
La loi de Poisson constitue la distribution canonique pour modéliser le décompte d’événements rares et indépendants survenant au sein d’un continuum temporel ou spatial déterminé, sous un taux moyen constant désigné par le paramètre d’intensité λ (lambda). Sur le plan théorique, l’espérance d’une variable de Poisson est strictement égale à son paramètre d’intensité : E(X) = λ. Néanmoins, l’implémentation d’une telle loi dans un tableur soulève un défi structurel majeur : son support mathématique est infini, s’étendant sur l’ensemble complet des entiers naturels ℕ.
Puisqu’une feuille de calcul ne saurait héberger un nombre infini de lignes, il est impératif d’opérer une troncature raisonnée de la queue de distribution. Si l’on modélise un processus de Poisson d’intensité λ = 4 via la fonction native =LOI.POISSON.N(A2; 4; FAUX), il convient d’étendre les lignes de réalisations k jusqu’à un seuil supérieur suffisant (par exemple k = 20) pour lequel la probabilité cumulée atteint 0,9999999, rendant le résidu stochastique omis asymptotiquement négligeable.
En exécutant le calcul =SOMMEPROD(A2:A22; B2:B22) sur cette plage tronquée, le résultat converge vers 3,999999. Cette quasi-concordance avec le paramètre théorique d’intensité 4 illustre concrètement l’impact de l’erreur de troncature dans les distributions à support non borné et souligne l’importance d’étendre suffisamment les vecteurs de calcul pour préserver la précision décimale requise par les normes industrielles.
10.3 Loi hypergéométrique appliquée aux tirages sans remise
À la différence de la loi binomiale, la loi hypergéométrique modélise des processus stochastiques sans remise au sein d’une population finie. Dans ce cadre, la probabilité d’un succès varie dynamiquement au cours des tirages successifs en raison de l’épuisement progressif des éléments de l’échantillon. Soit une population globale de taille N contenant un nombre total de succès K ; si l’on extrait un échantillon aléatoire de taille n sans remise, l’espérance mathématique théorique du nombre de succès s’établit selon la formule E(X) = n × (K / N).
Pour orchestrer cette distribution sous Excel, nous mobilisons la fonction dédiée =LOI.HYPERGEOMETRIQUE(échantillon_s; nombre_échantillon; succès_pop; nombre_pop; cumulé). Dans le cas d’un tirage de n = 5 éléments au sein d’un lot de N = 50 pièces contenant K = 10 éléments défectueux, nous listons les décomptes de pièces défectueuses potentielles dans la plage A2:A7 (de 0 à 5). La formule =LOI.HYPERGEOMETRIQUE(A2; 5; 10; 50; FAUX) génère alors rigoureusement le profil probabiliste discret.
L’évaluation vectorielle standard par =SOMMEPROD(A2:A7; B2:B7) délivre alors un résultat scrupuleusement égal à 1,0, concordant à l’identique avec le calcul théorique fermé 5 × (10 / 50) = 1,0. Cette validation confirme que, même lorsque la structure sous-jacente met en jeu des coefficients binomiaux combinatoires complexes, le calcul de l’espérance par sommation vectorielle demeure inébranlable dans sa fidélité mathématique.
11. Audit méthodologique, détection des anomalies et résolution des erreurs
11.1 Résolution des erreurs structurelles classiques d’Excel
Le déploiement de calculs stochastiques avancés au sein d’Excel s’accompagne inévitablement de confrontations ponctuelles avec les codes d’erreur standards émis par le moteur du tableur. Le diagnostic le plus fréquemment rencontré lors de la manipulation de la fonction SOMMEPROD est l’erreur #VALEUR!. Dans l’immense majorité des cas, cette anomalie est symptomatique d’une inadéquation dimensionnelle entre les matrices d’arguments. Si la plage des valeurs aléatoires s’étend de A2 à A11 (10 lignes) alors que la plage des probabilités s’étend par inadvertance de B2 à B12 (11 lignes), le produit tensoriel scalaire est mathématiquement indéfini, conduisant Excel à interrompre le calcul.
Une seconde source majeure d’erreur #VALEUR! découle de l’interférence de données textuelles au sein de la plage des probabilités. Si une cellule héberge une chaîne de caractères (par exemple la chaîne « N/A » saisie pour désigner une valeur absente, ou une valeur numérique corrompue par un format texte), l’opérateur de multiplication matricielle directe échoue à convertir implicitement ce contenu en scalaire numérique. Pour remédier à cet écueil sans altérer les formules fondamentales, il est préconisé d’utiliser la fonction CNUM pour contraindre la conversion numérique, ou de filtrer les cellules parasites en amont.
Enfin, l’apparition d’un message signalant une référence circulaire doit alerter immédiatement le modélisateur. Cette situation se produit typiquement lorsque la formule d’auto-normalisation ou de sommation est insérée par mégarde au sein de la plage même qui constitue son argument d’entrée (par exemple, insérer la formule =SOMME(B2:B12) directement dans la cellule B12). Cette boucle réflexive infinie paralyse l’arbre de recalcul et nécessite la relocalisation immédiate de la cellule terminale en dehors du périmètre sommatoire.
11.2 Détection des violations théoriques et incohérences logiques
Au-delà des erreurs de syntaxe logicielle, les modèles probabilistes sont vulnérables à des violations théoriques insidieuses qui ne provoquent aucun message d’erreur d’Excel, mais rendent les résultats stochastiques totalement dénués de sens physique. La plus pernicieuse de ces incohérences est l’introduction accidentelle d’une probabilité négative. Puisque le moteur arithmétique se contente d’exécuter des multiplications sans discernement ontologique, une ligne combinant une réalisation positive avec une probabilité de -0,10 réduira mécaniquement l’espérance finale sans que le tableur ne déclenche la moindre alerte logicielle.
Pour prévenir ces dérives d’admissibilité stochastique, il convient de concevoir un tableau de bord d’audit logique imbriquant des vérifications conditionnelles approfondies. La formule suivante, positionnée dans une cellule d’assurance qualité, scrute l’ensemble du vecteur probabiliste :
=SI(OU(NB.SI(B2:B11; "<0") > 0; NB.SI(B2:B11; ">1") > 0); "VIOLATION: Probabilités hors bornes"; "Probabilités Valides")
Ce test d’assertion bloque instantanément l’exploitation des résultats dès lors qu’un poids déroge à l’intervalle canonique [0, 1].
Un autre vecteur d’incohérence réside dans la troncature excessive d’une distribution discrète non bornée, conduisant à une amputation arbitraire de la masse stochastique. Si la somme des probabilités retenues n’atteint par exemple que 0,82, l’espérance calculée sera systématiquement sous-évaluée, le modèle omettant 18 % des états de la nature potentiels. L’audit méthodologique impose donc de combiner systématiquement le calcul de l’espérance avec la métrique de couverture stochastique totale afin d’assurer l’exhaustivité de l’espace échantillonnal représenté.
11.3 Techniques de traçabilité et documentation des formules
La pérennité et la gouvernance des modèles construits sous tableur exigent la mise en place d’une traçabilité documentaire rigoureuse. Les outils natifs d’audit de formules constituent le premier levier de cette documentation : les fonctionnalités « Repérer les antécédents » et « Repérer les dépendants » (situées dans le ruban Formules) permettent de visualiser sous forme de flèches graphiques le réseau de flux de données alimentant le calcul de l’espérance mathématique, facilitant le diagnostic rapide d’éventuelles ruptures de continuité dans les vecteurs.
Pour expliciter la signification conceptuelle de formules matricielles complexes sans surcharger l’espace visuel des cellules, il est vivement conseillé d’exploiter la fonction native N. Cette fonction possède la propriété remarquable de convertir une valeur non numérique en zéro lorsqu’elle est combinée dans une expression arithmétique, permettant ainsi d’insérer des commentaires textuels directement à l’intérieur de la syntaxe de la formule :
=SOMMEPROD(A2:A11; B2:B11) + N("Calcul de l'espérance mathématique de la distribution de Poisson tronquée")
Cette annotation n’altère en rien la valeur finale du calcul tout en offrant un éclairage documentaire précieux aux auditeurs ultérieurs du classeur.
Enfin, pour les modèles critiques assujettis à des exigences de conformité réglementaire (notamment dans les secteurs bancaire et actuariel soumis aux directives Solvabilité II ou Bâle III), il est impératif d’archiver des classeurs de référence contenant des feuilles de contrôle témoins figées. Ces feuilles archivent les jeux de tests historiques, les signatures de hachage des algorithmes et les benchmarks analytiques de comparaison, garantissant ainsi l’intégrité scientifique inaltérable des processus de calcul déployés sous Excel.
12. Au-delà de l’espérance : Dispersion, variance et modélisation stochastique
12.1 Calcul de la variance et de l’écart-type d’une variable discrète
L’espérance mathématique constitue une mesure de tendance centrale irremplaçable, mais elle demeure totalement aveugle à la dispersion stochastique qui caractérise la distribution d’une variable aléatoire. Deux investissements financiers peuvent présenter une espérance de rendement rigoureusement identique de 10 % tout en incarnant des profils de volatilité diamétralement opposés, le premier garantissant ce rendement avec une certitude quasi absolue, tandis que le second expose le capital à des risques de perte totale compensés par des gains mirifiques. Pour évaluer la dispersion autour du barycentre, le calcul du moment centré d’ordre deux, à savoir la variance mathématique, est indispensable.
L’implémentation de la variance sous Excel se simplifie considérablement en mobilisant le théorème fondamental de König-Huygens, lequel stipule que la variance d’une variable aléatoire est égale à l’espérance des carrés diminuée du carré de l’espérance mathématique : V(X) = E(X²) – [E(X)]². Dès lors, le calcul de la variance ne requiert pas la formulation pénible des écarts quadratiques centrés ligne par ligne. Il suffit d’évaluer directement l’espérance des carrés via l’opérateur matriciel SOMMEPROD(A2:A11^2; B2:B11), puis de lui soustraire le carré de l’espérance précédemment calculée.
La formule consolidée s’articule donc magistralement en une seule cellule sous la forme :
=SOMMEPROD(A2:A11^2; B2:B11) - (SOMMEPROD(A2:A11; B2:B11))^2
Pour rétablir l’homogénéité de dimension physique entre la mesure de dispersion et les valeurs initiales de la variable aléatoire, nous extrayons la racine carrée de cette variance via la fonction RACINE : =RACINE(Cellule_Variance). Nous obtenons ainsi l’écart-type théorique de la variable discrète, borne métrique pivot qui encadre l’amplitude probabiliste des fluctuations de part et d’autre de l’espérance mathématique.
12.2 Analyse conjointe de plusieurs variables et covariance stochastique
Dans les environnements complexes, les phénomènes aléatoires n’évoluent pas de façon isolée mais interagissent au sein de systèmes multidimensionnels. L’analyse conjointe de deux variables aléatoires discrètes X et Y nécessite la formalisation d’une table de contingence bidimensionnelle hébergeant leur loi de probabilité conjointe P(X = xi, Y = yj). Les valeurs possibles de X peuvent par exemple être disposées verticalement en bordure de lignes, tandis que les valeurs de Y sont alignées horizontalement en en-tête de colonnes.
Le calcul de l’espérance du produit croisé E(XY) requiert alors une multiplication tensorielle adaptée à la topologie de la table croisée. Sous Excel moderne, cette agrégation s’effectue en multipliant le vecteur colonne des réalisations de X par le vecteur ligne des réalisations de Y, pondéré matriciellement par la grille des probabilités conjointes intérieures :
=SOMMEPROD((PlageX) * (PlageY); MatriceProbabilitesConjointes)
Ce calcul fournit le moment conjoint fondamental qui gouverne la dynamique d’association des deux variables.
Une fois l’espérance conjointe E(XY) obtenue, la covariance stochastique théorique se déduit immédiatement par l’application de la relation : Cov(X, Y) = E(XY) – E(X)E(Y). Si cette covariance est nulle, nous concluons à l’absence de relation linéaire entre les deux variables. Si elle est positive, elle met en évidence une propension mutuelle des réalisations à s’élever simultanément au-dessus de leurs espérances respectives. La normalisation de cette covariance par le produit des écarts-types individuels permet enfin de dériver sous Excel le coefficient de corrélation linéaire de Pearson, métrique cardinale de l’analyse multivariée.
12.3 Simulation de Monte-Carlo pour vérifier empiriquement l’espérance
La puissance computationnelle moderne d’Excel permet de boucler notre exploration théorique en confrontant l’espérance mathématique formelle à l’épreuve d’une simulation de Monte-Carlo à grande échelle. L’objectif est d’engendrer artificiellement des milliers de tirages pseudo-aléatoires respectant la loi de probabilité discrète modélisée, puis de constater visuellement la stabilisation progressive de la moyenne d’échantillon vers l’espérance mathématique théorique, concrétisant ainsi la loi forte des grands nombres sous nos yeux.
Pour construire ce moteur de simulation dans Excel, nous calculons dans un premier temps la distribution cumulative stochastique en créant une colonne de probabilités cumulées via la sommation progressive de la colonne des probabilités élémentaires. Dans une nouvelle colonne de simulation, nous générons des réalisations virtuelles en combinant la fonction pseudo-aléatoire uniforme ALEA() avec la fonction d’interpolation de recherche approchée :
=RECHERCHEV(ALEA(); Table_Cumulee; Indice_Valeur; VRAI)
ou plus élégamment avec le couple moderne EQUIV et INDEX.
En étendant cette instruction stochastique sur dix mille lignes, nous constituons un échantillon synthétique massif de la variable aléatoire. En calculant en temps réel la moyenne mobile progressive de cette série d’expériences virtuelles via la formule =MOYENNE(D$2:D2) étirée le long de la colonne, puis en traçant cette série sur un graphique linéaire en superposition avec la ligne constante déterministe de l’espérance mathématique E(X), l’analyste contemple l’effacement graduel de l’aléa empirique devant la souveraineté de l’espérance théorique. Les fluctuations chaotiques des premiers tirages s’atténuent inexorablement pour venir s’écraser asymptotiquement sur le barycentre stochastique, clôturant ainsi magistralement le dialogue entre formalisme mathématique et puissance computationnelle sous Microsoft Excel.
Références
Bernoulli, D. (1954). Specimen theoriae novae de mensura sortis [Exposition of a new theory on the measurement of risk]. Econometrica, 22(1), 23-36. (Ouvrage original publié en 1738). https://doi.org/10.2307/1909829
Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3e éd.). John Wiley & Sons.
Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263-291. https://doi.org/10.2307/1914185
Kolmogorov, A. N. (1956). Foundations of the theory of probability (N. Morrison, Trad.; 2e éd.). Chelsea Publishing Company. (Ouvrage original publié en 1933 sous le titre Grundbegriffe der Wahrscheinlichkeitsrechnung).
Microsoft Corporation. (2024). Fonction SOMMEPROD – Support Microsoft. Microsoft Support. https://support.microsoft.com/fr-fr/office/sommeprod-fonction-sommeprod-167b1e72-8acf-4c81-85f0-45579d518a5d
Ross, S. M. (2014). Introduction to probability models (11e éd.). Academic Press.
Von Neumann, J., & Morgenstern, O. (1944). Theory of games and economic behavior. Princeton University Press.
Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2008). Mathematical statistics with applications (7e éd.). Cengage Learning.