
L’analyse computationnelle du langage naturel et le traitement automatique des données textuelles constituent aujourd’hui des piliers fondamentaux de la recherche scientifique, de l’ingénierie logicielle et des sciences cognitives. Dans cet univers dominé par des structures de données sémiotiques hautement variables, la question de la quantification des divergences orthographiques s’impose avec une acuité singulière. Comment, en effet, mesurer mathématiquement l’écart qui sépare deux séquences de symboles discrets ? De quelle manière peut-on évaluer la déformation d’un lemme sous l’effet d’une erreur typographique, d’une mutation dialectale ou d’un lapsus mnésique lors d’une tâche de rappel expérimental ? C’est précisément à cette interrogation méthodologique que répond la métrique proposée au milieu des années soixante par le mathématicien soviétique Vladimir Levenshtein.
Dans l’écosystème du calcul scientifique, le langage de programmation statistique R s’est imposé comme l’un des environnements les plus rigoureux et polyvalents pour appréhender les structures de données complexes. Bien que nativement orienté vers l’analyse matricielle et la modélisation probabiliste, R s’est enrichi au fil des décennies d’un ensemble de bibliothèques spécialisées permettant d’aborder la linguistique computationnelle et l’appariement de données imparfaites avec une efficacité remarquable. Le calcul de la distance d’édition, loin de se limiter à une curiosité algorithmique purement théorique, devient ainsi un outil opérationnel de premier plan pour les chercheurs, les biostatisticiens et les spécialistes de l’analyse exploratoire des données massives.
Ce guide exhaustif a pour vocation d’explorer en profondeur les fondements théoriques, les mécanismes mathématiques sous-jacents et les modalités pratiques de mise en œuvre de la distance de Levenshtein au sein de l’environnement R. À travers l’étude approfondie du formalisme algorithmique de Wagner-Fischer, l’analyse des propriétés topologiques de l’espace métrique induit, ainsi que l’appropriation méthodique du package hautement optimisé stringdist, le lecteur découvrira comment déployer des protocoles de comparaison textuelle robustes, reproductibles et capables de passer à l’échelle sur des corpus empiriques considérables.
1. Introduction théorique et fondements conceptuels de la distance de Levenshtein
1.1 Définition formelle de la métrique d’édition
La distance de Levenshtein, formulée initialement en 1965 par le mathématicien et théoricien de l’information Vladimir Levenshtein, trouve son origine dans l’étude de la transmission des signaux binaires à travers des canaux de communication bruités. Confronté à la problématique de la détection et de la correction d’erreurs de synchronisation au sein des codes correcteurs, Levenshtein a formalisé une mesure géométrique capable de quantifier la divergence minimale existant entre deux séquences de symboles issues d’un même alphabet fini. Contrairement aux approches probabilistes continues, cette mesure s’ancre dans une combinatoire discrète et déterministe où la divergence entre deux états lexicaux est directement proportionnelle à l’effort transformationnel nécessaire pour faire coïncider l’une des chaînes avec l’autre.
Sur le plan mathématique, la distance de Levenshtein entre une chaîne source et une chaîne cible se définit comme le nombre minimal d’opérations élémentaires d’édition requises pour transformer la séquence initiale en la séquence terminale. Ces opérations élémentaires comprennent conventionnellement l’insertion d’un caractère, la suppression d’un caractère et la substitution d’un caractère par un autre. La distance d’édition se distingue ainsi fondamentalement d’autres métriques plus restrictives, au premier rang desquelles figure la distance de Hamming. Cette dernière, élaborée dans le contexte exclusif de blocs de données de longueurs rigoureusement identiques, n’admet que la seule opération de substitution, rendant son application totalement inopérante dès lors qu’un décalage positionnel ou une variation dimensionnelle intervient entre les séquences observées.
Le rôle fondamental de la métrique de Levenshtein réside dans sa capacité à conférer une structure géométrique mesurable à l’ensemble des chaînes de caractères finies. En établissant une quantification formelle des divergences orthographiques, symboliques ou morphologiques, cette mesure transcende la simple binarité de l’égalité logique. Deux mots qui ne sont pas strictement identiques cessent d’être considérés comme arbitrairement distincts ; ils occupent dès lors des coordonnées spatiales relatives au sein d’un espace métrique discret, permettant ainsi l’évaluation graduelle des proximités lexicales et l’élaboration de modèles mathématiques prédictifs pour les sciences du langage et du signal.
1.2 Typologie des opérations élémentaires d’édition
L’architecture de la distance de Levenshtein repose sur un ensemble clos et universel de trois opérations atomiques, dont la combinaison séquentielle permet de décrire exhaustivement n’importe quel chemin de déformation textuelle. La première opération élémentaire est l’insertion. Ce mécanisme consiste à intégrer un nouveau symbole, extrait de l’alphabet de référence, au sein d’une position arbitraire de la chaîne source. D’un point de vue morphologique, l’insertion correspond à la prise en compte d’une omission dans la transcription initiale ou à l’adjonction d’un affixe flexionnel. Elle incrémente la longueur totale de la séquence d’une unité tout en modifiant l’indexation de l’ensemble des caractères subséquents situés en aval de la position d’adjonction.
La deuxième opération fondamentale est la suppression, parfois qualifiée d’élision ou d’effacement. Inverse symétrique de l’insertion, elle consiste à retirer un symbole préalablement présent au sein de la chaîne source à un indice donné. Dans l’analyse computationnelle des erreurs, la suppression permet de modéliser les accidents de frappe résultant de la saisie involontaire de caractères parasites ou la troncature accidentelle de désinences lexicales. Tout comme l’insertion, la suppression engendre un réalignement dynamique des indices de position pour les symboles restants, ce qui confère à ces deux opérations conjointes une puissance de restructuration globale bien supérieure à celle de simples permutations statiques.
La troisième opération élémentaire est la substitution, qui consiste à échanger un caractère de la chaîne source contre un caractère distinct provenant de l’alphabet pour faire correspondre les positions respectives des deux séquences. Bien que la substitution puisse être théoriquement décomposée en une séquence consécutive comprenant une suppression suivie d’une insertion, le paradigme originel de Levenshtein l’érige en opération unitaire atomique. Selon la convention standard établie par le modèle classique, chacune de ces trois opérations se voit assigner un coût unitaire uniforme équivalant à 1. La distance totale correspond alors à l’optimisation globale visant à identifier le coût cumulé le plus faible parmi tous les arbres transformationnels possibles reliant la source à la cible.
1.3 Pertinence de la mesure dans l’étude computationnelle du langage
Dans le domaine du traitement automatique du langage naturel et de la linguistique quantitative, l’introduction de la distance de Levenshtein a permis de formaliser objectivement ce qui relevait historiquement de l’intuition perceptive ou du jugement phonétique subjectif. La similarité lexicale, qu’elle soit évaluée du point de vue de l’observateur humain ou d’un algorithme de classification automatique, dépend intrinsèquement du degré de superposition des structures de surface des mots. En fournissant une fonction de coût continue et invariante par translation, la distance d’édition permet de cartographier avec une précision mathématique la nébulosité morphologique qui entoure chaque unité du lexique mental d’une langue donnée.
Sur le plan psycholinguistique et empirique, la modélisation des erreurs de frappe, des lapsus calami et des approximations orthographiques constitue un champ d’application privilégié de cette métrique. Lorsqu’un scripteur saisit un mot sur un clavier physique ou numérique, les déviations observées par rapport à la norme orthographique ne se répartissent pas de manière purement aléatoire à travers l’espace des chaînes de caractères. Elles résultent de contraintes neuromotrices, de confusions phonétiques ou de défaillances mnésiques locales. La métrique de Levenshtein fournit un cadre computationnel élégant pour isoler ces distorsions en mesurant la dérive minimale par rapport au lemme de référence, facilitant ainsi l’émergence d’algorithmes de correction orthographique probabiliste fondés sur le principe du voisinage de coût minimal.
Enfin, en dialectométrie et en linguistique diachronique comparative, la quantification des divergences textuelles permet d’objectiver l’évolution temporelle et spatiale des systèmes linguistiques. L’application de la distance de Levenshtein à des listes de mots apparentés permet de mesurer mathématiquement la distance génétique séparant des idiomes issus d’une même souche, d’établir des dendrogrammes phylogénétiques rigoureux et d’étudier la diffusion des innovations phonologiques sans dépendre exclusivement de jugements qualitatifs subjectifs.
2. Modélisation mathématique et algorithmique de la distance d’édition
2.1 L’algorithme de programmation dynamique de Wagner-Fischer
Bien que la définition mathématique de la distance d’édition soit conceptuellement limpide, son calcul pratique sur des chaînes de caractères non triviales pose un défi combinatoire majeur. En effet, l’exploration naïve de l’ensemble des séquences d’opérations d’édition possibles menant d’une chaîne source de longueur m à une chaîne cible de longueur n génère une explosion combinatoire d’une complexité exponentielle. Pour pallier cette inefficacité fondamentale, Robert Wagner et Michael Fischer ont formalisé en 1974 un algorithme révolutionnaire fondé sur les principes de la programmation dynamique, théorisés initialement par Richard Bellman. Cet algorithme repose sur la décomposition du problème global en sous-problèmes emboîtés et sur l’exploitation du principe d’optimalité.
La formulation repose sur une relation de récurrence stricte liant les préfixes des deux chaînes analysées. Considérons une chaîne source s de longueur m et une chaîne cible t de longueur n. Définissons une matrice D de dimensions (m + 1) par (n + 1), où chaque cellule D(i, j) représente la distance de Levenshtein exacte entre le préfixe de longueur i de la chaîne s et le préfixe de longueur j de la chaîne t. L’initialisation de la matrice s’effectue de manière déterministe en établissant que la distance entre une chaîne quelconque et la chaîne vide équivaut à la longueur de la chaîne non vide. Dès lors, pour tout i compris entre 0 et m, la cellule D(i, 0) prend la valeur i, ce qui modélise l’application de i suppressions successives. De même, pour tout j compris entre 0 et n, la cellule D(0, j) reçoit la valeur j, modélisant l’application de j insertions consécutives.
Pour le calcul incrémental des cellules intérieures, pour tout indice i supérieur à 0 et tout indice j supérieur à 0, l’algorithme évalue le coût local en comparant le caractère source s[i] avec le caractère cible t[j]. Si les deux symboles sont rigoureusement identiques, le coût d’adaptation est nul ; s’ils diffèrent, ce coût est fixé à 1. La valeur de la cellule D(i, j) est alors déterminée par le choix optimal local minimisant trois transitions potentielles : la suppression modélisée par D(i – 1, j) majoré de 1, l’insertion modélisée par D(i, j – 1) majoré de 1, et la substitution modélisée par D(i – 1, j – 1) majoré du coût local. La cellule finale D(m, n) contient par construction la distance minimale totale recherchée, et la rétro-ingénierie du chemin matriciel depuis cette cellule terminale jusqu’à l’origine permet de reconstituer l’alignement optimal explicite.
2.2 Analyse de la complexité computationnelle
L’algorithme canonique de Wagner-Fischer présente une complexité temporelle rigoureusement quadratique, notée en notation grand O comme O(m * n), où m et n représentent respectivement les longueurs des deux chaînes soumises à la comparaison. Cette complexité temporelle découle directement de la nécessité de parcourir et de renseigner chacune des cellules de la matrice de dimensions (m + 1) par (n + 1), chaque calcul de cellule individuelle n’exigeant qu’un nombre constant d’opérations arithmétiques et de comparaisons élémentaires en temps constant O(1). Dans le cas où les deux chaînes présentent des longueurs comparables de l’ordre de n, l’effort de calcul total croît donc proportionnellement au carré de la longueur des séquences, noté O(n²).
Sur le plan de la complexité spatiale, l’implémentation naïve qui alloue l’intégralité de la grille matricielle en mémoire vive consomme également un volume d’espace mémoire d’ordre quadratique O(m * n). Toutefois, une analyse fine de l’équation de récurrence démontre que le calcul des valeurs de la ligne courante i ne requiert impérativement que les valeurs de la ligne immédiatement précédente i – 1 et les valeurs déjà calculées au sein de la ligne i elle-même. Dès lors, une stratégie d’optimisation classique consiste à ne conserver en mémoire que deux lignes simultanées, réduisant drastiquement l’exigence spatiale à un ordre linéaire O(min(m, n)). Cette optimisation s’avère particulièrement précieuse lorsque l’on souhaite uniquement extraire la valeur scalaire de la distance sans reconstruire le graphe d’alignement complet.
Cependant, lorsque l’on quitte le domaine du mot isolé pour aborder le traitement computationnel de séquences textuelles étendues, telles que des paragraphes entiers, des transcriptions orales complètes ou des alignements de génomes de plusieurs millions de nucléotides, cette complexité quadratique se transforme en un goulot d’étranglement infranchissable. Pour atténuer ces contraintes massives, la recherche contemporaine en algorithmique a développé des variantes heuristiques ou contraintes par bandes d’exploration, à l’image de l’algorithme d’Ukkonen. Ce dernier restreint le parcours de la matrice à une diagonale centrale d’épaisseur k, ramenant la complexité temporelle à O(k * min(m, n)), ce qui permet de rejeter très précocement les paires de séquences dont la divergence excède un seuil critique d’intérêt.
2.3 Propriétés topologiques et métriques de l’espace de Levenshtein
Pour qu’une fonction de divergence mathématique soit reconnue formellement comme une véritable métrique au sens de la topologie générale, elle doit satisfaire de manière inconditionnelle à quatre axiomes fondamentaux. L’ensemble des chaînes de caractères finies construites sur un alphabet donné, couplé à la fonction de distance de Levenshtein d, forme un espace métrique discret complet. La première propriété axiomatique est la non-négativité : pour toutes chaînes arbitraires x et y, la distance d(x, y) est strictement supérieure ou égale à 0. L’effort transformationnel nécessaire pour passer d’une séquence à une autre ne peut en aucun cas être négatif, chaque opération unitaire ayant un coût positif ou nul.
La deuxième propriété est l’identité des indiscernables, qui postule que la distance d(x, y) est égale à 0 si et seulement si les chaînes x et y sont rigoureusement identiques, caractère par caractère et dans un ordre parfaitement préservé. Réciproquement, si x diffère de y par au moins une position ou une dimension, le coût minimal d’édition sera obligatoirement supérieur ou égal à 1. La troisième propriété fondamentale est la symétrie : la distance d(x, y) est égale à la distance d(y, x). En effet, toute opération d’insertion permettant de progresser de x vers y possède pour image miroir une opération de suppression de coût équivalent pour régresser de y vers x, et toute substitution d’un caractère a par un caractère b admet la substitution réciproque de b par a avec une pondération parfaitement isomorphe.
Enfin, la fonction satisfait rigoureusement à l’inégalité triangulaire : pour toutes séquences x, y et z, nous avons invariablement la relation d(x, z) inférieure ou égale à la somme de d(x, y) et de d(y, z). Cette propriété mathématique est capitale d’un point de vue algorithmique. Elle garantit qu’il est impossible de réduire le coût d’édition global reliant deux chaînes en introduisant arbitrairement une chaîne intermédiaire de transition. Sur le plan de la recherche informatique, le respect strict de l’inégalité triangulaire autorise l’indexation spatiale des dictionnaires lexicaux au sein de structures arborescentes spécialisées, telles que les arbres de Burkhard-Keller (BK-trees) ou les Vantage-Point trees, permettant d’effectuer des recherches de plus proches voisins sans devoir calculer la distance de manière exhaustive contre chaque élément du corpus.
3. L’environnement R et l’écosystème pour l’analyse textuelle
3.1 Limites des fonctions natives de manipulation de chaînes dans R
L’environnement standard de R met à disposition de l’utilisateur un éventail de fonctions primitives destinées à la manipulation séquentielle des chaînes de caractères. Des outils fondamentaux tels que nchar, qui renvoie le nombre de caractères d’une chaîne, substr, qui permet l’extraction ou la substitution de sous-chaînes délimitées par des indices fixes, ou encore chartr, qui applique des translations de symboles terme à terme, constituent les briques de base de la syntaxe de manipulation textuelle. De même, les fonctions de recherche par motifs réguliers, incarnées par grep, grepl et regmatches, offrent une grande flexibilité pour tester la présence de structures syntaxiques formellement prévisibles au sein de vecteurs atomiques.
Cependant, dès lors que l’analyste se trouve confronté à des données bruitées, entachées d’erreurs d’encodage ou nécessitant une évaluation probabiliste d’appariement flou, ce noyau natif révèle ses limites structurelles. Le moteur de R de base ne dispose d’aucune implémentation optimisée et vectorisée de l’algorithme d’édition de Levenshtein. Bien que la fonction native adist existe au sein du package utils fourni par défaut avec la distribution de base de R, son architecture historique demeure restreinte sur le plan de la configurabilité des métriques, de la gestion fine des encodages exotiques et de la flexibilité algorithmique globale face à des charges massives.
La tentation naïve de compenser ces lacunes par l’écriture manuelle d’un algorithme de Wagner-Fischer au moyen de boucles imbriquées for en pur code interprété R se heurte immédiatement au coût computationnel prohibitif de l’interpréteur. En raison des mécanismes internes de gestion de la mémoire, de la vérification dynamique des types et de la surcharge liée à l’évaluation paresseuse des expressions, une boucle de programmation dynamique codée en R pur peut s’avérer plusieurs milliers de fois plus lente qu’une routine compilée. Pour des corpus comprenant des dizaines de milliers d’occurrences textuelles, une telle approche artisanale paralyse irrémédiablement les capacités de calcul de la machine hôte.
3.2 Architecture du package stringdist de Mark van der Loo
Afin de combler de manière définitive ce déficit de performance et d’offrir à la communauté scientifique une infrastructure de calcul métrique de classe industrielle, le statisticien Mark van der Loo a conçu et développé le package stringdist. Accessible librement via le Comprehensive R Archive Network (CRAN), cette bibliothèque logicielle s’est imposée comme la référence incontournable en matière d’évaluation des distances textuelles dans l’univers de programmation R. Son succès phénoménal repose avant tout sur une scission architecturale élégante entre une interface utilisateur expressive en R et un cœur de calcul computationnel bas niveau intégralement implémenté en langage C ANSI compilé.
L’intégration de routines C natives permet d’exécuter les calculs de programmation dynamique directement au plus près des registres du microprocesseur, éliminant intégralement la surcharge interprétative de R. Les allocations de mémoire nécessaires à la construction des matrices de programmation dynamique sont optimisées au niveau du tas système, exploitant au maximum la réduction spatiale à deux lignes pour maintenir une empreinte mémoire microscopique lors des comparaisons scalaires ou vectorielles. De surcroît, le cœur algorithmique du package stringdist intègre nativement la prise en charge du calcul parallèle multi-cœurs grâce aux directives OpenMP, permettant d’accélérer de manière quasi linéaire les opérations matricielles massives sur les architectures informatiques modernes composées de multiples unités centrales.
Au-delà de ses performances brutes spectaculaires, la force du package stringdist réside dans son unification conceptuelle. Plutôt que de disperser les métriques au sein de fonctions disparates aux signatures incompatibles, l’auteur a structuré une interface de programmation (API) cohérente et hautement modulaire. Au travers d’une poignée de fonctions mères telles que stringdist et stringdistmatrix, l’utilisateur a la possibilité de basculer instantanément de la métrique de Levenshtein standard vers des dizaines d’autres variantes algorithmiques, telles que les distances de Jaro-Winkler, de Damerau-Levenshtein, du q-gramme ou du cosinus, tout en maintenant un formalisme de paramétrage parfaitement homogène.
3.3 Configuration rigoureuse de la session de travail
L’exécution de travaux scientifiques impliquant la manipulation fine de données textuelles exige une configuration méthodologique rigoureuse de la session logicielle afin de garantir une reproductibilité absolue des résultats. Dans le cadre de l’écosystème R, la première étape consiste à s’assurer de la conformité de l’environnement matériel et logiciel en contrôlant la version courante de R et en vérifiant la disponibilité des compilateurs C nécessaires à l’installation optimale des packages depuis les sources. L’utilisation d’outils d’isolation d’environnements, tels que le package renv, permet de figer l’arbre des dépendances et de consigner formellement les numéros de version exacts de stringdist et des bibliothèques associées.
Un enjeu technique prépondérant lors du calcul des distances d’édition réside dans la gestion irréprochable de l’encodage des caractères. Les alphabets comprenant des signes diacritiques, des cédilles, des ligatures ou des caractères non latins sont particulièrement vulnérables aux corruptions de type mojibake lorsqu’un fichier texte transite entre des systèmes d’exploitation aux configurations disparates (tels que Windows, macOS et les distributions GNU/Linux). Dans le cadre de l’analyse textuelle, une mauvaise interprétation d’un caractère accentué codé sur deux octets sous la norme UTF-8 peut conduire l’algorithme à quantifier artificiellement deux opérations élémentaires d’édition là où une seule modification graphique était conceptuellement attendue. Il est donc impératif de contraindre la locale système et de forcer la conversion des vecteurs de chaînes en représentation UTF-8 normalisée dès l’importation initiale.
Enfin, la configurabilité de la session doit intégrer la fixation déterministe des options globales régissant la gestion des chaînes de caractères. Depuis la version 4.0.0 de R, le paramètre stringsAsFactors est désactivé par défaut lors de la création de structures de données tabulaires, éliminant ainsi les conversions implicites et pernicieuses de colonnes textuelles en variables qualitatives factorielles. L’analyste veillera à maintenir cette convention afin que les arguments transmis aux routines de calcul métrique conservent leur nature stricte de vecteurs de caractères atomiques, évitant les erreurs de conversion de types ou les comportements indéterminés au sein des flux de traitement analytique.
4. Prise en main du package stringdist : installation et syntaxe de base
4.1 Installation et chargement de la bibliothèque
La procédure de déploiement du package stringdist s’inscrit dans le flux de travail standardisé de l’écosystème CRAN. L’analyste procède à l’installation initiale du module en sollicitant la commande install.packages(« stringdist ») au sein de la console R. Cette instruction télécharge les archives binaires précompilées adaptées au système d’exploitation cible ou procède à la compilation locale du code source C si l’environnement dispose de la suite d’outils de compilation appropriée. Une fois l’installation menée à son terme sans avertissement critique, le chargement de la bibliothèque au sein de la session active s’effectue via l’instruction library(stringdist).
Il est scientifiquement recommandé d’inspecter systématiquement la version du package ainsi déployé en invoquant packageVersion(« stringdist »). Cette précaution garantit que les fonctionnalités récentes d’optimisation multi-threadées et les correctifs algorithmiques sont effectivement opérationnels sur la machine d’analyse. La documentation interne de l’ensemble des routines peut être consultée de manière exhaustive en exécutant help(package = « stringdist »), ce qui permet d’accéder au catalogue formel des arguments, aux spécifications mathématiques des fonctions d’évaluation et aux références bibliographiques associées aux algorithmes implémentés.
Dans un contexte d’ingénierie de données robuste, l’analyste combinera fréquemment le chargement de stringdist avec des utilitaires de diagnostic système. Il s’assurera notamment de la bonne détection du nombre de cœurs de calcul accessibles pour OpenMP en interrogeant les fonctions de détection matérielle, assurant ainsi que les paramètres d’exécution parallèle seront dimensionnés de manière idoine en fonction des capacités physiques de la station de travail ou du cluster de calcul haute performance mobilisé.
4.2 Paramétrage fondamental de la fonction stringdist()
La fonction maîtresse du package pour la comparaison vectorielle simple s’intitule stringdist(). Sa signature générale présente une architecture intuitive tout en offrant un contrôle paramétrique extrêmement poussé. Les deux premiers arguments obligatoires, traditionnellement nommés a et b, acceptent des vecteurs de chaînes de caractères de longueurs arbitraires. Lorsque deux chaînes scalaires unitaires sont transmises, la fonction procède à l’évaluation directe de leur divergence d’édition. Si des vecteurs de dimensions distinctes sont fournis, la fonction applique rigoureusement les règles classiques de recyclage vectoriel de R, permettant d’effectuer des comparaisons sérielles continues avec une concision syntaxique absolue.
L’argument clé déterminant le comportement mathématique de la routine est le paramètre method. Pour forcer l’utilisation de la métrique de Levenshtein classique telle que théorisée en 1965, l’utilisateur doit obligatoirement spécifier method = « lv ». Si ce paramètre est omis, la fonction applique par défaut la méthode « osa » (Optimal String Alignment), qui intègre la transposition de caractères adjacents et s’écarte par conséquent de la définition formelle de Levenshtein pure. Le choix explicite et rigoureux de la chaîne d’identification method = « lv » constitue donc le garant de l’intégrité théorique de l’analyse.
Le type de retour produit par la fonction stringdist() est systématiquement un vecteur numérique de nombres réels ou d’entiers représentant la distance quantifiée entre chaque paire d’éléments comparés. Ce vecteur conserve une structure dimensionnelle rigoureusement indexée sur la longueur maximale résultant du recyclage des vecteurs d’entrée, ce qui facilite son intégration transparente et immédiate au sein de structures de données tabulaires plus vastes, telles que les data.frames de base ou les tibbles modernes.
4.3 Gestion des cas limites et valeurs particulières
L’analyse empirique des données textuelles confronte inévitablement les algorithmes à des situations limites susceptibles d’induire des comportements indéterminés ou des plantages applicatifs si elles ne sont pas anticipées avec rigueur. Le premier cas limite classique concerne la comparaison impliquant une chaîne vide, notée « » en syntaxe R, présentant une longueur égale à 0 caractère. Conformément aux axiomes de la métrique d’édition, la distance séparant une chaîne vide d’une chaîne textuelle quelconque de longueur n correspond rigoureusement à la valeur n, traduisant le fait que n opérations d’insertion unitaire sont requises pour forger la séquence complète à partir du néant symbolique. Lorsque deux chaînes vides sont mutuellement comparées, la fonction stringdist(a = « », b = « », method = « lv ») renvoie logiquement et sans ambiguïté la valeur 0.
Le second enjeu majeur a trait au traitement systématique des valeurs manquantes, désignées conventionnellement par le symbole NA (Not Available) au sein de l’environnement R. Par conception, le package stringdist applique le principe de propagation logique des valeurs inconnues : toute comparaison d’édition impliquant au moins une opérande définie à NA produira invariablement la valeur NA_real_ comme résultat de sortie. Il convient toutefois de souligner l’existence de paramètres avancés permettant de modifier cette politique de propagation si des protocoles spécifiques l’exigent, bien que le maintien du statut manquant constitue la norme méthodologique la plus prudente sur le plan de l’intégrité inférentielle.
Enfin, la sensibilité à la casse (distinction impérative entre les lettres minuscules et les majuscules) constitue un facteur déterminant du résultat métrique. Dans son fonctionnement par défaut, la méthode de Levenshtein au sein de stringdist traite le caractère minuscule « a » et le caractère majuscule « A » comme deux symboles totalement distincts issus de l’alphabet machine, imposant ainsi un coût de substitution unitaire égal à 1 pour les aligner. L’analyste doit être pleinement conscient de cette séparation binaire : à défaut d’une étape de normalisation orthographique préalable, des variations typographiques purement superficielles peuvent être comptabilisées à tort comme des divergences morphologiques substantielles.
5. Exemple pratique 1 : Calcul de la distance de Levenshtein entre deux chaînes simples
5.1 Cas d’école : transition orthographique de ‘party’ à ‘park’
Pour appréhender concrètement le déploiement algorithmique de la métrique et saisir les transformations élémentaires qui s’opèrent lors de la résolution de la récurrence de Bellman, il est pédagogique d’étudier un cas d’école emblématique. Analysons la transition orthographique nécessaire pour transformer la chaîne source « party » en la chaîne cible « park ». La chaîne initiale se compose de cinq symboles consécutifs (p, a, r, t, y), tandis que la séquence terminale est constituée de quatre symboles (p, a, r, k). Une observation visuelle immédiate révèle une conservation parfaite du préfixe commun trilitère formé par les caractères « par ».
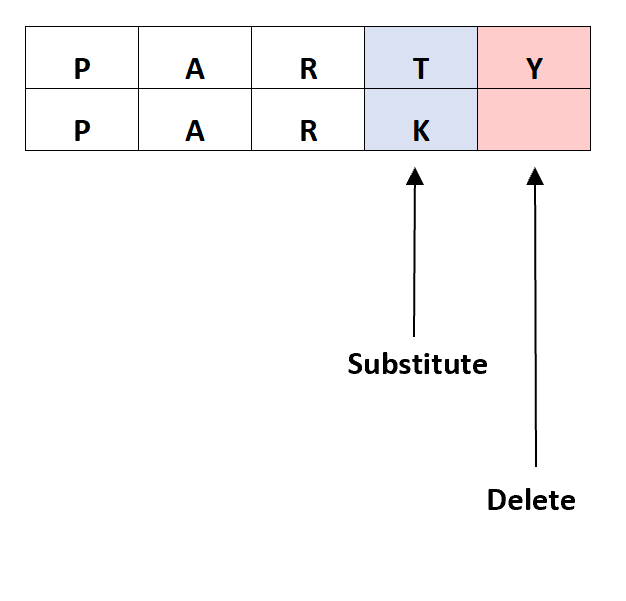
L’effort transformationnel se concentre exclusivement sur les segments terminaux des deux unités lexicales. Pour opérer la mutation de la quatrième position, le caractère « t » de la chaîne source doit être remplacé par le caractère « k » de la chaîne cible. Cette première intervention matérialise une opération de substitution unitaire, dont le coût conventionnel est fixé à 1. À ce stade intermédiaire de l’édition, la chaîne transformée prend la forme hypothétique « parky ». Il subsiste dès lors un symbole excédentaire en cinquième position, à savoir le caractère « y », qui ne trouve aucun homologue au sein du mot cible. La seconde étape requiert par conséquent une opération de suppression unitaire portant sur ce caractère final, consommant une seconde unité de coût d’édition.
La chaîne résultante correspond alors fidèlement au mot « park ». Aucune autre trajectoire de transformation ne permet d’accomplir ce passage en consommant un nombre inférieur d’opérations élémentaires. La sommation arithmétique des coûts associés aux modifications irréductibles identifiées (une substitution unitaire et une suppression unitaire) établit formellement que la distance de Levenshtein minimale séparant « party » de « park » est rigoureusement égale à 2. Ce résultat géométrique quantifie sans équivoque la proximité morphologique de ces deux unités lexicales au sein de l’espace d’édition discret.
5.2 Code commenté et exécution pas à pas dans RStudio
La transcription de cette démonstration formelle au sein de l’environnement RStudio se caractérise par une simplicité syntaxique exemplaire. L’analyste procède dans un premier temps à l’affectation formelle des chaînes d’intérêt au sein de deux variables scalaires distinctes à l’aide de l’opérateur d’assignation standard. Nous déclarons la variable mot_source recevant la valeur textuelle « party » et la variable mot_cible recevant la chaîne « park ». Cette pratique consistant à encapsuler les termes dans des identifiants explicites renforce la clarté et la maintenabilité des scripts d’analyse.
Dans un second temps, nous invoquons directement la routine principale du package en renseignant minutieusement l’ensemble des arguments requis : resultat_distance <- stringdist(a = mot_source, b = mot_cible, method = « lv »). L’exécution de cette ligne de commande commande au compilateur C sous-jacent d’allouer la matrice de Wagner-Fischer, de renseigner les conditions initiales aux frontières, et de faire converger le processus dynamique vers la cellule de coût minimal. L’inspection immédiate de l’objet resultat_distance via la console de R affiche sans surprise l’entier numérique 2.
Il est particulièrement instructif de valider la propriété fondamentale de symétrie topologique en exécutant la commande inverse, à savoir stringdist(a = mot_cible, b = mot_source, method = « lv »). La console renvoie à nouveau rigoureusement la valeur 2. Dans cette configuration rétrospective, le chemin d’édition optimal consiste d’abord à insérer le caractère « y » en fin de mot, puis à substituer le caractère « k » par le caractère « t ». Bien que la nature des opérations individuelles soit inversée (l’insertion succédant à la suppression), la métrique globale conserve une invariance absolue, démontrant ainsi la conformité de l’implémentation de stringdist avec les propriétés de symétrie de l’espace métrique.
5.3 Pondération personnalisée des coûts d’édition
L’hypothèse classique d’une équipondération stricte des opérations élémentaires d’édition, où chaque modification se voit affecter une pénalité identique fixée à 1, constitue une simplification théorique commode mais parfois inadaptée à la réalité empirique de certains domaines de recherche. En linguistique appliquée, par exemple, la substitution d’une voyelle par une autre au sein d’une racine morphologique peut être perçue comme une altération phonétique beaucoup plus légère et probable que la suppression radicale d’une consonne fondamentale. De même, en bio-informatique, les taux de mutation par délétion ou insertion ne s’alignent pas nécessairement sur les fréquences de transition nucléotidique.
Pour répondre à cette exigence de personnalisation analytique, la fonction stringdist() intègre le paramètre avancé weight. Ce paramètre attend un vecteur numérique de trois valeurs réelles positives spécifiant respectivement et successivement les pénalités associées aux opérations d’insertion, de suppression et de substitution. Par défaut, ce triplet de pondération est initialisé à c(1, 1, 1). Si un chercheur souhaite concevoir un protocole où l’altération de substitution est lourdement pénalisée par rapport aux ajustements de longueur, il peut assigner un vecteur asymétrique tel que weight = c(1, 1, 2.5).
Reprenons notre cas d’école reliant « party » à « park » sous cette nouvelle contrainte pondérée. Le chemin d’édition optimal identifié précédemment comprend une suppression (coût unitaire 1) et une substitution (désormais pénalisée à hauteur de 2.5). L’exécution de la commande stringdist(« party », « park », method = « lv », weight = c(1, 1, 2.5)) engendre une réévaluation instantanée de la métrique, laquelle produit désormais un score de distance composite de 3.5. La flexibilité de cette paramétrisation confère à l’analyste un pouvoir de modélisation considérable, lui permettant d’ajuster l’espace métrique aux propriétés distributionnelles et morphologiques précises de son objet d’investigation.
6. Exemple pratique 2 : Comparaison vectorielle et traitement par lots dans R
6.1 Vectorisation native et comparaison d’un terme à une liste
L’un des atouts architecturaux les plus puissants du langage R réside dans son paradigme de vectorisation native. Contrairement aux environnements de développement impératifs traditionnels qui contraignent le programmeur à formaliser des boucles itératives séquentielles pour parcourir les collections de données, R traite intrinsèquement les vecteurs comme des entités globales. Le package stringdist exploite intégralement cette philosophie computationnelle : ses fonctions sont nativement conçues pour accepter des collections vectorielles étendues en lieu et place de simples scalaires isolés, opérant ainsi une transition fluide vers le traitement par lots à haute performance.
Considérons la situation concrète où l’analyste souhaite mesurer le degré de divergence d’un lemme fautif ou suspect, par exemple le mot cible « chovalle », en le comparant simultanément à une liste normative de termes zoologiques comprenant « cheval », « chameau », « chouette », « chien » et « chevreuil ». L’exécution de la commande vectorielle stringdist(a = « chovalle », b = c(« cheval », « chameau », « chouette », « chien », « chevreuil »), method = « lv ») ne requiert aucune boucle explicite. En coulisses, le moteur compilé en C procède au recyclage de l’opérande scalaire pour évaluer de façon séquentielle et optimisée l’ensemble des distances d’édition associées.
La sortie générée par cette instruction est immédiatement matérialisée sous la forme d’un vecteur numérique complet, où chaque position correspond rigoureusement à l’indice du mot homologue dans le vocabulaire cible. L’élimination radicale des boucles de haut niveau en R garantit non seulement une clarté syntaxique remarquable, mais permet également d’atteindre des vitesses d’exécution maximales, les itérations étant déportées au niveau matériel par le code binaire compilé.
6.2 Identification du voisin le plus proche au sein d’un dictionnaire
L’étape succédant immédiatement au calcul des distances vectorielles consiste fréquemment à identifier l’élément du vocabulaire qui minimise la divergence textuelle, matérialisant ainsi la recherche du plus proche voisin orthographique. Pour automatiser cette extraction avec élégance au sein de R, nous combinons la sortie métrique de stringdist() avec les fonctions d’indexation conditionnelle de base, principalement which.min(). Cette fonction utilitaire inspecte le vecteur numérique résultant et retourne l’indice spatial correspondant à la première occurrence de la valeur minimale observée.
Appliquée à notre ensemble zoologique, l’instruction indice_optimal <- which.min(distances_calculees) isole précisément l’index positionnel du terme présentant la divergence d’édition la plus faible. En utilisant cet indice pour sous-échantillonner le vecteur de référence original dictionnaire[indice_optimal], l’analyste extrait instantanément le mot « cheval », dont la distance minimale est de 2 (résultant de la substitution de la lettre « o » par « e » et de la suppression du caractère « l » redondant). Cette routine constitue le noyau algorithmique de tout système élémentaire de correction orthographique automatisée.
Toutefois, une méthodologie analytique rigoureuse exige d’anticiper la présence potentielle d’ex æquo, c’est-à-dire de multiples termes équidistants de la chaîne cible au sein du dictionnaire. Dans ce cas de figure, la fonction which.min() présente la limitation de ne renvoyer arbitrairement que la première occurrence rencontrée. Pour lever cette incertitude et préserver l’intégrité de l’exploration lexicale, il est préférable de mobiliser l’expression logique dictionnaire[distances_calculees == min(distances_calculees)]. Cette formulation retourne l’ensemble exhaustif des candidats partageant la proximité minimale, permettant au chercheur d’appliquer ultérieurement des critères de départage plus subtils, tels que la fréquence d’usage lexicale ou le contexte syntaxique immédiat.
6.3 Intégration dans un flux de travail moderne avec dplyr
Dans l’ingénierie de données contemporaine sous R, les opérations d’analyse textuelle ne s’effectuent que rarement sur des vecteurs orphelins déconnectés de leur contexte d’observation. Elles s’insèrent le plus souvent au cœur de pipelines de manipulation élaborés s’appuyant sur l’écosystème Tidyverse, et plus spécifiquement sur le package dplyr. Grâce à sa vectorisation irréprochable, la fonction stringdist() s’intègre harmonieusement au sein des verbes de transformation tabulaire standard sans nécessiter d’adaptateurs complexes.
Imaginons un jeu de données expérimental stocké sous la forme d’un tibble, documentant les réponses fournies par des participants lors d’une tâche de dénomination rapide d’images. Ce tableau comporte une colonne identifiant le participant, une colonne transcription_produite contenant la saisie brute, et une colonne cible_attendue contenant la réponse canonique correcte. L’analyste peut quantifier instantanément l’exactitude de la restitution lexicale pour l’ensemble des observations en mobilisant la fonction mutate() : donnees_analysees <- donnees_brutes %>% mutate(ecart_levenshtein = stringdist(transcription_produite, cible_attendue, method = « lv »)).
Cette syntaxe déclarative permet ensuite de chaîner immédiatement des opérations d’agrégation statistique ou de filtrage conditionnel. Il devient par exemple trivial d’isoler les productions textuelles modérément altérées pour une inspection qualitative approfondie en appliquant un filtre sélectif : filter(ecart_levenshtein > 0 & ecart_levenshtein <= 2). De même, l’adjonction d’un tri hiérarchique via arrange(desc(ecart_levenshtein)) permet de réordonner l’ensemble du corpus pour identifier immédiatement les cas de déviance extrême ou les anomalies de transcription les plus sévères, garantissant ainsi un contrôle qualité d’une efficacité chirurgicale.
7. Exemple pratique 3 : Calcul de matrices de distance pour l’analyse lexicale
7.1 Génération de matrices complètes avec stringdistmatrix()
Tandis que la fonction stringdist() réalise des comparaisons terme à terme en appliquant les règles de recyclage vectoriel, certaines investigations structurales exigent la comparaison croisée et exhaustive de chaque élément d’un vocabulaire contre tous les autres membres d’un ensemble textuel. Pour satisfaire ce besoin analytique fondamental sans contraindre l’utilisateur à implémenter des produits cartésiens fastidieux, le package met à disposition la fonction dédiée stringdistmatrix(). Cette dernière produit en sortie une véritable matrice bidimensionnelle regroupant l’ensemble des distances d’édition possibles.
Lorsque la fonction stringdistmatrix(a, method = « lv ») est invoquée en lui passant un unique vecteur textuel de longueur p, elle génère une matrice carrée de dimensions p par p. Chaque cellule matricielle M(i, j) contient alors la distance de Levenshtein séparant le i-ème mot du j-ème mot du vecteur d’entrée. Par construction mathématique, la diagonale principale d’une telle matrice ne contient que des zéros stricts, matérialisant l’identité des indiscernables, tandis que les triangles supérieur et inférieur s’organisent en parfaite symétrie miroir conformément aux propriétés métriques précédemment démontrées.
De surcroît, la fonction permet de transmettre deux ensembles lexicaux distincts a et b présentant respectivement des longueurs p et q. Dans cette configuration, stringdistmatrix(a, b, method = « lv ») engendre une matrice rectangulaire de dimensions p par q. Ce cas d’usage s’avère particulièrement fécond lorsque l’analyste cherche à projeter un vocabulaire expérimental nouveau sur un lexique de référence normatif établi au préalable, offrant ainsi une vision globale et tabulée de l’ensemble des appariements potentiels au sein d’une structure de données mathématiquement optimisée.
7.2 Conversion de la matrice au format objet ‘dist’
Bien que les matrices carrées standard issues de stringdistmatrix() fournissent une représentation explicite et intuitive de l’espace métrique, leur structure redondante pose des limites évidentes en termes de consommation de mémoire vive. En effet, stocker simultanément la diagonale nulle et les deux triangles symétriques équivaut à dupliquer inutilement l’information géométrique. Dans l’écosystème R, la classe d’objets standard dédiée à la représentation formelle des dissimilarités triangulaires est la classe « dist ».
Pour convertir une matrice de distance de Levenshtein carrée en une structure d’analyse spatiale canonique, il convient d’appliquer la fonction de conversion as.dist(). L’instruction matrice_compacte <- as.dist(matrice_brute) élague instantanément les redondances diagonales et supérieures, ne conservant en mémoire que le vecteur condensé représentant le triangle inférieur strict. Cette transformation allège l’empreinte mémoire d’environ la moitié du volume matriciel initial, ce qui s’avère crucial lorsque l’analyse porte sur des lexiques comprenant plusieurs milliers d’unités lexicales distinctes.
Au-delà du gain spatial indéniable, la conversion au format « dist » confère à l’objet résultant une interopérabilité absolue avec l’ensemble des algorithmes de statistique multivariée et de classification non supervisée intégrés au socle de base de R. Les fonctions d’ordination multidimensionnelle (telles que cmdscale pour le positionnement multidimensionnel classique) et les moteurs de segmentation hiérarchique reconnaissent nativement cette classe d’objets, assurant une passerelle technique transparente entre le calcul d’édition textuelle et l’exploration géométrique avancée.
7.3 Exploration visuelle par classification hiérarchique (dendrogramme)
L’une des exploitations analytiques les plus stimulantes d’une matrice de Levenshtein condensée réside dans la classification ascendante hiérarchique des formes lexicales. L’objectif consiste à agréger progressivement les mots présentant les plus faibles coûts d’édition mutuels afin de révéler l’architecture taxinomique sous-jacente du corpus étudié. Pour concrétiser cette modélisation, l’analyste mobilise la fonction fondamentale hclust() en lui injectant directement l’objet de dissimilarité converti : classification_orthographique <- hclust(matrice_compacte, method = « ward.D2 »).
Le choix de la méthode d’agrégation conditionne la topologie de la classification. Si le critère du lien complet privilégie des grappes compactes aux diamètres métriques restreints, le critère d’inertie minimale de Ward (ward.D2) tend à structurer des partitions équilibrées et particulièrement lisibles en minimisant la variance intra-groupe à chaque étape de fusion. Le passage de cette modélisation statistique à sa restitution graphique s’effectue simplement via l’instruction générique plot(classification_orthographique), qui projette instantanément le dendrogramme associé sur le périphérique visuel de R.
L’observation du dendrogramme résultant permet de visualiser avec une clarté remarquable les proximités généalogiques et dérivationnelles des mots. Les lexèmes partageant des racines étymologiques communes, des flexions grammaticales similaires ou des compositions morphologiques apparentées s’associent spontanément au sein des branches inférieures de l’arbre avant de se fondre dans des macro-structures plus hétérogènes. Cette méthodologie d’exploration visuelle fournit aux linguistes et aux humanistes numériques un outil de synthèse quantitatif exceptionnel pour cartographier le paysage morphologique de corpus textuels volumineux.
8. Applications en psycholinguistique et sciences cognitives computationnelles
8.1 Modélisation du voisinage orthographique et accès au lexique mental
En psycholinguistique cognitive, la question de l’accès au lexique mental constitue un domaine d’investigation central depuis plusieurs décennies. Comment le système visuel et cérébral humain parvient-il, en quelques centaines de millisecondes, à reconnaître un mot écrit parmi des dizaines de milliers de représentations stockées en mémoire à long terme ? Les modèles théoriques de l’activation interactive postulent que la présentation visuelle d’un stimulus déclenche l’activation parallèle non seulement du mot cible, mais également d’un ensemble de candidats lexicaux structurellement similaires, désignés sous le concept de « voisins orthographiques ».
Historiquement, Max Coltheart et ses collaborateurs ont formalisé la mesure du voisinage orthographique (connue sous l’appellation de N de Coltheart) comme le nombre total de mots de même longueur pouvant être formés en substituant une seule lettre au stimulus de référence. Si cette métrique a permis des avancées notables, elle souffre d’une limitation théorique majeure : son incapacité intrinsèque à intégrer des mots de longueurs différentes résultant d’une simple insertion ou délétion. L’adoption de la distance de Levenshtein par les sciences cognitives computationnelles a permis de dépasser ce carcan rigide grâce au formalisme du « Levenshtein Distance 20 » (OLD20). Développé initialement par Emmanuel Keuleers et ses pairs, le score OLD20 calcule pour un mot cible donné la distance moyenne de Levenshtein qui le sépare de ses 20 voisins les plus proches au sein d’un lexique normé.
Les investigations chronométriques démontrent une corrélation robuste entre la densité du voisinage mesurée par la métrique d’édition et le temps de décision lexicale mesuré chez des participants humains. Un mot isolé au sein d’un désert orthographique (présentant un indice de divergence moyen élevé par rapport au reste du dictionnaire) fait l’objet d’un traitement perceptif significativement plus rapide qu’un mot immergé au cœur d’un voisinage dense, ce dernier provoquant une intense compétition inhibitrice entre représentations candidates. En automatisant le calcul de ces indices métriques continus au travers de R, les chercheurs peuvent ainsi calibrer avec une rigueur paramétrique inédite leurs stimuli expérimentaux et tester des modèles computationnels de lecture de haute précision.
8.2 Quantification des distorsions dans les épreuves de rappel verbal
L’évaluation quantitative des performances de la mémoire épisodique et de la mémoire de travail mobilise fréquemment des protocoles de rappel libre ou indicé au cours desquels les sujets sont invités à restituer oralement ou par écrit une liste de lemmes préalablement mémorisés. Dans les contextes cliniques de neuropsychologie (notamment dans l’évaluation des démences de type Alzheimer, des aphasies progressives ou des traumatismes crâniens), les défaillances mnésiques ne se traduisent pas uniquement par des omissions franches, mais également par la production d’intrusions, de néologismes ou de paraphasies phonémiques complexes.
L’analyse manuelle et discrétionnaire de ces distorsions verbales présente des risques manifestes d’inconsistance et de biais inter-évaluateurs. L’application systématique de la distance de Levenshtein permet de transformer une évaluation qualitative subjective en une mesure biométrique continue et hautement standardisée. En calculant la distance d’édition séparant chaque production erronée du stimulus originellement présenté, le chercheur quantifie avec précision l’amplitude de la dégradation de la trace mnésique. Un patient produisant des formes situées à une distance de Levenshtein de 1 ou 2 manifeste une préservation partielle de la structure phonologique du mot cible, tandis qu’une divergence supérieure ou égale à 4 traduit une déstructuration lexicale profonde ou l’émergence d’une intrusion sémantique non apparentée.
Cette approche algorithmique autorise l’automatisation intégrale du calcul des scores de fidélité mémorielle sur des cohortes cliniques massives. Au sein de R, des scripts dédiés peuvent ingérer des milliers de protocoles de rappel transcrits, calculer les matrices de déviation d’édition par rapport aux référentiels normatifs, et modéliser ces trajectoires d’altération au moyen de régressions linéaires à effets mixtes, ouvrant ainsi la voie à un phénotypage cognitif d’une finesse diagnostique sans précédent.
8.3 Nettoyage automatique des réponses libres dans les questionnaires psychométriques
La collecte de données psychométriques ou épidémiologiques au moyen de questionnaires numériques auto-administrés sur Internet s’est imposée comme une pratique méthodologique incontournable pour atteindre de larges échantillons de participants. Néanmoins, l’inclusion de questions ouvertes appelant des réponses textuelles courtes (telles que le nom de la profession exercée, la localisation géographique de résidence ou la dénomination d’une substance consommée) se heurte inévitablement à la prolificité des coquilles typographiques, des erreurs d’orthographe et des variations dialectales introduites par les sondés lors de la frappe au clavier.
Le traitement manuel de ces incohérences lexicales mobilise des ressources humaines considérables et introduit des décisions d’arbitrage difficilement reproductibles. Grâce à l’algorithme de Levenshtein déployé sous stringdist, il devient possible de concevoir une chaîne de traitement automatisée et parfaitement documentée de standardisation des réponses ouvertes. Le protocole consiste à confronter chaque saisie brute non reconnue à une nomenclature normative officielle (par exemple, le répertoire des métiers ou le dictionnaire des communes) et à évaluer la distance métrique minimale.
En établissant un seuil de décision prudent — par exemple en n’autorisant la correction automatique que pour des réponses présentant une distance d’édition strictement égale à 1 par rapport à un unique candidat de référence —, le chercheur préserve l’intégrité de ses données qualitatives tout en réduisant le bruit d’échantillonnage de manière spectaculaire. Les cas plus ambigus ou présentant des distances supérieures peuvent être isolés algorithmiquement pour un examen ciblé, optimisant ainsi le temps d’intervention humaine et garantissant la traçabilité intégrale de chaque modification appliquée au corpus empirique.
9. Variantes métriques et distinctions algorithmiques dans stringdist
9.1 La distance de Damerau-Levenshtein (méthode ‘dl’)
Si la métrique de Levenshtein classique fournit un modèle mathématique élégant, elle présente une lacune notable dès lors qu’il s’agit d’étudier les erreurs motrices résultant de la saisie sur un clavier dactylographique. L’accident de frappe le plus répandu chez l’opérateur humain consiste en effet en une inversion rapide de deux lettres consécutives, désignée sous le terme technique de transposition de caractères adjacents (par exemple, saisir par inadvertance « tehcno » au lieu de « techno »). Dans le cadre strict de Levenshtein, une telle transposition requiert obligatoirement deux opérations distinctes : la suppression d’un caractère suivie de sa réinsertion ultérieure, ou une double substitution croisée, portant le coût métrique total à 2.
Pour remédier à cette anomalie descriptive, Fred Damerau a proposé d’enrichir le jeu des opérations élémentaires en élevant la transposition de deux symboles immédiatement adjacents au rang d’opération atomique recevant un coût unitaire fixé à 1. Dans le package stringdist, cette variante algorithmique est invoquée en spécifiant method = « dl ». L’algorithme de Damerau-Levenshtein complet modélise fidèlement cette dynamique, autorisant l’application de transpositions répétées même sur des sous-chaînes ayant déjà fait l’objet d’éditions antérieures.
La distance de Damerau-Levenshtein présente une pertinence phénoménologique supérieure dès lors que l’on analyse des corpus issus de la communication médiée par ordinateur, des messages de réseaux sociaux ou des protocoles expérimentaux chronométrés où les participants tapent sous contrainte temporelle. Dans ces contextes, traiter une transposition comme une déformation simple de coût 1 reflète fidèlement la réalité biomécanique du geste de frappe, évitant ainsi de surévaluer artificiellement la divergence cognitive séparant la saisie de son modèle orthographique.
9.2 La distance d’alignement optimal (méthode ‘osa’)
Une subtilité algorithmique fondamentale, trop souvent ignorée des praticiens, réside dans la distinction entre la véritable distance de Damerau-Levenshtein et la distance dite d’alignement optimal des chaînes, désignée sous l’acronyme anglais Optimal String Alignment (OSA). Au sein du package stringdist, cette dernière correspond à l’identifiant method = « osa », qui constitue d’ailleurs la valeur par défaut appliquée par la fonction lorsque l’argument de méthode n’est pas explicité par l’utilisateur.
L’algorithme OSA, parfois dénommé distance de Levenshtein restreinte, autorise la transposition de deux caractères adjacents avec un coût unitaire de 1, mais impose une contrainte algorithmique stricte : aucune sous-chaîne individuelle ne peut subir plus d’une opération d’édition unitaire au cours du processus global de transformation. Cette limitation structurelle simplifie la mise en œuvre de la programmation dynamique en interdisant le retour arrière complexe sur des segments déjà modifiés, ce qui garantit des performances computationnelles optimales.
Cependant, cette restriction brise une propriété mathématique capitale : la métrique OSA ne respecte pas inconditionnellement l’inégalité triangulaire, ce qui l’exclut au sens strict de la catégorie des véritables métriques topologiques. Considérons à titre d’illustration la transformation reliant la chaîne « ca » à la chaîne « abc ». Selon l’algorithme complet de Damerau-Levenshtein (méthode « dl »), nous pouvons insérer un « b » initial pour former « bca », puis transposer « bc » en « cb » pour obtenir « cba », et ainsi de suite. Selon l’algorithme « osa », l’impossibilité de rééditer la même sous-chaîne interdit l’exploitation optimale de cette transposition combinée, forçant l’application d’une séquence plus coûteuse de suppressions et d’insertions pures (produisant un coût métrique de 3 au lieu de 2). L’analyste se doit d’être conscient de ces nuances formelles afin de sélectionner l’algorithme en parfaite adéquation avec ses impératifs mathématiques.
9.3 La distance de Hamming (méthode ‘hamming’)
Parmi les métriques alternatives implémentées au sein de l’architecture de stringdist, la distance de Hamming, sélectionnable via method = « hamming », représente le cas limite le plus contraignant et le plus élémentaire de l’analyse d’édition. Élaborée par Richard Hamming en 1950 dans le cadre de la théorie des codes et des circuits numériques, cette mesure se focalise exclusivement sur la détection des inversions de symboles position par position au sein de séquences dimensionnellement fixes.
La contrainte structurelle inhérente à la méthode de Hamming réside dans l’obligation stricte d’égalité des longueurs des chaînes comparées. La métrique exclut catégoriquement toute opération d’insertion ou de suppression de caractères. Le calcul de la distance consiste simplement à énumérer le nombre d’indices positionnels i pour lesquels le caractère a[i] diffère formellement du caractère b[i]. Si l’utilisateur tente de soumettre à stringdist(a, b, method = « hamming ») deux vecteurs de chaînes présentant des nombres de caractères inégaux, la routine interrompt le traitement et renvoie systématiquement la valeur infinie (Inf) assortie d’un message d’avertissement formel.
En conséquence, les cas d’usage de la distance de Hamming demeurent circonscrits à des contextes expérimentaux très particuliers où la taille des séquences est rigoureusement invariante par construction. On la retrouve fréquemment en bio-informatique lors de la comparaison d’alignements multiples de gènes préalablement recalés et complétés par des tirets d’espacement, ou en morphométrie expérimentale pour l’analyse de motifs combinatoires codés sous forme de vecteurs binaires ou d’acronymes standardisés de longueur fixe. Pour toute problématique générale d’analyse textuelle ouverte, la distance de Levenshtein demeure la référence indiscutable par sa tolérance aux fluctuations de longueur.
10. Prétraitement textuel et normalisation avant le calcul de distance
10.1 Harmonisation de la casse et suppression des diacritiques
La mise en œuvre efficiente et sémantiquement pertinente de la distance de Levenshtein dépend au premier chef de la qualité du pipeline de nettoyage textuel exécuté en amont des calculs algorithmiques. En effet, les fonctions d’édition opèrent au niveau de la forme de surface des chaînes de caractères et demeurent rigoureusement aveugles à la signification des symboles manipulés. L’absence d’une harmonisation systématique de la typographie peut induire des distorsions métriques majeures qui faussent l’interprétation des résultats empiriques.
La première phase incontournable de ce prétraitement consiste en l’harmonisation intégrale de la casse typographique, généralement réalisée en convertissant l’intégralité des corpus textuels en lettres minuscules au moyen de la fonction tolower() du socle de base de R. Cette opération simple élimine instantanément les variations dues à l’emploi de majuscules de position en début de phrase ou à l’utilisation expressive de majuscules intégrales, évitant ainsi que chaque divergence de casse ne soit comptabilisée à tort comme une substitution orthographique de coût unitaire.
La seconde phase, particulièrement cruciale pour le traitement de la langue française et d’autres idiomes à forte charge orthographique, concerne le traitement des accents et signes diacritiques (accents aigus, graves, circonflexes, trémas et cédilles). Si le protocole expérimental vise à évaluer la structure morphologique abstraite plutôt que l’exactitude typographique absolue, il est hautement recommandé de procéder à la désaccentuation des chaînes. L’outil le plus robuste pour mener à bien cette opération sans risque de corruption d’encodage est la fonction stri_trans_general() issue du package stringi, en lui appliquant la transformation translittérative « Latin-ASCII ». Ce traitement dissout élégamment les diacritiques en transformant un « é » ou un « è » en simple « e », harmonisant ainsi l’espace symbolique d’entrée.
10.2 Nettoyage des espaces et des caractères de ponctuation
Les espaces blancs, qu’ils se matérialisent sous la forme de pressions sur la barre d’espace, de tabulations horizontales ou de retours à la ligne, constituent des caractères à part entière du point de vue de l’ordinateur. Dans les corpus issus de saisies expérimentales ou de formulaires numériques, il est extrêmement fréquent que des espaces parasites s’insèrent involontairement au début ou à la fin des réponses formulées par les sujets. La présence d’un espace final surnuméraire dans la chaîne « maison » comparée à « maison » engendre mécaniquement une distance de Levenshtein égale à 1, reflétant l’insertion d’un caractère d’espacement invisible à l’œil nu.
Pour immuniser les calculs contre ces artéfacts géométriques, l’analyste applique systématiquement la fonction native trimws() à l’ensemble de ses vecteurs textuels, ce qui assure la suppression immédiate de tous les blancs de tête et de queue. Par ailleurs, lorsque les réponses libres comportent plusieurs mots successifs séparés de manière anarchique par des espaces multiples, l’utilisation conjointe d’expressions régulières via gsub(« s+ », » « , texte) permet d’écraser toute séquence continue d’espacements en un blanc typographique unique et canonique.
Enfin, la gestion de la ponctuation et des symboles non alphabétiques doit faire l’objet d’un arbitrage méthodologique explicite. Dans la majorité des contextes de classification lexicale, les apostrophes, tirets, points et virgules ne participent pas de la variabilité morphologique fondamentale et doivent être éliminés ou standardisés. L’application d’un filtre régulier ciblé, tel que gsub(« [[:punct:]] », « », texte), permet de purger les chaînes de tout résidu sémiotique parasite, garantissant que la distance de Levenshtein calculée ultérieurement reflétera exclusivement la dynamique transformationnelle des structures alphabétiques sous-jacentes.
10.3 Résolution des problèmes d’encodage multilingue
L’une des sources d’erreurs les plus pernicieuses en informatique linguistique réside dans l’hétérogénéité des systèmes d’encodage de caractères. Un fichier textuel ancien encodé sous la norme ISO-8859-1 (Latin-1) interprété par une session logicielle moderne configurée nativement sous le standard universel UTF-8 peut voir ses caractères étendus altérés ou dédoublés au niveau de la couche d’octets machine. Dès lors qu’un caractère accentué est malencontreusement représenté par une séquence de deux octets distincts non décodés, la fonction d’édition calculera les distances sur la base de ces fragments octaux dégradés plutôt que sur l’entité graphémique réelle.
Pour prévenir ces dérives critiques, il est impératif d’intégrer une étape de validation et de conversion d’encodage en tête de tout script d’analyse textuelle dans R. La fonction stringi::stri_enc_isutf8() permet de vérifier immédiatement la conformité de l’ensemble des éléments d’un vecteur avec le standard UTF-8. En cas de non-conformité avérée ou de doute structurel sur l’origine des fichiers sources, l’instruction iconv(texte, from = « », to = « UTF-8 ») force une réencapsulation rigoureuse des chaînes de caractères au sein de la table d’encodage de référence de la session.
De surcroît, le standard Unicode admet parfois plusieurs représentations binaires formellement distinctes pour un même caractère graphique perçu à l’écran (phénomène connu sous le nom de formes de normalisation NFC et NFD, où un caractère accentué peut être codé sous forme de point de code précomposé unique ou par la décomposition d’une lettre de base suivie d’un diacritique combinatoire indépendant). Pour neutraliser cette variabilité sous-jacente, il est fortement conseillé d’invoquer stringi::stri_trans_nfc(texte). Cette normalisation canonique garantit une uniformité totale de la structure binaire des symboles avant leur injection dans les matrices de programmation dynamique de stringdist, préservant ainsi l’exactitude des calculs métriques.
11. Optimisation des performances et passage à l’échelle sur de volumineux corpus
11.1 Exploitation du multithreading avec le paramètre nthread
Lorsque la taille des corpus textuels franchit le cap de plusieurs centaines de milliers d’occurrences, le volume combinatoire des calculs de programmation dynamique peut rapidement saturer les capacités d’un cœur de processeur unique. Consciente de ces impératifs de passage à l’échelle industrielle, l’architecture du package stringdist intègre une prise en charge native du parallélisme à mémoire partagée via l’interface de programmation OpenMP, directement implémentée au niveau des boucles de bas niveau en langage C.
Cette fonctionnalité d’accélération s’active et se calibre aisément au travers du paramètre optionnel nthread présent au sein des fonctions stringdist() et stringdistmatrix(). Par défaut, le package interroge le système d’exploitation pour déterminer le nombre de threads logiques allouables sans déstabiliser l’environnement de travail. Toutefois, dans le cadre de serveurs de calcul haute performance ou de stations de travail multi-processeurs, l’analyste peut assigner explicitement une puissance de feu dédiée, par exemple via nthread = 8 ou nthread = parallel::detectCores() – 1, afin de mobiliser l’ensemble des ressources physiques disponibles.
Les gains de temps de calcul observés lors de l’activation du multithreading sont spectaculaires et s’approchent fréquemment d’une scalabilité linéaire sur des matrices de comparaison étendues. La distribution des paires de chaînes entre les différents threads s’effectue avec une empreinte mémoire globale maîtrisée, évitant la copie redondante des structures de données volumineuses inhérente aux architectures de parallélisme par sockets réseau. Cette efficacité permet d’aborder sereinement des chantiers de fouille de données textuelles massives qui auraient nécessité des heures de traitement sous une exécution mono-threadée séquentielle.
11.2 Filtrage précoce par seuil avec le paramètre maxDist
Dans un nombre considérable de scénarios analytiques, tels que la recherche de doublons lexicaux ou la détection d’erreurs de frappe légères, l’analyste ne s’intéresse en réalité qu’aux paires de mots présentant une proximité orthographique très étroite (par exemple, une distance de Levenshtein inférieure ou égale à 1 ou 2). Calculer l’intégralité des coûts d’édition pour des paires de mots totalement disparates dont la distance réelle s’élève à 10 ou 15 représente un gaspillage massif de cycles processeur.
Pour répondre à cette problématique d’optimisation sélective, stringdist propose le paramètre stratégique maxDist. En assignant à cet argument un seuil numérique plafond, par exemple maxDist = 2, l’utilisateur active un mécanisme d’interruption algorithmique précoce. En interne, l’algorithme C surveille en permanence la progression des coûts au sein de la matrice d’édition. Dès qu’il est mathématiquement démontré, sur la base des longueurs de préfixes et de la diagonale courante, que la distance finale excédera inéluctablement le seuil de 2, le calcul de la cellule est instantanément avorté.
Pour les paires de séquences dont la divergence dépasse la limite spécifiée, la fonction retourne immédiatement la valeur spéciale Inf (l’infini mathématique) sans gaspiller de ressources de calcul supplémentaires. Cette heuristique permet d’accélérer les temps de traitement d’un ou deux ordres de grandeur sur des vocabulaires hétérogènes, réduisant des opérations massives à quelques secondes d’exécution tout en fournissant l’exacte information d’appariement recherchée par le chercheur pour les sous-ensembles pertinents.
11.3 Benchmarking et comparaison de performances
Pour évaluer de manière scientifique et objective l’efficacité des différentes solutions computationnelles disponibles dans l’environnement R, il est essentiel de déployer des protocoles de métrologie chronométrique rigoureux. L’outil de référence pour mener à bien ces évaluations de performance est le package microbenchmark, qui exécute de manière répétée et contrôlée les instructions cibles tout en neutralisant les artéfacts liés à l’activité asynchrone du système d’exploitation et aux cycles du ramasse-miettes (garbage collector) de R.
Une comparaison expérimentale classique oppose l’implémentation artisanale d’une boucle de Wagner-Fischer en code R pur, la fonction native adist() de la bibliothèque de base utils, et la fonction stringdist() paramétrée avec method = « lv ». Les résultats obtenus sur un échantillon représentatif de plusieurs milliers de comparaisons textuelles sont sans appel : l’algorithme codé en R interprété accuse un retard rédhibitoire, se montrant couramment 500 à 1 500 fois plus lent que les routines optimisées. La fonction native adist() offre un comportement intermédiaire honorable, mais reste largement distancée par stringdist(), qui se révèle entre 5 et 15 fois plus rapide grâce à la compilation C ANSI et à l’optimisation des vecteurs de cache.
Au-delà de 100 000 paires de données à traiter, l’adoption combinée de stringdist(), du multithreading OpenMP et du seuillage par maxDist s’impose comme l’unique stratégie viable pour maintenir des temps de traitement compatibles avec les exigences de la recherche computationnelle moderne. Ces benchmarks démontrent avec force que le choix de la bibliothèque logicielle et la compréhension fine de ses mécanismes sous-jacents conditionnent directement la faisabilité technique d’un projet de recherche textuelle à grande échelle.
12. Cas d’usage avancé : Jointures floues et correction automatisée dans les protocoles de recherche
12.1 Appariement flou de tables de données avec le package fuzzyjoin
Dans la pratique quotidienne des sciences expérimentales et de la gestion de données de cohortes longitudinales, l’un des obstacles les plus récurrents réside dans la réconciliation de bases de données hétérogènes dépourvues de clés primaires d’identification strictes. Les identifiants textuels (tels que les noms de famille des participants, les intitulés de spécialités médicales ou les adresses géographiques) sont fréquemment altérés d’une vague d’enquête à l’autre par des variations de saisie, des coquilles d’encodage ou des troncatures involontaires. Une jointure relationnelle classique de type inner_join() ou left_join() échoue lamentablement à apparier ces enregistrements en raison de l’absence d’égalité logique stricte.
Pour surmonter cette impasse méthodologique, l’écosystème Tidyverse propose le package spécialisé fuzzyjoin, développé par David Robinson. Ce module étend la syntaxe expressive de dplyr en permettant d’effectuer des jointures conditionnelles fondées sur des métriques de distance non nulles. La fonction maîtresse stringdist_join() encapsule directement l’algorithme de stringdist au cœur de la mécanique de jointure tabulaire, offrant ainsi un cadre d’appariement flou d’une robustesse exceptionnelle.
L’utilisation de stringdist_inner_join(table_a, table_b, by = « identifiant_participant », method = « lv », max_dist = 2) permet de réconcilier automatiquement deux tables distinctes dès lors que la divergence de Levenshtein séparant les identifiants textuels n’excède pas 2 opérations d’édition élémentaires. L’analyste doit toutefois calibrer scrupuleusement la valeur du paramètre max_dist : un seuil trop permissif engendre des faux positifs pernicieux en appariant indûment des individus distincts portant des patronymes morphologiquement proches, tandis qu’un seuil trop conservateur entraîne une déperdition d’observations précieuses. L’inspection statistique post-jointure des distances effectives constitue à cet égard une étape indispensable de contrôle qualité.
12.2 Implémentation d’un correcteur orthographique contextuel
L’application la plus démonstrative de la distance de Levenshtein réside dans la construction d’un moteur autonome de correction orthographique adapté aux spécificités lexicales d’un protocole expérimental donné. Contrairement aux correcteurs commerciaux généralistes qui reposent sur des dictionnaires normatifs figés et intègrent des règles morphosyntaxiques complexes, un correcteur contextuel de laboratoire peut être configuré de manière extrêmement épurée et reproductible directement au sein d’un script R.
La première phase opérationnelle consiste à établir la table lexicale normative du protocole. Ce dictionnaire de vérité terrain rassemble l’exhaustivité des termes acceptables pour l’expérience, associés le cas échéant à leurs fréquences d’apparition relatives au sein du corpus de référence. Lorsqu’une chaîne textuelle saisie par un participant est soumise au système, ce dernier teste en premier lieu son appartenance stricte au dictionnaire via une instruction conditionnelle simple. Si le mot est reconnu sans ambiguïté, il est préservé sans modification.
En cas de non-reconnaissance, l’algorithme déclenche le calcul vectoriel de la distance de Levenshtein entre le mot inconnu et chaque entrée du dictionnaire normatif. Le programme isole les candidats minimisant la métrique d’édition. En cas d’unicité du plus proche voisin, le terme fautif est automatiquement substitué par cette cible optimale. Dans l’éventualité où plusieurs candidats émergent ex æquo au même niveau de distance minimale (par exemple, à une distance de 1), l’algorithme opère un départage probabiliste rigoureux en sélectionnant le terme présentant la fréquence d’usage la plus élevée dans la population générale. L’évaluation continue de ce dispositif expérimental au moyen de métriques de précision et de rappel permet de garantir une correction transparente, neutre et mathématiquement documentée des corpus textuels recueillis.
12.3 Recommandations méthodologiques et reproductibilité scientifique
L’intégration de la distance de Levenshtein et des techniques de fouille textuelle au sein des protocoles scientifiques contemporains impose une conformité exemplaire avec les standards actuels de la science ouverte et de la reproductibilité computationnelle. La validité des conclusions empiriques déduites de corpus textuels nettoyés ou analysés par voie algorithmique repose intégralement sur la capacité des pairs à répliquer chaque étape du traitement avec une fidélité absolue.
Dans cette perspective, il est primordial que les chercheurs documentent formellement, au sein de leurs publications académiques ou de leurs cahiers de laboratoire électroniques, la version exacte de la distribution R et des bibliothèques mobilisées (particulièrement stringdist et stringi). Le nom complet de la méthode métrique appliquée (en explicitant impérativement s’il s’agit de la distance de Levenshtein pure « lv », de l’alignement optimal « osa », ou de Damerau-Levenshtein « dl ») ainsi que les pondérations vectorielles exactes affectées aux opérations d’édition doivent être consignés de manière transparente dans la section méthodologique.
Enfin, la communauté de recherche encourage vivement la publication en libre accès, sur des dépôts institutionnels ou des plateformes pérennes telles que Zenodo ou l’Open Science Framework (OSF), des scripts R exhaustifs assurant le prétraitement des chaînes, le calcul des métriques et l’appariement des tables. Ce niveau d’exigence méthodologique garantit non seulement l’intégrité scientifique des analyses menées sous R, mais participe activement à la constitution d’un corpus partagé d’outils computationnels standardisés pour l’avancement collectif des sciences du langage et de l’information.
Références
- Coltheart, M., Davelaar, E., Jonasson, J. T., & Besner, D. (1977). Access to the internal lexicon. Dans S. Dornic (Dir.), Attention and Performance VI (pp. 535–555). Lawrence Erlbaum Associates.
- Damerau, F. J. (1964). A technique for computer detection and correction of spelling errors. Communications of the ACM, 7(3), 171–176. https://doi.org/10.1145/363958.363994
- Hamming, R. W. (1950). Error detecting and error correcting codes. Bell System Technical Journal, 29(2), 147–160. https://doi.org/10.1002/j.1538-7305.1950.tb00463.x
- Keuleers, E., & Brysbaert, M. (2010). Wuggy: A multilingual pseudoword generator. Behavior Research Methods, 42(3), 627–633. https://doi.org/10.3758/BRM.42.3.627
- Levenshtein, V. I. (1966). Binary codes capable of correcting deletions, insertions, and reversals. Soviet Physics Doklady, 10(8), 707–710.
- Robinson, D. (2020). fuzzyjoin: Join tables together on inexact matching (R package version 0.1.6). Comprehensive R Archive Network. https://cran.r-project.org/package=fuzzyjoin
- Ukkonen, E. (1985). Algorithms for approximate string matching. Information and Control, 64(1–3), 100–118. https://doi.org/10.1016/S0019-9958(85)80046-2
- van der Loo, M. P. J. (2014). The stringdist package for approximate string matching. The R Journal, 6(1), 111–122. https://doi.org/10.32614/RJ-2014-011
- Wagner, R. A., & Fischer, M. J. (1974). The string-to-string correction problem. Journal of the ACM, 21(1), 168–173. https://doi.org/10.1145/321796.321811
- Wickham, H., François, R., Henry, L., & Müller, K. (2023). dplyr: A grammar of data manipulation (R package version 1.1.4). Comprehensive R Archive Network. https://cran.r-project.org/package=dplyr