
Dans le champ de l’analyse statistique contemporaine et de la psychométrie appliquée, le traitement des distributions empiriques se heurte fréquemment au postulat restrictif de la normalité. Alors que la majorité des manuels d’introduction privilégient la distribution de Gauss et sa règle empirique associée, les praticiens et chercheurs en sciences quantitatives observent régulièrement des jeux de données caractérisés par une asymétrie prononcée, une multimodalité sous-jacente ou des queues de distribution épaisses. Face à ces architectures distributionnelles non gaussiennes, l’application aveugle des intervalles de confiance paramétriques conventionnels introduit des distorsions méthodologiques majeures susceptibles de biaiser l’interprétation des scores d’évaluation ou des indicateurs comportementaux.
Pour pallier ces défaillances théoriques, le théorème de Tchebychev, également désigné sous le nom d’inégalité de Bienaymé-Tchebychev, offre un cadre inférentiel universel d’une élégance mathématique remarquable. Formulé initialement par le mathématicien russe Pafnouti Tchebychev au XIXe siècle en s’appuyant sur les travaux précurseurs d’Irénée-Jules Bienaymé, ce résultat fondamental établit une borne inférieure garantie quant à la proportion d’observations comprises à l’intérieur d’un intervalle défini autour de la moyenne arithmétique, exprimé en multiples d’écarts-types. L’atout conceptuel réside dans le caractère non paramétrique de cette proposition : aucune hypothèse relative à la symétrie, à l’aplatissement ou à la continuité de la densité sous-jacente n’est requise.
L’environnement de calcul fourni par Microsoft Excel constitue une plateforme particulièrement adaptée pour opérationnaliser ce principe statistique fondamental. Qu’il s’agisse de traiter des temps de latence cognitive, des scores cliniques d’inventaire ou des métriques organisationnelles de performance, le tableur permet d’automatiser le calcul des bornes, d’évaluer la dispersion relative et de confronter les garanties théoriques minimales aux fréquences empiriques observées. Ce guide encyclopédique détaille de manière exhaustive l’ensemble des fondements mathématiques, des configurations logicielles, des démarches algorithmiques et des applications sectorielles nécessaires pour maîtriser le théorème de Tchebychev dans Excel avec une rigueur analytique irréprochable.
1. Introduction théorique au théorème de Tchebychev et son utilité statistique
1.1 Définition formelle et portée universelle du théorème
L’énoncé mathématique fondamental de l’inégalité de Tchebychev postule que pour toute variable aléatoire réelle, notée X, possédant une moyenne arithmétique finie mu et une variance finie sigma au carré, la probabilité que la variable s’éloigne de sa moyenne d’au moins k fois son écart-type est au plus égale à l’inverse du carré de k. Par complémentarité stochastique, la probabilité que cette variable se situe à une distance strictement inférieure à k écarts-types de son espérance mathématique est au moins égale à un moins l’inverse du carré de k. Cette relation s’écrit de manière formelle : P(|X – mu| < k * sigma) >= 1 – (1 / k^2), pour tout réel strictement supérieur à l’unité (k > 1).
La puissance épistémologique de cette proposition réside dans son indépendance totale vis-à-vis de la forme distributionnelle des données. Qu’une série statistique présente une asymétrie positive marquée, un étalement bimodal, une uniformité stricte ou un aplatissement leptokurtique extrême, l’inégalité demeure inconditionnellement valide. Dans le contexte de la psychométrie, de la neuropsychologie et des sciences du comportement, cette propriété s’avère providentielle : de nombreuses variables, telles que les temps de réponse à des paradigmes d’inhibition ou les inventaires de détresse psychologique, violent systématiquement les conditions d’application de la courbe en cloche de Gauss.
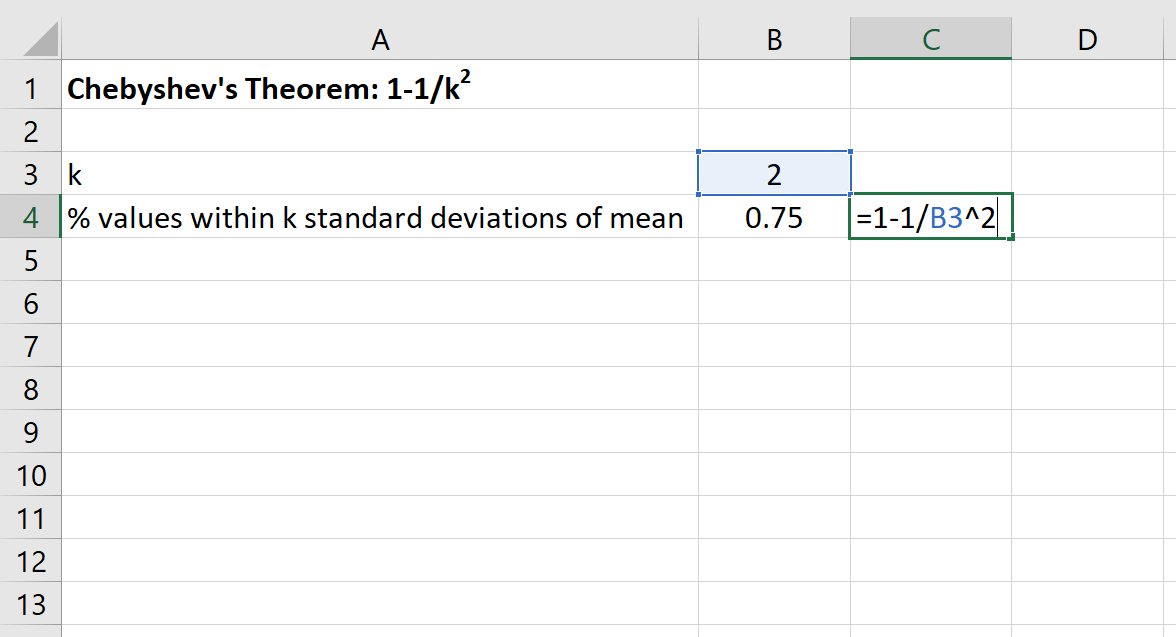
Il importe toutefois de distinguer la borne minimale garantie par Tchebychev de la distribution empirique effective. Le théorème ne prétend pas déterminer la proportion exacte des données au sein de l’intervalle considéré, mais établit un plancher probabiliste absolu en deçà duquel la densité cumulée ne peut descendre, quelle que soit l’irrégularité du profil de dispersion. Les observations empiriques réelles affichent ainsi presque invariablement un pourcentage de concentration supérieur à cette limite théorique conservatrice, conférant au modèle une robustesse décisionnelle essentielle dans les démarches diagnostiques critiques.
1.2 Importance de la modélisation sous tableur dans la recherche quantitative
Dans le domaine de la recherche quantitative et de l’analyse de données appliquées, Microsoft Excel demeure l’un des outils d’ingénierie analytique les plus omniprésents au sein des laboratoires universitaires, des services de ressources humaines et des structures hospitalières. L’implémentation du théorème de Tchebychev au sein d’un tableur permet de s’affranchir des progiciels statistiques opaques souvent perçus comme des boîtes noires par les analystes non mathématiciens. Le tableur offre une visibilité directe sur la chaîne de traitement algébrique, favorisant une compréhension fine des interactions entre mesures de position centrale et indices d’éparpillement.
L’automatisation de calculs de dispersion non gaussiens au sein d’Excel présente un double avantage technique. D’une part, elle permet de traiter dynamiquement des jeux de données volumineux sans recourir à des transformations de variables artificielles (telles que les transformations logarithmiques ou de Box-Cox) qui compliquent considérablement l’interprétation des unités cliniques natives. D’autre part, la structure tabulaire d’Excel permet de juxtaposer de façon transparente les métriques réelles et les seuils normatifs théoriques, facilitant ainsi la détection des anomalies sans fausser les conclusions analytiques.
Sur le plan pédagogique, la construction d’un modèle sous tableur permet d’ancrer les concepts de variabilité et de bornage statistique dans une démarche concrète. En manipulant des curseurs de paramètres ou en intégrant des formules imbriquées, l’analyste visualise instantanément la manière dont la modification de la dispersion affecte l’étendue des intervalles d’inclusion. Cette approche démystifie les concepts statistiques abstraits et garantit une reproductibilité méthodologique intégrale des études menées sur des échantillons asymétriques.
2. Fondements mathématiques et structure de l’inégalité de Tchebychev
2.1 Anatomie de la formule : 1 – (1 / k²)
La composante centrale du théorème repose sur l’expression algébrique 1 – (1 / k^2), où k représente le multiplicateur de dispersion, c’est-à-dire la distance standardisée séparant les bornes de l’intervalle de la moyenne centrale, exprimée en unités d’écart-type. Ce paramètre k est fondamentalement un nombre réel adimensionnel qui normalise l’écart métrique en le rapportant à la volatilité intrinsèque de la distribution étudiée. Lorsque k est égal à l’unité, l’expression mathématique s’annule : 1 – (1 / 1^2) = 0. Cette valeur nulle n’indique pas qu’aucune donnée n’est présente dans l’intervalle, mais traduit simplement l’inaptitude du théorème à fournir une garantie minimale non triviale lorsque la distance à la moyenne ne dépasse pas un écart-type.
Pour toute valeur où k est inférieur ou égal à un, la formule engendre un résultat mathématiquement stérile, voire négatif, soulignant la contrainte absolue k > 1 pour toute exploitation inférentielle rationnelle. Dès lors que k dépasse le seuil unitaire, l’expression 1 / k^2 décroît selon une loi en carré inverse, entraînant une augmentation progressive de la proportion garantie. Cette décroissance rapide de la queue de probabilité reflète la concentration inhérente des masses de probabilité autour du centre de gravité de la variable aléatoire.
À mesure que le paramètre k progresse vers l’infini, le terme soustractif tend asymptotiquement vers zéro, conduisant l’expression globale à converger vers la certitude absolue, soit 100 %. Cette trajectoire asymptotique démontre que l’inégalité capture la décroissance universelle de la densité marginale des grands écarts : quelle que soit la pathologie ou l’asymétrie de la fonction de répartition, il devient mathématiquement impossible pour une distribution de maintenir une masse de probabilité significative à des distances démesurées de son espérance sans que sa variance n’explose vers l’infini.
2.2 Seuils théoriques majeurs et leurs interprétations
Pour appréhender l’utilité pratique du théorème, il est d’usage d’examiner une série de seuils canoniques correspondant à des valeurs entières ou semi-entières de k fréquemment mobilisées dans les protocoles d’investigation statistique. Lorsque l’analyste fixe k = 1,5, le théorème stipule que :
- Au moins 1 – (1 / 1,5^2) = 1 – (1 / 2,25) = 1 – 0,4444 = 55,56 % des observations doivent impérativement être comprises dans l’intervalle défini par la moyenne plus ou moins 1,5 écart-type. Même dans la configuration distributionnelle la plus défavorable possible, plus de la moitié de l’échantillon demeure regroupée dans cette fenêtre resserrée.
- Pour le seuil hautement conventionnel k = 2, le calcul aboutit à 1 – (1 / 2^2) = 1 – 0,25 = 75,00 %. Il est ainsi rigoureusement démontré qu’au minimum trois quarts des données d’une série statistique quelconque sont confinés à moins de deux écarts-types de la moyenne, écartant définitivement l’hypothèse qu’une dispersion chaotique puisse diluer la majorité des cas au-delà de cette frontière.
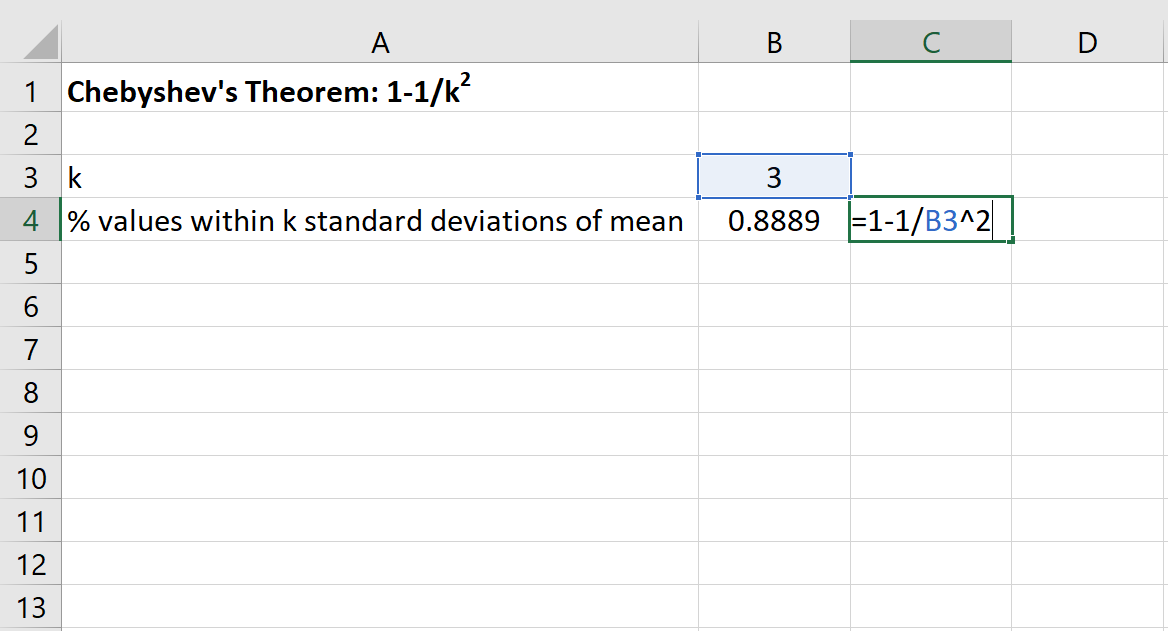
- Lorsque l’écartement s’accroît jusqu’à k = 3, le ratio s’élève à 1 – (1 / 3^2) = 1 – (1 / 9) = 88,89 %. Cette proportion atteste qu’au moins huit observations sur neuf se situent dans la plage définie par trois écarts-types autour de la tendance centrale.
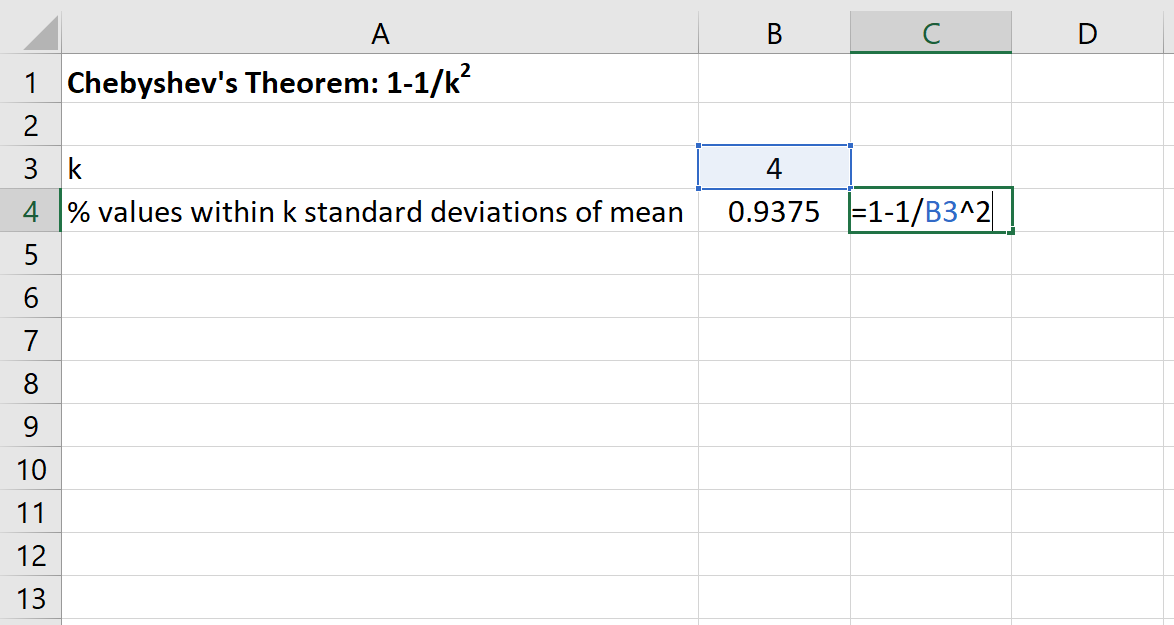
- Enfin, au niveau k = 4, le rendement de la formule atteint 1 – (1 / 4^2) = 1 – (1 / 16) = 93,75 %, établissant qu’une infime fraction résiduelle d’au plus 6,25 % peut logiquement déborder de ces limites extrêmes.
L’évaluation de ces seuils illustre la nature intrinsèquement protectrice de l’inégalité. Alors que la loi normale postule qu’environ 95,45 % des valeurs gravitent à l’intérieur de deux écarts-types, le théorème de Tchebychev ne promet que 75,00 % pour ce même intervalle. Cette différence d’amplitude quantifie précisément le prix de l’agnosticisme distributionnel : ne formuler aucune hypothèse sur la forme des données impose de renoncer à l’optimisme des estimations paramétriques pour s’abriter derrière une sécurité mathématique inattaquable.
3. Configuration et structuration des données dans Microsoft Excel
3.1 Organisation optimale d’une feuille d’analyse psychométrique
La mise en œuvre professionnelle du théorème de Tchebychev dans Excel débute par une architecture tabulaire rigoureuse. La dispersion anarchique des données et des formules sur une feuille de calcul constitue le facteur prépondérant d’erreurs de pointage et d’écarts de calcul. Il convient de segmenter l’espace de travail en trois zones fonctionnelles distinctes : un tableau de saisie des données brutes, un cartouche de calcul des paramètres descriptifs globaux, et une matrice opérationnelle dédiée aux bornes de Tchebychev et aux vérifications empiriques.
Le tableau des données primaires, idéalement positionné à partir de la colonne A, doit consigner chaque unité d’observation sur une ligne unique avec ses métadonnées contextuelles (identifiant du sujet, statut expérimental, variables sociodémographiques) et la variable quantitative continue ciblée. L’utilisation systématique de la fonctionnalité Tableau Excel (accessible via le raccourci Ctrl+L ou l’onglet Insertion > Tableau) est impérative. En nommant cette structure de données, par exemple Tbl_Recherche, l’analyste active le référencement structuré dynamique : toute nouvelle donnée intégrée en bas de tableau élargit automatiquement le champ des formules d’analyse sans exiger d’ajustement manuel des coordonnées de plages.
Le bloc des constantes et indicateurs fondamentaux gagne à être implanté dans une zone dédiée (colonnes de droite ou feuille distincte de métriques). On y réservera des cellules identifiables pour l’effectif total N, la moyenne arithmétique empirique, la variance et l’écart-type. L’attribution de noms explicites à ces cellules clés via le Gestionnaire de noms (Formules > Définir un nom) garantit une lisibilité maximale des équations subséquentes. Rédiger une formule sous la forme de calculs faisant référence à des étiquettes sémantiques évite les risques d’omissions inhérents aux références de type absolu dollar-colonne-dollar-ligne.
3.2 Contrôle de l’intégrité et nettoyage préalable des données
Avant d’exécuter la moindre modélisation de dispersion, une inspection scrupuleuse de la qualité du jeu de données s’impose. L’inégalité de Tchebychev est extrêmement sensible aux erreurs d’encodage matériel : l’introduction involontaire d’une virgule décimale décalée ou d’une valeur zéro en lieu et place d’un champ non renseigné altère dramatiquement la moyenne et gonfle artificiellement l’écart-type, faussant irrémédiablement le dimensionnement du multiplicateur k.
La recherche des valeurs manquantes ou des cellules corrompues s’opère efficacement au moyen de formules combinées. Pour identifier les enregistrements invalides au sein de la colonne de score psychométrique, on utilisera une formule d’audit telle que :
=SI(OU(ESTVIDE(Tbl_Recherche[@Score]); NON(ESTNUM(Tbl_Recherche[@Score]))); « Donnée Invalide »; « OK »)
Dans les versions modernes d’Excel pour Microsoft 365, la fonction FILTRE permet de dériver instantanément une sous-matrice assainie exempte de cellules vides :
=FILTRE(Tbl_Recherche[Score]; ESTNUM(Tbl_Recherche[Score]))
Ce protocole préalable permet également d’apprécier la nature véritablement continue de la variable. Le théorème de Tchebychev, bien que compatible avec les variables discrètes, délivre des résultats d’une plus grande élégance interprétative lorsque la métrique ne souffre pas d’un effet de plancher ou de plafond artificiel excessif. Les valeurs aberrantes extrêmes doivent faire l’objet d’un examen qualitatif minutieux : sous l’optique non paramétrique de Tchebychev, une observation inhabituelle n’a pas vocation à être caviardée ou supprimée par principe d’ajustement gaussien, mais son authenticité matérielle doit être formellement corroborée avant l’amorce des calculs.
4. Calcul de la moyenne et de l’écart-type dans Excel
4.1 Extraction des paramètres de tendance centrale et de dispersion
Le théorème de Tchebychev s’articule entièrement autour de deux métriques cardinales de la statistique descriptive : le centre de gravité de la série (la moyenne arithmétique) et son échelle de variabilité (l’écart-type). L’implémentation de la fonction MOYENNE dans Excel s’exécute de manière directe sur la colonne structurée du tableau expérimental. Par exemple, si la variable d’étude est le temps d’inspection cognitive consigné dans la colonne Score, la formule générale prend la forme suivante :
=MOYENNE(Tbl_Recherche[Score])
Une vigilance épistémologique stricte s’impose lors de l’estimation de l’écart-type. Microsoft Excel met à disposition deux fonctions distinctes dont la confusion engendre des décalages d’estimation : ECARTYPE.STANDARD et ECARTYPE.PEARSON. La fonction ECARTYPE.PEARSON applique au dénominateur l’effectif intégral N de la population ; elle ne doit être retenue que dans l’éventualité où le jeu de données englobe l’exhaustivité absolue de la population cible étudiée, une situation rarissime dans le domaine de la recherche empirique.
Dans la quasi-totalité des investigations psychométriques et comportementales, l’analyste opère sur un échantillon probabiliste extrait d’une population parente plus vaste. L’estimation sans biais de la dispersion exige alors l’application de la correction de Bessel au dénominateur, soit une division par l’effectif réduit d’un degré de liberté (N – 1). Il convient donc d’utiliser de manière systématique la formule :
=ECARTYPE.STANDARD(Tbl_Recherche[Score])
Cette distinction est d’autant plus prégnante sur les petits échantillons où l’omission du degré de liberté sous-estimerait la variance réelle, rétrécissant indûment les intervalles calculés et fragilisant la garantie de Tchebychev. Dès leur établissement, ces résultats devront être stockés dans des cellules baptisées respectivement Moyenne_Val et EcartType_Val pour fluidifier la saisie des syntaxes futures.
4.2 Vérification de l’asymétrie et de l’aplatissement
L’abandon délibéré des règles d’inférence normales au profit de l’inégalité de Tchebychev doit être scientifiquement documenté et justifié. Dans les publications académiques ou les rapports d’expertise, il ne suffit pas d’affirmer l’utilité d’un modèle non paramétrique ; il convient d’en attester la nécessité par la quantification objective des distorsions distributionnelles à l’aide des moments statistiques d’ordre supérieur : l’asymétrie (skewness) et l’aplatissement (kurtosis).
Le coefficient d’asymétrie empirique est calculé sous Excel à l’aide de la fonction native COEFFICIENT.ASYMETRIE :
=COEFFICIENT.ASYMETRIE(Tbl_Recherche[Score])
Cette fonction implémente le moment centré d’ordre trois normalisé. Une distribution symétrique théorique présente un coefficient égal à zéro. Si la cellule renvoie une valeur positive substantielle (par exemple supérieure à +0,8 ou +1,0), cela démontre l’existence d’une longue queue d’étalement vers les scores élevés, caractéristique classique des temps de latence ou des coûts de traitement de l’information. Une valeur négative inférieure à -0,8 signale à l’inverse une accumulation massive de sujets vers les scores supérieurs avec étirement vers les valeurs basses.
Simultanément, l’analyse de l’aplatissement s’effectue via la formule de kurtosis de Fisher :
=KURTOSIS(Tbl_Recherche[Score])
La fonction KURTOSIS d’Excel fournit directement l’excès de kurtosis par rapport à la distribution normale de référence (pour laquelle l’excès équivaut à zéro). Une valeur fortement positive met en exergue une leptokurticité prononcée : la distribution possède un sommet effilé et des queues épaisses saturées en valeurs extrêmes. L’identification conjointe d’un coefficient d’asymétrie non nul et d’un excès de kurtosis déviant confirme l’inadéquation rédhibitoire de la loi de Gauss standard et justifie formellement le repli méthodologique sur les bornes minimales universelles du théorème de Tchebychev.
5. Détermination méthodique de la valeur k dans Excel
5.1 Scénario A : k déterminé à partir de bornes numériques prédéfinies
Dans la pratique de l’évaluation quantitative, il est fréquent que l’analyste dispose de bornes opérationnelles fixées a priori par des impératifs cliniques, des seuils de certification ou des contraintes expérimentales, et cherche à quantifier la garantie probabiliste associée à cet intervalle spécifique. Supposons une limite inférieure désignée par Borne_Inf et une limite supérieure notée Borne_Sup entourant la tendance centrale.
Puisque le théorème classique postule une déviation symétrique k * sigma de part et d’autre de la moyenne, la conversion des bornes physiques en facteur standardisé k requiert d’isoler l’écart relatif. Pour la borne supérieure, la relation s’établit par :
k_sup = (Borne_Sup – Moyenne_Val) / EcartType_Val
Pour la limite basse de l’intervalle, la formule miroir s’écrit :
k_inf = (Moyenne_Val – Borne_Inf) / EcartType_Val
Dans une configuration rigoureusement équidistante, k_sup égale exactement k_inf. Pour formaliser cette vérification d’équidistance au sein de la feuille de calcul et s’assurer de l’absence de biais asymétrique dans la définition des seuils, on emploie la fonction ABS (valeur absolue) dans une condition d’équivalence :
=SI(ARRONDI(ABS((Borne_Sup – Moyenne_Val) – (Moyenne_Val – Borne_Inf)); 4) = 0; (Borne_Sup – Moyenne_Val) / EcartType_Val; « Attention : Intervalle Asymétrique »)
Dans l’éventualité courante où les bornes imposées ne sont pas parfaitement symétriques par rapport à la moyenne empirique calculée, l’orthodoxie méthodologique relative au théorème de Tchebychev standard impose de retenir la plus conservatrice des deux valeurs pour k. En sélectionnant la valeur minimale entre k_sup et k_inf au moyen de la formule suivante :
=MIN((Borne_Sup – Moyenne_Val) / EcartType_Val; (Moyenne_Val – Borne_Inf) / EcartType_Val)
L’analyste s’assure que l’intervalle symétrique restreint résultant garantit le pourcentage calculé pour l’ensemble du domaine couvert par les deux bornes, garantissant ainsi l’intégrité de la conclusion probabiliste.
5.2 Scénario B : k fixé arbitrairement pour déduire les intervalles
La démarche inverse consiste à postuler d’emblée un niveau d’exigence statistique minimal en fixant a priori la valeur du multiplicateur k, afin de cartographier la fenêtre métrique dans laquelle la cohorte d’observations sera captive. Le chercheur ou le gestionnaire sélectionne généralement des valeurs canoniques ou ciblées, telles que k = 2 (garantissant au minimum 75 % de couverture), k = 2,5 (garantissant au minimum 84 % de couverture) ou k = 3 (garantissant 88,89 % de concentration).
Dès lors que le multiplicateur k est consigné dans une cellule de paramétrage dédiée (par exemple nommée Multiplicateur_k), la dérivation des frontières dimensionnelles s’effectue par des équations arithmétiques directes. Pour la limite inférieure du domaine garanti, la formule à implémenter dans la cellule correspondante est :
=Moyenne_Val – (Multiplicateur_k * EcartType_Val)
Symétriquement, la formulation de la borne supérieure s’établit par l’addition de la marge de dispersion standardisée :
=Moyenne_Val + (Multiplicateur_k * EcartType_Val)
Il est fondamental de souligner que les valeurs résultantes conservent scrupuleusement l’unité de mesure native du phénomène analysé. Qu’il s’agisse de millisecondes de latence neuronale, de points à une échelle de dépression de Beck ou d’unités de glycémie à jeun, l’intervalle produit par ces deux cellules constitue l’enveloppe opérationnelle au sein de laquelle l’observateur est mathématiquement certain de retrouver la fraction minimale garantie de sa population. Si la limite inférieure engendre une valeur négative pour une grandeur physiquement ou psychométriquement bornée à zéro, cela indique simplement la largeur protectrice de l’intervalle dans les conditions de non-normalité observées.
6. Implémentation pas-à-pas de la formule de Tchebychev dans Excel
6.1 Syntaxe de base et mise en forme du résultat
La formalisation algorithmique de la proportion théorique garantie sous Excel nécessite la transcription exacte de la déduction mathématique de Tchebychev en exploitant les opérateurs arithmétiques du tableur. En supposant que le multiplicateur standardisé k réside dans la cellule B10, la syntaxe directe peut être rédigée sous l’une des deux formes syntaxiques équivalentes suivantes :
=1 – (1 / (B10 ^ 2))
ou en ayant recours à la fonction de puissance explicite d’Excel :
=1 – (1 / PUISSANCE(B10; 2))
Par défaut, le tableur calcule ce résultat sous forme de valeur décimale à virgule flottante comprise entre 0 et 1 (par exemple 0,75 pour k = 2). Pour assurer une lisibilité analytique immédiate, il est requis d’attribuer à la cellule cible un formatage de pourcentage. Cette configuration s’applique en sélectionnant la cellule, puis via l’onglet Accueil > groupe Nombre > Style de pourcentage (ou par le raccourci clavier Ctrl+Maj+%), en prenant soin de fixer l’affichage à deux décimales significatives afin de discerner la nuance entre des valeurs telles que 88,89 % (pour k = 3) et 93,75 % (pour k = 4).
Néanmoins, laisser cette formule s’exécuter sans garde-fou logique expose le modèle à des incohérences fondamentales. Si un opérateur saisit par inadvertance une valeur de k égale ou inférieure à 1, le calcul renverra un pourcentage nul, voire négatif, totalement dépourvu de signification probabiliste. Il est par conséquent indispensable de conditionner l’évaluation via la fonction logique SI :
=SI(B10 > 1; 1 – (1 / (B10 ^ 2)); « k doit être > 1 »)
Cette précaution algorithmique garantit que la feuille de calcul ne produira aucun résultat numérique erroné susceptible d’induire en erreur les utilisateurs du modèle.
6.2 Intégration d’une gestion d’erreur robuste
Au-delà de la restriction mathématique sur k, un modèle Excel destiné à être partagé ou audité au sein d’une équipe de recherche doit comporter un niveau d’étanchéité supérieur vis-à-vis des erreurs techniques. La division par zéro (erreur typique #DIV/0!) survient fréquemment lorsqu’une cellule dépendante est vidée ou effacée par accident, ou si la cellule référençant k contient une chaîne de caractères alphabétiques.
L’arsenal défensif d’Excel offre la fonction SIERREUR, particulièrement indiquée pour encapsuler les opérations d’analyse quantitative. Pour garantir une restitution saine de l’information sous toutes les conditions de manipulation, la formule globale gagne à être structurée de la manière suivante :
=SIERREUR(SI(ESTNUM(B10); SI(B10 > 1; 1 – (1 / (B10 ^ 2)); « Condition Invalide : k <= 1 »); « Valeur k non numérique »); « Erreur de Référence »)
Cette imbrication méthodique procède à un triple contrôle :
- Elle examine en premier lieu si l’entrée injectée dans la cellule B10 appartient au type numérique.
- Elle valide ensuite le respect strict du postulat du théorème (k strictement supérieur à l’unité).
- Elle intercepte enfin toute instabilité générale de calcul en retournant un message d’audit explicite au lieu des drapeaux d’erreur bruts du moteur d’Excel.
Cette approche systématique garantit que la proportion de couverture minimale est protégée contre les erreurs de manipulation, certifiant que l’intervalle demeure continuellement confiné dans l’intervalle ouvert ]0 % ; 100 %[.
7. Étude d’un cas classique : Analyse pas-à-pas avec données réelles
7.1 Présentation du problème (Moyenne = 50, Écart-type = 10)
Pour illustrer la mécanique opératoire avec une clarté absolue, considérons un scénario classique en psychologie cognitive différentielle. Une équipe clinique évalue la capacité de régulation émotionnelle d’une cohorte de 200 participants au moyen d’un score composite standardisé. L’inspection préliminaire des fréquences révèle une distribution asymétrique positive, marquée par une concentration de scores dans les zones de basse intensité et quelques profils de régulation hautement atypiques étirant la distribution vers le haut.
L’analyse descriptive brute délivre une moyenne arithmétique empirique de 50 points et un écart-type échantillonnal de 10 points. Les praticiens souhaitent déterminer formellement la proportion minimale garantie de participants dont le score d’évaluation se situe impérativement à l’intérieur de l’intervalle métrique borné entre 30 points (borne inférieure) et 70 points (borne supérieure), sans formuler la moindre supposition hasardeuse sur la normalité de l’inventaire.
La résolution analytique débute par le calcul de l’écartement de chaque borne par rapport à l’indice de centralité :
Distance Supérieure = 70 – 50 = 20 points
Distance Inférieure = 50 – 30 = 20 points
La symétrie de l’intervalle étant rigoureusement établie (20 points de part et d’autre de la moyenne), la standardisation par l’écart-type de référence fournit immédiatement la valeur de k :
k = 20 / 10 = 2
La condition k > 1 étant vérifiée, le théorème de Tchebychev garantit mathématiquement qu’au moins 1 – (1 / 2^2) = 1 – 0,25 = 0,75, soit 75,00 % des sujets, présentent un score strictement compris entre 30 et 70 points, quelle que soit l’irrégularité morphologique de la courbe réelle.
7.2 Transcription technique directe dans la feuille de calcul
Pour matérialiser ce cas d’école dans Microsoft Excel, configurons un classeur de travail selon la disposition matricielle suivante :
- Cellule A1 : Saisir le libellé Moyenne ; Cellule B1 : Saisir la valeur numérique 50
- Cellule A2 : Saisir le libellé Écart-type ; Cellule B2 : Saisir la valeur numérique 10
- Cellule A3 : Saisir le libellé Borne Inférieure ; Cellule B3 : Saisir la valeur numérique 30
- Cellule A4 : Saisir le libellé Borne Supérieure ; Cellule B4 : Saisir la valeur numérique 70
- Cellule A5 : Saisir le libellé Facteur k
- Cellule A6 : Saisir le libellé Proportion Minimale Garantie
Dans la cellule B5, l’opérateur transcrit l’équation de standardisation en s’assurant de la symétrie par l’expression :
=(B4 – B1) / B2
Le tableur évalue cette relation et renvoie sans ambiguïté la valeur exacte 2. Dans la cellule B6, on inscrit l’évaluation du théorème sous la forme :
=SI(B5 > 1; 1 – (1 / (B5 ^ 2)); « k non recevable »)
En assignant le format de pourcentage avec deux décimales à la cellule B6, le tableur affiche immédiatement 75,00 %. Pour finaliser la modélisation sous un angle d’aide à la décision clinique, on insérera en cellule A8 un commentaire d’interprétation automatisé combinant texte statique et valeurs dynamiques via l’opérateur de concaténation (&) :
= »Conclusion : Au minimum » & TEXTE(B6; « 0,00% ») & » des participants présentent un score compris entre » & B3 & » et » & B4 & » points, indépendamment de toute loi de distribution. »
Cette architecture dynamique assure une mise à jour instantanée des conclusions textuelles et numériques dès lors que la moyenne, l’écart-type ou les bornes d’évaluation sont modifiés.
8. Automatisation dynamique et table matricielle sous Excel
8.1 Conception d’une table de sensibilité paramétrique
Si l’évaluation d’un seuil unitaire k répond à des besoins ponctuels, une compréhension approfondie de la structure d’un jeu de données exige d’étudier la sensibilité de la couverture pour un continuum de valeurs de k. L’objectif est d’édifier une table de simulation paramétrique permettant d’observer comment la borne minimale évolue de k = 1,1 jusqu’à k = 4,0 avec une résolution fine par incréments de 0,1.
Dans les versions contemporaines d’Excel intégrant le moteur de calcul matriciel dynamique (Microsoft 365 et Office 2021), cette table se génère en quelques secondes grâce à la fonction SEQUENCE. En se positionnant dans la première cellule d’une colonne vierge (par exemple D2), la séquence complète des valeurs de k est projetée par la formule :
=SEQUENCE(30; 1; 1,1; 0,1)
Cette formule engendre instantanément une plage dynamique verticale de 30 lignes s’étirant de 1,1 à 4,0. Dans la colonne contiguë (cellule E2), on évalue la borne de Tchebychev correspondante en tirant parti du mécanisme de propagation matricielle (l’opérateur dièse # indiquant la référence à la plage dynamique débordée) :
=1 – (1 / (D2# ^ 2))
Pour enrichir la portée analytique de cette matrice de sensibilité, deux colonnes supplémentaires doivent encadrer ce pourcentage théorique afin de restituer les frontières métriques concrètes dans les unités d’origine de la recherche :
En cellule F2 (Borne Inférieure Calculée) :
=Moyenne_Val – (D2# * EcartType_Val)
En cellule G2 (Borne Supérieure Calculée) :
=Moyenne_Val + (D2# * EcartType_Val)
L’analyste obtient ainsi une table paramétrique complète et entièrement réactive : tout changement dans la cohorte d’origine réajuste instantanément l’ensemble des 30 intervalles et leurs pourcentages associés, offrant une vue synoptique immédiate des marges de confinement du phénomène observé.
8.2 Calcul du pourcentage empirique réel observé
Le point d’orgue de l’analyse consiste à confronter les bornes théoriques de Tchebychev à la réalité empirique du jeu de données. Cette comparaison permet de vérifier l’inégalité et d’apprécier la marge de sécurité offerte par le modèle. Il s’agit de dénombrer le nombre exact de participants dont les performances s’inscrivent effectivement dans chaque intervalle calculé, puis de convertir ce dénombrement en un ratio de fréquence relative.
Excel excelle dans cette tâche grâce à la fonction NB.SI.ENS, qui prend en compte simultanément plusieurs conditions d’inclusion. En reprenant les bornes calculées dans la table matricielle, la formule de dénombrement s’établit en cellule H2 comme suit :
=NB.SI.ENS(Tbl_Recherche[Score]; « >= » & F2; Tbl_Recherche[Score]; « <= » & G2)
Pour transformer ce comptage brut en pourcentage d’observation empirique réel, on normalise l’expression par le cardinal total de l’échantillon à l’aide de la fonction NB :
=NB.SI.ENS(Tbl_Recherche[Score]; « >= » & F2; Tbl_Recherche[Score]; « <= » & G2) / NB(Tbl_Recherche[Score])
En propageant cette équation le long de la table matricielle, l’analyste fait apparaître en regard du pourcentage théorique minimal garanti (colonne E) le taux d’inclusion réel (colonne H). L’examen comparatif de ces deux colonnes livre un résultat constant : la fréquence observée dans l’échantillon est systématiquement supérieure ou égale au seuil de Tchebychev :
Pourcentage Réel (Colonne H) >= Pourcentage Théorique (Colonne E)
Cette vérification algorithmique apporte la démonstration empirique de la validité de l’inégalité et illustre concrètement le caractère protecteur de la borne mathématique.
9. Analyse comparative : Théorème de Tchebychev versus Règle empirique normale
9.1 Divergences structurelles des postulats probabilistes
La confusion entre le théorème de Tchebychev et la règle empirique normale (souvent qualifiée de règle 68-95-99,7) constitue l’un des écueils méthodologiques les plus fréquents en analyse de données. Ces deux constructions probabilistes reposent sur des postulats diamétralement opposés. La règle empirique gaussienne n’est applicable que sous la condition sine qua non que la distribution sous-jacente s’ajuste rigoureusement à une fonction de densité normale standard, caractérisée par une symétrie parfaite (skewness = 0) et un mésokurtisme strict (aplatissement = 3, soit un excès de 0).
Le tableau comparatif suivant met en perspective les divergences radicales de proportions entre ces deux approches :
- Pour k = 1 écart-type : La loi normale postule qu’environ 68,27 % des valeurs sont captives de la zone moyenne +/- 1 sigma. Le théorème de Tchebychev, quant à lui, renvoie 1 – (1 / 1^2) = 0 %, ne fournissant aucune borne informative minimale pour une déviation aussi restreinte.
- Pour k = 2 écarts-types : La règle empirique normale affirme que 95,45 % de la cohorte est englobée. Tchebychev ne garantit, pour sa part, qu’au moins 75,00 % des cas.
- Pour k = 3 écarts-types : Le modèle gaussien prédit un confinement quasi-total avec 99,73 % d’inclusion, tandis que Tchebychev garantit un plancher de 88,89 %.
- Pour k = 4 écarts-types : La normalité confine la proportion résiduelle extérieure à un infime 0,006 % (99,994 % à l’intérieur), alors que l’inégalité universelle garantit 93,75 % d’inclusion minimale.
Cet écart d’amplitude illustre la dépendance des estimations paramétriques à leurs hypothèses de base. La règle normale est plus resserrée et informative, mais perd toute validité statistique dès lors que les données s’écartent de la symétrie gaussienne. À l’inverse, Tchebychev conserve une intégrité mathématique absolue face aux distributions les plus déviantes, au prix d’une borne minimale plus large et conservatrice.
9.2 Conséquences méthodologiques en psychométrie appliquée
En psychométrie appliquée, l’utilisation abusive de la loi normale pour des distributions asymétriques produit des erreurs diagnostiques manifestes. Lorsqu’un praticien utilise les tables gaussiennes pour étalonner un test de santé mentale fortement asymétrique (comme une échelle mesurant l’idéation suicidaire ou l’addiction comportementale), il commet une faute méthodologique majeure : présumer qu’un individu situé à deux écarts-types de la moyenne appartient au centile 97,5 sous-estime gravement la réalité des distributions réelles à queue épaisse.
Sous une distribution asymétrique réelle, un score situé à +2 sigma peut aisément correspondre au 85e ou 90e centile effectif, et non au 97,5e prédit par la courbe en cloche. Si le clinicien classe les sujets nécessitant une intervention thérapeutique d’urgence sur la base illusoire des 95 % de normalité gaussienne, il risque d’exclure à tort de nombreux patients en détresse sévère. Le recours aux bornes de Tchebychev offre ici une sécurité d’évaluation essentielle : en affirmant uniquement qu’au moins 75 % des sujets se trouvent sous cette valeur, le modèle préserve le système diagnostique de conclusions trompeuses.
Pour guider le choix méthodologique au sein d’Excel, l’analyste peut concevoir un arbre de décision logique automatisé. En croisant les valeurs des cellules évaluant l’asymétrie et le kurtosis, une formule renvoie automatiquement le modèle d’inférence recommandé :
=SI(ET(ABS(COEFFICIENT.ASYMETRIE(Tbl_Recherche[Score])) < 0,5; ABS(KURTOSIS(Tbl_Recherche[Score])) < 0,5); « Règle Normale Autorisée (Gauss) »; « Recours Impératif à Tchebychev »)
Ce type de contrôle algorithmique garantit que le traitement statistique reste aligné sur les caractéristiques réelles du jeu de données, prévenant toute utilisation hasardeuse des postulats paramétriques.
10. Visualisation graphique avancée des bornes de Tchebychev dans Excel
10.1 Construction d’un histogramme de distribution superposé
La visualisation graphique de la dispersion enrichit considérablement l’analyse chiffrée. Dans Microsoft Excel, la création d’un graphique combiné permet d’illustrer la confrontation entre la forme réelle de la distribution et les frontières théoriques issues du théorème de Tchebychev. La première phase repose sur l’édification d’un histogramme de fréquences réelles pour appréhender la géométrie des données brutes.
Pour construire cet histogramme, on exploite la fonction FREQUENCE sur une série d’intervalles de classes réguliers (bins), ou l’on insère directement un objet graphique Histogramme depuis l’onglet Insertion > Graphiques. Dès que le profil de la distribution s’affiche (mettant en évidence l’asymétrie ou la multimodalité des scores), il convient d’y adjoindre des marqueurs visuels pour identifier la position de la tendance centrale ainsi que les seuils critiques.
Pour concrétiser ces limites sur le graphique, on superpose une série de données fictives construite à l’aide de graphiques combinés (histogramme et courbe sur axe secondaire). On définit des lignes verticales matérialisant :
- La moyenne arithmétique (Moyenne_Val), représentée par un trait plein contrasté ;
- L’intervalle de Tchebychev à k = 2 (Moyenne_Val +/- 2 * EcartType_Val), délimité par des barres verticales en pointillés colorés ;
- L’intervalle de Tchebychev à k = 3 (Moyenne_Val +/- 3 * EcartType_Val), figuré par des lignes de délimitation externe.
En appliquant un remplissage translucide ou un motif texturé sur la plage comprise entre -2 sigma et +2 sigma, l’analyste fait ressortir visuellement la zone de confinement garantie à 75 %. Cette composition graphique met en relief la portion de l’échantillon qui déborde effectivement des seuils théoriques, facilitant grandement la restitution pédagogique des résultats auprès d’interlocuteurs non statisticiens.
10.2 Création d’un graphique de la fonction de Tchebychev
Un second dispositif graphique très formateur consiste à tracer la fonction continue f(k) = 1 – (1 / k^2) pour k variant de 1 à 5, afin d’illustrer l’évolution du rendement d’inclusion théorique. Pour enrichir la portée analytique de cette figure, on y superposera un marqueur ponctuel dynamique représentant la valeur spécifique de k sélectionnée dans l’analyse courante.
La réalisation technique de ce graphique sous Excel s’organise selon les étapes suivantes :
- Sélectionner les colonnes D et E de la table de sensibilité préalablement conçue, regroupant la série des k (de 1,1 à 4,0) et leurs pourcentages garantis associés.
- Générer un graphique de type Nuage de points avec lignes lissées (Insertion > Graphiques > Nuage de points). La courbe obtenue illustre l’ascension initiale rapide de la garantie probabiliste suivie de son écrasement asymptotique vers l’axe des 100 %.
- Créer une table auxiliaire d’une seule ligne isolant le paramètre k actuellement étudié dans l’analyse de l’échantillon ainsi que son résultat calculé (par exemple k = 2,5 et 84,00 %).
- Ajouter cette série ponctuelle additionnelle au graphique existant (via Clic Droit sur le tracé > Sélectionner des données > Ajouter).
- Attribuer à ce point unique un formatage marquant (par exemple un marqueur circulaire large et coloré, doté d’une étiquette de données indiquant explicitement les coordonnées du seuil).
Le graphique produit constitue un support visuel de premier ordre pour les publications scientifiques ou les rapports de diagnostic organisationnel. Il illustre de façon limpide où se positionne le compromis statistique retenu sur la trajectoire théorique universelle du théorème de Tchebychev.
11. Applications psychologiques et psychopathologiques concrètes
11.1 Étude de cas 1 : Temps de latence cognitive post-traumatique
L’exploration des conséquences neuropsychologiques du trouble de stress post-traumatique (TSPT) offre un terrain d’application particulièrement pertinent pour le théorème de Tchebychev. Les protocoles expérimentaux évaluant l’inhibition cognitive par des tâches de type Stroop émotionnel collectent des temps de réaction chronométriques (mesurés en millisecondes). Ces métriques de latence ne se conforment jamais à la loi normale : elles suivent presque invariablement des distributions ex-gaussiennes ou log-normales fortement étirées vers la droite par des épisodes d’interférence cognitive majeure.
Considérons un protocole neuropsychologique conduit auprès de 150 vétérans diagnostiqués avec un TSPT. La latence moyenne d’inhibition cognitive se chiffre à 820 millisecondes, avec un écart-type échantillonnal de 180 millisecondes. En raison de l’asymétrie marquée des chronométrages individuels, l’application de la théorie normale minorerait artificiellement les seuils de ralentissement pathologique.
L’implémentation de la modélisation sous Excel permet d’établir des frontières rigoureuses sans recourir à des transformations logarithmiques qui obscurciraient les unités temporelles natives. En fixant un seuil de sécurité statistique à k = 2,5 :
Borne Inférieure = 820 – (2,5 * 180) = 820 – 450 = 370 millisecondes
Borne Supérieure = 820 + (2,5 * 180) = 820 + 450 = 1270 millisecondes
Garantie de Tchebychev = 1 – (1 / 2,5^2) = 1 – (1 / 6,25) = 1 – 0,16 = 84,00 %
Le praticien dispose ainsi d’un constat d’une robustesse méthodologique irréfutable : indépendamment de la géométrie asymétrique des temps de réponse de la cohorte, au moins 84,00 % des patients présentent une latence comprise entre 370 et 1270 millisecondes. Tout patient enregistrant une latence excédant 1270 millisecondes se situe au-delà de cette borne de référence, signalant un effondrement atypique des fonctions attentionnelles exécutives sans qu’aucun artefact de distribution ne puisse être invoqué.
11.2 Étude de cas 2 : Évaluation des scores d’épuisement professionnel (Burnout)
Le diagnostic de l’épuisement professionnel dans les organisations de soins hospitaliers constitue une autre application préférentielle de l’inégalité de Tchebychev. Lorsqu’une direction médicale administre le questionnaire d’inventaire d’épuisement professionnel de Maslach (MBI) à un collectif de 400 soignants, la distribution des scores d’épuisement émotionnel adopte fréquemment un profil bimodal : une fraction saine du personnel affiche des niveaux de détresse bas, tandis qu’une sous-population en souffrance sévère se concentre aux valeurs limites supérieures de l’échelle.
Une telle polarisation biquadratique invalide l’usage des statistiques paramétriques classiques fondées sur la moyenne et l’écart-type gaussien. Supposons que l’évaluation globale délivre une moyenne empirique de 28 points (sur une échelle graduée de 0 à 54 points) et un écart-type substantiel de 12 points. Les autorités de santé au travail souhaitent déterminer un intervalle de référence conservateur englobant le cœur de la distribution pour isoler les profils en détresse critique.
En mobilisant la feuille Excel configurée, l’analyste positionne un multiplicateur k = 2. Le tableur génère instantanément :
- Borne Supérieure d’Épuisement = 28 + (2 * 12) = 52 points ;
- Borne Inférieure de Sérénité = 28 – (2 * 12) = 4 points ;
- Pourcentage minimal d’inclusion = 1 – (1 / 2^2) = 75,00 %.
Sur le plan organisationnel, cette modélisation démontre qu’au moins 75 % de l’ensemble des personnels soignants se situent entre 4 et 52 points. Bien que cette amplitude paraisse étendue à première vue, elle capture fidèlement la dispersion extrême inhérente aux dynamiques de groupe bimodal. Surtout, elle certifie qu’au maximum 25 % des individus peuvent présenter un état plus dégradé que la borne de 52 points, offrant ainsi un socle d’action managériale inattaquable pour déclencher des cellules de soutien psychologique d’urgence.
12. Bonnes pratiques, pièges à éviter et dépannage dans Excel
12.1 Erreurs méthodologiques et confusions fréquentes
L’exploitation du théorème de Tchebychev dans les environnements professionnels se heurte régulièrement à une série d’erreurs méthodologiques qu’il convient de proscrire rigoureusement. Le premier écueil conceptuel consiste à interpréter la borne théorique calculée comme une prédiction exacte ou une espérance ponctuelle de la fréquence observée. Déclarer qu’« exactement 75 % des données se trouvent à moins de deux écarts-types » constitue une dénaturation formelle du théorème. La formule délivre un minimum mathématique garanti, et la réalité des données observera presque toujours une concentration sensiblement plus forte.
La deuxième dérive récurrente concerne la tentative d’application du théorème pour des multiplicateurs k inférieurs ou égaux à 1. Dans les contextes professionnels d’évaluation, il est fréquent que des analystes néophytes cherchent à calculer la proportion minimale garantie dans un rayon d’un seul écart-type autour de la moyenne. L’introduction de k = 1 dans la formule produit une valeur nulle (0 %), ce qui n’apporte aucune information empirique utile et suscite souvent l’incompréhension des décideurs. Les intervalles de Tchebychev ne deviennent pertinents et exploitables qu’à compter de k strictement supérieur à l’unité.
Le troisième piège majeur réside dans la sous-estimation des conséquences d’un échantillon trop exigu sur la robustesse du modèle. Le théorème mathématique est irréprochable au niveau de la population, mais son application sous Excel repose généralement sur une moyenne et un écart-type empiriques d’échantillon. Lorsque l’effectif N est inférieur à 30 ou 40 observations, la variance d’échantillonnage de l’écart-type devient très instable. Une sous-évaluation involontaire de sigma contracte artificiellement les bornes calculées, risquant d’invalider localement la garantie d’inclusion minimale observée.
12.2 Optimisation technique des feuilles de calcul et pérennité
Pour assurer la fiabilité et la pérennité des outils d’analyse basés sur le théorème de Tchebychev, plusieurs règles de bonne gouvernance de tableur doivent être rigoureusement appliquées dans l’environnement Microsoft Excel :
- Verrouillage et protection structurelle : Les cellules contenant les formules d’estimation des paramètres de Tchebychev doivent être expressément verrouillées (Format de cellule > Protection > Verrouillée) puis la feuille protégée par un mot de passe d’administration. Seules les zones réservées à l’encodage des données et au choix de k doivent demeurer modifiables par les utilisateurs finaux, prévenant toute altération accidentelle du cœur algorithmique du classeur.
- Documentation intégrée et infobulles explicatives : L’ajout d’infobulles de saisie (via l’outil Validation des données > Message de saisie) sur les cellules de paramétrage de k permet de rappeler les contraintes mathématiques (k > 1) et d’expliciter le sens des calculs réalisés. Cette documentation in situ limite considérablement les risques de mauvaise interprétation par des tiers non mathématiciens.
- Compatibilité ascendante des formules : Bien que les fonctions modernes telles que FILTRE ou SEQUENCE apportent un réel confort opérationnel sur Microsoft 365, il demeure pertinent, au sein d’environnements hospitaliers ou universitaires hétérogènes utilisant d’anciennes versions d’Excel (2016, 2019), de maintenir une version de recours bâtie sur des fonctions universelles historiques (telles que LIGNE, DECALER ou les formules matricielles classiques validées par Ctrl+Maj+Entrée).
En observant ces normes techniques et conceptuelles, l’analyste quantitative confère à ses classeurs Excel un statut de véritable outil d’ingénierie statistique, alliant la rigueur non paramétrique du théorème de Tchebychev à l’efficacité opérationnelle d’un tableur moderne.
Références
Bienaymé, I.-J. (1853). Considérations à l’appui de la découverte de Laplace sur la loi de probabilité dans la méthode des moindres carrés. Comptes Rendus de l’Académie des Sciences, 37, 309-324.
Chebyshev, P. L. (1867). Des valeurs moyennes. Journal de Mathématiques Pures et Appliquées, 2(12), 177-184. https://gallica.bnf.fr/ark:/12148/bpt6k16400c
Howell, D. C. (2012). Statistical Methods for Psychology (8e éd.). Wadsworth, Cengage Learning.
Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156-166. https://doi.org/10.1037/0033-2909.105.1.156
Microsoft Corporation. (2024). Documentation de prise en main des fonctions statistiques sous Microsoft Excel. Support technique Microsoft. https://support.microsoft.com/fr-fr/excel
Saw, J. G., Yang, M. C., & Mo, T. C. (1984). Chebyshev-type inequalities: An overview. The American Statistician, 38(2), 130-132. https://doi.org/10.2307/2683248
Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7e éd.). Pearson.
Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2008). Mathematical Statistics with Applications (7e éd.). Duxbury Press.